
Материалы по тегу:
|
10.11.2026 [14:58], Руслан Авдеев
Microsoft выходит из соглашения с Oracle по аренде вычислительных мощностей, заключенного в 2023 годуКомпания Microsoft намерена выйти из соглашения с Oracle от 2023 года о предоставлении вычислительных мощностей. Оно предусматривало использование уже устаревшего на сегодня оборудования NVIDIA, передаёт Bloomberg. Стоимость контракта не раскрывалась. Сообщалось, что оборудование Oracle должно было обслуживать поисковик Bing с ИИ-ассистентом. При этом более новые соглашения компании, вероятно, продолжат действовать. В марте CNBC сообщало, что Oracle строит «вчерашние» дата-центры с устаревающим оборудованием за счёт будущих долгов. По данным Oracle, спрос на инфраструктуру компании по-прежнему высок, в т.ч. на оборудование старых поколений. Компания заявляла, что клиенты платили при перезаключении в I квартале 2027 финансового года контрактов на использование оборудование четырёхлетней давности на 20 % больше, чем изначально. В июне 2026 года сорвалась сделка на сумму $3 млрд, поскольку Oracle не смогла обеспечить необходимую систему безопасности. Т.н. программа Federal Risk and Authorization Management Program (FedRAMP) устанавливает требования к безопасности облачных сервисов для размещения американских правительственных данных. По слухам, Oracle не захотела внедрять её, хотя сама компания называла данные журналистов недостоверными, заявляя, что Microsoft является партнёром и, одновременно, клиентом Oracle Cloud Infrastructure (OCI). 
Источник изображения: Mina Rad/unsplash.com По имеющимся данным, Microsoft пересматривает по тому же принципу и действующие контракты с неооблачными провайдерами. Год назад обязательства компании по аренде мощностей у таких бизнесов составляли $60 млрд, а сейчас эта сумма выросла до $80 млрд. Вместе с тем компания укрепляет контроль за некоторым проектами строительства ЦОД своих партнёров компаниями Nebius, IREN и Nscale, а от «рискованных» проектов отказывается. При этом Microsoft остаётся одним из крупнейших клиентов неооблачных провайдеров и имеет с ними крупные действующие контракты. В компании подчёркивают, что отношения с инфраструктурными партнёрами выстраиваются с учётом требований Microsoft и спроса со стороны клиентов, планы корректируются по мере изменения обстоятельств. Подчёркивается, что это «обычная и ответственная» практика управления крупными и сложными инфраструктурными проектами, помогающая обеспечивать надёжный и эффективны ввод в эксплуатацию новых мощностей.
10.11.2026 [14:48], Сергей Карасёв
ИИ-ускорители Rebellions тоже обзаведутся поддержкой NVIDIA NVLinkКомпании NVIDIA, Rebellions и SK Telecom объявили о сотрудничестве с целью развития суверенной инфраструктуры ИИ в Южной Корее. Инициативу поддерживает Министерство науки и информационно-коммуникационных технологий страны (MSIT). Речь идёт об использовании модульной архитектуры NVIDIA MGX для создания ИИ-систем, а также технологии NVIDIA NVLink Fusion, которая позволяет использовать фирменный интерконнект NVLink для подключения ускорителей, разработанных сторонними компаниями. В данном случае будут задействованы ИИ-решения Rebel R200, разработанные специалистами южнокорейской Rebellions. Эти изделия спроектированы специально для выполнения вычислений с низкой задержкой и небольшим энергопотреблением: они подходят для работы с передовыми ИИ-моделями, включая нейросети с архитектурой Mixture-of-Experts (MoE) с несколькими триллионами параметров. Южнокорейский оператор SK Telecom в рамках партнёрства развернёт MGX-стойки с ускорителями Rebel R200 и картами NVIDIA в своём дата-центре для задач ИИ. Компании намерены разработать схему дезагрегированного инференса, перенося различные этапы генерации ИИ-ответа на ту аппаратную часть, которая лучше всего подходит для этого. В частности, для предварительного заполнения будут использоваться GPU NVIDIA, а для декодирования — Rebel R200. Такой подход позволит повысить общую производительность и оптимизировать энергопотребление. 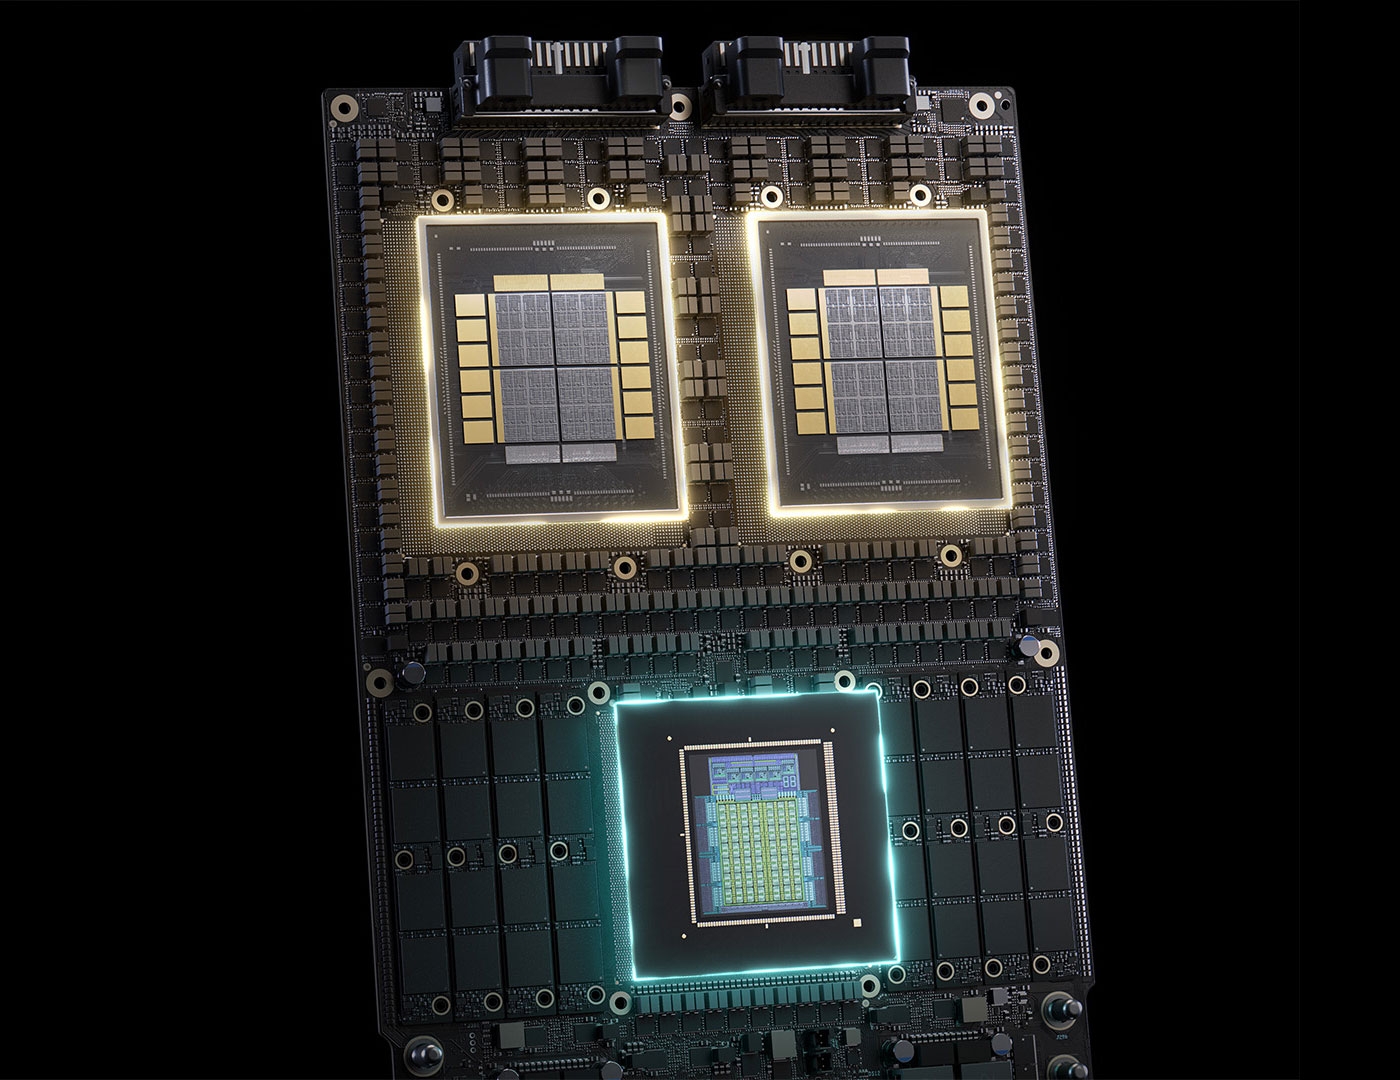
Источник изображения: NVIDIA SK Telecom планирует интегрировать новую инфраструктуру с общедоступными сервисами, в том числе в рамках государственного проекта «Искусственный интеллект для всех». При этом будут использоваться собственные ИИ-модели, адаптированные к корейскому языку и региональным отраслям промышленности. Нужно отметить, что к альянсу NVLink Fusion уже присоединились многие другие известные компании. В их число входят Qualcomm, Arm, d-Matrix, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek.
10.11.2026 [14:43], Сергей Карасёв
ИИ-чипы DeepX DX-M2 обеспечат производительность до 80 TOPS при энергопотреблении 5 ВтЮжнокорейский стартап DeepX, по сообщению ресурса EE Times, завершил разработку ИИ-чипа второго поколения — изделия DX-M2, предназначенного для локального запуска больших языковых моделей (LLM) с 20–100 млрд параметров. Решение ориентировано на робототехнику, беспилотные летательные аппараты, различные периферийные устройства и пр. Для ускорителя DX-M2 предусмотрено применение 2-нм технологии производства. Заявленное ИИ-быстродействие достигает 80 TOPS при энергопотреблении на уровне 5 Вт. Скорость работы варьируется от 10 до 30 токенов в секунду в зависимости от модели. Ключевой особенностью решения является использование памяти Samsung LPDDR5X-PIM (Processor-In-Memory). Эти чипы не просто хранят данные, но и умеют самостоятельно выполнять простые вычисления, в частности, операции GEMV (общее матрично-векторное умножение). Благодаря такому подходу значительно повышается общая эффективность. Пропускная способность памяти по сравнению с изделиями первого поколения (DX-M1) увеличилась примерно в три раза — с 50 до 153,6 Гбайт/с. 
Источник изображения: DeepX Моделирование, проведенное DeepX, показывает, что перенос операций GEMV в память LPDDR5x-PIM обеспечит повышение производительности при работе с моделью Llama3.1-8B в 6,7 раза по сравнению с DX-M2 без технологии PIM. Однако при этом общее энергопотребление возрастает в 2,7 раза. При сохранении затрат энергии на сопоставимом уровне можно добиться двукратного выигрыша в быстродействии. Для DX-M2 предусмотрены несколько конфигураций. Это изделие в виде модуля M.2 или карты расширения PCIe с внешней памятью LPDDR5X объёмом до 96 Гбайт (153,6 Гбайт/с) и энергопотреблением 5 Вт (только SoC). Кроме того, будут предлагаться модули M.2 с интегрированной памятью LPDDR5X ёмкостью 24 и 48 Гбайт с пропускной способностью 76,8 и 153,6 Гбайт/с соответственно. В первом случае энергопотребление составляет 5 Вт (3 Вт у SoC и 2 Вт у DRAM), во втором — 8,5 Вт (4,5 Вт у SoC и 4 Вт у DRAM). Компания DeepX сотрудничает с клиентами в США, Китае, Вьетнаме и Корее. Утверждается, что стартап получил более 100 заказов на DX-M1 от разработчиков продуктов в различных областях, связанных с физическим ИИ, включая дроны, робототехнику, умные заводы, камеры видеонаблюдения, аэрокосмическую и оборонную промышленность, здравоохранение и интернет вещей. Образцы изделий DX-M2, как ожидается, появятся в марте следующего года, а серийное производство планируется начать осенью 2027-го.
10.11.2026 [01:23], Владимир Мироненко
Суперкомпьютер МГУ получил российскую СХД на процессорах Baikal-S
astra linux
baikal-s
hardware
hpc
sds
импортозамещение
сделано в россии
спинтроника
суперкомпьютер
схд
«Группа Астра» и компания «Спинтроника» сообщили о завершении проекта по созданию СХД для нового суперкомпьютера МГУ им. М.В. Ломоносова. Программно–определяемое хранилище SDS TROK от «Группы Астра» было развёрнуто на серверах производства «Спинтроники» с отечественными процессорами Baikal–S для использования в качестве СХД для ПАК «Исток». «Исток» эксплуатируется в МГУ имени М.В. Ломоносова с I квартала 2026 года. Доступ к данным осуществляется по NFS. Весь технологический стек — полностью российский, начиная от аппаратной части. Это было одним из главных требований МГУ — наличие отечественных комплектующих и совместимость с процессорами Baikal–S. Заявка МГУ одержала победу на открытом конкурсном отборе по реализации мероприятий, направленных на обновление материально-технической базы организаций, выполняющих научные исследования и разработки. Благодаря этом финансирование проекта осуществлялась за счёт госбюджета через Министерство науки и высшего образования РФ (Соглашение № 075-15-2025-541). Команда SDS TROK выстроила конвейер сборки и провела тестирование в два этапа: сначала на виртуальных машинах, затем на физическом оборудовании, подтвердив стабильную работу и соответствие заявленными характеристика. Доработка СХД вошла в основную кодовую базу продукта и теперь находится в открытом доступе. 
Источник изображения: «Группа Астра» SDS TROK, по словам создателей, гарантирует сохранность результатов вычислений при отказе оборудования на уровне архитектуры:
Также администратору не требуются вручную управлять репликацией или запускать процедуры восстановления.
09.11.2026 [21:49], Владимир Мироненко
Google представила ИИ-ускорители TPU 8tx и TPU 8i MaxGoogle представила ИИ-ускорители TPU 8tx и TPU 8i Max. С учётом анонсированных ранее в этом году ускорителей TPU 8t и TPU 8i семейство TPU Google восьмого поколения теперь включает четыре модели. Как отметил в блоге Амин Вахдат (Amin Vahdat), старший вице-президент и главный технолог Google по ИИ и инфраструктуре, TPU восьмого поколения предназначены «для решения конкретных задач на разных этапах жизненного цикла ИИ: TPU 8t — для масштабного обучения моделей; TPU 8i — для выполнения инференса с низкой задержкой; TPU 8tx — для конфиденциальных вычислений; а TPU 8i Max — для обработки огромных контекстных окон и обеспечения максимальной плотности вычислений в серверной стойке». TPU 8t и TPU 8i стали фундаментом для этого поколения: TPU 8t — инструмент для обучения масштабных базовых моделей, обеспечивающий максимальный показатель «полезной производительности» (goodput) — то есть объём эффективных вычислений на каждый ватт затраченной энергии. А TPU 8i — вычислительный модуль для инференса и «размышлений», разработанный для преодоления «барьера памяти» (memory wall) и сокращения задержек при обмене данными между чипами — вплоть до 50 %. 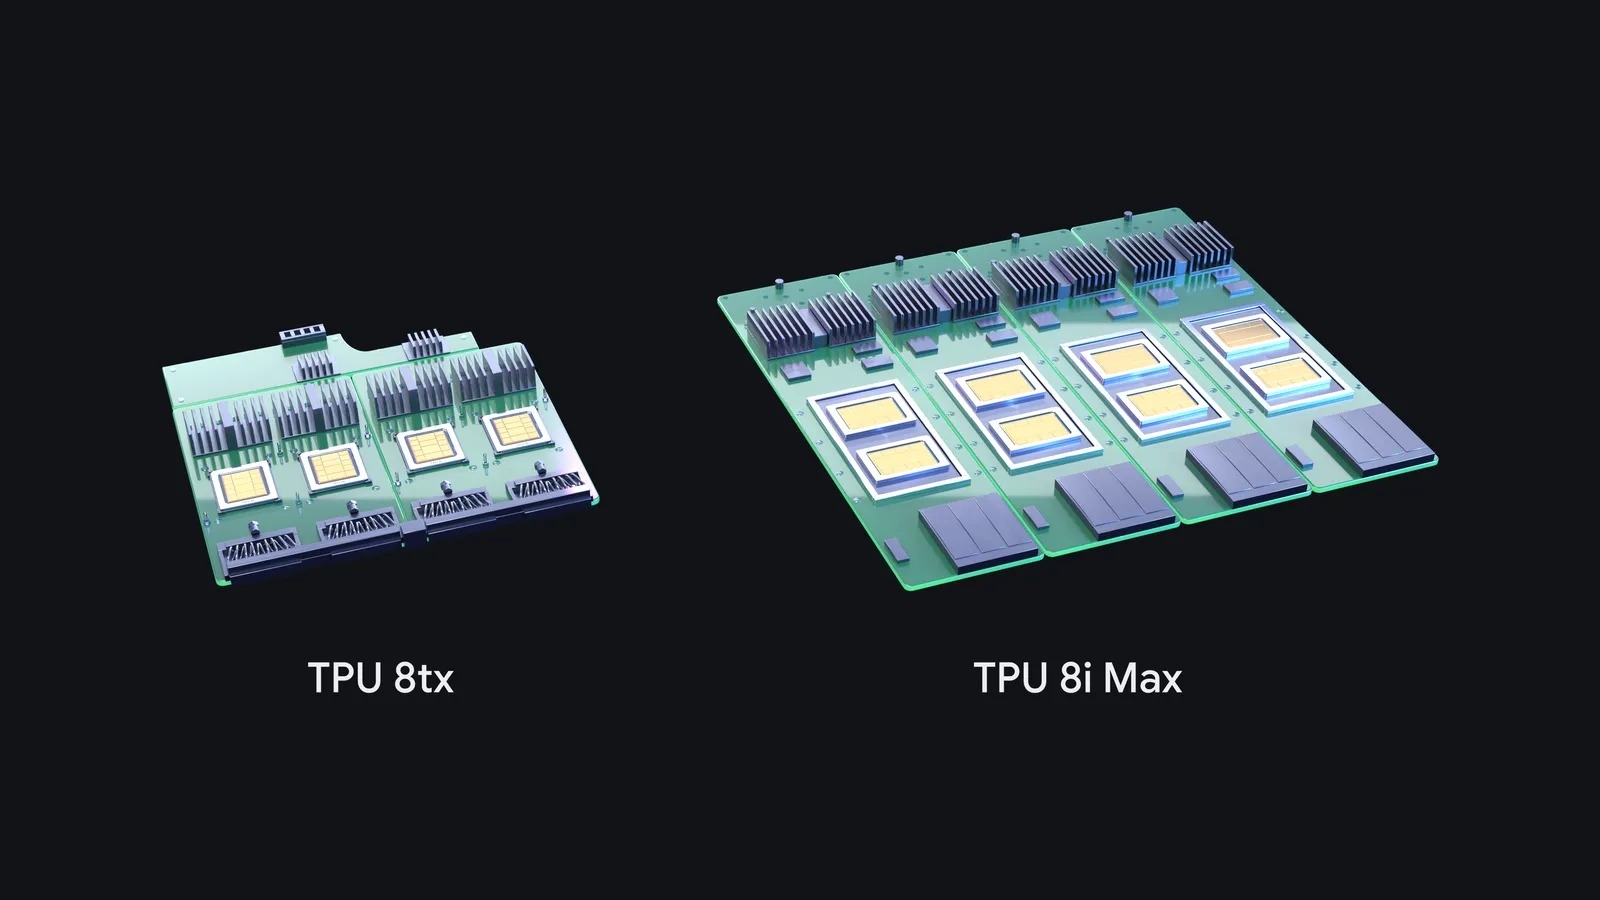
Источник изображений: Google В свою очередь, TPU 8tx оптимизирован для безопасного и конфиденциального инференса, а также обучения моделей в небольших масштабах. Он создан для организаций, работающих в регулируемых отраслях, и государственных структур, которые используют передовые или проприетарные модели и автономных агентов для работы с наиболее конфиденциальными данными. Система TPU 8tx, построенная на той же аппаратной базе, что и TPU 8t, и работающая в связке с процессорами AMD EPYC Turin, обеспечивает безопасность на уровне «железа», сохраняя конфиденциальные данные и веса моделей защищенными и изолированными даже при их использовании. В сочетании с сетевой топологией Boardfly с низкой задержкой TPU 8tx ускоряет работу многошаговых агентов, обеспечивая снижение задержки до двух раз по сравнению с TPU 8t практически без потери производительности. TPU 8tx также позволяет дообучать (fine-tune) модели на собственных закрытых данных, выполнять дистилляцию (сжатие) крупных моделей и обучать с подкреплением агентов без необходимости перемещать конфиденциальные данные между отдельными кластерами. 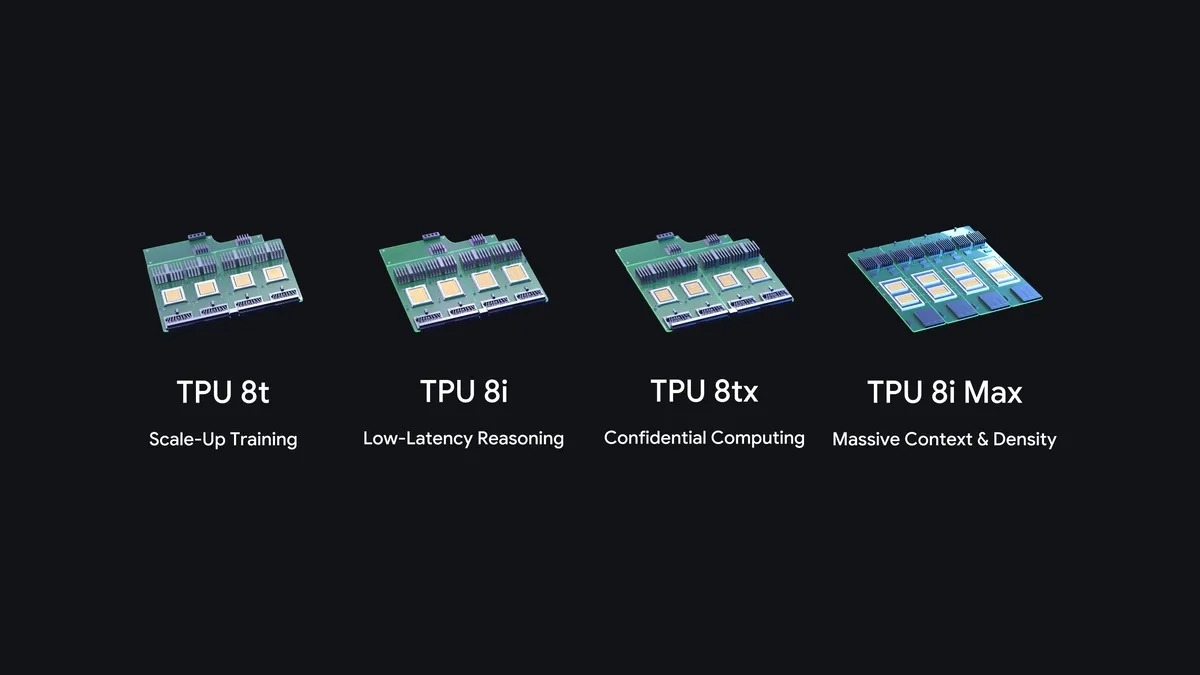 Модель TPU 8i Max, объединившая два TPU 8i, была разработана для решения проблемы «барьера памяти» (memory wall) — разрыва между скоростью вычислений и пропускной способностью памяти. Двухчиповая система предлагает вдвое больше вычислительных ресурсов, вдвое больше SRAM и вдвое более высокую пропускную способность HBM по сравнению с TPU 8i. Вычислительные мощности и объём памяти в ней масштабируются синхронно. Поскольку TPU 8i Max вмещает вдвое больше кремниевых компонентов в рамках той же серверной стойки, дата-центры могут значительно увеличить вычислительную мощность на единицу площади и на ватт потребляемой энергии, сообщил Вахдат. Вахдат также заявил, что компания выпустила набор инструментов TPU Agent (сейчас доступен в режиме превью) для упрощения оптимизации оборудования. Он интегрируется в среды разработки — например, Claude Code, Cursor и Google Antigravity — и позволяет за считанные минуты подготовить систему к работе с TPU, выявить «узкие места» и автоматически настроить ядра (kernels) с помощью простых текстовых команд. Для промышленного использования был разработан открытый движок XLA Serving Engine, который позволяет обучать модели на Python, а затем запускать их в высокопроизводительной среде на C++ с минимальной задержкой — на базе TPU, GPU или CPU.
09.11.2026 [15:14], Руслан Авдеев
6 ГВт для ИИ в аризонских пустынях — SpaceXAI намерена построить крупнейший в мире ЦОДSpaceXAI готовится начать строительство комплекса ЦОД в округе Кочис (Cochise, шт. Аризона). Компания заявляет, что после полного завершения строительства новому кампусу потребуется 6 ГВт электроэнергии, сообщает Datacenter Dynamics. Всего планируется освоить два участка общей площадью более 300 га на расстоянии около 130 км от Тусона (Tucson). Сейчас участки принадлежат энергокомпаниям Arizona Electric Power Cooperative (AEPCO) и Southline Transmission LLC. Через аффилированную со SpaceXAI компанию Tombstone Resources LLC в округе Кочис подана заявка на получение специального разрешения на строительство. Согласно заявке, кампус получит до девяти зданий ЦОД, каждое по 45 801 м2. Компания намерена ввести их в эксплуатацию в четыре этапа по 1,5 ГВт, строительство начнётся в марте 2027 года, если будет получено разрешение на использование земли для ЦОД. Сроки доступности вычислительных мощностей будут зависеть от завершения модернизации электросетей. Компания намерена оплатить соответствующие работы и потратить $3,6 млрд на энергетическую инфраструктуру. На работы, необходимые для начала строительства первой очереди ЦОД, необходимо $500 млн. Площадка находится неподалёку от электростанции AEPCO Apache Generating Station мощностью 626 МВт, использующей уголь, природный газ и солнечные элементы. SpaceXAI рассчитывает установить аккумуляторное энергохранилище на 24 ГВт·ч на случае колебаний спроса на энергию. В результате работа ЦОД не будет оказывать негативного влияния на энергосистему Аризоны. 
Источник изображения: Robert Murray/unsplash.com SpaceXAI уже эксплуатирует кластер кампусов ЦОД в районе Мемфиса, один из которых находится в Теннесси, а остальные — за границей штата в Миссисипи. Они используются для обеспечения ИИ Grok самой компании, облачные сервисы предоставляются Anthropic и Google. На прошлой неделе анонсировано строительство в Миссисипи двух новых ЦОД — Gun Range и Spam. 6-ГВт ЦОД стал бы крупнейшим в мире проектом такого рода, с огромным отрывом от конкурентов. Энергии для него в Аризоне, возможно, будет достаточно, согласно имеющимся у государства данным, но получить ИИ-ускорители и энергетическое и охлаждающее оборудование в достаточных объёмах, вероятно, будет непросто. На днях сообщалось, что всего SpaceX намерена запустить в 2027 году 10 ГВт мощностей ИИ ЦОД.
09.11.2026 [15:03], Сергей Карасёв
IBM, AMD и ORNL запустили платформу для разработки технологий квантовой коррекции ошибокКомпании IBM и AMD, а также Центр квантовой науки (QSC) в составе Окриджской национальной лаборатории (ORNL) Министерства энергетики США (DOE) объявили о запуске специализированной платформы для разработки технологий квантовой коррекции ошибок. Система объединяет HPC и квантовые вычисления для решения одной из ключевых проблем на пути масштабирования квантовых компьютеров. Физические кубиты (квантовые биты) крайне чувствительны к малейшим колебаниям температуры, электромагнитным полям и дефектам материалов. Уровень шума растёт экспоненциально по мере увеличения количества кубитов и глубины алгоритма, а поэтому без эффективной квантовой коррекции ошибок масштабирование квантовых компьютеров невозможно. Новая платформа использует самый мощный квантовый процессор IBM — изделие Quantum Nighthawk со 120 кубитами. Задействована НРС-система ORNL Umbra на процессорах AMD EPYC Turin и ускорителях Instinct MI355X: она обеспечивает классические вычислительные ресурсы для исследований в области квантовой коррекции ошибок, оптимизации декодирования и оркестровки программного обеспечения. 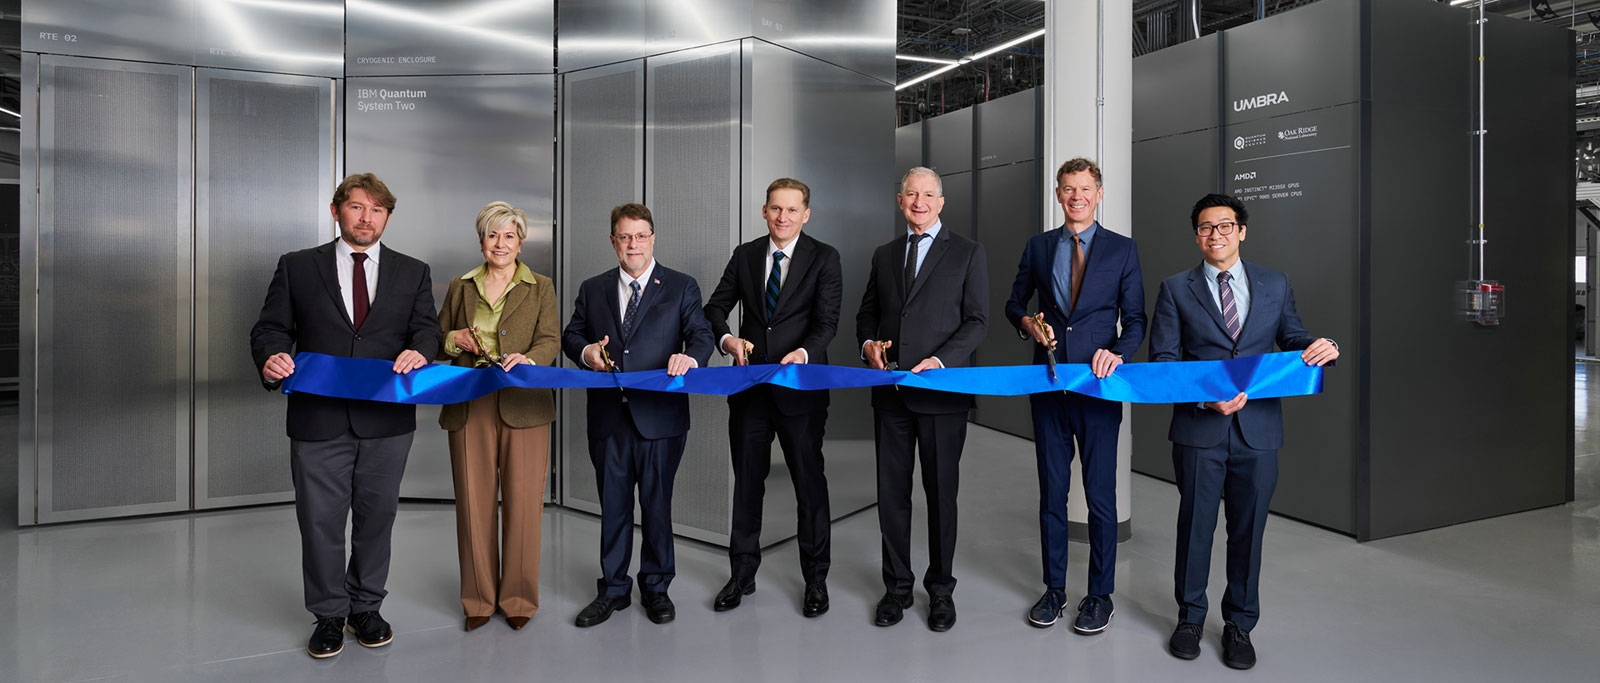
Источник изображения: IBM Запущенная платформа позволяет оценивать различные подходы и определять оптимальные архитектуры квантовой коррекции ошибок. Ученые смогут проверять сложные многоуровневые коды коррекции, которые в будущем позволят проектировать полностью отказоустойчивые квантовые машины. Конечная цель заключается в том, чтобы ускорить создание масштабируемой и эффективной вычислительной инфраструктуры на основе квантовых процессоров. В целом, проект поддерживает масштабную инициативу DOE под названием Quantum Genesis Mission, которая направлена на разработку к 2028 году системы со 100 логическими кубитами, способными выполнять 100 тыс. сложных операций. Такой машине потребуется высокоэффективный механизм квантовой коррекции ошибок.
09.11.2026 [14:48], Сергей Карасёв
Два чипа Intel Xeon D и 24 отсека U.2/U.3 NVMe: QNAP представила СХД ES2486AFdc типа All-FlashКомпания QNAP Systems анонсировала систему хранения ES2486AFdc — своё первое устройство корпоративного класса типа All-Flash с двумя контроллерами, функционирующими в режиме «активный — активный». Новинка ориентирована на среды виртуализации, базы данных и другие ресурсоёмкие нагрузки. Каждый из контроллеров несёт на борту процессор Intel Xeon D-2142IT (8C/16T, 1,9–3,0 ГГц). Объём оперативной памяти RDIMM DDR4 ECC составляет 64 Гбайт на контроллер с возможностью расширения до 512 Гбайт в конфигурации 8 × 64 Гбайт (до 1 Тбайт на систему). Кроме того, есть 4 Гбайт флеш-памяти для программного обеспечения (с функцией Dual Boot OS Protection). Во фронтальной части расположены 24 отсека для SFF-накопителей U.2/U.3 с интерфейсом PCIe (NVMe); допускается горячая замена. Заявленная пропускная способность достигает 15 Гбайт/с, показатель IOPS (операций ввода/вывода в секунду) — 616 тыс. при произвольном чтении данных блоками по 4 Кбайт. 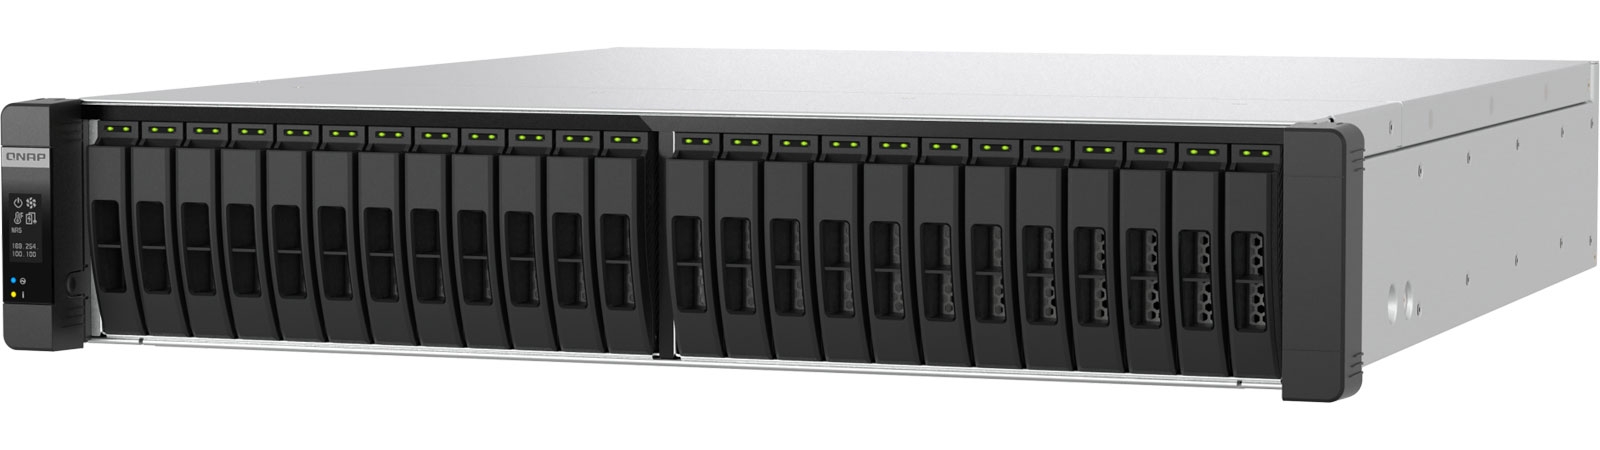
Источник изображений: QNAP Systems Каждый из контроллеров располагает двумя слотами PCIe 3.0 x8 для адаптеров 25GbE или Fibre Channel, четырьмя портами 10GbE SFP+ и тремя портами 2.5GbE, один из которых зарезервирован для удалённого управления. Кроме того, есть по два разъёма USB 3.0 Type-A. 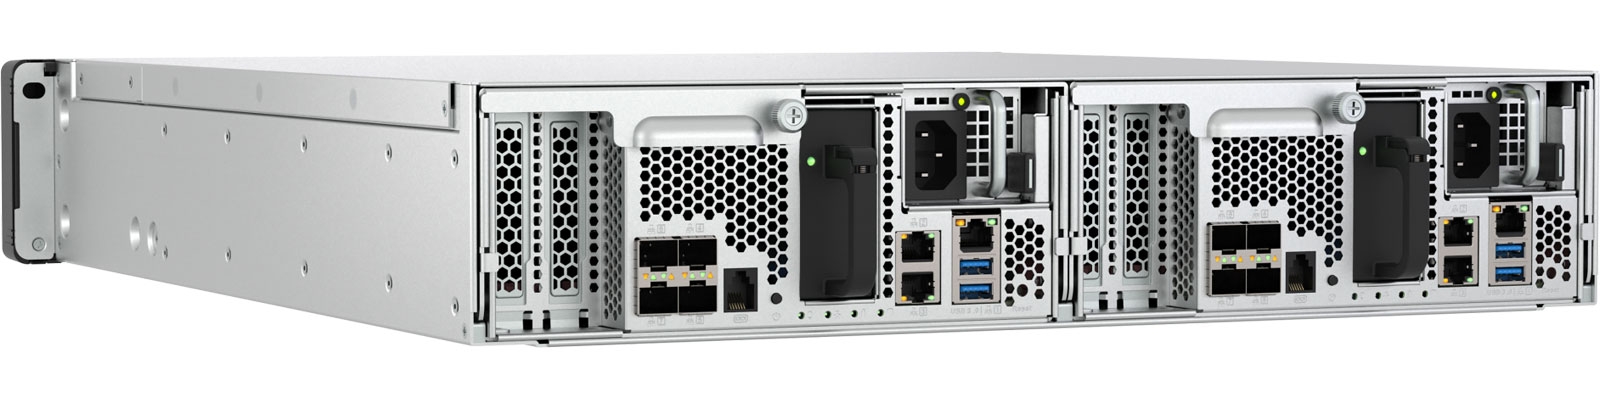 СХД выполнена в форм-факторе 2U с габаритами 88,3 × 483 × 525,18 мм, а масса составляет около 22 кг без установленных накопителей. Применены два блока питания мощностью 700 Вт с резервированием. В системе охлаждения задействованы вентиляторы диаметром 60 мм с возможностью горячей замены. Диапазон рабочих температур простирается от 0 до +40 °C. В качестве программной платформы используется QES 2.2.1. Приём заказов на новинку уже начался.
09.11.2026 [14:43], Сергей Карасёв
Ядра RISC-V пропишутся в чипах AMD Zen 6 — для TEE и PSPКак сообщает ресурс Phoronix, исходный код в репозиториях Linux указывает на то, что в конструкцию процессоров AMD на архитектуре Zen 6 попали ядра RISC-V для реализации защищённой среды TEE (Trusted Execution Environment) и подсистемы PSP (Platform Security Processor). AMD TEE — это аппаратно-изолированная среда, предназначенная для защиты конфиденциальных данных и выполнения критически важных вычислений отдельно от основной операционной системы и гипервизора. В свою очередь, PSP представляет собой аппаратный микроконтроллер безопасности, который отвечает за работу TEE и аппаратного шифрования. Традиционно в чипах AMD для работы TEE/PSP применялись 32-бит ядра Arm — в частности, Cortex-A5 с технологией TrustZone. В изделиях поколения Zen 6, судя по обнародованной информации, реализована доверенная среда выполнения на открытой архитектуре RISC-V. При этом говорится о поддержке большего объёма разделяемой памяти и расширенного набора политик (до 20 пользовательских входных параметров BIOS). 
Источник изображения: AMD Изменения касаются в том числе доверенного инструментария AMD Platform Management Framework (PMF) для управления питанием, температурой и поведением системы. С точки зрения конечных пользователей ничего не изменится: чипы Zen 6 — это x86-совместимые процессоры, позволяющие запускать привычный софт и стандартные ОС, включая Windows. Архитектура Zen 6 лежит, в частности, в основе серверных CPU семейства EPYC Venice 9006, которые насчитывают до 256 вычислительных ядер.
09.11.2026 [14:36], Руслан Авдеев
Совет директоров NVIDIA начал расследование в отношении главы компании Дженсена Хуанга в связи со шпионским скандаломСовет директоров NVIDIA инициировал расследование в отношении главы компании Дженсена Хуанга (Jensen Huang) после того, как появилась информация о его связи с женщиной, которую американские власти считают вероятной китайской разведчицей, сообщает The Register. В минувшее воскресенье совет директоров опубликовал официальное заявление на этот счёт, заявив о начале «независимого расследования». Ключевым источником стала публикация The New York Times, в которой сообщалось, что американские спецслужбы занялись расследованием деятельности женщины, известной под именами Элис Хуанг (Alice Huang) и/или Хуанг Ле (Huang Le). Предполагается, что та передавала Пекину разведывательную информацию. В своей истории издание использовало определение «близкие отношения» для описания контактов Хуанга как с данной женщиной, так и с президентом США Дональдом Трампом (Donald Trump). В воскресенье оно сообщило, что с женщиной, по мнению американских властей, бизнесмена связывали «романтические» отношения. Предполагается, что Элис Хуанг — гражданка Китая, работавшая на базирующуюся в Сингапуре компанию Megaspeed, купившую немало оборудования NVIDIA и уже попавшую под санции. Власти США подозревают, что оно было приобретено, чтобы обеспечить доступ к передовым технологиям китайским пользователям. В частности, оборудование предполагалось использовать или в дата-центрах за пределами Китая, или непосредственно поставлять его в КНР. США годами запрещали или ограничивали экспорт передовых чипов в КНР, отчасти из-за опасений, что китайские военные смогут использовать их в своих целях для создания систем, способных подорвать военное превосходство США. В этом свете любые отношения Хуанга с сотрудницей китайской разведки вызвали бы сильную обеспокоенность. В компании заявили, что общение Дженсена и Элис Хуанг носило исключительно обычный характер контактов генерального директора с представителем клиента и угроз интеллектуальной собственности компании или национальной безопасности США эти контакты не представляли. Вскоре после публикации заявления совета директоров NVIDIA Хуанг признал, что его поведению в отношении семьи нет оправдания и он сожалеет о случившемся. Также он поддержал решение совета директоров о начале расследования и заявил, что намерен оказать ему «полное содействие». По его словам, руководство NVIDIA — величайшая привилегия в его жизни и коллеги из компании, в том числе работавшие с ним десятилетиями, акционеры и партнёры «заслуживали от него большего». 
Источник изображения: Etienne Girardet/unsplash.com Хуанг заявил, что любит страну и компанию и намерен защищать NVIDIA и помогать защите национальной безопасности США. Бизнесмен подчеркнул, что гордится тем, что является американцем и благодарен за это. При этом никаких данных о «романтическом» характере отношений между Хуангом и гражданкой Китая в заявлениях совета директоров и бизнесмена не имеется. Не менее загадочным The Register называет и отношения Хуанга с Сингапуром, на долю которого приходится до 22 % выручки NVIDIA в некоторые периоды. Развернуть всё купленное оборудование в стране нет никакой возможности. Комментируя такую странность, в NVIDIA заявляли, что сингапурский бизнес покупает оборудование от имени конечных пользователей в других странах. При этом подчёркивалось, что такие сделки не используются для обхода санкций. Хотя NVIDIA не особенно часто оказывается в центре скандалов, в 2022 году компания признала, что ранее вводила общественность в заблуждение относительно влияния криптомайнинга на продажи своих игровых решений. Кроме того, КНР инициировала в отношении компании антимонопольное расследование, а власти США, возможно, рассматривали аналогичные меры. Тем не менее, Дженсен Хуанг никогда не пользовался репутацией бизнесмена, балансирующего на грани законности на регулярной основе. Кроме того, для принятия важных единоличных решений он не владеет достаточным количеством акций NVIDIA и достаточным количеством голосов при голосовании. Другими словами, не исключено, что глава крупнейшего в мире производителя ИИ-ускорителей и оборудования совершил вполне человеческую ошибку. Так или иначе, продукция NVIDIA нередко попадает в новости в связи со скандалами, касающимися контрабанды передовых ИИ-решений в Китай. Так, в марте сообщалось, что в США предъявили обвинения трём людям, связанным с производителем ИИ-серверов Supermicro, включая его соучредителя, в сговоре с целью контрабанды передовых чипов NVIDIA в КНР и нарушении американского экспортного контроля, запрещающего их продажу в Китай без лицензии. |
|

