Материалы по тегу: ускоритель
|
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 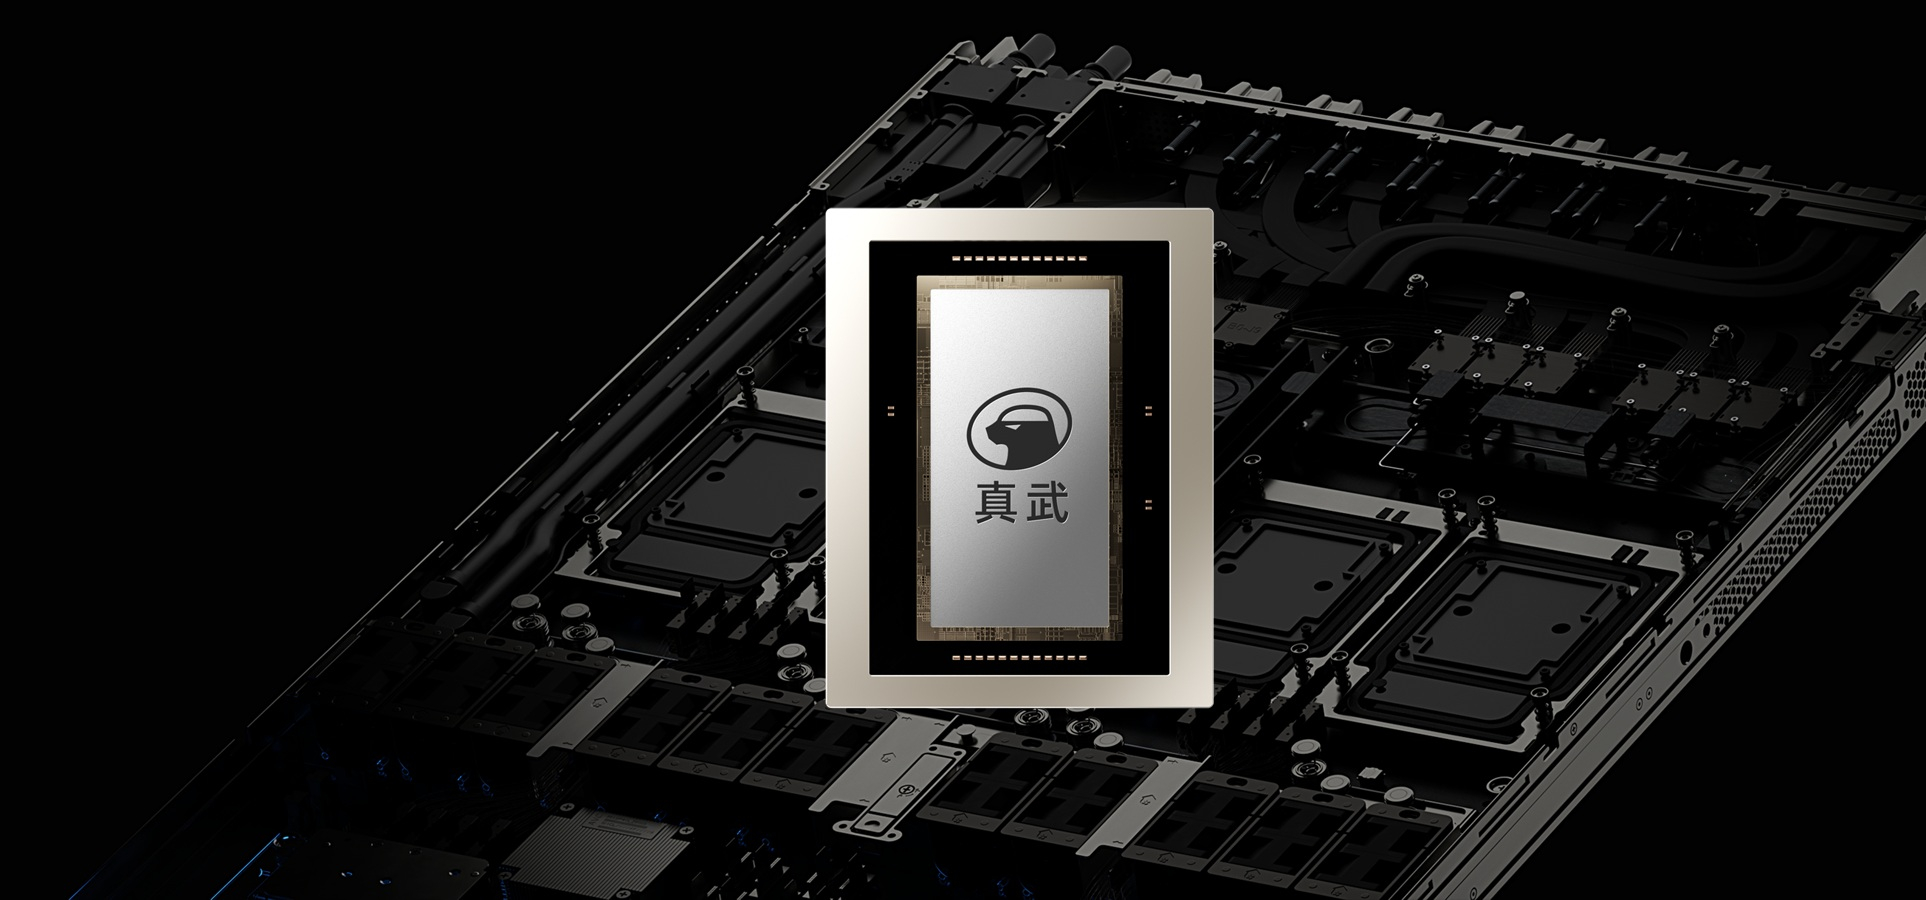
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 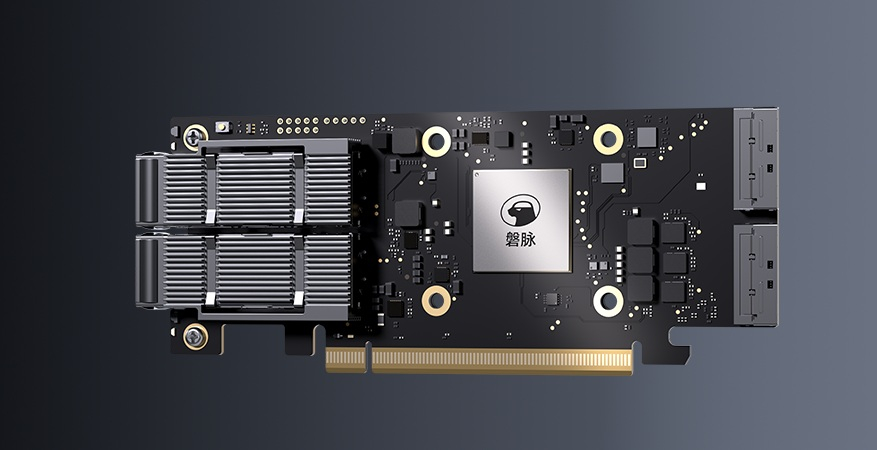
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
18.09.2026 [17:42], Сергей Карасёв
ИИ-ускорители Huawei Ascend 960DT с 288 Гбайт памяти выйдут в начале 2027 годаHuawei поделилась планами по выпуску новых ИИ-ускорителей Ascend. Сообщается, что в I квартале следующего года дебютирует изделие Ascend 960DT, которое придёт на смену Ascend 950. В состав 960DT (аббревиатура расшифровывается как Decode/Training — декодирование/обучение) войдут 288 Гбайт памяти с пропускной способностью 9,6 Тбайт/с — в 2,4 раза больше по сравнению с Ascend 950. При этом сетевые источники указывают на использование памяти HiZQ — собственного решения Huawei, позиционирующегося в качестве альтернативы НВМ. Пропускная способность интерконнекта Ascend 960DT составит 2,2 Тбайт/с. Для нового ускорителя заявлена поддержка форматов FP32, HF32, FP16, BF16, FP8, MXFP8, HiF8, MXFP4 и HiF4. ИИ-производительность в режиме FP8 будет достигать 2 Пфлопс, в режиме FP4 — 4 Пфлопс. В один кластер могут объединяться тысячи таких изделий для масштабирования быстродействия. В частности, посредством NPO могут быть связаны до 4096 эксземпляров Ascend 960DT, что обеспечит суммарную FP4-производительность на уровне 16 Эфлопс. 
Источник изображения: wccftech.com На III четверть 2027 года намечен анонс карты Ascend 960PR (Prefill/Recommenders — заполнение/рекомендации). Она будет нести на борту 192 Гбайт памяти с пропускной способностью 2,4 Тбайт/с (скорость интерконнекта сохранится на уровне 2,2 Тбайт/с). Это решение обеспечит быстродействие до 2 Пфлопс на операциях FP8 и до 8 Пфлопс в режиме FP4. В 2028 году, как ожидается, появится ускоритель Ascend 970 с 288 Гбайт памяти с пропускной способностью 14,4 Тбайт/с. У данной модели пропускная способность интерконнекта поднимется до 4,4 Тбайт/с. Производительность FP8 и FP4 — до 3,6 и 14 Пфлопс соответственно. Наконец, на 2029-й запланирован выпуск изделия Ascend 980 с 384 Гбайт памяти (38,4 Тбайт/с) и интерконнектом на 8 Тбайт/с. Карта сможет выдавать 7,2 Пфлопс на операциях FP8 и 28 Пфлопс в режиме FP4.
16.09.2026 [15:38], Сергей Карасёв
Axelera AI начала поставки ИИ-чипов Europa для высокоэффективного инференсаНидерландский стартап Axelera AI объявил о начале отгрузок изделий Europa — специализированных ИИ-чипов следующего поколения (AI Processing Unit, AIPU). Они ориентированы прежде всего на выполнение инференса с высокой энергетической эффективностью. Первая информация о решениях Europa появилась в октябре прошлого года. Конструкция чипов включает восемь ядер ИИ, 16 векторных ядер с архитектурой RISC-V, 256-бит интерфейс LPDDR5 с пропускной способностью 200 Гбайт/с и 128 Мбайт памяти L2 SRAM. Заявленное быстродействие достигает 629 TOPS на операциях INT8. При производстве применяется 5-нм технология Samsung. Заказчики могут приобретать чипы Europa для самостоятельного проектирования ИИ-ускорителей. Кроме того, изделия доступны в составе PCIe-карты Axelera Edge 232p формата HHHL с одним AIPU и платы Axelera Server 250p типоразмера FHFL с четырьмя AIPU. Эти устройства могут устанавливаться в серверы и рабочие станции. 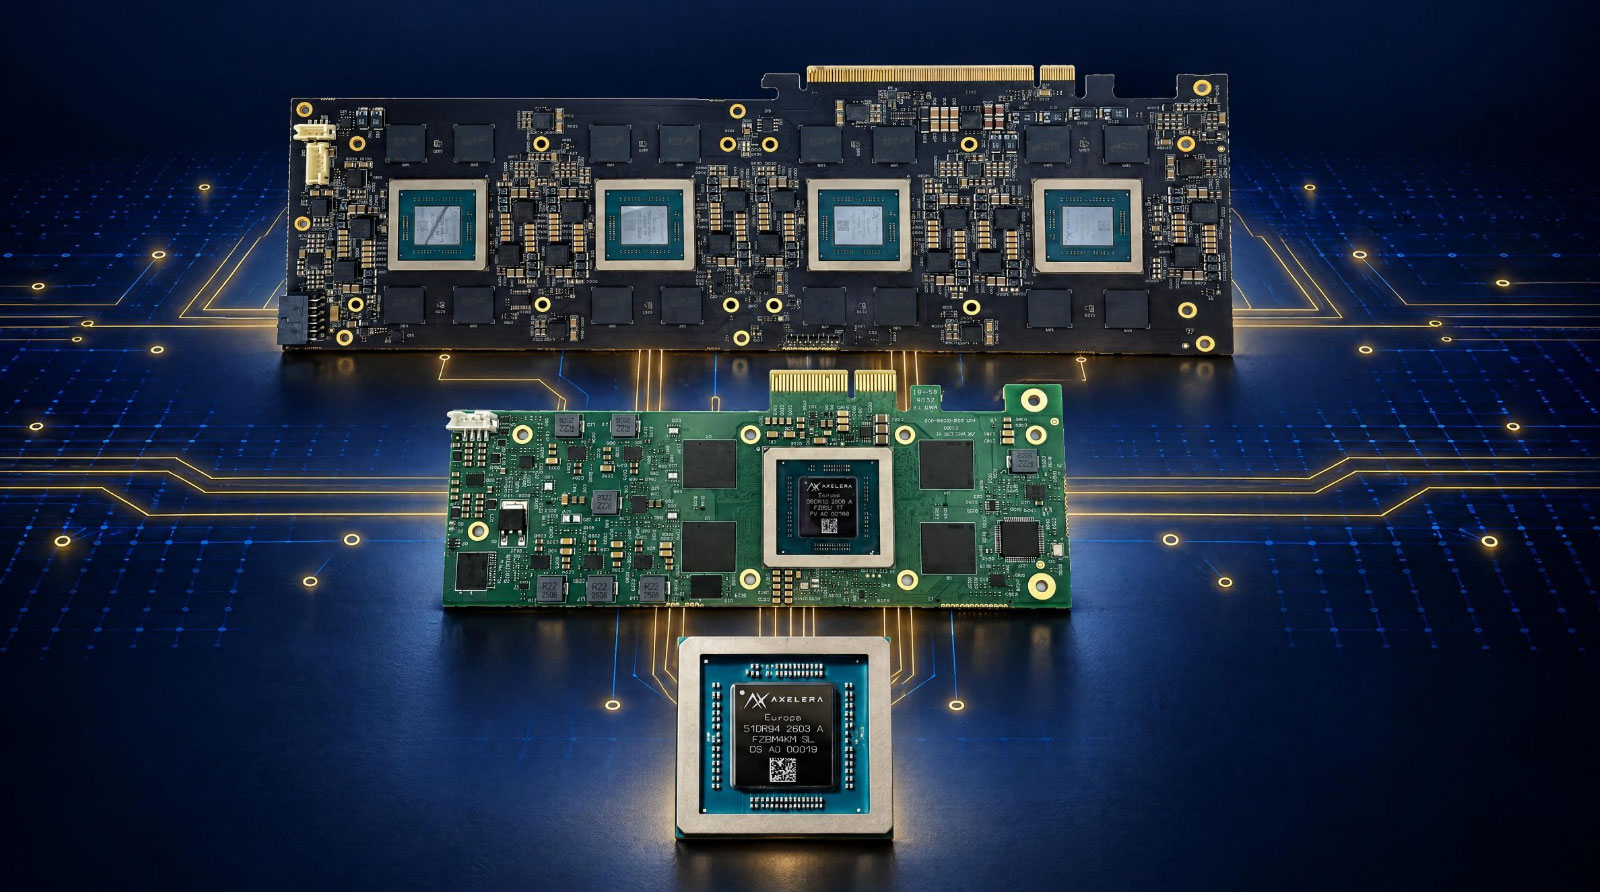
Источник изображений: Axelera AI Как утверждает Axelera AI, решения на базе Europa обеспечивают в шесть раз более высокую производительность (токенов в секунду) на 1 Вт затрачиваемой энергии по сравнению с ускорителями на базе GPU. Новые карты могут применяться не только в составе дата-центров и облачных платформ, но и на периферии, а также на корпоративных площадках. 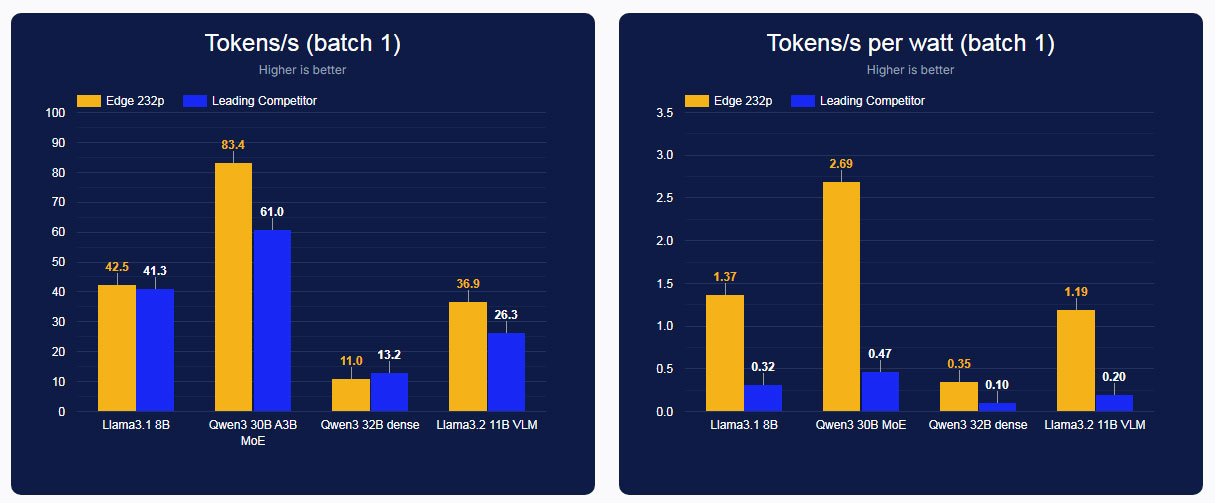 Ускорители Axelera Edge 232p будут доступны в составе серверов Dell XE5 и Supermicro 111AD. Кроме того, о поддержке Europa объявили такие компании, как 2CRSi, Advantech, Axiomtek, HPE, Lenovo, Seco и др. Продукты Axelera AI внедрили более 600 клиентов по всему миру, включая заказчиков в сферах оборонной промышленности, робототехники, беспилотных летательных аппаратов, розничной торговли и безопасности. Стартап говорит об общем портфеле заказов стоимостью свыше $1,5 млрд.
15.09.2026 [11:10], Сергей Карасёв
NVIDIA представила ускоритель RTX Pro 5500 Blackwell Workstation Edition с 84 Гбайт памяти GDDR7Компания NVIDIA анонсировала ускоритель RTX Pro 5500 Blackwell Workstation Edition для профессиональных рабочих станций. Изделие подходит для решения задач в области агентного ИИ, физического моделирования, обработки высококачественной графики, анализа данных, видеопроизводства и пр. Новинка построена на архитектуре Blackwell с чипом GB202. Конфигурация включает 21 760 ядер CUDA и 84 Гбайт памяти GDDR7 с 416-битной шиной, обеспечивающей пропускную способность до 1398 Гбайт/с. Задействованы тензорные ядра пятого поколения и ядра RT четвёртого поколения. Карта использует интерфейс PCIe 5.0 x16. Максимальное энергопотребление заявлено на уровне 600 Вт. Ускоритель ориентирован на рабочие станции в стоечном исполнении. При этом может применяться воздушная или жидкостная система охлаждения. Могут использоваться до четырёх разъёмов DisplayPort 2.1b: они позволяют выводить изображение на мониторы с разрешением до 8K при 240 Гц и 16K при 60 Гц. Движки NVIDIA NVENC девятого поколения значительно ускоряют кодирование видео и улучшают качество в профессиональных видеоприложениях. Кроме того, применяются блоки декодирования NVIDIA NVDEC шестого поколения. Говорится о поддержке форматов 4:2:2 H.264 и HEVC. 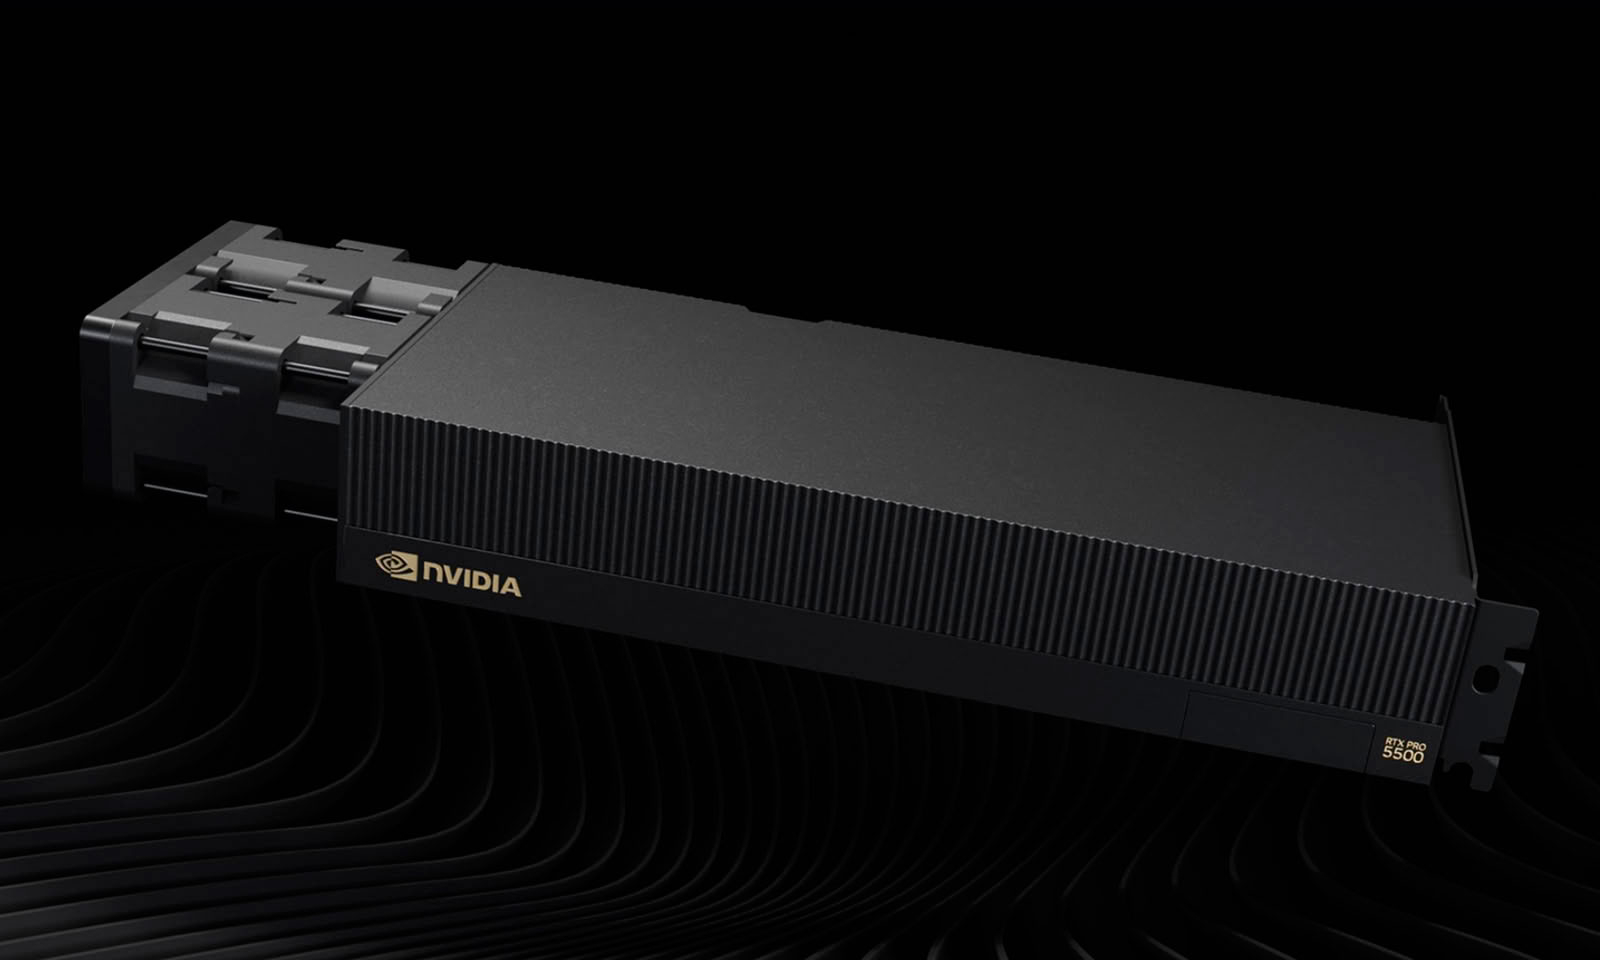
Источник изображения: NVIDIA В новинке реализована технология MIG (Multi-Instance GPU): она позволяет разделить один физический графический процессор на несколько независимых аппаратных разделов. Каждый из них функционирует как полноценный самостоятельный GPU со своей выделенной памятью, кешем и вычислительными ядрами. В случае RTX Pro 5500 Blackwell Workstation Edition могут быть сформированы два раздела с 42 Гбайт памяти GDDR7.
13.09.2026 [22:57], Владимир Мироненко
Oracle поставила более 300 тыс. GPU — почти втрое больше, чем в предыдущем кварталеOracle объявила о финансовых результатах I квартала 2027 финансового года, превзошедших ожидания Уолл-стрит, и сообщила о меньшем, чем ожидалось, расходовании денежных средств. Это вселило в инвесторов уверенность в том, что инвестиции в ИИ приносят отдачу, не создавая чрезмерной нагрузки на баланс компании, пишет Reuters. Акции Oracle, упавшие более чем на 21 % с начала года, выросли на 4 % на дополнительных торгах после того, как компания сообщила о резком увеличении объёма невыполненных заказов. Всего за отчётный квартал Oracle поставила клиентам более 300 тыс. ускорителей, что почти втрое превышает показатель IV квартала 2026 финансового года и, по словам со-генерального директора Клэя Магуйрка (Clay Magouyrk), составляет 73 % от общего объёма поставок за предыдущий финансовый год, о чём сообщил DataCenter Dynamics. В минувшем квартале Oracle ввела в эксплуатацию дополнительные мощности дата-центров объёмом 850 МВт. При этом спрос клиентов на облачные сервисы для обучения моделей ИИ и выполнения инференса продолжает расти быстрее, чем предложение. 
Источник изображений: Oracle В I финансовом квартале, завершившемся 31 августа, выручка Oracle выросла на 30 % до рекордного уровня в $19,35 млрд при консенсус-прогнозе аналитиков, опрошенных LSEG, в размере $19,14 млрд (по данным CNBC). Скорректированная прибыль на акцию (non-GAAP) составила $1,92 при прогнозе от LSEG в $1,74. Чистая прибыль (GAAP) составила $4,68 млрд ($1,56 на разводнённую акцию), превысив на 60 % показатель годом ранее в размере $2,93 млрд ($1,01 на разводнённую акцию). Выручка от облачных сервисов (IaaS + SaaS) в отчётном квартале подскочила на 62 %, до $11,61 млрд, превысив консенсус-прогноз аналитиков, опрошенных StreetAccount, в размере $11,51 млрд. При этом выручка от облачной инфраструктуры (IaaS) выросла на 121 % до $7,4 млрд, также превзойдя ожидания аналитиков в $7,09 млрд, а выручка от облачных приложений (SaaS) увеличилась на 10 % до $4,2 млрд. Выручка от продажи ПО снизилась на 3 % до $5,5 млрд, что отражает продолжающийся переход клиентов от локального (on-premise) ПО к облачным решениям. Это ниже консенсус-прогноза StreetAccount в размере $5,61 млрд. Выручка от оказания услуг составила $1,41 млрд (рост на 5 %), а выручка от продажи аппаратного обеспечения — $0,77 млрд (рост на 15 %). 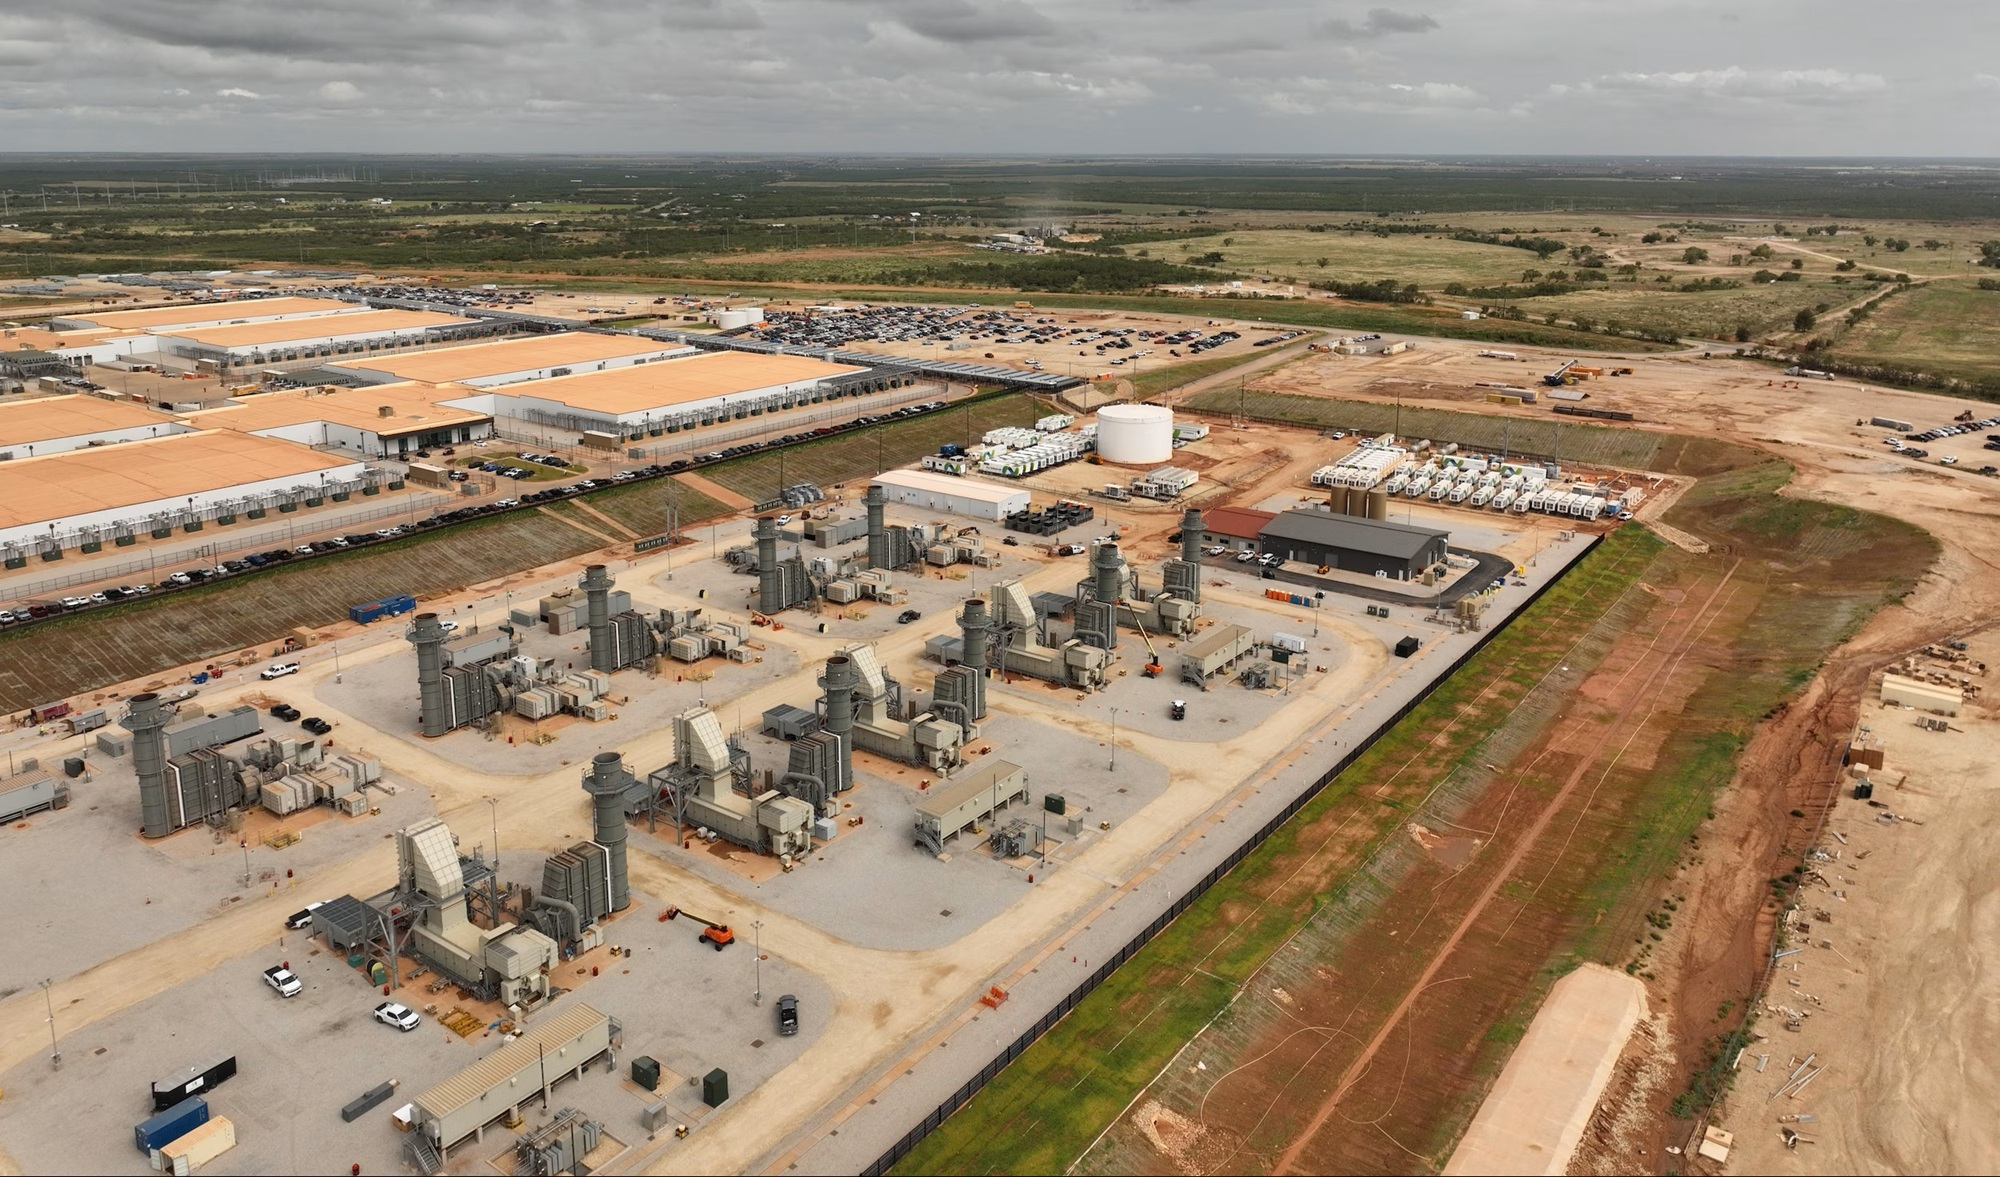 На II финансовый квартал Oracle прогнозирует скорректированную прибыль на акцию в диапазоне $1,85–$1,93 и рост выручки на 30–34 %. Опрошенные LSEG аналитики ожидают скорректированную прибыль на акцию на уровне $1,89 и выручку в размере $21,20 млрд (что соответствует росту на 32 %). Также компания ожидает, что общая выручка от облачных услуг вырастет на 64–70 %. В целом за 2027 финансовый год Oracle прогнозирует выручку не менее $90 млрд и скорректированную прибыль на акцию (non-GAAP) — $8,10, что выше её предыдущего прогноза в размере $8,05. Прогноз аналитиков от LSEG составляет $8,07 на акцию скорректированной прибыли и $89,76 млрд выручки. Высокие показатели операционной прибыли Oracle обеспечили рекордный для I квартала операционный денежный поток в размере $23 млрд (рост на 184 %). Вместе с тем свободный денежный поток в I финансовом квартале оказался отрицательным, составив –$5,4 млрд, поскольку компания продолжала инвестировать в развитие своего бизнеса облачной инфраструктуры. Годом ранее этот показатель равнялся –$362 млн. Вместе с тем, это ниже прогноза аналитиков Уолл-стрит, ожидавших –$9,56 млрд. Также Oracle теперь имеет кредиторскую задолженность в размере $125 млрд, возникшую в связи с привлечением заёмных средств в ходе масштабного строительства ИИ-дата-центров. Капитальные затраты Oracle в I финансовом квартале резко возросли — до $28,50 млрд с $8,50 млрд годом ранее. Компания подчеркнула, что около $11,36 млрд из этой суммы было покрыто за счёт предоплаты от клиентов. 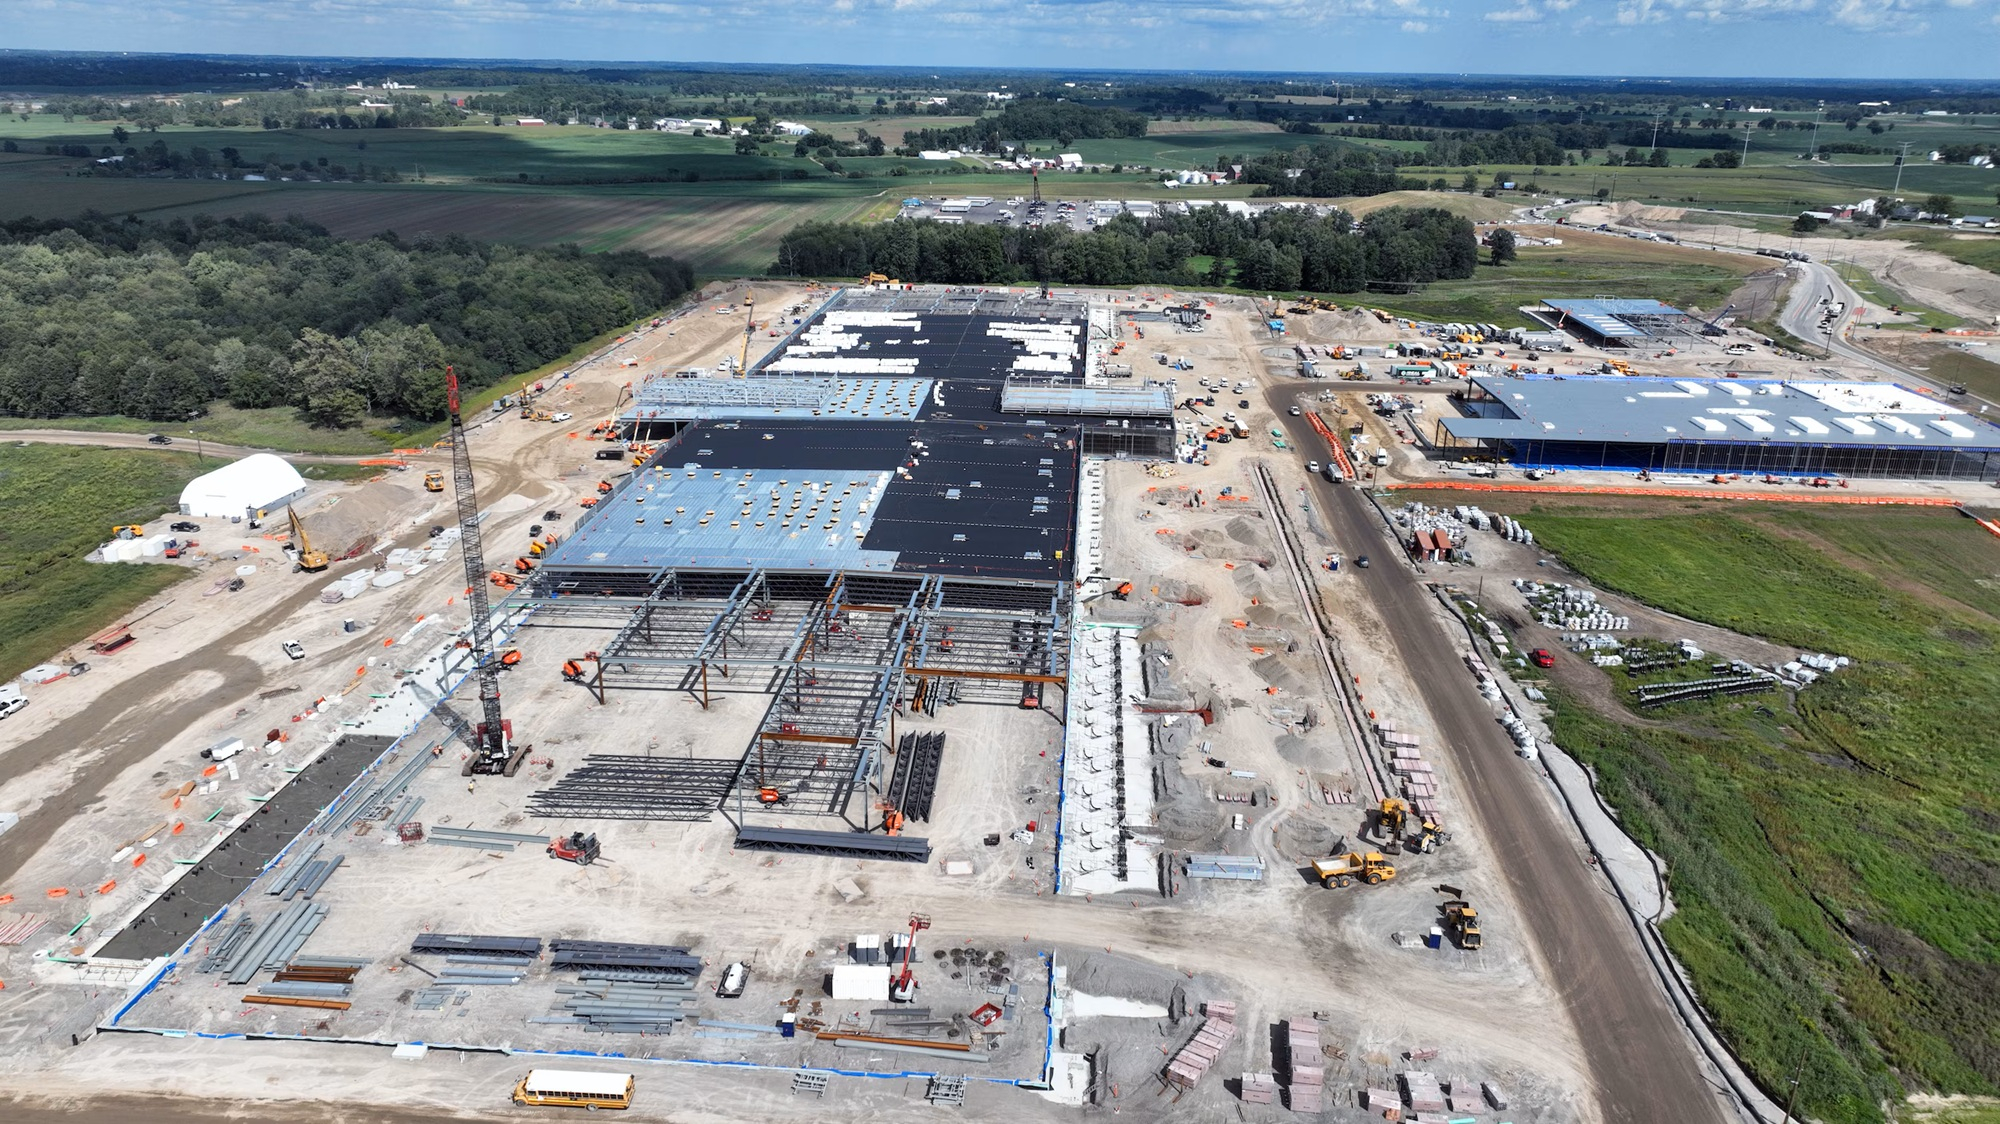 «Новая информация о предоплатах клиентов — это очень позитивный сигнал для рынка… К тому же, это, пожалуй, первый за долгое время квартал, когда состояние баланса фактически улучшилось, что позволяет компании заявить об отсутствии дополнительной нагрузки на планы по капитальным затратам», — отметили в REX Financial. В 2027 финансовом году, согласно прогнозу Oracle, объём капитальных вложений составит от $90 до $95 млрд, что значительно меньше показателей других гиперскейлеров. Например, Amazon Web Services планирует потратить около $220 млрд за год (с учётом розничного подразделения), а Microsoft — $175 млрд, снизив в июле прогноз с предыдущих $190 млрд. Компания заключила новые контракты в сфере облачных ИИ-сервисов на сумму более $30 млрд, из-за чего объём неисполненных обязательств по выполнению контрактов (RPO) вырос до $664 млрд, превысив прошлогодний показатель на $209 млрд, а также прогноз аналитиков, ожидавших $639,89 млрд (согласно данным Visible Alpha). Финансовый директор Хилари Максон (Hilary Maxson) отметила, что «подавляющее большинство» этих контрактов предусматривает «предоплату, использование собственного оборудования заказчика или аналогичные схемы, не требующие от Oracle дополнительных капиталовложений», что позволит компании уложиться в запланированный годовой объём расходов. 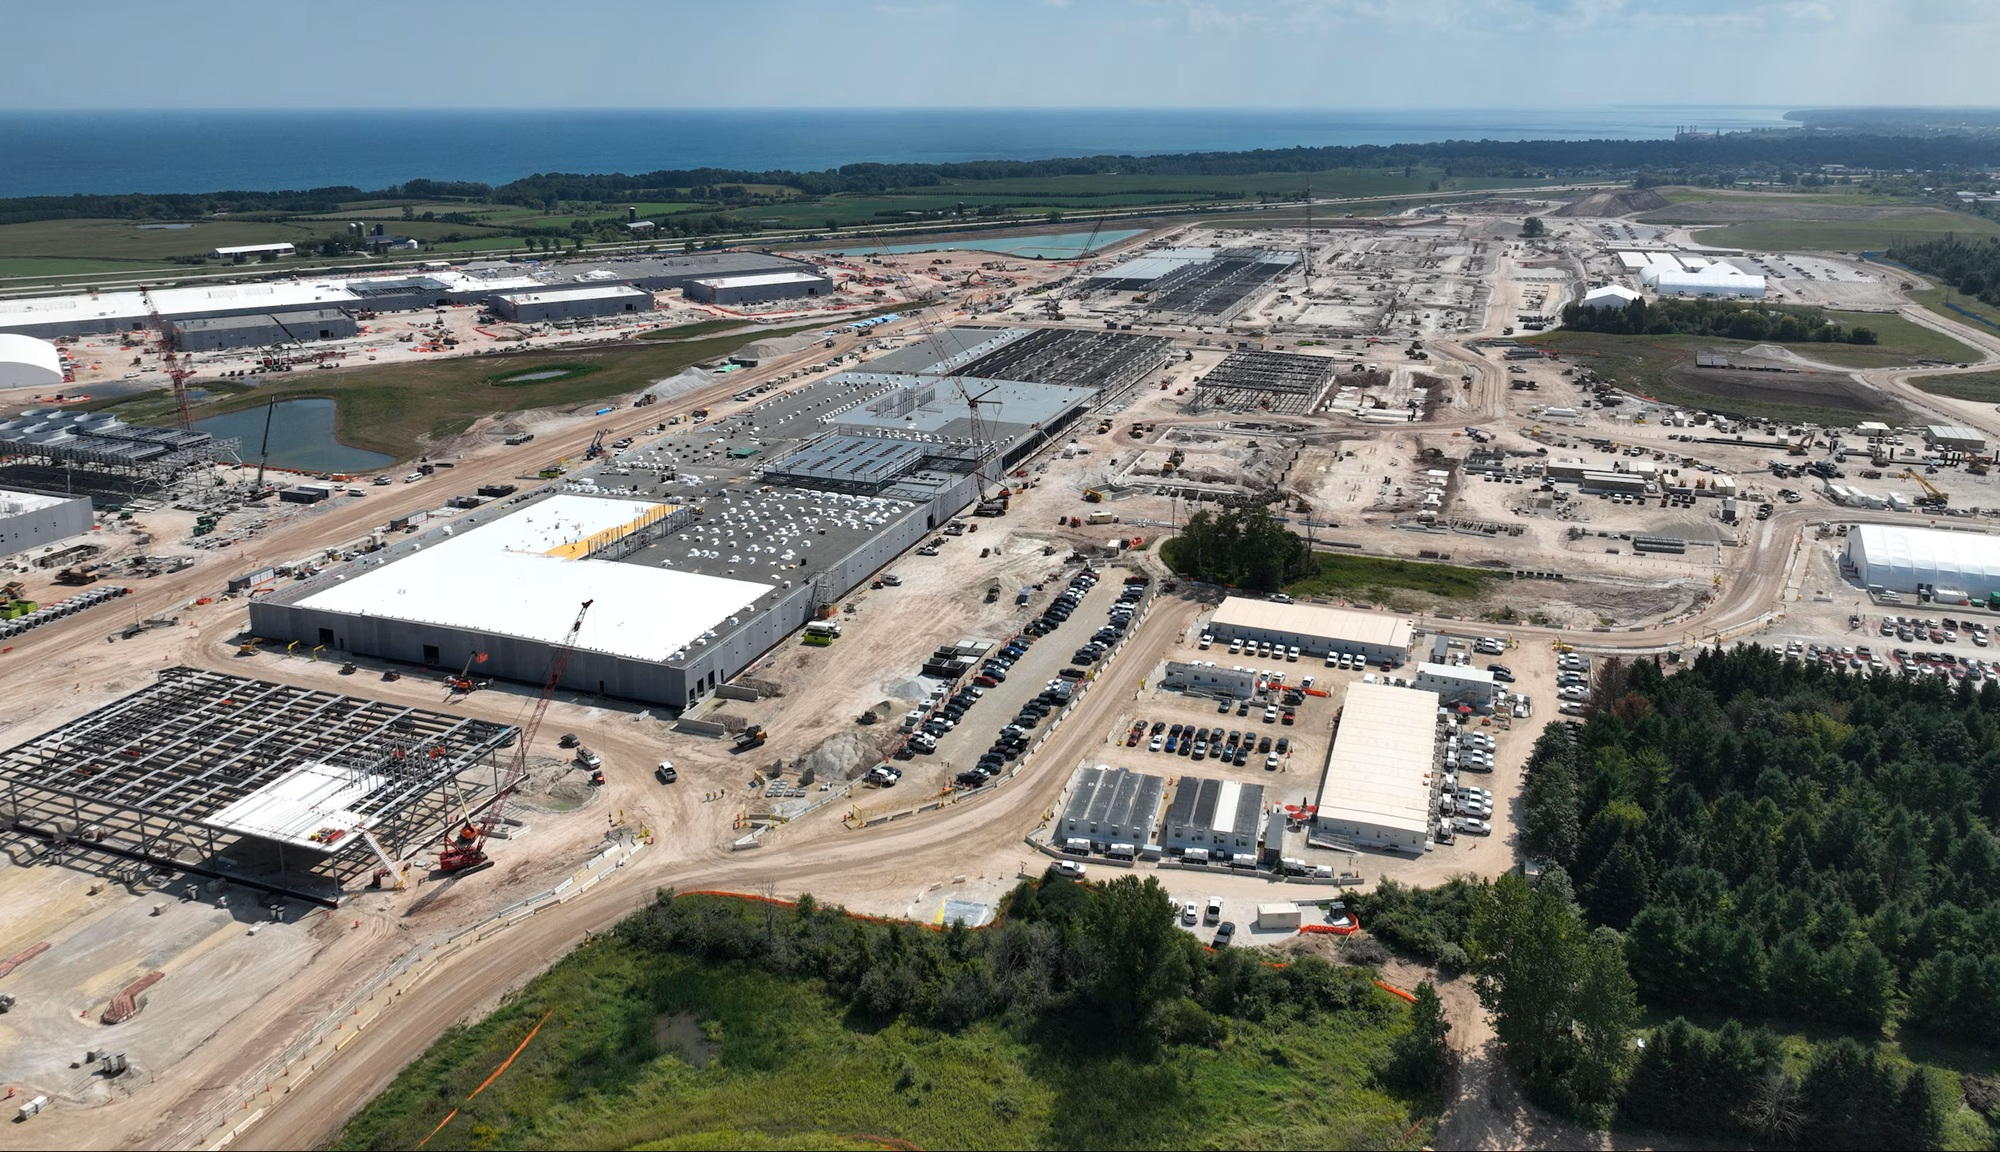 Компания ожидает, что около половины текущего объёма невыполненных заказов будет реализовано в виде продаж в течение следующих 36 меся. «Для Oracle и её клиентов вопрос окупаемости инвестиций в ИИ перешёл в практическую плоскость. Уверенные результаты свидетельствуют о том, что клиенты Oracle “голосуют своими кошельками”, и компании необходимо продолжать продвигать мысль о том, что рост портфеля заказов — это история не только про OpenAI», — отметили в Valoir. Компания также сообщила, что уровень загрузки мощностей остаётся высоким и составляет 97,9 %. Договоры аренды GPU, срок действия которых истек в отчётном квартале, были продлены или переоформлены на новых клиентов с наценкой в 20 % по сравнению с предыдущими контрактами, несмотря на то что большинство этих GPU были выпущены четыре года назад или более. Что примечательно, со-генеральный директор Майк Сицилия (Mike Sicilia) заявил, что в октябре на конференции AI World компания представит новый ускоритель для агентного ИИ, «призванный изменить подход клиентов к развёртыванию приложений Oracle, сделав этот процесс более быстрым, простым и значительно менее затратным».
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
07.09.2026 [09:32], Сергей Карасёв
Корейский стартап HyperAccel представил ускорители Bertha для ИИ-инференсаЮжнокорейский стартап HyperAccel продемонстрировал специализированные ускорители Bertha, предназначенные для выполнения ИИ-инференса. Ключевой особенностью изделий, по заявлениям разработчика, является высокая экономическая эффективность. Вместо дорогостоящей памяти HBM в решениях Bertha применяются чипы LPDDR. При этом задействована фирменная архитектура Streamlined Dataflow, которая минимизирует перемещение данных. Обеспечивается точное согласование пропускной способности памяти с вычислительными возможностями ускорителя, что позволяет использовать до 90 % имеющихся аппаратных ресурсов во время инференса. Благодаря этому достигается в пять раз более высокое значение токенов в секунду при сопоставимой величине TOPS по сравнению с обычными решениями. 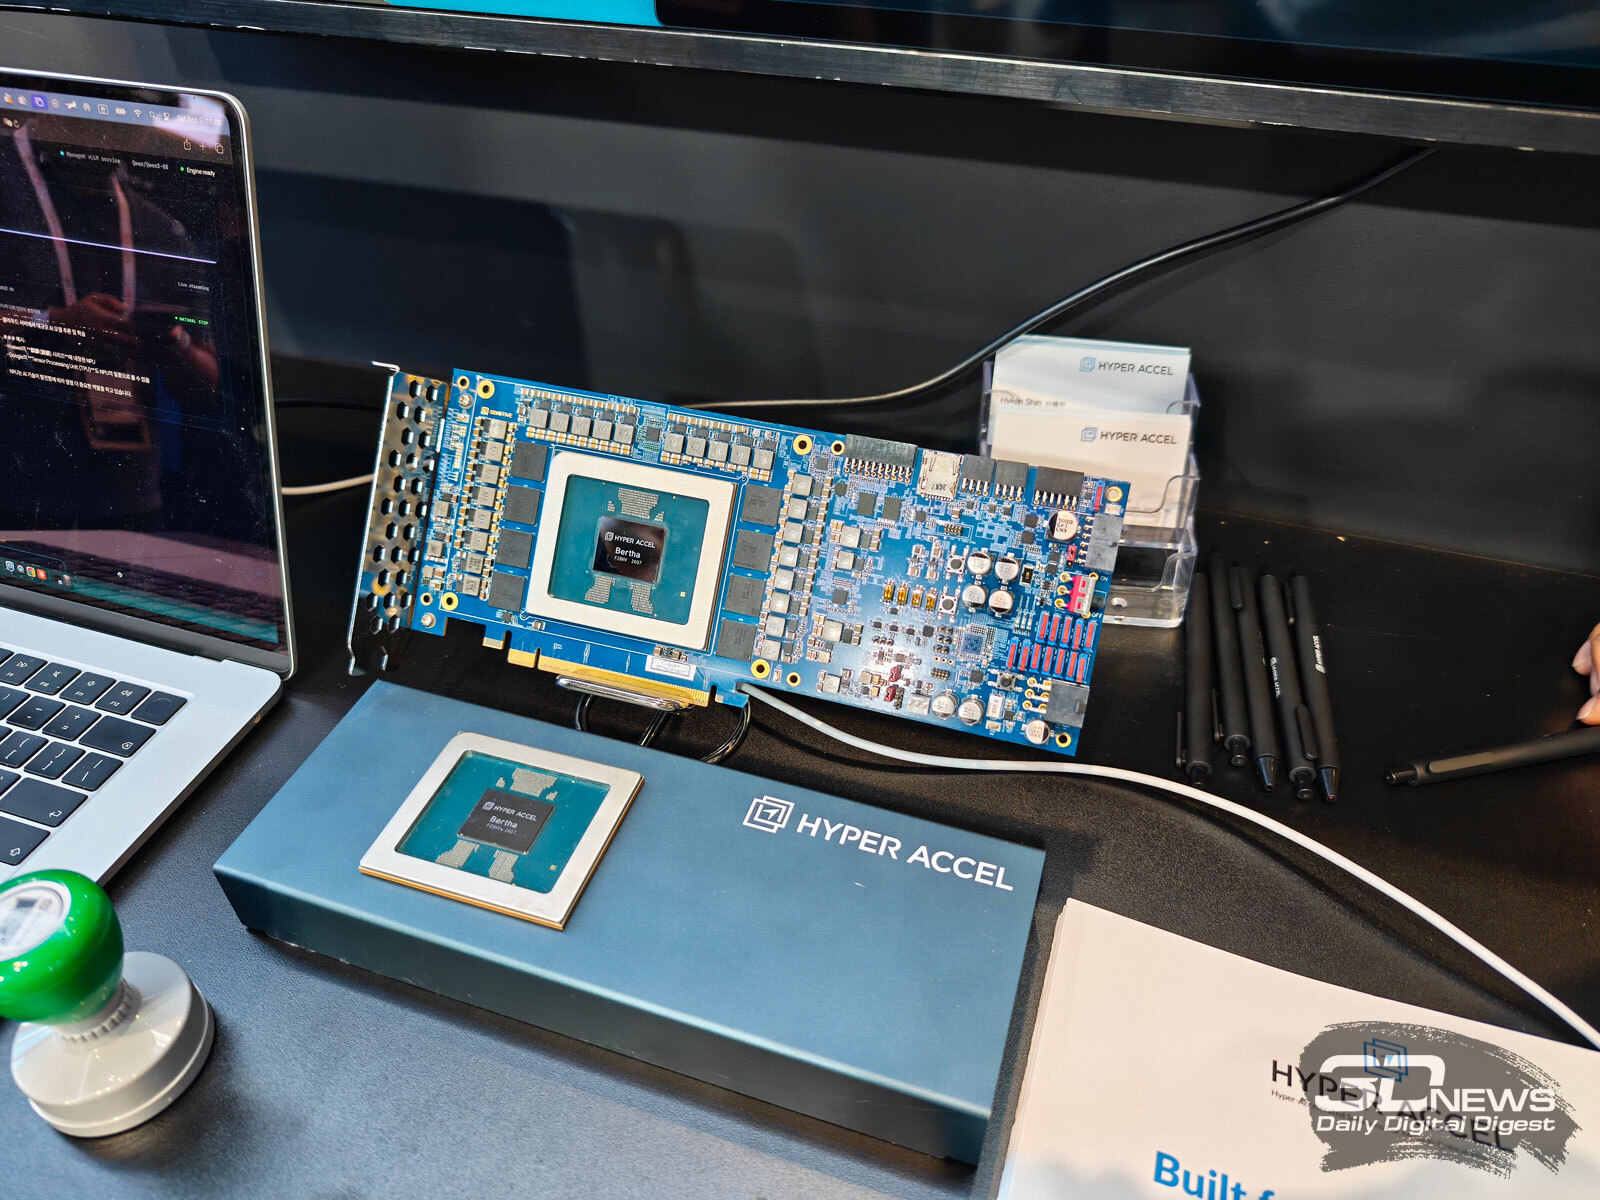 HyperAccel показала ускоритель Bertha 500, который изготавливается с применением 4-нм технологии Samsung. Это устройство, выполненное в виде двухслотовой карты расширения, содержит 32 ядра LPU, четыре ядра Arm Cortex-A53, 256 Мбайт SRAM и 128 Гбайт LPDDR5X (в перспективе — 256 Гбайт) с пропускной способностью до 546 Гбайт/с. Показатель TDP равен 250 Вт. Новинка обеспечивает производительность до 768 Тфлопс в режиме FP8/INT8 и до 384 Тфлопс на операциях FP16. Кроме того, поддерживаются форматы FP4, BF16, INT4. Серийное производство планируется организовать в начале 2027 года. 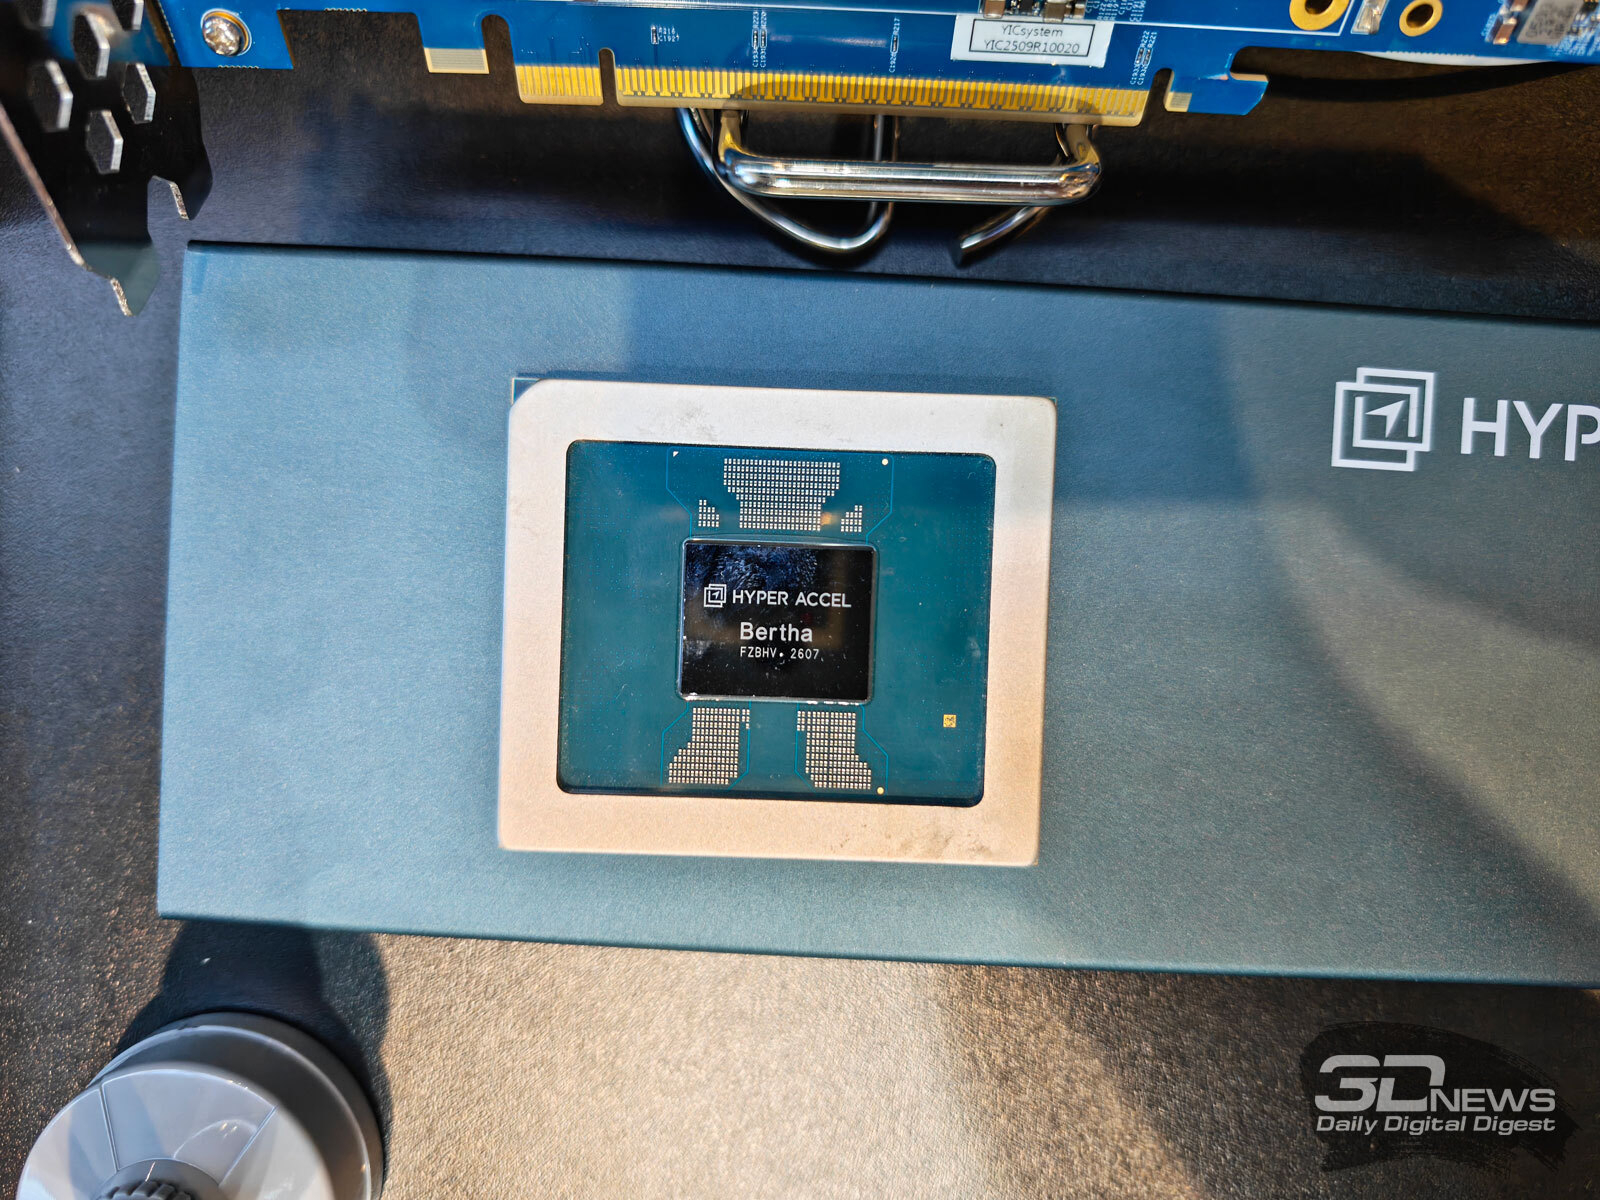 Компания HyperAccel также готовит ускоритель Bertha 100 для агентного ИИ. Это изделие получило форм-фактор M.2. Оно несёт на борту 16 Гбайт LPDDR5X с пропускной способностью 64 Гбайт/с. Быстродействие находится на отметке 32 Тфлопс на операциях FP8. Поддерживаются также режимы BF16, FP4, INT8 и INT4. Образцы изделия появятся в IV квартале нынешнего года. Ускорители совместимы с фреймворками PyTorch, ONNX, vLLM и др. Разработчикам доступен комплект SDK для дальнейшей оптимизации, развёртывания и профилирования решений в соответствии с конкретными потребностями. По заявлениям HyperAccel, Bertha в пять раз энергоэффективнее NVIDIA H100 и даёт примерно в 20 раз лучшее соотношение цены и производительности. По состоянию на февраль 2026 года компания HyperAccel привлекла $45 млн инвестиций, а её штат насчитывает около 80 человек.
01.09.2026 [15:27], Руслан Авдеев
Anthropic хотела купить разработчика ИИ-чипов MatX за $7 млрд, но передумалаЖелая ускорить создание собственных полупроводников и оборудования, компания Anthropic обсуждала покупку разработчика ИИ-чипов MatX приблизительно за $7 млрд. Позже диалог о выкупе сменился обсуждением возможного партнёрства, сообщает Reuters. Пока нет данных, почему переговоры о покупке бизнеса прекратились. MatX, основанная бывшими разработчиками TPU Google, ищет возможность привлечь новые средства с сопутствующей оценкой капитализации на уровне $4 млрд. Сами компании слухи не комментируют. Anthropic намерена самостоятельно разрабатывать ИИ-чипы, способные удовлетворить её запросы и снизить зависимость от сторонних ускорителей, в первую очередь NVIDIA. Компания нанимает опытных разработчиков и управленцев для ускорения разработчик собственных чипов, но на это могут уйти годы. При этом компания планирует диверсифицировать закупки ускорителей, работая с различными поставщиками. На разработку и организацию масштабного производства одного чипа может уйти не менее года и сотни миллионов долларов. Покупка стартапа, занимающегося созданием ИИ-чипов тут же обеспечила бы Anthropic необходимые компетенции и помогла бы снизить издержки в долгосрочной перспективе. Особенно чипы MatX могли бы быть полезны при обучении ИИ-моделей, хотя большинство конкурентов Anthropic заинтересованы скорее в ASIC для инференса. 
Источник изображения: Cherrydeck/unsplash.com. Anthropic планирует потратить десятки миллиардов долларов на аренду вычислительных мощностей, а также намерена покупать чипы напрямую. Компания рассчитывает купить ИИ-чипов Google на $36 млрд, а также подписала соглашение об аренде вычислительных мощностей у Nscale на $45 млрд, заключила сделку с Fluidstack на $50 млрд, со SpaceX — на $45 млрд, с Lambda — на $35 млрд. И это не считая всё расширяющегося сотрудничества с Amazon на $100 млрд. В последние недели компания провела ряд встреч с многочисленными стартапами, занимающимися ИИ-чипами, чтобы лучше понять современные подходы к проектированию ускорителей. Недавно она наняла ветерана отрасли из Google — Амира Салека (Amir Salek) в рамках развития проекта, связанного с разработкой вычислительного «железа». В июне она переманила бывшего разработчика из OpenAI, работавшего над ускорителем Jalapeño, который превзошёл решения NVIDIA в инференсе. Создание кастомного чипа может также помочь Anthropic обезопасить свой бизнес на фоне дефицита чипов NVIDIA, которые, по данным последней, будут в дефиците минимум до 2027 года. Собственные TPU выпускает Google, а Amazon создала семейства Trainium и Inferentia. Anthropic стала одной из первых компаний, эксплуатирующих свои модели на решениях нескольких вендоров, включая NVIDIA, Google и Amazon.
27.08.2026 [09:25], Владимир Мироненко
MTIA 300: первый ИИ-чип Meta✴ со встроенными 800GbE-адаптерами и механизмами разгрузки коммуникацийMeta✴ сообщила новые подробности о 667-Вт ИИ-ускорителе MTIA 300 — своём первом чипе, оптимизированном для обучения DLRM-моделей. В отличие от LLM, требующих огромной пропускной способности вычислений с плавающей запятой, рекомендательные модели сталкиваются с проблемой необходимости быстрого и эффективного взаимодействия ускорителей в сочетании с большой ёмкостью памяти и высокой пропускной способностью интерконнекта. Их таблицы эмбеддингов могут содержать более 99 % параметров модели, что требует гибридного параллелизма, генерирующего частые коллективные операции AllReduce, AllToAll и AllGather на сотнях ускорителей. На таких чипах, как GPU, эти коммуникационные операции конкурируют с вычислениями за одни и те же ресурсы, часто приводя к неэффективному использованию дорогостоящего оборудования. Для решения этой проблемы разработчики, используя совместную разработку MTIA 300 с HCCL, библиотекой коммуникационных интерфейсов, созданной на основе разработанного с нуля оборудования, сделали коммуникацию первостепенной задачей в проектировании микросхем. На практике HCCL обеспечивает пропускную способность передачи данных до 940 Гбайт/с в пределах одной стойки. На модели со 150 млрд параметров, работающей на 40 ускорителях, общее время обмена данными при использовании MTIA 300 в 3,9 раза меньше, чем у эквивалентного кластера на базе GPU. 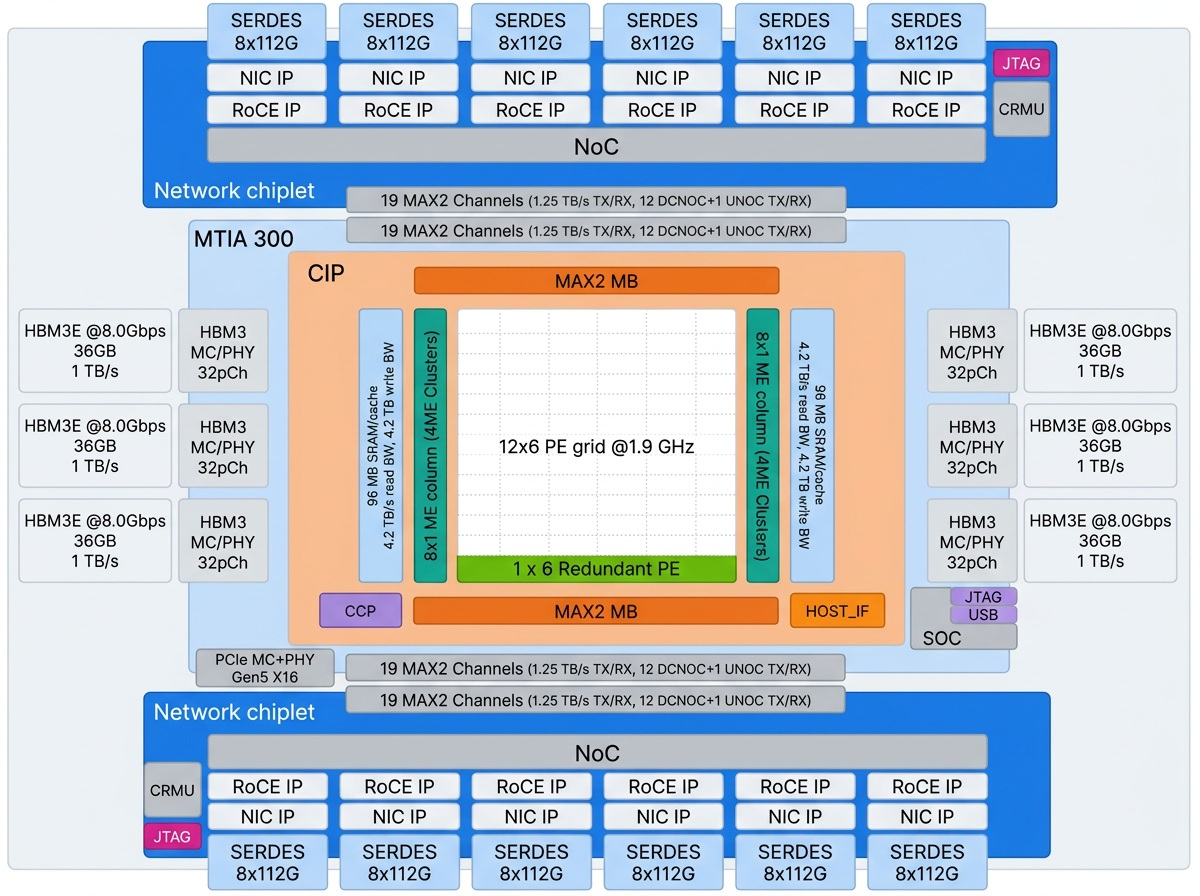
Источник изображения: Meta✴ В MTIA 300 сетевой интерфейс находится внутри самой упаковки микросхемы. Два 5-нм сетевых чиплета, каждый из которых содержит по шесть специализированных 800GbE RoCE-адаптеров, обеспечивают общую пропускную способность I/O 1,2 Тбайт/с без пересечения c шиной PCIe. Это устраняет узкое место в цепочке «хост-устройство-NIC», присутствующей в традиционных архитектурах GPU, где CPU должен выступать посредником между ускорителем и сетью, и позволяет избежать перегрузки PCIe между ускорителем и NIC. При этом NIC можно гибко использовать для масштабирования. Поскольку используются одни и те же 12 NIC на базе Ethernet для вертикального масштабирования (внутри стойки из 16 узлов, до 1 Тбайт/с) и горизонтального масштабирования (между стойками, до 200 Гбайт/с), можно гибко распределять NIC в соответствии с меняющимися потребностями. По мере изменения требований модели можно переконфигурировать сеть, а не само оборудование. Для минимизации задержки транзакций разработчики внедрили экспресс-оповещения (doorbell). Сама запись запроса на выполнение служит оповещением, исключая дополнительное чтение из памяти и экономя около 800 нс на операцию. 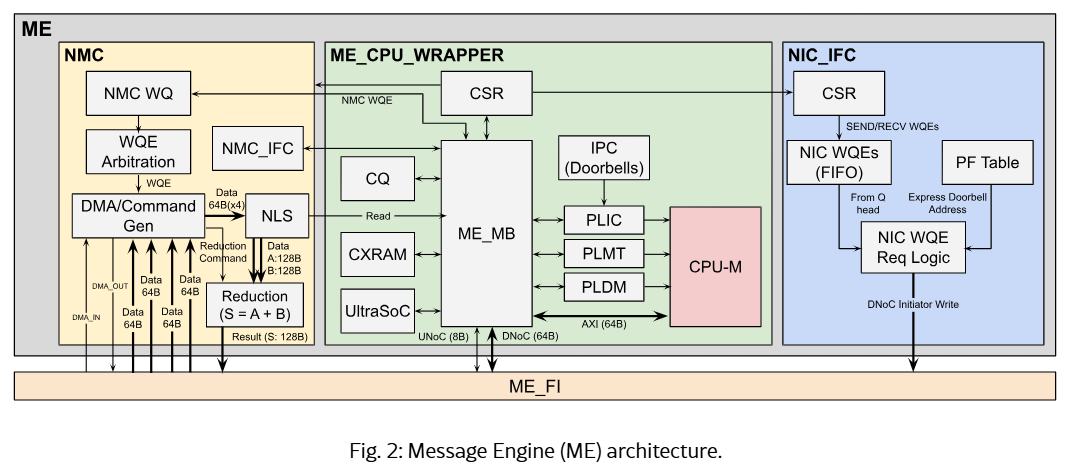
Источник изображения: Meta✴ В случае GPU библиотеки вроде NCCL реализуют операции коллективных коммуникаций в виде вычислительных ядер (kernel), которые используют те же ресурсы, что нужны для вычислений при обучении. Пересечение коллективных операций и операций обучения приводит к замедлению обоих и того, и другого. В MTIA 300 использовали другой подход. Наряду с матрицей из 72 3-нм вычислительных элементов (PE), чип включает 16 выделенных механизмов обработки сообщений (ME), которые обрабатывают всю коммуникацию независимо. ME содержит ядро RISC-V для оркестрации; сетевой интерфейс, который направляет запросы к нужному NIC; вычислительный блок Near-Memory Computing (NMC), который выполняет операции редукции со скоростью 128 байт/цикл. Расположенные по краям чипа, рядом с HBM и кешем, NMC в совокупности обеспечивают пропускную способность редукции более 2,8 Тбайт/с — более чем вдвое превышающую пропускную способность I/O. Это позволяет выполнять коллективные операции AllReduce и ReduceScatter на линейной скорости NIC без использования ресурсов PE. 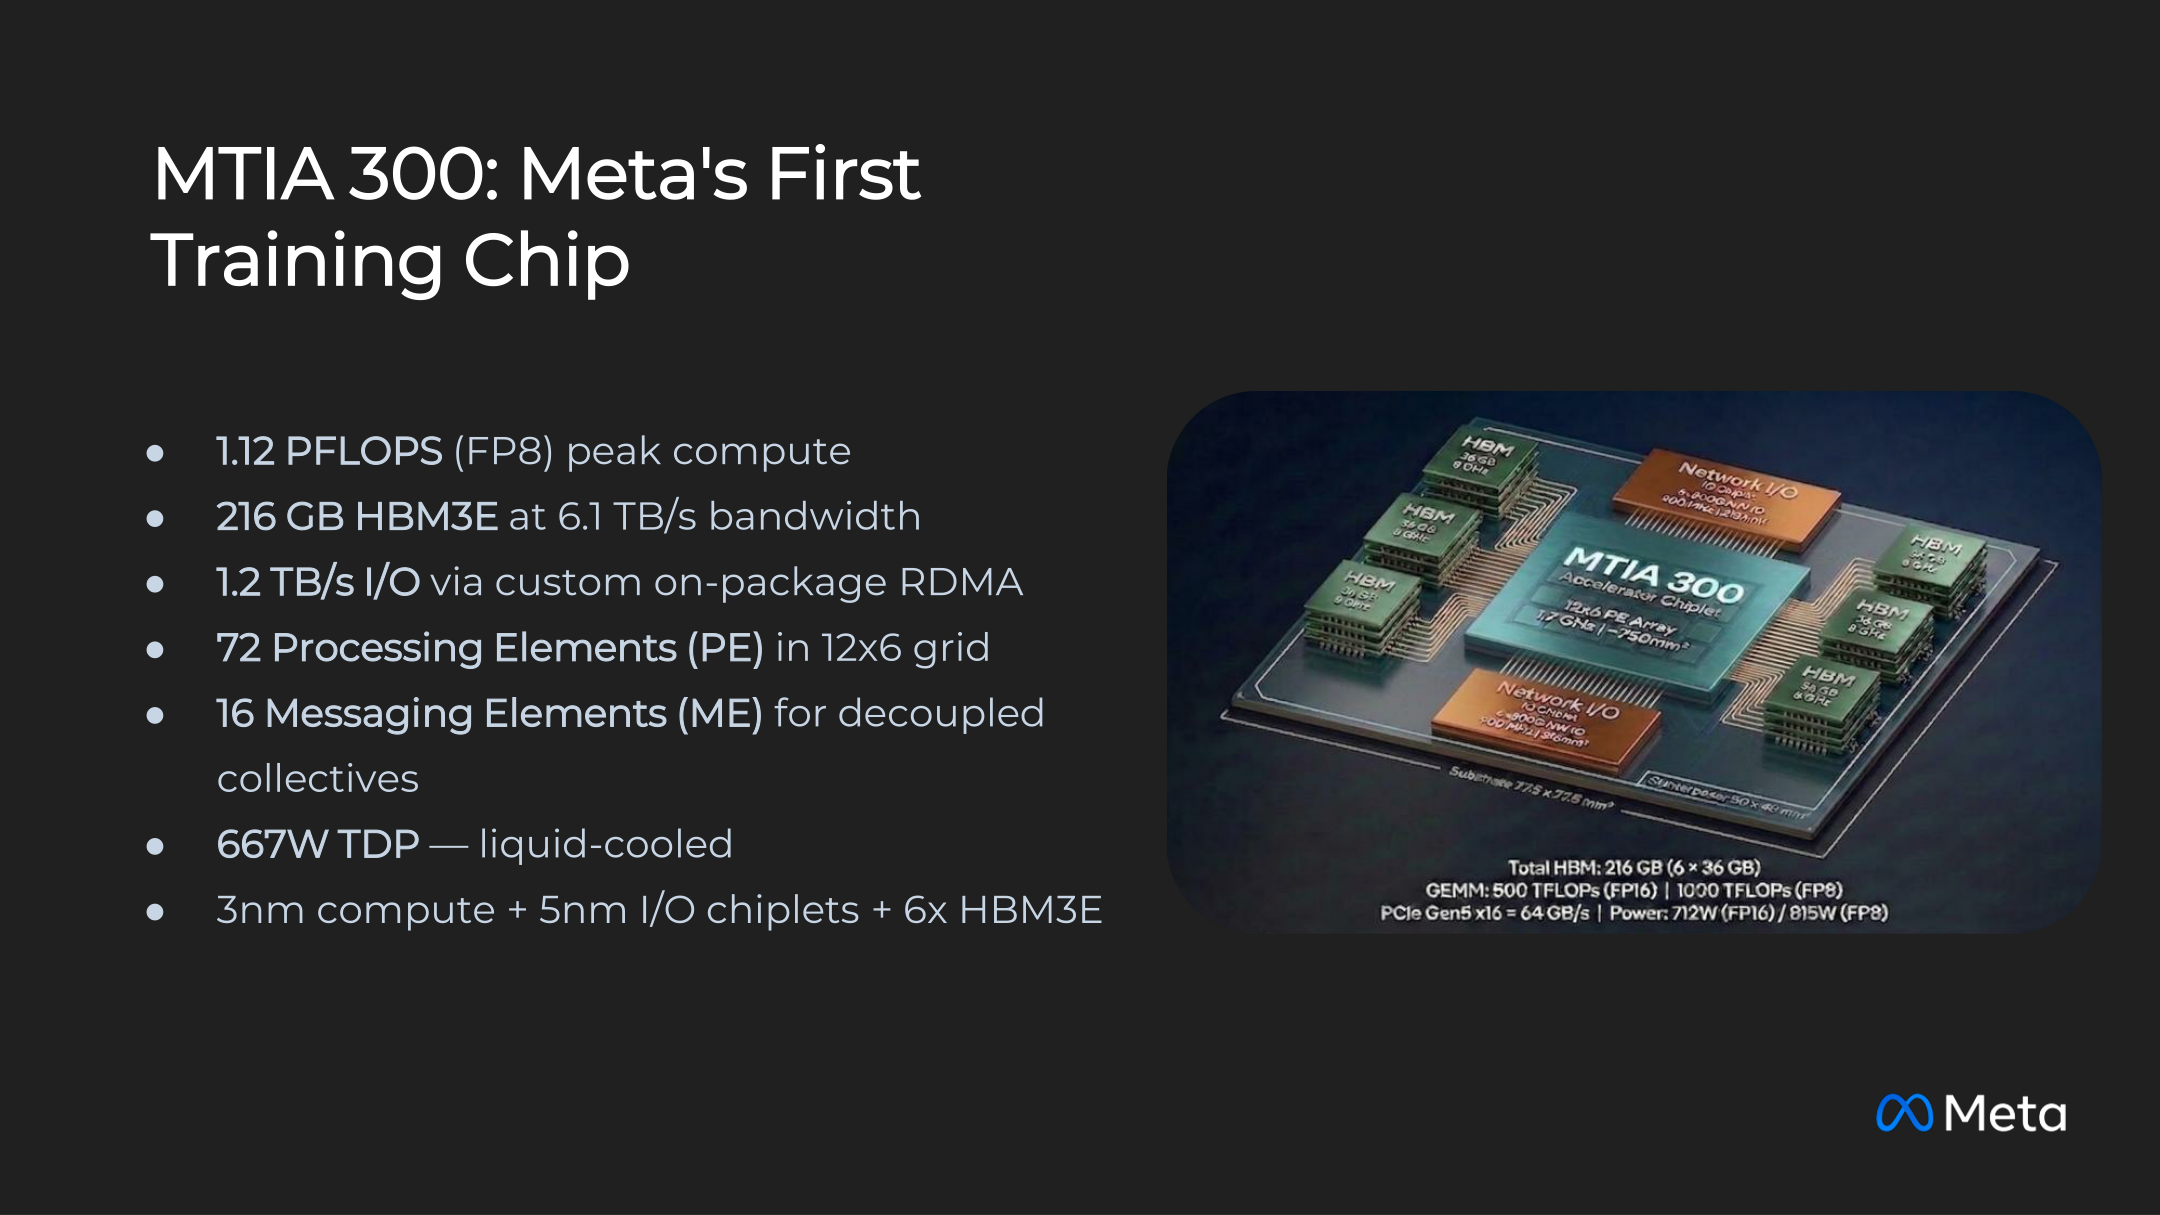
Источник изображения: Meta✴ В результате обеспечивается практически идеальная изоляция операций. Одновременное выполнение больших GEMM-операций с коллективными операциями приводит к снижению вычислительной пропускной способности менее чем на 0,5 %, в отличие от традиционных GPU, где снижение может превышать 20 % из-за использования одних и тех же ресурсов на обмен данными и вычисления. Разработанная совместно с MTIA 300 библиотека HCCL вместо управления обменом данными с хостом во время выполнения компилирует каждую коллективную операцию в полный набор подграфов (массивы очередей задач с явным указанием зависимостей), которые отправляются на ME для полностью автономного выполнения. Таким образом, хост лишь единожды отправляет ускорителю набор сетевых инструкций и более не вмешивается в работу сети. 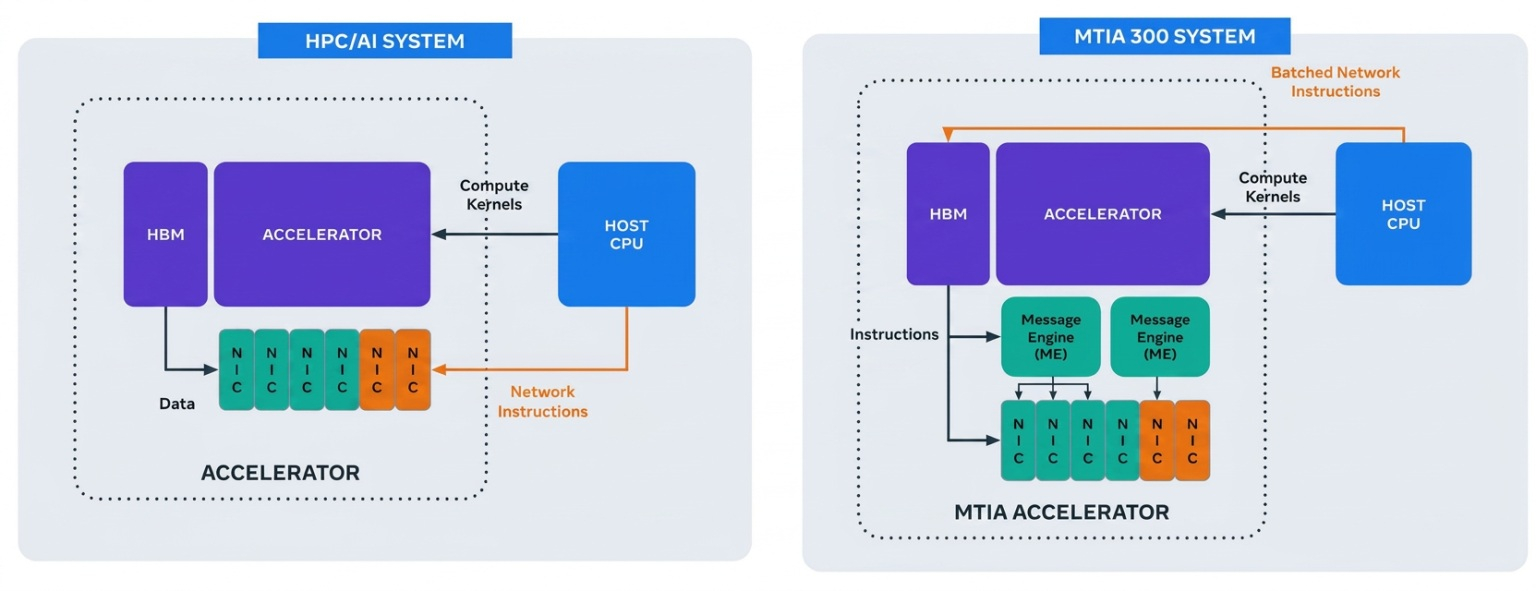
Источник изображения: Meta✴ По словам Meta✴, такая архитектура естественным образом интегрируется с PyTorch. Коллективные операции компилируются в единый граф вместе с вычислительными задачами. HCCL сама выбирает алгоритмы, учитывающие топологию сети и асимметричность полос пропускания, по возможности минимизируя межстоечный трафик. Для инференса были разработаны дополнительные пути: односторонняя коммуникация, когда PE используют экспресс-оповещения, и параллельный запуск коллективных операций по сигналу от kernel'а без прерывания работы последнего. Компания отметила, что MTIA 300 имеет и другие плюсы 216 Гбайт HBM3E (6,1 Тбайт/с) позволяют разместить больше данных на одном чипе, а не загружать их лишний раз извне; на каждый ускоритель приходится всего один CPU, что позволяет нагружать его интенсивными вычислениями на некоторых этапах; высокая пропускная способность сети позволяет при необходимости использовать форматы данных с более высокой точностью. Хотя сочетание умеренной FP-производительности с ёмкой и быстрой HBM в MTIA 300 изначально было оптимизировано для обучения DLRM, эти качества позволяет эффективно использовать чипа для более широкого спектра нагрузок, включая инференс моделей генеративного ИИ. Стоит отметить, что подход Meta✴ с внедрением NIC непосредственно в чип не нов сам по себе. Например, чипы Intel/Habana Gaudi2, представленные в 2022 году, использовали 24 100GbE-интерфейса RoCE для вертикального и горизонтального масштабирования.
27.08.2026 [08:59], Владимир Мироненко
OpenAI: Jalapeño опередил в тестах чипы NVIDIAOpenAI сообщила новые подробности об ИИ-ускорителе Jalapeño, разработанном в сотрудничестве с Broadcom, пишет The Register. Как утверждает OpenAI, Jalapeño, предназначенный для инференса, показал в тестах лучше результаты, чем текущая линейка ускорителей NVIDIA — GB200 и GB300. Тестирование в бенчмарк-пакете SemiAnalysis InferenceX показало, что системы OpenAI на базе Jalapeño обеспечивают в 1,5–1,9 раза больший объём «работы ИИ» при пиковой пропускной способности и в 1,7–3,6 раза меньшую сквозную задержку, чем у конкурентов, на GPT-OSS-120B, DeepSeek R1 670B и Kimi K2.5 1T. Во время внутренних тестов Jalapeño также хорошо показал себя при работе с некоторыми крупными, продвинутыми моделями OpenAI, которые ещё не выпущены. Это говорит о том, что конструкция чипа «становится более ценной по мере роста рабочих нагрузок и повышения их сложности», сообщила компания в блоге. На системном уровне стойка со 128 ускорителями Jalapeño обеспечивает 1,7 Эфлопс 4-бит вычислений, имеет 27,5 Тбайт HBM4 с агрегированной пропускной способностью чуть менее 2 Пбайт/с. Чип сочетает вычислительный кристалл с шестью стеками HBM4 общим объёмом 216 ГиБ (15,4 Тбайт/с), обеспечивая производительность 13,4 Пфлопс в операциях MXFP4, и масштабируется до 27 Эфлопс и 432 ТиБ памяти в системе из 2048 ASIC. 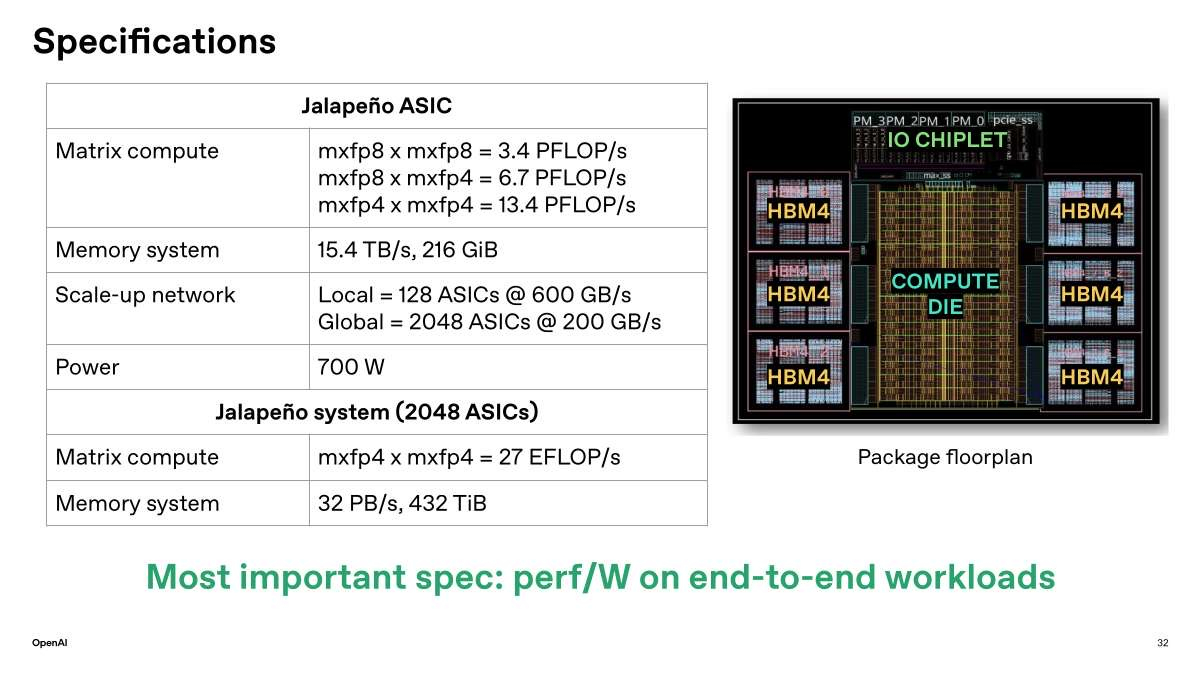
Источник изображений: OpenAI/ServeTheHome Поскольку чип демонстрирует высокие результаты при низком энергопотреблении — 700 Вт — Jalapeno позволит OpenAI экономить средства при эксплуатации своих ЦОД, где электроэнергия является ключевой статьей расходов, заявил агентству Bloomberg вице-президент по аппаратному обеспечению OpenAI Ричард Хо (Richard Ho). Новейшие стоечные системы AMD и NVIDIA работают быстрее, обеспечивая в 1,46–2 раза больше вычислительных ресурсов и до 12 % больше памяти (Helios), но имеют всего лишь 85 % пропускной способности памяти стойки OpenAI. Ричард Хо сообщил, что чип был разработан для минимизации перемещения данных и хранения промежуточных операций. «Мы разработали Jalapeño таким образом, чтобы минимизировать перемещение данных и задержки связи. Это означает, что состояние модели, включая KV-кеш, используемый при генерации ответа, может быть явно размещено и храниться локально, пока система активирует правильную комбинацию вычислительных ресурсов, памяти и сети для каждой фазы инференса», — сообщила компания в своем блоге. 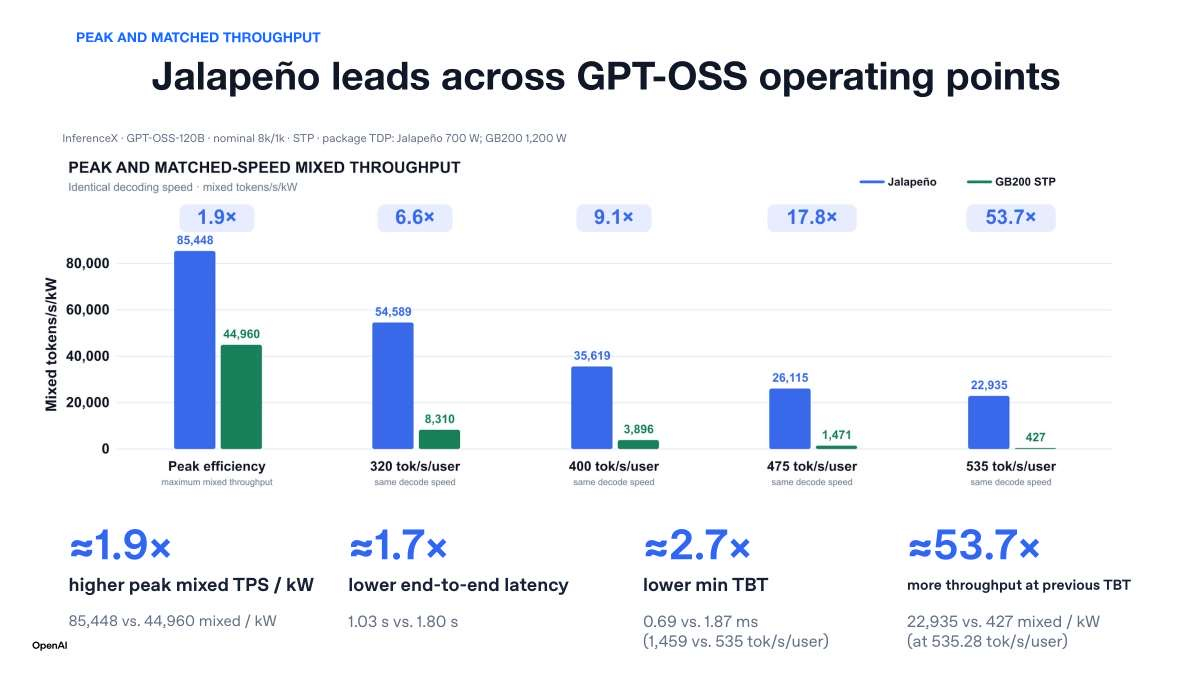 В отличие от стоек NVIDIA Groq LPX, Jalapeño не является узкоспециализированным решением. В компании сообщили ресурсу The Register, что он оптимизирован как для ресурсоёмких операций предварительного заполнения, где обрабатываются промты, так и для фазы декодирования, требующей большой пропускной способности памяти, где генерируются выходные токены. Также следует отметить, что благодаря использованию ИИ для проектирования архитектуры и оптимизации чипа для инференса, OpenAI потратила на его разработку от начала до готовности первого пробного чипа всего девять месяцев. Процесс включал использование собственных моделей для оптимизации механизмов обработки инференса и для написания пользовательских ядер по мере внедрения новых моделей. 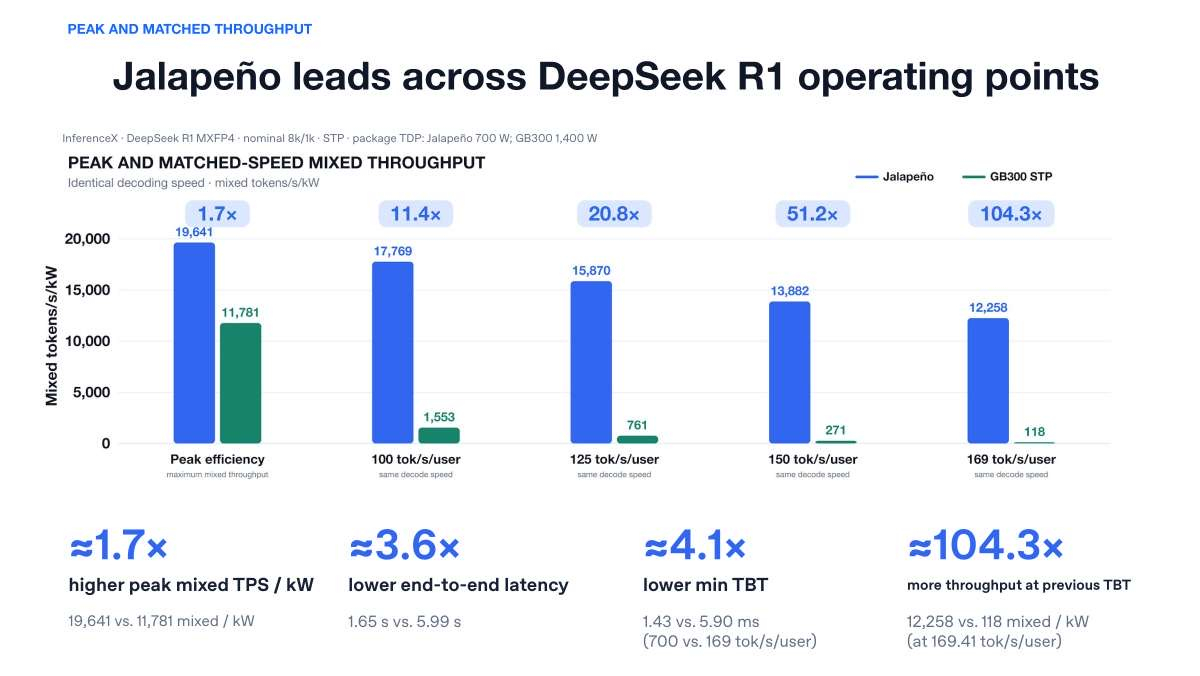 Преимущество Jalapeño в скорости настолько велико, что OpenAI может получать результаты, ранее достижимые только с помощью чипов, использующих другой тип памяти и конструкцию. Например, в настоящее время OpenAI использует чипы Cerebras для некоторых своих LLM, которые, по словам Хо, лучше всего подходят для небольших моделей. Jalapeño, напротив, может обрабатывать более крупные модели, отметил он. Тем не менее, компания не собирается отказываться от сотрудничества с другими поставщиками, включая NVIDIA. «У нас огромная потребность в вычислительных мощностях, поэтому мы привлекли так много разных поставщиков, — сказал он. — Это будет продолжаться ещё некоторое время». Ожидается, что Jalapeño будет выпущен в ограниченных объёмах в конце этого года с дальнейшим увеличение производства в следующем году. 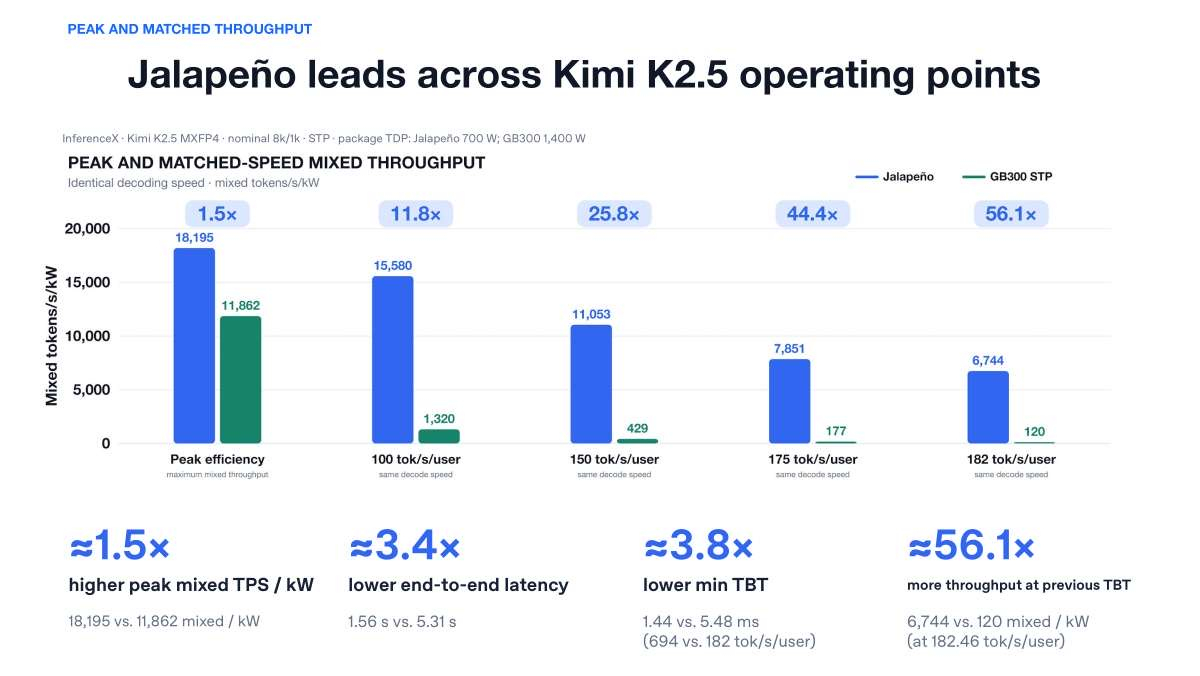 Вторая версия Jalapeño находится на продвинутой стадии разработки, готовность к производству ожидается в «ближайшие месяцы», сказал Хо. Также уже разрабатывается концепция чипа третьего поколения. The Register призвал относиться с осторожностью к заявлениям OpenAI. Новый чип тестировался в сравнении с системами NVIDIA GB200 NVL72 и GB300 NVL72, выпущенными в 2024 и 2025 годах соответственно, но не сравнивался с Vera Rubin, поставки которого только начались. |
|

