Материалы по тегу: cpu
|
22.10.2026 [17:27], Сергей Карасёв
TrendForce: поставки серверных CPU в 2026 году вырастут на третьАналитики TrendForce подготовили свежий прогноз по мировому рынку серверных процессоров на текущий и следующий годы. Спрос на такие изделия стремительно растет на фоне продолжающегося расширения глобальной инфраструктуры дата-центров для задач ИИ и НРС. Ожидается, что поставки серверных CPU в 2026-м увеличатся практически на треть по сравнению с предыдущим годом — на 31 %. При этом на долю Intel придётся около 50 % отгрузок. Ещё 27 % составят чипы AMD, примерно 12 % — решения NVIDIA. Вклад AWS и Google прогнозируется в размере 4 % и 3 % соответственно. Суммарная доля всех прочих игроков вместе взятых окажется на уровне 4 %. В 2027 году, по мнению экспертов TrendForce, ситуация существенно изменится. В целом, отгрузки серверных CPU поднимутся на 40 % по отношению к предыдущему году. Доля Intel при этом сократится до 42 %, а AMD — вырастет до 28 %. NVIDIA продолжит контролировать около 12 % сектора. Позиции Google укрепятся до 6 %, AWS — до 5 %. На остальных поставщиков придётся 7 % отгрузок. 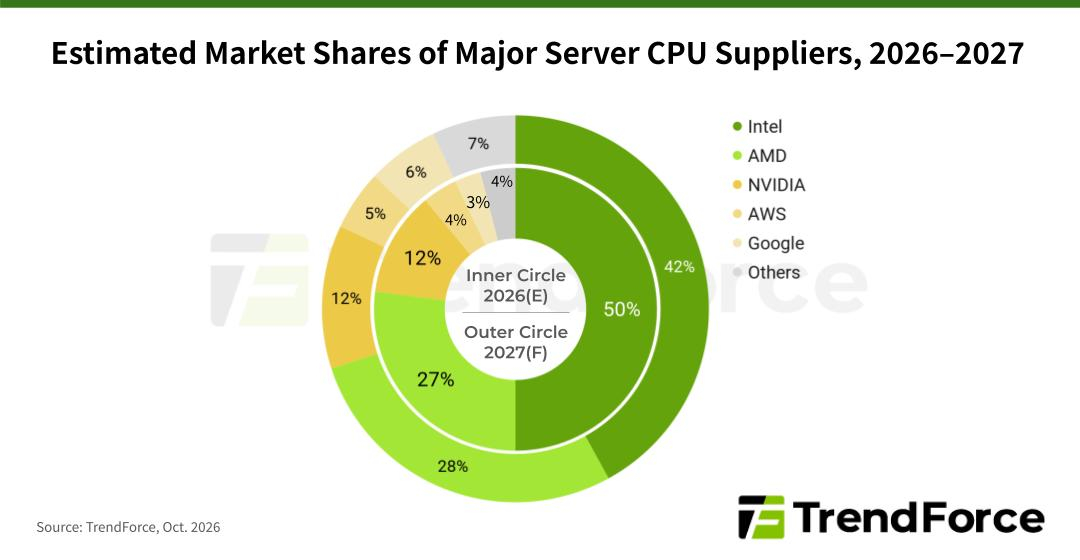
Источник изображения: TrendForce Аналитики говорятся о резком увеличении продаж серверных чипов с архитектурой Arm. Если в 2025 году на них приходилось только около 10 % отгрузок, то в 2027-м показатель может увеличиться до 30 %. Рост будет обусловлен главным образом существенным увеличением поставок изделий NVIDIA Vera, а также массовым производством новых чипов Google, AWS, Microsoft, OpenAI и Huawei. Отмечается также, что на фоне быстрого внедрения агентного ИИ изменится соотношение CPU и GPU/ASIC в серверах. Если сейчас этот показатель преимущественно равен 1:8, то в обозримом будущем он составит 1:2 или даже 1:1. Это станет дополнительным фактором роста поставок серверных CPU.
20.10.2026 [09:33], Сергей Карасёв
46 ядер RISC-V и 8 каналов DDR5: SpacemiT представила чипы Vital Stone V100Китайская компания SpacemiT анонсировала серверные процессоры Vital Stone V100 с открытой архитектурой RISC-V. Изделия, как утверждается, подходят для решения самых разных задач — от построения СХД и периферийных серверов до обучения ИИ-моделей и инференса. Конфигурация Vital Stone V100 включает в общей сложности 46 вычислительных ядер RISC-V. Это 6 ядер Xiangshan Kunming Lake V2R2 с максимальной тактовой частотой 2,1 ГГц и 40 ядер Iterative Spacetime X100 c частотой до 2,4 ГГц. В первом случае объём кеша L2 составляет 1 Мбайт, во втором — 2 Мбайт. Чипы могут использоваться в двухсокетных системах, что в сумме обеспечит 92 вычислительных ядра. 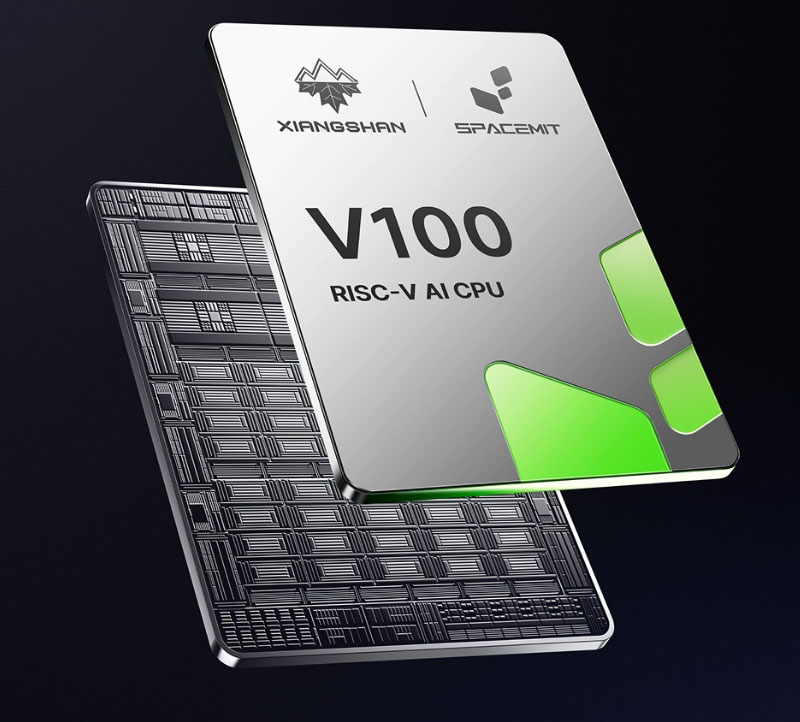
Источник изображений: SpacemiT Реализованы восемь каналов оперативной памяти DDR5-4800 и 52 линии PCIe 5.0. Показатель TDP находится на уровне 120 Вт. Заявлена поддержка интерфейсов 1 × QSPI, 1 × LPC, 1 × eSPI, 3 × SPI Master, 1 × SPI Slave, 4 × I3C, 12 × I2C, 12 × SMBUS, 5 × UART. Упомянуты криптографические алгоритмы AES, SHA, RSA, SM2, SM3, SM4. Процессоры производятся по 12-нм технологии в корпусе FCBGA с размерами 58,5 × 75,4 мм. 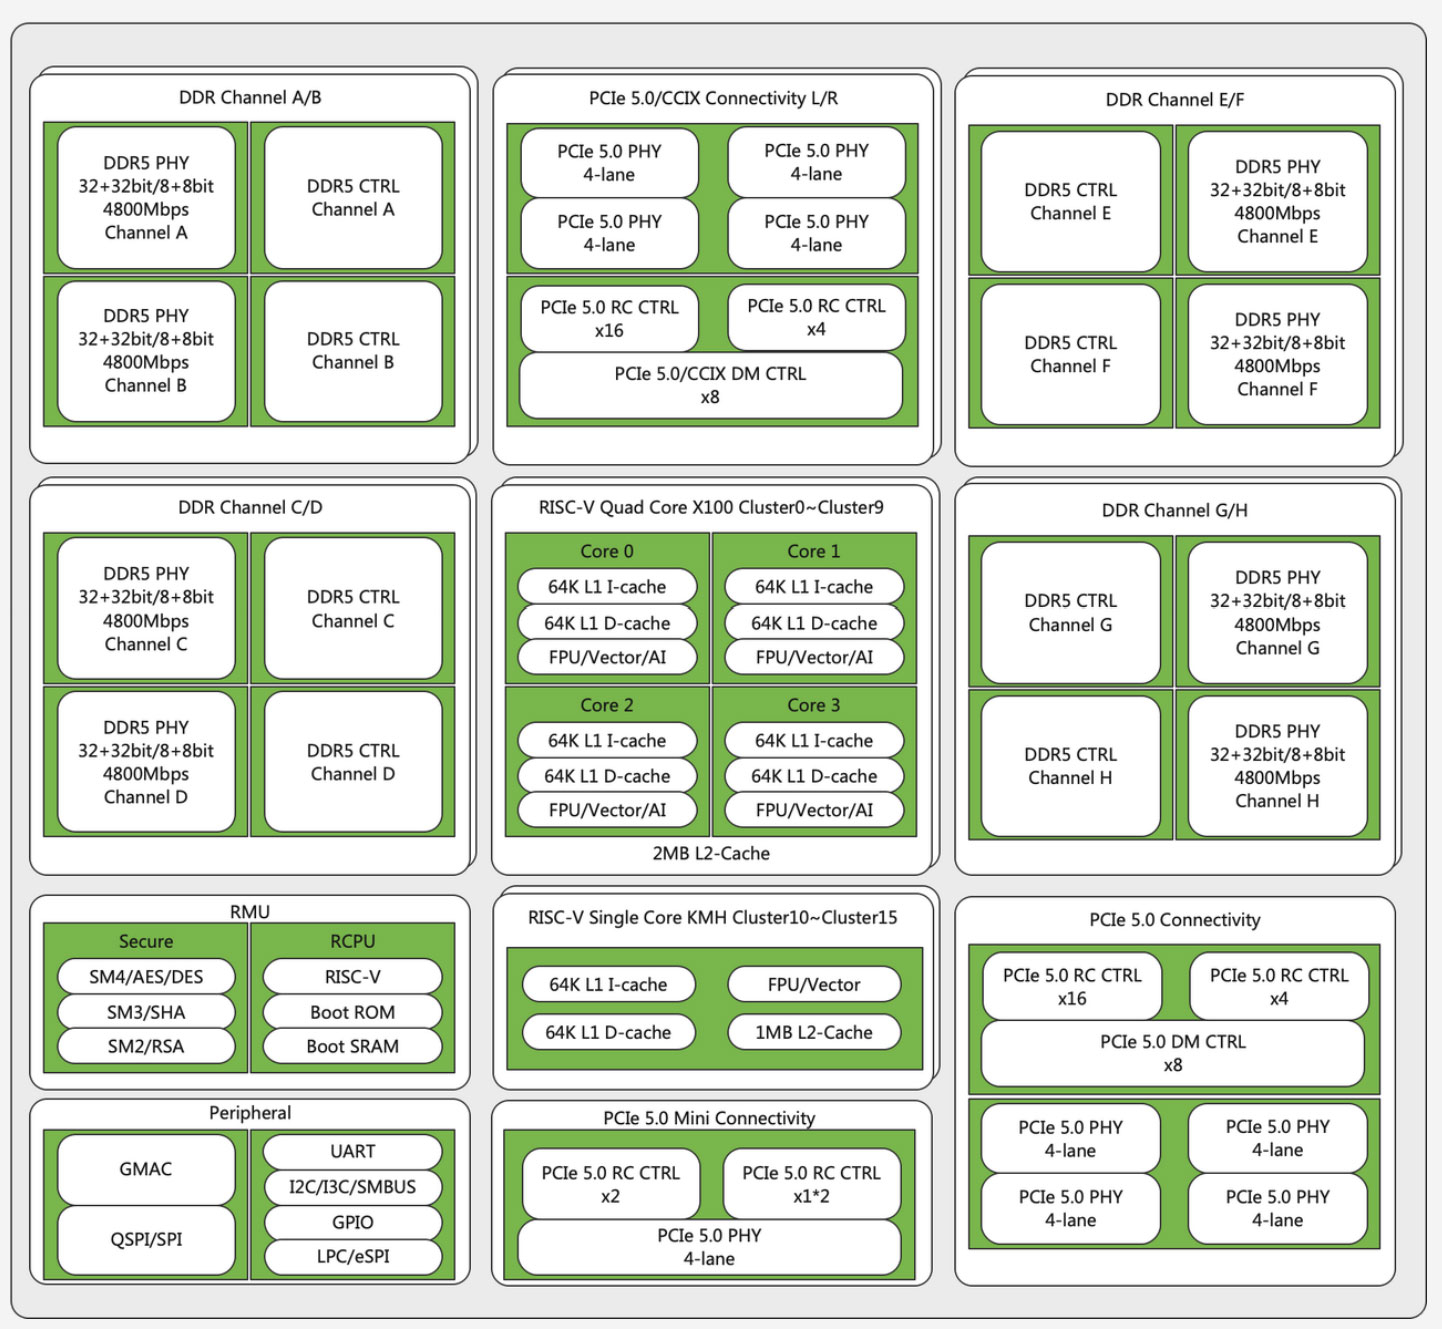 Подчёркивается, что Vital Stone V100 — это первые изделия, полностью соответствующие серверной спецификации RISC-V, включая поддержку UEFI, ACPI, SMBIOS. Кроме того, заявлена полная совместимость с профилем RVA23, который стандартизирует набор инструкций ISA. Реализованы такие функции, как векторные операции, инструкции с плавающей запятой и атомарные инструкции, которые востребованы в сферах НРС и ИИ. Новая аппаратная платформа поддерживает ОС openEuler, openKylin, Ubuntu, Debian и Fedora, программные стеки Tomcat, Redis, Apache, MySQL и PostgreSQL, а также виртуализацию и контейнеризацию KVM, QEMU, Docker.
19.10.2026 [11:01], Владимир Мироненко
Microsoft: компонуемая память поможет преодолеть ограничения в ИИ-инфраструктуреНа фоне дефицита памяти, используемой в ИИ ЦОД, гиперскейлеры пересматривают подходы к её распределению. Компонуемая память (composable memory), позволяющая объединять ресурсы памяти нескольких серверов и выделять их для рабочих нагрузок по мере необходимости, является одним из наиболее практичных решений этой проблемы, считают в Microsoft, о чём пишет SiliconANGLE. По словам Самира Раджадни (Samir Rajadnya, на фото ниже), главного архитектора Microsoft, команда специалистов компании изучает системные технологии, которые позволили бы превратить память из ресурса, «запертого» внутри конкретного сервера, в общий, динамически распределяемый ресурс в рамках всей платформы Azure. 
Источник изображения: SiliconANGLE theCUBE/YouTube «Как можно заметить из публикаций в СМИ, сейчас наблюдается нехватка памяти, — сообщил топ-менеджер Microsoft. — Следовательно, мы должны использовать её гораздо эффективнее. Важно, чтобы память направлялась туда, где того требует конкретная рабочая нагрузка. Если же память оказывается “запертой” в рамках задачи, которая её в данный момент не использует, мы попросту растрачиваем ценный ресурс». Он назвал компонуемую архитектуру одним из ключевых направлений развития на ближайшие годы. «Раньше всё было жестко привязано к CPU или GPU; память фактически выступала лишь вспомогательным элементом для них. Теперь же память рассматривается как самостоятельный, критически важный ресурс», — заявил Раджадня. Говоря о корпоративном сегменте, Раджадня отметил, что сегодня всё сводится к вопросу вертикальной интеграции: рабочей нагрузки, системы, ПО, аппаратной части — всё в едином комплексе. И такой подход необходим даже на уровне отдельных предприятий, подчеркнул он. Эффективная работа подобных систем в крупных масштабах зависит от того, как организованы соединения между памятью и CPU или XPU, говорит Самир Раджадня. «Сейчас появляется множество замечательных инноваций как в сфере памяти, так и в области CPU и ускорителей (XPU), — сообщил он. — Но ключевой вопрос — как связать всё это воедино? Именно здесь критически важны технологии интерконнекта. В частности, значимую роль будут играть разработки в области оптических соединений. Всё это поможет нам создать так называемую компонуемую память». Ранее Microsoft в партнёрстве с SAP и Intel запустила в облаке Azure виртуальные машины семейства M-Series с технологией Compute Express Link (CXL). Сообщается, что поддержка CXL способствует более эффективной работе SAP S/4HANA, обеспечивая, в том числе, больше гибкости в плане конфигурирования платформы при одновременном снижении совокупной стоимости владения.
18.10.2026 [23:00], Владимир Мироненко
SK hynix придумала энергоэффективные и компактные ядра H-TPU для сверхбыстрых SSD будущегоКомпания SK hynix представила архитектуру H-TPU (Hynix Transaction Processing Unit, не путать с Google TPU), разработанную для снижения нагрузки на универсальные процессорные ядра в будущих SSD-контроллерах. Ядра H-TPU предназначены исключительно для выполнения низкоуровневых и повторяющихся задач, включая обработку команд чтения и записи, управление метаданными и контроль буфера. Это разгрузит основной процессор, который продолжит отвечать за более сложные задачи, такие как управление политиками хранения данных, восстановление после ошибок и обработка исключительных ситуаций. H-TPU потребляют около 2,5 % энергии и занимают примерно 4 % площади кристалла по сравнению с универсальными CPU. SK hynix отметила, что процессоры в контроллерах SSD достигли своих пределов с точки зрения энергопотребления и занимаемой площади. В представленной компанией на Международной конференции по проектированию SoC (ISOCC 2026) презентации отмечено, что пропускная способность интерфейса PCIe удваивается с каждым новым поколением, тогда как тактовая частота и управляющие возможности CPU в составе контроллеров растут гораздо медленнее. 
Источник изображений: SK hynix Эта проблема особенно остро стоит в сегменте SSD корпоративного класса. В условиях растущей конкуренции по показателю IOPS увеличение числа процессорных ядер в контроллерах стало общепринятой практикой, однако это привело к росту энергопотребления и увеличению площади кристалла. Например, контроллер Marvell Bravera SC6 с поддержкой PCIe 6.0, содержит 16 ядер: 12 ядер Cortex-R82, три ядра Cortex-M7 и одно ядро Cortex-M3. Предшественник Bravera SC5 (PCIe 5.0) имеет лишь 11 ядер. Архитектура H-TPU базируется на четырёхступенчатом конвейере с последовательным выполнением команд (in-order execution) и не поддерживает суперскалярность или внеочередное выполнение. H-TPU — программируемый процессор, специализирующийся на управлении потоками данных в SSD и обработке транзакций. H-TPU распределяет специфические для работы с данными операции между более чем 100 компактными вычислительными элементами. Каждый такой блок отвечает за выполнение одной конкретной задачи. Ядра, не задействованные в текущей операции I/O, переходят в режим минимального энергопотребления. 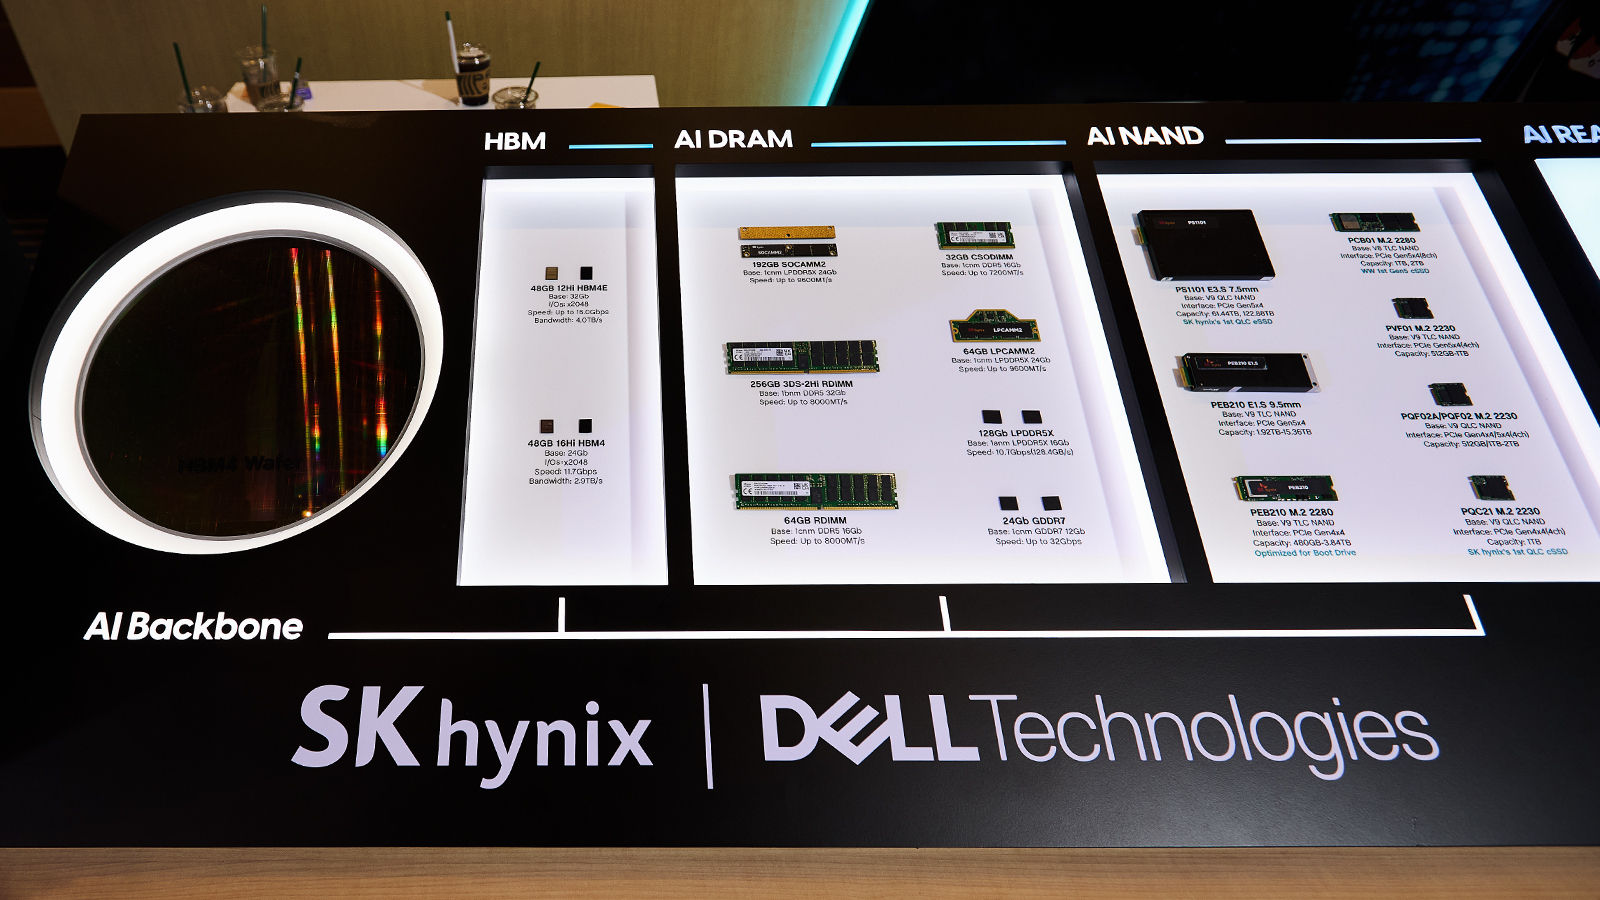 Преимущество такого подхода заключается не только в снижении энергопотребления контроллера. Перенос обработки команд на специализированные блоки высвобождает основные Arm-ядра для выполнения задач прошивки, которые с трудом поддаются распараллеливанию. Кроме того, это позволяет масштабировать контроллер для поддержки большего числа каналов NAND-памяти без увеличения размера или энергопотребления основной вычислительной подсистемы, пишет Blocks & Files. Подход сам по себе не является принципиально новым. Например, Phison в рамках концепции CoXProcessor объединил в контроллере X1 два ядра Arm Cortex-R5 и 32 «микроядра», каждое из которых предназначено для выполнения одной-двух конкретных задач. H-TPU от SK hynix развивает и масштабирует эту идею. В патенте, поданном компанией ещё в ноябре 2020 года, описывается архитектура, в которой CPU отвечает за управление (control plane), а множество небольших сопроцессоров формируют уровень I/O (I/O plane), отвечая за приём данных от хоста, работу с кешем, энергонезависимой памятью и адресами, образуя I/O-конвейер. 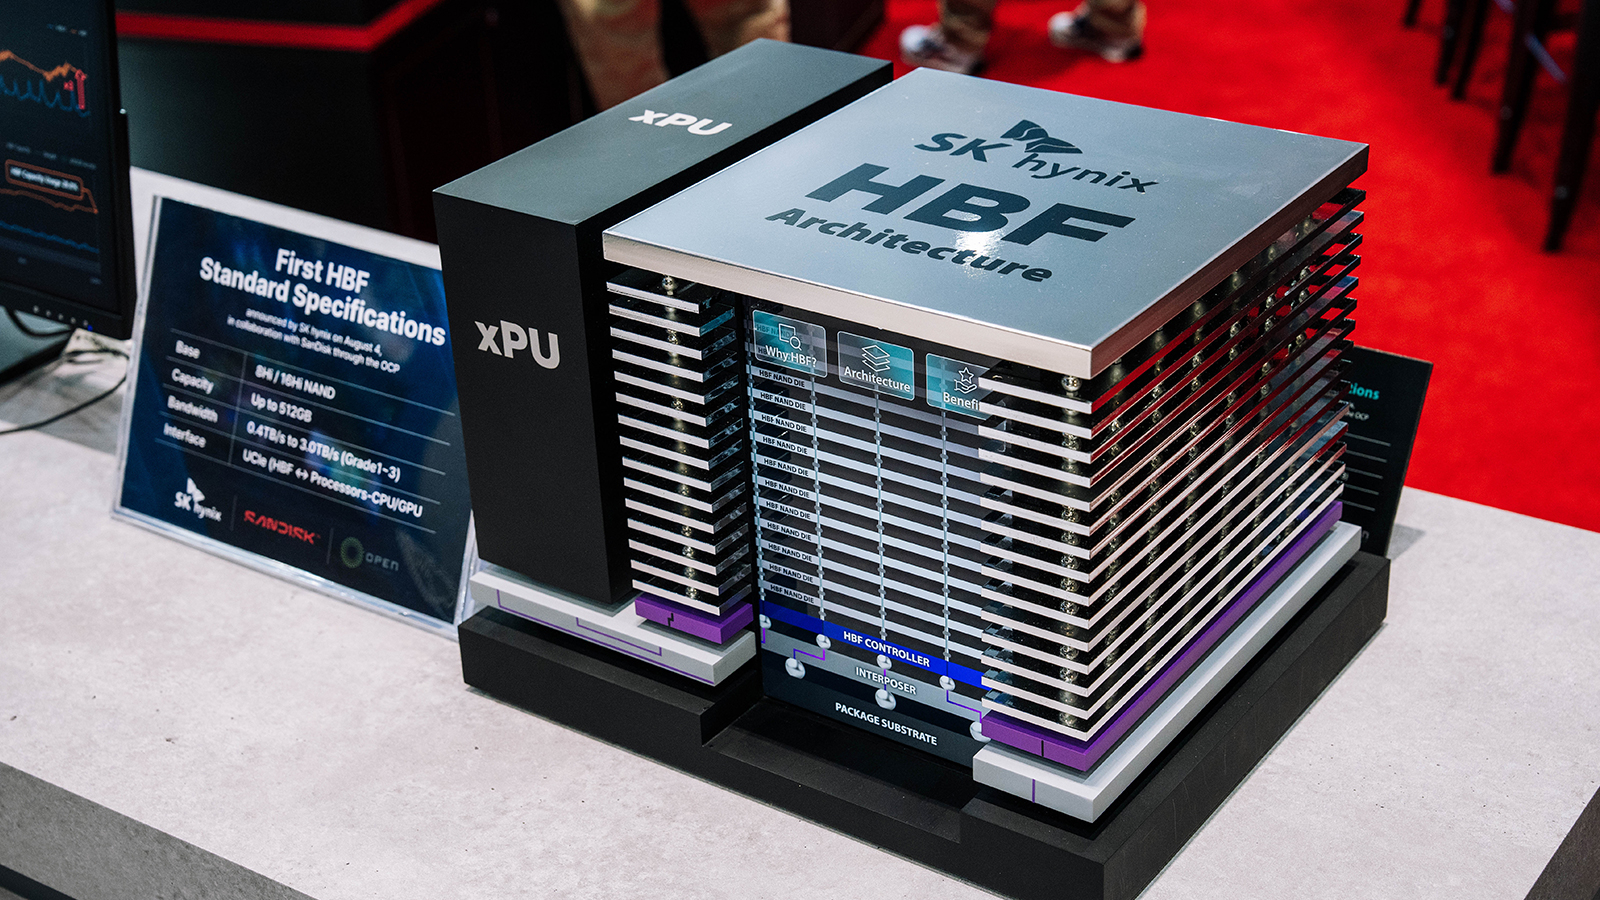 В дальнейшем компания планирует развивать аппаратную автоматизацию (HWA). В рамках концепции HWA простые, но трудоёмкие задачи по управлению хранилищем данных — обработка повторяющихся команд, поиск адресов, копирование информации во временные буферы и т.п. — полностью передаются специализированным аппаратным схемам, которые выполняют их автоматически для повышения предсказуемости времени завершения операций. В корпоративных SSD, где требуется высокий показатель IOPS, стабильность времени завершения операций I/O особенно критична. В свою очередь, CPU и H-TPU используются только для задач высокого уровня: например, для обработки исключительных ошибок или принятия критически важных управляющих решений. Также планируется использование H-TPU в рамках совместного с NVIDIA проекта Storage Next с целью уменьшения гранулярности доступа к NAND-памяти примерно до 512 байт (что меньше действующих стандартов), оптимизируя работу системы для ИИ-задач. H-TPU найдёт применение в контроллерах для устройств серии AIN. Кроме того, H-TPU предполагается интегрировать в память типа High Bandwidth Flash (HBF), выпуск которой намечен на следующий год.
15.10.2026 [16:31], Владимир Мироненко
Лучше меньше да лучше: Intel верит, что развитие агентного ИИ вернёт CPU значимость в инфраструктуре ЦОДIntel заявила, что следующий этап развития ИИ будет определять не обучение моделей, а их использование (инференс), и что развитие агентного ИИ вернёт CPU в центр инфраструктуры дата-центров, сообщил SiliconANGLE. Сейчас по умолчанию любой запрос как правило отправляется в компаниях к самой мощной модели — независимо от того, требует ли этого сама задача. Intel предлагает альтернативу: уровень оркестрации, который анализирует каждый запрос, оценивая необходимый уровень «интеллекта», объём контекста, допустимую задержку, требования к конфиденциальности и суверенитету данных, а также затраты и энергопотребление. «Для каждого запроса — своё решение», — подчеркнул Николас Дюбе (Nicolas Dubé), корпоративный вице-президент Intel. Если для глубоких исследований использование передовой модели может быть оправдано, то для рутинных задач — написание кода, составление резюме или операционные процессы — могут использоваться более компактные открытые моделей, что обходится значительно дешевле. Дюбе отметил, что open source модели расширяют возможности компаний по внедрению ИИ. «Чтобы полностью раскрыть их потенциал, организациям необходима инфраструктура, способная подобрать для каждой конкретной задачи оптимальный уровень интеллектуальных возможностей, вычислительных ресурсов и экономических затрат», — говорит он. 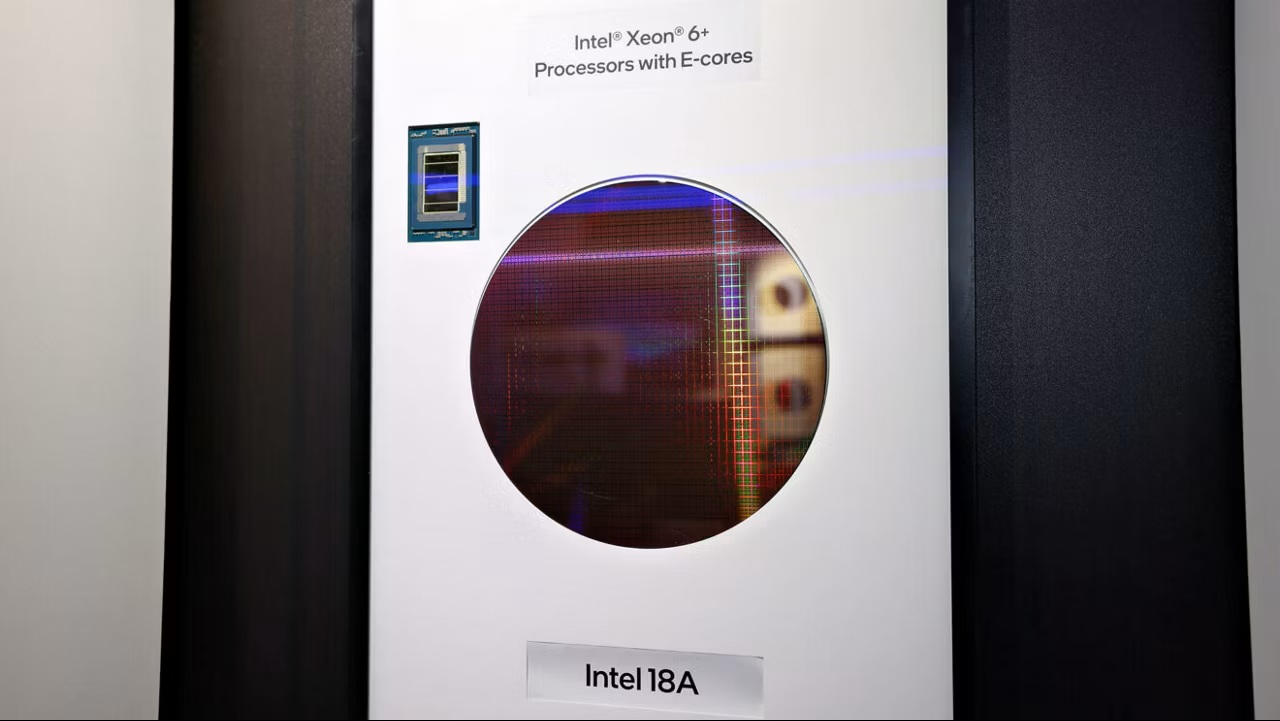
Источник изображения: Intel Только что представленный 350-Вт ускоритель Intel GPU D270 (Crescent Island), совместимый со стандартными серверами с воздушным охлаждением, позволяет компании начать с одного устройства, затем перейти к серверу с восемью ускорителями и масштабировать инфраструктуру до уровня целой стойки только тогда, когда этого потребует рабочая нагрузка. Инференс становится ключевой задачей в сфере ИИ, и корпорациям необходима инфраструктура, которая сделает переход к нему более простым и экономически выгодным. Опционально GPU можно дополнить ускорителями RDU SambaNova. Также компания продемонстрировала разработанные партнёрами стоечные системы (в том числе ORv3) на базе Xeon. Например, доступные конфигурации с Xeon 6+ (Clearwater Forest), масштабируемыми до более чем 46 тыс. ядер на стойку при мощности 133,45 кВт. Высокоплотные Xeon 6+ с E-ядрами ориентированы на высокопроизводительные агентские нагрузки, в то время как Xeon 6 (Granite Rapids-SP) с P-ядрами справляются с задачами, зависящими от скорости однопоточного выполнения. Intel утверждает, что теперь следует исходить не из количества ядер, а количества одновременно работающих агентов, которые может поддерживать стойка при целевой задержке. В результате формируется гетерогенная система: Xeon используется для оркестрации, обработки данных и запуска вспомогательных инструментов, а GPU серии D и RDU — для инференса открытых моделей. При этом Дюбе пояснил, что Intel объединяет систему с помощью программной архитектуры, разрабатываемой совместно с сообществом. Она является открытой, доступной для загрузки уже сегодня и спроектированной для работы на самых разных аппаратных платформах. 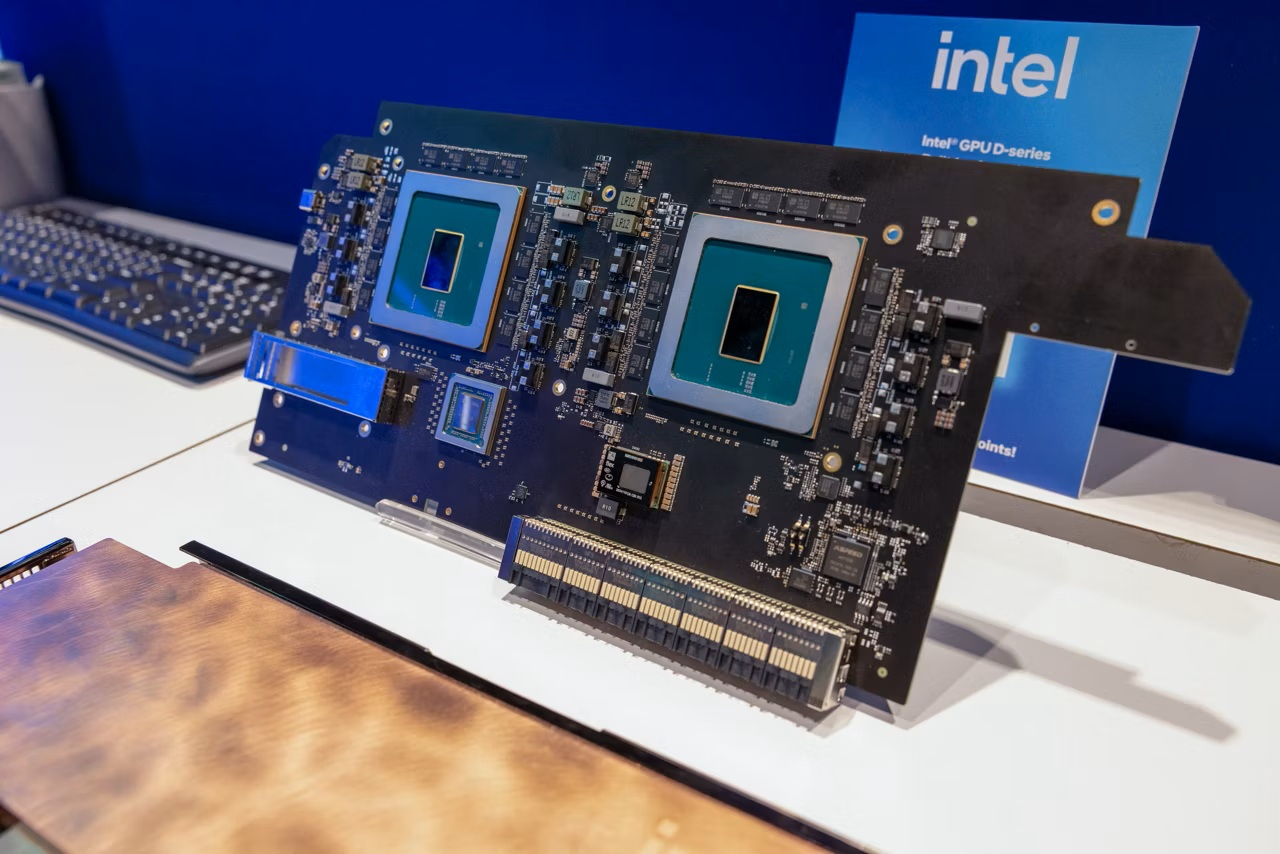
Источник изображения: Intel Как отметил SiliconANGLE, разработки в области «агентных стоек» (agentic racks) подстегивают спрос на Xeon — ключевой драйвер текущих показателей, — позиционируя Intel не просто как традиционного поставщика оборудования, а как важнейшего провайдера инфраструктуры для ИИ-агентов. А Crescent Island даёт Intel возможность предложить решения для ускорения вычислений, где компании не обязательно превосходить NVIDIA по пиковой производительности. Это может стать наиболее практичным и энергоэффективным способом запуска открытых ИИ-моделей в уже существующих ЦОД. Именно такую стратегию выбрал гендиректор Intel Лип-Бу Тан (Lip-Bu Tan): перестать пытаться выиграть в каждой битве и сосредоточиться на тех направлениях, где у Intel есть структурное преимущество. Intel не обязательно доминировать в сфере обучения передовых моделей. Ей следует занять нишу в корпоративном сегменте — это гораздо более масштабная возможность, чем принято считать. ZK Research предлагает ИТ-руководителям провести аудит используемых промптов и классифицировать их по типам задач, объёму контекста, требования к конфиденциальности и т.п., а затем настроить маршрутизацию запросов к наиболее подходящим моделям. Кроме того, рекомендуется пересмотреть подход к оценке инфраструктуры, перестав ориентироваться на «голые» цифры вроде FLOPS или количества ядер и начав требовать от вендоров соблюдения целевых показателей задержки, стоимости обработки миллиона токенов и энергоэффективности для конкретных используемых моделей, промптов и контекста.
09.10.2026 [19:22], Владимир Мироненко
NVIDIA Vera показал превосходство над чипами AMD и Intel в HPC-бенчмаркахРесурс Phoronix провёл тестирование процессора NVIDIA Vera в двухсокетной конфигурации (в сумме 176 ядер и 352 потока) в ряде HPC-задач, включая OpenFOAM (CFD) и WRF, сравнив его с двухсокетными системами на базе AMD EPYC 9575F (Turin) с общим количеством 128 ядер и 256 потоков, а также системами с двумя EPYC 9755 (всего 256 ядер и 512 потоков) и двумя процессорами Intel Xeon 6980P (Granite Rapids-AP) с 256 ядрами и 512 потоками. 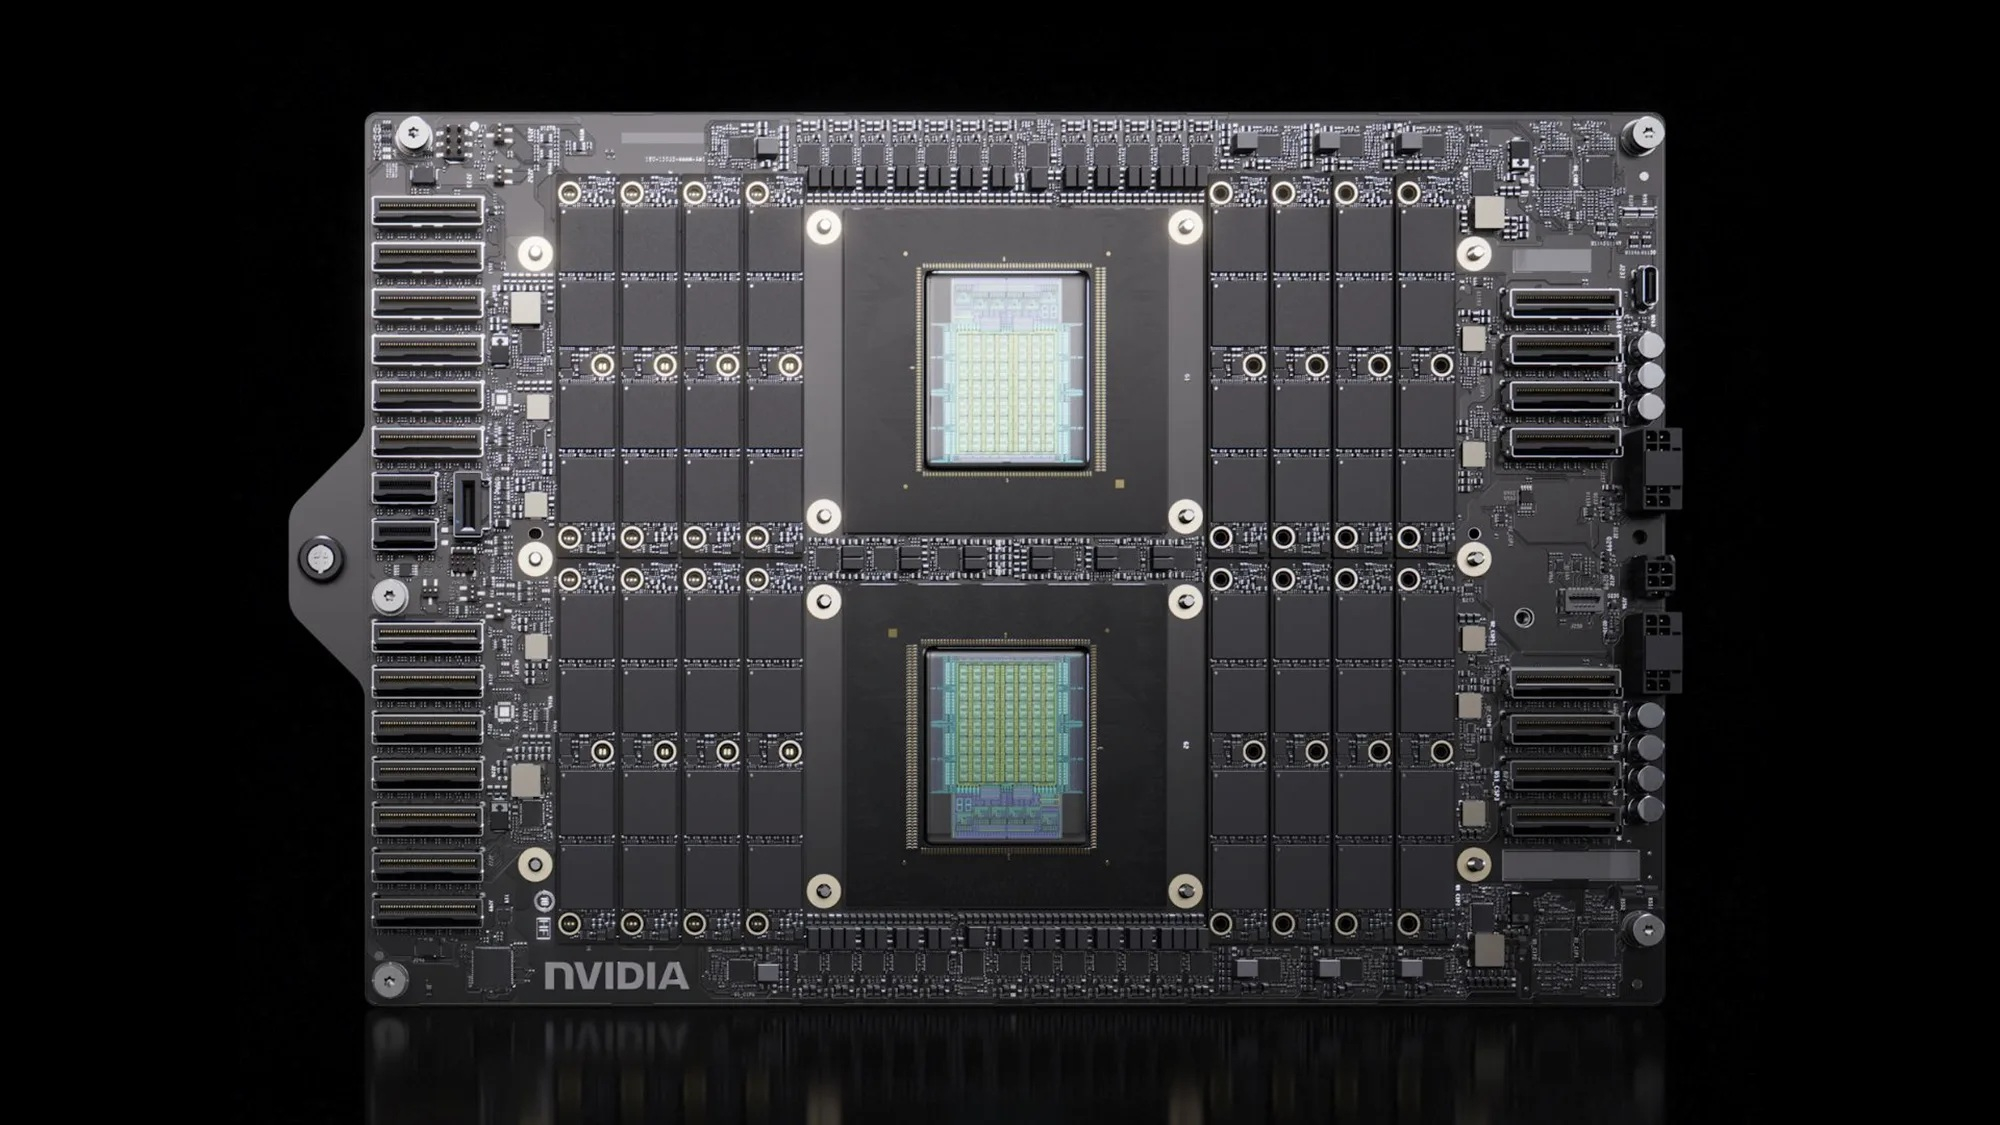
Источник изображения: NVIDIA Что касается оперативной памяти, то у системы NVIDIA Vera было 16 × 96 Гбайт LPDDR5x-9600 Samsung M564K6LC3CL0-CCVS7. В топовой конфигурации процессоры AMD EPYC 9575F (2P) и EPYC 9755 (2P) имели память DDR5-6400 Samsung M321R8GA0PB1-CCPKC ёмкостью 24 × 64 Гбайт, а Intel Xeon 6980P (2P) — 24 × 64Гбайт памяти MRDIMM-8800. Особенно высокие результаты NVIDIA Vera продемонстрировал в рабочих нагрузках с интенсивной пропускной способностью, где память LPDDR5x-9600 превосходила DDR5-6400 с серверами AMD EPYC 5-го поколения или MRDIMM-8800 с процессором Intel Xeon 6. Производительность Vera ещё более впечатляет, если учесть, что 88 ядер конкурировали со 128 P-ядрами процессоров Xeon и EPYC. 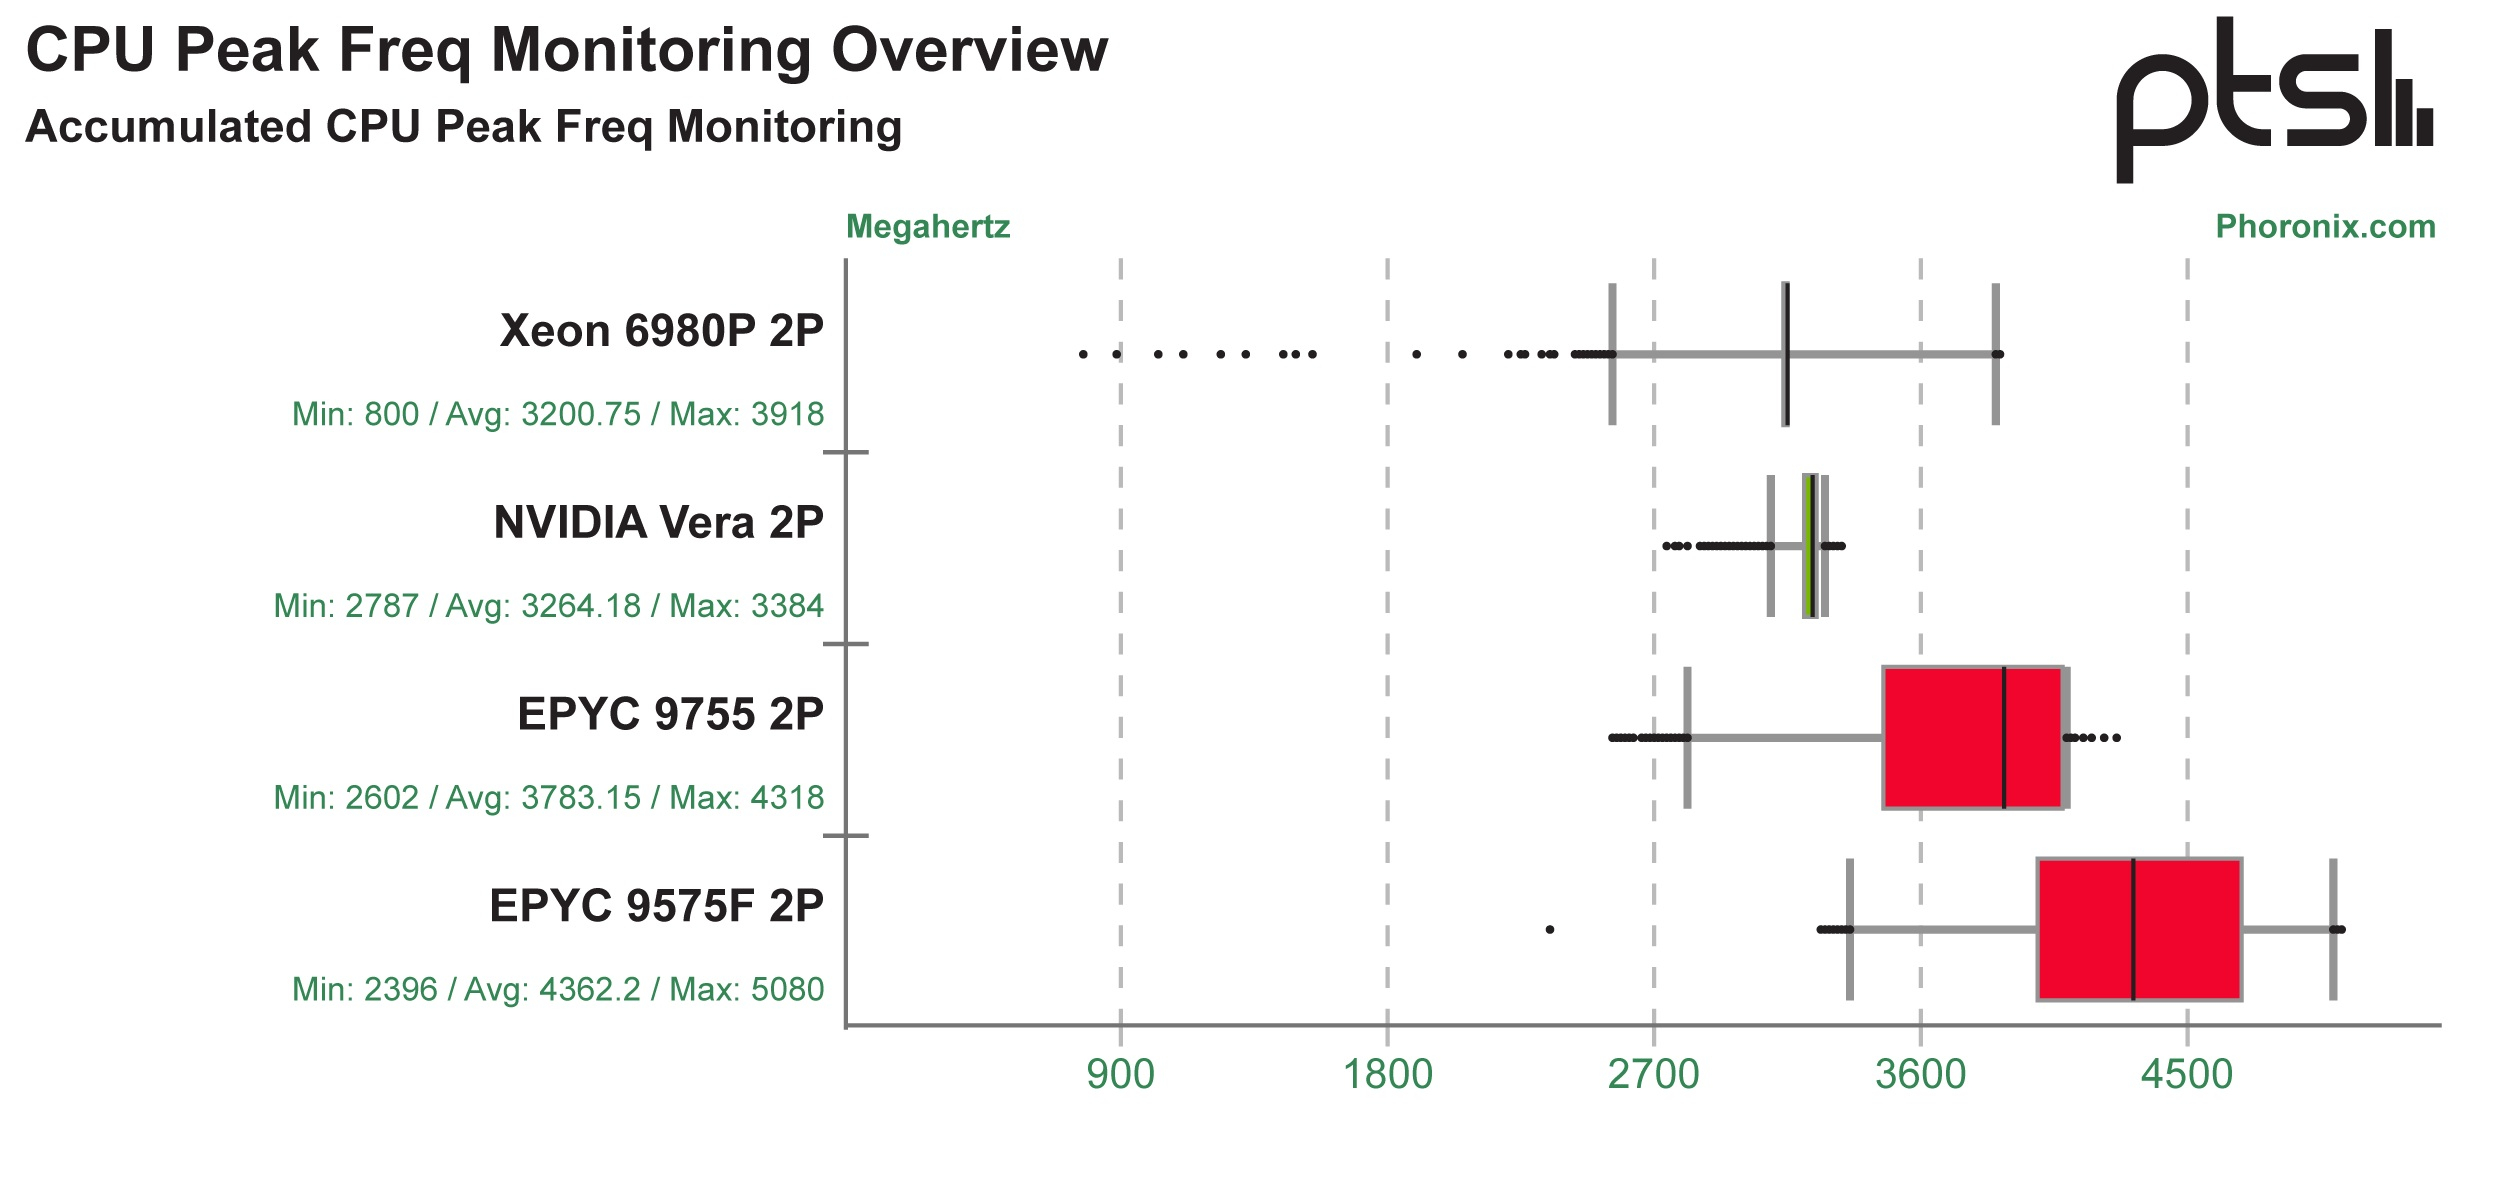
Источник изображений: Phoronix При анализе пиковой частоты процессора в преобладающем диапазоне высокопроизводительных вычислений выяснилось, что NVIDIA Vera, как правило, имел пиковую частоту 3,2–3,3 ГГц по сравнению с Xeon 6980P с максимальной частотой 3,9 ГГц, EPYC 9755 с частотой 4,3 ГГц и EPYC 9575F с частотой 5,0 ГГц. Ядра Olympus продемонстрировали чрезвычайно высокую производительность на такт с учётом всех факторов. 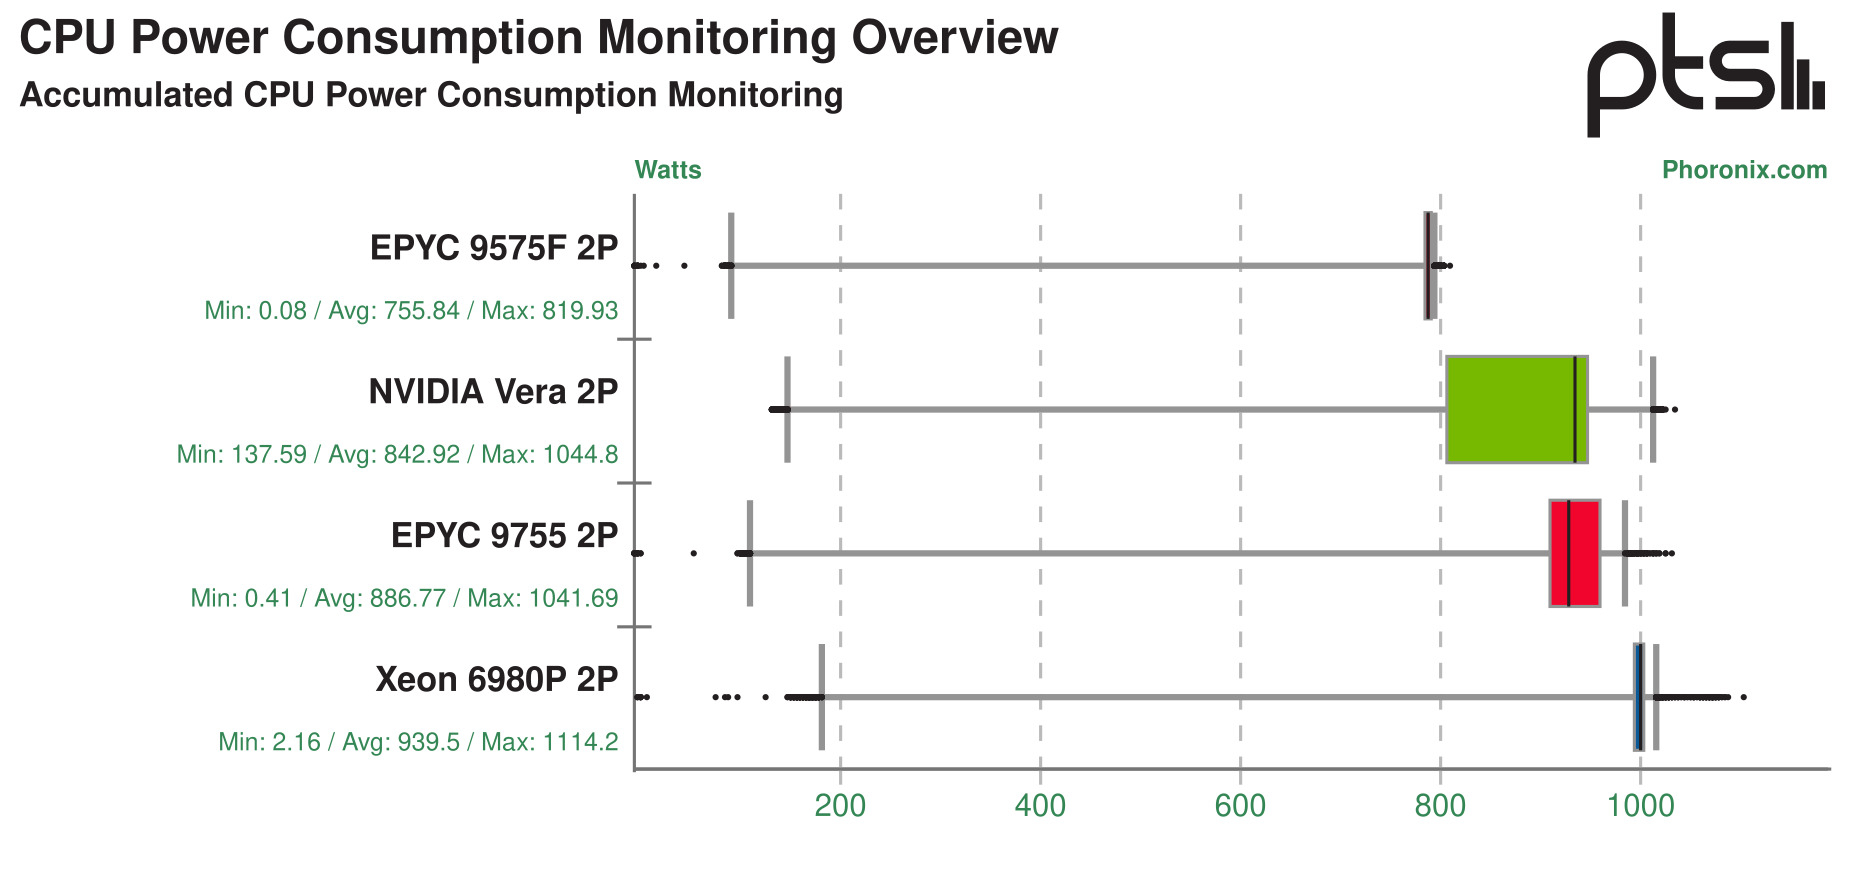 В ходе бенчмарков с фокусом на HPC, таких как как OpenFOAM CFD, WRF и т.д., энергопотребление двух процессоров NVIDIA Vera в среднем составило 842 Вт при пиковом значении в 1044 Вт, что аналогично показателю двух EPYC 9755, и немного меньше среднего энергопотребления двух EPYC 9575F. Процессоры Intel Xeon 6980P потребляли больше всего энергии, приближаяь к киловатту. 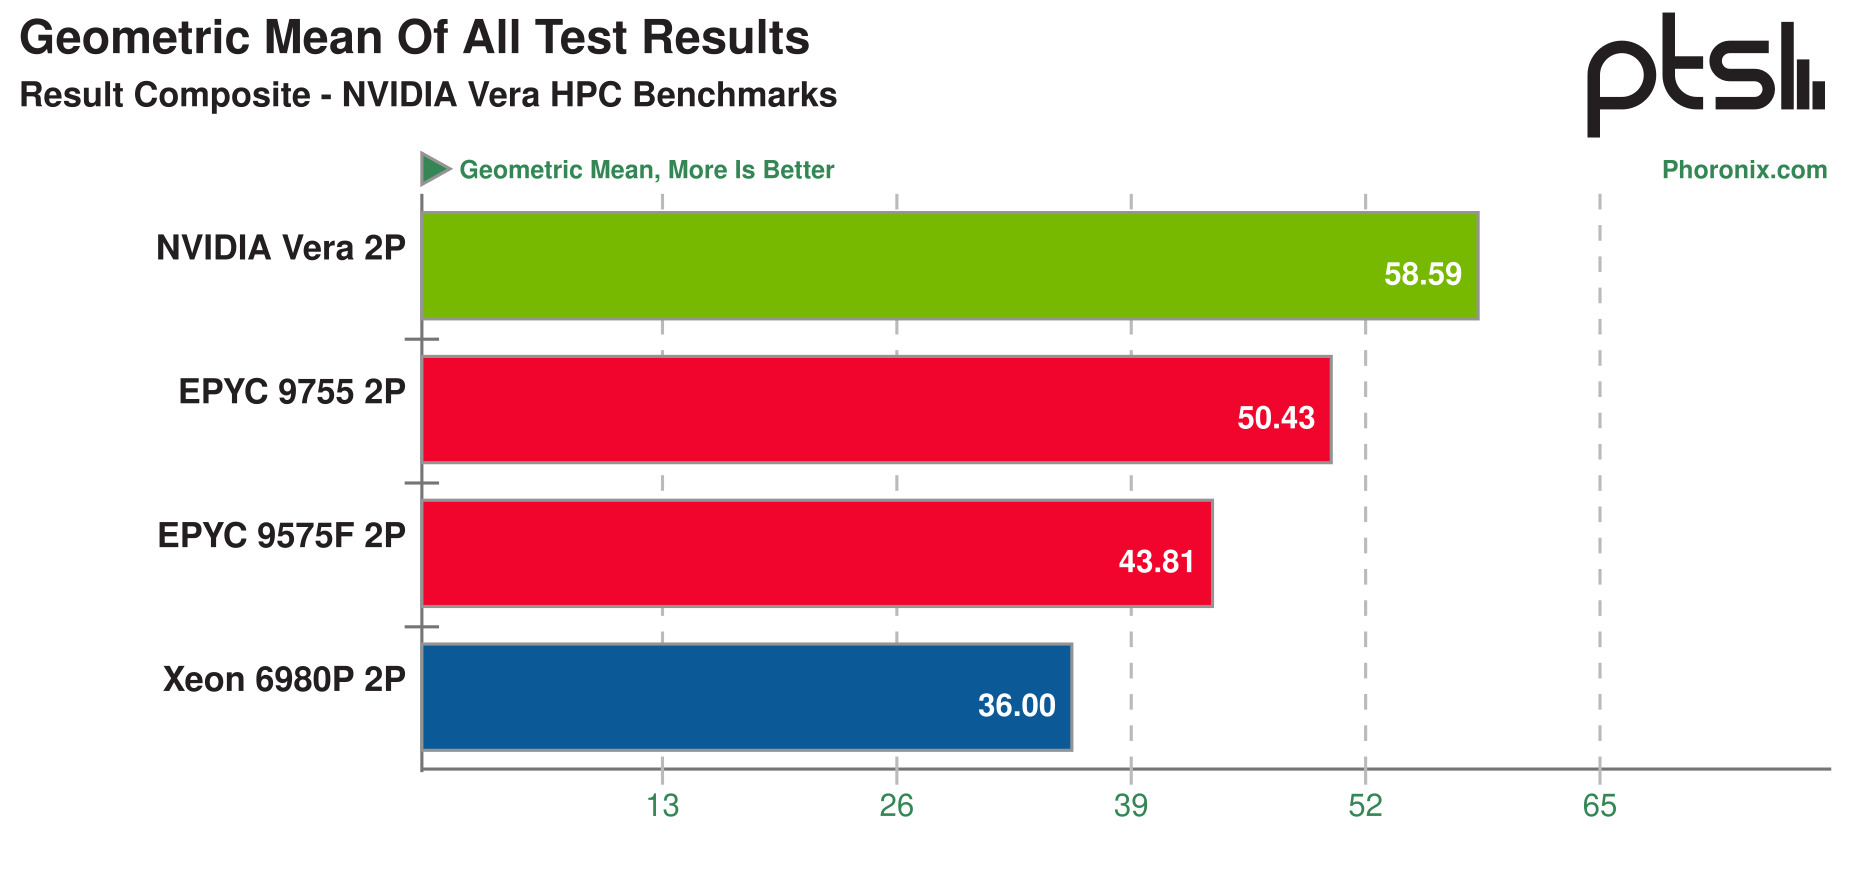 Геометрическое среднее по всем результатам тестов (Geometric Mean Of All Test Results) с формированием комплексного показателя (Result Composite) в рамках набора NVIDIA Vera HPC Benchmarks, дающее общую оценку производительности системы, отражает тот факт, что самым быстрым является решение NVIDIA Vera (2P). Как отметил Phoronix, NVIDIA Vera по-прежнему остаётся самым производительным серверным процессором на Arm64 из числа когда-либо тестировавшихся этим сайтом.
29.09.2026 [11:12], Сергей Карасёв
AMD раскрыла цены всех процессоров EPYC Venice 9006: более 30 моделей оценили от $700 до $14 904Компания AMD назвала цены на серверные процессоры EPYC Venice 9006, официальная презентация которых состоялась в июле нынешнего года. В общей сложности для заказа доступны более 30 моделей чипов в исполнениях SP7 и SP8 для одно- и двухсокетных систем. В частности, в семейство SP7 вошли девять изделий EPYC Venice 9006, насчитывающих от 64 до 256 вычислительных ядер, каждое из которых способно обрабатывать два потока инструкций. Объём кеша третьего уровня варьируется от 384 до 1024 Мбайт, показатель TDP — от 300 до 600 Вт. Базовая тактовая частота в зависимости от модификации достигает 3,75 ГГц, частота в турбо-режиме — 5 ГГц. Реализована поддержка 16-канальной оперативной памяти RDIMM DDR5-8000 и MRDIMM DDR5-12800 с пропускной способностью соответственно до 1024 Гбайт/с и 1638 Гбайт/с на сокет. Цена чипов при заказе партиями от 1 тыс. штук находится в диапазоне от $8008 до $14 904. 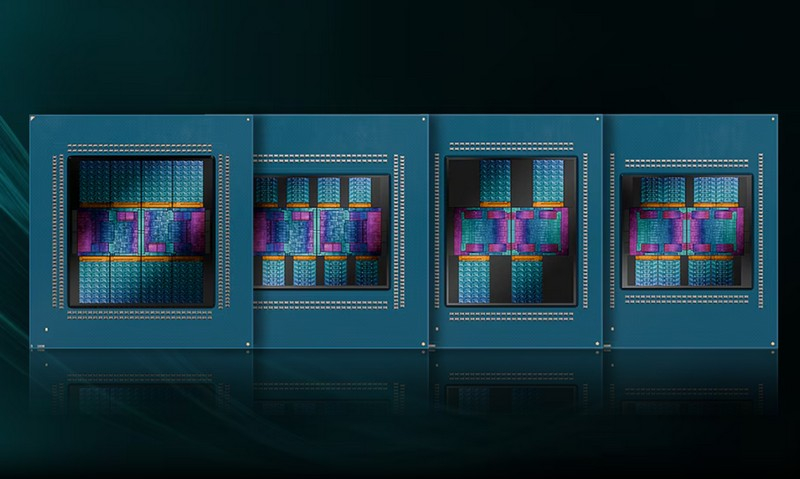
Источник изображения: AMD Серия SP8, в свою очередь, представлена 22 моделями. У них количество вычислительных ядер составляет от 8 до 128 (с поддержкой многопоточности), размер кеша L3 — от 48 до 512 Мбайт. Величина TDP — от 130 до 400 Вт. Базовая тактовая частота достигает 3,8 ГГц, максимальная частота — 5 ГГц. Реализована 8-канальная подсистема памяти DDR5 с возможностью использования модулей RDIMM (512 Гбайт/с) и MRDIMM (819,2 Гбайт/с). Цена чипов данной серии — от $700 до $11 679 при заказе партиями от 1 тыс. единиц. 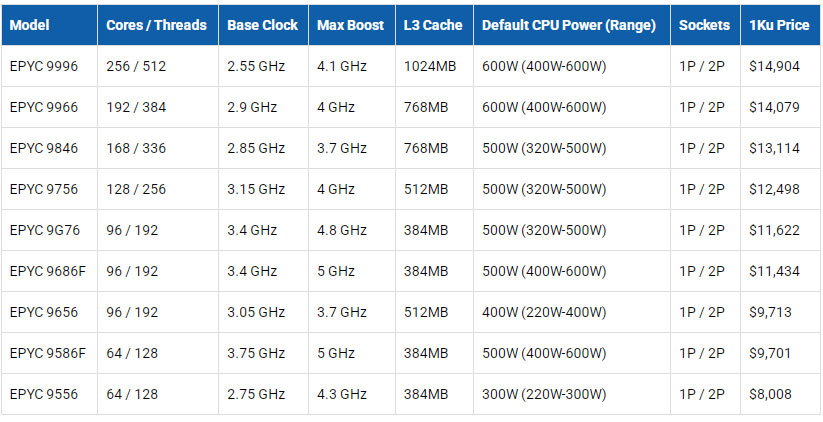
Источник изображений: storagereview.com AMD также уточнила некоторые технические характеристики процессоров. Ранее говорилось, что для решений поколения EPYC Venice 9006 предусмотрена поддержка «до 128 линий» PCIe 6.0 в односокетной конфигурации. Теперь сообщается, что такое количество линий справедливо только для изделий в исполнении SP8, тогда как чипы SP7 используют 96 линий. 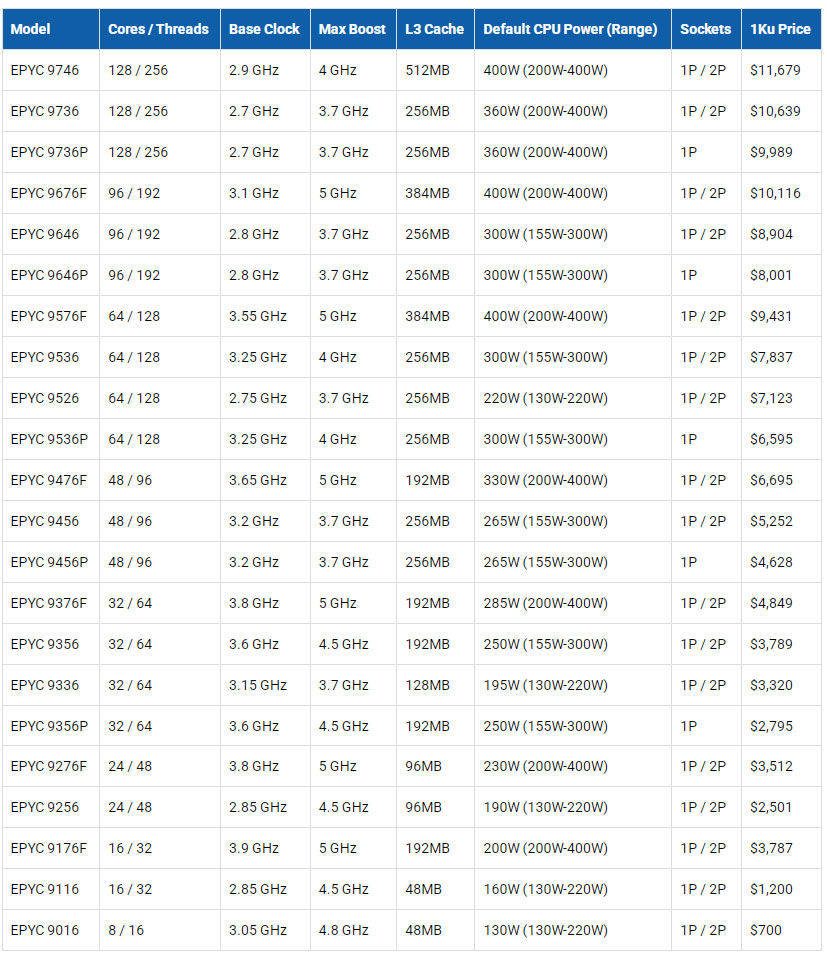 Процессоры изготавливаются с применением 2-нм технологии. Компания AMD подчеркивает, что чипы подходят как для задач общего назначения, так и для нагрузок, связанных с ИИ, включая агентный ИИ. Разработчик указывает на самые высокие в отрасли показатели производительности в расчёте на 1 Вт затрачиваемой энергии и на оптимальную совокупную стоимость владения (TCO).
24.09.2026 [13:29], Сергей Карасёв
Четыре ядра, DDR5 и PCIe 4.0: дебютировали китайские x86-чипы Hygon 1000 для встраиваемых системКитайская компания Hygon Information Technology анонсировала процессоры Hygon 1000, выполненные на базе x86-совместимой архитектуры C86. Чипы предназначены для применения во встраиваемых системах, платформах промышленной автоматизации, робототехнике, периферийном оборудовании и пр. Конструкция изделий включает четыре вычислительных ядра с возможностью одновременной обработки до восьми потоков инструкций. Говорится о поддержке оперативной памяти DDR4/DDR5 (ЕСС), а также интерфейса PCIe 4.0 и расширений TSN (Time-Sensitive Networking). Тактовая частота и размер кеша пока не раскрываются. 
Источник изображения: SCMP В состав процессоров входит графическое ядро (iGPU) с возможностью обработки двух видеопотоков в формате 4K с кадровой частотой 60 Гц. Упомянута поддержка программных интерфейсов DirectX, OpenGL 3.3 и OpenCL 3.0. Предусмотрен встроенный криптографический модуль с аппаратным ускорением китайских национальных алгоритмов SM2/SM3/SM4. Кроме того, реализованы безопасная загрузка (Secure Boot) и другие механизмы защиты. Показатель TDP изделий Hygon 1000 находится на уровне 10 Вт: благодаря этому чипы могут применяться в устройствах с пассивным охлаждением. Диапазон рабочих температур простирается от -40 до +105 °C. Hygon гарантирует доступность процессоров в течение как минимум 10 лет с момента начала поставок. Среди возможных сфер использования названы облачные терминалы, NAS-серверы, системы видеонаблюдения, роботы, индустриальные устройства управления, шлюзы безопасности и универсальные платформы с ИИ-функциями.
23.09.2026 [15:54], Владимир Мироненко
SiPearl поставила первые образцы европейского серверного Arm-процессора Rhea1 для суперкомпьютера JUPITERФранцузский разработчик процессоров SiPearl предоставил образцы своего первого процессора Rhea1 компании Bull, которая приступила к интеграции чипа в свою платформу BullSequana XH3000 для первого в Европе суперкомпьютера экзафлопсного класса JUPITER (Joint Undertaking Pioneer for Innovative and Transformative Exascale Research) в суперкомпьютерном центре Forschungszentrum Juelich (FZJ) в Юлихе (Jülich, Германия). На данном этапе производятся работы по созданию процессорного блейд-модуля для JUPITER, дополняющего GPU-сегмент, что открывает возможность полноценной модульной интеграции всего комплекса. Поставка оборудования для JUPITER стала первым заказом на серверные процессоры Rhea1 для компании SiPearl. Процессор включает 80 ядер Arm Neoverse V1 (Zeus), четыре стека памяти HBM2e (64 Гбайт), а также четыре канала памяти DDR5 (2DPC). Поддерживаются 104 линии PCIe 5.0 в виде шести комплексов x16 и двух x4. Благодаря этим ключевым характеристикам Rhea1 идеально подходит для выполнения самых ресурсоёмких HPC-задач, обеспечивая при этом безопасность без бэкдоров и «выключателей», энергоэффективность и гибкость, отмечено в пресс-релизе. Выход Rhea1 на рынок запланирован на конец 2026 года. 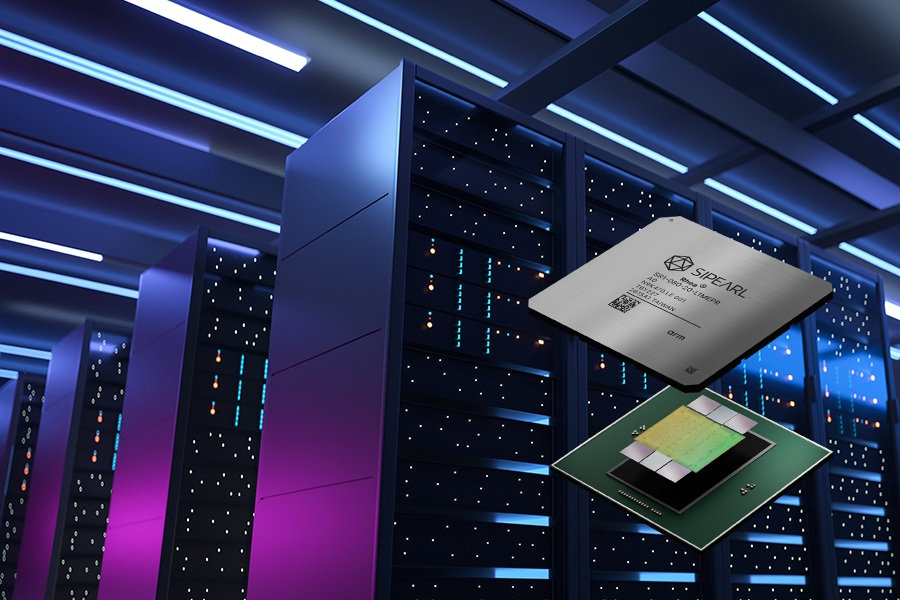
Источник изображения: SiPearl «Благодаря высокой пропускной способности памяти этот процессор особенно хорошо подходит для приложений, которым необходим эффективный доступ к большим объёмам данных», — отметил директор Юлихского суперкомпьютерного центра Исследовательского центра Юлиха, а исполнительный директор EuroHPC JU назвал поставку образцов «важной вехой на пути к суверенитету Европы в области суперкомпьютерных технологий». Вторая европейская система экзафлопсного уровня Alice Recoque, будет установлена в центре CEA/DAM к югу от Парижа. В ней будет использоваться процессор Rhea2. Генеральный директор и основатель SiPearl сообщил, что компания сейчас ведёт переговоры с предприятиями оборонного сектора по поводу поставок ещё одного продукта — Athena1 — специализированной версии Rhea1 для приложений двойного назначения.
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 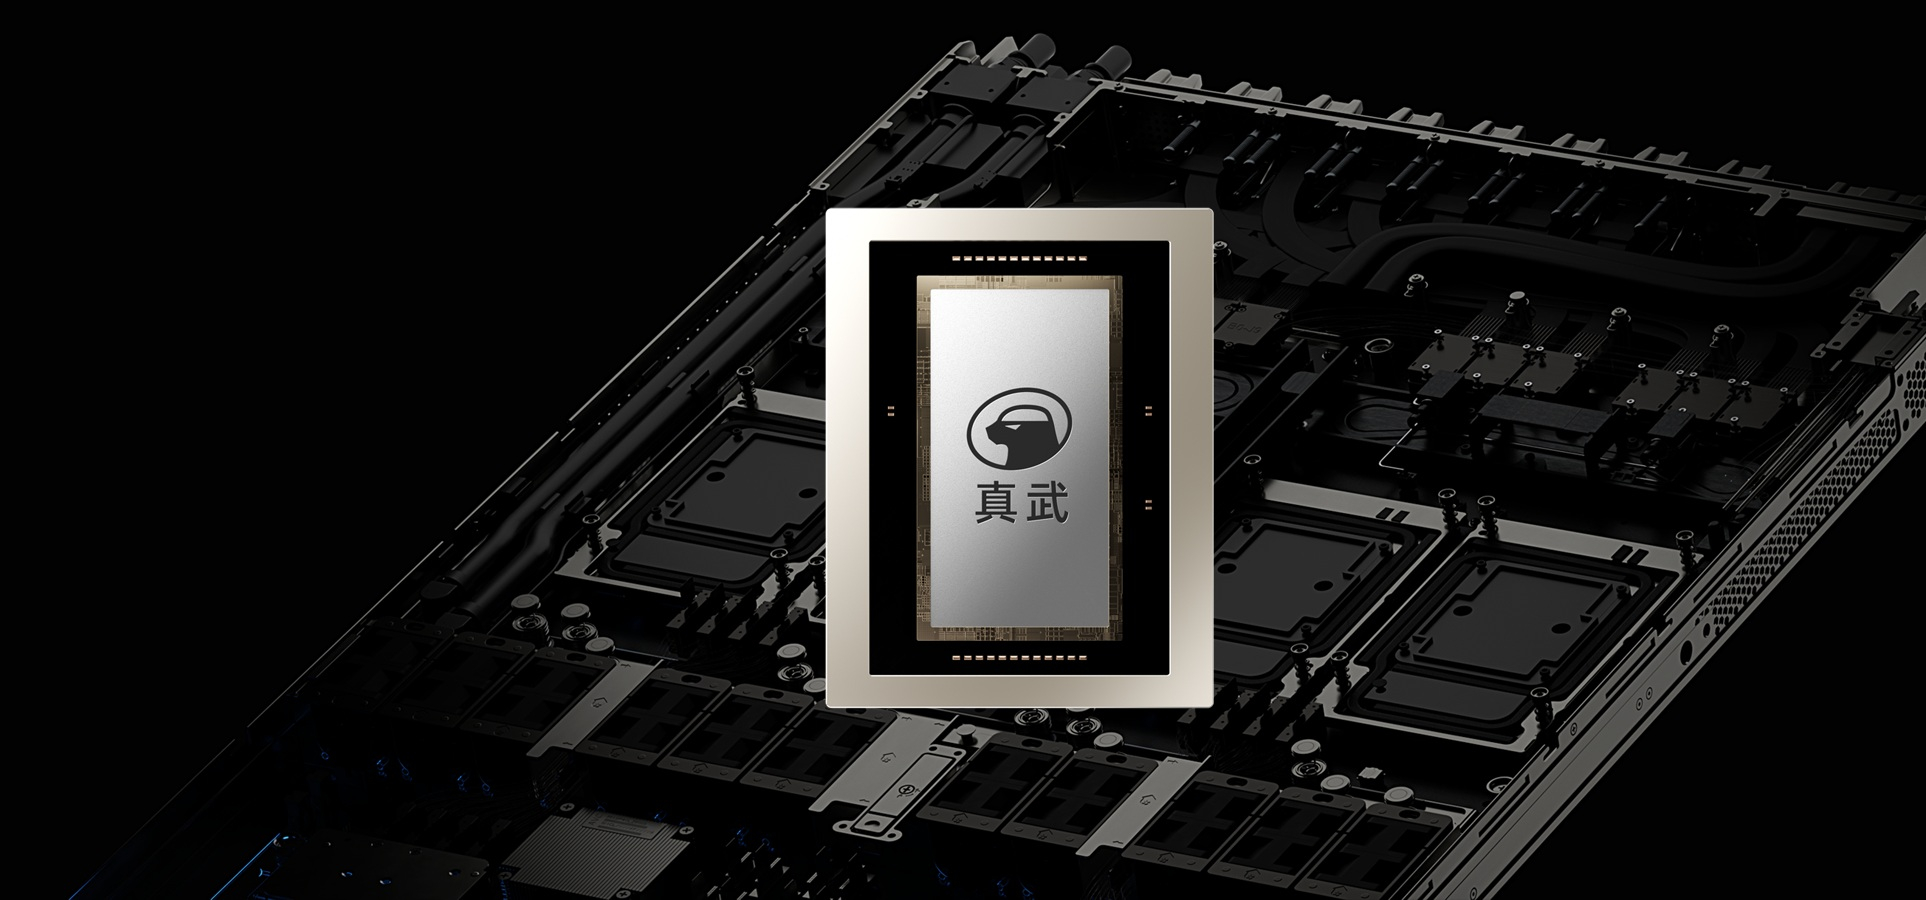
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 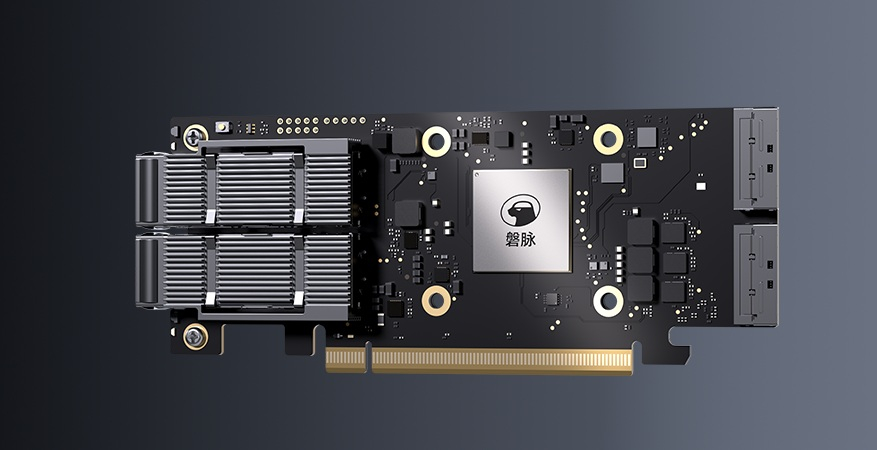
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт. |
|

