Материалы по тегу: amd
|
01.10.2026 [15:54], Сергей Карасёв
AMD представила ИИ-ассистента Ross для разработки встраиваемых системКомпания AMD анонсировала специализированный агентный ИИ-инструмент под названием Ross: это интерактивный помощник, призванный упростить создание различных встраиваемых систем. Ross, как утверждается, охватывает весь процесс разработки — от проектирования печатных плат, анализа схем и отладки до оптимизации, написания сопутствующего софта и развёртывания. В отличие от обычных чат-ботов и ассистентов по программированию, Ross глубоко интегрирован в экосистему AMD. При помощи запросов на естественном языке разработчики могут искать документацию и необходимые инструменты, выполнять те или иные команды, внедрять проверенные рабочие процессы и пр. При этом Ross предоставляет командам возможность гибко использовать предпочитаемые ими большие языковые модели (LLM) и интегрированные среды разработки (IDE). 
Источник изображений: AMD Одним из компонентов Ross является специализированная база знаний. Она содержит руководства пользователя, инструкции по продуктам, технические документы, примечания к приложениям и пр. Доступ к информации может предоставляться через облако или в локальной среде. Кроме того, разработчикам доступны навыки ИИ-агентов (Agent Skills): это открытые, подготовленные специалистами файлы в формате Markdown, которые содержат проверенные и готовые к повторному использованию методики для решения типовых задач проектирования. Такие навыки помогают большой языковой модели шаг за шагом выполнять сложные рабочие процессы — например, оптимизировать временные параметры схемы или перестраивать код на C++ для повышения производительности в среде Vitis HLS. 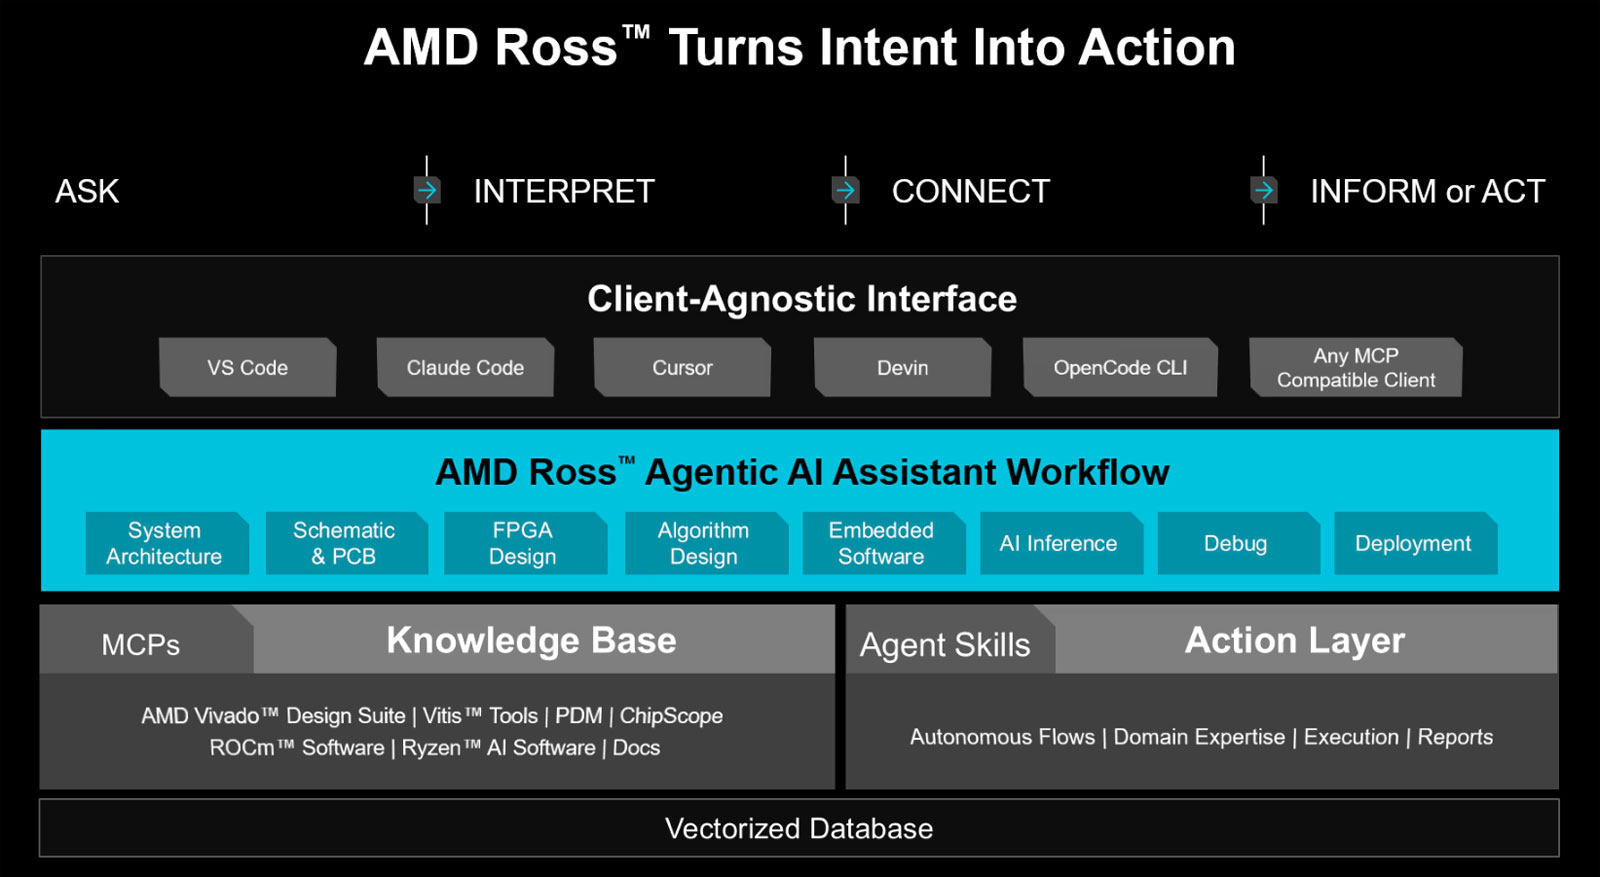 Примеры готовых проектов помогут понять, как навыки агентов могут использоваться в реальных встраиваемых системах. Среди других функций Ross названы возможность оптимизации конструкции микросхем и создания необходимого софта, оценка потребляемой мощности и пр. В целом, как подчёркивается, Ross — это не просто ИИ-помощник для программирования, наложенный поверх стандартных средств разработки. Новый ассистент объединяет инструменты AMD Embedded, экспертные знания и готовые рабочие процессы в едином интерфейсе. Ross предоставляет контекстные рекомендации и функции автоматизацию, которые не в состоянии обеспечить стандартные ИИ-помощники.
01.10.2026 [14:35], Сергей Карасёв
OpenYard выпустила GPU-серверы RG2D4 на базе Intel Xeon Granite Rapids и AMD EPYC TurinРоссийский разработчик и производитель оборудования OpenYard анонсировал GPU-серверы семейства RG2D4 для задач машинного обучения и ИИ, обработки больших данных, видеоаналитики, визуальных вычислений и других ресурсоёмких приложений. Дебютировали модели RG2D4I и RG2D4A, построенные на аппаратной платформе Intel и AMD соответственно. Все новинки выполнены в форм-факторе 2U. Возможна установка до восьми ускорителей NVIDIA H100 NVL или NVIDIA L40s либо до четырёх изделий NVIDIA H200 NVL или NVIDIA RTX PRO 6000 Blackwell Server Edition. Доступны также два дополнительных слота PCIe 5.0 x16 для низкопрофильных карт расширения, например, сетевых адаптеров. Модель RG2D4I рассчитана на два процессора Intel Xeon 6500/6700 поколения Granite Rapids-SP. Реализованы 24 слота для модулей оперативной памяти DDR5-8000 MRDIMM суммарным объёмом до 3 Тбайт. В свою очередь, модификация RG2D4A позволяет задействовать два чипа AMD EPYC 9004 Genoa или EPYC 9005 Turin. Могут быть установлены до 24 модулей DDR5 RDIMM (до 3 Тбайт). Оба сервера оборудованы восемью фронтальными отсеками для SFF-накопителей NVMe/SATA/SAS с возможностью горячей замены. Имеются аппаратный RAID-контроллер с поддержкой RAID 0/1/5/6/10/50/60 и контроллер ASPEED AST2600. В оснащение включены два сетевых порта 10GbE RJ45 (Broadcom BCM57416), выделенный сетевой порт управления 1GbE RJ45, аналоговый разъём D-Sub, два порта USB 3.0 Type-A. В качестве опции доступны адаптеры 10/25/40/100/200/400GbE и FC16/32. 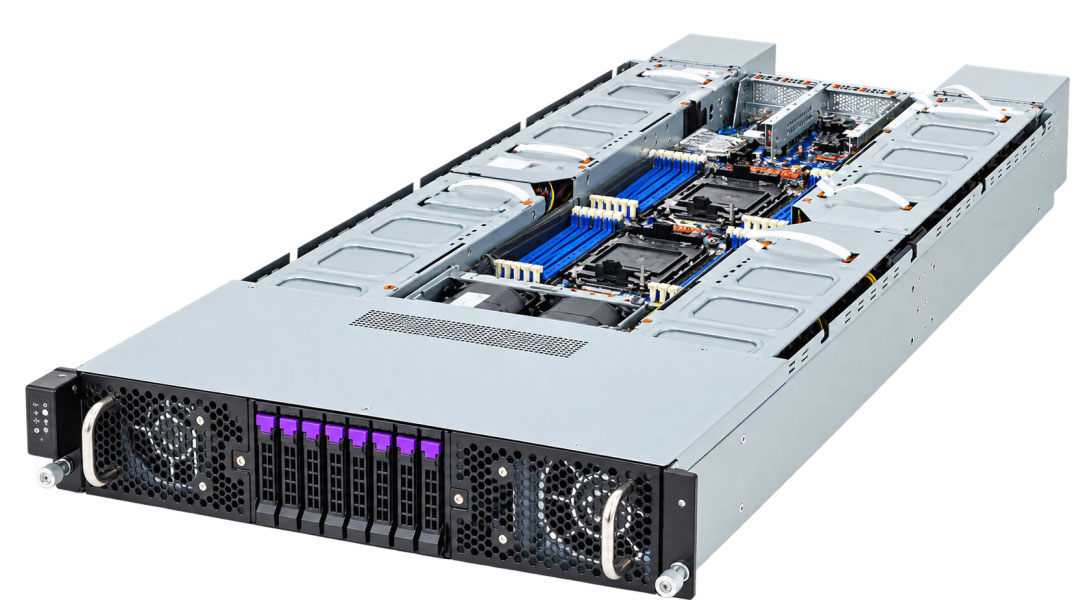
Источник изображения: OpenYard Питание обеспечивают два блока с резервирование мощностью 3000 Вт (80 PLUS Platinum). Габариты устройств составляют 448 × 87,5 × 962 мм. Применена система воздушного охлаждения; диапазон рабочих температур — от +10 до +35 °C.
29.09.2026 [11:12], Сергей Карасёв
AMD раскрыла цены всех процессоров EPYC Venice 9006: более 30 моделей оценили от $700 до $14 904Компания AMD назвала цены на серверные процессоры EPYC Venice 9006, официальная презентация которых состоялась в июле нынешнего года. В общей сложности для заказа доступны более 30 моделей чипов в исполнениях SP7 и SP8 для одно- и двухсокетных систем. В частности, в семейство SP7 вошли девять изделий EPYC Venice 9006, насчитывающих от 64 до 256 вычислительных ядер, каждое из которых способно обрабатывать два потока инструкций. Объём кеша третьего уровня варьируется от 384 до 1024 Мбайт, показатель TDP — от 300 до 600 Вт. Базовая тактовая частота в зависимости от модификации достигает 3,75 ГГц, частота в турбо-режиме — 5 ГГц. Реализована поддержка 16-канальной оперативной памяти RDIMM DDR5-8000 и MRDIMM DDR5-12800 с пропускной способностью соответственно до 1024 Гбайт/с и 1638 Гбайт/с на сокет. Цена чипов при заказе партиями от 1 тыс. штук находится в диапазоне от $8008 до $14 904. 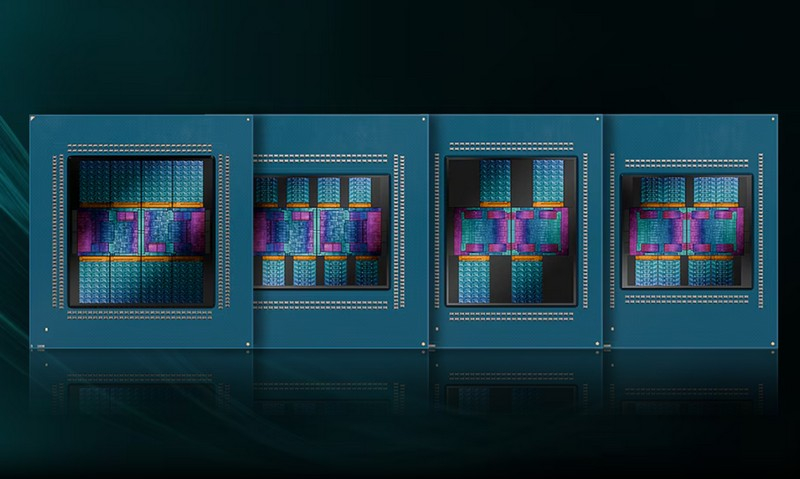
Источник изображения: AMD Серия SP8, в свою очередь, представлена 22 моделями. У них количество вычислительных ядер составляет от 8 до 128 (с поддержкой многопоточности), размер кеша L3 — от 48 до 512 Мбайт. Величина TDP — от 130 до 400 Вт. Базовая тактовая частота достигает 3,8 ГГц, максимальная частота — 5 ГГц. Реализована 8-канальная подсистема памяти DDR5 с возможностью использования модулей RDIMM (512 Гбайт/с) и MRDIMM (819,2 Гбайт/с). Цена чипов данной серии — от $700 до $11 679 при заказе партиями от 1 тыс. единиц. 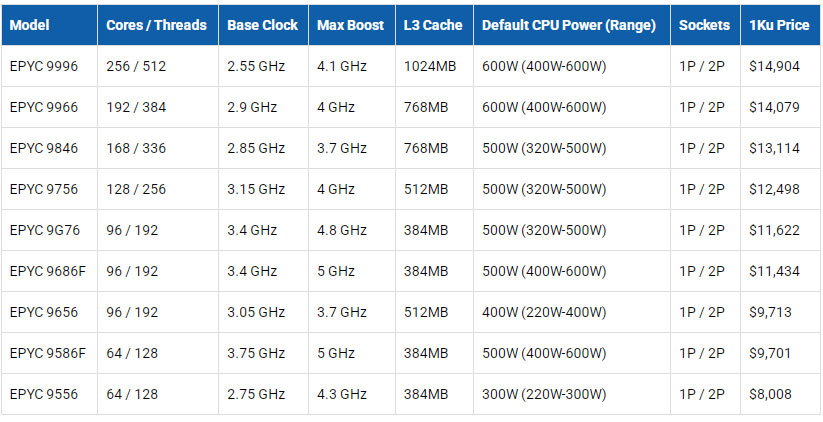
Источник изображений: storagereview.com AMD также уточнила некоторые технические характеристики процессоров. Ранее говорилось, что для решений поколения EPYC Venice 9006 предусмотрена поддержка «до 128 линий» PCIe 6.0 в односокетной конфигурации. Теперь сообщается, что такое количество линий справедливо только для изделий в исполнении SP8, тогда как чипы SP7 используют 96 линий. 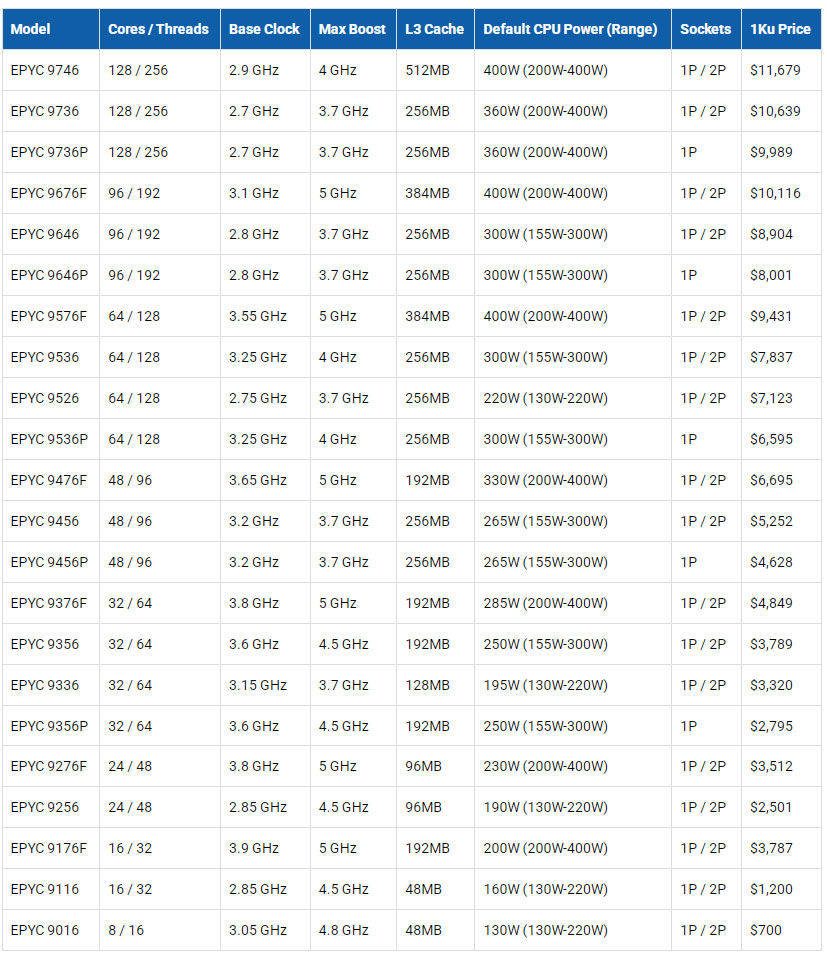 Процессоры изготавливаются с применением 2-нм технологии. Компания AMD подчеркивает, что чипы подходят как для задач общего назначения, так и для нагрузок, связанных с ИИ, включая агентный ИИ. Разработчик указывает на самые высокие в отрасли показатели производительности в расчёте на 1 Вт затрачиваемой энергии и на оптимальную совокупную стоимость владения (TCO).
16.09.2026 [13:10], Руслан Авдеев
SiFive и AMD займутся оптимизацией ROCm для RISC-VSiFive и AMD показали возможность работы программной экосистемы AMD ROCm на представленной недавно серверной платформе BigSky Datacenter Development Platform. Компании показали запуск современной ИИ-модели Gemma4-E2B с применением ROCm 10.0 на серверах SiFive с ядрами SiFive P870-D. Непосредственно за инференс отвечали ускорители AMD Radeon AI PRO R9700. Взаимодействие компания позволит использовать open source ПО, экосистему ROCm и аппаратные решения на архитектуре RISC-V для создания системы ИИ-вычислений в ЦОД нового поколения. Партнёры продолжат заниматься оптимизацией ROCm для RISC-V, желая обеспечить в перспективе ускоренное время обработки данных и большее число сценариев использования ИИ-ускорителей и более крупных ИИ-моделей. По словам представителя SiFive, комбинация передовой открытой стандартной архитектуры с ПО с открытым исходным кодом позволяет гиперскейлерам и разработчикам решать современные ИИ-задачи на RISC-V. Это будет способствовать ускоренному внедрению RISC-V в ЦОД. 
Источник изображения: SiFive RISC-V-сервер BigSky SF-2U870 разработан специально для портирования, оптимизации и валидации ПО. Платформа включает 32 ядра P870-D (тактовая частота 2,0 ГГЦ), 256 Гбайт DDR5-5600, четыре слота PCIe 5.0 x16 и слот PCIe 3.0 x4. Также используется два SSD U.2 NVMe SSD по 7,68 Тбайт и сетевая карта OCP 3.0 NIC 10/25GbE. Аналогичную интеграцию с своей платформы с архитектурой RISC-V продвигает и NVIDIA. Ранее компания уже официально объявила о поддержке CUDA соответствующих решений, что позволяет использовать CPU на RISC-V для управления ИИ-ускорителями. Также компания поддержала включение SiFive в свою партнёрскую программу NVLink Fusion.
12.09.2026 [20:53], Сергей Карасёв
ASUS выпустила СХД высокой плотности OJ340A-RS60 на базе AMD EPYC GenoaКомпания ASUS анонсировала программно-определяемую платформу хранения высокой плотности OJ340A-RS60, оптимизированную для рабочих нагрузок в сферах HPC и ИИ, включая обучение больших языковых моделей (LLM), инференс, сложную аналитику и масштабируемые озера данных. Новинка выполнена в форм-факторе 4U на аппаратной платформе AMD EPYC Genoa: может быть установлен один процессор в исполнении Socket SP5 (LGA 6096P) с показателем TDP до 360 Вт. Доступны 12 слотов для модулей DDR5-4800 RDIMM / 3DS RDIMM суммарным объёмом до 3 Тбайт. Базовая комплектация включает чип EPYC 9654P с 96 ядрами (192 потока) с тактовой частотой 2,4–3,7 ГГц и 384 Гбайт ОЗУ. Есть по два слота PCIe 5.0 x16 для карт FHHL и PCIe 5.0 x8 для плат HHHL: это даёт возможность устанавливать сетевые адаптеры 100GbE/200GbE и аппаратные RAID-контроллеры. 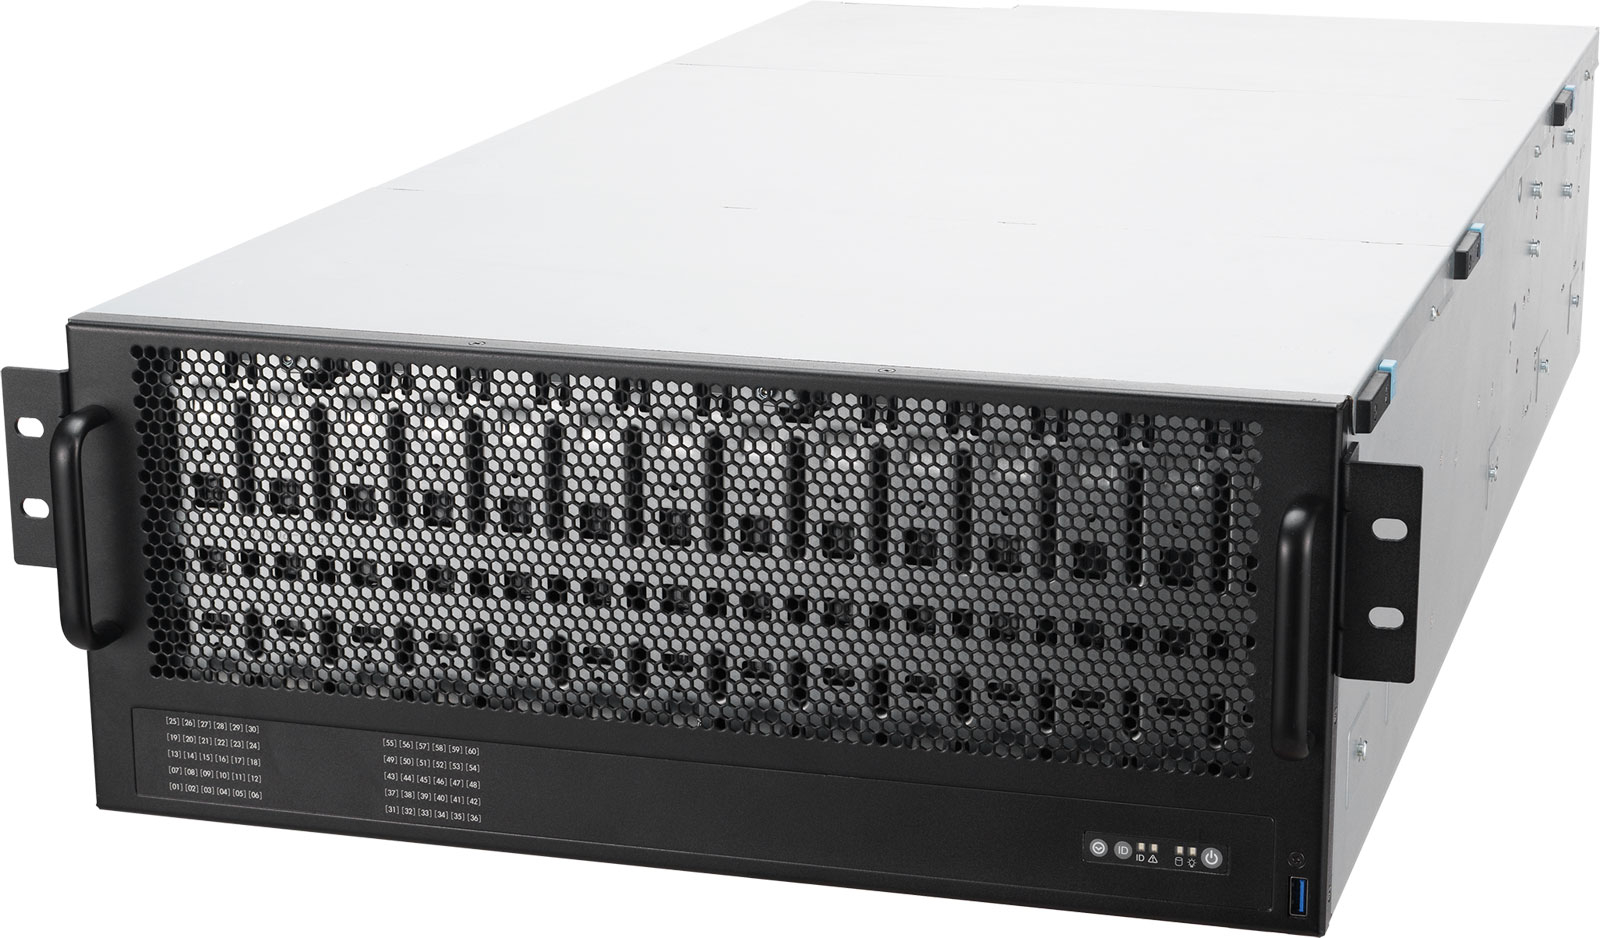
Источник изображений: ASUS СХД получила 60 посадочных мест для накопителей типоразмера LFF/SFF с интерфейсом SATA/SAS. Кроме того, в тыльной части корпуса предусмотрены восемь отсеков для SFF-изделий в конфигурации 6 × NVMe + 2 × SATA. Во всех случаях допускается горячая замена. Помимо этого, имеется коннектор для SSD формата M.2 2280 с интерфейсом PCIe 5.0 x4 (поддерживается работа в SATA-режиме). 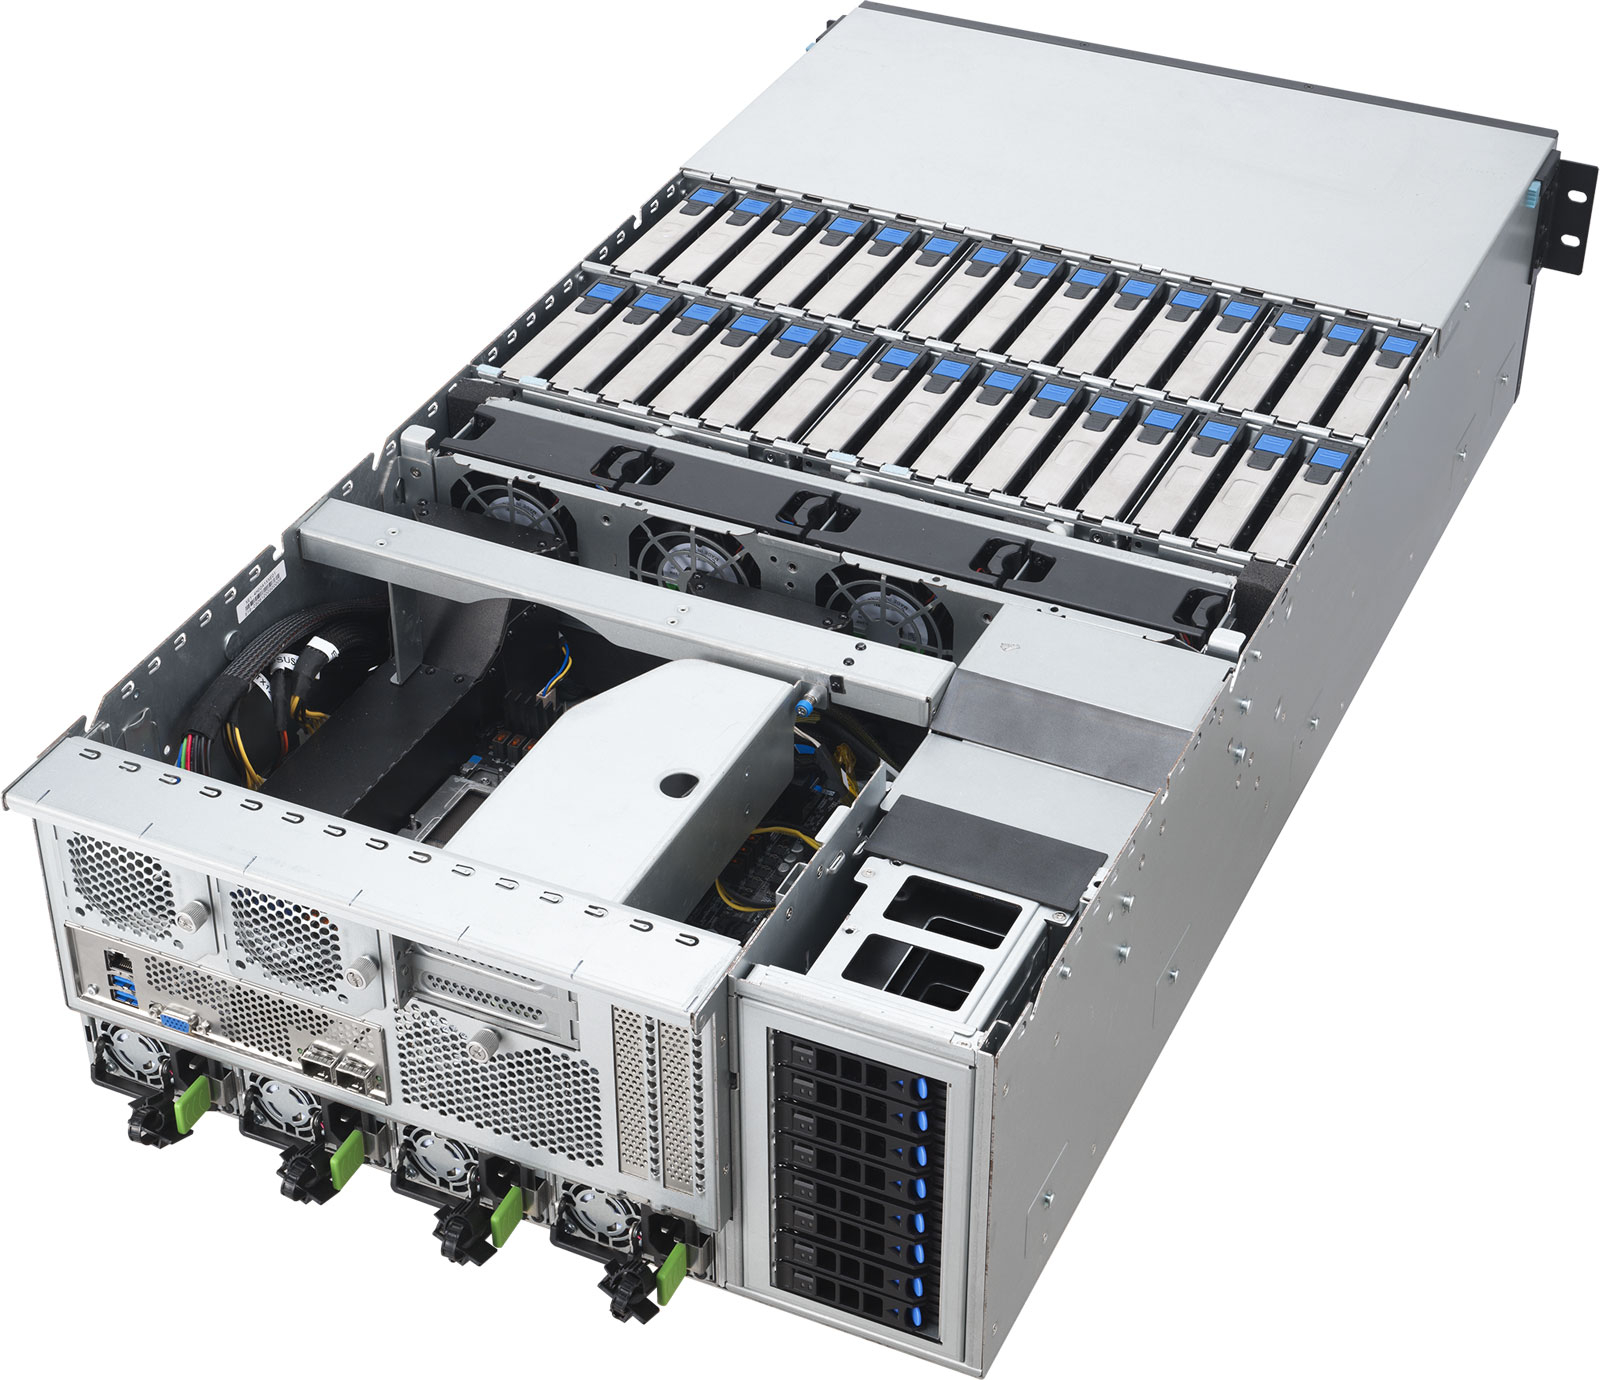 В оснащение входят два сетевых порта 25GbE SFP28 (опционально — четыре), контроллер Aspeed AST2600, выделенный сетевой порт управления RJ45, интерфейс D-Sub, а также порты USB 3.2 Type-A. Установлены четыре системных вентилятора. Питание обеспечивают четыре блока мощностью 800 Вт с резервированием и сертификатом 80 PLUS Platinum. Габариты сервера составляют 878,5 × 434 × 176 мм, масса — 33,3 кг.
10.09.2026 [17:40], Сергей Карасёв
Synology выпустила СХД RS11626xs+ формата 3U на базе AMD EPYC MilanКомпания Synology анонсировала систему хранения корпоративного класса RS11626xs+ на аппаратной платформе AMD. Новинка, выполненная в форм-факторе 3U, может использоваться для построения гибридных хранилищ, объединяющих HDD и SSD. В основу устройства положен чип EPYC 7303 (16C/32T, 2,4/3,4 ГГц). Объём оперативной памяти DDR4 ECC в стандартной конфигурации составляет 64 Гбайт, в максимальной — 1 Тбайт (16 модулей RDIMM по 64 Гбайт). СХД оборудована 16 фронтальными отсеками для LFF-накопителей и четырьмя отсеками для SFF-изделий (во всех случаях применяется интерфейс SATA-3). Дополнительно установлены два системных SSD формата M.2 (NVMe). Возможно подключение до восьми полок расширения RX1222sas с 12 отсеками LFF. Таким образом, в общей сложности в рамках одной системы могут быть объединены до 116 накопителей, что обеспечит суммарную вместимость на уровне 2,6 Пбайт (при использовании HDD ёмкостью 24 Тбайт). Поддерживается горячая замена дисков. 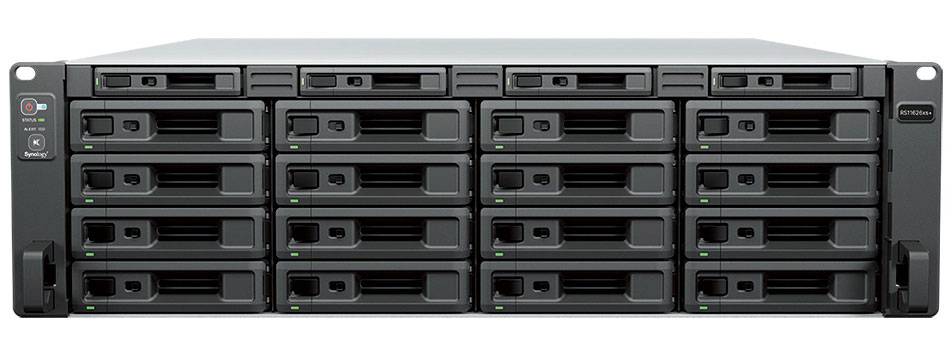
Источник изображений: Synology Устройство располагает двумя сетевыми портами 10GbE RJ45 с возможностью агрегации и выделенным сетевым портом управления RJ45. Реализованы два слота PCIe 4.0 x16, в которые могут быть установлены адаптеры 10GbE/25GbE SFP+/SFP28 или Fibre Channel. За питание отвечают два блока мощностью 800 Вт с резервированием. Габариты составляют 132,3 × 482 × 724 мм, масса — около 20 кг (без накопителей). 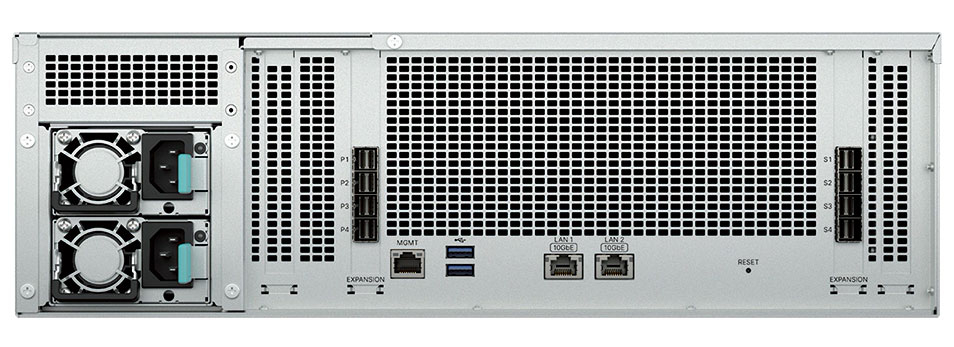 Применена фирменная программная платформа DiskStation Manager (DSM). Говорится о поддержке протоколов SMB, AFP, NFS, FTP, WebDAV и Rsync, а также различных средств виртуализации, включая VMware vSphere, VMware vSphere и Citrix XenServer. Продажи новинки уже начались.
10.09.2026 [09:04], Сергей Карасёв
QNAP представила гибридные NAS серии TVS-hx77AX на платформе AMD Ryzen 7000QNAP Systems анонсировала гибридные сетевые хранилища серии TVS-hx77AX с поддержкой NFS over RDMA. Устройства ориентированы на ресурсоёмкие задачи, такие как обучение ИИ-моделей, виртуализация и совместная работа с видеоматериалами в формате 4K. В семейство вошли модели TVS-h1677AX, TVS-h1277AX и TVS-h877AX в «настольном» форм-факторе. Все они комплектуются процессором AMD Ryzen 5 7000 с шестью ядрами (12 потоков), работающими на тактовой частоте до 5,1 ГГц, и интегрированным ускорителем AMD Radeon Graphics. Объём оперативной памяти DDR5 в стандартной комплектации составляет 16 Гбайт, в максимальной — 192 Гбайт (4 × 48 Гбайт). Хранилища получили по два сетевых порта 2.5GbE и 10GbE, по два разъёма USB 2.0 и USB 3.1 Type-C, а также интерфейс HDMI 1.4b (до 4096 × 2160 пикселей; 30 Гц). Кроме того, реализованы два слота PCIe 4.0 x4 и один слот PCIe 4.0 x4/х8: в них могут быть установлены дискретные GPU-ускорители или дополнительные сетевые адаптеры, в частности, 25GbE. 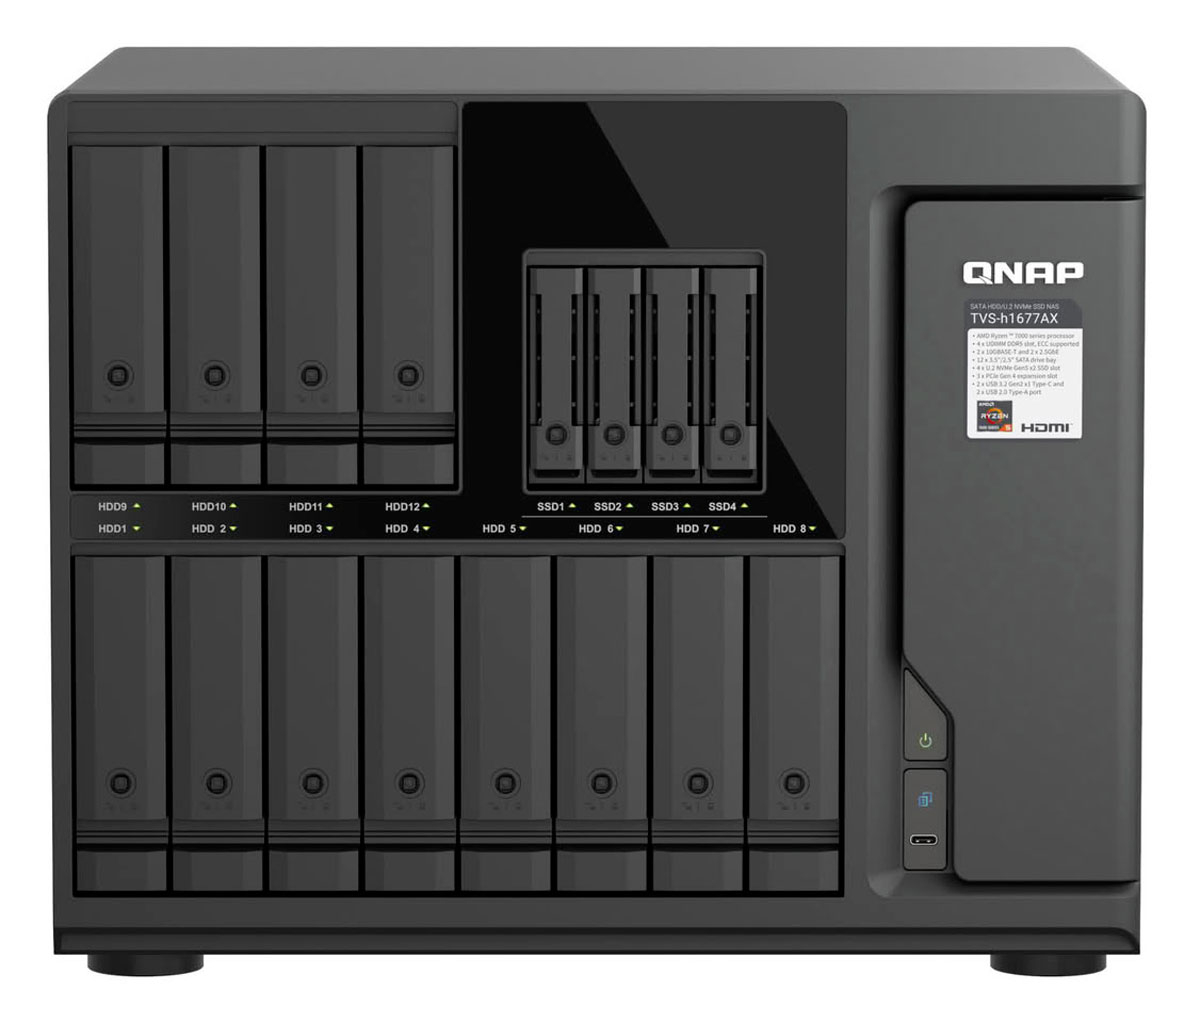
Источник изображений: QNAP Вариант TVS-h1677AX располагает 16 отсеками для накопителей в конфигурации 12 × LFF (SATA) и 4 × SFF (U.2 NVMe / PCIe 4.0 x2). У версии TVS-h1277AX количество посадочных мест под LFF-диски уменьшено до восьми. Модификация TVS-h877AX поддерживает шесть накопителей LFF и два SFF. Во всех случаях допускается горячая замена. 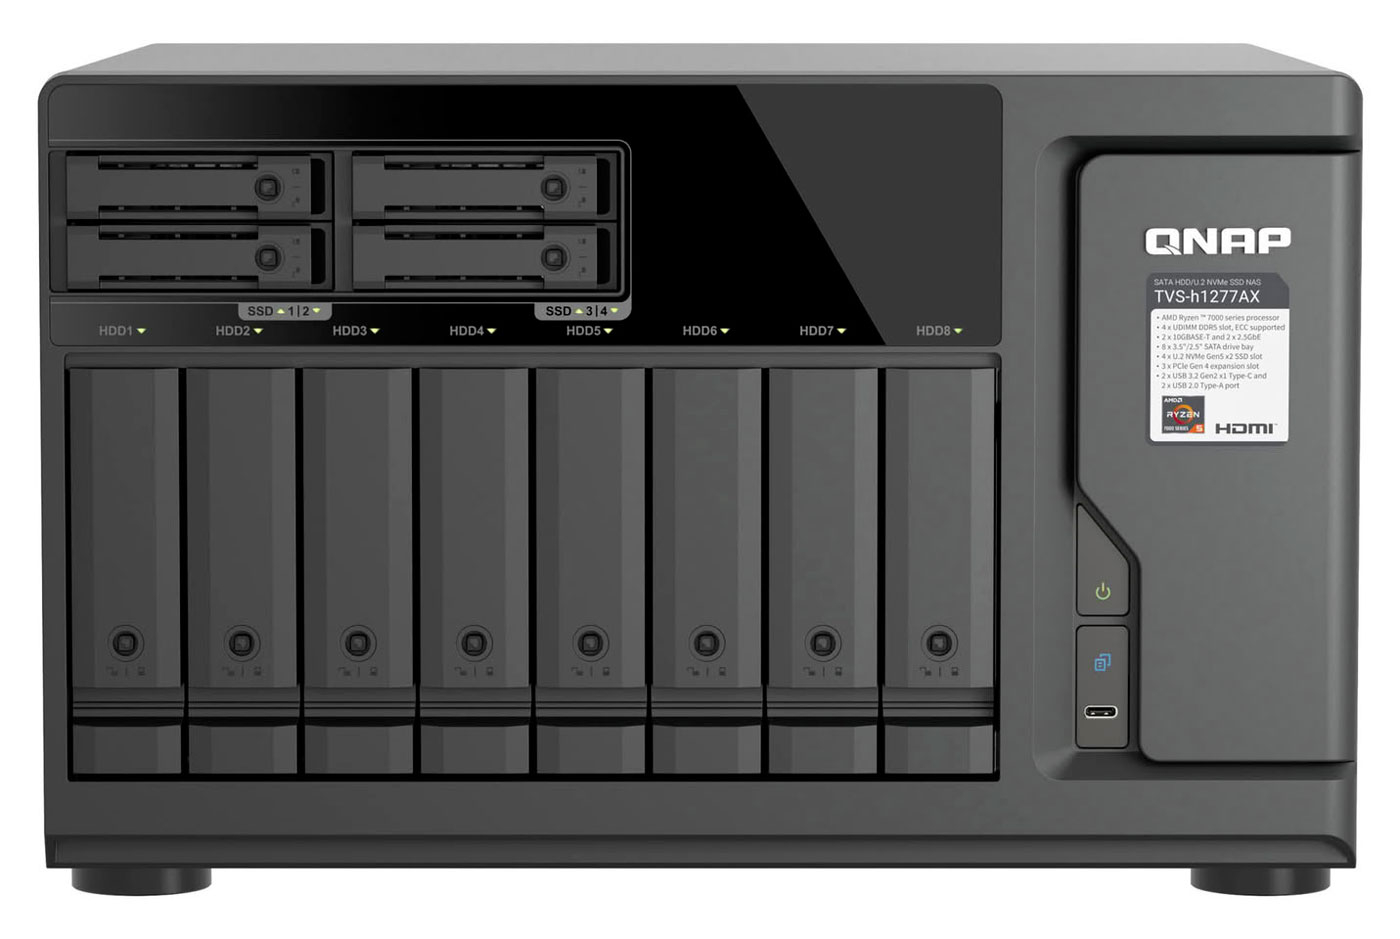 Все новинки оборудованы блоком питания мощностью 500 Вт. Диапазон рабочих температур простирается от 0 до +40 °C. В качестве программной платформы применяется QuTS hero h5.2.9. На решения предоставляется пятилетняя гарантия. 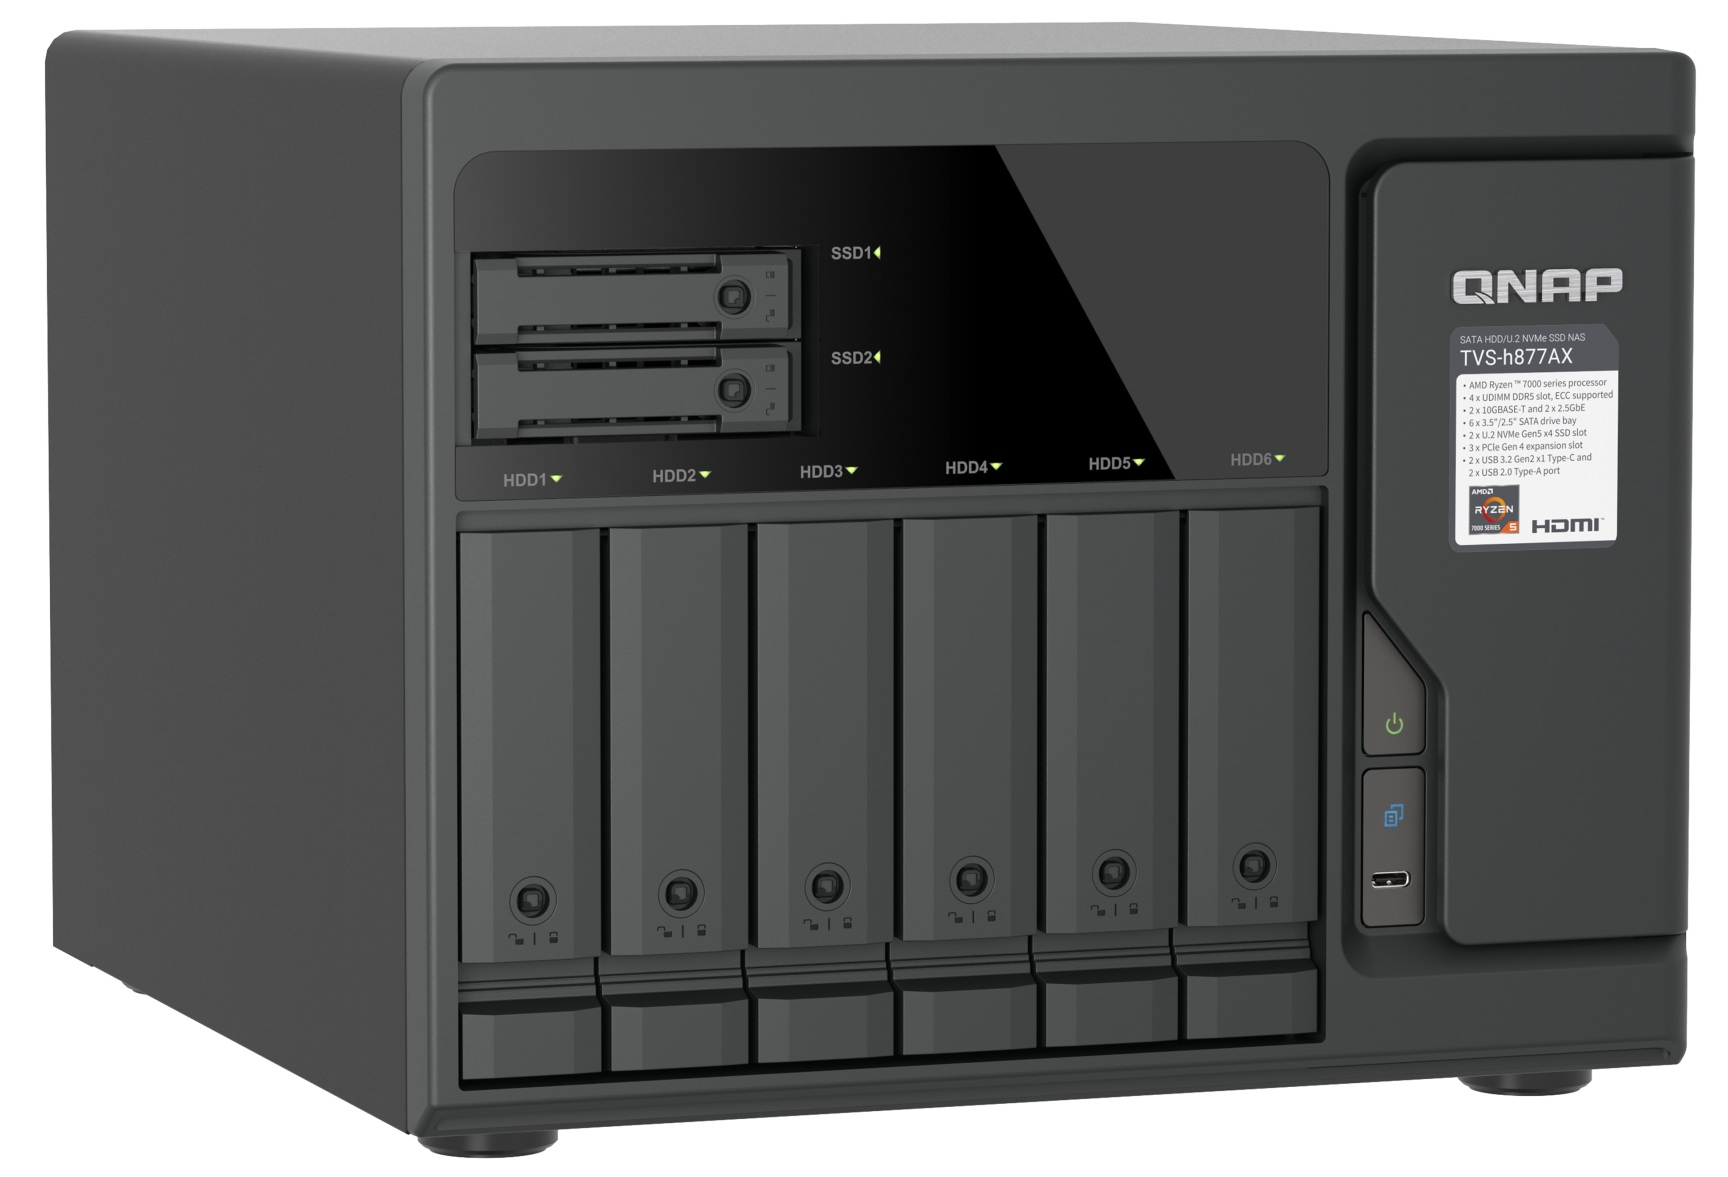
09.09.2026 [10:15], Владимир Мироненко
FP64 — это не Святой Грааль: Мацуока встал на защиту ОзакиВ своей опубликованной не так давно статье Сатоши Мацуока (Satoshi Matsuoka), директор Центра вычислительной науки RIKEN в Кобе (Япония), подверг сомнению устоявшиеся представления о необходимости FP64-вычислений для HPC-задач и встал на защиту схемы Озаки II. Мацуока, по сути, утверждает, что аппаратная поддержка FP64 — не лучший способ выполнения определённых HPC-нагрузок, требующих 64-бит точности, на новых моделях ускорителей NVIDIA. В подтверждение он демонстрирует возможность использования FP8-расчётов с использованием схемы Озаки II для ускорения вычислений при сохранении той же 64-бит точности. Используя терминологию автомобильных гонок, Мацуока говорит: прекратите использовать автомобили «Формулы-1» (FP64) для максимально быстрого перемещения по трассе HPC и замените их множеством «электровелосипедов» (FP8). Как отметил ресурс HPCwire, формат FP64 десятилетиями отвечал за производительность вычислений с плавающей запятой для приложений HPC. Исторически сложилось так, что производители CPU и GPU неизменно демонстрировали рост производительности в FP64-расчётах на протяжении поколений. Но на рынке, движимом ИИ нового поколения, предпочтение отдаётся увеличению FP8-производительности. В то время как HPC требуют FP64, для обучения и инференса в ИИ нового поколения достаточно низкой точности расчётов. Ориентируясь на более крупный рынок, NVIDIA снизила производительность FP64 в ускорителях нового поколения (у AMD таких планов нет) и создала разрыв, который, по мнению Мацуоки, может быть заполнен «электровелосипедами» FP8. В связи с этим сообщество HPC задаётся вопросом: «Где мы будем получать производительность в формате FP64? Похоже, мы стали второсортными участниками рынка NVIDIA». 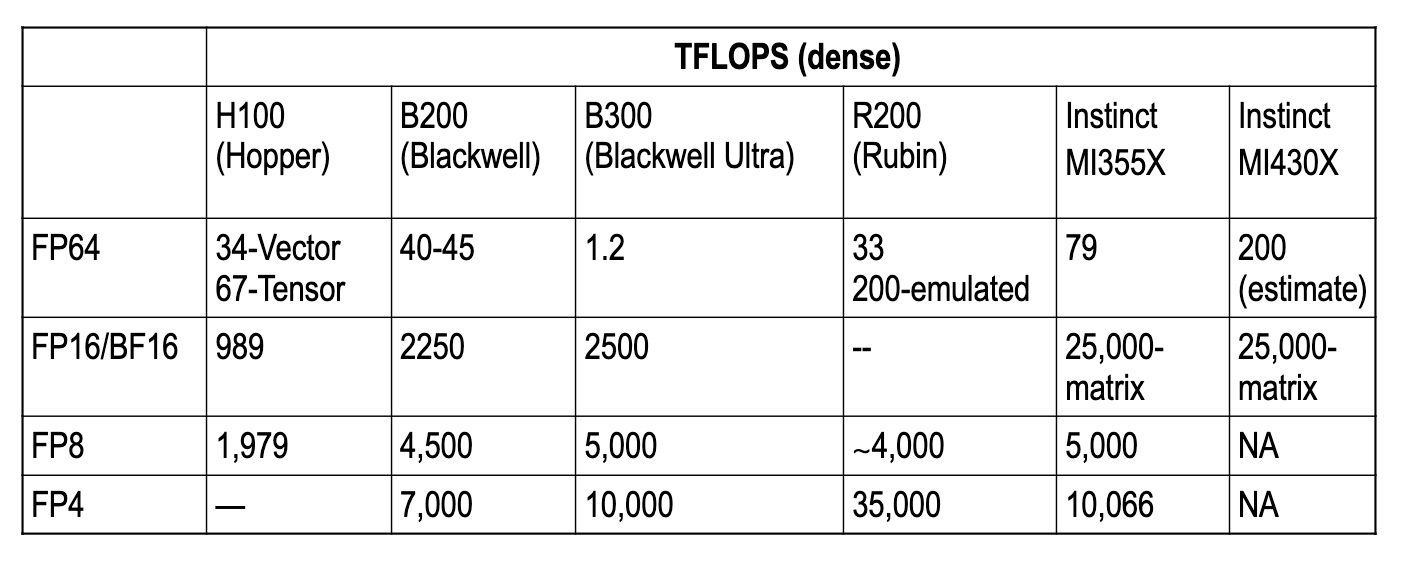
Источник изображений: HPCwire Следует отметить, что по сравнению с традиционной схемой Озаки I, Озаки II обеспечивает более высокую вычислительную эффективность и лучшую масштабируемость для крупномасштабных высокоточных численных вычислений. В начале 2026 года Кацухиса Озаки (Katsuhisa Ozaki) и два других японских исследователя отметили, что исходный алгоритм Озаки II не может быть напрямую адаптирован к матричным MAC-блокам (умножение и сложение) FP8. В связи с этим они ввели квантование, которое имитирует модульную арифметику в FP8. Благодаря этому Ozaki II поддерживается Blackwell Ultra и Rubin, которые ограничили развитие INT8-производительности в пользу FP8/FP4. В качестве аргумента Мацуоки привёл графики работы HCP-приложений на конкретных чипах. В целом, на все приложения, работающие на GPU, действует одно из двух ограничений. Первое — это пропускная способность памяти (диагональная линия в левой части графика). Второе ограничение — это пиковая скорость, с которой может работать чип (горизонтальная линия в верхней части изображения). 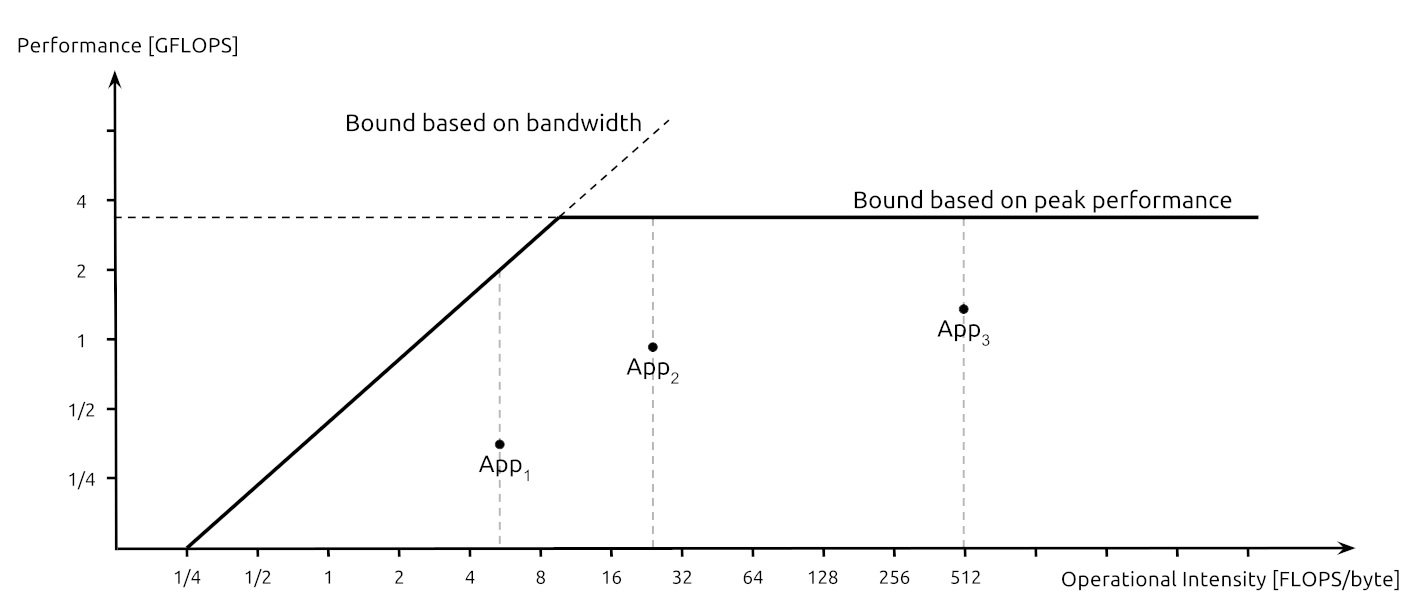 В точке пересечения линий пропускной способности памяти и пиковой производительности GPU получает данные с той скоростью, с которой он может их обрабатывать, что представляет собой хороший баланс между характеристиками подсистемы памяти процессора. При этом, большинство HPC-приложений ограничены пропускной способностью памяти, т.е. диагональной линией на графике. Снижение FP64-производительности резко меняет эти «пределы» для новых GPU NVIDIA. Мацуока указал на два важных следствия этих изменений. Во-первых, ранее ограничиваемые памятью ядра (kernel) теперь упираются в вычислительные ресурсы. У B300 соотношение производительности к пропускной способности памяти находится на уровне 0,16 флопс/байт (1,3 Тфлопс/8 Тбайт/с). Во-вторых, тензорные блоки низкой точности (FP4 и FP8) при работе с типичным HPC-ядром, поддерживающим только FP64, простаивают и никак не влияют на время, затрачиваемое ядром на решение. Эта ситуация является наглядным проявлением различия между ИИ-нагрузками и HPC. Мацуока также отметил, что несмотря на быстрое развитие алгоритмов Ozaki-I и Ozaki-II для операций GEMM (General Matrix-Matrix Multiply), все опубликованные исследования производительности сосредоточены на режиме, ограниченном вычислительными ресурсами, когда метод Ozaki наиболее очевидно в выигрыше благодаря огромному количеству тензорных блоков. Исследователь указал, что ни в одном опубликованном анализе никто не задавался вопросом: когда Ozaki-II становится выгодным для ядер, ограниченных объёмом памяти? Общепринятое мнение заключается в том, что методы EFT, в т.ч. Ozaki-I и II, не могут помочь ядрам с ограниченной пропускной способностью. Поэтому Мацуока категорически называет нативную FP64-обработку единственным способом достижения производительности уровня HPC при использовании NVIDIA B300 и более поздних версий лишь догмой. Для обоснования своего утверждения Мацуока анализирует производительность с использованием четырех стандартных примитивов HPC:
В таблице ниже приведены данные об ускорении вычислений на GPU нескольких поколения при использовании Ozaki-II в FP8-режиме относительно производительности тех же GPU в нативном режиме FP64. За базовый уровень взята производительность H100, последнего ускорителя NVIDIA, архитектура которого сбалансированна и подходит для HPC, а не исключительно для ИИ-инференса. 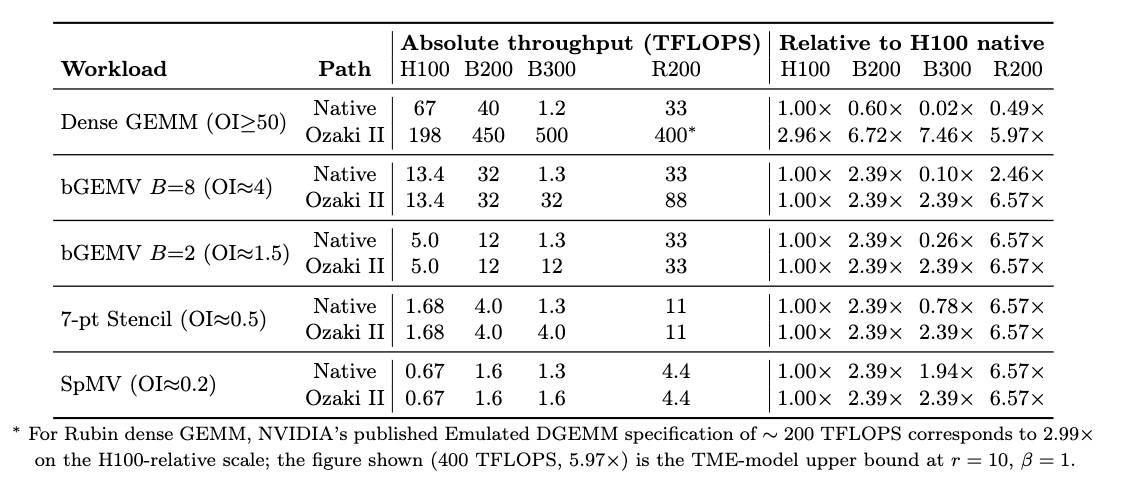 Мацуока утверждает, что согласно приведённым данным, схема Ozaki-II не ухудшает производительность по сравнению с базовым уровнем H100; напротив, она восстанавливает или улучшает масштабируемость для каждой рабочей нагрузки. «Ozaki-II — это не просто механизм компенсации регрессии NVIDIA в FP64; это механизм, который преобразует экономию площади кремния в <…> более быстрый FP64 с точки зрения приложения», — заявил исследователь. AMD же повышает FP64-производительность, «поскольку метод Озаки не оправдывает ожиданий». Ранее компания указала на несколько проблем с EFT-методами. Во-первых, такое ПО не соответствует стандарту IEEE и не дает тех же результатов, что запуск кода на реальном FP-64оборудовании. Во-вторых, схема Озаки нацелена на квадратные матрицы. Если таковые в расчётах не используется, то производительность оказывается ниже, чем у нативного FP64-исполнения. В-третьих, традиционные HPC-задачи основаны на векторных расчётах, для которых методы Озаки малоэффективны — менее 10 % таких приложений охвачены матричными расчётами, позволяющими использовать EFT-методы. Но и для тех, что поддерживают такие методы, всё равно придётся переписывать код. Вместе с тем AMD не собирается отказываться от поддержки эмуляции Озаки на своих чипах в качестве резервного варианта. В правительстве США выразили поддержку обеим концепциям. «В ходе обсуждений с Лизой Су (Lisa Su) и Дженсеном Хуангом (Jensen Huang) я убедился в их твёрдой приверженности формату FP64 и его дальнейшему развитию, — сказал ранее в интервью СМИ заместитель министра энергетики США (DoE) по науке и инновациям. «Это взаимодополняющие технологии», которые будут работать вместе, чтобы поддержать цель миссии Genesis — расширение границ в науке и технике с использованием ИИ. Следует уточнить, что он никогда прямо не заявлял о методах Озаки как о «запасном варианте» по сравнению с традиционными методами FP64 и и не объявлял об использовании эмуляции Озаки в целом.
05.09.2026 [16:36], Сергей Карасёв
AMD анонсировала рабочую станцию Threadripper Halo Station с Instinct MI350P для ИИ-задачAMD анонсировала мощную рабочую станцию Threadripper Halo Station, предназначенную для локального использования ИИ-моделей, насчитывающих более чем 1 трлн параметров. В продажу новинка поступит в следующем году. Как отмечает старший вице-президент и генеральный директор AMD по вычислительным и графическим решениям, на сегодняшний день Threadripper Halo Station — это самая мощная рабочая станция в мире. Она может использоваться, например, для локального запуска сотен ИИ-агентов. В основу положен процессор Ryzen Threadripper PRO 9995WX (Shimada Peak): 96C/192T, 2,5/5,4 ГГц, L3-кеш 384 Мбайт. Может использоваться до 2 Тбайт DDR5. Стандартная конфигурация включает два ускорителя Instinct MI350P, каждый из которых несёт на борту 144 Гбайт HBM3E с 4096-бит шиной и пропускной способностью до 4 Тбайт/с. 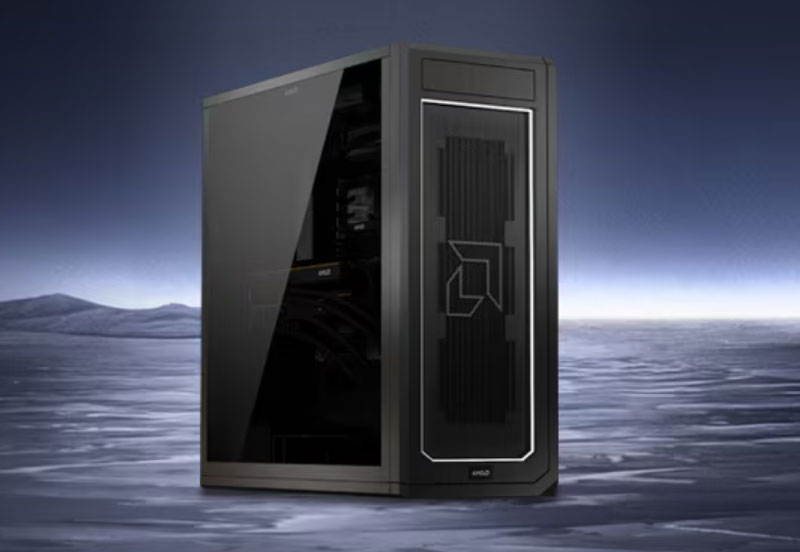
Источник изображений: AMD В максимальной комплектации могут быть задействованы четыре таких карты, что в сумме даст 576 Гбайт HBM3E. Применяется СЖО, которая охватывает независимо каждый из экземпляров Instinct, а также CPU. Отмечается, что агрегированная пропускная способность памяти GPU достигает 16 Тбайт/с, системной памяти — 410 Гбайт/с. Прочие технические характеристики на текущий момент не раскрываются. 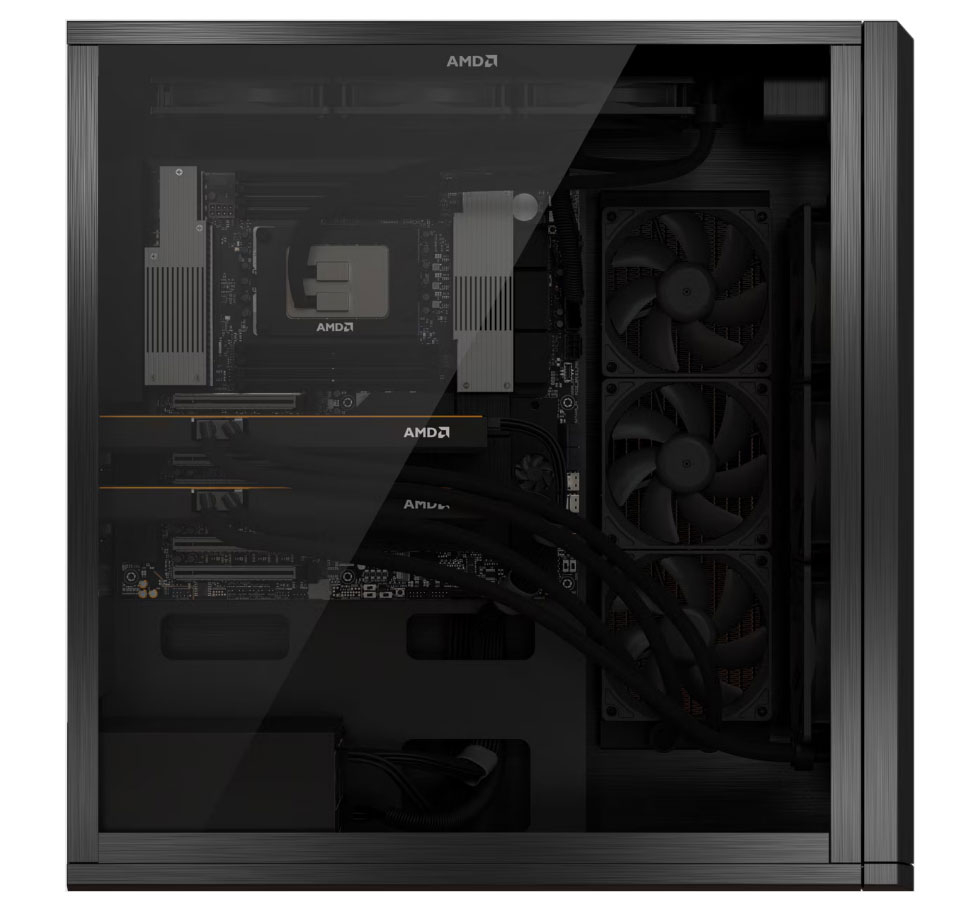 Каждый из установленных ИИ-ускорителей потребляет до 600 Вт, тогда как показатель TDP процессора Ryzen Threadripper Pro 9995WX составляет 350 Вт. Таким образом, с учётом энергопотребления памяти, установленных накопителей, СЖО и прочих компонентов рабочая станция при максимальной нагрузке может требовать более 3 кВт.
05.09.2026 [16:28], Сергей Карасёв
ASUS анонсировала ИИ-серверы на чипах Intel Xeon 6 и AMD EPYC 9006Компания ASUS анонсировала серверы RS700-E12-RS4U и RS720-E12-RS12U на аппаратной платформе Intel, а также RS720A-E14B-R32U, RS500A-E14B-R12U и ESC8000A-E13P на процессорах AMD для приложений ИИ, HPC и нагрузок, связанных с интенсивным использованием данных. Двухсокетные модели RS700-E12-RS4U и RS720-E12-RS12U рассчитаны на чипы Xeon 6 (Granite Rapids-SP/Sierra Forest-SP). Доступны 32 слота для модулей DDR5-6400 суммарным объёмом до 8 Тбайт. Устройство RS700-E12-RS4U выполнено в формате 1U. Есть два слота PCIe 5.0 x16 для карт расширения FHHL, два разъёма OCP 3.0 PCIe 5.0 x16 (SFF), два коннектора для SSD типоразмера M.2 2280/2260 (PCIe 5.0 х2), четыре отсека для SFF-накопителей NVMe/SATA/SAS. В свою очередь, версия RS720-E12-RS12U формата 2U предлагает до десяти слотов расширения: 6 × PCIe 5.0 x8 или 3 × PCIe 5.0 x16 (FHFL), 2 × PCIe 5.0 x16 (FHHL) и 2 × OCP3.0 PCIe 5.0 x16 (SFF). Доступны 12 посадочных мест для SFF-накопителей NVMe/SATA/SAS и два коннектора M.2 2280/2260 (PCIe 5.0 х2). Обе системы располагают контроллером Aspeed AST2600, портами RJ45, Mini-DP и USB 3.0. Серверы RS720A-E14B-R32U и RS500A-E14B-R12U комплектуются чипами EPYC Venice (9006). Первая из этих машин выполнена в формате 2U: она рассчитана на два процессора и 32 модуля DDR5 суммарным объёмом до 4 Тбайт. Могут быть установлены 32 накопителя EDSFF E3.S и два SSD стандарта М.2 22110/2280/2260 с интерфейсом PCIe 4.0 x4. Слоты расширения выполнены по следующей схеме: 2 × PCIe 6.0 x8 или 1 × PCIe 6.0 x16 (FHFL), 1 × PCIe 6.0 x16 (FHHL) и 2 × OCP 3.0 PCIe 6.0 x16 (SFF). 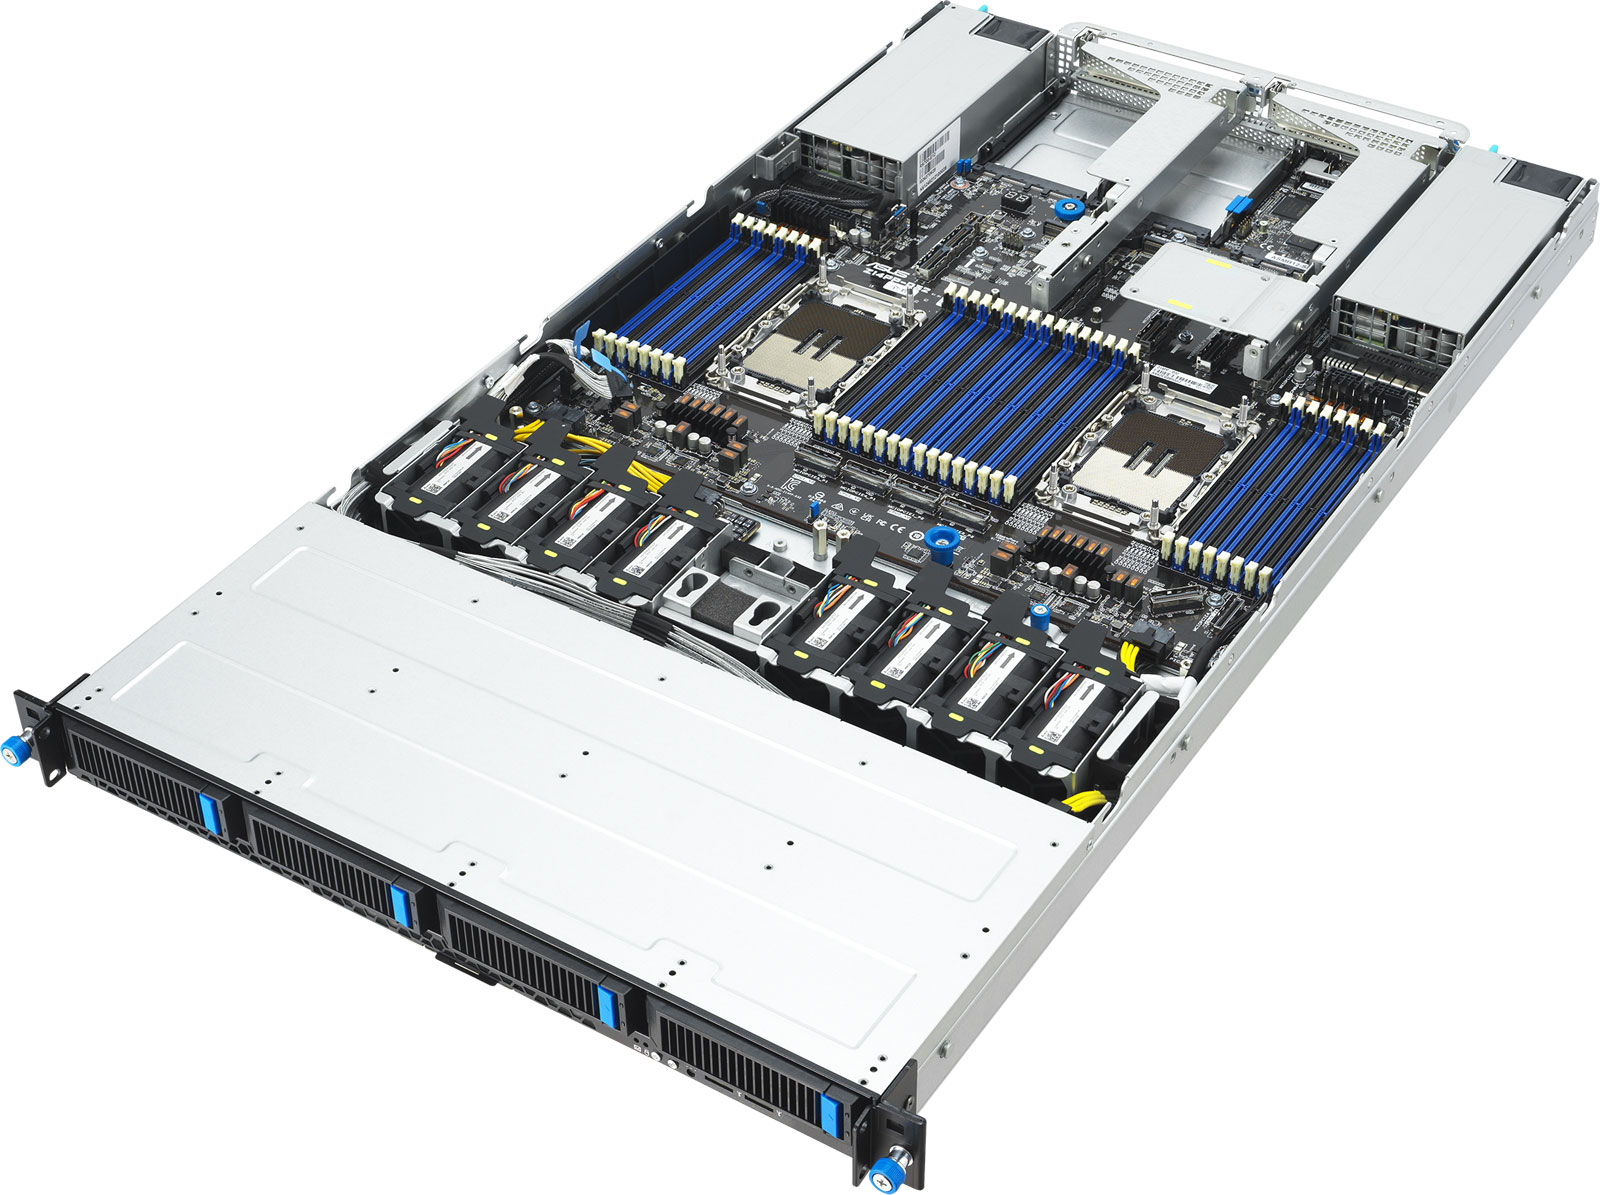
Источник изображений: ASUS Вариант RS500A-E14B-R12U формата 1U имеет односокетную конструкцию с поддержкой 16 модулей DDR5 (до 2 Тбайт). Реализованы по два слота PCIe 6.0 x16 (FHHL) и OCP 3.0 PCIe 6.0 х16, 12 фронтальных отсеков для SFF-накопителей NVMe/SATA/SAS и два коннектора M.2. Системы оборудованы контроллером Aspeed AST2700. 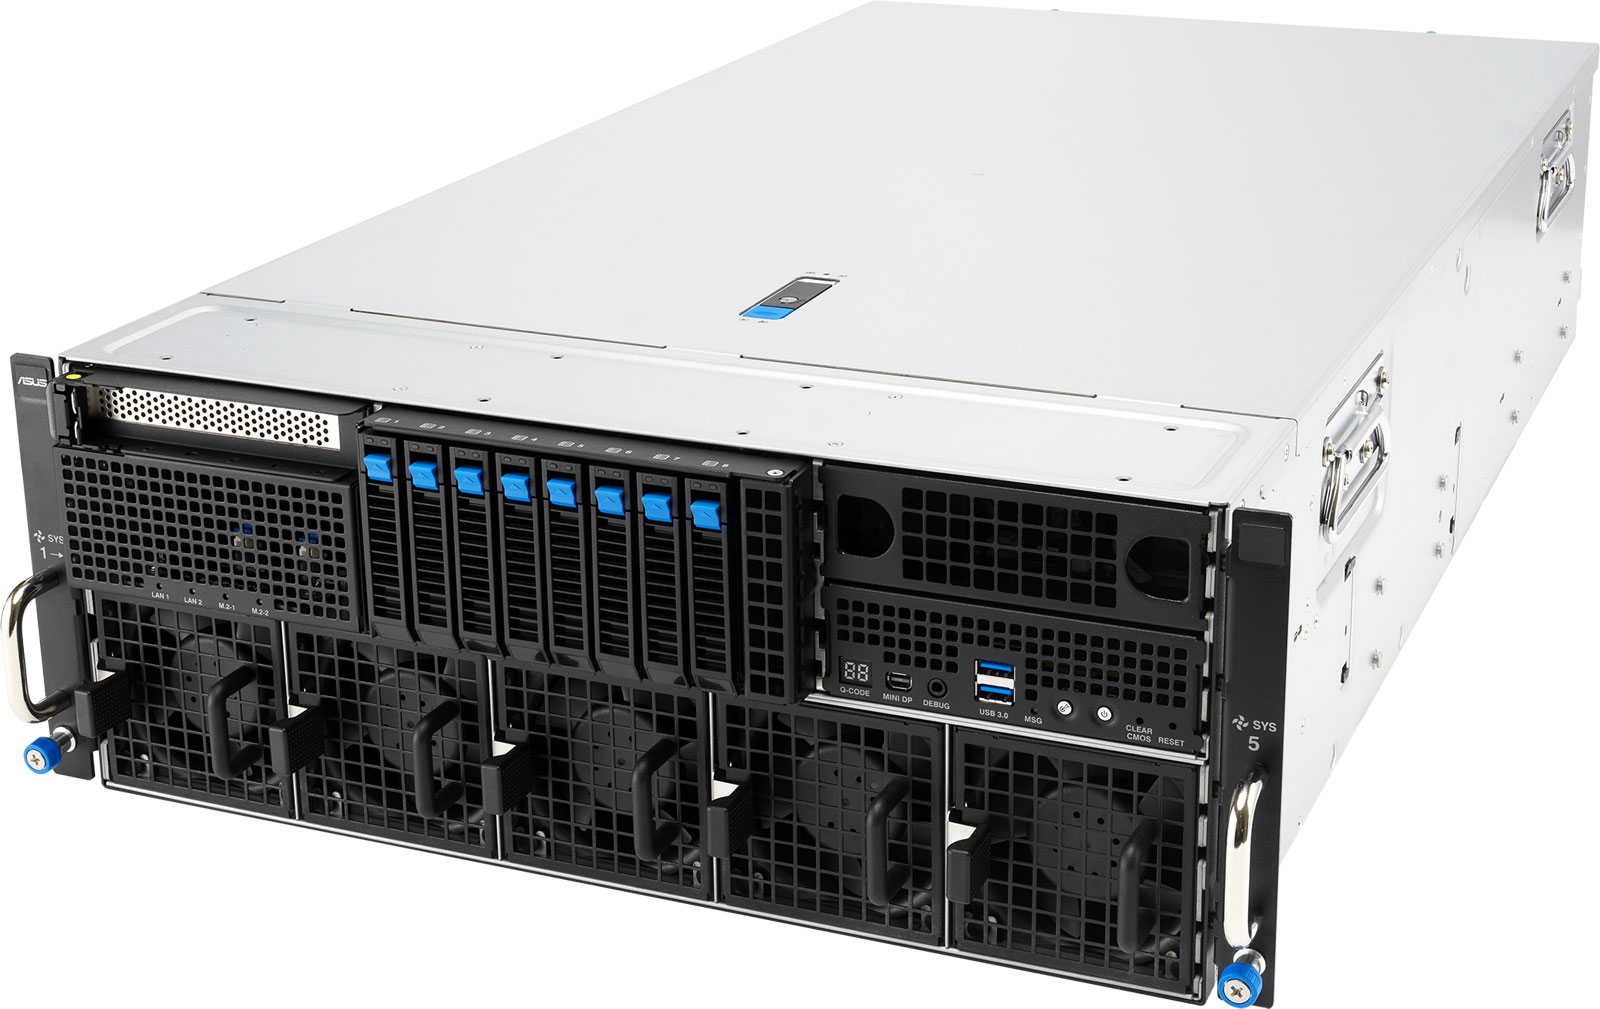 Наконец, сервер ESC8000A-E13P типоразмера 4U поддерживает установку двух процессоров EPYC Turin (9005). Доступны 24 слота для модулей DDR5-6400/5600 суммарным объёмом до 3 Тбайт. Могут быть смонтированы до восьми двухслотовых ускорителей NVIDIA H200, NVIDIA RTX PRO 6000 Blackwell Server Edition, NVIDIA RTX PRO 4500 Blackwell Server Edition или AMD Instinct MI350P. Кроме того, предусмотрены пять слотов PCIe 5.0 x16 для карт NIC/BlueField-3, восемь фронтальных отсеков для SFF-накопителей и два коннектора M.2 (NVMe). Реализованы два сетевых порта 10GbE (X710-AT2). |
|

