
Материалы по тегу: gb300
|
03.11.2026 [14:23], Руслан Авдеев
Spam и Gun Range: Colossus 2 от SpaceXAI обзаведётся двумя новыми ЦОД к концу годаГлава SpaceXAI/SpaceXSI Илон Маск (Elon Musk) объявил о расширении проекта Colossus 2 с добавлением двух площадок в Саутхейвене (Southaven, шт. Миссисипи), называющихся Gun Range и Spam, сообщает Datacenter Dynamics. Изначально основные мощности проекта располагались в Мемфисе (Memphis, Теннесси), но позже инфраструктуру расширили в соседний штат Миссисипи. На территории Gun Range ранее располагался центр обучения полиции и пожарных, на площадке Spam находился склад, где хранилась мясная продукция под известным брендом Spam. Если новые мощности Gun Range будут предназначены для обучения ИИ, то площадку Spam задействуют для инференса. Всего на площадках разместят около 420 тыс. ускорителей в составе платформы NVIDIA GB300. На территории Gun Range площадью около 22,6 га будут построены два одноэтажных здания, на площадке Spam площадью 21,4 га в ЦОД переоборудуют одноэтажный склад. По словам Маска, ожидается, что Gun Range заработает к концу ноября, а Spam — в декабре. Новые площадки дополнят инфраструктурный кластер, в который уже входят площадки Colossus 2 — Macrohard, Macrohardrr и Minihard, в которых планируется разместить 330 тыс., 220 тыс. и 220 тыс. ИИ-ускорителей соответственно. Всего, по прогнозам Маска, к концу года Colossus 2 разместит около 1,2 млн ускорителей Blackwell. В последние месяцы SpaceXAI начала активно сдавать в аренду мощности своих ЦОД сторонним клиентам, в числе прочего заключив крупные соглашения с Reflection, Anthropic и Google. 
Источник изображения: Frames For Your Heart/unsplash.com Впервые компания начала строительство в Мемфисе в 2024 году, а в марте 2025 года приобрела площадку для Colossus 2, сам ЦОД заработал в январе 2026-го. Хотя Маск говорил о запуске мощностей на 1 ГВт, анализ спутниковых снимков свидетельствовал, что охлаждающего оборудования хватило бы только на 350 МВт. Третий ЦОД анонсировали в январе 2026 года, он расположен в Саутхейвене. Новости о нём появились в марте, когда компания подала заявку для получения разрешения на строительство ещё одного здания на участке рядом, стоимость проекта составила $659 млн. В июле 2026 года компания подтвердила строительство Minihard, строительство началось на участке неподалёку от границы Теннесси и Миссисипи. В октябре SpaceXAI сообщила о получении её дочерней структурой MZX Tech LLC уведомления от Департамента качества окружающей среды Миссисипи (Mississippi Department of Environmental Quality, MDEQ). В документе утверждалось, что земляные и строительные работы были начаты до того, как на них распространилось действие генерального разрешения штата Миссисипи на сброс ливневых вод со строительных объектов крупного масштаба. MDEQ добивалось наложения на компанию штрафов в размере до $25 тыс. за каждый день нарушения, в общей сложности около $6,1 млн по трём площадкам. SpaceXAI говорила об активном сотрудничестве с MDEQ. Практически в то же время суд отклонил попытку Министерства юстиции заблокировать иск к компании со стороны НКО NAACP, в котором компания утверждала, что бизнес нарушил федеральный закон и нормы штата, построив и эксплуатируя газовую электростанцию в Саутхейвене без предварительного получения разрешений. SpaceXAI использует газовые турбины для электроснабжения как Colossus 1, так и Colossus 2. В своё время компания воспользовалась лазейкой в законе о чистом воздухе — Clean Air Act для того, чтобы эксплуатировать в течение года до 35 турбин без получения разрешения. В 2025 году регуляторы выдали разрешение на работу 15 турбин до 2027 года. По данным NAACP, xAI незаконно установила и использует 57 турбин в Саутхейвене. В первоначальном иске НКО заявляла, что газовая электростанция Colossus (Colossus Gas Plant) выбрасывает в окружающую среду значительные объёмы загрязняющих веществ, включая оксиды азота и формальдегид, влияющих на здоровье людей. На днях сообщалось, что компания не смогла добиться отклонения судом иска со стороны NAACP.
24.10.2026 [13:53], Сергей Карасёв
В Швеции появился суперкомпьютер Sferical One на базе NVIDIA DGX GB300Консорциум Sferical AI объявил о запуске в Швеции суперкомпьютера Sferical One, предназначенного для проведения совместных исследований и реализации проектов в области ИИ. В основу вычислительного комплекса положена аппаратная платформа NVIDIA. В Sferical AI входят AstraZeneca, Ericsson, Saab, SEB и Wallenberg Investments. Стратегическим партнёром выступает SKF. Основная цель проекта заключается в том, чтобы обеспечить шведскую отрасль независимой и безопасной инфраструктурой для разработки и внедрения ИИ-решений. Суперкомпьютер Sferical One состоит из двух кластеров NVIDIA DGX SuperPOD, которые включают 16 серверных стоек NVIDIA DGX GB300 NVL72. Каждая из них насчитывает 36 чипов Grace и 72 процессора Blackwell Ultra. Таким образом, в общей сложности задействованы 1152 ускорителя NVIDIA Blackwell Ultra. Реализовано жидкостное охлаждение. Показатели быстродействия Sferical One не раскрываются. Но одна система GB300 NVL72 обеспечивает ИИ-производительность на уровне 720 Пфлопс на операциях FP8/FP6 и 100 Тфлопс в режиме FP64. Таким образом, 16 стоек теоретически могут выдавать 11,52 Эфлопс и 1,6 Пфлопс соответственно. 
Источник изображения: Sferical AI «Уникальность Sferical One заключается в том, что несколько крупнейших шведских компаний используют одну и ту же инфраструктуру, совместно разрабатывают решения и обмениваются опытом. Это создаёт ценность, выходящую за рамки самой аппаратной платформы», — говорит Дженни Нордлёв (Jenny Nordlöw), генеральный директор Sferical AI. Среди направлений использования Sferical One — разработка лекарственных препаратов в AstraZeneca, создание базовых ИИ-моделей для телекоммуникационных приложений в Ericsson, оборонные технологии в Saab, финансовые услуги в SEB, а также промышленные решения в SKF, включая предиктивное техническое обслуживание и контроль качества.
22.10.2026 [00:36], Владимир Мироненко
Google Cloud и NVIDIA запустят в ноябре инстансы на базе Vera Rubin NVL72Google Cloud и NVIDIA объявили, что в следующем месяце в Европе станут общедоступны инстансы Google Cloud A5X на базе систем NVIDIA Vera Rubin NVL72. Они предоставят клиентам комплексную платформу для обучения моделей, инференса и масштабного обучения с подкреплением. A5X интегрирует архитектуру Vera Rubin в систему Google Cloud AI Hypercomputer, объединяя вычислительные мощности, сетевые ресурсы и системы хранения данных для поддержки обучения на основе опыта. A5X используют системы NVIDIA Vera Rubin NVL72, сетевые адаптеры NVIDIA ConnectX-9 SuperNIC, сеть Virgo Network и передовую технологию жидкостного охлаждения четвертого поколения от Google Cloud. Сообщается, что Google Cloud планирует расширить инфраструктуру на базе архитектуры Vera Rubin, доведя количество ускорителей Rubin до 960 тыс. единиц, размещённых на различных площадках. По мере развёртывания агентских систем компаниям необходимо обеспечивать защиту проприетарных моделей и конфиденциальных данных, лежащих в основе этих систем, даже при использовании инфраструктуры сторонней организации. Google Cloud станет одним из первых облачных провайдеров, предлагающих NVIDIA Confidential Computing в масштабе стойки на bare-metal-инстансах, таких как A4X Max на базе NVIDIA GB300 NVL72. 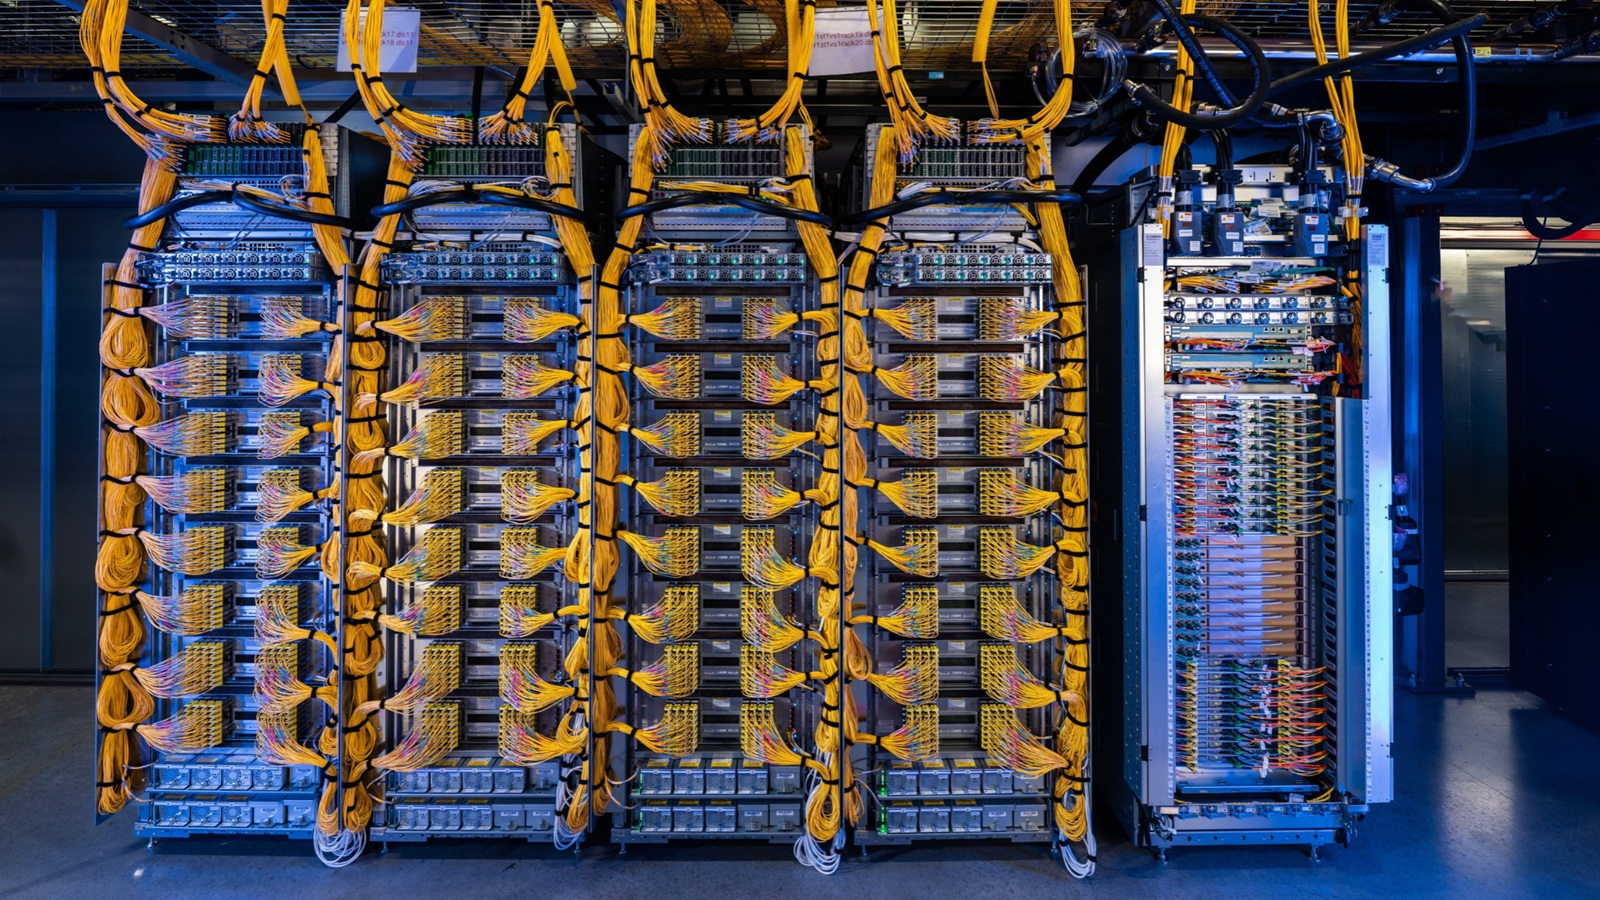
Источник изображения: NVIDIA Кроме того, Google Cloud делает конфиденциальные вычисления (Confidential Computing) общедоступными на виртуальных машинах G4 на базе ускорителей NVIDIA RTX PRO 6000 Blackwell Server Edition, предлагая гибкую платформу для конфиденциального инференса и тонкой настройки. Клиенты, включая Vertebrae, Polaris Cloud и Confidential Core AI, используют ВМ Confidential G4 для обеспечения конфиденциальности разговоров, проверяемой работы агентов и корпоративного ИИ, управляемого в рамках заданных политик. Google Cloud и NVIDIA также изучают возможности комплекса технологий NVIDIA DSX MaxLPS для инфраструктуры на базе Vera Rubin, чтобы оптимизировать производительность на Вт и расширить возможности в рамках доступного бюджета электропитания ЦОД.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 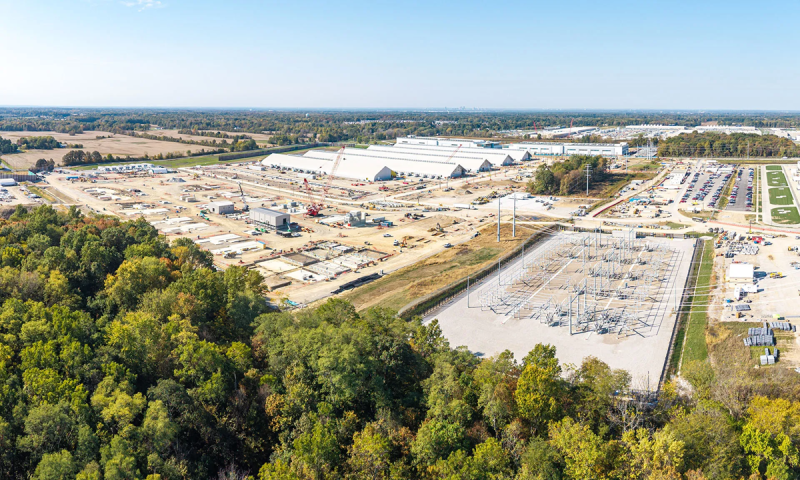
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
11.10.2026 [21:55], Руслан Авдеев
«Машины, которые делают машины»: NVIDIA и Foxconn повысили эффективность сборки платформ NVIDIA GB300 с помощью роботовNVIDIA и тайваньская Hon Hai Precision Industry Co (Foxconn) повысили эффективность на ключевых этапах сборки стоечной ИИ-платформы NVIDIA GB300 NVL72, использовав специализированных роботов, сообщает Taipei Times. В посте «Машины, которые делают машины» NVIDIA рассказала, как компания при поддержке Foxconn организовала обучение роботов для сборки критических компонентов серверов, повысив стабильность производства и эффективность рабочего процесса. Компания заявила, что доля успешного выполнения сборочных операций превысила 90 %, также заявлено, что компания уделила основное внимание сборке тестовых лотков GB300, используемых для проверки работоспособности и производительности вычислительных систем NVIDIA перед поставками заказчикам. Ключевыми задачами для роботов стали установка токопроводящих шин и подключение разъёмов. Одной из главных сложностей при установке шины питания было обучение роботов её захвату, перемещению, установке на место и креплению винтами в 16 точках. Также роботам нужно было научиться управляться с двумя большими (DC-SCI) и двумя маленькими (MCIO) разъёмами с подсоединёнными кабелями, которые необходимо аккуратно вставить в гнёзда на серверной плате, причём допуски для этого очень малы. 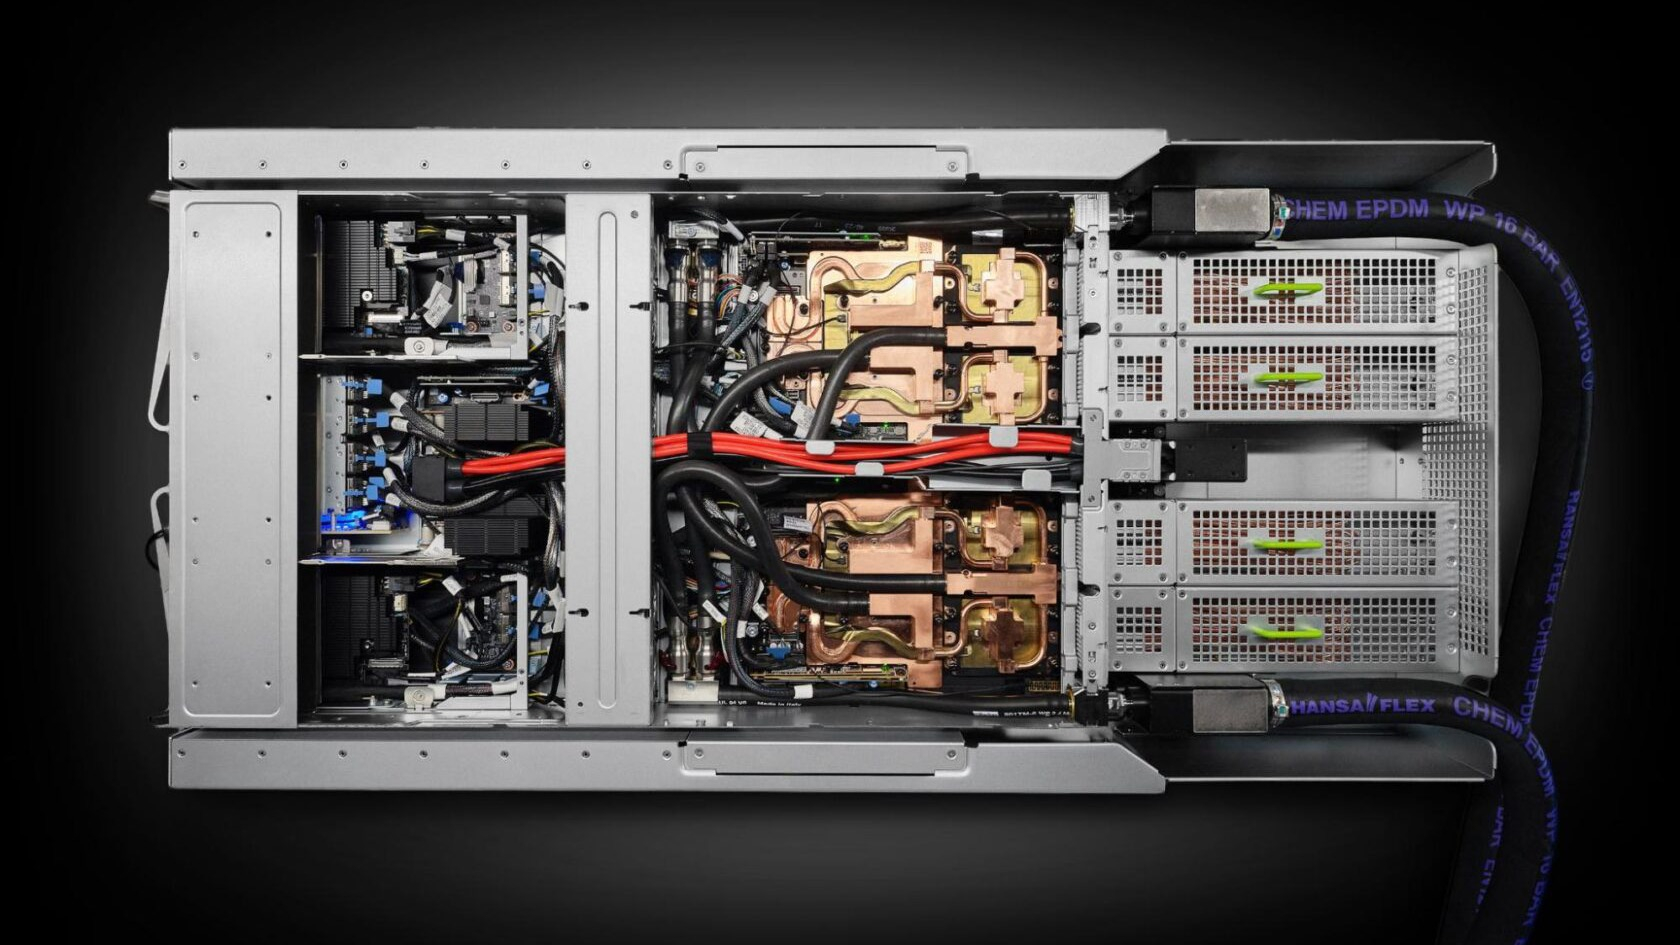
Источник изображений: NVIDIA Согласно тестовым данным, новый механизм автоматизации обеспечил уровень успешности установки DC-шины более 95 %, при этом время выполнения операции составляет 160 с. Это пока ниже целевых показателей в 99,5 % и 124 с соответственно. В случае с подключением коннекторов уровень успешности выполнения операции составил 90–95 %, а среднее время — 40 с на один кабель. При этом целевое время выполнения — не более 72 с на все четыре кабеля. 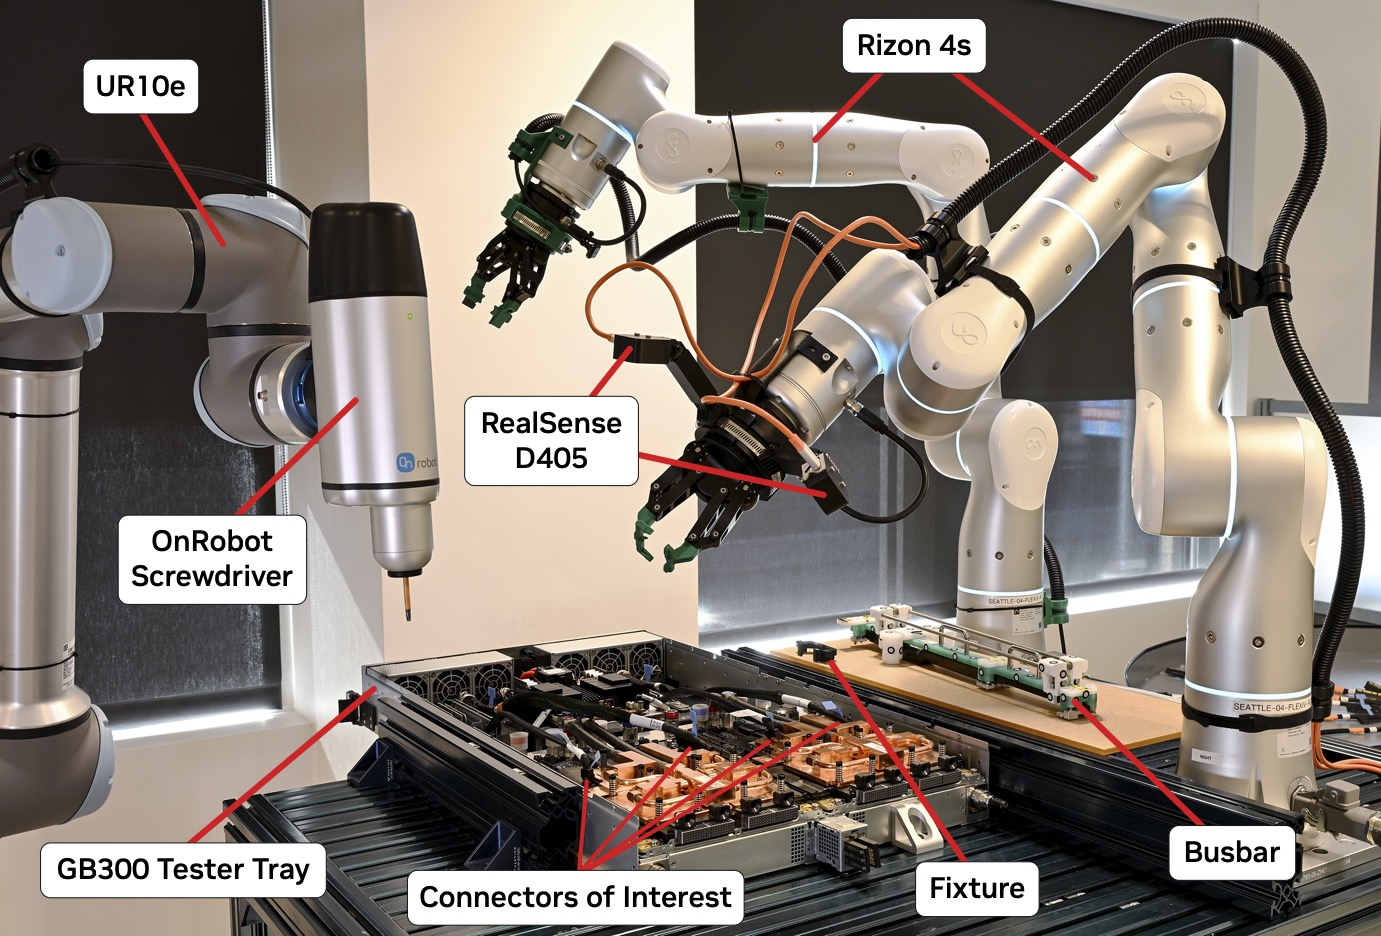 В NVIDIA подчеркнули, что при сборке тестовых лотков для GB300 нужны системы автоматизации, готовые к «неопределённости», поскольку быстрая смена циклов разработки и относительно небольшие объёмы производства делают создание сборочных линий с жёстко заданными параметрами нецелесообразным — роботы для реакции на изменения в процессе сборки должны быть достаточно «адптивными» и при этом надёжными. Подчёркивается, что технология пока не готова к массовому внедрению, поскольку есть проблемы с координацией роборук при подключении разъёмов и др. 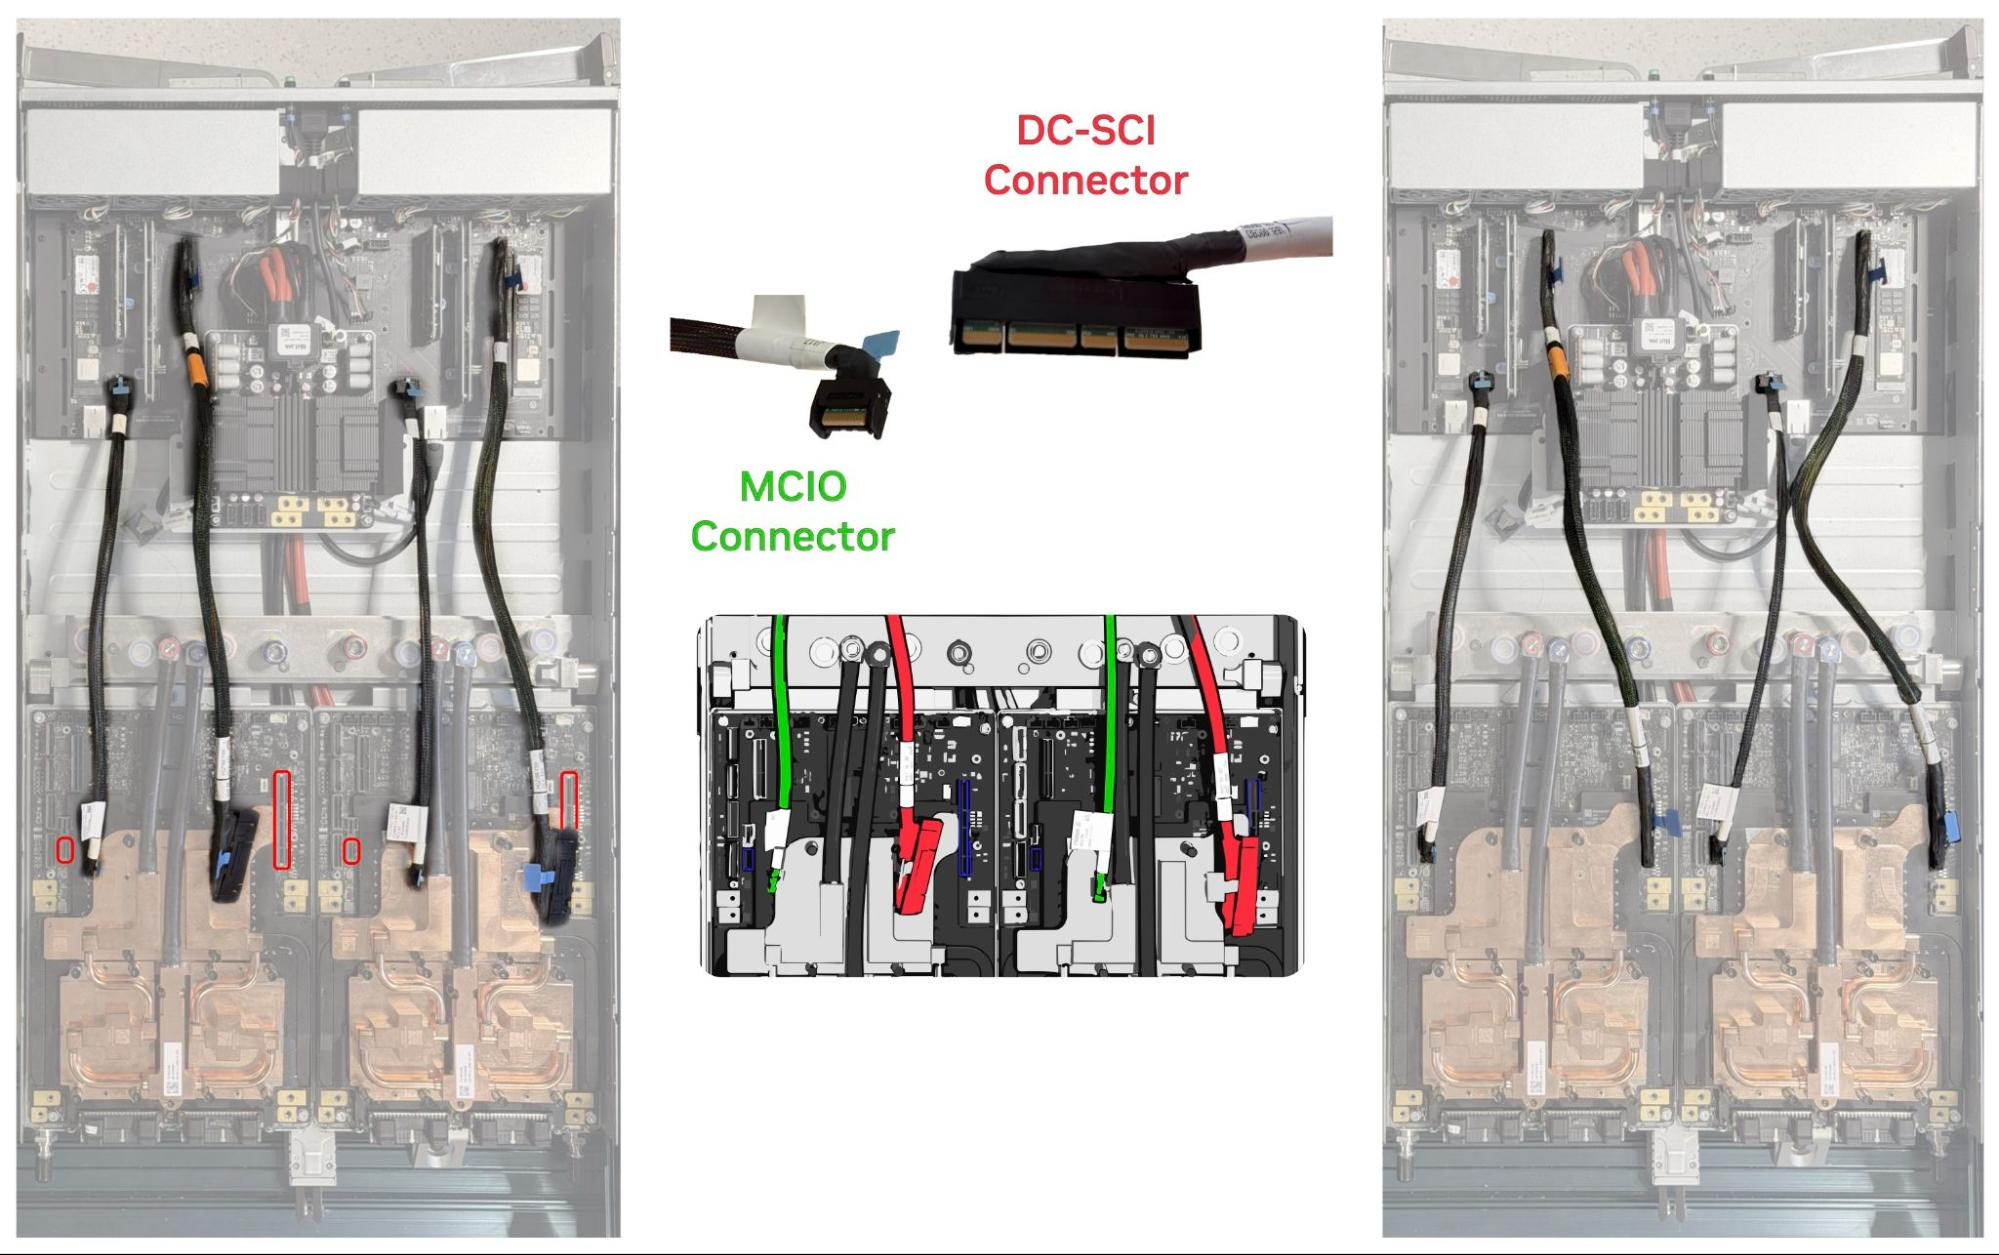 Foxconn является одним из ключевых производственных партнёров NVIDIA. В прошлом году компания объявила, что работала с последней для строительства умного завода на площадке в Хьюстоне (Houston) в Техасе с использованием человекоподобных роботов, управляемых ИИ от NVIDIA, для выпуска ИИ-серверов для самой NVIDIA. Foxconn рассчитывает расширить применение подобных роботов на другие производства в Техасе, Висконсине и Калифорнии. 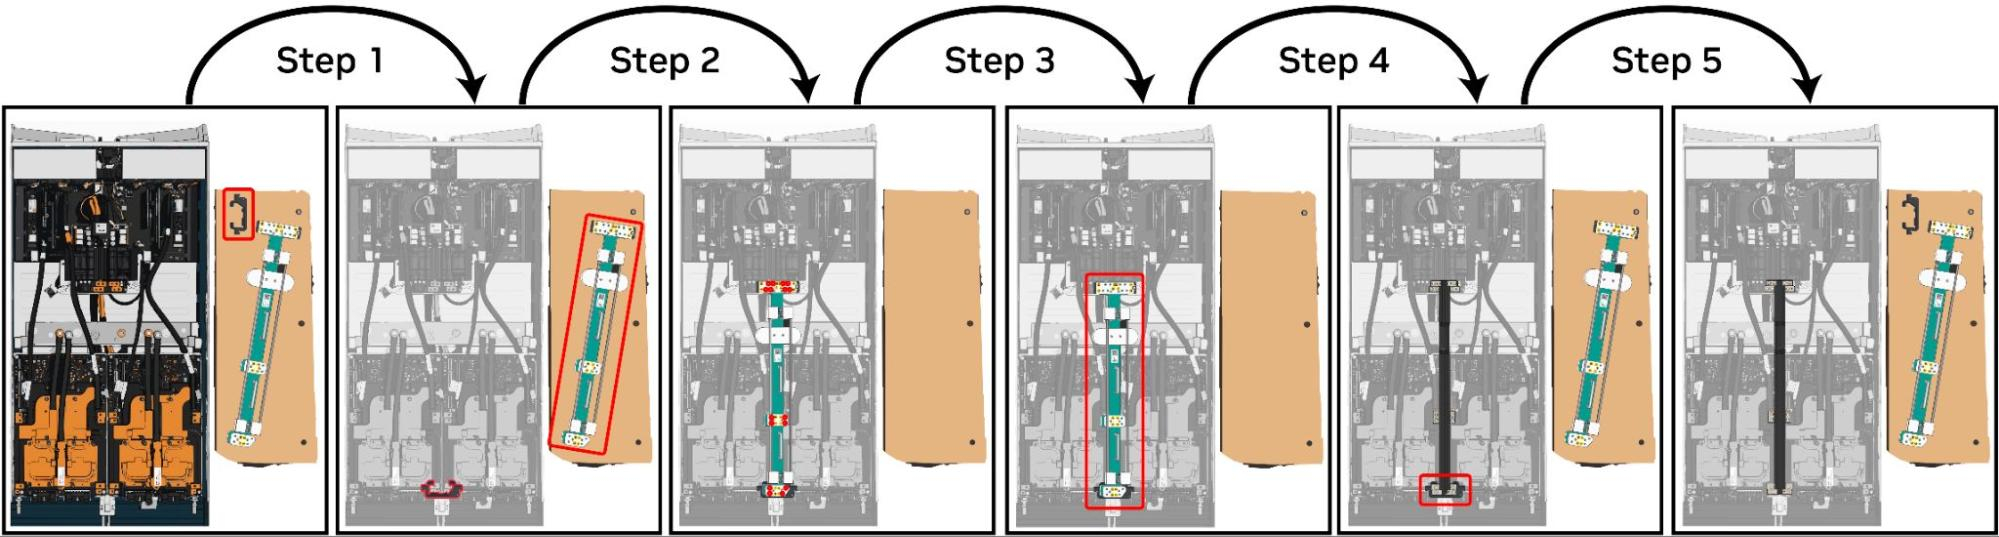 На долю Foxconn приходится более 40 % мирового рынка ИИ-серверов. При этом она сохраняет оптимизм относительно будущего этой отрасли. На конференции для инвесторов в августе она заявила, что поставки её стоечных ИИ-систем более чем удвоятся в сравнении с предыдущим годом.
25.09.2026 [11:09], Сергей Карасёв
Giga Computing развернула ИИ-полигон GAIFA на базе NVIDIA GB300 NVL72Компания Giga Computing, являющаяся подразделением Gigabyte, объявила о создании площадки GAIFA (Gigabyte AI Factory Accelerator) — своего первого вычислительного центра в области ИИ. Он расположился в Синьбэе (Новом Тайбэе) на территории Тайваня. GAIFA представляет собой полигон для проверки и отладки сверхплотных серверных стоек, систем жидкостного охлаждения и электропитания, а также других компонентов и модулей, которые применяются в составе современных ИИ-инфраструктур. Причём специализация GAIFA выходит за рамки аппаратного обеспечения, охватывая весь процесс формирования ИИ ЦОД: от планирования объекта до установки вычислительных и сетевых узлов. В среде GAIFA могут тестироваться самые разные нагрузки — от обучения больших языковых моделей (LLM) с огромным количеством параметров до инференса и профессиональных визуальных вычислений. 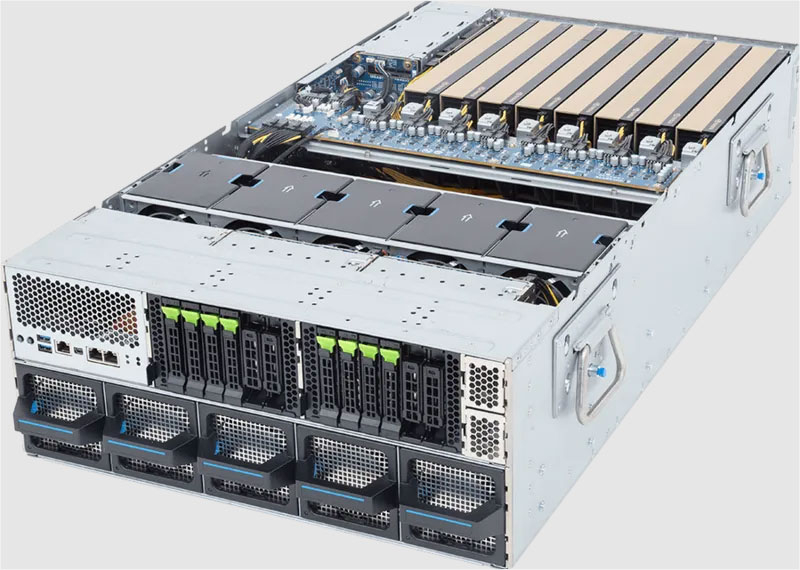
Источник изображений: Gigabyte Архитектура площадки выполнена по модульному принципу. В частности, задействованы две стойки NVIDIA GB300 NVL72. Каждая из них объединяет 18 вычислительных лотков, содержащих по два Arm-процессора Grace (72 ядра Neoverse V2) и по четыре чипа Blackwell Ultra. В сумме это даёт 36 изделий Grace и 72 экземпляра Blackwell Ultra на стойку (включая 17 Тбайт памяти LPDDR5X и 20 Тбайт HBM3E). Применяются сетевые адаптеры NVIDIA ConnectX-8 SuperNIC. 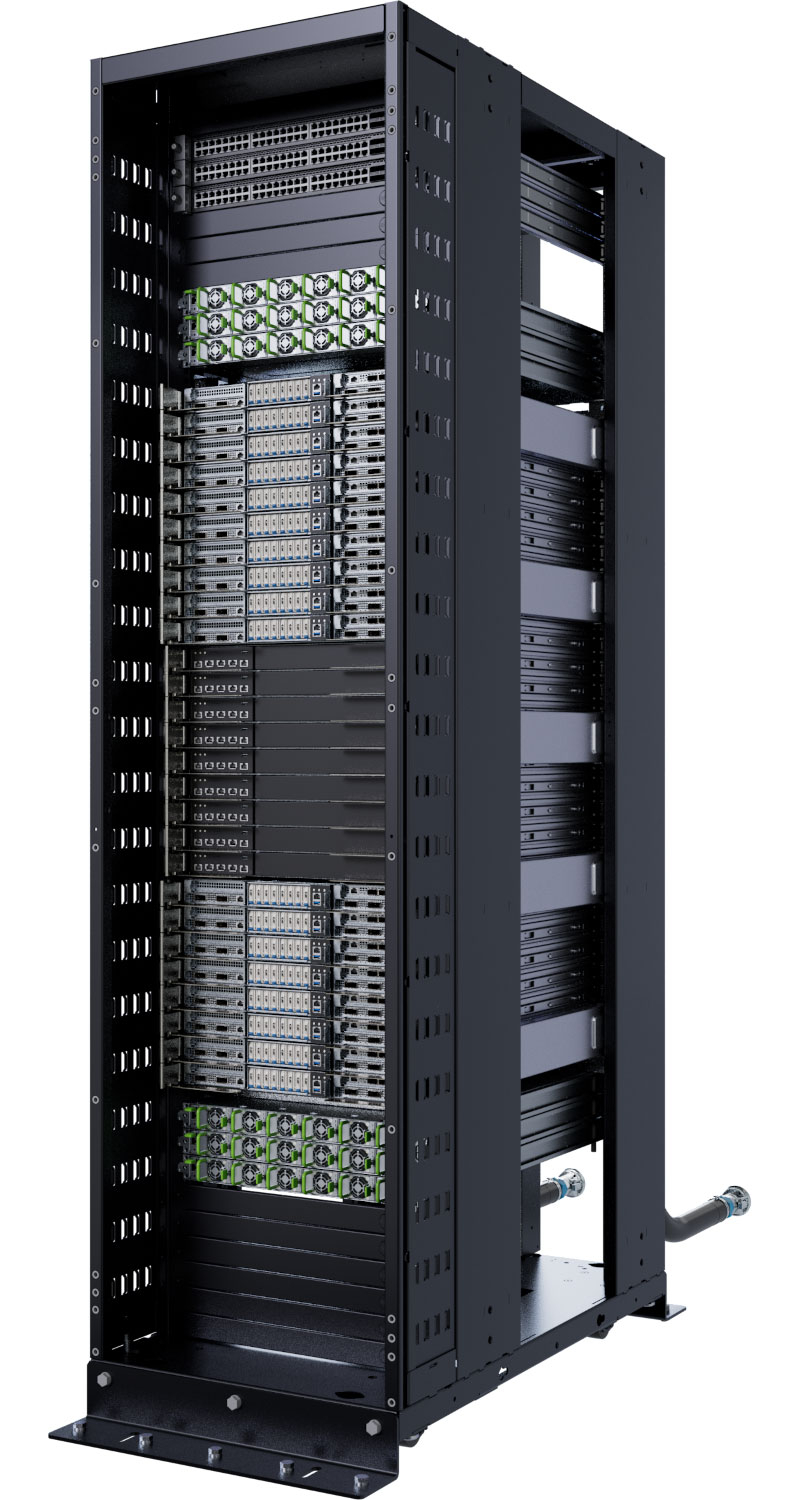 Кроме того, в состав GAIFA входит одна стойка на основе серверов G4L4-SD3-LAX7, использующих аппаратную платформу NVIDIA HGX B300 (восемь SXM-ускорителей Blackwell Ultra). Эти машины наделены системой прямого жидкостного охлаждения (DLC) с функцией обнаружения протечек. Дополнительно установлены серверы XL44-SX2-AAS1 с восемью ускорителями NVIDIA RTX Pro 6000 Blackwell Server Edition (96 Гбайт памяти GDDR7). Наконец, применены 10-узловые серверы B683-Z80-LAS1 на платформе AMD EPYC 9005 Turin с СЖО. На текущем этапе общая мощность площадки GAIFA находится на уровне 700 кВт. В дальнейшем показатель будет увеличиваться — по мере расширения объекта и добавления дополнительного оборудования.
10.09.2026 [13:15], Сергей Карасёв
Рабочая станция HP ZGX Fury AI на базе NVIDIA GB300 вышла в двух форм-факторахКомпания HP анонсировала рабочую станцию ZGX Fury AI на аппаратной платформе Blackwell Ultra для задач в области ИИ. Новинка доступна для заказа в двух исполнениях: «настольном» башенном форм-факторе и в корпусе 5U для монтажа в серверную стойку. В основу системы положен суперчип Grace Blackwell GB300. Задействованы процессор Grace с 72 Arm-ядрами, функционирующий в тандеме с 496 Гбайт памяти LPDDR5X-6400 SOCAMM, и ускоритель B300 с 252 Гбайт памяти HBM3E. Применена система жидкостного охлаждения. Устройство располагает адаптером NVIDIA ConnectX-8 с двумя портами 400Gb QSFP112: они позволяют объединить две рабочие станции в единую вычислительную платформу. 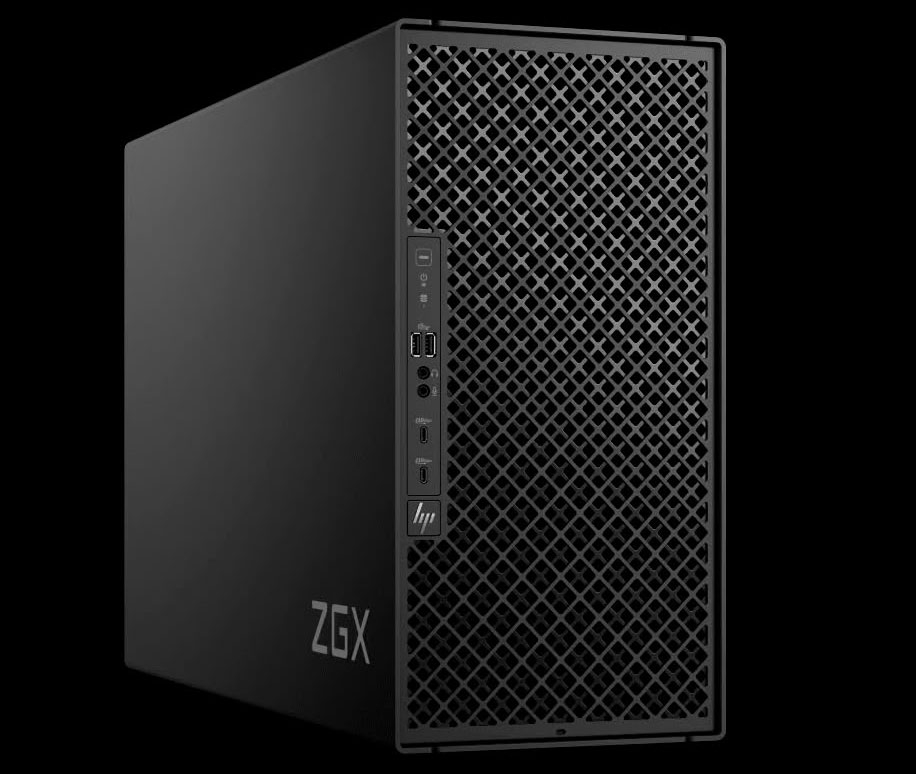
Источник изображений: HP Рабочая станция несёт на борту накопители HP Z Turbo Drive PCIe M.2 SSD вместимостью 2 и 4 Тбайт, а также Z Turbo PCIe NVMe M.2 SED NMIC SSD на 2 Тбайт. Доступны четыре дополнительных слота М.2 — два с интерфейсом PCIe 5.0 x4 и два с поддержкой PCIe 6.0 x4. Могут формироваться массивы RAID 0/1. Присутствуют три слота PCIe 5.0 x16, два из которых работают в режиме х8. При необходимости может быть добавлен дискретный ускоритель NVIDIA RTX PRO 4000 Blackwell (24 Гбайт GDDR7) или NVIDIA RTX PRO 2000 Blackwell (16 Гбайт GDDR7). 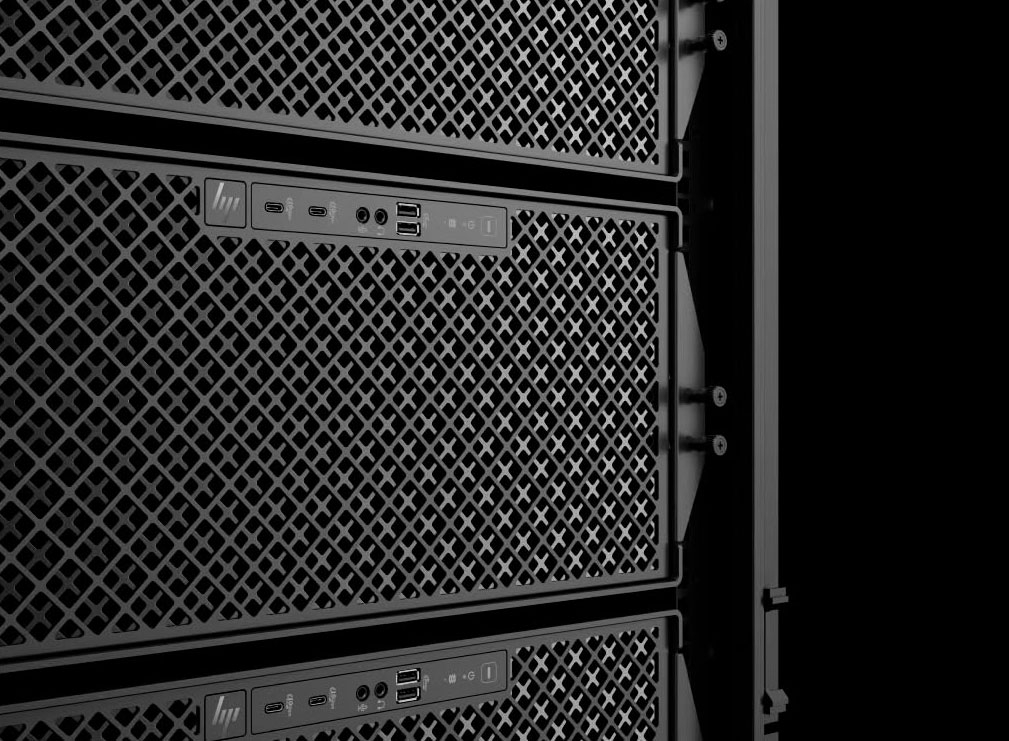 Спереди предусмотрены по два порта USB 3.0 Type-A и USB 3.1 Type-C, а также аудиогнёзда на 3,5 мм. Сзади расположены четыре разъёма USB 3.1 Type-А, сетевые порты 1GbE RJ45 (удалённое управление) и 10GbE RJ45, набор аудиогнёзд, интерфейс Mini-DP. Питание обеспечивает блок мощностью 1600 Вт с сертификатом 80 PLUS Titanium. Говорится о совместимости с Ubuntu 24.04 LTS (с набором инструментов NVIDIA AI Developer Tools).
27.08.2026 [17:51], Руслан Авдеев
Amazon купит ещё 2 млн чипов NVIDIA и укрепит сотрудничество по другим направлениямКомпания Amazon намерена добавить в свой парк ускорителей ещё 2 млн чипов NVIDIA в следующие два года. Это свидетельствует о том, что компания по-прежнему намерена использовать продукты NVIDIA, хотя и разрабатывает уже не первое поколение собственных конкурентоспособных ускорителей, сообщает Bloomberg. Последняя сделка включает чипы NVIDIA поколений Blackwell Ultra, Rubin и Rubin Ultra. Впрочем, финансовых условий NVIDIA и Amazon не раскрывали. Крупнейшие и лучшими покупатели продуктов NVIDIA — Amazon, Microsoft и Google — довольно успешно занимаются разработкой собственных ускорителей. Облачные гиганты делают ставку на то, что они лучше могут адаптировать продукты к собственным дата-центрам, от прироста эффективности могут выиграть и их клиенты. В последние годы Amazon активно инвестировала в собственное подразделение, занимавшееся разработкой чипов Annapurna Labs, которое предлагает как CPU, так и ускорители, призванные конкурировать с продуктами NVIDIA. Тем не менее, компании сохраняют теснейшее сотрудничество. Так, новейшее поколение ускорителей Trainium4 будет пользоваться преимуществами технологии NVLink Fusion. Заказчикам NVLink компания также предлагает и память NVHBM. 
Источник изображения: NVIDIA Дополнительно, как сообщает NVIDIA, компании намерены внедрять в AWS инфраструктуру на основе CPU Vera и создавать в интересах правительства США ИИ-фабрики, в том числе для задач обеспечения национальной безопасности. Платформу NVIDIA планируется интегрировать с AWS Nitro и EFA для обеспечения повышенной безопасности использования. Также продолжится поддержка открытых ИИ-моделей NVIDIA Nemotron платформами Amazon Bedrock и Amazon SageMaker, благодаря чему пользователи последних получат расширенный набор ИИ-инструментов. Планируется и ускорить обработку данных, в т.ч. в Amazon EMR и Amazon OpenSearch путём использования библиотек NVIDIA cuDF и cuVS CUDA-X. Наконец, партнёры намерены и дальше развивать ИИ в сфере робототехники с внедрением платформы NVIDIA Physical AI компанией Amazon Robotics. Это ускорит автоматизацию работы складов и развитие роботов нового поколения.
09.08.2026 [21:59], Владимир Мироненко
Крупнейшая в СНГ ИИ-фабрика NVIDIA появится в Армении — Firebird развернула 15 из 300 МВтАмериканская неооблачная компания Firebird объявила о запуске в Раздане (Армения) ИИ ЦОД, который, по словам NVIDIA, позиционируется как крупнейшая ИИ-фабрика в СНГ. Она создана на эталонной платформе NVIDIA DSX AI Factory — комплексном решении NVIDIA для создания и эксплуатации ИИ-фабрик — с использованием серверов Dell. Как утверждает NVIDIA, эта платформа позволяет разместить до 40 % больше GPU на той же площади, «производя больше токенов на доллар и извлекая больше выгоды из каждого мегаватта мощности». На строительство первой очереди ЦОД в Раздане ушло всего полгода. Schneider Electric обеспечила ЦОД энергетической инфраструктурой, включая распределительные устройства среднего и низкого напряжения, трехфазные системы ИБП и стоечные решения. А Vertiv предоставила архитектуру охлаждения, сочетающую технологию охлаждения с использованием охлаждённой воды, передовые системы управления и технологию Vertiv TrimCooler для эффективного отвода тепла. Система управления охлажденной водой iCOM CWM от Vertiv централизованно координирует ресурсы охлаждения в зависимости от рабочих нагрузок. Согласно данным Firebird, в настоящее время вычислительный комплекс DC-1 включает 6144 ускорителя NVIDIA B200 общей мощностью 15 МВт. К концу 2027 года Firebird планирует развернуть более 70 тыс. GPU NVIDIA Rubin и Blackwell — всего 300 МВт инфраструктурных мощностей. Планируемый кластер DC-2 рассчитан на 75 тыс. GPU в составе NVIDIA VR200 общей мощностью 125 МВт. Также в планах компании строительство третьей очереди аналогичного масштаба. Для масштабирования с 15 до 300 МВт потребуется как-то решить вопрос энергоснабжения, обратил внимание ресурс TECHi. 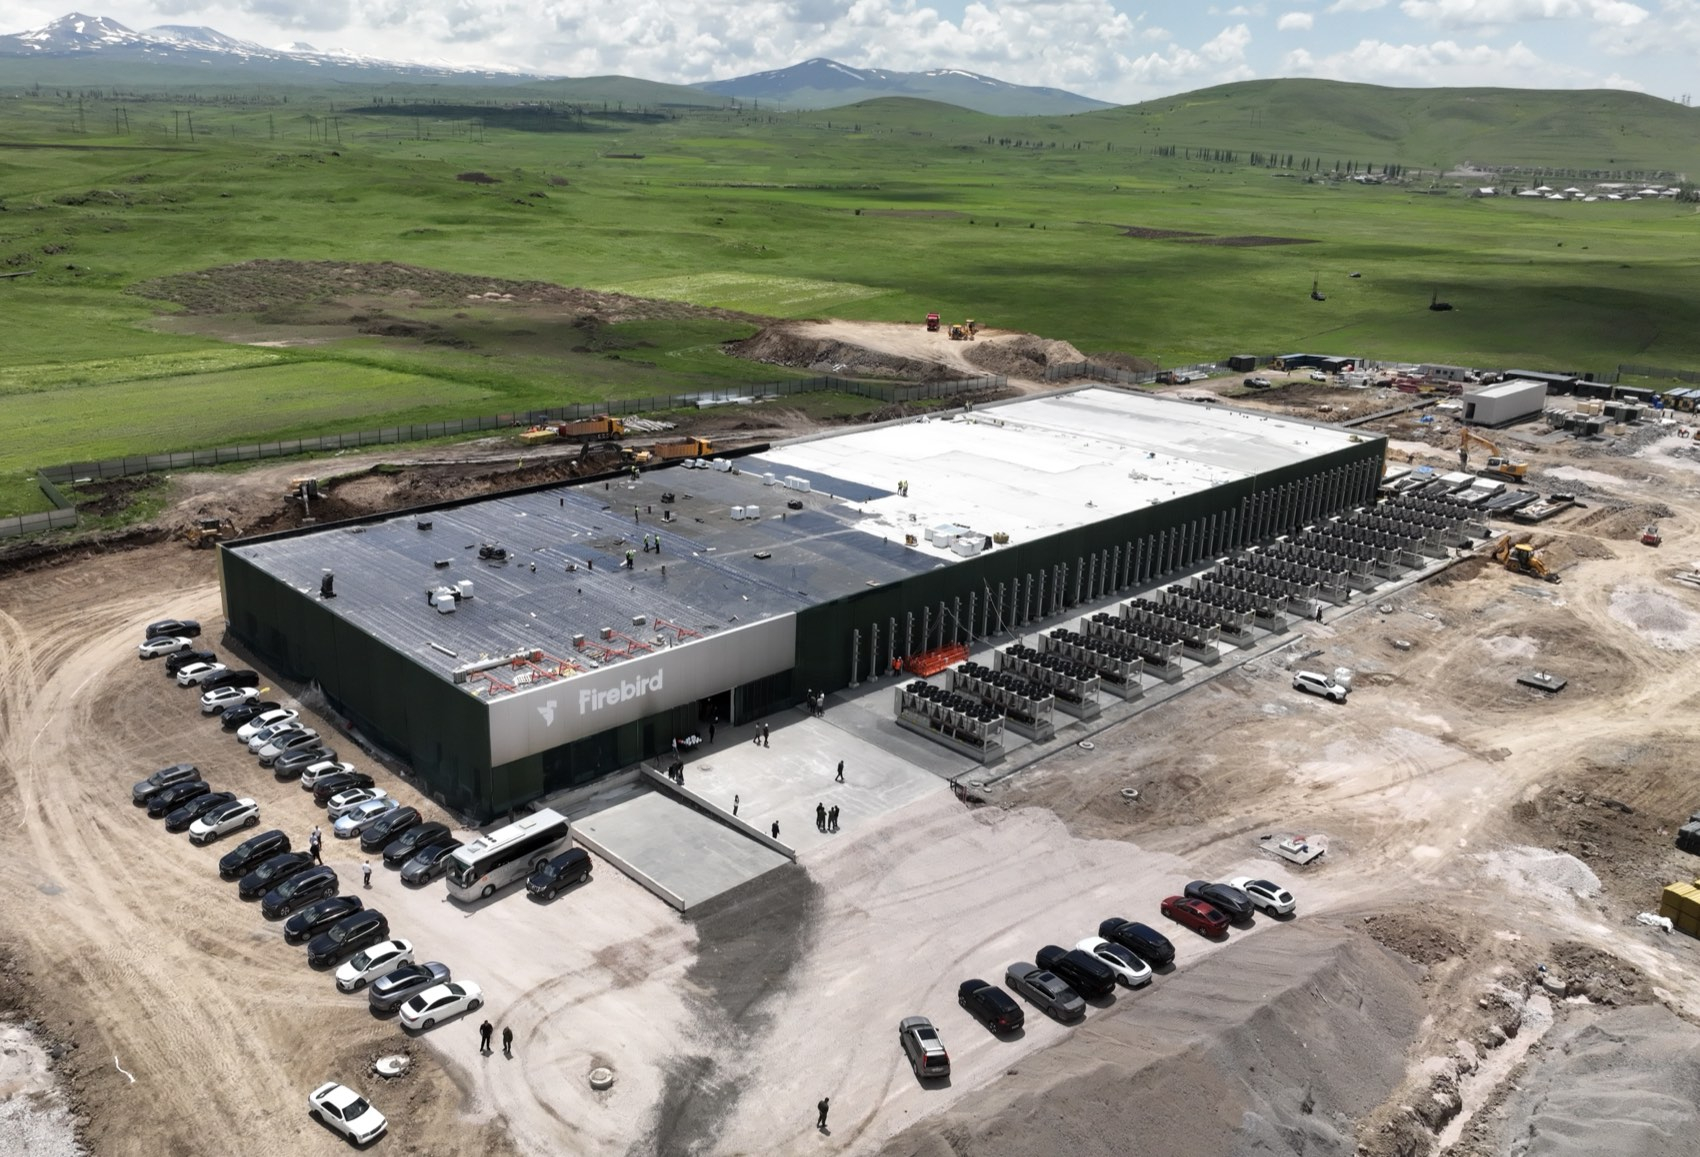
Источник изображения: Firebird В ноябре 2025 года Firebird получила экспортную лицензию США на поставку в Армению передовых чипов NVIDIA. Стоимость первого этапа строительства ИИ-фабрики оценивается в $500 млн. В феврале этого года во время визита в Армению вице-президента США было объявлено об увеличении стоимости проекта до $4 млрд с развёртыванием около 50 тыс. GPU с лицензированием ещё 41 тыс. NVIDIA GB300. Firebird сообщила, что одним из первых клиентов ЦОД в Армении стала Perplexity. Она получит доступ к инфраструктуре ИИ Firebird для поддержки своего механизма обработки ответов и платформы для ИИ-агентов. Впрочем, стоимость контракта с Perplexity и сроки его действия не раскрываются. Компания также объявила о намерении NVIDIA инвестировать в её деятельность вслед за инвестициями в CoreWeave в этом году. Это поможет ей в реализации планов по расширению глобальной инфраструктуры. Сумма планируемых инвестиций не указана. При поддержке NVIDIA компания реализует план развития ИИ-инфраструктуры мощностью около 2 ГВт, охватывающей Армению, Казахстан и другие рынки. Следуя циклической схеме, NVIDIA приобретает долю в компании, которая затем покупает у неё чипы в больших масштабах. NVIDIA уже инвестировала более $40 млрд в акции компаний, занимающихся ИИ-технологиями.
23.07.2026 [10:26], Сергей Карасёв
Wistron открыла в США передовой завод по производству ИИ-ускорителей NVIDIAТайваньская компания Wistron открыла свою первую производственную площадку на территории США. Передовой завод D1, расположившийся в городе Форт-Уэрте (Fort Worth) в штате Техас, займётся выпуском изделий NVIDIA для ИИ-систем, включая продукты Grace Blackwell Ultra и Vera Rubin. В церемонии запуска предприятия приняли участие генеральный директор NVIDIA Дженсен Хуанг (Jensen Huang) и председатель совета директоров Wistron Саймон Лин (Simon Lin). Завод занимает площадь 30,1 тыс. м2. Инвестиции в его строительство составили около $700 млн. На текущий момент здесь сформированы примерно 500 рабочих мест, а к концу года их количество удвоится. Подчёркивается, что Wistron спроектировала и полностью смоделировала весь объект ещё до начала его возведения в виде цифрового двойника. Для этого использовалась открытая платформа NVIDIA, включая модели Nemotron и Cosmos Frontier, библиотеки Omniverse и Metropolis, а также открытые фреймворки, в том числе PhysicsNeMo. Благодаря такому подходу инженеры Wistron смогли протестировать компоновку сборочных линий, оптимизировать производственные процессы и обучить будущих сотрудников стандартным рабочим процедурам в виртуальном формате. 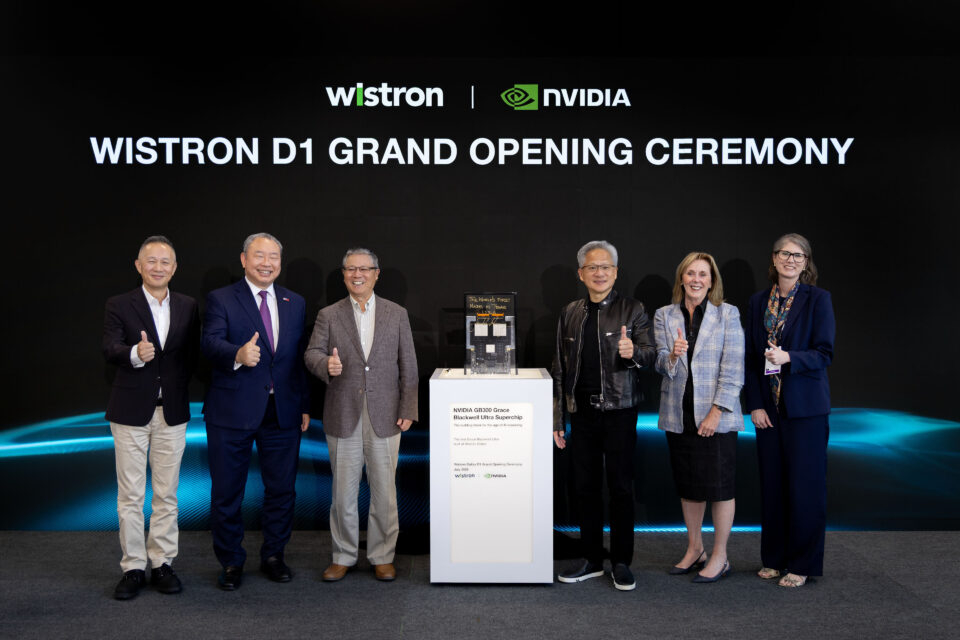
Источник изображений: NVIDIA На предприятии развёрнуты два производственных участка. На одном из них изготавливаются суперчипы NVIDIA GB300. Второй ориентирован на выпуск изделий NVIDIA Vera Rubin. Ожидается, что уже в текущем году объёмы выпуска продукции будут доведены до десятков тысяч плат в месяц. 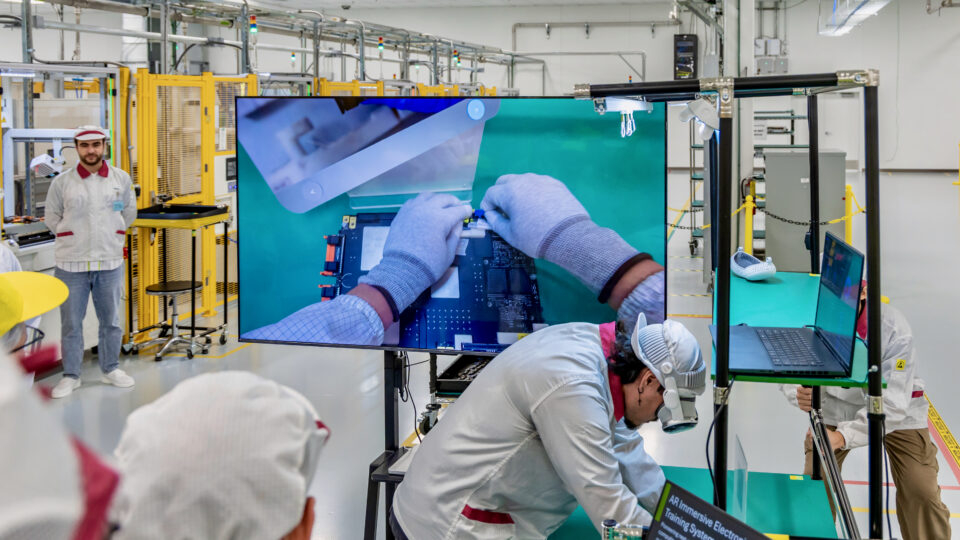 Ранее NVIDIA объявила о намерении до конца текущего десятилетия организовать создание ИИ-инфраструктуры в США на сумму до $500 млрд. Запуск предприятия Wistron является одним из проектов в рамках этой масштабной инициативы. |
|

