
Материалы по тегу: сбой
|
19.11.2026 [17:18], Павел Котов
ИИ ЦОД SpaceXAI «протёк»: из системы охлаждения вылилось до 23 тыс. л пропиленгликоляНа объекте подразделения SpaceXAI (SpaceXSI) в штате Миссисипи произошла утечка химического вещества — до 23 000 л пропиленгликоля, сообщает Tom’s Hardware. Пропиленгликоль выступает теплоносителем и используется, в частности, в составе антифризов. Угрозы для здоровья или безопасности местных жителей нет, заявили в Департаменте охраны окружающей среды штата Миссисипи: вещество попало в дренажную канаву, и специалисты ведомства заверили население в отсутствии непосредственной опасности. Тем не менее, было принято решение взять пробы воды для лабораторного анализа. На месте происшествия продолжаются работы по очистке территории, специалисты ведут мониторинг ситуации. Утечка, как сообщается, ограничилась пределами канавы, и химикат не попал в расположенный неподалёку ручей Хорн-Лейк-Крик (Horn Lake Creek). 
Источник изображения: SpaceXAI Ноябрь оказался для SpaceXAI в Саутхейвене (Southaven, шт. Миссисипи) непростым. У компании возникли трудности из-за судебного разбирательства, касающегося загрязнения окружающей среды дата-центром. Поданный в апреле иск затрагивает газовую электростанцию, которая обеспечивает энергией объект компании в агломерации Мемфиса (Memphis, шт. Теннесси). Истцы утверждают, что 27 газовых турбин были установлены без получения необходимых разрешений, и что электростанция ежегодно может выбрасывать в атмосферу более 5 тыс. т оксидов азота и 47 т канцерогенного формальдегида. Признав негативное отношение местных жителей к своему присутствию, SpaceX предложила скидку 50 % на услуги спутникового интернета Starlink всем, кто проживает рядом с двумя её ЦОД в районе Мемфиса, а также выразила готовность взять на себя расходы на оборудование — за счёт этоо можно сэкономить $349. С конца июня по начало сентября абонентами Starlink стали около 2000 жителей Мемфиса и Саутхейвена. Администрация Мемфиса также объявила о готовности осуществить свою первую крупную инвестицию в рамках постановления о социальных благах для местного сообщества (Community Benefits Ordinance) — эта программа финансируется за счёт доходов от объекта Colossus 1 подразделения SpaceXAI. Около $3,3 млн будут направлены на нужды города — поддержку жилищного сектора и благоустройство района.
16.11.2026 [21:47], Владимир Мироненко
К глобальному сбою в системах Microsoft 365 привела ошибка в обновлении служебной Windows трёхмесячной давностиКомпания Microsoft сообщила причины масштабного сбоя её сервисов, произошедшего на прошлой неделе, о чём пишет iTnews. Согласно предварительному отчёту, сбой связан с исправлением в Windows, подготовленным специально для сетевых шлюзовых серверов Microsoft 365 и запущенном в июле. В Microsoft подчеркнули, что данная ошибка и само исправление не имеют отношения к стандартным версиям Windows, используемым на пользовательских компьютерах. При этом обновление успешно прошло нагрузочное тестирование и было развернуто без каких-либо негативных последствий. И в течение трёх месяцев данная ошибка никак себя не проявляла. По словам исполнительного вице-президента Microsoft по направлению Copilot, агентов и платформы, дефект заключался в возникновении конкуренции за блокировку (lock contention) внутри одного из внутренних процессов. Это приводило к тому, что при определённых нагрузках серверы переставали отвечать на запросы. Нагрузочное тестирование не выявило эту проблему, поскольку производилось на менее производительном оборудовании с меньшим количеством ядер, тогда как проблема конкуренции за блокировку обостряется именно на более современных машинах с большим числом процессорных ядер. 
Источник изображения: Markus Spiske/unsplash.com Сбой спровоцировало событие, произошедшее примерно за 15 часов до его начала: сервис Teams был переключён с отдельной шлюзовой системы на основную — ту самую, которая обслуживает и Exchange Online. Это увеличило нагрузку и изменило характер распределения трафика. В это же время около 14 % мощностей шлюза были недоступны из-за другой, возникшей ранее проблемы, не связанной с данным происшествием. Сочетание этих факторов привело к проявлению дефекта, что вызвало настоящий хаос. Далее события развивались по классическому сценарию каскадного сбоя. Серверы начали выходить из строя в период пиковой нагрузки в США. При потере связи с сервером трафик перенаправлялся на следующий доступный узел, который, в свою очередь, сталкивался с той же проблемой. В течение двух часов дефект распространился на всю инфраструктуру Microsoft. В пиковый момент более 80 % серверов перестали отвечать на запросы. Изоляция между тысячами единиц ёмкости шлюза и его регионами должна была ограничить масштаб ущерба, однако этого не произошло — «из-за отдельной проблемы». Процесс восстановления затянулся, поскольку после перезапуска серверы вскоре снова выходили из строя под нагрузкой возобновившегося потока запросов. В то время как для сервисов Teams, SharePoint и OneDrive удалось перенаправить трафик в обход, и они восстановились раньше, для Exchange Online — в силу масштабов его работы — полноценное переключение маршрутов оказалось невозможным. Именно этим объясняется длительный период недоступности Exchange Online (который многие пользователи воспринимали как сбой в работе Outlook). К тому же автоматизированные механизмы восстановления Microsoft не были рассчитаны на столь масштабный сбой. А поскольку скрытая ошибка возникла ещё несколько месяцев назад, стандартные процедуры отката, поэтапного развёртывания и использования функциональных флагов не позволили быстро отменить внесенные изменения. Вместо этого в Microsoft разработали «исправление для исправления» — обновление, возвращающее код в исходное состояние, и применили его сразу к крупным группам серверов — в ряде случаев охватывающим более половины региона. Кроме того, были увеличены вычислительные мощности и продлён период доставки электронных писем, чтобы попавшие в очередь сообщения не были отклонены как недоставленные.
15.11.2026 [21:27], Руслан Авдеев
Microsoft 364: на устранение сбоя облачных сервисов компании ушло больше сутокКомпания Microsoft восстановила работу ряда своих инструментов после общемирового сбоя, который коснулся более 70 стран, нарушив работу государственных и частных структур, а также обычных пользователей — в мире продуктами, затронутыми сбоем, пользуются более 430 млн человек. Microsoft уже извинилась за неполадки и рассказала, что те возникли в ходе модернизации сети и не связаны с кибератаками или действиями ИИ-агентов. По словам экспертов, инцидент стал наглядной демонстрацией того, насколько сильно бизнес и жизненно важные сервисы зависят от небольшой группы технологических компаний. Впервые пользователи начали сообщать о проблемах доступа к продуктам Microsoft 365 в четверг. К пятнице проблема уже коснулась самых разных учреждений, от правительства Японии и Верховного суда Филиппин до австралийских спецслужб, систем железнодорожного транспорта, больниц и судов в Северной Америке. К вечеру пятницы (по Москве) сервисы начали восстанавливать работу, с момента появления первых неполадок прошло около 24 часов. 
Источник изображения: ELLA DON/unsplash.com Впервые Microsoft оповестила пользователей о неполадках с доступом к почтовым ящикам Exchange Online в странах Северной и Южной Америке в 20:54 (МСК) в четверг. Вскоре после этого компания предупредила, что сбой, возможно, коснулся пользователей Microsoft 365 по всему миру. Компания инициировала расследование причин произошедшего и начала работать над восстановлением работы сервисов, но к 07:36 (МСК) пятницы сообщалось только о «частичном восстановлении» работы в некоторых частях света. К 16:32 (МСК) компания отчиталась о «более широком улучшении ситуации» в Северной Америке, «устойчивом улучшении» в большей части Европы и «обнадёживающих признаках восстановления» в Азиатско-Тихоокеанском регионе. По данным Microsoft, восстановление шло постепенно из-за масштабов проблемы и необходимости обеспечить стабильность работы сервисов после возобновления работы. В компании выразили «глубокое сожаление» из-за перебоев, сказавшихся на работе клиентов и партнёров. Полный отчёт о произошедшем будет опубликован после внутренней проверки. По словам экспертов, сценарии реагирования на случай масштабных сбоев в IT-сфере обычно предполагают использование для обеспечения устойчивой работы резервного сервиса. Тем не менее, на практике бизнесу «практически невозможно» обойтись без таких инструментов, как пакет ПО Microsoft. Сервисы Microsoft уже не первый раз страдают от сбоев. Так, в июле 2024 года масштабный сбой Microsoft Azure наложился на сбой CrowdStrike. В октябре 2025 года Microsoft объявила об успешном решении проблем с конфигурацией DNS, вызвавших сбои на платформе Azure. Инцидент повлиял на работу сервисов компании и затронул множество отраслей по всему миру.
13.11.2026 [12:14], Руслан Авдеев
Работа сервисов Microsoft нарушена в результате сбоя глобального масштабаВ четверг произошёл масштабный сбой в работе многочисленных программных продуктов и сервисов Microsoft, надолго лишивший компании и индивидуальных пользователей доступа к важным инструментам, сообщает The New York Times. По информации Downdetector, данные о сбое появились в четверг, в 00:15–01:00 по «восточному» времени (19:15–20:00 МСК в пятницу), когда люди и офисы по всему миру начали сообщать о неполадках в работе инструментария Microsoft 365, в т.ч. почтовые сервисы и программы для обмена сообщениями. Проблемы сохранились до позднего вечера четврга, по некоторым данным, местами они сохраняются и сейчас. По данным Downdetector, между 19:15–20:00 МСК более 130 тыс. пользователей сообщили о проблемах в работе Microsoft Outlook, Microsoft Teams, ИИ-помощника Copilot и Microsoft Store. Согласно обновлённым данным, появившимся в социальных сетях около полуночи пятницы по московскому времени, Microsoft заявила, что задействует все доступные способы восстановления работы сервисов, поскольку предпринятые меры не принесли желаемого результата. В 05:13 МСК компания объявила, что внесённые изменения «не дают ожидаемого эффекта». 
Источник изображения: blue sky/unsplash.com Ранее Microsoft сообщала, что часть её инфраструктуры испытывала «повышенную нагрузку» в нескольких регионах. Позже компания заявила, что уже начала перераспределять трафик между разными сегментами своей глобальной инфраструктуры для того, чтобы сбалансировать нагрузку и перезапускать пострадавшие от сбоев серверы. Позже агентство Reuters сообщило, что сбой продолжился в рабочие часы пятницы, в том числе в Азиатско-Тихоокеанском регионе. Неполадки коснулись организаций и пользователей в Австралии, Японии, США и Индии, повлияли на работу компаний OpenAI и Anthropic. По словам Министра внутренних дел и кибербезопасности Австралии Тони Берка (Tony Berk), Microsoft не считает случившееся кибератакой. Он не исключил, что ситуация может напоминать случившееся с CrowdStrike в 2024 году, когда причиной сбоя стало неудачное обновление ПО. Как объявила Microsoft в соцсети X «мы видим положительные результаты в плане стабильности сервиса и увеличения пропускной способности в результате наших последних действий по оптимизации трафика. Мы внедряем эти действия шире по всем затронутым регионам, стремясь достичь устойчивого восстановления». В конце октября масштабный сбой произошёл в западноевропейском сегменте Google Cloud. Возникли неполадки в зоне доступности europe-west-2-b, одной из трёх в лондонском регионе.
11.11.2026 [14:40], Павел Котов
С отключением 2G-сетей в Великобритании придётся заменить до 13 миллионов умных счётчиковОт 12 до 13 млн умных счётчиков в Великобритании могут перестать работать должным образом, когда к 2033 году операторы связи отключат сети 2G и 3G — замена всех этих счётчиков может обойтись в сумму около £4 млрд ($5,3 млрд), пишет The Register со ссылкой на разработчика технологий связи Wirepas. Вопрос умных счётчиков оказался для жителей страны непростым из-за неудачного внедрения этой технологии правительством. К 2020 году, как предполагалось, они должны были появиться в 80 % домохозяйств. Препятствием стали многочисленные задержки и технические неполадки — например, когда потребители обнаружили, что «умные» функции этих счётчиков при смене поставщика энергии перестают работать. Ещё одна проблема в том, что показания этих счётчиков передаются поставщикам по сетям 2G или 3G — версии с 4G начали появляться лишь в конце 2024 года. При этом ещё в 2021 году власти страны объявили о поэтапном отказе от сетей 2G и 3G к 2033 году, то есть заранее было известно, что срок службы этого оборудования будет ограничен. Мобильные операторы уже начали отказываться от услуг 3G, и все они намерены поэтапно закрыть доступ к 2G до установленного правительством срока в 2033 году. BT/EE начнёт сворачивать свою сеть в мае 2029 года, VMO2 начнёт данный процесс тем же летом, Vodafone намерен отключить 2G весной 2030 года. 
Источник изображения: Sergio Martins / unsplash.com В результате Великобритания столкнулась с двумя существенными статьями расходов. Первая охватывает счётчики нового поколения SMETS2, в которых требуется замена только модуля связи — только это обойдётся от £1,3–1,4 млрд ($1,7–1,9 млрд) даже без учёта дополнительных расходов, подсчитали в Wirepas. Вторая относится к 7 млн старых счётчиков первого поколения (SMETS1) со встроенными сотовыми модулями — такие счётчики придётся менять целиком. Это, по оценке авторов отчёта, обойдётся ещё в £2,1–2,45 ($2,8–3,3 млрд) при ориентировочной сумме замены от £300 до £350 ($399–466) за единицу. Выходит около £4 млрд затрат на замену, которые отразятся на счетах за электроэнергию для домохозяйств. Часть оборудования подлежит плановой замене, но отключение обеспечивающих его работу сотовых сетей делает этот процесс неизбежным и определяет сроки, когда это должно случиться. Замена SMETS2 преимущественно коснётся центра и юга Великобритании, потому что счётчики второго поколения подключаются по радиосети дальнего действия, и их отключение сетей 2G/3G не коснётся. Проблема старых SMETS1 актуальна по всей стране. Специализирующаяся на решениях в области IoT компания Wirepas предлагает решение проблемы в виде технологии NR+. Она основана на стандарте DECT-2020, предназначается для масштабирования и работает в нелицензируемой области спектра 1,9 ГГц. К концу срока службы подойдёт и стандарт 4G, напоминают в компании, и тогда счётчики придётся менять заново.
10.11.2026 [18:07], Павел Котов
Доступ более чем к 97 % данных Yandex Cloud восстановлен, по умолчанию включено резервное копированиеПосле атак на ЦОД инженеры «Яндекса» сумели восстановить доступ к 97,16 % данных клиентов на платформе Yandex Cloud, сообщила пресс-служба компании. Остальные 2,84 % оказались утеряны безвозвратно в связи с критическими повреждениями оборудования и отсутствия бэкапов у клиентов на платформе. Компания продолжает распределять вычислительные ресурсы платформы Yandex Cloud по новым самостоятельным локациям в российских регионах. Число локаций продолжает расти, добавили в «Яндексе». Сохранить все 100 % данных сумели клиенты Yandex Cloud, которые пользовались инструментами резервного копирования на платформе. По итогам инцидента в Yandex Cloud изменили подход к бэкапам — ранее механизм резервного копирования клиентам приходилось активировать самостоятельно. Теперь, когда создаётся новая виртуальная машина, эта функция включается по умолчанию. Услуга работает на прежних условиях — клиенты могут от неё отказаться, но, напомнили в «Яндексе», она является основным способом снизить риски в чрезвычайных обстоятельствах. 
Источник изображения: yandex.ru/company В октябре дата-центры «Яндекса» трижды подвергались атакам БПЛА — пострадали объекты в Сасово Рязанской области, в Калуге и Владимире. Суперкомпьютеры компании в результате инцидентов не пострадали. Чтобы компенсировать ущерб клиента компания до конца месяца отменила плату за все сервисы Yandex Cloud. На аналогичную меру ранее пошла платформа AWS, когда атакам БПЛА подверглись ЦОД в ОАЭ и Бахрейне.
09.11.2026 [01:17], Руслан Авдеев
Авиасообщение в США, наконец, перестанет зависеть от дискетФедеральное управление гражданской авиации США (Federal Aviation Administration, FAA) всё ещё использует компьютеры, работающие с классическими дискетами. Избавляться от устаревшего оборудования начнут в ближайшие годы, но для этого будут нужны дополнительные средства, сообщает The Register. FAA, отвечающее за безопасность авиаперелётов в США, наконец избавляется от систем, разработанных ещё в 1980-х гг., которые до сих пор используются более чем на 400 объектов в стране. Новая система Enterprise Information Display System (E-IDS) предполагает объединение на единой цифровой платформе данных из различных, уже действующих систем. Это позволяет авиадиспетчерам получать доступ к рабочим данным и предупреждениям, необходимым для управления полётами. E-IDS заменит четыре устаревших системы, включая Information Display System 4, используемую для отслеживания данных о погоде и получения оперативной информации, Automated Surface Observing System Controller Equipment Information Display System, также передающую метеоданные, NAS Information Display System — данные об аэропортах и En Route Information Display System (ERIDS), которая отвечает за обработку информации об авиарейсах. FAA объявило, что E-IDS поможет улучшить процесс сбора и распространения докладов пилотов (Pilot Reports), а также извещений для авиаперсонала (Notices to Airmen, NOTAM). Стоит отметить, что в американской системе управления авиаперелётами ранее уже случались серьёзные сбои. Так, в 2023 году случайное удаление файла в системе NOTAM привело к приостановке внутренних вылетов в масштабах США. 
Источник изображения: Niklas König/unsplash.com По данным FAA, управление уже определило пять объектов, для которых предусмотрено пилотное внедрение E-IDS. Это аэропорты Атлантик-Сити, Нэшвилла и Рочестера (Rochester, шт. Нью-Йорк), а также ЦОД в Атланте и Солт-Лейк-Сити. Всего к концу 2028 года планируется установка системы на 435 объектах. Названные сроки соответствуют масштабному трёхлетнему плану управления по модернизации национальной системы контроля за воздушным движением, представленному в 2025 году. Помимо четырёх систем, которые призвана заменить E-IDS, у FAA имеется немало устаревших технологий. По некоторым данным, 51 из 138 систем управления воздушным движением в распоряжении FAA находятся в неустойчивом состоянии, а для сохранения их работоспособности не хватает ни комплектующих, ни финансирования. Американский закон Big Beautiful Bill предусматривает выделение FAA $12,5 млрд, но этого недостаточно для решения всех задач управления. В декабре 2025 года сообщалось, что на обновление инфраструктуры необходимо $20 млрд сверх предусмотренного финансирования, и потребность, вероятно, сохраняется и по сей день. По словам главы FAA Брайана Бедфорда (Brian Bedford), чтобы продолжить модернизацию объектов управления авиасообщением, необходимо принять закон Modern Skies Act, предполагающий выделение $30 млрд на завершение обновления соответствующей системы. Закон позволит модернизировать систему управления воздушным движением, а также заменить приходящую в упадок авиационную инфраструктуру и построить по всей стране аэропорты мирового уровня. Главное контрольно-финансовое управление США (GAO) заявило в сентябре, что финансовые потребности FAA всё ещё удовлетворяются в недостаточном объёме. Для второго этапа модернизации дополнительно нужны $10,2 млрд, а сроки завершения этого этапа пока неизвестны.
08.11.2026 [23:59], Руслан Авдеев
Более сотни протестующих проникли на стройплощадку ЦОД Microsoft в АмстердамеБолее 100 активистов проникли на площадку строящегося дата-центра в Амстердаме. Ещё сотни человек провели мирную акцию через дорогу — акция стала частью масштабного общеевропейского марша против строительства ЦОД, запланированного на текущие выходные, сообщает Datacenter Dynamics. Строящийся ЦОД принадлежит компании Pure Data Centres (Pure DC), единственным арендатором объекта должна стать Microsoft. Ранее те же активисты уже захватывали площадку в июле, на короткое время приостановив стройку. Тот же 78-МВт объект привлёк в июне и внимание и других активистов, забросавших объект шариками с кислотой и краской. Pure DC заявляла, что инцидент никак не сказался на ходе строительства. В компании заявили, что понимают, что объект вызывает сильные эмоции у людей и подчеркнули, что уважают право людей выражать свою позицию мирными средствами. При этом не одобряются любые незаконные действия или активность, ставящая под угрозу безопасность людей. 
Источник изображения: Ahmet AZAKLI/unsplash.com В ходе протестов, связанных с ЦОД для Microsoft, активисты указывали, что IT-гигант сотрудничает с рядом государственных органов, чьи действия они не одобряют. Кроме того, протестующие ссылались на более масштабные проблемы, связанные с применением ИИ для слежки, климатическими изменениями, использованием воды и др. Также организаторов строительства обвинили в попытке обойти общенациональный запрет на строительство крупных дата-центров, разбив один крупный проект на три более мелких объекта. На деле проект ЦОД в Нидерландах одобрили до вступления общенационального запрета в силу в 2022 году, и даже до временного моратория в Амстердаме от 2019 года. Обновлённые ограничения в Амстердаме от 2025 года позволили продолжить реализацию некоторых проектов, в т.ч. на данной площадке. Кроме того, площадь объекта меньше, чем пороговое значение в соответствии с общенациональными ограничениями. Стоит отметить, что протесты в Нидерландах пока носят довольно безобидный характер. В апреле 2026 года появилась новость, что дом одного из членов городского совета Индианаполиса (США) обстреляли, оставив записку «Нет дата-центрам».
04.11.2026 [14:42], Павел Котов
Beget сообщил о полной потере части данных и начале восстановления работоспособности сервисовХостинг-провайдер Beget сообщил об утере данных в облачной инфраструктуре в результате атаки на его ресурсы. Это затронуло данные VPS, S3, Kubernetes, а также настройки CDN и IP. При этом сохранены сохранены файловые бэкапы VPS, но не бинарные копии. Компания занята восстановлением функциональности всех сервисов. Кибератака произошла в ночь с 1 на 2 ноября 2026 года. Наиболее сильно в результате инцидента пострадала облачная инфраструктура. Провайдер говорит о возможности восстановления последних, но для этого необходимо вернуть работоспособность инфраструктуры. Виртуальный хостинг пострадал меньше — компания рассчитывает восстановить почти 100 % размещённых здесь сайтов. Beget уже занимается восстановлением этих серверов, но задача потребует значительного времени. Уже 2 ноября удалось вернуть в работу выделенные серверы без администрирования Beget. Принадлежащие клиентам домены не пострадали, заверил хостер. Первой после инцидента компания восстановила работу панели управления доменами. Компания договорилась с КЦ (Координационный центр сети Интернет), чтобы домены, у которых заканчивается срок делегирования, продолжали работать. По международным доменам работа продолжается. На 80 % восстановлена работа инфраструктуры почтового сервиса. 
Источник изображения: Beget Хостер начал запускать серверы виртуального хостинга и серверы с администрированием Beget; первые сайты уже начали открываться и работать, сообщила компания 4 ноября. Это займёт продолжительное время, пояснили в компании — каждый сервер проверяется отдельно, очищается от вредоносных механизмов, проверяется целостность данных. Для ускорения процесса работа проводится в параллельном режиме. Точные сроки восстановления работы всех систем в Beget пока не указывают. В октябре FirstVDS и несколько других провайдеров сообщили о взломе своих систем — проблема оказалась в уязвимости системы управления виртуализацией VMmanager 6, разработку которой ведёт ISPsystem (входит в «Группу Астра»).
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 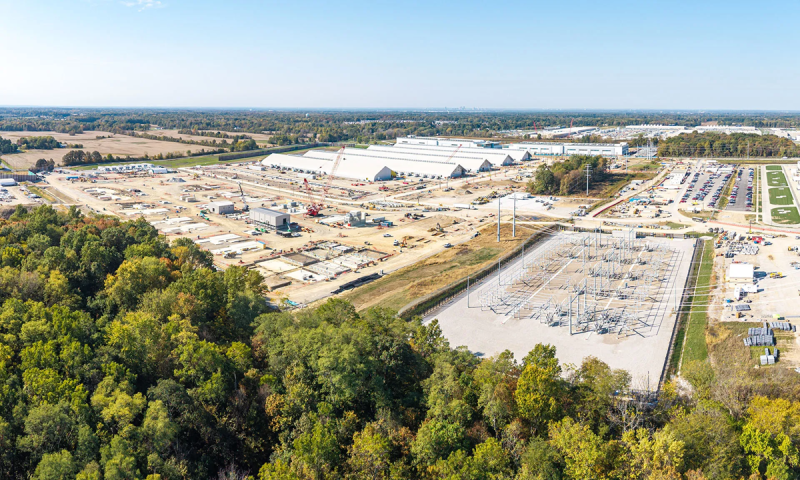
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 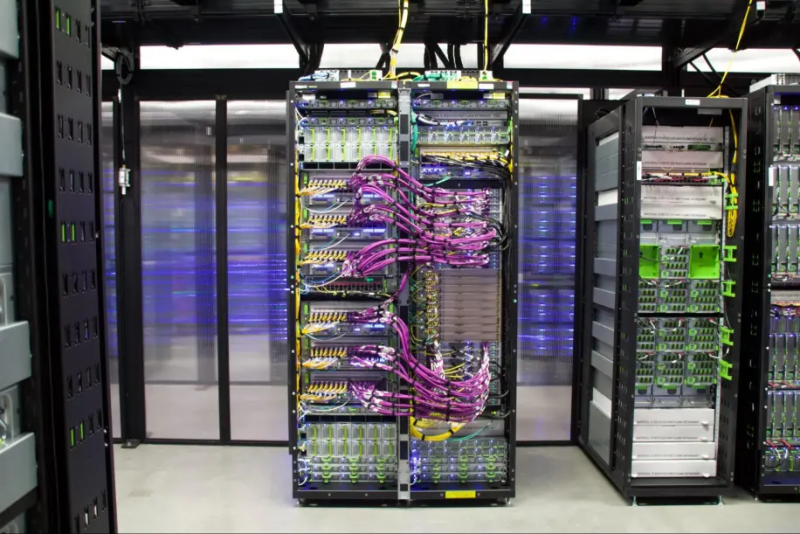
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов. |
|

