
Материалы по тегу: software
|
18.11.2026 [15:49], Андрей Крупин
В «Яндекс 360» для бизнеса появилась поддержка плагинов — они позволяют расширить возможности виртуального офисаОблачная площадка «Яндекс 360», предоставлявшая доступ к инструментам для совместной работы и делового общения, дополнилась каталогом плагинов — программных надстроек, позволяющих бизнесу расширить функциональные возможности виртуального офиса. В настоящий момент в каталоге собраны 50 плагинов — для «Трекера», «Почты», «Календаря», «Диска», «Вики» и «Форм». С их помощью можно, например, превратить входящее письмо из «Почты» в задачу в «Трекере», составить недельную сводку встреч в «Календаре» или сгенерировать QR-код со ссылкой на вики-страницу или опрос в «Формах». В будущем поддержка расширений появится во всех сервисах «Яндекс 360». 
Источник изображения: 360.yandex.ru Разработать собственный плагин и опубликовать его в каталоге может любая организация, которая использует «Почту» для доменов. «Яндекс 360» предоставляет весь необходимый инструментарий и документацию. Перед добавлением в каталог расширения проходят модерацию. Плагин можно сделать доступным всем компаниям или только своим сотрудникам. Ранее собственный каталог плагинов появился у «Алисы AI» для бизнеса. Посредством надстроек можно подключить ИИ-ассистента к корпоративным сервисам — «Алиса AI» будет использовать информацию из них в своих ответах.
18.11.2026 [09:55], Владимир Мироненко
NVIDIA ускорила эмуляцию FP64-вычислений на своих ИИ-чипахВо многих научных симуляциях — от молекулярной химии до материаловедения — львиная доля времени вычислений уходит на выполнение операций умножения плотных матриц (GEMM) с высокой точностью: DGEMM (для вещественных 64-бит чисел с плавающей запятой двойной точности) и ZGEMM (для комплексных 64-бит чисел с плавающей запятой двойной точности). В задачах HPC и ИИ для ускорения операций GEMM и других базовых подпрограмм линейной алгебры (BLAS) на ускорителях NVIDIA широко используется библиотека cuBLAS. Активное развитие аппаратных средств, оптимизированных для вычислений с более низкой точностью, стимулировало разработку нового класса алгоритмов, которые позволяют получать результаты с полноценной двойной точностью, используя при этом более быстрые тензорные ядра (Tensor Cores), изначально предназначенные для целочисленных вычислений. NVIDIA отметила, что с выходом CUDA Toolkit 13.4.2 при использовании cuBLAS больше не нужно выбирать между точностью и скоростью. Библиотека разбивает каждое число двойной точности на целочисленные компоненты, выполняет их умножение на тензорных ядрах, а затем восстанавливает точный результат. Итоговые значения имеют полную точность (double precision), но при этом вычисления выполняются без использования аппаратных FP64-блоков. 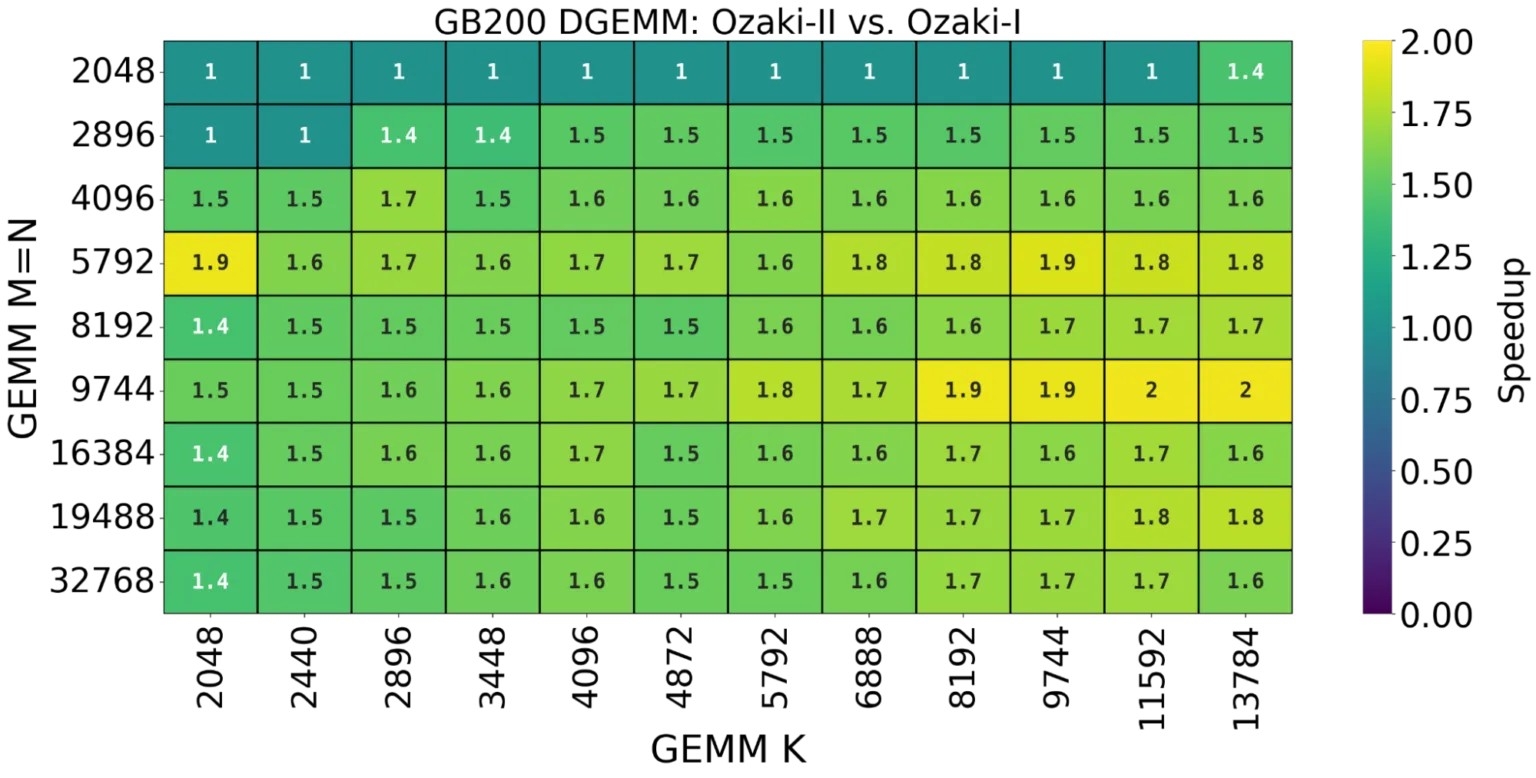 Росту эффективности процесса способствуют два новых алгоритма: схема Ozaki-II требует меньше целочисленных умножений, чем предыдущая версия Ozaki-I, а алгоритм 2M для эффективного умножения комплексных матриц сокращает количество операций по сравнению с классическим подходом с четырёх до двух. Решение основано на концепции автоматической динамической точности (Automatic Dynamic Precision, ADP). Схемы Озаки-I и Озаки-II имеют общий первый этап, но различаются способом выполнения умножения больших целых чисел. cuBLAS использует эвристический подход для автоматического выбора между алгоритмами для достижения максимальной производительности, хотя доступен и ручной выбор типа расчётов. Архитектура Rubin вводит новый числовой формат — TI16 (12-бит знаково целое с диапазоном значений от -2047 до +2047), который отлично подходит для ускорения вычислений по схеме Озаки. В библиотеке cuBLAS 13.4 формат TI16 используется для ускорения Ozaki-I и Ozaki-II с помощью инструкции `tcgen05.mma` на ускорителях Rubin. На рисунке ниже показан прирост скорости операции DGEMM в cuBLAS при использовании метода Ozaki-II по сравнению с нативным FP64 на системе VR200 NVL72. 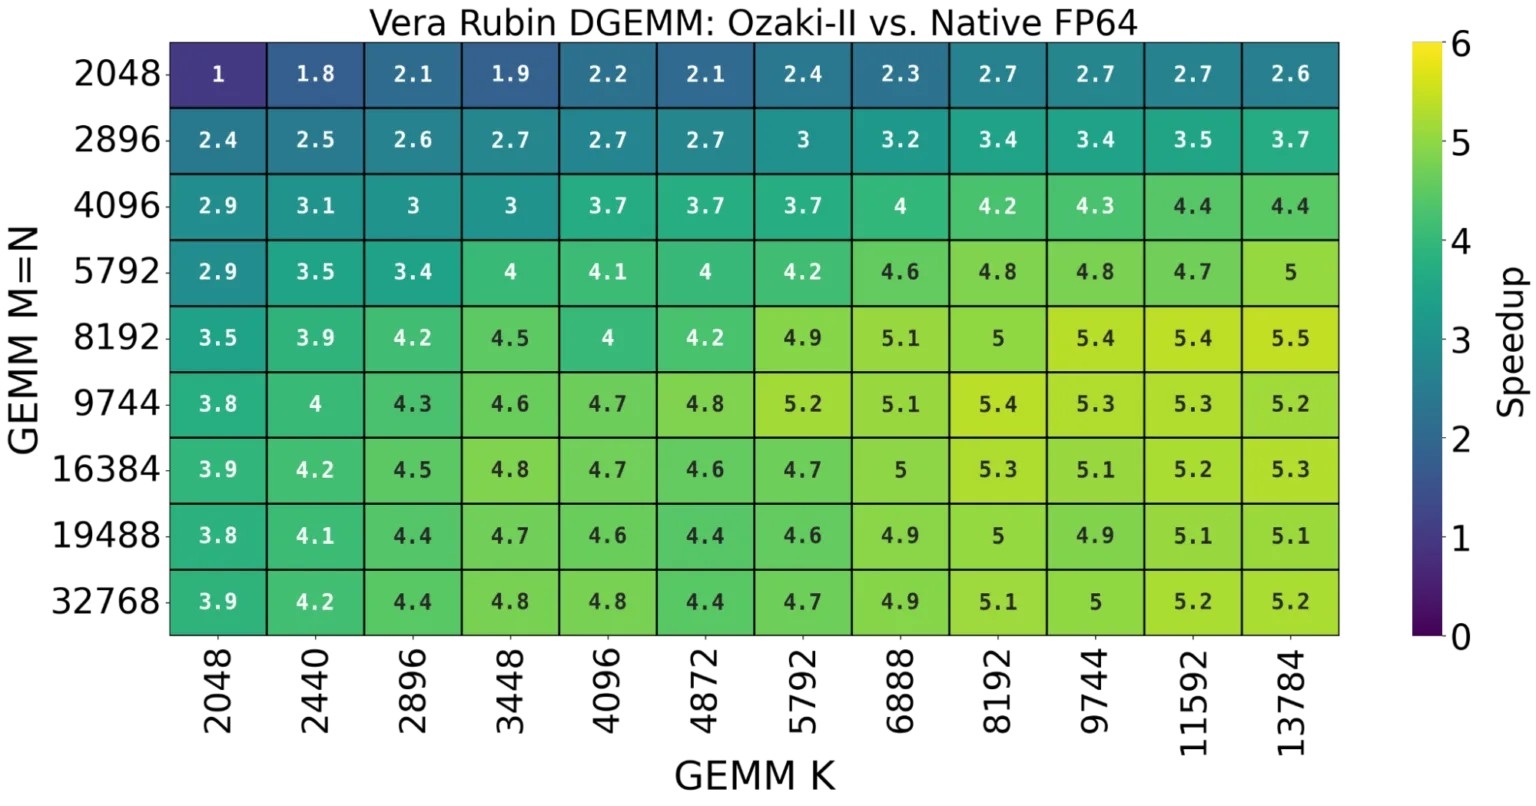 Верхний предел прироста производительности зависит от соотношения пропускной способности целочисленных тензорных ядер ускорителя и производительности его аппаратных блоков для вычислений в формате FP64. Это соотношение существенно варьируется в зависимости от конкретной модели устройства. Компания продемонстрировала это на примере ускорителя RTX PRO 6000 Blackwell Server Edition. На рисунке ниже представлено ускорение DGEMM при использовании схемы Ozaki-II по сравнению с нативным выполнением FP64 на данной модели. 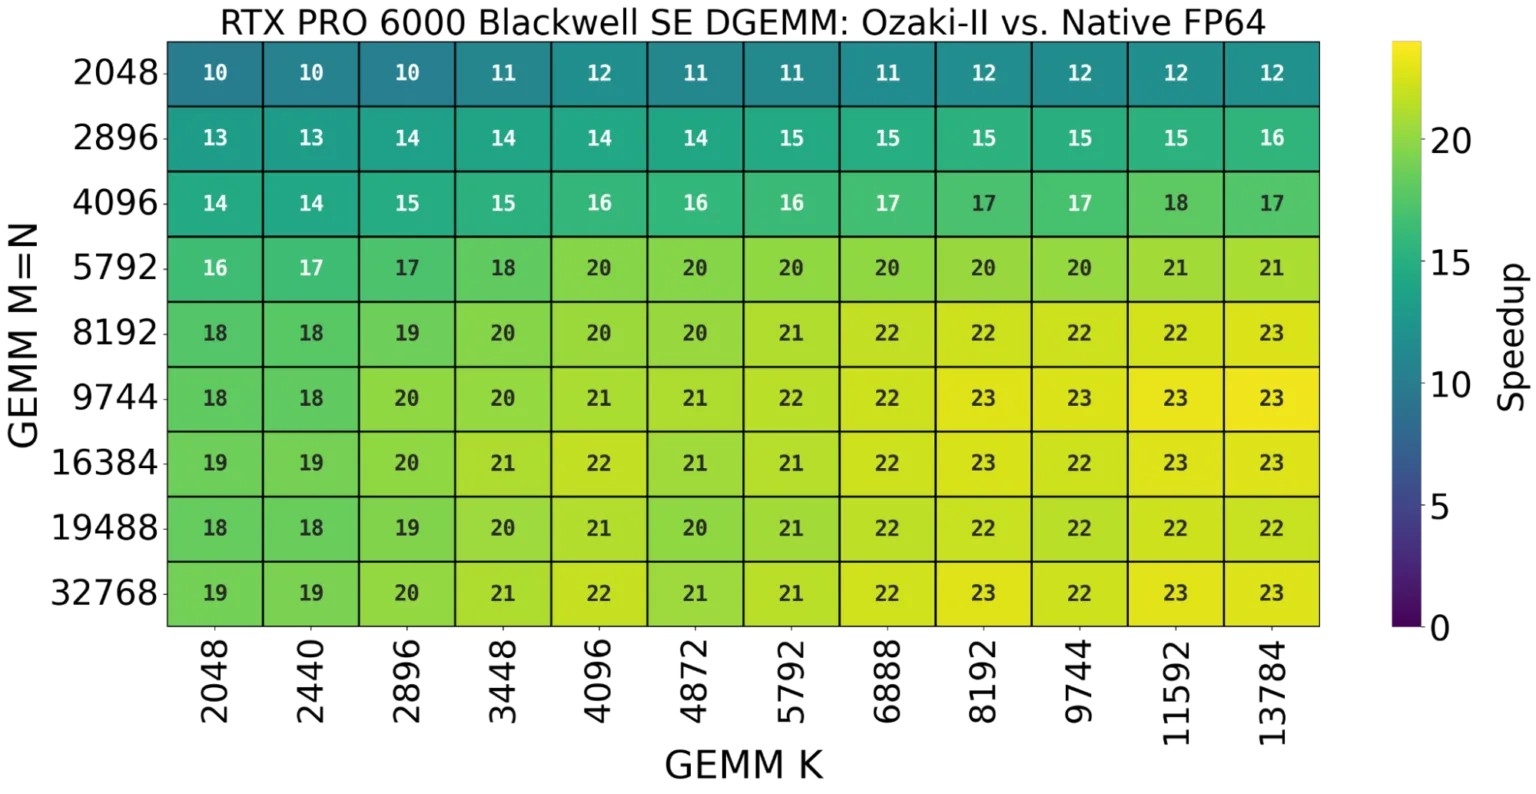 Применение Ozaki-II обеспечивает преимущество во всем диапазоне протестированных размеров матриц: даже для самых маленьких матриц скорость растёт в 10 раз, а для самых крупных — в 23 раза. NVIDIA осознанно предпочитает использовать эмуляцию для повышения производительности HPC на ИИ-ускорителях вместо создания специализированных блоков для аппаратных FP64-вычислений. В свою очередь, в AMD считают, что это FP64 остаётся золотым стандартом для научных вычислений и подход NVIDIA к этому вопросу оправдан не для всех сценариев. Разработчики AMD уверены, что в настоящее время нет замены «сырой» производительности FP64 и планируют увеличить нативную FP64-производительность ускорителя Instinct MI430X. Предполагается, что для «Миссии Генезис» (Genesis Mission) будут использоваться оба подхода, но в основном она будет полагаться на эмуляцию. Впрочем, NVIDIA Rubin HPC так или иначе обещает значительно повысить скорость обработки HPC-задач, но до выхода этого ускорителя пока далеко.
17.11.2026 [21:18], Павел Котов
Японский суперкомпьютер Fugaku взломали через страницу мониторингаЯпонский Центр компьютерных наук RIKEN, где размещается суперкомпьютер Fugaku, сообщил о несанкционированных попытках доступа вследствие утечки данных. В период с 10 по 13 ноября неизвестные произвели атаку на веб-панель, отображающую рабочие параметры Fugaku, передаёт The Register. С 2020 по 2022 год Fugaku возглавлял рейтинг TOP500 самых мощных суперкомпьютеров в мире. В обновлённой версии рейтинга он занимает девятое место. В результате взлома панели злоумышленники, по всей видимости, смогли проникнуть в сеть RIKEN. Они получили доступ к ряду серверов, содержащих данные авторизованных пользователей, и установили на них вредоносное ПО. На серверах хранились имена и адреса электронной почты пользователей, а также учётные данные, которые использовались для доступа к другим суперкомпьютерам и сервисам, не находящимся под управлением RIKEN. Злоумышленники предприняли попытки воспользоваться этими учётными данными. Сейчас RIKEN совместно с эксплуатирующими эти суперкомпьютеры организациями проводит расследование с целью установить, увенчались ли эти попытки успехом. 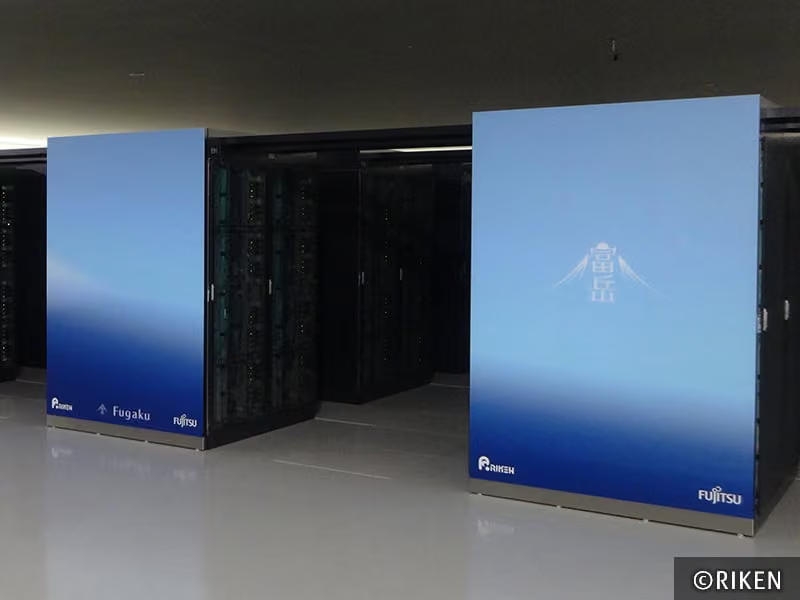
Источник изображения: Fujitsu В исследовательском центре пока не установили, как именно была произведена атака, нет и уверенности, к какой информации получили доступ злоумышленники и какие именно данные они могли похитить. Известно, что под угрозой оказались данные 4222 зарегистрированных пользователей Fugaku и 375 пользователей менее мощного суперкомпьютера RIKYU. 13 ноября была предпринята попытка войти в систему Fugaku, после чего специалисты центра оперативно отключили суперкомпьютер от Сети. Запустив свои рабочие процессы на одной из машин, злоумышленники могли нанести серьёзный ущерб. Fugaku используется для научных исследований. Доступ к нему предоставляется по заранее составленному графику, и вынужденный простой создаёт серьёзные препятствия для учёных, которые ожидали своей очереди. Признаков утечки исследовательских данных пока обнаружить не удалось. В научно-исследовательском центре пообещали тщательно расследовать инцидент. Власти Токио выделили экстренное финансирование в расчёте на то, что дополнительные средства оперативно помогут укрепить национальную систему киберзащиты.
16.11.2026 [21:47], Владимир Мироненко
К глобальному сбою в системах Microsoft 365 привела ошибка в обновлении служебной Windows трёхмесячной давностиКомпания Microsoft сообщила причины масштабного сбоя её сервисов, произошедшего на прошлой неделе, о чём пишет iTnews. Согласно предварительному отчёту, сбой связан с исправлением в Windows, подготовленным специально для сетевых шлюзовых серверов Microsoft 365 и запущенном в июле. В Microsoft подчеркнули, что данная ошибка и само исправление не имеют отношения к стандартным версиям Windows, используемым на пользовательских компьютерах. При этом обновление успешно прошло нагрузочное тестирование и было развернуто без каких-либо негативных последствий. И в течение трёх месяцев данная ошибка никак себя не проявляла. По словам исполнительного вице-президента Microsoft по направлению Copilot, агентов и платформы, дефект заключался в возникновении конкуренции за блокировку (lock contention) внутри одного из внутренних процессов. Это приводило к тому, что при определённых нагрузках серверы переставали отвечать на запросы. Нагрузочное тестирование не выявило эту проблему, поскольку производилось на менее производительном оборудовании с меньшим количеством ядер, тогда как проблема конкуренции за блокировку обостряется именно на более современных машинах с большим числом процессорных ядер. 
Источник изображения: Markus Spiske/unsplash.com Сбой спровоцировало событие, произошедшее примерно за 15 часов до его начала: сервис Teams был переключён с отдельной шлюзовой системы на основную — ту самую, которая обслуживает и Exchange Online. Это увеличило нагрузку и изменило характер распределения трафика. В это же время около 14 % мощностей шлюза были недоступны из-за другой, возникшей ранее проблемы, не связанной с данным происшествием. Сочетание этих факторов привело к проявлению дефекта, что вызвало настоящий хаос. Далее события развивались по классическому сценарию каскадного сбоя. Серверы начали выходить из строя в период пиковой нагрузки в США. При потере связи с сервером трафик перенаправлялся на следующий доступный узел, который, в свою очередь, сталкивался с той же проблемой. В течение двух часов дефект распространился на всю инфраструктуру Microsoft. В пиковый момент более 80 % серверов перестали отвечать на запросы. Изоляция между тысячами единиц ёмкости шлюза и его регионами должна была ограничить масштаб ущерба, однако этого не произошло — «из-за отдельной проблемы». Процесс восстановления затянулся, поскольку после перезапуска серверы вскоре снова выходили из строя под нагрузкой возобновившегося потока запросов. В то время как для сервисов Teams, SharePoint и OneDrive удалось перенаправить трафик в обход, и они восстановились раньше, для Exchange Online — в силу масштабов его работы — полноценное переключение маршрутов оказалось невозможным. Именно этим объясняется длительный период недоступности Exchange Online (который многие пользователи воспринимали как сбой в работе Outlook). К тому же автоматизированные механизмы восстановления Microsoft не были рассчитаны на столь масштабный сбой. А поскольку скрытая ошибка возникла ещё несколько месяцев назад, стандартные процедуры отката, поэтапного развёртывания и использования функциональных флагов не позволили быстро отменить внесенные изменения. Вместо этого в Microsoft разработали «исправление для исправления» — обновление, возвращающее код в исходное состояние, и применили его сразу к крупным группам серверов — в ряде случаев охватывающим более половины региона. Кроме того, были увеличены вычислительные мощности и продлён период доставки электронных писем, чтобы попавшие в очередь сообщения не были отклонены как недоставленные.
16.11.2026 [16:45], Сергей Карасёв
XXII конференция «Свободное программное обеспечение в высшей школе»«Базальт СПО» совместно с Институтом программных систем им. А.К. Айламазяна проводят XXII Ежегодную конференцию «Свободное программное обеспечение в высшей школе» (OSEDUCONF). Мероприятие пройдёт 5–7 февраля 2027 года в г. Переславле-Залесском на базе ИПС РАН. Ведущие учёные, педагоги, разработчики и администраторы расскажут об опыте внедрения СПО и организации образовательного процесса, создания благоприятных условий для вовлечения студентов в реальные проекты разработки свободных программных продуктов. Принимаются заявки на доклады по следующим темам:
Источник изображения: «Базальт СПО» Сроки подачи заявокДля докладчиков:
Для слушателей:
Участие для докладчиков и слушателей бесплатное. Тезисы докладов выйдут отдельным сборником и будут опубликованы в национальной библиографической базе данных научного цитирования РИНЦ. 21 января будет опубликована программа конференции и разосланы уведомления докладчикам. Требования к докладамДоклады о проприетарном ПО не допускаются. Не рассматриваются заявки на доклады без:
Онлайн-трансляция конференции будет доступна на VK Видео и странице конференции. Зарегистрироваться на конференцию и ознакомиться с информацией о форматах и шаблонах тезисов можно на сайте. По вопросам, связанным с докладами, тезисами, программой конференции, регистрацией, размещением, трансфером можно обратиться к организаторам по электронной почте conference@lists.altlinux.org.
15.11.2026 [21:27], Руслан Авдеев
Microsoft 364: на устранение сбоя облачных сервисов компании ушло больше сутокКомпания Microsoft восстановила работу ряда своих инструментов после общемирового сбоя, который коснулся более 70 стран, нарушив работу государственных и частных структур, а также обычных пользователей — в мире продуктами, затронутыми сбоем, пользуются более 430 млн человек. Microsoft уже извинилась за неполадки и рассказала, что те возникли в ходе модернизации сети и не связаны с кибератаками или действиями ИИ-агентов. По словам экспертов, инцидент стал наглядной демонстрацией того, насколько сильно бизнес и жизненно важные сервисы зависят от небольшой группы технологических компаний. Впервые пользователи начали сообщать о проблемах доступа к продуктам Microsoft 365 в четверг. К пятнице проблема уже коснулась самых разных учреждений, от правительства Японии и Верховного суда Филиппин до австралийских спецслужб, систем железнодорожного транспорта, больниц и судов в Северной Америке. К вечеру пятницы (по Москве) сервисы начали восстанавливать работу, с момента появления первых неполадок прошло около 24 часов. 
Источник изображения: ELLA DON/unsplash.com Впервые Microsoft оповестила пользователей о неполадках с доступом к почтовым ящикам Exchange Online в странах Северной и Южной Америке в 20:54 (МСК) в четверг. Вскоре после этого компания предупредила, что сбой, возможно, коснулся пользователей Microsoft 365 по всему миру. Компания инициировала расследование причин произошедшего и начала работать над восстановлением работы сервисов, но к 07:36 (МСК) пятницы сообщалось только о «частичном восстановлении» работы в некоторых частях света. К 16:32 (МСК) компания отчиталась о «более широком улучшении ситуации» в Северной Америке, «устойчивом улучшении» в большей части Европы и «обнадёживающих признаках восстановления» в Азиатско-Тихоокеанском регионе. По данным Microsoft, восстановление шло постепенно из-за масштабов проблемы и необходимости обеспечить стабильность работы сервисов после возобновления работы. В компании выразили «глубокое сожаление» из-за перебоев, сказавшихся на работе клиентов и партнёров. Полный отчёт о произошедшем будет опубликован после внутренней проверки. По словам экспертов, сценарии реагирования на случай масштабных сбоев в IT-сфере обычно предполагают использование для обеспечения устойчивой работы резервного сервиса. Тем не менее, на практике бизнесу «практически невозможно» обойтись без таких инструментов, как пакет ПО Microsoft. Сервисы Microsoft уже не первый раз страдают от сбоев. Так, в июле 2024 года масштабный сбой Microsoft Azure наложился на сбой CrowdStrike. В октябре 2025 года Microsoft объявила об успешном решении проблем с конфигурацией DNS, вызвавших сбои на платформе Azure. Инцидент повлиял на работу сервисов компании и затронул множество отраслей по всему миру.
13.11.2026 [12:14], Руслан Авдеев
Работа сервисов Microsoft нарушена в результате сбоя глобального масштабаВ четверг произошёл масштабный сбой в работе многочисленных программных продуктов и сервисов Microsoft, надолго лишивший компании и индивидуальных пользователей доступа к важным инструментам, сообщает The New York Times. По информации Downdetector, данные о сбое появились в четверг, в 00:15–01:00 по «восточному» времени (19:15–20:00 МСК в пятницу), когда люди и офисы по всему миру начали сообщать о неполадках в работе инструментария Microsoft 365, в т.ч. почтовые сервисы и программы для обмена сообщениями. Проблемы сохранились до позднего вечера четврга, по некоторым данным, местами они сохраняются и сейчас. По данным Downdetector, между 19:15–20:00 МСК более 130 тыс. пользователей сообщили о проблемах в работе Microsoft Outlook, Microsoft Teams, ИИ-помощника Copilot и Microsoft Store. Согласно обновлённым данным, появившимся в социальных сетях около полуночи пятницы по московскому времени, Microsoft заявила, что задействует все доступные способы восстановления работы сервисов, поскольку предпринятые меры не принесли желаемого результата. В 05:13 МСК компания объявила, что внесённые изменения «не дают ожидаемого эффекта». 
Источник изображения: blue sky/unsplash.com Ранее Microsoft сообщала, что часть её инфраструктуры испытывала «повышенную нагрузку» в нескольких регионах. Позже компания заявила, что уже начала перераспределять трафик между разными сегментами своей глобальной инфраструктуры для того, чтобы сбалансировать нагрузку и перезапускать пострадавшие от сбоев серверы. Позже агентство Reuters сообщило, что сбой продолжился в рабочие часы пятницы, в том числе в Азиатско-Тихоокеанском регионе. Неполадки коснулись организаций и пользователей в Австралии, Японии, США и Индии, повлияли на работу компаний OpenAI и Anthropic. По словам Министра внутренних дел и кибербезопасности Австралии Тони Берка (Tony Berk), Microsoft не считает случившееся кибератакой. Он не исключил, что ситуация может напоминать случившееся с CrowdStrike в 2024 году, когда причиной сбоя стало неудачное обновление ПО. Как объявила Microsoft в соцсети X «мы видим положительные результаты в плане стабильности сервиса и увеличения пропускной способности в результате наших последних действий по оптимизации трафика. Мы внедряем эти действия шире по всем затронутым регионам, стремясь достичь устойчивого восстановления». В конце октября масштабный сбой произошёл в западноевропейском сегменте Google Cloud. Возникли неполадки в зоне доступности europe-west-2-b, одной из трёх в лондонском регионе.
12.11.2026 [15:46], Андрей Крупин
Под оком BOSS'а: «Базис» представил ИИ-платформу для контроля IT- и бизнес-систем«Базис» (входит в ГК «РТК-ЦОД») выпустил платформу наблюдаемости Basis Observability System Suite (BOSS). Решение предназначено для организаций, в том числе финансового и государственного секторов, которым критично контролировать всю цепочку работы цифровых сервисов: от действия пользователей до приложений, баз данных и инфраструктуры. Основой для BOSS стали технологии отечественного разработчика «ПротоСервисез», 70 % которого «Базис» приобрёл в сентябре 2026 года. BOSS оценивает состояние корпоративной IT-среды на уровне бизнес-единиц, связывая технические показатели с бизнес-системами, процессами и операциями, помогая определить, какие из них затронул сбой. Анализ пользовательских сессий и карт пути помогает определить, где возникают затруднения и какие действия не удаётся завершить. Система контролирует целевые показатели качества сервисов и допустимый объём сбоев. Для обнаружения аномалий, анализа взаимосвязей и решения прочих сложных задач используются инструменты искусственного интеллекта и машинного обучения. 
Источник изображения: Compagnons / unsplash.com BOSS сопоставляет метрики, журналы событий и трассировки — данные о прохождении запросов через компоненты системы. Автоматически формируемая ресурсно-сервисная модель показывает связи между приложениями и инфраструктурой. На основе этой информации ИИ помогает выявить вероятную причину инцидента, восстановить цепочку сбоя и предложить рекомендации по его устранению. Алгоритмы машинного обучения выявляют аномалии с учётом сезонности и объединяют связанные оповещения в инциденты. Во встроенном чате специалист может на естественном языке уточнить, какие сервисы затронуты сбоем или почему увеличилось время ответа приложения. Для ИИ-функций можно подключить языковую модель с OpenAI-совместимым интерфейсом, в том числе развёрнутую у заказчика. По оценке разработчиков, уже в первой версии Basis Observability System Suite реализовано 95 %: функциональности ключевых зарубежных решений соответствующего класса: Dynatrace, Datadog и New Relic.
12.11.2026 [15:31], Андрей Крупин
DLP-система SecureTower дополнилась модулем DCAP для защиты данных «в покое»Компания «Фалконгейз» объявила о выпуске новой версии программного решения SecureTower 8.0 Titanium, предназначенного для защиты конфиденциальной информации в корпоративных сетях. SecureTower, по словам создателей, представляет собой полнофункциональную систему предотвращения утечек данных (Data Loss Prevention, DLP), посредством которой обеспечивается контроль максимального количества возможных каналов утечки информации. Продукт обладает арсеналом средств для мониторинга активности сотрудников и служит инструментом управления репутационными, операционными и правовыми рисками. Решение не требует изменения сетевой структуры организации. Перехват данных осуществляется централизованно либо с помощью агентов, устанавливаемых на рабочие станции в удалённом режиме. Платформа SecureTower зарегистрирована в реестре отечественного ПО. 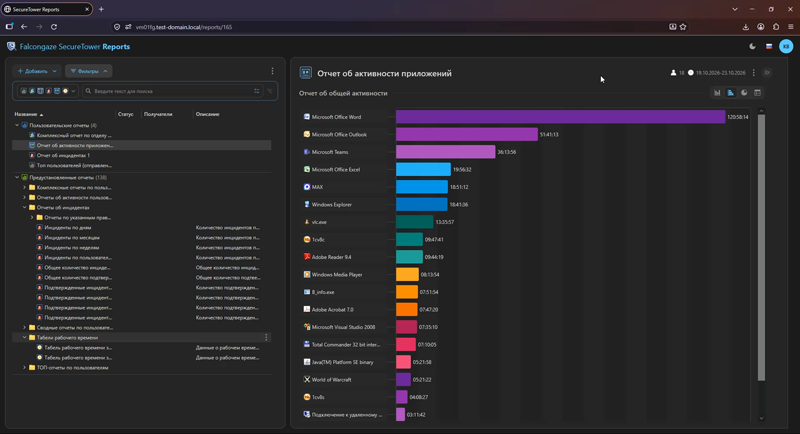
Веб-консоль SecureTower 8.0 Titanium (здесь и далее источник изображений — falcongaze.com) Главным нововведением SecureTower 8.0 Titanium стал модуль DCAP (Data-Centric Audit and Protection), предназначенный для аудита и защиты неструктурированных данных — файлов в сетевых папках, на файловых серверах, в общих ресурсах и облачных хранилищах. Теперь программный комплекс осуществляет контроль конфиденциальной информации не только в движении, но и в покое, информируя ИБ-службу в соответствии с заданными политиками о том, где хранятся данные, кто имеет к ним доступ, и нет ли у сотрудников избыточных прав. Система находит важные документы на рабочих станциях, присваивает им класс и уровень критичности и следит, чтобы конфиденциальная информация находилась только в разрешённых директориях. 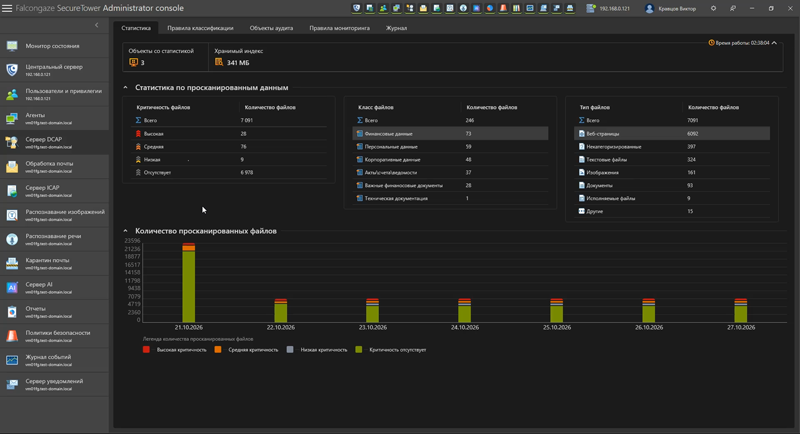
Модуль DCAP В числе прочих значимых доработок SecureTower 8.0 Titanium разработчиком отмечаются веб-консоль, повышающая мобильность сотрудников отдела ИБ, средства мониторинга используемых персоналом ИИ-сервисов и агент для macOS, в котором реализованы функции перехвата сетевого трафика и контроля печати. В дополнение к этому в новой версии DLP-системы добавлена блокировка отправки файлов, в том числе по содержимому, в мессенджерах Max и Aitu, появился перехват сообщений, файлов и звонков в «1С Коннект», а также перехват звонков в веб-версиях Telegram, Mac, Teams и «Контур.Толк» с распознаванием речи. 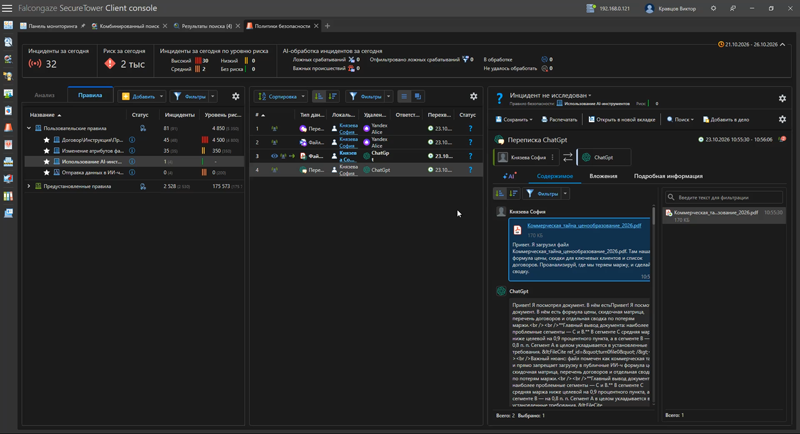
Модуль перехвата ИИ-сервисов Из других нововведений: расширены условия запуска записи экрана и микрофона в аудио/видеомониторинге; добавлена история местоположений сотрудников в модуле «Оборудование и программы» с возможностью настройки уведомлений об отклонениях в местоположении и конфигурации ПК на почту и в Telegram; появилась возможность блокировки подключения к недоверенным Wi-Fi-сетям; функциональность карантина почтовых писем стала доступна для организаций, использующих в работе Microsoft Exchange; добавлена возможность выбора типов данных для распознавания речи и др.
12.11.2026 [10:00], Сергей Карасёв
РТК-ЦОД дополнил платформу защиты и восстановления данных «Ковчег» модулями «Бункер» и «Феникс»РТК-ЦОД, ИТ-сервис-провайдер полного цикла, на площадке CNews Forum представил расширенную архитектуру платформы резервного копирования и восстановления данных «Ковчег». О модулях «Бункер» и «Феникс» в ходе своего выступления рассказал технический директор компании Алексей Забродин. Представленные решения дополняют базовый контур хранения «Резерв» в составе «Ковчега» и позволяют выстроить многоуровневую защиту данных заказчика. В основе платформы «Ковчег» лежит принцип жёсткой изоляции: резервные данные физически вынесены за пределы основной инфраструктуры заказчика. Базовым контуром выступает модуль «Резерв», который размещает критически важную информацию на удалённой площадке и применяет строгую ролевую модель доступа. Архитектура решения выстроена так, что даже полная компрометация ИТ-среды заказчика не позволяет изменить защищённые резервные копии или удалить их. Модуль «Бункер» представляет собой ещё один уровень защиты данных, реализованный в виде отдельной инсталляции, физически размещённой на дополнительной площадке. По заданному графику «Бункер» подключается к «Резерву» и забирает актуальные снэпшоты — мгновенные копии, фиксирующие точное состояние данных на конкретный момент времени. Затем он переносит их в физически изолированное, неизменяемое хранилище. Режим работы по расписанию с возможностью отключения системы хранения данных обеспечивает дополнительную защиту за счёт периодической недоступности хранилища. 
Источник изображения: РТК-ЦОД «Феникс» представляет собой изолированную доверенную среду восстановления. Если модули «Резерв» и «Бункер» отвечают за хранение резервных копий, то «Феникс» позволяет развернуть и проверить их в чистой среде, перед восстановлением в продуктивную инфраструктуру. В зависимости от требований заказчика решение может быть реализовано в нескольких конфигурациях. Первая предполагает выделение готовых вычислительных ресурсов в облаке РТК-ЦОД. Второй вариант — построение частного облака. Третий сценарий — предоставление инфраструктуры по модели bare metal. РТК-ЦОД передаёт заказчику подключенное к облаку оборудование, на котором он самостоятельно или с участием специалистов провайдера настраивает свой ИТ-ландшафт. Для восстановления «Феникс» может задействовать и резервные мощности самого заказчика. Для крупных компаний с особыми требованиями к архитектуре доступен ещё один сценарий — создание индивидуальной «холодной» площадки. РТК-ЦОД готовит выделенную инфраструктуру, повторяющую ИТ-ландшафт заказчика в ограниченном или полноценном формате. Такая инсталляция находится в режиме ожидания и активируется при необходимости срочного восстановления основного ЦОД. «Феникс» может использоваться не только для экстренного восстановления после сбоев или атак, но и как резервный ЦОД. В штатном режиме заказчик может оптимизировать затраты, перераспределив часть поддерживающих систем на площадку «Феникса» и снизив нагрузку на основную инфраструктуру. «"Ковчег" — это не просто бэкап, это решение, которое разрывает цепочку атаки. С модулями «Бункер» и «Феникс» мы завершаем архитектуру: теперь данные не просто хранятся, они физически недоступны для атакующих, а у бизнеса есть безопасная среда для их проверки и перезапуска ИТ-инфраструктуры. РТК-ЦОД предлагает заказчикам не только защиту резервных копий, но и план восстановления, а также обеспечивает полный цикл эксплуатации и поддержки. Это комплексный подход, который реально спасает бизнес в критической ситуации», — заявил технический директор РТК-ЦОД Алексей Забродин. |
|

