
Лента новостей
|
18.11.2026 [09:55], Владимир Мироненко
NVIDIA ускорила эмуляцию FP64-вычислений на своих ИИ-чипахВо многих научных симуляциях — от молекулярной химии до материаловедения — львиная доля времени вычислений уходит на выполнение операций умножения плотных матриц (GEMM) с высокой точностью: DGEMM (для вещественных 64-бит чисел с плавающей запятой двойной точности) и ZGEMM (для комплексных 64-бит чисел с плавающей запятой двойной точности). В задачах HPC и ИИ для ускорения операций GEMM и других базовых подпрограмм линейной алгебры (BLAS) на ускорителях NVIDIA широко используется библиотека cuBLAS. Активное развитие аппаратных средств, оптимизированных для вычислений с более низкой точностью, стимулировало разработку нового класса алгоритмов, которые позволяют получать результаты с полноценной двойной точностью, используя при этом более быстрые тензорные ядра (Tensor Cores), изначально предназначенные для целочисленных вычислений. NVIDIA отметила, что с выходом CUDA Toolkit 13.4.2 при использовании cuBLAS больше не нужно выбирать между точностью и скоростью. Библиотека разбивает каждое число двойной точности на целочисленные компоненты, выполняет их умножение на тензорных ядрах, а затем восстанавливает точный результат. Итоговые значения имеют полную точность (double precision), но при этом вычисления выполняются без использования аппаратных FP64-блоков. 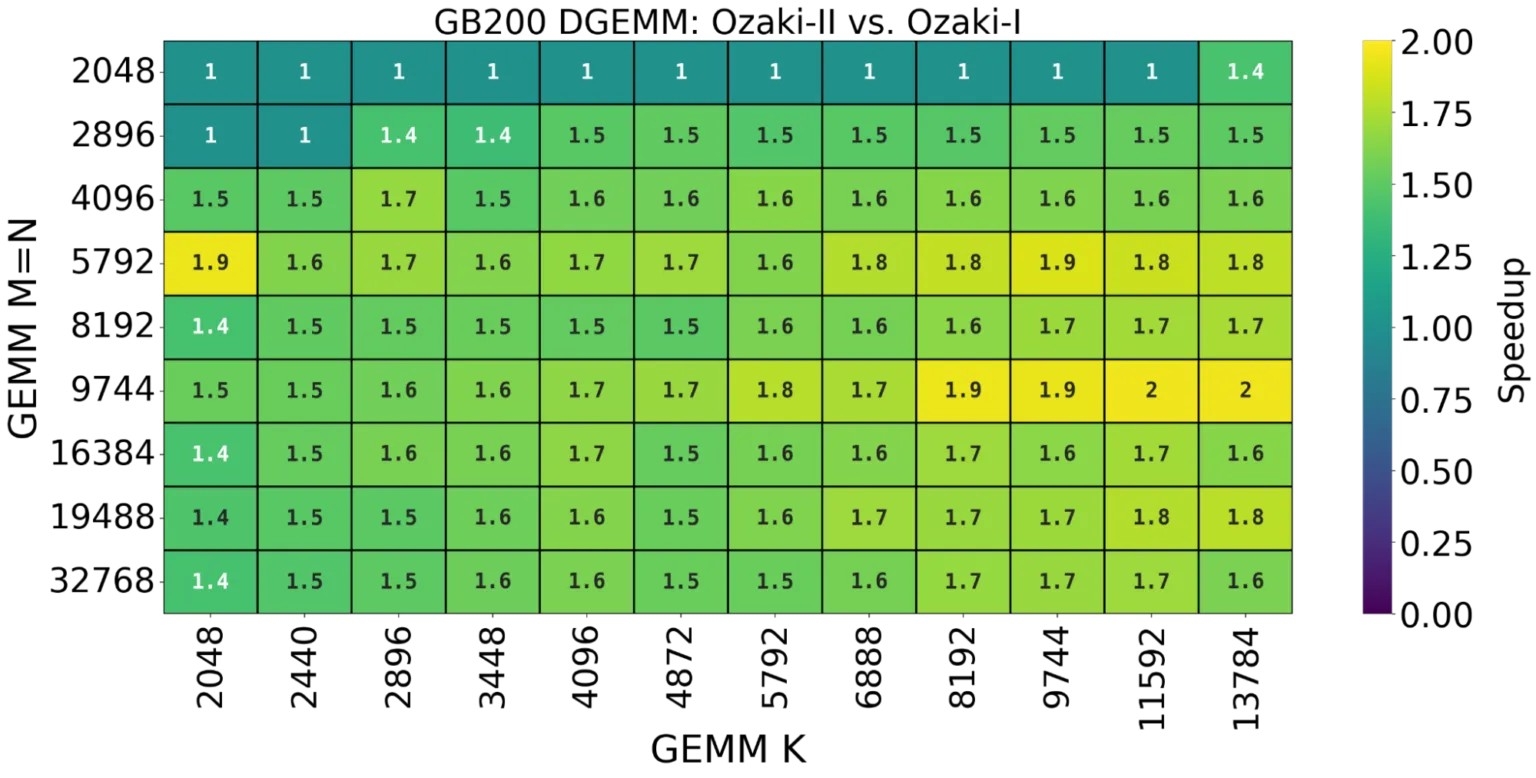 Росту эффективности процесса способствуют два новых алгоритма: схема Ozaki-II требует меньше целочисленных умножений, чем предыдущая версия Ozaki-I, а алгоритм 2M для эффективного умножения комплексных матриц сокращает количество операций по сравнению с классическим подходом с четырёх до двух. Решение основано на концепции автоматической динамической точности (Automatic Dynamic Precision, ADP). Схемы Озаки-I и Озаки-II имеют общий первый этап, но различаются способом выполнения умножения больших целых чисел. cuBLAS использует эвристический подход для автоматического выбора между алгоритмами для достижения максимальной производительности, хотя доступен и ручной выбор типа расчётов. Архитектура Rubin вводит новый числовой формат — TI16 (12-бит знаково целое с диапазоном значений от -2047 до +2047), который отлично подходит для ускорения вычислений по схеме Озаки. В библиотеке cuBLAS 13.4 формат TI16 используется для ускорения Ozaki-I и Ozaki-II с помощью инструкции `tcgen05.mma` на ускорителях Rubin. На рисунке ниже показан прирост скорости операции DGEMM в cuBLAS при использовании метода Ozaki-II по сравнению с нативным FP64 на системе VR200 NVL72. 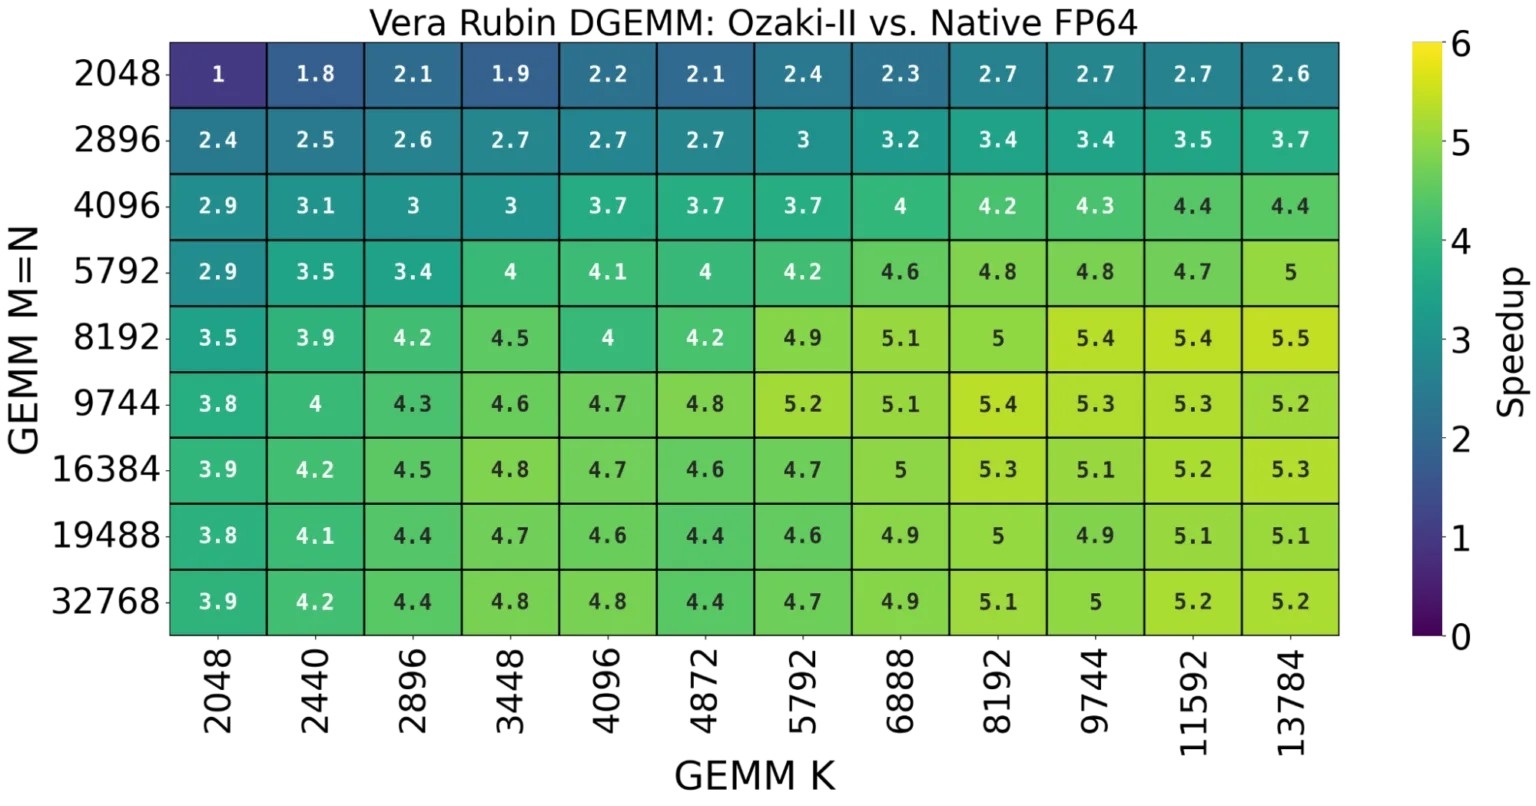 Верхний предел прироста производительности зависит от соотношения пропускной способности целочисленных тензорных ядер ускорителя и производительности его аппаратных блоков для вычислений в формате FP64. Это соотношение существенно варьируется в зависимости от конкретной модели устройства. Компания продемонстрировала это на примере ускорителя RTX PRO 6000 Blackwell Server Edition. На рисунке ниже представлено ускорение DGEMM при использовании схемы Ozaki-II по сравнению с нативным выполнением FP64 на данной модели. 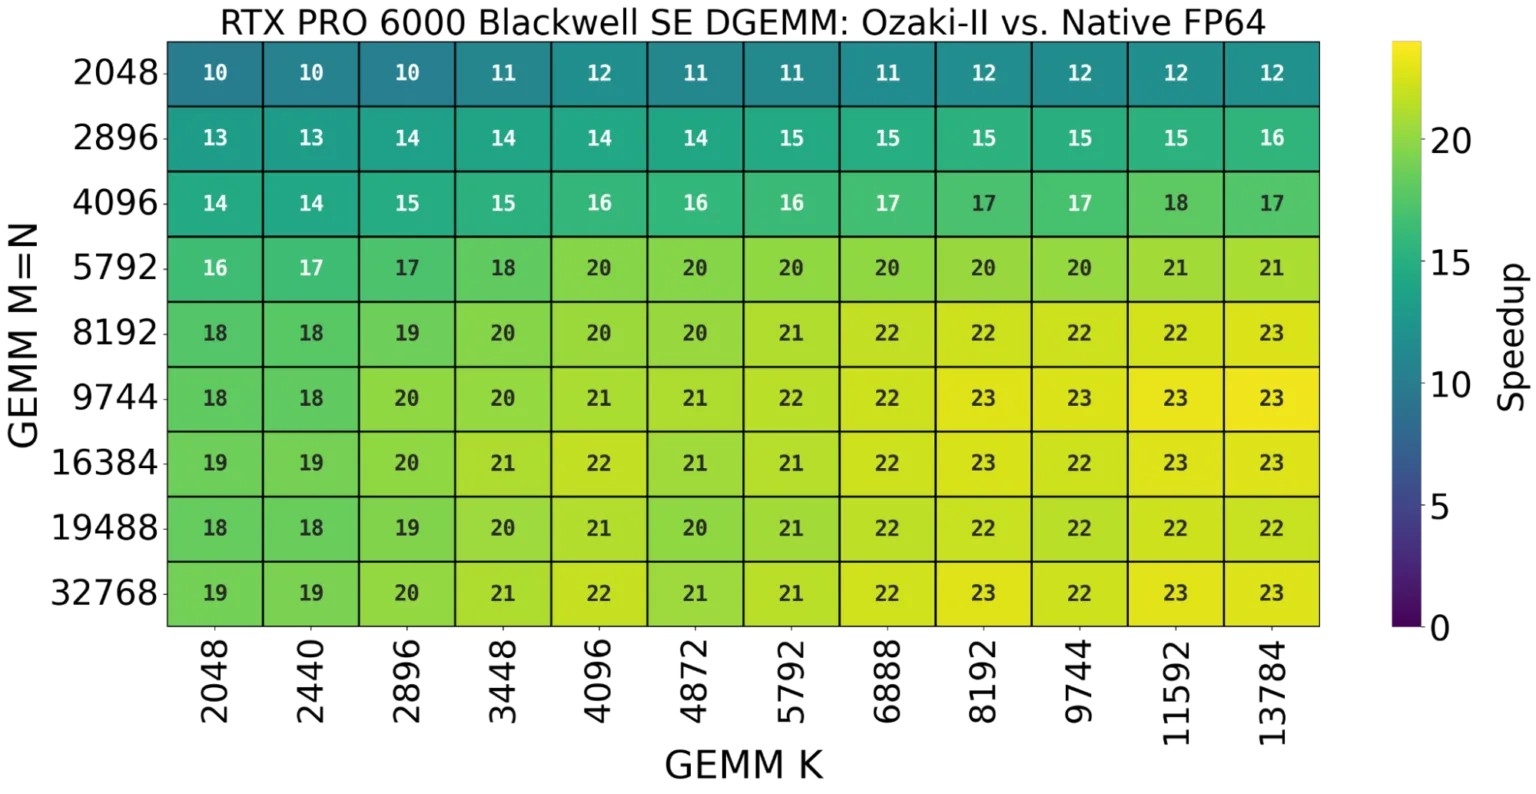 Применение Ozaki-II обеспечивает преимущество во всем диапазоне протестированных размеров матриц: даже для самых маленьких матриц скорость растёт в 10 раз, а для самых крупных — в 23 раза. NVIDIA осознанно предпочитает использовать эмуляцию для повышения производительности HPC на ИИ-ускорителях вместо создания специализированных блоков для аппаратных FP64-вычислений. В свою очередь, в AMD считают, что это FP64 остаётся золотым стандартом для научных вычислений и подход NVIDIA к этому вопросу оправдан не для всех сценариев. Разработчики AMD уверены, что в настоящее время нет замены «сырой» производительности FP64 и планируют увеличить нативную FP64-производительность ускорителя Instinct MI430X. Предполагается, что для «Миссии Генезис» (Genesis Mission) будут использоваться оба подхода, но в основном она будет полагаться на эмуляцию. Впрочем, NVIDIA Rubin HPC так или иначе обещает значительно повысить скорость обработки HPC-задач, но до выхода этого ускорителя пока далеко.
18.11.2026 [09:22], Руслан Авдеев
Компьютер LEO, открывший эпоху коммерческого применения вычислительной техники, отмечает 75-летиеВ ноябре исполняется 75 лет бизнес-вычислениям. Кембриджский Центр истории вычислительной техники (Centre for Computing History, Великобритания) устраивает праздник LEO@75 в честь машины, положившей начало коммерческому применению вычислительной техники, сообщает The Register. Центр представляет собой интерактивный музей компьютеров. В 2018 году он получил грант Национальной лотереи Великобритании (National Lottery), призванный помочь сохранить, архивировать и оцифровывать различные артефакты, документы и личные воспоминания, связанные с компьютерами LEO (Lyons Electronic Office). LEO был одним из первых компьютеров, важность разработки трудно переоценить. Его архитектура была построена на основе системы EDSAC Кембриджского университета, созданной командой, возглавлявшейся одним из пионеров компьютерных вычислений — Морисом Винсентом Уилксом (Maurice Vincent Wilkes, 1913–2010). 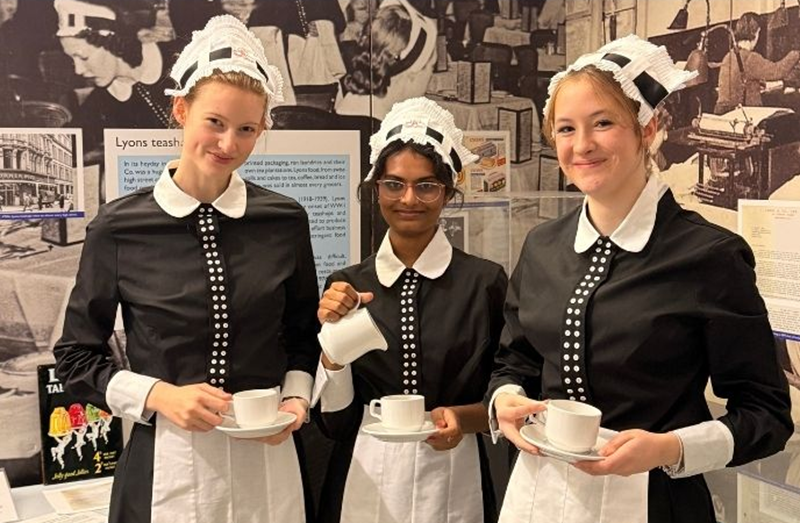
Источник изображения: Centre For Computing History При разработке EDSAC использовались идеи, изложенные в незавершённом документе «Первый проект отчёта об EDVAC» (First Draft of a Report on the EDVAC) Джона фон Неймана (John von Neumann). Черновик документа распространили в 1945 году, за четыре года до появления самого компьютера. В том же году завершились работы над его предшественником — ENIAC. Изначально тот программировался с помощью переключателей и перекоммутации кабелей. EDVAC же проектировали как машину, способную хранить команды непосредственно в собственной памяти. В докладе были изложены принципы, ныне известные как «архитектура фон Неймана» (принстонская архитектура). На эти идеи опирались Морис Уилкс (Maurice Wilkes) и Дуглас Хартри (Douglas Hartree) при разработке EDSAC, ставшено непосредственным предшественником LEO. EDSAC выполнил свою первую программу в мае 1949 года, за несколько месяцев до поставки модели BINAC, созданной Эккертом (Eckert) и Мокли (Mauchly) и ставшей первой машиной с хранимой программой за авторством данных исследователей. Первой работавшей электронной машиной с хранимой программой был экспериментальный компьютер Manchester Baby (Small-Scale Experimental Machine), выполнивший свою первую программу в 1948 году. LEO выполнил первую коммерческую программу в 1951 году, и в том же году Бюро переписи населения США (US Census Bureau) получило компьютер UNIVAC I, разработанный Эккертом и Мокли.
17.11.2026 [22:05], Павел Котов
LANL испытает ускорители Maverick-2 — это уже вторая система NextSilicon для Министерства энергетики СШАМинистерство энергетики США развернуло на базе испытательного стенда Darwin в Лос-Аламосской национальной лаборатории (LANL) второй кластер Maverick-2 израильского стартапа NextSilicon, сообщает The Register. Новая система значительно меньше развёрнутого ранее в в Сандийских национальных лабораториях первого суперкомпьютера на базе технологий NextSilicon с 64 вычислительными узлами и 128 ускорителями — она располагает всего четырьмя ускорителями. Подобные компактные системы позволяют специалистам LANL проверять и адаптировать для новых чипов широкий спектр программных кодов, выявлять неполадки, совместно с NextSilicon устранять их и непосредственно влиять на функциональные возможности чипов будущих поколений. Интерес LANL к Maverick-2 — это первый шаг к масштабному внедрению решений NextSilicon в будущие суперкомпьютеры Министерства энергетики. Инженерам необходим прямой доступ к оборудованию, поскольку некоторые из решаемых в лаборатории задач невозможно запускать на общедоступных вычислительных системах. Помимо ядерного оружия, лаборатория занимается моделированием процессов, например, термоядерного синтеза. 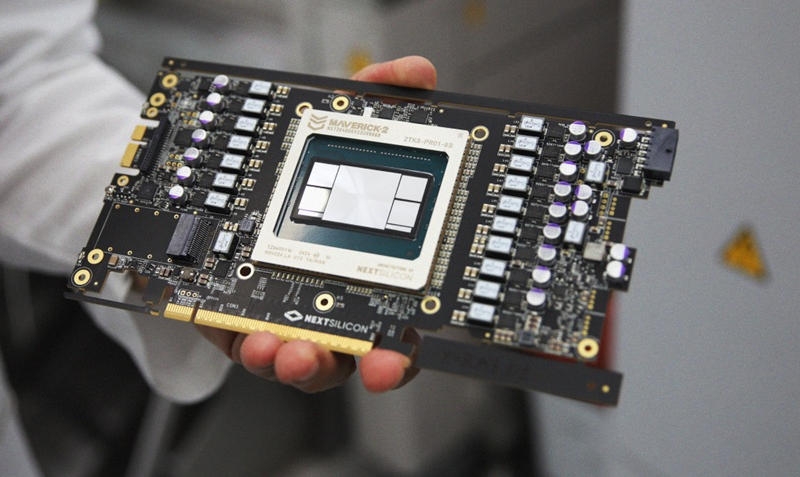
Источник изображения: NextSilicon «NextSilicon подходит для переконфигурирования системы в соответствии с рабочей нагрузкой, по запросу. Надежда в том, что нам не придётся больше жёстко определять объём требуемых ресурсов CPU и GPU. Мы можем пользоваться более гибкой, конфигурируемой архитектурой, адаптируемой к рабочему процессу», — рассказал главный научный сотрудник LANL Гален Шипман (Galen Shipman). Архитектуры на основе потоков данных могут быть эффективными в задачах с ограничениями пропускной способности памяти. Поэтому ускорители с похожей архитектурой, такие как Groq,Cerebras и SambaNova всё чаще используются в задачах инференса. Решения NextSilicon отличаются изначальной поддержкой разреженных FP64-вычислений. Однако разработка для таких чипов сложнее, поэтому NextSilicon создала компилятор, преобразующий существующий программный код на C, Python, Fortran или CUDA в граф для запуска на Maverick. Предельная производительность Maverick-2 варьируется в зависимости от типа рабочей нагрузки, поэтому в NextSilicon решили не афишировать пиковые теоретические показатели. NextSilicon протестировала свои системы в HPCG, LAMMPS и Sparta. В HPCG один чип Maverick демонстрирует производительность 600 Гфлопс — это сопоставимо с показателями современных GPU, но при вдвое меньшем потреблении энергии.
17.11.2026 [21:31], Павел Котов
AWS продаст Blackstone два кампуса ЦОД и тут же арендует ихAWS и инвестиционная компания Blackstone заключили сделку, согласно которой последняя становится владельцем двух кампусов ЦОД AWS и передаёт их в обратно аренду Amazon на первоначальный срок в 12 лет, сообщает The Register. Ранее AWS решила передать чипы NVIDIA Grace Blackwell на сумму около $8 млрд созданной специально для этих целей компании (SPV), чтобы взять их назад в аренду. Только что сформированная структура Blackstone Digital Infrastructure Trust (BXDC) получит долю в 75 % в двух совместных предприятиях (СП) с AWS. Сумма сделки оценивается в $5 млрд. AWS сохраняет за собой долю в 25 % в этих СП и принимает объекты на условиях полной ответственности за их содержание. Это значит, что, помимо арендной платы, компания обязуется покрывать расходы на уплату налогов на недвижимость, страхование зданий, а также затраты на их техническое обслуживание и ремонт. Активы BXDC включают 13 недавно построенных объектов для размещения серверного оборудования общей мощностью 647 МВт, гласит поданная Blackstone в Комиссию по ценным бумагам и биржам США (SEC) форма 8-K. Один из кампусов включает девять зданий, расположенных на сервере штата Индиана; второй — ещё четыре объекта в штате Миссисипи. AWS арендует мощности и у других операторов ЦОД — в этом году компания заключила соглашение со STACK Infrastructure о развитии кампусов в северо-западной части штата Луизиана; проект оценивается в $12 млрд. Также AWS увеличила инвестиции в ИИ ЦОД в Луизиане, но отозвала заявку на строительство ЦОД в Вирджинии. 
Источник изображения: Amazon Сделки по схеме продажи с обратной арендой также нередко встречаются в отрасли ЦОД — форматом REIT пользуются многие девелоперы и операторы. QTS Realty Trust, также входящая в Blackstone, строила объекты, которые впоследствии передавались в аренду Microsoft. По словам Omdia, схема продажи с обратной арендой может быть более оправданной экономически. Важно понимать, что речь идёт о здании и инфраструктуре, а не оборудовании, которое размещается на объекте. «Также очевидно, что масштабные капзатраты гиперскейлеров создают нагрузку на их финансовые показатели, и они вынуждены обращаться к рынку заёмного капитала для финансирования строительства. Конечно, использование заёмных средств — стандартная практика, но можно предположить, что сейчас объём долга для развития ИИ-инфраструктуры значительно выше, чем в прошлом», — говорит Omdia. Сделка, как ожидается, будет закрыта в IV квартале 2026 года при соблюдении условий. Любая из сторон может расторгнуть соглашение, если оно не будет закрыто к 31 декабря 2026 года, гласит форма 8-K. В этом случае сторона, не являющаяся причиной расторжения договора, имеет право на получение компенсации за расторжение сделки в размере $150 млн.
17.11.2026 [21:18], Павел Котов
Японский суперкомпьютер Fugaku взломали через страницу мониторингаЯпонский Центр компьютерных наук RIKEN, где размещается суперкомпьютер Fugaku, сообщил о несанкционированных попытках доступа вследствие утечки данных. В период с 10 по 13 ноября неизвестные произвели атаку на веб-панель, отображающую рабочие параметры Fugaku, передаёт The Register. С 2020 по 2022 год Fugaku возглавлял рейтинг TOP500 самых мощных суперкомпьютеров в мире. В обновлённой версии рейтинга он занимает девятое место. В результате взлома панели злоумышленники, по всей видимости, смогли проникнуть в сеть RIKEN. Они получили доступ к ряду серверов, содержащих данные авторизованных пользователей, и установили на них вредоносное ПО. На серверах хранились имена и адреса электронной почты пользователей, а также учётные данные, которые использовались для доступа к другим суперкомпьютерам и сервисам, не находящимся под управлением RIKEN. Злоумышленники предприняли попытки воспользоваться этими учётными данными. Сейчас RIKEN совместно с эксплуатирующими эти суперкомпьютеры организациями проводит расследование с целью установить, увенчались ли эти попытки успехом. 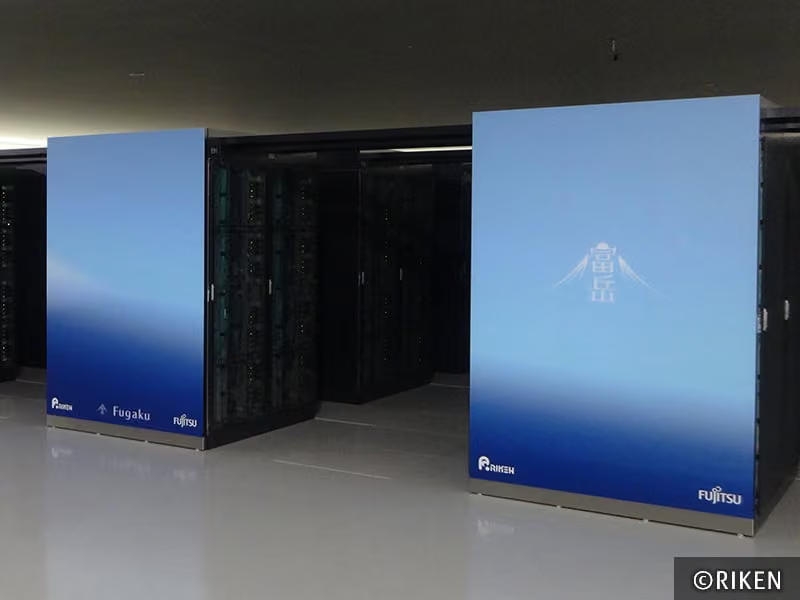
Источник изображения: Fujitsu В исследовательском центре пока не установили, как именно была произведена атака, нет и уверенности, к какой информации получили доступ злоумышленники и какие именно данные они могли похитить. Известно, что под угрозой оказались данные 4222 зарегистрированных пользователей Fugaku и 375 пользователей менее мощного суперкомпьютера RIKYU. 13 ноября была предпринята попытка войти в систему Fugaku, после чего специалисты центра оперативно отключили суперкомпьютер от Сети. Запустив свои рабочие процессы на одной из машин, злоумышленники могли нанести серьёзный ущерб. Fugaku используется для научных исследований. Доступ к нему предоставляется по заранее составленному графику, и вынужденный простой создаёт серьёзные препятствия для учёных, которые ожидали своей очереди. Признаков утечки исследовательских данных пока обнаружить не удалось. В научно-исследовательском центре пообещали тщательно расследовать инцидент. Власти Токио выделили экстренное финансирование в расчёте на то, что дополнительные средства оперативно помогут укрепить национальную систему киберзащиты.
17.11.2026 [17:39], Руслан Авдеев
Нордическая ИИ-гигафабрика: Финляндия, Эстония, Латвия и Швеция вместе построят распределённую ИИ-инфраструктуруNokia, Nscale, Skeleton, Telia и Verda объявили о создании консорциума AI Gigafactory Northern (AIGF Northern). Он нацелен на создание надёжной, распределённой ИИ-инфраструктуры путём создания «гигафабрики» (Gigafactory) в странах Северной Европы и Балтии, сообщила Nokia. Отдельные площадки будут объединены в единый кластер под европейским управлением. Масштабные вычислительные ИИ-мощности будут сочетаться с суверенными облачными сервисами и платформенными решениями в сфере ИИ, высокопроизводительными каналами связи и низкоуглеродными источниками энергии. Участники проекта намерены подать заявку на строительство и управление AIGF Northern в рамках конкурса на создание консорциума ИИ-гигафабрики, объявленного Европейским совместным предприятием по развитию высокопроизводительных вычислений (EuroHPC JU). В июле сообщалось, что EuroHPC JU объявила о начале приёма заявок на участие в тендере для строительства и эксплуатации ИИ-гигафабрик (AI Gigafactories/AIGF), сообщает HPC Wire. Гигафабрики вместе с «обычными» ИИ-фабриками обеспечат доступность ИИ-сервисов и мощностей для государственных структур и частных пользователей из государств, участвующих в проекте. AIGF Northern объединит инфраструктуру многочисленных площадок в Северной Европе и Балтии, что позволит бизнесам, исследователям и государственным организациям Европы получить доступ к масштабируемым сервисам в сфере доверенных вычислений, облачных решений и связи. Распределение вычислительных мощностей по разным странам позволяет снизить риски, связанные с их концентрацией, и повысить устойчивость европейской ИИ-экосистемы. 
Источник изображения: Danny Rienecker/unsplash.com Консорциум формируется на фоне наращивания инвестиций Евросоюза в ИИ-мощности Европы. В рамках инициативы InvestAI планируется привлечь €30 млрд: €20 млрд из частных источников и €10 млрд из бюджета Евросоюза, а также бюджетов государств объединения. AIGF Northern объединит объекты в Оулу (Oulu, Финляндия), Иру (Iru, Эстония), Валмиере (Valmiera, Латвия). Где находится площадка в Швеции, пока не определено. Распределение мощностей между объектами позволит использовать разные источники низкоуглеродной энергии, а также расширить вычислительную инфраструктуру там, где есть для этого необходимые ресурсы и снизить зависимость от одной площадки или одного поставщика. Подобный подход усилит операционную устойчивость проекта и обеспечит поддержку трансграничного расширения по мере роста спроса на ИИ в Евросоюзе. Консорциум поддерживают и ведущие структуры в сфере исследований и инноваций, включая Финский технический исследовательский центр VTT (VTT Technical Research Centre of Finland), Королевский технологический институт KTH — крупнейший технический университет Швеции. Они и другие партнёры инициативы помогут связать инфраструктурные планы AIGF Northern с научными, инновационными и кадровыми ресурсами стран. 
Источник изображения: Samuel Regan-Asante/unsplash.com Nokia обеспечит проекту защищённую и высокопроизводительную инфраструктуру связи, необходимую для объединения площадок, надёжной передачи данных и обеспечения устойчивости системы. Nscale намерена предоставить облачную платформу и экспертизу в сфере ИИ-инфраструктуры для создания масштабируемых сред с целью обучения ИИ-моделей и инференса. Telia, совместно с дочерней структурой Telia Cygate, поделится компетенциями в области связи, передачи данных, эксплуатации инфраструктуры и облачных решений. Verda предоставит специализированную инфраструктуру, оптимизированную для ИИ-задач, а также экспертизу в сфере облачных технологий. Это позволит обеспечить масштабируемые мощности для обучения ИИ-моделей и инференса. Skeleton предоставит системы высокой мощности, повышающие эффективность и стабильность ЦОД в больших масштабах и снижающие нагрузку на электросети, а также способствующие сокращению углеродного следа. В июле сообщалось, что консорциум ÆTHER (AETHER), включающий европейских компаний-лидеров в сфере ИИ, облачных вычислений и энергетики объединил усилия всех участников для строительства ИИ-гигафабрик (AI Gigafactory) в рамках проекта Еврокомиссии AI Continent Action Plan. Европейские власти уже подтвердили поддержку проекта. Особое внимание будет уделяться экономическому развитию, созданию рабочих мест, региональной реиндустриализаци, обеспечению суверенитета и развития технологий. По словам консорциума, ИИ является исторической возможностью для реиндустриализации Европы.
17.11.2026 [17:38], Павел Котов
Lambda развернула CPO-коммутаторы NVIDIA Quantum-XНеооблачный провайдер Lambda объединил посредством CPO-коммутаторов NVIDIA Quantum-X 10 тыс. ускорителей в составе стоек GB300 NVL72. Это помогло снизить потребление энергии, повысить отказоустойчивость и увеличить среднее время между сбоями в ИИ ЦОД. Задержка сократилась примерно на 4 % на уровне стойки и на величину до 10 % на уровне вычислительного модуля. При этом сеть сохранила показатель пропускной способности, сопоставимый с показателями традиционных подключаемых оптических модулей. Отказ от традиционных подключаемых трансиверов в пользу интегрированной оптики повысил энергоэффективность до пяти раз, а надёжность работы — до 15 рах. В такой системе используется вчетверо меньше лазеров, что означает сокращение числа компонентов, подверженных выходу из строя. 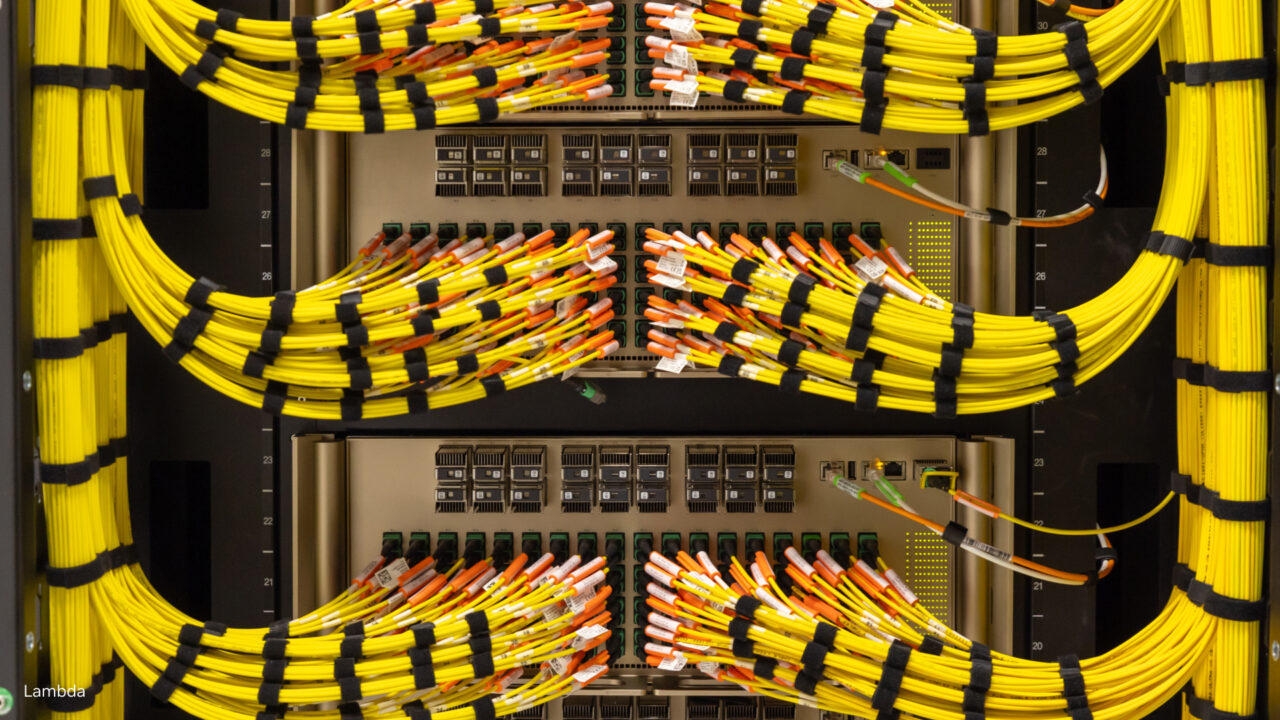
Источник изображения: NVIDIA Для отвода тепла от чипа коммутатора и оптических модулей используется СЖО. Медианная температура оптических компонентов составляет 36 °C — для сравнения, у традиционных сменных оптических модулей она равна 51 °C. В ходе проведённых испытаний было установлено, что повысилась стабильность целостности сигнала. Каждый коммутатор комплектуется 18 съёмными внешними источниками света, которые подают излучение на оптические модули. Оптические модули можно заменять непосредственно на месте эксплуатации — в отличие от традиционных подключаемых оптических компонентов, где при выходе лазера из строя менять приходится весь модуль целиком. Близкое размещение компонентов друг к другу в десятки раз сокращает путь электрического сигнала, сокращая потери. Кроме того, отпадает необходимость в использовании ретаймеров — в итоге снижаются как энергопотребление, так и количество компонентов на пути передачи сигнала.
17.11.2026 [16:05], Сергей Карасёв
Curator: в преддверии Черной пятницы активность вредоносных ботов выросла на 20 %В начале сезона ноябрьских распродаж провайдер решений в области кибербезопасности и доставки контента Curator зафиксировал рост активности вредоносных ботов на 20 % по сравнению с предшествующим периодом. При этом, согласно статистике Curator.Antibot за III квартал 2026 года, именно электронная коммерция остаётся главной целью такой автоматизированной активности: на интернет-магазины пришлось 55,6 % всех заблокированных вредоносных бот-запросов против 43,67 % кварталом ранее. Таким образом, доля электронной коммерции в общем объёме вредоносного бот-трафика увеличилась почти на 12 %. На втором месте по доле вредоносных бот-запросов оказались медиаресурсы (15,3 %), на третьем — онлайн-ставки (8,9 %). В отличие от DDoS-атак, цель которых — нарушить доступность ресурса, вредоносные боты не обязательно стремятся вывести сайт из строя. Они могут автоматически собирать информацию о ценах и остатках товаров, копировать каталоги, подбирать учётные данные пользователей или злоупотреблять функциональностью интернет-магазинов. Сайт при этом может работать в обычном режиме, а вредоносная активность — оставаться незаметной для покупателей. 
Источник изображения: unsplash.com / Markus Stickling Атаки ботов способны продолжаться несколько суток. Так, самая долгая бот-атака в III квартале длилась около 6,5 дней и была направлена на организацию из сегмента «Электронная коммерция» — за это время Curator заблокировал порядка 60 млн вредоносных запросов. После этого активность не прекратилась, однако её острая фаза завершилась и интенсивность уменьшилась. В целом, в июле-сентябре 2026 года Curator.Antibot блокировал в среднем около 1,8 млрд запросов ежемесячно. Этот показатель практически не изменился по сравнению со II кварталом, однако распределение активности по отраслям заметно сместилось в сторону электронной коммерции. Структура бот-трафика при этом постепенно усложняется: доля API-ботов держится на уровне 45,6 % от общего объёма, а доля «умных» ботов, способных распознавать и обходить защитные проверки, хоть и остаётся небольшой (0,5 %), но входит в число растущих типов автоматизации. Это значит, что значительная часть бот-трафика в e-commerce сегодня не ограничивается примитивным скрапингом страниц, а эксплуатирует API интернет-магазинов напрямую — в том числе для автоматизированного оформления заказов и проверки остатков в реальном времени. «В период крупных распродаж интернет-магазины готовятся прежде всего к наплыву покупателей и пиковым нагрузкам, но высокий трафик создаёт благоприятные условия и для автоматизированных злоупотреблений. Боты могут собирать информацию о ценах и остатках, промокоды, массово скупать дефицитные товары, подбирать пароли к аккаунтам с сохранёнными картами, а посредники могут зарабатывать, перепродавая такие данные или доступ, — комментирует генеральный директор Curator Дмитрий Ткачёв. — Поэтому при подготовке к распродажам важно учитывать не только устойчивость инфраструктуры к большим нагрузкам и DDoS-атакам, но и характер самого трафика. За высоким трафиком могут скрываться не только реальные покупатели, но и автоматизированные запросы, которые создают дополнительную нагрузку и затрагивают бизнес-процессы интернет-магазина». Реклама | ООО «Эйч-Эль-Эль» ИНН 7704773923 erid: F7NfYUJCUneVfSGdEiRS
17.11.2026 [14:35], Руслан Авдеев
OpenAI арендует у TensorWave 457 МВт ИИ-мощностей на базе AMD InstinctOpenAI заключила шестилетнее соглашение с облачной TensorWave о предоставлении ИИ-мощностей объёмом 457 МВт. Это произошло вскоре после того, как Fermi официально расторгла предварительный договор аренды с той же компанией, касающийся кампуса Project Matador в Техасе, сообщает Datacenter Dynamics. Согласно новому договору, TensorWave предоставит OpenAI выделенные вычислительные мощности на базе ускорителей AMD Instinct MI455X. Последние разместят в нескольких ЦОД. Доступ к ним должен появиться в I половине 2027 года, а все мощности должны быть развёрнуты к началу 2028 года. В TensorWave контракт назван крупнейшей сделкой по развёртыванию ИИ-инфрастурктуры за всю историю компании. Речь фактически идёт о развитии ранее анонсированного партнёрства OpenAI и AMD. Объявлению предшествовала новость о расторжении сделки Fermi и TensorWave об аренде мощностей и предоставлении услуг в ЦОД, заключенной в августе 2026 года. Предполагалось, что TensorWave арендует до 650 МВт мощностей в кампусе Project Matador близ Амарилло (Amarillo, шт. Техас), а AMD обеспечит кредитную поддержку сделки. По данным самой скандально известной Fermi, действие соглашения об аренде официально прекратили после того, как стороны не уложились в установленный срок, отведённый для завершения сделки, и у девелопера теперь не осталось арендатора для кампуса. 
Источник изображения: Amina Atar/unsplash.com Тем не менее Fermi объявила о заключении отдельного соглашения с неназванным гиперскейлером на 600 МВт мощностей в рамках инициативы Project Matador. Клиент обязался заплатить вперёд $200 млн, в т.ч. на подведение к площадке электроснабжения. Ожидается, что ввод мощностей в эксплуатацию начнётся с 2027 года. Также гиперскейлер выделит $15 млн на подготовительные строительные работы. Попутно идёт окончательное согласование договора на закупку стали и других стройматериалов на $90 млн, которых должно хватить на возведение нескольких ЦОД. В Fermi подчеркнули, что заказчик принял на себя финансовые обязательства, обещав участвовать в развитии проекта до подписания договора аренды из-за необходимости обеспечить объекту доступ к электроснабжению в соответствии с графиком. Fermi заявляет, что текущее портфолио проектов на стадии разработки включает потенциальных заказчиков, в перспективе способных освоить уже запланированные мощности на 2,2 ГВт. При этом реализация планов зависит от дальнейшей разработки проектов и заключения договоров аренды мощностей.
17.11.2026 [14:25], Владимир Мироненко
Платформа NVIDIA Vera Rubin обошла конкурентов во всех тестах MLPerf Training v6.1Дебют платформы NVIDIA Vera Rubin в бенчмарках MLPerf был отмечен её лидерством по производительности в таких областях, как обучение моделей, постобучение и выполнение задач интеллектуальными агентами (agentic inference), сообщила NVIDIA. NVIDIA опередила конкурентов во всех тестах MLPerf Training v6.1. При этом, в категории MLPerf Endpoints компания показала более чем десятикратный прирост (по сравнению с предыдущим поколением) пропускной способности на ватт для систем на базе ИИ-агентов. NVIDIA стала единственной, показавшей результаты во всех тестах текущего цикла — от больших языковых моделей и генерации изображений до рекомендательных систем и постобучения моделей с подкреплением. При этом система Vera Rubin NVL72 продемонстрировала до двух раз более высокую производительность в расчете на один GPU по сравнению с NVIDIA GB300 NVL72. NVIDIA также провела тестирование на 10 240 GPU в составе систем GB300 — это самый масштабный показатель в данном раунде. А платформа Microsoft Azure провела тесты, задействовав 10 240 GPU NVIDIA в системах GB200. 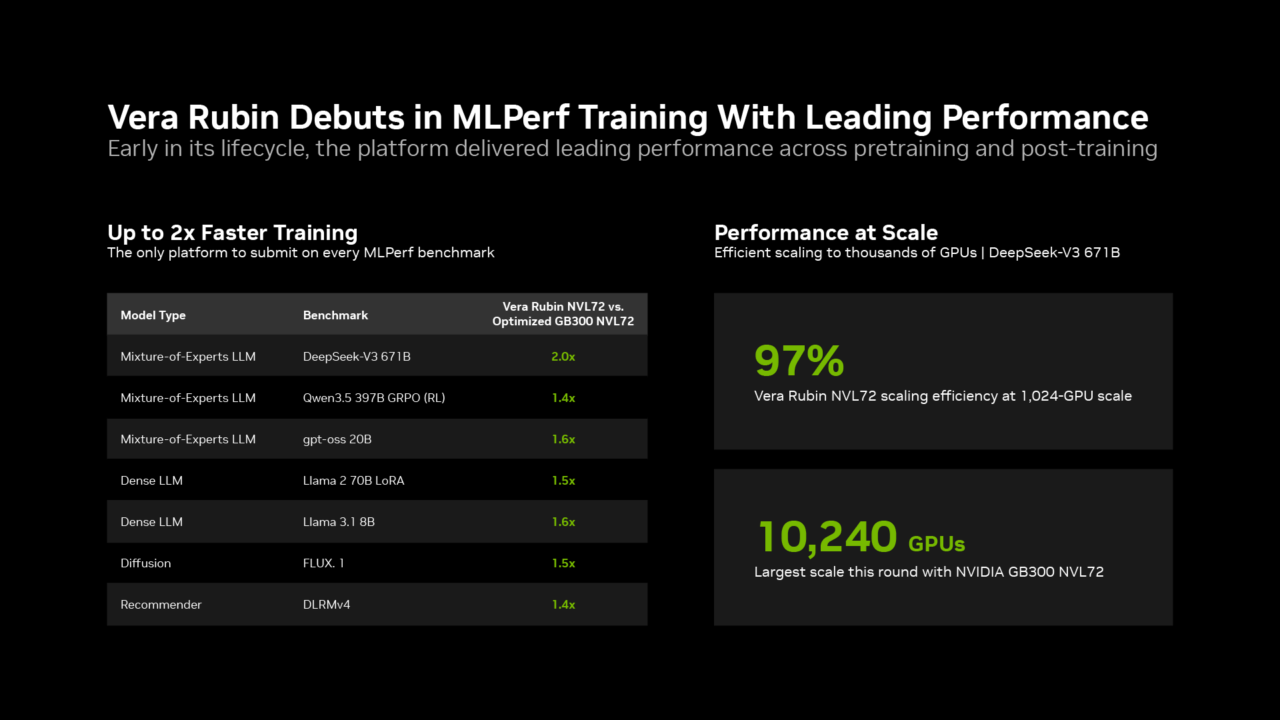
Источник изображений: NVIDIA NVIDIA Vera Rubin стала лидером в области агентных вычислений (agentic inference) по результатам тестов MLPerf Endpoints, показав лучшие показатели во всех бенчмарках, ориентированных на работу AI-агентов. Тестирование MLPerf Endpoints оценивает производительность систем в реальных сценариях работы AI-агентов, одновременно проверяя, насколько успешно и корректно они справляются с поставленными целями. Согласно предварительным результатам для Kimi K3 — крупной открытой модели, разработанной специально для агентных рабочих процессов, — системы VR200 NVL72 обеспечили более чем десятикратное преимущество по пропускной способности на ватт затраченной энергии по сравнению с GB300 NVL72 при идентичной скорости отклика. Предварительные результаты для системы Vera Rubin ожидают подтверждения со стороны ассоциации MLCommons. 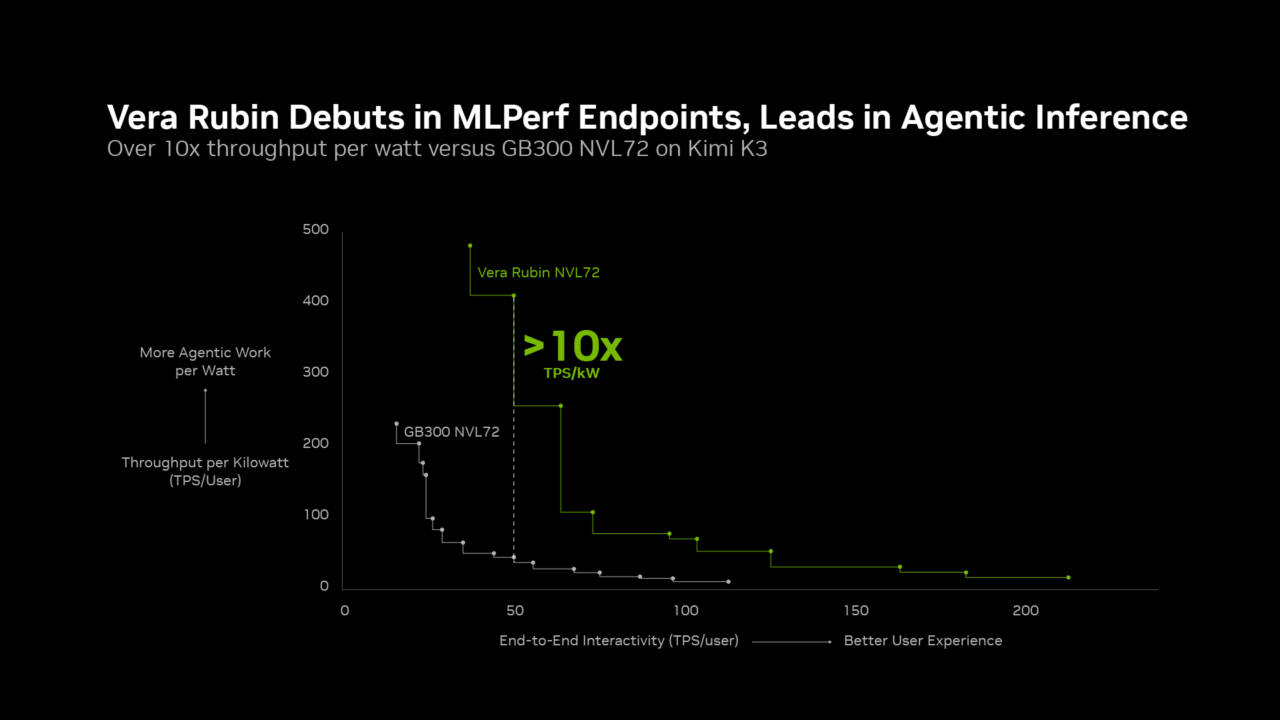 NVIDIA отметила, что Vera Rubin также демонстрирует передовые показатели в независимых бенчмарках, таких как SemiAnalysis AgentX и Artificial Analysis AgentPerf, что подтверждает широкие возможности инфраструктура NVIDIA, способной эффективно поддерживать самые разные задачи: от предварительного и последующего обучения моделей до выполнения агентных вычислений (agentic inference), а также решать задачи, не связанные напрямую с ИИ — например, обеспечивать HPC. |
|

