
Материалы по тегу: hpc
|
08.11.2026 [23:49], Сергей Карасёв
К европейской суперкомпьютерной программе EuroHPC JU присоединилась КанадаКанада официально присоединилась к Европейскому совместному предприятию по развитию высокопроизводительных вычислений (EuroHPC JU), став 39-м государством — участником данного проекта. Об этом было объявлено на саммите EU–Canada в Монреале. Отмечается, что Евросоюз и Канада стремятся к построению более глубокого и эффективного взаимодействия, основанного на совместном доступе к рынкам, общих ценностях и взаимодополняющих сильных сторонах их экономик. Сотрудничество, как ожидается, укрепит потенциал в области суперкомпьютерных технологий и развития научных исследований. В рамках программы EuroHPC JU Канада получит доступ к европейским HPC-ресурсам, ИИ-системам и платформам квантовых вычислений. Канадские ученые также смогут сотрудничать с европейскими коллегами при реализации передовых научно-технических инициатив. В целом, увеличение количества участников EuroHPC JU поможет создать в Европе суперкомпьютерную экосистему мирового класса. 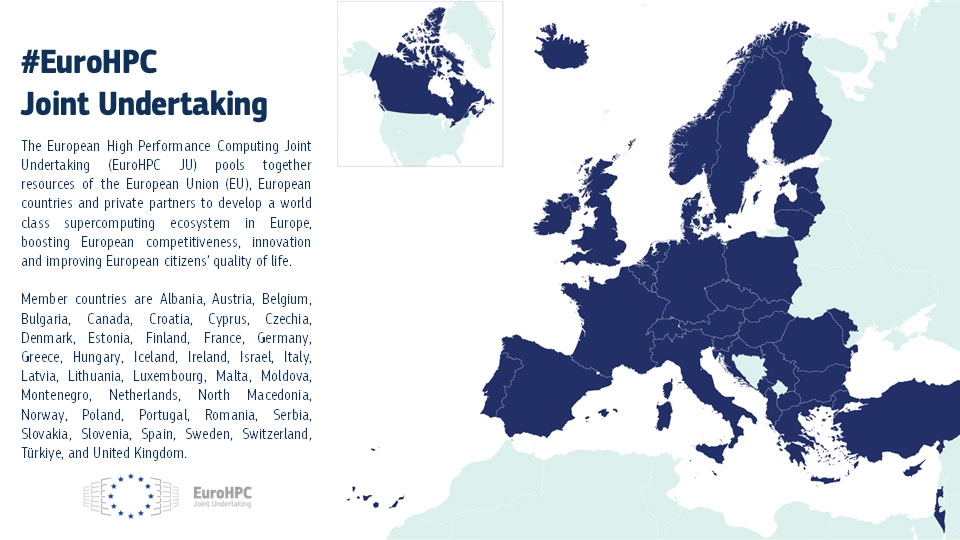
Источник изображения: EuroHPC JU На сегодняшний день совместное предприятие EuroHPC JU закупило 12 суперкомпьютеров, распределённых по всему региону. В их число входят первая экзафлопсная система в Европе JUPITER (Германия), а также машины Leonardo (Италия), LUMI (Финляндия), Daedalus (Греция), Arrhenius (Швеция), Vega (Словения) и др. Кроме того, ведётся строительство второго европейского экзафлопсного суперкомпьютера — комплекса Alice Recoque. Дополнительно организация EuroHPC JU курирует создание 19 «фабрик искусственного интеллекта» (AI Factories), которые будут дополнены 13 региональными представительствами (AI Factory Antennas) — они бесплатно предоставляют адресную поддержку стартапам и малому бизнесу. Кроме того, EuroHPC JU развёртывает европейскую инфраструктуру квантовых вычислений, интегрируя различные квантовые технологии с существующими в регионе суперкомпьютерами. В частности, недавно были запущены квантовые системы Sol (Италия), Lucy (Франция) и Euro-Q-Exa (Германия).
05.11.2026 [08:45], Павел Котов
Рынок серверов для HPC и научных ИИ-задач вырос почти на 20 % — впервые за четверть века в лидеры выбилась DellОбъём рынка локальных серверов для HPC и научных ИИ-задач продемонстрировал годовой рост, близкий к 20 %, сообщает HPCwire со ссылкой на Hyperion Research. Первое место по доле рынка заняла Dell — по итогам I полугодия её выручка от продажи этого оборудования достигла $4,2 млрд. До этого момента лидерство в данном сегменте на протяжении более 25 лет удерживала HPE. Выручка в сегменте инфраструктуры HPC и научных ИИ-задач подвержена циклическим колебаниям. В 2025 году HPE получила в данном сегменте значительный доход, поставив несколько суперкомпьютеров экзафлопсного класса, но рассчитывать на подобные закупки ежегодно было бы нереалистично. Dell сумела добиться роста за счёт нескольких крупных контрактов и стремительного расширения клиентской базы: многие организации закупают ИИ-серверы среднего класса, чтобы интегрировать функции ИИ в традиционные научные и инженерные рабочие процессы. 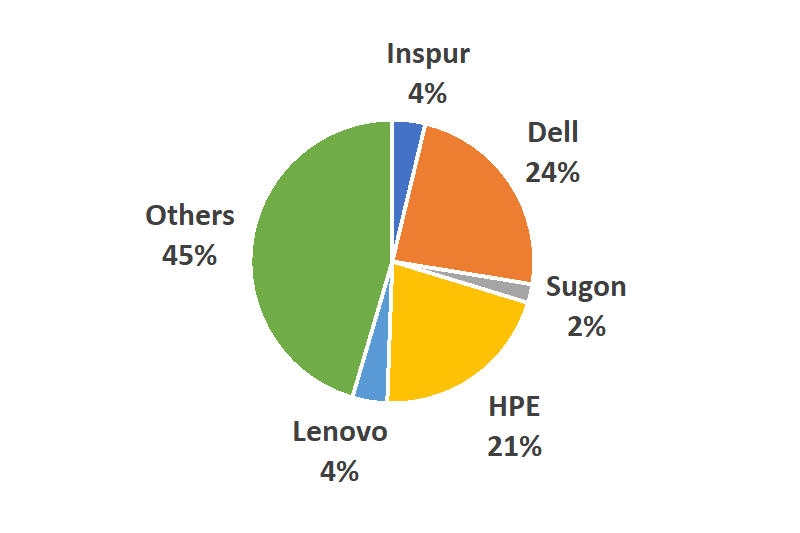
Источник изображения: Hyperion Research По итогам I половины 2026 года выручка на рынке локальных серверов HPC и научных ИИ-задач составила $16,5 млрд, что соответствует росту на 19,9 % — годом ранее данный показатель составлял $13,8 млрд. Примечательно, что в количественном выражении продажи за тот же период показали рост всего на 4,4 %. Это свидетельствует о резком увеличении стоимости систем, потому что выросла доля GPU-систем, а оперативная память подорожала. Проведённый Hyperion Research анализ рынка базируется на результатах многочисленных опросов, проведённых среди поставщиков и покупателей оборудования. Новые показатели рынка указывают на значительные изменения его динамики. Его связывают с внедрением технологий ИИ и закупками систем с мощными GPU. HPC-системы выступают фундаментом для многих приложений в сфере ИИ и смежных областей. По итогам всего 2025 года глобальные расходы в области ИИ и НРС превысили $70 млрд, подсчитали ранее в Hyperion Research. На 2024 год аналитики компании прогнозировали рынку локальных HPC-серверов объём в $25,4 млрд.
28.10.2026 [18:57], Павел Котов
На eBay выставили б/у суперкомпьютер за $60 миллионовКомпания Core 4 Solutions выставила на платформе eBay бывший в употреблении ИИ-суперкомпьютер, включающий 300 стоек, обращает внимание Tom’s Hardware. Цена лота — $59 млн. Кластер включает 9600 ускорителей NVIDIA A100 и 4200 64-ядерных процессора EPYC Rome. Учитывая, что цена на современные стойки NVIDIA доходит до $7,8 млн за единицу, системы на базе A100 представляются разумной бюджетной альтернативой, если у вас хватает энергии и охлаждения. И не придётся ждать в очереди на поставку новейшего оборудования NVIDIA. Каждая стойка кластера включает четыре вычислительных и три управляющих узла. В состав каждого вычислительного узла входят два 64-ядерных процессора AMD EPYC Rome, восемь ускорителей A100 (версия SXM4 с 40 Гбайт памяти) и 1 Тбайт DDR4-2933. Каждый узел управления оснащается двумя 64-ядерными процессорами EPYC и 192 Гбайт DDR4. В общей сложности кластер включает до 9600 ускорителей A100 и 4200 процессоров AMD. Учитывая, что каждый процессор содержит 64 вычислительных ядра Zen 2, на кластер приходятся 268 800 ядер. Объём оперативной памяти составляет до 1401,6 Тбайт. Ценник в $59,7 млн представляется обоснованным. По грубым подсчётам, одни только ускорители NVIDIA A100 обойдутся примерно в $24 млн, $3 млн будут стоить EPYC и ещё $1,1 млн — память DDR4. Итого около $28,1 млн только за основные компоненты. В состав кластера также входят стойки, системы охлаждения, блоки питания, сетевые адаптеры NVIDIA Mellanox ConnectX-6 SmartNIC и другое оборудование. По неофициальным данным, на продажу выставлен один из кластеров Microsoft Azure. 
Источник изображения: nvidia.com На eBay попадаются порой неожиданные лоты, и суперкомпьютер — едва ли самый удивительный вариант. Core 4 Solutions вполне может рассчитывать, что на него найдётся покупатель. По мере расширения ИИ-инфраструктуры и ЦОД могут найтись корпоративные клиенты, которые оценят выгоду и возможности, предлагаемые в этом объявлении. Ранее власти США всего за $480 тыс. продали суперкомпьютер Cheyenne, который десять лет назад стоил $25 млн.
27.10.2026 [10:02], Сергей Карасёв
В Германии появится суперкомпьютер на базе NVIDIA GB200 Grace Blackwell для моделирования климатаНемецкий климатический вычислительный центр (DKRZ) сообщил о заключении контракта с компанией Bull на строительство нового суперкомпьютера. Систему High-Performance Computing System for Earth System Research 5 (HLRE-5) планируется ввести в эксплуатацию в 2028 году. Применять суперкомпьютер планируется для сложного моделирования климата, в том числе с использованием ИИ. В частности, система сможет одновременно запускать две глобальные климатические симуляции с разрешением 5 км. Основой вычислительного комплекса послужит платформа BullSequana XH3500, которая использует открытую модульную конструкцию. Реализованная архитектура позволяет свободно комбинировать блоки CPU, GPU и сетевые компоненты от различных производителей. Говорится о применении передовой технологии прямого жидкостного охлаждения (DLC). В состав HLRE-5 войдут GPU- и CPU-разделы. В основу первого лягут суперчипы NVIDIA GB200: эта секция обеспечит основные вычислительные ресурсы для ИИ-алгоритмов. В свою очередь, раздел CPU объединит процессоры NVIDIA Vera. Такая конфигурация, как отмечается, позволит добиться высокой энергетической эффективности. В качестве интерконнекта будет задействована технология NVIDIA Quantum-2 InfiniBand с низкой задержкой и скоростью передачи данных между узлами до 400 Гбит/с. 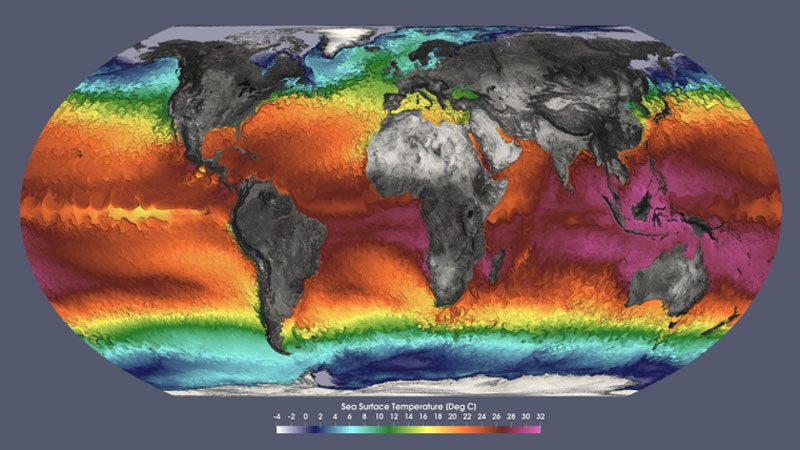
Источник изображения: Michael Böttinger, DKRZ Подсистема хранения данных объединит массив IBM Storage Scale System 6000 вместимостью 60 Пбайт с пропускной способностью до 340 Гбайт/с и высокопроизводительный флеш-уровень объёмом 500 Тбайт. Общие инвестиция в проект составят €40 млн, включая пятилетний договор на техническое обслуживание. Финансирование обеспечивается Ассоциацией имени Гельмгольца, Обществом Макса Планка и администрацией Гамбурга. Кроме того, инициативу поддерживает Федеральное министерство исследований, технологий и космоса в рамках программы «Высокотехнологичная повестка дня Германии» (HTAD).
24.10.2026 [13:53], Сергей Карасёв
В Швеции появился суперкомпьютер Sferical One на базе NVIDIA DGX GB300Консорциум Sferical AI объявил о запуске в Швеции суперкомпьютера Sferical One, предназначенного для проведения совместных исследований и реализации проектов в области ИИ. В основу вычислительного комплекса положена аппаратная платформа NVIDIA. В Sferical AI входят AstraZeneca, Ericsson, Saab, SEB и Wallenberg Investments. Стратегическим партнёром выступает SKF. Основная цель проекта заключается в том, чтобы обеспечить шведскую отрасль независимой и безопасной инфраструктурой для разработки и внедрения ИИ-решений. Суперкомпьютер Sferical One состоит из двух кластеров NVIDIA DGX SuperPOD, которые включают 16 серверных стоек NVIDIA DGX GB300 NVL72. Каждая из них насчитывает 36 чипов Grace и 72 процессора Blackwell Ultra. Таким образом, в общей сложности задействованы 1152 ускорителя NVIDIA Blackwell Ultra. Реализовано жидкостное охлаждение. Показатели быстродействия Sferical One не раскрываются. Но одна система GB300 NVL72 обеспечивает ИИ-производительность на уровне 720 Пфлопс на операциях FP8/FP6 и 100 Тфлопс в режиме FP64. Таким образом, 16 стоек теоретически могут выдавать 11,52 Эфлопс и 1,6 Пфлопс соответственно. 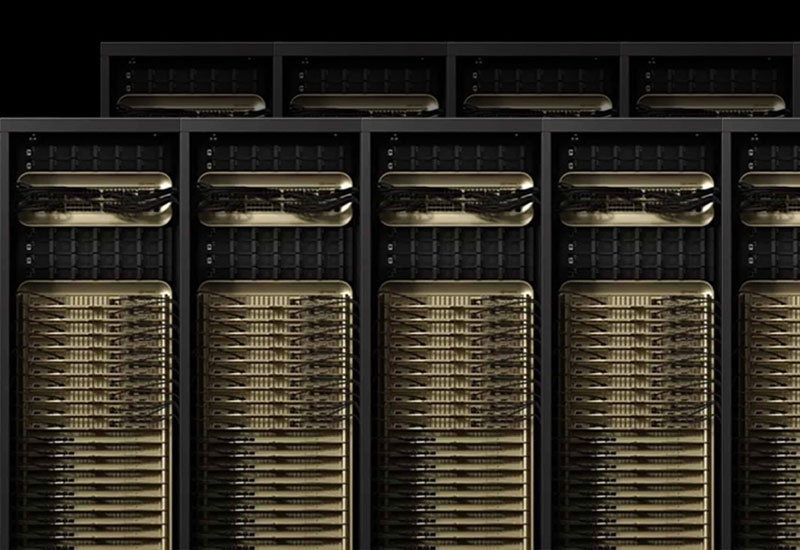
Источник изображения: Sferical AI «Уникальность Sferical One заключается в том, что несколько крупнейших шведских компаний используют одну и ту же инфраструктуру, совместно разрабатывают решения и обмениваются опытом. Это создаёт ценность, выходящую за рамки самой аппаратной платформы», — говорит Дженни Нордлёв (Jenny Nordlöw), генеральный директор Sferical AI. Среди направлений использования Sferical One — разработка лекарственных препаратов в AstraZeneca, создание базовых ИИ-моделей для телекоммуникационных приложений в Ericsson, оборонные технологии в Saab, финансовые услуги в SEB, а также промышленные решения в SKF, включая предиктивное техническое обслуживание и контроль качества.
24.10.2026 [13:51], Сергей Карасёв
Запущен суперкомпьютер Daedalus — самая мощная НРС-система ГрецииЕвропейское совместное предприятие по развитию высокопроизводительных вычислений (EuroHPC JU) объявило об официальном запуске суперкомпьютера Daedalus — самой мощной вычислительной системы Греции. Комплекс занял 31-строку актуального списка TOP500. Церемония открытия Daedalus состоялась в Технологическом культурном парке Лаврион Национального технического университета Афин (NTUA). В мероприятии приняла участие GRNET S.A. (National Infrastructures for Research and Technology) — государственная технологическая компания Греции, которая работает под эгидой Министерства цифрового управления. Суперкомпьютер размещён в новом дата-центре в здании бывшей электростанции NTUA. Соглашение на создание Daedalus было заключено между EuroHPC JU и НРЕ в апреле 2025 года. Сообщается, что стоимость проекта составила €36 млн. Со стороны EuroHPC JU поступило 35 % от этой суммы, а оставшиеся средства предоставлены в рамках Национального плана восстановления и обеспечения устойчивости «Греция 2.0» (при поддержке фонда ЕС NextGenerationEU). С учётом затрат на инфраструктуру и сопутствующие работы создание Daedalus обошлось в €58,9 млн. В специально созданный консорциум Daedalus вошли Кипр, Черногория и Северная Македония. 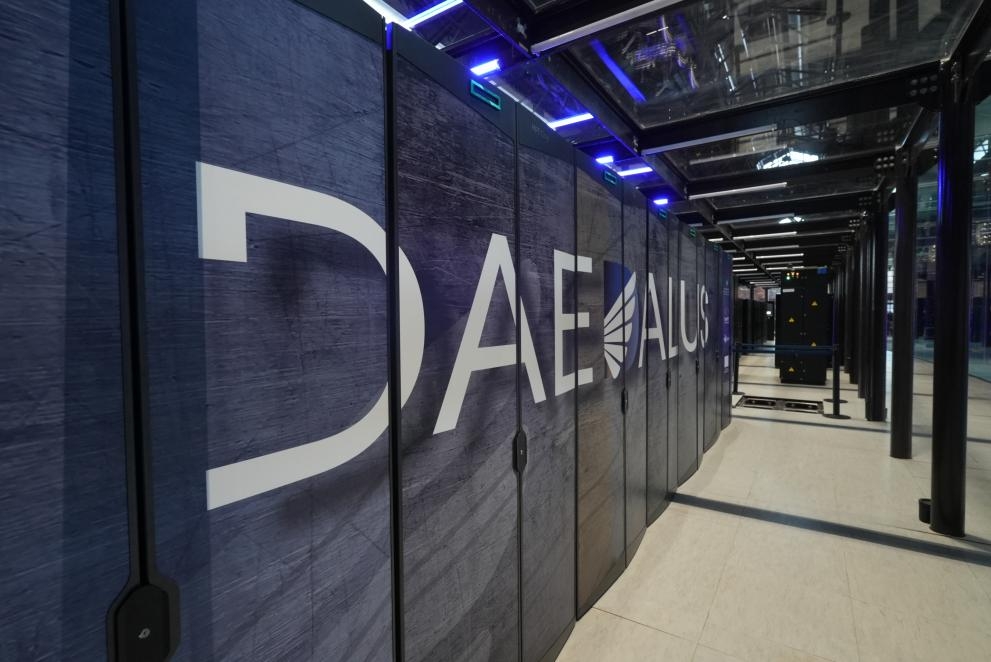
Источник изображения: EuroHPC JU С технической точки зрения суперкомпьютер базируется на аппаратной платформе NVIDIA в составе более чем 2 тыс. суперчипов GH200 Grace Hopper. Реализована передовая система прямого жидкостного охлаждения. Хранилище включает высокопроизводительный NVMe-уровень вместимостью 1 Пбайт, а общая доступная ёмкость достигает 10 Пбайт. Производительность находится на уровне 85,69 Пфлопс, пиковое быстродействие — 115,08 Пфлопс. Питание обеспечивается в том числе от солнечной фермы мощностью 2 МВт. Использовать Daedalus планируется для решения сложных задач в различных областях, включая ИИ, медицину, климатические и метеорологические исследования, инженерию, анализ больших данных, интеллектуальные транспортные системы и кибербезопасность.
21.10.2026 [17:22], Владимир Мироненко
На Луне вот-вот появится почти обычный суперкомпьютер на колёсах — он будет запускать ИИ и обрабатывать данные прямо на местеКомпания HPE представила HPE Spaceborne Computer-4 (SBC4) — передовой вычислительный модуль, разработанный для работы в космосе. Он будет установлен на луноходе Flex Lunar Innovation Platform (FLIP) компании Astrolab, который в конце 2026 года доставят в район горы Монс-Мутон (Mons Mouton) недалеко от южного полюса Луны. Доставка будет осуществляться в рамках программы NASA Commercial Lunar Payload Services (CLPS) с помощью посадочного модуля Griffin-1, разработанного компанией Astrobotic, подразделением Voyager Technologies. Цель проекта — оценить пригодность современных вычислительных систем для будущих миссий и развивающейся лунной экономики. Согласно плану, в рамках годовой миссии лунохода на южном полюсе Луны SBC4 будет задействован в ряде экспериментов, связанных с ИИ и HPC. По словам HPE, результаты этих экспериментов помогут заложить технологический фундамент, необходимый для будущих миссий и исследований на лунной поверхности. В рамках эксперимента FLUID (Federated Learning for Unbounded and Intelligent Decentralization — «Федеративное обучение для неограниченной интеллектуальной децентрализации») NASA задействует ИИ-модель, обученную на данных, полученных на Земле, Луне и МКС. Это позволит продемонстрировать координацию трёх отдельных моделей. Кроме того, NASA проведёт испытания большой языковой модели (LLM) с возможностями семантической обработки, которая поможет искать и интерпретировать бортовую документацию. LLM будет использоваться для получения аналитических данных, обработки визуальной информации и обеспечения автономного мониторинга непосредственно на месте проведения работ. 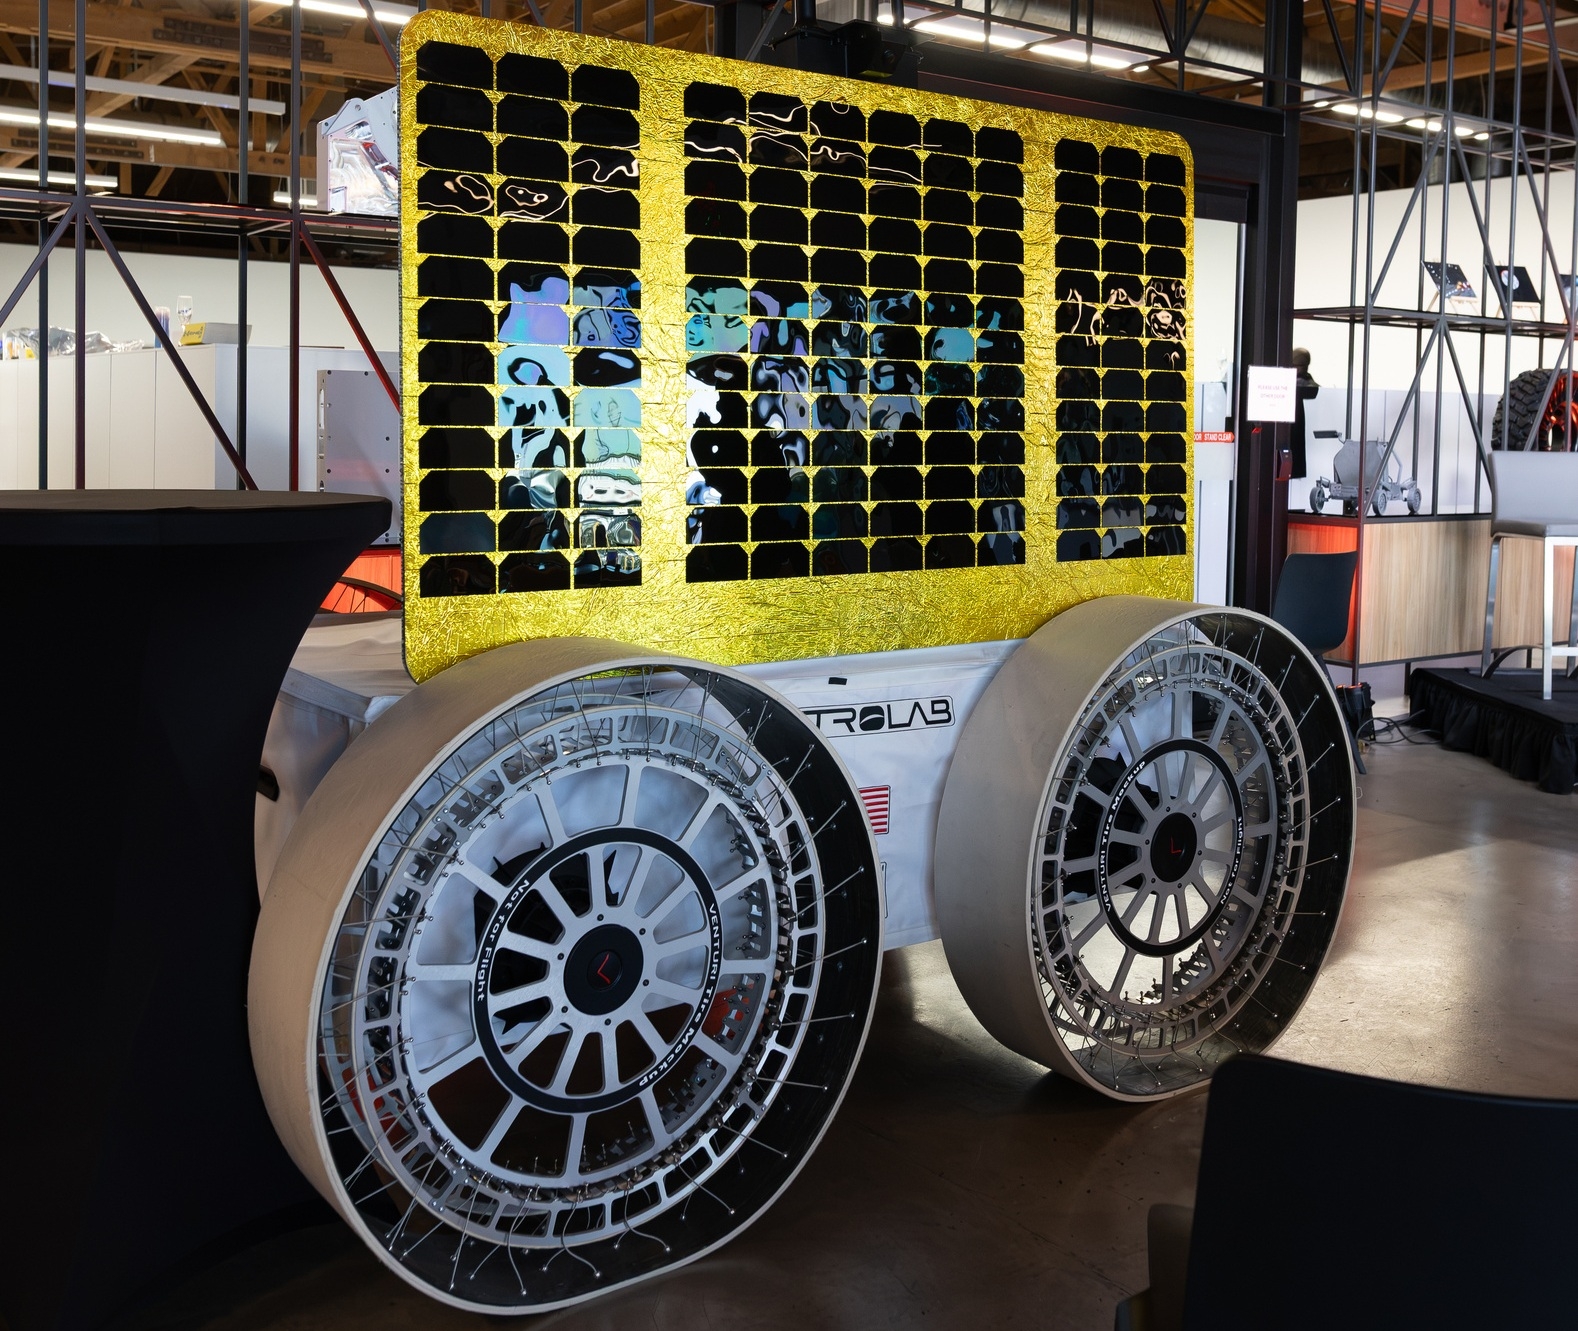
Источник изображения: HPE Также на SBC4 проведут несколько тестов производительности (HPC-бенчмарков), призванных проверить возможности системы на пределе её мощности. Среди них — тесты HPL (Linpack) и HPCG, отметил The Register. Кроме того, будут проведены испытания по обработке данных, полученных с датчиков LiDAR, необходимых для картографирования, навигации, анализа рельефа и развития инфраструктуры. Также будет продемонстрировано развёртывание масштабируемых сервисов на базе ИИ. А Silent Shield компании Deloitte, предназначенная для обнаружения кибервторжений, обеспечит прогностическую кибераналитику и выявление аномалий практически в режиме реального времени. Подготовленный HPE пакет ПО позволит оптимизировать взаимодействие с наземными ресурсами и обеспечить безопасную передачу данных и результатов исследований с Луны на Землю. Кроме того, HPE обеспечит поддержку центра управления полётами Astrolab в Хоторне (Hawthorne, штат Калифорния) с помощью решения HPE Private Cloud, которое поможет получать аналитические данные в режиме реального времени. В дополнение к этому ПО HPE CloudOps предоставит единую гибкую среду для управления рабочими нагрузками и их автоматизации. Известно, что система SBC4 оснащена энергоэффективными CPU и GPU, а также двумя M.2 SSD Kioxia BG6 в RAID1 общей ёмкостью 1 Тбайт. Как сообщает The Register, партнёр HPE, предоставивший вычислительные компоненты, пожелал сохранить своё имя в тайне, поскольку не хотел бы, чтобы в случае выхода оборудования из строя название его бренда ассоциировалось с неудачей. Устройство имеет небольшие размеры — 130 × 250 × 25 мм. 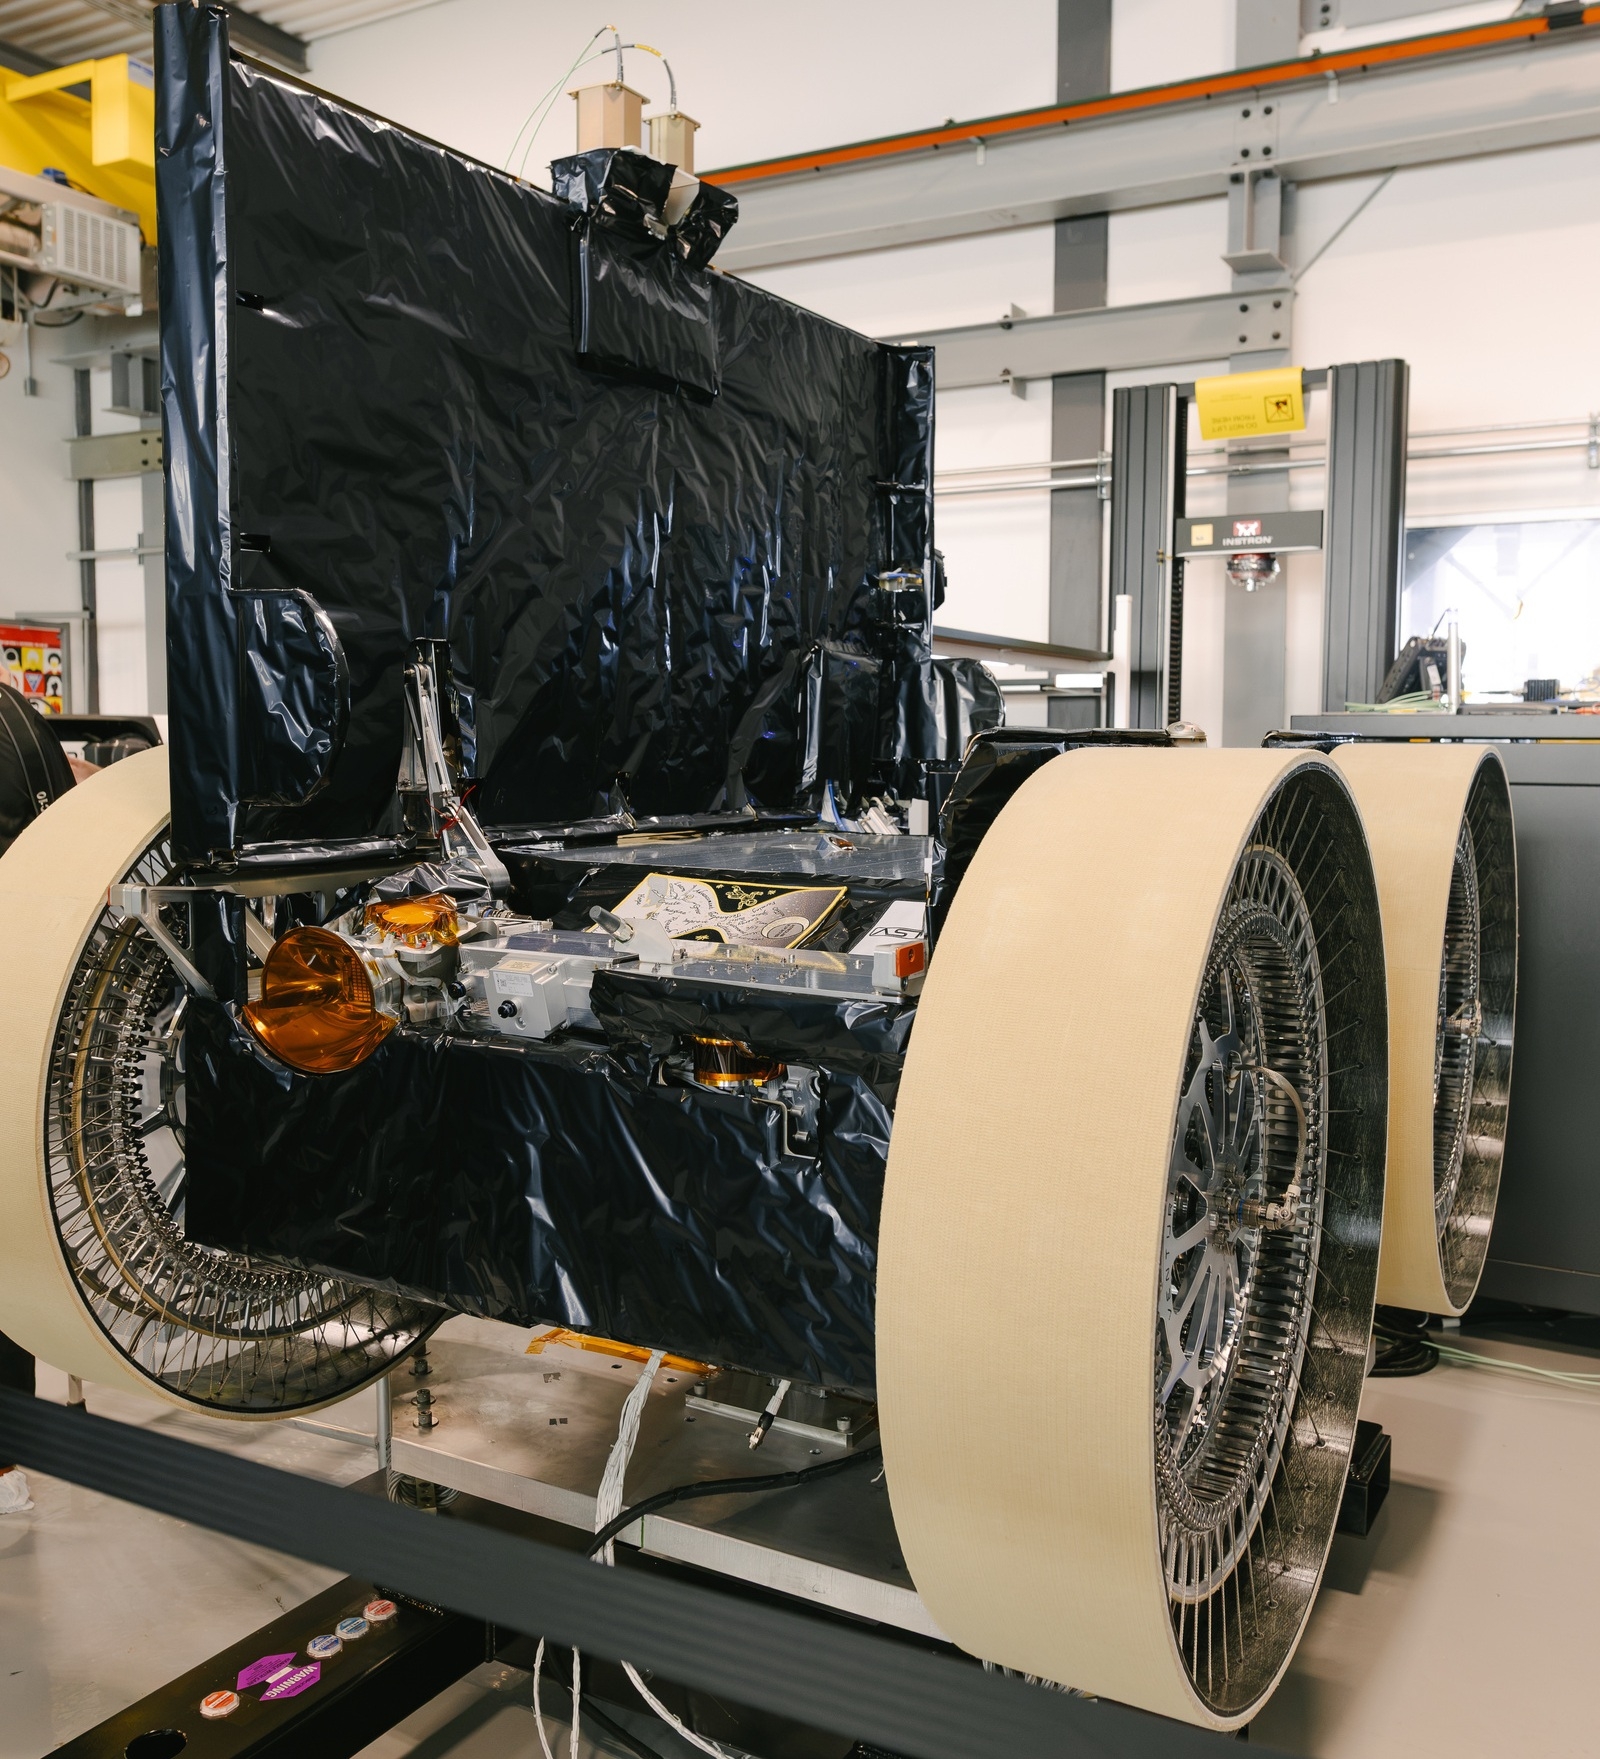
Источник изображения: HPE Луноходу, а значит, и SBC4, предстоит выдерживать экстремальные вибрационные нагрузки во время запуска и посадки, а также резкие перепады температур. Кроме того, аппаратуре придётся противостоять воздействию космических лучей и солнечной радиации, поскольку на Луне нет плотной атмосферы и магнитного поля, которые защищают вычислительные системы на Земле. По словам Марка Фернандеса (Mark Fernandez), главного научного сотрудника HPE по космическим технологиям и решениям, система SBC4 в основном собрана из стандартных серийно выпускаемых компонентов, включая SSD. Вместе с тем HPE вложила значительные средства в программные механизмы резервирования и восстановления. Фернандес называет это «аппаратной защитой на программном уровне». Суть подхода заключается в том, что свободные вычислительные ресурсы процессора используются для непрерывного мониторинга аппаратных показателей и их сравнения с эталонными значениями. Если какой-либо параметр выходит за установленные пределы, система SBC4 принимает меры для самозащиты. «Если говорить в общих чертах: в идеале я хочу работать на полной скорости. Если это невозможно — снижаю скорость. Если и это не помогает, система переходит в состояние загрузки, но без запуска каких-либо задач — возможно, сервер сможет восстановиться. В худшем случае лучше просто отключить питание, чем допустить полное разрушение оборудования», — пояснил он. 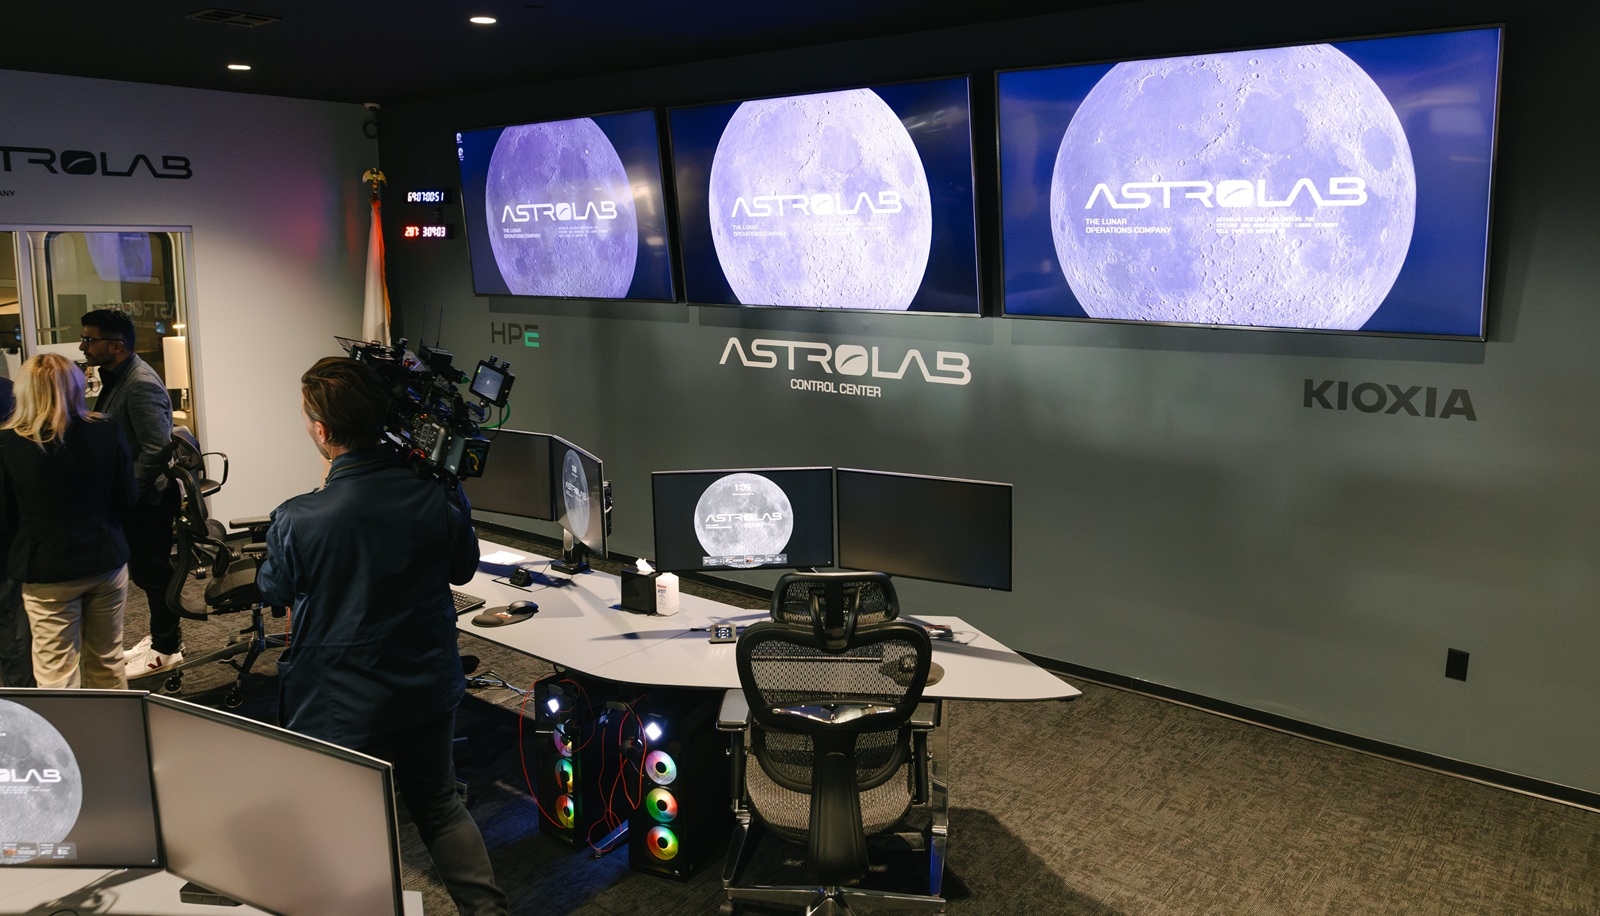
Источник изображения: HPE Проект FLIP был задуман прежде всего как концептуальная демонстрация — своего рода испытательный полигон для технологий, которые в будущем могут быть использованы в других миссиях на Луну. Учитывая ограниченную пропускную способность каналов связи с Землёй, гораздо эффективнее обрабатывать значительную часть данных и телеметрии, поступающих с камер, лидаров и датчиков лунохода, непосредственно на месте. По словам Фернандеса, именно поэтому система SBC4 спроектирована для работы «на самом краю» (at the edge of the edge) — непосредственно в месте сбора данных. Первая версия HPE Spaceborne прошла тестирование на МКС в 2017 году, проработав на орбите 615 дней. А HPE Spaceborne 2, который стал вдвое производительнее предшественника, с успехом использовался в 24 экспериментах на МКС. Луна становится своего рода полигоном для испытания возможностей вычислительных систем в условиях космоса. Ранее Lonestar Data Holdings протестировала на поверхности естественного спутника Земли свою микро-ЦОД. А в конце этого года американская частная аэрокосмическая компания Firefly Aerospace планирует запуск на орбиту Луны в рамках проекта Blue Ghost Mission 2 космического аппарата, в котором будет использоваться вычислительная платформу NVIDIA Jetson для обработки изображений Луны с использованием ИИ-алгоритмов.
12.10.2026 [08:53], Сергей Карасёв
Arista представила интерконнект Etherlink SU-144 для кластеров ИИ и НРСКомпания Arista Networks анонсировала сетевую архитектуру Etherlink SU-144, призванную перенести стандарт Ethernet в ту область, в которой ранее превалировали такие технологии, как NVIDIA NVLink и InfiniBand. Новое решение ориентировано на масштабные кластеры ИИ и НРС. Arista отмечает, что рынок ИИ стремительно расширяется. По мере усложнения больших языковых моделей (LLM) и появления нагрузок, которым необходима тесная синхронизация данных между огромными пулами ускорителей, возможностей интерфейсов PCIe, CXL и проприетарных интерконнектов становится недостаточно для эффективного масштабирования ресурсов. Такие технология хорошо работают внутри серверов, но создают определённые трудности на уровне кластеров из-за применения ускорителей разных поколений и конструктивных особенностей систем, объединяющих сотни и тысячи XPU. В такой ситуации сеть больше не является просто связующим звеном между серверами — она становится частью самой вычислительной системы. Архитектура Etherlink SU-144, как ожидается, поможет в удовлетворении растущих потребностей в высокоскоростном обмене данными. 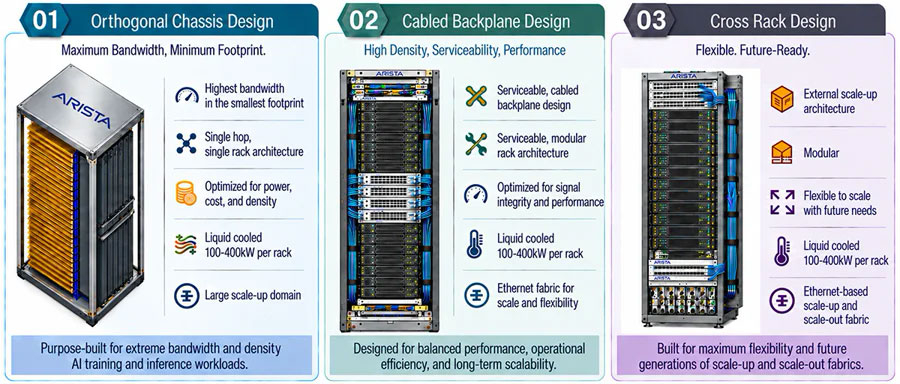
Источник изображения: Arista Networks Новая технология разработана в рамках инициативы Ethernet for Scale-Up Networks (ESUN). В проекте также принимают участие AMD, Arm, Broadcom, d-Matrix, Meta✴, Microsoft и Qualcomm. Благодаря Etherlink SU-144 в пределах одной стойки могут быть объединены до 144 ускорителей, а в массиве из нескольких стоек — до 1024. Расчётная мощность при этом может варьироваться от 100 до 400 кВт на стойку, что требует применения исключительно жидкостного охлаждения. Для Etherlink SU-144 предусмотрены три физических форм-фактора под разные сценарии. Это, в частности, ортогональное шасси, когда серверы располагаются спереди, а коммутационные карты — сзади. Такое исполнение обеспечивает максимальную плотность компоновки и высокую пропускную способность при интенсивных нагрузках обучения и инференса ИИ-моделей. Ещё один вариант — шасси с бэкплейном: решение обеспечивает оптимальное сочетание производительности, операционной эффективности и долгосрочной масштабируемости. Наконец, третий подход предполагает формирование межстоечной связи — для максимальной гибкости и будущих развёртываний. Для архитектуры Etherlink SU-144 заявлена поддержка динамической балансировки нагрузки, а также оптических технологий XPO и CPO/NPO с перспективой повышения пропускной способности до 6,5 Пбит/с на стойку.
09.10.2026 [19:22], Владимир Мироненко
NVIDIA Vera показал превосходство над чипами AMD и Intel в HPC-бенчмаркахРесурс Phoronix провёл тестирование процессора NVIDIA Vera в двухсокетной конфигурации (в сумме 176 ядер и 352 потока) в ряде HPC-задач, включая OpenFOAM (CFD) и WRF, сравнив его с двухсокетными системами на базе AMD EPYC 9575F (Turin) с общим количеством 128 ядер и 256 потоков, а также системами с двумя EPYC 9755 (всего 256 ядер и 512 потоков) и двумя процессорами Intel Xeon 6980P (Granite Rapids-AP) с 256 ядрами и 512 потоками. 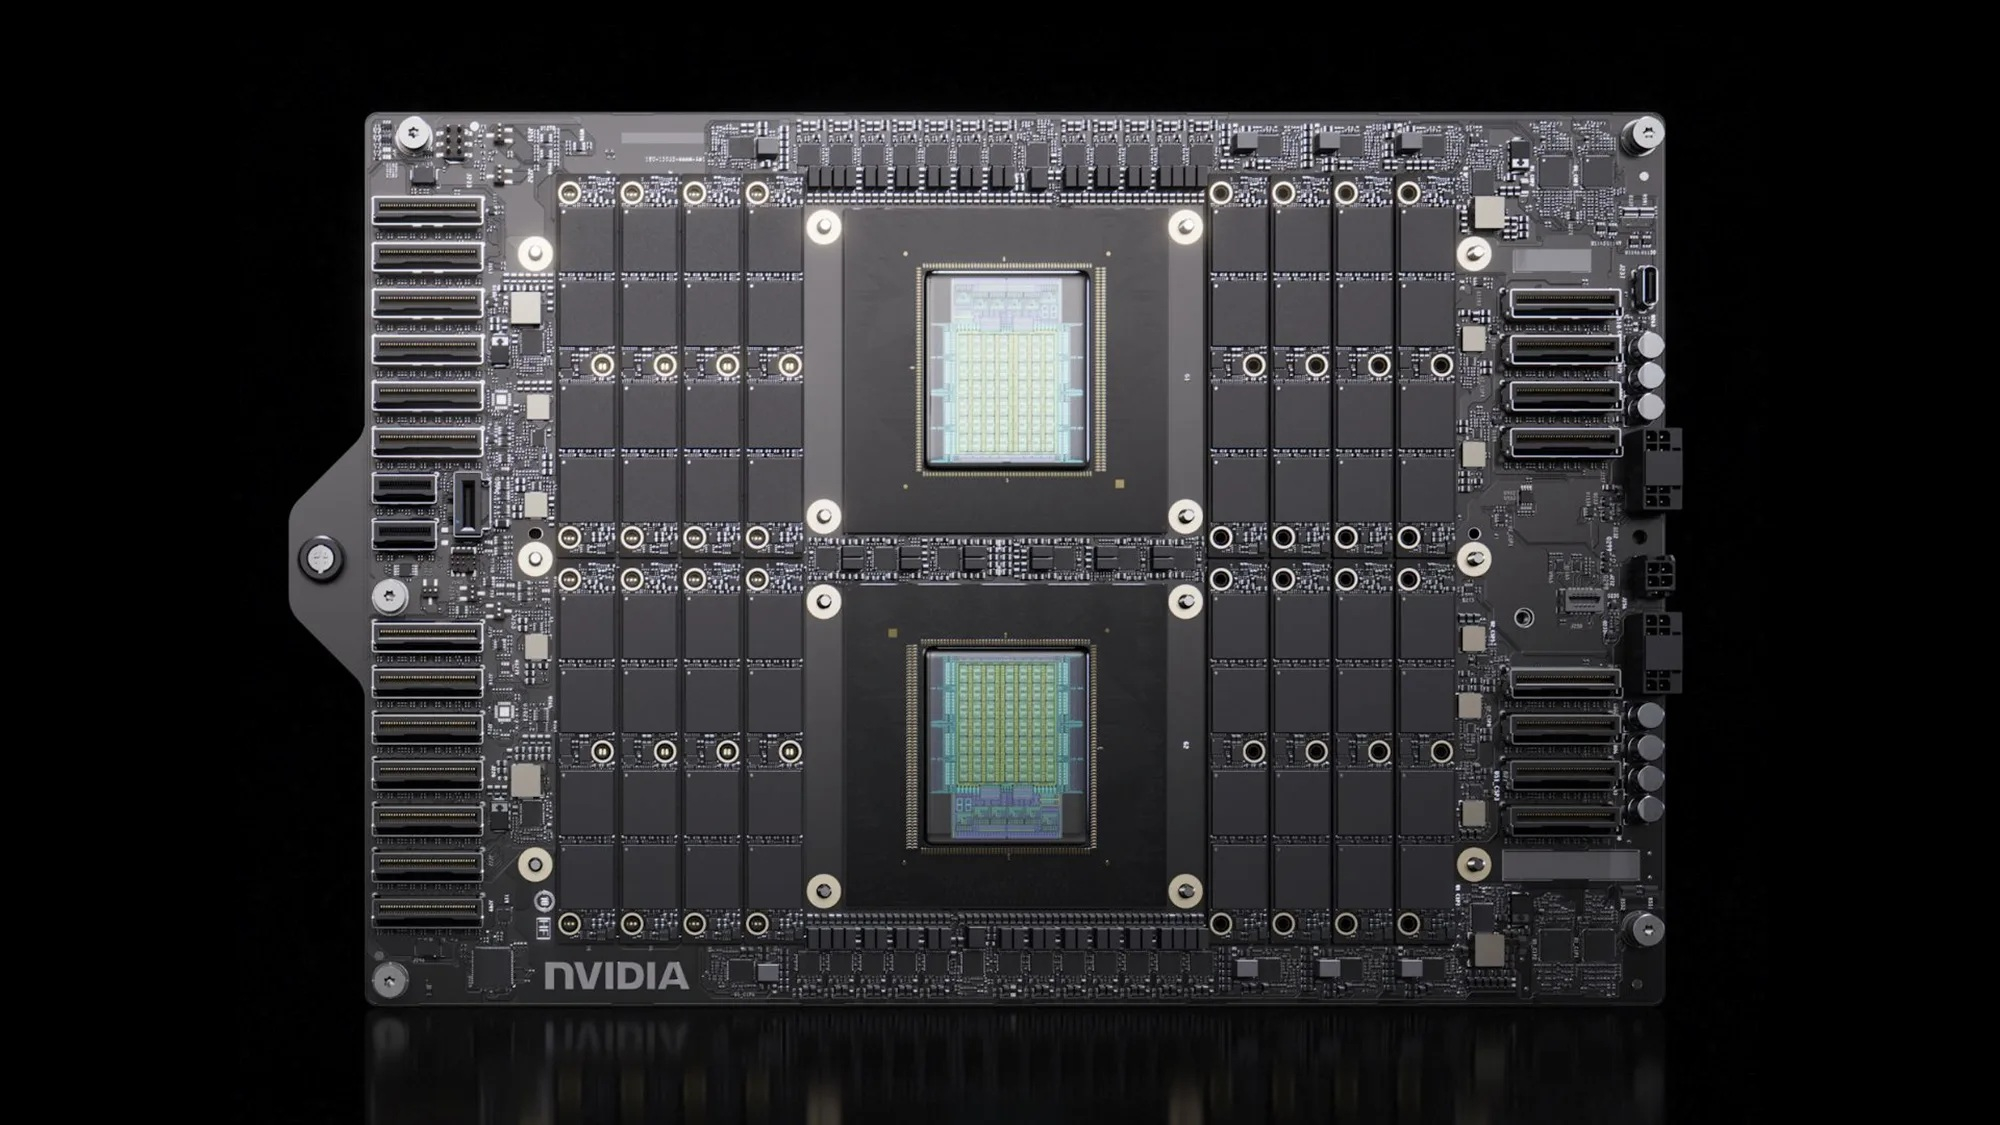
Источник изображения: NVIDIA Что касается оперативной памяти, то у системы NVIDIA Vera было 16 × 96 Гбайт LPDDR5x-9600 Samsung M564K6LC3CL0-CCVS7. В топовой конфигурации процессоры AMD EPYC 9575F (2P) и EPYC 9755 (2P) имели память DDR5-6400 Samsung M321R8GA0PB1-CCPKC ёмкостью 24 × 64 Гбайт, а Intel Xeon 6980P (2P) — 24 × 64Гбайт памяти MRDIMM-8800. Особенно высокие результаты NVIDIA Vera продемонстрировал в рабочих нагрузках с интенсивной пропускной способностью, где память LPDDR5x-9600 превосходила DDR5-6400 с серверами AMD EPYC 5-го поколения или MRDIMM-8800 с процессором Intel Xeon 6. Производительность Vera ещё более впечатляет, если учесть, что 88 ядер конкурировали со 128 P-ядрами процессоров Xeon и EPYC. 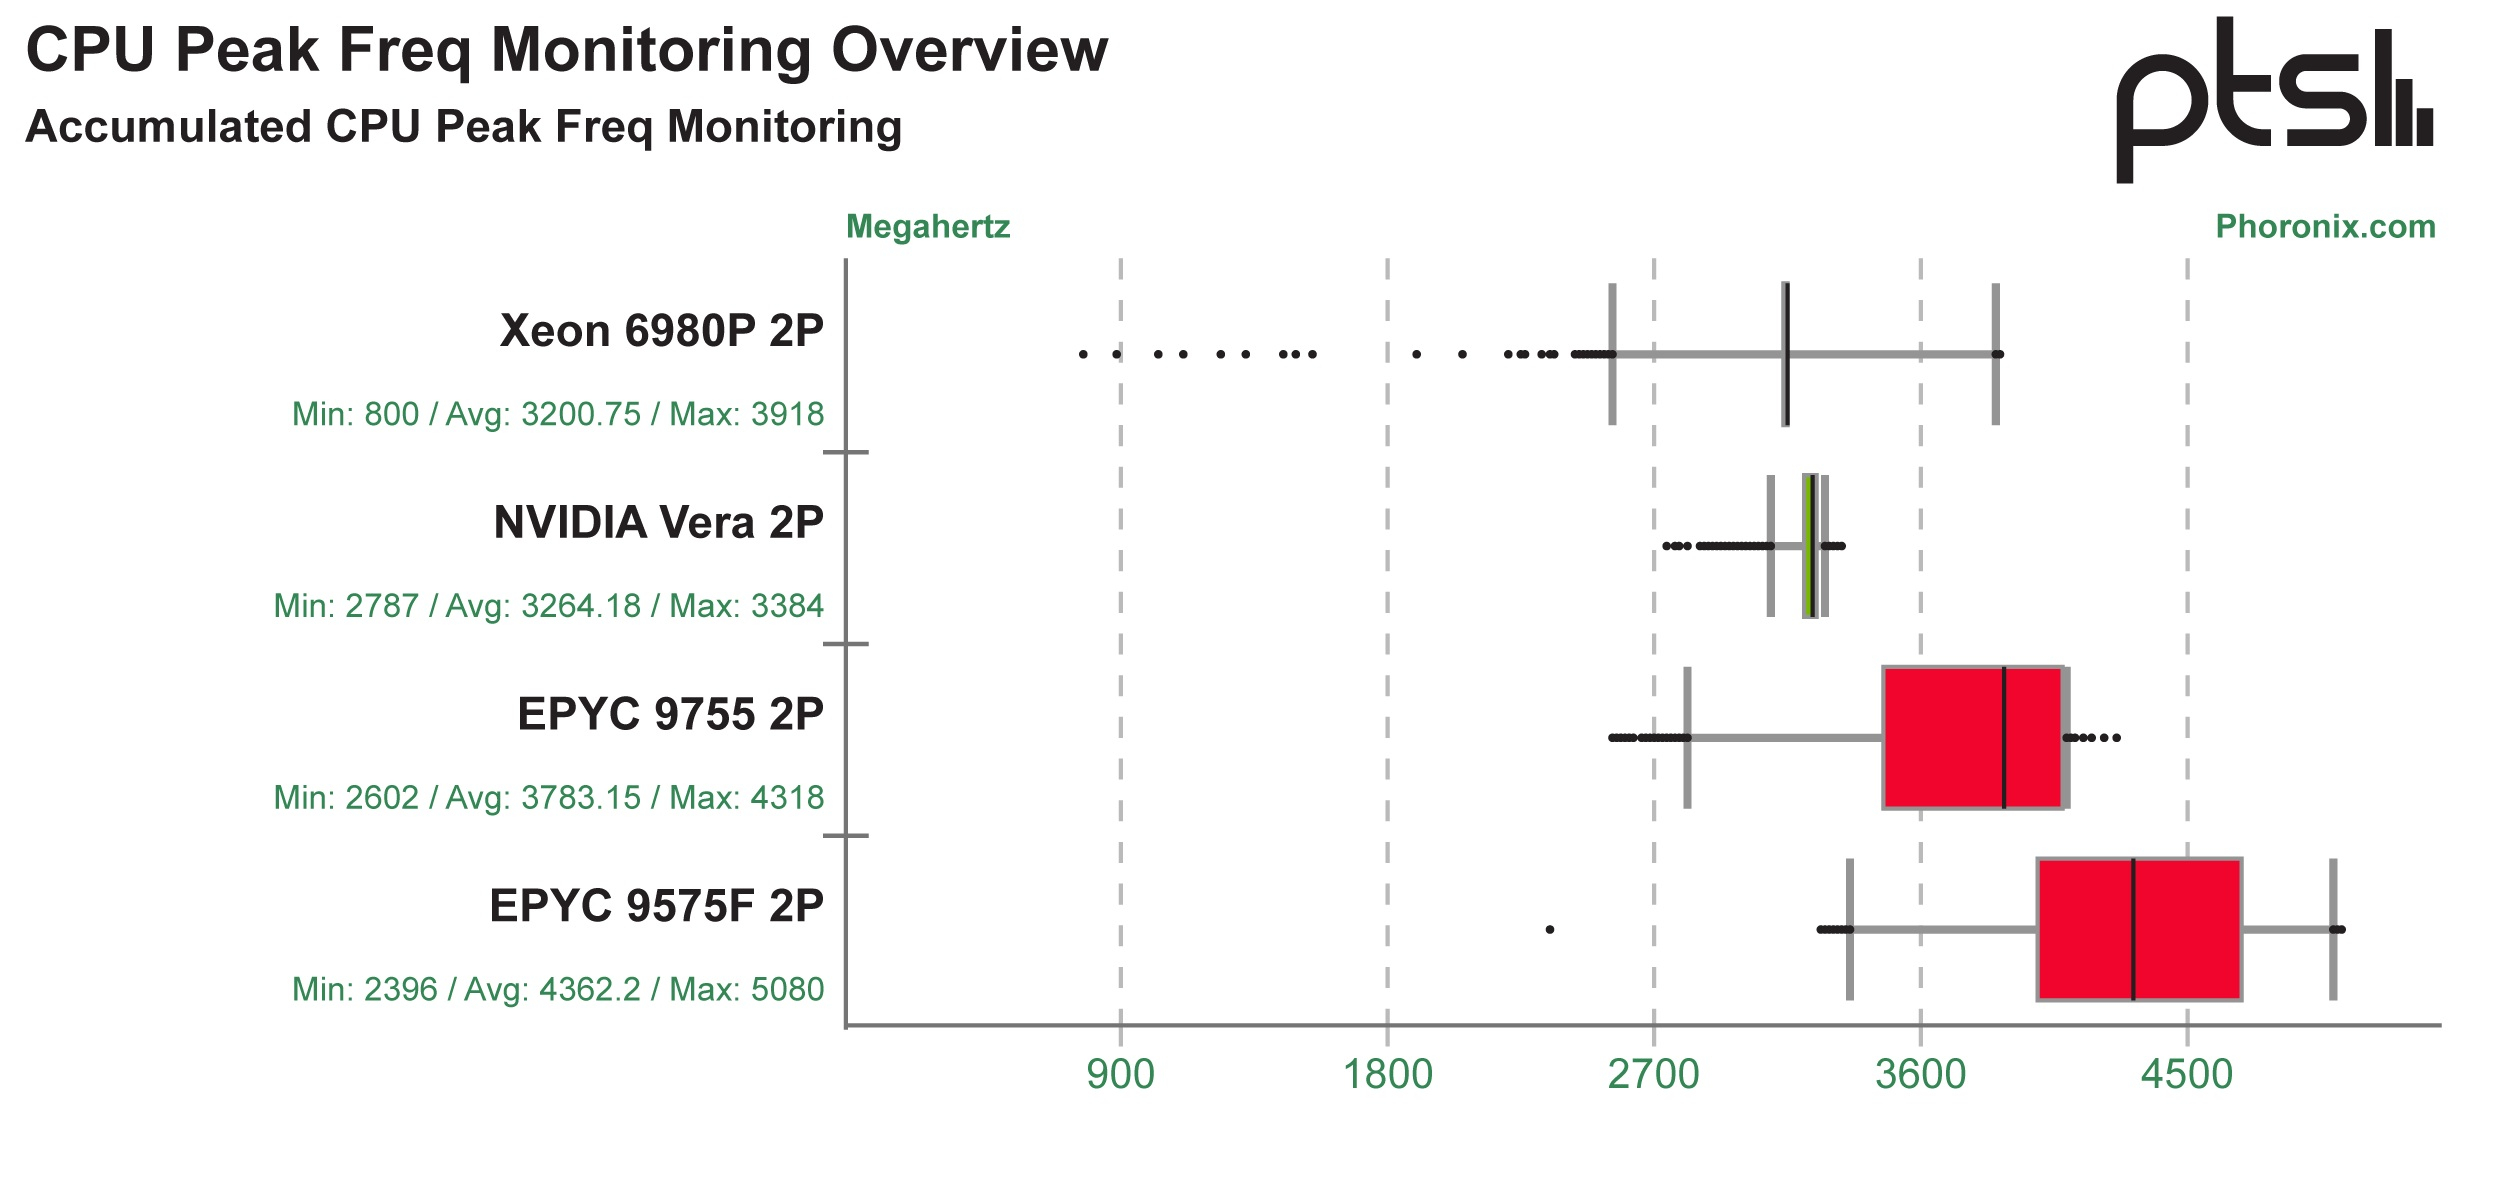
Источник изображений: Phoronix При анализе пиковой частоты процессора в преобладающем диапазоне высокопроизводительных вычислений выяснилось, что NVIDIA Vera, как правило, имел пиковую частоту 3,2–3,3 ГГц по сравнению с Xeon 6980P с максимальной частотой 3,9 ГГц, EPYC 9755 с частотой 4,3 ГГц и EPYC 9575F с частотой 5,0 ГГц. Ядра Olympus продемонстрировали чрезвычайно высокую производительность на такт с учётом всех факторов. 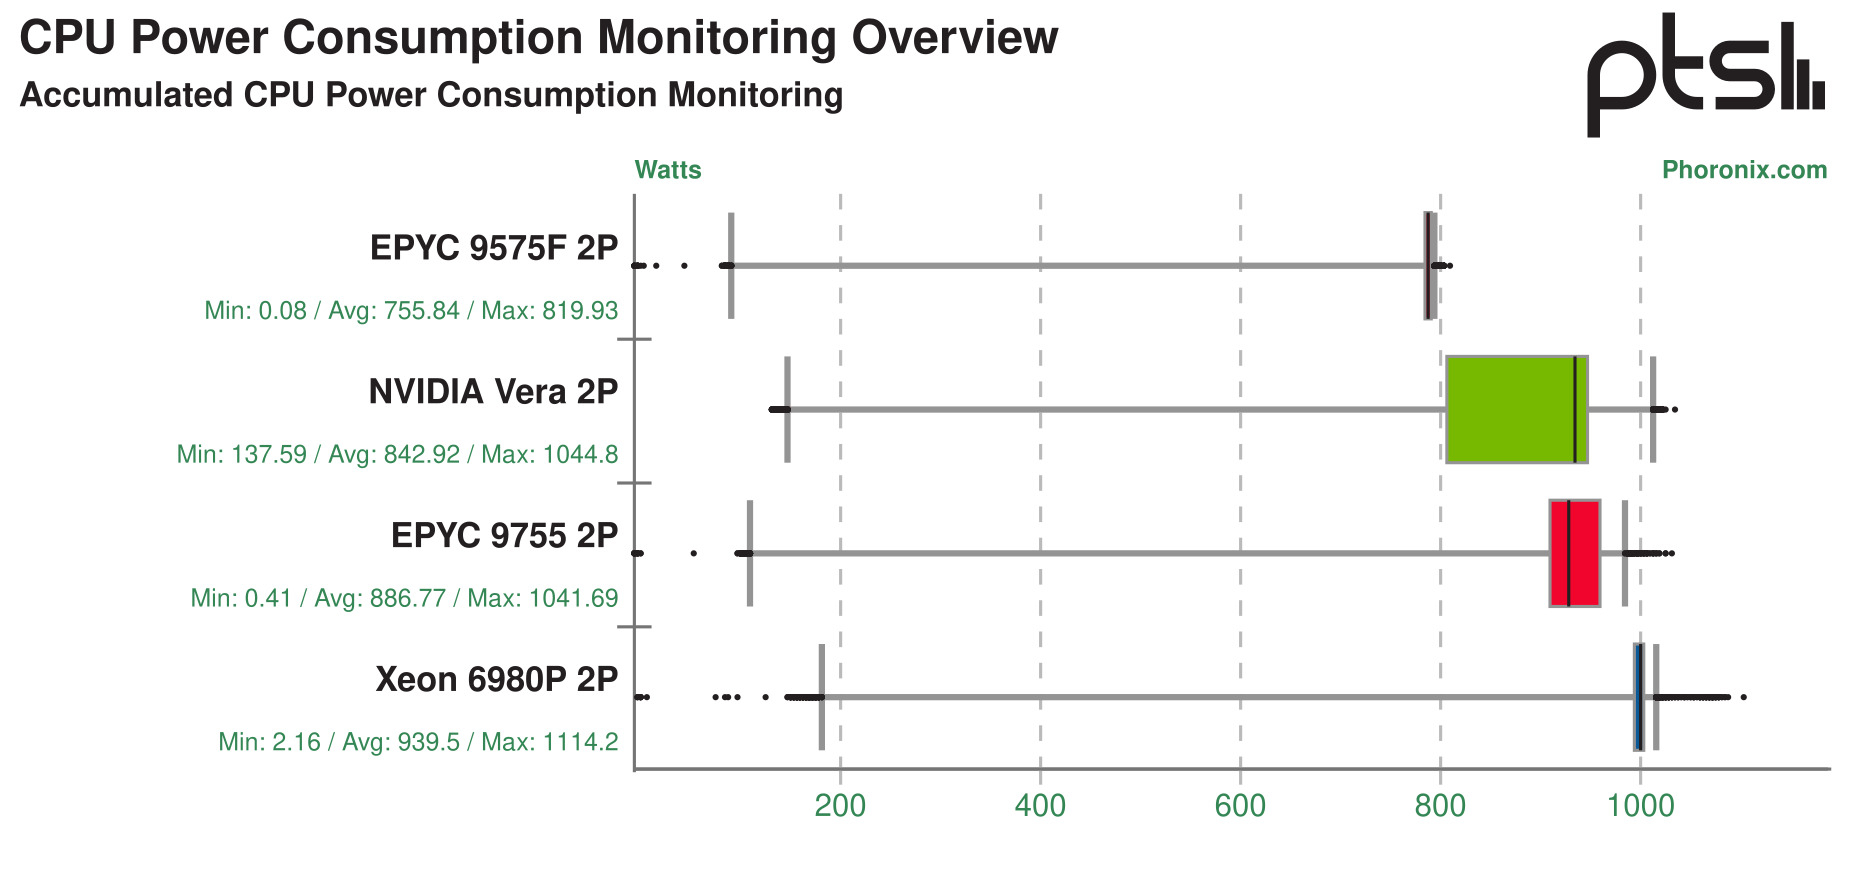 В ходе бенчмарков с фокусом на HPC, таких как как OpenFOAM CFD, WRF и т.д., энергопотребление двух процессоров NVIDIA Vera в среднем составило 842 Вт при пиковом значении в 1044 Вт, что аналогично показателю двух EPYC 9755, и немного меньше среднего энергопотребления двух EPYC 9575F. Процессоры Intel Xeon 6980P потребляли больше всего энергии, приближаяь к киловатту. 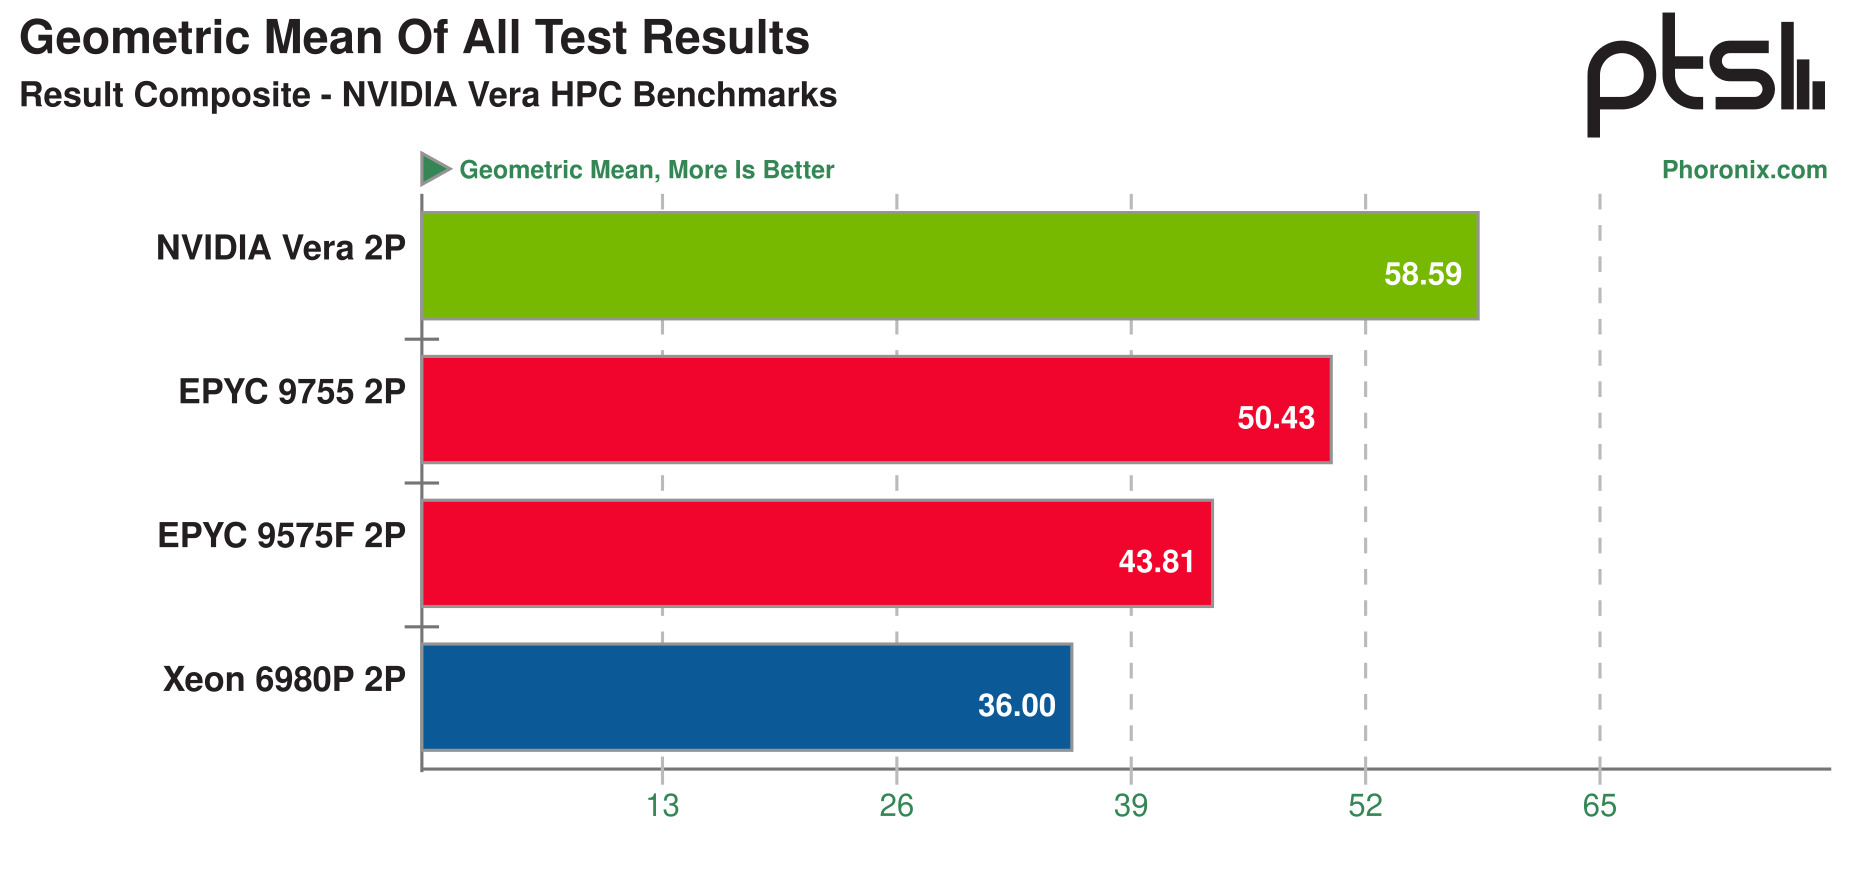 Геометрическое среднее по всем результатам тестов (Geometric Mean Of All Test Results) с формированием комплексного показателя (Result Composite) в рамках набора NVIDIA Vera HPC Benchmarks, дающее общую оценку производительности системы, отражает тот факт, что самым быстрым является решение NVIDIA Vera (2P). Как отметил Phoronix, NVIDIA Vera по-прежнему остаётся самым производительным серверным процессором на Arm64 из числа когда-либо тестировавшихся этим сайтом.
06.10.2026 [22:44], Владимир Мироненко
NetApp представила зеттабайтную платформу храненния Novus для ИИ-фабрик с миллионами GPUКомпания NetApp представила дезагрегированную архитектуру нового поколения NetApp Novus, поддерживающую хранение данных зеттабайтного масштаба, которая позволит ИИ-фабрикам обеспечивать непрерывную подачу данных на миллионы GPU, повышая до максимума эффективность, уровень загрузки ресурсов и окупаемость инвестиций. NetApp позиционирует Novus как самую быструю на планете систему хранения. Компания отметила, что неооблака и провайдеры GPUaaS создают ИИ-фабрики такого масштаба, на который не были рассчитаны традиционные архитектуры СХД. Это приводит к возникновению «узких мест», снижающих коэффициент использования GPU и увеличивающих затраты на инфраструктуру. При использовании традиционных архитектур загрузка GPU может падать ниже 30%, если система не способна обеспечить подачу достаточного объёма данных для получения необходимых результатов и окупаемости вложений. «ИИ-фабрики давно нуждались в инфраструктуре, способной масштабироваться со скоростью развития технологий ИИ», — отметил Сьям Наир (Syam Nair), директор по продуктам NetApp. По его словам, используя преимущества платформы NetApp, решение Novus обеспечивает совокупную пропускную способность 100 Тбайт/с с возможностью неограниченного горизонтального масштабирования. 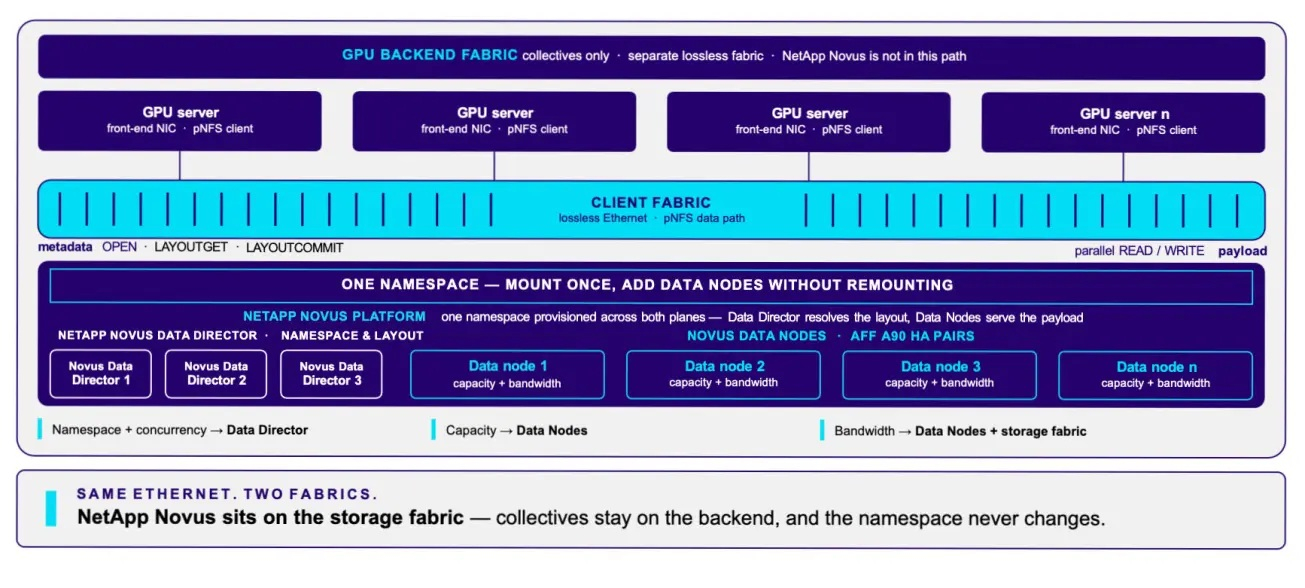
Источник изображения: NetApp Ариндам Банерджи (Arindam Banerjee), главный архитектор платформ и технологий NetApp, пояснил, что Novus использует принцип федерации для объединения нескольких кластеров хранения в единое пространство имен, при этом пропускная способность системы растёт по мере добавления новых кластеров. Архитектура опирается на стандартные протоколы pNFS и Flex Files, что позволяет использовать стандартное ядро Linux. Это избавляет операторов от необходимости развёртывать, обновлять и проверять проприетарные клиентские решения для тысяч образов узлов, различных поколений GPU и сред разных арендаторов. Такой подход устраняет значительный источник постоянных накладных расходов, сохраняя при этом единое пространство имен для совместной инфраструктуры ИИ. Novus переносит надёжность, безопасность и возможности многопользователького доступа платформы ONTAP в архитектуру, специально разработанную для ИИ-фабрик, говорит он. Novus разделяет потоки метаданных и данных, позволяя каждому из них масштабироваться независимо. Банерджи отметил, что в Novus службы обработки метаданных разделены на независимо масштабируемые уровни (протоколов, состояний и каталогов). Это позволяет устранить «узкие места», возникающие при рабочих нагрузках ИИ, когда интенсивные операции чтения и записи данных сочетаются с масштабными операциями с метаданными. Серверы данных Novus будут работать под управлением ОС ONTAP, что позволит распространить на новую архитектуру уже существующие в решениях NetApp механизмы обеспечения целостности данных, отказоустойчивости, безопасности, изоляции и качества обслуживания (QoS). 
Источник изображения: NetApp Единое пространство имен упрощает эксплуатацию. Когда данные задачи распределены по разным системам, их приходится перемещать, перемонтировать, перебалансировать, а также отслеживать каждую копию. Единое пространство имён зеттабайтного масштаба устраняет эту проблему, обеспечивая постоянную доступность наборов данных, контрольных точек и артефактов модели по мере роста среды. Архитектура Novus позволяет операторам добавлять ёмкость и повышать производительность без необходимости внесения изменений в приложения, прерывания работы или сбоев в работе клиентов. Вместо того, чтобы делать топологию хранения видимой для каждой рабочей нагрузки, Novus предоставляет единую согласованную среду данных, созданную для масштабов ИИ-фабрики. Первые версии Novus объединяют ПО для управления метаданными NetApp Novus Data Director (работающее на сертифицированной инфраструктуре Supermicro) и сервисы обработки данных NetApp ONTAP, реализованные на базе систем AFF A90. В совокупности они формируют дезагрегированную архитектуру, рассчитанную на пропускную способность свыше 100 Тбайт/с и высокую степень загрузки сотен тысяч GPU, при этом сохраняя надёжные корпоративные сервисы обработки данных ONTAP, которым доверяют клиенты. Как отметил ресурс Blocks&Files, системы ONTAP на базе платформ AFF (A800, A90 и аналогичных) поддерживают технологию GDS (GPU Direct Storage) c NFS поверх RDMA, начиная с версии ONTAP 9.12.1. Опубликованные результаты демонстрируют показатели ~171 ГиБ/с (для A800) и ~351 ГиБ/с (для кластера A90), так что Novus с запасом превзойдёт эти цифры. Решение NetApp AFX (дезагрегированная версия ONTAP для ИИ) сертифицировано для использования с NVIDIA DGX SuperPOD и прошло тестирование с технологией Magnum IO GPUDirect Storage. NetApp зафиксировала устойчивую пропускную способность 457 ГиБ/с при работе восьми узлов AFX. В документации AFX заявлена поддержка NFS/RDMA, включая технологии GPU Direct, pNFS и Session Trunking. 
Источник изображения: NetApp По словам гендиректора NetApp Джорджа Куриана (George Kurian), благодаря пропускной способности в 100 Тбайт/с и доступу к объёму данных, превышающему 1 Збайт, в рамках единого пространства имен, NetApp Novus поможет ускорить научные исследования: например, учёные смогут в реальном времени запускать сложные симуляции и модели, а биологи — задействовать десятки тысяч компьютеров для отслеживания поведения каждой молекулы белка в клетке. Как отметила NetApp, клиенты, внедряющие архитектуру Novus, получают следующие преимущества:
|
|

