
Материалы по тегу: 800gbe
|
19.10.2026 [09:32], Владимир Мироненко
Восемь на одного: Meta✴ представила сетевую архитектуру Flattened Planar Fabric для ИИ-инфраструктурыMeta✴ представила ИИ-архитектуру Flattened Planar Fabric (FPF), созданную для масштабирования обширной ИИ-инфраструктуры и поддержки вычислительных нагрузок нового поколения. В архитектуре FPF каждый GPU подключается посредством восьми независимых каналов по 100 Гбит/с к восьми разным коммутаторам. 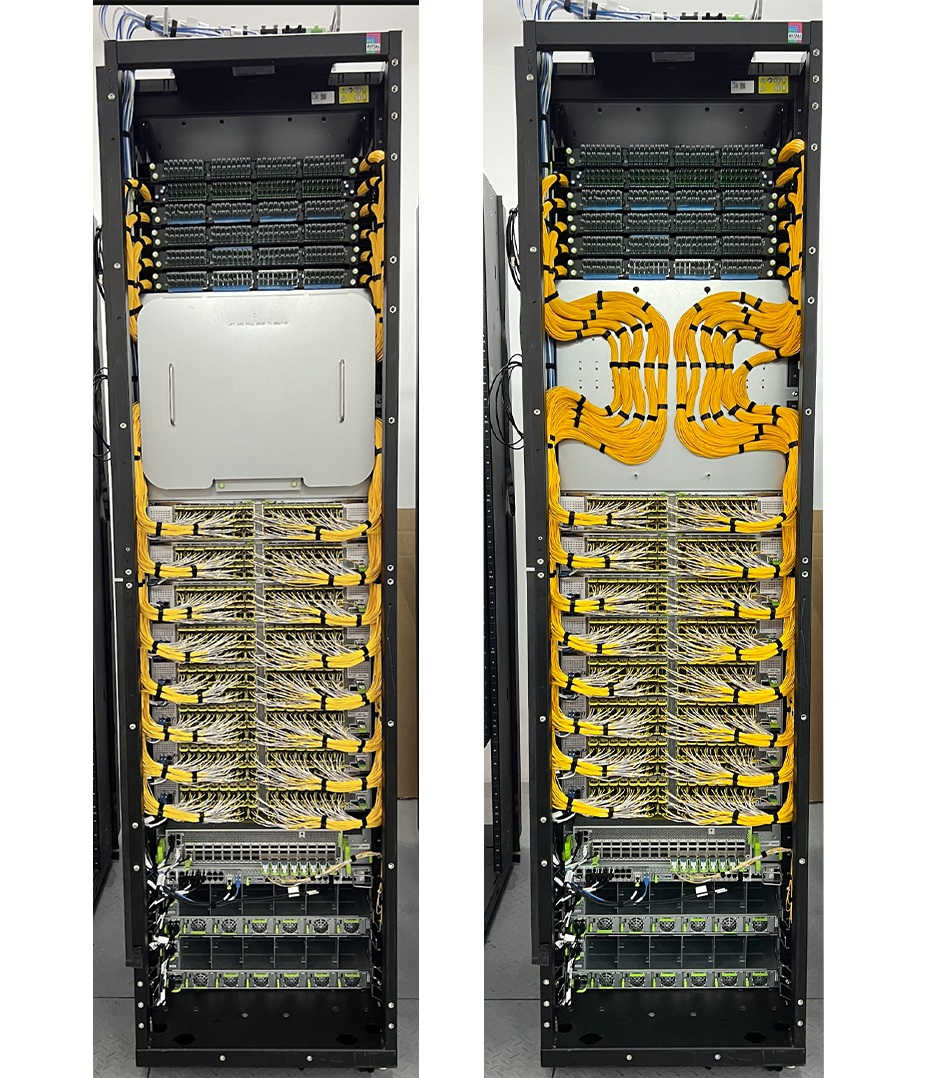
Источник изображений: Meta✴ Такой подход приходит на смену традиционной архитектуре единичных восходящих каналов (uplink), обеспечивая четыре ключевых преимущества:
Оборудование включает коммутаторы IceCube с пропускной способностью 102,4 Тбит/с в стойке IcePack (ORv3-HPRv1) с жидкостным охлаждением. Внутри каждой стойки размещаются модули коммутации IceCube — устройства с пропускной способностью 102,4 Тбит/с, обеспечивающие неблокирующую коммутацию для 128 портов по 800 Гбит/с каждый. Модули IceCube представлены в двух вариантах: на базе специализированных интегральных схем (ASIC) Broadcom Tomahawk6C или NVIDIA Spectrum-6. 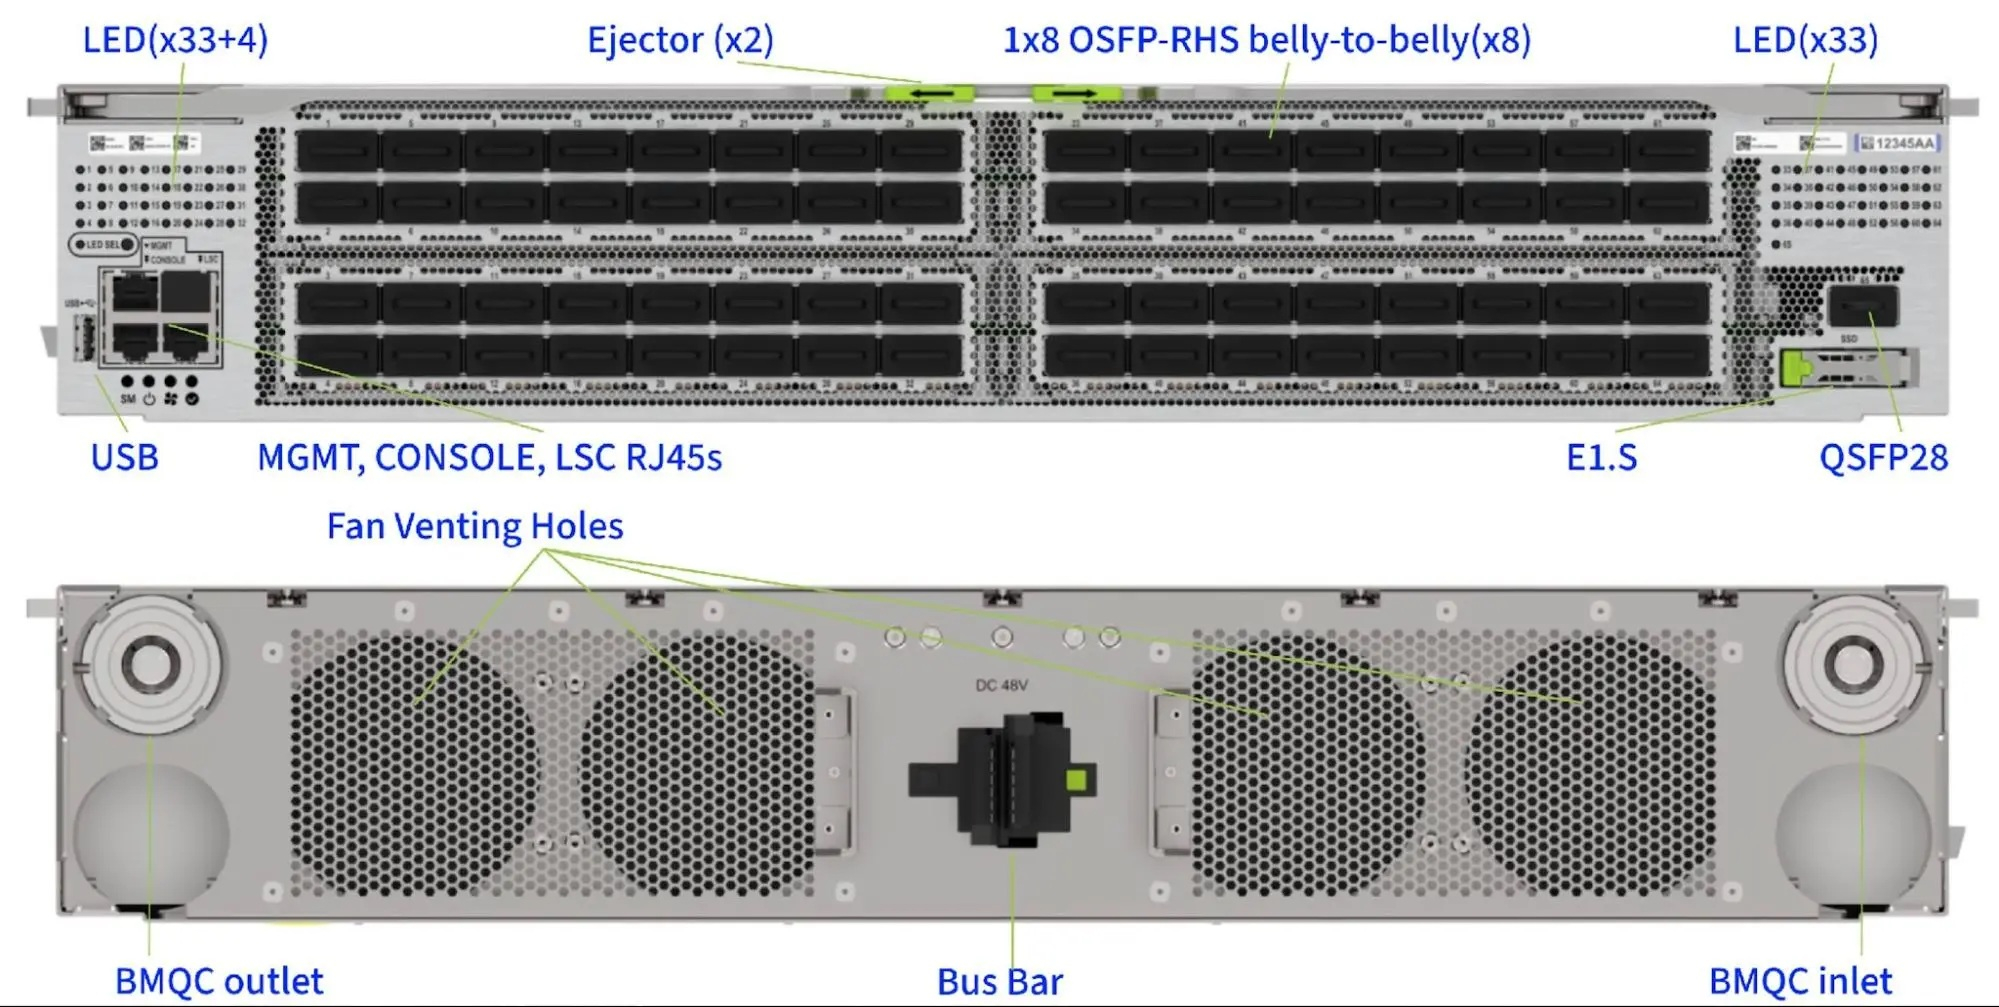
IceCube Оба решения работают под управлением открытой NOS FBOSS от Meta✴, которая использует интерфейс абстракции коммутаторов OCP SAI (Switch Abstraction Interface). Архитектура Open Switch Platform Architecture (OSPA) обращается к функциям управления, включая последовательность включения питания, обнаружение компонентов, терморегулирование, восстановление микропрограммного обеспечения и диагностика. 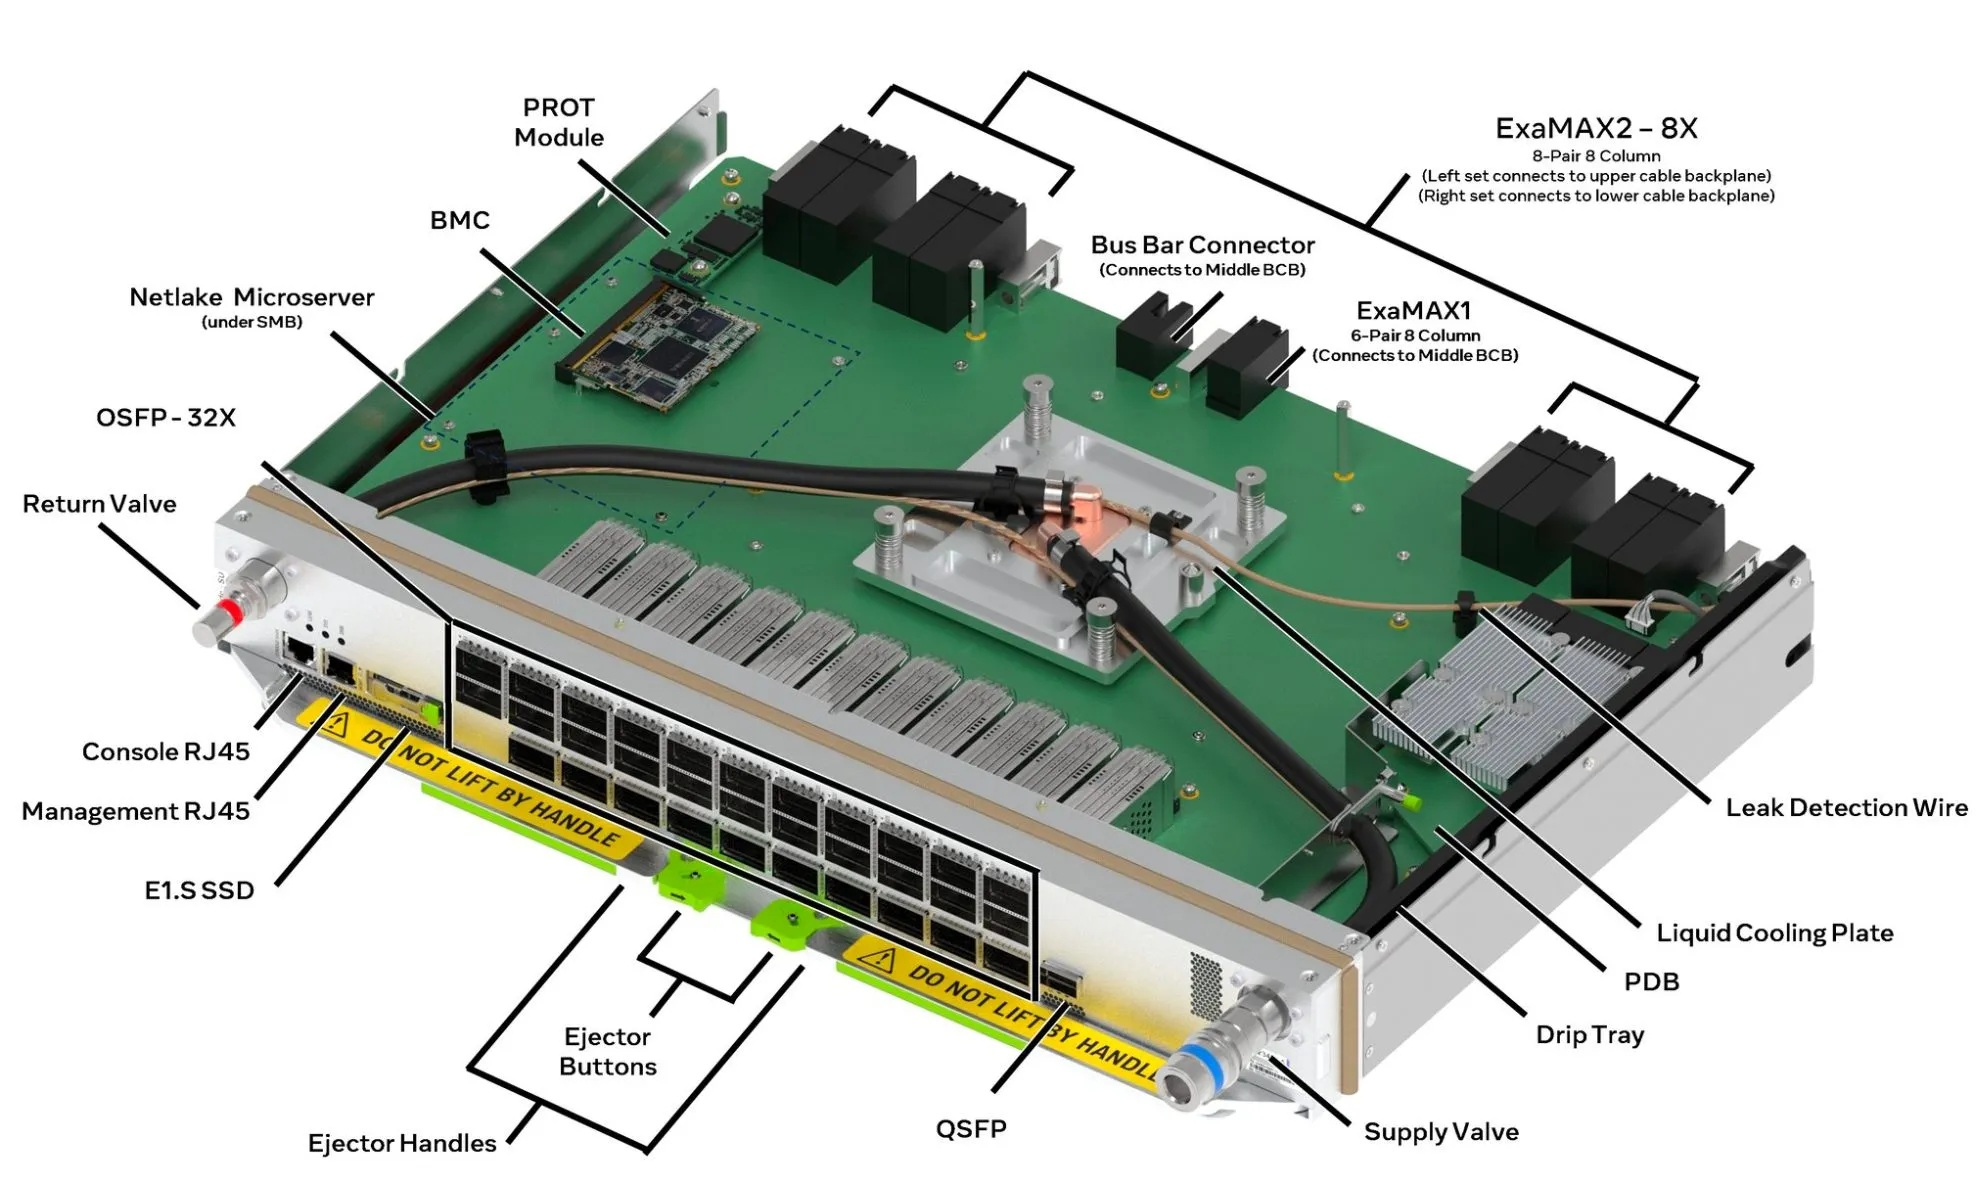
Tahan FPF переносит управление платформой преимущественно на сторону хоста, сохраняя при этом традиционный BMC для функций контроля и восстановления. FPGA-мосты I/O, подключённые через PCIe, объединяют периферийные интерфейсы, а модель учёта аппаратных средств, организованная в виде иерархической структуры, предоставляет ПО согласованный способ перечисления компонентов. Предложение также охватывает автономное управление питанием, обнаружение утечек и резервные образы прошивки. Следует отметить, что это проектные требования, находящиеся на стадии рассмотрения, а не доказательство функциональной совместимости между всеми решениями участвующих вендоров. 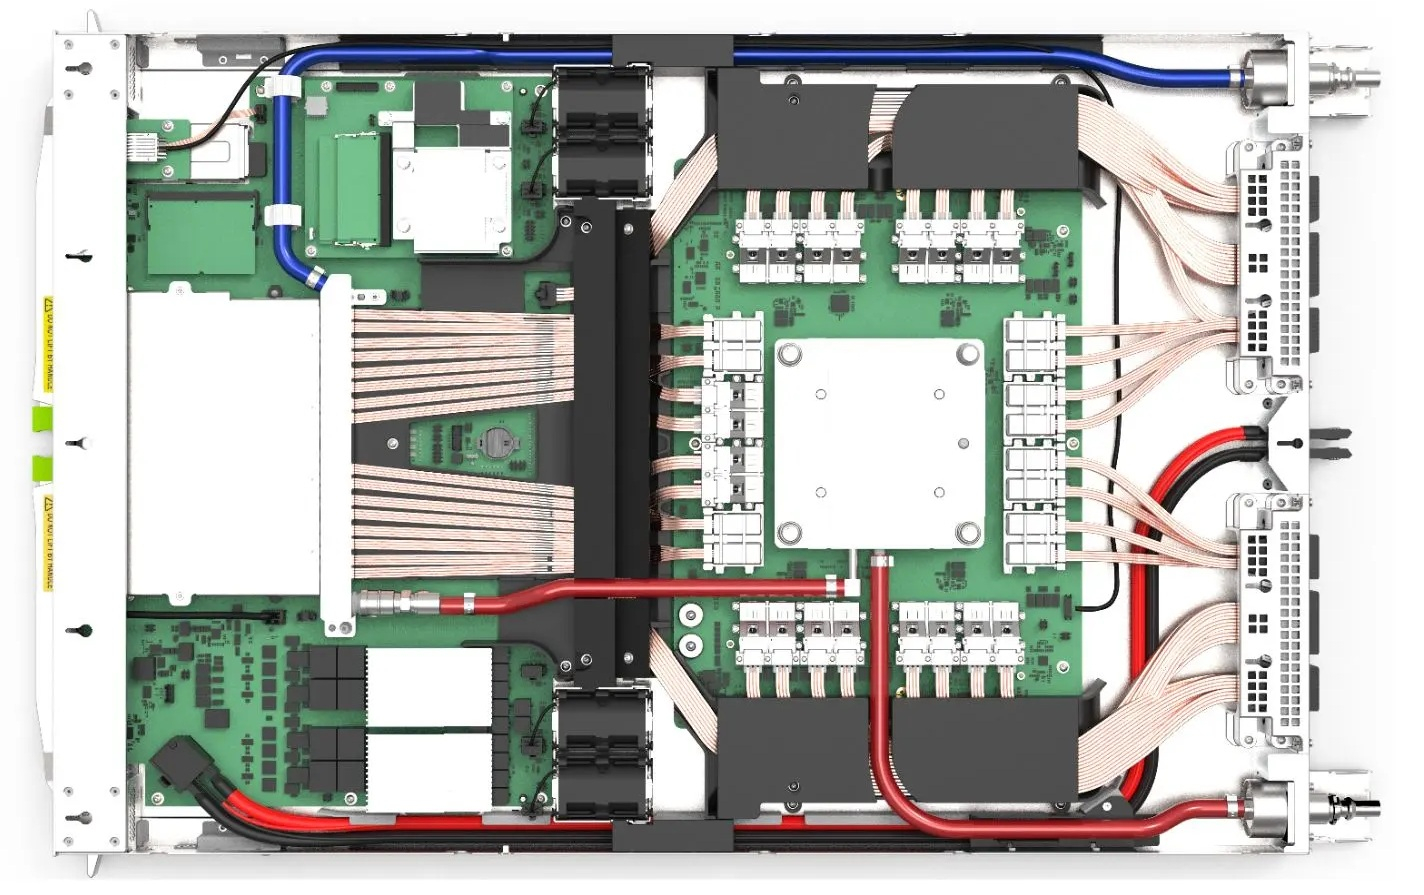
ESUN для MTIA 300 Также Meta✴ сообщила подробности о коммутаторе Tahan Ethernet Scale Up для MTIA 300, показала прототип стойки на 72 ускорителя и анонсировала открытую реализацию MetaRoCE. Эти элементы отражают разные стадии разработки: сейчас Tahan использует режим lossless RoCE, в будущих аппаратных решениях для вертикального масштабирования планируется переход на ESUN, а версия OSPA 1.0.0 пока остаётся на рассмотрении в OCP. 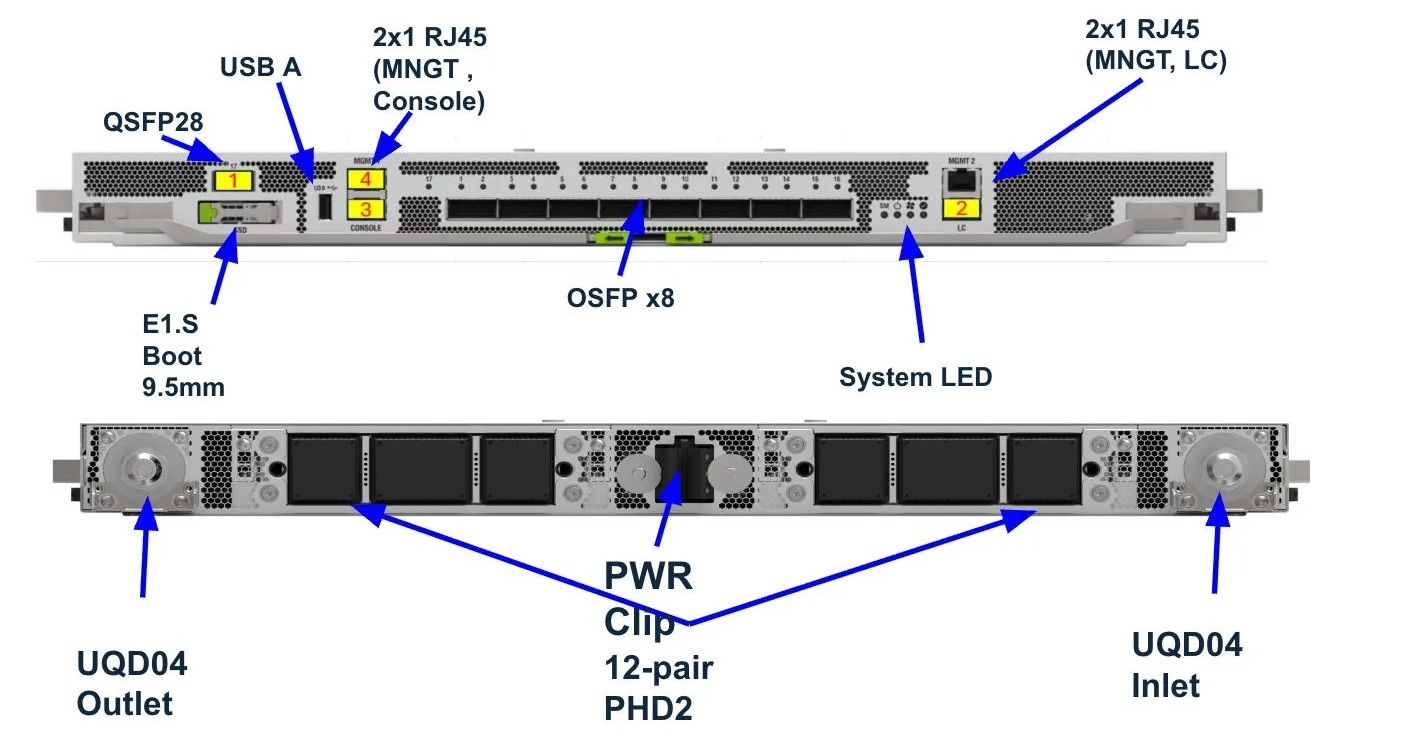
ESUN для MTIA 300 Tahan построен на базе ASIC Tomahawk 5 с пропускной способностью 51,2 Тбит/с (64 × 800G). Четыре коммутатора Tahan соединяют 16 ускорителей в неблокирующей топологии. Компания отметила, что Tahan использует тот же самый lossless RoCE (маршрутизируемый IPv6, PFC и QoS, настроенный для ИИ), объединяя scale-up и scale-out сети под управлением FBOSS. Параллельно компания работает над CXL-фабриками масштаба целого ЦОД.
17.10.2026 [16:43], Сергей Карасёв
Micas Networks представила коммутаторы класса 102,4 Тбит/с на базе Broadcom Tomahawk 6Американская компания Micas Networks на мероприятии OCP Global Summit 2026 анонсировала семейство высокопроизводительных коммутаторов с пропускной способностью 102,4 Тбит/с для дата-центров, ориентированных на ИИ-нагрузки. Устройства построены на чипах Broadcom Tomahawk 6. В частности, дебютировала модель Micas M2-W6950-128OC-FA. Этот коммутатор выполнен в форм-факторе 4U для монтажа в стандартную 19″ серверную стойку. Применяется традиционное воздушное охлаждение. Задействована ASIC-микросхема Broadcom BCM78910 Tomahawk 6P. На фронтальной панели располагаются 128 портов OSFP со скоростью передачи данных 800 Гбит/с каждый. Кроме того, доступны дополнительные сетевые разъёмы, включая RJ45, и порт USB Type-A. Производство устройства планируется организовать в текущем квартале. Ещё одна новинка — изделие Micas M2-W6951-64HC-CP типоразмера 2U с жидкостным охлаждением. Его конфигурация включат 64 порта OSFP с пропускной способностью 1,6 Тбит/с каждый. Данная модель предназначена для применения в ИИ-инфраструктурах высокой плотности. Серийный выпуск, как ожидается, начнётся до конца 2026 года. 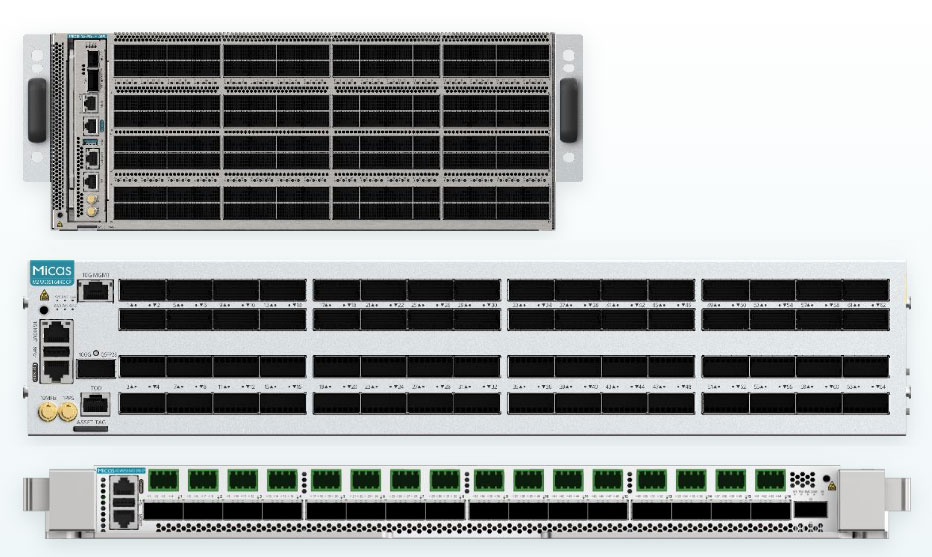
Источник изображения: Micas Networks Наконец, представлен коммутатор Micas M2-W6950-64X3-DR8-CP08-DC с интегрированной оптикой CPO (Co-Packaged Optics) на базе ASIC Broadcom Tomahawk 6 (Davisson). Он оснащён 64 оптическими портами MMC DR8 со скоростью 1,6 Тбит/с. Данная модель, получившая исполнение 1U, оборудована жидкостным охлаждением. Производство будет начато в I квартале 2027 года. На коммутаторах применяется сетевая операционная система SONiC с открытым кодом. Использование этой платформы, как подчёркивается, поможет операторам ИИ ЦОД снизить зависимость от закрытых сетевых архитектур.
17.10.2026 [00:53], Павел Котов
«Выделенка» для ИИ: южнокорейская KT запустила 800G-каналы для ЦОДЮжнокорейский оператор связи KT представил услугу выделенных линий для ИИ ЦОД с каналами шириной 400 и 800 Гбит/с, сообщает Seoul Economic Daily. Ранее компания предлагала корпоративные линии связи со скоростью до 100 Гбит/с. Это важно для рабочих нагрузок ИИ: при крупномасштабном обучении и инференсе могут возникать устойчивые всплески трафика — загрузка наборов данных, синхронизация состояния модели и репликация. Сервис будет использовать общенациональную инфраструктуру ВОЛС, протяжённость которой составляет 840 тыс. км, для построения кратчайших маршрутов между различными ЦОД. Предусмотрено создание дублирующих каналов. Каналы базируются на архитектуре полностью оптических сетей (APN), благодаря чему количество преобразований сигнала из оптического формата в электрический и обратно сводится к минимуму — в результате снижаются задержки. Среди потенциальных клиентов услуги — операторы ИИ ЦОД и компании, которые создают GPU-кластеры. Для них важны поддержка механизмов распределённого обучения ИИ и выполнения запросов к моделям. Оператор проектирует маршруты с учётом расположения ЦОД и сетевых узлов, стремясь сократить длину пути передачи данных, а также соотносится с особенностями сети на объекте заказчика. 
Источник изображения: KT Новая услуга KT согласуется с общемировой тенденцией перехода к оптическим 800G-интерконнектам в ИИ-инфраструктуре. Доля оптических трансиверов, работающих на скоростях 800 Гбит/с и выше, в общем объёме мировых поставок вырастет с 19,5 % в 2024 году до более чем 60 % по итогам 2026 года, гласит прогноз TrendForce. Они становятся стандартными компонентами для ИИ ЦОД. Технологическая гонка выходит за рамки 800G: оборудование нового поколения демонстрирует скорость передачи данных более 1,2 Тбит/с на одной длине волны; следующим этапом станет переход к классу 1,6 Тбит/с. Как именно реализуется архитектура APN, как производится переключение на резервный маршрут, с каким шагом задаётся полоса в оптических каналах, и какие показатели задержки передачи данных предусмотрены для услуги, в KT не раскрыли. Поэтому пока рано давать оценку, насколько услуга окажется выгоднее альтернативных решений для связи между ЦОД. Ранее оператор объявил о намерении построить 1 ГВт мощностей ЦОД и обеспечить пропускную способность межгосударственных подводных кабелей на уровне 90 Тбит/с в течение пяти лет.
12.10.2026 [09:37], Владимир Мироненко
Upscale AI представил архитектуру Token Fabric для ИИ-фабрикСтартап Upscale AI представил архитектуру Token Fabric, призванную объединить вертикальное и горизонтальное масштабирование в рамках одной сетевой платформы. Решение сочетает в себе фирменный чип SkyFabriX (scale-up), NVIDIA Spectrum-X Ethernet (scale-out) и единый программный уровень для управления. Система, построенная на открытых стандартах, должна обеспечить непрерывную работу ИИ-чипов, чтобы они не простаивали в ожидании данных, тем самым помогая клиентам повысить отдачу от своих инвестиций. Token Fabric включает:
Клиенты могут внедрять Token Fabric, выбирая отдельные компоненты (чипы, системы, ПО) или весь стек целиком. Вариант с полным стеком рассчитан на неооблака и корпоративных клиентов, не располагающих сетевыми командами масштаба гиперскейлеров. Вариант с интегрированными системами предназначен для производителей XPU, которым требуется проверенное оборудование без необходимости самостоятельной разработки сетевого стека. Третий вариант предусматривает поставку чипов или специализированных систем вместе с SDK/SAI от Upscale, поверх которых работает собственная NOS заказчика. 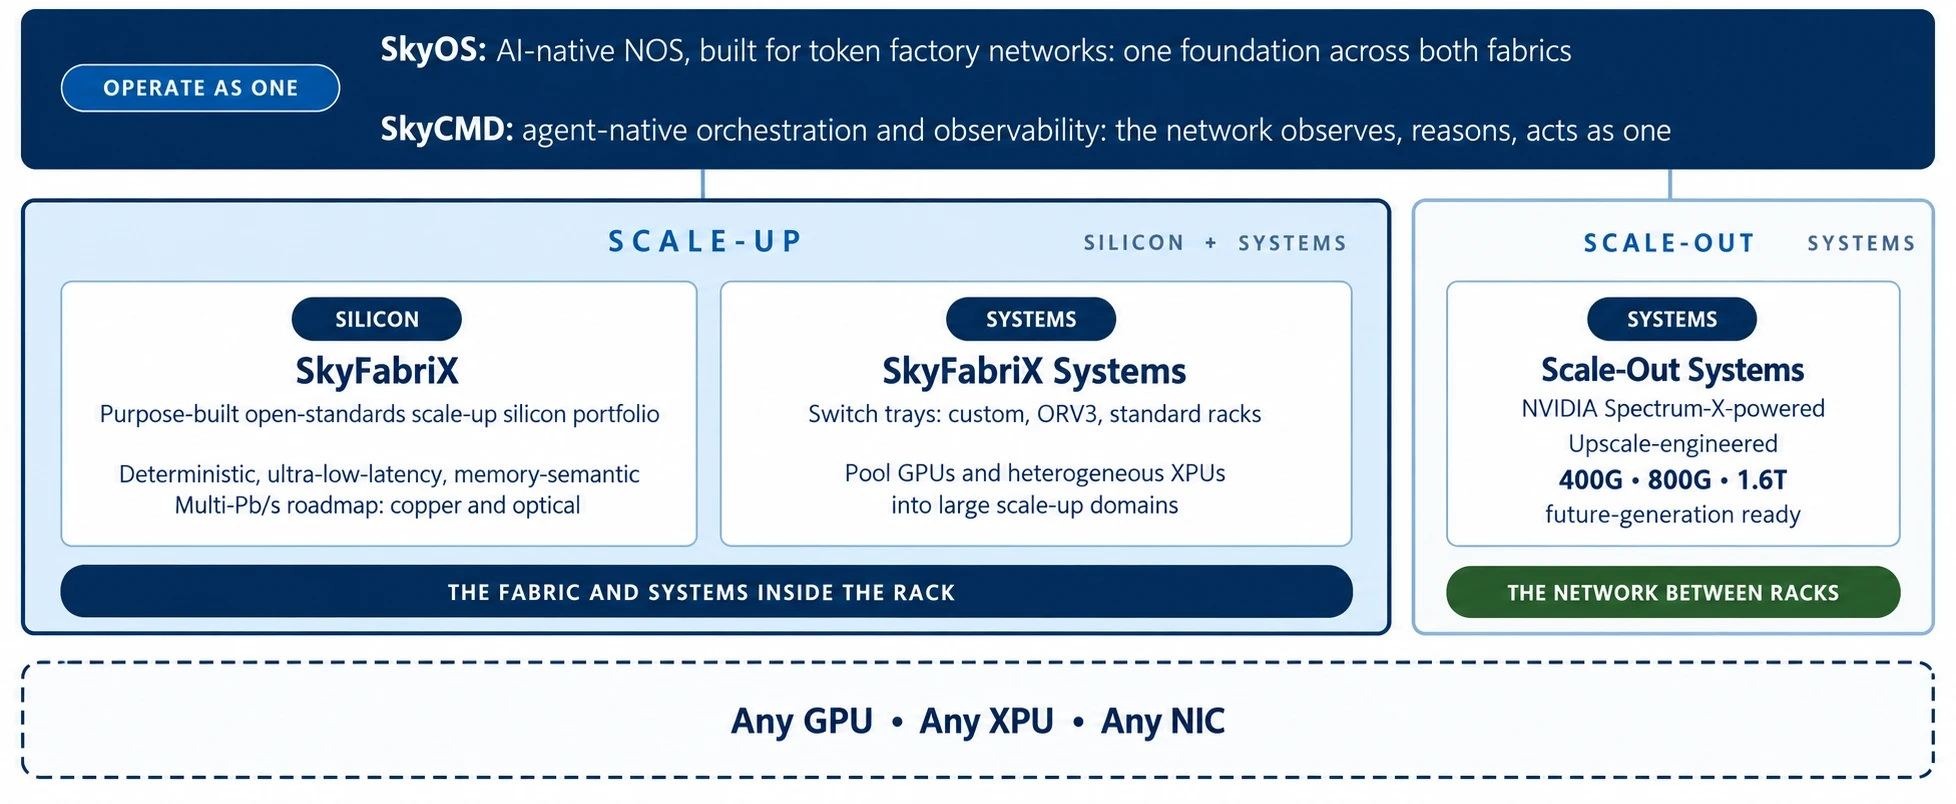
Источник изображения: Upscale AI Upscale AI расширяет существующие протоколы, а не заменяет их, говорит компания. Upscale AI также вносит вклад в открытые проекты, лежащие в основе стека. К ним относятся SONiC, расширения интерфейса абстракции коммутатора (SAI) для поддержки ESUN, а также инициативы Ultra Ethernet Consortium (UEC) и UALink. SkyOS абстрагирует нижележащее оборудование и обеспечивает единую плоскость управления для всего кластера, а SkyCMD унифицирует управление. Любая вычислительная платформа в гетерогенном кластере может использовать этот интерфейс для управления сетью. «Операционная система должна быть компактной и эффективной, чтобы обеспечивать быстродействие, гибкость и безопасность, — сообщил изданию Network World Барун Кар (Barun Kar), генеральный директор Upscale AI. — Кроме того, поверх неё необходим уровень оркестрации, позволяющий поддерживать такие возможности, как гетерогенные вычисления». Полномасштабный выпуск Token Fabric запланирован на начало 2027 года; в настоящее время действуют программы раннего доступа и совместного тестирования. Компания Upscale AI вышла из скрытого (stealth) режима в сентябре 2025 года. Она привлекла $100 млн в рамках посевного раунда финансирования, потом — $200 млн в раунде A, а затем — ещё $190 млн, при оценке капитализации в $2 млрд. В результате общий объём инвестиций составил $500 млн. Стартап поддерживают как NVIDIA, Salesforce и сингапурский государственный инвестиционный фонд Temasek. Главный инвестор — фонд Premji Invest. Штат компании превышает 300 сотрудников.
03.09.2026 [17:31], Владимир Мироненко
Тонущую GoPro поглотили за $285 млн, и теперь она займётся оптикой для ЦОДИспытывающий финансовые трудности производитель экшн-камер GoPro заключил окончательное соглашения о слиянии с американской компанией Starman Optical, в результате которого акционеры GoPro получат в общей сложности $285 млн или $1,14 за акцию и сохранят за собой примерно 10 % акций компании. Непогашенный долг GoPro в размере приблизительно $92 млн будет полностью погашен на момент закрытия сделки, которое ожидается к концу этого года. Как сообщает GoPro, сделка позволит «максимизировать ценность интеллектуальной собственности GoPro и потенциал роста на потребительском, коммерческом и оборонном рынках путем рекапитализации компании, укрепления её баланса, инвестиций в развитие и переноса производства продукции для стратегических рынков в страну». При этом она останется публичной компанией и продолжит оказывать полную поддержку своим существующим потребительским продуктам. Компания Starman Optical была зарегистрирована в Делавэре 31 августа. Она позиционируется как «оптико-фотонная компания, специализирующаяся на разработке и внутреннем производстве оптических трансиверов и связанных с ними фотонных технологий через своё подразделение Starman New Photonics (SNP)». И Starman Optical, и Starman New Photonics входят в состав Starman Holding, которой принадлежат такие бренды потребительской электроники, как Incase, Incipio и Griffin. SNP представила на выставке OFC 2026 продукты Liberty, в том числе трансиверы 800G и 1,6T для ИИ ЦОД. 
Источник изображения: GoPro Сообщается, что SNP планирует инвестировать $150 млн в реконструкцию завода площадью 9300 м2 в Уоррене (Warren, штат Нью-Джерси), на котором будет осуществлять высокоточное производство оптических трансиверов, сборку, упаковку и научно-исследовательские разработки, создав 250 рабочих мест. Ожидается, что оптические трансиверы Starman, производимые в США, будут добавлены в портфель GoPro, что расширит присутствие компании на быстрорастущем рынке ИИ-инфраструктуры. Как отметил ресурс Converge! Network Digest, для Starman компания GoPro потенциально может предоставить инженерные ресурсы, опыт в области оптики, интеллектуальную собственность, включающую 2500 зарегистрированных в США патентов, и доступ к публичным рынкам капитала; для GoPro Starman — это возможность выйти на быстрорастущий рынок оптики для ЦОД. «Сочетание мирового класса оптической экспертизы и интеллектуальной собственности GoPro с передовыми возможностями трансиверов Starman и американской производственной платформой создаёт уникальную возможность. Вместе мы намерены вернуть производство этих критически важных компонентов в США», — заявил Чарльз Тебеле (Charles Tebele), генеральный директор Starman Holdings. Спрос на оптику для ИИ-систем стимулирует значительные инвестиции в наращивание производственных мощностей по всей отрасли. Например, компания Applied Optoelectronics (AOI) расширяет производство оптики для систем с пропускной способностью 800 Гбит/с и 1,6 Тбит/с в Техасе, а Coherent вкладывает значительные средства в наращивание мощностей по производству полупроводников на основе фосфида индия по мере роста спроса на системы с пропускной способностью 1,6 Тбит/с. Запланированное открытие производства в Нью-Джерси позволит компании SNP добавить ещё один производственный объект в цепочку поставок оптики, которая исторически в значительной степени полагалась на мощности в Азии.
27.08.2026 [09:25], Владимир Мироненко
MTIA 300: первый ИИ-чип Meta✴ со встроенными 800GbE-адаптерами и механизмами разгрузки коммуникацийMeta✴ сообщила новые подробности о 667-Вт ИИ-ускорителе MTIA 300 — своём первом чипе, оптимизированном для обучения DLRM-моделей. В отличие от LLM, требующих огромной пропускной способности вычислений с плавающей запятой, рекомендательные модели сталкиваются с проблемой необходимости быстрого и эффективного взаимодействия ускорителей в сочетании с большой ёмкостью памяти и высокой пропускной способностью интерконнекта. Их таблицы эмбеддингов могут содержать более 99 % параметров модели, что требует гибридного параллелизма, генерирующего частые коллективные операции AllReduce, AllToAll и AllGather на сотнях ускорителей. На таких чипах, как GPU, эти коммуникационные операции конкурируют с вычислениями за одни и те же ресурсы, часто приводя к неэффективному использованию дорогостоящего оборудования. Для решения этой проблемы разработчики, используя совместную разработку MTIA 300 с HCCL, библиотекой коммуникационных интерфейсов, созданной на основе разработанного с нуля оборудования, сделали коммуникацию первостепенной задачей в проектировании микросхем. На практике HCCL обеспечивает пропускную способность передачи данных до 940 Гбайт/с в пределах одной стойки. На модели со 150 млрд параметров, работающей на 40 ускорителях, общее время обмена данными при использовании MTIA 300 в 3,9 раза меньше, чем у эквивалентного кластера на базе GPU. 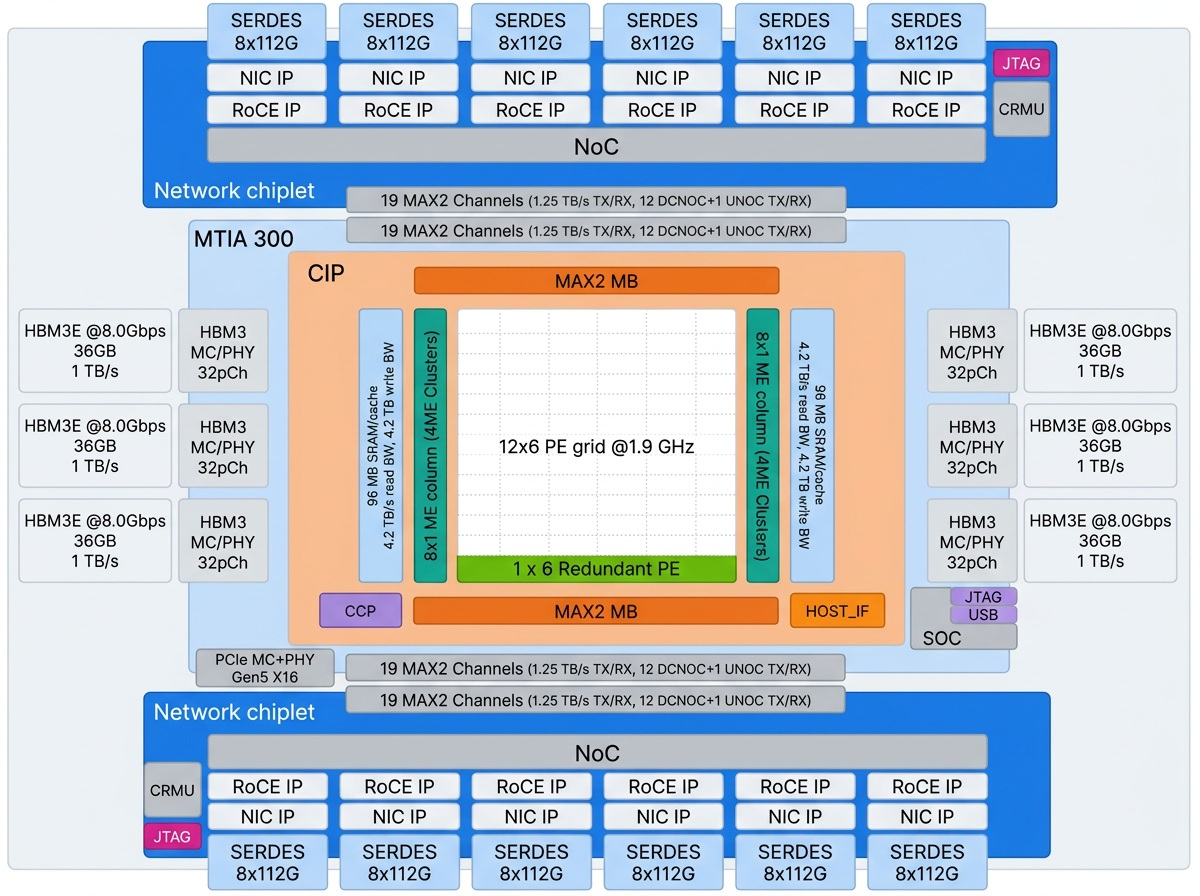
Источник изображения: Meta✴ В MTIA 300 сетевой интерфейс находится внутри самой упаковки микросхемы. Два 5-нм сетевых чиплета, каждый из которых содержит по шесть специализированных 800GbE RoCE-адаптеров, обеспечивают общую пропускную способность I/O 1,2 Тбайт/с без пересечения c шиной PCIe. Это устраняет узкое место в цепочке «хост-устройство-NIC», присутствующей в традиционных архитектурах GPU, где CPU должен выступать посредником между ускорителем и сетью, и позволяет избежать перегрузки PCIe между ускорителем и NIC. При этом NIC можно гибко использовать для масштабирования. Поскольку используются одни и те же 12 NIC на базе Ethernet для вертикального масштабирования (внутри стойки из 16 узлов, до 1 Тбайт/с) и горизонтального масштабирования (между стойками, до 200 Гбайт/с), можно гибко распределять NIC в соответствии с меняющимися потребностями. По мере изменения требований модели можно переконфигурировать сеть, а не само оборудование. Для минимизации задержки транзакций разработчики внедрили экспресс-оповещения (doorbell). Сама запись запроса на выполнение служит оповещением, исключая дополнительное чтение из памяти и экономя около 800 нс на операцию. 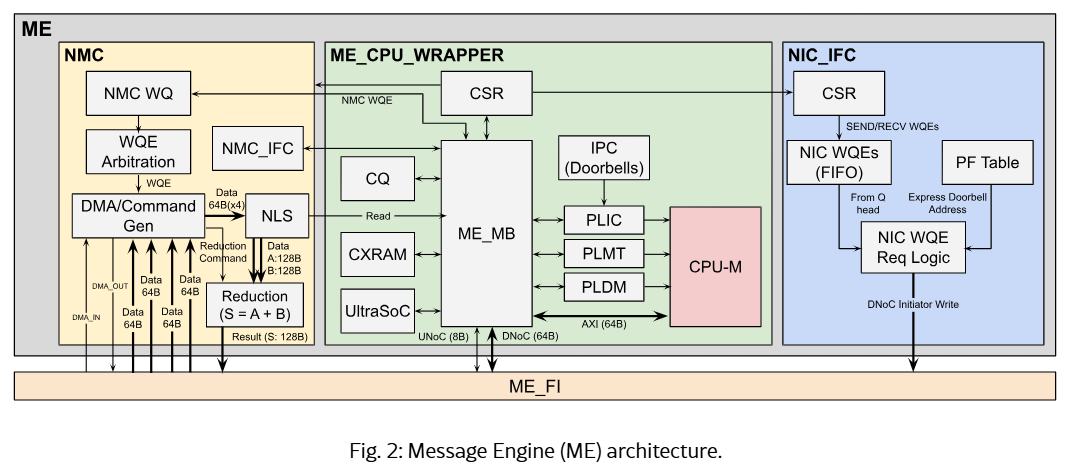
Источник изображения: Meta✴ В случае GPU библиотеки вроде NCCL реализуют операции коллективных коммуникаций в виде вычислительных ядер (kernel), которые используют те же ресурсы, что нужны для вычислений при обучении. Пересечение коллективных операций и операций обучения приводит к замедлению обоих и того, и другого. В MTIA 300 использовали другой подход. Наряду с матрицей из 72 3-нм вычислительных элементов (PE), чип включает 16 выделенных механизмов обработки сообщений (ME), которые обрабатывают всю коммуникацию независимо. ME содержит ядро RISC-V для оркестрации; сетевой интерфейс, который направляет запросы к нужному NIC; вычислительный блок Near-Memory Computing (NMC), который выполняет операции редукции со скоростью 128 байт/цикл. Расположенные по краям чипа, рядом с HBM и кешем, NMC в совокупности обеспечивают пропускную способность редукции более 2,8 Тбайт/с — более чем вдвое превышающую пропускную способность I/O. Это позволяет выполнять коллективные операции AllReduce и ReduceScatter на линейной скорости NIC без использования ресурсов PE. 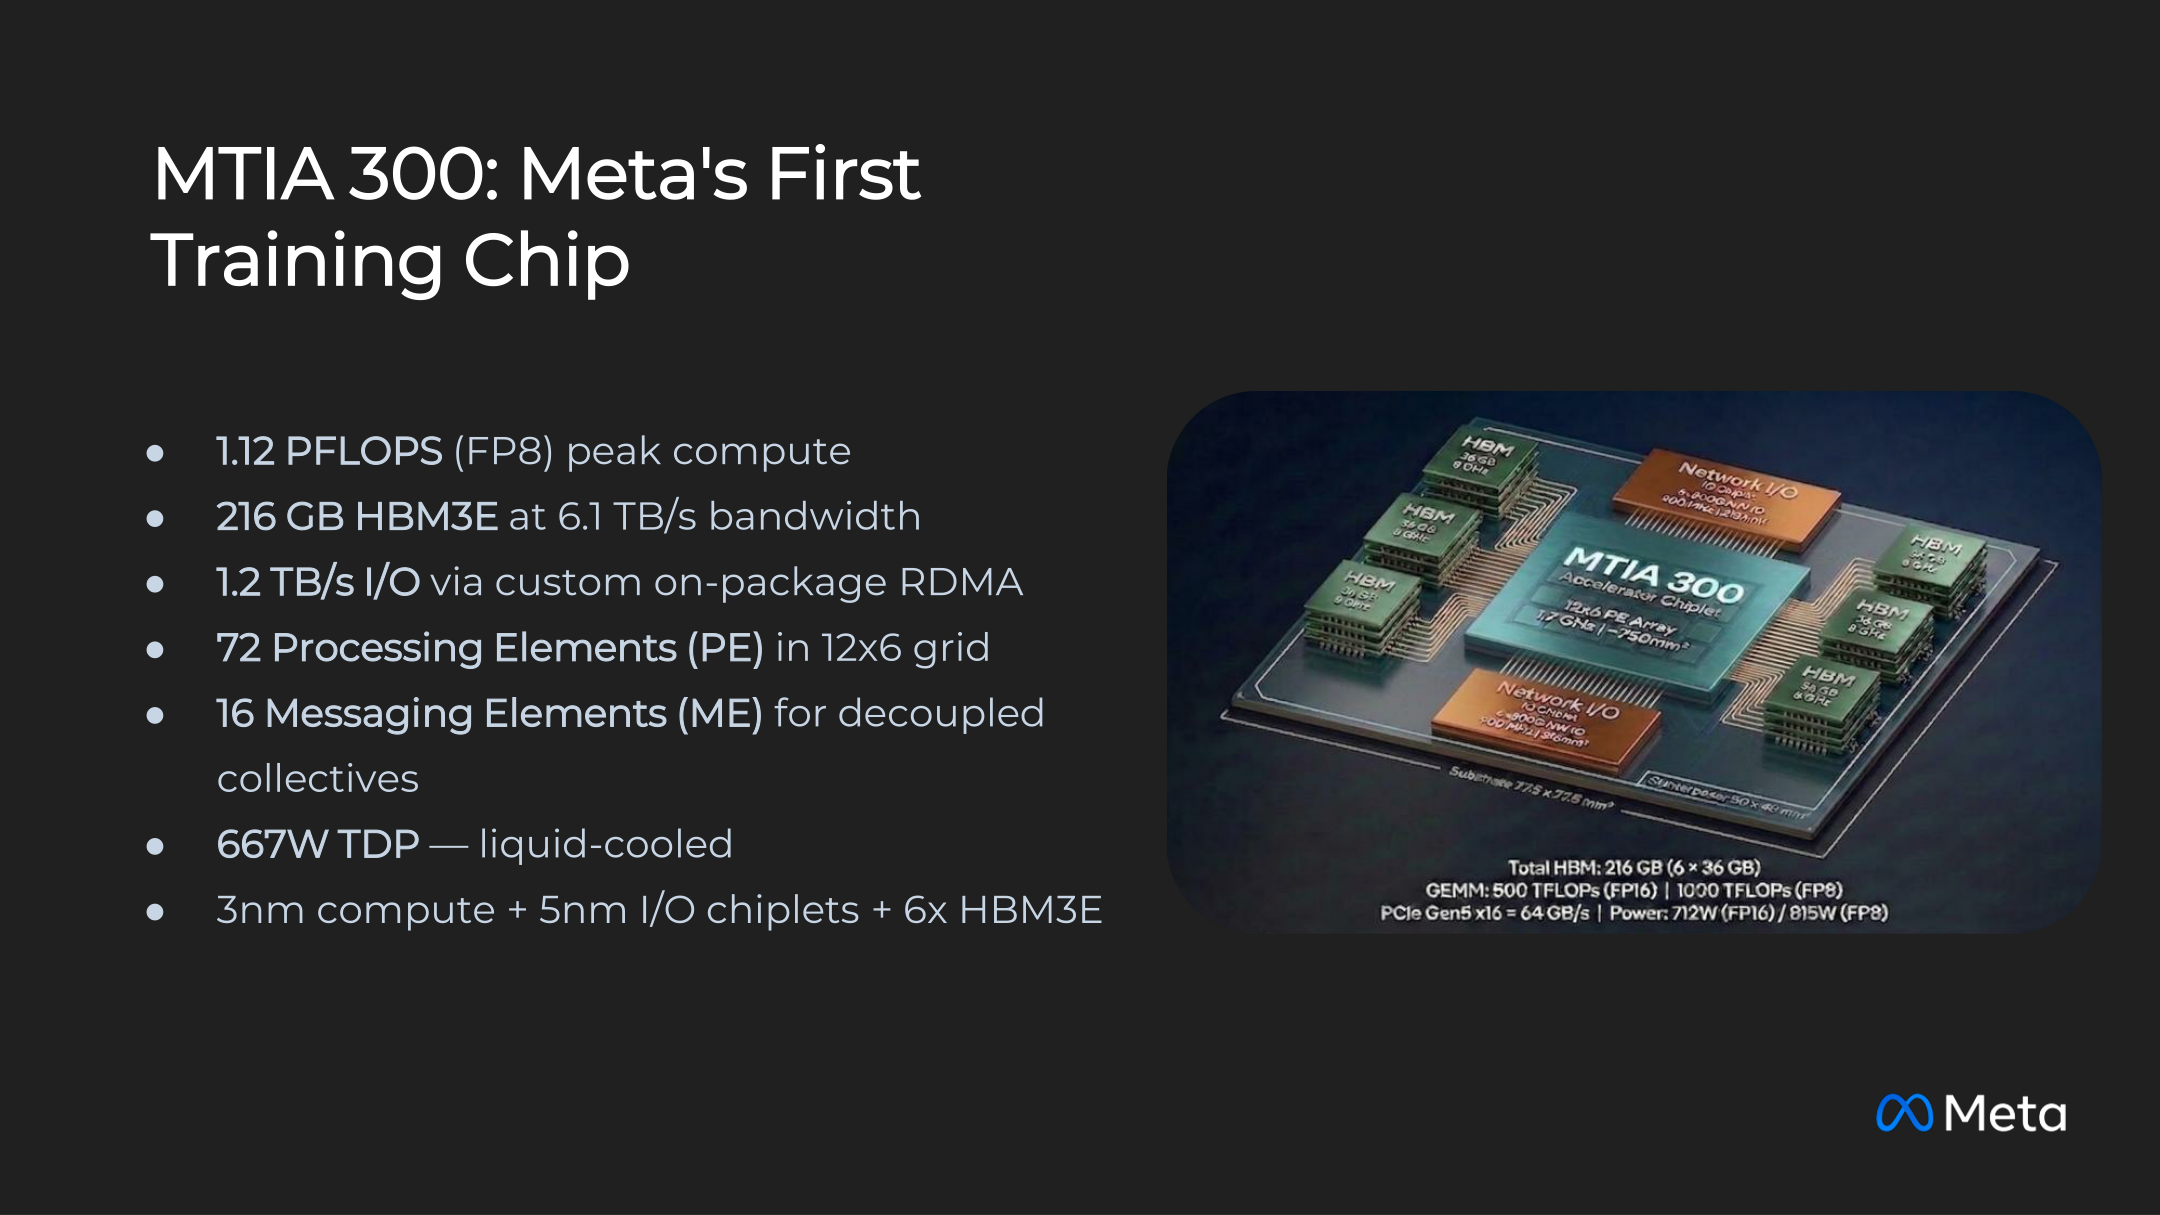
Источник изображения: Meta✴ В результате обеспечивается практически идеальная изоляция операций. Одновременное выполнение больших GEMM-операций с коллективными операциями приводит к снижению вычислительной пропускной способности менее чем на 0,5 %, в отличие от традиционных GPU, где снижение может превышать 20 % из-за использования одних и тех же ресурсов на обмен данными и вычисления. Разработанная совместно с MTIA 300 библиотека HCCL вместо управления обменом данными с хостом во время выполнения компилирует каждую коллективную операцию в полный набор подграфов (массивы очередей задач с явным указанием зависимостей), которые отправляются на ME для полностью автономного выполнения. Таким образом, хост лишь единожды отправляет ускорителю набор сетевых инструкций и более не вмешивается в работу сети. 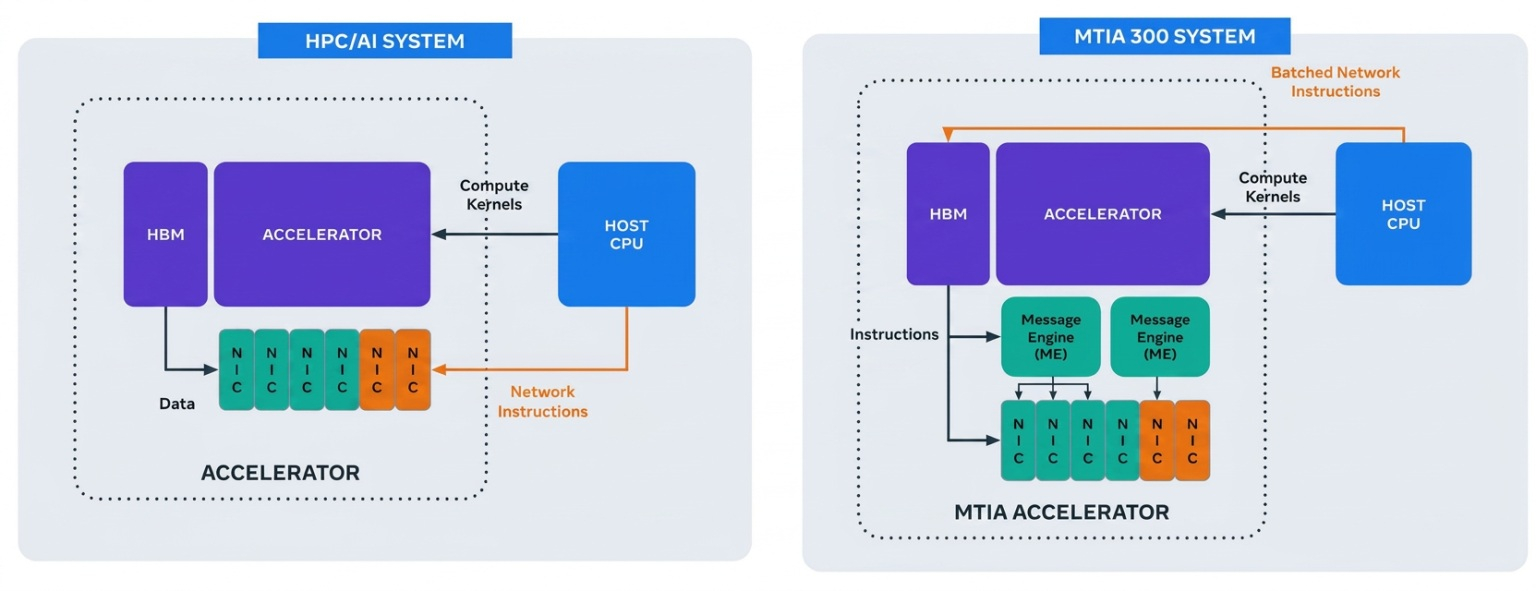
Источник изображения: Meta✴ По словам Meta✴, такая архитектура естественным образом интегрируется с PyTorch. Коллективные операции компилируются в единый граф вместе с вычислительными задачами. HCCL сама выбирает алгоритмы, учитывающие топологию сети и асимметричность полос пропускания, по возможности минимизируя межстоечный трафик. Для инференса были разработаны дополнительные пути: односторонняя коммуникация, когда PE используют экспресс-оповещения, и параллельный запуск коллективных операций по сигналу от kernel'а без прерывания работы последнего. Компания отметила, что MTIA 300 имеет и другие плюсы 216 Гбайт HBM3E (6,1 Тбайт/с) позволяют разместить больше данных на одном чипе, а не загружать их лишний раз извне; на каждый ускоритель приходится всего один CPU, что позволяет нагружать его интенсивными вычислениями на некоторых этапах; высокая пропускная способность сети позволяет при необходимости использовать форматы данных с более высокой точностью. Хотя сочетание умеренной FP-производительности с ёмкой и быстрой HBM в MTIA 300 изначально было оптимизировано для обучения DLRM, эти качества позволяет эффективно использовать чипа для более широкого спектра нагрузок, включая инференс моделей генеративного ИИ. Стоит отметить, что подход Meta✴ с внедрением NIC непосредственно в чип не нов сам по себе. Например, чипы Intel/Habana Gaudi2, представленные в 2022 году, использовали 24 100GbE-интерфейса RoCE для вертикального и горизонтального масштабирования.
08.08.2026 [01:58], Владимир Мироненко
Lumilens вышла из скрытого режима и привлекла $700 млн с оценкой в $5,51 млрдСтартап Lumilens, специализирующийся на разработке решений для оптическими сетей для ЦОД, объявил о выходе из скрытого режима (stealth mode) и успешном завершении раунда финансирования серии C, в ходе которого он привлёк $700 млн. В результате общий объём инвестиций в него превысил $900 млн, а оценка рыночной стоимости стартапа выросла до $5,51 млрд. Раунд совместно возглавили Atreides Management, Bain Capital Ventures, Meritech, Seligman Ventures и Spark Capital при участии Addition, Alkeon, Harbourvest, J.P. Morgan Private Capital, Mayfield, MVP Ventures, Qualcomm Ventures, Peak XV, Redpoint Ventures, Seifdune и других ведущих инвесторов. Компания сообщила, что использует привлечённые средства для расширения своих операций в сфере инженерии и производства. Lumilens отметила, что спустя всего два года с момента основания её первый продукт прошел квалификацию и начал поставляться в ЦОД одного из четырёх ключевых гиперскейлеров в рамках многомиллиардного соглашения. Это может относиться к одному из технологических гигантов: Amazon, Alphabet, Microsoft и Meta✴, считает Reuters. 
Источник изображений: Lumilens Lumilens проектирует и производит оптические интерконнекты для обоих типов сетей внутри ИИ ЦОД — вертикально масштабируемой (scale-up) сети, которая напрямую соединяет GPU в рамках одной вычислительной системы, и горизонтально масштабируемой (scale-out) сети, которая объединяет различные стойки и кластеры. Для горизонтально масштабируемых сетей Lumilens предлагает подключаемые оптические трансиверы класса 800G/1.6T. Для вертикально масштабируемых сетей компания разрабатывает решения CPO (Co-Packaged Optics) и NPO (Near-Package Optics), предназначенные для замены медного интерконнекта малой дальности и, в конечном итоге, для обеспечения работы десятков тысяч GPU в качестве единой тесно связанной ИИ-системы. Все продукты основаны на разработанной компанией платформе LumiCore, объединяющей кремниевую фотонику, интегральные схемы со смешанным сигналом, электрооптические интерпозеры и оптические системы. Единая платформа для всего портфеля продукции позволяет Lumilens переходить от проектирования к сертифицированному клиентом продукту за считанные месяцы, и гарантирует, что каждый продукт с самого начала разработан для крупномасштабного производства.  Компания сообщила, что разработала новаторскую технологию электрооптических интерпозеров, которая значительно упрощает сборку фотонных чипов, а также собственные технологические процессы, специализированную робототехнику и автоматизацию тестирования, масштабируя мощности через производственных партнёров и собственных крупномасштабных предприятий. «Ограничение для ИИ сместилось с количества GPU, которые вы можете купить, на количество, которое вы можете подключить», — утверждает Анкур Сингла (Ankur Singla), основатель и генеральный директор Lumilens. Сингла ранее создал и продал две инфраструктурные компании: Contrail Systems, занимающуюся программно-определяемыми сетями, которую Juniper Networks приобрела в 2012 году примерно за $176 млн, а затем Volterra, платформу для периферийных и облачных вычислений, которую F5 купила почти за $500 млн в январе 2021 года. В период между работой в Volterra и Lumilens он также основал Exaforce, платформу безопасности на основе ИИ, которая сейчас оценивается примерно в $725 млн, где он по-прежнему занимает должность исполнительного председателя. Lumilens — его четвёртая инфраструктурная компания, отметил ресурс Tech Funding News. Её команда включает специалистов из Cisco, Juniper Networks, Meta✴, Marvell, Lumentum и Coherent.
04.07.2026 [13:30], Сергей Карасёв
DriveNets представила коммутаторы 2600SL и 2601S с 64 портами на 1,6 Тбит/сКомпания DriveNets анонсировала сетевые коммуникационные платформы 2600SL и 2601S, рассчитанные на гиперскейлеров, облачных провайдеров и операторов ИИ ЦОД. В основу новинок положен чип Broadcom Tomahawk 6, обеспечивающий коммутационную способность до 102,4 Тбит/с. Модель DriveNets 2601S выполнена в форм-факторе 3U и оснащена воздушным охлаждением. В свою очередь, версия DriveNets 2600SL соответствует типоразмеру 2OU (ORv3): это устройство оснащено полностью жидкостным охлаждением, что, как утверждает разработчик, обеспечивает максимальную энергоэффективность. Обе системы оснащены 64 портами OSFP224 с пропускной способностью 1,6 Тбит/с каждый. Говорится также о поддержке конфигураций 128 × 800GbE, 256 × 400GbE и 512 × 200GbE. Кроме того, реализованы три порта управления — два 50GbE SFP56 и один 1GbE RJ45. Поддерживается до 64 Гбайт DDR4-2666 в виде двух модулей RDIMM/SODIMM (ECC). 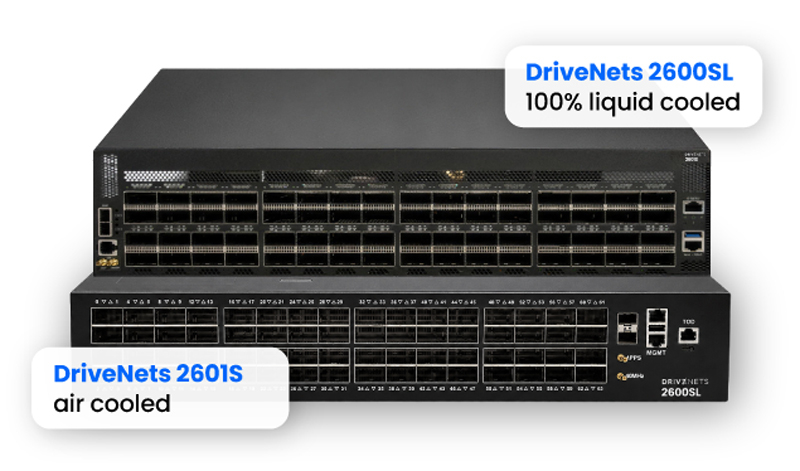
Источник изображения: DriveNets DriveNets отмечает, что коммутаторы оптимизированы для работы в инфраструктурах, ориентированных на наиболее ресурсоёмкие нагрузки ИИ. Это может быть обучение больших языковых моделей (LLM) с огромным количеством параметров или инференс. Поставки устройств 2600SL и 2601S планируется организовать в текущем квартале. «Чипы Broadcom Tomahawk 6 в сочетании с платформой DriveNets обеспечивают беспрецедентную производительность и надёжность в крупномасштабных кластерах», — отмечает Broadcom.
03.07.2026 [08:51], Сергей Карасёв
Квартальные продажи Ethernet-коммутаторов взлетели на 40 %, а NVIDIA выбилась в лидеры в ЦОД-сегментеIDC подвела итоги исследования глобального рынка Ethernet-коммутаторов корпоративного класса в I квартале текущего года: продажи таких устройств в денежном выражении достигли $15,4 млрд, что на 39,8 % больше по сравнению с аналогичным периодом 2025-го. Отмечается, что в сегменте дата-центров выручка взлетела в годовом исчислении на 61,0 %, составив около $10 млрд. Столь значительный рост аналитики связывают с продолжающимся развитием инфраструктуры ИИ, а также расширением мощностей гиперскейлеров. В ЦОД-секторе 35,8 % продаж в деньгах обеспечили коммутаторы стандарта 800GbE, ещё 34,1 % — решения класса 200/400GbE. С географической точки зрения спрос на коммутаторы поднялся во всех ключевых регионах. Так, на американском рынке прибавка составила 49,7 % в годовом исчислении. В странах EMEA (Европа, Ближний Восток и Африка) зафиксирован рост на 32,2 %, а в Азиатско-Тихоокеанском регионе — на 25,9 %. 
Источник изображения: Lambda Подчёркивается, что в сегменте Ethernet-коммутаторов для дата-центров в лидеры вырвалась NVIDIA, у которой продажи в денежном выражении подскочили год к году на 192,7 % — до $2,1 млрд: это соответствует доли в 21,5 % в соответствующей области. Однако в целом по рынку лидирует Cisco с 29,3 % и выручкой в объёме $4,5 млрд (+24,0 % по отношению к I кварталу 2025 года). У Arista Networks продажи поднялись на 37,3 % — до $2,2 млрд, что соответствует 14,6 % отрасли. В пятёрку ведущих игроков также входят НРЕ с 6,4 % и $985 млн (+15,4 % г/г) и Huawei с 5,8 % и $895 млн (+27,2 %). В исследовании говорится, что продажи маршрутизаторов для предприятий и поставщиков услуг по итогам I четверти 2026 года составили $3,8 млрд, что соответствует росту на 11,3 % в годовом исчислении. На поставщиков услуг пришлось 77,2 % от указанной суммы, или $2,9 млрд (+12,9 % г/г). Еще $867 млн принесли маршрутизаторы корпоративного класса — +6,1 % по отношению к I кварталу прошлого года.
28.06.2026 [15:48], Сергей Карасёв
Китайские x86-процессоры Hygon C86-5G получили 128 ядер с поддержкой 512 потоковКитайская компания Hygon, по сообщениям сетевых источников, создала процессоры нового поколения с архитектурой x86. Речь идёт об изделиях C86-5G, которые, как ожидается, будут применяться в оборудовании для дата-центров. Кроме того, в разработке находятся другие продукты, включая ИИ-ускорители. Решения C86-5G придут на смену изделиям C86-4G, которые являются наследниками AMD Zen1. Чипы C86-4G насчитывают 16 вычислительных ядер с возможностью одновременной обработки до 32 потоков инструкций, а тактовая частота составляет 2,8 ГГц. Реализована поддержка оперативной памяти DDR5 и интерфейса PCIe 5.0. Известно, что процессоры C86-5G получат до 128 вычислительных ядер. Упомянута технология многопоточности SMT4, которая позволит каждому ядру обрабатывать четыре потока инструкций, что в сумме даст 512 потоков. Упомянута поддержка 104 линий PCIe 5.0, инструкций AVX512 (ISA на уровне Zen 5), а также режимов INT8 и BF16. Заявленная производительность — 10 Тфлопс на операциях FP64 (до 32 операций за такт). Ожидается, что в ЦОД-сегменте новые китайские процессоры станут альтернативой Intel Xeon 6. 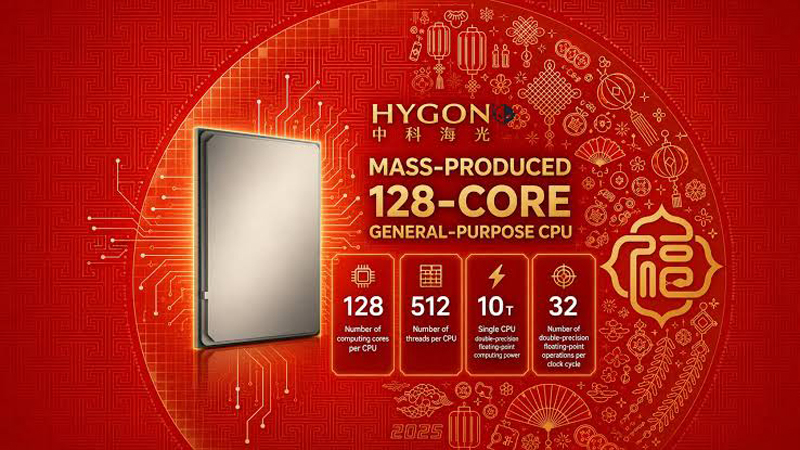
Источник изображений: Hygon Производство C86-5G уже началось. Чипы станут основой ряда серверов, включая двухсокетную модель H620G59 формата 2U с воздушным охлаждением. Эта система оборудована 32 слотами для модулей DDR5-6400, тремя разъёмами PCIe 5.0 х16, двумя слотами ОСР 3.0, восемью фронтальными отсеками для накопителей стандарта SFF, а также двумя внутренними коннекторами для SSD типоразмера М.2. Кроме того, готовятся серверные стойки высокой плотности TC800G6 (PUE — 1,08) и TC8600H G5 (PUE — 1,04) с жидкостным охлаждением. 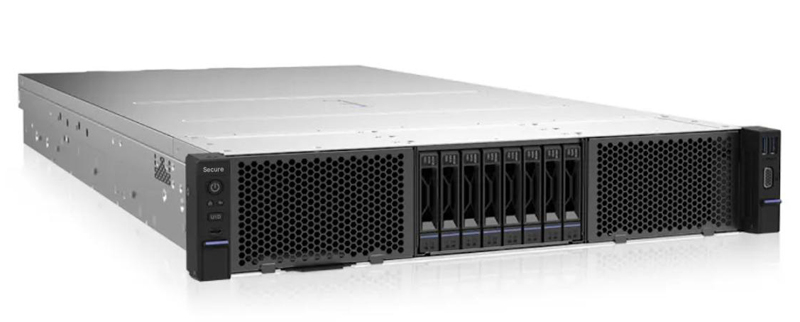 Вместе с тем Hygon намерена выпустить GPU с памятью HBM и высокоскоростным интерконнектом. Известно, что это устройство допускает работу в режимах FP64/PF16/BF16. Новинка, предположительно, сможет составить конкуренцию NVIDIA A100. Наконец, в разработке находятся коммутационные решения класса 400/800 Гбит/с. Это чип с поддержкой 104 линий PCIe 5.0, высокоскоростной интерконнект для вертикального масштабирования (сопоставим с NVLink), решение ScaleFabric 400G (для NIC), а также ScaleFabric 400/800G. Последняя из перечисленных новинок обеспечивает поддержку 80 портов на 400 Гбит/с с RDMA, а коммутационная способность достигает 64 Тбит/с. Это устройство рассматривается в качестве альтернативы InfiniBand NDR. |
|

