Материалы по тегу: интерконнект
|
05.10.2026 [13:40], Руслан Авдеев
Разработчик «неубиваемого» оптического интерконнекта CScale вышел из «стелс-режима», получив $145 млн от NVIDIA и IntelЗанимающийся разработкой оптических интерконнектов стартап CScale вышел из «стелс-режима» после раунда финансирования серии C. Компания привлекла $145 млн, участие в раунде приняли NVIDIA и Intel Capital, сообщает Datacenter Dynamics. Раунд совместно возглавили Atreides Management, Valor Equity Partners и Premji Invest, также в нём приняли участие Sutter Hill Ventures и Maverick Silicon. Общая сумма привлечённых средств достигла $188 млн. Они помогут ускорить разработку и коммерческое внедрение дебютного оптического интерконнекта. Основанная в 2023 году компания разрабатывает оптические интерконнекты для масштабирования ИИ-систем. Пока подробностей о технологии компании немного, но в официальном заявлении CScale объявила, что занимается проектированием интерконнекта по принципу, в соответствии с которым оптические сбои «локализуются без прерывания вычислений». 
Источник изображения: CScale По словам компании, на фоне того, как ИИ-системы начинают занимать десятки стоек, оптические интерконнекты становятся необходимостью для создания сетевой инфраструктуры для масштабирования ИИ-систем. Надёжная связь имеет решающее значение для экономической эффективности системы. Упрощённая замена компонентов при этом делает обслуживание более удобным, но не обеспечивает бесперебойности работы системы. Компания работает именно над вариантом интерконнекта, с расчётом на обеспечение непрерывной работы. В Atreides Management отметили, что масштабируемые ИИ-системы приближаются к гигаваттному уровню и пропускная способность интерконнектов ничего не даёт без обеспечения бесперебойной работы. При этом, с учётом масштаба проектов, отказы — не гипотетическая возможность, а неизбежность, поэтому CScale разрабатывает надёжные оптические продукты для нового поколения ИИ-фабрик. Судя по описанию вакансии на сайте компании, технология CScale будет интегрирована в SoC, оснащённый CPU. Последний может понадобиться для работы сетевого ПО для автоматизации. Компания описывает свой продукт как «интегрированный световой модуль» (integrated light engine).
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 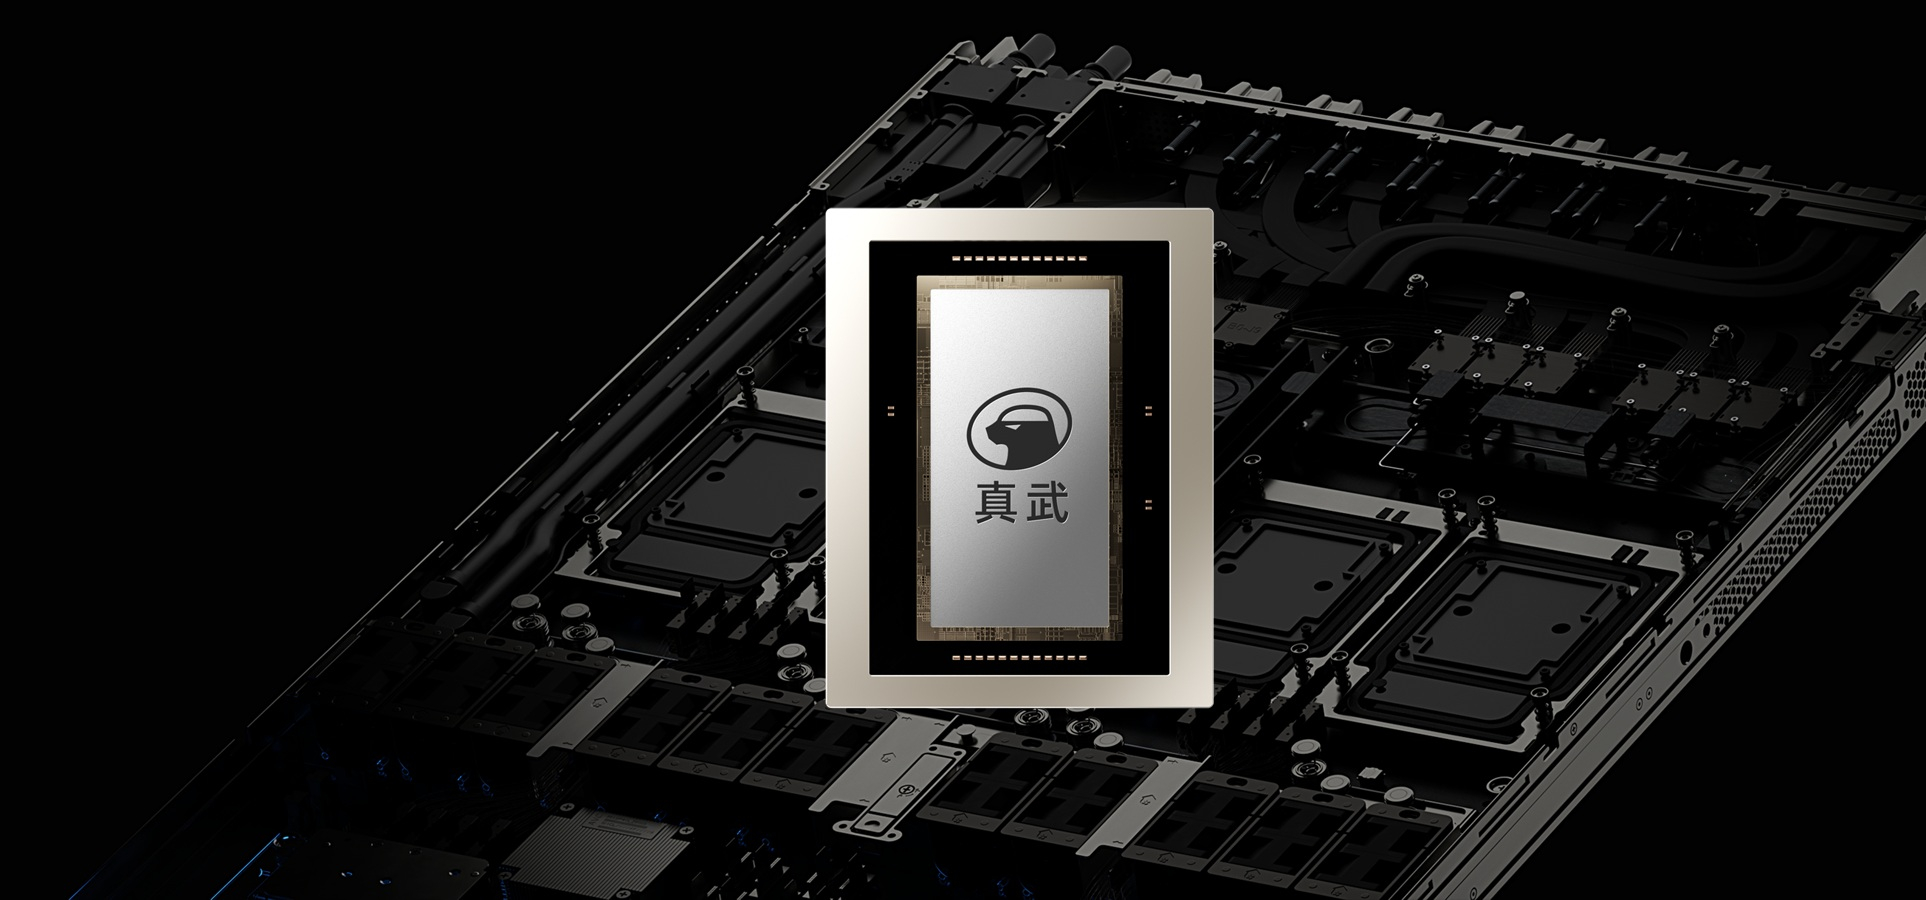
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 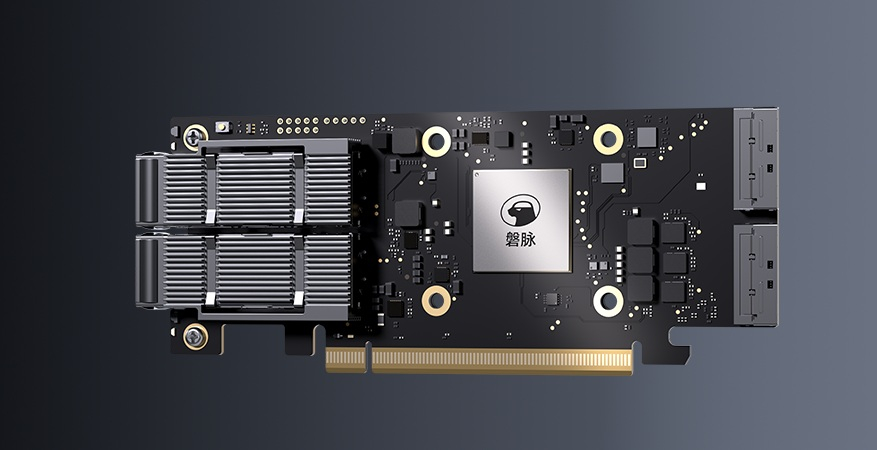
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
21.09.2026 [13:53], Сергей Карасёв
Huawei представила архитектуру UnifiedBus для повышения производительности ИИ-кластеровHuawei объявила о разработке архитектуры интерконнекта нового поколения UnifiedBus (UB). Технология призвана решить проблемы скорости передачи данных в крупномасштабных вычислительных кластерах, ориентированных на ресурсоёмкие задачи ИИ. В традиционных системах для ЦОД эффективность использования ресурсов снижается по мере масштабирования платформы. Так, в кластере из 100 тыс. NPU фактически задействуется всего около 20 % доступной вычислительной мощности, в то время как оставшиеся ресурсы простаивают в ожидании данных, утверждает Huawei. Обучение модели с триллионами параметров требует передачи колоссальных объёмов промежуточных сведений, а современные ИИ-агенты регулярно генерируют запросы, создавая постоянную нагрузку на коммуникационные линии. Всё это приводит к необходимости гибкого перераспределения меняющейся нагрузки между CPU и NPU. Кроме того, резко возрастают требования к хранению данных на всех уровнях вычислительных платформ. В результате, недостаточная пропускная способность интерконнекта становится главным узким местом, ограничивающим производительность современных ИИ-кластеров. 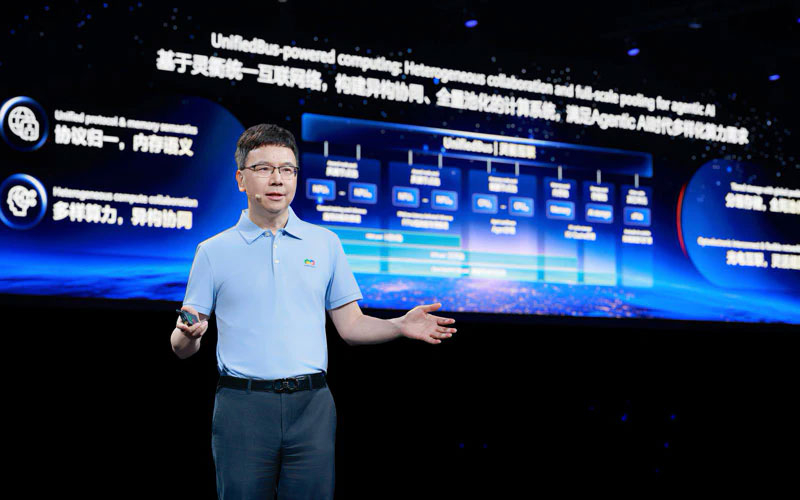
Источник изображения: Huawei Архитектура UnifiedBus позволяет устранить существующие недостатки, объединив более десяти различных протоколов и увеличив общую пропускную способность интерконнекта с примерно 100 Гбайт/с до уровня в несколько Тбайт/с, тогда как задержка (RTT) уменьшается с 7 до 2 мкс. Новая архитектура также предусматривает единую глобальную адресацию памяти внутри ИИ-узлов SuperPoD. Помимо этого, UnifiedBus напрямую соединяет CPU, NPU, RAM и SSD, обеспечивая децентрализованную одноранговую связь между ними и гибкое распределение имеющихся ресурсов. В рамках концепции UnifiedBus чипы DDR выступают в качестве альтернативной памяти для NPU, снижая задержки для поисковых, рекомендательных и других сервисов, а также удваивая производительность векторного поиска. При этом сокращаются требования к ёмкости HBM в составе ИИ-ускорителей. В целом, UnifiedBus служит глобальной «магистралью данных» со сверхвысокой пропускной способностью и малой задержкой, обеспечивая гибкое масштабирование вычислительных ресурсов. Специальный модуль интерконнекта UnifiedBus LinkBlade с бескабельным дизайном обеспечивает высокоскоростную связь внутри стоек вычислительного кластера. Утверждается, что в составе SuperPoD с 4096 NPU применение LinkBlade позволяет сэкономить около 196 км медных соединений. Для обмена данными между отдельными стойками решение UnifiedBus LinkDevice предлагает 176 портов с пропускной способностью 1,6 Тбит/с каждый, обеспечивая полностью оптическое соединение со скоростью 280 Тбит/с. При этом могут формироваться кластеры с миллионами NPU. Huawei продемонстрировала суперкластер для работы с агентным ИИ на базе UnifiedBus, который состоит из узлов SuperPoD TaiShan 950 и Atlas 960, хранилища данных OceanStor M900 и коммутатора Xinghe UBG. Эта платформа поддерживает многоуровневое объединение ресурсов, обеспечивая эффективную работу с различными нагрузками.
21.09.2026 [08:32], Сергей Карасёв
Huawei разработала модуль NPO с пропускной способностью до 7,2 Тбит/сКомпания Huawei, по сообщению The Register, продемонстрировала оптические модули NPO (Near-Packaged Optics), предназначенные для организации высокоскоростного интерконнекта в дата-центрах для ИИ-задач. В традиционных коммутаторах оптические блоки обычно располагаются на передней панели, а длина соединения от собственно чипа до собственно оптических компонентов довольно велика. Энергопотребление и тепловыделение таких решений увеличиваются с ростом скоростей передачи данных, что становится серьезной проблемой в свете активного внедрения стандартов 800 Гбит/с и 1,6 Тбит/с. Кроме того, длинные электрические трассы и интенсивная обработка сигналов в DSP приводят к увеличению задержек. 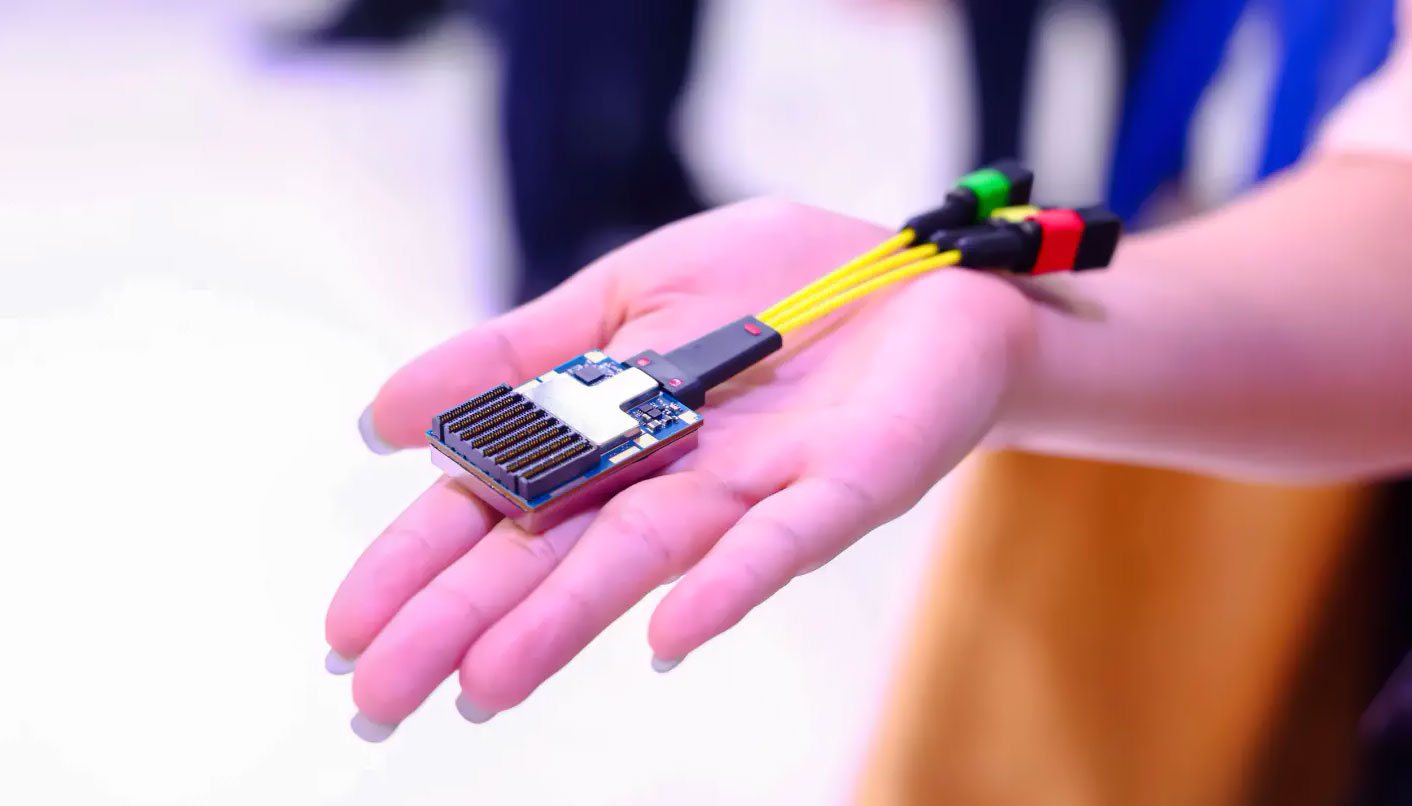
Источник изображения: The Register Одним из способов повышения эффективности является применение технологии CPO (Co-Packaged Optics). Она предполагает размещение оптического модуля на той же подложке, что и ASIC. Такой подход обеспечивает небольшие задержки и низкое энергопотребление, однако затрудняет замену вышедших из строя оптических модулей и значительно удорожает производство. В результате, возрастают эксплуатационные затраты в ЦОД. Платформа NPO, предложенная компанией Huawei, предусматривает монтаж оптического движка в виде отдельного компонента на плате рядом с ASIC. При этом конструкция NPO исключает необходимость в отдельном DSP-чипе — соответствующие функции интегрируются в ASIC. Таким образом, сохраняется возможность замены оптического модуля в случае его выхода из строя, тогда как задержки по сравнению с традиционными решениями снижаются со 100 до 10 нс, а энергопотребление уменьшается примерно на 60 %. В NPO-решении Huawei используются 36 линий 200G, что в сумме даёт 7,2 Тбит/с. Предполагается, что предложенная технология будет использоваться в следующих поколениях ИИ-узлов SuperPoD.
18.09.2026 [17:40], Владимир Мироненко
Вглубь и вширь: Cornelis анонсировала архитектуру Active Compute FabricCornelis представила Active Compute Fabric — открытую архитектуру, охватывающую сетевые системы класса scale-up (вертикальное масштабирование) и scale-out (горизонтальное масштабирование) и включающую встроенные средства программируемых вычислений. В настоящее время ИИ-кластеры выросли до многих тысяч GPU. Количество параметров в моделях увеличилось с миллиардов до триллионов. Однако фундаментальное поведение большинства сетей ЦОД не эволюционировало так быстро — они в основном перемещают данные из точки А в точку Б, обеспечивая максимально надёжную передачу. Современные рабочие ИИ-нагрузки не всегда ведут себя как традиционные HPC и другие распределённые приложения. В них доминируют синхронизация, коллективные операции и зависимости, а также значительный трафик между серверами (east-west). Когда сеть не справляется с огромными требованиями к пропускной способности таких рабочих нагрузок, ускорители часто простаивают, иногда в течение длительного времени. Проблему простоя поставщики пытаются решить преимущественно за счёт увеличения пропускной способности, а не изменения принципов работы самой сетевой инфраструктуры. «ИИ-инфраструктура достигла того этапа, когда одного лишь повышения быстродействия конечных узлов уже недостаточно. Сетевая фабрика должна стать активным компонентом вычислительной системы», — заявила Лиза Спелман (Lisa Spelman), генеральный директор Cornelis. 
Источник изображений: Cornelis Networks Архитектура Active Compute Fabric переносит программируемые вычислительные функции непосредственно на уровень сети. Сетевая фабрика может производить манипуляции над данными прямо во время передачи: собирать данные KV-кеша для дезагрегированного инференса, координировать распределение экспертов для моделей MoE, ускорять коллективные операции, такие как AllReduce, и сжимать градиенты при передаче, разгружая вычислительные узлы, уменьшая накладные расходы на синхронизацию и отвечая за целостность передачи данных. При этом она может брать на себя новые функции по мере развития алгоритмов ИИ и ПО. Нечто похожее, например, NVIDIA начала предлагать в InfiniBand несколько поколений назад (SHARP), но, по слухам, данная функциональность особой популярностью не пользуется. Cornelis опирается на открытые Ethernet-стандарты UALink для вертикального масштабирования и Ultra Ethernet — для горизонтального, что даёт поддержку широкого спектра ускорителей. Это важный фактор, поскольку компании всё больше диверсифицируют оборудование и технологии, используемые в своих ЦОД. Клиенты, использующие решения для ИИ, всё чаще обращаются к решениям стоечного масштаба, сталкиваясь при этом с проблемой привязки к конкретному поставщику, а Cornelis позиционирует себя как нейтральная, открытая альтернатива. Это явный кивок в сторону NVIDIA, хотя тот же UALink пока трудно назвать действительно зрелой технологией. 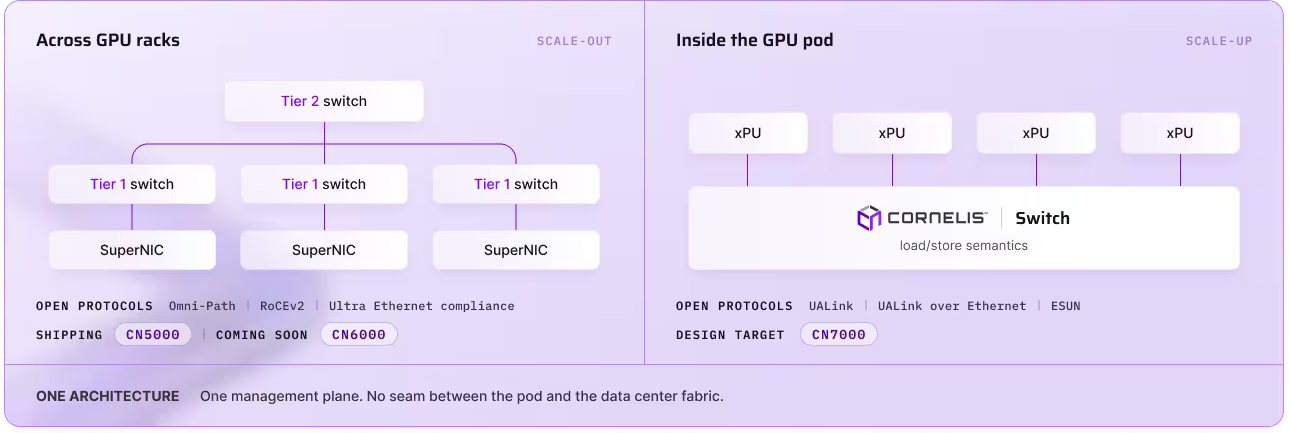 Видение Cornelis по поводу открытых и эффективных сетей, масштабируемых по принципу «масштабирование и расширение», разделяет Qualcomm, которая присоединилась к Cornelis на конференции AI Infra Summit. Cornelis отметила, что обе компании разделяют общее видение проблем, стоящих перед ИИ-инфраструктурой: использование пассивных сетевых архитектур, обеспечивающих лишь передачу данных, приводит к недогрузке вычислительных ускорителей, что напрямую сказывается на экономической эффективности процессов инференса. По мере перехода к созданию ИИ-систем стоечного масштаба, обе компании рассматривают сеть как ключевой элемент проектирования, а не как второстепенный компонент. Лиза Спелман отдельно отметила в интервью CRN схожесть подходов с Qualcomm: «Мы видим много общего в отношении проблем инфраструктуры ИИ, проблем, с которыми сталкиваются клиенты, и множество возможностей и потенциала для объединения наших технологий и решения этих проблем для клиентов <…> Мы считаем, что сейчас идеальное время для выхода на этот рынок. Ещё многое предстоит решить», — сказала Спелман. Как отметил CRN, проблема для Cornelis заключается в том, что NVIDIA более года продвигает свою собственную технологию интерконнекта NVLink Fusion как де-факто интерконнект для вертикального масштабирования. К альянсу уже присоединились Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel, d-Matrix и MediaTek. Это позволяет NVIDIA оставаться важнейшим поставщиком для рынка ИИ-инфраструктуры и открывает новый источник дохода. 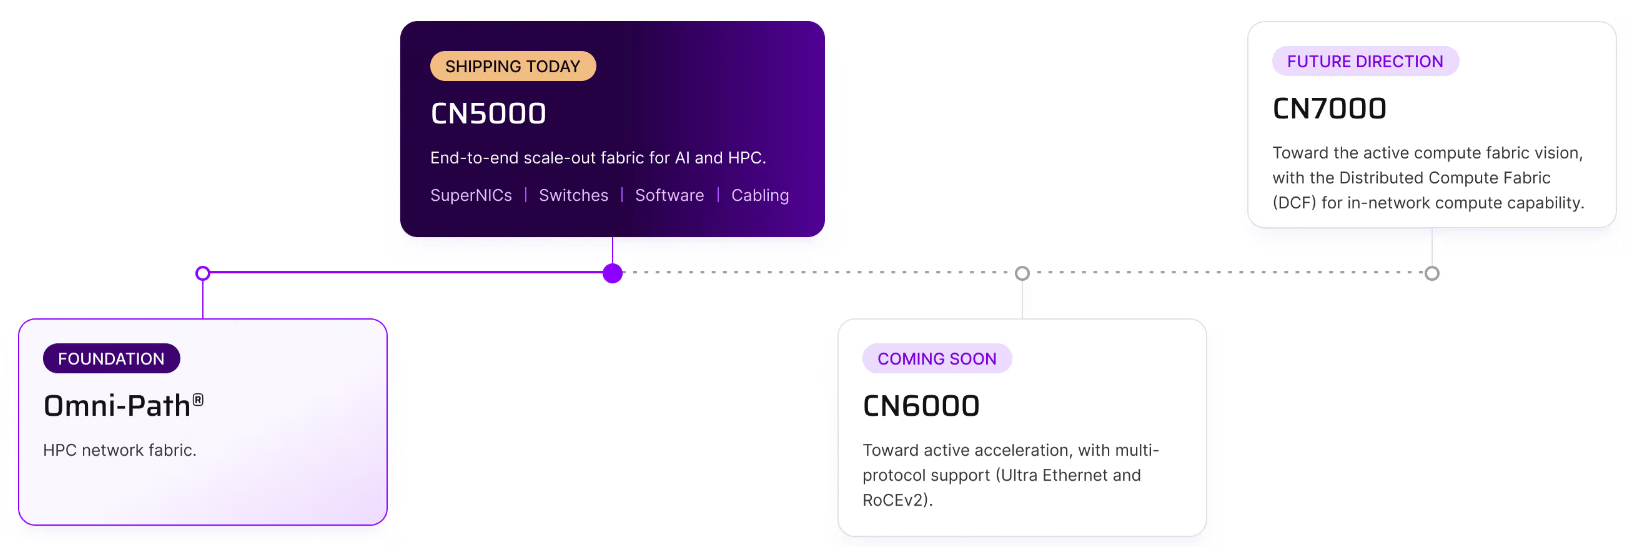 Cornelis также объявила о привлечении финансирования в размере $205 млн. Средства будут направлены на масштабирование производства, укрепление партнёрских отношений с клиентами и ускорение реализации планов по выводу продукции на рынок. Ресурс Forbes считает, что для компании в сегменте HPC-сетей такой уровень инвестиций значителен и свидетельствует о том, что рынок считает проблему узкого места в сетевых технологиях реальной, и что Cornelis продемонстрировала достаточный прогресс благодаря текущим внедрениям в ЦОД для ИИ и HPC, чтобы оправдать дальнейшее расширение. «Потенциал рынка сетевых решений на базе открытых стандартов для масштабирования ИИ (как вертикального, так и горизонтального) к 2030 году превысит $55 млрд. Мы убеждены, что именно сетевая инфраструктура будет определять, какая часть инвестиций в развёртывание систем ИИ принесёт реальную отдачу», — заявили в IAG Capital Partners.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
11.09.2026 [08:51], Владимир Мироненко
ЦОД как чип: Meta✴ и Panmnesia предложили CXL-фабрику размером с целый дата-центрКомпания Meta✴ и южнокорейский стартап Panmnesia, специализирующийся на разработке интерконнекта для ИИ-инфраструктур, представили архитектуру ИИ ЦОД нового поколения, в которой весь дата-центр функционирует как единый чип. Описание архитектуры опубликовано в журнале Nature Reviews Electrical Engineering (NREE), входящем в портфолио издательства Nature. В исследовании отмечено, что в современных дата-центрах ускорители внутри одной стойки могут взаимодействовать через высокоскоростные интерфейсы для вертикального масштабирования (scale-up), тогда как трафик, выходящий за пределы стойки, обычно опирается на более медленные сети с горизонтальным масштабированием (scale-out), такие как Ethernet или InfiniBand. 
Источник изображений: Panmnesia Компании отметили, что для эффективной работы ИИ ЦОД необходимы контроль и координация как внутри стоек с GPU, памятью и СХД, так и между ними. В масштабной ИИ-инфраструктуре снижение вариативности задержек (джиттера) между устройствами — чтобы весь ЦОД функционировал предсказуемо — имеет такое же значение, как и повышение производительности отдельных устройств или скорости каналов связи.  Meta✴ и Panmnesia предлагают взять за основу стандарт CXL, дополнив его новыми возможностями по объединению нескольких стоек с GPU для минимизации колебаний задержки при передаче данных за пределы каждой отдельной стойки. Конечная цель — создать дата-центр, работающий столь же предсказуемо, как отдельный чип. В этой схеме расширенный CXL обеспечивает когерентность кеш-памяти между стойками ускорителей, поддерживая большее количество устройств по сравнению со стоечными решениями NVIDIA уровня GB200 NVL72 (на базе NVLink) и UALink. Для минимизации и ограничения вариативности задержек предлагается использовать три специализированных аппаратных компонента: неблокирующий коммутатор с высокой плотностью портов, блок ускорения передачи данных и контроллер сетевой фабрики.  Неблокирующий коммутатор с большим количеством портов (high-fan-out) обеспечивает одновременное подключение множества устройств, сокращая количество переходов (hop) и выравнивая длину путей прохождения сигнала независимо от источника. Блок ускорения передачи (Link Acceleration Unit, LAU) переносит повторяющиеся операции обработки протокола в каждой точке соединения на специализированный аппаратный конвейер, обеспечивая стабильность системы на уровне отдельных этапов передачи и ограничивая колебания задержки.  Контроллер фабрики (Fabric Controller) применяет единую политику упорядочивания запросов во всей системе, обеспечивая согласованную обработку транзакций через все устройства. Для преодоления физических ограничений дальности передачи электрических сигналов рассматривается использование оптических каналов связи (CXL-over-optics) для увеличения радиуса действия фабрики CXL. Консорциум PCI-SIG уже работает над оптической версией PCIe, да и первые чипы тоже уже были анонсированы.  По словам Panmnesia, комбинированный контроллер фабрики CXL/PCIe и блок LAU уже прошли проверку работоспособности на кремниевых чипах; также изготовлен коммутатор фабрики, и начаты поставки предсерийных образцов. Архитектура решения предусматривает группировку CPU, ускорителей, памяти и коммутаторов по функциональному признаку в модули (узлы), объединение модулей в группы (поды) и объединение подов посредством коммутационной фабрики. Такая упорядоченная иерархия призвана обеспечить стабильные пути передачи данных с фиксированным количеством сетевых переходов и предсказуемыми временными характеристиками.  По сравнению с NVIDIA GB200 NVL72 данная схема:
«Объединение устройств такого масштаба в единую среду выполнения позволит обучать гораздо более крупные ИИ-модели без прерывания процесса или одновременно запускать несколько сервисов на общей инфраструктуре, исключая взаимное замедление их работы», — отметили компании. При этом платформы с PCIe/CXL-интерконнектом уровня стойки уже есть — например, Liqid UltraStack.
09.09.2026 [13:25], Сергей Карасёв
Qualcomm и Amazon займутся разработкой ИИ-чипов и оптического интерконнектаКомпании Qualcomm Technologies и Amazon объявили о заключении многолетнего соглашения о сотрудничестве. Работы будут осуществляться по нескольким направлениям, включая создание кастомизированных чипов для дата-центров, ориентированных на ИИ-задачи. Партнёры отмечают, что в настоящее время наблюдается экспоненциальный рост нагрузок, связанных с ИИ. Это приводит к стремительному увеличению спроса на вычислительные ресурсы и хранилища данных. Одновременно повышаются требования к пропускной способности каналов связи. Совместные усилия Qualcomm и Amazon как раз и будут направлены на создание аппаратных решений для высокопроизводительных ИИ-инфраструктур следующих поколений. Компании, в числе прочего, займутся разработкой передовых чипов, оптимизированных для задач инференса в крупномасштабных дата-центрах. Qualcomm и Amazon также намерены сотрудничать в области высокопроизводительных оптических систем связи: речь идёт о решениях класса 1,6 Тбит/с и выше. При этом будут использоваться технологии Qualcomm, включая DSP и SerDes. 
Источник изображения: Qualcomm В рамках сотрудничества Qualcomm намерена расширить использование облачной инфраструктуры AWS, включая платформу Amazon Bedrock, которая обеспечивает доступ к большим языковым моделям (LLM) и ИИ-инструментам через общий интерфейс. Эти сервисы Qualcomm будет применять для автоматизации проектирования электроники (EDA), что позволит значительно ускорить процессы создания передовых микросхем. Конечной целью сотрудничества Qualcomm и Amazon называют формирование высокопроизводительной, эффективной и экономичной инфраструктуры для ИИ и сопутствующих нагрузок.
04.09.2026 [08:56], Владимир Мироненко
MetaRoCE — RDMA-транспорт от Meta✴ для крупных ИИ-кластеров с обычным EthernetMeta✴ представила MetaRoCE — новый транспортный RDMA-протокол на базе обычного Ethernet, созданный для крупных ИИ-кластеров. Компания разместила спецификации MetaRoCE, эталонную программную реализацию и набор тестов на соответствие требованиям (Compliance Test Suite, CTS) в рамках OCP, предоставив возможность его внедрения всем желающим. В Meta✴ настаивают на том, что Ethernet должен быть предпочтительной инфраструктурой для ИИ, продемонстрировав, что её реализация RoCE может обеспечивать распределённое обучение ИИ в масштабе, объединяя миллионы GPU. Компания отметила, что в ходе инференса низкая задержка коммуникации между распределёнными сегментами модели напрямую влияет на время отклика для сотен миллионов пользователей. Даже небольшие сетевые помехи ограничивают вычислительную мощность. Протокол RoCE (RDMA over Converged Ethernet) предполагает, что сеть будет доставлять каждый пакет в определённом порядке, используя PFC и препятствуя распылению пакетов, обеспечивая производительность в многоплоскостных и крупномасштабных сетях. При использовании MetaRoCE в строгом выполнении очерёдности передачи данных нет необходимости. Главная задача — обеспечение высокой пропускной способности, низкой задержки в конце очереди распределения и простоты эксплуатации по мере роста сети при увеличении количества ускорителей и расстояний между ними. 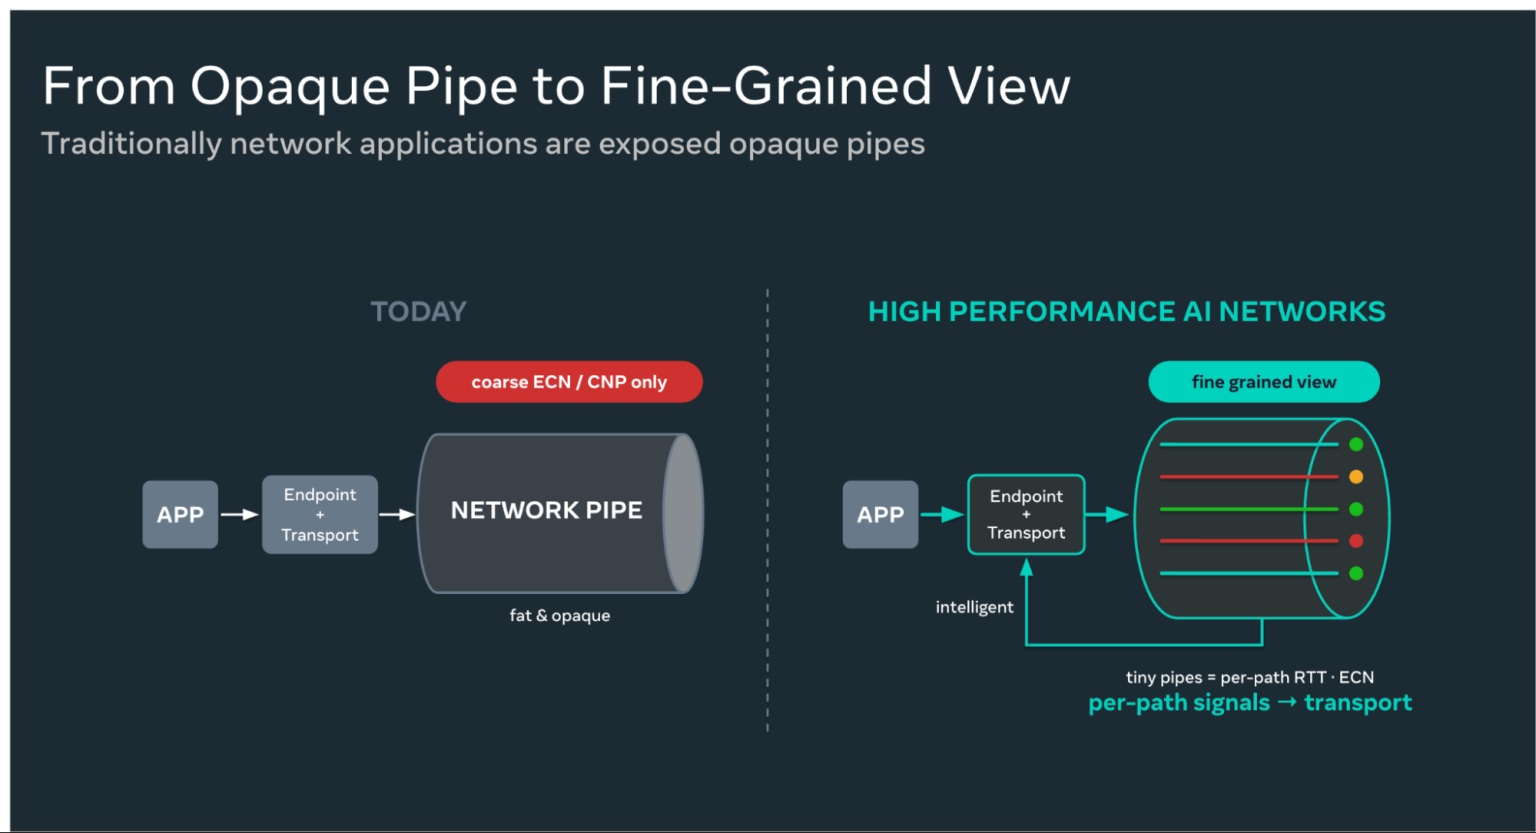
Источник изображений: engineering.fb.com Как указано в блоге Meta✴, суть MetaRoCE проста: сетевая фабрика видит пакеты, а сетевая карта (NIC) — намерения. Традиционные архитектуры ориентированы на «ум» фабрики, полагаясь на коммутаторы для обеспечения отсутствия потерь и поддержания порядка. Перенося интеллектуальные функции на конечную точку, MetaRoCE декомпозирует сеть на множество детализированных (мелкозернистых) логических путей, каждый из которых имеет свою собственную телеметрию в реальном времени — время приёма-передачи данных для каждого пути (Per-path RTT), состояние ECN и загрузку. Такая прозрачность открывает возможности, которые трудно достичь с помощью традиционного RDMA. MetaRoCE распределяет пакеты по множеству путей, поэтому они поступают не в том порядке, в каком были отправлены. Транспортный уровень рассматривает неупорядоченное поступление как обычный случай. Каждый пакет имеет свой адрес назначения, а данные записываются непосредственно в конечную область памяти по мере их поступления, без буфера переупорядочивания и блокировок. При этом MetaRoCE всегда рассматривает Ethernet-фабрику как систему с потерями и не требует от неё иного поведения. Прикладной уровень практически не затрагивается — существующие RDMA-«глаголы» и программные стеки работают без изменений, а дополнительные функции поддерживаются с помощью расширений стандартных API. 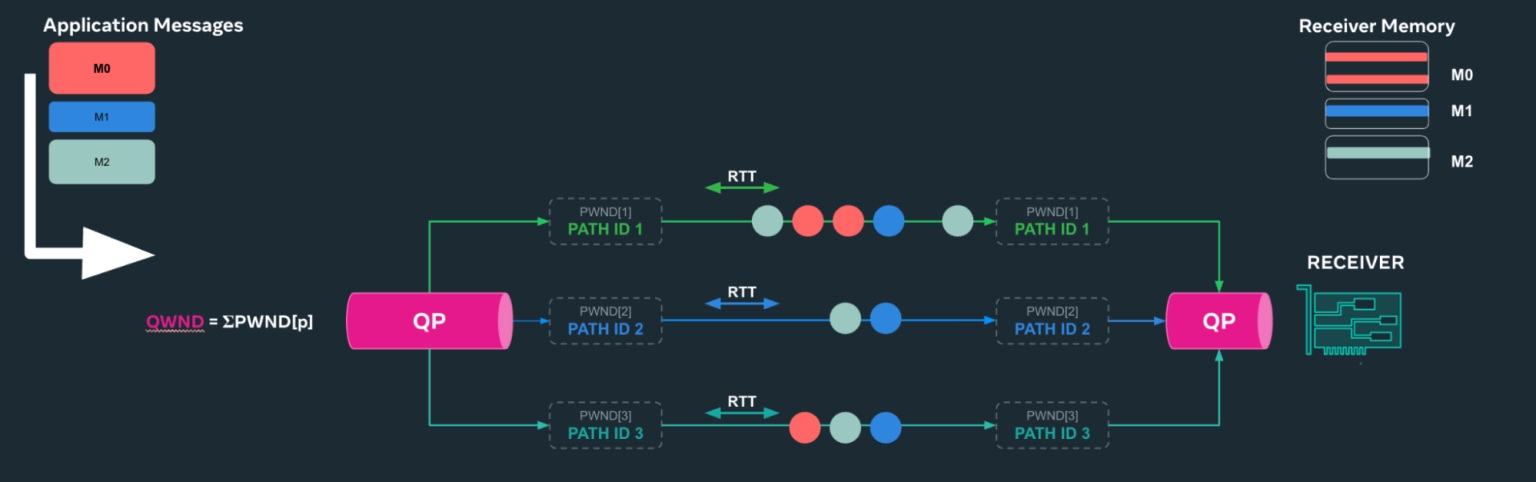 MetaRoCE предоставляет каждому соединению несколько путей и распределяет по ним пакет за пакетом. Каждый путь имеет свой уникальный исходный UDP-порт в качестве энтропии ECMP, который сетевая карта может изменить в любой момент, чтобы перенаправить трафик с неподходящего маршрута. Выбор пути пакета полностью зависит от NIC, так что и эффективность работы всей фабрики зависит от NIC. Оценка каждого пути позволяет явно отличить перегрузку и от сбоя, и сделать перебалансировку, избавившись от плохо работающего пути без обрыва соединение целиком и с возможностью переотправки ровно того пакета, который потерялся из-за сбоя или перегрузки. MetaRoCE сочетает в себе традиционный ECN-контроль перегрузки с AIMD у отправителя с обратной связью со стороны получателя, который при каждом ACK уведомляет отправителя о выделенной ему доле из общей доступной получателю полосы. MetaRoCE запрашивает у фабрики олько две функции, которые уже есть в каждом коммутаторе: ECN и ECMP. Протокол Meta✴ не требует обрезки пакетов, внутрисетевой телеметрии, управления потоком на основе кредитов или распыления пакетов на стороне коммутатора, но и наличие этих функций не мешает работе протокола. MetaRoCE совместим практически с любыми топологиями, в том числе с сегментами в облачных системах, конфигурацию которых нельзя контролировать. В протоколе нет проприетарных компонентов, поэтому фабрика может свободно оптимизироваться с точки зрения стоимости и кабельной разводки. 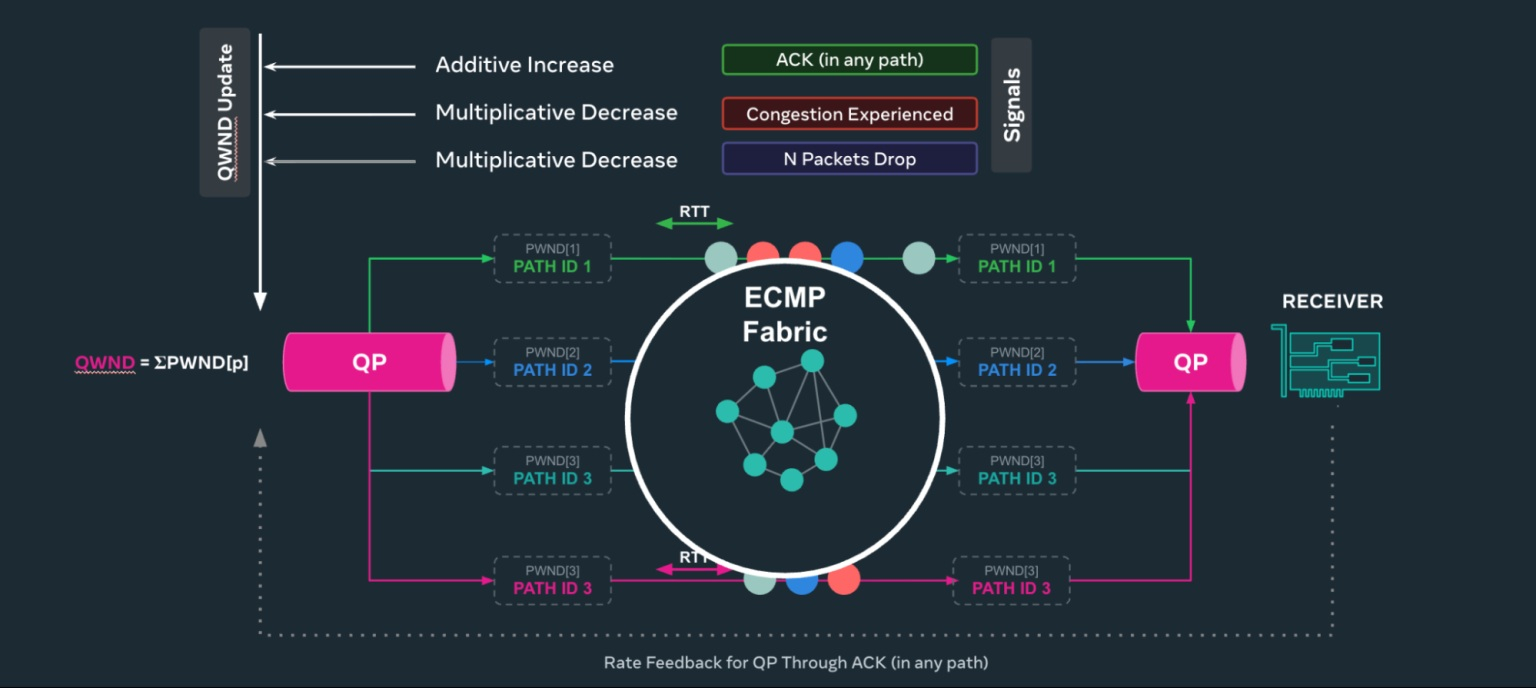 Очередь отправки и очередь приёма (Queue Pair, QP) отвечают как за упорядоченный поток сообщений, так и за пропускную способность. Традиционный RDMA получает больше того или другого путём открытия большего количества QP (по несколько десятков на каждую пару узлов), не знающих ничего ни о друг друге в плане перегрузки, ни об их состоянии в NIC. MetaRoCE использует одно соединение для множества независимых упорядоченных потоков (в т.ч. по одному на каждую коллективную операцию), использующее множественные пути под управлением одного контроллера перегрузки. Чтобы ускорить проверку аппаратного обеспечения, Meta✴ совместно с AMD реализовала MetaRoCE на DPU Pensando. На 64-узловом кластере GPU AMD, работающем под управлением RCCL, компании напрямую сравнили MetaRoCE с RoCEv2 при выполнении коллективных операций All-Reduce и All-to-All. 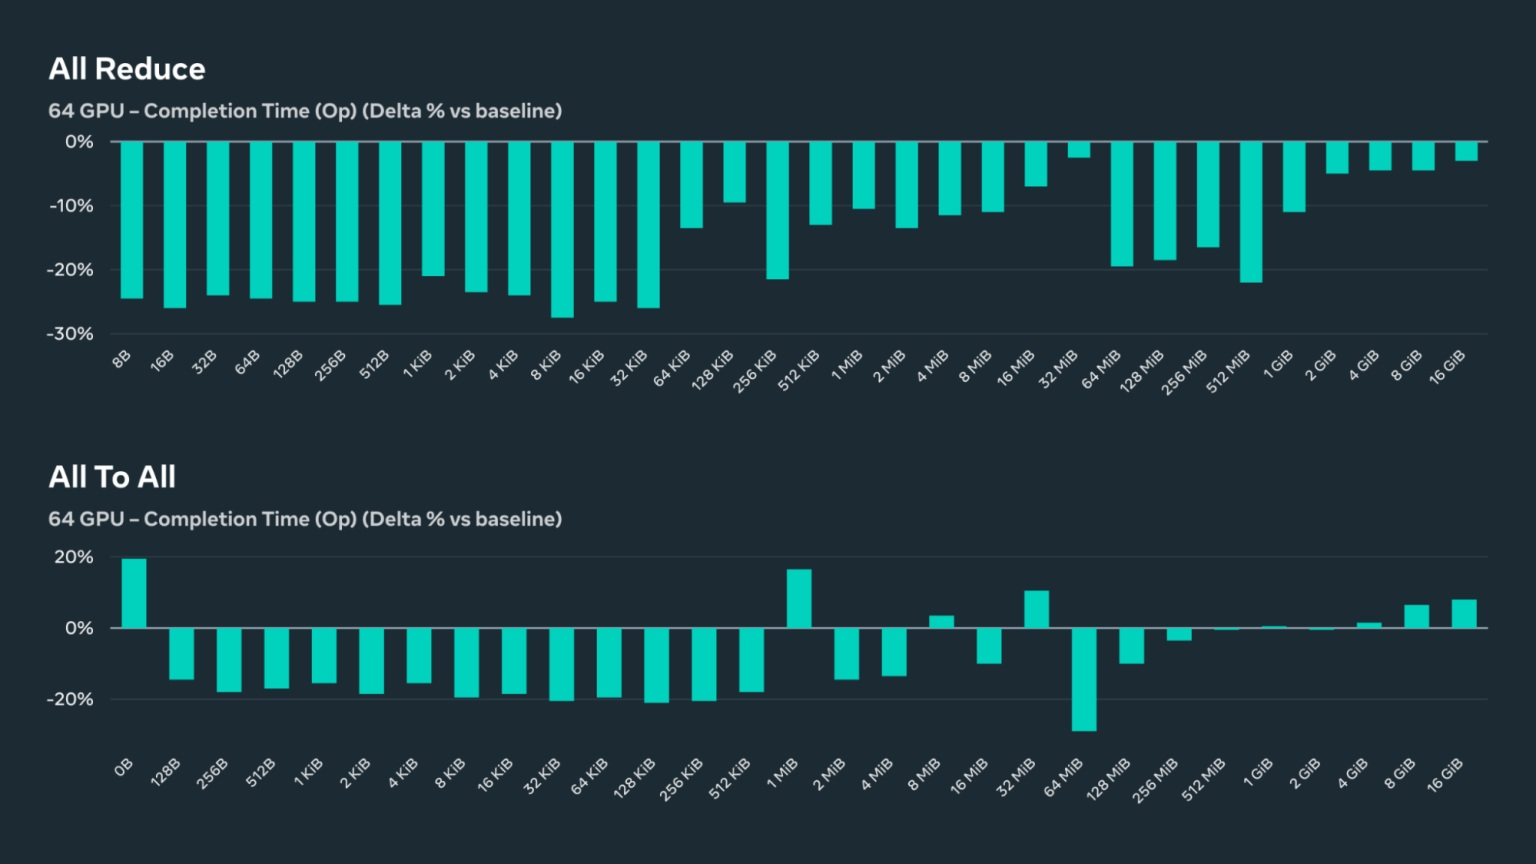 Результаты, как утверждает Meta✴, соответствуют поставленным целям:
Эти результаты подтверждают правильность выбора, сделанного при разработке MetaRoCE, отметила Meta✴. Благодаря тому, что протокол с самого начала разрабатывался с учётом возможных потерь пакетов, а интеллектуальные функции вынесены на периферию, он обеспечивает более высокую производительность в идеальных условиях и плавно снижает нагрузку при сбоях. Компания подчеркнула, что протокол MetaRoCE является открытым, его спецификации добавлены в OCP, и любой поставщик может с их помощью создать и реализовать совместимое оборудование. Впрочем, во многом похожий протокол MRC (Multipath Reliable Connection) также передан в OCP, да и Ultra Ethernet тоже решает схожие задачи.
01.09.2026 [12:00], Сергей Карасёв
MediaTek даст NVIDIA NVLink Fusion кастомным ASIC, а NVIDIA вложит в MediaTek $3,5 млрдNVIDIA и MediaTek объявили о расширении долгосрочного партнёрства, направленного на создание платформ нового поколения для ИИ-задач. Сотрудничество охватывает три ключевых направления: это ИИ-инфраструктуры, локальные ИИ-вычисления и автомобилестроение. В рамках партнёрства разработчики кастомных чипов в MediaTek возьмут на вооружение технологию NVIDIA NVLink Fusion, что позволит гиперскейлерам, облачным провайдерам и разработчикам передовых ИИ-моделей создавать собственные ускорители (XPU) и интегрировать их в ИИ-фабрики стоечного масштаба на базе NVLink. Платформа NVLink Fusion предлагает основу для разработки многокристальных решений. Применяется специализированный чиплет NVLink Fusion для обеспечения связи XPU с интерконнектом NVLink с использованием фотонного или электрического интерконнекта. Задействована технология NVIDIA NVLink-C2C для когерентного объединения процессоров, графических чипов и других микросхем. Кроме того, применяется архитектура памяти NVIDIA NVHBM для повышения пропускной способности и энергоэффективности. В целом, платформа NVLink Fusion сокращает сроки вывода решений на рынок благодаря готовой инженерной базе. 
Источник изображения: NVIDIA NVIDIA и MediaTek также продолжат сотрудничество в области разработки изделий RTX Spark и DGX Spark следующих поколений, которые будут использоваться в потребительских системах, суперкомпьютерах для ИИ-разработчиков и рабочих станциях корпоративного класса. В таких устройствах GPU разработки NVIDIA будут соседствовать с однокристальными системами MediaTek. Наконец, партнёры займутся созданием платформ для программно-определяемых автомобилей с ИИ. Говорится об интеграции решений NVIDIA в состав платформы MediaTek Dimensity Auto для создания интеллектуальных автомобильных кабин. По условиям расширенного соглашения о сотрудничестве, компания NVIDIA инвестировала $3,5 млрд в конвертируемые облигации MediaTek. |
|

