Материалы по тегу: risc-v
|
20.10.2026 [11:15], Владимир Мироненко
Tenstorrent завершила раунд финансирования на $1,5 млрд с оценкой $6,2 млрдTenstorrent объявила о завершении раунда финансирования серии E на сумму $1,5 млрд, по итогам которого оценка рыночной стоимости компании достигла $6,2 млрд. В качестве ведущих инвесторов раунда выступили Trace Capital и Innovation X. В финансировании также приняли участие новые и действующие инвесторы, среди которых Agostinelli Group, ARK Invest, Cadence Ventures, Eclipse, Fidelity, Maverick Silicon, Morgan Stanley, Protagonist, Sandisk, T. Rowe Price, Tether Investments, Virtu Financial и XTX Markets. 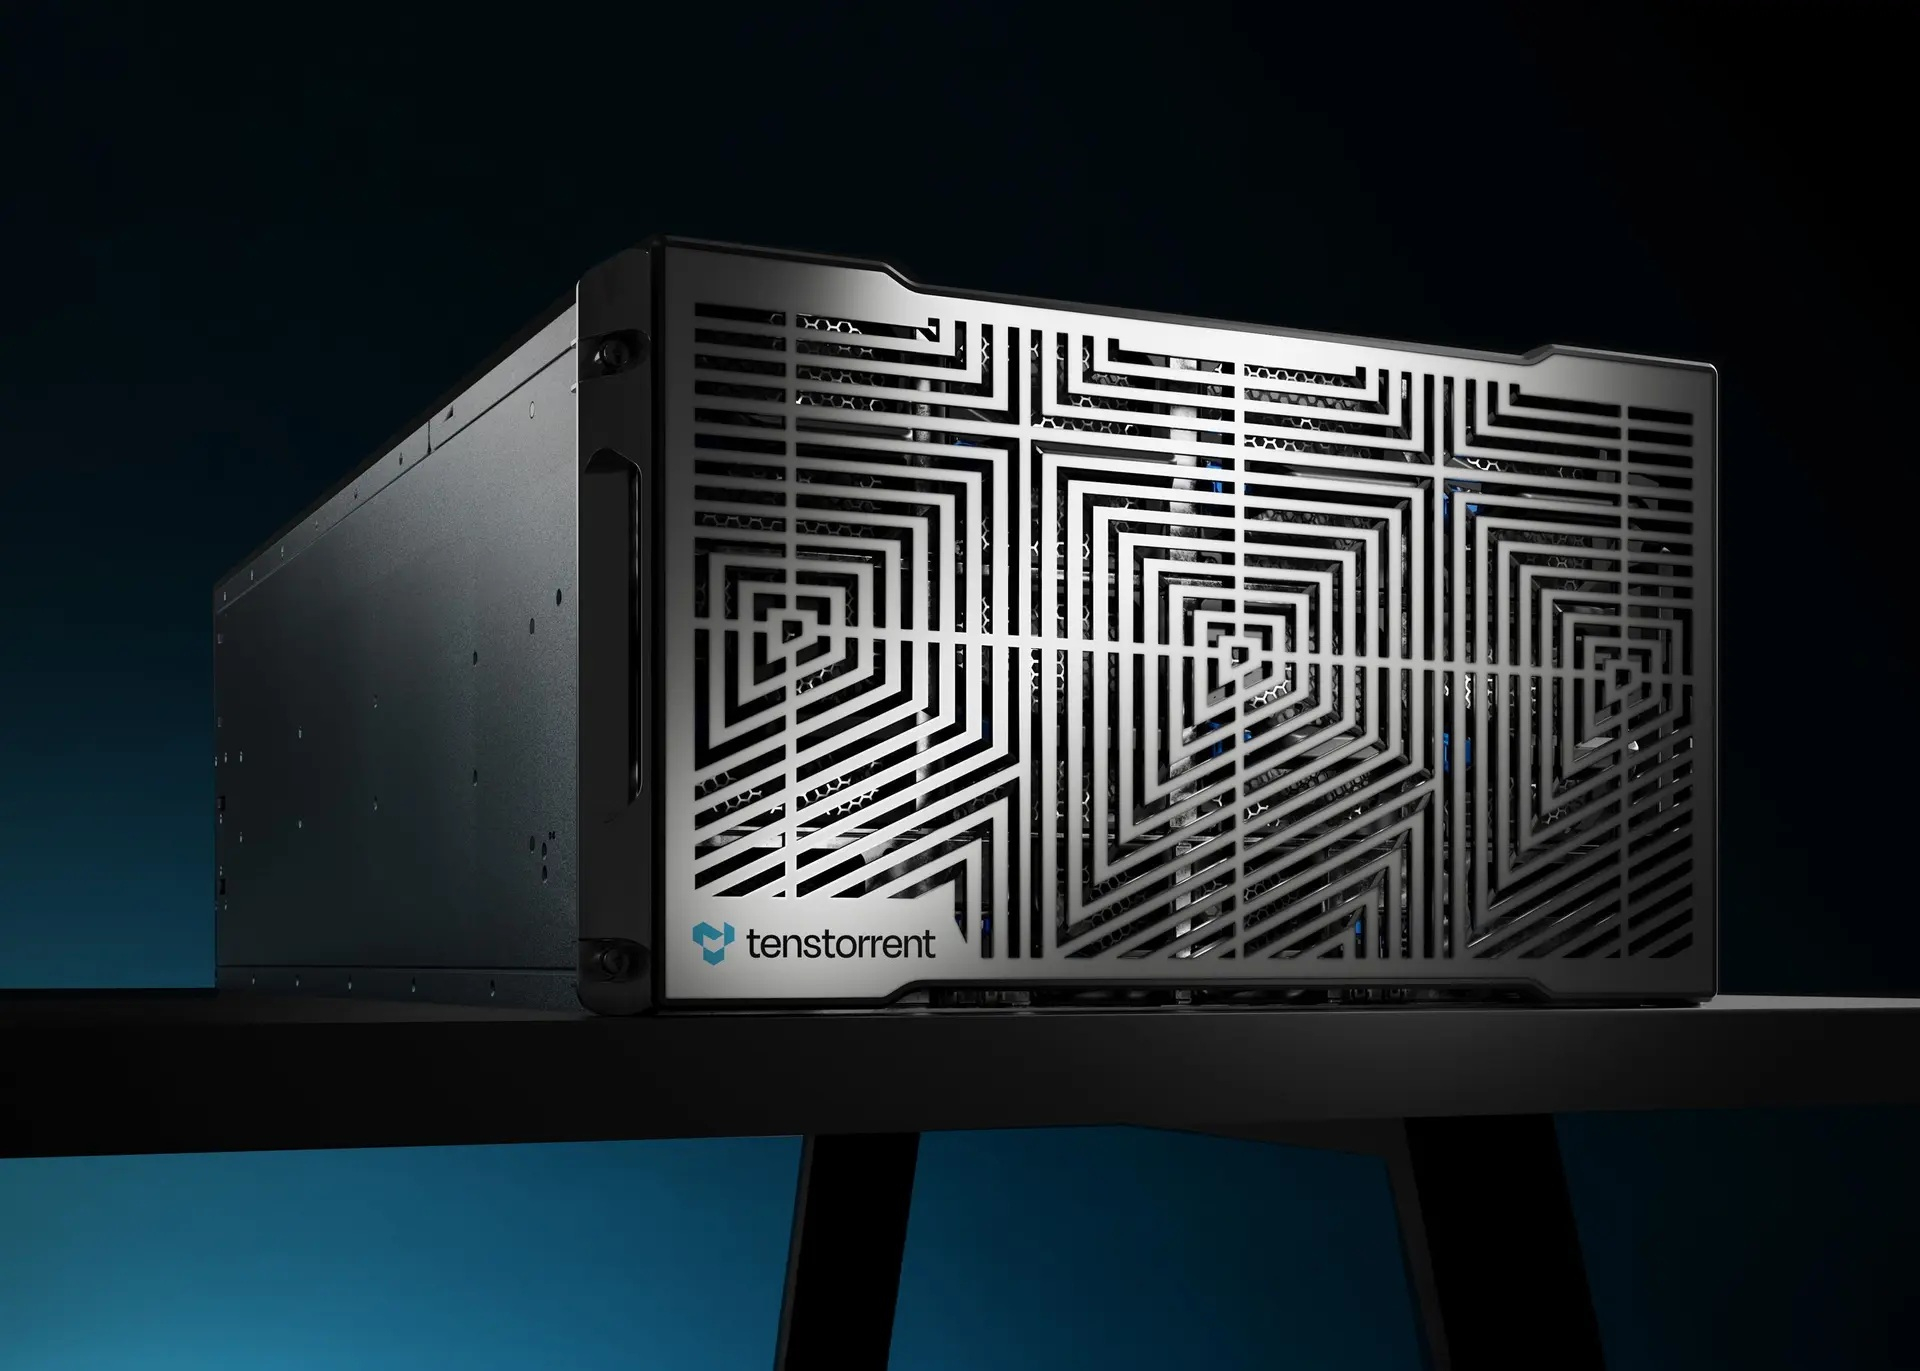
Источник изображения: Tenstorrent Как сообщает Bloomberg, новая оценка компании более чем вдвое превышает показатель в $2,6 млрд, зафиксированный после предыдущего раунда финансирования в 2024 году. Привлечённые средства Tenstorrent планирует направить на масштабное развёртывание серверов Galaxy, поддерживающих работу моделей с открытыми весами, — от больших языковых моделей до инструментов генерации видео. Кроме того, компания намерена развивать технологии в области ИИ и процессорные архитектуры (IP), лицензируемые клиентам, создающим собственные чипы, включая Samsung и LG. Компания предлагает широкий спектр решений: от отдельных плат и рабочих станций до серверных стоек, суперкластеров и специализированных конфигураций. В процессорах Tenstorrent используется открытая архитектура RISC-V. Компания также предоставляет доступ к своему программному стеку на условиях открытого исходного кода (open source). Комплексный портфель вычислительных платформ для ИИ Tenstorrent включает от серверов Galaxy и рабочих станций TT-QuietBox до специализированных плат Blackhole, предназначенных для ноутбуков и рабочих станций. «Мы создали единую архитектуру, которая масштабируется для любых задач, — отметил Джим Келлер (Jim Keller), генеральный директор Tenstorrent, участвовавший в разработке передовых чипов для таких компаний, как Intel, Advanced Micro Devices, Apple и Tesla. — Будущее вычислительных технологий — за открытостью, масштабируемостью и контролем со стороны тех, кто создает на их основе свои продукты. Наши инвесторы разделяют этот подход, и мы очень ценим их поддержку». В Tenstorrent работают 1150 сотрудников. Её офисы расположены в Санта-Кларе, Остине, Торонто, Белграде, Токио и Бангалоре. Келлера называют архитектором процессоров Apple A4 и A5, архитектуры AMD Zen, а также чипа для системы автономного вождения Tesla (Full Self-Driving). По его словам, ранее в этом году Tenstorrent вела переговоры с рядом компаний, включая Intel и Qualcomm, о возможном поглощении, но предпочла привлечь дополнительные средства, а не продавать бизнес. В мае компания достигла важного технического рубежа: её серверы Galaxy успешно справились с запуском высокопроизводительных моделей ИИ, разработанных DeepSeek. Келлер также отметил, что Tenstorrent способна конкурировать по цене и брать заказы, которые могут быть слишком малы для более крупных игроков рынка. Аналитик компании Constellation Research Хольгер Мюллер (Holger Mueller) сообщил ресурсу SiliconANGLE, что Tenstorrent — один из множества инновационных стартапов, стремящихся создать более эффективные вычислительные платформы для ИИ. А благодаря внушительному профессиональному опыту Джима Келлера, Tenstorrent можно считать одним из самых перспективных игроков на рынке. «Мало кто из компаний разрабатывает одновременно и чип, и ПО для него, а Tenstorrent делает и то, и другое. При этом результаты компании в области генерации видео превосходят отраслевые стандарты и даже наши ожидания», — говорит Джордж Бусис (George Bousis), соучредитель и управляющий партнёр фонда Protagonist.
20.10.2026 [09:33], Сергей Карасёв
46 ядер RISC-V и 8 каналов DDR5: SpacemiT представила чипы Vital Stone V100Китайская компания SpacemiT анонсировала серверные процессоры Vital Stone V100 с открытой архитектурой RISC-V. Изделия, как утверждается, подходят для решения самых разных задач — от построения СХД и периферийных серверов до обучения ИИ-моделей и инференса. Конфигурация Vital Stone V100 включает в общей сложности 46 вычислительных ядер RISC-V. Это 6 ядер Xiangshan Kunming Lake V2R2 с максимальной тактовой частотой 2,1 ГГц и 40 ядер Iterative Spacetime X100 c частотой до 2,4 ГГц. В первом случае объём кеша L2 составляет 1 Мбайт, во втором — 2 Мбайт. Чипы могут использоваться в двухсокетных системах, что в сумме обеспечит 92 вычислительных ядра. 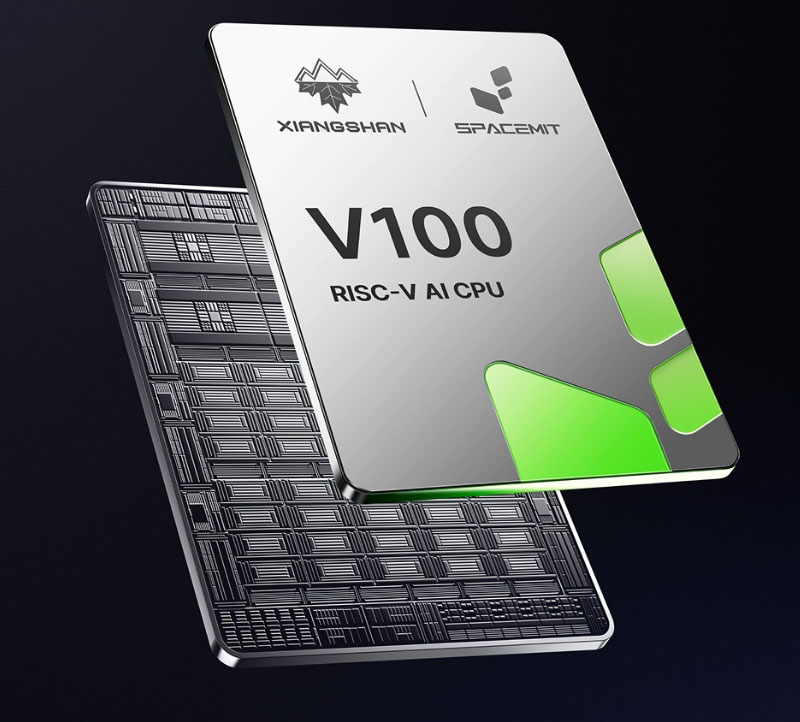
Источник изображений: SpacemiT Реализованы восемь каналов оперативной памяти DDR5-4800 и 52 линии PCIe 5.0. Показатель TDP находится на уровне 120 Вт. Заявлена поддержка интерфейсов 1 × QSPI, 1 × LPC, 1 × eSPI, 3 × SPI Master, 1 × SPI Slave, 4 × I3C, 12 × I2C, 12 × SMBUS, 5 × UART. Упомянуты криптографические алгоритмы AES, SHA, RSA, SM2, SM3, SM4. Процессоры производятся по 12-нм технологии в корпусе FCBGA с размерами 58,5 × 75,4 мм. 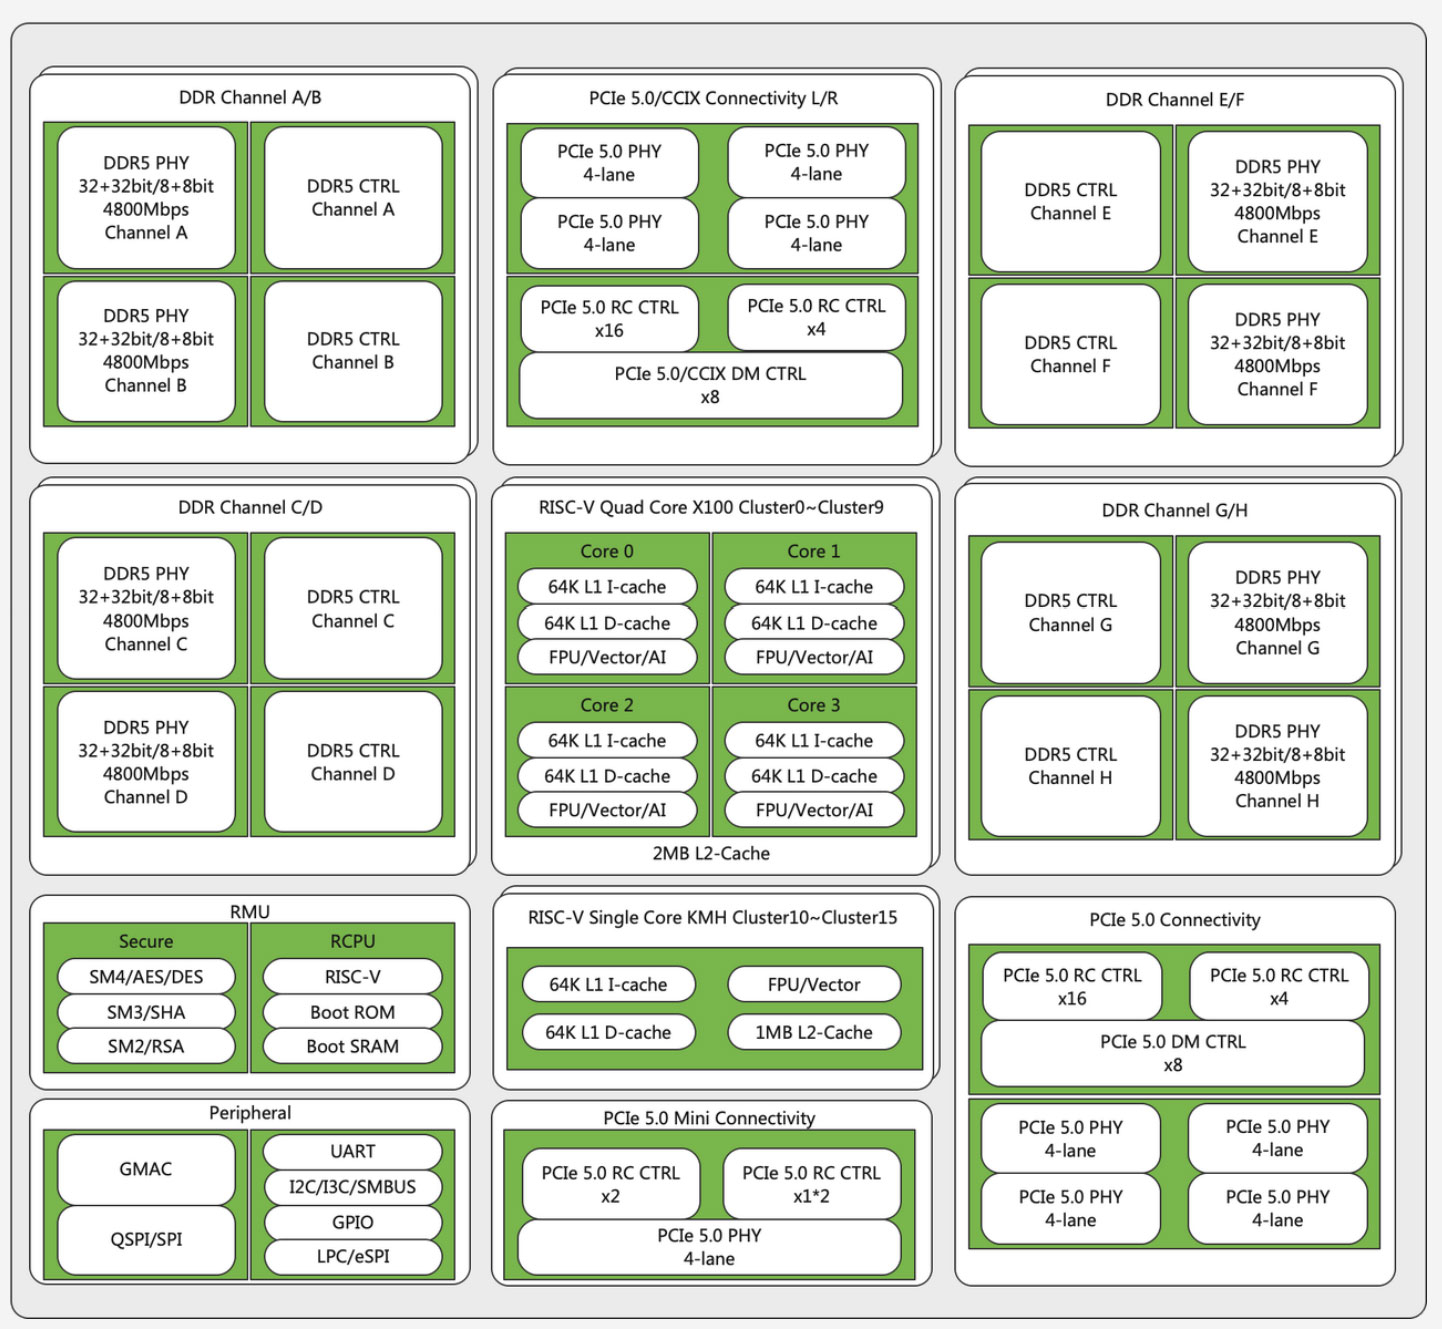 Подчёркивается, что Vital Stone V100 — это первые изделия, полностью соответствующие серверной спецификации RISC-V, включая поддержку UEFI, ACPI, SMBIOS. Кроме того, заявлена полная совместимость с профилем RVA23, который стандартизирует набор инструкций ISA. Реализованы такие функции, как векторные операции, инструкции с плавающей запятой и атомарные инструкции, которые востребованы в сферах НРС и ИИ. Новая аппаратная платформа поддерживает ОС openEuler, openKylin, Ubuntu, Debian и Fedora, программные стеки Tomcat, Redis, Apache, MySQL и PostgreSQL, а также виртуализацию и контейнеризацию KVM, QEMU, Docker.
16.09.2026 [15:38], Сергей Карасёв
Axelera AI начала поставки ИИ-чипов Europa для высокоэффективного инференсаНидерландский стартап Axelera AI объявил о начале отгрузок изделий Europa — специализированных ИИ-чипов следующего поколения (AI Processing Unit, AIPU). Они ориентированы прежде всего на выполнение инференса с высокой энергетической эффективностью. Первая информация о решениях Europa появилась в октябре прошлого года. Конструкция чипов включает восемь ядер ИИ, 16 векторных ядер с архитектурой RISC-V, 256-бит интерфейс LPDDR5 с пропускной способностью 200 Гбайт/с и 128 Мбайт памяти L2 SRAM. Заявленное быстродействие достигает 629 TOPS на операциях INT8. При производстве применяется 5-нм технология Samsung. Заказчики могут приобретать чипы Europa для самостоятельного проектирования ИИ-ускорителей. Кроме того, изделия доступны в составе PCIe-карты Axelera Edge 232p формата HHHL с одним AIPU и платы Axelera Server 250p типоразмера FHFL с четырьмя AIPU. Эти устройства могут устанавливаться в серверы и рабочие станции. 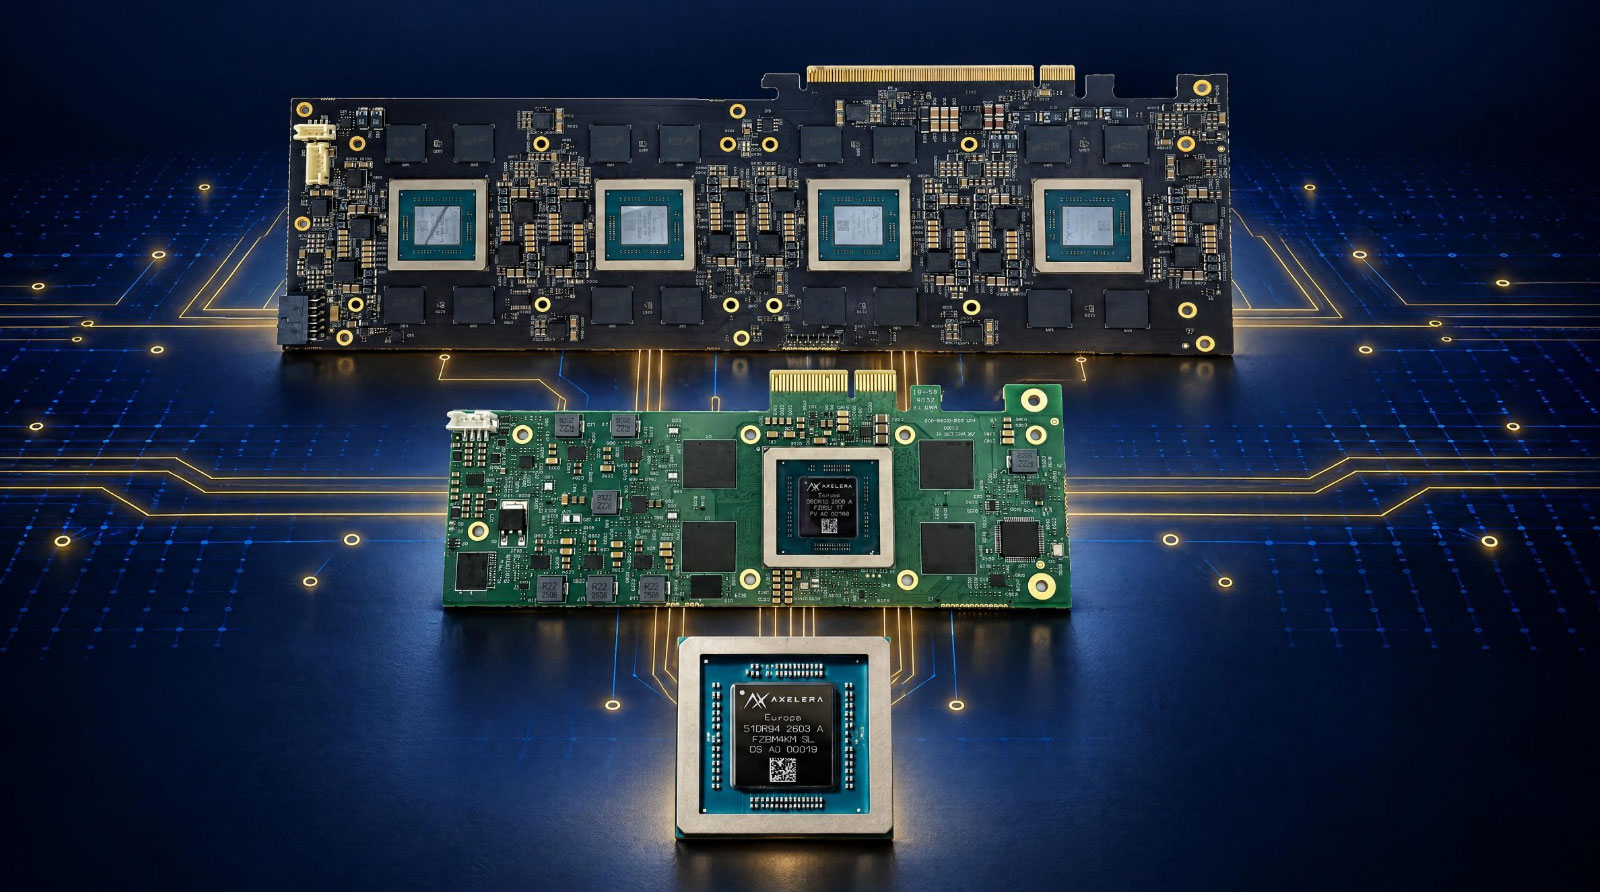
Источник изображений: Axelera AI Как утверждает Axelera AI, решения на базе Europa обеспечивают в шесть раз более высокую производительность (токенов в секунду) на 1 Вт затрачиваемой энергии по сравнению с ускорителями на базе GPU. Новые карты могут применяться не только в составе дата-центров и облачных платформ, но и на периферии, а также на корпоративных площадках. 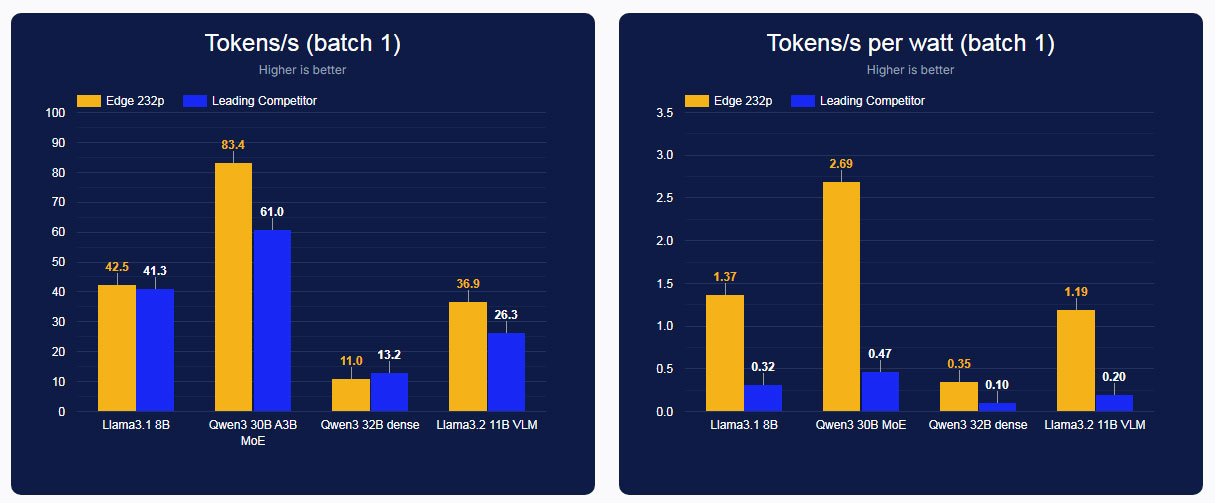 Ускорители Axelera Edge 232p будут доступны в составе серверов Dell XE5 и Supermicro 111AD. Кроме того, о поддержке Europa объявили такие компании, как 2CRSi, Advantech, Axiomtek, HPE, Lenovo, Seco и др. Продукты Axelera AI внедрили более 600 клиентов по всему миру, включая заказчиков в сферах оборонной промышленности, робототехники, беспилотных летательных аппаратов, розничной торговли и безопасности. Стартап говорит об общем портфеле заказов стоимостью свыше $1,5 млрд.
16.09.2026 [13:10], Руслан Авдеев
SiFive и AMD займутся оптимизацией ROCm для RISC-VSiFive и AMD показали возможность работы программной экосистемы AMD ROCm на представленной недавно серверной платформе BigSky Datacenter Development Platform. Компании показали запуск современной ИИ-модели Gemma4-E2B с применением ROCm 10.0 на серверах SiFive с ядрами SiFive P870-D. Непосредственно за инференс отвечали ускорители AMD Radeon AI PRO R9700. Взаимодействие компания позволит использовать open source ПО, экосистему ROCm и аппаратные решения на архитектуре RISC-V для создания системы ИИ-вычислений в ЦОД нового поколения. Партнёры продолжат заниматься оптимизацией ROCm для RISC-V, желая обеспечить в перспективе ускоренное время обработки данных и большее число сценариев использования ИИ-ускорителей и более крупных ИИ-моделей. По словам представителя SiFive, комбинация передовой открытой стандартной архитектуры с ПО с открытым исходным кодом позволяет гиперскейлерам и разработчикам решать современные ИИ-задачи на RISC-V. Это будет способствовать ускоренному внедрению RISC-V в ЦОД. 
Источник изображения: SiFive RISC-V-сервер BigSky SF-2U870 разработан специально для портирования, оптимизации и валидации ПО. Платформа включает 32 ядра P870-D (тактовая частота 2,0 ГГЦ), 256 Гбайт DDR5-5600, четыре слота PCIe 5.0 x16 и слот PCIe 3.0 x4. Также используется два SSD U.2 NVMe SSD по 7,68 Тбайт и сетевая карта OCP 3.0 NIC 10/25GbE. Аналогичную интеграцию с своей платформы с архитектурой RISC-V продвигает и NVIDIA. Ранее компания уже официально объявила о поддержке CUDA соответствующих решений, что позволяет использовать CPU на RISC-V для управления ИИ-ускорителями. Также компания поддержала включение SiFive в свою партнёрскую программу NVLink Fusion.
03.09.2026 [09:14], Владимир Мироненко
VMware: RISC-V никому не нужен, а Arm до зрелости ещё несколько летВ Broadcom считают, что Arm-серверы не будут занимать значительную долю рынка в корпоративном секторе ещё, как минимум, три-пять лет. Об этом заявил Рам Велага (Ram Velaga), с 1 января возглавляющий подразделение корпоративного ПО Broadcom, включающее бывшие бизнес-подразделения VMware, Symantec и CA. VMware по-прежнему является наиболее широко используемым поставщиком средств виртуализации корпоративных серверов, и её пользователи в ближайшее время не смогут использовать Arm–серверы без того, чтобы Arm-платформы не превратились в самодостаточный обособленный сегмент — сценарий, который мало кому понравится, отметил The Register. Велага заявил, что миссия VMware не изменится при его руководстве. «Мы будем слоем абстракции для CPU и GPU, независимо от набора инструкций», — сказал он. В настоящее время VMware виртуализирует серверы, хранилища и сети, но только на архитектуре x86. Также компания расширила свою деятельность в области виртуализации GPU, поддерживая ускорители NVIDIA, AMD и Intel. 
Источник изображения: VMware Кроме того, VMware уделяет внимание решениям, связанным с SmartNIC/DPU, где как раз обычно используются Arm-процессоры. Ещё в 2020 году компания начала проект Project Monterey по переносу части функций NSX на такие устройства. Речь в первую очередь про брандмауэры и средства обнаружения вторжений. Работая над этим проектом, VMware также продвигалась к созданию гипервизора для Arm-серверов и недавно представила превью этой технологии. Но… и пять лет назад компания занималась тем же, хотя тогда поддержка ограничивалась лишь процессорами Ampere Altra. Велага допустил, что Arm, вероятно, станет частью корпоративного ИТ-рынка. Вместе с тем он выразил мнение о том, что пройдёт несколько лет, прежде чем серверы Arm займут значительную долю рынка в корпоративном секторе, и поэтому VMware нет смысла спешить с портированием своего гипервизора. Он добавил, что клиенты VMware совершенно не заинтересованы в процессорах, построенных на RISC-V. Велага рассказал, что около 60 % из $5 млрд ежегодных расходов на исследования его подразделения идёт на обновление текущих продуктов VMware. Оставшаяся часть средств направляется на разработку новых продуктов, таких как анонсированная на днях ИИ-фабрика VMware AI Factory. ИИ сейчас в тренде. Серверы на базе Arm — нет. Поэтому нетрудно догадаться, куда VMware направит средства для R&D в ближайшие годы, пишет The Register.
27.08.2026 [09:25], Владимир Мироненко
MTIA 300: первый ИИ-чип Meta✴ со встроенными 800GbE-адаптерами и механизмами разгрузки коммуникацийMeta✴ сообщила новые подробности о 667-Вт ИИ-ускорителе MTIA 300 — своём первом чипе, оптимизированном для обучения DLRM-моделей. В отличие от LLM, требующих огромной пропускной способности вычислений с плавающей запятой, рекомендательные модели сталкиваются с проблемой необходимости быстрого и эффективного взаимодействия ускорителей в сочетании с большой ёмкостью памяти и высокой пропускной способностью интерконнекта. Их таблицы эмбеддингов могут содержать более 99 % параметров модели, что требует гибридного параллелизма, генерирующего частые коллективные операции AllReduce, AllToAll и AllGather на сотнях ускорителей. На таких чипах, как GPU, эти коммуникационные операции конкурируют с вычислениями за одни и те же ресурсы, часто приводя к неэффективному использованию дорогостоящего оборудования. Для решения этой проблемы разработчики, используя совместную разработку MTIA 300 с HCCL, библиотекой коммуникационных интерфейсов, созданной на основе разработанного с нуля оборудования, сделали коммуникацию первостепенной задачей в проектировании микросхем. На практике HCCL обеспечивает пропускную способность передачи данных до 940 Гбайт/с в пределах одной стойки. На модели со 150 млрд параметров, работающей на 40 ускорителях, общее время обмена данными при использовании MTIA 300 в 3,9 раза меньше, чем у эквивалентного кластера на базе GPU. 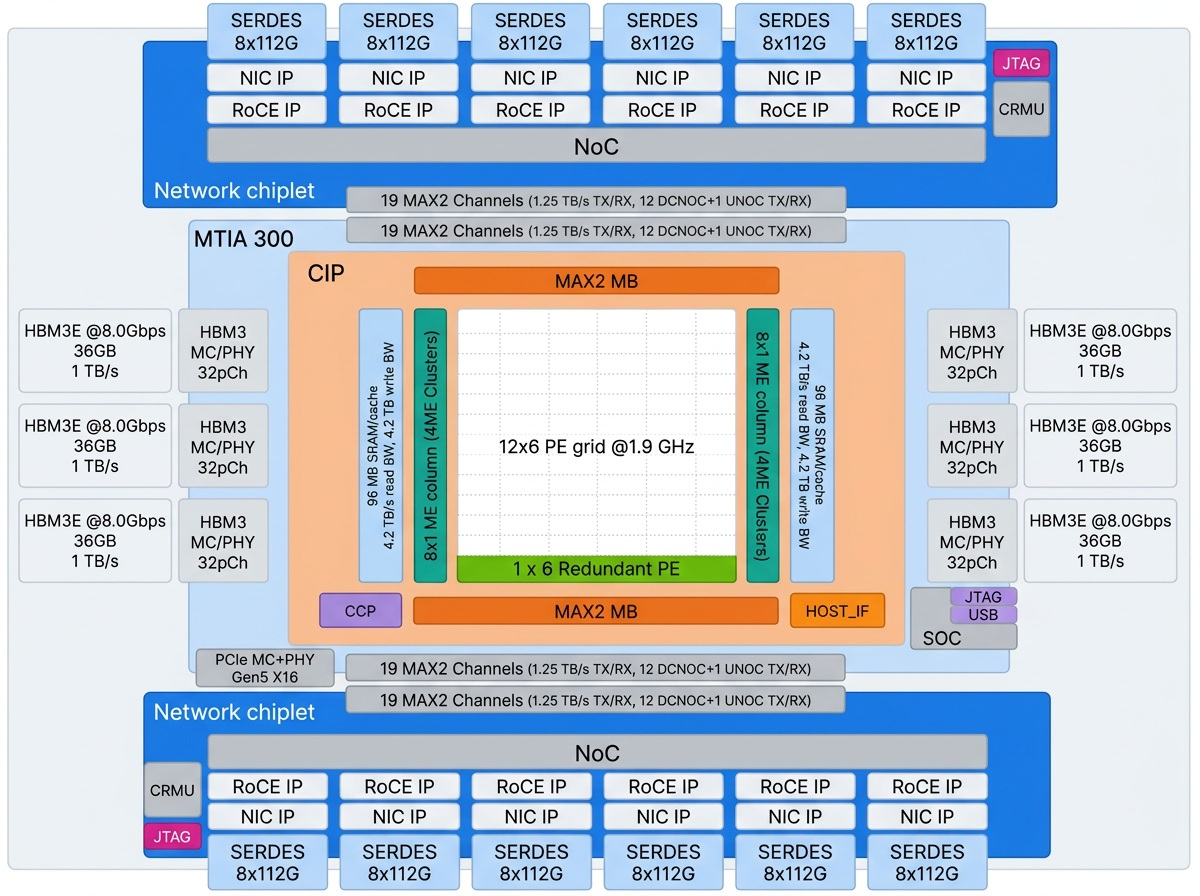
Источник изображения: Meta✴ В MTIA 300 сетевой интерфейс находится внутри самой упаковки микросхемы. Два 5-нм сетевых чиплета, каждый из которых содержит по шесть специализированных 800GbE RoCE-адаптеров, обеспечивают общую пропускную способность I/O 1,2 Тбайт/с без пересечения c шиной PCIe. Это устраняет узкое место в цепочке «хост-устройство-NIC», присутствующей в традиционных архитектурах GPU, где CPU должен выступать посредником между ускорителем и сетью, и позволяет избежать перегрузки PCIe между ускорителем и NIC. При этом NIC можно гибко использовать для масштабирования. Поскольку используются одни и те же 12 NIC на базе Ethernet для вертикального масштабирования (внутри стойки из 16 узлов, до 1 Тбайт/с) и горизонтального масштабирования (между стойками, до 200 Гбайт/с), можно гибко распределять NIC в соответствии с меняющимися потребностями. По мере изменения требований модели можно переконфигурировать сеть, а не само оборудование. Для минимизации задержки транзакций разработчики внедрили экспресс-оповещения (doorbell). Сама запись запроса на выполнение служит оповещением, исключая дополнительное чтение из памяти и экономя около 800 нс на операцию. 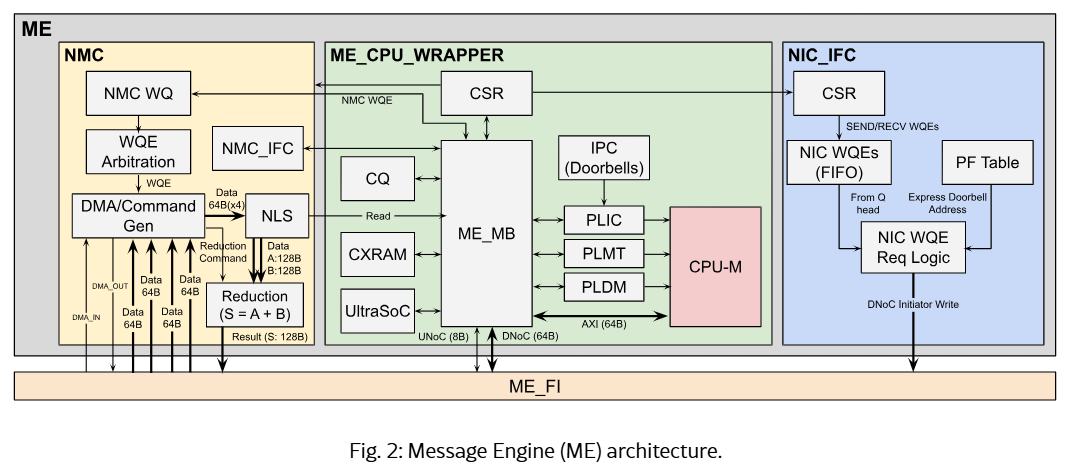
Источник изображения: Meta✴ В случае GPU библиотеки вроде NCCL реализуют операции коллективных коммуникаций в виде вычислительных ядер (kernel), которые используют те же ресурсы, что нужны для вычислений при обучении. Пересечение коллективных операций и операций обучения приводит к замедлению обоих и того, и другого. В MTIA 300 использовали другой подход. Наряду с матрицей из 72 3-нм вычислительных элементов (PE), чип включает 16 выделенных механизмов обработки сообщений (ME), которые обрабатывают всю коммуникацию независимо. ME содержит ядро RISC-V для оркестрации; сетевой интерфейс, который направляет запросы к нужному NIC; вычислительный блок Near-Memory Computing (NMC), который выполняет операции редукции со скоростью 128 байт/цикл. Расположенные по краям чипа, рядом с HBM и кешем, NMC в совокупности обеспечивают пропускную способность редукции более 2,8 Тбайт/с — более чем вдвое превышающую пропускную способность I/O. Это позволяет выполнять коллективные операции AllReduce и ReduceScatter на линейной скорости NIC без использования ресурсов PE. 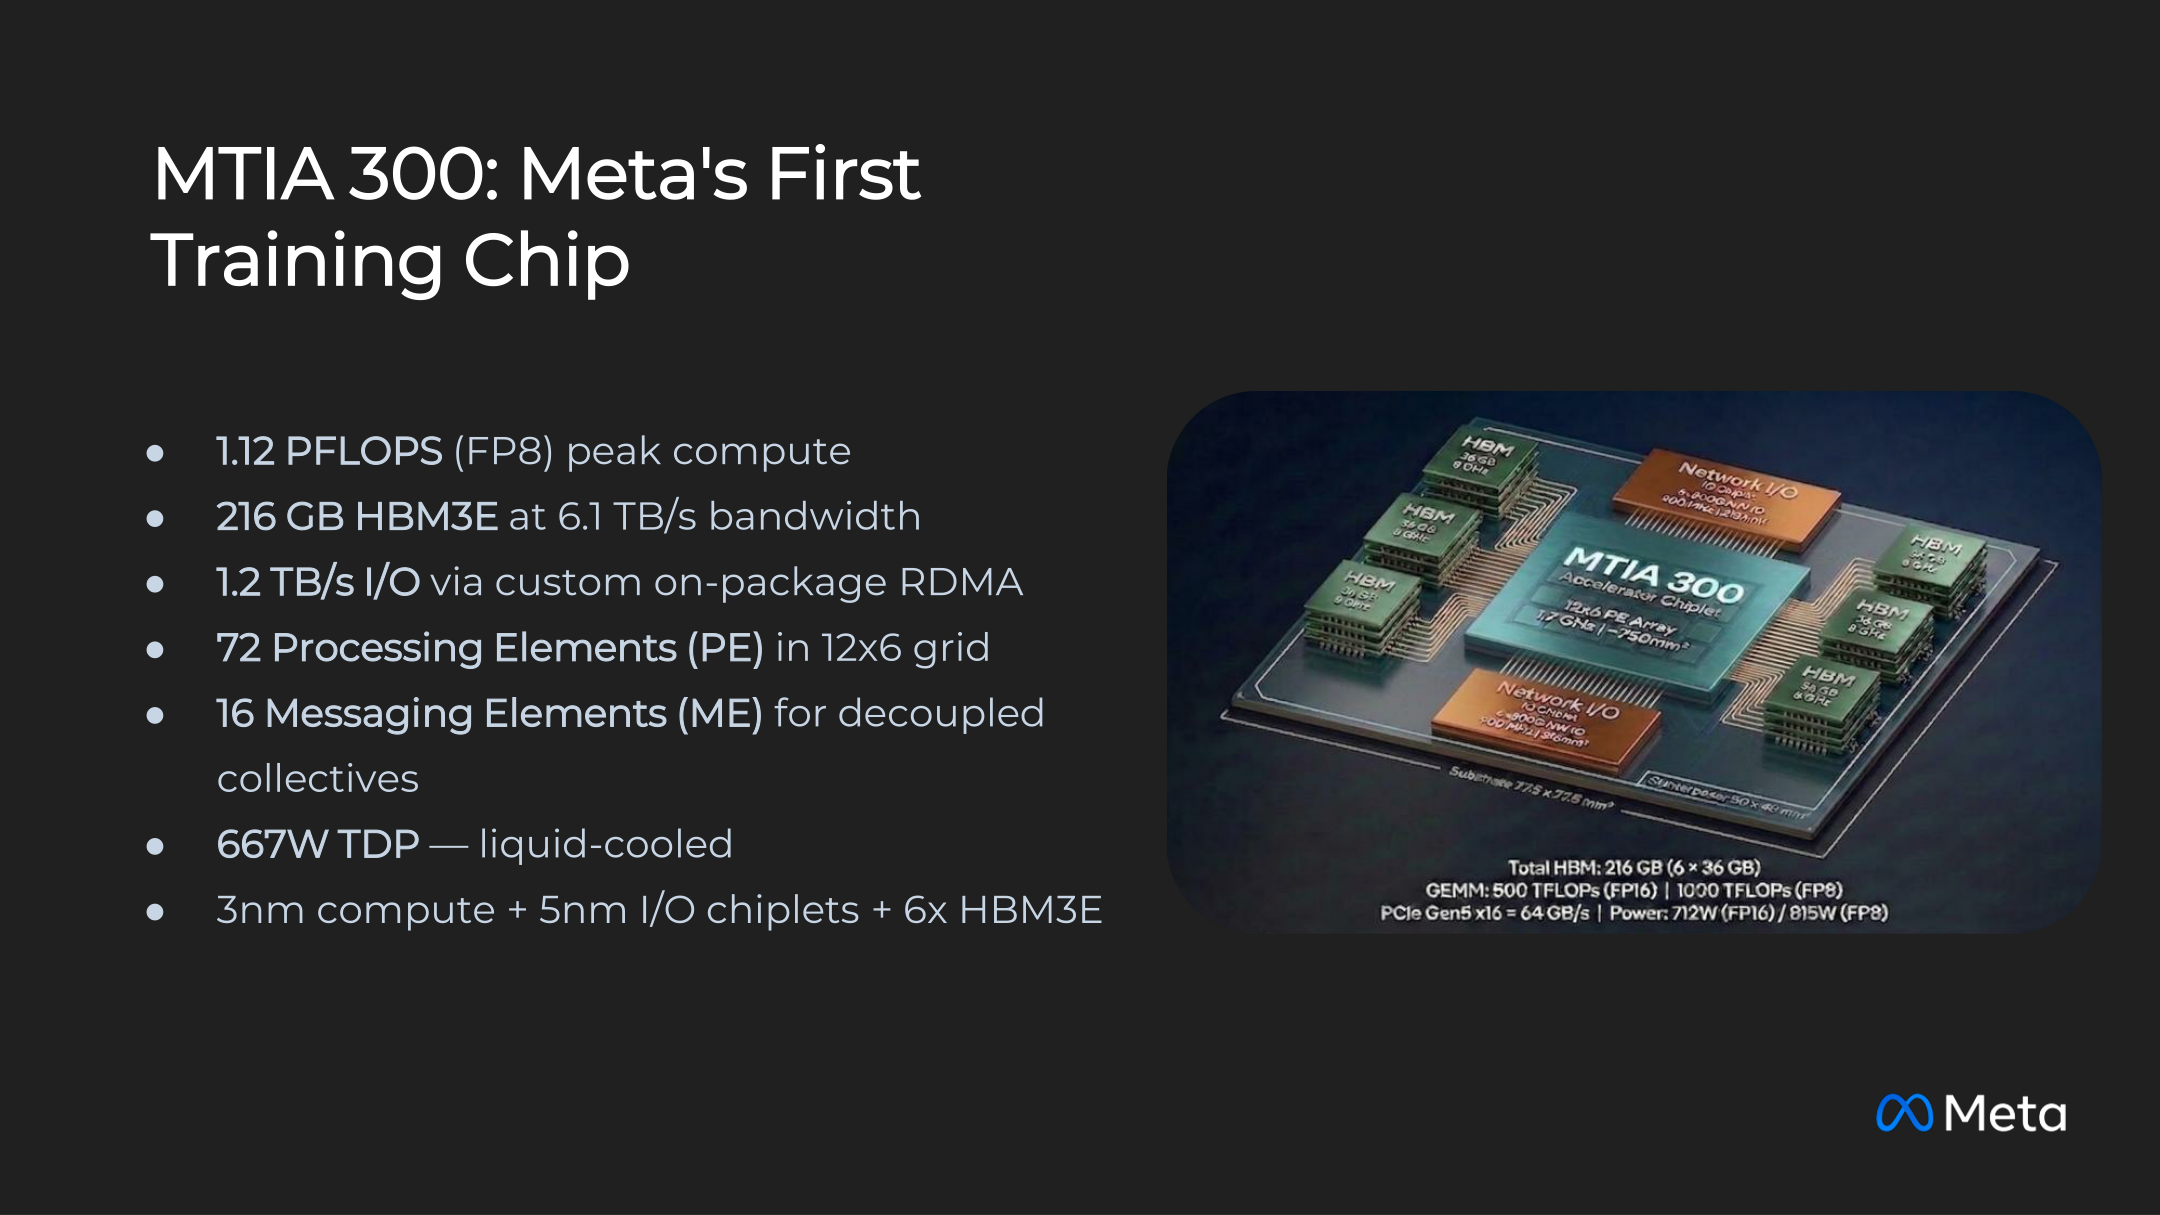
Источник изображения: Meta✴ В результате обеспечивается практически идеальная изоляция операций. Одновременное выполнение больших GEMM-операций с коллективными операциями приводит к снижению вычислительной пропускной способности менее чем на 0,5 %, в отличие от традиционных GPU, где снижение может превышать 20 % из-за использования одних и тех же ресурсов на обмен данными и вычисления. Разработанная совместно с MTIA 300 библиотека HCCL вместо управления обменом данными с хостом во время выполнения компилирует каждую коллективную операцию в полный набор подграфов (массивы очередей задач с явным указанием зависимостей), которые отправляются на ME для полностью автономного выполнения. Таким образом, хост лишь единожды отправляет ускорителю набор сетевых инструкций и более не вмешивается в работу сети. 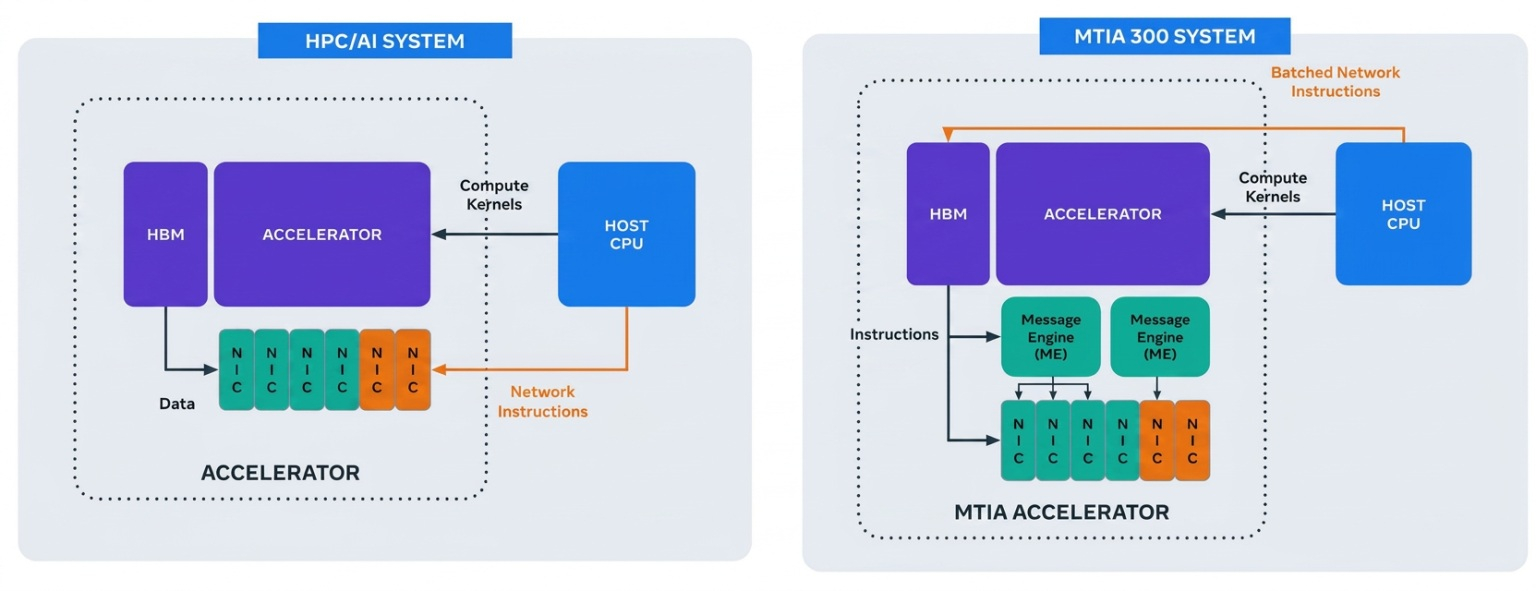
Источник изображения: Meta✴ По словам Meta✴, такая архитектура естественным образом интегрируется с PyTorch. Коллективные операции компилируются в единый граф вместе с вычислительными задачами. HCCL сама выбирает алгоритмы, учитывающие топологию сети и асимметричность полос пропускания, по возможности минимизируя межстоечный трафик. Для инференса были разработаны дополнительные пути: односторонняя коммуникация, когда PE используют экспресс-оповещения, и параллельный запуск коллективных операций по сигналу от kernel'а без прерывания работы последнего. Компания отметила, что MTIA 300 имеет и другие плюсы 216 Гбайт HBM3E (6,1 Тбайт/с) позволяют разместить больше данных на одном чипе, а не загружать их лишний раз извне; на каждый ускоритель приходится всего один CPU, что позволяет нагружать его интенсивными вычислениями на некоторых этапах; высокая пропускная способность сети позволяет при необходимости использовать форматы данных с более высокой точностью. Хотя сочетание умеренной FP-производительности с ёмкой и быстрой HBM в MTIA 300 изначально было оптимизировано для обучения DLRM, эти качества позволяет эффективно использовать чипа для более широкого спектра нагрузок, включая инференс моделей генеративного ИИ. Стоит отметить, что подход Meta✴ с внедрением NIC непосредственно в чип не нов сам по себе. Например, чипы Intel/Habana Gaudi2, представленные в 2022 году, использовали 24 100GbE-интерфейса RoCE для вертикального и горизонтального масштабирования.
27.08.2026 [07:15], Сергей Карасёв
SiFive представила первый RISC-V-сервер BigSky SF-2U870SiFive анонсировала платформу для разработки ЦОД-систем BigSky SF-2U870. На её основе в сотрудничестве с гиперскейлерами и отраслевыми партнёрами SiFive создала, по её словам, первый в мире 2U-сервер на базе RISC-V. В основу BigSky SF-2U870 положены 32 ядра SiFive P870-D (64 бит) с поддержкой набора инструкций RVA23, Vector 1.0 и Vector Crypto. Чип функционирует на тактовой частоте 2 ГГц. Реализована поддержка функций обеспечения повышенной надёжности RAS (Reliability, Availability and Serviceability). В состав P870-D входят распределённый масштабируемый блок IOMMU, система безопасности WorldGuard и Uncore-агент, отвечающий за питание, отладку, трассировку и пр. 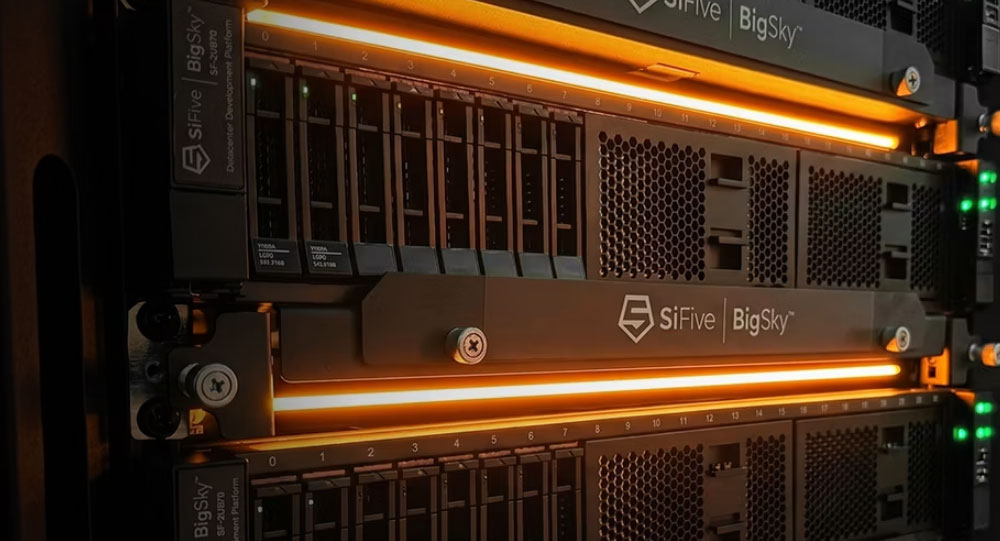
Источник изображения: SiFive Сервер располагает 256 Гбайт DDR5-5600 и двумя накопителями U.2 NVMe SSD вместимостью 7,68 Тбайт. Имеется адаптер OCP 3.0 NIC с поддержкой 10/25GbE-портов. Упомянуты четыре слота PCIe 5.0 x16 и слот PCIe 3.0 x4. Допускается установка GPU-ускорителя двойной ширины. Заявлена поддержка стандартных корпоративных версий Linux, таких как Canonical Ubuntu 26.04 LTS и Red Hat RHEL10. Платформа BigSky SF-2U870, как ожидается, ускорит портирование ПО для дата-центров, оптимизацию рабочих нагрузок и проверку систем. В конечном итоге, это поможет облегчить развёртывание решений корпоративного класса на базе RISC-V. В частности, SiFive сотрудничает с NVIDIA для портирования CUDA и интеграции NVLink Fusion в будущие платформы. Пробные поставки новинки уже начались.
08.08.2026 [16:10], Сергей Карасёв
Bull и Kalray займутся разработкой сетевых технологий для ИИ и НРСФранцузские компании Bull и Kalray объявили о стратегическом партнёрстве, направленном на развитие передовых сетевых технологий для инфраструктур ИИ и НРС. Стороны, в частности, намерены сотрудничать в сфере Ultra Ethernet — нового стандарта на базе Ethernet, ориентированного на современные ресурсоёмкие нагрузки. Bull и Kalray сосредоточат усилия на разработке решений следующего поколения, отвечающих высоким требованиям производительности, масштабируемости и эффективности. Речь идёт, в частности, об интерконнекте с большой пропускной способностью и малыми задержками. В рамках партнёрства Kalray предоставит свою сетевую платформу Kalray Networking Engine, предназначенную для работы с огромными массивами данных в составе ЦОД, инфраструктур ИИ и НРС. Эта платформа предусматривает использование 64 ядер KV5 с открытой архитектурой RISC-V. Заявленная пропускная способность достигает 1,6 Тбит/с. В свою очередь, Bull ускорит развитие собственного интерконнекта BXI (Bull eXascale Interconnect) — это специализированная высокоскоростная сетевая архитектура для суперкомпьютеров и систем высокопроизводительных вычислений. В частности, планируется добавление в состав BXI новых функций безопасности и виртуализации, необходимых для облачных и ИИ-нагрузок. В целом, развитие BXI будет смещено в сторону стандарта Ethernet. 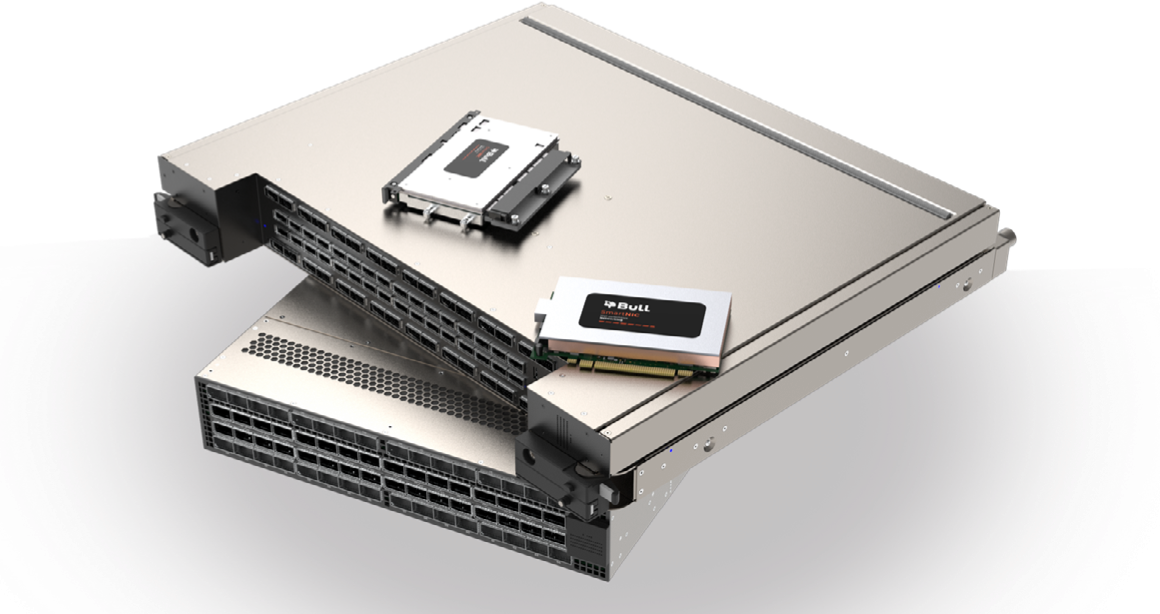
Источник изображения: Bull Соглашение между Bull и Kalray предусматривает совместную разработку технологических блоков, совместимых с Ultra Ethernet, и их интеграцию в будущие поколения сетевых решений Bull. Сотрудничество, как ожидается, откроет новые возможности для OEM-производителей и поставщиков инфраструктурных решений. Помимо этого, партнёрство будет способствовать развитию отраслевых стандартов, обеспечивающих масштабируемость, совместимость и долгосрочный потенциал платформ для ИИ и НРС. Планируется, что первые решения, разработанные совместными усилиями Bull и Kalray, станут доступны для коммерческого использования в 2028 году.
01.08.2026 [15:49], Сергей Карасёв
Xcena представила вычислительную память MX1 для генеративного ИИЮжнокорейский стартап Xcena анонсировал продукты семейства MX1, призванные решить проблему дефицита памяти в масштабных платформах, ориентированных на задачи генеративного ИИ. По мере того как генеративный ИИ требует всё более крупных моделей, более длинных контекстных окон и стремительно растущих объёмов KV-кеша, память становится главным ограничивающим фактором для инфраструктуры ИИ. Изделия HBM остаются крайне дорогими при ограниченной ёмкости, тогда как расширение путём добавления серверов приводит к формированию избытка вычислительных ресурсов и росту совокупной стоимости владения, говорит Xcena. Устройства MX1 призваны переломить ситуацию. Речь идёт об использовании вычислительной памяти. Идея заключается в том, чтобы увеличить основную память системы, добавив модули DDR5 DIMM вкупе с ядрами RISC-V. Реализована поддержка PCIe 6.0 и CXL 3.2, а технология NDP (Near Data Processing) сводит к минимуму задержку при перемещении данных между интерфейсами. В результате, значительно ускоряется выполнение ресурсоёмких задач при одновременном снижении нагрузки на CPU. 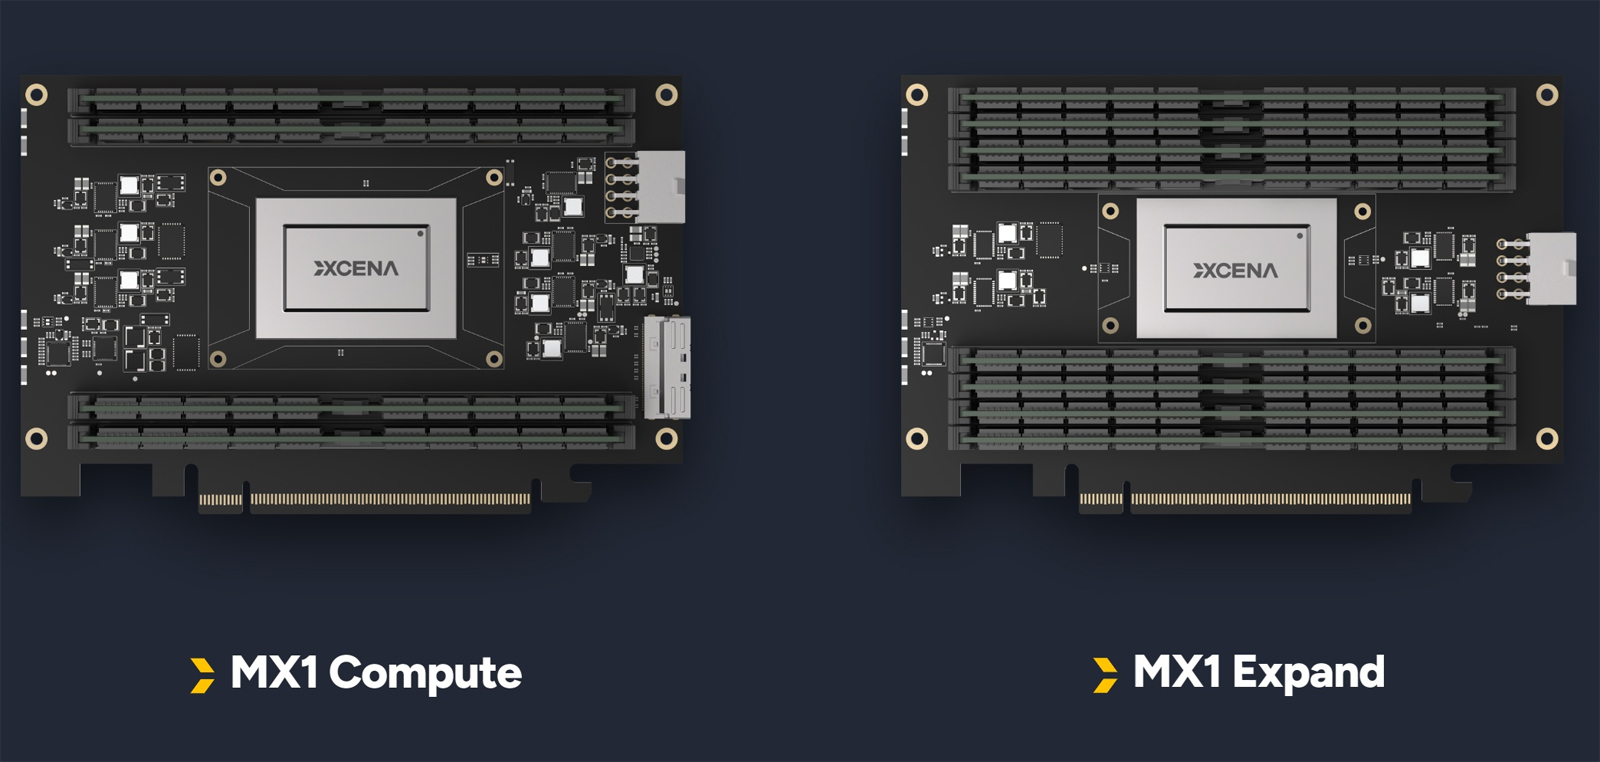
Источник изображения: Xcena В семейство входят изделия MX1 Compute и MX1 Expand. Первое представляет собой CXL-решение с 2048 ядрами RISC-V и четырьмя слотами DRAM, что позволяет выполнять вычисления рядом с памятью. Благодаря этому устраняется перемещения данных между CPU и памятью, что повышает производительность инференса и сокращает энергопотребление. В свою очередь, MX1 Expand предоставляет восемь слотов DRAM для эффективного масштабирования пула памяти.
31.07.2026 [17:42], Сергей Карасёв
Openchip представила европейский 2-нм процессор BER10 с архитектурой RISC-VКомпания Openchip анонсировала суверенный европейский процессор BER10, построенный на открытой архитектуре RISC-V. Изделие ориентировано на различные устройства, функционирующие под управлением Linux. Это могут быть серверы, периферийные платформы и пр. Чип BER10 получил четыре 64-бит вычислительных ядра с внеочередным исполнением инструкций. Тактовая частота и размер кеш-памяти пока не раскрываются. Но отмечается, что при производстве применяется передовая технология Gate-All-Around (GAA) с нормами «менее 2 нм». Таким образом, можно предположить, что решение обладает высокой энергетической эффективностью. 
Источник изображения: Openchip В процессоре реализована поддержка многоканальной оперативной памяти и высокоскоростных интерфейсов, таких как PCIe и AXI (Advanced eXtensible Interface). Кроме того, имеется аппаратный векторный блок, предназначенный для ускорения операций, связанных с ИИ, научными расчётами, обработкой изображений и другими ресурсоёмкими задачами. Openchip подчёркивает, что BER10 — это не исследовательский прототип, а чип, рассчитанный на серийное производство. Иными словами, изделие готово для работы с реальными операционными системами и прикладным софтом. Впрочем, о начале массовых поставок процессоров разработчик умалчивает. Европейская безфабричная компания Openchip была основана в Барселоне в 2021 году. В настоящее время она ведёт деятельность в Испании, Италии, Франции, Польше, Германии и Ирландии. В штат входят более 200 специалистов — в основном в области исследований и разработок. Ключевым направлением деятельности является проектирование энергоэффективных «систем на кристалле» (SoC) на основе архитектуры RISC-V. |
|

