
Материалы по тегу: инференс
|
13.11.2026 [20:15], Павел Котов
Microsoft стала третьим клиентом-гиперскейлером CerebrasПроизводитель гигантских ИИ-ускорителей Cerebras в ходе квартального финансового отчёта объявил о заключении контракта с Microsoft, сообщает DataCenter Dynamics. Это уже третий облачный гигант, решивший использовать это оборудование — ранее Cerebras заключила соглашения с AWS и Oracle. Подробности сделки пока не раскрываются — детальную информацию гендиректор компании Эндрю Фельдман (Andrew Feldman) пообещал представить в 2027 году. Этот год проходит под знаком наращивания мощностей и расширения функциональных возможностей: в 2027 году выручка Cerebras, по её собственным прогнозам, может вырасти строе. В III квартале доход компании составил $231 млн — это на 10 % больше, чем в минувшем квартале и на 70 % больше, чем за аналогичный период прошлого года; оба показателя превзошли ожидания. На долю облачных ИИ-сервисов пришлись $145 млн. В IV квартале компания ожидает, что данный показатель сохранится примерно на прежнем уровне, что обусловлено ограничением мощностей ЦОД. Их наращивание начнётся не раньше декабря, причём основная часть запланированных компанией мощностей (всего 700 МВт) уже законтрактована и будет введена в эксплуатацию к середине 2027 года. К 2027 году более 75 % запланированных мощностей Cerebras будут находиться за пределами США, где политическая конъюнктура вносит новые сложности в отрасль ЦОД, — новые объекты компании появятся в Канаде, Франции и Норвегии, и ввод этих объектов в эксплуатацию ожидается в ближайшие месяцы. Завершается согласование контракта на создание ЦОД в Сан-Паулу — это будет первый объект компании в Южной Америке. 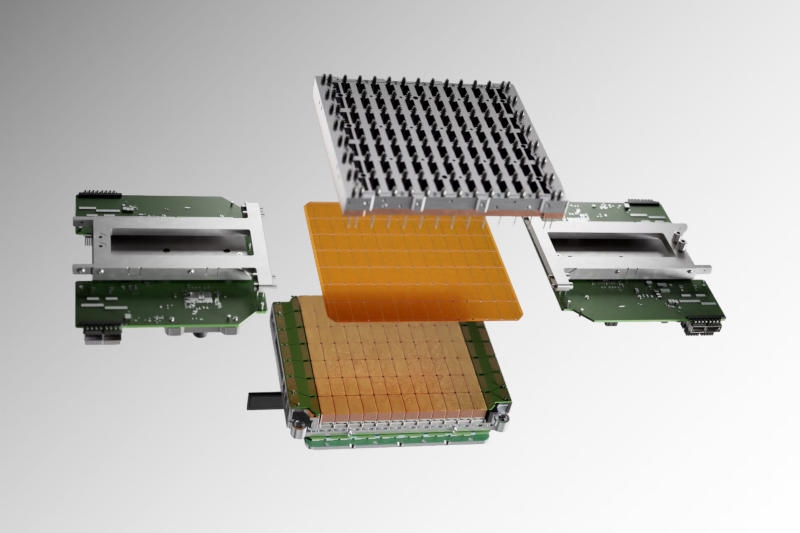
Источник изображения: cerebras.ai Выручка от реализации основного оборудования за квартал составила $86 млн без учёта заключённого ранее соглашения с Oracle. В I квартале 2027 года Cerebras намерена перейти от моделей CS-3 к CS-4, а к середине года запустить производство ускорителей нового поколения CS-5. К концу 2026 года производственные мощности компании должны десятикратно превзойти показатели начала года. Валовая маржа составила 41 %; в следующем квартале этот показатель, как ожидается, вырастет до 48 %, в ближайшей перспективе — до 50 %, в долгосрочной — до 60 %. Чистая прибыль компании приняла положительное значение и составила $30 млн; скорректированный показатель EBITDA с начала года также оказался положительным и составил $2 млн. По состоянию на 30 сентября 2026 года объём неисполненных обязательств по контрактам вырос до $26,1 млрд без учёта сделок с Oracle и Microsoft. Прогноз по основной выручке за весь 2026 год повышен до диапазона $940–$960 млн. В III квартале компания расширила соглашение с OpenAI по сравнению со II кварталом, а работа модели OpenAI GPT-5.6 в сверхбыстром режиме (Ultrafast) превзошла все ожидания. При этом Cerebras пока не располагает достаточным мощностями, чтобы обеспечить полноценный запуск Ultrafast, в том числе для модели Astra, хотя технически это осуществимо. В рамках партнёрских проектов возникли задержки: компании потребовалось больше времени на заключение контрактов и ввод в эксплуатацию дополнительных мощностей ЦОД, в результате чего Cerebras отстала от графика. При задержках дольше 90 дней стороны имеют право аннулировать соответствующую часть контракта — сейчас под это условие могут подпадать около 5 % от общей стоимости соглашений, но прецедентов пока не было. Относительно низкая валовая прибыль от поставок оборудования связана не с низким выходом годных изделий, а с тем, что компания наращивает производственные мощности, заверил Фельдман. Специализирующаяся на игре на понижение инвестиционная компания Culper Research открыла короткую позицию по акциям Cerebras — трейдеры утверждают, что полупроводниковые пластины компании выходят из строя примерно через два года эксплуатации, что может поставить под угрозу весь её бизнес.
13.11.2026 [15:30], Павел Котов
На замену NVIDIA RTX6000: Axelera AI раскрыла подробности об ИИ-ускорителях TitaniaНидерландская Axelera AI рассказала об архитектуре Titania — ИИ-ускорителях третьего поколения, выполненных с использованием чиплетной компоновки. Архитектуру, по словам создателей, отличают высокая программируемость и энергоэффективность в сочетании с высокой производительностью. Решение вписывается в существующие ограничения по энергопотреблению и охлаждению в современных ЦОД и призвано заменить серверы с NVIDIA RTX 6000. Titania обеспечит семикратный прирост производительности на Вт по сравнению с существующими решениями для ЦОД, обещает разработчик, а совокупная стоимость владения (TCO) сократится до 20 раз. Каждый SiP-модуль содержит два чиплета. Модули можно реализовать в различных формфакторах — от стандартных карт PCIe 6.0 x16 до плат OCP UBB, объединяющих восемь модулей Titania OAM. Клиенты подтвердили заказы на сумму более $300 млн — решения будут доступны через OEM-партнёров в составе серверов для задач инференса с поддержкой как воздушного, так и жидкостного охлаждения. Архитектура Titania развивает концепцию вычислений в оперативной памяти (Digital In-Memory Computing — D-IMC), впервые представленную в платформе Metis и дополненную в архитектуре Europa. После встраиваемых систем и периферийных вычислений решения Axelera AI теперь охватывают масштабные задачи инференса в ЦОД. Модуль включает средства связи между ускорителями и программируемые вычислительные ядра на архитектуре RISC-V. 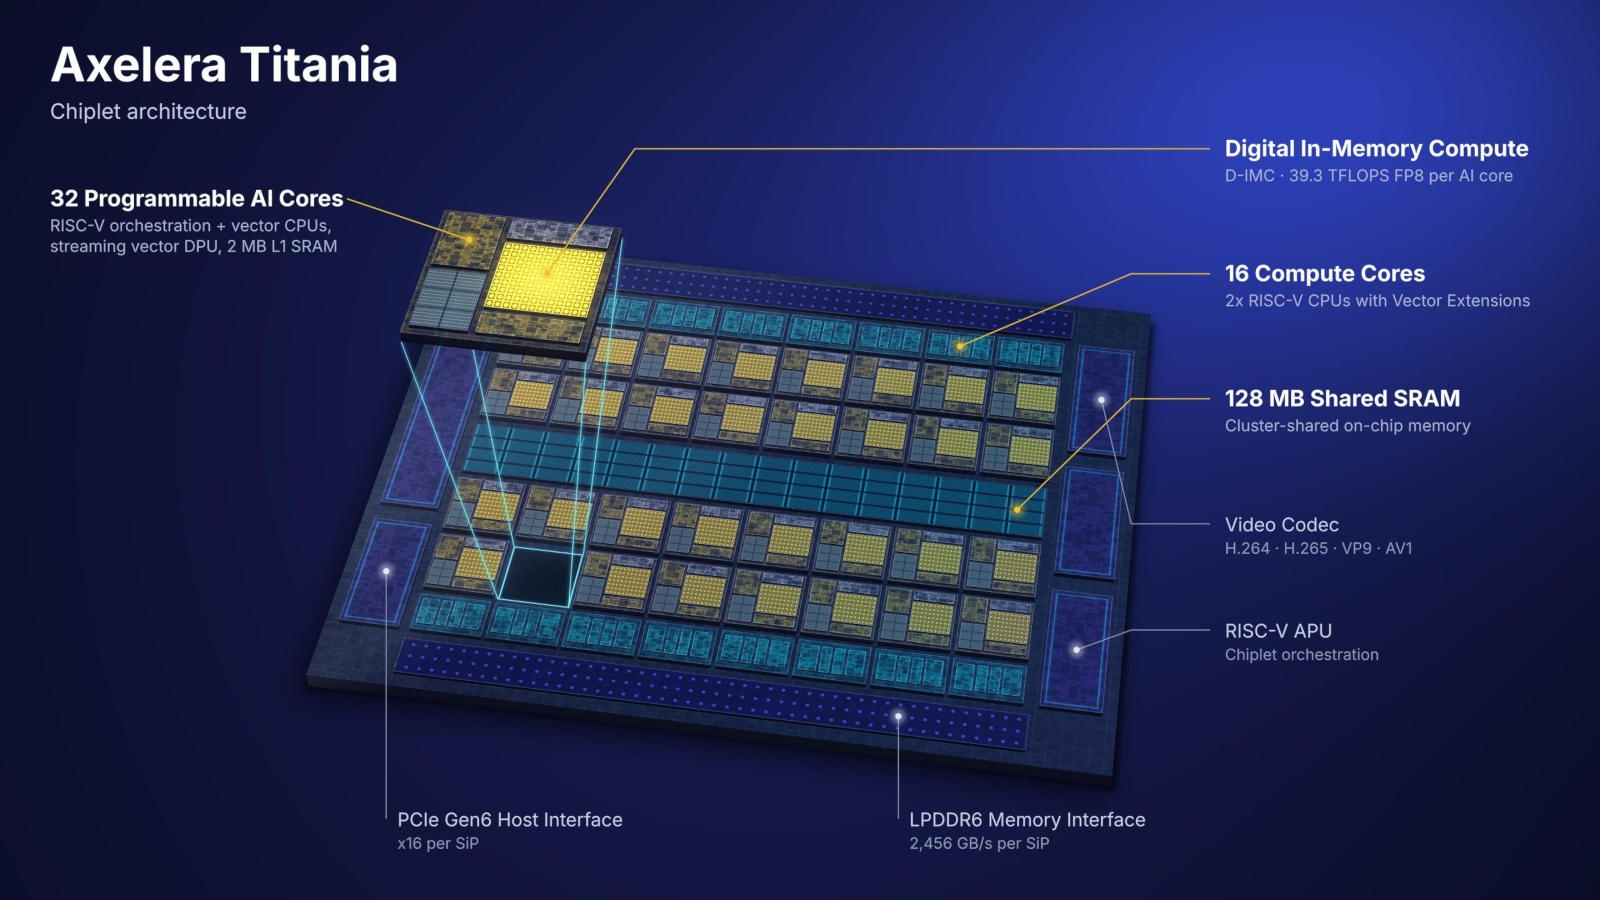
Источник изображения: Axelera AI Titania предусматривает работу с доступной и недорогой памятью LPDDR вместо дефицитной HBM. На каждый модуль приходятся 128 Гбайт LPDDR6 (с пропускной способностью 2456 Гбайт/с на модуль) — это особенно актуально для разреженных MoE-моделей с большим общим числом параметров и относительно небольшим количеством активных, поэтому здесь важнее ёмкость и эффективность памяти, а не высокая пропускная способность, которая нередко остаётся невостребованной. Чиплет содержит 32 программируемых ИИ-ядра с производительностью до 39,3 Тфлопс (FP8) каждое, а также 16 дополнительных вычислительных ядер на базе RISC-V с векторными расширениями. В наличии 128 Мбайт общей SRAM и 2 Мбайт кеша первого уровня для программируемых ИИ-ядер. За взаимодействие чиплетов отвечает отдельный блок RISC-V APU. Эталонный сервер Titania с кодовым названием AX8 комплектуется восемью SiP-модулями, предлагает производительность 20 Пфлопс (FP8) и располагает 1 Тбайт памяти с агрегированной пропускной способностью 19,6 Тбайт/с. Всё это размещается в стандартном корпусе 4U с воздушным охлаждением при типичном энергопотреблении 5–6 кВт, что позволяет развернуть его в обычном ЦОД. Один сервер Axelera может запускать модель размером 1,6 трлн параметров (в формате FP4) с запасом памяти для KV-кеша. В качестве программных средств используются представленные ранее Voyager SDK и язык AxeleraScript (AxScript). Плата Titania в формфакторе PCIe спроектирована как прямая замена модели Axelera Server 250p на архитектуре Europa — развёрнутые на платформе предыдущего поколения модели в 2028 году можно будет перенести на Titania без необходимости адаптировать код. Одна плата может работать с большими языковыми и мультимодальными моделями, а также с видеоданными — аппаратные блоки для декодирования (8K) и кодирования (4K) с поддержкой кодеков H.264, H.265, VP9 и AV1 снимают нагрузку с хост-системы. Серийное производство ускорителей на архитектуре Titania стартует в III квартале 2027 года.
10.11.2026 [14:48], Сергей Карасёв
ИИ-ускорители Rebellions тоже обзаведутся поддержкой NVIDIA NVLinkКомпании NVIDIA, Rebellions и SK Telecom объявили о сотрудничестве с целью развития суверенной инфраструктуры ИИ в Южной Корее. Инициативу поддерживает Министерство науки и информационно-коммуникационных технологий страны (MSIT). Речь идёт об использовании модульной архитектуры NVIDIA MGX для создания ИИ-систем, а также технологии NVIDIA NVLink Fusion, которая позволяет использовать фирменный интерконнект NVLink для подключения ускорителей, разработанных сторонними компаниями. В данном случае будут задействованы ИИ-решения Rebel R200, разработанные специалистами южнокорейской Rebellions. Эти изделия спроектированы специально для выполнения вычислений с низкой задержкой и небольшим энергопотреблением: они подходят для работы с передовыми ИИ-моделями, включая нейросети с архитектурой Mixture-of-Experts (MoE) с несколькими триллионами параметров. Южнокорейский оператор SK Telecom в рамках партнёрства развернёт MGX-стойки с ускорителями Rebel R200 и картами NVIDIA в своём дата-центре для задач ИИ. Компании намерены разработать схему дезагрегированного инференса, перенося различные этапы генерации ИИ-ответа на ту аппаратную часть, которая лучше всего подходит для этого. В частности, для предварительного заполнения будут использоваться GPU NVIDIA, а для декодирования — Rebel R200. Такой подход позволит повысить общую производительность и оптимизировать энергопотребление. 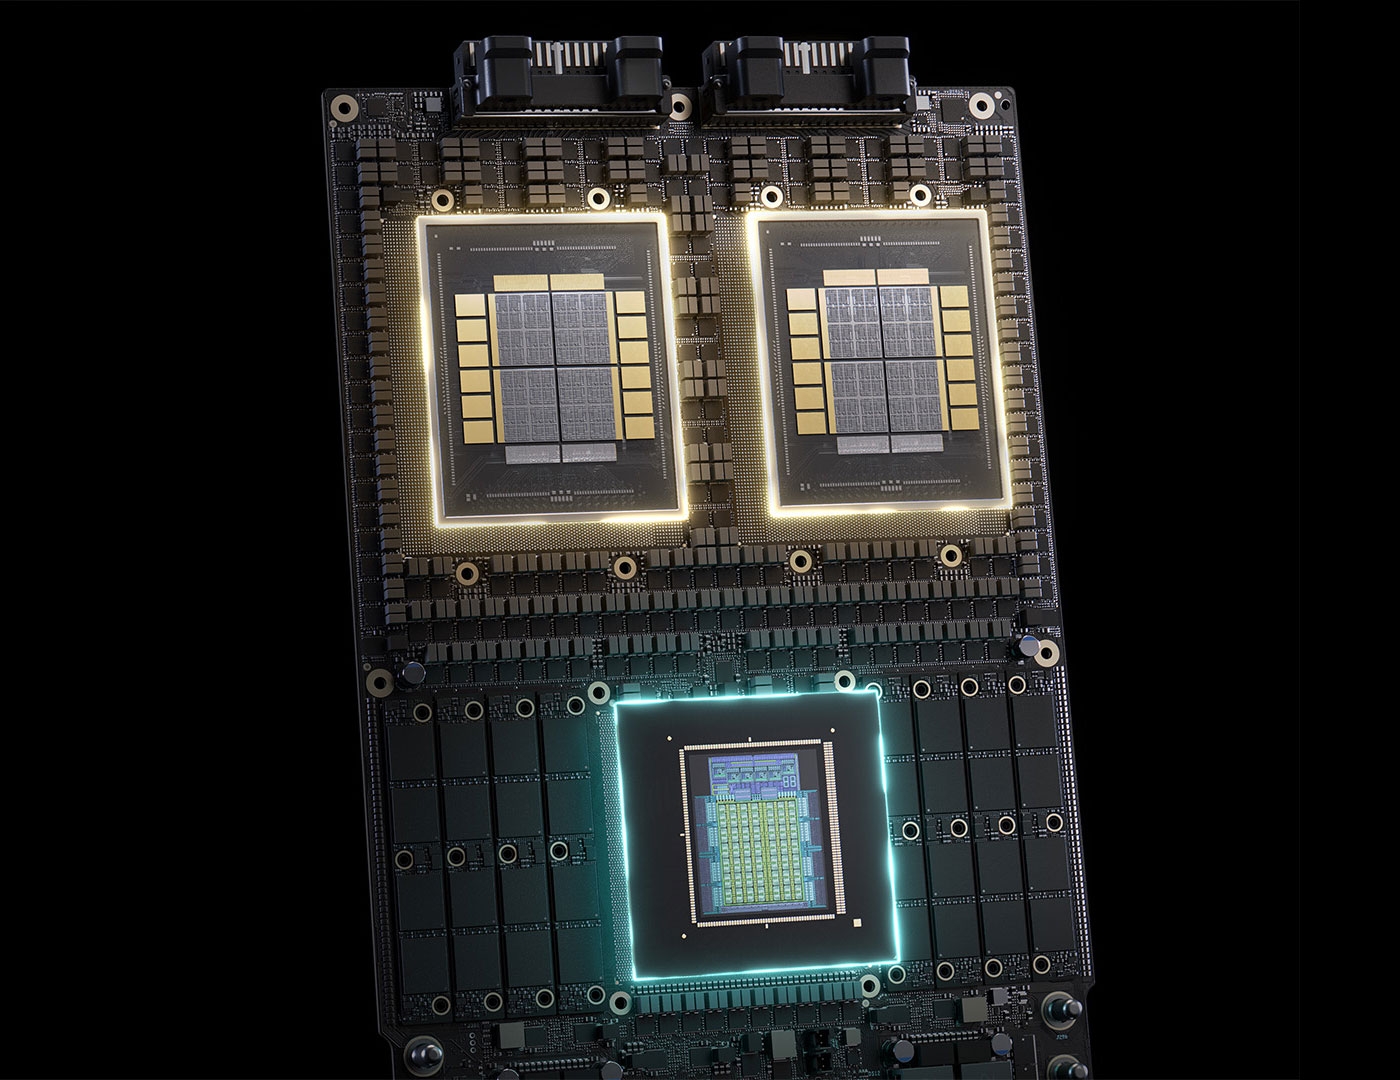
Источник изображения: NVIDIA SK Telecom планирует интегрировать новую инфраструктуру с общедоступными сервисами, в том числе в рамках государственного проекта «Искусственный интеллект для всех». При этом будут использоваться собственные ИИ-модели, адаптированные к корейскому языку и региональным отраслям промышленности. Нужно отметить, что к альянсу NVLink Fusion уже присоединились многие другие известные компании. В их число входят Qualcomm, Arm, d-Matrix, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek.
10.11.2026 [14:43], Сергей Карасёв
ИИ-чипы DeepX DX-M2 обеспечат производительность до 80 TOPS при энергопотреблении 5 ВтЮжнокорейский стартап DeepX, по сообщению ресурса EE Times, завершил разработку ИИ-чипа второго поколения — изделия DX-M2, предназначенного для локального запуска больших языковых моделей (LLM) с 20–100 млрд параметров. Решение ориентировано на робототехнику, беспилотные летательные аппараты, различные периферийные устройства и пр. Для ускорителя DX-M2 предусмотрено применение 2-нм технологии производства. Заявленное ИИ-быстродействие достигает 80 TOPS при энергопотреблении на уровне 5 Вт. Скорость работы варьируется от 10 до 30 токенов в секунду в зависимости от модели. Ключевой особенностью решения является использование памяти Samsung LPDDR5X-PIM (Processor-In-Memory). Эти чипы не просто хранят данные, но и умеют самостоятельно выполнять простые вычисления, в частности, операции GEMV (общее матрично-векторное умножение). Благодаря такому подходу значительно повышается общая эффективность. Пропускная способность памяти по сравнению с изделиями первого поколения (DX-M1) увеличилась примерно в три раза — с 50 до 153,6 Гбайт/с. 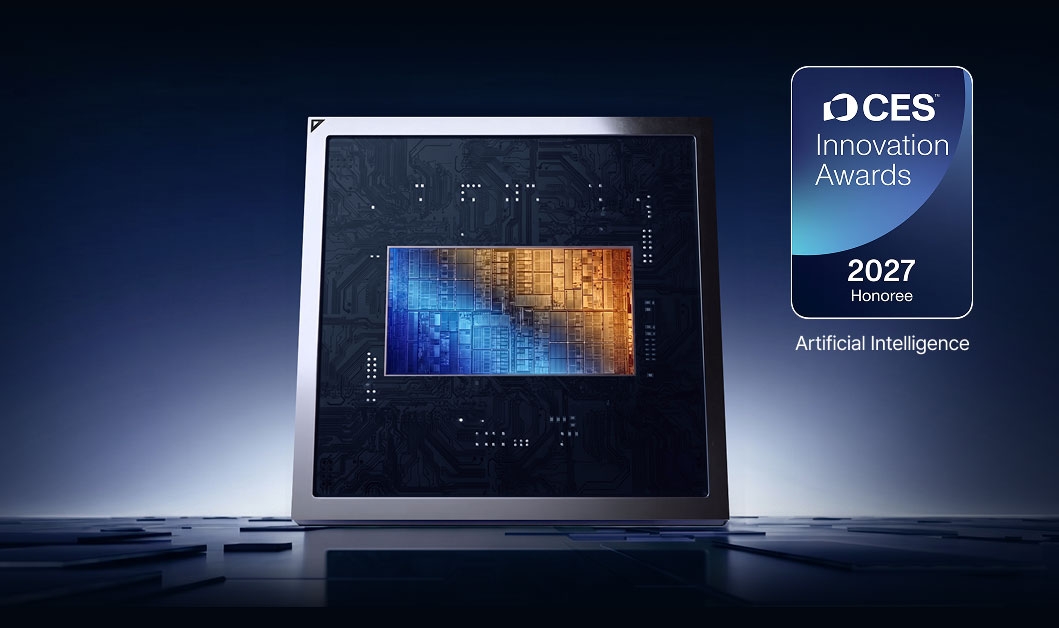
Источник изображения: DeepX Моделирование, проведенное DeepX, показывает, что перенос операций GEMV в память LPDDR5x-PIM обеспечит повышение производительности при работе с моделью Llama3.1-8B в 6,7 раза по сравнению с DX-M2 без технологии PIM. Однако при этом общее энергопотребление возрастает в 2,7 раза. При сохранении затрат энергии на сопоставимом уровне можно добиться двукратного выигрыша в быстродействии. Для DX-M2 предусмотрены несколько конфигураций. Это изделие в виде модуля M.2 или карты расширения PCIe с внешней памятью LPDDR5X объёмом до 96 Гбайт (153,6 Гбайт/с) и энергопотреблением 5 Вт (только SoC). Кроме того, будут предлагаться модули M.2 с интегрированной памятью LPDDR5X ёмкостью 24 и 48 Гбайт с пропускной способностью 76,8 и 153,6 Гбайт/с соответственно. В первом случае энергопотребление составляет 5 Вт (3 Вт у SoC и 2 Вт у DRAM), во втором — 8,5 Вт (4,5 Вт у SoC и 4 Вт у DRAM). Компания DeepX сотрудничает с клиентами в США, Китае, Вьетнаме и Корее. Утверждается, что стартап получил более 100 заказов на DX-M1 от разработчиков продуктов в различных областях, связанных с физическим ИИ, включая дроны, робототехнику, умные заводы, камеры видеонаблюдения, аэрокосмическую и оборонную промышленность, здравоохранение и интернет вещей. Образцы изделий DX-M2, как ожидается, появятся в марте следующего года, а серийное производство планируется начать осенью 2027-го.
09.11.2026 [21:49], Владимир Мироненко
Google представила ИИ-ускорители TPU 8tx и TPU 8i MaxGoogle представила ИИ-ускорители TPU 8tx и TPU 8i Max. С учётом анонсированных ранее в этом году ускорителей TPU 8t и TPU 8i семейство TPU Google восьмого поколения теперь включает четыре модели. Как отметил в блоге Амин Вахдат (Amin Vahdat), старший вице-президент и главный технолог Google по ИИ и инфраструктуре, TPU восьмого поколения предназначены «для решения конкретных задач на разных этапах жизненного цикла ИИ: TPU 8t — для масштабного обучения моделей; TPU 8i — для выполнения инференса с низкой задержкой; TPU 8tx — для конфиденциальных вычислений; а TPU 8i Max — для обработки огромных контекстных окон и обеспечения максимальной плотности вычислений в серверной стойке». TPU 8t и TPU 8i стали фундаментом для этого поколения: TPU 8t — инструмент для обучения масштабных базовых моделей, обеспечивающий максимальный показатель «полезной производительности» (goodput) — то есть объём эффективных вычислений на каждый ватт затраченной энергии. А TPU 8i — вычислительный модуль для инференса и «размышлений», разработанный для преодоления «барьера памяти» (memory wall) и сокращения задержек при обмене данными между чипами — вплоть до 50 %. 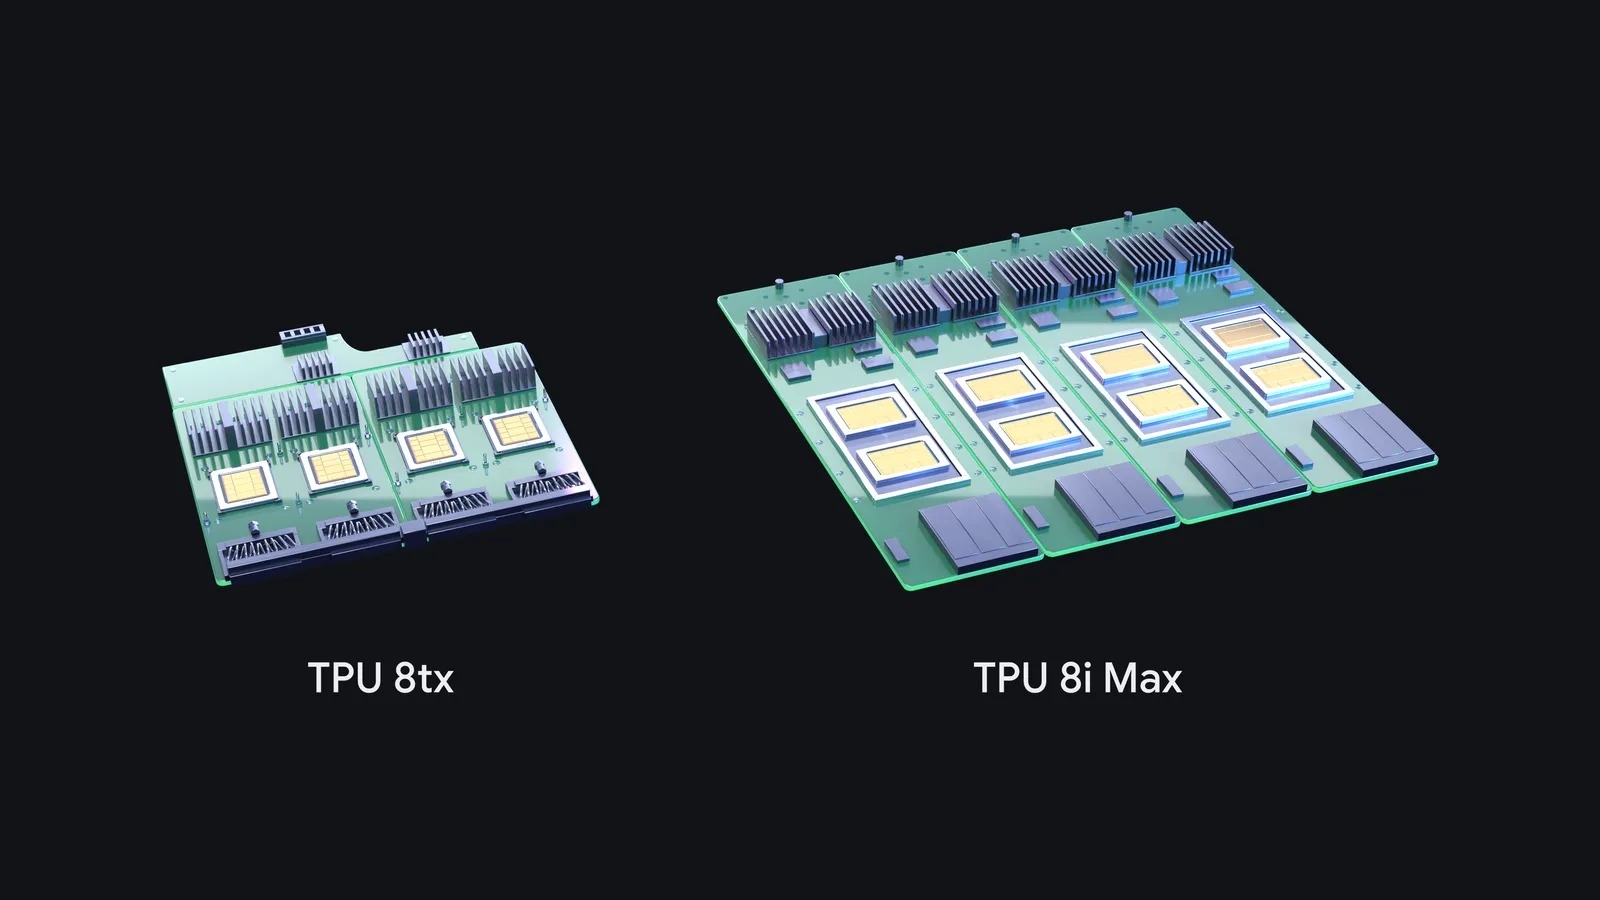
Источник изображений: Google В свою очередь, TPU 8tx оптимизирован для безопасного и конфиденциального инференса, а также обучения моделей в небольших масштабах. Он создан для организаций, работающих в регулируемых отраслях, и государственных структур, которые используют передовые или проприетарные модели и автономных агентов для работы с наиболее конфиденциальными данными. Система TPU 8tx, построенная на той же аппаратной базе, что и TPU 8t, и работающая в связке с процессорами AMD EPYC Turin, обеспечивает безопасность на уровне «железа», сохраняя конфиденциальные данные и веса моделей защищенными и изолированными даже при их использовании. В сочетании с сетевой топологией Boardfly с низкой задержкой TPU 8tx ускоряет работу многошаговых агентов, обеспечивая снижение задержки до двух раз по сравнению с TPU 8t практически без потери производительности. TPU 8tx также позволяет дообучать (fine-tune) модели на собственных закрытых данных, выполнять дистилляцию (сжатие) крупных моделей и обучать с подкреплением агентов без необходимости перемещать конфиденциальные данные между отдельными кластерами. 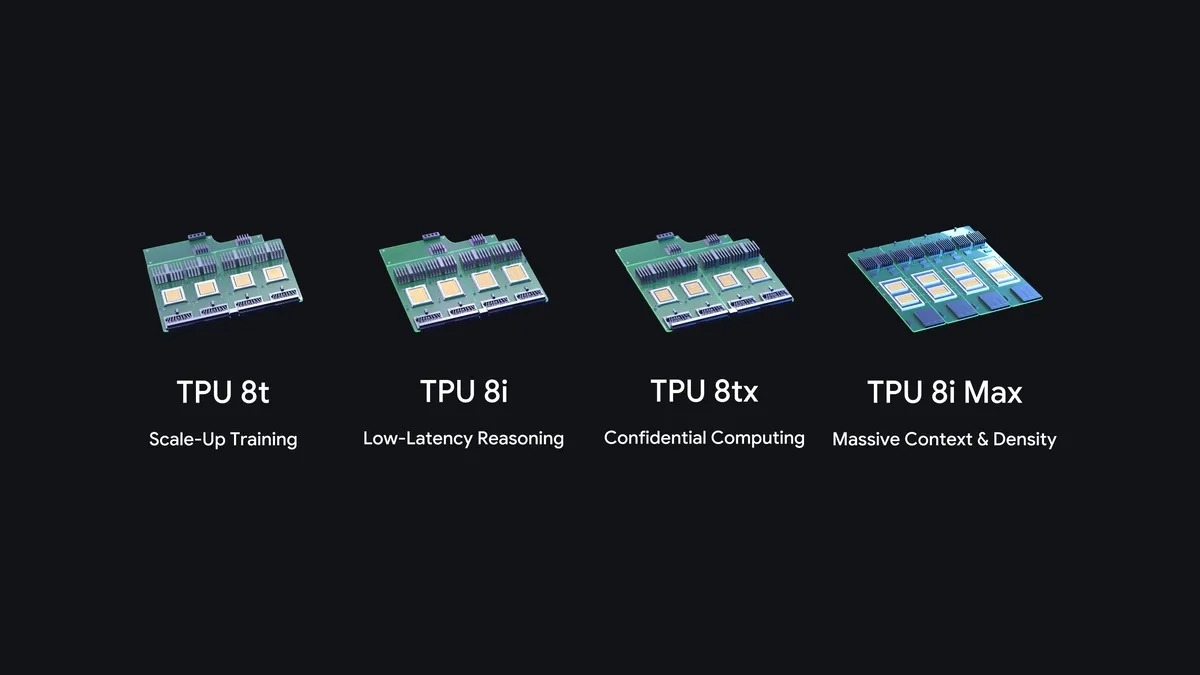 Модель TPU 8i Max, объединившая два TPU 8i, была разработана для решения проблемы «барьера памяти» (memory wall) — разрыва между скоростью вычислений и пропускной способностью памяти. Двухчиповая система предлагает вдвое больше вычислительных ресурсов, вдвое больше SRAM и вдвое более высокую пропускную способность HBM по сравнению с TPU 8i. Вычислительные мощности и объём памяти в ней масштабируются синхронно. Поскольку TPU 8i Max вмещает вдвое больше кремниевых компонентов в рамках той же серверной стойки, дата-центры могут значительно увеличить вычислительную мощность на единицу площади и на ватт потребляемой энергии, сообщил Вахдат. Вахдат также заявил, что компания выпустила набор инструментов TPU Agent (сейчас доступен в режиме превью) для упрощения оптимизации оборудования. Он интегрируется в среды разработки — например, Claude Code, Cursor и Google Antigravity — и позволяет за считанные минуты подготовить систему к работе с TPU, выявить «узкие места» и автоматически настроить ядра (kernels) с помощью простых текстовых команд. Для промышленного использования был разработан открытый движок XLA Serving Engine, который позволяет обучать модели на Python, а затем запускать их в высокопроизводительной среде на C++ с минимальной задержкой — на базе TPU, GPU или CPU.
07.11.2026 [00:30], Владимир Мироненко
Tesla сообщила о планах по выпуску ИИ-ускорителей SI и Dojo 3Tesla представила обновлённые планы выпуска ИИ-ускорителей, включающие чипы SI пятого и шестого поколения, предназначенные для инференса, и чип Dojo 3 (D3) для обучения моделей. Компания изменила брендинг чипов AI на SI, поскольку вместо термина «искусственный интеллект» (artificial intelligence) теперь использует «суперинтеллект» (super intelligence), соответственно AI4 (ранее HW4), AI5 и AI6 теперь называются SI4, SI5 и SI6. Dojo 3 будет существенно отличаться от своих предшественников — Dojo D1 и Dojo D2. Он описывается компанией как решение на базе чиплетов, объединяющее технологии 2.5D- и 3D-компоновки со стековой памятью HBM. Это знаменует собой значительный отход от архитектуры Dojo D1, которая представляла собой систему на кремниевой пластине (system-on-wafer), где 25 процессоров D1 были объединены в единую структуру с использованием памяти SRAM объёмом 11 Гбайт. 
Источник изображения: Prometheus/unsplash.com Tesla не стала вдаваться в подробности о вычислительной мощности, объёме памяти, техпроцессе или сроках разработки D3, заявив, что система Dojo D3 будет оптимизирована с точки зрения «занимаемого пространства, обучения моделей и масштабируемости». Также предполагается, что D3, по всей видимости, будет оптимизирован для работы в условиях космоса, что означает радиационную стойкость (по крайней мере, для отдельных модификаций устройства). Как сообщается, чип SI6 в 80 раз превосходи SI4/AI4/HW4 по производительности, и в 9 раз по объёму памяти. В зависимости от того, как именно измеряется производительность SI4, речь идёт о показателях в диапазоне 17 280–46 080 TOPS или 17,28–46,08 POPS, подсчитал ресурс Tom's Hardware. Он привёл для сравнения данные NVIDIA Rubin — 50 Пфлопс (NVFP4) для задач инференса, 35 Пфлопс (NVFP4) — для обучения нейросетей, а также 17,5 Пфлопс при использовании форматов FP8/FP6. При этом ресурс отметил, что Rubin уже поставляется заказчикам, тогда как выход SI6 ожидается в 2029–2030 гг. Илон Маск (Elon Musk) ранее сообщил, что разработка чипа Tesla AI5 (теперь SI5) почти завершена, а чип AI6 (SI6) находится на «ранней стадии» разработки, добавив, что компания также планирует создать чипы AI7, AI8 и AI9 (SI7, SI8 и SI9). Выпуском автомобильного чипа SI5 будут заниматься TSMC (3 нм) и Samsung Foundry (2 нм), которые создадут разные версии чипа. Сообщается, что он получит 40-кратный прирост производительности по сравнению с SI4. Контракт по поводу выпуска SI6 заключён с Samsung Foundry. Он будет продлён до 2033 года. Для производства чипа будет использоваться 2-на техпроцесс.
06.11.2026 [16:37], Сергей Карасёв
Supermicro, IBM и NVIDIA представили хранилище для работы с KV-кешемКомпания Supermicro в партнёрстве с IBM и NVIDIA анонсировала специализированную аппаратно-программную платформу, предназначенную для работы с KV-кешем. Система позволяет значительно сократить время, необходимое ИИ-моделям для начала генерации ответа по запросу пользователя. Аппаратной основой платформы служат серверы хранения Supermicro Petascale класса All-Flash. Такие устройства выполнены в форм-факторе 1U на процессоре AMD EPYC Turin (до 96 ядер). Поддерживается до 9 Тбайт DDR5-4400 в виде 24 модулей. Упомянуто применение сетевых технологий NVIDIA Spectrum-X. Питание обеспечивают два блока мощностью 1600 Вт с резервированием и сертификатом 80 Plus Titanium. Во фронтальной части узлов хранения расположены 16 отсеков для накопителей E3.S 1T с интерфейсом PCIe 5.0 x4 (NVMe). Кроме того, есть два внутренних коннектора M.2 M-key 2280/22110 для SSD с интерфейсами PCIe 3.0 x2 и PCIe 3.0 x4. Предусмотрены два слота PCIe 5.0 x16 для карт FHHL и два разъёма OCP 3.0 (PCIe 5.0 x16). Устройство оборудовано сетевым портом управления 1GbE (RJ45), коннектором D-Sub и четырьмя портами USB 3.0 Type-A (по два спереди и сзади). Используется воздушное охлаждение с восемью вентиляторами диаметром 40 мм. Программная часть включает софт IBM Storage Scale, а также фреймворк NVIDIA Dynamo. В тестах новой платформы на модели со 120 млрд параметров при длине промпта в 130 тыс. токенов время до выдачи первого ответа оказалось в 56 раз меньше по сравнению с обычными системами. Кроме того, при увеличении длины запроса с 30 тыс. до 130 тыс. токенов задержка поднялась всего на 0,377 с. 
Источник изображения: Supermicro
31.10.2026 [23:11], Павел Котов
Орбитальный ЦОД Google Suncatcher вышел на связь и написал хайкуСпутник Google Suncatcher, выступающий прототипом космического ЦОД, начал работу и установил связь с Землёй, сообщает TechCrunch. Он отправился на орбиту в начале октября вместе более чем с сотней других космических аппаратов на ракете SpaceX Falcon 9. Suncatcher, оснащённый четырьмя ИИ-ускорителями Google TPU, вырабатывает до 1 кВт электроэнергии. Проект призван проложить путь к созданию целых группировок спутников, работающих в тесной связке и выполняющих масштабные задачи инференса прямо на орбите. Пока из-за высокого энергопотребления спутник может задействовать только один TPU за раз — и то не более чем на 20 минут, что усложняет и без того непростую задачу обмена данными между космосом и Землёй. Пусконаладочные работы заняли три недели: все системы аппарата протестировали, и спутник стал готов к эксплуатации. На этой неделе инженеры с Земли отправили первый запрос, попросив заранее загруженную на борт модель Google Gemma 4 написать хайку о пребывании в космосе. Ответ был таким: «Голубой шар внизу, В Google также протестировали модель, поставив ей задачу написать несколько лимериков на космическую тематику. Компания также поручила аппарату собрать данные об условиях на орбите в месте его нахождения. 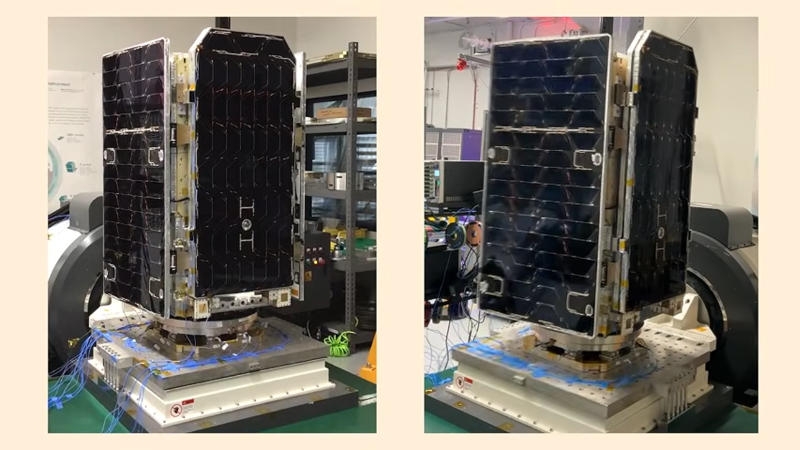
Источник изображений: Google В ходе текущей серии испытаний специалисты изучат, как чипы ведут себя в условиях тепловых нагрузок и космической радиации. До этого компания проводила масштабные проверки TPU на наземных ускорителях частиц, и теперь ей предстоит выяснить, как в реальных космических условиях на оборудование влияет радиация. Она может вызывать инверсию битов — самопроизвольное изменение значений в памяти, которое способно привести к искажению данных и остаться незамеченным для стандартных систем мониторинга. Радиация должна оказывать минимальное влияние на инференс, но она может создать некоторые сложности на этапе обучения моделей. Если установленные на борту TPU подтвердят свою эффективность, в 2027 году компания запустить ещё два спутника с ИИ-ускорителями. Новые аппараты смогут вырабатывать больше электроэнергии, они также продемонстрируют работу оптических каналов связи между спутниками. 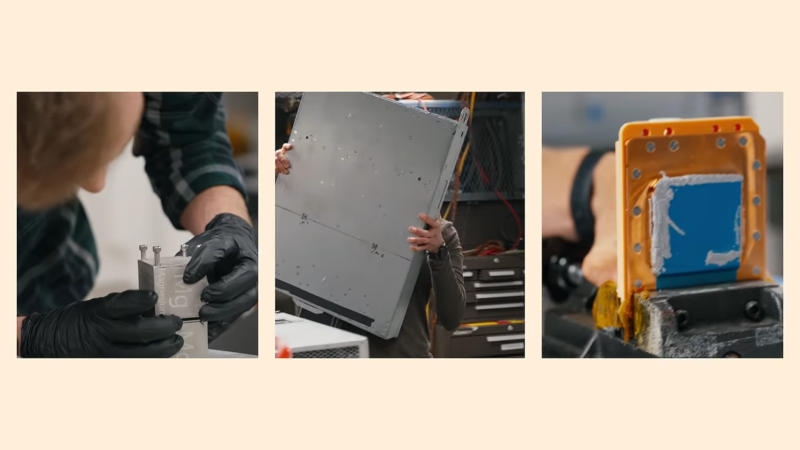 Сейчас Google Suncatcher является едва ли не единственным проектом ЦОД, предусматривающим создание высокоскоростных каналов связи между спутниками для поддержки согласованных распределённых вычислительных сред. В проектах орбитальных ЦОД SpaceX лазерную связь предполагают использовать на слишком больших расстояниях, чтобы аппараты производили совместные вычисления. Starcloud и Cowboy Space планируют выполнять инференс на отдельных спутниках. В остальном концепции Google и SpaceX тесно связаны: холдинг Alphabet владеет значительной долей в SpaceX. И для полномасштабного развёртывания орбитальных ЦОД потребуется ракета класса Starship. Чтобы добиться такого же снижения затрат путём накопления опыта, какое наблюдалось при эксплуатации предыдущих моделей ракет SpaceX, компании потребуется произвести 1800 запусков Starship, подсчитали авторы проекта Suncatcher. Инфраструктура Suncatcher станет экономически выгодной лишь к следующему десятилетию. Но успех начинания может зависеть от того, как остальная часть корпорации в ближайшей перспективе отреагирует на вызовы и возможности, связанные с развитием ИИ. Ранее SpaceX подала заявку на развёртывание 1 млн аппаратов — орбитальных ЦОД. Blue Origin хочет запустить 51 тыс. таких спутников, Cowboy Space — 20 тыс., подобные проекты разрабатывают индийские NeevCloud и Agnikul Cosmos. А российская RuVDS запустила спутник-платформу ещё в феврале.
28.10.2026 [18:52], Павел Котов
В Oracle Cloud Infrastructure появятся ускорители CerebrasНа платформе Oracle Cloud Infrastructure (OCI) будет организован доступ к технологиям высокоскоростного ИИ-инференса Cerebras. Решение предназначено для исследовательских лабораторий в сфере ИИ, корпораций и разработчиков, которые создают интерактивные интеллектуальные приложения. Партнёрство затрагивает существующую инфраструктуру Oracle и её возможности в области ИИ-инференса, включая специализированные кластеры (Dedicated AI Clusters) в составе сервиса OCI Enterprise AI. Царь-чип Cerebras Wafer-Scale Engine (WSE), разработанный специально для высокоскоростного ИИ-инференса, объединяет вычислительные мощности и память на одном кристалле размером с целую кремниевую пластину. Такая архитектура сокращает перемещение данных и необходимость обмена информацией между отдельными чипами, в результате чего обеспечивается быстрая генерация токенов даже в длинных цепочках рассуждений и многоэтапных процессах, которые выполняют ИИ-агенты. 
Источник изображения: cerebras.ai Решение Cerebras Inference станет доступным в OCI в 2027 году — клиенты облачной платформы Oracle получат новый инструмент для создания ИИ-приложений, в которых скорость имеет решающее значение. Ранее AMD и Cerebras представили платформу для ИИ-инференса со сверхнизкой задержкой. Разработчик царь-чипов к концу года намерен развернуть в Европе 200 МВт ИИ-мощностей. Только в Финляндии компания получит объект на 165 МВт.
28.10.2026 [16:14], Владимир Мироненко
Oracle станет первым гиперскейлером, предлагающим Google TPUOracle и Google объявили о расширении партнёрства, в рамках которого тензорные процессоры Google TPU станут доступны через облачную инфраструктуру Oracle Cloud Infrastructure (OCI). Таким образом Oracle станет первым гиперскейлером, предлагающим Google TPU за пределами экосистемы Google. Сообщается, что TPU появятся на платформе OCI, начиная с 2027 года. «Различные задачи в сфере ИИ требуют разных вычислительных мощностей, — отметил Махеш Тиагараджан (Mahesh Thiagarajan), президент OCI. — Доступ к TPU от Google в среде OCI позволяет клиентам использовать несколько передовых архитектур для вычислений в области ИИ в рамках одного облака. Такая свобода выбора дает возможность подобрать оптимальную инфраструктуру с точки зрения производительности, пропускной способности и экономической эффективности для каждой конкретной задачи ИИ». В настоящее время Google предлагает TPU восьмого поколения. Модель TPU 8t предназначена для обучения нейросетей, TPU 8i — это чип для инференса (выполнения вычислений в обученных моделях), оптимизированный для решения итеративных задач, характерных для работы специализированных ИИ-агентов. 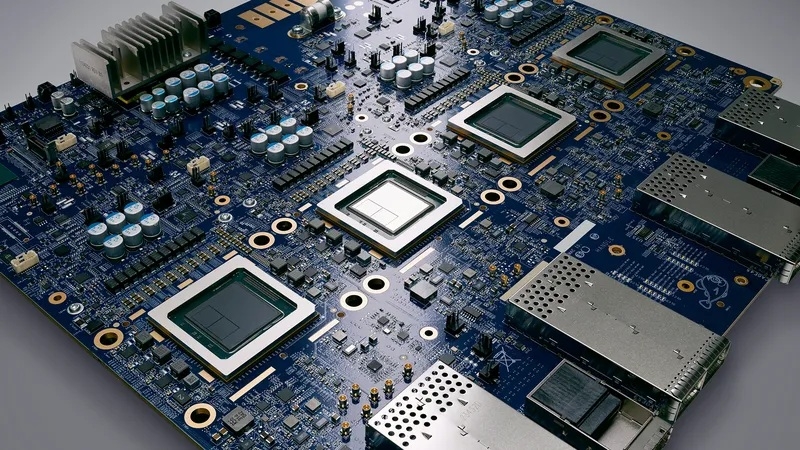
Источник изображения: Google На прошедшей на прошлой неделе конференции PyTorch Conference 2026 Google объявила, что TorchTPU — нативный стек PyTorch для TPU Google — теперь доступен в формате открытого исходного кода на платформе GitHub. Это позволяет обучать, обслуживать и развёртывать модели на TPU, используя привычные инструменты, такие как vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec, Hugging Face и LiteRT. Как отметила Google, такая переносимость даёт командам возможность выбирать для каждой задачи тот ускоритель, который обеспечивает минимальную стоимость одного токена или максимальную скорость обучения — и всё это без необходимости переписывать код модели. А благодаря нынешнему анонсу вскоре можно будет запускать такие задачи на TPU как в Google Cloud, так и в инфраструктуре Oracle. Кроме того, Google сотрудничает с компанией Blackstone в создании облачной платформы на территории США, которая также будет предоставлять доступ к TPU, отметил ресурс Data Center Dynamics. Не исключено, что эта платформа может опередить Oracle и раньше её начнёт предлагать TPU клиентам. |
|

