
Материалы по тегу: инференс
|
12.10.2026 [21:40], Владимир Мироненко
AMD «загнала» ИИ-агентов в стойку HelionAMD представила эталонный проект AMD Helion для агентных систем, выполненный в форм-факторе серверной стойки ORv3 высотой 44OU. По словам компании, Helion, созданный на основе спецификаций Open Compute Project (OCP), является дальнейшим развитием подхода к открытой платформе, заложенном в решении AMD Helios. 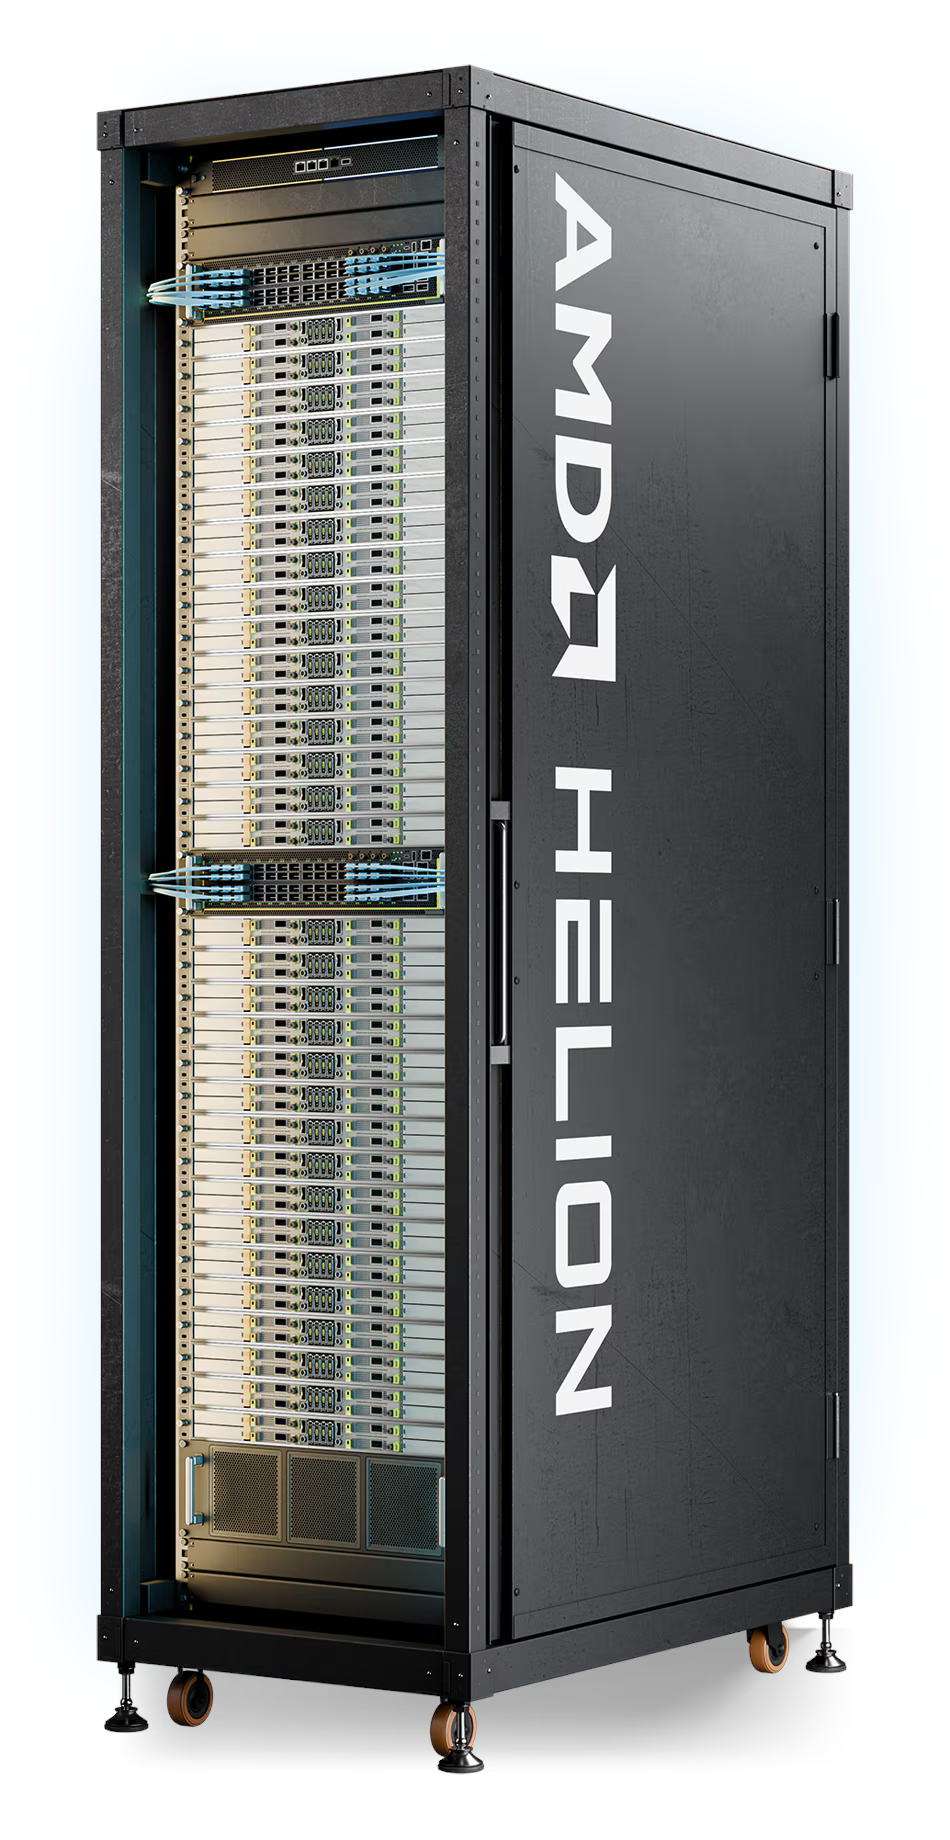
Источник изображений: AMD С помощью AMD Helion заказчики смогут оптимально сочетать производительность CPU, плотность ядер и энергопотребление с возможностями ускорения на базе GPU, исходя из специфики задач, выполняемых ИИ-агентами. Решение может поставляться как на базе исключительно CPU (для гиперскейлеров), так и с интеграцией CPU/GPU (для корпоративного сектора). 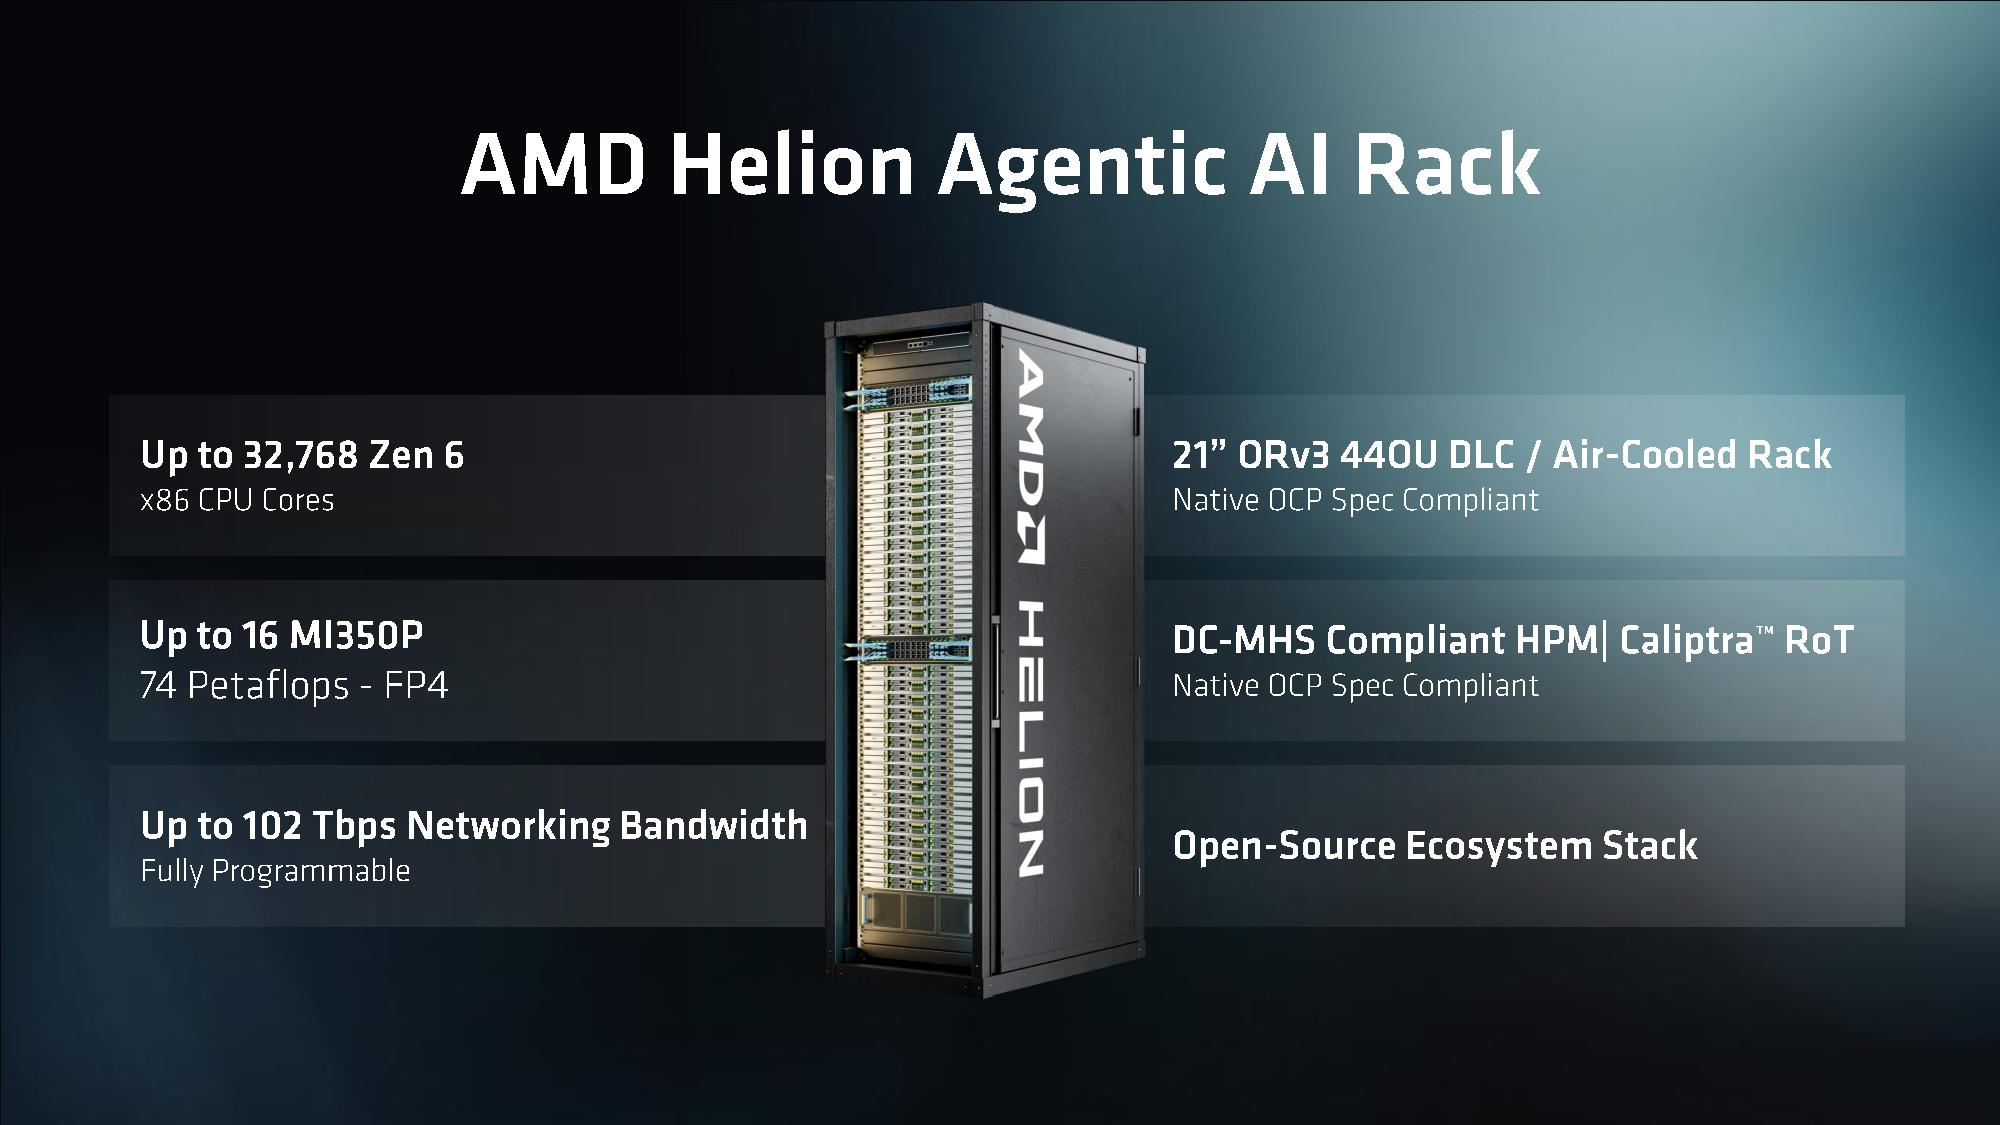 OCP-архитектура стойки AMD Helion поддерживает открытое ПО и допускает различные варианты конфигурации, включая версии с жидкостным и воздушным охлаждением. Это позволяет заказчикам создавать практически любые системы, отвечающие их конкретным требованиям. 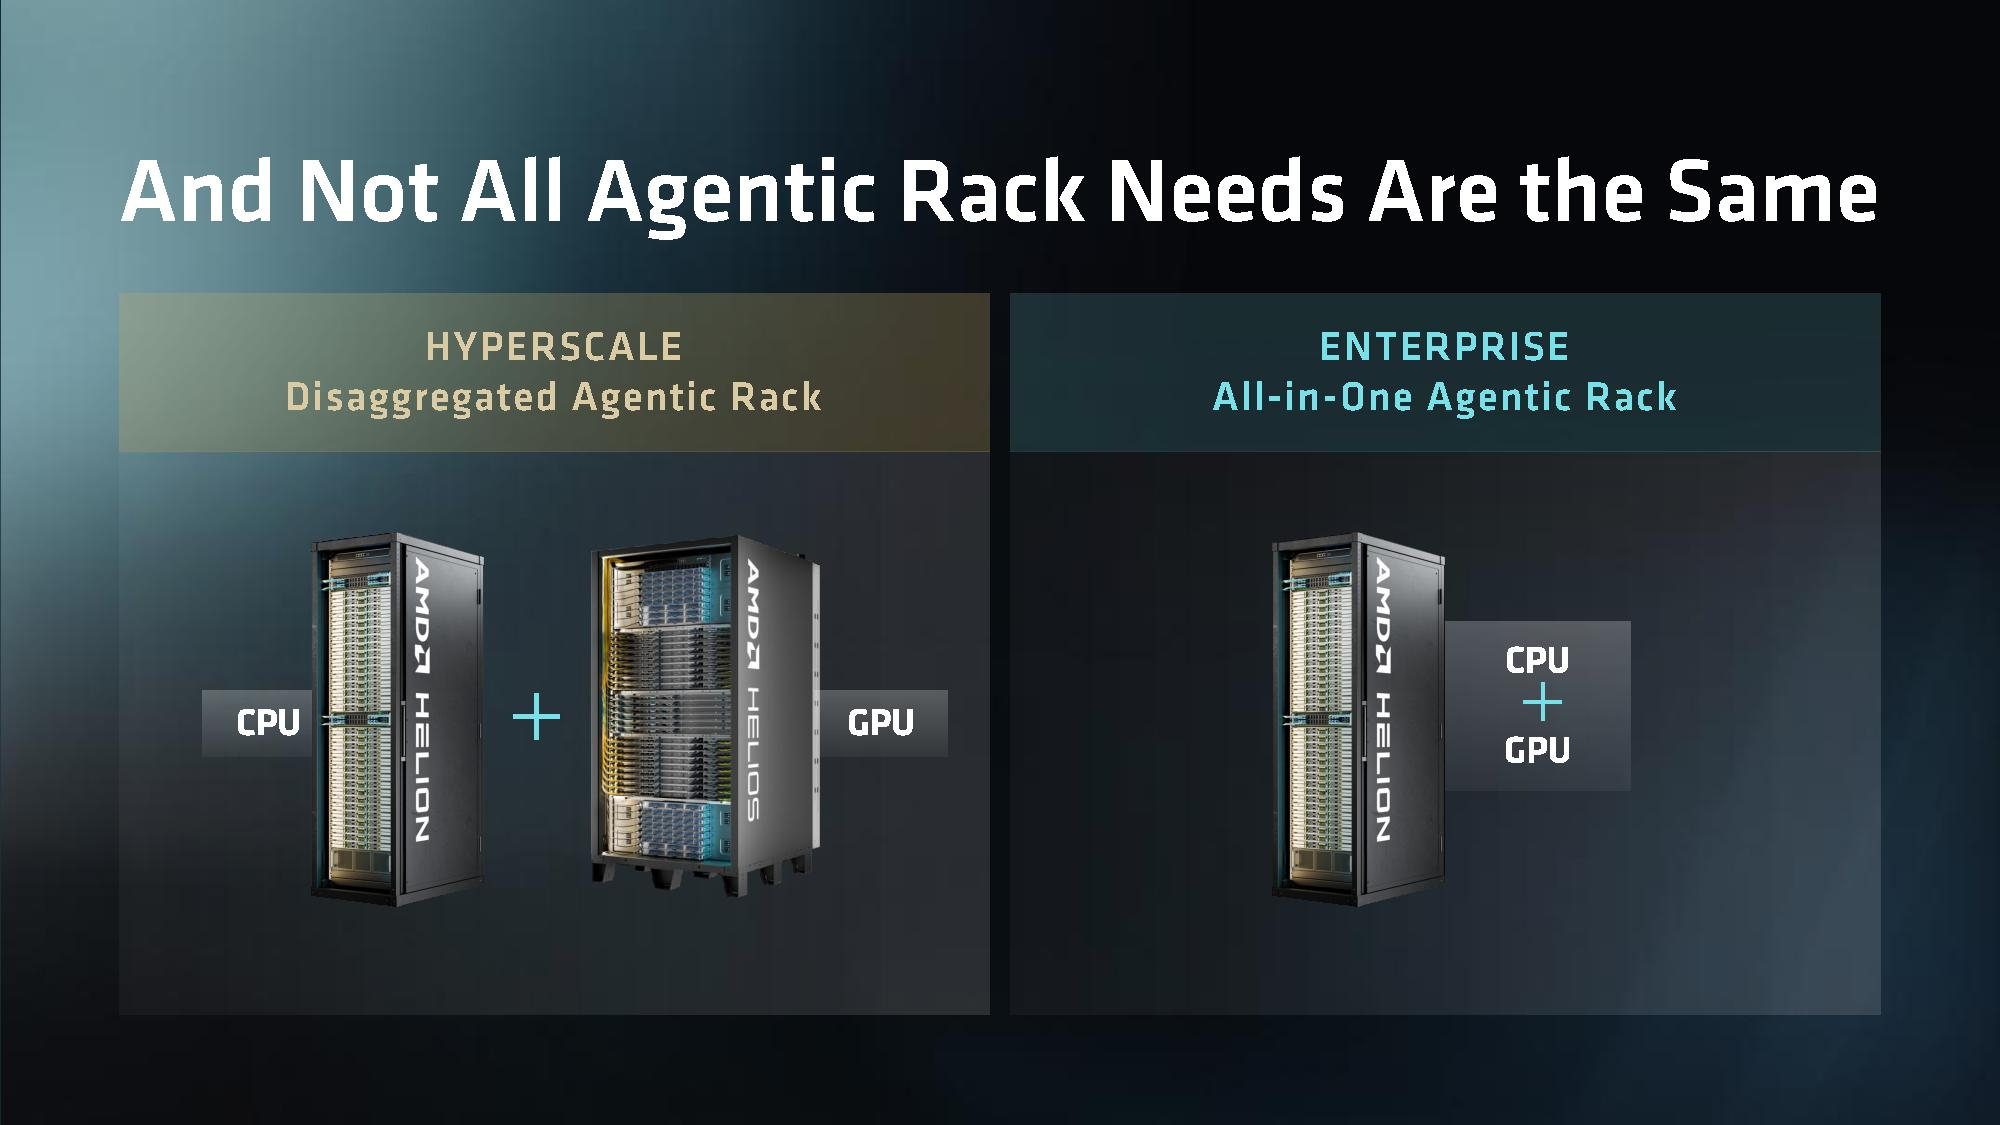 Например, стойка, использующая только CPU (на базе AMD EPYC Venice) и поддерживающая до 32 768 ядер, предназначена для систем гиперскейлеров. Она обеспечивает выделенные мощности для выполнения задач агентов, а также возможность подключения к отдельной инфраструктуре для инференса моделей. 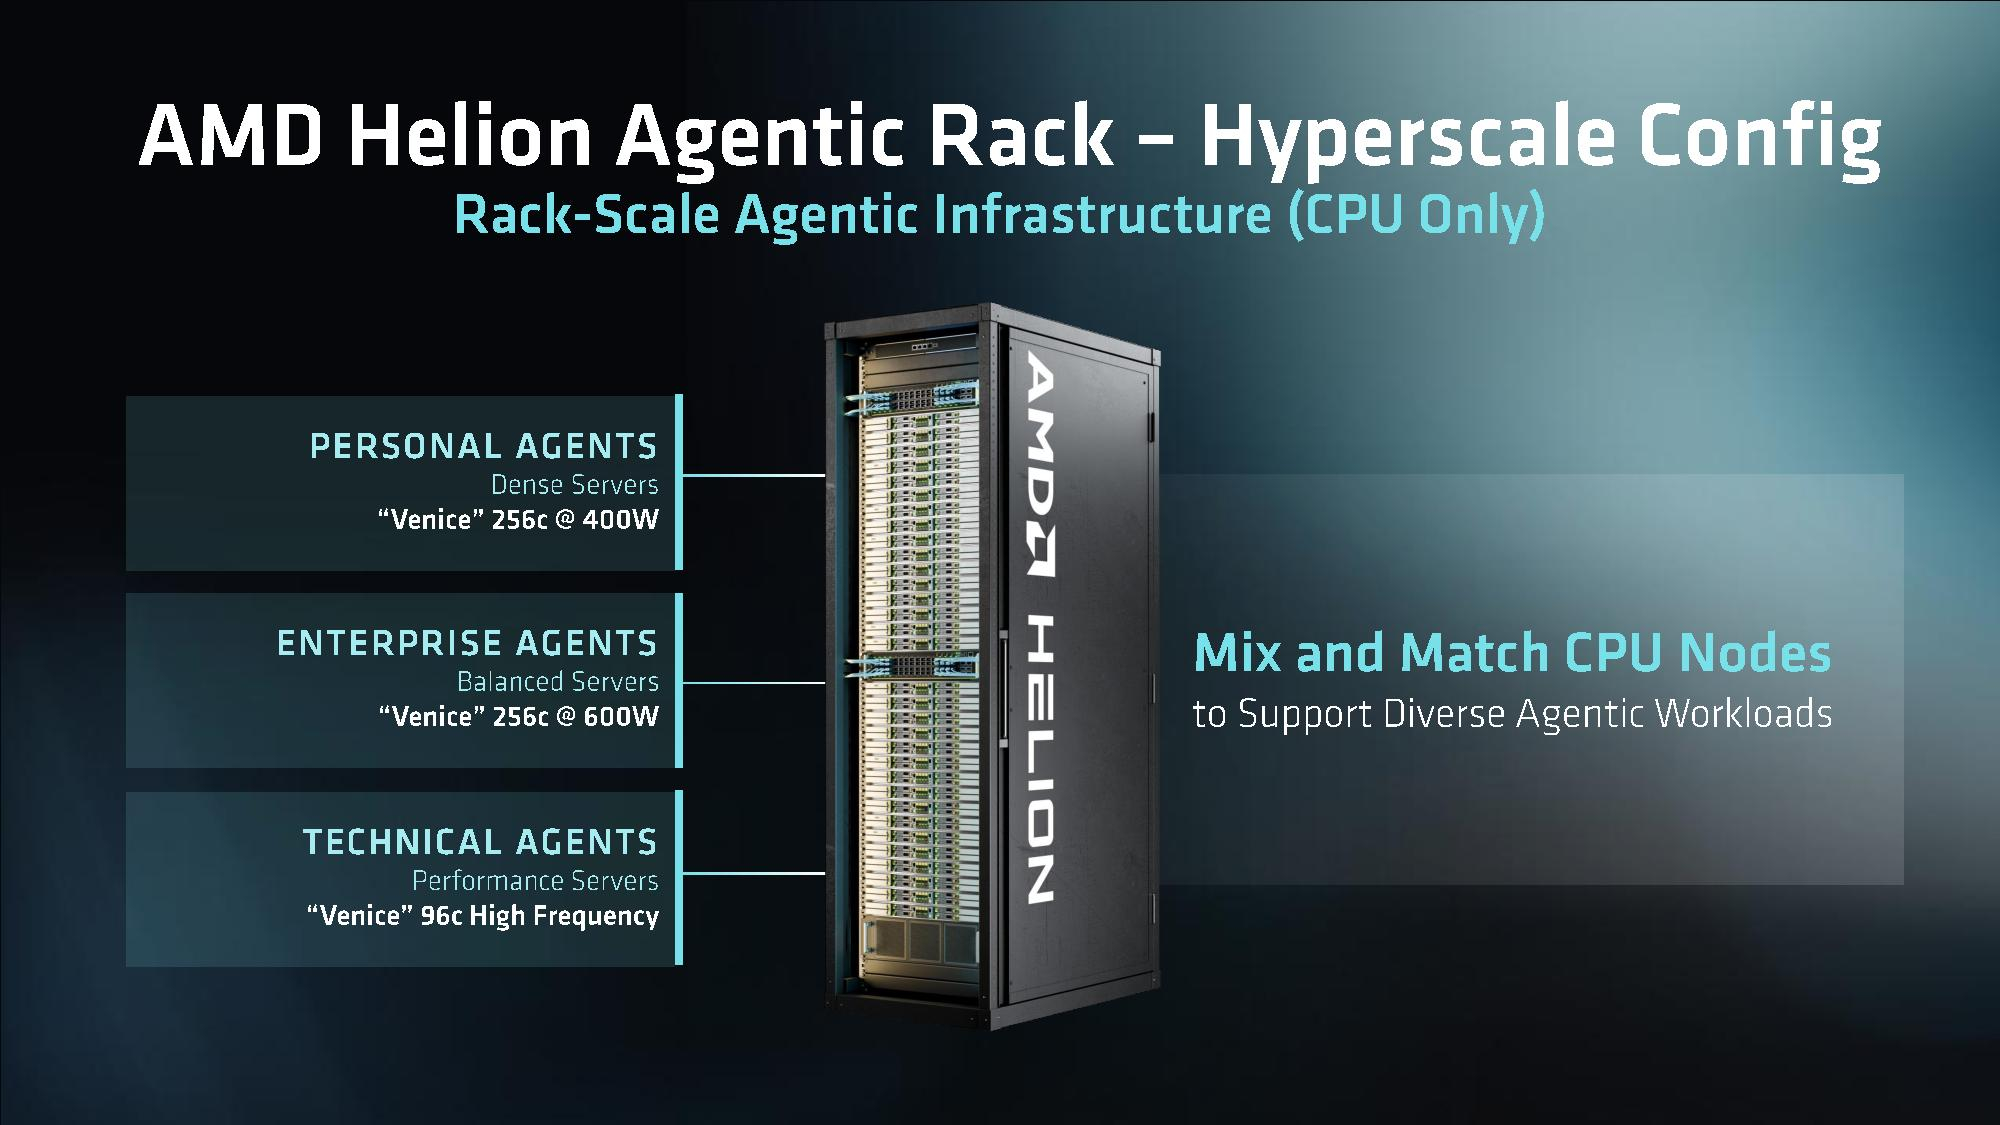 В свою очередь, комплексное стоечное решение, объединяющее на одной платформе узлы с EPYC, узлы с Instinct MI350P (до 16 единиц), интерконнект с пропускной способностью до 102,4 Тбит/с и вычислительные ресурсы общего назначения, представляет собой универсальный вариант для внедрения агентного ИИ корпоративного уровня. 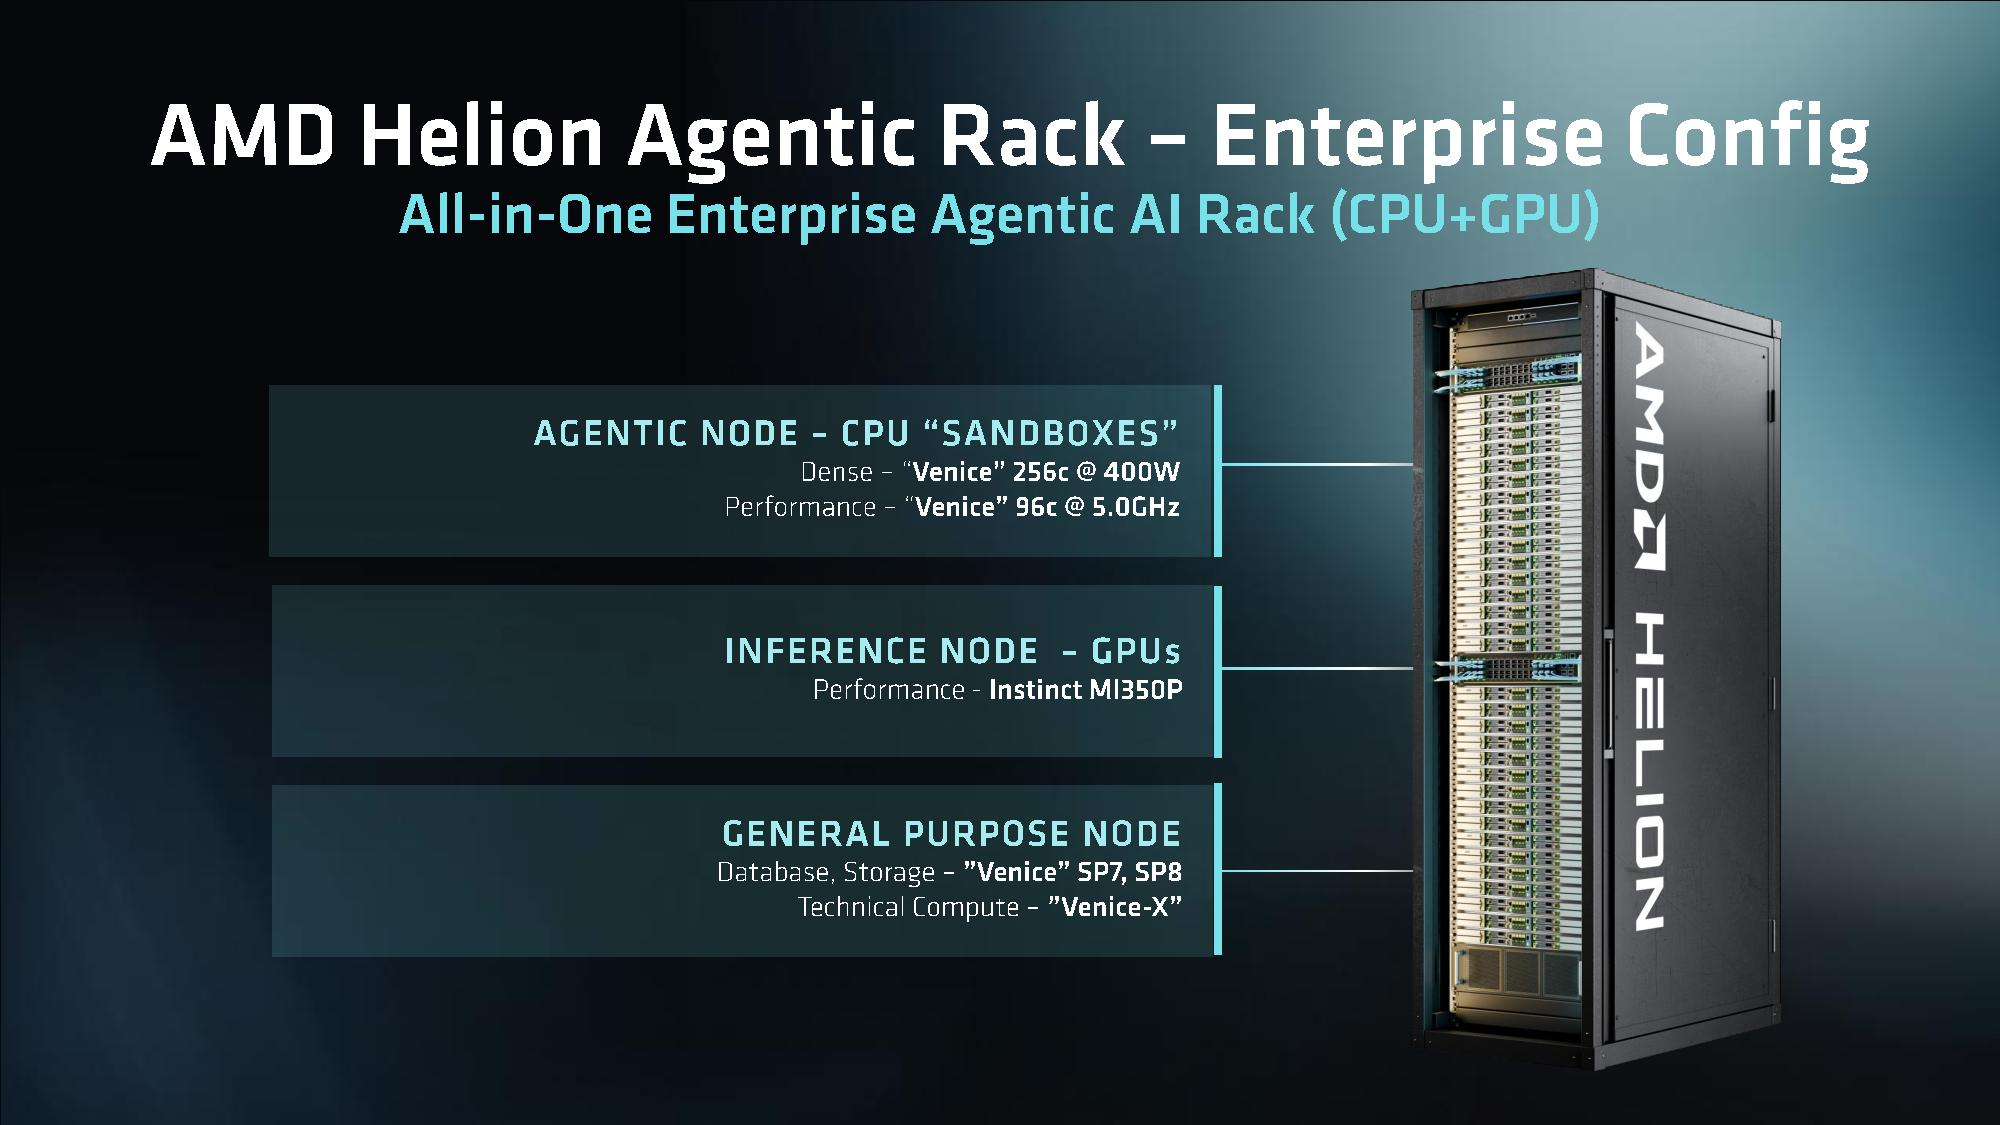 AMD Helion позволяет клиентам развёртывать системы агентного ИИ в рамках уже имеющейся ИТ-инфраструктуры, адаптируя конфигурации CPU и GPU под конкретные рабочие нагрузки и подбирая оптимальное соотношение ресурсов для выполнения задач агентов, инференса моделей и вспомогательных вычислений с учётом требований к производительности, энергопотреблению и стоимости. 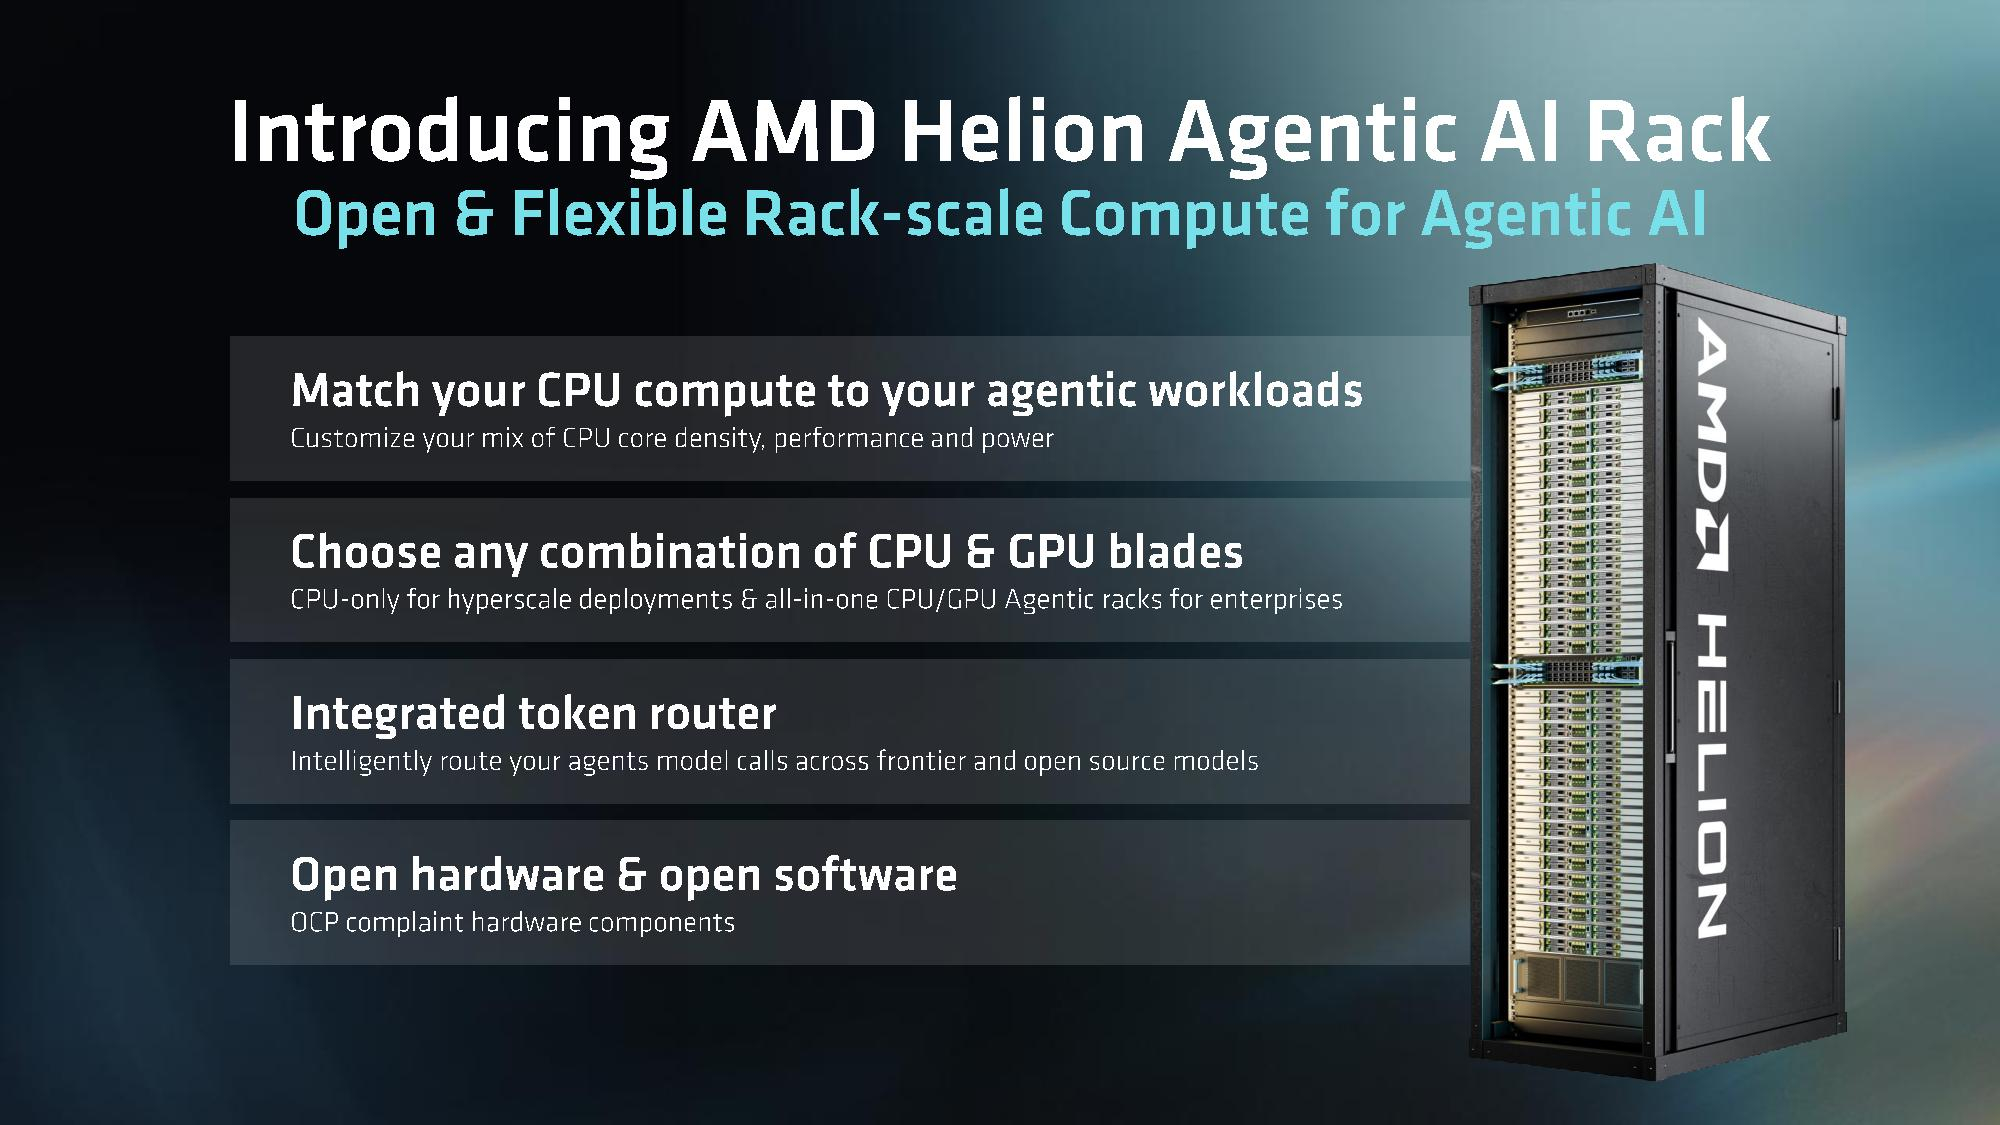 AMD сообщила, что планирует передать спецификацию AMD Helion организации OCP (Open Compute Project), сделав её доступной для сообщества с целью дальнейшей разработки и внедрения. Конфигурации стоек AMD Helion для агентного ИИ в настоящее время разрабатываются совместно с партнёрами по экосистеме; их выпуск запланирован на ноябрь 2026 года.
06.10.2026 [08:43], Руслан Авдеев
Электрозаправки Xeal Laitent оснастят периферийными ИИ ЦОДКомпания Xeal, управляющая инфраструктурой для зарядки электромобилей в 500 городах США, представила платформу Laitent. Сеть периферийных ЦОД сможет использовать более 200 МВт разрешённой и установленной мощности зарядных станций для электромобилей в 1,6 тыс. локаций, сообщает Datacenter Dynamics. В общей сложности компания намерена развернуть 100 тыс. ИИ-ускорителей NVIDIA для инференса. По данным Xeal, зарядные площадки для электромобилей в США должны получать разрешения на заданную максимальную энергетическую нагрузку, но обычно используют менее 10 % от максимальной мощности. Оставшиеся 90 % можно потратить на питание ИИ-ускорителей. Станции Laitent Pod, разработанные Xeal, используют ПО для динамической оркестрации и способны управлять и целой сетью ускорителей в разных кластерах в пределах города, и активировать даже часть единственного ускорителя. Каждый модуль размером приблизительно с одно парковочное место и может вмещать до 48 ускорителей NVIDIA Hopper или Blackwell, подключение жидкостного охлаждения не понадобится. 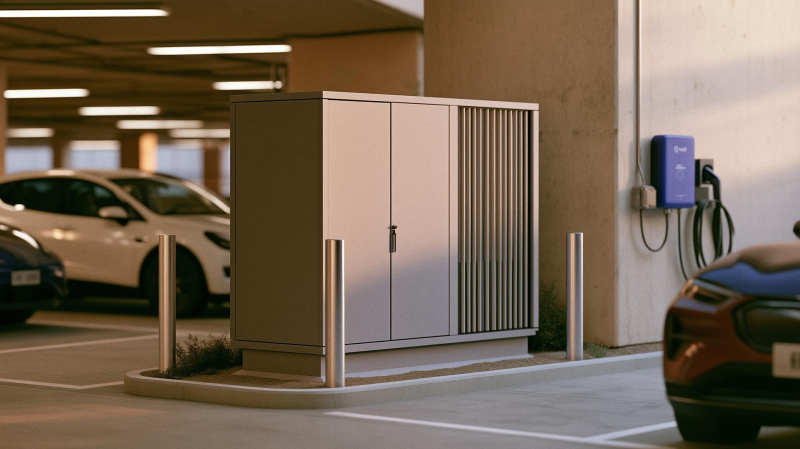
Источник изображения: Xeal По словам Xeal, если кому-то нужен инференс, а дожидаться ввода в эксплуатацию нового ЦОД слишком долго, Laitent может ускорить запуск с нескольких лет до нескольких месяцев. Laitent — самый быстрый способ ввести их в эксплуатацию, поскольку станции уже получили разрешения и подключены к электросетям. При этом они расположены оптимально для обеспечения низкой задержки. Xeal работает над оркестрацией ИИ-инфраструктуры с Rafay Systems, со Spectrum Business в сфере оптоволоконных решений и с JVM Realty для ввода станций в эксплуатацию. Компания обещает большие финансовые выгоды для владельцев автопарковок, утверждая, что станции могут добавить к стоимости их собственности по миллиону долларов «с малыми или нулевыми инвестициями». Впрочем, организовать ИИ-вычисления на парковках предлагается не впервые. Музыкальная ИИ-платформа Auddia, впоследствии переключившаяся на проекты ЦОД, в марте заявила, что намерена внедрять ИИ-ускорители с питанием от солнечных панелей на парковках, принадлежащих компании, специализирующейся на «медицинской» недвижимости. Бельгийский стартап Tonomia в 2025 году объявил, что работает с британским поставщиком оборудования Panchaea для создания ИИ-платформы eCloud, модули которой планируется размещать в «солнечных навесах» тоже на парковках. А Tesla предложила запитать крупные ЦОД от домашних аккумуляторов и электромобилей — в США насчитали 16 ГВт таких мощностей.
05.10.2026 [12:22], Сергей Карасёв
Everpure представила технологию PureKVA для ускорения ИИ-инференсаКомпания Everpure (ранее Pure Storage) анонсировала набор новых функций для своих платформ хранения и управления данными: реализованные возможности призваны ускорить и упростить внедрение ИИ в рамках корпоративных экосистем. Одним из представленных инструментов стало решение PureKVA (Key-Value Accelerator). Благодаря этой технологии системы FlashBlade класса All-Flash заранее загружают контекст инференса непосредственно в память GPU. Такой подход, как утверждается, даёт возможность сократить время до получения первого токена (TTFT) в 20 раз. PureKVA помогает решить проблему простоя ИИ-ускорителей и уменьшить задержку отклика для приложений реального времени. Кроме того, может быть реализована многопользовательская архитектура. Дополнительно появился режим постоянного сжатия Always-On DeepReduce Data Compression. Система FlashBlade непрерывно сканирует данные для обнаружения идентичных участков в подблоках, которые не удается выявить с помощью традиционной дедупликации. Эта функция работает даже в отношении предварительно сжатого контента. В результате, полезная ёмкость хранилища автоматически увеличивается — без негативного влияния на производительность записи и без необходимости ручного планирования. Как следствие, существенно сокращаются затраты на ресурсы хранения информации. 
Источник изображения: Everpure Появилась интеграция с MCP (Model Context Protocol): это позволяет ИИ-агентам искать нужную информацию в каталогах «живых» данных, используя естественный язык. Наконец, средства Privacy-First File Intelligence показывают, кто может получить доступ к тому или иному файлу в общей папке, не читая его содержимое. Этот же инструмент отображает, насколько устарели файлы, что позволяет оптимизировать пространство хранения.
29.09.2026 [03:00], Владимир Мироненко
Anthropic получит доступ к ИИ-инфраструктуре Akamai в рамках сделки на $11,6 млрдКомпания Akamai Technologies заключила с Anthropic соглашение стоимостью $11,6 млрд, в рамках которого её подразделение Akamai Cloud в течение семи лет будет предоставлять разработчику ИИ услуги распределённой облачной инфраструктуры и ПО. До этого, в мае, Anthropic заключила с Akamai соглашение на сумму $1,8 млрд. В рамках нового соглашения Akamai предоставила Anthropic варрант на покупку конвертируемых привилегированных акций серии B без права голоса. Варрант распространяется на 7,7 млн акций (около 5 % находящихся в обращении обыкновенных акций Akamai) с ценой исполнения $111,33 за акцию. Ожидается, что право на покупку (вестинг) примерно 2 % акций возникнет в рамках первоначального соглашения на вышеуказанную сумму — $11,6 млрд. Право на приобретение остальных 3 % акция Anthropic получит, если в течение семилетнего периода увеличит объём закупок на сумму до $9 млрд. За каждые дополнительные $3 млрд, потраченные на облачные услуги на согласованных сторонами условиях, Anthropic получит право на покупку ещё примерно 1 % акций Akamai. 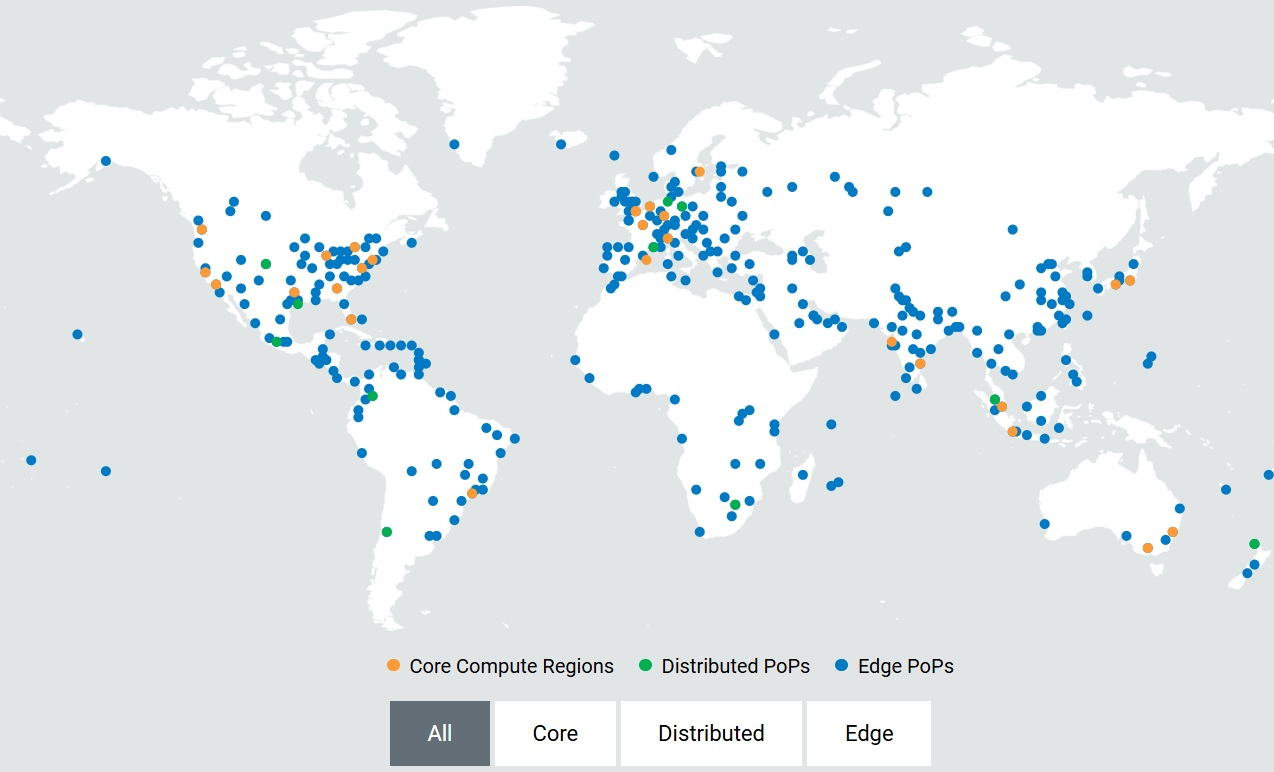
Источник изображения: Akamai Akamai отметила, что её инфраструктура поддерживает полный жизненный цикл приложений — в том числе используемых в сфере ИИ — и обеспечивает высокую скорость, надёжность и безопасность. По её оценкам, совокупные капитальные затраты, связанные с реализацией соглашения с Anthropic, составят около $5,5 млрд. Akamai прогнозирует увеличение капитальных затрат в этом году примерно на $1,7 млрд — главным образом для предварительной закупки критически важных компонентов, включая модули памяти, сохранив прежним прогноз по выручке. Общая стоимость многолетних облачных контрактов Akamai, заключённых компанией в текущем году, без учёта этой сделки, превышает $2,8 млрд.
24.09.2026 [20:41], Владимир Мироненко
Crusoe подписала соглашение с Thinking Machines Lab на $65 млн о предоставлении услуг инференсаCrusoe объявила о заключении ежегодного соглашения на сумму $65 млн с ИИ-стартапом Thinking Machines Lab основанным в феврале 2025 года Мирой Мурати (Mira Murati), занимавшей ранее пост технического директора OpenAI. В рамках соглашения Thinking Machines Lab получит доступ к платформе Crusoe Cloud для инференса. С помощью сервиса Crusoe Managed Inference она будет обрабатывать ряд производственных нагрузок, включая свои модели Inkling, а также GLM 5.2 и 5.3, на специализированных системах. Также на этой платформе будут работать её собственные дообученные (fine-tuned) версии моделей. Рабочие задачи будут выполняться на выделенной инфраструктуре, состоящей из систем NVIDIA HGX B200 с интерконнектом Quantum-2 InfiniBand. Crusoe будет самостоятельно эксплуатировать и обслуживать этот кластер в рамках формата Tailored Deployment (индивидуальное развёртывание). Клиент предоставляет модель и определяет требования, а Crusoe берёт на себя остальные аспекты развёртывания. 
Источник изображения: Crusoe Это означает предоставление выделенной, протестированной на производительность конечной точки с гарантированным уровнем обслуживания (SLA). Благодаря этому Thinking Machines Lab избавляется от необходимости самостоятельно управлять стеком для выполнения инференса. Компании также рассматривают возможность использования пакетного инференса (batch inference) для масштабной генерации синтетических данных. «Crusoe Managed Inference позволил нам быстро перейти от оценки к промышленной эксплуатации и обеспечил соответствие стандартам, которые мы предъявляем к собственным системам. Это дало нам необходимые масштабы и экономическую эффективность для реинвестирования в исследования, лежащие в основе нашей деятельности», — сказал Майл Отт (Myle Ott), руководитель отдела инфраструктуры машинного обучения Thinking Machines Lab. «У Thinking Machines Lab очень сильная инженерная команда, которая ожидает, что партнёры будут соответствовать их высоким стандартам по мере роста», — заявил Эрван Менар (Erwan Menard), старший вице-президент по управлению продуктами в Crusoe Cloud. Как сообщается, благодаря этой сделке менее чем через год после запуска Crusoe Managed Inference законтрактованный объём годовой регулярной выручки (ARR) в сегменте управляемых услуг инференса компании превысил $100 млн.
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 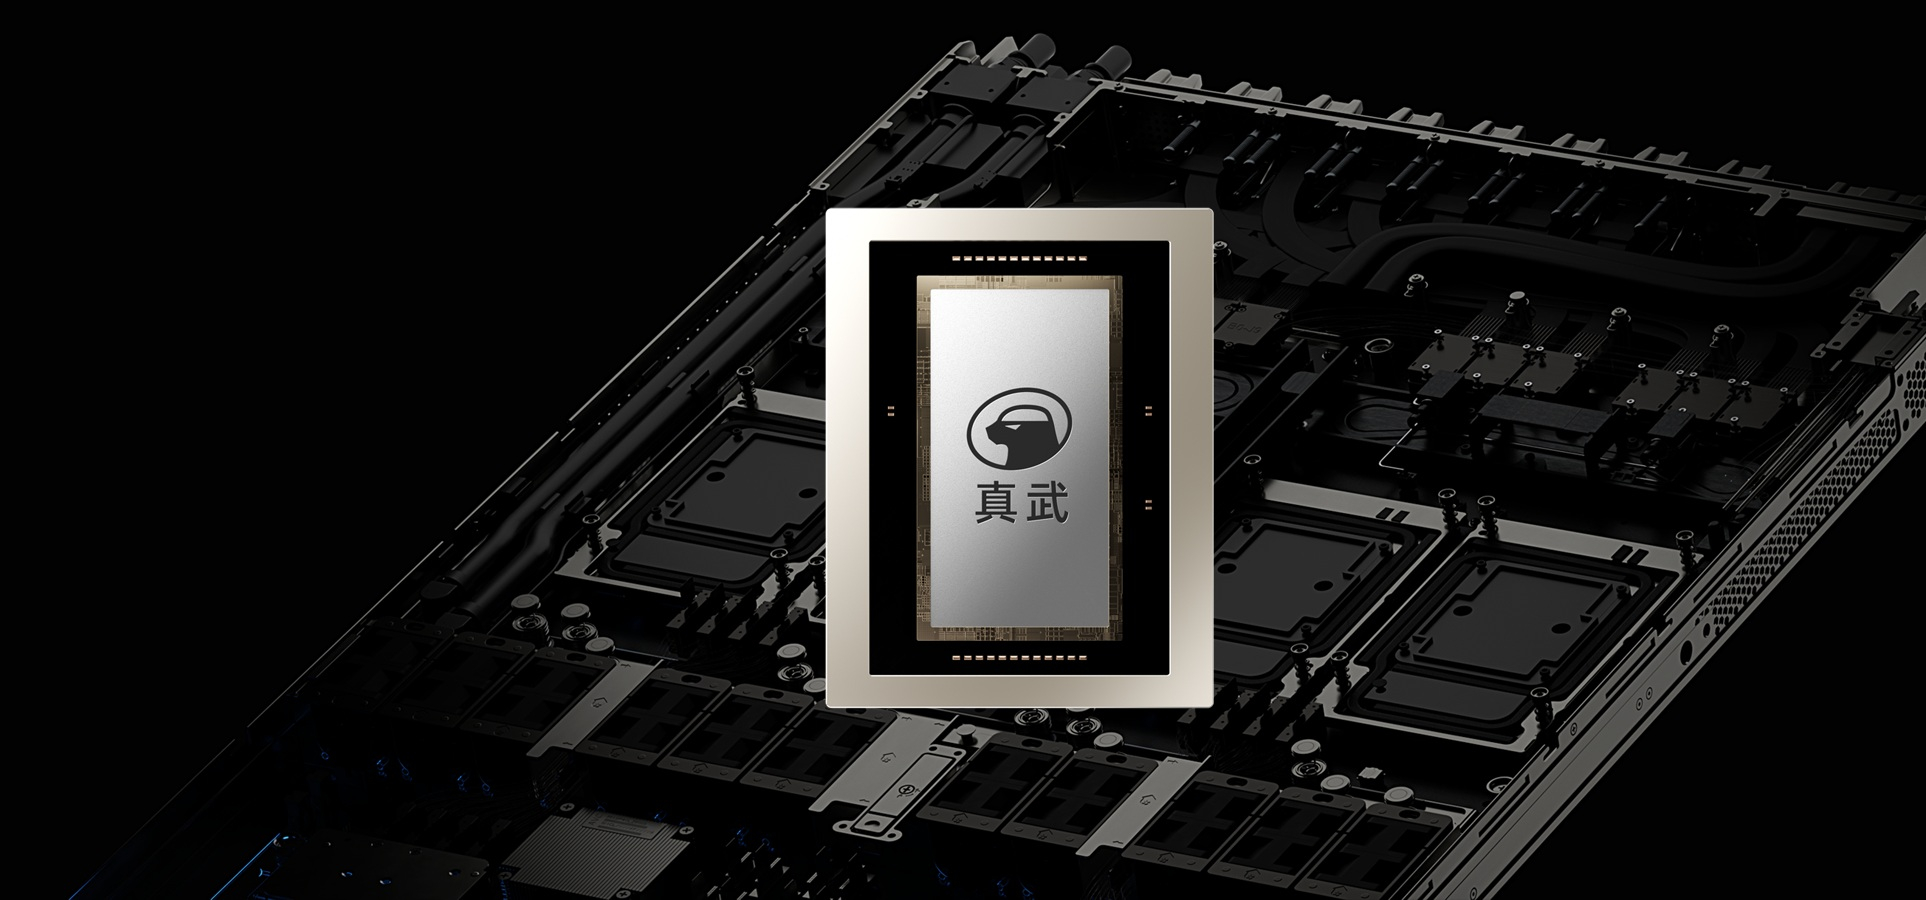
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 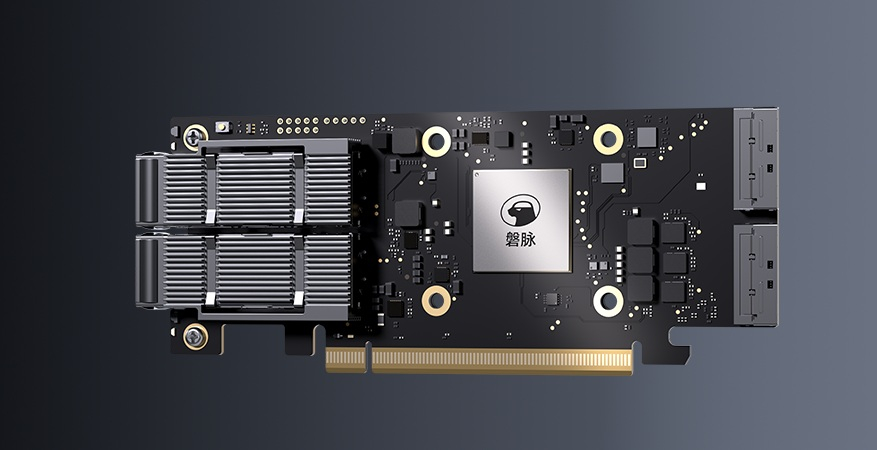
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
20.09.2026 [02:14], Владимир Мироненко
Anthropic и OpenAI переключились на аренду небольших ИИ ЦОДAnthropic и OpenAI прорабатывают варианты заключения сделок по аренде мощностей в небольших дата-центрах с целью расширения ИИ-инфраструктуры на фоне усиления дефицита, сообщил ресурс CNBC со ссылкой на источники. По словам инсайдеров, обе компании заключили за последний год крупные соглашения об использовании дата-центров мощностью в сотни мегаватт и даже гигаватты, но теперь они также проявляют интерес к сделкам на 20–30 МВт. В частности, Anthropic изучала возможность заключения соглашений такого масштаба в Великобритании и странах Северной Европы, а OpenAI также рассматривала варианты развёртывания мощностей меньшего объёма в странах Северной Европы. Один из источников сообщил о переговорах с участием Anthropic и OpenAI по поводу развёртывания вычислительных мощностей аналогичного масштаба в США. Такие сделки позволяют компаниям быстрее запускать рабочие нагрузки в условиях бума ИИ-технологий. «Мы формируем диверсифицированный портфель вычислительных мощностей, чтобы удовлетворить растущий спрос на ИИ во всём мире», — заявил представитель OpenAI ресурсу CNBC. Он пояснил, что разные рабочие нагрузки требуют использование разной инфраструктуры, поэтому компания ведёт переговоры с широким кругом партнёров и оценивает возможности, исходя из своих требований, а также показателей производительности, надёжности, сроков реализации и стоимости. 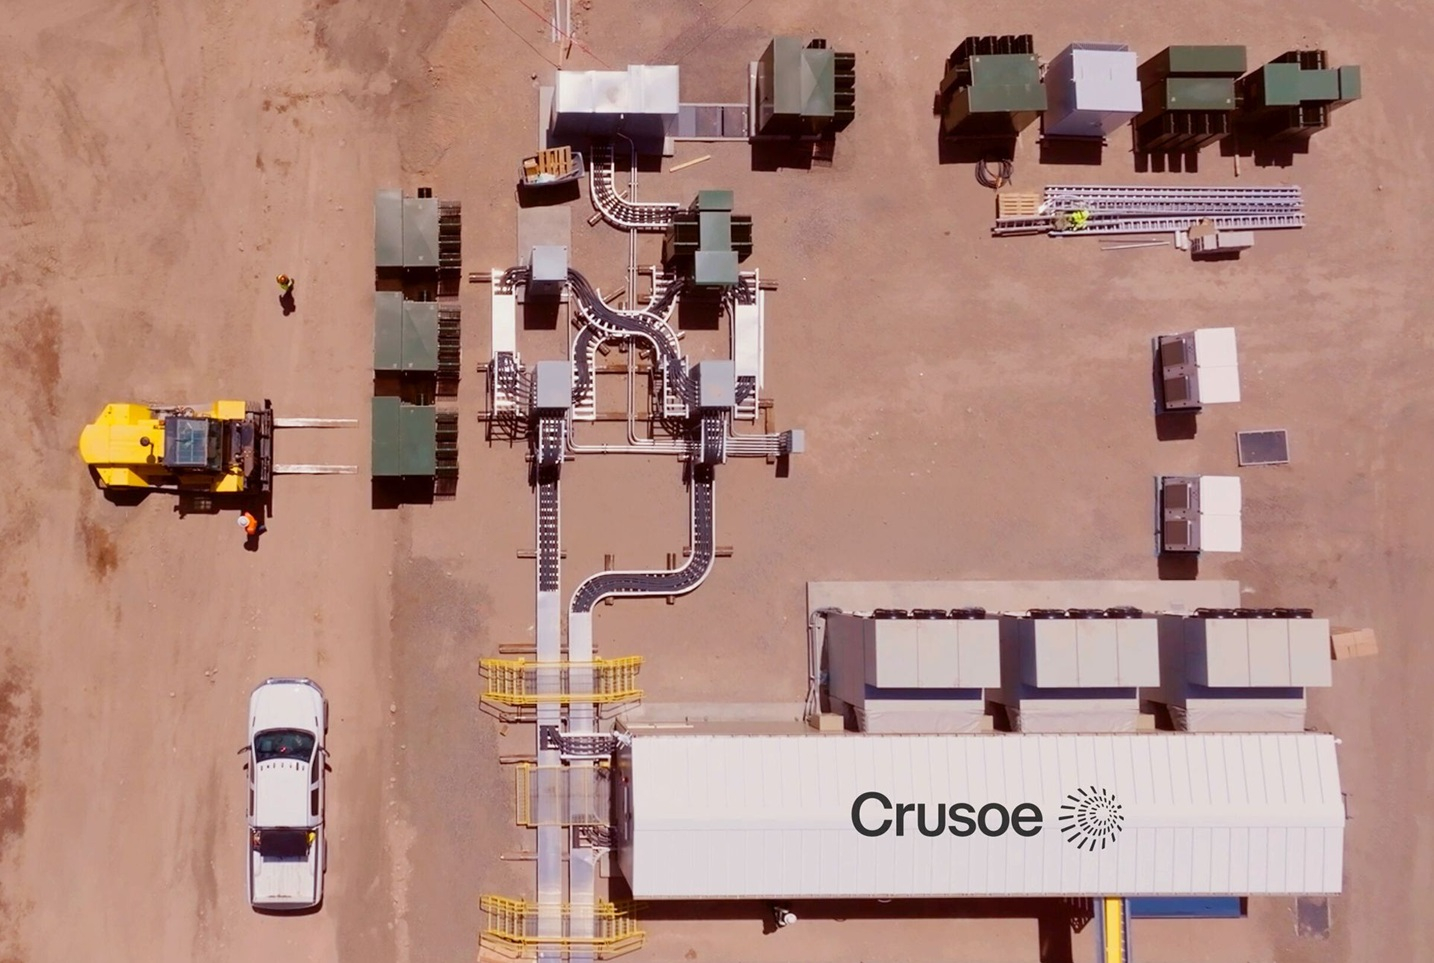
Источник изображения: Crusoe Обе компании обычно арендуют вычислительные мощности у операторов дата-центров и неооблаков, отдавая предпочтение масштабным долгосрочным соглашениям. В августе стало известно о сделке Anthropic с Nscale по поводу аренды мощностей в строящемся ЦОД в Западной Вирджинии на 460 МВт. OpenAI заявила, что ещё в апреле превысила первоначальный план по выделению 10 ГВт мощности для своего инфраструктурного проекта Stargate, и уже после этого взяла на себя обязательства по обеспечению дополнительных 3 ГВт мощностей в Джорджии и 8 ГВт в Огайо. Масштабные проекты по строительству ЦОД в США и других странах всё чаще сталкиваются с противодействием со стороны местных жителей. Также во многих регионах Европы наблюдается дефицит свободных земельных участков и энергетических мощностей для развёртывания ЦОД. По словам Structure Research, привлекательность сделок относительно меньших вычислительных мощностей заключается в том, что они позволяют быстрее получить доступ к готовой инфраструктуре: «Получить доступ к нескольким мегаваттам на уже подключенном к энергосети объекте может быть практичнее, чем ждать выделения гораздо большего блока мощностей в одной локации. Для рабочих нагрузок, способных функционировать на разрозненных площадках, совокупность небольших объектов может в итоге обеспечить значительный объём мощностей». 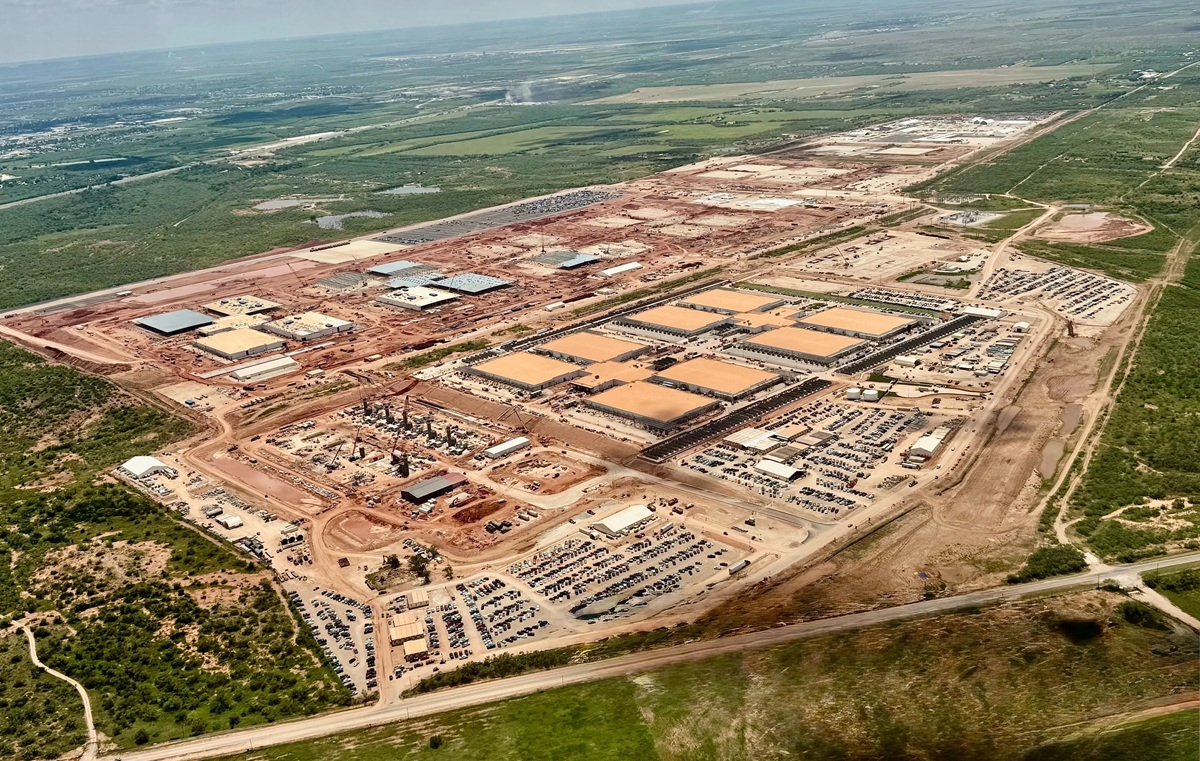
Источник изображения: Crusoe Обучение моделей ИИ требует огромных вычислительных ресурсов для обработки колоссальных массивов данных, но инференс может осуществляться с использованием более компактных кластеров чипов. По словам Тана, многие задачи инференса позволяют обрабатывать отдельные запросы на разрозненных небольших кластерах. При этом всё большая часть вычислительных ресурсов ИИ перенаправляется от обучения ИИ-моделей к их непосредственной эксплуатации. По оценкам JLL, к 2027 году доля мощностей ЦОД, используемых для инференса, должна превысить долю мощностей, выделяемых для обучения моделей. В 2025 году на инференс приходилось 9 % от общего объёма рабочих нагрузок в глобальных ЦОД, тогда как на обучение — 14 %. К 2030 году, как ожидается, на инференс будет приходиться 37 % этих мощностей, а на обучение моделей — лишь 13 %. В феврале сообщалось о планах NVIDIA начать сотрудничать с рядом участников рынка ЦОД для изучения возможностей создания небольших объектов, предназначенных для распределённого инференса. Напомним, что Crusoe, построившая крупный комплекс дата-центров Stargate в Абилине (Abilene, Техас), используемый OpenAI, теперь инвестирует в создание более компактных ЦОД, на развёртывание которых уходит меньше времени, и этот процесс обходится гораздо дешевле запуска крупных комплексов, строительство которых сейчас сталкивается с задержками на всей территории США.
18.09.2026 [17:40], Владимир Мироненко
Вглубь и вширь: Cornelis анонсировала архитектуру Active Compute FabricCornelis представила Active Compute Fabric — открытую архитектуру, охватывающую сетевые системы класса scale-up (вертикальное масштабирование) и scale-out (горизонтальное масштабирование) и включающую встроенные средства программируемых вычислений. В настоящее время ИИ-кластеры выросли до многих тысяч GPU. Количество параметров в моделях увеличилось с миллиардов до триллионов. Однако фундаментальное поведение большинства сетей ЦОД не эволюционировало так быстро — они в основном перемещают данные из точки А в точку Б, обеспечивая максимально надёжную передачу. Современные рабочие ИИ-нагрузки не всегда ведут себя как традиционные HPC и другие распределённые приложения. В них доминируют синхронизация, коллективные операции и зависимости, а также значительный трафик между серверами (east-west). Когда сеть не справляется с огромными требованиями к пропускной способности таких рабочих нагрузок, ускорители часто простаивают, иногда в течение длительного времени. Проблему простоя поставщики пытаются решить преимущественно за счёт увеличения пропускной способности, а не изменения принципов работы самой сетевой инфраструктуры. «ИИ-инфраструктура достигла того этапа, когда одного лишь повышения быстродействия конечных узлов уже недостаточно. Сетевая фабрика должна стать активным компонентом вычислительной системы», — заявила Лиза Спелман (Lisa Spelman), генеральный директор Cornelis. 
Источник изображений: Cornelis Networks Архитектура Active Compute Fabric переносит программируемые вычислительные функции непосредственно на уровень сети. Сетевая фабрика может производить манипуляции над данными прямо во время передачи: собирать данные KV-кеша для дезагрегированного инференса, координировать распределение экспертов для моделей MoE, ускорять коллективные операции, такие как AllReduce, и сжимать градиенты при передаче, разгружая вычислительные узлы, уменьшая накладные расходы на синхронизацию и отвечая за целостность передачи данных. При этом она может брать на себя новые функции по мере развития алгоритмов ИИ и ПО. Нечто похожее, например, NVIDIA начала предлагать в InfiniBand несколько поколений назад (SHARP), но, по слухам, данная функциональность особой популярностью не пользуется. Cornelis опирается на открытые Ethernet-стандарты UALink для вертикального масштабирования и Ultra Ethernet — для горизонтального, что даёт поддержку широкого спектра ускорителей. Это важный фактор, поскольку компании всё больше диверсифицируют оборудование и технологии, используемые в своих ЦОД. Клиенты, использующие решения для ИИ, всё чаще обращаются к решениям стоечного масштаба, сталкиваясь при этом с проблемой привязки к конкретному поставщику, а Cornelis позиционирует себя как нейтральная, открытая альтернатива. Это явный кивок в сторону NVIDIA, хотя тот же UALink пока трудно назвать действительно зрелой технологией. 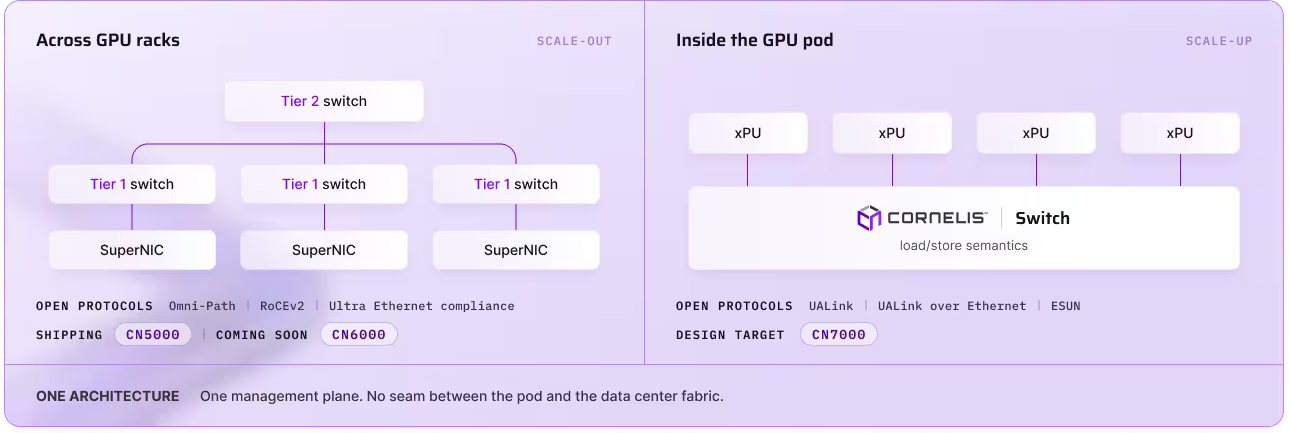 Видение Cornelis по поводу открытых и эффективных сетей, масштабируемых по принципу «масштабирование и расширение», разделяет Qualcomm, которая присоединилась к Cornelis на конференции AI Infra Summit. Cornelis отметила, что обе компании разделяют общее видение проблем, стоящих перед ИИ-инфраструктурой: использование пассивных сетевых архитектур, обеспечивающих лишь передачу данных, приводит к недогрузке вычислительных ускорителей, что напрямую сказывается на экономической эффективности процессов инференса. По мере перехода к созданию ИИ-систем стоечного масштаба, обе компании рассматривают сеть как ключевой элемент проектирования, а не как второстепенный компонент. Лиза Спелман отдельно отметила в интервью CRN схожесть подходов с Qualcomm: «Мы видим много общего в отношении проблем инфраструктуры ИИ, проблем, с которыми сталкиваются клиенты, и множество возможностей и потенциала для объединения наших технологий и решения этих проблем для клиентов <…> Мы считаем, что сейчас идеальное время для выхода на этот рынок. Ещё многое предстоит решить», — сказала Спелман. Как отметил CRN, проблема для Cornelis заключается в том, что NVIDIA более года продвигает свою собственную технологию интерконнекта NVLink Fusion как де-факто интерконнект для вертикального масштабирования. К альянсу уже присоединились Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel, d-Matrix и MediaTek. Это позволяет NVIDIA оставаться важнейшим поставщиком для рынка ИИ-инфраструктуры и открывает новый источник дохода. 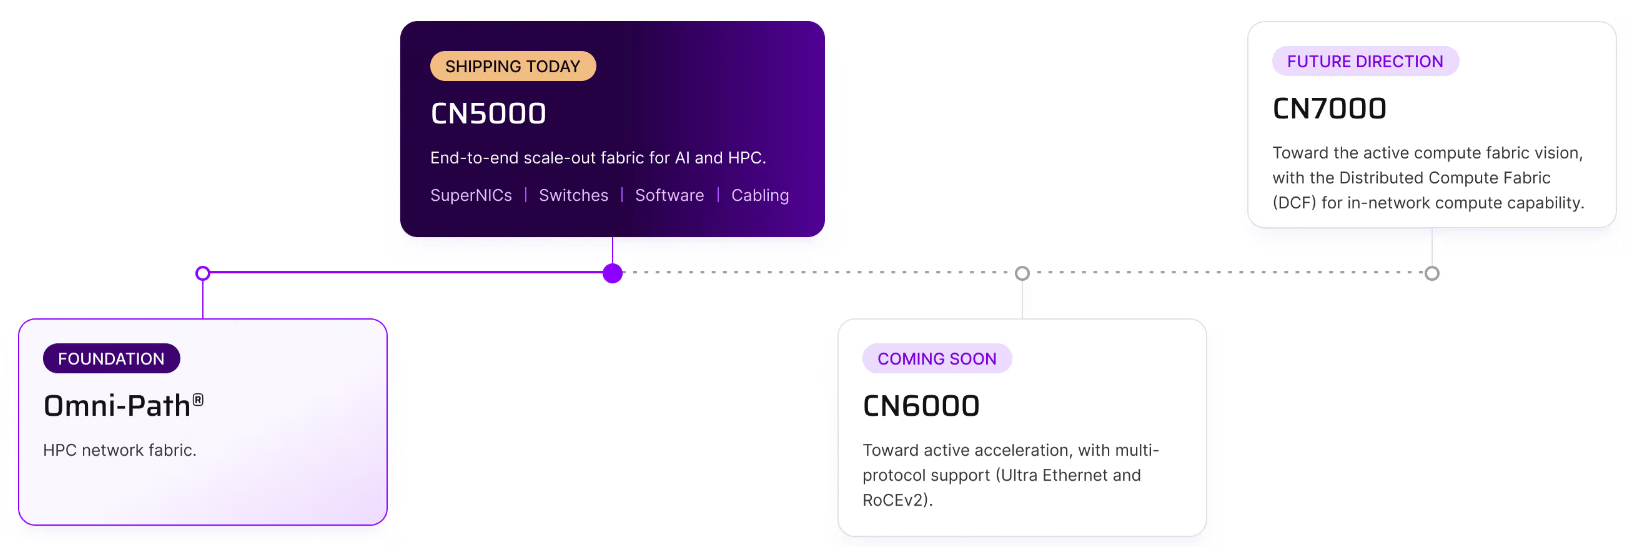 Cornelis также объявила о привлечении финансирования в размере $205 млн. Средства будут направлены на масштабирование производства, укрепление партнёрских отношений с клиентами и ускорение реализации планов по выводу продукции на рынок. Ресурс Forbes считает, что для компании в сегменте HPC-сетей такой уровень инвестиций значителен и свидетельствует о том, что рынок считает проблему узкого места в сетевых технологиях реальной, и что Cornelis продемонстрировала достаточный прогресс благодаря текущим внедрениям в ЦОД для ИИ и HPC, чтобы оправдать дальнейшее расширение. «Потенциал рынка сетевых решений на базе открытых стандартов для масштабирования ИИ (как вертикального, так и горизонтального) к 2030 году превысит $55 млрд. Мы убеждены, что именно сетевая инфраструктура будет определять, какая часть инвестиций в развёртывание систем ИИ принесёт реальную отдачу», — заявили в IAG Capital Partners.
18.09.2026 [00:48], Владимир Мироненко
Crusoe, застройщик ЦОД OpenAI Stargate, привлекла $3,9 млрд с оценкой в $30,9 млрд и сделала ставку на малые модульные дата-центрыСтартап Crusoe завершил новый раунд финансирования серии F в размере $3,9 млрд с оценкой его рыночной стоимости примерно в $30,9 млрд, сообщил ресурс The Wall Street Journal. По словам гендиректора Crusoe Чейза Лохмиллера (Chase Lochmiller), раунд финансирования возглавили Atreides Management, Valor Equity Partners и Mubadala Investment. В число других инвесторов входят Founders Fund, TPG и несколько суверенных фондов, включая Катарское инвестиционное управление (Qatar Investment Authority, QIA). После двух лет строительства комплекса ЦОД Stargate в Абилине (Abilene, Техас), используемого OpenAI, Crusoe теперь делает ставку на создание небольших модульных ЦОД Spark, которые она может производить на собственных заводах и развёртывать там, где есть доступ к электроэнергии. Это будет быстрее и дешевле, чем полагаться исключительно на крупные строительные проекты, которые становятся всё дороже и сталкиваются с задержками по всей стране. Лохмиллер заявил, что для инференса не требуются огромные ИИ-кластеры. «В настоящее время для этого не нужен ЦОД по типу того, в Абилине», — сказал Лохмиллер. По его словам, инференс в таком ЦОД «может быть излишним». Меньшие по размеру ЦОД Spark предоставляют компании ещё одно преимущество: скорость, поскольку для них не требуются месяцы планирования, строительства и согласования с местными жителями. ЦОД Spark уже работают в Рино (Reno, штат Невада) с питанием от б/у батарей электромобилей и солнечных панелей. 
Источник изображения: Crusoe Crusoe отличается от других стартапов в сфере ИИ-инфраструктуры тем, что не делает ставку на одно направление деятельности. Например, неооблачные компания занимаются в основном лишь тем, что покупают дорогостоящие чипы и сдают в аренду доступ к ним. В свою очередь, Crusoe разрабатывает и сдаёт в аренду ЦОД, сдаёт в аренду GPU в них и запускает ИИ-модели для клиентов и взимает плату за вычислительные ресурсы (токены). «Мы продаём ЦОД, GPU и токены», — сказал Лохмиллер. По словам источников The Wall Street Journal, эта стратегия временами вызывала недовольство совета директоров, который предлагал сузить сферу деятельности компании. Однако Лохмиллер считает, что его стратегия помогает компании строить лучшие ЦОД, поскольку даёт понимание того, как меняется спрос. Crusoe ожидает, что большая часть её облачных вычислений будет выполняться в небольших ЦОД Spark. «Мы собираемся устанавливать их повсюду», — заявил Лохмиллер.
16.09.2026 [15:38], Сергей Карасёв
Axelera AI начала поставки ИИ-чипов Europa для высокоэффективного инференсаНидерландский стартап Axelera AI объявил о начале отгрузок изделий Europa — специализированных ИИ-чипов следующего поколения (AI Processing Unit, AIPU). Они ориентированы прежде всего на выполнение инференса с высокой энергетической эффективностью. Первая информация о решениях Europa появилась в октябре прошлого года. Конструкция чипов включает восемь ядер ИИ, 16 векторных ядер с архитектурой RISC-V, 256-бит интерфейс LPDDR5 с пропускной способностью 200 Гбайт/с и 128 Мбайт памяти L2 SRAM. Заявленное быстродействие достигает 629 TOPS на операциях INT8. При производстве применяется 5-нм технология Samsung. Заказчики могут приобретать чипы Europa для самостоятельного проектирования ИИ-ускорителей. Кроме того, изделия доступны в составе PCIe-карты Axelera Edge 232p формата HHHL с одним AIPU и платы Axelera Server 250p типоразмера FHFL с четырьмя AIPU. Эти устройства могут устанавливаться в серверы и рабочие станции. 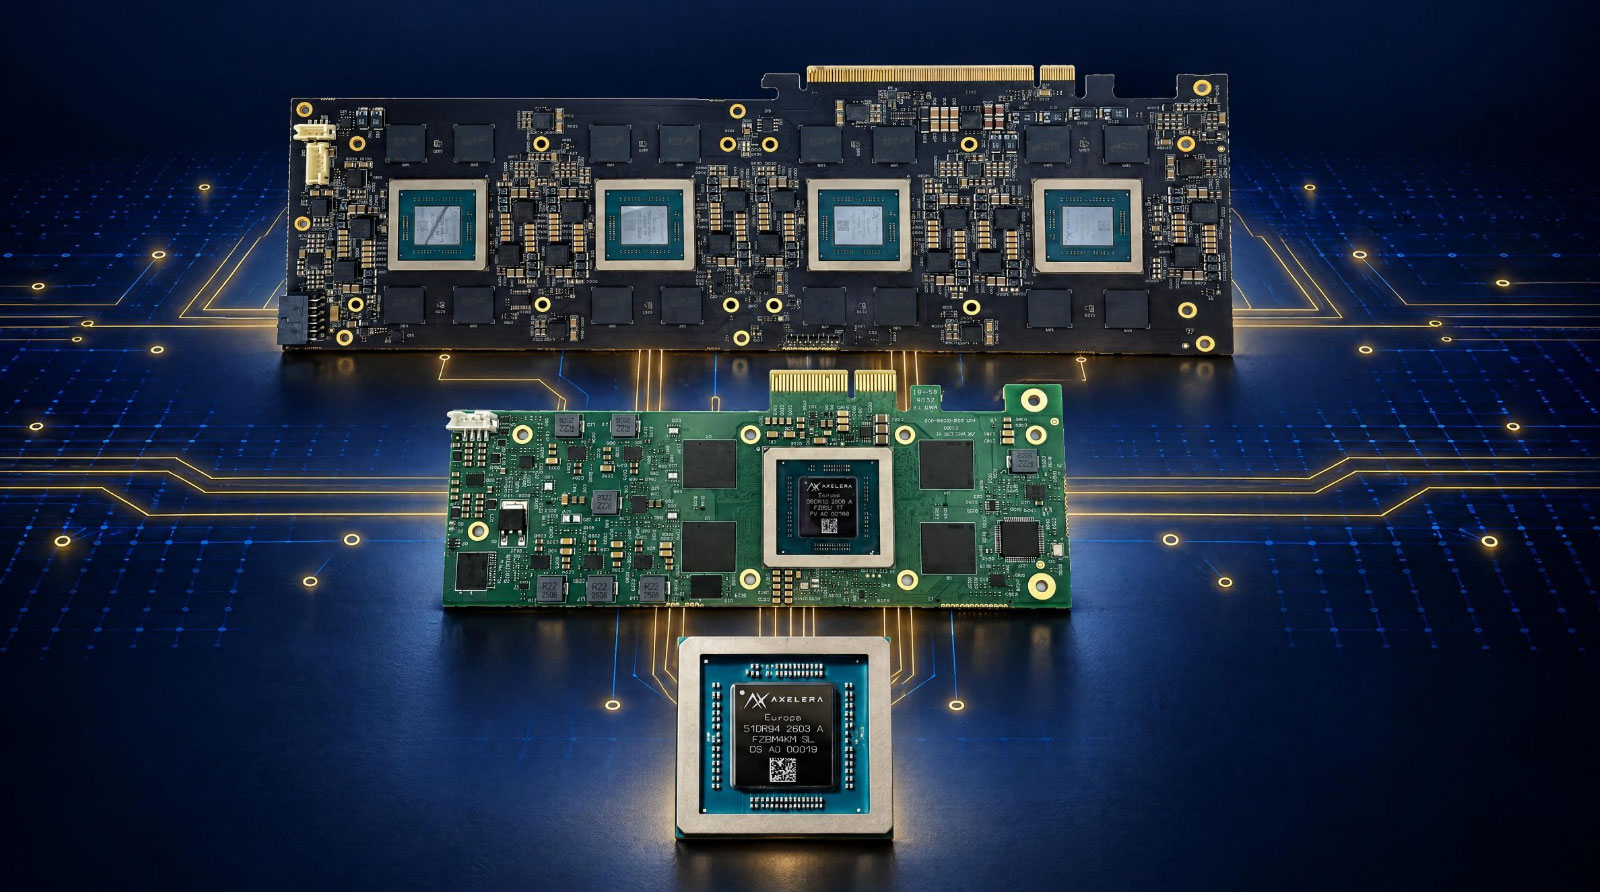
Источник изображений: Axelera AI Как утверждает Axelera AI, решения на базе Europa обеспечивают в шесть раз более высокую производительность (токенов в секунду) на 1 Вт затрачиваемой энергии по сравнению с ускорителями на базе GPU. Новые карты могут применяться не только в составе дата-центров и облачных платформ, но и на периферии, а также на корпоративных площадках. 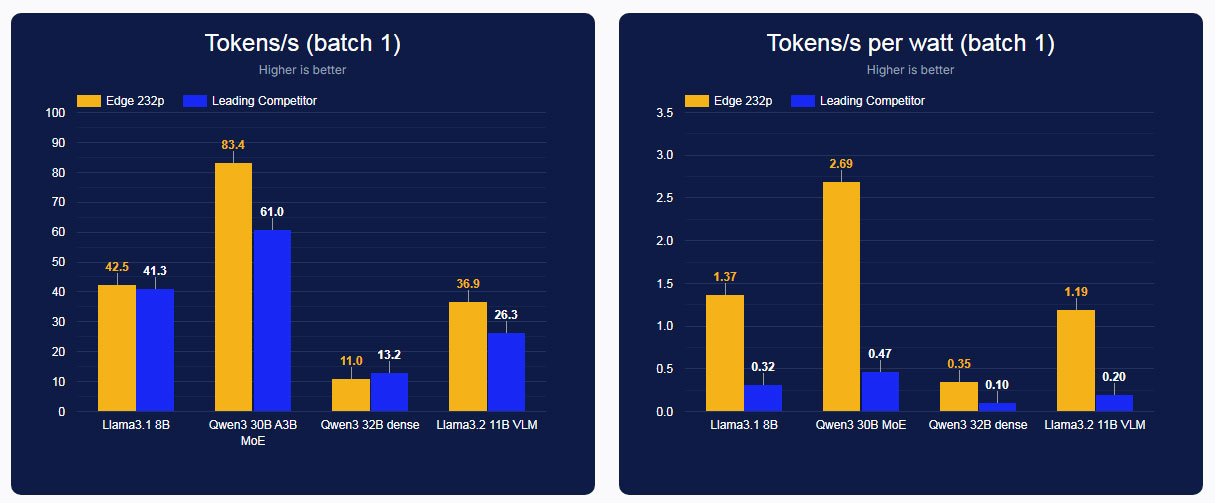 Ускорители Axelera Edge 232p будут доступны в составе серверов Dell XE5 и Supermicro 111AD. Кроме того, о поддержке Europa объявили такие компании, как 2CRSi, Advantech, Axiomtek, HPE, Lenovo, Seco и др. Продукты Axelera AI внедрили более 600 клиентов по всему миру, включая заказчиков в сферах оборонной промышленности, робототехники, беспилотных летательных аппаратов, розничной торговли и безопасности. Стартап говорит об общем портфеле заказов стоимостью свыше $1,5 млрд. |
|

