
Материалы по тегу: instinct
|
13.11.2026 [22:32], Владимир Мироненко
AMD представила ускорители Instinct MI450X с уменьшенным объёмом памятиAMD сообщила дополнительные подробности о GPU Instinct MI430X, предназначенных для HPC и научных задач с применением ИИ, а также представила результаты тестирования производительности в задачах инференса ускорителей Instinct MI455X в составе стоечного решения AMD Helios. Кроме того, компания анонсировала GPU Instinct MI450X, предоставляющий пользователям AMD Helios ещё один вариант подбора объёма памяти в соответствии с требованиями их ИИ-нагрузок и спецификой развёртывания систем. Компания отметила, что научное моделирование, передовые ИИ-системы и интерактивный инференс предъявляют разные требования к инфраструктуре, и ускорители серии MI400 позволяют их удовлетворять благодаря поддержке вычислений с двойной точностью (FP64) на аппаратном уровне, большому объёму памяти для ресурсоёмких моделей ИИ и расширенным вариантам конфигурации. Так, Instinct MI430X разработан для задач, сочетающих высокоточное моделирование и ИИ. Аппаратная поддержка FP64-вычислений позволяет выполнять сложные научные расчёты, а наличие 432 Гбайт HBM4 (ПСП до 23,3 Тбайт/с) — работать с более масштабными моделями и наборами данных. AMD по-прежнему отдаёт должное роли аппаратной поддержки FP64-вычислений в научных исследованиях. В её новом исследовании рассматриваются 47 конфигураций рабочих нагрузок в 11 приложениях и бенчмарках. В нём анализируется, в каких случаях может быть полезна эмуляция вычислений с двойной точностью, а в каких — научные программные коды требуют «родной» поддержки FP64. Результаты исследований подтверждают правильность выбранного курса: Instinct MI430X призван удовлетворить разнообразные вычислительные потребности в HPC и ИИ для научных исследований. 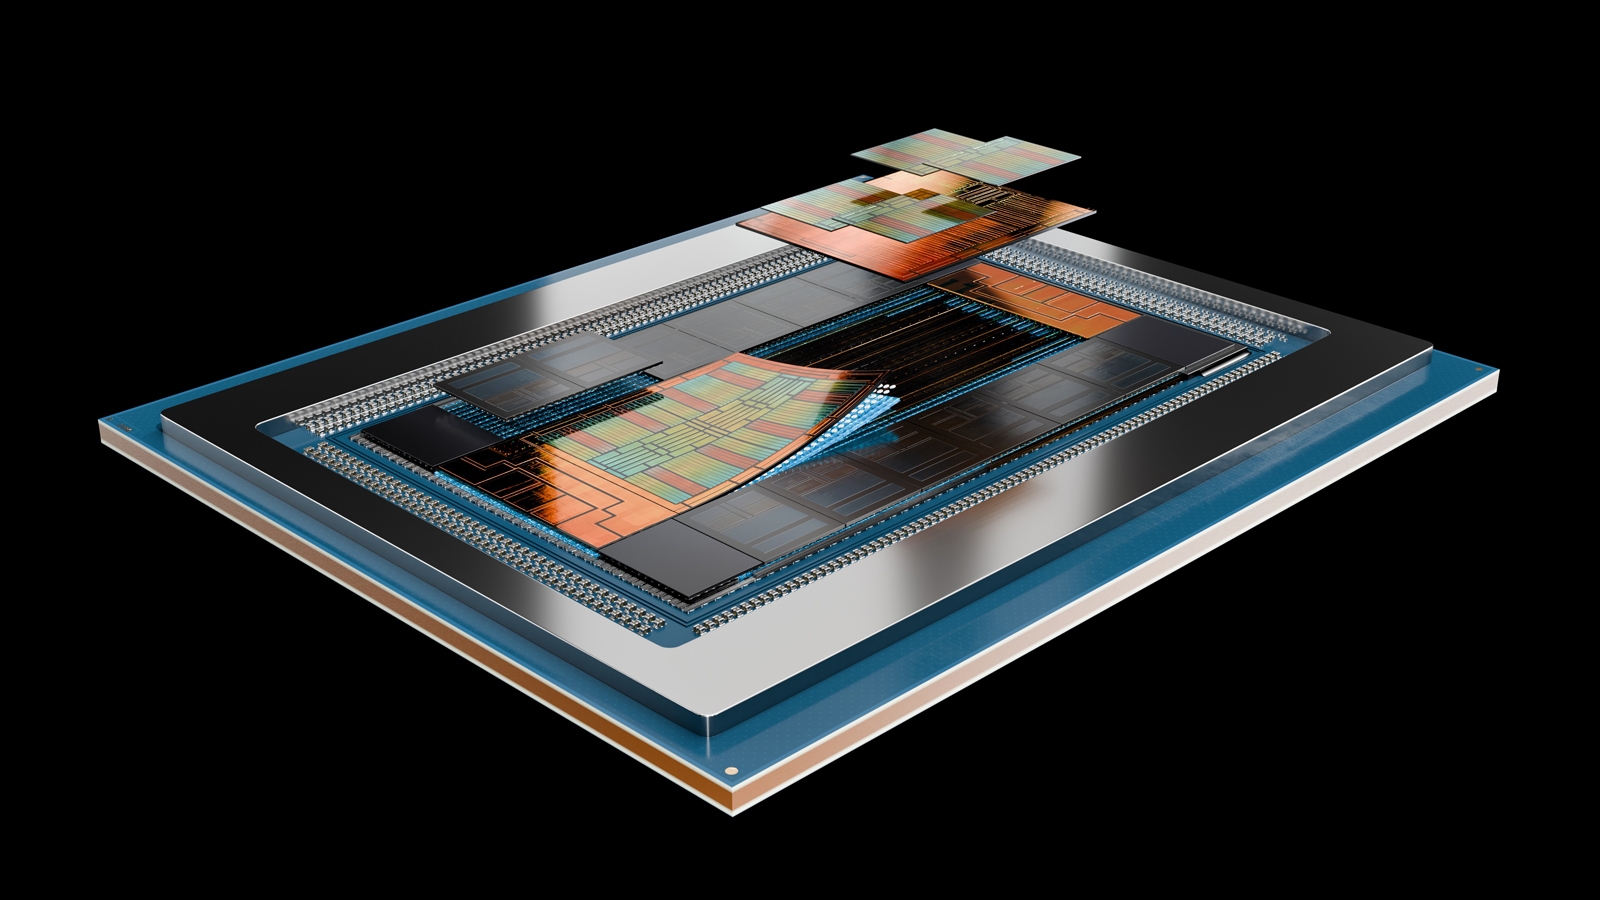
Источник изображения: AMD Новое тестирование AMD демонстрирует возможности MI455X в составе системе AMD Helios в задачах инференса: показатель достиг 21 333 токенов в секунду на один GPU при работе с моделью DeepSeek-R1 (согласно методике MLPerf Inference Offline). Это обеспечивает пропускную способность на 30 % выше, чему NVIDIA Vera Rubin в том же тесте MLPerf (согласно последним опубликованным результатам). Система AMD Helios обладает на 20 % более высокой пропускной способностью памяти HBM и более широкой полосой пропускания для масштабирования внутри узла (scale-up) по сравнению с NVIDIA Vera Rubin, что и отражают результаты. Анонсированный GPU AMD Instinct MI450X предоставляет пользователям AMD Helios больше гибкости при выборе оборудования, соответствующего их задачам в области ИИ и требованиям к развёртыванию. Чип оснащён 288 Гбайт памяти HBM4, что является главным отличием от MI455X. При этом у него те же вычислительные возможности, пропускная способность памяти и функции масштабирования (как внутри узла, так и между узлами), что и у MI455X. Для рабочих нагрузок, которые «умещаются» в MI450X, новинка становится ещё одним эффективным решением: она позволяет достичь целевых показателей пропускной способности и времени отклика, оптимизируя при этом операционные расходы. Оба варианта поддерживаются единой открытой архитектурой стоечного уровня и программной платформой AMD ROCm, но у MI455X дополнительный запас памяти — что важно для работы с более крупными моделями, длинными контекстами или при необходимости обработки большего количества запросов одновременно.
12.10.2026 [21:40], Владимир Мироненко
AMD «загнала» ИИ-агентов в стойку HelionAMD представила эталонный проект AMD Helion для агентных систем, выполненный в форм-факторе серверной стойки ORv3 высотой 44OU. По словам компании, Helion, созданный на основе спецификаций Open Compute Project (OCP), является дальнейшим развитием подхода к открытой платформе, заложенном в решении AMD Helios. 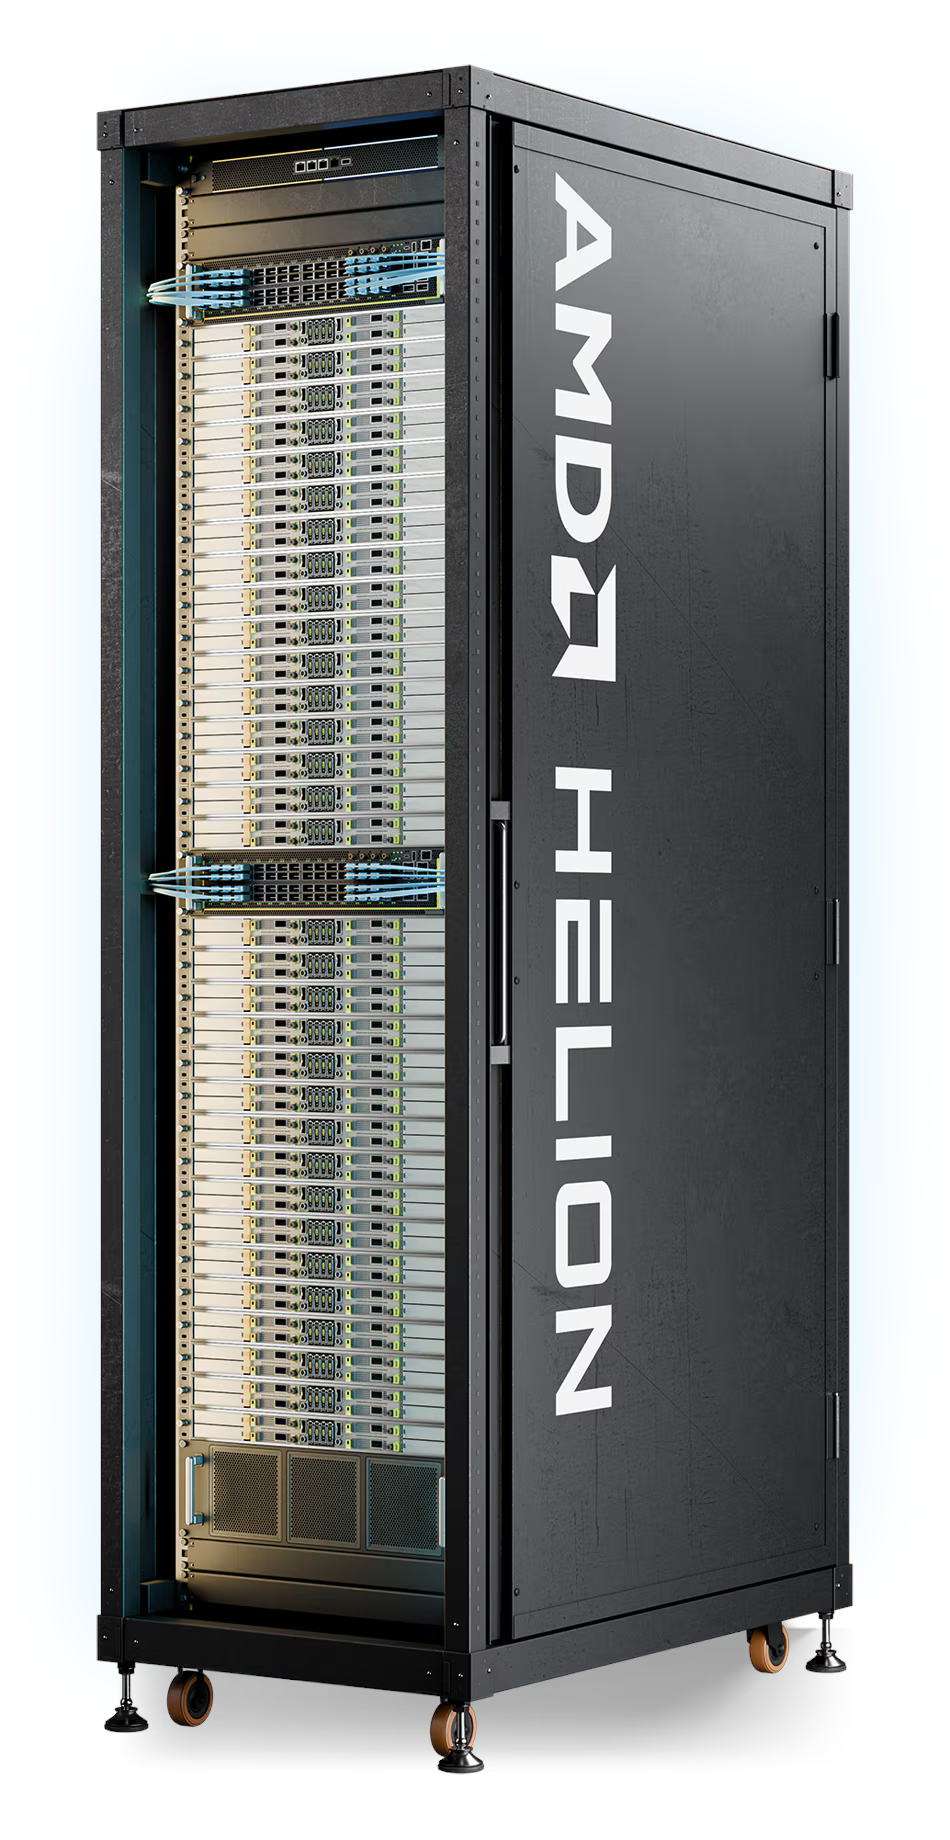
Источник изображений: AMD С помощью AMD Helion заказчики смогут оптимально сочетать производительность CPU, плотность ядер и энергопотребление с возможностями ускорения на базе GPU, исходя из специфики задач, выполняемых ИИ-агентами. Решение может поставляться как на базе исключительно CPU (для гиперскейлеров), так и с интеграцией CPU/GPU (для корпоративного сектора). 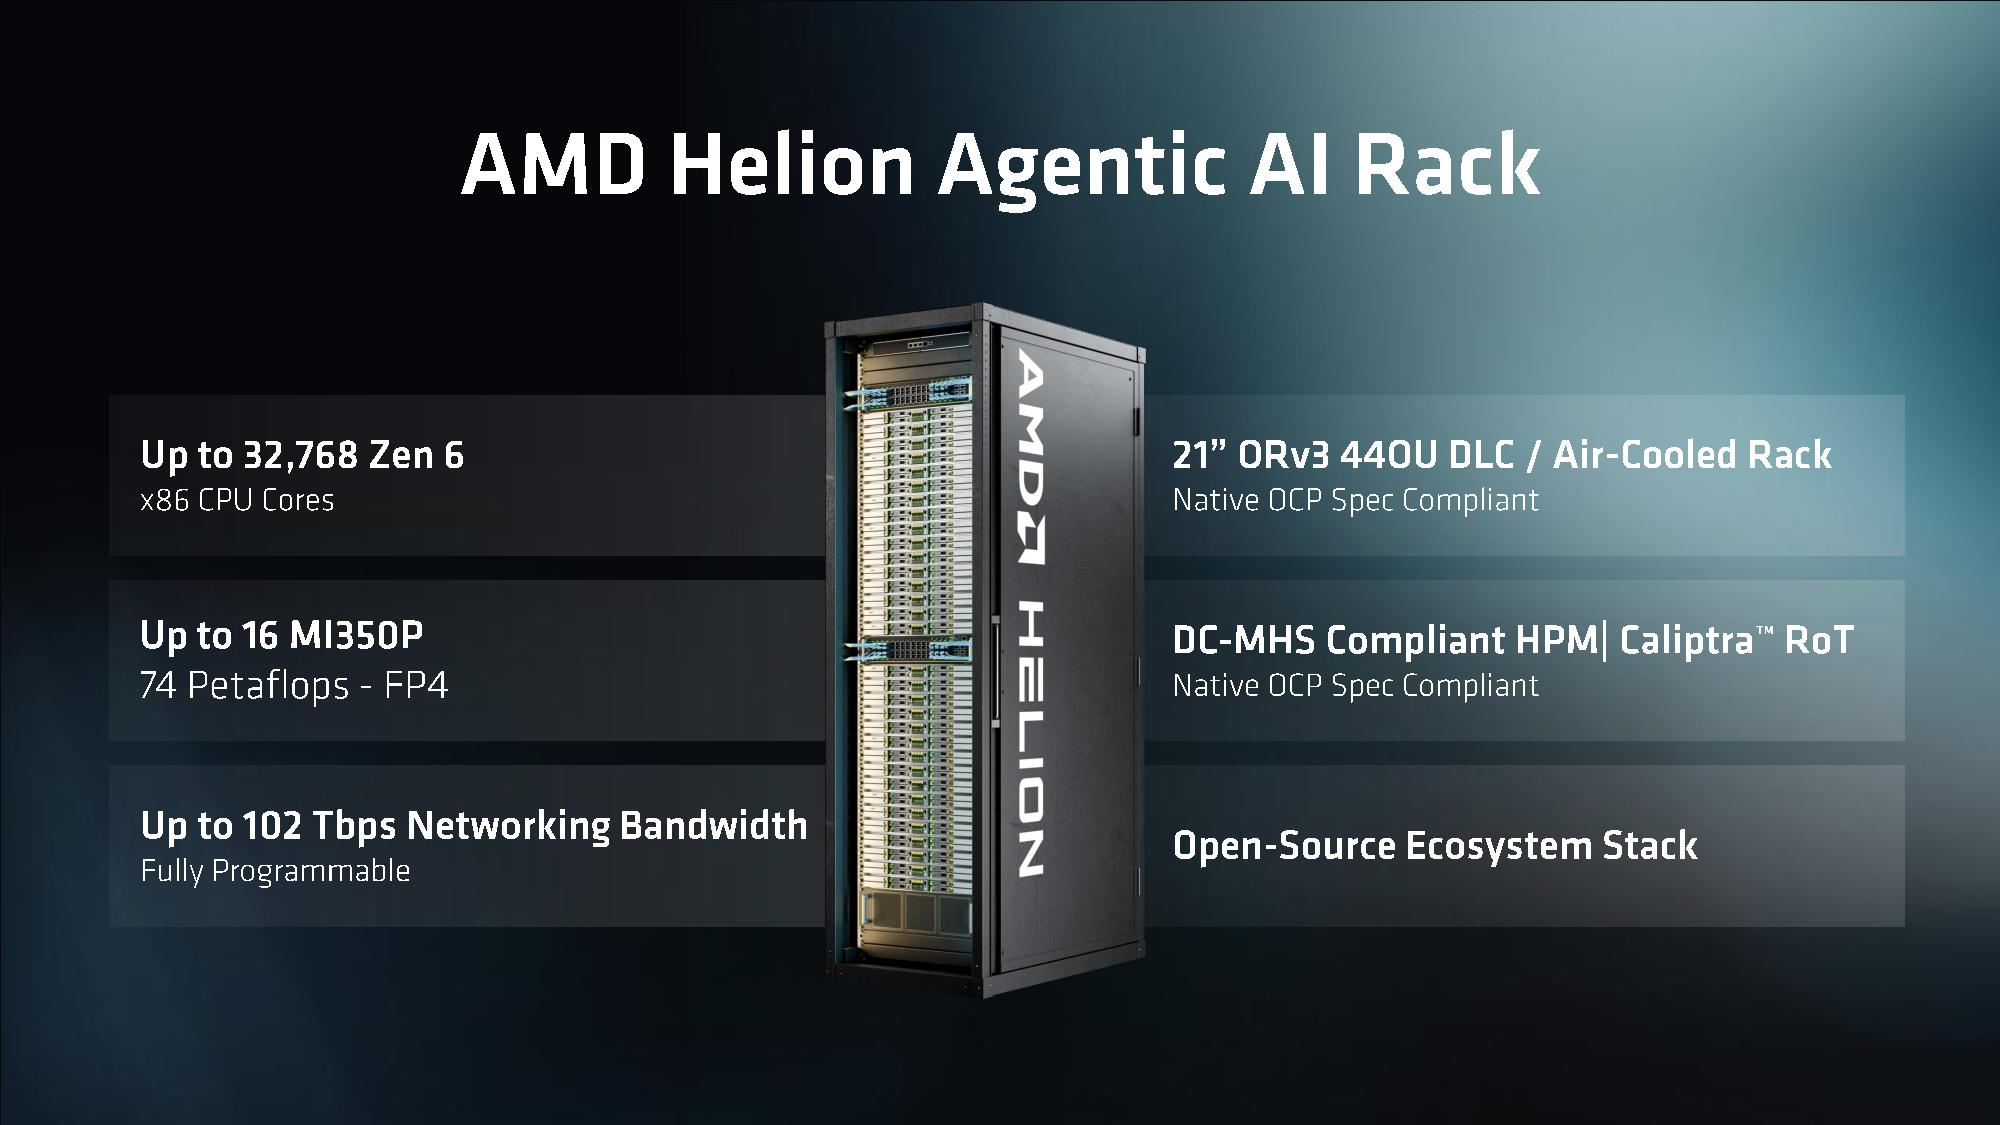 OCP-архитектура стойки AMD Helion поддерживает открытое ПО и допускает различные варианты конфигурации, включая версии с жидкостным и воздушным охлаждением. Это позволяет заказчикам создавать практически любые системы, отвечающие их конкретным требованиям. 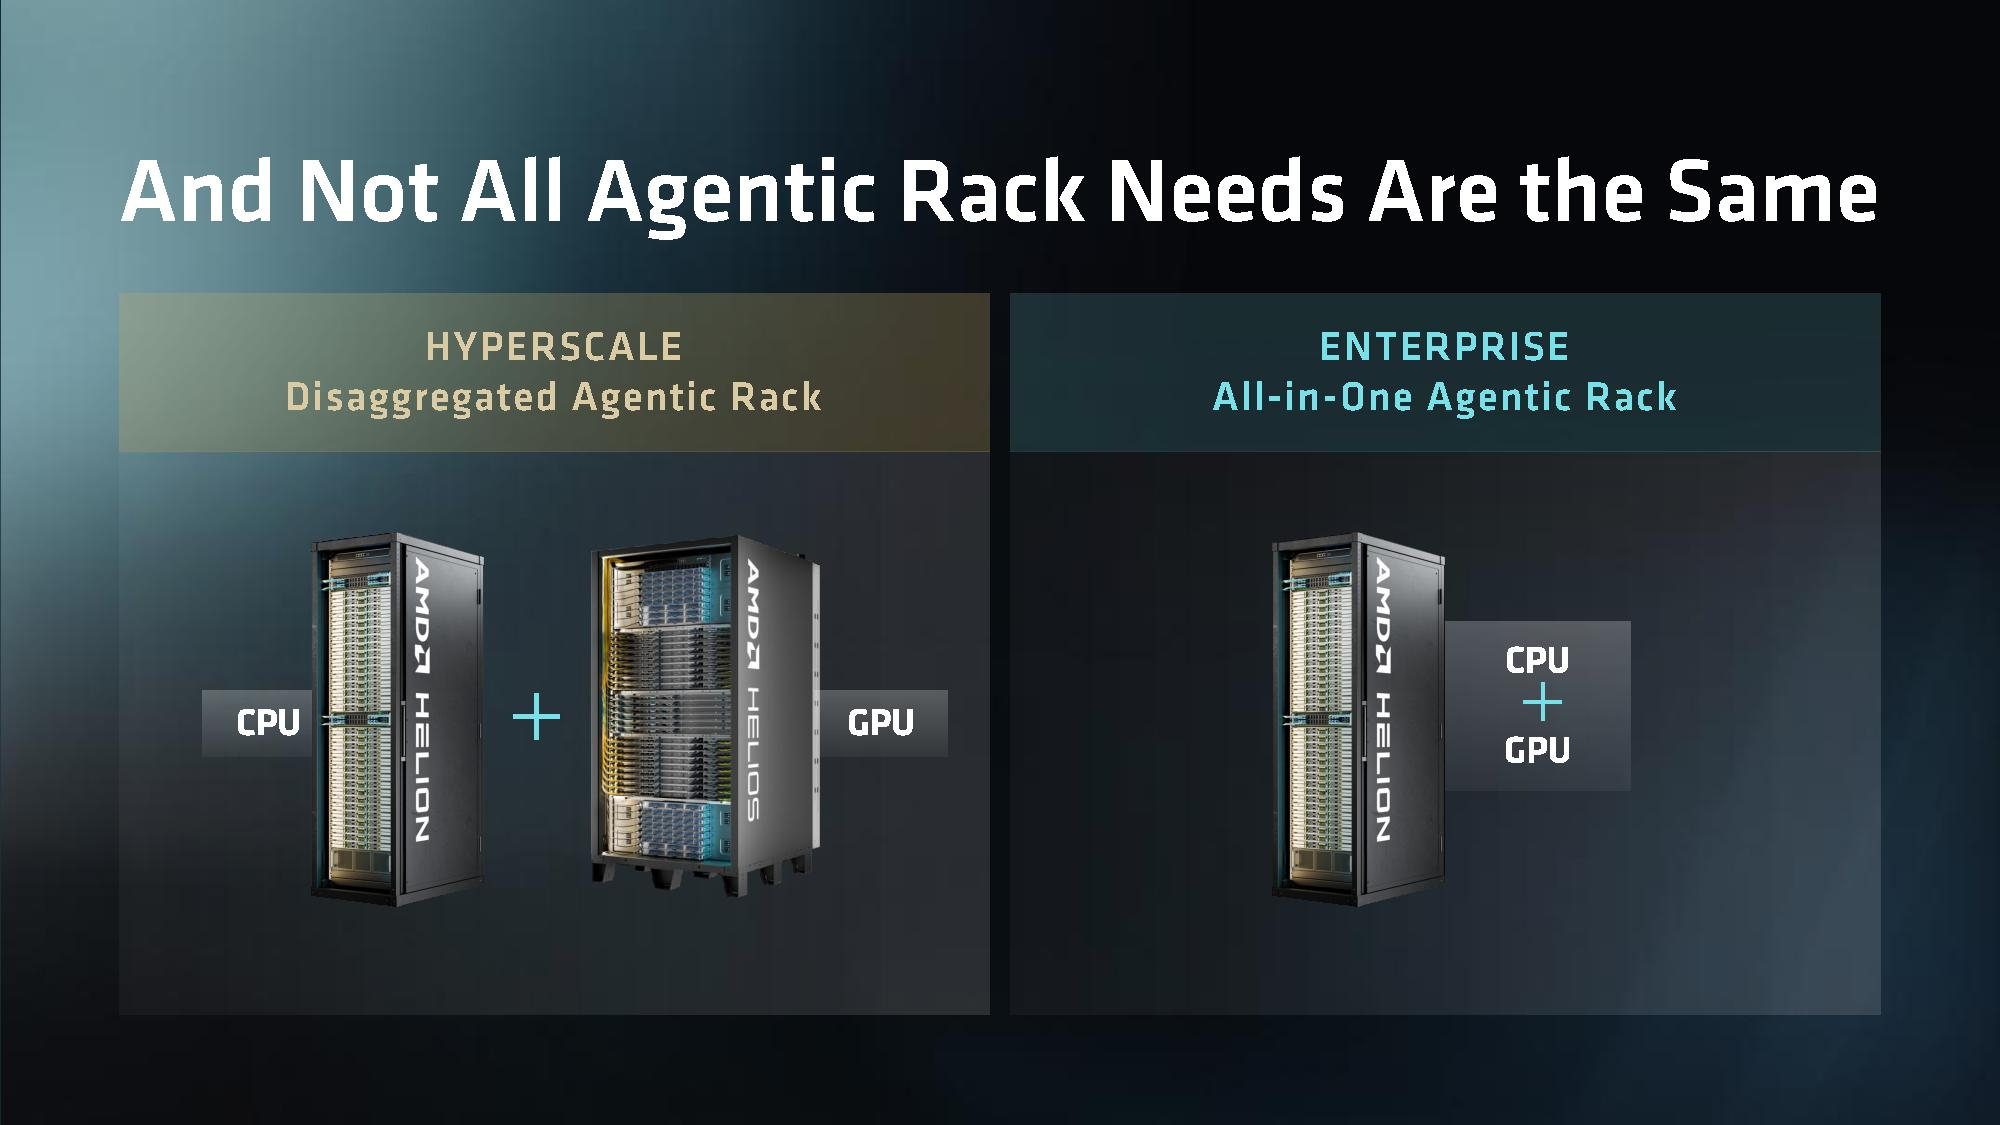 Например, стойка, использующая только CPU (на базе AMD EPYC Venice) и поддерживающая до 32 768 ядер, предназначена для систем гиперскейлеров. Она обеспечивает выделенные мощности для выполнения задач агентов, а также возможность подключения к отдельной инфраструктуре для инференса моделей. 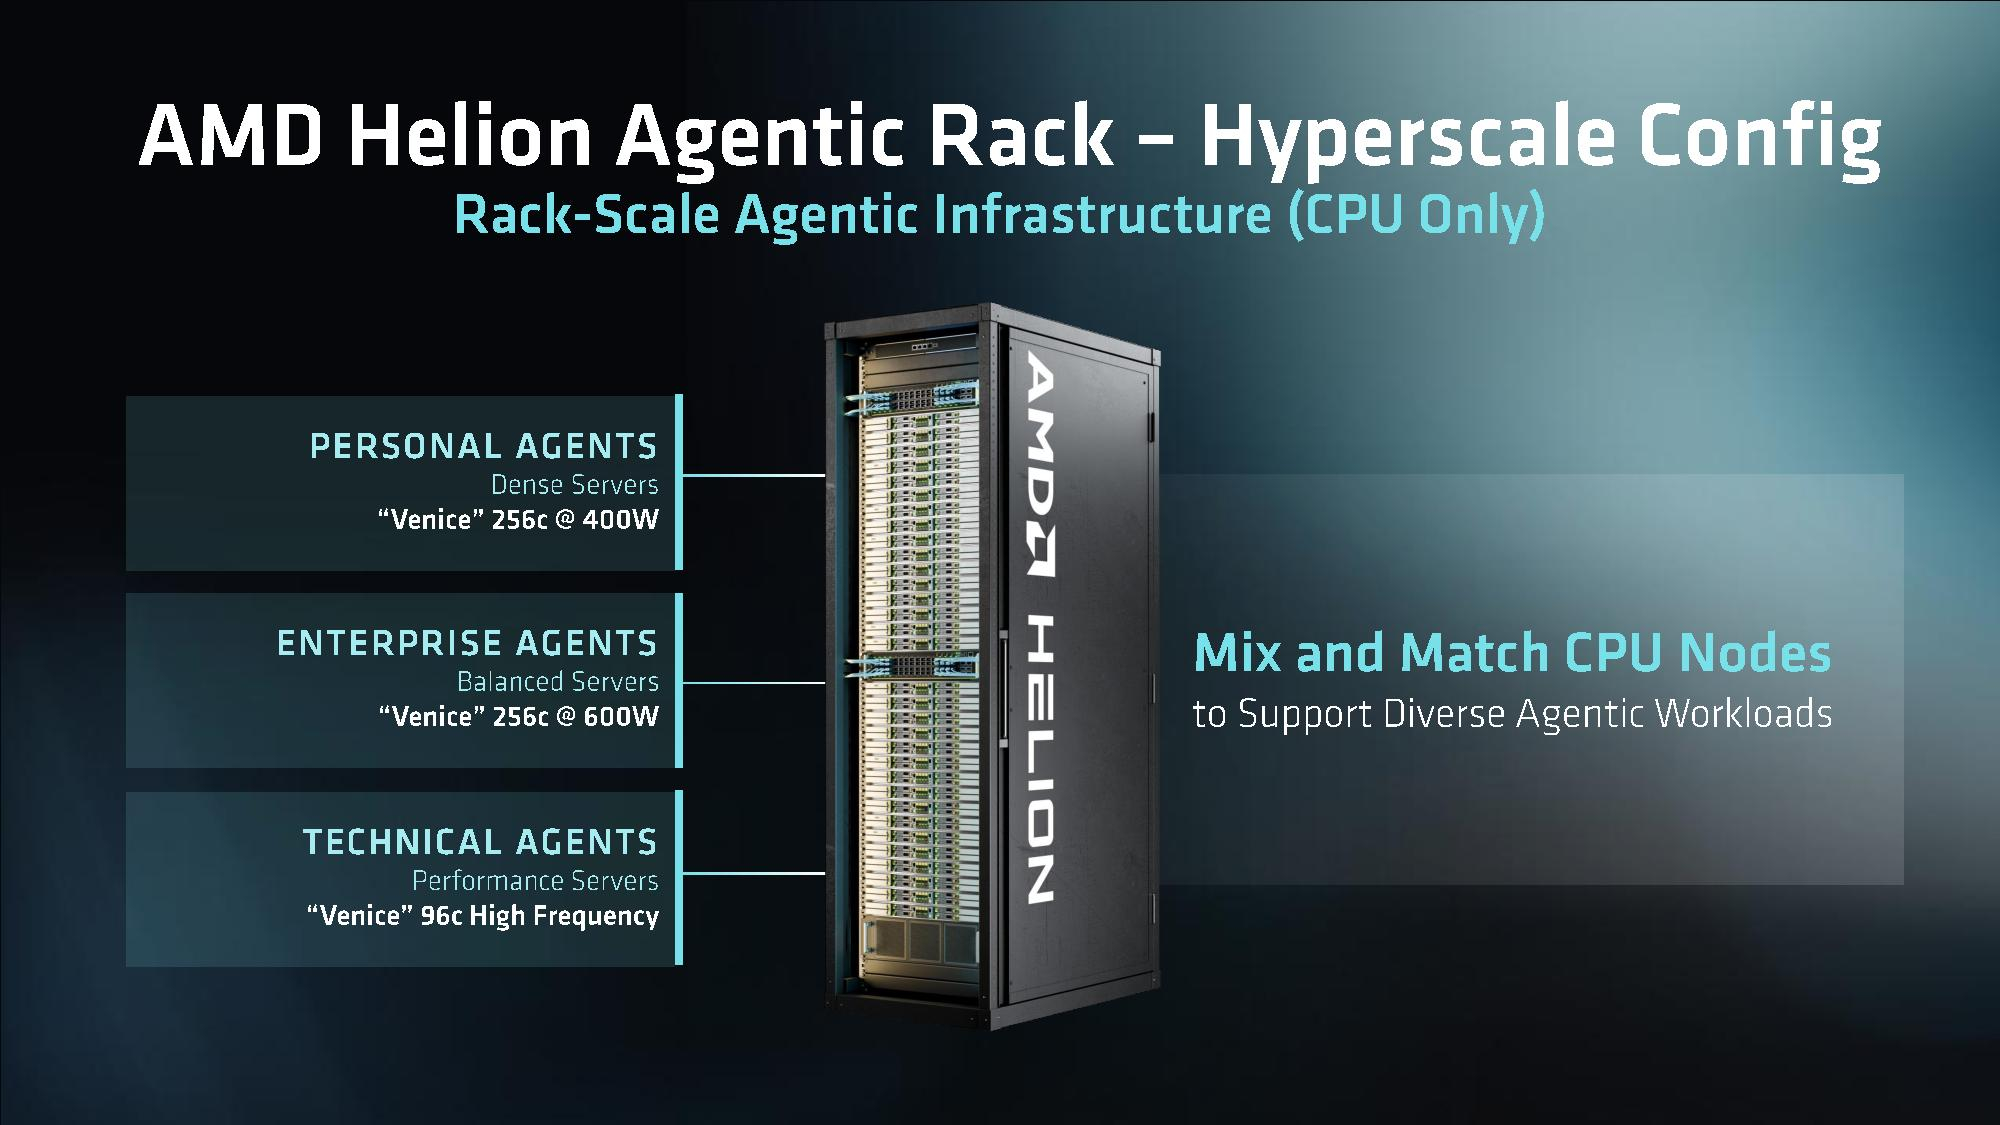 В свою очередь, комплексное стоечное решение, объединяющее на одной платформе узлы с EPYC, узлы с Instinct MI350P (до 16 единиц), интерконнект с пропускной способностью до 102,4 Тбит/с и вычислительные ресурсы общего назначения, представляет собой универсальный вариант для внедрения агентного ИИ корпоративного уровня. 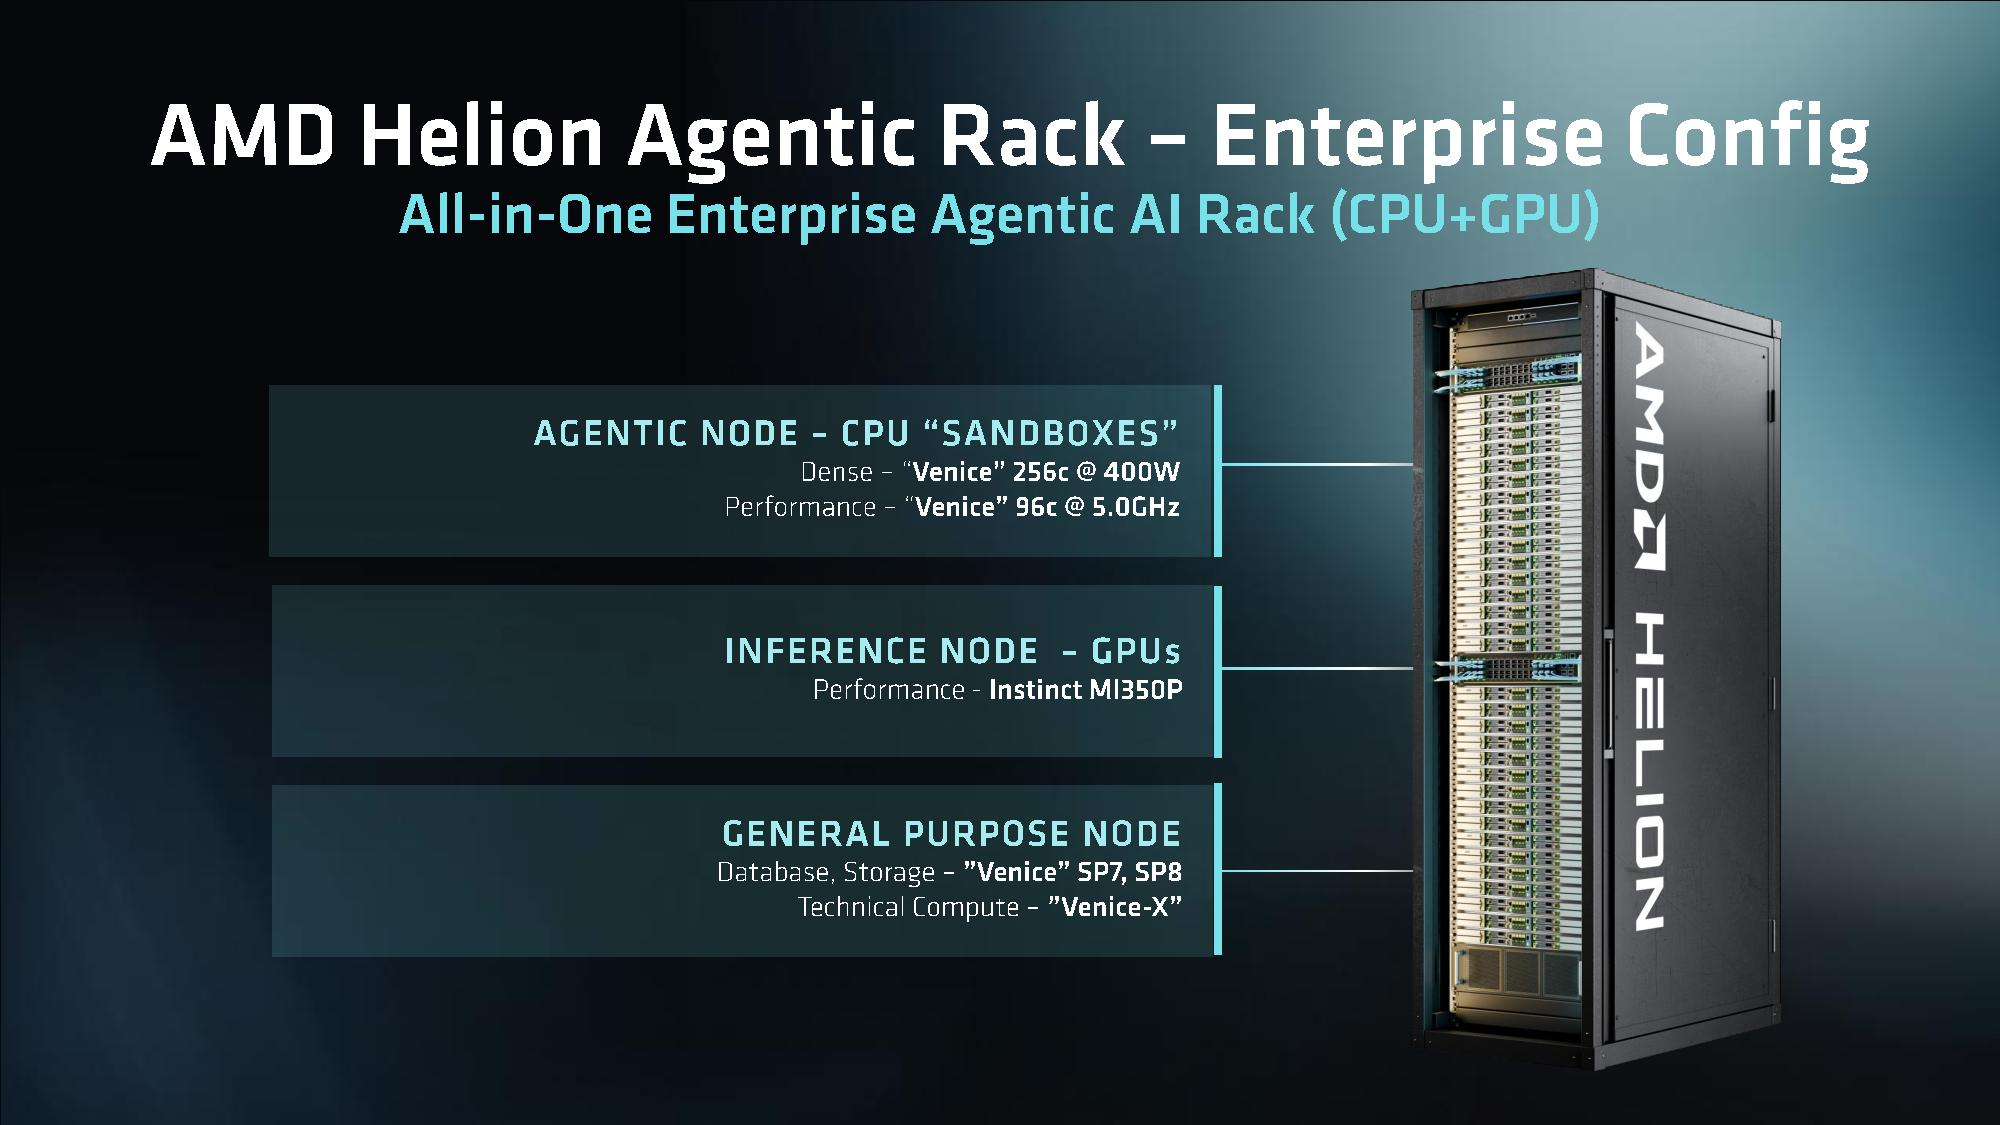 AMD Helion позволяет клиентам развёртывать системы агентного ИИ в рамках уже имеющейся ИТ-инфраструктуры, адаптируя конфигурации CPU и GPU под конкретные рабочие нагрузки и подбирая оптимальное соотношение ресурсов для выполнения задач агентов, инференса моделей и вспомогательных вычислений с учётом требований к производительности, энергопотреблению и стоимости. 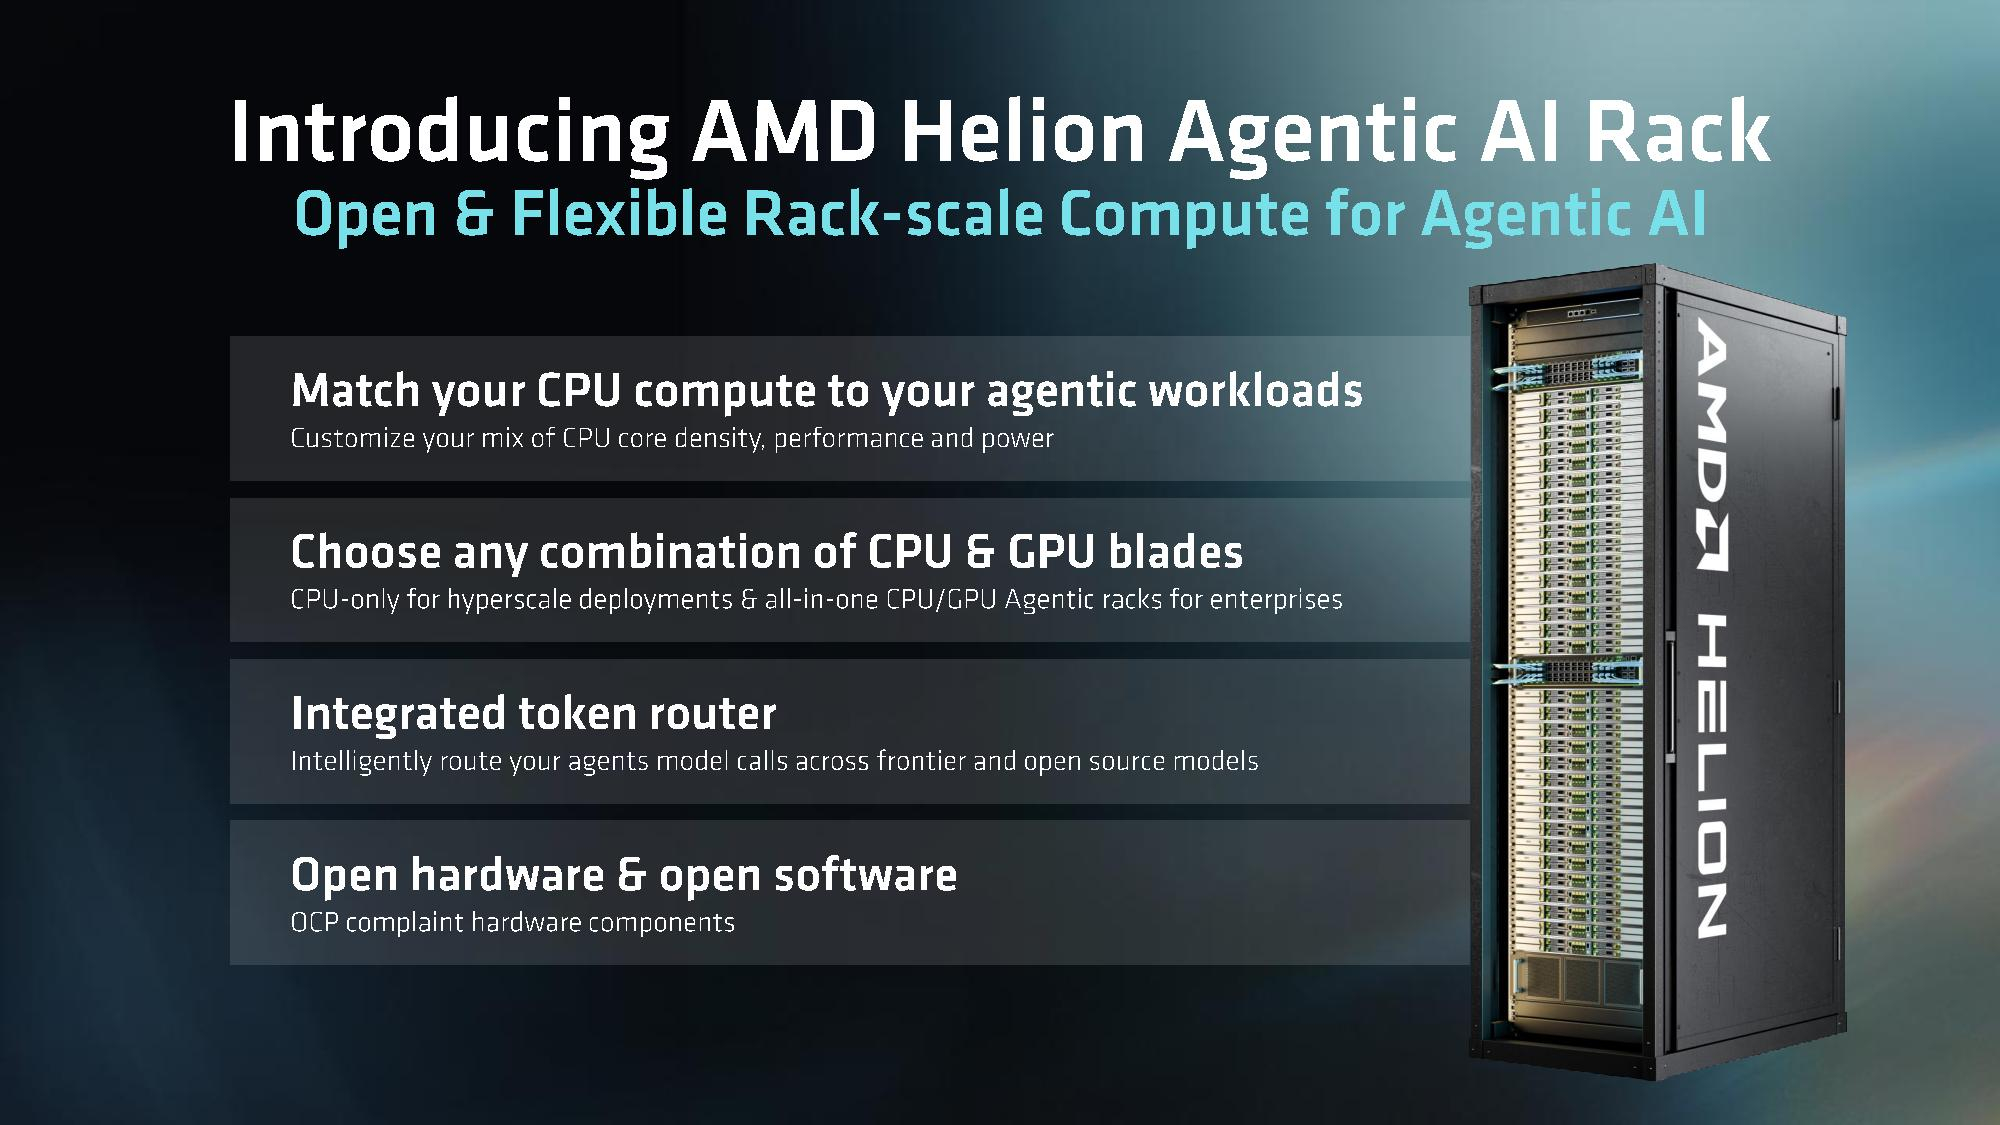 AMD сообщила, что планирует передать спецификацию AMD Helion организации OCP (Open Compute Project), сделав её доступной для сообщества с целью дальнейшей разработки и внедрения. Конфигурации стоек AMD Helion для агентного ИИ в настоящее время разрабатываются совместно с партнёрами по экосистеме; их выпуск запланирован на ноябрь 2026 года.
05.09.2026 [16:36], Сергей Карасёв
AMD анонсировала рабочую станцию Threadripper Halo Station с Instinct MI350P для ИИ-задачAMD анонсировала мощную рабочую станцию Threadripper Halo Station, предназначенную для локального использования ИИ-моделей, насчитывающих более чем 1 трлн параметров. В продажу новинка поступит в следующем году. Как отмечает старший вице-президент и генеральный директор AMD по вычислительным и графическим решениям, на сегодняшний день Threadripper Halo Station — это самая мощная рабочая станция в мире. Она может использоваться, например, для локального запуска сотен ИИ-агентов. В основу положен процессор Ryzen Threadripper PRO 9995WX (Shimada Peak): 96C/192T, 2,5/5,4 ГГц, L3-кеш 384 Мбайт. Может использоваться до 2 Тбайт DDR5. Стандартная конфигурация включает два ускорителя Instinct MI350P, каждый из которых несёт на борту 144 Гбайт HBM3E с 4096-бит шиной и пропускной способностью до 4 Тбайт/с. 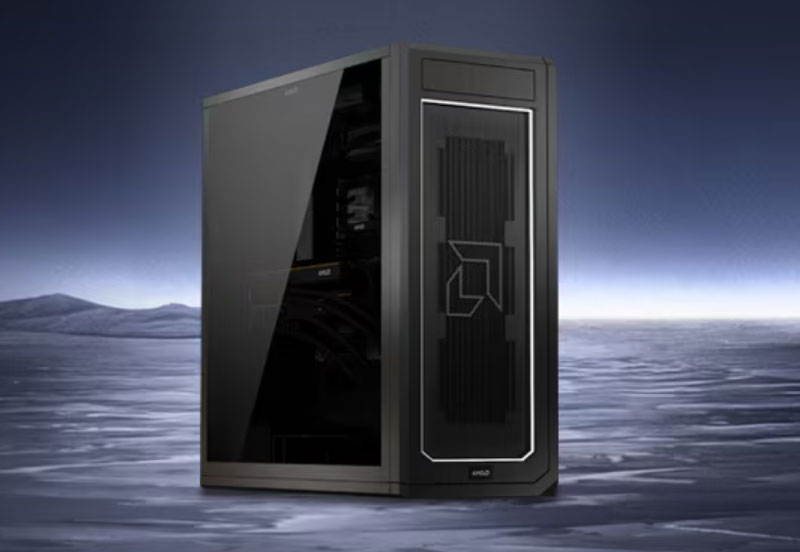
Источник изображений: AMD В максимальной комплектации могут быть задействованы четыре таких карты, что в сумме даст 576 Гбайт HBM3E. Применяется СЖО, которая охватывает независимо каждый из экземпляров Instinct, а также CPU. Отмечается, что агрегированная пропускная способность памяти GPU достигает 16 Тбайт/с, системной памяти — 410 Гбайт/с. Прочие технические характеристики на текущий момент не раскрываются. 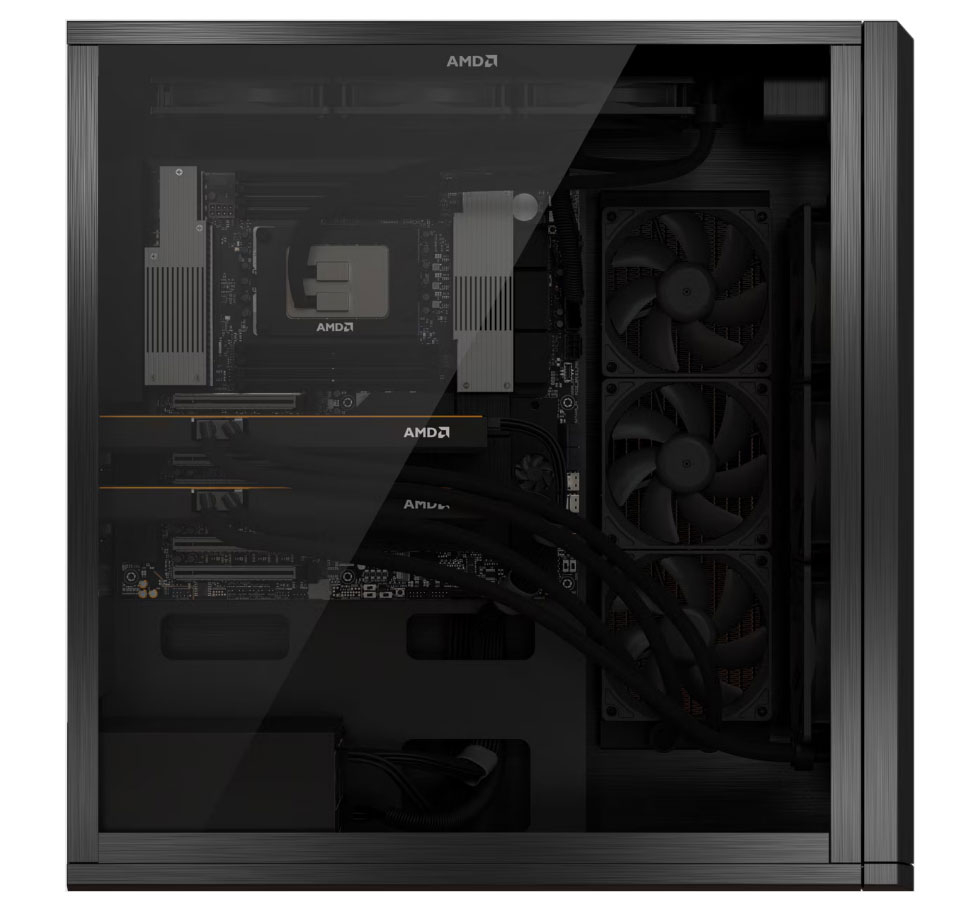 Каждый из установленных ИИ-ускорителей потребляет до 600 Вт, тогда как показатель TDP процессора Ryzen Threadripper Pro 9995WX составляет 350 Вт. Таким образом, с учётом энергопотребления памяти, установленных накопителей, СЖО и прочих компонентов рабочая станция при максимальной нагрузке может требовать более 3 кВт.
01.09.2026 [16:00], Владимир Мироненко
Broadcom представила частное ИИ-облако VMware AI Factory, позаимствовав у NVIDIA термин для партнёрства с AMDКомпания Broadcom представила решение VMware AI Factory в качестве программно-определяемой основы для VMware Private AI Cloud, предлагающей клиентам более простой путь к внедрению ИИ благодаря инновациям в автоматизации развёртывания готовой к ИИ инфраструктуры, её сопровождении и поддержке. Как утверждает Broadcom, с помощью её ИИ-фабрики клиенты смогут ускорить развёртывание первой модели и лучше управлять токеномикой ИИ. «Мы предоставляем клиентам программно-определяемую основу, которая автоматизирует развёртывание инфраструктуры, объединяет управление жизненным циклом и позволяет им выбирать предпочтительное оборудование и проверенные модели. В результате — ускорение развёртывания первой модели, предсказуемые затраты на частное облако и лучший контроль над токеномикой ИИ», — заявил главный директор по продуктам подразделения VMware Cloud Foundation. VMware AI Factory предоставляет ИИ-приложения непосредственно к частным данным предприятия в защищённой среде частного облака. Благодаря возможностям автоматизации инфраструктуры VCF время от развёртывания на физическом сервере до запуска первой ИИ-модели сокращается с недель до нескольких часов. VMware AI Factory упрощает управление ИИ-инфраструктурой, полностью автоматизируя выделение оборудования, включение программного стека и управление жизненным циклом от начала до конца. 
Источник изображения: Broadcom VMware AI Factory построена на платформе VMware Cloud Foundation (VCF), которая объединяет и совместно использует ресурсы GPU в масштабах всей организации, позволяя командам запускать несколько моделей на общем оборудовании вместо выделения инфраструктуры для каждой рабочей нагрузки. Новые и готовящиеся к запуску частные ИИ-сервисы включают:
VMware AI Factory поддерживает сертифицированные узлы VCF AI ReadyNodes от Cisco, Dell, Lenovo и Supermicro, а также других производителей. Broadcom также объявила о сотрудничестве с AMD для интеграции VCF с GPU AMD Instinct и программной экосистемой ROCm. Любопытно, что идею ИИ-фабрики (AI Factory) первой предложила NVIDIA в качестве эталонной архитектуры, описывающей всё оборудование и ПО, необходимые для выполнения ИИ-нагрузок. ИИ-фабрики NVIDIA основаны на собственном оборудовании и ПО, а также на серверах Dell, Lenovo, HPE и др., которые тоже называют свои продукты ИИ-фабриками. Вице-президент по маркетингу продуктов в подразделении VCF компании Broadcom, сообщил изданию The Register, что VMware AI Factory — это «эволюция» VMware Private AI Foundation with NVIDIA, добавив, что NVIDIA является «нашим самым давним партнёром среди поставщиков GPU». Несмотря на давнее партнёрство, VMware позаимствовала название продукта NVIDIA для конкурирующего предложения, продвигающего её главного соперника AMD. Впрочем, VMware сообщила, что не исключает возможность создания AI Factory for NVIDIA.
01.09.2026 [15:41], Руслан Авдеев
К 2030 году AMD, Cisco и Humain развернут в Саудовской Аравии 1 ГВт суверенной ИИ-инфраструктурыAMD, Cisco и саудовская Humain запустили первую в Саудовской Аравии промышленную ИИ-инфраструктуру на основе ускорителей Instinct в формате GPUaaS. Инфраструктура объединяет ИИ-ускорители AMD Instinct MI355X, CPU AMD EPYC, коммутаторы Cisco Silicon One (N9000) и оптический 800G-интерконнекты. Компании заявляют, что инфраструктура обслуживает клиентов Humain в Саудовской Аравии и на других рынках, поддерживая различные задачи, от обучения ИИ-моделей до инференса. Система — первый этап более масштабного проекта строительства ИИ-инфраструктуы. В 2027 году AMD, Cisco и Humain рассчитывают начать внедрение до 250 МВт мощностей с использованием новейших AMD Instinct MI400 Series во II полугодии 2027 года. К 2030 году планируется развернуть до 1 ГВт. Новая архитектура позиционируется как суверенная ИИ-платформа, с помощью которой Humain рассчитывает обеспечить государственные органы, предприятия, исследовательские организации и разработчиков решением, работающим непосредственно на территории страны. AMD предоставляет вычислительные мощности и открытое ПО (ROCm), а Cisco — совместимую сетевую архитектуру и инструменты для централизованного управления инфраструктурой. ИИ-модели предоставит, в частности, Mistral. 
Источник изображения: سيف الظاهر/unsplash.com Для американских компаний наиболее важен переход архитектуры AMD/Cisco к промышленной эксплуатации. Планируемый переход от AMD Instinct MI355X к поколению MI400 демонстрирует, как быстро должна, по мнению создателей, развиваться инфраструктура. Также проект демонстрирует, как политика суверенного ИИ и архитектура гиперскейл-уровня пересекаются всё теснее. Если заявленные планы реализуют, Саудовская Аравия получит в своё распоряжение ИИ-платформу, по мощности энергопотребления сопоставимую с кампусами гиперскейл-уровня.
01.09.2026 [12:09], Сергей Карасёв
Bull займётся созданием европейского ИИ-суперкомпьютера LUMI-AI стоимостью €387,8 млнЕвропейское совместное предприятие по развитию высокопроизводительных вычислений (EuroHPC JU) и консорциумом LUMI AI Factory выбрали французскую компанию Bull в качестве подрядчика для реализации проекта LUMI-AI — ИИ-суперкомпьютера стоимостью €387,8 млн. Ожидается, что этот комплекс существенно расширит возможности Европы в сфере HPC. Система LUMI-AI расположится в IT-центре CSC в Каяани (Финляндия) рядом с действующим суперкомпьютером LUMI. Новая машина проектируется с прицелом на широкий спектр нагрузок — от обучения ИИ-моделей и инференса до масштабных научных симуляций, критически важных для поддержания прорывных исследований. В основу суперкомпьютера LUMI-AI ляжет новейшая архитектура BullSequana XH3500 с жидкостным охлаждением. Говорится о применении 256-ядерных процессоров AMD EPYC Venice 9006 и ускорителей AMD Instinct MI430X. Платформа BullSequana XH3500 использует открытую модульную конструкцию: такой подход позволяет свободно комбинировать блоки CPU, GPU и сетевые компоненты от различных производителей. Так, в качестве технологических партнёров в рамках проекта LUMI-AI выступают IBM (отвечает за хранилище на основе Storage Scale) и Nokia (экспертиза в области сетевых технологий). Ожидается, что LUMI-AI обеспечит десятикратный прирост производительности для нагрузок ИИ, а также почти двукратное увеличение быстродействия для HPC-задач по сравнению с существующим суперкомпьютером LUMI. Производительность последнего находится на отметке 379,7 Пфлопс. Новый вычислительный комплекс будет работать исключительно на возобновляемой энергии, соответствуя строгим экологическим стандартам. Генерируемое тепло планируется направлять в городскую систему теплоснабжения Каяани. 
Источник изображения: Bull Проект LUMI-AI финансируется на паритетных началах предприятием EuroHPC JU и консорциумом LUMI AI Factory, в который входят Финляндия, Чехия, Дания, Эстония, Норвегия и Польша. Развёртывание суперкомпьютера намечено на II половину 2027 года.
31.07.2026 [23:44], Владимир Мироненко
AMD представила архитектуру CDNA 5Компания AMD официально представила архитектуру CDNA 5 для серверных нагрузок. Вместо простого обновления архитектуры предыдущего поколения CDNA 4, она включает в себя некоторые элементы из ориентированной на потребителя архитектуры RDNA и вносит изменения в вычислительные блоки, кеш, технологию производства и память. Результатом стало заметное повышение эффективности для ИИ-задач. С момента своего появления в качестве эволюции архитектуры GCN, CDNA отличалась от RDNA (Radeon DNA) только в своей ориентации на оптимизацию производительности. GCN уже была разработана для высокопроизводительных вычислительных задач на серверах и в исследовательских средах, и именно такой она и должна была оставаться. В свою очередь, RDNA ориентирована на потребительские игры. CDNA 5 — первая итерация, которая разрушает границы дизайна между двумя линейками. Более того, AMD публично заявила о своём намерении в будущем объединить CDNA и RDNA в единую архитектуру (UDNA). 
Источник изображений: AMD Вычислительные блоки (CU) в CDNA 5 переименованы в Workgroup Processor (WGP). Один WGP обеспечивает вдвое большую пропускную способность, чем CU предыдущего поколения, и более высокую производительность на такт. Его конструкция очень похожа на WGP, используемый в RDNA. Каждый чиплет вычислений XCD содержит 32 блока WGP. Для быстрого перемещения ИИ-данных из памяти в кеш в WGP добавлен выделенный блок перемещения тензорных данных (Tensor Data Mover), который может загружать данные непосредственно из видеопамяти в локальное хранилище данных без дополнительных промежуточных шагов, что ещё больше снижает задержку. Также следует отметить такие нововведения, как функция многоадресной рассылки L2, которая позволяет использовать одну выборку из памяти для обслуживания нескольких WGP для устранения избыточного трафика памяти, барьеры для более эффективной синхронизации и кластеризацию WGP для взаимодействия нескольких WGP на матричных операциях. 
Новая архитектура обеспечивает выполнение режима Wave32, снижая затраты на синхронизацию и улучшая использование SIMD, а также предоставляет усовершенствованный математический ИИ-движок с новыми инструкциями tanh и улучшенной пропускной способностью. Это позволяет снизить вычислительные затраты и улучшить реальное использование вычислительных блоков, причем эффект становится более заметным при переключении между различными форматами данных. Новый техпроцесс N2 от TSMC предлагает преимущества, особенно с точки зрения энергопотребления, но меньше с точки зрения тактовой частоты или плотности транзисторов. MI455X содержит 320 млрд транзисторов, что более чем на 50 % больше, чем у NVIDIA B200 с 208 млрд, который производится с использованием 4NP (обозначения NVIDIA для модифицированного процесса N5). Это преимущество в техпроцессе может сохраниться как минимум до появления продуктов Vera Rubin во II половине 2026 года, что на данный момент выводит AMD на лидирующие позиции в сегменте серверных чипов. 
В CDNA 5 компания отказалась от кеша Infinity Cache, использовавшегося в предыдущем поколении CDNA 4 для буферизации VRAM. Кеш L2, ранее интегрированный в XCD, полностью перемещён на выделенный чип FCD, что увеличивает общую ёмкость до 192 Мбайт и скорость доступа до 27 Тбайт/с. Упрощение иерархии кеша напрямую снижает задержку доступа для рабочих нагрузок ИИ. Для соединения XCD используются два чипа Fabric and Cache Dies (FCD). На каждом FCD размещено четыре XCD. Четыре XCD совместно используют 96 Мбайт кеша L2 и не могут получить доступ к кешу другого FCD. Чип FCD, ориентированный на кеш и скорость доступа, производится по техпроцессу TSMC N3P. Что касается памяти, архитектура использует 12 стеков HBM4. Объём памяти увеличен с 288 до 432 Гбайт в сумме, а ПСП составляет 23,3 Тбайт/с. Такая компоновка с 12 стеками стала возможной благодаря использованию новой технологии упаковки CoWoS-L от TSMC. Вместо традиционного кремниевого интерпозера применён слой перераспределения для увеличения площади корпусировки и размещения большего количества стеков памяти. 
Если 432 Гбайт на одной карте окажется недостаточно для обучения сверхбольших моделей, память всех GPU в стойке может быть объединена, что позволит получить до 31 Тбайт общей доступной памяти HBM4 в стойке Helios. В этом случае доступ будет ограничен скоростью сетевого соединения в 100 Гбайт/с, но встроенные коммутаторы обеспечат прямое подключение каждого GPU к каждому другому GPU, полностью соответствующее требованиям к памяти при обучении больших моделей. В CDNA 5 также добавлена поддержка типов данных MXFP4/MXFP8. Эти форматы уменьшают избыточное использование на элемент данных за счёт совместного использования битов экспоненты, а MXFP4 также поддерживает совместное использование битов мантиссы. Это помогает экономить как объём памяти, так и пропускную способности. CDNA 5 также поддерживает функцию гиперболического тангенса (tanh) на аппаратном уровне. В машинном обучении он используется для активации следующего «шага» мышления. Поскольку он очень ресурсоёмкий с точки зрения вычислений, AMD теперь внедрила аппаратное ускорение, которое удваивает пропускную способность tanh.
27.07.2026 [12:55], Сергей Карасёв
Supermicro представила серверы на платформе AMD EPYC VeniceКомпания Supermicro анонсировала серверы семейства H15, построенные на аппаратной платформе AMD EPYC Venice 9006. Эти машины, как утверждаются, обеспечивают 1,7-кратный прирост производительности по сравнению с устройствами предыдущего поколения. В серию H15 входит большое количество систем, оптимизированных для широкого спектра корпоративных и инфраструктурных приложений, включая ИИ-нагрузки. Это, в частности, флагманские двухпроцессорные устройства Hyper, одно- и двухсокетные решения CloudDC для облачных сред, 2U-серверы высокой плотности GrandTwin, модели FlexTwin формата 1OU, платформы хранения Petascale Storage типа All-Flash в корпусах 1U и 2U, модели SuperBlade и пр. Кроме того, дебютировали GPU-серверы AS-5126GS-TNRT и AS-5126GS-TNRT2, которые комплектуются соответственно восемью и десятью ускорителями AMD Instinct MI350P. Обе системы выполнены в форм-факторе 5U и оснащены воздушным охлаждением. Первая из этих машин располагает в общей сложности девятью слотами для карт PCIe 5.0 x16 FHFL, вторая — тринадцатью. Во фронтальной части корпуса расположены отсеки для SFF-накопителей. Питание обеспечивают шесть блоков мощностью 2700 Вт с сертификатом 80 PLUS Titanium. Реализованы два сетевых порта 10GbE (RJ45), выделенный сетевой порт управления 1GbE (RJ45) и разъём D-Sub. Заявлена совместимость с Oracle Linux 10.0, RHEL 9.6/10.0, RHEL AI 3.0, Windows Server 2022/2025. 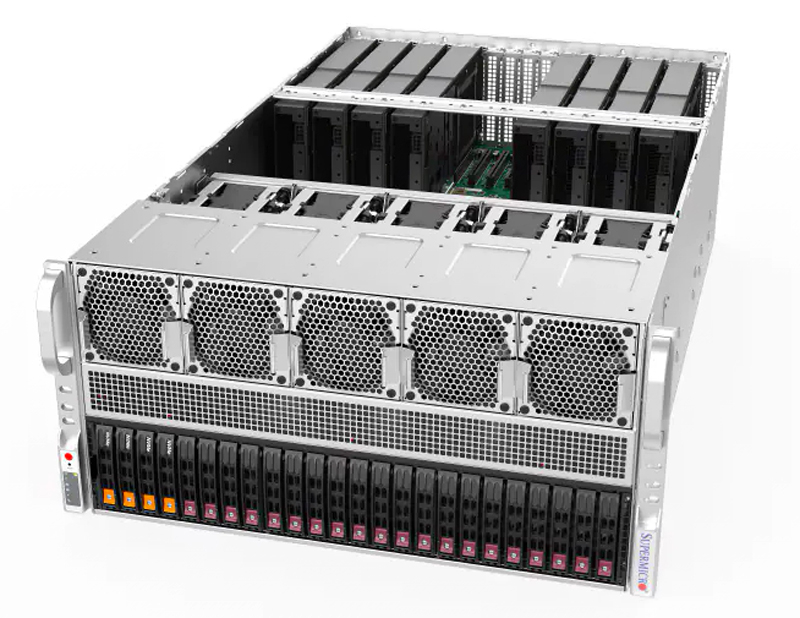
Источник изображения: Supermicro Supermicro также сообщила о сотрудничестве с AMD с целью поставок стоечной платформы Helios AI с 72 ускорителями Instinct MI455X. Она ориентирована на обучение ИИ-моделей в масштабе и на инференс с высокой пропускной способностью. Предусмотрено применение жидкостного охлаждения, сетевых устройств AMD Pensando и программного стека AMD ROCm.
27.07.2026 [11:40], Сергей Карасёв
81 920 ядер на стойку: HPE представила узлы Cray Supercomputing GX5000 на базе AMD EPYC Venice 9006Компания HPE обновила суперкомпьютерную платформу HPE Cray Supercomputing GX5000 нового поколения. Система высокой плотности ориентирована на НРС-задачи и ресурсоёмкие нагрузки, связанные с ИИ. В основу положены серверы с процессорами AMD EPYC Venice 9006. В конфигурации с чипами EPYC 9996 (256 вычислительных ядер) суммарное количество ядер на серверную стойку достигает 81 920. По заявлениям производителя, это на 40 % больше по сравнению с ближайшей конкурирующей системой высокой плотности. Для новой платформы будут доступны серверы HPE Cray Supercomputing GX350a Accelerated Blade и HPE Cray Supercomputing GX250 Compute Blade. Первые ориентированы на смешанные вычисления: они объединяют один процессор AMD EPYC Venice и четыре ускорителя AMD Instinct MI430X. В одной стойке могут быть размещены до 28 таких узлов, что в сумме даст 112 ускорителей. В свою очередь, сервер GX250 рассчитан на FP64-операции: он несёт на борту восемь процессоров EPYC Venice 9006 (без ускорителей). В одной стойке могут размещаться до 40 узлов, содержащих в сумме 320 CPU. Предусмотрена возможность использования прямого жидкостного охлаждения. По сравнению с системами предыдущего поколения новая платформа HPE Cray Supercomputing GX5000 обеспечивает возможность сокращения пространства в дата-центре на 25 % при сопоставимой вычислительной мощности. 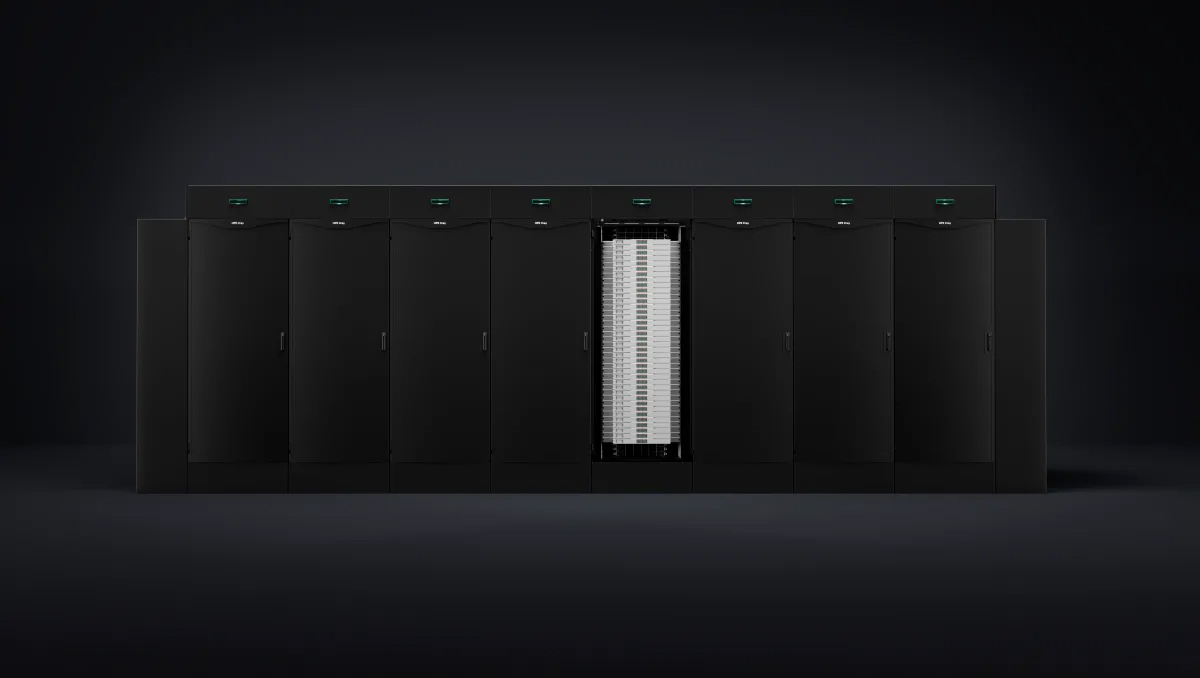
Источник изображения: HPE Отмечается, что в число первых пользователей платформы входят Окриджская национальная лаборатория (ORNL) Министерства энергетики США (DOE) и Центр высокопроизводительных вычислений Штутгартского университета (HLRS).
25.07.2026 [21:30], Сергей Карасёв
ИИ-платформа Liqid UltraStack объединяет 30 ускорителей AMD Instinct MI350PКомпания Liqid объявила о стратегическом сотрудничестве с AMD, направленном на создание решений следующего поколения для ИИ-инфраструктур. В рамках партнёрства представлена аппаратная платформа Liqid UltraStack 30, оптимизированная для задач инференса. В состав системы входят сервер с двумя процессорами AMD EPYC 9005 Turin и коммутатор Liqid PCIe Fabric Switch. Ключевыми компонентами являются три GPU-блока, каждый из которых содержит десять ускорителей AMD Instinct MI350P (144 Гбайт памяти HBM3E с 4096-бит шиной). Таким образом, в общей сложности задействованы 30 названных карт и 4,3 Тбайт памяти HBM3E. Заявленная производительность достигает 69 Пфлопс в режиме FP8. Говорится о возможности работы с общими пулами памяти по высокоскоростному стандарту CXL. Суммарное энергопотребление платформы находится на уровне 22 кВт. По заявлениям Liqid, система обеспечивает 3,7-кратный прирост показателя токенов в секунду по сравнению с традиционными решениями. Количество токенов в пересчете на $1 увеличивается в 2,1 раза, а токенов на 1 Вт затрачиваемой энергии — в 1,8 раза. Затраты на развёртывание могут быть уменьшены на 65 %. 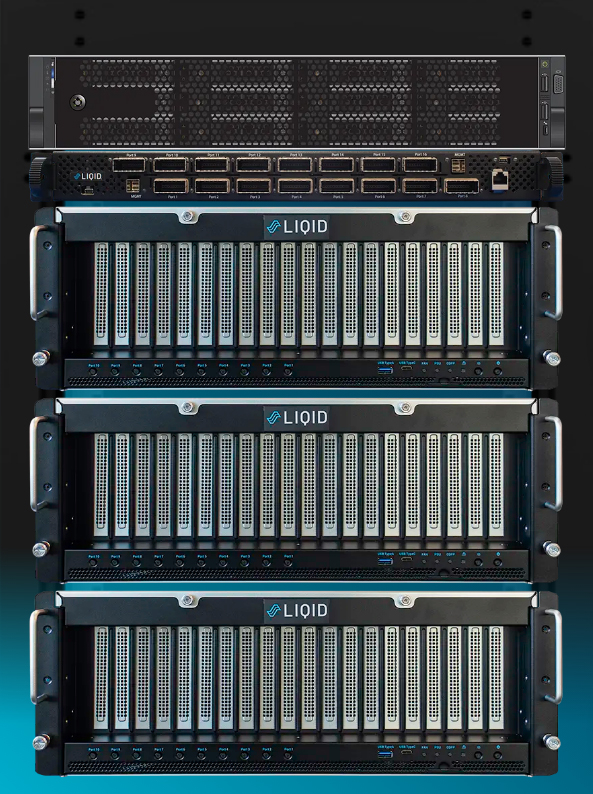
Источник изображения: Liqid Программное обеспечение Liqid Matrix объединяет GPU-ускорители и в реальном времени распределяет их ресурсы между рабочими нагрузками через высокоскоростную PCIe-шину. При этом все карты остаются в пределах одного узла. В целом, платформа Liqid UltraStack 30, как утверждается, устраняет накладные расходы, связанные с использованием нескольких узлов, обеспечивает предсказуемое линейное масштабирование и доводит загрузку GPU почти до 100 %. Упомянута поддержка Kubernetes для работы с несколькими моделями. |
|

