Материалы по тегу: instinct
|
24.07.2026 [12:11], Владимир Мироненко
AMD представила Instinct MI455X — первый ускоритель на архитектуре CDNA 5AMD представила AMD Instinct MI455X — первый ускоритель, построенный на новой архитектуре AMD CDNA 5-го поколения и разработанный специально для стоечного решения AMD Helios, обеспечивая высокую производительность при обработке ИИ-нагрузок, включая ИИ-инференс, обучение и тонкую настройку. Созданный на базе комбинации 2-нм и 3-нм чиплетов, ускоритель имеет 432 Гбайт памяти HBM4 с пиковой пропускной способностью 23,3 Тбайт/с. Вычислительные (XCD) чиплеты основаны на техпроцессе TSMC N2 — 2 нм с круговым затвором, — в то время как чиплеты FCD и MID используют техпроцесс N3P (3 нм FinFET). Упаковка объединяет 8 чиплетов XCD, 2 IOD и 2 FCD, а также 12 стеков HBM4, что в сумме составляет 320 млрд транзисторов. AMD Instinct MI455X поддерживает NUM до восьми NUMA-доменов. В режиме NPS1 адреса распределяются по 12 стекам HBM на двух чиплетах, а в профиле NPS2 адреса распределяются на два раздела по 6 стекам HBM без обмена данными между чиплетами. 
Источник изображений: AMD Четыре чиплета XCD размещены поверх каждого чиплета кеш-памяти (FCD) с использованием гибридного соединения. В свою очередь, два чиплета FCD соединены с шестью стеками HBM4, двумя чиплетами IO и друг с другом с помощью технологии CoWoS-L от TSMC. Каждый XCD включает по 32 активных процессора WGP (Work Group Processor), что в сумме составляет 256. Чиплеты HBM4 соединены через 192-канальный интерфейс. Имеется 16 блоков кеша L2 по 16 Мбайт каждый, что в сумме составляет 192 Мбайт разделяемого кеша LLC. 16 линий AMD Infinity Fabric обеспечивает 256 Гбайт/с в двунаправленном режиме. Масштабирование в стойке обеспечивает 72 линии UALoE (3,6 Тбайт/с в двунаправленном режиме).  Согласно данным производителя, AMD Instinct MI455X обеспечивает 20 Пфлопс пиковой мощности в операциях MXFP6 и MXFP8, 40,3 Пфлопс пиковой мощности в операциях MXFP4. Также сообщается о поддержке типы данных FP4, FP6 и FP8. Для FP64-нагрузок будет представлена модификация MI430X По сравнению с предыдущим поколением Instinct MI355X обеспечивает до 4 раз увеличение пиковой вычислительной мощности, до 2,9 раза увеличение пропускной способности памяти и 1,5-кратное увеличение ёмкости памяти. Благодаря этому обеспечивается увеличению пропускной способности токенов в 18 раз и до 34-кратного снижения стоимости токенов при использовании DeepSeek V4 Flash FP4, сообщил TechPowerUp.
24.07.2026 [11:58], Сергей Карасёв
AMD и Cerebras представили платформу для ИИ-инференса со сверхнизкой задержкойКомпании AMD и Cerebras Systems объявили о сотрудничестве, в раках которого планируется вывод на рынок новой аппаратной платформы для ИИ-инференса со сверхнизкой задержкой и высокой пропускной способностью. Речь идёт об объединении стоечных решений AMD Helios и ускорителей Cerebras Wafer-Scale Engine (WSE). Это своего рода ответа на интеграцию Groq в платформу NVIDIA Vera Rubin. Напомним, система Helios двойной ширины объединяет процессоры EPYC Venice с ядрами Zen 6, ускорители Instinct MI400 и DPU Vulcano. Данная платформа спроектирована специально с прицелом на ресурсоёмкие ИИ-задачи. В свою очередь, изделия WSE, насчитывающие сотни тысяч ядер, оптимизированы для сверхбыстрого обучения и запуска ИИ-моделей. Совместное решение AMD и Cerebras объединяет сильные стороны Helios и WSE в общий рабочий процесс для достижения максимальной производительности и эффективности инференса. В частности, формируется дезагрегированная среда, в которой два основных этапа задачи оптимизируются независимо друг от друга. Стойки Helios обеспечивают сверхвысокую пропускную способность, обрабатывая запросы и большие контекстные окна. Ускорители WSE при этом отвечают за генерацию токенов с минимальной задержкой. 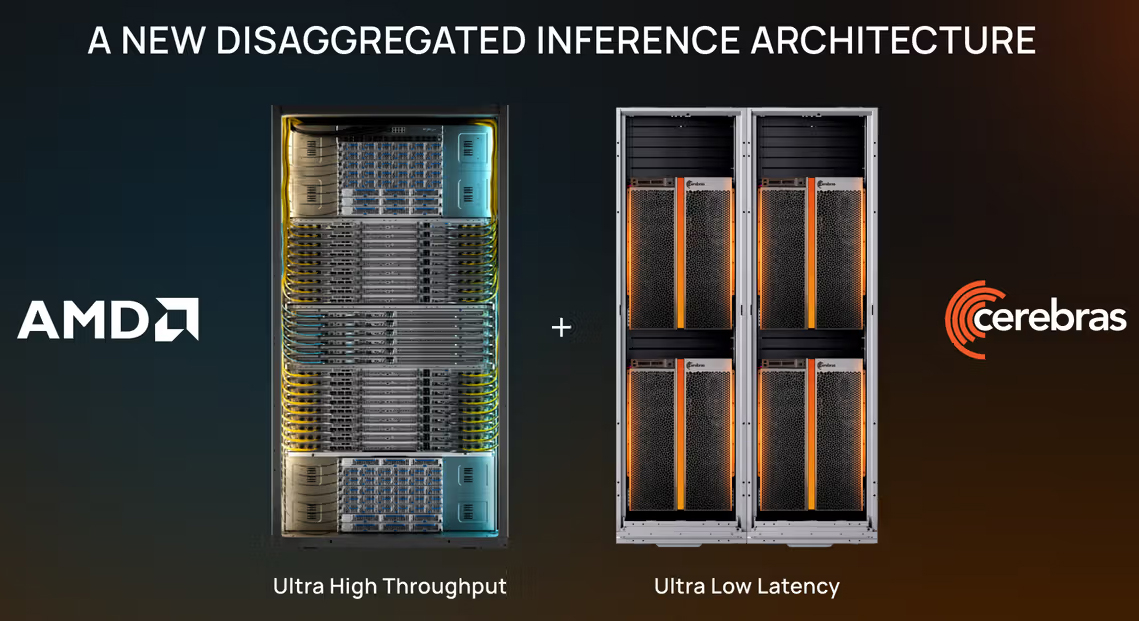
Источник изображения: Cerebras В целом, новая платформа AMD и Cerebras, как утверждается, даёт возможность повысить показатель токенов в секунду на ватт (Т/с/Вт) в пять раз по сравнению с конфигурациями, в которых используются только лишь изделия WSE (при работе с мультимодальной моделью Kimi 2.6 1T, насчитывающей 1 трлн параметров). В рамках партнёрства с AMD компания Cerebras намерена развернуть системы Helios в своих дата-центрах. Новое аппаратное решение станет доступно клиентам через облако Cerebras Cloud во II половине текущего года.
22.07.2026 [23:23], Владимир Мироненко
Anthropic купит у AMD ИИ-стойки Helios AI с Instinct MI450 на 2 ГВт, а AMD инвестирует в Anthropic $5 млрдКомпании AMD и Anthropic объявили о стратегическом партнёрстве, в рамках которого Anthropic развернёт в ЦОД на 2 ГВт ускорителей Instinct MI450 в стоечных решениях AMD Helios AI, а AMD инвестирует в неё $5 млрд. Запуск ускорителей на первый ГВт начнётся в I половине 2027 года. Anthropic также использует ускорители Instinct MI355X. Соглашение является примером циклической сделки, когда производители чипов инвестируют в компании в сфере ИИ, которые входят в число их крупнейших клиентов. Как сообщает The Wall Street Journal, часть приобретённых Anthropic чипов AMD будет развёрнута в её собственных ЦОД, часть — в арендованных. По словам генерального директора AMD Лизы Су (Lisa Su), Anthropic и AMD работают вместе над поиском ЦОД для размещения этих чипов. Инвестиции AMD в Anthropic будут связаны с достижением определённых этапов развёртывания, сообщило агентство Reuters. У OpenAI, прямого конкурента Anthropic, есть похожие сделки с AMD и NVIDIA. Кроме того, AMD и Anthropic договорились о многолетнем инженерном сотрудничестве, в рамках которого модель Claude будет использоваться для ускорения разработки ПО AMD, в частности, для оптимизации рабочих нагрузок для ускорителей AMD Instinct и ускорения разработки ROCm. AMD также планирует широко внедрять Claude в работе своих инженерных и продуктовых команд. 
Источник изображения: AMD Крупные технологические компании с инвестиционным кредитным рейтингом всё чаще ведут переговоры о поддержке аренды или выделении заёмных средств ИИ-стартапам, которые в противном случае не смогли бы привлечь капитал на выгодных условиях. Например, Google согласилась поддержать некоторые сделки Anthropic по ЦОД и инвестировать в неё $40 млрд, чтобы помочь ей получить доступ к своим TPU. Рост спроса на её ИИ-инструменты вынудил Anthropic ограничить возможности пользователей в использовании своих ИИ-сервисов и заняться поиском дополнительных вычислительных мощностей. В мае Anthropic заключила сделку со SpaceX Илона Маска (Elon Musk) на использование всех мощностей ЦОД Colossus 1. В апреле компания заключила многомиллиардное соглашение с Amazon, а также соглашение о предоставлении вычислительных мощностей на несколько гигаватт с Google и Broadcom. Также Anthropic ведёт предварительные переговоры об аренде вычислительных мощностей у Meta✴.
20.07.2026 [21:41], Владимир Мироненко
Microsoft внедрит новейшую платформу AMD Helios AI в облако AzureAMD объявила о расширении стратегического партнёрства с Microsoft, охватывающего ускорители, процессоры, сетевое оборудование и ПО на платформе Azure. AMD начнёт поставки Helios клиентам, включая Microsoft, во II половине 2026 года, но именно Microsoft первой среди «большой тройки» облаков публично заявила о массовом развёртывании новой платформы. В рамках партнёрства Microsoft внедрит в ЦОД Azure платформу AMD Helios AI с EPYC Venice и MI455X. Эти решения будут лежать в основе трёх будущих семейств инстансов Azure: HDv2 для обработки данных, HXv2 для автоматизации проектирования электроники (EDA) и ND MI455X v7 для рабочих нагрузок ИИ-инференса. Инстансы HDv2, разработанные совместно с AMD, предназначены для самых ресурсоёмких задач, связанных с ИИ, включая подготовку данных, поиск, обучение с подкреплением и координацию агентов. Благодаря почти 500 физическим ядрам в составе AMD EPYC Venice, 4 Тбайт RAM, 32 Тбайт локального NVMe-хранилища и 400GbE DPU Azure Boost, HDv2 способны удовлетворить потребности самых требовательных клиентов в области ИИ, отметила Microsoft. Инстанcы HXv2 развивают сильные стороны виртуальных машин HX, запущенных в партнёрстве с AMD в 2023 году. HXv2 тоже предлагает дифференциацию для рабочих нагрузок моделирования на уровне RTL и тоже использует технологию 3D V-Cache, вместе с тем получив значительные улучшения в части производительности ядер и памяти в однопоточных задачах. ВМ HXv2 будут оснащены 176 ядрами процессоров EPYC Venice с тактовой частотой более 5 ГГц, наполовину большим кешем, доступному каждому ядре, и порядка 2 или 4 Тбайт RAM. 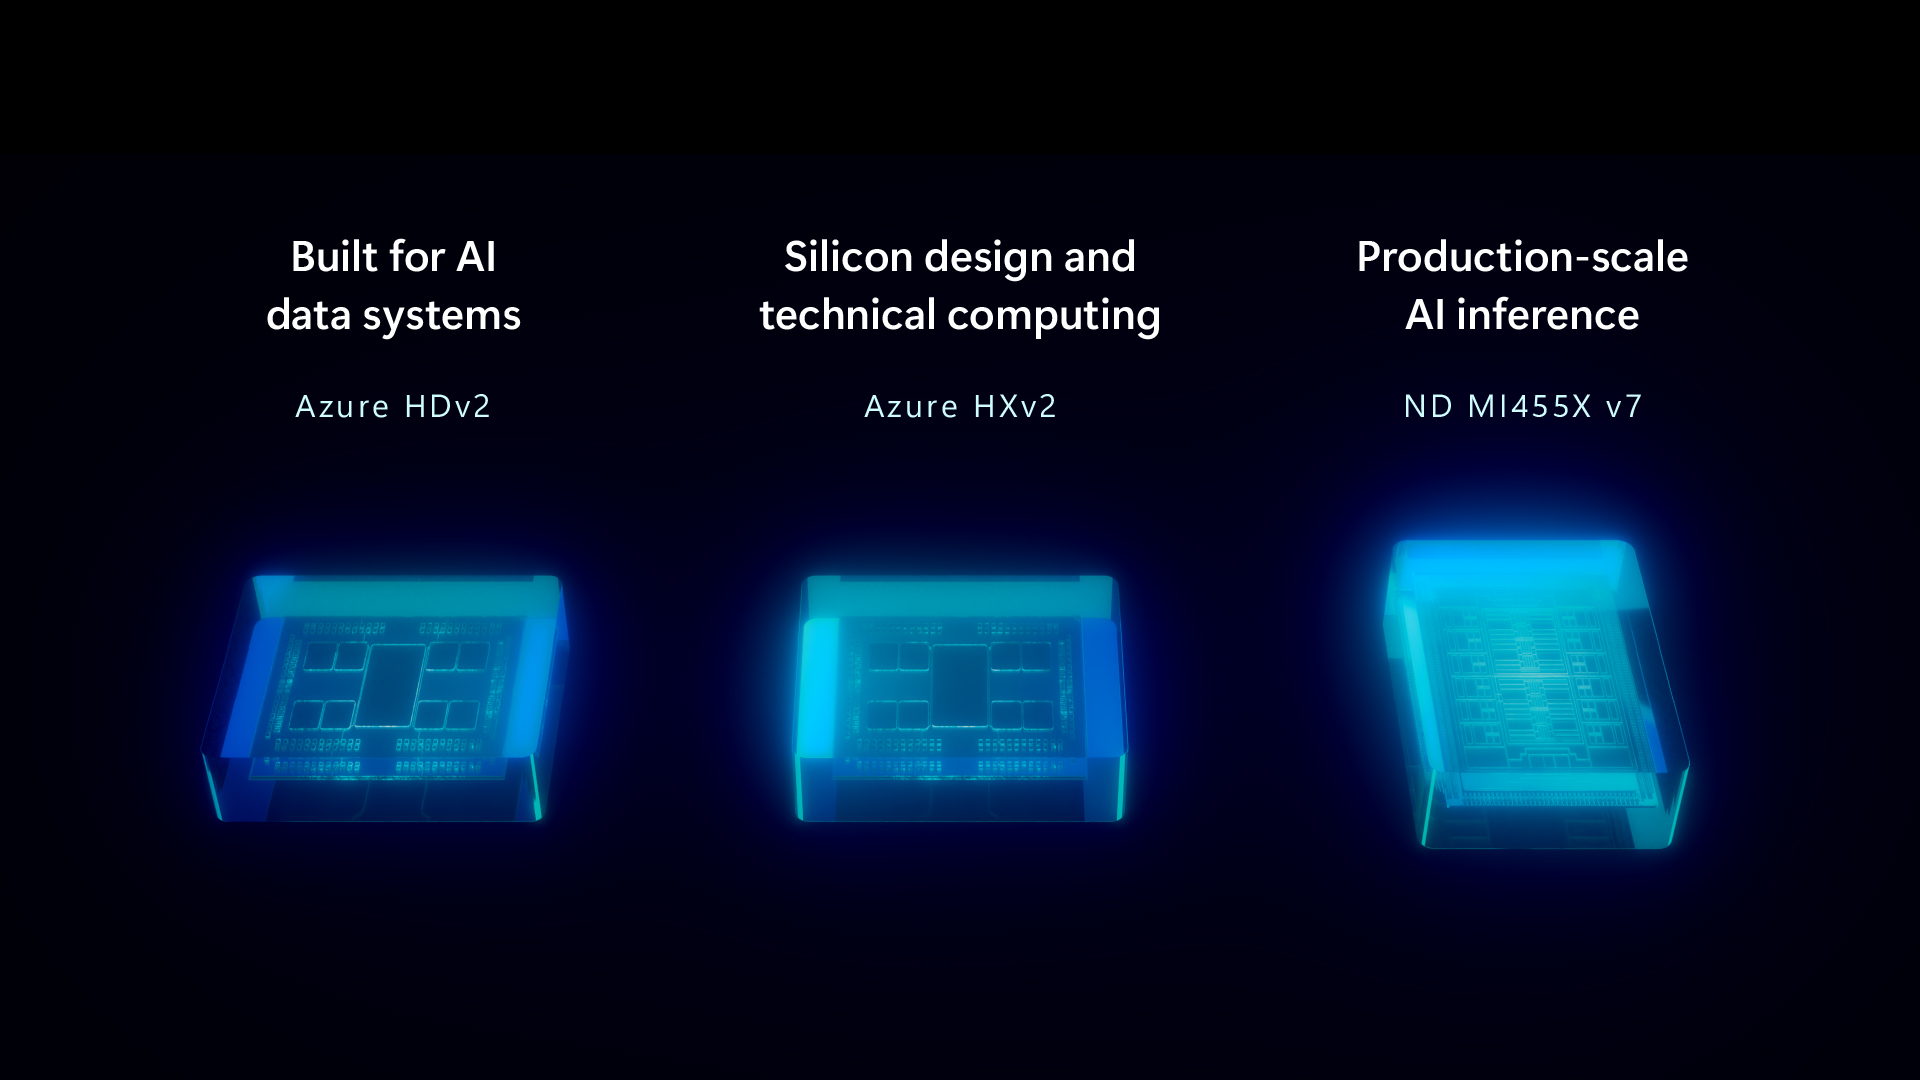
Источник изображения: Microsoft При этом Azure HXv2 поддерживает более широкий спектр технических вычислительных задач, включая научное моделирование, инженерный анализ и другие приложения с распределённой памятью. Значительно повышенная производительность на ВМ и на ядро, а также наличие 800G-подключения InfiniBand, позволяют проводить крупномасштабные симуляции на основе MPI и делают HXv2 идеальным решением для широкого круга клиентов, использующих HPC, сообщила Microsoft. В свою очередь, инстансы ND MI455X v7 разработаны для ИИ-инференса в производственных масштабах — для рабочих нагрузок рассуждений, поиска и агентных вычислений, лежащих в основе современных ИИ-сервисов. Сотрудничество также распространяется на сетевой уровень. DPU Pensando уже активно используются Microsoft, а теперь компании интегрируют Azure Boost с технологиями AMD для повышения производительности сети, эффективности и обработки подключений в облачном масштабе. Сотрудничество расширяет доступ к ИИ-инфраструктуре AMD в Azure. Разработчики передовых моделей смогут использовать инфраструктуру на базе AMD для обучения и обслуживания крупномасштабных ИИ-моделей, а корпоративные клиенты могут развёртывать и масштабировать рабочие нагрузки ИИ в производственной среде с помощью управляемых вычислительных ресурсов Azure Foundry.
19.06.2026 [14:01], Руслан Авдеев
Rackspace развернёт ИИ-оборудование AMD на 30 МВт в ЦОД по всему мируКомпании AMD и Rackspace Technology подписали соглашение, посвящённое внедрению первых 30 МВт ИИ-оборудования на основе чипов AMD. Оно будет использоваться в дата-центрах Rackspace по всему миру. Внедрение начнётся в конце текущего года и продлится до 2028-го. В рамках нового соглашения AMD становится стратегическим поставщиком чипов для реализации ИИ-стратегии Rackspace. Для поддержки обучения ИИ-моделей, инференса и корпоративных нагрузок будут использоваться ИИ-ускорители AMD Instinct, включая модели MI355X, MI350P и чипы будущих поколений, а также серверные процессоры семейства AMD EPYC. Соглашение также предусматривает совместную деятельность по освоению рынков. Компании выделят маркетинговые ресурсы и персонал для разработки и продвижения предложений на базе инфраструктуры AMD — для клиентов из регулируемых отраслей. После полного внедрения экосистема мощностью 30 МВт обеспечит вычислительные ресурсы для корпоративных пользователей, включая организации из сферы здравоохранения и прочие компании из регулируемых секторов. В Rackspace сообщают, что соответствующая инфраструктура необходима для поддержки масштабных ИИ-инициатив в медицине, для инференса и выполнения других задач, требующих администрирования, отчётности и операционного надзора. 
Источник изображения: AMD Компании рассчитывают интегрировать аппаратный стек AMD в архитектуру Enterprise AI Cloud компании Rackspace. Платформа будет автоматически подбирать вычислительные ресурсы под конкретные нагрузки, в то же время обеспечивая централизованное управление и оперативный учёт работы всей инфраструктуры. По словам Rackspace, регулируемые отрасли требуют полностью управляемой инфраструктуры, а не подборки решений от независимых вендоров. Сотрудничество позволит объединить вычислительные мощности и операционные сервисы в одну управляемую экосистему, с ответственностью от аппаратного уровня до конечных бизнес-результатов. В AMD подчеркнули, что корпоративные проекты всё чаще требуют комбинации вычислительных ресурсов, использующих как классические аппаратные решения, так и ИИ-ускорители для разных типов нагрузок. Предполагается, что проект ускорит запуск сервисов, предусмотренных меморандумом о взаимопонимании, подписанным ранее:
В целом решения формируют управляемый инфраструктурный ИИ-стек от выделенных физических серверов до полностью обслуживаемых сервисов инференса. Компании позиционируют инициативу, как альтернативу традиционным «самоуправляемым» ИИ-кластерам на базе bare-metal серверов. Основная аудитория — компании, переходящие от пилотных ИИ-проектов к полномасштабному внедрению ИИ и агентных рабочих процессов в ключевые бизнес-системы.
16.06.2026 [16:21], Сергей Карасёв
В Кембриджском университете запущен AMD-суперкомпьютер ZenithВ Кембриджском университете (University of Cambridge) в Великобритании состоялась церемония запуска высокопроизводительного вычислительного комплекса Zenith, предназначенного для научных исследований с использованием ИИ. Инвестиции в проект составили около £36 млн ($48,3 млн). В создании суперкомпьютера приняли участие компании AMD и Dell Technologies. Полностью характеристики машины пока не раскрываются. Известно, что в её основу положены серверы PowerEdge, оборудованные процессорами AMD EPYC поколения Turin. Кроме того, задействованы ИИ-ускорители Instinct MI355X с 288 Гбайт памяти HBM3E (8 Тбайт/с). Вместе с тем AMD, Dell и Кембриджский университет объявили о планах создания на территории Великобритании Лаборатории инноваций в области суверенного ИИ (Sovereign AI Innovation Lab — SAIL). Инициатива, как ожидается, позволит расширить доступ к передовой ИИ-инфраструктуре и НРС-ресурсам для исследователей, медицинских организаций, государственных учреждений и других участников отрасли. На площадке SAIL компании смогут разрабатывать, оценивать и внедрять передовые технологии ИИ. Ключевой задачей SAIL названо формирование открытой ИИ-экосистемы на базе вычислительных платформ AMD, программного обеспечения AMD ROCm и облачных технологий. Отмечается, что благодаря появлению SAIL исследователи смогут масштабировать ИИ-решения с применением суверенной инфраструктуры, что ускорит инновации в таких областях, как здравоохранение, энергетика, экология, передовые инженерные разработки и пр. 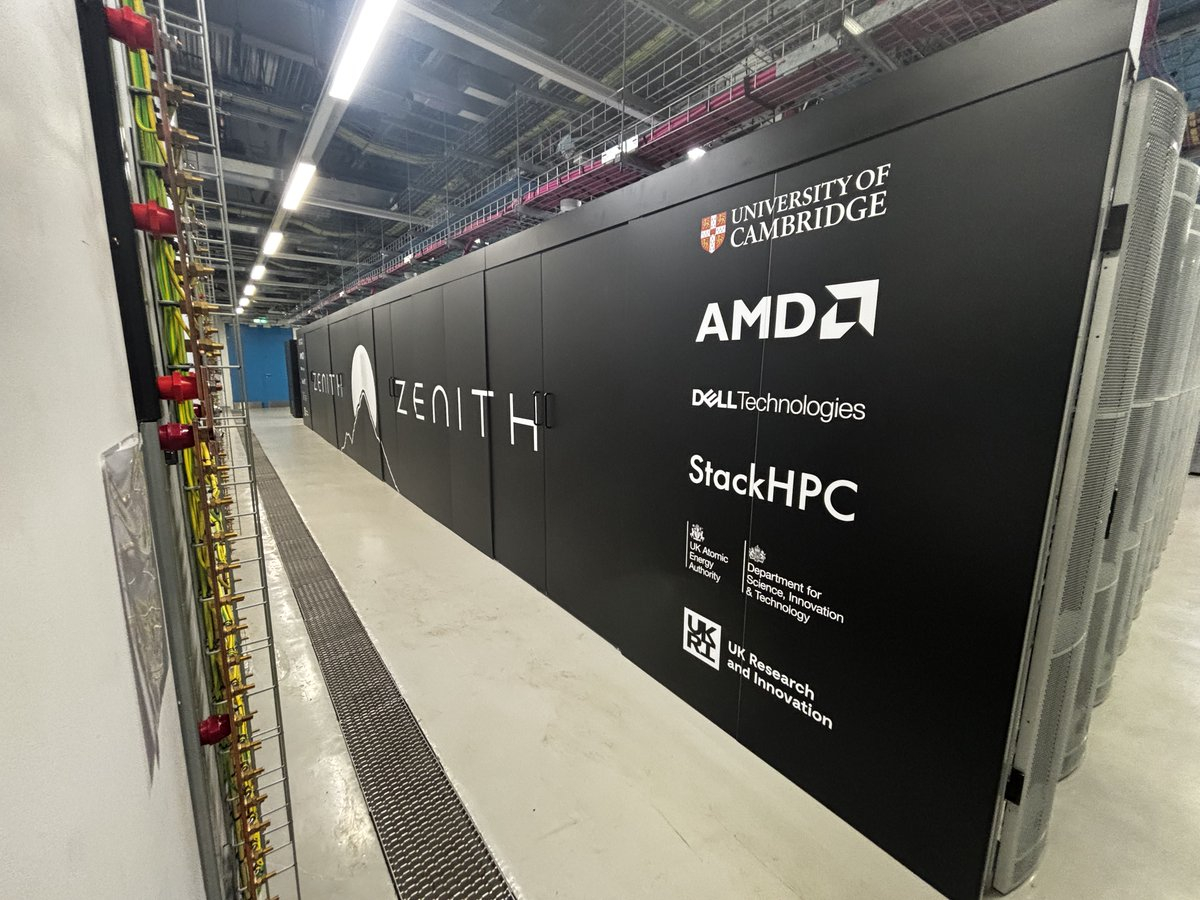
Источник изображения: University of Cambridge Одновременно AMD и Dell занимаются созданием ещё одного британского ИИ-суперкомпьютера — системы Sunrise. Этот проект финансируется Департаментом энергетической безопасности и достижения нулевого уровня выбросов (DESNZ) в составе Агентства по атомной энергии Великобритании (UKAEA).
09.06.2026 [13:58], Руслан Авдеев
AMD поддержит суверенный ИИ в Великобритании, инвестировав в ИИ-отрасль страны £2 млрд
amd
dell
epyc
hardware
hpc
instinct
великобритания
ии
инвестиции
инференс
суперкомпьютер
финансы
фотоника
В следующие пять лет AMD рассчитывает инвестировать в усиление ИИ-экосистемы Великобритании до £2 млрд ($2,7 млрд), создав новую инфраструктуру, программы совместных исследований и подготовки кадров. По словам представителя техногиганта, новая стратегия согласуется с правительственным проектом AI Opportunities Action Plan и стратегией AI Hardware Strategy, с основным акцентом на суверенные ИИ-возможности, научные вычисления и передовые исследования, сообщает Converge! Digest. Ключевой компонент инициативы — расширение вычислительной ИИ-инфраструктуры. AMD и Dell Technologies поддерживают две новые суперкомпьютерные системы в Кембриджском университете. Суперкомпьютер Zenith AI, финансирование которого осуществляется Министерством науки, инноваций и технологий (DSIT) и структурой UK Research and Innovation (UKRI), строится как платформа для использования ИИ в науке. Система Sunrise создаётся совместно с Управлением по атомной энергии Великобритании для поддержки исследований в сфере термоядерных технологий. Оба суперкомпьютера будут использовать ускорители AMD Instinct, процессоры EPYC и ПО AMD для решения задач в сфере здравоохранения, климатологии, материаловедения, разработки научных ИИ-моделей и др. Также AMD анонсировала исследовательские партнёрства с Имперским колледжем Лондона и компанией Oriole Networks. В первом случае взаимодействие сосредоточено на вычислительных дисциплинах, здравоохранении, моделировании климата, ИИ-оптимизации, обработке значительных объёмов данных и др. В то же время AMD и Oriole Networks принимают участие в проекте Scaling Inference Lab британского агентства ARIA (Advanced Research and Invention Agency). Проект стоимостью £50 млн направлен на устранение ряда проблем современной ИИ-инфраструктуры. Он объединяет фотонную сетевую архитектуру PRISM компании Oriole, ускорители AMD Instinct, а также процессоры EPYC для оценки новых подходов к масштабированию задач ИИ-инференса с меньшей задержкой и повышенной энергоэффективностью. 
Источник изображения: Robert Bye/unsplash.com По словам Converge!, лондонский стартап Oriole Networks намерен преодолеть традиционные ограничения классических ИИ-кластеров. Если в стандартных сетях на основе InfiniBand или Ethernet многократные преобразования оптического сигнала в электрический и обратно создают дополнительные задержки, то архитектура PRISM (Photonic Routing Infrastructure for Scalable Models) заменяет активные электронные коммутаторы «пассивным» оптическим ядром маршрутизации. Прямые оптические соединения узлов позволяют сократить время простоя GPU, связанное с ожиданием обмена данными, что мешает масштабным ИИ-нагрузкам. PRISM обеспечивает обработку динамического ИИ-трафика без использования электрических буферов пакетов данных. Многомерная коммутация каналов позволяет перенастраивать соединения в режиме реального времени и оптимизировать сеть под интенсивный обмен данными, характерный для больших языковых моделей. Кроме того, Oriole утверждает, что её технология позволяет объединять до миллиона оконечных устройств. В конечном счёте сокращение энергопотребления сетевого ядра может составить до 81 %. Ключевым элементом архитектуры PRISM является независимость от конкретного типа используемых процессоров и ускорителей. Вместо использования проприетарных интерконнектов, «привязывающих» операторов к определённой аппаратной платформе, Oriole разделяет транспортный и вычислительный уровни инфраструктуры. Компания заявляет, что её технологии интегрируются в существующие стеки ПО через стандартные драйверы PCIe и специализированные библиотеки ускорения вроде NCCL для NVIDIA или RCCL для AMD. Благодаря этому можно поддерживать разные аппаратные платформы без трансформации базовых ИИ-фреймворков. Будущее внедрение технологии в рамках ARIA Scaling Inference Lab станет значимой проверкой её жизнеспособности для отрасли и продемонстрирует, способны ли полностью фотонные сети гарантировать предсказуемую производительность и обеспечивать открытость проприетарных вычислительных систем в промышленных масштабах.
12.05.2026 [13:23], Сергей Карасёв
Dell выпустила ИИ-сервер PowerEdge XE9785 с ускорителями AMD Instinct MI355XКомпания Dell анонсировала сервер PowerEdge XE9785 на аппаратной платформе AMD, предназначенный для ресурсоёмких задач в области ИИ, включая обучение моделей и инференс. Двухсокетное устройство выполнено в форм-факторе 10U и оснащено воздушным охлаждением. Допускается установка двух процессоров AMD EPYC 9005 Turin, насчитывающих до 192 вычислительных ядер. Доступны 24 слота для модулей оперативной памяти DDR5-6400 RDIMM суммарным объёмом до 6 Тбайт. Во фронтальной части могут быть установлены до 16 NVMe-накопителей E3.S (PCIe 5.0) общей вместимостью до 245,76 Тбайт или до 10 NVMe-изделий U.2 суммарной ёмкостью до 153,6 Тбайт. Кроме того, есть два внутренних коннектора для SSD типоразмера М.2. Сервер несёт на борту восемь ускорителей AMD Instinct MI355X с 288 Гбайт памяти HBM3E (8 Тбайт/с). Задействован интерконнект AMD Infinity Fabric. В качестве альтернативного варианта предлагается конфигурация с восемью ускорителями NVIDIA HGX B300 и технологией NVIDIA NVLink. Питание обеспечивают 12 блоков мощностью 3200 Вт с сертификатом 80 Plus Titanium (с возможностью горячей замены). 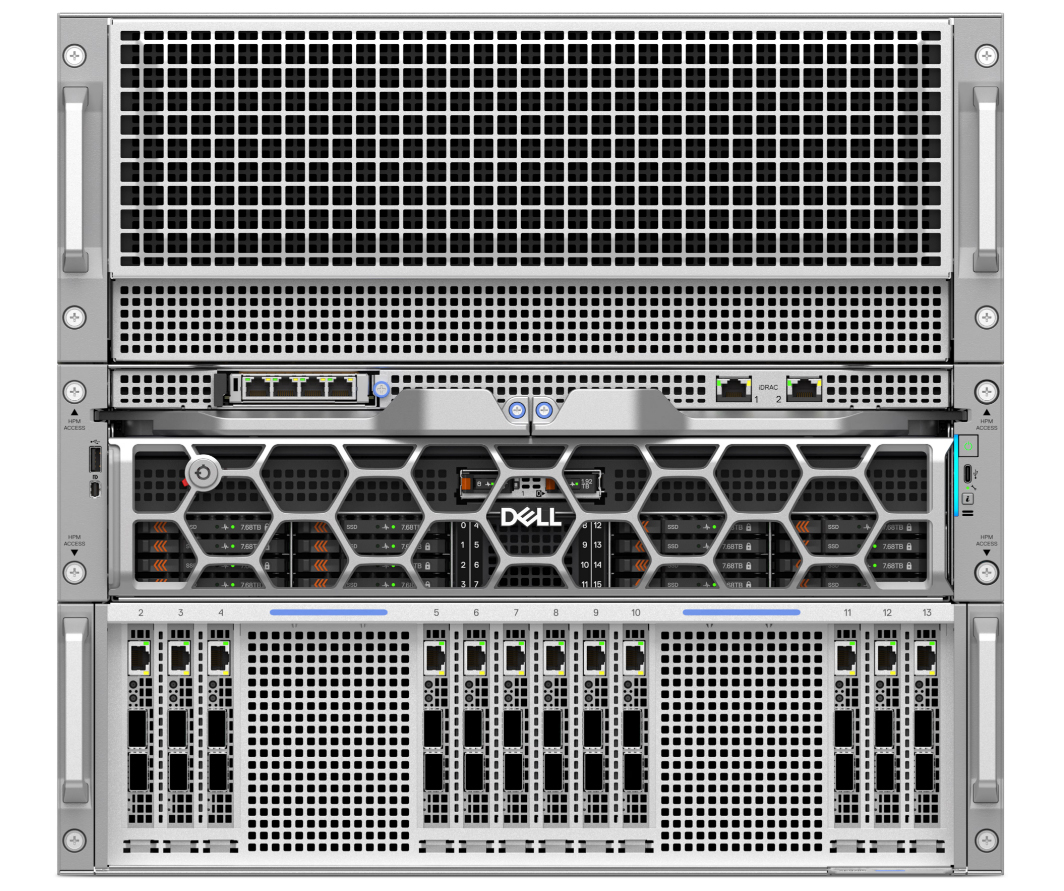
Источник изображения: Dell Габариты системы составляют 439,5 × 482,3 × 1044,7 мм, масса — 172,3 кг (с установленными картами MI355X). В зоне GPU находятся 15 вентиляторов, в области CPU — пять (все с поддержкой горячей замены). Среди прочего упомянуты слот OCP 3.0 (PCIe 5.0 x8), два сетевых порта RJ45, интерфейс Mini-DisplayPort, по одному порту USB Type-A и Type-C. Кроме того, компания Dell объявила о возможности использования ускорителей AMD Instinct MI350P в составе своих серверов PowerEdge XE7745 и R7725. Эти устройства рассчитаны на приложения ИИ, платформы виртуализации, базы данных и пр.
08.05.2026 [01:10], Владимир Мироненко
AMD представила ускоритель Instinct MI350P — CDNA 4 в формате PCIeAMD представила Instinct MI350P с интерфейсом PCIe — двухслотовую FHFL-карту для стандартных серверов с воздушным охлаждением. MI350P предназначена для локального развёртывания инференса в рамках существующей инфраструктуры электропитания, охлаждения и серверных стоек ЦОД предприятий. AMD отметила, что новинки с возможностью установки до 8 ед. в одно шасси «идеально подходят для инференса малых, средних и крупных ИИ-моделей и конвейеров RAG». Это первая PCIe-карта Instinct, выпущенная AMD за последние четыре года после выхода модели Instinct MI210. 600-Вт чип MI350P, по сути, представляет собой половинку MI350X (четыре XCD). У MI350P PCIe вдвое меньше вычислительных блоков — 128, что соответствует 8192 потоковым процессорам и 512 матричным ядрам. Пиковая частота составляет 2200 МГц. Кроме того, вместо двух IOD-кристаллов тут только один, он изготовлен по 6-нм техпроцессу TSMC. Сам ускоритель сделан по 3-нм технологии TSMC как MI350X. Весь чип содержит 73 млрд транзисторов. 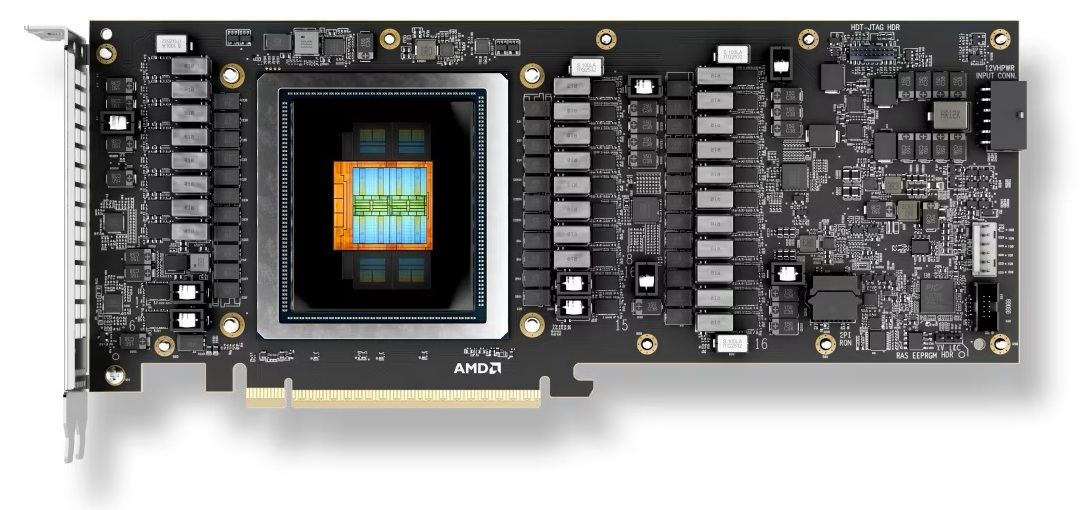
Источник изображений: AMD Ускоритель оснащён 128 Мбайт кеш-памяти Infinity Cache и 144 Гбайт памяти HBM3E с 4096-бит шиной, обеспечивающей пропускную способность 4 Тбайт/с. Для сравнения, MI350X оснащён 288 Гбайт памяти HBM3E с 8192-бит шиной. Плата 16-контактный разъём для подачи дополнительного питания. TBP можно установить на уровне 450 Вт вместо стандартных 600 Вт, что снизит производительность и ещё больше — энергопотребление. Интерфейс — PCIe 5.0 x16. Чуть позже будет реализована поддержка SR-IOV и возможность поделить чип на два или четыре vGPU. 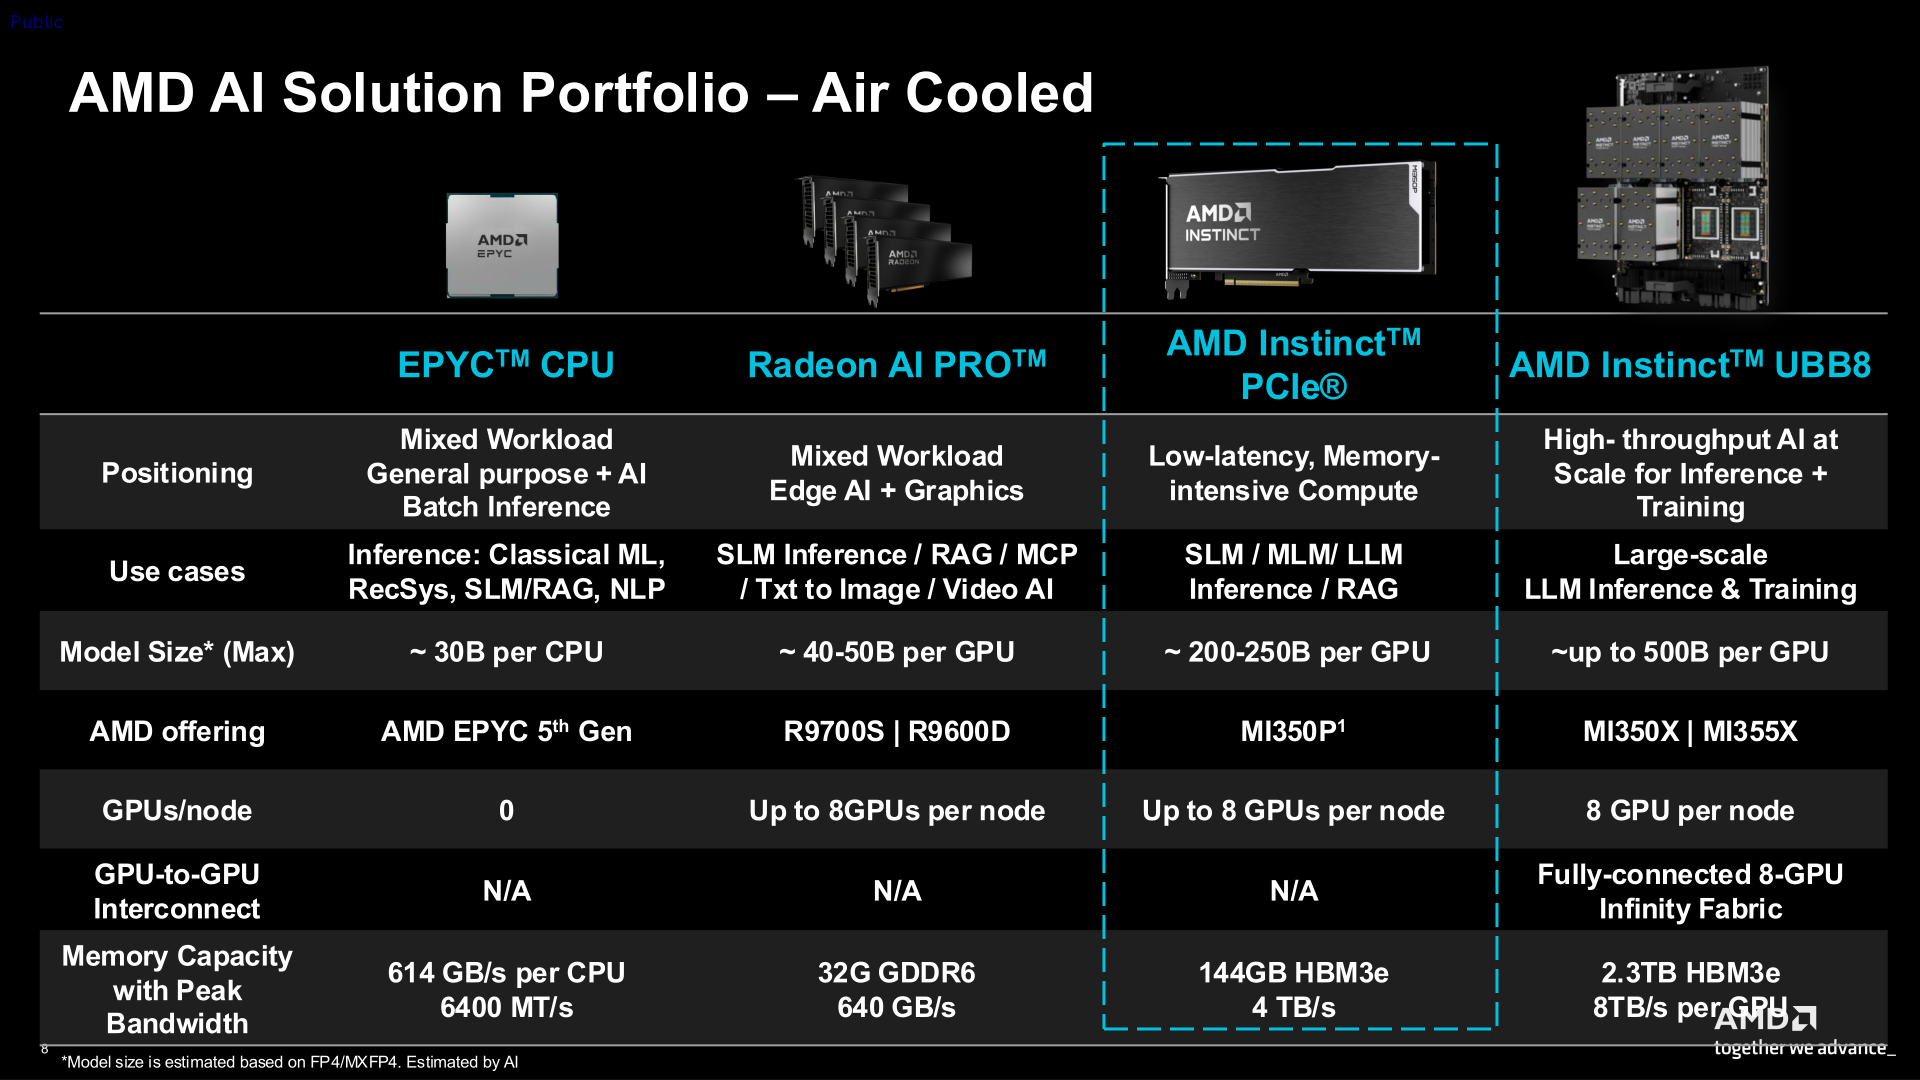 Расчётная производительность Instinct MI350P в MXFP4-расчётах составляет 2,3 Пфлопс, а пиковая — 4,6 Пфлопс. Это самая высокая производительность среди PCIe-ускорителей корпоративного класса, отметила компания. Предусмотрена поддержка разрежённости для форматов FP16, BF16, INT8 и OCP-FP8, что позволяет ускорить обработку данных. Векторная и матричная FP64-производительности составляет 36 Тфлопс. Кроме того, ускоритель снабжён декодерами HEVC/H.265, AVC/h.264, VP9 и AV1, а также кодеками (M)JPEG. 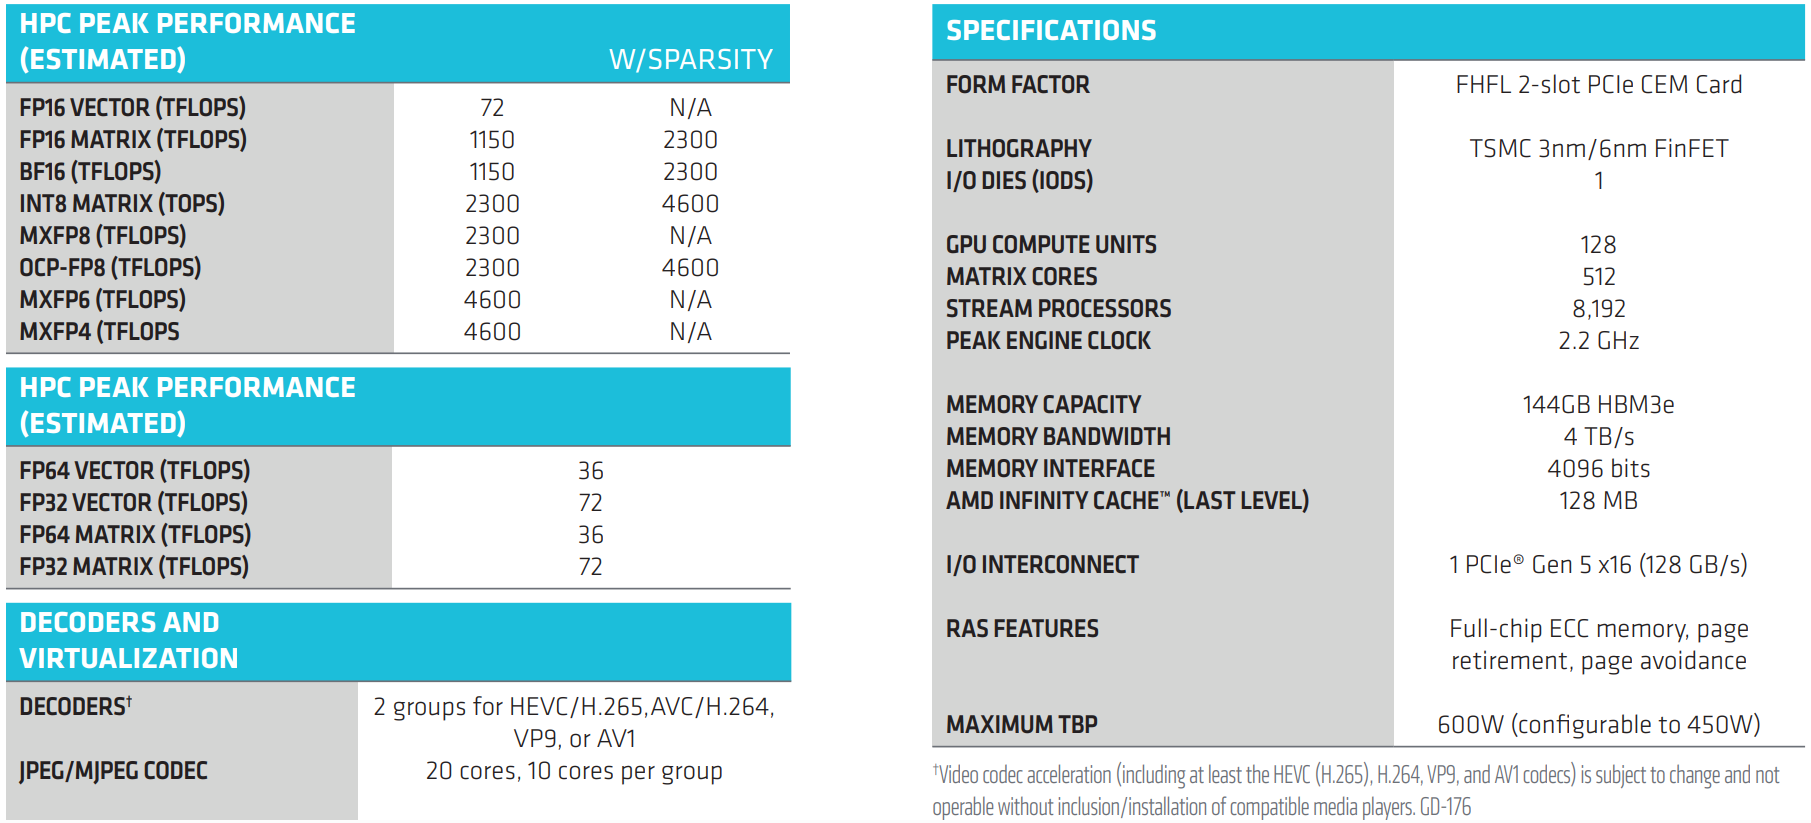 Самым существенным недостатком новинки — это отсутствие прямой связи между ускорителями посредством Infinity Fabric. Всё общение внутри одного узла происходит посредством PCIe-шины, так что наличие восьми MI350P в одном сервере позволит эффективно обслуживать восемь отдельных моделей (до 200–250 млрд параметров), а не одну большую, которая не помещается в памяти единичного ускорителя. NVIDIA попыталась чуть смягчить эту проблему, представив для своих PCIe-ускорителей плату с адаптерами ConnectX-8 SuperNIC со встроенными коммутаторами PCIe 6.0. 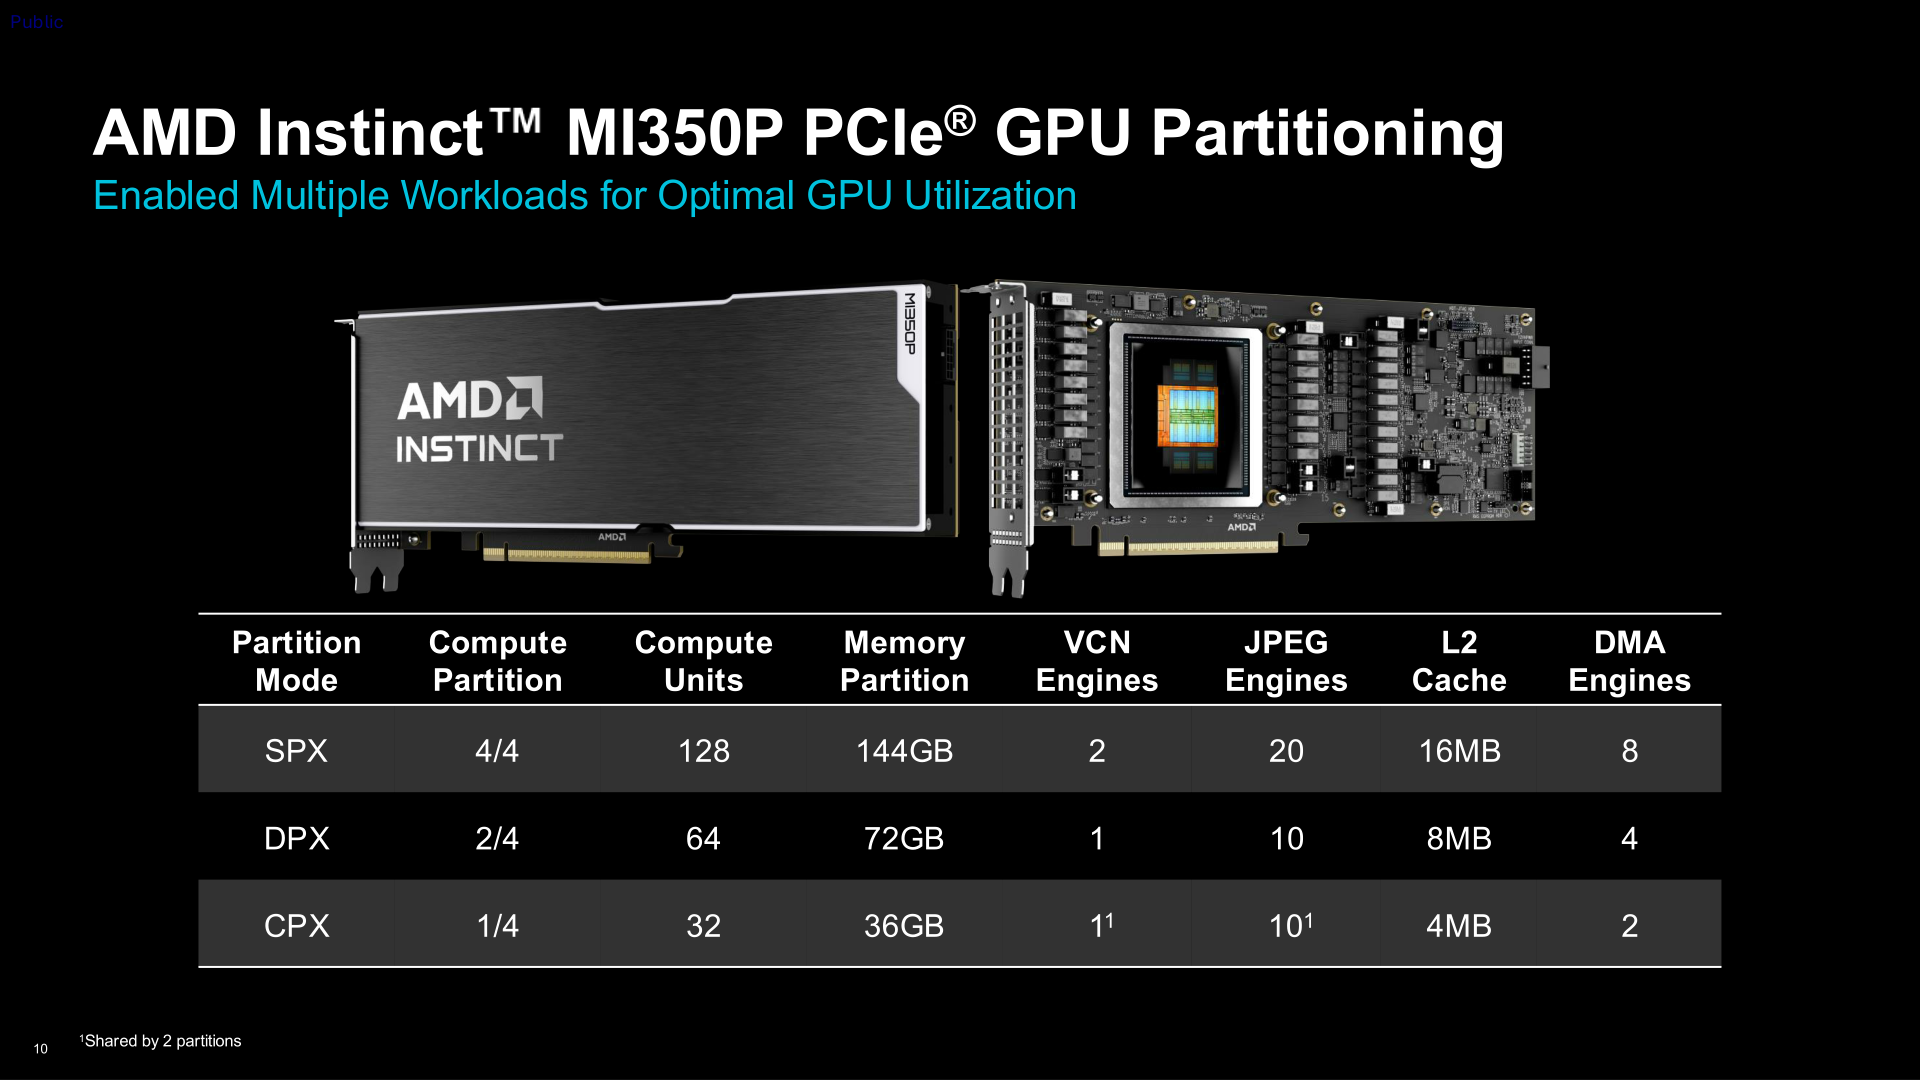 Сообщается, что Instinct MI350P доступны у различных партнёров компании. Они предлагают полностью открытую экосистему и программный стек Enterprise Ready AI с поддержкой ROCm. AMD заявила, что её эталонный open source пакет AMD Enterprise AI предоставляется партнёрам без каких-либо затрат на лицензирование. Это обеспечивает большую прозрачность кода и помогает снизить операционные расходы. В сочетании с картами Instinct MI350P и решениями от партнёров этот стек позволяет компаниям быстро развёртывать локальные системы без постоянных затрат на токены, говорит AMD.
07.05.2026 [16:26], Владимир Мироненко
200 Тфлопс в FP64: AMD поделилась первыми подробностями об Instinct MI430XAMD поделилась информацией о производительности Instinct MI430X. Это не ИИ-ускоритель — чип ориентирован на задачи в сегменте высокопроизводительных вычислений (HPC): вычисления с двойной точностью (FP64) остаются чрезвычайно важными в науке, моделировании и многих других приложениях, пишет ресурс ComputerBase. AMD официально подтвердила выпуск чипа прошлой осенью, когда уже получила первые крупные заказы. Теперь компания демонстрирует первые показатели решения с 432 Гбайт HBM4. Обладая производительностью более 200 TFLOPS в нативном режиме FP64, он будет «более чем в шесть раз быстрее» ускорителя NVIDIA Rubin. Однако следует отметить, что сравнение несколько некорректно. Во-первых, Rubin — это чистый ИИ-ускоритель, ориентированный на FP4 и аналогичные форматы, а не на FP64. Во-вторых, AMD прямо не уточняет, идёт ли речь о векторных и/или матричных вычислениях. Хотя, вероятно, речь всё-таки о векторных расчётах, поскольку в режиме эмуляции со схемой Озаки Rubin, как обещает NVIDIA, будет выдавать те же 200 Тфлопс в FP64. 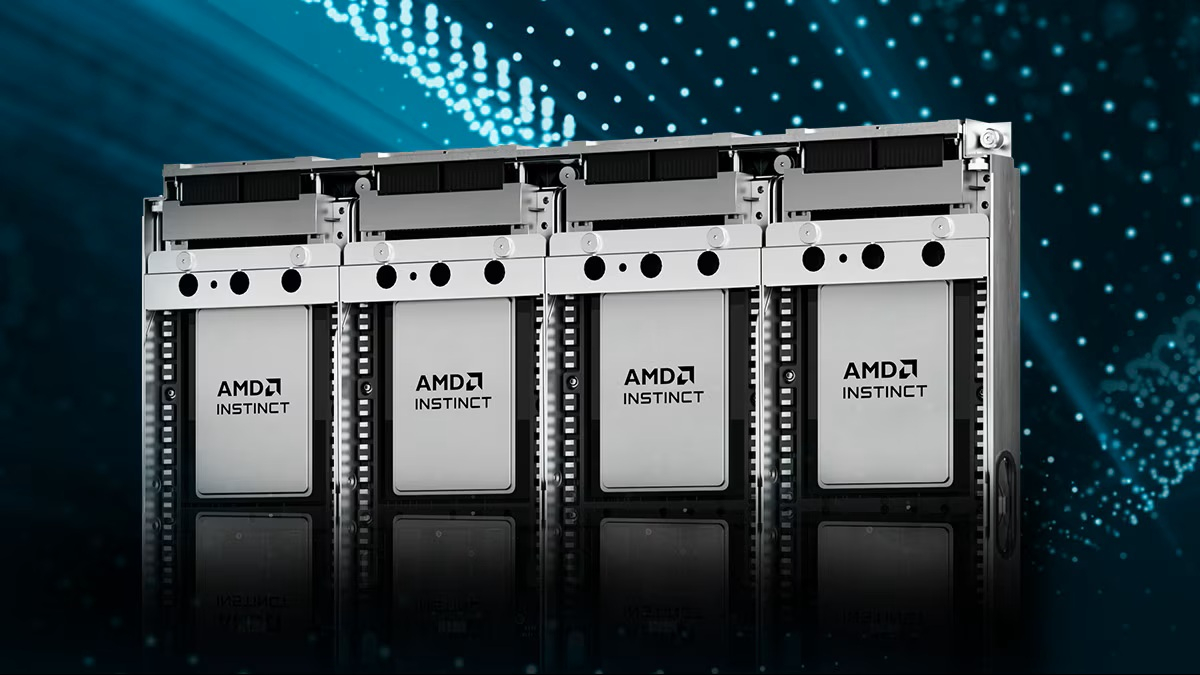
Источник изображений: AMD При этом реального конкурента, кроме Instinct M430X, у Rubin в FP64 нет. С другой стороны, Rubin, в свою очередь, по всей видимости, превосходит MI430X в приложениях FP4 — AMD пока не раскрыла его возможности в таких вычислениях. Кроме того, компания сама говорила о возможности поддержки схемы Озаки (Ozaki) для чипов Instinct. Фактически AMD в своих же чипах «отклонилась от курса», решив наращивать ИИ-производительность. В Instinct MI355X FP64-производительность и векторных, и матричных вычислений была на уровне 78,6 Тфлопс, тогда как вышедший ранее MI325X выдавал 81,6 Тфлопс, а ещё более «древний» MI300X — 81,7 Тфлопс.  О решении AMD нарастить нативную FP64-производительность ускорителя Instinct MI430X стало известно этой весной. До этого компания усомнилась в эффективности эмуляции научных расчётов на тензорных ядрах NVIDIA. NVIDIA же давно сделала ставку исключительно на ИИ, отказавшись от развития в новейших ускорителях FP64-блоков, но учёные указывают на то, что отказ от поддержки этого направления грозит лидерству США в HPC и дальнейшим инновациям. В Министерстве энергетики США (DoE) также отметили, что FP64-вычисления по-прежнему «очень важны» для «Миссии Генезис» (Genesis Mission) и для реализации её цели — ускорения научных открытий с помощью ИИ.  AMD добилась больших успехов в сегменте HPC, поставляя оборудование для самых быстрых в мире суперкомпьютеров. Именно этот рынок является целевым для Instinct MI430X, о чем свидетельствуют первые заказы, включая машину Discovery Национальной лаборатории Ок-Ридж (ORNL) в США и Alice Recoque во Франции. Как сообщается, производительность Alice Recoque составит более 1 Эфлопс в FP64, что сделает его одной из самых быстрых HPC-систем в Европе. |
|

