
Материалы по тегу: b200
|
27.10.2026 [10:02], Сергей Карасёв
В Германии появится суперкомпьютер на базе NVIDIA GB200 Grace Blackwell для моделирования климатаНемецкий климатический вычислительный центр (DKRZ) сообщил о заключении контракта с компанией Bull на строительство нового суперкомпьютера. Систему High-Performance Computing System for Earth System Research 5 (HLRE-5) планируется ввести в эксплуатацию в 2028 году. Применять суперкомпьютер планируется для сложного моделирования климата, в том числе с использованием ИИ. В частности, система сможет одновременно запускать две глобальные климатические симуляции с разрешением 5 км. Основой вычислительного комплекса послужит платформа BullSequana XH3500, которая использует открытую модульную конструкцию. Реализованная архитектура позволяет свободно комбинировать блоки CPU, GPU и сетевые компоненты от различных производителей. Говорится о применении передовой технологии прямого жидкостного охлаждения (DLC). В состав HLRE-5 войдут GPU- и CPU-разделы. В основу первого лягут суперчипы NVIDIA GB200: эта секция обеспечит основные вычислительные ресурсы для ИИ-алгоритмов. В свою очередь, раздел CPU объединит процессоры NVIDIA Vera. Такая конфигурация, как отмечается, позволит добиться высокой энергетической эффективности. В качестве интерконнекта будет задействована технология NVIDIA Quantum-2 InfiniBand с низкой задержкой и скоростью передачи данных между узлами до 400 Гбит/с. 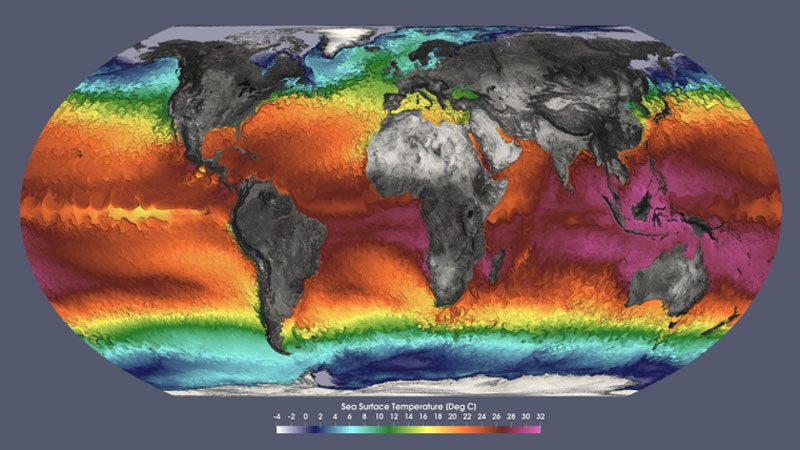
Источник изображения: Michael Böttinger, DKRZ Подсистема хранения данных объединит массив IBM Storage Scale System 6000 вместимостью 60 Пбайт с пропускной способностью до 340 Гбайт/с и высокопроизводительный флеш-уровень объёмом 500 Тбайт. Общие инвестиция в проект составят €40 млн, включая пятилетний договор на техническое обслуживание. Финансирование обеспечивается Ассоциацией имени Гельмгольца, Обществом Макса Планка и администрацией Гамбурга. Кроме того, инициативу поддерживает Федеральное министерство исследований, технологий и космоса в рамках программы «Высокотехнологичная повестка дня Германии» (HTAD).
23.10.2026 [13:01], Павел Котов
Казахстан расширит мощности ИИ ЦОД на чипах NVIDIAКазахстан продолжает наращивать свою вычислительную базу, планируя развёртывание инфраструктуры на архитектуре NVIDIA Vera Rubin. Движущей силой на данном этапе роста выступают компании, изначально ориентированные на отрасль искусственного интеллекта. Казахстанская экосистема ИИ переходит от этапа планирования инфраструктуры к её практическому развёртыванию. Процесс охватывает весь арсенал технологий ИИ от проектирования инфраструктуры и моделей до конечных приложений. Firebird, построившая свою ИИ-фабрику в Армении, расширяет своё присутствие в Казахстане. Компания получила от властей США экспортную лицензию на поставку 45 тыс. Grace Blackwell — первый этап проекта реализуется совместно с «Казахтелекомом» в «Долине ЦОД»; коммерческий запуск намечен на III квартал 2027 года. На втором этапе планируется довести совокупную мощность инфраструктуры Firebird в Казахстане примерно до 500 МВт. Компания намерена создать подразделение Firebird Labs Kazakhstan для поддержки местных ИИ-стартапов, проведения исследований и развития кадрового потенциала. Для реализации проекта задействуют механизмы финансирования, обеспечения доступа к вычислительным ресурсам и научно-исследовательское партнёрство. 
Источник изображения: nvidia.com «Казахтелеком», крупнейший телекоммуникационный оператор в стране, уже развернул 400 ускорителей H200 и 480 B300 в Астане и Алматы. В следующем году компания планирует разместить более 1000 чипов в «Долине ЦОД» и ещё более 1000 чипов в составе платформы NVIDIA Vera Rubin в районе Экибастуза. Эта инфраструктура позволит выполнять широкий спектр задач и будет доступна для предприятий и разработчиков. Ранее Akashi Data Center рассказала о планах построить в Казахстане Tier IV ЦОД мощностью 100 МВт. В минувшем году стало известно о намерении запустить в стране самый мощный суперкомпьютер в Центральной Азии. С Россией обсуждается план прокладки интернет-кабеля по дну Каспийского моря.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 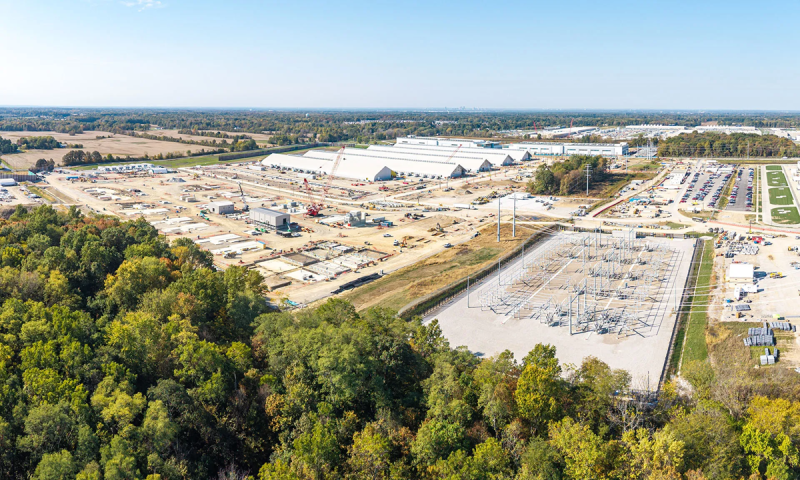
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 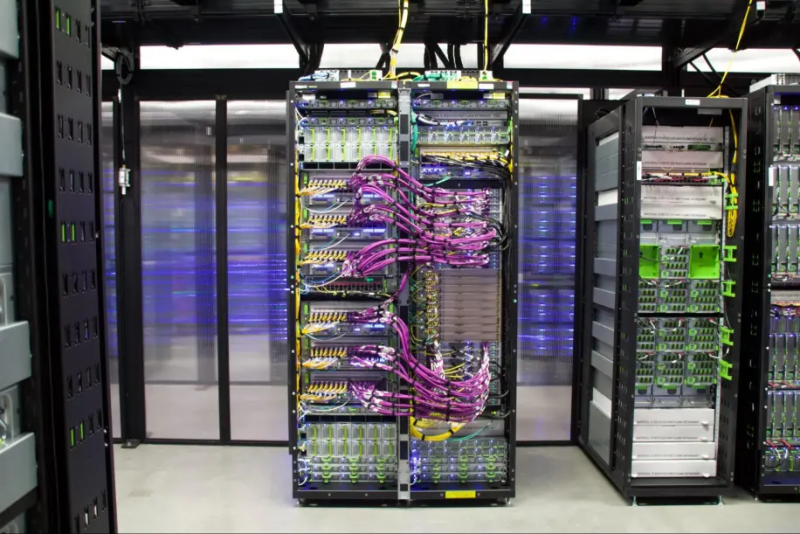
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
09.08.2026 [21:59], Владимир Мироненко
Крупнейшая в СНГ ИИ-фабрика NVIDIA появится в Армении — Firebird развернула 15 из 300 МВтАмериканская неооблачная компания Firebird объявила о запуске в Раздане (Армения) ИИ ЦОД, который, по словам NVIDIA, позиционируется как крупнейшая ИИ-фабрика в СНГ. Она создана на эталонной платформе NVIDIA DSX AI Factory — комплексном решении NVIDIA для создания и эксплуатации ИИ-фабрик — с использованием серверов Dell. Как утверждает NVIDIA, эта платформа позволяет разместить до 40 % больше GPU на той же площади, «производя больше токенов на доллар и извлекая больше выгоды из каждого мегаватта мощности». На строительство первой очереди ЦОД в Раздане ушло всего полгода. Schneider Electric обеспечила ЦОД энергетической инфраструктурой, включая распределительные устройства среднего и низкого напряжения, трехфазные системы ИБП и стоечные решения. А Vertiv предоставила архитектуру охлаждения, сочетающую технологию охлаждения с использованием охлаждённой воды, передовые системы управления и технологию Vertiv TrimCooler для эффективного отвода тепла. Система управления охлажденной водой iCOM CWM от Vertiv централизованно координирует ресурсы охлаждения в зависимости от рабочих нагрузок. Согласно данным Firebird, в настоящее время вычислительный комплекс DC-1 включает 6144 ускорителя NVIDIA B200 общей мощностью 15 МВт. К концу 2027 года Firebird планирует развернуть более 70 тыс. GPU NVIDIA Rubin и Blackwell — всего 300 МВт инфраструктурных мощностей. Планируемый кластер DC-2 рассчитан на 75 тыс. GPU в составе NVIDIA VR200 общей мощностью 125 МВт. Также в планах компании строительство третьей очереди аналогичного масштаба. Для масштабирования с 15 до 300 МВт потребуется как-то решить вопрос энергоснабжения, обратил внимание ресурс TECHi. 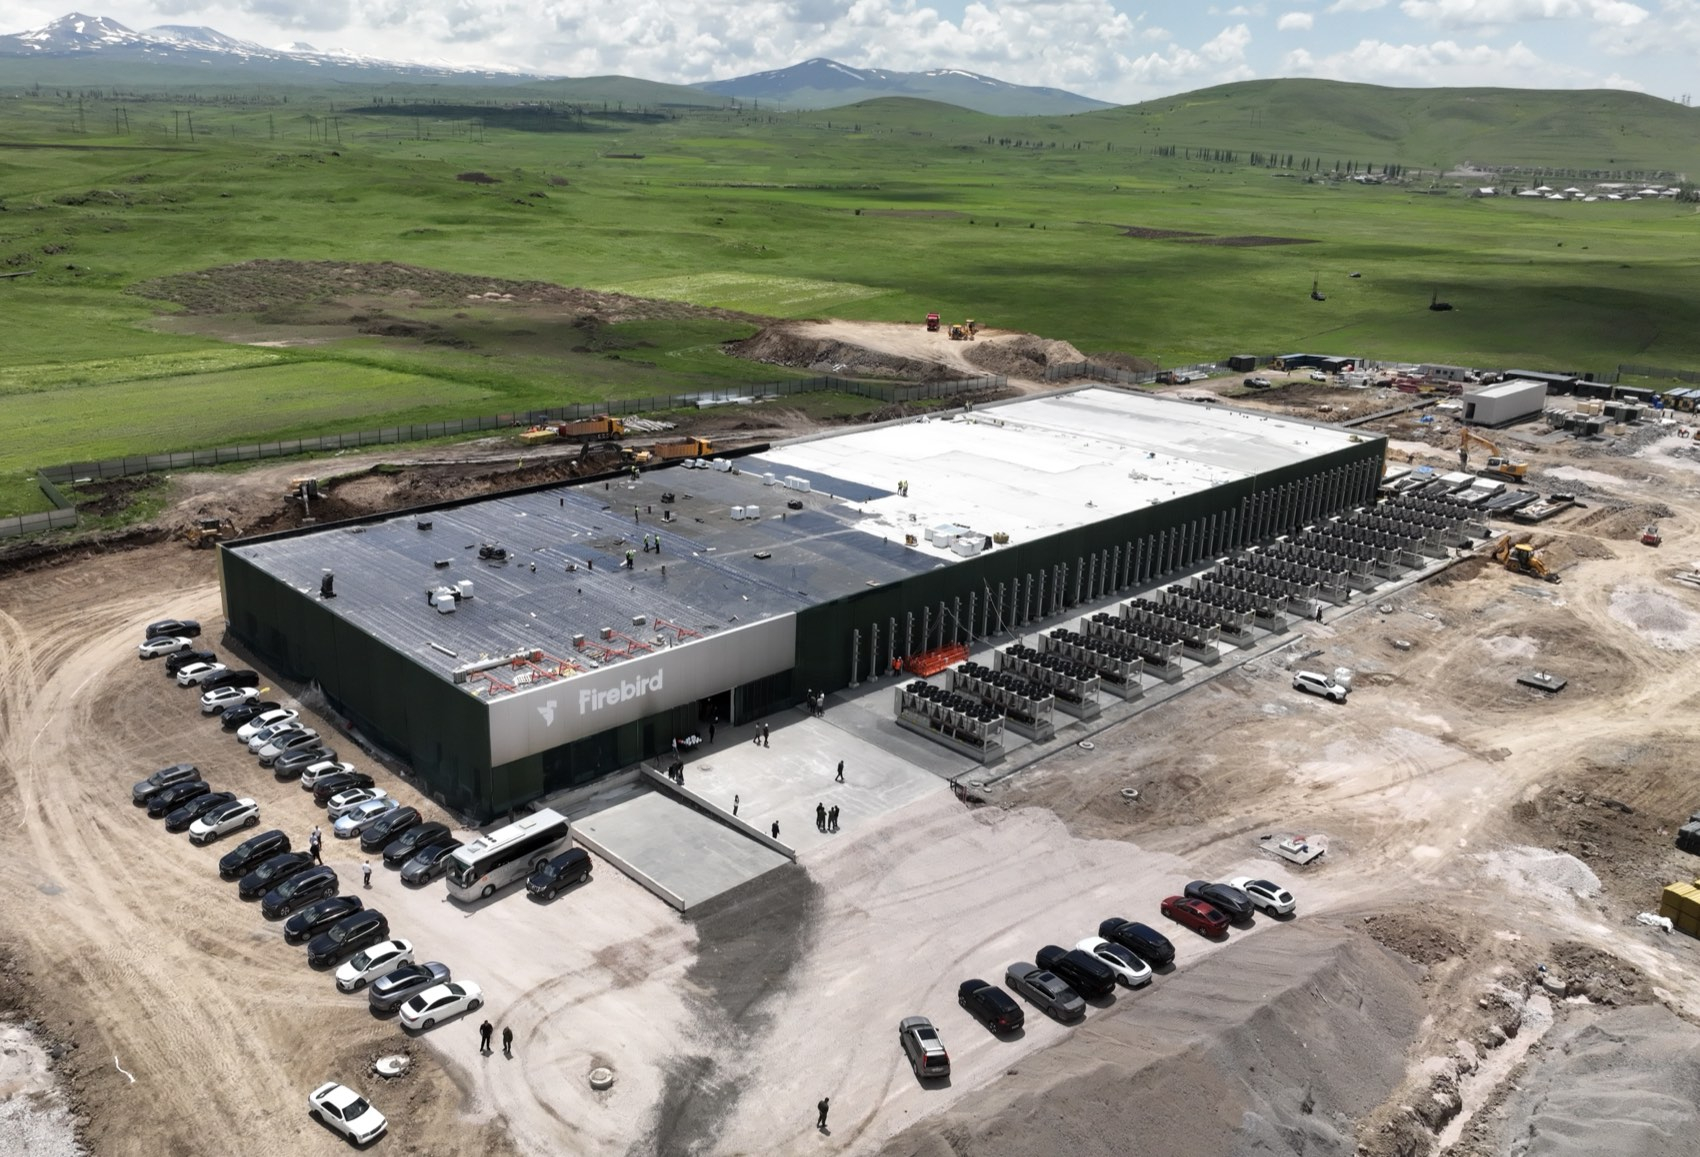
Источник изображения: Firebird В ноябре 2025 года Firebird получила экспортную лицензию США на поставку в Армению передовых чипов NVIDIA. Стоимость первого этапа строительства ИИ-фабрики оценивается в $500 млн. В феврале этого года во время визита в Армению вице-президента США было объявлено об увеличении стоимости проекта до $4 млрд с развёртыванием около 50 тыс. GPU с лицензированием ещё 41 тыс. NVIDIA GB300. Firebird сообщила, что одним из первых клиентов ЦОД в Армении стала Perplexity. Она получит доступ к инфраструктуре ИИ Firebird для поддержки своего механизма обработки ответов и платформы для ИИ-агентов. Впрочем, стоимость контракта с Perplexity и сроки его действия не раскрываются. Компания также объявила о намерении NVIDIA инвестировать в её деятельность вслед за инвестициями в CoreWeave в этом году. Это поможет ей в реализации планов по расширению глобальной инфраструктуры. Сумма планируемых инвестиций не указана. При поддержке NVIDIA компания реализует план развития ИИ-инфраструктуры мощностью около 2 ГВт, охватывающей Армению, Казахстан и другие рынки. Следуя циклической схеме, NVIDIA приобретает долю в компании, которая затем покупает у неё чипы в больших масштабах. NVIDIA уже инвестировала более $40 млрд в акции компаний, занимающихся ИИ-технологиями.
18.07.2026 [13:06], Сергей Карасёв
Для ИИ и для «квантов»: В Японии заработали суперкомпьютеры RIKYU и ROQUO на базе NVIDIA GB200 NVL4В Центре вычислительных наук Института физико-химических исследований Японии (RIKEN Center for Computational Science, R-CCS) началась эксплуатация высокопроизводительных комплексов RIKYU и ROQUO, выполненных на аппаратной платформе NVIDIA. Обе системы ориентированы на ресурсоёмкие задачи ИИ. В частности, RIKYU может применяться для разработки открытых фундаментальных моделей, а также проведения исследований в сферах наук о жизни, материаловедения и пр. Задействованы 400 узлов Supermicro PIO-121GL-NBIB-01 на базе NVIDIA GB200 NVL4 (два процессора Grace и четыре ускорителя Blackwell, объединенных посредством NVLink). Применяются жидкостное охлаждение и 800G-интерконнект InfiniBand XDR. Кроме того, в состав суперкомпьютера входят 16 узлов Supermicro SYS-212HA-TN с процессорами Intel Xeon 6980P (Granite Rapids-AP), 1,5 Тбайт памяти и хранилищем с накопителями NVMe SSD. Производительность в режиме FP64 достигает 59,63 Пфлопс, в режиме FP8 — 15,539 Эфлопс. 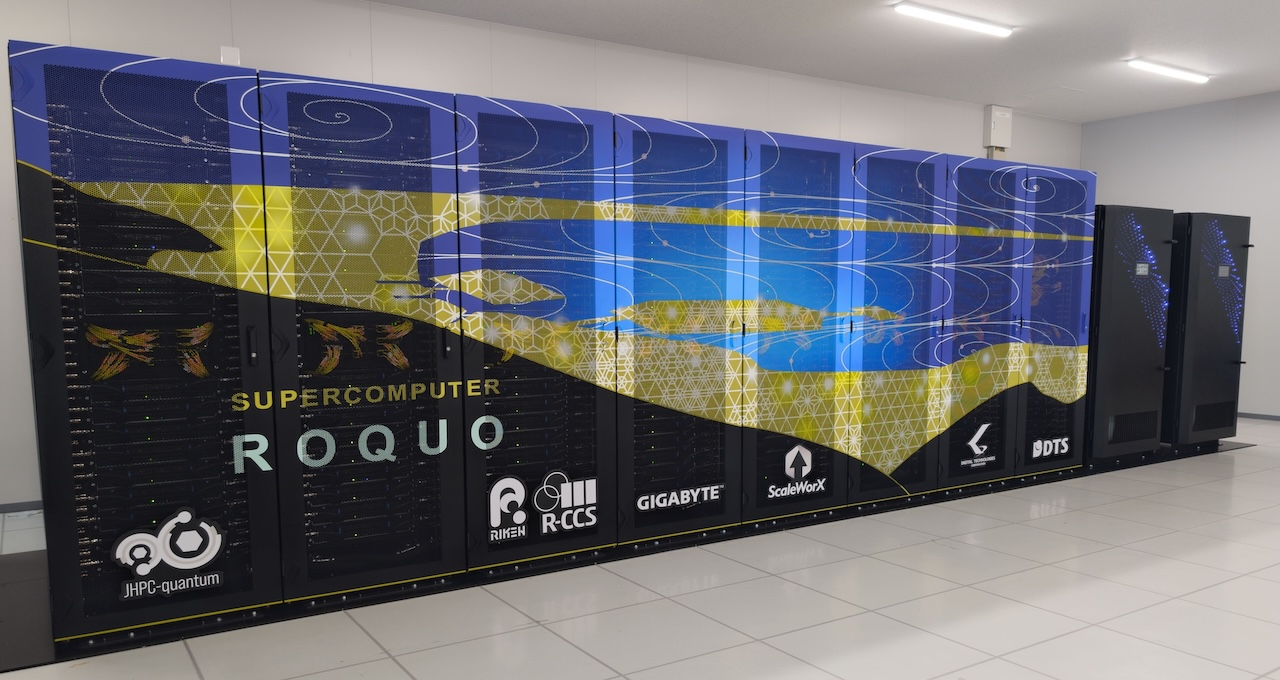
Источник изображения: RIKEN В свою очередь, суперкомпьютер ROQUO спроектирован с прицелом на гибридные квантово-классические вычисления. Он получил 135 вычислительных узлов на основе NVIDIA GB200 NVL4. Интерконнект NVIDIA Quantum-X800 InfiniBand обеспечивает пропускную способность до 3,2 Тбит/с. Применено жидкостное охлаждение. Быстродействие в режиме FP64 находится на отметке 19,8 Пфлопс с пиковым значением 21 Пфлопс. Производительность в режиме FP8 превышает 5 Эфлопс. Вычислительный комплекс может функционировать в связке с квантовыми системами Quantinuum Reimei и IBM Quantum System Two. В целом, новые суперкомпьютеры формируют единую исследовательскую платформу, в составе которой RIKYU обеспечивает ресурсы для научных задач с использованием ИИ, а ROQUO позволяет сочетать классические ИИ-вычисления с квантовыми методами. Такая связка даёт учёным гибкий инструментарий для работы со сложными моделями и для решения комплексных задач.
10.07.2026 [11:34], Сергей Карасёв
Национальный научный фонд США выделил $10 млн на суперкомпьютер Bridges-3 с AMD EPYC и NVIDIA B200Национальный научный фонд США (NSF), по сообщению Datacenter Dynamics, выделил $10 млн Питтсбургскому суперкомпьютерному центру (PSC) на создание вычислительного комплекса следующего поколения Bridges-3. Монтаж системы начнётся в начале следующего года. Новый суперкомпьютер станет преемником нынешней машины Bridges-2 (на изображении). Этот комплекс имеет гетерогенную архитектуру с узлами разных типов под различные задачи. В частности, задействованы 504 узла Regular Memory с 256/512 Гбайт оперативной памяти и двумя процессорами AMD EPYC 7742 каждый. Кроме того, присутствуют узлы Extreme Memory, несущие на борту по четыре чипа Intel Xeon Platinum 8260M Cascade Lake и 4 Тбайт ОЗУ. Наконец, применяются GPU-узлы в нескольких конфигурациях — в том числе с ускорителями NVIDIA H100 и NVIDIA L40S. 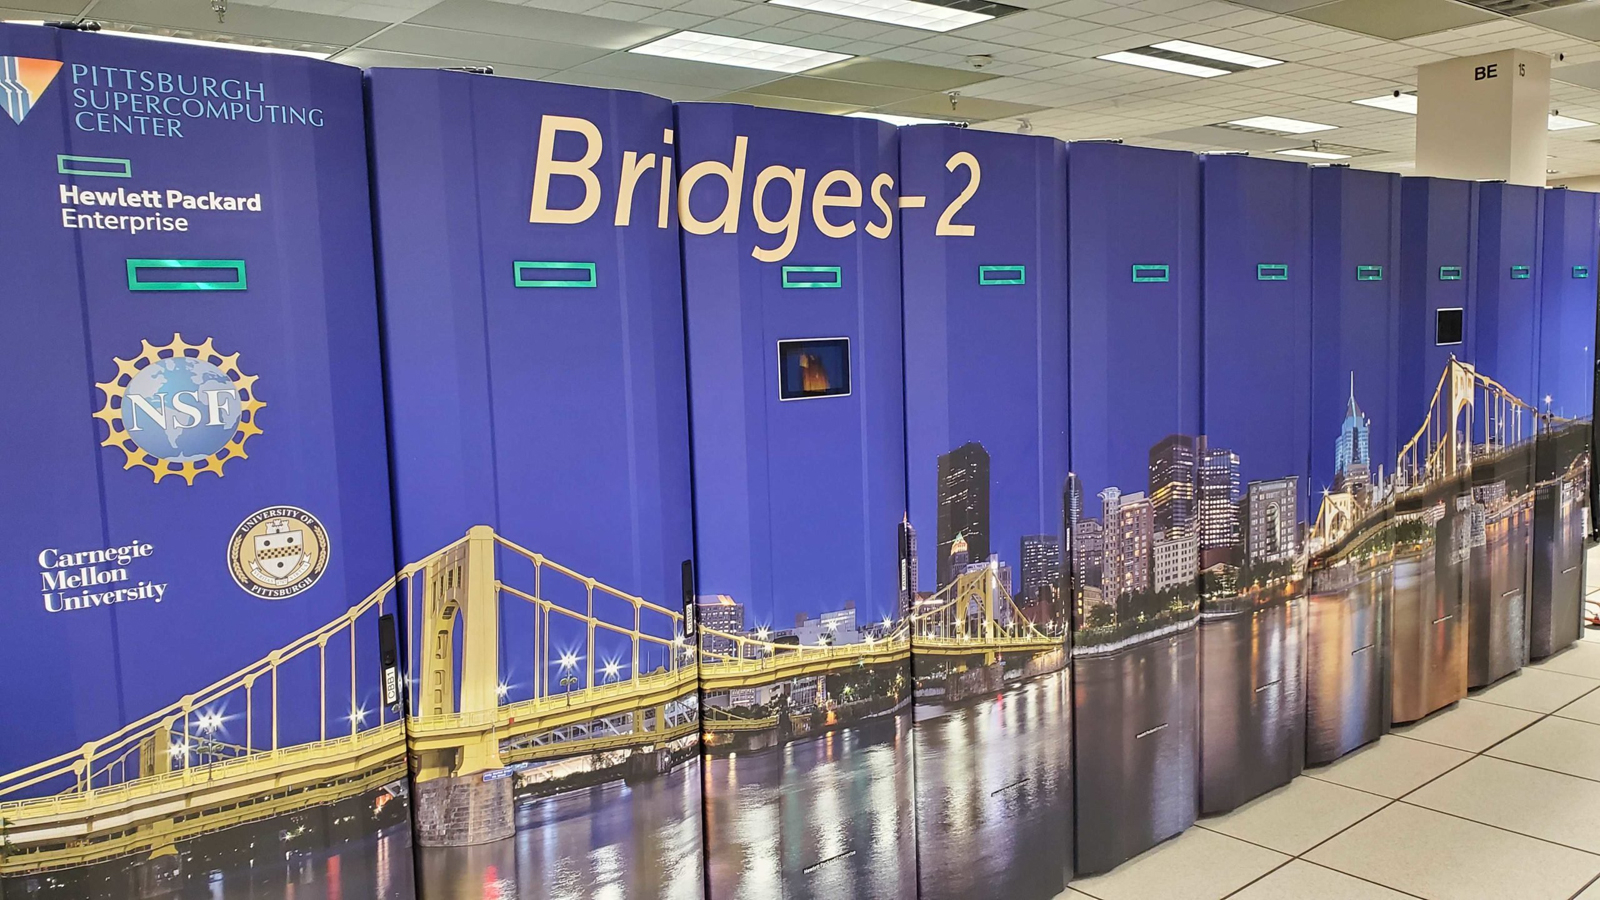
Источник изображения: PSC Технические характеристики Bridges-3 пока полностью не раскрываются. Но известно, что созданием вычислительного комплекса займётся HPE. Система получит серверы на основе неназванных процессоров AMD с «большим количеством ядер». Будут применяться ИИ-ускорители NVIDIA B200. Упомянуты интерконнект InfiniBand и хранилище типа All-Flash на базе Lustre. Бруно Абреу (Bruno Abreu), заместитель научного директора PSC и главный специалист проекта Bridges-3 отмечает, что проектируемая система сохранит все ключевые возможности своего предшественника, получив при этом современные CPU и GPU, обеспечивающие существенное повышение производительности для задач моделирования, симуляции, анализа данных и ИИ. Суперкомпьютер расположится в новом дата-центре PSC. Ввод Bridges-3 в эксплуатацию намечен на лето 2027 года.
24.06.2026 [01:23], Владимир Мироненко
Европа получит 35 суперкомпьютеров на чипах NVIDIANVIDIA объявила о разработке по всей Европе 35 суперкомпьютеров на базе её чипов, которые позволят более 3 млн исследователей ускорить проведение научных исследований и внедрение промышленных инноваций в сфере ИИ. Это крупнейшее за год расширение в Европе сети суперкомпьютеров, охватывающее национальные суперкомпьютерные центры, ИИ-фабрики и академические исследовательские институты. Эти системы будут поддерживать исследования в области климатологии, здравоохранения, декарбонизации чистой энергетики, квантовых вычислений и фундаментальной науки. Работу большей части европейских ИИ-фабрик обеспечивают платформы Blackwell и Hopper, при этом с прошлого года было развернуто или анонсировано 800 Эфлопс вычислительных мощностей для ИИ. Эти суперкомпьютеры, включая обновлённый EuroHPC MareNostrum5 AI Барселонского суперкомпьютерного центра (BSC-CNS), Blue Swan (BavariaAI), IT4LIA, HammerHAI Центра высокопроизводительных вычислений в Штутгарте (HLRS) и ИИ-фабрика Mimer Национальной академической суперкомпьютерной инфраструктуры Швеции (NAISS), основаны на передовой ИИ-инфраструктуре NVIDIA, говорит компания. Так, суперкомпьютер MareNostrum 5 будет дооснащён системами GB300 NVL72 и GB200 NVL4, объединённых интерконнектом NVIDIA Quantum-X800 InfiniBand. Система, обеспечивающая производительность до 20 Эфлопс при обучении ИИ и 33 Эфлопс при ИИ-инференсе, позволит ускорить работу генеративного ИИ, климатическое моделирование, исследования в области здравоохранения и биотехнологий, устойчивого сельского хозяйства, энергетических систем и госсервисов. 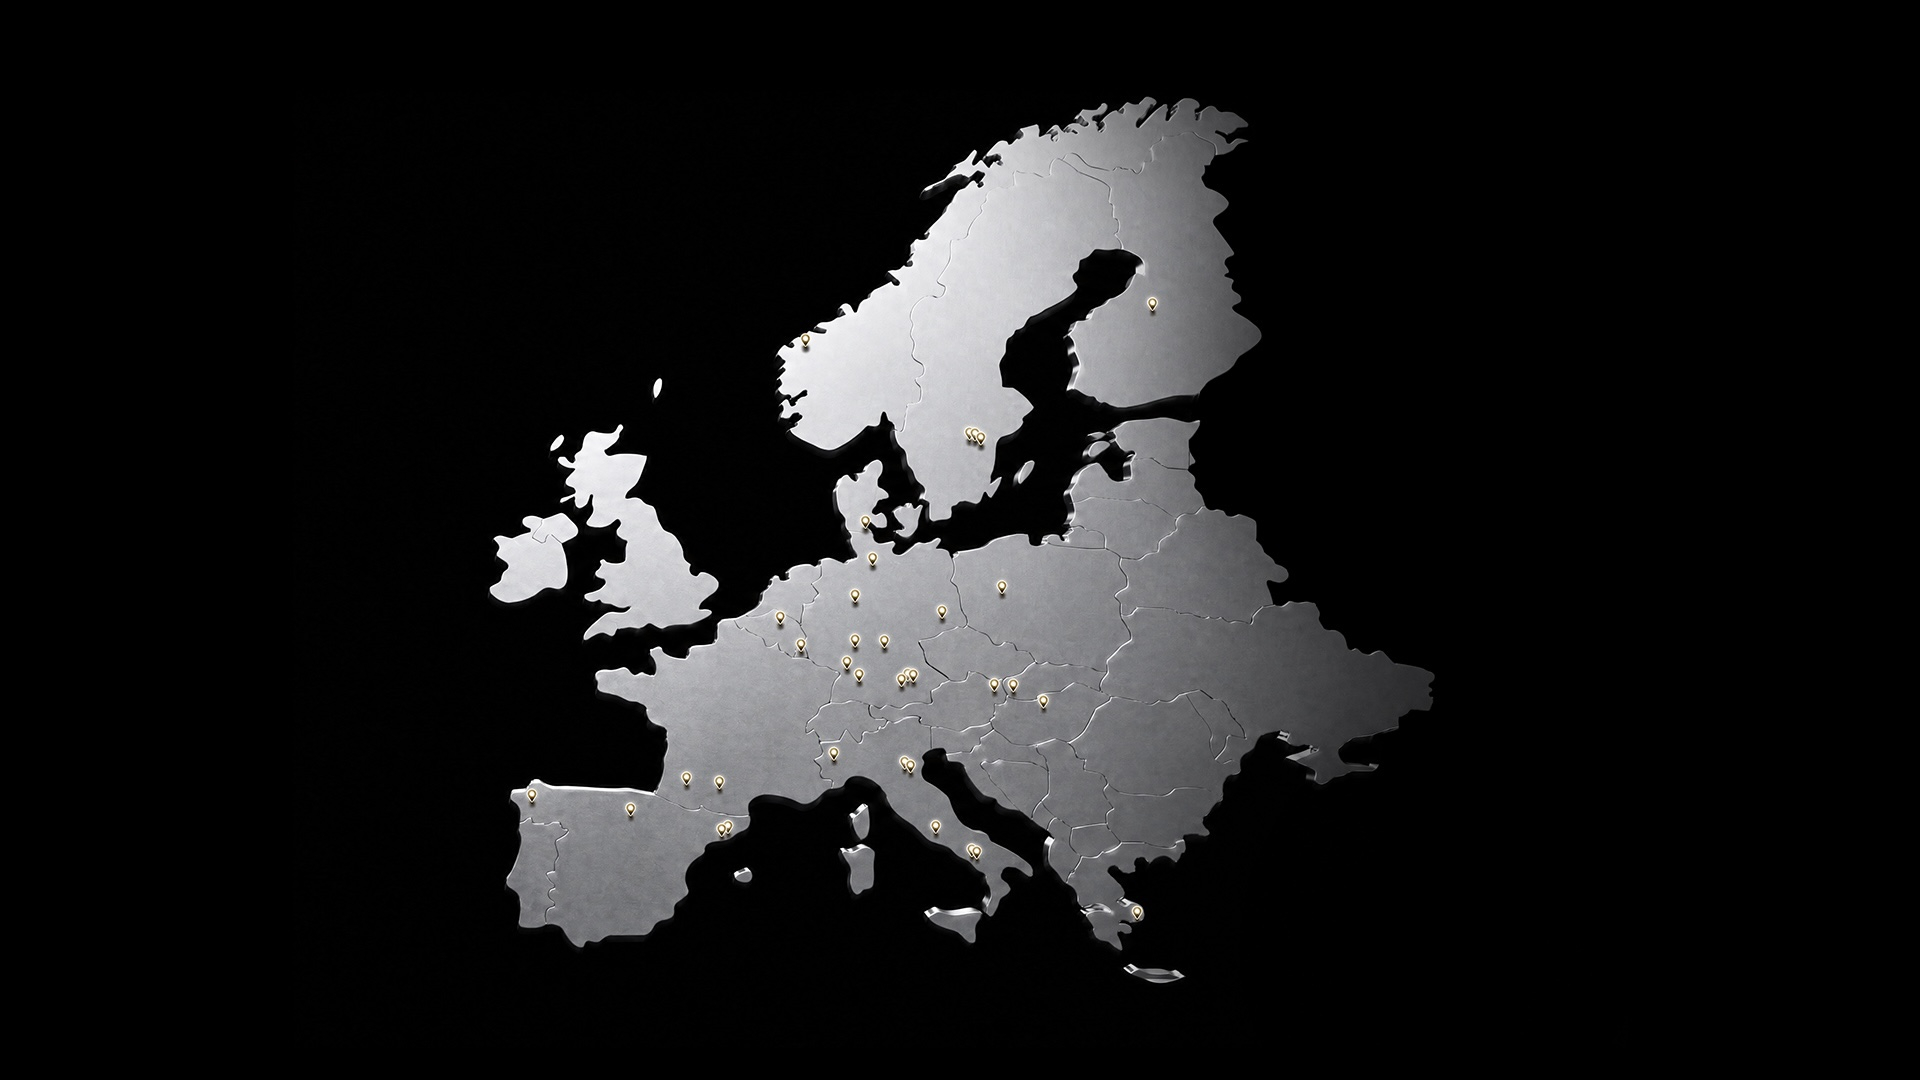
Источник изображения: NVIDIA Система Blue Swan (BavariaAI) добавит 1 тыс. ускорителей (GB200 NVL4 и Quantum-2 InfiniBand) суперкомпьютерным центрам FAU Erlangen и LRZ. Платформа обеспечит производительность до 11 Эфлопс при обучении ИИ и 22 Эфлопс при ИИ-инференсе. Она будет поддерживать инициативу Баварии по созданию базовых моделей, продвигая открытые мультимодальные модели для науки, государственного управления, исследований в области здравоохранения, робототехники и т.д. HammerHAI (HLRS) представляет собой первую в Германии ИИ-фабрику с более чем 850 GPU на базе GB200 NVL4 с Quantum-X800 InfiniBand. Суперкомпьютер HammerHAI, обеспечивающий производительность до 8 Эфлопс при обучении ИИ и 15 Эфлопс при ИИ-инференсе, обеспечит исследователям и промышленным пользователям безопасную ИИ-инфраструктуру для инженерного моделирования, инференса и научных исследования. Суперкомпьютер Mimer EuroHPC AI Factory (NAISS), размещённый в Линчёпингском университете (LiU, Швеция), будет использовать 100 систем GB200 NVL4 и сеть ConnectX-8. Обеспечивая производительность до 4 Эфлопс при обучении ИИ и около 7 Эфлопс при ИИ-инференсе, Mimer AI Factory будет способствовать развитию шведской ИИ-экосистемы в таких областях, как биологические науки, материаловедение, автономные системы, доверенный ИИ и т.д. Наконец, ИИ-фабрика IT4LIA с более чем 8 тыс. GPU на базе GB200 NVL4 с Quantum-X800 InfiniBand и ПО NVIDIA AI Enterprise обеспечивает производительность в размере 82 Эфлопс при обучении ИИ и 164 Эфлопс при ИИ-инференсе.
23.06.2026 [11:33], Сергей Карасёв
В Японии появился гибридный квантово-классический суперкомпьютер Roquo производительностью 19,8 ПфлопсВ Центре вычислительных наук японского Института физико-химических исследований (R-CCS) введён в строй гибридный квантово-классический суперкомпьютер Roquo, названный в честь горы Рокко к северу от города Кобе. В создании НРС-системы приняли участие DTS, NVIDIA, Giga Computing, DDN и ScaleWorX. Roquo состоит из 135 вычислительных узлов на базе NVIDIA GB200 NVL4. В общей сложности задействованы 540 чипов Blackwell и 270 чипов NVIDIA Grace. Применяется интерконнект NVIDIA Quantum-X800 InfiniBand с общей пропускной способностью до 3,2 Тбит/с (установлены коммутаторы Q3400, поддерживающие скорость передачи данных 800 Гбит/с на порт). Реализовано жидкостное охлаждение. Заявленная производительность на операциях FP64 составляет 19,8 Пфлопс, а теоретическое пиковое быстродействие на операциях FP8 превышает 5 Эфлопс. Суперкомпьютер использует интерфейс SQC, что позволяет формировать гибридные среды с поддержкой традиционных и квантовых вычислений. 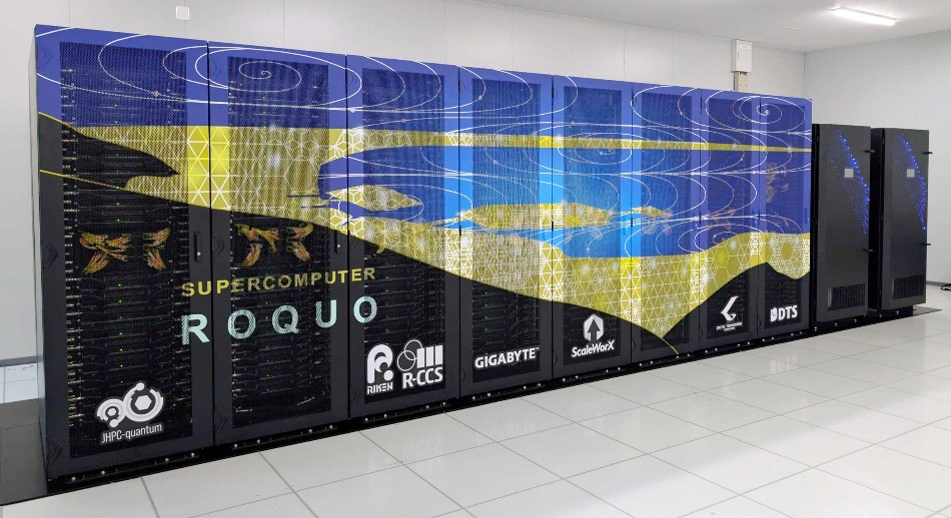
Источник изображения: RIKEN В рамках проекта по созданию Roquo корпорация DTS осуществляла общую разработку платформы в соответствии с требованиями R-CCS. В свою очередь, NVIDIA предоставила базовые вычислительные и сетевые компоненты, тогда как Giga Computing отвечала за проектирование и производство серверов. DDN предоставила высокоскоростное файловое хранилище. Наконец, специалисты ScaleWorX осуществили общую системную интеграцию. Суперкомпьютер Roquo, как ожидается, поможет ускорить разработку и оценку эффективности новых квантовых алгоритмов. Кроме того, система будет использоваться для решения сложных задач, с которыми не в состоянии справиться классические НРС-комплексы.
20.06.2026 [15:45], Сергей Карасёв
В Словении запущена НРС-система FRIDA с ускорителями NVIDIA BlackwellЛюблянский университет в Словении (University of Ljubljana), по сообщению DataCenter Dynamics, запустил высокопроизводительную систему FRIDA, ориентированную на задачи ИИ и машинного обучения. Это не классический суперкомпьютер, а модульный контейнерный дата-центр, размещённый на крыше здания Факультета компьютерных и информационных наук (FRI) в Любляне. Известно, что в составе FRIDA задействованы 104 ускорителя на основе GPU. В частности, применяются изделия NVIDIA Blackwell B200 и B300. Суммарный объём GPU-памяти составляет 16,8 Тбайт. Комплекс оборудован гибридной воздушно-жидкостной системой охлаждения. Все вычислительные узлы связаны интерконнектом с высокой пропускной способностью. Отмечается, что производительность FRIDA при вычислениях с низкой точностью достигает 708 Пфлопс. Пиковое быстродействие при операциях с разреженными матрицами низкой точности заявлено на уровне 1,42 Эфлопс. FRIDA дополнит словенскую НРС-систему Vega, которая была введена в строй в 2021 году в рамках проекта Европейского совместного предприятия по развитию высокопроизводительных вычислений (EuroHPC JU). Эта машина, основанная на процессорах AMD и ускорителях NVIDIA, демонстрирует FP64-производительность на уровне 6,9 Пфлопс. 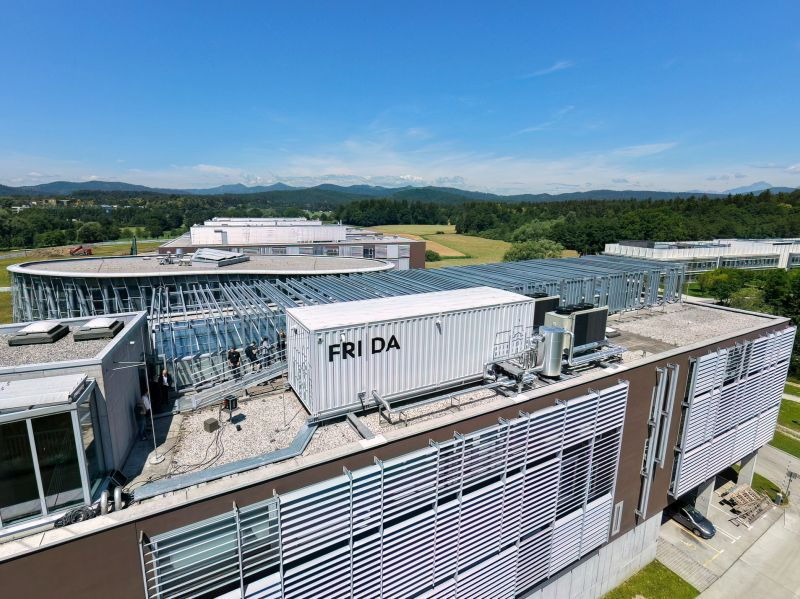
Источник изображения: linkedin.com Vega задумывалась как универсальная платформа для сложных вычислений: она может применяться для решения задач в самых разных областях, включая биоинженерию и разработку новых лекарств, изучение климата и прогнозирование погоды, персонализированную медицину, создание новых материалов и пр. В свою очередь, система FRIDA ориентирована прежде всего на нагрузки, связанные с ИИ.
14.06.2026 [11:51], Сергей Карасёв
В Австралии запущен суперкомпьютер MAVERIC на базе NVIDIA GB200 NVL72Университет Монаша (Monash University) в Австралии в партнёрстве с компаниями NVIDIA, Dell Technologies и ЦОД-оператором CDC Data Centres объявил о запуске суперкомпьютера MAVERIC (Monash AdVanced Environment for Research and Intelligent Computing). Новый НРС-комплекс смонтирован в Бруклинском центре CDC в Мельбурне. В основу системы положены серверы Dell PowerEdge XE9712 на платформе NVIDIA GB200 NVL72. Эти суперускорители объединяют 72 чипа B200 и 36 процессоров Grace. При этом каждое изделие B200 содержит 16 896 ядер CUDA, 528 тензорных ядер и 192 Гбайт памяти HBM3Е. MAVERIC использует передовую технологию жидкостного охлаждения с замкнутым контуром, благодаря чему отпадает необходимость в постоянном водоснабжении. Утверждается, что такое конструктивное решение не только снижает негативное влияние на окружающую среду, но и устанавливает новый стандарт для устойчивых высокопроизводительных вычислений. 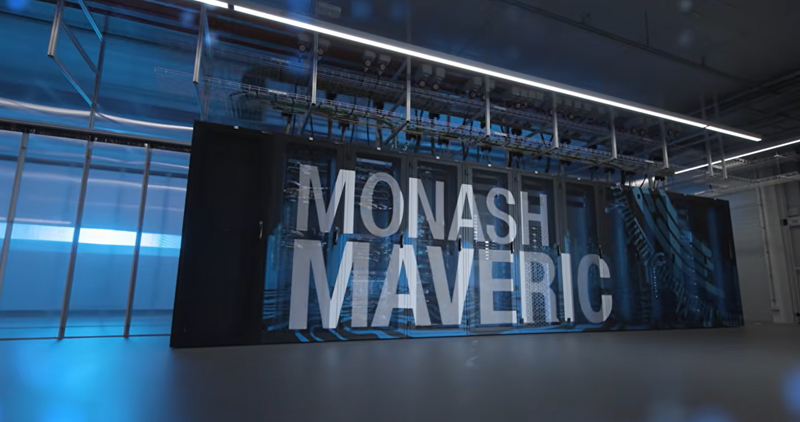
Источник изображения: Университет Монаша Показатели производительности MAVERIC не раскрываются. Но отмечается, что суперкомпьютер специально разработан для крупномасштабных задач ИИ и обработки больших объемов данных. Предполагается, что запуск машины поможет в решении важнейших глобальных проблем здравоохранения, включая раннюю диагностику рака, лечение хронических заболеваний, открытие новых лекарств и пр. Использовать ресурсы системы планируется и в других областях, включая моделирование климата и обработку конфиденциальной информации. |
|

