
Материалы по тегу: кластер
|
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 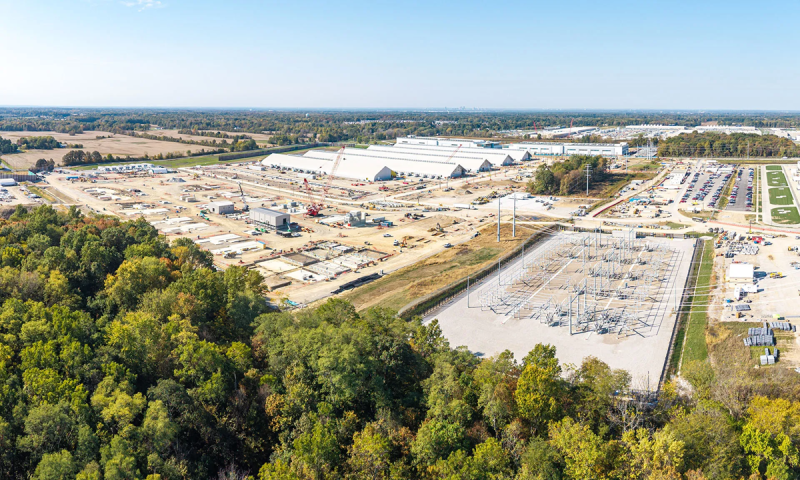
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 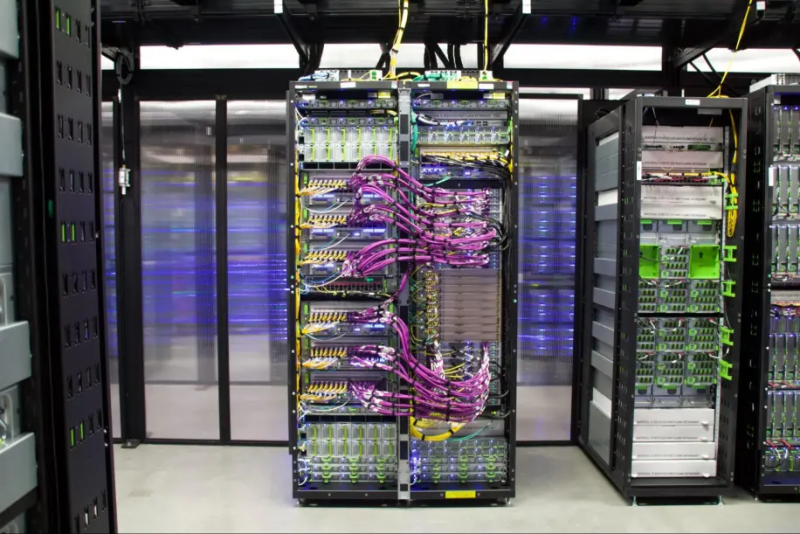
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
21.10.2026 [14:52], Андрей Крупин
«Труконф» представил TrueConf Cluster — отказоустойчивое решение для систем коммуникаций и совместной работыРоссийский разработчик решений для видеоконференцсвязи «Труконф» представил новую серверную архитектуру TrueConf Cluster. Решение предназначено для построения отказоустойчивых систем унифицированных коммуникаций в государственных структурах, банках и промышленных предприятиях. Архитектура TrueConf Cluster позволяет объединять несколько серверов в единый логический кластер с автоматическим перераспределением нагрузки и мгновенным переключением на резервные узлы при сбоях. По данным разработчика, система обеспечивает непрерывность сеансов связи: при выходе из строя одного из узлов активные конференции не прерываются, а пользователи незаметно для себя переводятся на работающие мощности. В основу архитектуры TrueConf Cluster положена фирменная технология компании «Труконф»: каждый участник взаимодействует только со «своим» узлом кластера, а медиаданные передаются напрямую между задействованными узлами — такой подход обеспечивает равномерную нагрузку на сеть. 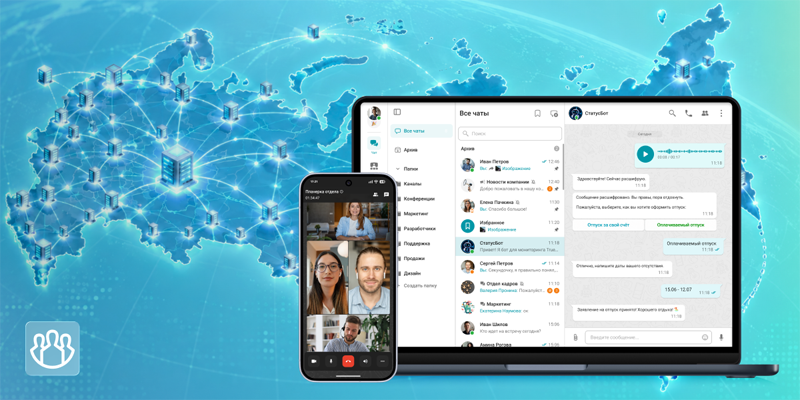
Источник изображения: «Труконф» / trueconf.ru Кластер может быть развёрнут в контуре заказчика или его доверенного подрядчика — в том числе в изолированных сетях. Настройка узлов TrueConf Cluster и конфигурирование системы осуществляется через единый портал с мониторингом нагрузки и активности в реальном времени, а также централизованным управлением правами групп пользователей и администраторов. TrueConf Cluster поддерживает взаимодействие со сложными LDAP-лесами, настройку многофакторной авторизации и механизма единого входа, а также интеграцию со сторонними средствами защиты цифровых угроз. Благодаря возможностям масштабирования продукт может использоваться в организациях любого размера, будь то ведомственные предприятия, территориально распределённые или международные компании с широкой географией офисов.
14.10.2026 [18:07], Владимир Мироненко
Эскадрон ИИ-агентов шальных: d-Matrix анонсировала мегаваттные кластеры Squadron для инференсаd-Matrix анонсировала d-Matrix Squadron — вычислительный комплекс из многостоечных систем, обеспечивающий мощность порядка мегаватт для выполнения задач ИИ-инференса. По словам компании, благодаря вычислительной архитектуре d-Matrix, ориентированной на работу с памятью (memory-centric), кластеры Squadron идеально подходят для исследовательских лабораторий в сфере ИИ, корпораций и государственных организаций. Они оптимальны для приложений, критически чувствительных к задержкам, включая инструменты для написания кода, персональных ИИ-агентов, системы кибербезопасности и платформы для высокочастотного трейдинга (HFT). Система Squadron, разработанная в партнёрстве с компаниями Arista, Broadcom и Supermicro, уже задействована в дата-центре d-Matrix в Аризоне для внутренних исследований и разработок. Компания начала её поставки приоритетным клиентам для внедрения в их ЦОД. Кроме того, в свободную продажу поступили отдельные компоненты системы: серверы и стойки d-Matrix Corsair SquadRack. 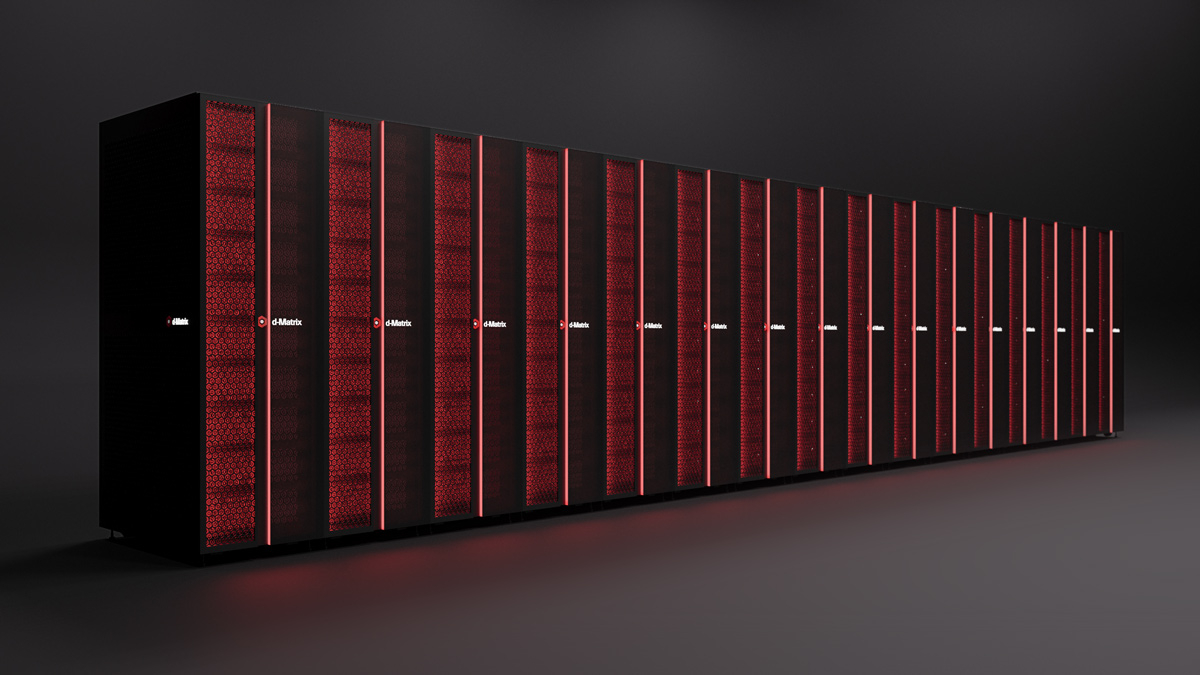
Источник изображения: d-Matrix Система Squadron предлагается в различных конфигурациях: от отдельных стоек d-SquadRack (в каждой — восемь серверов) до полномасштабных интегрированных вычислительных кластеров, включающих до 1024 ускорителей Corsair. Кластеры объединяются в единую сеть с помощью 400G-адаптеров JetStream, а ПО d-Matrix Aviator упрощает их развёртывание. Поскольку кластеры Squadron используют воздушное охлаждение и созданы на базе отраслевых стандартов, заказчики могут интегрировать их в уже существующие ЦОД без необходимости внедрения СЖО или реконструкции инфраструктуры. Кластеры Squadron, оптимизированные для быстрого и эффективного развёртывания ИИ-систем, способны обеспечиваать работу моделей исключительно на чипах Corsair. Они рассчитаны на работу в гетерогенных средах с использованием дезагрегированных вычислений. Генеральный директор и соучредитель d-Matrix сообщил, что компания успешно реализовала технологию дезагрегации Attention-FFN (AFD), используя собственную систему Squadron в связке с серверами на базе GPU. При переносе вычислений компонентов Experts/FFN на стойки Corsair гетерогенная система обеспечила генерацию 845 т/с на одного пользователя. При одновременной работе 64 пользователей такая гетерогенная конфигурация с поддержкой AFD продемонстрировала общую пропускную способность 20 415 т/с. d-Matrix уверяет, что первой в отрасли продемонстрировала реализацию концепции AFD на реальном «железе», доступном уже сегодня.
22.09.2026 [15:40], Сергей Карасёв
Huawei представила ИИ-систему Atlas 960E SuperPoD на базе UnifiedBus и NPOHuawei анонсировала ИИ-систему Atlas 960E SuperPoD. Это, как утверждается, первый в отрасли кластер с технологией NPO (Near-Packaged Optics), предназначенный для работы с большими языковыми моделями, насчитывающими до 10 трлн параметров. В составе Atlas 960E SuperPoD применяются оптические модули Hi-ONE на базе NPO. Данная технология предполагает монтаж оптического движка в виде отдельного узла на плате рядом с ASIC: преимуществами подхода являются снижение задержек и энергопотребления, а также возможность замены компонента при выходе из строя. Пропускная способность достигает 7,2 Тбит/с. Atlas 960E SuperPoD может оснащаться ИИ-ускорителями Huawei Ascend 960, включая будущие изделия 960DT и 960PR. Посредством NPO могут быть связаны до 4096 карт: в случае Ascend 960DT суммарная FP4-производительность составит до 16 Эфлопс. При этом 5500 оптических движков Hi-ONE могут заменить 48 тыс. традиционных оптических модулей стандарта 800G. Это снижает энергопотребление более чем на 550 кВт, одновременно удваивая время безотказной работы системы: показатель доступности достигает 99,8 %. 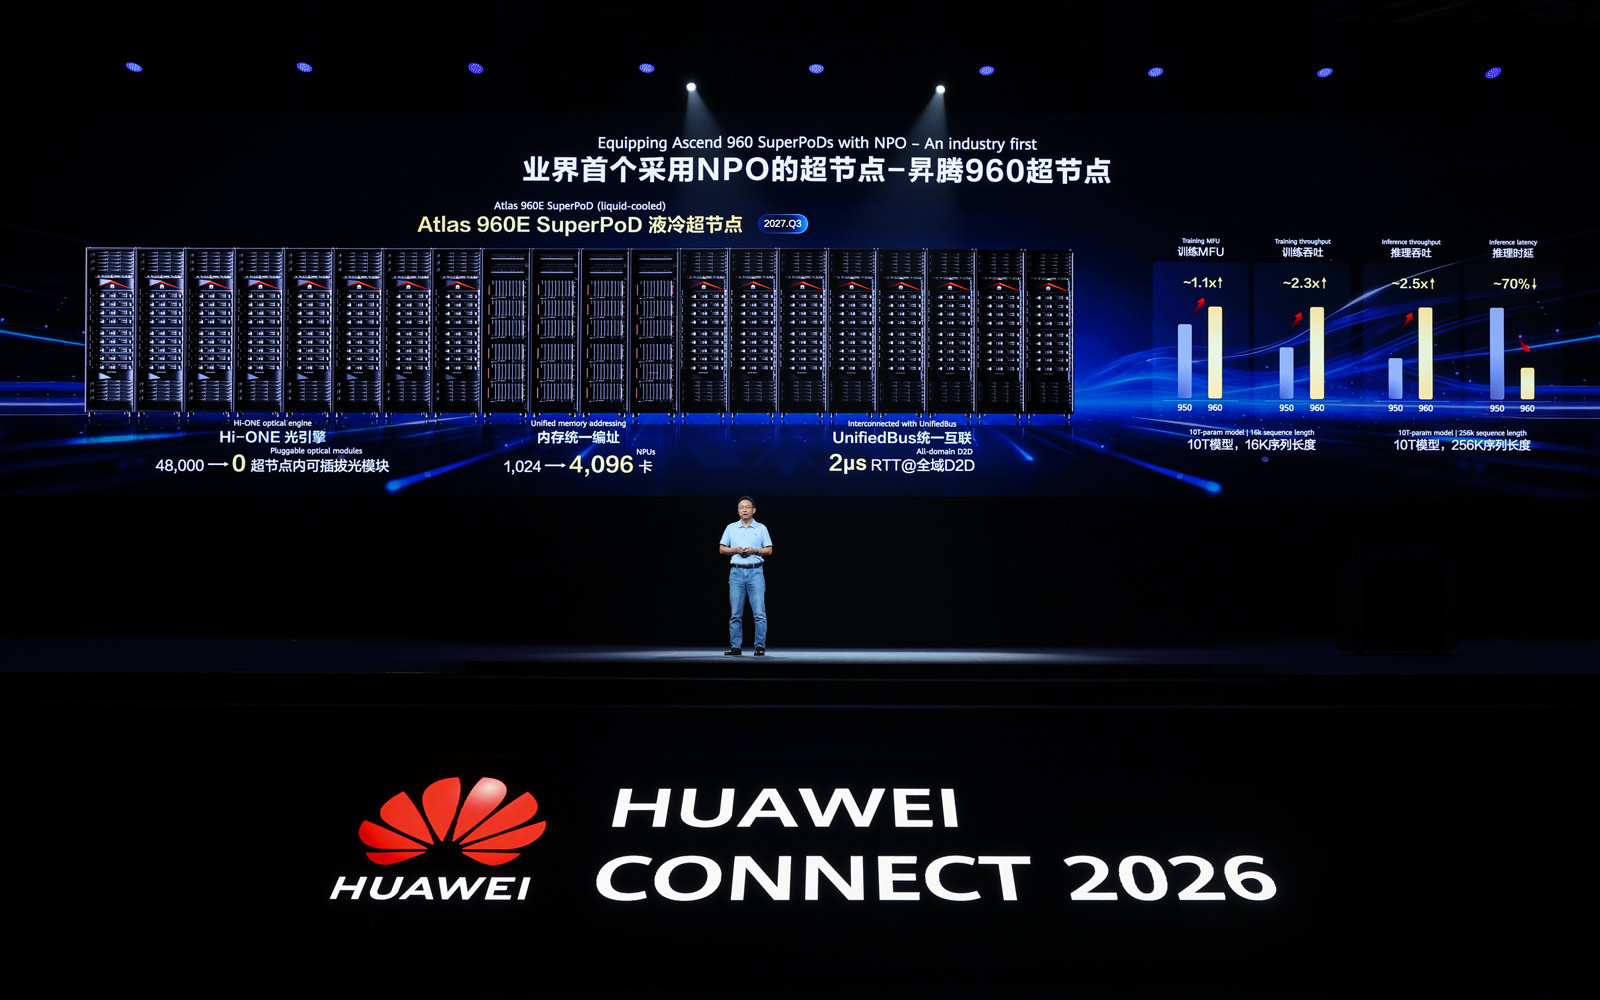
Источник изображения: Huawei Платформа предполагает применение интерконнекта нового поколения UnifiedBus (UB), который обеспечивает пропускную способность в несколько Тбайт/с и задержку (RTT) на уровне 2 мкс. UnifiedBus даёт возможность сформировать единый пул памяти объёмом до 256 Тбайт. Через сеть UnifiedBus и RoCE отдельные экземпляры SuperPoD можно объединять в суперкластеры (SuperCluster). В частности, двухуровневая четырёхплоскостная архитектура Clos позволяет связать воедино до 512 тыс. NPU. А в сочетании с топологией Multi-rail такой кластер может насчитывать до 1 млн ускорителей.
25.05.2026 [10:18], Сергей Карасёв
Представлен 48-узловой ИИ-сервер Firefly CSC2-N48SPK3 с архитектурой RISC-VКомпания Firefly анонсировала многоузловой сервер CSC2-N48SPK3, предназначенный для решения ИИ-задач. Суммарная заявленная производительность этой системы, выполненной на архитектуре RISC-V, достигает 2880 TOPS на операциях INT4. Устройство получило форм-фактор 2U с 48 вычислительными узлами. Каждый из них содержит процессор SpacemiT Key Stone K3 с восемью 64-бит ядрами RISC-V X100M с тактовой частотой до 2,4 ГГц, 8/16/32 Гбайт оперативной памяти LPDDR5 и флеш-накопитель UFS 2.2 вместимостью 128 Гбайт. Говорится о полной поддержке профиля RVA23. Кроме того, в состав сервера входит один узел управления с процессором Rockchip RK3588: он содержит по четыре ядра Cortex-A76 (2,4 ГГц) и Cortex-A55 (1,8 ГГц), а также графический блок Arm Mali-G610 и нейропроцессорный узел (NPU) с производительностью до 6 TOPS. Объём ОЗУ этого узла равен 8 Гбайт. Реализован консольный порт RJ45. 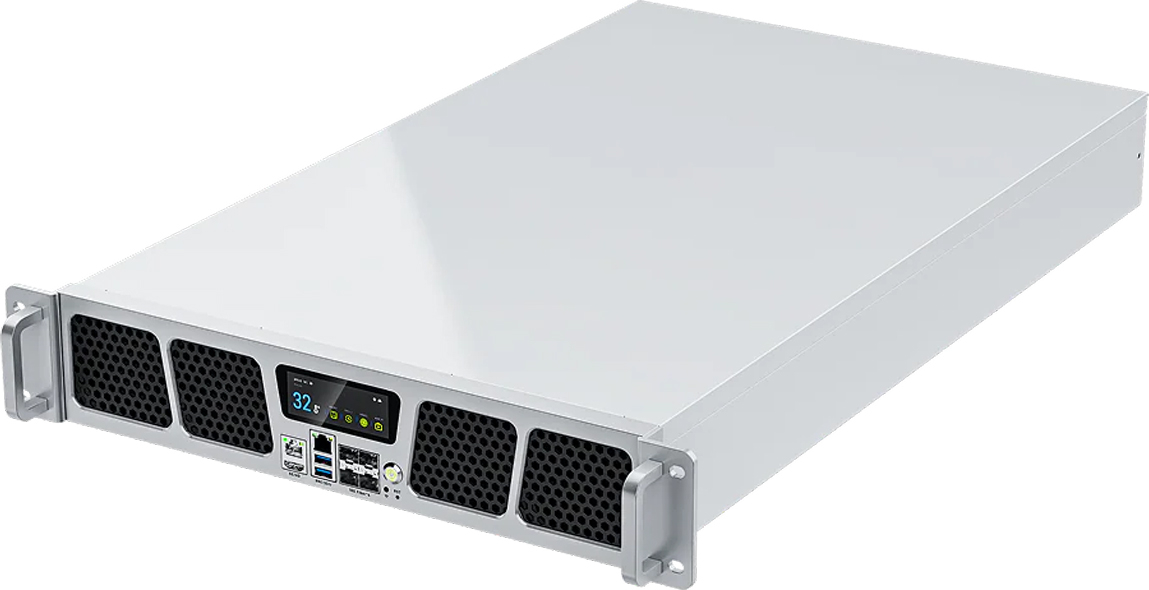
Источник изображения: Firefly Новинка располагает интерфейсом HDMI с поддержкой видео 1080p60, четырьмя сетевыми разъёмами 10GbE SFP+, двумя портами USB 3.0 и сенсорным дисплеем во фронтальной части, на котором отображаются различные параметры (температура, скорость вращения вентиляторов, сетевые данные и пр.). Опционально предлагается возможность установки до 48 накопителем формата M.2 2280 с интерфейсом PCIe (NVMe): при использовании SSD вместимостью 16 Тбайт суммарная ёмкость подсистемы хранения может достигать 768 Тбайт. Габариты составляют 724 × 430 × 88,8 мм, масса — 23,1 кг. Питание обеспечивают два блока с резервированием и возможностью горячей замены. Сервер Firefly CSC2-N48SPK3 доступен для заказа по цене $38 829 в комплектации с 48 вычислительными узлами, оборудованными 16 Гбайт оперативной памяти каждый.
18.05.2026 [20:00], Руслан Авдеев
NVIDIA представила платформу Fleet Intelligence для мониторинга парка ИИ-ускорителей
dcim
nvidia
software
ии
информационная безопасность
кластер
конфиденциальность
мониторинг
облако
оркестрация
телеметрия
цод
NVIDIA представила управляемую платформу Fleet Intelligence, предназначенную для мониторинга состояния крупных кластеров ускорителей, используемых в ИИ-инфраструктуре. Сервис уже доступен бесплатно для клиентов, использующих продукты NVIDIA на основе ускорителей семейств Hopper, Blackwell и Vera Rubin. NVIDIA позиционирует платформу как независимый слой телеметрии и мониторинга, позволяющий отслеживать работу с гетерогенными инфраструктурными средами, независимо от стека оркестрации или планировщика задач. Платформа применяет «лёгкий», интегрируемый в хост-систему агент, который передаёт телеметрию с ИИ-ускорителей в облачную службу Fleet Intelligence, работающую в экосистеме платформы NGC (NVIDIA GPU Cloud). Агент применяет несколько технологий NVIDIA, включая службу мониторинга ускорителей — GPUd, инструмент управления и диагностики чипов DCGM (NVIDIA Data Center GPU Manager) и средства проверки целостности оборудования и ПО NVIDIA Attestation SDK. Компания также выложила код агента Fleet Intelligence на GitHub, что позволит операторам ИИ-инфраструктуры самостоятельно оценить механизмы телеметрии. Fleet Intelligence ведёт сбор данных о степени загруженности ускорителей, пропускной способности памяти, энергопотреблении системы, состоянии интерконнектов NVLink, температуре системы, ошибках ECC, а также показателях состояния аппаратной составляющей. Это помогает операторам ЦОД организовать раннее выявление недоиспользованных ресурсов и ошибок и снизить простои крупных ИИ-кластеров. 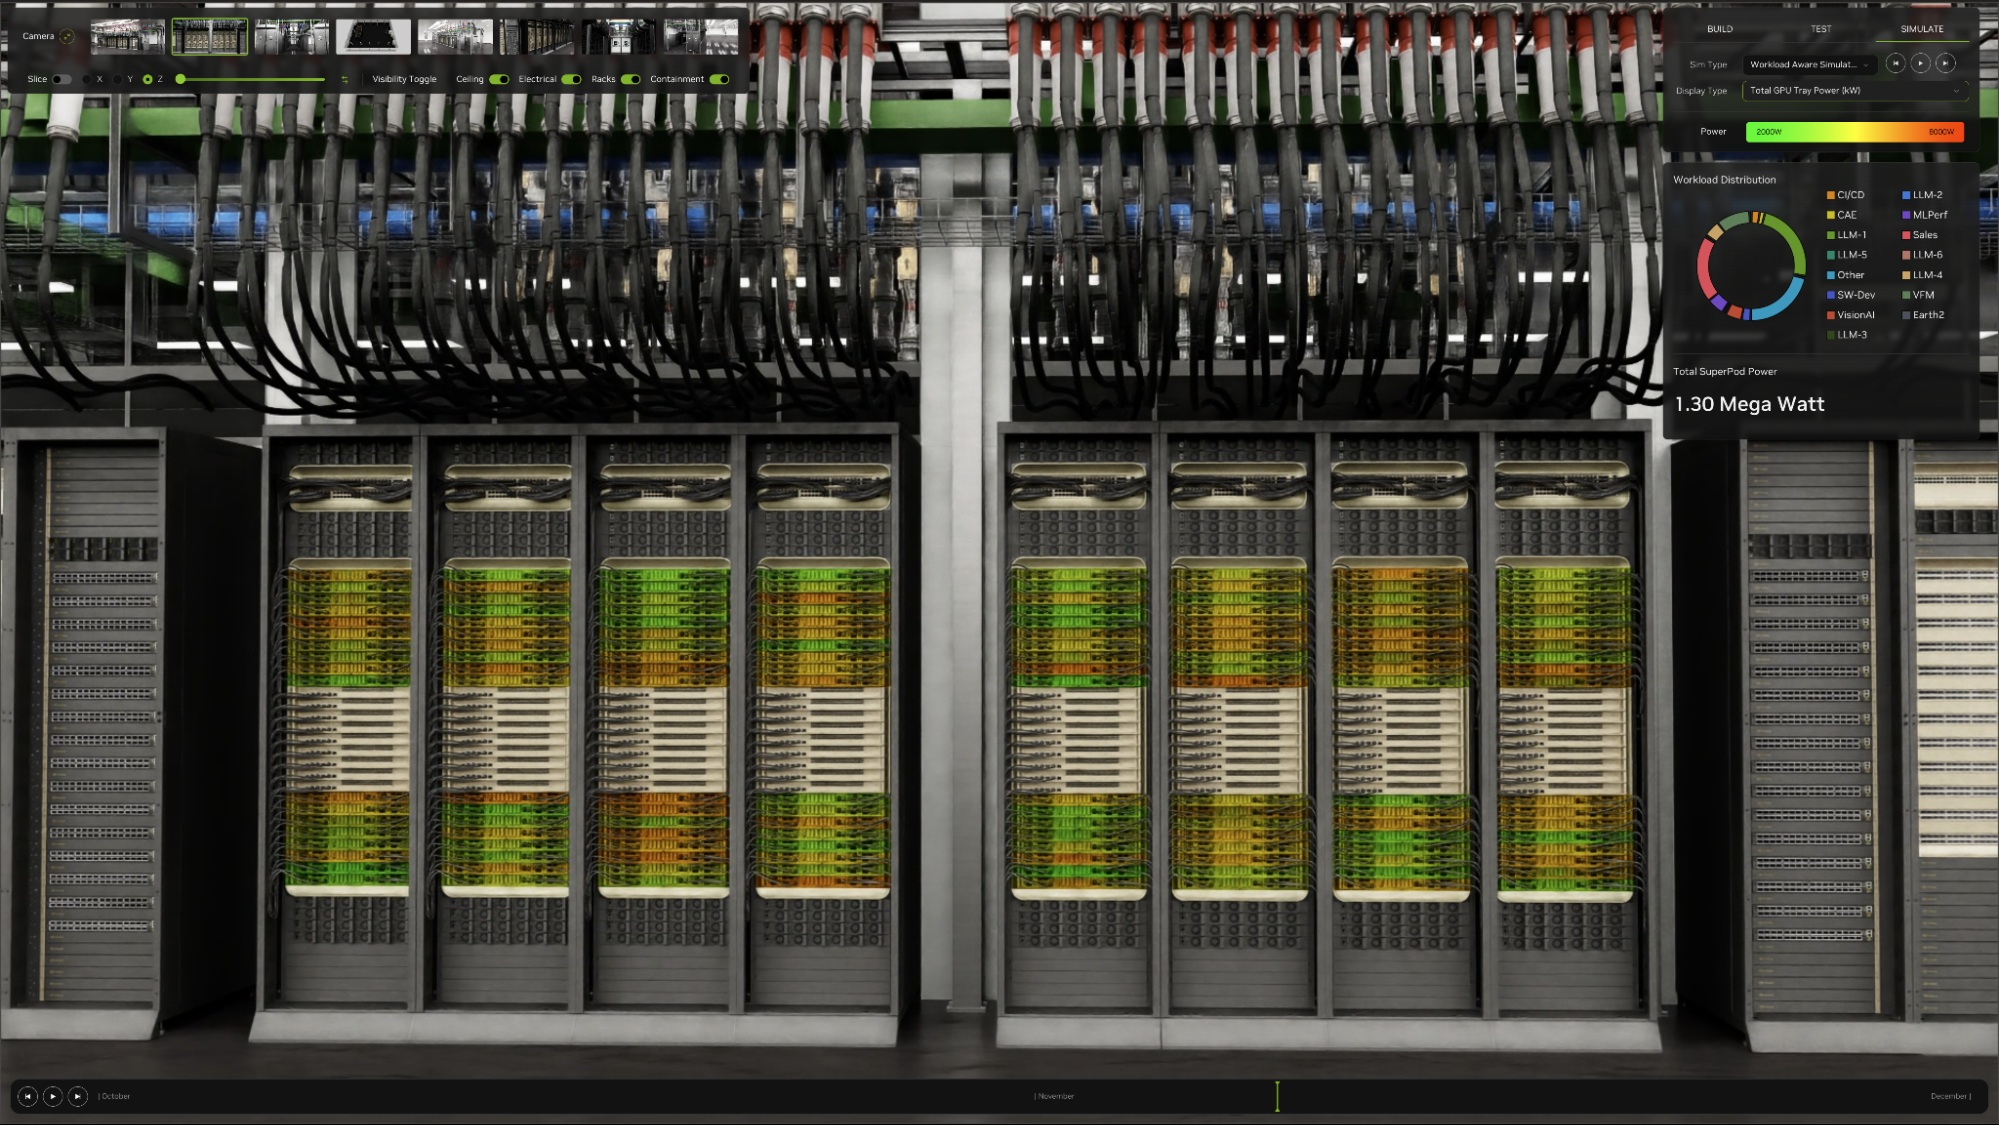
Источник изображений: NVIDIA Одними из основных свойств платформы стали возможности проверки целостности и аттестации на основе технологий защищённых вычислений NVIDIA Confidential Computing. Fleet Intelligence проводит криптографическую валидацию прошивок ИИ-ускорителей и целостность среды выполнения с помощью корневых сертификатов доверия NVIDIA, а также сервиса удалённой проверки оборудования NRAS (NVIDIA Remote Attestation Service). Платформа может подтвердить, что ускорители используют утверждённую прошивку и использует манифесты целостности Reference Integrity Manifests, привязанные к определённым версиям vBIOS. 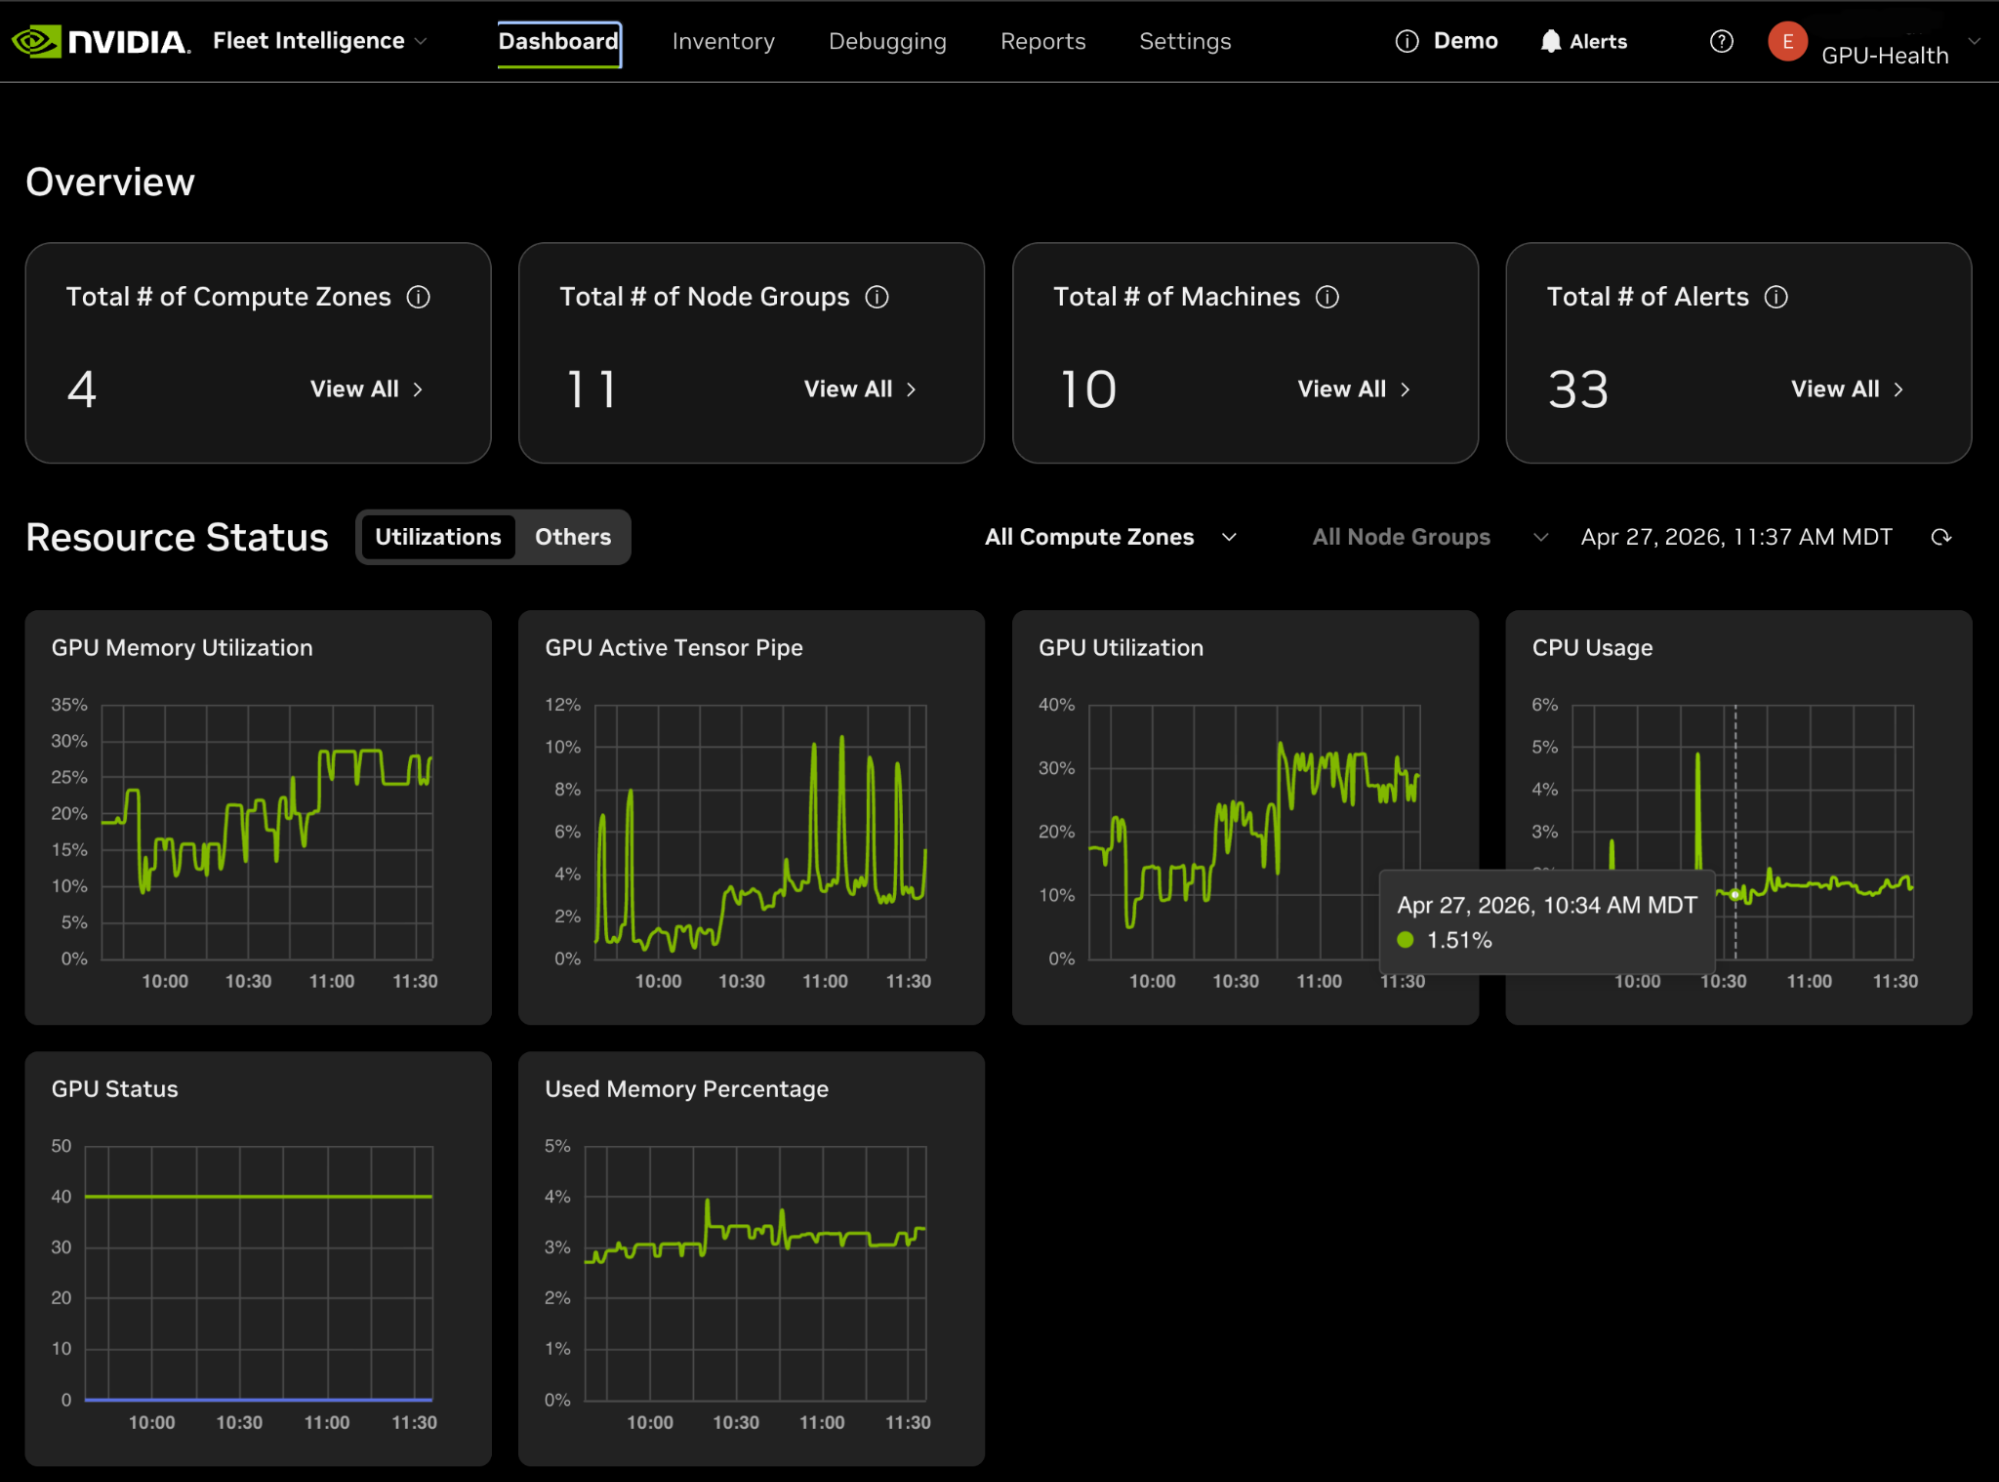 По словам NVIDIA, при разработке Fleet Intelligence применяли опыт эксплуатации облачных платформ NVIDIA DGX Cloud, использовавших сотни тысяч ИИ-ускорителей. В числе корпоративных пользователей, получивших ранний доступ к платформе — Lambda и Iren, обе предоставляли обратную связь в ходе работ. Премьера Fleet Intelligence свидетельствует, что амбиции NVIDIA простираются далеко за пределы простой разработки ИИ-ускорителей, компания развивает ПО и инструменты управления для ИИ-фабрик. Это дополнение уже имеющегося стека компании, включающего системы DGX, интерконнекты NVLink, сетевые продукты Spectrum-X, платформу оркестрации Mission Control и решения для защищённых вычислений. 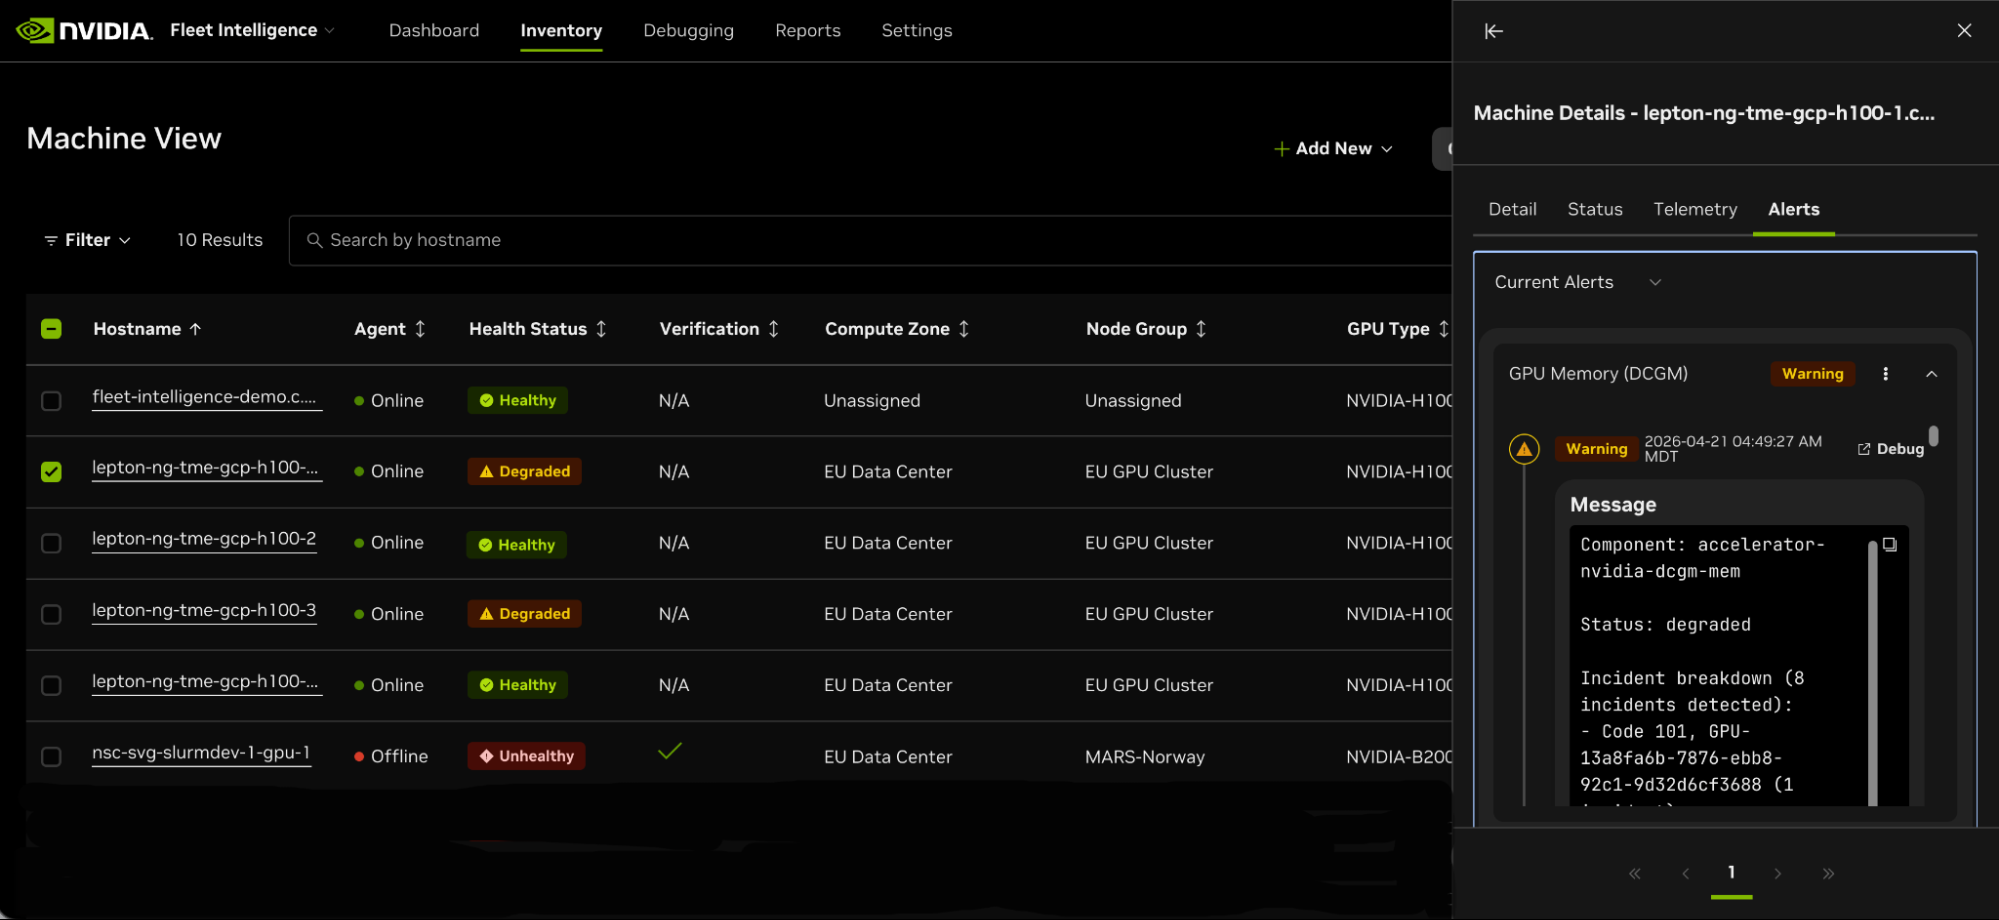 Добавление масштабной телеметрии и предиктивной аналитики отражает растущий спрос гиперскейлеров и корпоративных клиентов на максимальное использование ресурсов ускорителей. Кроме того, премьера платформы является отражением роста конкуренции на рынке систем мониторинга и эксплуатации ИИ-инфраструктуры. Облачные операторы и другие компании, включая AMD, Intel и т.п., строят собственные платформы для телеметрии, диагностики и управления крупными ИИ-кластерами. Возможность NVIDIA интегрировать аппаратную телеметрию, проверку надёжности прошивок и операционную аналитику напрямую в инфраструктурный стек усиливает позиции компании в роли вертикально интегрированного поставщика ИИ-инфраструктуры.
29.04.2026 [01:23], Владимир Мироненко
Tenstorrent представила ИИ-серверы Galaxy Blackhole для быстрой генерации токенов и без дезагрегацииTenstorrent представила вычислительную систему Galaxy Blackhole на базе ускорителей Blackhole с архитектурой RISC-V, которая позиционируется как системная ИИ-платформа, способная конкурировать с другими решениями за счёт стабильной производительности инференса, высокоскоростного доступа к памяти и масштабируемой сети — трёх факторов, которые всё чаще определяют эффективность развёртывания ИИ в реальных условиях, пишет Forbes. 6U-сервер Tensorrent Galaxy Blackhole с воздушным охлаждением основан на 32 ИИ-ускорителях Blackhole суммарной производительностью 23 Пфлопс в режиме FP8. Система включает 6,2 Гбайт SRAM (суммарно 2,9 Пбайт/с) и 1 Тбайт GDDR6 (суммарно 16 Тбайт/с). Высокоскоростную связь между узлами при горизонтальном масштабировании обеспечивают 800GbE-порты — до 56 портов на систему с общей пропускной способностью 11,2 Тбайт/с (в дуплексе). Стоимость системы Tensorrent Galaxy Blackhole составляет $110 тыс. Восьмичиповые системы NVIDIA DGX будут производительнее, но и обойдутся в три-пять раз дороже, сообщил The Register. Базовый суперкластер Galaxy Supercluster стоимостью в $440 тыс. включает четыре системы Blackhole. При этом архитектура Tenstorrent поддерживает масштабирование до 32 узлов с 1024 ускорителями. Mesh-сеть Tenstorrent не ограничивается одним узлом. Подобно кластерам TPU от Google или Trainium2 от Amazon, её можно расширить для поддержки более крупных моделей, более высокой пропускной способности или большей интерактивности, добавив больше узлов и отрегулировав параллелизм тензоров и конвейеров. 
Источник изображений: Tenstorrent Как сообщает Tenstorrent, для DeepSeek V3 её четырёхузловые суперкластеры Blackhole Galaxy Supercluster могут обрабатывать запрос на 100 тыс. токенов — эквивалент 166 страниц текста — менее чем за четыре секунды. Tenstorrent заявила, что кластеры Galaxy Blackhole могут генерировать видео быстрее, чем в реальном времени, а также очень быстро генерировать токены LLM. Демонстрационные версии систем Tenstorrent настроены на обычный режим с генерацией текста с удобочитаемой скоростью, и режим Blitz, обеспечивающий максимально быструю обработку данных, подходящую для таких приложений, как генерация кода и агентный ИИ. В режиме Blitz MoE-модель DeepSeek-671B обеспечивает «до 350 т/с на пользователя со временем получения первого токена менее 4 с», сообщила компания. Ресурс EE Times протестировал этот режим за несколько дней до официального запуска, получив 255 т/с на пользователя для коротких запросов в стиле чат-бота. Этот режим поддерживает пакетную обработку от 8 до 64 и длину контекста до 128 тыс токенов. Он работает на 16 серверах Galaxy (512 чипов) с использованием конвейерного параллелизма на этапе декодирования.  Компания отметила, что её системы не нуждаются в дезагрегации. «Мы можем выполнять и [предварительное заполнение, и декодирование] на одном узле, — сообщил генеральный директор Tenstorrent Джим Келлер (Jim Keller) изданию EE Times. — Мы создаём большой кластер, на котором можно запускать предварительное заполнение и декодирование LLM, генерацию видео, агентный ИИ… мы не специализируемся на чём-то одном. У нас много чипов, большой объём SRAM, но все чипы имеют DRAM, и все они тесно связаны между собой, поэтому наша платформа гораздо более универсальна».
24.04.2026 [11:15], Руслан Авдеев
Tesla развернула ИИ-кластер Cortex 2 на территории Gigafactory в ТехасеTesla ввела в эксплуатацию кластер Cortex 2 для обучения ИИ, расположенный на территории кампуса Gigafactory Texas. Это знаменует новый шаг на пути компании к расширению собственных вычислительных мощностей для создания систем автономного вождения, робототехники и других задач в сфере ИИ, сообщает Converge Digest. В презентации для акционеров, посвящённой итогам I квартала 2026 года, компания указала, что кластер Cortex 2 находится на стадии «раннего масштабирования». Установленная годовая производительность составляет эквивалент более 130 тыс. ИИ-ускорителей NVIDIA H100. Кроме того, имеется ещё и кластер Cortex 1, эквивалентный 100 тыс. H100. По данным Tesla, Cortex 2 уже выполняет задачи обучения моделей. Кроме того, компания разрабатывает и архитектуру Dojo 3 для суперкомпьютеров нового поколения, чтобы снизить затраты на обучение в будущем. Развитие ИИ-инфраструктуры Tesla напрямую связывается с с масштабированием планов по созданию роботизированных такси и Optimus. В материалах отчёта также упоминается, что расширение вычислительных мощностей осуществляется в рамках более масштабного плана развития в сфере аккумуляторных технологий, материалов и сервисов мобильности. 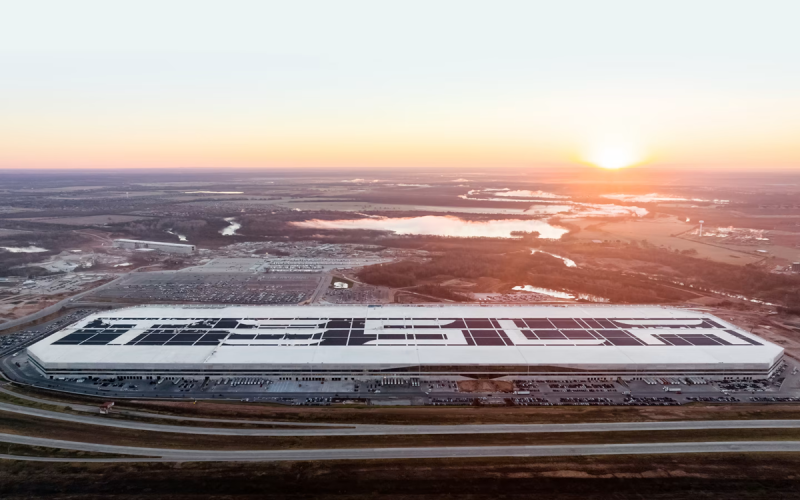
Источник изображения: Tesla Кроме того, в отчёте указано на запуск в апреле системы FSD (Supervised) версии 14.3, улучшении «обучения с подкреплением» и обработки в системах машинного зрения, задержка инференса сокращена на 20 %. Кроме того, т.н. Digital Optimus обозначен как следующий этап развития ИИ-платформы Tesla. Также раскрыты планы компании в полупроводниковой отрасли. Было заявлено, что Tesla расширяет сферу производства и намерена заняться выпуском полупроводников, начиная с мощностей Research Fab на территории Gigafactory в Техасе. Сообщалось, что в апреле компания окончательно завершила разработку чипа нового поколения AI5. Также объявлено, что партнёрство со SpaceX направлено на создание «крупнейшего в истории» завода по выпуску чипов, с вертикальной интеграцией, включающей логические микросхемы, память и передовые технологии упаковки. Утверждение о масштабе, конечно, является словами самой Tesla, но оно косвенно свидетельствует о том, насколько агрессивно компания сейчас связывает ИИ-вычисления, разработку чипов и производственную стратегию.
08.04.2026 [22:38], Владимир Мироненко
Alibaba и China Telecom запустили ИИ-кластер на базе 10 тыс. ИИ-ускорителей ZhenwuAlibaba объявила о развёртывании в сотрудничестве с мобильным оператором China Telecom вычислительного ИИ-кластера из 10 тыс. ИИ-ускорителей Zhenwu, разработанных подразделением Alibaba T-Head. По словам Alibaba Cloud, передовые вычислительные мощности Китая «переходят от высокопроизводительных прорывов к крупномасштабному промышленному внедрению». ИИ-кластер размещён в дата-центре оператора China Telecom в Шаогуане (Shaoguan, провинция Гуандун). Как отметило облачное подразделение Alibaba, этот «полностью отечественный» кластер стал первым проектом такого масштаба на базе чипов Zhenwu в районе Большого залива (Greater Bay Area, GBA) — одном из ключевых стратегических регионов в планах национального развития Китая. По данным Alibaba Cloud, новый кластер обеспечивает сверхнизкую задержку в 4 мс и позволяет 10 тыс. чипам работать как единая система, способная обучать ИИ-модели с сотнями миллиардов параметров. China Telecom и Alibaba заявили, что вычислительный ИИ-кластер может использоваться в различных отраслях, от здравоохранения до разработки передовых материалов. Также сообщается, что в дальнейшем он будет расширен до 100 тыс. чипов. 
Источник изображения: www.alibabagroup.com Запуск ИИ-кластера на базе чипов Zhenwu является ещё одним свидетельством того, что Китай удваивает усилия по развитию собственной инфраструктуры для ускорения быстро развивающихся ИИ-технологий и удовлетворения растущего спроса на фоне обострения конкуренции в области ИИ с американскими соперниками, включая Meta✴, Microsoft и xAI, пишет South China Morning Post. Объявление Alibaba о создании ИИ-кластера последовало за запуском в конце прошлого месяца первого в стране интеллектуального вычислительного кластера на базе 10 тыс. чипов Huawei Ascend 910C общей ИИ-производительностью 11 Эфлопс в Шэньчжэне (Shenzhen, провинция Гуандун). В прошлом году компания запустила ИИ-кластер с производительностью 3 Эфлопс. По данным Shenzhen Special Zone Daily, почти 50 организаций подписали рамочные соглашения на использование вычислительных мощностей нового кластера, в результате чего общий уровень бронирования по обоим кластерам достиг 92 %.
22.12.2025 [12:28], Сергей Карасёв
Китайская Sugon представила ИИ-платформу ScaleX с 10 тыс. ускорителейКитайский разработчик суперкомпьютеров Sugon (Dawning Information Industry), по сообщению газеты South China Morning Post, анонсировал платформу ScaleX для решения ресурсоёмких задач в области ИИ. Система призвана составить конкуренцию продуктам NVIDIA и Huawei. По заявлениям Sugon, ScaleX представляет собой первый в КНР суперкластер, объединяющий около 10 тыс. ускорителей. ИИ-производительность превышает 5 Эфлопс (точность вычислений не называется). Платформа может применяться для работы с ИИ-моделями, насчитывающими триллионы параметров. В основу суперкластера положены 16 стоек Sugon ScaleX640, каждая из которых может нести на борту до 640 ускорителей. Таким образом, общее количество ИИ-карт в составе платформы достигает 10 240. Конструкция стоек предполагает использование иммерсионного жидкостного охлаждения с фазовым переходом и высоковольтных источников питания постоянного тока (DC). Стойки связаны друг с другом высокоскоростным интерконнектом ScaleFabric. Sugon отмечает, что для моделей ИИ с триллионами параметров ScaleX640 обеспечивает повышение производительности на 30–40 % на задачах обучения и инференса по сравнению с традиционными НРС-системами. 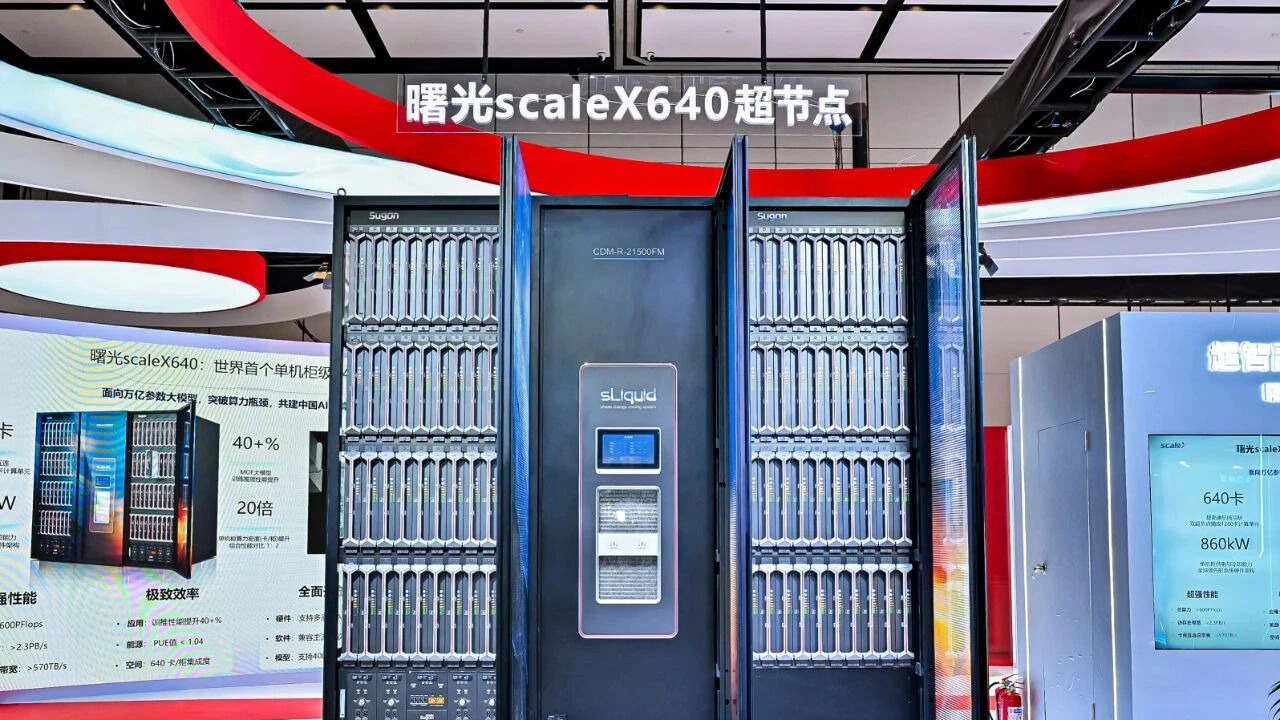
Источник изображения: Sugon Предполагается, что ScaleX будет соперничать с будущими решениями Huawei, в частности, с суперкластерами Atlas 950 и Atlas 960. В их основу лягут ИИ-ускорители Ascend нового поколения, о подготовке которых стало известно в сентябре уходящего года. Система Atlas 950 SuperCluster, выход которой ожидается к концу 2026 года, будет содержать в общей сложности более 500 тыс. NPU, а Atlas 960 SuperCluster — свыше 1 млн. Сейчас у Huawei есть платформа CloudMatrix 384, которая объединяет 384 ускорителя Huawei Ascend 910C. |
|

