Материалы по тегу: китай
|
02.10.2026 [21:52], Руслан Авдеев
Tencent арендовала 100 тыс. чипов у Oracle чтобы ускорить развитие своих ИИ-системКомпания Tencent подписала свою крупнейшую за пределами Китая сделку об аренде вычислительных мощностей — с американским облачным провайдером Oracle. Речь идёт о доступе к более 100 тыс. передовых ИИ-чипов, сообщает The Financial Times. По данным источников, на которые ссылается издание, знакомых с ситуацией, китайский IT-гигант в текущем году договорился о пятилетней аренде в многочисленных дата-центрах Oracle в Юго-Восточной Азии. Согласно имеющимся данным, сделка оценивается в $7 млрд, авансом будет выплачено около 30 % от этой суммы. Её участники новость пока не комментируют, однако само заключение такого договора наглядно свидетельствует о растущих потребностях Tencent в вычислительных мощностях для дальнейшего расширения своего ИИ-бизнеса. Компания наращивает инвестиции в разработку и внедрение ИИ-моделей. В конце прошлого года компания уже заключила сделку с японским неооблаком Datasection о доступе к десяткам тысяч подсанкционных чипов NVIDIA B200/B300. Китайские компании стремятся обеспечить себе доступ к ИИ-чипам на фоне ужесточения экспортных ограничений США и продвижения Пекином китайских альтернатив американским ИИ-ускорителям. На днях Huawei уже заявила, что в самой КНР ускорители компании обошли по продажам продукцию NVIDIA. 
Источник изображения: Ruthson Zimmerman/unsplash.com Каким образом нынешняя сделка оформлена в правовом и политическом полях, не уточняется. В ноябре 2025 года сообщалось, что китайская INF Tech обошла санкции США на доступ к ИИ-чипам NVIDIA Blackwell через индонезийское облако. Тогда же появились данные, что Alibaba и ByteDance стали тренировать передовые ИИ-модели в ЦОД Юго-Восточной Азии, а в марте 2026 года ByteDance заключила соглашение с Aolani Cloud, развернувшей в Малайзии инфраструктуру с примерно 36 тыс. NVIDIA B200. При этом сообщалось, что ещё с февраля 2025 года Aolani сдаёт ByteDance в аренду серверы с NVIDIA H100. Однако американские власти и их азиатские партнёры относятся к подобным сделкам не вполне лояльно. В апреле сообщалось, что Bridge Data Centres выгнала из своих ЦОД сингапурское ИИ-неооблако Megaspeed, подозреваемое в нарушении антикитайских санкций США. Каким образом на этом фоне будет обеспечено взаимодействие Tencent и Oracle, данных пока нет.
02.10.2026 [02:45], Руслан Авдеев
Глава Huawei: ускорители Ascend уже обошли NVIDIA по продажам в КитаеАмериканские экспортные ограничения не помешали Huawei заполнить освободившуюся на китайском рынке нишу. По словам главы компании Эрика Сюя (Eric Xu), по продажам в Китае чипы Ascend обогнали продукцию NVIDIA, сообщает The Register. В пресс-релизе компании отмечается, что статистику о рыночной доле NVIDIA в КНР собрать непросто, но, судя по полученным Huawei данным, Ascend уже впереди. Сюй отметил, что его соотечественники остро ощущают, когда следует действовать быстро и не принимают будущее, в котором кто-то извне будет принимать решения, сможет ли КНР получать доступ к определённым продуктам. Администрация Трампа после прихода к власти в США постепенно смягчила ограничения на поставки американских ускорителей в Китай, а к концу прошлого года даже объявила о разрешении продаж ускорителей NVIDIA H200. Тем не менее, решение было принято с опозданием. Пока NVIDIA ожидала разрешения, Пекин, озабоченный запретом на поставку менее производительных H20 ранее в том же году, начал принимать экстренные меры. Чиновники начали стимулировать переход китайских компаний на ускорители местного производства. В ходе финансового отчёта NVIDIA за II квартал было озвучено, что компания начала поставки небольших партий H200 в регион, но на эти поставки пришлось менее 1 % выручки компании от бизнеса ЦОД. Сюй подчеркнул, что китайские ускорители не такие производительные, как импортные, зато их поставки гарантированы, поэтому для правительства КНР и Huawei совершенно очевидно, что необходимо стремиться к полной самостоятельности в производстве чипов и суверенитету цепочки поставок для выпуска полупроводников в целом. 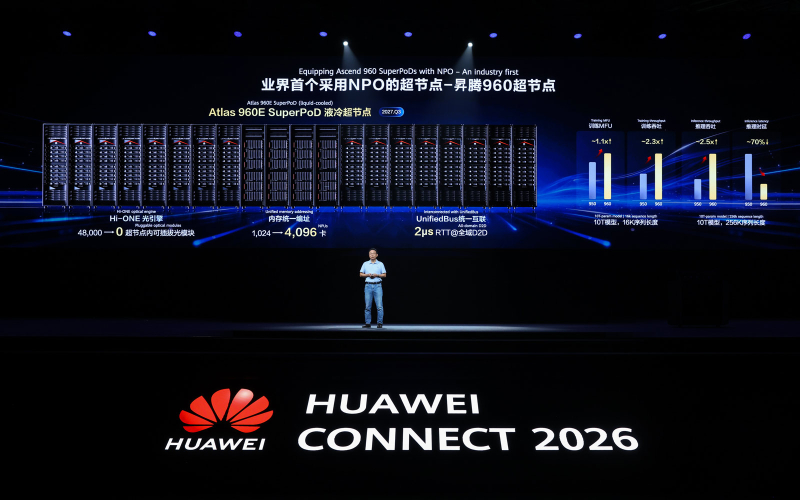
Источник изображения: Huawei Хотя по формальным признакам новейшие ускорители Huawei всё ещё уступают продуктам NVIDIA и AMD, это компенсируется масштабами внедрения. Компания представила кластер Atlas 950 SuperCluster на сотни тысяч чипов, а новая архитектура поддерживает обучение и инференс моделей с триллионами параметров и масштабирование до миллиона ускорителей. На днях Huawei представила Atlas 960E SuperPoD на базе UnifiedBus и технологии NPO (Near-Packaged Optics). Впрочем, Сюй признал, что за пределами Китая Huawei, вероятно, ещё некоторое время не будет рассматриваться как угроза NVIDIA, поскольку у компании недостаточно производственных мощностей для удовлетворения спроса даже в Китае. Расширение присутствия за рубежом пока не планируется, поскольку приоритет отдаётся китайским заказчикам. При этом бизнесмен признал, что ведутся поставки ограниченному числу заказчиков за рубежом. Переходу на продукты Huawei способствует не только давление китайских властей, поощряющих это, но и изменение программных подходов. Например, с чипами Huawei более года работает DeepSeek. Как считают в HiSilicon, входящей в структуру Huawei, основное препятствие было связано не с аппаратной частью. Речь шла о программном «барьере» для ускорителей Ascend и продуктов других компаний помимо NVIDIA. В компании отметили, что ситуация изменилась за последние 18 мес. Если ещё два года назад обучение ИИ осуществлялось в основном с помощью фреймворка PyTorch поверх экосистемы CUDA, то теперь изменения в архитектуре ИИ-моделей подтолкнули разработчиков к пересмотру подходов и снижению зависимости от специальных возможностей CUDA. Передовые ИИ-лаборатории более не считают экосистему CUDA такой важной, как два года назад. В связи с этим DeepSeek на днях представила набор программных инструментов, призванных упростить использование Huawei Ascend и другим ИИ-разработчикам. Huawei же ускоряет разработку новых чипов. В начале 2027 года выйдут ИИ-ускорители Huawei Ascend 960DT, а в III квартале должна появиться модель Ascend 960PR. В 2028 году ожидается ускоритель Ascend 970 с 288 Гбайт памяти с пропускной способностью 14,4 Тбайт/с.
24.09.2026 [13:29], Сергей Карасёв
Четыре ядра, DDR5 и PCIe 4.0: дебютировали китайские x86-чипы Hygon 1000 для встраиваемых системКитайская компания Hygon Information Technology анонсировала процессоры Hygon 1000, выполненные на базе x86-совместимой архитектуры C86. Чипы предназначены для применения во встраиваемых системах, платформах промышленной автоматизации, робототехнике, периферийном оборудовании и пр. Конструкция изделий включает четыре вычислительных ядра с возможностью одновременной обработки до восьми потоков инструкций. Говорится о поддержке оперативной памяти DDR4/DDR5 (ЕСС), а также интерфейса PCIe 4.0 и расширений TSN (Time-Sensitive Networking). Тактовая частота и размер кеша пока не раскрываются. 
Источник изображения: SCMP В состав процессоров входит графическое ядро (iGPU) с возможностью обработки двух видеопотоков в формате 4K с кадровой частотой 60 Гц. Упомянута поддержка программных интерфейсов DirectX, OpenGL 3.3 и OpenCL 3.0. Предусмотрен встроенный криптографический модуль с аппаратным ускорением китайских национальных алгоритмов SM2/SM3/SM4. Кроме того, реализованы безопасная загрузка (Secure Boot) и другие механизмы защиты. Показатель TDP изделий Hygon 1000 находится на уровне 10 Вт: благодаря этому чипы могут применяться в устройствах с пассивным охлаждением. Диапазон рабочих температур простирается от -40 до +105 °C. Hygon гарантирует доступность процессоров в течение как минимум 10 лет с момента начала поставок. Среди возможных сфер использования названы облачные терминалы, NAS-серверы, системы видеонаблюдения, роботы, индустриальные устройства управления, шлюзы безопасности и универсальные платформы с ИИ-функциями.
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 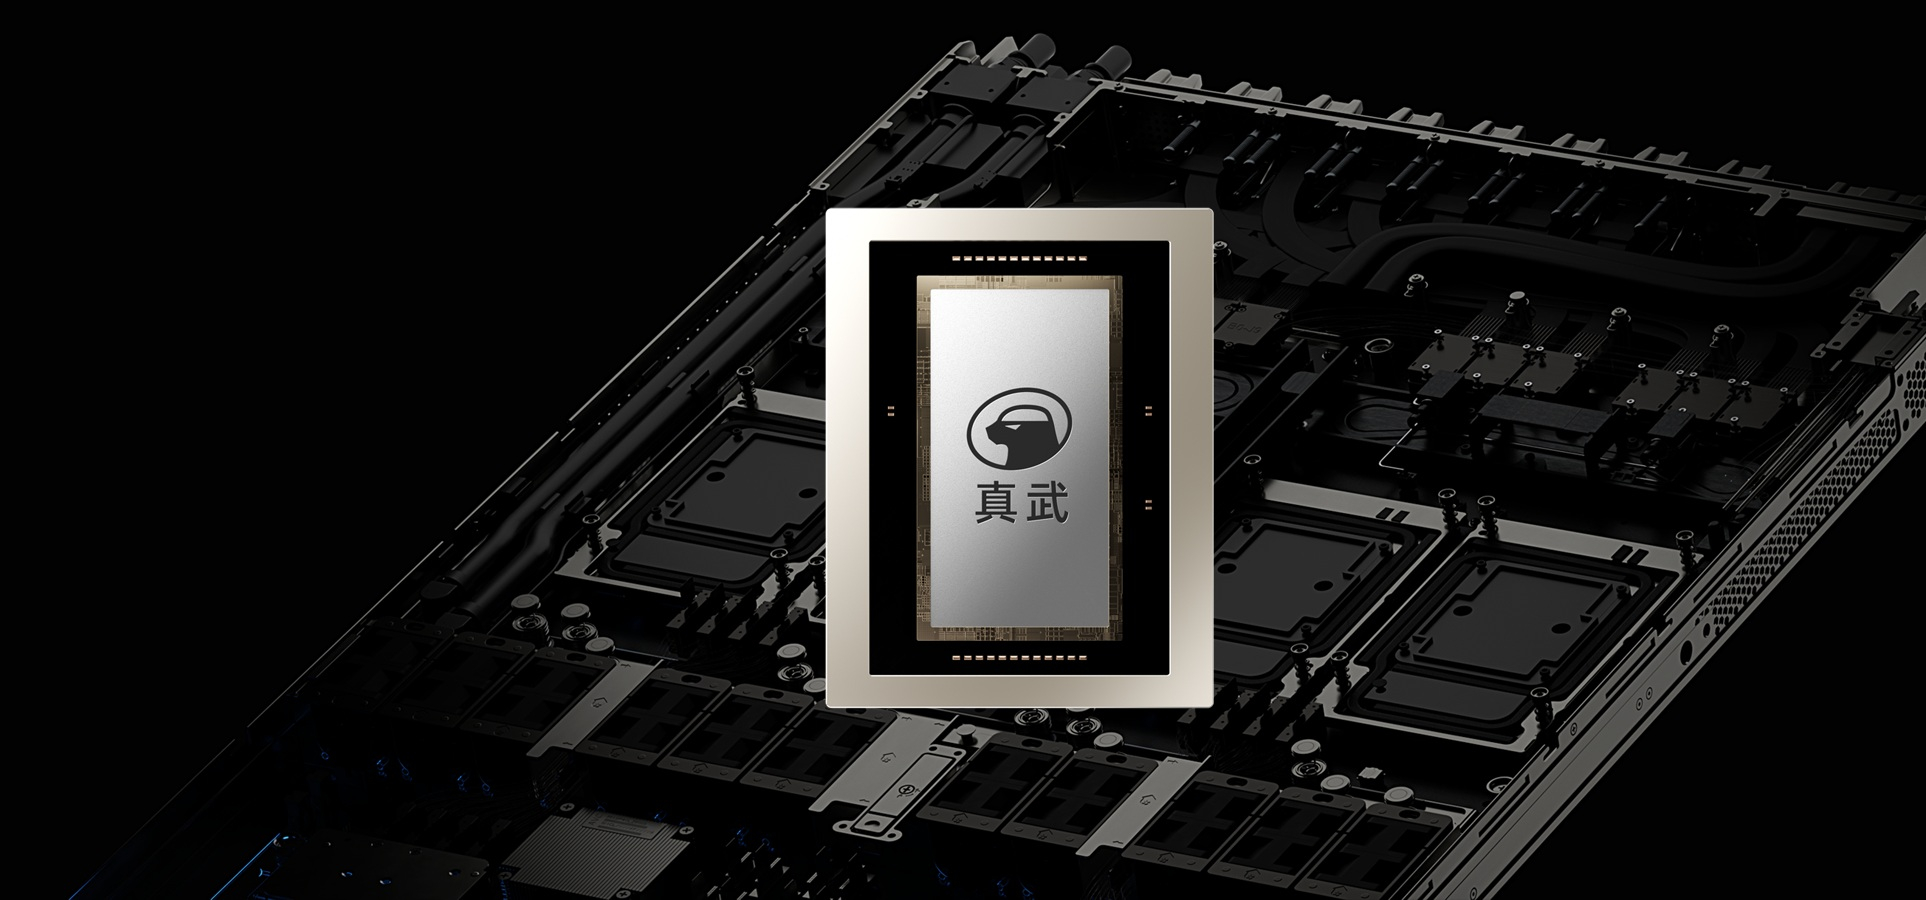
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 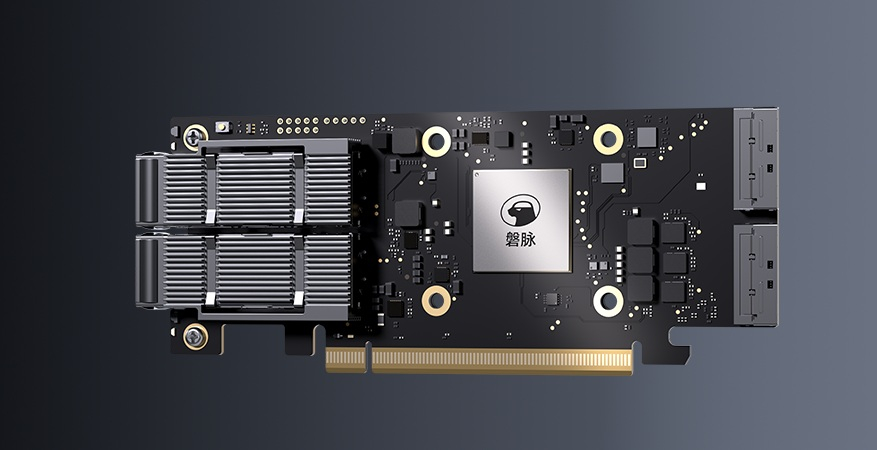
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
22.09.2026 [15:40], Сергей Карасёв
Huawei представила ИИ-систему Atlas 960E SuperPoD на базе UnifiedBus и NPOHuawei анонсировала ИИ-систему Atlas 960E SuperPoD. Это, как утверждается, первый в отрасли кластер с технологией NPO (Near-Packaged Optics), предназначенный для работы с большими языковыми моделями, насчитывающими до 10 трлн параметров. В составе Atlas 960E SuperPoD применяются оптические модули Hi-ONE на базе NPO. Данная технология предполагает монтаж оптического движка в виде отдельного узла на плате рядом с ASIC: преимуществами подхода являются снижение задержек и энергопотребления, а также возможность замены компонента при выходе из строя. Пропускная способность достигает 7,2 Тбит/с. Atlas 960E SuperPoD может оснащаться ИИ-ускорителями Huawei Ascend 960, включая будущие изделия 960DT и 960PR. Посредством NPO могут быть связаны до 4096 карт: в случае Ascend 960DT суммарная FP4-производительность составит до 16 Эфлопс. При этом 5500 оптических движков Hi-ONE могут заменить 48 тыс. традиционных оптических модулей стандарта 800G. Это снижает энергопотребление более чем на 550 кВт, одновременно удваивая время безотказной работы системы: показатель доступности достигает 99,8 %. 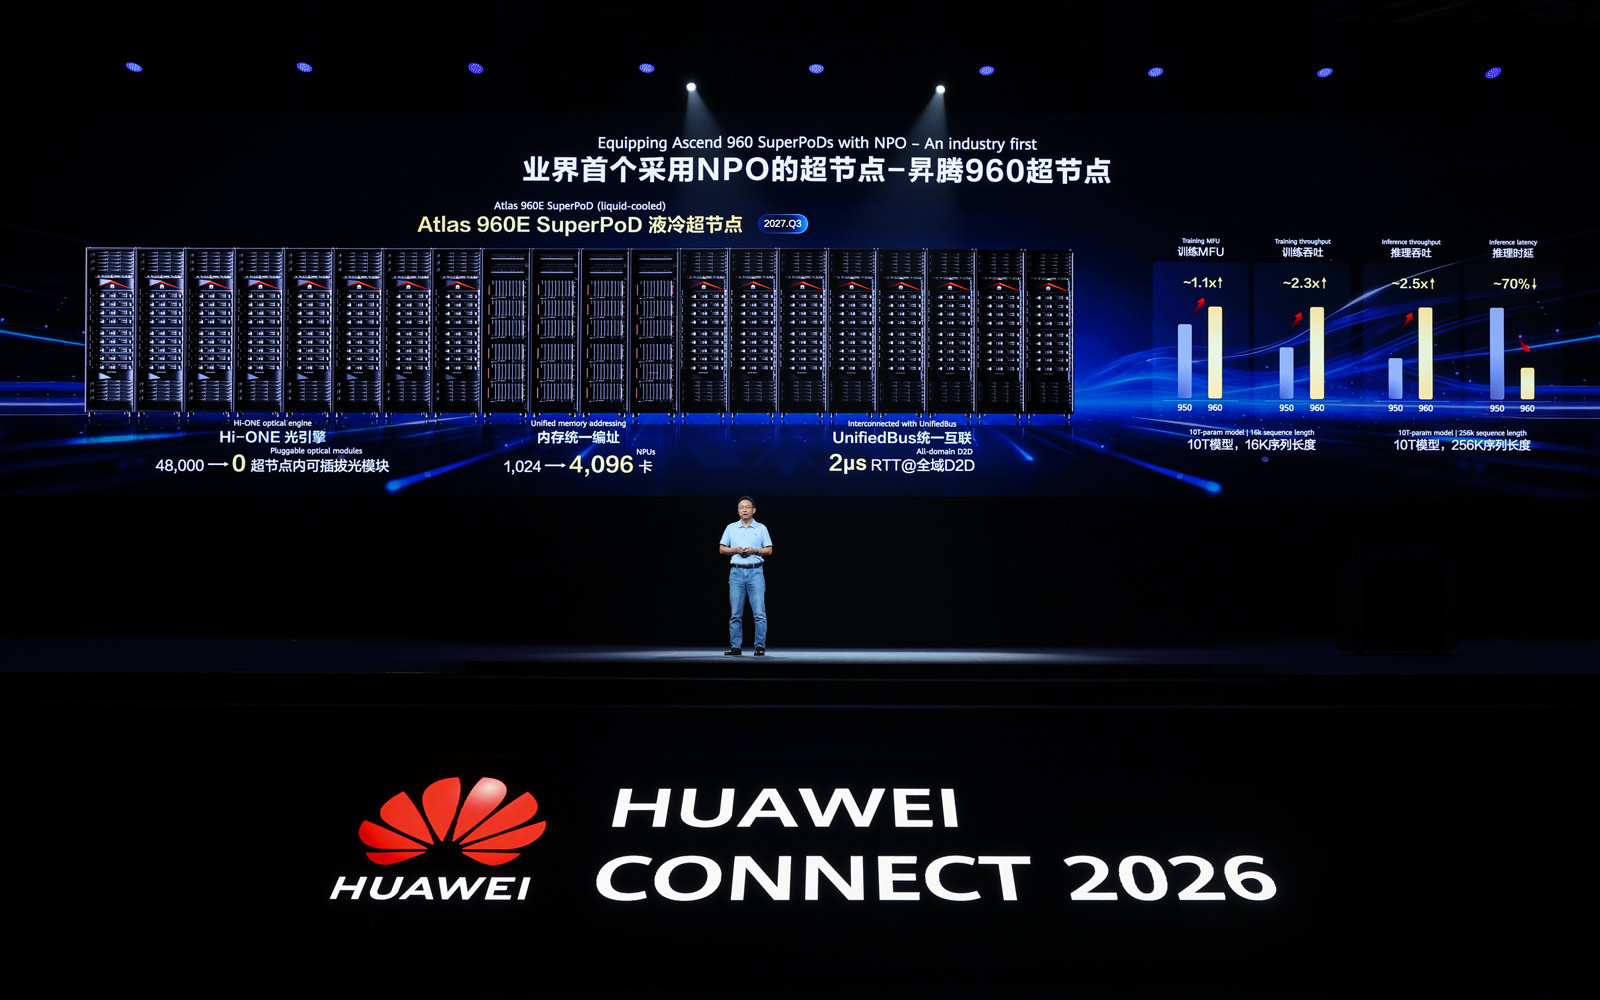
Источник изображения: Huawei Платформа предполагает применение интерконнекта нового поколения UnifiedBus (UB), который обеспечивает пропускную способность в несколько Тбайт/с и задержку (RTT) на уровне 2 мкс. UnifiedBus даёт возможность сформировать единый пул памяти объёмом до 256 Тбайт. Через сеть UnifiedBus и RoCE отдельные экземпляры SuperPoD можно объединять в суперкластеры (SuperCluster). В частности, двухуровневая четырёхплоскостная архитектура Clos позволяет связать воедино до 512 тыс. NPU. А в сочетании с топологией Multi-rail такой кластер может насчитывать до 1 млн ускорителей.
18.09.2026 [17:42], Сергей Карасёв
ИИ-ускорители Huawei Ascend 960DT с 288 Гбайт памяти выйдут в начале 2027 годаHuawei поделилась планами по выпуску новых ИИ-ускорителей Ascend. Сообщается, что в I квартале следующего года дебютирует изделие Ascend 960DT, которое придёт на смену Ascend 950. В состав 960DT (аббревиатура расшифровывается как Decode/Training — декодирование/обучение) войдут 288 Гбайт памяти с пропускной способностью 9,6 Тбайт/с — в 2,4 раза больше по сравнению с Ascend 950. При этом сетевые источники указывают на использование памяти HiZQ — собственного решения Huawei, позиционирующегося в качестве альтернативы НВМ. Пропускная способность интерконнекта Ascend 960DT составит 2,2 Тбайт/с. Для нового ускорителя заявлена поддержка форматов FP32, HF32, FP16, BF16, FP8, MXFP8, HiF8, MXFP4 и HiF4. ИИ-производительность в режиме FP8 будет достигать 2 Пфлопс, в режиме FP4 — 4 Пфлопс. В один кластер могут объединяться тысячи таких изделий для масштабирования быстродействия. В частности, посредством NPO могут быть связаны до 4096 эксземпляров Ascend 960DT, что обеспечит суммарную FP4-производительность на уровне 16 Эфлопс. 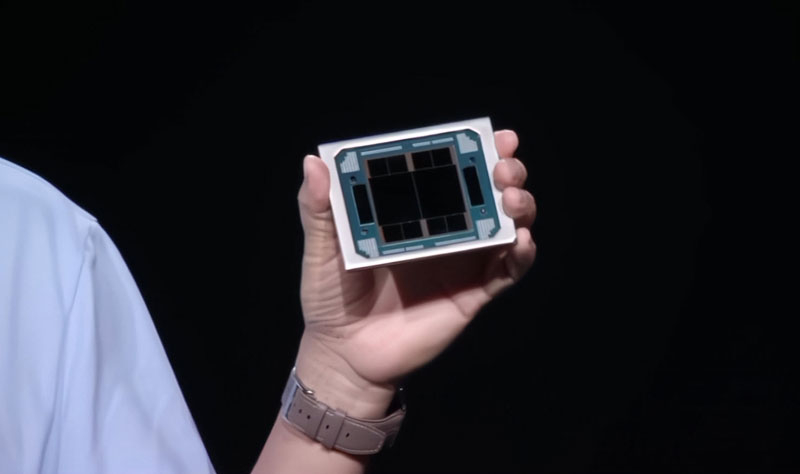
Источник изображения: wccftech.com На III четверть 2027 года намечен анонс карты Ascend 960PR (Prefill/Recommenders — заполнение/рекомендации). Она будет нести на борту 192 Гбайт памяти с пропускной способностью 2,4 Тбайт/с (скорость интерконнекта сохранится на уровне 2,2 Тбайт/с). Это решение обеспечит быстродействие до 2 Пфлопс на операциях FP8 и до 8 Пфлопс в режиме FP4. В 2028 году, как ожидается, появится ускоритель Ascend 970 с 288 Гбайт памяти с пропускной способностью 14,4 Тбайт/с. У данной модели пропускная способность интерконнекта поднимется до 4,4 Тбайт/с. Производительность FP8 и FP4 — до 3,6 и 14 Пфлопс соответственно. Наконец, на 2029-й запланирован выпуск изделия Ascend 980 с 384 Гбайт памяти (38,4 Тбайт/с) и интерконнектом на 8 Тбайт/с. Карта сможет выдавать 7,2 Пфлопс на операциях FP8 и 28 Пфлопс в режиме FP4.
17.09.2026 [02:35], Владимир Мироненко
Huawei представила четырёхуровневый 3D-ЦОД в качестве эталона для ИИ-кластеровКомпания Huawei представила четырёхуровневый 3D-ЦОД в Уху (Wuhu, провинция Аньхой, Китай) с вертикально расположенными системами охлаждения, вычислительным оборудованием, энергосистемами и резервным источником питания, сообщил ресурс TechRepublic. По словам компании, архитектура разработана для размещения более плотной ИИ-инфраструктуры, включая кластеры суперузлов, содержащие более 100 тыс. ускорителей. Использование ИИ-ускорителей в ЦОД влечёт за собой гораздо более высокую плотность энергопотребления. По словам Huawei, мощность серверных стоек выросла с нескольких киловатт до 100 кВт и 200 кВт и, как ожидается, продолжит увеличиваться. А использование масштабных моделей с триллионами параметров и быстро растущий спрос на токены предъявляют повышенные требования к ИИ-инфраструктуре искусственного интеллекта. Поэтому кластеры на базе суперузлов Ascend с более чем 100 тыс. картами станут базовой конфигурацией. 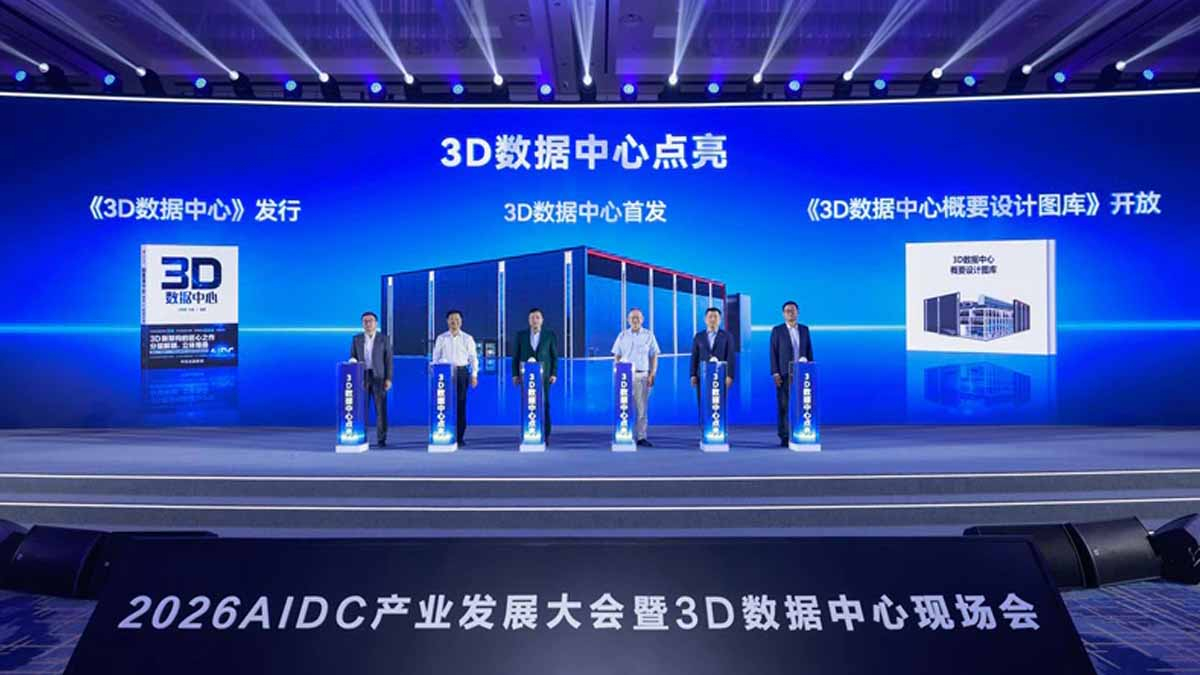
Источник изображения: Huawei «Мы рассматриваем ЦОД как стандартный продукт, который можно тиражировать в больших масштабах, а не как индивидуальный инженерный проект», — заявили в компании. По словам Huawei, более 90 % механических и электрических систем для ЦОД могут предлагаться уже в собранном виде, что сокращает их сроки поставки после заказа примерно с шести до трех месяцев. По данным Pandaily, процесс строительства объекта в Уху занял около девяти месяцев, что гораздо меньше 18-24 месяцев, требующихся для строительства подобных ЦОД. Huawei также представила обзорную библиотеку дизайна 3D-ЦОД, включающую пять разделов: «Вычислительная мощность», «Трансформация», «Реконструкция постоянного тока», «Скачок стоимости», «Шедевр» и «Смена парадигмы». Она охватывает системы водоснабжения, кондиционирования, электрические системы высокого и низкого напряжения и многое другое.
11.09.2026 [22:05], Сергей Карасёв
Китайскую СХД выписали из лидеров IO500 — возможно, её и вовсе не существуетИз обновлённого рейтинга производительности систем хранения данных IO500 исключен китайский комплекс ParaStor F9000, разработанный компанией Sugon. По состоянию на сентябрь 2026 года комитет IO500 не смог получить достоверной информации о его внедрении — есть вероятность, что хранилище в коммерческом виде вообще не существует. Ранее сообщалось, что СХД ParaStor F9000 выполнена на базе 2U-узлов с 24 отсеками для NVMe SSD. Платформа оборудована двумя контроллерами (Active–Active), каждый из которых использует неназванный 64-ядерный процессор и четыре сетевых адаптера 400G ScaleFabric InfiniBand. Заявленная производительность достигает 5 млн IOPS и 190 Гбайт/с в расчёте на узел. На выставке ISC 2026 компания Sugon представила несколько различных конфигураций стоек на базе ParaStor F9000 — 42U, 36U и 26U. Тогда же СХД заняла первые места в рейтингах IO500 Production (производственная система) и IO500 Production 10 Node (конфигурация из 10 узлов), набрав соответственно 79 110,05 балла и 7839,3 балла. 
Источник изображения: Sugon Однако в обновлённых списках ParaStor F9000 отсутствует. На первое место при этом вернулась система хранения (DAOS) суперкомпьютера Aurora, принадлежащего Аргоннской национальной лаборатории (ANL) Министерства энергетики США (DoE). В рейтинге IO500 Production она демонстрирует результат в 32 165,9 балла, а в Production 10 Node — 2885,57 балла.
10.09.2026 [11:03], Руслан Авдеев
JD Cloud и Moore Threads совместно создадут кластер из 100 тыс. китайских ИИ-ускорителейКитайские облако JD Cloud и производитель чипов Moore Threads из КНР намерены совместно создать кластер из 100 тыс. ИИ-ускорителей. Представленный в ходе мероприятия 2026 Global Technology Explorers Conference компании JD проект предполагает использование китайских комплектующих, сообщает Datacenter Dynamics. По данным китайских СМИ, кластер будет состоять из «полнофункциональных» ИИ-ускорителей Moore Threads и будет предназначен для обучения крупномасштабных ИИ-моделей, инференса и задач, связанных с т.н. «воплощённым» (embodied) искусственным интеллектом, готовым взаимодействовать с реальным миром. Ранее компании уже имели партнёрское соглашение о создании ИИ-кластера из 10 тыс. ускорителей. О моделях используемых чипов пока не сообщается. Как следует из информации с сайта Moore Threads, компания предлагает ИИ-ускоритель MTT S5000 на архитектуре PingHu, на основе разработанного ей же чипа PH100. Компания заявляет, что может обеспечить вычисления в диапазоне от FP8 до FP64. Также предлагаются модели S4000 и S3000 на чипе ChunXiao. В свою очередь, облачный провайдер JD Cloud управляет дата-центрами в Поднебесной, а ключевые облачные регионы расположены в Пекине, Гуанчжоу, Шанхае и Суцяне. 
Источник изображения: Moore Threads Moore Threads, иногда называемой «маленькой NVIDIA», основана бывшим топ-менеджером NVIDIA Джеймс Чжан Цзяньчжуном (James Zhang Jianzhong) в 2020 году. Компания привлекла средства Shenzhen Capital Group, GGV Capital, Sequoia Capital China, ByteDance и Tencent. В декабре 2025 года состоялось IPO на Шанхайской фондовой бирже (Shanghai Stock Exchange). После выхода на биржу её акции поднялись в цене более чем впятеро. На данный момент компания состоит в чёрном списке (Entity List) Бюро промышленности и безопасности США (US Bureau of Industry and Security). Ранее NVIDIA неоднократно жаловалась, что вводимые США ограничения на поставки американских ИИ-ускорителей в Китай лишь ставят под сомнение доминирование Соединённых Штатов в мире ИИ. В декабре 2025 года сообщалось, что в МФТИ изучили альтернативы ИИ-ускорителям NVIDIA — привлекательные показатели продемонстрировали Moore Threads и MetaX.
08.09.2026 [13:48], Руслан Авдеев
Китай рассчитывает вчетверо увеличить вычислительные мощности для ИИ к 2030 годуПо статистике Министерства промышленности и информационных технологий Китая (MIIT), к концу июня текущего года общая мощность ИИ-вычислений в стране составила 2185 Эфлопс. Это на 177 % больше, чем годом ранее. А к концу июля, по данным Национальной комиссии по развитию и реформам, они превысили 2450 Эфлопс. В дальнейшем ожидается их кратное увеличение, сообщает SCMP. КНР намерена развёртывать ИИ-кластеры по 100 тыс. ускорителей и стремительно наращивать национальные ИИ-мощности в следующие пять лет. Пока же власти наращивают инвестиции в инфраструктуру, необходимую для реализации этих амбициозных планов с сфере искусственного интеллекта. MIIT в своём отраслевом пятилетнем плане поставило цель добиться мощности ИИ-вычислений на уровне 9800 Эфлопс (9,8 Зфлопс) к 2030 году. На развитие информационной инфраструктуры в 2026–2023 гг. намерены потратить ¥3,7 трлн ($532 млрд). В частности, планом предусматривается «упорядоченное развёртывание» кластеров интеллектуальных вычислений по 10 тыс. ИИ-ускорителей, а также объектов по 100 тыс. и более ускорителей. В то же время будут создаваться специальные вычислительные мощности для инференса, адаптированные под различные задачи и отрасли. Также предполагается развитие инфраструктуры с учётом использования ИИ-чипов китайского производства. 
Источник изображения: Road Trip with Raj/unsplash.com Новые цели — продолжение курса на активное наращивание ИИ-инфраструктуры страны. MIIT сообщает, что на конец июня страна построила 52 объекта для ИИ-вычислений за год, каждый из которых оснащён более 10 тыс. ИИ-ускорителей. Другими словами, для достижения поставленной Китаем на 2030 год цели, стране придётся нарастить вычислительные мощности более чем вчетверо. Расширение инфраструктуры тесно связано с инициированным в 2022 году проектом «Восточные данные — западные вычисления» (East Data, West Computing), предполагающие перенос вычислительных нагрузок из восточных регионов с высокой плотностью населения и дефицитом земли и энергоресурсов, на западные территории, где земля дешева, а энергии в достатке. С тех пор Китай уже создал сеть из восьми национальных вычислительных центров, 10 кластеров ЦОД и трёх регионов, делающих акцент на координации вычислительной инфраструктуры с энергоснабжением. Впрочем, пока соответствующая программа не вполне оправдала себя — дата-центры простаивают, а для продажи их мощностей приходится прикладывать усилия. |
|

