
Материалы по тегу: huawei
|
22.09.2026 [15:40], Сергей Карасёв
Huawei представила ИИ-систему Atlas 960E SuperPoD на базе UnifiedBus и NPOHuawei анонсировала ИИ-систему Atlas 960E SuperPoD. Это, как утверждается, первый в отрасли кластер с технологией NPO (Near-Packaged Optics), предназначенный для работы с большими языковыми моделями, насчитывающими до 10 трлн параметров. В составе Atlas 960E SuperPoD применяются оптические модули Hi-ONE на базе NPO. Данная технология предполагает монтаж оптического движка в виде отдельного узла на плате рядом с ASIC: преимуществами подхода являются снижение задержек и энергопотребления, а также возможность замены компонента при выходе из строя. Пропускная способность достигает 7,2 Тбит/с. Atlas 960E SuperPoD может оснащаться ИИ-ускорителями Huawei Ascend 960, включая будущие изделия 960DT и 960PR. Посредством NPO могут быть связаны до 4096 карт: в случае Ascend 960DT суммарная FP4-производительность составит до 16 Эфлопс. При этом 5500 оптических движков Hi-ONE могут заменить 48 тыс. традиционных оптических модулей стандарта 800G. Это снижает энергопотребление более чем на 550 кВт, одновременно удваивая время безотказной работы системы: показатель доступности достигает 99,8 %. 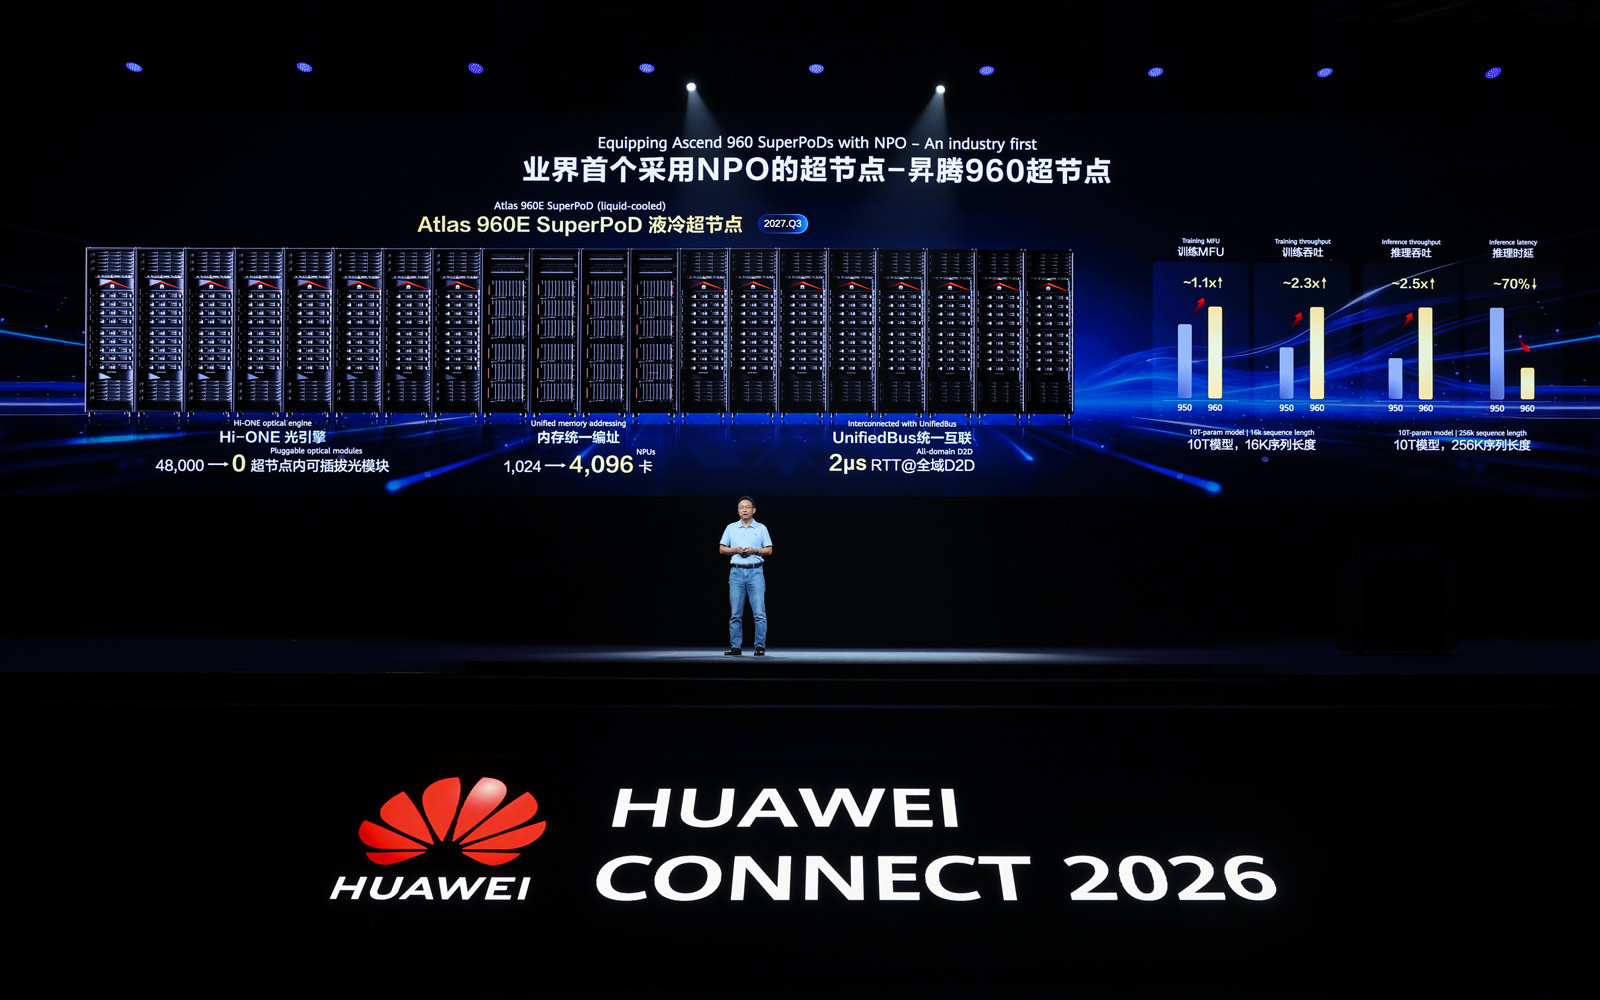
Источник изображения: Huawei Платформа предполагает применение интерконнекта нового поколения UnifiedBus (UB), который обеспечивает пропускную способность в несколько Тбайт/с и задержку (RTT) на уровне 2 мкс. UnifiedBus даёт возможность сформировать единый пул памяти объёмом до 256 Тбайт. Через сеть UnifiedBus и RoCE отдельные экземпляры SuperPoD можно объединять в суперкластеры (SuperCluster). В частности, двухуровневая четырёхплоскостная архитектура Clos позволяет связать воедино до 512 тыс. NPU. А в сочетании с топологией Multi-rail такой кластер может насчитывать до 1 млн ускорителей.
21.09.2026 [13:53], Сергей Карасёв
Huawei представила архитектуру UnifiedBus для повышения производительности ИИ-кластеровHuawei объявила о разработке архитектуры интерконнекта нового поколения UnifiedBus (UB). Технология призвана решить проблемы скорости передачи данных в крупномасштабных вычислительных кластерах, ориентированных на ресурсоёмкие задачи ИИ. В традиционных системах для ЦОД эффективность использования ресурсов снижается по мере масштабирования платформы. Так, в кластере из 100 тыс. NPU фактически задействуется всего около 20 % доступной вычислительной мощности, в то время как оставшиеся ресурсы простаивают в ожидании данных, утверждает Huawei. Обучение модели с триллионами параметров требует передачи колоссальных объёмов промежуточных сведений, а современные ИИ-агенты регулярно генерируют запросы, создавая постоянную нагрузку на коммуникационные линии. Всё это приводит к необходимости гибкого перераспределения меняющейся нагрузки между CPU и NPU. Кроме того, резко возрастают требования к хранению данных на всех уровнях вычислительных платформ. В результате, недостаточная пропускная способность интерконнекта становится главным узким местом, ограничивающим производительность современных ИИ-кластеров. 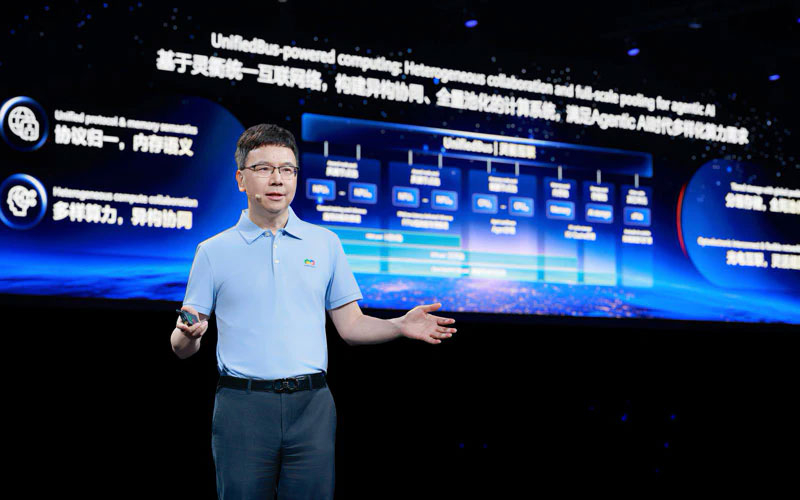
Источник изображения: Huawei Архитектура UnifiedBus позволяет устранить существующие недостатки, объединив более десяти различных протоколов и увеличив общую пропускную способность интерконнекта с примерно 100 Гбайт/с до уровня в несколько Тбайт/с, тогда как задержка (RTT) уменьшается с 7 до 2 мкс. Новая архитектура также предусматривает единую глобальную адресацию памяти внутри ИИ-узлов SuperPoD. Помимо этого, UnifiedBus напрямую соединяет CPU, NPU, RAM и SSD, обеспечивая децентрализованную одноранговую связь между ними и гибкое распределение имеющихся ресурсов. В рамках концепции UnifiedBus чипы DDR выступают в качестве альтернативной памяти для NPU, снижая задержки для поисковых, рекомендательных и других сервисов, а также удваивая производительность векторного поиска. При этом сокращаются требования к ёмкости HBM в составе ИИ-ускорителей. В целом, UnifiedBus служит глобальной «магистралью данных» со сверхвысокой пропускной способностью и малой задержкой, обеспечивая гибкое масштабирование вычислительных ресурсов. Специальный модуль интерконнекта UnifiedBus LinkBlade с бескабельным дизайном обеспечивает высокоскоростную связь внутри стоек вычислительного кластера. Утверждается, что в составе SuperPoD с 4096 NPU применение LinkBlade позволяет сэкономить около 196 км медных соединений. Для обмена данными между отдельными стойками решение UnifiedBus LinkDevice предлагает 176 портов с пропускной способностью 1,6 Тбит/с каждый, обеспечивая полностью оптическое соединение со скоростью 280 Тбит/с. При этом могут формироваться кластеры с миллионами NPU. Huawei продемонстрировала суперкластер для работы с агентным ИИ на базе UnifiedBus, который состоит из узлов SuperPoD TaiShan 950 и Atlas 960, хранилища данных OceanStor M900 и коммутатора Xinghe UBG. Эта платформа поддерживает многоуровневое объединение ресурсов, обеспечивая эффективную работу с различными нагрузками.
21.09.2026 [08:32], Сергей Карасёв
Huawei разработала модуль NPO с пропускной способностью до 7,2 Тбит/сКомпания Huawei, по сообщению The Register, продемонстрировала оптические модули NPO (Near-Packaged Optics), предназначенные для организации высокоскоростного интерконнекта в дата-центрах для ИИ-задач. В традиционных коммутаторах оптические блоки обычно располагаются на передней панели, а длина соединения от собственно чипа до собственно оптических компонентов довольно велика. Энергопотребление и тепловыделение таких решений увеличиваются с ростом скоростей передачи данных, что становится серьезной проблемой в свете активного внедрения стандартов 800 Гбит/с и 1,6 Тбит/с. Кроме того, длинные электрические трассы и интенсивная обработка сигналов в DSP приводят к увеличению задержек. 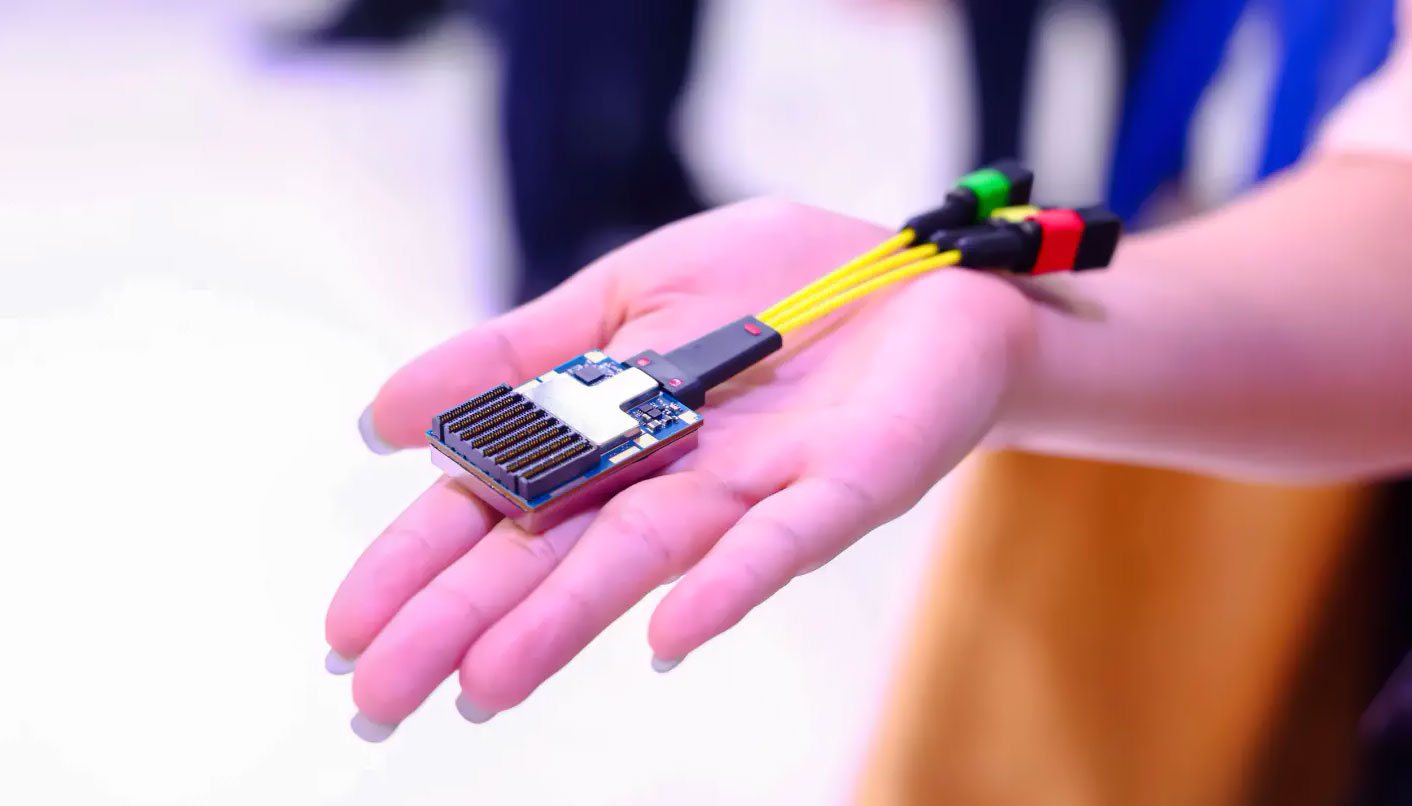
Источник изображения: The Register Одним из способов повышения эффективности является применение технологии CPO (Co-Packaged Optics). Она предполагает размещение оптического модуля на той же подложке, что и ASIC. Такой подход обеспечивает небольшие задержки и низкое энергопотребление, однако затрудняет замену вышедших из строя оптических модулей и значительно удорожает производство. В результате, возрастают эксплуатационные затраты в ЦОД. Платформа NPO, предложенная компанией Huawei, предусматривает монтаж оптического движка в виде отдельного компонента на плате рядом с ASIC. При этом конструкция NPO исключает необходимость в отдельном DSP-чипе — соответствующие функции интегрируются в ASIC. Таким образом, сохраняется возможность замены оптического модуля в случае его выхода из строя, тогда как задержки по сравнению с традиционными решениями снижаются со 100 до 10 нс, а энергопотребление уменьшается примерно на 60 %. В NPO-решении Huawei используются 36 линий 200G, что в сумме даёт 7,2 Тбит/с. Предполагается, что предложенная технология будет использоваться в следующих поколениях ИИ-узлов SuperPoD.
19.09.2026 [16:07], Сергей Карасёв
До 64 Пбайт для KV-кеша: Huawei представила платформу хранения OceanStor M900 для ИИ ЦОДHuawei представила платформу OceanStor M900, спроектированную для работы с KV-кешем в крупномасштабных дата-центрах. Новинка позволяет решить проблему нехватки DRAM, которая создает «бутылочное горлышко» в современных ИИ-кластерах. Отмечается, что в настоящее время в сфере ИИ наблюдается переход от технологических экспериментов к широкомасштабному внедрению. Приложения ИИ эволюционировали от чат-ботов до агентов, способных автономно выполнять сложные задачи. Большие языковые модели (LLM) нового поколения могут насчитывать до 10 трлн параметров. Современные системы с огромными контекстными окнами (более 1 млн токенов) и многошаговые ИИ-агенты генерируют колоссальные объёмы KV-кеша, для обработки которого ресурсов HBM и DRAM недостаточно. Платформа OceanStor M900 помогает преодолеть эти ограничения путём использования высокоскоростных SSD. По заявлениям Huawei, в OceanStor M900 впервые в отрасли применена передовая архитектура, объединяющая CPU, сетевой контроллер и контроллер NAND. Она обеспечивает собственную KV-семантику для одношагового соединения ИИ-ускорителей в составе узлов SuperPoD с твердотельными накопителями. Это устраняет необходимость применения различных протоколов, благодаря чему задержка доступа сокращается на 90 % по сравнению с традиционными подходами — с нескольких миллисекунд до 60 мкс. Один кластер обеспечивает суммарную пропускную способность до 40 Тбайт/с, что в 1,5 раза выше, чем у существующих решений. При этом объём памяти, доступной для каждого нейропроцессора (NPU), увеличивается с гигабайт до терабайт. 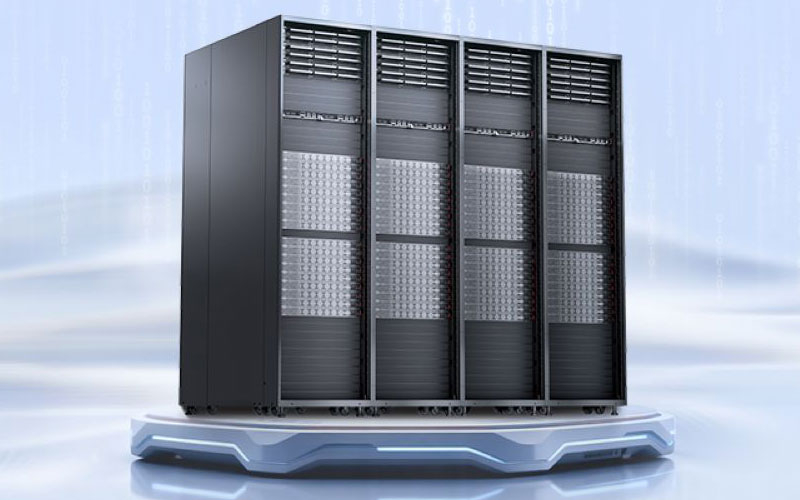
Источник изображения: Huawei Платформа OceanStor M900 использует высокоскоростной интерконнект UnifiedBus. Общая вместимость может достигать 64 Пбайт. В системе реализована технология адаптивного хранения (KV-Aware Adaptive Storage), которая прогнозирует жизненный цикл KV-кеша и перераспределяет нагрузку между SSD для достижения максимальной эффективности и надёжности. В результате, показатель DWPD (полных перезаписей в сутки) для установленных SSD поднимается до 24, что в 16 раз превосходит обычные значения. Благодаря этому значительно снижаются расходы на эксплуатацию, поскольку сокращается необходимость в замене дорогостоящих накопителей. В целом, OceanStor M900 позволяет раскрыть вычислительную мощность SuperPoD-устройств, ресурсы которых в противном случае могут простаивать из-за нехватки памяти для работы с KV-кешем.
18.09.2026 [17:42], Сергей Карасёв
ИИ-ускорители Huawei Ascend 960DT с 288 Гбайт памяти выйдут в начале 2027 годаHuawei поделилась планами по выпуску новых ИИ-ускорителей Ascend. Сообщается, что в I квартале следующего года дебютирует изделие Ascend 960DT, которое придёт на смену Ascend 950. В состав 960DT (аббревиатура расшифровывается как Decode/Training — декодирование/обучение) войдут 288 Гбайт памяти с пропускной способностью 9,6 Тбайт/с — в 2,4 раза больше по сравнению с Ascend 950. При этом сетевые источники указывают на использование памяти HiZQ — собственного решения Huawei, позиционирующегося в качестве альтернативы НВМ. Пропускная способность интерконнекта Ascend 960DT составит 2,2 Тбайт/с. Для нового ускорителя заявлена поддержка форматов FP32, HF32, FP16, BF16, FP8, MXFP8, HiF8, MXFP4 и HiF4. ИИ-производительность в режиме FP8 будет достигать 2 Пфлопс, в режиме FP4 — 4 Пфлопс. В один кластер могут объединяться тысячи таких изделий для масштабирования быстродействия. В частности, посредством NPO могут быть связаны до 4096 эксземпляров Ascend 960DT, что обеспечит суммарную FP4-производительность на уровне 16 Эфлопс. 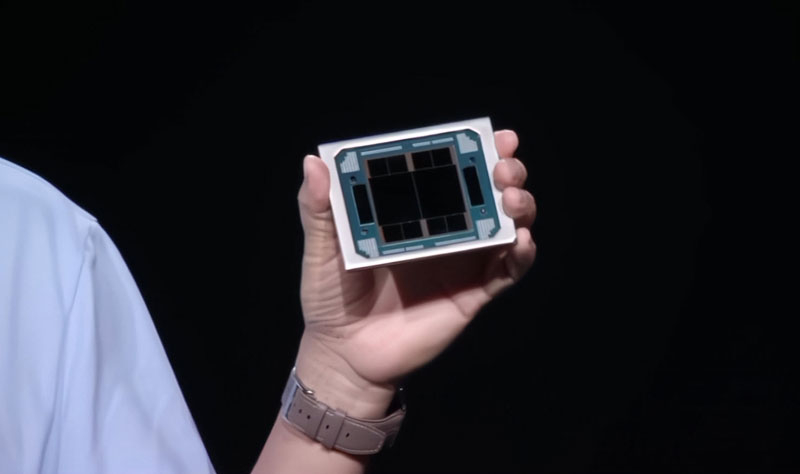
Источник изображения: wccftech.com На III четверть 2027 года намечен анонс карты Ascend 960PR (Prefill/Recommenders — заполнение/рекомендации). Она будет нести на борту 192 Гбайт памяти с пропускной способностью 2,4 Тбайт/с (скорость интерконнекта сохранится на уровне 2,2 Тбайт/с). Это решение обеспечит быстродействие до 2 Пфлопс на операциях FP8 и до 8 Пфлопс в режиме FP4. В 2028 году, как ожидается, появится ускоритель Ascend 970 с 288 Гбайт памяти с пропускной способностью 14,4 Тбайт. У данной модели пропускная способность интерконнекта поднимется до 4,4 Тбайт/с. Производительность FP8 и FP4 — до 3,6 и 14 Пфлопс соответственно. Наконец, на 2029-й запланирован выпуск изделия Ascend 980 с 384 Гбайт памяти (38,4 Тбайт/с) и интерконнектом на 8 Тбайт/с. Карта сможет выдавать 7,2 Пфлопс на операциях FP8 и 28 Пфлопс в режиме FP4.
17.09.2026 [02:35], Владимир Мироненко
Huawei представила четырёхуровневый 3D-ЦОД в качестве эталона для ИИ-кластеровКомпания Huawei представила четырёхуровневый 3D-ЦОД в Уху (Wuhu, провинция Аньхой, Китай) с вертикально расположенными системами охлаждения, вычислительным оборудованием, энергосистемами и резервным источником питания, сообщил ресурс TechRepublic. По словам компании, архитектура разработана для размещения более плотной ИИ-инфраструктуры, включая кластеры суперузлов, содержащие более 100 тыс. ускорителей. Использование ИИ-ускорителей в ЦОД влечёт за собой гораздо более высокую плотность энергопотребления. По словам Huawei, мощность серверных стоек выросла с нескольких киловатт до 100 кВт и 200 кВт и, как ожидается, продолжит увеличиваться. А использование масштабных моделей с триллионами параметров и быстро растущий спрос на токены предъявляют повышенные требования к ИИ-инфраструктуре искусственного интеллекта. Поэтому кластеры на базе суперузлов Ascend с более чем 100 тыс. картами станут базовой конфигурацией. 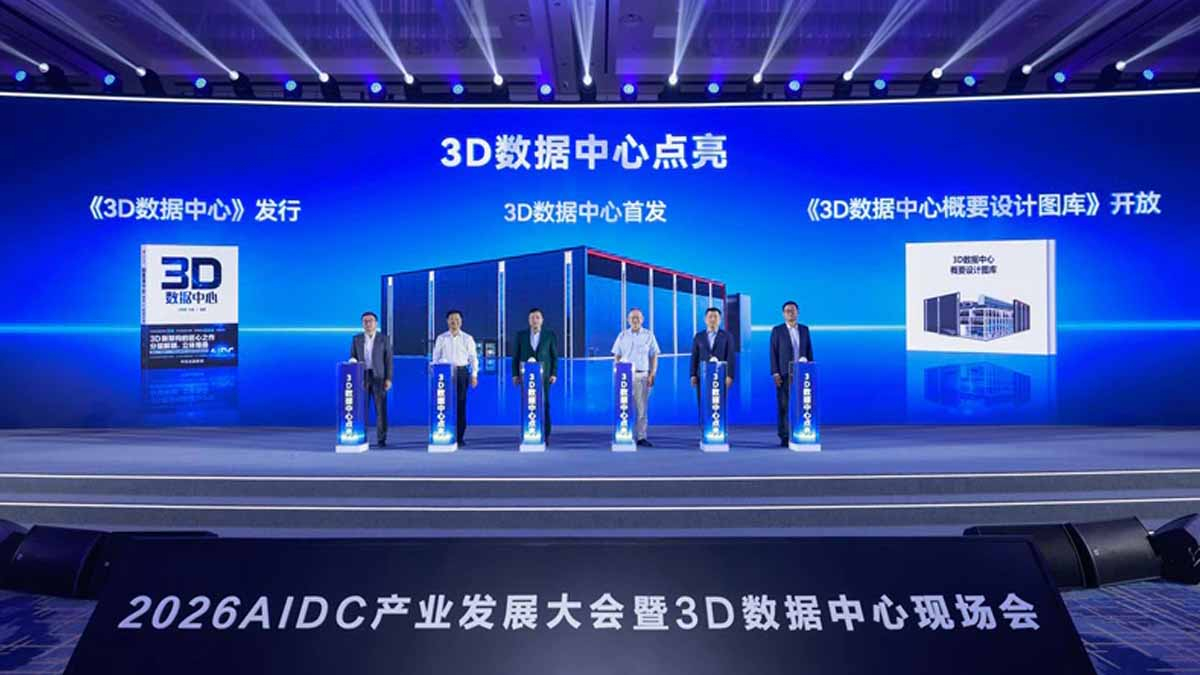
Источник изображения: Huawei «Мы рассматриваем ЦОД как стандартный продукт, который можно тиражировать в больших масштабах, а не как индивидуальный инженерный проект», — заявили в компании. По словам Huawei, более 90 % механических и электрических систем для ЦОД могут предлагаться уже в собранном виде, что сокращает их сроки поставки после заказа примерно с шести до трех месяцев. По данным Pandaily, процесс строительства объекта в Уху занял около девяти месяцев, что гораздо меньше 18-24 месяцев, требующихся для строительства подобных ЦОД. Huawei также представила обзорную библиотеку дизайна 3D-ЦОД, включающую пять разделов: «Вычислительная мощность», «Трансформация», «Реконструкция постоянного тока», «Скачок стоимости», «Шедевр» и «Смена парадигмы». Она охватывает системы водоснабжения, кондиционирования, электрические системы высокого и низкого напряжения и многое другое.
03.07.2026 [18:09], Владимир Мироненко
Новый рейтинг IO500 возглавила СХД Huawei OceanStor A800Организация IO500 Foundation опубликовала свежий рейтинг IO500, в лидеры которого попала ИИ-система Peng Cheng Cloud Brain III на базе хранилища Huawei OceanStor A800. Система показала результат в 2,8 раза выше предыдущего рекорда, отметила Huawei. СХД Huawei OceanStor A800 была развёрнута для подключения к 664 вычислительным узлам. Её протестировали в сложных условиях с использованием 79 680 параллельных процессов и в 13 тестовых сценариях. СХД с ФС OceanFS набрала 603 334,58 балла с пропускной способностью 8291,11 ГиБ/с и производительностью на метаданных 43 903 983,64 kIOP/s. Это обеспечило Peng Cheng Cloud Brain III первое место как в исследовательском списке (Research List), так и в общем списке (Full List), демонстрируя высокую производительность и стабильность СХД Huawei OceanStor A800. 
Источник изображения: Huawei Благодаря архитектуре разделения плоскостей управления и данных, хранилище Huawei OceanStor A800 напрямую передаёт данные с DPU на SSD, реализуя сквозной ввод-вывод. В нём также используется высокопроизводительный механизм ускорения работы с файлами DataTurbo и интеллектуальная политика многоуровневого кеширования для увеличения объёма операций с метаданными при работе с массивом файлов небольшого размера. Кроме того, СХД поддерживает возможности как горизонтального, так и вертикального масштабирования, обеспечивая совокупную пропускную способность в сотни Тбайт/с при одновременном расширении ёмкости на уровне Эбайт.
26.05.2026 [16:07], Руслан Авдеев
Выручка xFusion, отделившейся из-за санкций от Huawei, за четыре года выросла шестикратно на фоне поддержки ИИ-отрасли государствомКитайский производитель серверов xFusion, отделившийся от Huawei и получивший бизнес x86-серверов последней, объявил о выручке в объёме ¥58,2 млрд (порядка $8,6 млрд) в 2025 году. Кратный рост в сравнении с прошлыми годами связывают с курсом КНР на создание собственной цепочки поставок для ИИ-индустрии и поддержкой в стране местных вендоров, занимающихся высокопроизводительными серверами, сообщает DigiTimes. В ходе конференции, проводившейся xFusion на днях, компания представила стратегию развития, новые продукты и поделилась достижениями. По словам представителя компании, ИИ уже меняет не только цифровой, но и физический мир, а в ближайшие 3–5 лет на рынке окончательно оформится разделение на лидеров и отстающих. xFusion — один из ключевых производителей серверов в провинции Хэнань (Henan), недавно компания завершила подготовку к выходу на публичные торги. Сегодня она выпускает ИИ-серверы, СЖО для ЦОД и сдаёт вычислительные мощности в аренду. По данным IDC, в 2025 году компания, созданная в ходе реструктуризации серверного бизнеса Huawei, заняла 12,7 % доли рынка китайских серверов на архитектуре x86, уступив только Inspur с 31,3 %, но опередив H3C, Lenovo и ZTE. 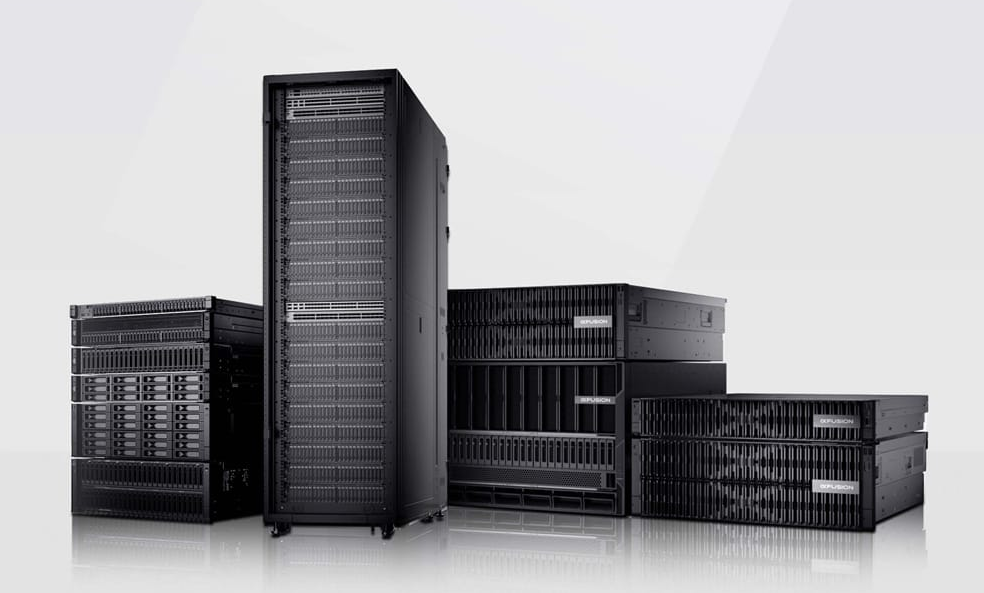
Источник изображения: xFusion В 2021 году Huawei испытывала проблемы с поставками компонентов, включая CPU производства Intel и AMD для серверов, поэтому серверное направление было решено выделить, чтобы освободить его от санкций. В ноябре 2021 года была зарегистрирована xFusion, а контроль получили инвесторы во главе с государственными структурами. Уже через 55 дней после регистрации начался выпуск серверов под брендом xFusion и было налажено массовое производство. После того, как компания отделилась от Huawei, она сосредоточила усилия на рынке вычислительных мощностей и ИИ-инфраструктуры. Её выручка выросла с ¥10 млрд в 2021 году до почти ¥60 млрд в 2025-м. Успех компании принесли высокопроизводительные серверы, поскольку она не разбрасывалась на производство относительно бюджетных вариантов — в этом сегменте и так наблюдается избыток предложения. Кроме того, компания является одним из лидеров в сфере СЖО в Китае. x86-решения xFusion совместимы с ИИ-ускорителями Huawei Ascend и соответствующей платформой в целом. Кроме того, xFusion даже входит в мировую цепочку поставок NVIDIA. По мнению экспертов, поддержка государственного сектора может превратить xFusion в одного из ключевых игроков в сфере развития собственной ИИ-инфраструктуры в Китае. Кроме того, это может помочь снизить зависимость от зарубежных технологий.
25.05.2026 [09:20], Владимир Мироненко
Аппаратный «ZIP-ускоритель» Huawei сжимает архивные данные в 90 разHuawei анонсировала аппаратный ускоритель для СХД для резервного копирования Huawei OceanProtect, который использует «алгоритмы HZU для глубокого сжатия с коэффициентом до 90:1», что, как утверждает производитель, на 20 % выше, чем у лучшего аналога, передаёт Blocks & Files. Кроме того, по словам Huawei, она имеет единственную в отрасли эффективную гарантию ёмкости, «исключая необходимость в оценке коэффициента компрессии». Huawei использует комбинацию многоуровневой, встроенной дедупликации данных с блоками переменной длины (VLD) с сжатием на основе свойств и компактизацией на уровне байтов, применяемой к резервным копиям. Как правило, они отличаются высокой избыточностью данных. Особенно это касается таких операций, как ежедневное полные снимки виртуальных машин. Семейство алгоритмов сжатия HZU (HZBC), разработанных Huawei, включает в себя «быстрое нелинейное преобразование и упрощённый метод прогнозирования контекста». Как утверждает Huawei эти алгоритмы могут обеспечить результаты, превосходящие результаты LZ-алгоритмов и повысить коэффициент сжатия примерно на 30 %». 
Источник изображения: Tim Johnson / Unsplash Как полагает Blocks & Files, используется четырёхэтапная схема компрессии:
Huawei запатентовала используемые алгоритмы дедупликации и сжатия. Технология включает выбор алгоритмов сжатия, наиболее подходящих для резервного копирования конкретных типов данных, а фактический коэффициент сжатия зависит от типа приложения и политики резервного копирования. Утверждается, что аппаратный ускоритель разгружает основной процессор СХД до 22 %. Поскольку системы OceanProtect используют All-Flash-накопители, а не более дешёвые диски, то чем эффективнее компрессии, тем лучше. Huawei использует QLC-накопители с выделенной адаптивной SLC-зоной для обработки «горячих» данных и более быстрого восстановления данных. У Everpure также есть аппаратный ускоритель DirectCompress Accelerator на базе FPGA для сжатия данных на лету и разгрузки CPU хранилища. Портфолио Huawei включает системы OceanProtect X3000, X6000 и E8000. Недавно были анонсированы также Huawei X8100 и X9100. Более ранние системы, использующие технологии сжатия предыдущих поколений, поддерживали коэффициент сжатия до 72:1. А новые системы к тому же работают до 50 % быстрее. Также отмечается, что OceanProtect X8100 обеспечивает защиту от программ-вымогателей на 99,99 %.
22.05.2026 [20:34], Владимир Мироненко
Huawei выпустила 122-Тбайт SSD с фирменной технологией DoB
all-flash
hardware
huawei
nearline
nvme
pci express 4.0
pci express 5.0
qlc nand
ssd
дефицит
импортозамещение
китай
санкции
схд
Компания Huawei выпустила 122-Тбайт SSD-накопители, не имея доступа к новейшей 100-слойной 3D NAND от основных поставщиков NAND, задействовав собственную технологию упаковки Die-on-Board (DoB), сообщил ресурс Blocks & Files. DoB предполагает размещение кристаллов NAND непосредственно на печатной плате (PCB). В свою очередь, ведущие поставщики SSD, такие как Samsung с V-NAND, Kioxia и Sandisk с BiCS, а также Micron, используют многоярусную компоновку кристаллов внутри корпусов TSOP, BGA и т.д. Это распространённая практика при изготовлении SSD-накопителей большой ёмкости, в которых используется многослойная 3D NAND внутри кристалла. Не имея доступа к новейшим чипам 3D NAND с использованием американских технологий из-за санкций США, Huawei будет вынуждена, как только её запасы исчерпаются, использовать NAND китайского производства от YMTC и др. А это означает, что в корпусах TSOP или BGA SSD-накопители Huawei получат меньшую ёмкость по сравнению с изделиями конкурентов. Поэтому Huawei использовала собственную разработку DoB, что обеспечивает более высокую плотность хранения, чем при традиционном корпусировании NAND-чипов. Сообщается, что недостатком такого подхода являются необходимость управления тепловым режимом и возможные проблемы с целостностью сигнала. DoB обеспечивает повышение плотности ёмкости на треть. Фирменная технология используется в масштабируемом хранилище OceanStor Pacific 9926 AFA с SSD OceanDisk QLC PCIe 4.0 ёмкостью 61,44 и 122 Тбайт. Количество ярусов не разглашается. На мероприятии Huawei ID Forum 2026 в Париже компания сообщила о трёх новых моделях SSD-накопителей ёмкостью 61,44, 122,88 и 245 Тбайт. Первые две уже находятся в производстве. 
Источник изображения: Huawei/Blocks & Files Как пишет Blocks & Files, в публикации на сайте inf.news приводятся сведения о трёх новых накопителях для использования с ИИ-нагрузками:
В публикации говорится, что 36-слойная упаковка Huawei (36-layer stacking process) «преодолевает ограничения традиционного 16-слойного процесса». Архитектура Huawei AI SSD «интегрирует блок ускорения ИИ в основной управляющий чип SSD, обеспечивая одновременное хранение и вычисления, снижая энергопотребление при передаче данных на 80 %». СХД Huawei OceanStor Pacific 9926 с 36 NVMe SSD ёмкостью 122,88 Тбайт каждый с поддержкой PCIe 5.0 обеспечивает 4,42 Пбайт «сырой» ёмкости в 2U-шасси; эффективная ёмкость составляет 11 Пбайт при сжатии 2,5:1. Как отметил Blocks & Files, это контрастирует с 10 Пбайт «сырой» ёмкости СХД Dell в 2U-шасси, использующей 40 NVMe SSD Kioxia LC9 (QLC) ёмкостью 245,88 Тбайт каждый. Накопители LC9 имеют форм-фактор E3.L, в то время как твердотельные накопители Huawei OceanDisk выполнены в проприетарном компактном корпусе размером с ладонь. |
|

