Материалы по тегу: a100
|
17.08.2026 [12:49], Сергей Карасёв
CoreWeave продлила использование NVIDIA A100 до 2029 годаКомпания CoreWeave, специализирующаяся на облачных услугах для ИИ-задач, по сообщению ресурса Business Insider, объявила о намерении предоставлять в аренду устаревающие ускорители NVIDIA A100 как минимум до 2029 года. Связано это с огромным спросом на вычислительные мощности в дата-центрах, ориентированных на нейросетевые нагрузки. Изделие NVIDIA A100 дебютировало ещё в 2020 году. Устройство предлагается в вариантах PCIe и SXM с 80 Гбайт памяти HBM2e с пропускной способностью до 1935 и 2039 Гбайт/с соответственно. Показатель TDP в первом случае составляет 300 Вт, во втором — 400 Вт. Заявленная производительность достигает 19,5 Тфлопс в режиме FP32 и 312 Тфлопс на операциях FP16. Финансовый директор CoreWeave рассказал, что компания недавно подписала контракт о сдаче NVIDIA A100 в аренду до 2029-го. Иными словами, некоторые клиенты намерены использовать эти ускорители даже спустя девять лет после анонса. Впрочем, CoreWeave не одинока — AWS ранее тоже завила о том, что A100 по-прежнему раскупают. 
Источник изображения: CoreWeave Вместе с тем сегмент аппаратного обеспечения для ИИ стремительно развивается. Некоторые аналитики указывают, что быстрый прогресс NVIDIA может приводить к устареванию ИИ-чипов предыдущего поколения в течение двух–трёх лет в связи с появлением всё более производительных и совершенных решений. В такой ситуации компаниям, тратящим миллиарды долларов на развитие инфраструктуры ИИ, вероятно, придётся списывать эти инвестиции гораздо быстрее, что негативно скажется на прибыли. С другой стороны, даже после появления новых ускорителей старые GPU могут оставаться полезными в течение длительного времени. В частности, их можно перепрофилировать для менее ресурсоёмких задач. В результате, эффективный срок службы ИИ-изделий может составлять 7–8 лет, если вопрос энергоэффективности не стоит.
07.02.2026 [17:23], Руслан Авдеев
AWS: ни один сервер с NVIDIA A100 не выведен из эксплуатации, а некоторые клиенты всё ещё используют Intel Haswell — не всем нужен ИИПо словам главы AWS Мэтта Гармана (Matt Garman), клиенты до сих пор использует серверы на основе ИИ-ускорителей NVIDIA A100, представленных в 2020 году. Отчасти это происходит потому, что спрос на вычислительные ресурсы превышает предложение, так что устаревшие чипы по-прежнему востребованы, передаёт Datacenter Dynamics. По словам Гармана, все ресурсы фактически распроданы, а серверы с A100 из эксплуатации никогда не выводились. Комментарии Гармана перекликаются с прошлогодним заявлением Амина Вахдата (Amin Vahdat), отвечающего в Google за ИИ и инфраструктуру. По его словам, в Google одновременно работают семь поколений тензорных ускорителей (TPU). Ускорители возрастом семь-восемь лет загружены на 100 %, а спрос на TPU так высок, что Google вынуждена отказывать некоторым клиентам. Впрочем, оба топ-менеджера, возможно, несколько кривят душой и пытаются развеять опасения инвесторов относительно того, что ИИ-ускорители, на которые тратятся огромные деньги, через два-три года придётся выкинуть, чтобы купить более современные, энергоэффективные и, конечно же, дорогие. И что за это время они не успеют окупиться. Хотя Гарман назвал главной причиной сохранения работы серверов на A100 высокий спрос, он признал, что есть и другие причины. В частности, современные ИИ-чипы снижают точность вычислений с плавающей запятой. В результате некоторые клиенты попросту не могут перейти на Blackwell или вовсе вынуждены использовать Intel Xeon Haswell десятилетней давности для HPC-подобных вычислений, поскольку точности у современных ИИ-ускорителей недостаточно. В июне 2025 года AWS заявила о снижении цены доступа к устаревшим NVIDIA H100, H200 и A100 на своей платформе, причём для A100 стоимость снизилась на треть. 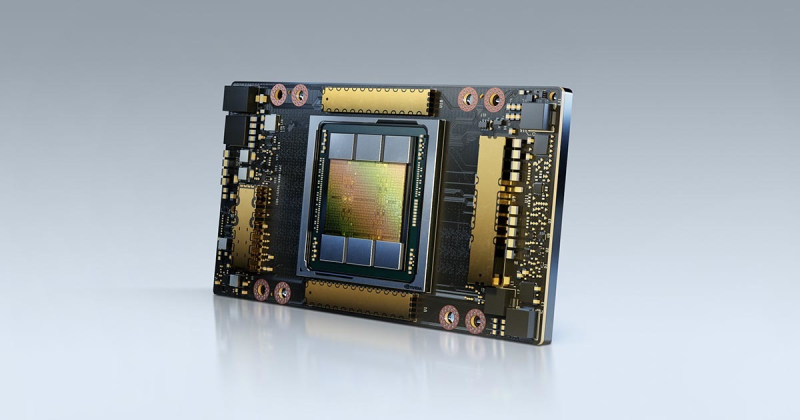
Источник изображения: NVIDIA Стоит отметить, что «устаревшие» ускорители долго остаются востребованными, поскольку всё равно обладают большой производительностью. Наиболее яркий пример — разрешение на поставку в Китай чипов NVIDIA H200. Хотя США и их союзники готовятся к внедрению ускорителей поколения Vera Rubin, китайский бизнес готов покупать H200, поскольку те значительно производительнее, экономически выгоднее и удобнее отечественных ускорителей.
28.08.2025 [13:03], Руслан Авдеев
Китайский бизнес переходит на подержанные ускорители NVIDIA A100 и H100 из-за проблем с поставками H20Китайская ИИ-индустрия постепенно переходит на восстановленные или подержанные ИИ-ускорители NVIDIA A100 и H100 после того, как очередные экспортные ограничения на NVIDIA H20 заставили компании искать альтернативы этому продукту. Искусственно ослабленный ускоритель H20 должен был сохранить присутствие NVIDIA на китайском рынке, но чип фактически «оказался на обочине» даже после того, как на его продажи вновь дали зелёный свет после временного запрета — китайские регуляторы поставили под сомнение его безопасность, сообщает Tom’s Hardware со ссылкой на Digitimes. Всё это привело к стремительному росту спроса на старые модели A100 и H100, китайские компании проводят некую «реконфигурацию» таких ускорителей для использования в недорогих, но высокопроизводительных системах инференса. Последний требует значительно меньше ресурсов, чем обучение ИИ-моделей, рабочие нагрузки могут эффективно выполняться на относительно слабом оборудовании. Именно поэтому даже A100 с 80 Гбайт HBM2e (2 Тбайт/с), представленный ещё в 2020 году, в некоторых случаях остаётся вполне востребованным. Хотя архитектура Ampere уступает Hopper по пиковой производительности, она всё ещё эффективна для инференса благодаря относительно большому объёму памяти и развитой экосистеме ПО CUDA. Для чат-ботов и рекомендательных систем экономически эффективно использовать системы без самых современных чипов. Представленные в 2022 году H100 значительно производительнее A100 в задачах, связанных с обучением. В то же время H20 изначально был оптимизирован для менее ресурсоёмкого инференса, но его возможности урезали так сильно, что производительность в сравнении с H100 у этой модели ниже в 3–7 раз, а в задачах, связанных с вычислениями FP64, он медленнее более чем в 30 раз. Другими словами, даже A100 всё ещё могут быть привлекательнее для китайских покупателей, чем новые H20. 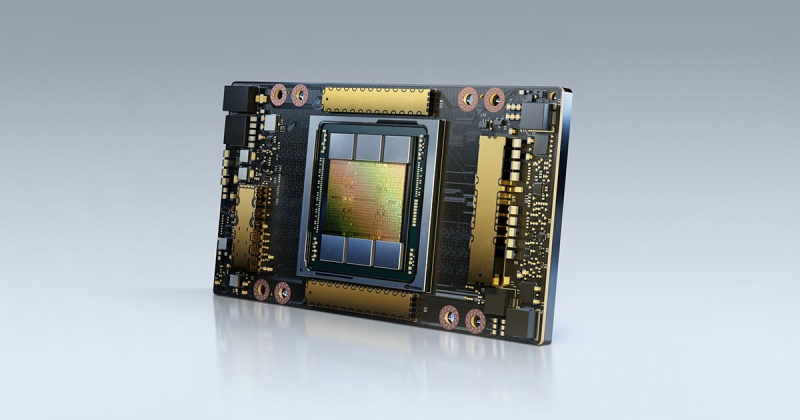
Источник изображения: NVIDIA Поскольку пока никому не удалось создать что-то сопоставимое с программной экосистемой NVIDIA CUDA, старые GPU вполне востребованы. Тем более что оборудование для инференса менее требовательно во всех отношениях, а китайские ЦОД, по-видимому, не испытывают проблем с энергий и готовы платит за восстановленную устаревшую электронику, даже с пониженной надёжностью. В результате NVIDIA оказалась в странном положении. Компания в своё время списала $5,5 млрд из-за нераспроданных запасов H20 — когда в США решили полностью запретить их поставки в Китай. После снятия запрета компания резко нарастила выпуск H20, но теперь столкнулась уже с нежеланием властей КНР видеть эти чипы в стране. Тем не менее, её ускорители по-прежнему являются одним из главных катализаторов бума ИИ в Китае. Другими словами, чипы компании по-прежнему доминируют на рынке Поднебесной, но активность на теневых рынках может снизить выгоду от бизнеса с Китаем. Впрочем, уже появилась информация о разработке нового ускорителя на основе современной архитектуры Blackwell — хотя и тоже ослабленного.
22.06.2025 [23:30], Руслан Авдеев
Meta✴ ведёт переговоры о покупке венчурного фонда NFDG, у которого есть собственный ИИ-кластер AndromedaMeta✴ Platforms решила обновить свои компетенции в сфере ИИ, наняв ведущих отраслевых игроков — Ната Фридмана (Nat Friedman) и Дэниэла Гросса (Daniel Gross). Также компания намерена выкупить их венчурный фонд NFDG, сообщает The Information. Марк Цукерберг (Mark Zuckerberg) сначала пытался купить ИИ-стартап Safe Superintelligence (SSI) бывшего «главным учёным» OpenAI Ильи Суцкевера (Ilya Sutskever). После отказа Цукерберг попросту собрался нанять генерального директора SSI — Гросса. Ранее тот руководил ИИ-разработками в Apple и был партнёром Y Combinator. Фридман был главой GitHub и советником Midjourney. Гросс и Фридман были соучредителями инвестиционного фонда NFDG. NFDG имеет доли в в известных ИИ-компаниях, включая SSI, Perplexity и Character.ai. Ранее компания инвестировала в Weights & Biases, которую приобрела CoreWeave. NFDG занимается не только финансированием компаний, но и предлагает программу грантов, в рамках которой стартапам предоставляется финансирование на $250 тыс., а также $250 тыс. в виде облачных кредитов Microsoft Azure. В период дефицита ИИ-ускорителей NFDG построил собственный суперкомпьютер. Кластер Andromeda изначально включал 2512 ускорителей NVIDIA H100. С тех пор он вырос до 3 200 H100 в 400 узлах и ещё 432 H100 в 54 узлах, связанных 400G-интерконнектом InfiniBand, а также 768 A100 с 200G InfiniBand. Теперь Andromeda могут арендовать и компании, которые не относятся к NFDG, за $2,4–$3 за ускоритель в час. Сейчас можно арендовать до 2 тыс. H100 и получить доступ к ним в течение нескольких часов. 
Источник изображения: Amina Atar/unspalsh.com Помимо возможного найма Гросса и Фридмана, Meta✴ ведёт переговоры, конечной целью которых является выкуп значительной части активов NFDG и вывод из него партнёров за сумму более $1 млрд. При этом сделка не даст Meta✴ контроля над фондом или информации о бизнесе. Кому достанется Andromeda, не уточняется. Если сделка будет завершена, она войдёт в число более масштабных реформ в Meta✴, связанных с ИИ. Цукерберг планирует сформировать новую лабораторию по разработке «суперинтеллекта» и пересмотреть стратегию выкупа продуктов. В этом месяце Meta✴ уже подтвердила, что намерена потратить порядка $14 млрд на долю в Scale AI, специализирующейся на разметке данных для обучения ИИ.
11.06.2025 [09:11], Владимир Мироненко
AWS резко снизила стоимость EC2-инстансов с ускорителями NVIDIA, но только для старых моделейAWS объявила об очередном снижении тарифов на GPU-инстансы, которое, по словам компании, стало регулярной практикой благодаря активной работе над снижением расходов. Впрочем, в период острого дефицита вычислительных мощностей в последние год-два, когда использование ускорителей даже для внутренних нужд было резко ограничено, компания наверняка заработала достаточно, чтобы неоднократно окупить закупку и обслуживание соответствующего «железа». На прошлой неделе была снижена до 45 % стоимость использования инстансов EC2 на базе ускорителей NVIDIA, включая семейства P4 (P4d и P4de на базе A100) и P5 (P5 и P5en на базе H100 и H200 соответственно). Снижение стоимости тарифов On-Demand и Savings Plan распространяется на все регионы, где доступны эти инстансы. На On-Demand — с 1 июня, на Savings Plan — после 4 июня. Savings Plans предлагает гибкую модель ценообразования с низкими ценами на использование вычислений в обмен на обязательство по постоянному объёму использования (измеряется в $/час) в течение 1 года или 3 лет. AWS предлагает два типа Savings Plans:
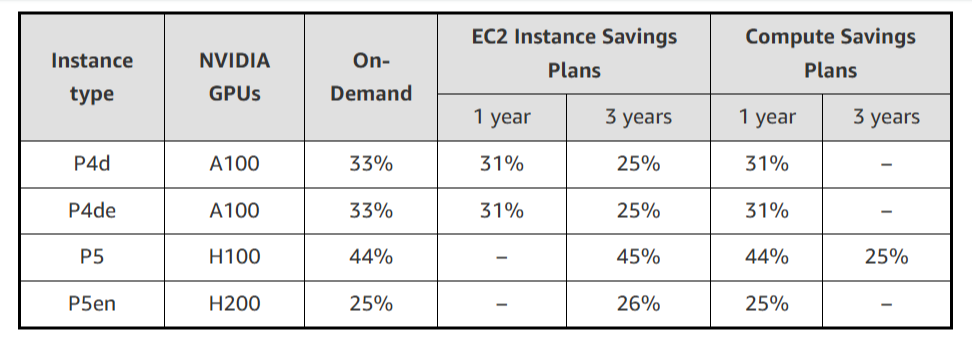
Источник изображения: AWS Чтобы обеспечить повышенную доступность по сниженным ценам, AWS предоставляет масштабируемую ёмкость в рамках тарифа On-Demand для:
Также теперь AWS предлагает инстансы Amazon EC2 P6-B200 в рамках тарифа Savings Plan для поддержки крупномасштабных развёртываний, которые стали доступны 15 мая 2025 года при запуске только через EC2 Capacity Blocks для машинного обучения. Инстансы EC2 P6-B200 на базе ускорителей NVIDIA Blackwell обеспечивают обработку широкого спектра рабочих нагрузок, но особенно хорошо подходят для крупномасштабного распределённого обучения и ИИ-инференса, отметила AWS.
29.11.2024 [10:22], Владимир Мироненко
«РТК-ЦОД» запустил в работу обновленный сервис BareMetal 2.0 с ускорителями NVIDIAСервис-провайдер «РТК-ЦОД» (дочерняя компания «Ростелекома», предоставляющая услуги дата-центров и облачные услуги) объявил о запуске обновлённого сервиса BareMetal 2.0 с GPU-ускорителями. Как сообщает «РТК-ЦОД», сервис BareMetal 2.0 обеспечивает максимально эффективное использование вычислительных ресурсов, в том числе, с помощью интеграции физических серверов в единую сеть с виртуальной облачной инфраструктурой. Это дает возможность выстраивать гибридные IaaS-решения для повышения производительности и масштабируемости. По словам компании, обновлённый сервис идеально подходит для задач, требующих максимальной производительности: от анализа данных и машинного обучения до научных исследований и обработки графики. Согласно пресс-релизу, работу BareMetal 2.0 обеспечивают выделенные серверы без виртуализации, предоставляемые в составе «Публичного облака». Доступные конфигурации включают процессоры с частотой 2,6 и 3,0 ГГц, поддержку до 48 ядер и объём оперативной памяти до 1024 Гбайт с возможностью использования высокоскоростных сетевых SSD для хранения данных. В обновлённом сервисе для работы с графикой, 3D-моделированием, рендерингом, интенсивными вычислительными задачами можно выбрать сервер с ускорителями NVIDIA L4 (24 Гбайт), RTX A6000 (48 Гбайт) или A100 (80 Гбайт). 
Источник изображения: «РТК-ЦОД» Клиентам доступен выделенный менеджер и команда архитекторов, которые помогут адаптировать решение под индивидуальные задачи. BareMetal 2.0 и другие облачные сервисы РТК-ЦОД можно самостоятельно настроить через единый портал, а также использовать инструменты для удалённого управления.
09.11.2022 [14:50], Владимир Мироненко
Производители специально ухудшают характеристики чипов для китайских серверов, чтобы избежать санкций СШАВ связи с вводом Соединёнными Штатами новых экспортных ограничений на поставки в Китай, производители стали намеренно снижать производительность чипов, чтобы соответствовать требованиям экспортного контроля США и избежать проблем с получением специальных лицензий. Как отметил ресурс The Register, у систем, построенных на чипах NVIDIA, изготовленных на производственных мощностях TSMC для поставок в Китай, характеристики хуже по сравнению с теми, что были ранее. В частности, китайский производитель серверов Inspur указал на использование вместо ускорителя NVIDIA A100 чипа A800, разработанного NVIDIA специально для Китая в соответствии с экспортными ограничениями. Китайские производители H3C и Omnisky тоже представили решения на базе A800. Данный ускоритель, по словам NVIDIA, начала производиться в III квартале этого года. У A800 скорость передачи данных составляет 400 Гбайт/с, тогда как у A100 этот показатель равен 600 Гбайт/с, причём обойти эти ограничения, по словам NVIDIA, невозможно. Речь, судя по всему, идёт о характеристиках интерконнекта NVLink, которые прямо влияют на производительность кластеров из двух и более ускорителей в машинном обучении и других задачах. Изменения касаются 40- и 80-Гбайт вариантов с интерфейсами PCIe и SXM. 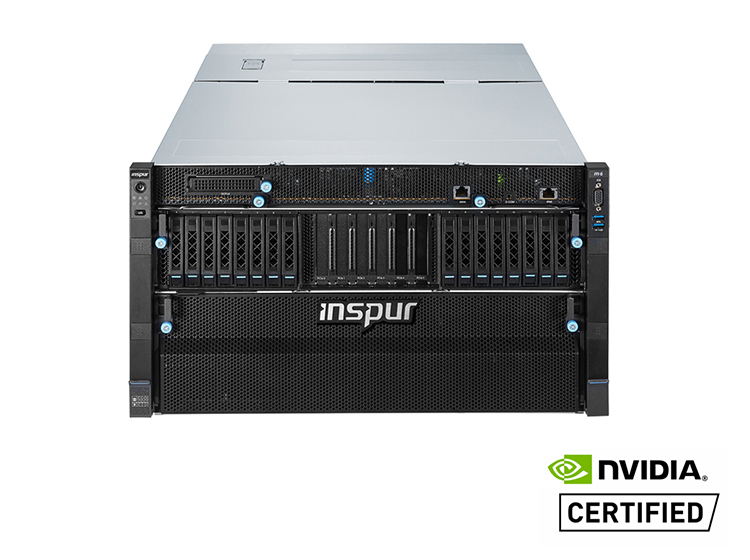
Источник изображения: Inspur Между тем ускорители, находящиеся в разработке и выпускаемые TSMC по контракту с Alibaba и стартапом Biren Technology, тоже, как сообщается, имеют пониженную скорость передачи данных. Это позволит выпускать данные чипы на заводе TSMC, не опасаясь санкций США. До этого TSMC приостановила выпуск 7-нм чипов ускорителей Biren BR100 как раз из-за возможных санкций со стороны Вашингтона.
10.08.2022 [22:05], Владимир Мироненко
На пути к Aurora: запущен «тренировочный» суперкомпьютер PolarisАргоннская национальная лаборатория (ANL) Министерства энергетики США объявила о доступности суперкомпьютера Polaris, ранний вариант которого занял 14-е место в последней версии списка TOP500. Он будет использоваться для проведения научных исследований и в качестве испытательного стенда для 2-Эфлопс суперкомпьютера Aurora, запуск которой намечен на ближайшие месяцы. Правда, аппаратно Aurora и Polaris отличаются. Созданная HPE система Polaris состоит из 560 узлов Apollo 6500, каждый из которых оснащён процессором AMD EPYC Milan, четырьмя ускорителями NVIDIA A100 (40 Гбайт) и 512 Гбайт DDR4-памяти. Эти узлы объединены в сеть интерконнектом HPE Slingshot 10 (осенью он будет обновлен до Slingshot 11) и подключены к сдвоенному 100-Пбайт Lustre-хранилищу (Grand и Eagle). Заявленная пиковая производительность должна составить 44 Пфлопс. «Polaris примерно в четыре раза быстрее нашего суперкомпьютера Theta, что делает его самым мощным компьютером в Аргонне на сегодняшний день», — отметил Майкл Папка (Michael Papka), директор Argonne Leadership Computing Facility (ALCF). Он добавил, что возможности Polaris позволят пользователям выполнять моделирование, анализ данных и ИИ-задачи с такими масштабом и скоростью, которые были невозможны с предыдущими вычислительными системами. 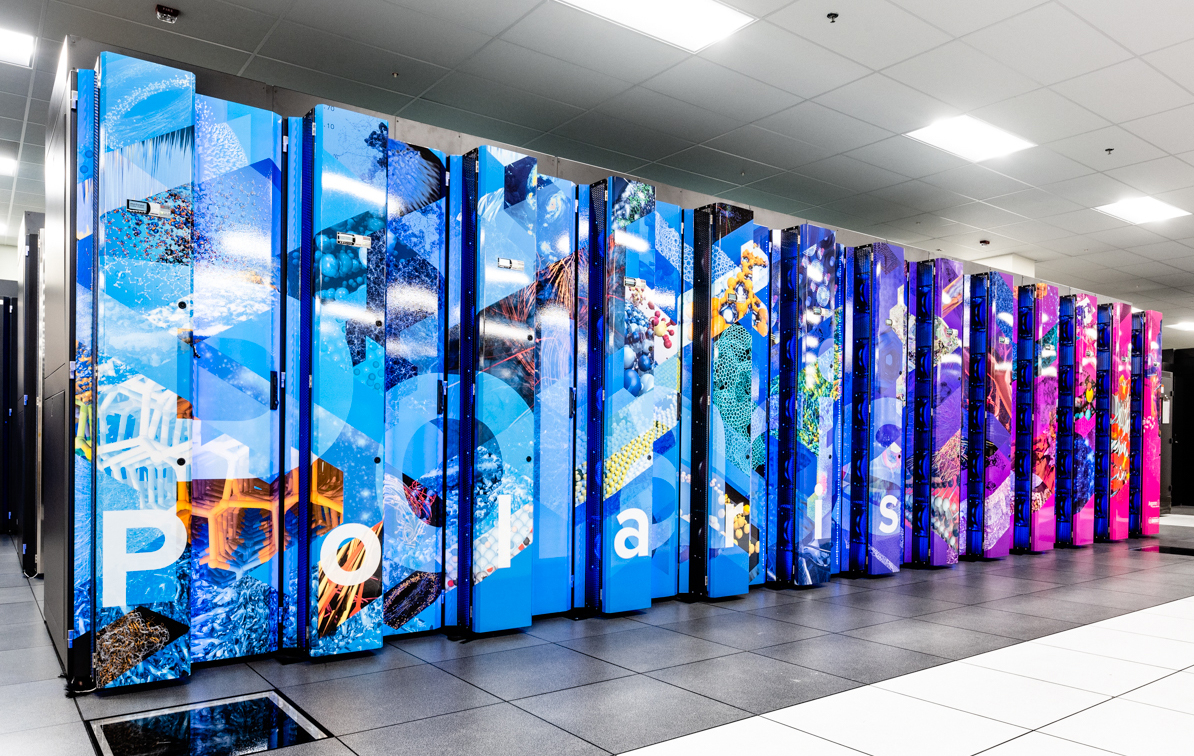
Фото: ANL Помимо работы над подготовкой к запуску Aurora, суперкомпьютер Polaris будет обслуживать внутренние потребности лаборатории, например, работу с комплексом Advanced Photon Source (APS) X-ray. «Благодаря тесной интеграции суперкомпьютеров ALCF с APS, CNM и другими экспериментальными установками мы можем помочь ускорить проведение анализа данных и предоставить информацию, которая позволит исследователям управлять своими экспериментами в режиме реального времени», — заявил Майкл Папка.
29.06.2021 [13:25], Владимир Мироненко
МТС запустила суперкомпьютер MTS GROM: третья российская система в TOP500Российская компания МТС объявила о запуске суперкомпьютера MTS GROM, который будет использоваться для развития цифровой экосистемы. С производительностью 2,26 Пфлопс в мировом рейтинге высокопроизводительных машин TOP500 он находится на 241 месте, а среди российских суперкомпьютеров рейтинга он занимает третье место (из трёх). Суперкомпьютер MTS GROM построен на базе программно-аппаратной платформы NVIDIA DGX A100 и включает 155 узлов: 2 × AMD EPYC 7742 (64C/128T, 2,25/2,4 ГГц, 256 Мбайт L3-кеш, TDP 225 Вт) + 8 × NVIDIA A100 (40 Гбайт) c NVSwitch. Суммарный объём RAM составляет 20,48 Тбайт, а число ядер CPU достигает 19840. Работает система под управлением Ubuntu 20.04.1 LTS. Узлы объединены посредством InfiniBand, а для хранения данных используется NVMe-oF СХД NetApp, благодаря чему достигается сверхбыстрое взаимодействие вычислительных узлов с СХД для сокращения времени обучения ИИ-моделей. Система построена является воплощением NVIDIA DGX SuperPOD for Enterprise и была развёрнута всего за месяц. 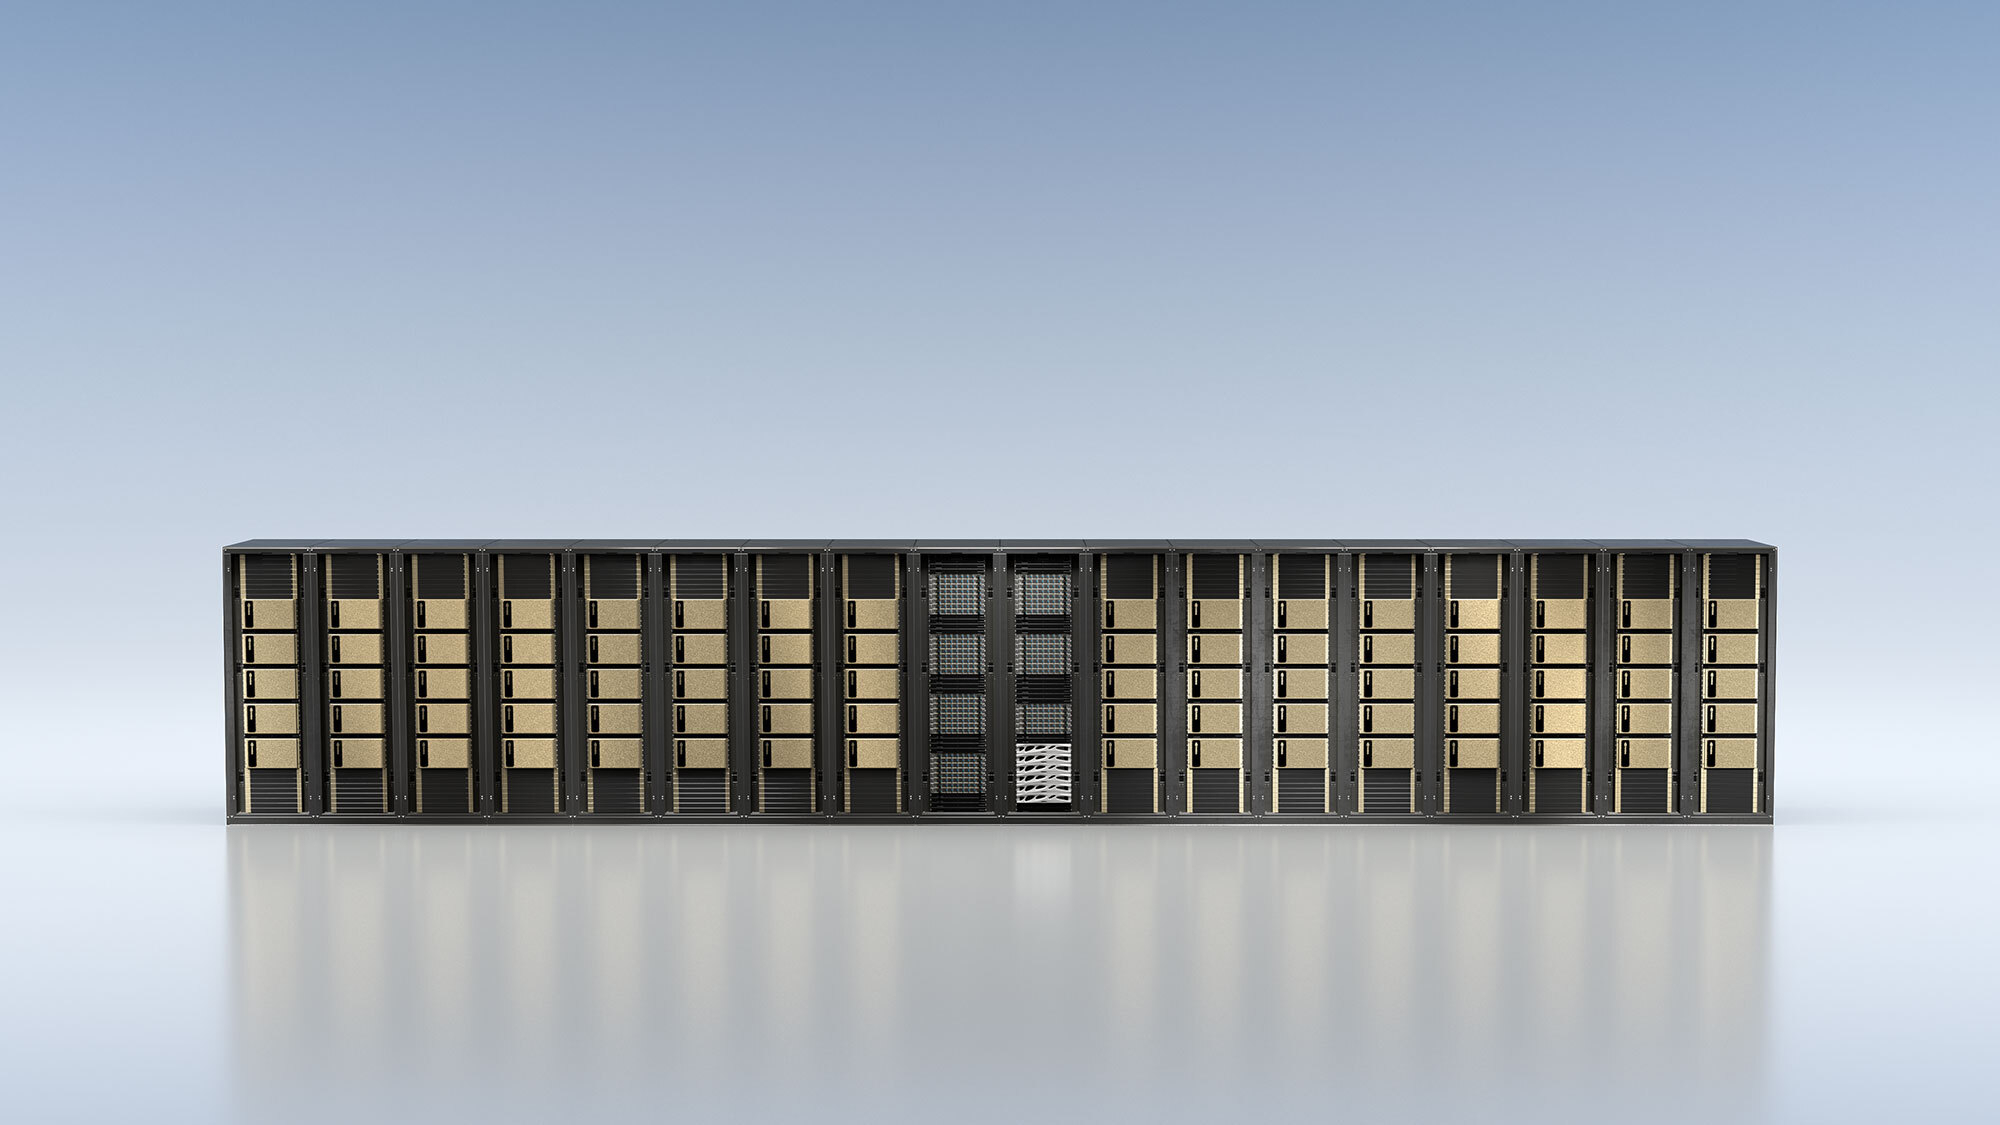 С помощью нового суперкомпьютера Центр искусственного интеллекта МТС планирует реализовывать внутренние и внешние проекты в области клиентского сервиса и повышения операционной эффективности бизнеса. В частности, MTS GROM будет полезен образовательным учреждениям, крупным научным и медицинским центрам в исследованиях, связанных с моделированием сложных процессов. Как сообщает компания, «в дальнейшем высокопроизводительные мощности MTS GROM станут доступны российским компаниям в портфеле провайдера #CloudMTS. Это позволит крупному бизнесу кратно сократить время на разработку и внедрение проектов на основе искусственного интеллекта и больших данных. Стартапам — в сотни раз снизить затраты на высокопроизводительные вычисления для анализа речи, обработки видео и распознавания лиц». Воспользоваться мощностями MTS GROM можно будет, оставив заявку на сайте #CloudMTS. «МТС формирует цифровую экосистему для российских компаний. На базе MTS GROM мы будем развивать самые перспективные технологии, связанные с искусственным интеллектом, анализом больших данных и облачными решениями. Суперкомпьютер MTS GROM призван повысить технологичность компании, а также лечь в основу будущих сервисов, которые бизнес и научные организации смогут получить в облаке #CloudMTS, значительно экономя», — отметил директор облачного бизнеса МТС Олег Мотовилов.
28.06.2021 [13:22], Алексей Степин
Обновление NVIDIA HGX: PCIe-вариант A100 с 80 Гбайт HBM2e, InfiniBand NDR и Magnum IO с GPUDirect StorageНа суперкомпьютерной выставке-конференции ISC 2021 компания NVIDIA представила обновление платформы HGX A100 для OEM-поставщиков, которая теперь включает PCIe-ускорители NVIDIA c 80 Гбайт памяти, InfiniBand NDR и поддержку Magnum IO с GPUDirect Storage. В основе новинки лежат наиболее продвинутые на сегодняшний день технологии, имеющиеся в распоряжении NVIDIA. В первую очередь, это, конечно, ускорители на базе архитектуры Ampere, оснащённые процессорами A100 с производительностью почти 10 Тфлопс в режиме FP64 и 624 Топс в режиме тензорных вычислений INT8. 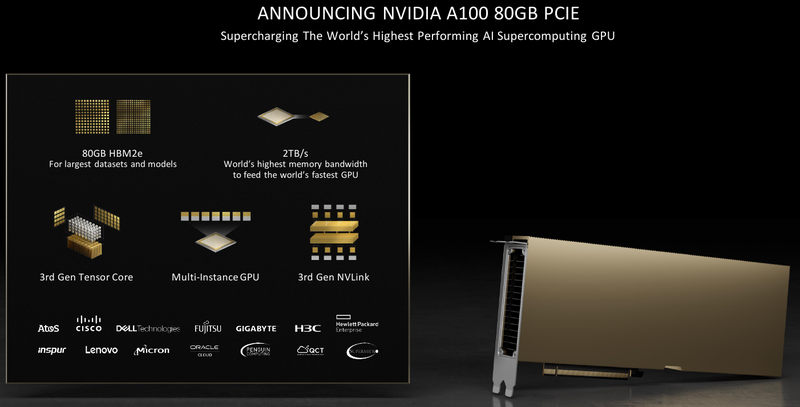 HGX A100 предлагает 300-Вт версию ускорителей с PCIe 4.0 x16 и удвоенным объёмом памяти HBM2e (80 Гбайт). Увеличена и пропускная способность (ПСП), в новой версии ускорителя она достигла 2 Тбайт/с. И если по объёму и ПСП новинки догнали SXM-версию A100, то в отношении интерконнекта они всё равно отстают, так как позволяют напрямую объединить посредством NVLink только два ускорителя. 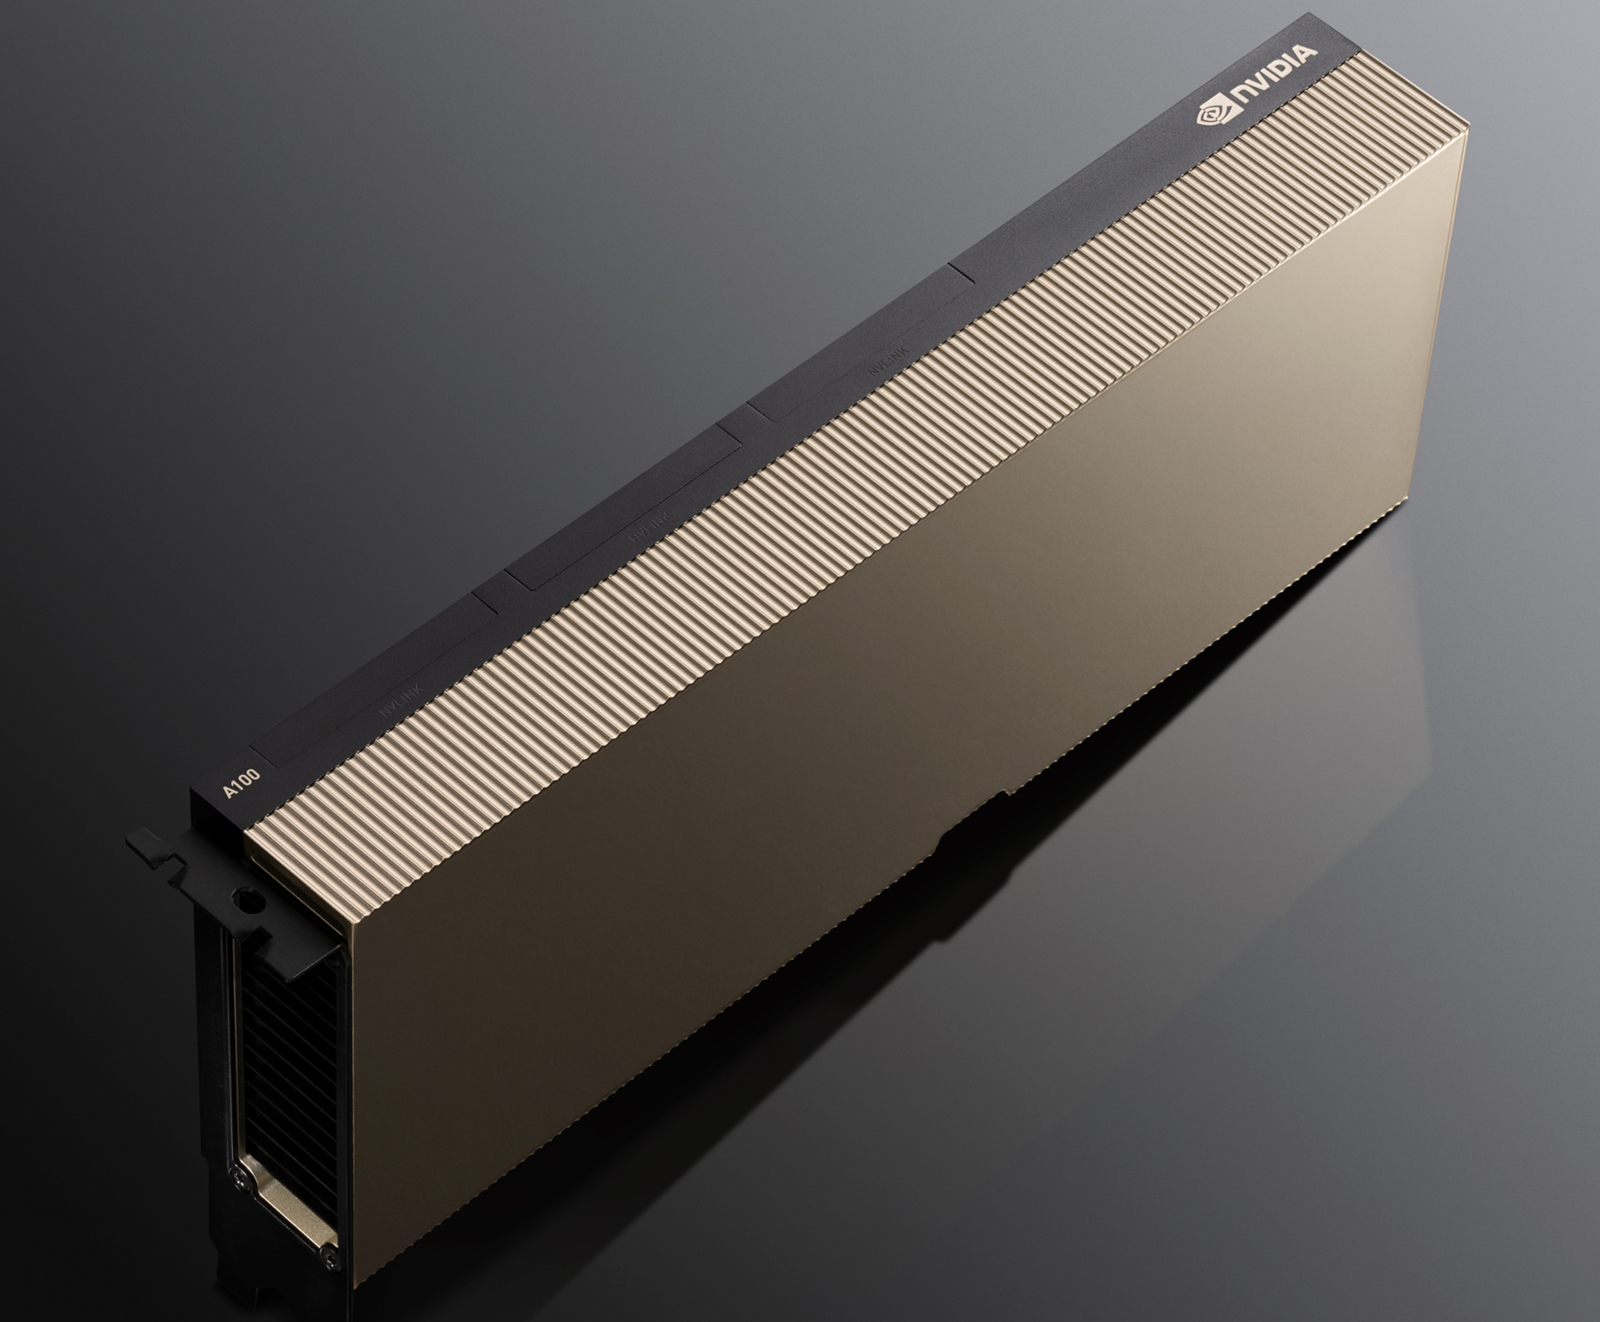 В качестве сетевой среды в новой платформе NVIDIA применена технология InfiniBand NDR со скоростью 400 Гбит/с. Можно сказать, что InfiniBand догнала Ethernet, хотя не столь давно её потолком были 200 Гбит/с, а в плане латентности IB по-прежнему нет равных. Сетевые коммутаторы NVIDIA Quantum 2 поддерживают до 64 портов InfiniBand NDR и вдвое больше для скорости 200 Гбит/с, а также имеют модульную архитектуру, позволяющую при необходимости нарастить количество портов NDR до 2048. Пропускная способность при этом может достигать 1,64 Пбит/с. 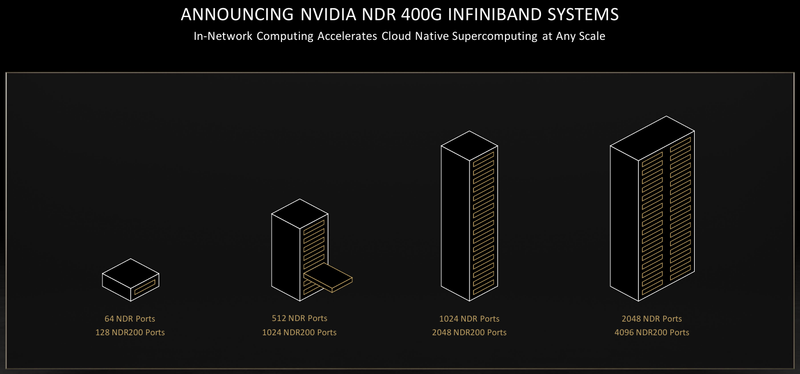 Технология NVIDIA SHARP In-Network Computing позволяет компании заявлять о 32-крантом превосходстве над системами предыдущего поколения именно в области сложных задач машинного интеллекта для индустрии и науки. Естественно, все преимущества машинной аналитики используются и внутри самого продукта — технология UFM Cyber-AI позволяет новой платформе исправлять большинство проблем с сетью на лету, что минимизирует время простоя. 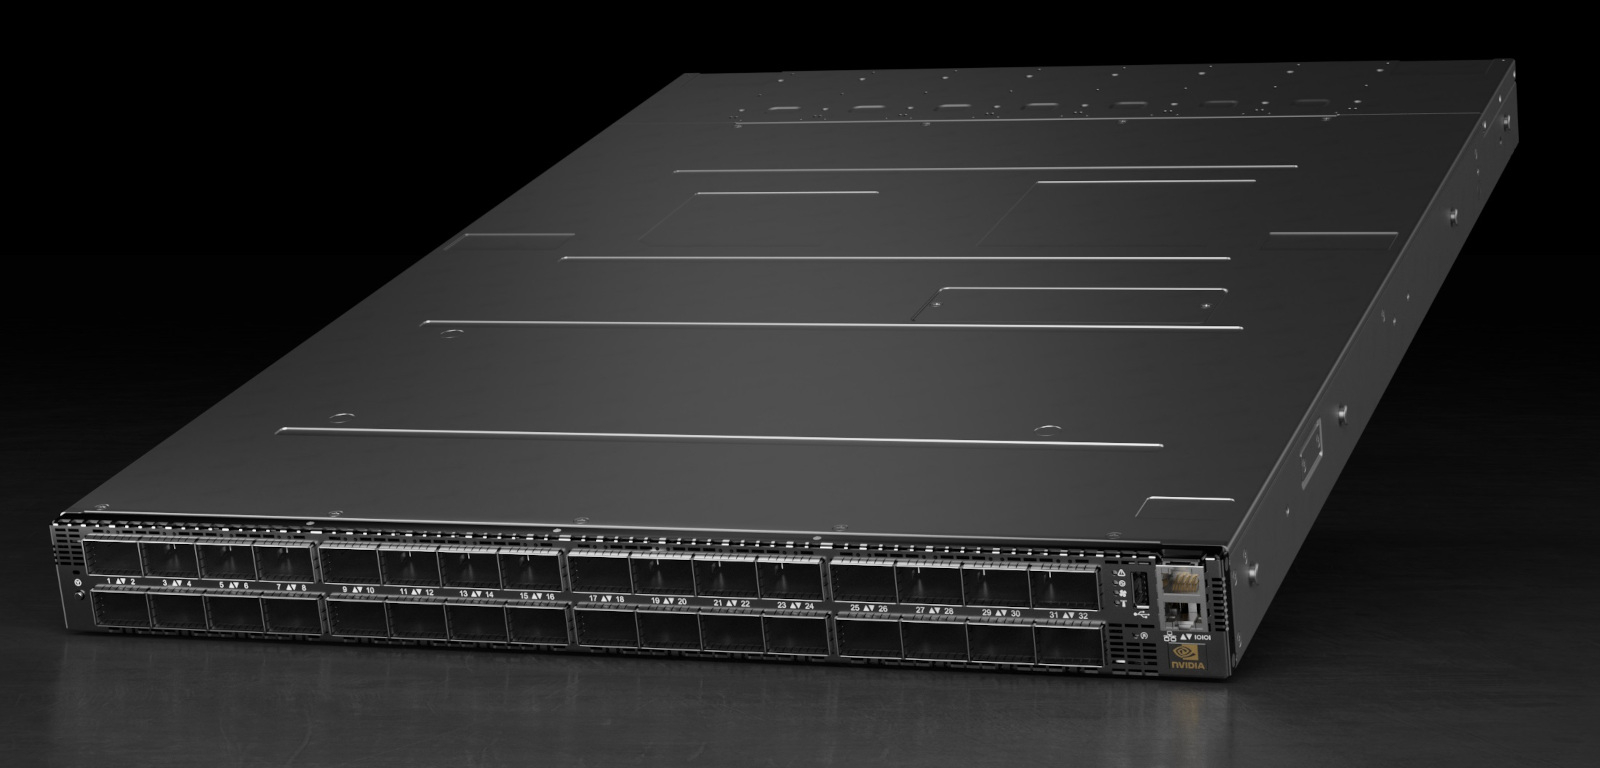 Отличным дополнением к новым сетевым возможностями является технология GPUDirect Storage, которая позволяет NVMe-накопителям общаться напрямую с GPU, минуя остальные компоненты системы. В качестве программной прослойки для обслуживания СХД новая платформа получила систему Magnum IO с поддержкой вышеупомянутой технологии, обладающую низкой задержкой ввода-вывода и по максимуму способной использовать InfiniBand NDR. 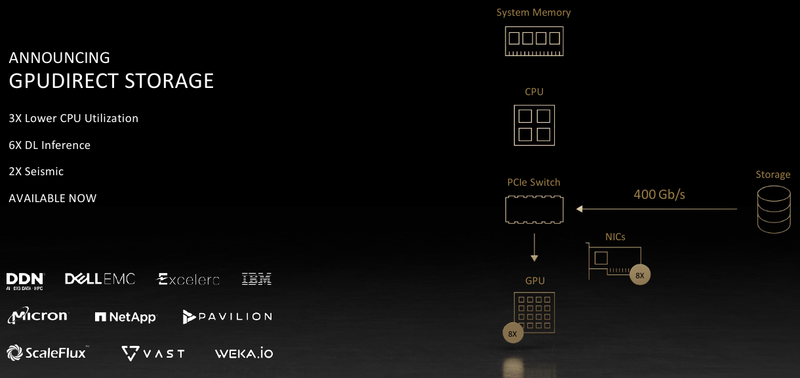 Три новых ключевых технологии NVIDIA помогут супервычислениям стать ещё более «супер», а суперкомпьютерам следующего поколения — ещё более «умными» и производительными. Достигнуты договорённости с такими крупными компаниями, как Atos, Dell Technologies, HPE, Lenovo, Microsoft Azure и NetApp. Решения NVIDIA используются как в индустрии — в качестве примера можно привести промышленный суперкомпьютер Tesla Automotive, так и в ряде других областей. 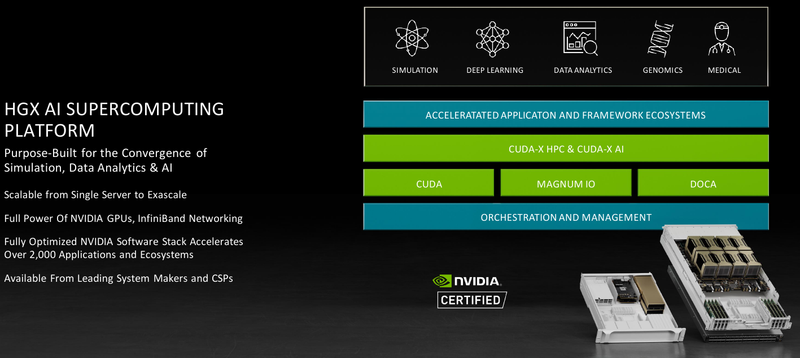 В частности, фармакологическая компания Recursion использует наработки NVIDIA в области машинного обучения для поиска новых лекарств, а национальный научно-исследовательский центр энергетики (NERSC) применяет ускорители A100 в суперкомпьютере Perlmutter при разработке новых источников энергии. И в дальнейшем NVIDIA продолжит своё наступление на рынок HPC, благо, она может предложить заказчикам как законченные аппаратные решения, так и облачные сервисы, также использующие новейшие технологии компании. |
|

