Материалы по тегу: бенчмарк
|
11.09.2026 [22:05], Сергей Карасёв
Китайскую СХД выписали из лидеров IO500 — возможно, её и вовсе не существуетИз обновлённого рейтинга производительности систем хранения данных IO500 исключен китайский комплекс ParaStor F9000, разработанный компанией Sugon. По состоянию на сентябрь 2026 года комитет IO500 не смог получить достоверной информации о его внедрении — есть вероятность, что хранилище в коммерческом виде вообще не существует. Ранее сообщалось, что СХД ParaStor F9000 выполнена на базе 2U-узлов с 24 отсеками для NVMe SSD. Платформа оборудована двумя контроллерами (Active–Active), каждый из которых использует неназванный 64-ядерный процессор и четыре сетевых адаптера 400G ScaleFabric InfiniBand. Заявленная производительность достигает 5 млн IOPS и 190 Гбайт/с в расчёте на узел. На выставке ISC 2026 компания Sugon представила несколько различных конфигураций стоек на базе ParaStor F9000 — 42U, 36U и 26U. Тогда же СХД заняла первые места в рейтингах IO500 Production (производственная система) и IO500 Production 10 Node (конфигурация из 10 узлов), набрав соответственно 79 110,05 балла и 7839,3 балла. 
Источник изображения: Sugon Однако в обновлённых списках ParaStor F9000 отсутствует. На первое место при этом вернулась система хранения (DAOS) суперкомпьютера Aurora, принадлежащего Аргоннской национальной лаборатории (ANL) Министерства энергетики США (DoE). В рейтинге IO500 Production она демонстрирует результат в 32 165,9 балла, а в Production 10 Node — 2885,57 балла.
27.08.2026 [08:59], Владимир Мироненко
OpenAI: Jalapeño опередил в тестах чипы NVIDIAOpenAI сообщила новые подробности об ИИ-ускорителе Jalapeño, разработанном в сотрудничестве с Broadcom, пишет The Register. Как утверждает OpenAI, Jalapeño, предназначенный для инференса, показал в тестах лучше результаты, чем текущая линейка ускорителей NVIDIA — GB200 и GB300. Тестирование в бенчмарк-пакете SemiAnalysis InferenceX показало, что системы OpenAI на базе Jalapeño обеспечивают в 1,5–1,9 раза больший объём «работы ИИ» при пиковой пропускной способности и в 1,7–3,6 раза меньшую сквозную задержку, чем у конкурентов, на GPT-OSS-120B, DeepSeek R1 670B и Kimi K2.5 1T. Во время внутренних тестов Jalapeño также хорошо показал себя при работе с некоторыми крупными, продвинутыми моделями OpenAI, которые ещё не выпущены. Это говорит о том, что конструкция чипа «становится более ценной по мере роста рабочих нагрузок и повышения их сложности», сообщила компания в блоге. На системном уровне стойка со 128 ускорителями Jalapeño обеспечивает 1,7 Эфлопс 4-бит вычислений, имеет 27,5 Тбайт HBM4 с агрегированной пропускной способностью чуть менее 2 Пбайт/с. Чип сочетает вычислительный кристалл с шестью стеками HBM4 общим объёмом 216 ГиБ (15,4 Тбайт/с), обеспечивая производительность 13,4 Пфлопс в операциях MXFP4, и масштабируется до 27 Эфлопс и 432 ТиБ памяти в системе из 2048 ASIC. 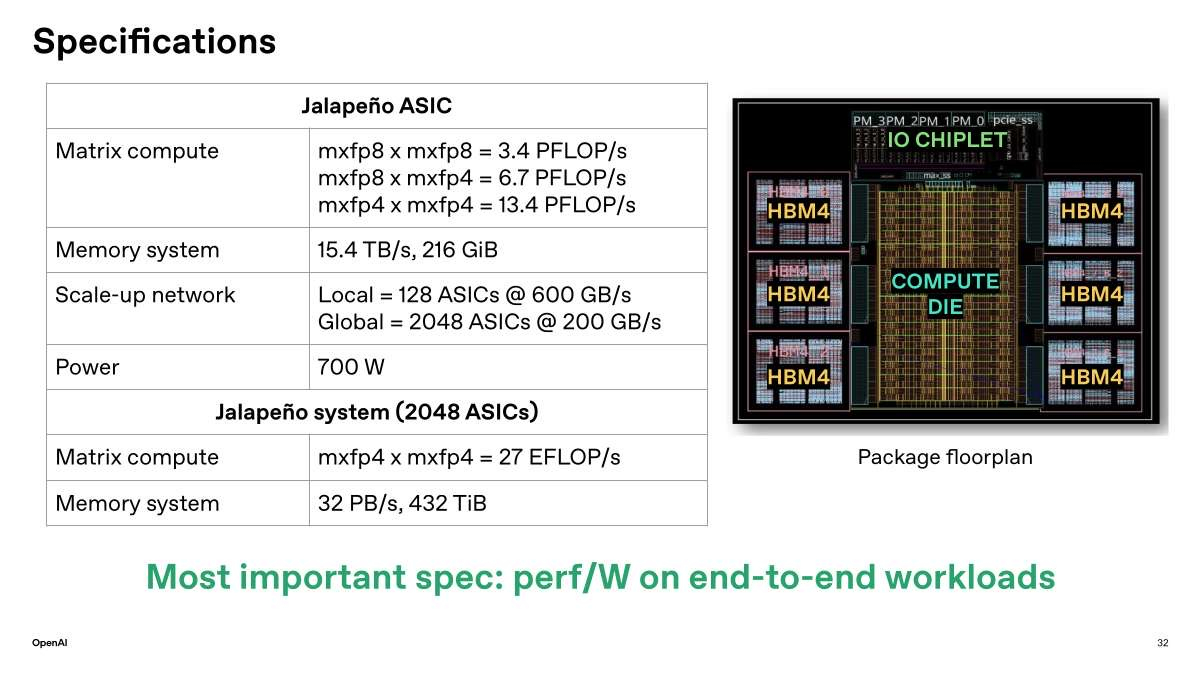
Источник изображений: OpenAI/ServeTheHome Поскольку чип демонстрирует высокие результаты при низком энергопотреблении — 700 Вт — Jalapeno позволит OpenAI экономить средства при эксплуатации своих ЦОД, где электроэнергия является ключевой статьей расходов, заявил агентству Bloomberg вице-президент по аппаратному обеспечению OpenAI Ричард Хо (Richard Ho). Новейшие стоечные системы AMD и NVIDIA работают быстрее, обеспечивая в 1,46–2 раза больше вычислительных ресурсов и до 12 % больше памяти (Helios), но имеют всего лишь 85 % пропускной способности памяти стойки OpenAI. Ричард Хо сообщил, что чип был разработан для минимизации перемещения данных и хранения промежуточных операций. «Мы разработали Jalapeño таким образом, чтобы минимизировать перемещение данных и задержки связи. Это означает, что состояние модели, включая KV-кеш, используемый при генерации ответа, может быть явно размещено и храниться локально, пока система активирует правильную комбинацию вычислительных ресурсов, памяти и сети для каждой фазы инференса», — сообщила компания в своем блоге. 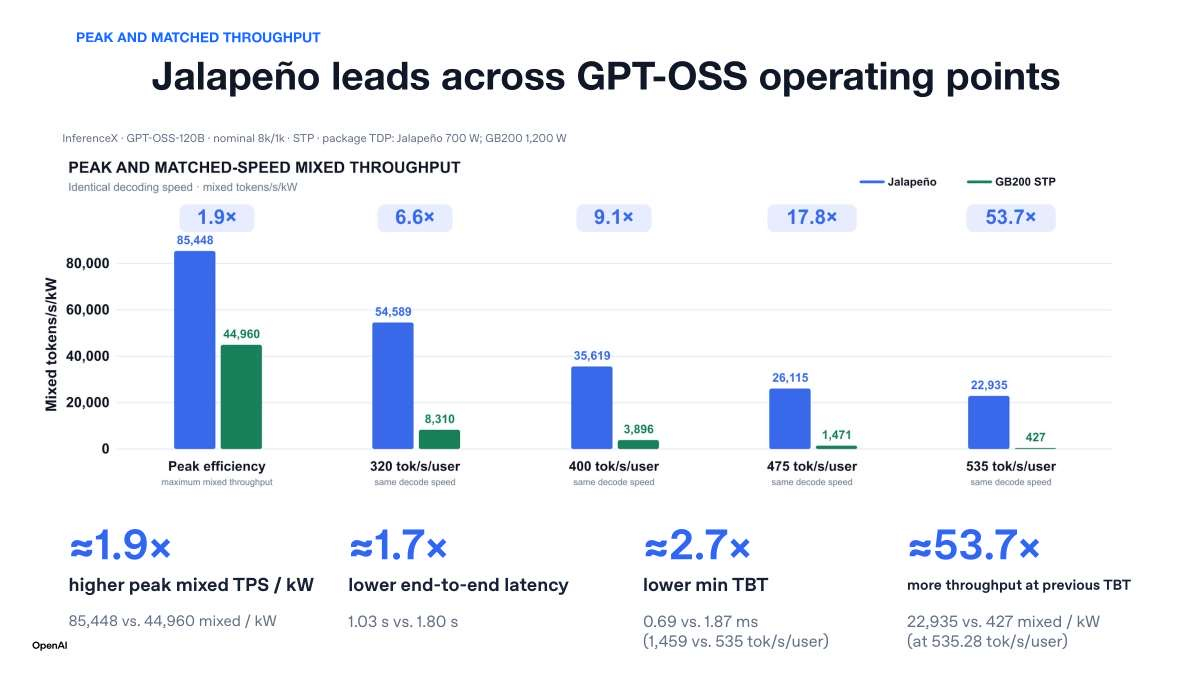 В отличие от стоек NVIDIA Groq LPX, Jalapeño не является узкоспециализированным решением. В компании сообщили ресурсу The Register, что он оптимизирован как для ресурсоёмких операций предварительного заполнения, где обрабатываются промты, так и для фазы декодирования, требующей большой пропускной способности памяти, где генерируются выходные токены. Также следует отметить, что благодаря использованию ИИ для проектирования архитектуры и оптимизации чипа для инференса, OpenAI потратила на его разработку от начала до готовности первого пробного чипа всего девять месяцев. Процесс включал использование собственных моделей для оптимизации механизмов обработки инференса и для написания пользовательских ядер по мере внедрения новых моделей. 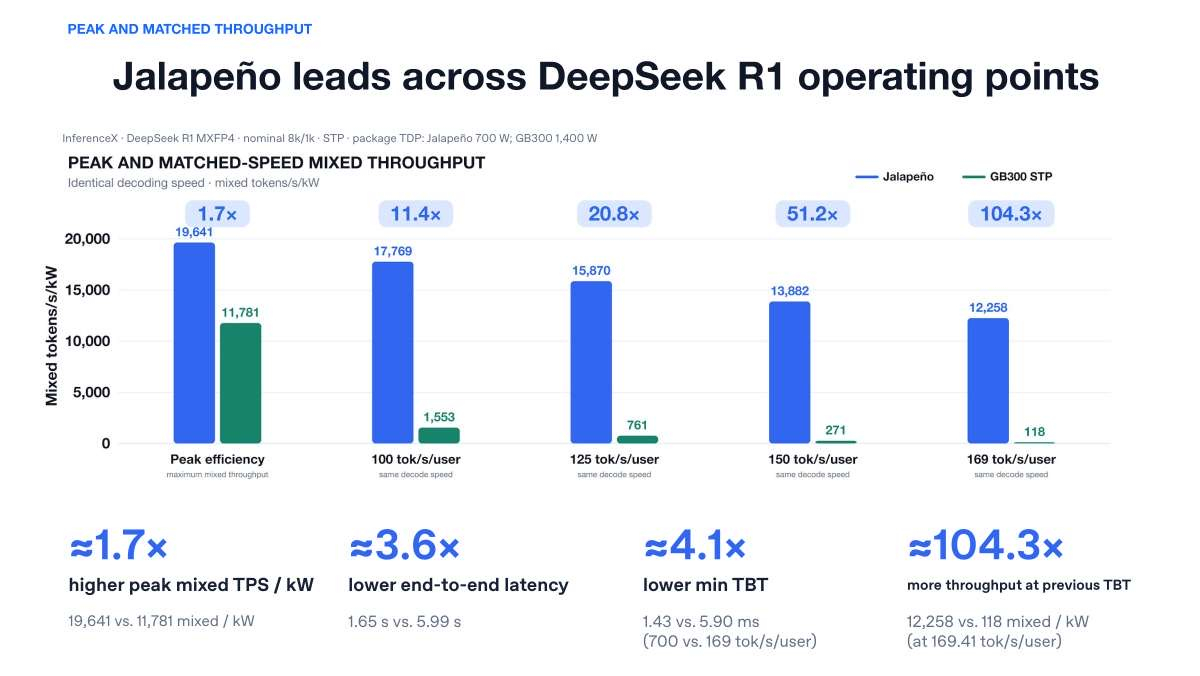 Преимущество Jalapeño в скорости настолько велико, что OpenAI может получать результаты, ранее достижимые только с помощью чипов, использующих другой тип памяти и конструкцию. Например, в настоящее время OpenAI использует чипы Cerebras для некоторых своих LLM, которые, по словам Хо, лучше всего подходят для небольших моделей. Jalapeño, напротив, может обрабатывать более крупные модели, отметил он. Тем не менее, компания не собирается отказываться от сотрудничества с другими поставщиками, включая NVIDIA. «У нас огромная потребность в вычислительных мощностях, поэтому мы привлекли так много разных поставщиков, — сказал он. — Это будет продолжаться ещё некоторое время». Ожидается, что Jalapeño будет выпущен в ограниченных объёмах в конце этого года с дальнейшим увеличение производства в следующем году. 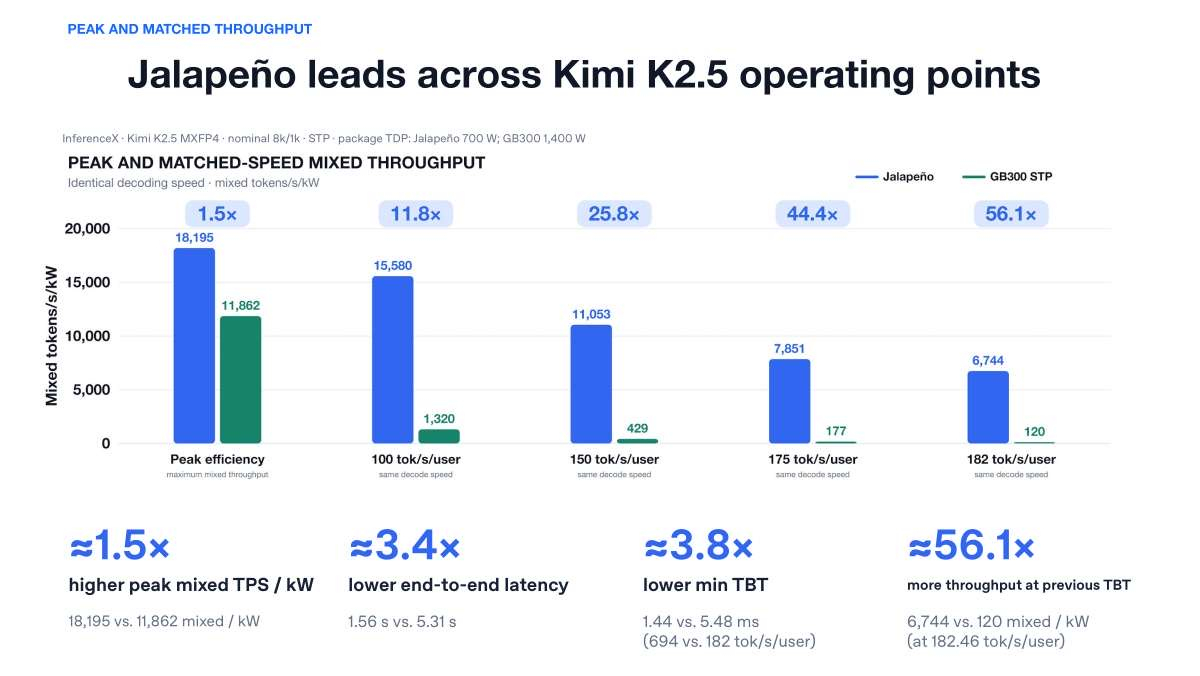 Вторая версия Jalapeño находится на продвинутой стадии разработки, готовность к производству ожидается в «ближайшие месяцы», сказал Хо. Также уже разрабатывается концепция чипа третьего поколения. The Register призвал относиться с осторожностью к заявлениям OpenAI. Новый чип тестировался в сравнении с системами NVIDIA GB200 NVL72 и GB300 NVL72, выпущенными в 2024 и 2025 годах соответственно, но не сравнивался с Vera Rubin, поставки которого только начались.
15.07.2026 [01:40], Владимир Мироненко
Arm-процессоры Graviton5 оказались быстрее Intel Xeon 6, но отстали от AMD EPYC Turin в тестах инстансов AWSПосле запуска серии AWS M9g, первых инстансов на базе процессоров Graviton5, ресурс Phoronix провёл сравнительные тесты производительности процессоров Graviton4 и Graviton5. Тесты показали значительное повышение производительности новых процессоров AWS Graviton благодаря переходу от ядер Arm Neoverse-V2 к Neoverse-V3 и от памяти DDR5-5600 к DDR5-8800, а также другим улучшениям. Кроме того, для сравнения были добавлены тесты инстансов m8a.4xlarge и m8i.4xlarge на базе актуальных AMD EPYC и Intel Xeon в семействе EC2 M. Инстансы M8a используют кастомные AMD EPYC 9R45 поколения Turin с максимальной частотой 4,5 ГГц и памятью DDR5-6400. Каждый vCPU в M8a поддерживается физическим ядром CPU (без SMT). Стоимость использования m8a.4xlarge по запросу на момент тестирования составила $0,97376/час, что значительно выше, чем $0,78272/час для m8g.4xlarge на базе Graviton5. Инстансы M8i используют кастомные же Intel Xeon 6975P-C поколения Granite Rapids-AP с турбочастотой 3,9 ГГц для всех ядер и памятью DDR5-7200 (хотя сами CPU поддерживают MRDIMM-8800). В отличие от инстансов M8g/M9g и M8a, в M8i используется SMT, так что 16 vCPU являются восемью физическими ядрами с HT. Почасовая стоимость по запросу для m8i.4xlarge составила $0,84672 — дешевле m8a.4xlarge, но всё ещё дороже m9g.4xlarge, да ещё и физических ядер вдвое меньше. В общей сложности порталом Phoronix было проведено более 120 тестов производительности для четырех типов инстансов Amazon EC2. При вычислении геометрического среднего всех показателей производительности инстанс с Graviton5 превзошел экземпляр с Intel Xeon 6, в то время как инстанс с Graviton4 ему немного уступил. Инстанс m9g.4xlarge с Graviton5 оказался примерно на 19 % быстрее, чем экземпляр m8i.4xlarge, хотя важно отметить, что в случае с инстансом на Intel Xeon речь идёт об SMT (HT). Помимо того, что Graviton5 на 19 % быстрее, чем Xeon 6, в этом сравнении почасовая стоимость по запросу была примерно на 8 % ниже, чем у экземпляра на базе Granite Rapids-AP. 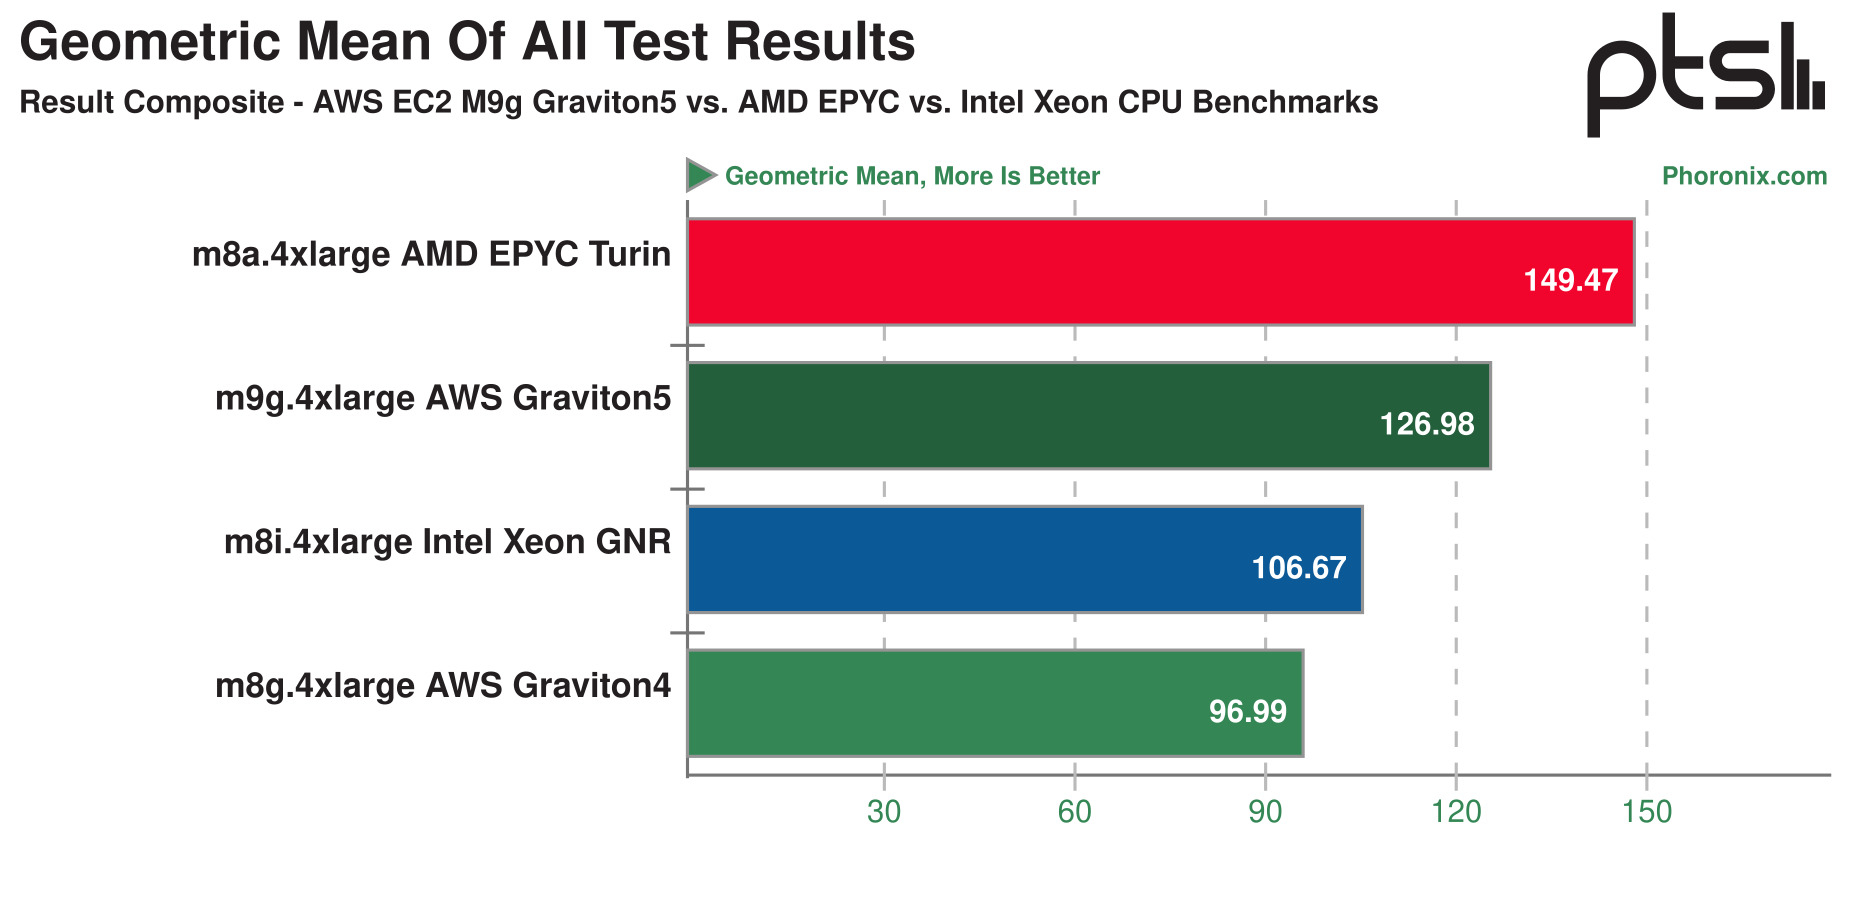
Источник изображения: phoronix.com Инстанс m8a.4xlarge на AMD EPYC Turin показал на 17 % выше производительность, чем инстанс на Graviton5 того же размера. Хотя при текущей ценовой политике по запросу инстанс m8a.4xlarge примерно на 24 % дороже в час, чем m9g.4xlarge с Graviton5, у Graviton5 всё ещё есть ценовое преимущество, поскольку это собственная разработка AWS. Однако, для некоторых рабочих нагрузок инстанс m8a.4xlarge обеспечил как лучшую производительность, так и соотношение производительности и цены, отметил Phoronix.
18.06.2026 [01:45], Владимир Мироненко
NVIDIA стала лидером во всех тестах MLPerf Training 6.0Консорциум MLCommons опубликовал результаты тестирования различных аппаратных решений в бенчмарке MLPerf Training 6.0. В нём появилось два новых теста — DeepSeek V3 и GPT-OSS 20B, что подчёркивает общеотраслевой переход к разреженным вычислениям, примером которого является архитектура MoE (Mixture-of-Experts). DeepSeek V3 — крупномасштабная MoE-модель c 671 млрд параметров, из которых 37 млрд активируются для генерации отдельного токена. Она предоставляет стандартизированную платформу для оценки эффективности обучения ведущей модели MoE с открытыми весами. GPT-OSS 20B — MoE-модель c 21 млрд параметров, из которых 3,6 млрд активируются для генерации одного токена. Она позволяет организациям оценивать сложную логику маршрутизации и шаблоны разреженных вычислений, характерные для архитектуры MoE, на аппаратных конфигурациях размером всего в один узел с восемью ускорителями. Версия MLPerf Training 6.0 установила новые рекорды по разнообразию представленных систем. Участники выложили результаты 95 уникальных систем, использующих тринадцать различных аппаратных ускорителей, 19 различных хост-процессоров и несколько различных программных фреймворков. 60 % систем были многоузловыми. При этом количество представленных облачных систем более чем вдвое больше, чем в раунде 5.1. 
Источник изображения: NVIDIA В раунде MLPerf Training v6.0 представлены заявки от 24 организаций: AMD, ASUSTeK, Azure, Cisco, CoreWeave, Dell, Fujitsu, GigaComputing, Google, HPE, Inventec, Krai, Lambda, MITAC, Nebius, Netweb Technologies India, NVIDIA, Oracle, Quanta Cloud Technologies, SCITIX, Supermicro, tinycorp, TTA и Vultr. «Мы особенно рады приветствовать участников, впервые представляющих свои результаты в MLPerf Training: Inventec, Netweb Technologies India, TTA и Vultr», — сообщил Дэвид Кантер (David Kanter), руководитель MLPerf в MLCommons. NVIDIA вновь стала лидером в новом раунде MLPerf Training, причём во всех тестах, в очередной раз став единственной платформой, которая предоставила результаты по всем тестам. Также NVIDIA была единственной платформой, представившей результаты по новым тестам, при этом система NVIDIA GB300 NVL72 «установила планку производительности благодаря оптимизированным программным стекам NVIDIA и конструкции, объединяющей 72 GPU Blackwell Ultra и 36 CPU Grace с использованием NVLink и NVLink Switch». В нескольких случаях партнёры NVIDIA масштабировали систему до 8192 ускорителей Blackwell, работающих согласованно в различных ЦОД. Эти результаты подтвердили реальную надёжность платформы Blackwell в масштабируемых кластерных средах, говорит NVIDIA. 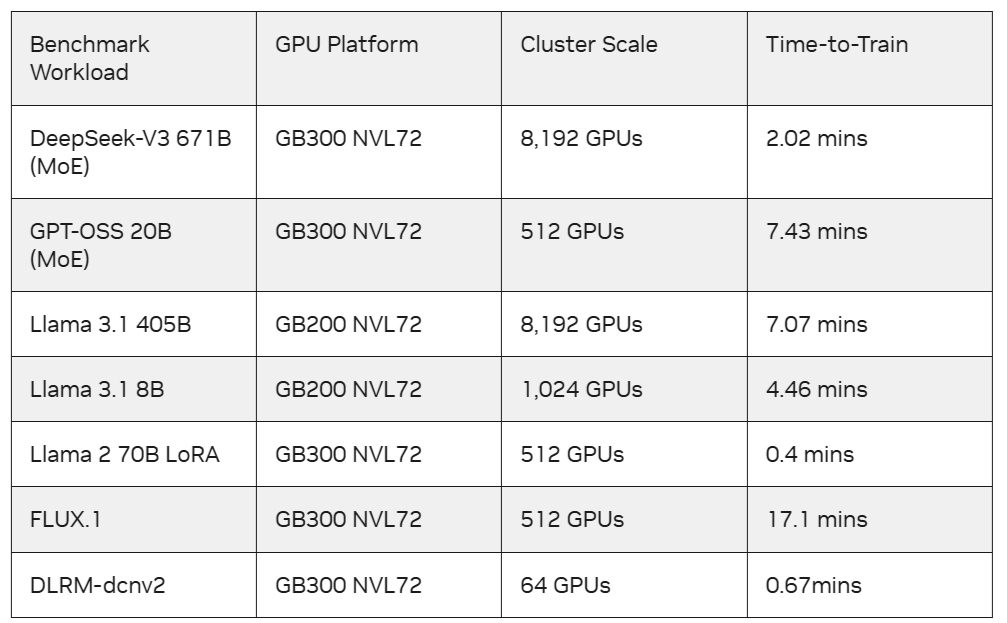
Источник изображения: NVIDIA Для достижения максимальной производительности таких моделей, как DeepSeek-V3, NVIDIA в этом раунде MLPerf Training применила несколько программных оптимизаций, включая использование итерационных графов CUDA для MoE без удаления токенов, применение CuTe DSL для продвинутых операций слияния ядер, алгоритм внимания MXFP8 для повышения производительности без ущерба для качества модели, оптимизацию маршрутизатора и оптимизацию схемы коммуникации 1F1B all-to-all overlap. Также NVIDIA оптимизировала компоновку и баланс параллельных этапов конвейера, минимизируя структурное простаивание. Для обработки DeepSeek-V3 671B компания NVIDIA использовала до 8192 GPU в системах GB200 NVL72, что стало самым масштабным результатом на основе Blackwell в MLPerf Training на сегодняшний день. NVIDIA также представила результаты на 5120 GPU с системами NVIDIA GB200 NVL72 в Llama 3.1 405B, одной из самых крупных LLM плотной архитектуры в этом бенчмарке. Результаты этого раунда также отражают тесное сотрудничество NVIDIA с компаниями-партнёрами в области системной архитектуры, сетей и ПО. Например, Microsoft Azure масштабировала обучение Llama 3.1 405B до 8192 GPU, используя системы GB200 NVL72, и достигла целевого эталонного значения за 7,07 мин., что является самым быстрым временем обучения для этого бенчмарка. А CoreWeave показала самое быстрое время обучения для DeepSeek-V3 671B, достигнув целевого качества за 2,02 мин. на 8192 GPU в составе GB300 NVL72, объединённых Spectrum-X Ethernet.
27.05.2026 [00:56], Владимир Мироненко
Серверные Arm-процессоры NVIDIA Vera обогнали современные Intel Xeon и AMD EPYC в некоторых тестахПортал Phoronix провёл тестирование серверного Arm-процессора NVIDIA Vera, разработанного специально для обеспечения функционирования агентного ИИ, взяв для сравнения одно- и двухсокетные конфигурации на базе Intel Xeon 6980P (Granite Rapids-AP), а также AMD EPYC Turin: 9755, 9575F и 9475F. Также в сравнительное тестирование включили процессоры NVIDIA первого поколения Grace на базе ядер Arm Neoverse V2 (Demeter). Сообщается, что NVIDIA дала добро на проведение на этом предрелизном чипе тестов только для определённых рабочих нагрузок, соответствующих предполагаемым задачам/областям применения Vera в ЦОД, включая стандартные рабочие нагрузки, такие как компиляция, STREAM, кодирование видео, Python/Java и производительность СУБД. Исходя из среднего геометрического значения результатов тестов NVIDIA Vera занял первое место, превысив почти на 11 % лучшие результаты самых передовых разработок AMD, и примерно на 55,3 % показатели лучшей односокетной конфигурации Intel Xeon. Он также превзошёл в тестах двухсокетные конфигурации, что говорит о проблемах масштабирования некоторых рабочих нагрузок на нескольких сокетах. Эти ограниченные тесты отражают превосходство NVIDIA Vera по сравнению с любой архитектурой на базе Arm, с TDP 450 Вт для процессора и 50 Вт для пула памяти объемом 768 Гбайт. 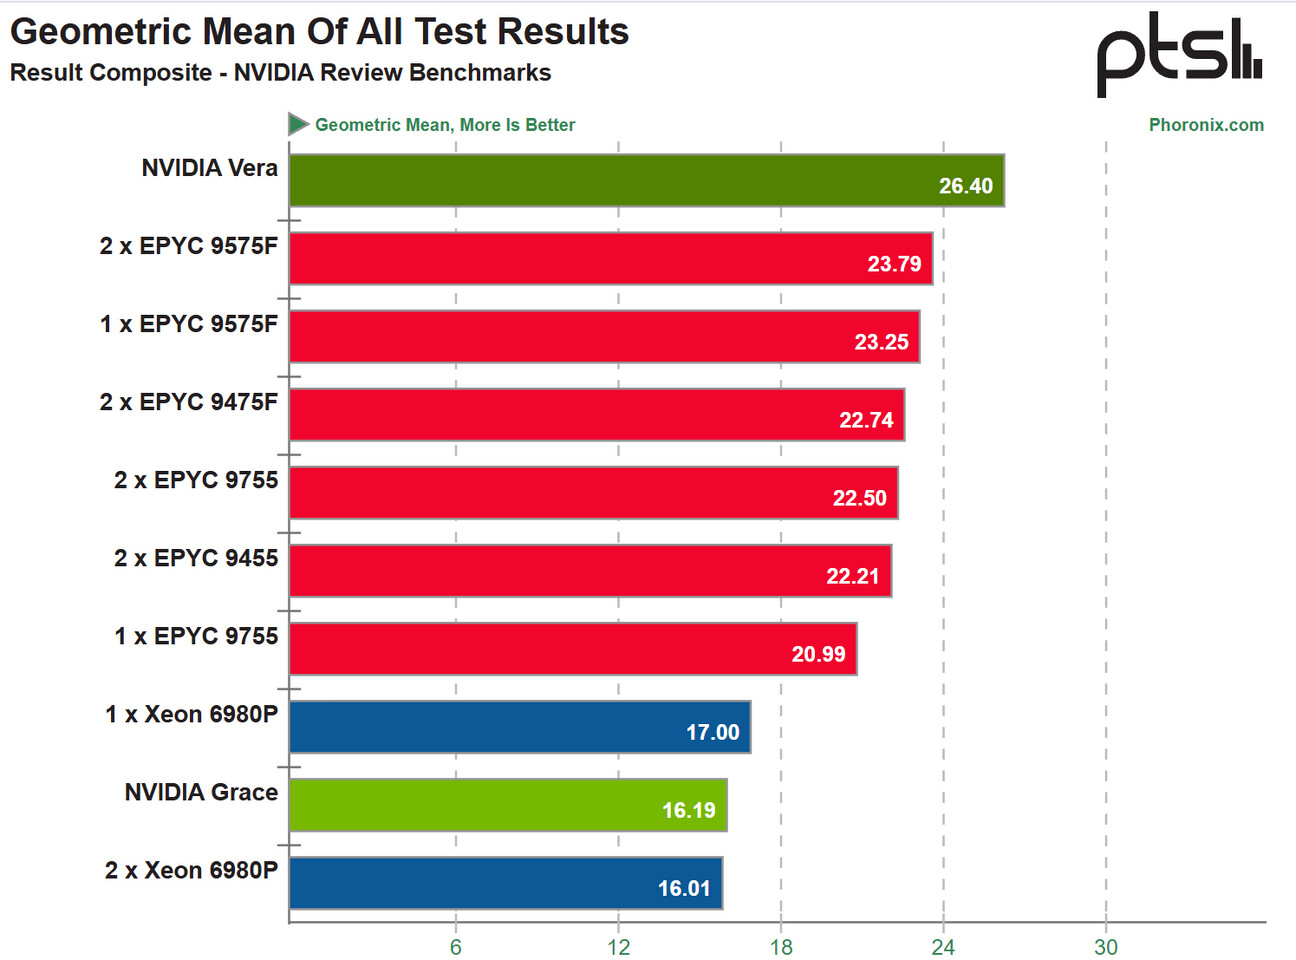
Источник изображения: Phoronix Предполагается, что NVIDIA продаст процессоров Vera и Grace на сумму около $20 млрд, охватив общий потенциальный рынок (TAM) в $200 млрд. NVIDIA сотрудничает со всеми крупными гиперскейлерами для поставки стоек с процессорами Vera (чаще всего в составе Vera Rubin), также наблюдается множество развёртываний у поставщиков инфраструктуры для их собственных задач и предложений для сторонних клиентов. Такой подход позволит NVIDIA выйти на огромный рынок процессоров, став одним из лидеров уже в этом году.
14.11.2025 [01:55], Владимир Мироненко
NVIDIA вновь впереди всех в новом раунде MLPerf Training v5.1Консорциум MLCommons опубликовал результаты тестирования различных аппаратных решений в бенчмарке MLPerf Training v5.1. На этот раз был установлен новый рекорд по разнообразию представленных систем. Участники этого раунда тестирования представили 65 уникальных систем, оснащённых 12 различными аппаратными ускорителями и различными программными платформами. Почти половина заявок была для многоузловых систем, что на 86 % больше, чем в раунде MLPerf Training 4.1 год назад, причём они так же отличались разнообразием сетевых архитектур. Раунд MLPerf Training v5.1 включает в себя результаты 20 компаний, подавших заявки: AMD, ASUS, Cisco, Dell, Giga Computing, HPE, Krai, Lambda, Lenovo, MangoBoost, MiTAC, Nebius, NVIDIA, Oracle, Quanta Cloud Technology (QCT), Supermicro, Supermicro + MangoBoost, Университет Флориды, Verda (DataCrunch), Wiwynn. 
Источник изображений: NVIDIA Также сообщается, что структура заявок свидетельствует о растущем внимании к тестам, ориентированным на задачи генеративного ИИ: количество заявок на тест Llama 2 70B LoRa увеличилось на 24 %, а на новый тест Llama 3.1 8B — на 15 % по сравнению с тестом, который он заменил (BERT). NVIDIA объявила, что её чипы на архитектуре NVIDIA Blackwell заняли первые позиции во всех семи тестах MLPerf Training v5.1, обеспечив максимально быстрое обучение в работе с большими языковыми моделями (LLM), генерацией изображений, рекомендательными системами, компьютерным зрением и графическими нейронными сетями. 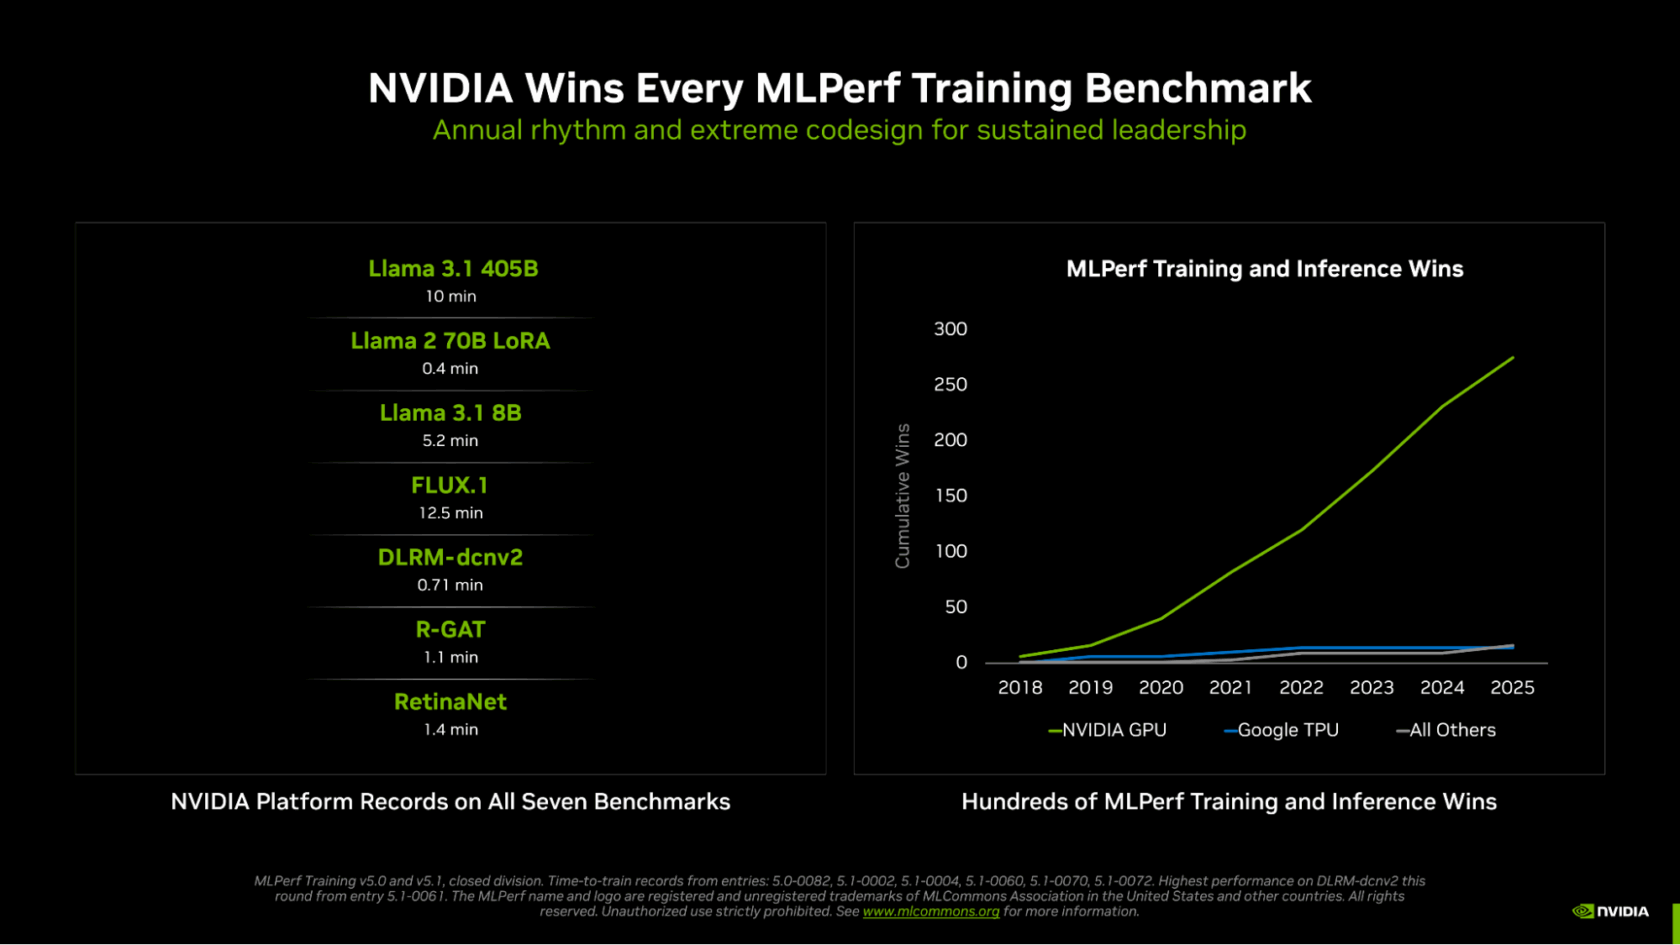 NVIDIA подчеркнула, что была единственной платформой, которая предоставила результаты по всем тестам — это, по словам компании, «подчёркивает широкие возможности программирования ускорителей NVIDIA, а также зрелость и универсальность программного стека CUDA». Компания сообщила, что в этом раунде MLPerf Training дебютировала стоечная система GB300 NVL72, работающая на базе ускорителя NVIDIA Blackwell Ultra, показав рекордные результаты и доказав, что является наилучшим выбором для интенсивных рабочих ИИ-нагрузок. При предварительном обучении Llama 3.1 40B ускорители GB300 обеспечивают более чем вчетверо большую производительность по сравнению с H100 и почти вдвое — по сравнению с GB200. Аналогичным образом, при точной настройке Llama 2 70B восемь ускорителей GB300 обеспечили в пять раз большую производительность по сравнению с H100.  NVIDIA отметила, что этого удалось достичь благодаря архитектурным усовершенствованиям Blackwell Ultra, включая новые тензорные ядра, которые обеспечивают ИИ-производительность в формате NVFP4 в размере 15 Пфлопс, вдвое большую производительность в работе механизма внимания (attention-layer compute) и 279 Гбайт HBM3e, а также новые методы обучения, которые позволили повысить вычислительную производительность архитектуры NVFP4. В MLPerf также дебютировала 800G-платформа Quantum-X800 InfiniBand, объединяющая несколько систем GB300 NVL72, которая удвоила пропускную способность сети по сравнению с предыдущим поколением. Но по словам компании, «ключом к выдающимся результатам в этом раунде было выполнение вычислений с использованием NVFP4 — впервые в истории MLPerf Training». NVIDIA обеспечила поддержку FP4 для обучения LLM на каждом уровне, что позволило удвоить скорость вычислений по сравнению с FP8. Ускоритель NVIDIA Blackwell может выполнять вычисления в формате FP4 (в т.ч. NVFP4 и др.) с удвоенной скоростью по сравнению с FP8, а Blackwell Ultra — с утроенной.  На сегодняшний день NVIDIA является единственной платформой, которая представила результаты MLPerf Training с вычислениями, выполненными с использованием FP4 при соблюдении строгих требований к точности в тесте. Эти результаты были получены с использованием 5120 ускорителей Blackwell GB200, которым потребовалось всего 10 мин. на бенчмарк Llama 3.1 405B, что является новым рекордом. Это в 2,7 раза быстрее, чем лучший результат с использованием архитектуры Blackwell, показанный в предыдущем раунде бенчмарка. NVIDIA также установила рекорды производительности в двух новых тестах: Llama 3.1 8B и FLUX.1. Llama 3.1 8B — компактная, но обладающая высокой производительностью LLM — заменила модель BERT-large, добавив в линейку базовых моделей современную LLM малого размера. NVIDIA представила результаты с использованием до 512 ускорителей Blackwell Ultra, потратив 5,2 мин. на прохождение теста. FLUX.1 — современная модель генерации изображений — заменила Stable Diffusion v2, и только платформа NVIDIA представила результаты этого теста. NVIDIA представила результаты с использованием 1152 ускорителей Blackwell, установив рекорд — 12,5 мин. обучения.
13.10.2025 [00:30], Владимир Мироненко
Вложи $5 млн — получи $75 млн: NVIDIA похвасталась новыми рекордами в комплексном бенчмарке InferenceMAX v1
b200
gb200
hardware
nvidia
open source
semianalysis
бенчмарк
ии
инференс
рекорд
финансы
энергоэффективность
NVIDIA сообщила о результатах, показанных суперускорителем GB200 NVL72, в новом независимом ИИ-бенчмарке InferenceMAX v1 от SemiAnalysis. InferenceMAX оценивает реальные затраты на ИИ-вычисления, определяя совокупную стоимость владения (TCO) в долларах на миллион токенов для различных сценариев, включая покупку и владение GPU в сравнении с их арендой. InferenceMAX опирается на инференс популярных моделей на ведущих платформах, измеряя его производительность для широкого спектра вариантов использования, а результаты может перепроверить любой желающий, говорят авторы бенчмарка. Суперускоритель GB200 NVL72 победил во всех категориях бенчмарка InferenceMAX v1. Чипы NVIDIA Blackwell показали наилучшую окупаемость инвестиций — вложение в размере $5 млн приносят $75 млн дохода от токенов DeepSeek R1, обеспечивая 15-кратную окупаемость (год назад NVIDIA обещала ROI на уровне 700 %). Также ускорители поколения Blackwell отличаются самой низкой совокупной стоимостью владения. например, оптимизация ПО NVIDIA B200 позволила добиться стоимости всего в два цента на миллион токенов на OpenAI gpt-oss-120b, обеспечив пятикратное снижение стоимости одного токена всего за два месяца. NVIDIA B200 первенствовал и по пропускной способности и интерактивности, обеспечив 60 тыс. токенов в секунду на ускоритель и 1 тыс. токенов в секунду на пользователя в gpt-oss с новейшим стеком NVIDIA TensorRT-LLM. NVIDIA сообщила, что постоянно повышает производительность путём оптимизации аппаратного и программного стека. Первоначальная производительность gpt-oss-120b на системе NVIDIA DGX Blackwell B200 с библиотекой NVIDIA TensorRT LLM уже была лидирующей на рынке, но команды NVIDIA и сообщество разработчиков значительно оптимизировали TensorRT LLM для ускорения исполнения открытых больших языковых моделей (LLM). 
Источник изображений: NVIDIA Компания отметила, что выпуск TensorRT LLM v1.0 стал значительным прорывом в повышении скорости инференса LLM благодаря распараллеливанию и оптимизации IO-операций. А у недавно вышедшей модели gpt-oss-120b-Eagle3-v2 используется спекулятивное декодирование — интеллектуальный метод, позволяющий предсказывать несколько токенов одновременно. Это уменьшает задержку и обеспечивает получение ещё более быстрых результатов — пропускная способность выросла втрое, до 100 токенов в секунду на пользователя (TPS/пользователь), а общая производительность на ускоритель выросла с 6 до 30 тыс. токенов. 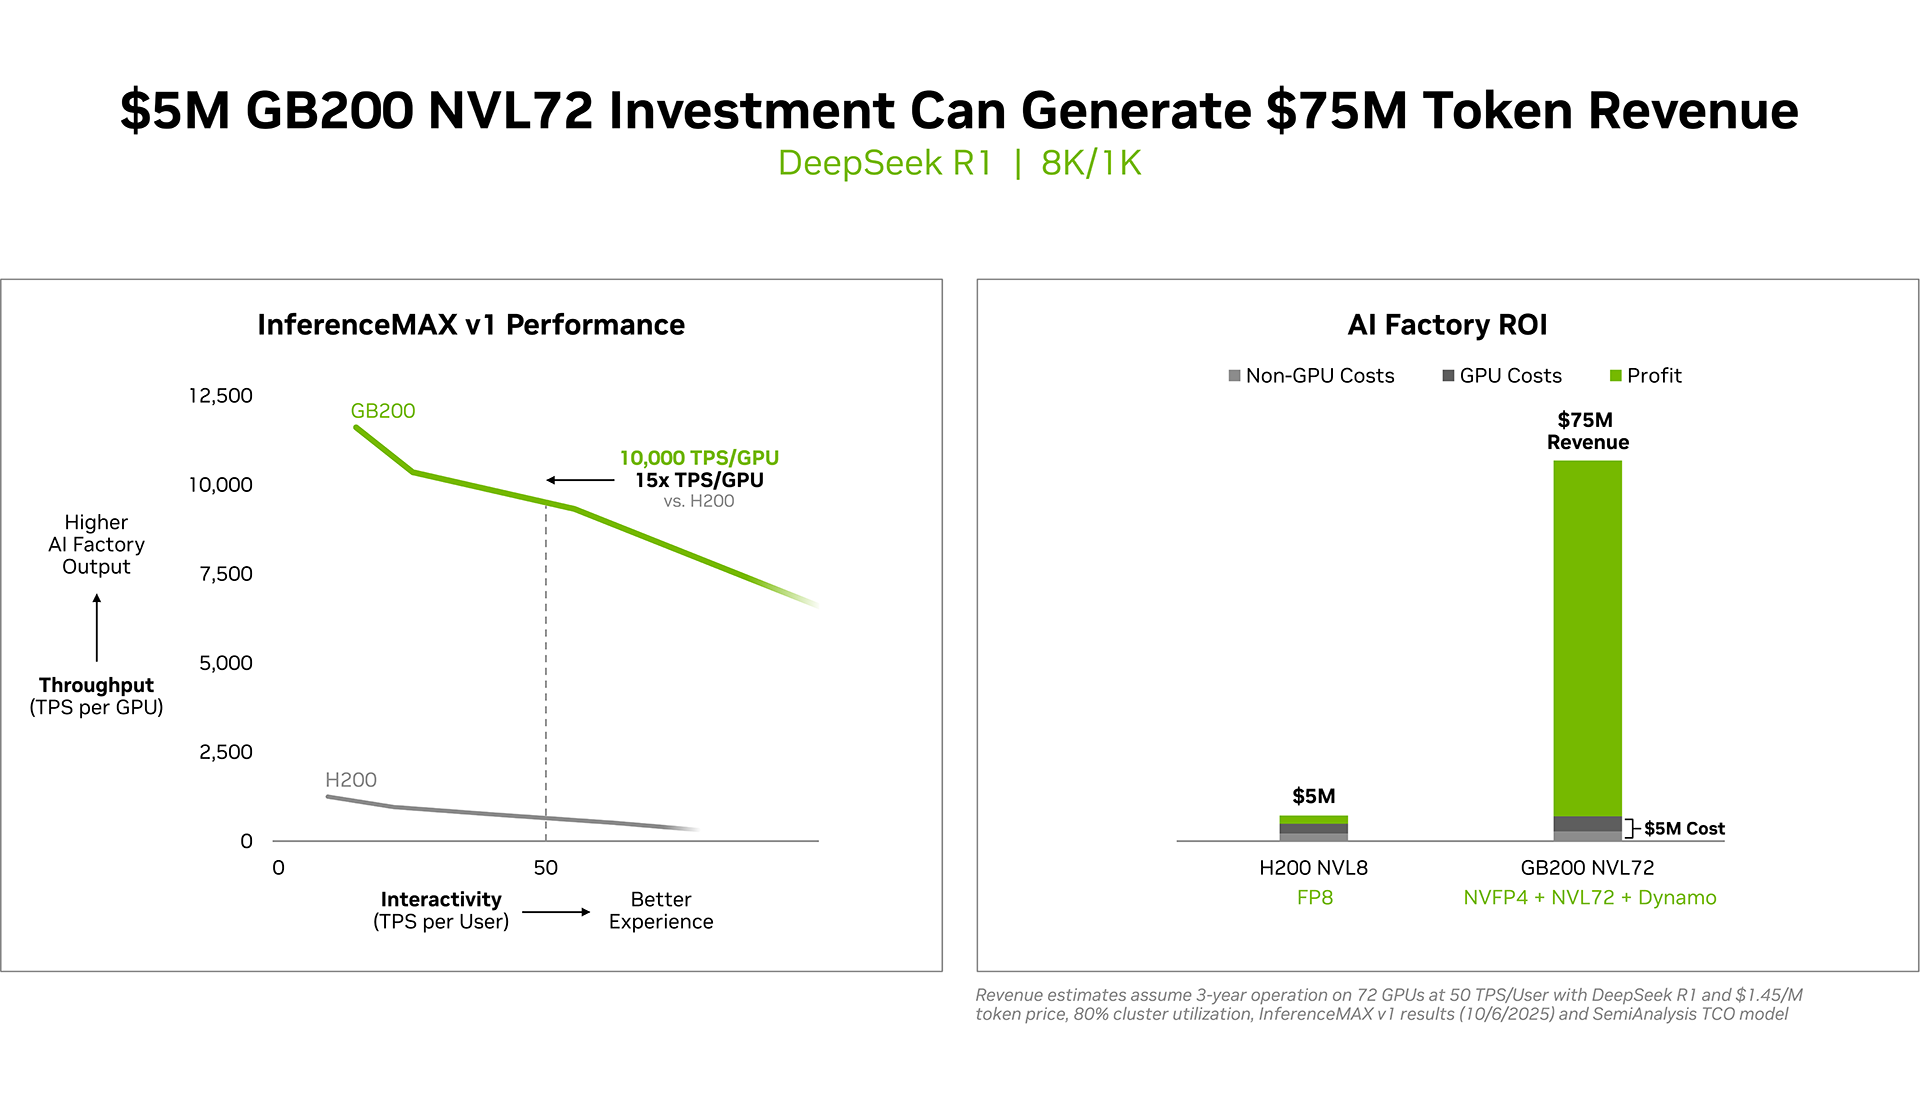 Для моделей с «плотной» архитектурой (Dense AI), таких как Llama 3.3 70b, которые требуют значительных вычислительных ресурсов из-за большого количества параметров и одновременного использования всех параметров в процессе инференса, NVIDIA Blackwell B200 достиг нового рубежа производительности в бенчмарке InferenceMAX v1, отметила NVIDIA. Суперускоритель показал более 10 тыс. токенов/с (TPS) на GPU при 50 TPS на пользователя, т.е. вчетверо более высокую пропускную способность на GPU по сравнению с NVIDIA H200. 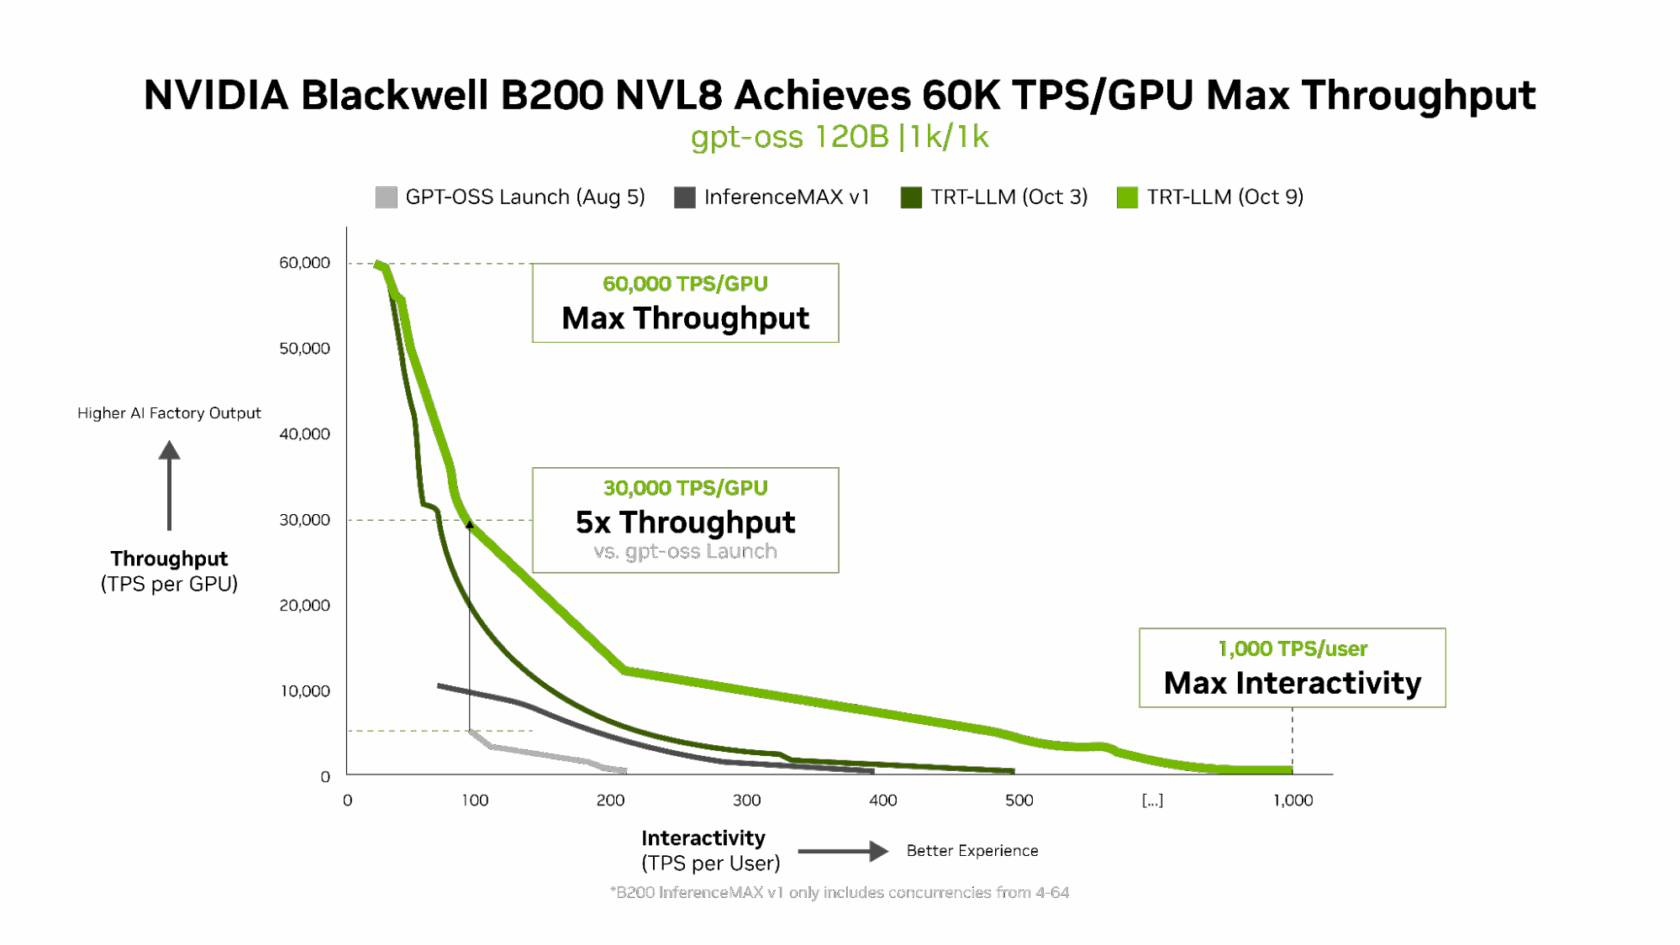 NVIDIA подчеркнула, что такие показатели, как количество токенов на Вт, стоимость на миллион токенов и TPS/пользователь не уступают по важности пропускной способности. Фактически, для ИИ-фабрик с ограниченной мощностью ускорители с архитектурой Blackwell обеспечивают до 10 раз лучшую производительность на МВт по сравнению с предыдущим поколением и позволяют получать более высокий доход от токенов. 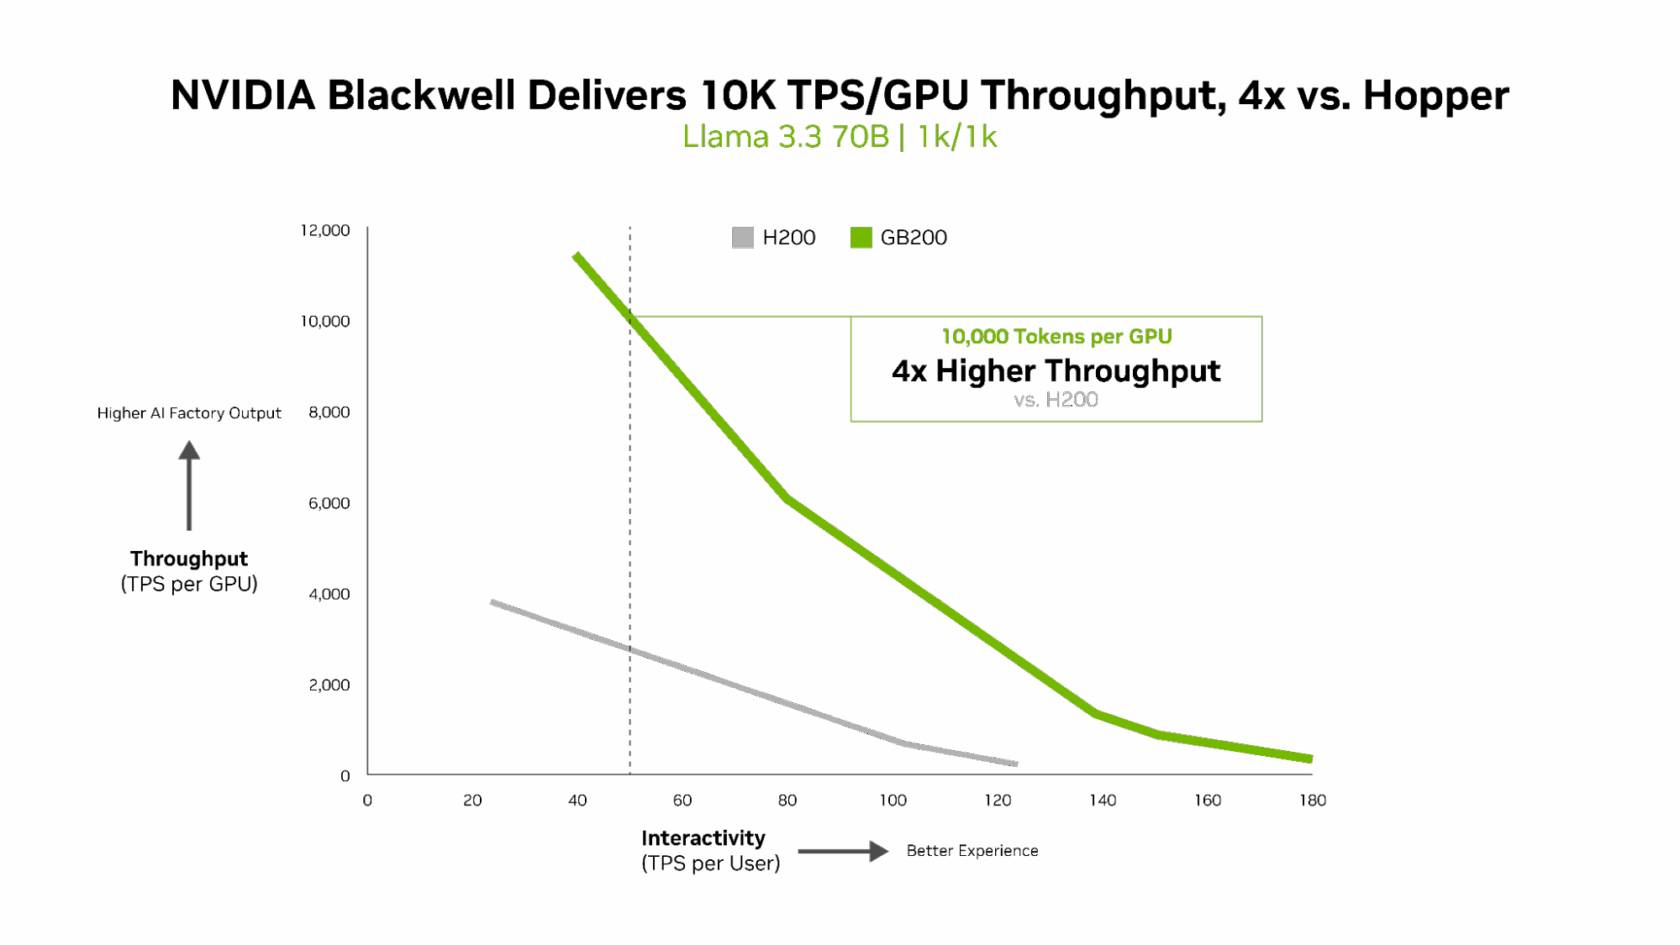 Компания отметила, что стоимость обработки одного токена (Cost per Token) имеет решающее значение для оценки эффективности ИИ-модели и напрямую влияет на эксплуатационные расходы. NVIDIA утверждает, что в целом архитектура NVIDIA Blackwell позволила снизить стоимость обработки миллиона токенов в 15 раз по сравнению с предыдущим поколением. 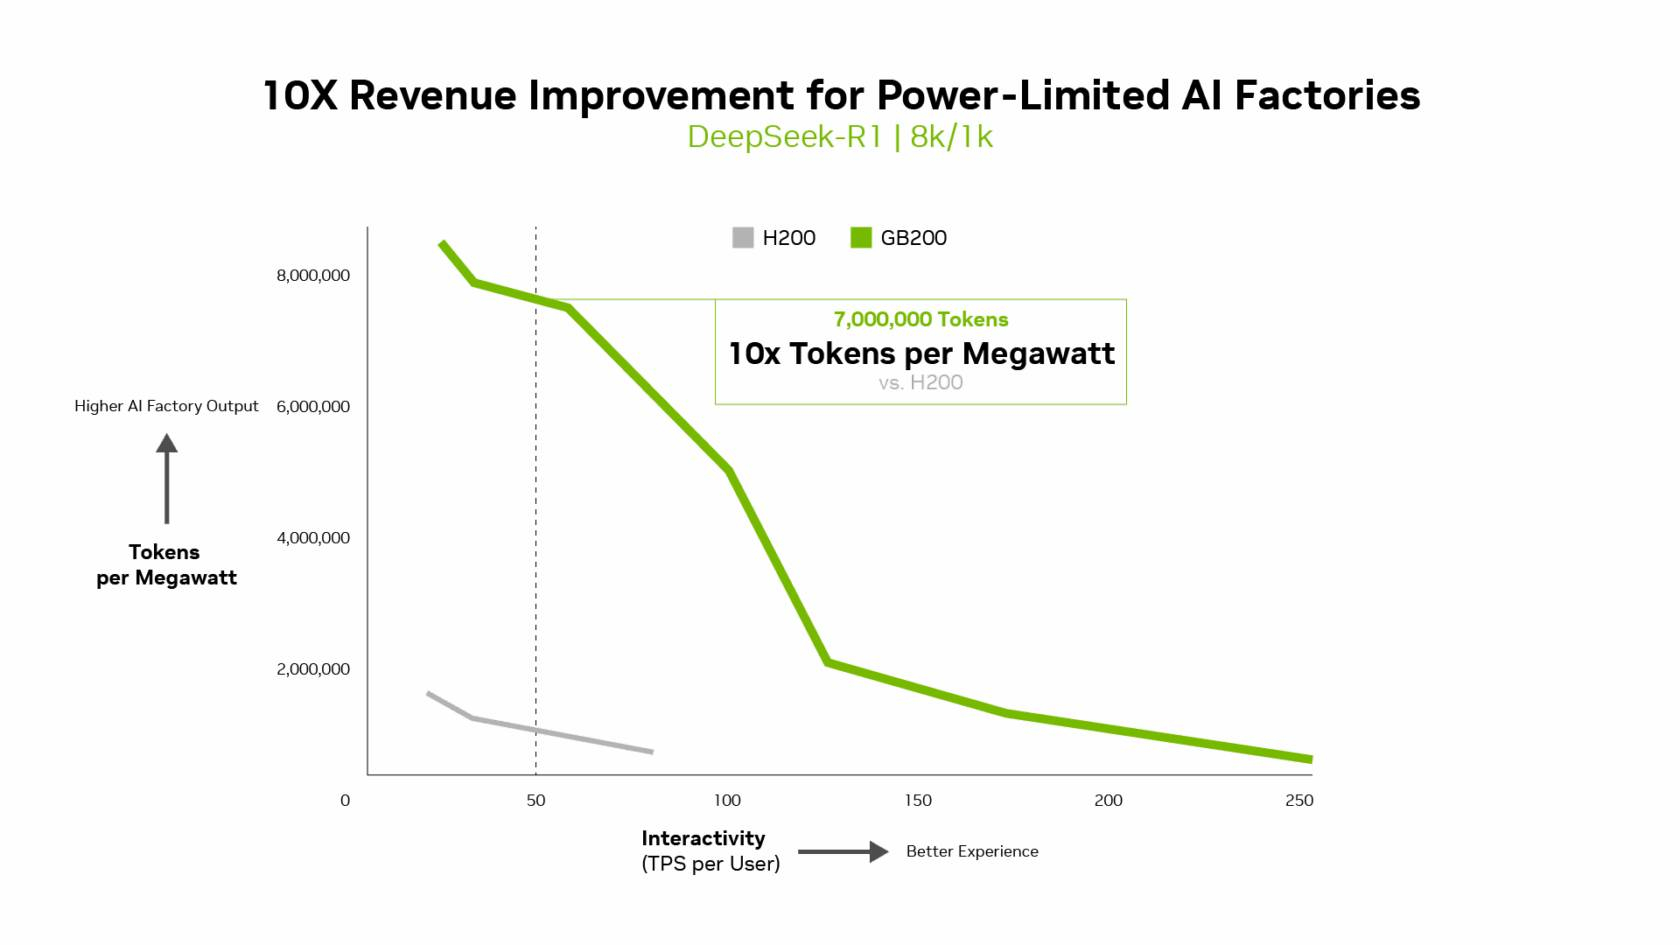 В InferenceMAX используется метод оценки эффективности Pareto front, определяющий наилучшее (компромиссное) сочетание различных факторов для оценки производительности ускорителя. Это показывает, насколько Blackwell лучше конкурентов справляется с балансом стоимости, энергоэффективности, пропускной способности и скорости отклика. Системы, оптимизированные только для одной метрики, могут демонстрировать пиковую производительность «в вакууме», но такая «экономика» не масштабируется в производственных средах. 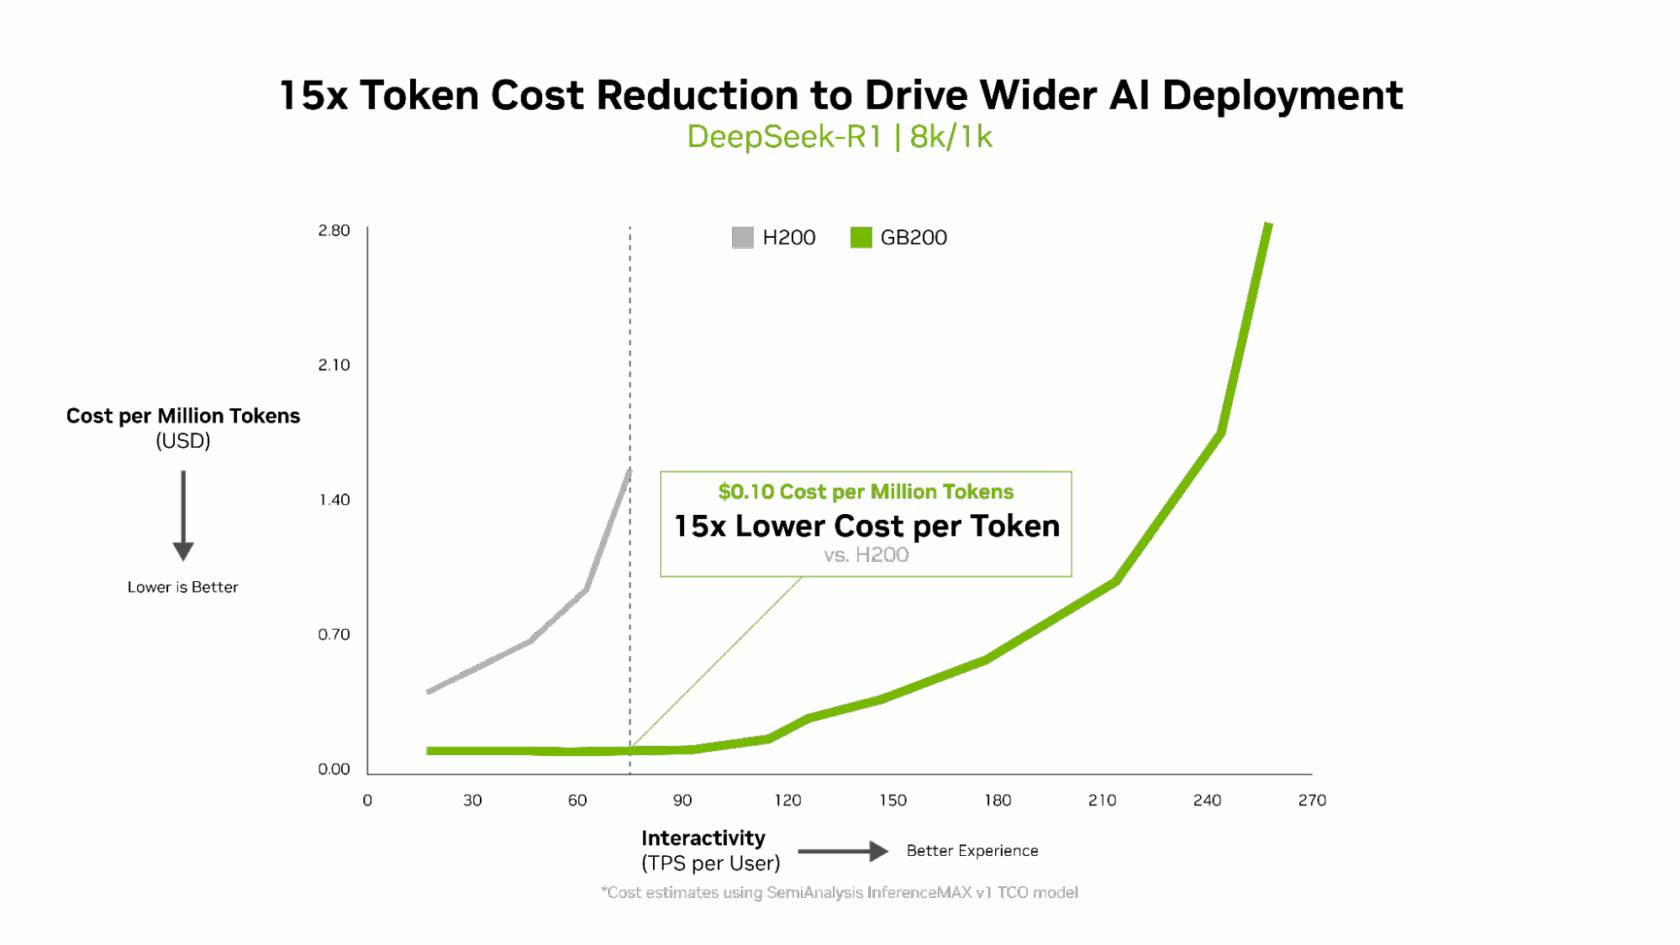 Компания отметила, что ИИ переходит от экспериментальных пилотных проектов к ИИ-фабрикам — инфраструктуре, которая производит интеллектуальные решения, преобразуя данные в токены и решения в режиме реального времени. Фреймворк NVIDIA Think SMART помогает предприятиям ориентироваться в этом переходе, демонстрируя, как полнофункциональная платформа инференса обеспечивает измеримую окупаемость инвестиций. Обещая 15-кратную окупаемость инвестиций и непрерывный рост производительности за счёт ПО, NVIDIA не просто лидирует в текущей гонке ИИ-технологий, но и задаёт правила для следующего этапа, где экономика будет определять победителей рынка, пишет The Tech Buzz. Для предприятий, делающих ставку на конкурирующие платформы в своих стратегиях по развёртыванию ИИ, результаты таких бенчмарков должны побудить к пересмотру выбора ИИ-инфраструктуры.
12.09.2025 [23:07], Владимир Мироненко
Intel Arc Pro впервые поучаствовали в бенчмарках MLPerf Inference, но в лидерах предсказуемо осталась NVIDIAMLCommons объявил результаты набора бенчмарков MLPerf Inference v5.1. Последний раунд демонстрирует, насколько быстро развивается инференс и соответствующие бенчмарки, пишет ресурс HPCwire. В этом раунде было рекордное количество заявок — 27. Представлены результаты сразу пяти новых ускорителей: AMD Instinct MI355X, Intel Arc Pro B60 48GB Turbo, NVIDIA GB300, NVIDIA RTX 4000 Ada 20GB, NVIDIA RTX Pro 6000 Blackwell Server Edition. Всего же количество результатов MLPerf перевалило за 90 тыс. результатов. В текущем раунде были представлены три новых бенчмарка: тест рассуждений на основе модели DeepSeek-R1, тест преобразования речи в текст на основе Whisper Large v3 и небольшой тест LLM на основе Llama 3.1 8B. Как отметил ресурс IEEE Spectrum, бенчмарк на основе модели Deepseek R1 671B (671 млрд параметров), более чем в 1,5 раза превышает самый крупный бенчмарк предыдущего раунда на основе Llama 3.1 405B. В модели Deepseek R1, ориентированной на рассуждения, большая часть вычислений выполняется во время инференса, что делает этот бенчмарк ещё более сложным. Что касается самого маленького бенчмарка, основанного на Llama 3.1 8B, то, как поясняют в MLCommons, в отрасли растёт спрос на рассуждения с малой задержкой и высокой точностью. SLM отвечают этим требованиям и являются отличным выбором для таких задач, как реферирование текста или периферийные приложения. В свою очередь бенчмарк преобразования голоса в текст, основанный на Whisper Large v3, был разработан в ответ на растущее количество голосовых приложений, будь то смарт-устройства или голосовые ИИ-интерфейсы. 
Источник изображения: NVIDIA NVIDIA вновь возглавила рейтинг MLPerf Inference, на этот раз с архитектурой Blackwell Ultra, представленной платформой NVIDIA GB300 NVL72, которая установила рекорд, увеличив пропускную способность DeepSeek-R1 на 45 % по сравнению с предыдущими системами GB200 NVL72 (Blackwell). NVIDIA также продемонстрировала высокие результаты в бенчмарке Llama 3.1 405B, который имеет более жёсткие ограничения по задержке. NVIDIA применила дезагрегацию, разделив фазы работы с контекстом и собственно генерацию между разными ускорителями. Этот подход, поддерживаемый фреймворком Dynamo, обеспечил увеличение в 1,5 раза пропускной способности на один ускоритель по сравнению с традиционным обслуживанием на системах Blackwell и более чем в 5 раз по сравнению с системами на базе Hopper. 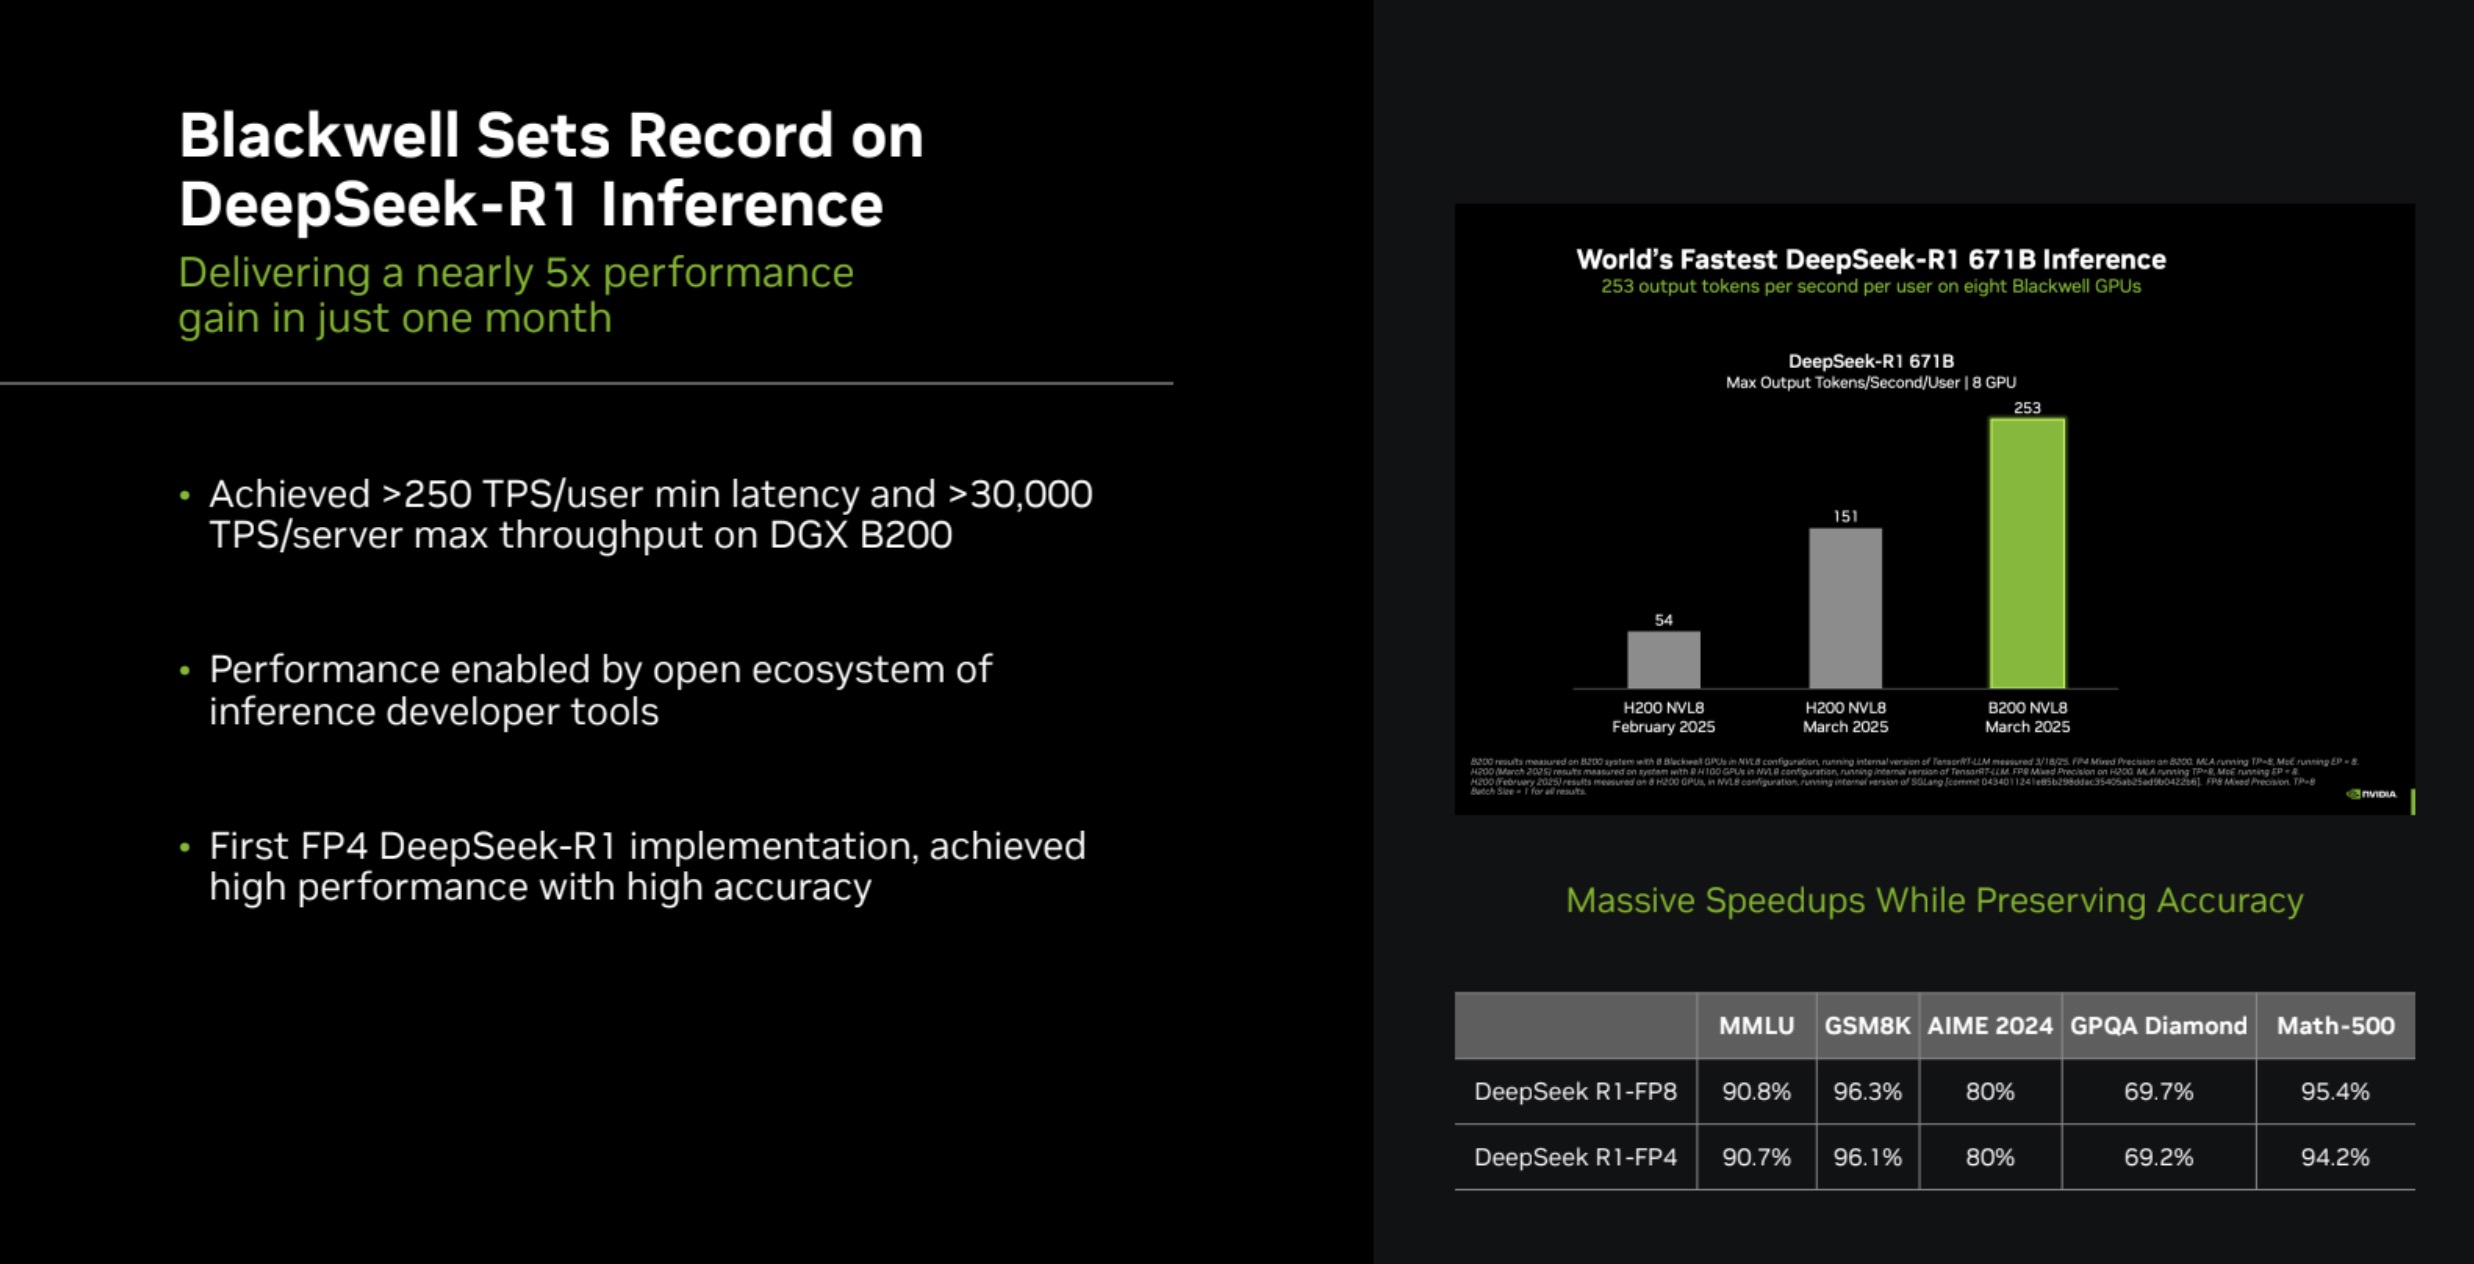
Источник изображения: NVIDIA NVIDIA назвала «дезагрегированное обслуживание» одним из ключевых факторов успеха, помимо аппаратных улучшений при переходе к Blackwell Ultra. Также свою роль сыграло использованием фирменного 4-бит формата NVFP4. «Мы можем обеспечить точность, сопоставимую с BF16», — сообщила компания, добавив, что при этом потребляется значительно меньше вычислительной мощности. Для работы с контекстом NVIDIA готовит соускоритель Rubin CPX. В более компактных бенчмарках решения NVIDIA также продемонстрировали рекордную пропускную способность. Компания сообщила о более чем 18 тыс. токенов/с на один ускоритель в бенчмарке Llama 3.1 8B в автономном режиме и 5667 токенов/с на один ускоритель в Whisper. Результаты были представлены в офлайн-, серверных и интерактивных сценариях, при этом NVIDIA сохранила лидерство в расчете на GPU во всех категориях. 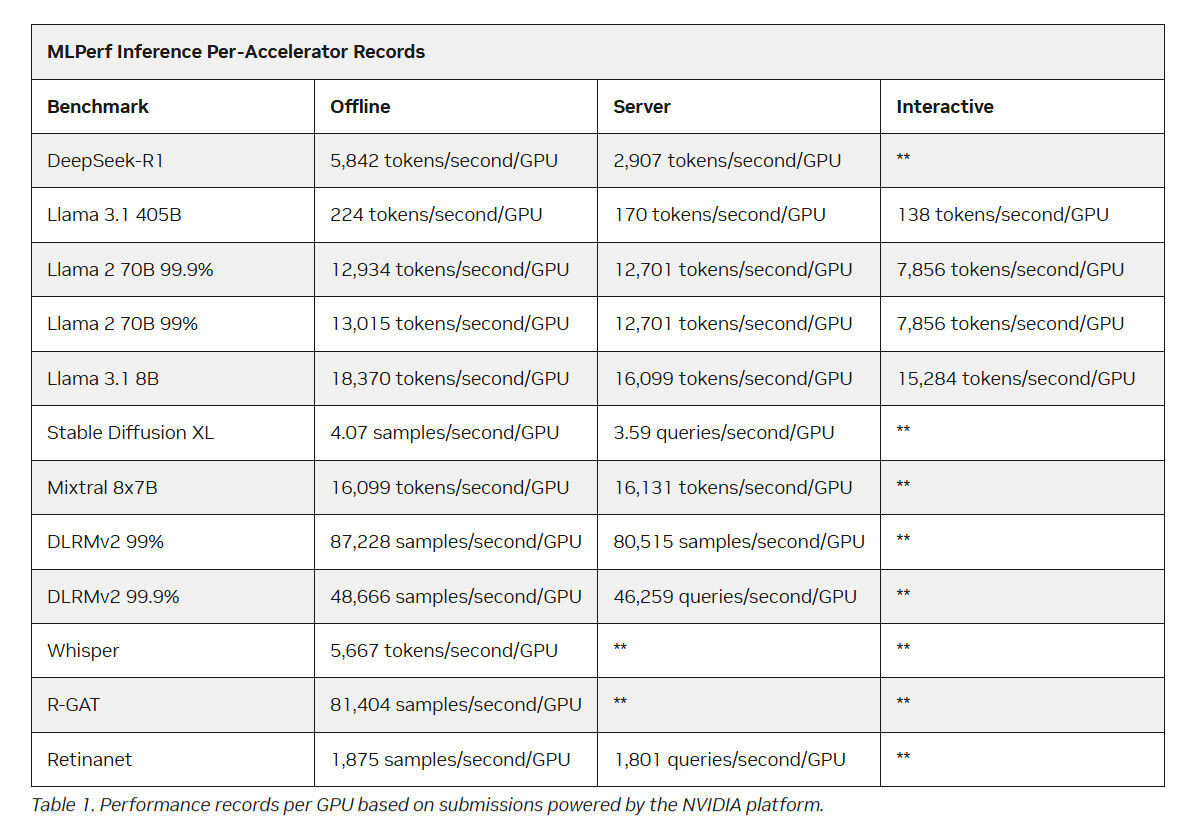
Источник изображения: NVIDIA/TechPowerUp AMD представила результаты AMD Instinct MI355X только в «открытой» категории, где разрешены программные модификации модели. Ускоритель MI355X превзошёл в бенчмарке Llama 2 70B ускоритель MI325X в 2,7 раза по количеству токенов/с. В этом раунде AMD также впервые обнародовала результаты нескольких новых рабочих нагрузок, включая Llama 2 70B Interactive, MoE-модель Mixtral-8x7B и генератор изображений Stable Diffusion XL. 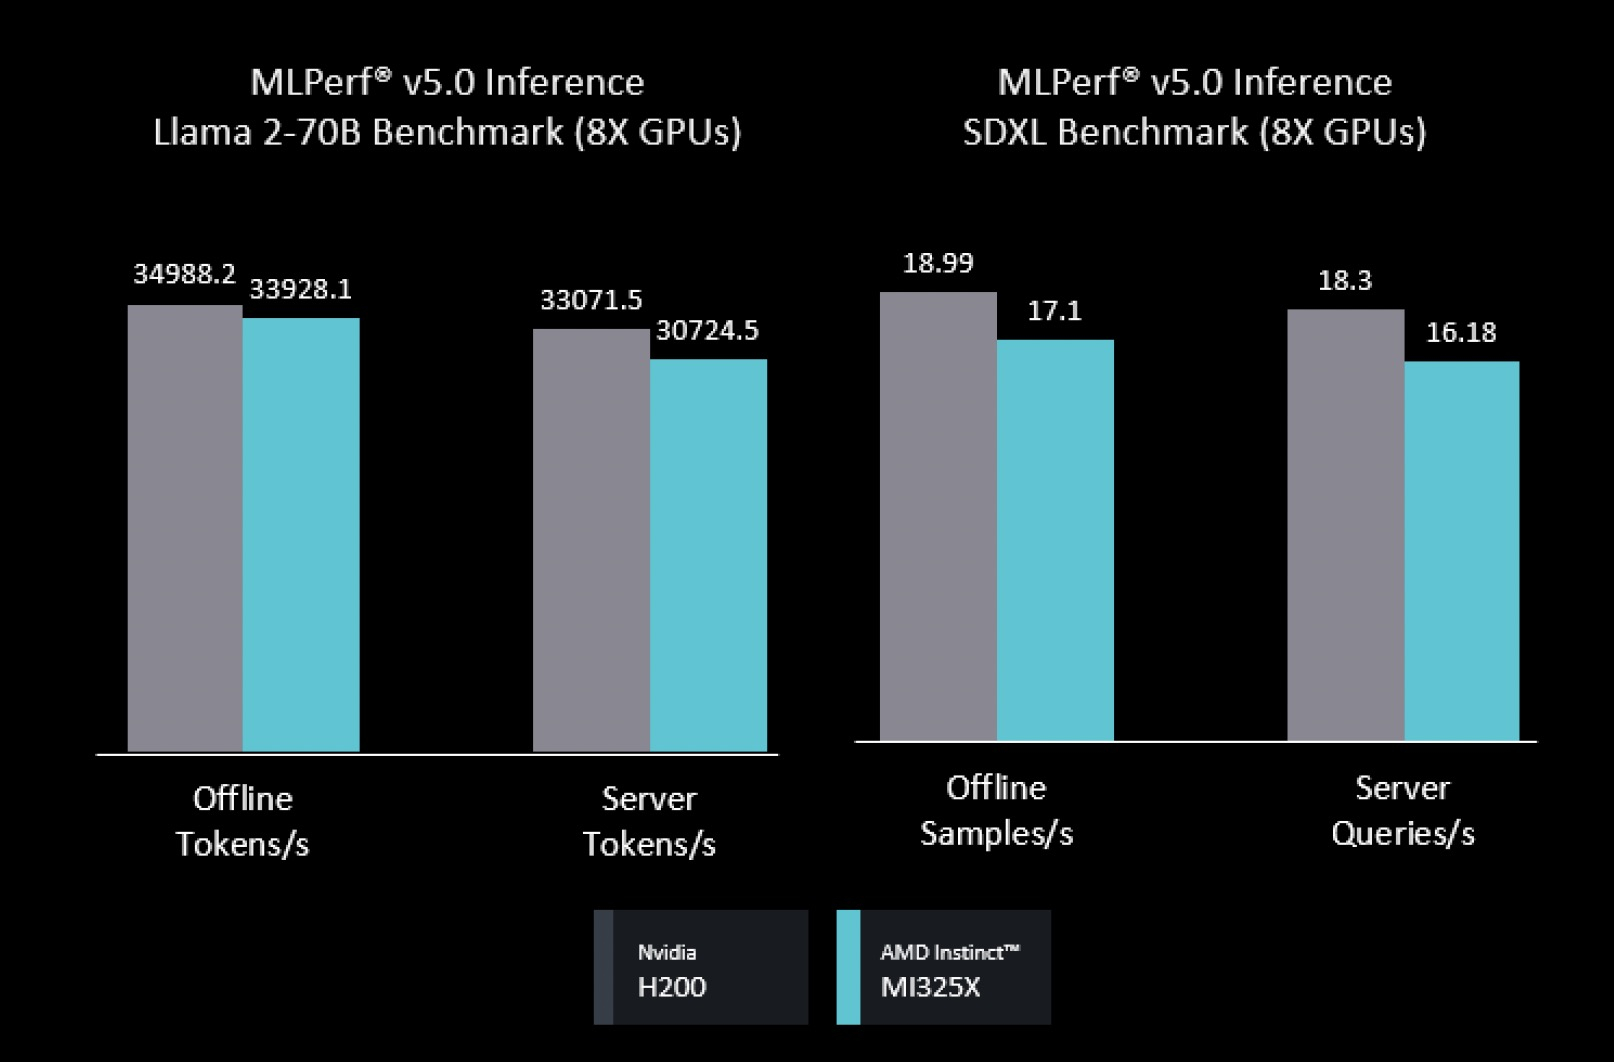
Источник изображения: AMD/ServeTheHome В число «закрытых» заявок AMD входили системы на базе ускорителей AMD MI300X и MI325X. Более продвинутый MI325X показал результаты, схожие с показателями систем на базе NVIDIA H200 на Llama 2 70b, в комбинированном тесте MoE и тестах генерации изображений. Кроме того, компанией была представлена первая гибридная заявка, в которой ускорители AMD MI300X и MI325X использовались для одной и той же задачи инференса — бенчмарка на базе Llama 2 70b. Возможность распределения нагрузки между различными типами ускорителей — важный шаг, отметил IEEE Spectrum. В этом раунде впервые был представлен и ускоритель Intel Arc Pro. Для бенчмарков использовалась видеокарта MaxSun Intel Arc Pro B60 Dual 48G Turbo, состоящая из двух GPU с 48 Гбайт памяти, в составе платформы Project Battlematrix, которая может включать до восьми таких ускорителей. Система показала результаты на уровне NVIDIA L40S в небольшом тесте LLM и уступила ему в тесте Llama 2 70b. 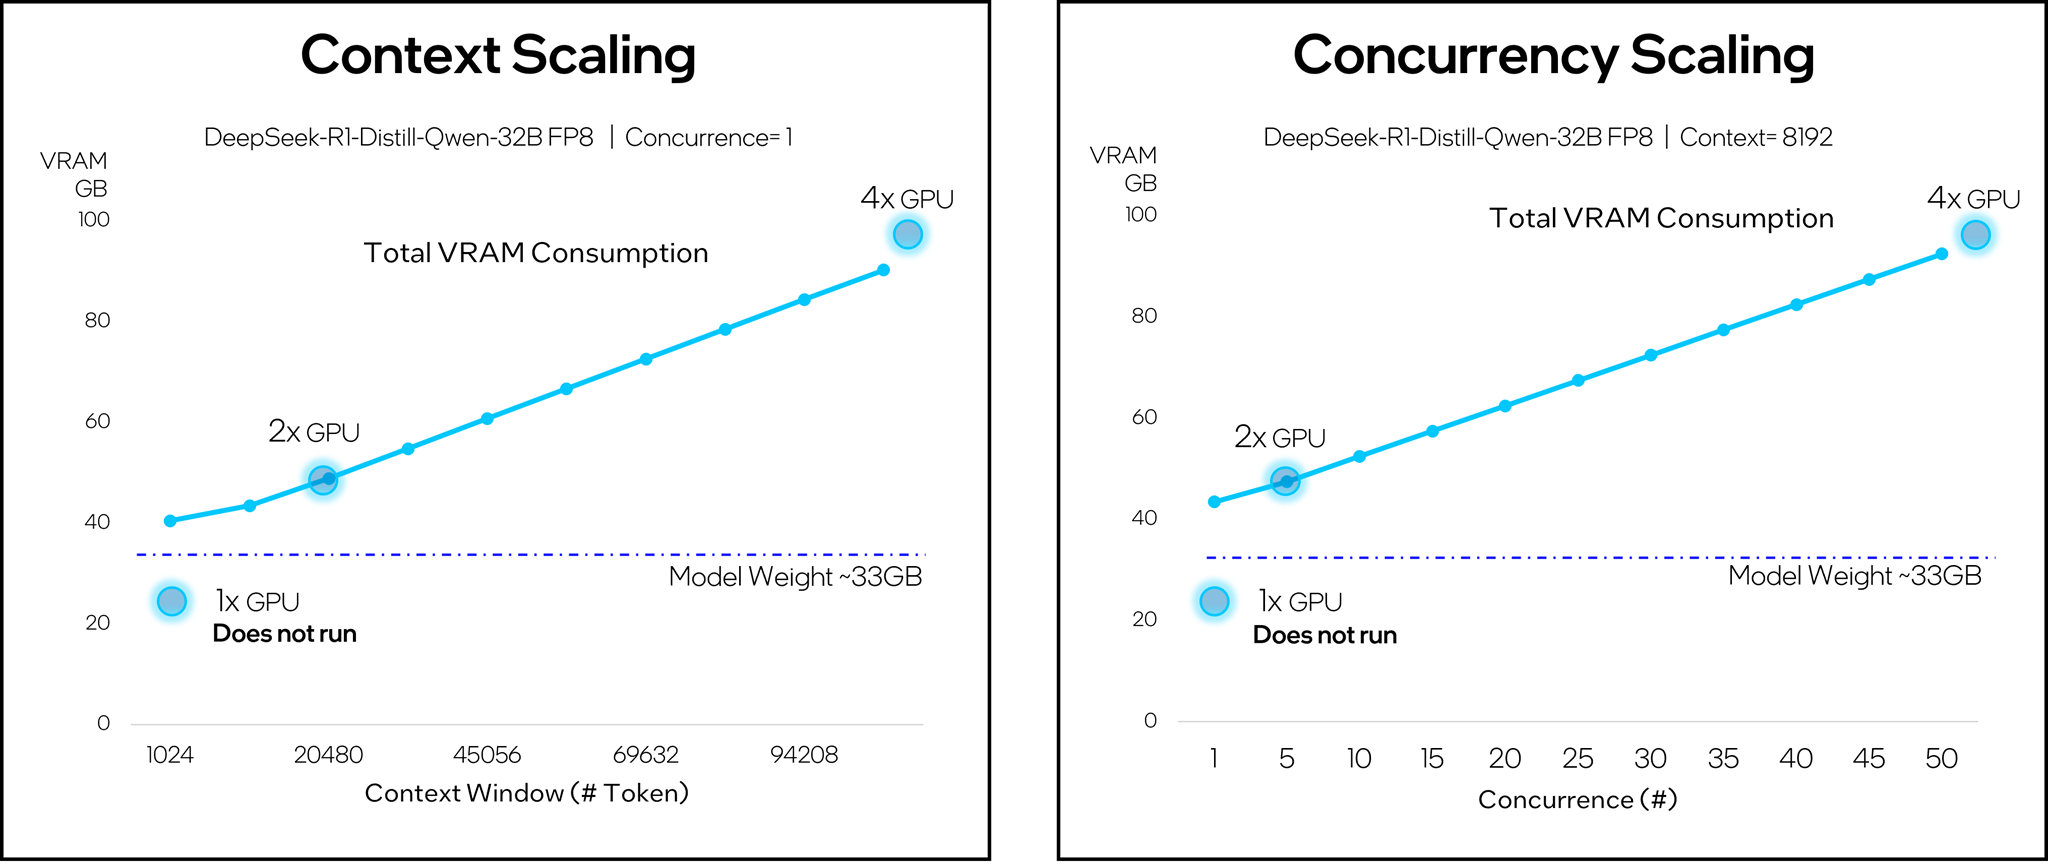
Источник изображения: Intel Следует также отметить, что в этом раунде, как и в предыдущем, участвовала Nebius (ранее Yandex N.V.). Компания отметила, что результаты, полученные на односерверных инсталляциях, подтверждают, что Nebius AI Cloud обеспечивает «высочайшие» показатели производительности для инференса базовых моделей, таких как Llama 2 70B и Llama 3.1 405B. В частности, Nebius AI Cloud установила новый рекорд производительности для NVIDIA GB200 NVL72. По сравнению с лучшими результатами предыдущего раунда, её однохостовая инсталляция показала прирост производительности на 6,7 % и 14,2 % при работе с Llama 3.1 405B в автономном и серверном режимах соответственно. «Эти два показателя также обеспечивают Nebius первое место среди других разработчиков MLPerf Inference v5.1 для этой модели в системах GB200», — сообщила компания.
07.06.2025 [16:24], Владимир Мироненко
AMD впервые приняла участие в бенчмарке MLPerf Training, но до рекордов NVIDIA ей ещё очень далекоКонсорциум MLCommons объявил новые результаты бенчмарка MLPerf Training v5.0, отметив быстрый рост и эволюцию в области ИИ, а также рекордное количество общих заявок и увеличение заявок для большинства тестов по сравнению с бенчмарком v4.1. MLPerf Training v5.0 предложил новый бенчмарк предварительной подготовки большой языковой модели на основе Llama 3.1 405B, которая является самой большой ИИ-моделью в текущем наборе тестов обучения. Он заменил бенчмарк на основе gpt3 (gpt-3-175B), входивший в предыдущие версии MLPerf Training. Целевая группа MLPerf Training выбрала его, поскольку Llama 3.1 405B является конкурентоспособной моделью, представляющей современные LLM, включая последние обновления алгоритмов и обучение на большем количестве токенов. Llama 3.1 405B более чем в два раза больше gpt3 и использует в четыре раза большее контекстное окно. Несмотря на то, что бенчмарк на основе Llama 3.1 405B был представлен только недавно, на него уже подано больше заявок, чем на предшественника на основе gpt3 в предыдущих раундах, отметил консорциум. 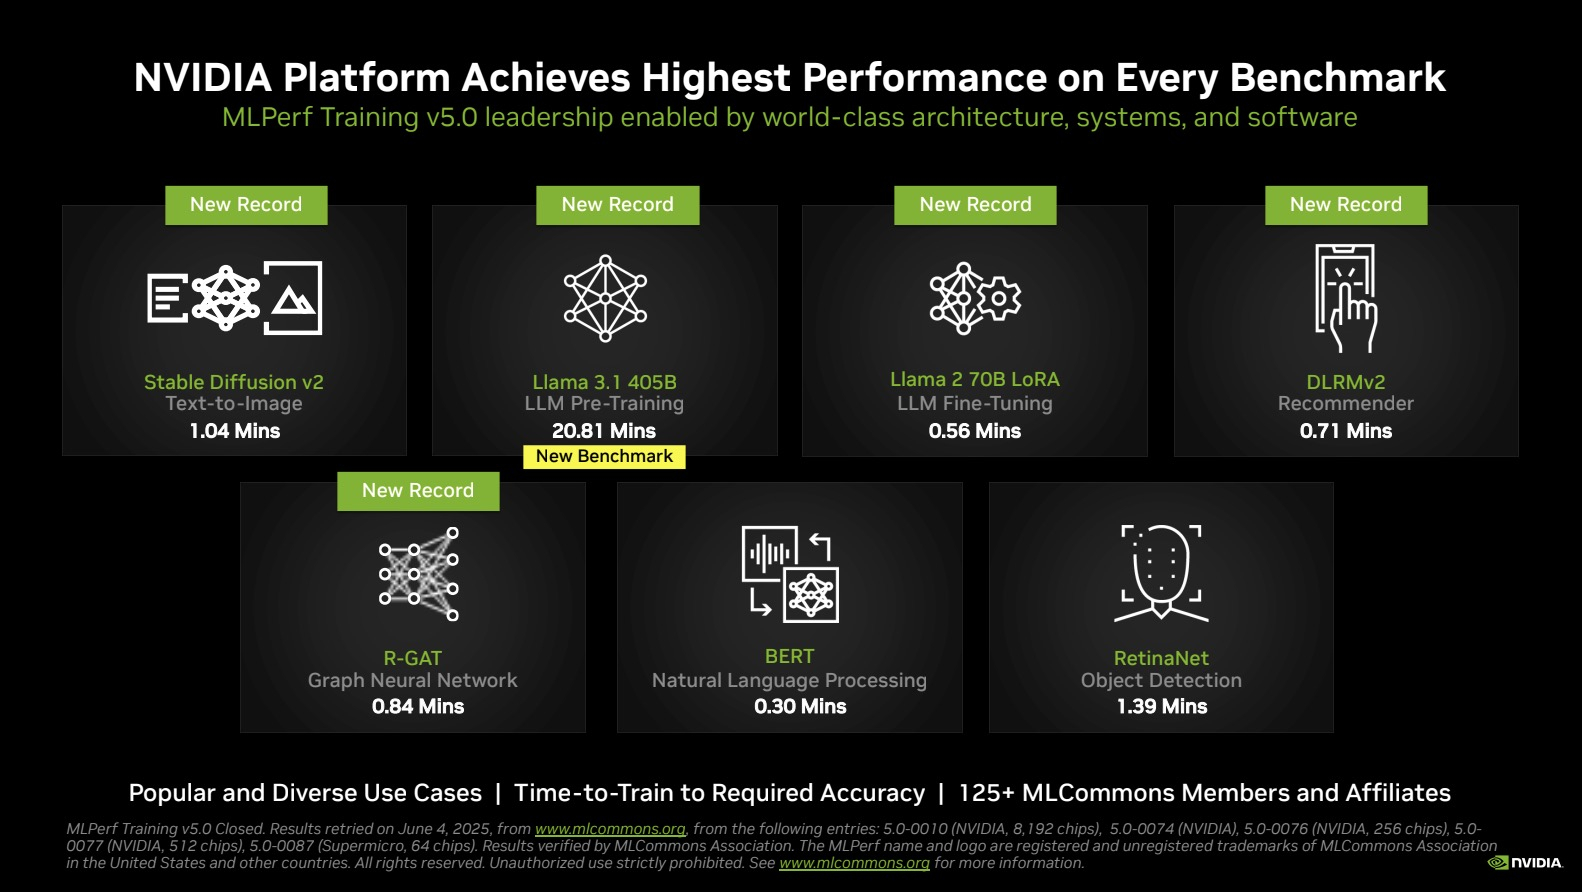
Источник изображения: NVIDIA MLCommons сообщил, что рабочая группа MLPerf Training регулярно добавляет новые рабочие нагрузки в набор тестов, чтобы гарантировать, что он отражает тенденции отрасли. Результаты бенчмарка Training 5.0 показывают заметный рост производительности для новых бенчмарков, что указывает на то, что отрасль отдаёт приоритет новым рабочим нагрузкам обучения, а не старым. Тест Stable Diffusion показал увеличение скорости в 2,28 раза для восьмичиповых систем по сравнению с версией 4.1, вышедшей шесть месяцев назад, а тест Llama 2.0 70B LoRA увеличил скорость в 2,10 раза по сравнению с версией 4.1; оба превзошли исторические ожидания роста производительности вычислений с течением времени в соответствии с законом Мура. Более старые тесты в наборе показали более скромные улучшения производительности. 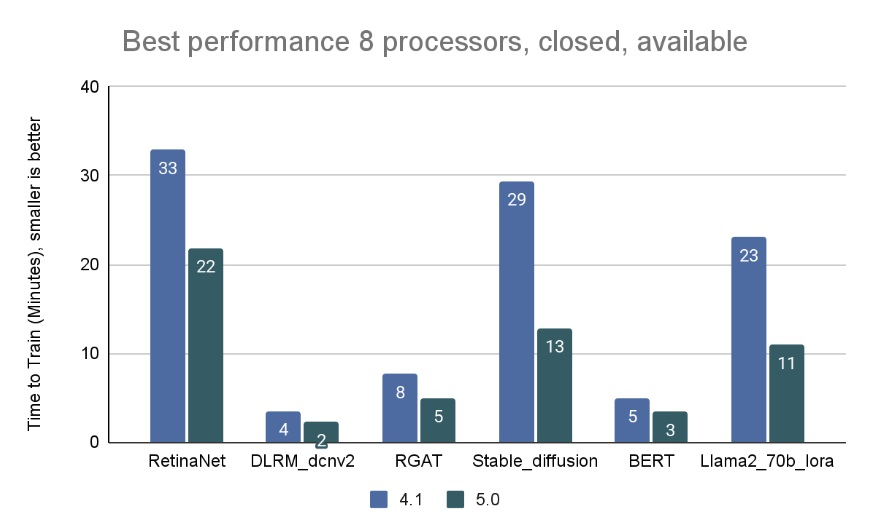
Источник изображений: MLCommons На многоузловых 64-чиповых системах тест RetinaNet показал ускорение в 1,43 раза по сравнению с предыдущим раундом тестирования v3.1 (самым последним, включающим сопоставимые масштабные системы), в то время как тест Stable Diffusion показал резкое увеличение в 3,68 раза. «Это признак надёжного цикла инноваций в технологиях и совместного проектирования: ИИ использует преимущества новых систем, но системы также развиваются для поддержки высокоприоритетных сценариев», — говорит Шрия Ришаб (Shriya Rishab), сопредседатель рабочей группы MLPerf Training. 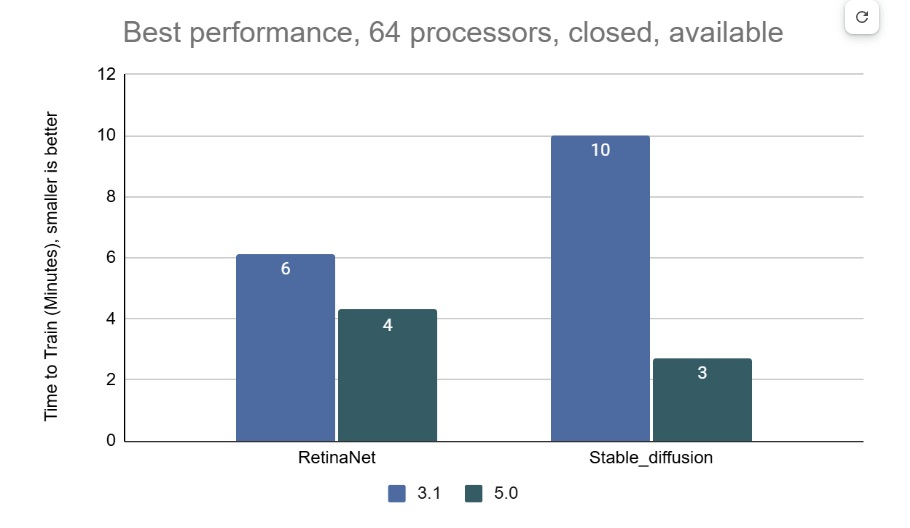 В заявках на MLPerf Training 5.0 использовалось 12 уникальных чиповых, все в категории коммерчески доступных. Пять из них стали общедоступными с момента выхода последней версии набора тестов MLPerf Training:
Заявки также включали три новых семейства процессоров:
Кроме того, количество представленных многоузловых систем увеличилось более чем в 1,8 раза по сравнению с версией бенчмарка 4.1. Хиуот Касса (Hiwot Kassa), сопредседатель рабочей группы MLPerf Training, отметил растущее число провайдеров облачных услуг, предлагающих доступ к крупномасштабным системам, что делает доступ к обучению LLM более демократичным. 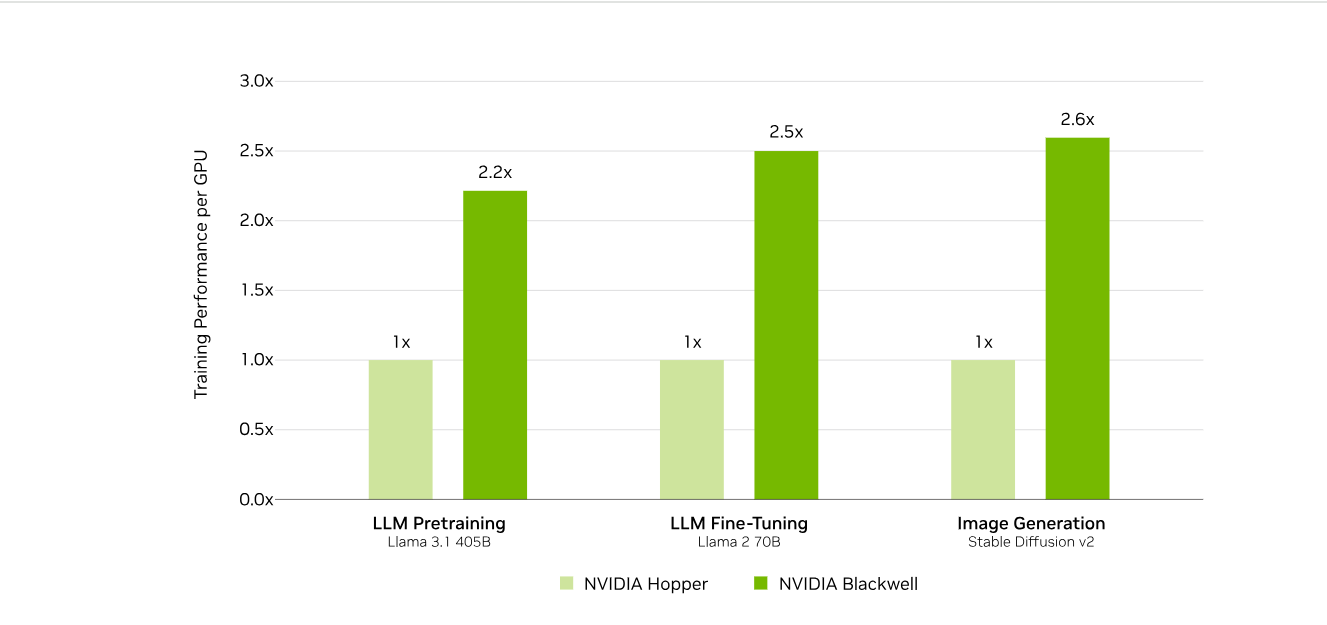
Источник изображений: NVIDIA Последние результаты MLPerf Training 5.0 от NVIDIA показывают, что её ускорители Blackwell GB200 демонстрируют рекордные результаты по времени обучения, демонстрируя, как стоечная конструкция «ИИ-фабрики» компании может быстрее, чем раньше, превращать «сырые» вычислительные мощности в развёртываемые модели, пишет ресурс HPCwire. Раунд MLPerf Training v5.0 включает 201 результат от 20 организаций-участников: AMD, ASUS, Cisco, CoreWeave, Dell, GigaComputing, Google Cloud, HPE, IBM, Krai, Lambda, Lenovo, MangoBoost, Nebius, NVIDIA, Oracle, QCT, SCITIX, Supermicro и TinyCorp. «Мы бы особенно хотели поприветствовать впервые подавших заявку на участие в MLPerf Training AMD, IBM, MangoBoost, Nebius и SCITIX, — сказал Дэвид Кантер (David Kanter), руководитель MLPerf в MLCommons. — Я также хотел бы выделить первый набор заявок Lenovo на результаты тестов энергопотребления в этом раунде — энергоэффективность в системе обучения ИИ-систем становится всё более важной проблемой, требующей точного измерения». 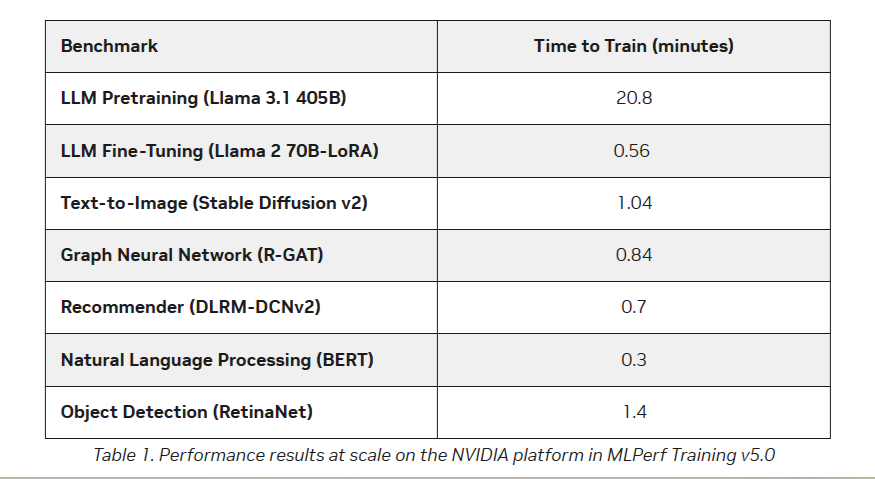 NVIDIA представила результаты кластера на основе систем GB200 NVL72, объединивших 2496 ускорителей. Работая с облачными партнерами CoreWeave и IBM, компания сообщила о 90-% эффективности масштабирования при расширении с 512 до 2496 ускорителей. Это отличный результат, поскольку линейное масштабирование редко достигается при увеличении количества ускорителей за пределами нескольких сотен. Эффективность масштабирования в диапазоне от 70 до 80 % уже считается солидным результатом, особенно при увеличении количества ускорителей в пять раз, пишет HPCwire. В семи рабочих нагрузках в MLPerf Training 5.0 ускорители Blackwell улучшили время сходимости «до 2,6x» при постоянном количестве ускорителей по сравнению с поколением Hopper (H100). Самый большой рост наблюдался при генерации изображений и предварительном обучении LLM, где количество параметров и нагрузка на память самые большие. 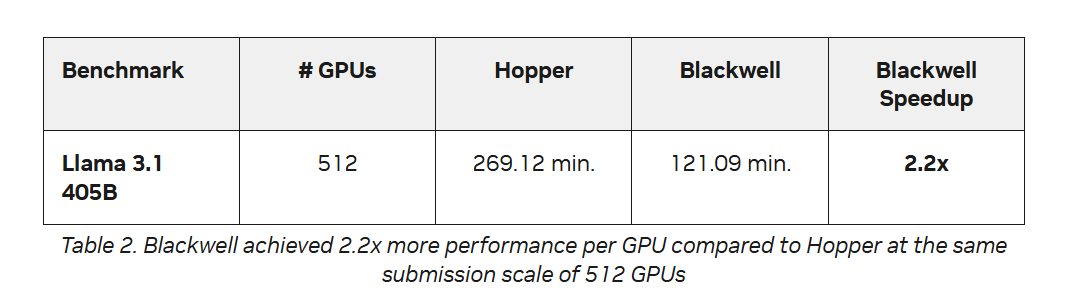 Хотя в бенчмарке проверялась скорость выполнения операций, NVIDIA подчеркнула, что более быстрое выполнение задач означает меньшее время аренды облачных инстансов и более скромные счета за электроэнергию для локальных развёртываний. Хотя компания не публиковала данные об энергоэффективности в этом бенчмарке, она позиционировала Blackwell как «более экономичное» решение на основе достигнутых показателей, предполагая, что усовершенствования дизайна тензорных ядер обеспечивают лучшую производительность на Ватт, чем у поколения Hopper. Также HPCwire отметил, что NVIDIA была единственным поставщиком, представившим результаты бенчмарка предварительной подготовки LLM на основе Llama 3.1 405B, установив начальную точку отсчёта для обучения с 405 млрд параметров. Это важно, поскольку некоторые компании уже выходят за рамки 70–80 млрд параметров для передовых ИИ-моделей. Демонстрация проверенного рецепта работы с 405 млрд параметров даёт компаниям более чёткое представление о том, что потребуется для создания ИИ-моделей следующего поколения. 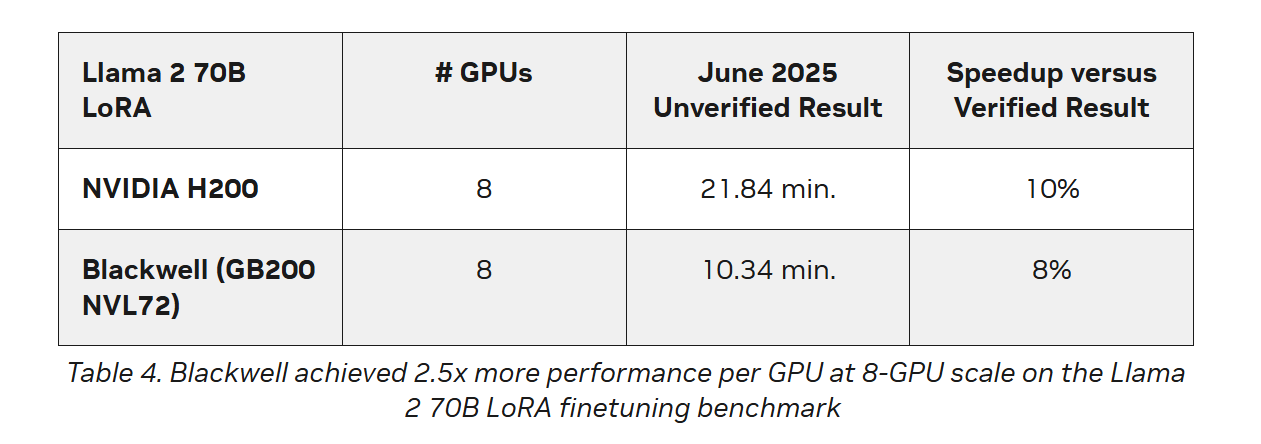 В ходе пресс-конференции Дэйв Сальватор (Dave Salvator), директор по ускоренным вычислительным продуктам в NVIDIA, ответил на распространенный вопрос: «Зачем фокусироваться на обучении, когда в отрасли в настоящее время все внимание сосредоточено на инференсе?». Он сообщил, что тонкая настройка (после предварительного обучения) остается ключевым условием для реальных LLM, особенно для предприятий, использующих собственные данные. Он обозначил обучение как «фазу инвестиций», которая приносит отдачу позже в развёртываниях с большим объёмом инференса. Этот подход соответствует более общей концепции «ИИ-фабрики» компании, в рамках которой ускорителям даются данные и питание для обучения моделей. А затем производятся токены для использования в реальных приложениях. К ним относятся новые «токены рассуждений» (reasoning tokens), используемые в агентских ИИ-системах. 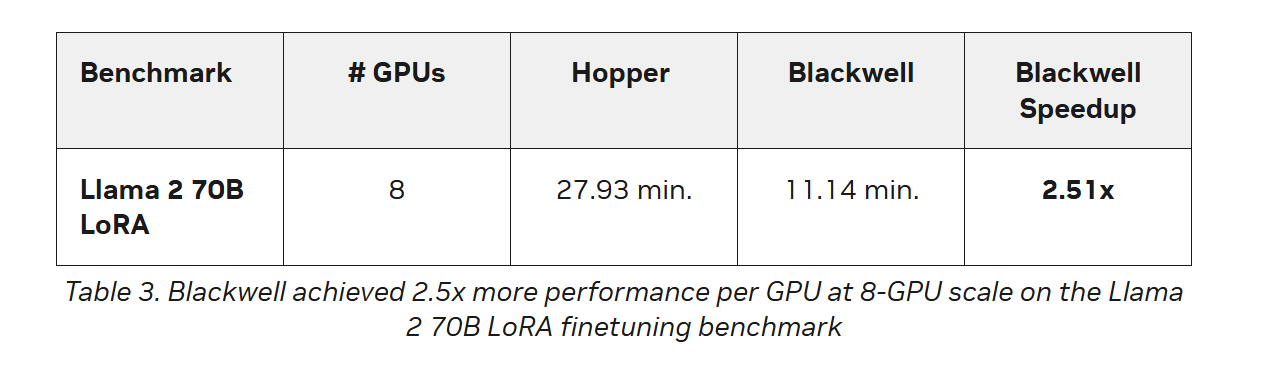
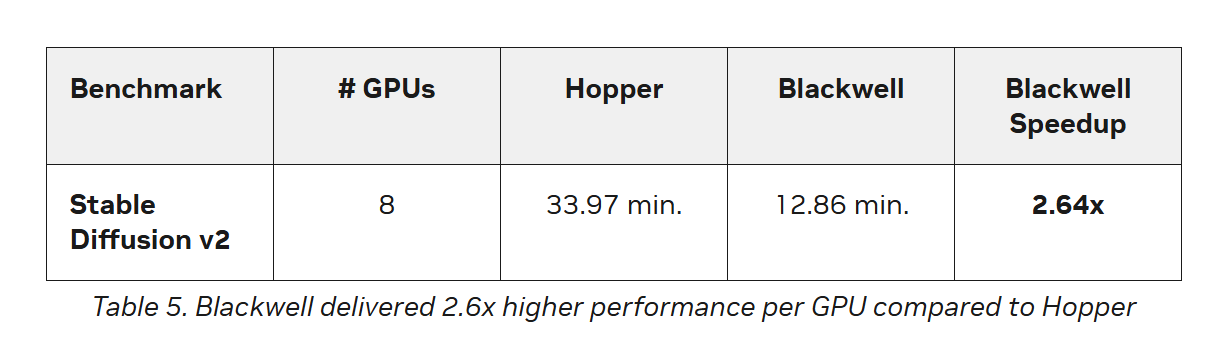 NVIDIA также повторно представила результаты по Hopper, чтобы подчеркнуть, что H100 остаётся «единственной архитектурой, кроме Blackwell», которая показала лидерские показатели по всему набору MLPerf Training, хотя и уступила Blackwell. Поскольку инстансы на H100 широко доступны у провайдеров облачных сервисов, компания, похоже, стремится заверить клиентов, что существующие развёртывания по-прежнему имеют смысл. 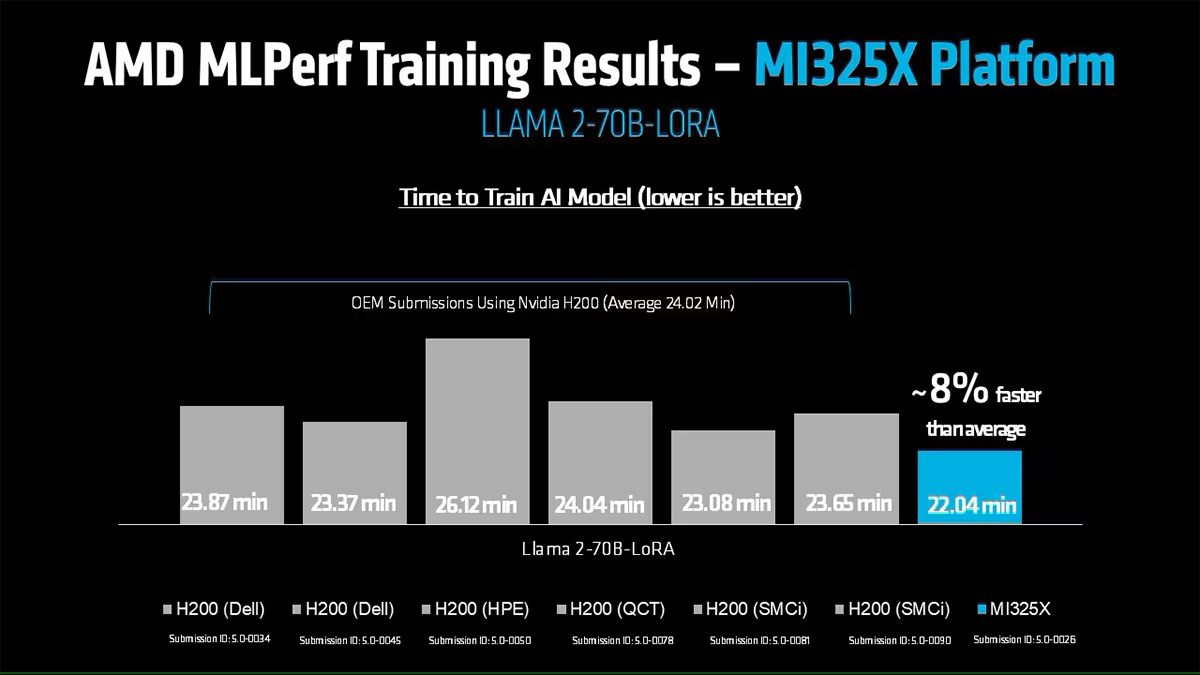
Источник изображений: AMD AMD, со своей стороны, продемонстрировала прирост производительности поколения чипов. В тесте Llama2 70B LoRA она показала 30-% прирост производительности AMD Instinct MI325X по сравнению с предшественником MI300X. Основное различие между ними заключается в том, что MI325X оснащён почти на треть более быстрой памятью. 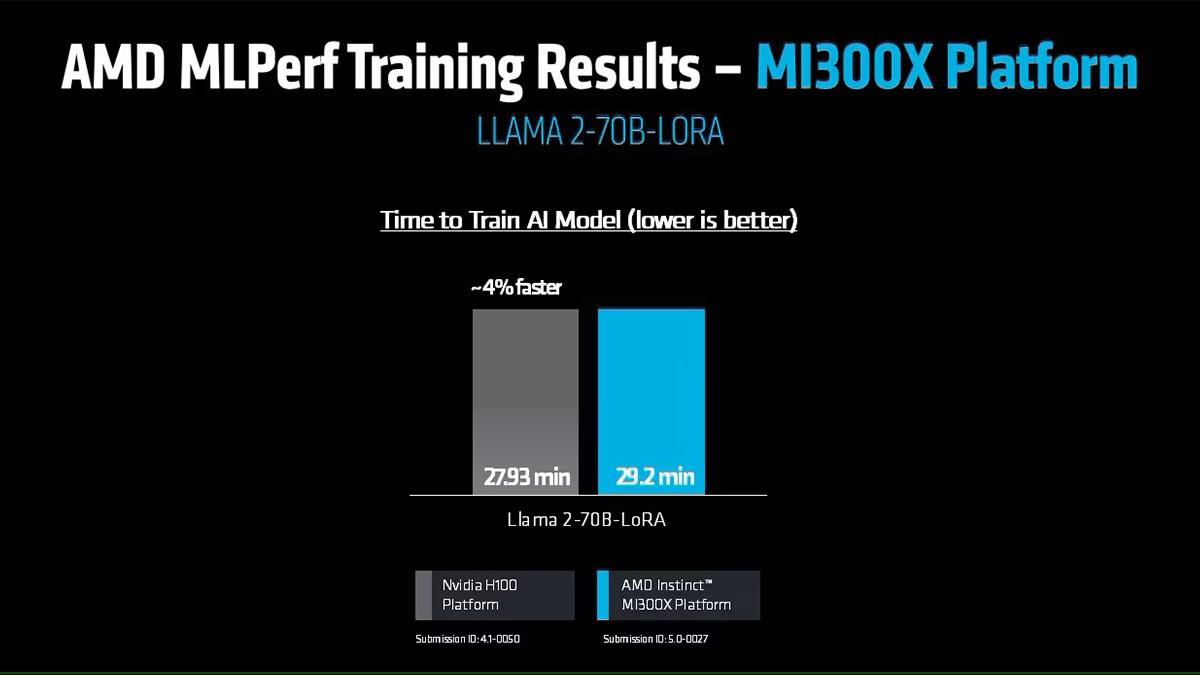 В самом популярном тесте, тонкой настройке LLM, AMD продемонстрировала, что её новейший ускоритель Instinct MI325X показывает результаты наравне с NVIDIA H200. Это говорит о том, что AMD отстает от NVIDIA на одно поколение, отметил ресурс IEEE Spectrum. 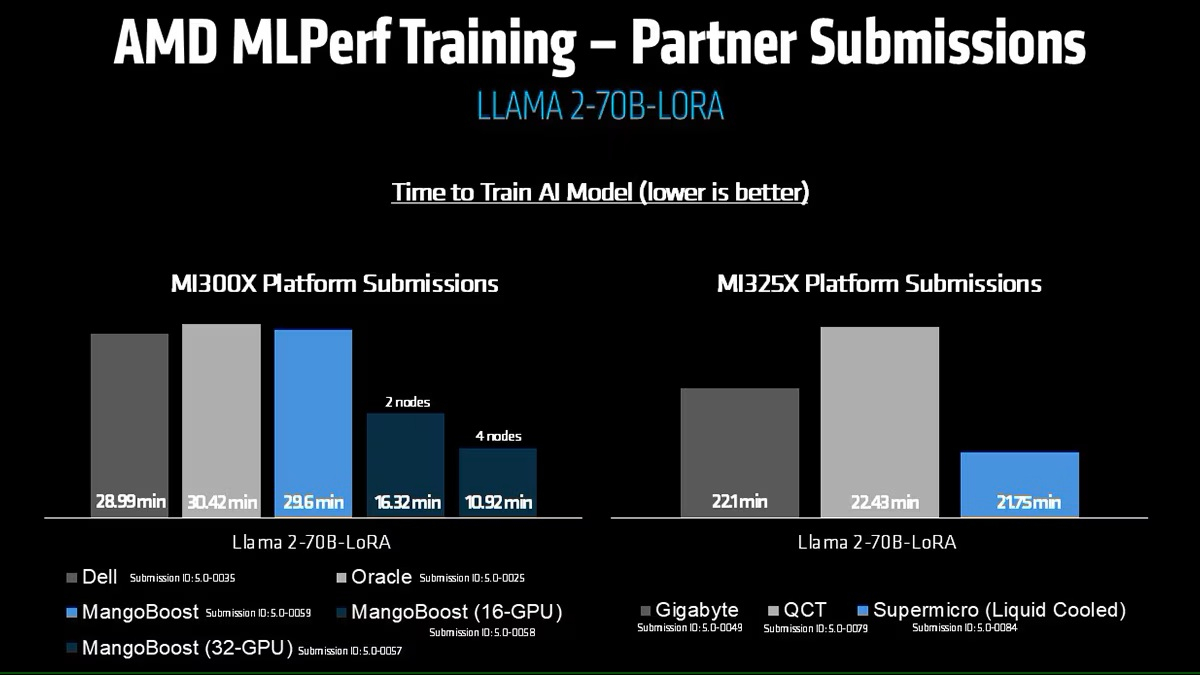 AMD впервые представила результаты MLPerf Training, хотя в предыдущие годы другие компании представляли результаты в этом тесте, используя ускорители AMD. В свою очередь, Google представила результаты лишь одного теста, задачи генерации изображений, с использованием Trillium TPU. Тест MLPerf также включает тест на энергопотребление, измеряющий, сколько энергии уходит на выполнение каждой задачи обучения. В этом раунде лишь Lenovo включила измерение этого показателя в свою заявку, что сделало невозможным сравнение между компаниями. Для тонкой настройки LLM на двух ускорителях Blackwell требуется 6,11 ГДж или 1698 КВт·ч — примерно столько энергии уходит на обогрев небольшого дома зимой.
21.05.2025 [10:39], Владимир Мироненко
GPU-маркетплейс NVIDIA DGX Cloud Lepton упростит доступ к дефицитным ИИ-ускорителямNVIDIA анонсировала GPU-маркетплейс NVIDIA DGX Cloud Lepton, которая позволит разработчикам со всего мира, создающим агентские и другие ИИ-приложения использовать NVIDIA Blackwell и другие модели ускорителей в глобальной сети партнёрских облаков (NCP): CoreWeave, Crusoe, Firmus, Foxconn, GMI Cloud, Lambda, Nebius, Nscale, Softbank и Yotta Data Services. Ожидается, что ведущие провайдеры облачных услуг и другие GPU-маркетплейсы также присоединятся к DGX Cloud Lepton. Разработчики смогут использовать вычислительные мощности ускорителй в определённых регионах как для вычислений по требованию, так и на постоянной основе. «NVIDIA DGX Cloud Lepton свяжет нашу сеть глобальных поставщиков облачных GPU с разработчиками в сфере ИИ, — заявил основатель и генеральный директор NVIDIA Дженсен Хуанг (Jensen Huang). — Вместе с нашими NCP мы строим ИИ-фабрику планетарного масштаба». По замыслу NVIDIA, платформа DGX Cloud Lepton поможет решить критическую задачу обеспечения разработчиков надёжными, высокопроизводительными ресурсами ускорителей путём унификации доступа к облачным ИИ-сервисам и мощностям собственных ускорителей. Платформа интегрирована с программным стеком NVIDIA, включая микросервисы NIM и NeMo, Blueprints и Cloud Functions. 
Источник изображений: NVIDIA В числе основных преимуществ новой платформы компания назвала:
А для самих провайдеров, участвующих в DGX Cloud Lepton, предоставляется ПО для управления, которое обеспечивает диагностику состояния ускорителей в реальном времени и автоматизирует анализ первопричин возникших проблем, избавляя от ручной диагностики и сокращая время простоев. 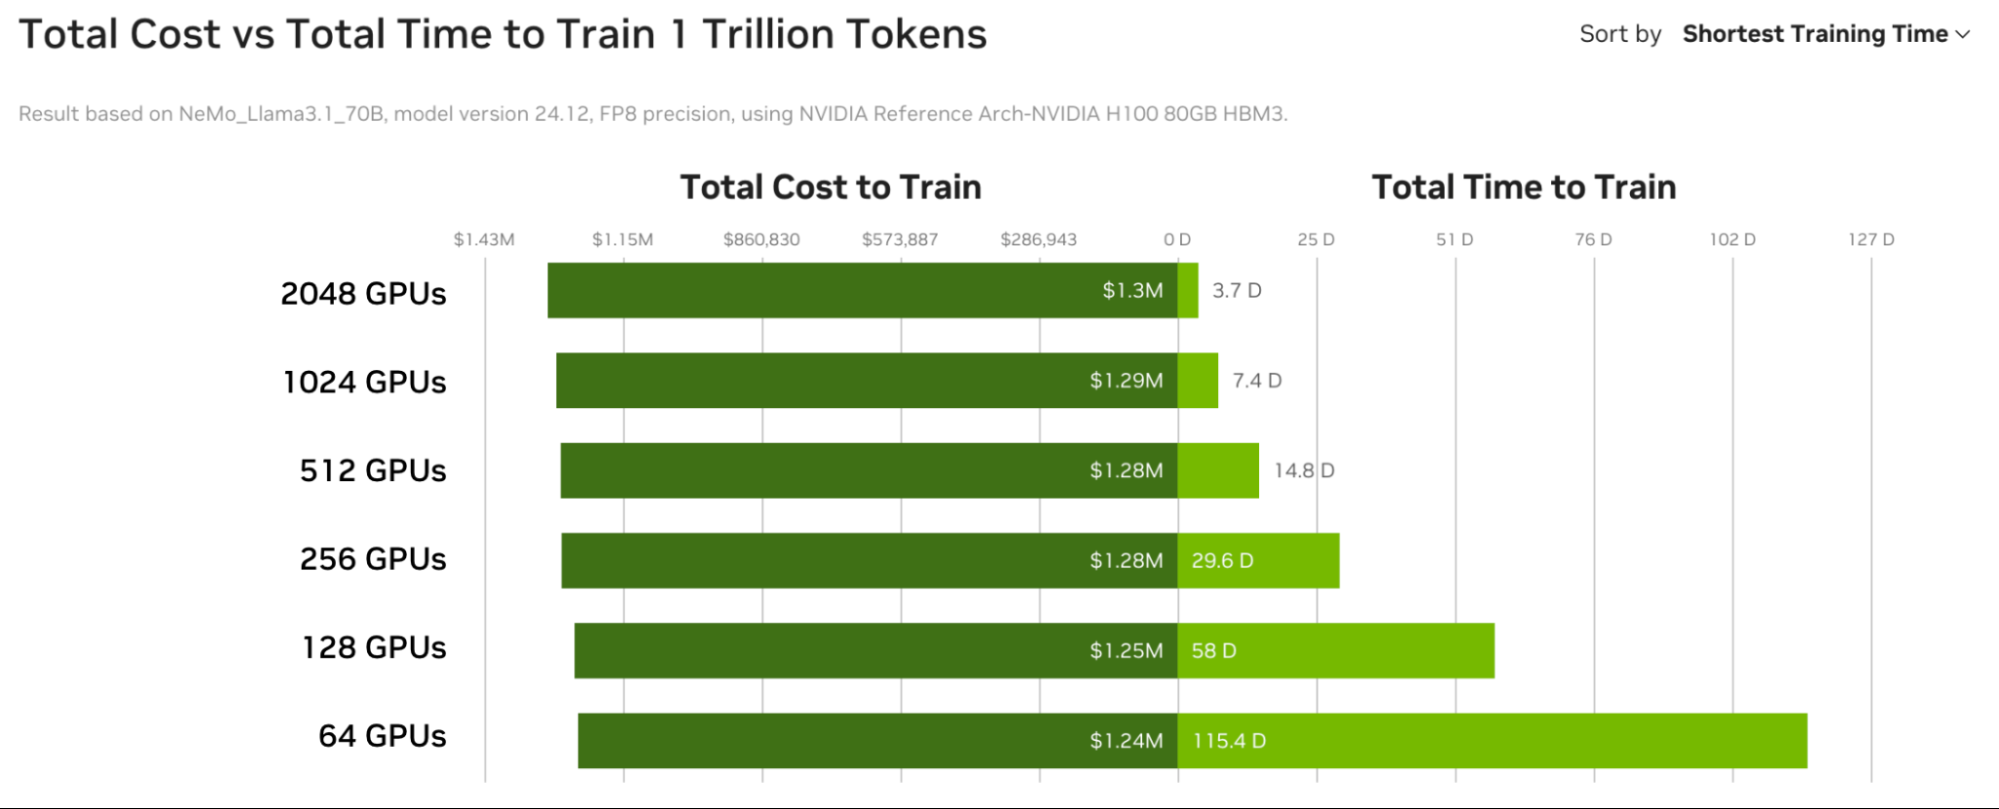 NVIDIA также анонсировала инициативу Exemplar Clouds, предназначенную для стандартизации прозрачного сравнительного анализа облачной ИИ-инфраструктуры. Это предложение должно решить серьёзную проблему, с которой сталкиваются разработчики и предприятия, развёртывающие рабочие ИИ-нагрузки — прогнозирование эффективности, надёжности и ценовой эффективности облачной платформы. Exemplar Clouds использует NVIDIA DGX Cloud Benchmarking, комплексный набор инструментов и рекомендаций для оптимизации производительности облачных ИИ-нагрузок и количественной оценки связи между стоимостью и производительностью. |
|

