Материалы по тегу: инференс
|
18.09.2026 [17:40], Владимир Мироненко
Вглубь и вширь: Cornelis анонсировала архитектуру Active Compute FabricCornelis представила Active Compute Fabric — открытую архитектуру, охватывающую сетевые системы класса scale-up (вертикальное масштабирование) и scale-out (горизонтальное масштабирование) и включающую встроенные средства программируемых вычислений. В настоящее время ИИ-кластеры выросли до многих тысяч GPU. Количество параметров в моделях увеличилось с миллиардов до триллионов. Однако фундаментальное поведение большинства сетей ЦОД не эволюционировало так быстро — они в основном перемещают данные из точки А в точку Б, обеспечивая максимально надёжную передачу. Современные рабочие ИИ-нагрузки не всегда ведут себя как традиционные HPC и другие распределённые приложения. В них доминируют синхронизация, коллективные операции и зависимости, а также значительный трафик между серверами (east-west). Когда сеть не справляется с огромными требованиями к пропускной способности таких рабочих нагрузок, ускорители часто простаивают, иногда в течение длительного времени. Проблему простоя поставщики пытаются решить преимущественно за счёт увеличения пропускной способности, а не изменения принципов работы самой сетевой инфраструктуры. «ИИ-инфраструктура достигла того этапа, когда одного лишь повышения быстродействия конечных узлов уже недостаточно. Сетевая фабрика должна стать активным компонентом вычислительной системы», — заявила Лиза Спелман (Lisa Spelman), генеральный директор Cornelis. 
Источник изображений: Cornelis Networks Архитектура Active Compute Fabric переносит программируемые вычислительные функции непосредственно на уровень сети. Сетевая фабрика может производить манипуляции над данными прямо во время передачи: собирать данные KV-кеша для дезагрегированного инференса, координировать распределение экспертов для моделей MoE, ускорять коллективные операции, такие как AllReduce, и сжимать градиенты при передаче, разгружая вычислительные узлы, уменьшая накладные расходы на синхронизацию и отвечая за целостность передачи данных. При этом она может брать на себя новые функции по мере развития алгоритмов ИИ и ПО. Нечто похожее, например, NVIDIA начала предлагать в InfiniBand несколько поколений назад (SHARP), но, по слухам, данная функциональность особой популярностью не пользуется. Cornelis опирается на открытые Ethernet-стандарты UALink для вертикального масштабирования и Ultra Ethernet — для горизонтального, что даёт поддержку широкого спектра ускорителей. Это важный фактор, поскольку компании всё больше диверсифицируют оборудование и технологии, используемые в своих ЦОД. Клиенты, использующие решения для ИИ, всё чаще обращаются к решениям стоечного масштаба, сталкиваясь при этом с проблемой привязки к конкретному поставщику, а Cornelis позиционирует себя как нейтральная, открытая альтернатива. Это явный кивок в сторону NVIDIA, хотя тот же UALink пока трудно назвать действительно зрелой технологией. 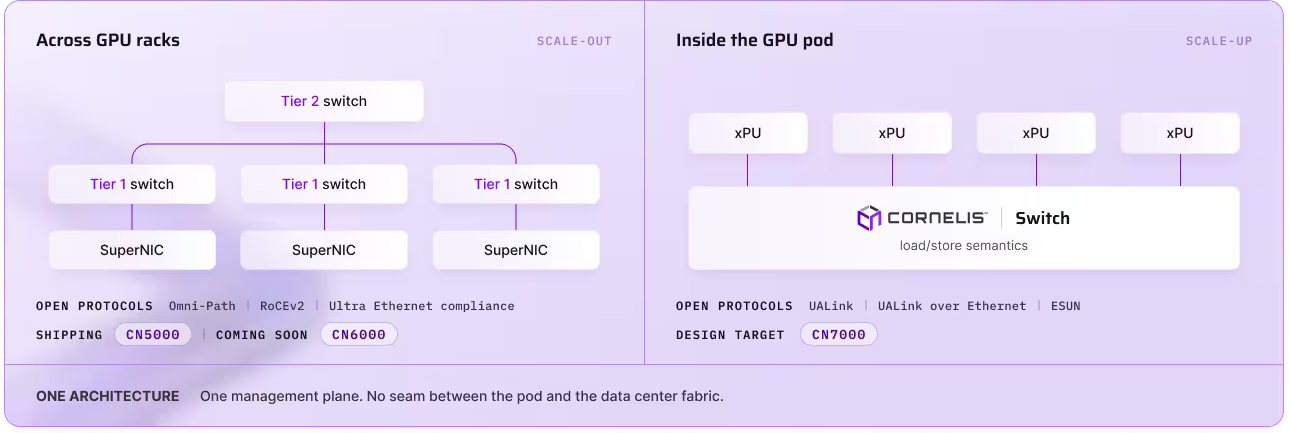 Видение Cornelis по поводу открытых и эффективных сетей, масштабируемых по принципу «масштабирование и расширение», разделяет Qualcomm, которая присоединилась к Cornelis на конференции AI Infra Summit. Cornelis отметила, что обе компании разделяют общее видение проблем, стоящих перед ИИ-инфраструктурой: использование пассивных сетевых архитектур, обеспечивающих лишь передачу данных, приводит к недогрузке вычислительных ускорителей, что напрямую сказывается на экономической эффективности процессов инференса. По мере перехода к созданию ИИ-систем стоечного масштаба, обе компании рассматривают сеть как ключевой элемент проектирования, а не как второстепенный компонент. Лиза Спелман отдельно отметила в интервью CRN схожесть подходов с Qualcomm: «Мы видим много общего в отношении проблем инфраструктуры ИИ, проблем, с которыми сталкиваются клиенты, и множество возможностей и потенциала для объединения наших технологий и решения этих проблем для клиентов <…> Мы считаем, что сейчас идеальное время для выхода на этот рынок. Ещё многое предстоит решить», — сказала Спелман. Как отметил CRN, проблема для Cornelis заключается в том, что NVIDIA более года продвигает свою собственную технологию интерконнекта NVLink Fusion как де-факто интерконнект для вертикального масштабирования. К альянсу уже присоединились Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel, d-Matrix и MediaTek. Это позволяет NVIDIA оставаться важнейшим поставщиком для рынка ИИ-инфраструктуры и открывает новый источник дохода. 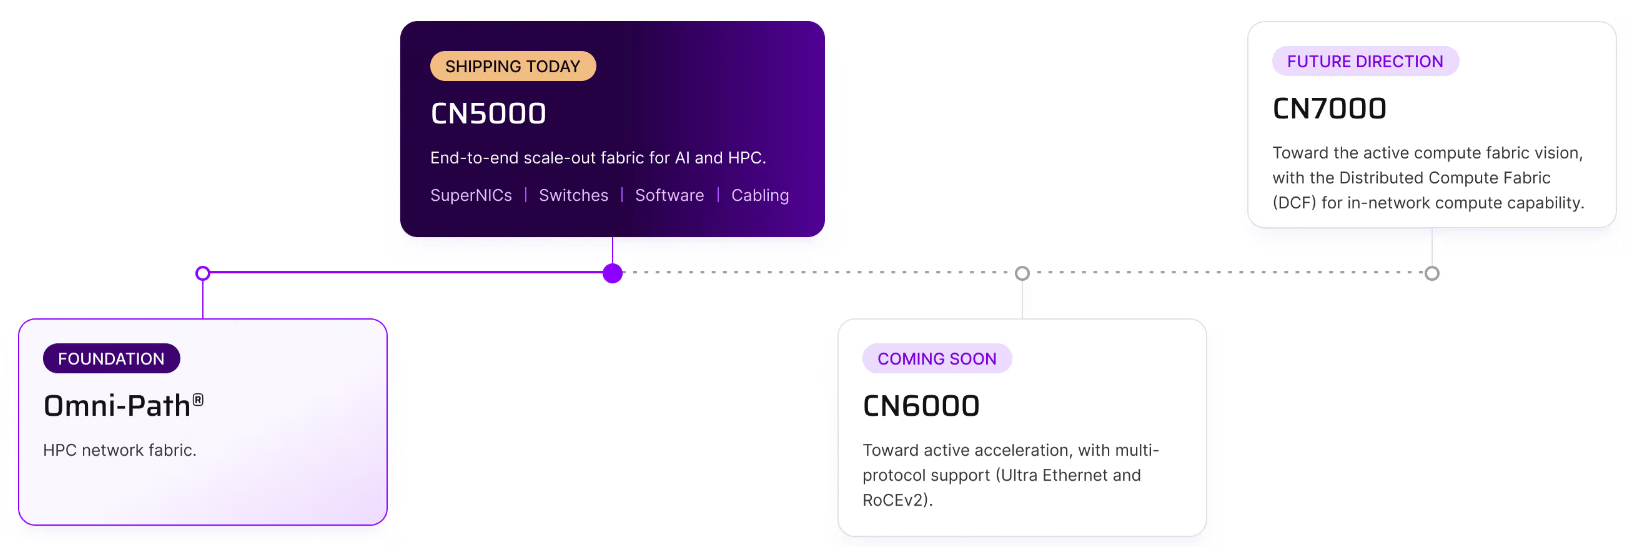 Cornelis также объявила о привлечении финансирования в размере $205 млн. Средства будут направлены на масштабирование производства, укрепление партнёрских отношений с клиентами и ускорение реализации планов по выводу продукции на рынок. Ресурс Forbes считает, что для компании в сегменте HPC-сетей такой уровень инвестиций значителен и свидетельствует о том, что рынок считает проблему узкого места в сетевых технологиях реальной, и что Cornelis продемонстрировала достаточный прогресс благодаря текущим внедрениям в ЦОД для ИИ и HPC, чтобы оправдать дальнейшее расширение. «Потенциал рынка сетевых решений на базе открытых стандартов для масштабирования ИИ (как вертикального, так и горизонтального) к 2030 году превысит $55 млрд. Мы убеждены, что именно сетевая инфраструктура будет определять, какая часть инвестиций в развёртывание систем ИИ принесёт реальную отдачу», — заявили в IAG Capital Partners.
18.09.2026 [00:48], Владимир Мироненко
Crusoe, застройщик ЦОД OpenAI Stargate, привлекла $3,9 млрд с оценкой в $30,9 млрд и сделала ставку на малые модульные дата-центрыСтартап Crusoe завершил новый раунд финансирования серии F в размере $3,9 млрд с оценкой его рыночной стоимости примерно в $30,9 млрд, сообщил ресурс The Wall Street Journal. По словам гендиректора Crusoe Чейза Лохмиллера (Chase Lochmiller), раунд финансирования возглавили Atreides Management, Valor Equity Partners и Mubadala Investment. В число других инвесторов входят Founders Fund, TPG и несколько суверенных фондов, включая Катарское инвестиционное управление (Qatar Investment Authority, QIA). После двух лет строительства комплекса ЦОД Stargate в Абилине (Abilene, Техас), используемого OpenAI, Crusoe теперь делает ставку на создание небольших модульных ЦОД Spark, которые она может производить на собственных заводах и развёртывать там, где есть доступ к электроэнергии. Это будет быстрее и дешевле, чем полагаться исключительно на крупные строительные проекты, которые становятся всё дороже и сталкиваются с задержками по всей стране. Лохмиллер заявил, что для инференса не требуются огромные ИИ-кластеры. «В настоящее время для этого не нужен ЦОД по типу того, в Абилине», — сказал Лохмиллер. По его словам, инференс в таком ЦОД «может быть излишним». Меньшие по размеру ЦОД Spark предоставляют компании ещё одно преимущество: скорость, поскольку для них не требуются месяцы планирования, строительства и согласования с местными жителями. ЦОД Spark уже работают в Рино (Reno, штат Невада) с питанием от б/у батарей электромобилей и солнечных панелей. 
Источник изображения: Crusoe Crusoe отличается от других стартапов в сфере ИИ-инфраструктуры тем, что не делает ставку на одно направление деятельности. Например, неооблачные компания занимаются в основном лишь тем, что покупают дорогостоящие чипы и сдают в аренду доступ к ним. В свою очередь, Crusoe разрабатывает и сдаёт в аренду ЦОД, сдаёт в аренду GPU в них и запускает ИИ-модели для клиентов и взимает плату за вычислительные ресурсы (токены). «Мы продаём ЦОД, GPU и токены», — сказал Лохмиллер. По словам источников The Wall Street Journal, эта стратегия временами вызывала недовольство совета директоров, который предлагал сузить сферу деятельности компании. Однако Лохмиллер считает, что его стратегия помогает компании строить лучшие ЦОД, поскольку даёт понимание того, как меняется спрос. Crusoe ожидает, что большая часть её облачных вычислений будет выполняться в небольших ЦОД Spark. «Мы собираемся устанавливать их повсюду», — заявил Лохмиллер.
16.09.2026 [15:38], Сергей Карасёв
Axelera AI начала поставки ИИ-чипов Europa для высокоэффективного инференсаНидерландский стартап Axelera AI объявил о начале отгрузок изделий Europa — специализированных ИИ-чипов следующего поколения (AI Processing Unit, AIPU). Они ориентированы прежде всего на выполнение инференса с высокой энергетической эффективностью. Первая информация о решениях Europa появилась в октябре прошлого года. Конструкция чипов включает восемь ядер ИИ, 16 векторных ядер с архитектурой RISC-V, 256-бит интерфейс LPDDR5 с пропускной способностью 200 Гбайт/с и 128 Мбайт памяти L2 SRAM. Заявленное быстродействие достигает 629 TOPS на операциях INT8. При производстве применяется 5-нм технология Samsung. Заказчики могут приобретать чипы Europa для самостоятельного проектирования ИИ-ускорителей. Кроме того, изделия доступны в составе PCIe-карты Axelera Edge 232p формата HHHL с одним AIPU и платы Axelera Server 250p типоразмера FHFL с четырьмя AIPU. Эти устройства могут устанавливаться в серверы и рабочие станции. 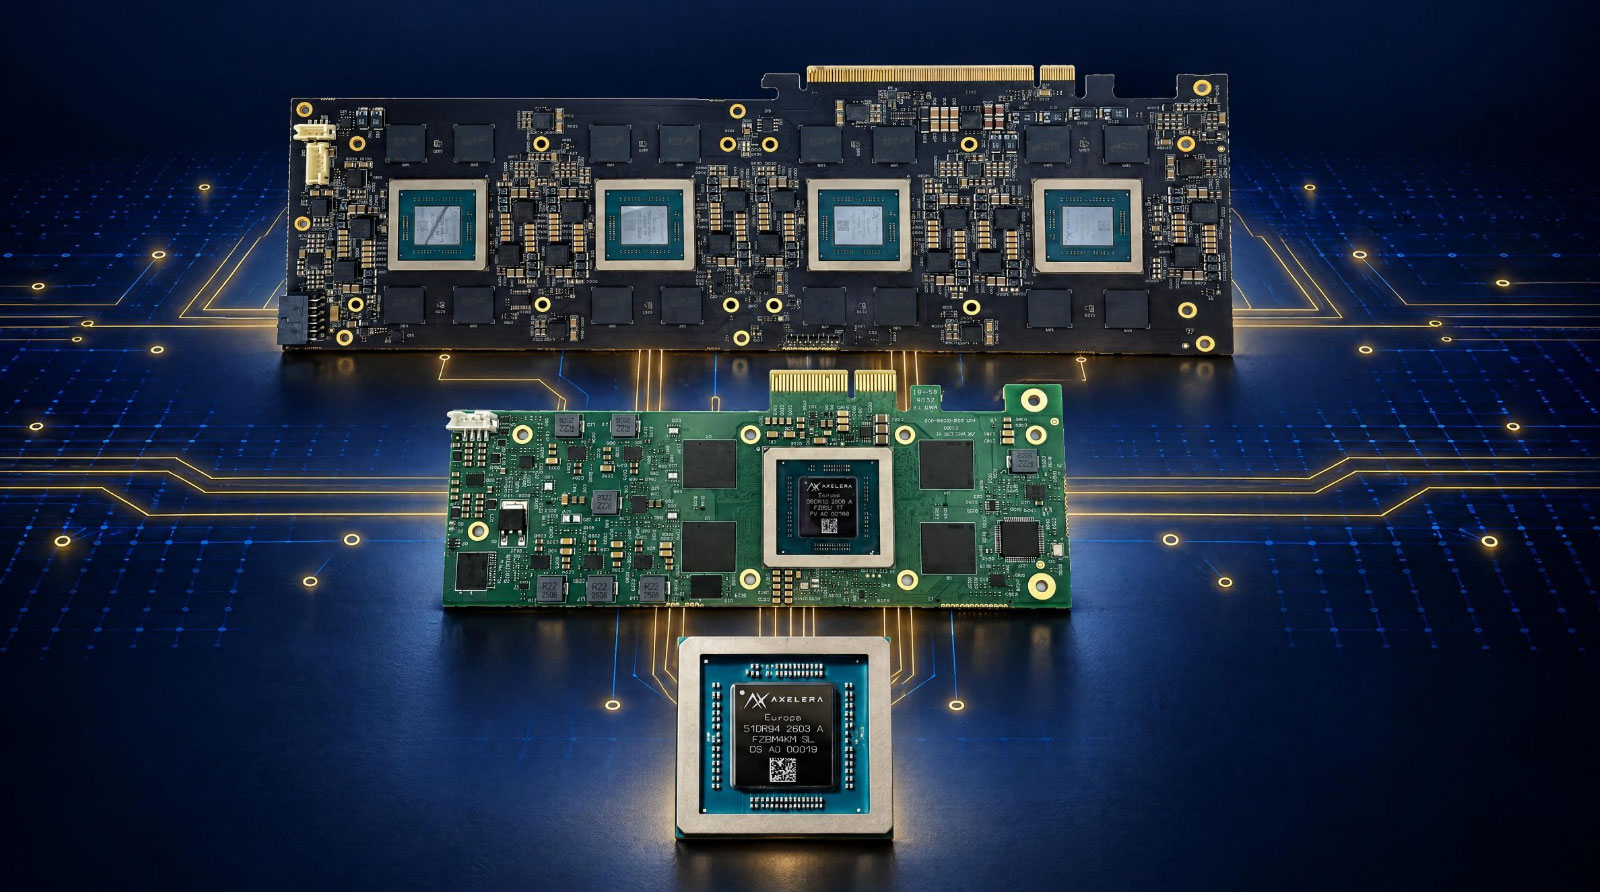
Источник изображений: Axelera AI Как утверждает Axelera AI, решения на базе Europa обеспечивают в шесть раз более высокую производительность (токенов в секунду) на 1 Вт затрачиваемой энергии по сравнению с ускорителями на базе GPU. Новые карты могут применяться не только в составе дата-центров и облачных платформ, но и на периферии, а также на корпоративных площадках. 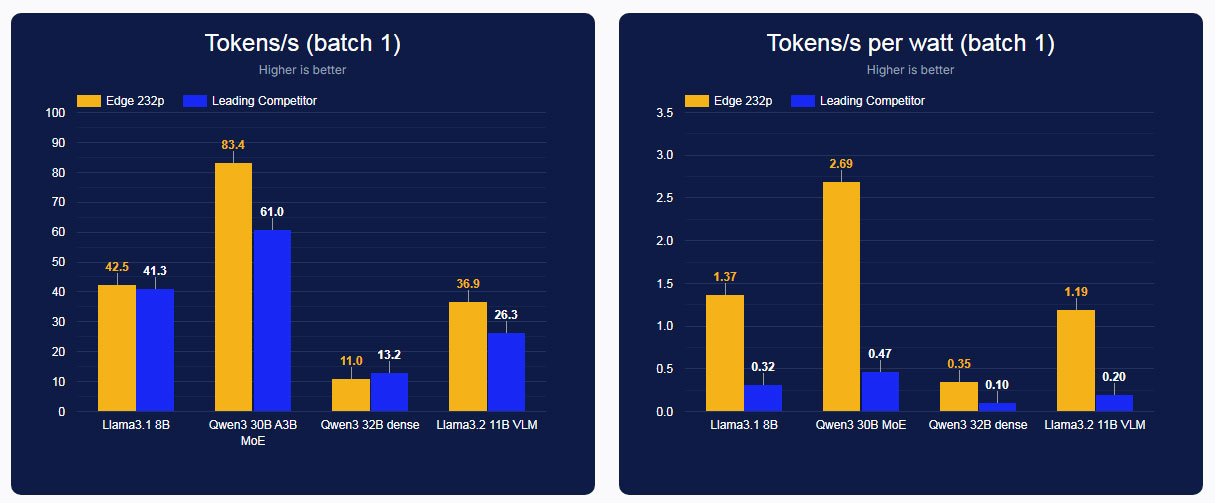 Ускорители Axelera Edge 232p будут доступны в составе серверов Dell XE5 и Supermicro 111AD. Кроме того, о поддержке Europa объявили такие компании, как 2CRSi, Advantech, Axiomtek, HPE, Lenovo, Seco и др. Продукты Axelera AI внедрили более 600 клиентов по всему миру, включая заказчиков в сферах оборонной промышленности, робототехники, беспилотных летательных аппаратов, розничной торговли и безопасности. Стартап говорит об общем портфеле заказов стоимостью свыше $1,5 млрд.
16.09.2026 [12:55], Руслан Авдеев
Anthropic заключила первое соглашение об аренде ИИ ЦОД в Австралии, одного из крупнейших в миреАмериканский ИИ-гигант Anthropic подписал первое соглашение об аренде дата-центров в Австралии. Компания стремится извлечь максимальную выгоду из благоприятной политической среды в стране и имеющихся на континенте в изобилии источников возобновляемой энергии для создания одного из крупнейших в мире вычислительных объектов, сообщает Reuters. Договор предусматривает аренду кампуса с проектной мощностью 2,16 ГВт — на уровне некоторых крупнейших дата-центров, уже действующих в мире. Предложенный кампус должен будет разместиться на сельскохозяйственных угодьях в 250 км от Брисбена (Brisbane), начало ввода в эксплуатацию предполагается в 2027 году. ОБъект будет использовать замкнутую систему охлаждения, позволяющую снизить потребности в чистой воде при отводе тепла от серверов. Благодаря сделке Anthropic станет последним «ИИ-тяжеловесом», закрепившим свои позиции в Австралии — после OpenAI, которая ещё в прошлом году заключила договор об использовании ЦОД в Сиднее. Компании конкурируют за возможность заранее закрепить за собой права на энергию и землю, поскольку там они значительно дешевле и доступнее в сравнении с более «загруженными» рынками США или Азии. 
Источник изображения: Megan Clark/unsplash.com Австралийское правительство в ответ на противодействие жителей строительству ЦОД пообещало ввести с 2027 года ограничения на использование ресурсов дата-центрами. При этом оно продолжает приветствовать инвестиционный бум, который, по прогнозам аналитиков, может принести в Австралию A$150 млрд ($107 млрд) к 2030 году. В целом же предполагается отход от полностью рыночных принципов, что даст властям рычаги давления на операторов ЦОД. В случае с Anthropic речь идёт об аренде ЦОД, строительство которого запланировано сингапурской Zerra DC, которая будет заключать сделки о покупке возобновляемой энергии (PPA) и сама намерена нести расходы по подключениям к сети, не перекладывая их тяжесть на имеющихся клиентов. По данным источников, объект планируют использовать для инференса, но не обучения. Ранее Австралия заявляла, что новые правила для ИИ-проектов ограничивают использование созданного в стране контента для «тренировки» ИИ-моделей. Anthropic уже говорила, что готова потратить миллиарды долларов на ЦОД в стране, но взамен требует переписать законы об интеллектуальной собственности. На тот момент она собиралась заняться именно обучением ИИ.
16.09.2026 [01:35], Владимир Мироненко
144-ядерные Arm-процессоры Fujitsu MONAKA станут доступны в ноябреFujitsu объявила о предстоящем старте глобальных продаж процессора нового поколения Fujitsu MONAKA, намеченном на ноябрь 2026 года. Также компания выпустит на базе новинок сервер Fujitsu MONAKA Server для суверенной ИИ-инфраструктуры, который станет доступен для заказа с ноября 2026 года операторам ЦОД, предприятиям, академическим учреждениями и HPC-центрам в Японии и Европе, и оборонному сектору. Массовые поставки начнутся в апреле следующего года. В процессоре Fujitsu MONAKA используется 3D-стековая архитектура с 2-нм техпроцессом для Arm-ядер и 5-нм техпроцессом для кеша и I/O-блоков. Чип имеет до 144 ядер, работает на частоте до 3,8 ГГц и поддерживает память DDR5-8800. Также сообщалось, что процессоры MONAKA получат продвинутую упаковку Broadcom 3.5D XDSiP. Использование собственной технологии Ultra Low Voltage обеспечивает высокую энергоэффективность процессора. MONAKA обеспечивает аппаратное ускорение матричных операций, используя специальные инструкции, которое в сочетании с поддержкой векторных вычислений SVE2 и программной оптимизацией позволяет ускорять ИИ-инференс непосредственно на уровне CPU. Как сообщает Fujitsu, чип обеспечивает вдвое большую пропускную способность для ИИ-инференса по сравнению с другими процессорами. 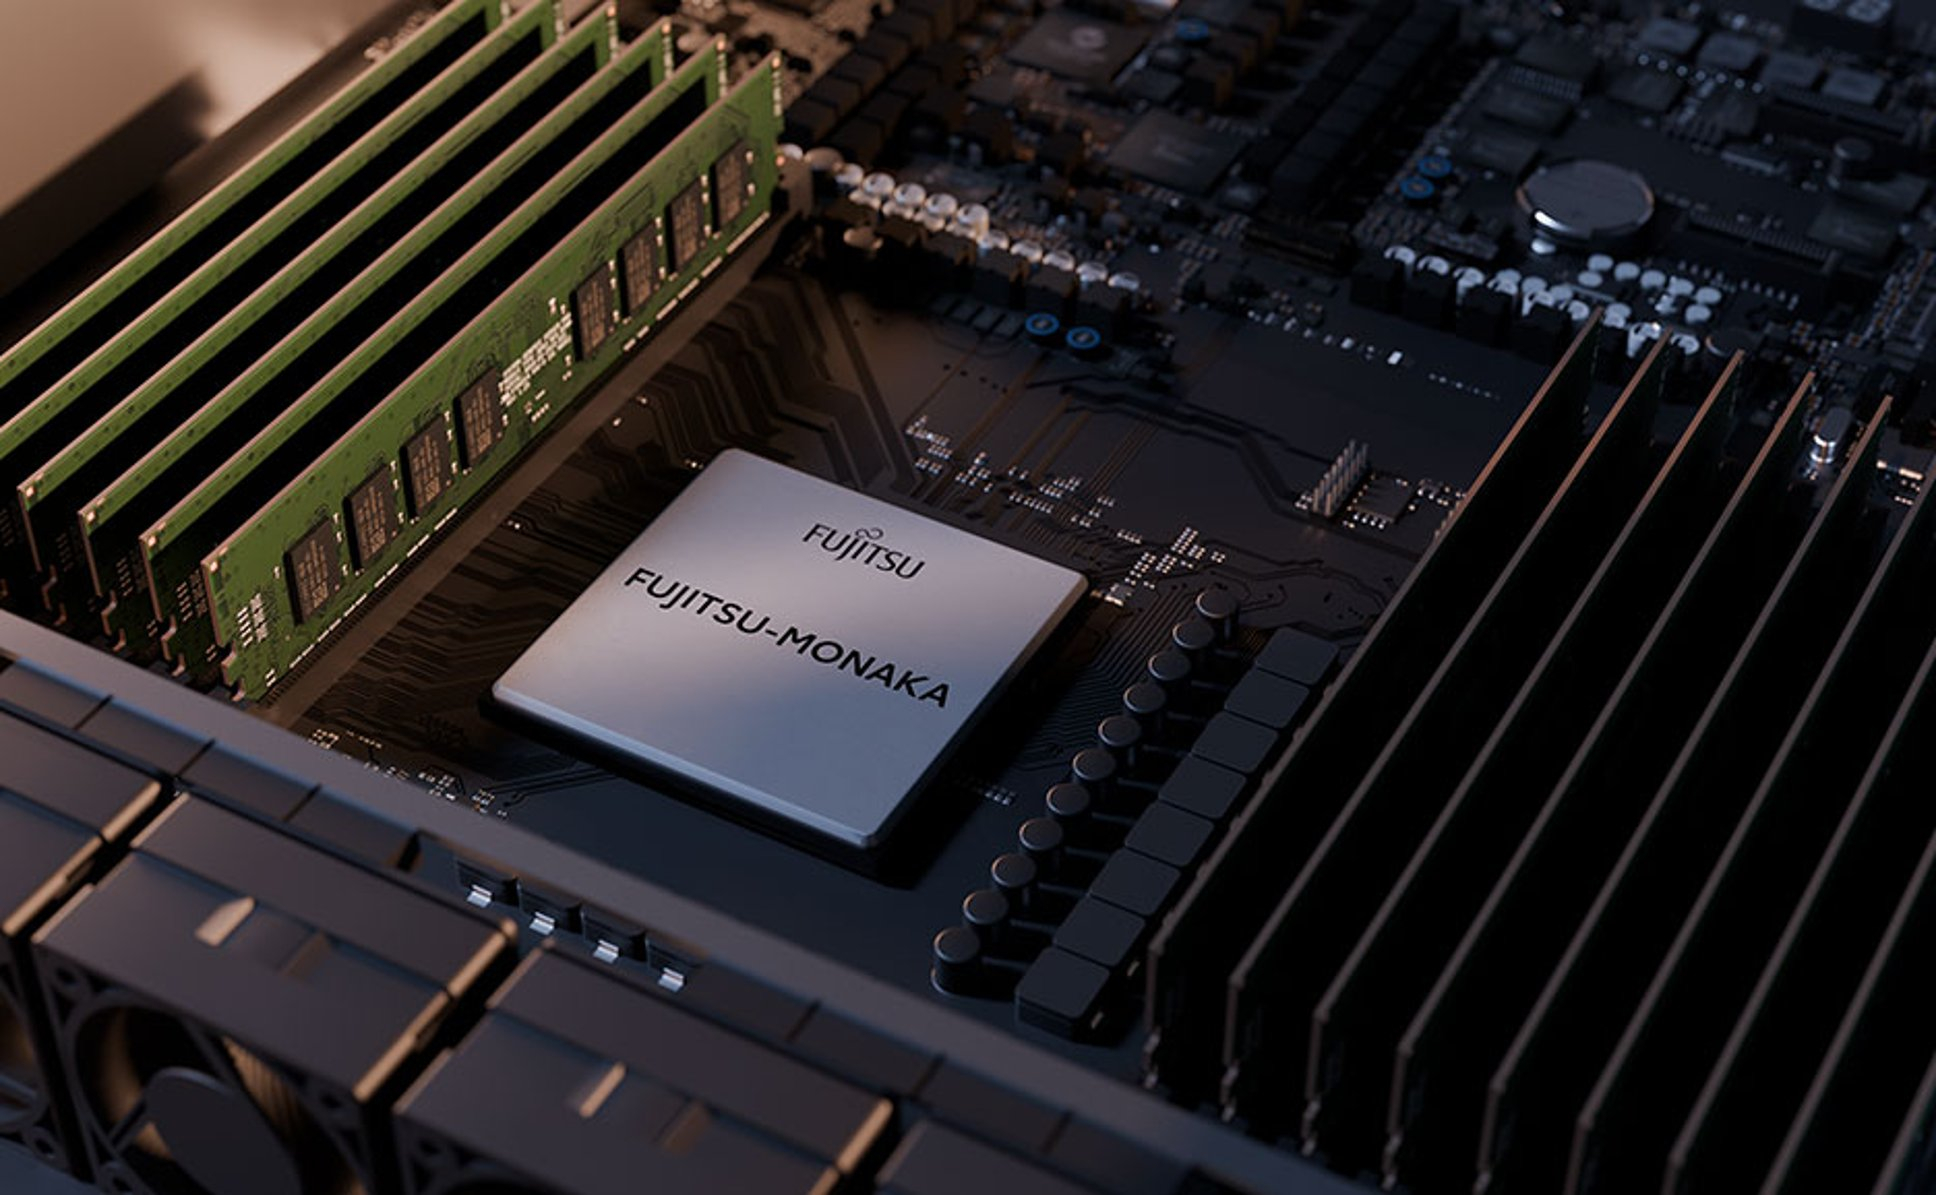
Источник изображений: Fujitsu Кроме того, MONAKA поддерживает конфиденциальные вычисления для защиты данных и приложений на аппаратном уровне с помощью технологии Arm CCA, которая обеспечивает шифрование приложений и данных непосредственно во время их выполнения в оперативной памяти, в том числе при работе в многопользовательских облачных средах с разделением ресурсов. 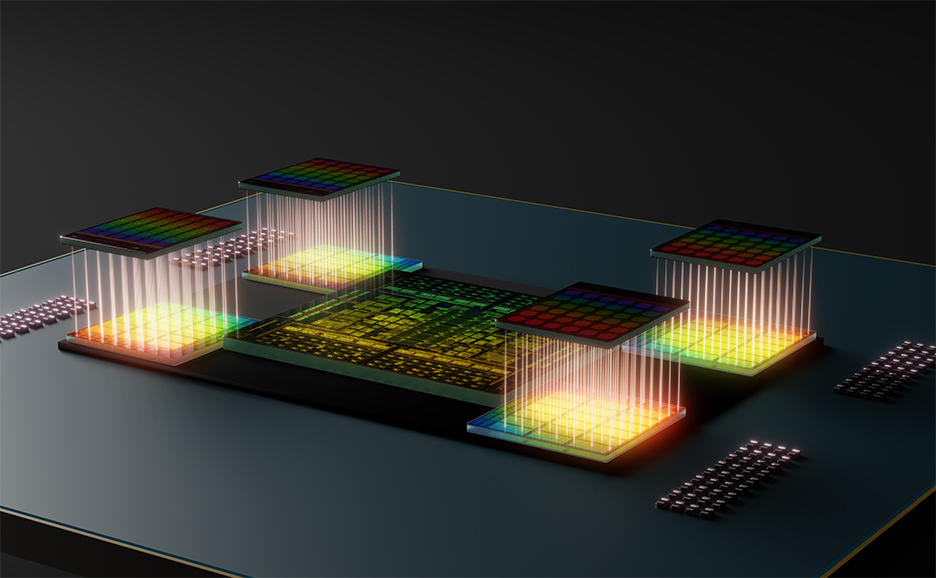 Первоначально серверы на базе MONAKA будут доступны в конфигурациях 1U (один или два сокета) и 2U (два сокета) для задач ИИ-инференса и работы ИИ-агентов. Также планируется выпуск отдельной многоузловой системы формата 2U4N (два сокета на узел) для академических целей и HPC. В частности, эта система подходит для создания суррогатных моделей и CFD-расчётов. 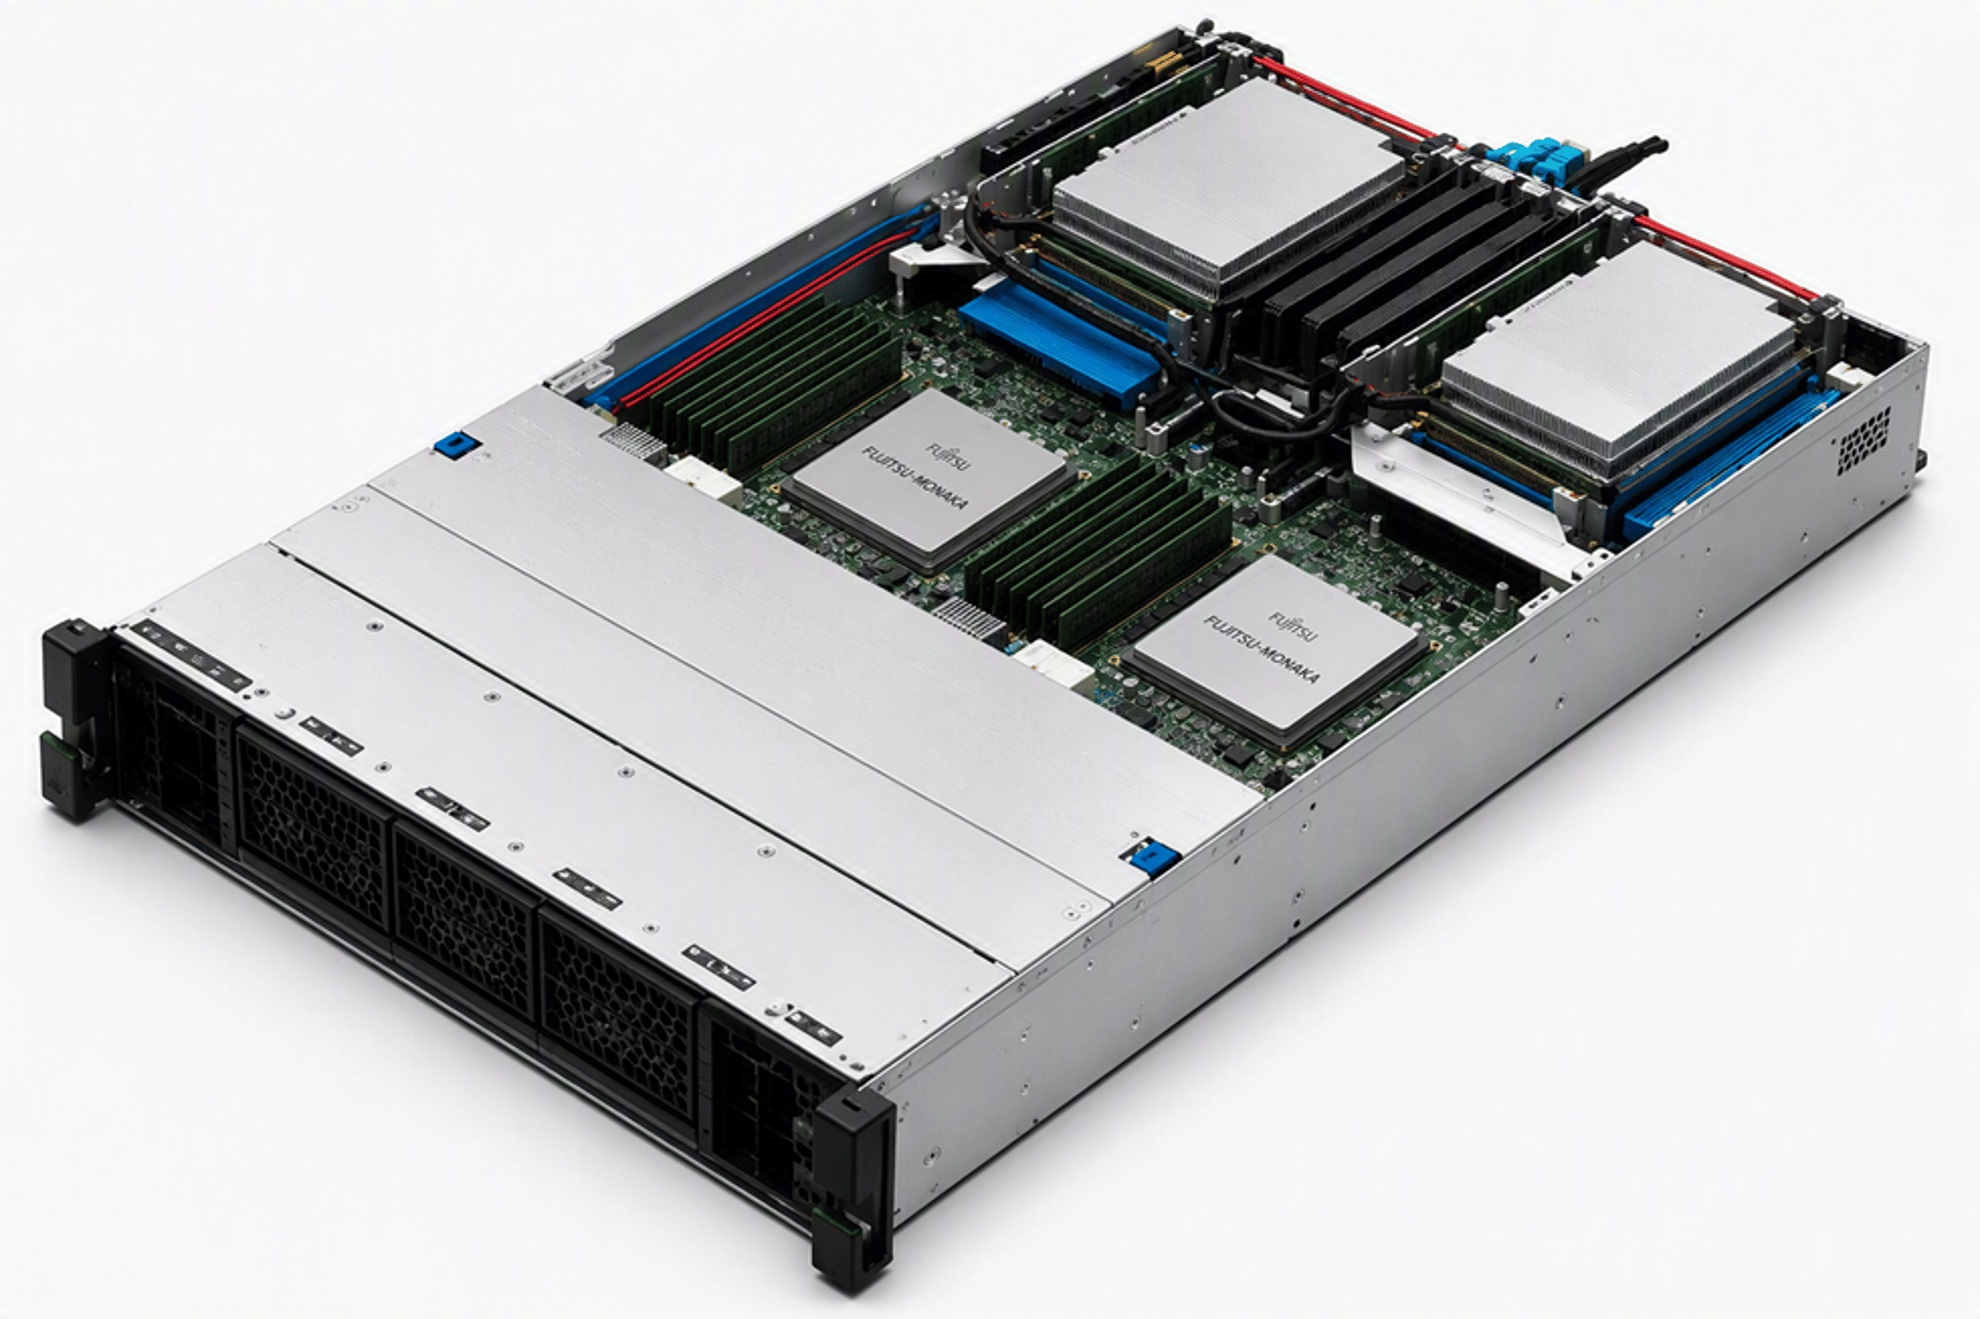 1U-версия поддерживает воздушное охлаждение с температурой окружающей среды до +40 °C (базовая частота ядер — 2,1 ГГц) и СЖО с температурой воды до +45 °C (базовая частота ядер — 2,9 ГГц) без необходимости в специализированной инфраструктуре охлаждения. Согласно Fujitsu, фирменная технология охлаждения серверов позволяет снизить энергопотребление систем охлаждения до 80 %. Каждому процессору полагается 12 слотов памяти. Подсистема хранения включает восемь слотов E3.S и два слота M.2. Основная шина — PCIe 6.0, но поддержка GPU не заявлена. 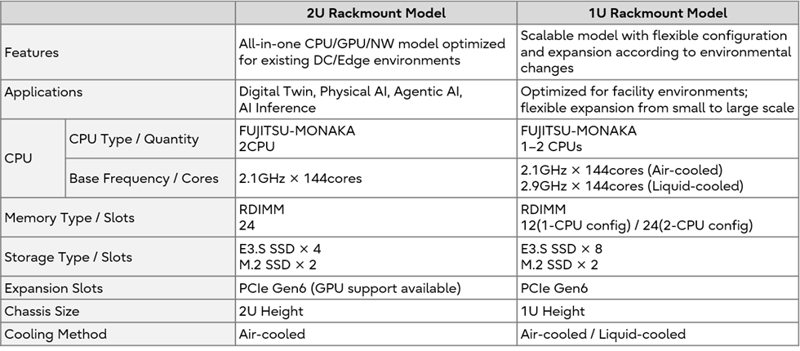 Кроме того, доступная память 1U-версии может быть расширена путём использования дезагеграции и CXL. Речь, вероятно, о внешних разделяемых пулах памяти. Такой подход решает проблему нехватки памяти — распространённую при ИИ-инференсе — и максимизирует эффективность использования ресурсов, обеспечивая гибкую адаптацию к будущим крупномасштабным ИИ-моделям и изменениям рабочих нагрузок, говорит Fujitsu. 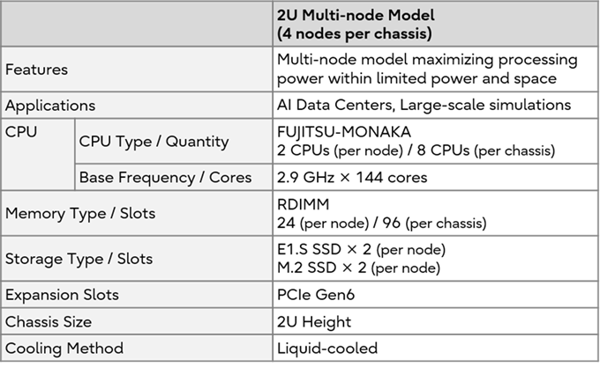 2U-сервер включает два процессора с базовой частотой 2,1 ГГц, 24 слота для памяти RDIMM, четыре слота для E.3 SSD и два — для M.2. Он поддерживает только воздушное охлаждение. Доступна установка GPU. Наконец, многоузловой 2U-сервер с СЖО включает восемь процессоров MONAKA с частотой 2,9 ГГц и 96 слотов для RDIMM. На каждый узел приходится лишь по паре E.3 и M.2 SSD, зато с PCIe 6.0. Разработкой серверов для новых CPU также занимается Supermicro.  Сервер Fujitsu MONAKA Server спроектирован, разработан и произведен в Японии для использования в системах, обеспечивающих технологический суверенитет. Производство осуществляется на заводе Fujitsu в Касашиме (Kasashima), где на всех этапах производства можно отследить происхождение компонентов и историю изготовления. На базе Fujitsu MONAKA Server строится вертикально интегрированная модель «суверенного ИИ», объединяющая ИИ-технологии Fujitsu (такие как платформа Fujitsu Kozuchi и корпоративный генеративный ИИ Takane) со специализированными отраслевыми моделями, что создает безопасную среду для предприятий и госучреждений.
14.09.2026 [22:55], Владимир Мироненко
Минюст США проверит сделку NVIDIA с Groq, но это ничего не изменитМинистерство юстиции США проводит проверку с целью выяснить, не была ли структура лицензионного соглашения NVIDIA с Groq стоимостью $20 млрд намеренно выстроена таким образом, чтобы избежать антимонопольного расследования, сообщила газета The New York Times со ссылкой на информированные источники. В рамках сделки, заключённой в прошлом году, которую компания Groq охарактеризовала как «неисключительное лицензионное соглашение с NVIDIA на технологии инференса», генеральный директор Groq Джонатан Росс (Jonathan Ross) и президент компании Санни Мадра (Sunny Madra), а также часть инженерной команды Groq перешли на работу в NVIDIA. Представитель NVIDIA Джон Риццо (John Rizzo) заявил, что «история с Groq — яркий пример того, как американская система работает именно так, как было задумано: она стимулирует инновации, вознаграждает предпринимателей и приносит пользу потребителям». Он добавил: «Законодательство призвано поддерживать экосистему стартапов в США и защищать фундаментальные права изобретателей и наемных работников на реализацию своих стремлений». Формально Groq осталась независимой компанией. Именно это сочетание обстоятельств и стало предметом расследования. Сделка не была заявлена на проверку регулятором возможного нанесения ущерба конкуренции на рынке, хотя NVIDIA получила не только технологии, но и двух ключевых руководителей Groq. По словам одного из источников, Министерство юстиции США начало расследование сделки с Groq вскоре после объявления о ней в декабре, направив в NVIDIA официальный запрос. Эндрю Фергюсон (Andrew Ferguson), возглавляющий Федеральную торговую комиссию (FTC) США, в январе сообщил агентству Bloomberg, что ведомство начало проверку с целью выяснить, не были ли подобные сделки намеренно структурированы так, чтобы избежать надзора со стороны регулирующих органов. 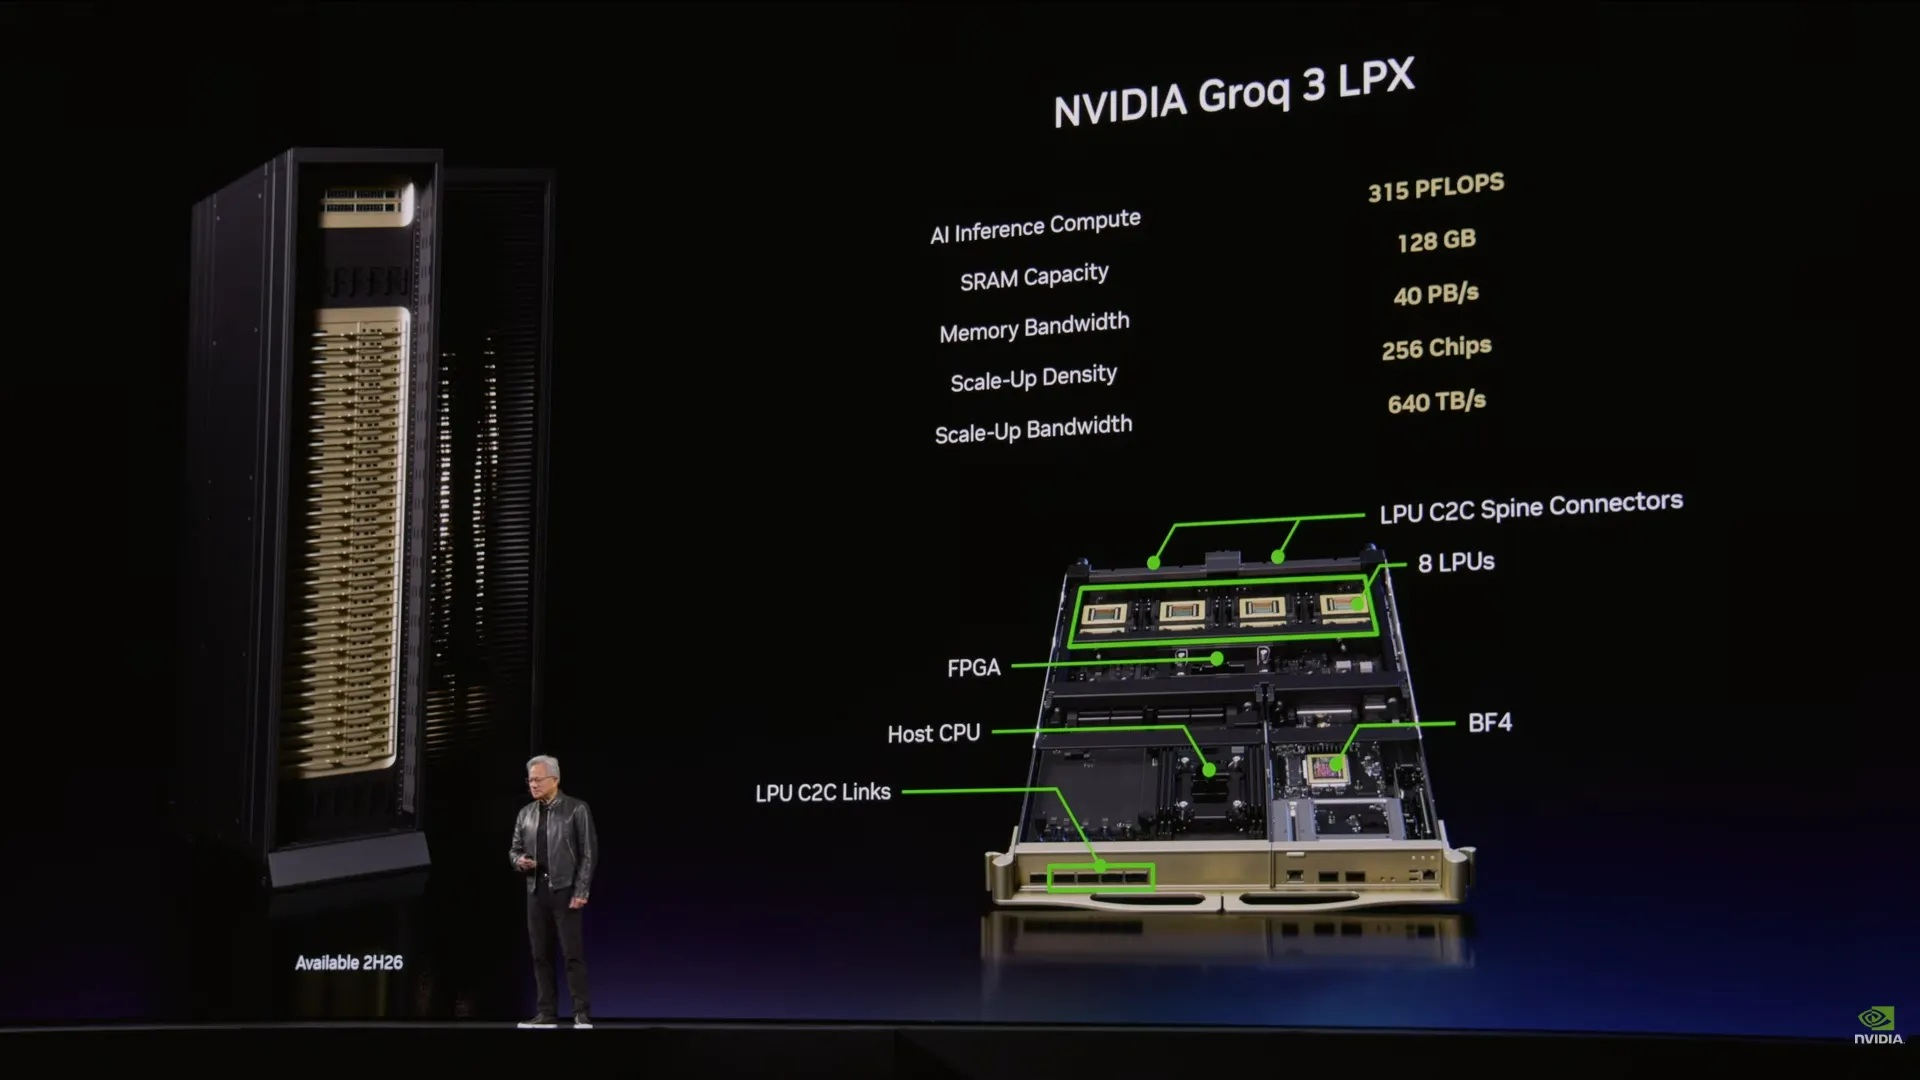
Источник изображения: NVIDIA Если Минюст США придёт к выводу, что NVIDIA должна была получить антимонопольное одобрение сделки, ведомство может потребовать взыскания гражданско-правовых штрафов. В то же время, по словам источника, окончательное решение ещё не принято, и Министерство юстиции в итоге может не обнаружить никаких нарушений. Впрочем, по данным Bloomberg, Минюст изучает возможные нарушения антимонопольного законодательства со стороны производителя чипов с 2024 года. Сообщается, что вопросы со стороны регулирующих органов относительно соглашения между NVIDIA и Groq возникли в начале текущего года в рамках этого более масштабного расследования. Сделки также привлекли внимание сенаторов, которые призвали FTC и Министерство юстиции США расследовать ряд таких сделок, включая партнёрство NVIDIA с компанией Groq. «По сути, эти сделки представляют собой фактические слияния, позволяющие компаниям объединять кадровые, информационные и финансовые ресурсы, при этом, судя по всему, пытаясь обойти процедуры контроля, обычно применяемые к сделкам по слиянию и поглощению», — указали сенаторы в письме, направленном в FTC и Министерство юстиции США. Хотя формально NVIDIA не покупала Groq, фактически её итоги равносильны поглощению. Внимание со стороны Министерства юстиции к этим вопросам возникло на фоне того, как NVIDIA — компания с рыночной капитализацией $5,4 трлн — фактически превратилась в «центральный банк» Кремниевой долины, используя свои огромные финансовые ресурсы для поддержки ИИ-стартапов и финансирования клиентов, отметила The New York Times. Главный вопрос для Министерства юстиции США заключается в том, нанесла ли эта сделка ущерб конкуренции; учитывая текущую ситуацию на рынке, доказать наличие такого ущерба может быть непросто, пишет The Register. Но даже если бы Минюст нашёл основания для судебного иска и добился отмены сделки, это вряд ли что-то кардинально изменило бы, отметил ресурс. 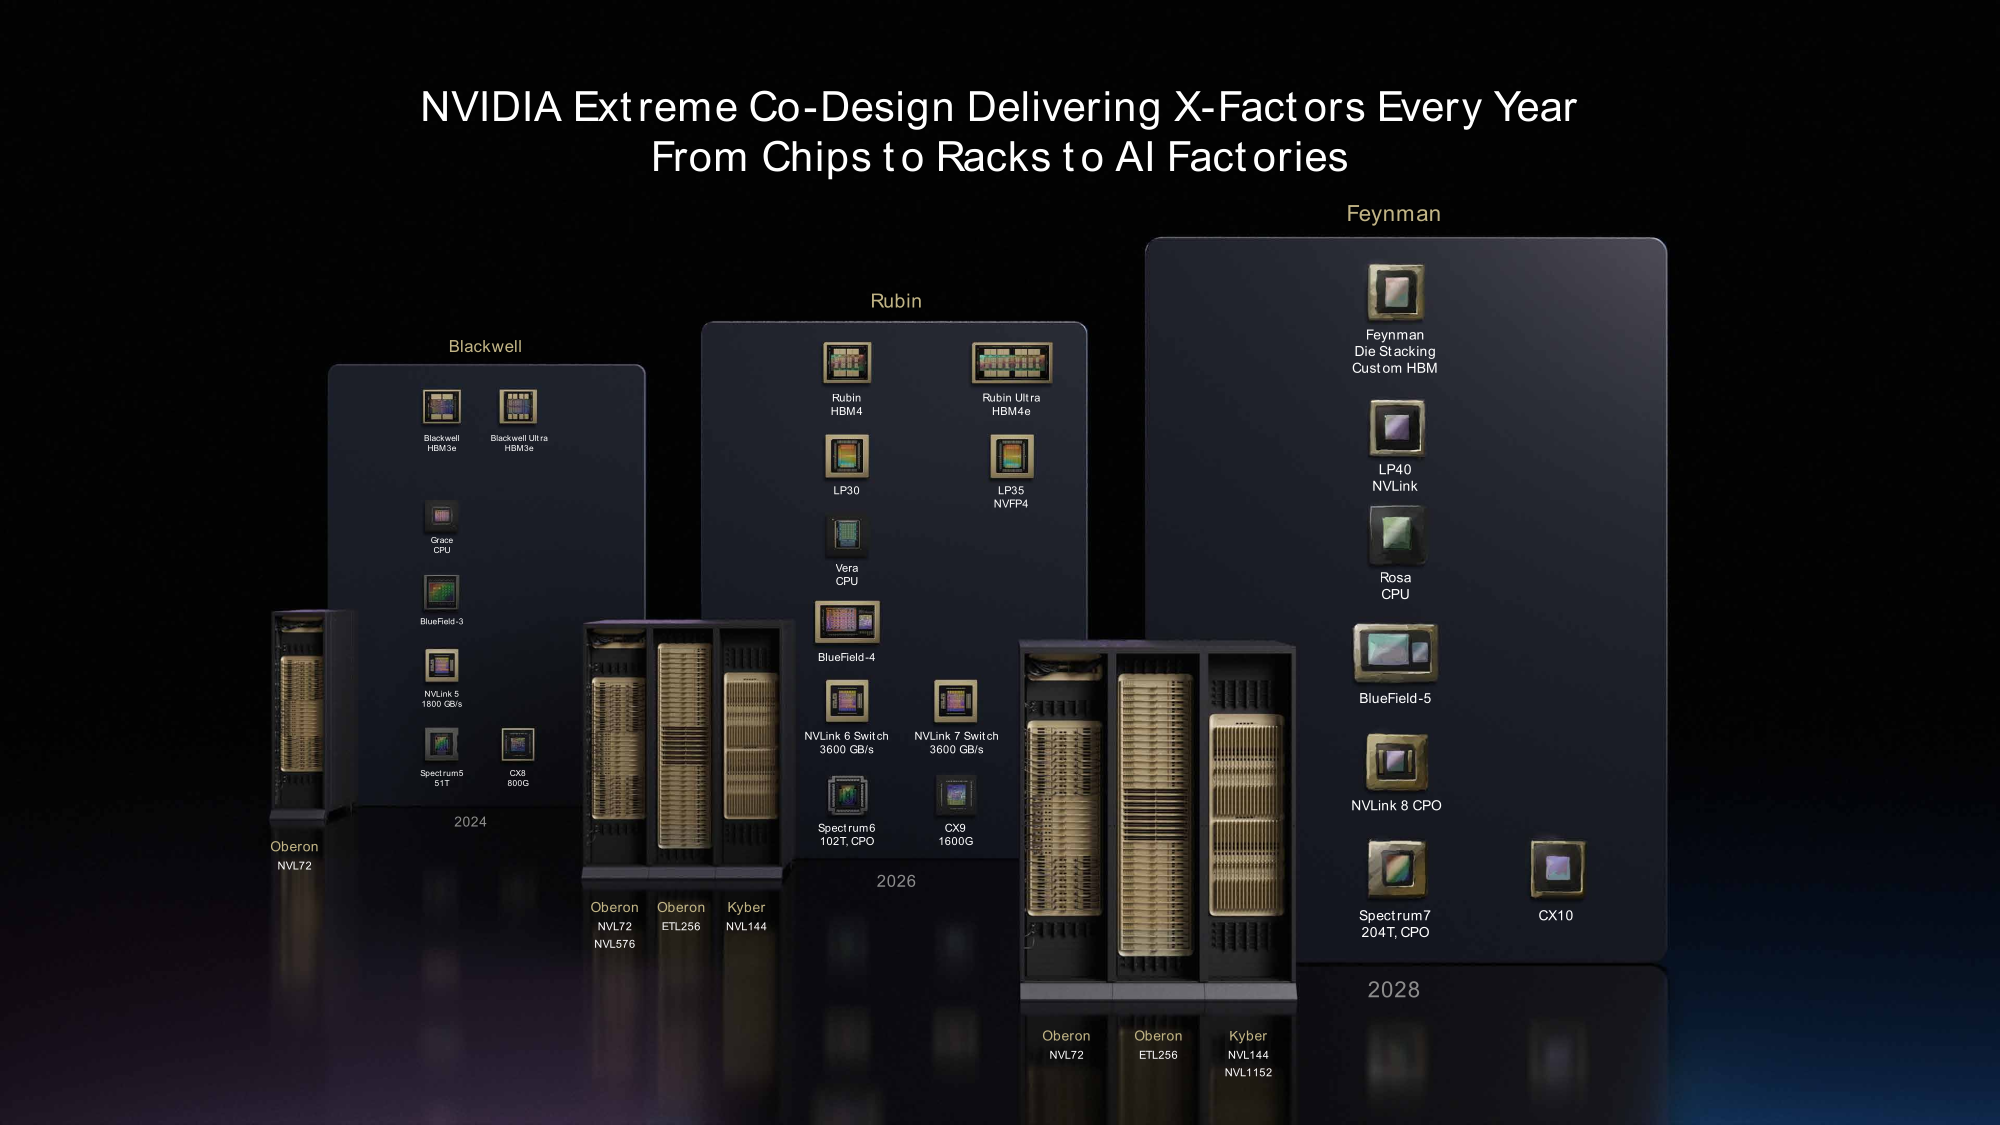 Сделка с Groq обеспечила NVIDIA два ключевых актива: готовые аппаратные решения (чипы) и специалистов, необходимых для их дальнейшей разработки. Groq стала известна благодаря созданию ускорителей с потоковой архитектурой и большим объёмом памяти SRAM, что позволило ускорить инференс больших языковых моделей (LLM) до показателей, которых системы NVIDIA на базе GPU самостоятельно достичь не могли. В марте NVIDIA представила стойки LPX, оснащённые 256 ускорителями LPU Groq 3. Глава NVIDIA пообещал, что связка Groq и Vera Rubin обеспечит оптимальную производительность для всего спектра задач инференса. The Register отметил, что дезагрегация вовсе не уникальная особенность Groq. Cerebras создаёт аналогичные системы совместно с AWS и AMD; SambaNova сотрудничает с Intel; а d-Matrix и ее партнёры объединяют свою платформу с GPU NVIDIA, преследуя те же цели, что и в случае комбинации Vera Rubin NVL72 с Groq 3 LPX. Ещё до объявления о сделке с Groq компания уже закладывала фундамент экосистемы, в центре которой находилось её подразделение сетевых технологий. Она передала свои проекты стоек MGX в Open Compute Project (OCP), позволив тем самым любому производителю чипов размещать свою продукцию в стойках, изначально спроектированных для GPU NVIDIA. Затем NVIDIA открыла доступ к своему интерконнекту в рамках программы NVLink Fusion. И теперь, если Министерство юстиции США заблокирует сделку (целью которой было поглощение компании ради получения её специалистов) и аннулирует соглашение с Groq, NVIDIA может лишиться прямого контроля над разработкой LPU и доходов от их продажи, но это не обязательно будет означать конец для стоек Groq LPX. Groq просто пополнит ряды растущего числа аппаратных партнёров NVIDIA, создающих решения для ИИ-фабрик (AI factory) этой компании. Более того, сама эта сделка гарантирует, что даже если регуляторы в итоге её сорвут, наготове окажется множество альтернатив.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
09.09.2026 [13:25], Сергей Карасёв
Qualcomm и Amazon займутся разработкой ИИ-чипов и оптического интерконнектаКомпании Qualcomm Technologies и Amazon объявили о заключении многолетнего соглашения о сотрудничестве. Работы будут осуществляться по нескольким направлениям, включая создание кастомизированных чипов для дата-центров, ориентированных на ИИ-задачи. Партнёры отмечают, что в настоящее время наблюдается экспоненциальный рост нагрузок, связанных с ИИ. Это приводит к стремительному увеличению спроса на вычислительные ресурсы и хранилища данных. Одновременно повышаются требования к пропускной способности каналов связи. Совместные усилия Qualcomm и Amazon как раз и будут направлены на создание аппаратных решений для высокопроизводительных ИИ-инфраструктур следующих поколений. Компании, в числе прочего, займутся разработкой передовых чипов, оптимизированных для задач инференса в крупномасштабных дата-центрах. Qualcomm и Amazon также намерены сотрудничать в области высокопроизводительных оптических систем связи: речь идёт о решениях класса 1,6 Тбит/с и выше. При этом будут использоваться технологии Qualcomm, включая DSP и SerDes. 
Источник изображения: Qualcomm В рамках сотрудничества Qualcomm намерена расширить использование облачной инфраструктуры AWS, включая платформу Amazon Bedrock, которая обеспечивает доступ к большим языковым моделям (LLM) и ИИ-инструментам через общий интерфейс. Эти сервисы Qualcomm будет применять для автоматизации проектирования электроники (EDA), что позволит значительно ускорить процессы создания передовых микросхем. Конечной целью сотрудничества Qualcomm и Amazon называют формирование высокопроизводительной, эффективной и экономичной инфраструктуры для ИИ и сопутствующих нагрузок.
07.09.2026 [09:32], Сергей Карасёв
Корейский стартап HyperAccel представил ускорители Bertha для ИИ-инференсаЮжнокорейский стартап HyperAccel продемонстрировал специализированные ускорители Bertha, предназначенные для выполнения ИИ-инференса. Ключевой особенностью изделий, по заявлениям разработчика, является высокая экономическая эффективность. Вместо дорогостоящей памяти HBM в решениях Bertha применяются чипы LPDDR. При этом задействована фирменная архитектура Streamlined Dataflow, которая минимизирует перемещение данных. Обеспечивается точное согласование пропускной способности памяти с вычислительными возможностями ускорителя, что позволяет использовать до 90 % имеющихся аппаратных ресурсов во время инференса. Благодаря этому достигается в пять раз более высокое значение токенов в секунду при сопоставимой величине TOPS по сравнению с обычными решениями. 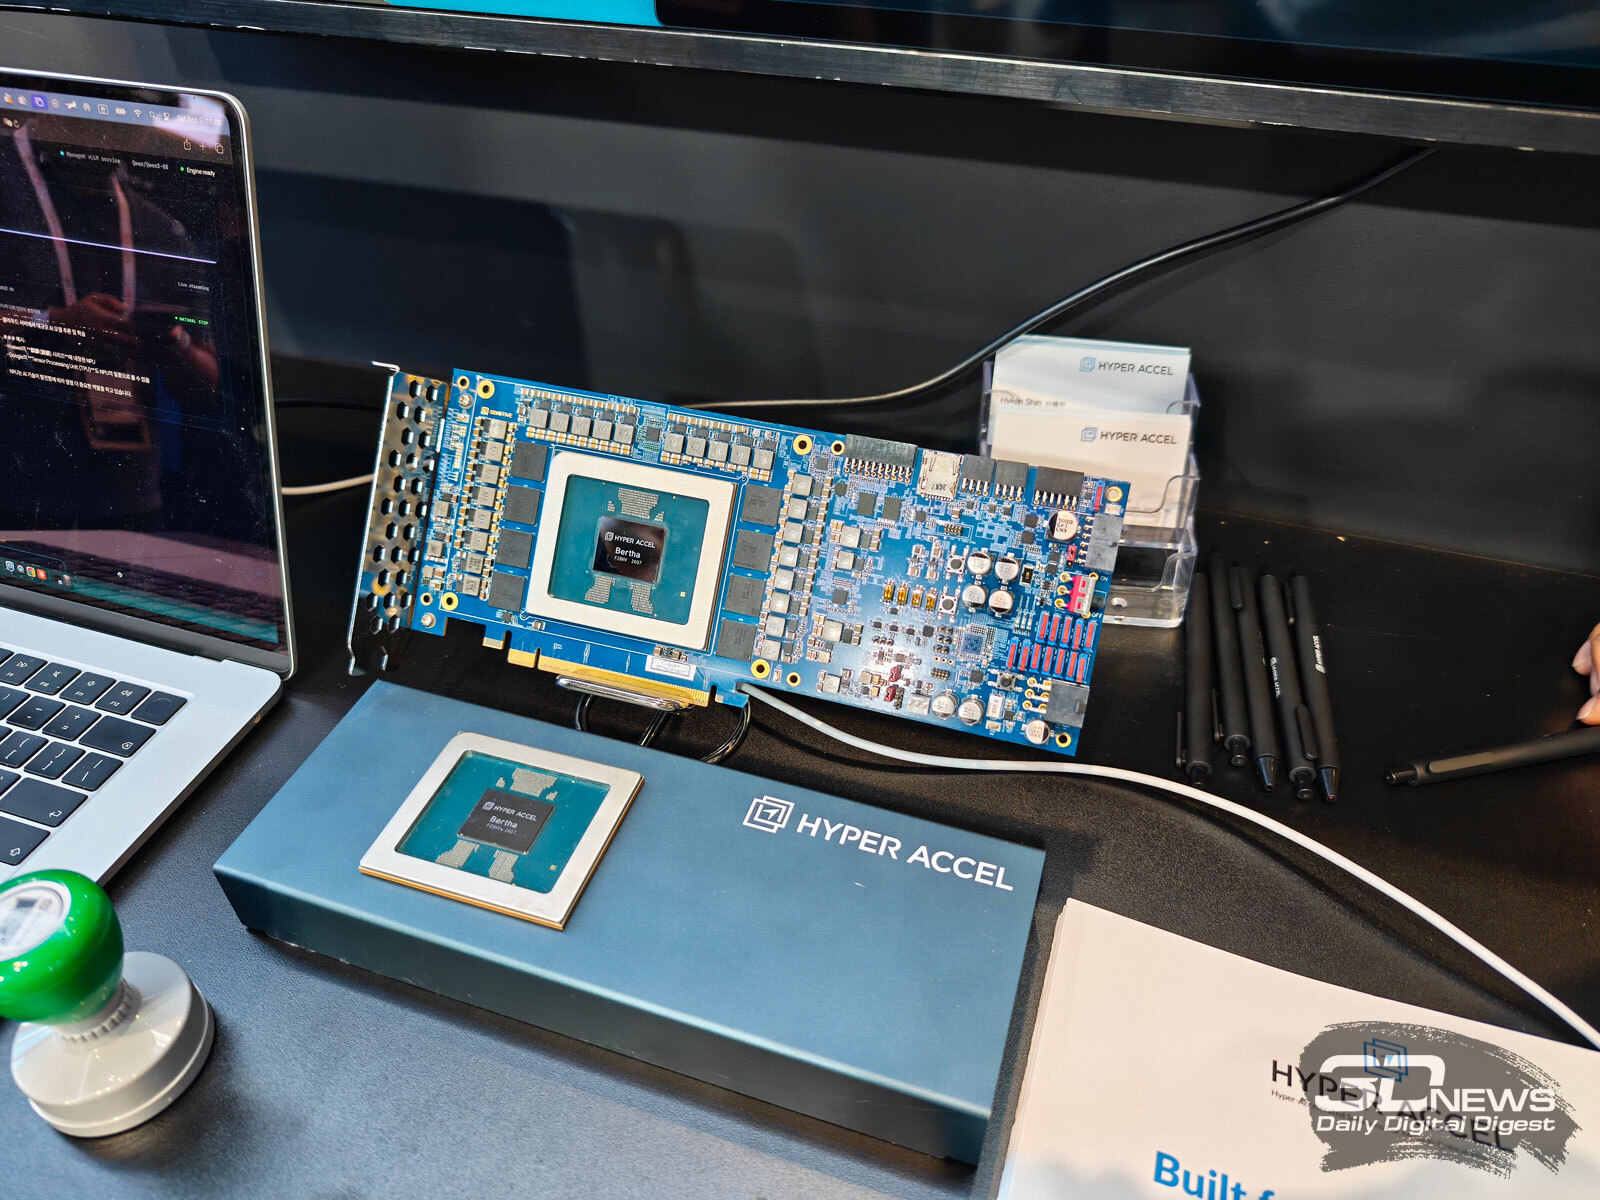 HyperAccel показала ускоритель Bertha 500, который изготавливается с применением 4-нм технологии Samsung. Это устройство, выполненное в виде двухслотовой карты расширения, содержит 32 ядра LPU, четыре ядра Arm Cortex-A53, 256 Мбайт SRAM и 128 Гбайт LPDDR5X (в перспективе — 256 Гбайт) с пропускной способностью до 546 Гбайт/с. Показатель TDP равен 250 Вт. Новинка обеспечивает производительность до 768 Тфлопс в режиме FP8/INT8 и до 384 Тфлопс на операциях FP16. Кроме того, поддерживаются форматы FP4, BF16, INT4. Серийное производство планируется организовать в начале 2027 года. 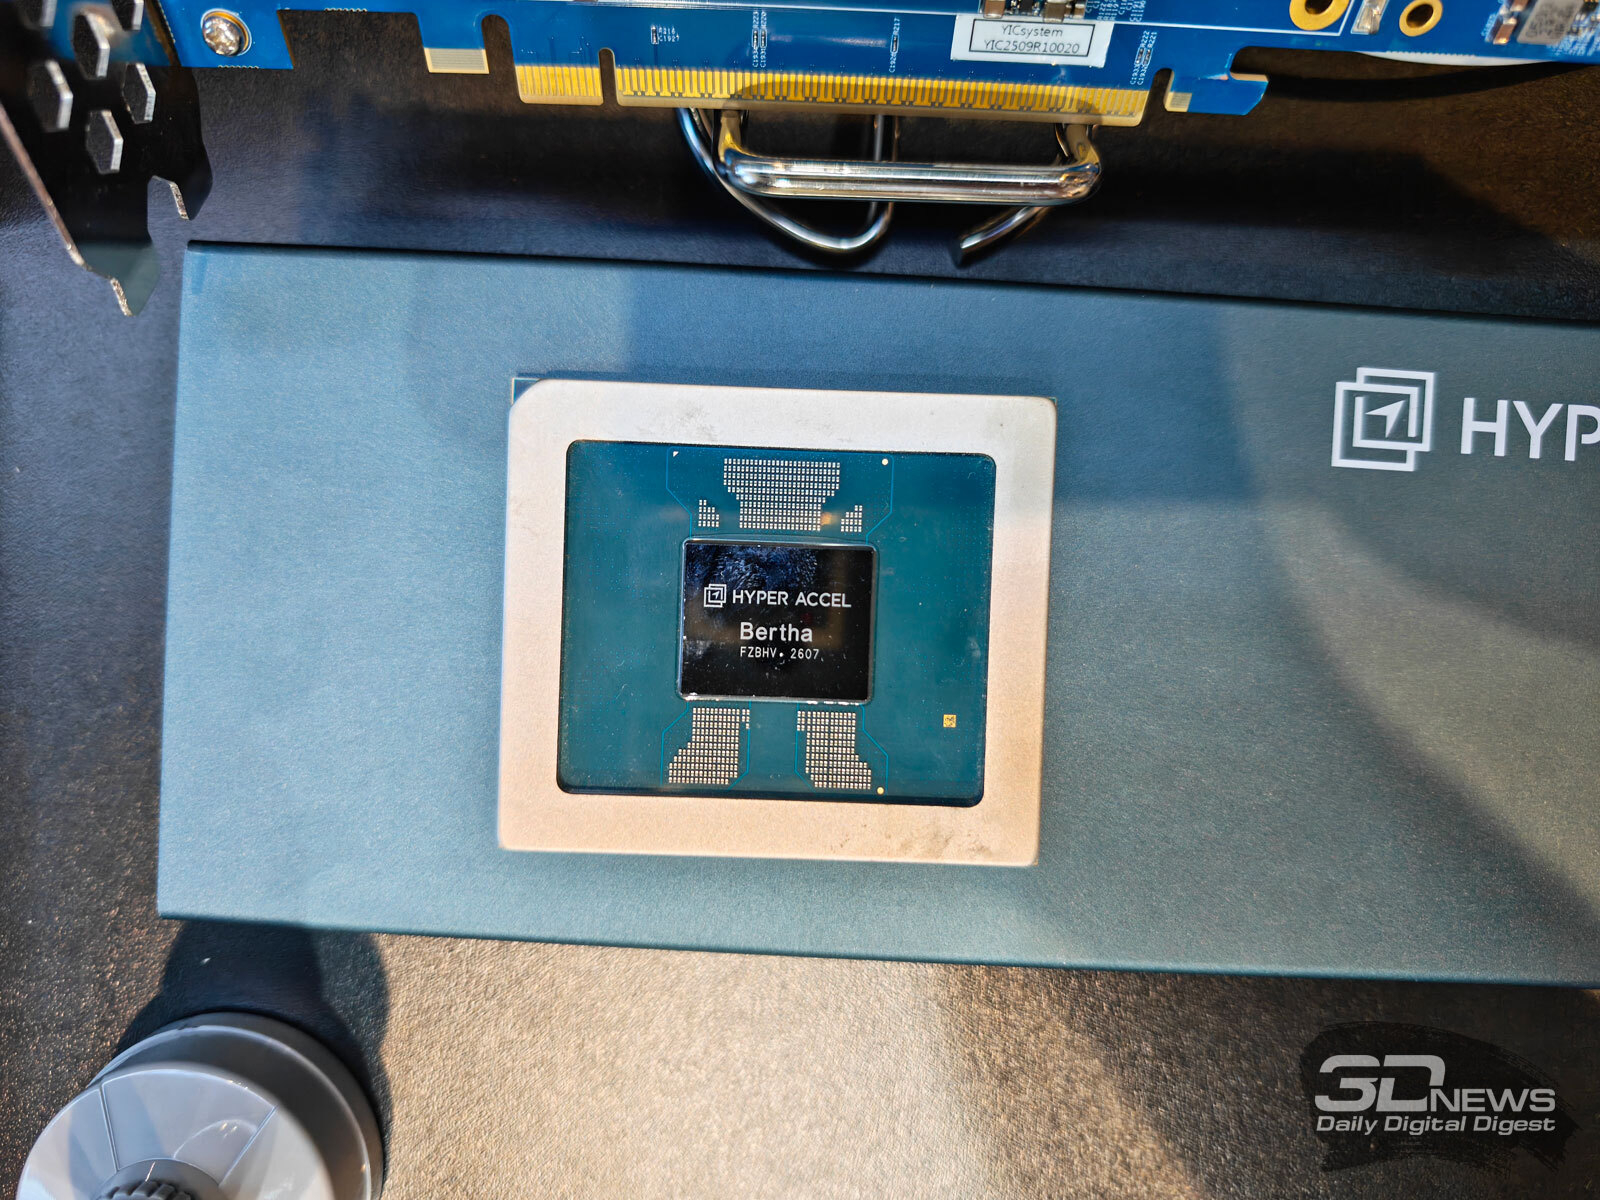 Компания HyperAccel также готовит ускоритель Bertha 100 для агентного ИИ. Это изделие получило форм-фактор M.2. Оно несёт на борту 16 Гбайт LPDDR5X с пропускной способностью 64 Гбайт/с. Быстродействие находится на отметке 32 Тфлопс на операциях FP8. Поддерживаются также режимы BF16, FP4, INT8 и INT4. Образцы изделия появятся в IV квартале нынешнего года. Ускорители совместимы с фреймворками PyTorch, ONNX, vLLM и др. Разработчикам доступен комплект SDK для дальнейшей оптимизации, развёртывания и профилирования решений в соответствии с конкретными потребностями. По заявлениям HyperAccel, Bertha в пять раз энергоэффективнее NVIDIA H100 и даёт примерно в 20 раз лучшее соотношение цены и производительности. По состоянию на февраль 2026 года компания HyperAccel привлекла $45 млн инвестиций, а её штат насчитывает около 80 человек.
04.09.2026 [18:44], Руслан Авдеев
Equinix представила решения Fabric One и Inference Exchange для распределённого ИИ-инференса в системах NVIDIA и Together AIКомпания Equinix расширяет платформу ЦОД и межсетевого взаимодействия, добавив взаимодополняющие сервисы, обеспечивающие распределённую эксплуатацию вычислительных ресурсов. Equinix Fabric One обеспечивает подключение между корпоративными площадками, облаками и ИИ-провайдерами, а Equinix Inference Exchange позволяет объединить эталонные решения NVIDIA Enterprise Reference Architectures с открытой платформой для инференса компании Together AI в пределах экосистемы Equinix. Сервисы позволят решить распространённую проблему архитектуры данных, когда корпоративная информация, приложения и пользователи распределены по разным объектам, облакам и юрисдикциям с отдельными правовыми нормами, а обслуживающие эти ресурсы вычислительные системы отделены от них и работают в других локациях. Equinix рассчитывает превратить распределение рабочих нагрузок и управление подключениями в единый управляемый сервис вместо того, чтобы реализовать сетевые подключения в рамках отдельных ИИ-проектов. Fabric One позволит клиентам описывать необходимый результат подключений на естественном языке. Equinix будет самостоятельно определять и организовывать маршрутизацию, облачные подключения, шифрование, управлять отказоустойчивостью и переключением на резервные ресурсы. 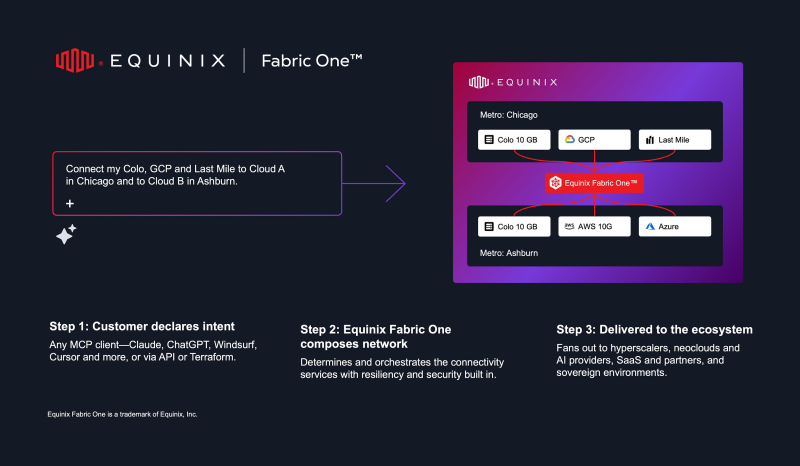
Источник изображения: Equinix Основными партнёрами по интеграции выступят AWS и Google Cloud, Fabric One будет использовать открытые спецификации OpenAPI 3.0 Interconnect, разработанные в рамках программ AWS и Google по организации мультиоблачных сетей, к которым присоединились Microsoft Azure и OCI. Приложения и инфраструктурные агенты смогут программно запрашивать необходимые соединения вместо того, чтобы полагаться на ручную координацию кросс-соединений и ручное предоставление сетевых ресурсов. Inference Exchange представляет собой распределённую платформу для ИИ-инференса. Equinix будет поставлять объекты, электроэнергию, передовые системы охлаждения, обеспечит эксплуатацию инфраструктуры после ввода в эксплуатацию и подключение через Equinix Fabric. NVIDIA обеспечит развёртывание с помощью проверенных эталонных архитектур Enterprise Reference Architectures, а Together AI обеспечит платформу для инференса с более 200 open source ИИ-моделей. Платформа будет поддерживать общие многопользовательские проекты и выделенные среды для отдельных клиентов, которым требуются гарантированные объёмы ресурсов и высокий уровень «изоляции» данных. 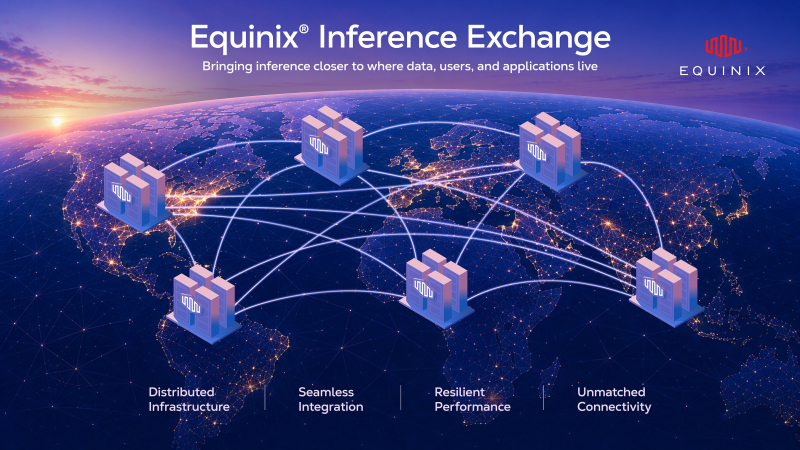
Источник изображения: Equinix По данным Storage Review, платформа Inference Exchange ориентирована на три ключевых топологии развёртывания. Во-первых, для инференса на уровне городских периферийных узлов организации способны запускать модели в рамках агломераций, с быстрым откликом API-обращений к открытым базовым моделям. Во-вторых, её можно использовать для перехода от закрытых проприетарных API на модели с открытым исходным кодом. Наконец, для обеспечения суверенного ИИ и выполнения нормативных требований локальных регуляторов — компании из регулируемых сфер могут обеспечить инференс и обработку данных в пределах заданных географических границ. Предполагается, что бета-тестирование Fabric One начнётся до конца 2026 года, а полная доступность сервиса запланирована на 2027 год, сначала в Северной Америке. Inference Exchange будет доступен в I квартале 2027 года. Стратегическим преимуществом Equinix является инфраструктура компании и плотность сосредоточенной вокруг неё экосистемы. На конец 2025 года она управляла 280 ЦОД на 77 рынках 36 стран. Платформа объединяет более 10,5 тыс. компаний, около 3 тыс. поставщиков облачных и IT-сервисов, а также более 500 тыс. физических и виртуальных интерконнектов. Объекты совредоточены в мегаполисах и городских агломерациях, где пересекаются телеком-операторы, облачные провайдеры, корпорации, платформы с контентом и и финансовые площадки. Для распределённого инференса близость всех игроков может быть важнее масштаба вычислительных ресурсов, поскольку часто корпоративные данные невозможно переместить в удалённый регион из-за требований к задержке, стоимости, управлению, безопасности, юрисдикции и т. п. Fabric One и Inference Exchange координируют два уровня физической инфраструктуры Equinix — на одном находятся объекты International Business Exchange (IBX), предназначенные для разных клиентов, на другом — дата-центры xScale для крупных заказчиков, в том числе гиперскейлеров. Fabric One координирует подключения между разными инфраструктурными доменами, а Inference Exchange позволяет размещать и эксплуатировать мощности для инференса ближе к локациям, где корпоративный спрос максимален. Впрочем, это не сделает инфраструктуру Equinix однородной, поскольку, например, некоторые IBX могут быть ограничены по своим проектным техническим характеристикам. Новые объекты IBX проектируются с расширенными возможностями в контексте электропитания и охлаждения. |
|

