Материалы по тегу: nvlink
|
14.09.2026 [22:55], Владимир Мироненко
Минюст США проверит сделку NVIDIA с Groq, но это ничего не изменитМинистерство юстиции США проводит проверку с целью выяснить, не была ли структура лицензионного соглашения NVIDIA с Groq стоимостью $20 млрд намеренно выстроена таким образом, чтобы избежать антимонопольного расследования, сообщила газета The New York Times со ссылкой на информированные источники. В рамках сделки, заключённой в прошлом году, которую компания Groq охарактеризовала как «неисключительное лицензионное соглашение с NVIDIA на технологии инференса», генеральный директор Groq Джонатан Росс (Jonathan Ross) и президент компании Санни Мадра (Sunny Madra), а также часть инженерной команды Groq перешли на работу в NVIDIA. Представитель NVIDIA Джон Риццо (John Rizzo) заявил, что «история с Groq — яркий пример того, как американская система работает именно так, как было задумано: она стимулирует инновации, вознаграждает предпринимателей и приносит пользу потребителям». Он добавил: «Законодательство призвано поддерживать экосистему стартапов в США и защищать фундаментальные права изобретателей и наемных работников на реализацию своих стремлений». Формально Groq осталась независимой компанией. Именно это сочетание обстоятельств и стало предметом расследования. Сделка не была заявлена на проверку регулятором возможного нанесения ущерба конкуренции на рынке, хотя NVIDIA получила не только технологии, но и двух ключевых руководителей Groq. По словам одного из источников, Министерство юстиции США начало расследование сделки с Groq вскоре после объявления о ней в декабре, направив в NVIDIA официальный запрос. Эндрю Фергюсон (Andrew Ferguson), возглавляющий Федеральную торговую комиссию (FTC) США, в январе сообщил агентству Bloomberg, что ведомство начало проверку с целью выяснить, не были ли подобные сделки намеренно структурированы так, чтобы избежать надзора со стороны регулирующих органов. 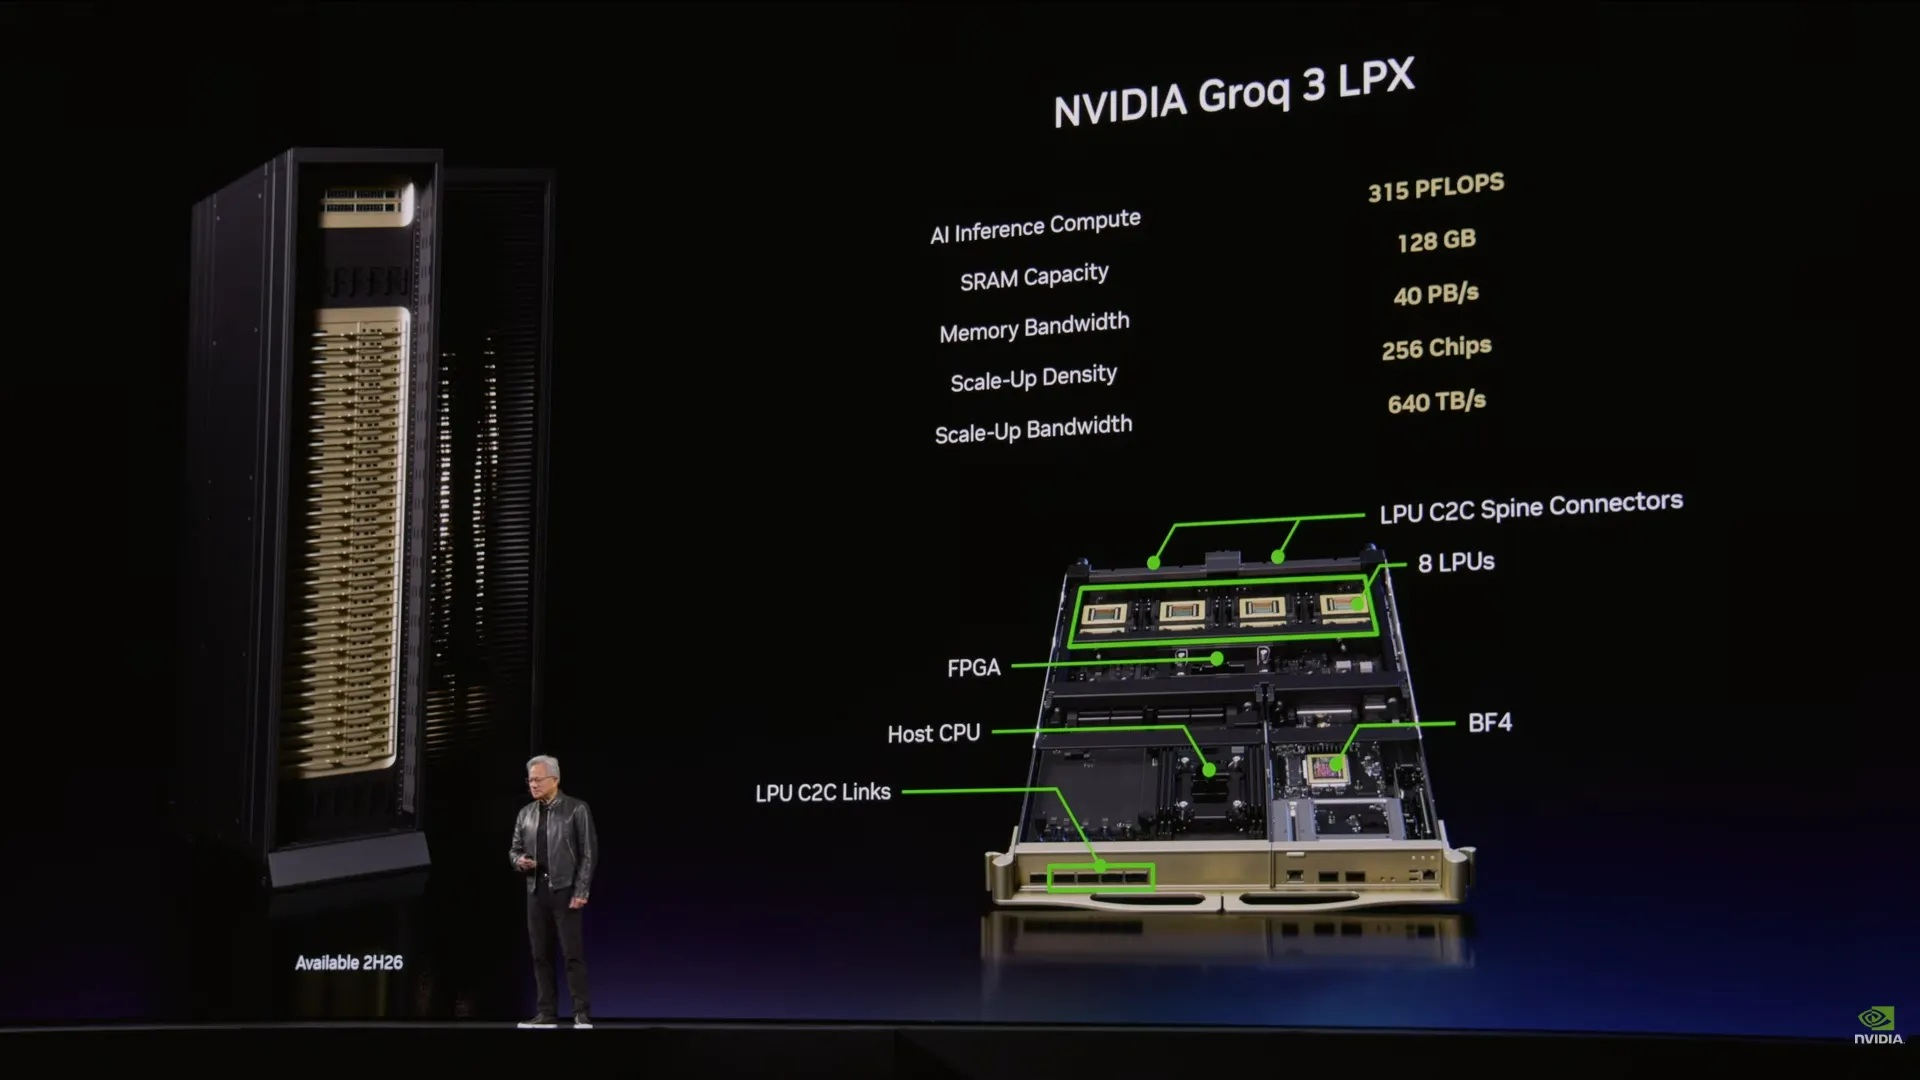
Источник изображения: NVIDIA Если Минюст США придёт к выводу, что NVIDIA должна была получить антимонопольное одобрение сделки, ведомство может потребовать взыскания гражданско-правовых штрафов. В то же время, по словам источника, окончательное решение ещё не принято, и Министерство юстиции в итоге может не обнаружить никаких нарушений. Впрочем, по данным Bloomberg, Минюст изучает возможные нарушения антимонопольного законодательства со стороны производителя чипов с 2024 года. Сообщается, что вопросы со стороны регулирующих органов относительно соглашения между NVIDIA и Groq возникли в начале текущего года в рамках этого более масштабного расследования. Сделки также привлекли внимание сенаторов, которые призвали FTC и Министерство юстиции США расследовать ряд таких сделок, включая партнёрство NVIDIA с компанией Groq. «По сути, эти сделки представляют собой фактические слияния, позволяющие компаниям объединять кадровые, информационные и финансовые ресурсы, при этом, судя по всему, пытаясь обойти процедуры контроля, обычно применяемые к сделкам по слиянию и поглощению», — указали сенаторы в письме, направленном в FTC и Министерство юстиции США. Хотя формально NVIDIA не покупала Groq, фактически её итоги равносильны поглощению. Внимание со стороны Министерства юстиции к этим вопросам возникло на фоне того, как NVIDIA — компания с рыночной капитализацией $5,4 трлн — фактически превратилась в «центральный банк» Кремниевой долины, используя свои огромные финансовые ресурсы для поддержки ИИ-стартапов и финансирования клиентов, отметила The New York Times. Главный вопрос для Министерства юстиции США заключается в том, нанесла ли эта сделка ущерб конкуренции; учитывая текущую ситуацию на рынке, доказать наличие такого ущерба может быть непросто, пишет The Register. Но даже если бы Минюст нашёл основания для судебного иска и добился отмены сделки, это вряд ли что-то кардинально изменило бы, отметил ресурс. 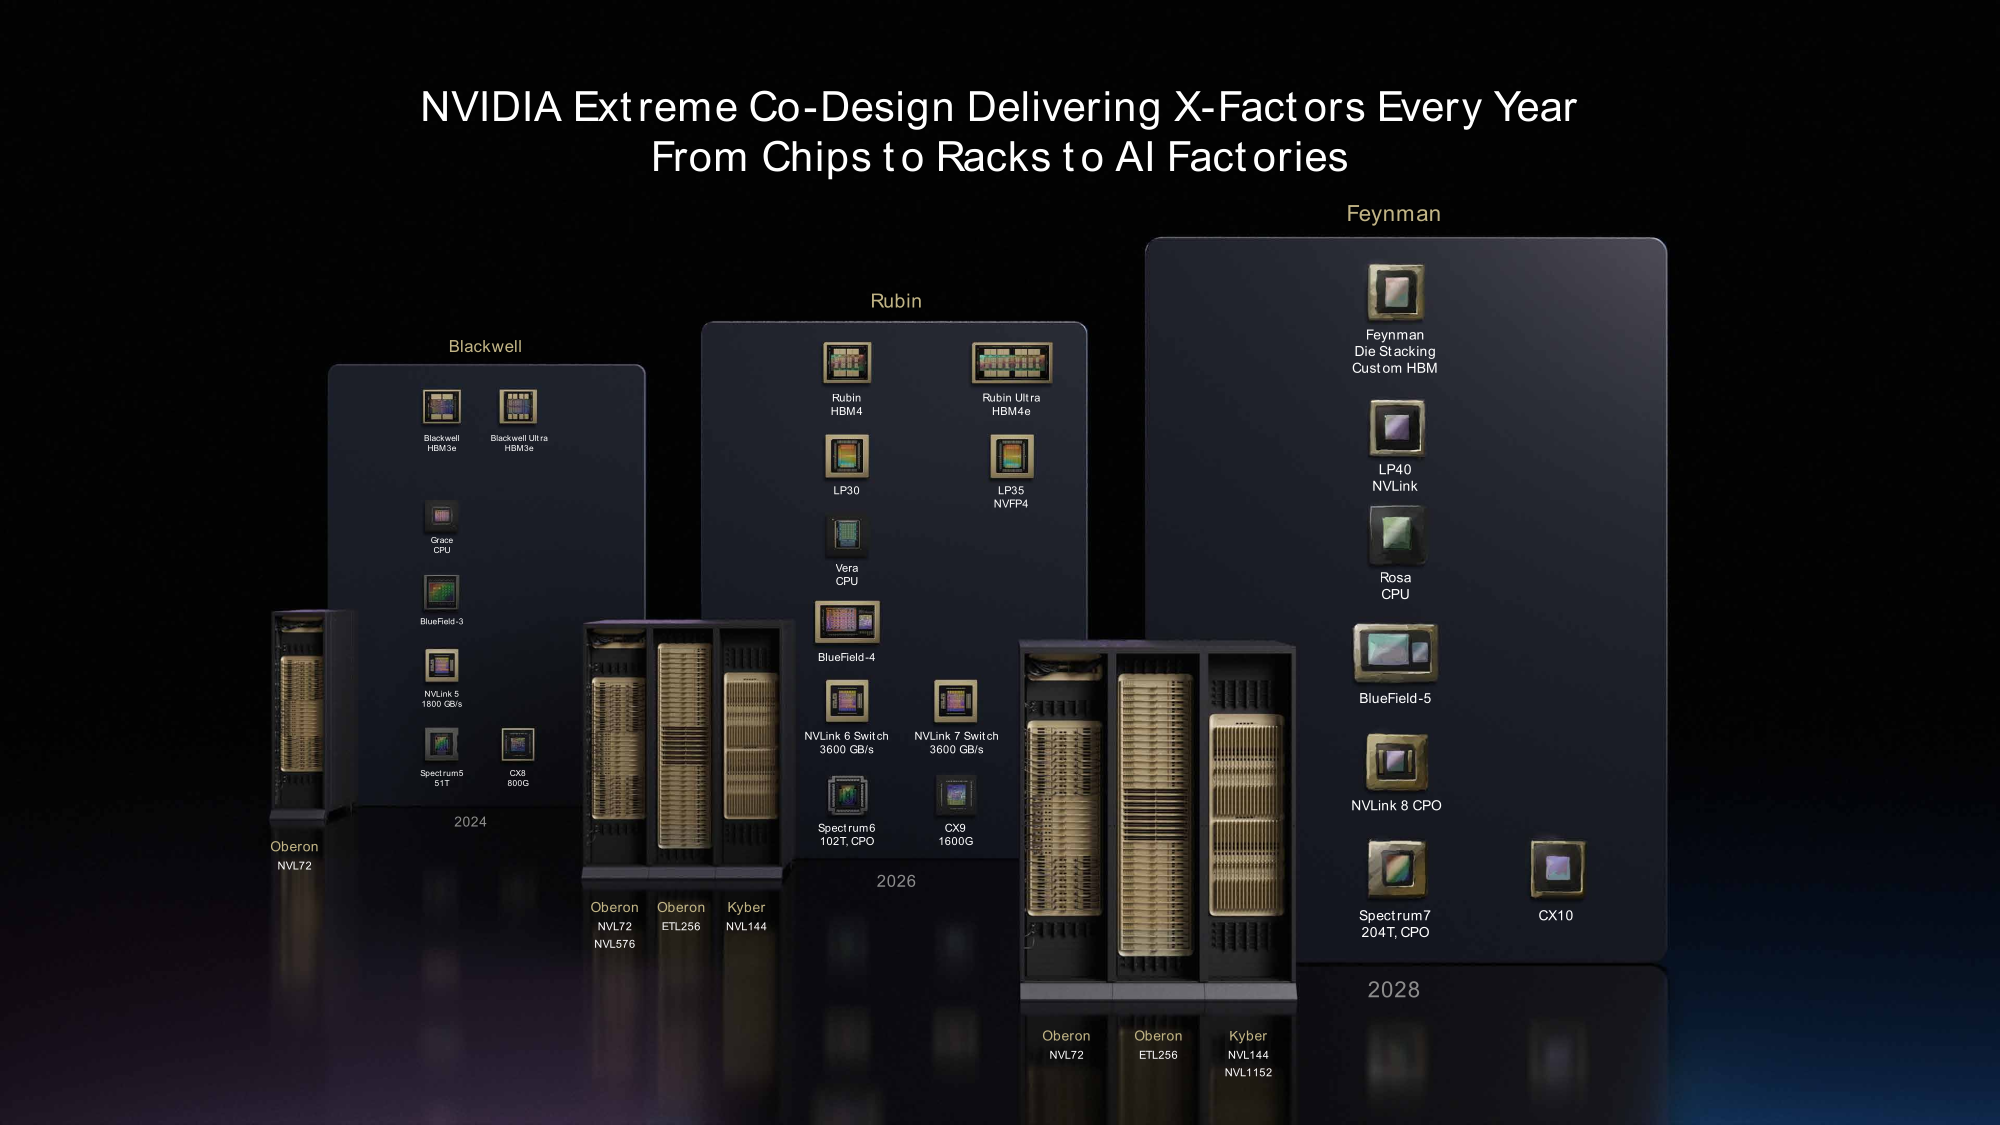 Сделка с Groq обеспечила NVIDIA два ключевых актива: готовые аппаратные решения (чипы) и специалистов, необходимых для их дальнейшей разработки. Groq стала известна благодаря созданию ускорителей с потоковой архитектурой и большим объёмом памяти SRAM, что позволило ускорить инференс больших языковых моделей (LLM) до показателей, которых системы NVIDIA на базе GPU самостоятельно достичь не могли. В марте NVIDIA представила стойки LPX, оснащённые 256 ускорителями LPU Groq 3. Глава NVIDIA пообещал, что связка Groq и Vera Rubin обеспечит оптимальную производительность для всего спектра задач инференса. The Register отметил, что дезагрегация вовсе не уникальная особенность Groq. Cerebras создаёт аналогичные системы совместно с AWS и AMD; SambaNova сотрудничает с Intel; а d-Matrix и ее партнёры объединяют свою платформу с GPU NVIDIA, преследуя те же цели, что и в случае комбинации Vera Rubin NVL72 с Groq 3 LPX. Ещё до объявления о сделке с Groq компания уже закладывала фундамент экосистемы, в центре которой находилось её подразделение сетевых технологий. Она передала свои проекты стоек MGX в Open Compute Project (OCP), позволив тем самым любому производителю чипов размещать свою продукцию в стойках, изначально спроектированных для GPU NVIDIA. Затем NVIDIA открыла доступ к своему интерконнекту в рамках программы NVLink Fusion. И теперь, если Министерство юстиции США заблокирует сделку (целью которой было поглощение компании ради получения её специалистов) и аннулирует соглашение с Groq, NVIDIA может лишиться прямого контроля над разработкой LPU и доходов от их продажи, но это не обязательно будет означать конец для стоек Groq LPX. Groq просто пополнит ряды растущего числа аппаратных партнёров NVIDIA, создающих решения для ИИ-фабрик (AI factory) этой компании. Более того, сама эта сделка гарантирует, что даже если регуляторы в итоге её сорвут, наготове окажется множество альтернатив.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
01.09.2026 [12:00], Сергей Карасёв
MediaTek даст NVIDIA NVLink Fusion кастомным ASIC, а NVIDIA вложит в MediaTek $3,5 млрдNVIDIA и MediaTek объявили о расширении долгосрочного партнёрства, направленного на создание платформ нового поколения для ИИ-задач. Сотрудничество охватывает три ключевых направления: это ИИ-инфраструктуры, локальные ИИ-вычисления и автомобилестроение. В рамках партнёрства разработчики кастомных чипов в MediaTek возьмут на вооружение технологию NVIDIA NVLink Fusion, что позволит гиперскейлерам, облачным провайдерам и разработчикам передовых ИИ-моделей создавать собственные ускорители (XPU) и интегрировать их в ИИ-фабрики стоечного масштаба на базе NVLink. Платформа NVLink Fusion предлагает основу для разработки многокристальных решений. Применяется специализированный чиплет NVLink Fusion для обеспечения связи XPU с интерконнектом NVLink с использованием фотонного или электрического интерконнекта. Задействована технология NVIDIA NVLink-C2C для когерентного объединения процессоров, графических чипов и других микросхем. Кроме того, применяется архитектура памяти NVIDIA NVHBM для повышения пропускной способности и энергоэффективности. В целом, платформа NVLink Fusion сокращает сроки вывода решений на рынок благодаря готовой инженерной базе. 
Источник изображения: NVIDIA NVIDIA и MediaTek также продолжат сотрудничество в области разработки изделий RTX Spark и DGX Spark следующих поколений, которые будут использоваться в потребительских системах, суперкомпьютерах для ИИ-разработчиков и рабочих станциях корпоративного класса. В таких устройствах GPU разработки NVIDIA будут соседствовать с однокристальными системами MediaTek. Наконец, партнёры займутся созданием платформ для программно-определяемых автомобилей с ИИ. Говорится об интеграции решений NVIDIA в состав платформы MediaTek Dimensity Auto для создания интеллектуальных автомобильных кабин. По условиям расширенного соглашения о сотрудничестве, компания NVIDIA инвестировала $3,5 млрд в конвертируемые облигации MediaTek.
27.08.2026 [10:12], Руслан Авдеев
NVIDIA придумала собственную память NVHBM с интегрированным контроллеромПо мере развития рынка ИИ-агентов и активного внедрения ИИ-моделей с триллионами параметров производительность сопутствующей ИИ-инфраструктуры требует не только роста вычислительных мощностей, но и эффективного проектирования в рамках единой системы вычислений, памяти, сети и ПО. Для помощи гиперскейлерам и другим клиентам, использующим NVLink Fusion, компания предложила память NVHBM. В традиционной архитектуре HBM-контроллер размещается на кристалле XPU, занимая некоторую площадь, которую можно было бы использовать для вычислений. NVHBM построена по той же технологии, что NVIDIA будет использовать в своих будущих GPU — кастомный контроллер памяти интегрируется в основной кристалл HBM, благодаря чему NVHBM обеспечит до 30 % роста пропускной способности памяти и до 15 % снижения энергопотребления, а также высвободит до 25 % больше площади основного кристалла XPU в сравнении со стандартной памятью HBM4E. 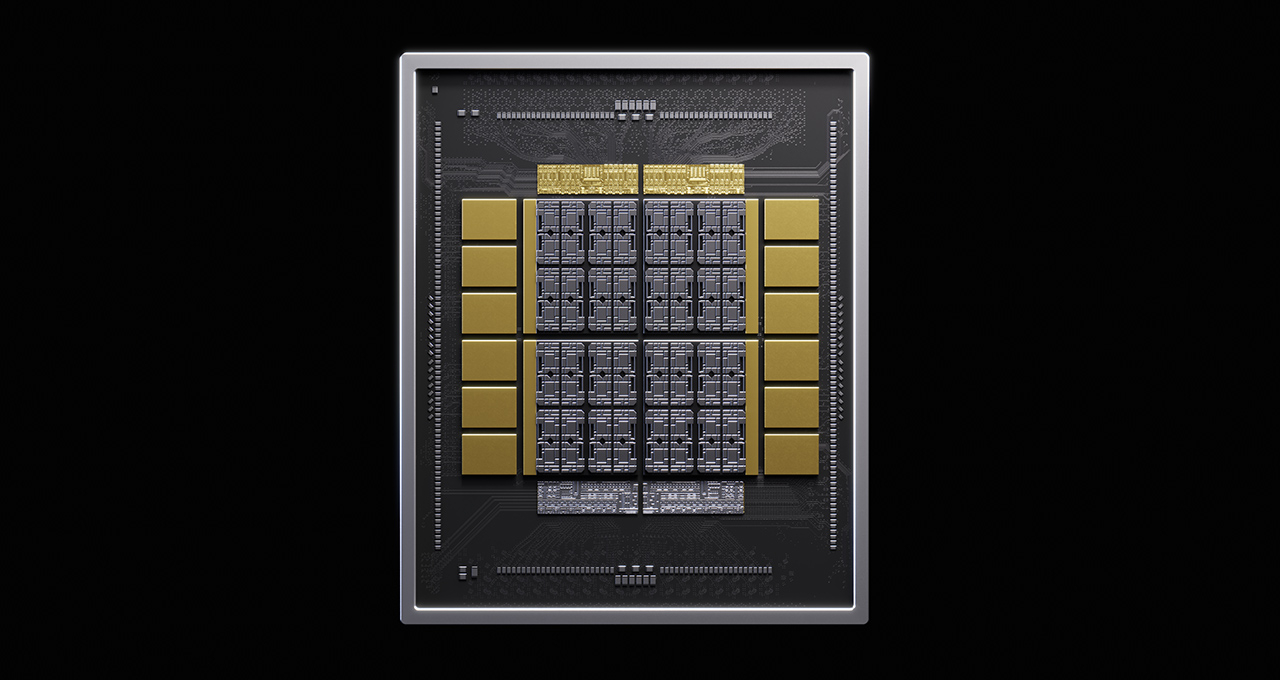
Источник изображения: NVIDIA Стандартный вариант реализации NVHBM будет доступен у нескольких поставщиков памяти. Это должно снизить объём инженерных работ, необходимых для интеграции и сертификации памяти разных производителей. Заказчики NVLink Fusion смогут быстрее выводить на рынок специализированные ИИ-ускорители. Подразделение Annapurna Labs компании Amazon первым получит возможность поработать над NVHBM в рамках более широкого сотрудничества с NVIDIA по развитию NVLink Fusion, которое предполагает интеграцию NVLink Fusion в ИИ-ускорители Trainium4. NVLink Fusion уже позволяет подключать XPU и CPU к стоечной платформе NVIDIA, партнёры компании могут получить доступ к чиплетам NVLink-C2C, сетевым коммутаторам NVLink и стойкам NVIDIA MGX. Также возможно использование широкой номенклатуры CPU различных партнёров, разработчиков ASIC и др.
03.06.2026 [15:09], Руслан Авдеев
Ayar Labs присоединилась к экосистеме NVIDIA NVLink Fusion с собственной CPO-технологиейAyar Labs присоединилась к экосистеме NVIDIA NVLink Fusion. Технология Co-Packaged Optics (CPO), предлагаемая компанией, позиционируется как решение для подключения будущих стоечных ИИ-систем на основе масштабируемой гетерогенной вычислительной архитектуры NVIDIA, сообщает Converge! Digest. Новый шаг объединяет технологию оптических интерконнектов Ayar Labs с оптическими и SerDes-технологиями NVIDIA. Это позволит крупным компаниям и разработчикам ИИ-систем интегрировать оптические соединения в ИИ-инфраструктуру на базе NVLink Fusion. ИИ-кластерам нового поколения необходимо обеспечить эффективную передачу огромных объёмов информации по мере увеличения гетерогенности систем и количества используемых ускорителей. Обычные интерконнекты практически достигли предела в контексте плотности пропускной способности, дальности действия, задержек и энергопотребления. Ayar Labs пытается преодолеть эти ограничения, интегрируя оптические модули с вычислительными. Это позволит нарастить как пропускную способность, так и дальность действия, одновременно снизив потребление электроэнергии. 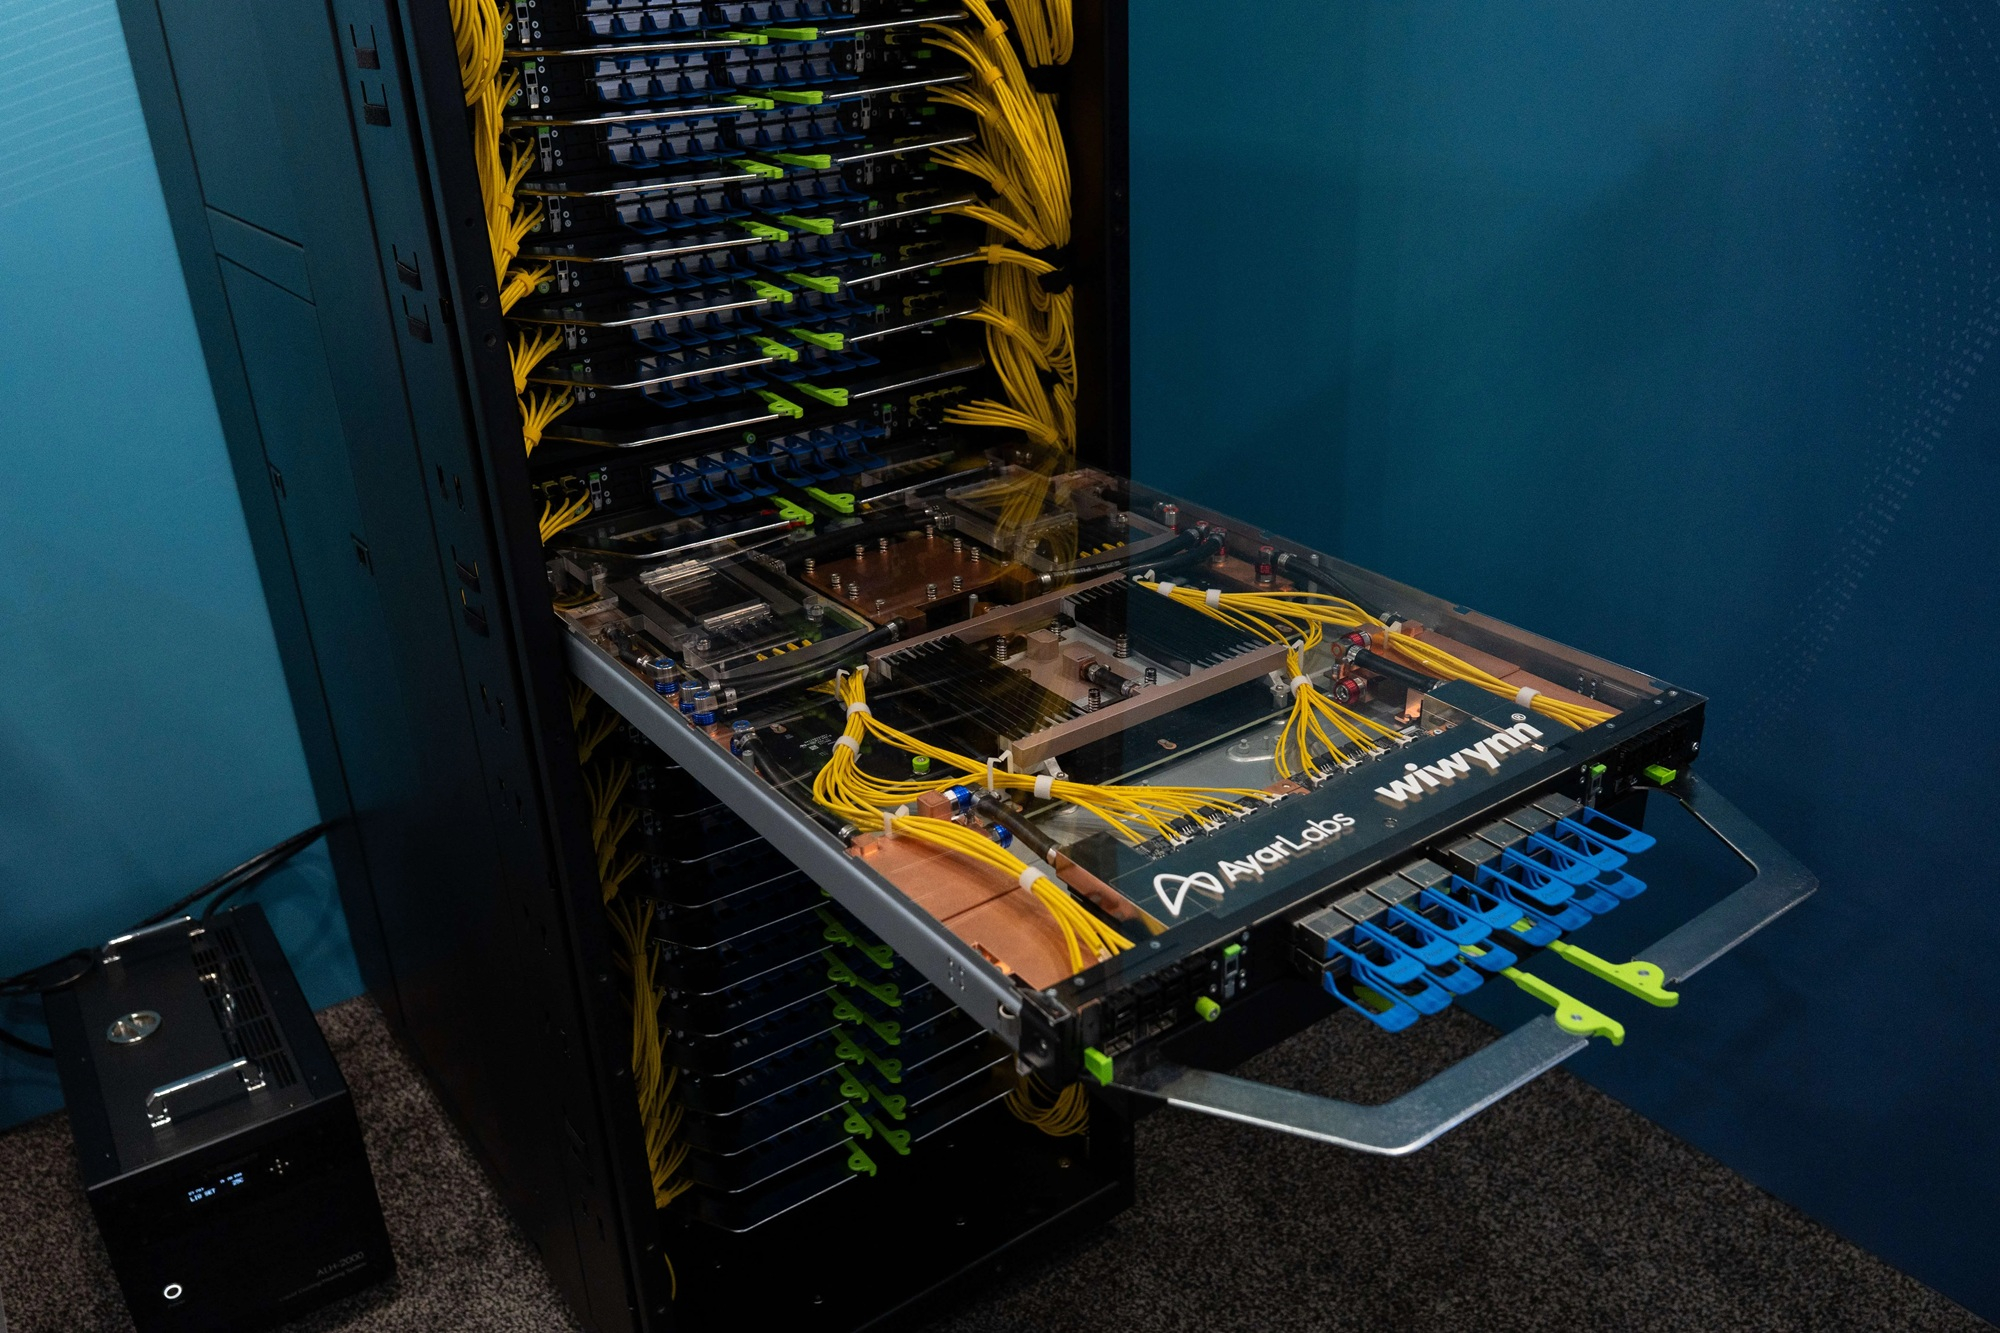
Источник изображения: Ayar Labs В рамках партнёрства с NVIDIA компания Ayar Labs намерена сотрудничать с клиентами и партнёрами по экосистеме, чтобы поддержать развёртывание своих CPO-решений в архитектурах на основе NVLink Fusion. Такая платформа позволяет интегрировать специализированные процессоры и ИИ-ускорители в стоечные системы NVIDIA, сохраняя совместимость с более широкой экосистемой NVLink. Благодаря оптической связи архитекторы систем получат ещё один вариант для проектирования крупных ИИ-фабрик. Объявление последовало за раундом финансирования серии E, в котором Ayar Labs, с 2015 года занимающаяся оптическими IO-технологиями для ИИ и HPC, привлекла $500 млн. В раунде приняла участие и компания NVIDIA. По словам Converge!, речь идёт о новой вехе для рынка CPO-технологий, поскольку этот шаг Ayar Labs приближает массовое внедрение таких решений в ИИ-инфраструктуру. Технология CPO годами рассматривалась как преемник подключаемых оптических модулей с высоким энергопотреблением и медных интерконнектов, и именно сегодня кластеры ИИ-ускорителей достигли такой производительности, что CPO становится всё более привлекательным вариантом для ИИ-систем. Решение NVIDIA включить Ayar Labs в экосистему NVLink Fusion свидетельствует о признании в отрасли ИИ того факта, что будущие системы могут потребовать использования оптики не только между стойками, но и внутри них. NVIDIA NVLink Fusion позволяет создавать кастомные ИИ-платформы со сторонними чипами и другими компонентами. Ранее NVIDIA заключила соглашения в отношении NVLink с Arm, AWS, Fujitsu, Intel, Marvell, MediaTek и SiFive.
31.03.2026 [20:09], Владимир Мироненко
NVIDIA инвестировала $2 млрд в Marvell, приобщив её к своей ИИ-экосистеме и NVLink FusionАкции Marvell Technology подскочили более чем на 9 % на предрыночных торгах после объявления NVIDIA об инвестициях в размере $2 млрд в рамках стратегического партнёрства с интеграцией решений Marvell в экосистему NVIDIA. Это позволит Marvell подключиться к ИИ-фабрике NVIDIA и экосистеме AI-RAN посредством NVIDIA NVLink Fusion, предоставляя клиентам, использующим архитектуры NVIDIA, больший выбор и гибкость при разработке инфраструктуры следующего поколения. Marvell предоставит клиентам специализированные XPU и масштабируемые сетевые решения, совместимые с NVLink Fusion, а NVIDIA — вспомогательные технологии, включая процессоры Vera, сетевые решения ConnectX и Bluefield, интерконнект NVLink и коммутаторы Spectrum-X, а также вычислительные ИИ-мощности в стоечном исполнении. Для клиентов, разрабатывающих специализированные XPU, NVLink Fusion предлагает гетерогенную ИИ-инфраструктуру, полностью совместимую с системами NVIDIA, обеспечивая бесшовную интеграцию с платформами NVIDIA GPU, LPU, сетевыми и СХД-платформами, используя технологический стек NVIDIA и глобальную экосистему поставок. Ранее NVIDIA заключила похожие соглашения в отношении NVLink с SiFive, AWS, Arm, Fujitsu, Intel и MediaTek. Компании также будут сотрудничать в ключевых областях, таких как кремниевая фотоника и телекоммуникационные сети с целью преобразования сетей в инфраструктуру ИИ с помощью NVIDIA Aerial AI-RAN для 5G/6G и развития передовых решений для оптического интерконнекта. «Вместе с Marvell мы даём клиентам возможность использовать экосистему ИИ-инфраструктуры NVIDIA и масштабировать её для создания специализированных вычислительных ИИ-мощностей», — заявил гендиректор NVIDIA Дженсен Хуанг (Jensen Huang). 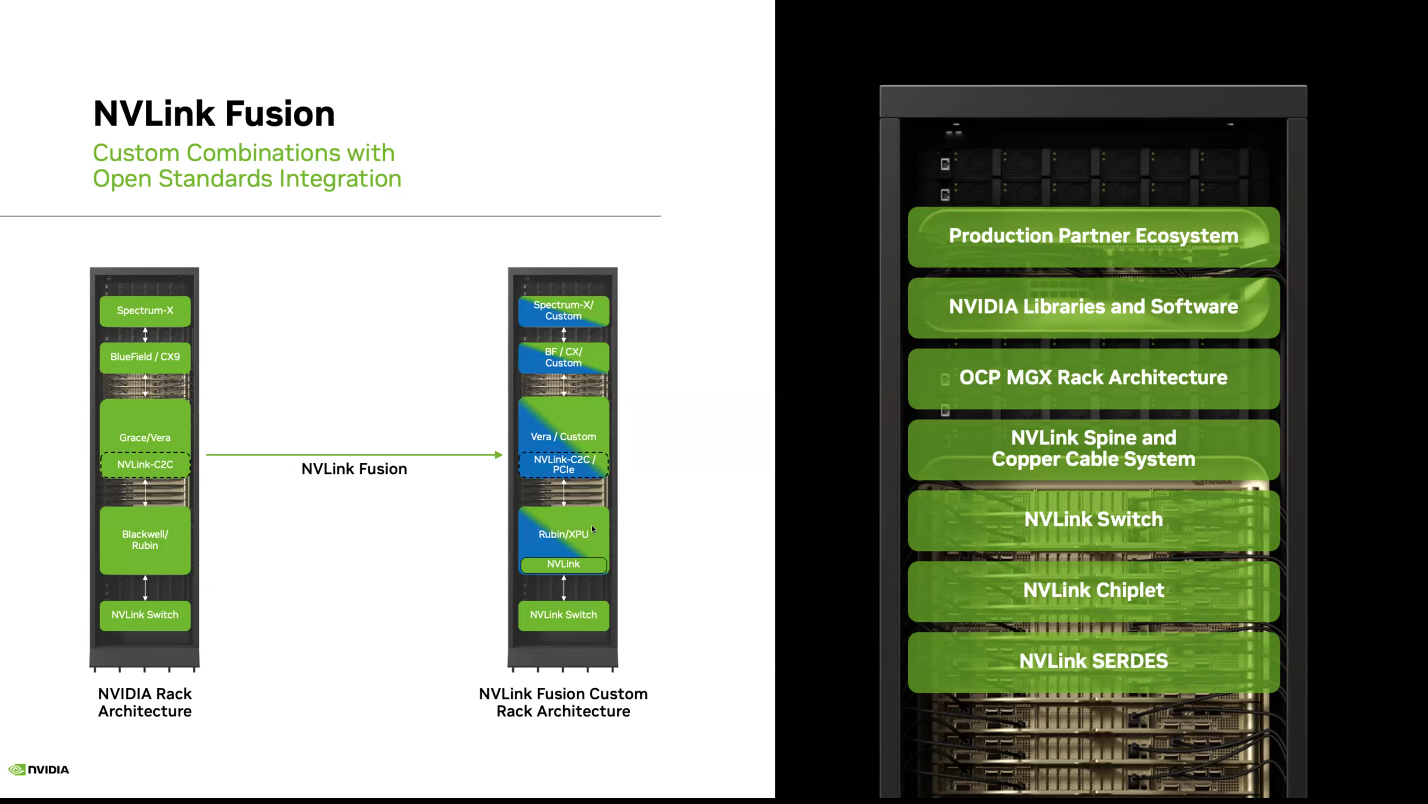
Источник изображения: NVIDIA Эта сделка является частью более широкой стратегии NVIDIA по инвестированию в ИИ-экосистему с целью укрепления своего лидерства на ИИ-рынке. Недавно NVIDIA инвестировала аналогичные суммы в несколько компаний, включая Synopsys, Nokia, CoreWeave, Coherent, Lumentum и Nebius, тем самым укрепляя свое влияние по всей цепочке создания стоимости. Таким образом NVIDIA стремится удовлетворить экспоненциальный рост спроса на вычислительные мощности, обусловленный ИИ-инференсом и генерацией контента. Используя стратегические партнёрства, NVIDIA намерена ускорить развёртывание специализированной инфраструктуры и обеспечить разработку необходимых технологий для роста сегмента.
16.01.2026 [23:14], Владимир Мироненко
NVIDIA добралась до RISC-V: NVLink Fusion пропишется в серверных процессорах SiFiveПродолжая укреплять свои лидирующие позиции на ИИ-рынке NVIDIA не скрывает стремления построить целую экосистему ИИ-платформ с привязкой к своим решениям. Эти усилия активизировались в прошлом году с анонсом технологии NVLink Fusion, позволяющей использовать NVLink в чипах сторонних производителей. Как стало известно, вслед за Arm, Intel и AWS, присоединившимися к программе в прошлом году, экосистема NVLink Fusion пополнилась первым поставщиком чипов на архитектуре RISC-V — компанией SiFive, которая объявила о планах внедрить NVLink Fusion в свои будущие чипы для ЦОД. SiFive отметила, что ИИ-вычисления вступают в фазу, когда архитектурная гибкость и энергоэффективность так же важны, как и пиковая пропускная способность. Нагрузки обучения и инференса растут быстрее, чем энергетические бюджеты, заставляя операторов ЦОД переосмыслить способы подключения и управления CPU, GPU и ASIC. Теперь производительность на Вт и эффективность перемещения данных стали первостепенными ограничениями при проектировании чипов. Патрик Литтл (Patrick Little), президент и генеральный директор SiFive заявил, что ИИ-инфраструктура больше не строится из универсальных компонентов, а разрабатывается совместно с нуля: «Интегрируя NVLink Fusion с высокопроизводительными вычислительными подсистемами SiFive, мы предоставляем клиентам открытую и настраиваемую платформу CPU, которая легко интегрируется с ИИ-инфраструктурой NVIDIA, обеспечивая исключительную эффективность в масштабах ЦОД». 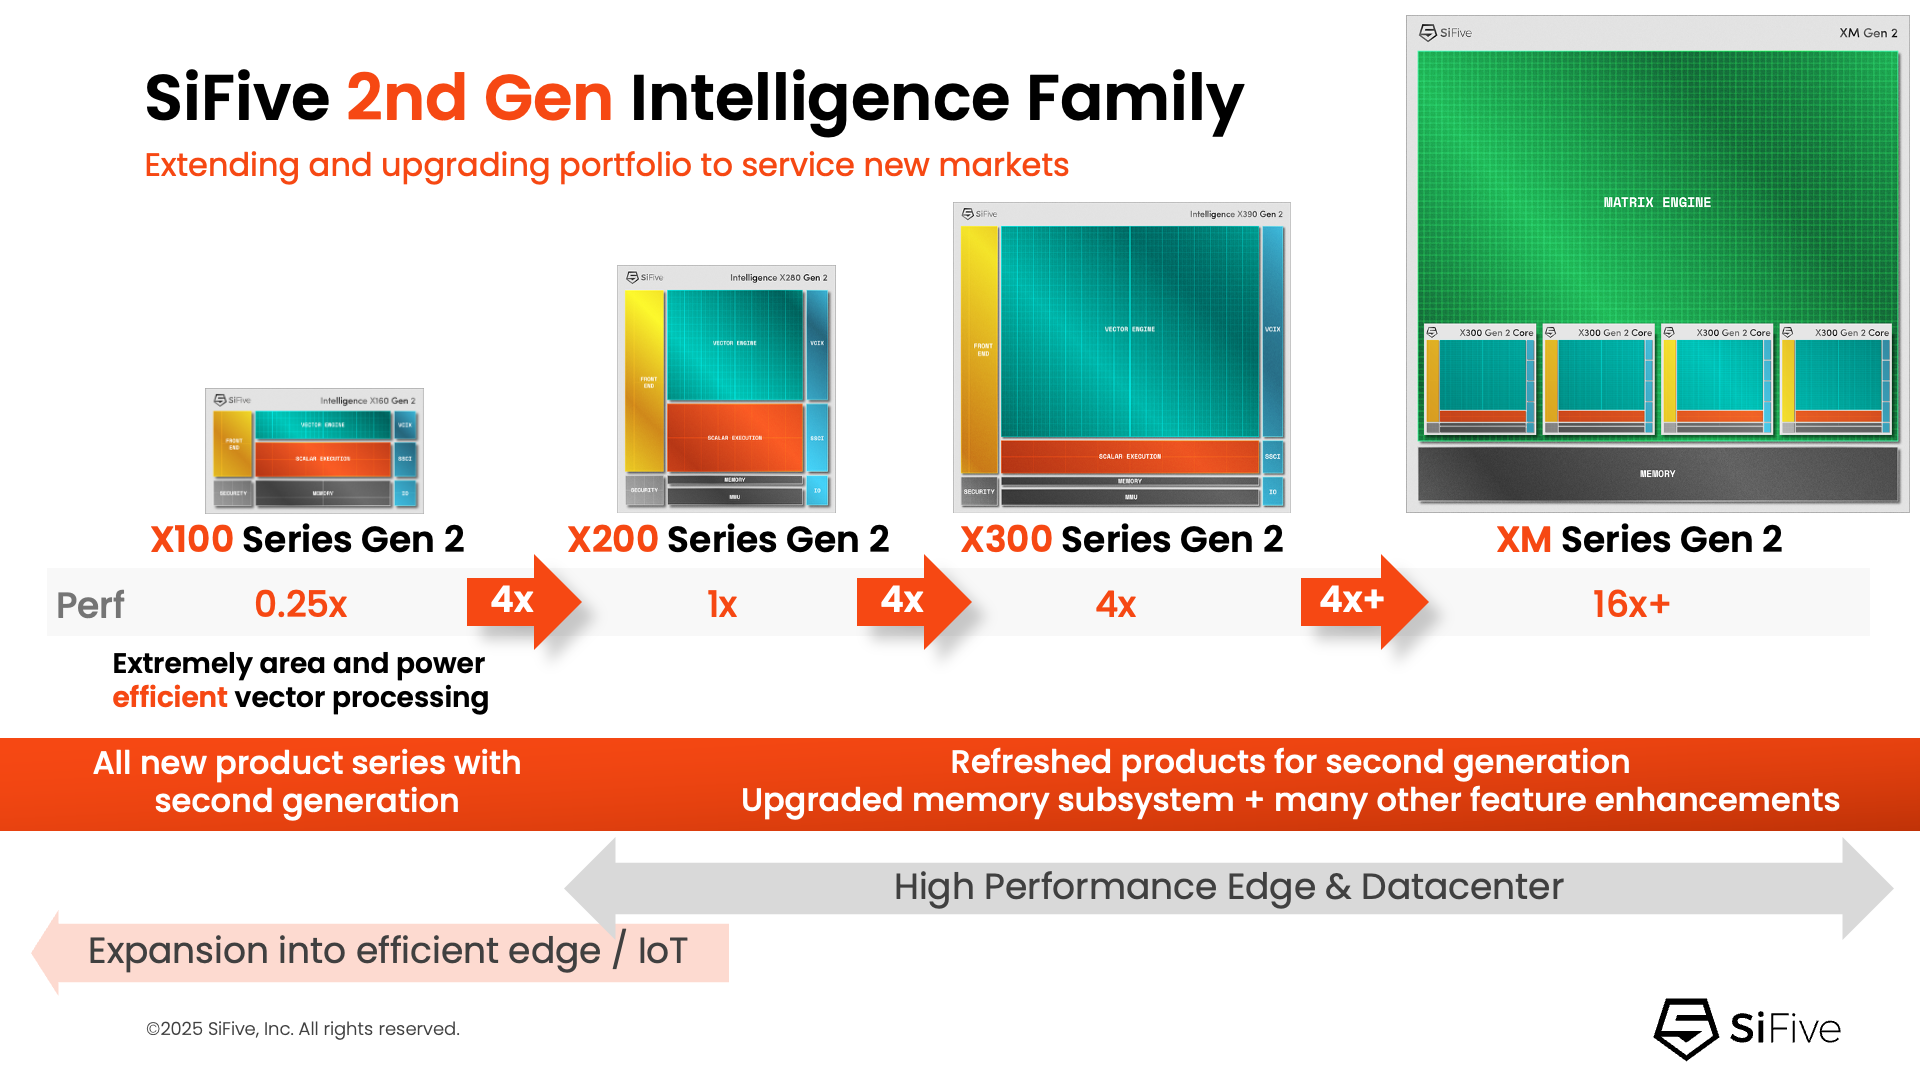
Источник изображения: SiFive Пресс-релиз SiFive не содержит каких-либо конкретных планов по продуктам, кроме сообщения о добавления поддержки NVLink к «высокопроизводительным решениям для ЦОД» SiFive. Предположительно, речь идёт о чипах платформы Vera Rubin или более поздних, т.е. о NVLink 6. Для SiFive — как поставщика IP-блоков RISC-V CPU — интерес заключается в использовании интерконнекта NVLink-C2C, который обеспечивает высокоскоростную, полностью кеш-когерентную связь между CPU и GPU, и это предпочтительный способ подключения к ускорителям NVIDIA в высокоинтегрированных системах. В рамках экосистемы NVLink Fusion NVIDIA предлагает NVLink-C2C в качестве лицензируемого IP-ядра, что упростит интеграцию шины в будущие чипы SiFive. Для SiFive это может стать конкурентным преимуществом. Кроме того, NVIDIA объявила о поддержке RISC-V — на эту архитектуру портируют CUDA и драйверы, что со временем откроет для компании новые рынки.
03.12.2025 [01:28], Владимир Мироненко
AWS «сдалась на милость» NVIDIA: анонсированы ИИ-ускорители Trainium4 с шиной NVLink FusionAWS готовит Arm-процессоры Graviton5, которые составят компанию ИИ-ускорителям Trainium4 с интерконнектом NVLink Fusion, фирменными EFA-адаптерам и DPU Nitro 6 с движком Nitro Isolation Engine. Но что более важно, все они будут «упакованы» в стойки стандарта NVIDIA MGX. Amazon и NVIDIA объявили о долгосрочном партнёрстве, в рамках которого ИИ-ускорители Trainium4 получит шину NVIDIA NVLink Fusion шестого поколения (по-видимому, 3,6 Тбайт/с в дуплексе), которая позволит создать стоечную платформу нового поколения, причём, что интересно, на базе архитектуры NVIDIA MGX, которая передана в OCP. Пикантность ситуации в том, что AWS годами практически игнорировала OCP, самостоятельно создавая стойки, их компоненты, включая СЖО, и архитектуру ИИ ЦОД в целом. Даже в нынешнем поколении стоек с GB300 NVL72 отказалась от референсного дизайна NVIDIA. NVIDIA же напирает на то, что для гиперскейлерам крайне трудно заниматься кастомными решениями — циклы разработки стоечной архитектуры занимают много времени, поскольку помимо проектирования специализированного ИИ-чипа, гиперскейлеры должны озаботиться вертикальным и горизонтальным масштабированием, интерконнектами, хранилищем, а также самой конструкцией стойки, включая лотки, охлаждение, питание и ПО. 
Источник изображения: NVIDIA Вместе с тем управление цепочкой поставок отличается высокой сложностью, так как требуется обеспечить согласованную работу десятков поставщиков, ответственных за десятки тысяч компонентов. И даже одна задержка поставки или замена одного компонента может поставить под угрозу весь проект. Платформа NVIDIA если не устраняет целиком, то хотя бы смягчает эти проблемы, предлагая готовые стандартизированные решения, которые могут поставлять множество игроков рынка. 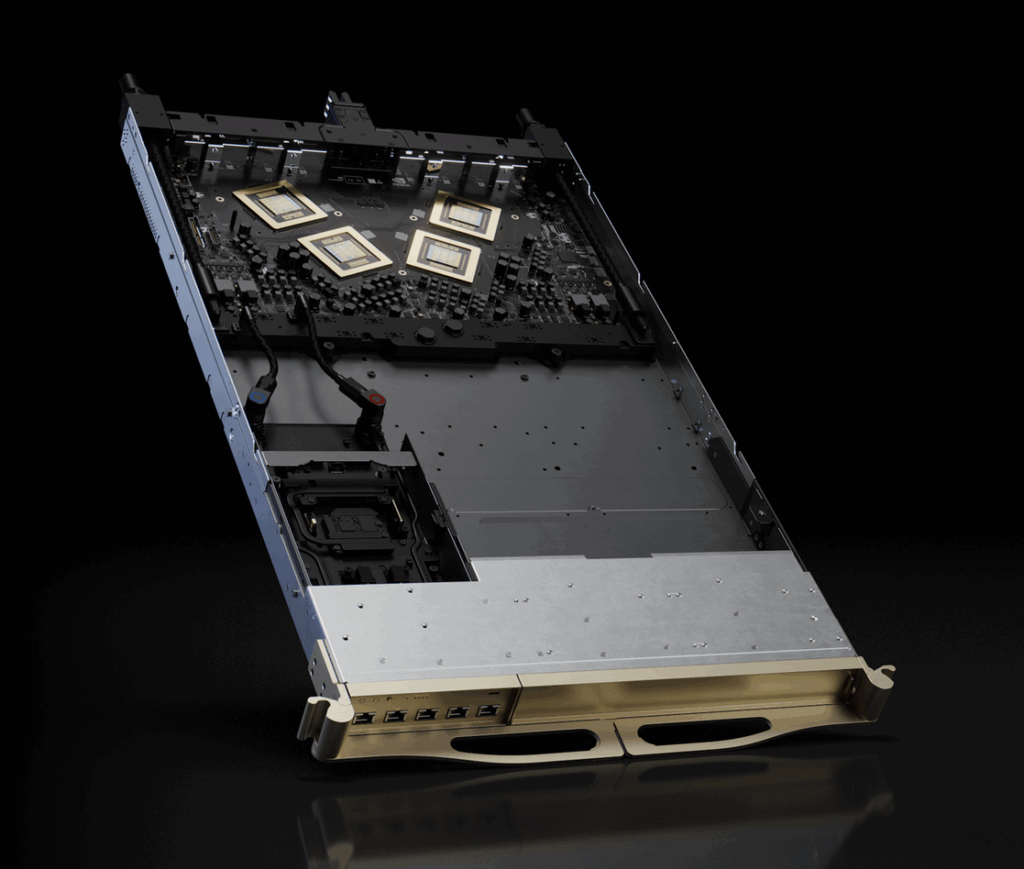
Источник изображения: NVIDIA По словам NVIDIA, в отличие от других подходов к масштабированию сетей, NVLink — проверенная и широко распространённая технология. В сочетании с фирменным ПО NVLink Switch обеспечивает увеличение производительности и дохода от ИИ-инференса до трёх раз, объединяя 72 ускорителя в одном домене. Пользователи, внедрившие NVLink Fusion, могут использовать любую часть платформы — каждый компонент может помочь им быстро масштабироваться для удовлетворения требований интенсивного инференса и обучения моделей агентного ИИ, говорит NVIDIA. 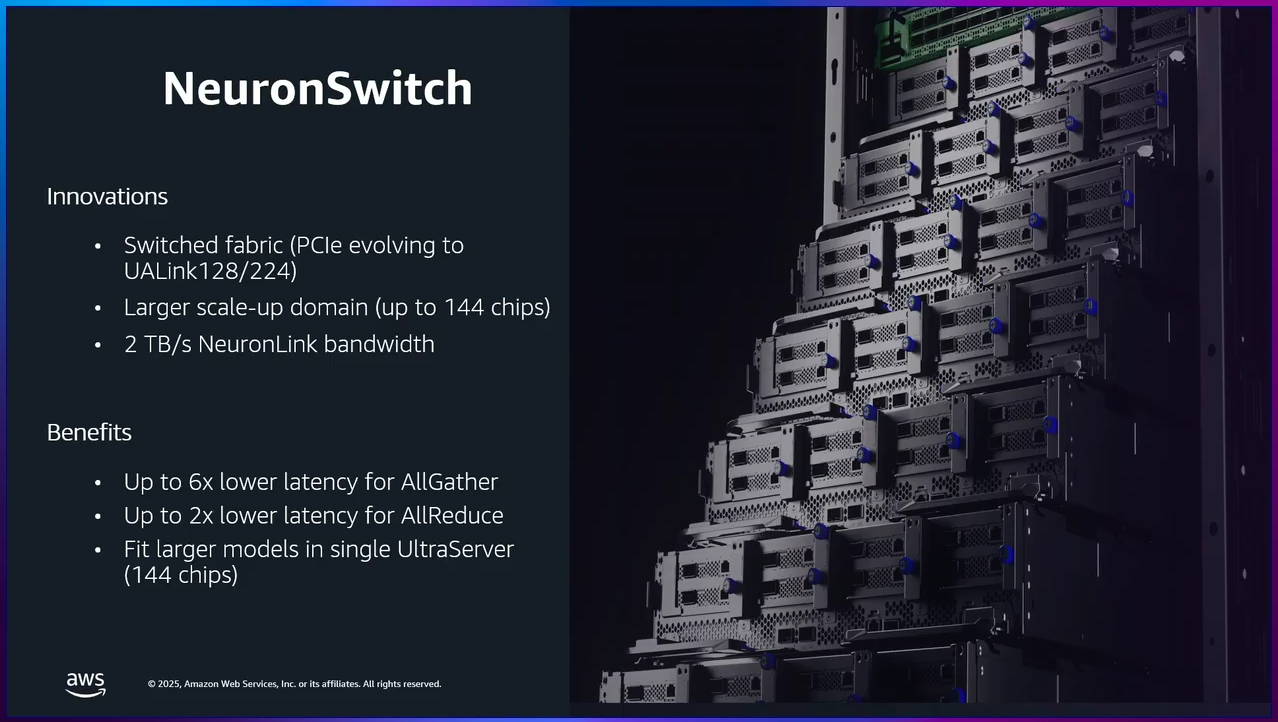
Источник изображения: AWS Что касается самих ускорителей Trainium4, то в сравнении с Trainium3 они будут вшестеро быстрее в FP4-расчётах, втрое быстрее в FP8-вычислениях, а пропускная способность памяти будет увеличена вчетверо. Впрочем, пока собственные ускорители Amazon не всегда могут составить конкуренцию чипам NVIDIA. Любопытно и то, что в рассказе о Trainium3 компания отметила о переходе от PCIe к UALink в коммутаторах NeuronSwitch для фирменного интерконнекта NeuronLink, объединяющего до 144 чипов Trainium. Однако после крупных инвестиций NVIDIA в Synopsys развитие UALink как открытой альтернативы NVLink теперь под вопросом.
18.11.2025 [23:59], Владимир Мироненко
Arm добавила Neoverse поддержку NVIDIA NVLink FusionArm объявила о расширении возможностей платформы Neoverse с помощью NVIDIA NVLink Fusion в рамках партнёрства с NVIDIA, обеспечивая всей экосистеме ту же производительность, пропускную способность и эффективность, которые впервые были реализованы на платформах Grace Hopper и Grace Blackwell. «NVLink Fusion — это связующее звено эпохи ИИ, объединяющее все CPU, GPU и ускорители в единую архитектуру стоечного масштаба», — заявил Дженсен Хуанг (Jensen Huang), основатель и генеральный директор NVIDIA. Как сообщается в пресс-релизе, два года назад Arm и NVIDIA представили платформу Grace Hopper, в которой технология NVLink обеспечила согласованную интеграцию CPU и GPU. NVLink Fusion обеспечивает компаниям возможность подключать вычислительные системы на базе Arm к предпочитаемым ими ускорителям через согласованный интерфейс с высокой пропускной способностью. 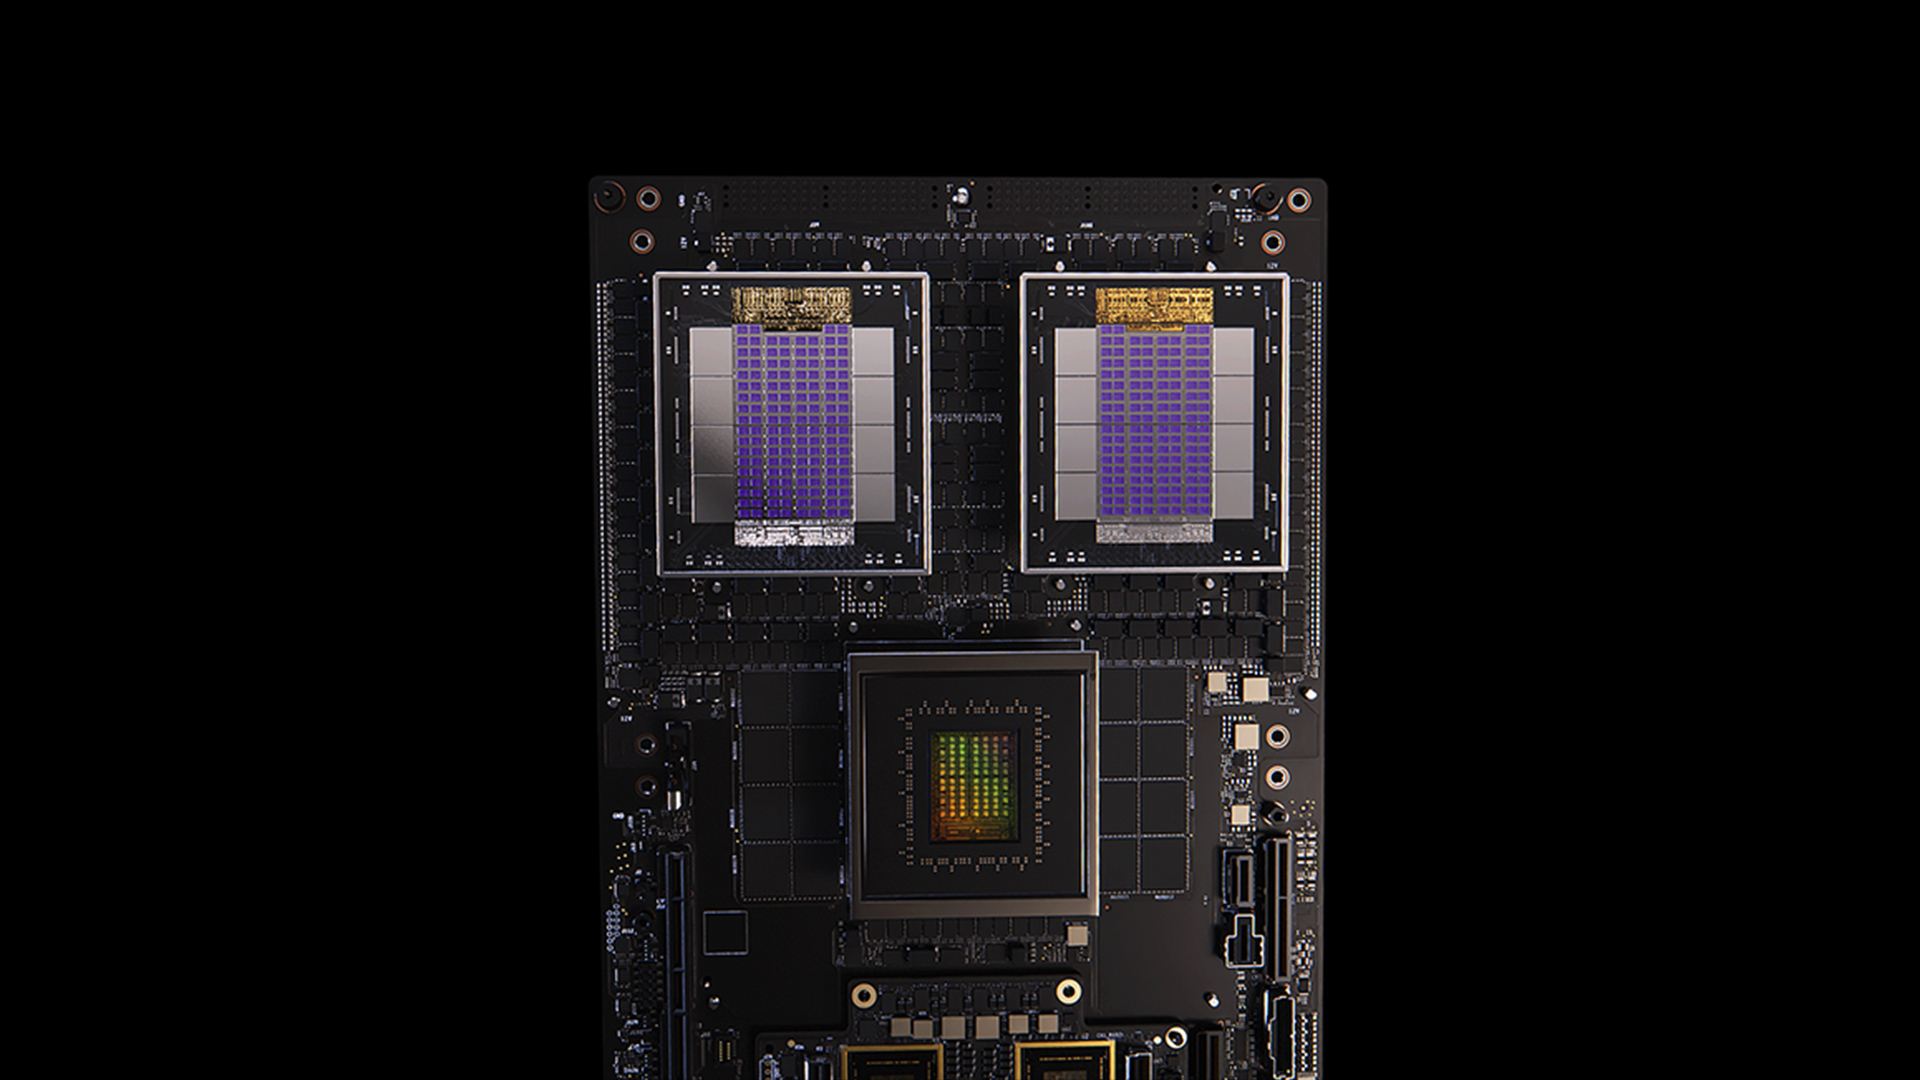
Источник изображения: NVIDIA Устойчивый спрос на Grace Blackwell способствует распространению NVLink Fusion во всей экосистеме Neoverse, позволяя партнёрам создавать дифференцированные, энергоэффективные ИИ-системы на базе Arm, отвечающие современным требованиям к производительности и масштабируемости. Arm отметила, что на текущий момент развёрнуто более чем 1 млрд ядер Neoverse и уверенно движется к достижению 50 % доли рынка среди ведущих гиперскейлеров к 2025 году. Все крупные провайдеры — AWS, Google, Microsoft, Oracle и Meta✴ — используют Neoverse, а ИИ ЦОД следующего поколения, такие как проект Stargate, используют Arm как основную вычислительную платформу. NVLink Fusion совместим с технологией AMBA CHI C2C (Coherent Hub Interface Chip-to-Chip) компании Arm, которая обеспечивает когерентное высокоскоростное соединения между CPU и ускорителями. Arm внедряет в платформу Neoverse последнюю версию протокола AMBA CHI C2C, чтобы SoC Neoverse могли беспрепятственно передавать данные между CPU Arm и ускорителями. Благодаря этому обеспечивается более быстрая интеграция, более быстрый вывод на рынок и большая гибкость для разработчиков ИИ-систем нового поколения. В свою очередь, NVIDIA работает над стандартизацией многих компонентов в этих системах для повышения надёжности и времени безотказной работы. С этой целью в CPU NVIDIA Vera следующего поколения будут использоваться кастомные ядра Arm вместо ядер Neoverse. Fujitsu также разрабатывает собственные Arm-процессоры MONAKA-X, которые тоже получат NVLink Fusion. NVLink Fusion получат и x86-процессоры Intel.
04.10.2025 [12:56], Сергей Карасёв
Fujitsu и NVIDIA создадут вычислительную ИИ-инфраструктуру нового поколенияЯпонская корпорация Fujitsu объявила о расширении стратегического сотрудничества с NVIDIA с целью создания полнофункциональной инфраструктуры ИИ следующего поколения, в состав которой войдут ИИ-агенты. Предполагается, что инициатива поможет ускорить развитие таких отраслей, как здравоохранение, производство, робототехника и др. Партнёры намерены работать по ряду направлений. В частности, Fujitsu и NVIDIA займутся созданием передовой вычислительной инфраструктуры для задач ИИ. Речь идёт об объединении серверных процессоров Fujitsu Monaka на архитектуре Arm с высокопроизводительными GPU разработки NVIDIA. Для этого будет задействована технология NVLink Fusion, позволяющая применять скоростные интерконнекты NVLink со сторонними чипами. Конечной целью является предоставление комплексной экосистемы HPC-ИИ с интегрированным софтом Fujitsu для Arm-процессоров и NVIDIA CUDA. Кроме того, сотрудничество предусматривает создание «саморазвивающейся» платформы ИИ-агентов. Она, как ожидается, обеспечит высокую производительность и безопасность. Планируется внедрение механизма, который позволит агентам и моделям ИИ развиваться автономно с возможностью оптимизации под запросы конкретных отраслей. В конечном итоге, такие агенты будут предоставляться заказчикам в виде микросервисов NVIDIA NIM. 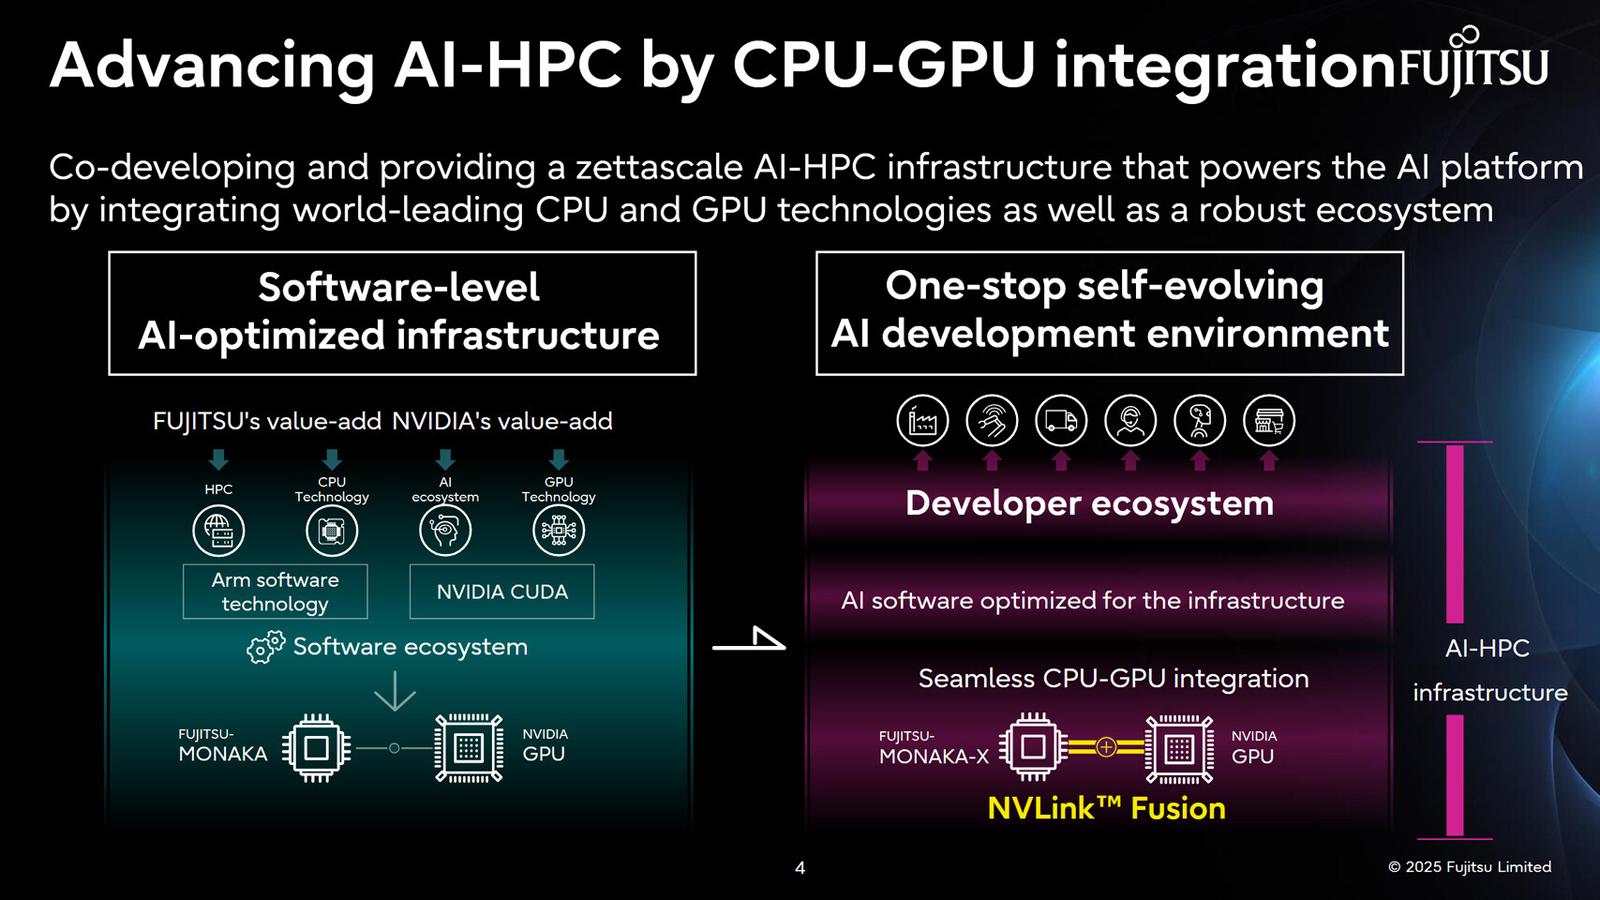
Источник изображений: Fujitsu Ещё одним направлением сотрудничества названо формирование партнёрской экосистемы для расширения использования агентов и моделей ИИ. Планируется также разработка передовых квантовых технологий, включая гибридные квантово-классические вычислительные системы на основе чипов Monaka и НРС-решений NVIDIA. 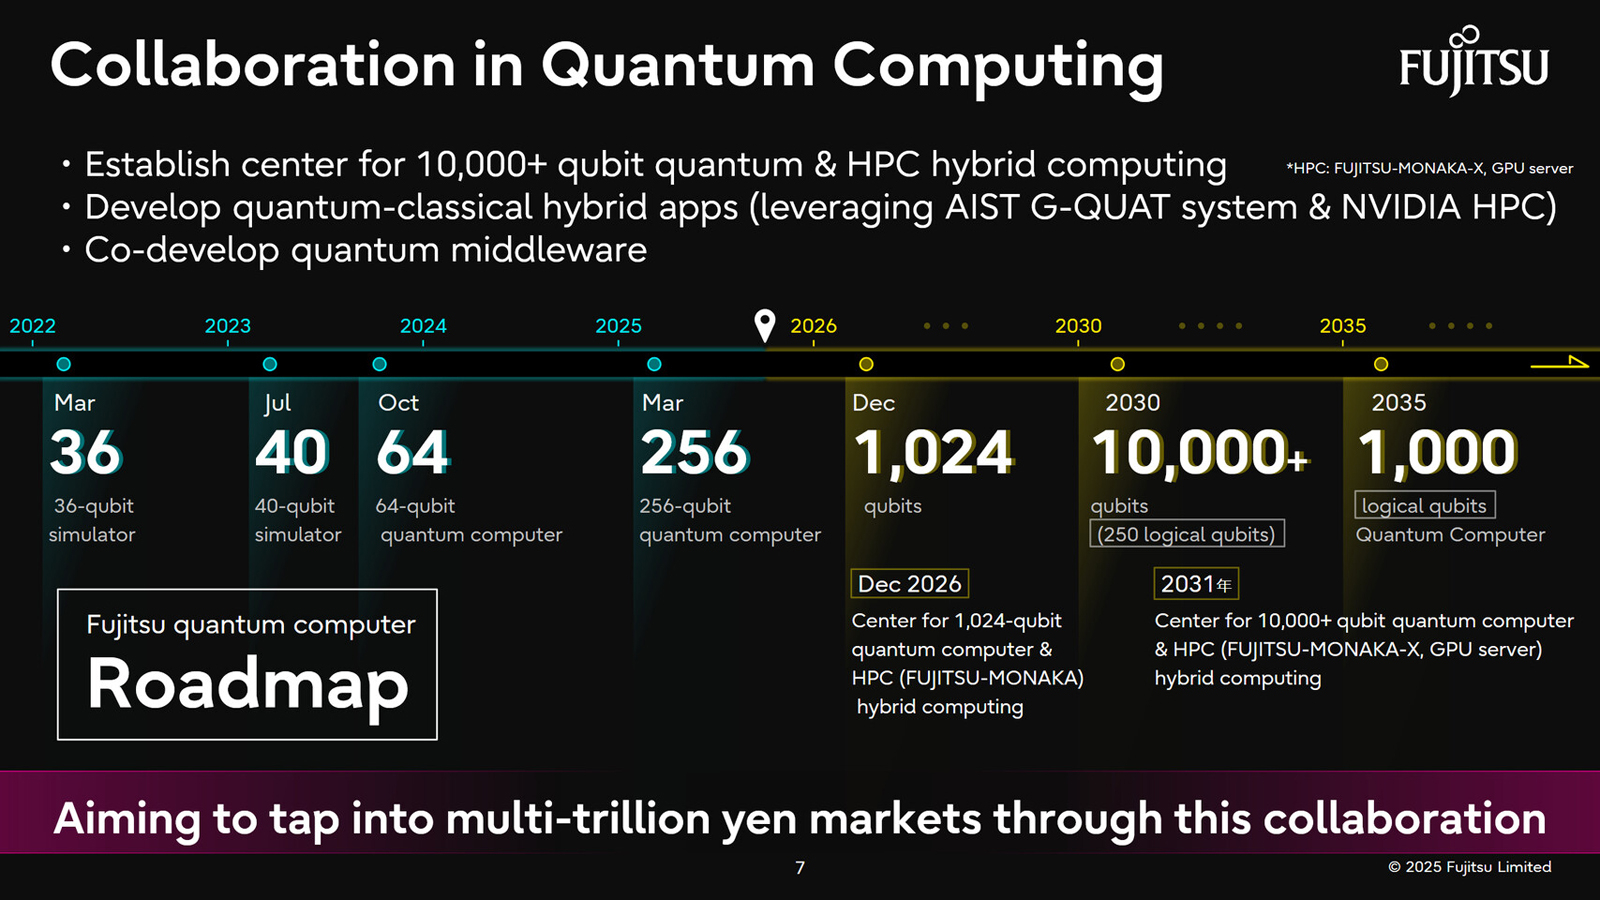 В целом, как отмечается, к 2030 году спрос на вычислительные мощности для ИИ в Японии вырастет в 320 раз по сравнению с 2020-м. На этом фоне местные компании, включая Fujitsu, SoftBank и KDDI, активно реализуют различные проекты, направленные на развитие рынка ИИ. |
|

