Материалы по тегу: arm
|
23.09.2026 [15:54], Владимир Мироненко
SiPearl поставила первые образцы европейского серверного процессора Rhea1 для суперкомпьютера JUPITERФранцузский разработчик процессоров SiPearl предоставил образцы своего первого процессора Rhea1 компании Bull, которая приступила к интеграции чипа в свою платформу BullSequana XH3000 для первого в Европе суперкомпьютера экзафлопсного класса JUPITER (Joint Undertaking Pioneer for Innovative and Transformative Exascale Research) в суперкомпьютерном центре Forschungszentrum Juelich (FZJ) в Юлихе (Jülich, Германия). На данном этапе производятся работы по созданию процессорного блейд-модуля для JUPITER, дополняющего GPU-сегмент, что открывает возможность полноценной модульной интеграции всего комплекса. Поставка оборудования для JUPITER стала первым заказом на серверные процессоры Rhea1 для компании SiPearl. Процессор включает 80 ядер Arm Neoverse V1 (Zeus), четыре стека памяти HBM2e (64 Гбайт), а также четыре канала памяти DDR5 (2DPC). Поддерживаются 104 линии PCIe 5.0 в виде шести комплексов x16 и двух x4. Благодаря этим ключевым характеристикам Rhea1 идеально подходит для выполнения самых ресурсоёмких HPC-задач, обеспечивая при этом безопасность без бэкдоров и «выключателей», энергоэффективность и гибкость, отмечено в пресс-релизе. Выход Rhea1 на рынок запланирован на конец 2026 года. 
Источник изображения: SiPearl «Благодаря высокой пропускной способности памяти этот процессор особенно хорошо подходит для приложений, которым необходим эффективный доступ к большим объёмам данных», — отметил директор Юлихского суперкомпьютерного центра Исследовательского центра Юлиха, а исполнительный директор EuroHPC JU назвал поставку образцов «важной вехой на пути к суверенитету Европы в области суперкомпьютерных технологий». Вторая европейская система экзафлопсного уровня Alice Recoque, будет установлена в центре CEA/DAM к югу от Парижа. В ней будет использоваться процессор Rhea2. Генеральный директор и основатель SiPearl сообщил, что компания сейчас ведёт переговоры с предприятиями оборонного сектора по поводу поставок ещё одного продукта — Athena1 — специализированной версии Rhea1 для приложений двойного назначения.
16.09.2026 [01:35], Владимир Мироненко
144-ядерные Arm-процессоры Fujitsu MONAKA станут доступны в ноябреFujitsu объявила о предстоящем старте глобальных продаж процессора нового поколения Fujitsu MONAKA, намеченном на ноябрь 2026 года. Также компания выпустит на базе новинок сервер Fujitsu MONAKA Server для суверенной ИИ-инфраструктуры, который станет доступен для заказа с ноября 2026 года операторам ЦОД, предприятиям, академическим учреждениями и HPC-центрам в Японии и Европе, и оборонному сектору. Массовые поставки начнутся в апреле следующего года. В процессоре Fujitsu MONAKA используется 3D-стековая архитектура с 2-нм техпроцессом для Arm-ядер и 5-нм техпроцессом для кеша и I/O-блоков. Чип имеет до 144 ядер, работает на частоте до 3,8 ГГц и поддерживает память DDR5-8800. Также сообщалось, что процессоры MONAKA получат продвинутую упаковку Broadcom 3.5D XDSiP. Использование собственной технологии Ultra Low Voltage обеспечивает высокую энергоэффективность процессора. MONAKA обеспечивает аппаратное ускорение матричных операций, используя специальные инструкции, которое в сочетании с поддержкой векторных вычислений SVE2 и программной оптимизацией позволяет ускорять ИИ-инференс непосредственно на уровне CPU. Как сообщает Fujitsu, чип обеспечивает вдвое большую пропускную способность для ИИ-инференса по сравнению с другими процессорами. 
Источник изображений: Fujitsu Кроме того, MONAKA поддерживает конфиденциальные вычисления для защиты данных и приложений на аппаратном уровне с помощью технологии Arm CCA, которая обеспечивает шифрование приложений и данных непосредственно во время их выполнения в оперативной памяти, в том числе при работе в многопользовательских облачных средах с разделением ресурсов. 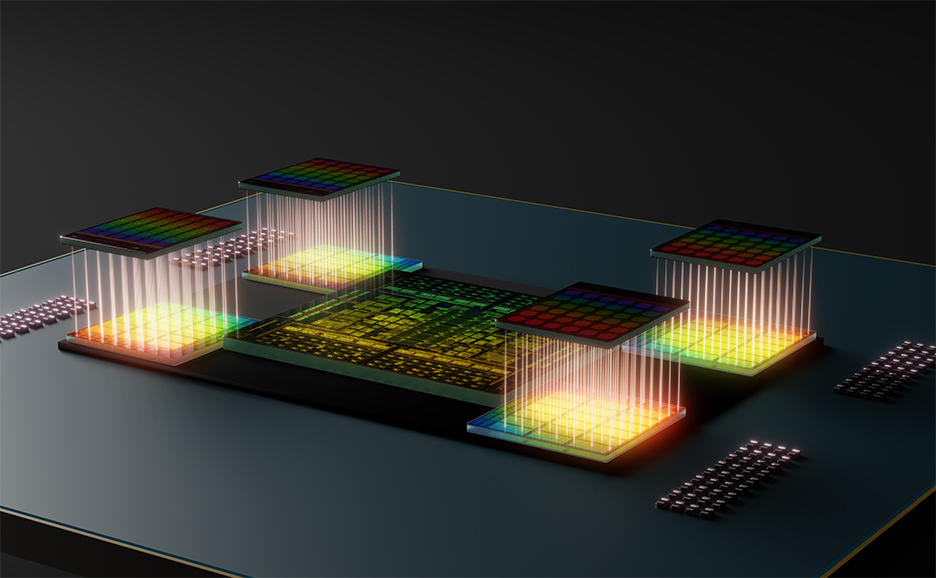 Первоначально серверы на базе MONAKA будут доступны в конфигурациях 1U (один или два сокета) и 2U (два сокета) для задач ИИ-инференса и работы ИИ-агентов. Также планируется выпуск отдельной многоузловой системы формата 2U4N (два сокета на узел) для академических целей и HPC. В частности, эта система подходит для создания суррогатных моделей и CFD-расчётов. 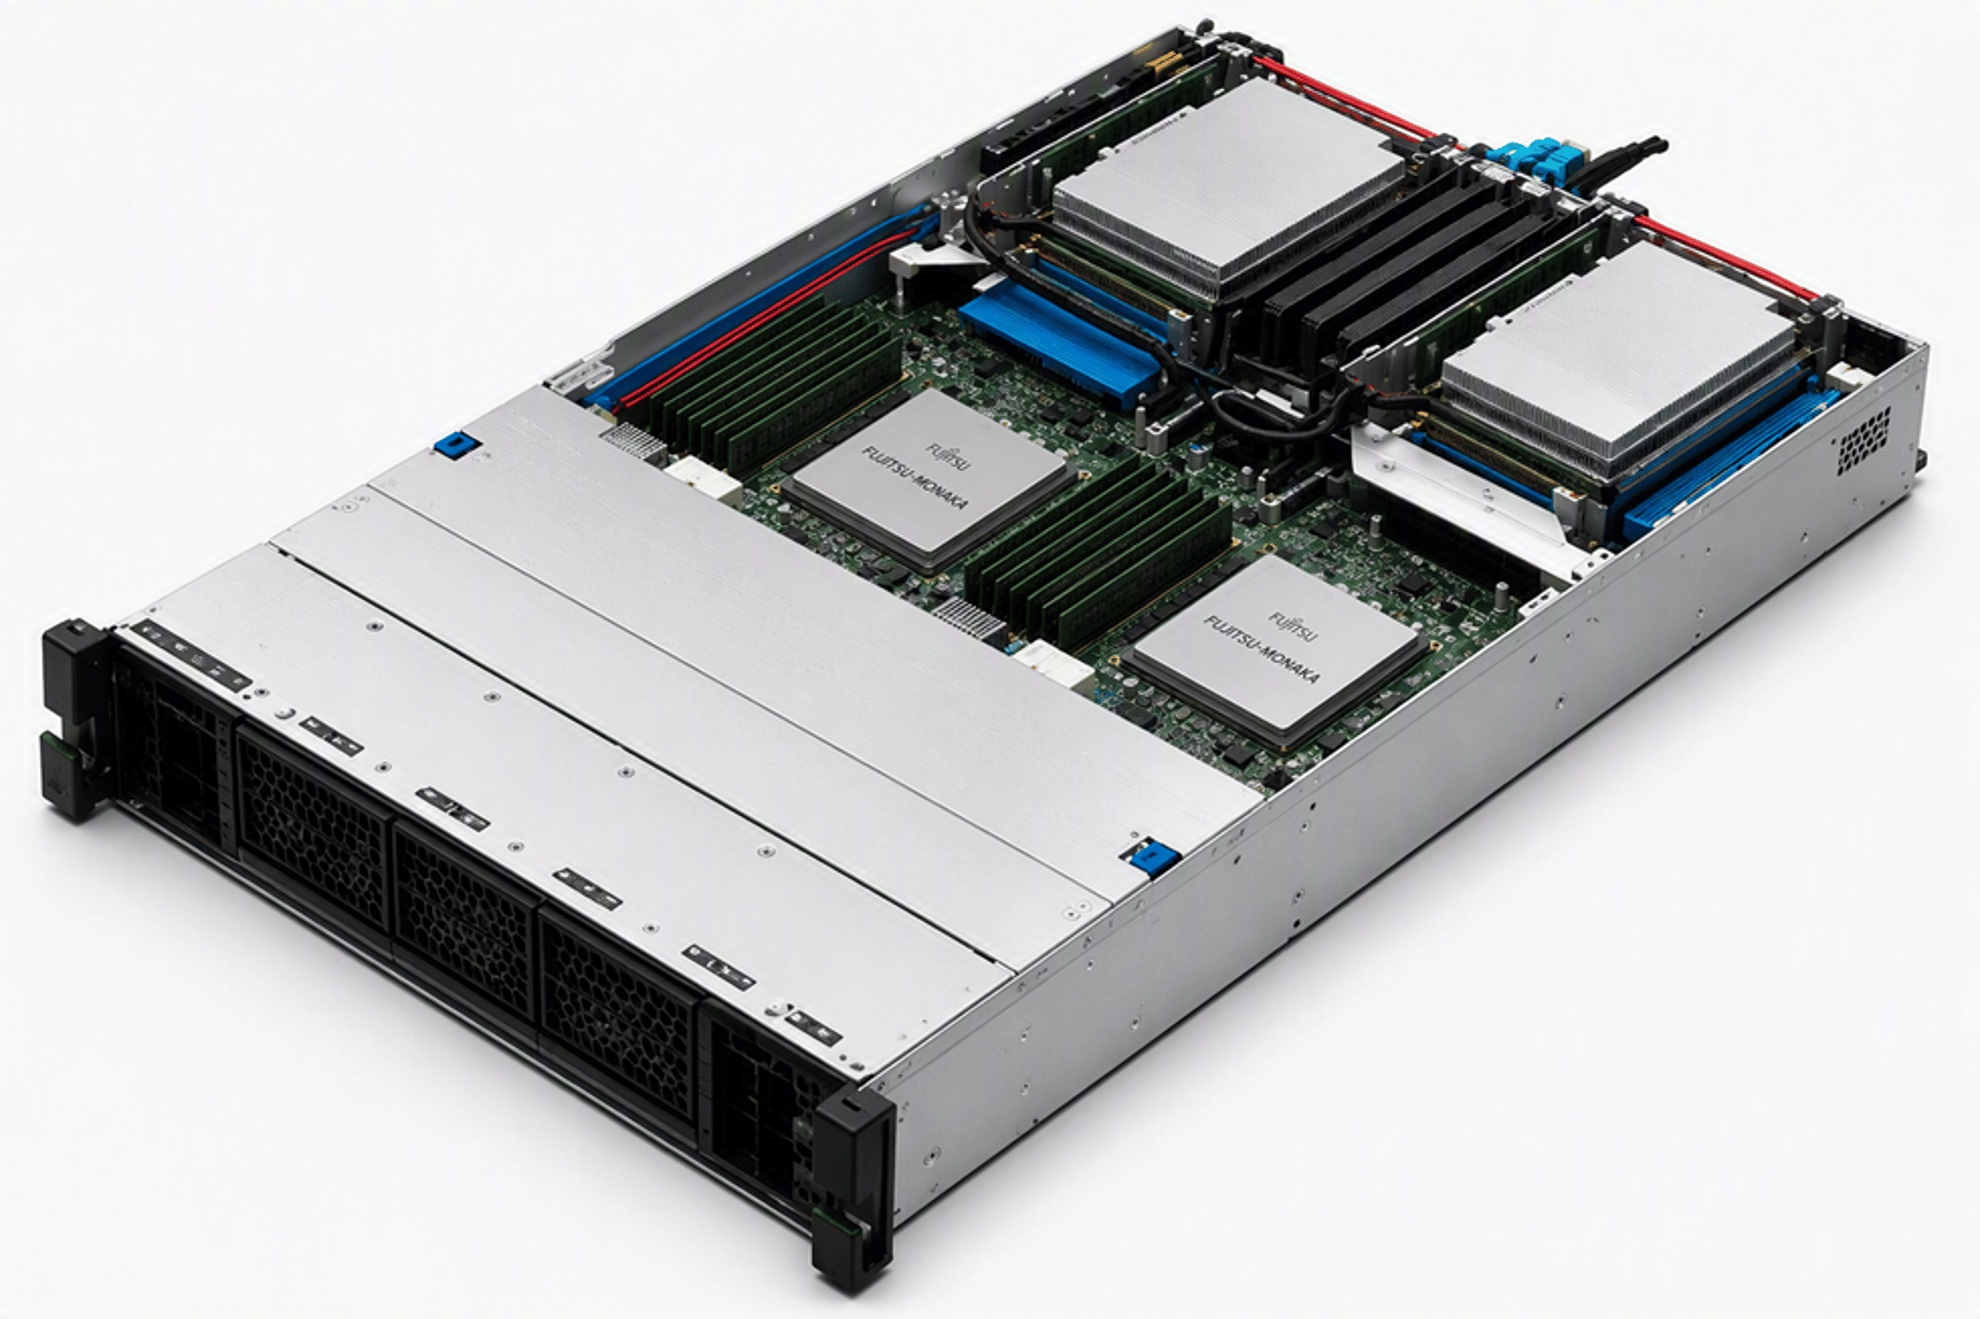 1U-версия поддерживает воздушное охлаждение с температурой окружающей среды до +40 °C (базовая частота ядер — 2,1 ГГц) и СЖО с температурой воды до +45 °C (базовая частота ядер — 2,9 ГГц) без необходимости в специализированной инфраструктуре охлаждения. Согласно Fujitsu, фирменная технология охлаждения серверов позволяет снизить энергопотребление систем охлаждения до 80 %. Каждому процессору полагается 12 слотов памяти. Подсистема хранения включает восемь слотов E3.S и два слота M.2. Основная шина — PCIe 6.0, но поддержка GPU не заявлена. 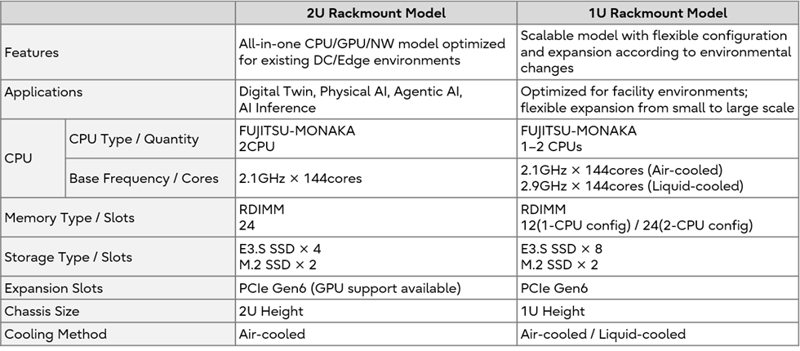 Кроме того, доступная память 1U-версии может быть расширена путём использования дезагеграции и CXL. Речь, вероятно, о внешних разделяемых пулах памяти. Такой подход решает проблему нехватки памяти — распространённую при ИИ-инференсе — и максимизирует эффективность использования ресурсов, обеспечивая гибкую адаптацию к будущим крупномасштабным ИИ-моделям и изменениям рабочих нагрузок, говорит Fujitsu. 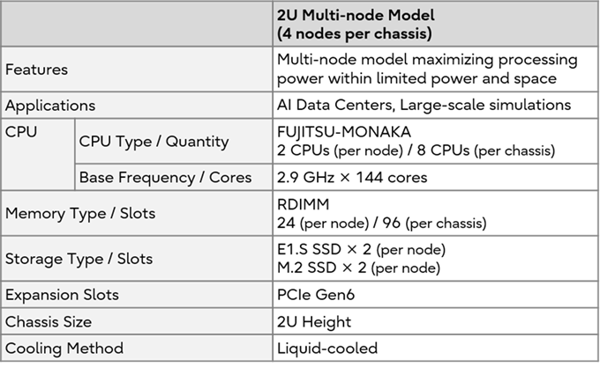 2U-сервер включает два процессора с базовой частотой 2,1 ГГц, 24 слота для памяти RDIMM, четыре слота для E.3 SSD и два — для M.2. Он поддерживает только воздушное охлаждение. Доступна установка GPU. Наконец, многоузловой 2U-сервер с СЖО включает восемь процессоров MONAKA с частотой 2,9 ГГц и 96 слотов для RDIMM. На каждый узел приходится лишь по паре E.3 и M.2 SSD, зато с PCIe 6.0. Разработкой серверов для новых CPU также занимается Supermicro.  Сервер Fujitsu MONAKA Server спроектирован, разработан и произведен в Японии для использования в системах, обеспечивающих технологический суверенитет. Производство осуществляется на заводе Fujitsu в Касашиме (Kasashima), где на всех этапах производства можно отследить происхождение компонентов и историю изготовления. На базе Fujitsu MONAKA Server строится вертикально интегрированная модель «суверенного ИИ», объединяющая ИИ-технологии Fujitsu (такие как платформа Fujitsu Kozuchi и корпоративный генеративный ИИ Takane) со специализированными отраслевыми моделями, что создает безопасную среду для предприятий и госучреждений.
08.09.2026 [19:29], Владимир Мироненко
Arm анонсировала платформу Neoverse CSS N4 для 128-ядерных серверных процессоров для ИИ ЦОДArm представила платформу нового поколения Neoverse Compute Subsystems (CSS) N4 для разработки серверных процессоров для ИИ ЦОД. Как сообщает компания, ИИ-инфраструктура становится всё более разнородной: для некоторых развёртываний требуются микросхемы, адаптированные под определённую системную архитектуру или функцию — от специализированных вычислительных платформ до цифровых сигнальных процессоров, сетевых и других специализированных решений. Новая платформа позволяет внедрить технологии Arm в эти решения, предоставляя партнёрам возможность адаптировать её под свои нужды, сокращая при этом трудозатраты на разработку, риски, связанные с интеграцией, и время, необходимое для создания микросхемы. По словам компании, Neoverse CSS N4 (Ranger) — это самая гибкая вычислительная подсистема Arm, обеспечивающая самый быстрый способ создания кастомных процессоров для ИИ ЦОД. Arm Compute Subsystems или CSS — это программа создания полукастомных решений, которая позволяет клиентам разрабатывать чипы на основе IP-ядер Arm, настраивая количество ядер, размер кеша, I/O-блоки и возможности подключения в соответствии со своими потребностями. Neoverse CSS N4 поддерживает от 8 до 128 ядер Neoverse N4 с тактовой частотой до 3,8 ГГц (первые в серии N с такой частотой), изготовленных по техпроцессу N3P от TSMC, с поддержкой мультичиплетной и мультисокетной архитектуры. 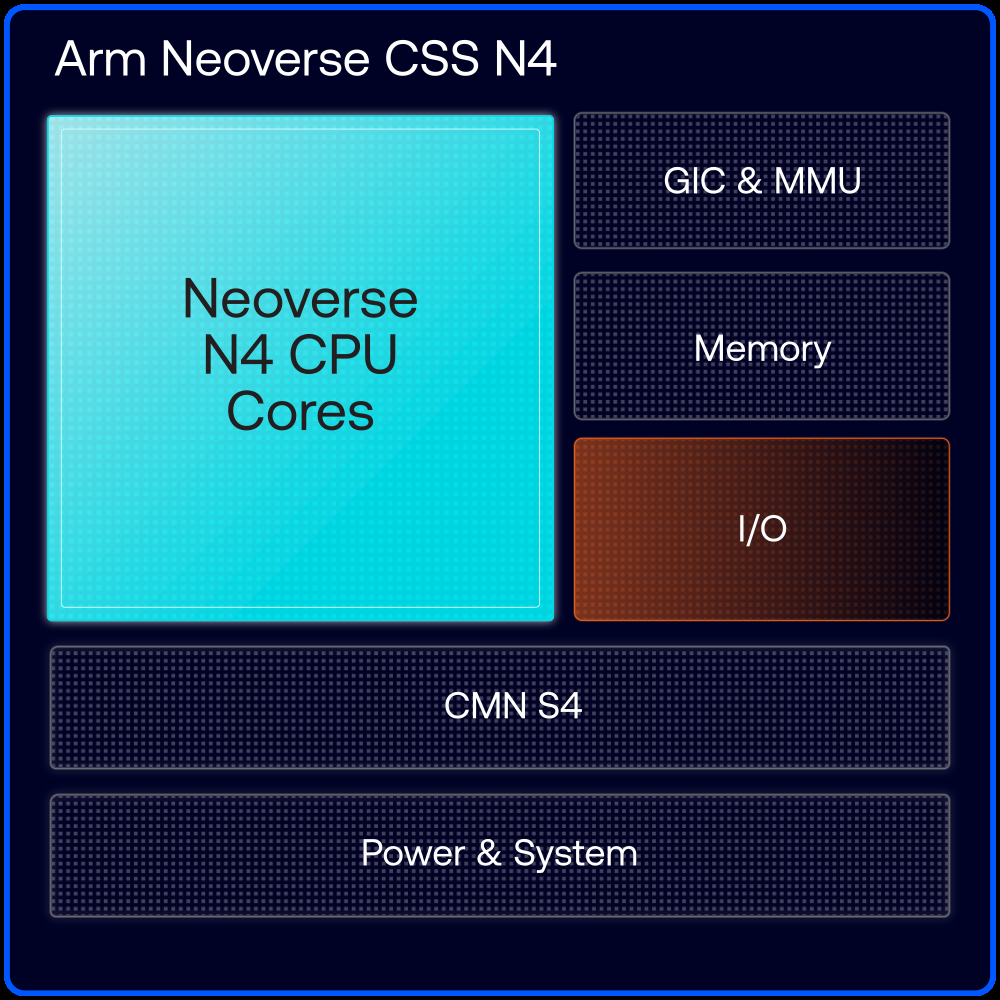
Источник изображения: Arm Платформа поддерживает память DDR5/LPDDR6, обеспечивает до 256 Мбайт L3-кеша с ECC на кристалл, до 2 Мбайт L2-кеша с ECC на ядро и по 64 Кбайт L1d/L1i-кеша на ядро. Также платформа поддерживает до 128 линий PCIe 6.0/7.0 (блоки по x16 с бифуркацией до x4) с CXL 4.0, интерфейсы AMBA CHI/AXI и UCIe. Для BMC предполагается использование ASPEED AST2600. По данным компании, Neoverse CSS N4 обеспечивает в 2 раза более высокую производительность, в 1,25 раза более высокую производительность на ватт и в 1,75 раза более высокую пропускную способность памяти по сравнению с Neoverse N3 (Hermes). Идея состоит в том, чтобы позволить разработчикам чипов тратить больше времени на добавление своих собственных элементов и меньше времени на то, чтобы разбираться, почему предположительно совместимые блоки перестали взаимодействовать друг с другом. CSS поставляется в виде RTL (Register-Transfer Level), который может быть интегрирован в современные EDA-процессы, с руководством по внедрению, поддержкой совместимости с IP-блоками сторонних производителей и интегрированным стеком ПО. Arm заявляет, что клиенты могут развернуть Linux для проверки и разработки ПО до того, как появится готовый чип. Компания также предложила клиентам, которые не хотят заниматься разработкой собственных чипов, объединить CSS N4 с процессором Arm AGI. Это уже готовый чип для рабочих нагрузок, требующих высокой скорости обработки данных, а CSS N4 позволяет гиперскейлерам и разработчикам чипов адаптировать его под конкретные стойки. По словам компании, OpenAI, Meta✴, Cloudflare, Oracle, SAP, Lenovo, Supermicro и Verda уже разрабатывают системы и сервисы на базе процессора AGI.
03.09.2026 [09:14], Владимир Мироненко
VMware: RISC-V никому не нужен, а Arm до зрелости ещё несколько летВ Broadcom считают, что Arm-серверы не будут занимать значительную долю рынка в корпоративном секторе ещё, как минимум, три-пять лет. Об этом заявил Рам Велага (Ram Velaga), с 1 января возглавляющий подразделение корпоративного ПО Broadcom, включающее бывшие бизнес-подразделения VMware, Symantec и CA. VMware по-прежнему является наиболее широко используемым поставщиком средств виртуализации корпоративных серверов, и её пользователи в ближайшее время не смогут использовать Arm–серверы без того, чтобы Arm-платформы не превратились в самодостаточный обособленный сегмент — сценарий, который мало кому понравится, отметил The Register. Велага заявил, что миссия VMware не изменится при его руководстве. «Мы будем слоем абстракции для CPU и GPU, независимо от набора инструкций», — сказал он. В настоящее время VMware виртуализирует серверы, хранилища и сети, но только на архитектуре x86. Также компания расширила свою деятельность в области виртуализации GPU, поддерживая ускорители NVIDIA, AMD и Intel. 
Источник изображения: VMware Кроме того, VMware уделяет внимание решениям, связанным с SmartNIC/DPU, где как раз обычно используются Arm-процессоры. Ещё в 2020 году компания начала проект Project Monterey по переносу части функций NSX на такие устройства. Речь в первую очередь про брандмауэры и средства обнаружения вторжений. Работая над этим проектом, VMware также продвигалась к созданию гипервизора для Arm-серверов и недавно представила превью этой технологии. Но… и пять лет назад компания занималась тем же, хотя тогда поддержка ограничивалась лишь процессорами Ampere Altra. Велага допустил, что Arm, вероятно, станет частью корпоративного ИТ-рынка. Вместе с тем он выразил мнение о том, что пройдёт несколько лет, прежде чем серверы Arm займут значительную долю рынка в корпоративном секторе, и поэтому VMware нет смысла спешить с портированием своего гипервизора. Он добавил, что клиенты VMware совершенно не заинтересованы в процессорах, построенных на RISC-V. Велага рассказал, что около 60 % из $5 млрд ежегодных расходов на исследования его подразделения идёт на обновление текущих продуктов VMware. Оставшаяся часть средств направляется на разработку новых продуктов, таких как анонсированная на днях ИИ-фабрика VMware AI Factory. ИИ сейчас в тренде. Серверы на базе Arm — нет. Поэтому нетрудно догадаться, куда VMware направит средства для R&D в ближайшие годы, пишет The Register.
02.09.2026 [14:16], Владимир Мироненко
AWS объявила о доступности инстансов EC2 R9g и R9gd на базе фирменных Arm-процессоров Graviton5AWS сообщила о доступности инстансов EC2 R9g и R9gd на базе Arm-процессоров Graviton5. Инстансы R9g оптимизированы для работы с памятью и обеспечивают до 25 % более высокую вычислительную производительность по сравнению с R8g на базе Graviton4. R9g предназначены для обработки ресурсоёмких рабочих нагрузок, включая базы данных, кеши in-memory (Valkey, Redis, MemCached), аналитику больших данных в реальном времени, рабочие нагрузки на базе Linux, включая контейнеризированные и микросервисные приложения (например, Kubernetes, Docker, EKS, ECS), а также приложения, созданные с использованием C/C++, Rust, Go, Java, Python, .NET Core, Node.js, Ruby и PHP. 
Источник изображений: Amazon Инстансы R9gd включают локальное блочное хранилище на основе NVMe SSD, подходящее для ресурсоёмких рабочих нагрузок, требующих быстрого локального хранилища с низкой задержкой, таких как СУБД, распределённая аналитика больших данных в реальном времени, большие in-memory базы данных и большие нагрузки по кешированию. Благодаря использованию процессоров Graviton5 инстансы R9g обеспечивают на 25 % выше производительность на vCPU по сравнению с R8g. Также используется память DDR5-8800 (по сравнению с DDR5-5600 в Graviton4), а L3-кеш у CPU впятеро больше для лучшей локализации данных. R9g обеспечивают вдвое более высокую пропускную способность сети и EBS для самых больших размеров экземпляров (до 100 Гбит/с сети, до 72 Гбит/с EBS на 48xlarge) и втрое более высокую производительность обработки пакетов. 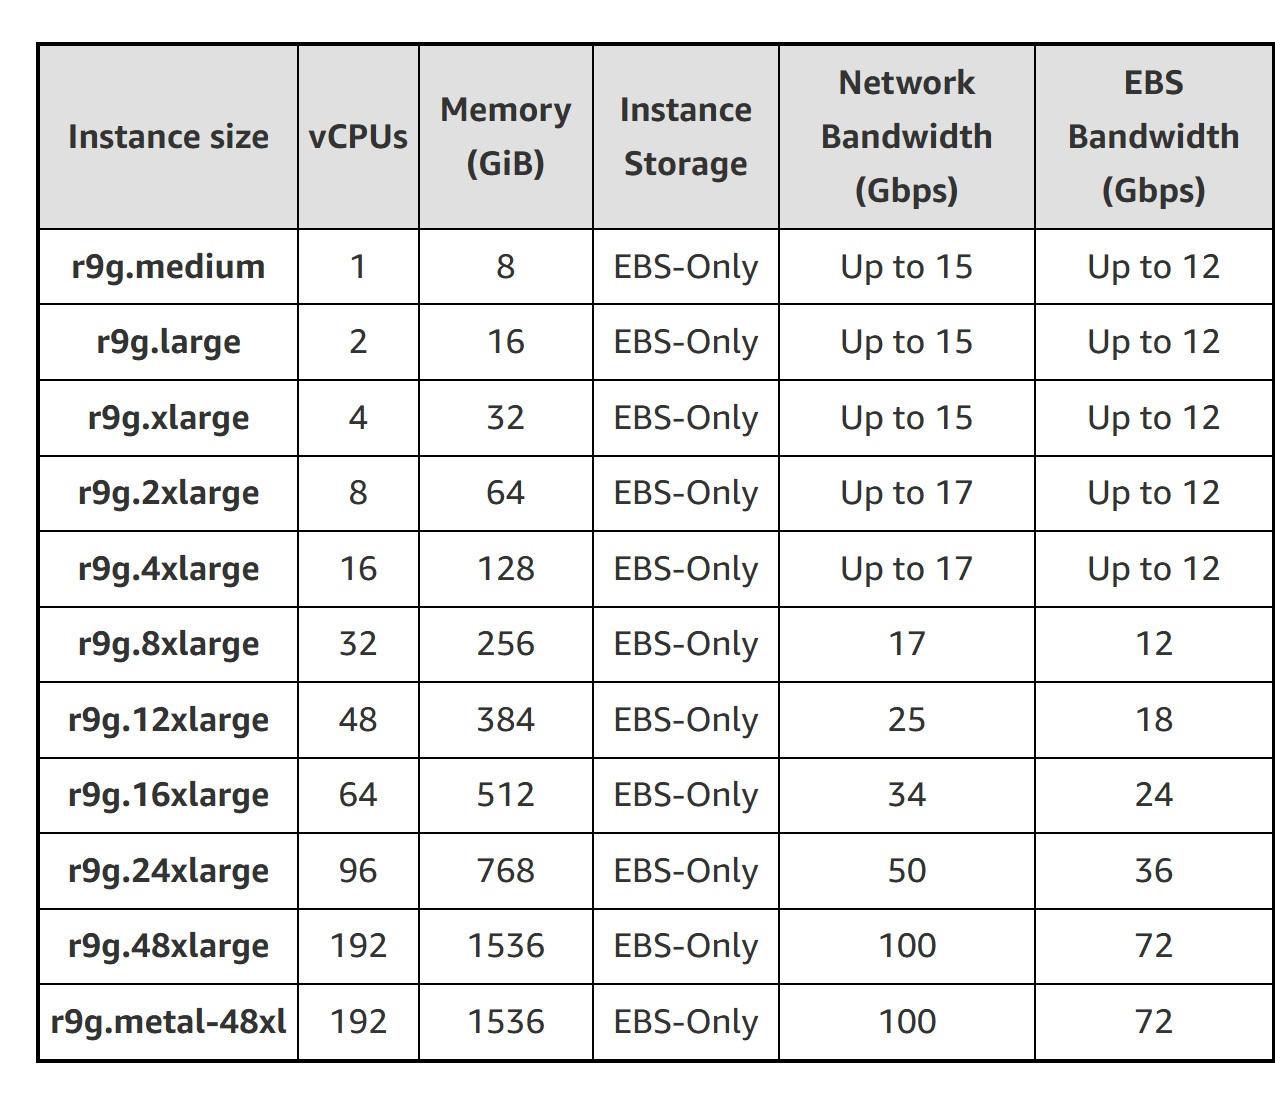 Инстансы R9g и R9gd поддерживают настройку пропускной способности инстанса Instance Bandwidth Configurations (IBC), которая позволяет скорректировать распределение полосы между EBS и VPC на 25%. Это помогает оптимизировать производительность для рабочих нагрузок со специфическими требованиями к пропускной способности, таких как базы данных и кеширование. Инстансы используют систему AWS Nitro. При этом инстансы R9g и R9gd оснащены механизмом изоляции Nitro (NIE), который использует формальную верификацию для обеспечения математической точности гарантий изоляции. 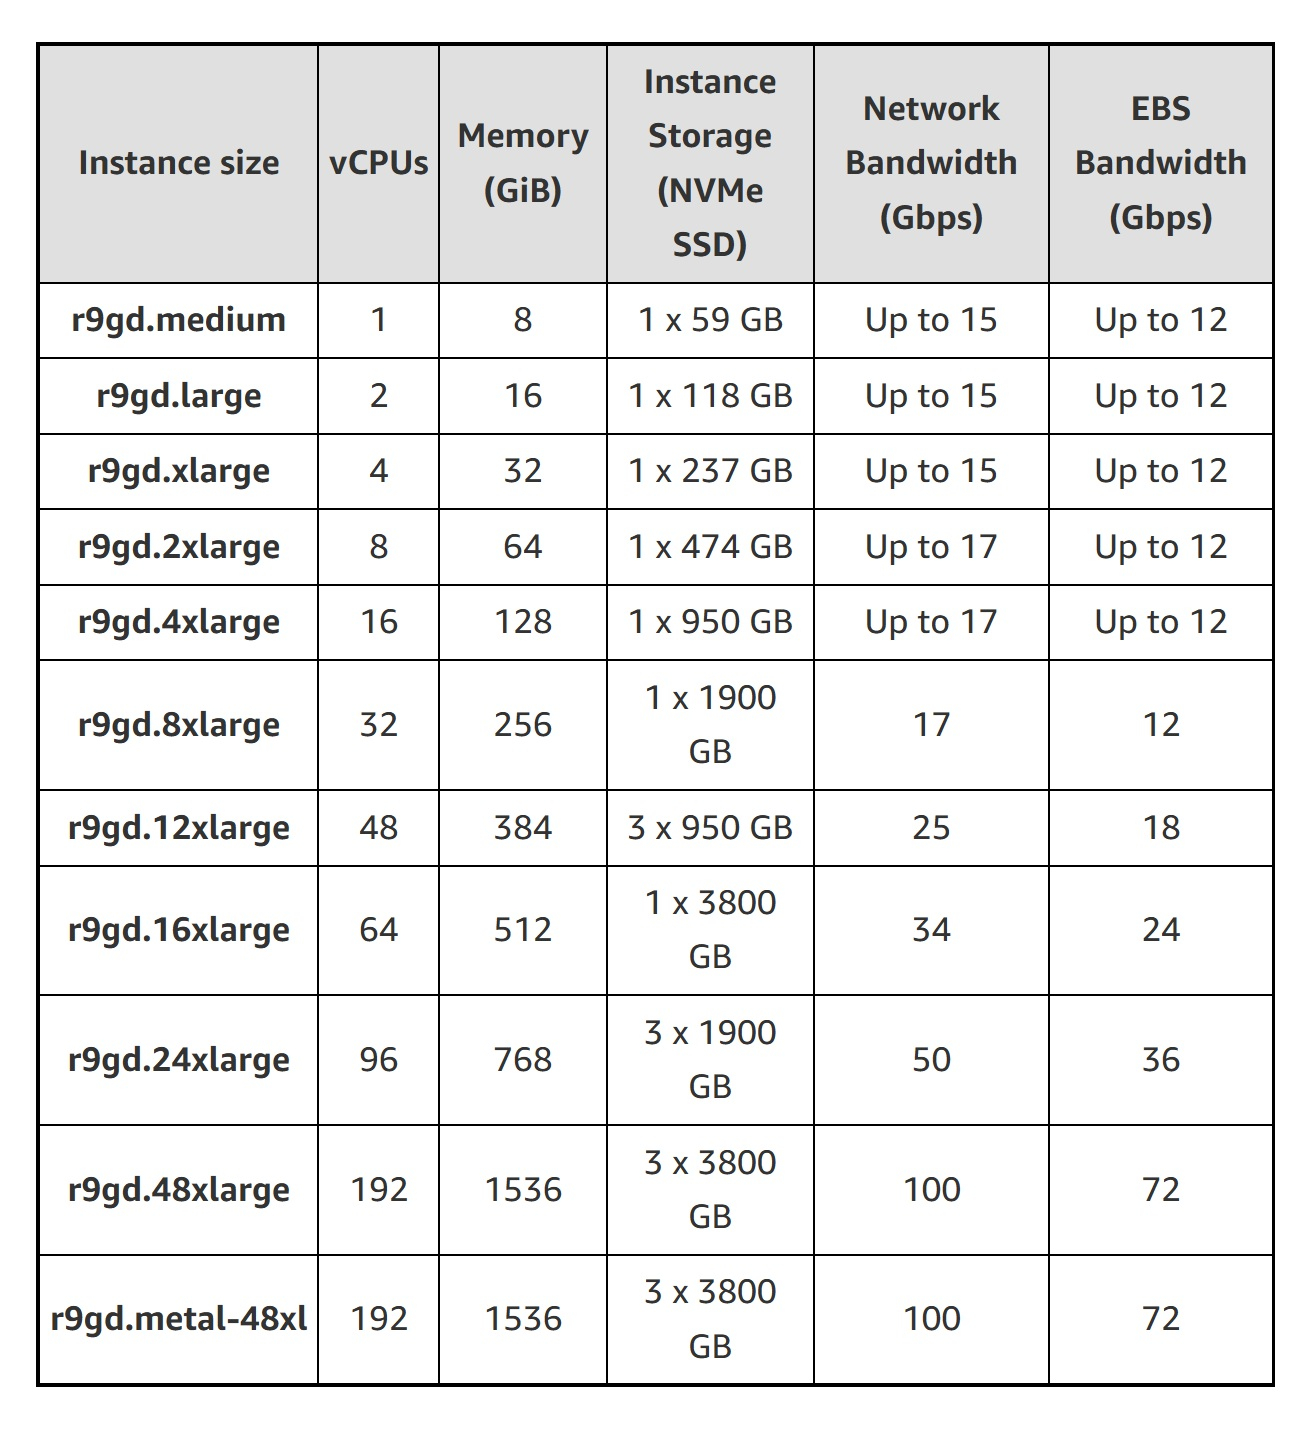 Инстансы R9g и R9gd доступны в 11 размерах, от среднего до metal-48xl, с количеством vCPU в пределах от 1 до 192, объёмом оперативной памяти — 8–1536 ГиБ. Пропускная способность сетевого подключения составляет от 15 до 100 Гбит/с, пропускная способность томов EBS — от 12 до 72 Гбит/с. Экземпляры R9gd обеспечивают ту же вычислительную и сетевую производительность, что и R9g, но дополнительно оснащены локальными NVMe SSD — до трёх штук по 3,8 Тбайт каждый Amazon EC2 R9g и R9gd доступны в регионах US East (Северная Вирджиния, Огайо), US West (Орегон) и Europe (Франкфурт) в рамках тарифных планов Savings Plans, On-Demand, Spot Instances, Dedicated Instances или Dedicated Hosts. Ранее компания также объявила о доступности семейств C9g и C9gd, рассчитанных на вычисления, и инстансов общего назначения M9g и M9gd.
27.08.2026 [08:00], Сергей Карасёв
До 136 ядер, 96 линий PCIe 6.0 и 12 каналов DDR5-8800: Arm раскрыла характеристики серверных процессоров AGIКомпания Arm раскрыла дополнительные подробности о процессорах AGI, официальная презентация которых состоялась в марте нынешнего года. Эти чипы предназначены для использования в дата-центрах, ориентированных на ИИ-нагрузки. Чипы выполнены на платформе Arm Neoverse CSS V3. Конструкция включает два чиплета, каждый из которых насчитывает свыше 50 млрд транзисторов. При производстве применяется технология TSMC N3P (3 нм). Процессоры AGI будут предлагаться в модификациях с 64, 128 и 136 ядрами Armv9.2, распределёнными между двумя чиплетами. Номинальная тактовая частота составляет 3,2 ГГц, частота с ускорением — до 3,7 ГГц. Каждое ядро содержит 2 Мбайт кеша L2 (от 128 до 272 Мбайт на чип) и два 128-бит блока SVE2, предназначенных для ускорения задач ИИ и машинного обучения. Поддерживаются форматы BF16 и INT8. Общий объём кеша на уровне системы (SLC) равен 128 Мбайт. 
Источник изображений: Arm Каждый из чиплетов содержит шесть каналов оперативной памяти (12 на процессор) с поддержкой 3 Тбайт DDR5-8800 (6 Тбайт на процессор). Суммарная пропускная способность памяти достигает 845 Гбайт/с, пропускная способность в пересчёте на ядро — от 6 до 13 Гбайт/с в зависимости от их количества. В то время как AMD, Intel и NVIDIA используют гетерогенный многочиплетный подход для увеличения вычислительных мощностей и повышения производительности, решение Arm основано на сочетании высокой пропускной способности памяти и небольшой задержки (менее 100 нс). Благодаря отсутствию необходимости передачи данных на отдельный чиплет с контроллером памяти повышается быстродействие в задачах, чувствительных к задержкам. Внутри каждого чиплета AGI используется интерконнект CMN-S3 с топологией 8 × 9, которая связывает вычислительные ядра, память, IO-блоки и ускорители. Упомянуты фильтрация запросов к памяти (snoop filtering) и иерархическое кеширование на основе HN-S (Super Home Node) — логического блока, выполняющего функции распределительного центра. Он управляет трафиком и данными внутри чипа, чтобы ускорить обмен информацией. 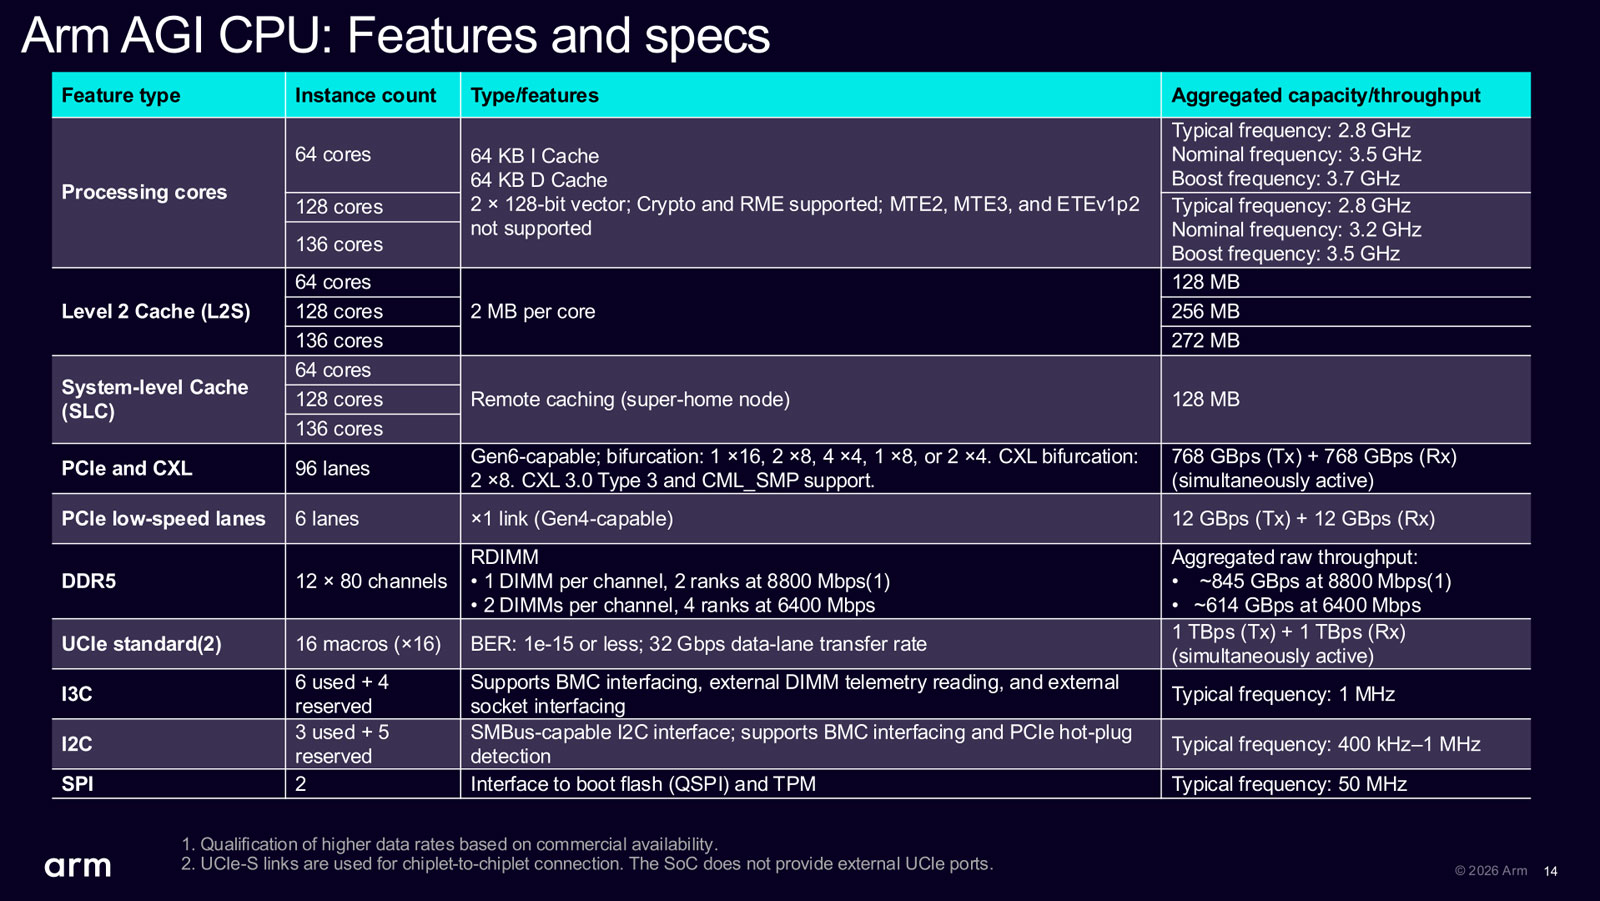 Если CPU-ядру требуется обратиться к памяти на другом чиплете, запрос передаётся по когерентному межчиповому интерконнекту, но при этом задержка увеличивается. Контроллеры DDR5 поддерживают ряд функций для достижения максимальной производительности в реальных рабочих нагрузках, включая полностью внеочередное планирование команд, оптимизированное отображение адресов и программируемые политики страничной адресации. Кроме того, реализован контроль и мониторинг пропускной способности памяти на основе технологии Memory Partitioning and Monitoring (MPAM). В сочетании с приоритизацией (QoS) и обратной связью о перегрузках это позволяет управлять конфликтами, когда множеству ядер и IO-устройствам требуется пропускная способность DRAM.
Процессор имеет 96 линий PCIe 6.0 с поддержкой CXL 3.0, четыре линии PCIe 4.0, а также интерфейсы I3C, I2C и SPI. Показатель TDP находится на уровне 300 Вт. Архитектура изделия рассчитана на стандартные воздушные системы охлаждения и позволяет эффективно использовать доступный лимит мощности. Утверждается, что в стандартной стойке на 36 кВт могут быть задействованы до 8160 вычислительных ядер AGI. В целом, решения AGI оптимизированы под сценарии, в которых CPU берёт на себя значительную часть ИИ-нагрузки. Это могут быть задачи инференса, координация вычислений в гетерогенных средах (CPU + GPU/TPU и т. п.), оркестрация ИИ-агентов и т. д. Реализована встроена аппаратная защита для мультитенантных сред: Runtime Security Engine (RSE), Pointer Authentication, Branch Target Identification.
25.08.2026 [18:35], Владимир Мироненко
IBM объединила архитектуры z и Arm в одном CPU для будущих мейнфреймовIBM анонсировала первый двухархитектурный процессор для мейнфреймов, который позволит запускать операционные системы и приложения на вычислительных платформах IBM (s390x) и Arm (AArch64) в будущих системах IBM z и LinuxONE. Компания отметила, что это первый этап в разработке процессора, достигнутый в рамках сотрудничества с Arm, стартовавшего в апреле 2026 года. 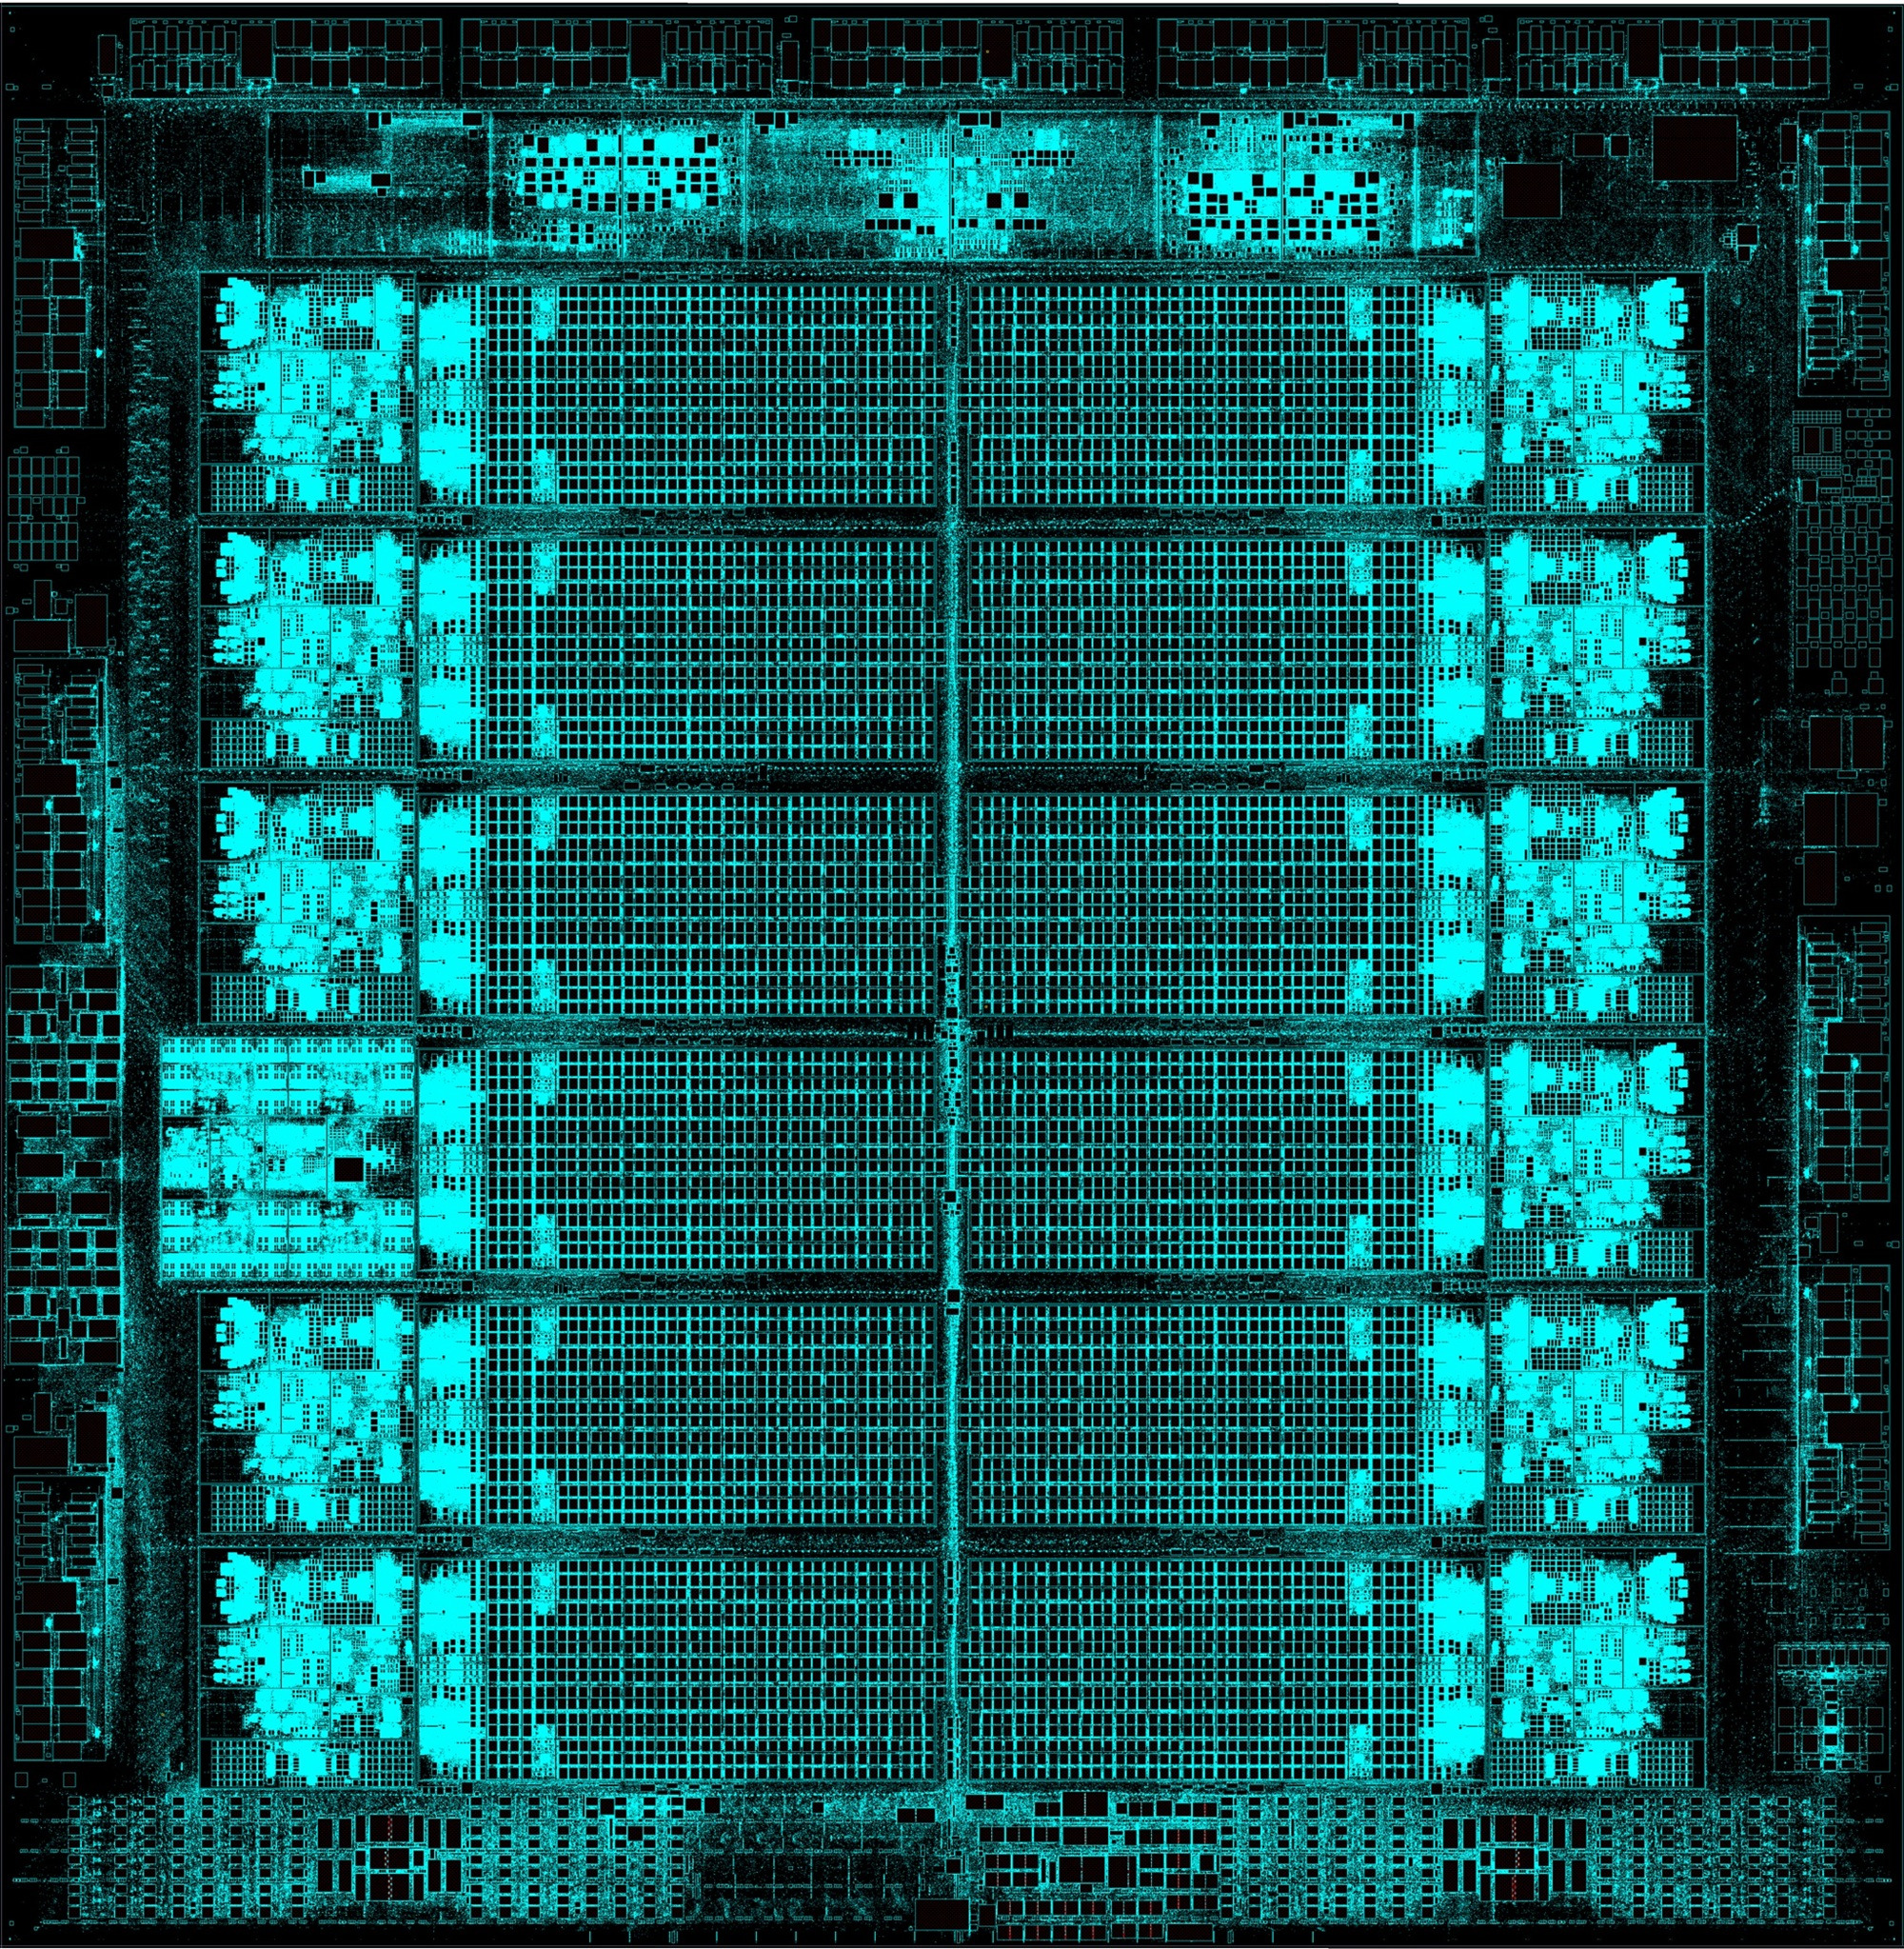
Источник изображения: IBM 2-нм процессор будет содержать 11 доступных двухпоточных (SMT 2) ядер, работающих на частоте более 5,7 ГГц, ускорители ИИ-инференса, специально разработанные для обнаружения мошенничества в финансовых транзакциях в режиме реального времени, выделенный встроенный DPU для ускорения I/O и большую кеш-архитектуру для ресурсоёмких корпоративных рабочих нагрузок с большими частными кешами L2 объёмом по 36 Мбайт, из которых формируются виртуальные L3/L4-кеши. Как отметил ресурс ServeTheHome, виртуальный L3 даёт 432 Мбайт, в то время как L4, объединяя все кеши всех ядер, обеспечит до 3,5 Гбайт памяти с очень низкой задержкой, что полезно для корпоративных рабочих нагрузок, таких как обработка транзакций и обслуживание баз данных. 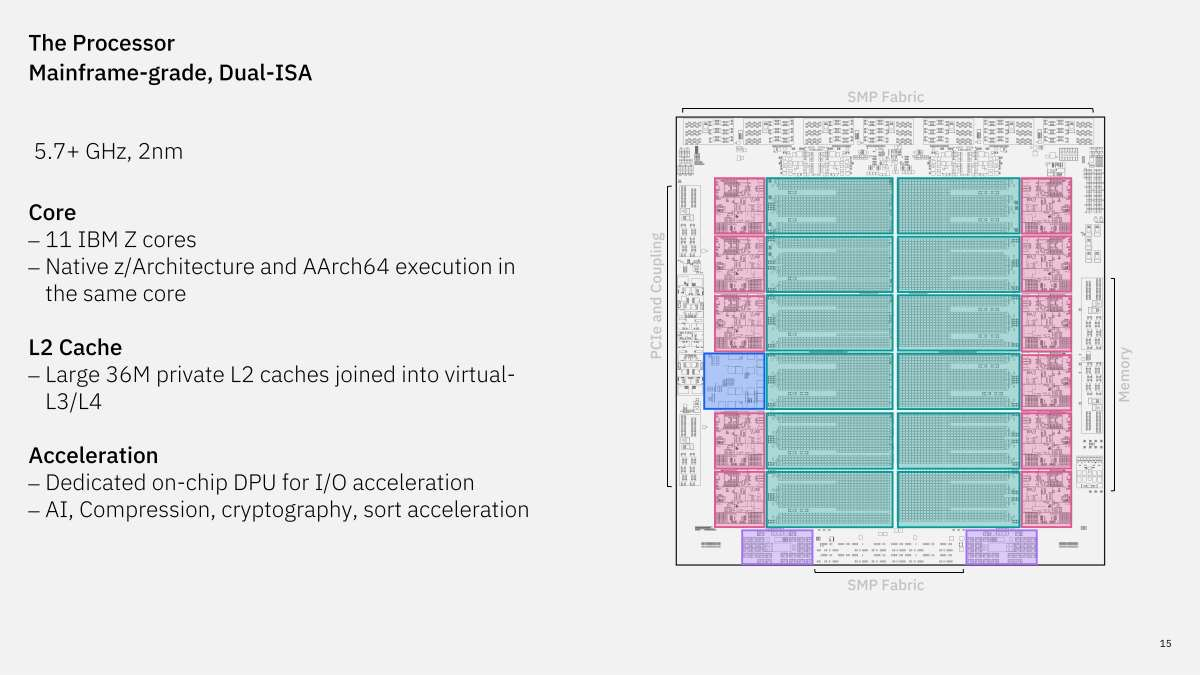
Источник изображений: IBM/ServeTheHome Компания отметила, что архитектура чипа не предусматривает отдельных ядер Arm и IBM: каждое процессорное ядро может одновременно выполнять инструкции Arm и IBM Z, или Arm и LinuxONE, отдавая приоритет установленным характеристикам платформы: производительности, безопасности, шифрования и доступности. Платформы IBM Z и LinuxONE способны масштабироваться до сотен ядер и десятков терабайт памяти. Подчёркивается, что ключевым моментом является то, что IBM реализовала AArch64 на аппаратном уровне, а не путём трансляции. В этом проекте используется реализация Arm с порядком байтов little-endian поверх архитектуры z/Architecture с порядком байтов big-endian. Заявлена поддержка Armv9.3, SVE и SVE2 — всего 2792 инструкции, что более чем в два раза больше, чем z-инструкций. IBM также заявляет о соответствии стандарту Arm SystemReady, что важно для совместимости с имеющимся ПО. Приложения Arm видят собственный полноценный процессор Arm, работая без изменений «из коробки». 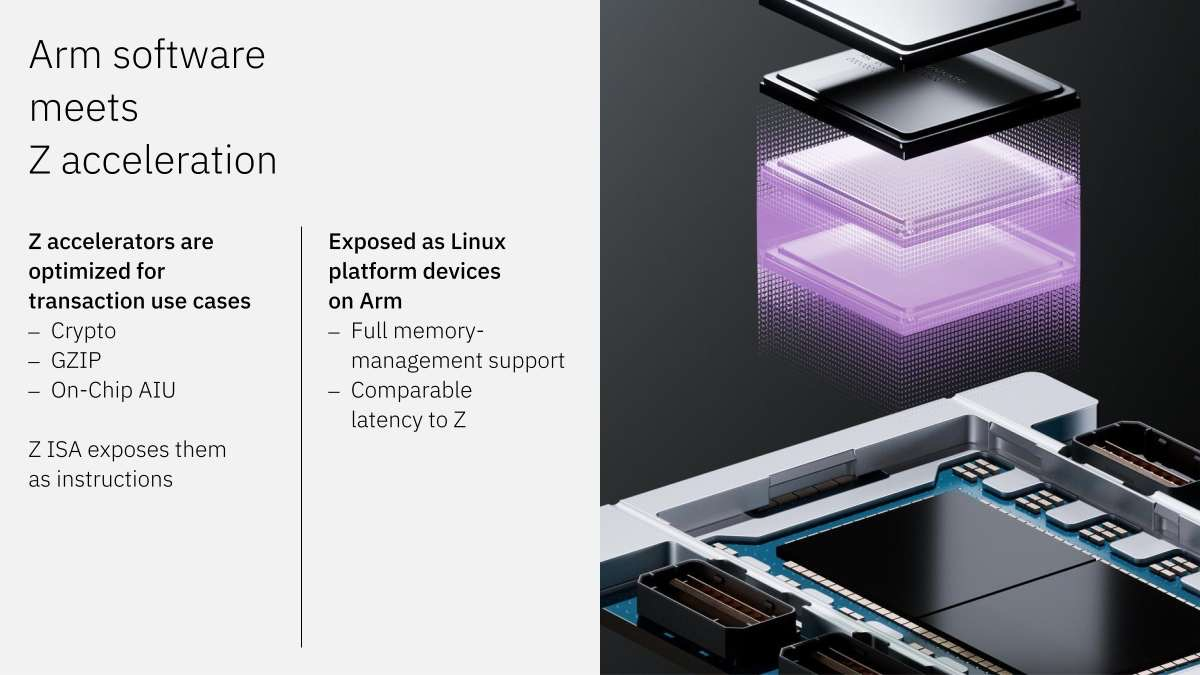 IBM говорит, что новый чип эффективно объединит две крупнейшие в мире вычислительные экосистемы, которые до сих пор были изолированы друг от друга. Мейнфреймы IBM z и системы LinuxONE составляют основу мировой экономики, обрабатывая, по оценкам аналитиков, около 70 % всех финансовых транзакций в мире, а также огромные объёмы данных в сфере здравоохранения. В свою очередь, программную экосистему Arm поддерживает более 22 млн разработчиков по всему миру. Она охватывает широкий и постоянно растущий спектр облачных и периферийных приложений, включая облачное ПО и ПО для ИИ. Предсказатель ветвлений демонстрирует, как существующая конструкция ядра IBM z может использоваться и для AArch64. Используется XML-описание архитектуры Arm для автоматического декодирования инструкций, диспетчеризации и отправки на исполнение. Переиспользуется возможность переименования регистров и основные пути исполнения инструкций, а также некоторые CISC-решения вроде копирования и очистки памяти. Но разработчиком всё равно пришлось добавить новые элементы управления для SVE, а также пути исполнения для FP16/Bfloat16 и криптографических функций. 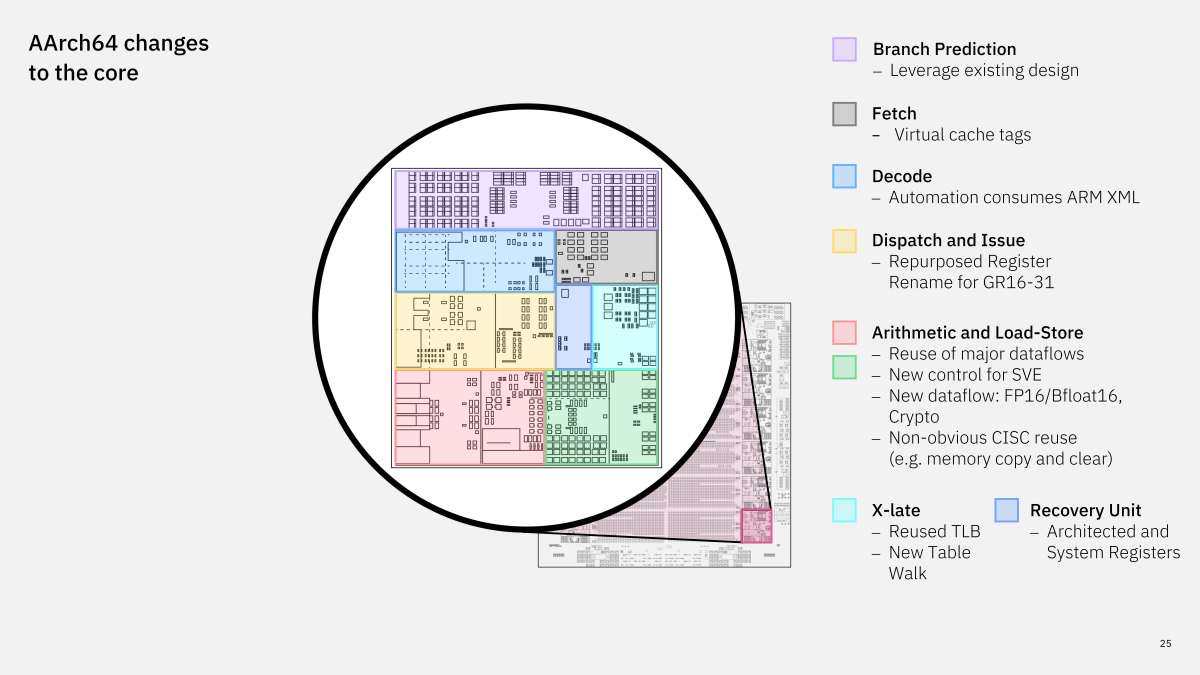 Встроенные ускорителям для криптографии, сжатия и инференса отображаются для Arm ПО представляются в качестве платформенных устройств в Linux на Arm. При этом процессор способен одновременно выполнять инструкции обеих ISA с сохранением сквозной проверки массивов и потоков данных/управления, прозрачного восстановления после нерегулярных сбоев, резервирования/замещения ядер при постоянных сбоях, параллельного восстановления и технологии аппаратной защиты оперативной памяти RAIM. Эта конструкции обеспечивает надёжность с целевым показателем доступности 99,999999 %. 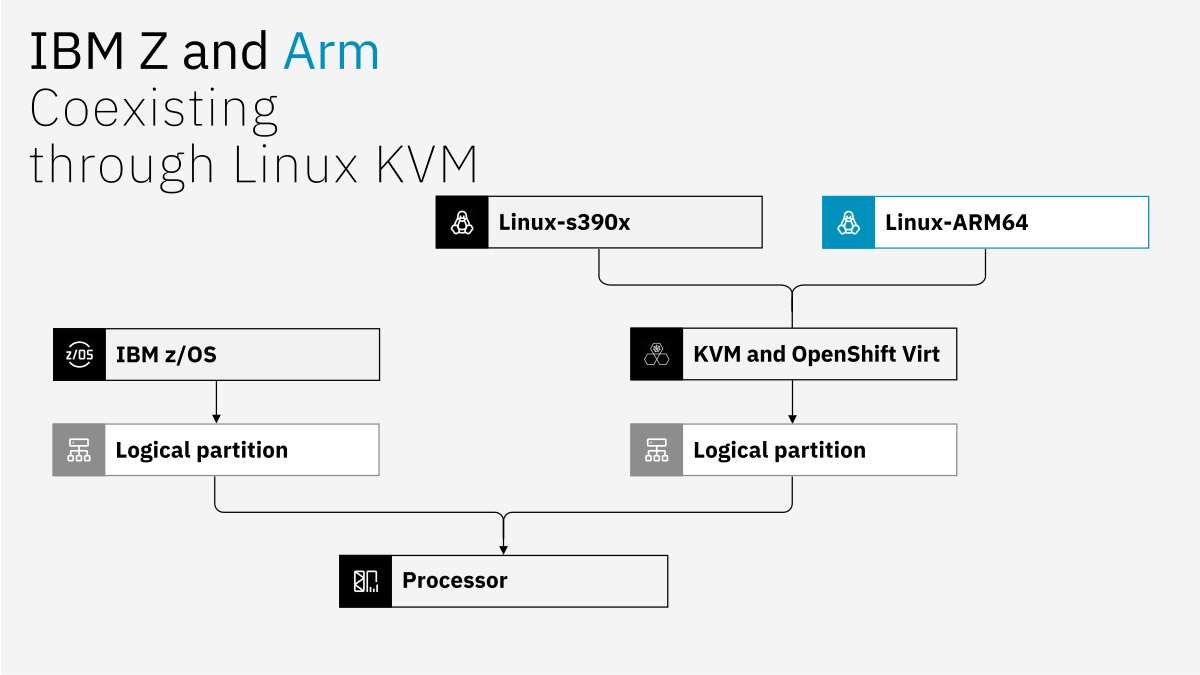 На программном уровне для запуска Linux-приложений для обеих архитектур используются KVM и OpenShift, которые, как нативные приложения z/OS, используют логически разделы, работающие на одном физическом процессоре. А каждый поток может работать как с инструкциями s390x, так и с Arm, при этом переключение занимает наносекунды. Такое сосуществование является залогом получения наилучших результатов от обеих программных экосистем, позволяя клиентам сохранять код для мейнфреймов, одновременно используя широкую базу ПО Arm, пишет SiliconANGLE. Дополнит новый CPU ускоритель ИИ-инференса второго поколения, который ориентирован на более крупные корпоративные рабочие нагрузки. Он содержит 16 активных ИИ-ядер (и одно резервное) с поддержкой FP4 и MXFP4, которые, по словам IBM, могут обеспечить четырёхкратное увеличение TOPS. Он получит 96 Гбайт HBM3e с ПСП до 4 Тбайт/с и PCIe 6.0 в качестве интерфейса одноранговой сети с низкой задержкой. IBM позиционирует чип как компонент для критически важных ИИ-систем, обеспечивающий надёжные вычисления, защищающие данные и модели в состоянии покоя, при передаче и использовании, в том числе с использованием криптографии с квантовой защитой. 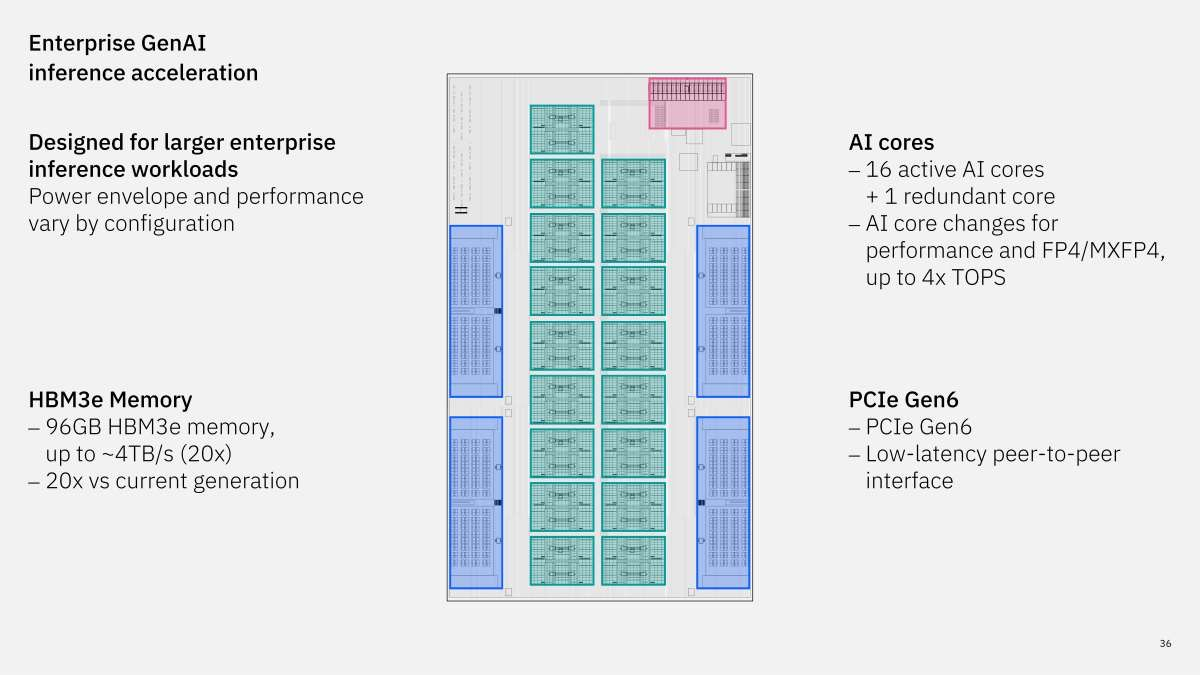 Как пишет SiliconANGLE, финансовые компании, работающие в условиях жёсткого регулирования, не могут отказаться от использования мейнфреймов и LinuxONE, известных своей исключительной безопасностью и надёжностью. Но для доступа к программной экосистеме Arm им приходилось отказываться от систем IBM. Новый чип меняет положение дел. «Этот процессор представляет собой значительный архитектурный прогресс для IBM z и LinuxONE, — сказал Кристиан Якоби (Christian Jacobi), главный технический директор и научный сотрудник IBM Systems Development. — Внедряя Arm непосредственно в наши платформы, мы объединяем доступ к одной из самых быстрых программных экосистем в отрасли с качествами, которые сделали системы IBM основой для ведения бизнеса». Двухпроцессорная архитектура IBM и Arm потенциально может способствовать новой волне внедрения ИИ компаниями в отраслях с жёстким регулированием. Вскоре разработчики смогут писать код для Arm и развёртывать его непосредственно на мейнфреймах, так что устаревшие аппаратные системы IBM останутся актуальными ещё долгие годы. Сообщается, что новый процессор будет доступен для клиентов в 2028 году. Это не первая попытка IBM скрестить две ISA в одном чипе. В 1994 году компания анонсировала процессор PowerPC 615, который объединил бы x86 и PPC, причём на уровне сокета он был совместим именно с Pentium-платформами, что, как ожидала IBM, привлечёт многочисленных производителей ПК. На деле чип поддерживался только Minix и особой версией OS/2, тогда как Microsoft отказалась участвовать в развитии ПО для него, а MacOS на нём, по-видимому, никто запускать и не собирался. В результате чип так и остался прототипом.
02.08.2026 [14:37], Владимир Мироненко
Arm объявила о растущем спросе на её процессор для ЦОД, но акции упали из-за ожидаемого снижения роялти от смартфоновArm Holdings сообщила результаты за I квартал 2027 финансового года, завершившийся 30 июня 2026 года. Выручка компании выросла год к году на 22 % до $1,29 млрд благодаря росту спроса на разработанные ею чипы для ИИ ЦОД, что привело к рекордным для I квартала показателям лицензирования и роялти. Выручка Arm превысила прогноз аналитиков, опрошенных FactSet, в размере $1,26 млрд (согласно данным The Wall Street Journal). Скорректированная прибыль составила 45¢ на акцию. Аналитики, опрошенные FactSet, прогнозировали 40¢ на акцию. Чистая прибыль достигла $270 млн или 25¢ на акцию, по сравнению со $130 млн, или 12¢ на акцию годом ранее. Выручка от роялти выросла на 22 % до $715 млн благодаря более чем двукратному увеличению роялти на технологии для чипов для ЦОД, а выручка от лицензирования увеличилась на 23 % до $574 млн. Росту выручки также способствовало продолжающееся внедрение технологий Arm с более высокими ставками роялти за чип, таких как Armv9 и Arm CSS. Генеральный директор Рене Хаас (Rene Haas) заявил, что спрос на CPU Arm AGI превзошёл ожидания, и превысил $2 млрд в 2027 и 2028 финансовых годах, что более чем вдвое превышает прогнозируемый компанией в прошлом квартале потенциальный объём в $1 млрд. Он добавил, что компания уже поставила первые чипы нескольким клиентам, включая Oracle. IDC сообщила, что расходы на ускоренные серверные платформы на базе Arm почти удвоились за последние два квартала и превысили расходы на платформы x86. 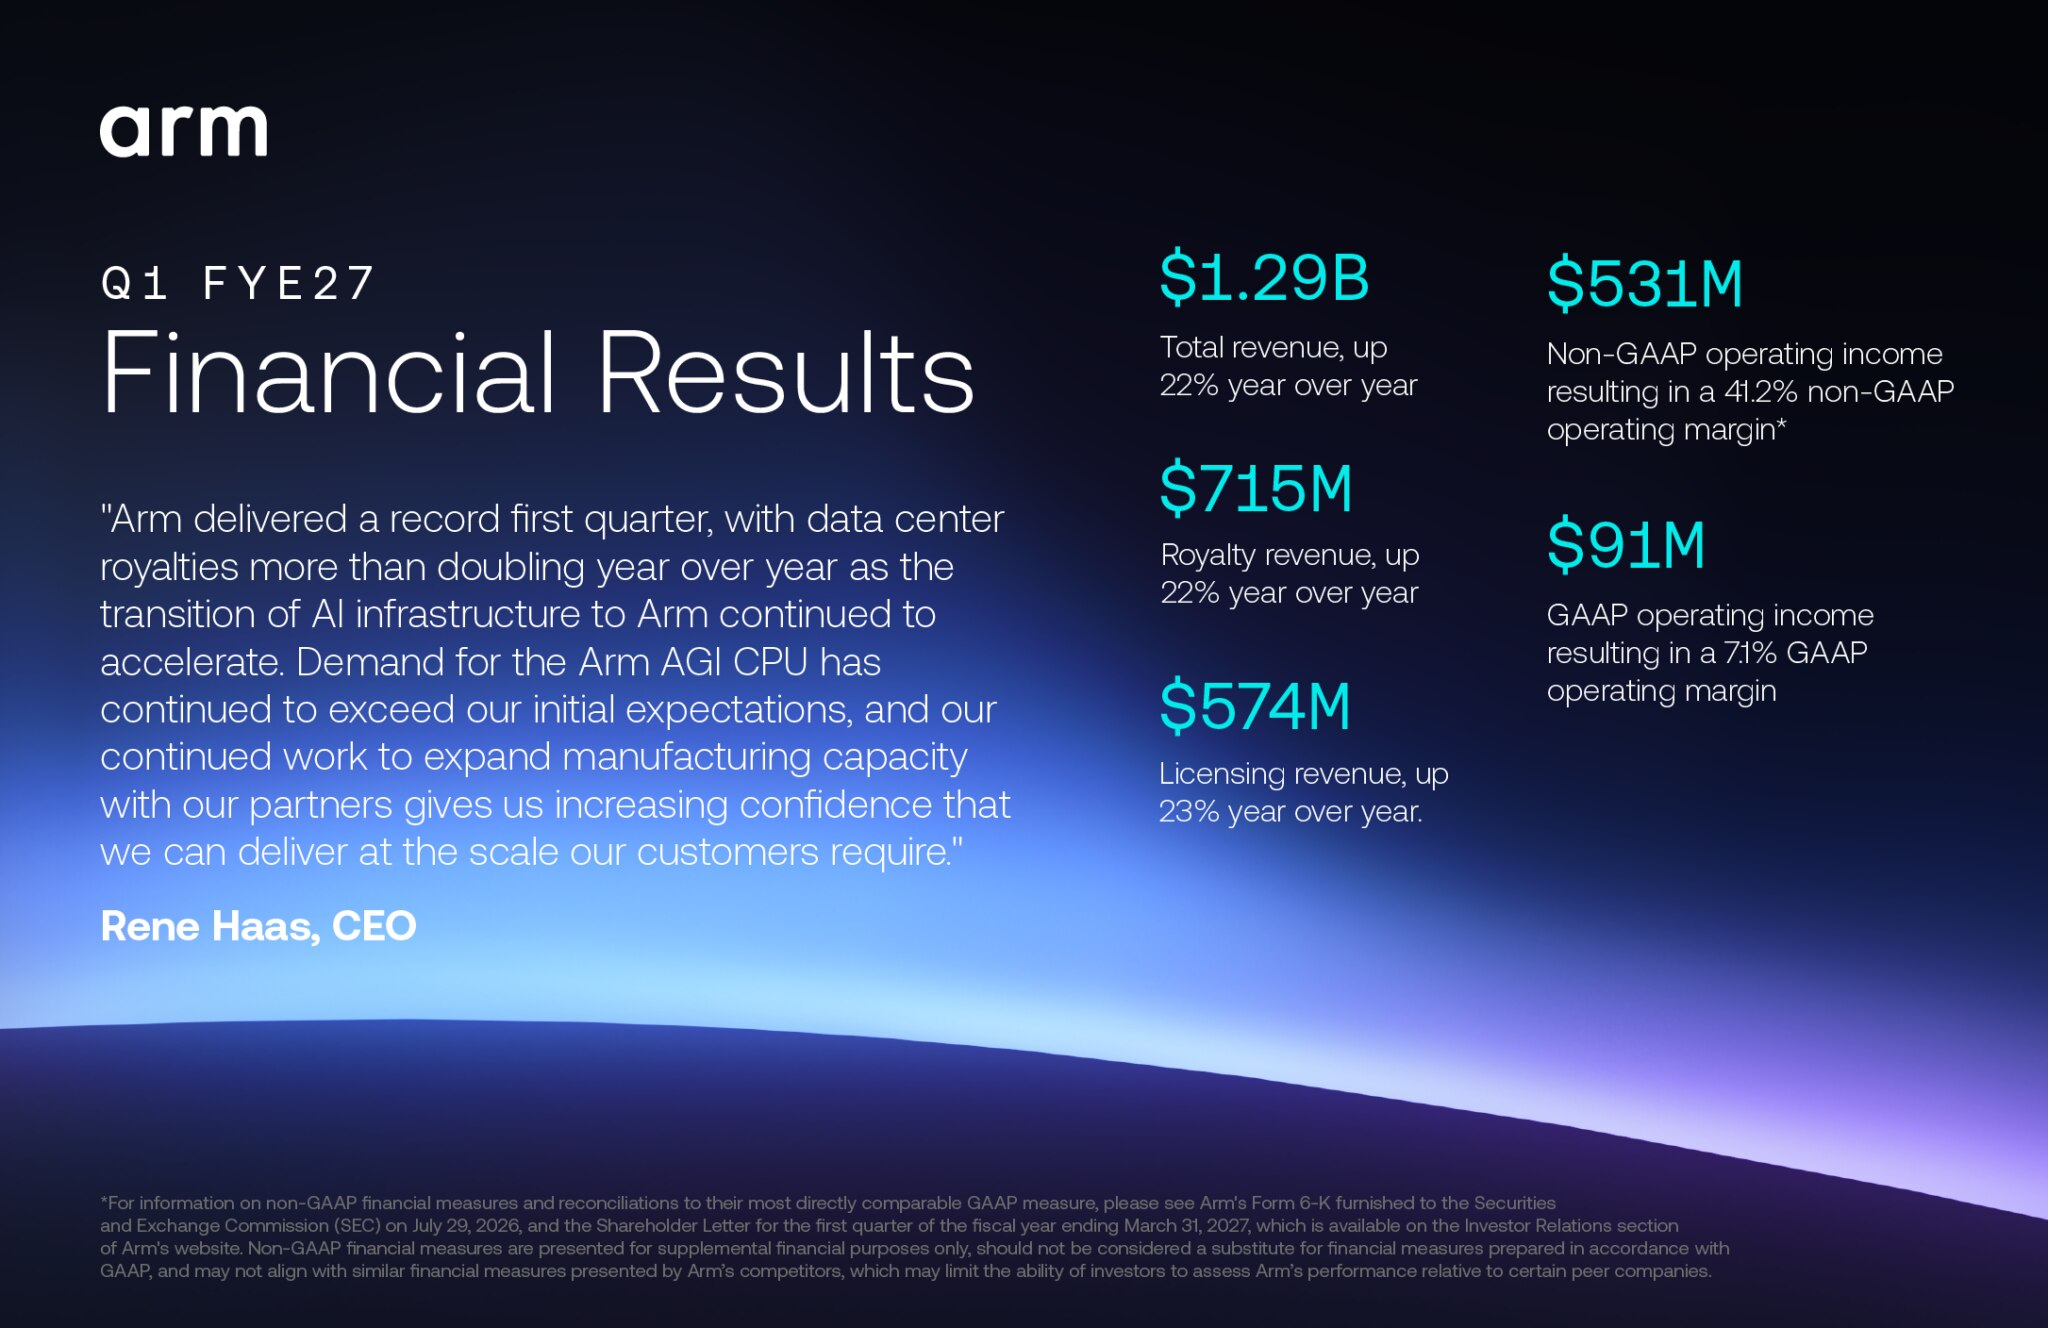
Источник изображения: Arm Arm сообщила, что продолжает привлекать новых клиентов, в том числе нескольких в США и Китае, в то время как общая стоимость портфеля заказов продолжает расти. Также компания отметила, что обеспечила производственные мощности, необходимые для поддержки потенциала в $1 млрд, обозначенного в предыдущем квартале, в период с 2027 по 2028 финансовый год и работает с партнёрами над дальнейшим расширением производства. Компания заявила, что переход ИИ-инфраструктуры на Arm продолжает набирать обороты. Эту архитектуру используют крупные провайдеры облачных услуг и производители микросхем, включая NVIDIA, AWS, Google, Microsoft и Qualcomm. Процессор Vera от NVIDIA, построенный на архитектуре Arm, запущен в полномасштабное производство, а AWS объявила о многолетнем соглашении с Meta✴ о развёртывании десятков млн ядер Graviton5 на базе Arm для рабочих ИИ-нагрузок. Поставки процессоров Neoverse для ЦОД уже превысили 1,5 млрд ядер. Во II финансовом квартале компания прогнозирует скорректированную прибыль в диапазоне от 43¢ до 51¢ на акцию при выручке от $1,33 до $1,43 млрд. Аналитики, опрошенные LSEG, прогнозируют скорректированную прибыль в размере 44¢ на акцию при выручке в $1,34 млрд. Несмотря на то, что прогноз компании по выручке за II финансовый квартал оказался выше ожиданий Уолл-стрит, её акции упали на 9 %, сообщило агентство Reuters. Акции упали после того, как Arm заявила, что ожидает снижения роялти от продаж смартфонов в следующем квартале.
17.07.2026 [17:12], Владимир Мироненко
Евросоюз объявил об успешном завершении второго этапа EPI для укрепления технологического суверенитетаВ Люксембурге состоялся заключительный обзор Европейской инициативы по процессорам (EPI), финансируемой EuroHPC. По итогам было объявлено об успешном завершении второго этапа проекта — EPI SGA2, целью которого было содействие укреплению технологического суверенитета Европы. В рамках обзора была проведена демонстрация уникальных технологий и микросхем, разработанных на обоих этапах проекта EPI. В частности, был продемонстрирован первый Arm-процессор SiPearl Rhea1, работающий с полным ПО для HPC. Чип запустили на тестовой плате со стандартным дистрибутивом Linux, работающим с высокоскоростной памятью HBM и соответствующими аппаратными счетчиками мониторинга производительности. Он успешно прошёл тесты HPL и STREAM, демонстрируя готовность всей аппаратной и программной экосистемы Rhea1 к высокопроизводительным вычислениям для систем экзафлопсного уровня. Также было проведено пять демонстраций, наглядно подтверждающих, что технология RISC-V, используемая EPI, перешла от отдельных блоков к полному программному стеку, реальному оборудованию и реальным приложениям и инструментам, которыми может воспользоваться обычный пользователь. Так, был развёрнут полный кластер на ускорителе VEC. Был показан новейший RTL-код (ядро RISC-V с внеочередным выполнением инструкций от Semidynamics, улучшенный векторный блок от Барселонского суперкомпьютерного центра) для запуска на FPGA в инфраструктуре MEEP. Было запущено реальное научное приложение Mini-Fall3D для оценки диффузии пыли в атмосфере, распараллеленное с помощью OpenMP и MPI, скомпилированное с использованием инструментария EPI LLVM и профилированное с помощью стандартных инструментов (PAPI, Extrae/Paraver). Запуски показали масштабируемость, продемонстрировав выполнения скалярных и векторных задач на разных узлах. 
Источник изображения: european-processor-initiative.eu Также был продемонстрирован готовый ИИ-чип EPAC 1.5 на базе RISC-V, подключённый к Arm-хосту через PCIe. Компилятор проекта генерирует один двоичный файл, содержащий код как Arm, так и RISC-V. Код RISC-V передаётся по PCIe через DMA, динамически загружается, выполняется, а результаты копируются обратно. Это демонстрирует оригинальную идею EPI по созданию гетерогенных систем с разными ISA и операционными средами, эффективно работающих вместе на реальном оборудовании. Kalray показала успешную доработку и оптимизацию ПО для своих KVX-процессоров на базе VLIW, которые также могут работать в режиме RISC-V. Menta продемонстрировала результаты оптимизации своей EDA Origami для больших eFPGA, которые позволили кратно ускорить разработку чипов и схем. Наконц, было продемонстрировано успешное использование технологии сжатия памяти в реальном времени ZeroPoint (DenseMem) на EPAC 1.5. Подводя итоги длившегося три года этапа SGA1 и четырёхлетнего SGA2, руководители проекта отметили, что путь к европейскому суверенитету в цифровых технологиях лежит в дальнейшем развитии этих результатов. Для этого научные партнёры проекта опубликуют результаты обширных исследований проекта, а промышленные партнёры продолжат дальнейшее развитие IP-блоков, полученных в его рамках.
15.07.2026 [01:40], Владимир Мироненко
Arm-процессоры Graviton5 оказались быстрее Intel Xeon 6, но отстали от AMD EPYC Turin в тестах инстансов AWSПосле запуска серии AWS M9g, первых инстансов на базе процессоров Graviton5, ресурс Phoronix провёл сравнительные тесты производительности процессоров Graviton4 и Graviton5. Тесты показали значительное повышение производительности новых процессоров AWS Graviton благодаря переходу от ядер Arm Neoverse-V2 к Neoverse-V3 и от памяти DDR5-5600 к DDR5-8800, а также другим улучшениям. Кроме того, для сравнения были добавлены тесты инстансов m8a.4xlarge и m8i.4xlarge на базе актуальных AMD EPYC и Intel Xeon в семействе EC2 M. Инстансы M8a используют кастомные AMD EPYC 9R45 поколения Turin с максимальной частотой 4,5 ГГц и памятью DDR5-6400. Каждый vCPU в M8a поддерживается физическим ядром CPU (без SMT). Стоимость использования m8a.4xlarge по запросу на момент тестирования составила $0,97376/час, что значительно выше, чем $0,78272/час для m8g.4xlarge на базе Graviton5. Инстансы M8i используют кастомные же Intel Xeon 6975P-C поколения Granite Rapids-AP с турбочастотой 3,9 ГГц для всех ядер и памятью DDR5-7200 (хотя сами CPU поддерживают MRDIMM-8800). В отличие от инстансов M8g/M9g и M8a, в M8i используется SMT, так что 16 vCPU являются восемью физическими ядрами с HT. Почасовая стоимость по запросу для m8i.4xlarge составила $0,84672 — дешевле m8a.4xlarge, но всё ещё дороже m9g.4xlarge, да ещё и физических ядер вдвое меньше. В общей сложности порталом Phoronix было проведено более 120 тестов производительности для четырех типов инстансов Amazon EC2. При вычислении геометрического среднего всех показателей производительности инстанс с Graviton5 превзошел экземпляр с Intel Xeon 6, в то время как инстанс с Graviton4 ему немного уступил. Инстанс m9g.4xlarge с Graviton5 оказался примерно на 19 % быстрее, чем экземпляр m8i.4xlarge, хотя важно отметить, что в случае с инстансом на Intel Xeon речь идёт об SMT (HT). Помимо того, что Graviton5 на 19 % быстрее, чем Xeon 6, в этом сравнении почасовая стоимость по запросу была примерно на 8 % ниже, чем у экземпляра на базе Granite Rapids-AP. 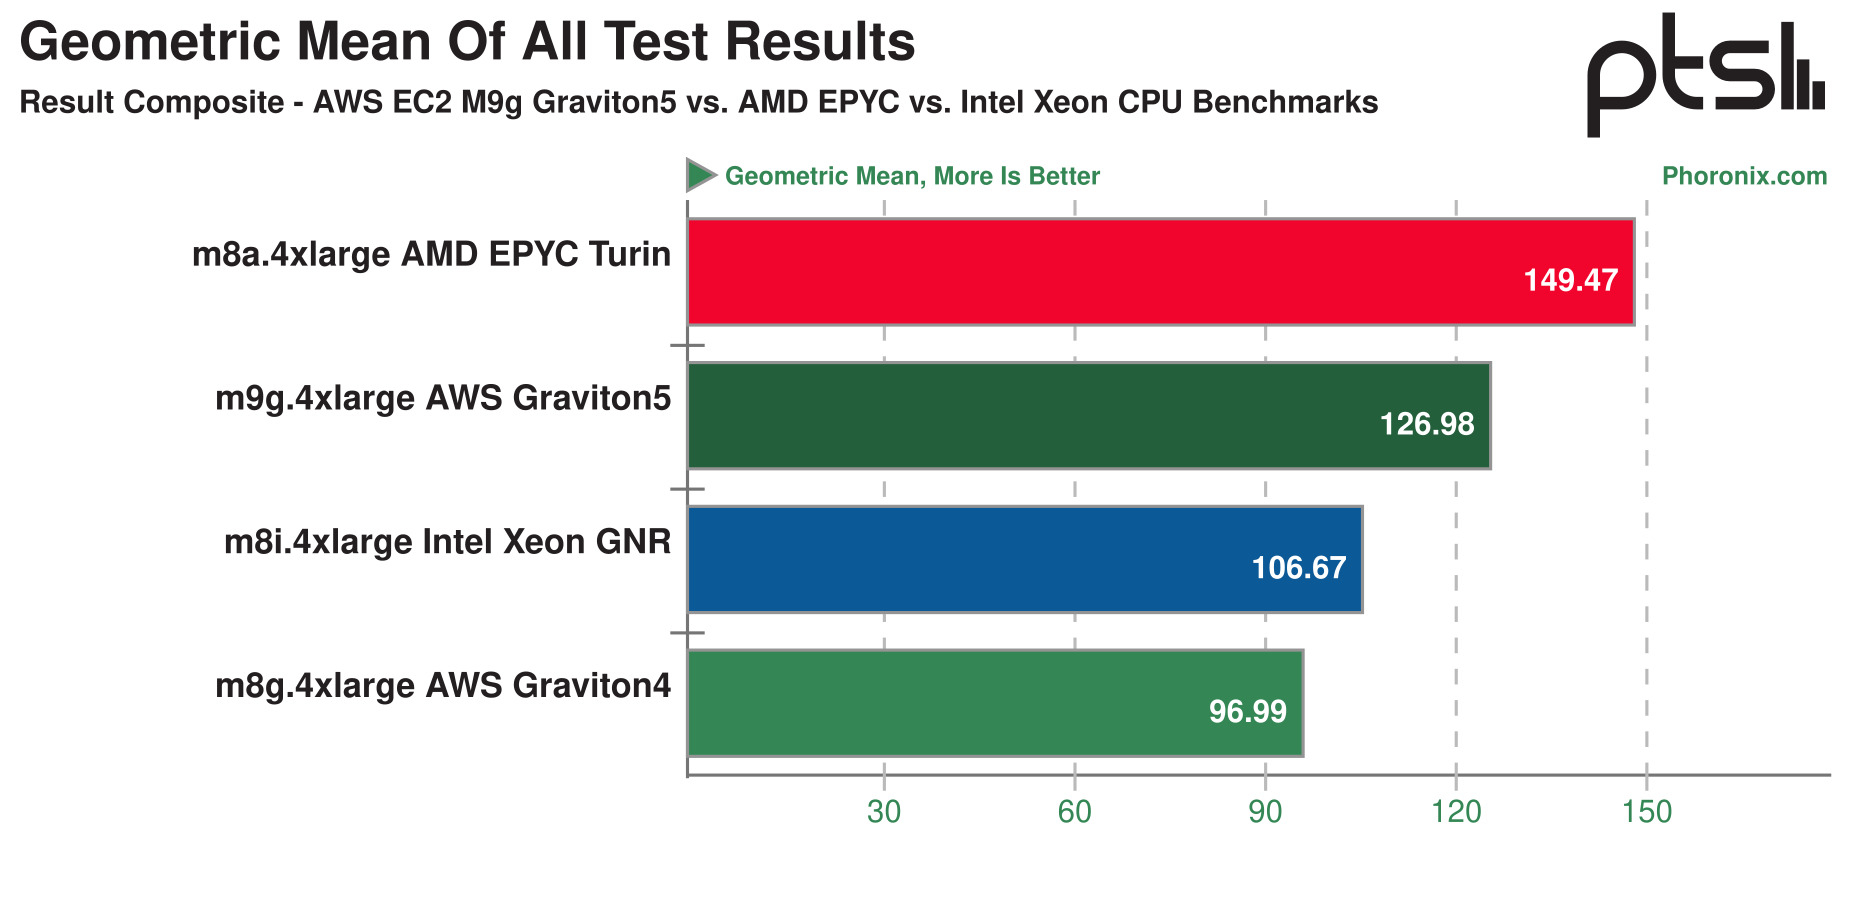
Источник изображения: phoronix.com Инстанс m8a.4xlarge на AMD EPYC Turin показал на 17 % выше производительность, чем инстанс на Graviton5 того же размера. Хотя при текущей ценовой политике по запросу инстанс m8a.4xlarge примерно на 24 % дороже в час, чем m9g.4xlarge с Graviton5, у Graviton5 всё ещё есть ценовое преимущество, поскольку это собственная разработка AWS. Однако, для некоторых рабочих нагрузок инстанс m8a.4xlarge обеспечил как лучшую производительность, так и соотношение производительности и цены, отметил Phoronix. |
|


