
Материалы по тегу: arm
|
27.08.2026 [08:00], Сергей Карасёв
До 136 ядер, 96 линий PCIe 6.0 и 12 каналов DDR5-8800: Arm раскрыла характеристики серверных процессоров AGIКомпания Arm раскрыла дополнительные подробности о процессорах AGI, официальная презентация которых состоялась в марте нынешнего года. Эти чипы предназначены для использования в дата-центрах, ориентированных на ИИ-нагрузки. Чипы выполнены на платформе Arm Neoverse CSS V3. Конструкция включает два чиплета, каждый из которых насчитывает свыше 50 млрд транзисторов. При производстве применяется технология TSMC N3P (3 нм). Процессоры AGI будут предлагаться в модификациях с 64, 128 и 136 ядрами Armv9.2, распределёнными между двумя чиплетами. Номинальная тактовая частота составляет 3,2 ГГц, частота с ускорением — до 3,7 ГГц. Каждое ядро содержит 2 Мбайт кеша L2 (от 128 до 272 Мбайт на чип) и два 128-бит блока SVE2, предназначенных для ускорения задач ИИ и машинного обучения. Поддерживаются форматы BF16 и INT8. Общий объём кеша на уровне системы (SLC) равен 128 Мбайт. 
Источник изображений: Arm Каждый из чиплетов содержит шесть каналов оперативной памяти (12 на процессор) с поддержкой 3 Тбайт DDR5-8800 (6 Тбайт на процессор). Суммарная пропускная способность памяти достигает 845 Гбайт/с, пропускная способность в пересчёте на ядро — от 6 до 13 Гбайт/с в зависимости от их количества. В то время как AMD, Intel и NVIDIA используют гетерогенный многочиплетный подход для увеличения вычислительных мощностей и повышения производительности, решение Arm основано на сочетании высокой пропускной способности памяти и небольшой задержки (менее 100 нс). Благодаря отсутствию необходимости передачи данных на отдельный чиплет с контроллером памяти повышается быстродействие в задачах, чувствительных к задержкам. Внутри каждого чиплета AGI используется интерконнект CMN-S3 с топологией 8 × 9, которая связывает вычислительные ядра, память, IO-блоки и ускорители. Упомянуты фильтрация запросов к памяти (snoop filtering) и иерархическое кеширование на основе HN-S (Super Home Node) — логического блока, выполняющего функции распределительного центра. Он управляет трафиком и данными внутри чипа, чтобы ускорить обмен информацией. 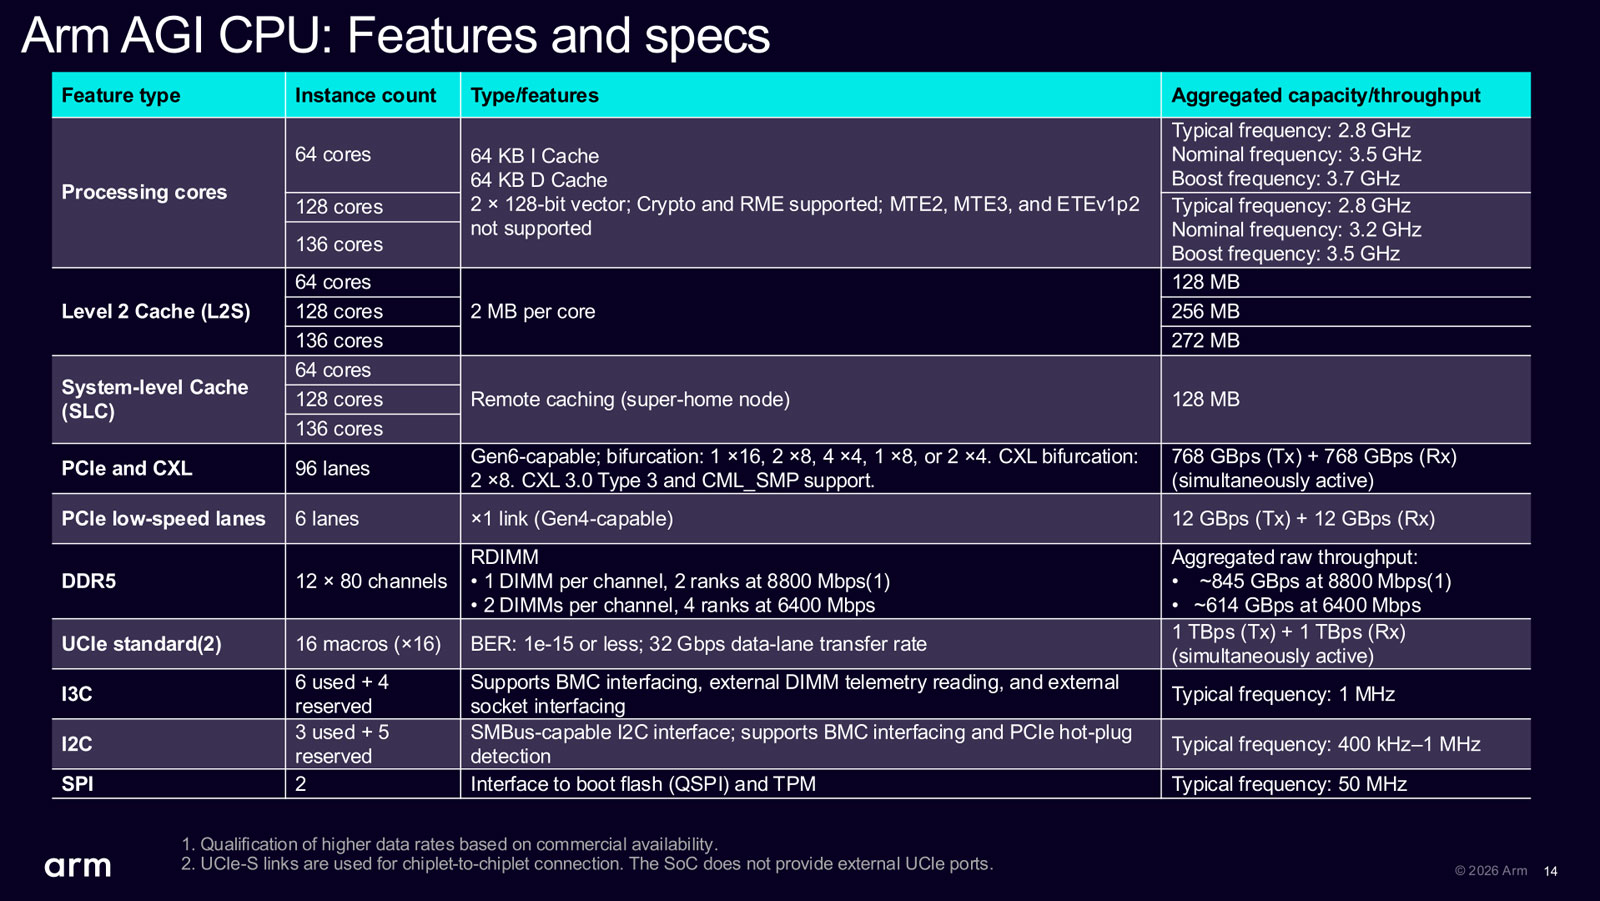 Если CPU-ядру требуется обратиться к памяти на другом чиплете, запрос передаётся по когерентному межчиповому интерконнекту, но при этом задержка увеличивается. Контроллеры DDR5 поддерживают ряд функций для достижения максимальной производительности в реальных рабочих нагрузках, включая полностью внеочередное планирование команд, оптимизированное отображение адресов и программируемые политики страничной адресации. Кроме того, реализован контроль и мониторинг пропускной способности памяти на основе технологии Memory Partitioning and Monitoring (MPAM). В сочетании с приоритизацией (QoS) и обратной связью о перегрузках это позволяет управлять конфликтами, когда множеству ядер и IO-устройствам требуется пропускная способность DRAM.
Процессор имеет 96 линий PCIe 6.0 с поддержкой CXL 3.0, четыре линии PCIe 4.0, а также интерфейсы I3C, I2C и SPI. Показатель TDP находится на уровне 300 Вт. Архитектура изделия рассчитана на стандартные воздушные системы охлаждения и позволяет эффективно использовать доступный лимит мощности. Утверждается, что в стандартной стойке на 36 кВт могут быть задействованы до 8160 вычислительных ядер AGI. В целом, решения AGI оптимизированы под сценарии, в которых CPU берёт на себя значительную часть ИИ-нагрузки. Это могут быть задачи инференса, координация вычислений в гетерогенных средах (CPU + GPU/TPU и т. п.), оркестрация ИИ-агентов и т. д. Реализована встроена аппаратная защита для мультитенантных сред: Runtime Security Engine (RSE), Pointer Authentication, Branch Target Identification.
25.08.2026 [18:35], Владимир Мироненко
IBM объединила архитектуры z и Arm в одном CPU для будущих мейнфреймовIBM анонсировала первый двухархитектурный процессор для мейнфреймов, который позволит запускать операционные системы и приложения на вычислительных платформах IBM (s390x) и Arm (AArch64) в будущих системах IBM z и LinuxONE. Компания отметила, что это первый этап в разработке процессора, достигнутый в рамках сотрудничества с Arm, стартовавшего в апреле 2026 года. 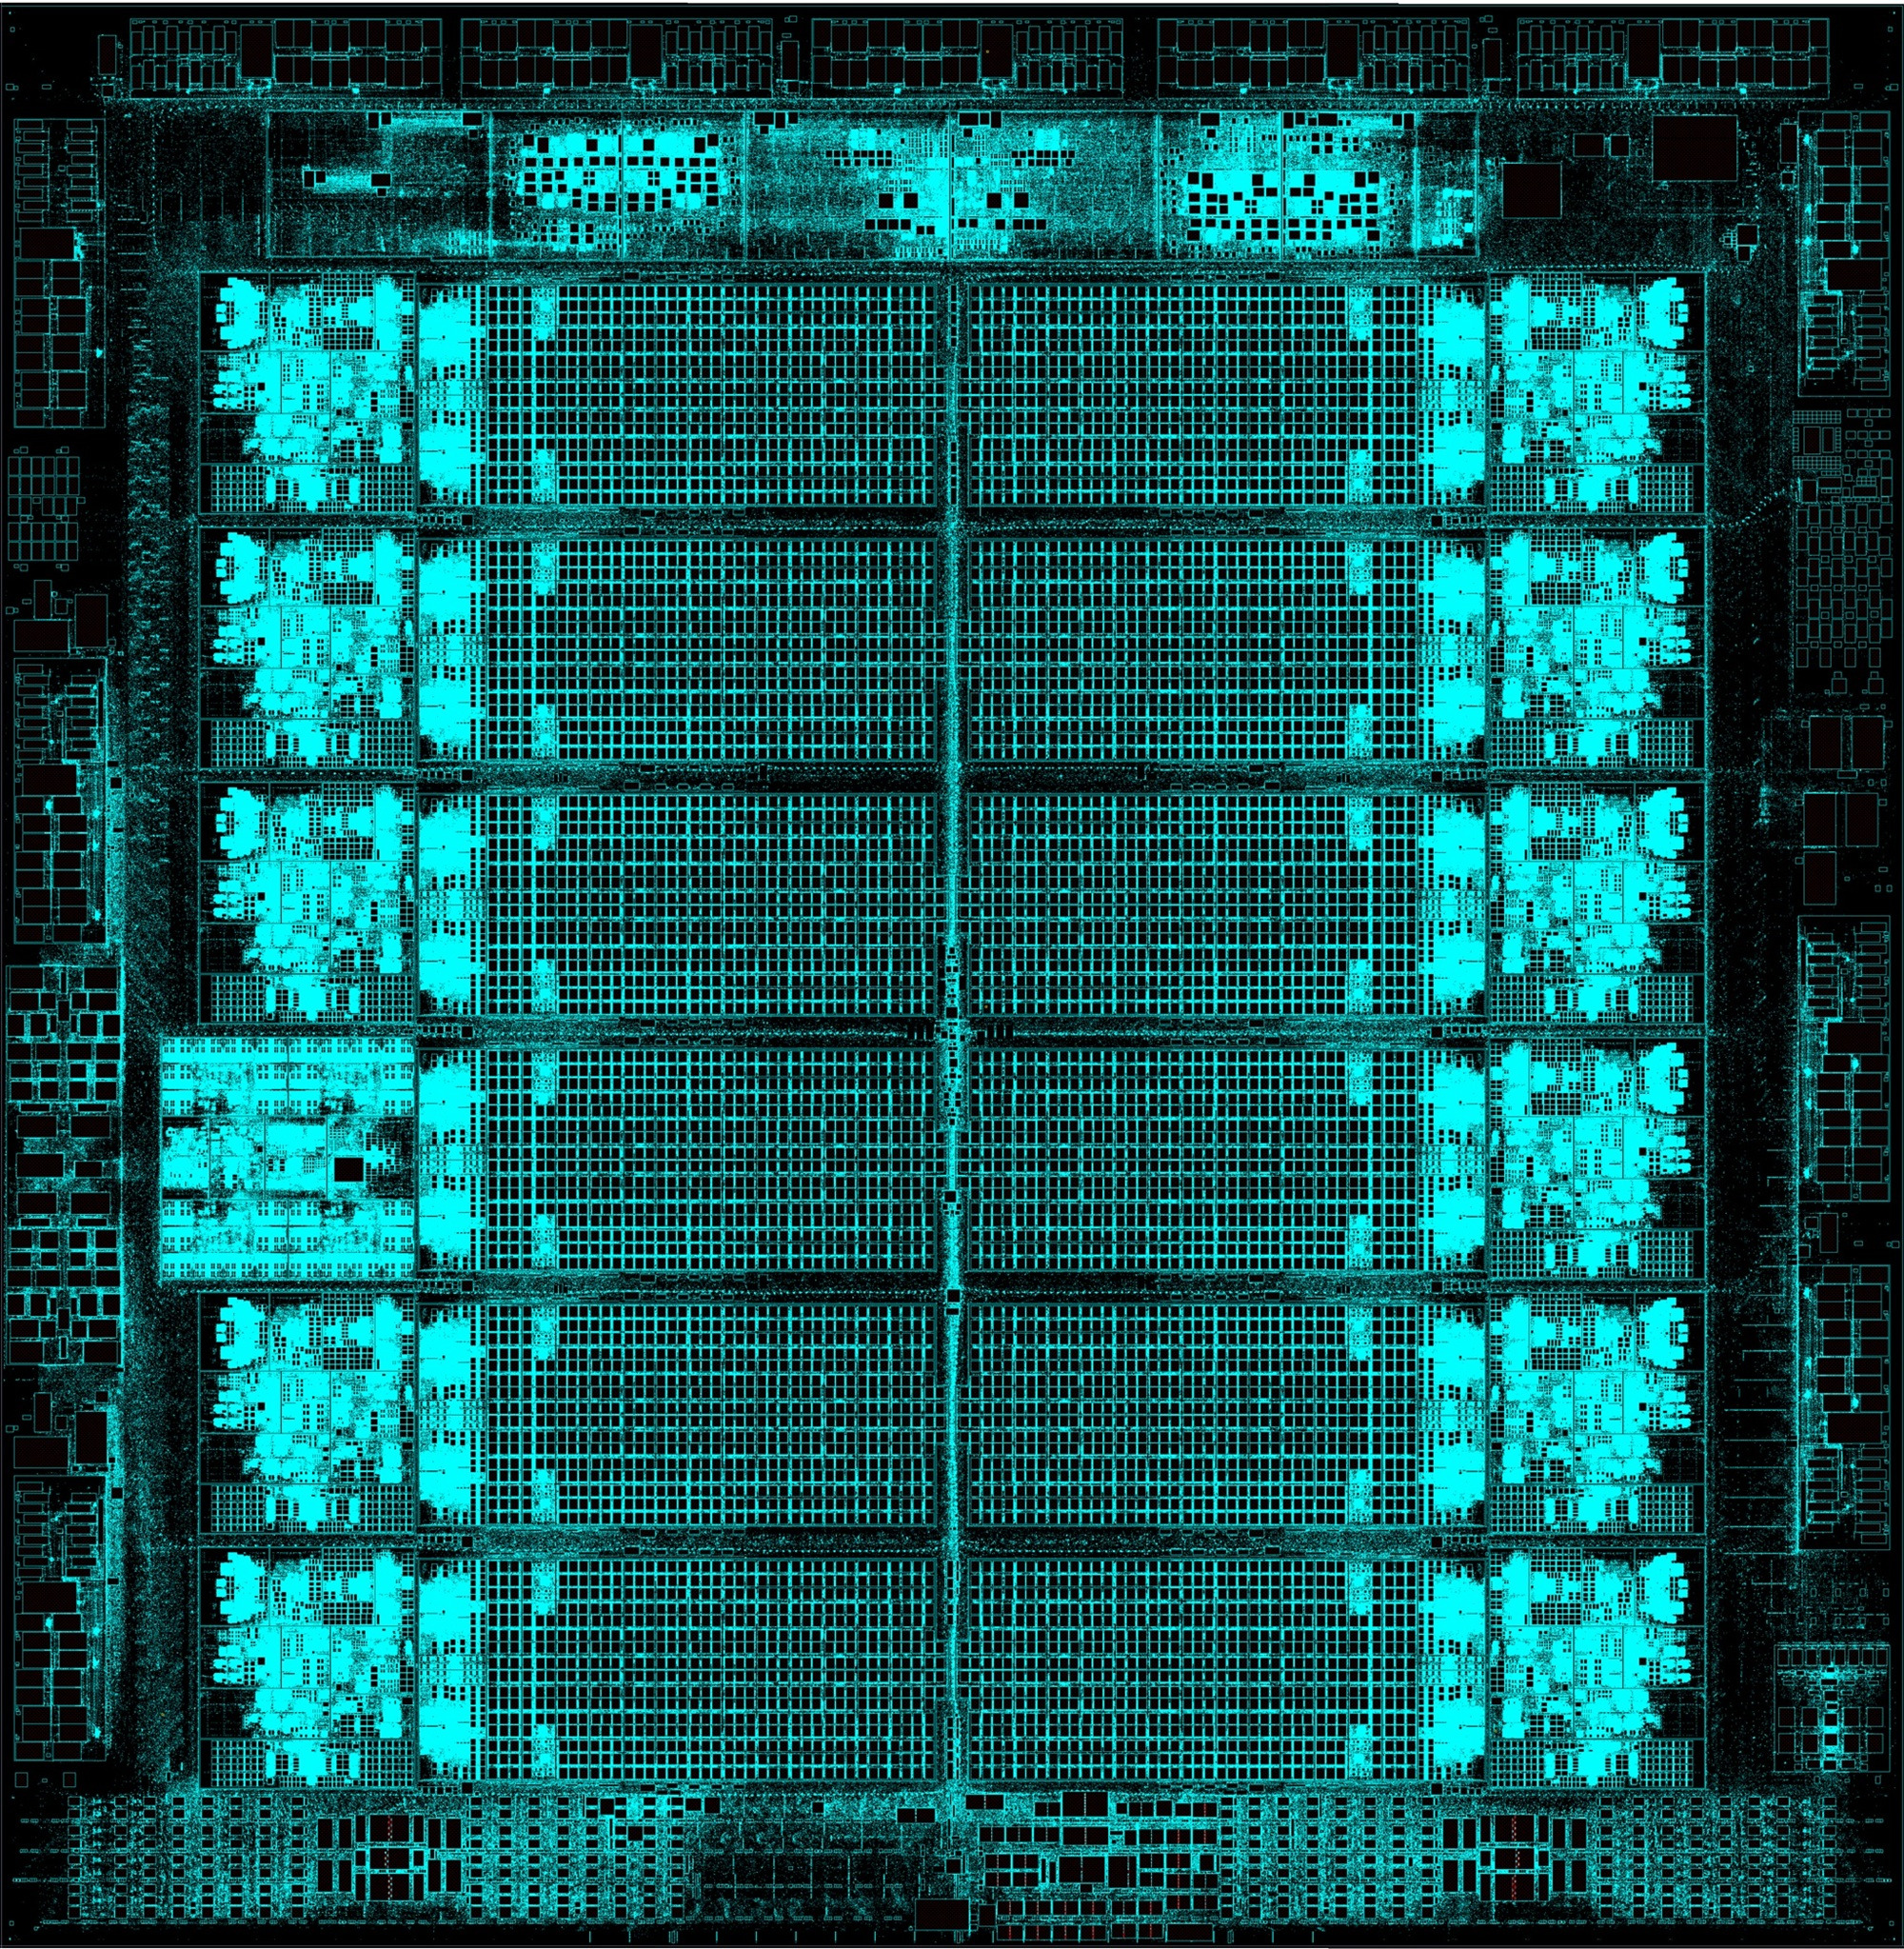
Источник изображения: IBM 2-нм процессор будет содержать 11 доступных двухпоточных (SMT 2) ядер, работающих на частоте более 5,7 ГГц, ускорители ИИ-инференса, специально разработанные для обнаружения мошенничества в финансовых транзакциях в режиме реального времени, выделенный встроенный DPU для ускорения I/O и большую кеш-архитектуру для ресурсоёмких корпоративных рабочих нагрузок с большими частными кешами L2 объёмом по 36 Мбайт, из которых формируются виртуальные L3/L4-кеши. Как отметил ресурс ServeTheHome, виртуальный L3 даёт 432 Мбайт, в то время как L4, объединяя все кеши всех ядер, обеспечит до 3,5 Гбайт памяти с очень низкой задержкой, что полезно для корпоративных рабочих нагрузок, таких как обработка транзакций и обслуживание баз данных. 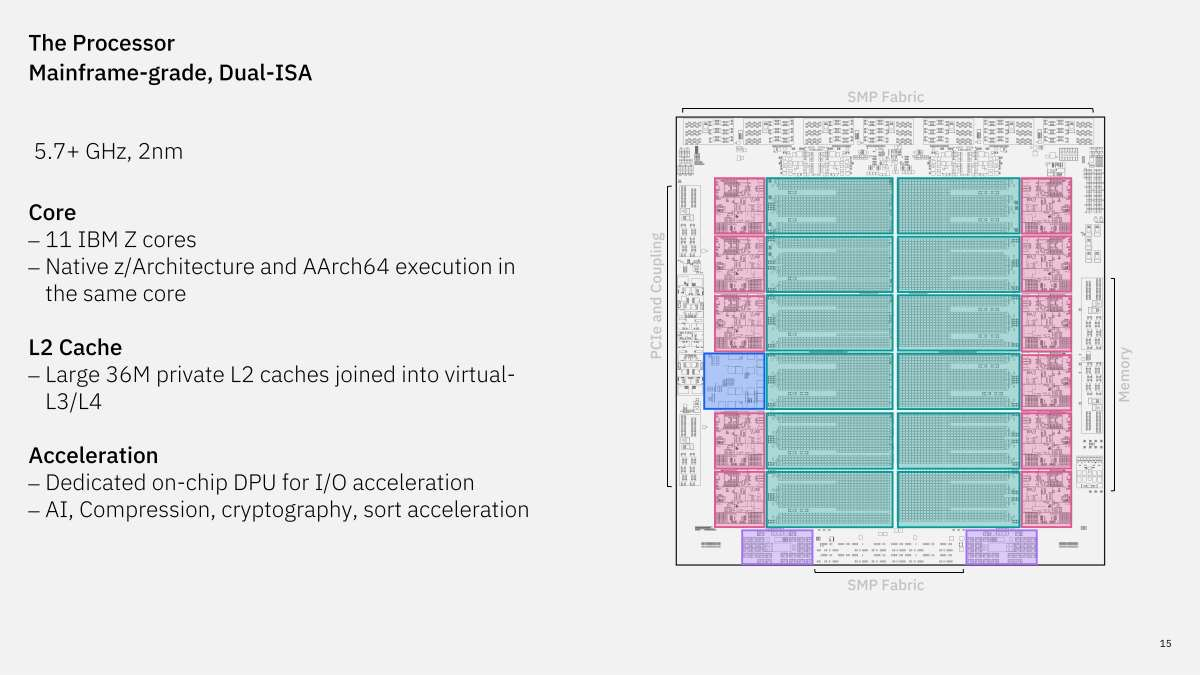
Источник изображений: IBM/ServeTheHome Компания отметила, что архитектура чипа не предусматривает отдельных ядер Arm и IBM: каждое процессорное ядро может одновременно выполнять инструкции Arm и IBM Z, или Arm и LinuxONE, отдавая приоритет установленным характеристикам платформы: производительности, безопасности, шифрования и доступности. Платформы IBM Z и LinuxONE способны масштабироваться до сотен ядер и десятков терабайт памяти. Подчёркивается, что ключевым моментом является то, что IBM реализовала AArch64 на аппаратном уровне, а не путём трансляции. В этом проекте используется реализация Arm с порядком байтов little-endian поверх архитектуры z/Architecture с порядком байтов big-endian. Заявлена поддержка Armv9.3, SVE и SVE2 — всего 2792 инструкции, что более чем в два раза больше, чем z-инструкций. IBM также заявляет о соответствии стандарту Arm SystemReady, что важно для совместимости с имеющимся ПО. Приложения Arm видят собственный полноценный процессор Arm, работая без изменений «из коробки». 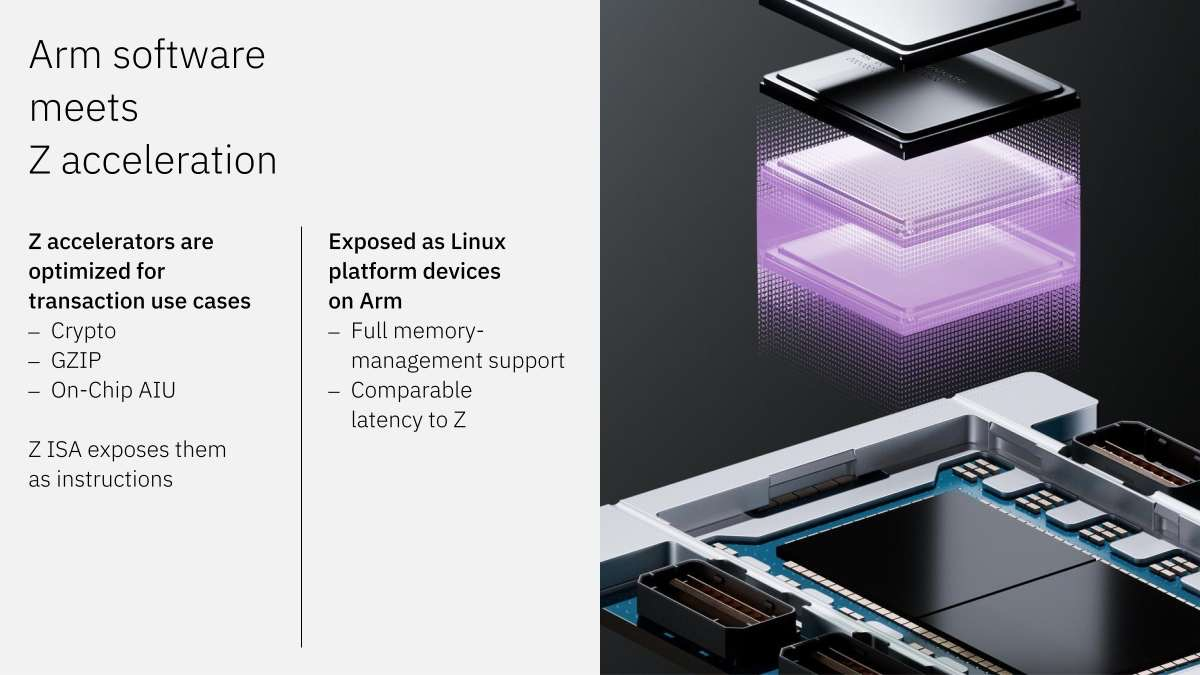 IBM говорит, что новый чип эффективно объединит две крупнейшие в мире вычислительные экосистемы, которые до сих пор были изолированы друг от друга. Мейнфреймы IBM z и системы LinuxONE составляют основу мировой экономики, обрабатывая, по оценкам аналитиков, около 70 % всех финансовых транзакций в мире, а также огромные объёмы данных в сфере здравоохранения. В свою очередь, программную экосистему Arm поддерживает более 22 млн разработчиков по всему миру. Она охватывает широкий и постоянно растущий спектр облачных и периферийных приложений, включая облачное ПО и ПО для ИИ. Предсказатель ветвлений демонстрирует, как существующая конструкция ядра IBM z может использоваться и для AArch64. Используется XML-описание архитектуры Arm для автоматического декодирования инструкций, диспетчеризации и отправки на исполнение. Переиспользуется возможность переименования регистров и основные пути исполнения инструкций, а также некоторые CISC-решения вроде копирования и очистки памяти. Но разработчиком всё равно пришлось добавить новые элементы управления для SVE, а также пути исполнения для FP16/Bfloat16 и криптографических функций. 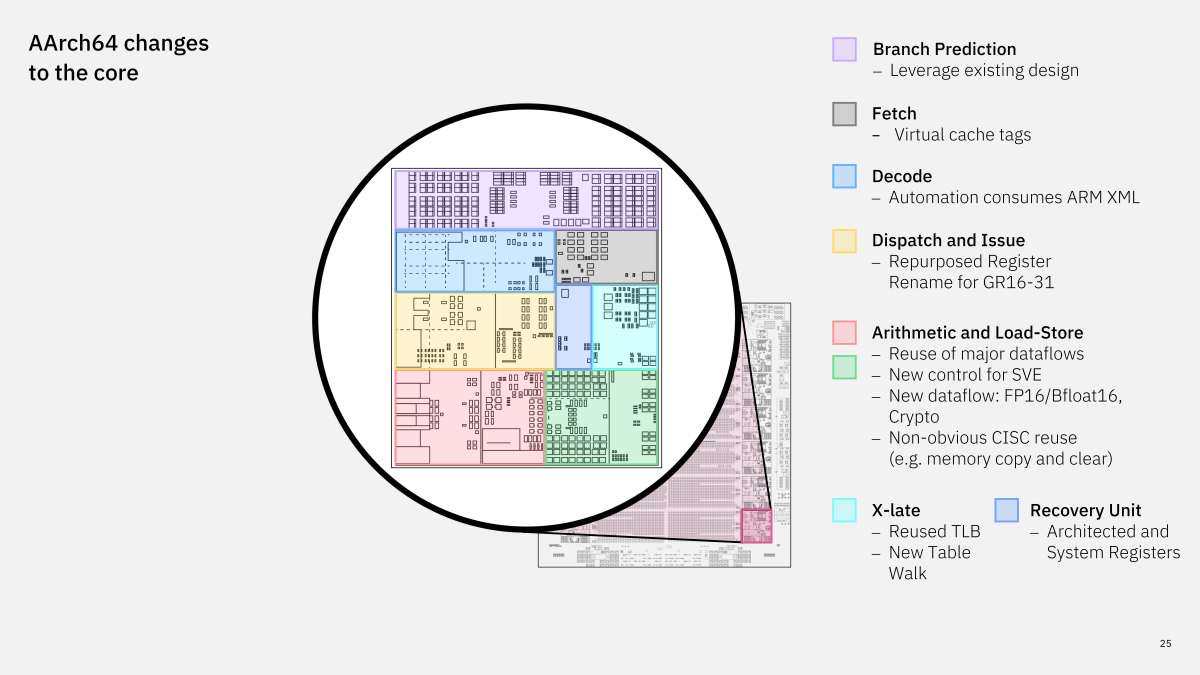 Встроенные ускорителям для криптографии, сжатия и инференса отображаются для Arm ПО представляются в качестве платформенных устройств в Linux на Arm. При этом процессор способен одновременно выполнять инструкции обеих ISA с сохранением сквозной проверки массивов и потоков данных/управления, прозрачного восстановления после нерегулярных сбоев, резервирования/замещения ядер при постоянных сбоях, параллельного восстановления и технологии аппаратной защиты оперативной памяти RAIM. Эта конструкции обеспечивает надёжность с целевым показателем доступности 99,999999 %. 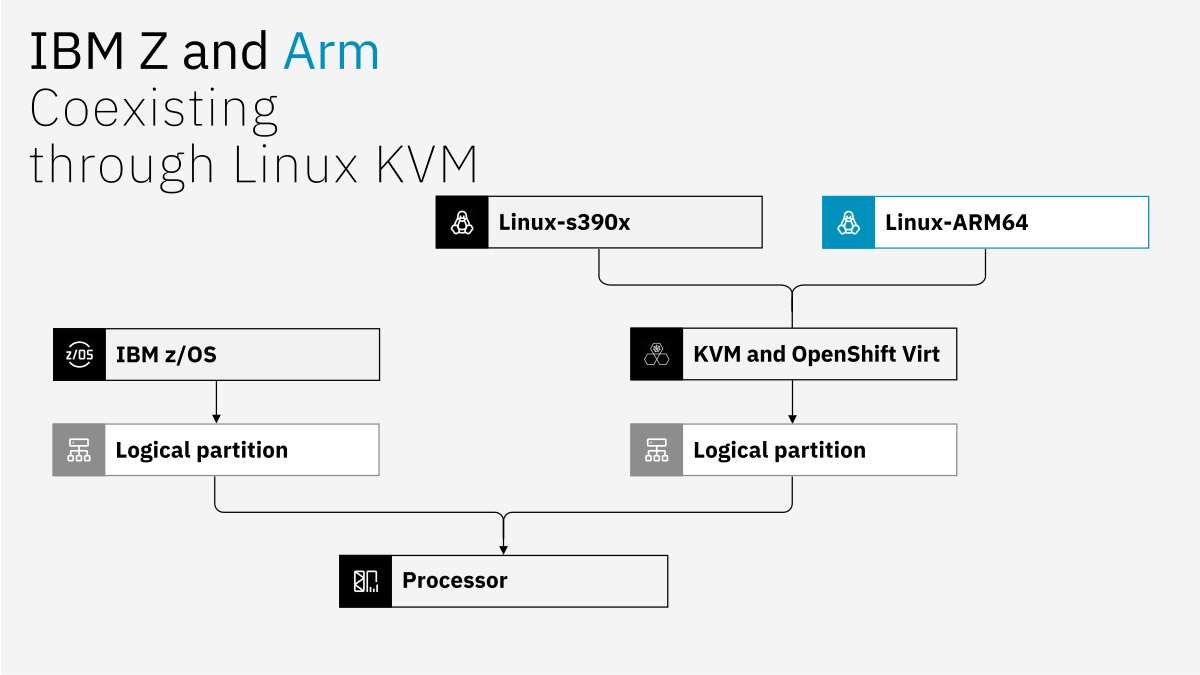 На программном уровне для запуска Linux-приложений для обеих архитектур используются KVM и OpenShift, которые, как нативные приложения z/OS, используют логически разделы, работающие на одном физическом процессоре. А каждый поток может работать как с инструкциями s390x, так и с Arm, при этом переключение занимает наносекунды. Такое сосуществование является залогом получения наилучших результатов от обеих программных экосистем, позволяя клиентам сохранять код для мейнфреймов, одновременно используя широкую базу ПО Arm, пишет SiliconANGLE. Дополнит новый CPU ускоритель ИИ-инференса второго поколения, который ориентирован на более крупные корпоративные рабочие нагрузки. Он содержит 16 активных ИИ-ядер (и одно резервное) с поддержкой FP4 и MXFP4, которые, по словам IBM, могут обеспечить четырёхкратное увеличение TOPS. Он получит 96 Гбайт HBM3e с ПСП до 4 Тбайт/с и PCIe 6.0 в качестве интерфейса одноранговой сети с низкой задержкой. IBM позиционирует чип как компонент для критически важных ИИ-систем, обеспечивающий надёжные вычисления, защищающие данные и модели в состоянии покоя, при передаче и использовании, в том числе с использованием криптографии с квантовой защитой. 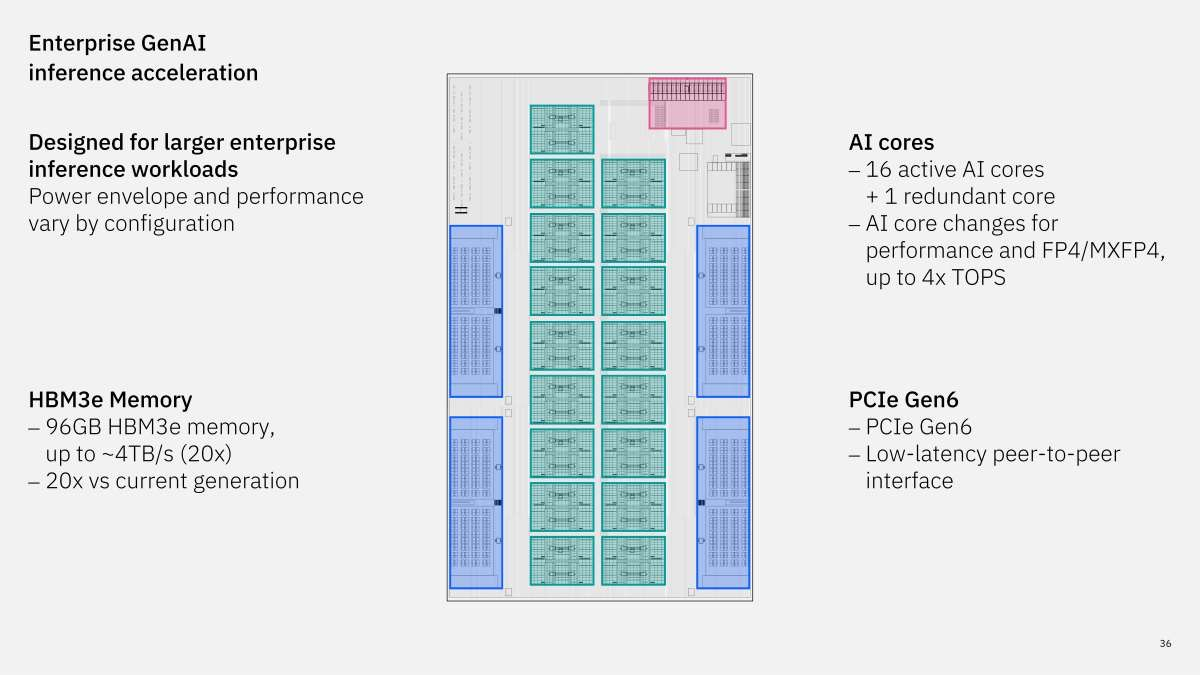 Как пишет SiliconANGLE, финансовые компании, работающие в условиях жёсткого регулирования, не могут отказаться от использования мейнфреймов и LinuxONE, известных своей исключительной безопасностью и надёжностью. Но для доступа к программной экосистеме Arm им приходилось отказываться от систем IBM. Новый чип меняет положение дел. «Этот процессор представляет собой значительный архитектурный прогресс для IBM z и LinuxONE, — сказал Кристиан Якоби (Christian Jacobi), главный технический директор и научный сотрудник IBM Systems Development. — Внедряя Arm непосредственно в наши платформы, мы объединяем доступ к одной из самых быстрых программных экосистем в отрасли с качествами, которые сделали системы IBM основой для ведения бизнеса». Двухпроцессорная архитектура IBM и Arm потенциально может способствовать новой волне внедрения ИИ компаниями в отраслях с жёстким регулированием. Вскоре разработчики смогут писать код для Arm и развёртывать его непосредственно на мейнфреймах, так что устаревшие аппаратные системы IBM останутся актуальными ещё долгие годы. Сообщается, что новый процессор будет доступен для клиентов в 2028 году. Это не первая попытка IBM скрестить две ISA в одном чипе. В 1994 году компания анонсировала процессор PowerPC 615, который объединил бы x86 и PPC, причём на уровне сокета он был совместим именно с Pentium-платформами, что, как ожидала IBM, привлечёт многочисленных производителей ПК. На деле чип поддерживался только Minix и особой версией OS/2, тогда как Microsoft отказалась участвовать в развитии ПО для него, а MacOS на нём, по-видимому, никто запускать и не собирался. В результате чип так и остался прототипом.
02.08.2026 [14:37], Владимир Мироненко
Arm объявила о растущем спросе на её процессор для ЦОД, но акции упали из-за ожидаемого снижения роялти от смартфоновArm Holdings сообщила результаты за I квартал 2027 финансового года, завершившийся 30 июня 2026 года. Выручка компании выросла год к году на 22 % до $1,29 млрд благодаря росту спроса на разработанные ею чипы для ИИ ЦОД, что привело к рекордным для I квартала показателям лицензирования и роялти. Выручка Arm превысила прогноз аналитиков, опрошенных FactSet, в размере $1,26 млрд (согласно данным The Wall Street Journal). Скорректированная прибыль составила 45¢ на акцию. Аналитики, опрошенные FactSet, прогнозировали 40¢ на акцию. Чистая прибыль достигла $270 млн или 25¢ на акцию, по сравнению со $130 млн, или 12¢ на акцию годом ранее. Выручка от роялти выросла на 22 % до $715 млн благодаря более чем двукратному увеличению роялти на технологии для чипов для ЦОД, а выручка от лицензирования увеличилась на 23 % до $574 млн. Росту выручки также способствовало продолжающееся внедрение технологий Arm с более высокими ставками роялти за чип, таких как Armv9 и Arm CSS. Генеральный директор Рене Хаас (Rene Haas) заявил, что спрос на CPU Arm AGI превзошёл ожидания, и превысил $2 млрд в 2027 и 2028 финансовых годах, что более чем вдвое превышает прогнозируемый компанией в прошлом квартале потенциальный объём в $1 млрд. Он добавил, что компания уже поставила первые чипы нескольким клиентам, включая Oracle. IDC сообщила, что расходы на ускоренные серверные платформы на базе Arm почти удвоились за последние два квартала и превысили расходы на платформы x86. 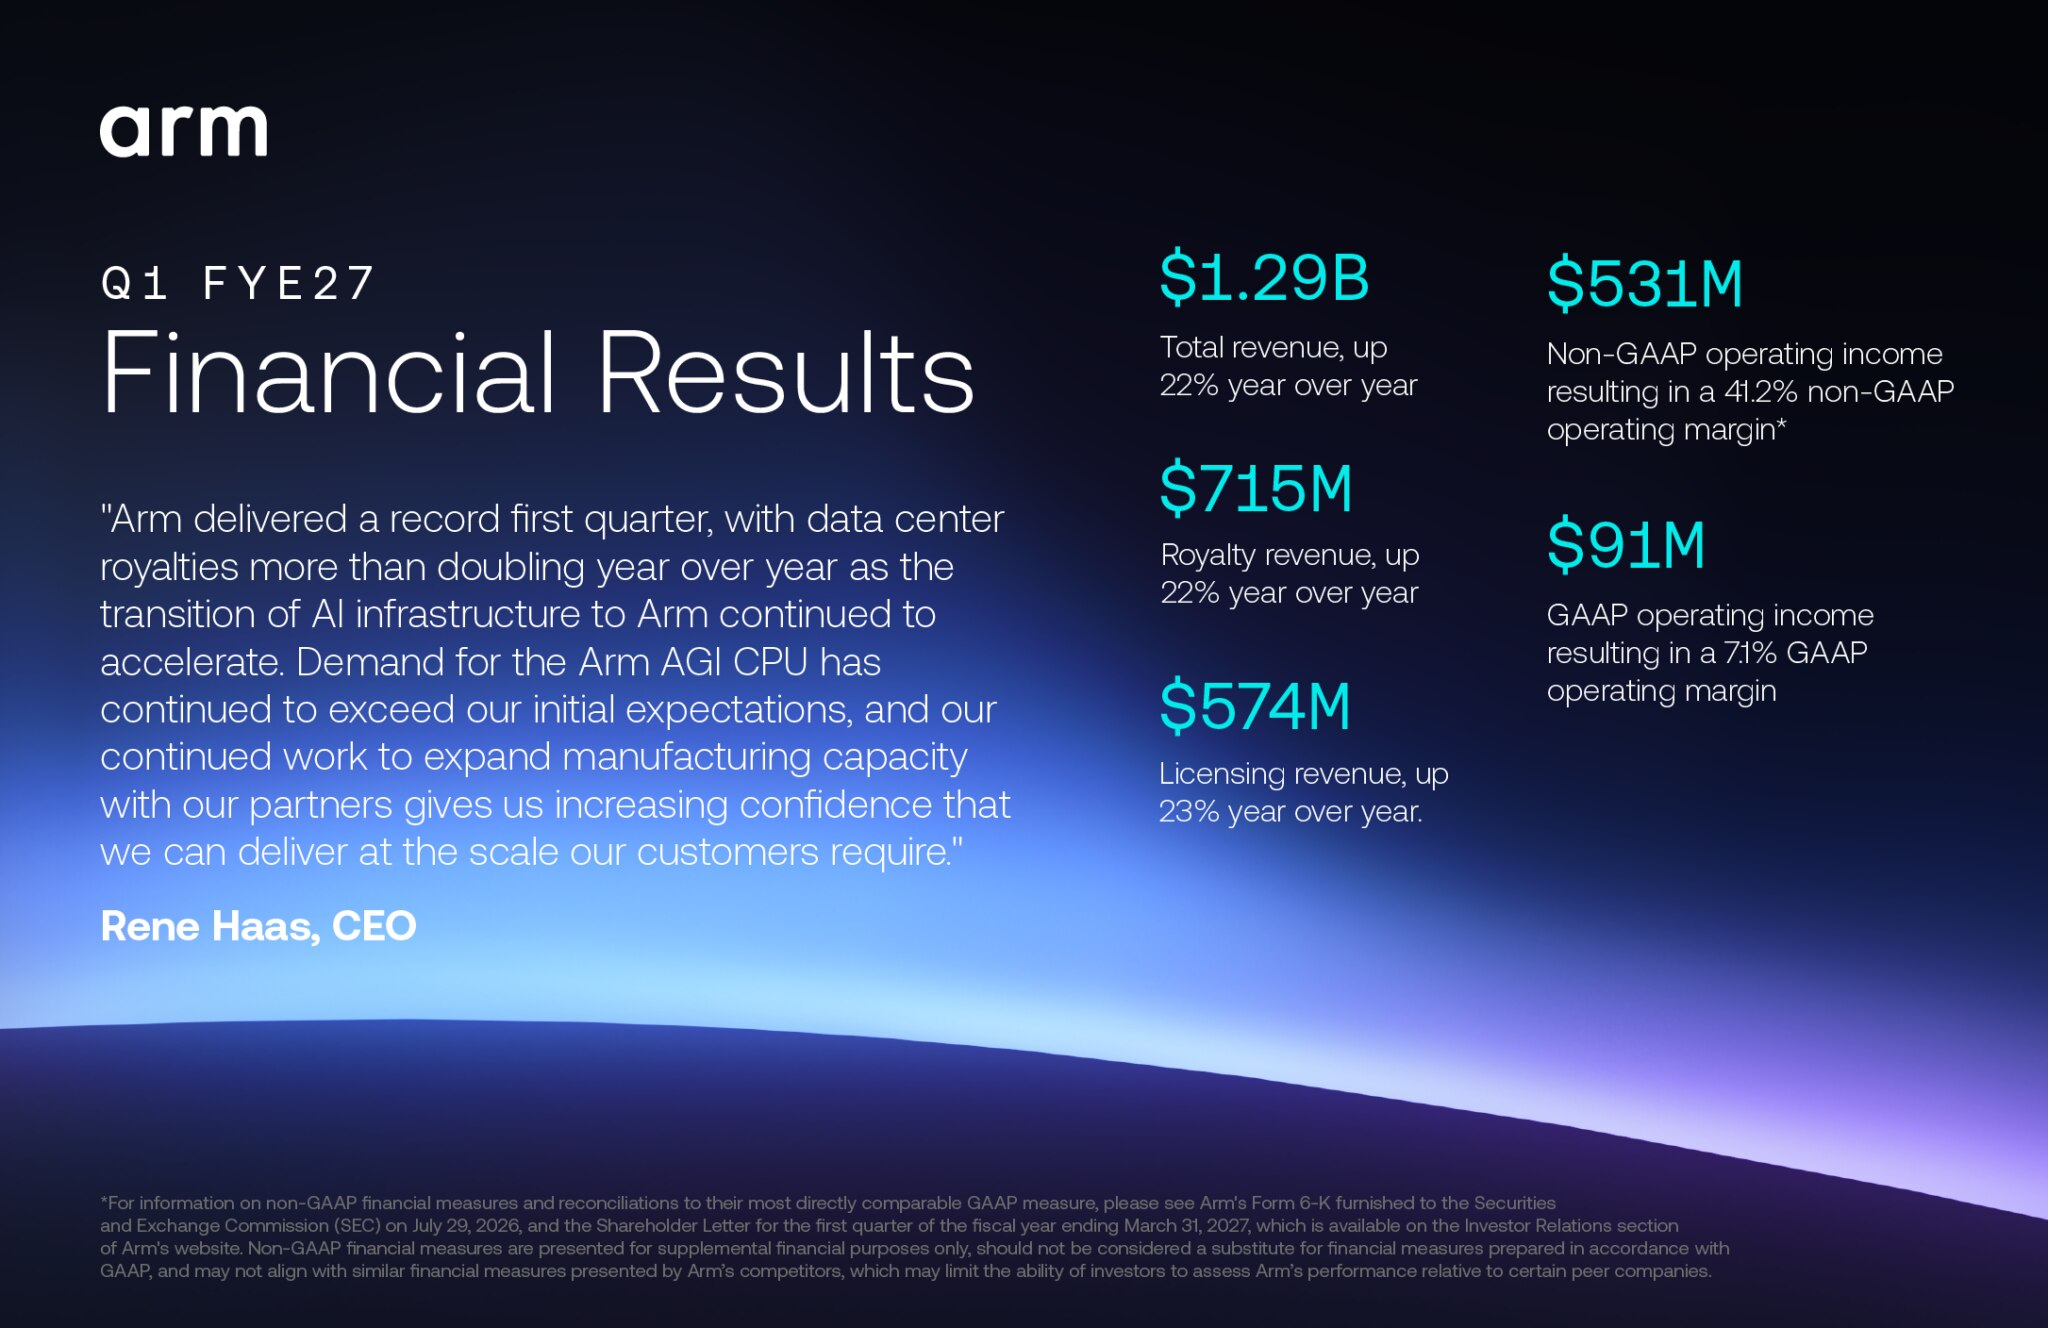
Источник изображения: Arm Arm сообщила, что продолжает привлекать новых клиентов, в том числе нескольких в США и Китае, в то время как общая стоимость портфеля заказов продолжает расти. Также компания отметила, что обеспечила производственные мощности, необходимые для поддержки потенциала в $1 млрд, обозначенного в предыдущем квартале, в период с 2027 по 2028 финансовый год и работает с партнёрами над дальнейшим расширением производства. Компания заявила, что переход ИИ-инфраструктуры на Arm продолжает набирать обороты. Эту архитектуру используют крупные провайдеры облачных услуг и производители микросхем, включая NVIDIA, AWS, Google, Microsoft и Qualcomm. Процессор Vera от NVIDIA, построенный на архитектуре Arm, запущен в полномасштабное производство, а AWS объявила о многолетнем соглашении с Meta✴ о развёртывании десятков млн ядер Graviton5 на базе Arm для рабочих ИИ-нагрузок. Поставки процессоров Neoverse для ЦОД уже превысили 1,5 млрд ядер. Во II финансовом квартале компания прогнозирует скорректированную прибыль в диапазоне от 43¢ до 51¢ на акцию при выручке от $1,33 до $1,43 млрд. Аналитики, опрошенные LSEG, прогнозируют скорректированную прибыль в размере 44¢ на акцию при выручке в $1,34 млрд. Несмотря на то, что прогноз компании по выручке за II финансовый квартал оказался выше ожиданий Уолл-стрит, её акции упали на 9 %, сообщило агентство Reuters. Акции упали после того, как Arm заявила, что ожидает снижения роялти от продаж смартфонов в следующем квартале.
17.07.2026 [17:12], Владимир Мироненко
Евросоюз объявил об успешном завершении второго этапа EPI для укрепления технологического суверенитетаВ Люксембурге состоялся заключительный обзор Европейской инициативы по процессорам (EPI), финансируемой EuroHPC. По итогам было объявлено об успешном завершении второго этапа проекта — EPI SGA2, целью которого было содействие укреплению технологического суверенитета Европы. В рамках обзора была проведена демонстрация уникальных технологий и микросхем, разработанных на обоих этапах проекта EPI. В частности, был продемонстрирован первый Arm-процессор SiPearl Rhea1, работающий с полным ПО для HPC. Чип запустили на тестовой плате со стандартным дистрибутивом Linux, работающим с высокоскоростной памятью HBM и соответствующими аппаратными счетчиками мониторинга производительности. Он успешно прошёл тесты HPL и STREAM, демонстрируя готовность всей аппаратной и программной экосистемы Rhea1 к высокопроизводительным вычислениям для систем экзафлопсного уровня. Также было проведено пять демонстраций, наглядно подтверждающих, что технология RISC-V, используемая EPI, перешла от отдельных блоков к полному программному стеку, реальному оборудованию и реальным приложениям и инструментам, которыми может воспользоваться обычный пользователь. Так, был развёрнут полный кластер на ускорителе VEC. Был показан новейший RTL-код (ядро RISC-V с внеочередным выполнением инструкций от Semidynamics, улучшенный векторный блок от Барселонского суперкомпьютерного центра) для запуска на FPGA в инфраструктуре MEEP. Было запущено реальное научное приложение Mini-Fall3D для оценки диффузии пыли в атмосфере, распараллеленное с помощью OpenMP и MPI, скомпилированное с использованием инструментария EPI LLVM и профилированное с помощью стандартных инструментов (PAPI, Extrae/Paraver). Запуски показали масштабируемость, продемонстрировав выполнения скалярных и векторных задач на разных узлах. 
Источник изображения: european-processor-initiative.eu Также был продемонстрирован готовый ИИ-чип EPAC 1.5 на базе RISC-V, подключённый к Arm-хосту через PCIe. Компилятор проекта генерирует один двоичный файл, содержащий код как Arm, так и RISC-V. Код RISC-V передаётся по PCIe через DMA, динамически загружается, выполняется, а результаты копируются обратно. Это демонстрирует оригинальную идею EPI по созданию гетерогенных систем с разными ISA и операционными средами, эффективно работающих вместе на реальном оборудовании. Kalray показала успешную доработку и оптимизацию ПО для своих KVX-процессоров на базе VLIW, которые также могут работать в режиме RISC-V. Menta продемонстрировала результаты оптимизации своей EDA Origami для больших eFPGA, которые позволили кратно ускорить разработку чипов и схем. Наконц, было продемонстрировано успешное использование технологии сжатия памяти в реальном времени ZeroPoint (DenseMem) на EPAC 1.5. Подводя итоги длившегося три года этапа SGA1 и четырёхлетнего SGA2, руководители проекта отметили, что путь к европейскому суверенитету в цифровых технологиях лежит в дальнейшем развитии этих результатов. Для этого научные партнёры проекта опубликуют результаты обширных исследований проекта, а промышленные партнёры продолжат дальнейшее развитие IP-блоков, полученных в его рамках.
15.07.2026 [01:40], Владимир Мироненко
Arm-процессоры Graviton5 оказались быстрее Intel Xeon 6, но отстали от AMD EPYC Turin в тестах инстансов AWSПосле запуска серии AWS M9g, первых инстансов на базе процессоров Graviton5, ресурс Phoronix провёл сравнительные тесты производительности процессоров Graviton4 и Graviton5. Тесты показали значительное повышение производительности новых процессоров AWS Graviton благодаря переходу от ядер Arm Neoverse-V2 к Neoverse-V3 и от памяти DDR5-5600 к DDR5-8800, а также другим улучшениям. Кроме того, для сравнения были добавлены тесты инстансов m8a.4xlarge и m8i.4xlarge на базе актуальных AMD EPYC и Intel Xeon в семействе EC2 M. Инстансы M8a используют кастомные AMD EPYC 9R45 поколения Turin с максимальной частотой 4,5 ГГц и памятью DDR5-6400. Каждый vCPU в M8a поддерживается физическим ядром CPU (без SMT). Стоимость использования m8a.4xlarge по запросу на момент тестирования составила $0,97376/час, что значительно выше, чем $0,78272/час для m8g.4xlarge на базе Graviton5. Инстансы M8i используют кастомные же Intel Xeon 6975P-C поколения Granite Rapids-AP с турбочастотой 3,9 ГГц для всех ядер и памятью DDR5-7200 (хотя сами CPU поддерживают MRDIMM-8800). В отличие от инстансов M8g/M9g и M8a, в M8i используется SMT, так что 16 vCPU являются восемью физическими ядрами с HT. Почасовая стоимость по запросу для m8i.4xlarge составила $0,84672 — дешевле m8a.4xlarge, но всё ещё дороже m9g.4xlarge, да ещё и физических ядер вдвое меньше. В общей сложности порталом Phoronix было проведено более 120 тестов производительности для четырех типов инстансов Amazon EC2. При вычислении геометрического среднего всех показателей производительности инстанс с Graviton5 превзошел экземпляр с Intel Xeon 6, в то время как инстанс с Graviton4 ему немного уступил. Инстанс m9g.4xlarge с Graviton5 оказался примерно на 19 % быстрее, чем экземпляр m8i.4xlarge, хотя важно отметить, что в случае с инстансом на Intel Xeon речь идёт об SMT (HT). Помимо того, что Graviton5 на 19 % быстрее, чем Xeon 6, в этом сравнении почасовая стоимость по запросу была примерно на 8 % ниже, чем у экземпляра на базе Granite Rapids-AP. 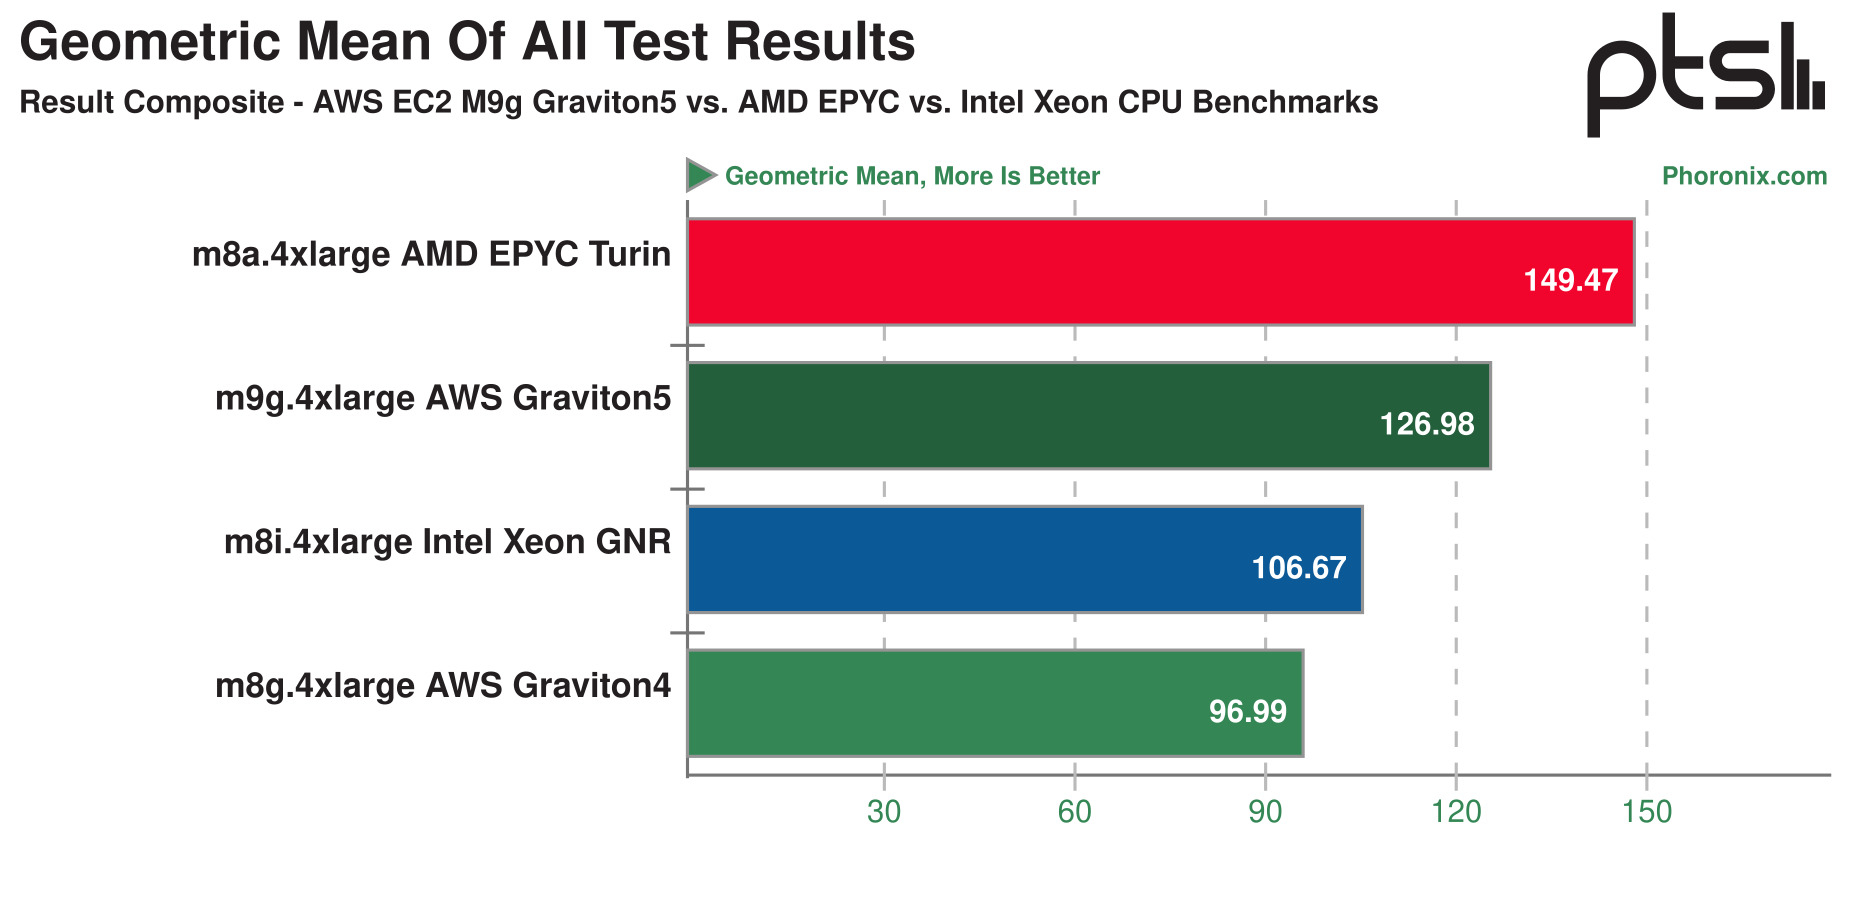
Источник изображения: phoronix.com Инстанс m8a.4xlarge на AMD EPYC Turin показал на 17 % выше производительность, чем инстанс на Graviton5 того же размера. Хотя при текущей ценовой политике по запросу инстанс m8a.4xlarge примерно на 24 % дороже в час, чем m9g.4xlarge с Graviton5, у Graviton5 всё ещё есть ценовое преимущество, поскольку это собственная разработка AWS. Однако, для некоторых рабочих нагрузок инстанс m8a.4xlarge обеспечил как лучшую производительность, так и соотношение производительности и цены, отметил Phoronix.
14.07.2026 [10:01], Сергей Карасёв
ИИ на батарейках: Ambient Scientific представила экономичный микроконтроллер GPX10 Pro для работы на периферииКомпания Ambient Scientific анонсировала микроконтроллер GPX10 Pro для встраиваемых ИИ-приложений, работающих в режиме Always-On на периферийных устройствах. Новинка характеризуется небольшим энергопотреблением (менее 100 мкВт), благодаря чему может получать питание от небольшой батарейки. Изделие оснащено ядром Arm Cortex-M4F, функционирующим на частоте от 100 кГц до 100 МГц. Есть 2048 Кбайт системной памяти SRAM и дополнительно 64 Кбайт памяти SRAM, которая используется Always-On-секцией. Для хранения данных может быть подключён внешний флеш-модуль SPI или QSPI. В составе микроконтроллера задействованы десять программируемых ядер MX8 для выполнения задач глубокого обучения со сверхнизким энергопотреблением. Применён фирменный ИИ-движок DigAn, который позволяет ядрам переключаться между режимами Master (ведущий) и Slave (ведомый). Максимальная производительность составляет 512 GOPS при частоте 100 МГц с КПД более 7 TOPS/Вт. Возможно выполнение до 2560 операций MAC (умножение с накоплением) за такт, или 256 операций за такт в пересчёте на ядро. Говорится о поддержке стандартных нейронных сетей (CNN, RNN, LSTM, FCN). 
Источник изображения: Ambient Scientific Реализованы следующие интерфейсы: 16 × GPIO, 1 × I2C Slave, 1 × I2C Master, 2 × SPI, 2 × UAR, DVP (камера и пр.). Могут быть одновременно подключены до десяти цифровых и аналоговых датчиков, до четырёх аналоговых и двух цифровых микрофонов. Поддерживается асимметричное шифрование по алгоритму AES-128. Разработчикам будет доступен специализированный SDK-комплект, совместимый с фреймворками для ИИ и машинного обучения Keras, Tensorflow и ONNX, средствами компиляции ONNX Runtime, MX8 Runtime, ONNX-MLIR и пр. Будет также предлагаться набор GPX10 Pro Development Kit с аналоговым и цифровым микрофонами, акселерометром, датчиком газа, встроенным разъёмом для камеры, модулем Bluetooth и другими компонентами. Заявлена поддержка операционных систем Windows и RTOS.
01.07.2026 [11:33], Сергей Карасёв
AMD представила SoС Versal Premium Gen 2 Memory on Package со встроенной памятью LPDDR5XКомпания AMD анонсировала адаптивные системы на чипе (SoC) серии Versal Premium Gen 2 Memory on Package (MoP), предназначенные для применения в таких областях, как профессиональные камеры и видеооборудование, устройства для обеспечения сетевой безопасности, тестовые платформы и пр. Особенность новинок заключается в наличии встроенной памяти LPDDR5X, объём которой может достигать 32 Гбайт (пропускная способность — до 288 Гбайт/с). Интеграция LPDDR5X непосредственно в корпус SoC обеспечивает более высокую производительность по сравнению с реализациями, в которых чипы памяти находятся отдельно. При этом достигается экономия пространства до 60 %, что позволяет проектировать более компактные устройства. Кроме того, разработчики получают дополнительную свободу при дизайне конструкции оборудования. А отказ от HBM снижает стоимость. 
Источник изображения: AMD В состав Versal Premium Gen 2 MoP входят два вычислительных ядра общего назначения Arm Cortex-A72 и два ядра реального времени Arm Cortex-R5F. В семейство вошли изделия 2VP3422, 2VP3522 и 2VP3622. Первое насчитывает 2,561 млн логических ячеек, 1,172 млн LUT и 6080 движков DSP; задействованы 56 трансиверов GTM2. Варианты 2VP3522 и 2VP3622 получили 3,273 млн логических ячеек, 1,496 млн LUT и 72 трансивера GTM2, а количество движков DSP составляет 2512 и 7616 соответственно. Упомянута поддержка CXL 3.1 и PCIe 6.0, а также 400/200/100/50/40/25/10GbE. Реализованы высокоскоростные криптографические модули 400G. AMD гарантирует доступность решений Versal Premium Gen 2 MoP в течение более чем 15 лет. Диапазон рабочих температур простирается от -40 до +110 °C. Пробные поставки новинок начнутся в конце текущего года, а массовое производство запланировано на II половину 2027-го.
26.06.2026 [12:44], Сергей Карасёв
Два кристалла, 304 ядра и 32 Гбайт HBM: подробности об Arm-чипах LX2 в китайском суперкомпьютере LineShineКитайский национальный суперкомпьютерный центр в Шэньчжэне (NSCCSZ) обнародовал дополнительную информацию о вычислительном комплексе LineShine, который возглавил свежий рейтинг самых мощных НРС-систем мира TOP500. FP64-производительность LineShine в тесте Linpack достигает 2,198 Эфлопс. В основу LineShine положены китайские 304-ядерные процессоры LX2 с архитектурой Arm. Конструкция этих изделий включает два вычислительных кристалла, каждый из которых содержит 152 ядра Armv9 с поддержкой Scalable Vector Extension (SVE) и Scalable Matrix Extension (SME). Тактовая частота составляет 1,55 ГГц. Каждый из кристаллов, в свою очередь, разделён на четыре NUMA-домена по 38 ядер. В состав каждого домена входят 4 Гбайт памяти HBM и 32 Гбайт памяти DDR5. Таким образом, в общей сложности используются 32 Гбайт HBM и 256 Гбайт DDR5. Энергопотребление LX2 находится на уровне 690 Вт. 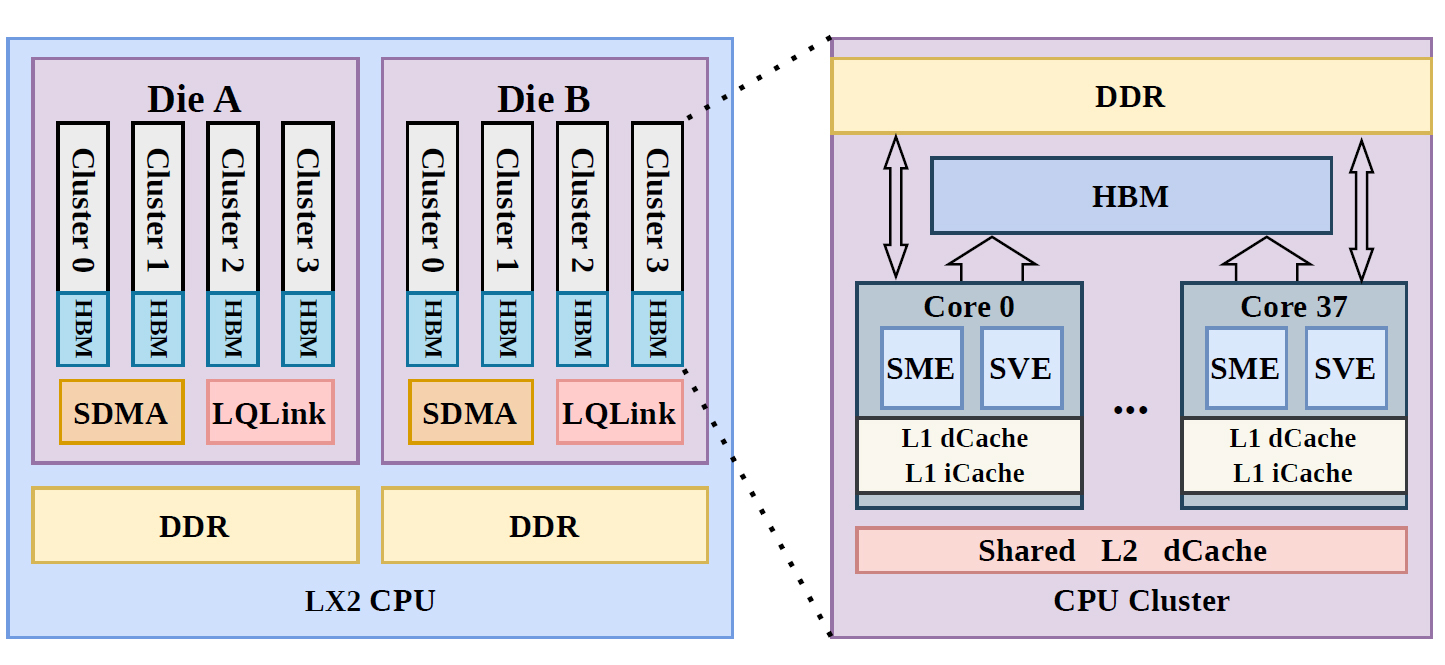
Источник изображения: NSCCSZ В составе LineShine два процессора LX2 формируют один вычислительный узел. Восемь таких узлов входят в один blade-сервер, а 16 серверов — в одно шасси. В одной стойке задействованы два шасси, что в сумме обеспечивает 512 процессоров. В целом, суперкомпьютер насчитывает около 90 стоек и примерно 14 млн вычислительных ядер. Энергопотребление LineShine достигает 42,2 МВт. Реализовано полностью жидкостное охлаждение на основе двусторонних водоблоков. Платформа использует проприетарный интерконнект LingQi, который обеспечивает пропускную способность между узлами до 1,6 Тбит/с. Технология LingQi поддерживает 2 млн портов и может масштабироваться до более чем 100 тыс. узлов. Вместимость подсистемы хранения данных LineShine составляет 200 Пбайт. Каждая стойка получает питание от шины постоянного тока LVDC на 380 В, обеспечивая вычислительную мощность до 580 кВт.
25.06.2026 [12:45], Владимир Мироненко
Qualcomm представила 250-ядерный серверный Arm-процессор Dragonfly C1000Qualcomm представила Qualcomm Dragonfly C1000 — специально разработанный для использования в ЦОД процессор, который по утверждению компании обеспечивает «лидирующие показатели производительности и эффективности использования для рабочих нагрузок агентов, общего назначения и узлов ИИ с лучшей в своем классе энергоэффективностью и совокупной стоимостью владения». В 2017 году компания уже пыталась выйти на серверный рынок, выпустив 10-нм 48-ядерные CPU Centriq 2400, но затем отменила проект в 2019 году. Qualcomm Dragonfly C1000 имеет чиплетную конструкцию с более чем 250 кастомизированными ядрами Qualcomm Oryon с частотой более 5 ГГц. По словам компании, чиплетная конструкция обеспечивает высокую производительность на ядро для агентных рабочих нагрузок, развёрнутых в масштабе. Также заявлено, что чип обеспечит лидирующую производительность в однопоточных вычислениях и в два раза лучшую производительность на Вт по сравнению с существующими эталонными показателями для конкурентных предложений серверных процессоров. 
Источник изображений: Qualcomm Qualcomm утверждает, что архитектура и конструкция Dragonfly C1000 обеспечивают оптимальную пропускную способность, масштабируемость, быстродействие и использование инфраструктуры для критически важных ЦОД, а также снижают капитальные и операционные затраты, обеспечивая лучшую в своём классе производительность на единицу совокупной стоимости владения в масштабе. Также многочиплетная архитектура обеспечивает модульную интеграцию с передовыми технологиями упаковки для масштабирования производительности и I/O, охватывая как процессоры общего назначения, так и ИИ-процессоры в ЦОД.  Процессор получит контроллер PCIe 7.0 (более 2 Тбайт/с) с CXL, поддержку ускорителей следующего поколения, таких как собственные продукты серии AI от Qualcomm, а также высокоскоростных сетей, хранилищ и дезагрегацию памяти с опциональным подключением модуля HBC (High Bandwidth Compute). Благодаря поддержке как воздушного, так и жидкостного охлаждения систему можно развёртывать в различных средах ЦОД с использованием стоек и серверов, совместимых с OCP ORv3. Что касается безопасности, Dragonfly C1000 получил расширенные функции надёжности, доступности и обслуживания (RAS), включая коррекцию ошибок памяти ECC, изоляцию неисправностей и отладку после ошибок, что обеспечивает отказоустойчивую работу в масштабе. Qualcomm сообщила, что коммерческая доступность Dragonfly C1000 ожидается в 2028 году.
23.06.2026 [12:00], Игорь Осколков
Китайский суперкомпьютер LineShine стал самым производительным в мире и возглавил TOP500Июньский рейтинг самых производительных суперкомпьютеров мира TOP500 принёс неожиданный сюрприз — впервые за несколько лет в список попала новая, крупная машина LineShine из Китая. И не только попала, но и сразу заняла в нём первое место. Более того, она же первой публично преодолела порог FP64-производительности 2 Эфлопс, опираясь только на CPU. Импортонезависимая система LineShine достигла 2,198 Эфлопс в бенчмарке HPL, что составляет порядка 80 % от пиковой теоретической производительности (2,736 Эфлопс), что для столь крупной машины хороший результат. Не менее примечательно, что и в HPCG эта система тоже занимает первое место с результатом 22 Пфлопс, обгоняя El Capitan (17,41 Пфлопс) и Fugaku (16,00). В Green500, правда, она занимает аж 50 место, поскольку потребляет 42,2 МВт, что даёт около 52,07 Гфлопс/Вт. Но, во-первых, данный суперкомпьютер лишён ускорителей, а во-вторых — улучшать энергоэффективность сложнее, чем производительность. LineShine находится в Национальном суперкомпьютерном центре Шэньчжэня (NSCCSZ) и базируется на кастомным китайских 304-ядерных Arm-процессорах LX2 (1,55 ГГц) и платформе LingKun.Всего 13,79 млн ядер, объединённых проприетарным интерконнектом LingQi работающих под управлением ОС Kylin. В ИИ-бенчмарке HPL-MxP система заняла четвёртое место с показателем 7,92 Эфлопс, т.е. разница между FP64-вычислениями в традиционном Linpack и вычислениями со смешанной точностью составляет довольно скромные 3,6x, что опять-таки указывает на архитектуру без выделенных ИИ-ускорителей. 
Источник изображения: Markus Winkler / Unsplash Ещё один новичок в первой десятке TOP500 — итальянский суперкомпьютер Eni HPC7 с устоявшейся производительностью 571,5 Пфлопс (в пике 861,13 Пфлопс), который занял шестое место. Он построен на ровно той же платформе, что и бывший лидер списка El Capitan: узлы HPE Cray EX255a с APU AMD Instinct MI300A. При этом у Eni теперь сразу две машины в Топ-10, поскольку система HPC6 (477,9/606,97 Пфлопс) находится на восьмом месте. Они бы, к слову, могли бы оказаться непосредственными соседями, если бы Microsoft решила обновить тесты своего облачного суперкомпьютера Eagle. Ресурсы у неё точно есть, а вот желание трать драгоценное машинное время ИИ-ускорителей на бенчмарки вряд ли есть. Система Fugaku также остаётся в первой десятке, уже шестой год подряд. Впрочем, если бы не нежелание Китая делиться информацией о своих системах, дефицита в которых явно нет, апдейты к TOP500 были бы гораздо чаще и интереснее. Авторы рейтинга отдельно отмечают разнообразие аппаратных платформ, подчёркивая, что добраться до экзафлопса можно разными путями. Речь и про процессоры, и про ускорители, и про интерконнекты. Всего в новом списке TOP500 появилось 44 новых машины, а минимальный порог вхождения повысился до округлённо 2,66 Пфлопс. Для вхождения же в первую десятку нужно как минимум 434,9 Пфлопс. Среди поставщиков в Топ-10 с точки зрения производительности лидирует HPE (El Capitan, Frontier, Aurora, HPC7, HPC6 и Alps). По процессорам в лидерах снова AMD (El Capitan, Frontier, HPC7 и HPC6). NVIDIA представлена в трёх системах (JUPITER Booster, Eagle, and Alps), а Intel — в двух (Aurora и Eagle). Atos/Eviden/Bull и Fujitsu поставили по одной системе, JUPITER Booster и Fugaku соответственно. Ну а LineShine гордо стоит в стороне от всех основных вендоров. Новых заявок от российских компаний по-прежнему нет. А из новичков среди стран можно упомянуть Индонезию с системой на объекте ASEAN-Korea HPC (436 место) и Узбекистан с государственным суперкомпьютером (321 место). |
|


