
Материалы по тегу: cxl
|
12.10.2026 [17:48], Сергей Карасёв
Медь и оптика: Astera Labs представила ретаймеры и редрайверы PCIe 7.0Astera Labs представила изделия семейства Aries 7 — первые в отрасли ретаймеры и редрайверы, поддерживающие стандарт PCIe 7.0 как по медным, так и по оптическим линиям связи. Эти чипы ориентированы на применение в высокопроизводительных ИИ-системах. Новинки призваны решить проблему затухания и искажения сигналов при переходе дата-центров на стандарт PCIe 7.0. Изделия обеспечивают возможность подключения устройств на расстояниях от нескольких сантиметров по печатной плате до более чем 50 м в пределах нескольких стоек. Ретаймеры и редрайверы поддерживают стандарт OCP Signal Conditioner Standard Footprint, предоставляя разработчикам возможность менять преобразователи сигналов без необходимости перепроектирования печатной платы. Иными словами, одна и та же платформа допускает установку медных или оптических модулей — в зависимости от конкретных требований. 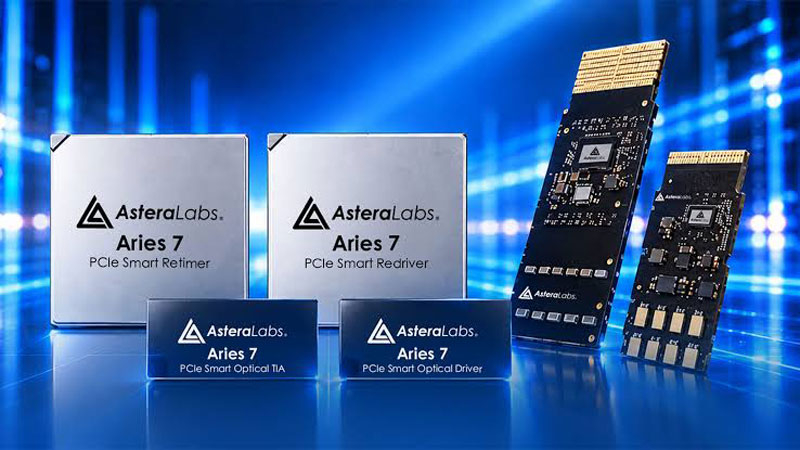
Источник изображения: Astera Labs В новое семейство также вошли интеллектуальные оптические драйверы и оптические трансимпедансные усилители (TIA), предназначенные для оборудования LPO и NPO. Сопутствующие программные инструменты Astera COSMOS обеспечивают централизованный мониторинг состояния соединений в реальном времени, диагностику и динамическую настройку каналов связи на базе медных и оптических компонентов. Корме того, Astera Labs анонсировала семейство специализированных умных контроллеров Leo X-Series, предназначенных для оптимизации работы ИИ-платформ. Они позволяют подключать дополнительную память напрямую к сетевому слою ИИ-ускорителей на базе GPU, полностью исключая CPU из цепочки передачи данных. Устройства берут на себя разгрузку KV-кеша и контекста агентов ИИ. Наконец, дебютировали контроллеры Leo 2 E-Series и Leo 2 P-Series на базе стандартов CXL 3.2 и PCIe 6.0. Изделия Leo 2 E-Series дают возможность расширять объём памяти, напрямую подключённой к одному CPU: в этом случае нет необходимости задействовать дополнительные процессорные разъёмы. В свою очередь, решения Leo 2 P-Series обеспечивает динамическое объединение и создание пулов памяти для нескольких хостов.
07.10.2026 [09:24], Владимир Мироненко
Everspin расширила память x86-сервера с помощью MRAM PERSYST и CXLКомпания Everspin Technologies, разработчик магниторезистивной энергонезависимой памяти с произвольным доступом (MRAM), объявила об успешной демонстрации первого в мире расширения памяти x86-сервера с помощью MRAM PERSYST, подключённой к серверу Supermicro посредством CXL. Для демонстрации использовался сервер Supermicro AS-1116CS-TN с 32-ядерным процессором AMD EPYC 9355, FPGA-платформа AMD Alveo U250 с контроллером Wolley CXL (по данным ресурса Blocks & Files — CXL 3.2, но c PCIe 3.0), подключённым к Everspin PERSYST DDR4 MRAM UDIMM ёмкостью 1 Гбайт (четыре модуля MRAM DDR4 в встроенных разъёмах DIMM на плате FPGA). Конфигурация предоставляет платформу, основанную на открытых стандартах, для демонстрации согласованного доступа к персистентной памяти MRAM через CXL. Она также позволяет объединять ресурсы памяти в пул и распределять их между хостами. Для ИИ-систем это создаёт возможности для использования таких решений, как контрольные точки и персистентный KV-кеш. В рамках демонстрации разработчики показали работу быстрого персистентного буфера и кеш-памяти с построчными доступом с задержкой на уровне наносекунд и записью данных в 100 раз быстрее, чем в SSD на базе NAND. 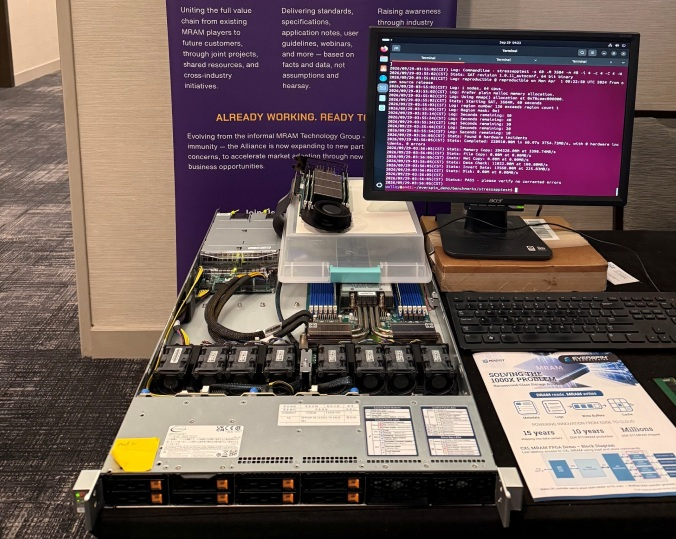
Источник изображения: Everpure Everspin планирует внедрить технологию MRAM в новые архитектуры памяти, включая персистентное кеширование, буферизацию записи и приложения для работы с метаданными. До сих пор, как и Optane, MRAM не удавалось из-за высокой цены добиться значительного прогресса за пределами специализированных рынков с малым объёмом продаж. Глава Everspin Санджив Аггарвал (Sanjeev Aggarwal) отметил, что CXL предоставляет стандартный способ использования памяти MRAM на гораздо более широком спектре вычислительных платформ: «Теперь у нас есть рабочая система, позволяющая заказчикам выполнять свои собственные рабочие нагрузки и оценивать преимущества для своих конкретных приложений». Генеральный директор Wolley сообщил, что их контроллер обеспечивает подключение к памяти и хранилищам данных через CXL, а демонстрация с Everspin наглядно показала, как MRAM может быть внедрена с использованием стандартной семантики. Как полагает Blocks & Files, основная идея в том, чтобы задействовать MRAM в периферийных x86-серверах или небольших ЦОД для хранения рабочих данных ИИ, таких как блоки KV-кеша, с возможностью считывания их быстрее, чем с внешних SSD (даже с RDMA), и без потери данных при отключении питания или сбое в работе.
11.09.2026 [08:51], Владимир Мироненко
ЦОД как чип: Meta✴ и Panmnesia предложили CXL-фабрику размером с целый дата-центрКомпания Meta✴ и южнокорейский стартап Panmnesia, специализирующийся на разработке интерконнекта для ИИ-инфраструктур, представили архитектуру ИИ ЦОД нового поколения, в которой весь дата-центр функционирует как единый чип. Описание архитектуры опубликовано в журнале Nature Reviews Electrical Engineering (NREE), входящем в портфолио издательства Nature. В исследовании отмечено, что в современных дата-центрах ускорители внутри одной стойки могут взаимодействовать через высокоскоростные интерфейсы для вертикального масштабирования (scale-up), тогда как трафик, выходящий за пределы стойки, обычно опирается на более медленные сети с горизонтальным масштабированием (scale-out), такие как Ethernet или InfiniBand. 
Источник изображений: Panmnesia Компании отметили, что для эффективной работы ИИ ЦОД необходимы контроль и координация как внутри стоек с GPU, памятью и СХД, так и между ними. В масштабной ИИ-инфраструктуре снижение вариативности задержек (джиттера) между устройствами — чтобы весь ЦОД функционировал предсказуемо — имеет такое же значение, как и повышение производительности отдельных устройств или скорости каналов связи.  Meta✴ и Panmnesia предлагают взять за основу стандарт CXL, дополнив его новыми возможностями по объединению нескольких стоек с GPU для минимизации колебаний задержки при передаче данных за пределы каждой отдельной стойки. Конечная цель — создать дата-центр, работающий столь же предсказуемо, как отдельный чип. В этой схеме расширенный CXL обеспечивает когерентность кеш-памяти между стойками ускорителей, поддерживая большее количество устройств по сравнению со стоечными решениями NVIDIA уровня GB200 NVL72 (на базе NVLink) и UALink. Для минимизации и ограничения вариативности задержек предлагается использовать три специализированных аппаратных компонента: неблокирующий коммутатор с высокой плотностью портов, блок ускорения передачи данных и контроллер сетевой фабрики.  Неблокирующий коммутатор с большим количеством портов (high-fan-out) обеспечивает одновременное подключение множества устройств, сокращая количество переходов (hop) и выравнивая длину путей прохождения сигнала независимо от источника. Блок ускорения передачи (Link Acceleration Unit, LAU) переносит повторяющиеся операции обработки протокола в каждой точке соединения на специализированный аппаратный конвейер, обеспечивая стабильность системы на уровне отдельных этапов передачи и ограничивая колебания задержки.  Контроллер фабрики (Fabric Controller) применяет единую политику упорядочивания запросов во всей системе, обеспечивая согласованную обработку транзакций через все устройства. Для преодоления физических ограничений дальности передачи электрических сигналов рассматривается использование оптических каналов связи (CXL-over-optics) для увеличения радиуса действия фабрики CXL. Консорциум PCI-SIG уже работает над оптической версией PCIe, да и первые чипы тоже уже были анонсированы.  По словам Panmnesia, комбинированный контроллер фабрики CXL/PCIe и блок LAU уже прошли проверку работоспособности на кремниевых чипах; также изготовлен коммутатор фабрики, и начаты поставки предсерийных образцов. Архитектура решения предусматривает группировку CPU, ускорителей, памяти и коммутаторов по функциональному признаку в модули (узлы), объединение модулей в группы (поды) и объединение подов посредством коммутационной фабрики. Такая упорядоченная иерархия призвана обеспечить стабильные пути передачи данных с фиксированным количеством сетевых переходов и предсказуемыми временными характеристиками.  По сравнению с NVIDIA GB200 NVL72 данная схема:
«Объединение устройств такого масштаба в единую среду выполнения позволит обучать гораздо более крупные ИИ-модели без прерывания процесса или одновременно запускать несколько сервисов на общей инфраструктуре, исключая взаимное замедление их работы», — отметили компании. При этом платформы с PCIe/CXL-интерконнектом уровня стойки уже есть — например, Liqid UltraStack.
31.08.2026 [09:38], Сергей Карасёв
Primemas представила модули расширения CXL с поддержкой 4 Тбайт DRAMКомпания Primemas анонсировала CXL-решения, предназначенные для расширения памяти в ИИ-системах. Кроме того, объявлено о партнёрстве с Micron в рамках проекта Abaco. В частности, дебютировали модули CXL, выполненные в виде карт расширения с интерфейсом PCIe. Изделия PMA14 и PMA16 оснащены соответственно 14 и 16 слотами RDIMM, что позволяет использовать до 3,5 и 4 Тбайт памяти DRAM (при установке изделий на 256 Гбайт). Применяется фирменная архитектура Primemas Hublet, которая даёт возможность формировать пулы памяти CXL огромной ёмкости. 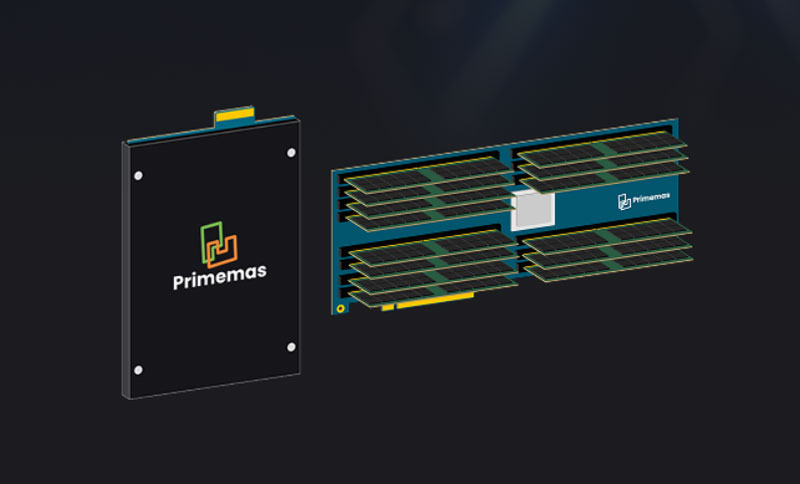
Источник изображения: Primemas Новые CXL-модули станут частью платформы Abaco — стоечной вычислительной системы с более чем 100 Тбайт памяти. Этот комплекс создаётся для Тихоокеанской северо-западной национальной лаборатории (PNNL) Министерства энергетики США (DoE). Предполагается, что Abaco будет использоваться для решения сложных задач в области ИИ и НРС, а также для обработки огромных массивов информации. Проект финансируется управлением научных исследований DoE в рамках программы перспективных научных вычислений (ASCR). Отмечается, что Abaco поможет решить проблему нехватки памяти в современных ИИ-инфраструктурах, когда GPU-ускорители вынуждены простаивать в ожидании данных для обработки. Ещё одним решением Primemas является SLiM (Switchless Pooled Memory) — новая архитектура памяти, оптимизированная для рабочих нагрузок ИИ с интенсивным использованием KV-кеша. Эта система типоразмера 1U позволяет нескольким серверам получать доступ к десяткам терабайт общей DRAM со сверхнизкой задержкой, без необходимости внешних коммутаторов CXL.
11.08.2026 [08:57], Сергей Карасёв
Synopsys представила полный стек решений CXL 4.0 для масштабируемых ИИ-инфраструктурКомпания Synopsys анонсировала, как утверждается, первый в отрасли полный набор решений стандарта CXL 4.0 для построения «систем на кристалле» (SoC), призванных ускорить развёртывание высокопроизводительных инфраструктур для ресурсоёмких задач ИИ. В состав стека интеллектуальной собственности (IP) входят четыре ключевых компонента: контроллер CXL, модули безопасности IDE, физический уровень (PHY) и средства верификации. Ключевое преимущество CXL 4.0 по сравнению со стандартом предыдущего поколения — удвоение пропускной способности: она достигает 128 ГТ/с, что соответствует показателям PCIe 7.0, при сохранении задержек на уровне CXL 3.x. Благодаря агрегации портов четыре линии x16 обеспечивают суммарную пропускную способность свыше 2 Тбайт/с, а восемь линий — более 4 Тбайт/с. Это критически важно на фоне взрывного роста ИИ-нагрузок. 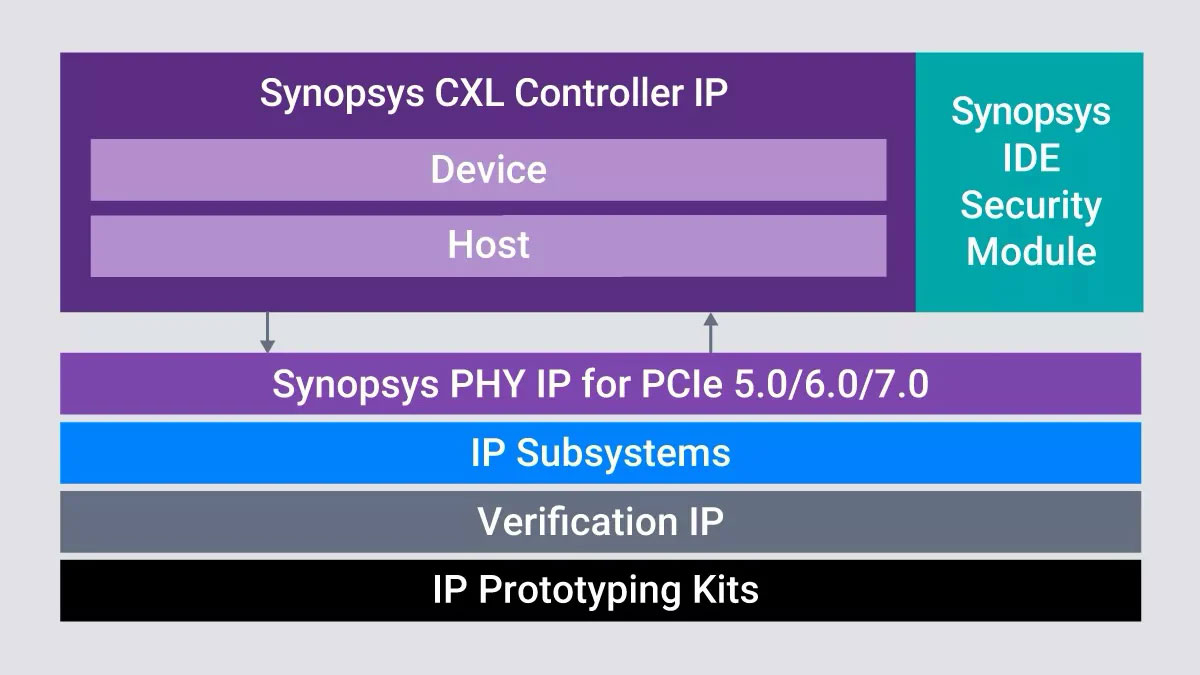
Источник изображения: Synopsys Новый контроллер CXL поддерживает все поколения соответствующего стандарта — от 1.x до 4.0. Реализованы агрегация физических портов (Bundled Ports) и 256-байт режим FLIT для снижения задержек. Стандарт CXL 4.0 позволяет задействовать до четырёх ретаймеров. Модули безопасности IDE используют шифрование и аутентификацию AES-GCM, а также поддерживают функции TSP и TDISP. Говорится о соответствии стандарту FIPS 140-3. В свою очередь, физический уровень реализован на базе PCIe 7.0 SerDes (128 ГТ/с) и адаптирован для техпроцессов с нормами от 5 до 2 нм. Средства верификации в составе стека Synopsys CXL 4.0 помогают сократить риски на этапе тестирования и ускорить вывод SoC на рынок. Новые возможности CXL 4.0 позволяют создавать более эффективные архитектуры. Например, при работе с KV-кешем через CXL обеспечивается прирост производительности в 3–6 раз по сравнению с решениями на базе SSD. Задержка доступа к памяти (CXL.mem) составляет менее 200 нс, а размер пулов памяти в рамках стойки может превышать 100 Тбайт. По оценкам Synopsys, такие преимущества позволяют снизить стоимость инференса на 50 %, что достигается благодаря более гибкому использованию ресурсов.
06.08.2026 [16:48], Сергей Карасёв
Marvell представила контроллеры и коммутаторы Structera CXL/PCIe 6.0 для ИИ-системMarvell анонсировала набор CXL-продуктов, призванных решить проблему дефицита памяти в системах, ориентированных на ресурсоёмкие ИИ-нагрузки. В частности, дебютировали специализированные контроллеры расширения памяти Structera X, чипы-ускорители Structera A и коммутаторы Structera S. 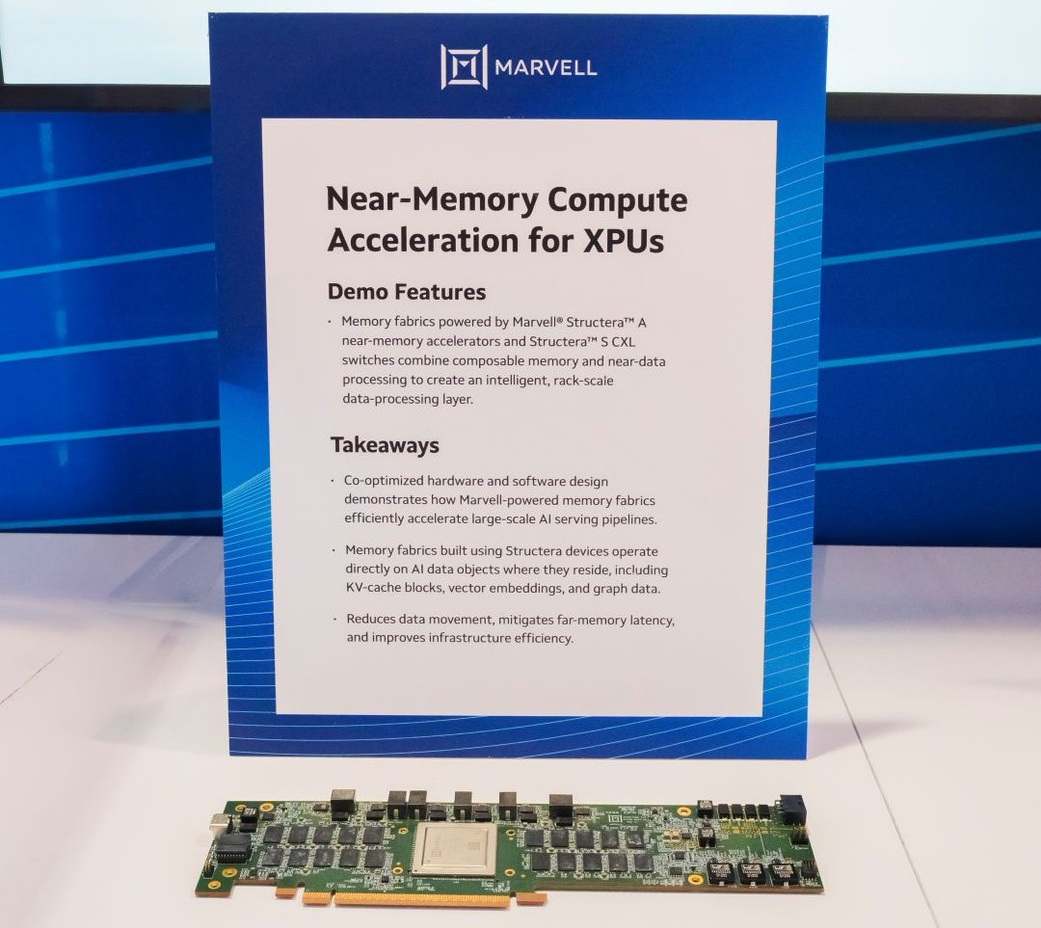
Источник изображений: Marvell Платформа Structera X оптимизирована специально для развёртывания на площадках гиперскейлеров. Изделия, как отмечается, разработаны в партнёрстве с ведущими мировыми компаниями в сфере облачных вычислений. В данное семейство вошли чипы Structera X 2404 и Structera X 2504, предназначенные для работы с памятью DDR4 и DDR5 соответственно. 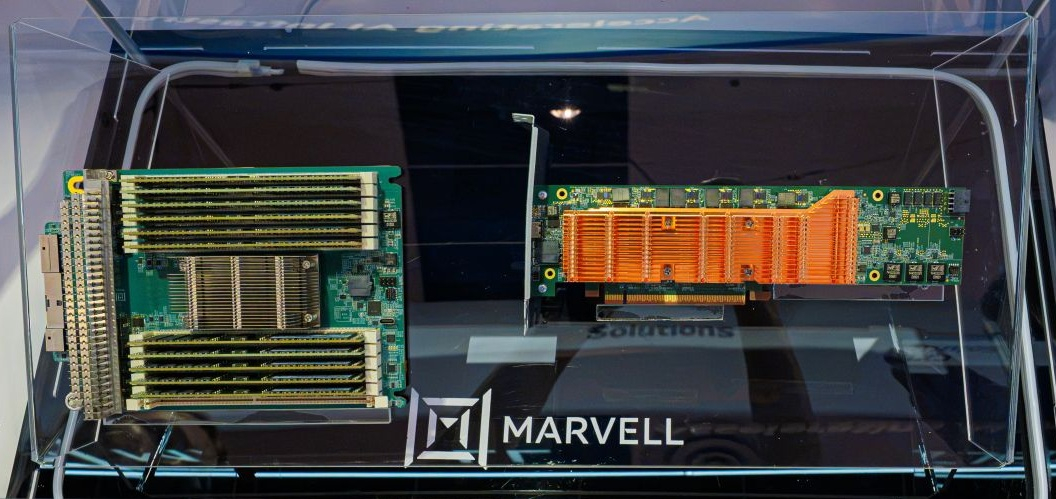 В свою очередь, решения Structera A предназначены для организации вычислений вблизи памяти (near-memory). В частности, представлен чип Structera A 2504, который объединяет 16 ядер Arm Neoverse V2, работающих на частоте 3,2 ГГц. Изделие поддерживает до 4 Тбайт памяти с пропускной способностью до 200 Гбайт/с, сжатие LZ4 и 256-бит шифрование XTS-AES. Чип позволяет снять часть нагрузки с CPU сервера, беря на себя такие задачи, как ИИ-инференс, обслуживание моделей рекомендаций на основе глубокого обучения (DLRM), векторный поиск и запуск резидентных баз данны. Вместе решения Structera X и Structera A предоставляют крупным компаниям комплексный инструментарий для масштабирования и оптимизации памяти в условиях дезагрегированной инфраструктуры ИИ.  Наконец, в серию Structera S вошло устройство 30260 — это коммутатор PCIe 6.0 / CXL 3.x на 260 линий, который позволяет подключать до 16 или 32 CPU или GPU к общему пулу памяти объёмом до 48 Тбайт. При этом обеспечивается суммарная пропускная способность до 4 Тбайт/с, тогда как задержки составляют менее 460 нс. Говорится о совместимости с памятью DDR4 и DDR5. По заявлениям Marvell, Structera S демонстрирует до 16 раз лучшую масштабируемость по сравнению с локальной памятью и на 72 % меньшую задержку, чем при использовании пула на основе RDMA. В конфигурациях на базе GPU достигается до 4,8 раза более высокая пропускная способность при инференсе, тогда как время до получения первого токена сокращается на 82,7 %.
06.08.2026 [09:21], Владимир Мироненко
Память вскладчину: Marvell анонсировала дезагрегированную платформу Photonic Fabric с оптическим интерконнектом для ИИ-инфраструктурMarvell отметила, что по мере масштабирования ИИ-инференса его производительность всё больше зависит не просто от увеличения вычислительных мощностей, а от того, насколько эффективно вычислительные мощности, память и интерконнекты работают в рамках единой инфраструктуры, а также насколько быстро ускорители могут получать доступ, перемещать и использовать ресурсы памяти. Также Marvell заявила, что современная иерархия памяти для ИИ не рассчитана на инференс в масштабах, необходимых для современных рабочих нагрузок. Память HBM, напрямую подключённая к GPU, обеспечивает исключительную производительность, но имеет ограниченную ёмкость и высокую стоимость. Системная DRAM обеспечивает большие пулы памяти, но не может экономично масштабироваться вместе со всеми ускорителями. NVMe SSD имеют большую ёмкость, но и большую задержку, что делает их непригодными для обслуживания активных рабочих нагрузок инференса. В связи с этим Marvell предложила расширить иерархию ИИ-памяти за счёт нового промежуточного уровня, обеспечивающего значительно большую ёмкость, обычно ожидаемую от хранилищ, находясь при этом гораздо ближе к вычислительным ресурсам, с очень низкой задержкой, близкой к непосредственно подключённой памяти. 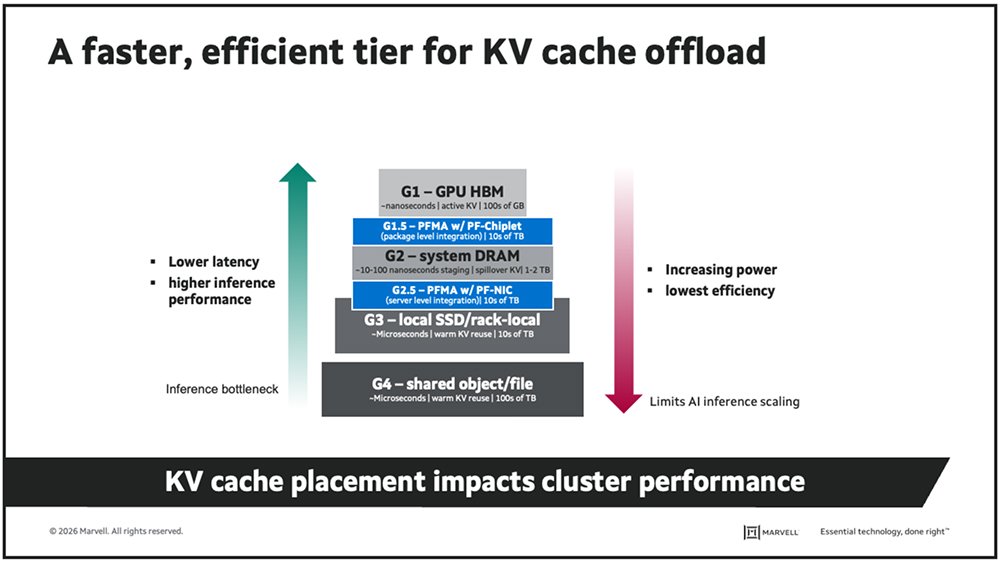
Источник изображений: Marvell Анонсированная Marvell платформа Marvell Photonic Fabric использует новую архитектуру оптического подключения для выполнения ИИ-задач, которая обеспечивает уровень общей для нескольких узлов памяти. Платформа, построенная на основе модуля памяти Marvell Photonic Fabric Memory Module (PFMM), сетевой карты Photonic Fabric NIC (PF-NIC) и чиплета Marvell Photonic Fabric, позволяет совместно использовать память в нескольких ИИ-стойках, расположенных на расстоянии до 30 м друг от друга, что даёт возможность значительно увеличить доступную для обработки ИИ-нагрузок память без пропорционального масштабирования вычислительных ресурсов. PFMM объединяет совместно используемую память DDR5, кеш HBM и высокоскоростной оптический интерконнект, обеспечивая расширение, объединение и дезагрегацию памяти в ИИ-инфраструктуре. 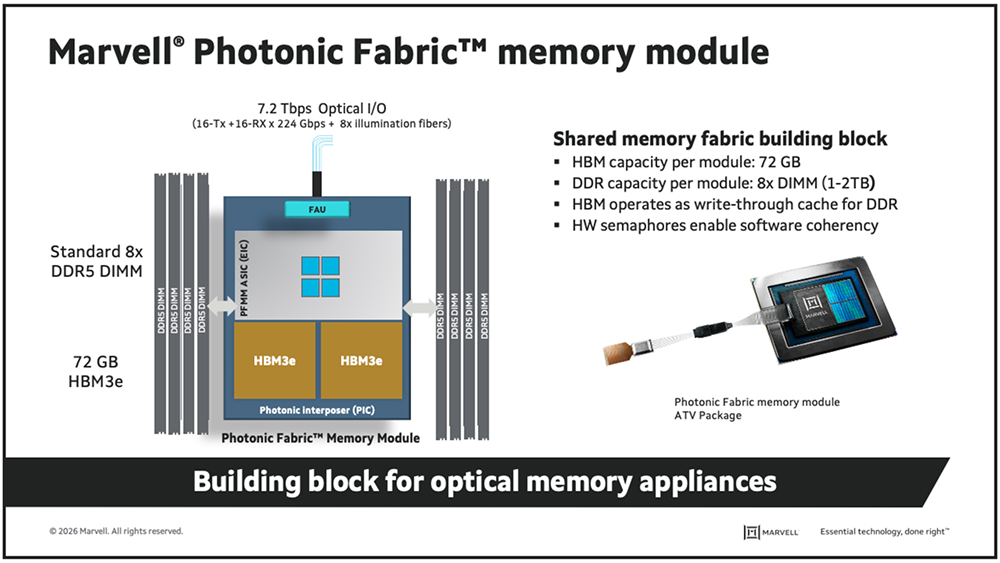 В основе платформы лежит первая в отрасли SoC с оптическим I/O, интегрированным в середину кремниевого кристалла. Разработанный специально для дезагрегации ИИ-памяти модуль PFMM поддерживает до 8 модулей DDR5 DIMM, дополненных кешем HBM объёмом 72 Гбайт и пропускной способностью оптической сети 7,2 Тбит/с. Архитектура обеспечивает NUMA-доступ за менее 350 нс на нескольких стойках, что позволяет ускорителям получать доступ к значительно большим объёмам ИИ-памяти без задержек, традиционно связанных с внешними СХД. 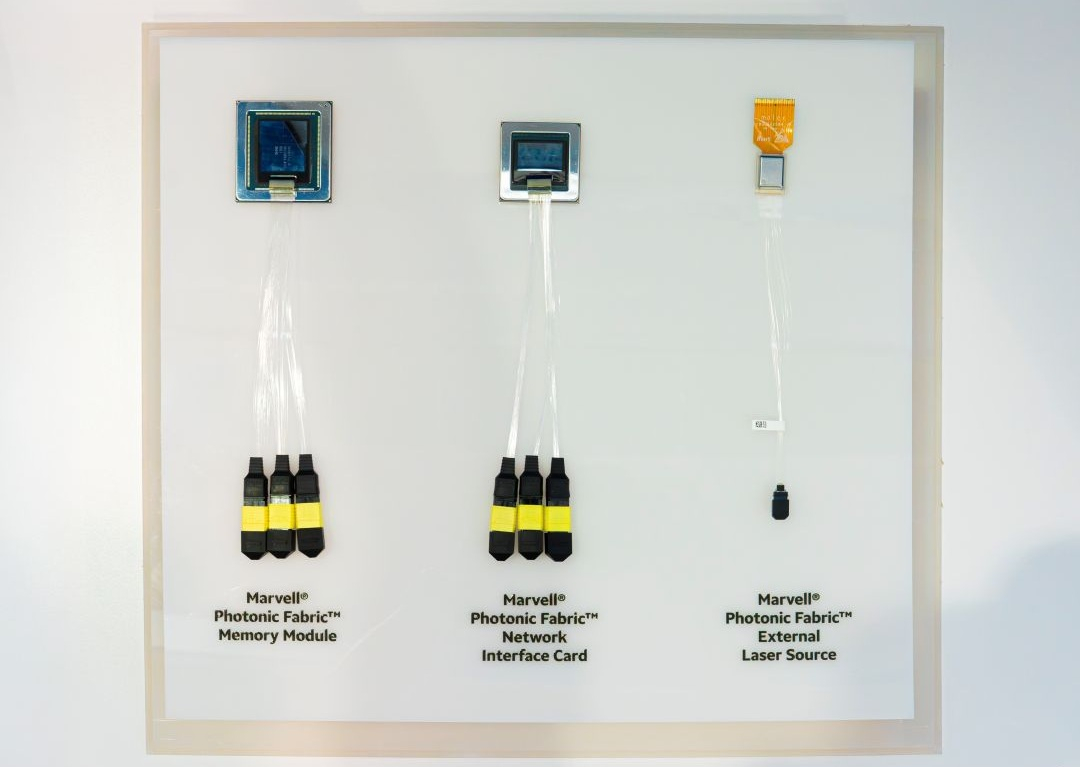 В дополнение к PFMM, сетевой адаптер PF-NIC предоставляет оптический сетевой интерфейс CXL 3.1 и PCIe 6.0, который соединяет ИИ-серверы с совместно используемой памятью. Вместе PFMM и PF-NIC позволяют использовать сторонние устройства с общей памятью, способные поддерживать увеличивающиеся KV-кеши, более крупные контексты моделей и всё более требовательные рабочие нагрузки инференса, сохраняя при этом совместимость с существующими программными ИИ-платформами. 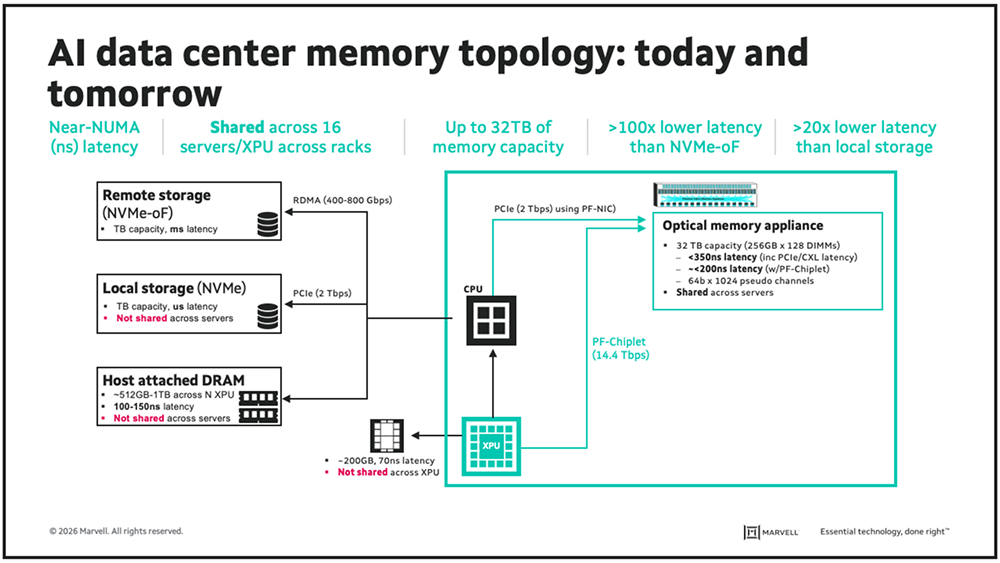 Сочетание оптического соединения с дезагрегацией памяти позволяет масштабировать объём памяти независимо от вычислительных ресурсов, сохраняя при этом пропускную способность и задержку, необходимые для крупномасштабного ИИ-инфренса. Результатом являются большие KV-кеши, улучшенное использование GPU, рост эффективности токенов и снижение энергопотребления при перемещении данных.
05.08.2026 [08:25], Сергей Карасёв
Kioxia анонсировала CXL-модули XL1 для ИИ-нагрузокKioxia анонсировала CXL-модули XL1, предназначенные для расширения памяти в ИИ-системах. В основу изделий положена фирменная флеш-память Kioxia XL-Flash (SCM). Она отличается низкой задержкой и высокой производительностью. По заявлениям разработчика, XL-Flash создана, чтобы устранить разрыв в быстродействии между энергозависимой памятью (включая DRAM) и обычной флеш-памятью. Как и любая флеш-память, XL-Flash способна сохранять данные при отключении питания. Полностью характеристики CXL-модулей XL1 пока не раскрываются. Но известно, что память XL-Flash использует технологию BiCS FLASH 3D. В случае SLC применяются кристаллы на 128 Гбит, а в случае MLC — на 256 Гбит. Возможны исполнения с двумя, четырьмя и восемью кристаллами в одном корпусе. 
Источник изображения: Kioxia Идея XL1 заключается в том, что эти модули берут на себя хранение «холодных» данных, к которым система обращается сравнительно редко. Вместе с тем часто используемые «горячие» данные остаются в более быстрой DRAM. Иными словами, XL-Flash выступает в качестве слоя расширения оперативной памяти. Для обмена информацией служит интерфейс CXL на основе PCIe. Таким образом, изделия XL1 помогут решить проблему нехватки памяти в составе ИИ-платформ и снизить затраты на масштабирование инфраструктуры. Пробные поставки новых модулей отдельным заказчикам начнутся в текущем месяце.
01.08.2026 [15:49], Сергей Карасёв
Xcena представила вычислительную память MX1 для генеративного ИИЮжнокорейский стартап Xcena анонсировал продукты семейства MX1, призванные решить проблему дефицита памяти в масштабных платформах, ориентированных на задачи генеративного ИИ. По мере того как генеративный ИИ требует всё более крупных моделей, более длинных контекстных окон и стремительно растущих объёмов KV-кеша, память становится главным ограничивающим фактором для инфраструктуры ИИ. Изделия HBM остаются крайне дорогими при ограниченной ёмкости, тогда как расширение путём добавления серверов приводит к формированию избытка вычислительных ресурсов и росту совокупной стоимости владения, говорит Xcena. Устройства MX1 призваны переломить ситуацию. Речь идёт об использовании вычислительной памяти. Идея заключается в том, чтобы увеличить основную память системы, добавив модули DDR5 DIMM вкупе с ядрами RISC-V. Реализована поддержка PCIe 6.0 и CXL 3.2, а технология NDP (Near Data Processing) сводит к минимуму задержку при перемещении данных между интерфейсами. В результате, значительно ускоряется выполнение ресурсоёмких задач при одновременном снижении нагрузки на CPU. 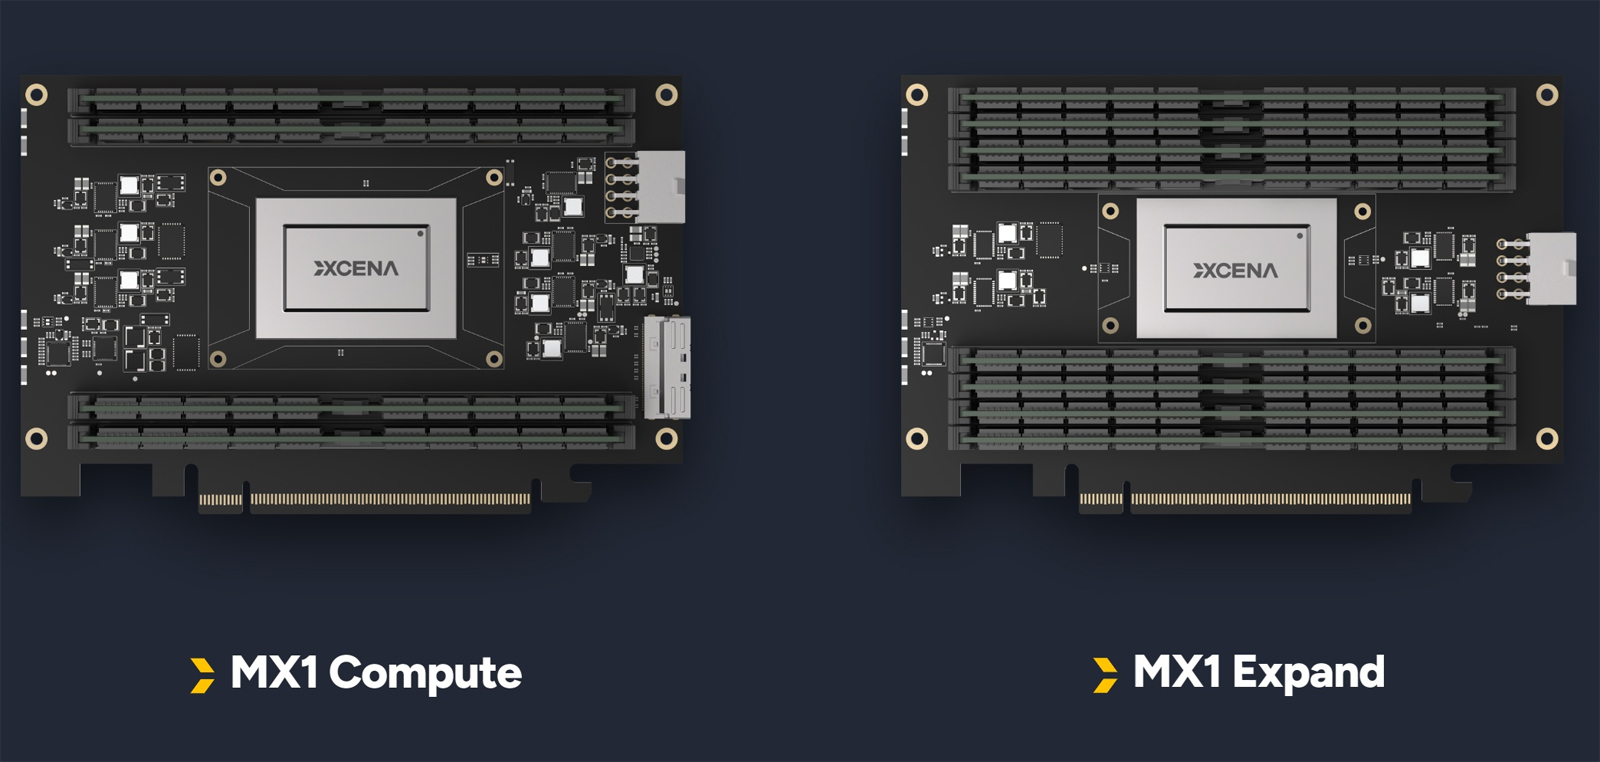
Источник изображения: Xcena В семейство входят изделия MX1 Compute и MX1 Expand. Первое представляет собой CXL-решение с 2048 ядрами RISC-V и четырьмя слотами DRAM, что позволяет выполнять вычисления рядом с памятью. Благодаря этому устраняется перемещения данных между CPU и памятью, что повышает производительность инференса и сокращает энергопотребление. В свою очередь, MX1 Expand предоставляет восемь слотов DRAM для эффективного масштабирования пула памяти.
25.07.2026 [21:30], Сергей Карасёв
ИИ-платформа Liqid UltraStack объединяет 30 ускорителей AMD Instinct MI350PКомпания Liqid объявила о стратегическом сотрудничестве с AMD, направленном на создание решений следующего поколения для ИИ-инфраструктур. В рамках партнёрства представлена аппаратная платформа Liqid UltraStack 30, оптимизированная для задач инференса. В состав системы входят сервер с двумя процессорами AMD EPYC 9005 Turin и коммутатор Liqid PCIe Fabric Switch. Ключевыми компонентами являются три GPU-блока, каждый из которых содержит десять ускорителей AMD Instinct MI350P (144 Гбайт памяти HBM3E с 4096-бит шиной). Таким образом, в общей сложности задействованы 30 названных карт и 4,3 Тбайт памяти HBM3E. Заявленная производительность достигает 69 Пфлопс в режиме FP8. Говорится о возможности работы с общими пулами памяти по высокоскоростному стандарту CXL. Суммарное энергопотребление платформы находится на уровне 22 кВт. По заявлениям Liqid, система обеспечивает 3,7-кратный прирост показателя токенов в секунду по сравнению с традиционными решениями. Количество токенов в пересчете на $1 увеличивается в 2,1 раза, а токенов на 1 Вт затрачиваемой энергии — в 1,8 раза. Затраты на развёртывание могут быть уменьшены на 65 %. 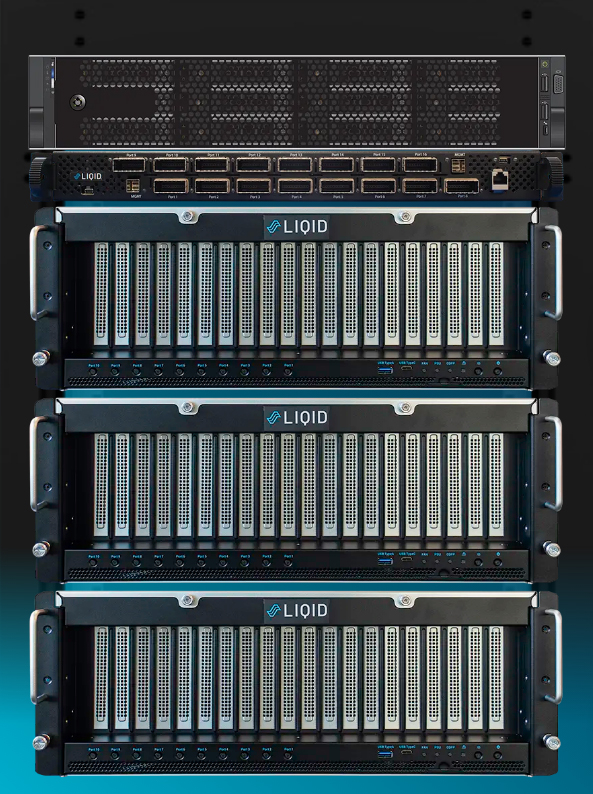
Источник изображения: Liqid Программное обеспечение Liqid Matrix объединяет GPU-ускорители и в реальном времени распределяет их ресурсы между рабочими нагрузками через высокоскоростную PCIe-шину. При этом все карты остаются в пределах одного узла. В целом, платформа Liqid UltraStack 30, как утверждается, устраняет накладные расходы, связанные с использованием нескольких узлов, обеспечивает предсказуемое линейное масштабирование и доводит загрузку GPU почти до 100 %. Упомянута поддержка Kubernetes для работы с несколькими моделями. |
|

