
Материалы по тегу: ethernet
|
21.10.2026 [11:25], Сергей Карасёв
Marvell представила ретаймер и DSP-чип нового поколения для ИИ-кластеровКомпания Marvell Technology анонсировала ретаймер Alaska E 3.2T и чип Alaska A 1.6T AEC DSP второго поколения для высокопроизводительных ИИ-инфраструктур. Изделия призваны решить проблему затухания сигналов и роста энергопотребления при построении сетей со сверхвысокими скоростями передачи данных. Ретаймер Alaska E 3.2T обеспечивает общую пропускную способность до 3,2 Тбит/с. Конфигурация включает 16 линий 224G PAM4 SerDes. Реализована поддержка протоколов Ethernet, UALink и ESUN. Говорится об ультранизкой задержке и об архитектуре, оптимизированной для ИИ-платформ высокой плотности. Ретаймер позволяет гибко размещать вычислительные узлы без потери качества сигнала. 
Источник изображения: Marvell В свою очередь, решение Alaska A 1.6T AEC DSP — это специализированный цифровой сигнальный процессор для активных электрических кабелей (AEC). Его конфигурация предусматривает использование восьми линий 224G PAM4, а пропускная способность составляет 1,6 Тбит/с. Изделие производится по 3-нм технологии в корпусе с размерами 12 × 14 мм. Заявленное энергопотребление — 12,8 Вт. Решение даёт возможность передавать сигнал 1,6 Тбит/с по медным кабелям на расстояние более 6 м, что вдвое превышает показатель чипов первого поколения. Упомянуты протоколы Ethernet, UALink и ESUN. У обеих новинок компенсация вносимых потерь превышает 45 дБ. Реализован полный набор диагностических возможностей. Пробные поставки Alaska E 3.2T и Alaska A 1.6T AEC DSP уже начались.
19.10.2026 [09:32], Владимир Мироненко
Восемь на одного: Meta✴ представила сетевую архитектуру Flattened Planar Fabric для ИИ-инфраструктурыMeta✴ представила ИИ-архитектуру Flattened Planar Fabric (FPF), созданную для масштабирования обширной ИИ-инфраструктуры и поддержки вычислительных нагрузок нового поколения. В архитектуре FPF каждый GPU подключается посредством восьми независимых каналов по 100 Гбит/с к восьми разным коммутаторам. 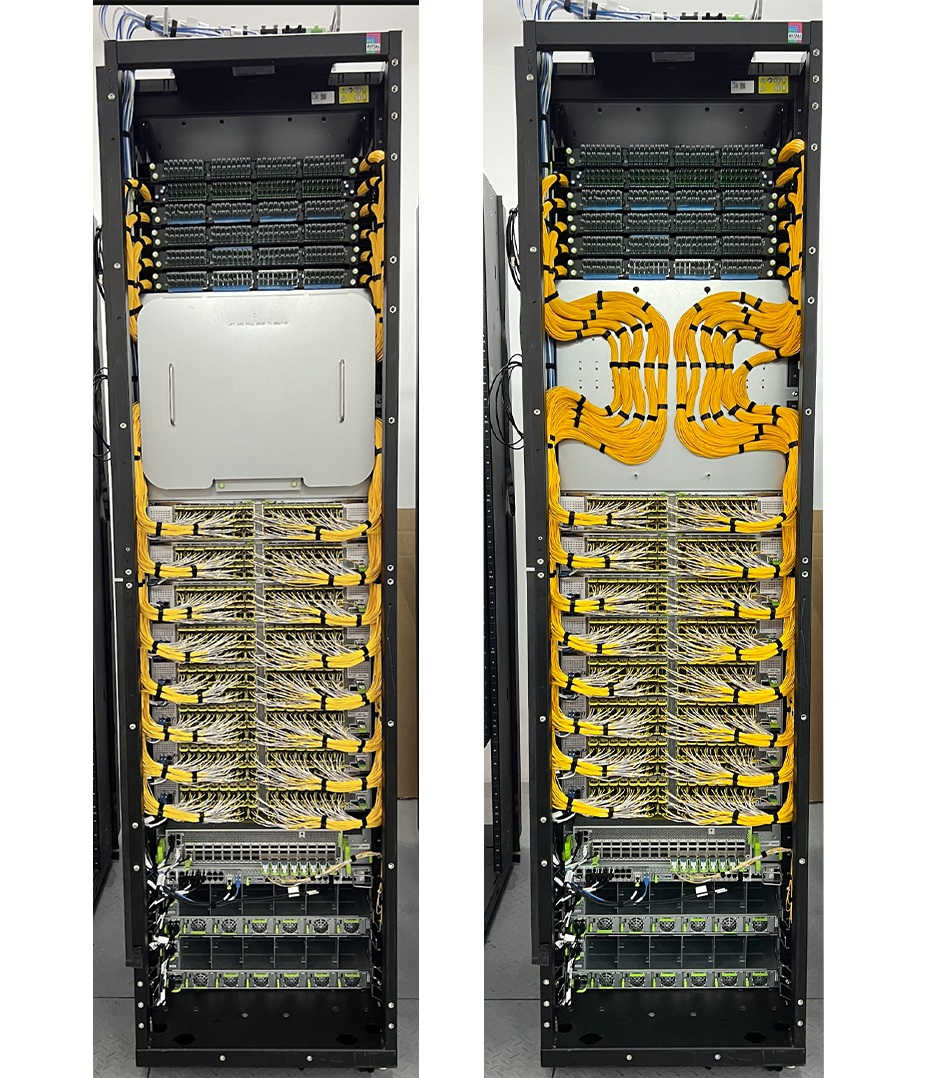
Источник изображений: Meta✴ Такой подход приходит на смену традиционной архитектуре единичных восходящих каналов (uplink), обеспечивая четыре ключевых преимущества:
Оборудование включает коммутаторы IceCube с пропускной способностью 102,4 Тбит/с в стойке IcePack (ORv3-HPRv1) с жидкостным охлаждением. Внутри каждой стойки размещаются модули коммутации IceCube — устройства с пропускной способностью 102,4 Тбит/с, обеспечивающие неблокирующую коммутацию для 128 портов по 800 Гбит/с каждый. Модули IceCube представлены в двух вариантах: на базе специализированных интегральных схем (ASIC) Broadcom Tomahawk6C или NVIDIA Spectrum-6. 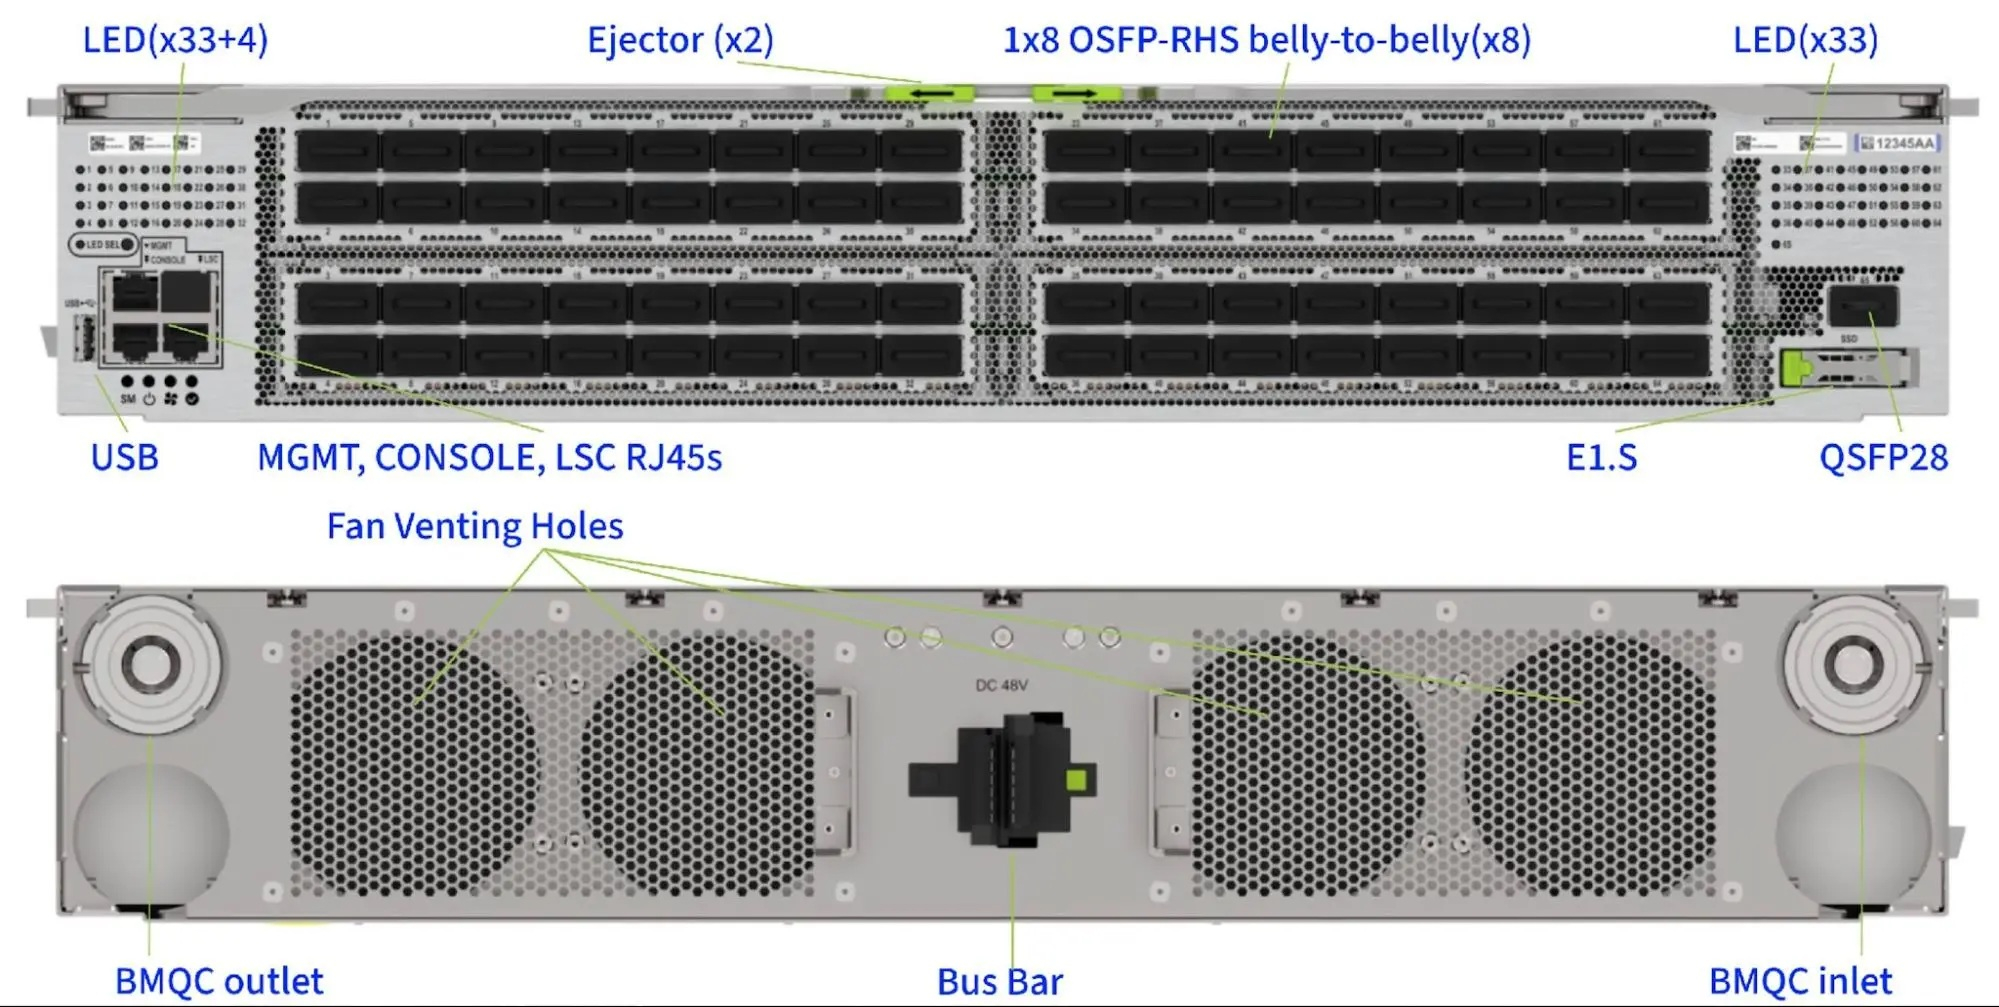
IceCube Оба решения работают под управлением открытой NOS FBOSS от Meta✴, которая использует интерфейс абстракции коммутаторов OCP SAI (Switch Abstraction Interface). Архитектура Open Switch Platform Architecture (OSPA) обращается к функциям управления, включая последовательность включения питания, обнаружение компонентов, терморегулирование, восстановление микропрограммного обеспечения и диагностика. 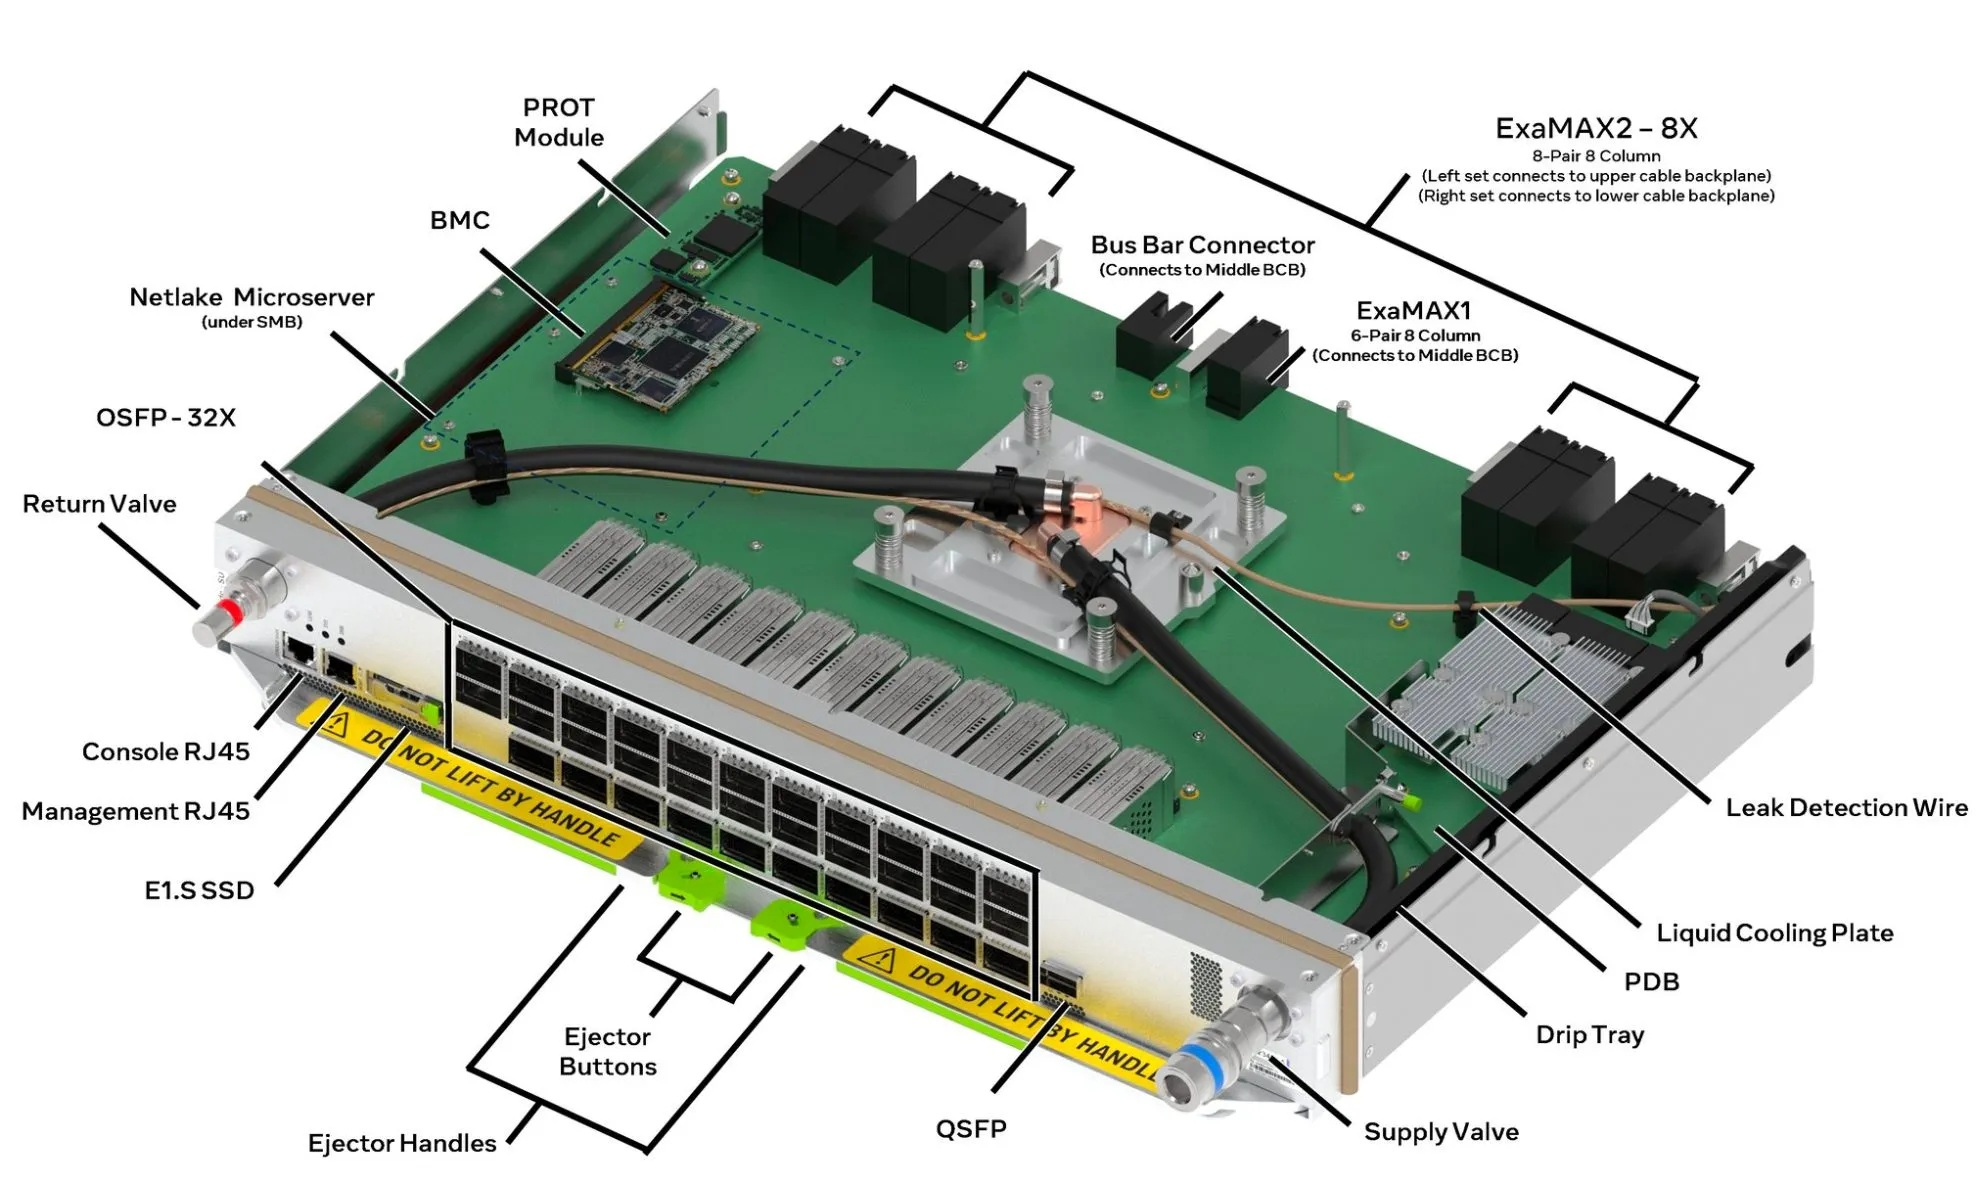
Tahan FPF переносит управление платформой преимущественно на сторону хоста, сохраняя при этом традиционный BMC для функций контроля и восстановления. FPGA-мосты I/O, подключённые через PCIe, объединяют периферийные интерфейсы, а модель учёта аппаратных средств, организованная в виде иерархической структуры, предоставляет ПО согласованный способ перечисления компонентов. Предложение также охватывает автономное управление питанием, обнаружение утечек и резервные образы прошивки. Следует отметить, что это проектные требования, находящиеся на стадии рассмотрения, а не доказательство функциональной совместимости между всеми решениями участвующих вендоров. 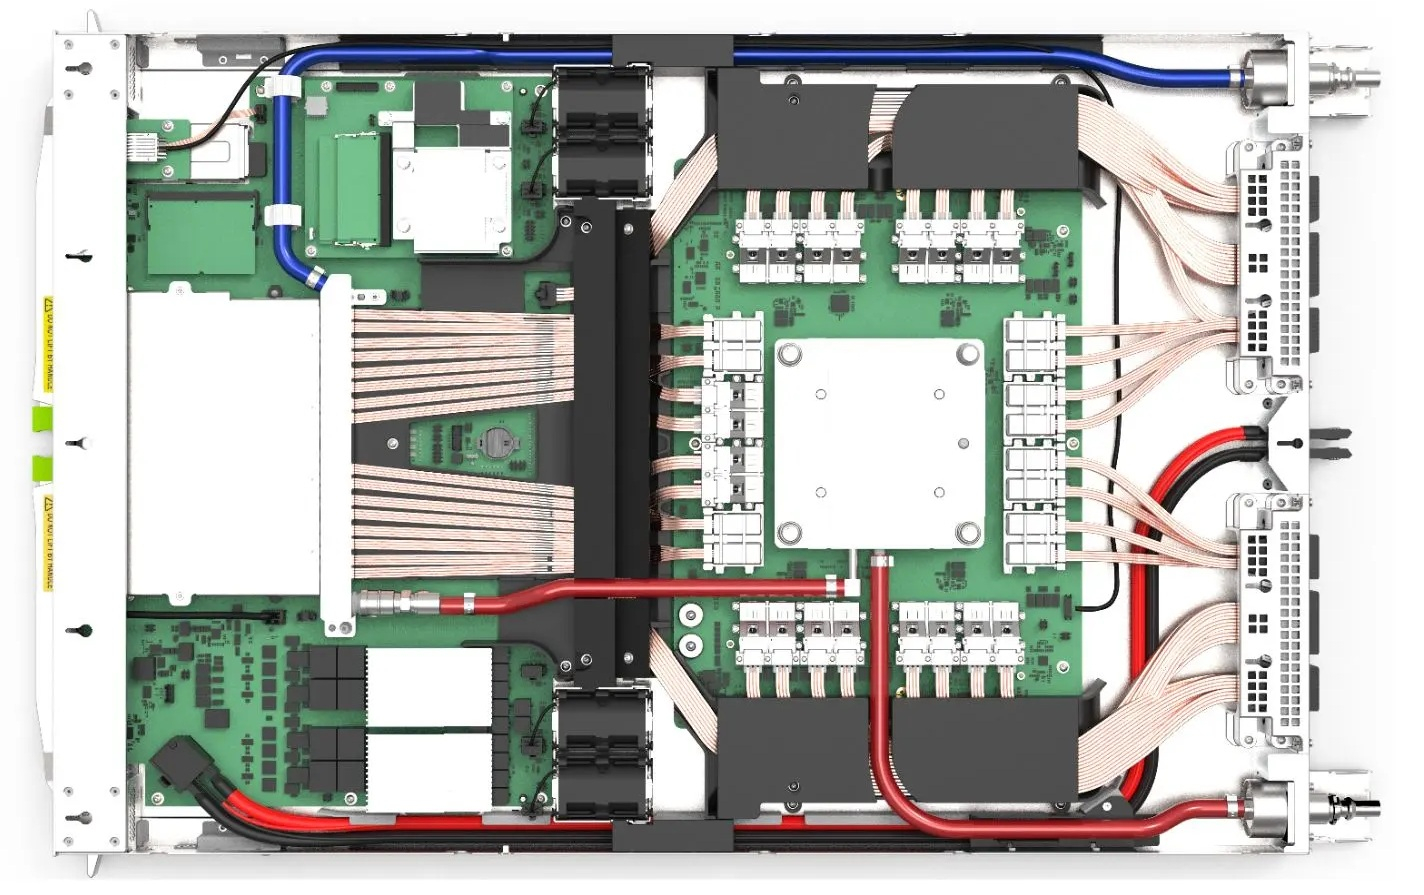
ESUN для MTIA 300 Также Meta✴ сообщила подробности о коммутаторе Tahan Ethernet Scale Up для MTIA 300, показала прототип стойки на 72 ускорителя и анонсировала открытую реализацию MetaRoCE. Эти элементы отражают разные стадии разработки: сейчас Tahan использует режим lossless RoCE, в будущих аппаратных решениях для вертикального масштабирования планируется переход на ESUN, а версия OSPA 1.0.0 пока остаётся на рассмотрении в OCP. 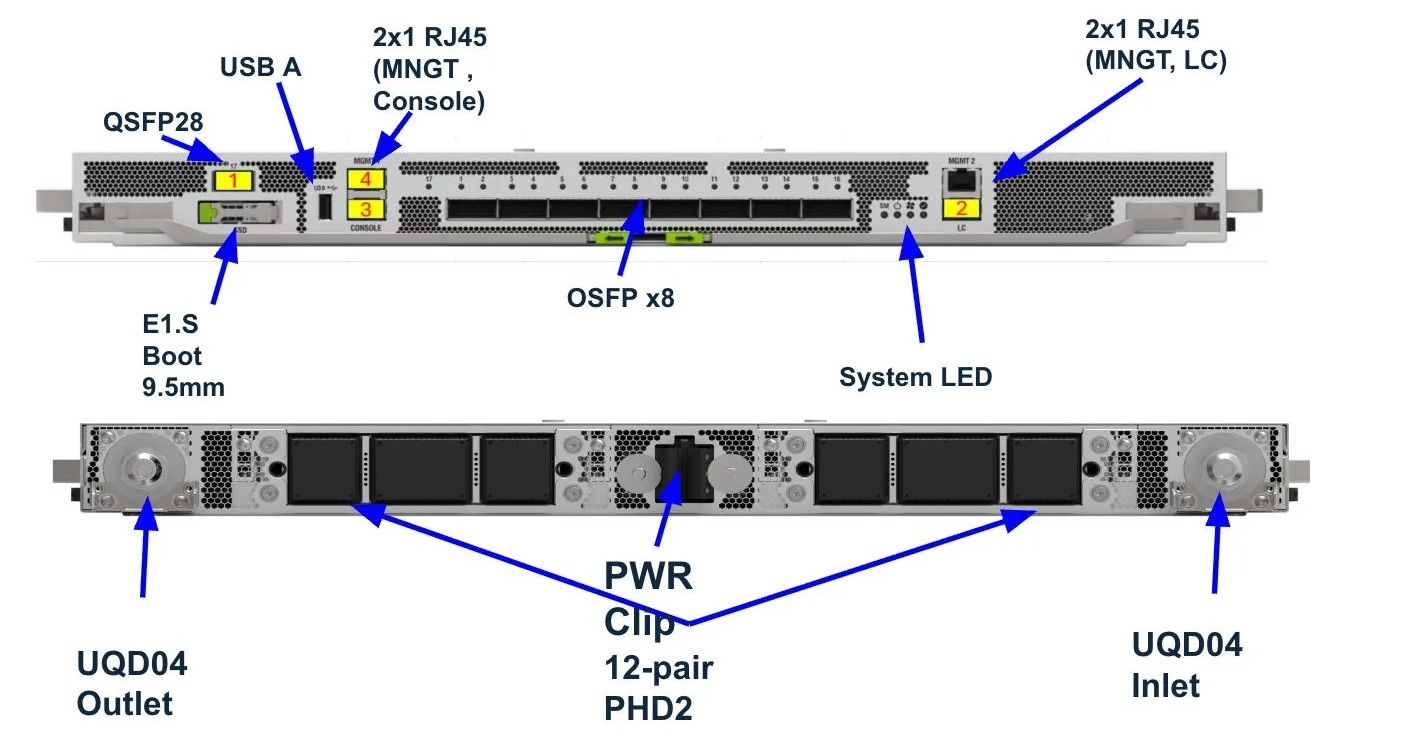
ESUN для MTIA 300 Tahan построен на базе ASIC Tomahawk 5 с пропускной способностью 51,2 Тбит/с (64 × 800G). Четыре коммутатора Tahan соединяют 16 ускорителей в неблокирующей топологии. Компания отметила, что Tahan использует тот же самый lossless RoCE (маршрутизируемый IPv6, PFC и QoS, настроенный для ИИ), объединяя scale-up и scale-out сети под управлением FBOSS. Параллельно компания работает над CXL-фабриками масштаба целого ЦОД.
12.10.2026 [09:37], Владимир Мироненко
Upscale AI представил архитектуру Token Fabric для ИИ-фабрикСтартап Upscale AI представил архитектуру Token Fabric, призванную объединить вертикальное и горизонтальное масштабирование в рамках одной сетевой платформы. Решение сочетает в себе фирменный чип SkyFabriX (scale-up), NVIDIA Spectrum-X Ethernet (scale-out) и единый программный уровень для управления. Система, построенная на открытых стандартах, должна обеспечить непрерывную работу ИИ-чипов, чтобы они не простаивали в ожидании данных, тем самым помогая клиентам повысить отдачу от своих инвестиций. Token Fabric включает:
Клиенты могут внедрять Token Fabric, выбирая отдельные компоненты (чипы, системы, ПО) или весь стек целиком. Вариант с полным стеком рассчитан на неооблака и корпоративных клиентов, не располагающих сетевыми командами масштаба гиперскейлеров. Вариант с интегрированными системами предназначен для производителей XPU, которым требуется проверенное оборудование без необходимости самостоятельной разработки сетевого стека. Третий вариант предусматривает поставку чипов или специализированных систем вместе с SDK/SAI от Upscale, поверх которых работает собственная NOS заказчика. 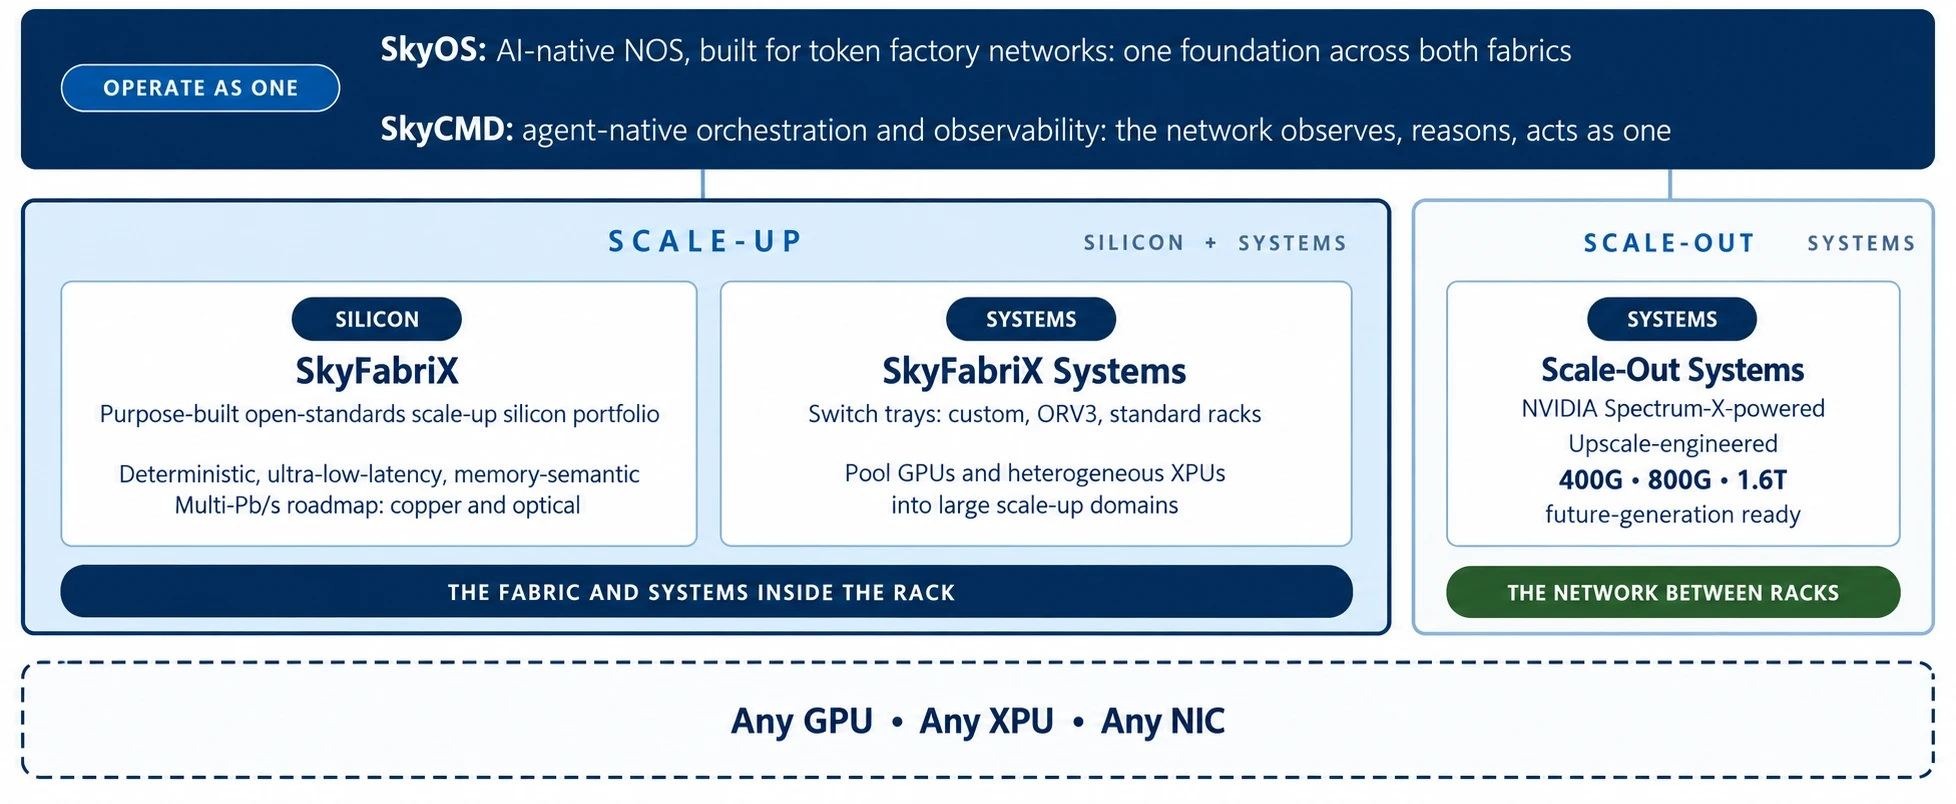
Источник изображения: Upscale AI Upscale AI расширяет существующие протоколы, а не заменяет их, говорит компания. Upscale AI также вносит вклад в открытые проекты, лежащие в основе стека. К ним относятся SONiC, расширения интерфейса абстракции коммутатора (SAI) для поддержки ESUN, а также инициативы Ultra Ethernet Consortium (UEC) и UALink. SkyOS абстрагирует нижележащее оборудование и обеспечивает единую плоскость управления для всего кластера, а SkyCMD унифицирует управление. Любая вычислительная платформа в гетерогенном кластере может использовать этот интерфейс для управления сетью. «Операционная система должна быть компактной и эффективной, чтобы обеспечивать быстродействие, гибкость и безопасность, — сообщил изданию Network World Барун Кар (Barun Kar), генеральный директор Upscale AI. — Кроме того, поверх неё необходим уровень оркестрации, позволяющий поддерживать такие возможности, как гетерогенные вычисления». Полномасштабный выпуск Token Fabric запланирован на начало 2027 года; в настоящее время действуют программы раннего доступа и совместного тестирования. Компания Upscale AI вышла из скрытого (stealth) режима в сентябре 2025 года. Она привлекла $100 млн в рамках посевного раунда финансирования, потом — $200 млн в раунде A, а затем — ещё $190 млн, при оценке капитализации в $2 млрд. В результате общий объём инвестиций составил $500 млн. Стартап поддерживают как NVIDIA, Salesforce и сингапурский государственный инвестиционный фонд Temasek. Главный инвестор — фонд Premji Invest. Штат компании превышает 300 сотрудников.
12.10.2026 [08:53], Сергей Карасёв
Arista представила интерконнект Etherlink SU-144 для кластеров ИИ и НРСКомпания Arista Networks анонсировала сетевую архитектуру Etherlink SU-144, призванную перенести стандарт Ethernet в ту область, в которой ранее превалировали такие технологии, как NVIDIA NVLink и InfiniBand. Новое решение ориентировано на масштабные кластеры ИИ и НРС. Arista отмечает, что рынок ИИ стремительно расширяется. По мере усложнения больших языковых моделей (LLM) и появления нагрузок, которым необходима тесная синхронизация данных между огромными пулами ускорителей, возможностей интерфейсов PCIe, CXL и проприетарных интерконнектов становится недостаточно для эффективного масштабирования ресурсов. Такие технология хорошо работают внутри серверов, но создают определённые трудности на уровне кластеров из-за применения ускорителей разных поколений и конструктивных особенностей систем, объединяющих сотни и тысячи XPU. В такой ситуации сеть больше не является просто связующим звеном между серверами — она становится частью самой вычислительной системы. Архитектура Etherlink SU-144, как ожидается, поможет в удовлетворении растущих потребностей в высокоскоростном обмене данными. 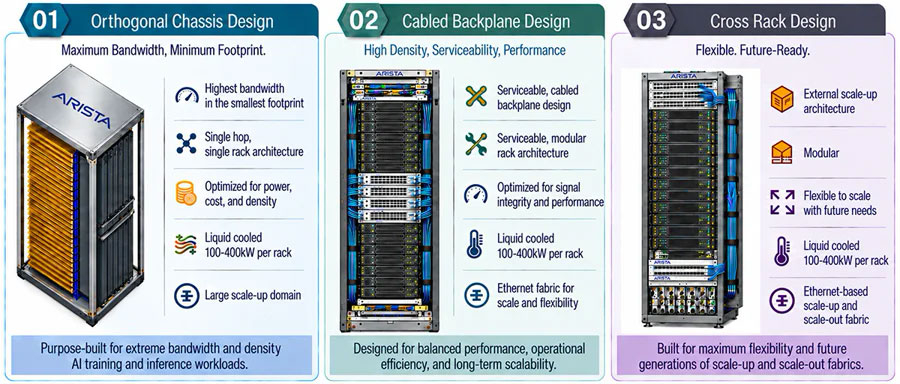
Источник изображения: Arista Networks Новая технология разработана в рамках инициативы Ethernet for Scale-Up Networks (ESUN). В проекте также принимают участие AMD, Arm, Broadcom, d-Matrix, Meta✴, Microsoft и Qualcomm. Благодаря Etherlink SU-144 в пределах одной стойки могут быть объединены до 144 ускорителей, а в массиве из нескольких стоек — до 1024. Расчётная мощность при этом может варьироваться от 100 до 400 кВт на стойку, что требует применения исключительно жидкостного охлаждения. Для Etherlink SU-144 предусмотрены три физических форм-фактора под разные сценарии. Это, в частности, ортогональное шасси, когда серверы располагаются спереди, а коммутационные карты — сзади. Такое исполнение обеспечивает максимальную плотность компоновки и высокую пропускную способность при интенсивных нагрузках обучения и инференса ИИ-моделей. Ещё один вариант — шасси с бэкплейном: решение обеспечивает оптимальное сочетание производительности, операционной эффективности и долгосрочной масштабируемости. Наконец, третий подход предполагает формирование межстоечной связи — для максимальной гибкости и будущих развёртываний. Для архитектуры Etherlink SU-144 заявлена поддержка динамической балансировки нагрузки, а также оптических технологий XPO и CPO/NPO с перспективой повышения пропускной способности до 6,5 Пбит/с на стойку.
18.09.2026 [17:40], Владимир Мироненко
Вглубь и вширь: Cornelis анонсировала архитектуру Active Compute FabricCornelis представила Active Compute Fabric — открытую архитектуру, охватывающую сетевые системы класса scale-up (вертикальное масштабирование) и scale-out (горизонтальное масштабирование) и включающую встроенные средства программируемых вычислений. В настоящее время ИИ-кластеры выросли до многих тысяч GPU. Количество параметров в моделях увеличилось с миллиардов до триллионов. Однако фундаментальное поведение большинства сетей ЦОД не эволюционировало так быстро — они в основном перемещают данные из точки А в точку Б, обеспечивая максимально надёжную передачу. Современные рабочие ИИ-нагрузки не всегда ведут себя как традиционные HPC и другие распределённые приложения. В них доминируют синхронизация, коллективные операции и зависимости, а также значительный трафик между серверами (east-west). Когда сеть не справляется с огромными требованиями к пропускной способности таких рабочих нагрузок, ускорители часто простаивают, иногда в течение длительного времени. Проблему простоя поставщики пытаются решить преимущественно за счёт увеличения пропускной способности, а не изменения принципов работы самой сетевой инфраструктуры. «ИИ-инфраструктура достигла того этапа, когда одного лишь повышения быстродействия конечных узлов уже недостаточно. Сетевая фабрика должна стать активным компонентом вычислительной системы», — заявила Лиза Спелман (Lisa Spelman), генеральный директор Cornelis. 
Источник изображений: Cornelis Networks Архитектура Active Compute Fabric переносит программируемые вычислительные функции непосредственно на уровень сети. Сетевая фабрика может производить манипуляции над данными прямо во время передачи: собирать данные KV-кеша для дезагрегированного инференса, координировать распределение экспертов для моделей MoE, ускорять коллективные операции, такие как AllReduce, и сжимать градиенты при передаче, разгружая вычислительные узлы, уменьшая накладные расходы на синхронизацию и отвечая за целостность передачи данных. При этом она может брать на себя новые функции по мере развития алгоритмов ИИ и ПО. Нечто похожее, например, NVIDIA начала предлагать в InfiniBand несколько поколений назад (SHARP), но, по слухам, данная функциональность особой популярностью не пользуется. Cornelis опирается на открытые Ethernet-стандарты UALink для вертикального масштабирования и Ultra Ethernet — для горизонтального, что даёт поддержку широкого спектра ускорителей. Это важный фактор, поскольку компании всё больше диверсифицируют оборудование и технологии, используемые в своих ЦОД. Клиенты, использующие решения для ИИ, всё чаще обращаются к решениям стоечного масштаба, сталкиваясь при этом с проблемой привязки к конкретному поставщику, а Cornelis позиционирует себя как нейтральная, открытая альтернатива. Это явный кивок в сторону NVIDIA, хотя тот же UALink пока трудно назвать действительно зрелой технологией. 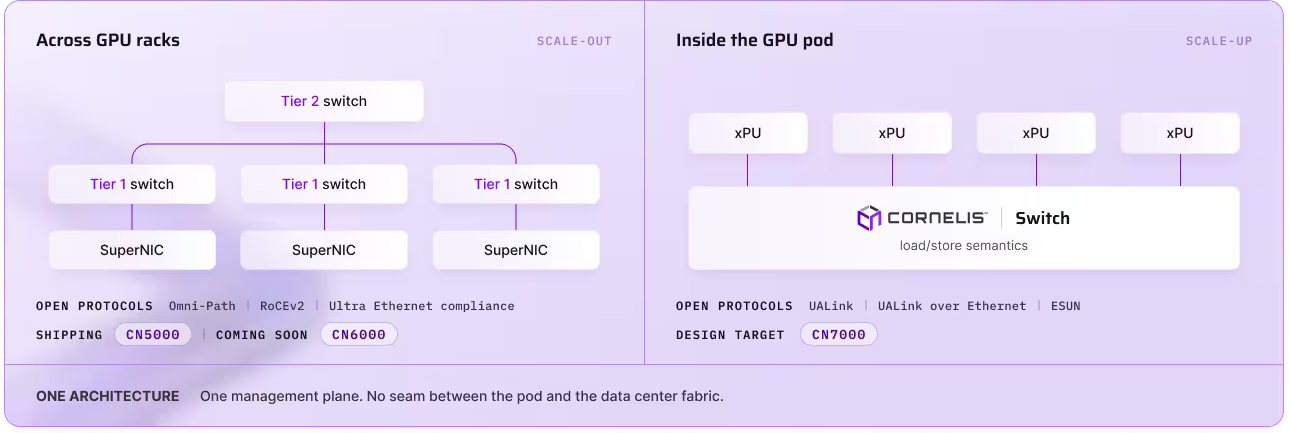 Видение Cornelis по поводу открытых и эффективных сетей, масштабируемых по принципу «масштабирование и расширение», разделяет Qualcomm, которая присоединилась к Cornelis на конференции AI Infra Summit. Cornelis отметила, что обе компании разделяют общее видение проблем, стоящих перед ИИ-инфраструктурой: использование пассивных сетевых архитектур, обеспечивающих лишь передачу данных, приводит к недогрузке вычислительных ускорителей, что напрямую сказывается на экономической эффективности процессов инференса. По мере перехода к созданию ИИ-систем стоечного масштаба, обе компании рассматривают сеть как ключевой элемент проектирования, а не как второстепенный компонент. Лиза Спелман отдельно отметила в интервью CRN схожесть подходов с Qualcomm: «Мы видим много общего в отношении проблем инфраструктуры ИИ, проблем, с которыми сталкиваются клиенты, и множество возможностей и потенциала для объединения наших технологий и решения этих проблем для клиентов <…> Мы считаем, что сейчас идеальное время для выхода на этот рынок. Ещё многое предстоит решить», — сказала Спелман. Как отметил CRN, проблема для Cornelis заключается в том, что NVIDIA более года продвигает свою собственную технологию интерконнекта NVLink Fusion как де-факто интерконнект для вертикального масштабирования. К альянсу уже присоединились Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel, d-Matrix и MediaTek. Это позволяет NVIDIA оставаться важнейшим поставщиком для рынка ИИ-инфраструктуры и открывает новый источник дохода. 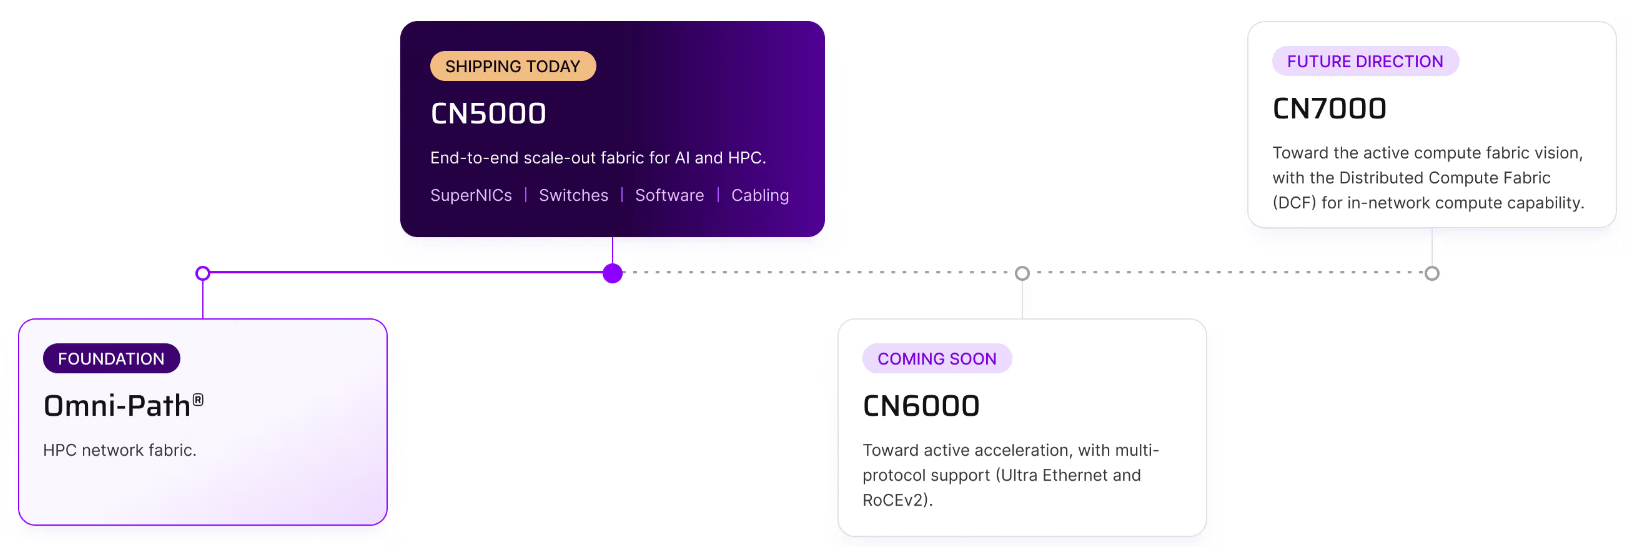 Cornelis также объявила о привлечении финансирования в размере $205 млн. Средства будут направлены на масштабирование производства, укрепление партнёрских отношений с клиентами и ускорение реализации планов по выводу продукции на рынок. Ресурс Forbes считает, что для компании в сегменте HPC-сетей такой уровень инвестиций значителен и свидетельствует о том, что рынок считает проблему узкого места в сетевых технологиях реальной, и что Cornelis продемонстрировала достаточный прогресс благодаря текущим внедрениям в ЦОД для ИИ и HPC, чтобы оправдать дальнейшее расширение. «Потенциал рынка сетевых решений на базе открытых стандартов для масштабирования ИИ (как вертикального, так и горизонтального) к 2030 году превысит $55 млрд. Мы убеждены, что именно сетевая инфраструктура будет определять, какая часть инвестиций в развёртывание систем ИИ принесёт реальную отдачу», — заявили в IAG Capital Partners.
04.09.2026 [08:56], Владимир Мироненко
MetaRoCE — RDMA-транспорт от Meta✴ для крупных ИИ-кластеров с обычным EthernetMeta✴ представила MetaRoCE — новый транспортный RDMA-протокол на базе обычного Ethernet, созданный для крупных ИИ-кластеров. Компания разместила спецификации MetaRoCE, эталонную программную реализацию и набор тестов на соответствие требованиям (Compliance Test Suite, CTS) в рамках OCP, предоставив возможность его внедрения всем желающим. В Meta✴ настаивают на том, что Ethernet должен быть предпочтительной инфраструктурой для ИИ, продемонстрировав, что её реализация RoCE может обеспечивать распределённое обучение ИИ в масштабе, объединяя миллионы GPU. Компания отметила, что в ходе инференса низкая задержка коммуникации между распределёнными сегментами модели напрямую влияет на время отклика для сотен миллионов пользователей. Даже небольшие сетевые помехи ограничивают вычислительную мощность. Протокол RoCE (RDMA over Converged Ethernet) предполагает, что сеть будет доставлять каждый пакет в определённом порядке, используя PFC и препятствуя распылению пакетов, обеспечивая производительность в многоплоскостных и крупномасштабных сетях. При использовании MetaRoCE в строгом выполнении очерёдности передачи данных нет необходимости. Главная задача — обеспечение высокой пропускной способности, низкой задержки в конце очереди распределения и простоты эксплуатации по мере роста сети при увеличении количества ускорителей и расстояний между ними. 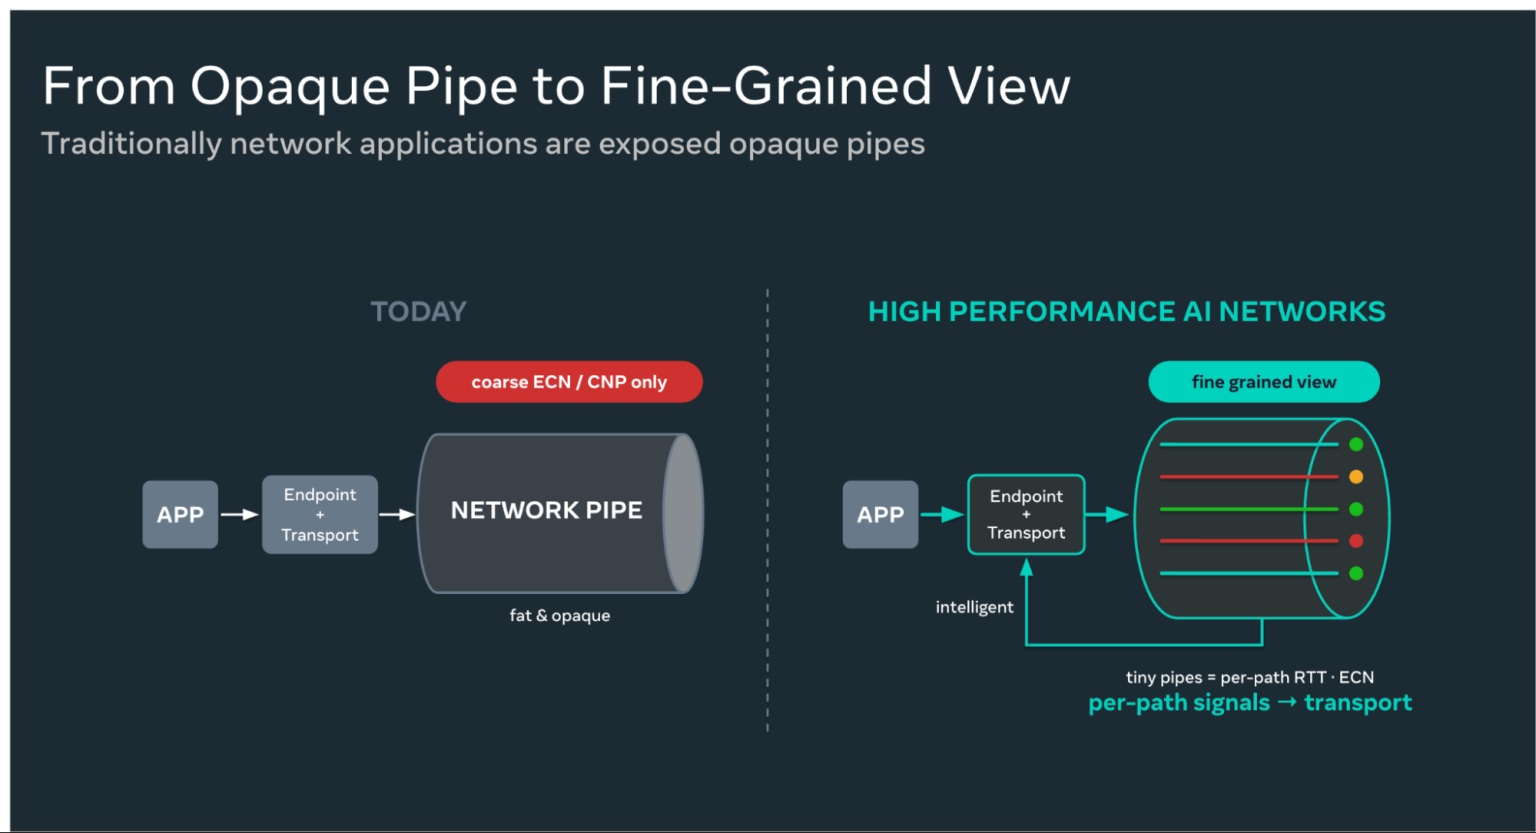
Источник изображений: engineering.fb.com Как указано в блоге Meta✴, суть MetaRoCE проста: сетевая фабрика видит пакеты, а сетевая карта (NIC) — намерения. Традиционные архитектуры ориентированы на «ум» фабрики, полагаясь на коммутаторы для обеспечения отсутствия потерь и поддержания порядка. Перенося интеллектуальные функции на конечную точку, MetaRoCE декомпозирует сеть на множество детализированных (мелкозернистых) логических путей, каждый из которых имеет свою собственную телеметрию в реальном времени — время приёма-передачи данных для каждого пути (Per-path RTT), состояние ECN и загрузку. Такая прозрачность открывает возможности, которые трудно достичь с помощью традиционного RDMA. MetaRoCE распределяет пакеты по множеству путей, поэтому они поступают не в том порядке, в каком были отправлены. Транспортный уровень рассматривает неупорядоченное поступление как обычный случай. Каждый пакет имеет свой адрес назначения, а данные записываются непосредственно в конечную область памяти по мере их поступления, без буфера переупорядочивания и блокировок. При этом MetaRoCE всегда рассматривает Ethernet-фабрику как систему с потерями и не требует от неё иного поведения. Прикладной уровень практически не затрагивается — существующие RDMA-«глаголы» и программные стеки работают без изменений, а дополнительные функции поддерживаются с помощью расширений стандартных API. 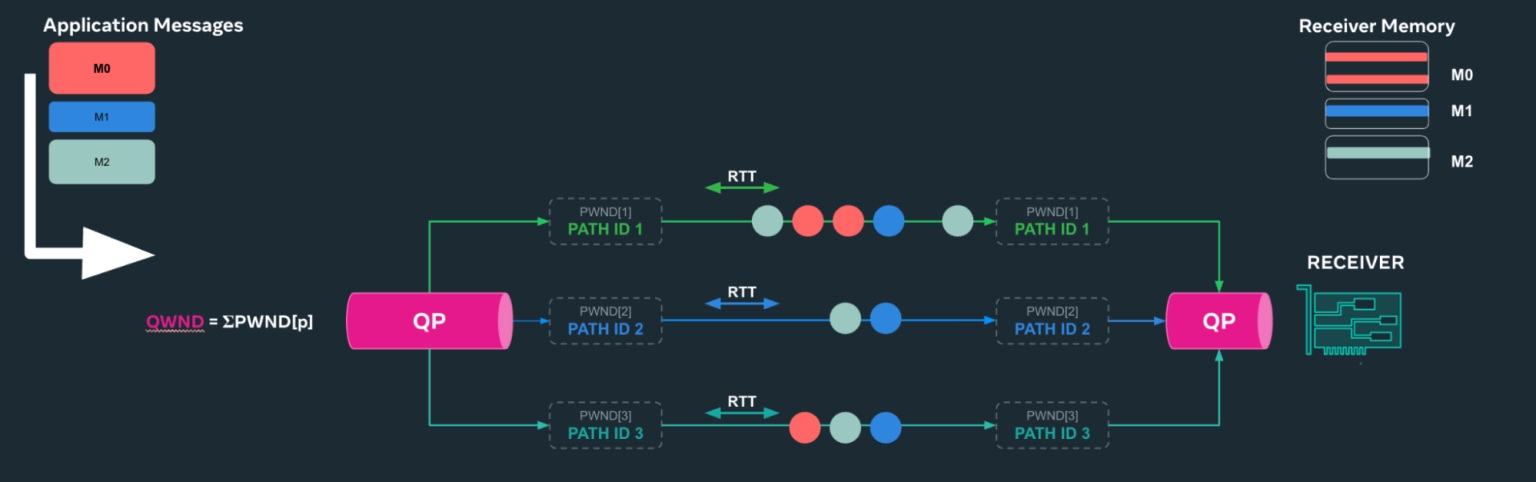 MetaRoCE предоставляет каждому соединению несколько путей и распределяет по ним пакет за пакетом. Каждый путь имеет свой уникальный исходный UDP-порт в качестве энтропии ECMP, который сетевая карта может изменить в любой момент, чтобы перенаправить трафик с неподходящего маршрута. Выбор пути пакета полностью зависит от NIC, так что и эффективность работы всей фабрики зависит от NIC. Оценка каждого пути позволяет явно отличить перегрузку и от сбоя, и сделать перебалансировку, избавившись от плохо работающего пути без обрыва соединение целиком и с возможностью переотправки ровно того пакета, который потерялся из-за сбоя или перегрузки. MetaRoCE сочетает в себе традиционный ECN-контроль перегрузки с AIMD у отправителя с обратной связью со стороны получателя, который при каждом ACK уведомляет отправителя о выделенной ему доле из общей доступной получателю полосы. MetaRoCE запрашивает у фабрики олько две функции, которые уже есть в каждом коммутаторе: ECN и ECMP. Протокол Meta✴ не требует обрезки пакетов, внутрисетевой телеметрии, управления потоком на основе кредитов или распыления пакетов на стороне коммутатора, но и наличие этих функций не мешает работе протокола. MetaRoCE совместим практически с любыми топологиями, в том числе с сегментами в облачных системах, конфигурацию которых нельзя контролировать. В протоколе нет проприетарных компонентов, поэтому фабрика может свободно оптимизироваться с точки зрения стоимости и кабельной разводки. 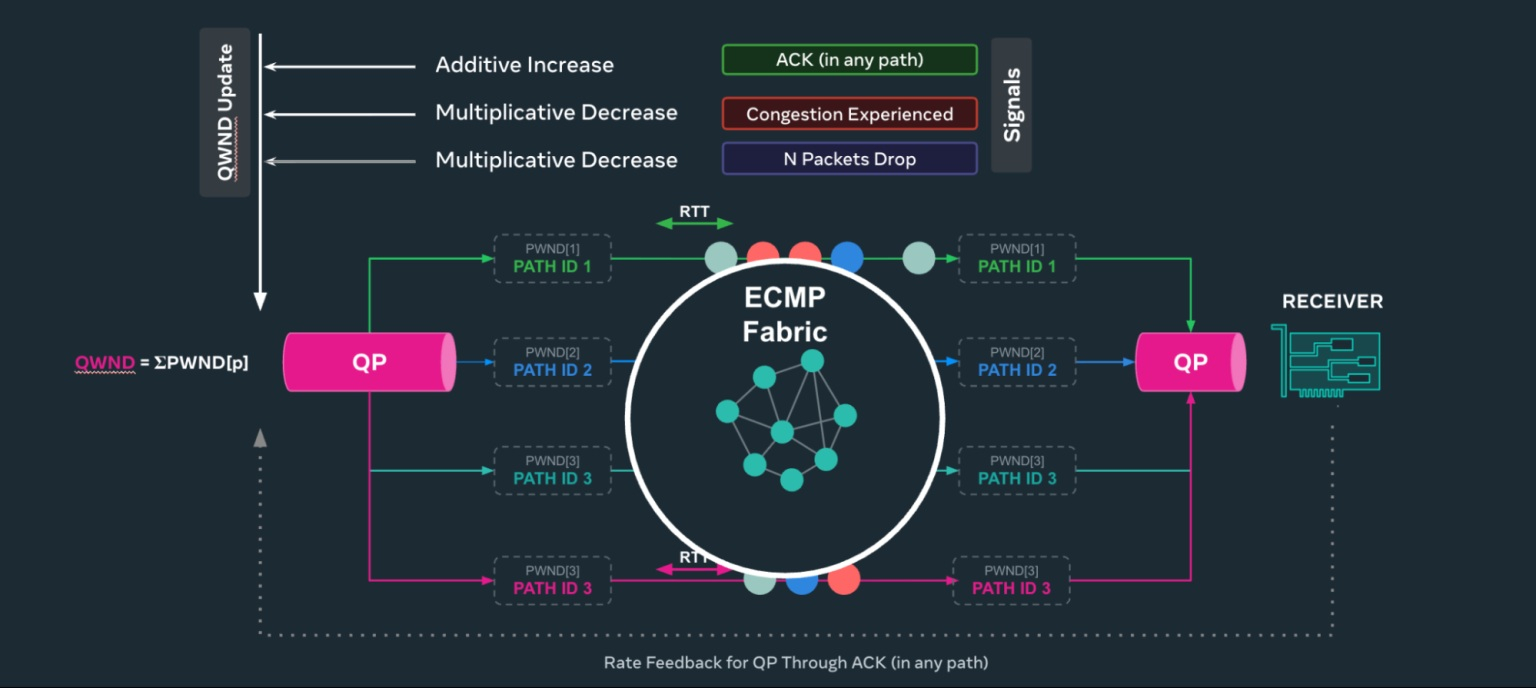 Очередь отправки и очередь приёма (Queue Pair, QP) отвечают как за упорядоченный поток сообщений, так и за пропускную способность. Традиционный RDMA получает больше того или другого путём открытия большего количества QP (по несколько десятков на каждую пару узлов), не знающих ничего ни о друг друге в плане перегрузки, ни об их состоянии в NIC. MetaRoCE использует одно соединение для множества независимых упорядоченных потоков (в т.ч. по одному на каждую коллективную операцию), использующее множественные пути под управлением одного контроллера перегрузки. Чтобы ускорить проверку аппаратного обеспечения, Meta✴ совместно с AMD реализовала MetaRoCE на DPU Pensando. На 64-узловом кластере GPU AMD, работающем под управлением RCCL, компании напрямую сравнили MetaRoCE с RoCEv2 при выполнении коллективных операций All-Reduce и All-to-All. 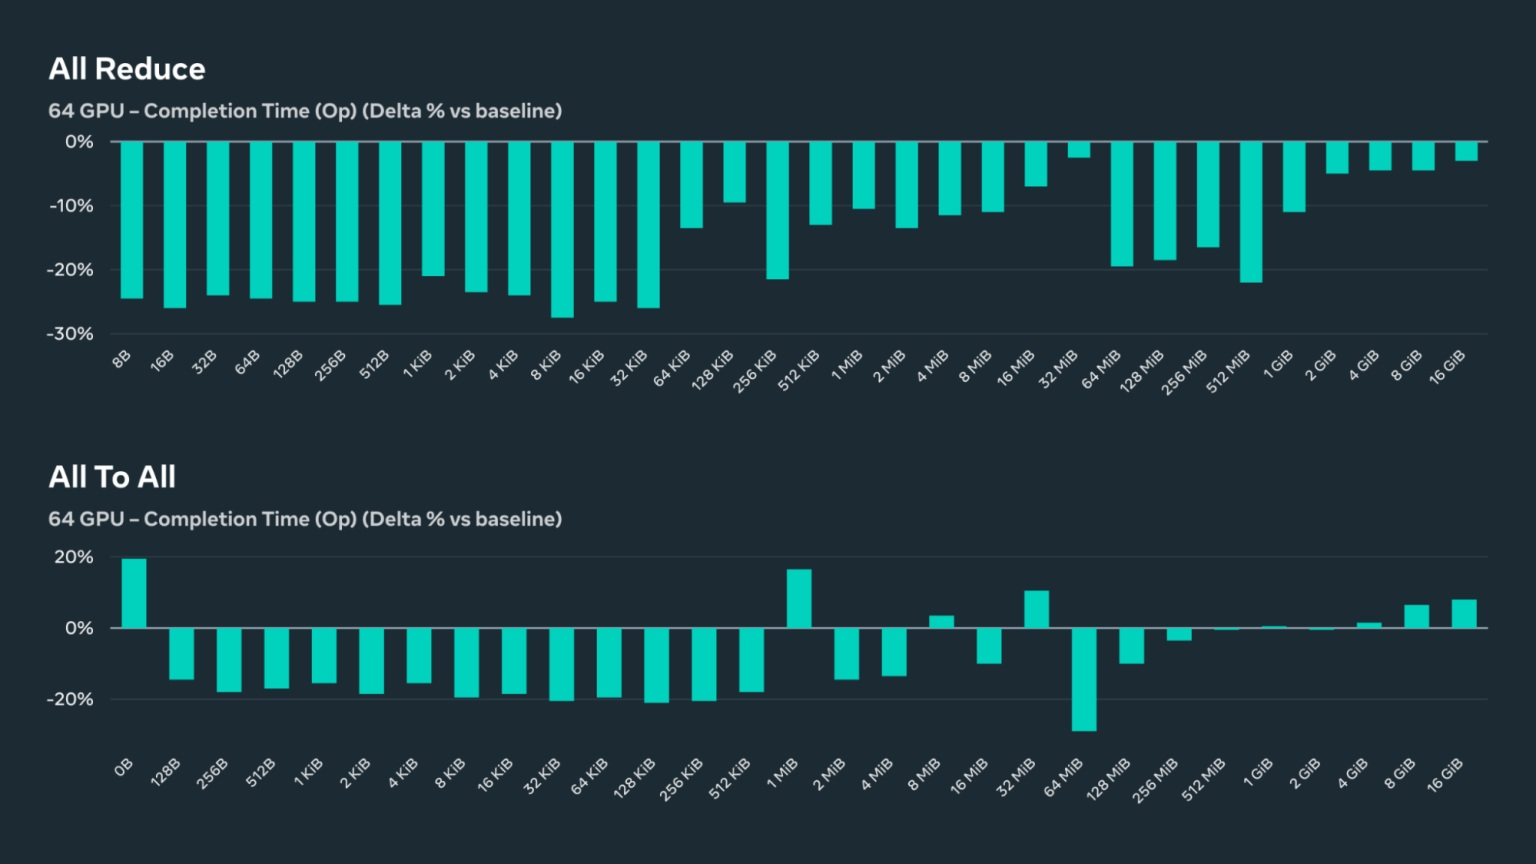 Результаты, как утверждает Meta✴, соответствуют поставленным целям:
Эти результаты подтверждают правильность выбора, сделанного при разработке MetaRoCE, отметила Meta✴. Благодаря тому, что протокол с самого начала разрабатывался с учётом возможных потерь пакетов, а интеллектуальные функции вынесены на периферию, он обеспечивает более высокую производительность в идеальных условиях и плавно снижает нагрузку при сбоях. Компания подчеркнула, что протокол MetaRoCE является открытым, его спецификации добавлены в OCP, и любой поставщик может с их помощью создать и реализовать совместимое оборудование. Впрочем, во многом похожий протокол MRC (Multipath Reliable Connection) также передан в OCP, да и Ultra Ethernet тоже решает схожие задачи.
08.08.2026 [16:10], Сергей Карасёв
Bull и Kalray займутся разработкой сетевых технологий для ИИ и НРСФранцузские компании Bull и Kalray объявили о стратегическом партнёрстве, направленном на развитие передовых сетевых технологий для инфраструктур ИИ и НРС. Стороны, в частности, намерены сотрудничать в сфере Ultra Ethernet — нового стандарта на базе Ethernet, ориентированного на современные ресурсоёмкие нагрузки. Bull и Kalray сосредоточат усилия на разработке решений следующего поколения, отвечающих высоким требованиям производительности, масштабируемости и эффективности. Речь идёт, в частности, об интерконнекте с большой пропускной способностью и малыми задержками. В рамках партнёрства Kalray предоставит свою сетевую платформу Kalray Networking Engine, предназначенную для работы с огромными массивами данных в составе ЦОД, инфраструктур ИИ и НРС. Эта платформа предусматривает использование 64 ядер KV5 с открытой архитектурой RISC-V. Заявленная пропускная способность достигает 1,6 Тбит/с. В свою очередь, Bull ускорит развитие собственного интерконнекта BXI (Bull eXascale Interconnect) — это специализированная высокоскоростная сетевая архитектура для суперкомпьютеров и систем высокопроизводительных вычислений. В частности, планируется добавление в состав BXI новых функций безопасности и виртуализации, необходимых для облачных и ИИ-нагрузок. В целом, развитие BXI будет смещено в сторону стандарта Ethernet. 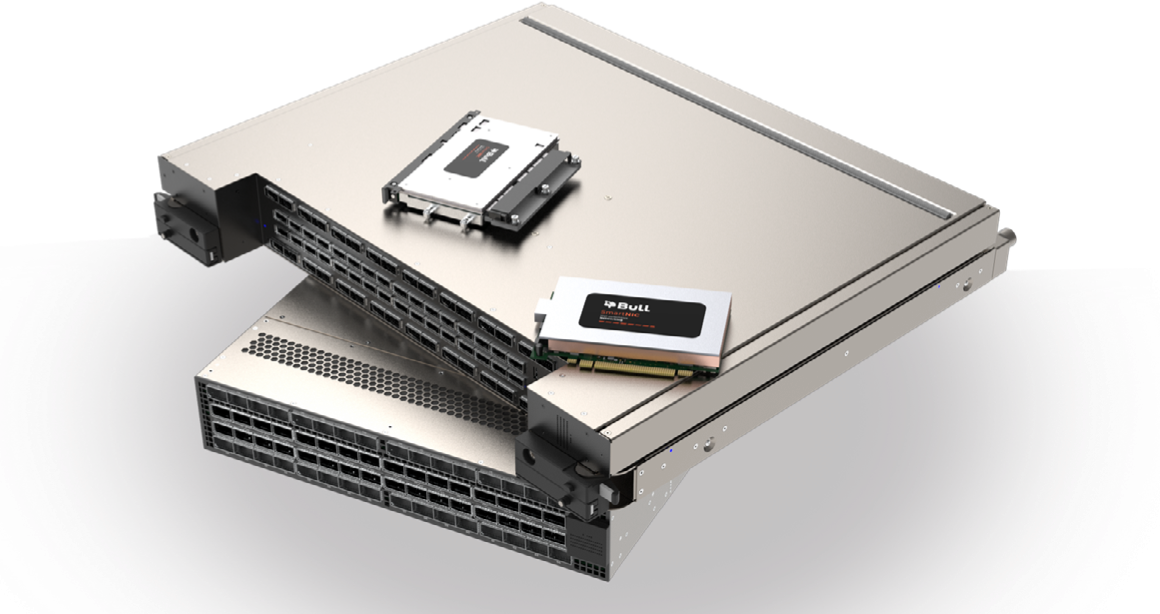
Источник изображения: Bull Соглашение между Bull и Kalray предусматривает совместную разработку технологических блоков, совместимых с Ultra Ethernet, и их интеграцию в будущие поколения сетевых решений Bull. Сотрудничество, как ожидается, откроет новые возможности для OEM-производителей и поставщиков инфраструктурных решений. Помимо этого, партнёрство будет способствовать развитию отраслевых стандартов, обеспечивающих масштабируемость, совместимость и долгосрочный потенциал платформ для ИИ и НРС. Планируется, что первые решения, разработанные совместными усилиями Bull и Kalray, станут доступны для коммерческого использования в 2028 году.
26.07.2026 [13:02], Сергей Карасёв
Astera Labs представила первые в отрасли 3,2-Тбит/с интеллектуальные ретаймеры и редрайверы для Ethernet и UALinkКомпания Astera Labs анонсировала ретаймеры и редрайверы семейства Taurus 3.2T: это, как утверждается, первые в отрасли изделия данного типа, соответствующие стандарту OCP Signal Conditioner Standard Footprint и поддерживающие скорость передачи данных до 3,2 Тбит/с. Представленные чипы содержат 16 линий с пропускной способностью 200 Гбит/с каждая. Говорится о совместимости с Ethernet, UALink (UALink over Ethernet) и ESUN (Ethernet for Scale-Up Networking). Устройства ориентированы на гиперскейлеров, провайдеров неооблаков и разработчиков масштабных ИИ-систем. В изделиях реализована технология Smart Swap. Она обеспечивает полную совместимость посадочного места по стандарту OCP, что позволяет менять ретаймеры на редрайверы и наоборот на одной и той же печатной плате. Иными словами, инженерам на этапе проектирования не требуется жёстко закреплять тип компонента. Впоследствии, опираясь на реальные замеры характеристик канала, можно выбирать ретаймер или редрайвер без необходимости перепроектирования самой печатной платы. 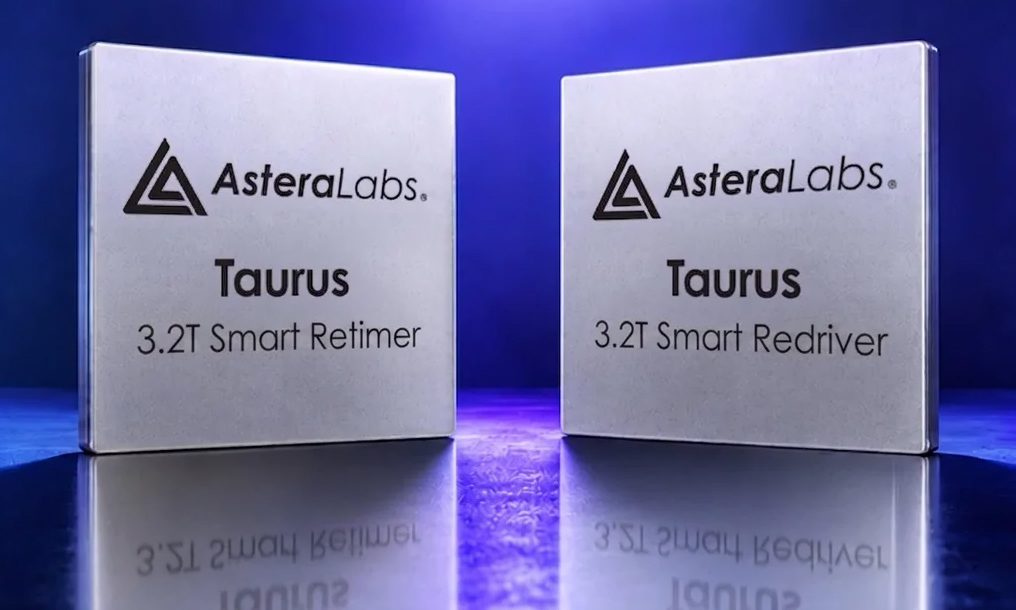
Источник изображений: Astera Labs Это даёт гибкость настройки: ретаймер поддерживает улучшенное усиление слабого сигнала (40+ дБ), но потребляет больше энергии и увеличивает задержку (не более 24 нс), тогда как редрайвер работает с более низкими задержками (менее 50 пс) и энергопотреблением (23 дБ), но на меньшем расстоянии. 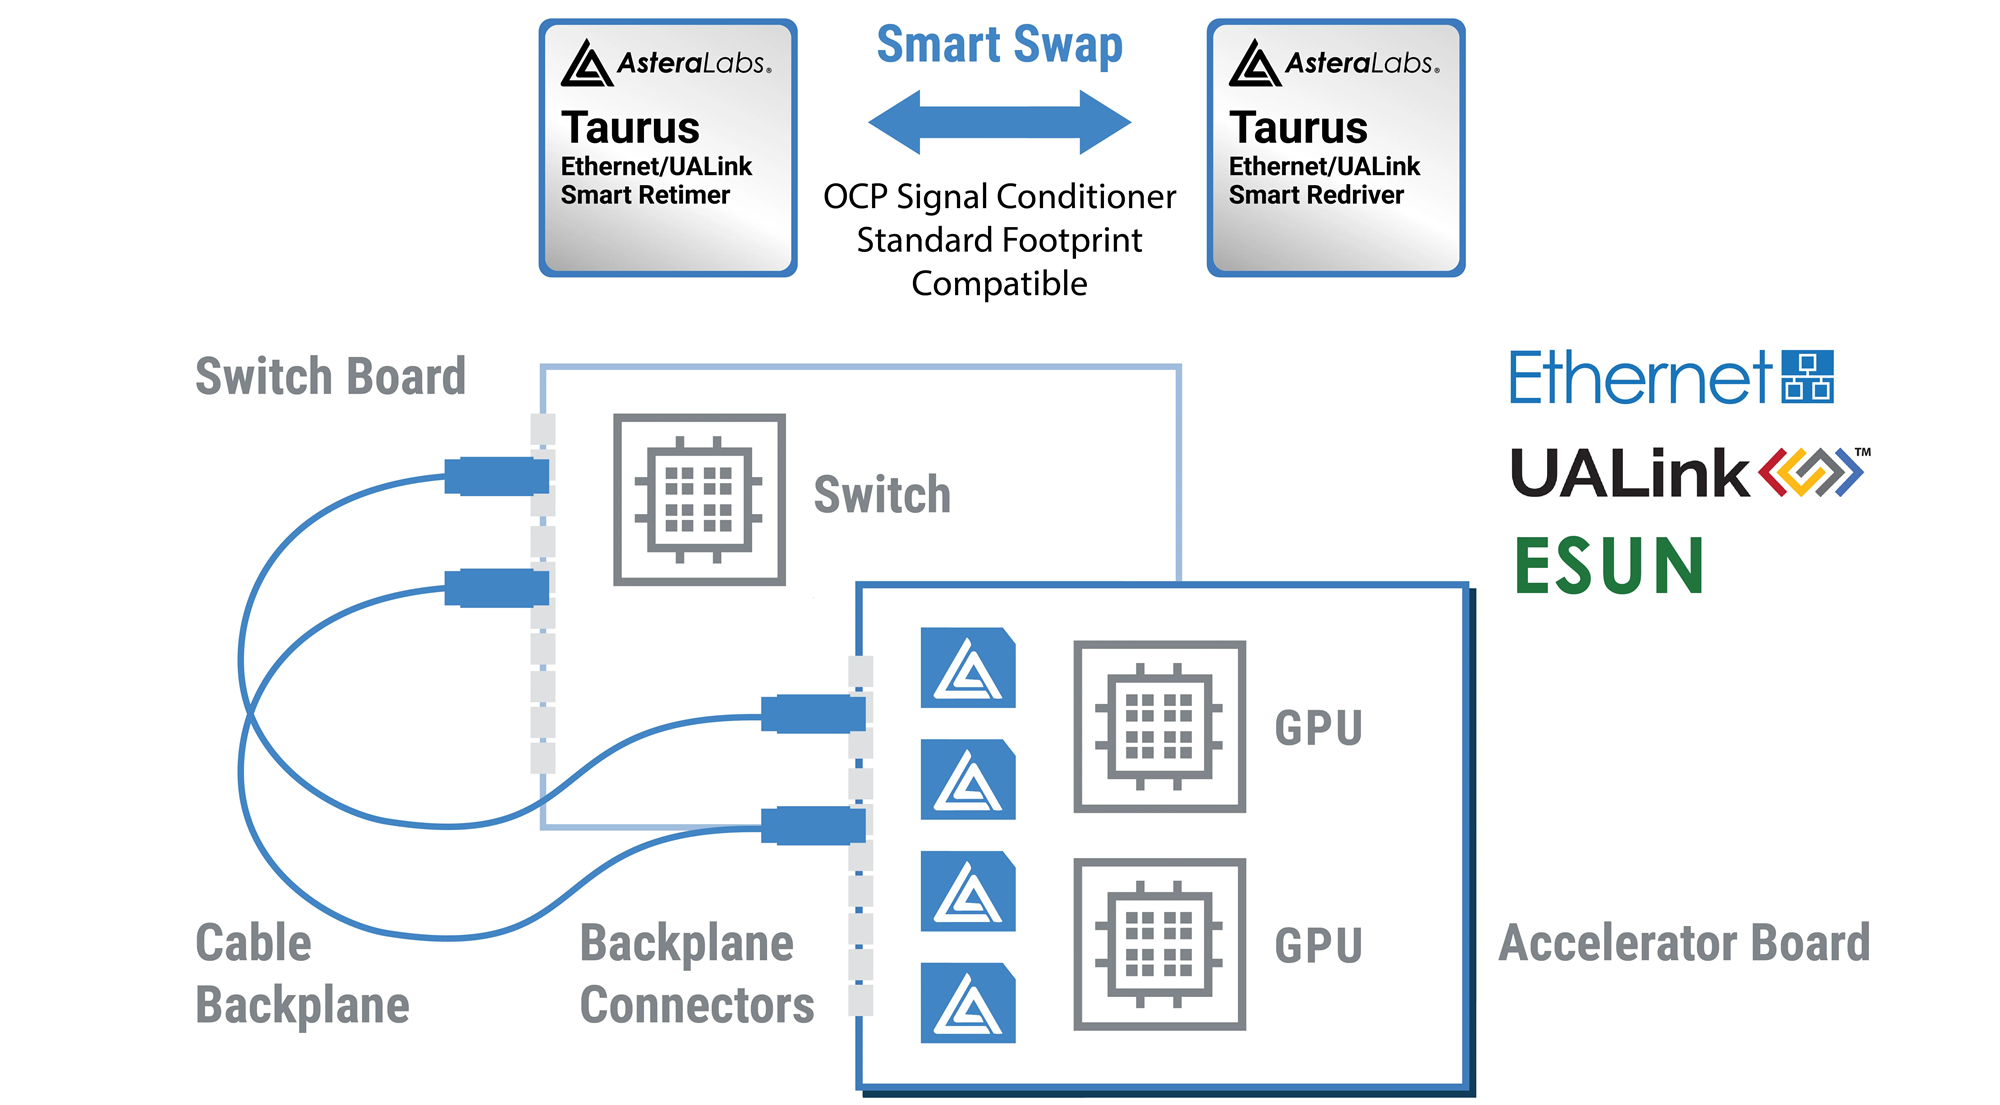 Ещё одна особенность новинок заключается в том, что они интегрированы в состав интеллектуальной программной платформы Astera COSMOS (COnnectivity System Management and Optimization Software). Она обеспечивает единый рабочий процесс для настройки, диагностики, проверки и мониторинга. В частности, интеллектуальные редрайверы Taurus предоставляют телеметрию и средства управления каналами связи, что помогает оптимизировать сетевую инфраструктуру, выявлять проблемы на ранних стадиях и поддерживать надёжную работу при изменении условий, включая температуру.
21.07.2026 [12:24], Сергей Карасёв
Chelsio представила 400GbE-решения седьмого поколения для ИИ ЦОДКомпания Chelsio Communications анонсировала интерконнект седьмого поколения для дата-центров, систем хранения и инфраструктур, ориентированных на ИИ. В состав представленной платформы AI Interconnect Platform входят сетевые адаптеры SmartNIC, контроллеры хранения и процессоры обработки данных (DPU). В основу AI Interconnect Platform положена архитектура Chelsio Unified Wire: она обеспечивает поддержку стандарта 400GbE и технологии Unified RDMA, объединяющей несколько протоколов удалённого прямого доступа к памяти (iWARP и RoCEv2). Кроме того, задействованы средства ускорения работы систем хранения и оптимизации ИИ-инфраструктуры для облачных, корпоративных развёртываний и гиперскейлеров. Среди ключевых особенностей платформы названы встроенные криптографические модули для протоколов QUIC, kTLS и IPsec/TLS/kTLS, различные варианты исполнения (PCIe 5.0, OCP 3.0) и лучшие в отрасли показатели производительности в расчёте на ватт потребляемой энергии. Говорится о поддержке виртуализации SR-IOV (Single Root I/O Virtualization), виртуальной коммутации vSwitch и пр. 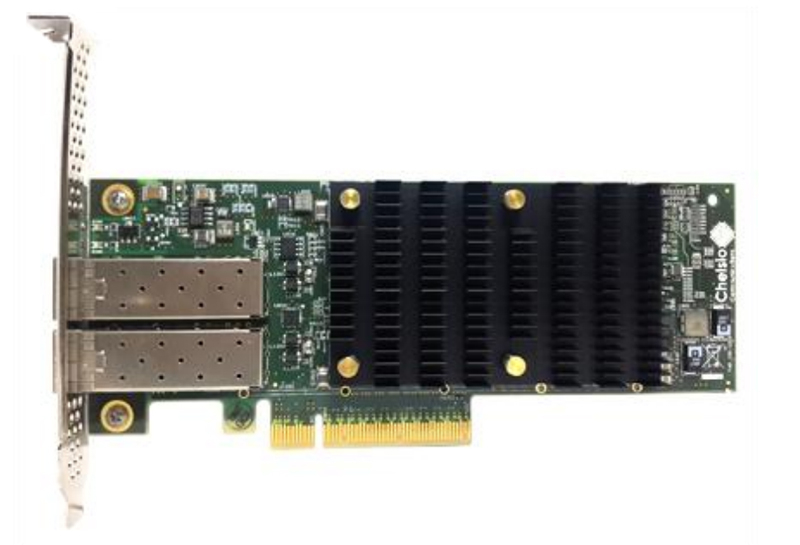
Источник изображений: Chelsio Communications В число анонсированных решений входят двух- и четырёхпортовые адаптеры S7250 / S7450 / S7450-OCP SmartNIC с поддержкой 1/10/25/50GbE. Эти изделия оптимизированы для виртуализации, встраиваемых систем и периферийных развёртываний. Кроме того, дебютировали решения S72200 / S72200-OCP SmartNIC с поддержкой 40/50/100/200GbE для масштабных облачных сред, HPC и ИИ-инфраструктур. Представлен также однопортовый адаптер S71400 SmartNIC класса 400GbE с возможностью работы в режимах 4 × 100GbE и 2 × 200GbE: устройство рассчитано на сверхмасштабные сетевые инфраструктуры. 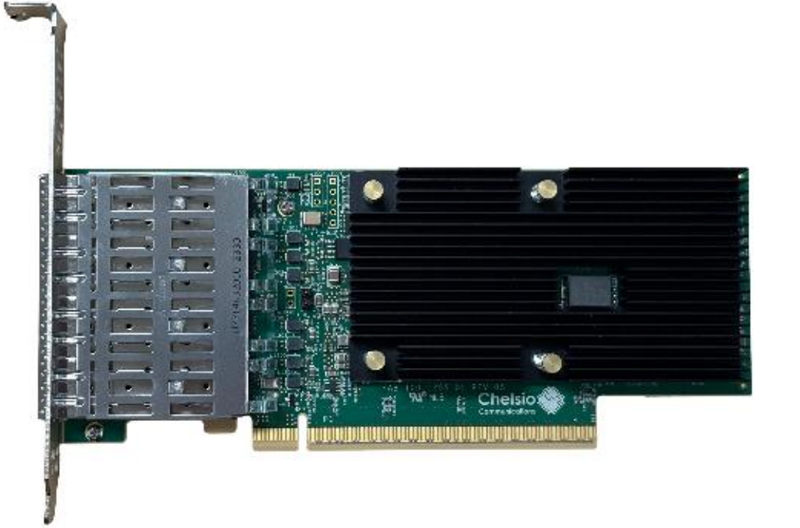 Кроме того, Chelsio выпустит контроллеры хранения T72200/T7450. Они предназначены для ускорения выполнения задач, связанных с обработкой данных. Обеспечивается аппаратная разгрузка для NVMe/TCP, NVMe-oF, iSCSI, RDMA и пр. Устройства будут предлагаться в форм-факторах PCIe и OCP. Все перечисленные изделия уже доступны для заказа. В декабре начнётся производство полностью программируемых карт T72200-DPU / T7450-DPU, которые сейчас доступны для ознакомления.
03.07.2026 [08:51], Сергей Карасёв
Квартальные продажи Ethernet-коммутаторов взлетели на 40 %, а NVIDIA выбилась в лидеры в ЦОД-сегментеIDC подвела итоги исследования глобального рынка Ethernet-коммутаторов корпоративного класса в I квартале текущего года: продажи таких устройств в денежном выражении достигли $15,4 млрд, что на 39,8 % больше по сравнению с аналогичным периодом 2025-го. Отмечается, что в сегменте дата-центров выручка взлетела в годовом исчислении на 61,0 %, составив около $10 млрд. Столь значительный рост аналитики связывают с продолжающимся развитием инфраструктуры ИИ, а также расширением мощностей гиперскейлеров. В ЦОД-секторе 35,8 % продаж в деньгах обеспечили коммутаторы стандарта 800GbE, ещё 34,1 % — решения класса 200/400GbE. С географической точки зрения спрос на коммутаторы поднялся во всех ключевых регионах. Так, на американском рынке прибавка составила 49,7 % в годовом исчислении. В странах EMEA (Европа, Ближний Восток и Африка) зафиксирован рост на 32,2 %, а в Азиатско-Тихоокеанском регионе — на 25,9 %. 
Источник изображения: Lambda Подчёркивается, что в сегменте Ethernet-коммутаторов для дата-центров в лидеры вырвалась NVIDIA, у которой продажи в денежном выражении подскочили год к году на 192,7 % — до $2,1 млрд: это соответствует доли в 21,5 % в соответствующей области. Однако в целом по рынку лидирует Cisco с 29,3 % и выручкой в объёме $4,5 млрд (+24,0 % по отношению к I кварталу 2025 года). У Arista Networks продажи поднялись на 37,3 % — до $2,2 млрд, что соответствует 14,6 % отрасли. В пятёрку ведущих игроков также входят НРЕ с 6,4 % и $985 млн (+15,4 % г/г) и Huawei с 5,8 % и $895 млн (+27,2 %). В исследовании говорится, что продажи маршрутизаторов для предприятий и поставщиков услуг по итогам I четверти 2026 года составили $3,8 млрд, что соответствует росту на 11,3 % в годовом исчислении. На поставщиков услуг пришлось 77,2 % от указанной суммы, или $2,9 млрд (+12,9 % г/г). Еще $867 млн принесли маршрутизаторы корпоративного класса — +6,1 % по отношению к I кварталу прошлого года. |
|

