
Материалы по тегу: инференс
|
25.08.2026 [18:35], Владимир Мироненко
IBM объединила архитектуры z и Arm в одном CPU для будущих мейнфреймовIBM анонсировала первый двухархитектурный процессор для мейнфреймов, который позволит запускать операционные системы и приложения на вычислительных платформах IBM (s390x) и Arm (AArch64) в будущих системах IBM z и LinuxONE. Компания отметила, что это первый этап в разработке процессора, достигнутый в рамках сотрудничества с Arm, стартовавшего в апреле 2026 года. 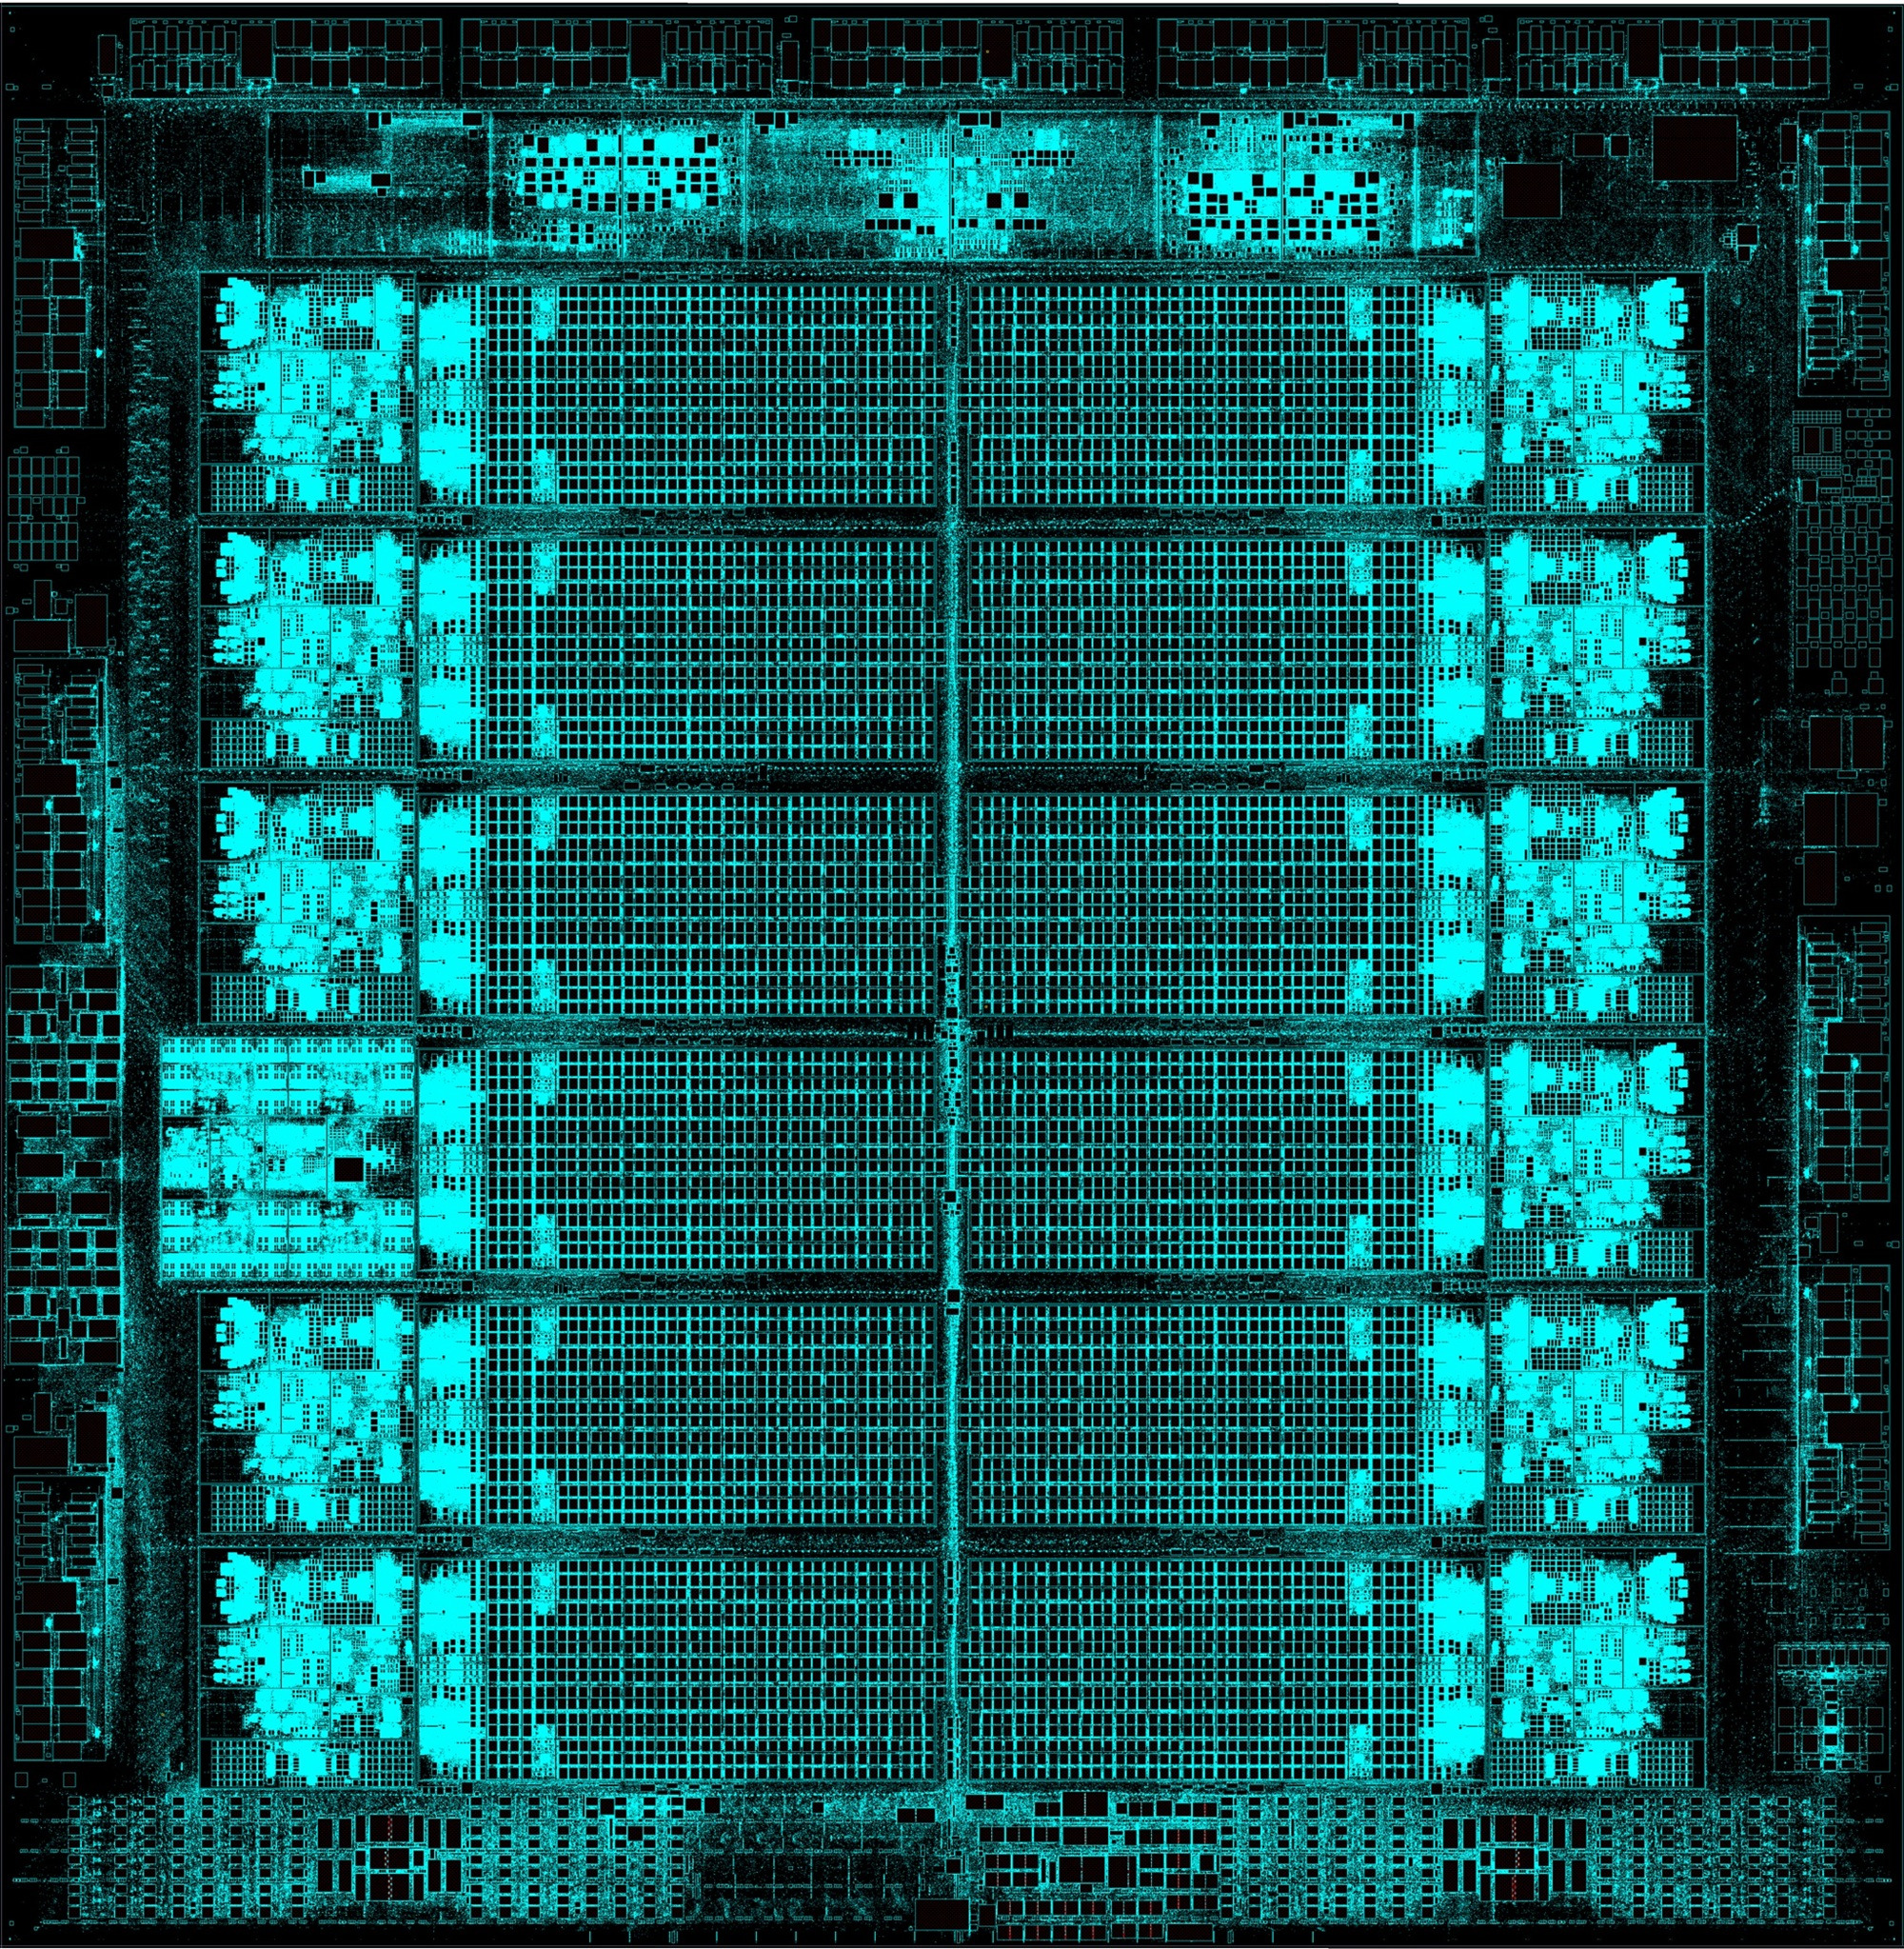
Источник изображения: IBM 2-нм процессор будет содержать 11 доступных двухпоточных (SMT 2) ядер, работающих на частоте более 5,7 ГГц, ускорители ИИ-инференса, специально разработанные для обнаружения мошенничества в финансовых транзакциях в режиме реального времени, выделенный встроенный DPU для ускорения I/O и большую кеш-архитектуру для ресурсоёмких корпоративных рабочих нагрузок с большими частными кешами L2 объёмом по 36 Мбайт, из которых формируются виртуальные L3/L4-кеши. Как отметил ресурс ServeTheHome, виртуальный L3 даёт 432 Мбайт, в то время как L4, объединяя все кеши всех ядер, обеспечит до 3,5 Гбайт памяти с очень низкой задержкой, что полезно для корпоративных рабочих нагрузок, таких как обработка транзакций и обслуживание баз данных. 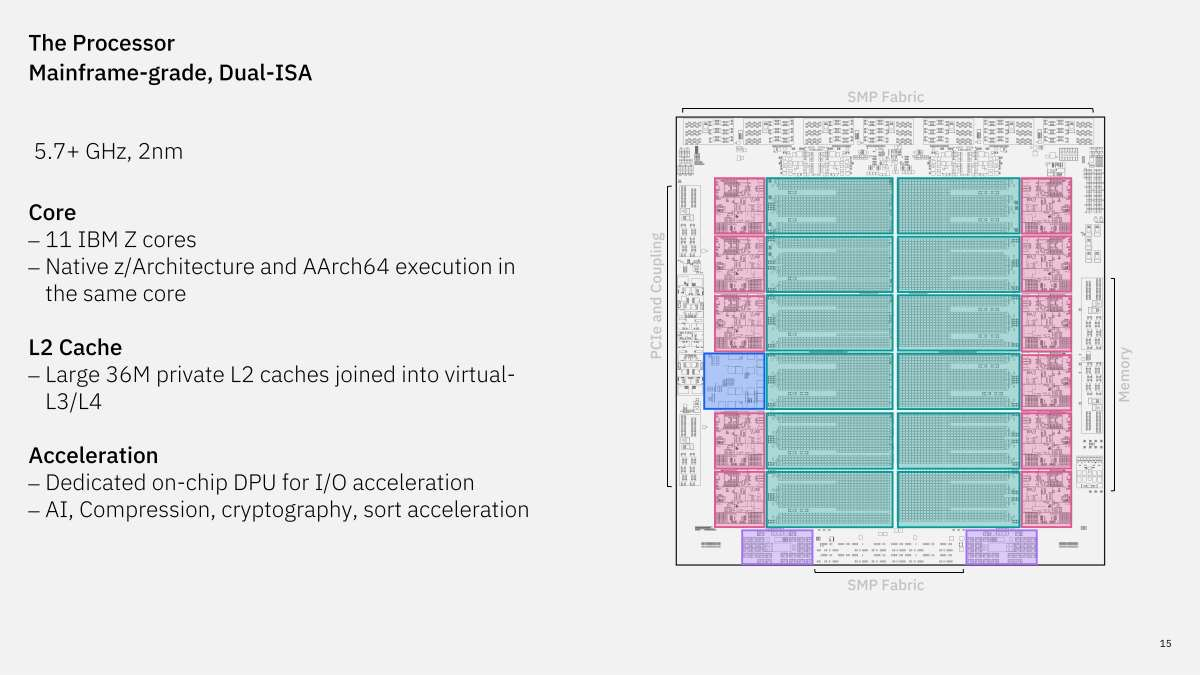
Источник изображений: IBM/ServeTheHome Компания отметила, что архитектура чипа не предусматривает отдельных ядер Arm и IBM: каждое процессорное ядро может одновременно выполнять инструкции Arm и IBM Z, или Arm и LinuxONE, отдавая приоритет установленным характеристикам платформы: производительности, безопасности, шифрования и доступности. Платформы IBM Z и LinuxONE способны масштабироваться до сотен ядер и десятков терабайт памяти. Подчёркивается, что ключевым моментом является то, что IBM реализовала AArch64 на аппаратном уровне, а не путём трансляции. В этом проекте используется реализация Arm с порядком байтов little-endian поверх архитектуры z/Architecture с порядком байтов big-endian. Заявлена поддержка Armv9.3, SVE и SVE2 — всего 2792 инструкции, что более чем в два раза больше, чем z-инструкций. IBM также заявляет о соответствии стандарту Arm SystemReady, что важно для совместимости с имеющимся ПО. Приложения Arm видят собственный полноценный процессор Arm, работая без изменений «из коробки». 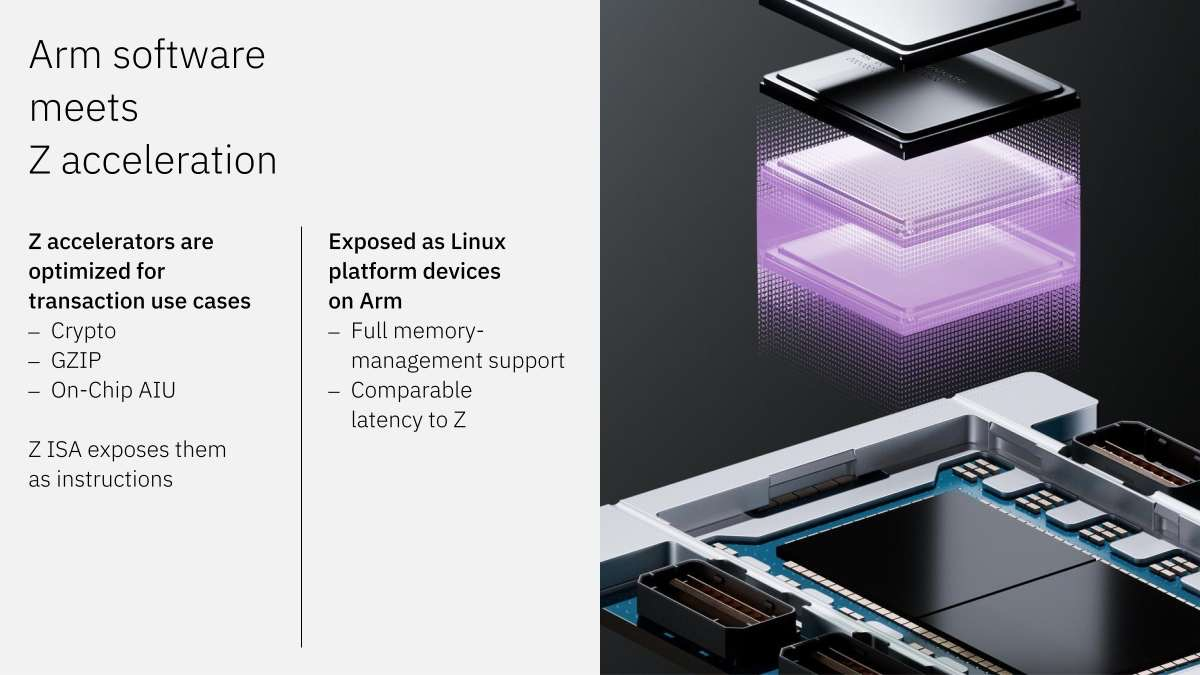 IBM говорит, что новый чип эффективно объединит две крупнейшие в мире вычислительные экосистемы, которые до сих пор были изолированы друг от друга. Мейнфреймы IBM z и системы LinuxONE составляют основу мировой экономики, обрабатывая, по оценкам аналитиков, около 70 % всех финансовых транзакций в мире, а также огромные объёмы данных в сфере здравоохранения. В свою очередь, программную экосистему Arm поддерживает более 22 млн разработчиков по всему миру. Она охватывает широкий и постоянно растущий спектр облачных и периферийных приложений, включая облачное ПО и ПО для ИИ. Предсказатель ветвлений демонстрирует, как существующая конструкция ядра IBM z может использоваться и для AArch64. Используется XML-описание архитектуры Arm для автоматического декодирования инструкций, диспетчеризации и отправки на исполнение. Переиспользуется возможность переименования регистров и основные пути исполнения инструкций, а также некоторые CISC-решения вроде копирования и очистки памяти. Но разработчиком всё равно пришлось добавить новые элементы управления для SVE, а также пути исполнения для FP16/Bfloat16 и криптографических функций. 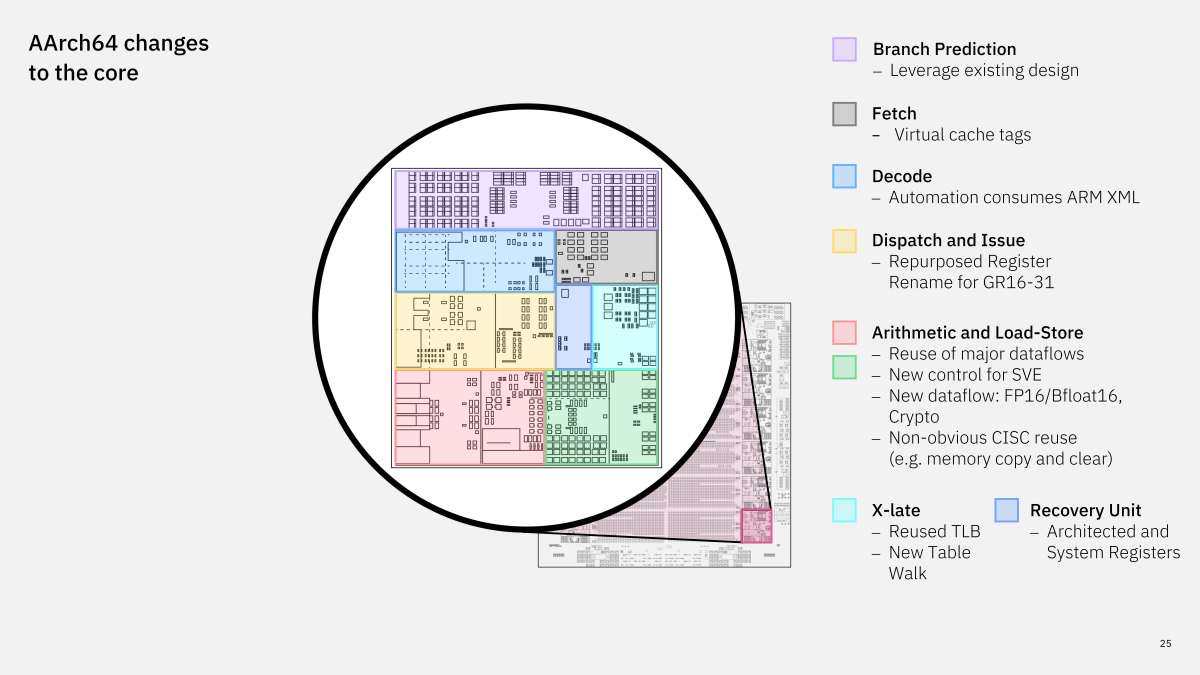 Встроенные ускорителям для криптографии, сжатия и инференса отображаются для Arm ПО представляются в качестве платформенных устройств в Linux на Arm. При этом процессор способен одновременно выполнять инструкции обеих ISA с сохранением сквозной проверки массивов и потоков данных/управления, прозрачного восстановления после нерегулярных сбоев, резервирования/замещения ядер при постоянных сбоях, параллельного восстановления и технологии аппаратной защиты оперативной памяти RAIM. Эта конструкции обеспечивает надёжность с целевым показателем доступности 99,999999 %. 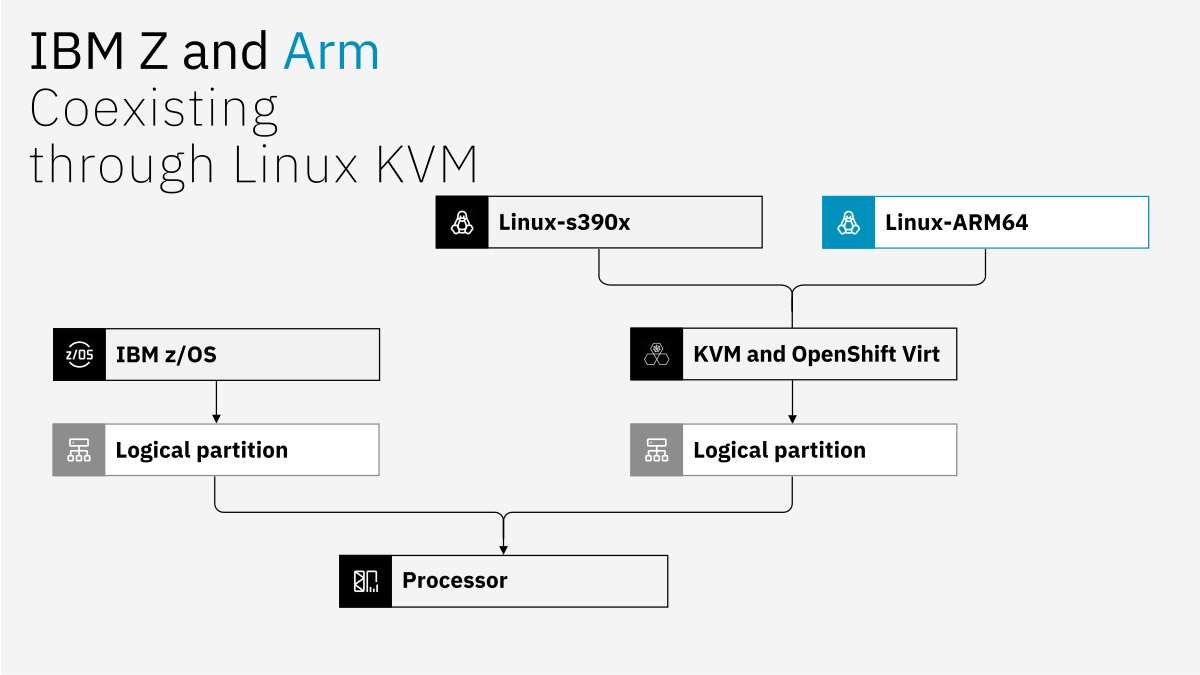 На программном уровне для запуска Linux-приложений для обеих архитектур используются KVM и OpenShift, которые, как нативные приложения z/OS, используют логически разделы, работающие на одном физическом процессоре. А каждый поток может работать как с инструкциями s390x, так и с Arm, при этом переключение занимает наносекунды. Такое сосуществование является залогом получения наилучших результатов от обеих программных экосистем, позволяя клиентам сохранять код для мейнфреймов, одновременно используя широкую базу ПО Arm, пишет SiliconANGLE. Дополнит новый CPU ускоритель ИИ-инференса второго поколения, который ориентирован на более крупные корпоративные рабочие нагрузки. Он содержит 16 активных ИИ-ядер (и одно резервное) с поддержкой FP4 и MXFP4, которые, по словам IBM, могут обеспечить четырёхкратное увеличение TOPS. Он получит 96 Гбайт HBM3e с ПСП до 4 Тбайт/с и PCIe 6.0 в качестве интерфейса одноранговой сети с низкой задержкой. IBM позиционирует чип как компонент для критически важных ИИ-систем, обеспечивающий надёжные вычисления, защищающие данные и модели в состоянии покоя, при передаче и использовании, в том числе с использованием криптографии с квантовой защитой. 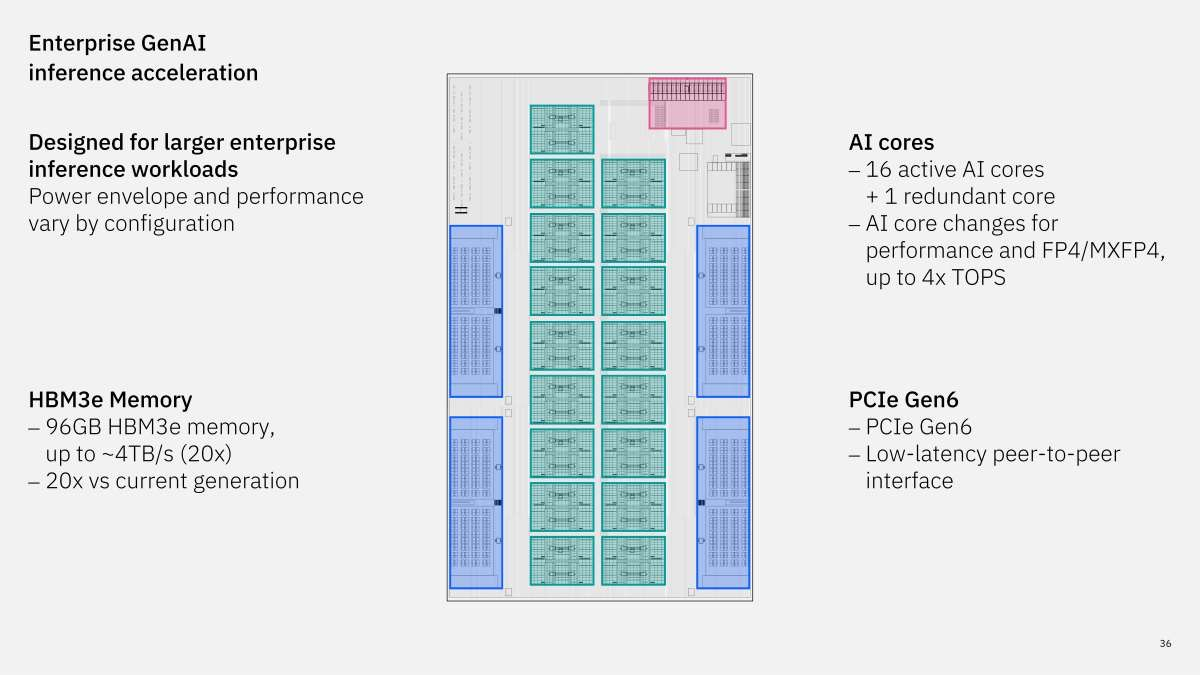 Как пишет SiliconANGLE, финансовые компании, работающие в условиях жёсткого регулирования, не могут отказаться от использования мейнфреймов и LinuxONE, известных своей исключительной безопасностью и надёжностью. Но для доступа к программной экосистеме Arm им приходилось отказываться от систем IBM. Новый чип меняет положение дел. «Этот процессор представляет собой значительный архитектурный прогресс для IBM z и LinuxONE, — сказал Кристиан Якоби (Christian Jacobi), главный технический директор и научный сотрудник IBM Systems Development. — Внедряя Arm непосредственно в наши платформы, мы объединяем доступ к одной из самых быстрых программных экосистем в отрасли с качествами, которые сделали системы IBM основой для ведения бизнеса». Двухпроцессорная архитектура IBM и Arm потенциально может способствовать новой волне внедрения ИИ компаниями в отраслях с жёстким регулированием. Вскоре разработчики смогут писать код для Arm и развёртывать его непосредственно на мейнфреймах, так что устаревшие аппаратные системы IBM останутся актуальными ещё долгие годы. Сообщается, что новый процессор будет доступен для клиентов в 2028 году. Это не первая попытка IBM скрестить две ISA в одном чипе. В 1994 году компания анонсировала процессор PowerPC 615, который объединил бы x86 и PPC, причём на уровне сокета он был совместим именно с Pentium-платформами, что, как ожидала IBM, привлечёт многочисленных производителей ПК. На деле чип поддерживался только Minix и особой версией OS/2, тогда как Microsoft отказалась участвовать в развитии ПО для него, а MacOS на нём, по-видимому, никто запускать и не собирался. В результате чип так и остался прототипом.
14.08.2026 [15:20], Владимир Мироненко
Круг замкнулся: Groq присоединилась к программе NVIDIA Cloud PartnerКомпания Groq, основная часть сотрудников которой перешла в NVIDIA в результате сделки стоимостью $20 млрд, объявила о присоединении к программе NVIDIA Cloud Partner (NCP). В качестве партнёра NCP компания Groq сертифицирована для проектирования, развёртывания и эксплуатации в любом регионе мира систем на базе ускорителей NVIDIA в соответствии со стандартами производителя чипов. Groq отметила, что после заключения неисключительного соглашения о лицензировании технологий обработки данных с NVIDIA и её участия в недавнем раунде финансирования, сертификация NCP формализует сотрудничество двух компаний. Компания сообщила, что статус облачного партнёра NVIDIA позволит ей повысить уровень комплексной поддержки клиентов, поскольку она сможет оснащать свои существующие ЦОД новейшими технологиями NVIDIA. Идёт ли речь исключительно об ускорителях LPU или о GPU тоже, не уточняется. Для масштабируемой обработки данных требуется глубокая интеграция по всему стеку — от вычислительных ресурсов и сетей до ПО и операций, отметила Groq. «Поэтому это сотрудничество важно: оно объединяет наши компании в понимании того, как должна строиться и эксплуатироваться современная инфраструктура ИИ», — добавила она. NVIDIA в рамках сделки не досталось облако GroqCloud, на обслуживание которого в формально до сих пор независимой Groq было оставлено минимум персонала. 
Источник изображения: Groq Groq заявила, что, управляя ЦОД в Северной Америке, Европе, на Ближнем Востоке и в Азиатско-Тихоокеанском регионе, а также обеспечивая более 6 млн разработчиков и тысячам компаний в сфере ИИ возможность создания приложений в GroqCloud, генерируя триллионы токенов каждую неделю, она является единственной в мире компанией с практическим опытом масштабного развёртывания и управления LPU. «Мы масштабируемся до более чем 200 МВт по мере роста спроса на обработку данных», — отметила компания. «Стать облачным партнёром NVIDIA — это естественный следующий шаг в нашем сотрудничестве с NVIDIA. Это подтверждает то, что наши клиенты уже знают: Groq управляет инфраструктурой ИИ по самым высоким стандартам в любой точке мира. Инференс становится крупнейшим и наиболее важным уровнем ИИ, и мы намерены управлять им лучше, чем кто-либо другой», — заявил генеральный директор Groq.
07.08.2026 [16:50], Владимир Мироненко
AMD купила разработчика ИИ-ускорителей TaalasAMD объявила о достижении окончательного соглашения о приобретении Taalas, канадского разработчика ускорителей для ИИ-инференса из Торонто. Финансовые подробности сделки не раскрываются. С момента основания в 2023 году Taalas привлекла в общей сложности $219 млн венчурных инвестиций в рамках трёх раундов финансирования, включая последний на $169 млн в феврале этого года. AMD сообщила, что технология Taalas дополнит полнофункциональную ИИ-платформу AMD, включая стоечные решения Helios, Instinct, EPYC, ROCm и расширяющуюся экосистему ИИ компании. Покупая Taalas, компания AMD решает те же задачи, что и NVIDIA при покупке Groq за $20 млрд в декабре прошлого года, говорят аналитики: сделать высокопроизводительные «премиальные» сервисы инференса, востребованные для ИИ-агентов, быстрее и дешевле в использовании. Taalas разрабатывает чипы, ориентированные на конкретные ИИ-модели, что обеспечивается путём прямой интеграции их весов в «кремний» вместе со значительным объёмом высокоскоростной памяти SRAM. 
Источник изображения: AMD Этот подход отличается от традиционных решений для инференса, которые полагаются на универсальные GPU. При этом он позволяет снизить задержку и вычислительные затраты за счёт устранения необходимости обращения к внешней памяти во время процесса инференса. Ресурс The Register отметил, что Taalas не раскрывает принцип работы своих чипов, но известно, что они состоят из двух основных областей: микросхемы памяти с маской (Mask-ROM), где вытравливаются веса модели, и собственно SRAM, где хранятся KV-кеши и т.д. Что важно, технология Taalas — это не просто концептуальная разработка. В феврале компания представила свой первый тестовый чип HC1, изготовленный по 6-нм техпроцессу TSMC с площадью кристалла 815 мм2, который содержит 53 млрд транзисторов. Первоначальные тесты показали, что чип обрабатывает Meta✴ Llama 3.1 8B со скоростью 16 960 токенов в секунду — на момент анонса в феврале прошлого года это было в 48 раз быстрее, чем NVIDIA H200, и в 8,5 раза быстрее, чем ускорители Cerebras. 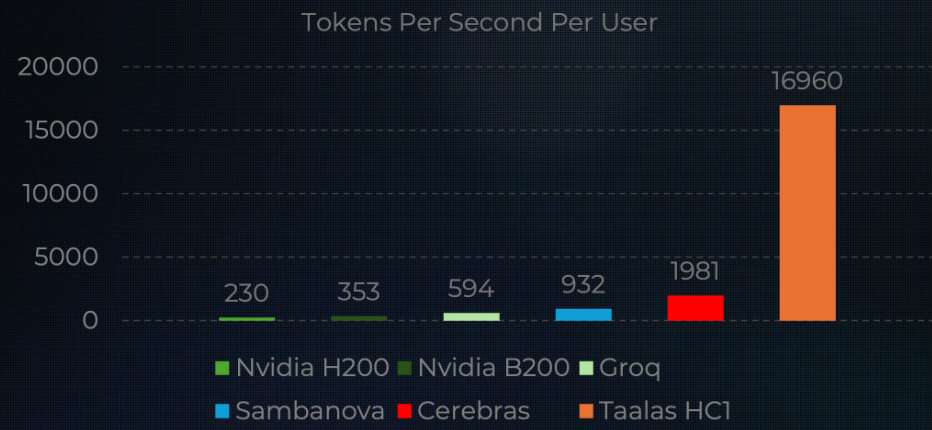
Источник изображения: Taals Taalas разработала совместно с TSMC оптимизированный для литографического производства рабочий процесс, который позволяет клиентам перейти от весов моделей к развёртываемым PCIe-картам, работающим с реальным инференсом, примерно за два месяца, говорит генеральный директор Taalas Любиша Байич (Ljubisa Bajic), о чём пишет ресурс CNBC. Это значительно быстрее по сравнению с традиционными циклами разработки заказных чипов, что делает кастомные кремниевые микросхемы более доступными для компаний, которые ранее не могли позволить себе разработку ASIC из-за высокой стоимости. В чипе HC2 второго поколения, который должен выйти этим летом, Taalas планирует увеличить количество параметров ИИ-модели до 20 млрд. При обработке больших ИИ-моделей, как и при использовании GPU, веса просто распределяются между несколькими ускорителями с использованием конвейерного параллелизма. Таким образом, для модели с 1 трлн параметров понадобится всего 50 ускорителей HC2, и у AMD как раз есть вычислительная платформа стоечного масштаба и собственная команда разработчиков систем. Это решение компактнее и энергоэффективнее NVIDIA LPX, для работы которого потребуется несколько десятков GPU и как минимум 2000 LPU Groq, отметил The Register. 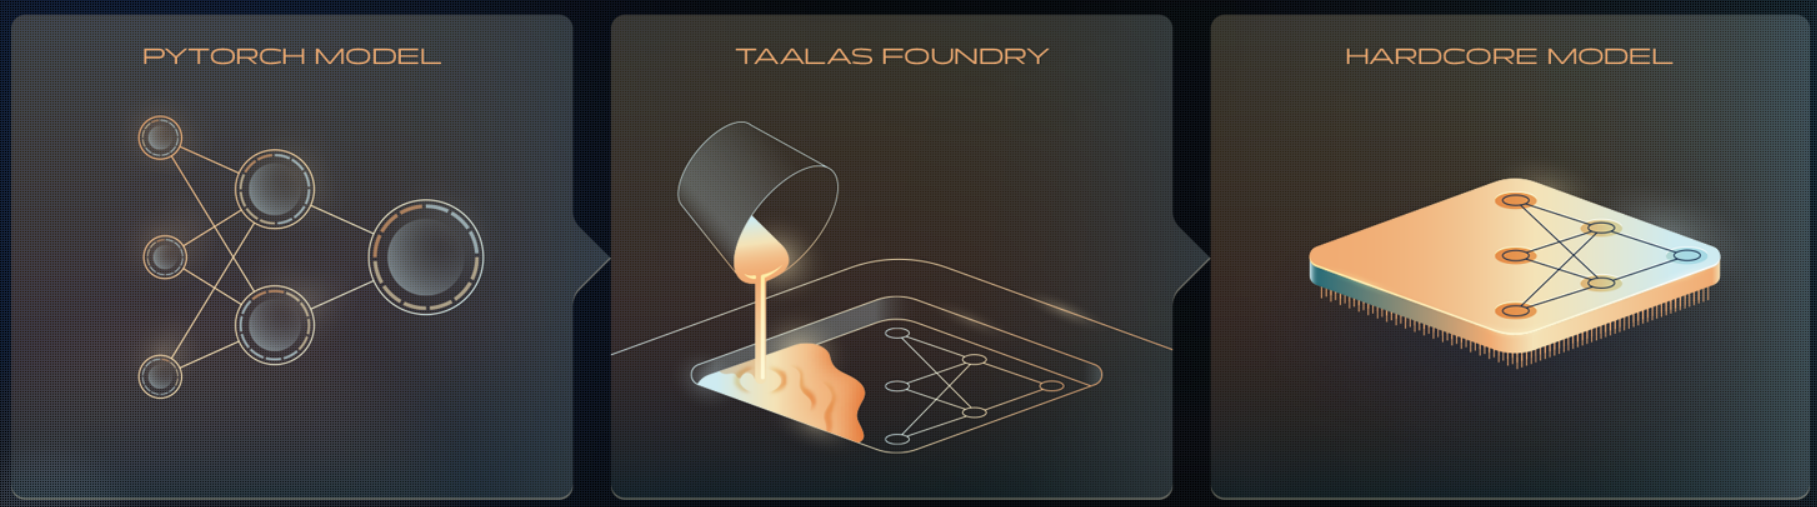
Источник изображения: Taals Альтернативные чипы, разработанные Taalas и Groq, особенно важны для приложений с «низкой задержкой», где время до первого ответа от ИИ-модели имеет большое значение. «Я твёрдо убеждена, что в отношении чипов нет универсального решения», — заявила генеральный директор AMD Лиза Су (Lisa Su) в июле. Она добавила, что AMD прогнозирует, что GPU будут и дальше составлять большую часть рынка ИИ-чипов, поскольку они достаточно гибкие, чтобы поддерживать новые ИИ-модели. Впрочем, AMD недавно заключила соглашение с Cerebras, которое тоже ориентировано на сверхбыстрый инференс. Разрабатывая чип специально для конкретной модели, компания жертвует гибкостью ради эффективности. Специализация позволяет сократить рабочую нагрузку, переведя её в более прямой поток данных, что снижает вычислительные и оперативные издержки, присущие универсальным решениям. Но стойку, построенную для использования одной модели, нельзя просто перенастроить при изменении модели. Это делает подход Taalas наиболее привлекательным для стабильного, высокопроизводительного инференса, который, по словам AMD, является наиболее быстрорастущим сегментом ИИ-рынка. При этом Taalas утверждает, что изменение весов, размеров матрицы и других важных параметров требует изменения всего двух слоев маски. Это означает, что даже если для каждой модели потребуется много разных чипов, количество дорогостоящих масок, которые необходимо будет изготовить, намного меньше, чем если бы, например, пришлось изготавливать два разных GPU, пишет ServeTheHome.
05.08.2026 [00:34], Владимир Мироненко
Samsung запустила в Южной Корее NPUaaS на базе ИИ-ускорителей FuriosaAI RNGDКомпания Samsung SDS запустила в Южной Корее сервис NPU-as-a-Service (NPUaaS) с использованием ИИ-ускорителей RNGD южнокорейского стартапа FuriosaAI. Теперь они доступны в облачной платформе Samsung, пишет Data Center Dynamics. Как утверждает компания, это первый сервис в стране с использованием этих чипов. ИИ-ускорители RNGD, построенные на 5-нм архитектуре Tensor Contraction Processor (TCP), обеспечивают вычислительную мощность 512 Тфлопс в режиме FP8 при TDP в пределах 180 Вт. Сервер может включать до восьми ускорителей RNGD, что позволяет его использовать для задач агентного ИИ. «Предоставление RNGD через Samsung SDS обеспечивает предприятиям новый способ развёртывания инфраструктуры для ИИ-инференса без необходимости управления соответствующим оборудованием», — сообщил Джун Пайк (June Paik), генеральный директор FuriosaAI. 
Источник изображения: developer.furiosa.ai Samsung SDS развернула чипы RNGD в своем ЦОД Dongtan IDC в Донтане (Dongtan) и уже виртуализировала сервер NXT RNGD от FuriosaAI, предоставляя доступ к инстансам в конфигурациях по запросу с 1, 2, 4 или 8 картами. ЦОД Dongtan IDC занимает шесть этажей и включает четыре серверных зала. Благодаря использованию естественного воздушного охлаждения его показатель PUE составляет 1,12.
04.08.2026 [17:31], Сергей Карасёв
ASUS выпустила «ИИ-брелок» UGen300 USB AI с ускорителем Hailo-10H и 8 Гбайт RAMКомпания ASUS начала продажи внешнего ИИ-ускорителя UGen300 USB AI, предназначенного для использования с ноутбуками, смартфонами, одноплатными компьютерами и пр. Новинка выполнена в виде USB-брелока, который можно подключать к устройствам с архитектурой x86 и ARM под управлением Linux, Windows и Android. В основу UGen300 USB AI положен чип Hailo-10H, обеспечивающий ИИ-производительность до 40 TOPS в режиме INT4 и до 20 TOPS на операциях INT8. Объём встроенной памяти LPDDR4-4266 равен 8 Гбайт. Заявленное энергопотребление — 2,5 Вт. Подключение осуществляется через порт USB 3.1 Type-C (10 Гбит/с). Габариты составляют 105 × 50 × 18 мм, масса — 150 г. Ускоритель даёт возможность локально запускать небольшие LLM, VLM и другие модели генеративного ИИ, снижая зависимость от облачных сервисов. Отсутствие необходимости передачи данных на удалённые серверы повышает уровень кибербезопасности, говорит ASUS. Говорится о совместимости с популярными фреймворками, включая Keras, TensorFlow, TensorFlowLite, PyTorch и ONNX. 
Источник изображений: ASUS Приобрести ИИ-ускоритель UGen300 USB AI можно по ориентировочной цене в $300. Готовится также более доступный вариант изделия, оборудованный 2 Гбайт RAM, однако эта модификация пока недоступна для заказа. Среди потенциальных сфер применения названы обучение навыкам работы с ИИ, создание прототипов различных ИИ-устройств и разработка сервисов с нейросетевыми алгоритмами, такими как компьютерное зрение, обнаружение объектов, классификация изображений и пр. 
25.07.2026 [21:30], Сергей Карасёв
ИИ-платформа Liqid UltraStack объединяет 30 ускорителей AMD Instinct MI350PКомпания Liqid объявила о стратегическом сотрудничестве с AMD, направленном на создание решений следующего поколения для ИИ-инфраструктур. В рамках партнёрства представлена аппаратная платформа Liqid UltraStack 30, оптимизированная для задач инференса. В состав системы входят сервер с двумя процессорами AMD EPYC 9005 Turin и коммутатор Liqid PCIe Fabric Switch. Ключевыми компонентами являются три GPU-блока, каждый из которых содержит десять ускорителей AMD Instinct MI350P (144 Гбайт памяти HBM3E с 4096-бит шиной). Таким образом, в общей сложности задействованы 30 названных карт и 4,3 Тбайт памяти HBM3E. Заявленная производительность достигает 69 Пфлопс в режиме FP8. Говорится о возможности работы с общими пулами памяти по высокоскоростному стандарту CXL. Суммарное энергопотребление платформы находится на уровне 22 кВт. По заявлениям Liqid, система обеспечивает 3,7-кратный прирост показателя токенов в секунду по сравнению с традиционными решениями. Количество токенов в пересчете на $1 увеличивается в 2,1 раза, а токенов на 1 Вт затрачиваемой энергии — в 1,8 раза. Затраты на развёртывание могут быть уменьшены на 65 %. 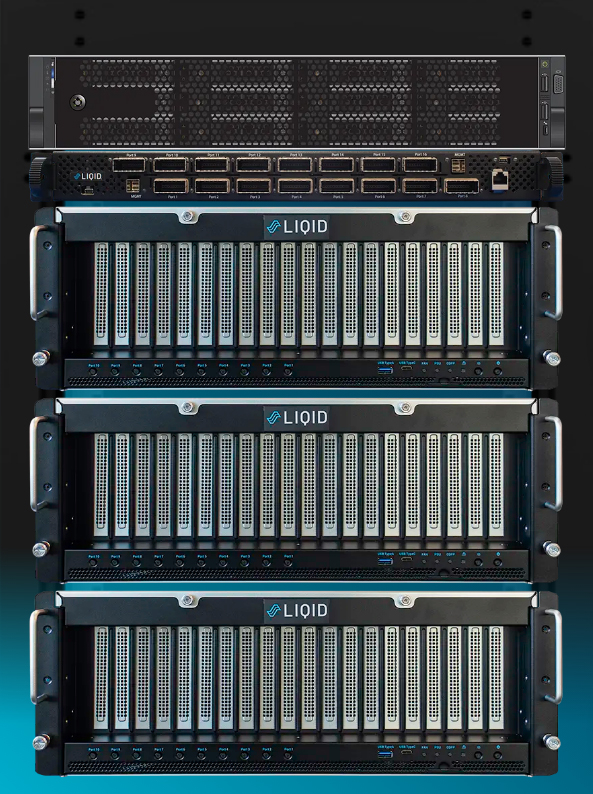
Источник изображения: Liqid Программное обеспечение Liqid Matrix объединяет GPU-ускорители и в реальном времени распределяет их ресурсы между рабочими нагрузками через высокоскоростную PCIe-шину. При этом все карты остаются в пределах одного узла. В целом, платформа Liqid UltraStack 30, как утверждается, устраняет накладные расходы, связанные с использованием нескольких узлов, обеспечивает предсказуемое линейное масштабирование и доводит загрузку GPU почти до 100 %. Упомянута поддержка Kubernetes для работы с несколькими моделями.
24.07.2026 [11:58], Сергей Карасёв
AMD и Cerebras представили платформу для ИИ-инференса со сверхнизкой задержкойКомпании AMD и Cerebras Systems объявили о сотрудничестве, в раках которого планируется вывод на рынок новой аппаратной платформы для ИИ-инференса со сверхнизкой задержкой и высокой пропускной способностью. Речь идёт об объединении стоечных решений AMD Helios и ускорителей Cerebras Wafer-Scale Engine (WSE). Это своего рода ответа на интеграцию Groq в платформу NVIDIA Vera Rubin. Напомним, система Helios двойной ширины объединяет процессоры EPYC Venice с ядрами Zen 6, ускорители Instinct MI400 и DPU Vulcano. Данная платформа спроектирована специально с прицелом на ресурсоёмкие ИИ-задачи. В свою очередь, изделия WSE, насчитывающие сотни тысяч ядер, оптимизированы для сверхбыстрого обучения и запуска ИИ-моделей. Совместное решение AMD и Cerebras объединяет сильные стороны Helios и WSE в общий рабочий процесс для достижения максимальной производительности и эффективности инференса. В частности, формируется дезагрегированная среда, в которой два основных этапа задачи оптимизируются независимо друг от друга. Стойки Helios обеспечивают сверхвысокую пропускную способность, обрабатывая запросы и большие контекстные окна. Ускорители WSE при этом отвечают за генерацию токенов с минимальной задержкой. 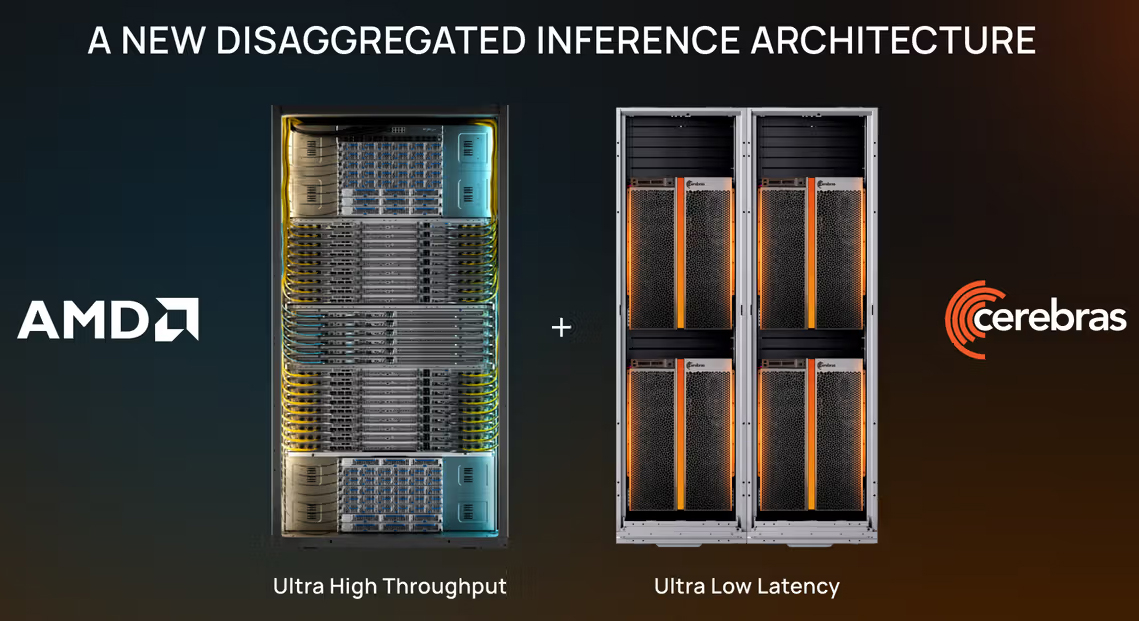
Источник изображения: Cerebras В целом, новая платформа AMD и Cerebras, как утверждается, даёт возможность повысить показатель токенов в секунду на ватт (Т/с/Вт) в пять раз по сравнению с конфигурациями, в которых используются только лишь изделия WSE (при работе с мультимодальной моделью Kimi 2.6 1T, насчитывающей 1 трлн параметров). В рамках партнёрства с AMD компания Cerebras намерена развернуть системы Helios в своих дата-центрах. Новое аппаратное решение станет доступно клиентам через облако Cerebras Cloud во II половине текущего года.
21.07.2026 [13:14], Руслан Авдеев
Google создаёт ИИ-ускоритель Frozen v2, оптимизированный специально для GeminiКомпания Google работает над новым ИИ-ускорителем под неформальным названием Frozen v2, который позволит интегрировать элементы ИИ-модели Gemini непосредственно в «железо», что позволит эффективнее исполнять ИИ-нагрузки, сообщает The Information. Чип, как ожидается, поможет разрешить проблему нехватки вычислительных мощностей для ИИ, уже заставившую Google Cloud отказаться от сделок с клиентами. По имеющимся данным, Google намерена начать внедрение новых чипов в 2028 году, хотя работы над новой архитектурой продолжаются. Кроме того, пока неизвестно, какая часть модели будет «прошита» в аппаратной составляющей. Предполагается, что чипы могут быть в 6–10 раз эффективнее, чем новейшие TPU, в пересчёте на количество токенов на Вт. При этом новые чипы призваны дополнить TPU, а не заменить их. По словам представителя Google Cloud, команды компании постоянно занимаются исследованиями и экспериментируют с инновационными решениями. Проектируя аппаратное и программное обеспечения с нуля, компания обеспечивает интеграцию и высокую степень оптимизации систем. 
Источник изображения: Google Как сообщает Silicon Angle, чипы, предлагаемые «по умолчанию», обычно включают компоненты, которые клиентам не нужны вовсе. Например, использование традиционных GPU для инференса делает ненужными блоки рендеринга. Разработка кастомных чипов помогает решить проблему. Компания может исключить ненужные модули, тем самым снижая цену производства, или же заменить ненужные элементы на модули, оптимизированные для специальных задач. Повышенная эффективность будет достигнута разными способами. В частности, в компании рассчитывают, что Froxen v2 позволит снизить количество вычислений для Gemini. Также ожидается снижение масштабов перемещения данных. Google может оснастить Frozen v2 достаточным количеством памяти для запуска Gemini полностью на чипе. Подобный дизайн избавил бы от необходимости отправлять данные к RAM и обратно.
09.07.2026 [16:51], Владимир Мироненко
Parasail скрестила NVIDIA Hopper и Blackwell с d-Matrix Corsair, ускорив инференс в 10 разКомпании Parasail и d-Matrix объявили о развёртывании кастомных ускорителей d-Matrix Corsair для инференса вместе с ускорителями NVIDIA Hopper и Blackwell в рамках гетерогенной дезагрегированной инфраструктуры, что позволит в 10 раз увеличить скорость инференса. В объединённой системе ускорители NVIDIA и Corsair будут работать согласованно, выполняя вычислительные задачи с учётом их возможностей. Чтобы улучшить экономику инференса для отдельных рабочих нагрузок, Parasail использует GPUтA для ресурсоёмкого предварительного заполнения, а ускорители d-Matrix Corsair — для чувствительного к задержке декодирования. К этому же стремится и сама NVIDIA, добавившая к своим GPU ускорители Groq. 
Источник изображения: Parasail Parasail управляет облаком для инференса, которое объединяет мощности ИИ-ускорителей в более чем 40 ЦОД в 15 странах. Разработанная ею технология автоматической оптимизации позволяет динамически распределять рабочие нагрузки между гетерогенным парком исходя из требований к моделям и обработке. Parasail делает ставку на гетерогенный вычислительный подход с d-Matrix, чтобы получить больше выгоды от уже имеющейся у неё ИИ-инфраструктуры NVIDIA. d-Matrix утверждает, что сочетание Corsair с GPU позволяет выполнять задачи инференса на порядок быстрее, втрое дешевле и впятеро энергоэффективнее, сообщил TNW. Ресурс отметил, что вместо борьбы с потенциальными конкурентами NVIDIA предлагает им сотрудничество, чтобы интегрировать их в свою экосистему. Заказчикам больше не нужен один гигантский GPU для всего. Они хотят получить самый дешевый чип для каждой задачи, объединённый с другими чипами в единую систему. План NVIDIA состоит в том, чтобы обеспечить продажи или занять место рядом с тем продуктом, который одержит победу, пишет TNW.
07.07.2026 [23:59], Владимир Мироненко
Китайская DeepSeek скрытно занимается разработкой собственного ИИ-ускорителя для инференсаКитайский стартап DeepSeek работает над созданием собственного чипа для ИИ-инференса, что позволит ему снизить зависимость от NVIDIA и Huawei, чьи ускорители используются для обучения и запуска его ИИ-моделей, сообщило агентство Reuters со ссылкой на информированные источники. По данным источников, работа DeepSeek над этим проектом началась около года назад и пока находится на ранней стадии: сейчас стартап ведёт переговоры с компаниями, занимающимися проектированием чипов, производством микросхем и памяти. В последние месяцы он увеличил найм инженеров-разработчиков микросхем, причём набор ведётся в частном порядке, без особой огласки и без размещения вакансий на публичных платформах. Для DeepSeek эта инициатива имеют дополнительное стратегическое измерение, поскольку США ввели экспортные ограничения на поставку китайским компаниям передовых чипов NVIDIA, а власти Китая оказывает давление на местные компании, продвигая разработку и внедрение отечественных альтернатив. 
Источник изображения: He Junhui/unsplash.com DeepSeek не единственная компания, кто стремится снизить зависимость от NVIDIA, доминирующей на рынке ИИ-чипов. Помимо гиперскейлеров Amazon (Trainium), Alibaba (Zhenwu), Google (TPU), Meta✴ (MTIA) и Microsoft (Maia), расширяющих использование собственных чипов, ещё ряд компаний предпринимает шаги в этом направлении. Например, в прошлом месяце OpenAI представила Jalapeño, свой первый кастомный чип для инференса, разработанный совместно с Broadcom. Anthropic тоже рассматривает возможность создания собственных ИИ-чипов. |
|

