
Материалы по тегу: цод
|
23.10.2026 [16:25], Руслан Авдеев
NVIDIA научилась разворачивать ИИ-ЦОД за две недели вместо полугодаNVIDIA представила эталонную архитектуру DSX Pod — модульного контейнерного ИИ-ЦОД, оснащаемого семью стойками Vera Rubin NVL72, а также необходимым для работы сетевым, охлаждающим и электротехническим оборудованием. Компания утверждает, что такая архитектура позволяет сократить время развёртывания ЦОД на заранее подготовленной площадке примерно с шести месяцев до двух недель, сообщает Datacenter Knowledge. Анонсированное в ходе мероприятия GTC Berlin модульное решение рассчитано на организации, которым требуется быстро ввести в эксплуатацию большие вычислительные мощности без длительного планирования, строительства и значительных трудозатрат, характерных для реализации обычных ИИ-проектов. NVIDIA заявила, что сотрудничает с 17 партнёрами, включая Bull, Dell Technologies, HPE, Lenovo, Eaton, Schneider Electric и Vertiv. Они начнут поставлять варианты решений на основе DSX Pod в начале 2027 года. По словам представителя NVIDIA, речь идёт о полностью собранном и протестированном контейнерном решении со стандартизированным вводом питания на 800 В постоянного тока (DC) и заранее смонтированными трубопроводами. Это строительный блок для будущих ИИ-фабрик. NVIDIA сообщает, что сама компания разрабатывает и проверяет эталонную архитектуру, а партнёры производят контейнеры, интегрируют оборудование, адаптируют системы электроснабжения и жидкостного охлаждения, а также устанавливают и обслуживают готовые комплексы. Речь идёт не об универсальном готовом продукте NVIDIA, а о проектной основе для решений разных вендоров. 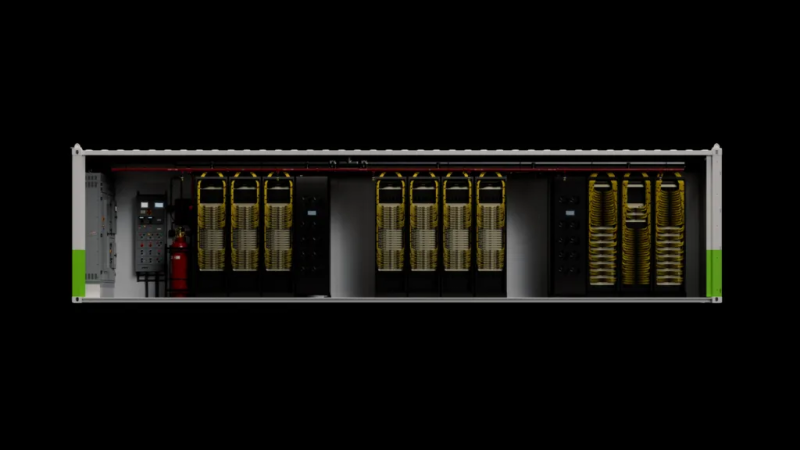 Хотя архитектура была представлена в Берлине, в компании подчеркнули, что контейнерный эталонный проект предназначен для внедрения по всему миру. Местом проведения мероприятия GTC Berlin выбрали Берлин, поскольку руководство NVIDIA считает модульную инфраструктуру быстрого развёртывания важным фактором развития ИИ в Европе. В компании подчеркнули, что решение разработано для организаций, желающих быстрее вводить в эксплуатацию сотни мегаватт вычислительных мощностей, упростив этот процесс по сравнению с реализацией обычных проектов. По мнению экспертов IDC, DSX Pod подходит для трёх сценариев развёртывания. Его можно использовать в суверенных проектах, требующих физической изоляции оборудования, в небольших ИИ-проектах для выполнения специализированных задач, а также для периферийных ИИ-вычислений — там, где необходимы комплексные решения для ускоренных вычислений «под ключ». Для удовлетворения спроса на ИИ-инфраструктуру NVIDIA и её партнёры по цепочке поставок намерены в следующие три года увеличить производственные мощности по выпуску подложек в 2,5 раза, а к 2028 году — нарастить мощности по передовому корпусированию более чем на 300 %. Кроме того, к середине 2027 года планируется увеличить объёмы производства оптических модулей на основе технологии интегрированной оптики Co-Packaged Optics (CPO) в 15 раз, а к концу 2028 года — дополнительно удвоить этот показатель. В ходе мероприятия компания также представила программное обеспечение и механизмы безопасности для масштабных ИИ-проектов. В частности, была представлена эталонная архитектура OpenShell Reference Architecture, призванная помочь организациям управлять ИИ-агентами. Она позволяет определять, к каким ресурсам могут обращаться агенты, отслеживать их активность и принудительно обеспечивать соблюдение заданных политик при выявлении небезопасного поведения. В компании рассказали, что архитектура объединяет инфраструктуру NVIDIA Vera Rubin NVL72 для обучения и инференса с системами на базе процессоров NVIDIA Vera, которые обеспечивают работу и управление средой выполнения ИИ-агентов. Между этими системами располагаются DPU BlueField, выполняющие функции изолированного средства контроля безопасности. Последние анализируют сетевой трафик и позволяют обновлять политики безопасности, в том числе отключая агента при выявлении его небезопасного поведения. По данным NVIDIA, среди компаний, использующих OpenShell Reference Architecture для повышения безопасности при работе с ИИ-агентами, — Anthropic, AWS, Google Cloud, Meta✴, Microsoft, OpenAI и Perplexity.
23.10.2026 [13:38], Руслан Авдеев
Era4 раскрыла подробности о гигаваттном ЦОД гиперскейл-уровня на месте бывшего металлургического завода в УэльсеБританский оператор ЦОД Era4 раскрыл новые подробности о планах по превращению бывшего металлургического завода в Ньюпорте (Newport, Уэльс) в кампус ИИ-ЦОД мощностью до 1 ГВт, сообщает Datacenter Dynamics. По данным компании, первую очередь строительства в рамках проекта The Mill («Мельница») на площадке Liberty Steel введут в эксплуатацию в следующем году. Весной сообщалось, что компания получила разрешение на застройку соответствующей площадки и планировала разместить модули дата-центра внутри существующих зданий. По информации Era4, площадку площадью 93 га обеспечат 1 ГВт электроэнергии. Предполагается размещение до 400 тыс. ускорителей NVIDIA Vera Rubin. Пока неизвестно, какая мощность будет доступна после ввода в эксплуатацию первой очереди проекта. В Era4 утверждают, что электричество будет подаваться из различных источников на основе долгосрочных контрактов, «не оказывающих негативного влияния на местное сообщество или промышленность». Предполагается использовать в ЦОД замкнутую систему охлаждения с минимальным расходом воды. Liberty Steel по-прежнему эксплуатирует производственный объект на этой площадке, но здание, выделенное под ЦОД, в настоящее время уже не используется. Era4 намерена сохранить кирпичную трубу предприятия, чтобы поддержать связь нового объекта с промышленным прошлым площадки. 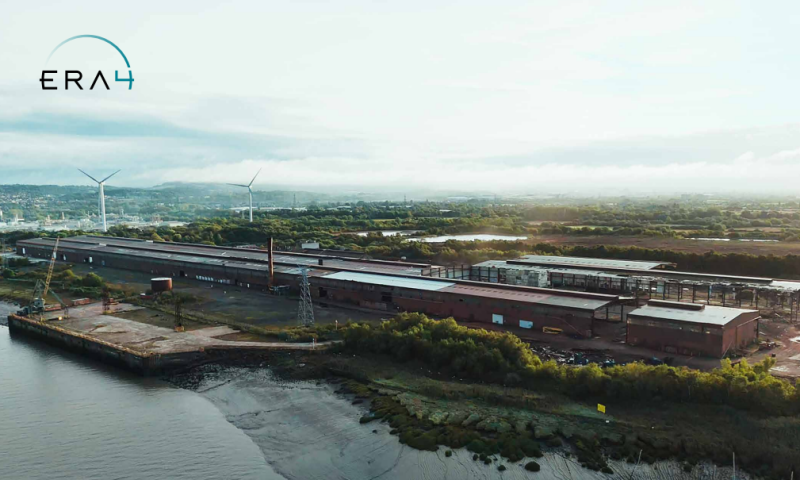
Источник изображения: Era4 Основанная в 2025 году Carbon3.ai была переименована в Era4 не так давно. Компания раскрыла подробности о создании общенациональной ИИ-инфраструктуры в сентябре того же года, рассказав, что в перспективе та будет включать 100 тыс. ИИ-ускорителей. Также сообщалось о намерении развернуть ИИ-мощности в более чем 30 локациях. В ноябре 2025 года компания представила планы создания модульного ИИ ЦОД в графстве Дербишир (Derbyshire), а в декабре она сообщила о подписании соглашения о развёртывании ИИ-инфраструктуры на основе NVIDIA Blackwell Ultra в составе серверов HPE с прямым жидкостным охлаждением. Предложение компании о строительстве площадки на острове Англси (Anglesey, Уэльс) отклонили, однако она предложила альтернативную площадку в графстве Кент (Kent). Энергоснабжение там предполагается обеспечить за счёт газа, выделяющегося на мусорных полигонах. В сентябре 2026 года Era4 объединила усилия с британской компанией Civo для запуска суверенного ИИ-облака. В том же месяце британская Barbour ABI сообщала, что портфолио обязательств по строительству дата-центров в Великобритании выросло до 173 проектов и более 14 ГВт мощностей. Основным драйвером является спрос на ИИ и намерение реализовать крупные проекты в Шотландии и на северо-востоке Англии.
23.10.2026 [13:01], Павел Котов
Казахстан расширит мощности ИИ ЦОД на чипах NVIDIAКазахстан продолжает наращивать свою вычислительную базу, планируя развёртывание инфраструктуры на архитектуре NVIDIA Vera Rubin. Движущей силой на данном этапе роста выступают компании, изначально ориентированные на отрасль искусственного интеллекта. Казахстанская экосистема ИИ переходит от этапа планирования инфраструктуры к её практическому развёртыванию. Процесс охватывает весь арсенал технологий ИИ от проектирования инфраструктуры и моделей до конечных приложений. Firebird, построившая свою ИИ-фабрику в Армении, расширяет своё присутствие в Казахстане. Компания получила от властей США экспортную лицензию на поставку 45 тыс. GPU NVIDIA Grace Blackwell — первый этап проекта реализуется совместно с «Казахтелекомом» в «Долине ЦОД»; коммерческий запуск намечен на III квартал 2027 года. На втором этапе планируется довести совокупную мощность инфраструктуры Firebird в Казахстане примерно до 500 МВт. Компания намерена создать подразделение Firebird Labs Kazakhstan для поддержки местных ИИ-стартапов, проведения исследований и развития кадрового потенциала. Для реализации проекта задействуют механизмы финансирования, обеспечения доступа к вычислительным ресурсам и научно-исследовательское партнёрство. 
Источник изображения: nvidia.com «Казахтелеком», крупнейший телекоммуникационный оператор в стране, уже развернул 400 GPU NVIDIA H200 и 480 единиц NVIDIA B300 в Астане и Алматы. В следующем году компания планирует разместить более 1000 GPU в «Долине ЦОД» и ещё более 1000 GPU в составе платформы NVIDIA Vera Rubin в районе Экибастуза. Эта инфраструктура позволит выполнять широкий спектр задач и будет доступна для предприятий и разработчиков. Специализирующиеся на ИИ местные компании также активно наращивают свои мощности и разрабатывают на них прикладные решения. Это даёт возможность обучать, донастраивать и эксплуатировать всё более совершенные модели. Успешные приложения формируют дополнительный спрос на вычислительные ресурсы. Перспективы развития казахстанской отрасли ИИ определяются не только числом GPU. Важна интеграция этой инфраструктуры с разработчиками, университетами, стартапами и различными отраслями экономики. Это помогает конвертировать вычислительные мощности в полезные прикладные решения. Представленные планы охватывают различные уровни этой экосистемы: развёртывание инфраструктуры, доступ к мощностям и разработку изначально созданных с расчётом на ИИ продуктов. Ранее Akashi Data Center рассказала о планах построить в Казахстане Tier IV ЦОД мощностью 100 МВт. В минувшем году стало известно о намерении запустить в стране самый мощный суперкомпьютер в Центральной Азии. С Россией обсуждается план проложить интернет-кабель по дну Каспийского моря.
23.10.2026 [11:49], Руслан Авдеев
Nebius арендует до 50 МВт в дата-центре в городе будущего Неом в Саудовской АравииNebius договорилась об аренде мощностей в ЦОД на территории плавучего района Oxagon, расположенного в «городе будущего» Неом (Neom) в Саудовской Аравии. Соглашение с компанией подписала саудовская ИИ-группа Humain и строитель/оператор дата-центров DataVolt, сообщает Datacenter Dynamics. Неооблачный провайдер Nebius станет якорным клиентом кампуса. На начальном этапе компания арендует до 50 МВт из 100 МВт мощностей строящегося объекта. Поэтапный ввод в эксплуатацию запланирован на IV квартал 2027 года. Строительство Oxagon стартовало в сентябре 2026 года. На первом этапе планируется создать 360 МВт мощностей, а весь кампус должен обеспечить 1,5 ГВт. Oxagon представляет собой шестиугольный искусственный район в юго-западной части технологического мегапроекта Неом, представленного наследным принцем Мухаммедом бин Салманом (Mohammed bin Salman) в 2017 году. Oxagon будет сдавать территорию в аренду DataVolt для строительства ЦОД и обеспечит оператору инфраструктурную поддержку. По некоторым данным, площадка будет обеспечиваться энергией от ветрогенераторов и солнечных электростанций. Nebius планирует разместить в арендованном ЦОД вычислительную инфраструктуру на основе решений NVIDIA для удовлетворения растущего спроса на свои сервисы. 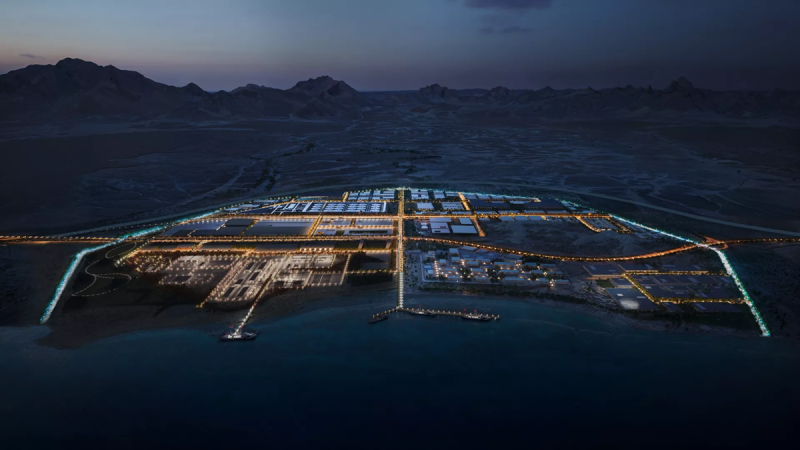
Источник изображения: Humain По словам представителя DataVolt, всего за шесть недель с начала строительства компания достигла продвинутого этапа переговоров с Nebius. Сообщается, что в Oxagon создаётся крупномасштабная инфраструктура с особым вниманием к обеспечению высокой конкурентоспособности затрат. Благодаря сочетанию энергетических преимуществ Саудовской Аравии и чёткой организации реализации проектов компания помогает создать площадку, способную на равных конкурировать на мировом рынке ИИ-вычислений. Это позволит королевству стать не только поставщиком энергоресурсов, но и поставщиком «цифровых мощностей». Nebius использует инфраструктуру ЦОД в США, на Ближнем Востоке и в Европе. Помимо действующего дата-центра в Мянтсяля (Mäntsälä) в Финляндии, компания арендует или намерена арендовать мощности в Великобритании — в Лондоне у Ark DC и Kao Data, в Уэльсе у Vantage. Во Франции речь идёт о ЦОД Equinix в Париже, также в Израиле, в Исландии, в Финляндии в Лаппенранте (Lappeenranta); в США — в Вайнленде (Vineland), шт. Нью-Джерси, у DataOne и в Канзас-Сити (Kansas City), шт. Миссури, у Patmos. Кроме того, Nebius заключила договоры об аренде мощностей с Volt в Нидерландах, а также AIB Data Centers в США. У компании есть и собственные строительные проекты. Она намерена построить ЦОД в Индепенденсе (Independence) близ Канзас-Сити, шт. Миссури, а также готовит гигаваттный проект в Пенсильвании. Nebius строит ЦОД мощностью 240 МВт и в Бетюне (Béthune) на севере Франции.
22.10.2026 [17:25], Павел Котов
Nebius привлекла $3,5 млрд от Citi на развитие сети ЦОДОблачный провайдер Nebius объявил о получении кредитной линии в размере $3,5 млрд от банка Citi. Средства будут направлены на дальнейшее развитие ЦОД и закупку GPU — компания стремится нарастить свои вычислительные мощности максимально быстро. Это сообщение появилось на фоне недавнего массового падения акций компаний, связанных с инфраструктурой для ИИ, напоминает Reuters. Инцидент был спровоцирован резко подешевевшими облигациями CoreWeave — конкурента Nebius. CoreWeave, как и Nebius, относят к числу ведущих представителей сегмента неооблачных провайдеров, которые специализируются на создании ЦОД для нужд ИИ. Срок погашения новой кредитной линии составляет 364 дня, а процентная ставка установлена на уровне 2,75 % от уровня базовой SOFR. 
Источник изображения: Nebius Финансирование обеспечит гибкость в выборе сроков и структуры привлечения капитала для обеспечения роста в 2027 году и в дальнейшем, отметили в компании. Другими источниками финансирования выступают предоплата от клиентов и операционный денежный поток. У Nebius есть и другие возможности для привлечения средств, в том числе получение кредитов под обеспечение будущими поступлениями по долгосрочным контрактам с заказчиками, у которых высокий кредитный рейтинг, отметил операционный директор Nebius Офир Наве (Ophir Nave). Общая сумма таких контрактов составляет $40 млрд, среди заказчиков значатся Microsoft и Meta✴. Nebius выступает приоритетным облачным провайдером у Palantir. Оператор ЦОД выпустил облигации на $5 млрд для расширения парка дата-центров и ИИ-ускорителей. Компания активно расширяется в Европе, строя и арендуя ЦОД в Эстонии, Финляндии и Великобритании.
22.10.2026 [17:05], Владимир Мироненко
GitHub перевела 99,99999 % репозиториев в облако AzureGitHub объявила о переносе 99,99999 % репозиториев в Azure. «За последний год, на фоне экспоненциального роста трафика Git, 99,99999 % репозиториев GitHub стали размещаться одновременно в двух местах: в наших собственных дата-центрах и в Azure. Оставшиеся репозитории — одни из самых активно используемых на платформе, и их переносу мешает лишь один фактор: задержка в 25 мс при обмене данными (round trip)», — сообщила компания. Компания объяснила сроки и формат перехода «агентным сдвигом» (agentic shift): стремительным ростом трафика, жёсткими ограничениями по энергопотреблению в её дата-центрах и прилегающих регионах, а также физическими трудностями в цепочках поставок. Рост трафика, генерируемого программными агентами, повысил нагрузку на критически важные сервисы (уровень Tier 0), обеспечивающие основные операции с репозиториями. 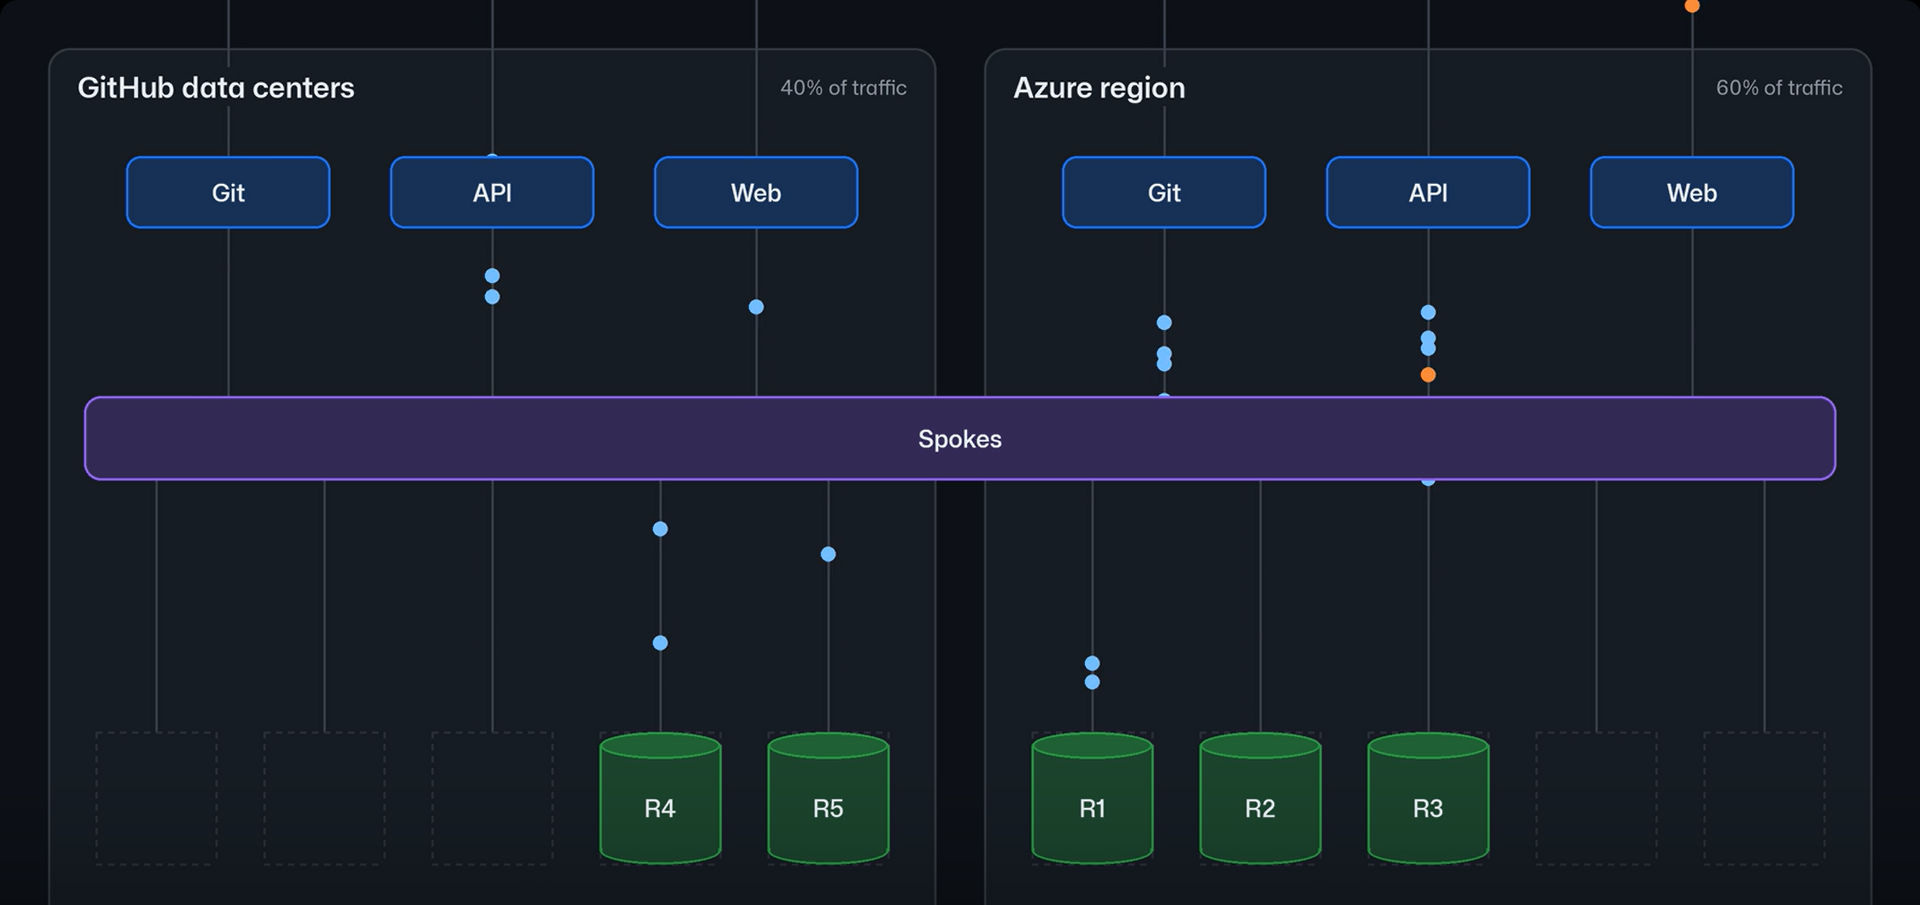
Источник изображения: GitHub Учитывая масштаб системы и её критическую важность для сообщества, GitHub тщательно выстроила последовательность действий, решив сначала перенести данные, сервисы и все сопутствующие зависимости, а затем, после их перемещения, развивать архитектуру. Первая копия репозитория была размещена в регионе Azure Central US в августе 2025 года. На данный момент у большинства репозиториев две из пяти реплик находятся в Azure, и на долю этой платформы приходится около половины всего трафика Git. На протяжении большей части этого периода Azure брала на себя растущую нагрузку, в то время как собственные дата-центры GitHub сохраняли стабильные показатели. При этом GitHub опиралась на два принципа: минимизацию координации и отделение хранилища от вычислительных ресурсов. В GitHub описывают эту работу как «мост» между текущей архитектурой (системой Spokes) и следующей моделью хранения данных. Для большинства репозиториев GitHub создаёт пять реплик, распределнных по разным регионам и зонам доступности. Сервис Spokes использует механизм предпочтительной маршрутизации, направляя каждый запрос к реплике, находящейся в том же регионе и зоне доступности, что и источник запроса. По мере переноса реплик в Azure доля трафика, обслуживаемого этой платформой, увеличивается — до тех пор, пока не будет перемещена последняя реплика, после чего старый регион полностью перестает получать запросы. В текущей архитектуре репозиторий, размещённый более чем в одном регионе, имеет более низкий предел пропускной способности для операций записи. Для их подтверждения системе Spokes требуется большинство реплик, при этом кворум ожидает ответа от каждой исправной реплики вплоть до истечения времени ожидания (тайм-аута). Задержка при записи определяется самой медленной из исправных реплик. Поскольку на время выполнения записи накладывается блокировка всего репозитория, эта задержка также ограничивает максимальную пропускную способность репозитория. Если одна из реплик оказывается в целевом регионе Azure — на расстоянии около 1600 км от дата-центров GitHub, — каждый цикл обмена данными по сети (round trip) занимает примерно 25 мс, а для выполнения записи требуется несколько таких циклов. Если репозиторий уже работает на пределе своей пропускной способности, он не сможет «поглотить» эти дополнительные временные затраты при каждой записи, в результате чего очередь операций push начнёт расти. Здесь вступает в силу принцип минимизации координации. В данном случае это означает: не стоит сериализовать (выполнять строго последовательно) те операции, которые в этом не нуждаются. В связи с этим меняется область действия кворума: теперь он распространяется не на весь репозиторий целиком, а на отдельные ссылки. Запись с привязкой к конкретной ссылке (ref) сохраняет порядок операций, требуемый Git. Git предполагает наличие опредёленной последовательности событий для каждой ссылки (ветки или тега): как только сервер принимает новое значение, клиент видит либо это значение, либо более позднее. Между независимыми ссылками требования к согласованности отсутствуют. При сериализации на уровне отдельных ссылок (per-reference serialization) ожидание репозитория, то есть его временная блокировка, требуется только в тех случаях, когда операции записи затрагивают одну и ту же общую ссылку. На практике большинство операций записи в репозиторий направлено на разные ссылки. Когда агенты и разработчики работают с разными ветками, их операции больше не блокируют друг друга. Хотя каждая операция записи по-прежнему подвержена задержкам, связанным с передачей данных между регионами, операции с разными ссылками могут выполняться параллельно. Такой подход устраняет необходимость в единой очереди для всего репозитория, сохраняя при этом гарантии согласованности, на которые полагаются клиенты Git. По данным внутреннего тестирования было зафиксировано, что при записи в разные ссылки пропускная способность возрастает в 3–4 раза, а задержки при этом снижаются. В большинстве репозиториев соотношение операций чтения к записи составляет от 100:1 до 1000:1. В текущей архитектуре реплик GitHub чтение и запись выполняются на одних и тех же вычислительных ресурсах, из-за чего они конкурируют за память и процессорное время, что исключает возможность их независимого масштабирования. Новая архитектура предусматривает разделение мощностей для чтения и записи, благодаря чему для каждой задачи можно задать собственную конфигурацию. На первом этапе объектное хранилище включается в состав кворума в качестве «виртуальной реплики записи» (virtual write replica) — временного узла, который передаёт входящие данные записи в Azure Blob Storage, но не обслуживает запросы на чтение. Spokes включает этот узел в кворум и отправляет подтверждение записи клиенту после того, как данные будут надёжно сохранены в объектном хранилище. Виртуальная реплика записи также объединяет транзакции, затрагивающие независимые ссылки, в единый пакет сетевых операций ввода-вывода при обращении к объектному хранилищу. Благодаря этому для активно используемого репозитория вместо отдельного сетевого запроса на каждую операцию записи выполняется лишь один запрос для целого ряда одновременных операций. На текущем этапе виртуальная реплика записи также отвечает за процесс уплотнения данных (compaction), а реплики чтения (read replicas) получают уже уплотнённое состояние. Использование виртуальных реплик записи позволяет по мере необходимости масштабировать систему, создавая любое количество виртуальных реплик чтения. Каждая такая реплика наполняет свой кеш данными из Azure Blob Storage и начинает обслуживать запросы на чтение, не становясь участником кворума. Единственным достоверным источником данных выступает объектное хранилище, с которым реплика в фоновом режиме согласовывает своё локальное состояние. Поскольку синхронизация проходит в фоновом режиме, реплики подходят не для всех типов рабочих нагрузок, связанных с чтением. Для поддержки любых видов операций чтения процесс синхронизации должен быть переведён в синхронный режим (in-line): реплика должна запрашивать только те данные и состояния, которые изменились с момента её последней синхронизации. Компания отметила, что, несмотря на эти изменения, кворум по-прежнему остаётся ограничивающим фактором для дальнейшего роста. GitHub утверждает, что Spokes обрабатывает более 100 млрд операций в день, и предупреждает, что его протокол фиксации изменений (commit protocol) не сможет обеспечить работу сервиса с миллиарда репозиториев до следующего миллиарда. Сегодня Spokes представляет собой интеллектуальный уровень маршрутизации и балансировки нагрузки, единый API, через который внутренние сервисы получают доступ к данным репозиториев, а также набор фоновых процессов — так называемых «чистильщиков» (sweepers), — которые управляют размещением репозиториев, их восстановлением и перераспределением между узлами хранения. Компания отметила, что после реализации этих шагов следующим ограничивающим фактором станет пропускная способность операций записи. Каждая операция записи по-прежнему зависит от реплик, каждая из которых хранит полную копию репозитория, хотя лишь малая часть данных, записываемых в репозиторий, требует строгого упорядочивания. Объекты Git неизменяемы и идентифицируются по своему содержимому, поэтому их можно сохранять без необходимости достижения консенсуса между узлами. Остаётся лишь небольшой объём данных, и самая сложная задача — упорядочить их максимально быстро, не создавая при этом «узкого места» в другом звене системы. Как ожидается, подробности о финальной версии архитектуры платформы компания сообщит на GitHub Universe.
22.10.2026 [15:14], Руслан Авдеев
Горсовет Мемфиса отклонил 18-месячный мораторий на строительство ЦОД — ограничения ввели на 135 днейПредложение ввести мораторий на строительство дата-центров в Мемфисе (Memphis, штат Теннесси) на 18 месяцев было отклонено местным городским советом. Вместо этого власти приняли решение ввести 135-дневную «паузу» в рассмотрении новых заявок на строительство ЦОД, сообщает Datacenter Dynamics. Такое ограничение по времени отчасти совпадает с 90-дневным исследованием, заказанным в начале октября мэром Полом Янгом (Paul Young). Оно призвано оценить влияние проектов цифровой инфраструктуры на Мемфис. Возможность введения 18-месячного моратория обсуждалась несколько недель. Ранее в октябре сообщалось, что местные законодатели отложили голосование по этому вопросу после заседания с участием общественности, завершившегося протестами и драками возле зала заседаний совета. В итоге голоса разделились поровну, хотя один из членов совета отсутствовал. Вместо предложенного моратория был поддержан альтернативный вариант, предусматривающий запрет на строительство на более короткий срок. По результатам исследования предполагается выработать «чёткие практические рекомендации» по регулированию деятельности крупных и сверхкрупных дата-центров в Мемфисе. Местные СМИ сообщали, что на заключительном заседании присутствовали сотни жителей города, в том числе те, кому ранее запретили присутствовать на заседаниях из-за нарушений правил во время встречи 6 октября. Суд счёл такой запрет необоснованным. 
Источник изображения: Joshua J. Cotten/unsplash.com Хотя рынок ЦОД в Мемфисе относительно небольшой, на территории города есть несколько крупных объектов xAI Илона Маска (Elon Musk), влившейся в SpaceXAI/SpaceXSI. Данные ЦОД, обеспечивающие работу ИИ Grok и облачных сервисов, в т.ч. для Anthropic, строились на протяжении последних двух лет. Объекты неоднократно становились предметом судебных исков. Например, НКО и экологи заявляли, что компания нарушила условия выданных на использование газовых турбин разрешений. Эти турбины в своё время позволили компании быстро ввести ЦОД в эксплуатацию, а позже она «исправилась», хотя по существу изменилось немногое. Хотя в Мемфисе растёт противодействие строительству ЦОД, некоторые члены городского совета утверждают, что введение моратория нанесёт ущерб экономическому развитию региона: операторы дата-центров перенаправят инвестиции в другие места, где и будут платить налоги. Один из ЦОД Маска уже разместили в соседнем штате Миссисипи (Mississippi), в непосредственной близости от административной границы с Теннесси. Моратории на новые ЦОД всё чаще вводят в США на фоне усиления общественного недовольства новыми ИИ-проектам и строительству инфраструктуры дата-центров. В некоторых случаях моратории вводятся на уровне штатов, а порой общественное недовольство выливается не только в потасовки и не обходится без стрельбы.
22.10.2026 [10:56], Сергей Карасёв
Gartner: мировые затраты на дата-центры в 2026 году взлетят более чем на 70 %Компания Gartner опубликовала свежий прогноз по глобальному IT-рынку на текущий и следующий годы. Отрасль демонстрирует быстрый рост, а ключевым драйвером остается ИИ, который стимулирует инвестиции в вычислительные инфраструктуры, облачные платформы и передовые программные экосистемы. По оценкам, в 2026-м объём рынка достигнет $6,39 трлн, увеличившись на 14,5 % по отношению к предыдущему году. В эту сумму включены расходы на дата-центры, электронные устройства, ПО корпоративного класса, IT-сервисы, телекоммуникационные сервисы и решения IaaS. Наибольший рост ожидается в области ЦОД — плюс 73,8 % в годовом исчислении с итоговым результатом около $879 млрд в 2026-м. Аналитики подчёркивают, что за последние 12 месяцев огромный спрос на оборудование со стороны операторов дата-центров привёл к более чем двукратному росту цен на память: это вызвало цепную реакцию в каналах поставок СХД, серверов, сетевого оборудования, ПК и прочих устройств. Как следствие, цены пошли вверх. Эксперты полагают, что наблюдающаяся тенденция сохранится до 2027 года, после чего стоимость оборудования начнёт стабилизироваться. 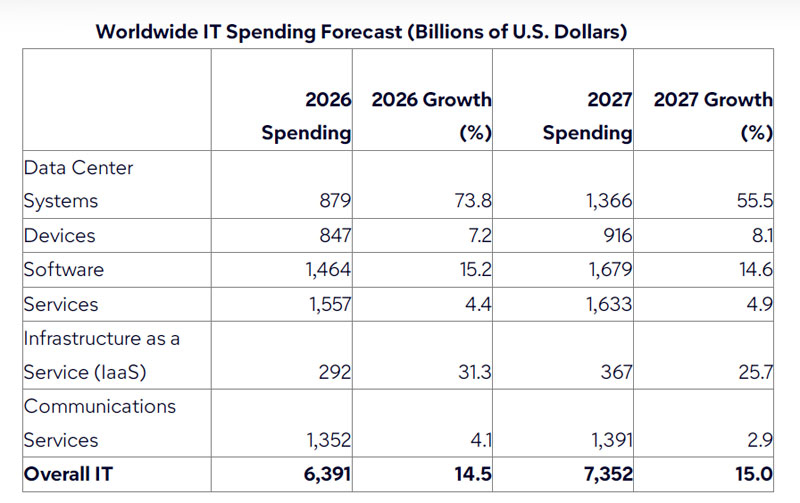
Источник изображения: Gartner Самый существенный вклад в общий объём рынка вносят IT-сервисы с прогнозируемым результатом $1,56 трлн в 2026 году и ростом на 4,4 %. Программные продукты, по оценкам, обеспечат $1,46 трлн (плюс 15,2 % по отношению к 2025-му), телекоммуникационные сервисы — $1,35 трлн (плюс 4,1 %). Ещё $847 млрд придётся на электронные устройств (плюс 7,2 %), $292 млрд — на платформы IaaS (плюс 31,3 %). В 2027 году объём глобального IT-рынка, по мнению экспертов Gartner, впервые в истории превысит отметку в $7 трлн, составив $7,35 трлн. Это будет соответствовать росту на 15 % по сравнению с предыдущим годом. В сегменте дата-центров затраты поднимутся на 55,5 % — до $1,37 трлн. Софт корпоративного класса принесёт $1,68 трлн, IT-сервисы — $1,63 трлн, телекоммуникационные сервисы — $1,39 трлн, электронные устройства — $916 млрд, решения IaaS — $367 млрд.
22.10.2026 [00:33], Руслан Авдеев
К 2030 году доходы рынка малых ЦОД в России достигнут 14,2 млрд рублейСогласно новому отчёту аналитической группы J’son & Partners Consulting, посвящённому динамике развития российского рынка малых ЦОД вместимостью до 50 стоек, доходы этого рынка к 2030 году достигнут 14,2 млрд руб. при среднегодовых темпах роста 26,8 %. Малые ЦОД активно используются государственными структурами, крупными корпорациями, а также средним и малым бизнесом. Такие объекты подходят как для построения геораспределённых сетей, так и для реализации приложений в отдельных локациях удалённых регионов России. По оценкам экспертов, в 2025 году объём мирового рынка малых ЦОД составил $7,8 млрд, а к 2035 году достигнет $53,6 млрд при среднегодовых темпах роста 21,8 %. На такие дата-центры будет приходиться 6,6 % общемировых доходов от ЦОД (в 2025 году этот показатель составлял лишь 2,6 %). Сегодня в России насчитывается более 450 действующих малых ЦОД. Доходы российского рынка малых ЦОД в 2025 году составили 4,4 млрд руб., а к 2030 году, как ожидается, вырастут до 14,2 млрд руб. При этом около 40 % объёма рынка приходится на дополнительные услуги, включая проектно-изыскательские и строительно-монтажные работы, транспортировку, поддержку и сервис. Другими словами, в цепочке продаж значительную роль играют интеграторы, выступающие непрямым каналом сбыта для производителей малых ЦОД и их собственных фронт-офисов. 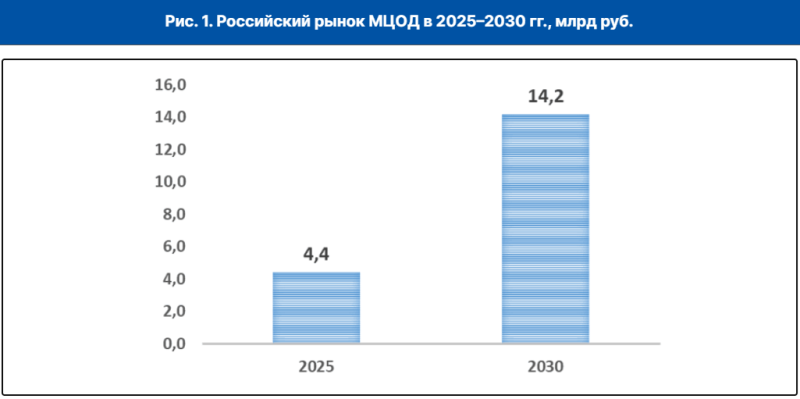
Источник изображения: J’son & Partners Consulting Крупнейшими потребительскими сегментами по числу малых ЦОД являются:
К преимуществам малых ЦОД относится универсальность базовых решений, подходящих для удалённых подразделений крупных компаний, малого и среднего бизнеса, государственных учреждений, систем здравоохранения и образования, а также городских служб. В формате малых ЦОД обычно предлагаются модульные решения, позволяющие последовательно наращивать вычислительные ресурсы и объём инвестиций по мере роста потребностей. Также малые дата-центры, по словам авторов доклада, можно подключать «в любой точке магистральных, региональных и локальных сетей ВОЛС», формируя геораспределённые системы передачи и обработки данных как национального, так и местного масштаба с возможностью интеграции с крупными дата-центрами головных офисов компаний. Наконец, в России реализуется национальный проект «Экономика данных и цифровая трансформация государства», рассчитанный на 2025–2030 годы. Кроме того, в стране действуют отраслевые программы цифровизации в различных сферах. Например, как заявил заместитель президента — председателя правления ПАО «Ростелеком» Валерий Ермаков на форуме РБК Tech, в нынешних условиях российским компаниям необходимы резервные ЦОД «судного дня» для быстрого восстановления сервисов.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо), либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты обучения моделей, таких как Muse Spark и последняя версия Muse Wonder, от аппаратных сбоев. 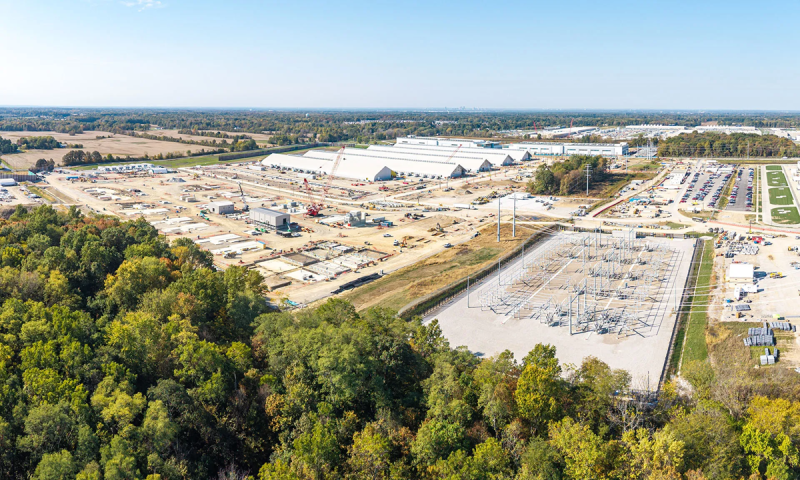
Источник изображения: Meta✴ На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в каждом домене NVLink, объединяющем ускорители высокоскоростными соединениями. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах на NVIDIA H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для поколения Blackwell масштаб домена по числу ускорителей увеличился в девять раз. Как заявили в компании, при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. 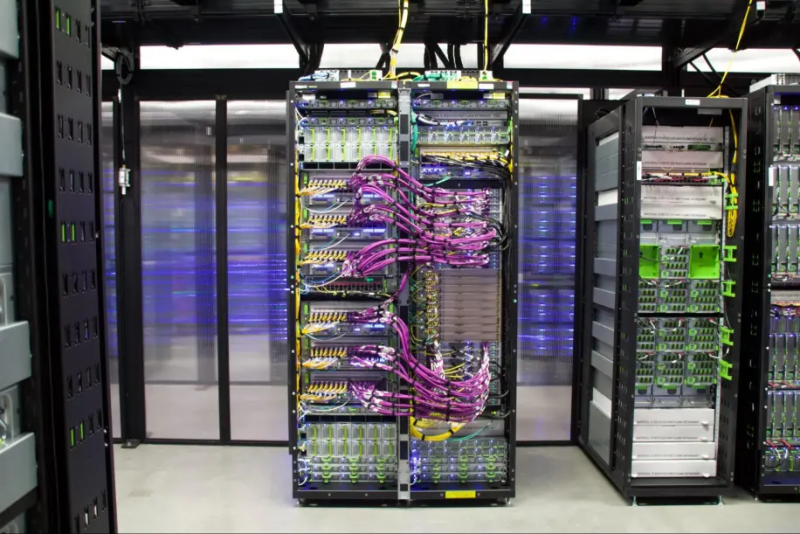
Источник изображения: Meta✴ Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов. |
|

