
Материалы по тегу: ии
|
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо), либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты обучения моделей, таких как Muse Spark и последняя версия Muse Wonder, от аппаратных сбоев. 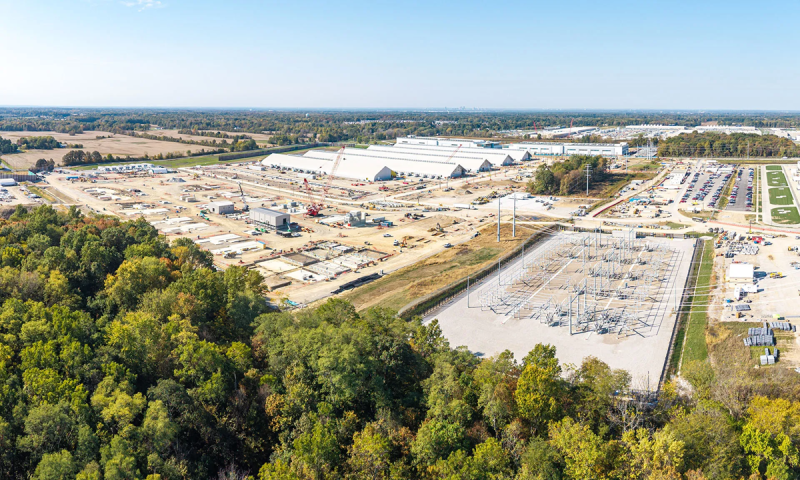
Источник изображения: Meta✴ На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в каждом домене NVLink, объединяющем ускорители высокоскоростными соединениями. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах на NVIDIA H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для поколения Blackwell масштаб домена по числу ускорителей увеличился в девять раз. Как заявили в компании, при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. 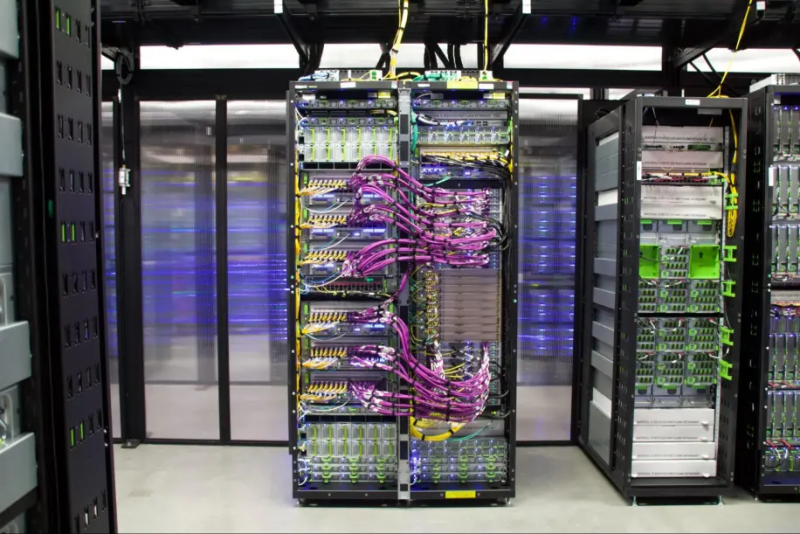
Источник изображения: Meta✴ Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
21.10.2026 [21:18], Руслан Авдеев
Amazon направит €16 млрд на расширение инфраструктуры в Германии в 2027 годуВ 2027 году компания Amazon намерена инвестировать €16 млрд ($17,98 млрд) в различные инфраструктурные проекты на территории Германии. Средства будут направлены на расширение парка ЦОД и развитие ИИ-инфраструктуры, высокоскоростного спутникового интернета в рамках инициативы Amazon Leo, а также новые проекты в направлении Prime Video, сообщает Datacenter Dynamics. С 2010 года Amazon уже потратила в Германии около €100 млрд. Из новых €16 млрд сумма в €4,8 млрд ($5,39 млрд) будет направлена на развитие ЦОД и ИИ-инфраструктуры, а также расширение облачного региона AWS Europe во Франкфурте. По словам представителя Amazon, Германия является одним из мировых центров инноваций и одним из самых привлекательных направлений для инвестиций в Европе. Поэтому компания уже вложила в стране значительные средства и намерена продолжить инвестиции. Регион Amazon Web Services (AWS) Frankfurt действует с 2014 года и неоднократно расширялся. В июне 2024 года AWS объявила о намерении инвестировать $9,44 млрд в развитие региона к 2026 году, а в ноябре 2025 года сообщила, что рассматривает возможность строительства ЦОД за пределами Франкфурта — в Шёнеке (Schöneck) и Майнтале (Maintal), в земле Гессен (Hesse). В Майнтале, помимо прочего, речь идёт о кампусе из двух зданий на территории площадью 10,5 га. 
Источник изображения: Steven Wei/unsplash.com Регион во Франкфурте включает три зоны доступности. В его составе работают четыре площадки ЦОД, ещё одна находится на стадии строительства. Также в Германии реализуется проект AWS Sovereign European Cloud. В 2024 году компания объявила, что инвестирует €7,8 млрд ($8,47 млрд) в развитие суверенной облачной инфраструктуры в Германии до 2040 года. Инфраструктура облака размещается в Бранденбурге. Компания не раскрыла, как будут разделены оставшиеся €11,2 млрд ($12,58 млрд) между Amazon Leo, логистическими проектами и Prime Video. Активность компании на рынке ИИ нарастает. В июле Amazon сообщала, что ожидает ещё больших расходов в соответствующий сегмент. Президент и генеральный директор Amazon Энди Джасси (Andy Jassy) объявил об увеличении прогноза капитальных затрат на 2026 год до $220 млрд с предыдущего в размере $200 млрд. Он пояснил это ростом цен на память, добавив, что значительные инвестиции Amazon вряд ли скоро прекратятся.
21.10.2026 [17:22], Владимир Мироненко
На Луне вот-вот появится почти обычный суперкомпьютер на колёсах — он будет запускать ИИ и обрабатывать данные прямо на местеКомпания HPE представила HPE Spaceborne Computer-4 (SBC4) — передовой вычислительный модуль, разработанный для работы в космосе. Он будет установлен на луноходе Flex Lunar Innovation Platform (FLIP) компании Astrolab, который в конце 2026 года доставят в район горы Монс-Мутон (Mons Mouton) недалеко от южного полюса Луны. Доставка будет осуществляться в рамках программы NASA Commercial Lunar Payload Services (CLPS) с помощью посадочного модуля Griffin-1, разработанного компанией Astrobotic, подразделением Voyager Technologies. Цель проекта — оценить пригодность современных вычислительных систем для будущих миссий и развивающейся лунной экономики. Согласно плану, в рамках годовой миссии лунохода на южном полюсе Луны SBC4 будет задействован в ряде экспериментов, связанных с ИИ и высокопроизводительными вычислениями (HPC). 
Источник изображения: NASA/unsplash.com По словам HPE, результаты этих экспериментов помогут заложить технологический фундамент, необходимый для будущих миссий и исследований на лунной поверхности. В рамках эксперимента FLUID (Federated Learning for Unbounded and Intelligent Decentralization — «Федеративное обучение для неограниченной интеллектуальной децентрализации») NASA задействует нейросетевую ИИ-модель, обученную на данных, полученных на Земле, Луне и МКС. Это позволит продемонстрировать координацию трёх отдельных ИИ-моделей. Кроме того, NASA проведёт испытания большой языковой модели (LLM) с возможностями семантической обработки, которая поможет искать и интерпретировать бортовую документацию. LLM будет использоваться для получения аналитических данных, обработки визуальной информации и обеспечения автономного мониторинга непосредственно на месте проведения работ. Также на SBC4 проведут несколько тестов производительности (HPC-бенчмарков), призванных проверить возможности системы на пределе её мощности. Среди них — тесты Linpack (HPL) и Conjugate Gradient (HPCG). Это означает, что HPE и Astrolab вскоре могут стать авторами первой в истории заявки в рейтинг Top500, отправленной с другого небесного тела, отметил The Register. Кроме того, будут проведены испытания по обработке данных, полученных с датчиков LiDAR, необходимых для картографирования, навигации, анализа рельефа и развития инфраструктуры. Также будет продемонстрировано развёртывание масштабируемых сервисов на базе ИИ. Система Silent Shield компании Deloitte, предназначенная для обнаружения кибервторжений, обеспечит прогностическую кибераналитику и выявление аномалий практически в режиме реального времени. Подготовленный HPE пакет программного обеспечения позволит оптимизировать взаимодействие с наземными ресурсами и обеспечить безопасную передачу данных и результатов исследований с Луны на Землю. Кроме того, HPE обеспечит поддержку центра управления полётами Astrolab в Хоторне (Hawthorne, штат Калифорния) с помощью решения HPE Private Cloud, которое поможет получать аналитические данные в режиме реального времени. В дополнение к этому ПО HPE CloudOps предоставит единую гибкую среду для управления рабочими нагрузками и их автоматизации. Известно, что система SBC4 оснащена энергоэффективными процессором и графическим процессором, а также двумя дублированными (зеркальными) SSD-накопителями Kioxia общей ёмкостью 1 Тбайт. Как сообщает The Register, партнёр HPE, предоставивший вычислительные компоненты, пожелал сохранить своё имя в тайне, поскольку не хотел бы, чтобы в случае выхода оборудования из строя название его бренда ассоциировалось с неудачей. Устройство имеет небольшие размеры — 130 × 250 × 25 мм. Луноходу, а значит, и SBC4, предстоит выдерживать экстремальные вибрационные нагрузки во время запуска и посадки, а также резкие перепады температур. Кроме того, аппаратуре придётся противостоять воздействию космических лучей и солнечной радиации, поскольку на Луне нет плотной атмосферы и магнитного поля, которые защищают вычислительные системы на Земле. По словам Марка Фернандеса (Mark Fernandez), главного научного сотрудника HPE по космическим технологиям и решениям, система SBC4 в основном собрана из стандартных серийно выпускаемых компонентов, включая SSD. В вычислительной платформе используются стандартные накопители Kioxia BG6 формата M.2, а основным средством защиты служит программный массив RAID 1. Вместе с тем HPE вложила значительные средства в программные механизмы резервирования и восстановления. Фернандес называет это «аппаратной защитой на программном уровне». Суть подхода заключается в том, что свободные вычислительные ресурсы процессора используются для непрерывного мониторинга аппаратных показателей и их сравнения с эталонными значениями. Если какой-либо параметр выходит за установленные пределы, система SBC4 принимает меры для самозащиты. «Если говорить в общих чертах: в идеале я хочу работать на полной скорости. Если это невозможно — снижаю скорость. Если и это не помогает, система переходит в состояние загрузки, но без запуска каких-либо задач — возможно, сервер сможет восстановиться. В худшем случае лучше просто отключить питание, чем допустить полное разрушение оборудования», — пояснил он. Проект FLIP был задуман прежде всего как концептуальная демонстрация — своего рода испытательный полигон для технологий, которые в будущем могут быть использованы в других миссиях на Луну. Учитывая ограниченную пропускную способность каналов связи с Землёй, гораздо эффективнее обрабатывать значительную часть данных и телеметрии, поступающих с камер, лидаров и датчиков лунохода, непосредственно на месте. По словам Фернандеса, именно поэтому система SBC4 спроектирована для работы «на самом краю» (at the edge of the edge) — непосредственно в месте сбора данных. Следует отметить, что ряд компаний, включая Google, Amazon и SpaceX, продвигают идею создания орбитальных дата-центров, работающих на солнечной энергии. Это позволило бы обойти ограничения, связанные с энергопотреблением на Земле. Однако экономическая целесообразность таких проектов пока не доказана, и на данный момент они остаются нерентабельными.
21.10.2026 [15:03], Павел Котов
Google представила TorchTPU — средство для работы с PyTorch на TPUGoogle представила программный комплекс TorchTPU с открытым исходным кодом, предназначенный для запуска ИИ-моделей с использованием фреймворка PyTorch на ускорителях TPU. Проект призван упростить использование ускорителей Google в обучении и инференсе ИИ; поддерживаются популярные программные средства — создавать отдельную программную среду для TPU не требуется. Разработанный совместно с командой PyTorch в Meta✴ инструментарий TorchTPU позволяет запускать существующие проекты в PyTorch с минимальными изменениями кода, используя привычный API. Поддерживаются отладка в обычном режиме PyTorch и механизмы распределенных вычислений. Google заручилась поддержкой Hugging Face, благодаря чему представленные на ИИ-платформе открытые модели могут запускаться нативно через TorchTPU — поддерживаются библиотеки Transformers v5 и Diffusers. 
Источник изображения: youtube.com/@googlecloudtech Программный модуль vLLM для TorchTPU поддерживает одновременную обработку множества запросов, квантизацию и распределение вычислений между чипами TPU; стандартные средства управления вычислениями и обработки запросов сохранены. Для TPU адаптирован инструмент SGLang — он позволяет ускорять сложные многоэтапные задачи, в том числе выполняемые ИИ-агентами; поддерживаются повторные обращения к KV-кешу и повторяющиеся префиксы запросов, за счёт чего одни и те же вычисления могут не выполняться заново. Версия SGLang-TorchTPU сохранила механизмы выполнения задач, распределения запросов и API. Средства обмена данными с HiCache помогают сократить задержку и оптимизировать вывод при сложной многоэтапной генерации. Совместно с Red Hat, IBM и сообществом разработчиков выпущен роутер llm-d 1.0 — он направляет запросы к экземплярам модели, где уже сохранен контекст, а также разделяет обработку входного запроса и генерацию ответа по вычислительным ресурсам, что позволяет использовать их эффективнее. В Google Kubernetes Engine этот инструмент поддерживает запуск моделей как на GPU, так и на TPU. Google интегрировала TorchTPU с TorchTitan — инструментом распределённого обучения крупных моделей; поддерживаются, в частности, Llama 3, Qwen 3 и FLUX.1. Поддержка появилась в VeRL — одном из наиболее популярных фреймворков для обучения с подкреплением, позволяющий улучшать модели в математических задачах, написании кода и многоэтапных агентских задачах. Заявлено о поддержке TorchTPU в Ray — инструмент для распределения вычислительных задач позволяет объединить обработку данных, обучение, и инференс в рабочий процесс с использованием центральных и графических процессоров, а также TPU. В экосистему PyTorch вошла библиотека LiteRT, предназначенная для запуска моделей на пользовательских устройствах. Google также представила предварительную версию TPU agent suite — при помощи плагинов этот набор инструментов помогает автоматизировать первоначальную настройку, диагностику и оптимизацию моделей в PyTorch. Поддержку PyTorch на своих ускорителях реализовали также Amazon, Intel и Meta✴.
21.10.2026 [14:52], Андрей Крупин
«Труконф» представил TrueConf Cluster — отказоустойчивое решение для систем коммуникаций и совместной работыРоссийский разработчик решений для видеоконференцсвязи «Труконф» представил новую серверную архитектуру TrueConf Cluster. Решение предназначено для построения отказоустойчивых систем унифицированных коммуникаций в государственных структурах, банках и промышленных предприятиях. Архитектура TrueConf Cluster позволяет объединять несколько серверов в единый логический кластер с автоматическим перераспределением нагрузки и мгновенным переключением на резервные узлы при сбоях. По данным разработчика, система обеспечивает непрерывность сеансов связи: при выходе из строя одного из узлов активные конференции не прерываются, а пользователи незаметно для себя переводятся на работающие мощности. В основу архитектуры TrueConf Cluster положена фирменная технология компании «Труконф»: каждый участник взаимодействует только со «своим» узлом кластера, а медиаданные передаются напрямую между задействованными узлами — такой подход обеспечивает равномерную нагрузку на сеть. 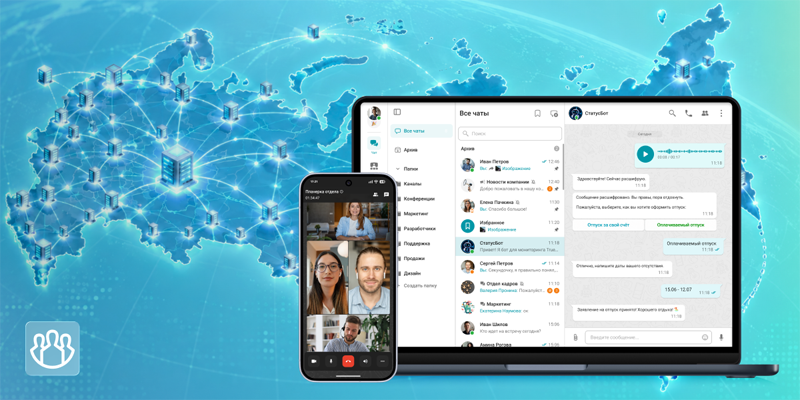
Источник изображения: «Труконф» / trueconf.ru Кластер может быть развёрнут в контуре заказчика или его доверенного подрядчика — в том числе в изолированных сетях. Настройка узлов TrueConf Cluster и конфигурирование системы осуществляется через единый портал с мониторингом нагрузки и активности в реальном времени, а также централизованным управлением правами групп пользователей и администраторов. TrueConf Cluster поддерживает взаимодействие со сложными LDAP-лесами, настройку многофакторной авторизации и механизма единого входа, а также интеграцию со сторонними средствами защиты цифровых угроз. Благодаря возможностям масштабирования продукт может использоваться в организациях любого размера, будь то ведомственные предприятия, территориально распределённые или международные компании с широкой географией офисов.
21.10.2026 [11:25], Сергей Карасёв
Marvell представила ретаймер и DSP-чип нового поколения для ИИ-кластеровКомпания Marvell Technology анонсировала ретаймер Alaska E 3.2T и чип Alaska A 1.6T AEC DSP второго поколения для высокопроизводительных ИИ-инфраструктур. Изделия призваны решить проблему затухания сигналов и роста энергопотребления при построении сетей со сверхвысокими скоростями передачи данных. Ретаймер Alaska E 3.2T обеспечивает общую пропускную способность до 3,2 Тбит/с. Конфигурация включает 16 линий 224G PAM4 SerDes. Реализована поддержка протоколов Ethernet, UALink и ESUN. Говорится об ультранизкой задержке и об архитектуре, оптимизированной для ИИ-платформ высокой плотности. Ретаймер позволяет гибко размещать вычислительные узлы без потери качества сигнала. 
Источник изображения: Marvell В свою очередь, решение Alaska A 1.6T AEC DSP — это специализированный цифровой сигнальный процессор для активных электрических кабелей (AEC). Его конфигурация предусматривает использование восьми линий 224G PAM4, а пропускная способность составляет 1,6 Тбит/с. Изделие производится по 3-нм технологии в корпусе с размерами 12 × 14 мм. Заявленное энергопотребление — 12,8 Вт. Решение даёт возможность передавать сигнал 1,6 Тбит/с по медным кабелям на расстояние более 6 м, что вдвое превышает показатель чипов первого поколения. Упомянуты протоколы Ethernet, UALink и ESUN. У обеих новинок компенсация вносимых потерь превышает 45 дБ. Реализован полный набор диагностических возможностей. Пробные поставки Alaska E 3.2T и Alaska A 1.6T AEC DSP уже начались.
20.10.2026 [18:47], Павел Котов
Amazon представила TorchNeuron — средство запуска PyTorch на чипах AWS TrainiumAmazon анонсировала TorchNeuron — инструментарий с открытым исходным кодом, позволяющий запускать рабочие нагрузки PyTorch на ИИ-ускорителях AWS Trainium. До настоящего момента запуск на чипах Trainium самого популярного в отрасли фреймворка PyTorch для разработки систем искусственного интеллекта требовал значительного объёма ручной работы — затраты на разработку увеличивались, создавался барьер для пользователей. TorchNeuron позволяет запускать проекты PyTorch на чипах Trainium, не внося масштабных изменений в код. Разработчикам, подчеркнули в Amazon, достаточно лишь задать параметр, какой именно чип следует использовать для выполнения задач. Поддерживаются Trainium2 и Trainium3 — две новейшие модели в линейке этих ускорителей; они подходят как для обучения, так и для инференса моделей. Более мощный из двух ускоритель Trainium3 оснащён восемью вычислительными ядрами, каждое из которых состоит из четырёх модулей, оптимизированных для определённых типов вычислений, необходимых ИИ-моделям при обработке данных. Объём встроенной памяти составляет 144 Гбайт. На сервере могут работать до 144 ускорителей Trainium3 — одна такая система способна выполнять до 362 квадриллионов операций в секунду при работе с данными в формате MXFP8, который широко применяется в моделях ИИ. 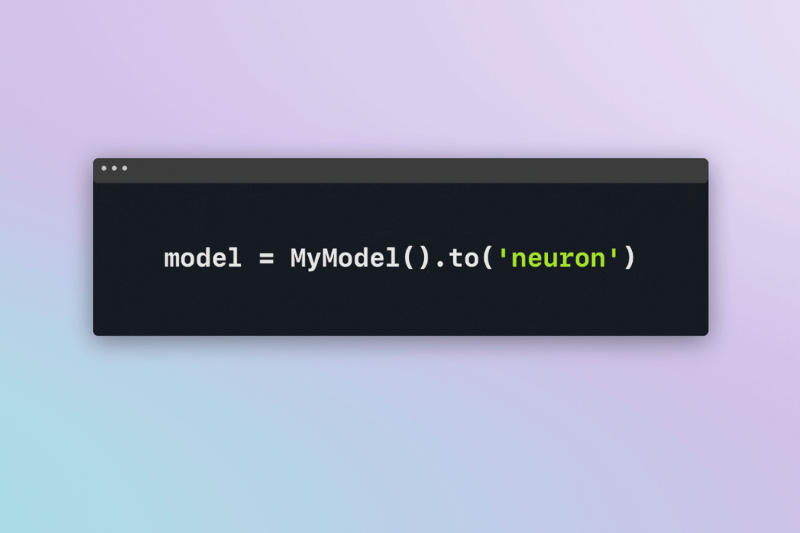
Источник изображения: aboutamazon.com Для серии Trainium был разработан собственный язык программирования NKI; благодаря наличию специального компилятора этот язык позволяет производить низкоуровневую оптимизацию моделей, за счёт чего снижается потребление аппаратных ресурсов и повышается скорость работы ИИ. В состав TorchNeuron входит набор готовых операторов NKI — программных компонентов, которые можно использовать при создании ИИ-моделей. Одни из них упрощают реализацию архитектуры Mixture-of-Experts, другие помогают сократить объём памяти, который занимают нейросети. Ускоряется выполнение и сопутствующих задач, например, квантования. TorchNeuron поддерживает не только PyTorch, но и другие открытые инструменты, которые разработчики часто используют в связке с этим фреймворком. Среди них поддерживается TorchTitan — популярный механизм для обучения ИИ-моделей. Он автоматизирует часть задач, связанных с распределением процессов между ускорителями; метод полностью сегментированного параллелизма данных разделяет не только обучаемую модель, но также состояния оптимизатора и градиенты. Оптимизатор — программа совершенствующая способности модели; градиенты — данные, которые играют в этом процессе важную роль. В состав TorchNeuron вошли функции, позволяющие дополнительно оптимизировать рабочий процесс обучения с использованием ускорителей Trainium. Ранее о поддержке PyTorch на своих ускорителях заявили Intel, Meta✴ и корейский стартап HyperAccel.
20.10.2026 [17:17], Руслан Авдеев
Microsoft отказалась от аренды мощностей в ЦОД Nscale из-за задержек с электроснабжениемКомпания Microsoft отказалась от участия в проекте, предусматривавшего аренду вычислительных мощностей в флагманском дата-центре компании Nscale, поддерживаемой NVIDIA. Такое решение было принято после того, как вероятные сроки подключения ЦОД к электроснабжению сдвинули на 2030-е годы — это стало наглядной демонстрацией того, что британские амбиции в сфере ИИ могут столкнуться с серьёзными препятствиями, сообщает Reuters. В понедельник американский техногигант объявил, что намерен продолжить взаимодействие с Nscale, в т.ч. в проектах по строительству цифровой инфраструктуры и развитию ИИ по всему миру. В компании подчёркивают, что отказ от сделки касается конкретной площадки в Лоутоне (Loughton) графства Эссекс. Именно там Nscale не смогла обеспечить своевременное подключение — представители оператора местных электросетей сообщили, что рассчитывают подавать энергию к ЦОД не раньше 2030-х гг. В самой Nscale также утверждают, что эта проблема с электросетевой инфраструктурой Лондона и прилегающих районов не повлияет на другие контракты. Nscale выразила намерение и далее развивать проект в Лоутоне, как и свой бизнес в Великобритании в целом. Пока изучаются альтернативные источники электроснабжения площадки, а также масштабирования присутствия в других регионах страны. 
Источник изображения: Nomadic Julien/unsplash.com Проект впервые анонсировали в ходе визита в Великобританию президента США Дональда Трампа (Donald Trump) в сентябре 2025 года, Предполагалось, что он продемонстрирует желание страны стать одним из мировых лидеров в ИИ-индустрии. Тем не менее, Великобритания столкнулась с дефицитом электричества для ЦОД из-за нехватки доступных энергетических мощностей. Из-за очередей на подключение сроки реализации проектов ЦОД могут быть отложены на срок до 13 лет. В 2025 году партнёры заявляли, что ЦОД в Лоутоне должен заработать в начале следующего года, 23 040 ускорителей NVIDIA GB300 должны были обеспечить 50 МВт вычислительных ИИ-мощностей в помощь сервисам Microsoft Azure в Соединённом Королевстве. В сентябре Nscale подала заявку на IPO в США. Предполагалось, что в числе крупнейших клиентов будут Anthropic и Microsoft. Nscale обеспечивает клиентам ИИ-инфраструктуру, включая вычислительные мощности, электроснабжение и собственно ЦОД, а также ПО для обучения и эксплуатации ИИ-моделей. С момента основания Nscale активно развивалась. За 2,5 года стоимость заключённых ей контрактов выросла с $100 млн до более $103 млрд. В число прямых конкурентов входят CoreWeave, Nebius, Crusoe и Lambda. Не все проекты удаётся реализовать одинаково успешно. Недавно сообщалось, что сдача ЦОД Nscale в норвежском Глом-фьорде отложена на полгода из-за пожара, утечек в системе охлаждения и более серьёзных проблем, включая ограничения со стороны местных властей.
20.10.2026 [16:28], Руслан Авдеев
Южная Корея раздала более 10 000 ИИ-ускорителей — активно используется только половинаТолько 51,8 % из 10 104 ИИ-ускорителей, выделенных бизнесу, предприятиям и другим организациям, в рамках государственных проектов Южной Кореи, активно использовались по состоянию на сентябрь 2026 года, сообщает TelecomPaper. По статистике Национального агентства по продвижению IT-индустрии (NIPA) Южной Кореи, используются лишь 5234 из 10 104 ускорителей, предоставленных при участии государства. Информация была раскрыта в ходе парламентского аудита государственных органов одним из депутатов страны, обратившим внимание на неэффективное расходование средств. Согласно статистике по секторам, в крупных компаниях уровень использования ускорителей наиболее высок и составляет 80,6 %. В научно-исследовательских структурах он значительно ниже — 61,2 %. Хуже всего показатели у малого бизнеса и университетов. На малых и средних предприятиях уровень использования составляет 56,5 %, в стартапах — 46,1 %, а в университетах — 42,1 %. 
Источник изображения: Mathew Schwartz/unsplash.com Более того, как минимум в 15 отдельных проектах, в том числе в 10 промышленных, академических и исследовательских проектах, а также в пяти инициативах в сфере ИИ, используется менее 20 % выделенных ускорителей. Отмечается, что агентство NIPA не сообщало о неэффективном использовании ресурсов. При этом ни одна партия ускорителей, выделенных при поддержке государства, не была отозвана, хотя действующие в стране правила позволяют возвращать ресурсы, если те не находят применения. Теперь NIPA заявило, что рассмотрит объяснения представителей проектов, недостаточно активно использовавших ускорители. Также будет изучена возможность отзыва ресурсов, если они используются не в должной мере. Как сообщает DigiTimes, тем временем, пока у одних организаций ускорители остаются неиспользованными, многие небольшие исследовательские команды и ИИ-стартапы среднего размера в стране жалуются на серьёзный дефицит вычислительных мощностей, проблемы с арендой оборудования и получением поддержки для обучения крупных ИИ-моделей. При этом в Южной Корее довольно решительно настроены на развитие ИИ-отрасли. Например, в июне сообщалось, что страна инвестирует почти $3 трлн в полупроводники и ИИ. В том же месяце было объявлено, что NVIDIA поможет SK hynix, Naver, Doosan, SK Telecom и LG расширить ИИ-инфраструктуру Южной Кореи.
20.10.2026 [13:12], Сергей Карасёв
Представлен мини-компьютер Sipeed MaixStation — конкурент NVIDIA DGX Spark с чипом Axera AX8860PКомпания Sipeed сообщила о разработке компьютера MaixStation небольшого форм-фактора, который позиционируется в качестве альтернативы устройству NVIDIA DGX Spark, дебютировавшему в марте 2025 года. Новинка предназначена для локальной работы с большими языковыми моделями (LLM), включая Qwen и DeepSeek. В основу MaixStation положен новый процессор AX8860P, разработанный китайской фирмой Axera. Чип объединяет 16 вычислительных ядер Arm Cortex-A55 и нейропроцессорный узел (NPU) с ИИ-производительностью до 256 TOPS в режиме FP4. Поддерживается до 128 Гбайт оперативной памяти LPDDR5X с 256-битной шиной и пропускной способностью до 273 Гбайт/с. Упомянута поддержка PCIe 5.0 и интерконнекта AXLink (C2C). Изделие изготавливается по 6-нм технологии, а энергопотребление под нагрузкой находится на уровне 40 Вт. 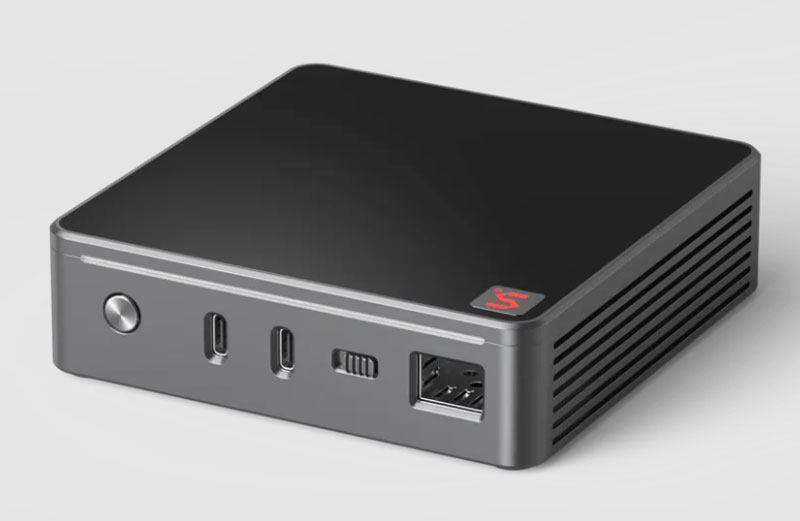
Источник изображения: Sipeed MaixStation может нести на борту 32 или 128 Гбайт памяти LPDDR5x. В первом случае заявлена поддержка модели Qwen3.8-27B (27 млрд параметров), во втором — Qwen3.8-Flash-Next 125B (125 млрд параметров). При объединении в кластер двух и четырёх мини-компьютеров становится возможной работа с LLM DeepSeek V4-Flash 284B (284 млрд параметров) и DeepSeek V4.1-Flash 552B. (552 млрд параметров). Устройство имеет размеры 110 × 110 × 30 мм. Предусмотрены сетевой порт 10GbE SFP+ и разъём USB 3.0 Type-C для подключения к ноутбуку. Питание подаётся через дополнительный порт USB Type-C (стандарт USB PD; мощность до 65 Вт). Ожидается, что новинка поступит в продажу по цене «менее $2000» за версию с 32 Гбайт памяти и «менее $4000» за модификацию со 128 Гбайт LPDDR5X. Для сравнения, упомянутый NVIDIA DGX Spark сейчас стоит $6950 (тогда как на момент анонса в 2025 году он предлагался по цене от $3000 до $4000). |
|

