
Материалы по тегу: i
|
22.09.2026 [15:40], Сергей Карасёв
Huawei представила ИИ-систему Atlas 960E SuperPoD на базе UnifiedBus и NPOHuawei анонсировала ИИ-систему Atlas 960E SuperPoD. Это, как утверждается, первый в отрасли кластер с технологией NPO (Near-Packaged Optics), предназначенный для работы с большими языковыми моделями, насчитывающими до 10 трлн параметров. В составе Atlas 960E SuperPoD применяются оптические модули Hi-ONE на базе NPO. Данная технология предполагает монтаж оптического движка в виде отдельного узла на плате рядом с ASIC: преимуществами подхода являются снижение задержек и энергопотребления, а также возможность замены компонента при выходе из строя. Пропускная способность достигает 7,2 Тбит/с. Atlas 960E SuperPoD может оснащаться ИИ-ускорителями Huawei Ascend 960, включая будущие изделия 960DT и 960PR. Посредством NPO могут быть связаны до 4096 карт: в случае Ascend 960DT суммарная FP4-производительность составит до 16 Эфлопс. При этом 5500 оптических движков Hi-ONE могут заменить 48 тыс. традиционных оптических модулей стандарта 800G. Это снижает энергопотребление более чем на 550 кВт, одновременно удваивая время безотказной работы системы: показатель доступности достигает 99,8 %. 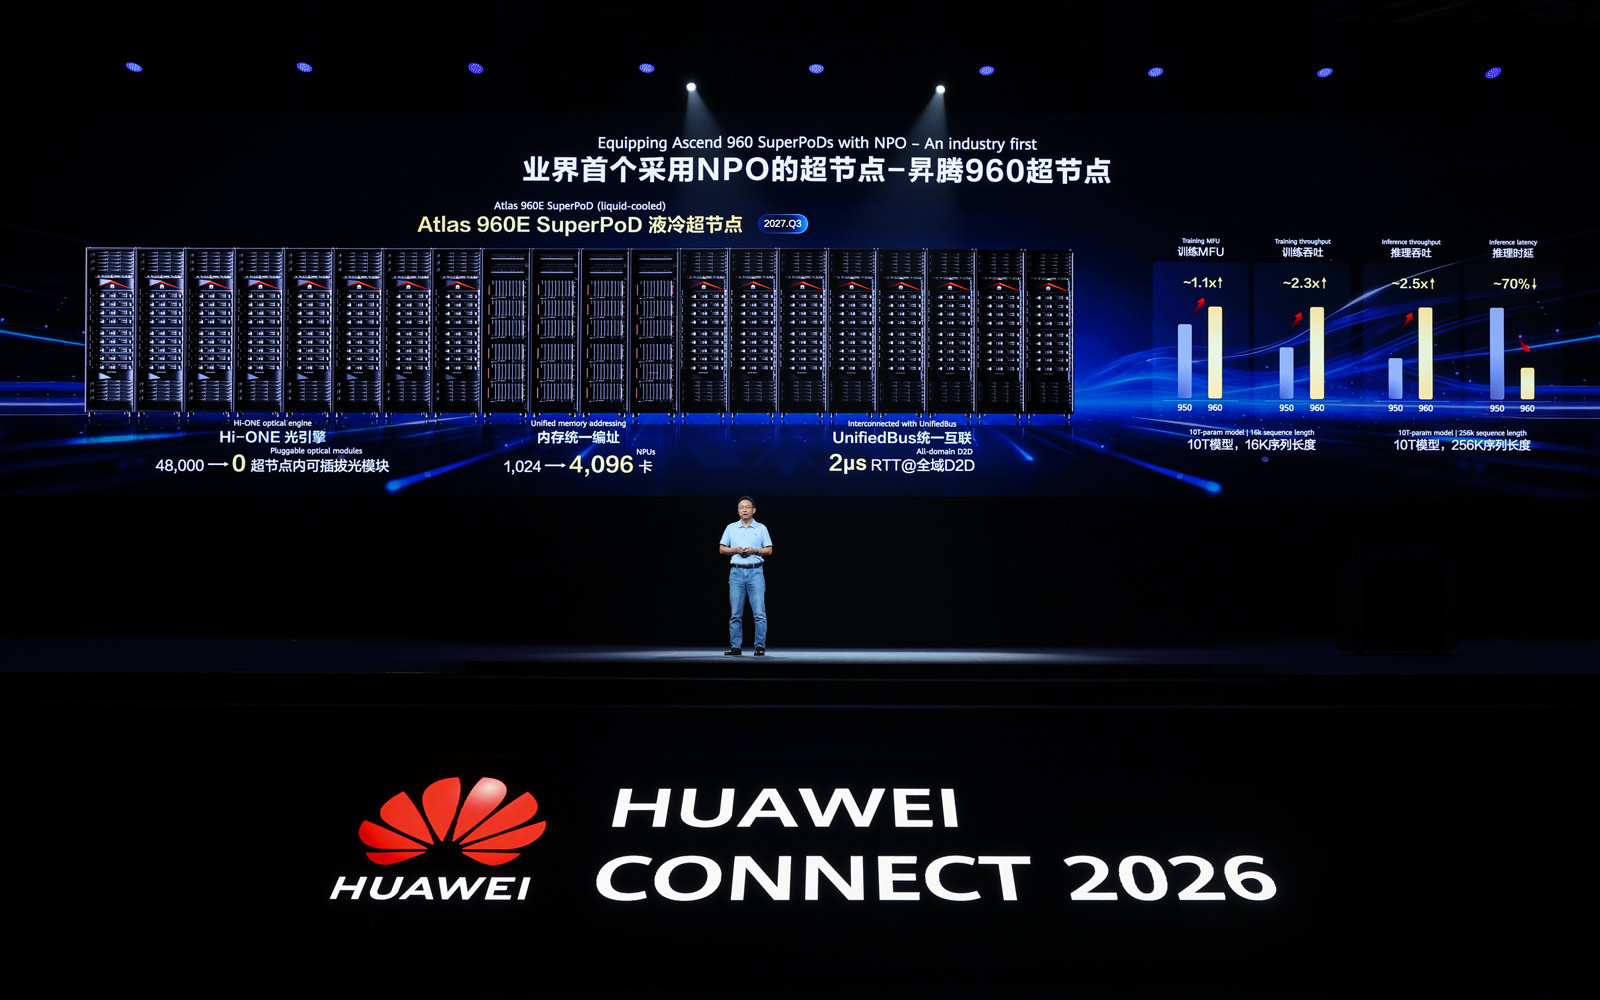
Источник изображения: Huawei Платформа предполагает применение интерконнекта нового поколения UnifiedBus (UB), который обеспечивает пропускную способность в несколько Тбайт/с и задержку (RTT) на уровне 2 мкс. UnifiedBus даёт возможность сформировать единый пул памяти объёмом до 256 Тбайт. Через сеть UnifiedBus и RoCE отдельные экземпляры SuperPoD можно объединять в суперкластеры (SuperCluster). В частности, двухуровневая четырёхплоскостная архитектура Clos позволяет связать воедино до 512 тыс. NPU. А в сочетании с топологией Multi-rail такой кластер может насчитывать до 1 млн ускорителей.
21.09.2026 [13:53], Сергей Карасёв
Huawei представила архитектуру UnifiedBus для повышения производительности ИИ-кластеровHuawei объявила о разработке архитектуры интерконнекта нового поколения UnifiedBus (UB). Технология призвана решить проблемы скорости передачи данных в крупномасштабных вычислительных кластерах, ориентированных на ресурсоёмкие задачи ИИ. В традиционных системах для ЦОД эффективность использования ресурсов снижается по мере масштабирования платформы. Так, в кластере из 100 тыс. NPU фактически задействуется всего около 20 % доступной вычислительной мощности, в то время как оставшиеся ресурсы простаивают в ожидании данных, утверждает Huawei. Обучение модели с триллионами параметров требует передачи колоссальных объёмов промежуточных сведений, а современные ИИ-агенты регулярно генерируют запросы, создавая постоянную нагрузку на коммуникационные линии. Всё это приводит к необходимости гибкого перераспределения меняющейся нагрузки между CPU и NPU. Кроме того, резко возрастают требования к хранению данных на всех уровнях вычислительных платформ. В результате, недостаточная пропускная способность интерконнекта становится главным узким местом, ограничивающим производительность современных ИИ-кластеров. 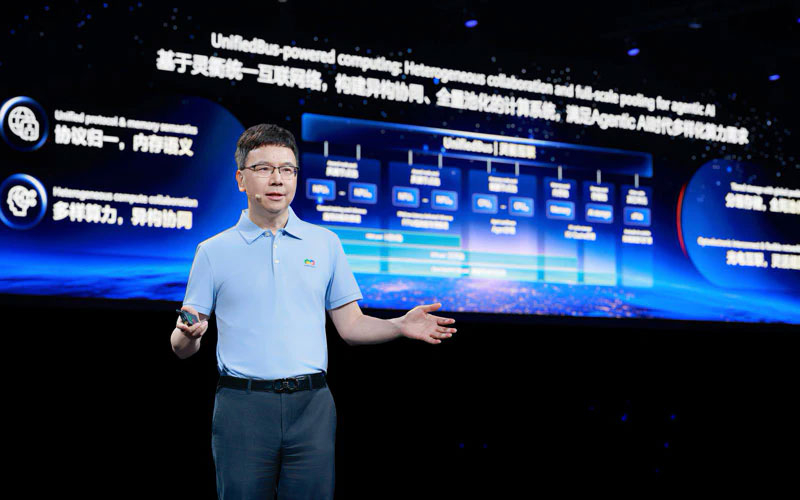
Источник изображения: Huawei Архитектура UnifiedBus позволяет устранить существующие недостатки, объединив более десяти различных протоколов и увеличив общую пропускную способность интерконнекта с примерно 100 Гбайт/с до уровня в несколько Тбайт/с, тогда как задержка (RTT) уменьшается с 7 до 2 мкс. Новая архитектура также предусматривает единую глобальную адресацию памяти внутри ИИ-узлов SuperPoD. Помимо этого, UnifiedBus напрямую соединяет CPU, NPU, RAM и SSD, обеспечивая децентрализованную одноранговую связь между ними и гибкое распределение имеющихся ресурсов. В рамках концепции UnifiedBus чипы DDR выступают в качестве альтернативной памяти для NPU, снижая задержки для поисковых, рекомендательных и других сервисов, а также удваивая производительность векторного поиска. При этом сокращаются требования к ёмкости HBM в составе ИИ-ускорителей. В целом, UnifiedBus служит глобальной «магистралью данных» со сверхвысокой пропускной способностью и малой задержкой, обеспечивая гибкое масштабирование вычислительных ресурсов. Специальный модуль интерконнекта UnifiedBus LinkBlade с бескабельным дизайном обеспечивает высокоскоростную связь внутри стоек вычислительного кластера. Утверждается, что в составе SuperPoD с 4096 NPU применение LinkBlade позволяет сэкономить около 196 км медных соединений. Для обмена данными между отдельными стойками решение UnifiedBus LinkDevice предлагает 176 портов с пропускной способностью 1,6 Тбит/с каждый, обеспечивая полностью оптическое соединение со скоростью 280 Тбит/с. При этом могут формироваться кластеры с миллионами NPU. Huawei продемонстрировала суперкластер для работы с агентным ИИ на базе UnifiedBus, который состоит из узлов SuperPoD TaiShan 950 и Atlas 960, хранилища данных OceanStor M900 и коммутатора Xinghe UBG. Эта платформа поддерживает многоуровневое объединение ресурсов, обеспечивая эффективную работу с различными нагрузками.
21.09.2026 [08:32], Сергей Карасёв
Huawei разработала модуль NPO с пропускной способностью до 7,2 Тбит/сКомпания Huawei, по сообщению The Register, продемонстрировала оптические модули NPO (Near-Packaged Optics), предназначенные для организации высокоскоростного интерконнекта в дата-центрах для ИИ-задач. В традиционных коммутаторах оптические блоки обычно располагаются на передней панели, а длина соединения от собственно чипа до собственно оптических компонентов довольно велика. Энергопотребление и тепловыделение таких решений увеличиваются с ростом скоростей передачи данных, что становится серьезной проблемой в свете активного внедрения стандартов 800 Гбит/с и 1,6 Тбит/с. Кроме того, длинные электрические трассы и интенсивная обработка сигналов в DSP приводят к увеличению задержек. 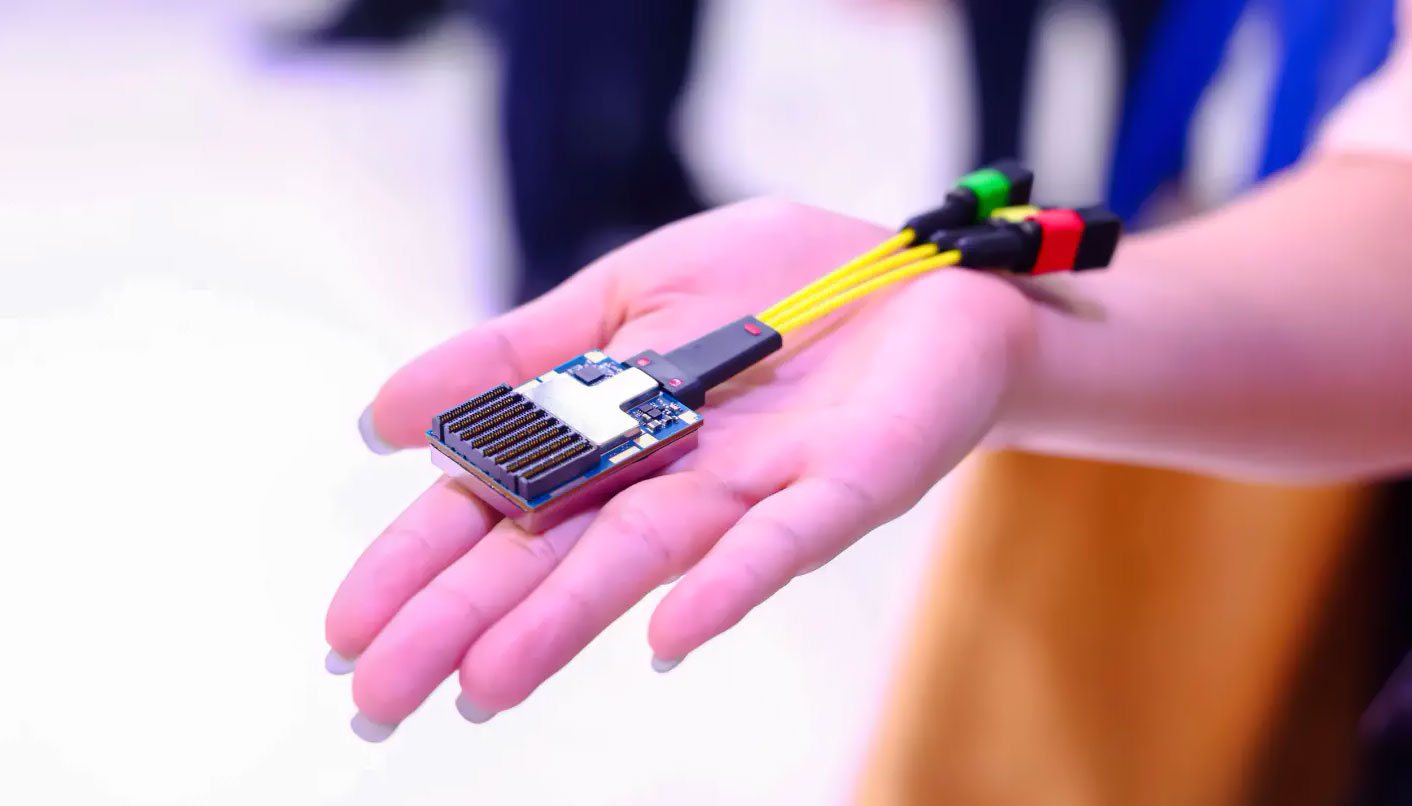
Источник изображения: The Register Одним из способов повышения эффективности является применение технологии CPO (Co-Packaged Optics). Она предполагает размещение оптического модуля на той же подложке, что и ASIC. Такой подход обеспечивает небольшие задержки и низкое энергопотребление, однако затрудняет замену вышедших из строя оптических модулей и значительно удорожает производство. В результате, возрастают эксплуатационные затраты в ЦОД. Платформа NPO, предложенная компанией Huawei, предусматривает монтаж оптического движка в виде отдельного компонента на плате рядом с ASIC. При этом конструкция NPO исключает необходимость в отдельном DSP-чипе — соответствующие функции интегрируются в ASIC. Таким образом, сохраняется возможность замены оптического модуля в случае его выхода из строя, тогда как задержки по сравнению с традиционными решениями снижаются со 100 до 10 нс, а энергопотребление уменьшается примерно на 60 %. В NPO-решении Huawei используются 36 линий 200G, что в сумме даёт 7,2 Тбит/с. Предполагается, что предложенная технология будет использоваться в следующих поколениях ИИ-узлов SuperPoD.
20.09.2026 [02:14], Владимир Мироненко
Anthropic и OpenAI переключились на аренду небольших ИИ ЦОДAnthropic и OpenAI прорабатывают варианты заключения сделок по аренде мощностей в небольших дата-центрах с целью расширения ИИ-инфраструктуры на фоне усиления дефицита, сообщил ресурс CNBC со ссылкой на источники. По словам инсайдеров, обе компании заключили за последний год крупные соглашения об использовании дата-центров мощностью в сотни мегаватт и даже гигаватты, но теперь они также проявляют интерес к сделкам на 20–30 МВт. В частности, Anthropic изучала возможность заключения соглашений такого масштаба в Великобритании и странах Северной Европы, а OpenAI также рассматривала варианты развёртывания мощностей меньшего объёма в странах Северной Европы. Один из источников сообщил о переговорах с участием Anthropic и OpenAI по поводу развёртывания вычислительных мощностей аналогичного масштаба в США. Такие сделки позволяют компаниям быстрее запускать рабочие нагрузки в условиях бума ИИ-технологий. «Мы формируем диверсифицированный портфель вычислительных мощностей, чтобы удовлетворить растущий спрос на ИИ во всём мире», — заявил представитель OpenAI ресурсу CNBC. Он пояснил, что разные рабочие нагрузки требуют использование разной инфраструктуры, поэтому компания ведёт переговоры с широким кругом партнёров и оценивает возможности, исходя из своих требований, а также показателей производительности, надёжности, сроков реализации и стоимости. 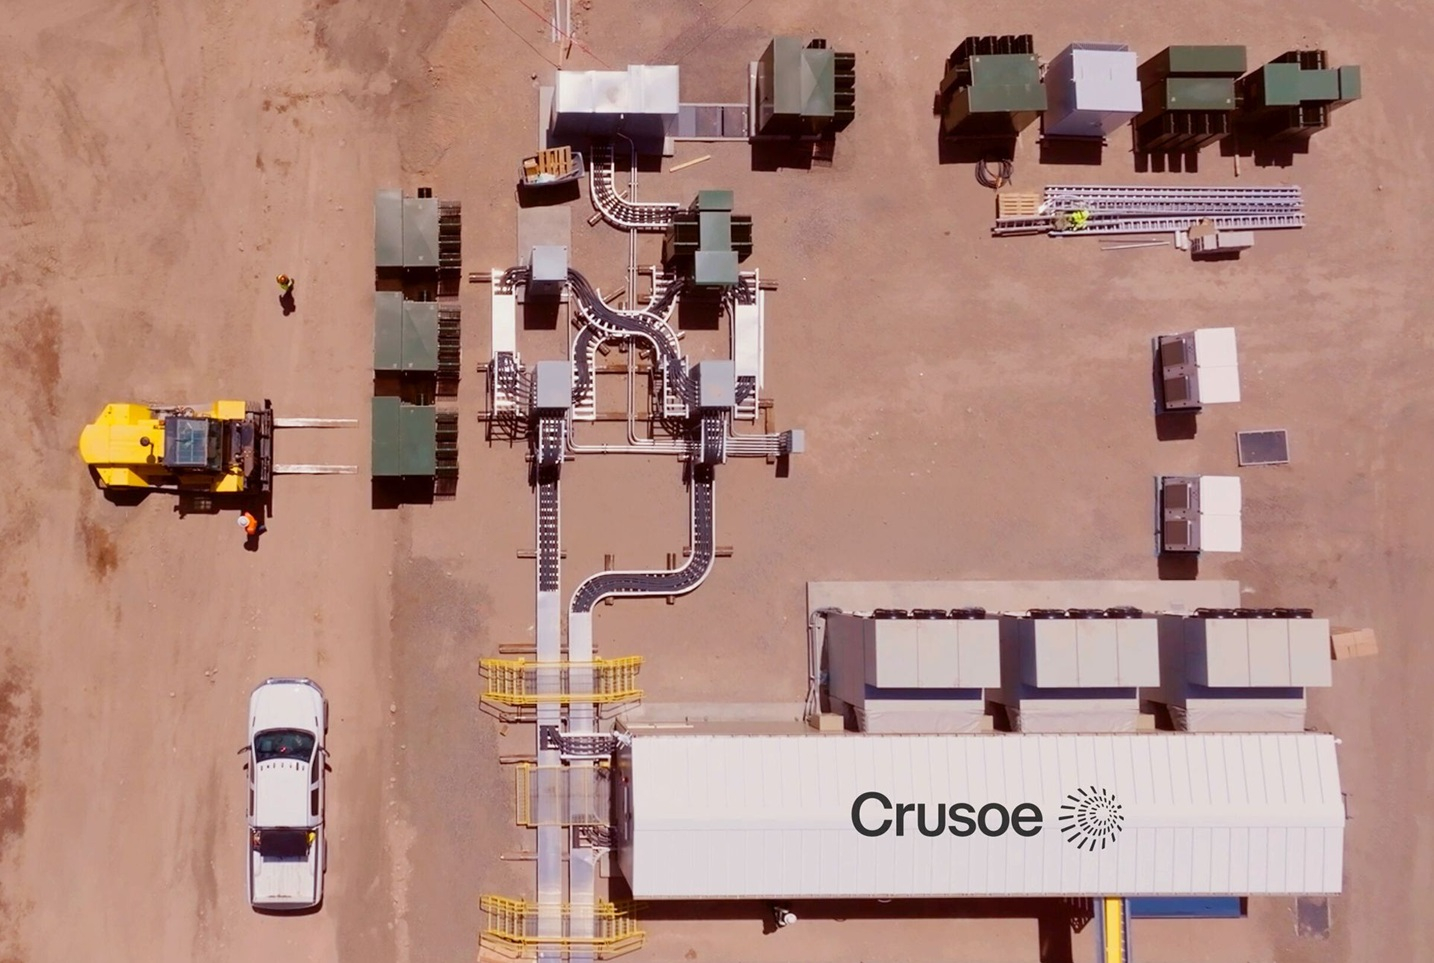
Источник изображения: Crusoe Обе компании обычно арендуют вычислительные мощности у операторов дата-центров и неооблаков, отдавая предпочтение масштабным долгосрочным соглашениям. В августе стало известно о сделке Anthropic с Nscale по поводу аренды мощностей в строящемся ЦОД в Западной Вирджинии на 460 МВт. OpenAI заявила, что ещё в апреле превысила первоначальный план по выделению 10 ГВт мощности для своего инфраструктурного проекта Stargate, и уже после этого взяла на себя обязательства по обеспечению дополнительных 3 ГВт мощностей в Джорджии и 8 ГВт в Огайо. Масштабные проекты по строительству ЦОД в США и других странах всё чаще сталкиваются с противодействием со стороны местных жителей. Также во многих регионах Европы наблюдается дефицит свободных земельных участков и энергетических мощностей для развёртывания ЦОД. По словам Structure Research, привлекательность сделок относительно меньших вычислительных мощностей заключается в том, что они позволяют быстрее получить доступ к готовой инфраструктуре: «Получить доступ к нескольким мегаваттам на уже подключенном к энергосети объекте может быть практичнее, чем ждать выделения гораздо большего блока мощностей в одной локации. Для рабочих нагрузок, способных функционировать на разрозненных площадках, совокупность небольших объектов может в итоге обеспечить значительный объём мощностей». 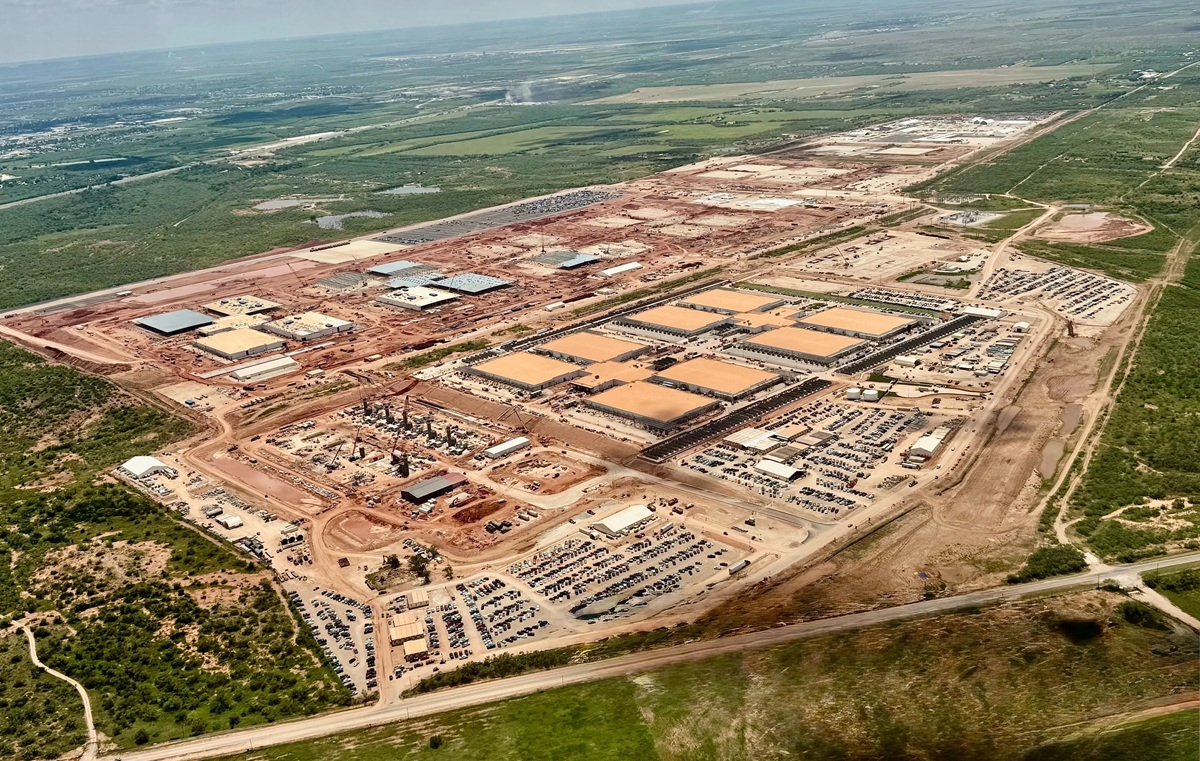
Источник изображения: Crusoe Обучение моделей ИИ требует огромных вычислительных ресурсов для обработки колоссальных массивов данных, но инференс может осуществляться с использованием более компактных кластеров чипов. По словам Тана, многие задачи инференса позволяют обрабатывать отдельные запросы на разрозненных небольших кластерах. При этом всё большая часть вычислительных ресурсов ИИ перенаправляется от обучения ИИ-моделей к их непосредственной эксплуатации. По оценкам JLL, к 2027 году доля мощностей ЦОД, используемых для инференса, должна превысить долю мощностей, выделяемых для обучения моделей. В 2025 году на инференс приходилось 9 % от общего объёма рабочих нагрузок в глобальных ЦОД, тогда как на обучение — 14 %. К 2030 году, как ожидается, на инференс будет приходиться 37 % этих мощностей, а на обучение моделей — лишь 13 %. В феврале сообщалось о планах NVIDIA начать сотрудничать с рядом участников рынка ЦОД для изучения возможностей создания небольших объектов, предназначенных для распределённого инференса. Напомним, что Crusoe, построившая крупный комплекс дата-центров Stargate в Абилине (Abilene, Техас), используемый OpenAI, теперь инвестирует в создание более компактных ЦОД, на развёртывание которых уходит меньше времени, и этот процесс обходится гораздо дешевле запуска крупных комплексов, строительство которых сейчас сталкивается с задержками на всей территории США.
19.09.2026 [16:07], Сергей Карасёв
До 64 Пбайт для KV-кеша: Huawei представила платформу хранения OceanStor M900 для ИИ ЦОДHuawei представила платформу OceanStor M900, спроектированную для работы с KV-кешем в крупномасштабных дата-центрах. Новинка позволяет решить проблему нехватки DRAM, которая создает «бутылочное горлышко» в современных ИИ-кластерах. Отмечается, что в настоящее время в сфере ИИ наблюдается переход от технологических экспериментов к широкомасштабному внедрению. Приложения ИИ эволюционировали от чат-ботов до агентов, способных автономно выполнять сложные задачи. Большие языковые модели (LLM) нового поколения могут насчитывать до 10 трлн параметров. Современные системы с огромными контекстными окнами (более 1 млн токенов) и многошаговые ИИ-агенты генерируют колоссальные объёмы KV-кеша, для обработки которого ресурсов HBM и DRAM недостаточно. Платформа OceanStor M900 помогает преодолеть эти ограничения путём использования высокоскоростных SSD. По заявлениям Huawei, в OceanStor M900 впервые в отрасли применена передовая архитектура, объединяющая CPU, сетевой контроллер и контроллер NAND. Она обеспечивает собственную KV-семантику для одношагового соединения ИИ-ускорителей в составе узлов SuperPoD с твердотельными накопителями. Это устраняет необходимость применения различных протоколов, благодаря чему задержка доступа сокращается на 90 % по сравнению с традиционными подходами — с нескольких миллисекунд до 60 мкс. Один кластер обеспечивает суммарную пропускную способность до 40 Тбайт/с, что в 1,5 раза выше, чем у существующих решений. При этом объём памяти, доступной для каждого нейропроцессора (NPU), увеличивается с гигабайт до терабайт. 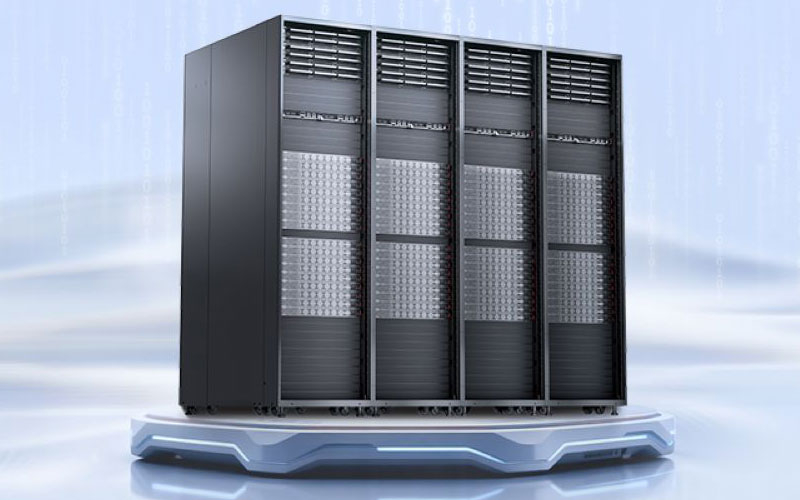
Источник изображения: Huawei Платформа OceanStor M900 использует высокоскоростной интерконнект UnifiedBus. Общая вместимость может достигать 64 Пбайт. В системе реализована технология адаптивного хранения (KV-Aware Adaptive Storage), которая прогнозирует жизненный цикл KV-кеша и перераспределяет нагрузку между SSD для достижения максимальной эффективности и надёжности. В результате, показатель DWPD (полных перезаписей в сутки) для установленных SSD поднимается до 24, что в 16 раз превосходит обычные значения. Благодаря этому значительно снижаются расходы на эксплуатацию, поскольку сокращается необходимость в замене дорогостоящих накопителей. В целом, OceanStor M900 позволяет раскрыть вычислительную мощность SuperPoD-устройств, ресурсы которых в противном случае могут простаивать из-за нехватки памяти для работы с KV-кешем.
18.09.2026 [17:42], Сергей Карасёв
ИИ-ускорители Huawei Ascend 960DT с 288 Гбайт памяти выйдут в начале 2027 годаHuawei поделилась планами по выпуску новых ИИ-ускорителей Ascend. Сообщается, что в I квартале следующего года дебютирует изделие Ascend 960DT, которое придёт на смену Ascend 950. В состав 960DT (аббревиатура расшифровывается как Decode/Training — декодирование/обучение) войдут 288 Гбайт памяти с пропускной способностью 9,6 Тбайт/с — в 2,4 раза больше по сравнению с Ascend 950. При этом сетевые источники указывают на использование памяти HiZQ — собственного решения Huawei, позиционирующегося в качестве альтернативы НВМ. Пропускная способность интерконнекта Ascend 960DT составит 2,2 Тбайт/с. Для нового ускорителя заявлена поддержка форматов FP32, HF32, FP16, BF16, FP8, MXFP8, HiF8, MXFP4 и HiF4. ИИ-производительность в режиме FP8 будет достигать 2 Пфлопс, в режиме FP4 — 4 Пфлопс. В один кластер могут объединяться тысячи таких изделий для масштабирования быстродействия. В частности, посредством NPO могут быть связаны до 4096 эксземпляров Ascend 960DT, что обеспечит суммарную FP4-производительность на уровне 16 Эфлопс. 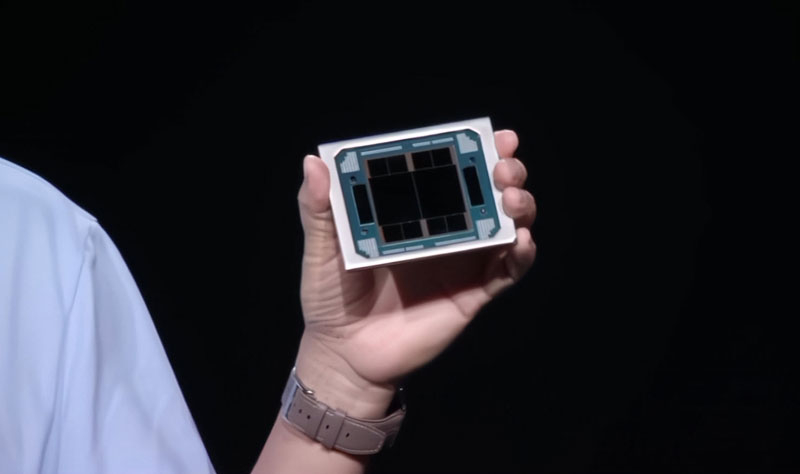
Источник изображения: wccftech.com На III четверть 2027 года намечен анонс карты Ascend 960PR (Prefill/Recommenders — заполнение/рекомендации). Она будет нести на борту 192 Гбайт памяти с пропускной способностью 2,4 Тбайт/с (скорость интерконнекта сохранится на уровне 2,2 Тбайт/с). Это решение обеспечит быстродействие до 2 Пфлопс на операциях FP8 и до 8 Пфлопс в режиме FP4. В 2028 году, как ожидается, появится ускоритель Ascend 970 с 288 Гбайт памяти с пропускной способностью 14,4 Тбайт/с. У данной модели пропускная способность интерконнекта поднимется до 4,4 Тбайт/с. Производительность FP8 и FP4 — до 3,6 и 14 Пфлопс соответственно. Наконец, на 2029-й запланирован выпуск изделия Ascend 980 с 384 Гбайт памяти (38,4 Тбайт/с) и интерконнектом на 8 Тбайт/с. Карта сможет выдавать 7,2 Пфлопс на операциях FP8 и 28 Пфлопс в режиме FP4.
17.09.2026 [02:35], Владимир Мироненко
Huawei представила четырёхуровневый 3D-ЦОД в качестве эталона для ИИ-кластеровКомпания Huawei представила четырёхуровневый 3D-ЦОД в Уху (Wuhu, провинция Аньхой, Китай) с вертикально расположенными системами охлаждения, вычислительным оборудованием, энергосистемами и резервным источником питания, сообщил ресурс TechRepublic. По словам компании, архитектура разработана для размещения более плотной ИИ-инфраструктуры, включая кластеры суперузлов, содержащие более 100 тыс. ускорителей. Использование ИИ-ускорителей в ЦОД влечёт за собой гораздо более высокую плотность энергопотребления. По словам Huawei, мощность серверных стоек выросла с нескольких киловатт до 100 кВт и 200 кВт и, как ожидается, продолжит увеличиваться. А использование масштабных моделей с триллионами параметров и быстро растущий спрос на токены предъявляют повышенные требования к ИИ-инфраструктуре искусственного интеллекта. Поэтому кластеры на базе суперузлов Ascend с более чем 100 тыс. картами станут базовой конфигурацией. 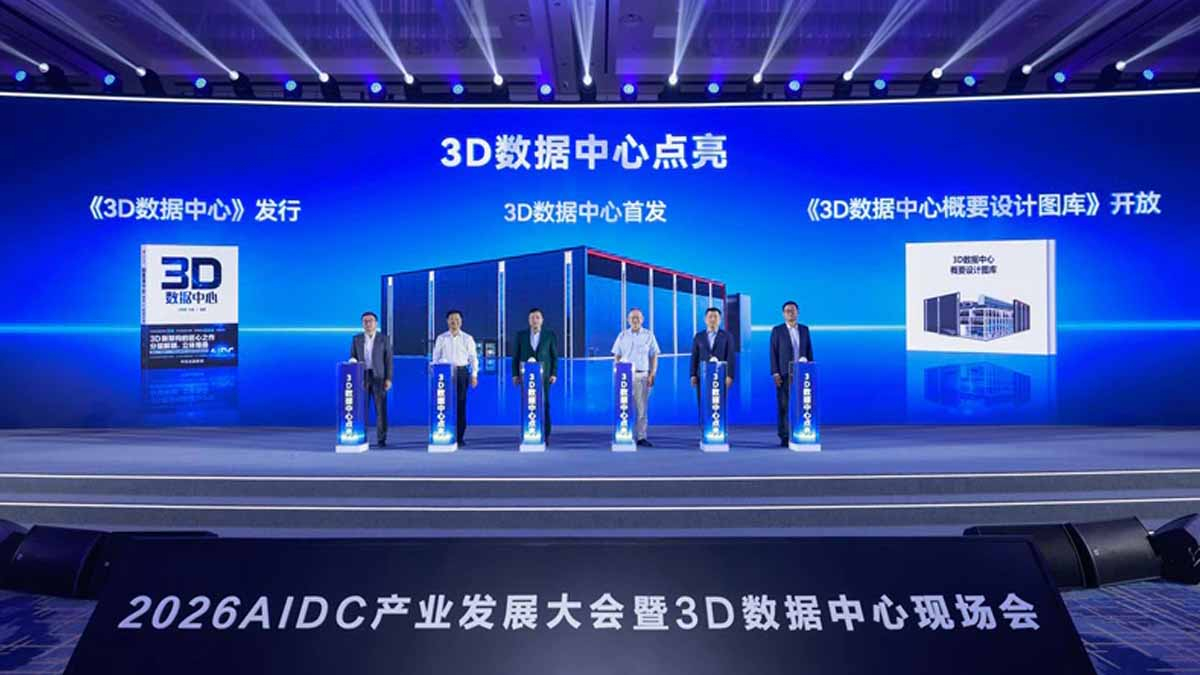
Источник изображения: Huawei «Мы рассматриваем ЦОД как стандартный продукт, который можно тиражировать в больших масштабах, а не как индивидуальный инженерный проект», — заявили в компании. По словам Huawei, более 90 % механических и электрических систем для ЦОД могут предлагаться уже в собранном виде, что сокращает их сроки поставки после заказа примерно с шести до трех месяцев. По данным Pandaily, процесс строительства объекта в Уху занял около девяти месяцев, что гораздо меньше 18-24 месяцев, требующихся для строительства подобных ЦОД. Huawei также представила обзорную библиотеку дизайна 3D-ЦОД, включающую пять разделов: «Вычислительная мощность», «Трансформация», «Реконструкция постоянного тока», «Скачок стоимости», «Шедевр» и «Смена парадигмы». Она охватывает системы водоснабжения, кондиционирования, электрические системы высокого и низкого напряжения и многое другое.
14.09.2026 [15:46], Руслан Авдеев
SpaceX/xAI заполучила загадочного заказчика, который будет приносить ей $13,3 млрд в годВ ходе мероприятия Goldman Sachs Communacopia + Technology Conference 2026 финансовый директор компании Брет Джонсон (Bret Johnson) заявил, что совокупная ежегодная выручка от сдачи в аренду ИИ-мощностей достигла $41,1 млрд, сообщает Datacenter Dynamics. По данным Investing.com, это стало результатом подписания компанией дополнительного контракта на $1,11 млрд/мес. ($13,2 млрд/год). Новый контракт начнёт непосредственно приносить деньги в декабре 2026 года, это уже четвёртый крупный договор SpaceX, заключённый в этом году. В компании говорят, что «хостинг» предоставят некоему ИИ-бизнесу, хотя какому именно — не разглашается. Ранее компания подписала похожие соглашения с Anthropic (до $1,25 млрд/мес.), с Google Cloud ($920 млн/мес. и Reflection AI ($150 млн/мес.). В июле, по слухам, компания вела переговоры с Пентагоном относительно сделки о предоставлении вычислительных мощностей в интересах военного ведомства, которая может приносить миллиарды долларов. На 30 июня SpaceX имела в своём распоряжении 1,4 ГВт мощностей ЦОД, но к концу года мощности должны превысить 2 ГВт, а к концу 2027 — достичь около 10 ГВт. Сейчас у компании есть кампусы ЦОД Colossus 1 и Colossus 2, ведутся работы над третьим, расположенным в Саутхейвене (Southaven). Также компания строит ещё один, четвёртый ЦОД в окрестностях Мемфиса. 
Источник изображения: SpaceXAI Влившаяся в состав SpaceX компания xAI изначально концентрировала усилия на разработке собственной ИИ-модели Grok и использовала вычислительные мощности кампуса ЦОД Colossus в Мемфисе (Теннесси). Похоже, ситуация изменилась, поскольку после сделки с Anthropic стоящий за управлением бизнесами SpaceX/xAI Илон Маск (Elon Musk) активно искал новых клиентов. SpaceX вышла на IPO в июне текущего года. После этого её стоимость значительно выросла и составила около $3 трлн, хотя с тех пор она несколько подешевела. На данный момент её рыночная капитализация составляет около $2 трлн.
10.09.2026 [17:36], Руслан Авдеев
NVIDIA расширит присутствие в Австралии благодаря облачным партнёрам, застройщикам ИИ ЦОД и разработчикамNVIDIA объявила о взаимодействии с расширяющейся в Австралии экосистемой облачных партнёров (NCP), а также с партнёрами в сфере ИИ-инфраструктуры — для того, чтобы сделать более доступными землю, энергоснабжение и готовые объекты ЦОД для размещения многочисленных поколений ИИ-фабрик NVIDIA DSX. Это поможет стране удовлетворить растущий спрос на вычислительные ИИ-мощности — общий объём строительства к 2027 году может достигнуть 2 ГВт. Участвующие в сделке провайдеры будут управлять этими ИИ-фабриками, а NVIDIA намерена предоставить платформу DSX, системы для ускоренных вычислений, сетевое оборудование, ПО и поддержку экосистемы. Австралийские компании с помощью продуктов NVIDIA смогут создавать ИИ-модели, приложения и ИИ-агентов, в то же время поддерживая генерацию электроэнергии. Расширение мощностей обеспечит австралийским разработчикам расширенный доступ к ускоренным вычислениям и открытым моделям NVIDIA Nemotron для решения связанных с ИИ-проектами задач, а развитая «зелёная» энергетика и квалифицированные кадры Австралии станут прочной основой для ИИ-стартапов, университетов, исследователей, ИИ-компаний и др., позволяя обучать, развёртывать и масштабировать ИИ-системы. Участники NCP и партнёры NVIDIA в сфере ИИ-инфраструктуры, включая Firmus, Sharon AI, IREN, Megaport, ResetData, CDC, NEXTDC и AirTrunk уже инвестируют в австралийские ИИ-фабрики на основе NVIDIA DSX. Firmus расширяет инициативу Project Southgate, Sharon AI внедряет десятки тысяч ускорителей NVIDIA, а Iren намерена ускорить внедрение крупномасштабных ИИ-фабрик благодаря компетенциям в сфере энергетики, земельных ресурсов, ЦОД, развёртывания и эксплуатации GPU и эксплуатации инфраструктуры — компания намерена освоить 800-МВт кампус Bundey в Южной Австралии. Latitude.sh (Megaport) и ResetData сделают упор на инференс с низкой задержкой, высокой скоростью отклика и соблюдением правил локализации данных. 
Источник изображения: Datingjungle/unsplash.com CDC построила в Австралии и Новой Зеландии готовую к ИИ и HPC инфраструктуру ЦОД с СЖО. CDC управляет более 550 МВт мощностей, ещё 800 МВт строится. Объекты целиком полагаются на энергию из возобновляемых источников и используют передовые технологии охлаждения без воды, сертифицированные для инфраструктуры NVIDIA. NEXTDC также построила инфраструктуру ЦОД с жидкостным охлаждением, готовую к высокоплотным ИИ-нагрузкам. Наконец, AirTrunk расширяет строительство ИИ ЦОД в регионе, включая решения, рассчитанные на СЖО и высокоплотные ИИ-нагрузки. Heidi и Atlassian уже используют open source модели NVIDIA Nemotron, датасеты и инструменты для разработки и кастомизации ИИ-систем. Так, Heidi комбинирует модели NVIDIA с клиническими данными, обеспечивая новый уровень применения искусственного интеллекта в здравоохранении без ущерба конфиденциальности. Atlassian совершенствует корпоративный семантический поиск Rovo с использованием ИИ NVIDIA, который лучше учитывает контекст и находит релевантные данные в сложных массивах и рабочих процессах. В совокупности данные проекты связывают ИИ-инфраструктуру с открытыми моделями и ПО, позволяющими превратить вычислительные мощности в реальные прикладные проекты. В результате NVIDIA и австралийская экосистема позволяют пользователям масштабировать ИИ внутри Австралии и выводить инновации на мировой рынок, говорит компания.
10.09.2026 [13:55], Руслан Авдеев
Samsung поможет OpenAI в создании следующего поколения ИИ-ускорителейOpenAI разработает ИИ-ускорители следующего поколения с помощью Samsung Electronics, сообщает The Register со ссылкой на Reuters. Компания совсем недавно продемонстрировала первое поколение своих ИИ-ускорителей Jalapeño, превосходящие NVIDIA Blackwell в ряде задач. Впрочем, биржевые игроки уже пришли к выводу, что рост востребованности ИИ ASIC не представляет угрозы NVIDIA, к тому же OpenAI не имеет собственных производственных мощностей. Подавляющее большинство современных чипов выпускает тайваньская TSMC, поэтому OpenAI приходится конкурировать за её производственные мощности с NVIDIA, AMD и практически всеми прочими производителями ИИ-ускорителей и гиперскейлерами. Ситуация с поставками HBM4 для Jalapeño (точнее, для Broadcom, участвующей в производстве), аналогична — предложение такой памяти ограниченно, поскольку её выпускают лишь SK hynix, Micron и Samsung. Сотрудничество с Samsung поможет OpenAI решить обе проблемы. 
Источник изображения: OpenAI Новые чипы OpenAI, вероятно, будут использовать более быструю HBM4E. При этом высока вероятность, что они будут полагаться на перенос контроллеров памяти и прочей «логики» с вычислительного модуля на сам стек HBM, приблизительно то же предусмотрено в NVIDIA NVHBM. Такие решения потребуют более тесного взаимодействия с поставщиком HBM, поэтому развитые отношения с Samsung крайне выгодны OpenAI, даже если вычислительные чиплеты в итоге будут выпускаться TSMC. 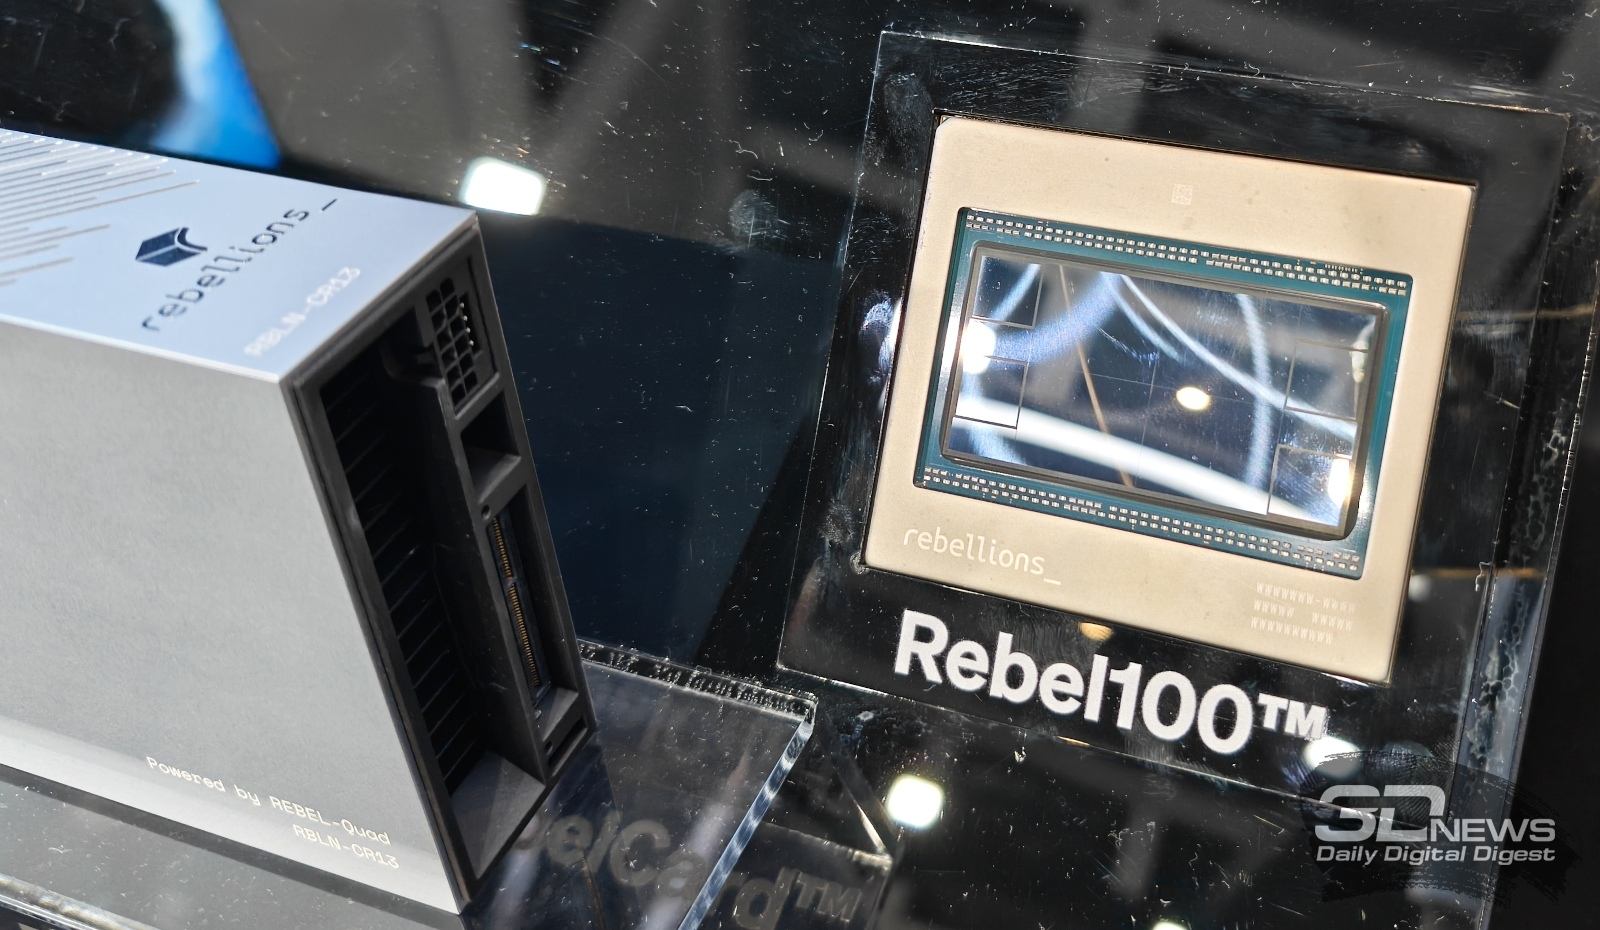 Samsung — второй по величине оператор контрактных фабрик в мире. Компания выпускала немало чипов для NVIDIA, Apple и др. К 2026 году Samsung стала значительно более привлекательным вендором, и разработчики вроде Rebellions, Tenstorrent и Groq активно выпускают на её мощностях свои ИИ-ускорители. Так, Rebel100 (Rebel Quad) использует многокристальную архитектуру и HBM3E, обе технологии нуждаются в передовых методах компоновки. Другими словами, Samsung вполне способна выпускать ускорители для OpenAI. |
|

