
Материалы по тегу: ff
|
10.11.2026 [23:05], Владимир Мироненко
Без CUDA никуда? Конкурентное преимущество NVIDIA в сфере ПО для ИИ сходит на нетКомпания NVIDIA долгое время удерживает лидерство на рынке чипов для искусственного интеллекта. Её ускорители — лучшие в своём классе, но самым значимым преимуществом является программный интерфейс CUDA, пишет The Motley Fool. В течение многих лет разработчики создавали фреймворки на базе CUDA для архитектуры NVIDIA, что, по факту, привязало многих провайдеров ЦОД к использованию чипов именно этого производителя. Но Alphabet, Meta✴ Platforms и Oracle могут пошатнуть серьезное конкурентное преимущество NVIDIA благодаря ряду новых разработок. В прошлом месяце Alphabet представила — технологический стек TorchTPU с открытым исходным кодом, который позволяет запускать рабочие нагрузки PyTorch на собственных тензорных процессорах (TPU), требуя при этом лишь минимальных правок в коде. Компания Amazon также анонсировала собственную программную среду TorchNeuron, обеспечивающую поддержку кода PyTorch на своих чипах Trainium. Meta✴ наладила сотрудничество с обеими компаниями, чтобы получить возможность использовать альтернативные ускорители и не зависеть исключительно от продукции NVIDIA. Следует отметить, что то, что PyTorch теперь можно легко запустить на TPU от Alphabet или чипах Trainium, ещё не означает, что производительность будет такой же высокой, как на GPU NVIDIA, поскольку PyTorch оптимизирован для работы с CUDA и оборудованием NVIDIA. Тем не менее последние достижения открывают путь для дальнейшей оптимизации и упрощают перенос кода, а конкурирующие чипы в будущем могут стать гораздо более производительными. А, например, у китайских компаний выбора вообще нет, поэтому они или адаптируют чипы под CUDA, или целиком отказываются от программной экосистемы NVIDIA. 
Источник изображения: NVIDIA В начале этого года Alphabet начала продавать системы на базе TPU сторонним компаниям, а недавно пресдставила ускорители TPU 8tx для корпоративного использования. Кроме того, с 2027 года TPU станут доступны в облаке Oracle Cloud Infrastructure (OCI). Это позволит клиентам Oracle перенести часть рабочих нагрузок на TPU — что может обеспечить более высокую производительность, более выгодные цены (или и то, и другое) по сравнению с GPU NVIDIA. Более того, это даёт шанс воспользоваться TPU тем разработчикам, которые «привязаны» к Oracle из-за размещения своих баз данных в OCI. Amazon теперь тоже готова продавать Trainium сторонним ЦОД. Появившаяся у провайдеров возможность получать высокую отдачу от инвестиций, используя альтернативные ускорители для ИИ-задач ещё больше ослабляет позиции NVIDIA. Ситуация для NVIDIA осложняется еще и тем, что благодаря развитию платформы PyTorch специализированные чипы — например, от Alphabet или Amazon — становятся всё более эффективными и востребованными. Доминирование NVIDIA в сегменте оборудования для ЦОД слабнет, и последние события указывают на то, что её отрыв от конкурентов может быть не таким значимым, как полагали некоторые инвесторы, подытожил ресурс Fool.com.
06.11.2026 [16:37], Сергей Карасёв
Supermicro, IBM и NVIDIA представили хранилище для работы с KV-кешемКомпания Supermicro в партнёрстве с IBM и NVIDIA анонсировала специализированную аппаратно-программную платформу, предназначенную для работы с KV-кешем. Система позволяет значительно сократить время, необходимое ИИ-моделям для начала генерации ответа по запросу пользователя. Аппаратной основой платформы служат серверы хранения Supermicro Petascale класса All-Flash. Такие устройства выполнены в форм-факторе 1U на процессоре AMD EPYC Turin (до 96 ядер). Поддерживается до 9 Тбайт DDR5-4400 в виде 24 модулей. Упомянуто применение сетевых технологий NVIDIA Spectrum-X. Питание обеспечивают два блока мощностью 1600 Вт с резервированием и сертификатом 80 Plus Titanium. Во фронтальной части узлов хранения расположены 16 отсеков для накопителей E3.S 1T с интерфейсом PCIe 5.0 x4 (NVMe). Кроме того, есть два внутренних коннектора M.2 M-key 2280/22110 для SSD с интерфейсами PCIe 3.0 x2 и PCIe 3.0 x4. Предусмотрены два слота PCIe 5.0 x16 для карт FHHL и два разъёма OCP 3.0 (PCIe 5.0 x16). Устройство оборудовано сетевым портом управления 1GbE (RJ45), коннектором D-Sub и четырьмя портами USB 3.0 Type-A (по два спереди и сзади). Используется воздушное охлаждение с восемью вентиляторами диаметром 40 мм. Программная часть включает софт IBM Storage Scale, а также фреймворк NVIDIA Dynamo. В тестах новой платформы на модели со 120 млрд параметров при длине промпта в 130 тыс. токенов время до выдачи первого ответа оказалось в 56 раз меньше по сравнению с обычными системами. Кроме того, при увеличении длины запроса с 30 тыс. до 130 тыс. токенов задержка поднялась всего на 0,377 с. 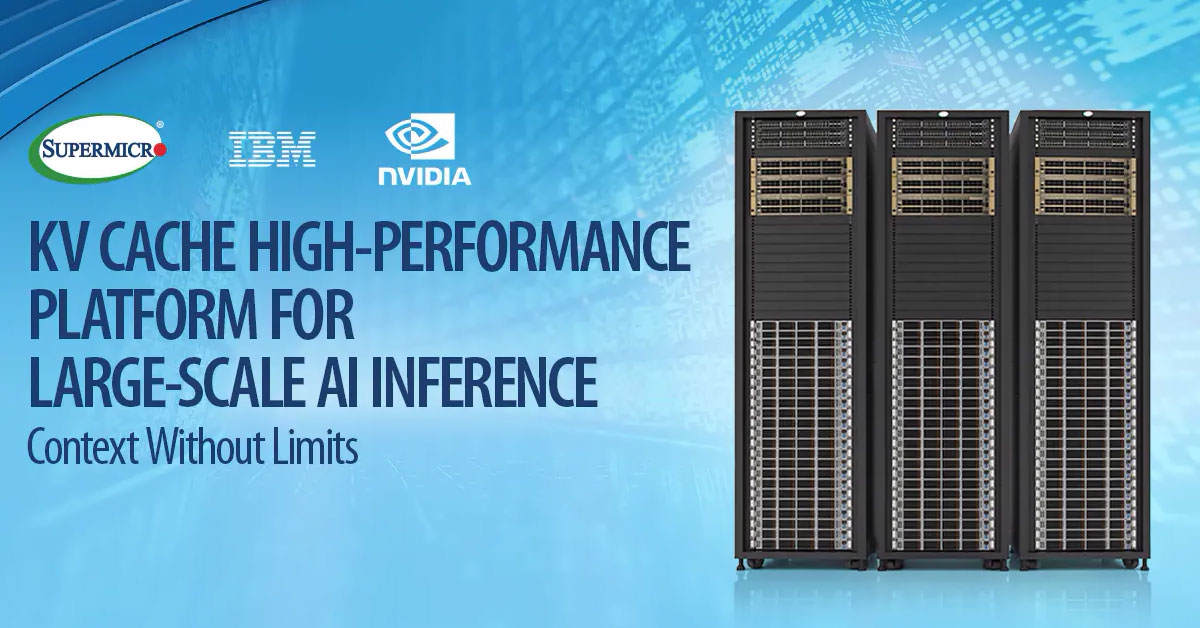
Источник изображения: Supermicro
28.10.2026 [11:42], Руслан Авдеев
NVIDIA, AMD и Broadcom купят акции Meta✴ на $5 млрдMeta✴ Platforms объявила о намерении NVIDIA и AMD приобрести акции компании на $4 млрд. Производители чипов купят их в рамках «распродажи» Meta✴ ценных бумаг на $95 млрд в ближайшем будущем — IT-гигант намерен получить средства для дальнейшего развития своих ИИ-проектов, сообщает Silicon Angle. По имеющимся данным, в покупке акций заинтересована и Broadcom. Всего, по информации Meta✴, три компании намерены инвестировать в акции $5 млрд. NVIDIA готова потратить на ценные бумаги Meta✴ $3 млрд в рамках расширения партнёрства. При этом Meta✴ готовится нарастить использование Vera Rubin, вероятно, в рамках систем Vera Rubin NVL72. Также Meta✴ намерена покупать больше сетевого оборудования NVIDIA. Она расширит использование семейства продуктов Spectrum-X, включая чипы SuperNIC/ BlueField-4 и коммутаторы. NVIDIA поможет Meta✴ увеличить производительность и рентабельность семейства ИИ-моделей Meta✴ Muse. Дополнительно Meta✴ планирует исследовать «возможности сотрудничества», связанные с представленной не так давно эталонной архитектурой NVIDIA — т.н. OpenShell Reference Architecture, представляющей собой набор технических ресурсов, позволяющих упростить использование инструментария NVIDIA OpenShell. Последний позволяет запускать ИИ-агентов в изолированных «песочницах» для минимизации киберугроз. 
Источник изображения: Towfiqu barbhuiya/unsplash.com AMD, готовая инвестировать в Meta✴ $1 млрд, раскрыла, что последняя взяла на вооружение стоечную платформу AMD Helios AI. Сообщается, что Meta✴ уже внедрила «начальный» набор стоек Helios и уже тестирует их. В будущем компания намерена расширить использование этих систем и развернуть кастомные ИИ-ускорители AMD Instinct. Производитель чипов, в свою очередь, будет использовать собранные в ходе сотрудничества технические данные для совершенствования своих чипов и дизайна стоек. Данные об инвестициях Broadcom не были официально обнародованы, но, учитывая, что NVIDIA и AMD готовы вложить в акции Meta✴ в общей сложности $4 млрд из заявленных $5 млрд, речь, вероятно, идёт об $1 млрд.
27.10.2026 [15:52], Руслан Авдеев
Meta✴ собралась привлечь $95 млрд на развитие ИИ-проектов и «суперинтеллекта»Компания Meta✴ объявила о намерении привлечь $95 млрд для поддержки инвестиций в ИИ-инфраструктуру и работы над «суперинтеллектом». Рынок ответил на анонс небольшим спадом, а NVIDIA, AMD и Broadcom выразили заинтересованность в покупке ценных бумаг на сумму до $5 млрд, сообщает CNBC. На первом этапе IT-гигант намерен привлечь $35 млрд путём публичного размещения акций с гарантированным выкупом андеррайтерами (underwritten public equity offerings), ещё $60 млрд рассчитывают привлечь через программу размещения акций на открытом рынке по текущим рыночным ценам. Новость появилась на фоне рекордных трат гиперскейлеров на ИИ-инфраструктуру. По оценкам Goldman Sachs, связанные с ИИ капитальные затраты могут составить порядка $7,6 трлн с 2026 по 2031 гг. в сегментах вычислительных мощностей, ЦОД и энергетики. Компания сообщала, что вырученные средства поддержат «новые возможности в сфере ИИ», включая семейство приложений Meta✴, ИИ-агента Muse и связанный с ЦОД бизнес. Планируется финансировать ИИ за счёт операционных денежных потоков компании, заёмных средств с инвестиционным кредитным рейтингом, партнёрств и акционерного капитала. 
Источник изображения: Jakub Żerdzicki/unsplash.com На прошлой неделе компания опубликовала финансовые результаты за III квартал, согласно которым выручка выросла на 26 % г/г, до $64,60 млрд против $63,37 млрд ожидавшихся. Впрочем, инвесторы обратили больше внимания на отрицательный свободный денежный поток и повышение годового прогноза капитальных затрат. Теперь компания рассчитывает, что капитальные затраты за год составят $135–$145 млрд, ранее речь шла о $130 млрд (по некоторым данным — об $115–135 млрд). По данным самого гиперскейлера, компания строит четыре суперкластера мощностью более 1 ГВт каждый и намерена почти удвоить инфраструктурную мощность в 2026 году в сравнении с предыдущим. Решение привлечь новые средства отражает огромный масштаб инвестиций, необходимых для участия в гонке ИИ. Тем временем на рынки капитала выходят другие гиганты вроде Google, Anthropic и SpaceX. Глава последней Илон Маск (Elon Musk) даже предрёк истощение финансирования для неооблачных бизнесов. Ранее Gartner сообщала, что большинство из них не переживёт ближайшие годы в роли самостоятельных бизнес-структур. Alphabet намерена привлечь $85 млрд в будущем июне, а SpaceX закрыла раунд финансирования на $40 млрд. Anthropic, тем временем, подала заявку на IPO. Кроме того, в ближайшие годы американское подразделение TikTok намерено обеспечить себе несколько гигаватт вычислительных мощностей.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 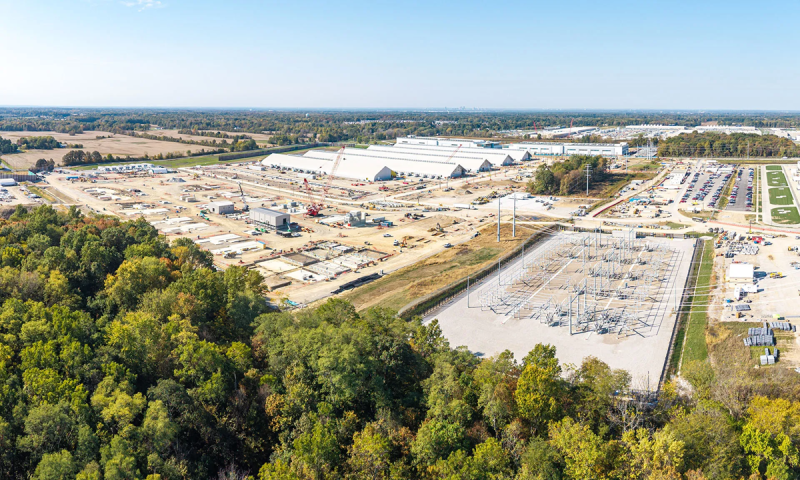
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 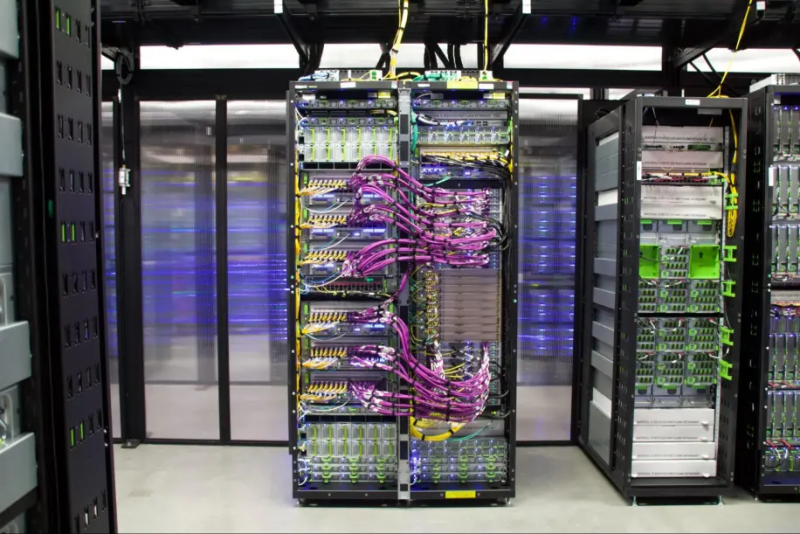
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
19.10.2026 [09:32], Владимир Мироненко
Восемь на одного: Meta✴ представила сетевую архитектуру Flattened Planar Fabric для ИИ-инфраструктурыMeta✴ представила ИИ-архитектуру Flattened Planar Fabric (FPF), созданную для масштабирования обширной ИИ-инфраструктуры и поддержки вычислительных нагрузок нового поколения. В архитектуре FPF каждый GPU подключается посредством восьми независимых каналов по 100 Гбит/с к восьми разным коммутаторам. 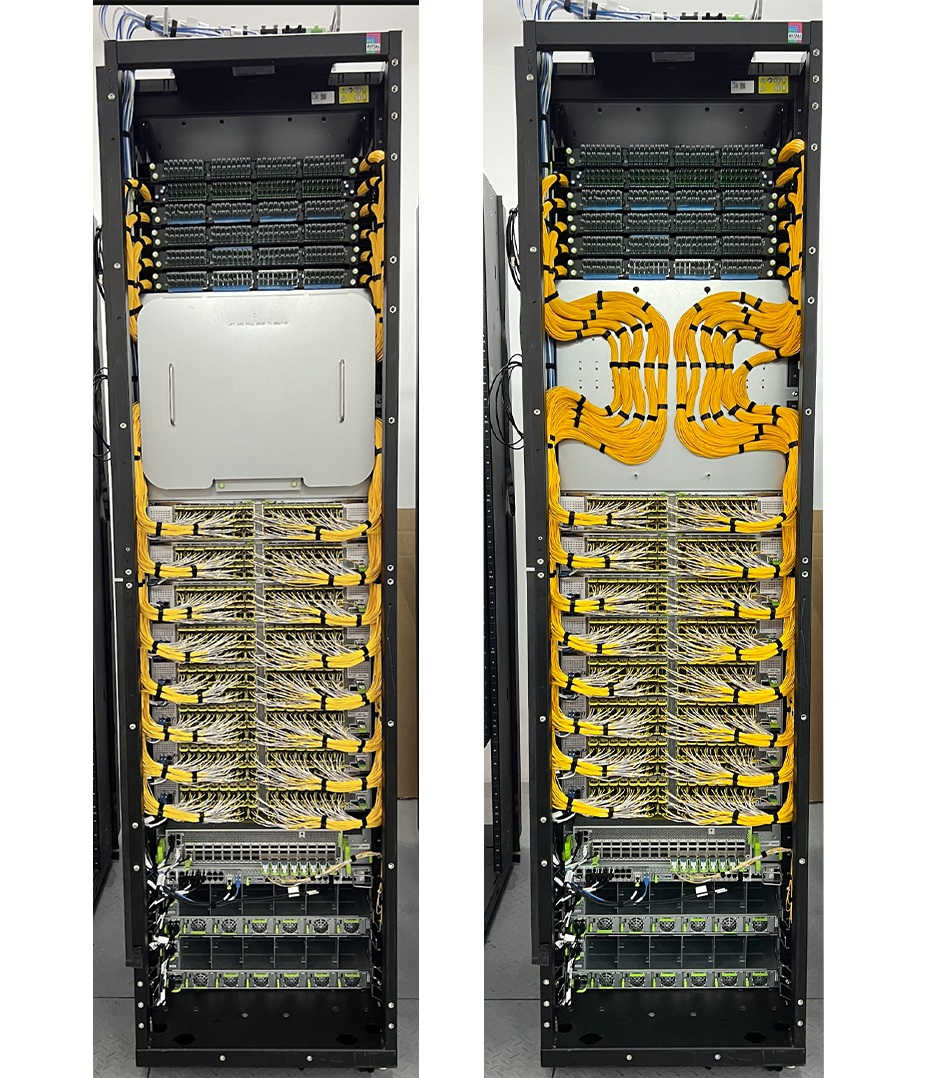
Источник изображений: Meta✴ Такой подход приходит на смену традиционной архитектуре единичных восходящих каналов (uplink), обеспечивая четыре ключевых преимущества:
Оборудование включает коммутаторы IceCube с пропускной способностью 102,4 Тбит/с в стойке IcePack (ORv3-HPRv1) с жидкостным охлаждением. Внутри каждой стойки размещаются модули коммутации IceCube — устройства с пропускной способностью 102,4 Тбит/с, обеспечивающие неблокирующую коммутацию для 128 портов по 800 Гбит/с каждый. Модули IceCube представлены в двух вариантах: на базе специализированных интегральных схем (ASIC) Broadcom Tomahawk6C или NVIDIA Spectrum-6. 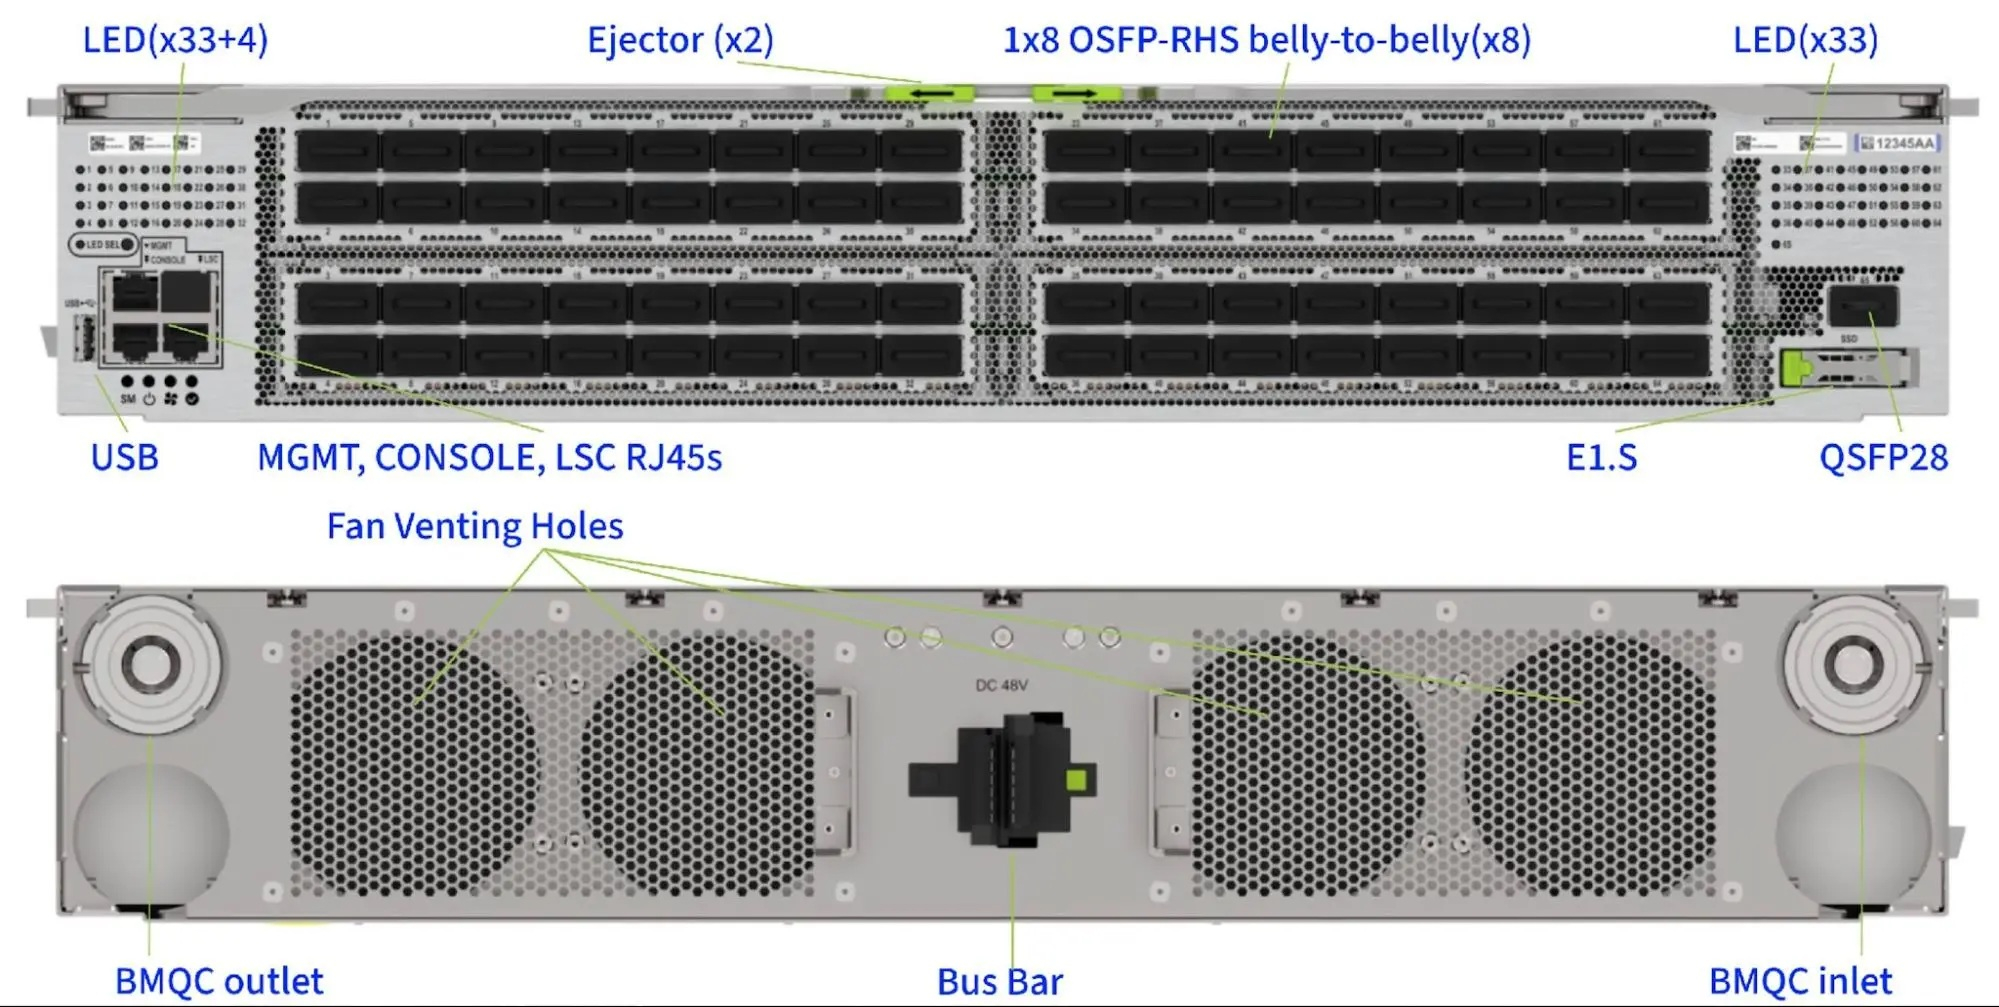
IceCube Оба решения работают под управлением открытой NOS FBOSS от Meta✴, которая использует интерфейс абстракции коммутаторов OCP SAI (Switch Abstraction Interface). Архитектура Open Switch Platform Architecture (OSPA) обращается к функциям управления, включая последовательность включения питания, обнаружение компонентов, терморегулирование, восстановление микропрограммного обеспечения и диагностика. 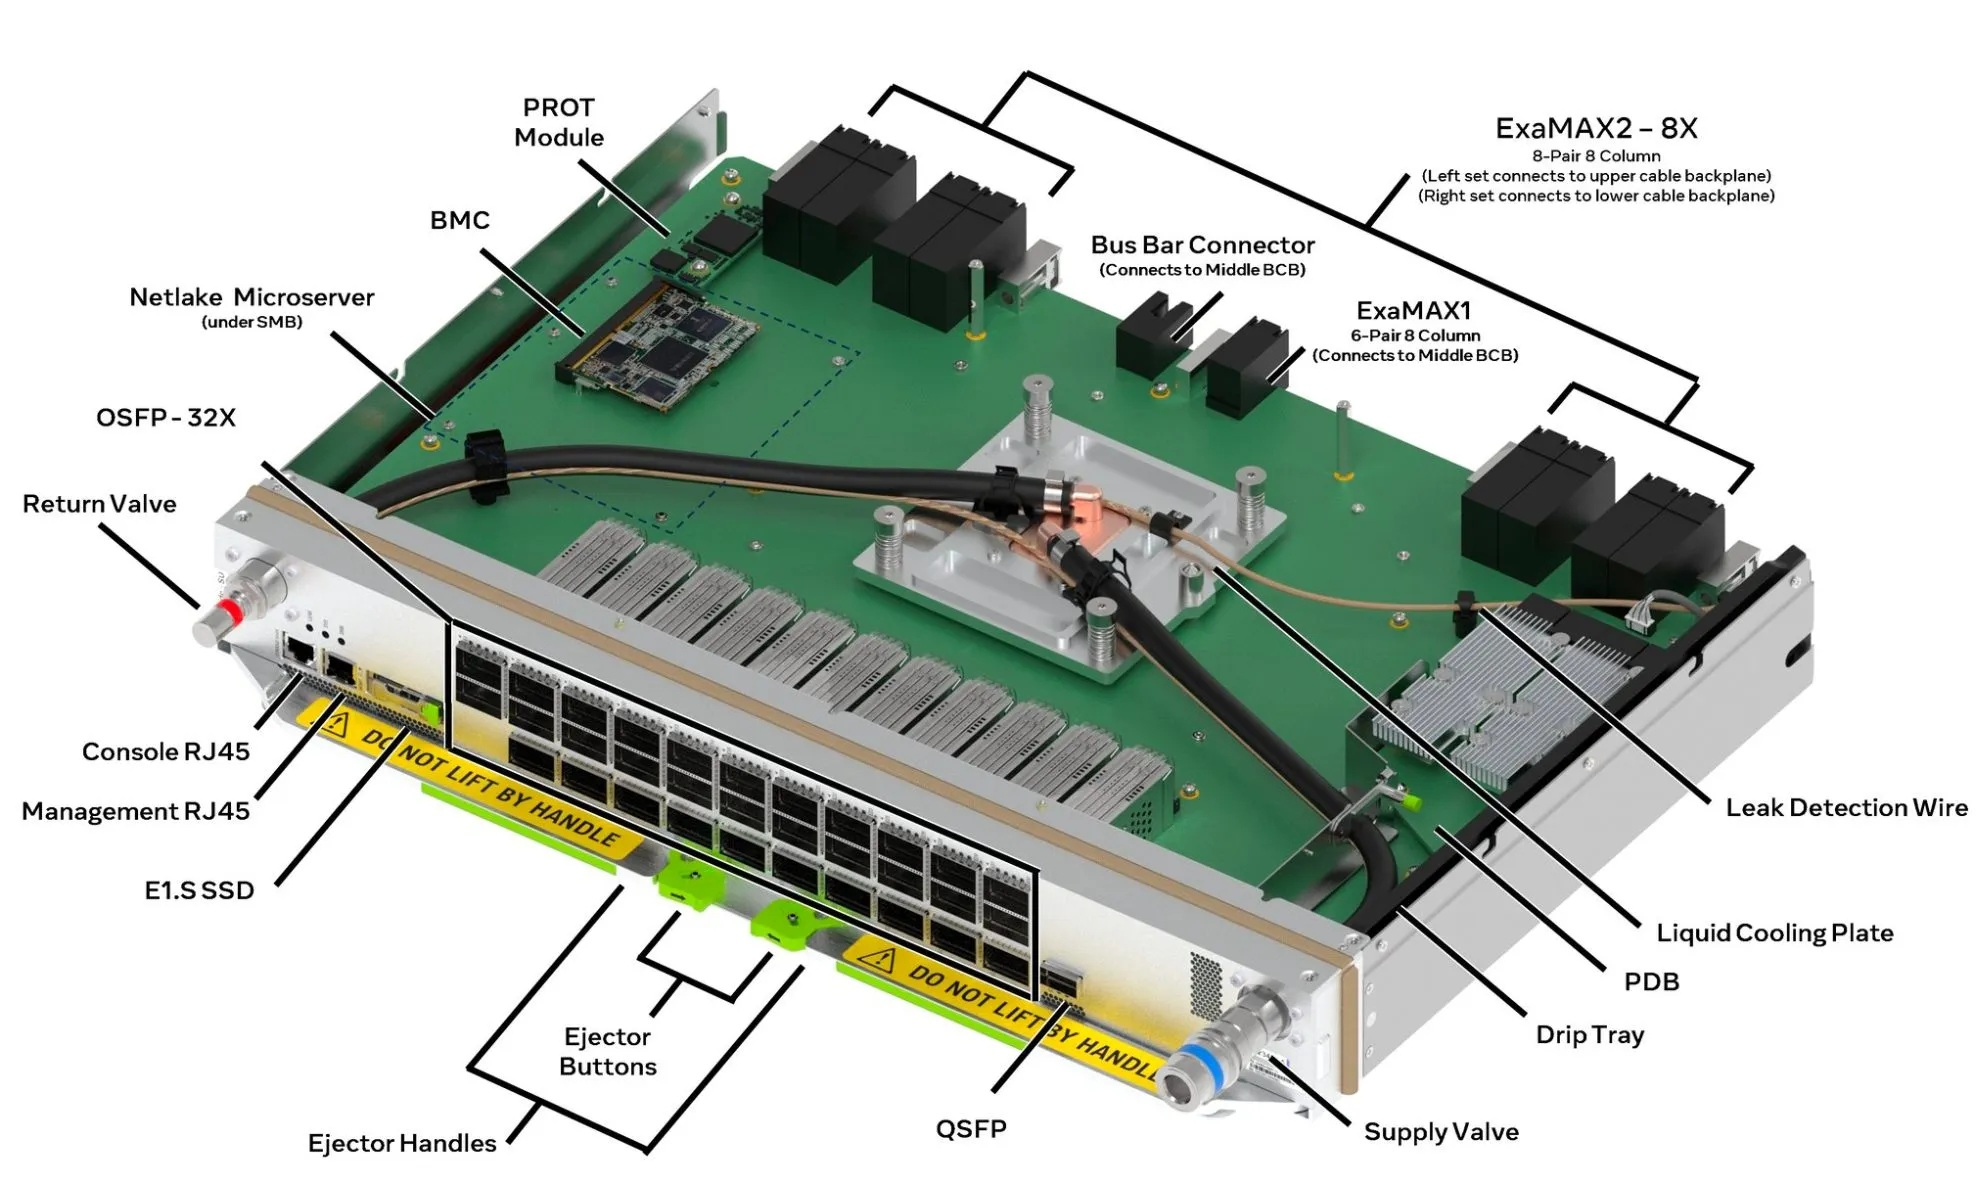
Tahan FPF переносит управление платформой преимущественно на сторону хоста, сохраняя при этом традиционный BMC для функций контроля и восстановления. FPGA-мосты I/O, подключённые через PCIe, объединяют периферийные интерфейсы, а модель учёта аппаратных средств, организованная в виде иерархической структуры, предоставляет ПО согласованный способ перечисления компонентов. Предложение также охватывает автономное управление питанием, обнаружение утечек и резервные образы прошивки. Следует отметить, что это проектные требования, находящиеся на стадии рассмотрения, а не доказательство функциональной совместимости между всеми решениями участвующих вендоров. 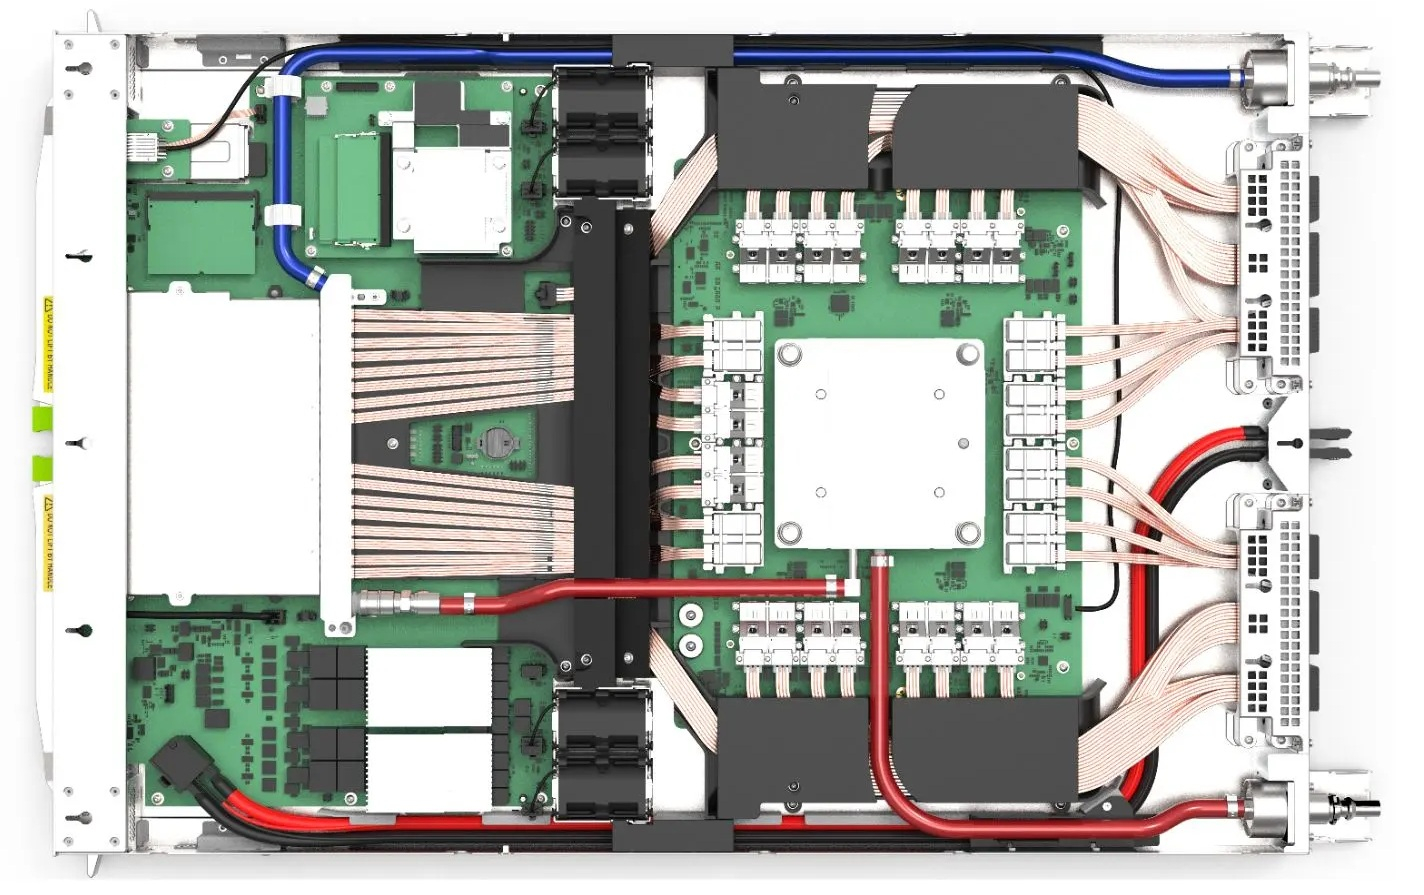
ESUN для MTIA 300 Также Meta✴ сообщила подробности о коммутаторе Tahan Ethernet Scale Up для MTIA 300, показала прототип стойки на 72 ускорителя и анонсировала открытую реализацию MetaRoCE. Эти элементы отражают разные стадии разработки: сейчас Tahan использует режим lossless RoCE, в будущих аппаратных решениях для вертикального масштабирования планируется переход на ESUN, а версия OSPA 1.0.0 пока остаётся на рассмотрении в OCP. 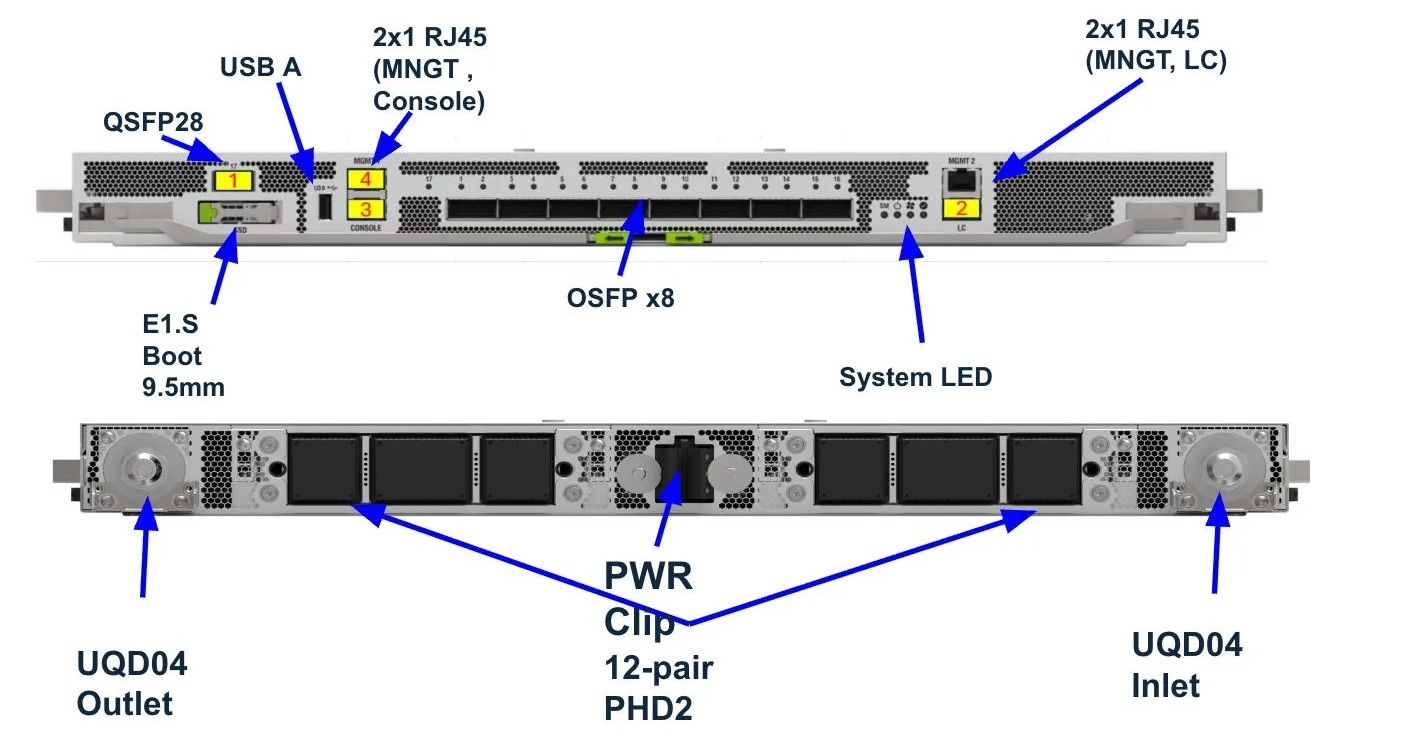
ESUN для MTIA 300 Tahan построен на базе ASIC Tomahawk 5 с пропускной способностью 51,2 Тбит/с (64 × 800G). Четыре коммутатора Tahan соединяют 16 ускорителей в неблокирующей топологии. Компания отметила, что Tahan использует тот же самый lossless RoCE (маршрутизируемый IPv6, PFC и QoS, настроенный для ИИ), объединяя scale-up и scale-out сети под управлением FBOSS. Параллельно компания работает над CXL-фабриками масштаба целого ЦОД.
17.10.2026 [09:53], Павел Котов
SP Industrial анонсировала шесть SSD на eTLC-памятью и ресурсом до 3 DWPDКомпания SP Industrial анонсировала шесть SSD на базе памяти 3D NAND eTLC, оснащённых DRAM-буфером и защитой от сбоев питания (PFP). Новинки доступны в форм-факторах E1.S, U.2, M.2 2280 и SATA SFF, передаёт StorageReview.com. Некоторые из моделей имеют повышенный ресурс работы — до трёх полных циклов перезапись в день (3 DWPD). Впрочем, полные характеристики новинок пока не приводятся. Ранее SP Industrial, являющаяся промышленным подразделением Silicon Power и выпускающая накопители для автомобильной электроники, сетевого оборудования, систем автоматизации и периферийных ИИ-вычислений, предлагала накопители U.2 с интерфейсом не выше PCIe 4.0, тогда как новые модели E1.S и U.2 имеют поддержку PCIe 5.0. Кроме того, новые U.2 SSD отличает ёмкость до 15,3 Тбайт. SP Industrial EE1S3F0 в форм-факторе E1.S поддерживает ZNS, имеет ёмкость до 7,6 Тбайт и доступна в вариантах 1 или 3 DWPD. Форм-фактор U.2 представлен тремя моделями ESSU3J0, ESSU3F0 и ESSU3I0 с поддержкой интерфейсов PCIe 4.0/5.0 и износостойкостью 1 или 3 DWPD (разбивка по моделям не приводится). Загрузочные накопители EMEC3I0 в форм-факторе M.2 2280 поддерживают только PCIe 4.0 и имеют ёмкость от 480 Гбайт до 1,9 Тбайт. Наконец, SFF-модель с интерфейсом SATA 3 имеет объёмот 480 Гбайт до 7,6 Тбайт. Для неё также доступны варианты с ресурсом 1 и 3 DWPD. Дополнительно производитель указывает на низкое потребление энергии и незначительный нагрев при работе — решение тоже позиционируется как загрузочное. 
Источник изображения: SP Industrial
14.10.2026 [13:18], Сергей Карасёв
Чтение до 20 млн IOPS: Kioxia показала SSD GP1 на базе XL-Flash третьего поколенияKioxia показала улучшенные твердотельные накопители серии GP1, построенные на основе памяти XL-Flash третьего поколения. Эти устройства ориентированы на высокопроизводительные ИИ-системы, где выполняют функции сверхбыстрого промежуточного уровня хранения между памятью HBM и стандартными SSD. Оригинальные изделия Kioxia GP1 дебютировали в августе нынешнего года. Они выполнены на флеш-памяти XL-Flash второго поколения и оснащены интерфейсом PCIe 6.0 (NVMe 2.2). Заявленный показатель IOPS (количество операций ввода-вывода в секунду) достигает 10 млн при произвольном чтении данных блоками по 512 байт. Доступны варианты в форм-факторах E3.S и E1.S. У новых SSD семейства GP1 величина IOPS при произвольном чтении увеличилась вдвое — до 20 млн. Кроме того, XL-Flash третьего поколения обеспечивает в три раза более высокую скорость чтения и примерно на 150 % более высокую скорость записи по сравнению с предшественниками. Новая флеш-память отличается укороченными шинами, что позволило снизить RC-задержку. 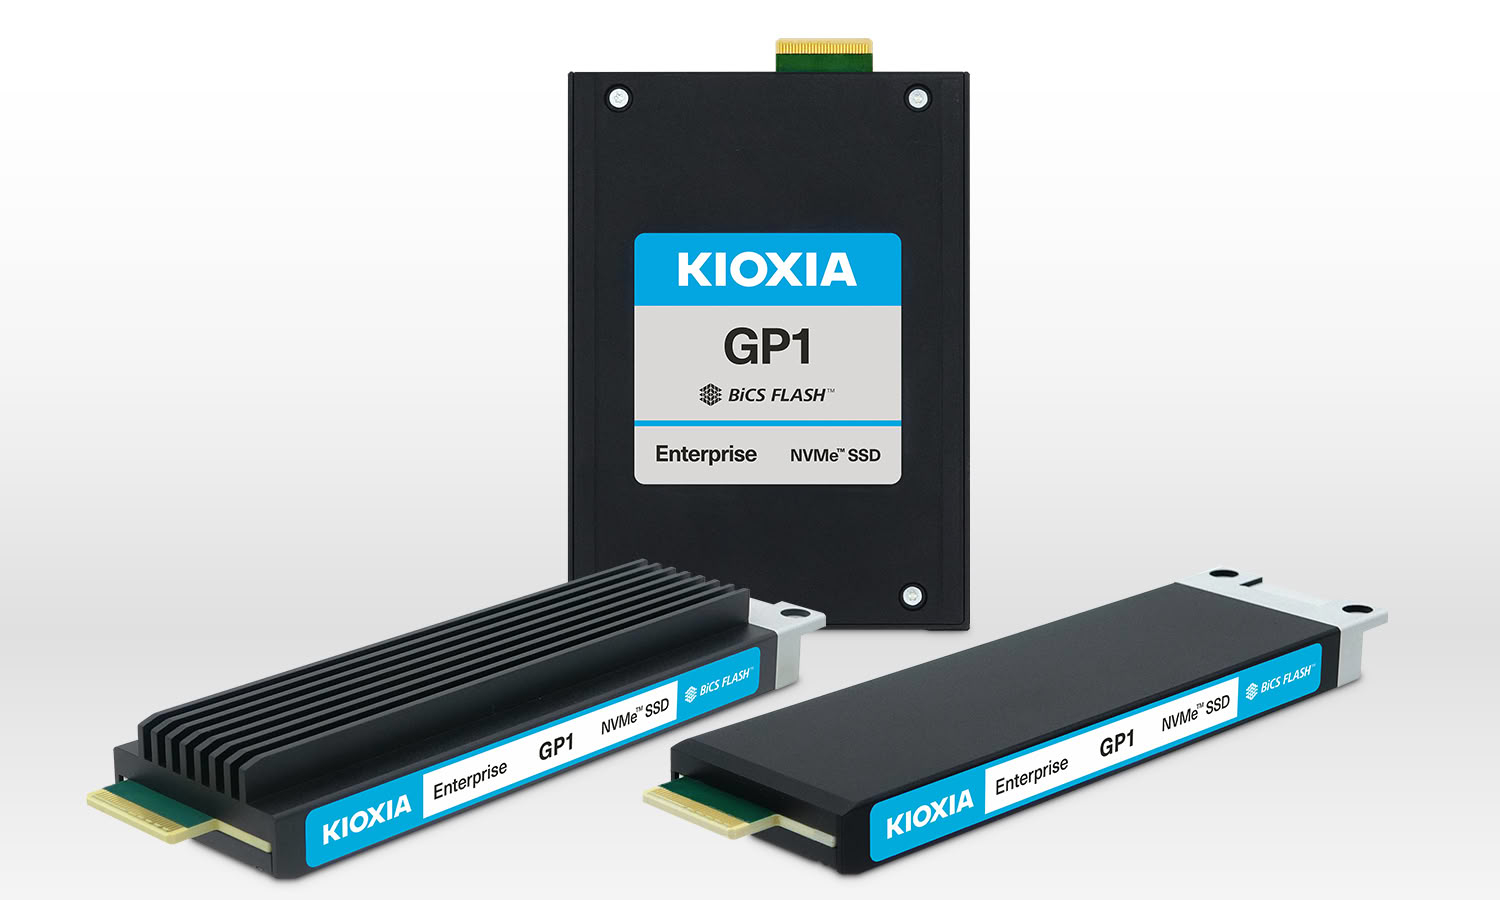
Источник изображения: Kioxia Кроме того, увеличилось количество независимых плоскостей памяти в расчёте на кристалл (XL-Flash второго поколения насчитывает 16 таких плоскостей). Общая эффективность выросла приблизительно на 40 % при чтении и на 80 % при записи, однако энергопотребление на каждую операцию, по оценкам, несколько увеличилось. Прочие технические характеристики улучшенных SSD пока не раскрываются. В оригинальных накопителях GP1 применяются ячейки MLC (два бита информации), работающие в режиме pSLC. Устройства способны выдерживать до 50 полных перезаписей в сутки (DWPD).
14.10.2026 [13:10], Сергей Карасёв
E3.S ёмкостью до 30,72 Тбайт: Kioxia представила SSD серии CM9-DLC с поддержкой СЖОKioxia анонсировала SSD семейства CM9-DLC с поддержкой прямого жидкостного охлаждения. Накопители ориентированы на применение прежде всего в ИИ-серверах для кеширования контекста. Изделия выполнены в форм-факторе E3.S с двухпортовой конфигурацией. Задействованы чипы флеш-памяти BiCS FLASH TLC NAND восьмого поколения; для обмена данными служит интерфейс PCIe 5.0 (NVMe 2.0, NVMe-MI 1.2). Говорится о поддержке отдельных положений спецификации OCP Datacenter NVMe SSD v2.5. Накопители CM9-DLC будут предлагаться в вариантах для смешанных нагрузок и интенсивного чтения. В первом случае вместимость составляет 6,4, 12,8 и 25,6 Тбайт. Скорость последовательного чтения варьируется от 13 500 до 14 800 Мбайт/с, скорость последовательной записи — от 9750 до 11 000 Мбайт/с. Величина IOPS при произвольном чтении данных блоками по 4 Кбайт составляет от 3,2 до 3,4 млн, при произвольной записи — 800 тыс. Такие устройства рассчитаны на три полных перезаписи в сутки (величина DWPD) на протяжении пяти лет. 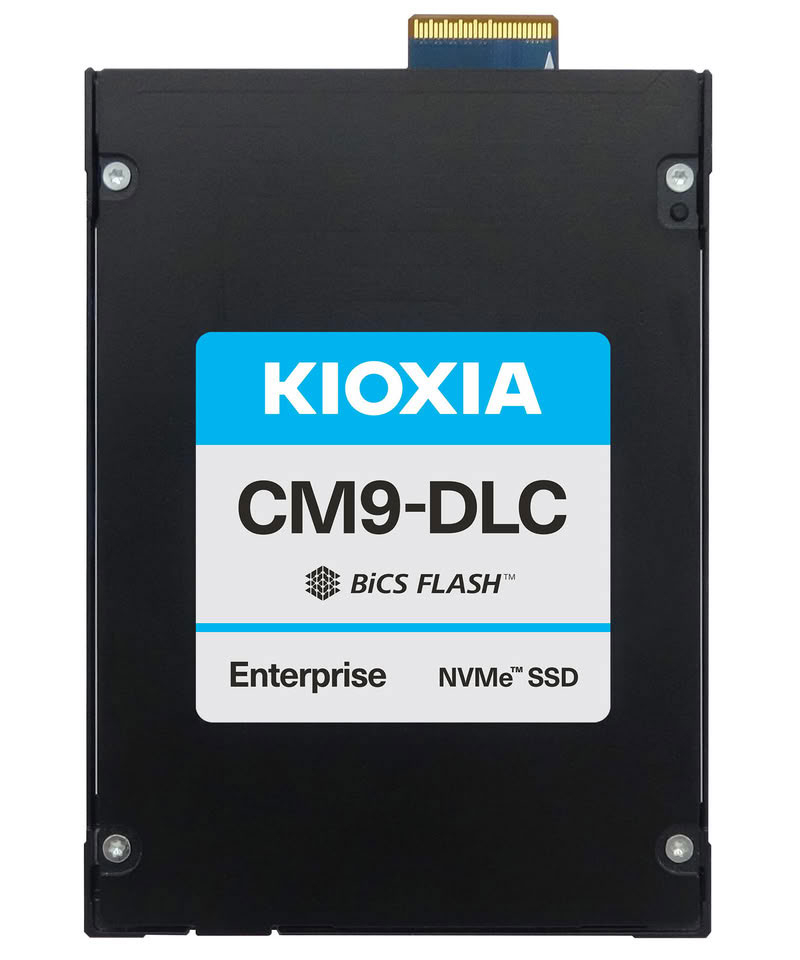
Источник изображения: Kioxia В свою очередь, изделия, оптимизированные для операций чтения, могут иметь ёмкость 7,68, 15,36 и 30,72 Тбайт. Их скоростные показатели аналогичны SSD для смешанных нагрузок. При этом значение IOPS при произвольном чтении находится в диапазоне от 2,75 до 3,4 млн, а при произвольной записи — от 270 до 500 тыс. Устройства выдерживают одну полную перезапись в сутки в течение пяти лет. Все новые накопители могут устанавливаться в серверы как с СЖО, так и с традиционным воздушным охлаждением. Предусмотрены средства защиты данных при внезапном отключении питания Power Loss Protection (PLP), функция мгновенного уничтожения информации (SIE) и инструменты сквозного шифрования. Пробные поставки SSD уже начались.
09.10.2026 [16:59], Сергей Карасёв
E1.L вместимостью до 122,88 Тбайт: Kioxia представила QLC SSD серии LD4Компания Kioxia анонсировала SSD семейства LD4 — свои первые твердотельные накопители типоразмера E1.L. Устройства предназначены для использования в серверах высокой плотности форм-фактора 1U, ориентированных на инфраструктуры гиперскейлеров и крупные дата-центры. В изделиях применены 218-слойные чипы флеш-памяти BiCS 8 QLC NAND. Говорится о соответствии стандарту PCIe 5.0, но фактически накопители работают в режиме PCIe 4.0 x4. На начальном этапе в серию войдут модели вместимостью 15,36 и 30,72 Тбайт, а в перспективе могут появиться модификации ёмкостью до 122,88 Тбайт. Новинки получили однопортовую конфигурацию. Упомянута поддержка спецификации NVMe 2.0e и отдельных положений спецификации OCP Datacenter NVMe SSD 2.6. Скорости чтения/записи, показатели IOPS и надёжности пока не раскрываются. При этом подчёркивается, что накопители оптимизированы для объектных хранилищ, задач ИИ и машинного обучения. Средства Power Loss Protection (PLP) отвечают за сохранность информации при внезапном отключении питания. Кроме того, реализовано сквозное шифрование. Габариты составляют 318,75 × 38,4 × 9,5 мм. 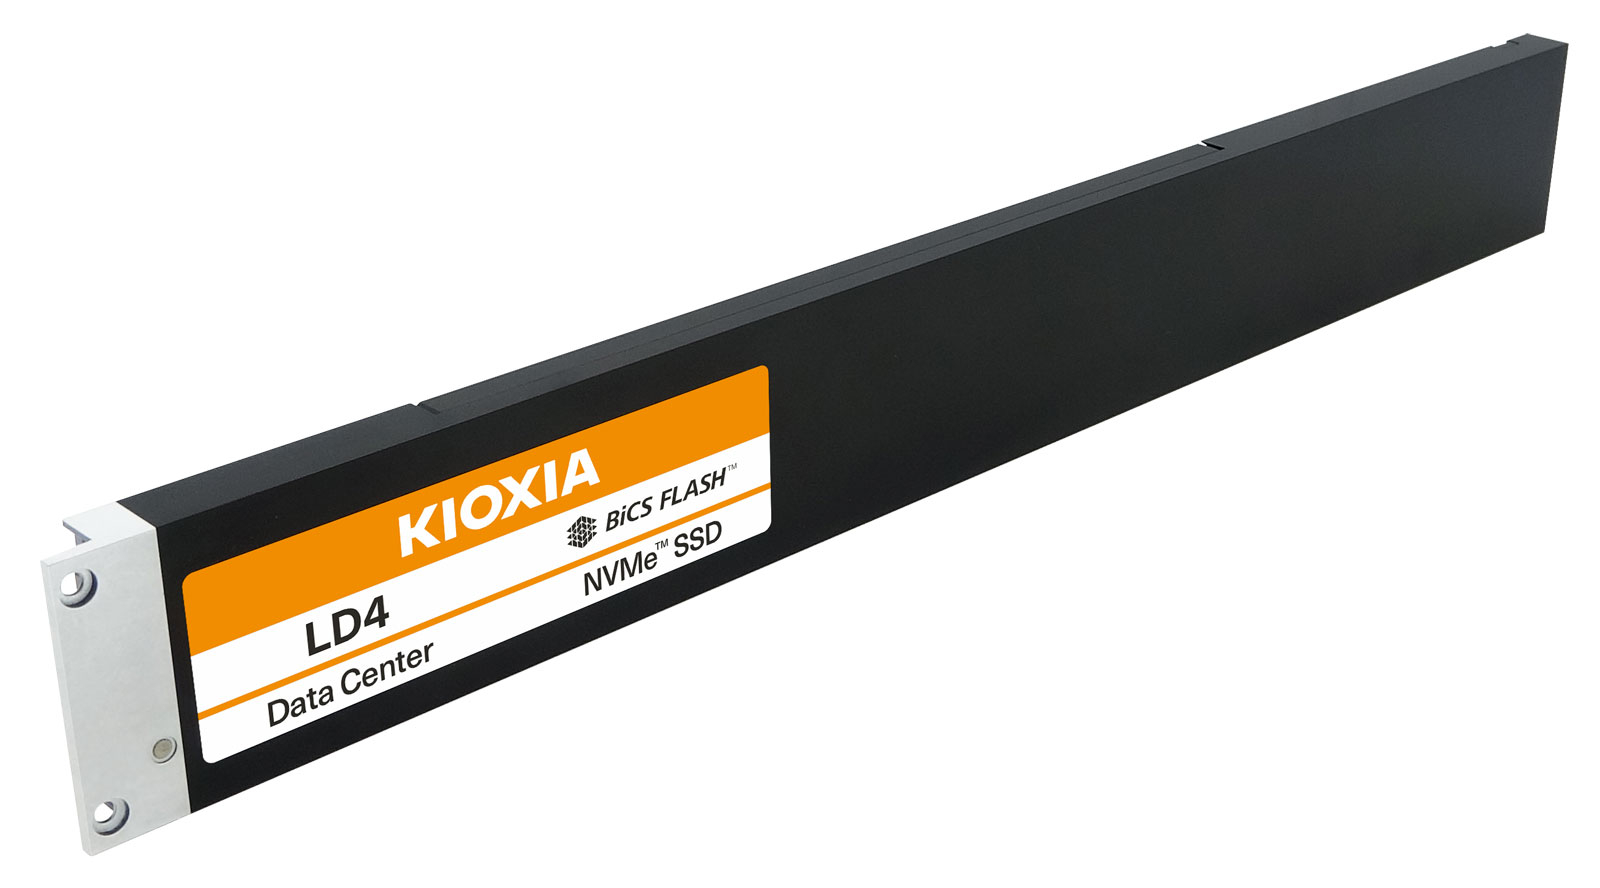
Источник изображения: Kioxia Накопители будут демонстрироваться на мероприятии OCP Global Summit 2026. Там же Kioxia покажет улучшенные SSD семейства GP Series на основе памяти XL-Flash третьего поколения. У них величина IOPS на операциях произвольного чтения блоков данных по 512 байт превышает 20 млн. Посетители саммита также смогут увидеть накопители Kioxia NX1 формата E1.S с жидкостным охлаждением. Все эти изделия рассчитаны на применение в современных дата-центрах. |
|

