
Материалы по тегу: оркестрация
|
29.10.2026 [01:22], Владимир Мироненко
IBM представила инструменты для контролируемого использования ИИ-агентов в бизнес-системахIBM анонсировала новые возможности, которые помогут разработчикам, IT-специалистам и экспертам по безопасности внедрять ИИ-агентов в бизнес-системы, обеспечивая чёткое разграничение полномочий и подотчётность. Компания предлагает инструменты для обнаружения агентов, проверки их подлинности, контроля доступа и оценки производительности, которые позволят понимать, кто является владельцем каждого агента, ограничивать его доступ к ресурсам, а также отслеживать действия агентов в существующих приложениях и инфраструктуре. Согласно прогнозам Gartner, к 2028 году типичная компания из списка Fortune 500 будет использовать более 150 тыс. ИИ-агентов. При этом лишь 13 % организаций считают, что у них выстроена надлежащая система управления ИИ-агентами — персистентные учётные данные, неясная принадлежность агентов и разрозненные механизмы контроля существенно затрудняют управление ими, особенно когда агенты взаимодействуют друг с другом, используют различные инструменты и работают в разных командах, на различных платформах и в облачных средах. 
Источник изображения: Igor Omilaev/unsplash.com «Чтобы агенты могли выполнять реальные задачи в критически важных для компании системах, необходима операционная модель ИИ. Она должна связывать агентов с данными, приложениями и инфраструктурой бизнеса, обеспечивая такой же уровень дисциплины, как и при работе с самыми важными корпоративными системами», — сообщил Динеш Нирмал (Dinesh Nirmal), старший вице-президент IBM Software. Он отметил, что предлагаемая компанией операционная модель для ИИ состоит из четырёх взаимосвязанных ключевых компонентов: агентов, данных, автоматизации и гибридной инфраструктуры. В основе этой модели лежат доверие и контроль, необходимые каждому агенту: подтвержденная идентификация, предоставление доступа исключительно в рамках необходимых полномочий, а также единая среда для обнаружения, защиты и оценки агентов — независимо от того, где они были созданы. Сообщается, что возможности платформы IBM HashiCorp Vault, позволяющей централизованно хранить, распределять и контролировать доступ к конфиденциальной информации, теперь будут распространяться на ИИ-агентов, предоставляя им защищённые краткосрочные учётные данные, которые ограничивают возможности каждого агента строго необходимой функциональностью. Платформа объединяет управление идентификацией агентов с контролем учётных данных, помогая организациям делегировать задачи при чётком определении полномочий и ответственности. При использовании вместе с HashiCorp Vault система идентификации агентов (Agent Identity) создает достоверный реестр для каждого агента: кто им владеет, каков его статус в жизненном цикле и какими правами он обладает. Это решение, призванное дополнить уже существующие инвестиции в идентификацию и безопасность, передает контекст прав доступа в механизмы управления учётными данными Vault. В результате обеспечивается принцип минимальных привилегий, а также возможность немедленного отзыва доступа, если агент пытается выполнить несанкционированное действие. Использование в Vault краткосрочных учетных данных и принципа минимальных привилегий позволяет дополнительно ограничить как круг доступных агенту ресурсов, так и продолжительность действия его прав. Дополнительные возможности включают:
Компаниям также необходимо видеть все имеющиеся у них агенты, независимо от того, где они были созданы. Платформа IBM watsonx Orchestrate работает в рамках всей экосистемы ИИ — а не только в среде одного конкретного поставщика, — предоставляя организациям единое пространство для обнаружения, защиты и оценки своих агентов. Её функциональные возможности включают:
Получив доступ к API и инструментам компании, агенты должны располагать сведениями о существующих ресурсах и связи различных систем. Платформа IBM Integration Intelligence Hub предоставляет необходимые данные через механизм Unified Context Engine. Благодаря этому агенты могут, например, устранять неполадки (например, зависшие сообщения) или развёртывать API, опираясь на уже имеющуюся инфраструктуру. Навыки (skills), политики утверждения и механизмы аудита позволяют держать действия агентов под контролем. Вместо того чтобы перестраивать ИТ-ландшафт под нужды ИИ, организации могут задействовать агентов в уже существующих системах, от которых зависит их бизнес. Инструменты Agent Identity и HashiCorp Vault также интегрируются с защищённой средой исполнения NVIDIA OpenShell. В совокупности они обеспечивают для агентов защищённую среду выполнения, а также подтвержденную идентификацию и временные учетные данные для каждого из них — благодаря этому любое действие можно отследить, ограничить и проверить. Инструменты IBM HashiCorp Vault 2.2, Agent Identity, watsonx Orchestrate уже общедоступны.
17.10.2026 [18:04], Владимир Мироненко
Сетевая «Швейцария»: Cisco изменила стратегию в эпоху агентного ИИ, став более открытой и нейтральнойС некоторых пор Cisco делает ставку на открытый, независимый от конкретных поставщиков подход к моделям и ИИ-агентам. В то время как некоторые вендоры активно продвигают собственные закрытые ИИ-экосистемы, стремясь таким образом привязать к своим решениям клиентов, Cisco позиционирует себя как нейтральный уровень оркестрации, связывающий между собой конкурирующие модели и ИИ-агентов, пишет CRN. На недавней конференции WebexOne 2026 компания заявила о поддержке сторонних моделей, отметив, что также выступает за открытость и совместимость ИИ-агентов, позиционируя себя в качестве универсальной платформы, позволяющей корпоративным клиентам работать с ИИ вне зависимости от того, кто является разработчиком базовой модели — Google, Anthropic, OpenAI или кто-то другой. Этот подход распространяется и на новое направление компании — агентный ИИ, сообщил Снорре Кьесбу (Snorre Kjesbu), старший вице-президент и генеральный менеджер подразделения Cisco Collaboration. «Взаимодействуя с множеством игроков, Cisco будет выступать в роли “Швейцарии”», — отметил он, подразумевая нейтральный статус этой страны. Кьесбу добавил, что подобного подхода компания придерживается и в сфере инструментов для совместной работы, обеспечивая совместимость своих решений с продуктами конкурентов. В рамках этой стратегии Cisco обеспечивает поддержку сторонних моделей и агентов ИИ на платформе Webex с возможностью использования собственных LLM, обеспечением взаимодействия между агентами, а также интеграцией с внешними поставщиками ИИ-технологий, не пытаясь привязывать клиентов к закрытому стеку собственных решений. 
Источник изображения: Cisco Как отметил партнёр Cisco Джо Бергер (Joe Berger), вице-президент по цифровым решениям компании World Wide Technology, интеграция решений компании с Claude, инструментами от OpenAI и другими ИИ-ассистентами свидетельствует о смене её стратегии: «Они вряд ли смогут доминировать во всех сферах, но вполне способны сотрудничать с большинством поставщиков, предоставляя отдельные компоненты решений. На мой взгляд, это верный подход, поскольку на данный момент явный лидер на рынке ещё не определился». По словам Бергера, в Cisco осознали, что нужно идти навстречу клиентам, даже если они пользуются решениями конкурентов. «Ещё пять лет назад для них было крайне сложно занять нейтральную позицию. Сегодня же они выигрывают больше сделок в сфере совместной работы, поскольку сотрудничают с Microsoft, Zoom, а теперь и с Google. Полагаю, такой подход стоит распространить и на другие направления портфеля Cisco», — считает он. В Cisco сообщили, что компания видит свою задачу в предоставлении инфраструктуры — сетевых решений, средств безопасности, инструментов для мониторинга (observability) и управления, — которая работает поверх различных ИИ-платформ. Такой подход выгоден и партнёрам, которые смогут создавать сервисы, опираясь на ряд различных моделей. В Long View Systems, партнёре Cisco, считают, что компания может занять уникальную нишу в качестве «нейтральной» ИИ-платформы, поскольку она не конкурирует с разработчиками самих моделей. В настоящее время клиенты комбинируют различные ИИ-модели, и, поскольку они не отдают предпочтение какому-то одному решению, на рынке открываются возможности для поставщика ИИ-технологий, не привязанного к конкретным вендорам. По словам эксперта, это напоминает подход, который Cisco применяет в своей платформе Cloud Control, основанной на использовании ИИ-агентов, которая стала доступна пользователям ранее в этом году и которая позволяет управлять устройствами сторонних вендоров.
15.10.2026 [16:31], Владимир Мироненко
Лучше меньше да лучше: Intel верит, что развитие агентного ИИ вернёт CPU значимость в инфраструктуре ЦОДIntel заявила, что следующий этап развития ИИ будет определять не обучение моделей, а их использование (инференс), и что развитие агентного ИИ вернёт CPU в центр инфраструктуры дата-центров, сообщил SiliconANGLE. Сейчас по умолчанию любой запрос как правило отправляется в компаниях к самой мощной модели — независимо от того, требует ли этого сама задача. Intel предлагает альтернативу: уровень оркестрации, который анализирует каждый запрос, оценивая необходимый уровень «интеллекта», объём контекста, допустимую задержку, требования к конфиденциальности и суверенитету данных, а также затраты и энергопотребление. «Для каждого запроса — своё решение», — подчеркнул Николас Дюбе (Nicolas Dubé), корпоративный вице-президент Intel. Если для глубоких исследований использование передовой модели может быть оправдано, то для рутинных задач — написание кода, составление резюме или операционные процессы — могут использоваться более компактные открытые моделей, что обходится значительно дешевле. Дюбе отметил, что open source модели расширяют возможности компаний по внедрению ИИ. «Чтобы полностью раскрыть их потенциал, организациям необходима инфраструктура, способная подобрать для каждой конкретной задачи оптимальный уровень интеллектуальных возможностей, вычислительных ресурсов и экономических затрат», — говорит он. 
Источник изображения: Intel Только что представленный 350-Вт ускоритель Intel GPU D270 (Crescent Island), совместимый со стандартными серверами с воздушным охлаждением, позволяет компании начать с одного устройства, затем перейти к серверу с восемью ускорителями и масштабировать инфраструктуру до уровня целой стойки только тогда, когда этого потребует рабочая нагрузка. Инференс становится ключевой задачей в сфере ИИ, и корпорациям необходима инфраструктура, которая сделает переход к нему более простым и экономически выгодным. Опционально GPU можно дополнить ускорителями RDU SambaNova. Также компания продемонстрировала разработанные партнёрами стоечные системы (в том числе ORv3) на базе Xeon. Например, доступные конфигурации с Xeon 6+ (Clearwater Forest), масштабируемыми до более чем 46 тыс. ядер на стойку при мощности 133,45 кВт. Высокоплотные Xeon 6+ с E-ядрами ориентированы на высокопроизводительные агентские нагрузки, в то время как Xeon 6 (Granite Rapids-SP) с P-ядрами справляются с задачами, зависящими от скорости однопоточного выполнения. Intel утверждает, что теперь следует исходить не из количества ядер, а количества одновременно работающих агентов, которые может поддерживать стойка при целевой задержке. В результате формируется гетерогенная система: Xeon используется для оркестрации, обработки данных и запуска вспомогательных инструментов, а GPU серии D и RDU — для инференса открытых моделей. При этом Дюбе пояснил, что Intel объединяет систему с помощью программной архитектуры, разрабатываемой совместно с сообществом. Она является открытой, доступной для загрузки уже сегодня и спроектированной для работы на самых разных аппаратных платформах. 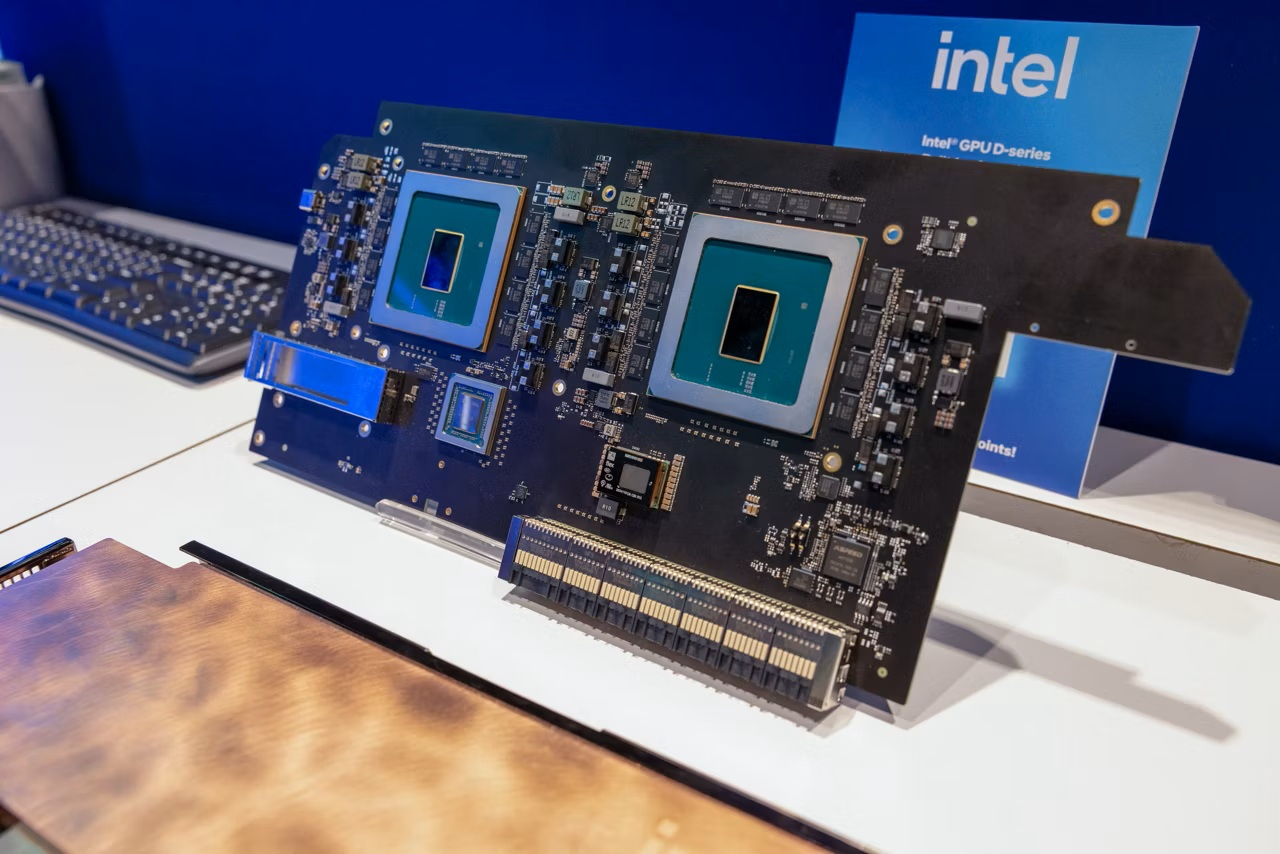
Источник изображения: Intel Как отметил SiliconANGLE, разработки в области «агентных стоек» (agentic racks) подстегивают спрос на Xeon — ключевой драйвер текущих показателей, — позиционируя Intel не просто как традиционного поставщика оборудования, а как важнейшего провайдера инфраструктуры для ИИ-агентов. А Crescent Island даёт Intel возможность предложить решения для ускорения вычислений, где компании не обязательно превосходить NVIDIA по пиковой производительности. Это может стать наиболее практичным и энергоэффективным способом запуска открытых ИИ-моделей в уже существующих ЦОД. Именно такую стратегию выбрал гендиректор Intel Лип-Бу Тан (Lip-Bu Tan): перестать пытаться выиграть в каждой битве и сосредоточиться на тех направлениях, где у Intel есть структурное преимущество. Intel не обязательно доминировать в сфере обучения передовых моделей. Ей следует занять нишу в корпоративном сегменте — это гораздо более масштабная возможность, чем принято считать. ZK Research предлагает ИТ-руководителям провести аудит используемых промптов и классифицировать их по типам задач, объёму контекста, требования к конфиденциальности и т.п., а затем настроить маршрутизацию запросов к наиболее подходящим моделям. Кроме того, рекомендуется пересмотреть подход к оценке инфраструктуры, перестав ориентироваться на «голые» цифры вроде FLOPS или количества ядер и начав требовать от вендоров соблюдения целевых показателей задержки, стоимости обработки миллиона токенов и энергоэффективности для конкретных используемых моделей, промптов и контекста.
17.09.2026 [22:06], Руслан Авдеев
NVIDIA, Google и Emerald AI создают альянс для развития ИИ ЦОД с гибким энергопотреблением — больше всех выиграет NVIDIAКомпании NVIDIA, Google и Emerald AI анонсировали создание объединения AI Energy Management Alliance (AEMA). Оно должно ускорить развитие ИИ ЦОД, готовых оптимизировать и корректировать своё энергопотребление в соответствии с текущим состоянием энергосистем. ИИ ЦОД будут взаимодействовать с сетями, при необходимости меняя нагрузку. NVIDIA полагает, что это поможет в ускоренном режиме подключать новые мощности, повысить надёжность энергосистем и эффективнее использовать доступную инфраструктуру. Как сообщает NVIDIA, обычные процедуры присоединения к сетям предполагают снабжение объектов с довольно стабильным энергопотреблением, но ИИ ЦОД к ним не относятся. При этом их вычислительные нагрузки можно будет произвольно менять, перенося вычисления, использовать системы накопления энергии, реагировать на инциденты в энергосистеме и др. Это позволит эффективнее использовать имеющиеся мощности электросетей, снижать энергопотребление во время пиковых нагрузок на энергосистему и даже откладывать затратную модернизацию инфраструктуры. Кроме того, более безопасным и быстрым становится подключение к сетям крупных ИИ ЦОД. При этом эксперты The Register обращают внимание на ограничения, касающиеся самой NVIDIA. Компания сможет продавать всё больше ИИ-ускорителей только в случае, если дата-центры будут получать достаточно энергии. В результате NVIDIA стремится «выжать» максимум из каждого доступного гигаватта. Например, обычный ЦОД на 100 МВт оставляет в резерве до 20 % мощности для компенсации неэффективности оборудования, потерь при преобразовании энергии и скачков потребления. 
Источник изображения: NVIDIA Одно из решений — платформа DSX MaxLPS, позволяющая использовать больше ИИ-ускорителей в рамках заданного «энергетического бюджета». Она координирует работу вычислительной и физической инфраструктуры, элементы которой могут обмениваться данными о работе друг друга, снижая энергопотребление в зависимости, например, от фактической загрузки серверов, без постоянной работы на максимальной мощности. API DSX Exchange также позволяют работать с совместимыми компонентами стороннего производства, в т.ч. оборудования Vertiv и Schneider Electric. DSX Flex непосредственно обеспечивает взаимодействие ЦОД и энергосистемы. NVIDIA, Emerald AI и Silicon Valley Power продемонстрировали способность временно высвобождать некоторые мощности ЦОД при росте нагрузок на электросети без остановки критически важных вычислений. Аналогичный эксперимент успешно провели National Grid, Emerald AI и Nebius. На уровне стоек NVIDIA и Lambda уже показали, что подобная умная координация позволяет уместить в пределах заданного энергетического бюджета больше вычислительных модулей — 19 вместо обычных 16, при этом производительность на ватт выросла приблизительно на четверть. Формально ничего принципиального нового в предложенной технологии нет. Ещё в 2023 году Google тестировала систему перепаспределения нагрузок в ЦОД в часы пик. То же делала и Microsoft, но в обоих случаях речь шла о переносе обработки несрочных фоновых задач во времени или между дата-центрами. В 2026 году Google модернизировала управление питанием своих ЦОД в США, добавив возможность более гибко регулировать их энергопотребление, которая подкреплена контрактами с несколькими энергокомпаниями. 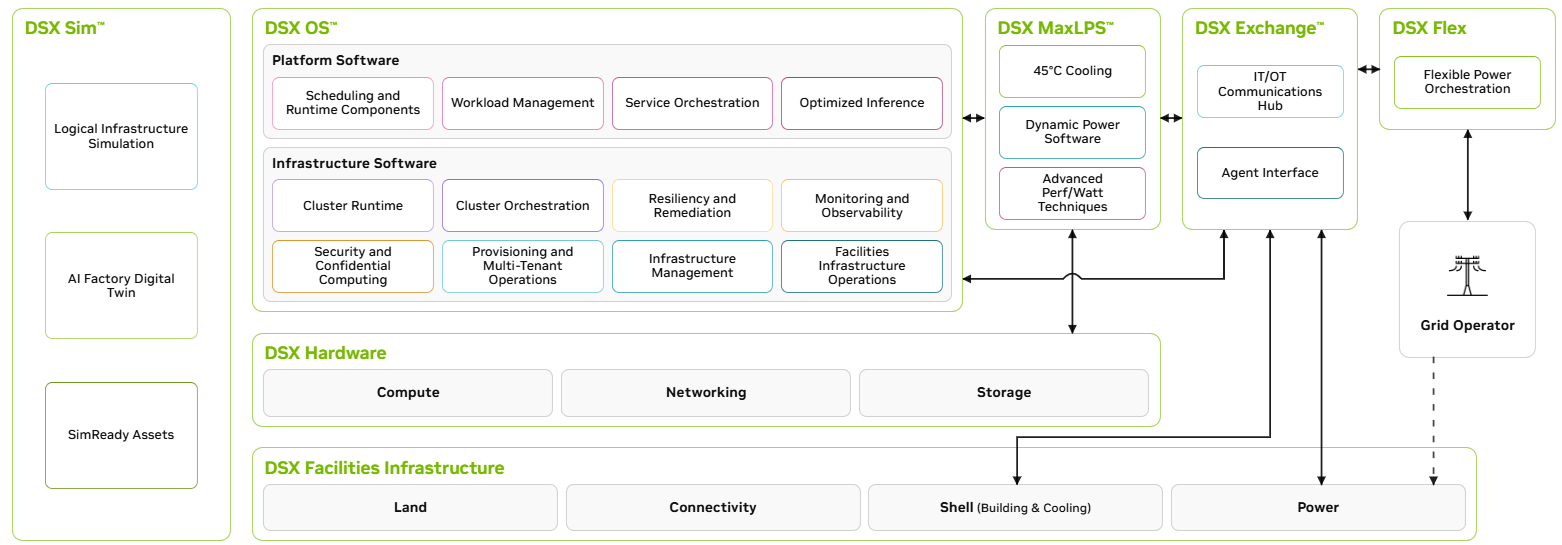
Источник изображения: NVIDIA NVIDIA намерена интегрировать подобную возможность в инфраструктуру ИИ ЦОД по умолчанию. Для компании смысл не только в снижении нагрузки на энергосеть, но и в оптимизации контактов с энергокомпаниями. Предполагается, что они смогут в упрощённом порядке разрешать подключение новых мощностей, если будут знать, что часть нагрузки можно быстро отключить. Впрочем, полную остановку работы ЦОД это не предусматривает, поскольку критически важные задачи будут выполняться, а второстепенные нагрузки приостановить или перенести в другие ЦОД. Альянс AEMA должен дополнить технологические решения разработкой общих правил взаимодействия ИИ ЦОД с энергосистемами, в том числе вопросы регулирования энергопотребления и реагирования на аварийные ситуации. Также предполагается стандартизировать технические требования, показатели эффективности и обмен эксплуатационными данными. AEMA позиционируется как технологически нейтральная инициатива, поскольку требования будет определять не использование того или иного конкретного оборудования или ПО, а измеряемые характеристики ЦОД — от скорости реакции на чрезвычайные ситуации до предсказуемости и продолжительности доступного сокращения нагрузки. Если объект способен подтвердить «гибкость», для него могут создать более простые и быстрые процедуры подключения к электросетям с учётом фактических рисков и преимуществ для энергосистемы.
20.05.2026 [09:09], Владимир Мироненко
От теории к практике ИИ: Dell анонсировала масштабное обновление платформы AI Factory with NVIDIA
dell
nvidia
software
ии
конфиденциальность
оркестрация
охлаждение
рабочая станция
сервер
схд
частное облако
Компания Dell Technologies объявила о масштабном обновлении платформы AI Factory with NVIDIA, призванном помочь предприятиям перейти от планирования к практическому применению ИИ. Платформа отличается модульной архитектурой данных для ИИ, где их преобразование, обработка и хранение работают вместе как специально разработанный стек. Компания отметила, что AI Factory используют более 5 тыс. клиентов по всему миру, и обновлённая версия платформы обеспечит более интегрированный подход к управлению данными и инфраструктурой, что позволит сократить время, необходимое для развёртывания решений ИИ. Одним из ключевых анонсов мероприятия стала презентация Dell Deskside Agentic AI. Это новое предложение, которое объединяет рабочие станции Dell, эталонный программный стек NemoClaw от NVIDIA и среду выполнения OpenShell, позволяя предприятиям создавать, запускать и управлять автономными агентами на системах, хранящих данные локально или на периферии сети, а не полагаться исключительно на облачную инфраструктуру. Dell позиционирует это предложение как решение для контроля затрат, снижения задержки и суверенитета данных, особенно для разработки ПО, исследований и регулируемых сред. Локальный подход разработан для таких секторов, как разработка ПО, академические исследования и регулируемые отрасли, позволяя этим группам хранить данные внутри компании и преобразовывать переменные расходы на облачные сервисы в предсказуемые инвестиции в инфраструктуру. Dell заявила, что этот подход позволит достичь паритета затрат с публичными облаками в течение трёх месяцев. 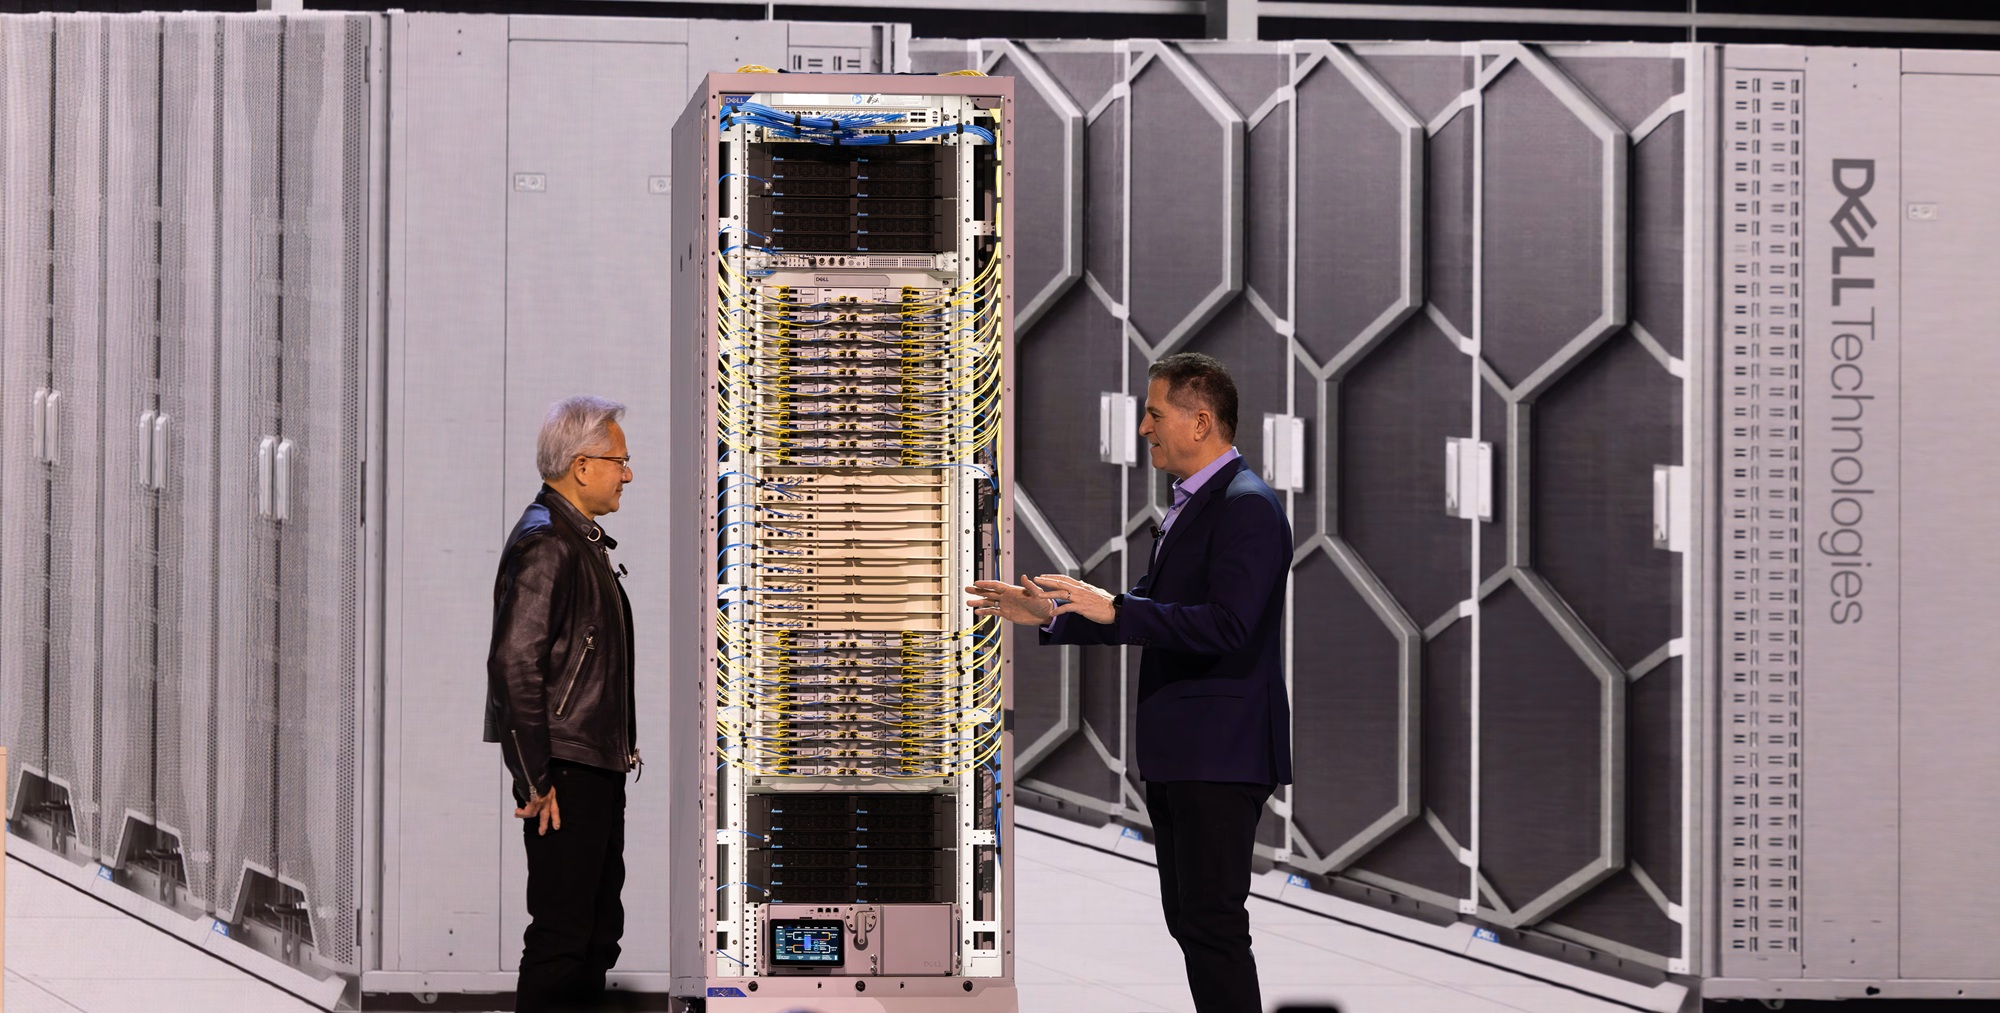
Источник изображений: Dell Dell также интегрирует NVIDIA OpenShell во все продукты портфеля Dell AI Factory, чтобы обеспечить «безопасную песочницу для запуска, создания, тестирования и тонкой настройки агентов» локально. Это обеспечивает Dell единый уровень среды выполнения и политик, охватывающий все уровни — от настольных рабочих станций до серверов Dell PowerEdge XE, с поддержкой Ubuntu и Red Hat AI. Dell также продвигает эталонную архитектуру Dell-NVIDIA AI-Q 2.0, работающую на базе Dell AI Data Platform with NVIDIA, как готовую к продуктовому развёртыванию основу для многоагентных рабочих процессов в таких секторах, как финансовые услуги, производство и госсектор, где требуется более жёсткий контроль над данными и операциями. Dell объявила о ряде улучшений платформы Dell AI Data Platform. В ней были расширены возможности механизма оркестрации данных Dell AI Data Platform путём глубокой интеграции MetadataIQ со всем портфелем хранилищ Dell, начиная с PowerScale — файлового механизма в рамках Dell AI Data Platform with NVIDIA — и расширяя его на другие платформы в будущем. 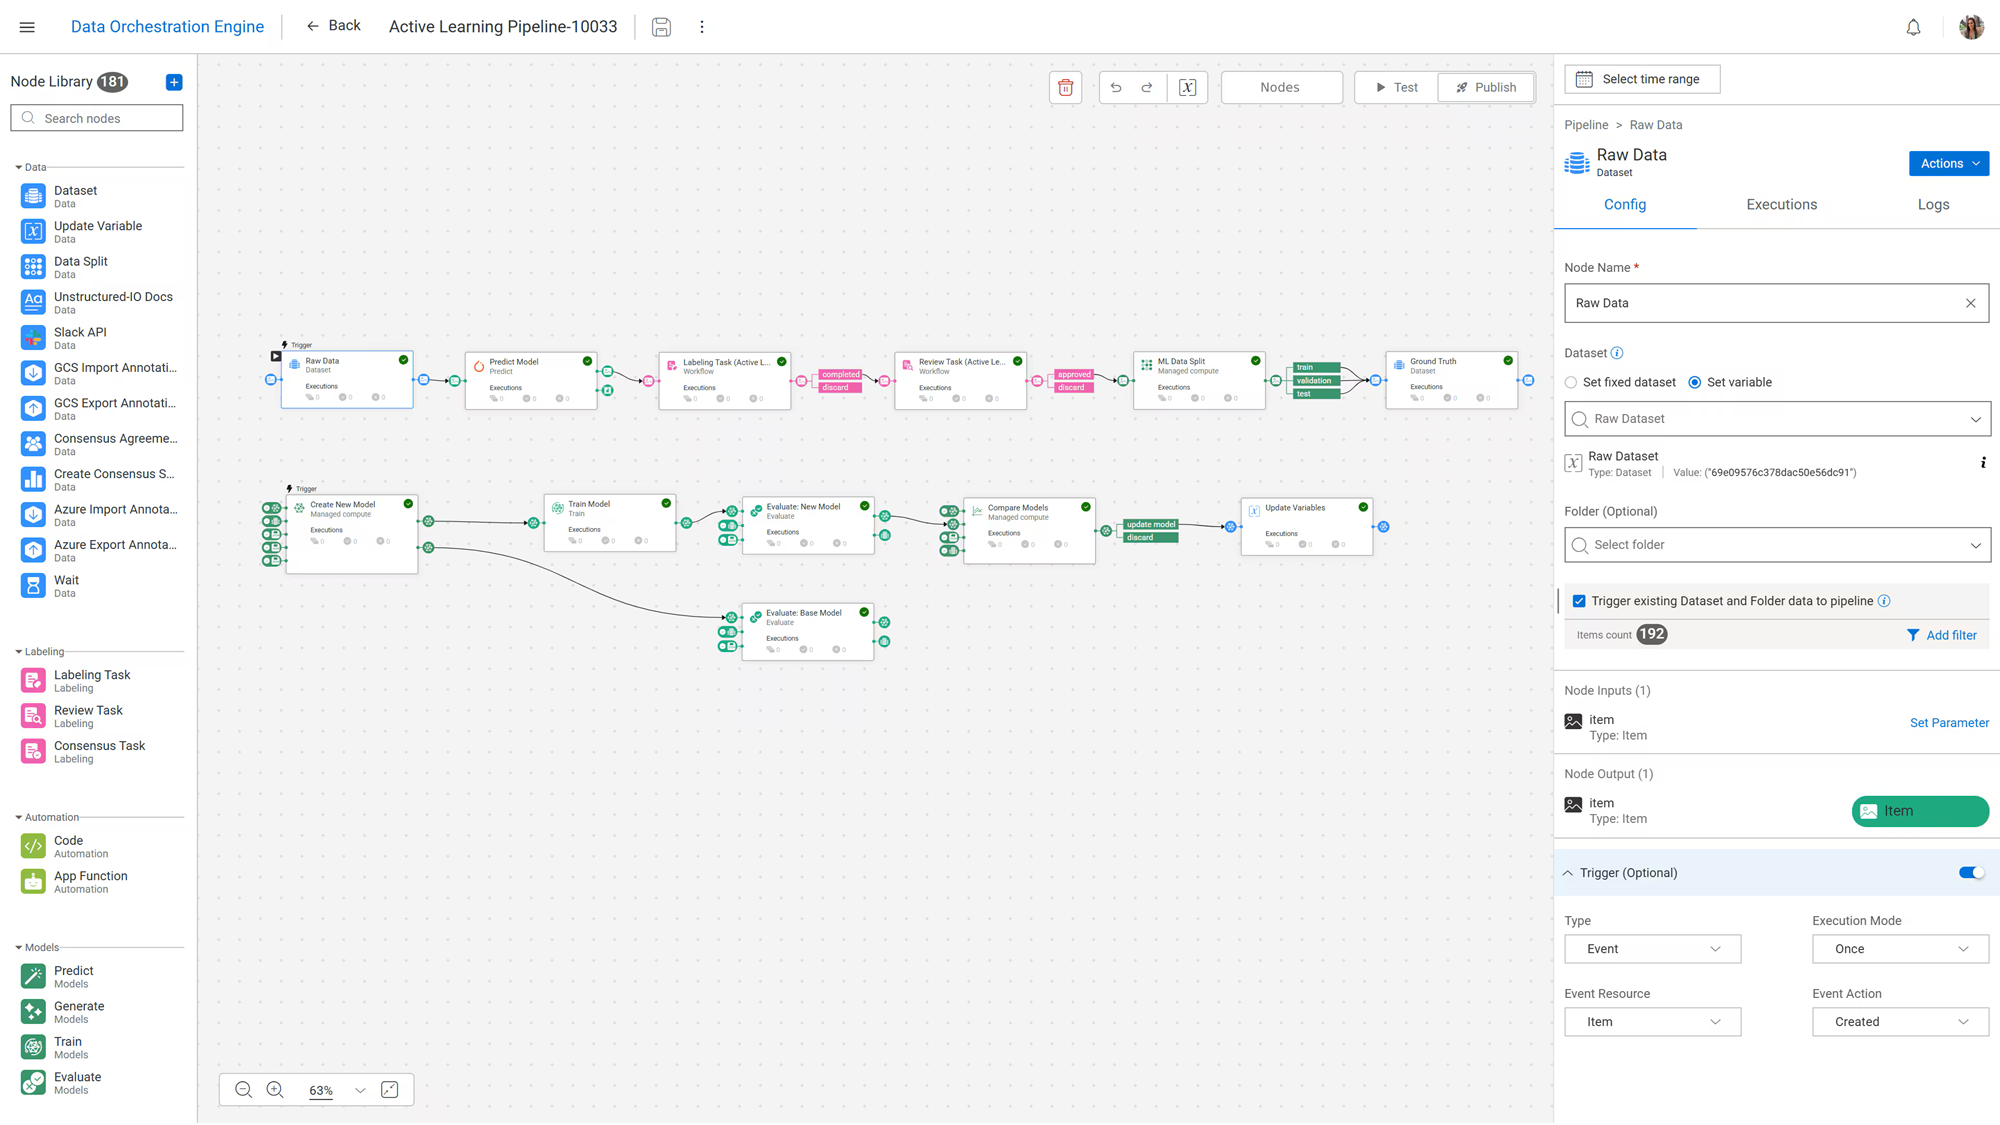 Уровень оркестрации теперь поддерживает индексирование миллиардов неструктурированных файлов и их привязку к управляемым конвейерам обработки данных. Благодаря партнёрству со Starburst и NVIDIA платформа предлагает аналитику SQL с ускорением на GPU через улучшенный Dell Data Analytics Engine, до шести раз быстрее на оборудовании NVIDIA Blackwell и с будущей поддержкой NVIDIA Vera. Это позволяет ускорить получение данных как для традиционной аналитики, так и для ресурсоёмких приложений ИИ с использованием агентов. Возможности хранения данных были расширены с помощью новой системы ObjectScale X7700, которая обеспечивает на 45 % большую ёмкость, чем предыдущее поколение, с гибким масштабированием вычислительных ресурсов и хранилища. В будущем появится поддержка флеш-накопителей объёмом 245 Тбайт, что более чем втрое увеличит плотность хранения. Благодаря интеграции с NVIDIA Omniverse корпоративные хранилища данных могут быть напрямую связаны с цифровыми двойниками и физическими рабочими процессами ИИ. 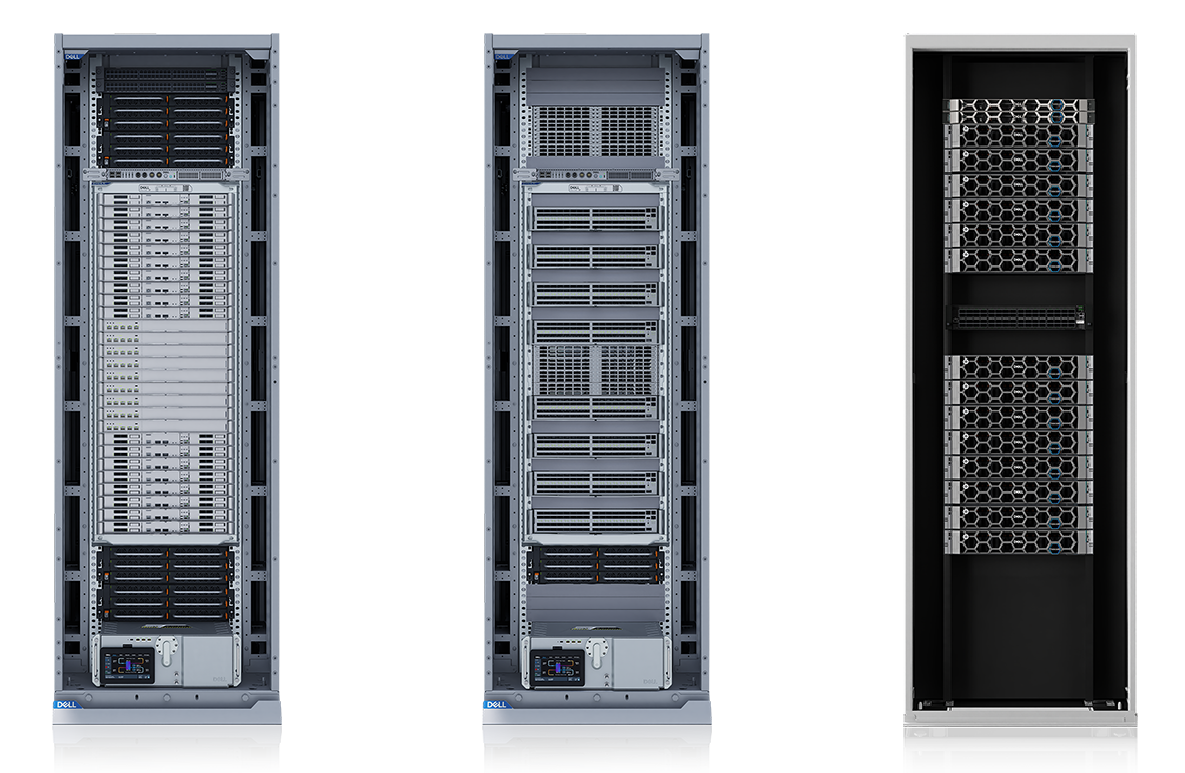 По мере роста объёма данных для ИИ, объектное хранилище становится логичным местом для обучающих данных, контрольных точек и долгосрочных баз знаний. Dell ObjectScale — объектный движок в рамках Dell AI Data Platform с NVIDIA — создан для выполнения этой роли, обладая высокопроизводительной архитектурой облачного масштаба и, по словам компании, лучшей в отрасли киберустойчивостью. Dell ObjectScale на серверах PowerEdge R7725xd также получил сертификацию NVIDIA Foundation, что означает его пригодность для высокоскоростного доступа к данным в средах с большим количеством GPU. Dell также расширила перечень инфраструктурных решений, запустив PowerRack, готовую систему стоечного масштаба, которая объединяет вычислительные ресурсы, сети, хранилище данных, охлаждение и управление в предварительно спроектированные блоки для развёртывания систем ИИ и HPC. Сообщается, что система может быть полностью настроена и введена в эксплуатацию в течение 6,5 ч. после доставки. 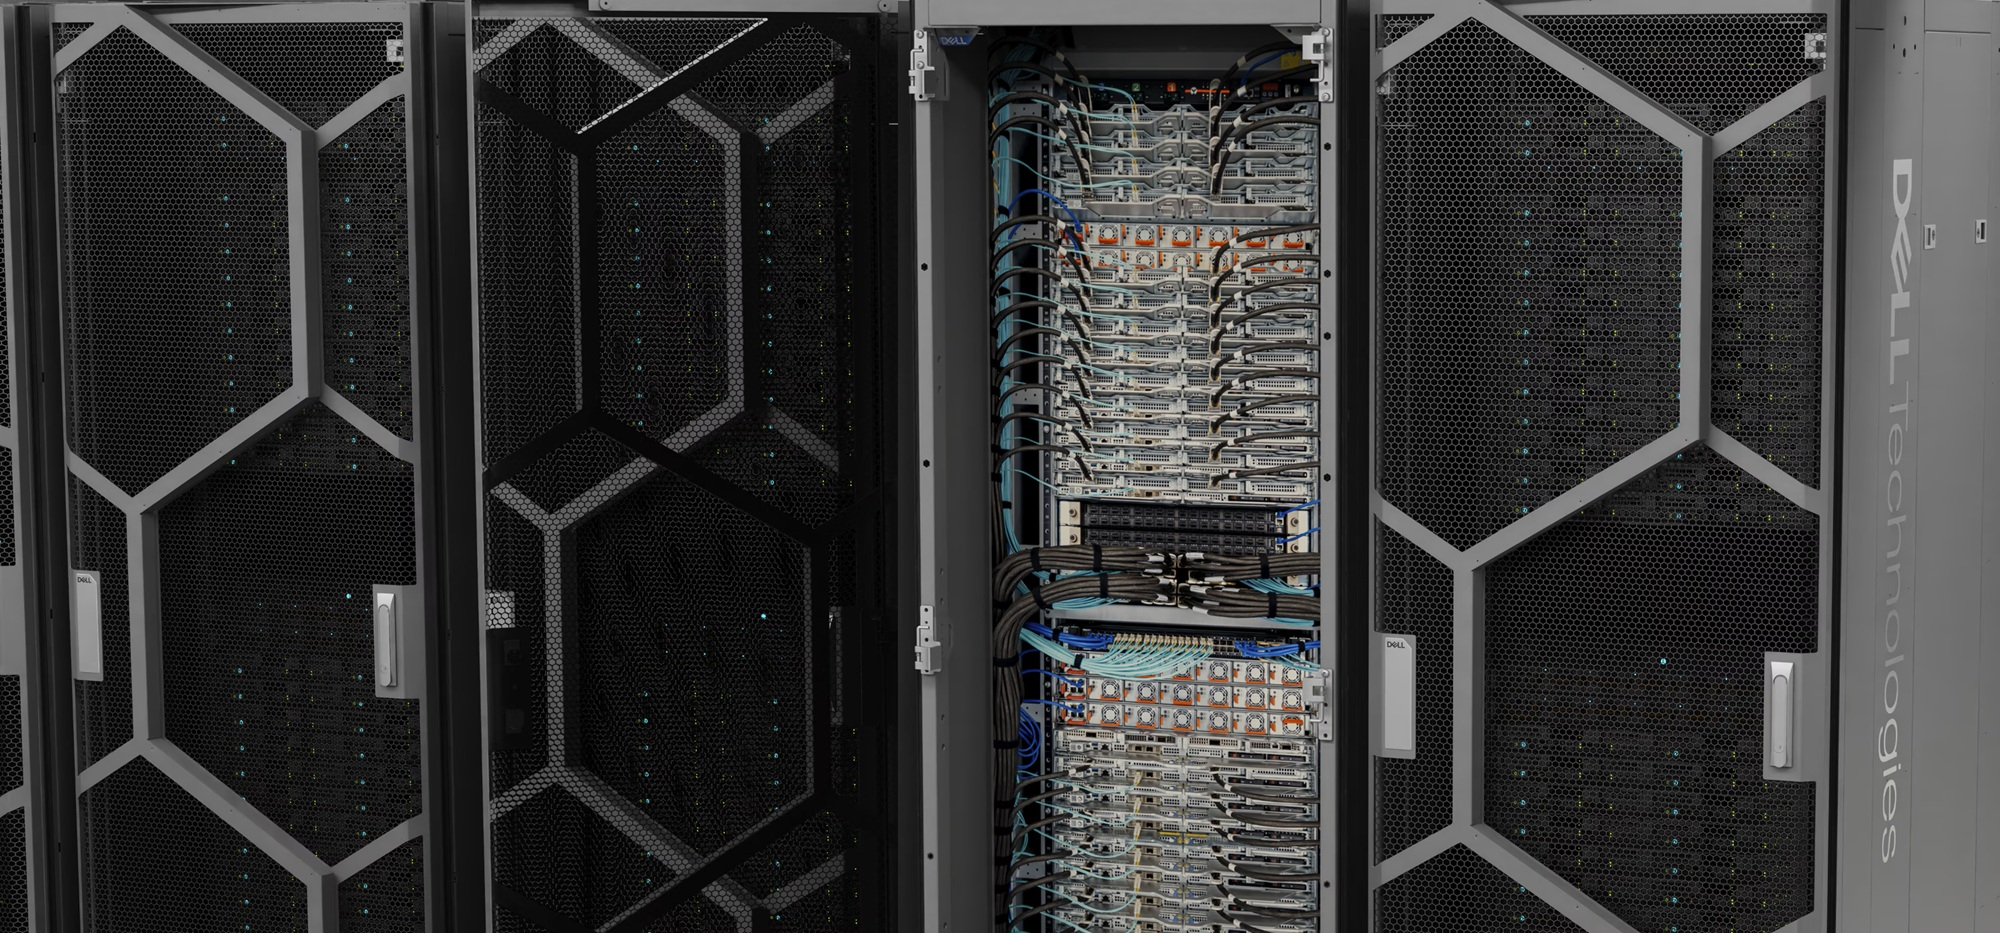 Как отметил ресурс Techzine, это не новая концепция, поскольку Dell поставляла комплексные решения и раньше, но компания расширяет возможности PowerRack по трём направлениям. Сетевой вариант обеспечивает коммутационную способность 800 Тбит/с благодаря восьми новым коммутаторам PowerSwitch SN6600 на стойку. Это в первую очередь предназначено для так называемого трафика east-west, поддерживающего рабочие нагрузки ИИ-инференса. Dell также интегрирует PowerFlex (решение «4-в-1») в свою архитектуру хранения данных Exascale, обеспечивая поддержку блочного, файлового и объектного хранения в стоечном исполнении через PowerFlex, PowerScale, Lightning File System и ObjectScale для нагрузок ИИ, HPC и ресурсоёмких корпоративных рабочих нагрузок. Dell также представила Pro Precision 7 R1 — стоечную рабочую станцию высотой 1U с ускорителями NVIDIA RTX PRO Blackwell Max-Q Workstation Edition и объёмом хранилища до 64 Тбайт. Обновлённые версии Dell Integrated Rack Controller и OpenManage Enterprise расширяют возможности на уровне стойки. В то же время новый PowerCool CDU C7000 разработан для отвода тепла от платформ NVIDIA следующего поколения в компактном стоечном форм-факторе. Это первый CDU для установки в стойку, отвечающий потребностям в охлаждении платформы NVIDIA Vera Rubin NVL72 в компактном форм-факторе 4U (19″) и расширяющий возможности охлаждения Dell и поддержку использования горячей воды с температурой до +40 °C. 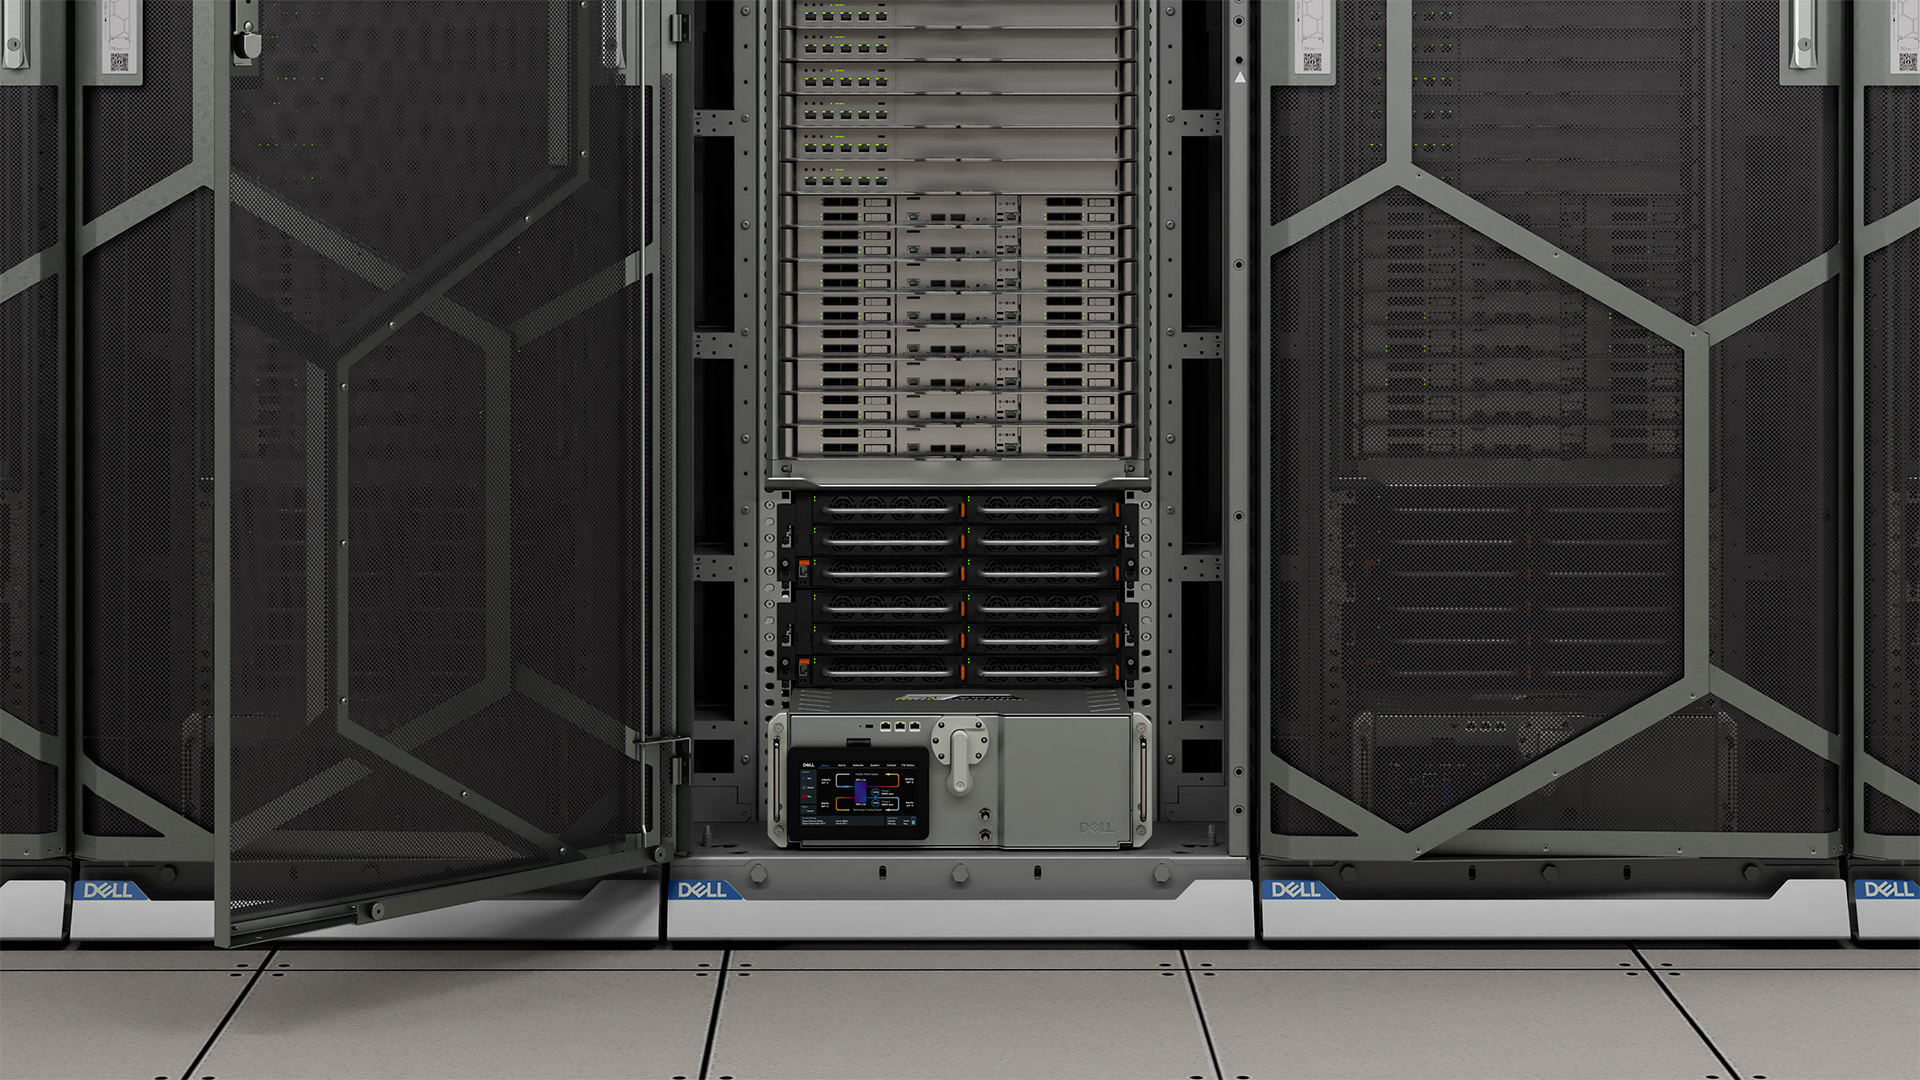 Сообщается, что Dell PowerRack для вычислительных систем уже доступна, PowerRack для сетей будет доступна в сентябре 2026 года, а для хранилищ — во II половине 2026 года. Также уже доступны решение Dell Deskside Agentic AI, поддержка NVIDIA OpenShell, NVIDIA AI-Q 2.0 для Dell AI Factory и эталонная архитектура Dell-NVIDIA AI-Q 2.0. В свою очередь, Dell Pro Precision 7 R1 будет доступна в июле 2026 года, Data Orchestration Engine с MetadataIQ — во II квартале 2026 года, CDU — в III квартале 2026 года, а Data Analytics Engine with Starburst — в I квартале 2027 года.
18.05.2026 [20:00], Руслан Авдеев
NVIDIA представила платформу Fleet Intelligence для мониторинга парка ИИ-ускорителей
dcim
nvidia
software
ии
информационная безопасность
кластер
конфиденциальность
мониторинг
облако
оркестрация
телеметрия
цод
NVIDIA представила управляемую платформу Fleet Intelligence, предназначенную для мониторинга состояния крупных кластеров ускорителей, используемых в ИИ-инфраструктуре. Сервис уже доступен бесплатно для клиентов, использующих продукты NVIDIA на основе ускорителей семейств Hopper, Blackwell и Vera Rubin. NVIDIA позиционирует платформу как независимый слой телеметрии и мониторинга, позволяющий отслеживать работу с гетерогенными инфраструктурными средами, независимо от стека оркестрации или планировщика задач. Платформа применяет «лёгкий», интегрируемый в хост-систему агент, который передаёт телеметрию с ИИ-ускорителей в облачную службу Fleet Intelligence, работающую в экосистеме платформы NGC (NVIDIA GPU Cloud). Агент применяет несколько технологий NVIDIA, включая службу мониторинга ускорителей — GPUd, инструмент управления и диагностики чипов DCGM (NVIDIA Data Center GPU Manager) и средства проверки целостности оборудования и ПО NVIDIA Attestation SDK. Компания также выложила код агента Fleet Intelligence на GitHub, что позволит операторам ИИ-инфраструктуры самостоятельно оценить механизмы телеметрии. Fleet Intelligence ведёт сбор данных о степени загруженности ускорителей, пропускной способности памяти, энергопотреблении системы, состоянии интерконнектов NVLink, температуре системы, ошибках ECC, а также показателях состояния аппаратной составляющей. Это помогает операторам ЦОД организовать раннее выявление недоиспользованных ресурсов и ошибок и снизить простои крупных ИИ-кластеров. 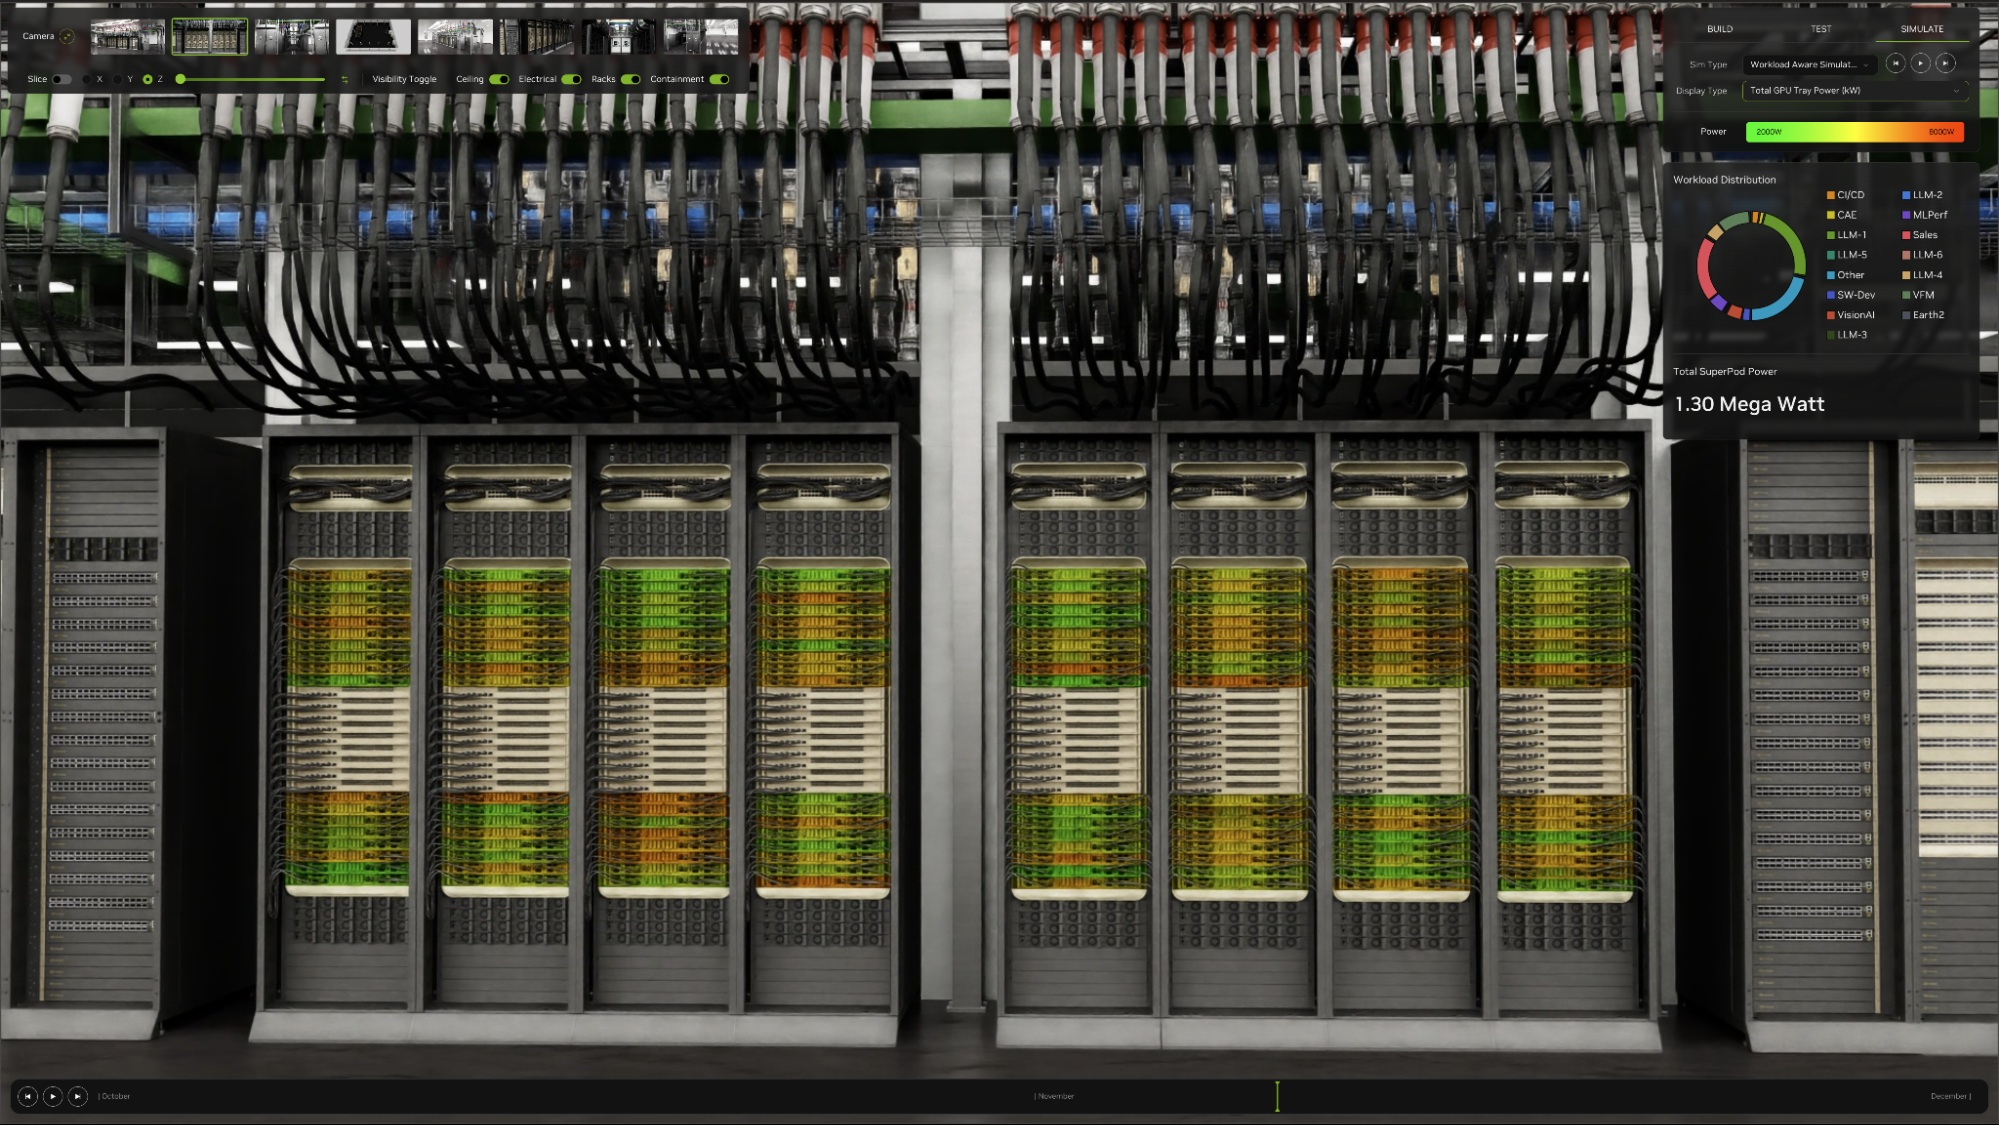
Источник изображений: NVIDIA Одними из основных свойств платформы стали возможности проверки целостности и аттестации на основе технологий защищённых вычислений NVIDIA Confidential Computing. Fleet Intelligence проводит криптографическую валидацию прошивок ИИ-ускорителей и целостность среды выполнения с помощью корневых сертификатов доверия NVIDIA, а также сервиса удалённой проверки оборудования NRAS (NVIDIA Remote Attestation Service). Платформа может подтвердить, что ускорители используют утверждённую прошивку и использует манифесты целостности Reference Integrity Manifests, привязанные к определённым версиям vBIOS. 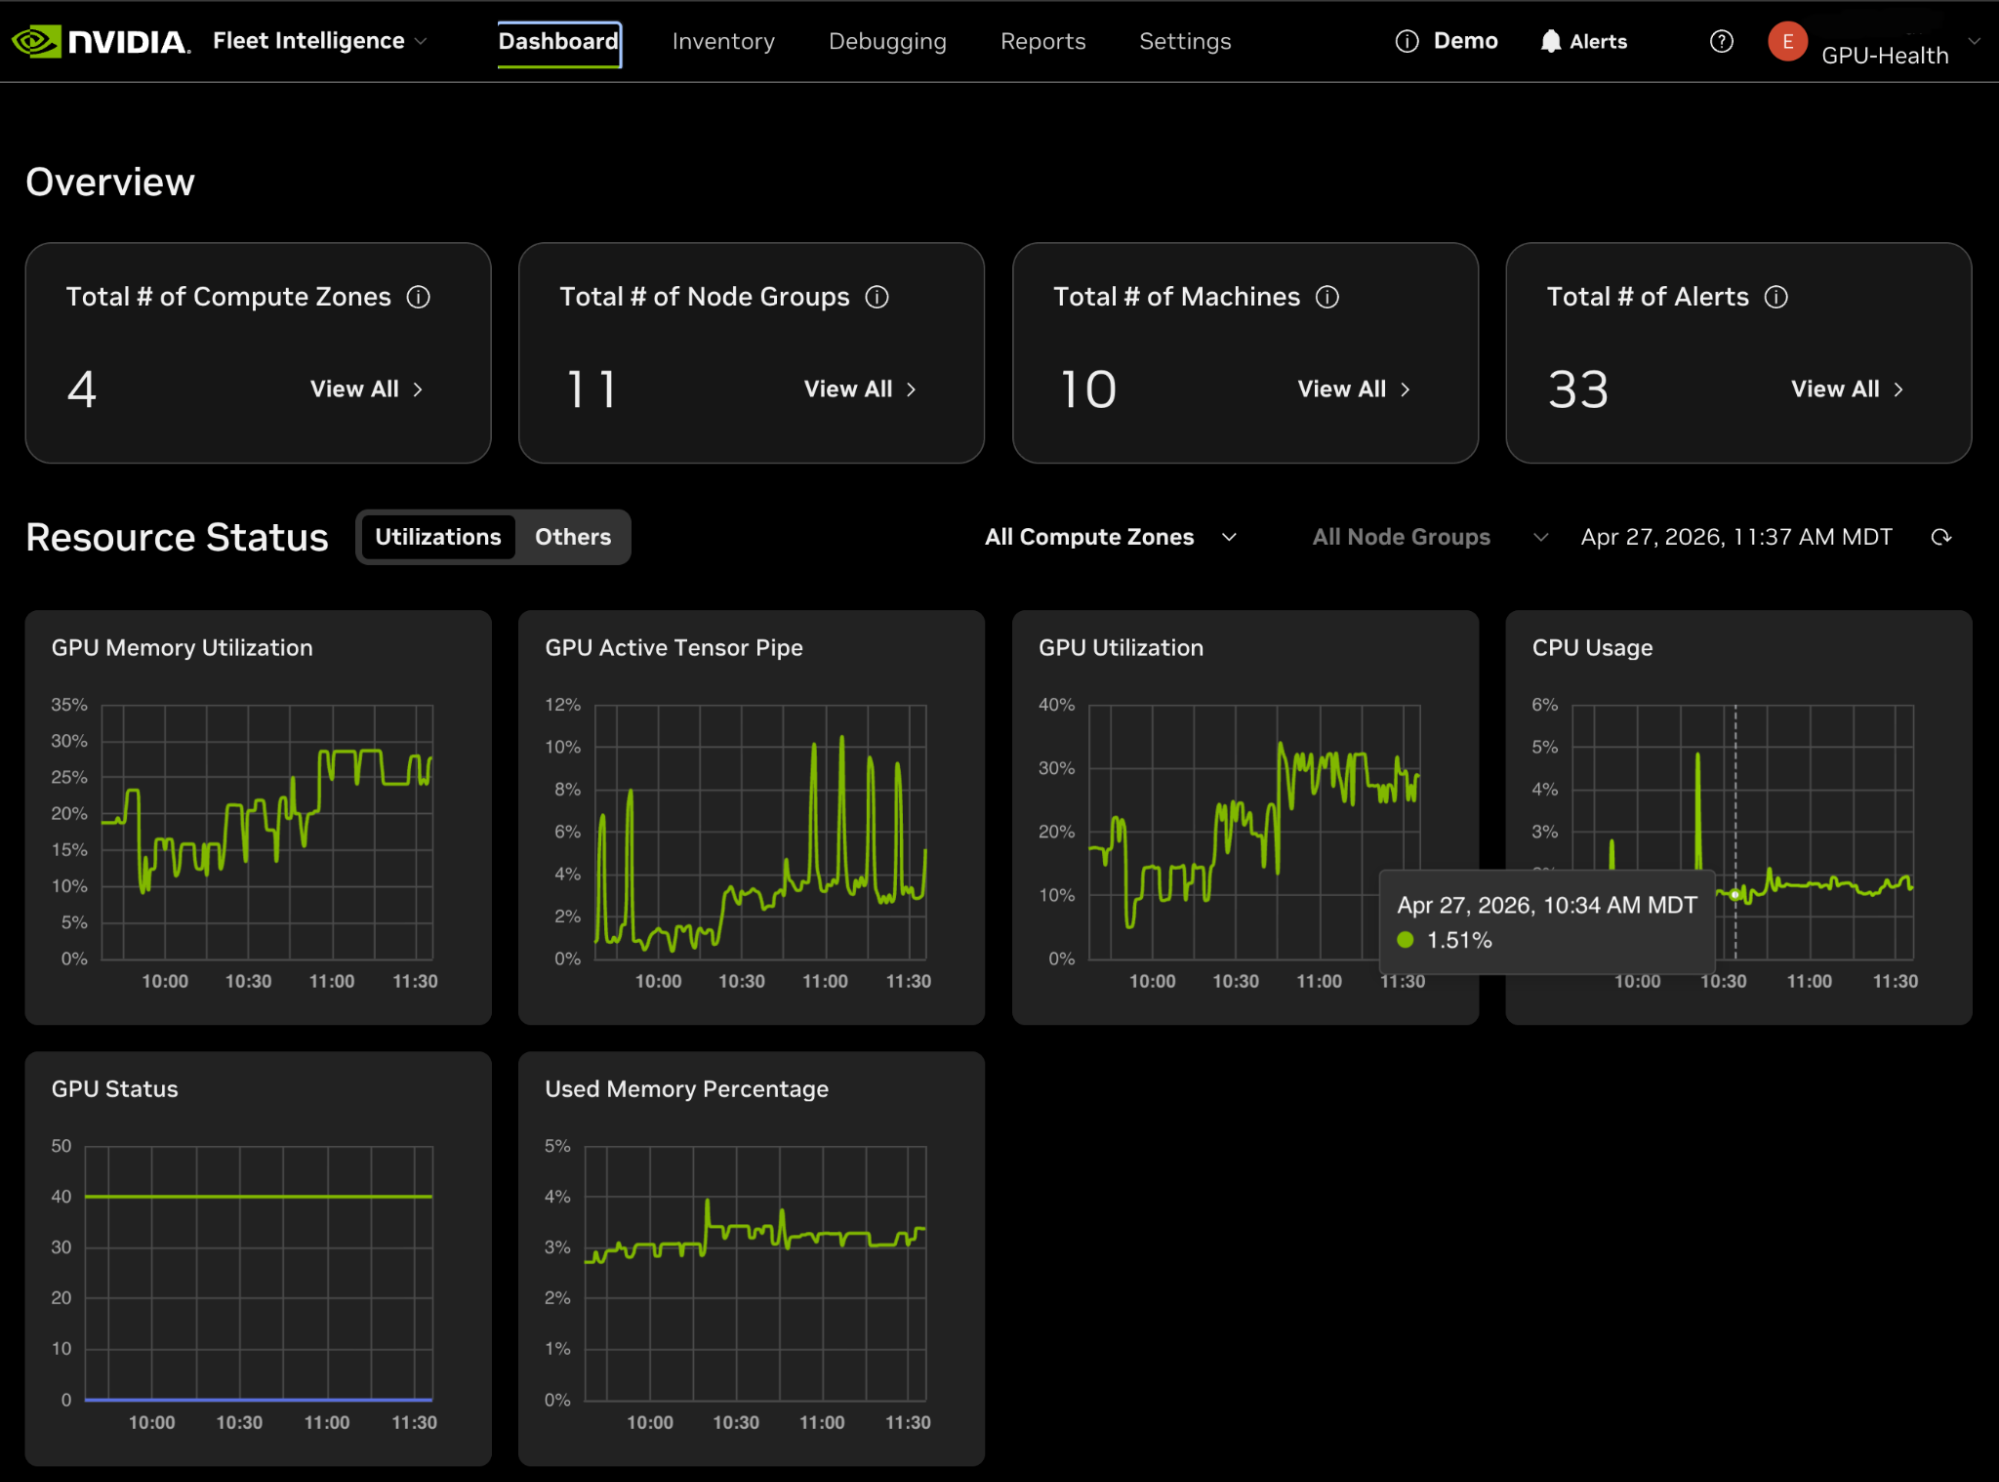 По словам NVIDIA, при разработке Fleet Intelligence применяли опыт эксплуатации облачных платформ NVIDIA DGX Cloud, использовавших сотни тысяч ИИ-ускорителей. В числе корпоративных пользователей, получивших ранний доступ к платформе — Lambda и Iren, обе предоставляли обратную связь в ходе работ. Премьера Fleet Intelligence свидетельствует, что амбиции NVIDIA простираются далеко за пределы простой разработки ИИ-ускорителей, компания развивает ПО и инструменты управления для ИИ-фабрик. Это дополнение уже имеющегося стека компании, включающего системы DGX, интерконнекты NVLink, сетевые продукты Spectrum-X, платформу оркестрации Mission Control и решения для защищённых вычислений. 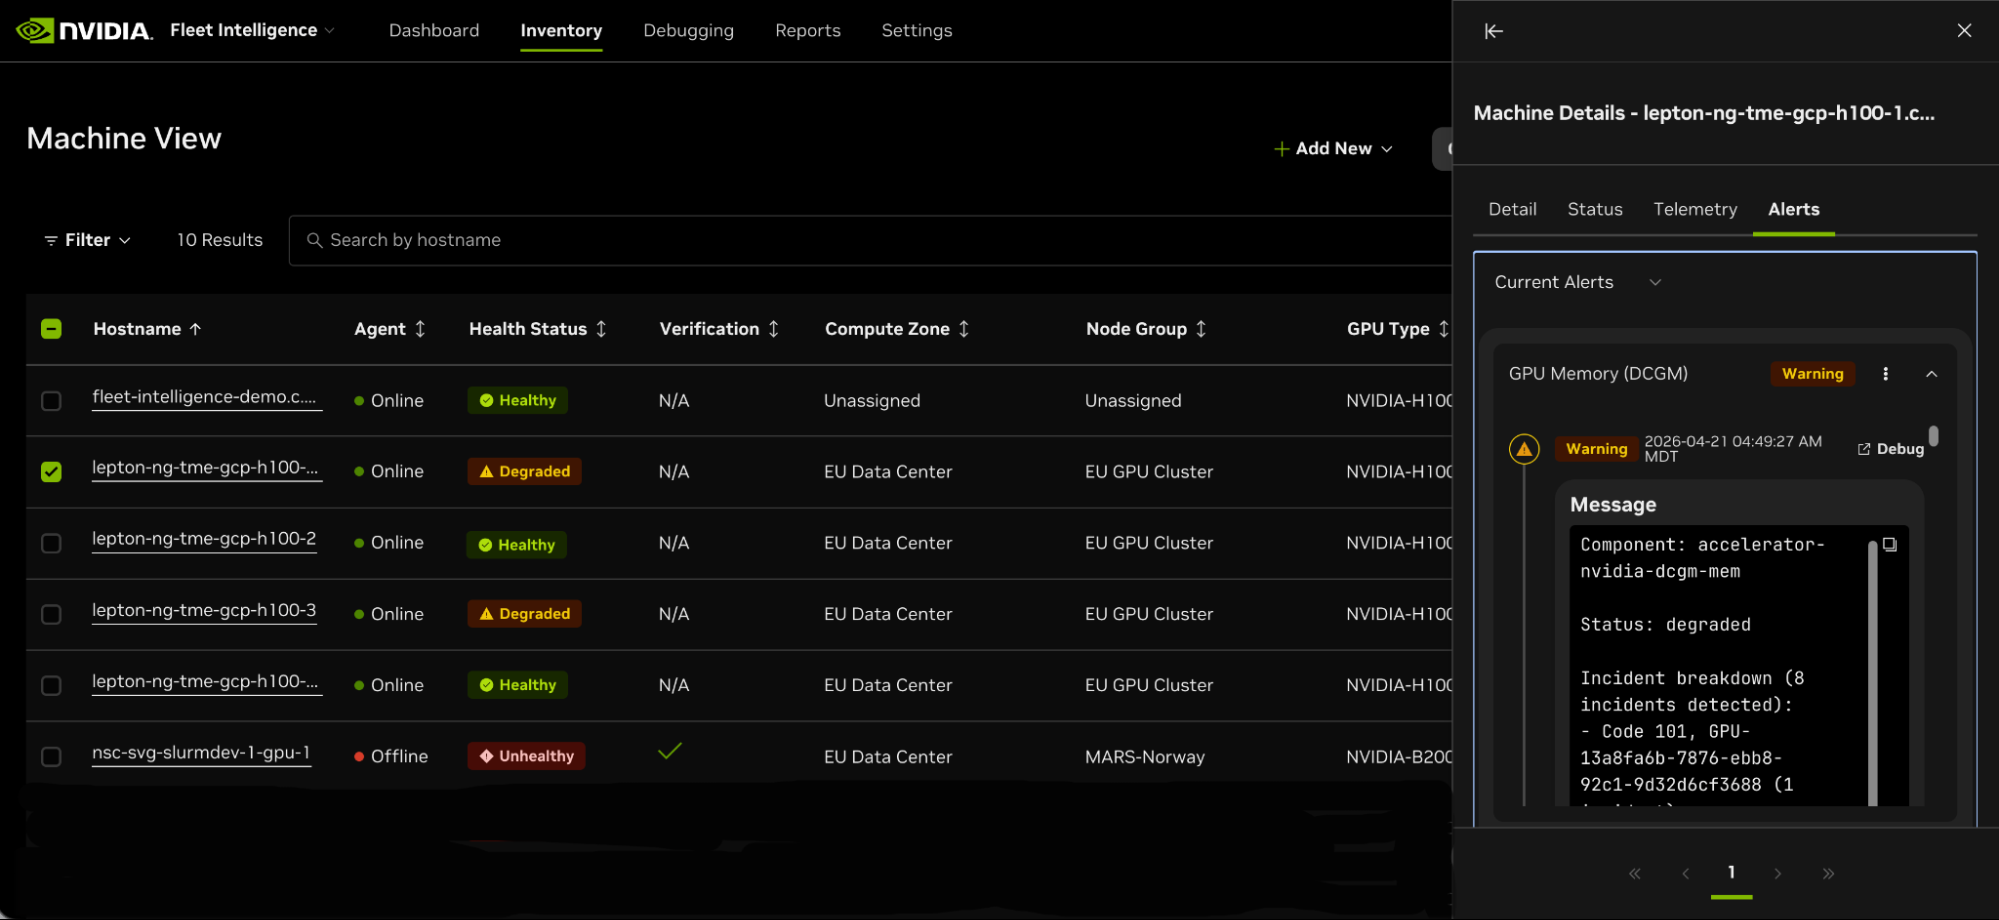 Добавление масштабной телеметрии и предиктивной аналитики отражает растущий спрос гиперскейлеров и корпоративных клиентов на максимальное использование ресурсов ускорителей. Кроме того, премьера платформы является отражением роста конкуренции на рынке систем мониторинга и эксплуатации ИИ-инфраструктуры. Облачные операторы и другие компании, включая AMD, Intel и т.п., строят собственные платформы для телеметрии, диагностики и управления крупными ИИ-кластерами. Возможность NVIDIA интегрировать аппаратную телеметрию, проверку надёжности прошивок и операционную аналитику напрямую в инфраструктурный стек усиливает позиции компании в роли вертикально интегрированного поставщика ИИ-инфраструктуры.
14.05.2026 [09:00], Сергей Карасёв
Basis Dynamix Cloud Control 5.5: новые безопасные инструменты для организации облачной инфраструктуры и хранения данныхКомпания «Базис», лидер российского рынка ПО управления динамической инфраструктурой, представила релиз 5.5 платформы для управления частными, публичными и гибридными облаками Basis Dynamix Cloud Control. В новой версии реализована интеграция со средством защиты виртуализации Basis Virtual Security, представлена гибкая ролевая модель, расширены возможности управления виртуальными центрами обработки данных и сетевой функциональностью. Basis Dynamix Cloud Control — облачное решение, позволяющее заказчику управлять различными платформами виртуализации — в том числе расположенными в разных ЦОДах — через единый графический интерфейс. Продукт обеспечивает создание и администрирование виртуальных центров обработки данных (ВЦОД), развёртывание платформенных сервисов, предбиллинг и разграничение доступа. Поддерживаются сегменты на базе Basis Dynamix Enterprise, Basis Dynamix Standard, VMware vSphere. Новые инструменты для управления виртуальным ЦОДВ обновлённом Basis Dynamix Cloud Control были существенно расширены возможности управления жизненным циклом виртуального ЦОД. В частности, для упрощения администрирования решение может при удалении одного дата-центра автоматически удалять и все связанные с ним компоненты — серверы, сети, порты, роутеры и диски. Для защиты от случайного удаления реализован механизм специального тега, при наличии которого операция блокируется. В релизе 5.5 жизненный цикл дополняется возможностью переносить виртуальный центр обработки данных между проектами, доступными администратору заказчика, в том числе между проектами разных клиентов. Новая возможность упрощает реорганизацию облачной инфраструктуры и администрирование мультитенантных сред. Также было снято ограничение на развёртывание платформенных сервисов (PaaS) — теперь можно запускать параллельно несколько таких сервисов в рамках одного ВЦОД. Это сокращает время подготовки комплексных виртуальных окружений, включающих несколько сервисов. Централизованное управление правами и доступомВ новом Basis Dynamix Cloud Control 5.5 была реализована интеграция с решением защиты Basis Virtual Security. Basis Virtual Security используется в качестве единого провайдера идентификации, оно обеспечивает поддержку технологии единого входа (Single Sign-On, SSO) и даёт администраторам возможность управлять учётными записями и правами доступа пользователей «из одного окна». Централизованное управление снижает нагрузку на администраторов, а пользователей платформы избавляет от необходимости вводить учётные данные при переходе между компонентами экосистемы «Базиса». 
Источник изображений: «Базис» Дополнительное удобство обеспечивает гибкая ролевая модель, с помощью которой администратор может тонко настраивать права доступа пользователей — собирать собственные роли из атомарных разрешений и назначать их в нужном объёме конкретным пользователям. Усовершенствованные политики хранения данных и поддержка внутренних сетейВ новой версии Basis Dynamix Cloud Control реализована поддержка политик хранения данных, используемых в Basis Dynamix Enterprise. Политики позволяют распределять нагрузку между пулами СХД в зависимости от их загруженности, что обеспечивает более равномерное использование ресурсов хранения и упрощает эксплуатацию крупных инсталляций с несколькими пулами. При создании сервера из пользовательского образа в сегментах Basis Dynamix Enterprise теперь можно выбрать профиль хранения индивидуально для каждого диска — как системного, так и дополнительных. Это даёт возможность распределять диски одного сервера по разным типам хранилищ в зависимости от требований к производительности и стоимости. В сегменте Basis Dynamix Enterprise также появилась возможность создавать образы дополнительных дисков: при создании образа сервера сохраняются данные не только на системном, но и на подключенных дисках. 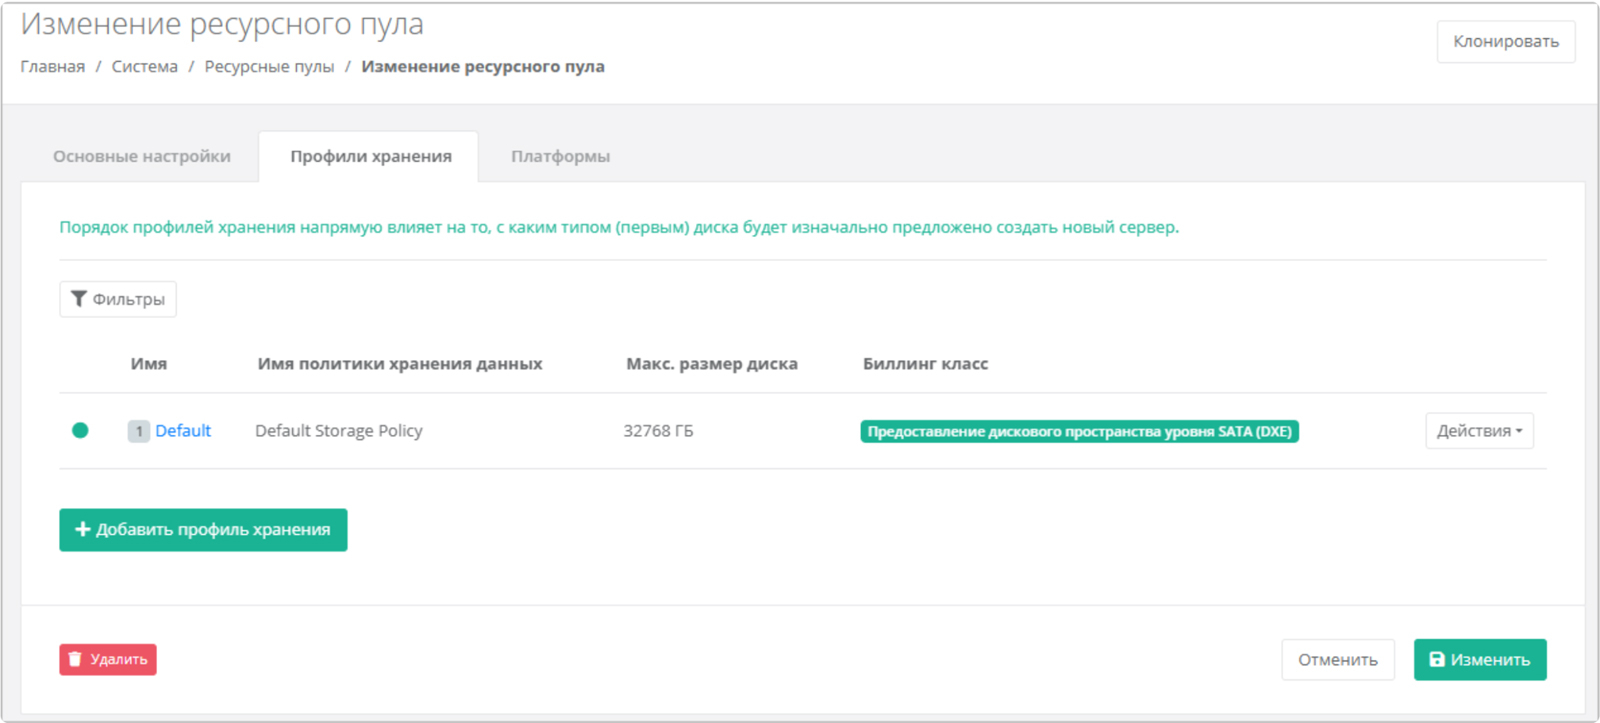 Для ресурсных пулов Basis Dynamix Standard было реализовано полноценное управление сетями и роутерами — аналогично другим сегментам оркестратора. В разделе управления сетевыми подключениями добавлены фильтры по восьми параметрам: типу устройства, серверу, роутеру, балансировщику, кластеру Kubernetes, IP-адресу, признаку служебного подключения и тегам. Это упрощает администрирование комплексной инфраструктуры, состоящей из большого количества физических и виртуальных компонентов. «Экосистемный подход остаётся приоритетом нашей разработки, поэтому в новом релизе Basis Dynamix Cloud Control мы сделали акцент на расширении совместимости с другими решениями нашей экосистемы. Кроме того, значительное внимание было уделено инструментам администрирования прав пользователей и удобству управления виртуальным ЦОД, что будет особенно полезно крупным заказчикам со сложной инфраструктурой», — отметил Дмитрий Сорокин, технический директор компании «Базис».
16.12.2025 [01:05], Владимир Мироненко
NVIDIA купила разработчика Slurm, пообещав не забрасывать open source решениеNVIDIA объявила о приобретении SchedMD — ведущего разработчика открытой системы оркестрации Slurm для высокопроизводительных вычислений (HPC) и ИИ. Финансовые условия сделки не разглашаются. Созданная SchedMD система Slurm обеспечивает планирование и управление большими вычислительными задачами в ЦОД, позволяя уменьшить количество ошибок, ускорить вывод продукции на рынок и снизить затраты. Как сообщает NVIDIA, сделка поможет укрепить экосистему ПО с открытым исходным кодом и стимулировать инновации в области ИИ для исследователей, разработчиков и предприятий. Компания отметила, что рабочие нагрузки HPC и ИИ включают сложные вычисления с выполнением параллельных задач на кластерах, для чего требуется организация очередей, планирование и распределение вычислительных ресурсов. По мере увеличения размеров и мощности кластеров HPC и ИИ задача эффективного использования ресурсов становится критически важной. 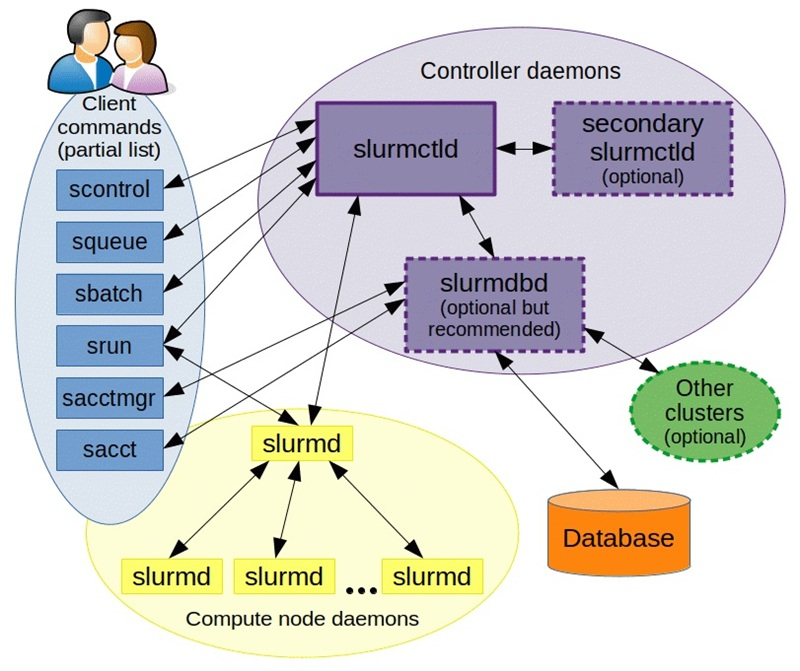
Источник изображения: SchedMD SchedMD была основана в 2010 году разработчиками ПО Slurm Моррисом «Мо» Джеттом (Morris «Moe» Jette) и Дэнни Оублом (Danny Auble) в Ливерморе (Livermore, штат Калифорния). В настоящее время персонал компании насчитывает 40 человек. Сейчас Slurm — ведущий менеджер рабочих нагрузок и планировщик заданий по масштабируемости, пропускной способности и управлению сложными политиками, который используется более чем в половине из десяти и ста лучших систем в списке TOP500 суперкомпьютеров. NVIDIA сообщила, что сотрудничает с SchedMD более десяти лет и продолжит инвестировать в разработку Slurm, чтобы сохранить его поизиции как ведущего планировщика с открытым исходным кодом для HPC и ИИ. NVIDIA обеспечит доступ SchedMD к новым системам, чтобы клиенты могли запускать гетерогенные кластеры с использованием последних инноваций Slurm. Также NVIDIA пообещала и далее поддерживать open source ПО, вкладываться в разработку Slurm и обучение. NVIDIA делает ставку на технологии с открытым исходным кодом и наращивает инвестиции в ИИ-экосистему, чтобы противостоять растущей конкуренции, отметил ресурс Reuters. В конце прошлого года NVIDIA завершила приобретение стартапа Run:ai, разрабатывающего ПО для управления рабочими нагрузками ИИ и оркестрации на базе Kubernetes. А в 2022 году она купила фирму Bright Computing, ещё одного известного разработчика инструментов оркестрации и управления кластерами.
17.11.2025 [16:09], Руслан Авдеев
Программный «ускоритель» Huawei обещает практически удвоить производительность дефицитных ИИ-чиповКитайский техногигант Huawei Technologies инфраструктурное ПО для повышения эффективности использования ИИ-ускорителей, сообщает гонконгская SCMP со ссылкой на государственные СМИ КНР. По имеющимся данным, технология позволит поднять эффективность использования ИИ-чипов, включая GPU и NPU, до 70 % по сравнению с нынешними 30–40 %. Это будет ещё одним крупным достижением в области «компенсации отставания в аппаратном обеспечении за счет совершенствования программного». Новая технология, премьера которой должна состояться на одной из посвящённых ИИ-тематике конференций, позволит «унифицированно управлять» не только ускорителями самой Huawei, но и NVIDIA, а также моделями прочих разработчиков. В самой Huawei от комментариев пока воздержались. Это особенно актуально в свете недоступности актуальных ускорителей NVIDIA, из-за чего китайские компании скупают чипы прошлых поколений. Важность оптимизации использования имеющихся ресурсов наглядна показала «революция DeepSeek». 
Источник изображения: Yiran Ding/unsplash.com Если информация подтвердится, технология может значительно улучшить продажи ИИ-чипов семейства Huawei Ascend в Китае (возможно, и за его пределами). Это может снизить зависимость КНР от чипов NVIDIA и других американских разработчиков. Утверждается, что новая технология Huawei будет аналогична продукту, разрабатывавшемуся израильским стартапом Run:ai и купленному NVIDIA в 2024 году за $700 млн. Его ПО позволяет организовать оркестрацию крупномасштабных ИИ-нагрузок между массивами ИИ-ускорителей. При этом и сама NVIDIA постоянно оптимизирует собственное ПО, повышая производительность исполнения рабочих нагрузок ИИ. Новость может стать хорошим дополнением к сентябрьскому анонсу. Тогда компания поделилась планами выпуска ИИ-ускорителей Ascend следующего поколения. Готовящиеся изделия призваны составить конкуренцию передовым чипов NVIDIA и подготовке мощных ИИ-систем SuperPOD, объединяющих 8192 и 15 488 ускорителей Ascend. На основе таких платформ будут формироваться суперкластеры, насчитывающие до 500 тыс. и более экземпляров Ascend.
08.10.2025 [08:53], Владимир Мироненко
HPE отдала Nokia «ненужные» технологии Juniper Networks для мобильных сетей, часть сотрудников и одного вице-президентаNokia объявила о сделке с HPE, в рамках которой она лицензировала технологии для развития своих решений для мобильных сетей и сетевой автоматизации на базе ИИ. Nokia получит доступ к технологиям, касающимся интеллектуальных контроллеров (RIC) сетей радиодоступа (RAN) и платформы по управлению и оркестрации сервисов (SMO) компании Juniper Networks, приобретённой HPE за $14 млрд. 1 октября 2025 года большая часть соответствующей команды разработчиков перешла в Nokia Mobile Networks, а вместе с ней и Константин Полихронопулос (Constantine Polychronopoulos), вице-президент группы Juniper Networks, о чём пишет Data Center Dynamics. Лицензированные технологии будут интегрированы с решениями платформы Nokia MantaRay для управления сервисами и оркестрации (SMO) и автоматизации сетей. MantaRay SMO — комплексное решение Nokia для автоматизации на базе ИИ без участия оператора, способное достичь 4-го уровня автономных сетей TM Forum. Решение также полностью совместимо с Open RAN и поддерживает открытый интерфейс R1 для rApps. 
Источник изображения: Nokia Как сообщает tele.net.in, за последние пять лет Juniper создала «лучшую в своем классе» платформу RIC, а также решение SMO, обеспечивающее сквозную динамическую «нарезку» сети (end-to-end dynamic network slicing) по требованию. По всей видимости, HPE решила, что бизнес SMO/RIC для неё не является целевым, подобно Broadcom, отказавшейся от разработки RIC в VMware, пишет ресурс The Mobile Network. RIC функционирует в процессе развёртывания Open RAN, выступая своего рода связующим звеном. Это позволяет операторам развёртывать xApps- и rApps-приложения для контроля и проектирования функций RAN, обеспечивая административный суверенитет RAN над функциями, которые обычно реализуются как проприетарные на базовых станциях. RIC также позволяет телекоммуникационным компаниям комбинировать сторонние сетевые приложения, такие как отключение базовых станций или перенаправление трафика из перегруженных сот, с радиоустройствами Ericsson или Nokia, предоставляя оператору больше контроля над своими средами Open RAN. Томми Уитто (Tommi Uitto), президент подразделения мобильных сетей Nokia, отметил, что сделка с HPE расширит возможности Nokia по предложению клиентам «автоматизации, оркестрации и открытых экосистем на базе ИИ, что позволит им эффективнее управлять сетями разных производителей и подготовиться к переходу с 5G на 6G». |
|

