
Материалы по тегу: x
|
05.11.2026 [21:16], Владимир Мироненко
SanDisk сделала ставку на HBF, но выпускать её пока негде, поскольку Kioxia выбрала иной путь развития памятиЯвляясь партнёрами по совместному предприятию в сфере производства NAND-памяти, компании Kioxia и SanDisk по-разному относятся к архитектуре High-Bandwidth Flash (HBF), сторонником которой является и SK hynix. Однако в отличие от SanDisk, разработавшей эту технологию в 2024 году, Kioxia пока занимает нейтральную позицию, предлагая альтернативный архитектурный подход, пишет Blocks & Files. Проблема в том, что у SanDisk нет собственных производственных мощностей для выпуска пластин, она сможет осуществлять выпуск пластин с памятью HBF NAND через СП с Kioxia. Однако маловероятно, что это СП будет производить пластины HBF NAND исключительно для нужд SanDisk. В 2026 году SanDisk и SK hynix инициировали создание консорциума по стандартизации спецификаций HBF, запустили профильное рабочее направление в рамках OCP и представили первые открытые технические спецификации, охватывающие такие аспекты, как стеки кристаллов NAND (8 или 16 кристаллов в стеке ёмкостью до 512 Гбайт), показатели пропускной способности (примерно 0,4–3,0 Тбайт/с), UCIe-интерфейс, особенности корпусировки, параметры надёжности и рекомендации по ПО. 
Источник изображения: SanDisk В октябре SanDisk сообщила, что технология HBF достигла важного рубежа — был осуществлён выпуск (tape-out) первого кристалла памяти HBF. При этом поставки образцов первых продуктов на базе HBF по-прежнему ожидаются в следующем календарном году. Однако сама Kioxia не стала присоединяться к консорциуму HBF. По данным издания Nikkei, она планирует использовать скоростную память NAND в сочетании с CXL в качестве альтернативы DRAM, что позволит сократить задержку при чтении данных более чем в десять раз по сравнению с традиционными решениями на базе NAND. В августе 2025 года Kioxia представила прототип флеш-модуля большой ёмкости (5 Тбайт) с высокой пропускной способностью (64 Гбайт/с), предназначенного для периферийных систем, а не для GPU-серверов в ЦОД. Его архитектура предусматривает последовательное соединение блоков флеш-памяти, а не их многослойную компоновку, с последовательной же передачей сигналов, а не параллельной (как в HBF). То есть Kioxia делает ставку на последовательное соединение без вертикального стекирования слоев, тогда как SanDisk и SK hynix отдают предпочтение стекированию слоёв с использованием параллельных соединений через сквозные кремниевые контакты (TSV). SanDisk рассматривает возможность запуска собственного производства памяти. В апреле этого года TrendForce со ссылкой на ETNews сообщила, что SanDisk начала сотрудничество с поставщиками материалов, компонентов и оборудования с целью создания пилотной линии по выпуску прототипов HBF, а Япония рассматривается как основной кандидат на роль производственной площадки. Ожидается, что пилотная линия будет запущена ближе к концу года, а запуск коммерческого производства намечен на 2027 год.
05.11.2026 [17:37], Павел Котов
SpaceX намерена запустить в 2027 году 10 ГВт мощностей ИИ ЦОД — цель представляется достижимойВ ходе квартального отчёта глава SpaceX Илон Маск (Elon Musk) выразил «полную уверенность», что только в 2027 году компания намерена ввести в строй 10 ГВт вычислительных мощностей, отмечает Tom’s Hardware. Поставленная цель вполне достижима, допускают аналитики Semiaccurate, — если все факторы сложатся удачно. В качестве доказательства приводятся высокие темпы строительства объектов Colossus 1 и Colossus 2 — их оценка приводится на основе аэрофотоснимков и доступной информации. Мощность электроснабжения Colossus 2 в январе составляла 0,4 ГВт, а к концу года она вырастет до запланированных 2,4 ГВт — судя по тому, с какой скоростью на площадку прибывает оборудование. На отслеживаемых объектах, включая комплексы Colossus и Starbase, могут быть развёрнуты до 9 ГВт вычислительных мощностей. На территории Colossus 2 размещены 89 газовых турбин, способных вырабатывать около 2,5 ГВт электроэнергии, и 1377 аккумуляторных систем Tesla Megapack. Но из-за экологических норм компании разрешат использовать собственные турбины для генерации только 1,24 ГВт. С учётом поступающих из внешней энергосети 1,2 ГВт остаётся дефицит в 300 МВт, который, вероятно, будет восполняться за счёт аккумуляторов и, возможно, дополнительных внешних источников. 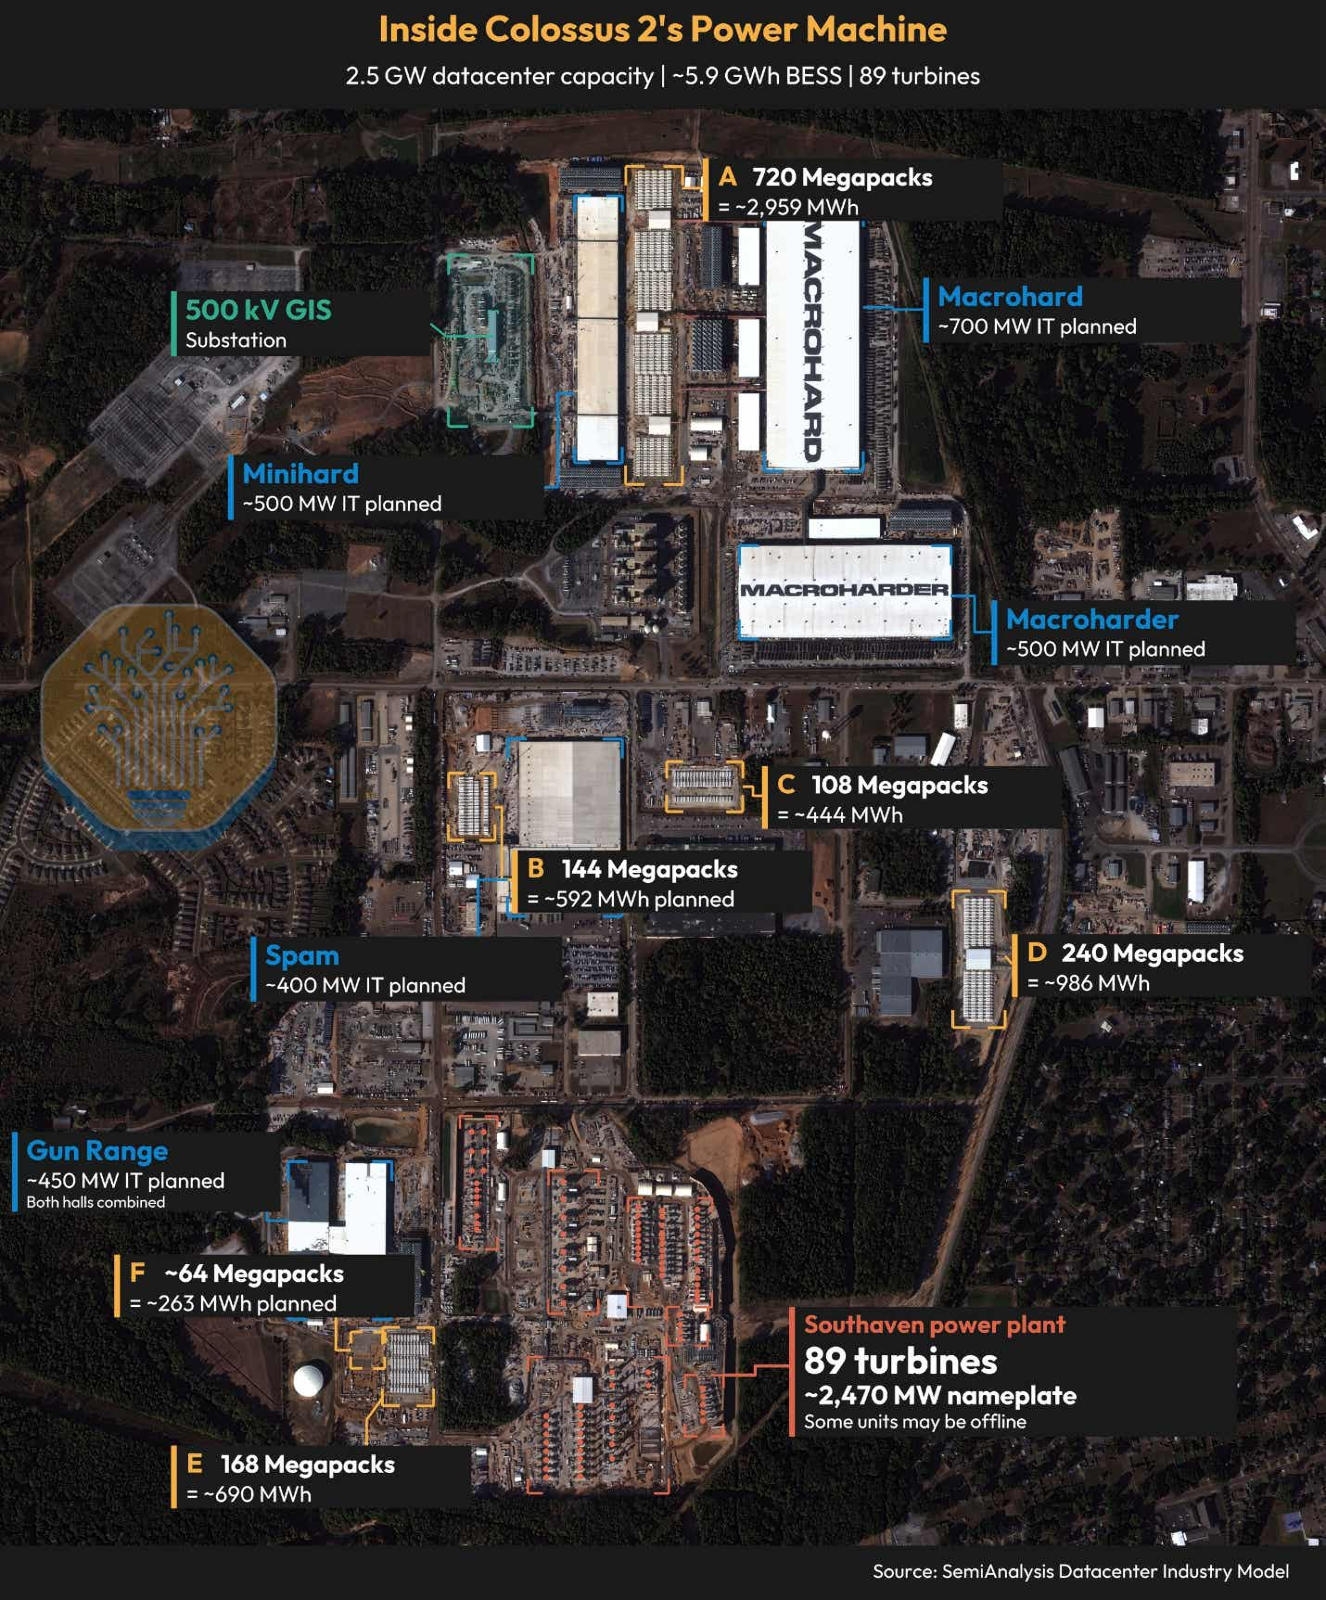
Источник изображения: semianalysis.com По состоянию на 25 сентября Маск сообщил, что в системе Colossus 2 уже задействованы 550 000 GPU — предположительно, на уже существующих объектах Macrohard и Macroharder. В кратчайшие сроки компания стремилась подготовить площадки Gun Range и Project SPAM. Работы там идут быстрыми темпами: там, где ещё несколько месяцев назад была голая земля, теперь появились строения. Но не факт, что в них уже установлены стойки с GPU. Темпы строительства настолько стремительные, что работы начинаются ещё до принятия окончательного решения о схеме электроснабжения и доставки необходимого оборудования. Если SpaceX удастся поддерживать непрерывный поток газовых турбин, это будет достижением. Tesla, возможно, производит механическое и электрическое оборудование в виде готовых модулей, которые развёртываются сразу после доставки с завода или прямо с грузовиков — временные турбины, в частности, размещены на платформах грузовых машин. Эти мобильные электростанции помогают обойти некоторые нормативные ограничения. Ранее SpaceX уже сталкивалась с проблемами из-за установки турбин для Colossus. Значительные мощности требуют колоссального количества ИИ-ускорителей — недавно стало известно, что SpaceX привлекла на их покупку $40 млрд заёмного капитала.
05.11.2026 [11:35], Сергей Карасёв
Прибыль Macronix бьёт рекорды на фоне дефицита флеш-памятиТайваньская компания Macronix International, крупный поставщик микросхем флэш-памяти NOR и NAND, отчиталась о работе в III четверти текущего года. По ключевым показателям зафиксирован значительный рост, что объясняется в том числе увеличением цен на продукцию на фоне сформировавшегося дефицита — компания является крупным поставщиком памяти для серверных плат. Выручка за трёхмесячный период достигла NT$24,24 млрд, или $758,6 млн. Это на 27 % выше показателя предыдущего квартала и на 195 % больше по сравнению с аналогичным периодом прошлого года. Валовая прибыль за квартал составила NT$17,09 млрд ($534,8 млн): рост в годовом исчислении — 1436 %. Валовая маржа оказалась на отметке 70,5 %. Чистая прибыль достигла рекордных NT$10,95 млрд, или $342,8 млн. Для сравнения, годом ранее Macronix понесла чистые квартальные убытки в объёме NT$862 млн. Прибыль в пересчёте на одну ценную бумагу составила NT$5,52 против NT$0,47 убытков на акцию по итогам III квартала 2025 года. Операционная прибыль указана в размере NT$12,93 млрд ($404,8 млн), операционная маржа — 53,4 %. Годом ранее компания продемонстрировала операционные убытки в NT$1,14 млрд. 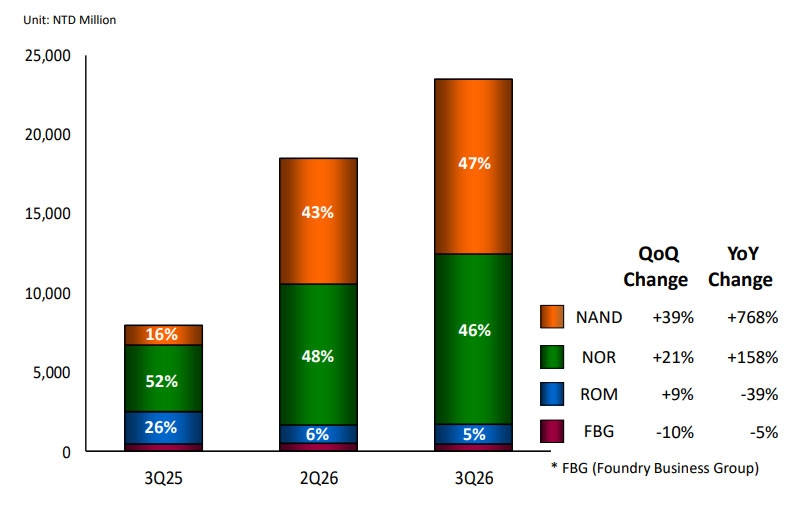
Источник изображения: Macronix В общей массе продаж продукции изделия NAND обеспечили примерно 47 % выручки. Ещё 46 % пришлось на решения NOR. Суммарный вклад всех прочих направлений деятельности составил приблизительно 7 % в денежном выражении. Если рассматривать исключительно сегмент NAND, то более половины продаж (52 %) обеспечили изделия для отрасли коммуникаций. Вклад потребительской сферы оценивается в 23 %, компьютерной — в 10 %, автомобильной — в 2 %.
03.11.2026 [14:08], Сергей Карасёв
NVIDIA скорректировала характеристики GPU Rubin, снизив пропускную способность HBM4 и NVLinkКомпания NVIDIA, по сообщению ресурса ServeTheHome, утвердила окончательные технические характеристики графических процессоров поколения Rubin, а также систем на их основе, включая Vera Rubin NVL72 и HGX Rubin NVL8. Ключевые изменения по сравнению с предварительными спецификациями связаны со скоростью работы подсистем. Первоначально NVIDIA планировала обеспечить пропускную способность памяти HBM4 на уровне 22 Тбайт/с в расчёте на один чип Rubin. В конфигурации с восемью стеками HBM4 (по 36 Гбайт, в сумме 288 Гбайт) это означало работу каждого стека со скоростью около 10,75 Гбит/с на контакт. В окончательном варианте значения снижены до 19,2 Тбайт/с и 9,375 Гбит/с соответственно, то есть примерно на 13 %. Вместе с тем пропускная способность интерконнекта NVLink уменьшена с 3,6 до 3 Тбайт/с — на 17 %. При этом пропускная способности интерконнекта для горизонтального масштабирования (Scale Out), напротив, увеличена с 0,4 до 0,45 Тбайт/с. 
Источник изображения: NVIDIA Несмотря на корректировки, показатели ИИ-производительности сохранились на прежнем уровне. На задачах инференса и обучения моделей в режиме NVFP4 быстродействие достигает 50 и 35 Пфлопс. На операциях INT8 показатель составляет до 250 TOPS, на операциях TF32 — до 2 Пфлопс. Таким образом, помимо указанных изменений, NVIDIA не внесла никаких других модификаций в характеристики Rubin. В случае флагманской системы Vera Rubin NVL72 общая пропускная способность подсистемы памяти HBM4 сократилась с 1580 до 1400 Тбайт/с, интерконнекта NVLink — с 260 до 216 Тбайт/с. Пропускная способности интерконнекта (Scale Out) поднялась с 28,8 до 32,4 Тбайт/с. Наконец, у HGX Rubin NVL8 показатель ПСП HBM4 упал со 176 до 130 Тбайт/с, NVLink — с 28,8 до 24 Тбайт/с, тогда как для сети значение выросло с 1,6 до 1,8 Тбайт/с. Причём у этих систем NVIDIA также уменьшила объём памяти HBM4. Если первоначально HGX Rubin NVL8 планировалось наделить 2,3 Тбайт HBM4, то в соответствии с окончательными спецификациями размер памяти составит 2 Тбайт.
02.11.2026 [14:56], Владимир Мироненко
«Группа Астра» предупредила об уязвимости ядра операционной системы LinuxРоссийский разработчик инфраструктурного ПО «Группа Астра» уведомл об обнаружении уязвимости ядра операционной системы Linux. В связи с этим компания оповестила регулирующие органы в установленном для подобных ситуаций порядке. Также на сайте компании сообщается, что методические рекомендации для нейтрализации угроз безопасности доступны клиентам в личных кабинетах пользователей и в разделах wiki.astralinux.ru:
Источник изображения: astra.ru В настоящее врем ведутся работы по устранению уязвимости на программном уровне. При этом специалисты компании осуществляют непрерывный мониторинг ситуации, принимая все необходимые меры для защиты интересов заказчиков. О выпуске патча будет объявлено после его готовности.
01.11.2026 [11:24], Руслан Авдеев
SpaceX не смогла отделаться от иска NAACP по поводу загрязнения воздуха в МемфисеИИ-подразделению SpaceX — компании SpaceXAI/SpaceXSI не удалось добиться отклонения судом иска со стороны НКО NAACP, обвиняющей техногиганта в загрязнении воздуха выбросами, связанными с работой ЦОД в Мемфисе, сообщает CNBC. Суд продолжит рассматривать дело в федеральном суде штата Миссисипи. Согласно иску, SpaceXAI нарушила закон США о чистом воздухе (Clean Air Act) из-за использования газовых турбин для выработки электроэнергии, предназначенной для своих ЦОД в районе Большого Мемфиса. Дата-центры Colossus и строящаяся электростанция в Саутхейвене (Southaven) вызывают недовольство местных жителей не первый год. В апреле 2026 года юристы Southern Environmental Law Center и НКО Earthjustice выступили с иском от имени NAACP. В иске, поданном в Окружной суд США по Северному округу Миссисипи, утверждается, что с августа по декабрь 2025 года xAI (позже влившаяся в состав SpaceXAI) и её дочерняя структура MZX Tech использовали в Саутхейвене 27 газовых турбин, не получив разрешения на выбросы в атмосферу загрязняющих веществ, без учёта воздействия на здоровье и безопасности живущих на на окружающей территории людей. Утверждается, что выбросы турбин имеют неприятный запах и угрожают здоровью местного населения, не считая прочих негативных последствий. 
Источник изображения: Benjamin Brunner/unsplash.com В поданном SpaceXAI ходатайстве об отклонении иска представители SpaceXAI подчёркивали, что попавшие в поле зрения правосудия турбины следует считать «мобильными источниками» выбросов, на которые требования о получении разрешений не распространяются. Также компания утверждала, что у NAACP нет права подавать иск на основании Clean Air Act и сама возможность подачи исков подобными инициативными группами неконституционны. Суд отклонил доводы ответчиков, подчеркнув, что истцы обладают предусмотренным Clean Air Act правом обращения в суд, поскольку газовые турбины не являются «мобильным» источником выбросов и поскольку не нарушается статья II конституции США и доктрина о недопустимости передачи частным лицам государственных полномочий. Поэтому рассмотрение требований истцов будет продолжено. Примечательно, что решение вынесено всего через пару недель после того, как тот же суд отклонил и ходатайство Министерства юстиции США — то предлагало прекратить разбирательство в отношении SpaceXAI по соображениям национальной безопасности. На днях сообщалось, что SpaceXAI грозит штраф в размере $6,1 млн, поскольку компания начала строить свои ЦОД в штате Миссисипи без необходимых разрешений.
30.10.2026 [17:22], Павел Котов
Altera представила семейство FPGA Agilex 2XAltera анонсировала линейку FPGA Agilex 2X, флагманом которой выступила модель Agilex 27, сообщает Converge! Digest. Она оснащена трансиверами со скоростью до 256 Гбит/с, аппаратными интерфейсами Ethernet на 800 Гбит/с и 1,6 Тбит/с и сетевой архитектурой HyperFlow. Поставка инженерных образцов стартует во II половине 2027 года. Agilex 2X предназначены для ИИ-инфраструктуры, сетей Ethernet терабитного класса, систем связи 6G, аэрокосмической отрасли и периферийных ИИ-вычислений. Старшей в серии выступает модель Agilex 27 — её отличают SerDes-блоки 256G, аппаратные интерфейсы 800GbE и 1,6TbE, а также распределённая внутрикристальная сеть передачи данных, обеспечивающая передачу данных между логическими блоками со скоростью несколько терабит в секунду. В архитектуре Agilex 27 сочетаются программируемая матрица HyperFlex третьего поколения и новая сеть передачи данных HyperFlow. HyperFlex предусматривает распределение регистров по всей коммутационной структуре чипа, что помогает распределять задержки между этапами обработки данных и производить их конвейерную обработку. HyperFlow отвечает за передачу данных внутри чипа по выделенному внутреннему интерконнекту, не расходуя ресурсов стандартной программируемой логики. По сравнению с моделями предыдущего поколения Agilex 7 производительность на Вт у новых устройств выросла в 1,8 раза. 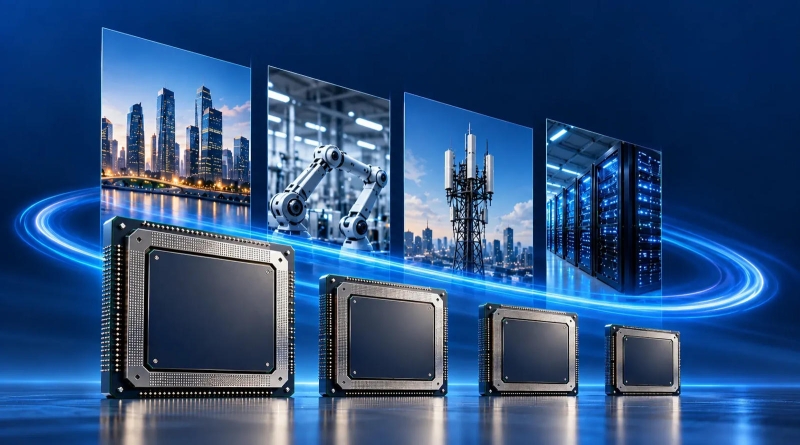
Источник изображения: altera.com Устройства поддерживают интерфейсы PCIe 6.0 и 7.0, память стандартов DDR5, LPDDR5X и LPDDR6, а также стандарт UCIe для чиплетной интеграции. Функции защиты включают безопасную загрузку, подтверждение подлинности устройства, поддержку постквантового шифрования, шифрование Ethernet-трафика MACsec, защиту целостности и шифрование данных при передаче данных по шине PCIe, а также шифрование оперативной памяти на лету. Модель Agilex 27 предназначена для инфраструктур с высокой пропускной способностью; Agilex 25 — для встраиваемых вычислений и высокоскоростных сенсорных систем; Agilex 23 — для промышленной автоматизации и робототехники; Agilex 22 — для систем управления с большим числом портов ввода-вывода. Все четыре серии используют единую среду разработки Quartus Prime и ИИ-помощника по проектированию QuartusIQ. Программные средства для Agilex 27 станут доступны в рамках программы раннего доступа в ноябре. Инженерные образцы Agilex 27 появятся во II половине 2027 года. Ранее Altera продлила жизненный цикл некоторых FPGA-решений до 2045 года. В минувшем году компания представила малые FPGA семейства Agilex 3 и запустила массовое производство моделей семейства Agilex 5.
30.10.2026 [17:17], Павел Котов
Китайская Iluvatar CoreX заявила, что её ИИ-ускоритель Tiangai 300 обошёл NVIDIA H200Китайский стартап Iluvatar CoreX объявил, что его GPU Tiangai 300 может работать на уровне NVIDIA H200, а в некоторых практических задачах ИИ и превосходить показатели американской модели, пишет South China Morning Post. Iluvatar CoreX провела демонстрацию работы Tiangai 300 для представителей китайских СМИ на примере сложных мультимодальных задач ИИ, в частности, касающихся генерации картинок и видео по текстовым запросам. При тестировании с созданием изображений по запросам китайский ускоритель на 100 % успешно выполнял задачи со скоростью 0,101 изображения в секунду — NVIDIA H200 показал 87,5 % и 0,086 изображения в секунду; отмечается, что китайский чип выполнял задачу на 0,64 с дольше. 
Источник изображения: iluvatar.com Поддерживаемая государством шанхайская INESA провела тестирование Tiangai 300 ещё в июле и установила, что «в типичных условиях развёртывания» китайский GPU демонстрирует пропускную способность, которая в 1,05 раза превышает показатели NVIDIA H200. Ещё в одной серии тестов Tiangai 300 показал пропускную способность на 15 % больше, чем у H200 при работе с ИИ-моделью на архитектуре MoE (Mixture-of-Experts); задержка при генерации первого токена при обработке длинных текстов уменьшилась на величину до 30 %. В задаче на дообучение открытой модели Alibaba Qwen3-32B китайский ускоритель сравнивали с американской моделью предыдущего поколения NVIDIA H100 — в этом случае Tiangai 300 оказался в 1,33 раза быстрее. Iluvatar CoreX намерена преодолеть лидирующее положение США на рынке ИИ-ускорителей — в январе компания представила дорожную карту, в соответствии с которой за два года она намерена обойти показатели передовой платформы NVIDIA Rubin. ИИ-ускорители Tiangai 300 демонстрируют высокие результаты не только в лабораторных условиях — компания развёртывает их в масштабах десятков тысяч, за счёт чего набирает опыт во внедрении и техническом обслуживании этих систем. Стартап работает не только с GPU для ИИ ЦОД, но и с оборудованием для периферийных вычислений. В тестах на инференс больших языковых моделей чип Tongyang TY1200 оказался на 20 % быстрее чипа NVIDIA Thor T5000. Китайская Z.AI уже построила гигантский ИИ ЦОД, в котором работают исключительно ускорители местного производства. Над аналогичным проектом в стране работают JD Cloud и Moore Threads. А DeepSeek намерена создать собственный ИИ-ускоритель.
28.10.2026 [16:16], Павел Котов
NVIDIA и Oracle расширят инфраструктуру OCI на базе Vera Rubin NVL72 до мультигигаваттного масштабаNVIDIA и Oracle объявили о планах по расширению суперкластеров в Oracle Cloud Infrastructure (OCI) с использованием систем Vera Rubin NVL72 и Vera CPU, сообщает HPCwire. Масштаб таких решений достигнет гигаваттных значений — системы помогут удовлетворить спрос клиентов на обучение, инференс, а также на работу ИИ-агентов. Суперкластеры OCI объединяют стоечные системы NVIDIA NVL72, сетевые решения Oracle Acceleron, в том числе NVIDIA Spectrum-X Ethernet с коммутаторами Spectrum-6 и DPU BlueField-4, а также системы электропитания и охлаждения. В стойке ускорители объединены с помощью NVLink, а отказоустойчивая многоплоскостная сеть OCI позволяет масштабировать систему до сотен тысяч GPU. Планируется также внедрение системы NVIDIA HGX Rubin NVL8 с двумя 64-ядерными процессорами Intel Xeon 6, 4 Тбайт DDR5 и RDMA-интерфейсом 6,4 Тбит/с. Это решение обеспечивает гибкие возможности для обучения, дообучения и инференса ИИ-моделей при сохранении совместимости с приложениями на базе архитектуры x86. Такая гибкость позволяет адаптировать инфраструктуру ИИ к различным моделям и рабочим нагрузкам по мере изменения потребностей. 
Источник изображения: BoliviaInteligente / unsplash.com Ранее Oracle призналась, что направление ИИ ЦОД является для неё рискованным. Компания обеспечила высокоскоростное подключение своей инфраструктуры к AWS, а также сдала китайской Tencent 100 тысяч передовых ускорителей в аренду для развития ИИ-систем.
28.10.2026 [13:56], Руслан Авдеев
SK hynix: дефицит памяти сохранится до 2030 года, а HBM4 станет мейнстримом в ближайшее времяЮжнокорейский производитель памяти SK hynix прогнозирует сохранение дефицита памяти на мировом рынке как минимум до 2030 года. По мнению компании, это обеспечит рост уже исключительно высоких доходов и прибыли, сообщает The Register. Одновременно с публикацией квартальной отчётности компания подчеркнула, что на рынке сформировался «благоприятный цикл»: повышение производительности благодаря ИИ, появление новых источников дохода в сферах разработки ПО, поиска информации и обслуживания клиентов стимулируют рост инвестиций в инфраструктуру. По данным SK hynix, в результате на рынок ИИ-инфраструктуры выходит всё больше покупателей. В ближайшие годы ожидается ещё больший рост спроса на память со стороны сегментов автономного транспорта и робототехники. Сама компания активно строит заводы по выпуску памяти, но руководство констатировало, что наращивать производство достаточно быстро, чтобы удовлетворить спрос, не удаётся. 
Источник изображения: SK hynix В компании утверждают, что предложение не успевает за ростом рынка. С учётом технической сложности передовых техпроцессов и длительных сроков строительства новых производств ожидается, что дефицит сохранится до 2030 года. При этом SK hynix уже заключила 14 долгосрочных соглашений с 14 крупными компаниями, которые вместе купят больше памяти, чем производитель выпустит в 2027 и 2028 годах. При этом некоторые из них намерены расширить соглашения. Впрочем, соглашения с SK hynix включают механизм, учитывающий рыночные условия в пределах согласованного с клиентами ценового диапазона. Это обеспечивает стабильную прибыль и в то же время позволяет гибко реагировать на изменения рынка. Благодаря заключённым соглашениям компания зарегистрировала рекордную квартальную выручку в размере ₩104,6 трлн ($78,1 млрд), что на 328 % выше показателя за аналогичный период прошлого года и на 32 % выше показателя предшествовавшего квартала. Операционная прибыль выросла на 486 % год к году. Инвесторам сообщили, что производство будет расширяться, а больше внимания будет уделяться высокорентабельной продукции. Однако компания констатирует, что поставки памяти для ПК и мобильных устройств на этом фоне, вероятно, сократятся. Также компания сообщила, что намерена наращивать производство памяти HBM4, уже в IV квартале по объёмам поставок этот тип памяти обойдёт HBM3E, как в количественном, так и в денежном выражении и станет массовым продуктом. Предусмотрен рост доли продукции, выпускаемой по техпроцессу шестого поколения (10-нм), предполагается расширение продаж памяти DDR5 и LPDDR5 SOCAMM для ИИ-серверов. Кроме того, планируется развитие технологий HBF. Инвесторы приняли заявления компании весьма положительно, а некоторые, похоже, расценили выкладки компании, как косвенное свидетельство того, что бум ИИ в ближайшее время не пойдёт на спад. Летом сообщалось, что SK Group и NVIDIA объявили о совместных инициативах в Южной Корее на $500 млрд. |
|

