
Материалы по тегу:
|
17.11.2026 [14:35], Руслан Авдеев
OpenAI арендует у TensorWave 457 МВт ИИ-мощностей на базе AMD InstinctOpenAI заключила шестилетнее соглашение с облачной TensorWave о предоставлении ИИ-мощностей объёмом 457 МВт. Это произошло вскоре после того, как Fermi официально расторгла предварительный договор аренды с той же компанией, касающийся кампуса Project Matador в Техасе, сообщает Datacenter Dynamics. Согласно новому договору, TensorWave предоставит OpenAI выделенные вычислительные мощности на базе ускорителей AMD Instinct MI455X. Последние разместят в нескольких ЦОД. Доступ к ним должен появиться в I половине 2027 года, а все мощности должны быть развёрнуты к началу 2028 года. В TensorWave контракт назван крупнейшей сделкой по развёртыванию ИИ-инфрастурктуры за всю историю компании. Речь фактически идёт о развитии ранее анонсированного партнёрства OpenAI и AMD. Объявлению предшествовала новость о расторжении сделки Fermi и TensorWave об аренде мощностей и предоставлении услуг в ЦОД, заключенной в августе 2026 года. Предполагалось, что TensorWave арендует до 650 МВт мощностей в кампусе Project Matador близ Амарилло (Amarillo, шт. Техас), а AMD обеспечит кредитную поддержку сделки. По данным самой скандально известной Fermi, действие соглашения об аренде официально прекратили после того, как стороны не уложились в установленный срок, отведённый для завершения сделки, и у девелопера теперь не осталось арендатора для кампуса. 
Источник изображения: Amina Atar/unsplash.com Тем не менее Fermi объявила о заключении отдельного соглашения с неназванным гиперскейлером на 600 МВт мощностей в рамках инициативы Project Matador. Клиент обязался заплатить вперёд $200 млн, в т.ч. на подведение к площадке электроснабжения. Ожидается, что ввод мощностей в эксплуатацию начнётся с 2027 года. Также гиперскейлер выделит $15 млн на подготовительные строительные работы. Попутно идёт окончательное согласование договора на закупку стали и других стройматериалов на $90 млн, которых должно хватить на возведение нескольких ЦОД. В Fermi подчеркнули, что заказчик принял на себя финансовые обязательства, обещав участвовать в развитии проекта до подписания договора аренды из-за необходимости обеспечить объекту доступ к электроснабжению в соответствии с графиком. Fermi заявляет, что текущее портфолио проектов на стадии разработки включает потенциальных заказчиков, в перспективе способных освоить уже запланированные мощности на 2,2 ГВт. При этом реализация планов зависит от дальнейшей разработки проектов и заключения договоров аренды мощностей.
17.11.2026 [14:25], Владимир Мироненко
Платформа NVIDIA Vera Rubin обошла конкурентов во всех тестах MLPerf Training v6.1Дебют платформы NVIDIA Vera Rubin в бенчмарках MLPerf был отмечен её лидерством по производительности в таких областях, как обучение моделей, постобучение и выполнение задач интеллектуальными агентами (agentic inference), сообщила NVIDIA. NVIDIA опередила конкурентов во всех тестах MLPerf Training v6.1. При этом, в категории MLPerf Endpoints компания показала более чем десятикратный прирост (по сравнению с предыдущим поколением) пропускной способности на ватт для систем на базе ИИ-агентов. NVIDIA стала единственной, показавшей результаты во всех тестах текущего цикла — от больших языковых моделей и генерации изображений до рекомендательных систем и постобучения моделей с подкреплением. При этом система Vera Rubin NVL72 продемонстрировала до двух раз более высокую производительность в расчете на один GPU по сравнению с NVIDIA GB300 NVL72. NVIDIA также провела тестирование на 10 240 GPU в составе систем GB300 — это самый масштабный показатель в данном раунде. А платформа Microsoft Azure провела тесты, задействовав 10 240 GPU NVIDIA в системах GB200. 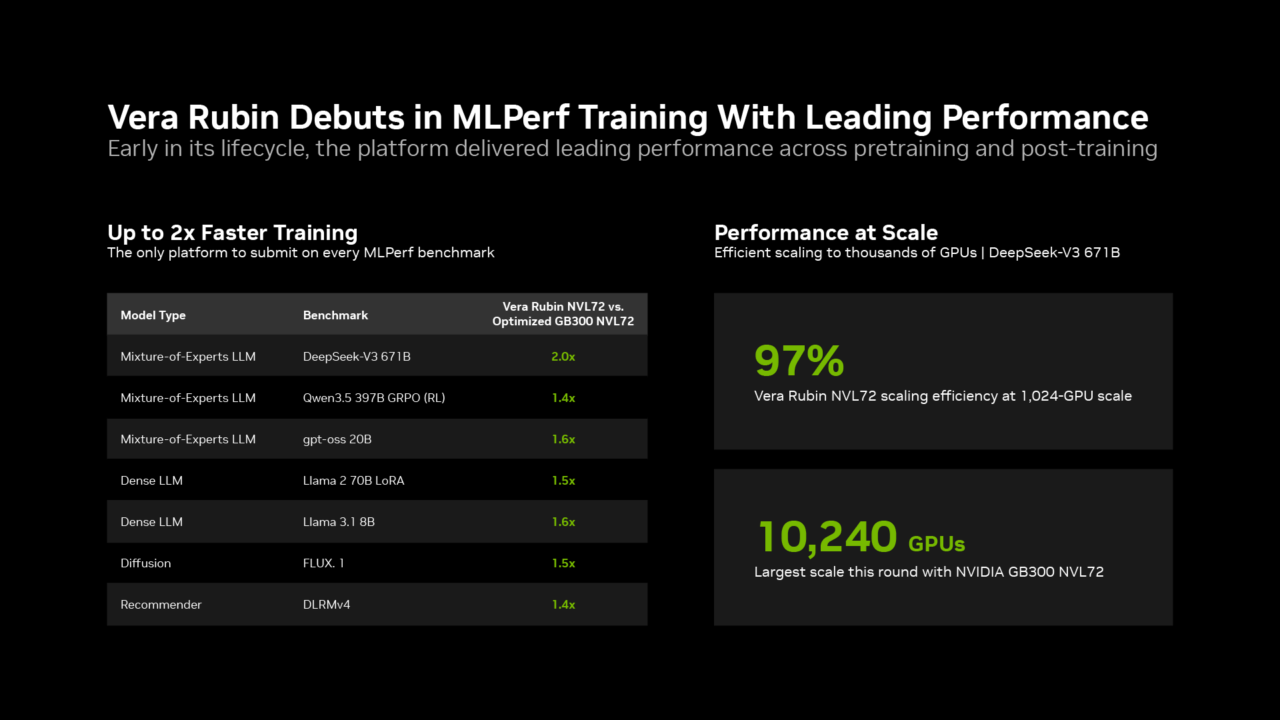
Источник изображений: NVIDIA NVIDIA Vera Rubin стала лидером в области агентных вычислений (agentic inference) по результатам тестов MLPerf Endpoints, показав лучшие показатели во всех бенчмарках, ориентированных на работу AI-агентов. Тестирование MLPerf Endpoints оценивает производительность систем в реальных сценариях работы AI-агентов, одновременно проверяя, насколько успешно и корректно они справляются с поставленными целями. Согласно предварительным результатам для Kimi K3 — крупной открытой модели, разработанной специально для агентных рабочих процессов, — системы VR200 NVL72 обеспечили более чем десятикратное преимущество по пропускной способности на ватт затраченной энергии по сравнению с GB300 NVL72 при идентичной скорости отклика. Предварительные результаты для системы Vera Rubin ожидают подтверждения со стороны ассоциации MLCommons. 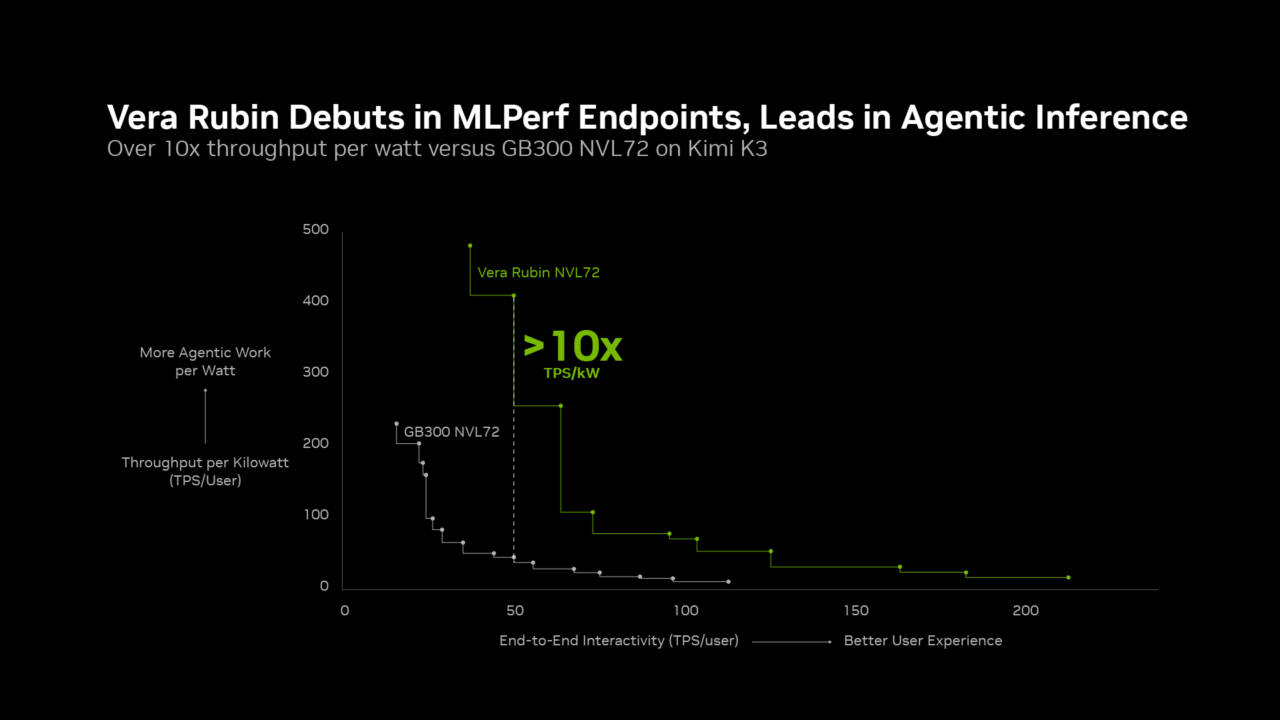 NVIDIA отметила, что Vera Rubin также демонстрирует передовые показатели в независимых бенчмарках, таких как SemiAnalysis AgentX и Artificial Analysis AgentPerf, что подтверждает широкие возможности инфраструктура NVIDIA, способной эффективно поддерживать самые разные задачи: от предварительного и последующего обучения моделей до выполнения агентных вычислений (agentic inference), а также решать задачи, не связанные напрямую с ИИ — например, обеспечивать HPC.
17.11.2026 [14:17], Руслан Авдеев
Иран, Казахстан и Туркменистан достигли предварительной договорённости о строительстве совместного цифрового коридораИран, Казахстан и Туркменистан заключили предварительное соглашение о создании совместного «цифрового коридора», связывающего Центральную Азию с Персидским заливом и соседними странами. Новые шаги направлены на усиление региональной телеком-инфраструктуры и расширение цифровой связности. Принципиальной договорённости удалось достигнуть в ходе трёхсторонней встречи между иранским министром информационных и коммуникационных технологий, туркменским министром связи, а также заместителем министра ИИ и цифрового развития Казахстана. Встречу провели на полях Полномочной конференции Международного союза электросвязи (МСЭ) (PP-26), проходящей в Катаре с 9 по 27 ноября. В рамках переговоров основное внимание уделялось укреплению взаимодействия в сфере телекоммуникаций и улучшению цифровой связанности в регионе. Предлагаемый коридор должен помочь усилить региональную телеком-инфраструктуру и повысить устойчивость цифровых сервисов благодаря развитию новых маршрутов передачи данных и увеличению пропускной способности между тремя странами, участвующими в соглашении. Также новый проект позволит этим странам лучше использовать своё географическое положение и существующую инфраструктуру для улучшения цифровой связи и ускоренного обмена данными между Центральной Азией, странами Персидского залива и соседними государствами. 
Источник изображения: Mehrshad Rajabi/unsplash.com Дополнительно сообщается, что Иран наращивает взаимодействие в сфере информационно-коммуникационных технологий с Бразилией и Ганой. В частности, с Бразилией предлагается укрепить сотрудничество в сфере коммуникационной инфраструктуры, ВОЛС, дата-центров, ИИ и кибербезопасности, а также некоторых других сферах, от научных связей до взаимодействия в нише космических технологий. Дополнительно состоялась встреча представителей Ирана и Ганы, в ходе которой обсуждались проекты развития технологического взаимодействия, в т.ч. в сфере ИИ. В частности, иранская сторона подчеркнула технологические возможности в сфере развития телеком-инфраструктуры и выразила готовность к сотрудничеству для подключения к инфраструктуре школ, медицинских учреждений и общественных центров в социально неблагополучных районах Ганы. Иран готов помочь в прокладке оптоволоконных сетей, поставках оборудования, обеспечить передачу технических знаний и обучение квалифицированных кадров. Параллельно Иран демонстрирует способность к более жёсткому подходу в региональных вопросах IT-индустрии. В сентябре AWS заявила, что не может восстановить доступ к ресурсам и данным в некоторых зонах доступности на Ближнем Востоке после того, как дата-центрам был нанесён урон.
17.11.2026 [14:06], Сергей Карасёв
Кремниевая фотоника и Xeon нового поколения: Intel рассказала о разработках в области ИИ и НРСКорпорация Intel, поделилась информацией о разработке передовых решений для платформ ИИ и НРС следующего поколения: Xeon 7, фотонике для каналов связи и квантовым компьютерам. К выпуску в числе прочего готовятся процессоры Xeon 7 Diamond Rapids. При создании этих чипов основной упор делается на повышении пропускной способности всех компонентов системы. В состав CPU войдут до 256 вычислительных ядер и до 1,28 Гбайт кеша L3. Говорится о поддержке технологий Intel AVX 10.2, Intel Advanced Performance Extensions (APX) и Intel Advanced Matrix Extensions (AMX). Возможно использование модулей памяти RDIMM-8000 и MRDIMM-12800, а заявленная пропускная способность при использовании 16 каналов достигает 1,6 Тбайт/с. В целом, процессоры Xeon 7 Diamond Rapids, как ожидается, позволят вывести производительность в ресурсоёмких приложениях на новый уровень. Intel подчёркивает, что в перспективе масштабирование суперкомпьютерных систем потребует преодоления физических ограничений в сетях передачи данных. По мере увеличения масштабов и мощности ИИ-кластеров применение традиционных медных линий становится всё более проблематичным из-за роста энергопотребления и наличия существенных задержек. С целью устранения указанных недостатков Intel развивает направление кремниевой фотоники. Оптическая связь позволит объединять высокопроизводительные ускорители, память и вычислительные ресурсы. 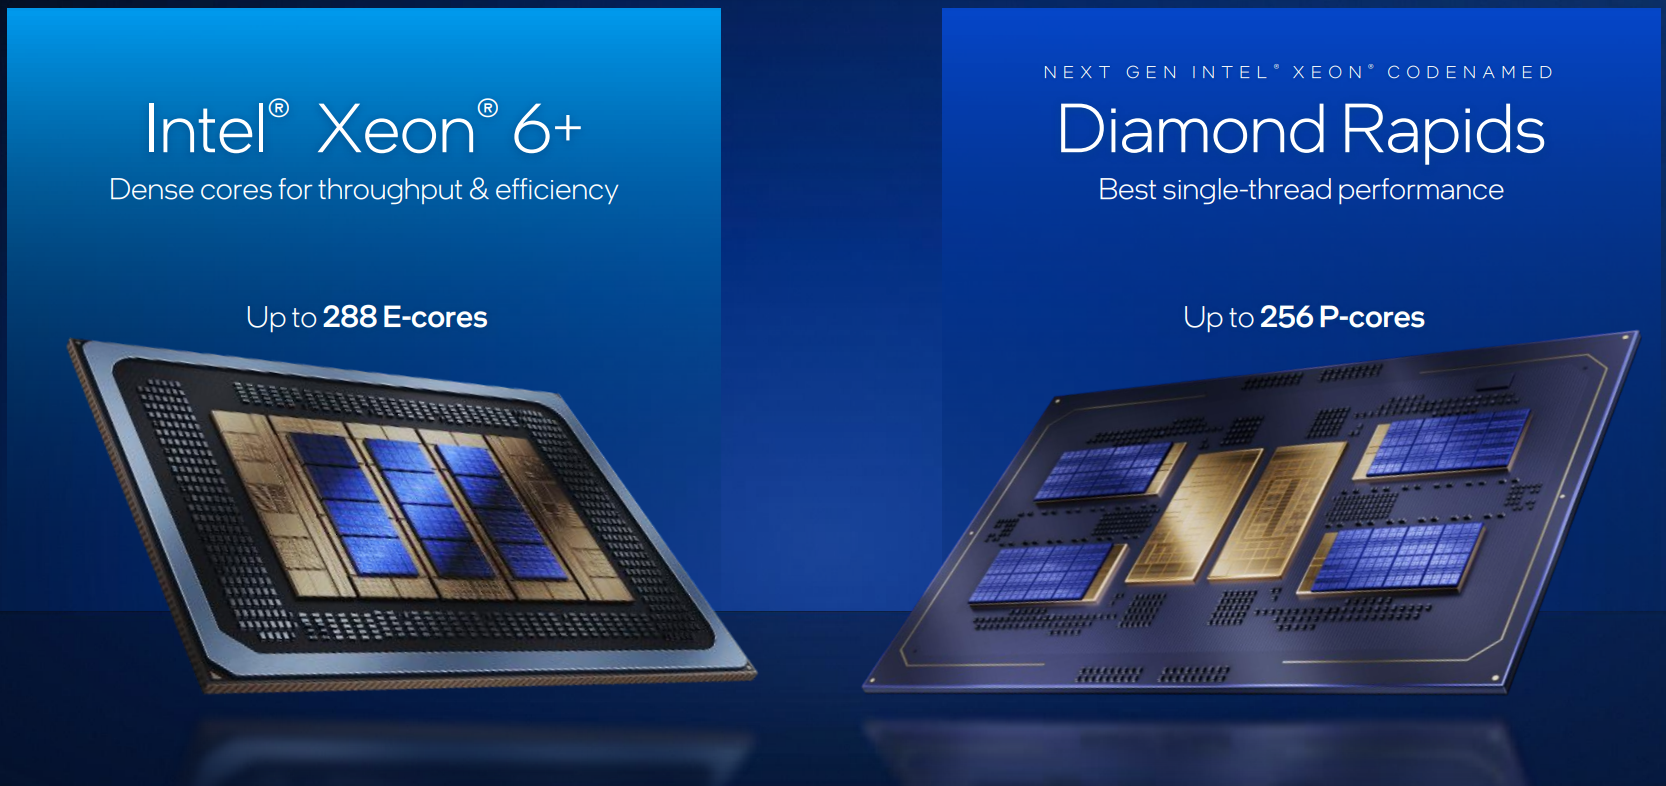
Источник изображения: Intel Ещё одним важным направлением Intel называет разработку квантовых технологий. Недавно корпорация объявила о приобретении израильского разработчика ПО для квантовых систем Classiq. Сделка позволит объединить платформу автоматизированного создания квантовых алгоритмов Classiq с кремниевыми спиновыми кубитами и производственными мощностями Intel. Главная цель состоит в том, чтобы абстрагироваться от сложной физики квантового оборудования. Это позволит разработчикам НРС-систем писать квантовые программы и создаст программную базу для вычислений следующего поколения.
17.11.2026 [13:58], Сергей Карасёв
Cornelis представила сетевую платформу CN6000 с поддержкой 800GКомпания Cornelis анонсировала сетевую платформу следующего поколения CN6000, разработанную для удовлетворения растущих требований к инфраструктуре передачи данных на фоне стремительного развития ИИ и НРС. Решение соответствует стандарту 800G (пропускная способность достигает 800 Гбит/с). В состав платформы вошли коммутатор CN6000 Omni-Path, а также сетевые адаптеры Omni-Path SuperNIC и Ethernet SuperNIC. Первое из этих устройств выполнено в форм-факторе 1U с 48 портами QSFP-DD со скоростью передачи данных 800 Гбит/с (или 96 портами на 400 Гбит/с). Пропускная способность в полнодуплексном режиме достигает 76,8 Тбит/с. Типовое энергопотребление составляет 856 Вт при использовании медных кабелей и 1663 Вт при подключении активных оптических кабелей на каждом порту. Коммутатор работает от сети 240–277 В AC или 48 В DC с возможностью горячей замены блоков питания. Адаптер CN6000 Omni-Path SuperNIC выполнен в виде низкопрофильной карты расширения с интерфейсом PCIe 6.0 x16. Реализованы два порта QSFP-DD, каждый из которых обеспечивает скорость до 400 Гбит/с. Производительность достигает 1,6 млрд сообщений в секунду. Энергопотребление — 42,4 Вт с пассивными медными кабелями и 57,5 Вт с активными оптическими кабелями. 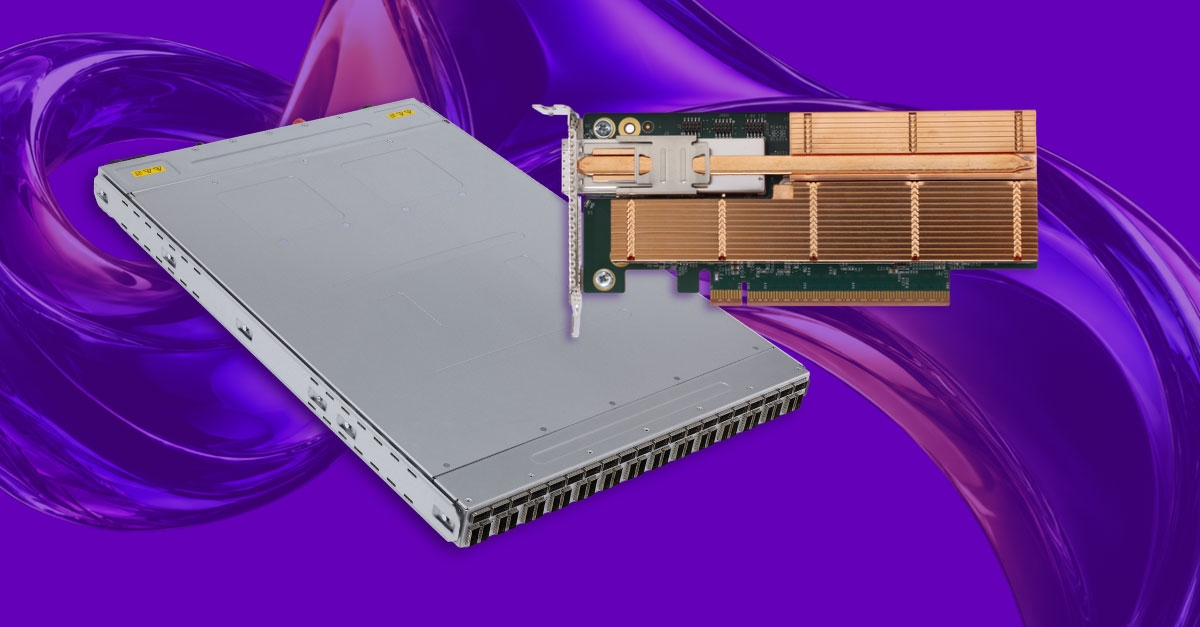
Источник изображения: Cornelis В свою очередь, адаптер CN6000 Ethernet SuperNIC также получил низкопрофильное исполнение с интерфейсом PCIe 6.0 x16 и два порта QSFP-DD. Подключение к стандартным коммутаторам Ethernet осуществляется по протоколу RoCEv2. Поддержка Ultra Ethernet будет добавлена позднее посредством обновления ПО. Для платформы CN6000 заявлена совместимость с процессорами AMD, Arm и Intel, а также с ускорителями AMD, NVIDIA и Qualcomm. О поддержке решения сообщили такие компании, как Dell Technologies, Hyve Solutions, Lenovo, NEC, Penguin Solutions, Supermicro и др.
17.11.2026 [01:55], Владимир Мироненко
NVIDIA анонсировала ускоритель Rubin HPC для моделирования и обработки данных в научных задачах с использованием ИИ-агентовNVIDIA анонсировала ускоритель Rubin HPC, разработанный для ускорения моделирования и обработки данных в научных, инженерных и аналитических задачах с использованием ИИ-агентов в составе платформы Vera Rubin. Компания отметила, что Rubin HPC оснащён рекордным количеством ядер CUDA — более 50 тыс. на одном чипе. Для ускорения обмена данными между ускорителями используется интерконнект NVLink 7. NVIDIA не предоставила подробных данных о его пропускной способности или физическом уровне. Однако из более ранних сообщений об этой технологии известно, что она имеет пропускную способность 3,6 Тбайт/с на один GPU, как изначально намечалось у NVLink 6. Также в Rubin HPC реализована технология ускорения обработки разреженных данных (sparse data), которая обеспечивает вычислительные ядра постоянной нагрузкой. Это решение нацелено на типичные для кода симуляций алгоритмические паттерны: от операций с разреженными матрицами и трафаретных вычислений (stencil computations) до сортировки и операций редукции. 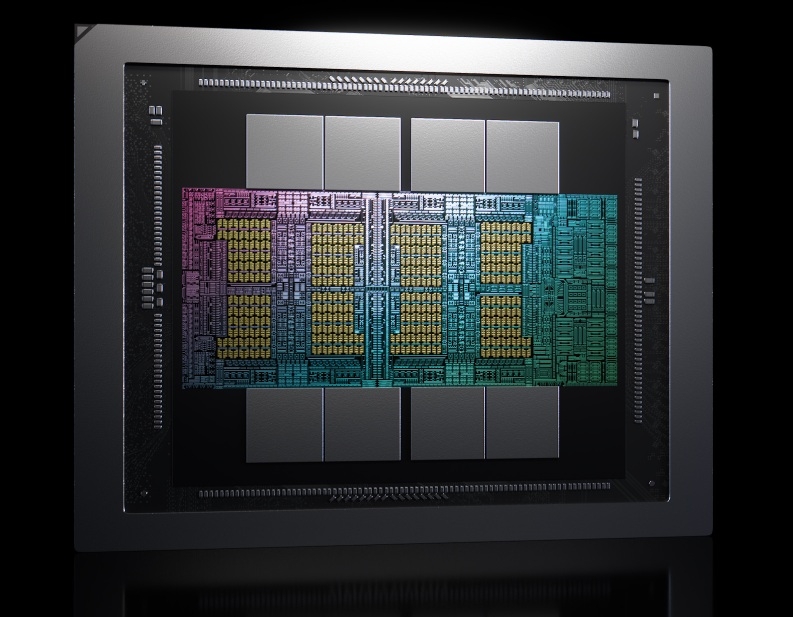
Источник изображения: NVIDIA Компания отметила, что в Rubin HPC используется сбалансированная архитектура, в которой одновременно масштабируются как вычислительные мощности, так и механизмы передачи данных. Именно этот баланс делает ускоритель оптимальным решением для научных вычислений, в котором обеспечивается непрерывная подача данных на рекордное количество ядер CUDA, благодаря чему они постоянно заняты вычислениями, а не простаивают в ожидании данных. Что касается ПО, то для Rubin HPC будут использоваться специализированные библиотеки NVIDIA CUDA-X, предлагающие обширный и постоянно пополняемый набор оптимизированных алгоритмов, которые могут использовать интеллектуальные агенты — в том числе алгоритмы, наиболее востребованные в сфере моделирования и аналитики. В сочетании с платформой Rubin HPC эти библиотеки позволяют агентам максимально быстро приходить к обоснованным выводам. 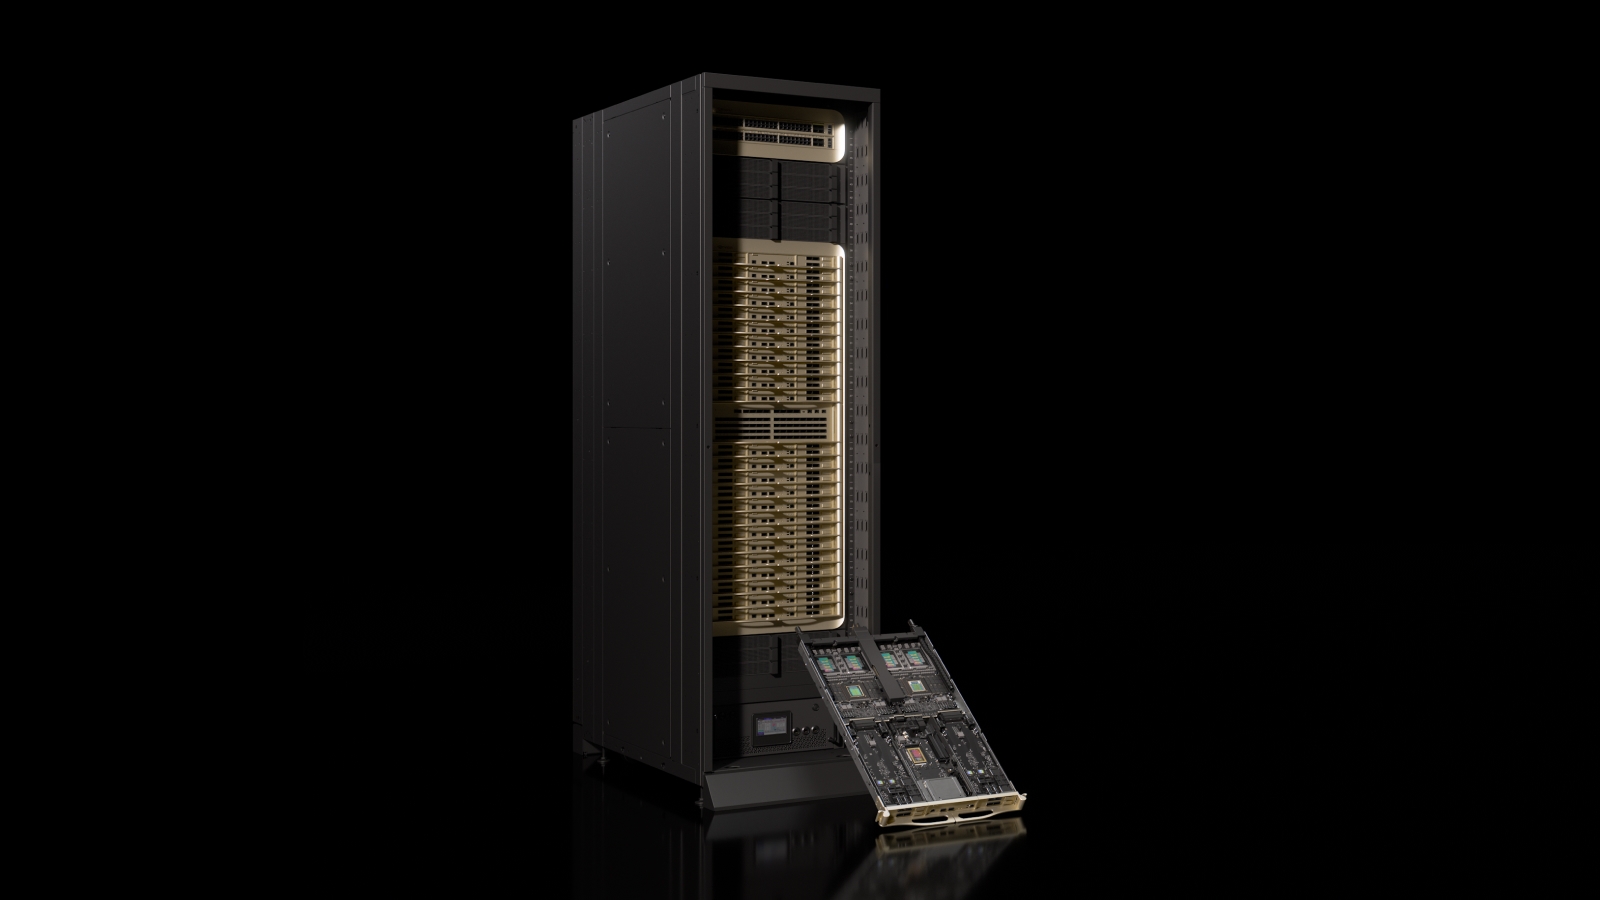
Источник изображения: NVIDIA Согласно описанию NVIDIA, в одном узле размещаются два суперчипа (NVL4), каждый из которых объединяет один CPU Vera и два GPU Rubin HPC. Таким образом, на один «суперчип» приходится более 100 тыс. ядер, а на весь узел — более 200 тыс. ядер. При этом NVIDIA пока не раскрыла объём HBM, пропускную способность памяти и FP64-производительность новинки. Выпуск чипа намечен на 2028 год, поэтому многое может измениться и есть риск, что компания поменяет планы, как это уже произошло с Rubin CPX. Анонс Rubin HPC формально знаменует собой возвращение компании к сфере традиционных HPC. В последние годы NVIDIA выстраивала свою стратегию на решениях для ЦОД, ориентируясь преимущественно на задачи обучения и инференса нейросетей. В сегменте FP64-вычислений NVIDIA не демонстрировала особого прогресса, полагаясь на их эмуляцию на тензорных ядрах. Поэтому для инвесторов важно знать, позволит ли новый чип сократить отставание NVIDIA от AMD в задачах, требующих высокой точности вычислений.
16.11.2026 [22:00], Сергей Карасёв
Самый скучный TOP500 за всю историю, но с небольшим китайским сюрпризомВ рамках международной конференции по высокопроизводительным вычислениям SC26 в Чикаго (США) обнародована свежая редакция рейтинга самых мощных суперкомпьютеров мира — ноябрьский список TOP500. Лидером остаётся китайский комплекс LineShine, FP64-производительность которого достигает 2,198 Эфлопс при пиковом значении 2,736 Эфлопс. Отмечается, что состав первой десятки не претерпел изменений по сравнению с июньской версией списка. Так, на второй позиции остаётся американская система El Capitan с быстродействием на уровне 1,809 Эфлопс, а замыкает тройку суперкомпьютер Frontier (1,353 Эфлопс), также расположенный в США. В сегменте экзафлопсных машин представлены ещё два НРС-комплекса — Aurora (1,012 Эфлопс) и JUPITER Booster (1 В рейтинг вошли только 27 новых систем, или 5,4 % от общего числа участников TOP500, — это самый низкий показатель за всю историю его формирования. Вместе с тем пороговые значения производительности в нижней части списка выросли, что свидетельствует о продолжающемся увеличении совокупных вычислительных мощностей, несмотря на замедление процесса строительства новых суперкомпьютеров. 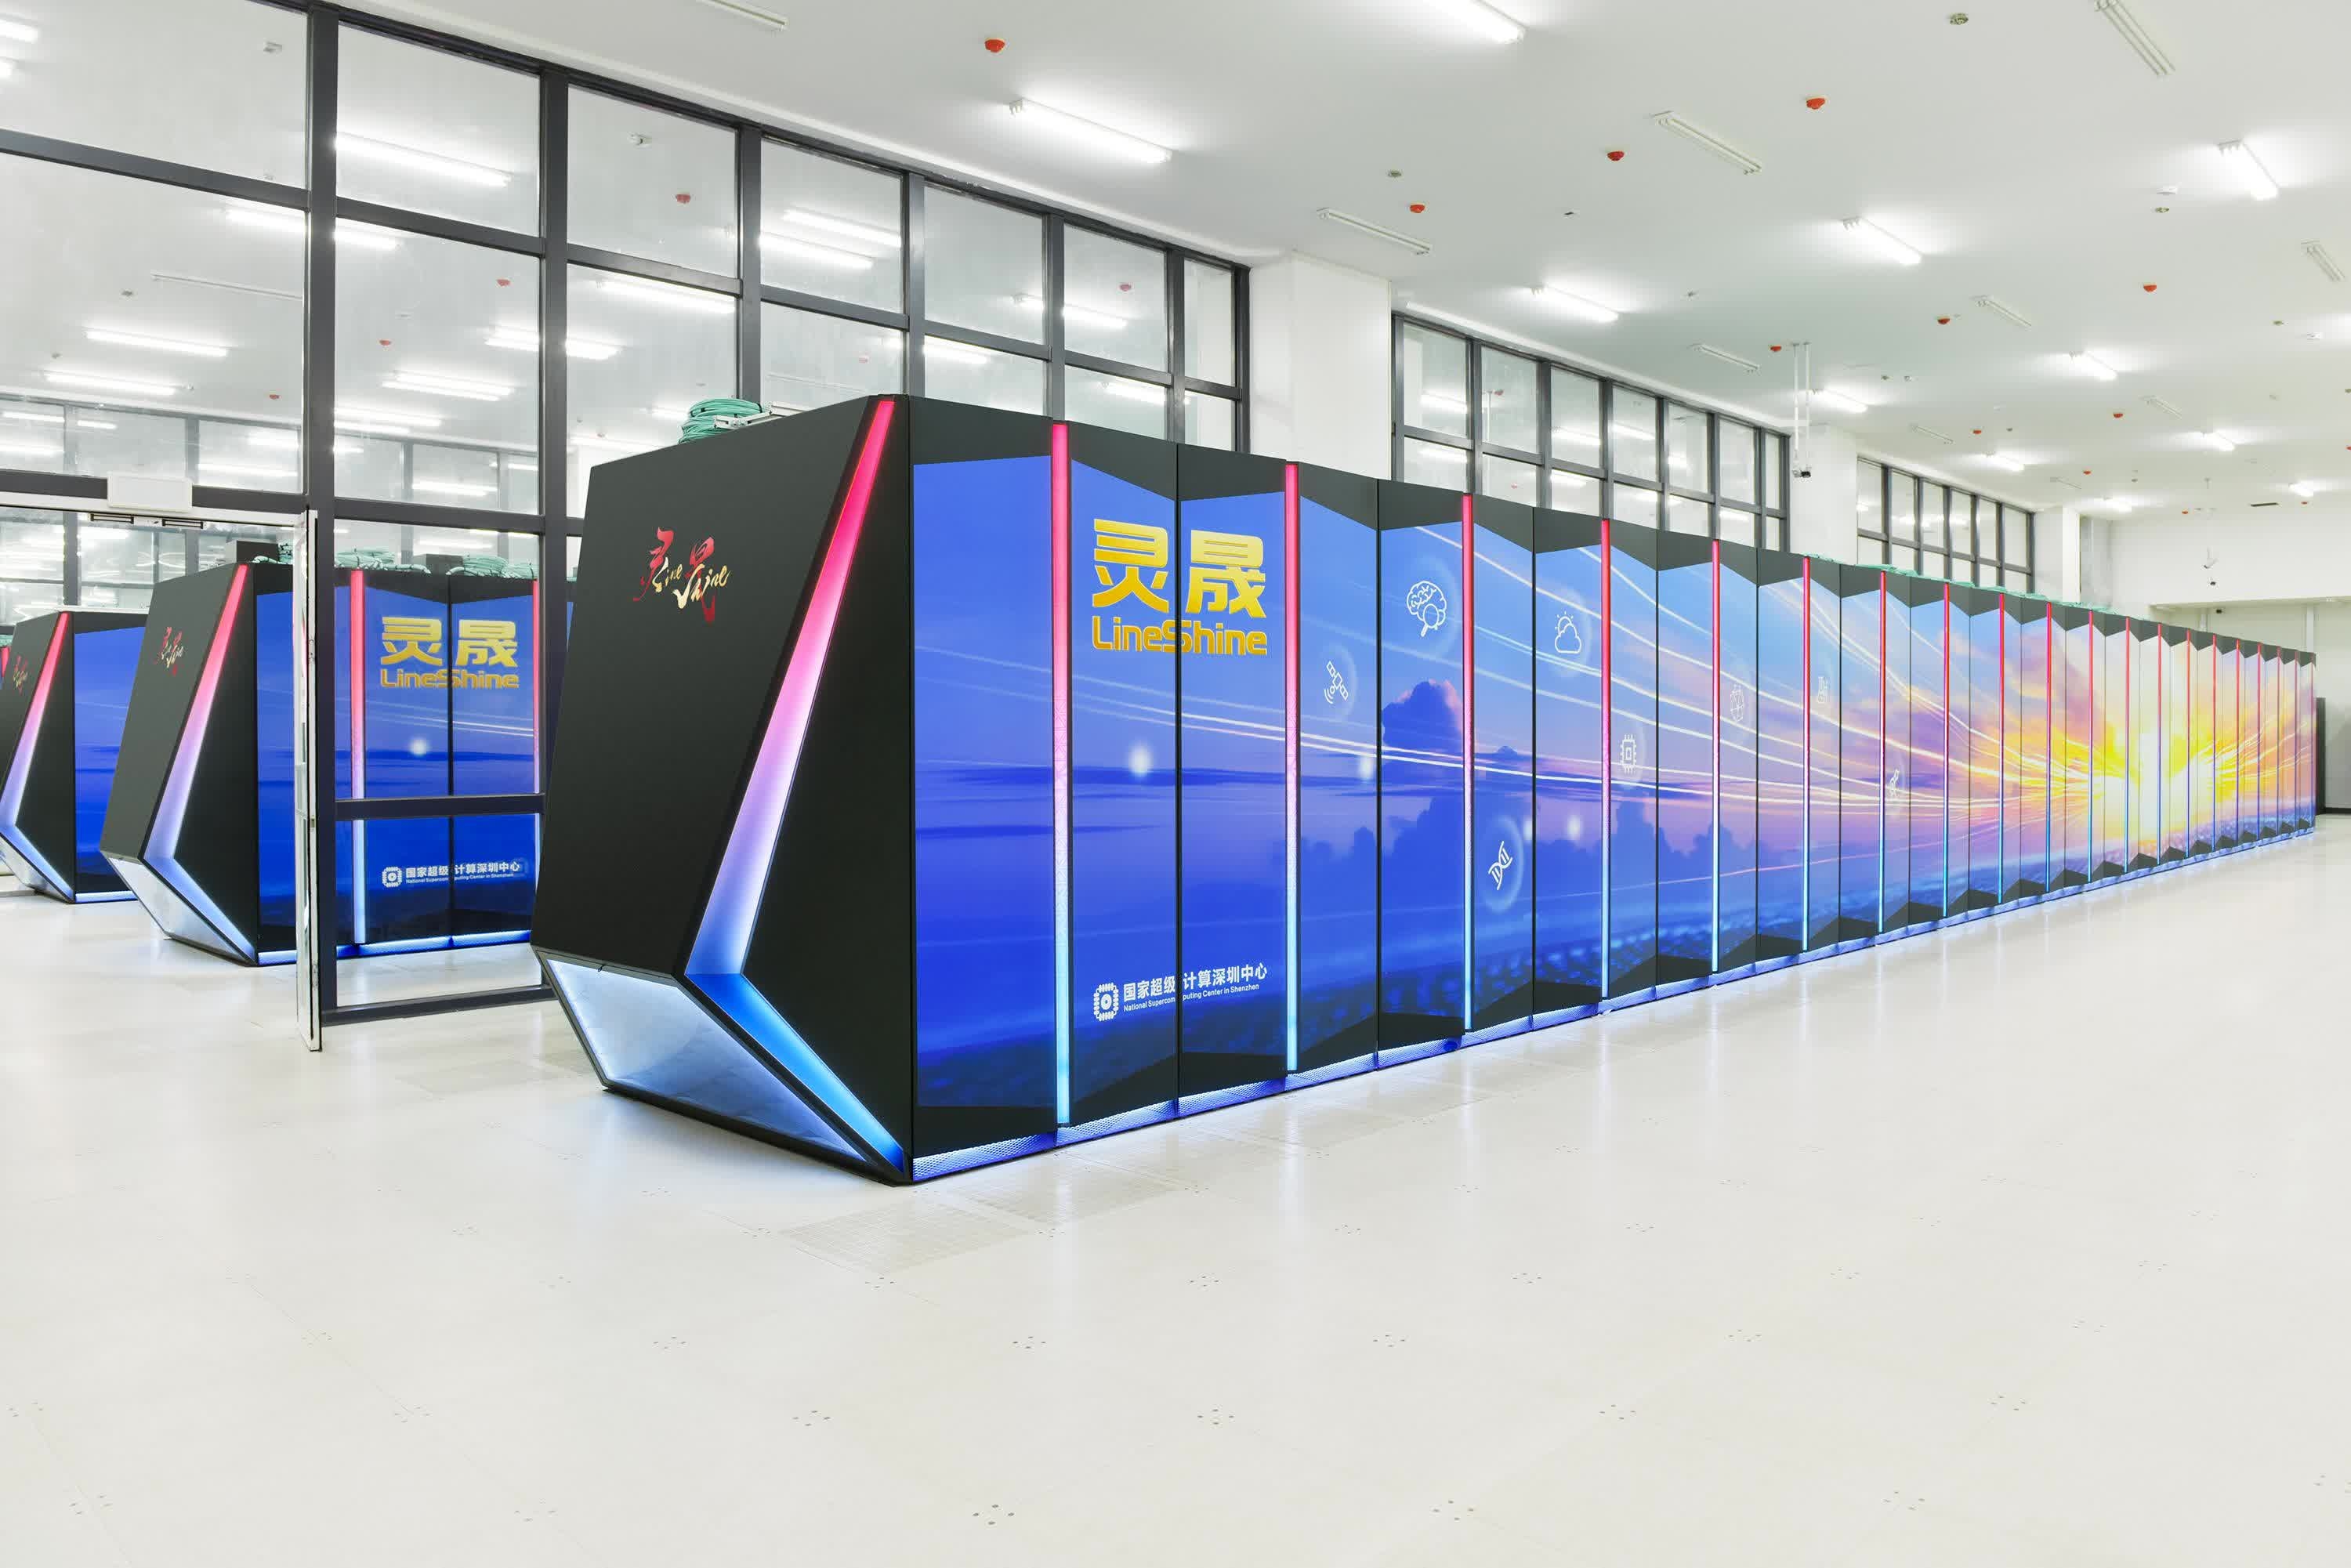
Источник изображения: National Supercomputing Centre in Shenzhen (NSCCSZ) Система, занимающая 500-е место, теперь демонстрирует результат 2,857 Пфлопс — это на 7,3 % больше по сравнению с 2,662 Пфлопс в июне нынешнего года. Порог для вхождения в TOP50 поднялся на 12 % — с 49,85 до 55,81 Пфлопс, тогда как для попадания в первую сотню требуется 22,74 Пфлопс против 21,85 Пфлопс в июне. Количество систем, обеспечивающих производительность не менее 100 Пфлопс, увеличилось с 25 до 27, а суммарное быстродействие всех 500 машин поднялось на 4,4 %, достигнув 19,57 Эфлопс. Самой высокопроизводительной машиной среди новичков стала система HANGANG, смонтированная в Суперкомпьютерном центре Корейского института научно-технической информации (KISTI). Новый комплекс с производительностью 342,6 Пфлопс оказался на 12-й позиции рейтинга. Суперкомпьютер построен на платформе HPE Cray EX254n с гибридными суперчипами NVIDIA GH200 и CPU NVIDIA Grace. 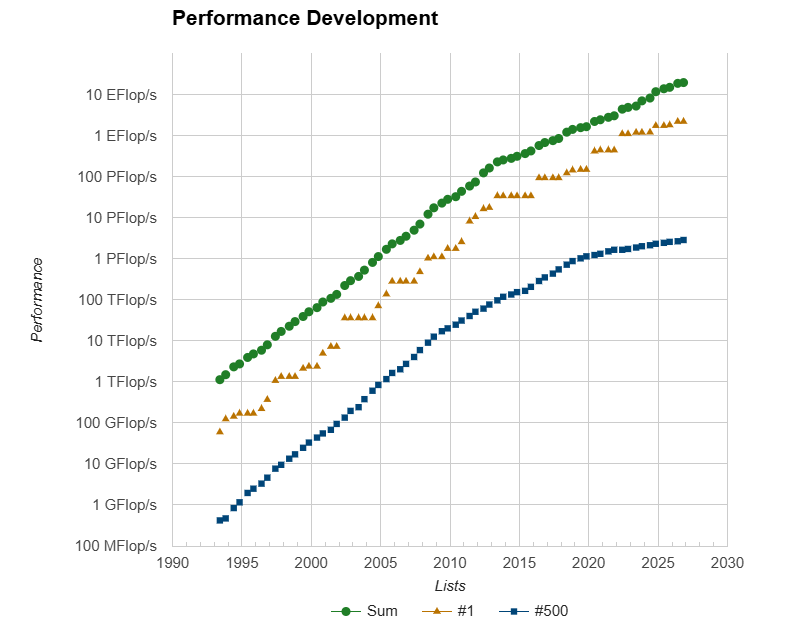
Источник изображения: TOP500 Одной из наиболее интересных новинок является система CTyun HPC — облачная платформа высокопроизводительных вычислений eSurfing Cloud китайского телекоммуникационного гиганта China Telecom. В её составе задействованы процессоры Hygon C86 7493 (56C/112T, 2,9 ГГц) и ускорители MetaX C588. Применяется операционная система CTyunOS 25.0. В последний раз чипы Hygon попадали в рейтинг в ноябре 2018-го. Говорится также, что примерно в половине всех суперкомпьютеров списка (в 50,4 %) используются процессоры Intel против 53,2 % в июне. В 199 системах (39,8 %) установлены чипы AMD (38,4 % в предыдущей редакции рейтинга). Различные ускорители присутствуют в 291 суперкомпьютере (58,2 %) против 275 в июне. В целом, наблюдающиеся тенденции указывают на то, что глобальный рынок НРС-систем достиг стадии зрелости: лидеры сохраняют свои позиции, количество новичков крайне мало, а наиболее заметный прогресс наблюдается в нижней части рейтинга.
16.11.2026 [21:47], Владимир Мироненко
К глобальному сбою в системах Microsoft 365 привела ошибка в обновлении служебной Windows трёхмесячной давностиКомпания Microsoft сообщила причины масштабного сбоя её сервисов, произошедшего на прошлой неделе, о чём пишет iTnews. Согласно предварительному отчёту, сбой связан с исправлением в Windows, подготовленным специально для сетевых шлюзовых серверов Microsoft 365 и запущенном в июле. В Microsoft подчеркнули, что данная ошибка и само исправление не имеют отношения к стандартным версиям Windows, используемым на пользовательских компьютерах. При этом обновление успешно прошло нагрузочное тестирование и было развернуто без каких-либо негативных последствий. И в течение трёх месяцев данная ошибка никак себя не проявляла. По словам исполнительного вице-президента Microsoft по направлению Copilot, агентов и платформы, дефект заключался в возникновении конкуренции за блокировку (lock contention) внутри одного из внутренних процессов. Это приводило к тому, что при определённых нагрузках серверы переставали отвечать на запросы. Нагрузочное тестирование не выявило эту проблему, поскольку производилось на менее производительном оборудовании с меньшим количеством ядер, тогда как проблема конкуренции за блокировку обостряется именно на более современных машинах с большим числом процессорных ядер. 
Источник изображения: Markus Spiske/unsplash.com Сбой спровоцировало событие, произошедшее примерно за 15 часов до его начала: сервис Teams был переключён с отдельной шлюзовой системы на основную — ту самую, которая обслуживает и Exchange Online. Это увеличило нагрузку и изменило характер распределения трафика. В это же время около 14 % мощностей шлюза были недоступны из-за другой, возникшей ранее проблемы, не связанной с данным происшествием. Сочетание этих факторов привело к проявлению дефекта, что вызвало настоящий хаос. Далее события развивались по классическому сценарию каскадного сбоя. Серверы начали выходить из строя в период пиковой нагрузки в США. При потере связи с сервером трафик перенаправлялся на следующий доступный узел, который, в свою очередь, сталкивался с той же проблемой. В течение двух часов дефект распространился на всю инфраструктуру Microsoft. В пиковый момент более 80 % серверов перестали отвечать на запросы. Изоляция между тысячами единиц ёмкости шлюза и его регионами должна была ограничить масштаб ущерба, однако этого не произошло — «из-за отдельной проблемы». Процесс восстановления затянулся, поскольку после перезапуска серверы вскоре снова выходили из строя под нагрузкой возобновившегося потока запросов. В то время как для сервисов Teams, SharePoint и OneDrive удалось перенаправить трафик в обход, и они восстановились раньше, для Exchange Online — в силу масштабов его работы — полноценное переключение маршрутов оказалось невозможным. Именно этим объясняется длительный период недоступности Exchange Online (который многие пользователи воспринимали как сбой в работе Outlook). К тому же автоматизированные механизмы восстановления Microsoft не были рассчитаны на столь масштабный сбой. А поскольку скрытая ошибка возникла ещё несколько месяцев назад, стандартные процедуры отката, поэтапного развёртывания и использования функциональных флагов не позволили быстро отменить внесенные изменения. Вместо этого в Microsoft разработали «исправление для исправления» — обновление, возвращающее код в исходное состояние, и применили его сразу к крупным группам серверов — в ряде случаев охватывающим более половины региона. Кроме того, были увеличены вычислительные мощности и продлён период доставки электронных писем, чтобы попавшие в очередь сообщения не были отклонены как недоставленные.
16.11.2026 [16:45], Сергей Карасёв
XXII конференция «Свободное программное обеспечение в высшей школе»«Базальт СПО» совместно с Институтом программных систем им. А.К. Айламазяна проводят XXII Ежегодную конференцию «Свободное программное обеспечение в высшей школе» (OSEDUCONF). Мероприятие пройдёт 5–7 февраля 2027 года в г. Переславле-Залесском на базе ИПС РАН. Ведущие учёные, педагоги, разработчики и администраторы расскажут об опыте внедрения СПО и организации образовательного процесса, создания благоприятных условий для вовлечения студентов в реальные проекты разработки свободных программных продуктов. Принимаются заявки на доклады по следующим темам:
Источник изображения: «Базальт СПО» Сроки подачи заявокДля докладчиков:
Для слушателей:
Участие для докладчиков и слушателей бесплатное. Тезисы докладов выйдут отдельным сборником и будут опубликованы в национальной библиографической базе данных научного цитирования РИНЦ. 21 января будет опубликована программа конференции и разосланы уведомления докладчикам. Требования к докладамДоклады о проприетарном ПО не допускаются. Не рассматриваются заявки на доклады без:
Онлайн-трансляция конференции будет доступна на VK Видео и странице конференции. Зарегистрироваться на конференцию и ознакомиться с информацией о форматах и шаблонах тезисов можно на сайте. По вопросам, связанным с докладами, тезисами, программой конференции, регистрацией, размещением, трансфером можно обратиться к организаторам по электронной почте conference@lists.altlinux.org.
16.11.2026 [15:39], Руслан Авдеев
Nscale ввела в эксплуатацию два ЦОД и 25 тыс. ИИ-ускорителей за 2,5 месяцаНедавно опубликованном проспекте IPO компания Nscale объявила, что теперь располагает 50 тыс. активных ИИ-ускорителей из планируемых 461 тыс. В предыдущем проспекте, датированным 31 августа, имелась информация лишь о 25 тыс. активных ускорителях, сообщает Datacenter Dynamics. Кроме того, у Nscale теперь семь активных площадок ЦОД, против пяти площадок с совокупной мощностью 55 МВт ранее. Общая мощность всех семи площадках не разглашается. Всего, как заявляет Nscale, имеется 1,37 ГВт активных и законтрактованных мощностей, из которых 1 ГВт относится к собственным площадкам компании, а 165 МВт — колокейшн-ЦОД. В целом компания видит потенциал получения до 10 ГВт энергетических мощностей. Также Nscale изменила систему отчётности о финансах. В прежнем проспекте она сообщала о выручке $140,6 млн за первые шесть месяцев 2026 года, рост составлял 1252 % г/г. При этом убытки также взлетели до $1,02 млрд против $368,9 млн годом ранее. В новом проспекте основное внимание уделили полному 2025 году, выручка за который составила $33 млн, что на 73 % выше в сравнении с $19,1 млн в 2024 году. Как сообщается в проспекте, совокупная стоимость активных контрактов с клиентами на принципе долгосрочной оплаты take-or-pay составляла около $6,4 млрд, а общая стоимость как активных, так и законтрактованных соглашений оказалась на уровне $105,8 млрд. Для сравнения, на 31 декабря 2025 года речь шла об $0,5 млрд и $38 млрд соответственно. Контракты предусматривают развёртывание около 461 тыс. действующих и законтрактованных на указанную дату ускорителей. 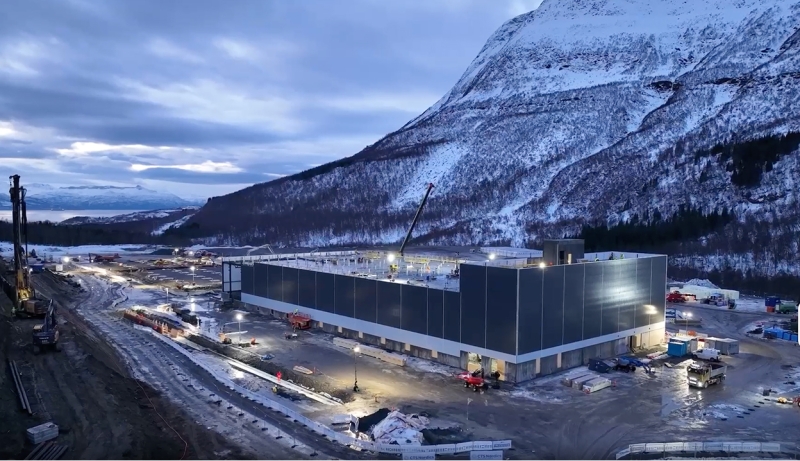
Источник изображения: Nscale Также компания рассказала о сделках с Anthropic. В августе партнёры подписали соглашение о предоставлении вычислительных мощностей на $45 млрд ($44,6 млрд), связанное с использованием мощностей будущей площадки Nscale — Monarch Compute Campus в западной Вирджинии. В новом проспекте подтверждается информация о переговорах, касающихся строительства второго здания ЦОД на площадке. Сообщается, что 29 сентября Anthropic воспользовалась правом законтрактовать дополнительные мощности в здании Building 2 на территории кампуса Monarch. У партнёров есть 60 дней на добросовестные переговоры по соглашению о Building 2. Право Anthropic в отношении Building 3 может быть реализовано в течение 15 рабочих дней после подписания соглашения по Building 2. Если это право будет реализовано, на переговоры по Building 3 отводится ещё 60 дней. Nscale заявила, что рассчитывает финансировать развёртывание инфраструктуры в интересах Anthropic за счёт внешнего финансирования и денежных потоков от операций компании. При этом в свете сделки с Anthropic проведена оценка возможностей рынка и проведены переговоры с его участниками относительно необходимости финансирования. Nscale подчеркнула, что имеет опыт привлечения средств на строительство ЦОД и покупку ИИ-ускорителей. Учитывая проделанную работу и предыдущий опыт, Nscale полагает, что сможет получить финансирование в установленные сроки. При этом у Nscale пока нет уже заключенных соглашений о финансировании. Если компания в установленные сроки не сможет предоставить Anthropic инфраструктуру ИИ-ускорителей, в т.ч. из-за задержек в цепочках поставок, Anthropic может получить право расторжения договора без обязательств. В рамках IPO компания намерена привлечь миллиарды долларов для финансирования строительства ИИ ЦОД. Вероятная оценка Nscale составит $30 млрд, но официальная дата размещения пока не объявлена. |
|

