
Материалы по тегу: hardware
|
18.11.2026 [09:22], Руслан Авдеев
Компьютер LEO, открывший эпоху коммерческого применения вычислительной техники, отмечает 75-летиеВ ноябре исполняется 75 лет бизнес-вычислениям. Кембриджский Центр истории вычислительной техники (Centre for Computing History, Великобритания) устраивает праздник LEO@75 в честь машины, положившей начало коммерческому применению вычислительной техники, сообщает The Register. Центр представляет собой интерактивный музей компьютеров. В 2018 году он получил грант Национальной лотереи Великобритании (National Lottery), призванный помочь сохранить, архивировать и оцифровывать различные артефакты, документы и личные воспоминания, связанные с компьютерами LEO (Lyons Electronic Office). LEO был одним из первых компьютеров, важность разработки трудно переоценить. Его архитектура была построена на основе системы EDSAC Кембриджского университета, созданной командой, возглавлявшейся одним из пионеров компьютерных вычислений — Морисом Винсентом Уилксом (Maurice Vincent Wilkes, 1913–2010). 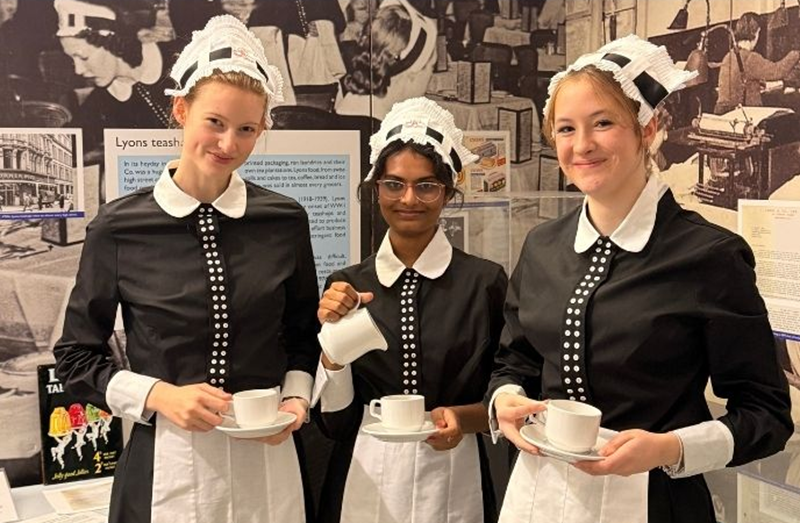
Источник изображения: Centre For Computing History При разработке EDSAC использовались идеи, изложенные в незавершённом документе «Первый проект отчёта об EDVAC» (First Draft of a Report on the EDVAC) Джона фон Неймана (John von Neumann). Черновик документа распространили в 1945 году, за четыре года до появления самого компьютера. В том же году завершились работы над его предшественником — ENIAC. Изначально тот программировался с помощью переключателей и перекоммутации кабелей. EDVAC же проектировали как машину, способную хранить команды непосредственно в собственной памяти. В докладе были изложены принципы, ныне известные как «архитектура фон Неймана» (принстонская архитектура). На эти идеи опирались Морис Уилкс (Maurice Wilkes) и Дуглас Хартри (Douglas Hartree) при разработке EDSAC, ставшено непосредственным предшественником LEO. EDSAC выполнил свою первую программу в мае 1949 года, за несколько месяцев до поставки модели BINAC, созданной Эккертом (Eckert) и Мокли (Mauchly) и ставшей первой машиной с хранимой программой за авторством данных исследователей. Первой работавшей электронной машиной с хранимой программой был экспериментальный компьютер Manchester Baby (Small-Scale Experimental Machine), выполнивший свою первую программу в 1948 году. LEO выполнил первую коммерческую программу в 1951 году, и в том же году Бюро переписи населения США (US Census Bureau) получило компьютер UNIVAC I, разработанный Эккертом и Мокли.
17.11.2026 [22:05], Павел Котов
LANL испытает ускорители Maverick-2 — это уже вторая система NextSilicon для Министерства энергетики СШАМинистерство энергетики США развернуло на базе испытательного стенда Darwin в Лос-Аламосской национальной лаборатории (LANL) второй кластер Maverick-2 израильского стартапа NextSilicon, сообщает The Register. Новая система значительно меньше развёрнутого ранее в в Сандийских национальных лабораториях первого суперкомпьютера на базе технологий NextSilicon с 64 вычислительными узлами и 128 ускорителями — она располагает всего четырьмя ускорителями. Подобные компактные системы позволяют специалистам LANL проверять и адаптировать для новых чипов широкий спектр программных кодов, выявлять неполадки, совместно с NextSilicon устранять их и непосредственно влиять на функциональные возможности чипов будущих поколений. Интерес LANL к Maverick-2 — это первый шаг к масштабному внедрению решений NextSilicon в будущие суперкомпьютеры Министерства энергетики. Инженерам необходим прямой доступ к оборудованию, поскольку некоторые из решаемых в лаборатории задач невозможно запускать на общедоступных вычислительных системах. Помимо ядерного оружия, лаборатория занимается моделированием процессов, например, термоядерного синтеза. 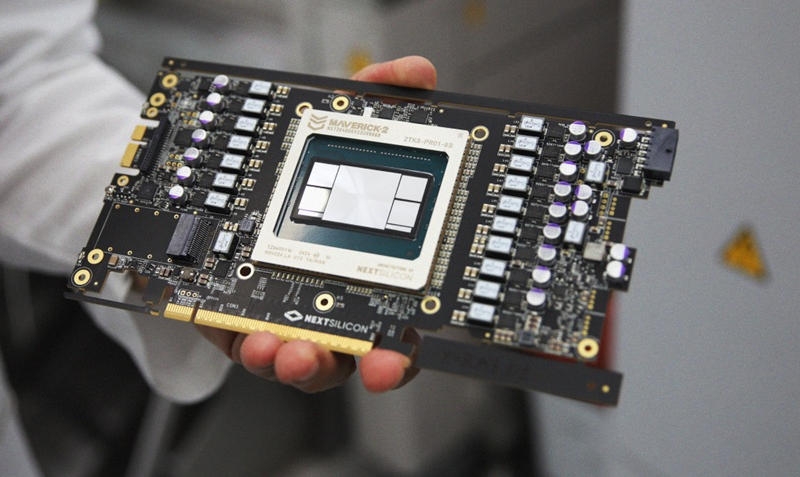
Источник изображения: NextSilicon «NextSilicon подходит для переконфигурирования системы в соответствии с рабочей нагрузкой, по запросу. Надежда в том, что нам не придётся больше жёстко определять объём требуемых ресурсов CPU и GPU. Мы можем пользоваться более гибкой, конфигурируемой архитектурой, адаптируемой к рабочему процессу», — рассказал главный научный сотрудник LANL Гален Шипман (Galen Shipman). Архитектуры на основе потоков данных могут быть эффективными в задачах с ограничениями пропускной способности памяти. Поэтому ускорители с похожей архитектурой, такие как Groq,Cerebras и SambaNova всё чаще используются в задачах инференса. Решения NextSilicon отличаются изначальной поддержкой разреженных FP64-вычислений. Однако разработка для таких чипов сложнее, поэтому NextSilicon создала компилятор, преобразующий существующий программный код на C, Python, Fortran или CUDA в граф для запуска на Maverick. Предельная производительность Maverick-2 варьируется в зависимости от типа рабочей нагрузки, поэтому в NextSilicon решили не афишировать пиковые теоретические показатели. NextSilicon протестировала свои системы в HPCG, LAMMPS и Sparta. В HPCG один чип Maverick демонстрирует производительность 600 Гфлопс — это сопоставимо с показателями современных GPU, но при вдвое меньшем потреблении энергии.
17.11.2026 [21:31], Павел Котов
AWS продаст Blackstone два кампуса ЦОД и тут же арендует ихAWS и инвестиционная компания Blackstone заключили сделку, согласно которой последняя становится владельцем двух кампусов ЦОД AWS и передаёт их в обратно аренду Amazon на первоначальный срок в 12 лет, сообщает The Register. Ранее AWS решила передать чипы NVIDIA Grace Blackwell на сумму около $8 млрд созданной специально для этих целей компании (SPV), чтобы взять их назад в аренду. Только что сформированная структура Blackstone Digital Infrastructure Trust (BXDC) получит долю в 75 % в двух совместных предприятиях (СП) с AWS. Сумма сделки оценивается в $5 млрд. AWS сохраняет за собой долю в 25 % в этих СП и принимает объекты на условиях полной ответственности за их содержание. Это значит, что, помимо арендной платы, компания обязуется покрывать расходы на уплату налогов на недвижимость, страхование зданий, а также затраты на их техническое обслуживание и ремонт. Активы BXDC включают 13 недавно построенных объектов для размещения серверного оборудования общей мощностью 647 МВт, гласит поданная Blackstone в Комиссию по ценным бумагам и биржам США (SEC) форма 8-K. Один из кампусов включает девять зданий, расположенных на сервере штата Индиана; второй — ещё четыре объекта в штате Миссисипи. AWS арендует мощности и у других операторов ЦОД — в этом году компания заключила соглашение со STACK Infrastructure о развитии кампусов в северо-западной части штата Луизиана; проект оценивается в $12 млрд. Также AWS увеличила инвестиции в ИИ ЦОД в Луизиане, но отозвала заявку на строительство ЦОД в Вирджинии. 
Источник изображения: Amazon Сделки по схеме продажи с обратной арендой также нередко встречаются в отрасли ЦОД — форматом REIT пользуются многие девелоперы и операторы. QTS Realty Trust, также входящая в Blackstone, строила объекты, которые впоследствии передавались в аренду Microsoft. По словам Omdia, схема продажи с обратной арендой может быть более оправданной экономически. Важно понимать, что речь идёт о здании и инфраструктуре, а не оборудовании, которое размещается на объекте. «Также очевидно, что масштабные капзатраты гиперскейлеров создают нагрузку на их финансовые показатели, и они вынуждены обращаться к рынку заёмного капитала для финансирования строительства. Конечно, использование заёмных средств — стандартная практика, но можно предположить, что сейчас объём долга для развития ИИ-инфраструктуры значительно выше, чем в прошлом», — говорит Omdia. Сделка, как ожидается, будет закрыта в IV квартале 2026 года при соблюдении условий. Любая из сторон может расторгнуть соглашение, если оно не будет закрыто к 31 декабря 2026 года, гласит форма 8-K. В этом случае сторона, не являющаяся причиной расторжения договора, имеет право на получение компенсации за расторжение сделки в размере $150 млн.
17.11.2026 [17:39], Руслан Авдеев
Нордическая ИИ-гигафабрика: Финляндия, Эстония, Латвия и Швеция вместе построят распределённую ИИ-инфраструктуруNokia, Nscale, Skeleton, Telia и Verda объявили о создании консорциума AI Gigafactory Northern (AIGF Northern). Он нацелен на создание надёжной, распределённой ИИ-инфраструктуры путём создания «гигафабрики» (Gigafactory) в странах Северной Европы и Балтии, сообщила Nokia. Отдельные площадки будут объединены в единый кластер под европейским управлением. Масштабные вычислительные ИИ-мощности будут сочетаться с суверенными облачными сервисами и платформенными решениями в сфере ИИ, высокопроизводительными каналами связи и низкоуглеродными источниками энергии. Участники проекта намерены подать заявку на строительство и управление AIGF Northern в рамках конкурса на создание консорциума ИИ-гигафабрики, объявленного Европейским совместным предприятием по развитию высокопроизводительных вычислений (EuroHPC JU). В июле сообщалось, что EuroHPC JU объявила о начале приёма заявок на участие в тендере для строительства и эксплуатации ИИ-гигафабрик (AI Gigafactories/AIGF), сообщает HPC Wire. Гигафабрики вместе с «обычными» ИИ-фабриками обеспечат доступность ИИ-сервисов и мощностей для государственных структур и частных пользователей из государств, участвующих в проекте. AIGF Northern объединит инфраструктуру многочисленных площадок в Северной Европе и Балтии, что позволит бизнесам, исследователям и государственным организациям Европы получить доступ к масштабируемым сервисам в сфере доверенных вычислений, облачных решений и связи. Распределение вычислительных мощностей по разным странам позволяет снизить риски, связанные с их концентрацией, и повысить устойчивость европейской ИИ-экосистемы. 
Источник изображения: Danny Rienecker/unsplash.com Консорциум формируется на фоне наращивания инвестиций Евросоюза в ИИ-мощности Европы. В рамках инициативы InvestAI планируется привлечь €30 млрд: €20 млрд из частных источников и €10 млрд из бюджета Евросоюза, а также бюджетов государств объединения. AIGF Northern объединит объекты в Оулу (Oulu, Финляндия), Иру (Iru, Эстония), Валмиере (Valmiera, Латвия). Где находится площадка в Швеции, пока не определено. Распределение мощностей между объектами позволит использовать разные источники низкоуглеродной энергии, а также расширить вычислительную инфраструктуру там, где есть для этого необходимые ресурсы и снизить зависимость от одной площадки или одного поставщика. Подобный подход усилит операционную устойчивость проекта и обеспечит поддержку трансграничного расширения по мере роста спроса на ИИ в Евросоюзе. Консорциум поддерживают и ведущие структуры в сфере исследований и инноваций, включая Финский технический исследовательский центр VTT (VTT Technical Research Centre of Finland), Королевский технологический институт KTH — крупнейший технический университет Швеции. Они и другие партнёры инициативы помогут связать инфраструктурные планы AIGF Northern с научными, инновационными и кадровыми ресурсами стран. 
Источник изображения: Samuel Regan-Asante/unsplash.com Nokia обеспечит проекту защищённую и высокопроизводительную инфраструктуру связи, необходимую для объединения площадок, надёжной передачи данных и обеспечения устойчивости системы. Nscale намерена предоставить облачную платформу и экспертизу в сфере ИИ-инфраструктуры для создания масштабируемых сред с целью обучения ИИ-моделей и инференса. Telia, совместно с дочерней структурой Telia Cygate, поделится компетенциями в области связи, передачи данных, эксплуатации инфраструктуры и облачных решений. Verda предоставит специализированную инфраструктуру, оптимизированную для ИИ-задач, а также экспертизу в сфере облачных технологий. Это позволит обеспечить масштабируемые мощности для обучения ИИ-моделей и инференса. Skeleton предоставит системы высокой мощности, повышающие эффективность и стабильность ЦОД в больших масштабах и снижающие нагрузку на электросети, а также способствующие сокращению углеродного следа. В июле сообщалось, что консорциум ÆTHER (AETHER), включающий европейских компаний-лидеров в сфере ИИ, облачных вычислений и энергетики объединил усилия всех участников для строительства ИИ-гигафабрик (AI Gigafactory) в рамках проекта Еврокомиссии AI Continent Action Plan. Европейские власти уже подтвердили поддержку проекта. Особое внимание будет уделяться экономическому развитию, созданию рабочих мест, региональной реиндустриализаци, обеспечению суверенитета и развития технологий. По словам консорциума, ИИ является исторической возможностью для реиндустриализации Европы.
17.11.2026 [14:35], Руслан Авдеев
OpenAI арендует у TensorWave 457 МВт ИИ-мощностей на базе AMD InstinctOpenAI заключила шестилетнее соглашение с облачной TensorWave о предоставлении ИИ-мощностей объёмом 457 МВт. Это произошло вскоре после того, как Fermi официально расторгла предварительный договор аренды с той же компанией, касающийся кампуса Project Matador в Техасе, сообщает Datacenter Dynamics. Согласно новому договору, TensorWave предоставит OpenAI выделенные вычислительные мощности на базе ускорителей AMD Instinct MI455X. Последние разместят в нескольких ЦОД. Доступ к ним должен появиться в I половине 2027 года, а все мощности должны быть развёрнуты к началу 2028 года. В TensorWave контракт назван крупнейшей сделкой по развёртыванию ИИ-инфрастурктуры за всю историю компании. Речь фактически идёт о развитии ранее анонсированного партнёрства OpenAI и AMD. Объявлению предшествовала новость о расторжении сделки Fermi и TensorWave об аренде мощностей и предоставлении услуг в ЦОД, заключенной в августе 2026 года. Предполагалось, что TensorWave арендует до 650 МВт мощностей в кампусе Project Matador близ Амарилло (Amarillo, шт. Техас), а AMD обеспечит кредитную поддержку сделки. По данным самой скандально известной Fermi, действие соглашения об аренде официально прекратили после того, как стороны не уложились в установленный срок, отведённый для завершения сделки, и у девелопера теперь не осталось арендатора для кампуса. 
Источник изображения: Amina Atar/unsplash.com Тем не менее Fermi объявила о заключении отдельного соглашения с неназванным гиперскейлером на 600 МВт мощностей в рамках инициативы Project Matador. Клиент обязался заплатить вперёд $200 млн, в т.ч. на подведение к площадке электроснабжения. Ожидается, что ввод мощностей в эксплуатацию начнётся с 2027 года. Также гиперскейлер выделит $15 млн на подготовительные строительные работы. Попутно идёт окончательное согласование договора на закупку стали и других стройматериалов на $90 млн, которых должно хватить на возведение нескольких ЦОД. В Fermi подчеркнули, что заказчик принял на себя финансовые обязательства, обещав участвовать в развитии проекта до подписания договора аренды из-за необходимости обеспечить объекту доступ к электроснабжению в соответствии с графиком. Fermi заявляет, что текущее портфолио проектов на стадии разработки включает потенциальных заказчиков, в перспективе способных освоить уже запланированные мощности на 2,2 ГВт. При этом реализация планов зависит от дальнейшей разработки проектов и заключения договоров аренды мощностей.
17.11.2026 [14:25], Владимир Мироненко
Платформа NVIDIA Vera Rubin обошла конкурентов во всех тестах MLPerf Training v6.1Дебют платформы NVIDIA Vera Rubin в бенчмарках MLPerf был отмечен её лидерством по производительности в таких областях, как обучение моделей, постобучение и выполнение задач интеллектуальными агентами (agentic inference), сообщила NVIDIA. NVIDIA опередила конкурентов во всех тестах MLPerf Training v6.1. При этом, в категории MLPerf Endpoints компания показала более чем десятикратный прирост (по сравнению с предыдущим поколением) пропускной способности на ватт для систем на базе ИИ-агентов. NVIDIA стала единственной, показавшей результаты во всех тестах текущего цикла — от больших языковых моделей и генерации изображений до рекомендательных систем и постобучения моделей с подкреплением. При этом система Vera Rubin NVL72 продемонстрировала до двух раз более высокую производительность в расчете на один GPU по сравнению с NVIDIA GB300 NVL72. NVIDIA также провела тестирование на 10 240 GPU в составе систем GB300 — это самый масштабный показатель в данном раунде. А платформа Microsoft Azure провела тесты, задействовав 10 240 GPU NVIDIA в системах GB200. 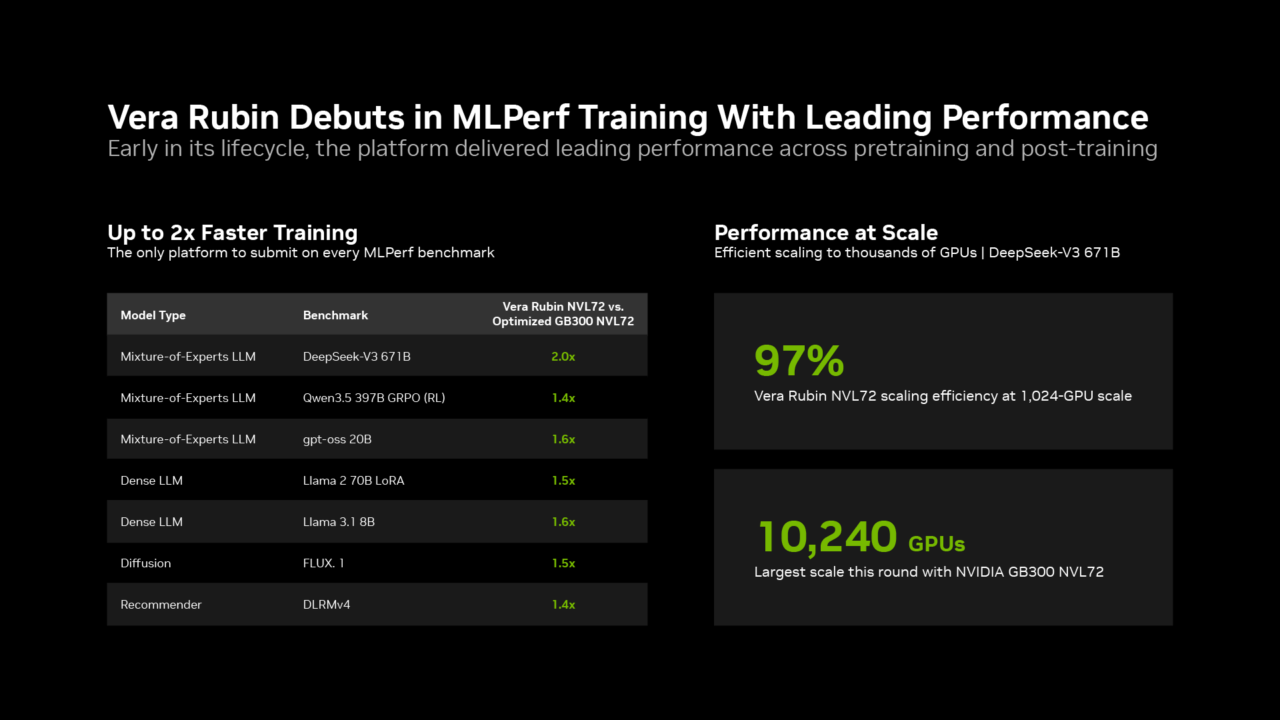
Источник изображений: NVIDIA NVIDIA Vera Rubin стала лидером в области агентных вычислений (agentic inference) по результатам тестов MLPerf Endpoints, показав лучшие показатели во всех бенчмарках, ориентированных на работу AI-агентов. Тестирование MLPerf Endpoints оценивает производительность систем в реальных сценариях работы AI-агентов, одновременно проверяя, насколько успешно и корректно они справляются с поставленными целями. Согласно предварительным результатам для Kimi K3 — крупной открытой модели, разработанной специально для агентных рабочих процессов, — системы VR200 NVL72 обеспечили более чем десятикратное преимущество по пропускной способности на ватт затраченной энергии по сравнению с GB300 NVL72 при идентичной скорости отклика. Предварительные результаты для системы Vera Rubin ожидают подтверждения со стороны ассоциации MLCommons. 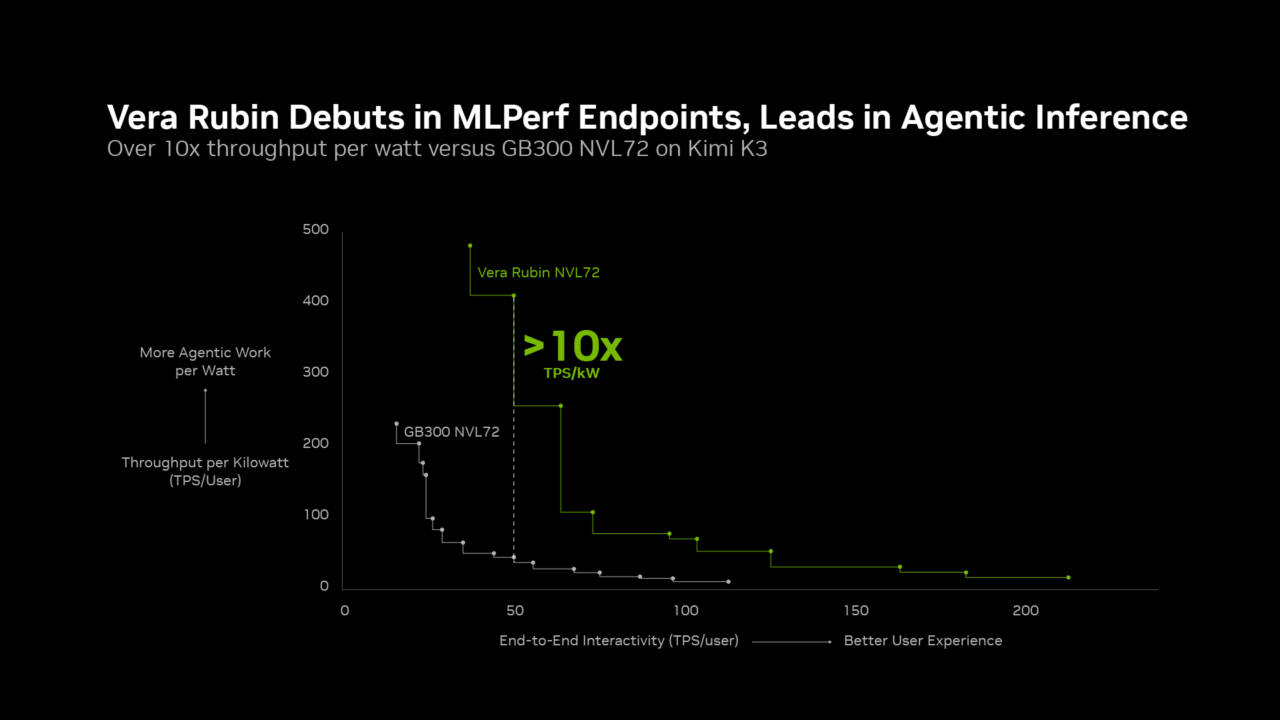 NVIDIA отметила, что Vera Rubin также демонстрирует передовые показатели в независимых бенчмарках, таких как SemiAnalysis AgentX и Artificial Analysis AgentPerf, что подтверждает широкие возможности инфраструктура NVIDIA, способной эффективно поддерживать самые разные задачи: от предварительного и последующего обучения моделей до выполнения агентных вычислений (agentic inference), а также решать задачи, не связанные напрямую с ИИ — например, обеспечивать HPC.
17.11.2026 [14:06], Сергей Карасёв
Кремниевая фотоника и Xeon нового поколения: Intel рассказала о разработках в области ИИ и НРСКорпорация Intel, поделилась информацией о разработке передовых решений для платформ ИИ и НРС следующего поколения: Xeon 7, фотонике для каналов связи и квантовым компьютерам. К выпуску в числе прочего готовятся процессоры Xeon 7 Diamond Rapids. При создании этих чипов основной упор делается на повышении пропускной способности всех компонентов системы. В состав CPU войдут до 256 вычислительных ядер и до 1,28 Гбайт кеша L3. Говорится о поддержке технологий Intel AVX 10.2, Intel Advanced Performance Extensions (APX) и Intel Advanced Matrix Extensions (AMX). Возможно использование модулей памяти RDIMM-8000 и MRDIMM-12800, а заявленная пропускная способность при использовании 16 каналов достигает 1,6 Тбайт/с. В целом, процессоры Xeon 7 Diamond Rapids, как ожидается, позволят вывести производительность в ресурсоёмких приложениях на новый уровень. Intel подчёркивает, что в перспективе масштабирование суперкомпьютерных систем потребует преодоления физических ограничений в сетях передачи данных. По мере увеличения масштабов и мощности ИИ-кластеров применение традиционных медных линий становится всё более проблематичным из-за роста энергопотребления и наличия существенных задержек. С целью устранения указанных недостатков Intel развивает направление кремниевой фотоники. Оптическая связь позволит объединять высокопроизводительные ускорители, память и вычислительные ресурсы. 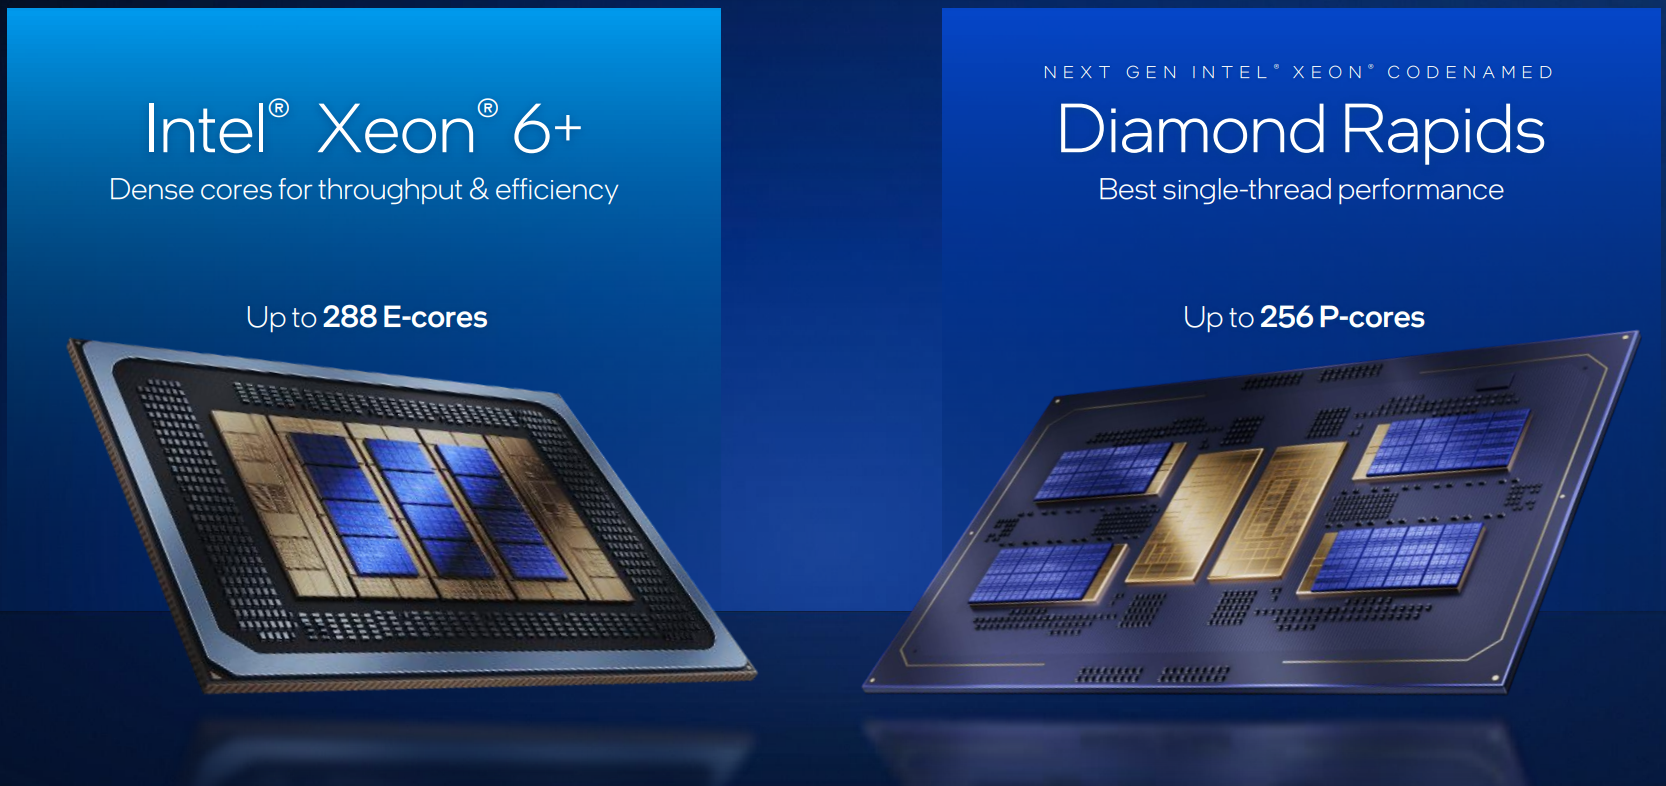
Источник изображения: Intel Ещё одним важным направлением Intel называет разработку квантовых технологий. Недавно корпорация объявила о приобретении израильского разработчика ПО для квантовых систем Classiq. Сделка позволит объединить платформу автоматизированного создания квантовых алгоритмов Classiq с кремниевыми спиновыми кубитами и производственными мощностями Intel. Главная цель состоит в том, чтобы абстрагироваться от сложной физики квантового оборудования. Это позволит разработчикам НРС-систем писать квантовые программы и создаст программную базу для вычислений следующего поколения.
17.11.2026 [01:55], Владимир Мироненко
NVIDIA анонсировала ускоритель Rubin HPC для моделирования и обработки данных в научных задачах с использованием ИИ-агентовNVIDIA анонсировала ускоритель Rubin HPC, разработанный для ускорения моделирования и обработки данных в научных, инженерных и аналитических задачах с использованием ИИ-агентов в составе платформы Vera Rubin. Компания отметила, что Rubin HPC оснащён рекордным количеством ядер CUDA — более 50 тыс. на одном чипе. Для ускорения обмена данными между ускорителями используется интерконнект NVLink 7. NVIDIA не предоставила подробных данных о его пропускной способности или физическом уровне. Однако из более ранних сообщений об этой технологии известно, что она имеет пропускную способность 3,6 Тбайт/с на один GPU, как изначально намечалось у NVLink 6. Также в Rubin HPC реализована технология ускорения обработки разреженных данных (sparse data), которая обеспечивает вычислительные ядра постоянной нагрузкой. Это решение нацелено на типичные для кода симуляций алгоритмические паттерны: от операций с разреженными матрицами и трафаретных вычислений (stencil computations) до сортировки и операций редукции. 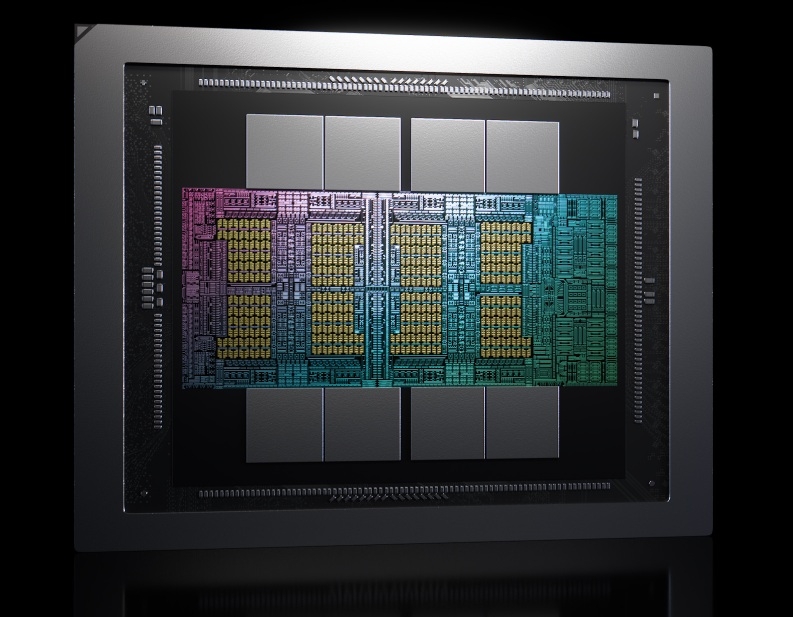
Источник изображения: NVIDIA Компания отметила, что в Rubin HPC используется сбалансированная архитектура, в которой одновременно масштабируются как вычислительные мощности, так и механизмы передачи данных. Именно этот баланс делает ускоритель оптимальным решением для научных вычислений, в котором обеспечивается непрерывная подача данных на рекордное количество ядер CUDA, благодаря чему они постоянно заняты вычислениями, а не простаивают в ожидании данных. Что касается ПО, то для Rubin HPC будут использоваться специализированные библиотеки NVIDIA CUDA-X, предлагающие обширный и постоянно пополняемый набор оптимизированных алгоритмов, которые могут использовать интеллектуальные агенты — в том числе алгоритмы, наиболее востребованные в сфере моделирования и аналитики. В сочетании с платформой Rubin HPC эти библиотеки позволяют агентам максимально быстро приходить к обоснованным выводам. 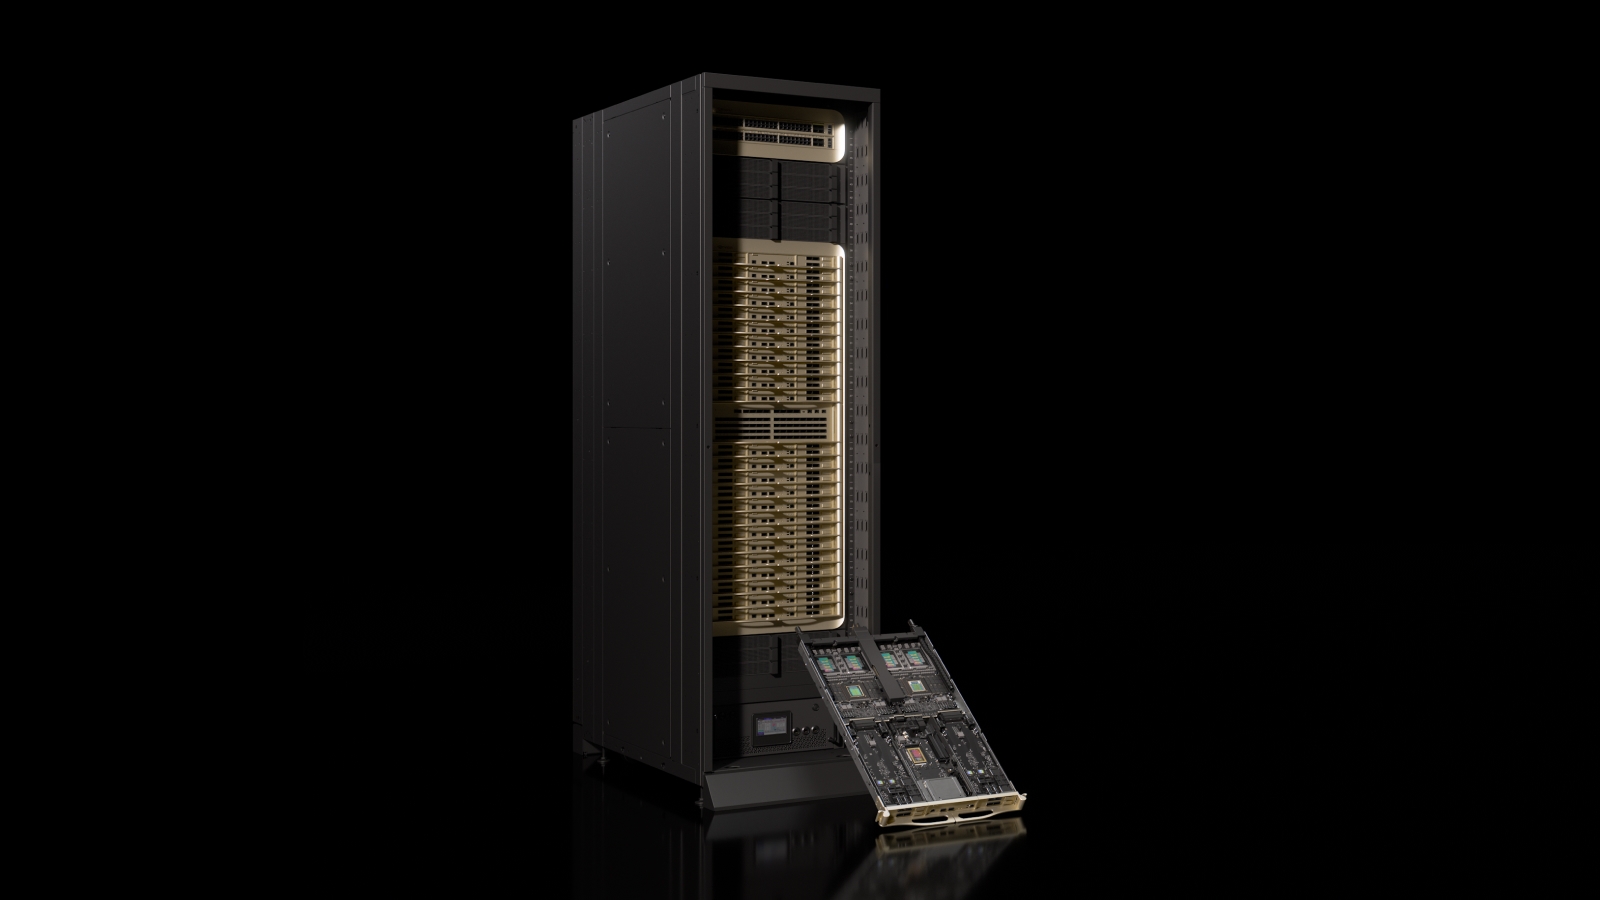
Источник изображения: NVIDIA Согласно описанию NVIDIA, в одном узле размещаются два суперчипа (NVL4), каждый из которых объединяет один CPU Vera и два GPU Rubin HPC. Таким образом, на один «суперчип» приходится более 100 тыс. ядер, а на весь узел — более 200 тыс. ядер. При этом NVIDIA пока не раскрыла объём HBM, пропускную способность памяти и FP64-производительность новинки. Выпуск чипа намечен на 2028 год, поэтому многое может измениться и есть риск, что компания поменяет планы, как это уже произошло с Rubin CPX. Анонс Rubin HPC формально знаменует собой возвращение компании к сфере традиционных HPC. В последние годы NVIDIA выстраивала свою стратегию на решениях для ЦОД, ориентируясь преимущественно на задачи обучения и инференса нейросетей. В сегменте FP64-вычислений NVIDIA не демонстрировала особого прогресса, полагаясь на их эмуляцию на тензорных ядрах. Поэтому для инвесторов важно знать, позволит ли новый чип сократить отставание NVIDIA от AMD в задачах, требующих высокой точности вычислений.
16.11.2026 [22:00], Сергей Карасёв
Самый скучный TOP500 за всю историю, но с небольшим китайским сюрпризомВ рамках международной конференции по высокопроизводительным вычислениям SC26 в Чикаго (США) обнародована свежая редакция рейтинга самых мощных суперкомпьютеров мира — ноябрьский список TOP500. Лидером остаётся китайский комплекс LineShine, FP64-производительность которого достигает 2,198 Эфлопс при пиковом значении 2,736 Эфлопс. Отмечается, что состав первой десятки не претерпел изменений по сравнению с июньской версией списка. Так, на второй позиции остаётся американская система El Capitan с быстродействием на уровне 1,809 Эфлопс, а замыкает тройку суперкомпьютер Frontier (1,353 Эфлопс), также расположенный в США. В сегменте экзафлопсных машин представлены ещё два НРС-комплекса — Aurora (1,012 Эфлопс) и JUPITER Booster (1 В рейтинг вошли только 27 новых систем, или 5,4 % от общего числа участников TOP500, — это самый низкий показатель за всю историю его формирования. Вместе с тем пороговые значения производительности в нижней части списка выросли, что свидетельствует о продолжающемся увеличении совокупных вычислительных мощностей, несмотря на замедление процесса строительства новых суперкомпьютеров. 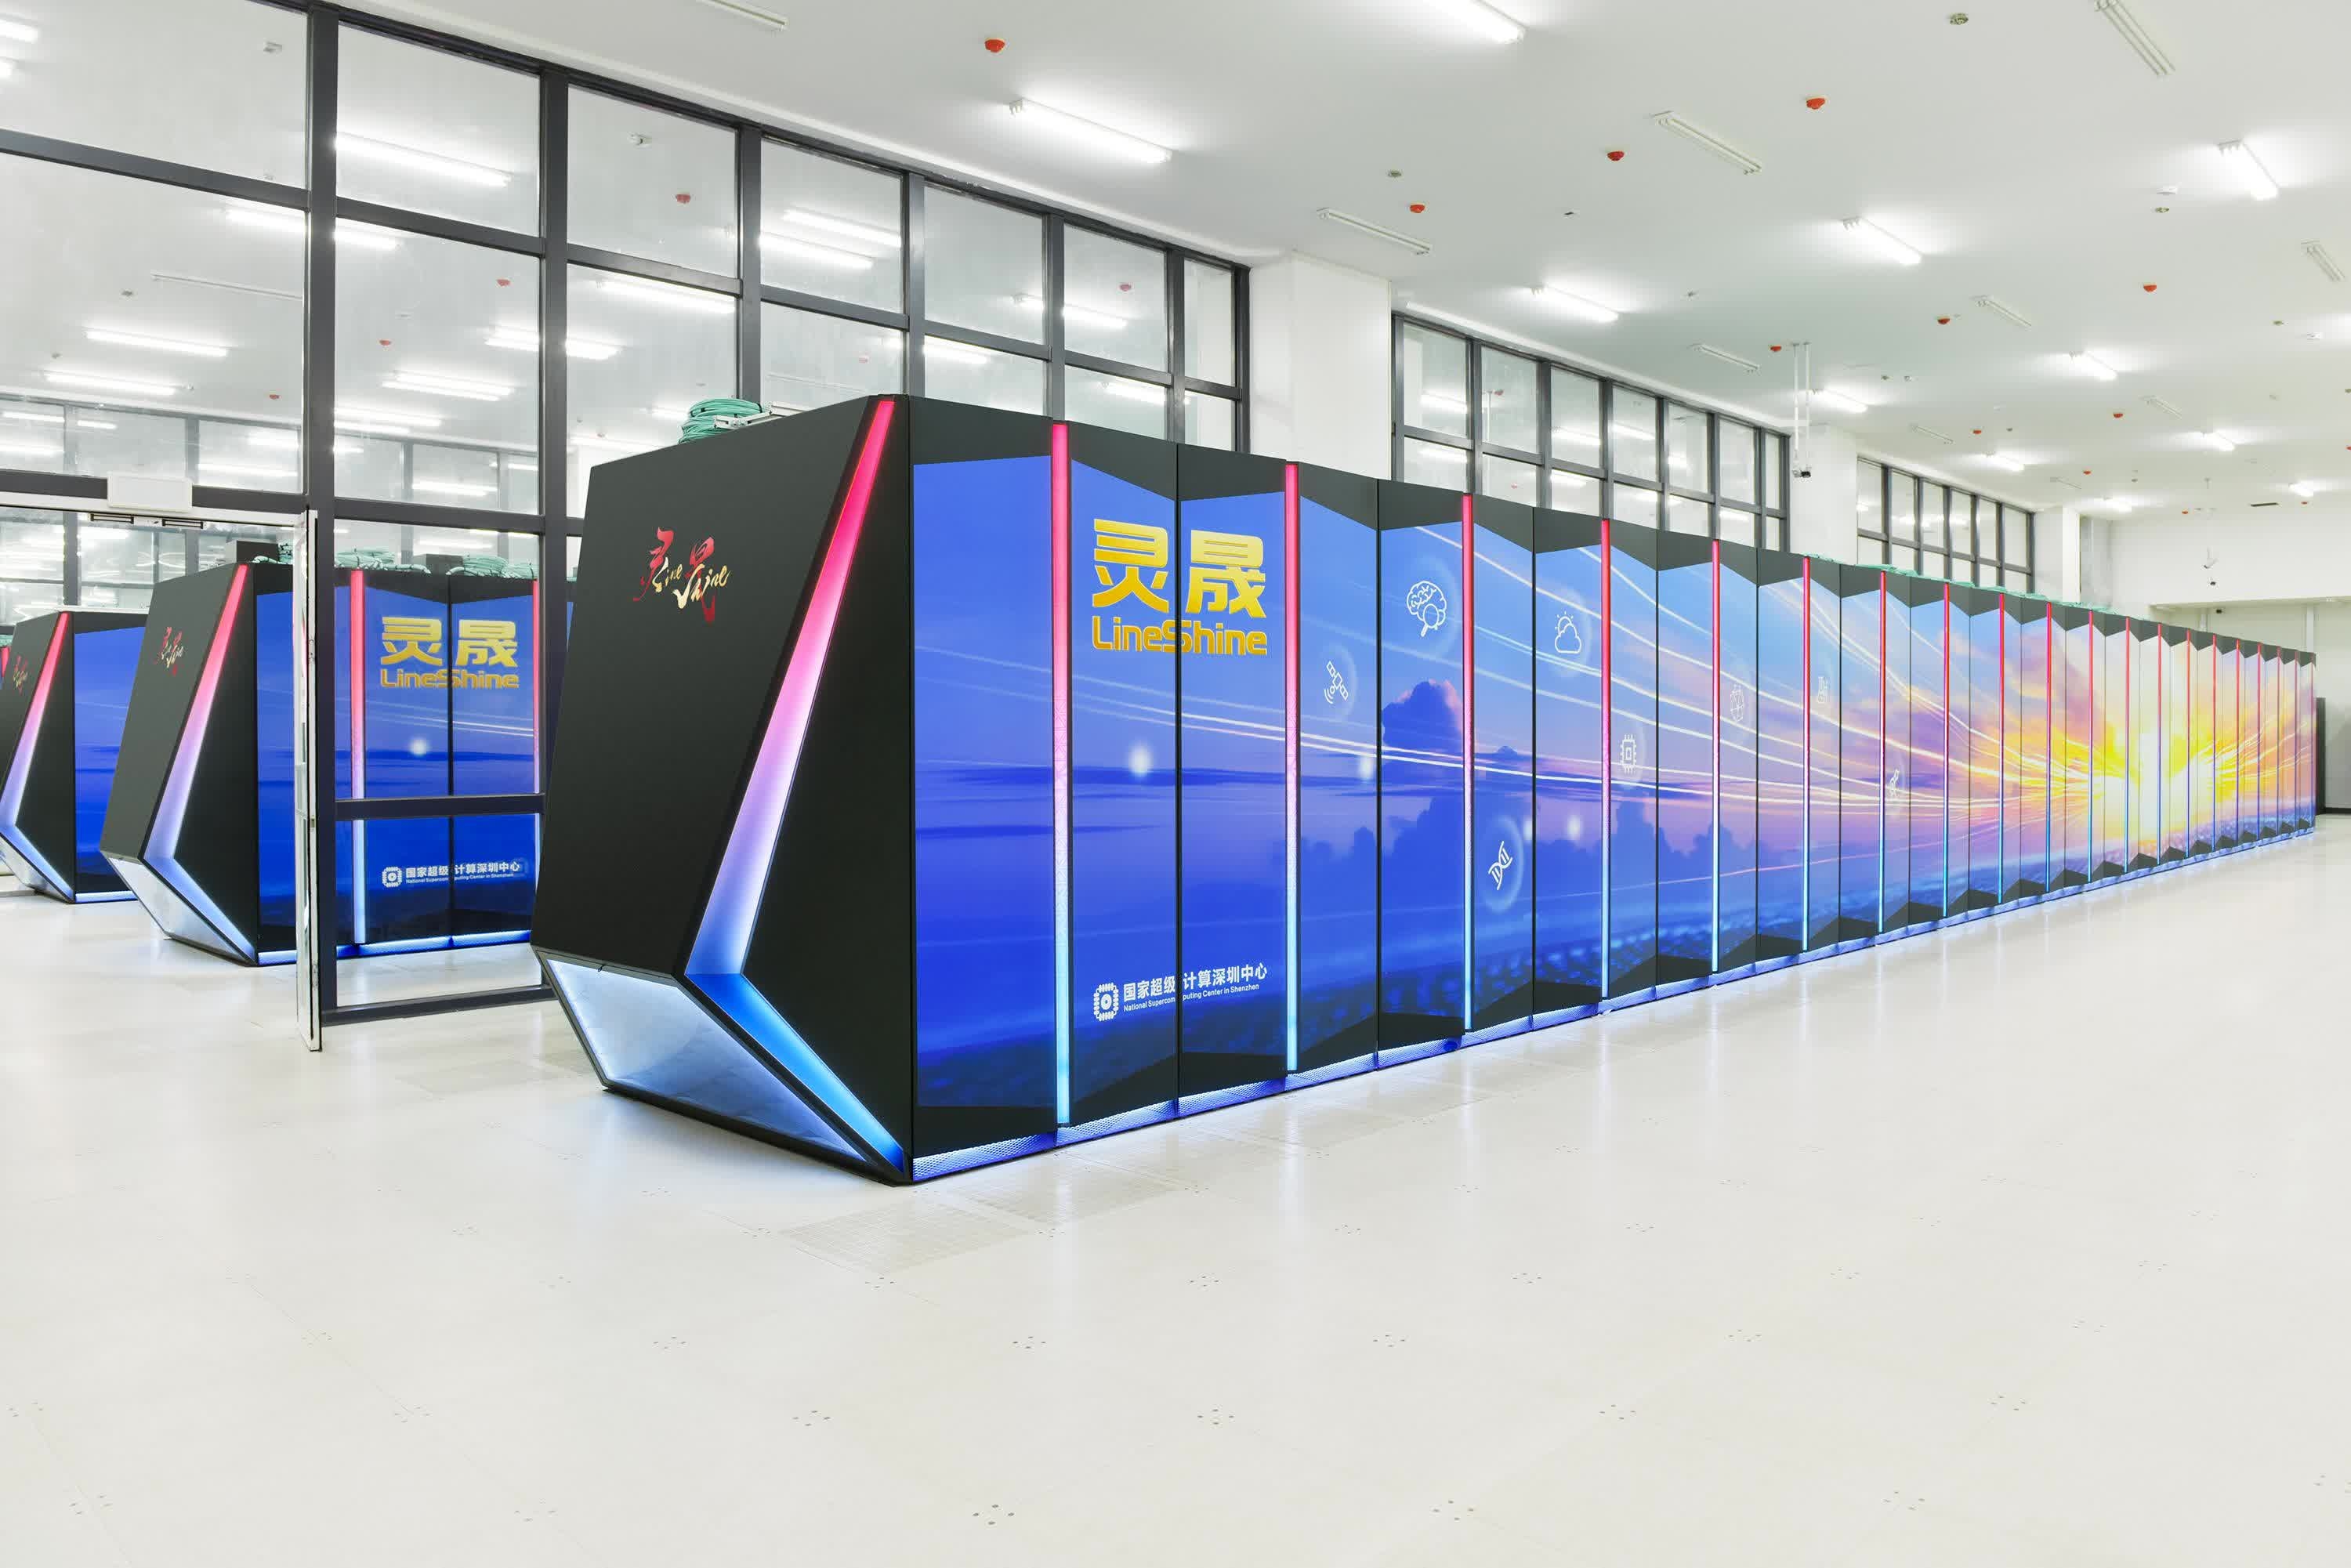
Источник изображения: National Supercomputing Centre in Shenzhen (NSCCSZ) Система, занимающая 500-е место, теперь демонстрирует результат 2,857 Пфлопс — это на 7,3 % больше по сравнению с 2,662 Пфлопс в июне нынешнего года. Порог для вхождения в TOP50 поднялся на 12 % — с 49,85 до 55,81 Пфлопс, тогда как для попадания в первую сотню требуется 22,74 Пфлопс против 21,85 Пфлопс в июне. Количество систем, обеспечивающих производительность не менее 100 Пфлопс, увеличилось с 25 до 27, а суммарное быстродействие всех 500 машин поднялось на 4,4 %, достигнув 19,57 Эфлопс. Самой высокопроизводительной машиной среди новичков стала система HANGANG, смонтированная в Суперкомпьютерном центре Корейского института научно-технической информации (KISTI). Новый комплекс с производительностью 342,6 Пфлопс оказался на 12-й позиции рейтинга. Суперкомпьютер построен на платформе HPE Cray EX254n с гибридными суперчипами NVIDIA GH200 и CPU NVIDIA Grace. 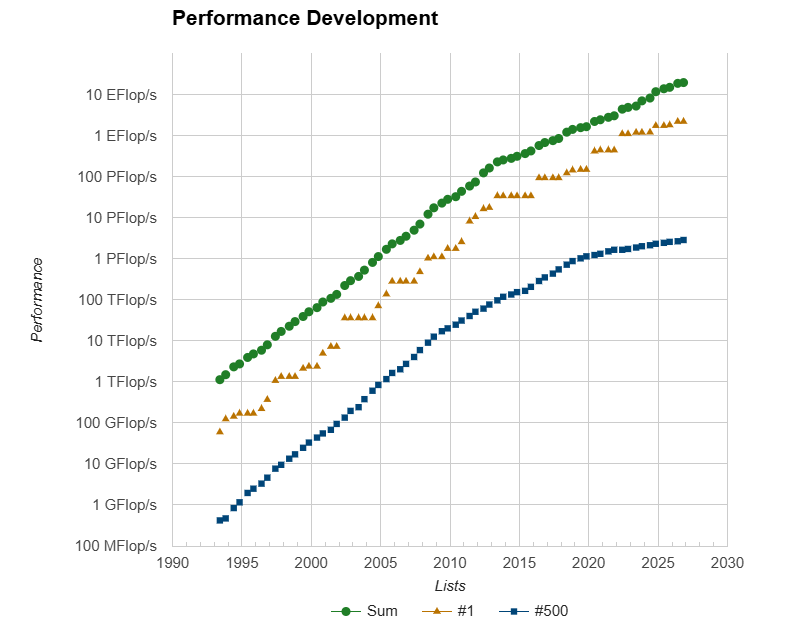
Источник изображения: TOP500 Одной из наиболее интересных новинок является система CTyun HPC — облачная платформа высокопроизводительных вычислений eSurfing Cloud китайского телекоммуникационного гиганта China Telecom. В её составе задействованы процессоры Hygon C86 7493 (56C/112T, 2,9 ГГц) и ускорители MetaX C588. Применяется операционная система CTyunOS 25.0. В последний раз чипы Hygon попадали в рейтинг в ноябре 2018-го. Говорится также, что примерно в половине всех суперкомпьютеров списка (в 50,4 %) используются процессоры Intel против 53,2 % в июне. В 199 системах (39,8 %) установлены чипы AMD (38,4 % в предыдущей редакции рейтинга). Различные ускорители присутствуют в 291 суперкомпьютере (58,2 %) против 275 в июне. В целом, наблюдающиеся тенденции указывают на то, что глобальный рынок НРС-систем достиг стадии зрелости: лидеры сохраняют свои позиции, количество новичков крайне мало, а наиболее заметный прогресс наблюдается в нижней части рейтинга.
16.11.2026 [15:39], Руслан Авдеев
Nscale ввела в эксплуатацию два ЦОД и 25 тыс. ИИ-ускорителей за 2,5 месяцаНедавно опубликованном проспекте IPO компания Nscale объявила, что теперь располагает 50 тыс. активных ИИ-ускорителей из планируемых 461 тыс. В предыдущем проспекте, датированным 31 августа, имелась информация лишь о 25 тыс. активных ускорителях, сообщает Datacenter Dynamics. Кроме того, у Nscale теперь семь активных площадок ЦОД, против пяти площадок с совокупной мощностью 55 МВт ранее. Общая мощность всех семи площадках не разглашается. Всего, как заявляет Nscale, имеется 1,37 ГВт активных и законтрактованных мощностей, из которых 1 ГВт относится к собственным площадкам компании, а 165 МВт — колокейшн-ЦОД. В целом компания видит потенциал получения до 10 ГВт энергетических мощностей. Также Nscale изменила систему отчётности о финансах. В прежнем проспекте она сообщала о выручке $140,6 млн за первые шесть месяцев 2026 года, рост составлял 1252 % г/г. При этом убытки также взлетели до $1,02 млрд против $368,9 млн годом ранее. В новом проспекте основное внимание уделили полному 2025 году, выручка за который составила $33 млн, что на 73 % выше в сравнении с $19,1 млн в 2024 году. Как сообщается в проспекте, совокупная стоимость активных контрактов с клиентами на принципе долгосрочной оплаты take-or-pay составляла около $6,4 млрд, а общая стоимость как активных, так и законтрактованных соглашений оказалась на уровне $105,8 млрд. Для сравнения, на 31 декабря 2025 года речь шла об $0,5 млрд и $38 млрд соответственно. Контракты предусматривают развёртывание около 461 тыс. действующих и законтрактованных на указанную дату ускорителей. 
Источник изображения: Nscale Также компания рассказала о сделках с Anthropic. В августе партнёры подписали соглашение о предоставлении вычислительных мощностей на $45 млрд ($44,6 млрд), связанное с использованием мощностей будущей площадки Nscale — Monarch Compute Campus в западной Вирджинии. В новом проспекте подтверждается информация о переговорах, касающихся строительства второго здания ЦОД на площадке. Сообщается, что 29 сентября Anthropic воспользовалась правом законтрактовать дополнительные мощности в здании Building 2 на территории кампуса Monarch. У партнёров есть 60 дней на добросовестные переговоры по соглашению о Building 2. Право Anthropic в отношении Building 3 может быть реализовано в течение 15 рабочих дней после подписания соглашения по Building 2. Если это право будет реализовано, на переговоры по Building 3 отводится ещё 60 дней. Nscale заявила, что рассчитывает финансировать развёртывание инфраструктуры в интересах Anthropic за счёт внешнего финансирования и денежных потоков от операций компании. При этом в свете сделки с Anthropic проведена оценка возможностей рынка и проведены переговоры с его участниками относительно необходимости финансирования. Nscale подчеркнула, что имеет опыт привлечения средств на строительство ЦОД и покупку ИИ-ускорителей. Учитывая проделанную работу и предыдущий опыт, Nscale полагает, что сможет получить финансирование в установленные сроки. При этом у Nscale пока нет уже заключенных соглашений о финансировании. Если компания в установленные сроки не сможет предоставить Anthropic инфраструктуру ИИ-ускорителей, в т.ч. из-за задержек в цепочках поставок, Anthropic может получить право расторжения договора без обязательств. В рамках IPO компания намерена привлечь миллиарды долларов для финансирования строительства ИИ ЦОД. Вероятная оценка Nscale составит $30 млрд, но официальная дата размещения пока не объявлена. |
|

