Материалы по тегу: hardware
|
13.10.2026 [16:17], Руслан Авдеев
Visionbay.ai разработала типовой проект ИИ-фабрики с питанием 800 В DC для платформы NVIDIA Vera RubinКомпания Visionbay.ai, подразделение Foxconn, представила референсный проект ИИ-фабрики нового поколения K-1 для платформы NVIDIA Vera Rubin с электропитанием 800 В DC и технологиями терморегуляции Vertiv. Использование стандартизированной LVDC-архитектуры создаёт условия для дальнейшего повышения плотности ИИ-инфраструктуры. При этом сохраняется возможность гибкой модернизации уже действующих объектов. Вместо полного одномоментного перехода на новые технологические решения предлагается поэтапное внедрение распределения питания 800 В DC там, где это целесообразнее всего. Такой подход даёт возможность операторам ЦОД подготовиться к появлению новых поколений ИИ-систем без необходимости масштабной разовой модернизации инженерной инфраструктуры зданий. Предложенная архитектура предполагает использование центров электропитания на уровне кластеров (cluster-level power centers) с централизацией преобразования переменного тока в постоянный (AC/DC) и распределяют питание 800 В DC ближе к вычислительным ресурсам. Поддерживается модульное расширение, возможно создание типовых инфраструктурных блоков для масштабирования ИИ-фабрик. 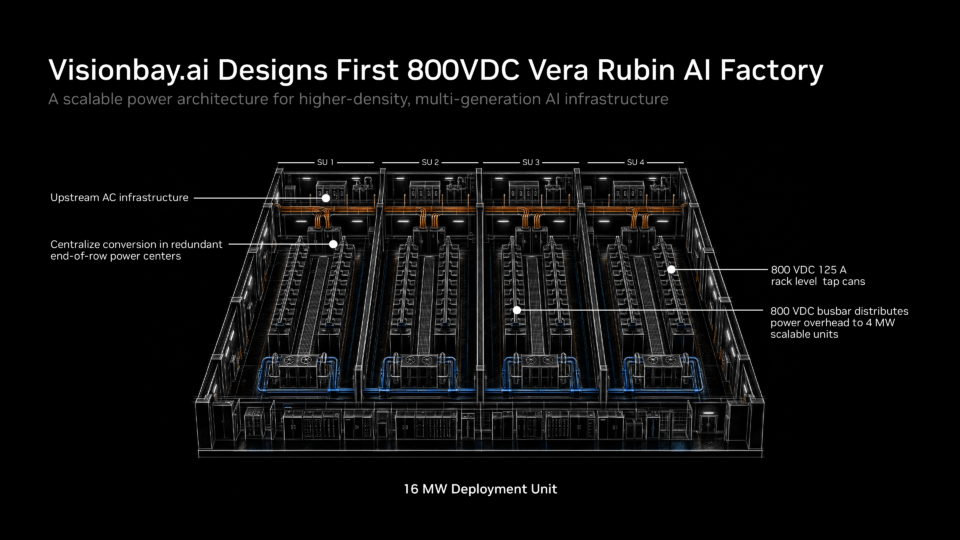
Источник изображения: NVIDIA K-1 отражает системный подход NVIDIA к проектированию ИИ-фабрик. С таким подходом электропитание, охлаждение и вычислительные ресурсы сразу разрабатываются как единая система. Поддержка инфраструктуры с СЖО, масштабируемого распределения электроэнергии и будущих систем класса Vera Rubin позволяет партнёрам экосистемы превращать референсную архитектуру ИИ-фабрик NVIDIA в готовую к развёртыванию инфраструктуру для нового этапа ускоренных вычислений. Примером реализации такой инфрастуркутуры стало предложение Supermicro.
13.10.2026 [16:01], Руслан Авдеев
Подрядчик Supermicro Тин-Вэй Сунь признался в контрабанде серверов с ИИ-чипами NVIDIA в КитайЧерез семь месяцев после ареста по подозрению в сговоре с целью контрабандных поставок ИИ-ускорителей NVIDIA в Китай внешний подрядчик Supermicro Тин-Вэй «Вилли» Сунь (Ting-Wei “Willy” Sun) признал себя виновным по четырём пунктам обвинения: в сговоре с целью обхода экспортных ограничений, контрабанды товаров, обмана властей США и воспрепятствовании правосудию, сообщает Datacenter Dynamics. Сунь был одним из трёх человек, работавших на Supermicro, которым власти США предъявили обвинение в контрабанде серверов с ИИ-ускорителями NVIDIA в Китай. Всего, согласно судебным документам, в КНР было направлено серверного оборудования приблизительно на $2,5 млрд — хотя лицензии Министерства торговли США на такую деятельность не было. В числе обвиняемых — один из учредителей Supermicro И-Шьян Лиау (Yih-Shyan Liaw), после ареста покинувший совет директоров компании. Весной текущего года он заявил о своей невиновности по предъявленным обвинениям в федеральном суде Манхэттена. По версии следствия, подсудимые переупаковывали серверы Supermicro в немаркированные коробки для сокрытия содержимого и использовали поддельные «копии» серверов для обмана при аудите. Судя по записям с камер видеонаблюдения, обвиняемые использовали фен для переклейки серийных номеров с настоящих серверов на копии. После этого использовалась зарегистрированная в Юго-Восточной Азии компания-посредник для сокрытия поставок оборудования с Тайваня в Китай. 
Источник изображения: LoboStudio Hamburg/unsplash.com Как следует из обвинительного заключения, в 2024 году посредник стал одним из крупнейших покупателей Supermicro, в IV квартале финансового года благодаря ему компания выручила $99,7 млн. Самой Supermicro обвинения не предъявляли. Ранее компания публично объявила, что тесно сотрудничает с тайваньскими властями для предотвращения экспорта передовых подсанкционных систем на китайский рынок и привержена защите передовых технологий и интеллектуальной собственности. В компании подчеркнули, что в результате такого взаимодействия властям удалось изъять 50 серверов, обманным путём купленных после продажи авторизованному реселлеру. Сами обвиняемые ранее отрицали нарушение законов. В июне появились сообщения о том, что в тайваньском офисе компании прошёл обыск. После этого Supermicro заявила, что сама компания «не является объектом данного расследования» и никаких обысков не было. В то же время она признала, что четверо работавших на неё людей задержаны на Тайване для допроса. Также сообщалось, что компания предоставила властям доступ к рабочим местам и электронике сотрудников. Двое из четырёх сотрудников остаются под стражей до суда, ещё двое выпущены под залог.
13.10.2026 [15:45], Владимир Мироненко
Анонсирован Intel GPU D270, оптимизированный для инференса агентного ИИIntel представила Intel GPU D270 — первый продукт серии ускорителей D-series, ранее известной под кодовым именем Crescent Island. Некоторые подробности о новой серии стали известны в августе. Уже начаты поставкм инженерных образцов чипа заказчикам: серверным OEM- и ODM-производителям, провайдерам облачных услуг, включая неооблака, и независимым разработчикам программного обеспечения. Как сообщается, Intel GPU D270 — это ускоритель для ЦОД, оптимизированный для задач инференса и разработанный с учётом требований применения агентного ИИ. Он предназначен для поддержки корпоративных ИИ-решений, сервисов SaaS и GPUaaS, а также развёртывания в государственных или суверенных облачных инфраструктурах, где необходимы энергоэффективные средства ускорения ИИ с большим объёмом памяти. Intel GPU D270 может использоваться промышленных задач ИИ-инференса, таких как агентный ИИ, генерация с дополненным поиском (RAG) с использованием длинного контекста, корпоративные ИИ-ассистенты, помощники для написания кода, анализ документов, мультимодальный ИИ, диффузионные модели и обслуживание запросов в условиях высокой конкурентности. Чип разработан с учётом специфики работы агентного ИИ, решающего задачи с разбивкой на несколько этапов: вызовы модели, использование внешних инструментов, поиск информации и генерация ответа. При создании Intel GPU D270 учитывалась специфика требований таких сценариев, включая обработку этапа предварительного заполнения (prefill), работу с увеличенным контекстом, достаточный объём памяти, поддержку высокой конкурентности и энергоэффективность. 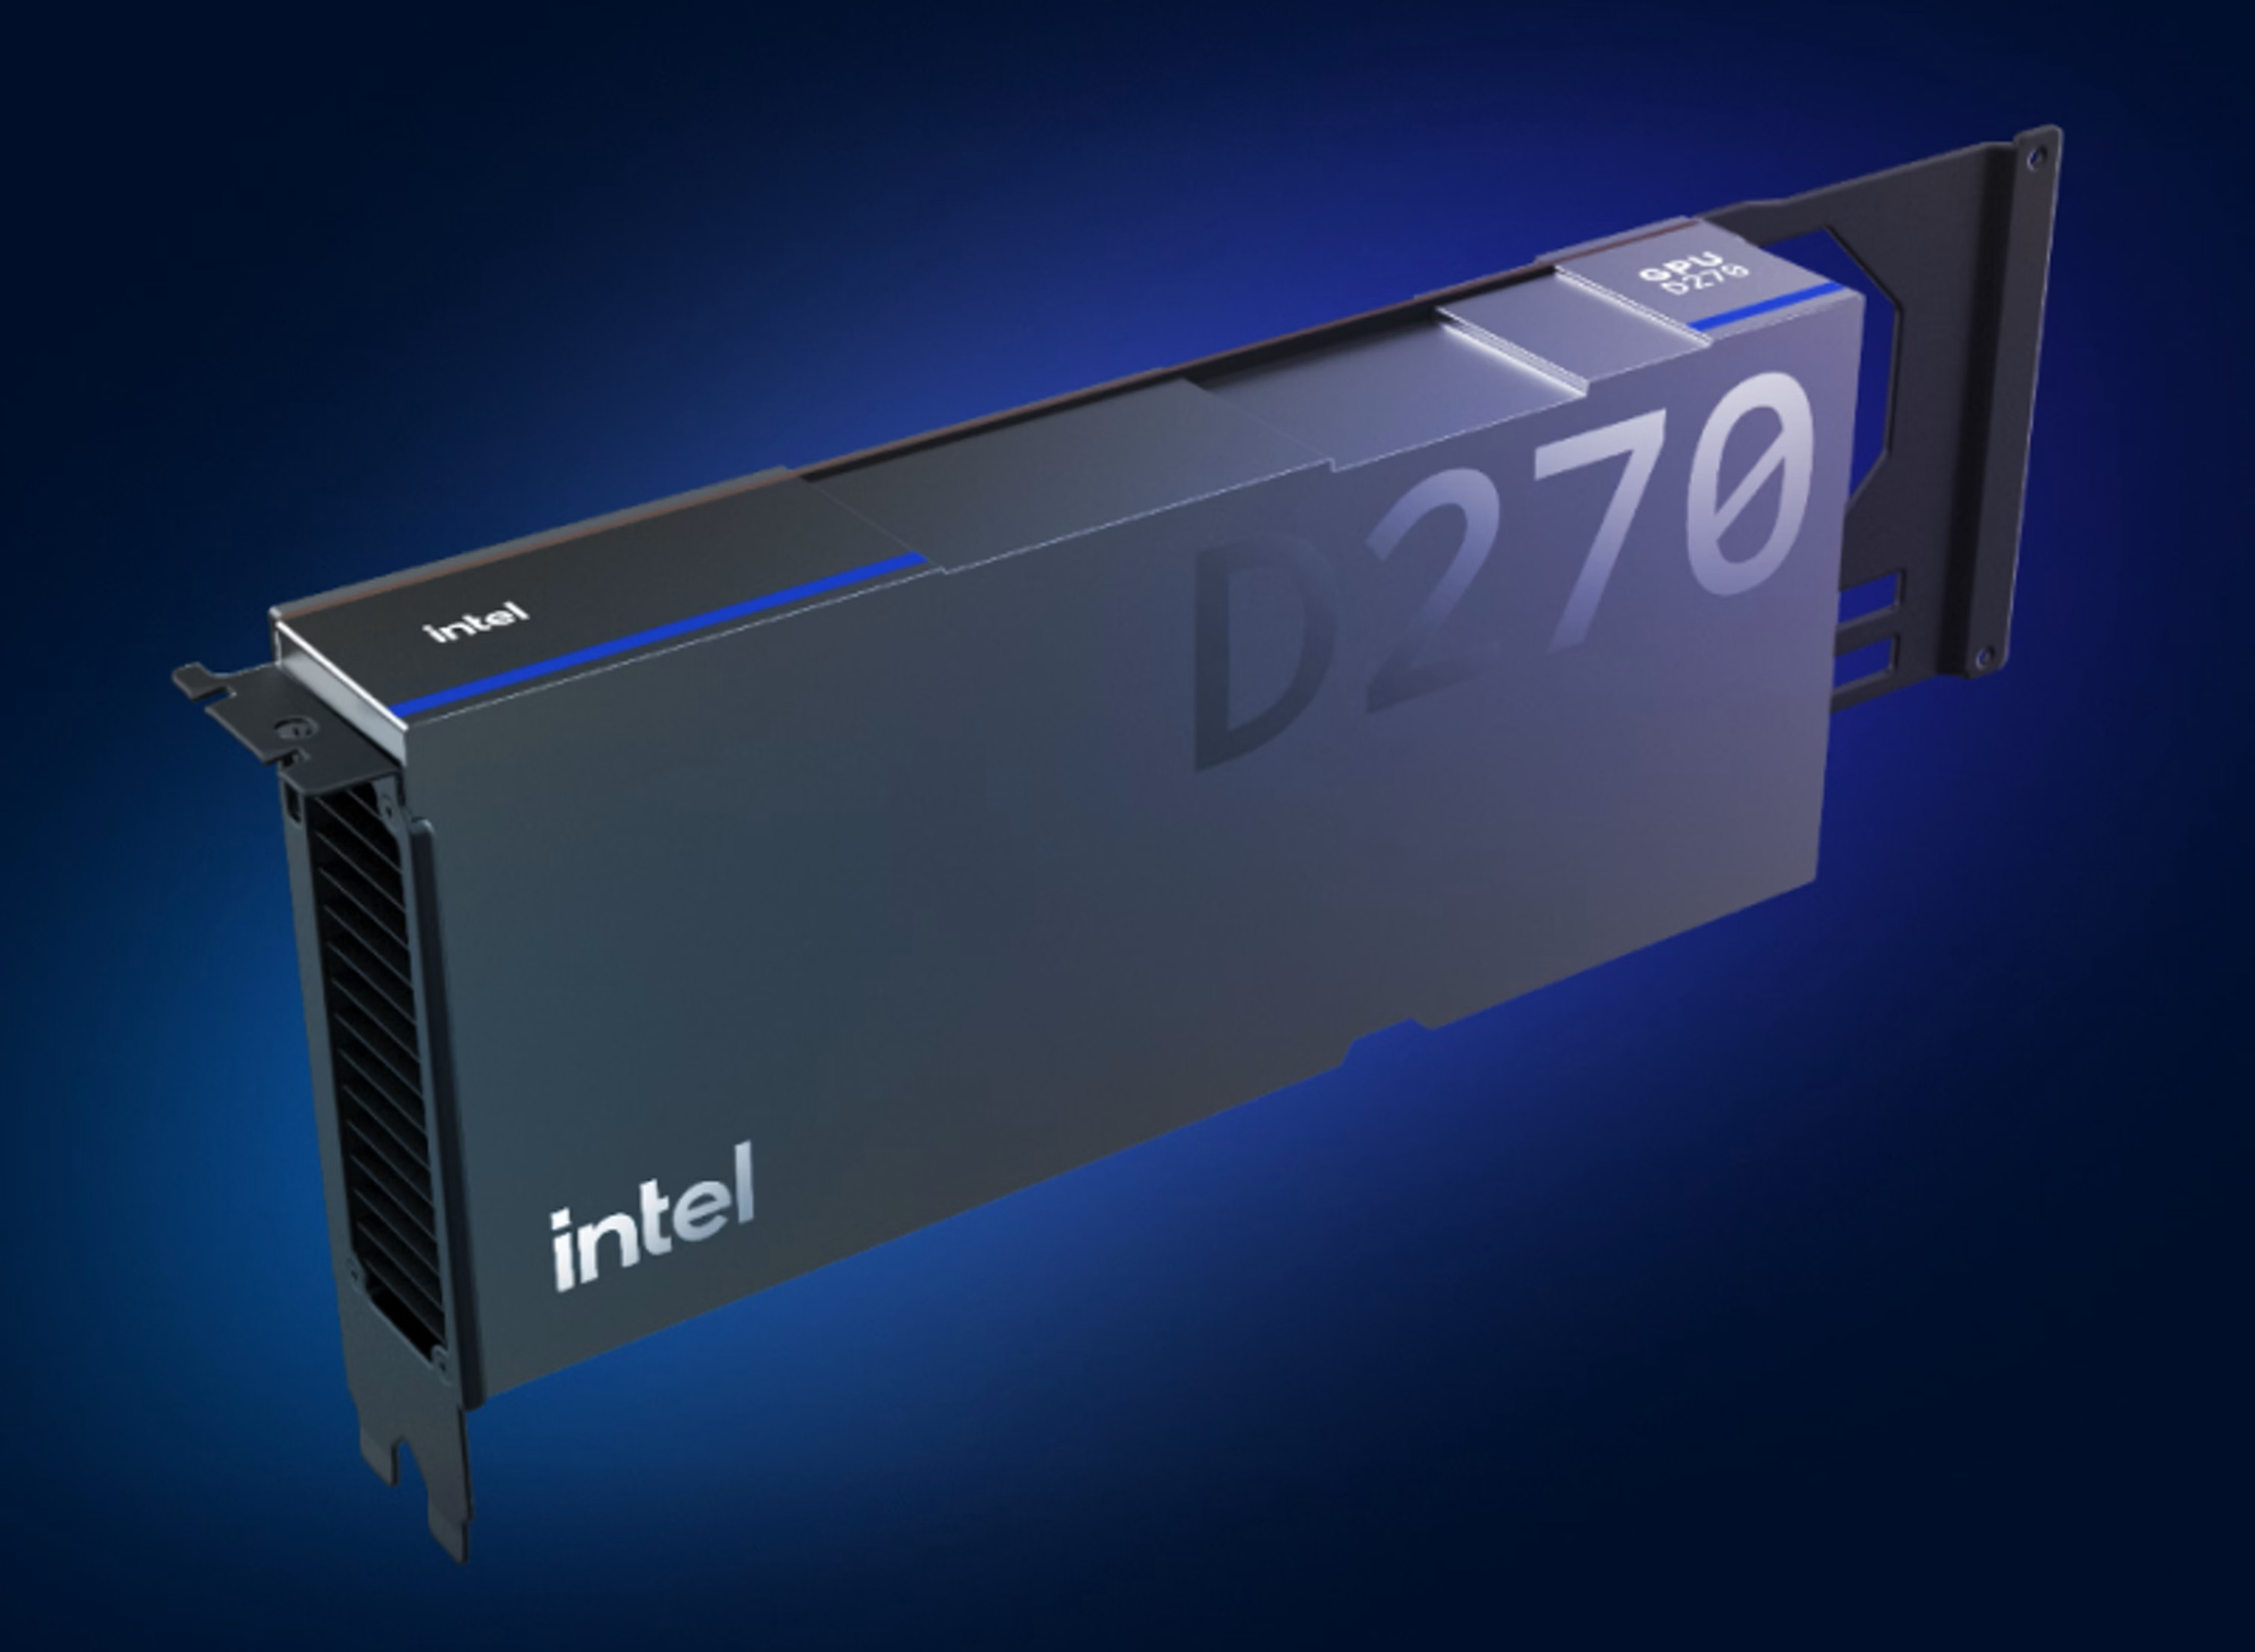
Источник изображения: Intel D270 обладает достаточно большим объёмом доступной памяти, что позволяет поддерживать более крупные модели, длинный контекст и большее количество одновременных сеансов, обеспечивая поддержку больших промптов, процессы с интенсивным поиском данных и рост KV-кеша в ходе инференса. LPDDR5X уступает HBM по пропускной способности, однако позволяет обеспечить большой объём при меньших затратах и энергопотреблении. Объём памяти составляет до 480 Гбайт в GPU сторонних производителей. Фирменный GPU от самой Intel оснащается 160 Гбайт памяти. Intel GPU D270 выполнен в форм-факторе двухслотовой карты с интерфейсом PCIe 5.0 x16. Архитектура Intel Xe3P — усовершенствованная версия графической архитектуры Xe3 — отличается увеличенным количеством матричных блоков XMX и расширенной подсистемой памяти LPDDR5X. Ускоритель включает 32 ядра Xe и 256 матричных блоков. Пропускная способность памяти (ПСП) составляет до 1,5 Тбайт/с, производительность в режиме FP8 — на уровне 1,3 Пфлопс при потреблении 350 Вт. Пиковая векторная производительность (FP64) — 10,2 Тфлопс. По данным Intel, одна карта серии D способна вместить модели с до 300 млрд параметров, а система с восемью такими ускорителями позволяет обслуживать модели с 1+ трлн параметров. При этом Intel делает ставку на такие метрики, как объём памяти на ватт и на доллар, считая их более важными для задач обслуживания моделей с интенсивным этапом декодирования, чем пиковая ПСП. «Выпуская GPU Intel D-series, мы стремимся сделать развёртывание систем инференса с большим объёмом памяти практичным, а их масштабирование — экономически выгодным», — заявила компания. Программная часть базируется на единой архитектуре Xe — код, написанный для GPU Arc Pro, можно перенести на серию D без переписывания ядер (kernels). Программный стек Intel объединяет стандартные среды выполнения (runtimes) и фреймворки для обслуживания моделей. Предусмотрена поддержка «нулевого дня» (Day 0) для модели Muse Glimmer от Meta✴. Инструментарий Intel AI for Enterprise Agent Toolkit, который уже работает на базе Xeon, будет адаптирован для работы с серией D, благодаря чему уровень оркестрации будет готов ещё до начала массовых поставок ускорителей. С Intel GPU D270 будут совместимы PyTorch, vLLM, SGLang и OpenAI Triton.
13.10.2026 [13:50], Руслан Авдеев
MGX 1.2: NVIDIA представила открытые спецификации стоек Vera RubinNVIDIA объявила о новых партнёрствах и технологических решениях для создания единой основы для ИИ-инфраструктуры нового поколения. В частности, OCP переданы спецификации стоек NVIDIA Vera Rubin и вычислительных узлов в рамках открытой архитектуры MGХ. В рамках инициативы Open DC Initiative проекта OCP компания присоединилась к лидерам отрасли, принимающим участие в разработке референсного дизайна ИИ ЦОД третьего поколения. Наряду с открытыми технологиями жидкостного охлаждения MQD и MQDB, работа над MGX позволит превратить проверенные решения для ИИ-фабрик в отраслевые стандарты, доступные для внедрения, производства и масштабирования другими участниками рынка. Обновлённая спецификация MGX 1.2 расширяет возможности открытой архитектуры за счёт СЖО со «слепым» (blind-mate) монтажом. Также стандартизирована совместимая стоечная инфраструктура интерконнектов и DC-шина на 5000 А с жидкостным охлаждением, рассчитанная на мощные ИИ-системы. Дополнительно добавлена поддержка 19″ оборудования и стоек с повышенной плотностью размещения оборудования. Дополнительно MGX 1.2 расширяет возможности модульной конфигурации. Так, добавлены конфигурируемые IO-модули, безвентиляторные вычислительные узлы с СЖО, стандартизированные интерфейсы электропитания и охлаждения и единая инфраструктурная основа, дающая партнёрам экосистемы строить совместимые платформы для ускоренных вычислений. 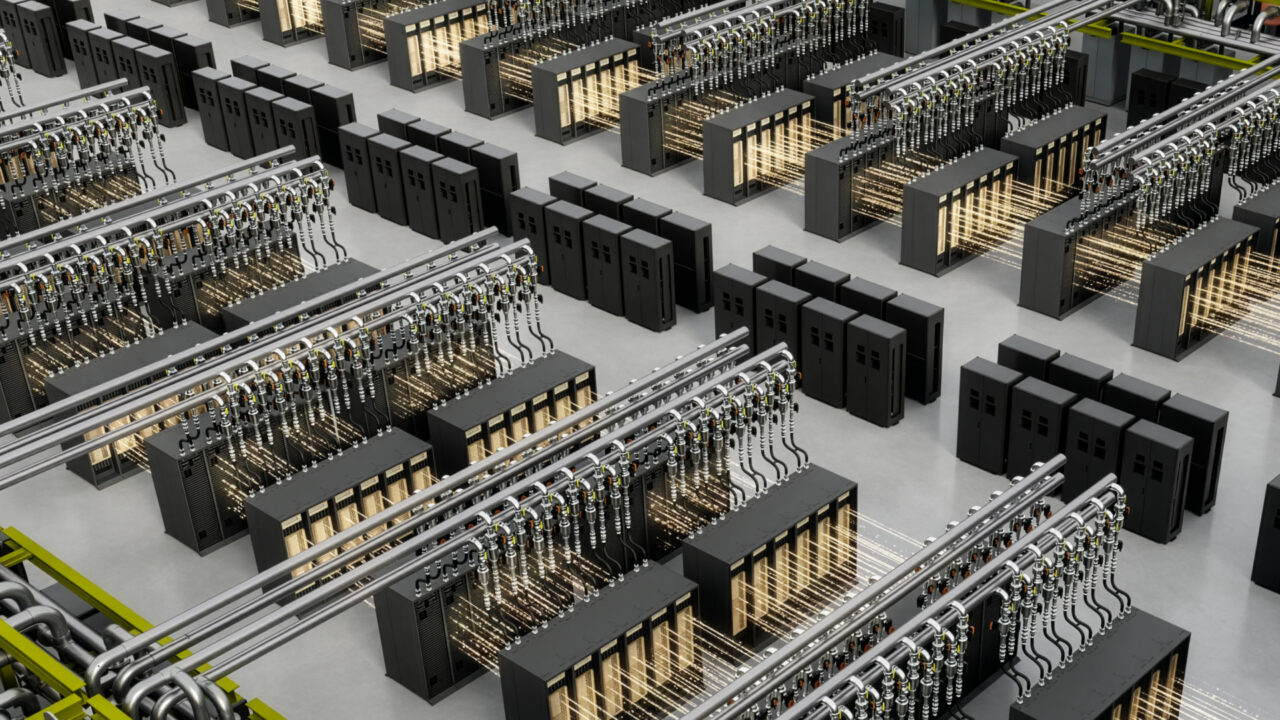
Источник изображения: NVIDIA Архитектура позволяет сокращать время сборки, тестирования и обслуживания оборудования. Это упрощает развёртывание и обслуживание на местах и должно повысить эффективность инфраструктуры. Архитектурой поддерживается конфигурация стоек до 250 кВт. В то же время упрощается техобслуживание проектов, ввод в эксплуатацию и даже повторное использование инфраструктуры. Спецификация стоек на основе CPU NVIDIA Vera дополнительно расширяет архитектуру MGX за пределы ускоренных вычислений. Фактически речь идёт о специализированной платформы эпохи агентного ИИ. Если NVIDIA Vera Rubin NVL72 служит основой для обучения и инференса ИИ-моделей, то стойки на основе CPU Vera предназначены для вызова инструментов, оркестрации и песочниц. Стойка Vera CPU на основе MGX третьего поколения использует те же принципы проектирования на уровне стоек — они позволяют объединять вычислительные ресурсы, сетевую инфраструктуру, электропитание и охлаждение в единой модульной платформе. Соответствующий подход позволяет NVIDIA и партнёрам обеспечивать развёртывание специализированной инфраструктуры, в то же время используя преимущества общей экосистемы, упрощённой интеграции и единой технологической базы для ИИ-фабрик нового поколения.
13.10.2026 [13:38], Руслан Авдеев
Минцифры и Минобороны РФ занялись вопросами защиты российских ЦОДНа фоне атак беспилотников на дата-центры «Яндекса» Минцифры занялось обсуждением возможных мер противодействия подобным инцидентам с Минобороны РФ, сообщает «Интерфакс». При этом базовая функциональность сервисов компании сохраняется несмотря на атаки. По словам главы Минцифры Максута Шадаева, тот факт, что при таком объёме атаки сервисы продолжают функционировать, свидетельствует, что «коллеги уделили необходимое внимание и резервированию, и разнесению мощностей». Как заявил Шадаев, «Яндекс» столкнулся с «беспрецедентной атакой». Министр подчеркнул, что сейчас «Минцифры совместно с Минобороны решает вопрос прикрытия этих объектов». По его словам, возникшие проблемы помогает решать вся отрасль ЦОД страны. Дополнительно, как сообщает «Российская газета», министр сообщил парламентариям, что планируется поддерживать строительство ЦОД на востоке России: «Точно есть необходимость в стимулировании строительства дата-центров в целом по стране, ну и на Урале, и в Восточной Сибири в частности». По данным главы Минцифры, в регионах наблюдается профицит энергии, тогда как в московской агломерации сосредоточено более 80 % всех ресурсов ЦОД, поэтому стоит задача более равномерного распределения. Сегодня в России 42 проекта ЦОД находятся на разных этапах реализации и их планируется взять под персональное сопровождение. 
Источник изображения: Ben Krb/unsplash.com В последние дни от атак БПЛА пострадали дата-центры «Яндекса» в Рязанской, Калужской и Владимирской областях. Наблюдаются перебои в работе сервисов «Яндекса», а также клиентов компании, пользующихся её мощностями. По данным пресс-службы компании, ведутся работы по восстановлению работоспособности служб, техническая поддержка продолжает оказывать помощь клиентам, а с другими облачными операторами имеются договорённости об ускоренном размещении и резервировании ресурсов, в т.ч. в Selectel, K2Cloud и VK Cloud. Заявление о стимулировании строительства ЦОД на востоке России дополняет данные NF Group о том, что планы ввода мощностей ЦОД в Московском регионе опережают возможности рынка. Ещё до атак она сообщала, что в 2026 году в регионе, вероятно, введут в эксплуатацию около трети от заявленных ранее мощностей ЦОД. Для оставшихся ⅔ сроки ввода перенесены.
13.10.2026 [09:35], Руслан Авдеев
CoreWeave получит 240 МВт в индийском кампусе AdaniConneX Taloja, где развернёт NVIDIA Vera RubinCoreWeave выходит на индийский рынок. Компания намерена развернуть ИИ-облако мощностью 240 МВт в кампусе Taloja местной компании AdaniConneX в Нави-Мумбаи (Navi Mumbai) и открыть локальный офис для работы с местными заказчиками, сообщает Converge! Digest. Возможно дальнейшее масштабирование проекта. Это первый инфраструктурный проект компании в Индии — компания последовательно осваивает всё новые рынки Азиатско-Тихоокеанского региона. Проект предусматривает использование трёх зданий ЦОД по 80 МВт с возможностью расширения в будущем до 480 МВт, CoreWeave выступит единственным арендатором. Компания развернёт новейшую платформу NVIDIA Vera Rubin. Первая очередь должна заработать в середине 2028 года. Объекты в кампусе Taloja специально разработаны для использования высокоплотной ИИ-инфраструктуры с применением СЖО (DLC) без испарительных систем. Равные доли в AdaniConneX принадлежат Adani Enterprises и EdgeConneX. Компания строит инфраструктуру крупных ЦОД в Индии, комбинируя возможности Adani в сфере инфраструктуры и энергетики с опытом EdgeConneX в сфере строительства дата-центров. Для индийского рынка ЦОД проект означает масштабное объединение местной инфраструктурной платформы и оператора облачных ИИ-вычислений глобального уровня. 
Источник изображения: C Rayban/unsplash.com Ранее CoreWeave уже объявила о намерении развернуть в Индонезии три ЦОД общей мощностью 360 МВт, а также в иных локациях за пределами Северной Америки и Европы. То есть общая мощность проектов в Азиатско-Тихоокеанском регионе составит около 600 МВт, причём оба региональных проекта должны заработать в 2028 году. CoreWeave стала одним из первых получателей систем на VR200 NVL72.
13.10.2026 [02:00], Владимир Мироненко
Microsoft представила ИИ-ускорители Azure Maia 300, которые помогут ей снизить зависимость от NVIDIAMicrosoft представила Azure Maia 300 — кастомный ИИ-ускоритель третьего поколения. По словам компании, это полноценная интеллектуальная система, созданная для новых типов ИИ-задач: обработки длинных контекстов, диалогового взаимодействия с жёсткими требованиями к задержке и выполнения длительных многоэтапных задач с использованием автономных агентов. Эффективность обработки таких задач достигается благодаря балансу между вычислительной мощностью, пропускной способностью памяти (ПСП), сетевыми возможностями и энергоэффективностью в масштабах облака. Благодаря повышению общей эффективности системы, Maia 300, по прогнозам компании, будет обрабатывать на 40 % больше токенов на мегаватт мощности по сравнению с ведущими системами на базе GPU. А в максимальной конфигурации с 96 ускорителями пропускная способность обработки токенов на уровне стойки будет всемеро выше, чем у Maia 200. 
Источник изображений: Microsoft Microsoft утверждает, что Maia 300 обеспечивает лучшую в отрасли ПСП/Вт для HBM, примерно вдвое выше в сравнении с Maia 200. Восемь стеков с 288 Гбайт HBM4 поддерживают пиковую ПСП 18,0 Тбайт/с при TDP 950 Вт, что позволяет эффективно запускать крупные модели и обрабатывать задачи с большим контекстом. А встроенную SRAM можно использовать в качестве программно-управляемой буферной памяти (scratchpad), снижая нагрузку на HBM. Это позволяет размещать больше данных модели и KV-кеша в непосредственной близости от вычислительных блоков. 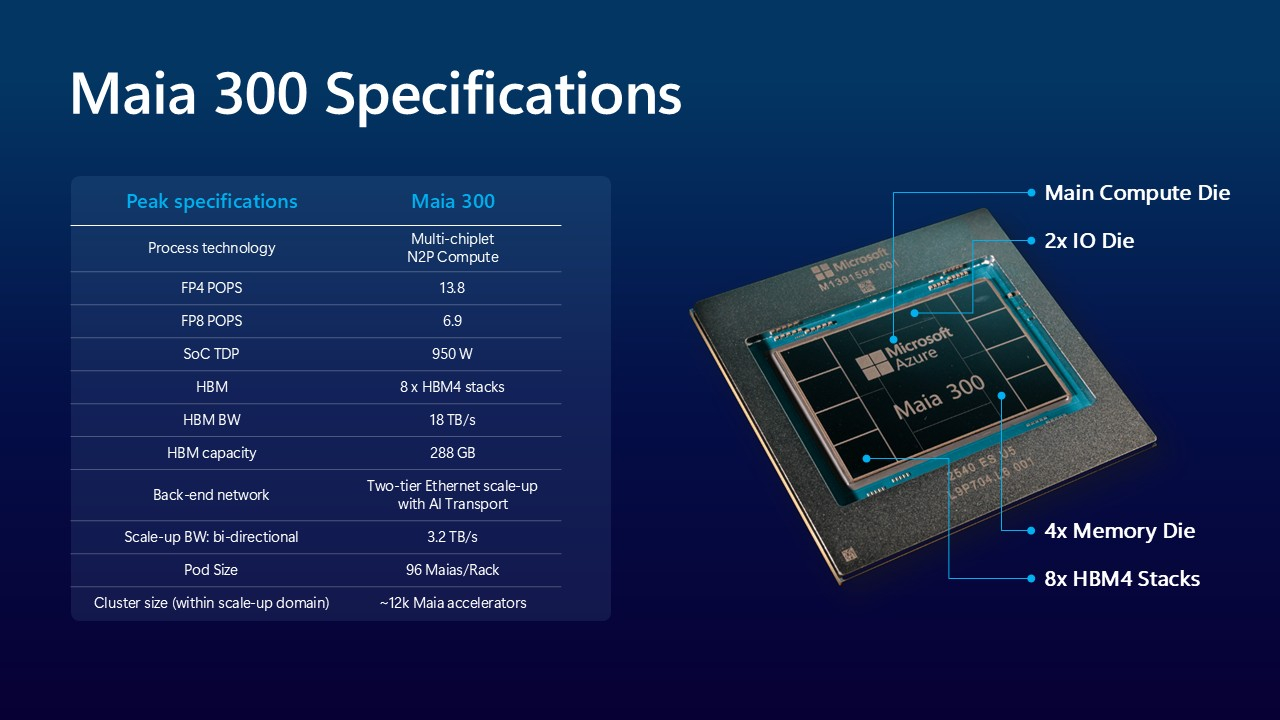 Новая архитектура на базе чиплетов разделяет функции вычислений, управления памятью и I/O, что улучшает эффективность, масштабируемость и экономические показатели. Вычислительные чиплеты производятся по техпроцессу TSMC N2P. Они дополнены интерфейсом PCIe 6.0 x16 и 32 интерфейсами 400GbE, которые используются в качестве основного интерконнекта для связи между ускорителями. 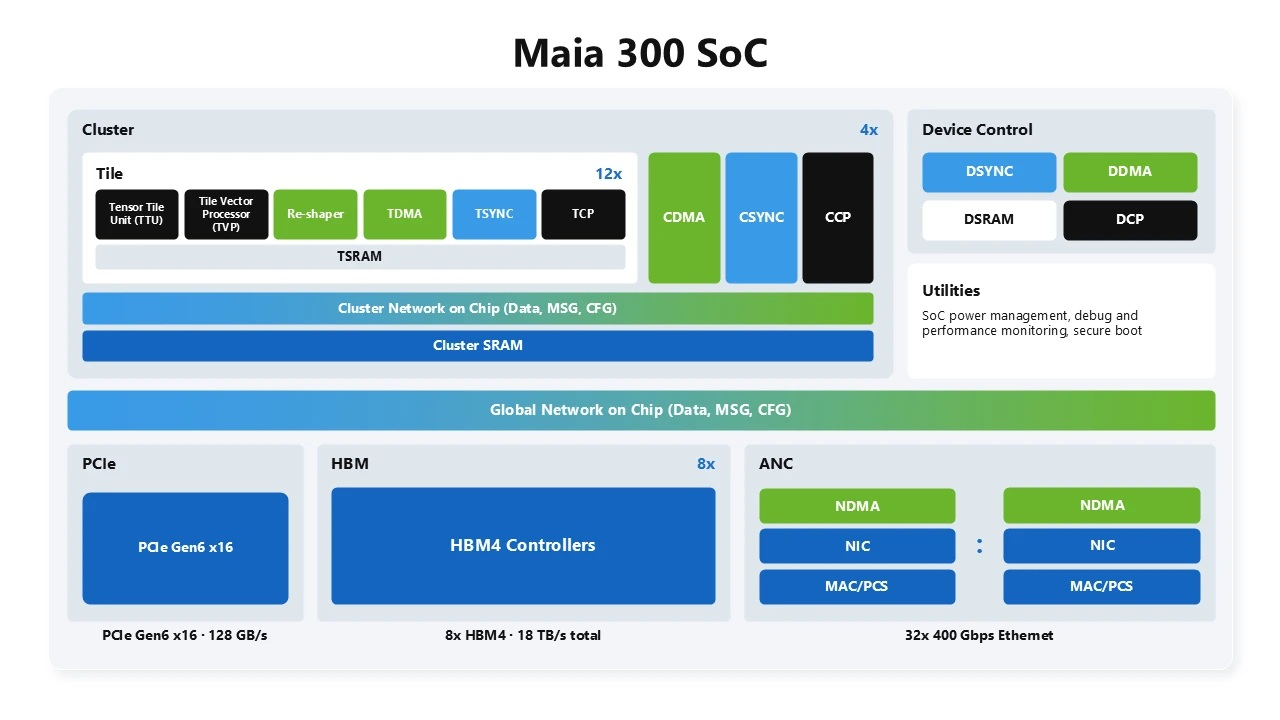 Чип поддерживает форматы с низкой точностью вычислений, такие как улучшенная версия MXFP4. Благодаря этому для хранения KV-кеша требуется меньше памяти, что позволяет увеличить размер контекстного окна. FP4-производительность Maia 300 составляет более 13,8 Пфлопс (у Maia 200 — 10,1 Пфлопс), в FP8-вычислениях — 6,9 Пфлопс (у Maia 200 — 5,1 Пфлопс). Одна стойка вмещает 96 ускорителей и потребляет 167 кВт. В совокупности они обеспечивают 27,6 Тбайт памяти HBM с агрегированной ПСП 1,7 Пбайт/с. Для сравнения: стойки NVIDIA GB300 вмещают 72 ускорителя и потребляют около 142 кВт, сообщает Reuters. 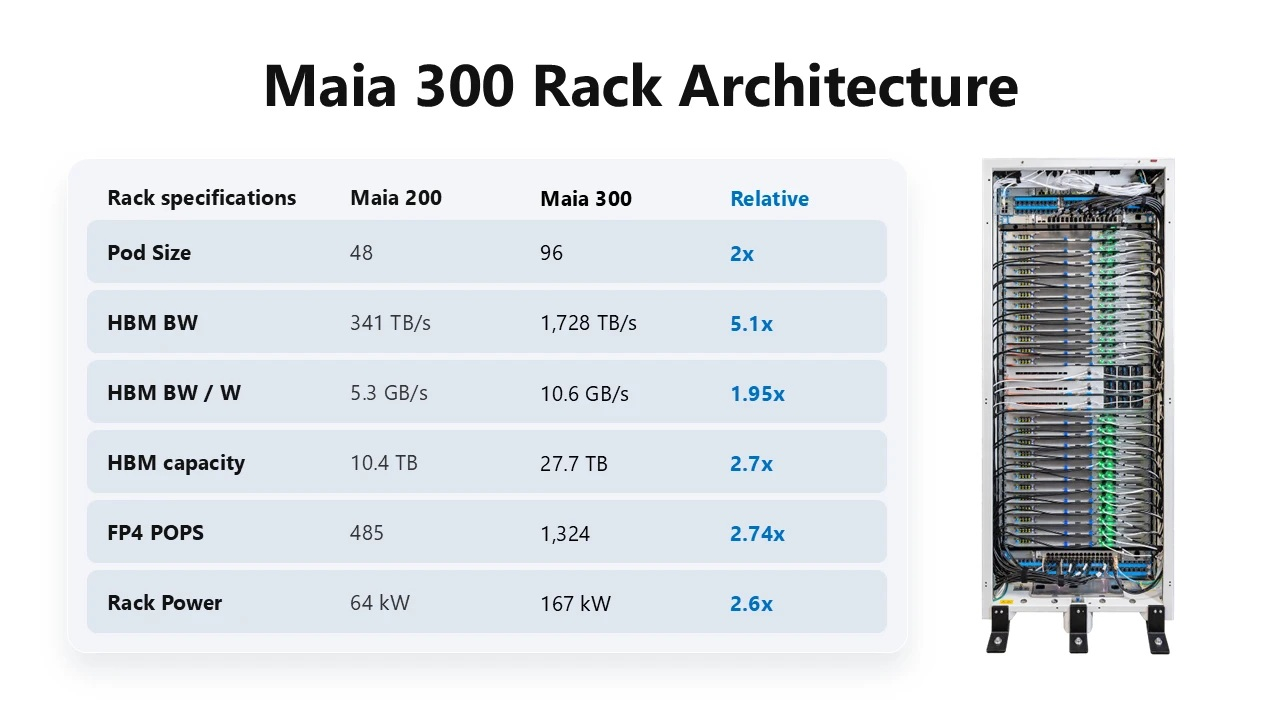 Ускорители распределены по 24 узлам, по четыре ускорителя в каждом; это вдвое увеличивает плотность размещения по сравнению с Maia 200. Каждый узел также включает хост-процессор, системную память, хранилище и систему охлаждения. Отказ от использования отдельных узлов для хост-процессоров позволяет высвободить место в стойке и управлять ресурсами питания и охлаждения как единой системой. 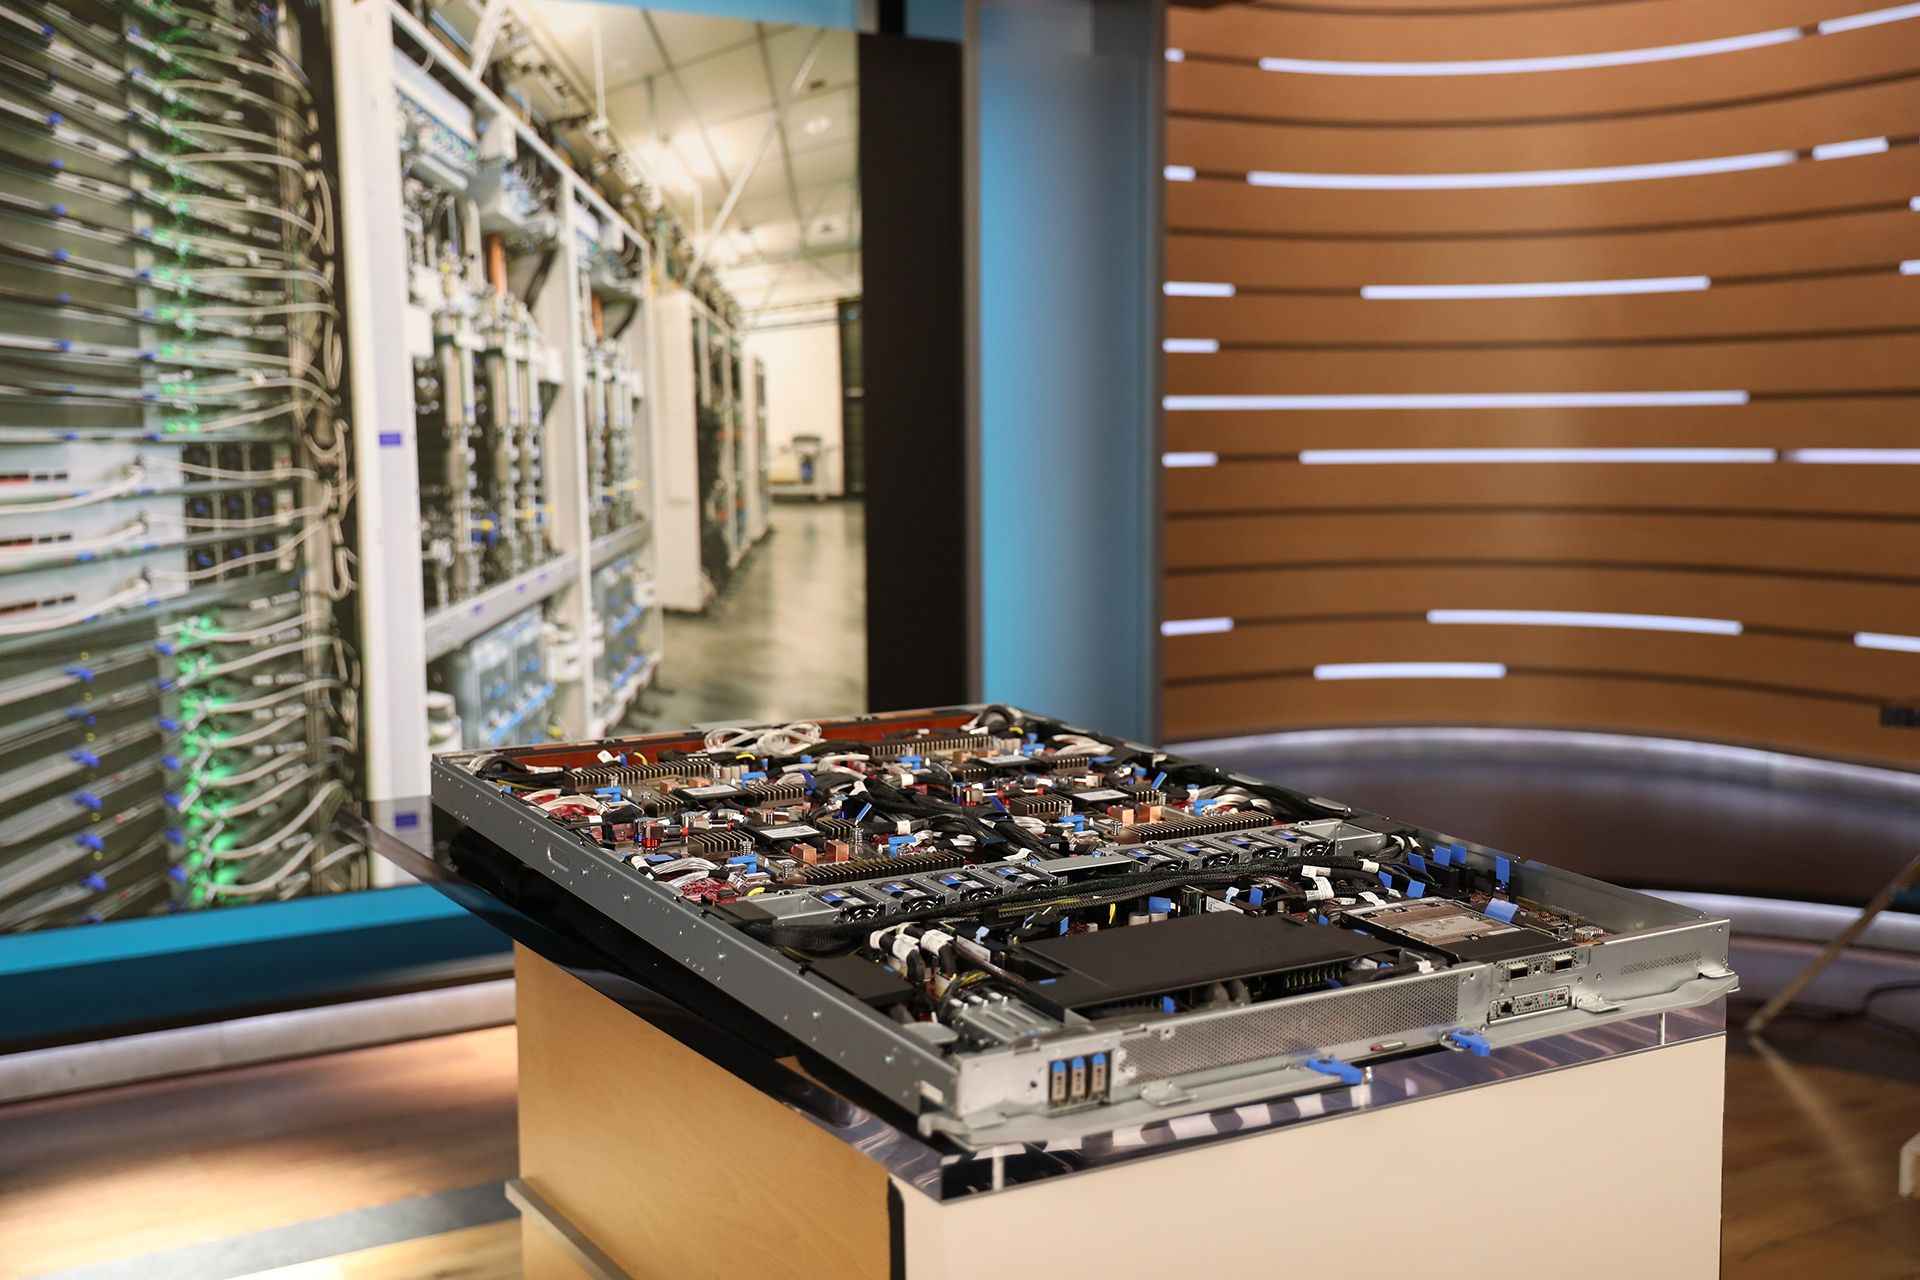 Шесть специализированных ASIC коммутации с высокой плотностью портов (high-radix) интегрированы в три модуля с жидкостным охлаждением. Это обеспечивает необходимые внутристоечные соединения для всех 96 ускорителей, минимизируя при этом занимаемое пространство и энергопотребление системы коммутации. Интерконнект оптимизирован для тензорного параллелизма, использует собственный протокол (на базе Ethernet) и позволяет легко масштабировать инфраструктуру от одной стойки до целого ЦОД. 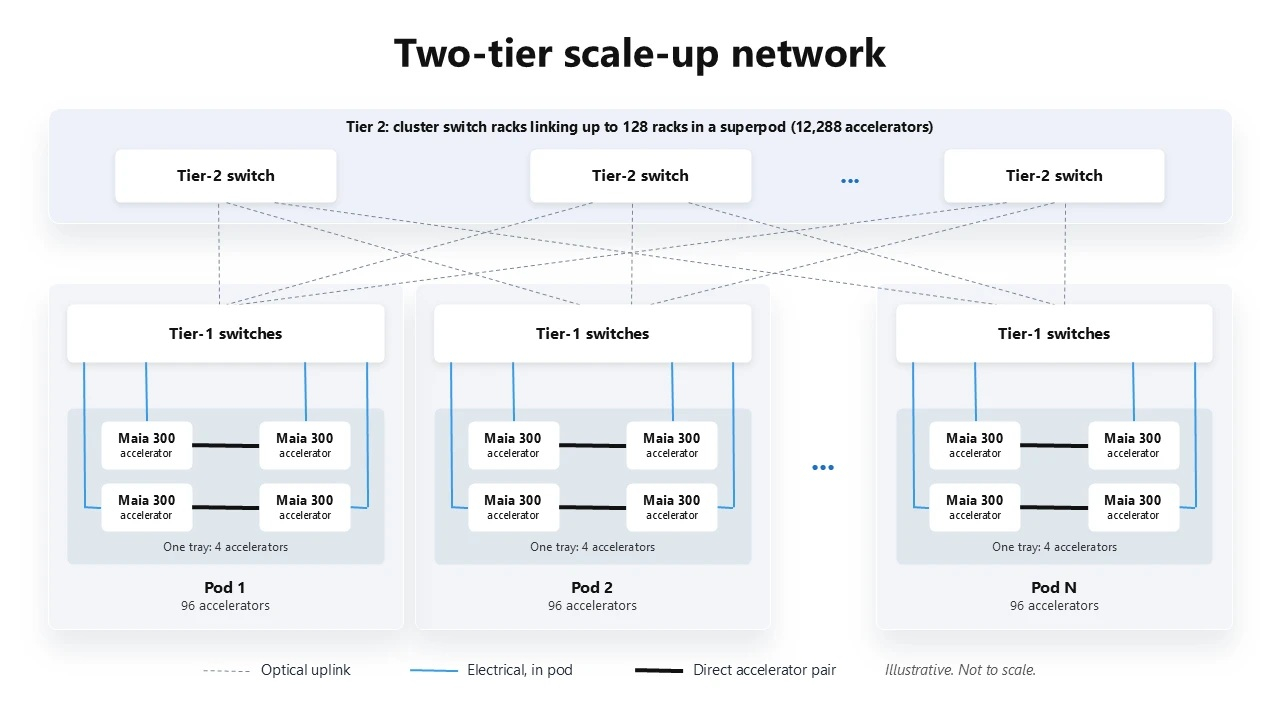 Двухуровневая сеть (scale-up) позволяет создать высокопроизводительный кластер (super pod), объединяющий до 12 288 ускорителей. Для ПО Maia представляет единую модель коммуникации: одни и те же семантические принципы используются для прямой передачи данных любому ускорителю в пределах кластера. Ускорители Maia могут напрямую инициировать обмен данными с любым ускорителем в кластера без участия хост-процессора или отдельного NIC для горизонтального масштабирования (scale-out). 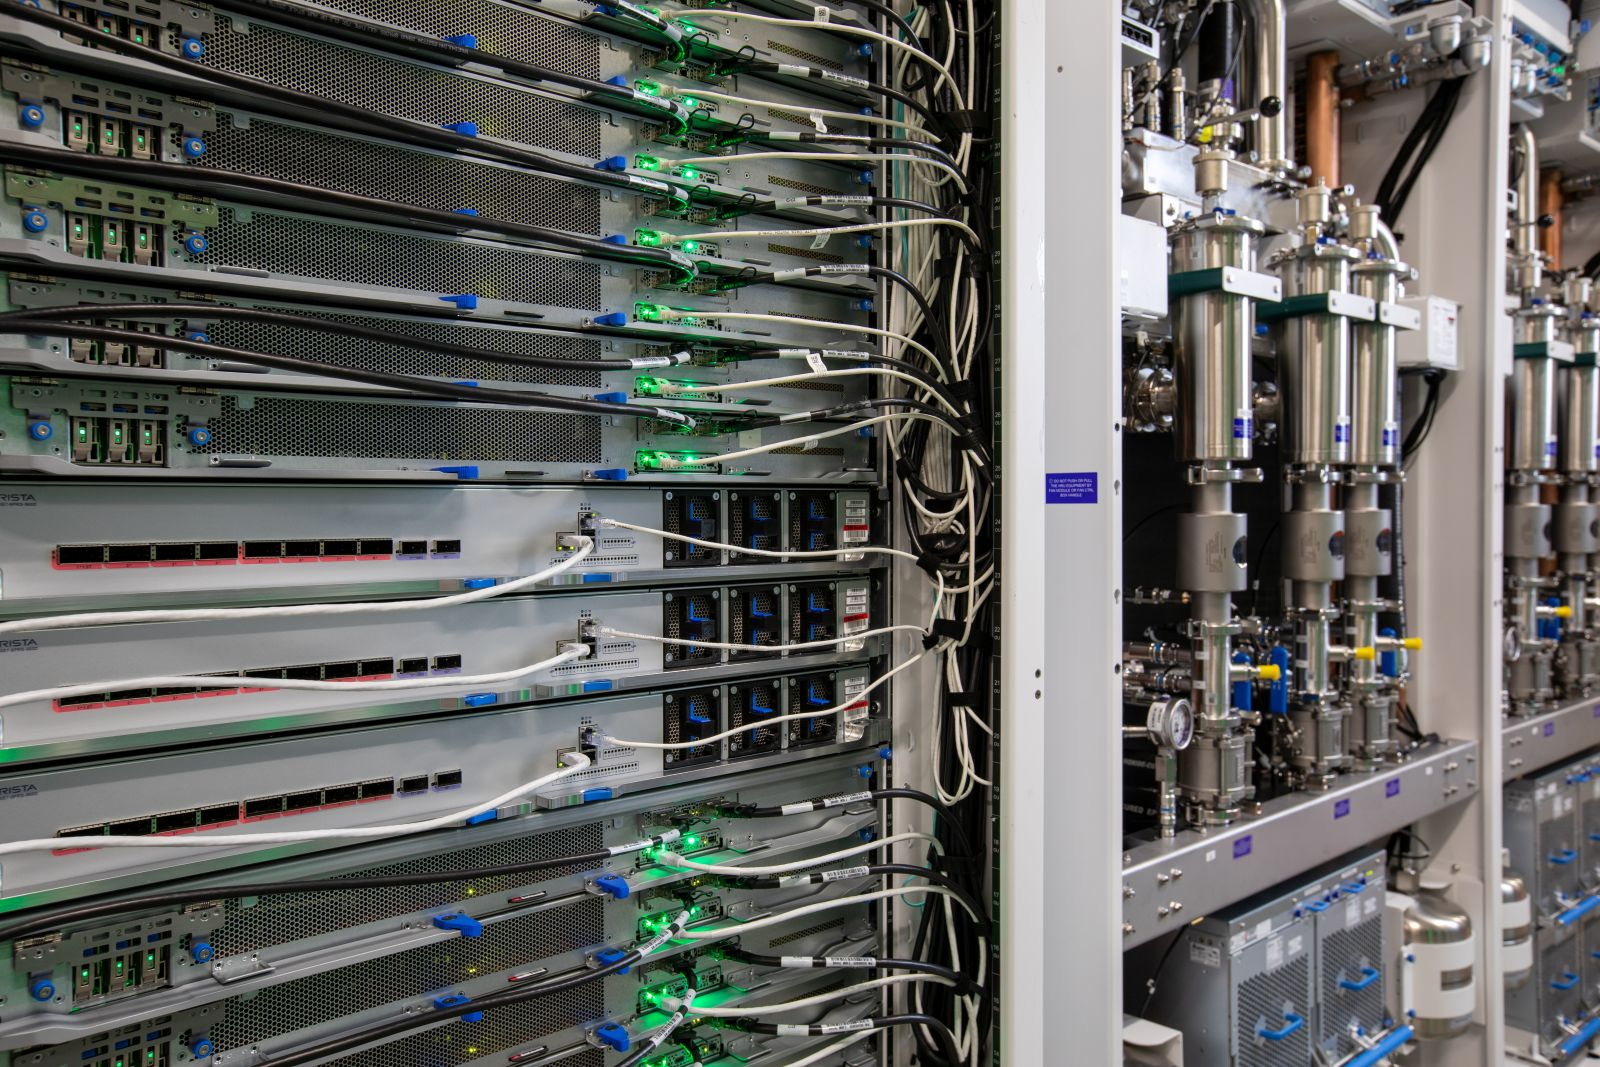 СЖО отводит более 80 % тепловой нагрузки стойки (от ускорителей, VRM и ASIC коммутаторов), в то время как воздушное охлаждение используется для модулей памяти, накопителей и других вспомогательных компонентов. Стойка Maia 300 может подключаться непосредственно к системе водообеспечения объекта (при её наличии) или использовать теплообменики в дата-центрах с воздушным охлаждением. Это обеспечивает большую гибкость в выборе мест и способов масштабного развёртывания системы. Такая плотность позволяет Microsoft обрабатывать больше одновременных запросов ИИ и выполнять более масштабные задачи на каждой стойке, повышая общую мощность дата-центра и улучшая экономическую эффективность расширения ИИ-сервисов. И если прошлые поколения Maia не смогли полноценно заменить системы NVIDIA, то Microsoft планирует масштабировать инфраструктуру Azure с Maia 300 до нескольких гигаватт, начиная с 2027 года, сделав новинки основной платформой для инференса в продуктах и сервисах компании.
12.10.2026 [21:40], Владимир Мироненко
AMD «загнала» ИИ-агентов в стойку HelionAMD представила эталонный проект AMD Helion для агентных систем, выполненный в форм-факторе серверной стойки ORv3 высотой 44OU. По словам компании, Helion, созданный на основе спецификаций Open Compute Project (OCP), является дальнейшим развитием подхода к открытой платформе, заложенном в решении AMD Helios. 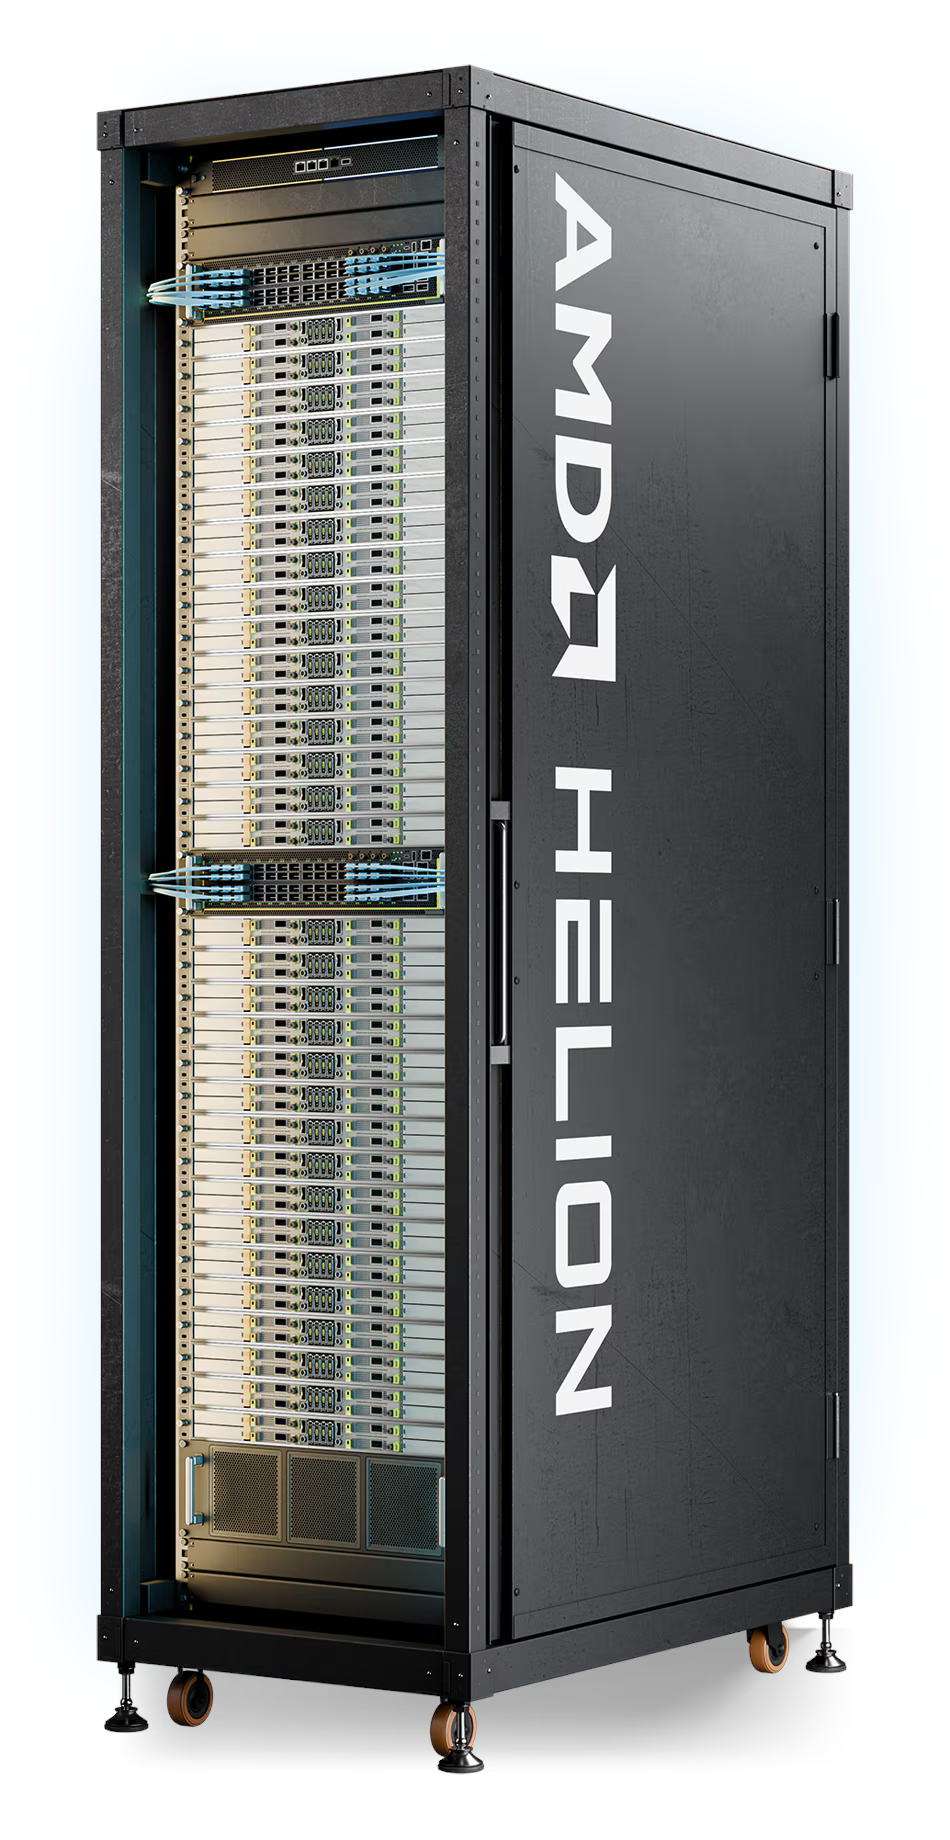
Источник изображений: AMD С помощью AMD Helion заказчики смогут оптимально сочетать производительность CPU, плотность ядер и энергопотребление с возможностями ускорения на базе GPU, исходя из специфики задач, выполняемых ИИ-агентами. Решение может поставляться как на базе исключительно CPU (для гиперскейлеров), так и с интеграцией CPU/GPU (для корпоративного сектора). 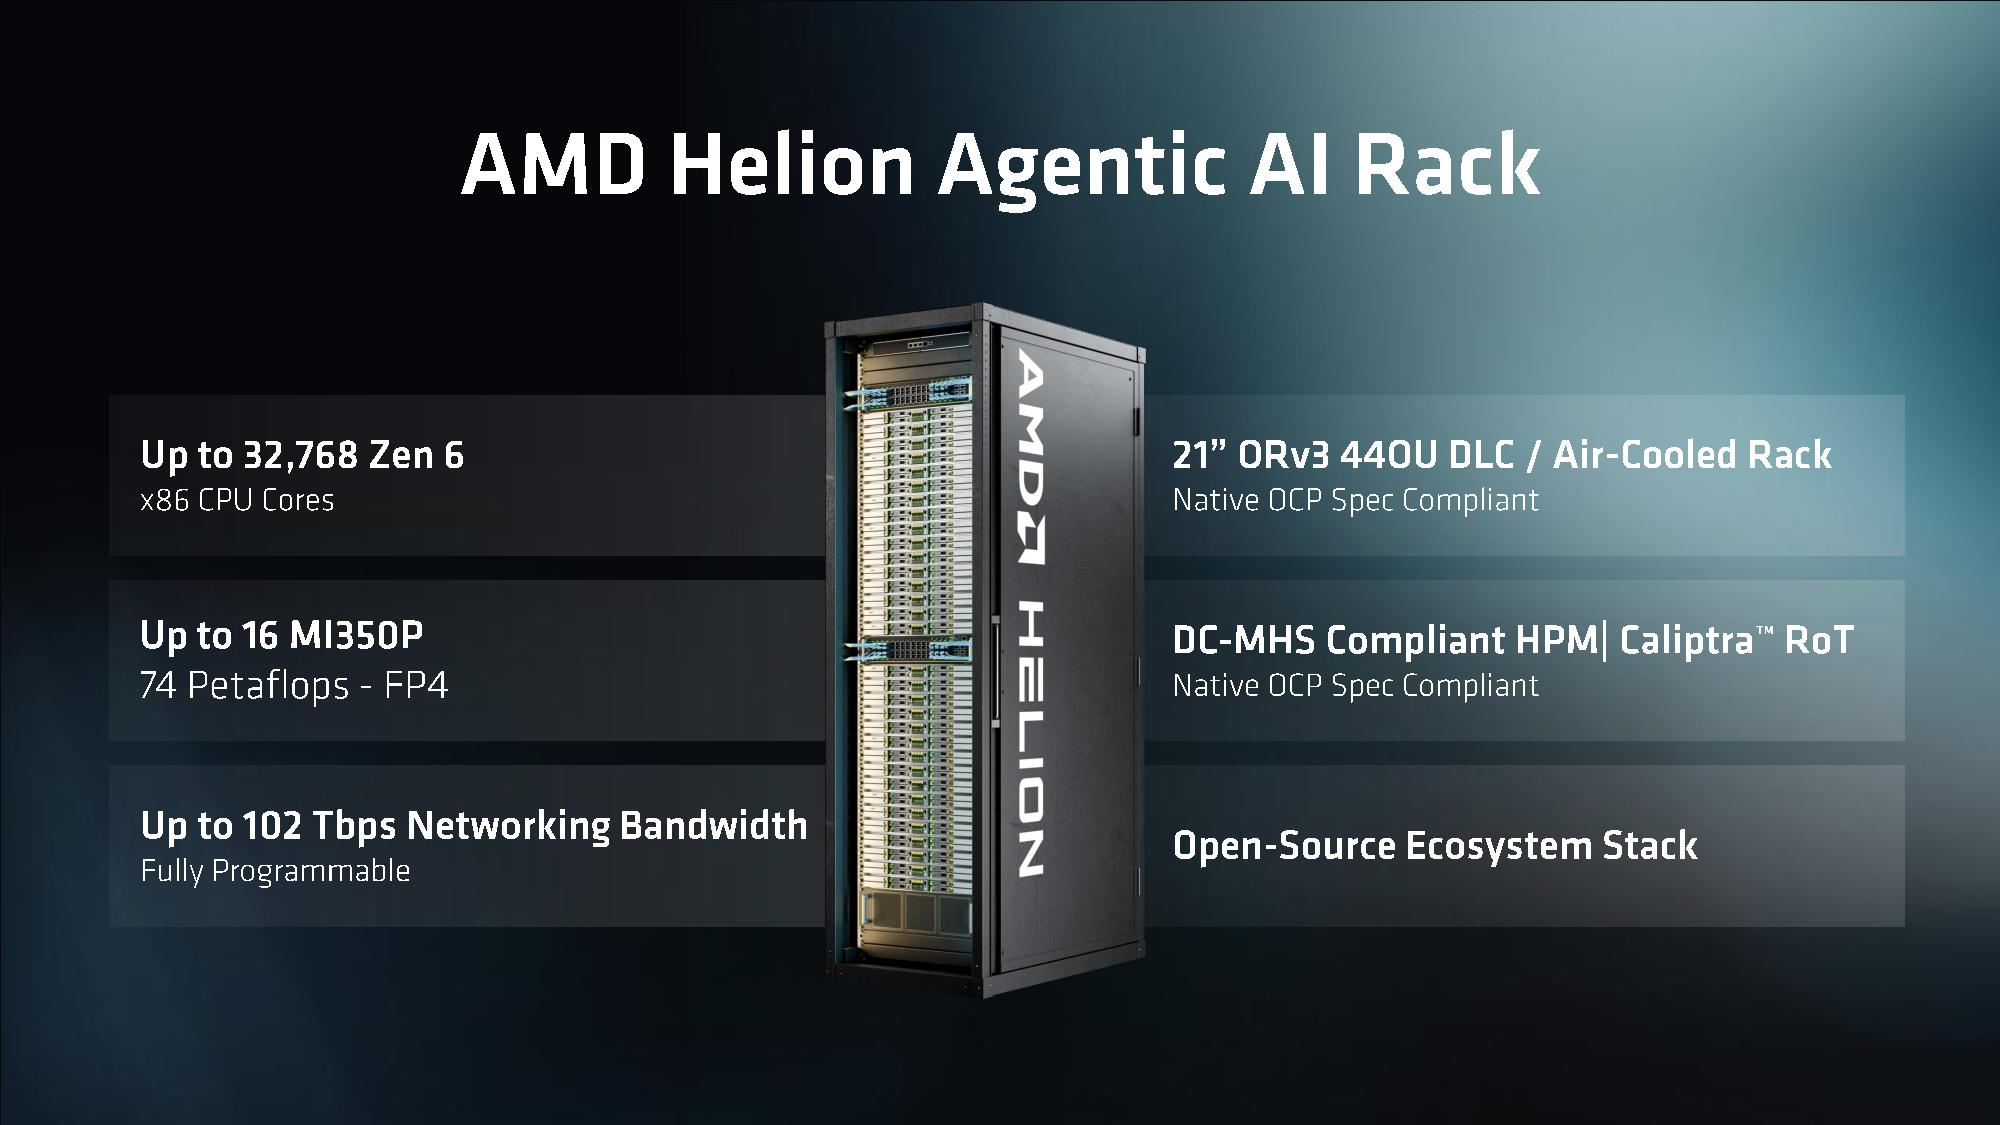 OCP-архитектура стойки AMD Helion поддерживает открытое ПО и допускает различные варианты конфигурации, включая версии с жидкостным и воздушным охлаждением. Это позволяет заказчикам создавать практически любые системы, отвечающие их конкретным требованиям. 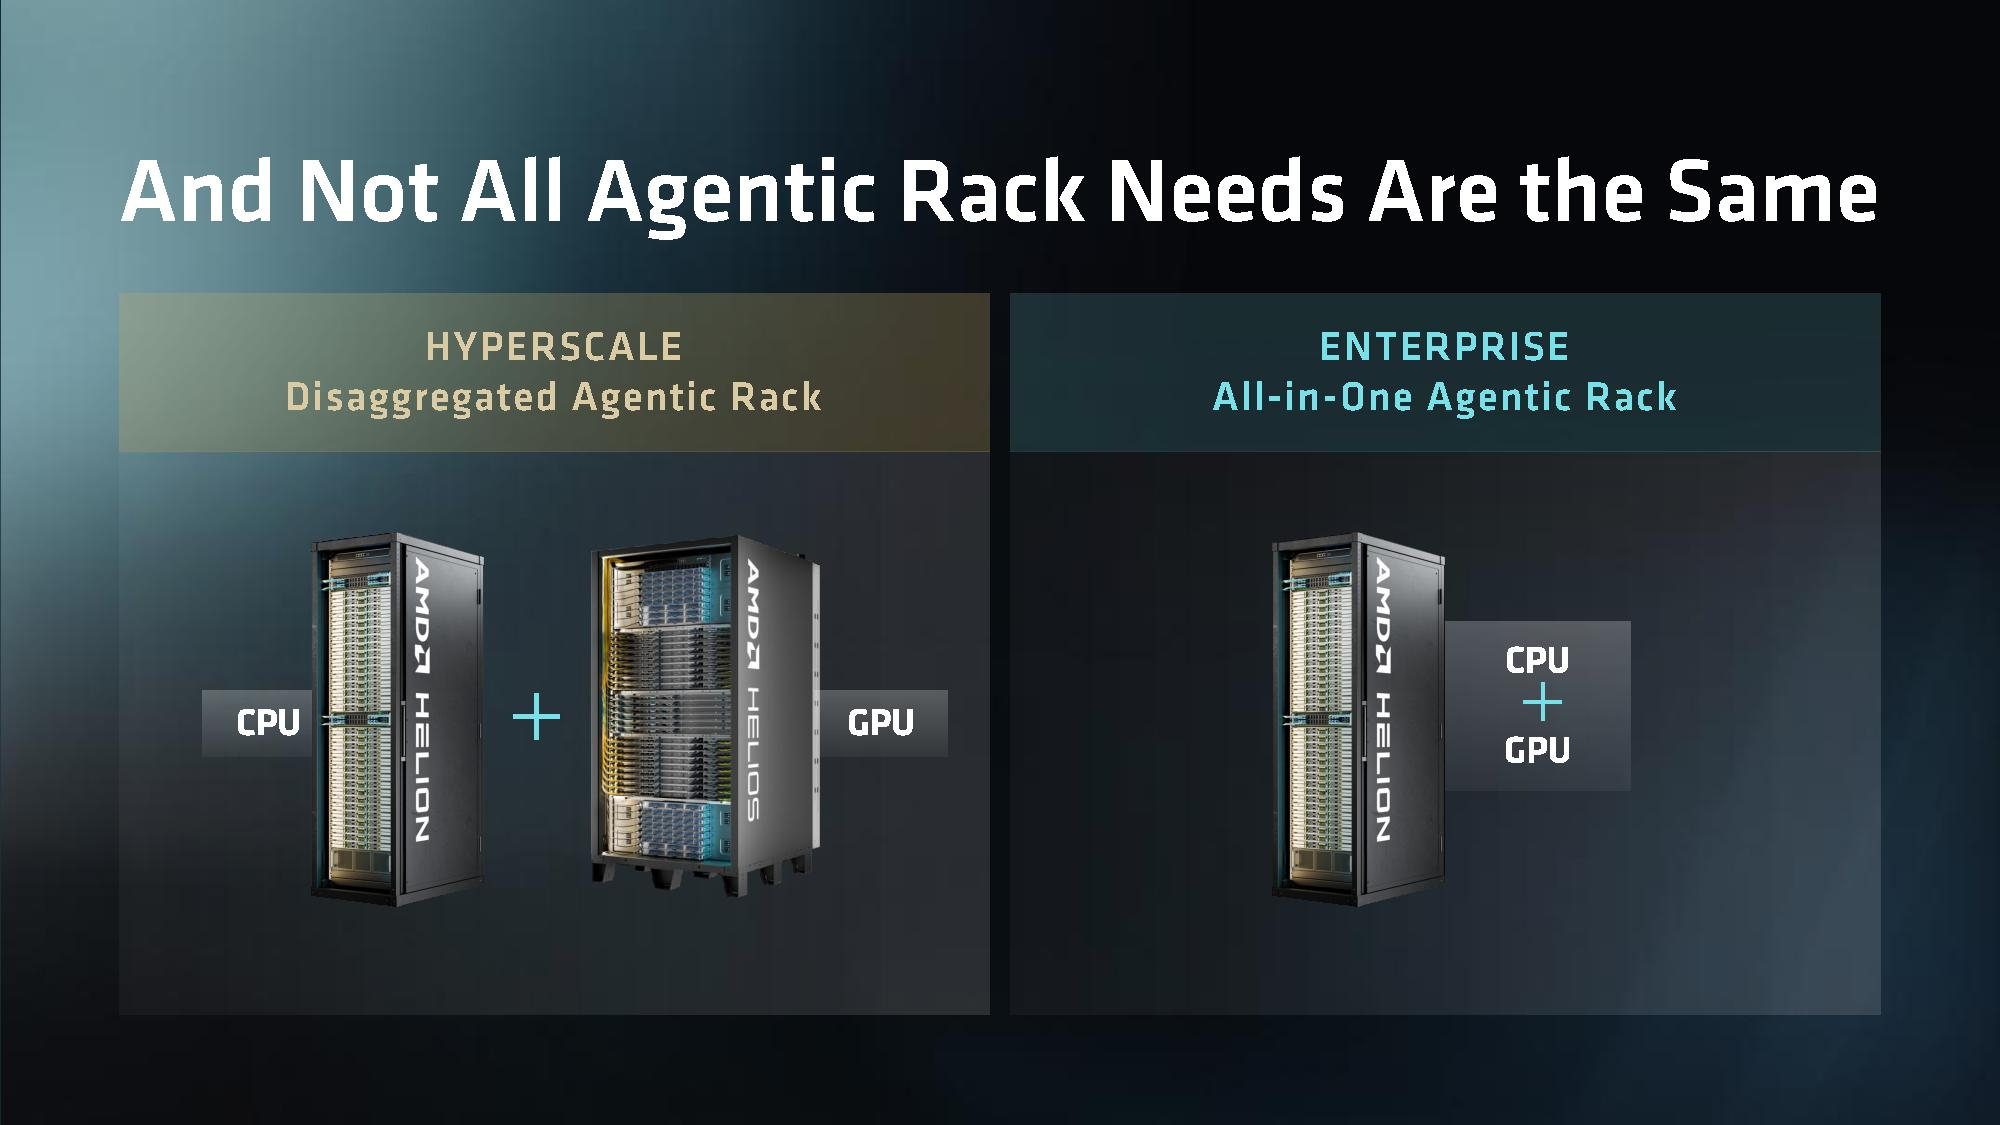 Например, стойка, использующая только CPU (на базе AMD EPYC Venice) и поддерживающая до 32 768 ядер, предназначена для систем гиперскейлеров. Она обеспечивает выделенные мощности для выполнения задач агентов, а также возможность подключения к отдельной инфраструктуре для инференса моделей. 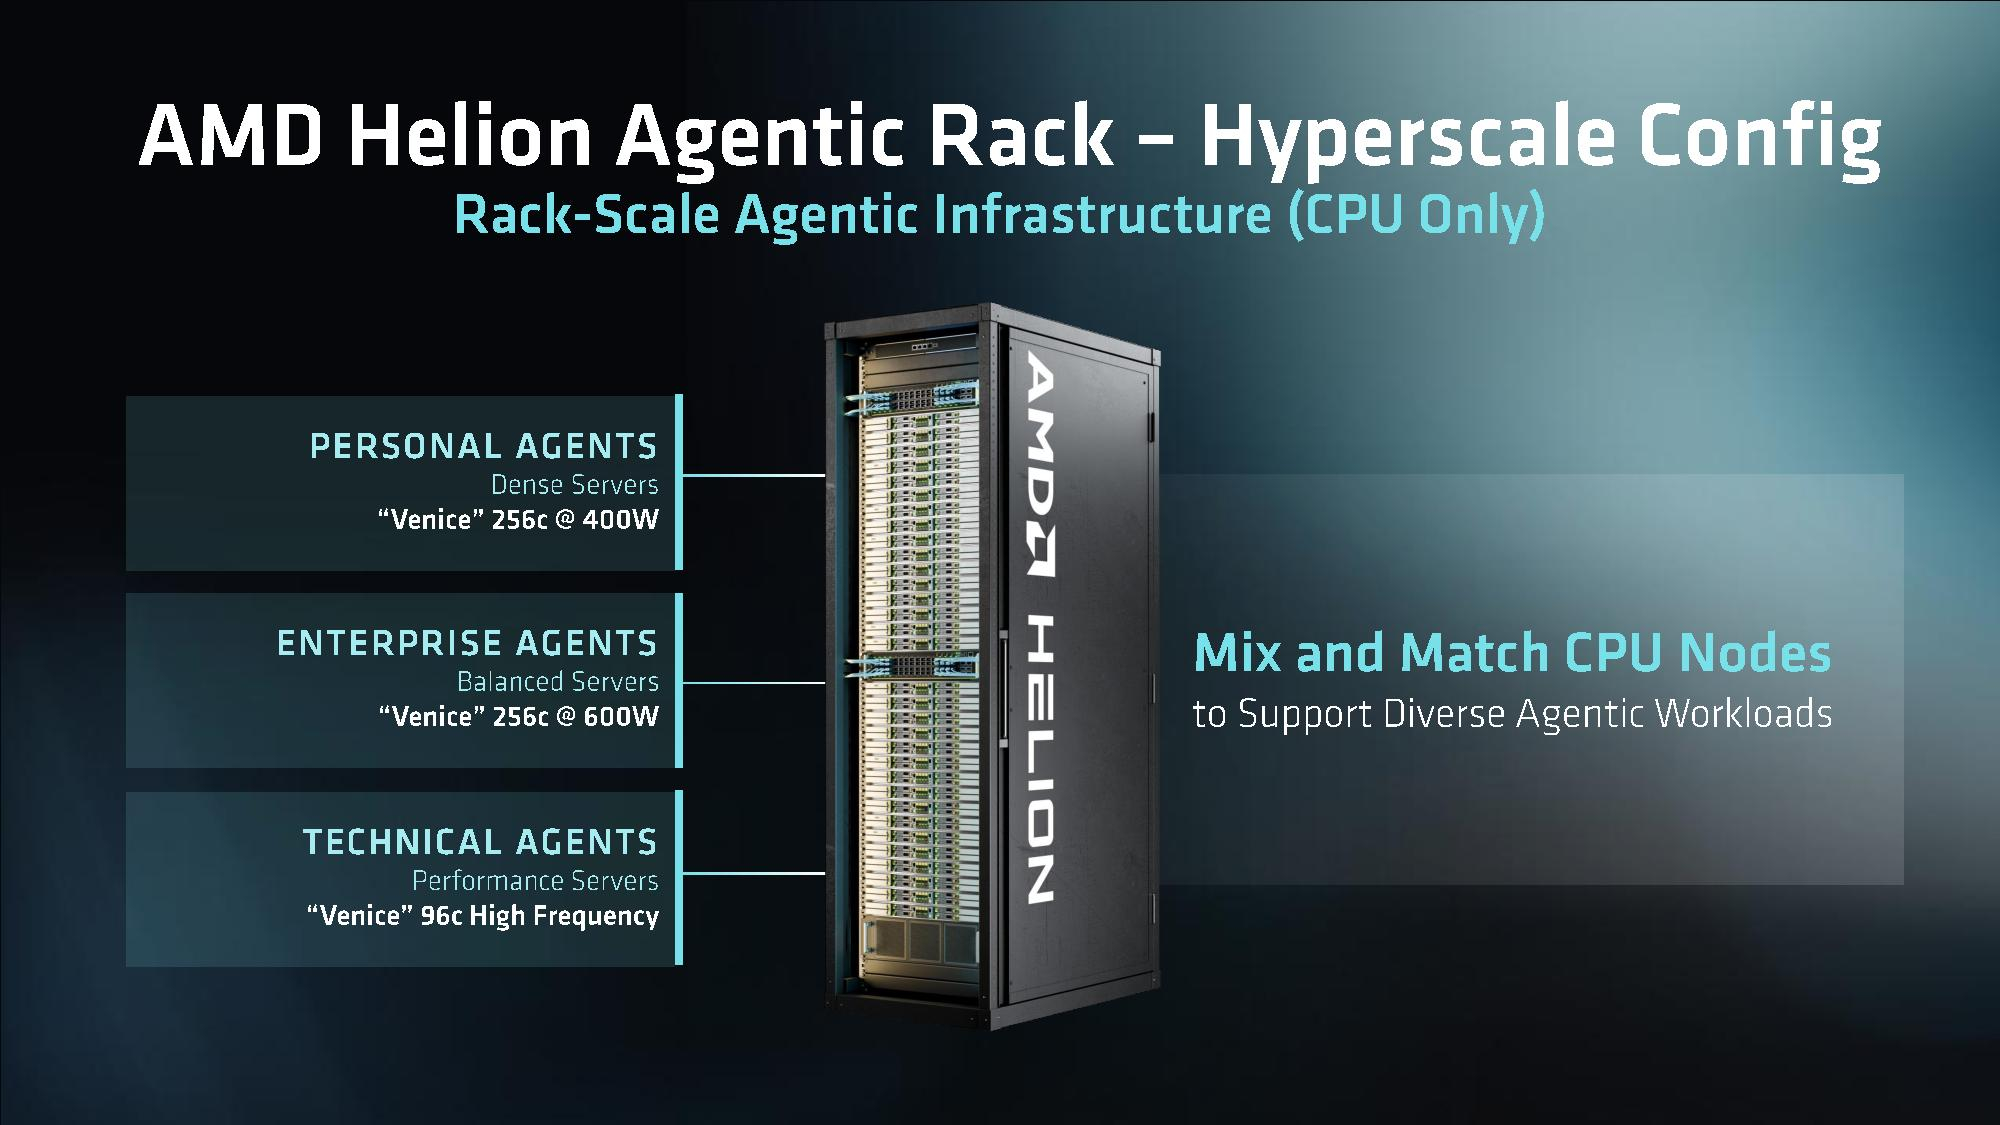 В свою очередь, комплексное стоечное решение, объединяющее на одной платформе узлы с EPYC, узлы с Instinct MI350P (до 16 единиц), интерконнект с пропускной способностью до 102,4 Тбит/с и вычислительные ресурсы общего назначения, представляет собой универсальный вариант для внедрения агентного ИИ корпоративного уровня. 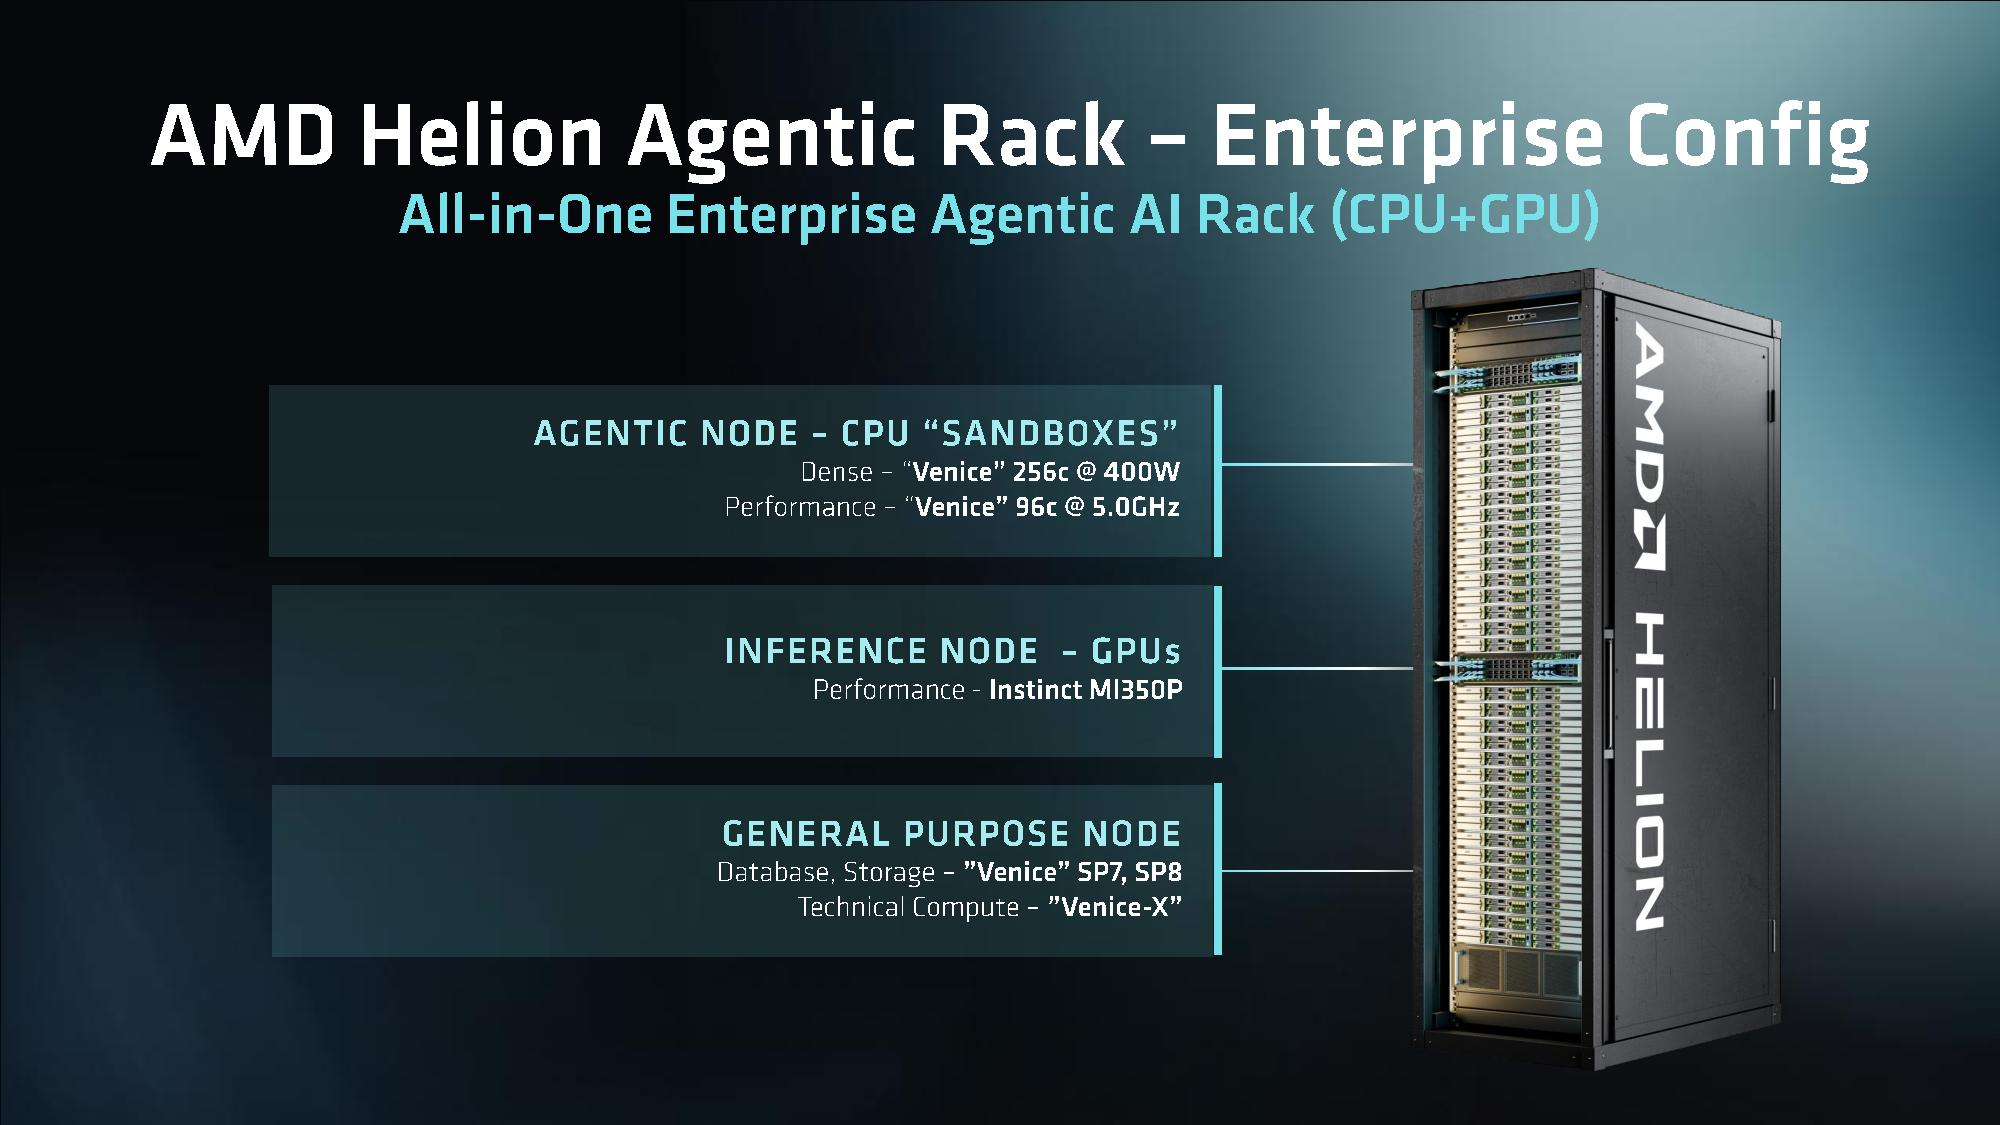 AMD Helion позволяет клиентам развёртывать системы агентного ИИ в рамках уже имеющейся ИТ-инфраструктуры, адаптируя конфигурации CPU и GPU под конкретные рабочие нагрузки и подбирая оптимальное соотношение ресурсов для выполнения задач агентов, инференса моделей и вспомогательных вычислений с учётом требований к производительности, энергопотреблению и стоимости. 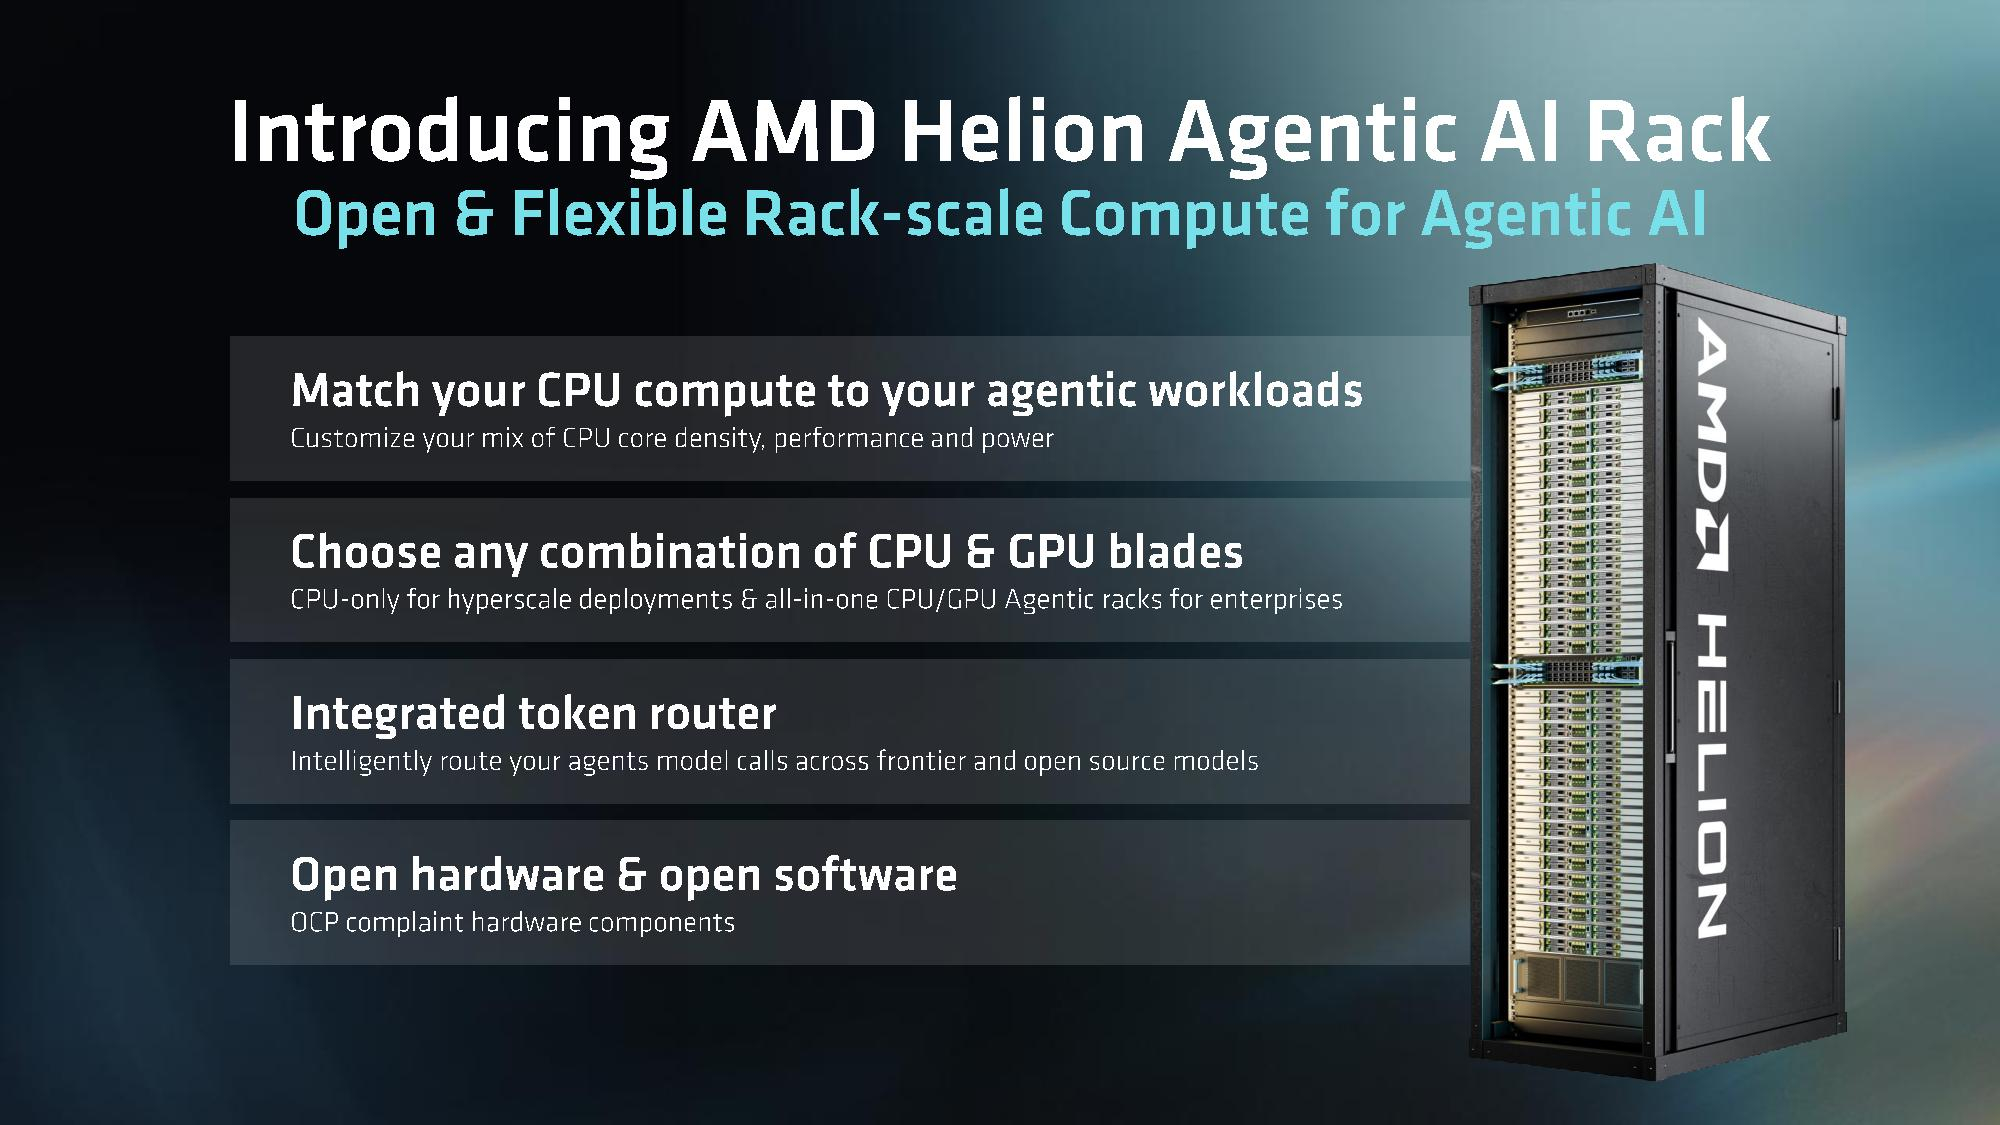 AMD сообщила, что планирует передать спецификацию AMD Helion организации OCP (Open Compute Project), сделав её доступной для сообщества с целью дальнейшей разработки и внедрения. Конфигурации стоек AMD Helion для агентного ИИ в настоящее время разрабатываются совместно с партнёрами по экосистеме; их выпуск запланирован на ноябрь 2026 года.
12.10.2026 [17:42], Сергей Карасёв
С 800 В до 6 В в один присест: Navitas и Microchip создали преобразователь напряжения для ИИ-стоекКомпании Microchip Technology и Navitas Semiconductor разработали эталонный дизайн преобразователя напряжения с 800 В на 6 В в соответствии со стандартом OCP. Решение, как ожидается, поможет в переходе на архитектуру LVDC, ориентированную на дата-центры нового поколения для задач ИИ. Платформа объединяет цифровое управление питанием и технологии безопасности от Microchip с силовыми компонентами Navitas GaNFast на основе нитрида галлия (GaN). Обеспечивается преобразование напряжения 800 В непосредственно в 6 В — минуя промежуточный этап в 50 В. Это существенно сокращает потери и повышает сквозную эффективность системы. Используются 16 транзисторов GaNFast FET (NV6034, 650 В, 17 мОм) в топологии «каскадный полумост». Корпус DFN 8 × 8 мм с двухсторонним охлаждением снижает тепловое сопротивление. Пиковая эффективность достигает 96 % при полной нагрузке на частоте переключения 1 МГц. Удельная мощность заявлена на уровне 2100 Вт/дюйм3. 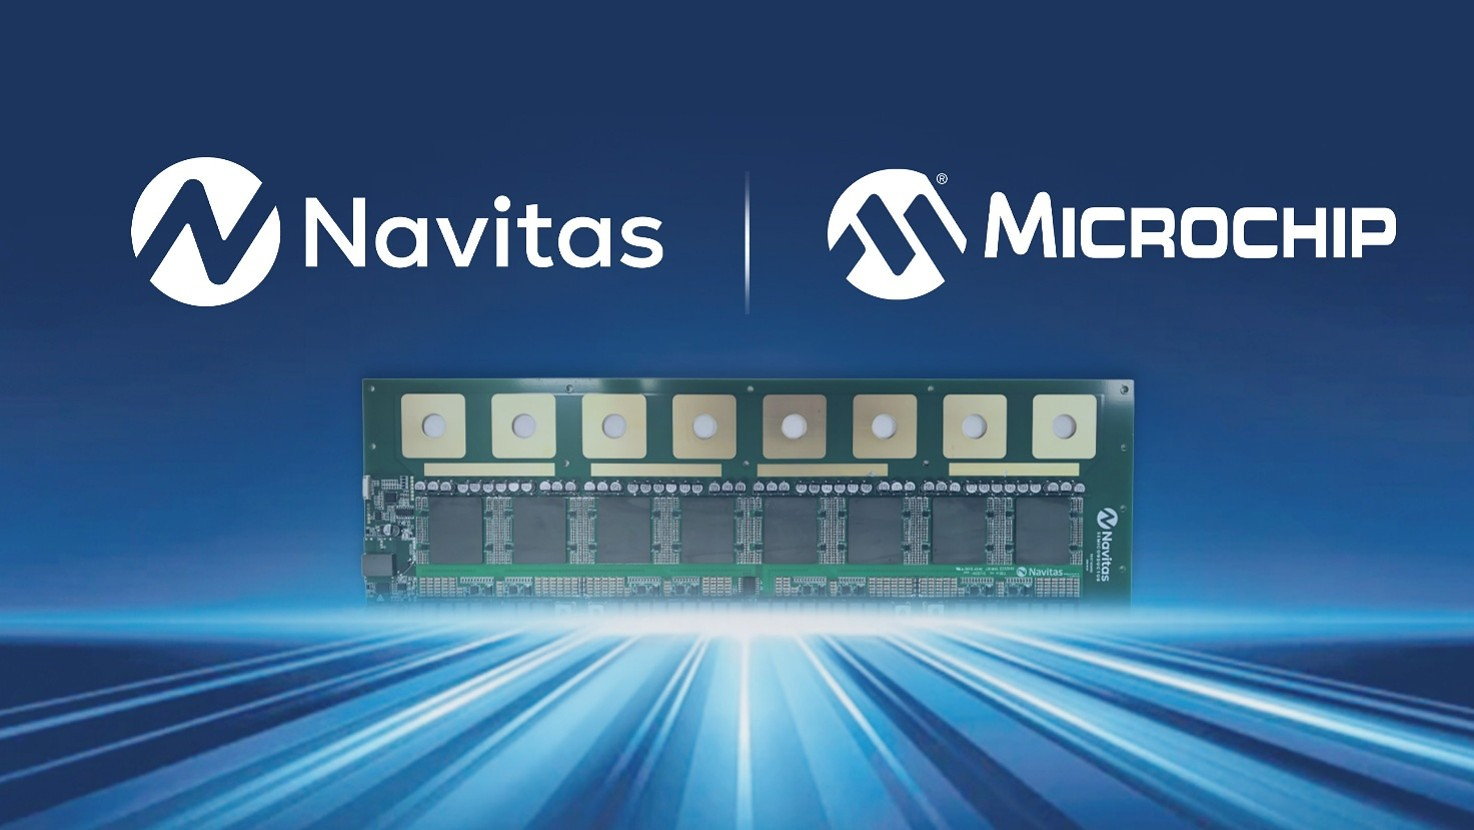
Источник изображения: Microchip В составе платформы задействованы микроконтроллеры Microchip dsPIC33AK256MPS306 с 32-бит ядром (200 МГц), модулем вычислений с двойной точностью (FPU), высокоточными ШИМ-блоками с временем отклика 78 пс и 12-битными АЦП со скоростью до 40 MSPS. Поддерживаются постквантовые криптографические алгоритмы в рамках пакета Commercial National Security Algorithm (CNSA) Suite 2.0, а также аппаратно-ускоренные криптографические функции для подключённых систем управления в реальном времени. За безопасность отвечает микросхема шифрования Microchip TA100 CryptoAuthentication: на её основе реализованы такие функции, как аутентификация кода и безопасная загрузка (Secure Boot), генерация кодов аутентификации сообщений (MAC), защищённое обновление встроенного ПО и поддержка протоколов управления ключами, включая TLS.
12.10.2026 [17:35], Сергей Карасёв
Renesas представила передовой GaN-чип для преобразователей питания в ИИ ЦОДКомпания Renesas Electronics анонсировала изделие TP65H020G4PLSGBD D-Mode для преобразователей питания в современных дата-центрах, ориентированных на ИИ. Это, как утверждается, первое в отрасли устройство на основе нитрида галлия (GaN) с поддержкой напряжения 650 В и двусторонним охлаждением. Новинка спроектирована с прицелом на архитектуру 800В DC (LVDC) — это новый стандарт распределения питания постоянного тока внутри ЦОД. Чип выполнен в сверхкомпактном корпусе PQFN с размерами 8 × 8 мм, а сопротивление в открытом состоянии составляет всего 20 мОм — один из лучших показателей в данном классе. Представленное решение базируется на силовых транзисторах GaN Gen IV Plus: эта технология создана для высокомощных систем энергоснабжения, требующих экстремальной энергоэффективности и компактности. Благодаря возможности отвода тепла как с верхней, так и с нижней стороны чипа тепловое сопротивление верхней стороны сокращается на 10 % по сравнению со стандартными изделиями. 
Источник изображения: Renesas Electronics Новое устройство разработано для нагрузок мегаваттного класса, характерных для ИИ ЦОД нового поколения с напряжением питания до 700 В. Чип ориентирован на каскад промежуточных преобразователей шины (IBC) 800 В постоянного тока в 48 В, 12 В или 6 В, а также на узлы резервного питания от батарей (BBU) и конденсаторных модулей (CBU). Renesas уже подтвердила эффективность предложенного решения на аппаратном уровне. В частности, эталонный DC/DC-преобразователь (IBC) топологии LLC мощностью 6 кВт со схемой включения постоянного трансформатора (DCX) для преобразования напряжения 800 В в 48 В достигает удельной мощности 2,6 кВт/дюйм3. При этом эффективность при полной нагрузке на 0,21 % выше, чем у аналогичного устройства на транзисторах в корпусе TOLT. |
|

