
Материалы по тегу:
|
22.09.2026 [23:59], Руслан Авдеев
К 2050 году из-за ИИ контейнеры с электронными отходами смогут шесть раз опоясать ЗемлюСогласно докладу, представленному НКО Basel Action Network (BAN), к 2050 году электронными отходами от ИИ-инфраструктуры можно будет заполнить цепочку морских контейнеров, способную шесть раз опоясать Землю, сообщает The Register. Хотя эти отходы, как ожидается, будут направлены на утилизацию, авторы отмечают тот факт, что существующие оценки в десятки раз занижают масштаб проблемы. Ранее при оценках внимание уделялось в основном серверам и ускорителям, на которые по массе приходится всего 13 % оборудования ЦОД. Если учитывать системы распределения энергии, резервные источники питания, охлаждение, сетевое оборудование и прочую инфраструктуру, отходов может и вовсе оказаться в 40–60 раз больше, чем прогнозируют сегодня известные эксперты. Всего речь идёт о 7 тыс. т отходов для условного ИИ ЦОД мощностью 100 МВт — при модернизации объекта значительная часть оборудования подлежит замене. В докладе How Big Is the AI Waste Wave? Исходят из заявленных отраслью планов строительства новых объектов. На основе этих планов рассчитывается потенциальный объём отходов, который, вероятно, возникнет благодаря ИИ-буму. С 2025 по 2050 гг. на ИИ-инфраструктуру придётся 395–617 млн т электронных отходов, которыми можно заполнить 15–23 млн морских контейнеров. Даже 20 млн поставленных друг за другом контейнеров растянутся на 244 тыс. км, что примерно в шесть раз больше длины окружности Земли. 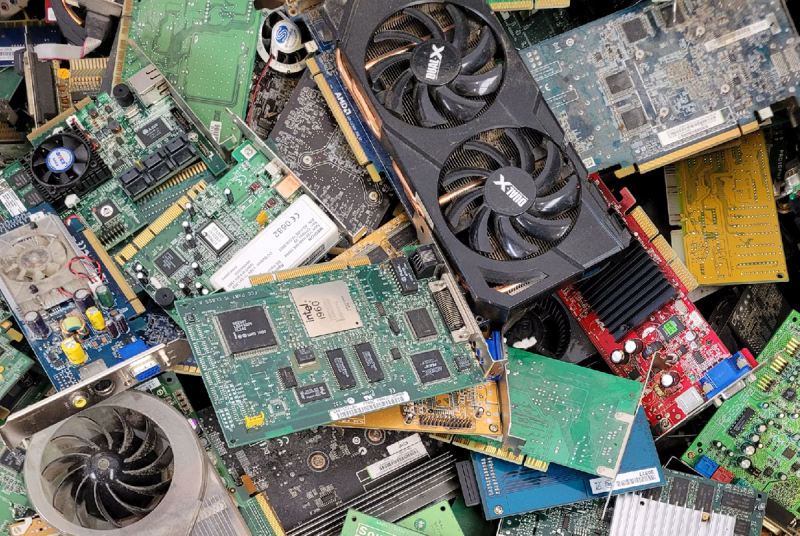
Источник изображения: Nathan Cima Оценка учитывает несколько допущений. Предполагается, что медь, сталь, охлаждающее и электрораспределительное, а также сетевое оборудование и вычислительные модули в современных ЦОД будут работать по несколько лет, а не десятилетиями — поскольку технологии будут морально устаревать. Так, при замене стоек мощностью 5–15 кВт на стойки 50–140 кВт, поддерживающие ИИ-нагрузки, придётся заменить и большую часть силовой инфраструктуры. Только в кабелях и шинопроводах ЦОД на 100 МВт содержится 2,7 тыс. т меди. ИИ-ускорители, по оценкам BAN, приходится менять каждые два-три года, тогда как у «классических» серверов жизненный цикл составляет порядка в 5–7 лет. Модель предполагает, что владельцы меняют серверы целиком, поскольку OEM-производители обычно поставляют полностью собранное и предварительно сконфигурированное системы. Для прочего оборудования циклы обновления разнятся. Так, для сетевой инфраструктуры цикл составляет 3–4 года, системы распределения электропитания меняют раз в восемь лет, а резервного электропитания — раз в пять лет, как и системы охлаждения. Это лишь первый доклад из серии исследований. Второй, как ожидается, позволит оценить возможности переработки и повторного использования компонентов для снижения электронных отходов. Третий посвятят потенциальной токсичности таких компонентов, включая загрязнение PFAS-химикатами, а четвёртый — способам снижения связанных рисков. Пока что ни один гиперскейлер или международная структура не публиковали планов переработки и использования электронных отходов в прогнозируемых НКО масштабах. Подчёркивается, что существующей инфраструктуры не хватает даже для безопасной переработки отходов в нынешних объёмах. По словам BAN, до сих пор связанные с ИИ дискуссии уделяли основное внимание электроснабжению, углеродным выбросам и водопользованию, в основном, не рассматривая вопрос того, что происходит непосредственно с оборудованием. В организации подчёркивают, что масштабное строительство ИИ-инфраструктуры может привести к катастрофическому кризису, если бизнес и власти не будут планировать действий в отношении «цунами отходов».
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 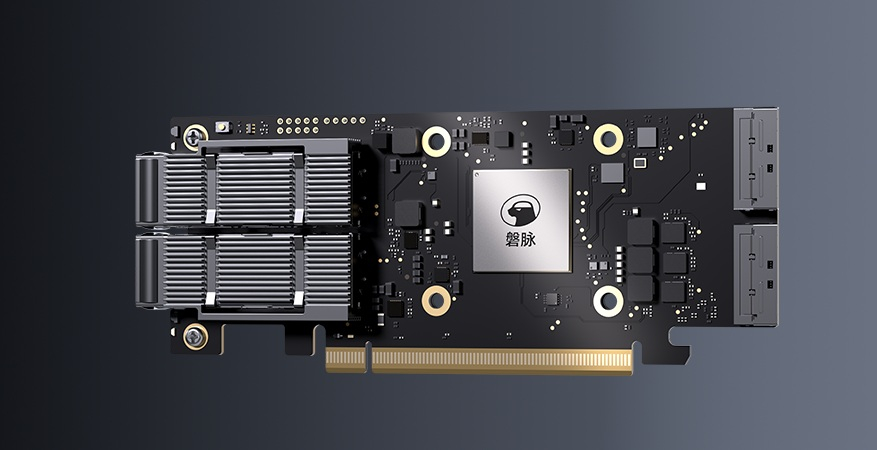
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
22.09.2026 [15:40], Сергей Карасёв
Huawei представила ИИ-систему Atlas 960E SuperPoD на базе UnifiedBus и NPOHuawei анонсировала ИИ-систему Atlas 960E SuperPoD. Это, как утверждается, первый в отрасли кластер с технологией NPO (Near-Packaged Optics), предназначенный для работы с большими языковыми моделями, насчитывающими до 10 трлн параметров. В составе Atlas 960E SuperPoD применяются оптические модули Hi-ONE на базе NPO. Данная технология предполагает монтаж оптического движка в виде отдельного узла на плате рядом с ASIC: преимуществами подхода являются снижение задержек и энергопотребления, а также возможность замены компонента при выходе из строя. Пропускная способность достигает 7,2 Тбит/с. Atlas 960E SuperPoD может оснащаться ИИ-ускорителями Huawei Ascend 960, включая будущие изделия 960DT и 960PR. Посредством NPO могут быть связаны до 4096 карт: в случае Ascend 960DT суммарная FP4-производительность составит до 16 Эфлопс. При этом 5500 оптических движков Hi-ONE могут заменить 48 тыс. традиционных оптических модулей стандарта 800G. Это снижает энергопотребление более чем на 550 кВт, одновременно удваивая время безотказной работы системы: показатель доступности достигает 99,8 %. 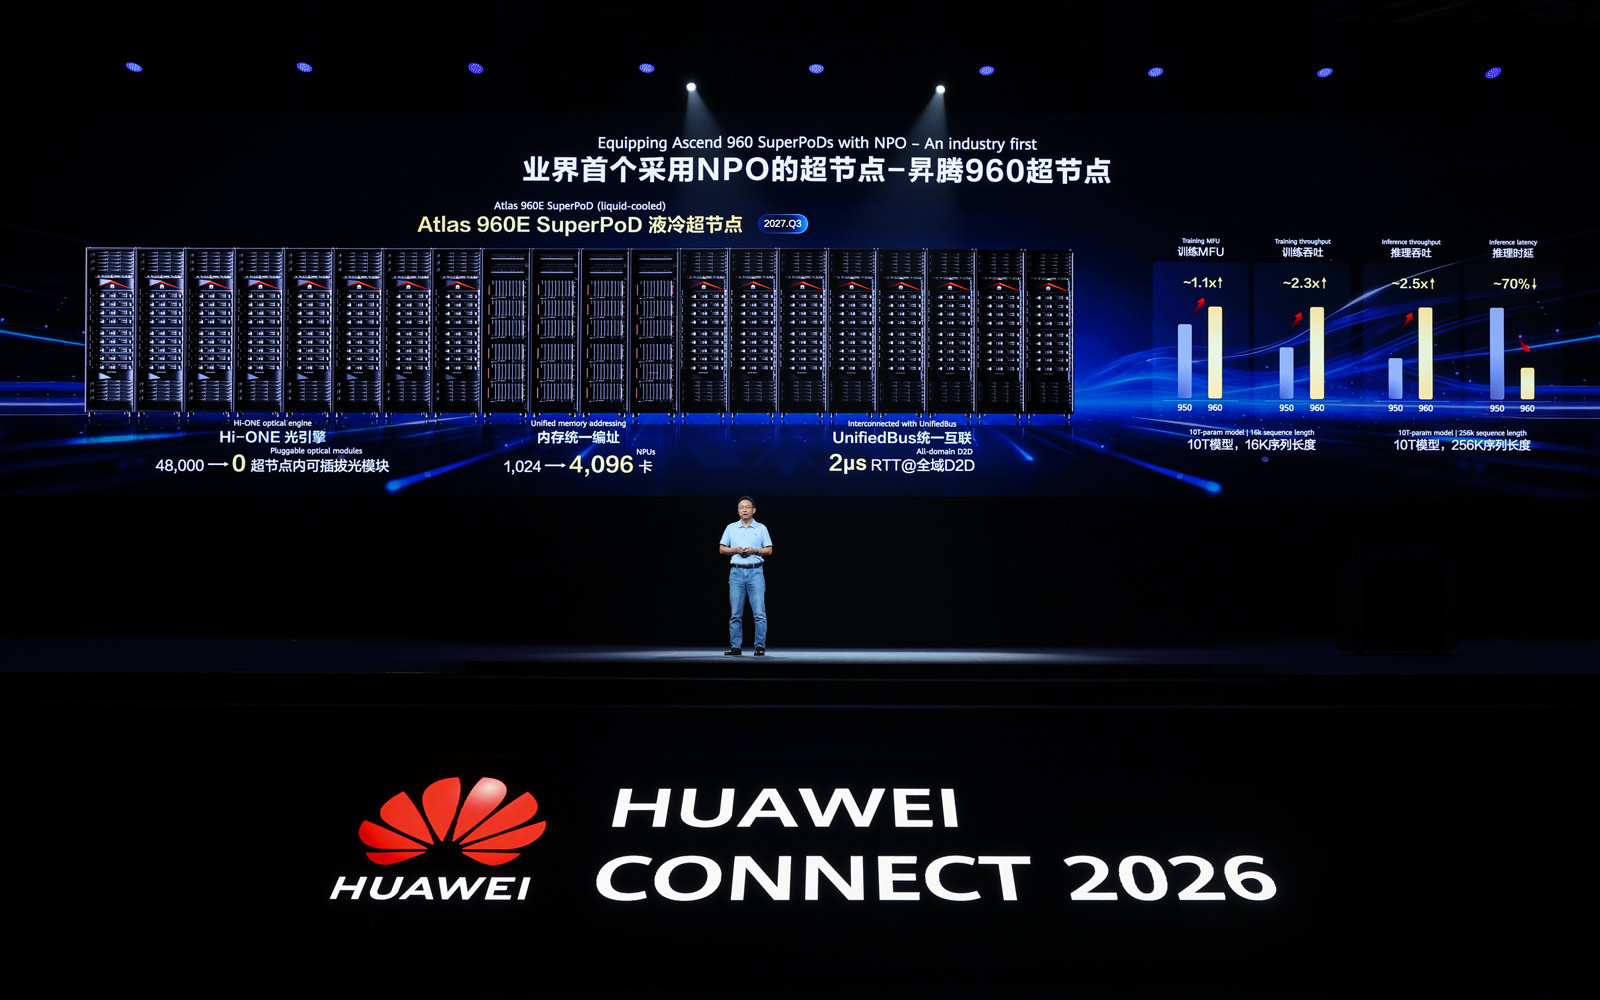
Источник изображения: Huawei Платформа предполагает применение интерконнекта нового поколения UnifiedBus (UB), который обеспечивает пропускную способность в несколько Тбайт/с и задержку (RTT) на уровне 2 мкс. UnifiedBus даёт возможность сформировать единый пул памяти объёмом до 256 Тбайт. Через сеть UnifiedBus и RoCE отдельные экземпляры SuperPoD можно объединять в суперкластеры (SuperCluster). В частности, двухуровневая четырёхплоскостная архитектура Clos позволяет связать воедино до 512 тыс. NPU. А в сочетании с топологией Multi-rail такой кластер может насчитывать до 1 млн ускорителей.
22.09.2026 [15:38], Руслан Авдеев
Петабит через Атлантику: Meta✴ анонсировала сверхбыстрый подводный интернет-кабель PetalКомпания Meta✴ анонсировала кабель Petal, названный «первой трансокеанской системой с пропускной способностью 1 Пбит/с». Кабель через Атлантику протяжённостью порядка 7 тыс. км свяжет США и Францию, ввод в эксплуатацию запланирован на 2029 год. Кабель получит 24 пары волокон, но отличительной особенностью Petal станет использование волокна с двумя сердцевинами в трансокеанском масштабе. Это позволит удвоить максимальную пропускную способность в сравнении с современными трансатлантическими системами, например — системой Aurora той же Meta✴, прокладка которой предусмотрена между США и Данией. В то же время в новом кабеле не предусмотрен двукратный рост энергопотребления и сопутствующей физической инфраструктуры. Также можно сравнить кабель с системой Meta✴ Anjana на 24 пары, тоже обеспечивающей около 500 Тбит/с. Из-за такого строения волокна пришлось поработать над снижением затухания сигнала при сохранении стандартного внешнего диаметра оптоволокна на уровне 125 мкм. Кроме того, потребовалась минимизация перекрёстных помех между сердцевинами. Для этого используется сверхчистый синтетический кварц и некоторые другие технические решения. За выпуск волокна отвечает японская Sumitomo. Каждая из сердцевин будет передавать трафик только в одном направлении, от Франции к США или от США к Франции. Для передачи данных используются C- и L-диапазоны. 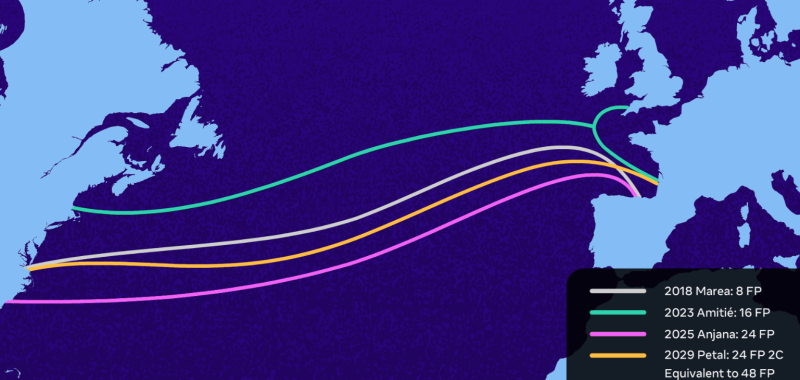
Источник изображения: Meta✴ Также компания разработала систему передовых усилителей-ретрансляторов. Обычно для маршрута длиной 7 тыс. км требуется порядка 100 модулей. Используемые в Petal ретрансляторы имеют по 96 усилителей. Сигнал из каждой сердцевины выводится и усиливается по отдельности, после чего снова «зашивается» в волокно. При этом ретрансляторы совместимы с существующими подсистемами питания на 18 кВ. Генеральным подрядчиком выбрана NEC, а за вывод кабеля на берег во Франции отвечает Orange. 
Источник изображения: Sumitomo Electric Meta✴ утверждает, что 1 Пбит/с хватит на то, чтобы около ¾ населения мира могли одновременно слушать музыку в стриминговых аудиосервисах. Подчёркивается, что при этом новые решения с высокой пропускной способностью позволяют сократить расход материалов и углеродный след, связанный с прокладкой системы — если сравнить его со строительством двух по 500 Тбит/с. 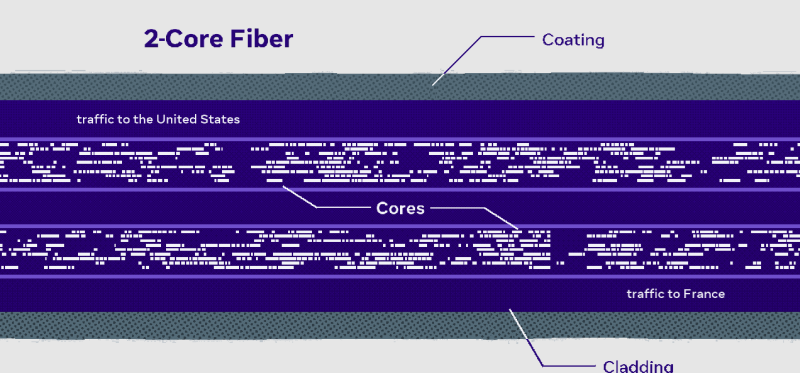
Источник изображения: Meta✴ Meta✴ не единственная, запустившая проект крупного масштаба в последнее время. На днях объявлено, что компания EXA Infrastructure взялась за прокладку подводного кабеля протяжённостью 6552 км, соединяющего Нью-Джерси (США) и Брин (Великобритания). Кабель EXA Meridian представляет собой систему из 24 оптоволоконных пар общей пропускной способностью около 500 Тбит/с. Её должны ввести в эксплуатацию в IV квартале 2029 года.
22.09.2026 [14:00], Владимир Мироненко
DSX Ready: NVIDIA взялась за сертификацию BESS и CDU для ИИ-фабрикNVIDIA запустила NVIDIA DSX Ready — программу сертификации продуктов и решений партнёров, которые соответствуют требованиям эталонного проекта ИИ-фабрики NVIDIA DSX. На начальном этапе программа включает две категории: аккумуляторные энергохранилища (BESS) и блоки распределения охлаждающей жидкости (CDU). Для каждой из категорий указаны требования к продуктам и оценка в рамках программы, что поможет упростить оценку предложений, снизить риски, связанные с интеграцией, и ускорить внедрение решений. Платформа NVIDIA DSX объединяет проектирование и эксплуатацию ИИ-фабрики, сетевых технологий, энергоснабжения, охлаждения, инфраструктуры и ПО. Она упрощает проектирование и эксплуатацию фабрику как единой системы с учётом имеющихся ограничений по энергоснабжению, охлаждению, водоснабжению и электросетям. Системный подход позволяет путём оптимизации одной части фабрики устранить узкое место в другой. NVIDIA DSX Ready предлагает поставщикам систем энергоснабжения и охлаждения ориентиры для создания на основе эталонных проектов сертифицированных решений, а разработчикам — более понятный способ поиска и оценки таких решений. 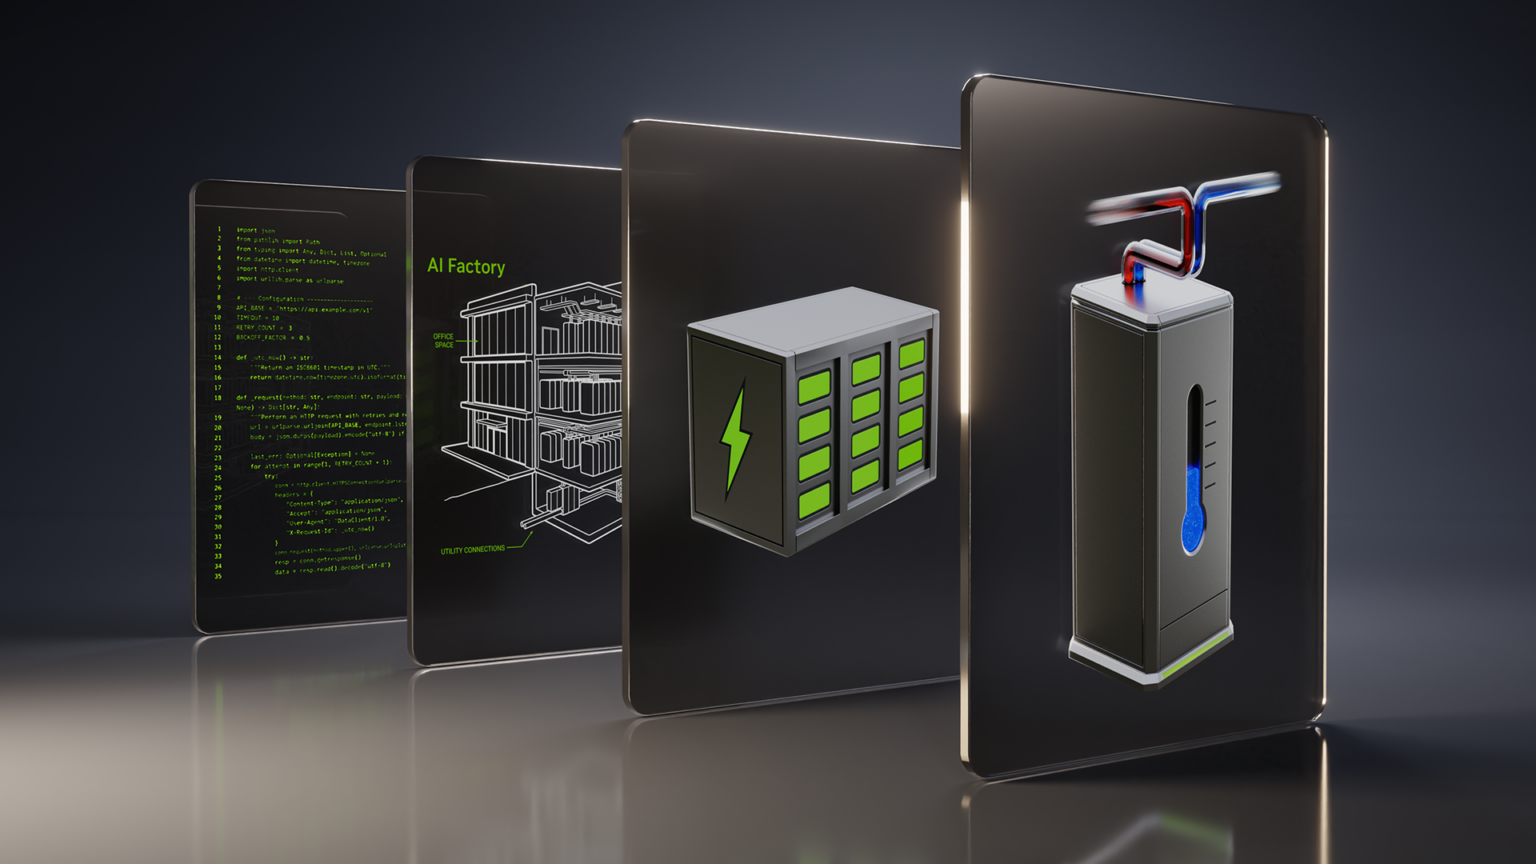
Источник изображения: NVIDIA На данный момент программа DSX Ready включает сертифицированные решения BESS от Hitachi Energy, LG Energy Solution и Tesla, а также сертифицированные решения CDU от LG Electronics, LiquidStack и Vertiv. Со временем будут добавлены категории, охватывающие инфраструктуру и ПО. Для поставщиков BESS партнёры проводят необходимые квалификационные испытания и предоставляют подтверждающие данные для рассмотрения и утверждения NVIDIA. Прохождение квалификации не заменяет собой инженерную проверку на уровне площадки. Для поставщиков CDU предусмотрен набор инструментов для самосертификации CDU, позволяющий определить степень соответствия решения требованиям NVIDIA.
22.09.2026 [13:45], Руслан Авдеев
LG представила чиллеры Air-Cooled Centrifugal Chiller для ИИ ЦОДЮжнокорейская LG представила центробежную систему воздушного охлаждения ИИ ЦОД Air-Cooled Centrifugal Chiller, не нуждающуюся в масле. В компании утверждают, что система разработана, чтобы повысить энергоэффективность и обеспечить процесс непрерывного охлаждения, сообщает Datacenter Dynamics. В основе конструкции лежит центробежный компрессор с безмасляными магнитными подшипниками. В LG утверждают, что подобная конструкция снижает механические потери от трения и обеспечивает более эффективное сжатие. Отдельный датчик, встроенный в систему подшипников, регистрирует положение оси вращения и зазор, а алгоритмы машинного обучения позволяют адаптировать режимы работы, помогая компенсировать скачки нагрузки. Обеспечено резервное электроснабжение, позволяющее снизить риск повреждения подшипников при остановке вала. Оптимальная производительность восстанавливается всего через три минуты после восстановления электроснабжения. Для снижения нагрузки на компрессор дополнительно используется фрикулинг. По данным LG, теплоноситель циркулирует без промежуточного теплообменника и не предусматривает использования состава на основе гликоля — это упрощает обслуживание, а также сводит к минимуму потери тепла и давления. Это означает, что ЦОД потребляет на 30 % меньше энергии в сравнении с традиционными фрикулинг-системами. LG не раскрывает, сколько тепла способна отводить система, но заявила, что доступны варианты 480–600 тонн охлаждения на модуль. Возможна конфигурация в соответствии с требованиями отдельных дата-центров. 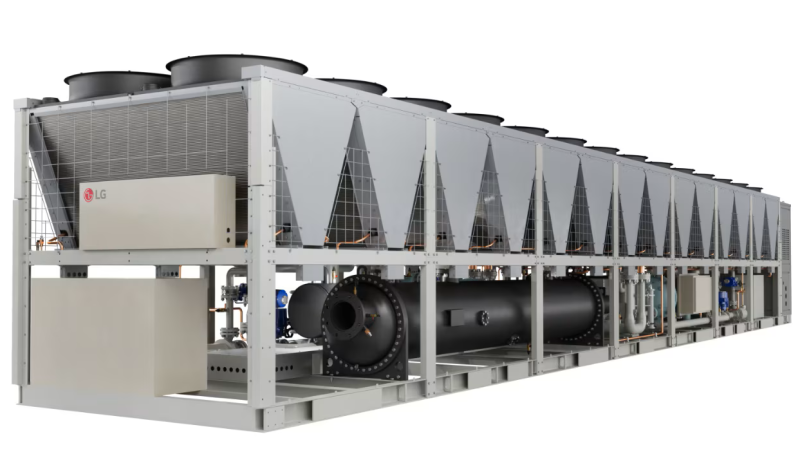
Источник изображения: LG Также LG расширяет возможности управления оборудованием с помощью системы Data Center Cooling Management (DCCM). Это ПО обеспечивает интегрированный мониторинг и управление сложной инфраструктурой охлаждения, включая модули распределения охлаждающей жидкости (CDU), центробежные чиллеры и пр. Система поддерживает бесперебойную работу оборудования благодаря раннему обнаружению сбоев и диагностики с помощью специальных датчиков, также обеспечивается оптимизация в реальном времени с учётом текущих нагрузок и др. Собственная технология LG Core Tech стала основой новой системы и включает различные компоненты, от компрессоров до электродвигателей, инверторов и магнитных подшипников. LG самостоятельно разрабатывает и выпускает эти компоненты, а затем интегрирует их в готовые системы для оптимизации производительности, обеспечения доступности запчастей и минимизации времени реагирования на инциденты при техобслуживании.
22.09.2026 [13:30], Руслан Авдеев
O-Green намерена нарастить ёмкость своих ЦОД в Омане и Европе к 2028 году до 200 МВтНовая оманская компания O-Green, поддерживаемая местными властями и специализирующаяся на «зелёной» энергетике, занялась строительством дата-центров для ИИ-проектов. Объекты разместятся как в самом султанате, так и в Испании и других европейских странах, сообщает Datacenter Dynamics. O-Green рассчитывает, что к 2028 году к работе будут готовы уже более 200 МВт мощностей. Основанная в 2025 году компания призвана ускорить «энергетический переход» и построить интегрированную «платформу чистой энергии». В число владельцев входит принадлежащая государству Naqaa Sustainable Energy и OQ Alternative Energy. O-Green состоит из трёх подразделений: O-Green Power, занимающегося реализацией международных проектов, связанных с «зелёной» энергетикой, O-Green Technologies, выпускающего ветряные турбины и развивающей «зелёные» технологии, а также O-Green Compute & Data Centers, которое строит ИИ ЦОД для облачных операторов и гиперскейлеров с питанием недорогой возобновляемой энергией в Омане и Европе. Проекты O-Green Power реализуют в 12 странах, общая мощность превышает 11 ГВт. Портфолио уже обеспеченных обязательствами проектов включает более 3,3 ГВт мощностей ветряной и солнечной генерации, а также более 2,3 ГВт аккумуляторных энергохранилищ (BESS) в Омане и Ботсване. 
Источник изображения: Muhammad Shoaib/unsplash.com В Дукме (Duqm, Оман) компания установила крупнейшую наземную ветряную турбину (без учёта проектов материкового Китая). Расположенная неподалёку от крупного нефтеперерабатывающего предприятия OQ8, турбина стала одним из знаковых объектов в рамках долговременной стратегии Oman Vision 2040, призванной сократить зависимость экономики от экспорта углеводородов, развивая технологии и источники возобновляемой энергии. В рамках той же национальной стратегии Оман быстро становится региональным цифровым хабом, помощь в этом оказывают государственные инициативы, развитие сети подводных кабелей в регионе и новые стратегические партнёрства. В мае компании из Омана, ОАЭ и Италии подписали соглашение о строительстве в султанате ЦОД гиперскейл-уровня мощностью 150 МВт. В 2025 году Oracle запустила в стране свой второй облачный регион OCI Dedicated Region. Всего, по данным DataCenterMap, в стране имеются 15 дата-центров, в т.ч. два, управляемых Equinix — в столице Маскате (Muscat) и втором во величине городе страны — Салале (Salalah). Хотя ранее сообщалось, что эскалация конфликта на Ближнем Востоке угрожает бизнесу ЦОД в регионе, реализация проектов там активно продолжается. Так, в мае Оман и Алжир договорились о совместном строительстве дата-центров, а в начале сентября появилась новость о том, что к 2030 году AMD, Cisco и Humain развернут в Саудовской Аравии 1 ГВт суверенной ИИ-инфраструктуры. Вместе с тем в результате атак ЦОД AWS в Бахрейне были уничтожены, а в ОАЭ — повреждены.
22.09.2026 [11:00], Сергей Карасёв
РТК-ЦОД и «Базальт СПО» представили совместное решение для управления распределёнными ИТ-системамиРТК-ЦОД, ИТ-сервис-провайдер полного цикла и «Базальт СПО», мировой производитель системного ПО на базе собственной платформы разработки, выпустили совместный продукт «Альт Инфраструктура» для централизованного управления географически распределёнными ИТ-системами федерального масштаба. Решение на базе платформы Smart Control и операционной системы «Альт Сервер» обеспечит заказчикам полный контроль над ИТ-инфраструктурой, высокий уровень информационной безопасности и снижение совокупной стоимости владения до 60 %. «Альт Инфраструктура» ориентирована на широкий круг заказчиков из госсектора и корпоративного сегмента, которым необходимо централизованное управление распределёнными ИТ-системами, а также важны импортозамещение, информационная безопасность, быстрый запуск и снижение издержек. Платформа представляет собой единый центр управления ИТ-инфраструктурой. Решение обеспечивает автоматическую инвентаризацию парка оборудования, при этом оно ведёт учёт не только серверов, ПК и сетевого оборудования, но также касс, фискальных регистраторов, сканеров, почтоматов, информационных экранов. Платформа выполняет сканирование сети, собирает детальную информацию об аппаратном и программном обеспечении, а также контролирует доступность объектов и отображает их местоположение. Согласно замерам, продукт сокращает время инвентаризации парка устройств на 70–90 %, а полнота сбора данных составляет 95 % для агентских устройств и 80 % — для безагентских. 
Источник изображения: РТК-ЦОД Система даёт возможность автоматизировать рутинные задачи за счёт выполнения сценариев, таких как установка и обновление программного обеспечения на компьютерах определённого подразделения. Она поддерживает до 10 тысяч управляемых объектов на одном сервере и оптимизирует сетевой трафик в филиалах через кеширующие серверы. Все подключения проходят через защищённую маршрутизацию с обязательной аутентификацией. Централизованное хранение настроек и временных ключей доступа исключает несанкционированный доступ к системе. При этом «Альт Инфраструктура» имеет глубокую интеграцию с инфраструктурой заказчика на основе Keycloak, Gitea и Registry. В составе платформы система Smart Control обеспечивает централизованную инвентаризацию, удалённое управление, автоматизацию и безопасный доступ, а операционная система «Альт Сервер» формирует отказоустойчивую и защищённую инфраструктурную основу с контейнеризацией, атомарными обновлениями и поддержкой работы в изолированных контурах. Такое сочетание позволяет заказчикам получить готовый комплексный продукт «из коробки», установка которого занимает не более одного дня и не требует глубокой кастомизации. Решение обладает полностью контейнерной архитектурой. «Альт Инфраструктура» разворачивается на собственных мощностях заказчика с использованием штатных компонентов операционной системы «Альт Сервер», а все его функции доступны через единый веб-портал. Продукт лицензируется по объектам, добавленным в систему, и поставляется по подписочной модели: стоимость лицензии включает право использования, все обновления и техническую поддержку без дополнительной тарификации. «"Альт Инфраструктура" — это решение, объединяющее надёжную отечественную операционную систему и продвинутые средства управления инфраструктурой. Продукт отвечает на запрос бизнеса по импортозамещению и одновременно служит инструментом повышения эффективности. Благодаря автоматизации инвентаризации и удалённой поддержке совокупная стоимость владения снижается на 40–60 %. Таким образом, заказчик получает полный контроль над распределёнными системами и предсказуемый бюджет на эксплуатацию», — заявил технический директор РТК-ЦОД Алексей Забродин. «Решение может работать в изолированных контурах, предъявляет минимальные требования к аппаратному обеспечению и разворачивается всего за один рабочий день — это критически важно для компаний, которые не могут позволить себе затяжные проекты внедрения. Продукт используется в рамках реализации комплексных программ цифровизации, и быстро окупается за счёт автоматизации и сокращения затрат на эксплуатацию. В основе "Альт Инфраструктуры" — наша операционная система "Альт Сервер" и решение от РТК-ЦОД Smart Control, в котором используется пакетная база развиваемого нами репозитория проекта "Сизиф". Это интегрированная разработка, которую мы вместе с РТК-ЦОД предлагаем рынку. Она одновременно решает задачу импортозамещения и даёт бизнесу ощутимую экономическую выгоду», — прокомментировал председатель совета директоров компании «Базальт СПО» Алексей Смирнов.
22.09.2026 [09:37], Владимир Мироненко
VMware отказалась от развития решений для SmartNIC и DPUVMware без особого шума свернула свои амбициозные планы в отношении SmartNIC/DPU, не вызвавшие интереса у клиентов, пишет The Register. Умеш Махаджан (Umesh Mahajan), вице-президент и генеральный менеджер подразделения сетевых приложений и безопасности Broadcom, сообщил о прекращении работы компании «в этом сегменте». Гиперскейлеры активно используют DPU и SmartNIC для выполнения задач по обеспечению безопасности, управлению сетью и т.д, разгружая ядра основного CPU, которые можно сдавать в аренду клиентам. Перенос вспомогательных задач на SmartNIC также способствует повышению уровня изоляции и безопасности; например, AWS подчеркивает преимущества собственной системы Nitro, которая в том числе отвечате за функции гипервизора. В своей стратегии по развитию частных облаков VMware исходила из предположения, что клиентам нужна локальная (on-premise) версия публичного облака — по крайней мере, с точки зрения операционной модели. Ещё будучи независимой компанией, VMware предположила, что клиенты оценят подход гиперскейлеров к аппаратному обеспечению, и адаптировала свою платформу для работы на SmartNIC. Изначально в рамках Project Monterey компания нацелилась на перенос части функций NSX, а со временем также планировала более полно реализовать функции vSAN и управления хостом. 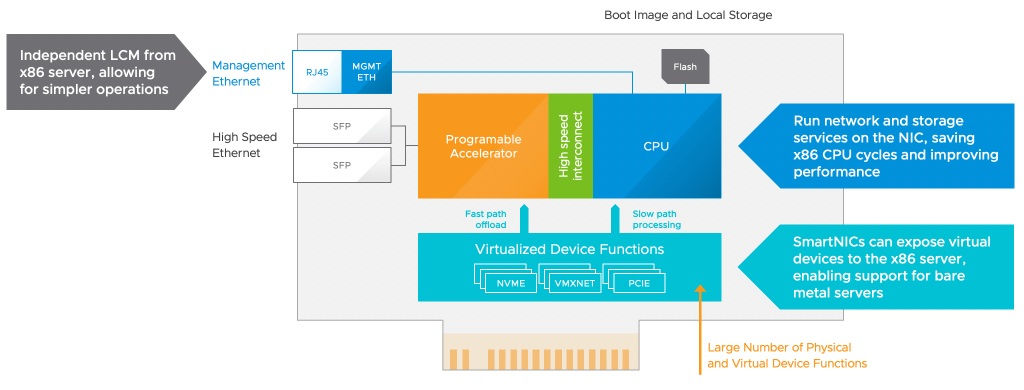
Источник изображений: VMware По словам Махаджана, VMware обеспечила работу своих продуктов на решениях AMD и NVIDIA, но с DPU Intel возникли трудности, поскольку для этого потребовалось вмешательство в микрокод. И даже когда VMware смогла решить эту проблему, покупатели не проявили к продукту интереса. «Клиенты продолжали обсуждать эту тему, но не покупали продукт», — отметил Махаджан, добавив, что в связи с этим дальнейшие затраты на разработку стало сложно обосновывать. 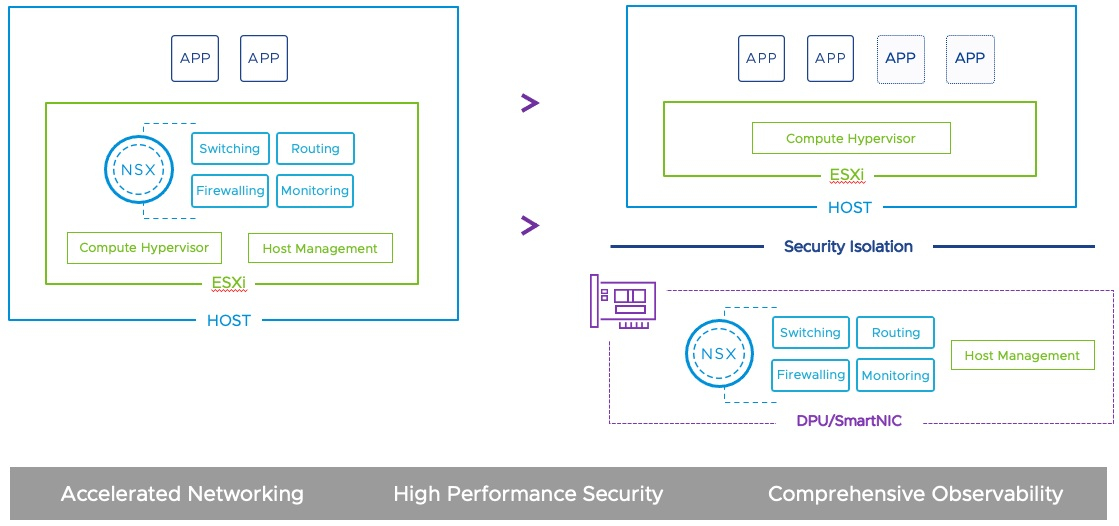 Между тем обычные сетевые карты (NIC) эволюционировали и увеличили пропускную способность до такой степени, что преимущества SmartNIC стали менее очевидными. В итоге VMware прекратила продажи распределённого брандмауэра. «VMware опередила отрасль в использовании DPU/SmartNIC для разгрузки и повышения эффективности инфраструктуры ЦОД; однако формирование полноценной экосистемы вокруг SmartNIC шло медленно», — сообщил изданию The Register представитель VMware. Он добавил, что компонент Distributed Services Engine для SmartNIC, остаётся частью VCF и будет получать поддержку. 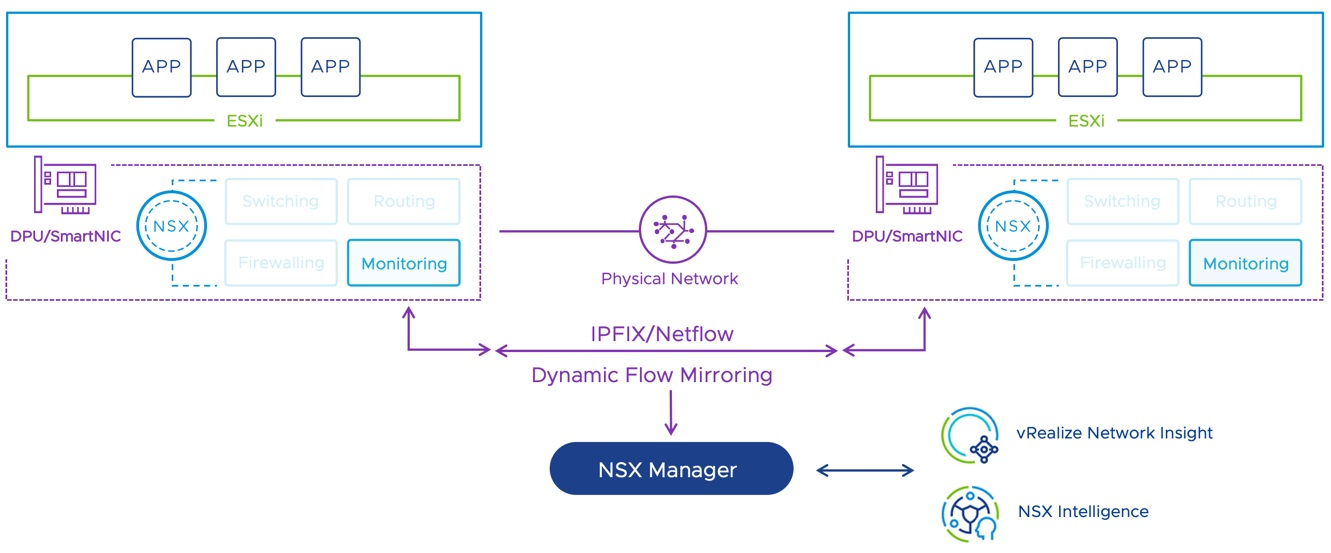 «Мы также продолжаем искать способы упростить взаимодействие с клиентами и при необходимости корректировать наш подход к продуктам, — сообщил представитель компании. — Например, мы разработали функцию прямой разгрузки (direct offloading) для ускорения сетевого трафика с помощью адаптеров ConnectX-7; этот механизм отличается от Distributed Services Engine». Он также упомянул инновации VMware в таких областях, как многоуровневое хранение данных в памяти (memory tiering), глобальная дедупликация и концепция AI Factory. NVIDIA также использует термин AI factory для обозначения комплекса аппаратных средств — включая SmartNIC/DPU, — необходимых для выполнения инференса. VMware и NVIDIA связывают партнёрские отношения. VMware также начала сотрудничать с AMD, чьи стоечные ИИ-системы Helios также используют SmartNIC. VMware почти наверняка не собирается окончательно отказываться от SmartNIC, считает The Register. А поскольку в таких решениях часто используются Arm-процессоры, наработки, созданные в рамках проекта Distributed Services Engine, могут найти применение в версии VMware ESXi on Arm.
22.09.2026 [00:50], Владимир Мироненко
Новая экспериментальная модель «Яндекса» Alice AI Foundation LLM опережает по возможностям зарубежные аналоги«Яндекс» предоставила открытый доступ к Alice AI Foundation LLM (AliceAI-Foundation-80B-A3B-Base) — новую, созданную с нуля предобученную LLM с архитектурой MoE (Mixture of Experts). Модель носит экспериментальный характер и включает 80 млрд параметров, из которых при обработке токена активны только 3 млрд, что позволяет увеличить скорость и задействовать меньше вычислительных ресурсов. Модель предоставляется под лицензией Apache 2.0, т.е. допускает её использование в коммерческих целях. В модель заложены способности к рассуждению и работе в агентных сценариях, благодаря чему она показывает высокую эффективность в сложных логических заданиях и программировании. Например, в решении олимпиадных задачах по математике она делит лидерство с Qwen3.5-35B-A3B-Base, а в тестах на написание кода превзошла модель NVIDIA Nemotron-3-Super-120B-Base, хотя у неё в четыре раза меньше активных параметров. В задачах, где нужны широкие фактические знания, Alice AI Foundation опережает более крупные открытые модели — например, DeepSeek-V4-Flash-Base с 284 млрд параметров и 13 млрд активных. Согласно бенчмаркам для оценки знания фактов, новая модель не уступает предыдущей закрытой модели Яндекса Alice AI LLM, у которой в три раза больше общих параметров и в семь раз больше активных. Для оценки знаний модели, актуальных для русскоязычных пользователей, компанией были разработаны два собственных бенчмарка WikiWebFacts и HardMultiQA, поскольку англоязычные бенчмарки не позволяют оценить объективно её русскоязычные знания. 
Источник изображения: Igor Omilaev/unsplash.com WikiWebFacts нацелен на проверку знания дат, определений, событий и персоналий на основе материалов онлайн-энциклопедий и частотных агрегированных поисковых запросов. HardMultiQA охватывает более редкие области знаний: от медицины и права до IT и искусства, предлагая выбрать несколько верных вариантов из списка, перечислить сразу несколько фактов, подходящих под условие вопроса, или найти фактическую ошибку в тексте. При обучении модели разработчики улучшили работу оптимизатора, чтобы пересылка данных между GPU шла параллельно с вычислениями. Это позволило ускорить шаги оптимизации примерно в два раза. Также была оптимизирована подготовка качественных обучающих данных. Вместо использования со старта для их отбора ресурсоёмкой модели, документы перед оценкой проходят через каскад классификаторов, и на каждом этапе более сложная и вычислительно затратная модель работает с меньшим количеством документов. Это позволило в десятки раз сократить количество вычислений, сохранив около 95 % полезных документов. Вдобавок разработчики значительно обогатили базу знаний модели в области права, медицины и математики. |
|

