
Материалы по тегу: nvidia
|
03.11.2026 [16:48], Павел Котов
NVIDIA ограничила сотрудничество облачных провайдеров с КитаемNVIDIA потребовала, чтобы выступающие её партнёрами облачные провайдеры оказывали не связанным с Китаем компаниям не менее 51 % услуг, сообщает Financial Times. Официальных документов компания по данному вопросу не издавала — требования доводятся до сведения клиентов в устной форме через отделы продаж и региональные подразделения производителя. Новые нормы касаются всех клиентов NVIDIA, а не только ЦОД в Азии, услугами которых пользуются китайские компании, лишённые возможности закупать передовые американские ИИ-ускорители. Требования распространяются только на новые контракты, но не на действующие соглашения. «ЦОД и облачная инфраструктура, созданные на базе американских чипов, выступают фундаментом, необходимым для разработчиков моделей и приложений из США для конкуренции на мировом рынке. Сформированная политика США поощряет использование американской инфраструктуры в облачных сервисах по всему миру, способствуя укреплению позиций США, их влияния и созданию рабочих мест в стране», — заявил представитель NVIDIA. 
Источник изображения: nvidia.com Американские власти пытаются пресекать действия посредников, которые в обход экспортных ограничений поставляют в Китай передовые ускорители, формируя тем самым чёрный рынок в стране. Вашингтон также стремится ограничить китайским компаниям доступ к облачным ресурсам, которые работают на передовых ускорителях. Инициатива, «безусловно, нанесёт ущерб бизнесу», если NVIDIA будет строго следить за соблюдением требований, заявили в одной из сингапурских компаний, потому что найти не связанных с Китаем клиентов довольно сложно. NVIDIA ужесточила политику поставки ИИ-ускорителей в Китай, из-за чего у местных технологических компаний образовался дефицит передовых вычислительных мощностей. Наглядным примером стала продажа в Китае комплекта ускорителей NVIDIA B300 за ¥18,5 млн ($2,8 млн) — на международном рынке он официально стоит $600 тыс., а в Китай их продажа запрещена. Производитель составил «белый список» организаций, прошедших его проверки на соответствие требованиям, направленным на предотвращение продаж её оборудования в Китай — в результате число азиатских клиентов NVIDIA сократилось более чем вдвое, а объём контрабандных поставок её продукции в страну действительно сократился. Это вынудило китайские технологические компании изыскивать возможности арендовать вычислительные мощности у зарубежных облачных провайдеров. Ранее китайская Tencent договорилась с Oracle об аренде 100 тыс. передовых ускорителей; ByteDance обеспечила себе доступ к 36 тыс. чипов, заключив соглашение с Aolani Cloud из Юго-Восточной Азии — при этом ещё в январе Палата представителей США приняла «Закон о безопасности удалённого доступа», который запрещает китайским компания доступ к передовым ускорителям в ЦОД за пределами КНР.
03.11.2026 [14:23], Руслан Авдеев
Spam и Gun Range: Colossus 2 от SpaceXAI обзаведётся двумя новыми ЦОД к концу годаГлава SpaceXAI/SpaceXSI Илон Маск (Elon Musk) объявил о расширении проекта Colossus 2 с добавлением двух площадок в Саутхейвене (Southaven, шт. Миссисипи), называющихся Gun Range и Spam, сообщает Datacenter Dynamics. Изначально основные мощности проекта располагались в Мемфисе (Memphis, Теннесси), но позже инфраструктуру расширили в соседний штат Миссисипи. На территории Gun Range ранее располагался центр обучения полиции и пожарных, на площадке Spam находился склад, где хранилась мясная продукция под известным брендом Spam. Если новые мощности Gun Range будут предназначены для обучения ИИ, то площадку Spam задействуют для инференса. Всего на площадках разместят около 420 тыс. ускорителей в составе платформы NVIDIA GB300. На территории Gun Range площадью около 22,6 га будут построены два одноэтажных здания, на площадке Spam площадью 21,4 га в ЦОД переоборудуют одноэтажный склад. По словам Маска, ожидается, что Gun Range заработает к концу ноября, а Spam — в декабре. Новые площадки дополнят инфраструктурный кластер, в который уже входят площадки Colossus 2 — Macrohard, Macrohardrr и Minihard, в которых планируется разместить 330 тыс., 220 тыс. и 220 тыс. ИИ-ускорителей соответственно. Всего, по прогнозам Маска, к концу года Colossus 2 разместит около 1,2 млн ускорителей Blackwell. В последние месяцы SpaceXAI начала активно сдавать в аренду мощности своих ЦОД сторонним клиентам, в числе прочего заключив крупные соглашения с Reflection, Anthropic и Google. 
Источник изображения: Frames For Your Heart/unsplash.com Впервые компания начала строительство в Мемфисе в 2024 году, а в марте 2025 года приобрела площадку для Colossus 2, сам ЦОД заработал в январе 2026-го. Хотя Маск говорил о запуске мощностей на 1 ГВт, анализ спутниковых снимков свидетельствовал, что охлаждающего оборудования хватило бы только на 350 МВт. Третий ЦОД анонсировали в январе 2026 года, он расположен в Саутхейвене. Новости о нём появились в марте, когда компания подала заявку для получения разрешения на строительство ещё одного здания на участке рядом, стоимость проекта составила $659 млн. В июле 2026 года компания подтвердила строительство Minihard, строительство началось на участке неподалёку от границы Теннесси и Миссисипи. В октябре SpaceXAI сообщила о получении её дочерней структурой MZX Tech LLC уведомления от Департамента качества окружающей среды Миссисипи (Mississippi Department of Environmental Quality, MDEQ). В документе утверждалось, что земляные и строительные работы были начаты до того, как на них распространилось действие генерального разрешения штата Миссисипи на сброс ливневых вод со строительных объектов крупного масштаба. MDEQ добивалось наложения на компанию штрафов в размере до $25 тыс. за каждый день нарушения, в общей сложности около $6,1 млн по трём площадкам. SpaceXAI говорила об активном сотрудничестве с MDEQ. Практически в то же время суд отклонил попытку Министерства юстиции заблокировать иск к компании со стороны НКО NAACP, в котором компания утверждала, что бизнес нарушил федеральный закон и нормы штата, построив и эксплуатируя газовую электростанцию в Саутхейвене без предварительного получения разрешений. SpaceXAI использует газовые турбины для электроснабжения как Colossus 1, так и Colossus 2. В своё время компания воспользовалась лазейкой в законе о чистом воздухе — Clean Air Act для того, чтобы эксплуатировать в течение года до 35 турбин без получения разрешения. В 2025 году регуляторы выдали разрешение на работу 15 турбин до 2027 года. По данным NAACP, xAI незаконно установила и использует 57 турбин в Саутхейвене. В первоначальном иске НКО заявляла, что газовая электростанция Colossus (Colossus Gas Plant) выбрасывает в окружающую среду значительные объёмы загрязняющих веществ, включая оксиды азота и формальдегид, влияющих на здоровье людей. На днях сообщалось, что компания не смогла добиться отклонения судом иска со стороны NAACP.
03.11.2026 [14:08], Сергей Карасёв
NVIDIA скорректировала характеристики GPU Rubin, снизив пропускную способность HBM4 и NVLinkКомпания NVIDIA, по сообщению ресурса ServeTheHome, утвердила окончательные технические характеристики графических процессоров поколения Rubin, а также систем на их основе, включая Vera Rubin NVL72 и HGX Rubin NVL8. Ключевые изменения по сравнению с предварительными спецификациями связаны со скоростью работы подсистем. Первоначально NVIDIA планировала обеспечить пропускную способность памяти HBM4 на уровне 22 Тбайт/с в расчёте на один чип Rubin. В конфигурации с восемью стеками HBM4 (по 36 Гбайт, в сумме 288 Гбайт) это означало работу каждого стека со скоростью около 10,75 Гбит/с на контакт. В окончательном варианте значения снижены до 19,2 Тбайт/с и 9,375 Гбит/с соответственно, то есть примерно на 13 %. Вместе с тем пропускная способность интерконнекта NVLink уменьшена с 3,6 до 3 Тбайт/с — на 17 %. При этом пропускная способности интерконнекта для горизонтального масштабирования (Scale Out), напротив, увеличена с 0,4 до 0,45 Тбайт/с. 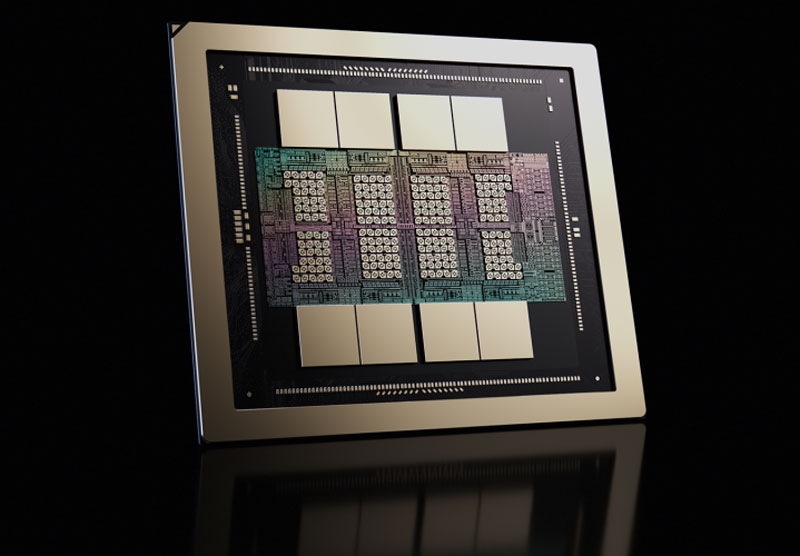
Источник изображения: NVIDIA Несмотря на корректировки, показатели ИИ-производительности сохранились на прежнем уровне. На задачах инференса и обучения моделей в режиме NVFP4 быстродействие достигает 50 и 35 Пфлопс. На операциях INT8 показатель составляет до 250 TOPS, на операциях TF32 — до 2 Пфлопс. Таким образом, помимо указанных изменений, NVIDIA не внесла никаких других модификаций в характеристики Rubin. В случае флагманской системы Vera Rubin NVL72 общая пропускная способность подсистемы памяти HBM4 сократилась с 1580 до 1400 Тбайт/с, интерконнекта NVLink — с 260 до 216 Тбайт/с. Пропускная способности интерконнекта (Scale Out) поднялась с 28,8 до 32,4 Тбайт/с. Наконец, у HGX Rubin NVL8 показатель ПСП HBM4 упал со 176 до 130 Тбайт/с, NVLink — с 28,8 до 24 Тбайт/с, тогда как для сети значение выросло с 1,6 до 1,8 Тбайт/с. Причём у этих систем NVIDIA также уменьшила объём памяти HBM4. Если первоначально HGX Rubin NVL8 планировалось наделить 2,3 Тбайт HBM4, то в соответствии с окончательными спецификациями размер памяти составит 2 Тбайт.
30.10.2026 [09:29], Руслан Авдеев
NVIDIA ведёт переговоры о кредитных гарантиях для Nscale в сделке с AnthropicКомпания NVIDIA ведёт переговоры о предоставлении неооблачному ИИ-провайдеру Nscale кредитных гарантий на миллиарды долларов. Эти гарантии призваны поддержать привлечение заёмного финансирования для строительства ЦОД в интересах Anthropic, сообщает The Information. По информации издания, такие гарантии помогут финансированию строительства инфраструктуры, а также ИИ ЦОД Nscale в Западной Вирджинии, мощностями которого рассчитывает пользоваться Anthropic. При этом NVIDIA является соинвестором Nscale. По данным источников, соглашение пока не подписано, поэтому его условия могут измениться со временем. Сама NVIDIA, Nscale и Anthropic информацию пока не комментируют. Разработчик ИИ Claude — компания Anthropic заключила сделку с Nscale в августе. Компания намерена потратить $45 млрд на аренду вычислительных мощностей в кампусе ЦОД Nscale в Западной Вирджинии. Также Nscale ведёт переговоры о продаже около 460 МВт вычислительных ИИ-мощностей для обеспечения ещё одного проекта Anthropic, который обойдётся последней тоже около $45 млрд. 
Источник изображения: Joshua Hummell/unsplash.com Новости появились на фоне данных о том, что компании вроде CoreWeave и Firmus, также поддерживаемые NVIDIA, столкнулись с проблемами из-за опасений инвесторов, связанных с долговым финансированием масштабного строительства ИИ-инфраструктуры. В частности, не так давно акции CoreWeave и других неооблачных компаний значительно подешевели на фоне опасений инвесторов, а Firmus пришлось отказаться от IPO из-за их недостаточного интереса.
29.10.2026 [17:36], Руслан Авдеев
Naver заключила сделку c Brookfield на $9 млрд для расширения ИИ-инфраструктурыЮжнокорейская компания Naver заключила сделку стоимостью $9 млрд с международной инвестиционной компанией Brookfield. Это позволит Naver получить доступ к новой вычислительной ИИ-инфраструктуре, сообщает The Elec. Соглашение обеспечивает выполнение условий NVIDIA, планирующей стратегические инвестиции в капитал Naver на сумму порядка $1 млрд. Naver рассчитывает завершить размещение новых акций и ускорить строительство 1-ГВт ИИ-фабрики. На днях компания заявила, что подписала соглашение об обеспечении вычислительной инфраструктурой с Brookfield. Оно является частью международного проекта по созданию ИИ-фабрики, в реализации которого участвуют Naver, NVIDIA и Brookfield. В рамках соглашения Brookfield создаст специальную проектную компанию (SPV) с предварительным названием Asset Co., которая инвестирует до $9 млрд в инфраструктуру для Naver Cloud, включая ИИ-ускорители и ЦОД. Эксплуатацией фабрики будет заниматься Naver. Вычислительные ресурсы будут использоваться для предоставления ИИ-сервисов и привлечения сторонних клиентов. Naver намерена опираться на имеющийся опыт создания крупных кластеров ИИ-ускорителей и эксплуатации дата-центров. Компания будет платить за использование инфраструктуры с привязкой к выручке бизнеса. По расчётам Naver, такая схема позволит компании избежать крупных собственных капитальных затрат на начальном этапе. 
Источник изображения: clarence Santos/unsplash.com Naver предоставит гарантии исполнения платёжных обязательств Naver Cloud на срок до восьми лет, гарантии будут касаться платежей за использование инфраструктуры. Хотя предоставление таких гарантий не предполагает дополнительных расходов, в случае возникновения финансовых проблем у Naver Cloud материнскую структуру ожидают дополнительные расходы. На начальном этапе ЦОД мощностью 55 МВт должен заработать в I половине 2027 года, в 2028 году мощность будет увеличена до 200 МВт. Naver намерена использовать свой ЦОД гиперскейл-уровня — GAK Sejong в качестве ключевого узла проекта и в конечном итоге намерена обеспечить себя ИИ-инфраструктурой на 1 ГВт. В свою очередь, NVIDIA обеспечит проекту техническую поддержку, основной акцент будет сделан на решениях на основе новейшей ИИ-платформы DSX. Заключение соглашения стало конкретным шагом к дальнейшей реализации международного проекта ИИ-фабрики Naver, развитие которого началось ещё в июне, когда компания впервые объявила о планах строительства 1-ГВт ИИ-инфраструктуры совместно с NVIDIA. Заключение окончательного соглашения завершает переговоры и позволяет перейти к инвестициям NVIDIA в капитал Naver. Подробности о размещении акций для NVIDIA будут обнародованы позднее. В июне сообщалось, что Южная Корея инвестирует почти $3 трлн в полупроводники и ИИ.
28.10.2026 [18:57], Павел Котов
На eBay выставили б/у суперкомпьютер за $60 миллионовКомпания Core 4 Solutions выставила на платформе eBay бывший в употреблении ИИ-суперкомпьютер, включающий 300 стоек, обращает внимание Tom’s Hardware. Цена лота — $59 млн. Кластер включает 9600 ускорителей NVIDIA A100 и 4200 64-ядерных процессора EPYC Rome. Учитывая, что цена на современные стойки NVIDIA доходит до $7,8 млн за единицу, системы на базе A100 представляются разумной бюджетной альтернативой, если у вас хватает энергии и охлаждения. И не придётся ждать в очереди на поставку новейшего оборудования NVIDIA. Каждая стойка кластера включает четыре вычислительных и три управляющих узла. В состав каждого вычислительного узла входят два 64-ядерных процессора AMD EPYC Rome, восемь ускорителей A100 (версия SXM4 с 40 Гбайт памяти) и 1 Тбайт DDR4-2933. Каждый узел управления оснащается двумя 64-ядерными процессорами EPYC и 192 Гбайт DDR4. В общей сложности кластер включает до 9600 ускорителей A100 и 4200 процессоров AMD. Учитывая, что каждый процессор содержит 64 вычислительных ядра Zen 2, на кластер приходятся 268 800 ядер. Объём оперативной памяти составляет до 1401,6 Тбайт. Ценник в $59,7 млн представляется обоснованным. По грубым подсчётам, одни только ускорители NVIDIA A100 обойдутся примерно в $24 млн, $3 млн будут стоить EPYC и ещё $1,1 млн — память DDR4. Итого около $28,1 млн только за основные компоненты. В состав кластера также входят стойки, системы охлаждения, блоки питания, сетевые адаптеры NVIDIA Mellanox ConnectX-6 SmartNIC и другое оборудование. По неофициальным данным, на продажу выставлен один из кластеров Microsoft Azure. 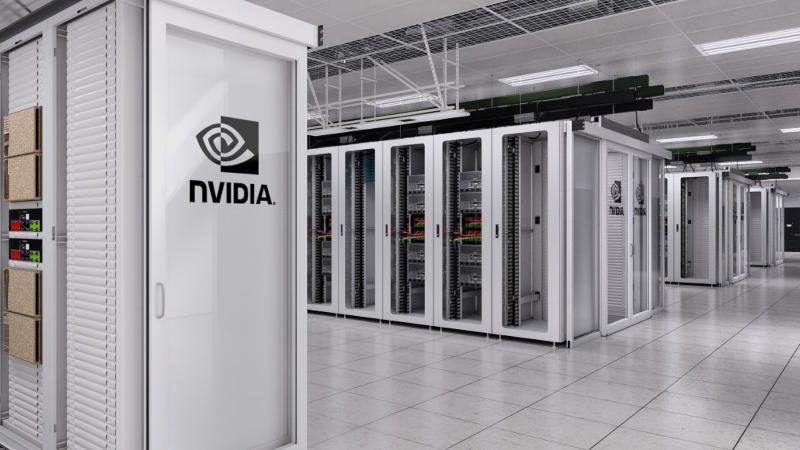
Источник изображения: nvidia.com На eBay попадаются порой неожиданные лоты, и суперкомпьютер — едва ли самый удивительный вариант. Core 4 Solutions вполне может рассчитывать, что на него найдётся покупатель. По мере расширения ИИ-инфраструктуры и ЦОД могут найтись корпоративные клиенты, которые оценят выгоду и возможности, предлагаемые в этом объявлении. Ранее власти США всего за $480 тыс. продали суперкомпьютер Cheyenne, который десять лет назад стоил $25 млн.
28.10.2026 [16:16], Павел Котов
NVIDIA и Oracle расширят инфраструктуру OCI на базе Vera Rubin NVL72 до мультигигаваттного масштабаNVIDIA и Oracle объявили о планах по расширению суперкластеров в Oracle Cloud Infrastructure (OCI) с использованием систем Vera Rubin NVL72 и Vera CPU, сообщает HPCwire. Масштаб таких решений достигнет гигаваттных значений — системы помогут удовлетворить спрос клиентов на обучение, инференс, а также на работу ИИ-агентов. Суперкластеры OCI объединяют стоечные системы NVIDIA NVL72, сетевые решения Oracle Acceleron, в том числе NVIDIA Spectrum-X Ethernet с коммутаторами Spectrum-6 и DPU BlueField-4, а также системы электропитания и охлаждения. В стойке ускорители объединены с помощью NVLink, а отказоустойчивая многоплоскостная сеть OCI позволяет масштабировать систему до сотен тысяч GPU. Планируется также внедрение системы NVIDIA HGX Rubin NVL8 с двумя 64-ядерными процессорами Intel Xeon 6, 4 Тбайт DDR5 и RDMA-интерфейсом 6,4 Тбит/с. Это решение обеспечивает гибкие возможности для обучения, дообучения и инференса ИИ-моделей при сохранении совместимости с приложениями на базе архитектуры x86. Такая гибкость позволяет адаптировать инфраструктуру ИИ к различным моделям и рабочим нагрузкам по мере изменения потребностей. 
Источник изображения: BoliviaInteligente / unsplash.com Ранее Oracle призналась, что направление ИИ ЦОД является для неё рискованным. Компания обеспечила высокоскоростное подключение своей инфраструктуры к AWS, а также сдала китайской Tencent 100 тысяч передовых ускорителей в аренду для развития ИИ-систем.
28.10.2026 [11:42], Руслан Авдеев
NVIDIA, AMD и Broadcom купят акции Meta✴ на $5 млрдMeta✴ Platforms объявила о намерении NVIDIA и AMD приобрести акции компании на $4 млрд. Производители чипов купят их в рамках «распродажи» Meta✴ ценных бумаг на $95 млрд в ближайшем будущем — IT-гигант намерен получить средства для дальнейшего развития своих ИИ-проектов, сообщает Silicon Angle. По имеющимся данным, в покупке акций заинтересована и Broadcom. Всего, по информации Meta✴, три компании намерены инвестировать в акции $5 млрд. NVIDIA готова потратить на ценные бумаги Meta✴ $3 млрд в рамках расширения партнёрства. При этом Meta✴ готовится нарастить использование Vera Rubin, вероятно, в рамках систем Vera Rubin NVL72. Также Meta✴ намерена покупать больше сетевого оборудования NVIDIA. Она расширит использование семейства продуктов Spectrum-X, включая чипы SuperNIC/ BlueField-4 и коммутаторы. NVIDIA поможет Meta✴ увеличить производительность и рентабельность семейства ИИ-моделей Meta✴ Muse. Дополнительно Meta✴ планирует исследовать «возможности сотрудничества», связанные с представленной не так давно эталонной архитектурой NVIDIA — т.н. OpenShell Reference Architecture, представляющей собой набор технических ресурсов, позволяющих упростить использование инструментария NVIDIA OpenShell. Последний позволяет запускать ИИ-агентов в изолированных «песочницах» для минимизации киберугроз. 
Источник изображения: Towfiqu barbhuiya/unsplash.com AMD, готовая инвестировать в Meta✴ $1 млрд, раскрыла, что последняя взяла на вооружение стоечную платформу AMD Helios AI. Сообщается, что Meta✴ уже внедрила «начальный» набор стоек Helios и уже тестирует их. В будущем компания намерена расширить использование этих систем и развернуть кастомные ИИ-ускорители AMD Instinct. Производитель чипов, в свою очередь, будет использовать собранные в ходе сотрудничества технические данные для совершенствования своих чипов и дизайна стоек. Данные об инвестициях Broadcom не были официально обнародованы, но, учитывая, что NVIDIA и AMD готовы вложить в акции Meta✴ в общей сложности $4 млрд из заявленных $5 млрд, речь, вероятно, идёт об $1 млрд.
28.10.2026 [11:41], Сергей Карасёв
Supermicro представила сервер ARC MGX 2U с двумя чипами NVIDIA VeraКомпания Supermicro анонсировала сервер ARS-222GL-NR класса ARC MGX, созданный на базе модульной эталонной архитектуры NVIDIA MGX в рамках концепции NVIDIA Aerial RAN Computer (ARC). Устройство ориентировано на телекоммуникационных операторов. Новинка рассчитана на два процессора NVIDIA Vera, каждый из которых содержит 88 ядер Olympus (Arm v9.2) с возможностью одновременной обработки до 176 потоков инструкций. Поддерживаются 16 модулей оперативной памяти SOCAMM2 LPDDR5X суммарным объёмом до 3 Тбайт. Система может быть оборудована двумя ускорителями NVIDIA RTX PRO 4500 Blackwell Server Edition или NVIDIA RTX PRO 6000 Blackwell Server Edition. Доступны три слота PCIe 6.0 x16 для карт FHFL двойной ширины, разъём CXL 2.0 x16, восемь отсеков для накопителей E1.S NVMe, а также два коннектора М.2 для SSD (NVMe/SATA). Сервер располагает выделенным сетевым портом управления 1GbE (RJ45), интерфейсом mini-DP и портом USB Type-A. Могут быть установлены три адаптера NVIDIA ConnectX-8 и DPU BlueField-3. Модель ARS-222GL-NR выполнена в форм-факторе 2U с габаритами 900 × 438,4 × 87 мм. Реализована система воздушного охлаждения с пятью вентиляторами диаметром 80 мм. Диапазон рабочих температур — от +10 до +35 °C. Питание обеспечивают четыре блока мощностью 3200 Вт с резервированием (3 + 1) и сертификатом 80 Plus Titanium. 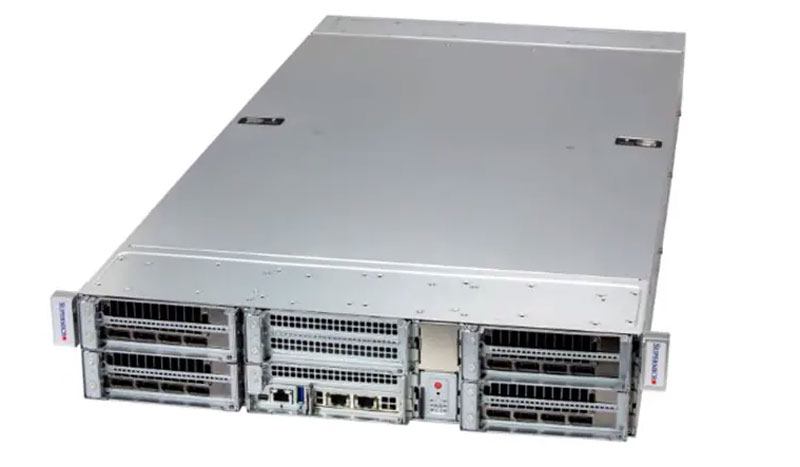
Источник изображения: Supermicro Кроме того, Supermicro представила аналогичный сервер ARC MGX 2U на аппаратной платформе Intel: модель SYS-222C-TN поддерживает два процессора Xeon 6700P и 6500P поколения Granite Rapids-SP или два чипа Xeon 6700E семейства Sierra Forest-SP в исполнении Socket E2 (LGA 4710) с показателем TDP до 350 Вт. Доступны 32 слота для DDR5-8000, до 24 фронтальных отсеков для SFF-накопителей NVMe/SAS/SATA, до восьми разъёмов PCIe 5.0 x16 и пр. Применены два блока питания мощностью до 3200 Вт с сертификатом 80 Plus Titanium.
27.10.2026 [10:02], Сергей Карасёв
В Германии появится суперкомпьютер на базе NVIDIA GB200 Grace Blackwell для моделирования климатаНемецкий климатический вычислительный центр (DKRZ) сообщил о заключении контракта с компанией Bull на строительство нового суперкомпьютера. Систему High-Performance Computing System for Earth System Research 5 (HLRE-5) планируется ввести в эксплуатацию в 2028 году. Применять суперкомпьютер планируется для сложного моделирования климата, в том числе с использованием ИИ. В частности, система сможет одновременно запускать две глобальные климатические симуляции с разрешением 5 км. Основой вычислительного комплекса послужит платформа BullSequana XH3500, которая использует открытую модульную конструкцию. Реализованная архитектура позволяет свободно комбинировать блоки CPU, GPU и сетевые компоненты от различных производителей. Говорится о применении передовой технологии прямого жидкостного охлаждения (DLC). В состав HLRE-5 войдут GPU- и CPU-разделы. В основу первого лягут суперчипы NVIDIA GB200: эта секция обеспечит основные вычислительные ресурсы для ИИ-алгоритмов. В свою очередь, раздел CPU объединит процессоры NVIDIA Vera. Такая конфигурация, как отмечается, позволит добиться высокой энергетической эффективности. В качестве интерконнекта будет задействована технология NVIDIA Quantum-2 InfiniBand с низкой задержкой и скоростью передачи данных между узлами до 400 Гбит/с. 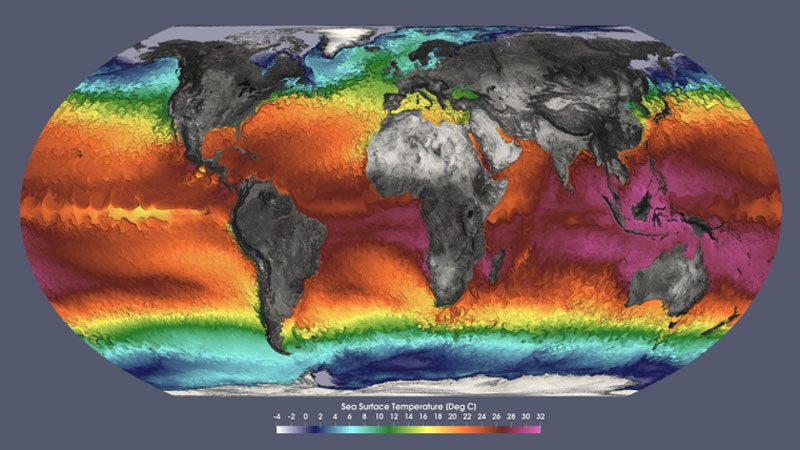
Источник изображения: Michael Böttinger, DKRZ Подсистема хранения данных объединит массив IBM Storage Scale System 6000 вместимостью 60 Пбайт с пропускной способностью до 340 Гбайт/с и высокопроизводительный флеш-уровень объёмом 500 Тбайт. Общие инвестиция в проект составят €40 млн, включая пятилетний договор на техническое обслуживание. Финансирование обеспечивается Ассоциацией имени Гельмгольца, Обществом Макса Планка и администрацией Гамбурга. Кроме того, инициативу поддерживает Федеральное министерство исследований, технологий и космоса в рамках программы «Высокотехнологичная повестка дня Германии» (HTAD). |
|

