
Материалы по тегу: gb200
|
27.10.2026 [10:02], Сергей Карасёв
В Германии появится суперкомпьютер на базе NVIDIA GB200 Grace Blackwell для моделирования климатаНемецкий климатический вычислительный центр (DKRZ) сообщил о заключении контракта с компанией Bull на строительство нового суперкомпьютера. Систему High-Performance Computing System for Earth System Research 5 (HLRE-5) планируется ввести в эксплуатацию в 2028 году. Применять суперкомпьютер планируется для сложного моделирования климата, в том числе с использованием ИИ. В частности, система сможет одновременно запускать две глобальные климатические симуляции с разрешением 5 км. Основой вычислительного комплекса послужит платформа BullSequana XH3500, которая использует открытую модульную конструкцию. Реализованная архитектура позволяет свободно комбинировать блоки CPU, GPU и сетевые компоненты от различных производителей. Говорится о применении передовой технологии прямого жидкостного охлаждения (DLC). В состав HLRE-5 войдут GPU- и CPU-разделы. В основу первого лягут суперчипы NVIDIA GB200: эта секция обеспечит основные вычислительные ресурсы для ИИ-алгоритмов. В свою очередь, раздел CPU объединит процессоры NVIDIA Vera. Такая конфигурация, как отмечается, позволит добиться высокой энергетической эффективности. В качестве интерконнекта будет задействована технология NVIDIA Quantum-2 InfiniBand с низкой задержкой и скоростью передачи данных между узлами до 400 Гбит/с. 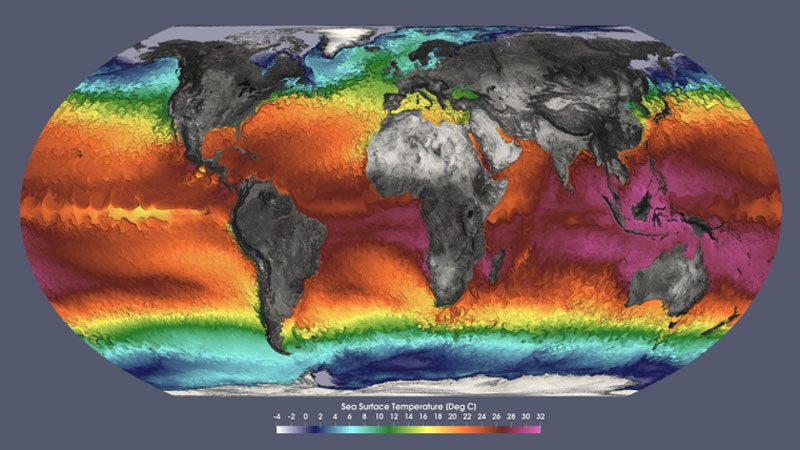
Источник изображения: Michael Böttinger, DKRZ Подсистема хранения данных объединит массив IBM Storage Scale System 6000 вместимостью 60 Пбайт с пропускной способностью до 340 Гбайт/с и высокопроизводительный флеш-уровень объёмом 500 Тбайт. Общие инвестиция в проект составят €40 млн, включая пятилетний договор на техническое обслуживание. Финансирование обеспечивается Ассоциацией имени Гельмгольца, Обществом Макса Планка и администрацией Гамбурга. Кроме того, инициативу поддерживает Федеральное министерство исследований, технологий и космоса в рамках программы «Высокотехнологичная повестка дня Германии» (HTAD).
23.10.2026 [13:01], Павел Котов
Казахстан расширит мощности ИИ ЦОД на чипах NVIDIAКазахстан продолжает наращивать свою вычислительную базу, планируя развёртывание инфраструктуры на архитектуре NVIDIA Vera Rubin. Движущей силой на данном этапе роста выступают компании, изначально ориентированные на отрасль искусственного интеллекта. Казахстанская экосистема ИИ переходит от этапа планирования инфраструктуры к её практическому развёртыванию. Процесс охватывает весь арсенал технологий ИИ от проектирования инфраструктуры и моделей до конечных приложений. Firebird, построившая свою ИИ-фабрику в Армении, расширяет своё присутствие в Казахстане. Компания получила от властей США экспортную лицензию на поставку 45 тыс. Grace Blackwell — первый этап проекта реализуется совместно с «Казахтелекомом» в «Долине ЦОД»; коммерческий запуск намечен на III квартал 2027 года. На втором этапе планируется довести совокупную мощность инфраструктуры Firebird в Казахстане примерно до 500 МВт. Компания намерена создать подразделение Firebird Labs Kazakhstan для поддержки местных ИИ-стартапов, проведения исследований и развития кадрового потенциала. Для реализации проекта задействуют механизмы финансирования, обеспечения доступа к вычислительным ресурсам и научно-исследовательское партнёрство. 
Источник изображения: nvidia.com «Казахтелеком», крупнейший телекоммуникационный оператор в стране, уже развернул 400 ускорителей H200 и 480 B300 в Астане и Алматы. В следующем году компания планирует разместить более 1000 чипов в «Долине ЦОД» и ещё более 1000 чипов в составе платформы NVIDIA Vera Rubin в районе Экибастуза. Эта инфраструктура позволит выполнять широкий спектр задач и будет доступна для предприятий и разработчиков. Ранее Akashi Data Center рассказала о планах построить в Казахстане Tier IV ЦОД мощностью 100 МВт. В минувшем году стало известно о намерении запустить в стране самый мощный суперкомпьютер в Центральной Азии. С Россией обсуждается план прокладки интернет-кабеля по дну Каспийского моря.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 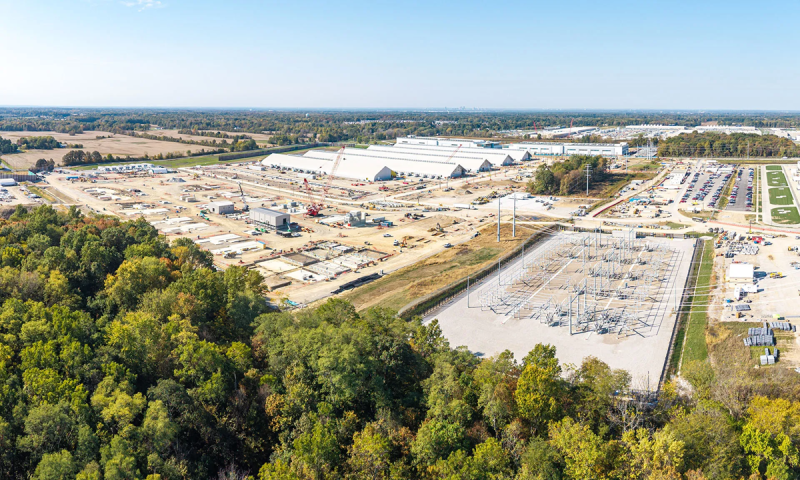
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 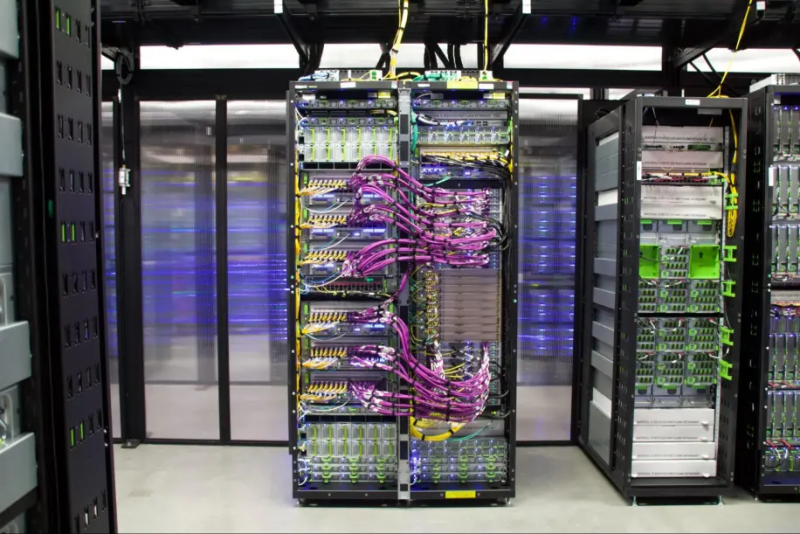
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
18.07.2026 [13:06], Сергей Карасёв
Для ИИ и для «квантов»: В Японии заработали суперкомпьютеры RIKYU и ROQUO на базе NVIDIA GB200 NVL4В Центре вычислительных наук Института физико-химических исследований Японии (RIKEN Center for Computational Science, R-CCS) началась эксплуатация высокопроизводительных комплексов RIKYU и ROQUO, выполненных на аппаратной платформе NVIDIA. Обе системы ориентированы на ресурсоёмкие задачи ИИ. В частности, RIKYU может применяться для разработки открытых фундаментальных моделей, а также проведения исследований в сферах наук о жизни, материаловедения и пр. Задействованы 400 узлов Supermicro PIO-121GL-NBIB-01 на базе NVIDIA GB200 NVL4 (два процессора Grace и четыре ускорителя Blackwell, объединенных посредством NVLink). Применяются жидкостное охлаждение и 800G-интерконнект InfiniBand XDR. Кроме того, в состав суперкомпьютера входят 16 узлов Supermicro SYS-212HA-TN с процессорами Intel Xeon 6980P (Granite Rapids-AP), 1,5 Тбайт памяти и хранилищем с накопителями NVMe SSD. Производительность в режиме FP64 достигает 59,63 Пфлопс, в режиме FP8 — 15,539 Эфлопс. 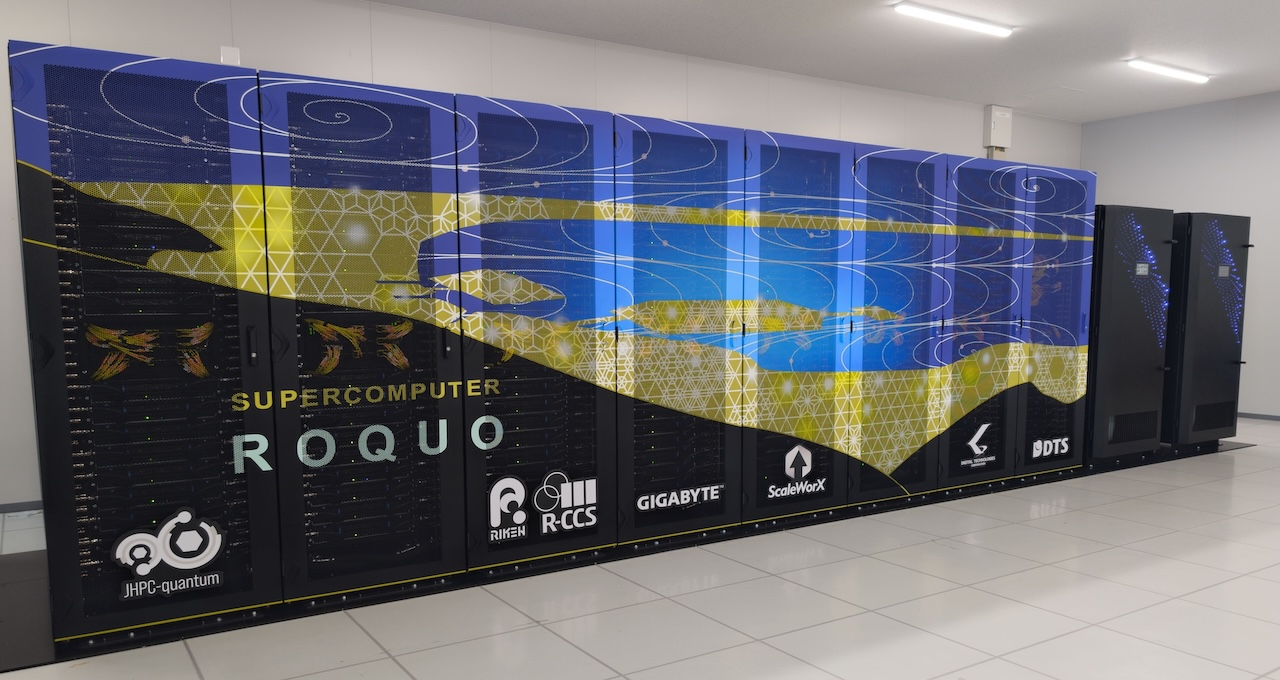
Источник изображения: RIKEN В свою очередь, суперкомпьютер ROQUO спроектирован с прицелом на гибридные квантово-классические вычисления. Он получил 135 вычислительных узлов на основе NVIDIA GB200 NVL4. Интерконнект NVIDIA Quantum-X800 InfiniBand обеспечивает пропускную способность до 3,2 Тбит/с. Применено жидкостное охлаждение. Быстродействие в режиме FP64 находится на отметке 19,8 Пфлопс с пиковым значением 21 Пфлопс. Производительность в режиме FP8 превышает 5 Эфлопс. Вычислительный комплекс может функционировать в связке с квантовыми системами Quantinuum Reimei и IBM Quantum System Two. В целом, новые суперкомпьютеры формируют единую исследовательскую платформу, в составе которой RIKYU обеспечивает ресурсы для научных задач с использованием ИИ, а ROQUO позволяет сочетать классические ИИ-вычисления с квантовыми методами. Такая связка даёт учёным гибкий инструментарий для работы со сложными моделями и для решения комплексных задач.
24.06.2026 [01:23], Владимир Мироненко
Европа получит 35 суперкомпьютеров на чипах NVIDIANVIDIA объявила о разработке по всей Европе 35 суперкомпьютеров на базе её чипов, которые позволят более 3 млн исследователей ускорить проведение научных исследований и внедрение промышленных инноваций в сфере ИИ. Это крупнейшее за год расширение в Европе сети суперкомпьютеров, охватывающее национальные суперкомпьютерные центры, ИИ-фабрики и академические исследовательские институты. Эти системы будут поддерживать исследования в области климатологии, здравоохранения, декарбонизации чистой энергетики, квантовых вычислений и фундаментальной науки. Работу большей части европейских ИИ-фабрик обеспечивают платформы Blackwell и Hopper, при этом с прошлого года было развернуто или анонсировано 800 Эфлопс вычислительных мощностей для ИИ. Эти суперкомпьютеры, включая обновлённый EuroHPC MareNostrum5 AI Барселонского суперкомпьютерного центра (BSC-CNS), Blue Swan (BavariaAI), IT4LIA, HammerHAI Центра высокопроизводительных вычислений в Штутгарте (HLRS) и ИИ-фабрика Mimer Национальной академической суперкомпьютерной инфраструктуры Швеции (NAISS), основаны на передовой ИИ-инфраструктуре NVIDIA, говорит компания. Так, суперкомпьютер MareNostrum 5 будет дооснащён системами GB300 NVL72 и GB200 NVL4, объединённых интерконнектом NVIDIA Quantum-X800 InfiniBand. Система, обеспечивающая производительность до 20 Эфлопс при обучении ИИ и 33 Эфлопс при ИИ-инференсе, позволит ускорить работу генеративного ИИ, климатическое моделирование, исследования в области здравоохранения и биотехнологий, устойчивого сельского хозяйства, энергетических систем и госсервисов. 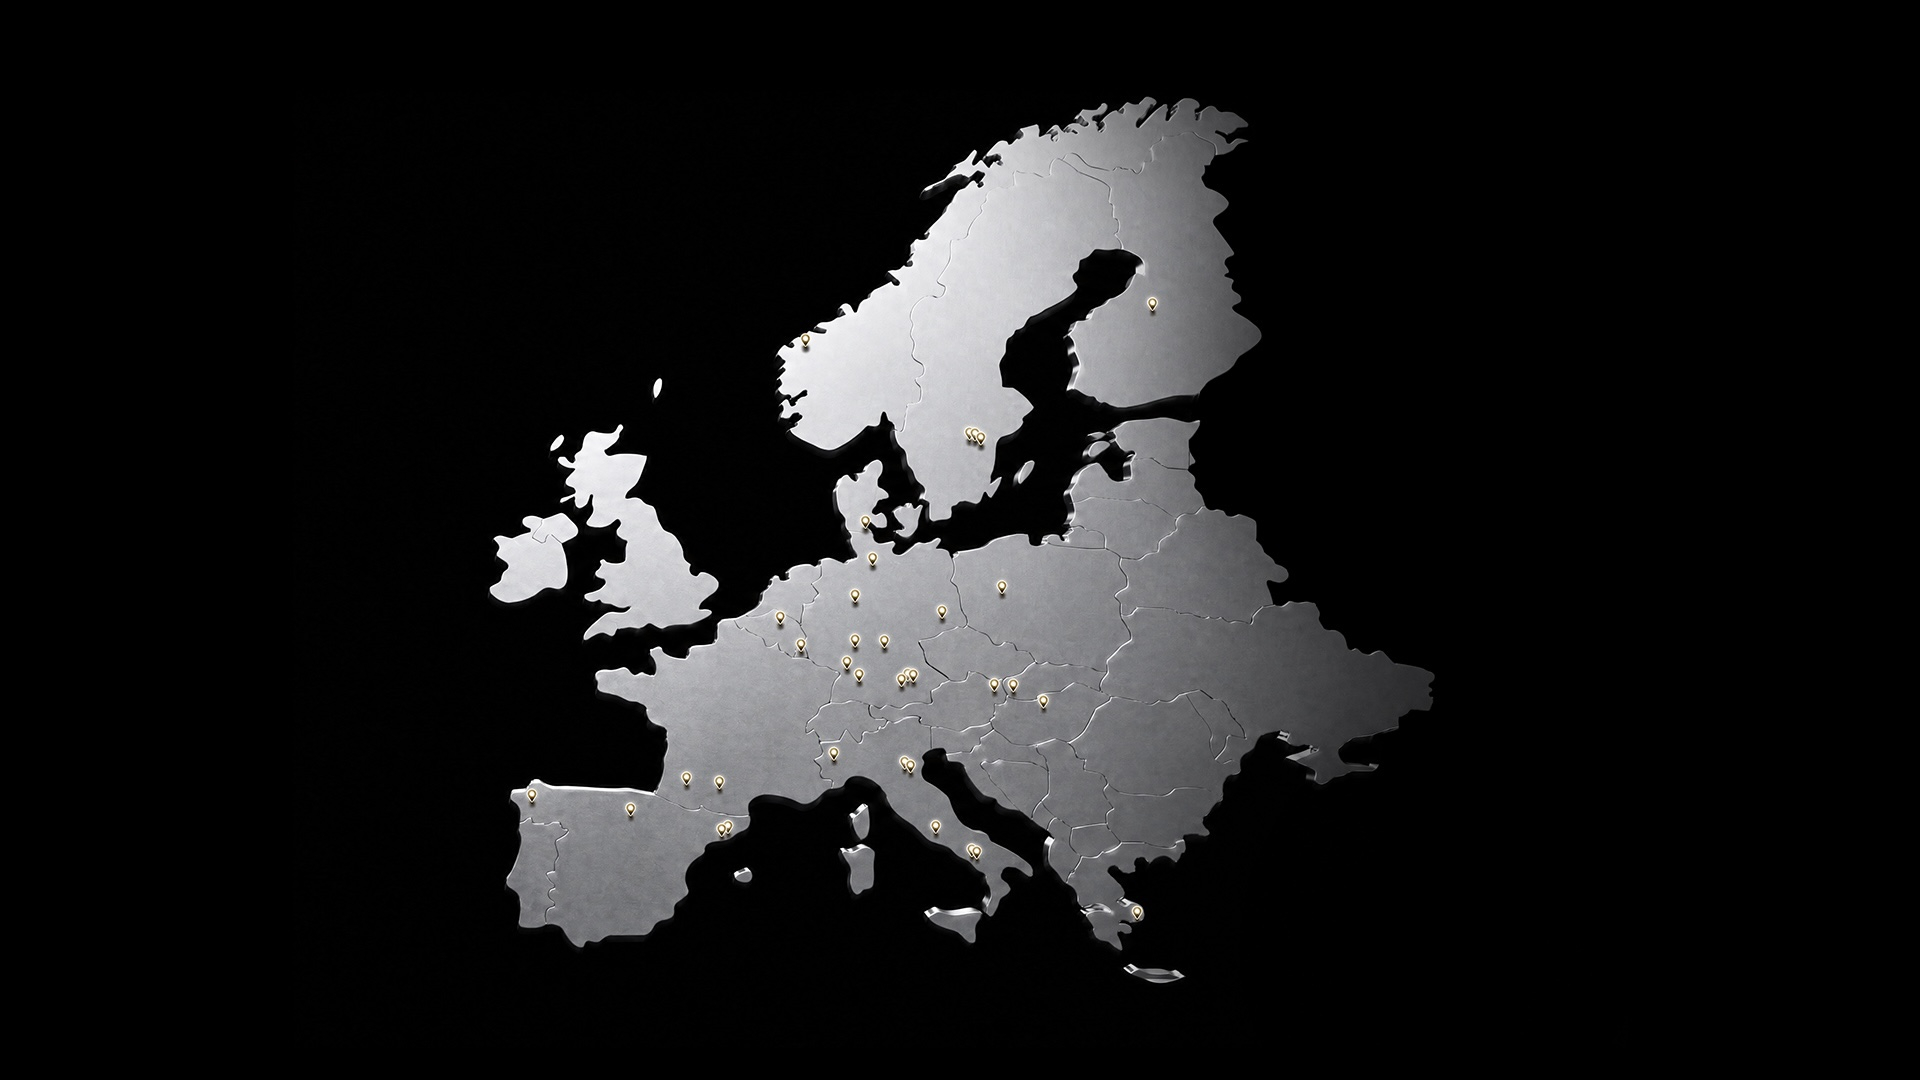
Источник изображения: NVIDIA Система Blue Swan (BavariaAI) добавит 1 тыс. ускорителей (GB200 NVL4 и Quantum-2 InfiniBand) суперкомпьютерным центрам FAU Erlangen и LRZ. Платформа обеспечит производительность до 11 Эфлопс при обучении ИИ и 22 Эфлопс при ИИ-инференсе. Она будет поддерживать инициативу Баварии по созданию базовых моделей, продвигая открытые мультимодальные модели для науки, государственного управления, исследований в области здравоохранения, робототехники и т.д. HammerHAI (HLRS) представляет собой первую в Германии ИИ-фабрику с более чем 850 GPU на базе GB200 NVL4 с Quantum-X800 InfiniBand. Суперкомпьютер HammerHAI, обеспечивающий производительность до 8 Эфлопс при обучении ИИ и 15 Эфлопс при ИИ-инференсе, обеспечит исследователям и промышленным пользователям безопасную ИИ-инфраструктуру для инженерного моделирования, инференса и научных исследования. Суперкомпьютер Mimer EuroHPC AI Factory (NAISS), размещённый в Линчёпингском университете (LiU, Швеция), будет использовать 100 систем GB200 NVL4 и сеть ConnectX-8. Обеспечивая производительность до 4 Эфлопс при обучении ИИ и около 7 Эфлопс при ИИ-инференсе, Mimer AI Factory будет способствовать развитию шведской ИИ-экосистемы в таких областях, как биологические науки, материаловедение, автономные системы, доверенный ИИ и т.д. Наконец, ИИ-фабрика IT4LIA с более чем 8 тыс. GPU на базе GB200 NVL4 с Quantum-X800 InfiniBand и ПО NVIDIA AI Enterprise обеспечивает производительность в размере 82 Эфлопс при обучении ИИ и 164 Эфлопс при ИИ-инференсе.
23.06.2026 [11:33], Сергей Карасёв
В Японии появился гибридный квантово-классический суперкомпьютер Roquo производительностью 19,8 ПфлопсВ Центре вычислительных наук японского Института физико-химических исследований (R-CCS) введён в строй гибридный квантово-классический суперкомпьютер Roquo, названный в честь горы Рокко к северу от города Кобе. В создании НРС-системы приняли участие DTS, NVIDIA, Giga Computing, DDN и ScaleWorX. Roquo состоит из 135 вычислительных узлов на базе NVIDIA GB200 NVL4. В общей сложности задействованы 540 чипов Blackwell и 270 чипов NVIDIA Grace. Применяется интерконнект NVIDIA Quantum-X800 InfiniBand с общей пропускной способностью до 3,2 Тбит/с (установлены коммутаторы Q3400, поддерживающие скорость передачи данных 800 Гбит/с на порт). Реализовано жидкостное охлаждение. Заявленная производительность на операциях FP64 составляет 19,8 Пфлопс, а теоретическое пиковое быстродействие на операциях FP8 превышает 5 Эфлопс. Суперкомпьютер использует интерфейс SQC, что позволяет формировать гибридные среды с поддержкой традиционных и квантовых вычислений. 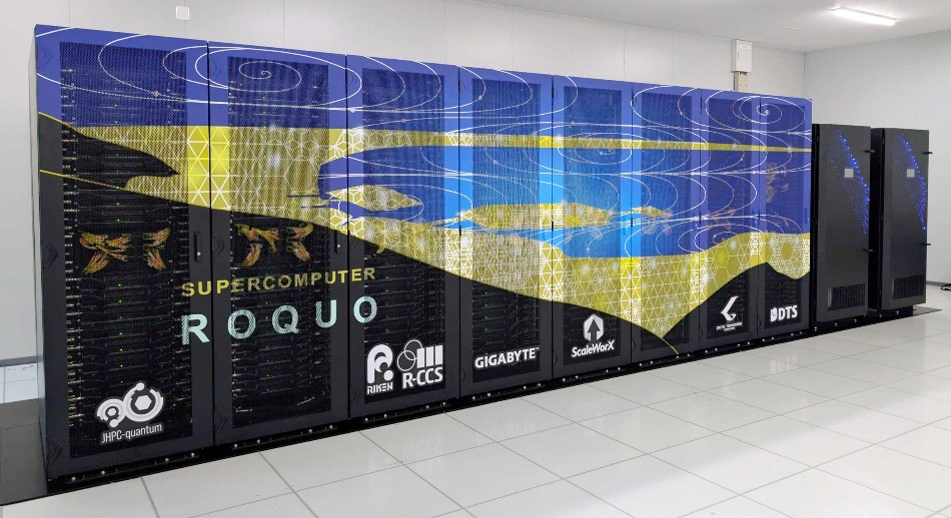
Источник изображения: RIKEN В рамках проекта по созданию Roquo корпорация DTS осуществляла общую разработку платформы в соответствии с требованиями R-CCS. В свою очередь, NVIDIA предоставила базовые вычислительные и сетевые компоненты, тогда как Giga Computing отвечала за проектирование и производство серверов. DDN предоставила высокоскоростное файловое хранилище. Наконец, специалисты ScaleWorX осуществили общую системную интеграцию. Суперкомпьютер Roquo, как ожидается, поможет ускорить разработку и оценку эффективности новых квантовых алгоритмов. Кроме того, система будет использоваться для решения сложных задач, с которыми не в состоянии справиться классические НРС-комплексы.
14.06.2026 [11:51], Сергей Карасёв
В Австралии запущен суперкомпьютер MAVERIC на базе NVIDIA GB200 NVL72Университет Монаша (Monash University) в Австралии в партнёрстве с компаниями NVIDIA, Dell Technologies и ЦОД-оператором CDC Data Centres объявил о запуске суперкомпьютера MAVERIC (Monash AdVanced Environment for Research and Intelligent Computing). Новый НРС-комплекс смонтирован в Бруклинском центре CDC в Мельбурне. В основу системы положены серверы Dell PowerEdge XE9712 на платформе NVIDIA GB200 NVL72. Эти суперускорители объединяют 72 чипа B200 и 36 процессоров Grace. При этом каждое изделие B200 содержит 16 896 ядер CUDA, 528 тензорных ядер и 192 Гбайт памяти HBM3Е. MAVERIC использует передовую технологию жидкостного охлаждения с замкнутым контуром, благодаря чему отпадает необходимость в постоянном водоснабжении. Утверждается, что такое конструктивное решение не только снижает негативное влияние на окружающую среду, но и устанавливает новый стандарт для устойчивых высокопроизводительных вычислений. 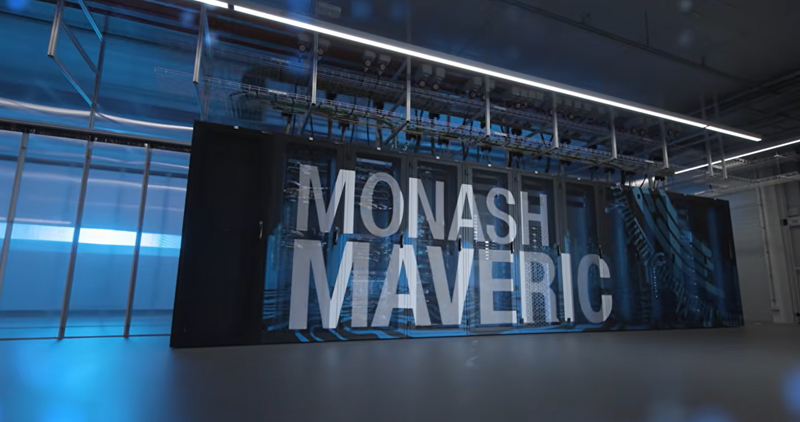
Источник изображения: Университет Монаша Показатели производительности MAVERIC не раскрываются. Но отмечается, что суперкомпьютер специально разработан для крупномасштабных задач ИИ и обработки больших объемов данных. Предполагается, что запуск машины поможет в решении важнейших глобальных проблем здравоохранения, включая раннюю диагностику рака, лечение хронических заболеваний, открытие новых лекарств и пр. Использовать ресурсы системы планируется и в других областях, включая моделирование климата и обработку конфиденциальной информации.
03.06.2026 [15:14], Руслан Авдеев
ЦОД проекта Microsoft Fairwater заработал в Висконсине, и он уже готов принять NVIDIA Vera RubinКомпания Microsoft запустила новую ИИ-фабрику проекта Fairwater в Висконсине. Ввод в эксплуатацию состоялся раньше запланированного срока, на объекте заработали сотни тысяч ИИ-систем NVIDIA Grace Blackwell, в частности NVIDIA GB200. Объект подключён к аналогичной ИИ-фабрике в Джорджии. В результате сформирована масштабируемая распределённая вычислительная система для самых требовательных передовых ИИ-моделей. Благодаря совместной работе над системами электроснабжения, охлаждения и сетевой инфраструктурой NVIDIA Spectrum-X Ethernet, а также новому сетевому протоколу Multipath Reliable Connection (MRC) с распределением пакетов данных по множественным маршрутам, архитектура Fairwater позволяет оптимизировать «экономику токенов» — стоимость обработки и генерации данных искусственным интеллектом. Дополнительно Microsoft завершила проверку платформы NVIDIA Vera Rubin. Облачный гигант подтвердил готовность платформы к развёртыванию в дата-центрах Microsoft Azure. NVIDIA Vera Rubin может использоваться наряду с системами Blackwell без необходимости модернизации инфраструктуры. Она обеспечивает производительность при инференсе до 10 раз выше на каждый затраченный мегаватт потребляемой мощности по сравнению с платформой-предшественницей. Интегрированная технология NVIDIA Confidential Computing защищает модели и данные в процессе работы ИИ-агентов. 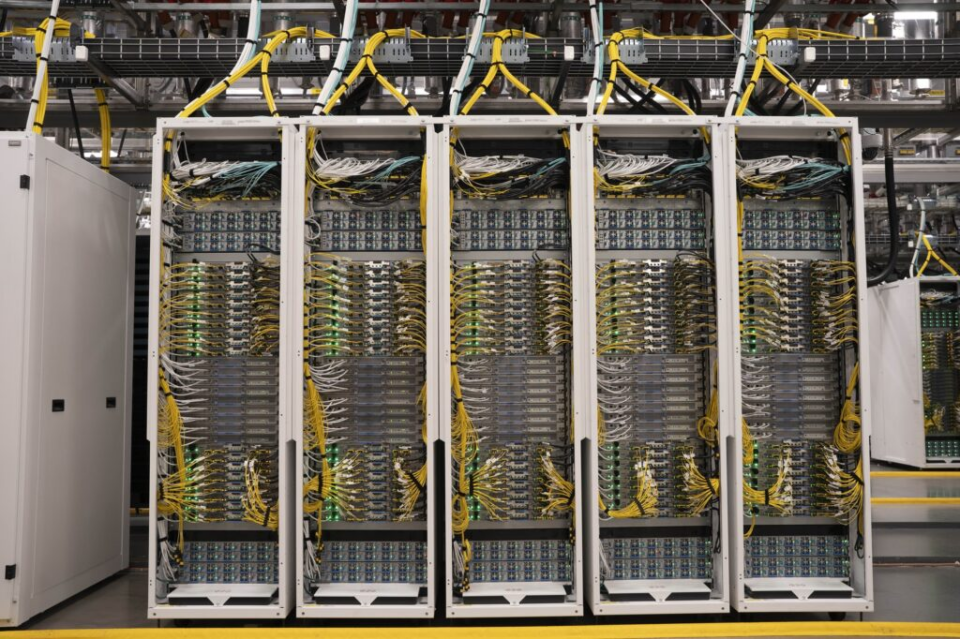
Источник изображения: NVIDIA Платформа NVIDIA Dynamo представляет собой программное решение для высокопроизводительного инференса, ускоряющее запуск и эксплуатацию ИИ-моделей. Кроме того, она ускоряет запуск моделей в среде AKS (Azure Kubernetes Service). Технология NVIDIA Grove отвечает за распределённую оркестрацию инференса в инфраструктуре Kubernetes. Речь идёт о запуске новой ИИ-фабрики Fairwater в США. Не так давно в эксплуатацию ввели объект в Атланте, хотя строительство в Висконсине началось довольно давно. В конце апреля глава Microsoft Сатья Наделла (Satya Nadella) заявил, что кампус строится ударными темпами и будет введён в эксплуатацию раньше намеченного срока.
22.04.2026 [10:45], Сергей Карасёв
Foxconn наладит массовое производство CPO-коммутаторов в III квартале 2026 годаТайваньский контрактный производитель электроники Foxconn начал пробные поставки коммутаторов с интегрированной оптикой CPO (Co-Packaged Optics). Об этом, как сообщает DigiTimes, рассказал Брэнд Ченг (Brand Cheng), председатель совета директоров Foxconn Industrial Internet (FII) — подразделения, которое специализируется на сетевых продуктах для облачных платформ. По его словам, отгрузки образцов CPO-коммутаторов FII организовала в I квартале 2026-го, тогда как их массовое производство запланировано на III четверть текущего года. Ожидается, что спрос на такое оборудование будет стремительно расти. По данным отраслевых исследований, продажи CPO-коммутаторов увеличатся с примерно 23 тыс. единиц в 2026 году до более чем 200 тыс. штук в 2030-м. Таким образом, прогнозируемый показатель CAGR (среднегодовой темп роста в сложных процентах) составляет 144 %. Как отмечает Ченг, FII рассчитывает на годовой объём продаж CPO-коммутаторов более 10 тыс. штук. По оценкам компании, выпуск таких устройств обеспечит существенно более высокую валовую прибыль по сравнению с нынешними продуктами 400–800G. Подчёркивается, что экосистема технологий CPO развивается в комплексе с архитектурами NVIDIA QuantumX и SpectrumX, а также Broadcom Tomahawk. Речь идёт о проектировании специализированных чипсетов и оптических компонентов, внедрении передовых технологий упаковки, системной интеграции и пр. По сложности такие решения значительно превосходят традиционные сетевые устройства. 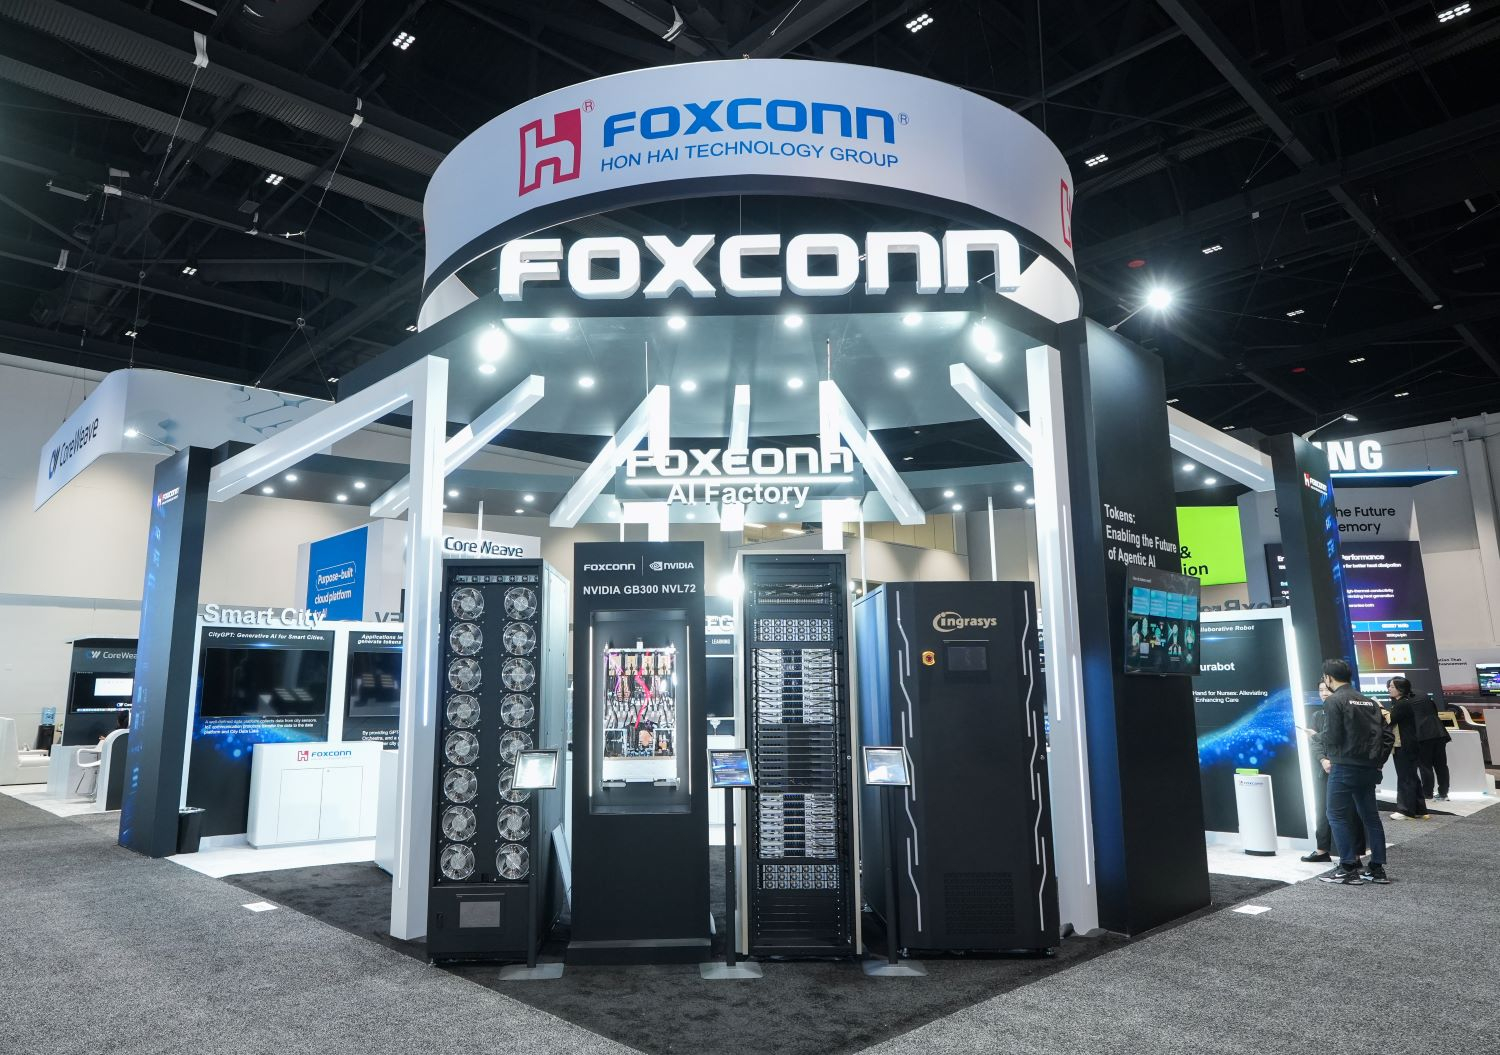
Источник изображения: Foxconn Ченг также сообщил о масштабировании производства ИИ-ускорителей NVIDIA GB200 и GB300. Кроме того, наблюдается рост заказов на выпуск ASIC-изделий со стороны крупнейших облачных провайдеров: ожидается, что отгрузки таких продуктов значительно увеличатся во II половине года. Ченг подчеркнул, что более 60 % основных элементов серверных ИИ-стоек теперь производится собственными силами. Компания сформировала необходимые запасы компонентов, в том числе чипов памяти, для выполнения заказов в сфере ИИ, включая выпуск GB200 и GB300. В 2025 году выручка FII составила ¥902,89 млрд ($132,36 млрд), что на 48,2 % больше, чем годом ранее. При этом чистая прибыль поднялась на 51,99 %, достигнув ¥35,286 млрд ($5,17 млрд). Выручка в облачном сегменте составила ¥602,679 млрд ($88,35 млрд), увеличившись на 88,7 % в годовом исчислении: на неё пришлось почти 70 % от общего объёма поступлений.
21.04.2026 [18:29], Руслан Авдеев
Глава Microsoft пообещал досрочно ввести в эксплуатацию самый мощный в мире ИИ ЦОД проекта FairwaterМногоцелевой ИИ-кампус Microsoft Fairwater в Висконсине строится ускоренными темпами и будет введён в эксплуатацию раньше запланированного срока, сообщает Datacenter Dynamics. Об этом на днях упомянул глава Microsoft Сатья Наделла (Satya Nadella). По его словам, это самый мощный в мире ИИ ЦОД, объединяющий «сотни тысяч» NVIDIA GB200, а оптоволокна в нём хватит, чтобы «обернуть планету четыре раза». Пока нет данных, готова ли уже площадка Fairwater к эксплуатации или просто будет сдана несколько раньше. О том, что кампус в городке Маунт-Плезант (Mount Pleasant) будет вот-вот достроен, сообщалось ещё осенью 2025 года. Тогда же компания объявила, что суммарные инвестиции в площадку в течение нескольких лет составят $7,3 млрд. Строительство началось ещё в 2023 году на территории производственной площадки Foxconn. Первоначально планировалось застроить более 127 га. Впоследствии компания получила разрешение застроить ещё 405 га, а чуть позже она купила за $43 млн ещё 65 га. В январе 2026 года Microsoft дано разрешение на строительство на территории кампуса ещё 15 зданий ЦОД. На данный момент Fairwater включает три больших объекта общей площадью около 11,5 тыс. м2. Для строительства понадобилось 74,9 км глубоких свай для фундамента, более 12 тыс. т строительной стали, 193 км подземного кабеля среднего напряжения и 116,8 км трубопроводов. 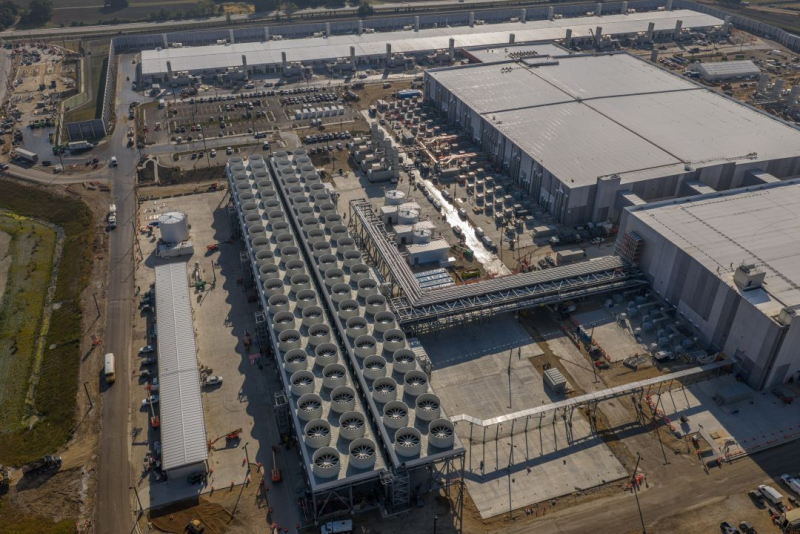
Источник изображения: Microsoft Похожий кампус Fairwater в Атланте (Джорджия) заработал в ноябре 2025 года, он будет напрямую связан с кампусом в Висконсине. Есть и планы строительства ЦОД в Лидсе (Leeds, Великобритания). По имеющимся данным компания, «близка» к получению разрешения на строительство в Западном Йоркшире. Кампус планируется построить на территории бывшей электростанции, он будет включать три трёхэтажных ЦОД (LBA10, 11 и 12) объекта площадью около 39 тыс. м2 каждый. Также на территории комплекса разместится электроподстанция. Строительство может стартовать в начале 2027 года. |
|

