
Материалы по тегу:
|
18.11.2026 [15:49], Андрей Крупин
В «Яндекс 360» для бизнеса появилась поддержка плагинов — они позволяют расширить возможности виртуального офисаОблачная площадка «Яндекс 360», предоставлявшая доступ к инструментам для совместной работы и делового общения, дополнилась каталогом плагинов — программных надстроек, позволяющих бизнесу расширить функциональные возможности виртуального офиса. В настоящий момент в каталоге собраны 50 плагинов — для «Трекера», «Почты», «Календаря», «Диска», «Вики» и «Форм». С их помощью можно, например, превратить входящее письмо из «Почты» в задачу в «Трекере», составить недельную сводку встреч в «Календаре» или сгенерировать QR-код со ссылкой на вики-страницу или опрос в «Формах». В будущем поддержка расширений появится во всех сервисах «Яндекс 360». 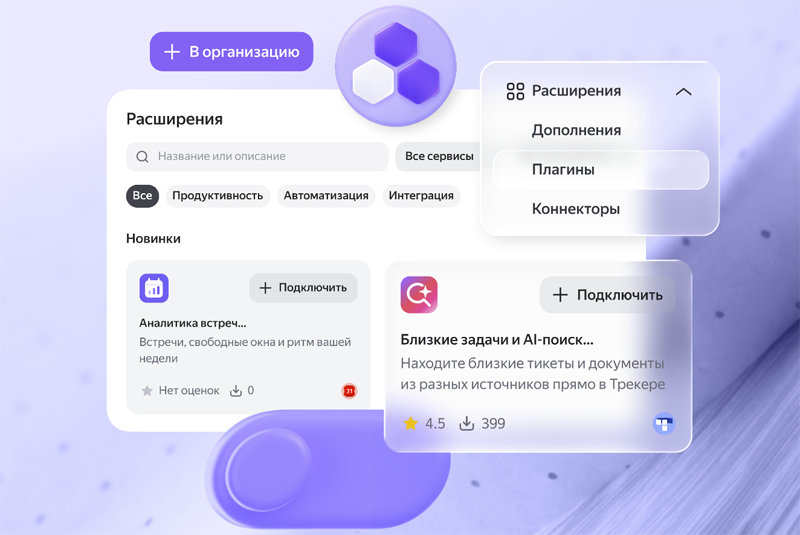
Источник изображения: 360.yandex.ru Разработать собственный плагин и опубликовать его в каталоге может любая организация, которая использует «Почту» для доменов. «Яндекс 360» предоставляет весь необходимый инструментарий и документацию. Перед добавлением в каталог расширения проходят модерацию. Плагин можно сделать доступным всем компаниям или только своим сотрудникам. Ранее собственный каталог плагинов появился у «Алисы AI» для бизнеса. Посредством надстроек можно подключить ИИ-ассистента к корпоративным сервисам — «Алиса AI» будет использовать информацию из них в своих ответах.
18.11.2026 [15:32], Руслан Авдеев
Американские ЦОД гиперскейл-уровня уже потребляют электроэнергию как целые штатыВ 2024–2025 гг. на американские ЦОД гиперскейлеров пришлось 1,8 % потребления электроэнергии США. При этом связанные с их работой выбросы оказались в 2-3 раза выше, чем ранее прогнозировалось для 2018 года, сообщает The Register со ссылкой на гарвардских исследователей. По словам учёных, совокупное потребление такими ЦОД электроэнергии при максимальной нагрузке приблизилось к аналогичным метрикам отдельных штатов вроде Индианы, Мичигана или Теннесси. Всего исследователи выявили 403 объекта благодаря базе ЦОД, спутниковым снимкам и данным OpenStreetMap. Вместо учёта показаний электросчётчиков исследователи оценили энергопотребление исходя из электрической мощности каждого ЦОД, а также количества часов в году и уровня загрузки оборудования объектов. Общее потребление электроэнергии составило 68–99 ТВт·ч, для сравнения — каждый из упомянутых штатов потребил за изучаемый период порядка 100 ТВт·ч. 
Источник изображения: Billy Joachim/unsplash.com Выбросы углекислого газа посчитали с использованием базы данных Агентства по охране окружающей среды США (EPA), содержащей сведения об объёмах генерации электричества и выбросах отдельных электростанций. Выбросы составили от 21 до 31 млн т CO2, в среднем — 25,7 млн т. Для сравнения, в 2018 году показатель был на уровне 10,5 млн т. Исследование охватило период с мая 2024 по апрель 2025 гг., но сегодня потребление энергии и выбросы углекислоты ещё выше, поскольку бум строительства ИИ ЦОД не замедлился. В докладе также рассматривается структура источников энергии, используемых для электроснабжения ЦОД гиперскейл-уровня. Она может заметно отличаться в зависимости от региона, поэтому место строительства объектов влияет на объём выбросов, связанных с их деятельностью. В среднем, как показало исследование, около 54 % электроэнергии для ЦОД генерировалось за счёт ископаемого топлива, в основном природного газа и угля. При этом интенсивность выбросов углерода для таких объектов была в среднем ниже, чем по энергосистеме США в целом. По словам исследователей, возможность полной оценки ограничена. Так, имеющихся данных недостаточно для оценки всех ЦОД гиперскейл-уровня в США, а имеющиеся данные не позволяют разделить энергопотребление на долю вычислений общего назначения и ИИ. По оценкам Howden, потребление электричества дата-центрами в США растёт приблизительно в десять раз быстрее, чем мощность местных электросетей. Это означает, что в ближайшем будущем операторы ЦОД, возможно, вынуждены будут сами обеспечивать себя энергией из альтернативных источников.
18.11.2026 [13:30], Руслан Авдеев
NVIDIA больше не будет продавать Китаю ускорители H200NVIDIA более не намерена продавать свои ИИ-ускорители H200 в Китай, заявила исполняющая обязанности главы компании Колетт Кресс (Colette Kress) во вторник, сообщает TechCrunch. Компания прекращает пользоваться лазейкой в американском запрете на экспорт передовых полупроводников в КНР. Доступ Китая к передовым ИИ-ускорителям стал одной из важных тем в беседе с инвесторами после того, как прежний глава Дженсен Хуанг (Jensen Huang) вынужденно покинул свой пост. Заявление сделано в тот же день, что и объявление о создании комитета по надзору за соблюдением требований национальной безопасности и экспортного контроля, а также за управлением рисками, созданного при совете директоров. Сделка по продаже чипов NVIDIA H200 была согласована Хуангом с президентом США Дональдом Трампом (Donald Trump). Прежние договорённости предполагали, что поставляться ускорители должны были через США со сбором в размере 25 % от их стоимости. Подобный подход вызвал недовольство у «ястребов» в США, требовавших лишить китайские структуры доступа к передовым ИИ-решениям для сохранения первенства США в гонке ИИ. При этом Хуанг долгое время настаивал, что США важнее сохранить активное присутствие на китайском рынке, поскольку закрытие его для американской технологической отрасли является медвежьей услугой для Соединённых Штатов. По времени уход Хуанга с поста на фоне шпионского/контрабандного скандала совпал с введением новых антикитайских правил. Введённые ограничения запрещают применять передовые американские чипы в иностранных ЦОД, удалённо обслуживающих китайских клиентов. 
Источник изображения: Haydn/unsplash.com Инвестиционный банк Jefferies прогнозирует, что эти правила приведут к снижению выручки NVIDIA в сегменте ЦОД в следующем году на $44-62 млрд. При этом новая глава — Колетт Кресс утверждает, что высокий неудовлетворенный спрос на передовые решения вроде Vera Rubin означает, что введение новых правил не окажет влияния на общую выручку компании. Тем не менее, в долгосрочной перспективе компания может потерять потенциальных клиентов в Сингапуре, Малайзии, Таиланде и Индонезии, поскольку, по некоторым оценкам, до 20 % выручки NVIDIA приходится на спрос, связанный с КНР. Так, выручка подразделения компании в Сингапуре в 2025 году составила $104 млрд, и после публикации NVIDIA перестала публиковать соответствующую статистику. Даже до того, как NVIDIA запретила экспорт H200 в Китай, тот уже в основном отказался принимать соответствующие ускорители, желая поддержать отечественных производителей. При этом крупные потребители вычислительных мощностей заинтересованы в передовом оборудовании NVIDIA и полагаются в первую очередь на импортные ускорители. Ведущие китайские ИИ-компании ищут способы получать доступ к решениям NVIDIA за пределами КНР. В китайских ИИ-моделях находят следы того, что их обучали на решениях Grace Blackwell, экспорт которых в Китай запрещён. Весьма вероятно, что обучение проходило в ЦОД вне Китая, но новые правила запрещают использовать ускорители подобным образом, поскольку дата-центры, предлагающие услуги китайским клиентам, тоже не смогут теперь покупать передовые решения NVIDIA. При покупке чипов придётся доказывать американским властям, что услуги не предоставляются китайским структурам. Если подтверждения предоставить не получится, операторам ЦОД, возможно, придётся перейти на альтернативные чипы, в результате чего доля NVIDIA на рынке ИИ-решений дополнительно сократится.
18.11.2026 [12:40], Сергей Карасёв
До 2 Тбайт и PCIe 4.0 x4: SSSTC представила М.2 SSD серии PQ2 для индустриальных приложенийКомпания Solid State Storage Technology Corporation (SSSTC), подразделение Kioxia, анонсировала накопители PQ2 — свои первые SSD индустриального класса на основе флеш-чипов памяти QLC NAND. Устройства предназначены для применения во встраиваемых системах, различных терминалах, сетевом оборудовании и компьютерах с ИИ-функциями. Новинки доступны в вариантах исполнения M.2 2280 и M.2 2230. В обоих случаях для обмена данными служит интерфейс PCIe 4.0 x4. Применены микросхемы 3D QLC производства Kioxia. Задействована технология CBA (CMOS directly Bonded to Array), которая, как утверждается, обеспечивает повышение энергоэффективности, производительности и плотности по сравнению с решениями предыдущего поколения. Кеш DRAM отсутствует. 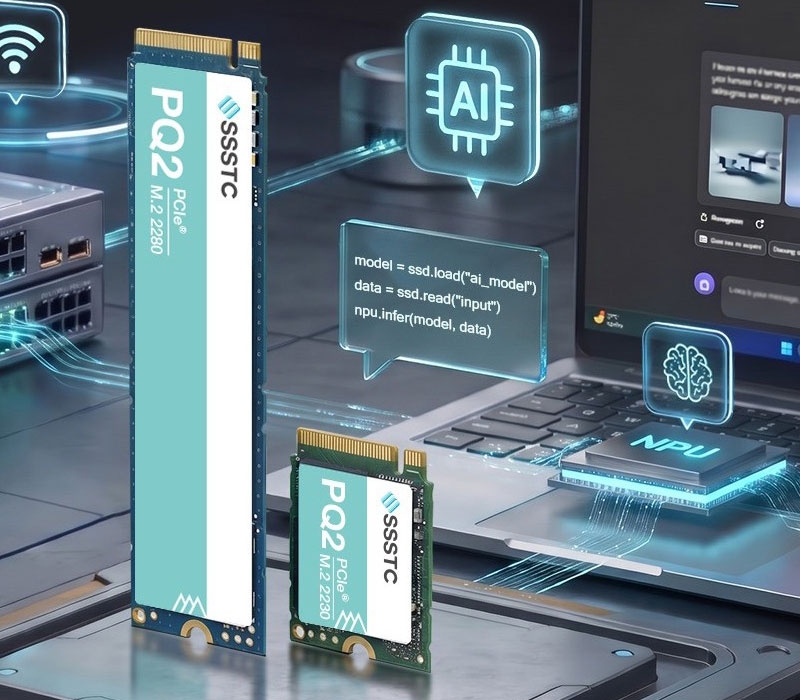
Источник изображения: SSSTC Вместимость может составлять 512 Гбайт, а также 1 и 2 Тбайт. Скорость последовательного чтения информации достигает 7000 Мбайт/с, скорость последовательной записи — 6200 Мбайт/с. Величина IOPS при произвольных чтении и записи данных блоками по 4 Кбайт — до 1 млн. Средняя наработка на отказ (MTBF) превышает 3 млн часов. Накопители способны выдерживать более одной полной перезаписи в сутки (1 DWPD) на протяжении трёх лет. Для SSD предусмотрена поддержка аппаратного шифрования по алгоритму AES-256, а также TCG Opal и TCG Pyrite (опционально). Упомянута программная защита от внезапного отключения питания (FW PLP). Диапазон рабочих температур простирается от 0 до +85 °C. Накопители оптимизированы для нагрузок с высокой интенсивностью чтения данных.
18.11.2026 [12:38], Сергей Карасёв
2048 ядер в 2U: Giga Computing выпустила 2U4N-сервер H295-D80-CS1 с СЖО на базе AMD EPYC VeniceКомпания Giga Computing, подразделение Gigabyte, анонсировала сервер H295-D80-CS1 высокой плотности для HPC-задач, облачных платформ и HCI. Новинка, выполненная в форм-факторе 2U, получила четырёхузловую конфигурацию с тыльным доступом. Каждый из узлов располагает двумя процессорами AMD EPYC Venice 9006 в исполнении Socket SP7 и 32 слотами для модулей оперативной памяти DDR5 (M)RDIMM (16-канальная подсистема памяти на процессор). Таким образом, в общей сложности сервер несёт на борту восемь CPU и до 128 модулей ОЗУ. Суммарное количество вычислительных ядер составляет до 2048 (при использовании 256-ядерных чипов). 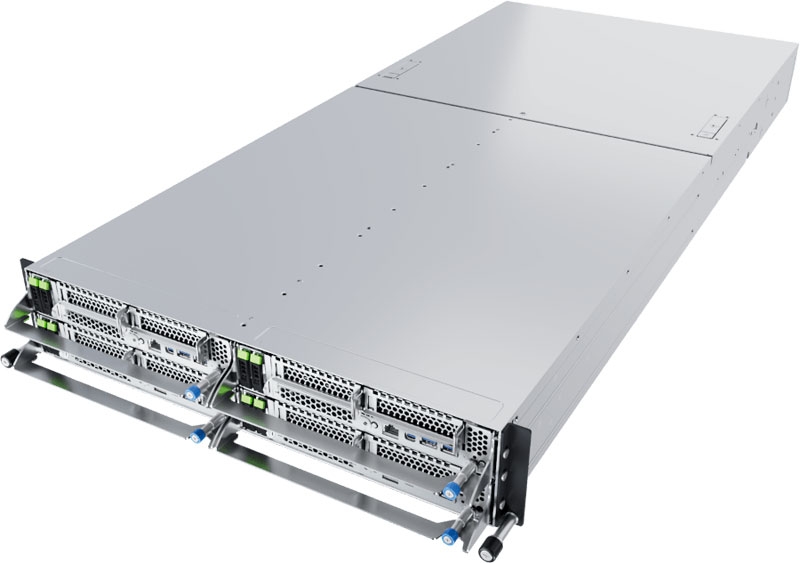
Источник изображений: Giga Computing В устройстве реализована замкнутая система прямого жидкостного охлаждения (Closed-loop DLC). Это упрощает установку сервера в существующих машинных залах дата-центров. Предусмотрена функция обнаружения протечек. 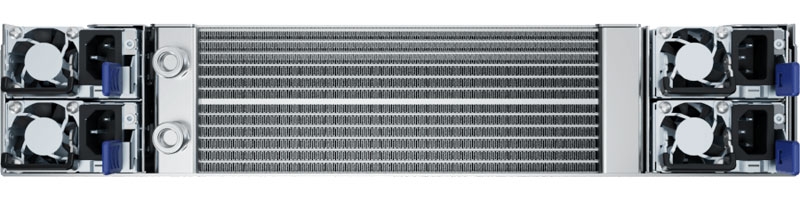 Модель H295-D80-CS1 допускает монтаж восьми накопителей E1.S с интерфейсом PCIe 6.0 (NVMe); поддерживается горячая замена. Доступны по четыре слота для низкопрофильных карт PCIe 6.0 x16 и PCIe 6.0 x8. Кроме того, есть четыре разъёма OCP NIC 3.0 (PCIe 6.0 x16). Питание обеспечивают четыре блока мощностью 3200 Вт каждый с резервированием и сертификатом 80 PLUS Titanium. Прочие технические характеристики сервера пока не раскрываются.
18.11.2026 [09:55], Владимир Мироненко
NVIDIA ускорила эмуляцию FP64-вычислений на своих ИИ-чипахВо многих научных симуляциях — от молекулярной химии до материаловедения — львиная доля времени вычислений уходит на выполнение операций умножения плотных матриц (GEMM) с высокой точностью: DGEMM (для вещественных 64-бит чисел с плавающей запятой двойной точности) и ZGEMM (для комплексных 64-бит чисел с плавающей запятой двойной точности). В задачах HPC и ИИ для ускорения операций GEMM и других базовых подпрограмм линейной алгебры (BLAS) на ускорителях NVIDIA широко используется библиотека cuBLAS. Активное развитие аппаратных средств, оптимизированных для вычислений с более низкой точностью, стимулировало разработку нового класса алгоритмов, которые позволяют получать результаты с полноценной двойной точностью, используя при этом более быстрые тензорные ядра (Tensor Cores), изначально предназначенные для целочисленных вычислений. NVIDIA отметила, что с выходом CUDA Toolkit 13.4.2 при использовании cuBLAS больше не нужно выбирать между точностью и скоростью. Библиотека разбивает каждое число двойной точности на целочисленные компоненты, выполняет их умножение на тензорных ядрах, а затем восстанавливает точный результат. Итоговые значения имеют полную точность (double precision), но при этом вычисления выполняются без использования аппаратных FP64-блоков. 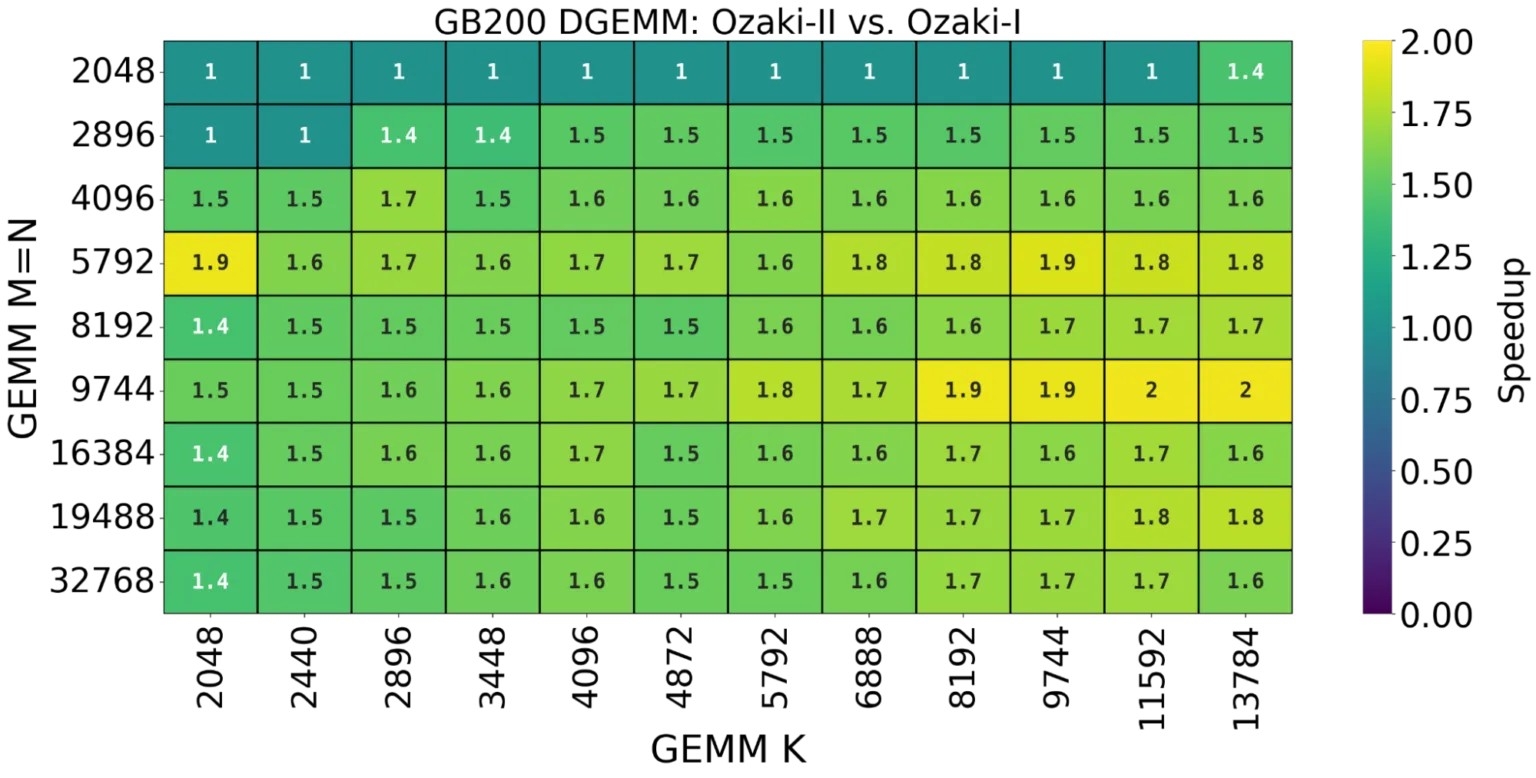 Росту эффективности процесса способствуют два новых алгоритма: схема Ozaki-II требует меньше целочисленных умножений, чем предыдущая версия Ozaki-I, а алгоритм 2M для эффективного умножения комплексных матриц сокращает количество операций по сравнению с классическим подходом с четырёх до двух. Решение основано на концепции автоматической динамической точности (Automatic Dynamic Precision, ADP). Схемы Озаки-I и Озаки-II имеют общий первый этап, но различаются способом выполнения умножения больших целых чисел. cuBLAS использует эвристический подход для автоматического выбора между алгоритмами для достижения максимальной производительности, хотя доступен и ручной выбор типа расчётов. Архитектура Rubin вводит новый числовой формат — TI16 (12-бит знаково целое с диапазоном значений от -2047 до +2047), который отлично подходит для ускорения вычислений по схеме Озаки. В библиотеке cuBLAS 13.4 формат TI16 используется для ускорения Ozaki-I и Ozaki-II с помощью инструкции `tcgen05.mma` на ускорителях Rubin. На рисунке ниже показан прирост скорости операции DGEMM в cuBLAS при использовании метода Ozaki-II по сравнению с нативным FP64 на системе VR200 NVL72. 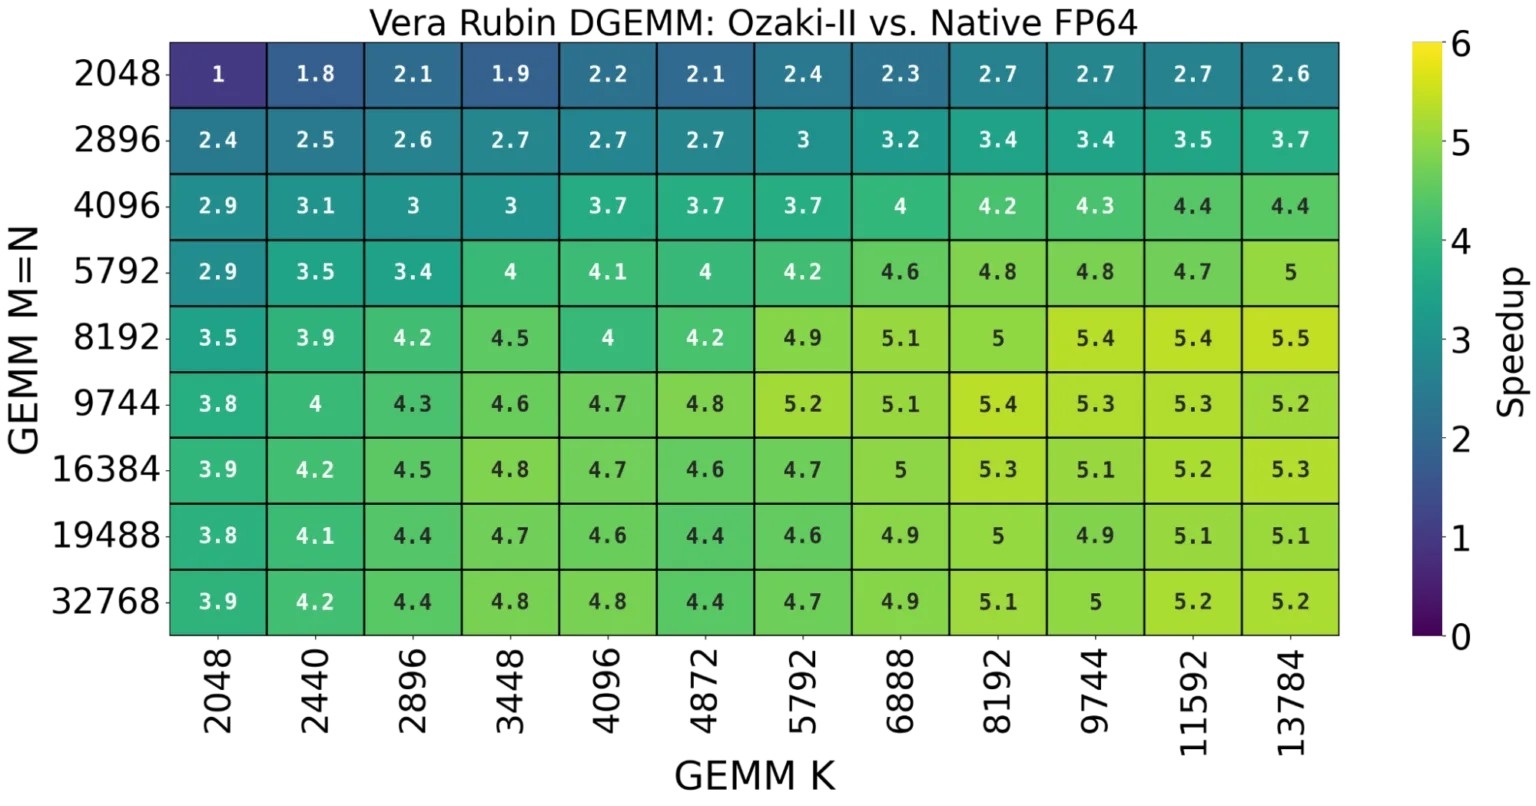 Верхний предел прироста производительности зависит от соотношения пропускной способности целочисленных тензорных ядер ускорителя и производительности его аппаратных блоков для вычислений в формате FP64. Это соотношение существенно варьируется в зависимости от конкретной модели устройства. Компания продемонстрировала это на примере ускорителя RTX PRO 6000 Blackwell Server Edition. На рисунке ниже представлено ускорение DGEMM при использовании схемы Ozaki-II по сравнению с нативным выполнением FP64 на данной модели. 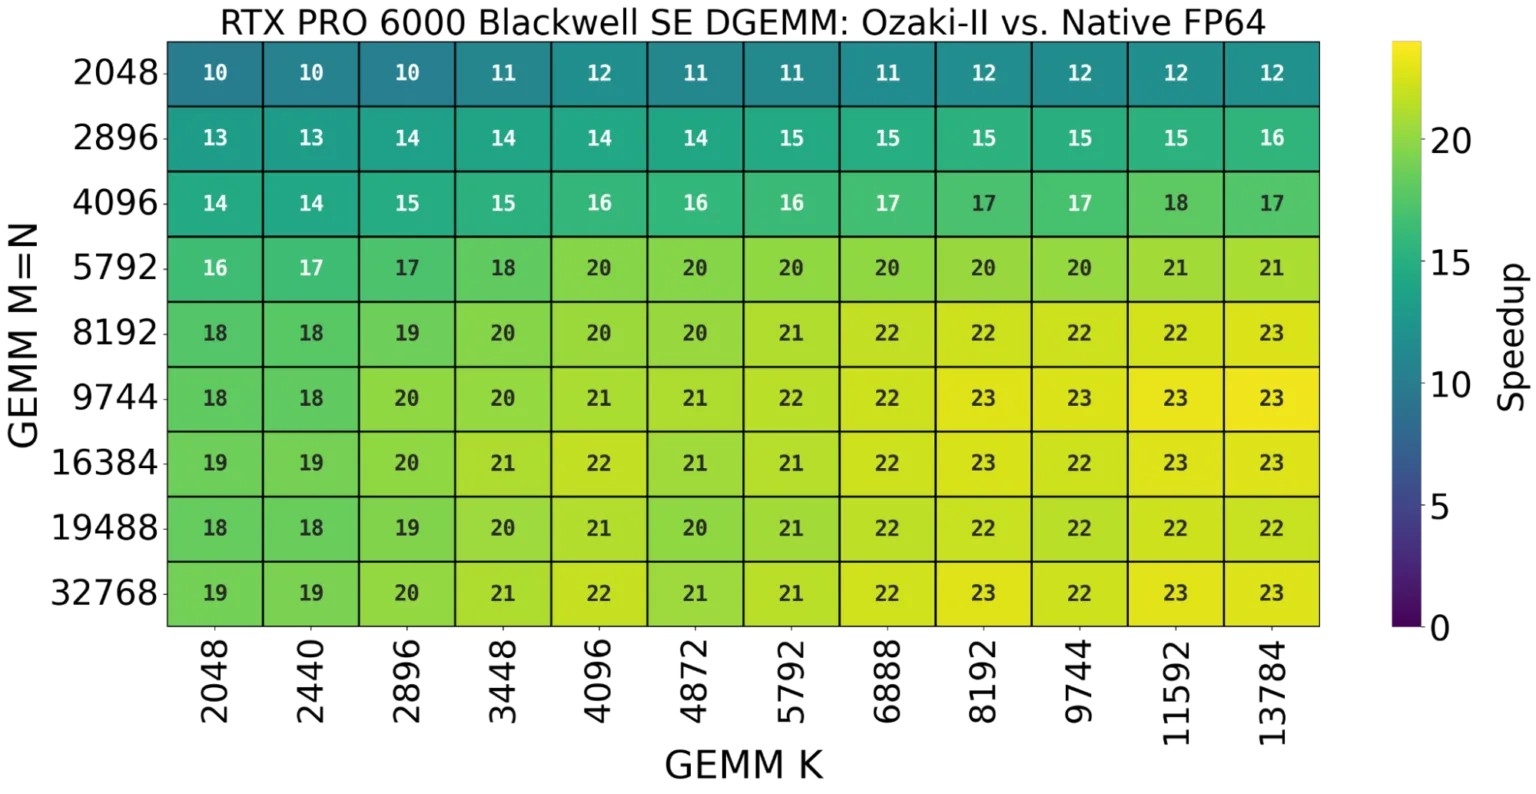 Применение Ozaki-II обеспечивает преимущество во всем диапазоне протестированных размеров матриц: даже для самых маленьких матриц скорость растёт в 10 раз, а для самых крупных — в 23 раза. NVIDIA осознанно предпочитает использовать эмуляцию для повышения производительности HPC на ИИ-ускорителях вместо создания специализированных блоков для аппаратных FP64-вычислений. В свою очередь, в AMD считают, что это FP64 остаётся золотым стандартом для научных вычислений и подход NVIDIA к этому вопросу оправдан не для всех сценариев. Разработчики AMD уверены, что в настоящее время нет замены «сырой» производительности FP64 и планируют увеличить нативную FP64-производительность ускорителя Instinct MI430X. Предполагается, что для «Миссии Генезис» (Genesis Mission) будут использоваться оба подхода, но в основном она будет полагаться на эмуляцию. Впрочем, NVIDIA Rubin HPC так или иначе обещает значительно повысить скорость обработки HPC-задач, но до выхода этого ускорителя пока далеко.
18.11.2026 [09:22], Руслан Авдеев
Компьютер LEO, открывший эпоху коммерческого применения вычислительной техники, отмечает 75-летиеВ ноябре исполняется 75 лет бизнес-вычислениям. Кембриджский Центр истории вычислительной техники (Centre for Computing History, Великобритания) устраивает праздник LEO@75 в честь машины, положившей начало коммерческому применению вычислительной техники, сообщает The Register. Центр представляет собой интерактивный музей компьютеров. В 2018 году он получил грант Национальной лотереи Великобритании (National Lottery), призванный помочь сохранить, архивировать и оцифровывать различные артефакты, документы и личные воспоминания, связанные с компьютерами LEO (Lyons Electronic Office). LEO был одним из первых компьютеров, важность разработки трудно переоценить. Его архитектура была построена на основе системы EDSAC Кембриджского университета, созданной командой, возглавлявшейся одним из пионеров компьютерных вычислений — Морисом Винсентом Уилксом (Maurice Vincent Wilkes, 1913–2010). 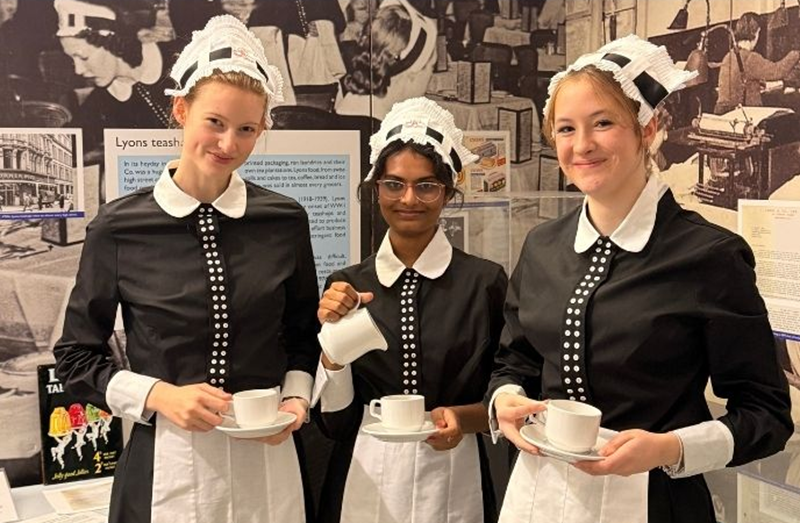
Источник изображения: Centre For Computing History При разработке EDSAC использовались идеи, изложенные в незавершённом документе «Первый проект отчёта об EDVAC» (First Draft of a Report on the EDVAC) Джона фон Неймана (John von Neumann). Черновик документа распространили в 1945 году, за четыре года до появления самого компьютера. В том же году завершились работы над его предшественником — ENIAC. Изначально тот программировался с помощью переключателей и перекоммутации кабелей. EDVAC же проектировали как машину, способную хранить команды непосредственно в собственной памяти. В докладе были изложены принципы, ныне известные как «архитектура фон Неймана» (принстонская архитектура). На эти идеи опирались Морис Уилкс (Maurice Wilkes) и Дуглас Хартри (Douglas Hartree) при разработке EDSAC, ставшено непосредственным предшественником LEO. EDSAC выполнил свою первую программу в мае 1949 года, за несколько месяцев до поставки модели BINAC, созданной Эккертом (Eckert) и Мокли (Mauchly) и ставшей первой машиной с хранимой программой за авторством данных исследователей. Первой работавшей электронной машиной с хранимой программой был экспериментальный компьютер Manchester Baby (Small-Scale Experimental Machine), выполнивший свою первую программу в 1948 году. LEO выполнил первую коммерческую программу в 1951 году, и в том же году Бюро переписи населения США (US Census Bureau) получило компьютер UNIVAC I, разработанный Эккертом и Мокли.
17.11.2026 [22:05], Павел Котов
LANL испытает ускорители Maverick-2 — это уже вторая система NextSilicon для Министерства энергетики СШАМинистерство энергетики США развернуло на базе испытательного стенда Darwin в Лос-Аламосской национальной лаборатории (LANL) второй кластер Maverick-2 израильского стартапа NextSilicon, сообщает The Register. Новая система значительно меньше развёрнутого ранее в в Сандийских национальных лабораториях первого суперкомпьютера на базе технологий NextSilicon с 64 вычислительными узлами и 128 ускорителями — она располагает всего четырьмя ускорителями. Подобные компактные системы позволяют специалистам LANL проверять и адаптировать для новых чипов широкий спектр программных кодов, выявлять неполадки, совместно с NextSilicon устранять их и непосредственно влиять на функциональные возможности чипов будущих поколений. Интерес LANL к Maverick-2 — это первый шаг к масштабному внедрению решений NextSilicon в будущие суперкомпьютеры Министерства энергетики. Инженерам необходим прямой доступ к оборудованию, поскольку некоторые из решаемых в лаборатории задач невозможно запускать на общедоступных вычислительных системах. Помимо ядерного оружия, лаборатория занимается моделированием процессов, например, термоядерного синтеза. 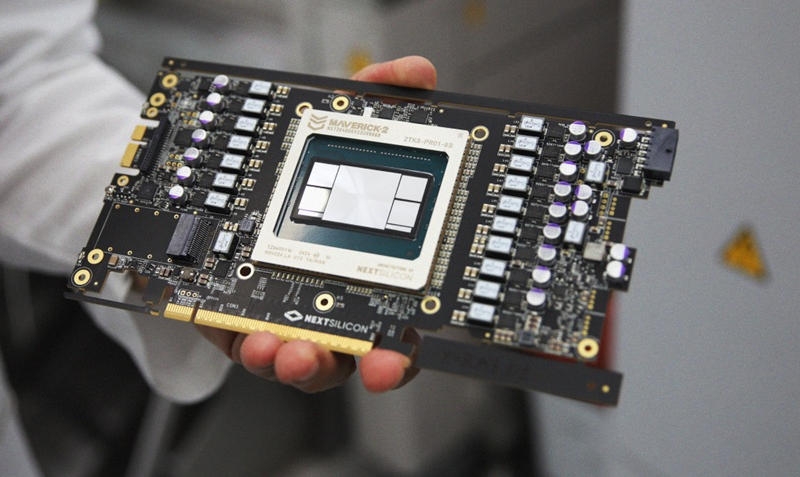
Источник изображения: NextSilicon «NextSilicon подходит для переконфигурирования системы в соответствии с рабочей нагрузкой, по запросу. Надежда в том, что нам не придётся больше жёстко определять объём требуемых ресурсов CPU и GPU. Мы можем пользоваться более гибкой, конфигурируемой архитектурой, адаптируемой к рабочему процессу», — рассказал главный научный сотрудник LANL Гален Шипман (Galen Shipman). Архитектуры на основе потоков данных могут быть эффективными в задачах с ограничениями пропускной способности памяти. Поэтому ускорители с похожей архитектурой, такие как Groq,Cerebras и SambaNova всё чаще используются в задачах инференса. Решения NextSilicon отличаются изначальной поддержкой разреженных FP64-вычислений. Однако разработка для таких чипов сложнее, поэтому NextSilicon создала компилятор, преобразующий существующий программный код на C, Python, Fortran или CUDA в граф для запуска на Maverick. Предельная производительность Maverick-2 варьируется в зависимости от типа рабочей нагрузки, поэтому в NextSilicon решили не афишировать пиковые теоретические показатели. NextSilicon протестировала свои системы в HPCG, LAMMPS и Sparta. В HPCG один чип Maverick демонстрирует производительность 600 Гфлопс — это сопоставимо с показателями современных GPU, но при вдвое меньшем потреблении энергии.
17.11.2026 [21:31], Павел Котов
AWS продаст Blackstone два кампуса ЦОД и тут же арендует ихAWS и инвестиционная компания Blackstone заключили сделку, согласно которой последняя становится владельцем двух кампусов ЦОД AWS и передаёт их в обратно аренду Amazon на первоначальный срок в 12 лет, сообщает The Register. Ранее AWS решила передать чипы NVIDIA Grace Blackwell на сумму около $8 млрд созданной специально для этих целей компании (SPV), чтобы взять их назад в аренду. Только что сформированная структура Blackstone Digital Infrastructure Trust (BXDC) получит долю в 75 % в двух совместных предприятиях (СП) с AWS. Сумма сделки оценивается в $5 млрд. AWS сохраняет за собой долю в 25 % в этих СП и принимает объекты на условиях полной ответственности за их содержание. Это значит, что, помимо арендной платы, компания обязуется покрывать расходы на уплату налогов на недвижимость, страхование зданий, а также затраты на их техническое обслуживание и ремонт. Активы BXDC включают 13 недавно построенных объектов для размещения серверного оборудования общей мощностью 647 МВт, гласит поданная Blackstone в Комиссию по ценным бумагам и биржам США (SEC) форма 8-K. Один из кампусов включает девять зданий, расположенных на сервере штата Индиана; второй — ещё четыре объекта в штате Миссисипи. AWS арендует мощности и у других операторов ЦОД — в этом году компания заключила соглашение со STACK Infrastructure о развитии кампусов в северо-западной части штата Луизиана; проект оценивается в $12 млрд. Также AWS увеличила инвестиции в ИИ ЦОД в Луизиане, но отозвала заявку на строительство ЦОД в Вирджинии. 
Источник изображения: Amazon Сделки по схеме продажи с обратной арендой также нередко встречаются в отрасли ЦОД — форматом REIT пользуются многие девелоперы и операторы. QTS Realty Trust, также входящая в Blackstone, строила объекты, которые впоследствии передавались в аренду Microsoft. По словам Omdia, схема продажи с обратной арендой может быть более оправданной экономически. Важно понимать, что речь идёт о здании и инфраструктуре, а не оборудовании, которое размещается на объекте. «Также очевидно, что масштабные капзатраты гиперскейлеров создают нагрузку на их финансовые показатели, и они вынуждены обращаться к рынку заёмного капитала для финансирования строительства. Конечно, использование заёмных средств — стандартная практика, но можно предположить, что сейчас объём долга для развития ИИ-инфраструктуры значительно выше, чем в прошлом», — говорит Omdia. Сделка, как ожидается, будет закрыта в IV квартале 2026 года при соблюдении условий. Любая из сторон может расторгнуть соглашение, если оно не будет закрыто к 31 декабря 2026 года, гласит форма 8-K. В этом случае сторона, не являющаяся причиной расторжения договора, имеет право на получение компенсации за расторжение сделки в размере $150 млн.
17.11.2026 [21:18], Павел Котов
Японский суперкомпьютер Fugaku взломали через страницу мониторингаЯпонский Центр компьютерных наук RIKEN, где размещается суперкомпьютер Fugaku, сообщил о несанкционированных попытках доступа вследствие утечки данных. В период с 10 по 13 ноября неизвестные произвели атаку на веб-панель, отображающую рабочие параметры Fugaku, передаёт The Register. С 2020 по 2022 год Fugaku возглавлял рейтинг TOP500 самых мощных суперкомпьютеров в мире. В обновлённой версии рейтинга он занимает девятое место. В результате взлома панели злоумышленники, по всей видимости, смогли проникнуть в сеть RIKEN. Они получили доступ к ряду серверов, содержащих данные авторизованных пользователей, и установили на них вредоносное ПО. На серверах хранились имена и адреса электронной почты пользователей, а также учётные данные, которые использовались для доступа к другим суперкомпьютерам и сервисам, не находящимся под управлением RIKEN. Злоумышленники предприняли попытки воспользоваться этими учётными данными. Сейчас RIKEN совместно с эксплуатирующими эти суперкомпьютеры организациями проводит расследование с целью установить, увенчались ли эти попытки успехом. 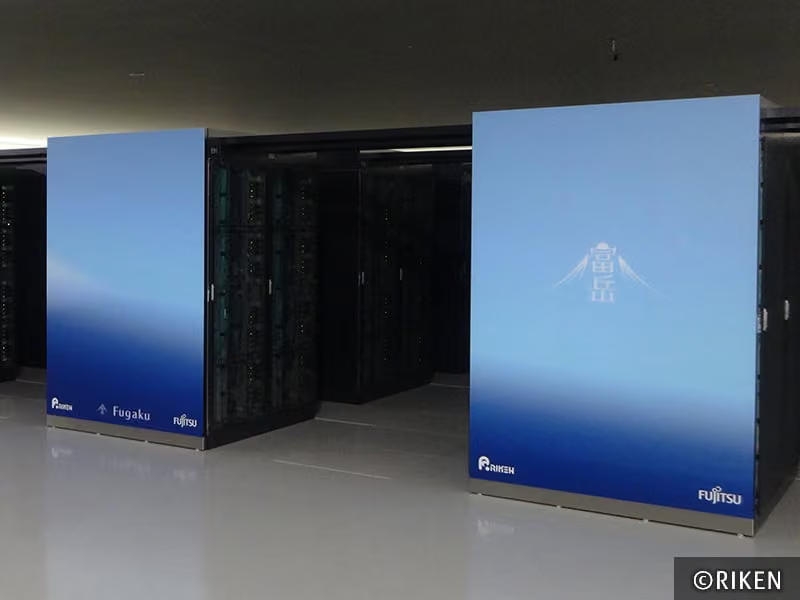
Источник изображения: Fujitsu В исследовательском центре пока не установили, как именно была произведена атака, нет и уверенности, к какой информации получили доступ злоумышленники и какие именно данные они могли похитить. Известно, что под угрозой оказались данные 4222 зарегистрированных пользователей Fugaku и 375 пользователей менее мощного суперкомпьютера RIKYU. 13 ноября была предпринята попытка войти в систему Fugaku, после чего специалисты центра оперативно отключили суперкомпьютер от Сети. Запустив свои рабочие процессы на одной из машин, злоумышленники могли нанести серьёзный ущерб. Fugaku используется для научных исследований. Доступ к нему предоставляется по заранее составленному графику, и вынужденный простой создаёт серьёзные препятствия для учёных, которые ожидали своей очереди. Признаков утечки исследовательских данных пока обнаружить не удалось. В научно-исследовательском центре пообещали тщательно расследовать инцидент. Власти Токио выделили экстренное финансирование в расчёте на то, что дополнительные средства оперативно помогут укрепить национальную систему киберзащиты. |
|

