Лента новостей
|
01.06.2022 [01:18], Владимир Мироненко
Ведущий специалист NERSC перешёл в Microsoft, заявив, что строящиеся экзафлопсные суперкомпьютеры будут последними в своём родеГленн Локвуд (Glenn K. Lockwood), ведущий специалист Национального научного вычислительного центра энергетических исследований (NERSC) при Министерстве энергетики США перешёл на работу в Microsoft. Он является архитектором высокопроизводительных масштабируемых систем хранения данных для суперкомпьютеров. Локвуд, в частности, руководил развёртыванием первого в мире 35-Пбайт All-Flash хранилища с ФС Lustre для суперкомпьютера Perlmutter. В своём блоге Локвуд объяснил, почему он ушёл из NERSC в Microsoft. По его словам, лидирующие HPC-системы балансируют на грани выживания, в то время как HPC-системы среднего клсса практически полностью обесцениваются поставщиками облачных услуг. При текущих тенденциях стоимость строительства нового дата-центра и обширной инфраструктуры питания и охлаждения для каждого нового мощного суперкомпьютера очень скоро станет непомерно высокой, говорит Локвуд. Он высказал мнение, что ЦОД мощностью 50–60 МВт, строящиеся сейчас для экзафлопсных суперкомпьютеров, будут последними в своём роде. 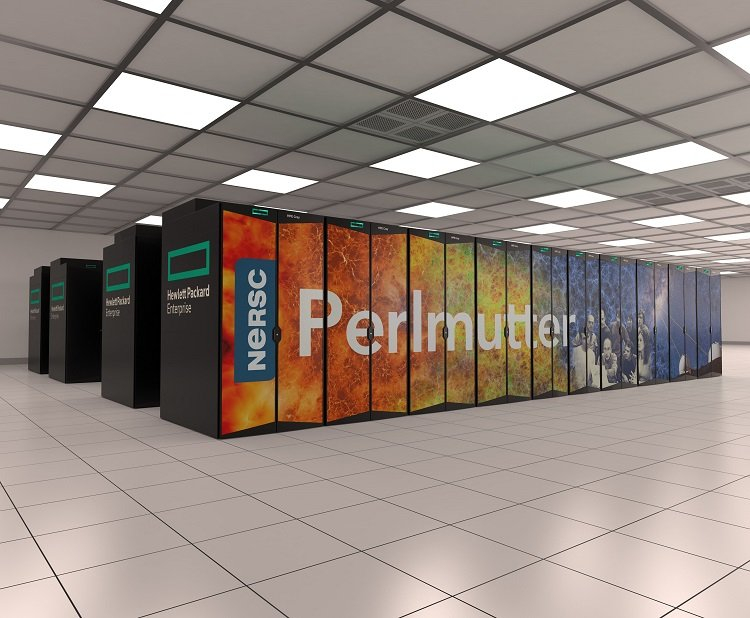
Источник изображения: AMD Что касается менее мощных систем, таких как Perlmutter, то необходимость в них постепенно сокращается по мере того, как облако набирает обороты. «Вы можете установить полную систему [HPE] Cray EX, идентичную той, что вы можете найти в NERSC или OLCF, в Azure <…> и интегрировать её с богатыми инфраструктурными возможностями облака», — говорит Локвуд. Кроме того, облака действительно гораздо быстрее внедряют новинки. Так, процессоры AMD EPYC MilanX и ускорители Instinct MI200 появились в инфраструктуре Microsoft Azure намного раньше, чем в HPC-центрах. «Я не утверждаю, что знаю будущее, и многое из того, что я изложил, является в лучшем случае гипотетическим», — заявил Гленн Локвуд, отметив, что приверженность Министерства энергетики США к независимым HPC-системам сохранится по меньшей мере ещё десятилетие. Локвуд стал очередным специалистом, покинувшем традиционный HPC-сектор и ушедшим в Microsoft. В 2020 году в Microsoft перешёл технический директор Cray Стив Скотт (Steve Scott). Год спустя к Microsoft присоединился соруководитель программы Cray PathForward доктор Дэн Эрнст (Dan Ernst).
30.05.2022 [23:43], Владимир Мироненко
HPE и SiPearl займутся совместной разработкой HPC-решений с использованием европейских Arm-процессоровSiPearl, европейский разработчик высокопроизводительных и энергоэффективных процессоров для суперкомпьютеров, и американская компания HPE объявили о стратегическом партнёрстве с целью совместной разработки решений для высокопроизводительных вычислений (HPC). Как ожидается, сотрудничество двух компаний, которое расширяет возможности гетерогенных вычислений для суперкомпьютеров и использует европейские архитектуры, позволит ускорить внедрение экзафлопсных систем в Европе. HPE и SiPearl займутся разработкой комплексной HPC-платформы, которая сочетает в себе решения HPE, разработанные с учётом требований нового поколения суперкомпьютеров к производительности и масштабируемости, и будущий Arm-процессор SiPearl Rhea, который позволит достичь экзафлопсного уровня производительности европейским суперкомпьютерам. Ранее SiPearl заключила похожие соглашения с Intel и NVIDIA. 
Источник изображения: SiPearl Ожидается, что HPE предоставит свою программно-аппаратную платформу, включая интерконнект Slingshot, фирменный компилятор и HPC-стек ПО. Причём изначально закладывается поддержка гетерогенных систем. Кроме того, в рамках партнёрства совместные решения HPE и SiPearl будут предоставлены Центру передового опыта (CoE) HPE в Гренобле (Франция), где проводятся исследования в области полупроводников, чтобы позволит ускорить тестирование и оптимизацию новых продуктов.
30.05.2022 [10:00], Игорь Осколков
Июньский TOP500: есть экзафлопс!59-я редакция TOP500, публичного рейтинга самых производительных суперкомпьютеров мира, стала наиболее знаменательной за последние 14 лет, поскольку официально был преодолён экзафлопсный барьер. Путь от петафлопса оказался долгим — первой петафлопсной системой стал суперкомпьютер IBM Roadrunner, и произошло это аж в 2008 году. Но минимальным порогом для попадания в TOP500 эта отметка стала только в 2019 году. Как и было обещано, официально и публично отметку в 1 Эфлопс в бенчмарке HPL на FP64-вычислениях первым преодолел суперкомпьютер Frontier — его устоявшаяся производительность составила 1,102 Эфлопс при теоретическом пике в 1,686 Эфлопс. Система на платформе HPE Cray EX235a использует оптимизированные 64-ядерные процессоры AMD EPYC Milan (2 ГГц), ускорители AMD Instinct MI250X и фирменный интерконнект Slingshot 11-го поколения. Система имеет суммарно 8 730 112 ядер, потребляет 21,1 МВт и выдаёт 52,23 Гфлопс/Вт, что делает её второй по энергоэффективности в мире. 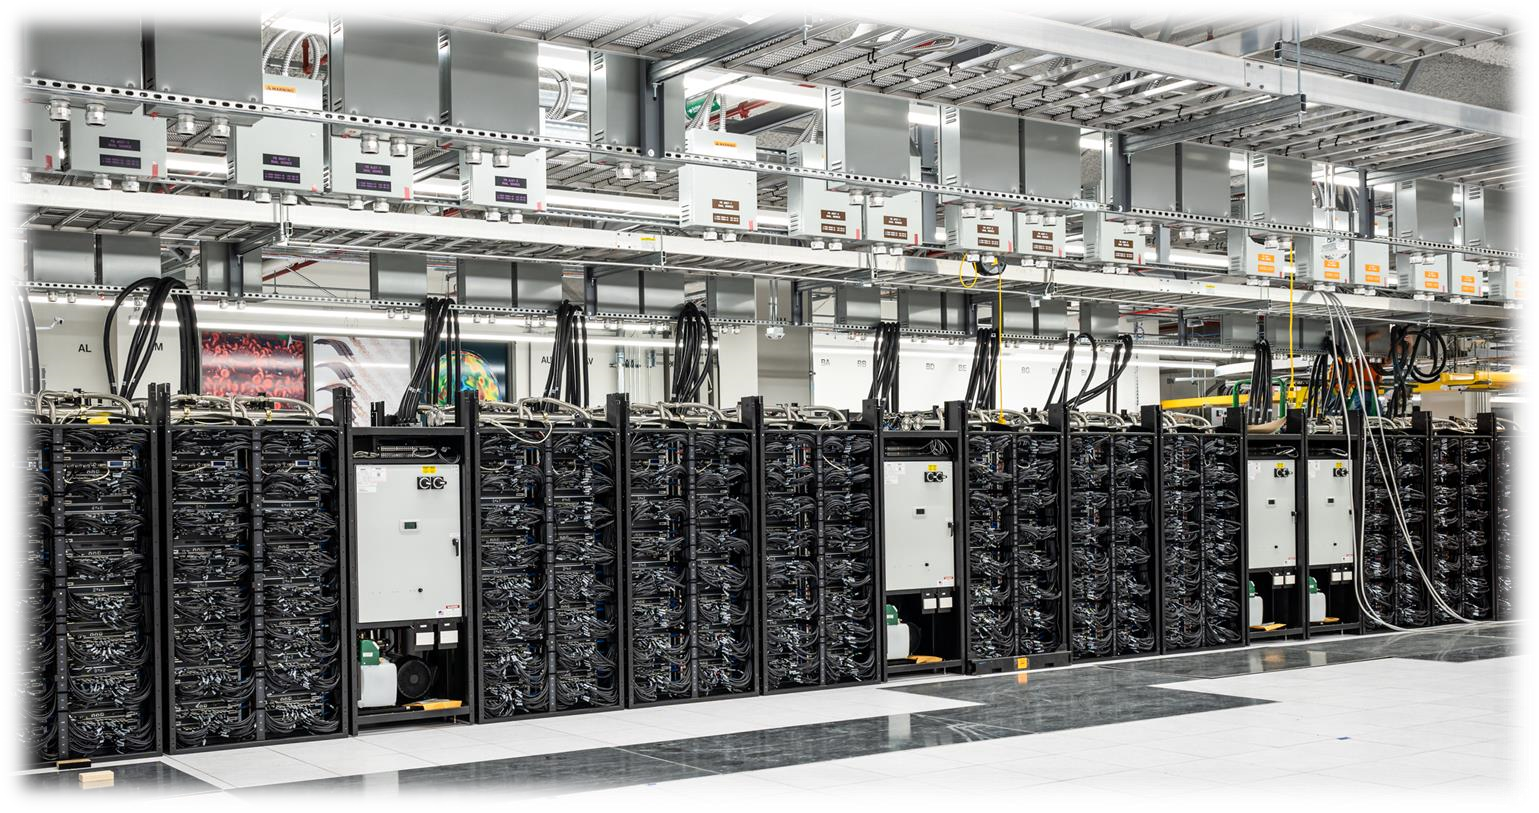
Суперкомпьютер Frontier (Фото: AMD) Впрочем, первое место в Green500 по данному показателю всё равно занимает тестовый кластер в составе всё того же Frontier: 120 832 ядра, 19,2 Пфлопс, 309 кВт, 62,68 Гфлопс/Вт. Третье и четвёртое места достались европейским машинам LUMI и Adastra, новичкам TOP500, которые по «железу» идентичны Frontier, но значительно меньше. Да и разница в Гфлопс/Вт между ними минимальна. Скопом они сместили предыдущего лидера — экзотичную японскую систему MN-3 от Preferred Networks. Японская система Fugaku, лидер по производительности в течение двух последних лет, сместилась на второе место TOP500. Третье место у финской системы LUMI с показателем производительности 151,9 Пфлопс — обратите внимание, насколько велик разрыв в первой тройке машин. Наконец, в Топ-10 последнее место занял новичок Adastra (46,1 Пфлопс), который расположен во Франции. 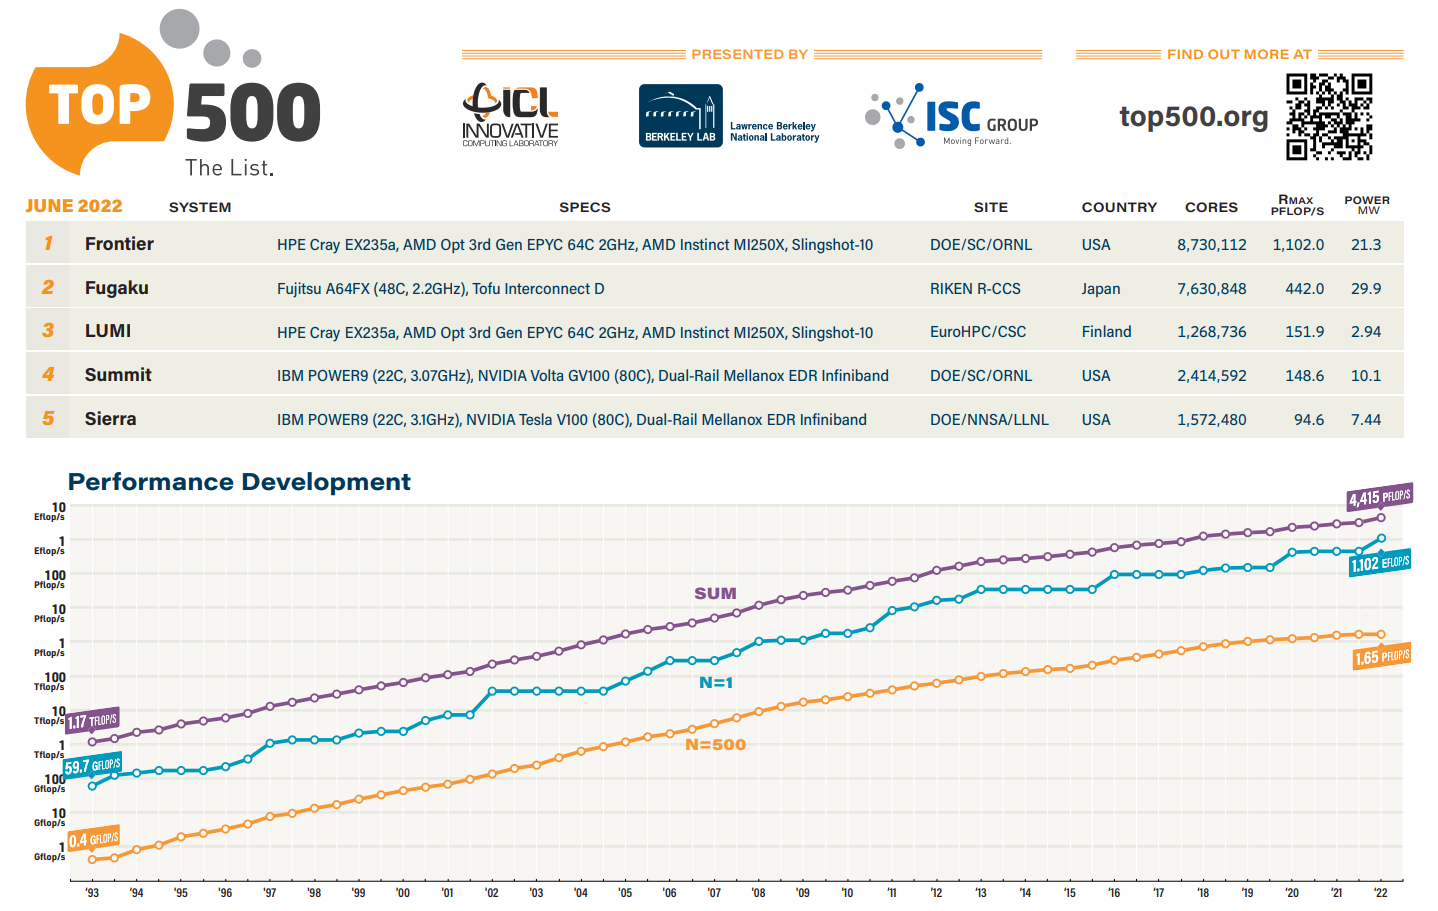
Источник: TOP500 В бенчмарке HPCG всё ещё лидирует Fugaku (16 Пфлопс), но, судя по всему, только потому, что для Frontier данных пока нет. Ну и потому, что результат суперкомпьютера LUMI, который почти на порядок медленнее Frontier, в HPCG составляет 1,94 Пфлопс. Наконец, в HPL-AI Frontier также отобрал первенство у Fugaku — 6,86 Эфлопс в вычислениях смешанной точности против 2 Эфлопс. В общем, у Frontier полная победа по всем фронтам, и эту машину можно назвать не только самой быстрой в мире, но первой по-настоящему экзафлопсной системой. Если, конечно, не учитывать неофициальные результаты OceanLight и Tianhe-3 из Поднебесной, которые в TOP500 никто не заявил. Число китайских систем в нынешнем рейтинге осталось прежним (173 шт.), тогда как США «ужались» со 150 до 127 шт. Российских систем в списке всё так же семь. Лидерами по числу поставленных систем остаются Lenovo, HPE и Inspur, а по их суммарной производительности — HPE, Fujitsu и Lenovo. С другой стороны, массовых изменений и не было — в нынешнем списке всего около сорока новых систем. 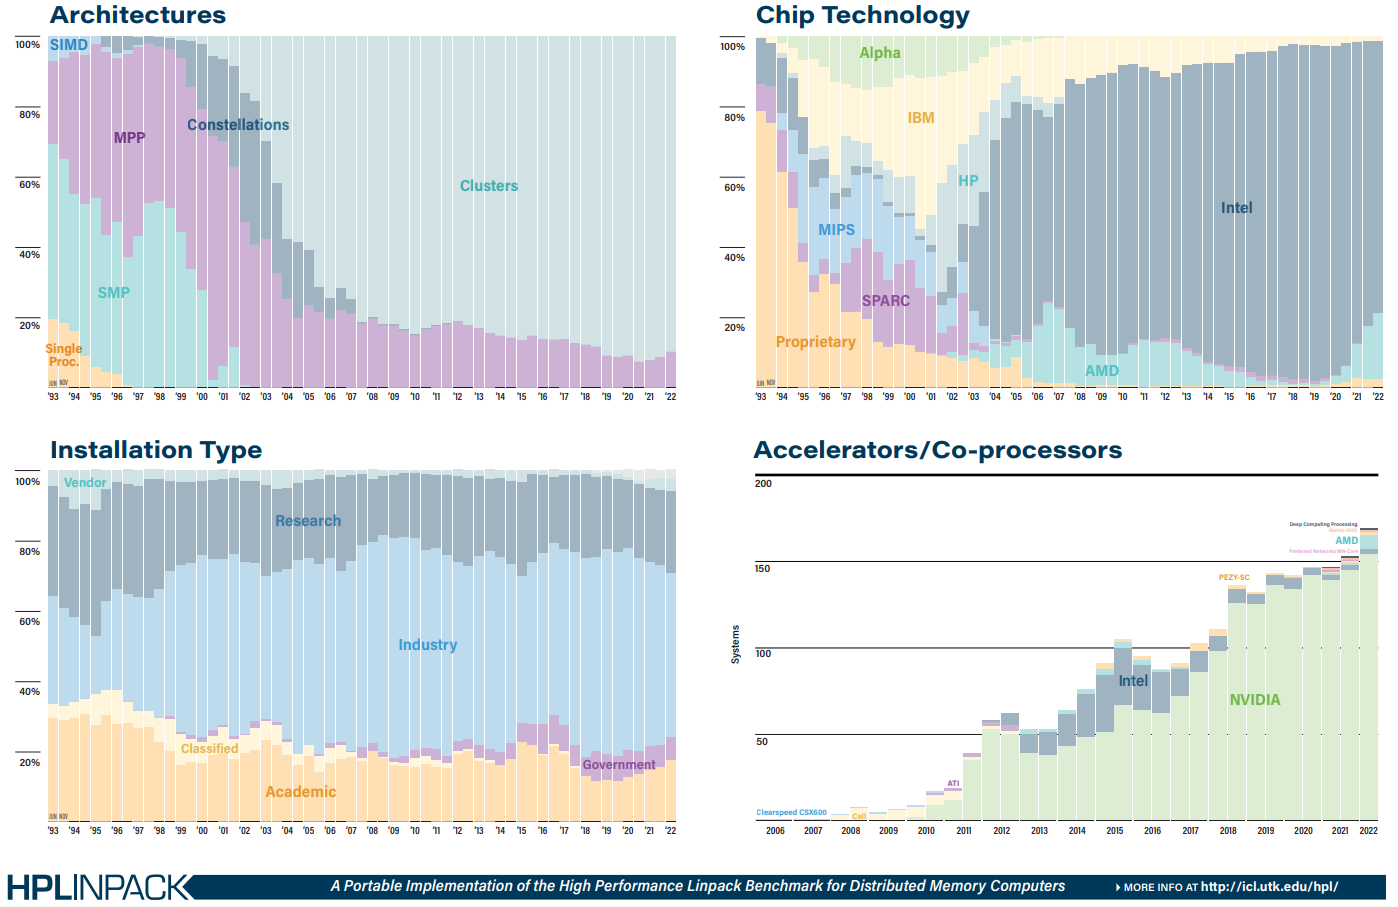
Источник: TOP500 Однако нельзя не отметить явный прогресс AMD — да, чуть больше трёх четвертей машин из списка используют процессоры Intel, но AMD удалось за полгода отъесть около 4 %. При этом AMD EPYC Milan присутствует в более чем трёх десятках систем, а доля Intel Xeon Ice Lake-SP вдвое меньше, хотя эти процессоры появились практически одновременно. Ускорители ожидаемо стали использовать больше — они применяются в 170 системах (было 150). Подавляющее большинство приходится на решения NVIDIA разных поколений, но и для новых Instinct MI250X нашлось место в восьми машинах. Ну а в области интерконнекта Infiniband потихоньку догоняет Ethernet: 226 машин против 196 + ещё 40 с Omni-Path + редкие проприетарные решения.
29.05.2022 [20:15], Игорь Осколков
Европейские Arm-процессоры SiPearl получат поддержку ускорителей и DPU NVIDIASiPearl, европейский разработчик высокопроизводительные и энергоэффективных процессоров для суперкомпьютеров, в том числе экзафлопсного класса, и NVIDIA объявили о сотрудничестве, в рамках которого предложат заказчикам совместные решения, включающие HPC-продукты и сетевые компоненты NVIDIA и CPU SiPearl (первым станет Rhea). Сотрудничество направленно на объединение портфолио аппаратных и программных решений обеих компаний, а также на совместную работу в области разработки продуктов и развития бизнеса. 
Источник: NVIDIA NVIDIA и SiPearl создадут прокси-платформу для переноса и анализа рабочих нагрузок, которая позволит наилучшим образом задействовать сильные стороны продуктов обеих компаний, например, HBM-память в процессорах SiPearl и массивно-параллельную архитектуру ускорителей NVIDIA. Кроме того, планируется совместная работа со сторонними европейскими исследовательскими институтами над открытыми инструментами для моделирования SoC и NoC. Компании намерены добиться полной совместимости на уровне «железа», а также совместно развивать программную экосистему для HPC-решений на базе платформы Arm. Ранее аналогичное соглашение о сотрудничестве было заключено между SiPearl и Intel. И в том и в другом случае SiPearl, штат которой, к слову, недавно вырос до более чем ста сотрудников, говорит о возможности предоставить европейским заказчикам наиболее оптимальное решение для их задач. Несмотря на то, что Европа стремится стать независимой от США в области высокопроизводительных вычислений (HPC), на первом этапе этого, судя по всему, исключительно своими силами обойтись будет нельзя.
26.05.2022 [11:53], Владимир Мироненко
Материнская компания розничной сети Lidl запустила конкурента AWS в ГерманииSchwarz Group, материнская компания европейской сети розничных продовольственных магазинов Lidl, официально объявила о доступности сервисов своего облачного подразделения StackIT для сторонних клиентов. О планах Schwarz Group по оказанию облачных услуг сторонним ретейлерам стало известно в 2020 году после приобретения ею компании Camao IDC, специализирующейся на разработке программного обеспечения. Сообщается, что Schwarz Group начала работу над облачным сервисом в 2018 году и запустила его для собственных нужд примерно в 2019 году. В ноябре 2021 года Schwarz Group приобрела контрольный пакет акций израильской фирмы по кибербезопасности XM Cyber. До нынешнего дня StackIT предоставляла услуги компаниям Schwarz Group, включая сети супермаркетов Lidl и гипермаркетов Kaufland, компанию по производству продуктов питания Schwarz Produktion и компанию по переработке вторичных отходов PreZero. 
Источник изображения: Schwartz Group / StackIT Помимо услуги колокейшна, StackIT предлагает ряд облачных и инфраструктурных сервисов, включая хранение данных, базы данных, вычислительные инстансы и многое другое. Компания предлагает услуги на базе объекта в австрийском Остермитинге, известного как DC10, и ЦОД в Эльхофене (Германия), известного как DC08. «Благодаря StackIT впервые становится доступным облачное решение, которое на 100 % “Сделано в Германии” и ориентировано на высокие требования и потребности в безопасности предприятий и организаций государственного сектора», — отметил директор по данным Schwarz Digital Рольф Шуман (Rolf Schumann).
25.05.2022 [16:02], Руслан Авдеев
Microsoft построит в США фабрику Circular Center по переработке серверов и компьютеровКомпания Microsoft подала заявку на строительство специального объекта Circular Center в городке Куинси штата Вашингтон. После ввода в эксплуатацию здесь планируется перерабатывать старые серверы и компьютеры. Городские власти пошли навстречу компании, подтвердив, что проект не должен оказать значительно негативного влияния на окружающую среду. Проект MWH90 CC предусматривает строительство здания площадью 1905 м2 для переработки бывших в эксплуатации компьютеров, серверов и комплектующих. Для этого в Куинси будет расширен и доработан кампус компании, на территории которого уже имеется функционирующий ЦОД. К 2025 году Microsoft планирует перерабатывать 90 % своего облачного оборудования, а к 2030 году этот показатель должен достигнуть 100 %. При этом в докладе за прошлый год упомянуто, что расширение инфраструктуры ЦОД и продажи Xbox привели к росту выбросов класса Scope 3 на 23 % — такие выбросы не являются прямым результатом деятельности компании, но она своей деятельностью косвенно влияет на их объёмы. Новый Circular Center будет очередным из специальных центров, строительство которых началось в 2020 году. В переработку там идут облачные серверы и прочее оборудование, причём некоторые компоненты могут быть использованы заново, перепроданы или перепрофилированы для использования в иных целях. Например, отдельные части могут использоваться даже в электронных игрушках и игровых системах. 
Изображение: ITRenew В 2020 году работу начали три Circular Center в Амстердаме, Дублине и американском Бойдтоне. В компании утверждают, что она уже получила возможность заново использовать 83 % критически важных комплектующих, снизив выбросы на 145 тыс. т. В обозримом будущем планируется строительство ещё нескольких центров аналогичного назначения по всему миру — от США до ЕС и Австралии. Прочие облачные компании, включая Google, Oracle и AWS реализуют похожие проекты, причём часть бывших в употреблении комплектующих используется в инфраструктуре самих компаний, а часть продаётся на вторичном рынке. Так, только Google и только в 2020 году продала 8,2 млн уже использовавшихся компонентов. А ITRenew, известный игрок на рынке утилизации оборудования гиперскейлеров, предлагает б/у серверы для микро-ЦОД и даже для отопления. Похожие решения есть и у Qarnot. Ранее сообщалось, что у Microsoft довольно необычный подход к защите природы. В январе появилась информация, что компания намерена вырубить более 2500 деревьев в Техасе для строительства дата-центра. В качестве компенсации компания обещала высадить более 800 новых и заплатить в фонд защиты деревьев около $1,5 млн.
24.05.2022 [14:09], Андрей Крупин
Selectel приступила к строительству в Москве нового 20-МВт дата-центра на 2 тыс. стоекКомпания Selectel, являющаяся специализированным поставщиком IT-решений на базе собственной сети дата-центров в Москве, Санкт-Петербурге и Ленинградской области, планирует ввести в эксплуатацию ещё один вычислительный комплекс. Новый центр обработки данных под названием «Юрловский» будет развёрнут в Москве и рассчитан на 2 тыс. серверных стоек. Дата-центр проектируется в соответствии с уровнем надёжности Tier IV. Основная ёмкость центра обработки данных будет задействована для предоставления облачных сервисов Infrastructure as a Service (IaaS). Особенностью ЦОД станет самый большой единый машинный зал в России площадью 4500 м2, в котором компания планирует разместить до 80 тыс. серверов. Общая подведённая мощность объекта составит 20 МВт, средняя мощность на стойку — 8 кВт. Selectel уже получила технические условия на подключение к ближайшему питающему центру с верхним уровнем напряжения 500 кВ, который расположен в 700 м от кампуса. Подключение будет выполнено по второй категории надёжности, то есть будет проложено две линии от независимых ячеек на подстанции, а между ними на стороне подстанции будет организован автоматический ввод резерва. 
Фото: Selectel Дата-центр «Юрловский» будет построен с применением технологии охлаждения без использования фреоновых систем, что позволит минимизировать воздействие на окружающую среду. ЦОД будет охлаждаться наружным воздухом (технология фрикулинга), а в качестве доохлаждения будут использоваться адиабатические маты. Предполагается, что эти и другие меры позволят Selectel экономить электроэнергию и занимать меньше полезной площади машинного зала. Среднегодовой коэффициент эффективности использования энергии (Power Usage Effectiveness, PUE) будет в диапазоне от 1,1 до 1,15. Таким образом, «Юрловский» станет самым «зелёным» дата-центром Selectel. 
Фото: Selectel В инфраструктуре дата-центра «Юрловский» будет задействована схема резервирования 6/5N — для каждой части на 1000 стоек будет выделено пять рабочих кластеров и один резервный. Фактически работать будут все шесть, но один можно в любой момент отключить. Кроме того, такой подход позволяет добиться физической изоляции резервируемых кластеров друг от друга. А автоматизации бесперебойной подачи питания и непрерывное охлаждение обеспечат возможность проводить любые профилактические и ремонтные работы без приостановки оказания услуг. Для поддержания связности новый ЦОД будет подключен несколькими независимым ВОЛС к MSK-IX (M9) и ЦОД «Берзарина», который уже имеется независимые подключения к нескольким IX. Вопрос с закупкой оборудования компания намерена решать в конце текущего года, поскольку в текущей ситуации прогнозировать что-либо затруднительно. На текущем этапе Selectel занимается проектированием и выполняет общестроительные работы. Ввод объекта в коммерческую эксплуатацию запланирован на 2023 год, однако сроки могут быть скорректированы в зависимости от ситуации на рынке. Инвестиции в проект оцениваются в миллиарды рублей.
24.05.2022 [07:00], Игорь Осколков
NVIDIA представила референсные платформы CGX, OVX и HGX на базе собственных Arm-процессоров GraceНа весенней конференции GTC 2022 NVIDIA поделилась подробностями о грядущих серверных Arm-процессорах Grace Superchip и гибридах Grace Hopper Superchip, а на Computex 2022 представила первые референсные платформы на базе этих чипов для OEM-производителей и объявила о расширении программы NVIDIA Certified. Последнее, впрочем, не означает отказ от x86-систем, поскольку программа будет просто расширена. Да и портирование стороннего и собственного ПО займёт некоторое время. Первые несколько десятков моделей серверов от ASUS, Foxconn, GIGABYTE, QCT, Supermicro и Wiwynn появятся в первой половине 2023 года. Представлены они будут в трёх категориях, причём все, за исключением одной, базируются на «сдвоенных» процессорах Grace Superchip, насчитывающих до 144 ядер. 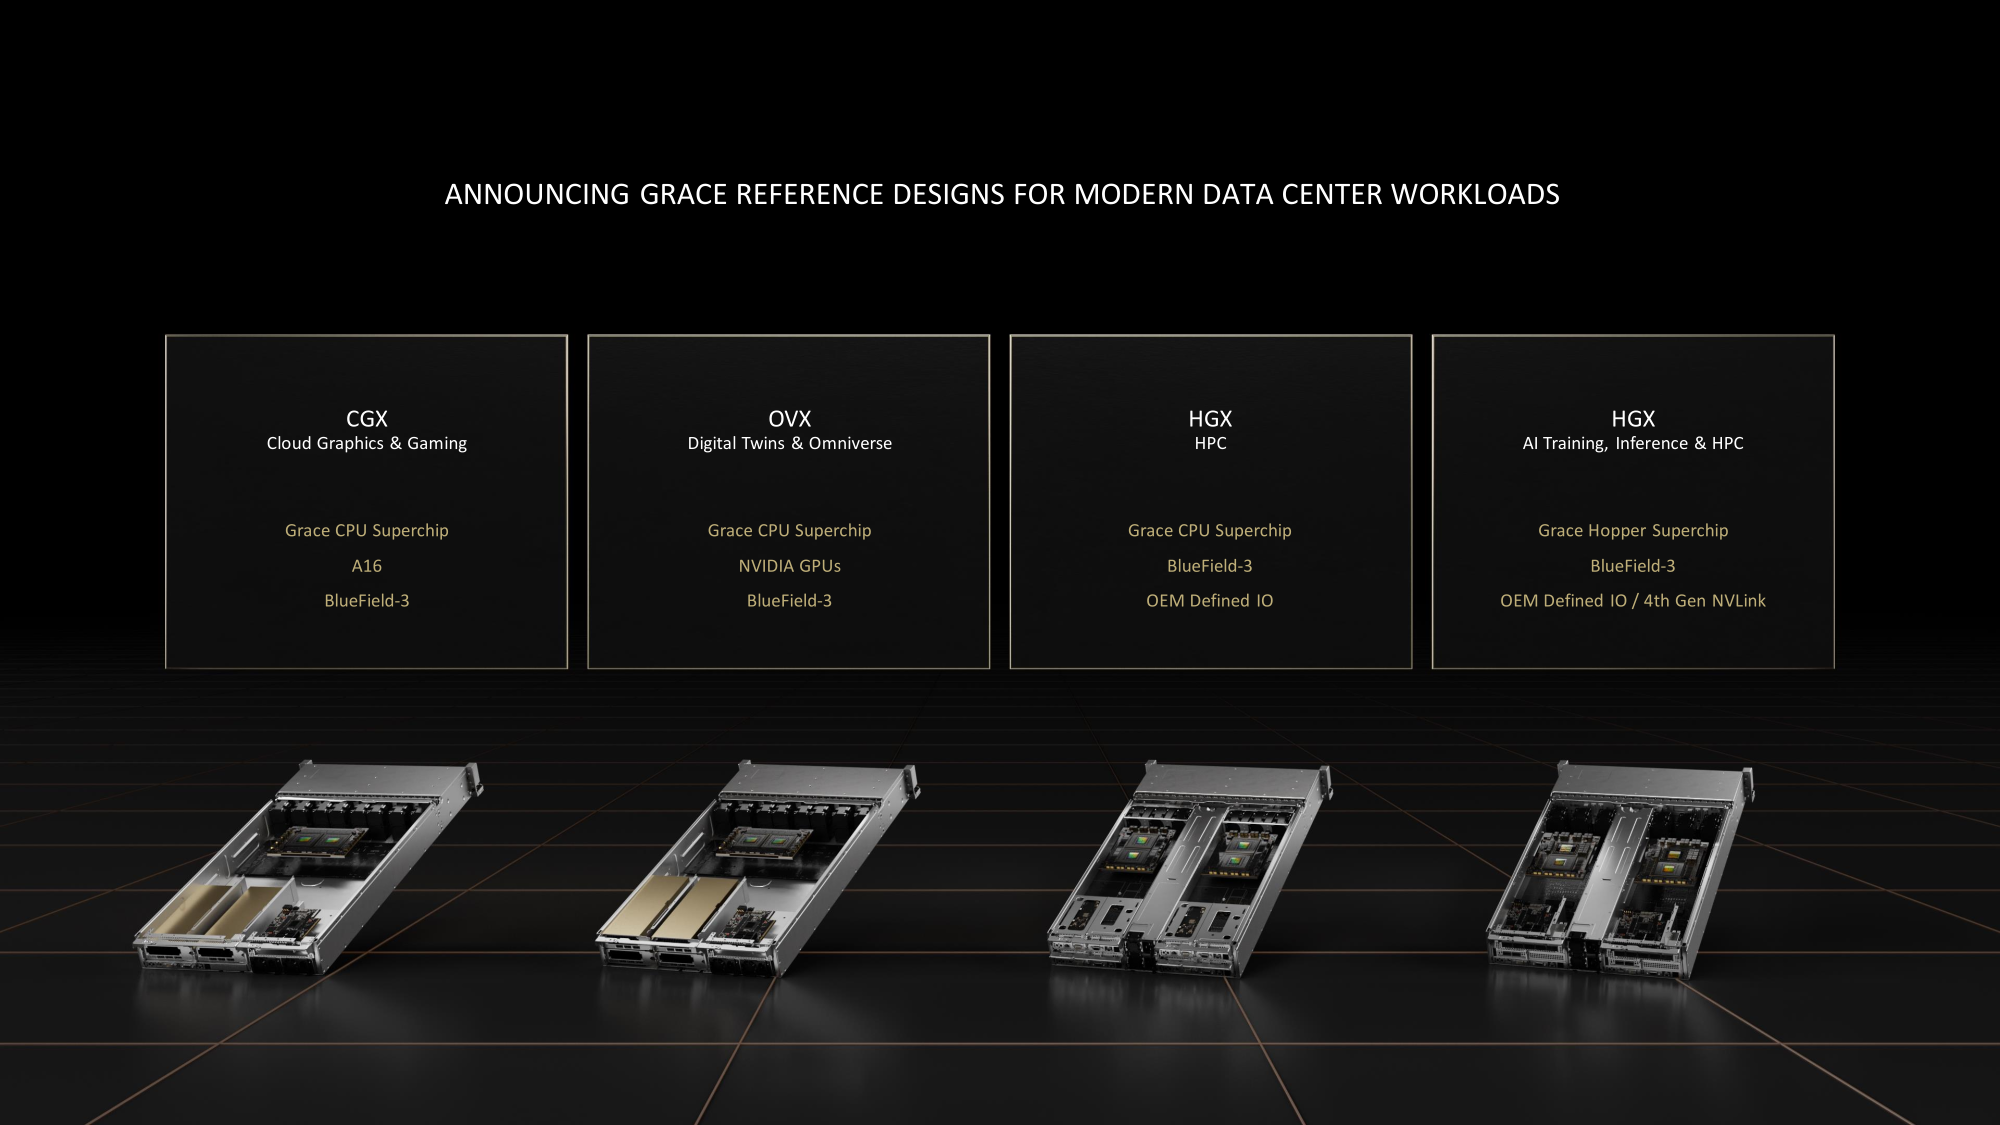
Источник: NVIDIA Системы серии OVX, представленной ранее, всё так же будут предназначены для цифровых двойников и Omniverse — NVIDIA продолжает наставить на том, что любое современное производство или промышленное предприятие должно быть интеллектуальным. Arm-версия OVA получит неназванные ускорители NVIDIA и DPU Bluefield-3. Новая платформа NVIDIA CGX очень похожа на OVX — она тоже получит DPU Bluefield-3 и до четырёх ускорителей NVIDIA A16. CGX создана специального для облачных гейминга и работы с графикой. А вот новое поколение платформы NVIDIA HGX гораздо интереснее. Оно заметно отличается от предыдущих, которые в основном представляли собой различные комбинации базовых плат NVIDIA с четырьмя или восемью ускорителями, вокруг которых OEM-партнёры строили системы в меру своих умений и фантазий. Нынешняя инкарнация NVIDIA HGX всё же несколько более комплексная, поскольку сейчас предлагается два варианта узлов, специально спроектированных для высокоплотных систем и явно ориентированных на высокопроизводительные вычисления (HPC). 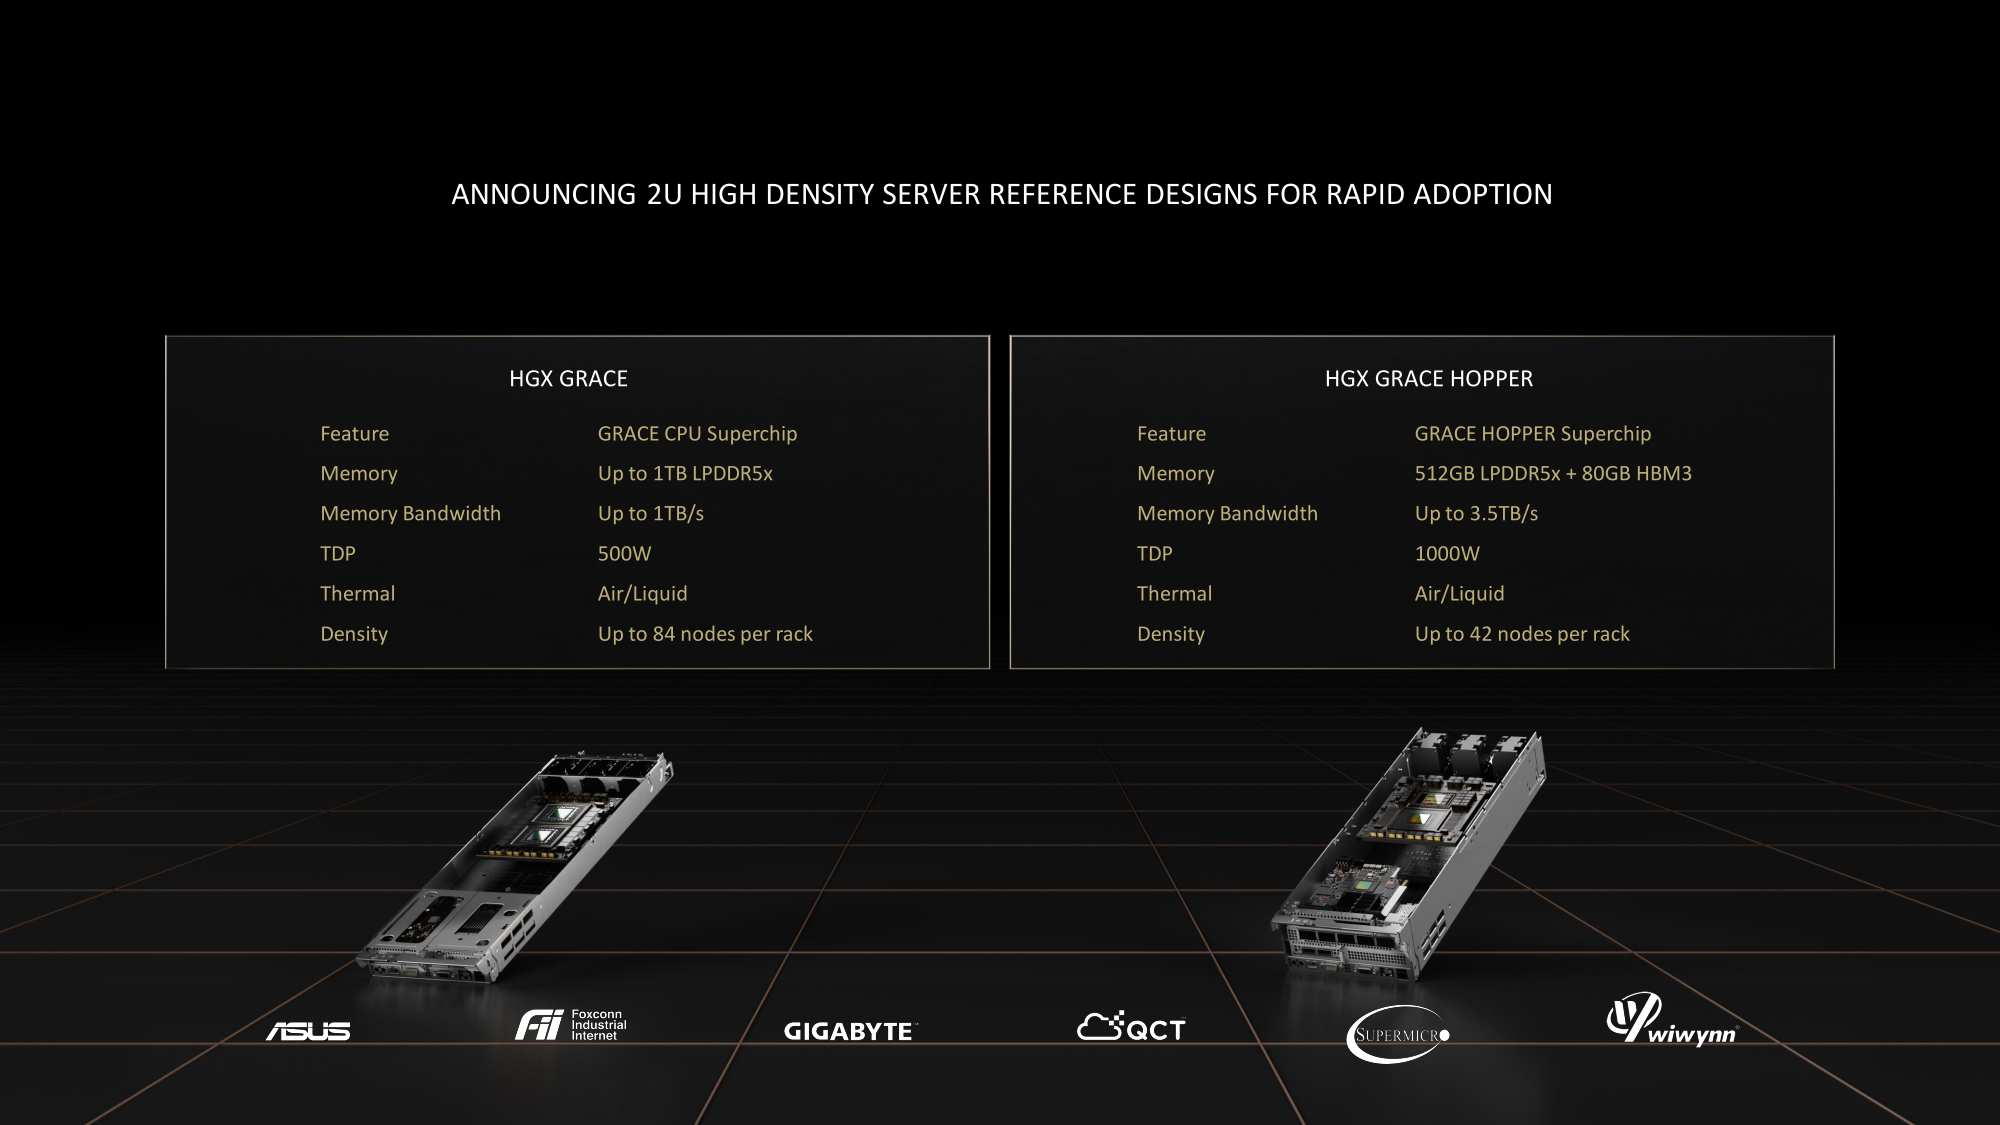
Источник: NVIDIA Первый вариант — это 1U-лезвие (до 84 шт. в стандартной стойке), которое включает один процессор Grace Superchip, до 1 Тбайт LPDDR5x-памяти с пропускной способностью (ПСП) до 1 Тбайт/с и DPU BlueField-3. Иные варианты сетевого подключения оставлены на усмотрение конечного производителя. Заявленный уровень TDP составляет 500 Вт, так что на выбор доступны системы с воздушным и жидкостным охлаждением. Второй вариант базируется на гибридных чипах Grace Hopper Superchip, объединяющих в себе посредством шины NVLink-C2C процессорную часть с 512 Гбайт LPDDR5x-памяти и ускоритель NVIDIA H100 c 80 Гбайт HBM3-памяти (ПСП до 3,5 Тбайт/с). Помимо DPU BlueField-3 опционально доступен и интерконнект NVLink 4.0, но и здесь вендору оставлена свобода выбора. Уровень TDP для данной платформы составляет 1 кВт, но вот обойтись одним только воздушным охлаждением (а такой вариант есть) при полном заполнении стойки всеми 42-мя 2U-лезвиями будет трудно.
17.05.2022 [21:56], Игорь Осколков
Суд обязал Oracle выплатить HPE $3 млрд в связи с отказом от поддержки ItaniumВерховный суд США отказал Oracle в последней попытке опротестовать принятое ранее решение о выплате $3 млрд в пользу HPE в качестве компенсации за отказ сопровождать свои программные продукты для платформы Itanium. Иск был подан в 2011 году от тогда ещё не разделившейся на две независимых компании HP, а сумма претензий окончательно утверждена судом в 2016 году. Конфликт между компаниями разгорелся после того, как Oracle в 2011 году заявила, что более не намерена поддерживать Itanium-серверы, которые выпускала HP, в связи с тем, что жизненный цикл данной платформы подходит к концу. Речь в первую очередь шла о СУБД, одним из ключевых продуктов Oracle. В 2010 году компании подписали двустороннее соглашение, в рамках которого пообещали поддерживать совместных клиентов. Со стороны HP было сказано о поддержке программных продуктов Oracle на аппаратных платформах компании, а Oracle пообещала и далее предлагать ПО для «железа» HP. 
Фото: Intel Интерпретация данного соглашения обеими сторона и стала камнем преткновения. Oracle заявила, что HP наложила на неё несправедливые обязательства по долгосрочной поддержке Itanium, хотя на тот момент она уже знала, что данные процессоры Intel больше не интересуют. Тем не менее, HP подала в суд на Oracle и в конечном итоге выиграла его. Oracle подала встречный иск, но дело проиграла и все эти годы пыталась добиться пересмотра размера компенсации, пытаясь снизить назначенную судом сумму в $3,14 млрд. 
Источник: Wikipedia Нынешнее решение Верховного суда США является окончательным и обжалованию более не подлежит, так что Oracle будет вынуждена выплатить одну из крупнейших в истории подобных разбирательств компенсацию. В 2011 году многие посчитали, что истинной причиной отказа от Itanium было желание Oracle продвинуть собственную программно-аппаратную платформу на базе SPARC, которая досталась ей в наследство от поглощённой Sun Microsystems. Хотя уже тогда появились слухи о прекращении работы над данной архитектурой. Как мы теперь знаем, обе платформы закончили свой путь практически синхронно. В 2019 году Intel заявила о прекращении поставок последнего поколения процессоров Itanium 9700 (Kittson), появившихся в 2017 году. Тогда же последнее крупное обновление SPARC-процессоров представили Fujitsu и Oracle, причём обе обещали поддерживать ПО до 2034 года и обе же в итоге обратились к Arm-решениям, хотя и в несколько разных сферах. Itanium-системы HPE обещала сопровождать до 2025 года.
16.05.2022 [23:41], Алексей Степин
Intel: UCIe объединит разнородные чиплеты внутри одной упаковки и за её пределамиШина PCI Express давно стала стандартом де-факто: она не требует много контактов, её производительность в пересчёте на линию уже достигла ≈4 Гбайт/с (32 ГТ/с) в версии PCIe 5.0, а использование стека CXL сделает PCI Express поистине универсальной. Но для соединения чиплетов или межпроцессорной коммуникации эта шина в текущем её виде подходит не лучшим образом. Но использование проприетарных технологий существенно ограничивает потенциал чиплетных решений, и для преодоления этого ограничения в марте этого года 10-ю крупными компаниями-разработчиками, включая AMD, Qualcomm, TSMC, Arm и Samsung, был основан новый стандарт Universal Chiplet Interconnect Express (UCIe). 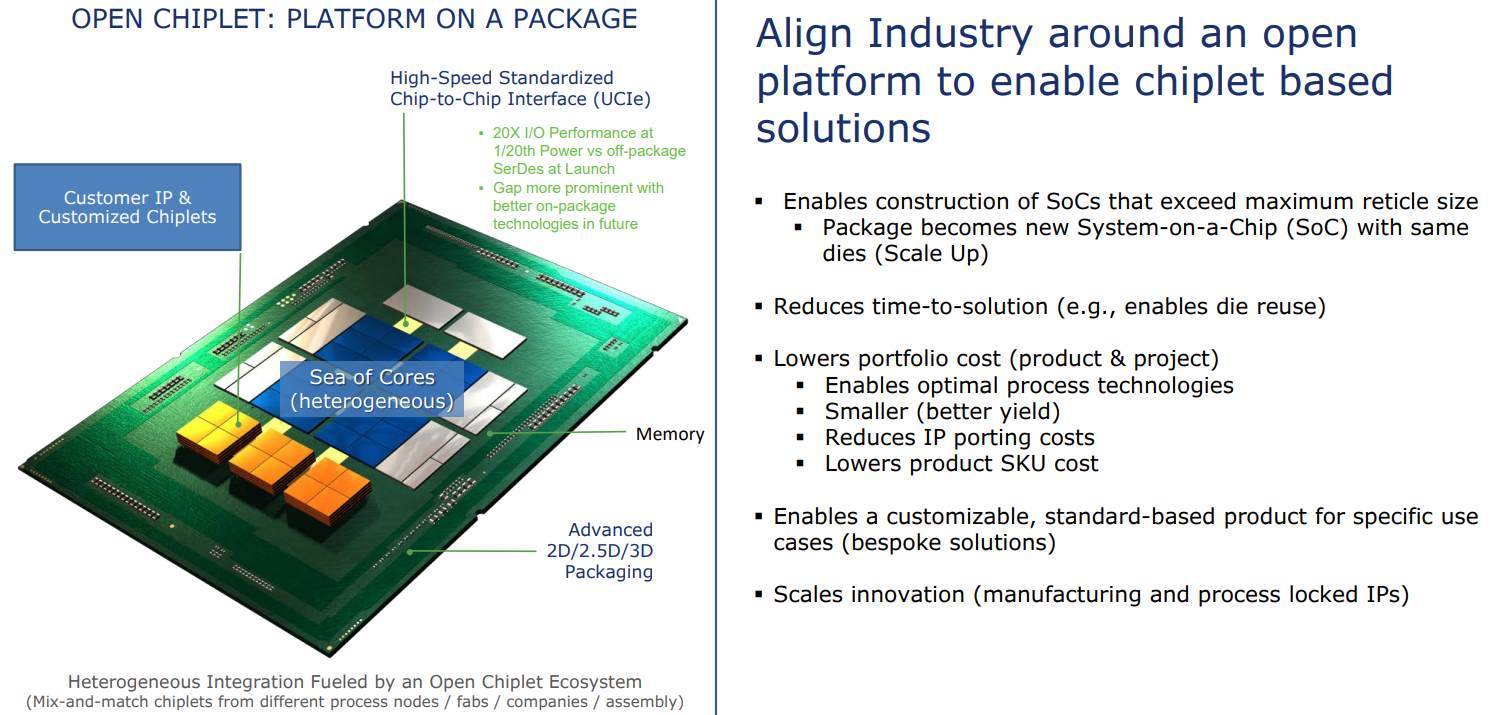
Изображение: UCIe Consortium Уже первая реализация UCIe должна превзойти PCI Express во многих аспектах: если линия PCIe 5.0 представляет собой четыре физических контакта с пропускной способностью 32 ГТ/с, то UCIe позволит передавать по единственному контакту до 12 Гбит/с, а затем планка будет повышена до 16 Гбит/с. При этом энергопотребление у UCIe ниже, а эффективность — выше. На равном с PCIe расстоянии новый стандарт может быть вчетверо производительнее при том же количестве проводников. В перспективе эта цифра может быть увеличена до 10–20 раз, то есть, узким местом между чиплетами UCIe явно не станет. Более того, новый интерконнект не только изначально совместим с CXL, но и гораздо лучше приспособлен к задачам дезагрегации. Иными словами, быстрая связь напрямую между чиплетами возможна не только в одной упаковке или внутри узла, но и за его пределами. 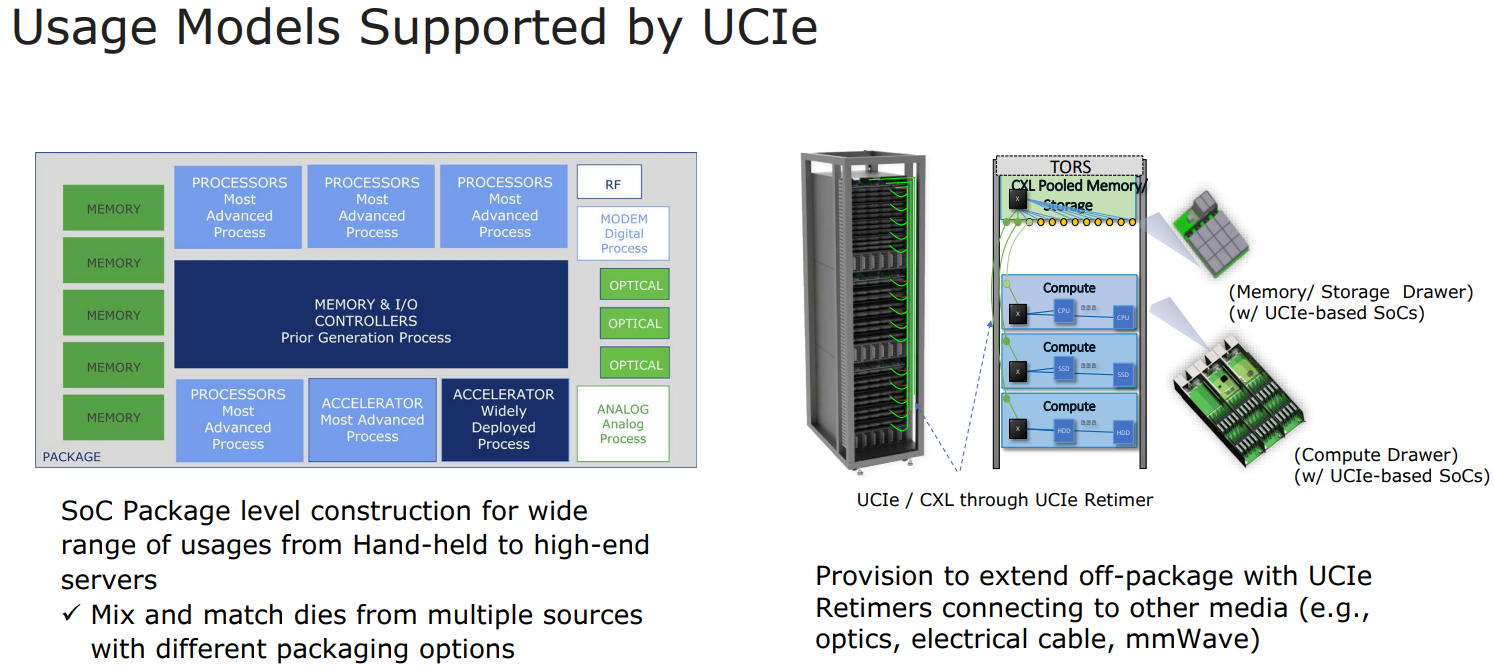
Изображение: UCIe Consortium Весьма заинтересована в новом стандарте Intel, которая планирует использовать UCIe таким образом, что в процессорах нового поколения ядра x86 смогут соседствовать с Arm или RISC-V. При этом планируется обеспечить совместимость UCIe с технологиями упаковки Intel EMIB и TSMC CoWoS, заодно добавив поддержку других шин, в том числе Arm AMBA, а также возможность легкой конвертации в проприетарные протоколы других разработчиков. В настоящее время Intel уже есть несколько примеров использования UCIe. Так, в одном из вариантов с помощью новой шины к процессорным ядрам подключаются ускорители и блок управления, а упаковка EMIB используется для подключения чипа к дезагрегированной памяти DDR5 и линиям PCI Express. |
|

