Материалы по тегу: mgx
|
14.09.2026 [22:55], Владимир Мироненко
Минюст США проверит сделку NVIDIA с Groq, но это ничего не изменитМинистерство юстиции США проводит проверку с целью выяснить, не была ли структура лицензионного соглашения NVIDIA с Groq стоимостью $20 млрд намеренно выстроена таким образом, чтобы избежать антимонопольного расследования, сообщила газета The New York Times со ссылкой на информированные источники. В рамках сделки, заключённой в прошлом году, которую компания Groq охарактеризовала как «неисключительное лицензионное соглашение с NVIDIA на технологии инференса», генеральный директор Groq Джонатан Росс (Jonathan Ross) и президент компании Санни Мадра (Sunny Madra), а также часть инженерной команды Groq перешли на работу в NVIDIA. Представитель NVIDIA Джон Риццо (John Rizzo) заявил, что «история с Groq — яркий пример того, как американская система работает именно так, как было задумано: она стимулирует инновации, вознаграждает предпринимателей и приносит пользу потребителям». Он добавил: «Законодательство призвано поддерживать экосистему стартапов в США и защищать фундаментальные права изобретателей и наемных работников на реализацию своих стремлений». Формально Groq осталась независимой компанией. Именно это сочетание обстоятельств и стало предметом расследования. Сделка не была заявлена на проверку регулятором возможного нанесения ущерба конкуренции на рынке, хотя NVIDIA получила не только технологии, но и двух ключевых руководителей Groq. По словам одного из источников, Министерство юстиции США начало расследование сделки с Groq вскоре после объявления о ней в декабре, направив в NVIDIA официальный запрос. Эндрю Фергюсон (Andrew Ferguson), возглавляющий Федеральную торговую комиссию (FTC) США, в январе сообщил агентству Bloomberg, что ведомство начало проверку с целью выяснить, не были ли подобные сделки намеренно структурированы так, чтобы избежать надзора со стороны регулирующих органов. 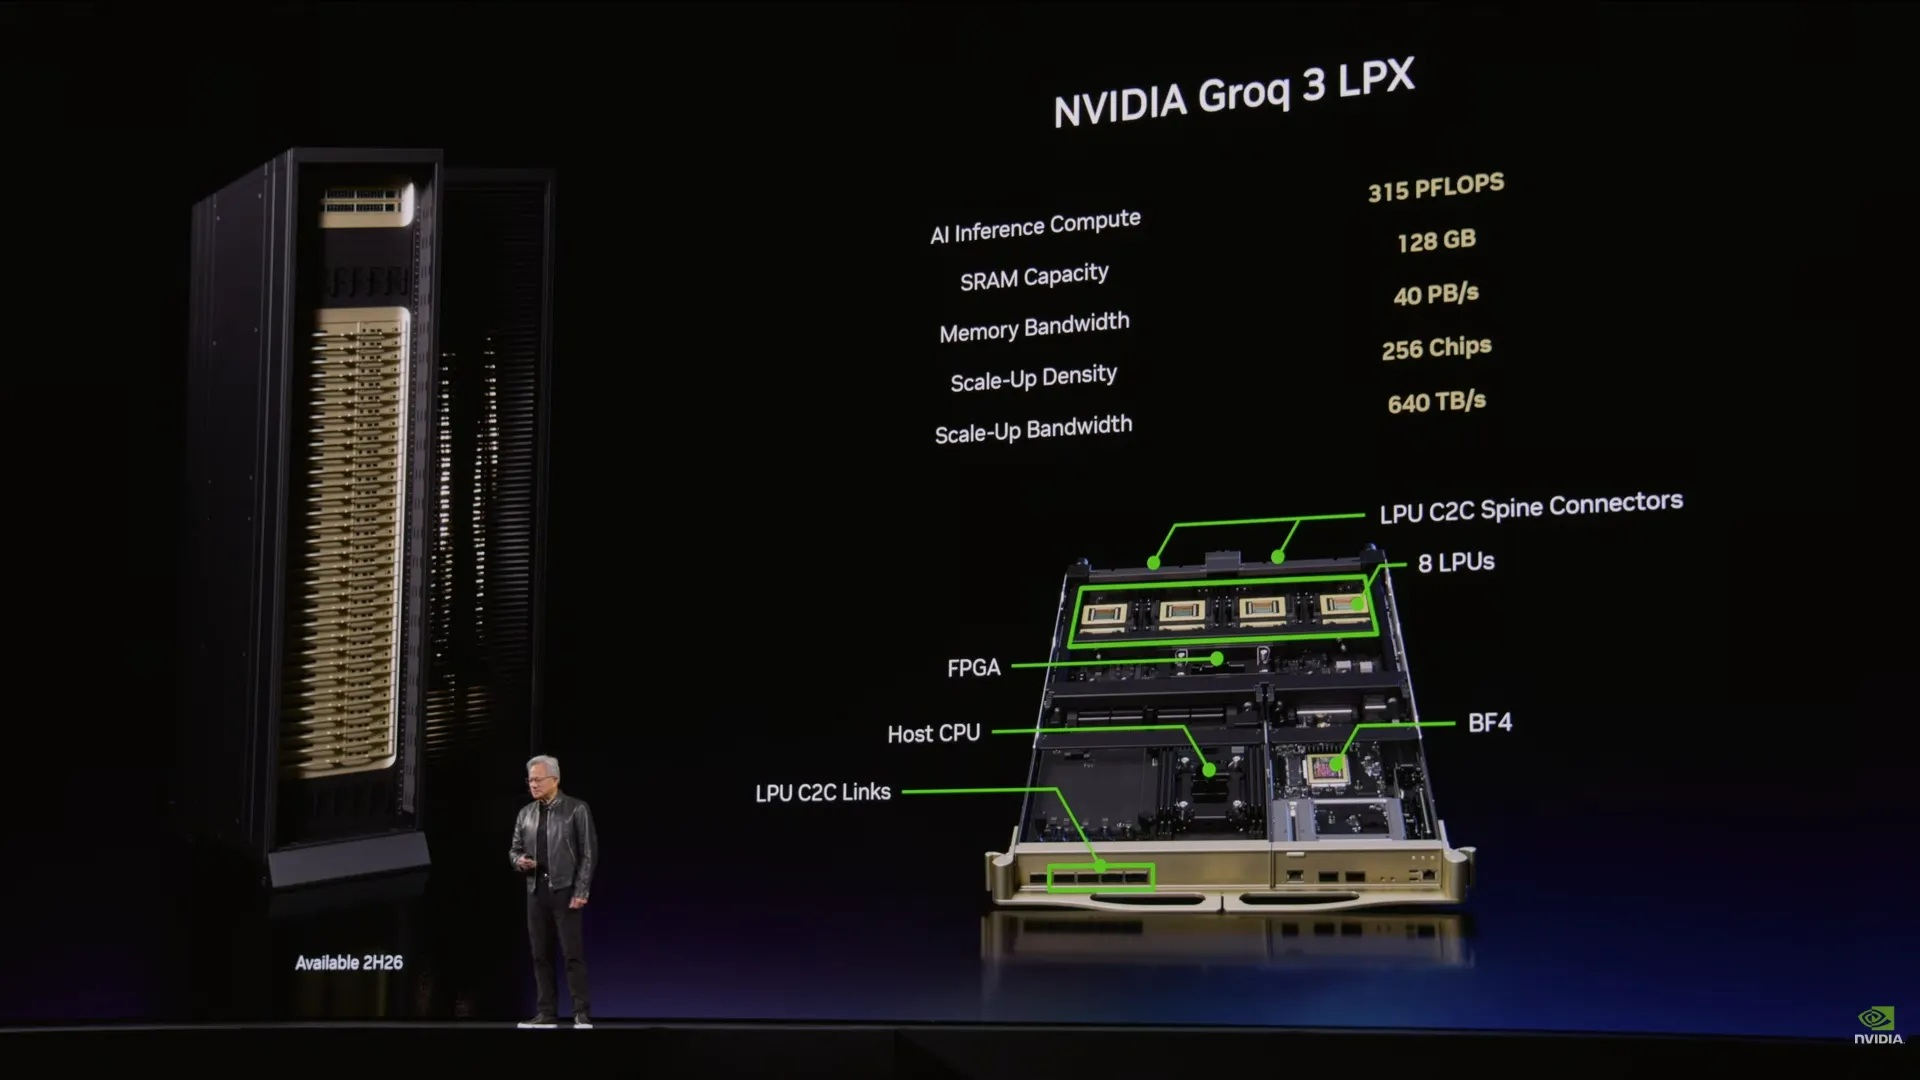
Источник изображения: NVIDIA Если Минюст США придёт к выводу, что NVIDIA должна была получить антимонопольное одобрение сделки, ведомство может потребовать взыскания гражданско-правовых штрафов. В то же время, по словам источника, окончательное решение ещё не принято, и Министерство юстиции в итоге может не обнаружить никаких нарушений. Впрочем, по данным Bloomberg, Минюст изучает возможные нарушения антимонопольного законодательства со стороны производителя чипов с 2024 года. Сообщается, что вопросы со стороны регулирующих органов относительно соглашения между NVIDIA и Groq возникли в начале текущего года в рамках этого более масштабного расследования. Сделки также привлекли внимание сенаторов, которые призвали FTC и Министерство юстиции США расследовать ряд таких сделок, включая партнёрство NVIDIA с компанией Groq. «По сути, эти сделки представляют собой фактические слияния, позволяющие компаниям объединять кадровые, информационные и финансовые ресурсы, при этом, судя по всему, пытаясь обойти процедуры контроля, обычно применяемые к сделкам по слиянию и поглощению», — указали сенаторы в письме, направленном в FTC и Министерство юстиции США. Хотя формально NVIDIA не покупала Groq, фактически её итоги равносильны поглощению. Внимание со стороны Министерства юстиции к этим вопросам возникло на фоне того, как NVIDIA — компания с рыночной капитализацией $5,4 трлн — фактически превратилась в «центральный банк» Кремниевой долины, используя свои огромные финансовые ресурсы для поддержки ИИ-стартапов и финансирования клиентов, отметила The New York Times. Главный вопрос для Министерства юстиции США заключается в том, нанесла ли эта сделка ущерб конкуренции; учитывая текущую ситуацию на рынке, доказать наличие такого ущерба может быть непросто, пишет The Register. Но даже если бы Минюст нашёл основания для судебного иска и добился отмены сделки, это вряд ли что-то кардинально изменило бы, отметил ресурс. 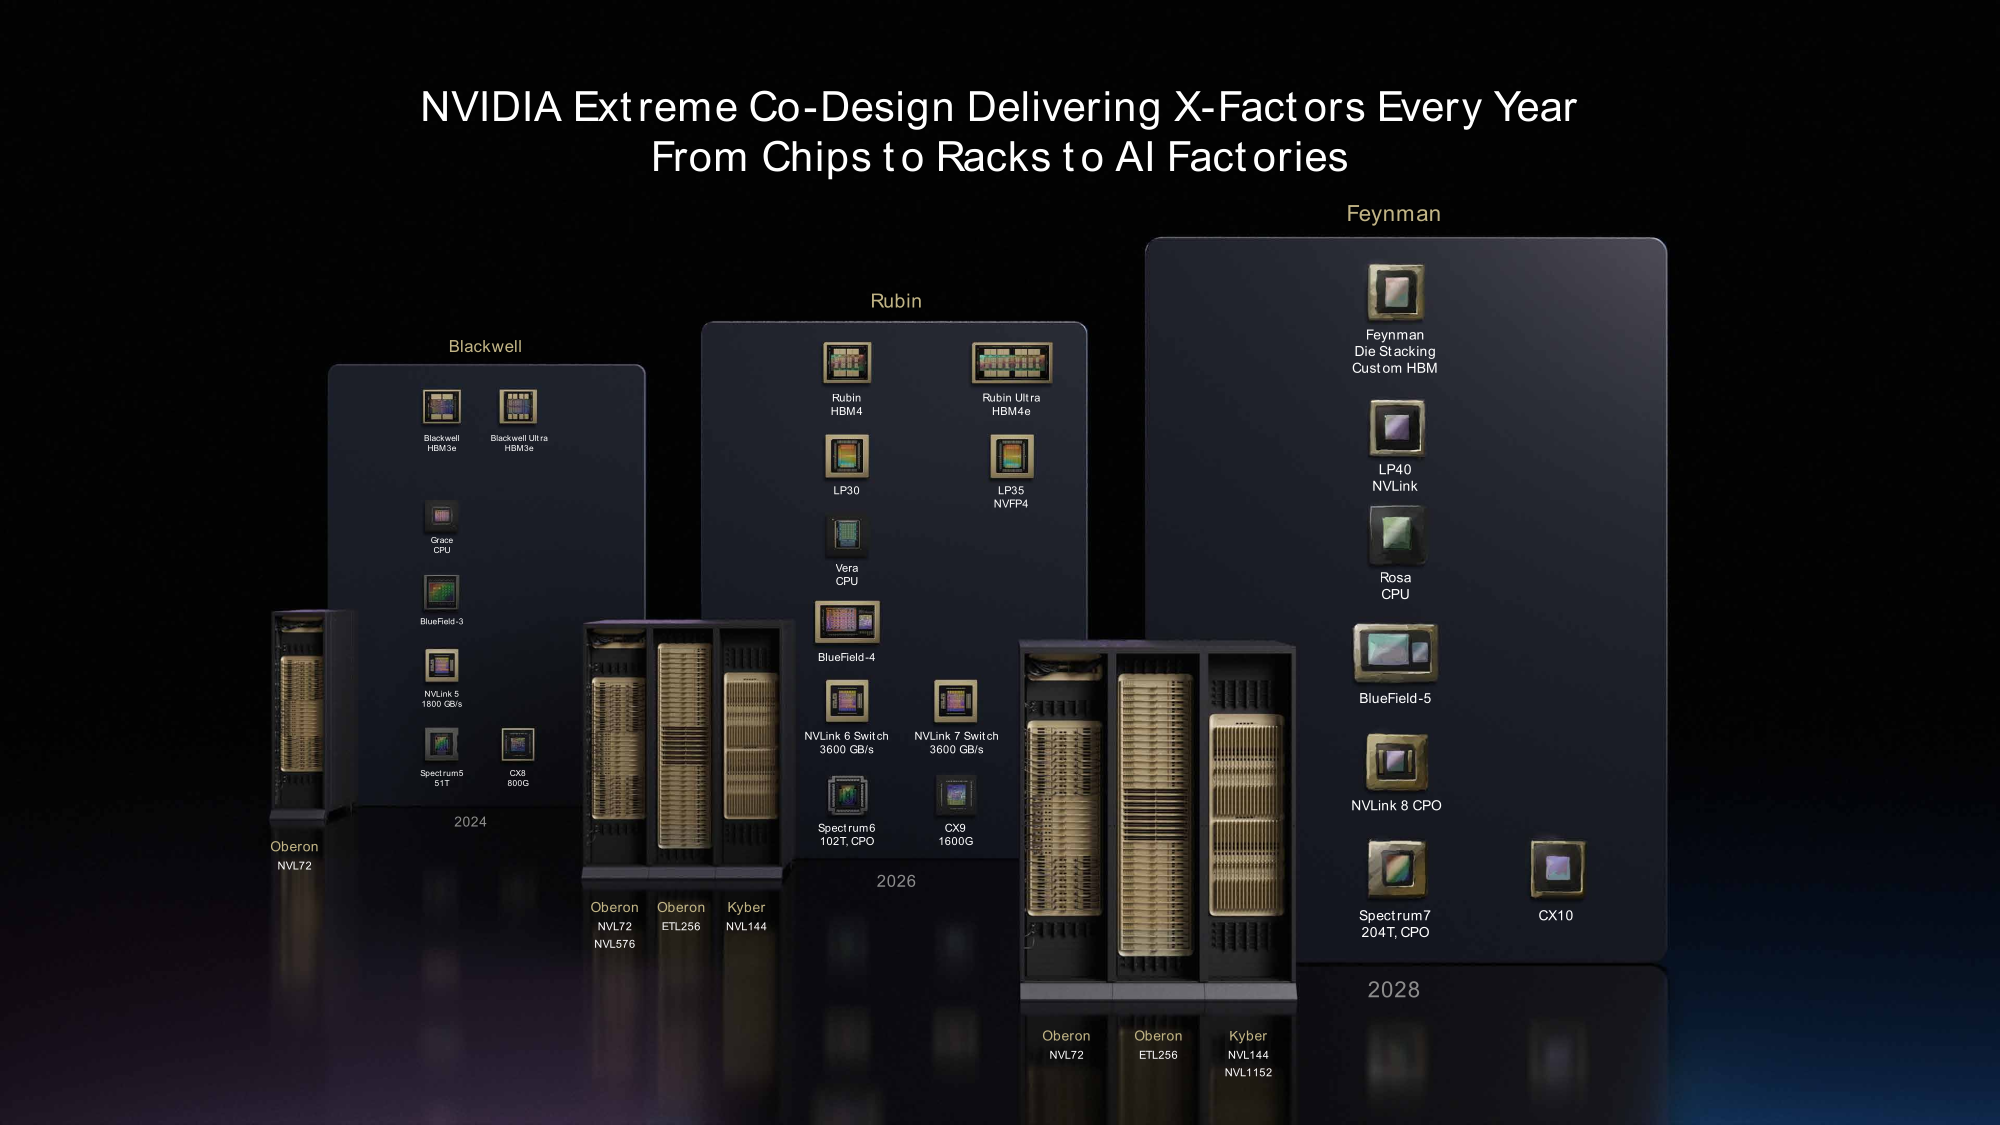 Сделка с Groq обеспечила NVIDIA два ключевых актива: готовые аппаратные решения (чипы) и специалистов, необходимых для их дальнейшей разработки. Groq стала известна благодаря созданию ускорителей с потоковой архитектурой и большим объёмом памяти SRAM, что позволило ускорить инференс больших языковых моделей (LLM) до показателей, которых системы NVIDIA на базе GPU самостоятельно достичь не могли. В марте NVIDIA представила стойки LPX, оснащённые 256 ускорителями LPU Groq 3. Глава NVIDIA пообещал, что связка Groq и Vera Rubin обеспечит оптимальную производительность для всего спектра задач инференса. The Register отметил, что дезагрегация вовсе не уникальная особенность Groq. Cerebras создаёт аналогичные системы совместно с AWS и AMD; SambaNova сотрудничает с Intel; а d-Matrix и ее партнёры объединяют свою платформу с GPU NVIDIA, преследуя те же цели, что и в случае комбинации Vera Rubin NVL72 с Groq 3 LPX. Ещё до объявления о сделке с Groq компания уже закладывала фундамент экосистемы, в центре которой находилось её подразделение сетевых технологий. Она передала свои проекты стоек MGX в Open Compute Project (OCP), позволив тем самым любому производителю чипов размещать свою продукцию в стойках, изначально спроектированных для GPU NVIDIA. Затем NVIDIA открыла доступ к своему интерконнекту в рамках программы NVLink Fusion. И теперь, если Министерство юстиции США заблокирует сделку (целью которой было поглощение компании ради получения её специалистов) и аннулирует соглашение с Groq, NVIDIA может лишиться прямого контроля над разработкой LPU и доходов от их продажи, но это не обязательно будет означать конец для стоек Groq LPX. Groq просто пополнит ряды растущего числа аппаратных партнёров NVIDIA, создающих решения для ИИ-фабрик (AI factory) этой компании. Более того, сама эта сделка гарантирует, что даже если регуляторы в итоге её сорвут, наготове окажется множество альтернатив.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
24.08.2026 [16:48], Сергей Карасёв
Фото дня: доставка суперускорителя NVIDIA Vera Rubin NVL72 в дата-центр MicrosoftГенеральный директор Microsoft Сатья Наделла (Satya Nadella) в своём блоге в социальной сети Х опубликовал ряд фотографий, демонстрирующих процесс доставки и распаковки высокопроизводительных систем NVIDIA Vera Rubin NVL72. Эта стоечная ИИ-платформа стала преемником решения GB200 NVL72. Стойка целиком весит около 1,8 т, при этом она достаточно хрупкая и поэтому требует особых условий транспортировки и установки в ЦОД, который тоже должен быть подготовлен к таким нагрузкам. А масса будущих стоек AMD Helios AI формата OCP ORW будет приближаться к 5 т. VR200 NVL72 объединяет 72 ускорителя Rubin и 36 процессоров Vera, каждый из которых содержит 88 вычислительных Arm-ядер Olympus (в сумме 3168 ядер). Объём памяти HBM4 достигает 20,7 Тбайт, её совокупная пропускная способность — 1580 Тбайт/с. Кроме того, используются 54 Тбайт памяти LPDDR5X. 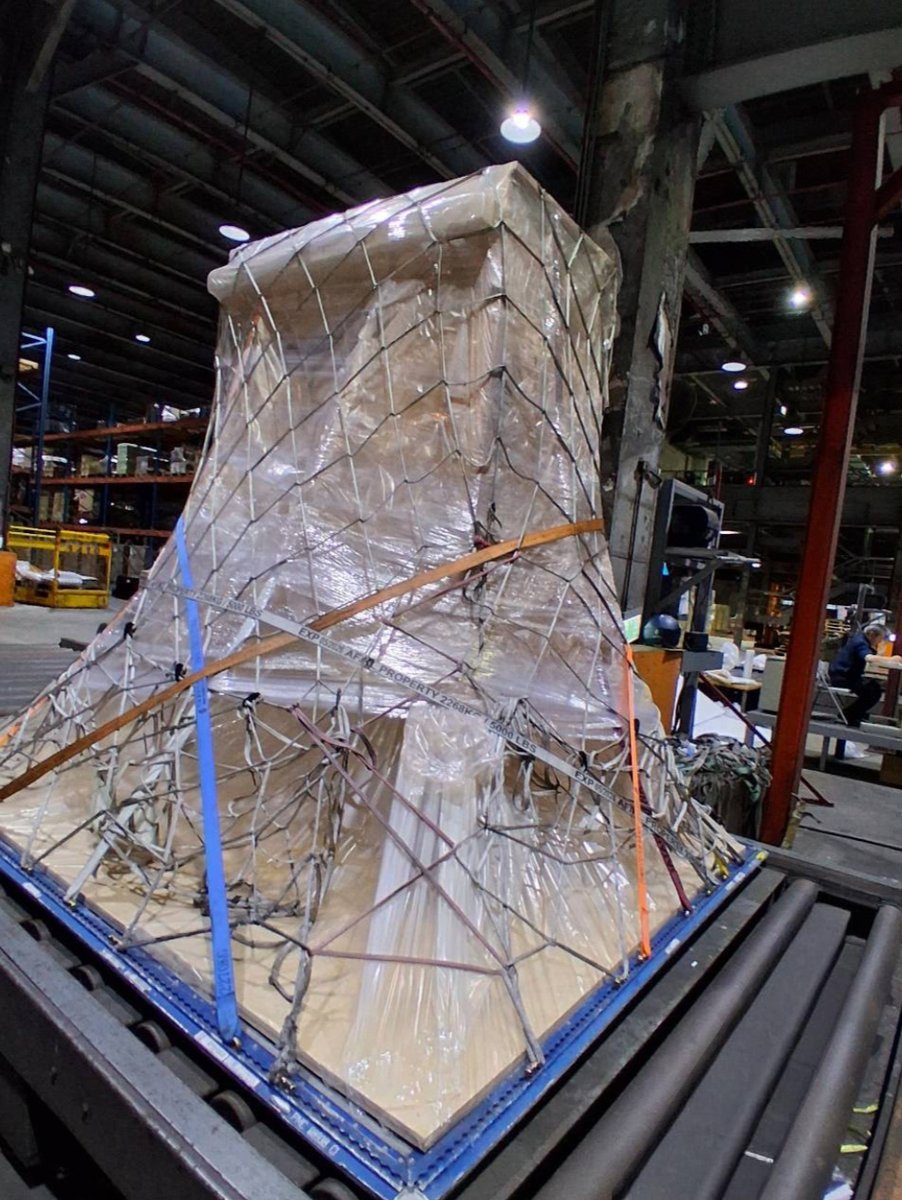
Источник изображения: Satya Nadella 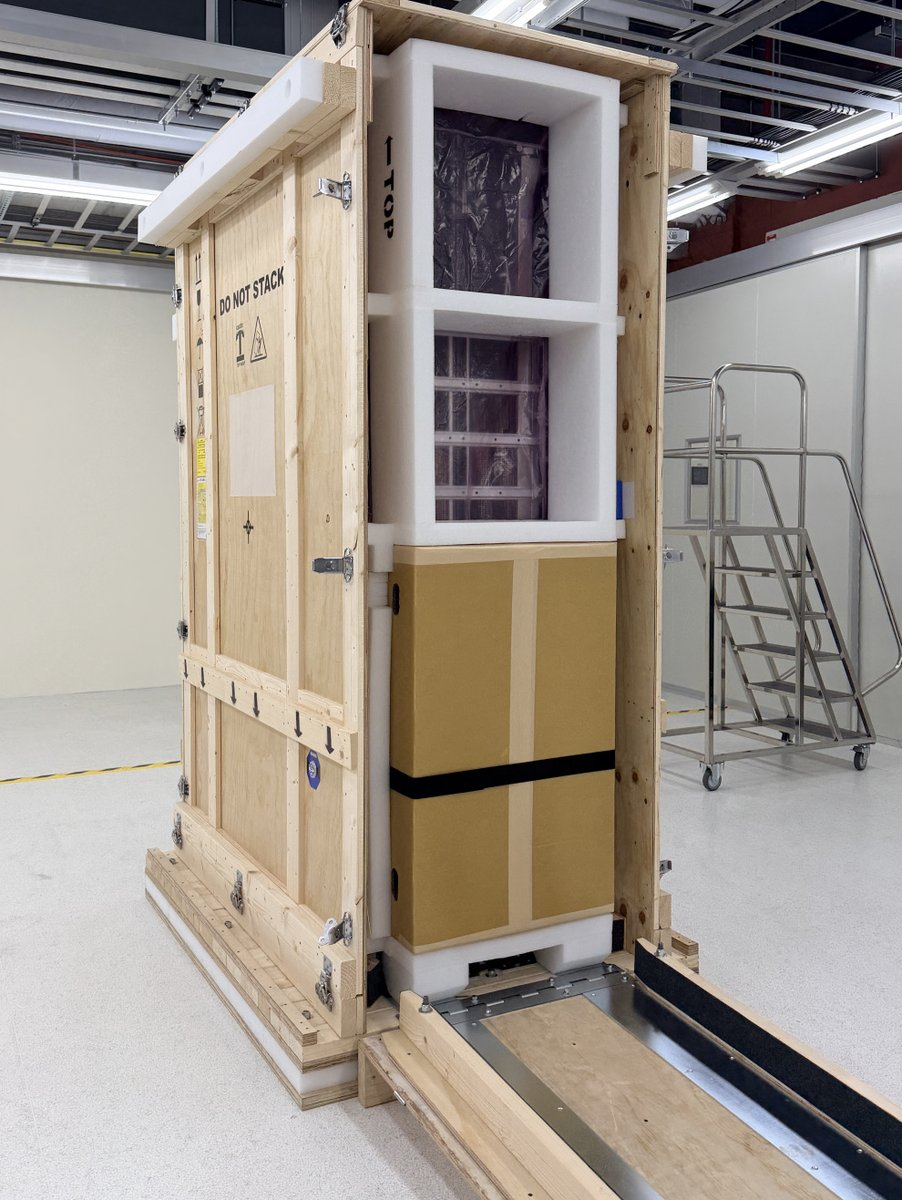
Источник изображения: Satya Nadella Стойка использует прямое жидкостное охлаждение, тогда как внутри самих лотков нет ни вентиляторов, ни шлангов. Примененные конструктивные решения существенно повышают скорость монтажа. При этом каждая стойка рассматривается как единая вычислительная единица. Заявленная производительность достигает 288 Пфлопс на операциях FP16/BF16 и 3,6 Эфлопс при инференсе в режиме NVFP4. 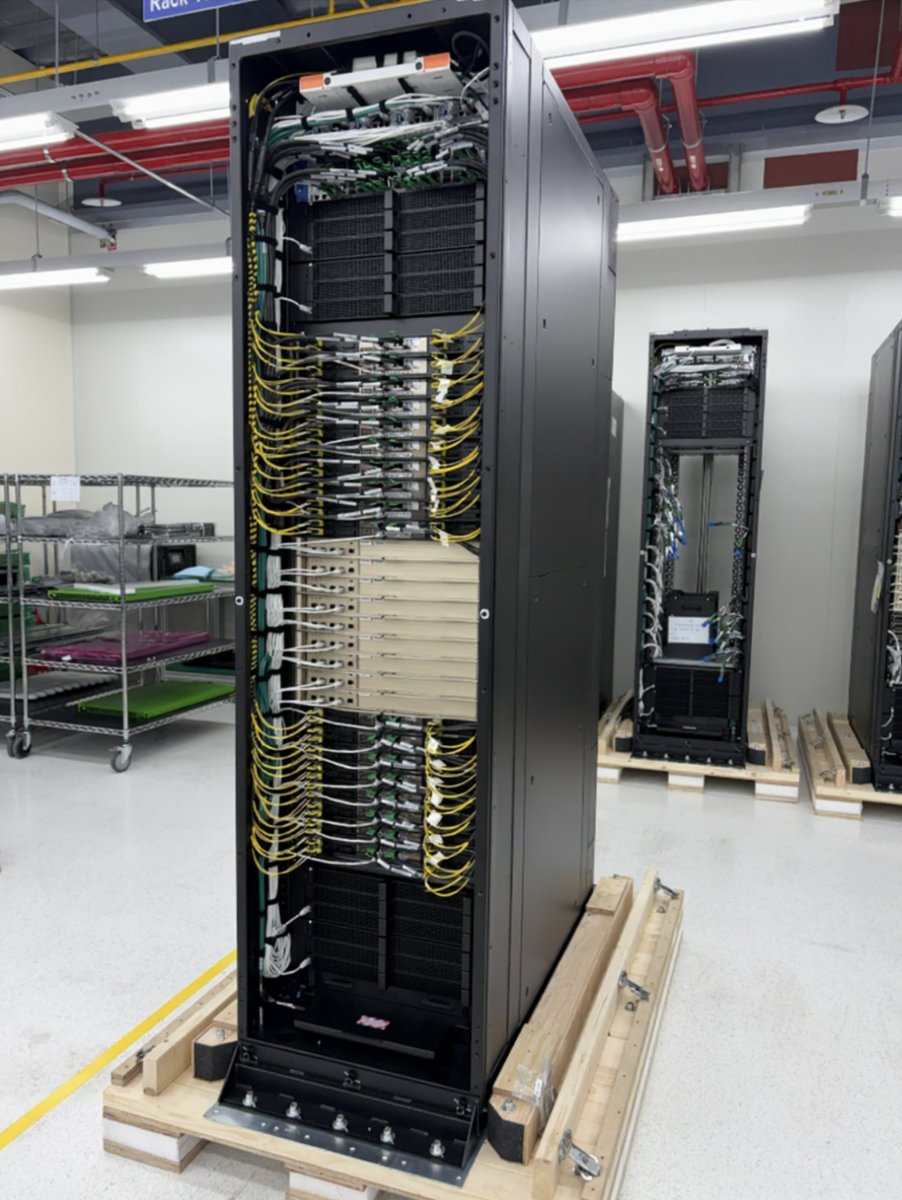
Источник изображения: Satya Nadella 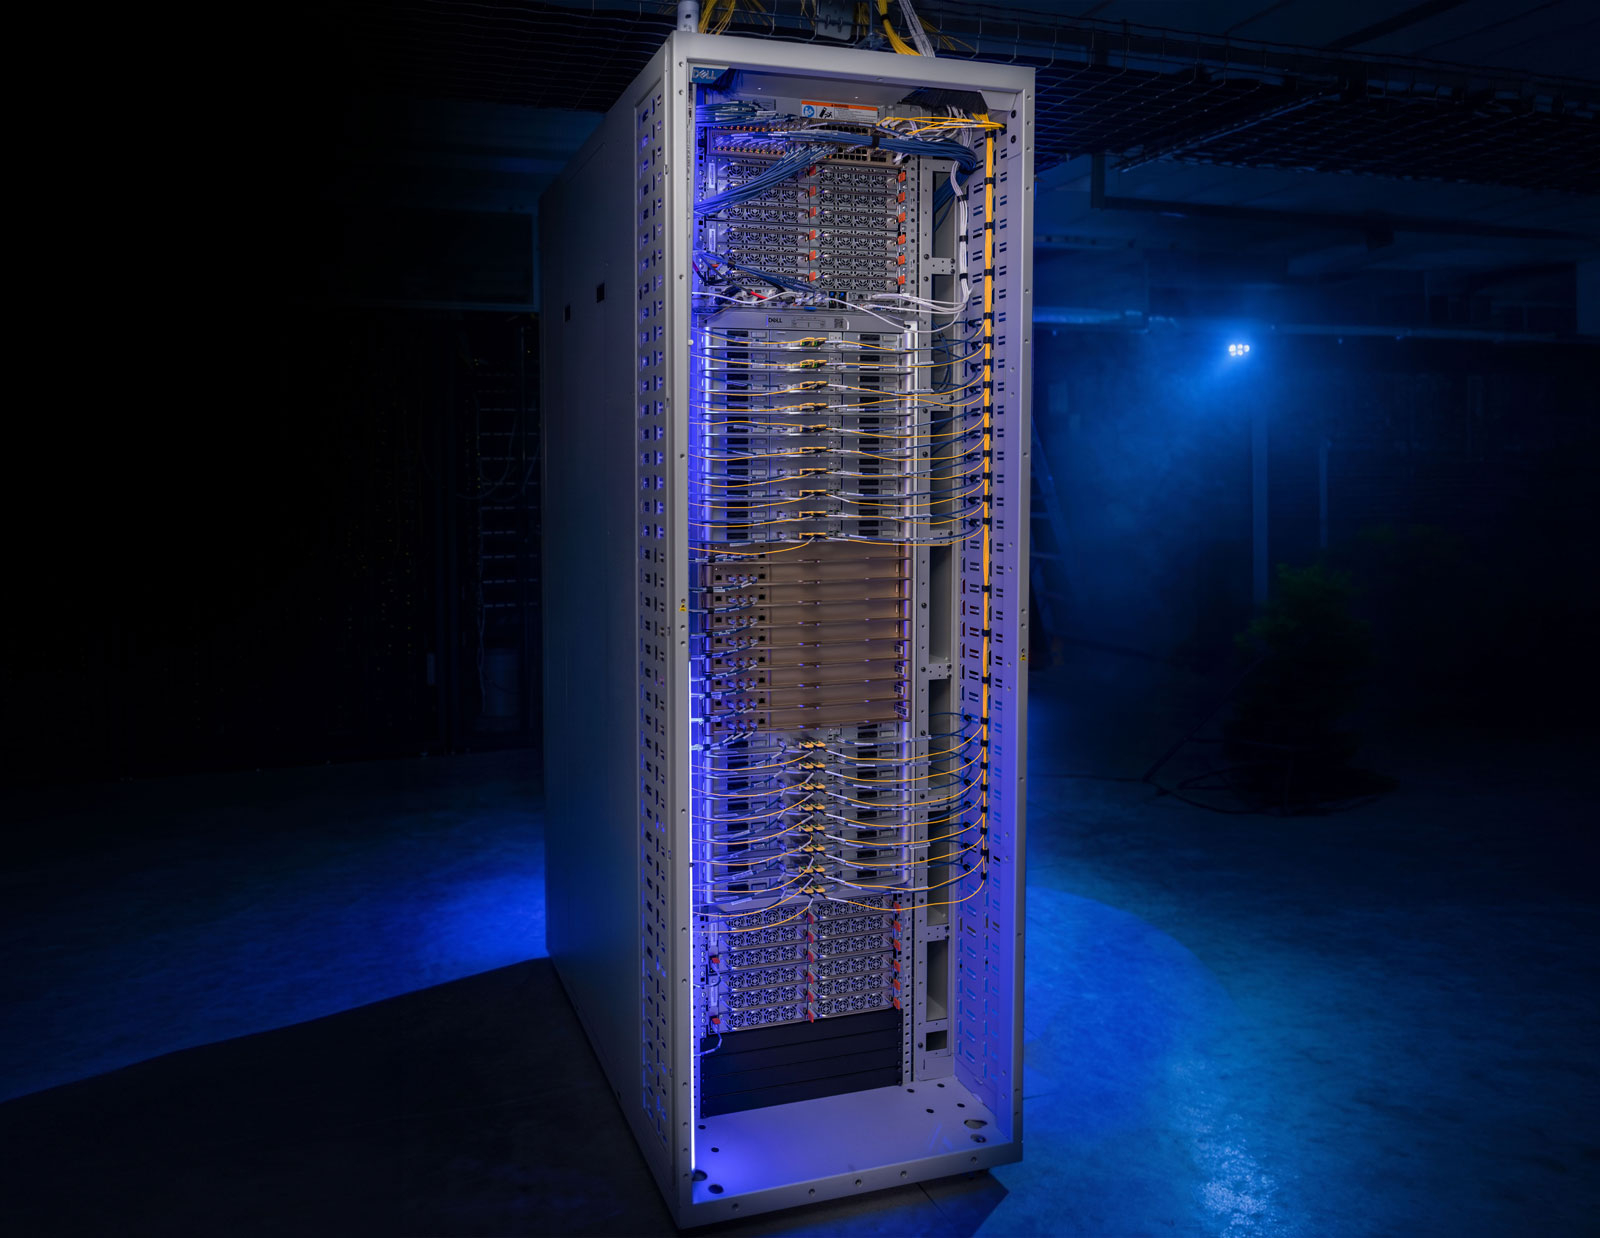
Источник изображения: NVIDIA/CoreWeave Нужно отметить, что развёртывание ИИ-систем на базе Vera Rubin NVL72 ведут и многие другие операторы ЦОД и неооблаков. В их число входят Nebius, CoreWeave, Google и пр. 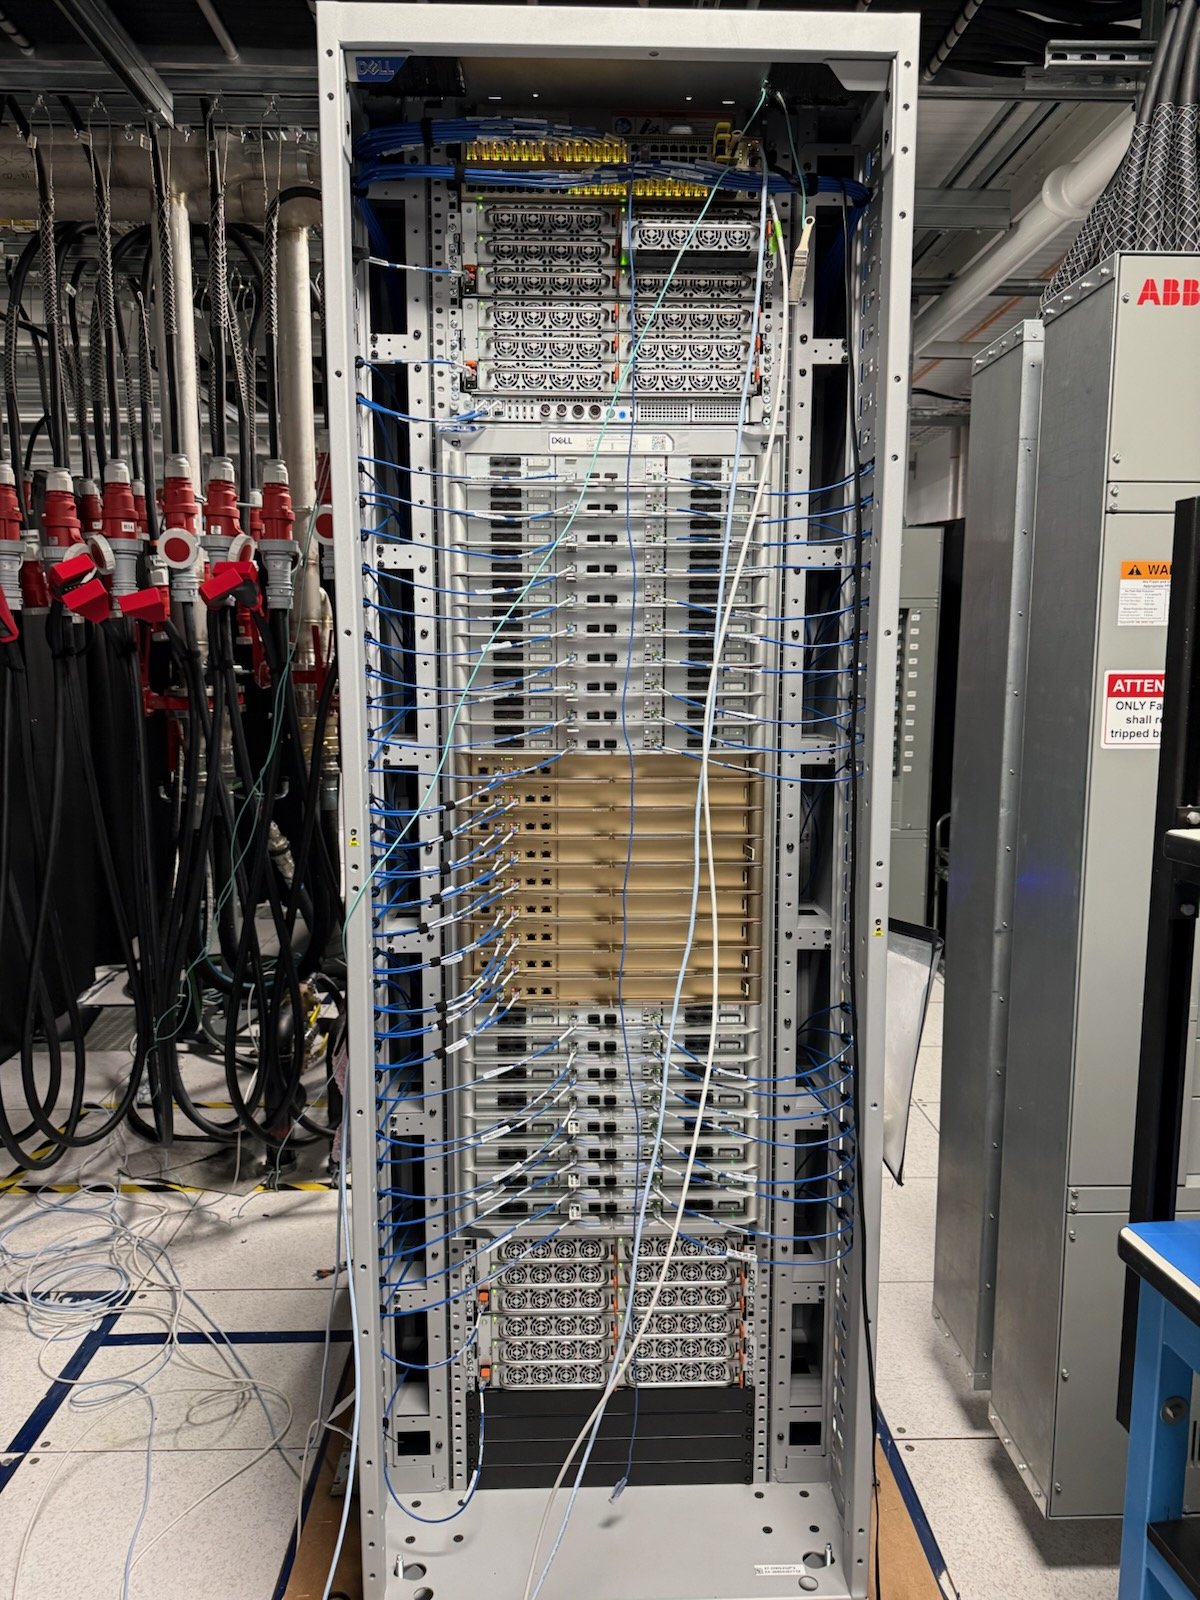
Источник изображения: Dell 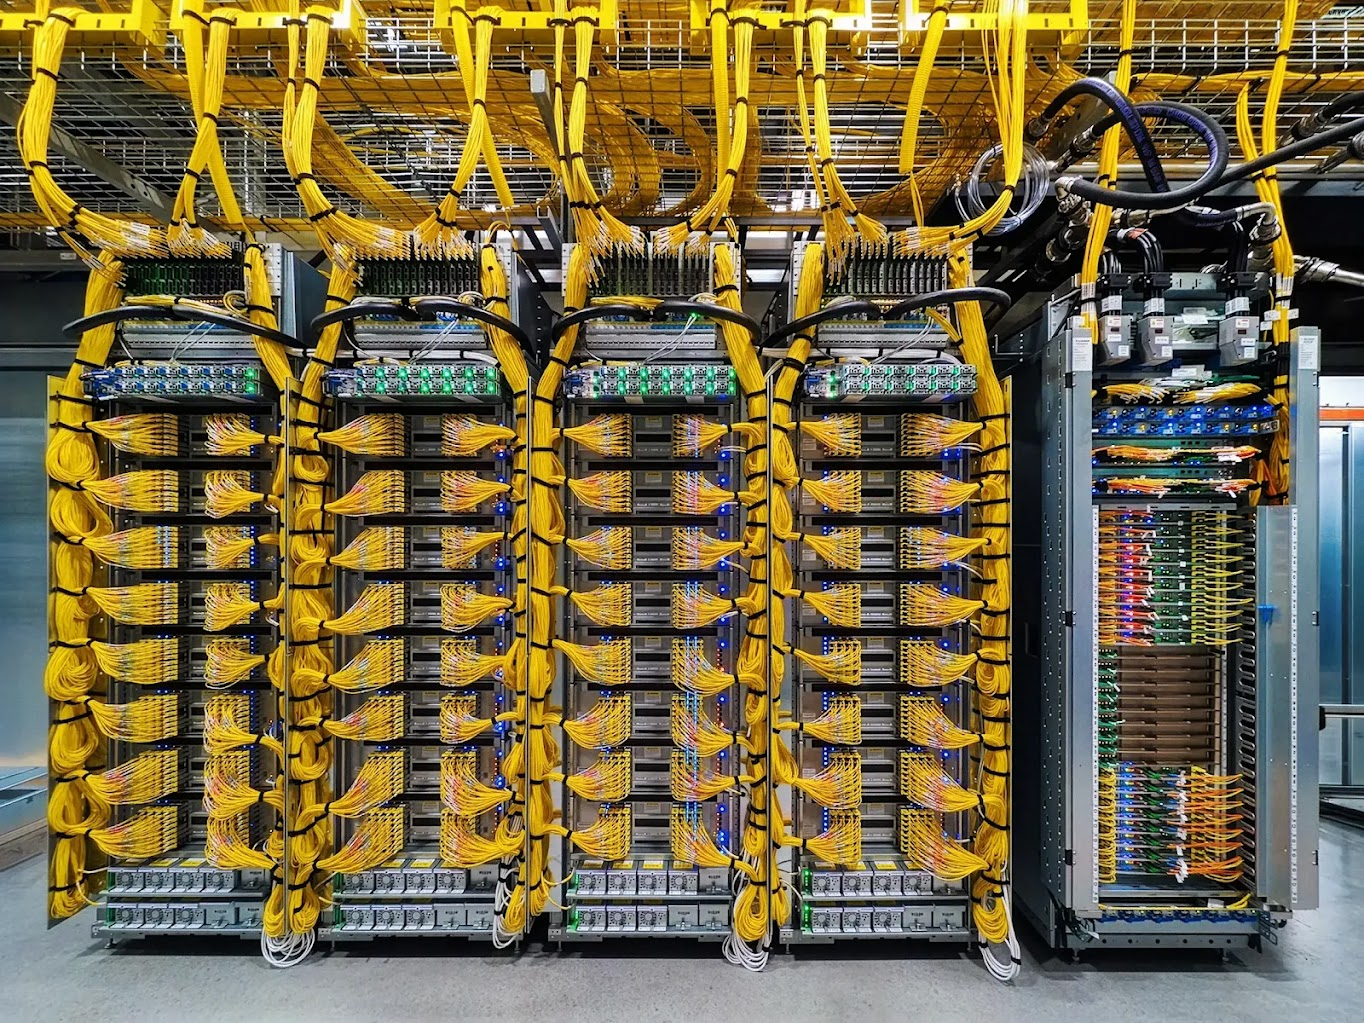
Источник изображения: NVIDIA/Google
02.08.2026 [14:46], Сергей Карасёв
Supermicro представила серверные стойки со статической нагрузкой до 2500 кгSupermicro расширила ассортимент серверных стоек, анонсировав десять моделей для систем высокой плотности, ориентированных на ресурсоёмкие задачи ИИ и другие критические нагрузки. Дебютировали решения на базе стандартов OCP ORv3 и NVIDIA MGX, а также традиционные 19″ варианты. Новинки входят в продуктовое семейство Supermicro Data Center Building Block Solutions (DCBBS). Стойки могут поставляться в предварительно сконфигурированном виде, что упрощает и ускоряет развёртывание: заказчикам и интеграторам не нужно монтировать на объекте вычислительные узлы, сетевые компоненты, а также элементы подсистем питания и охлаждения. Все анонсированные устройства рассчитаны на статическую нагрузку до 2500 кг. Это позволяет размещать мощные ИИ-серверы с ускорителями на базе GPU, высокопроизводительное силовое оборудование и пр. Изделия проходят испытания на вибро- и сейсмическую устойчивость. Говорится о гибких возможностях в плане применения жидкостного охлаждения: стойки совместимы с блоками распределения охлаждающей жидкости (CDU) различных типов, теплообменниками на задней двери (RDHx) и пр. Силовые и сетевые кабели полностью изолированы. 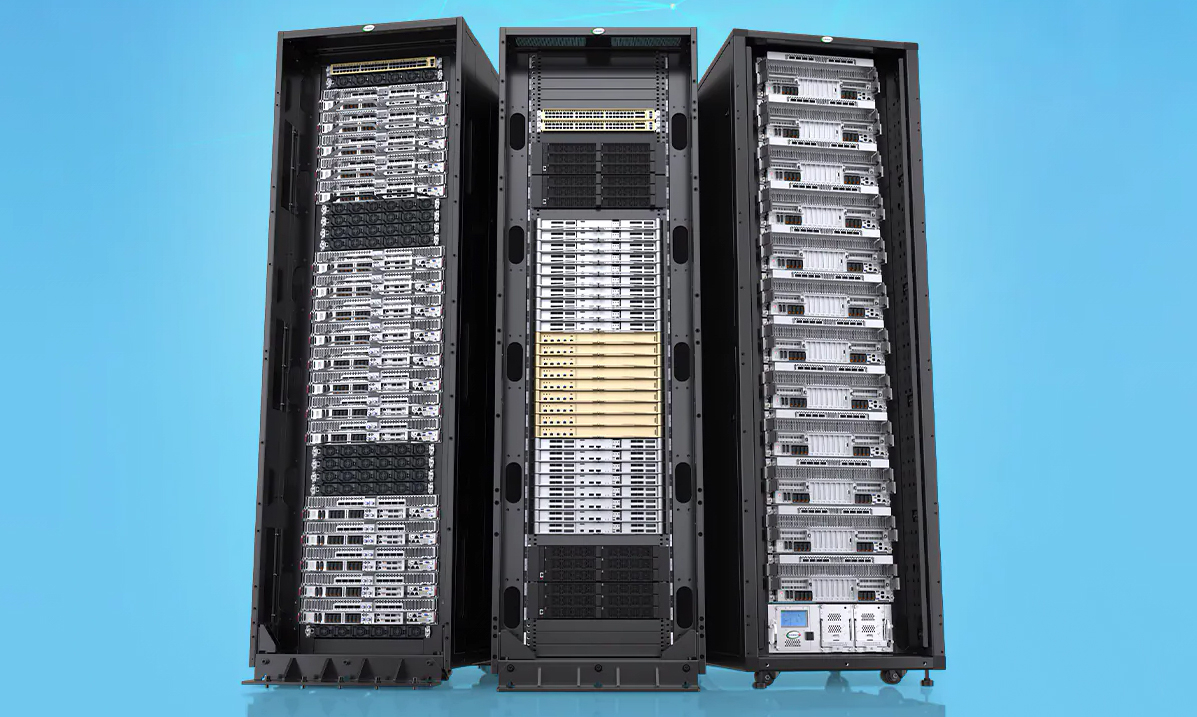
Источник изображения: Supermicro В число новинок входят стойки для платформ NVIDIA VR200/GB300 MGX в форматах 48U и 52U с вариантами ширины 600 и 750 мм. Кроме того, выпущены решения 44OU и 48OU стандарта ORv3 (типоразмера 21″). В традиционном 19″ исполнении доступны варианты 48U и 52U. Компания Supermicro отмечает, что её производственных возможностей достаточно для выпуска примерно 3 тыс. таких стоек в месяц. Из них около 2 тыс. могут комплектоваться СЖО.
15.06.2026 [09:32], Сергей Карасёв
96 NVMe SSD с СЖО и четыре RTX Pro 6000: Wiwynn показала сверхбыстрое хранилище на базе NVIDIA SCADAКомпания Wiwynn (дочерняя структура Wistron), по сообщению ресурса Tom's Hardware, продемонстрировала один из первых в отрасли серверов хранения NVIDIA SCADA (SCaled Accelerated Data Access). Устройство ориентировано на высокопроизводительную обработку больших объёмов данных в рамках задач обучения ИИ-моделей и инференса. 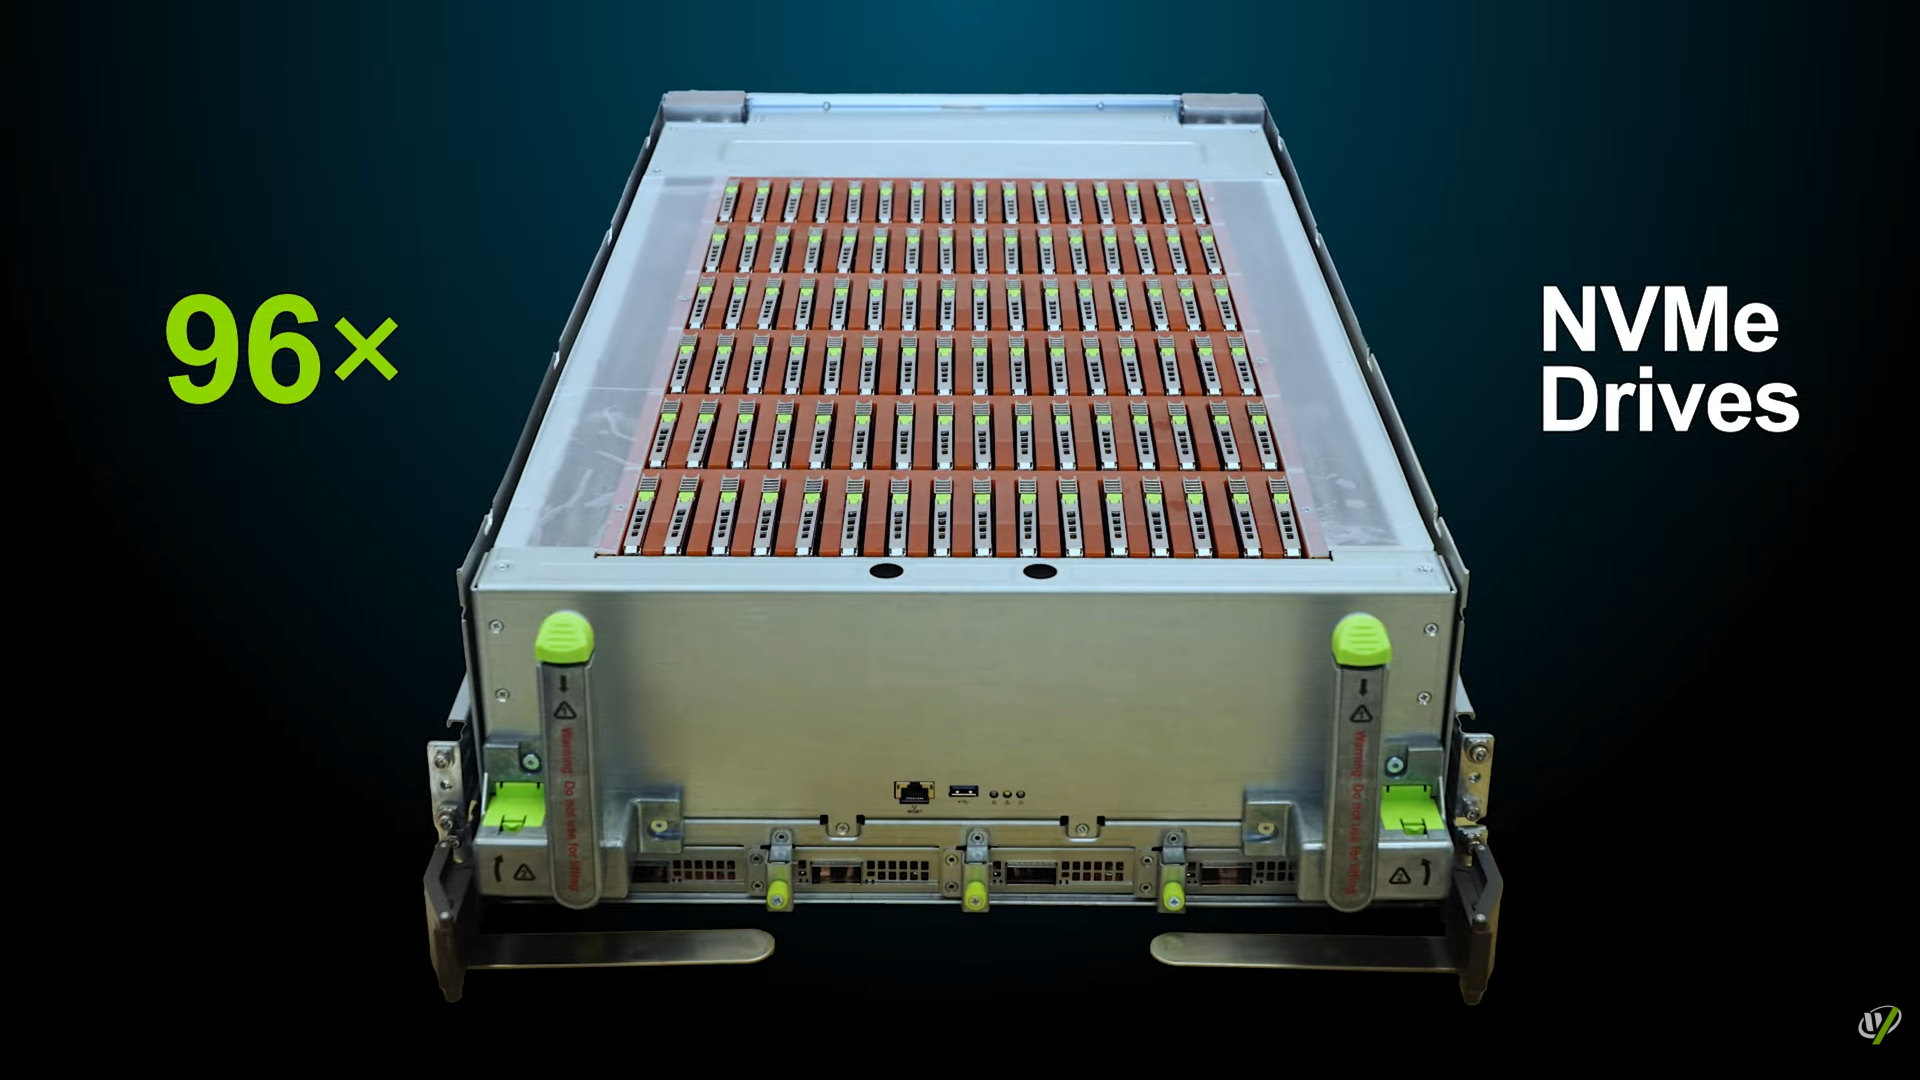
Источник изображений: Wiwynn Новинка выполнена в MGX-шасси высотой 6U и рассчитана на монтаж в 19″ серверную стойку. Задействован процессор NVIDIA Vera, который содержит 88 ядер Olympus, или Intel Xeon (в составе HPM-). Доступны восемь слотов для модулей DDR5. Система несёт на борту четыре ускорителя NVIDIA RTX Pro 6000 Blackwell Server Edition, четыре коммутатора PCIe 6.x и четыре 800G-карты ConnectX-9 SuperNIC/DPU BlueField-4 (опционально GPU можно поменять на DPU). Реализовано полностью жидкостное охлаждение. 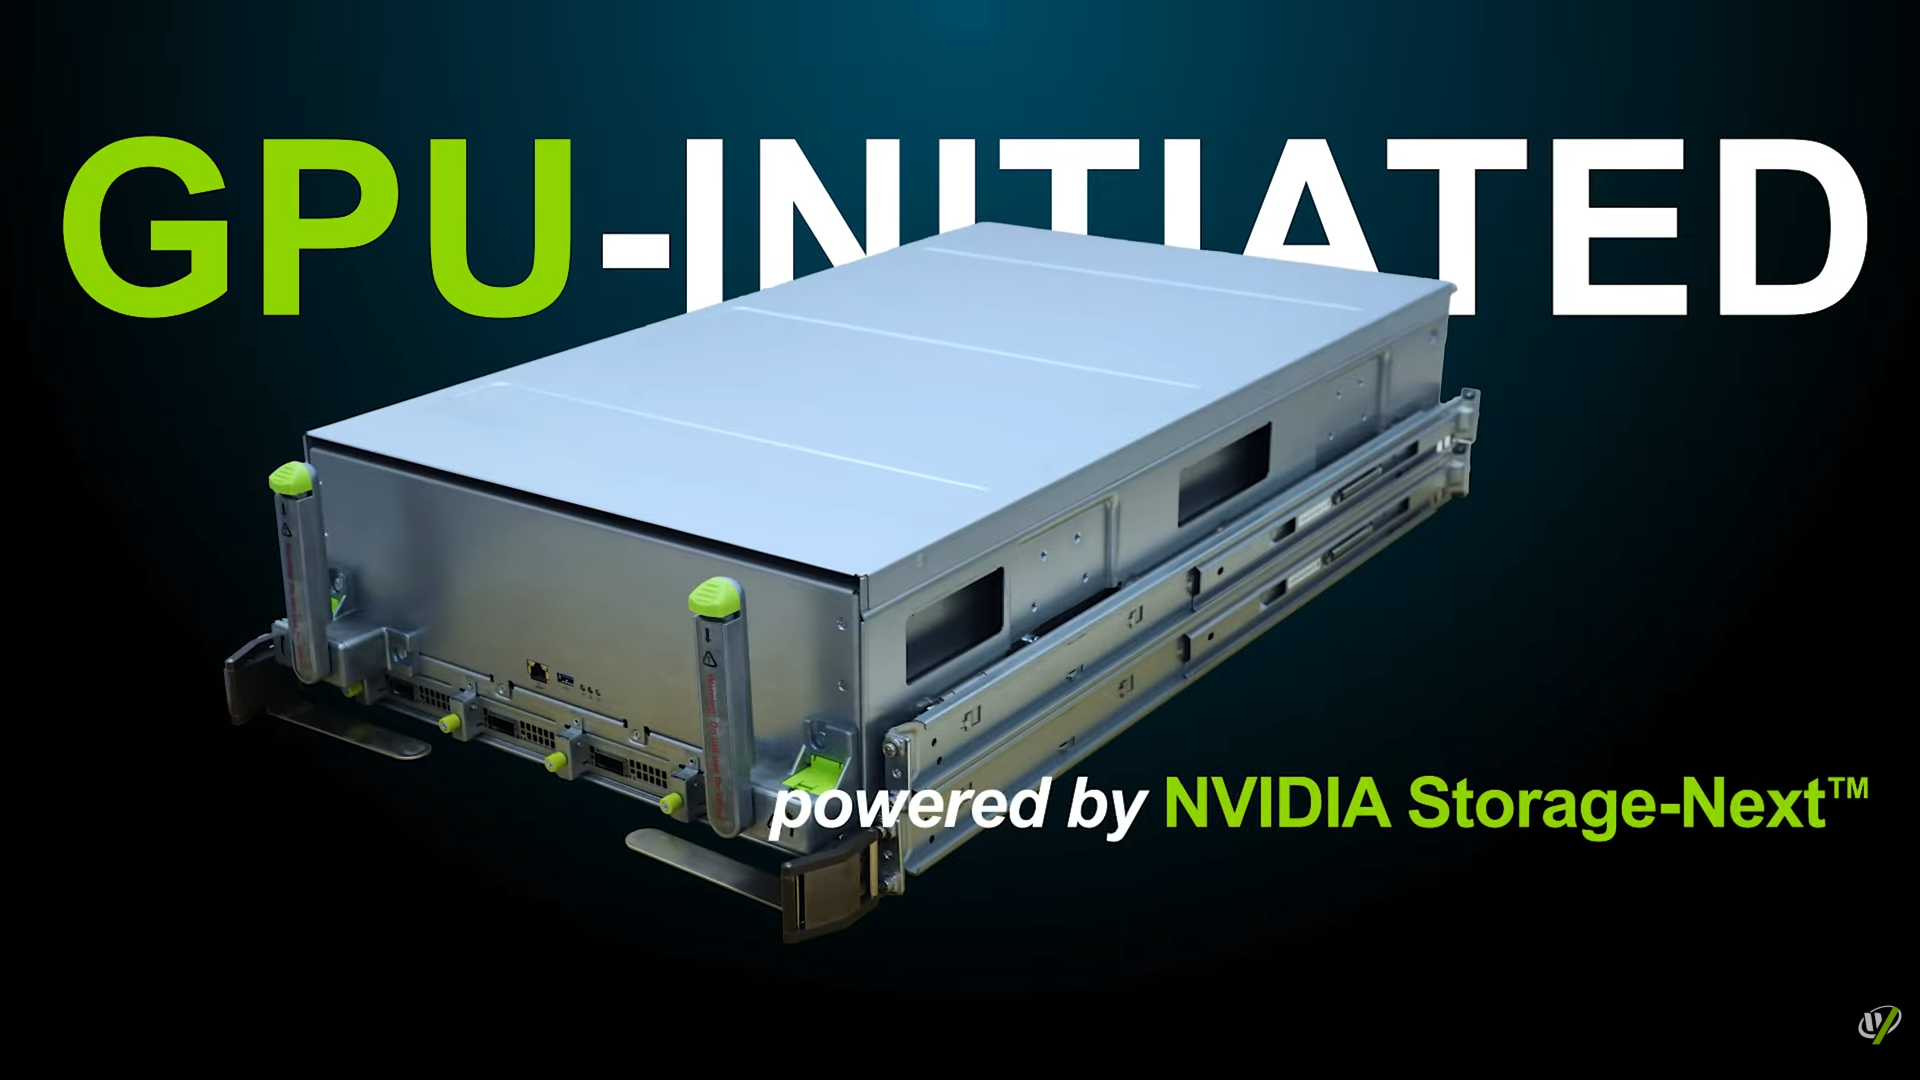 Сервер рассчитан на 96 накопителей EDSFF E3.S SSD с вертикальной загрузкой. При использовании изделий Micron 9650 Pro вместимостью 30,72 Тбайт с интерфейсом PCIe 6.0 суммарная ёмкость достигает 2,949 Пбайт. При этом обеспечивается показатель IOPS на операциях случайного чтения до 528 млн. Максимальное энергопотребление новинки — 9 кВт (питание DC 50 В). Кабели питания и гибкие шланги СЖО расположенные в нишах по бокам, что позволяет выдвигать лоток с накопителями и производить «горячую» замену SSD. 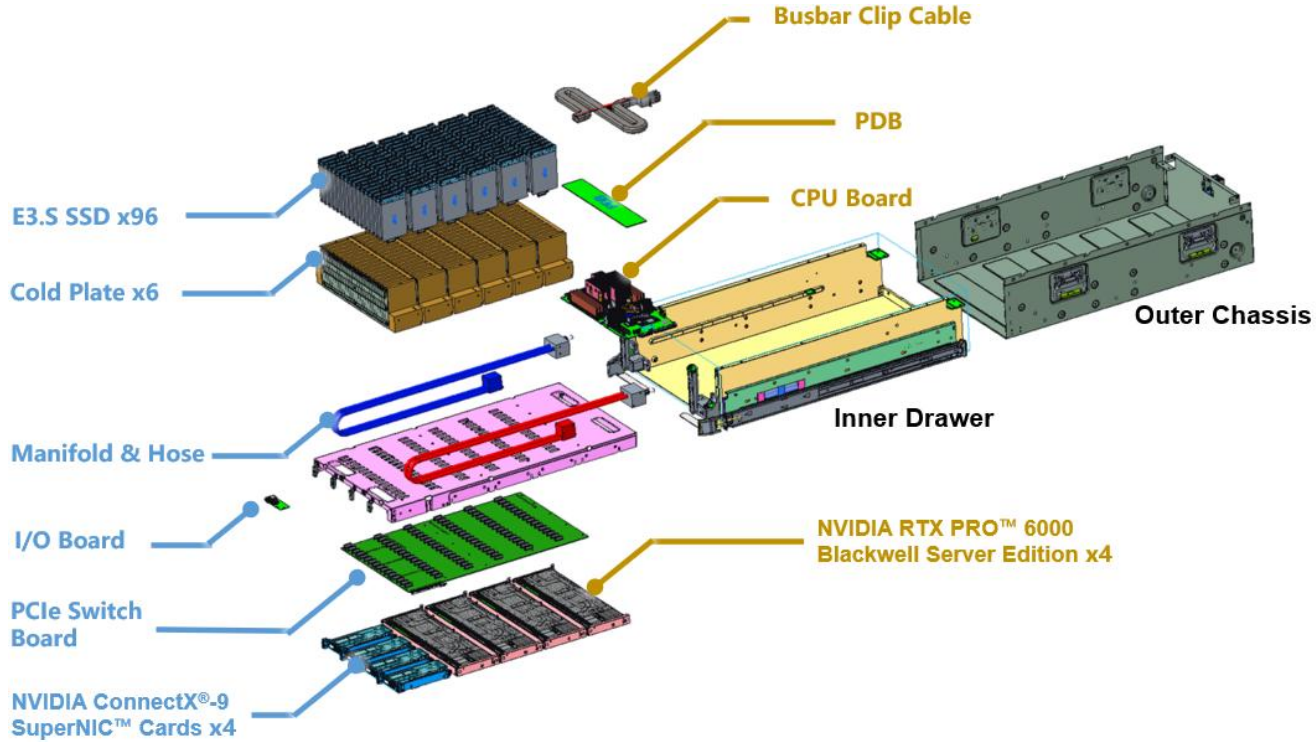 Отмечается, что традиционные серверы на основе CPU плохо справляются с такими задачами, как векторный поиск, генерация с дополненной выборкой (RAG), анализ графов и извлечение данных из KV-кеша. При таких нагрузках процессору необходимо выдавать команды, обрабатывать запросы и контролировать передачу данных, из-за чего создаются узкие места. 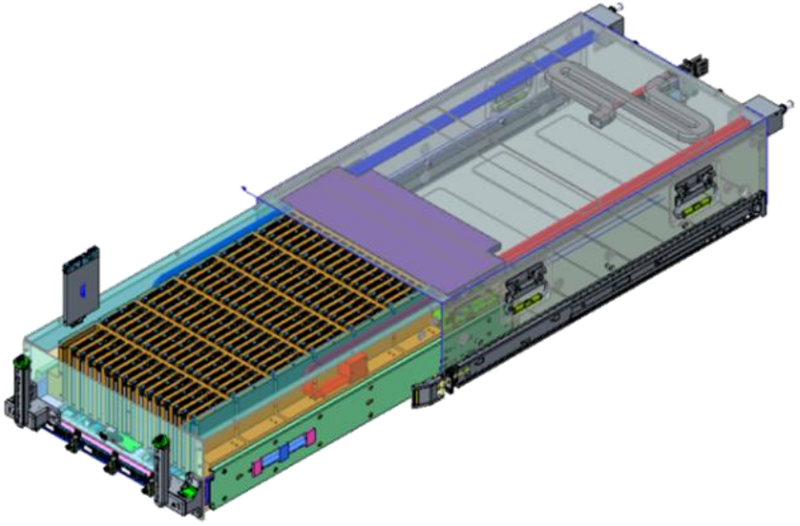 Платформа SCADA позволяет решить проблему благодаря тому, что операции ввода-вывода и обработка данных возлагаются на GPU — без участия CPU. По сути, ускорители RTX Pro 6000 Blackwell Server Edition в составе машины выполняют функции процессоров хранения, которые инициируют и обрабатывают транзакции и миллионы запросов со стороны ИИ-приложений, а также передают данные на вычислительные узлы посредством карт ConnectX-9.
27.03.2026 [21:04], Руслан Авдеев
«Не хотите ускорители? Возьмите хотя бы сеть!» — NVIDIA открыла свои ИИ-стойки для чужих чиповNVIDIA занялась разработкой серверных стоек, подходящих для решений на основе сторонних ИИ-ускорителей, сообщает The Information со ссылкой на знакомые с вопросом источники. Компания стремится остаться ключевым игроком на рынке ИИ-систем даже по мере того, как всё больше её клиентов разрабатывают решения, прямо конкурирующие с продуктами самой NVIDIA. На прошлой неделе компания представила новые стойки MGX ETL, специально разработанные для поддержки чипов как самой NVIDIA, так и поставщиков-конкурентов. Система основана на модульной архитектуре MGX (OCP), представленной в 2023 году и уже довольно распространённой. ETL предполагает использование сетевых решений NVIDIA Spectrum-X. Таким образом, «зелёные» чипы всё равно оказываются в инфраструктуре, даже если она базируется на сторонних решениях. Похожим образом компания развивает и фирменный интерконнект NVLink. NVLink Fusion можно интегрировать в другие чипы, что опять-таки даёт NVIDIA возможность заработать на чужих ИИ-системах. Но в случае ETL применяются широко поддерживаемые в индустрии стандарты Ethernet, что снижает для клиентов «порог вхождения» при внедрении оборудования NVIDIA. Модульный дизайн позволяет облачным гиперскейлерам одновременно использовать ускорители разных производителей, при этом оставаясь в сетевой и программной экосистемах NVIDIA. 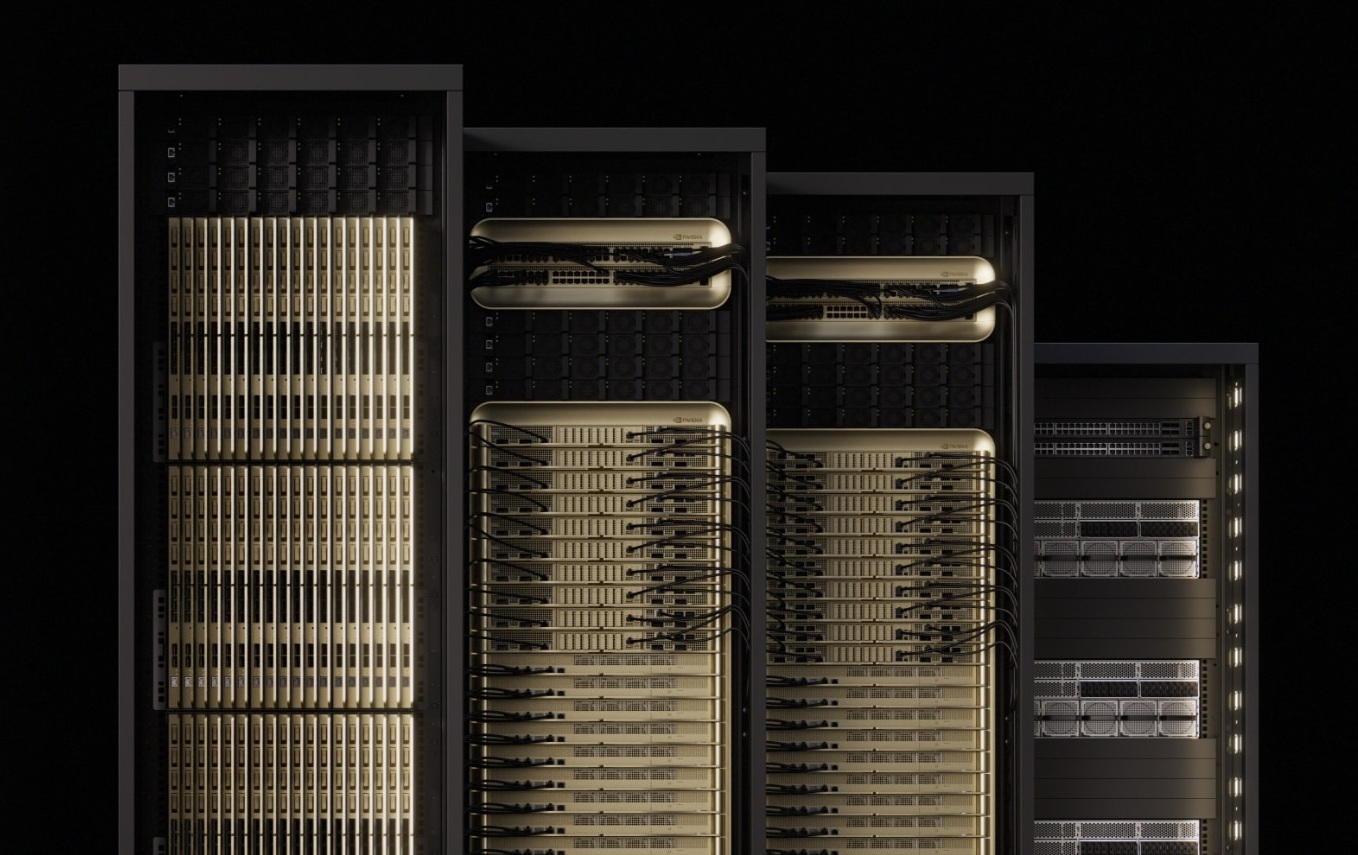
Источник изображения: NVIDIA NVIDIA позиционировала MGX как открытую «эталонную» архитектуру, не мешающую партнёрам использовать альтернативные компоненты. Гибкость также позволяет NVIDIA «проложить дорогу» на китайский рынок, где компании смогут применять со стойками NVIDIA чипы домашней разработки. Новый дизайн стоек также может помочь NVIDIA устранить обеспокоенность регуляторов практикой, когда компания связывала использование сетевого оборудования с определёнными ИИ-чипами. На этом фоне происходит ужесточение конкуренции на рынке технологий интерконнектов. Открытый стандарт UALink позиционируется как альтернатива NVLink и призван обеспечить высокоскоростную связь между ИИ-чипами без применения проприетарных технологий. Параллельно развивается и открытый стандарт Ultra Ethernet, который призван конкурировать и с технологией Infiniband, фактически единолично контролируемой NVIDIA. Сетевые решения являются чрезвычайно важной частью бизнеса NVIDIA. По итогам последнего квартала выручка компании в этом сегменте достигла $10,98 млрд (а за год все $31 млрд) — она выросла год к году на 268 % и составила более 15 % от всей выручки компании. При этом значительная часть сетевого оборудования продаётся не сама по себе, а в составе платформенных решений NVIDIA.
17.03.2026 [02:00], Владимир Мироненко
ИИ-ускорители Groq прописались в платформе NVIDIA Vera RubinNVIDIA объявила о том, что платформа Vera Rubin, объединяющая теперь уже семь различных чипов (ещё в январе их было шесть), которые вместе откроют новые горизонты агентного ИИ, запущена в производство. Платформа включает Arm-процессоры Vera, ускорители Rubin, интерконнект NVLink 6, адаптеры ConnectX-9 SuperNIC и DPU BlueField-4, а также Ethernet-коммутаторы Spectrum/Quantum-6. Седьмым чипом стал LPU Groq 3 — NVIDIA купила Groq за рекордные $20 млрд всего три месяца назад и активно наращивает производство LPU. Благодаря такому сочетанию компонентов платформа обеспечивает обработку ИИ-нагрузок на всех этапах — от масштабного предварительного обучения, постобучения и масштабирования во время тестирования до инференса агентных задач в реальном времени, говорит NVIDIA. «Vera Rubin — это скачок в развитии — семь прорывных чипов, пять стоек, один гигантский суперкомпьютер — созданный для обеспечения всех этапов работы ИИ», — сообщил Дженсен Хуанг (Jensen Huang), основатель и генеральный директор NVIDIA. Он отметил, что с появлением Vera Rubin в развитии агентного ИИ наступил переломный момент, положившей начало «крупнейшему в истории развёртыванию инфраструктуры». 
Источник изображений: NVIDIA «Платформа NVIDIA Vera Rubin предоставляет нам вычислительные ресурсы, сетевые возможности и системную архитектуру, позволяющие продолжать работу, одновременно повышая безопасность и надёжность, на которые полагаются наши клиенты», — подтвердил Дарио Амодеи (Dario Amodei), генеральный директор и соучредитель Anthropic. «Инфраструктура NVIDIA — это основа, которая позволяет нам расширять границы ИИ, — заявил Сэм Альтман (Sam Altman), генеральный директор OpenAI. — С NVIDIA Vera Rubin мы будем запускать более мощные модели и агентов в огромных масштабах и предоставлять более быстрые и надёжные системы сотням миллионов людей». Как отметила компания, Vera Rubin предлагает самую обширную комплексную ИИ-платформу — суперкомпьютер с множеством стоек, специально разработанных для ИИ, работающих как одна массивная, целостная система. NVIDIA Vera Rubin NVL72 обеспечивает высокую эффективность в обучение больших MoE-моделей с использованием вчетверо меньшего количества ускорителей по сравнению с платформой Blackwell и достижение до 10 раз большей пропускной способности инференса на ватт при в десять раз меньшей стоимости токена. 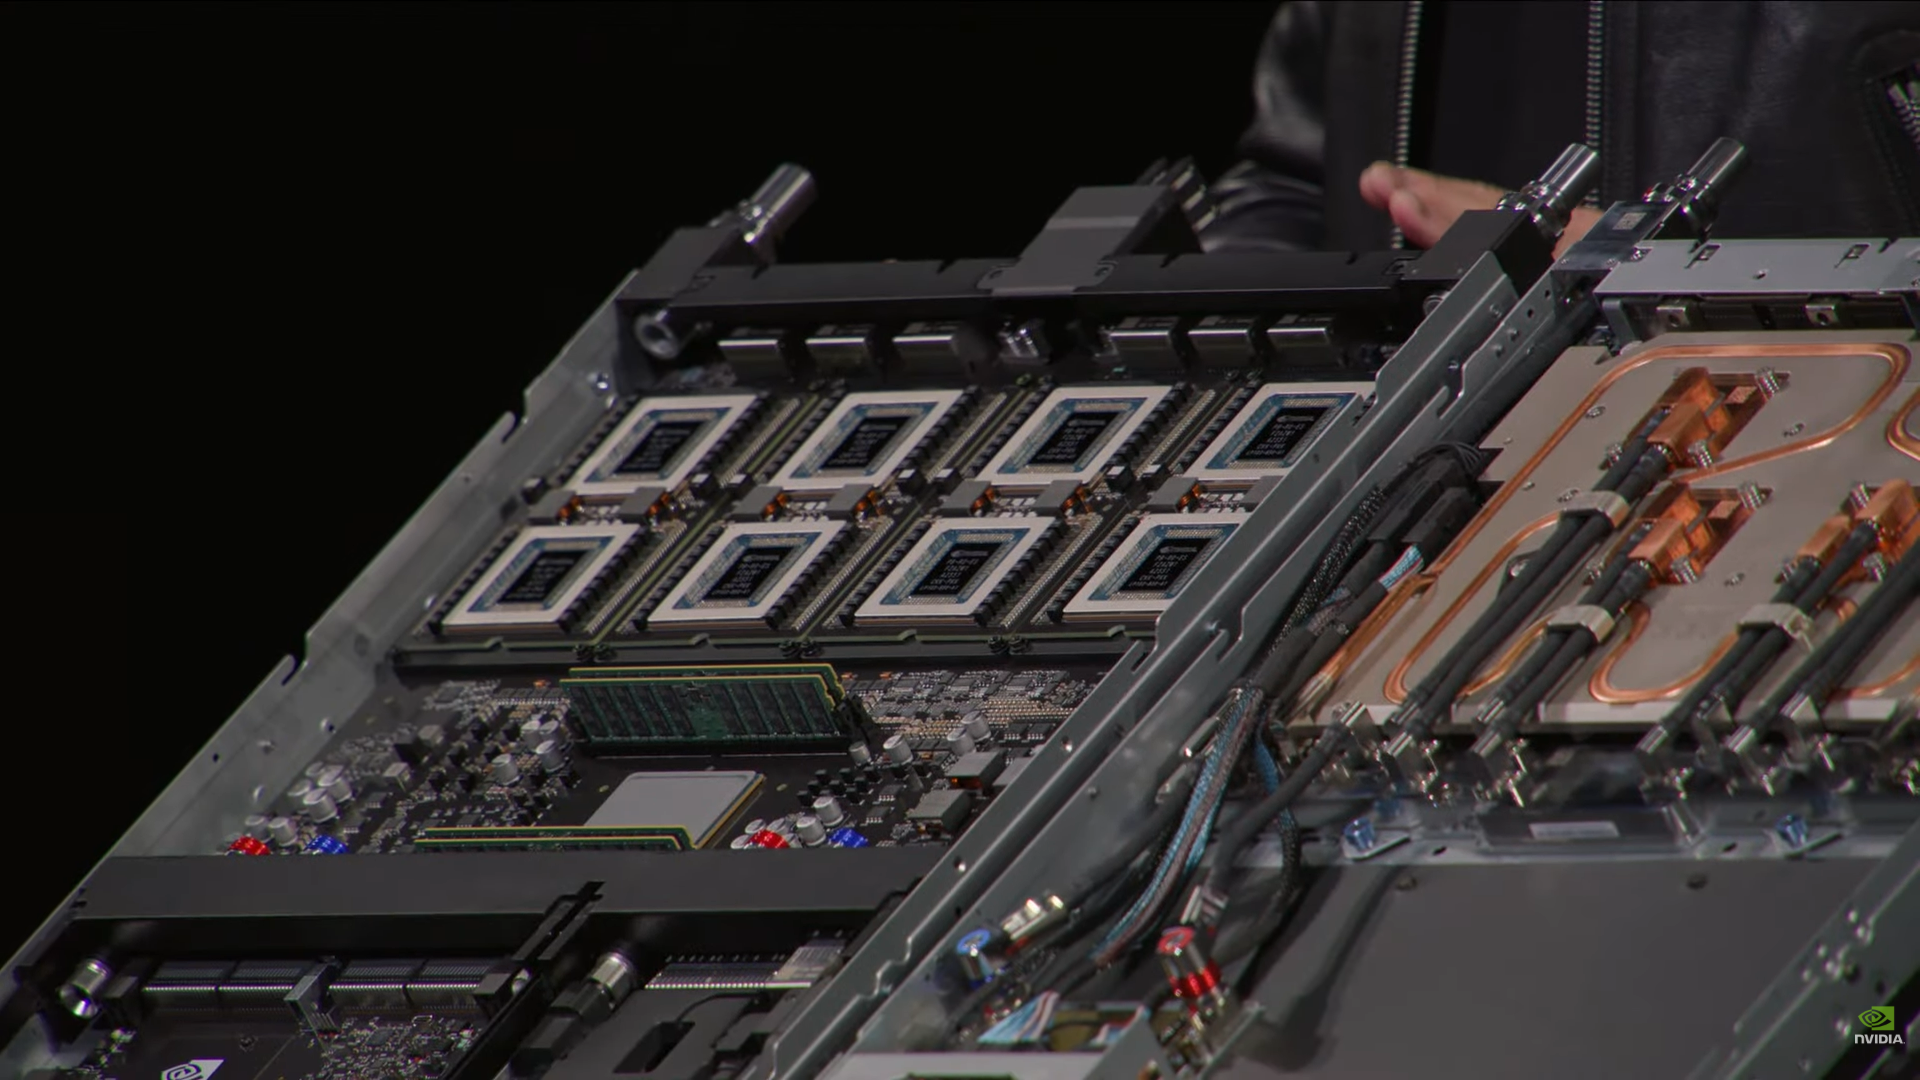 CPU-стойка Vera — это высокоплотная MGX-платформа с СЖО, объединяющая 256 процессоров Vera для обеспечения масштабируемой, энергоэффективной производительности с первоклассной однопоточной обработкой, что обеспечивает возможности для масштабируемого агентного ИИ. Стойки Vera имеют тесную синхронизацию сред во всей ИИ-фабрике. Вместе со стойками Rubin они обеспечивают основу крупномасштабных систем агентного ИИ и обучения с подкреплением — при этом Vera обеспечивает результаты в два раза эффективнее и наполовину быстрее, чем традиционные CPU (впрочем, в NVL8 по-прежнему будут Intel Xeon). Стойки Groq 3 LPX (тоже с СЖО и тоже на базе MGX) и Vera Rubin, разработанные для обеспечения низкой задержки и обработки больших контекстов, необходимых для агентных систем, обеспечивают до 35 раз более высокую пропускную способность инференса на мегаватт и до 10 раз больший потенциал дохода для моделей с триллионами параметров. В масштабе предприятия парк LPU функционирует как единый гигантский процессор для быстрого и детерминированного ускорения инференса. 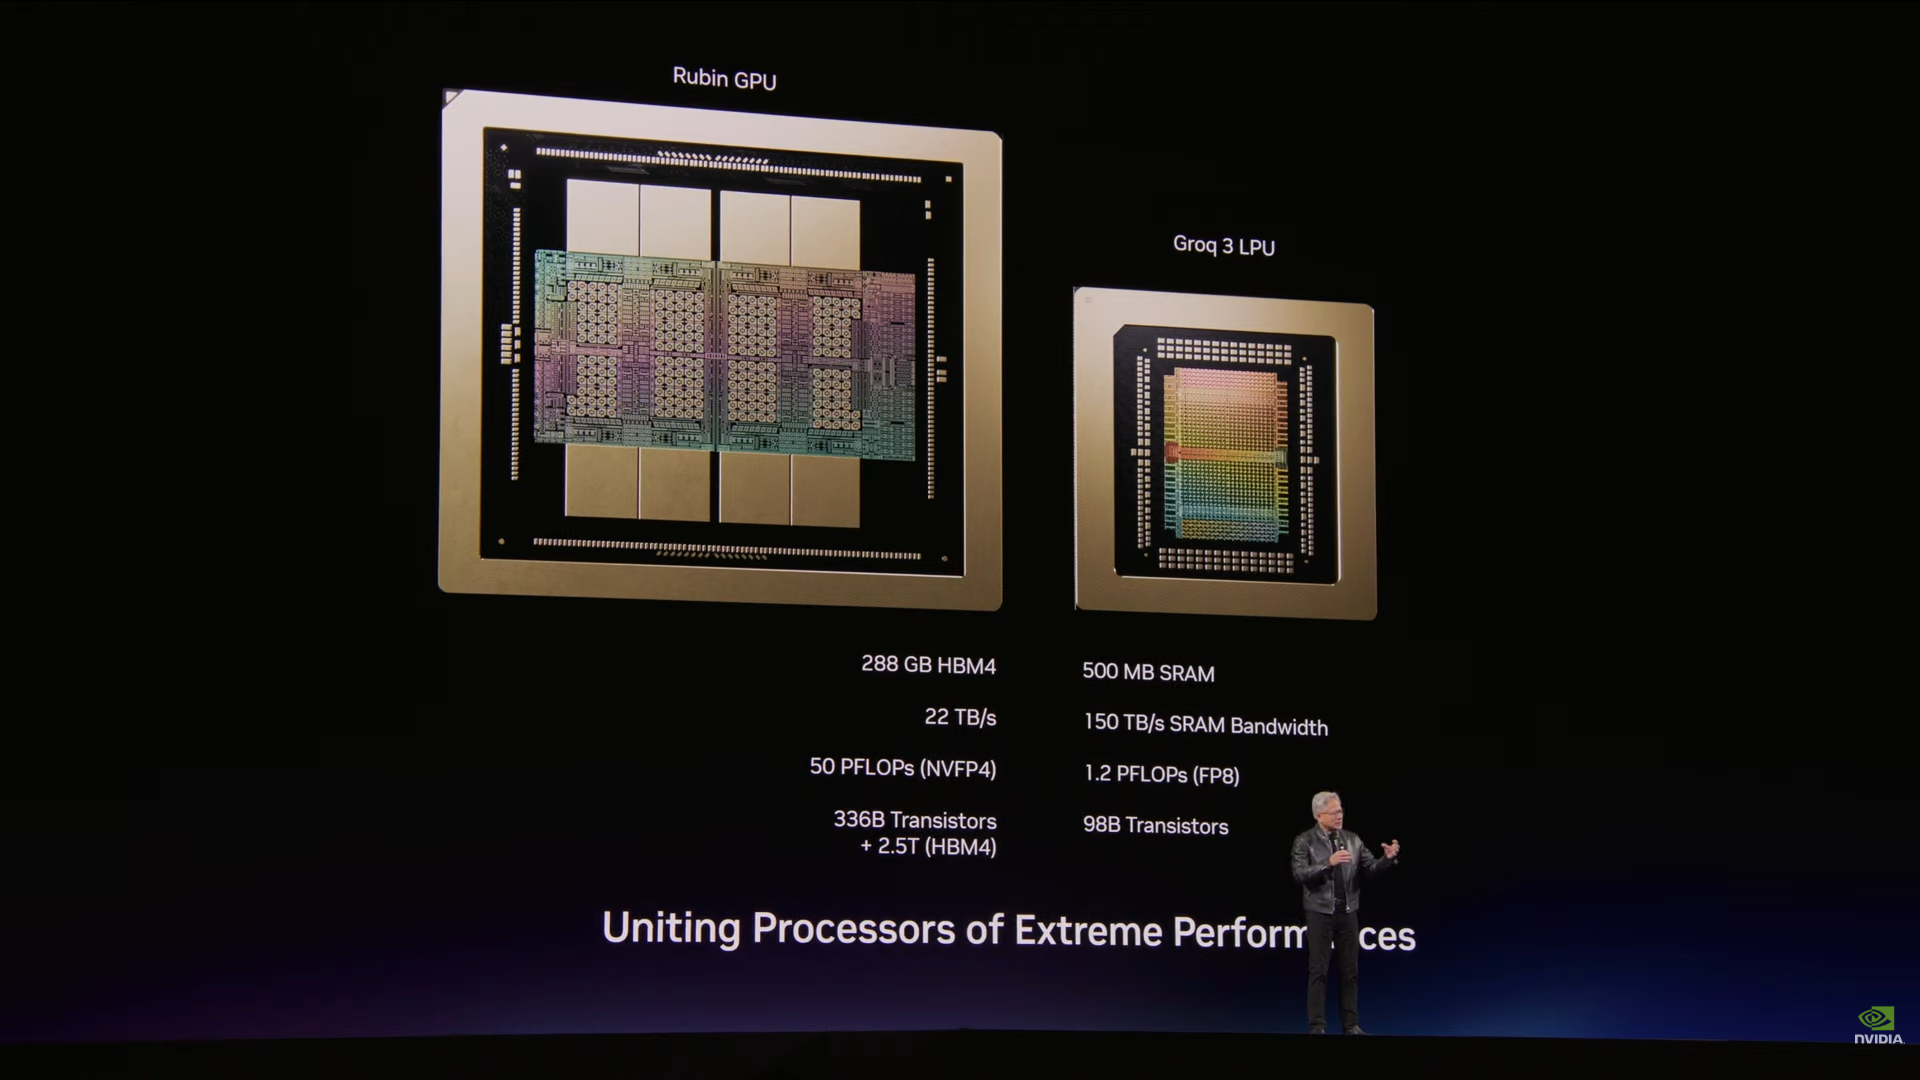 Стойка LPX с 256 LPU-чипами имеет 128 Гбайт SRAM с агрегированной пропускной способностью 640 Тбайт/с. В сочетании с Vera Rubin NVL72 чипы LPU повышают эффективность декодирования, совместно вычисляя каждый слой модели ИИ для каждого выходного токена. Всё это позволяет работать с моделями с триллионами параметров и контектсным окном в миллионы токенов, сохраняя максимальную эффективность по энергопотреблению, памяти и вычислительным ресурсам. Любопытно, что Rubin CPX в этот раз NVIDIA решила особо не упоминать. Анонсированная вместе с Vera Rubin СХД BlueField-4 STX разработана специально для ИИ-нагрузок, обеспечивая бесперебойное расширение памяти GPU по всему POD-кластеру. Впрочем, теперь компания говорит, что BlueField-4 включает CPU Vera, а не Grace, и ConnectX-9 SuperNIC. STX обеспечивает высокоскоростной общий слой данных, оптимизированный для хранения и извлечения больших объёмов KV-кеша, генерируемых LLM и рабочими процессами агентного ИИ. А программная платформа DOCA Memos позволяет использовать выделенное KV-хранилище для увеличения пропускной способности инференса до пяти раз, также повышая энергоэффективность по сравнению с архитектурами хранения общего назначения. 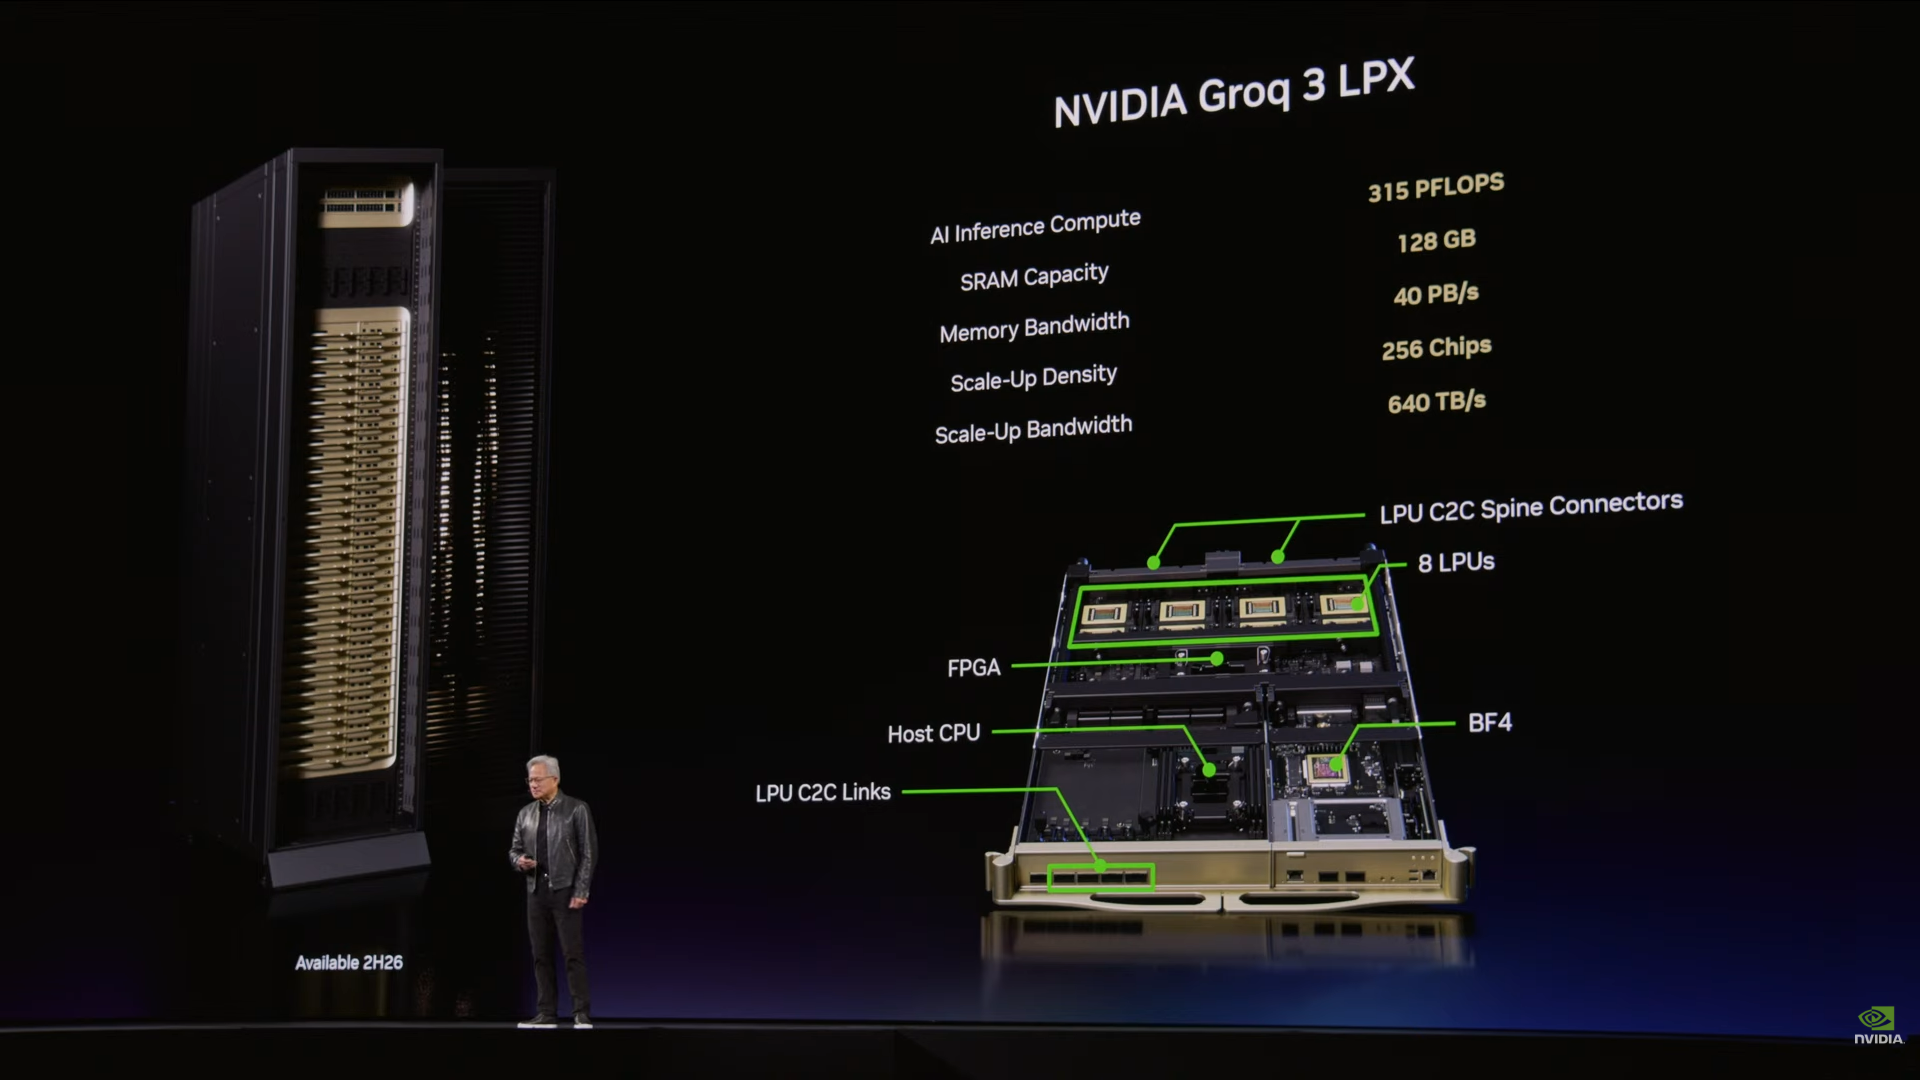 Также NVIDIA совместно с более чем 200 партнёрами анонсировала платформу NVIDIA DSX для Vera Rubin, которая включает технологию DSX Max-Q, позволяющую динамически управлять питанием всей ИИ-фабрики целиком, позволяя увеличить на 30 % ИИ-инфраструктуру в ЦОД при том же энергопотреблении. ПО DSX Flex обеспечивает ИИ-фабрикам гибкость в работе с энергосетями, позволяя освоить до 100 ГВт неиспользуемой мощности сетей. Кроме того, NVIDIA выпустила эталонный проект Vera Rubin DSX AI Factory — схему для совместно разработанной ИИ-инфраструктуры, которая максимизирует количество токенов на ватт и общую пропускную способность, повышая отказоустойчивость системы и ускоряя развётывание. 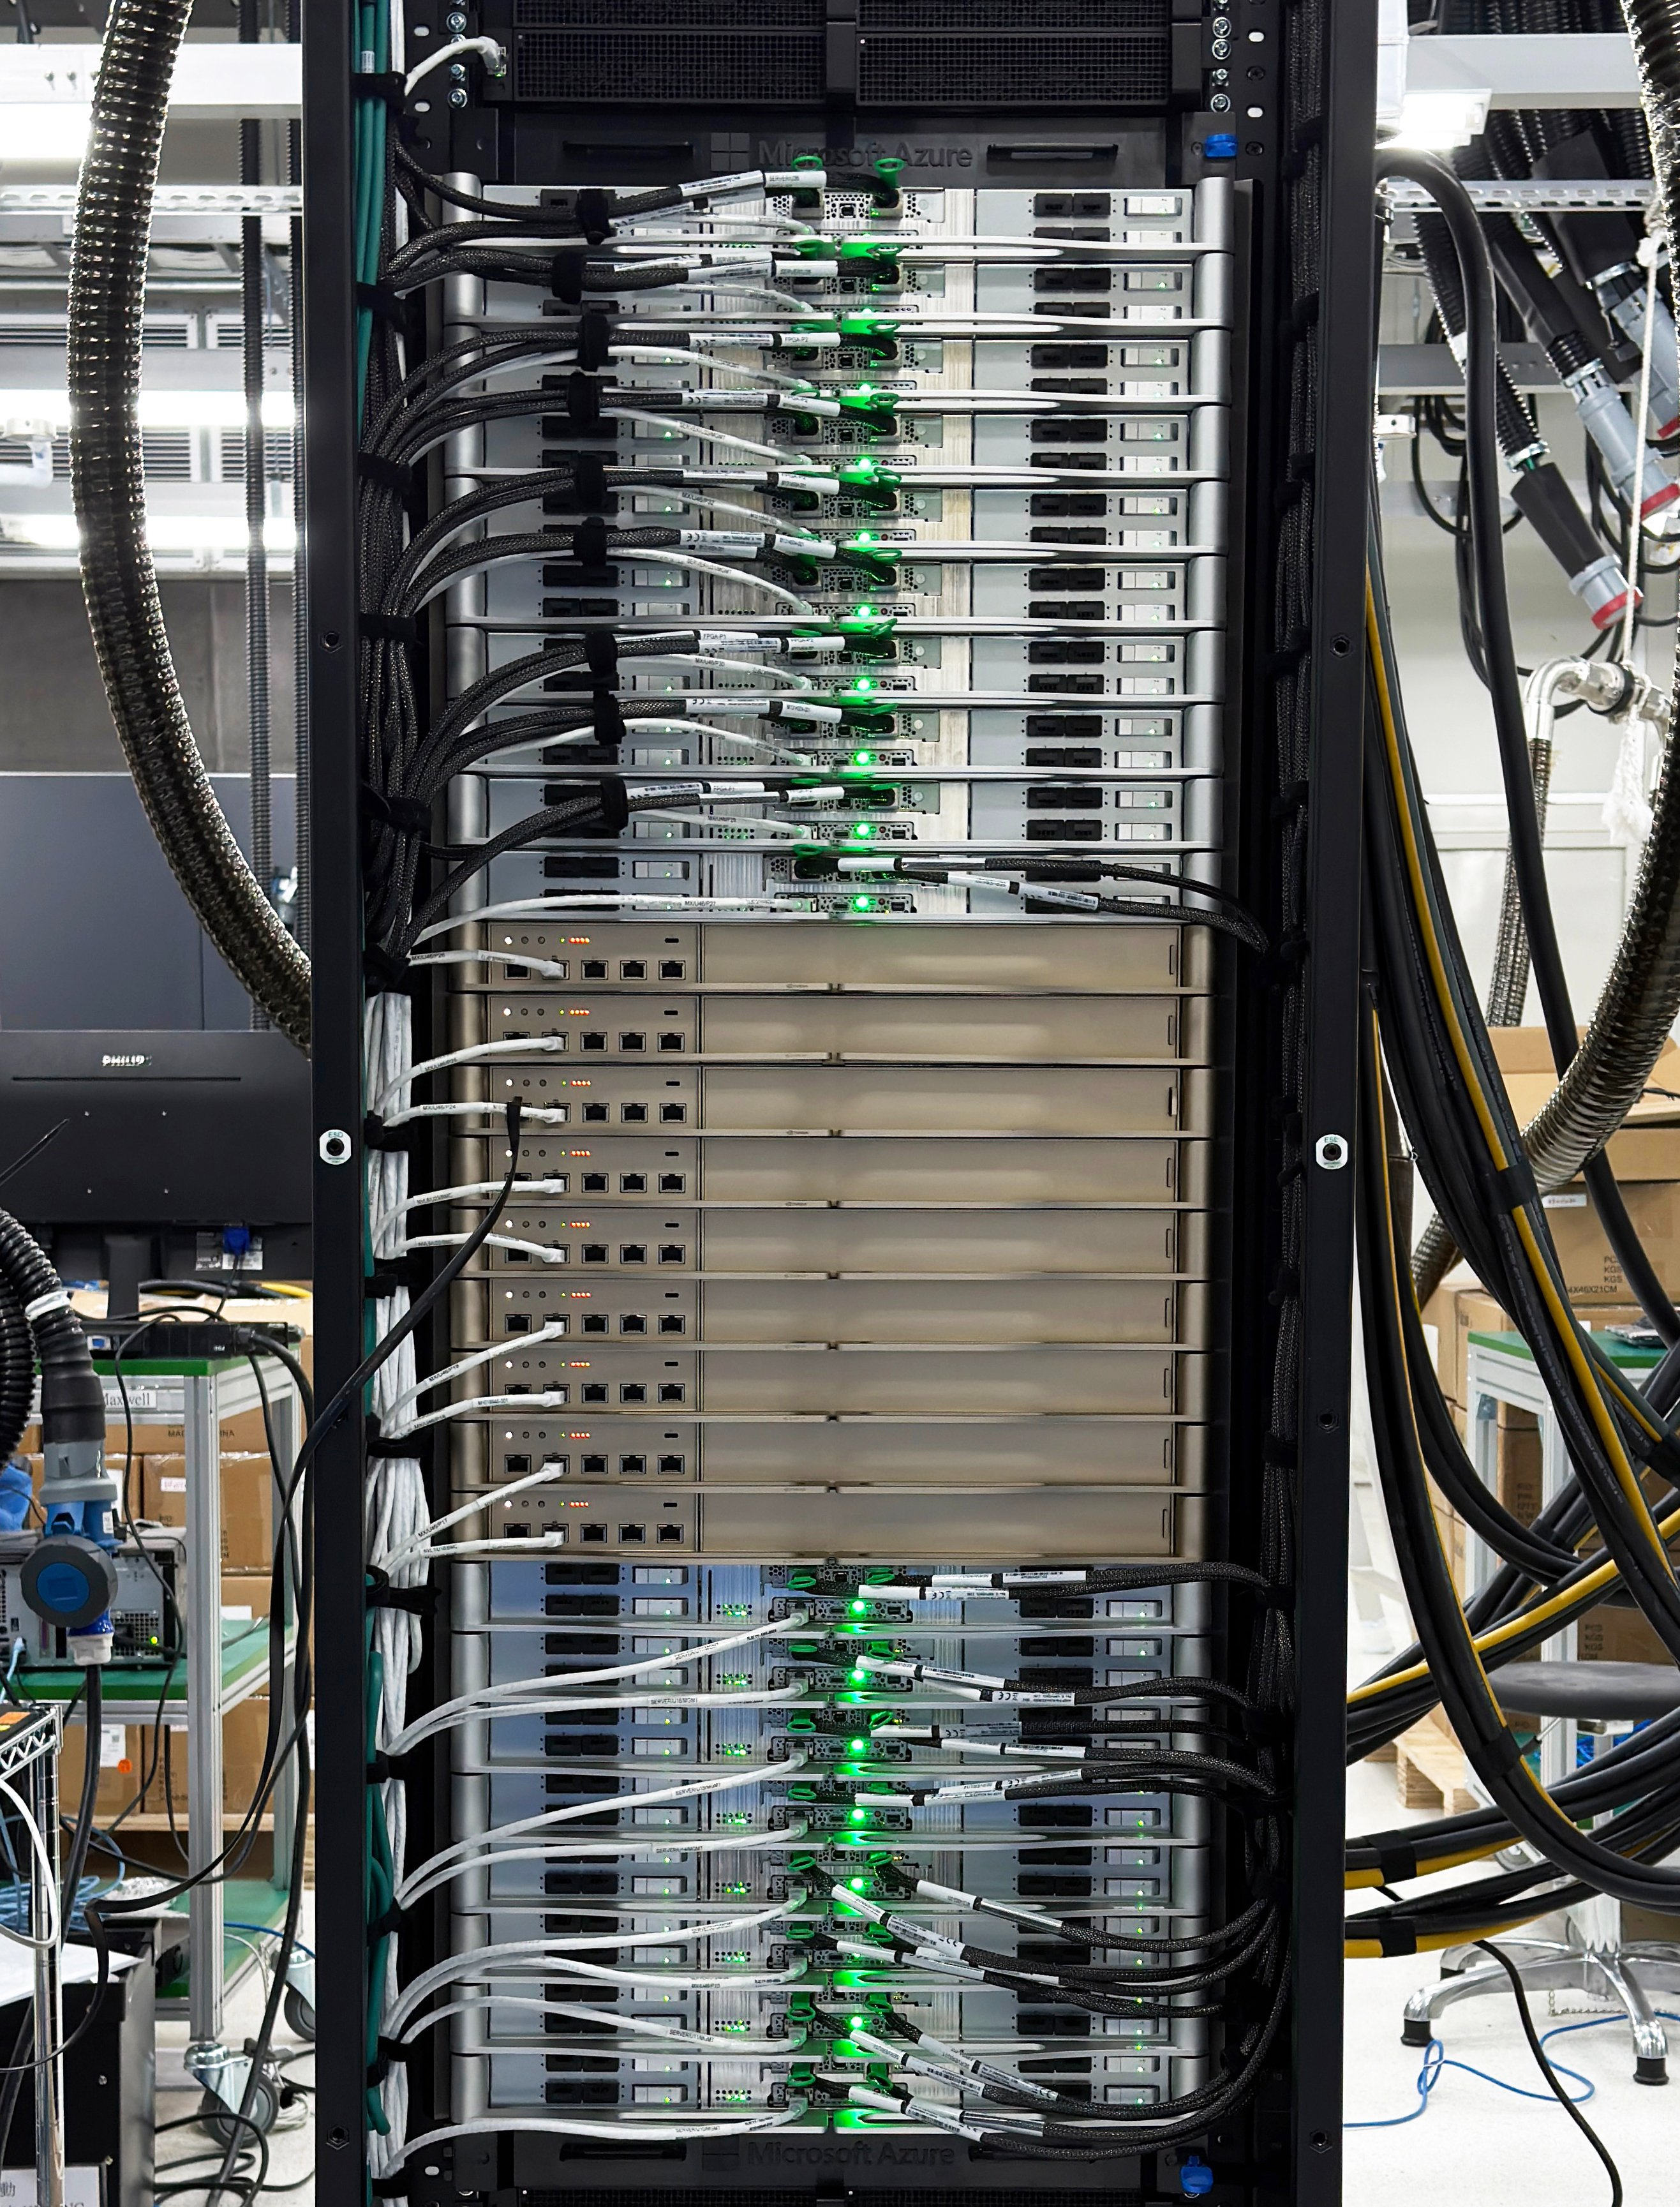
В Microsoft Azure появились первые Vera Rubin (Источник изображения: X/@satyanadella) Продукты на базе Vera Rubin будут доступны у партнёров NVIDIA, начиная со II половины этого года. В их число входят гиперскейлеры AWS, Google Cloud, Microsoft Azure и Oracle Cloud, а также партнёры NVIDIA Cloud — CoreWeave, Crusoe, Lambda, Nebius, Nscale и Together AI. Ожидается, что широкий спектр серверов на базе продуктов Vera Rubin будут поставлять глобальные производители систем Cisco, Dell Technologies, HPE, Lenovo и Supermicro, а также Aivres, ASUS, Foxconn, GIGABYTE, Inventec, Pegatron, Quanta Cloud Technology (QCT), Wistron и Wiwynn.
03.12.2025 [01:28], Владимир Мироненко
AWS «сдалась на милость» NVIDIA: анонсированы ИИ-ускорители Trainium4 с шиной NVLink FusionAWS готовит Arm-процессоры Graviton5, которые составят компанию ИИ-ускорителям Trainium4 с интерконнектом NVLink Fusion, фирменными EFA-адаптерам и DPU Nitro 6 с движком Nitro Isolation Engine. Но что более важно, все они будут «упакованы» в стойки стандарта NVIDIA MGX. Amazon и NVIDIA объявили о долгосрочном партнёрстве, в рамках которого ИИ-ускорители Trainium4 получит шину NVIDIA NVLink Fusion шестого поколения (по-видимому, 3,6 Тбайт/с в дуплексе), которая позволит создать стоечную платформу нового поколения, причём, что интересно, на базе архитектуры NVIDIA MGX, которая передана в OCP. Пикантность ситуации в том, что AWS годами практически игнорировала OCP, самостоятельно создавая стойки, их компоненты, включая СЖО, и архитектуру ИИ ЦОД в целом. Даже в нынешнем поколении стоек с GB300 NVL72 отказалась от референсного дизайна NVIDIA. NVIDIA же напирает на то, что для гиперскейлерам крайне трудно заниматься кастомными решениями — циклы разработки стоечной архитектуры занимают много времени, поскольку помимо проектирования специализированного ИИ-чипа, гиперскейлеры должны озаботиться вертикальным и горизонтальным масштабированием, интерконнектами, хранилищем, а также самой конструкцией стойки, включая лотки, охлаждение, питание и ПО. 
Источник изображения: NVIDIA Вместе с тем управление цепочкой поставок отличается высокой сложностью, так как требуется обеспечить согласованную работу десятков поставщиков, ответственных за десятки тысяч компонентов. И даже одна задержка поставки или замена одного компонента может поставить под угрозу весь проект. Платформа NVIDIA если не устраняет целиком, то хотя бы смягчает эти проблемы, предлагая готовые стандартизированные решения, которые могут поставлять множество игроков рынка. 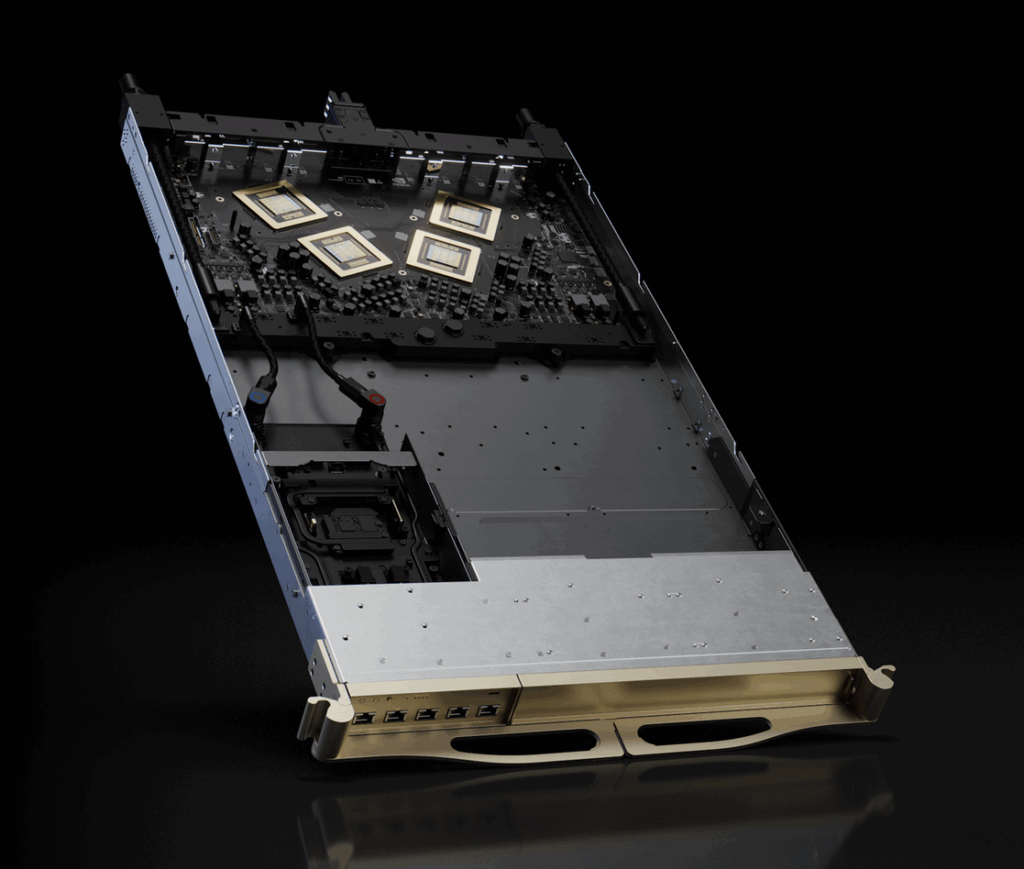
Источник изображения: NVIDIA По словам NVIDIA, в отличие от других подходов к масштабированию сетей, NVLink — проверенная и широко распространённая технология. В сочетании с фирменным ПО NVLink Switch обеспечивает увеличение производительности и дохода от ИИ-инференса до трёх раз, объединяя 72 ускорителя в одном домене. Пользователи, внедрившие NVLink Fusion, могут использовать любую часть платформы — каждый компонент может помочь им быстро масштабироваться для удовлетворения требований интенсивного инференса и обучения моделей агентного ИИ, говорит NVIDIA. 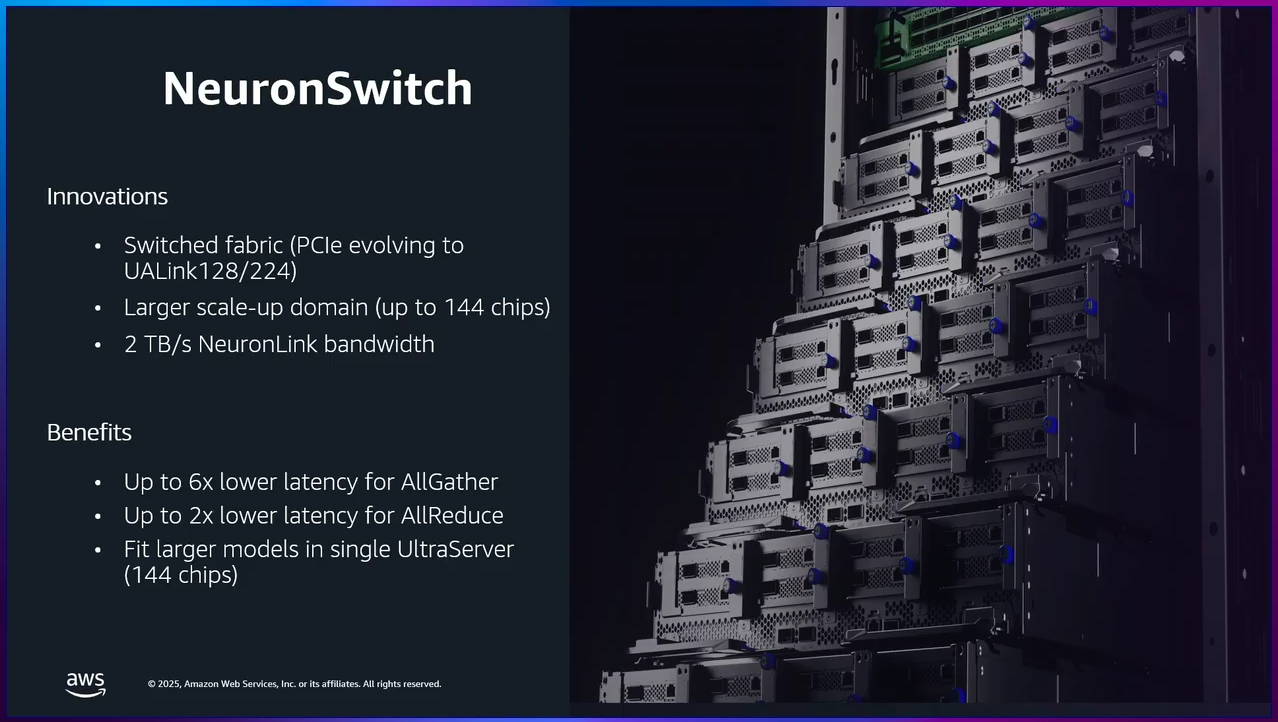
Источник изображения: AWS Что касается самих ускорителей Trainium4, то в сравнении с Trainium3 они будут вшестеро быстрее в FP4-расчётах, втрое быстрее в FP8-вычислениях, а пропускная способность памяти будет увеличена вчетверо. Впрочем, пока собственные ускорители Amazon не всегда могут составить конкуренцию чипам NVIDIA. Любопытно и то, что в рассказе о Trainium3 компания отметила о переходе от PCIe к UALink в коммутаторах NeuronSwitch для фирменного интерконнекта NeuronLink, объединяющего до 144 чипов Trainium. Однако после крупных инвестиций NVIDIA в Synopsys развитие UALink как открытой альтернативы NVLink теперь под вопросом.
29.11.2025 [14:58], Сергей Карасёв
MGX-сервер MSI CG480-S6053 получил чипы AMD EPYC Turin и восемь слотов PCIe 5.0 x16 для FHFL-карт двойной шириныКомпания MSI анонсировала сервер CG480-S6053, предназначенный для ресурсоёмких задач ИИ и НРС. Устройство выполнено в форм-факторе 4U на архитектуре NVIDIA MGX. Возможна установка двух процессоров AMD EPYC 9005 Turin в исполнении Socket SP5 с показателем TDP до 500 Вт. Доступны 24 слота для модулей оперативной памяти DDR5-6400 RDIMM/RIMM-3DS суммарным объёмом до 6 Тбайт (в конфигурации 24 × 256 Гбайт). Во фронтальной части расположены восемь отсеков для SFF-накопителей U.2 с интерфейсом PCIe 5.0 x4 (NVMe); допускается горячая замена. Есть два внутренних коннектор М.2 для SSD типоразмера 2280/22110 с интерфейсом PCIe 3.0 x2 (NVMe). Сервер оснащён восемью слотами PCIe 5.0 x16 для карт FHFL двойной ширины. Могут устанавливаться, в частности, ИИ-ускорители NVIDIA H200 NVL и RTX Pro 6000 Blackwell Server Edition. Кроме того, есть пять слотов PCIe 5.0 x16 для карт FHFL одинарной ширины. Сервер располагает контроллером ASPEED AST2600, двумя сетевыми портами 10GbE (RJ45) на основе Intel X710-AT2, выделенным сетевым портом управления 1GbE, разъёмами USB 3.0/2.0 Type-A и Mini-DisplayPort. Модификация системы с обозначением CG481-S6053 получила восемь портом 400GbE на базе NVIDIA ConnectX-8 SuperNIC. Предусмотрен модуль TPM 2.0. 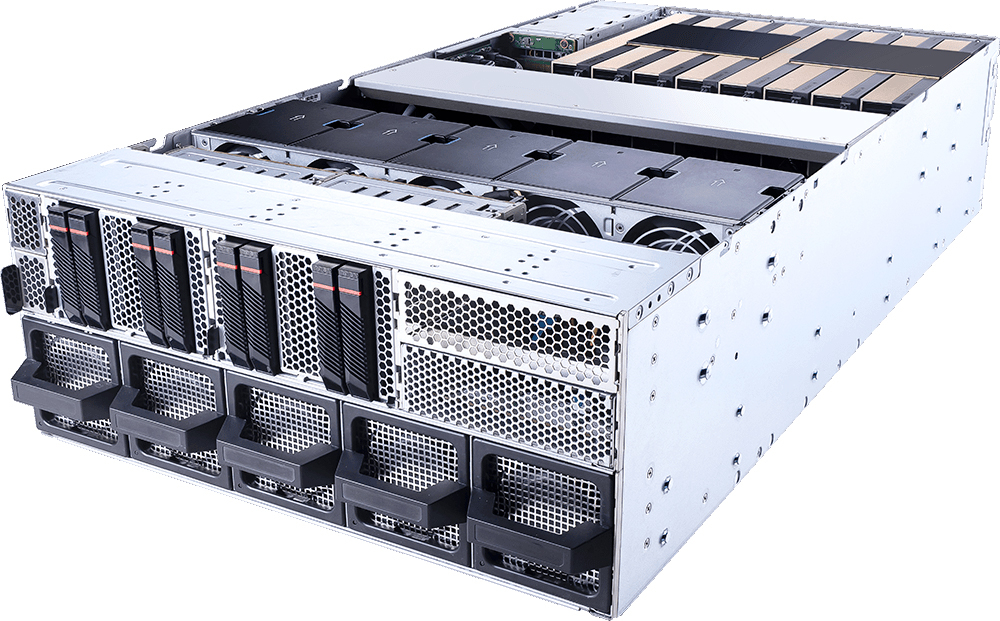
Источник изображения: MSI Новинка имеет размеры 438,5 × 175 × 800 мм. Питание обеспечивают четыре блока с резервированием мощностью 3200 Вт (80 PLUS Titanium). Применено воздушное охлаждение с десятью системными вентиляторами диаметром 80 мм с возможностью горячей замены. Диапазон рабочих температур — от +10 до +35 °C.
14.11.2025 [10:03], Руслан Авдеев
NVIDIA ужесточит контроль над выпуском ИИ-платформ, задвинув Foxconn и других партнёров на второй планКомпания NVIDIA готовится изменить текущую бизнес-модель в контексте ИИ-серверов. Она намерена получить под свой контроль производство ИИ-платформ целиком, а не отдельные элементы цепочек поставок, сообщает Wccftech. Если обычно экосистема поставок NVIDIA опирается на партнёров, выпускающих компоненты конечных продуктов — Foxconn, Quanta (QCT) и Wistron (Wiwynn) — со своими собственными разработками, то в будущем компания фактически возьмёт под контроль всё производство вплоть до уровня стоек. До сих пор NVIDIA поставляла в основном ключевые компоненты, такие как ИИ-ускорители и системные платы вроде Bianca Port UPB. Тем не менее, в ходе отчёта Wistron за III квартал 2025 года представитель JPMorgan заявил, что компания, похоже, переходит к «прямым поставкам» полноценных систем. Если раньше NVIDIA отвечала за ключевые элементы стоек — ИИ-ускорители и платы, — то за остальную архитектуру отвечали подрядчики вроде Foxconn, Quanta и других компаний. Теперь, как полагают в JPMorgan, NVIDIA станет напрямую поставлять системы Level-10 (почти полный блок серверной стойки). Компания унифицирует конструкцию систем, заставит подрядчиков строго придерживаться предлагаемых чертежей и дизайна и запретит использование проприетарных архитектур, созданных самими подрядчиками. 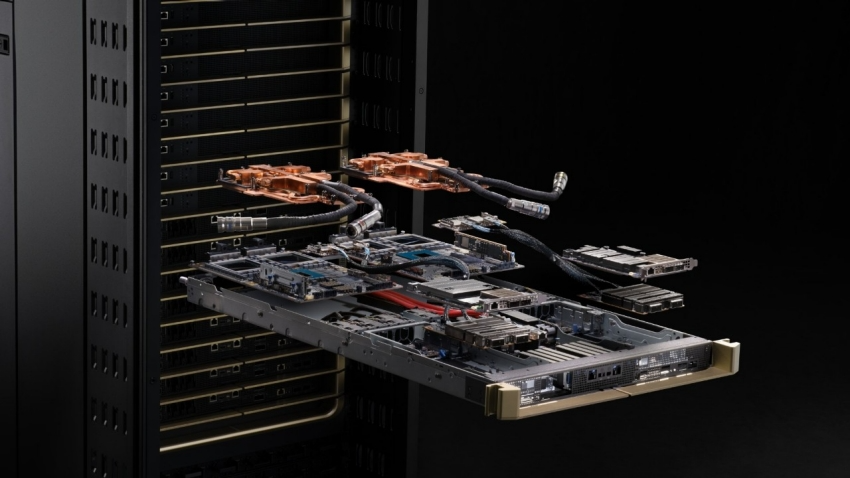
Источник изображения: NVIDIA Фактически — это развитие философии MGX-архитектуры, предполагающей единые стандарты от серверного узла до полнофункциональной ИИ-фабрики. При этом время развёртывания таких комплексных систем сократится с 9–12 мес. до 90 дней, т.е. 3 мес. Поскольку 80 % наполнения систем будет предварительно определяться NVIDIA, новые платформы вроде Rubin/Rubin CPX можно будет внедрять ускоренными темпами. NVIDIA выиграет от быстрого вывода систем на рынок, роста маржинальности и расширения так называемого «общего адресуемого рынка» (TAM). В Wistron утверждают, что новая модель выгодна и заказчикам, поскольку ключевые работы по созданию ИИ-оборудования всё равно выполняет компания-подрядчик. В целом NVIDIA стремится перейти от роли обычного поставщика ИИ-чипов к модели, при которой IT-гигант контролирует развёртывание инфраструктуры целиком. Это как ускорит выпуск ИИ-систем, так и укрепит позиции компании. Впрочем, пока информация об изменениях поступает из сторонних источников — в самой NVIDIA её не подтверждали. При этом для гиперскейлеров, которые самостоятельно занимаются разработкой ИИ-платформ, пока, по-видимому, ничего не поменяется. |
|

