
Материалы по тегу: x
|
01.09.2026 [15:27], Руслан Авдеев
Anthropic хотела купить разработчика ИИ-чипов MatX за $7 млрд, но передумалаЖелая ускорить создание собственных полупроводников и оборудования, компания Anthropic обсуждала покупку разработчика ИИ-чипов MatX приблизительно за $7 млрд. Позже диалог о выкупе сменился обсуждением возможного партнёрства, сообщает Reuters. Пока нет данных, почему переговоры о покупке бизнеса прекратились. MatX, основанная бывшими разработчиками TPU Google, ищет возможность привлечь новые средства с сопутствующей оценкой капитализации на уровне $4 млрд. Сами компании слухи не комментируют. Anthropic намерена самостоятельно разрабатывать ИИ-чипы, способные удовлетворить её запросы и снизить зависимость от сторонних ускорителей, в первую очередь NVIDIA. Компания нанимает опытных разработчиков и управленцев для ускорения разработчик собственных чипов, но на это могут уйти годы. При этом компания планирует диверсифицировать закупки ускорителей, работая с различными поставщиками. На разработку и организацию масштабного производства одного чипа может уйти не менее года и сотни миллионов долларов. Покупка стартапа, занимающегося созданием ИИ-чипов тут же обеспечила бы Anthropic необходимые компетенции и помогла бы снизить издержки в долгосрочной перспективе. Особенно чипы MatX могли бы быть полезны при обучении ИИ-моделей, хотя большинство конкурентов Anthropic заинтересованы скорее в ASIC для инференса. 
Источник изображения: Cherrydeck/unsplash.com. Anthropic планирует потратить десятки миллиардов долларов на аренду вычислительных мощностей, а также намерена покупать чипы напрямую. Компания рассчитывает купить ИИ-чипов Google на $36 млрд, а также подписала соглашение об аренде вычислительных мощностей у Nscale на $45 млрд, заключила сделку с Fluidstack на $50 млрд, со SpaceX — на $45 млрд, с Lambda — на $35 млрд. И это не считая всё расширяющегося сотрудничества с Amazon на $100 млрд. В последние недели компания провела ряд встреч с многочисленными стартапами, занимающимися ИИ-чипами, чтобы лучше понять современные подходы к проектированию ускорителей. Недавно она наняла ветерана отрасли из Google — Амира Салека (Amir Salek) в рамках развития проекта, связанного с разработкой вычислительного «железа». В июне она переманила бывшего разработчика из OpenAI, работавшего над ускорителем Jalapeño, который превзошёл решения NVIDIA в инференсе. Создание кастомного чипа может также помочь Anthropic обезопасить свой бизнес на фоне дефицита чипов NVIDIA, которые, по данным последней, будут в дефиците минимум до 2027 года. Собственные TPU выпускает Google, а Amazon создала семейства Trainium и Inferentia. Anthropic стала одной из первых компаний, эксплуатирующих свои модели на решениях нескольких вендоров, включая NVIDIA, Google и Amazon.
31.08.2026 [15:52], Андрей Крупин
В российской серверной ОС SelectOS прописался ИИ-агент AishПровайдер Selectel объявил о запуске Aish — специализированного агента искусственного интеллекта, интегрированного непосредственно в серверную операционную систему SelectOS. Решение доступно бесплатно всем пользователям платформы. На рынке системного администрирования сегодня доминируют облачные нейросети, которые требуют передачи контекста сессии внешним провайдерам, что создаёт риски утечки данных и лишает организации возможности аудита действий ИИ-модели, говорит Selectel. В отличие от них, Aish развёрнут локально на серверах Selectel или собственном оборудовании клиента. Модель физически находится внутри защищённого периметра, а каждое действие агента подтверждается оператором перед исполнением. 
Источник изображения: selectel.ru ИИ-агент Aish понимает команды на естественном языке, интерпретирует их и переводит в исполняемый формат. Он способен выполнять цепочки действий, собирать диагностические данные, находить причины сбоев и предлагать исправления с учётом конкретного состояния сервера. Решение может использоваться для анализа состояния сервисов, логов и конфигурационных файлов, разбора инцидентов, поиска причин отказа сервисов и выполнение рутинных операций без обращения к документации. Агент формирует командные инструкции, объясняет их действие, но финальный запуск выполняет только оператор.
25.08.2026 [17:52], Руслан Авдеев
«Зомби-иск» о коде Linux вот-вот окончательно закопаютМноголетняя судебная тяжба, касающаяся прав собственности на Linux, которому сегодня исполнилось 35 лет, ближе к завершению чем когда-либо. Три судьи апелляционного суда в США вынесли решение о том, что иск в отношении IBM и Red Hat не имеет оснований, а срок для дальнейших юридических манёвров истёк, сообщает The Register. История началась ещё в 1998 году, когда в IBM пришли к выводу, что миру достаточно одной версии ОС UNIX, способной работать на разных архитектурах процессоров. Для этого компания совместно с Santa Cruz Operation (SCO), выпускавшей версию UNIX на архитектуре x86, Intel и Sequent заключили соглашение о реализации т.н. Project Monterey, который конкурировать с Linux не смог. Поэтому IBM решила перенести в Linux часть кода, созданного в процессе реализации Project Monterey, после чего SCO и её юридические преемники заявили, что код Linux в некоторой степени принадлежит им, как и, отчасти, права на операционную систему. В 2021 году TSG Group, представлявшая интересы части некогда причастных к SCO структур и лиц, заключила с IBM мировое соглашение на $14,25 млн. Такая сумма свидетельствует, скорее, об отсутствии сильных доказательств SCO, чем об успехе инициаторов тяжб. Ещё одна преемница — Xinuos подала новый иск, требуя привлечь IBM к ответственности, поскольку та якобы использовала не принадлежащий ей код для Linux, и знала об этом — у IBM была лишь неэксклюзивная лицензия на его использование. Xinuos утверждала, что передав код Project Monterey в Linux, IBM нарушила условия лицензирования. 
Источник изображения: ZBRA Marketing/unsplash.com Xinuos представила соответствующие аргументы в окружном суде США по Южному округу Нью-Йорка, но так и не сумела убедить судей в том, что IBM и Red Hat вообще должны нести перед ней ответственность. Первоначально иск отклонили ещё в 2025 году, поскольку Xinuos ещё тогда не смогла доказать, что имеет право быть истцом в этом деле. После подачи апелляции Апелляционный суд США второго округа решил, что решение окружного суда не подлежит пересмотру. Суд посчитал, что представленные документы не позволяют вновь рассматривать вопрос по исходному решению, касающемуся Project Monterey — слишком поздно. Кроме того, истец пытался представить дело, как спор о лицензировании, тогда как фактически речь шла об установлении права собственности, которого у Xinuos, вероятно, нет вообще. Xinuos не намерена сдаваться — компания намерена ходатайствовать о рассмотрении дела полным составом Апелляционного суда. Вероятно, этого никогда не случится, поскольку такое происходит крайне редко и если суд обнаружит существенные ошибки или важные юридические упущения, которые оправдывали бы повторное рассмотрение дел. Данный окружной апелляционный суд соглашался на пересмотры дел в 0,03 % случаев. Другими словами, возвращение «зомби-иска» к жизни крайне маловероятно.
25.08.2026 [12:50], Руслан Авдеев
SpaceX и NVIDIA разрабатывают вариант Vera Rubin NVL72 специально для космосаКомпания SpacxeXAI (SpaceX/xAI) разработала оптимизированные специально для космоса ИИ-системы NVIDIA Vera Rubin NVL72. Вывод на орбиту планируется в IV квартале 2027 года, сообщает NVIDIA в социальной сети X. NVIDIA объявила, что партнёры намерены масштабировать проект в 2028 году. Ранее глава SpaceX Илон Маск (Elon Musk) уже объявил, что считает архитектуру NVIDIA Vera Rubin «лучшей» и подчеркнул, что NVIDIA будет эксклюзивным партнёром его бизнеса. Отдельным постом NVIDIA сообщила, что SpaceX внедряет CPU Vera (важная часть ИИ-решений Vera Rubin) для ускорения оркестрации, выполнения кода и обработки данных для обеспечения работы ИИ-агентов нового поколения. Утверждается, что это позволит поддерживать работу GPU и обеспечит быструю работу ИИ-агентам. NVIDIA подчеркнула, что одна и та же архитектура будет использована повсеместно, от гигаваттных ИИ-фабрик на Земле до космической орбиты. В феврале SpaceX подала заявку на размещение миллиона дата-центров компании на околоземной орбите, поэтому оптимизированное для космоса оборудование её, безусловно, пригодится в больших объёмах. В июне она раскрыла подробности строительства будущих ЦОД на околоземной орбите. 
Источник изображения: NVIDIA Так, сообщалось, что первоначально ИИ-спутники обеспечат по 120–150 кВт вычислительных мощностей — это приблизительно эквивалентно одной современной стойке на основе систем класса NVIDIA GB300. Размах «крыльев» спутника составит 70 м, высота в развёрнутом состоянии — 20 м. Солнечные элементы, изначально разработанные для спутников Starlink V3, обеспечат мощность до 250 Вт/м2, а двусторонние радиаторы — отвод до 1400 Вт/м2. Платформы-ЦОД не предназначены для обеспечения связи — они будут состоять из солнечных батарей, радиаторов, вычислительного оборудования и оптических интерконнектов. По словам Маска (Elon Musk), радиатор площадью 110 м2 будет использовать систему жидкостного охлаждения с «резервными насосными контурами», вероятно, для поддержания циркуляции жидкости.
24.08.2026 [16:48], Сергей Карасёв
Фото дня: доставка суперускорителя NVIDIA Vera Rubin NVL72 в дата-центр MicrosoftГенеральный директор Microsoft Сатья Наделла (Satya Nadella) в своём блоге в социальной сети Х опубликовал ряд фотографий, демонстрирующих процесс доставки и распаковки высокопроизводительных систем NVIDIA Vera Rubin NVL72. Эта стоечная ИИ-платформа стала преемником решения GB200 NVL72. Стойка целиком весит около 1,8 т, при этом она достаточно хрупкая и поэтому требует особых условий транспортировки и установки в ЦОД, который тоже должен быть подготовлен к таким нагрузкам. А масса будущих стоек AMD Helios AI формата OCP ORW будет приближаться к 5 т. VR200 NVL72 объединяет 72 ускорителя Rubin и 36 процессоров Vera, каждый из которых содержит 88 вычислительных Arm-ядер Olympus (в сумме 3168 ядер). Объём памяти HBM4 достигает 20,7 Тбайт, её совокупная пропускная способность — 1580 Тбайт/с. Кроме того, используются 54 Тбайт памяти LPDDR5X. 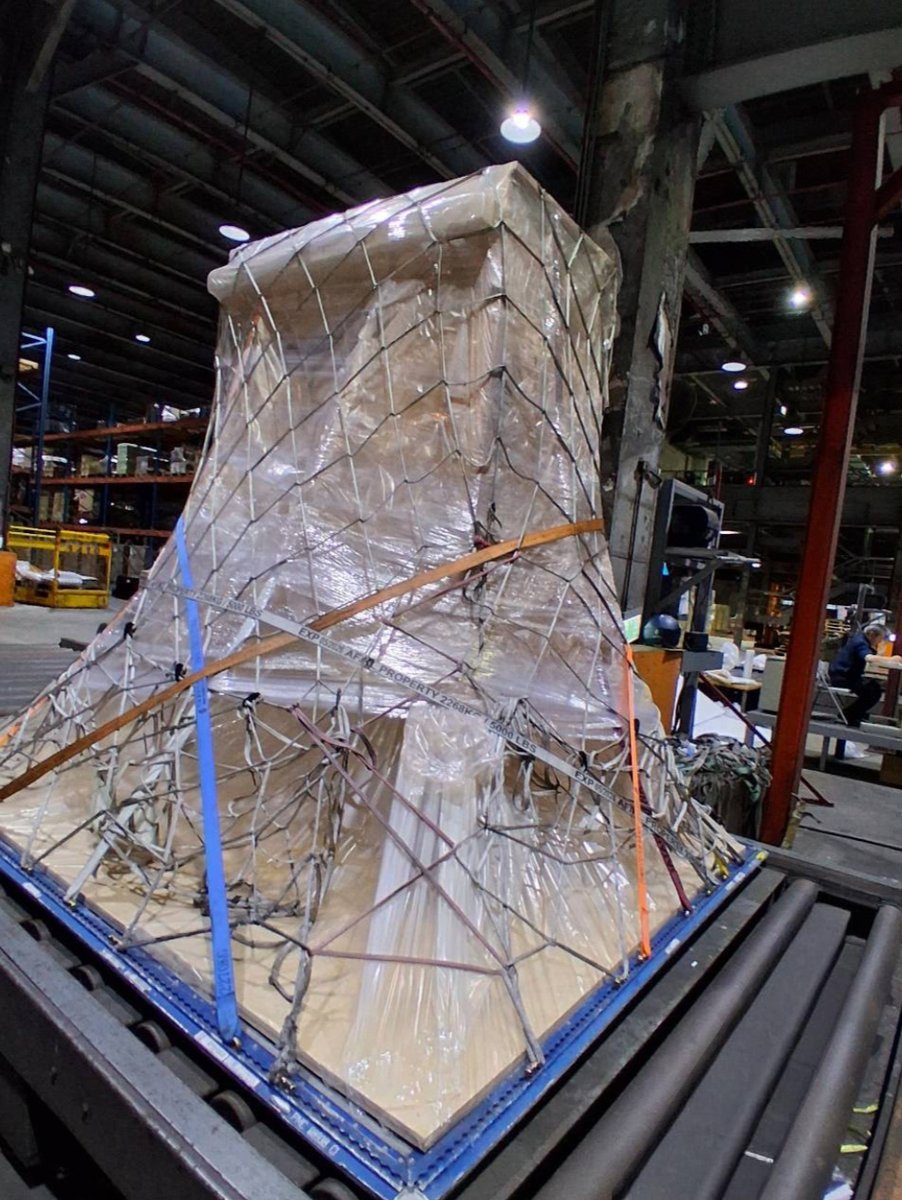
Источник изображения: Satya Nadella 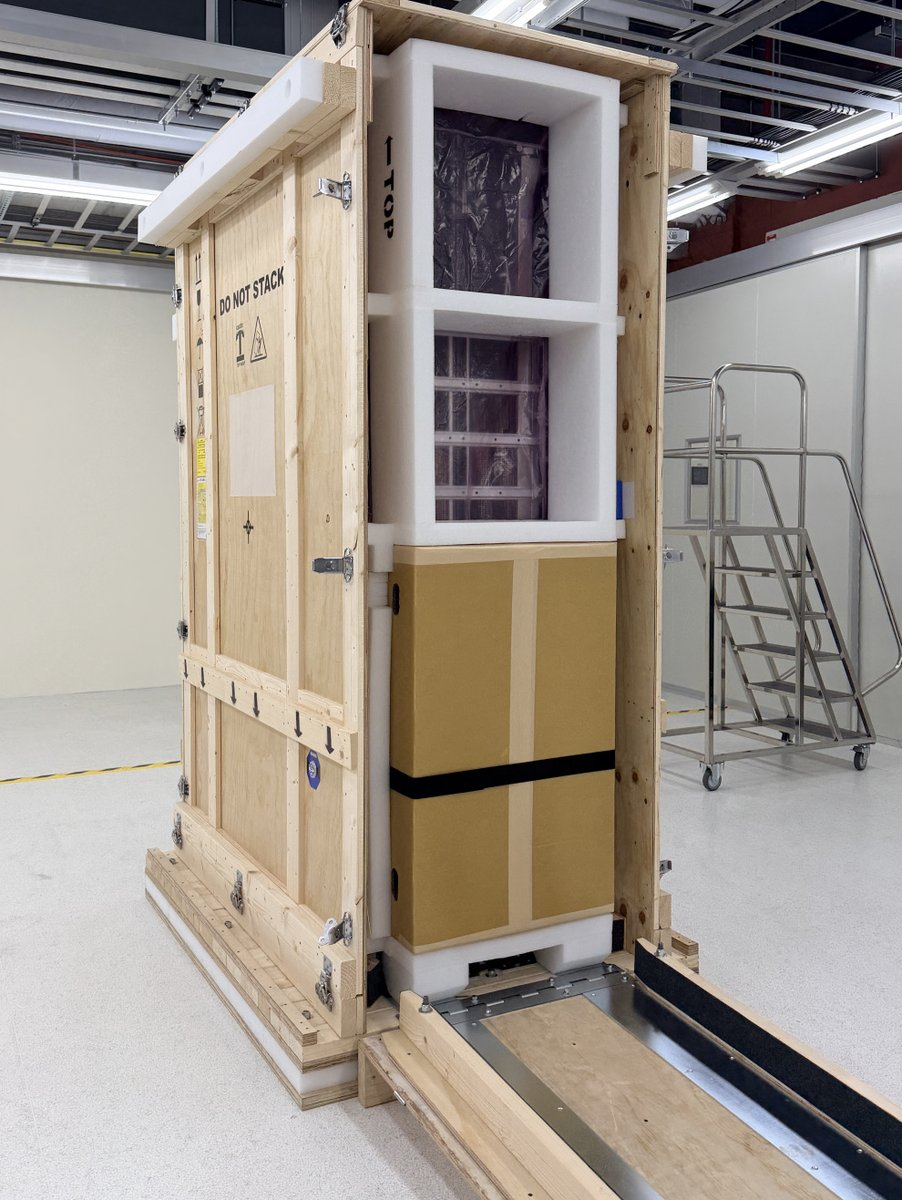
Источник изображения: Satya Nadella Стойка использует прямое жидкостное охлаждение, тогда как внутри самих лотков нет ни вентиляторов, ни шлангов. Примененные конструктивные решения существенно повышают скорость монтажа. При этом каждая стойка рассматривается как единая вычислительная единица. Заявленная производительность достигает 288 Пфлопс на операциях FP16/BF16 и 3,6 Эфлопс при инференсе в режиме NVFP4. 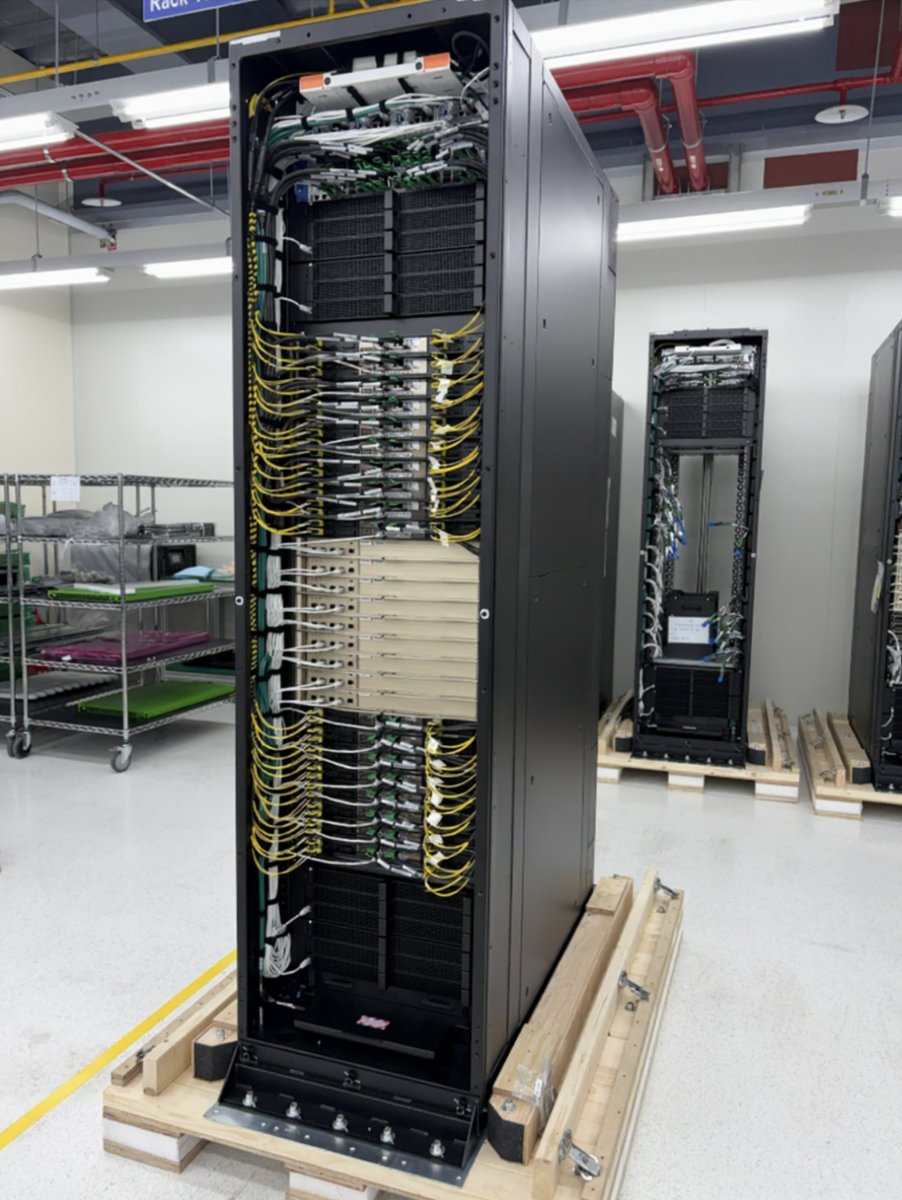
Источник изображения: Satya Nadella 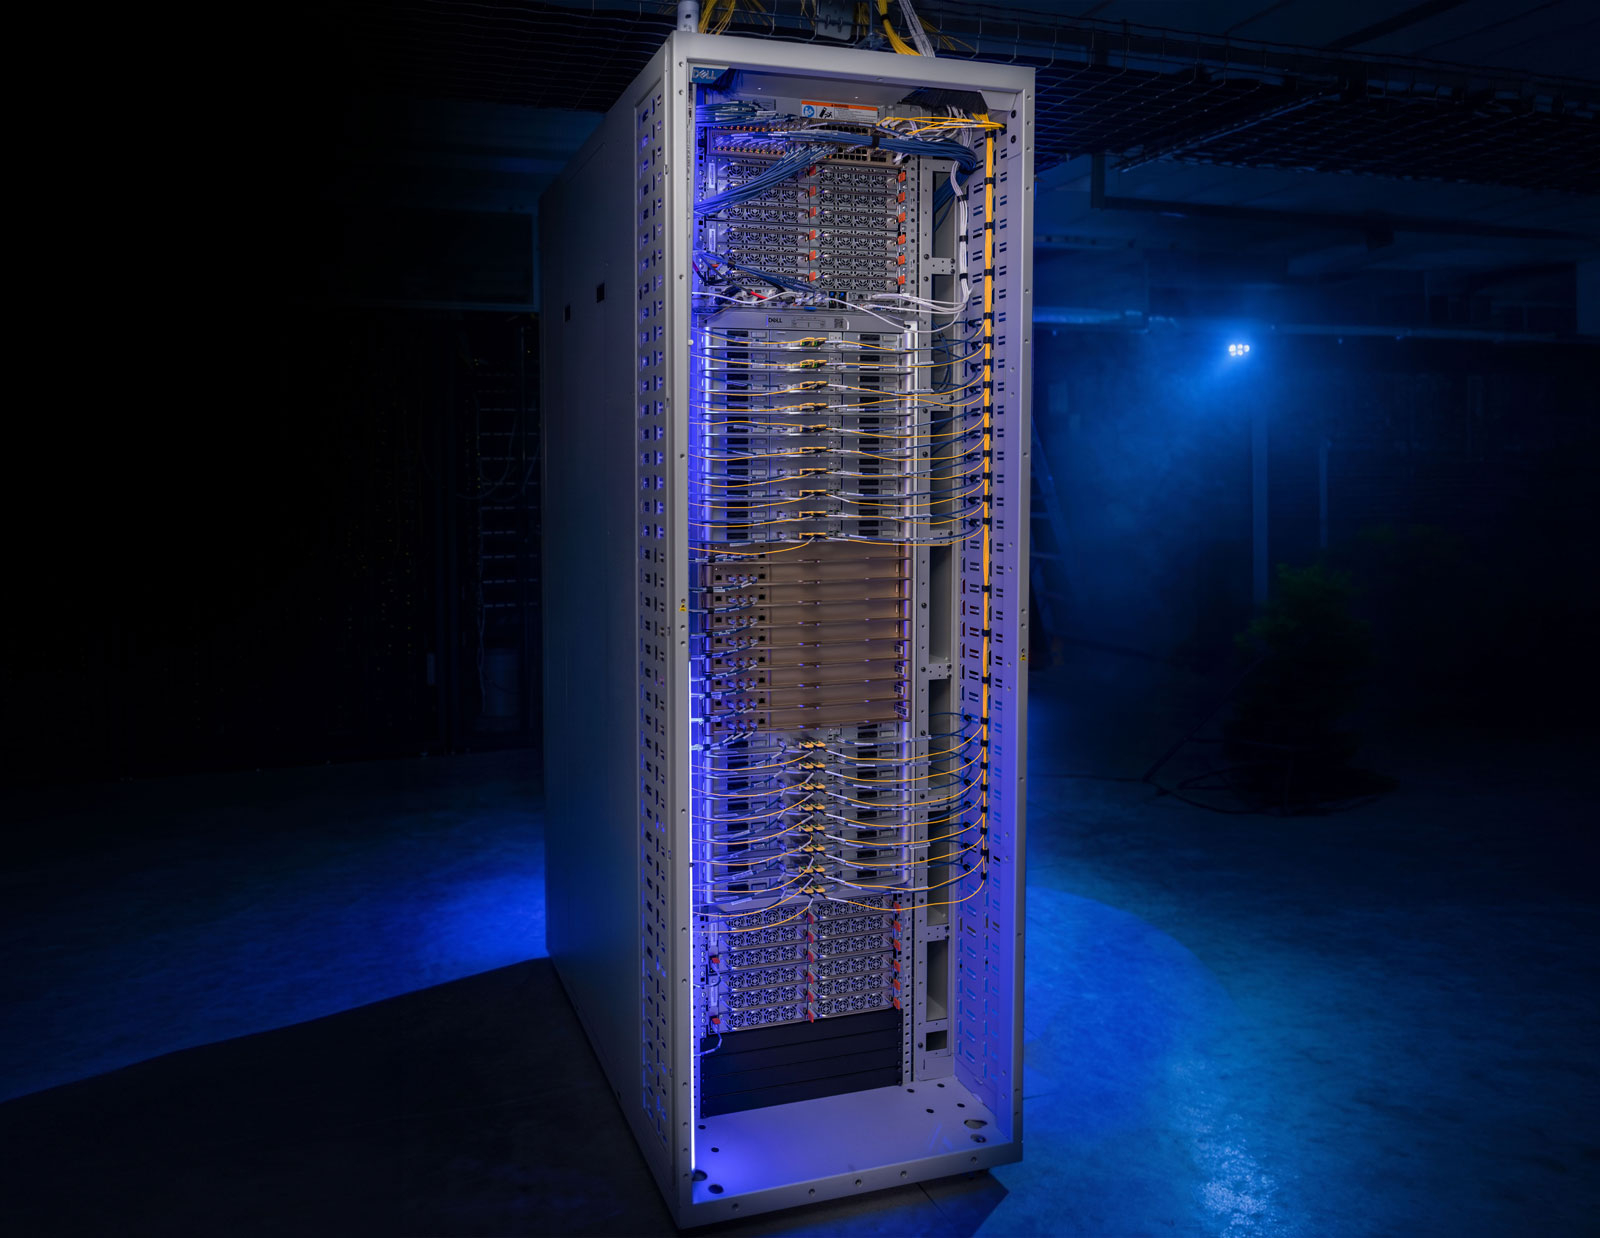
Источник изображения: NVIDIA/CoreWeave Нужно отметить, что развёртывание ИИ-систем на базе Vera Rubin NVL72 ведут и многие другие операторы ЦОД и неооблаков. В их число входят Nebius, CoreWeave, Google и пр. 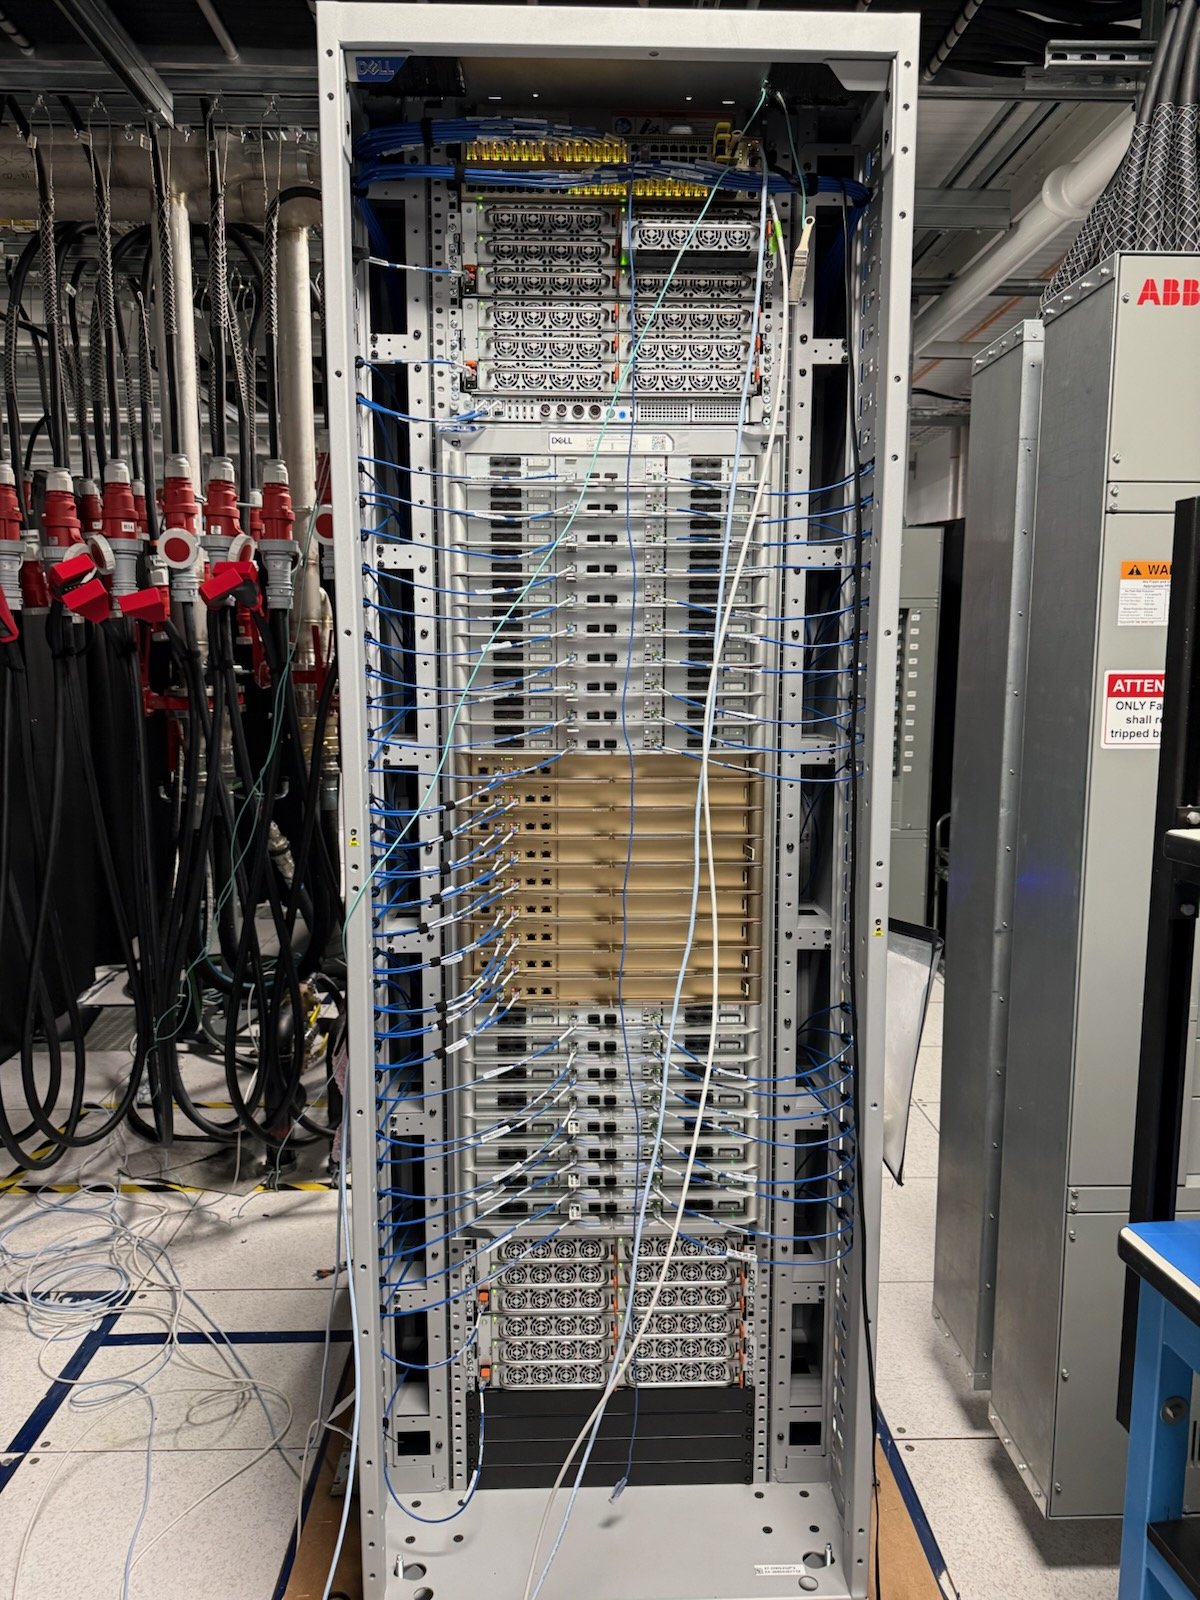
Источник изображения: Dell 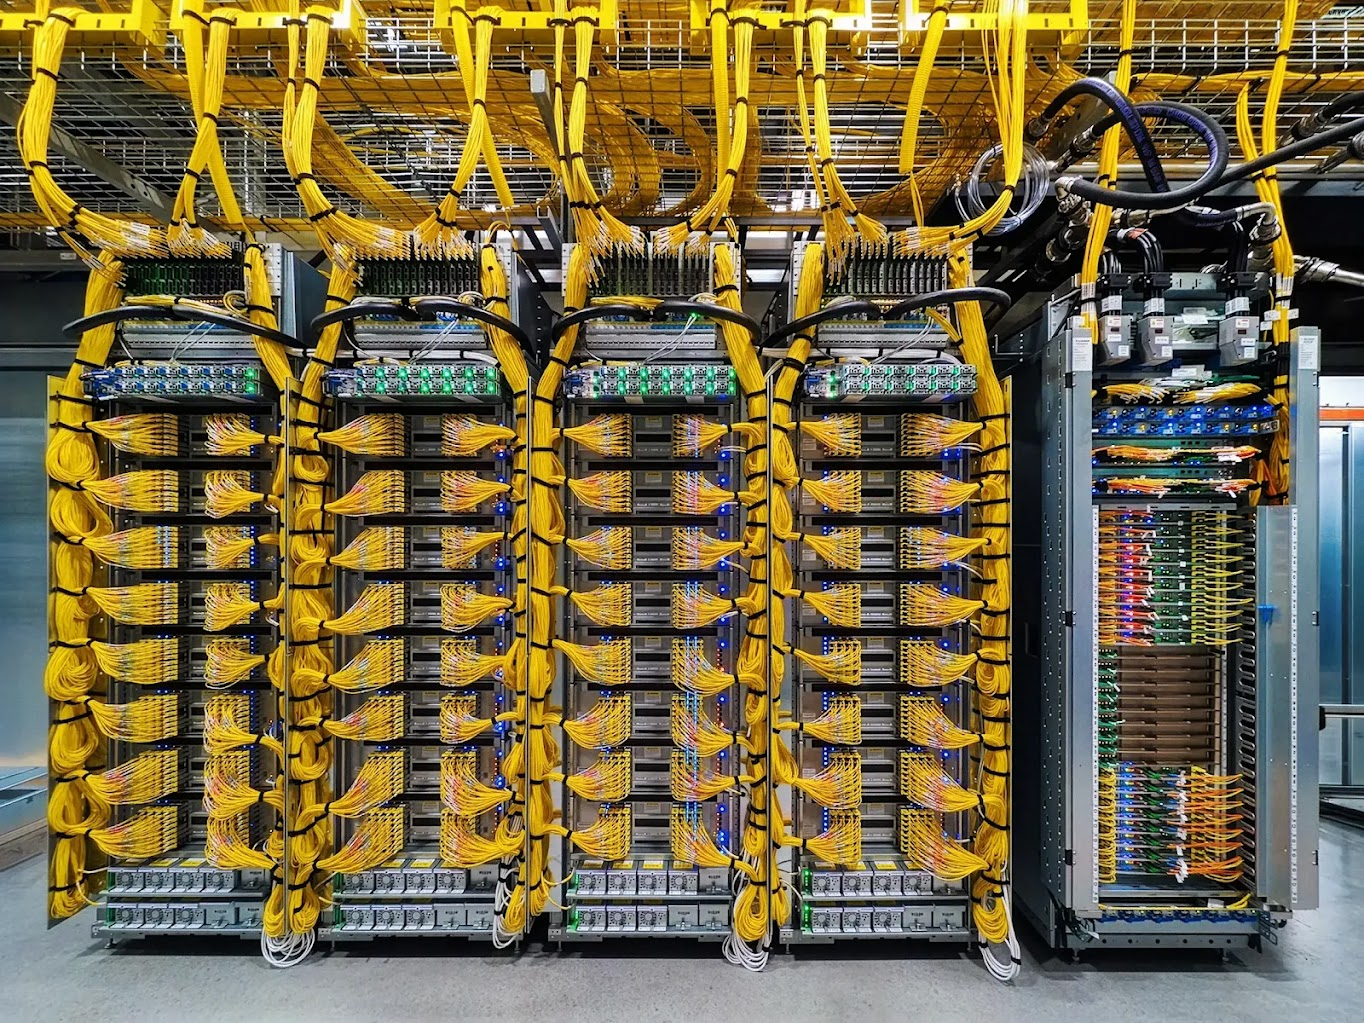
Источник изображения: NVIDIA/Google
24.08.2026 [09:52], Владимир Мироненко
От чипов до стоек: SK hynix делает ставку на CPO в деле масштабирования ИИ-инфраструктурSK hynix опубликовала в журнале Nature Electronics статью, подготовленную совместно с исследователями из США, Сингапура и Южной Кореи, под названием «CPO для HPC и ИИ». В ней изложены планы по развитию интегрированной оптики (CPO) — технологии оптического интерконнекта следующего поколения, которая решает проблемы узких мест в передаче данных с точки зрения целостной системы, выходящей за рамки одной только памяти и охватывающей стойки целиком, пишет StorageReview.com. По мере того как кластеры ИИ-систем масштабируются до тысяч GPU и стеков HBM, традиционные медные каналы связи достигают своих пределов, а более высокие скорости и большие расстояния приводят к увеличению энергопотребления, задержек и сложности передачи сигналов, отметила SK hynix. Согласно исследованию SK hynix, производительность вычислительных систем растёт примерно в три раза каждые два года, в то время как пропускная способность интерконнекта за тот же период увеличивается примерно в 1,4 раза, что приводит к барьеру, который всё больше ограничивает перемещение данных между ИИ-системами. Даже если GPU будут становиться всё более быстрее, производительность ИИ-кластера не будет расти с той же скоростью, если данные не смогут достаточно быстро перемещаться между процессорами, памятью и ускорителями. 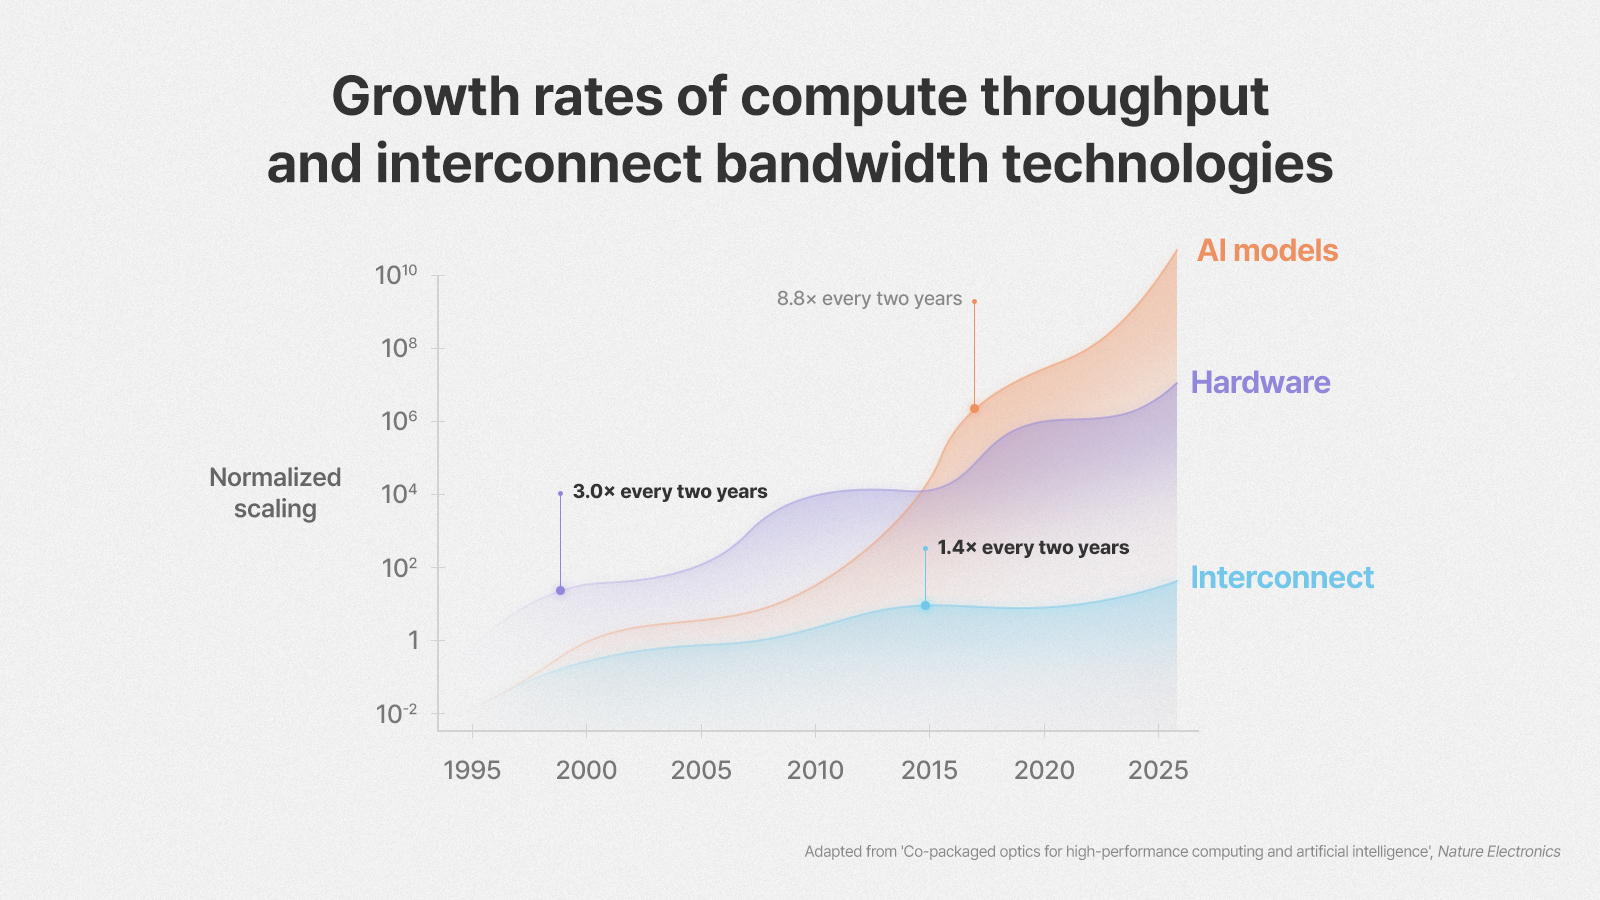
Источник изображений: SK hynix CPO позволяет решить эту проблему, размещая оптические трансиверы вблизи процессора или ускорителя на той же подложке. Преобразование высокоскоростных электрических сигналов в фотонные каналы, непосредственно прилегающие к вычислительному кремнию, минимизирует длину электрических дорожек, уменьшая паразитную ёмкость и затухание или искажение сигнала. Эта архитектура обеспечивает оптическую передачу с низкими потерями и высокой пропускной способностью по платам, стойкам и модулям, сохраняя при этом более высокую плотность полосы пропускания и улучшенную устойчивость к электромагнитным помехам. Физическая упаковка накладывает ограничения на количество процессоров и модулей памяти, которые можно разместить на одной подложке. Оптическая связь предлагает возможность их физического разделения, позволяя им при этом работать как часть гораздо более крупной вычислительной системы. 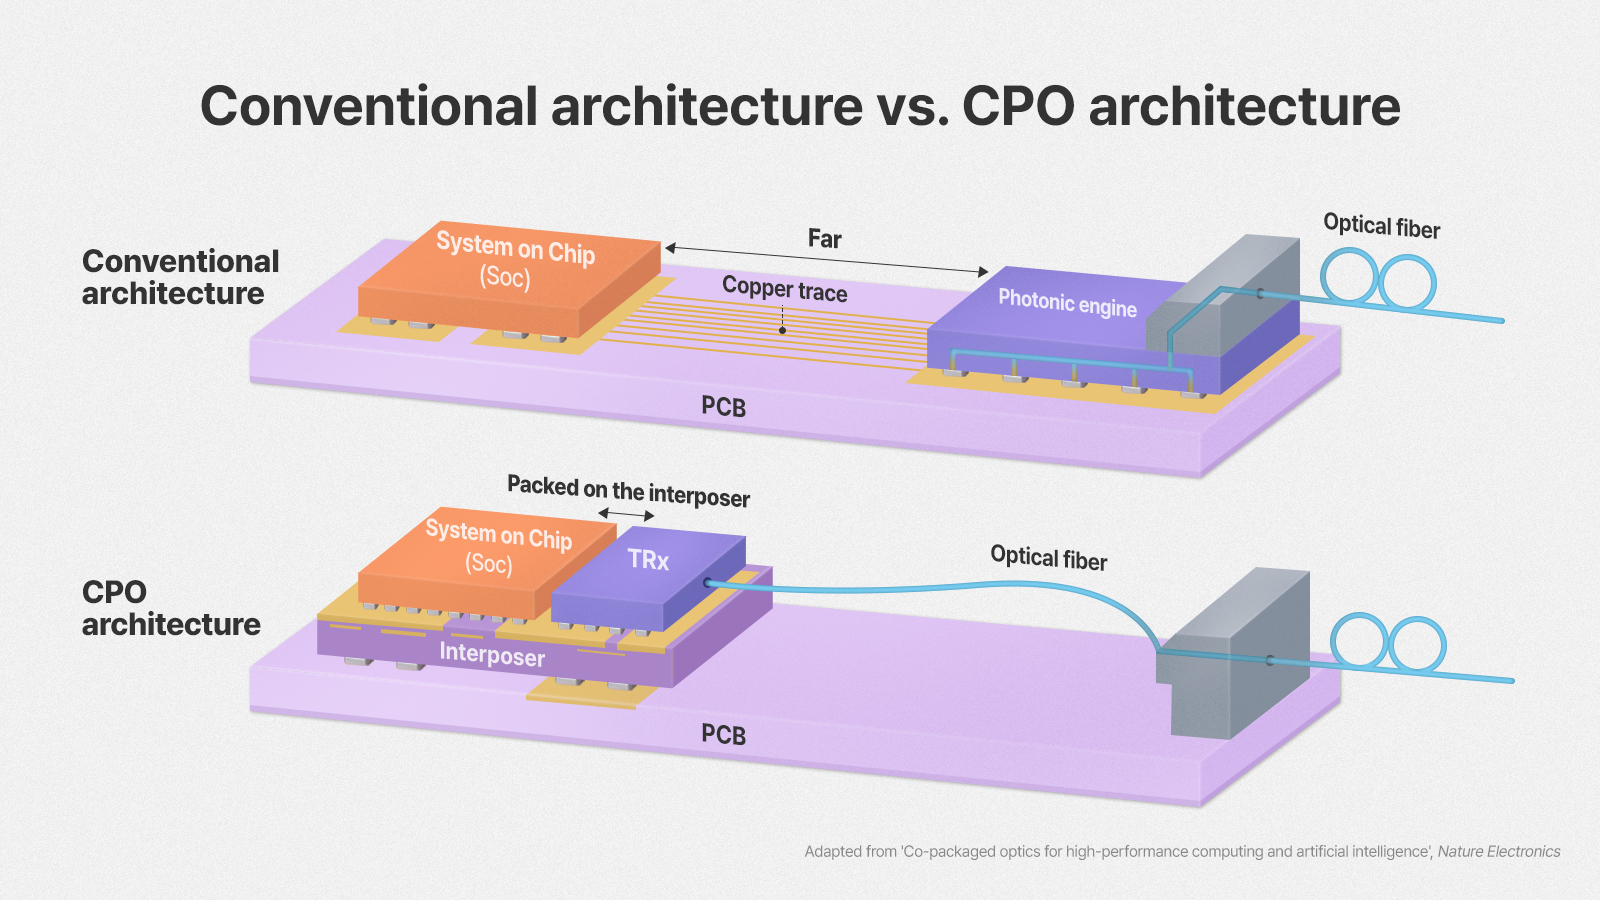 Концептуальная схема оптико-ориентированной архитектуры напрямую соединяет пулы вычислительных ресурсов (XPU) и пулы памяти посредством оптических сигналов с использованием интерпозера. Такой подход позволяет создавать дезагрегированные пулы общей памяти с низкой задержкой, где несколько вычислительных модулей могут получать доступ к общей ёмкости через оптическую объединительную плату без типичных для традиционных сетевых фабрик затрат на (де-)сериализацию, обеспечивая более гибкое перемещение данных на системном уровне и более быструю реакцию на растущий масштаб ИИ-моделей. Как отметил ресурс The Korea Times, значение статьи в Nature Electronics заключается не только в определении CPO как потенциального решения, но и в определении целей для будущей ИИ-инфраструктуры. Исследователи предполагают, что в будущем системы будут обеспечивать пропускную способность более 100 Тбит/с на узел, потребляя менее 1 пДж/бит и поддерживая межчиповую задержку менее 10 нс. SK hynix также прогнозирует архитектурную эволюция от стандартных 2D-многочиповых модулей и интеграции 2.5D-кремниевых интерпозеров к 3D-гетерогенной стековой компоновке. 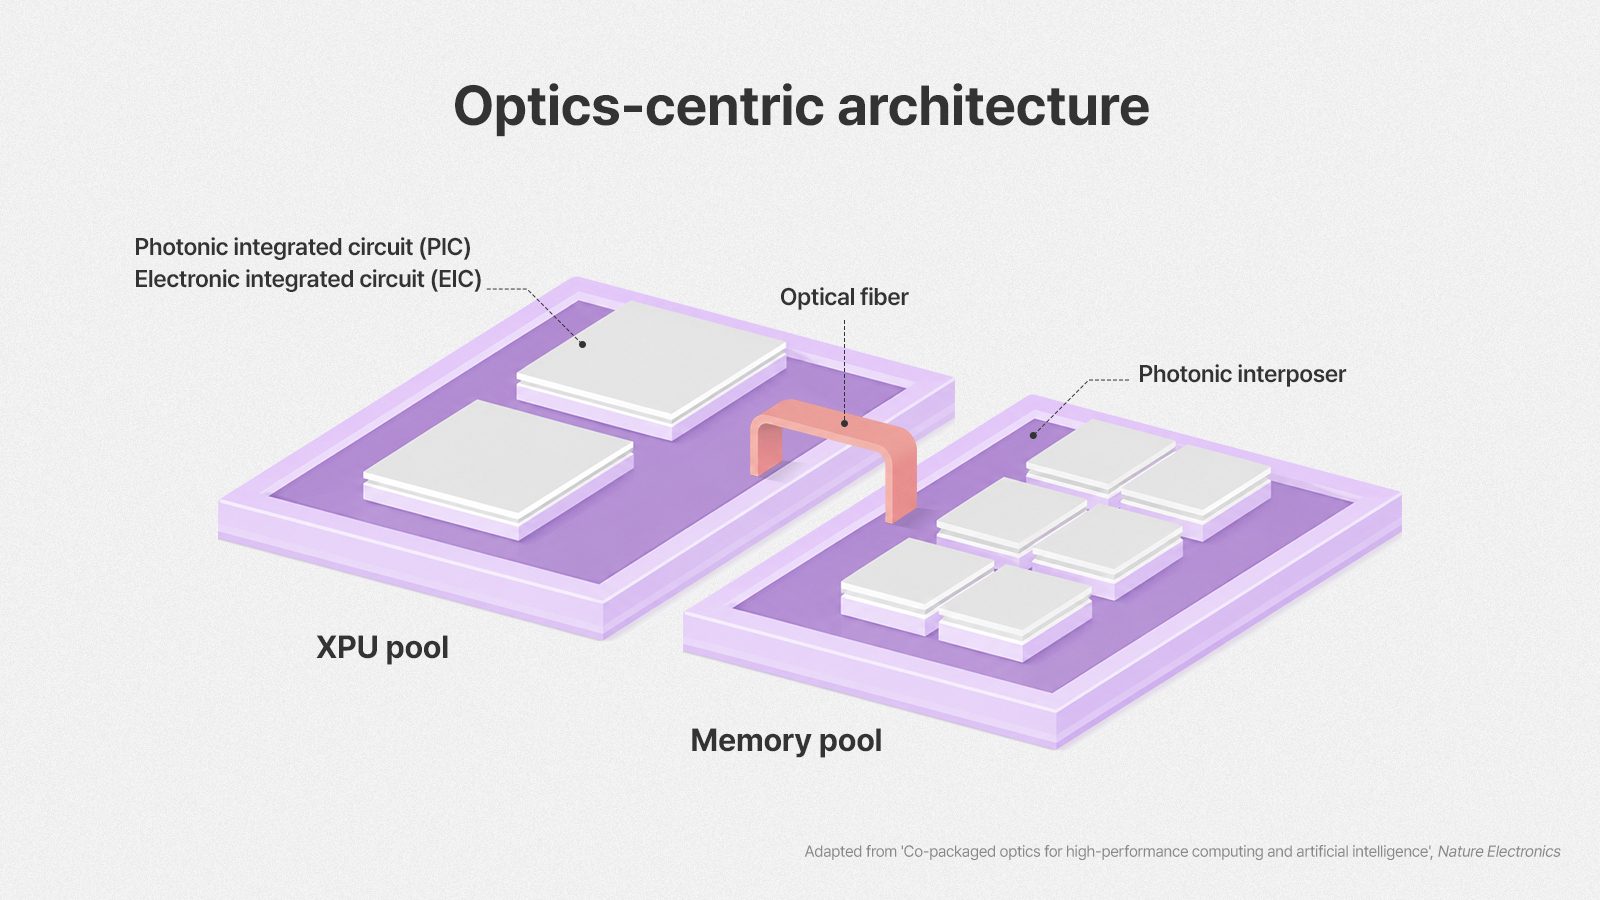 Кроме того, были указаны ключевые проблемы коммерциализации. Переход от демонстрации передовых вариантов упаковки к серийному производству оборудования сопряжён с рядом нерешенных инженерных проблем. Интеграция маломощных кремниевых фотонных устройств вместе с мощной логикой хоста требует сложной теплоизоляции и передовых микроканальных или иных систем прямого охлаждения упаковки. Также отрасли необходимо разработать стандартизированные протоколы когерентности с низкой задержкой, способные координировать операции с оптически связанной памятью без дополнительных затрат на проприетарные решения. Надёжная коммерциализация потребует комплексного проектирования оборудования, охватывающего топологии кристаллов DRAM, специализированные контроллеры памяти, фотонные модули и гетерогенную упаковку подложек. Статья также даёт представление о том, как SK hynix позиционирует себя на следующем этапе развития ИИ-инфраструктуры. Компания стала одним из главных бенефициаров бума генеративного ИИ благодаря HBM. Следующий этап требует, чтобы устройства памяти, контроллеры, оптические компоненты, процессоры и передовые технологии упаковки проектировались совместно, а не оптимизировались по отдельности. Именно поэтому исследователи делают акцент на «совместном проектировании». Нечто похожее уже разрабатывает Marvell, Lightmatter, Ayar Labs и другие вендоры. OCP также взялась за стандартизацию CPO, а группа гиперскейлеров сформировала альянс OCI MSA.
20.08.2026 [13:08], Сергей Карасёв
Pine64 прекратила выпуск Linux-устройств из-за дефицита чипов памятиКомпания Pine64, разрабатывающая одноплатные компьютеры с поддержкой Linux и другие продукты, сообщила о приостановке выпуска устройств. Причина — дефицит комплектующих, прежде всего чипов оперативной и флеш-памяти. Цены на эти компоненты продолжают расти, что создаёт производственные трудности и снижает рентабельность бизнеса. В официальном заявлении Pine64 говорится, что из-за сформировавшейся нехватки изделий DRAM и eMMC выпуск новых устройств на Linux в ближайшее время не планируется. Будет ли производство возобновлено в обозримом будущем, зависит от цен на эти компоненты после середины 2027 года. При этом компания намерена продолжить поставки решений на базе микроконтроллеров. «В целом, ситуация с Linux-устройствами не самая радужная, но в магазине PineStore по-прежнему доступны устройства на базе MCU — ассортимент таких продуктов в дальнейшем будет расширяться», — сказано в заявлении Pine64. Таким образом, купить оборудование Pine64 под управлением Linux будет невозможно после исчерпания оставшихся запасов. При этом компания продолжит реализацию таких товаров, как умные часы PineTime, блок питания PinePower и пр. 
Источник изображения: Pine64 Между тем другие участники рынка на фоне дефицита чипов памяти вынуждены поднимать цены на свои продукты. В частности, значительно увеличилась стоимость популярных одноплатных компьютеров и вычислительных модулей Raspberry Pi: некоторые решения подорожали сразу на $150. Кроме того, NVIDIA подняла цены на модули Jetson — стоимость отдельных устройств подскочила вдвое. Вместе с тем продолжается стремительный рост цен на SSD корпоративного класса.
19.08.2026 [23:41], Владимир Мироненко
Sandisk спроектировала первый кристалл HBF и готовит выпуск образцов в 2027 годуСпустя всего несколько дней после презентации совместно с SK hynix первых спецификаций стандарта High Bandwidth Flash (HBF), компания SanDisk объявила о завершении финального этапа проектирования (стадии tape-out) первого кристалла HBF, продемонстрировав его образец на слайде. Заодно компания сообщила подробности о своей стратегии роста и долговременной экономической модели. В HBF используется многослойная архитектура NAND вместо DRAM с размещением её рядом с ускорителем, подобно HBM. HBF использует запатентованную технологию, которая помогает уменьшить напряжение и деформацию кристалла и улучшить теплопроводность, позволяя использовать многослойную структуру из 16 кристаллов для достижения целевой ёмкости и пропускной способности. 
Источник изображений: SanDisk Как сообщила SanDisk, первое поколение HBF нацелено на 512 Гбайт на один стек — 16 кристаллов по 256 Гбайт с общей пропускной способностью 1,6 Тбайт/с при чтении. SanDisk утверждает, что HBF обеспечивает в 8–16 раз большую ёмкость, чем HBM, при аналогичной стоимости и в упаковке, по размерам, высоте стека и энергопотреблению практически не уступающем HBM4. А поскольку это NAND-память, она энергонезависима.  Ожидается, что второе и третье поколение HBF обеспечат скорость чтения, превышающую 2 и 3,2 Тбайт/с соответственно, а ёмкость многослойной структуры достигнет 1 и 1,5 Тбайт на стек. При этом они будут потреблять соответственно в 0,8 и 0,64 раза меньше энергии, чем память первого поколения. Как сообщает StorageReview.com, в презентации SanDisk были чётко обозначены целевые рабочие нагрузки HBF: LLM с MoE-архитектурой, длинные контекстные окна и большие KV-кеши — всё с учётом предложений крупных клиентов в области облачных вычислений и ИИ.  В представленной презентации также указаны три варианта развёртывания памяти HBF в рамках одного XPU. Она может дополнять HBM, заполняя некоторые позиции в стеке вокруг xPU, или полностью заменять её, занимая аналогичную площадь. Либо же она будет хранить веса декодирования и KV-кеши, тогда как HBM (меньшего объёма) будет работать как кеш. Эта гибкость важнее, чем кажется на первый взгляд, поскольку позволяет использовать HBF, не требуя от производителя ускорителя отказа от HBM. SanDisk показала результаты внутренних тестов генерации токенов для одного GPU c HBF, четырёх GPU с HBF и восемью GPU с HBM. На основе тестов компания сделала два заявления. Первое — о восьмикратном увеличении эффективности капитальных затрат исходя из минимальной конфигурации, необходимой для запуска модели: один GPU с HBF против восьми GPU с HBM. Второе — о двукратном увеличении эффективности GPU: четыре GPU с HBF выдают тот же объём токенов, что и восемь GPU с HBM.  HBF показывает результат, отличающийся от HBM с высокой пропускной способностью всего на 2,2 % при чтении весов для Llama 3.1 405B. Следует учесть, что речь идёт о предварительных данных самой SanDisk, где, например, не даны точные значения по скорости генерации токенов. Но в целом компания говорит о том, что увеличение объёма набортной памяти ускорителя в 8–16 раз при той же пропускной способности и примерно той же мощности, что у HBM, потребует меньшего количества ускорителей для хранения одной и той же модели, а сами ускорители будут тратить меньше времени на ожидание данных.  Как сообщает TrendForce со ссылкой на Mizuho Securities и Goldman Sachs, компания планирует выпустить первые образцы HBF в 2027 году, а массовое производство, как ожидается, начнётся в 2028 году. В Mizuho Securities полагают, что HBF вряд ли полностью заменит HBM, но позволит создавать дезагрегированные архитектуры для ИИ-инференса — консорциум HBF, куда входят Google, Meta✴, SK hynix и Tenstorrent, работает над развитием этого подхода. TrendForce полагает, что в долгосрочной перспективе выиграет гибридная архитектура, где HBM будет использоваться для высокоскоростных вычислений, а HBF — для повышения плотности хранения. Такая иерархия памяти может стать ключевым фактором крупномасштабной коммерциализации ИИ.
18.08.2026 [12:58], Сергей Карасёв
Gigabyte представила сервер G4L4-ZD3 на базе AMD EPYC Turin и NVIDIA HGX B300 с СЖОКомпания Gigabyte пополнила ассортимент ИИ-серверов моделью G4L4-ZD3-LAX7 в форм-факторе 4U. Устройство выполнено на аппаратной платформе AMD EPYC 9005 Turin в сочетании с NVIDIA HGX B300 (SXM). Допускается установка двух процессоров EPYC в исполнении Socket SP5 (LGA 6096) с показателем TDP до 500 Вт. Доступны 24 слота для модулей оперативной памяти DDR5-6400, а также четыре слота PCIe 5.0 x16 для карт типоразмера FHHL. Питание обеспечивают десять блоков мощностью 3000 Вт с резервированием и сертификатом 80 PLUS Titanium. Сервер располагает контроллером ASPEED AST2600, двумя сетевыми портами 10GbE на базе Intel X710-AT2, а также выделенным сетевым портом управления 1GbE. Могут быть реализованы восемь OSFP-портов InfiniBand XDR с пропускной способностью до 800 Гбит/с или сдвоенные 400GbE-порты на базе NVIDIA ConnectX-8 SuperNIC. Упомянута совместимость с DPU NVIDIA BlueField-3. Во фронтальной части расположены восемь отсеков для SFF-накопителей с интерфейсом PCIe 5.0 (NVMe). Кроме того, есть два внутренних коннектора M.2 (2280/22110) для SSD с интерфейсами PCIe 3.0 x4 и PCIe 3.0 x1. Предусмотрены два фронтальных порта USB 3.0 Type-A, разъём D-Sub и три гнезда RJ45 для сетевых кабелей. 
Источник изображения: Gigabyte Применяется жидкостное охлаждение, которое охватывает все ключевые компоненты, в том числе CPU, GPU и RAM. Дополнительно установлены вентиляторы диаметром 60 мм в области материнской платы и 80 мм в зоне слотов PCIe. Диапазон рабочих температур — от +10 до +35 °C. Опционально доступен модуль TPM 2.0 для обеспечения безопасности.
18.08.2026 [12:55], Сергей Карасёв
AAEON выпустила 2,5″ одноплатный компьютер Pico-ADN2 с поддержкой ИБП на базе суперконденсатораКомпания AAEON анонсировала одноплатный компьютер Pico-ADN2 в форм-факторе Pico-ITX (примерно 2,5″), предназначенный для использования в сфере промышленной автоматизации, на транспорте и пр. Устройство, как отмечается, спроектировано для работы в непредсказуемых условиях, когда велика вероятность сбоев в электроснабжении. Новинка имеет размеры 100 × 72 мм. Возможно исполнение с 2-контактным разъёмом для внешнего суперконденсатора, выполняющего функции ИБП: его заряда хватит как минимум на 48 часов работы одноплатного компьютера. Ещё одной особенностью изделия является применение преимущественно фиксируемых штыревых разъёмов вместо привычных портов: это обеспечивает большую надёжность при эксплуатации в условиях сильной вибрации. Диапазон рабочих температур простирается от -20 до +70 °C. 
Источник изображения: AAEON В основу положена аппаратная платформа Intel Alder Lake-N. В зависимости от модификации применяется чип Intel Processor N97 (4C/4T; до 3,6 ГГц; 12 Вт) или Core i3-N305 (8C/8T; до 3,8 ГГц; 15 Вт). Имеется встроенный контроллер Intel UHD Graphics. Объём памяти LPDDR5 составляет 16 Гбайт (впаяна). Допускается вывод изображения одновременно на три монитора через интерфейсы LVDS (1920 × 1200 точек; 60 Гц), eDP 1.4 (3840 × 2160 пикселей; 60 Гц; опционально) и HDMI 1.4 (3840 × 2160 точек; 30 Гц). Через разъёмы на плате могут быть задействованы два сетевых порта 1GbE (контроллеры Intel I226-IT и Realtek RTL8111H-CG), по два порта USB 3.0 и USB 2.0, два последовательных порта (RS-232/422/485). Реализованы полноразмерный слот mSATA/mPCIe для накопителя и коннектор M.2 2230 E-Key (PCIe 3.0 x1 + USB 2.0) для адаптера Wi-Fi. Допускается подключение вентилятора охлаждения через 4-контактный разъём. Заявлена совместимость с Windows 10/11 и Ubuntu 24.04.2. |
|

