
Материалы по тегу: h200
|
05.12.2024 [13:37], Сергей Карасёв
AWS представила инстансы EC2 P5en на базе NVIDIA H200 и кастомизированных чипов Intel XeonОблачная платформа AWS объявила о доступности инстансов EC2 P5en, рассчитанных на такие нагрузки, как глубокое обучение, генеративный ИИ, обработка данных в реальном времени и приложения HPC. В основу новых экземпляров положены аппаратные компоненты Intel и NVIDIA. В частности, задействованы кастомизированные процессоры Xeon Sapphire Rapids. У них все ядра могут одновременно работать на турбо-частоте 3,2 ГГц, а максимальная частота отдельных ядер достигает 3,8 ГГц. Кроме того, применяются ИИ-ускорители NVIDIA H200 и адаптеры AWS Elastic Fabric Adapter (EFA) v3 с пропускной способностью до 3,2 Тбит/с. Конфигурация инстансов EC2 P5en включает 192 vCPU, 2048 ГиБ памяти, восемь ускорителей H200 и восемь SSD вместимостью 3,84 Тбайт каждый. Пропускная способность EBS составляет 100 Гбит/с. Отмечается, что экземпляры P5en демонстрируют увеличение производительности локального хранилища до двух раз и пропускной способности EBS до 25 % по сравнению с инстансами P5 на базе NVIDIA H100. 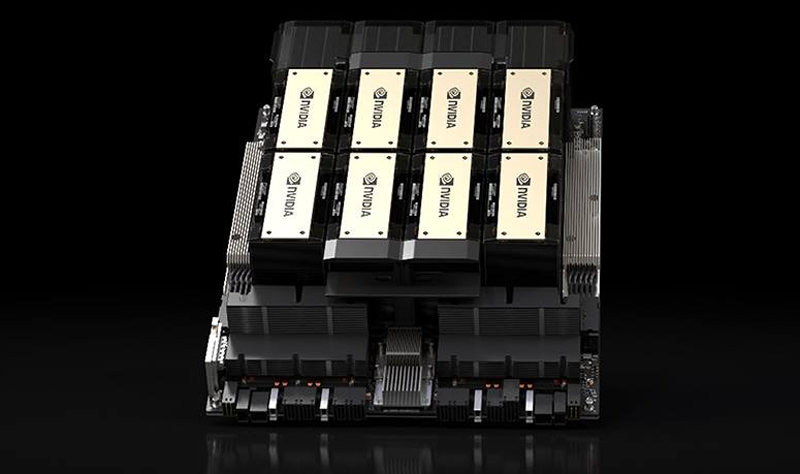
Источник изображения: NVIDIA На сегодняшний день инстансы EC2 P5en доступны в американских регионах AWS US East (Огайо) и US West (Орегон), а также в Азиатско-Тихоокеанском регионе в Токио. Предлагаются различные тарифные опции, включая оплату по мере использования. Ранее были представлены инстансы EC2 P5e с процессорами AMD EPYC Milan, 2 ТиБ памяти, восемью ускорителями NVIDIA H200 и восемью NVMe SSD на 3,84 Тбайт каждый. У этих экземпляров пропускная способность EBS равна 80 Гбит/с.
02.12.2024 [11:39], Сергей Карасёв
Один из модулей будущего европейского экзафлопсного суперкомпьютера JUPITER вошёл в двадцатку самых мощных систем мираЮлихский исследовательский центр (FZJ) в Германии объявил о достижении важного рубежа в рамках проекта JUPITER (Joint Undertaking Pioneer for Innovative and Transformative Exascale Research) по созданию европейского экзафлопсного суперкомпьютера. Введён в эксплуатацию JETI — второй модуль этого НРС-комплекса. Напомним, контракт на создание JUPITER заключён между Европейским совместным предприятием по развитию высокопроизводительных вычислений (EuroHPC JU) и консорциумом, в который входят Eviden (подразделение Atos) и ParTec. Суперкомпьютер JUPITER создаётся на базе модульного дата-центра, за строительство которого отвечает Eviden. Система JUPITER получит, в частности, энергоэффективные высокопроизводительные Arm-процессоры SiPearl Rhea1 с HBM. Кроме того, в состав машины входят узлы с NVIDIA Quad GH200, а общее количество суперчипов GH200 Grace Hopper составит почти 24 тыс. Узлы объединены интерконнектом NVIDIA Mellanox InfiniBand. Запущенный модуль JETI (JUPITER Exascale Transition Instrument) обладает FP64-производительностью 83,14 Пфлопс, тогда как пиковый теоретический показатель достигает 95 Пфлопс. С такими результатами эта машина попала на 18-ю строку нынешнего рейтинга мощнейших суперкомпьютеров мира TOP500. В составе JETI задействованы в общей сложности 391 680 ядер. Энергопотребление модуля равно 1,31 МВт. Отмечается, что JETI обеспечивает примерно одну двенадцатую от общей расчётной производительности машины JUPITER. Попутно JETI занял шестое место в рейтинге энергоэффективных систем Green500. 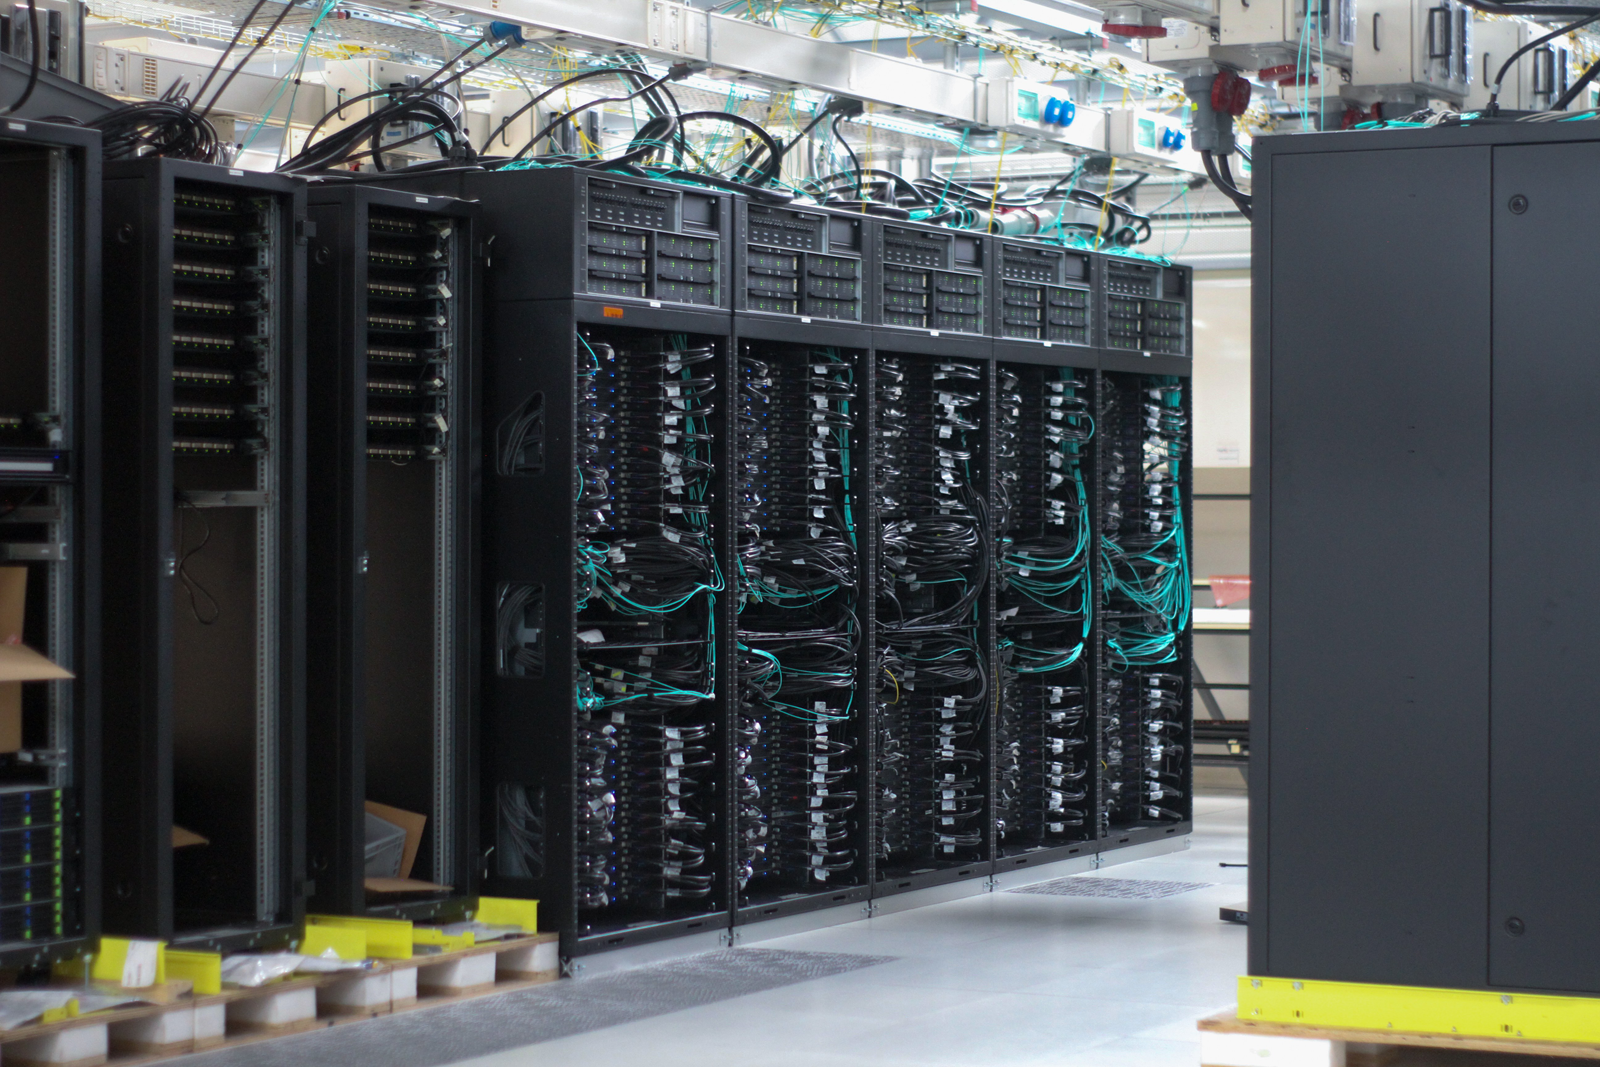
Источник изображения: Eviden Ожидается, что после завершения строительства суммарное быстродействие JUPITER на операциях обучения ИИ составит до 93 Эфлопс, а FP64-производительность превысит 1 Эфлопс. Затраты на создание комплекса оцениваются в €273 млн, включая доставку, установку и обслуживание НРС-системы.
22.11.2024 [10:15], Сергей Карасёв
Oracle объявила о доступности облачного ИИ-суперкомпьютера из 65 тыс. NVIDIA H200Корпорация Oracle сообщила о доступности облачного суперкластера с ускорителями NVIDIA H200, предназначенного для ресурсоёмких ИИ-нагрузок, включая обучение больших языковых моделей (LLM). Арендовать мощности системы можно по цене от $10 в час в расчёте на GPU. Кластер масштабируется до 65 536 ускорителей. В максимальной конфигурации теоретическое пиковое быстродействие достигает 260 Эфлопс на операциях FP8, что более чем в четыре раза превышает показатели систем предыдущего поколения. Утверждается, что на сегодняшний день это самый высокопроизводительный облачный ИИ-суперкомпьютер, доступный в облаке. Сейчас компания готовится к созданию облачного кластера из 131 тыс. NVIDIA B200. Новые инстансы получили обозначение BM.GPU.H200.8. Каждая виртуальная машина типа Bare Metal (без гипервизора) содержит восемь изделий NVIDIA H200 (141 Гбайт памяти HBM3e), объединённых посредством NVIDIA NVLink. Задействованы два процессора Intel Xeon Platinum 8480+ поколения Sapphire Rapids (56C/112T; до 3,8 ГГц; 350 Вт). Объём системной памяти DDR5 составляет 3 Тбайт. В состав локального хранилища входят восемь NVMe SSD вместимостью 3,84 Тбайт каждый. 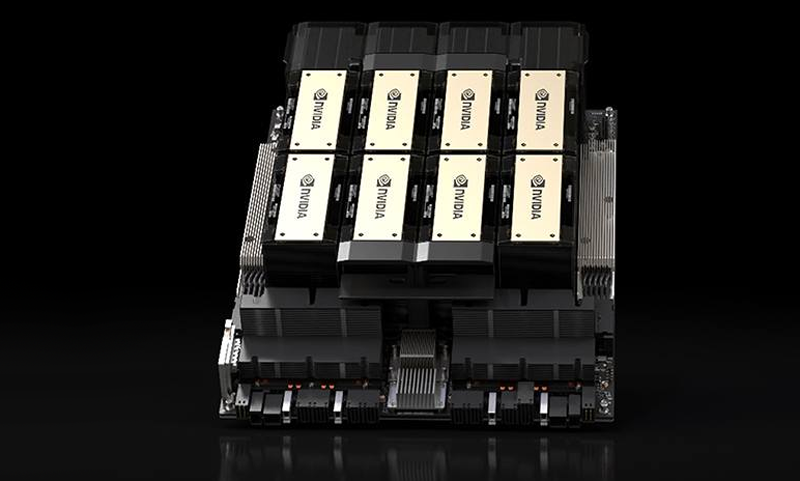
Источник изображения: NVIDIA Кластер использует кастомную RoCE-сеть на базе NVIDIA ConnectX-7 с суммарной пропускной способностью 3200 Гбит/с (восемь каналов по 400 Гбит/с) на узел. Инстансы включают frontend-сеть с пропускной способностью 200 Гбит/с. По данным Oracle, каждый инстанс в суперкластере содержит на 76 % больше памяти HBM по сравнению с виртуальными машинами на основе NVIDIA H100, а пропускная способность памяти увеличена на 40 %. Таким образом, производительность инференса выросла в 1,9 раза.
20.11.2024 [12:11], Сергей Карасёв
Dell представила ИИ-серверы PowerEdge XE9685L и XE7740Компания Dell анонсировала серверы PowerEdge XE9685L и PowerEdge XE7740, предназначенные для НРС и ресурсоёмких рабочих нагрузок ИИ. Устройства могут монтироваться в 19″ стойку высокой плотности Dell Integrated Rack 5000 (IR5000), что позволяет экономить место в дата-центрах. 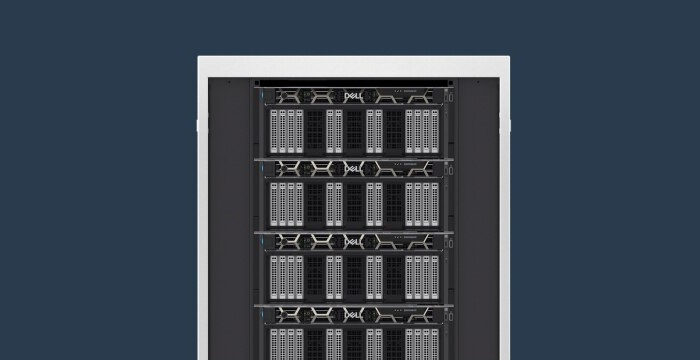
Источник изображений: Dell Модель PowerEdge XE9685L в форм-факторе 4U рассчитана на установку двух процессоров AMD EPYC Turin. Применяется жидкостное охлаждение. Доступны 12 слотов для карт расширения PCIe 5.0. Говорится о возможности использования ускорителей NVIDIA HGX H200 или B200. По заявлениям Dell, система PowerEdge XE9685L предлагает самую высокую в отрасли плотность GPU с поддержкой до 96 ускорителей NVIDIA в расчёте на стойку. Новинка подходит для организаций, решающих масштабные вычислительные задачи, такие как создание крупных моделей ИИ, запуск сложных симуляций или выполнение геномного секвенирования. Конструкция сервера обеспечивает оптимальные тепловые характеристики при высоких рабочих нагрузках, а наличие СЖО повышает энергоэффективность. 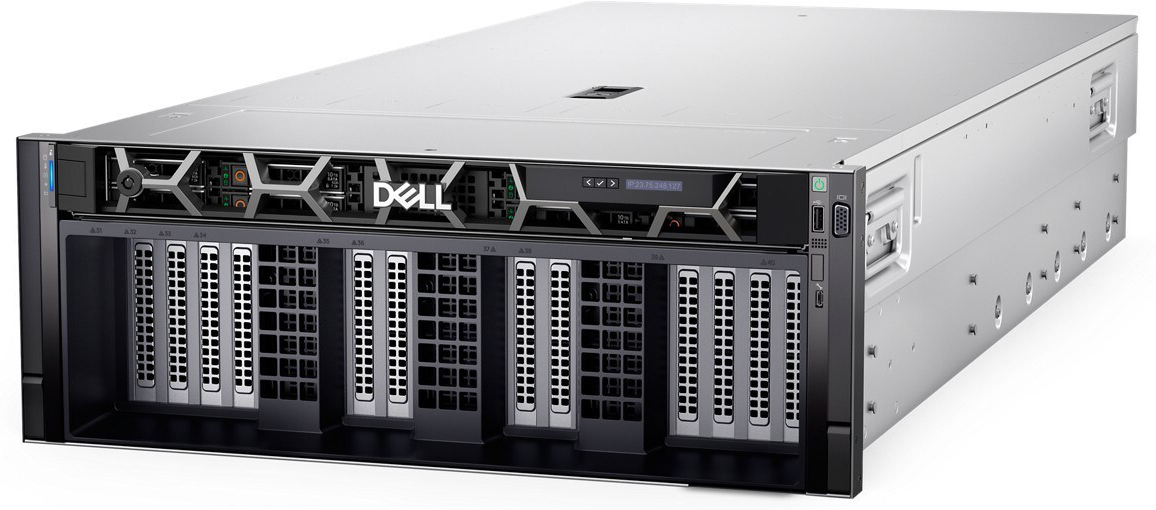 Вторая модель, PowerEdge XE7740, также имеет типоразмер 4U, но использует воздушное охлаждение. Допускается установка двух процессоров Intel Xeon 6 на базе производительных ядер P-core (Granite Rapids). Заказчики смогут выбирать конфигурации с восемью ИИ-ускорителями двойной ширины, включая Intel Gaudi 3 и NVIDIA H200 NVL, а также с 16 ускорителями одинарной ширины, такими как NVIDIA L4. 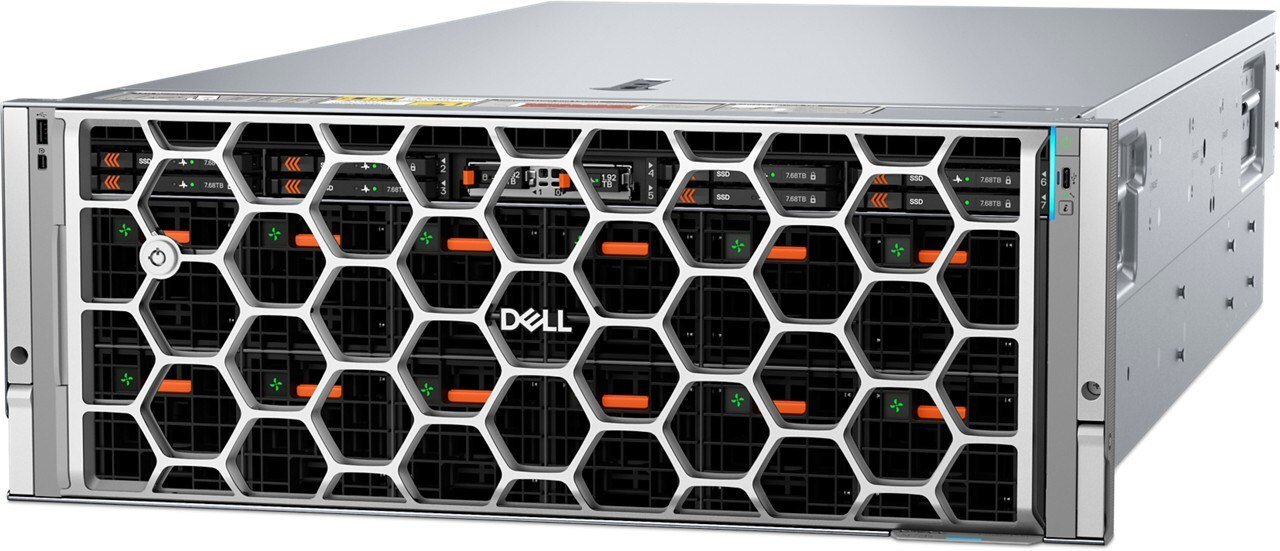 Сервер подходит для различных вариантов использования, например, для тонкой настройки генеративных моделей ИИ, инференса, аналитики данных и пр. Конструкция машины позволяет эффективно сбалансировать стоимость, производительность и масштабируемость. Dell также готовит к выпуску новый сервер PowerEdge XE на базе NVIDIA GB200 NVL4. Говорится о поддержке до 144 GPU на стойку формата 50OU (Dell IR7000).
20.11.2024 [10:59], Сергей Карасёв
Nebius, бывшая Yandex, развернёт в США своей первый ИИ-кластер на базе NVIDIA H200Nebius, бывшая материнская компания «Яндекса», объявила о создании своего первого вычислительного ИИ-кластера на территории США. Система будет развёрнута на базе дата-центра Patmos в Канзас-Сити (штат Миссури), а её ввод в эксплуатацию запланирован на I квартал 2025 года. На начальном этапе в составе кластера Nebius будут использоваться ИИ-ускорители NVIDIA H200. В следующем году планируется добавить решения поколения NVIDIA Blackwell. Мощность площадки может быть увеличена с первоначальных 5 МВт до 40 МВт: это позволит задействовать до 35 тыс. GPU. По заявлениям Nebius, фирма Patmos была выбрана в качестве партнёра в связи с гибкостью и опытом в поэтапном строительстве ЦОД. Первая фаза проекта включает развёртывание необходимой инфраструктуры, в том числе установку резервных узлов, таких как генераторы. Новая зона доступности, как ожидается, позволит Nebius более полно удовлетворять потребности американских клиентов, занимающихся разработками и исследованиями в области ИИ. 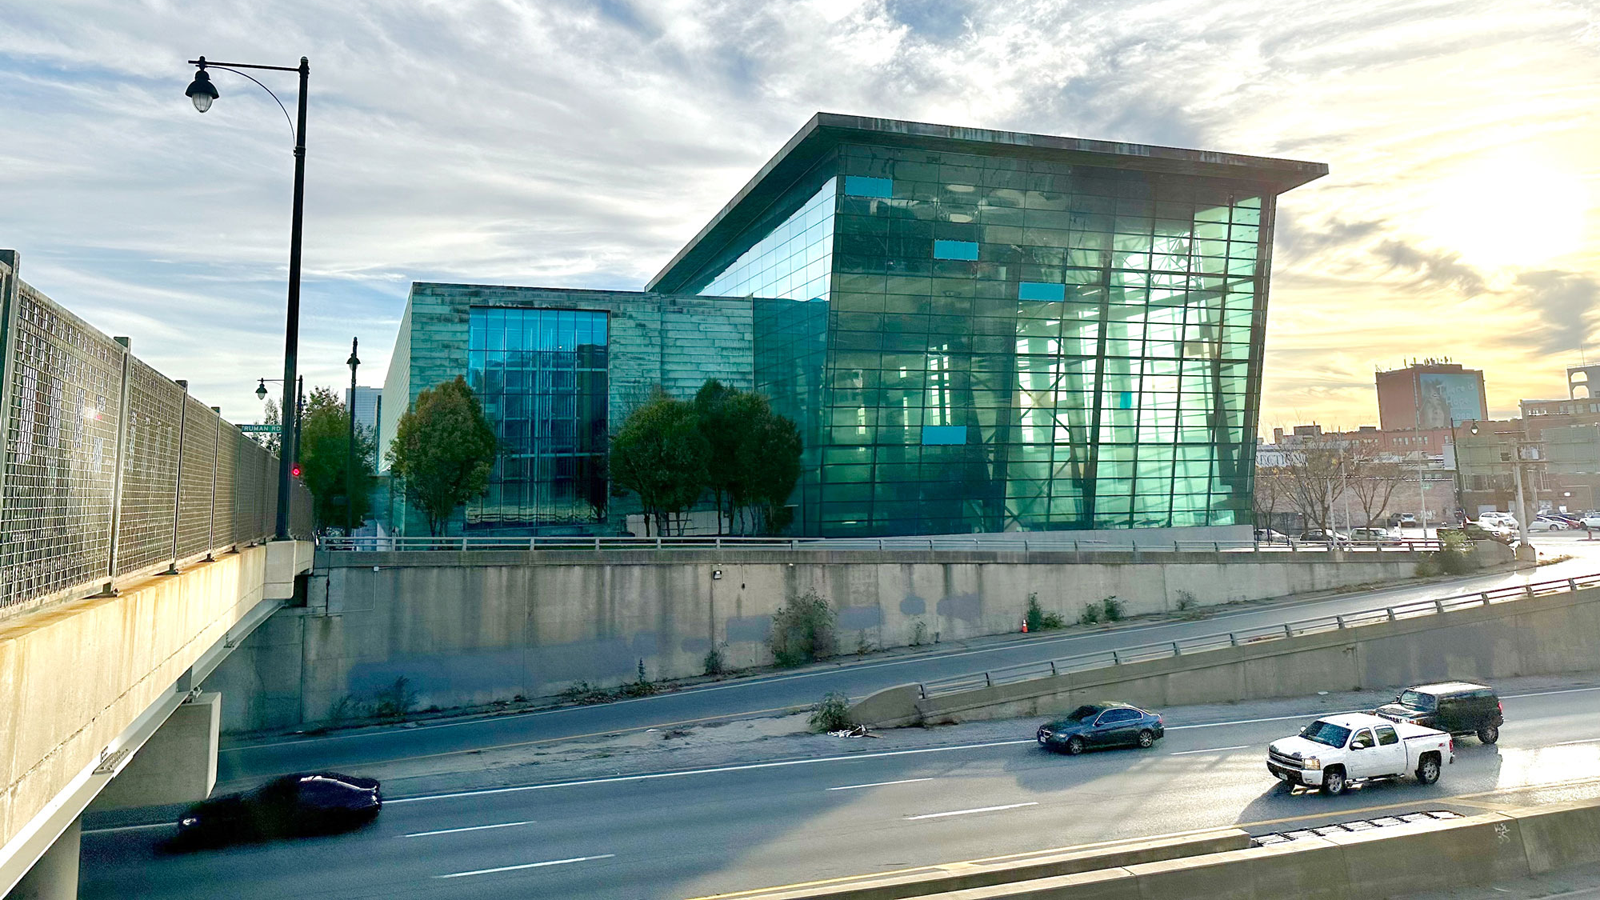
Источник изображения: Nebius Говорится, что Nebius активно наращивает присутствие в США в рамках стратегии по формированию ведущего поставщика инфраструктуры для ИИ-задач. На 2025 год намечено создание второго — более масштабного — кластера GPU в США. Кроме того, компания открыла два центра по работе с клиентами — в Сан-Франциско и Далласе, а третий офис до конца текущего года заработает в Нью-Йорке. Напомним, что ранее Nebius запустила первый ИИ-кластер во Франции на базе NVIDIA H200. У компании также есть площадка в Финляндии. К середине 2025 года Nebius намерена инвестировать более $1 млрд в инфраструктуру ИИ в Европе. А около месяца назад компания представила облачную ИИ-платформу с ускорителями NVIDIA H100 и H200.
19.11.2024 [23:28], Алексей Степин
HPE обновила HPC-портфолио: узлы Cray EX, СХД E2000, ИИ-серверы ProLiant XD и 400G-интерконнект Slingshot
400gbe
amd
epyc
gb200
h200
habana
hardware
hpc
hpe
intel
mi300
nvidia
sc24
turin
ии
интерконнект
суперкомпьютер
схд
Компания HPE анонсировала обновление модельного ряда HPC-систем HPE Cray Supercomputing EX, а также представила новые модели серверов из серии Proliant. По словам компании, новые HPC-решения предназначены в первую очередь для научно-исследовательских институтов, работающих над решением ресурсоёмких задач. 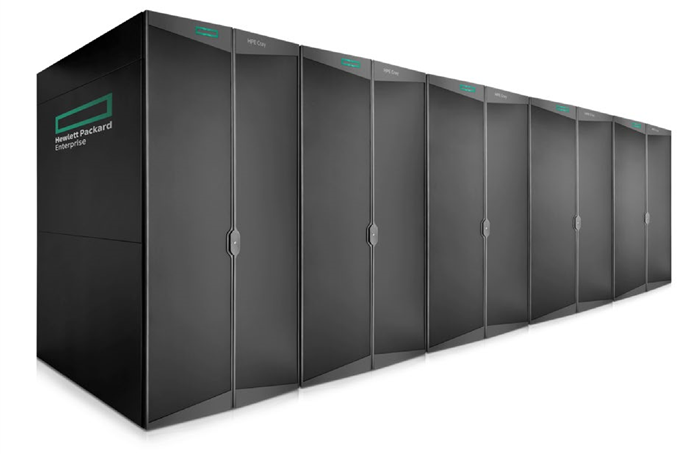
Источник изображений: HPE Обновление касается всех компонентов HPE Cray Supercomputing EX. Открывают список новые процессорные модули HPE Cray Supercomputing EX4252 Gen 2 Compute Blade. В их основе лежит пятое поколение серверных процессоров AMD EPYС Turin, которое на сегодняшний день является самым высокоплотным x86-решениями. Новые модули позволят разместить до 98304 ядер в одном шкафу. Отчасти это также заслуга фирменной системы прямого жидкостного охлаждения. Она охватывает все части суперкомпьютера, включая СХД и сетевые коммутаторы. Начало поставок узлов намечено на весну 2025 года. 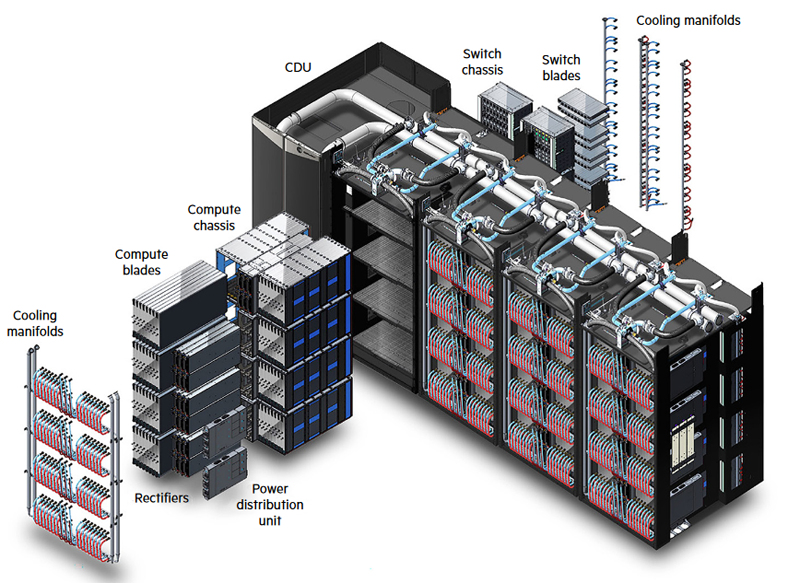 Процессорные «лезвия» дополнены новыми GPU-модулями HPE Cray Supercomputing EX154n Accelerator Blade, позволяющими разместить в одном шкафу до 224 ускорителей NVIDIA Blackwell. Речь идёт о новейших сборках NVIDIA GB200 NVL4 Superchip. Этот компонент появится на рынке позднее — HPE говорит о конце 2025 года. Обновление коснулось и управляющего ПО HPE Cray Supercomputing User Services Software, получившего новые возможности для пользовательской оптимизации вычислений, в том числе путём управления энергопотреблением. Апдейт получит и фирменный интерконнект HPE Slingshot, который «дорастёт» до 400 Гбит/с, т.е. станет вдвое быстрее нынешнего поколения Slingshot. Пропускная способность коммутаторов составит 51,2 Тбит/c. В новом поколении будут реализованы функции автоматического устранения сетевых заторов и адаптивноой маршрутизации с минимальной латентностью. Дебютирует HPE Slingshot interconnect 400 осенью 2024 года. 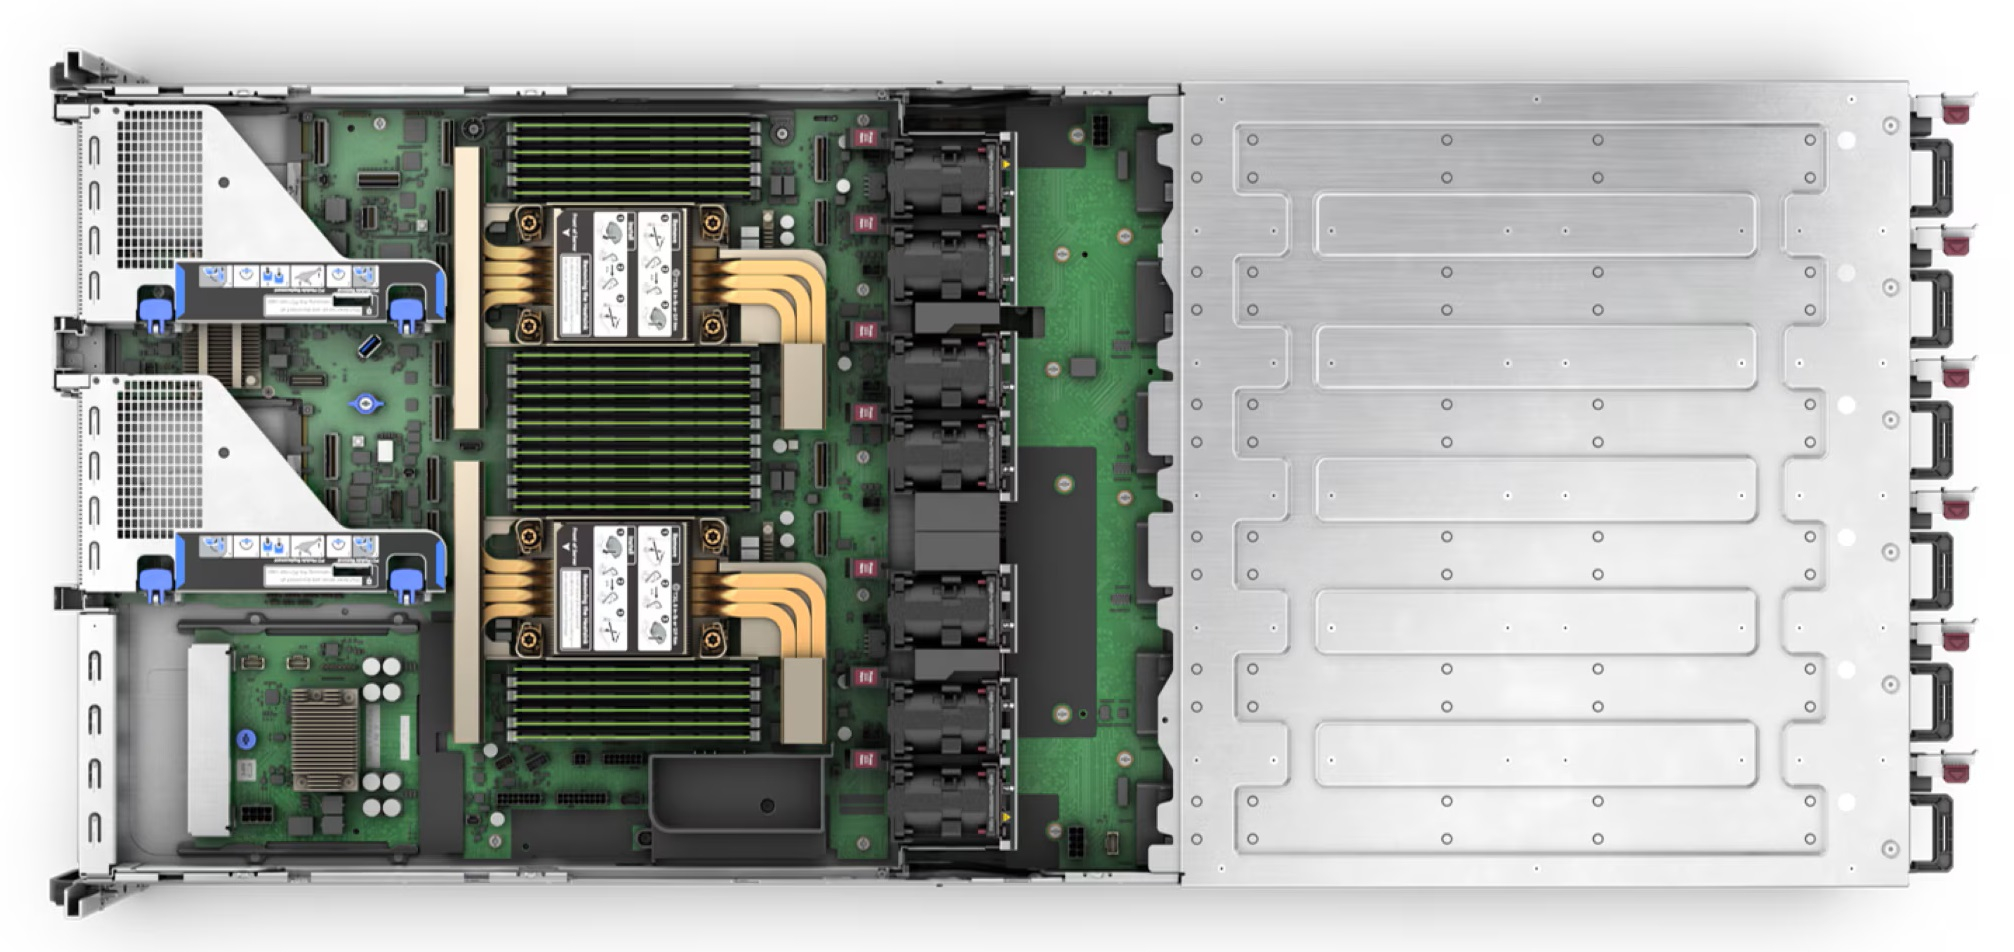 Ещё одна новинка — СХД HPE Cray Supercomputing Storage Systems E2000, специально разработанная для применения в суперкомпьютерах HPE Cray. В сравнении с предыдущим поколением, новая система должна обеспечить более чем двукратный прирост производительности: с 85 и 65 Гбайт/с до 190 и 140 Гбайт/с при чтении и записи соответственно. В основе новой СХД будет использована ФС Lustre. Появится Supercomputing Storage Systems E2000 уже в начале 2025 года. 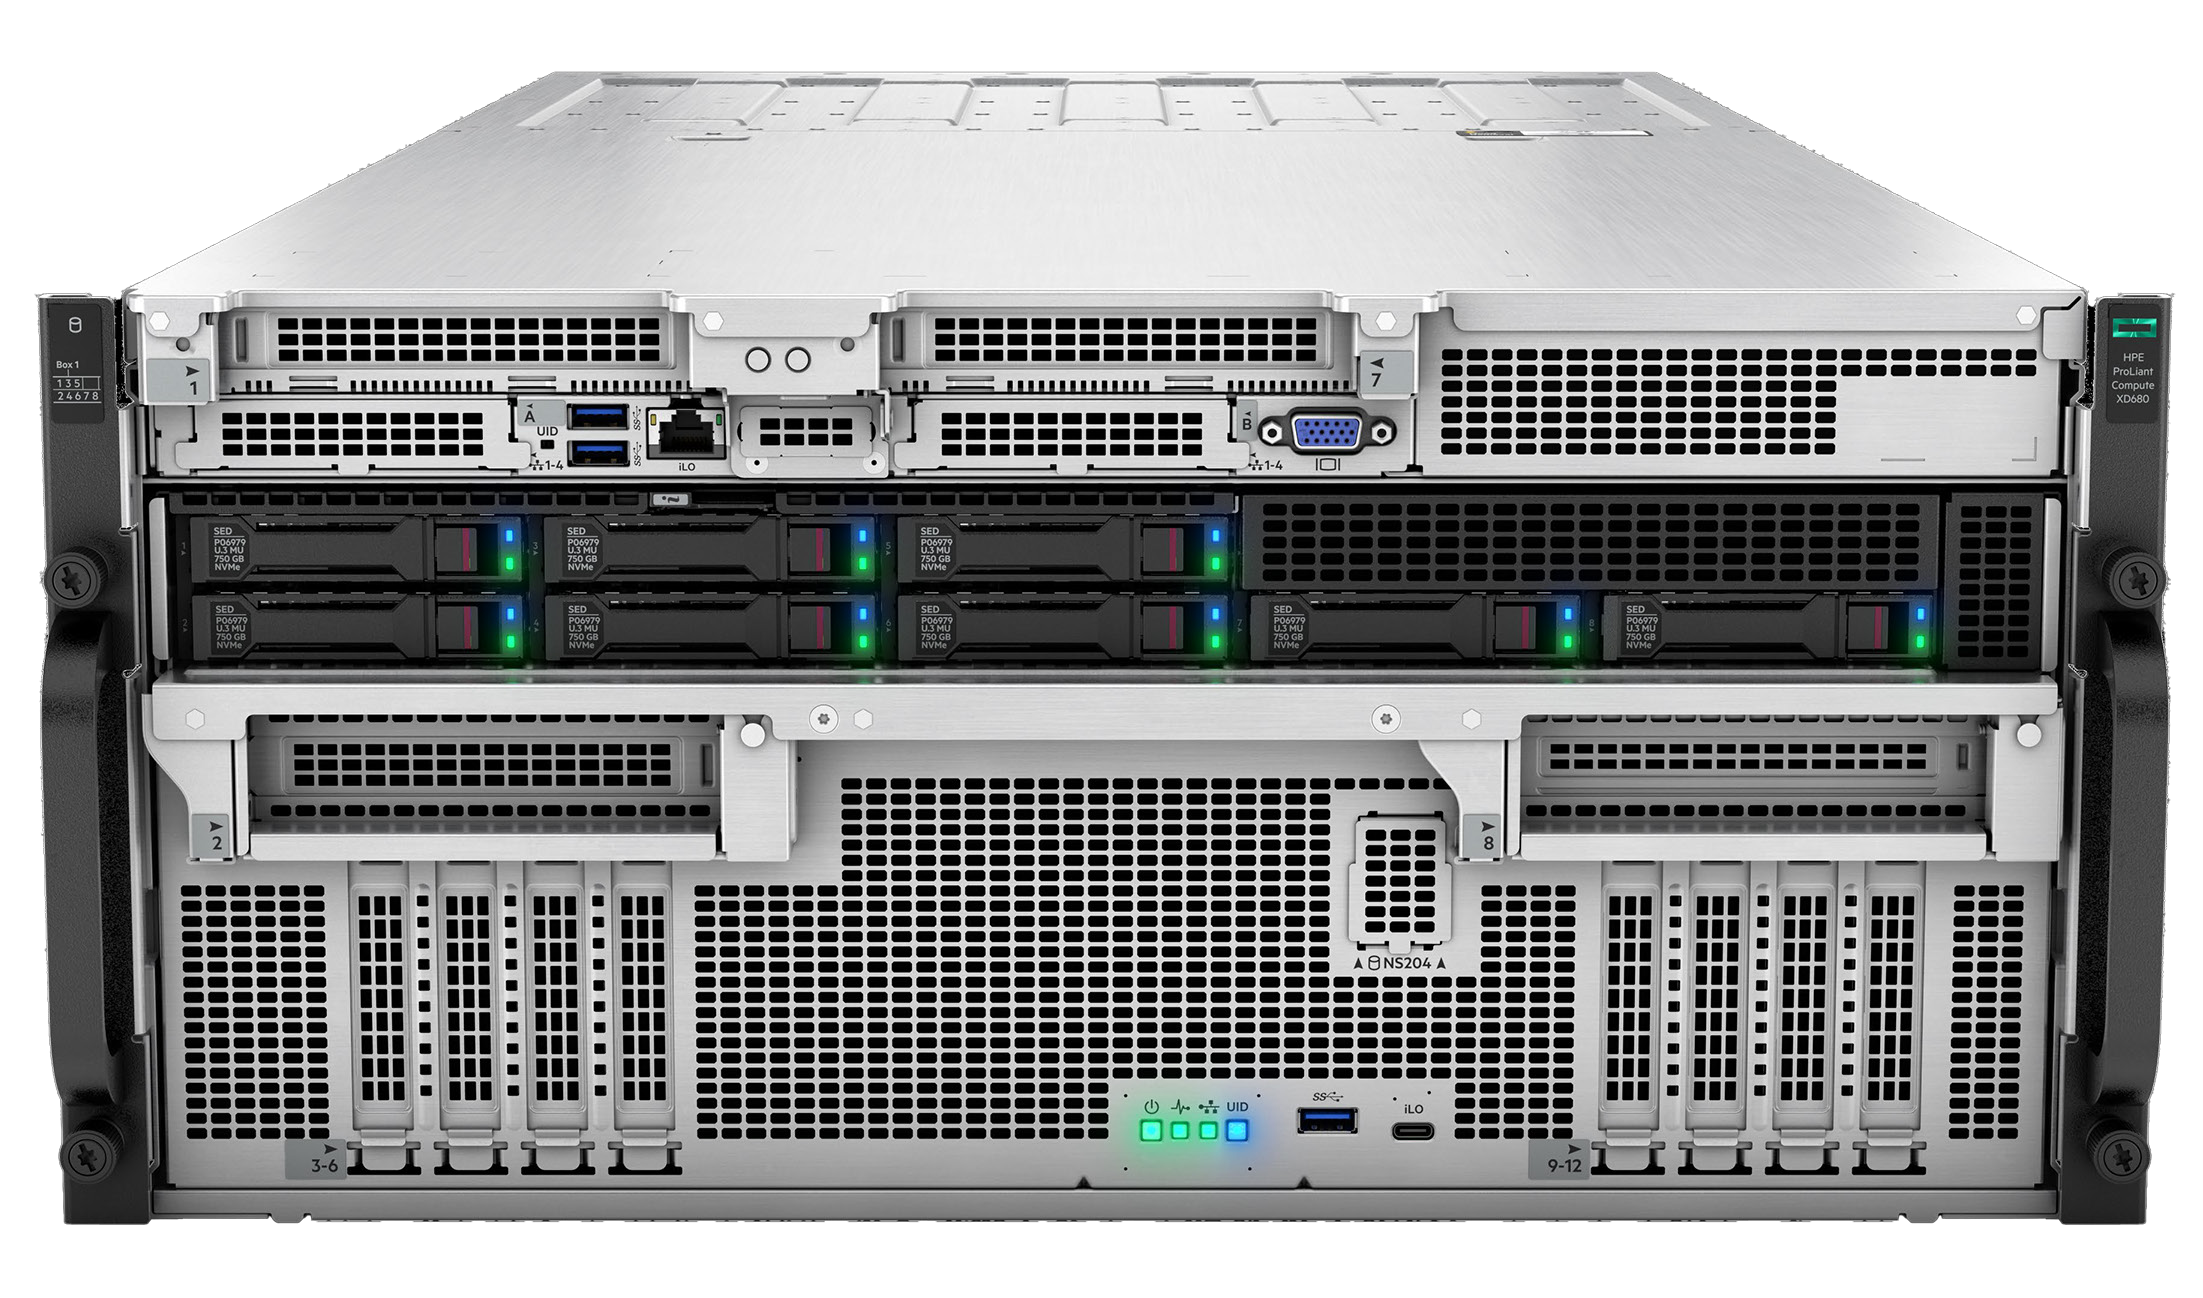 Что касается новинок из серии Proliant, то они, в отличие от вышеупомянутых решений HPE Cray, нацелены на рынок обычных ИИ-систем. 5U-сервер HPE ProLiant Compute XD680 с воздушным охлаждением представляет собой решение с оптимальным соотношением производительности к цене, рассчитанное как на обучение ИИ-моделей и их тюнинг, так и на инференс. Он оснащён восемью ускорителями Intel Gaudi3 и двумя процессорами Intel Xeon Emerald Rapids. Новинка поступит на рынок в декабре текущего года. 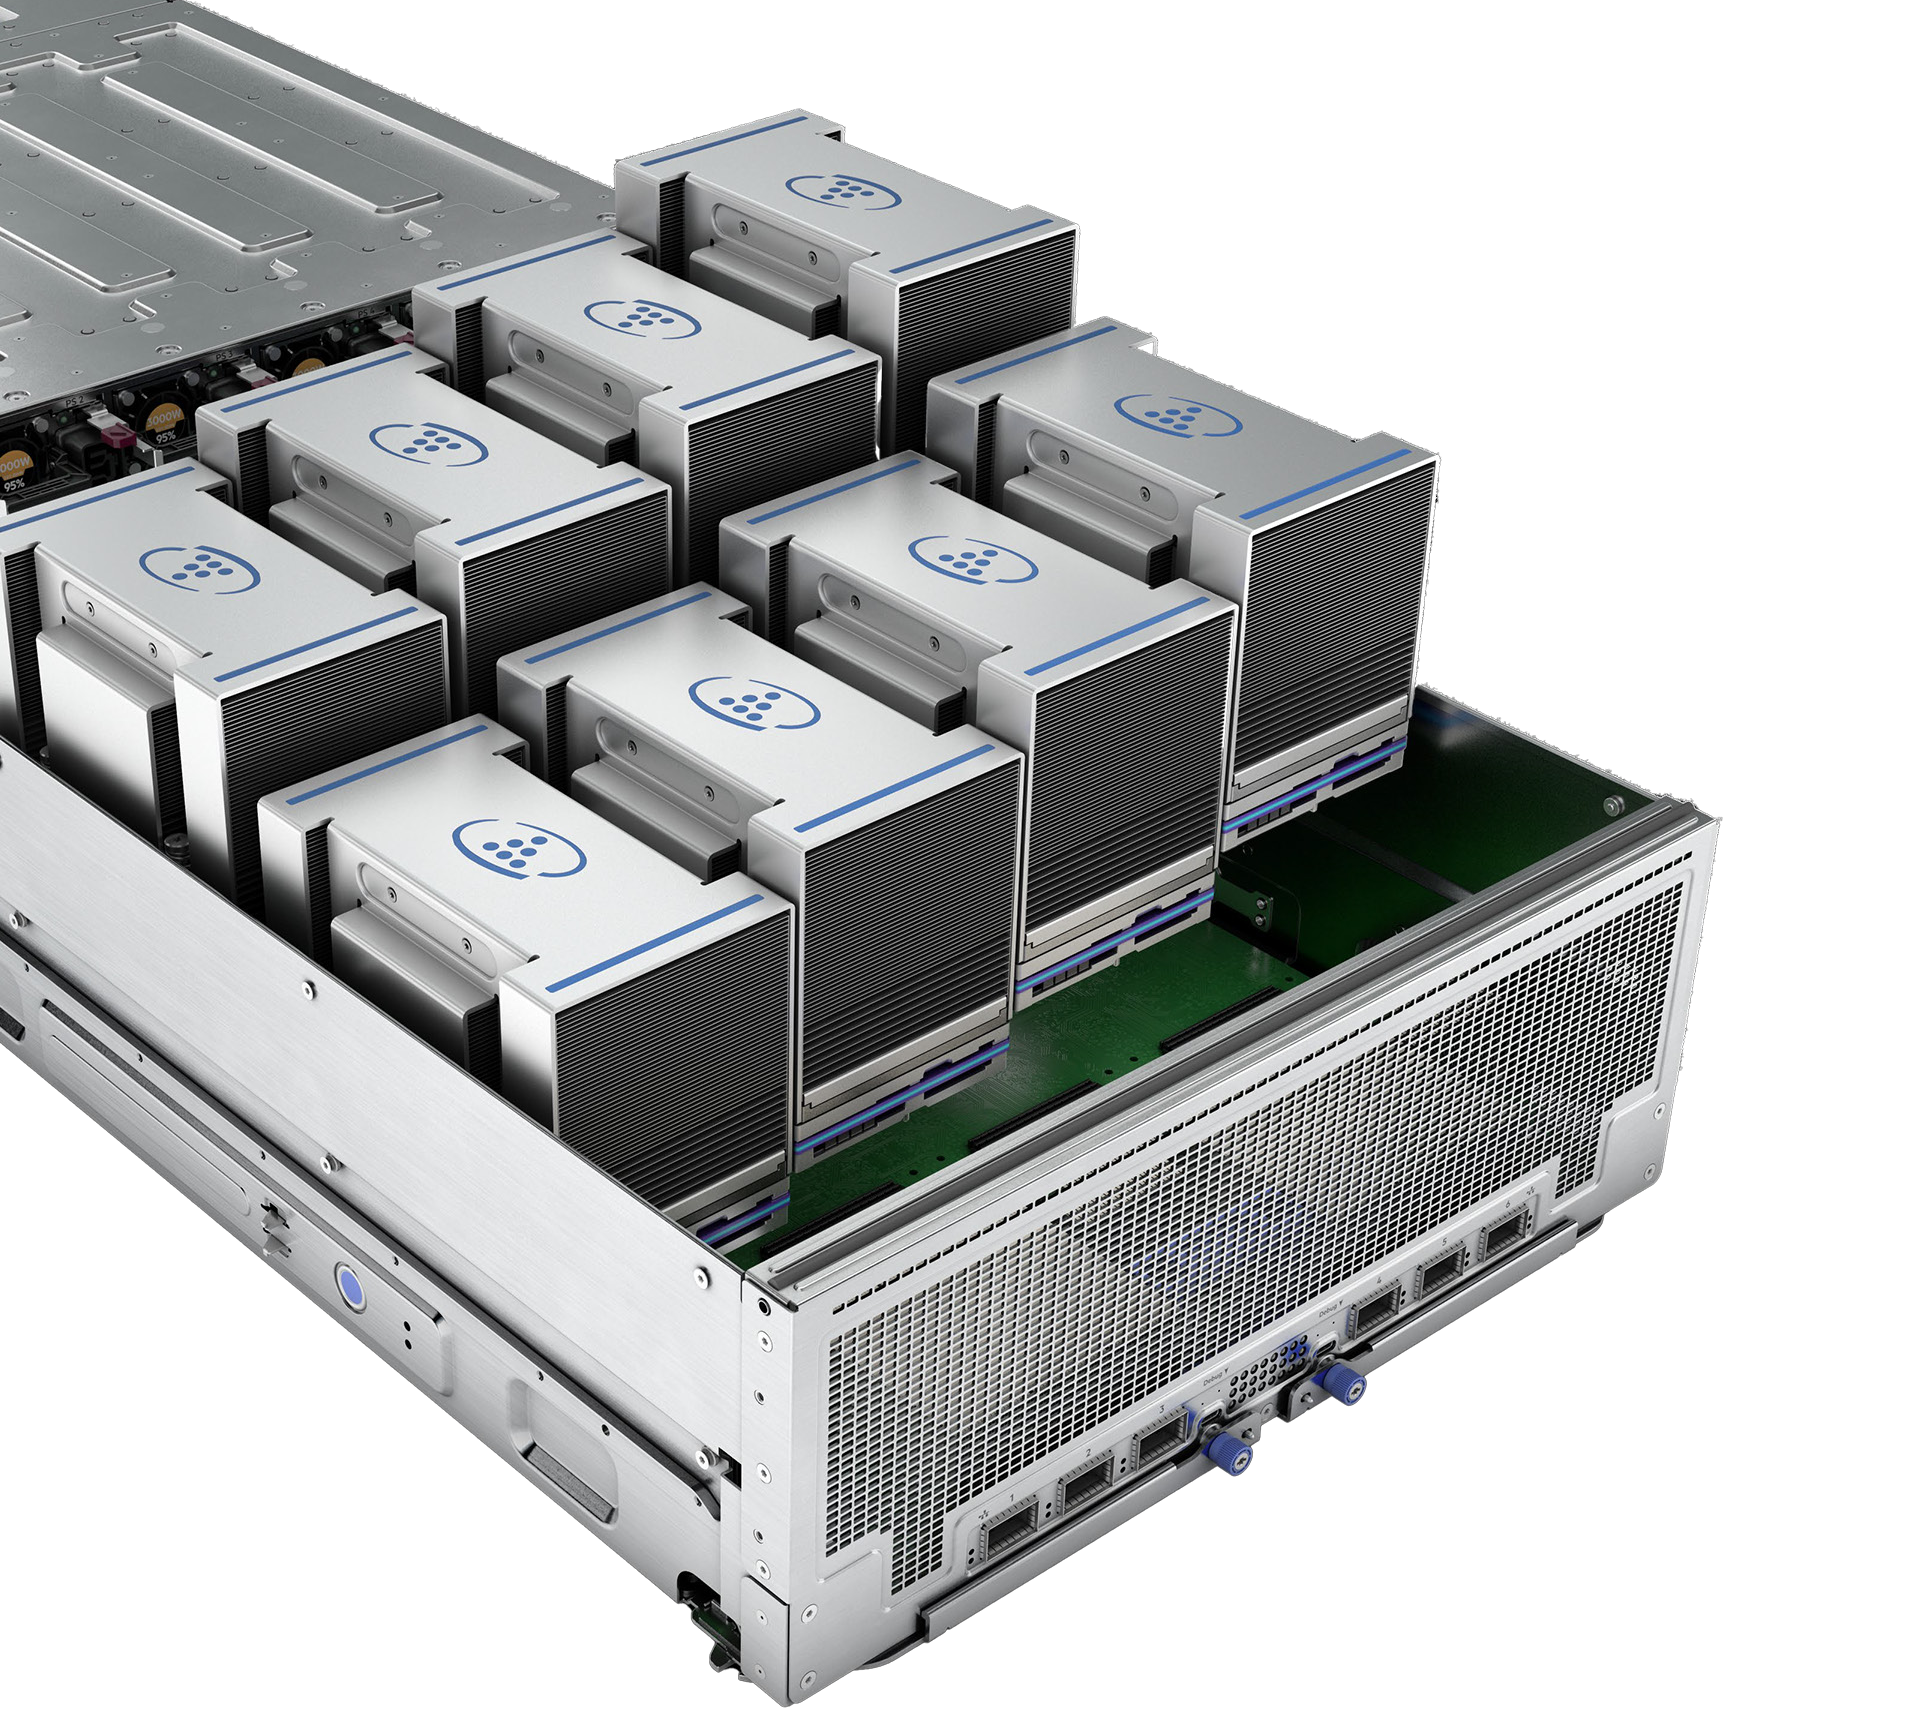 Более производительный HPE ProLiant Compute XD685 всё так же выполнен в корпусе высотой 5U, но рассчитан на жидкостное охлаждение. Он будет оснащаться восемью ускорителями NVIDIA H200 в формате SXM, либо более новыми решениями Blackwell, но последняя конфигурация будет доступна не ранее 2025 года, когда ускорители поступят на рынок. Уже доступен ранее анонсированный вариант с восемью ускорителями AMD Instinict MI325X и процессорами AMD EPYC Turin.
18.11.2024 [21:30], Сергей Карасёв
Счетверённые H200 NVL и 5,5-кВт GB200 NVL4: NVIDIA представила новые ИИ-ускорителиКомпания NVIDIA анонсировала ускоритель H200 NVL, выполненный в виде двухслотовой карты расширения PCIe. Изделие, как утверждается, ориентировано на гибко конфигурируемые корпоративные системы с воздушным охлаждением для задач ИИ и НРС. Как и SXM-вариант NVIDIA H200, представленный ускоритель получил 141 Гбайт памяти HBM3e с пропускной способностью 4,8 Тбайт/с. При этом максимальный показатель TDP снижен с 700 до 600 Вт. Четыре карты могут быть объединены интерконнкетом NVIDIA NVLink с пропускной способностью до 900 Гбайт/с в расчёте на GPU. При этом к хост-системе ускорители подключаются посредством PCIe 5.0 x16. В один сервер можно установить две такие связки, что в сумме даст восемь ускорителей H200 NVL и 1126 Гбайт памяти HBM3e, что весьма существенно для рабочих нагрузок инференса. Заявленная производительность FP8 у карты H200 NVL достигает 3,34 Пфлопс против примерно 4 Пфлопс у SXM-версии. Быстродействие FP32 и FP64 равно соответственно 60 и 30 Тфлопс. Производительность INT8 — до 3,34 Пфлопс. Вместе с картами в комплект входит лицензия на программную платформа NVIDIA AI Enterprise. 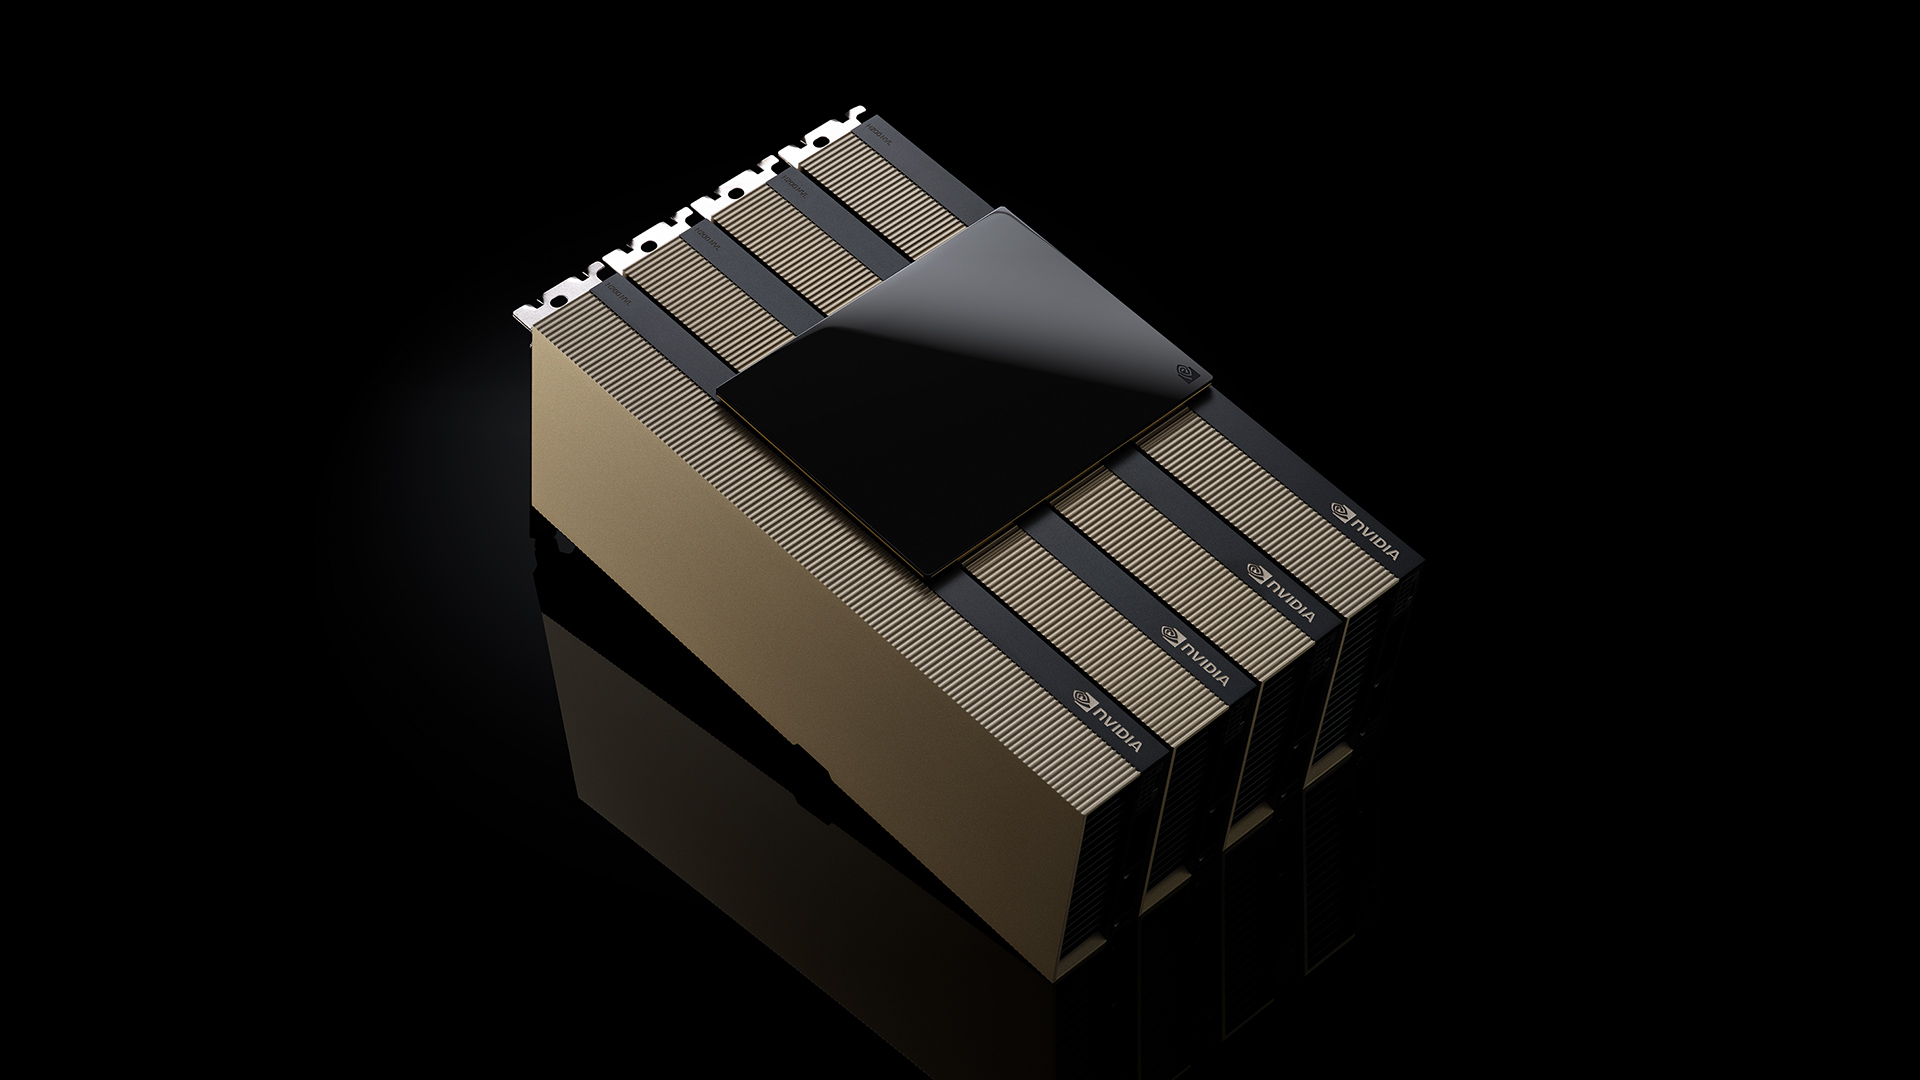
Источник изображения: NVIDIA Кроме того, NVIDIA анонсировала ускорители GB200 NVL4 с жидкостным охлаждением. Они включает два суперчипа Grace-Backwell, что даёт два 72-ядерных процессора Grace и четыре ускорителя B100. Объём памяти LPDDR5X ECC составляет 960 Гбайт, памяти HBM3e — 768 Гбайт. Задействован интерконнект NVlink-C2C с пропускной способностью до 900 Гбайт/с, при этом всем шесть чипов CPU-GPU находятся в одном домене. 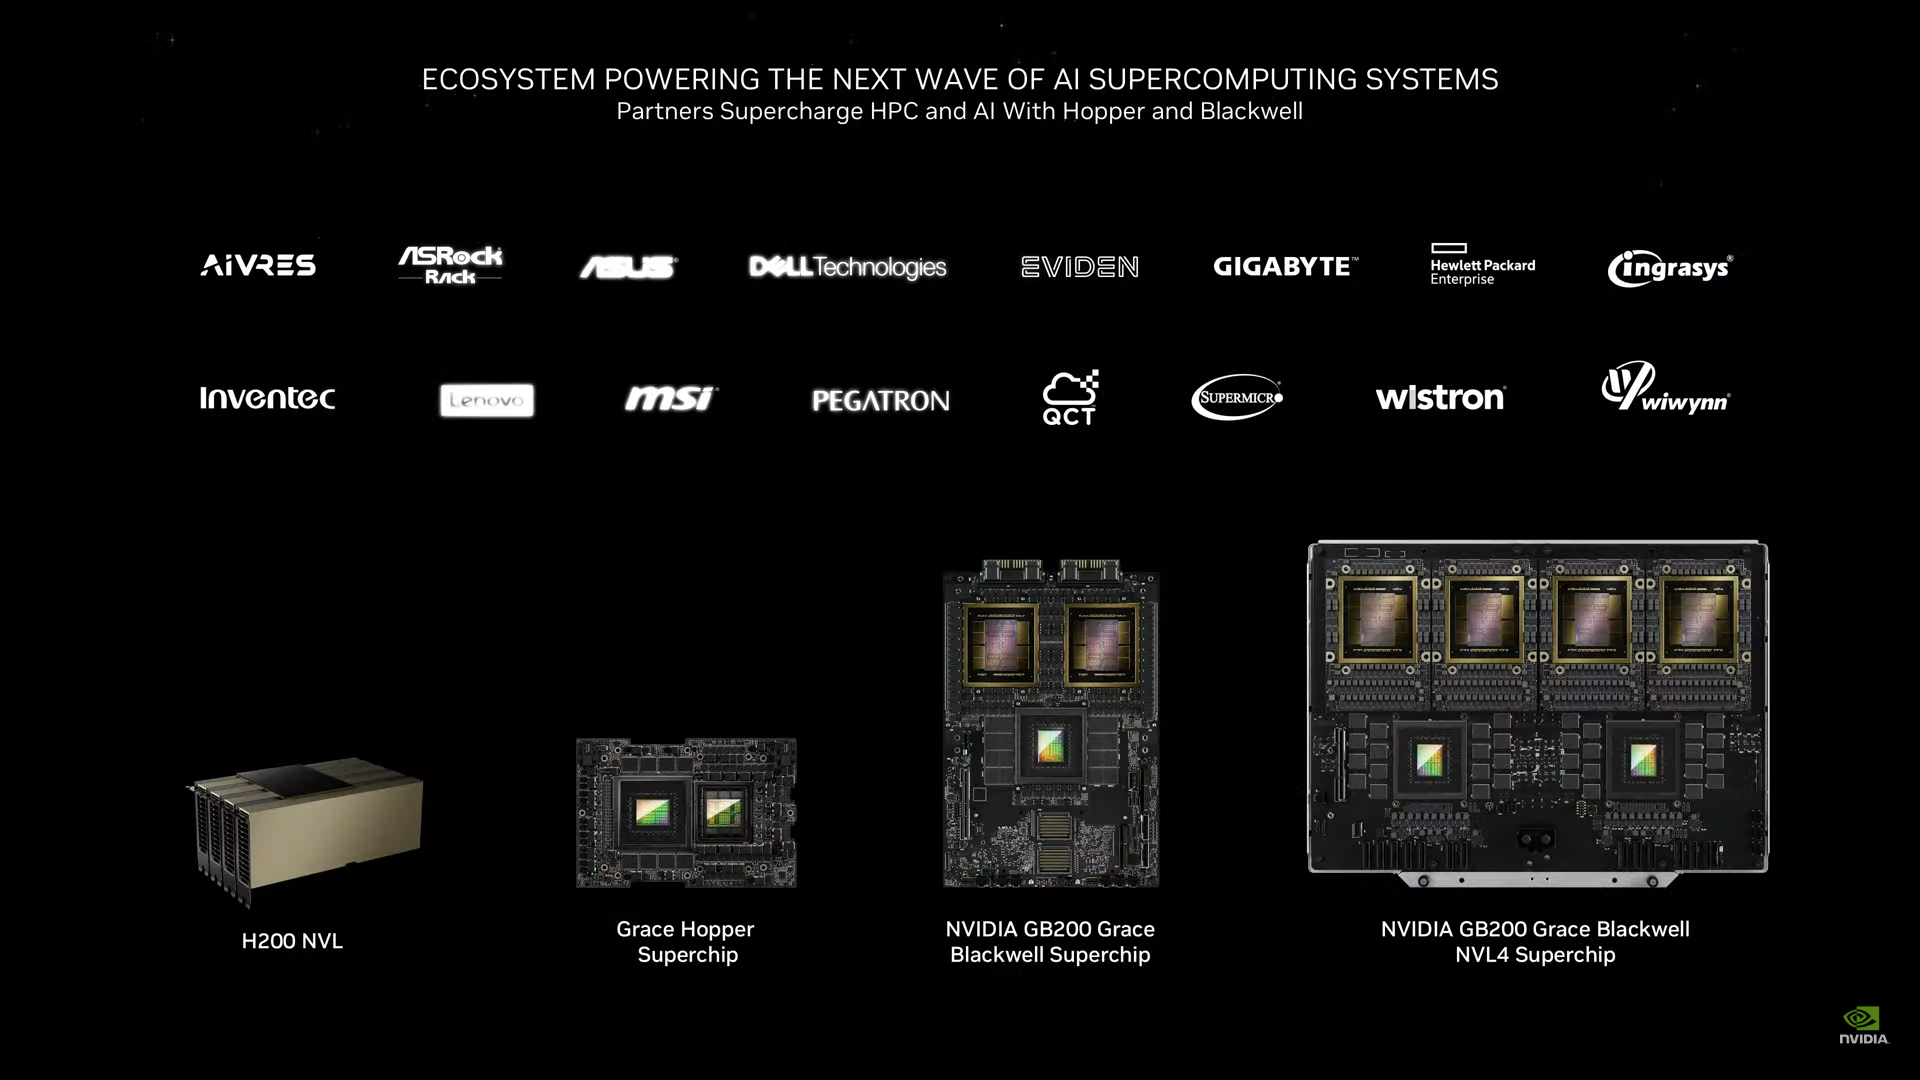
Источник изображения: NVIDIA Система GB200 NVL4 наделена двумя коннекторами M.2 22110/2280 для SSD с интерфейсом PCIe 5.0, восемью слотами для NVMe-накопителей E1.S (PCIe 5.0), шестью интерфейсами для карт FHFL PCIe 5.0 x16, портом USB, сетевым разъёмом RJ45 (IPMI) и интерфейсом Mini-DisplayPort. Устройство выполнено в форм-факторе 2U с размерами 440 × 88 × 900 мм, а его масса составляет 45 кг. TDP настраиваемый — от 2,75 кВт до 5,5 кВт.
28.11.2023 [22:20], Игорь Осколков
NVIDIA анонсировала суперускоритель GH200 NVL32 и очередной самый мощный в мире ИИ-суперкомпьютер Project CeibaAWS и NVIDIA анонсировали сразу несколько новых совместно разработанных решений для генеративного ИИ. Основным анонсом формально является появление ИИ-облака DGX Cloud в инфраструктуре AWS, вот только облако это отличается от немногочисленных представленных ранее платформ DGX Cloud тем, что оно первом получило гибридные суперчипах GH200 (Grace Hoppper), причём в необычной конфигурации. 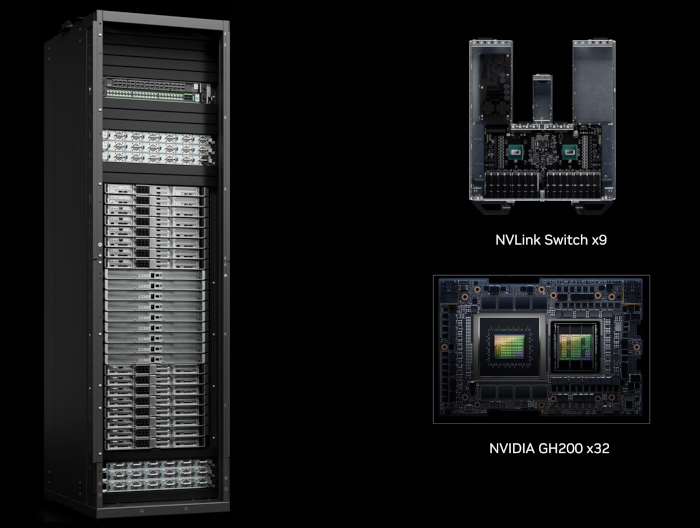
Изображения: NVIDIA В основе AWS DGX Cloud лежит платформа GH200 NVL32, но это уже не какой-нибудь сдвоенный акселератор вроде H100 NVL, а целая, готовая к развёртыванию стойка, включающая сразу 32 ускорителя GH200, провязанных 900-Гбайт/с интерконнектом NVLink. В состав такого суперускорителя входят 9 коммутаторов NVSwitch и 16 двухчиповых узлов с жидкостным охлаждением. По словам NVIDIA, GH200 NVL32 идеально подходит как для обучения, так и для инференса действительно больших LLM с 1 трлн параметров. 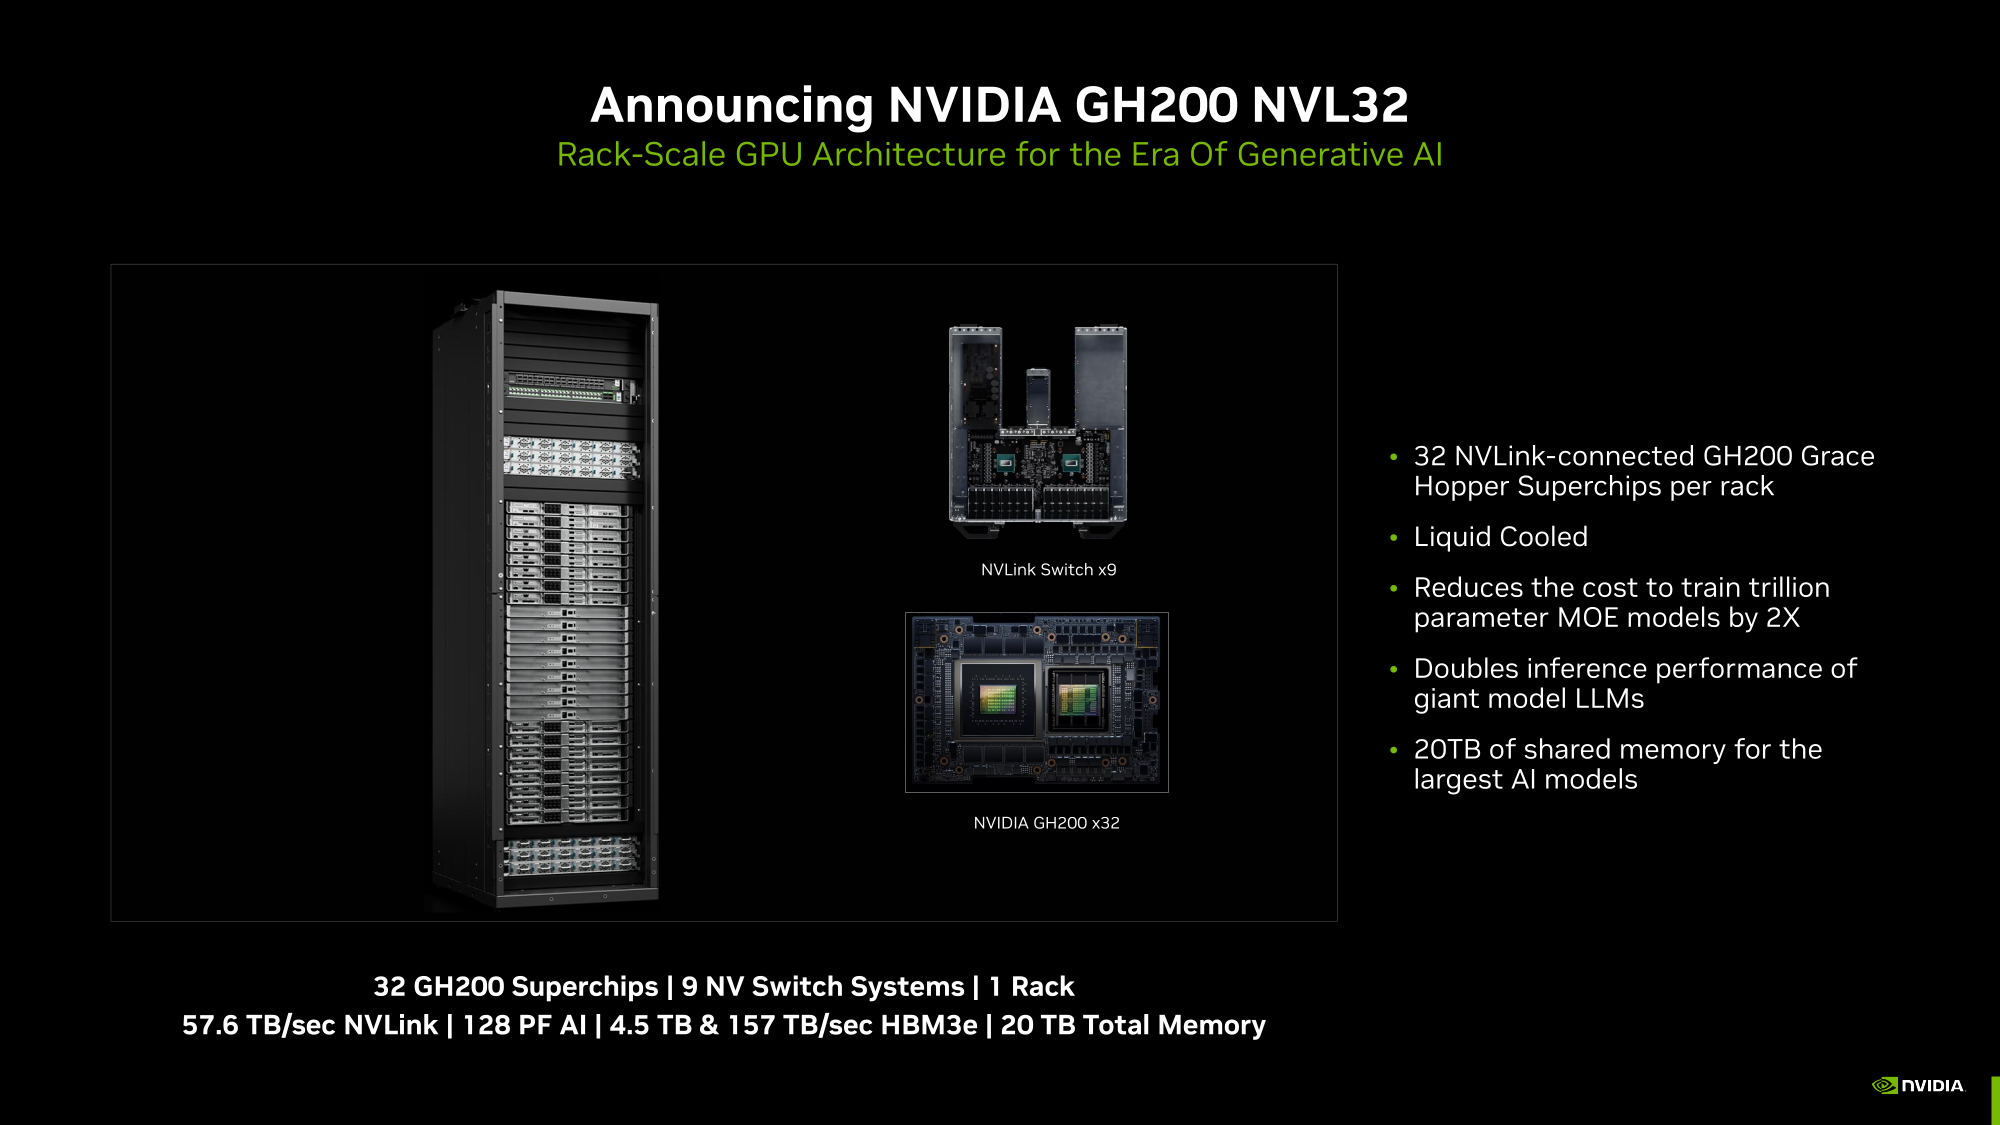 Простым перемножением количества GH200 на характеристики каждого ускорителя получаются впечатляющие показатели: 128 Пфлопс (FP8), 20 Тбайт оперативной памяти, из которых 4,5 Тбайт приходится на HBM3e с суммарной ПСП 157 Тбайтс, и агрегированная скорость NVLink 57,6 Тбайт/с. И всё это с составе одного EC2-инстанса! Да, новая платформа использует фирменные DPU AWS Nitro и EFA-подключение (400 Гбит/с на каждый GH200). Новые инстансы, пока что безымянные, можно объединять в кластеры EC2 UltraClasters. 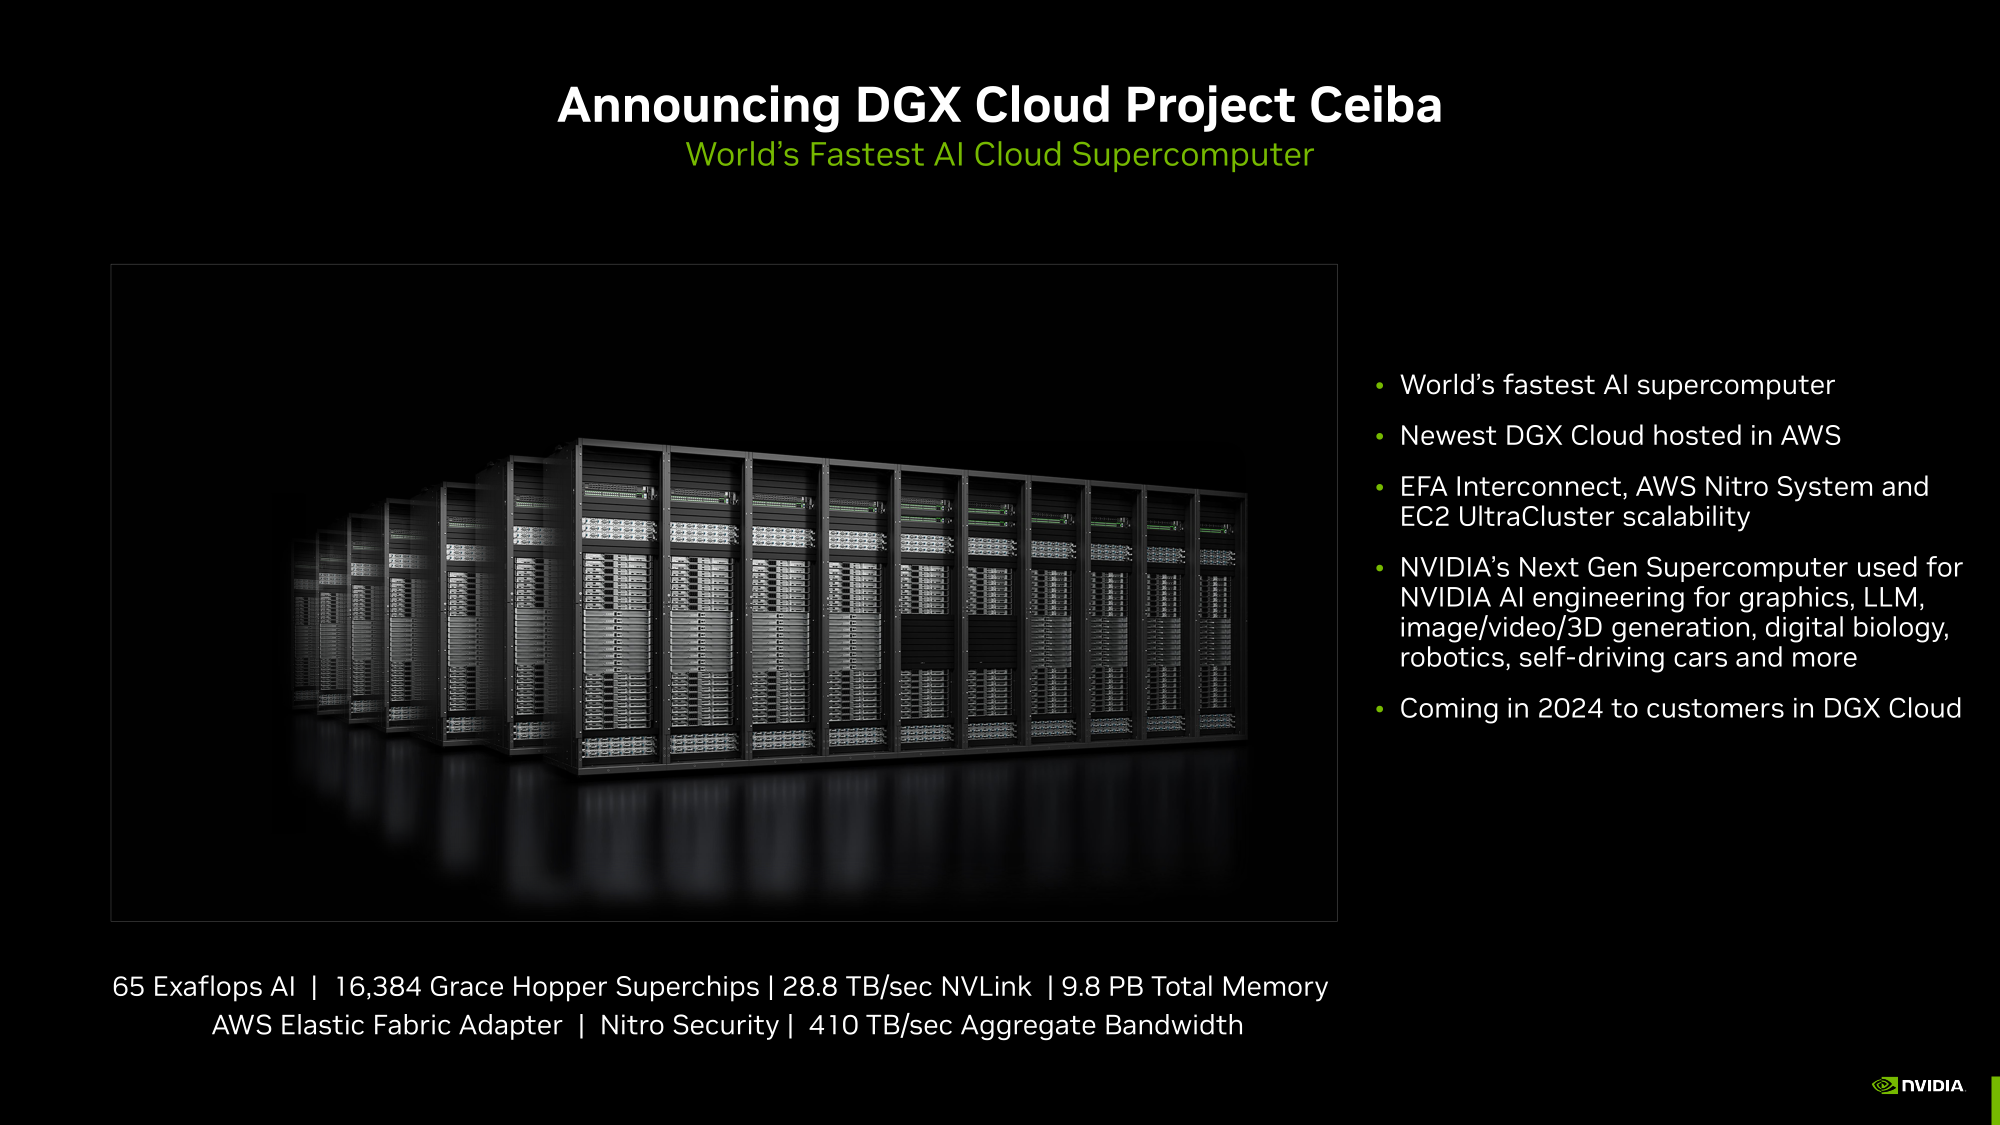 Одним из таких кластеров станет Project Ceiba, очередной самый мощный в мире ИИ-суперкомпьютер с FP8-производительность 65 Эфлопс, объединяющий сразу 16 384 ускорителя GH200 и имеющий 9,1 Пбайт памяти, а также агрегированную пропускную способность интерконнекта на уровне 410 Тбайт/с (28,8 Тбайт/с NVLink). Он и станет частью облака AWS DGX Cloud, которое будет доступно в начале 2024 года. В скором времени появятся и EC2-инстансы попроще: P5e с NVIDIA H200, G6e с L40S и G6 с L4. 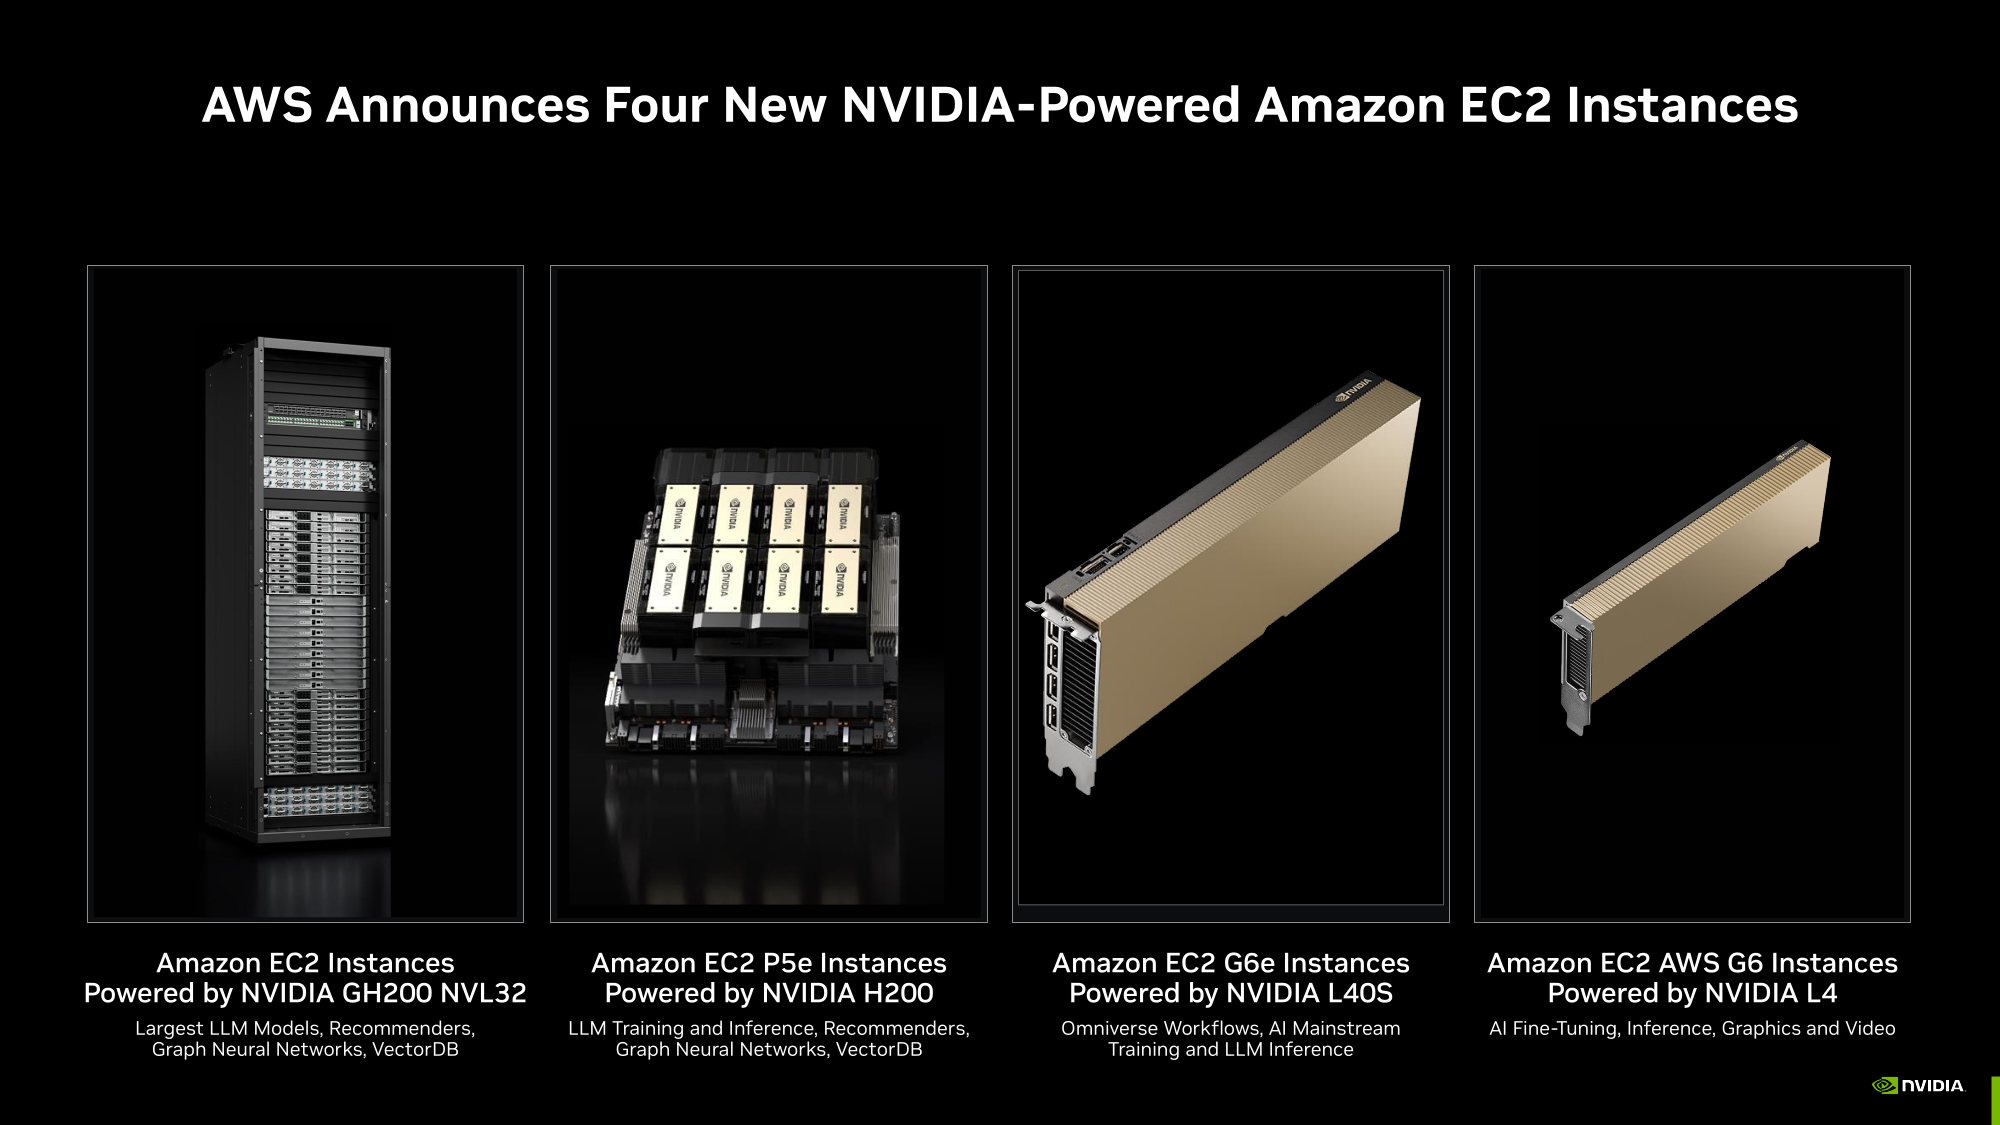
13.11.2023 [17:00], Игорь Осколков
NVIDIA анонсировала ускорители H200 и «фантастическую четвёрку» Quad GH200NVIDIA анонсировала ускорители H200 на базе всё той же архитектуры Hopper, что и их предшественники H100, представленные более полутора лет назад. Новый H200, по словам компании, первый в мире ускоритель, использующий память HBM3e. Вытеснит ли он H100 или останется промежуточным звеном эволюции решений NVIDIA, покажет время — H200 станет доступен во II квартале следующего года, но также в 2024-м должно появиться новое поколение ускорителей B100, которые будут производительнее H100 и H200. 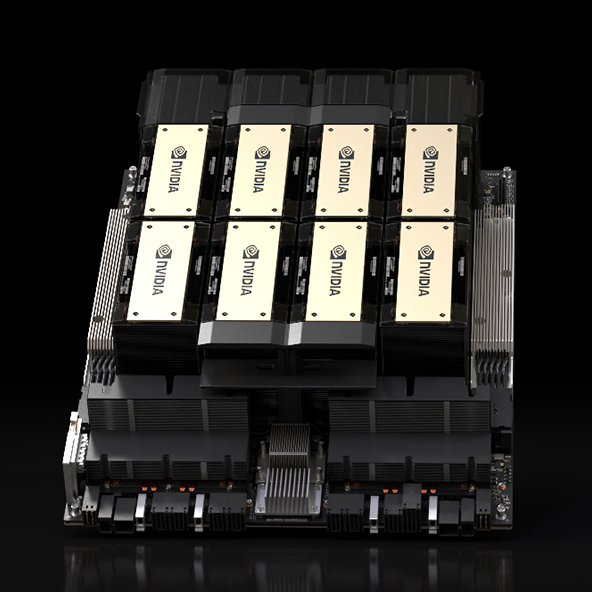
HGX H200 (Источник здесь и далее: NVIDIA) H200 получил 141 Гбайт памяти HBM3e с суммарной пропускной способностью 4,8 Тбайт/с. У H100 было 80 Гбайт HBM3, а ПСП составляла 3,35 Тбайт/с. Гибридные ускорители GH200, в состав которых входит H200, получат до 480 Гбайт LPDDR5x (512 Гбайт/с) и 144 Гбайт HBM3e (4,9 Тбайт/с). Впрочем, с GH200 есть некоторая неразбериха, поскольку в одном месте NVIDIA говорит о 141 Гбайт, а в другом — о 144 Гбайт HBM3e. Обновлённая версия GH200 станет массово доступна после выхода H200, а пока что NVIDIA будет поставлять оригинальный 96-Гбайт вариант с HBM3. Напомним, что грядущие конкурирующие AMD Instinct MI300X получат 192 Гбайт памяти HBM3 с ПСП 5,2 Тбайт/с. 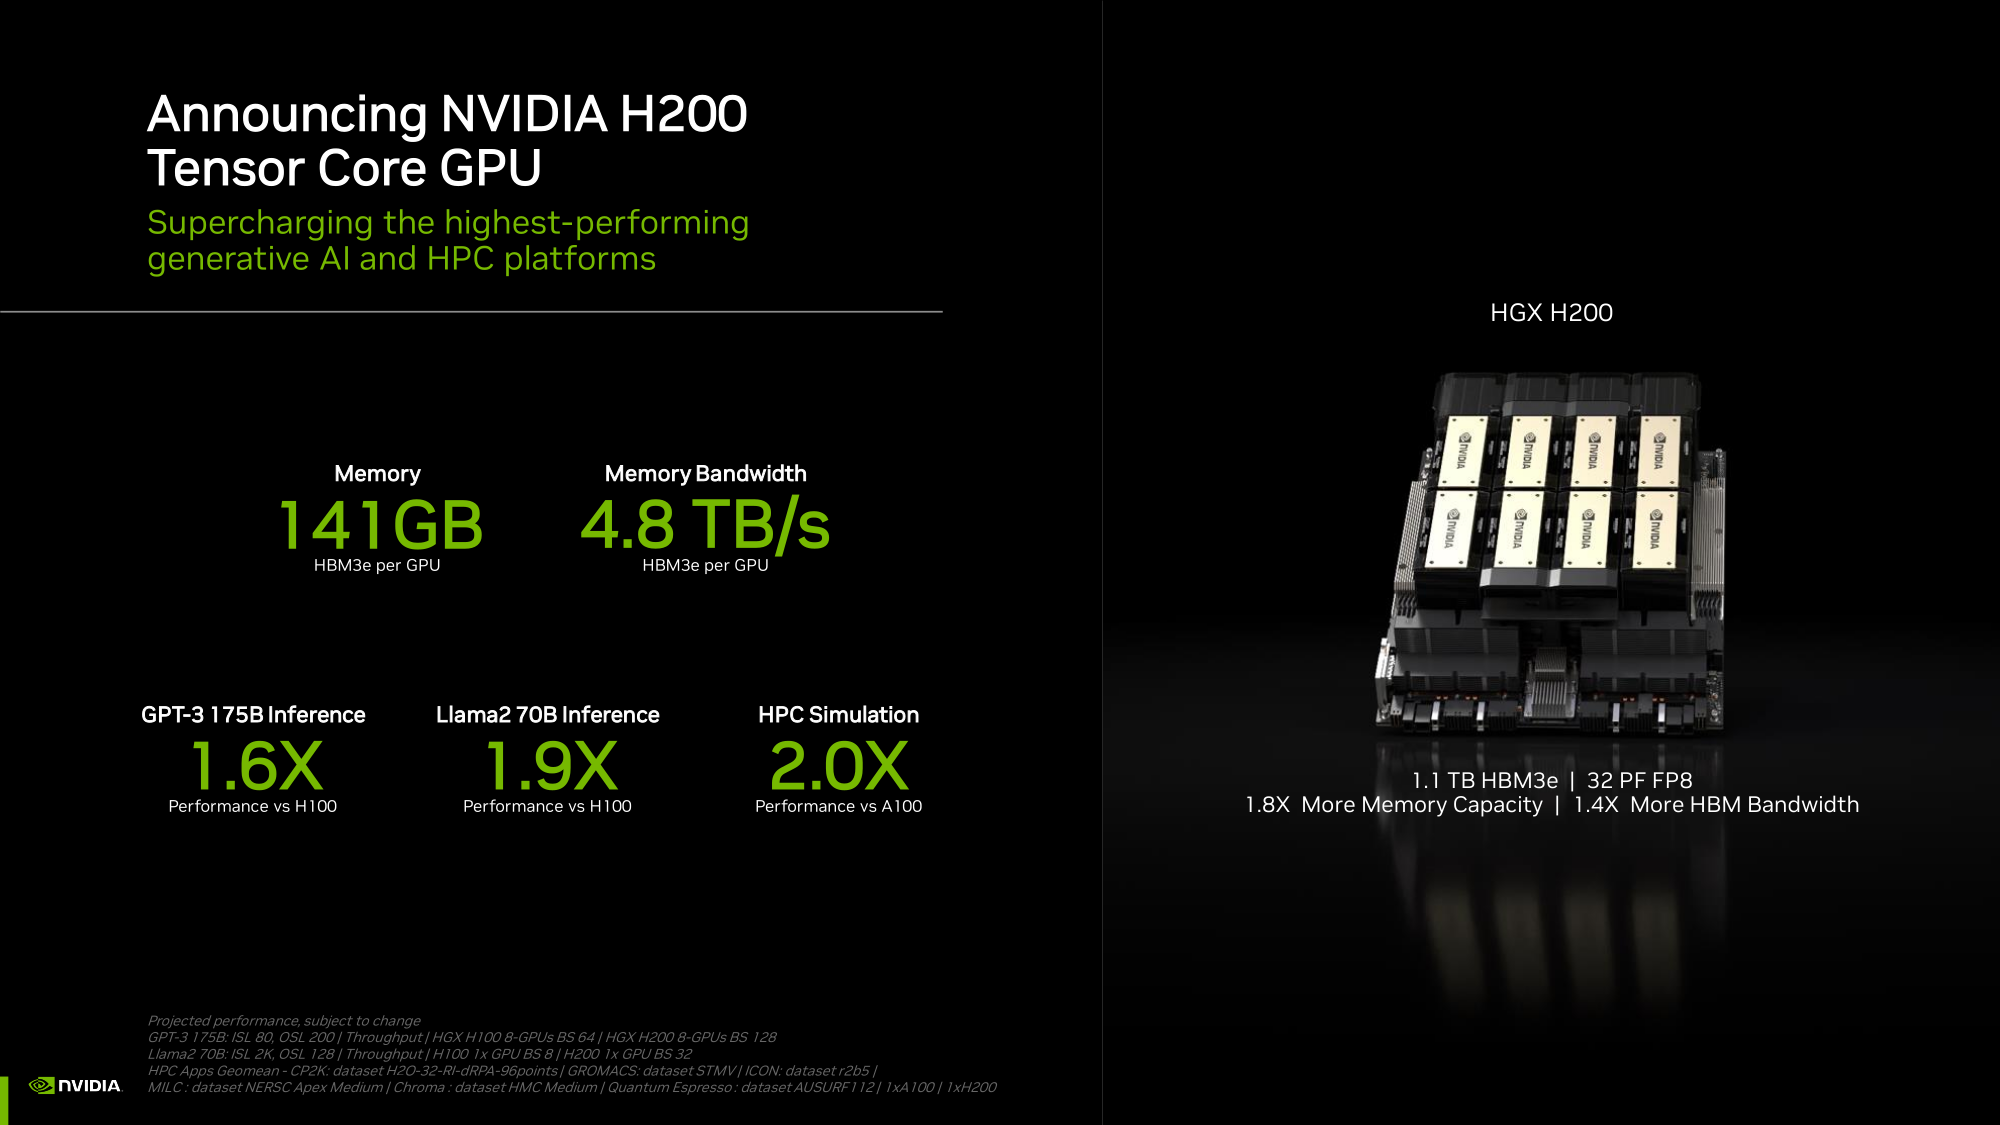 На момент написания материала NVIDIA не раскрыла полные характеристики H200, но судя по всему, вычислительная часть H200 осталась такой же или почти такой же, как у H100. NVIDIA приводит FP8-производительность HGX-платформы с восемью ускорителями (есть и вариант с четырьмя), которая составляет 32 Пфлопс. То есть на каждый H200 приходится 4 Пфлопс, ровно столько же выдавал и H100. Тем не менее, польза от более быстрой и ёмкой памяти есть — в задачах инференса можно получить прирост в 1,6–1,9 раза. 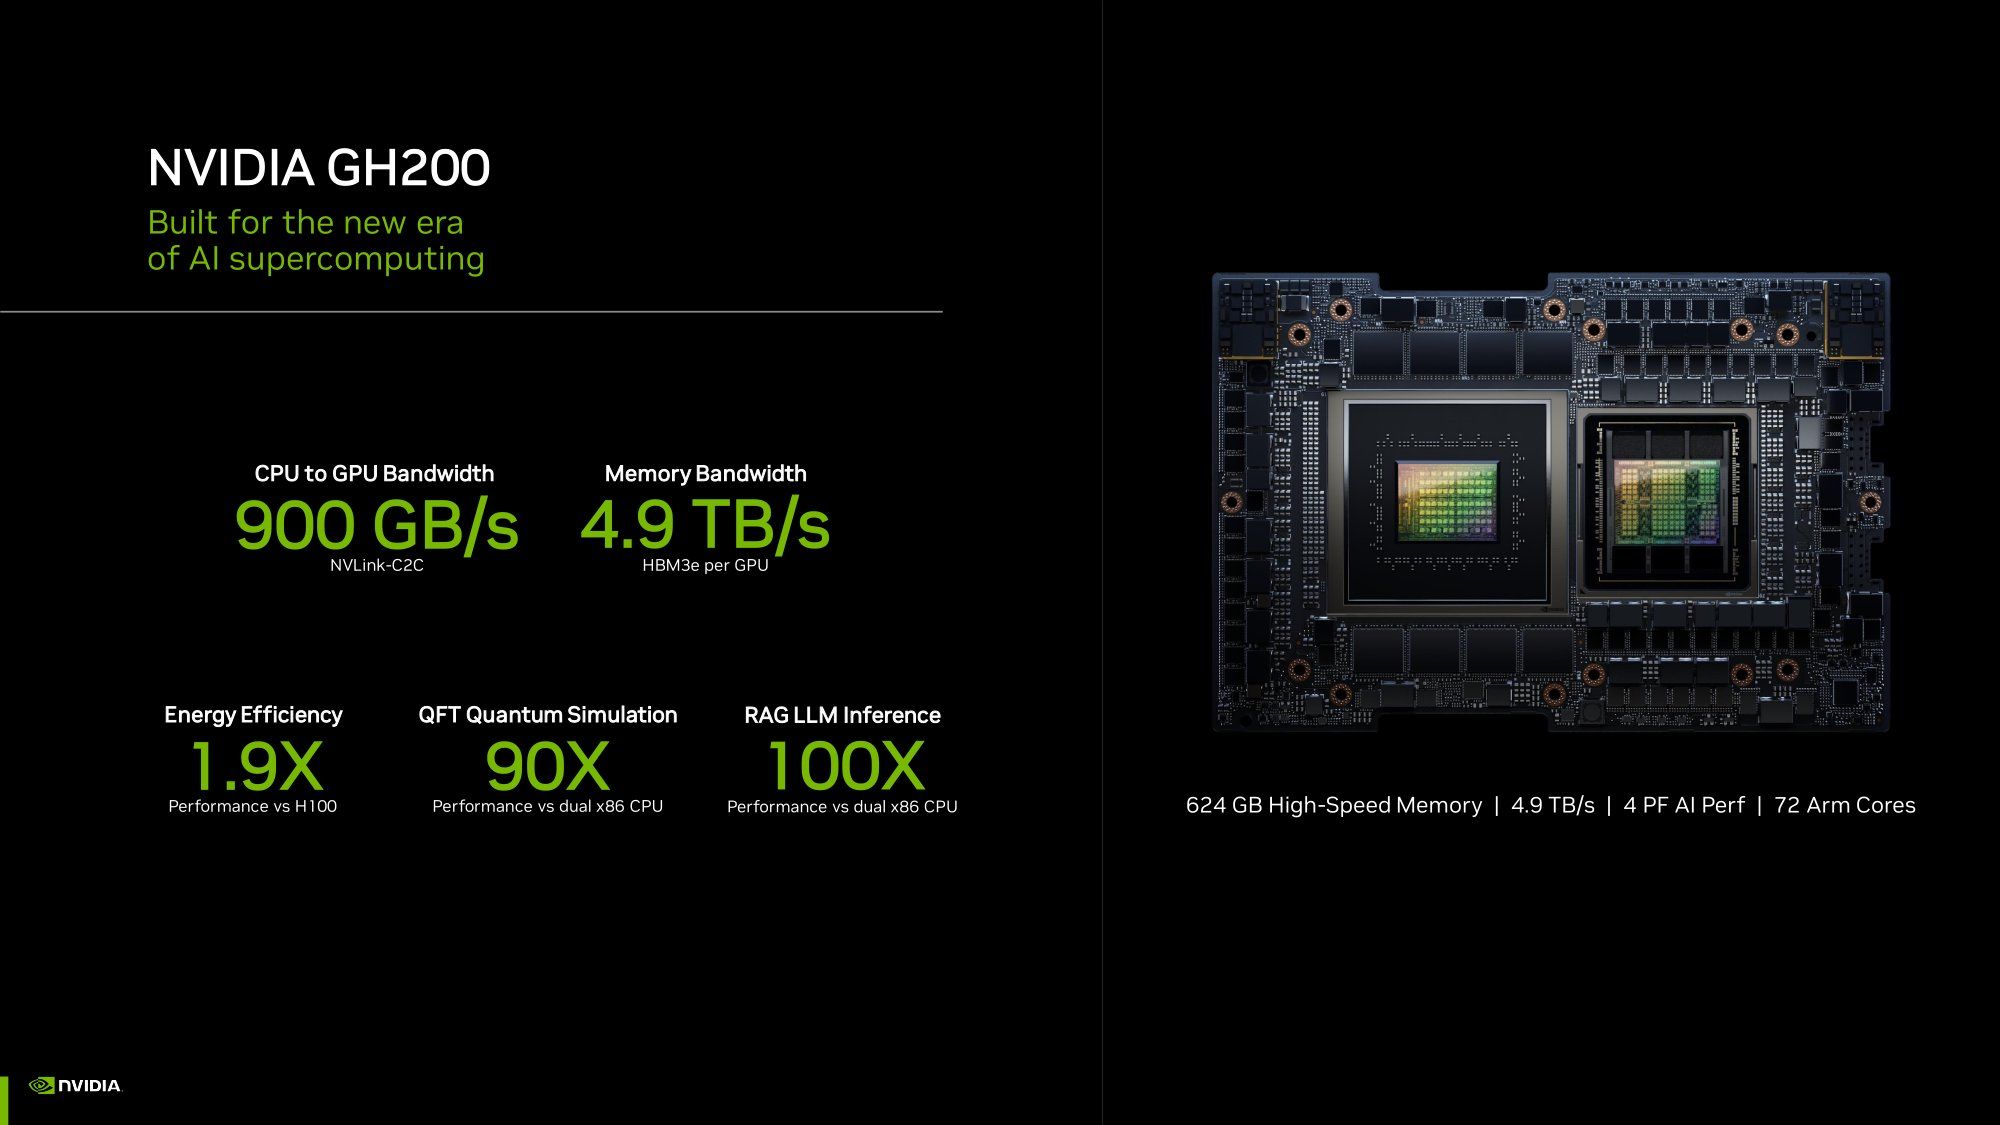 При этом платы HGX H200 полностью совместимы с уже имеющимися на рынке платформами HGX H100 как механически, так и с точки зрения питания и теплоотвода. Это позволит очень быстро обновить предложения партнёрам компании: ASRock Rack, ASUS, Dell, Eviden, GIGABYTE, HPE, Lenovo, QCT, Supermicro, Wistron и Wiwynn. H200 также станут доступны в облаках. Первыми их получат AWS, Google Cloud Platform, Oracle Cloud, CoreWeave, Lambda и Vultr. Примечательно, что в списке нет Microsoft Azure, которая, похоже, уже страдает от недостатка H100. 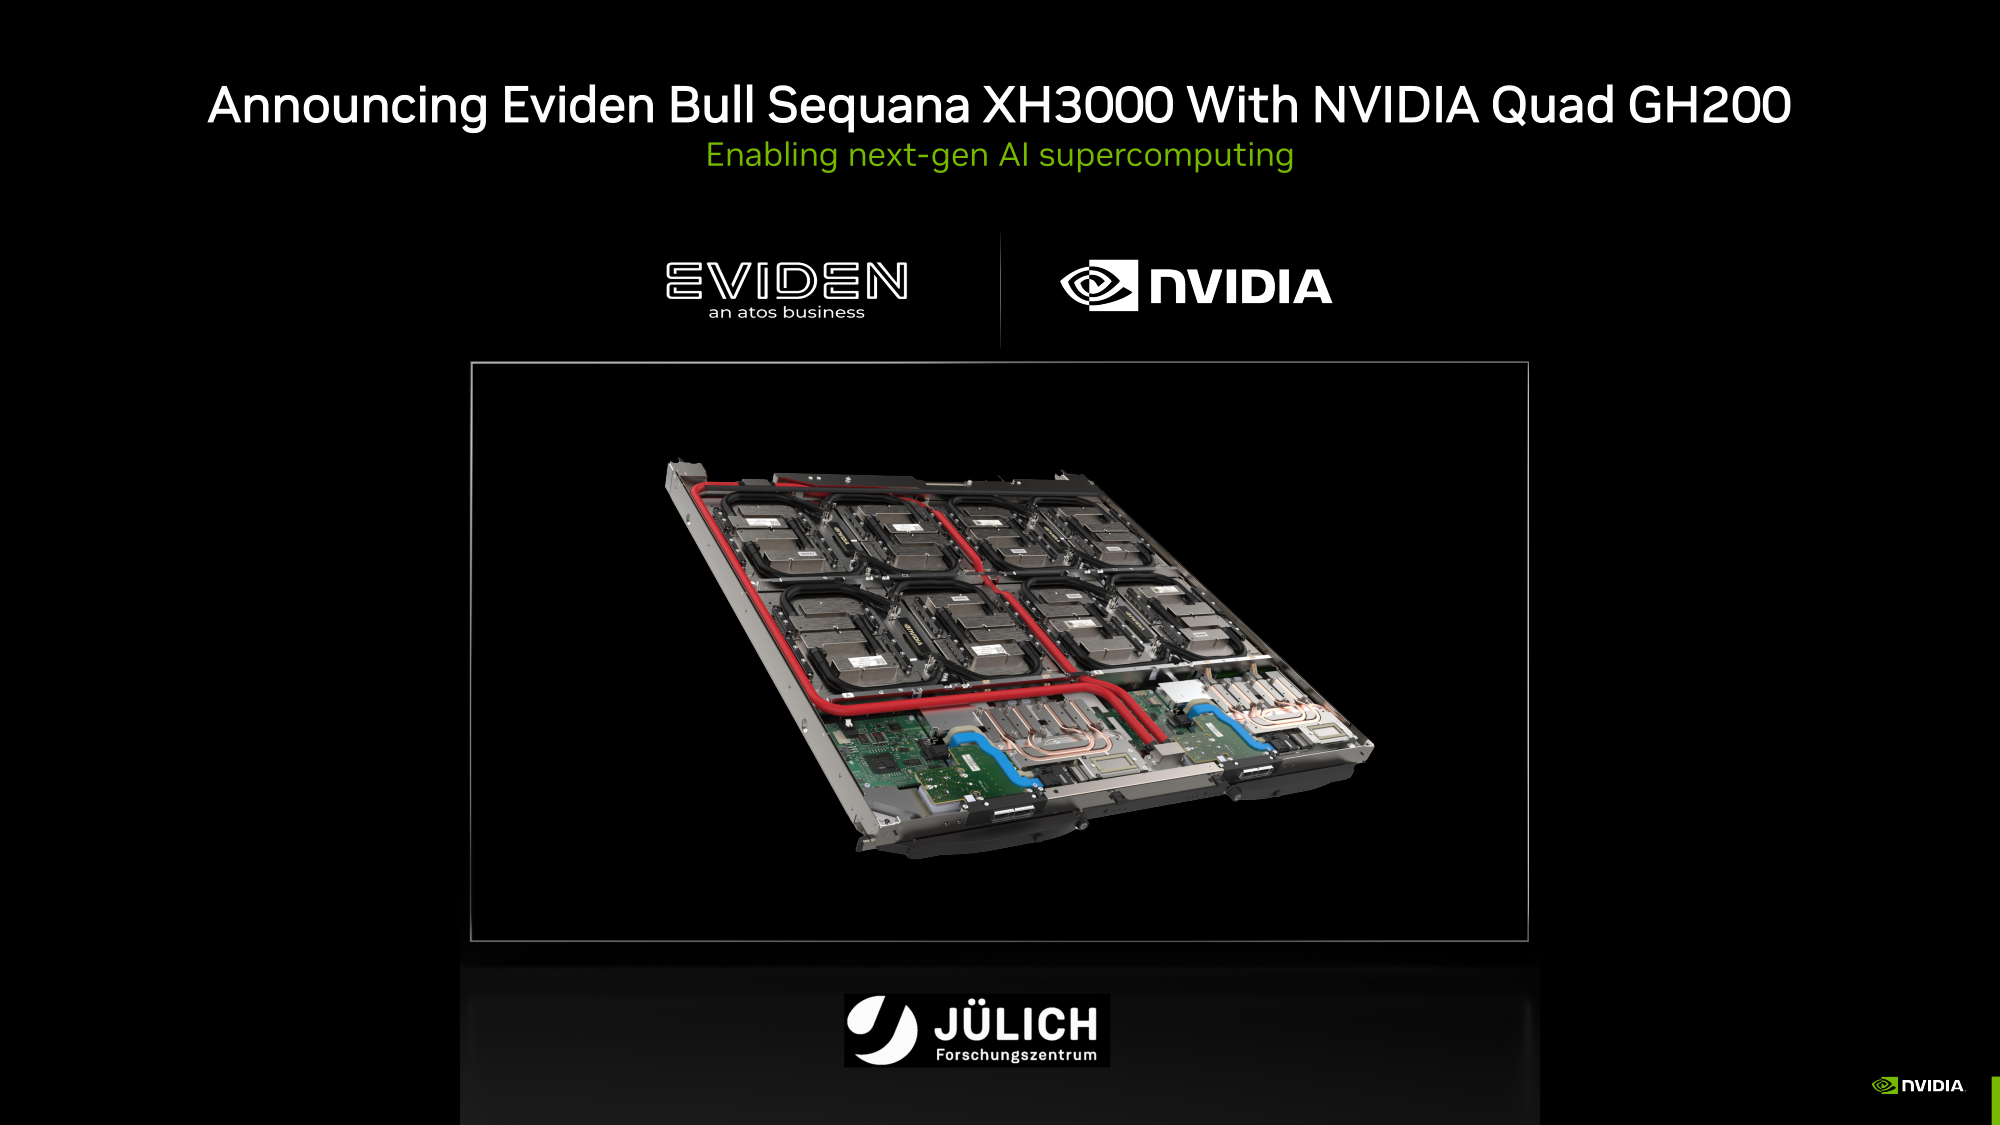 GH200 уже доступны избранным в облаках Lamba Labs и Vultr, а в начале 2024 года они появятся у CoreWeave. До конца этого года поставки серверов с GH200 начнут ASRock Rack, ASUS, GIGABYTE и Ingrasys. В скором времени эти чипы также появятся в сервисе NVIDIA Launchpad, а вот про доступность там H200 компания пока ничего не говорит. 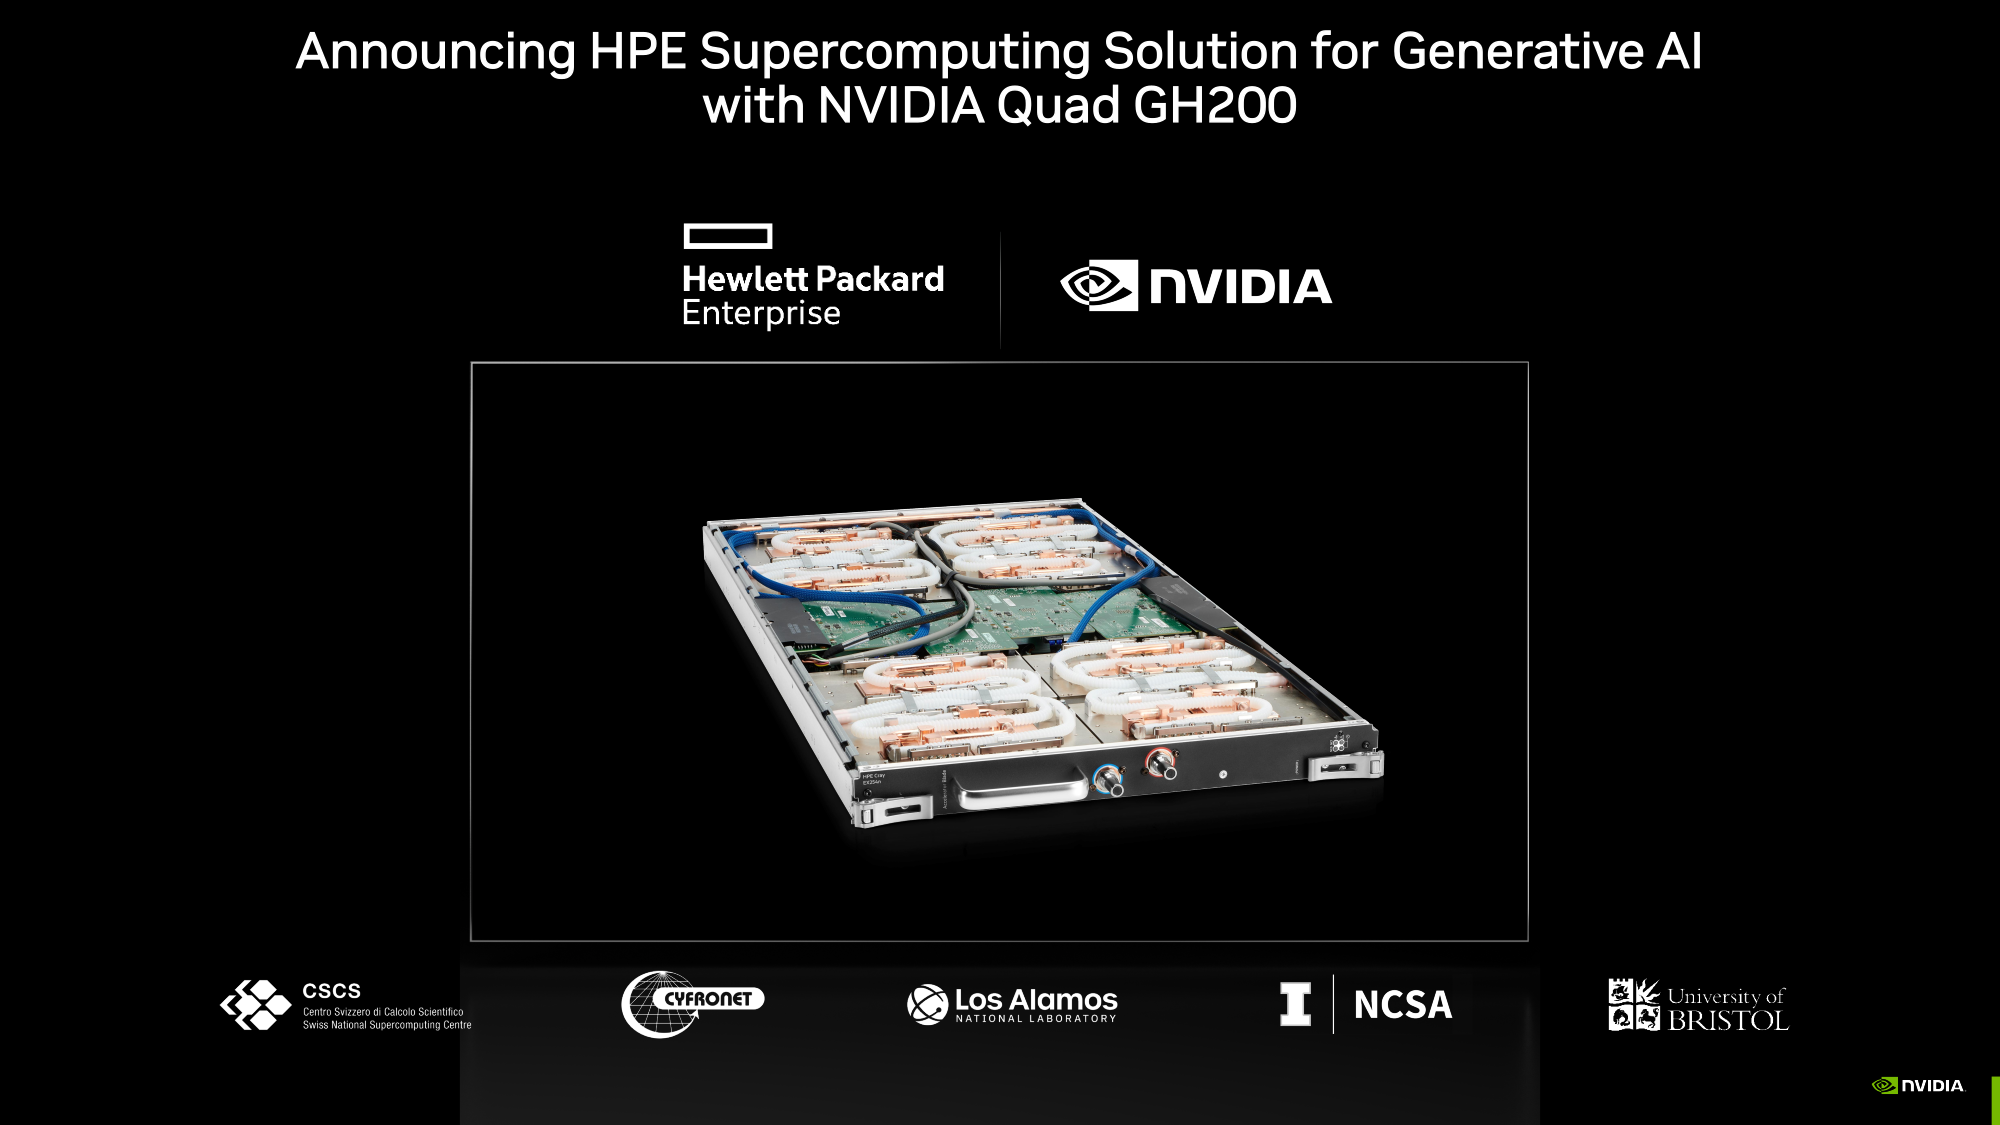 Одновременно NVIDIA представила и базовый «строительный блок» для суперкомпьютеров ближайшего будущего — плату Quad GH200 с четырьмя чипами GH200, где все ускорители связаны друг с другом посредством NVLink по схеме каждый-с-каждым. Суммарно плата несёт более 2 Тбайт памяти, 288 Arm-ядер и имеет FP8-производительность 16 Пфлопс. На базе Quad GH200 созданы узлы HPE Cray EX254n и Eviden Bull Sequana XH3000. До конца 2024 года суммарная ИИ-производительность систем с GH200, по оценкам NVIDIA, достигнет 200 Эфлопс.
29.05.2023 [07:30], Сергей Карасёв
NVIDIA представила 1-Эфлопс ИИ-суперкомпьютер DGX GH200: 256 суперчипов Grace Hopper и 144 Тбайт памятиКомпания NVIDIA анонсировала вычислительную платформу нового типа DGX GH200 AI Supercomputer для генеративного ИИ, обработки огромных массивов данных и рекомендательных систем. HPC-платформа станет доступна корпоративным заказчикам и организациям в конце 2023 года. Платформа представляет собой готовый ПАК и включает, в частности, наборы ПО NVIDIA AI Enterprise и Base Command. Для платформы предусмотрено использование 256 суперчипов NVIDIA GH200 Grace Hopper, объединённых при помощи NVLink Switch System. Каждый суперчип содержит в одном модуле Arm-процессор NVIDIA Grace и ускоритель NVIDIA H100. Задействован интерконнект NVLink-C2C (Chip-to-Chip), который, как заявляет NVIDIA, значительно быстрее и энергоэффективнее, нежели PCIe 5.0. В результате, скорость обмена данными между CPU и GPU возрастает семикратно, а затраты энергии сокращаются примерно в пять раз. Пропускная способность достигает 900 Гбайт/с. 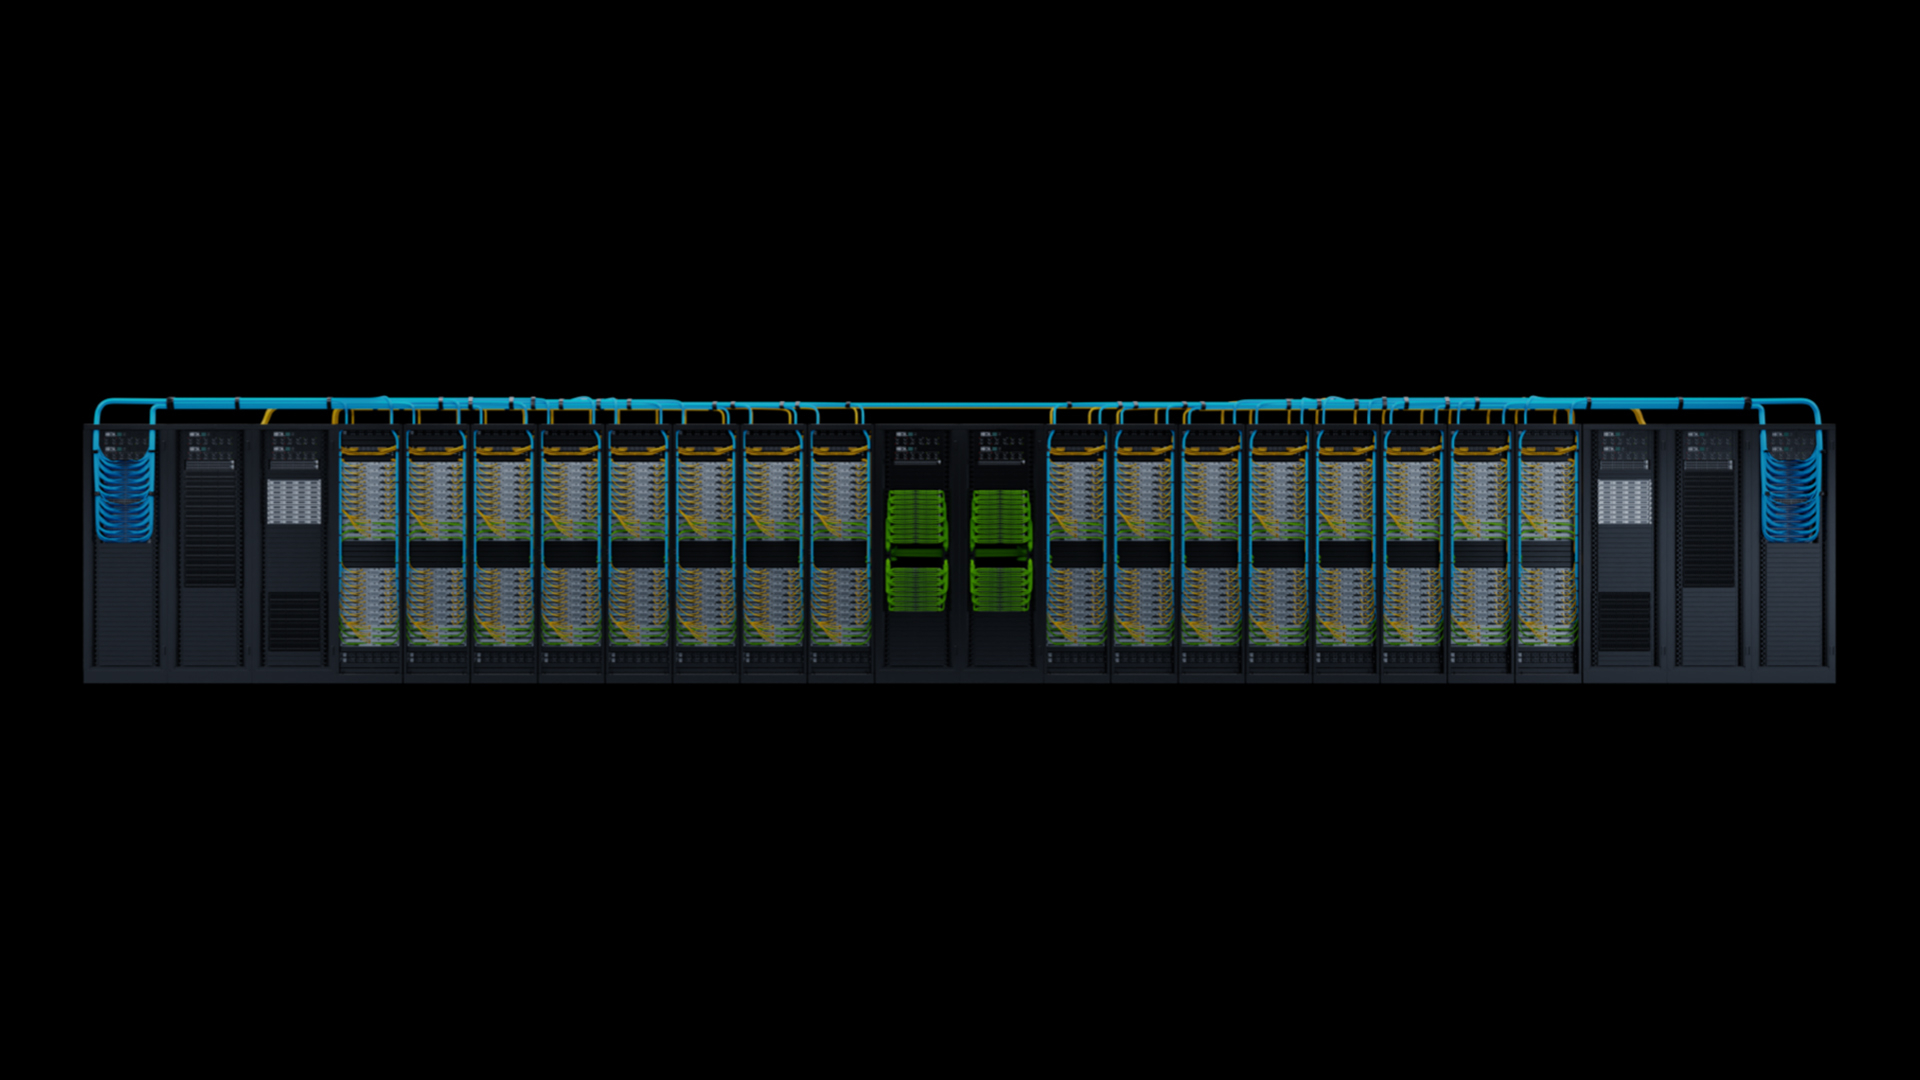
Источник изображений: NVIDIA Технология NVLink Switch позволяет всем ускорителям в составе системы функционировать в качестве единого целого. Таким образом обеспечивается производительность на уровне 1 Эфлопс (~ 9 Пфлопс FP64), а суммарный объём памяти достигает 144 Тбайт — это почти в 500 раз больше, чем в одной системе NVIDIA DGX A100. Архитектура DGX GH200 AI Supercomputer позволяет добиться 10-кратного увеличения общей пропускной способности по сравнению с HPC-платформой предыдущего поколения. 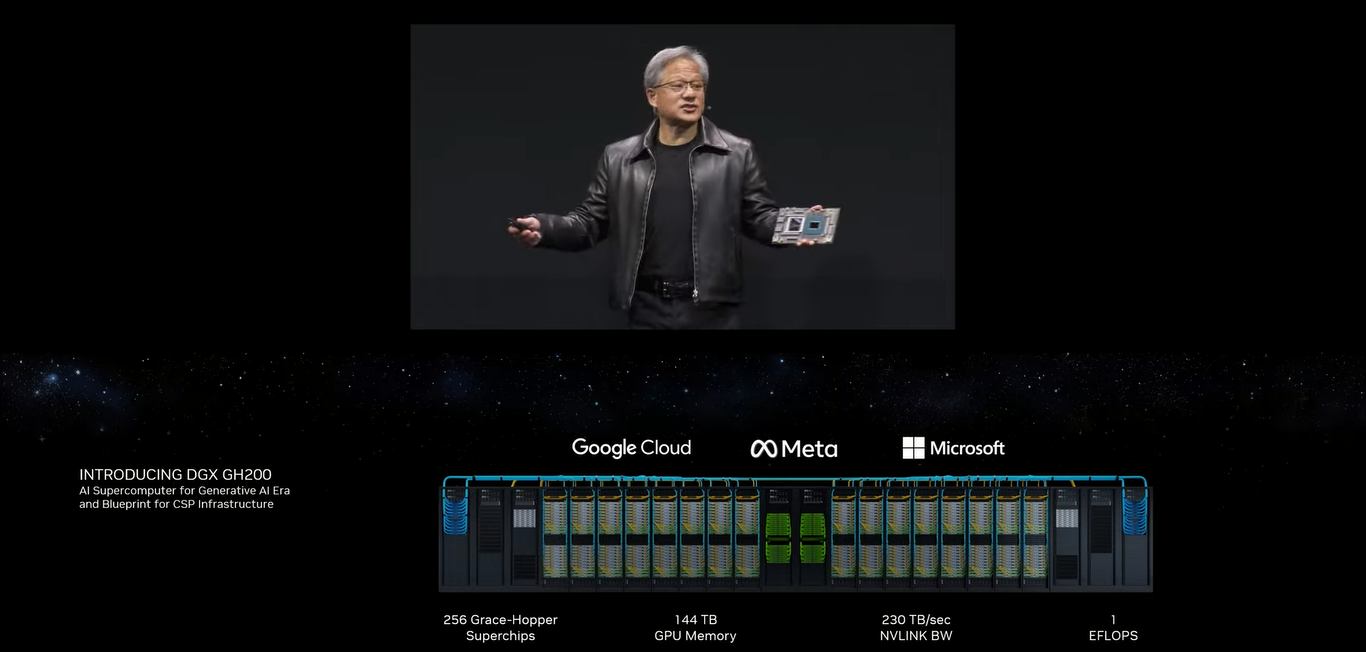 Ожидается, что Google Cloud, Meta✴ и Microsoft одними из первых получат доступ к суперкомпьютеру DGX GH200, чтобы оценить его возможности для генеративных рабочих нагрузок ИИ. В перспективе собственные проекты на базе DGX GH200 смогут реализовывать крупнейшие провайдеры облачных услуг и гиперскейлеры. Для собственных нужд NVIDIA до конца 2023 года построит суперкомпьютер Helios, который посредством Quantum-2 InfiniBand объединит сразу четыре DGX GH200. |
|

