Материалы по тегу: интерконнект
|
27.08.2026 [09:25], Владимир Мироненко
MTIA 300: первый ИИ-чип Meta✴ со встроенными 800GbE-адаптерами и механизмами разгрузки коммуникацийMeta✴ сообщила новые подробности о 667-Вт ИИ-ускорителе MTIA 300 — своём первом чипе, оптимизированном для обучения DLRM-моделей. В отличие от LLM, требующих огромной пропускной способности вычислений с плавающей запятой, рекомендательные модели сталкиваются с проблемой необходимости быстрого и эффективного взаимодействия ускорителей в сочетании с большой ёмкостью памяти и высокой пропускной способностью интерконнекта. Их таблицы эмбеддингов могут содержать более 99 % параметров модели, что требует гибридного параллелизма, генерирующего частые коллективные операции AllReduce, AllToAll и AllGather на сотнях ускорителей. На таких чипах, как GPU, эти коммуникационные операции конкурируют с вычислениями за одни и те же ресурсы, часто приводя к неэффективному использованию дорогостоящего оборудования. Для решения этой проблемы разработчики, используя совместную разработку MTIA 300 с HCCL, библиотекой коммуникационных интерфейсов, созданной на основе разработанного с нуля оборудования, сделали коммуникацию первостепенной задачей в проектировании микросхем. На практике HCCL обеспечивает пропускную способность передачи данных до 940 Гбайт/с в пределах одной стойки. На модели со 150 млрд параметров, работающей на 40 ускорителях, общее время обмена данными при использовании MTIA 300 в 3,9 раза меньше, чем у эквивалентного кластера на базе GPU. 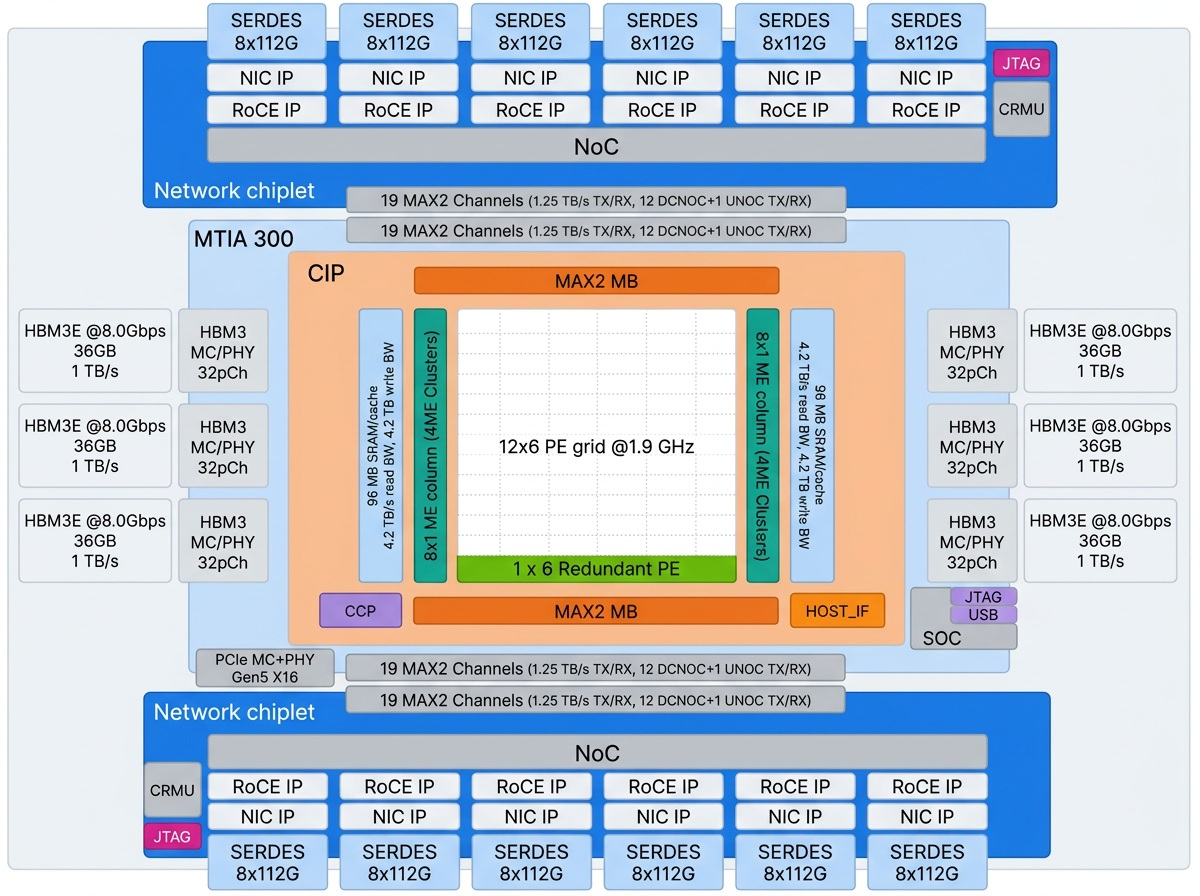
Источник изображения: Meta✴ В MTIA 300 сетевой интерфейс находится внутри самой упаковки микросхемы. Два 5-нм сетевых чиплета, каждый из которых содержит по шесть специализированных 800GbE RoCE-адаптеров, обеспечивают общую пропускную способность I/O 1,2 Тбайт/с без пересечения c шиной PCIe. Это устраняет узкое место в цепочке «хост-устройство-NIC», присутствующей в традиционных архитектурах GPU, где CPU должен выступать посредником между ускорителем и сетью, и позволяет избежать перегрузки PCIe между ускорителем и NIC. При этом NIC можно гибко использовать для масштабирования. Поскольку используются одни и те же 12 NIC на базе Ethernet для вертикального масштабирования (внутри стойки из 16 узлов, до 1 Тбайт/с) и горизонтального масштабирования (между стойками, до 200 Гбайт/с), можно гибко распределять NIC в соответствии с меняющимися потребностями. По мере изменения требований модели можно переконфигурировать сеть, а не само оборудование. Для минимизации задержки транзакций разработчики внедрили экспресс-оповещения (doorbell). Сама запись запроса на выполнение служит оповещением, исключая дополнительное чтение из памяти и экономя около 800 нс на операцию. 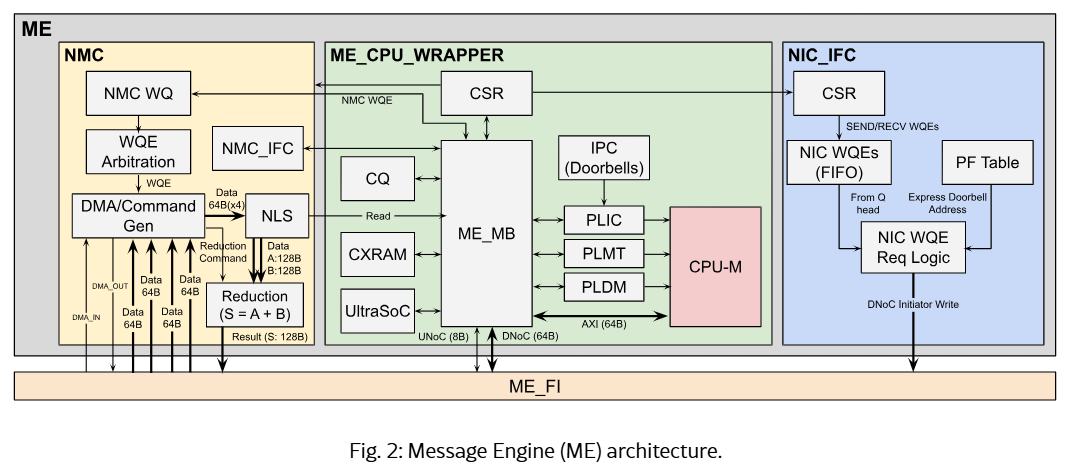
Источник изображения: Meta✴ В случае GPU библиотеки вроде NCCL реализуют операции коллективных коммуникаций в виде вычислительных ядер (kernel), которые используют те же ресурсы, что нужны для вычислений при обучении. Пересечение коллективных операций и операций обучения приводит к замедлению обоих и того, и другого. В MTIA 300 использовали другой подход. Наряду с матрицей из 72 3-нм вычислительных элементов (PE), чип включает 16 выделенных механизмов обработки сообщений (ME), которые обрабатывают всю коммуникацию независимо. ME содержит ядро RISC-V для оркестрации; сетевой интерфейс, который направляет запросы к нужному NIC; вычислительный блок Near-Memory Computing (NMC), который выполняет операции редукции со скоростью 128 байт/цикл. Расположенные по краям чипа, рядом с HBM и кешем, NMC в совокупности обеспечивают пропускную способность редукции более 2,8 Тбайт/с — более чем вдвое превышающую пропускную способность I/O. Это позволяет выполнять коллективные операции AllReduce и ReduceScatter на линейной скорости NIC без использования ресурсов PE. 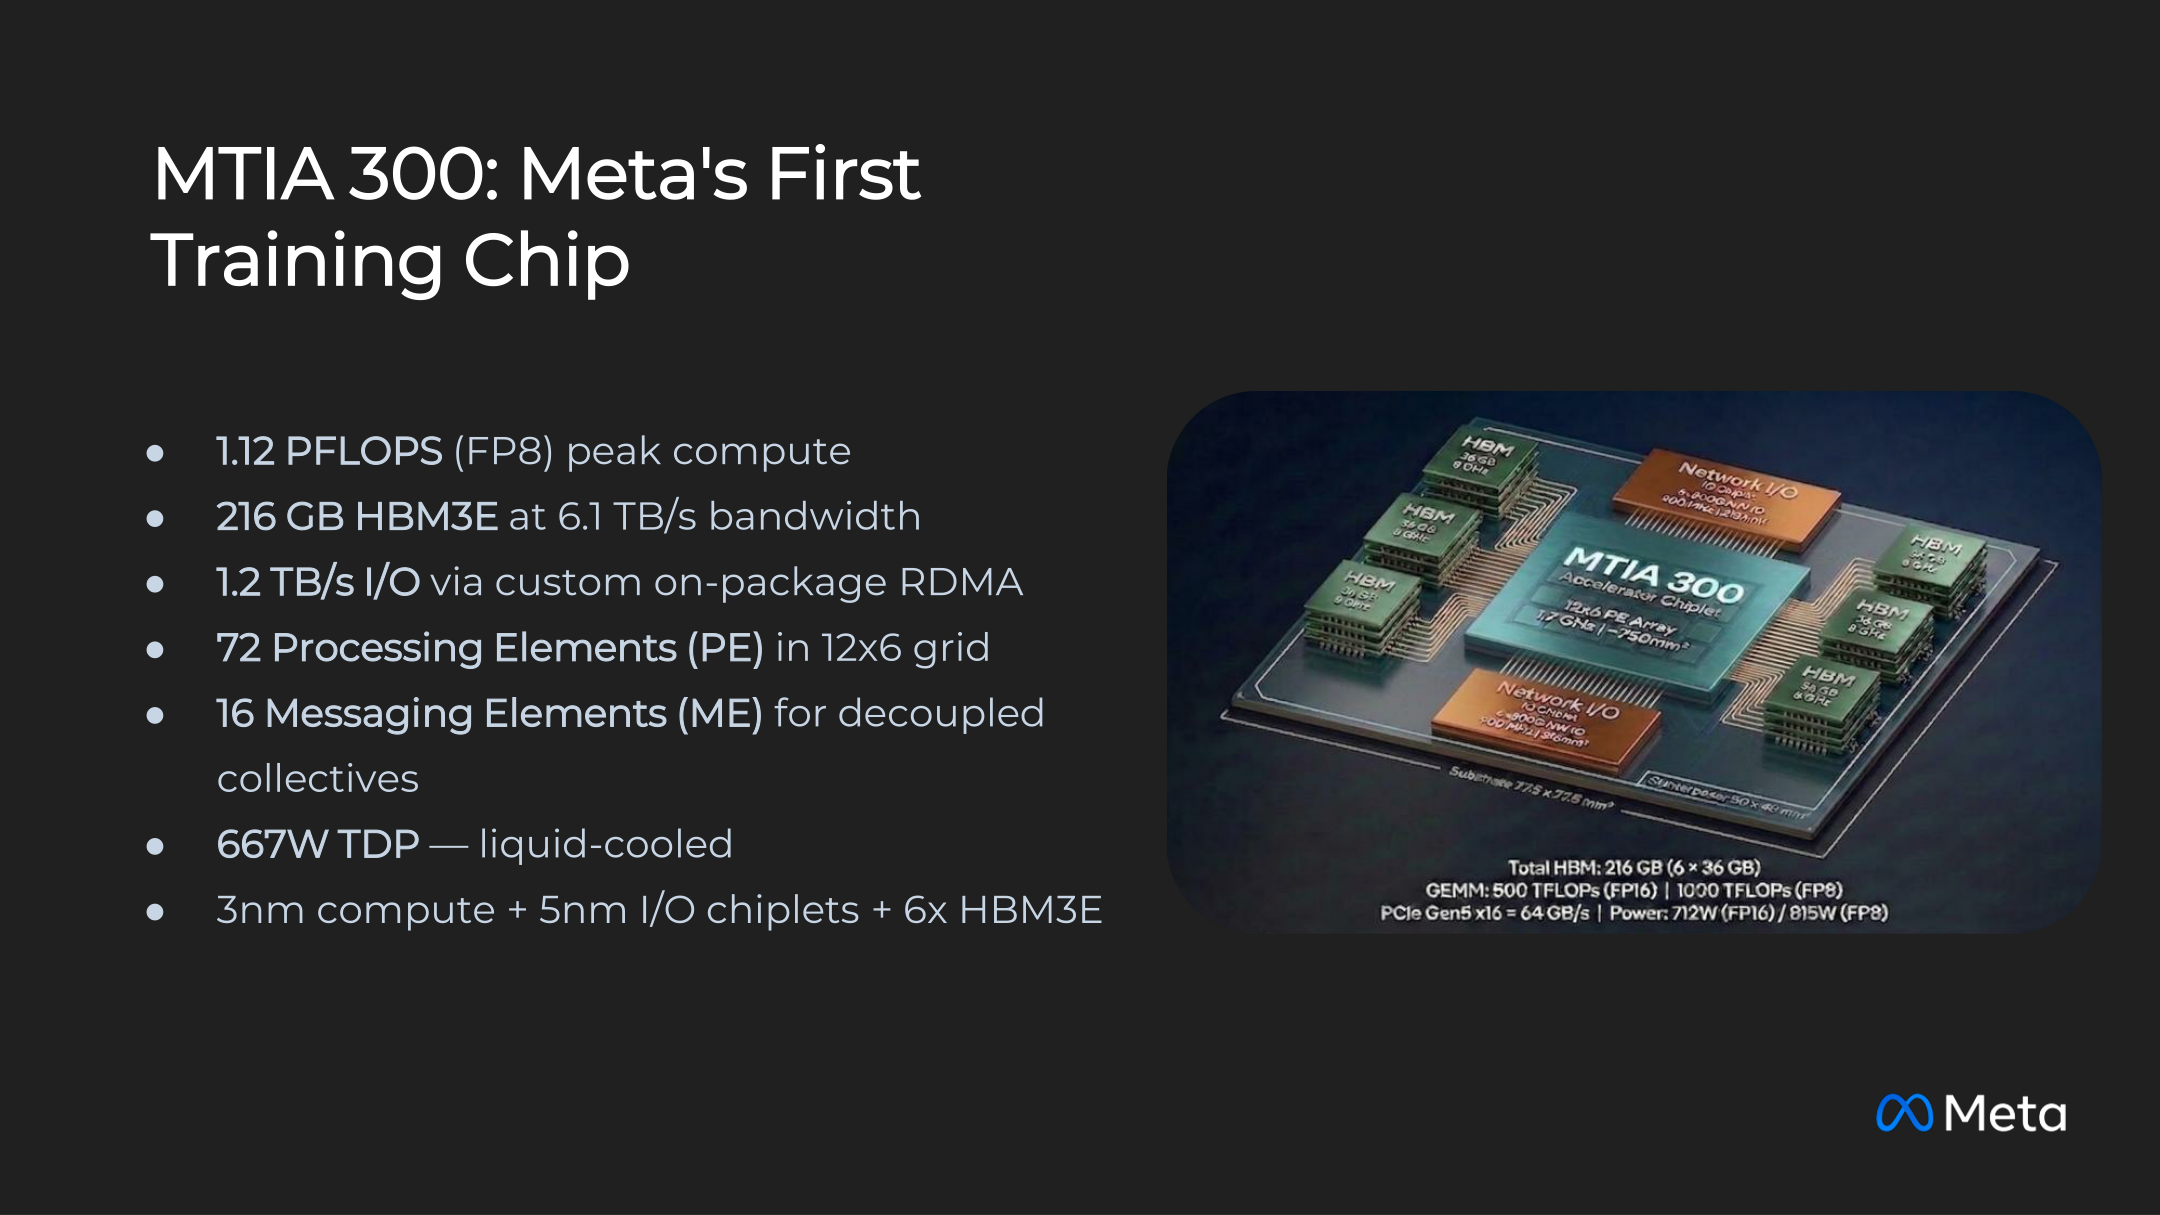
Источник изображения: Meta✴ В результате обеспечивается практически идеальная изоляция операций. Одновременное выполнение больших GEMM-операций с коллективными операциями приводит к снижению вычислительной пропускной способности менее чем на 0,5 %, в отличие от традиционных GPU, где снижение может превышать 20 % из-за использования одних и тех же ресурсов на обмен данными и вычисления. Разработанная совместно с MTIA 300 библиотека HCCL вместо управления обменом данными с хостом во время выполнения компилирует каждую коллективную операцию в полный набор подграфов (массивы очередей задач с явным указанием зависимостей), которые отправляются на ME для полностью автономного выполнения. Таким образом, хост лишь единожды отправляет ускорителю набор сетевых инструкций и более не вмешивается в работу сети. 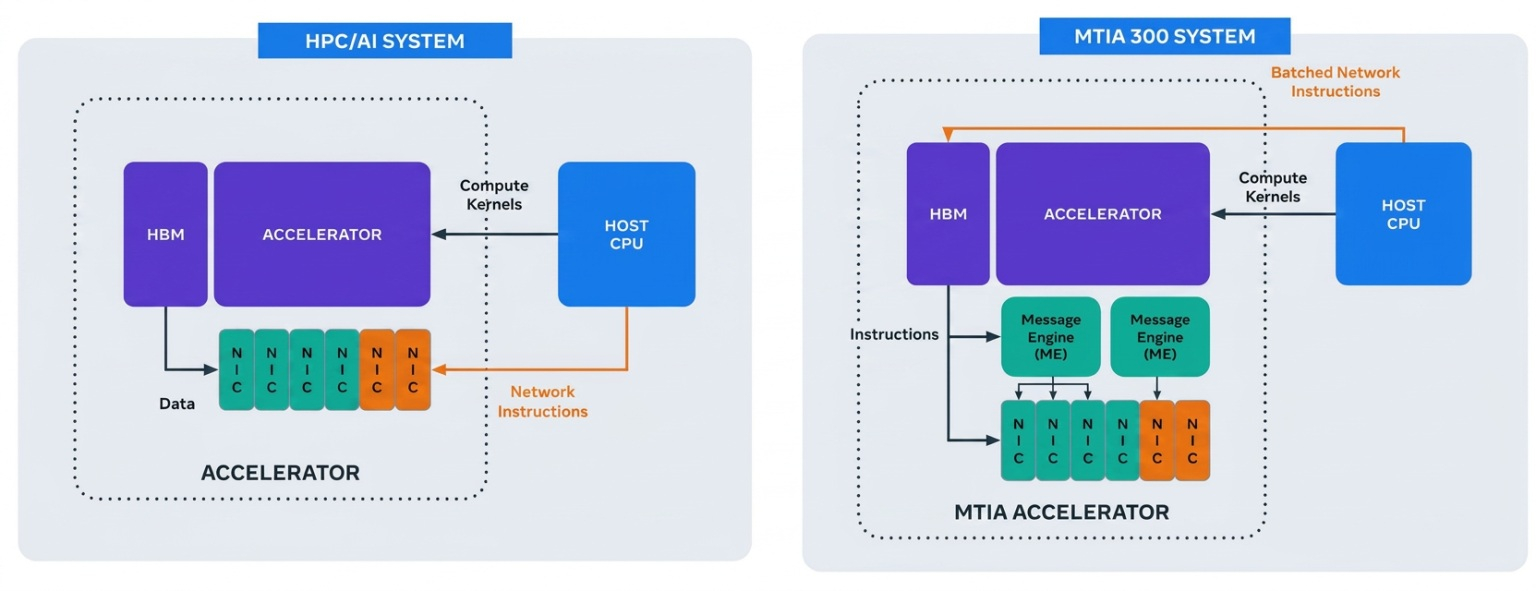
Источник изображения: Meta✴ По словам Meta✴, такая архитектура естественным образом интегрируется с PyTorch. Коллективные операции компилируются в единый граф вместе с вычислительными задачами. HCCL сама выбирает алгоритмы, учитывающие топологию сети и асимметричность полос пропускания, по возможности минимизируя межстоечный трафик. Для инференса были разработаны дополнительные пути: односторонняя коммуникация, когда PE используют экспресс-оповещения, и параллельный запуск коллективных операций по сигналу от kernel'а без прерывания работы последнего. Компания отметила, что MTIA 300 имеет и другие плюсы 216 Гбайт HBM3E (6,1 Тбайт/с) позволяют разместить больше данных на одном чипе, а не загружать их лишний раз извне; на каждый ускоритель приходится всего один CPU, что позволяет нагружать его интенсивными вычислениями на некоторых этапах; высокая пропускная способность сети позволяет при необходимости использовать форматы данных с более высокой точностью. Хотя сочетание умеренной FP-производительности с ёмкой и быстрой HBM в MTIA 300 изначально было оптимизировано для обучения DLRM, эти качества позволяет эффективно использовать чипа для более широкого спектра нагрузок, включая инференс моделей генеративного ИИ. Стоит отметить, что подход Meta✴ с внедрением NIC непосредственно в чип не нов сам по себе. Например, чипы Intel/Habana Gaudi2, представленные в 2022 году, использовали 24 100GbE-интерфейса RoCE для вертикального и горизонтального масштабирования.
24.08.2026 [09:52], Владимир Мироненко
От чипов до стоек: SK hynix делает ставку на CPO в деле масштабирования ИИ-инфраструктурSK hynix опубликовала в журнале Nature Electronics статью, подготовленную совместно с исследователями из США, Сингапура и Южной Кореи, под названием «CPO для HPC и ИИ». В ней изложены планы по развитию интегрированной оптики (CPO) — технологии оптического интерконнекта следующего поколения, которая решает проблемы узких мест в передаче данных с точки зрения целостной системы, выходящей за рамки одной только памяти и охватывающей стойки целиком, пишет StorageReview.com. По мере того как кластеры ИИ-систем масштабируются до тысяч GPU и стеков HBM, традиционные медные каналы связи достигают своих пределов, а более высокие скорости и большие расстояния приводят к увеличению энергопотребления, задержек и сложности передачи сигналов, отметила SK hynix. Согласно исследованию SK hynix, производительность вычислительных систем растёт примерно в три раза каждые два года, в то время как пропускная способность интерконнекта за тот же период увеличивается примерно в 1,4 раза, что приводит к барьеру, который всё больше ограничивает перемещение данных между ИИ-системами. Даже если GPU будут становиться всё более быстрее, производительность ИИ-кластера не будет расти с той же скоростью, если данные не смогут достаточно быстро перемещаться между процессорами, памятью и ускорителями. 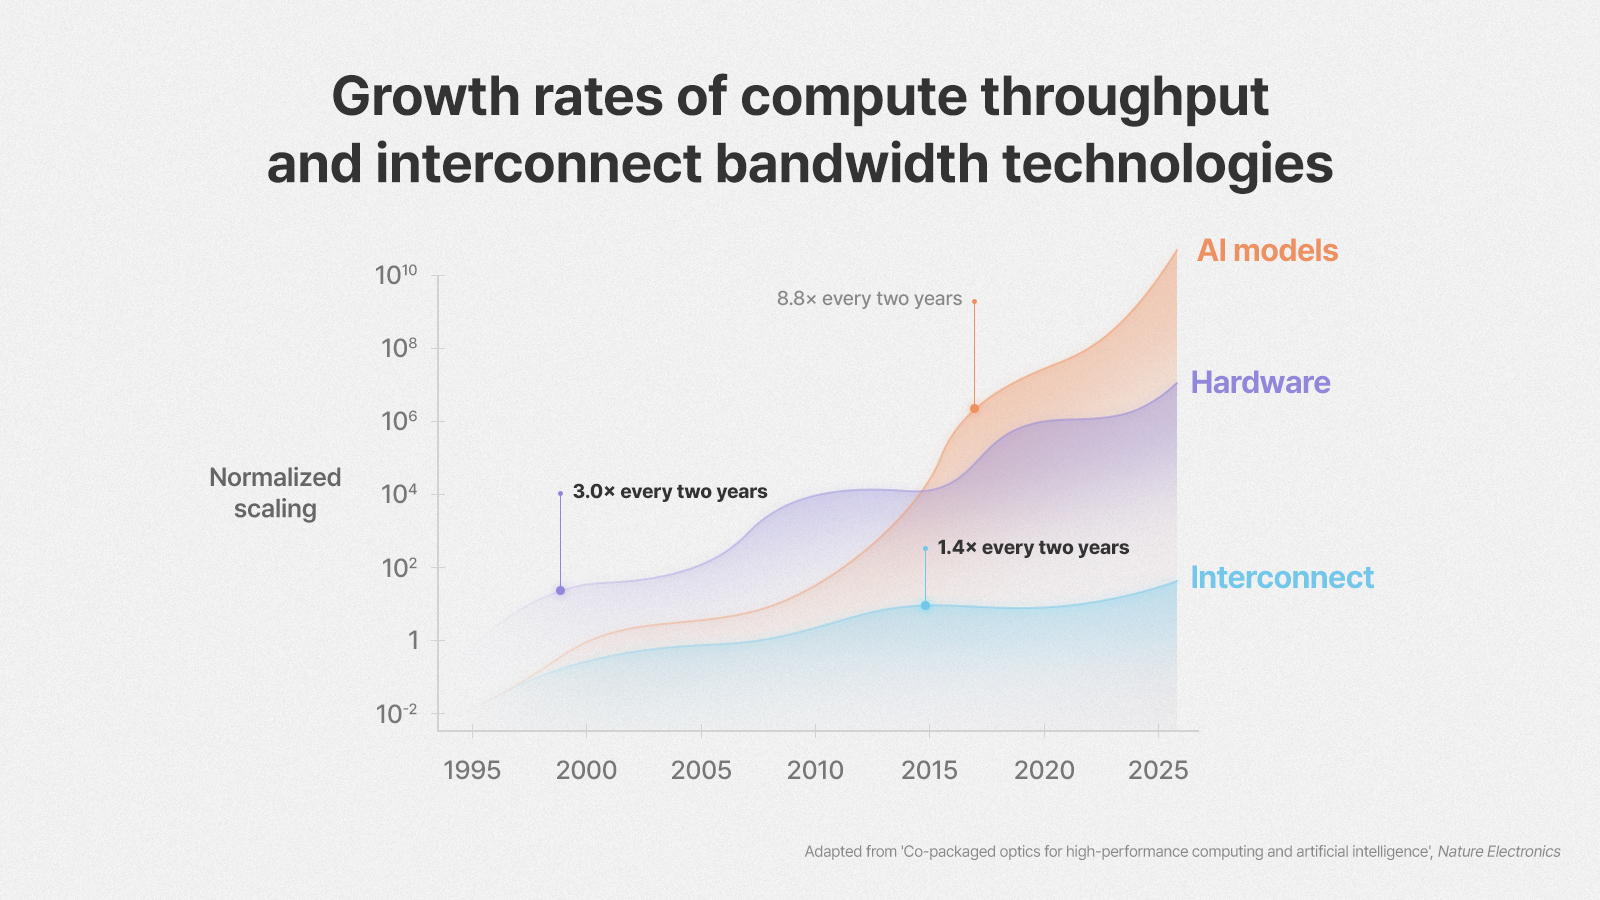
Источник изображений: SK hynix CPO позволяет решить эту проблему, размещая оптические трансиверы вблизи процессора или ускорителя на той же подложке. Преобразование высокоскоростных электрических сигналов в фотонные каналы, непосредственно прилегающие к вычислительному кремнию, минимизирует длину электрических дорожек, уменьшая паразитную ёмкость и затухание или искажение сигнала. Эта архитектура обеспечивает оптическую передачу с низкими потерями и высокой пропускной способностью по платам, стойкам и модулям, сохраняя при этом более высокую плотность полосы пропускания и улучшенную устойчивость к электромагнитным помехам. Физическая упаковка накладывает ограничения на количество процессоров и модулей памяти, которые можно разместить на одной подложке. Оптическая связь предлагает возможность их физического разделения, позволяя им при этом работать как часть гораздо более крупной вычислительной системы. 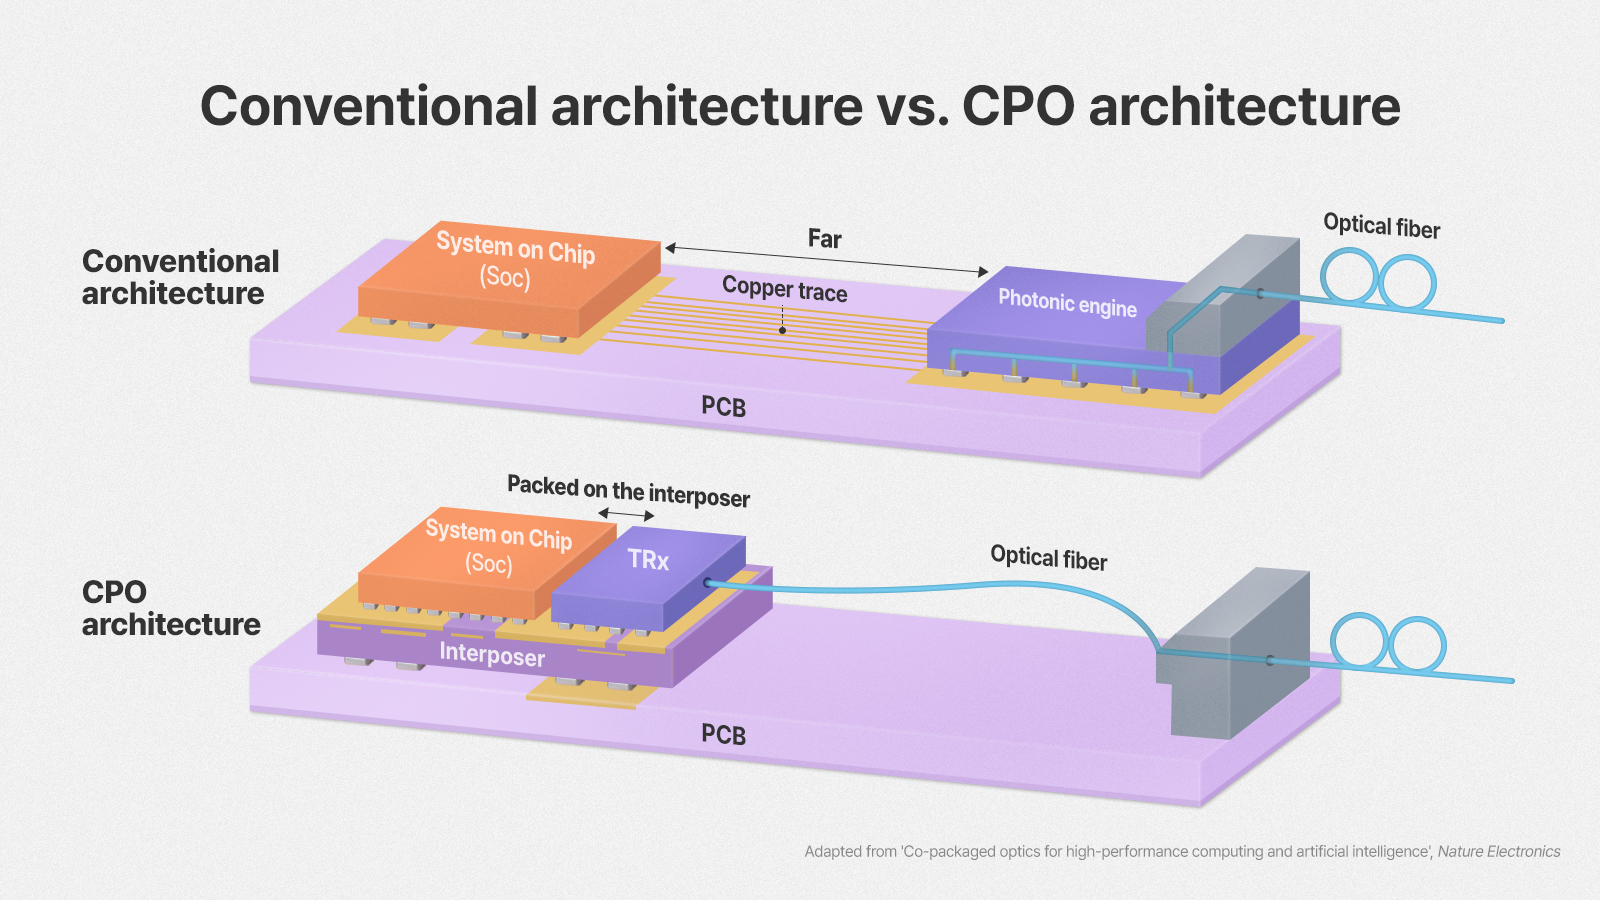 Концептуальная схема оптико-ориентированной архитектуры напрямую соединяет пулы вычислительных ресурсов (XPU) и пулы памяти посредством оптических сигналов с использованием интерпозера. Такой подход позволяет создавать дезагрегированные пулы общей памяти с низкой задержкой, где несколько вычислительных модулей могут получать доступ к общей ёмкости через оптическую объединительную плату без типичных для традиционных сетевых фабрик затрат на (де-)сериализацию, обеспечивая более гибкое перемещение данных на системном уровне и более быструю реакцию на растущий масштаб ИИ-моделей. Как отметил ресурс The Korea Times, значение статьи в Nature Electronics заключается не только в определении CPO как потенциального решения, но и в определении целей для будущей ИИ-инфраструктуры. Исследователи предполагают, что в будущем системы будут обеспечивать пропускную способность более 100 Тбит/с на узел, потребляя менее 1 пДж/бит и поддерживая межчиповую задержку менее 10 нс. SK hynix также прогнозирует архитектурную эволюция от стандартных 2D-многочиповых модулей и интеграции 2.5D-кремниевых интерпозеров к 3D-гетерогенной стековой компоновке. 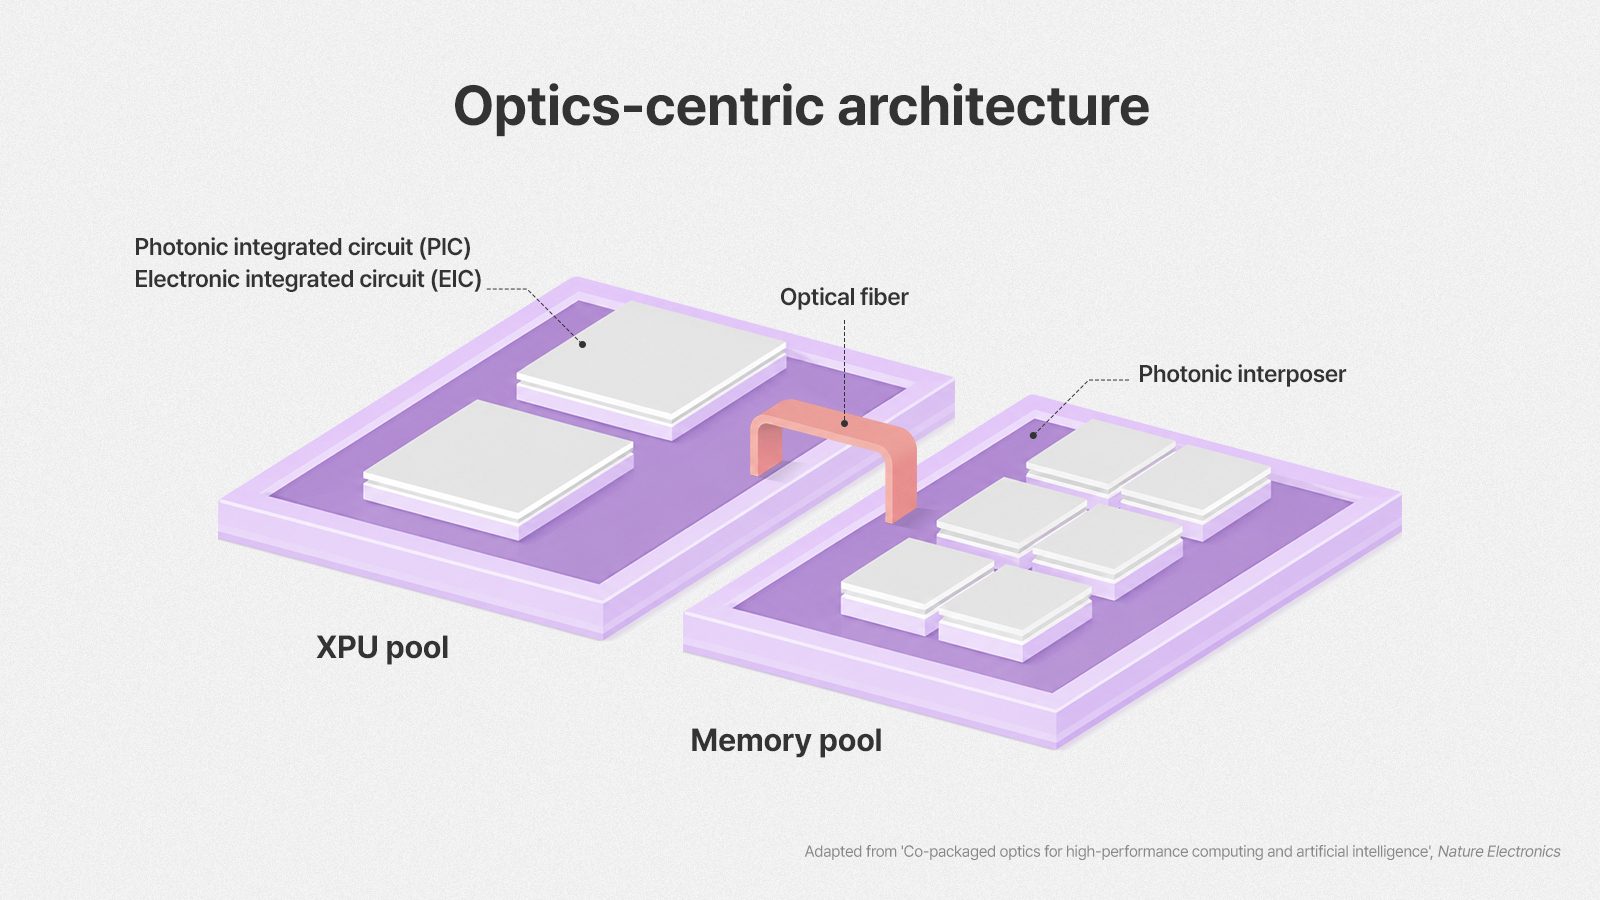 Кроме того, были указаны ключевые проблемы коммерциализации. Переход от демонстрации передовых вариантов упаковки к серийному производству оборудования сопряжён с рядом нерешенных инженерных проблем. Интеграция маломощных кремниевых фотонных устройств вместе с мощной логикой хоста требует сложной теплоизоляции и передовых микроканальных или иных систем прямого охлаждения упаковки. Также отрасли необходимо разработать стандартизированные протоколы когерентности с низкой задержкой, способные координировать операции с оптически связанной памятью без дополнительных затрат на проприетарные решения. Надёжная коммерциализация потребует комплексного проектирования оборудования, охватывающего топологии кристаллов DRAM, специализированные контроллеры памяти, фотонные модули и гетерогенную упаковку подложек. Статья также даёт представление о том, как SK hynix позиционирует себя на следующем этапе развития ИИ-инфраструктуры. Компания стала одним из главных бенефициаров бума генеративного ИИ благодаря HBM. Следующий этап требует, чтобы устройства памяти, контроллеры, оптические компоненты, процессоры и передовые технологии упаковки проектировались совместно, а не оптимизировались по отдельности. Именно поэтому исследователи делают акцент на «совместном проектировании». Нечто похожее уже разрабатывает Marvell, Lightmatter, Ayar Labs и другие вендоры. OCP также взялась за стандартизацию CPO, а группа гиперскейлеров сформировала альянс OCI MSA.
19.08.2026 [14:00], Сергей Карасёв
Credo организовала разработку открытого чиплетного интерконнекта для ИИ-систем в рамках OCPАмериканская компания Credo Technology Group Holding Ltd, специализирующаяся на создании высокоскоростных решений для передачи данных, объявила о планах по разработке стандартного интерконнекта в рамках проекта OCP (Open Compute Project). Предполагается, что новая технология поможет в решении проблемы «стены памяти» в современных ИИ-системах. В настоящее время наблюдается значительный разрыв в вычислительных мощностях ИИ-ускорителей и возможностях памяти. Производительность ИИ-ядер растет в разы быстрее, чем пропускная способность шин и модулей памяти. В результате, ускорители большую часть времени простаивают в ожидании данных. Это приводит к неэффективному использованию доступных ресурсов и падению быстродействия всей системы в целом. При этом чипы HBM, которыми оснащаются передовые GPU-карты, остаются не только очень дорогими, но и ограниченными по ёмкости. 
Источник изображения: Credo Для решения проблемы Credo сформировала рабочую группу OCP Open Chiplet Economy (OCE) Lightweight Serial Interconnect (LSI) Workstream. Она займётся стандартизацией высокоэффективного последовательного интерконнекта для связи чиплетов и модулей в составе ИИ-платформ. Предполагается, что новая технология снизит зависимость от НВМ и поможет более полно использовать доступные вычислительные мощности. Разработчики ИИ-систем смогут адаптировать архитектуру под разные модели, потоки данных и характеристики нагрузок. Такой подход, как утверждается, обеспечит увеличение плотности памяти до 25 раз по сравнению с нынешними решениями и позволит поднять пропускную способность на 5 % по отношению к HBM4. В целом, инициатива будет способствовать переходу к компонуемой инфраструктуре, в которой вычислительные ресурсы, память и хранилища данных могут комбинироваться для достижения оптимальных показателей производительности и экономической эффективности. В рамках проекта Credo предоставит ОСР спецификацию OmniConnect Lightweight AXI Framer.
19.08.2026 [10:08], Владимир Мироненко
CPO в OCP: 19 компаний договорились о стандартизации и развитии интегрированной фотоники для ИИ-платформКомпания Lightmatter объявила об официальном запуске инициативы «Открытая кремниевая фотоника для ИИ-систем» (Open Silicon Photonics for AI Systems), анонсированной ранее в этом году в рамках проекта Open Compute Project (OCP), в сотрудничестве с расширенной коалицией, которая помимо 10 компаний-учредителей теперь включает девять новых участников. В коалицию входят Celestica, Dell Technologies, Flex, Foxconn Interconnect Technology, Global Unichip Corporation, Hyve Solutions, Keysight, Lightmatter, Qualcomm, Quanta Cloud Technology и другие. Также был опубликован основополагающий документ инициативы под названием «Архитектурное видение: открытая кремниевая фотоника для систем ИИ» (Architecture Vision: Open Silicon Photonics for AI Systems). Этот 300-страничный документ послужит руководством для разработки общей концепции CPO (Community-Outdoor Office) для масштабирования ИИ-кластеров, совместимых с MHS-платформами и ORv3-стойками, с 72–1024 (и более) узлов, обеспечивая при этом совместимость с оборудованием разных производителей и значительно более высокую загрузку вычислительных кластеров. 
Источник изображения: Fujiphilm/unsplash.com В отличие от подключаемой оптики, где трансиверы отделены от основных микросхем, CPO интегрирует оптические и электрические компоненты, такие как оптические модули и коммутирующие ASIC, на одной компактной подложке. Эталонная архитектура предлагает гиперскейлерам основу для поддержки перехода от медных подключений к фотонике, что необходимо для масштабируемости и совместимости между несколькими поколениями SerDes, циклами проектирования коммутаторов и XPU. Технологически независимый подход архитектуры также обеспечивает поддержку разнообразных фотонных решений, включая кремниевую фотонику, VCSEL и MicroLED, способствуя созданию надёжной мультивендорной цепочки поставок, которая может масштабироваться для удовлетворения потребностей в производительности и энергопотреблении. «Интерконнекты стали столь же фундаментальными для производительности ИИ-инфраструктуры, как и вычислительные ресурсы», — заявил основатель и генеральный директор Lightmatter. «Переход отрасли к кремниевой фотонике откроет следующий крупный скачок в возможностях передовых моделей. Этот документ закладывает основу, на которой это растущее сообщество OCP будет разрабатывать общую архитектуру стоек CPO на основе MHS, которая впишется в процессы гиперскейлеров», — добавил он.
11.08.2026 [17:48], Владимир Мироненко
Разработчик радиокабелей Point2 Technology получил $136 млн инвестиций от Arm, Bosch, NVIDIA и др.Point2 Technology, разработчик активных радиокабелей (ARC) для замены оптических и медных подключений в ЦОД, объявил о расширении раунда финансирования серии B до $136 млн в связи с присоединением к раунду Arm. Раунд возглавила LB Investment при участии Maverick Silicon, а также NVIDIA, UMC Capital, Molex и Bosch Ventures. Компания из Сан-Хосе планирует использовать привлечённые средства для ускорения коммерциализации своего интерконнекта e-Tube на базе решений Active RF Cable (ARC), Near-Packaged e-Tube (NPE) и Co-Packaged e-Tube (CPE) для будущих вычислительных систем стоечного формата. 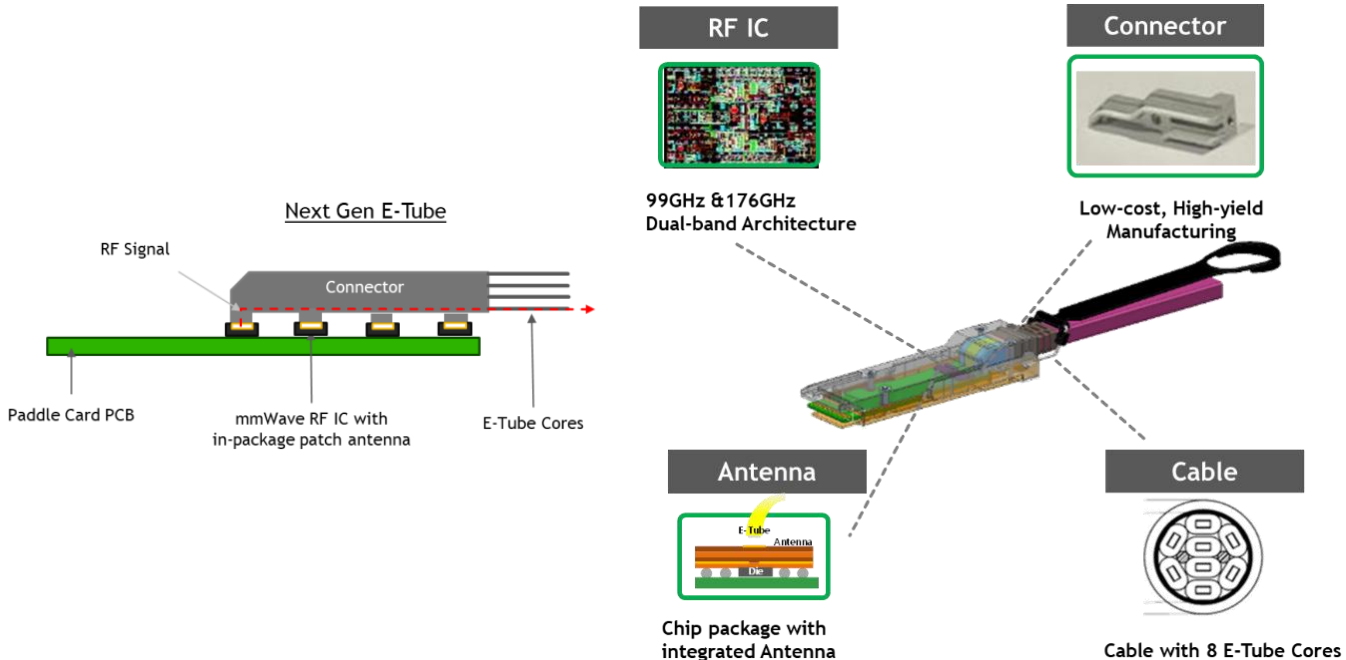
Источник изображения: Point2 Technologies Соучредитель и генеральный директор Point2 Technology отметил, что по мере масштабирования ИИ-систем и роста требований к пропускной способности в Тбит/с, интерконнект стал узким местом в развитии ИИ ЦОД: «Последние инвестиции от Arm, LB Investment, Maverick Silicon и других подтверждают, что наша платформа e-Tube становится критически важным решением для интерконнекта в ИИ-фабриках следующего поколения». Технологическая платформа e-Tube компании Point2 построена на RF-архитектуре с использованием пластиковых волноводов для передачи данных, предлагая новую категорию активных кабелей, которые позволяют преодолеть ограничения медных и оптоволоконных кабелей. Технология e-Tube обеспечивает в 10 раз большую дальность передачи, чем у медных кабелей, в 3 раза меньшее энергопотребление и в тысячу раз меньшую задержку, чем у оптических кабелей.
08.08.2026 [16:10], Сергей Карасёв
Bull и Kalray займутся разработкой сетевых технологий для ИИ и НРСФранцузские компании Bull и Kalray объявили о стратегическом партнёрстве, направленном на развитие передовых сетевых технологий для инфраструктур ИИ и НРС. Стороны, в частности, намерены сотрудничать в сфере Ultra Ethernet — нового стандарта на базе Ethernet, ориентированного на современные ресурсоёмкие нагрузки. Bull и Kalray сосредоточат усилия на разработке решений следующего поколения, отвечающих высоким требованиям производительности, масштабируемости и эффективности. Речь идёт, в частности, об интерконнекте с большой пропускной способностью и малыми задержками. В рамках партнёрства Kalray предоставит свою сетевую платформу Kalray Networking Engine, предназначенную для работы с огромными массивами данных в составе ЦОД, инфраструктур ИИ и НРС. Эта платформа предусматривает использование 64 ядер KV5 с открытой архитектурой RISC-V. Заявленная пропускная способность достигает 1,6 Тбит/с. В свою очередь, Bull ускорит развитие собственного интерконнекта BXI (Bull eXascale Interconnect) — это специализированная высокоскоростная сетевая архитектура для суперкомпьютеров и систем высокопроизводительных вычислений. В частности, планируется добавление в состав BXI новых функций безопасности и виртуализации, необходимых для облачных и ИИ-нагрузок. В целом, развитие BXI будет смещено в сторону стандарта Ethernet. 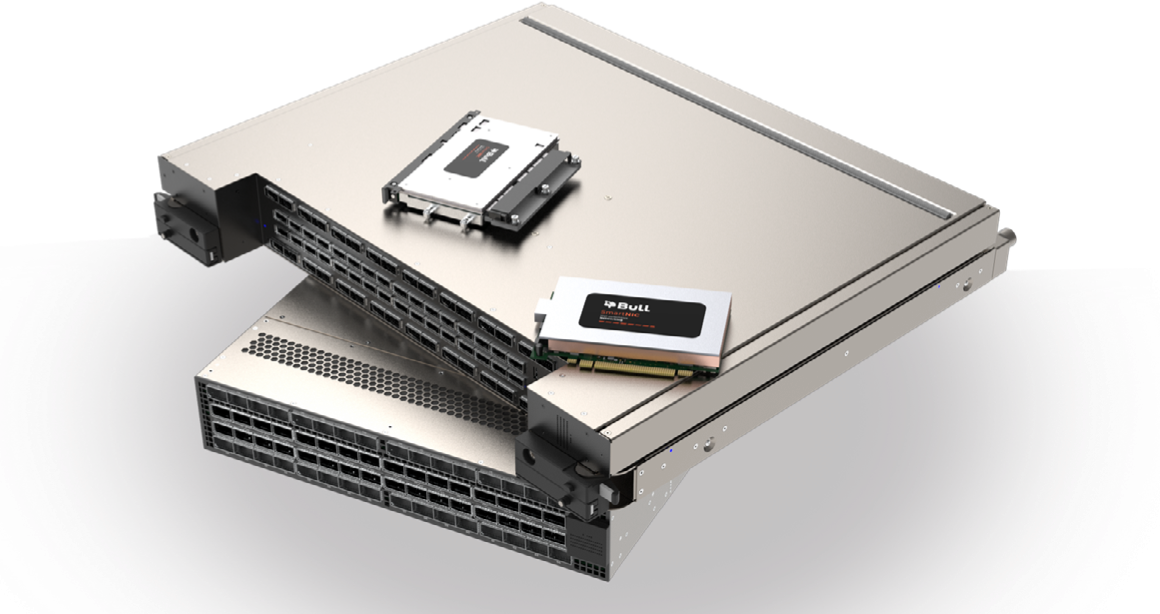
Источник изображения: Bull Соглашение между Bull и Kalray предусматривает совместную разработку технологических блоков, совместимых с Ultra Ethernet, и их интеграцию в будущие поколения сетевых решений Bull. Сотрудничество, как ожидается, откроет новые возможности для OEM-производителей и поставщиков инфраструктурных решений. Помимо этого, партнёрство будет способствовать развитию отраслевых стандартов, обеспечивающих масштабируемость, совместимость и долгосрочный потенциал платформ для ИИ и НРС. Планируется, что первые решения, разработанные совместными усилиями Bull и Kalray, станут доступны для коммерческого использования в 2028 году.
08.08.2026 [01:58], Владимир Мироненко
Lumilens вышла из скрытого режима и привлекла $700 млн с оценкой в $5,51 млрдСтартап Lumilens, специализирующийся на разработке решений для оптическими сетей для ЦОД, объявил о выходе из скрытого режима (stealth mode) и успешном завершении раунда финансирования серии C, в ходе которого он привлёк $700 млн. В результате общий объём инвестиций в него превысил $900 млн, а оценка рыночной стоимости стартапа выросла до $5,51 млрд. Раунд совместно возглавили Atreides Management, Bain Capital Ventures, Meritech, Seligman Ventures и Spark Capital при участии Addition, Alkeon, Harbourvest, J.P. Morgan Private Capital, Mayfield, MVP Ventures, Qualcomm Ventures, Peak XV, Redpoint Ventures, Seifdune и других ведущих инвесторов. Компания сообщила, что использует привлечённые средства для расширения своих операций в сфере инженерии и производства. Lumilens отметила, что спустя всего два года с момента основания её первый продукт прошел квалификацию и начал поставляться в ЦОД одного из четырёх ключевых гиперскейлеров в рамках многомиллиардного соглашения. Это может относиться к одному из технологических гигантов: Amazon, Alphabet, Microsoft и Meta✴, считает Reuters. 
Источник изображений: Lumilens Lumilens проектирует и производит оптические интерконнекты для обоих типов сетей внутри ИИ ЦОД — вертикально масштабируемой (scale-up) сети, которая напрямую соединяет GPU в рамках одной вычислительной системы, и горизонтально масштабируемой (scale-out) сети, которая объединяет различные стойки и кластеры. Для горизонтально масштабируемых сетей Lumilens предлагает подключаемые оптические трансиверы класса 800G/1.6T. Для вертикально масштабируемых сетей компания разрабатывает решения CPO (Co-Packaged Optics) и NPO (Near-Package Optics), предназначенные для замены медного интерконнекта малой дальности и, в конечном итоге, для обеспечения работы десятков тысяч GPU в качестве единой тесно связанной ИИ-системы. Все продукты основаны на разработанной компанией платформе LumiCore, объединяющей кремниевую фотонику, интегральные схемы со смешанным сигналом, электрооптические интерпозеры и оптические системы. Единая платформа для всего портфеля продукции позволяет Lumilens переходить от проектирования к сертифицированному клиентом продукту за считанные месяцы, и гарантирует, что каждый продукт с самого начала разработан для крупномасштабного производства.  Компания сообщила, что разработала новаторскую технологию электрооптических интерпозеров, которая значительно упрощает сборку фотонных чипов, а также собственные технологические процессы, специализированную робототехнику и автоматизацию тестирования, масштабируя мощности через производственных партнёров и собственных крупномасштабных предприятий. «Ограничение для ИИ сместилось с количества GPU, которые вы можете купить, на количество, которое вы можете подключить», — утверждает Анкур Сингла (Ankur Singla), основатель и генеральный директор Lumilens. Сингла ранее создал и продал две инфраструктурные компании: Contrail Systems, занимающуюся программно-определяемыми сетями, которую Juniper Networks приобрела в 2012 году примерно за $176 млн, а затем Volterra, платформу для периферийных и облачных вычислений, которую F5 купила почти за $500 млн в январе 2021 года. В период между работой в Volterra и Lumilens он также основал Exaforce, платформу безопасности на основе ИИ, которая сейчас оценивается примерно в $725 млн, где он по-прежнему занимает должность исполнительного председателя. Lumilens — его четвёртая инфраструктурная компания, отметил ресурс Tech Funding News. Её команда включает специалистов из Cisco, Juniper Networks, Meta✴, Marvell, Lumentum и Coherent.
06.08.2026 [09:21], Владимир Мироненко
Память вскладчину: Marvell анонсировала дезагрегированную платформу Photonic Fabric с оптическим интерконнектом для ИИ-инфраструктурMarvell отметила, что по мере масштабирования ИИ-инференса его производительность всё больше зависит не просто от увеличения вычислительных мощностей, а от того, насколько эффективно вычислительные мощности, память и интерконнекты работают в рамках единой инфраструктуры, а также насколько быстро ускорители могут получать доступ, перемещать и использовать ресурсы памяти. Также Marvell заявила, что современная иерархия памяти для ИИ не рассчитана на инференс в масштабах, необходимых для современных рабочих нагрузок. Память HBM, напрямую подключённая к GPU, обеспечивает исключительную производительность, но имеет ограниченную ёмкость и высокую стоимость. Системная DRAM обеспечивает большие пулы памяти, но не может экономично масштабироваться вместе со всеми ускорителями. NVMe SSD имеют большую ёмкость, но и большую задержку, что делает их непригодными для обслуживания активных рабочих нагрузок инференса. В связи с этим Marvell предложила расширить иерархию ИИ-памяти за счёт нового промежуточного уровня, обеспечивающего значительно большую ёмкость, обычно ожидаемую от хранилищ, находясь при этом гораздо ближе к вычислительным ресурсам, с очень низкой задержкой, близкой к непосредственно подключённой памяти. 
Источник изображений: Marvell Анонсированная Marvell платформа Marvell Photonic Fabric использует новую архитектуру оптического подключения для выполнения ИИ-задач, которая обеспечивает уровень общей для нескольких узлов памяти. Платформа, построенная на основе модуля памяти Marvell Photonic Fabric Memory Module (PFMM), сетевой карты Photonic Fabric NIC (PF-NIC) и чиплета Marvell Photonic Fabric, позволяет совместно использовать память в нескольких ИИ-стойках, расположенных на расстоянии до 30 м друг от друга, что даёт возможность значительно увеличить доступную для обработки ИИ-нагрузок память без пропорционального масштабирования вычислительных ресурсов. PFMM объединяет совместно используемую память DDR5, кеш HBM и высокоскоростной оптический интерконнект, обеспечивая расширение, объединение и дезагрегацию памяти в ИИ-инфраструктуре.  В основе платформы лежит первая в отрасли SoC с оптическим I/O, интегрированным в середину кремниевого кристалла. Разработанный специально для дезагрегации ИИ-памяти модуль PFMM поддерживает до 8 модулей DDR5 DIMM, дополненных кешем HBM объёмом 72 Гбайт и пропускной способностью оптической сети 7,2 Тбит/с. Архитектура обеспечивает NUMA-доступ за менее 350 нс на нескольких стойках, что позволяет ускорителям получать доступ к значительно большим объёмам ИИ-памяти без задержек, традиционно связанных с внешними СХД.  В дополнение к PFMM, сетевой адаптер PF-NIC предоставляет оптический сетевой интерфейс CXL 3.1 и PCIe 6.0, который соединяет ИИ-серверы с совместно используемой памятью. Вместе PFMM и PF-NIC позволяют использовать сторонние устройства с общей памятью, способные поддерживать увеличивающиеся KV-кеши, более крупные контексты моделей и всё более требовательные рабочие нагрузки инференса, сохраняя при этом совместимость с существующими программными ИИ-платформами.  Сочетание оптического соединения с дезагрегацией памяти позволяет масштабировать объём памяти независимо от вычислительных ресурсов, сохраняя при этом пропускную способность и задержку, необходимые для крупномасштабного ИИ-инфренса. Результатом являются большие KV-кеши, улучшенное использование GPU, рост эффективности токенов и снижение энергопотребления при перемещении данных.
07.07.2026 [09:19], Владимир Мироненко
Sugon создала китайский аналог NVIDIA InfiniBand NDR — интерконнект ScaleFabricСогласно информации EEWorld, китайская компания Sugon (Dawning Information Industry) объявила о запуске высокоскоростного интерконнекта 400G ScaleFabric с нулевыми потерями пакетов, представленного в марте этого года. Это первый в Китае продукт, использующий технологию InfiniBand (IB) и RDMA для сверхвысокоскоростных сетей. Sugon разработала весь стек собственными силами. Он специально разработан для крупномасштабных кластеров и адаптирован для HPC-сценариев, таких как обучение больших ИИ-моделей. Сообщается, что интерконнект ScaleFabric уже более 10 мес. обеспечивает работу кластера Национального суперкомпьютерного интернета в Чжэнчжоу на базе 30 тыс. ускорителей, выполняющего реальные задачи обучения ИИ. Развёртывание всей сети кластера заняло всего 36 ч. ScaleFabric является частью платформы Sugon ScaleX640. По словам компании, благодаря собственной разработке IP-ядра и SerDes 112G, ScaleFabric достиг лучшего в отрасли показателя времени восстановления маршрутизации при сбоях каналов связи — менее 1 мс, при этом задержка не увеличивается с ростом масштаба сети, обеспечивая стабильность работы сверхбольших кластеров с самого начала. 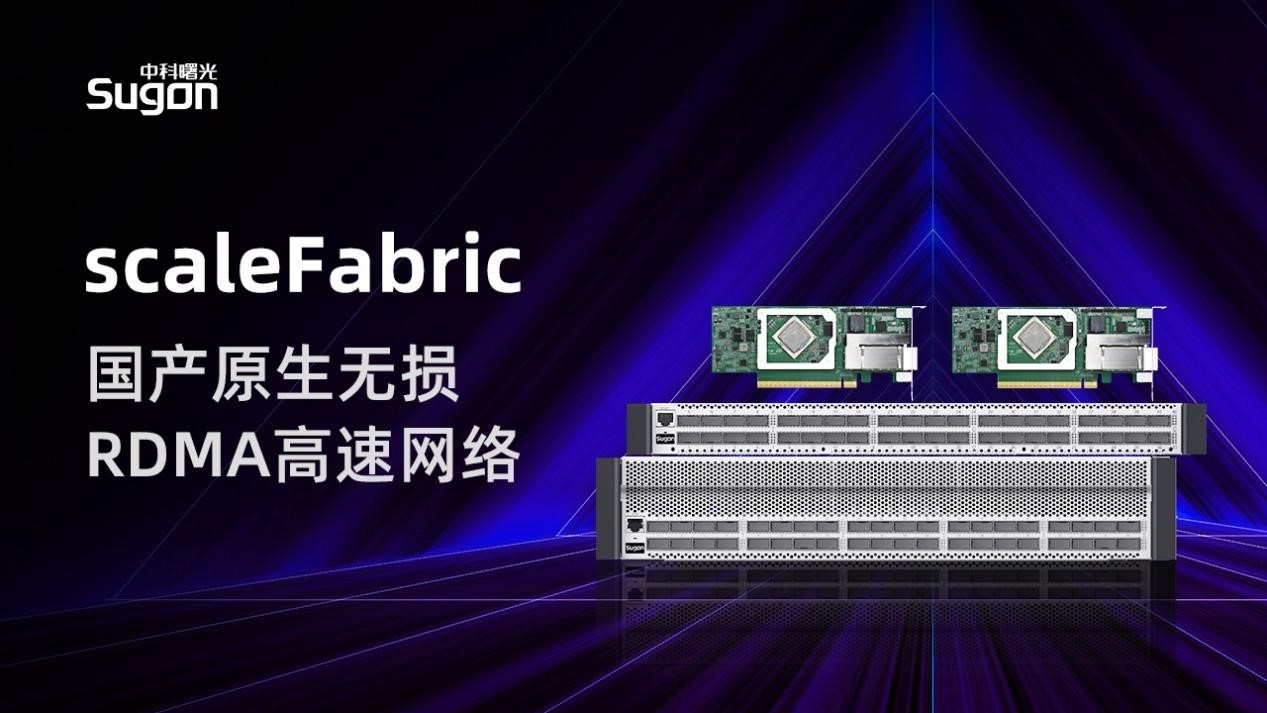
Источник изображения: MyDrivers В настоящее время компания Sugon выпустила три устройства: стандартную однопортовую сетевую карту ScaleFabric 400 с PCIe 5.0, с пропускной способностью порта 400 Гбит/с и сквозной задержкой связи 0,9 мс, 80-портовый коммутатор ScaleFabric 400 1U с жидкостным охлаждением и 80-портовый коммутатор ScaleFabric 400 2U с воздушным охлаждением. Коммутаторы обладают пропускной способностью одного порта до 800 Гбит/с, общей коммутационной способностью до 64 Тбит/с в двунаправленном режиме, задержкой около 260 нс и поддерживают расширение портов до 800G×40 или 400G×80. Интерконнект ScaleFabric полностью совместим с основными интерфейсами коммуникационных библиотек, такими, как RCCL, NCCL и Intel MPI, и поддерживает прямую миграцию основных фреймворков для больших языковых моделей и приложений HPC, таких, как Llama, DeepSeek и Kimi, что обеспечивает бесперебойное развёртывание приложений. Таким образом, Sugon стала вторым в мире заметным поставщиком InfiniBand после NVIDIA, которой эта технология досталась после поглощения Mellanox в 2019 г. Согласно данным Sugon, технические характеристики ScaleFabric 400 соответствуют уровню NVIDIA InfiniBand NDR и превосходят его по некоторым ключевым показателям. Плотность портов коммутатора увеличена на 25 %, максимальное количество пар очередей (Queue Pair, QP) для отправки и приёма данных на карту вдвое больше — до 256 тыс., масштаб интерконнекта в одной подсети в 2,33 раза больше, чем у NDR, и он может поддерживать развёртывание кластера до 114 тыс. карт. А общая стоимость сети меньше примерно на 30 %.
28.06.2026 [15:48], Сергей Карасёв
Китайские x86-процессоры Hygon C86-5G получили 128 ядер с поддержкой 512 потоковКитайская компания Hygon, по сообщениям сетевых источников, создала процессоры нового поколения с архитектурой x86. Речь идёт об изделиях C86-5G, которые, как ожидается, будут применяться в оборудовании для дата-центров. Кроме того, в разработке находятся другие продукты, включая ИИ-ускорители. Решения C86-5G придут на смену изделиям C86-4G, которые являются наследниками AMD Zen1. Чипы C86-4G насчитывают 16 вычислительных ядер с возможностью одновременной обработки до 32 потоков инструкций, а тактовая частота составляет 2,8 ГГц. Реализована поддержка оперативной памяти DDR5 и интерфейса PCIe 5.0. Известно, что процессоры C86-5G получат до 128 вычислительных ядер. Упомянута технология многопоточности SMT4, которая позволит каждому ядру обрабатывать четыре потока инструкций, что в сумме даст 512 потоков. Упомянута поддержка 104 линий PCIe 5.0, инструкций AVX512 (ISA на уровне Zen 5), а также режимов INT8 и BF16. Заявленная производительность — 10 Тфлопс на операциях FP64 (до 32 операций за такт). Ожидается, что в ЦОД-сегменте новые китайские процессоры станут альтернативой Intel Xeon 6. 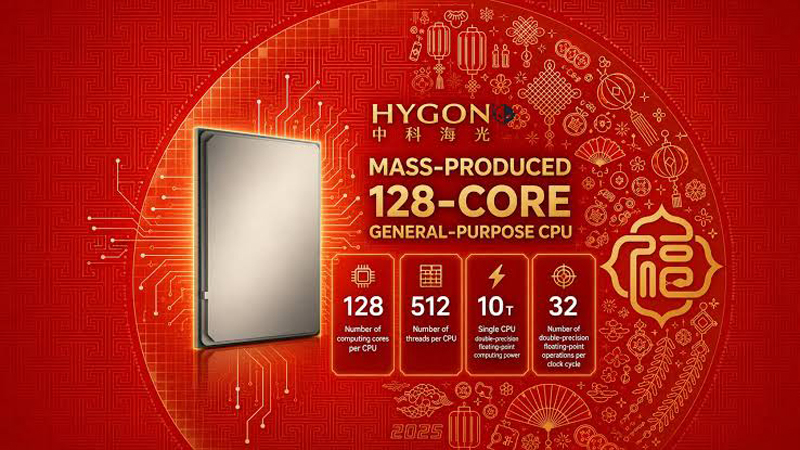
Источник изображений: Hygon Производство C86-5G уже началось. Чипы станут основой ряда серверов, включая двухсокетную модель H620G59 формата 2U с воздушным охлаждением. Эта система оборудована 32 слотами для модулей DDR5-6400, тремя разъёмами PCIe 5.0 х16, двумя слотами ОСР 3.0, восемью фронтальными отсеками для накопителей стандарта SFF, а также двумя внутренними коннекторами для SSD типоразмера М.2. Кроме того, готовятся серверные стойки высокой плотности TC800G6 (PUE — 1,08) и TC8600H G5 (PUE — 1,04) с жидкостным охлаждением. 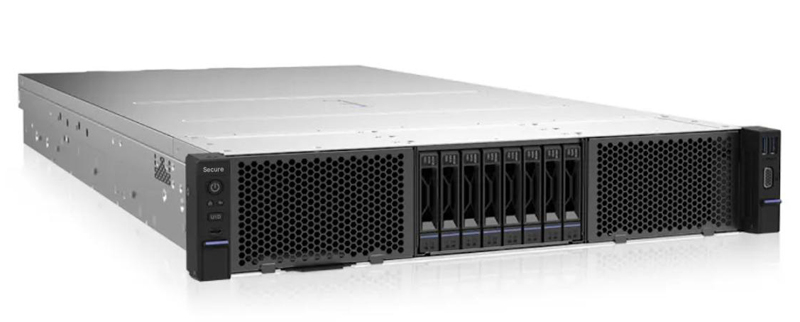 Вместе с тем Hygon намерена выпустить GPU с памятью HBM и высокоскоростным интерконнектом. Известно, что это устройство допускает работу в режимах FP64/PF16/BF16. Новинка, предположительно, сможет составить конкуренцию NVIDIA A100. Наконец, в разработке находятся коммутационные решения класса 400/800 Гбит/с. Это чип с поддержкой 104 линий PCIe 5.0, высокоскоростной интерконнект для вертикального масштабирования (сопоставим с NVLink), решение ScaleFabric 400G (для NIC), а также ScaleFabric 400/800G. Последняя из перечисленных новинок обеспечивает поддержку 80 портов на 400 Гбит/с с RDMA, а коммутационная способность достигает 64 Тбит/с. Это устройство рассматривается в качестве альтернативы InfiniBand NDR. |
|

