
Материалы по тегу: дезагрегация
|
24.08.2026 [09:52], Владимир Мироненко
От чипов до стоек: SK hynix делает ставку на CPO в деле масштабирования ИИ-инфраструктурSK hynix опубликовала в журнале Nature Electronics статью, подготовленную совместно с исследователями из США, Сингапура и Южной Кореи, под названием «CPO для HPC и ИИ». В ней изложены планы по развитию интегрированной оптики (CPO) — технологии оптического интерконнекта следующего поколения, которая решает проблемы узких мест в передаче данных с точки зрения целостной системы, выходящей за рамки одной только памяти и охватывающей стойки целиком, пишет StorageReview.com. По мере того как кластеры ИИ-систем масштабируются до тысяч GPU и стеков HBM, традиционные медные каналы связи достигают своих пределов, а более высокие скорости и большие расстояния приводят к увеличению энергопотребления, задержек и сложности передачи сигналов, отметила SK hynix. Согласно исследованию SK hynix, производительность вычислительных систем растёт примерно в три раза каждые два года, в то время как пропускная способность интерконнекта за тот же период увеличивается примерно в 1,4 раза, что приводит к барьеру, который всё больше ограничивает перемещение данных между ИИ-системами. Даже если GPU будут становиться всё более быстрее, производительность ИИ-кластера не будет расти с той же скоростью, если данные не смогут достаточно быстро перемещаться между процессорами, памятью и ускорителями. 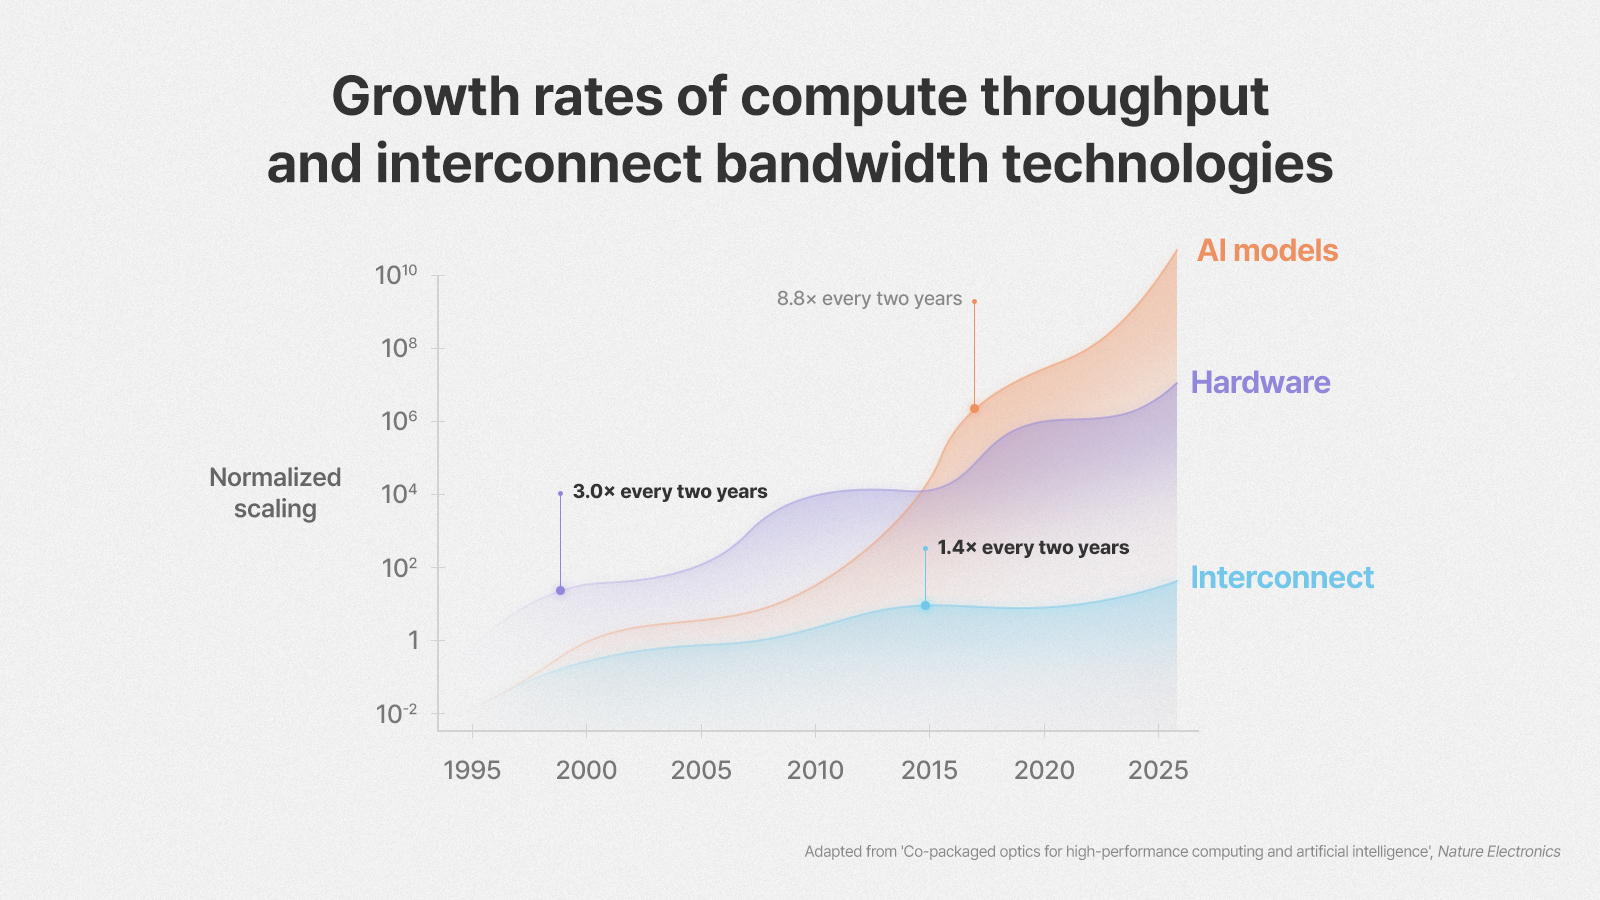
Источник изображений: SK hynix CPO позволяет решить эту проблему, размещая оптические трансиверы вблизи процессора или ускорителя на той же подложке. Преобразование высокоскоростных электрических сигналов в фотонные каналы, непосредственно прилегающие к вычислительному кремнию, минимизирует длину электрических дорожек, уменьшая паразитную ёмкость и затухание или искажение сигнала. Эта архитектура обеспечивает оптическую передачу с низкими потерями и высокой пропускной способностью по платам, стойкам и модулям, сохраняя при этом более высокую плотность полосы пропускания и улучшенную устойчивость к электромагнитным помехам. Физическая упаковка накладывает ограничения на количество процессоров и модулей памяти, которые можно разместить на одной подложке. Оптическая связь предлагает возможность их физического разделения, позволяя им при этом работать как часть гораздо более крупной вычислительной системы. 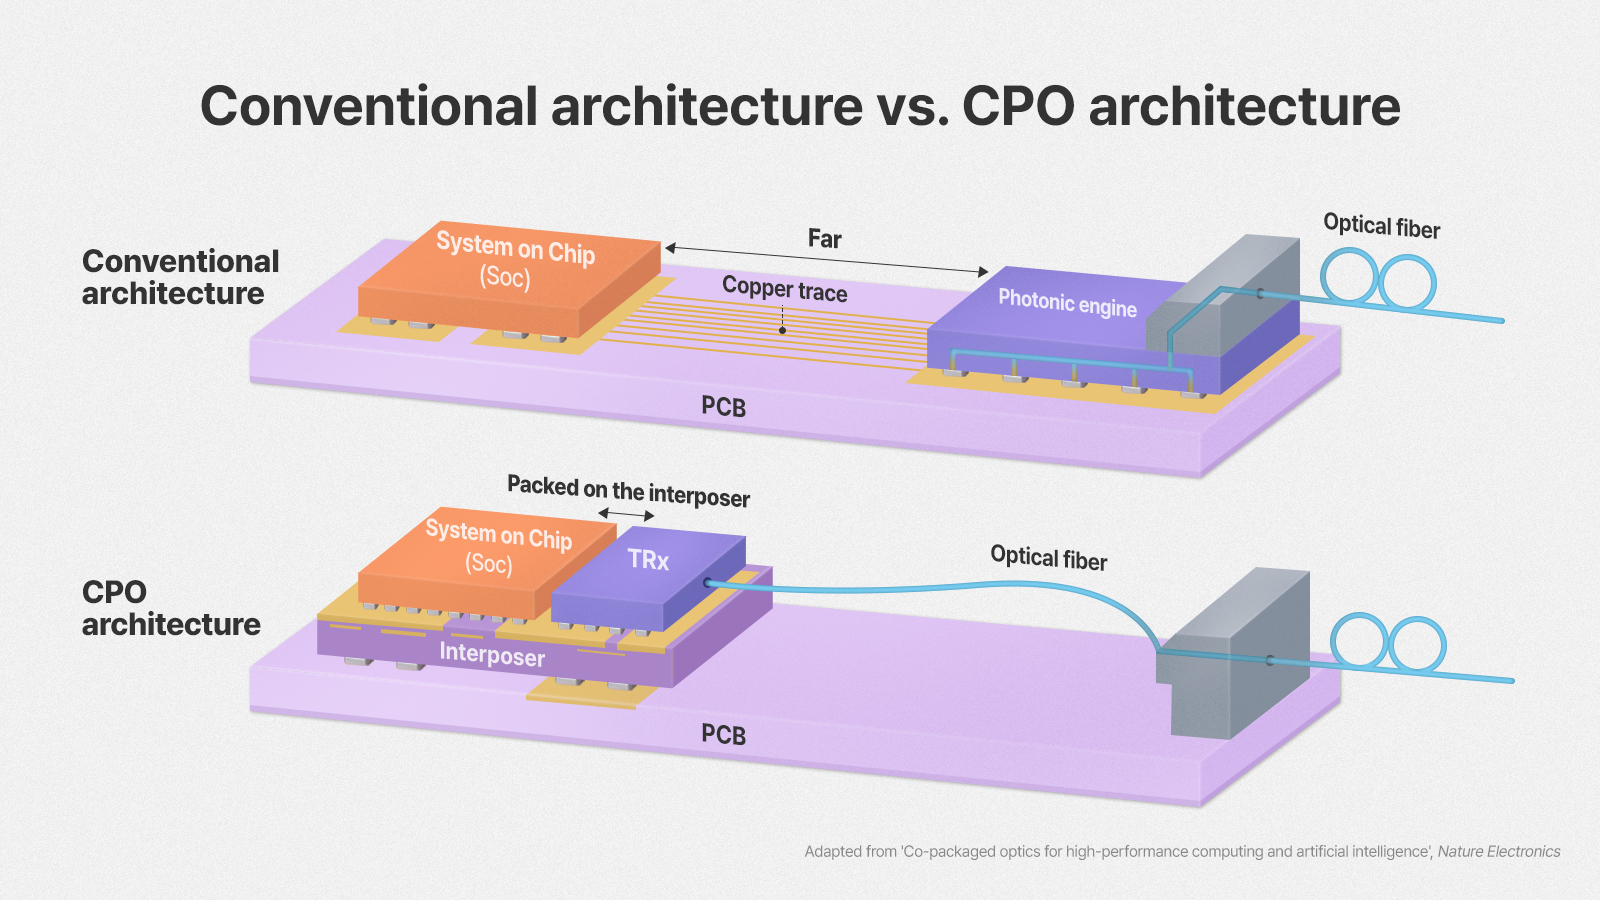 Концептуальная схема оптико-ориентированной архитектуры напрямую соединяет пулы вычислительных ресурсов (XPU) и пулы памяти посредством оптических сигналов с использованием интерпозера. Такой подход позволяет создавать дезагрегированные пулы общей памяти с низкой задержкой, где несколько вычислительных модулей могут получать доступ к общей ёмкости через оптическую объединительную плату без типичных для традиционных сетевых фабрик затрат на (де-)сериализацию, обеспечивая более гибкое перемещение данных на системном уровне и более быструю реакцию на растущий масштаб ИИ-моделей. Как отметил ресурс The Korea Times, значение статьи в Nature Electronics заключается не только в определении CPO как потенциального решения, но и в определении целей для будущей ИИ-инфраструктуры. Исследователи предполагают, что в будущем системы будут обеспечивать пропускную способность более 100 Тбит/с на узел, потребляя менее 1 пДж/бит и поддерживая межчиповую задержку менее 10 нс. SK hynix также прогнозирует архитектурную эволюция от стандартных 2D-многочиповых модулей и интеграции 2.5D-кремниевых интерпозеров к 3D-гетерогенной стековой компоновке. 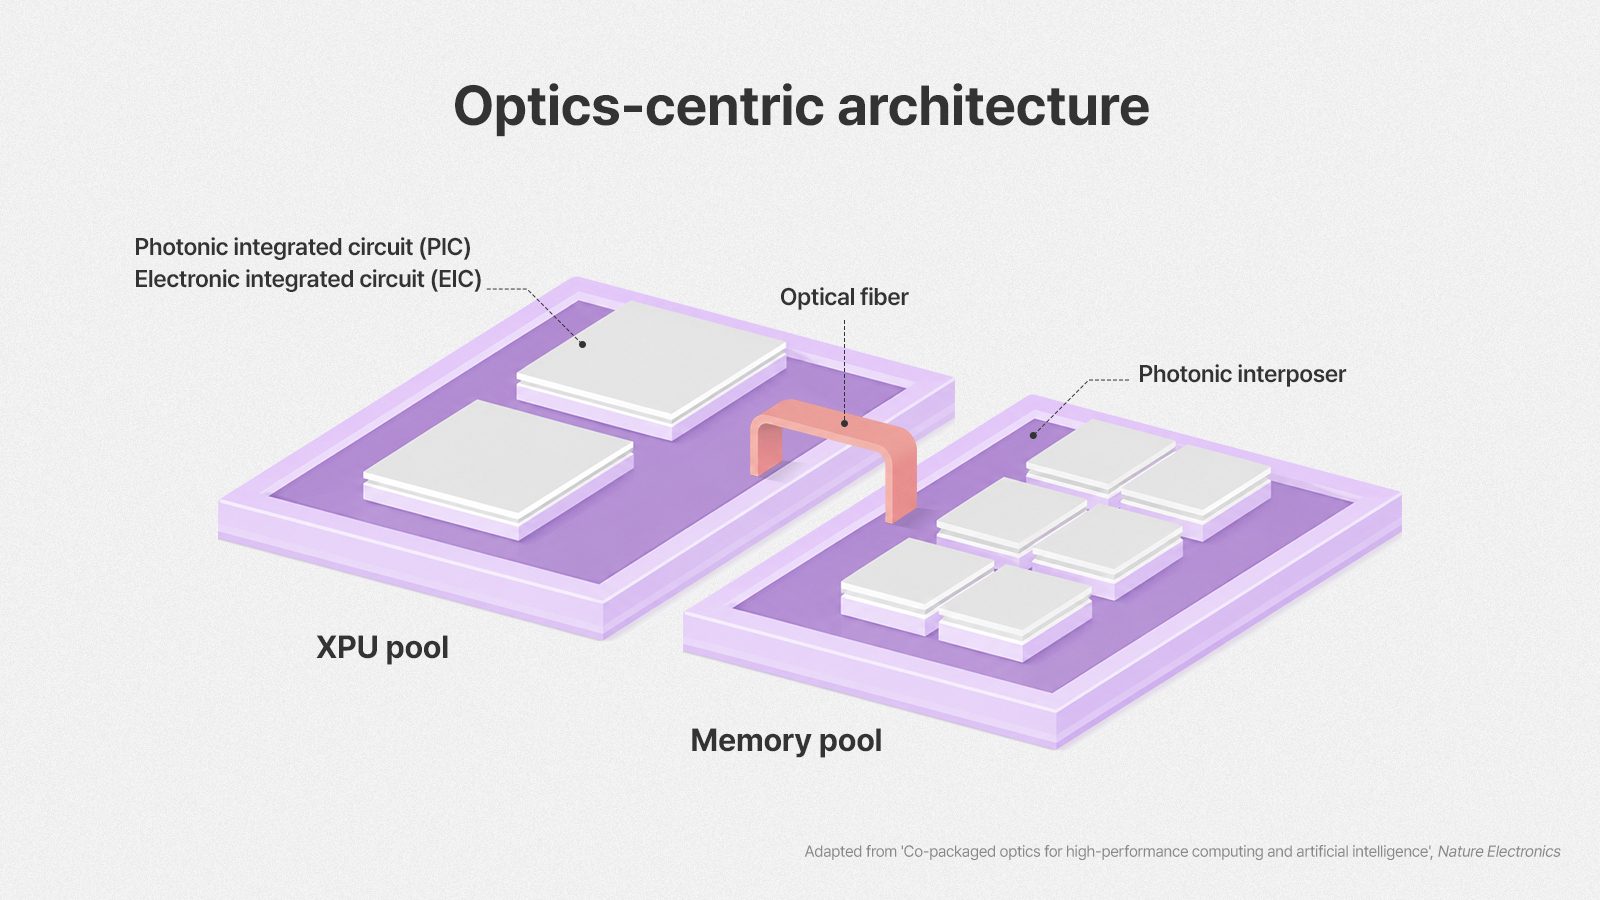 Кроме того, были указаны ключевые проблемы коммерциализации. Переход от демонстрации передовых вариантов упаковки к серийному производству оборудования сопряжён с рядом нерешенных инженерных проблем. Интеграция маломощных кремниевых фотонных устройств вместе с мощной логикой хоста требует сложной теплоизоляции и передовых микроканальных или иных систем прямого охлаждения упаковки. Также отрасли необходимо разработать стандартизированные протоколы когерентности с низкой задержкой, способные координировать операции с оптически связанной памятью без дополнительных затрат на проприетарные решения. Надёжная коммерциализация потребует комплексного проектирования оборудования, охватывающего топологии кристаллов DRAM, специализированные контроллеры памяти, фотонные модули и гетерогенную упаковку подложек. Статья также даёт представление о том, как SK hynix позиционирует себя на следующем этапе развития ИИ-инфраструктуры. Компания стала одним из главных бенефициаров бума генеративного ИИ благодаря HBM. Следующий этап требует, чтобы устройства памяти, контроллеры, оптические компоненты, процессоры и передовые технологии упаковки проектировались совместно, а не оптимизировались по отдельности. Именно поэтому исследователи делают акцент на «совместном проектировании». Нечто похожее уже разрабатывает Marvell, Lightmatter, Ayar Labs и другие вендоры. OCP также взялась за стандартизацию CPO, а группа гиперскейлеров сформировала альянс OCI MSA.
06.08.2026 [09:21], Владимир Мироненко
Память вскладчину: Marvell анонсировала дезагрегированную платформу Photonic Fabric с оптическим интерконнектом для ИИ-инфраструктурMarvell отметила, что по мере масштабирования ИИ-инференса его производительность всё больше зависит не просто от увеличения вычислительных мощностей, а от того, насколько эффективно вычислительные мощности, память и интерконнекты работают в рамках единой инфраструктуры, а также насколько быстро ускорители могут получать доступ, перемещать и использовать ресурсы памяти. Также Marvell заявила, что современная иерархия памяти для ИИ не рассчитана на инференс в масштабах, необходимых для современных рабочих нагрузок. Память HBM, напрямую подключённая к GPU, обеспечивает исключительную производительность, но имеет ограниченную ёмкость и высокую стоимость. Системная DRAM обеспечивает большие пулы памяти, но не может экономично масштабироваться вместе со всеми ускорителями. NVMe SSD имеют большую ёмкость, но и большую задержку, что делает их непригодными для обслуживания активных рабочих нагрузок инференса. В связи с этим Marvell предложила расширить иерархию ИИ-памяти за счёт нового промежуточного уровня, обеспечивающего значительно большую ёмкость, обычно ожидаемую от хранилищ, находясь при этом гораздо ближе к вычислительным ресурсам, с очень низкой задержкой, близкой к непосредственно подключённой памяти. 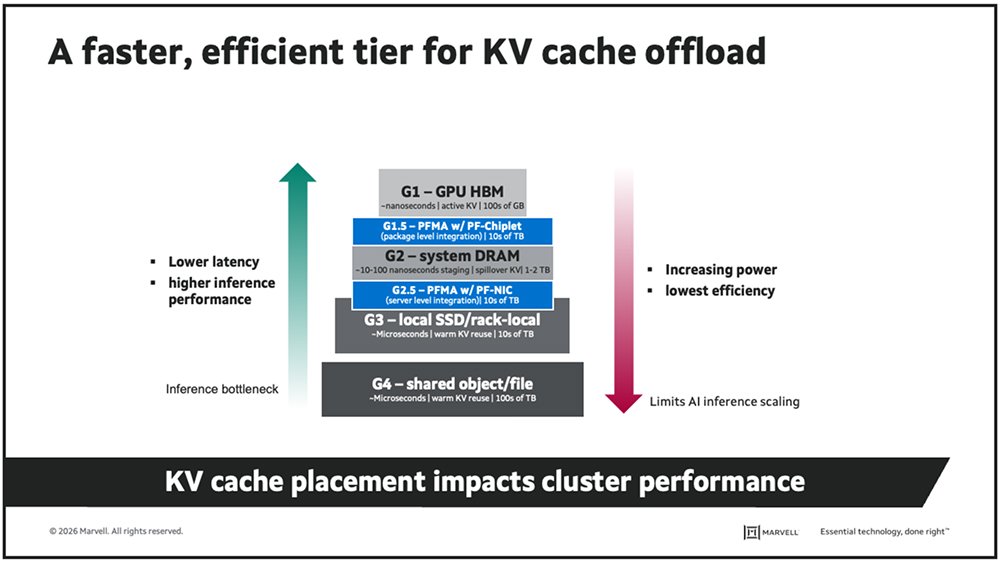
Источник изображений: Marvell Анонсированная Marvell платформа Marvell Photonic Fabric использует новую архитектуру оптического подключения для выполнения ИИ-задач, которая обеспечивает уровень общей для нескольких узлов памяти. Платформа, построенная на основе модуля памяти Marvell Photonic Fabric Memory Module (PFMM), сетевой карты Photonic Fabric NIC (PF-NIC) и чиплета Marvell Photonic Fabric, позволяет совместно использовать память в нескольких ИИ-стойках, расположенных на расстоянии до 30 м друг от друга, что даёт возможность значительно увеличить доступную для обработки ИИ-нагрузок память без пропорционального масштабирования вычислительных ресурсов. PFMM объединяет совместно используемую память DDR5, кеш HBM и высокоскоростной оптический интерконнект, обеспечивая расширение, объединение и дезагрегацию памяти в ИИ-инфраструктуре. 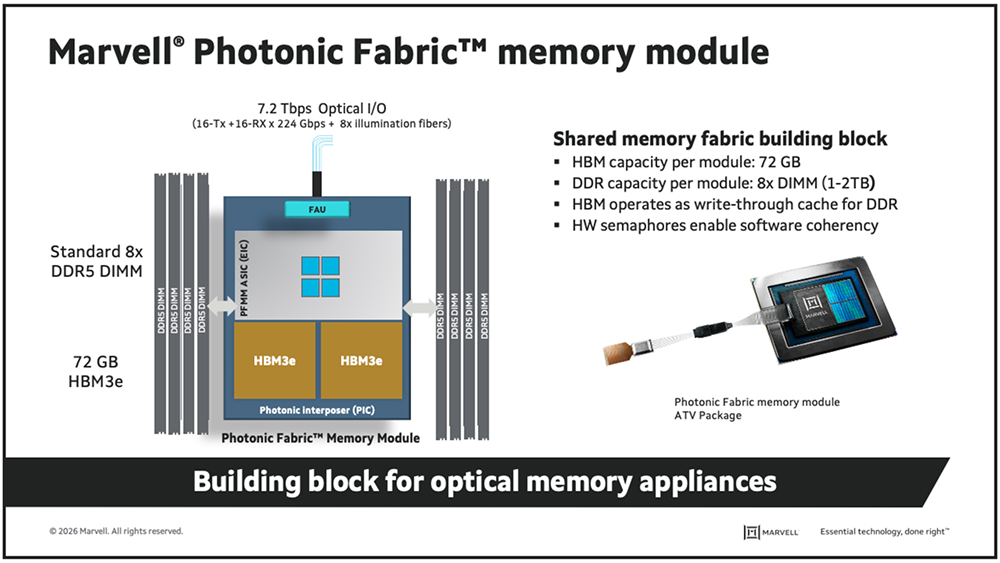 В основе платформы лежит первая в отрасли SoC с оптическим I/O, интегрированным в середину кремниевого кристалла. Разработанный специально для дезагрегации ИИ-памяти модуль PFMM поддерживает до 8 модулей DDR5 DIMM, дополненных кешем HBM объёмом 72 Гбайт и пропускной способностью оптической сети 7,2 Тбит/с. Архитектура обеспечивает NUMA-доступ за менее 350 нс на нескольких стойках, что позволяет ускорителям получать доступ к значительно большим объёмам ИИ-памяти без задержек, традиционно связанных с внешними СХД. 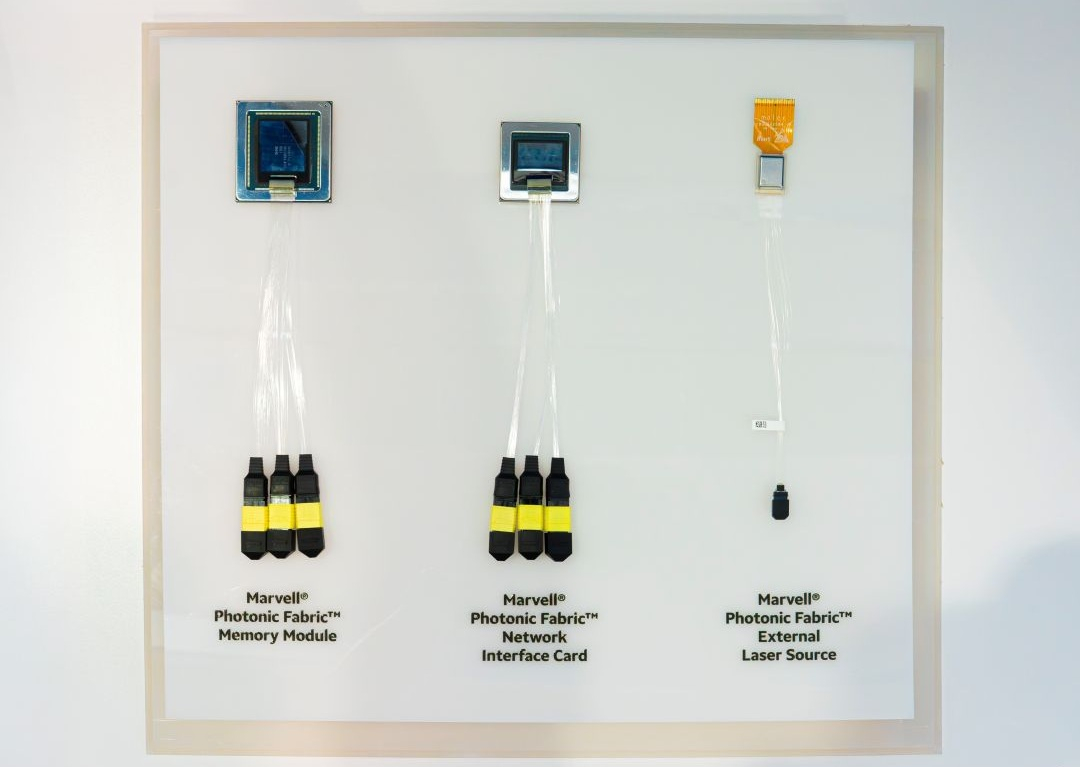 В дополнение к PFMM, сетевой адаптер PF-NIC предоставляет оптический сетевой интерфейс CXL 3.1 и PCIe 6.0, который соединяет ИИ-серверы с совместно используемой памятью. Вместе PFMM и PF-NIC позволяют использовать сторонние устройства с общей памятью, способные поддерживать увеличивающиеся KV-кеши, более крупные контексты моделей и всё более требовательные рабочие нагрузки инференса, сохраняя при этом совместимость с существующими программными ИИ-платформами. 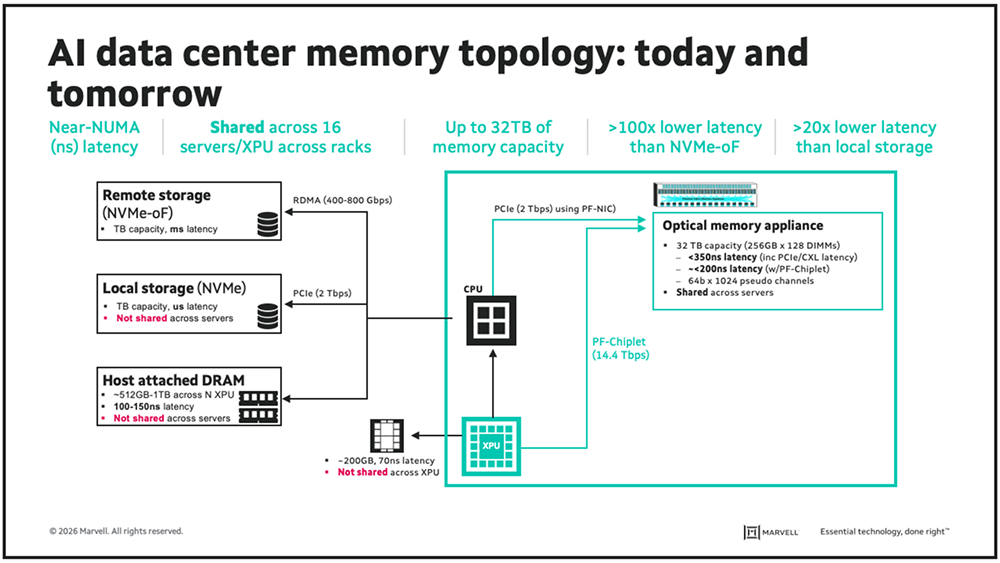 Сочетание оптического соединения с дезагрегацией памяти позволяет масштабировать объём памяти независимо от вычислительных ресурсов, сохраняя при этом пропускную способность и задержку, необходимые для крупномасштабного ИИ-инфренса. Результатом являются большие KV-кеши, улучшенное использование GPU, рост эффективности токенов и снижение энергопотребления при перемещении данных.
20.11.2025 [09:34], Владимир Мироненко
Представлены спецификации CXL 4.0: PCIe 7.0, агрегация портов и поддержка четырёх ретаймеровКонсорциум CXL Consortium объявил о выходе спецификации Compute Express Link (CXL) 4.0, которая более соответствует растущим требованиям рабочих нагрузок в современных ЦОД. По словам Дерека Роде (Derek Rohde), президента CXL Consortium, также занимающего пост главного инженера в NVIDIA, выпуск спецификации CXL 4.0 открывает новую веху в развитии когерентной работы с памятью, удваивая пропускную способность по сравнению с предыдущим поколением и предлагая новые функции. Он отметил, что выпуск отражает стремление компаний-членов консорциума продвигать открытые стандарты, которые способствуют инновациям и открывают всей отрасли возможность масштабироваться для будущих моделей использования. Новый стандарт CXL 4.0 получил поддержку линий с пропускной способности в 128 ГТ/с, что вдвое больше по сравнению с предыдущим, причём без увеличения задержки. Фактически стандарт приведён в соответствие с PCI Express 7.0. Также были сохранены ранее реализованные улучшения протокола CXL 3.0: FLIT-кадры размером 256 байт, FEC и CRC. Сохраняется и полная обратная совместимость со всеми предыдущими версиями — CXL 3.x, 2.0, 1.1 и 1.0. Впрочем, тут есть нюансы. В CXL 4.0 появилась агрегация физических портов (Bundled Ports) в один логический порт, позволяющая одному устройству Type 1/2 одновременно подключаться к нескольким root-портам хоста или коммутатора для увеличения пропускной способности. При этом один из физических портов должен быть полнофункциональным, тогда как остальные порты могут быть оптимизированы исключительно для передачи данных. Агрегированные порты также поддерживают 256-байт FLIT-режим, но как минимум один физический порт должен поддерживать 68-байт режим ради обратной совместимости. 
Источник изображения: CXL Consortium Также спецификация реализует поддержку до четырёх ретаймеров для увеличения дальности передачи сигнала, повышение надёжности (RAS), снижение количества возможных ошибок, а также более детальные и актуальные отчёты о проблемах. Кроме того, появилась функция Post Package Repair (PPR), позволяющая хосту инициировать проверку устройства во время загрузки, т.е. до запуска рабочих нагрузок. Комментируя выход CXL 4.0, Alibaba заявила, что как член-учредитель консорциума CXL, она активно поддерживает экосистему CXL: «Мы рады выпуску CXL 4.0, поддерживающей PCIe 7.0 и объединение портов, что отвечает растущим требованиям к пропускной способности памяти для современных облачных рабочих нагрузок. Кроме того, CXL 4.0 повышает надёжность и удобство обслуживания памяти благодаря расширенным возможностям оповещения об ошибках и резервирования памяти. Мы считаем, что CXL 4.0 представляет собой еще одну важную веху на пути к компонуемым, масштабируемыми надёжным стоечным архитектурам для ЦОД нового поколения».
27.05.2024 [22:20], Алексей Степин
Тридцать на одного: Liqid UltraStack 30 позволяет подключить десятки GPU к одному серверуКомпания Liqid сотрудничает с Dell довольно давно — ещё в прошлом году она смогла добиться размещения 16 ускорителей в своей платформе UltraStack L40S. Но на этом компания не остановилась и представила новую композитную платформу UltraStack 30, в которой смогла довести число одновременно доступных хост-системе ускорителей до 30. Для подключения, конфигурации и управления ресурсами ускорителей Liqid использует комбинацию фирменного программного обеспечения Matrix CDI и интерконнекта Liqid Fabric. В основе последнего лежит PCI Express. Это позволяет динамически конфигурировать аппаратную инфраструктуру с учётом конкретных задач с её возвратом в общий пул ресурсов по завершению работы. Сами «капсулы» с ресурсами подключены к единственному хост-серверу, что упрощает задачу масштабирования, минимизирует потери производительности, повышает энергоэффективность и позволяет добиться наиболее плотной упаковки вычислительных ресурсов, нежели это возможно в классическом варианте с раздельными серверами. А благодаря гибкости конфигурирования буквально «на лету» исключается простой весьма дорогостоящих аппаратных ресурсов. 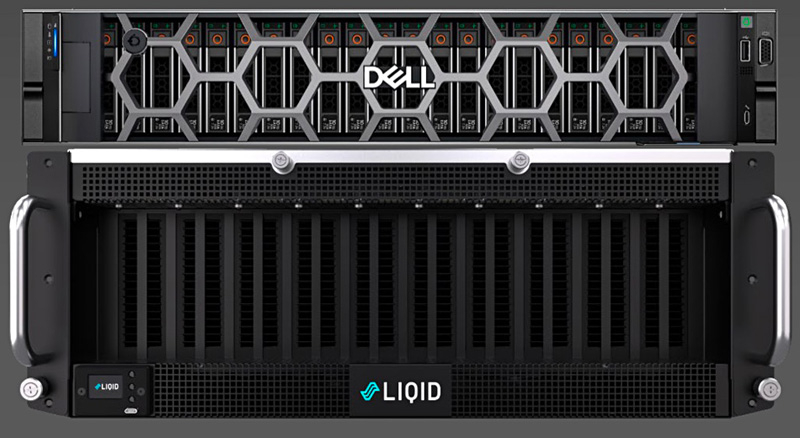
Источник здесь и далее: Liqid В случае UltraStack 30 основой по умолчанию является сервер серии Dell PowerEdge R760 с двумя Xeon Gold 6430 и 1 Тбайт оперативной памяти, однако доступен также вариант на базе Dell R7625, оснащённый процессорами AMD EPYC 9354. Опционально можно укомплектовать систему NVMe-хранилищем объёмом 30 Тбайт, в качестве сетевых опций доступны либо пара адаптеров NVIDIA ConnectX-7, либо один DPU NVIDIA Bluefield-3. 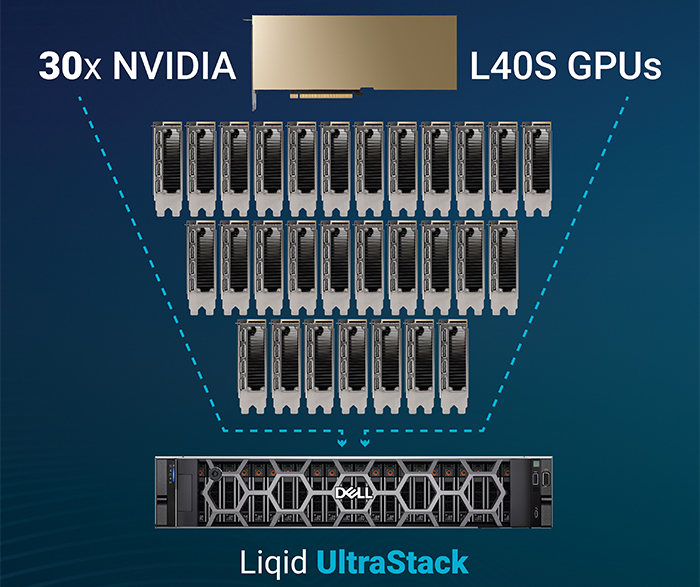 За общение с ускорительными модулями отвечает 48-портовой коммутатор PCI Express 4.0 вкупе с фирменными хост-адаптерами Liqid. Технология ioDirect позволяет ускорителям общаться друг с другом и хранилищем данных напрямую, без посредничества CPU. В трёх модулях расширения установлено по 10 ускорителей NVIDIA L40S, каждый несет на борту 48 Гбайт памяти GDDR6. Такая конфигурация теоретически способна развить 7,3 Пфлопс на вычислениях FP16, вдвое больше на FP8, и почти 1,1 Пфлопс на тензорных ядрах в формате TF32. 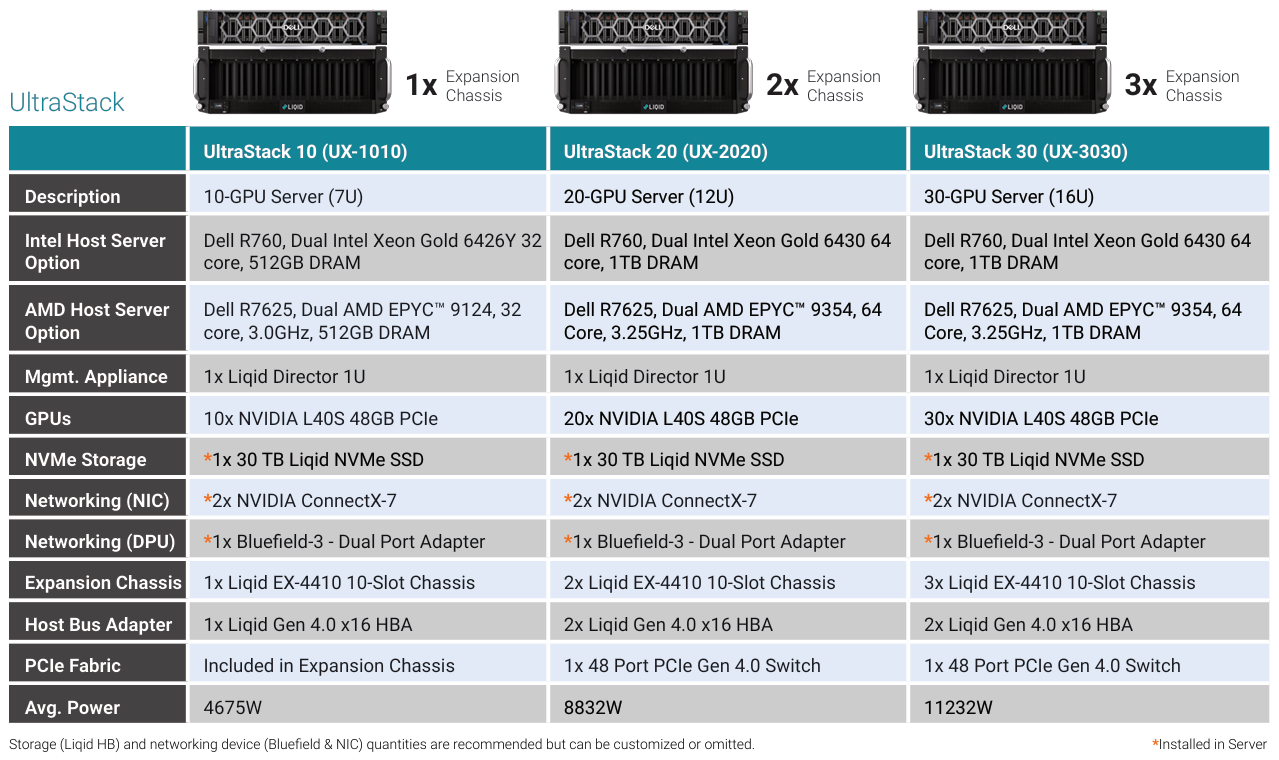 Платформа UltraStack 30 предназначена в первую очередь для быстрого развёртывания достаточно мощной ИИ-инфраструктуры там, где требуется тонкая подстройка и дообучение уже «натасканных» больших моделей. При этом стоит учитывать довольно солидное энергопотребление, составляющее более 11 кВт. Также в арсенале компании есть решения SmartStack на базе модульных систем Dell PowerEdge C-Series, позволяющие подключать к каждому из лезвийных модулей MX760c, MX750с и MX740c до 20 ускорителей. Модульные решения Liqid поддерживают также ускорители других производителей, включая достаточно экзотические, такие как Groq.
11.11.2023 [23:59], Алексей Степин
СуперДупер: GigaIO SuperDuperNODE позволяет объединить посредством PCIe сразу 64 ускорителяКомпания GigaIO, чьей главной разработкой является система распределённого интерконнекта на базе PCI Express под названием FabreX, поставила новый рекорд — в новой платформе разработчикам удалось удвоить количество одновременно подключаемых PCIe-устройств, увеличив его с 32 до 64. О разработках GigaIO мы рассказывали читателям неоднократно. Во многом они действительно уникальны, поскольку созданная компанией композитная инфраструктура позволяет подключать к одному или нескольким серверам существенно больше различных ускорителей, нежели это возможно в классическом варианте, но при этом сохраняет высокий уровень утилизации этих ускорителей. 
GigaIO SuperNODE. Источник изображений здесь и далее: GigaIO В начале года компания уже демонстрировала систему с 16 ускорителями NVIDIA A100, а летом GigaIO представила мини-кластер SuperNODE. В различных конфигурациях система могла содержать 32 ускорителя AMD Instinct MI210 или 24 ускорителя NVIDIA A100, дополненных СХД ёмкостью 1 Пбайт. При этом система в силу особенностей FabreX не требовала какой-либо специфической настройки перед работой. 
FabreX позволяет физически объединить все типы ресурсов на базе существующего стека технологий PCI Express На этой неделе GigaIO анонсировала новый вариант своей HPC-системы, получившей незамысловатое название SuperDuperNODE. В ней она смогла удвоить количество ускорителей с 32 до 64. Как и прежде, система предназначена, в первую очередь, для использования в сценариях генеративного ИИ, но также интересна она и с точки зрения ряда HPC-задач, в частности, вычислительной гидродинамики (CFD). Система SuperNODE смогла завершить самую сложную в мире CFD-симуляцию всего за 33 часа. В ней имитировался полёт 62-метрового авиалайнера Конкорд. Хотя протяжённость модели составляет всего 1 сек, она очень сложна, поскольку требуется обсчёт поведения 40 млрд ячеек объёмом 12,4 мм3 на протяжении 67268 временных отрезков. 29 часов у системы ушло на обсчёт полёта, и ещё 4 часа было затрачено на рендеринг 3000 4К-изображений. С учётом отличной масштабируемости при использовании SuperDuperNODE время расчёта удалось сократить практически вдвое. Как уже упоминалось, FabreX позволяет малой кровью наращивать число ускорителей и иных мощных PCIe-устройств на процессорный узел при практически идеальном масштабировании. Обновлённая платформа не подвела и в этот раз: в тесте HPL-MxP пиковый показатель утилизации составил 99,7 % от теоретического максимума, а в тестах HPL и HPCG — 95,2 % и 88 % соответственно. Компания-разработчик сообщает о том, что программное обеспечение FabreX обрело завершённый вид и без каких-либо проблем обеспечивает переключение режимов SuperNODE между Beast (система видна как один большой узел), Swarm (множество узлов для множества нагрузок) и Freestyle Mode (каждой нагрузке выделен свой узел с заданным количеством ускорителей). Начало поставок SuperDuperNODE запланировано на конец года. Партнёрами, как и в случае с SuperNODE, выступят Dell и Supermicro.
18.07.2023 [22:45], Сергей Карасёв
Суперкомпьютер в стойке: GigaIO SuperNODE позволяет объединить 32 ускорителя AMD Instinct MI210Компания GigaIO анонсировала HPC-систему SuperNODE, предназначенную для решения ресурсоёмких задач в области генеративного ИИ. SuperNODE позволяет связать воедино до 32 ускорителей посредством компонуемой платформы GigaIO FabreX. Архитектура FabreX на базе PCI Express, по словам создателей, намного лучше InfiniBand и NVIDIA NVLink по уровню задержки и позволяет объединять различные компоненты — GPU, FPGA, пулы памяти и пр. SuperNODE даёт возможность более эффективно использовать ресурсы, нежели в случае традиционного подхода с ускорителями в составе нескольких серверов. В частности для SuperNODE доступны конфигурации с 32 ускорителями AMD Instinct MI210 или 24 ускорителями NVIDIA A100 с хранилищем ёмкостью до 1 Пбайт. При этом платформа компактна, энергоэффективна (до 7 кВт) и не требует дополнительной настройки перед работой. 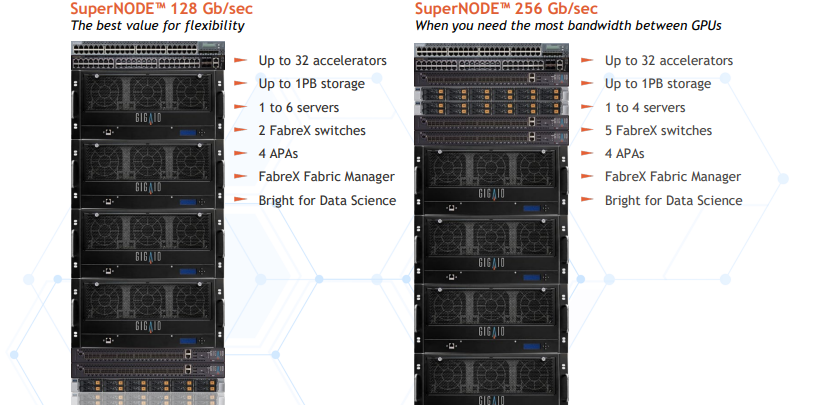
Источник изображений: GigaIO Поскольку приложения с большими языковыми моделями требуют огромных вычислительных мощностей, технологии, которые сокращают количество необходимых обменов данными между узлом и ускорителем, имеют решающее значение для обеспечения необходимой скорости выполнения операций при снижении общих затрат на формирование инфраструктуры. Что немаловажно, платформ, по словам разработчиков, демонстрирует хорошую масштабируемость производительности при увеличении числа ускорителей. 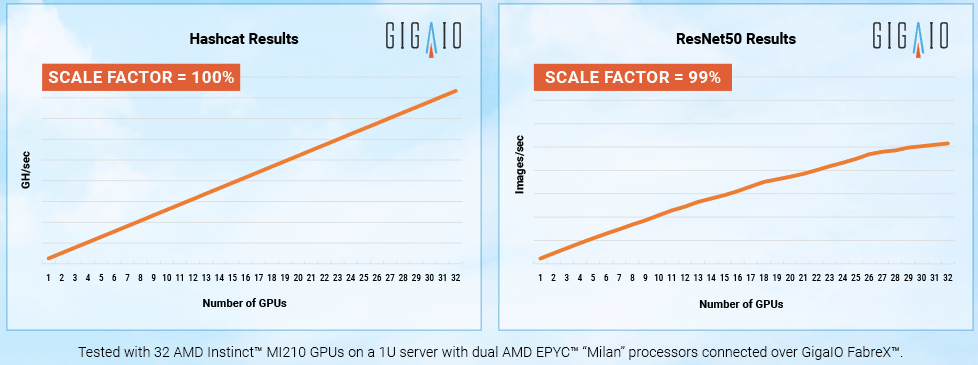 «Система SuperNODE, созданная GigaIO и работающая на ускорителях AMD Instinct, обеспечивает привлекательную совокупную стоимость владения как для традиционных рабочих нагрузок HPC, так и для задач генеративного ИИ», — сказал Эндрю Дикманн (Andrew Dieckmann), корпоративный вице-президент и генеральный менеджер по дата-центрам AMD. Стоит отметить, что у AMD нет прямого аналога NVIDIA NVLink, так что для объединение ускорителей в большие пулы с высокой скоростью подключения возможно как раз с использованием SuperNODE.
25.01.2023 [18:30], Алексей Степин
GigaIO FabreX обещает удвоить эффективность использования ресурсов ускорителей для платформ на базе Sapphire RapidsКомпания GigaIO, разработчик компонуемой платформы FabreX также поддержала выпуск новых процессоров Intel Xeon. Сертифицированная платформа GigaIO GigaPod на базе Sapphire Rapids показала возросший на 106 % уровень утилизации ускорителей в сравнении с платформой NVIDIA DGX, использующей InfiniBand. 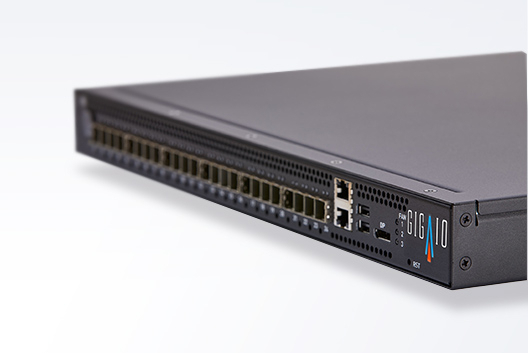
Коммутатор FabreX. Источник здесь и далее: GigaIO Конфигурация тестовой системы включала в себя сервер на базе Sapphire Rapids, к которому с помощью FarbeX были подключены 16 ускорителей NVIDIA A100. Как показало тестирование, такая конфигурация куда эффективнее использует ресурсы, нежели в случае традиционного подхода, когда ускорители «раскиданы» по нескольким серверам и коммуникация между ними осуществляется посредством высокоуровневой сети вроде InfiniBand. 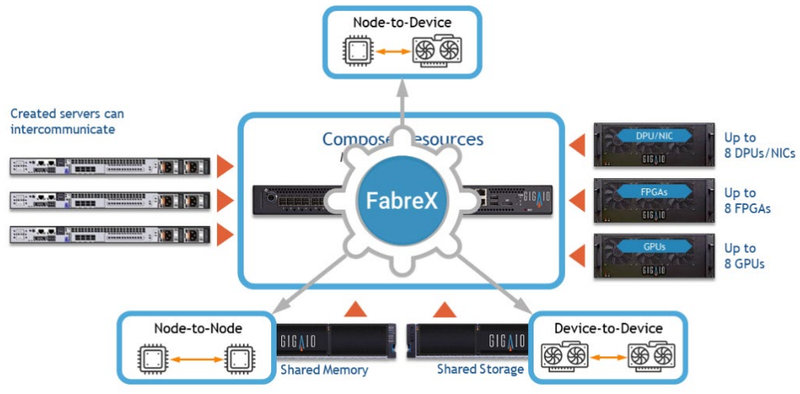
Интерконнект GigaIO FabreX универсален и поддерживает подключение любых типов устройств в рамках платформы GigaPod Глава GigaIO отметил, что в классическом варианте уровень загрузки ускорителей может опускаться до 15 %, и это при том, что стоимость мощных ускорителей иногда составляет до 80 % стоимости всей системы. Финальный выигрыш в стоимости GigaPod в версии с процессорами Sapphire Rapids может достигать 30 % в пользу решения GigaIO. Компонуемая архитектура, продвигаемая GigaIO, существенно эффективнее традиционных: в её основе лежит PCI Express, что гарантирует задержку на уровне менее 1 мкс. По этому показателю FabreX превосходит и InfiniBand, и NVIDIA NVLink. При этом полностью поддерживается DMA. 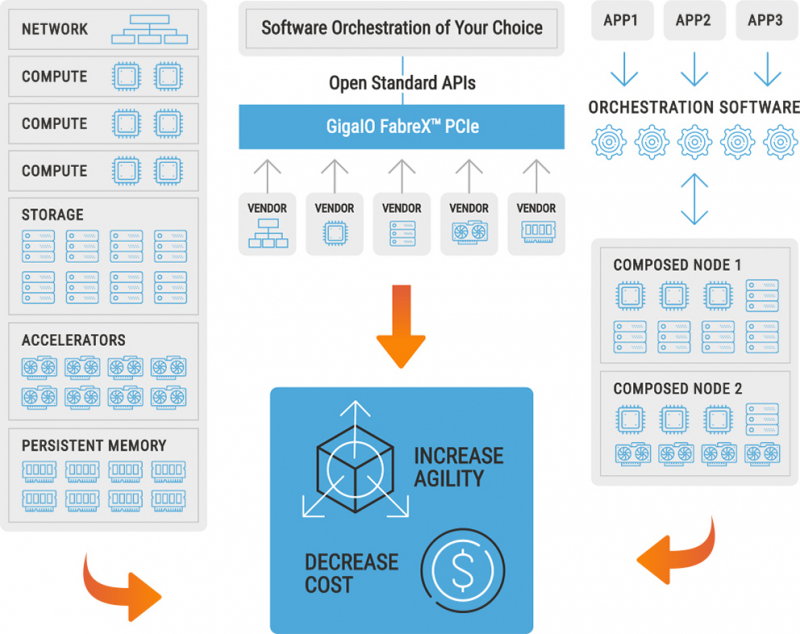
Программная архитектура FabreX Платформа FabreX универсальна, она позволяет подключать к системе практически любые компоненты, от GPU до пулов памяти и FPGA, в том числе с CXL. Ещё на SC20 компания продемонстрировала 5U-шасси, вмещающие до 10 ускорителей с интерфейсом PCIe 4.0. Архитектура GigaIO является программно-определяемой и совместима с большей частью современного ПО для управления и распределения нагрузки, в ней реализован набор открытых API Redfish.
02.08.2022 [16:00], Алексей Степин
Опубликованы спецификации Compute Express Link 3.0Мало-помалу стандарт Compute Express Link пробивает себе путь на рынок: хотя процессоров с поддержкой ещё нет, многие из элементов инфраструктуры для нового интерконнекта и базирующихся на нём концепций уже готово — в частности, регулярно демонстрируются новые контроллеры и модули памяти. Но развивается и сам стандарт. В версии 1.1, спецификации на которую были опубликованы ещё в 2019 году, были только заложены основы. Но уже в версии 2.0 CXL получил массу нововведений, позволяющих говорить не просто о новой шине, но о целой концепции и смене подхода к архитектуре серверов. А сейчас консорциум, ответственный за разработку стандарта, опубликовал свежие спецификации версии 3.0, ещё более расширяющие возможности CXL. 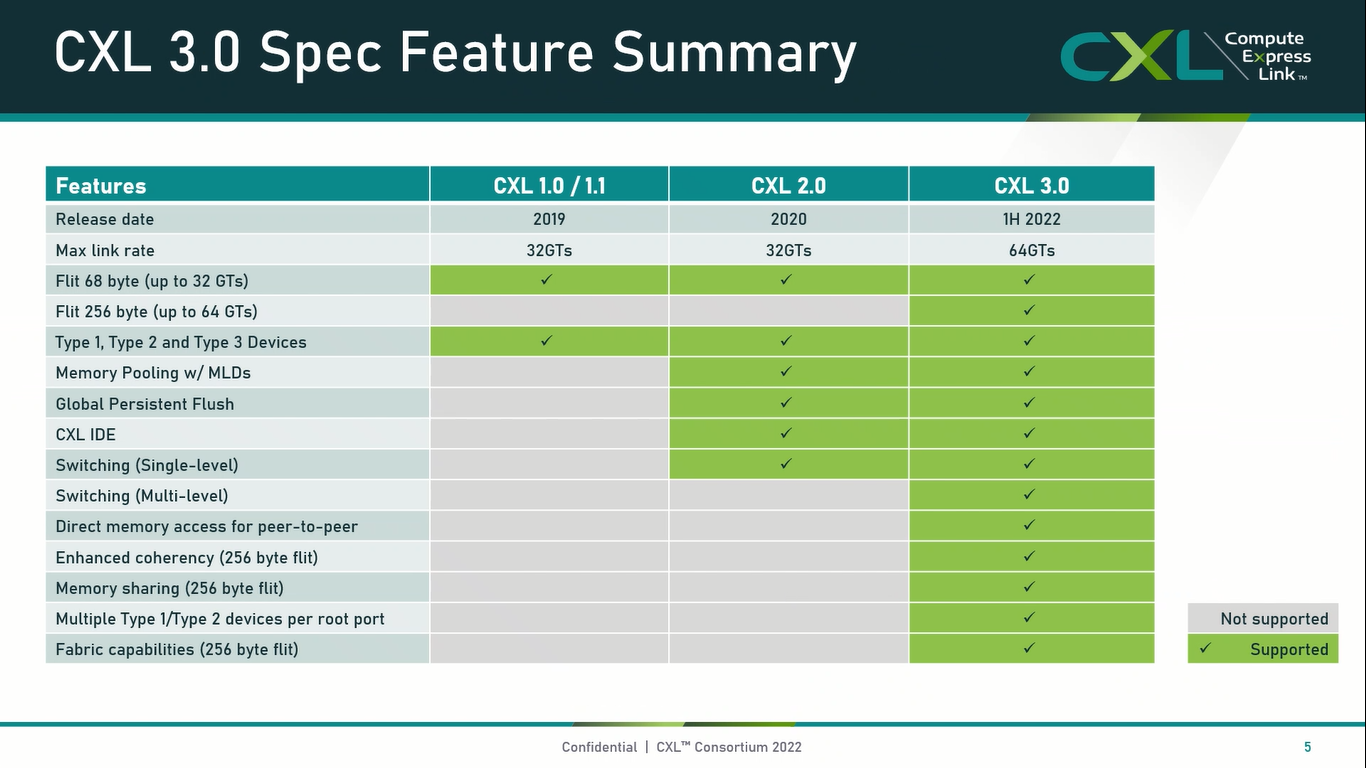
Источник: CXL Consortium И не только расширяющие: в версии 3.0 новый стандарт получил поддержку скорости 64 ГТ/с, при этом без повышения задержки. Что неудивительно, поскольку в основе лежит стандарт PCIe 6.0. Но основные усилия разработчиков были сконцентрированы на дальнейшем развитии идей дезагрегации ресурсов и создания компонуемой инфраструктуры. 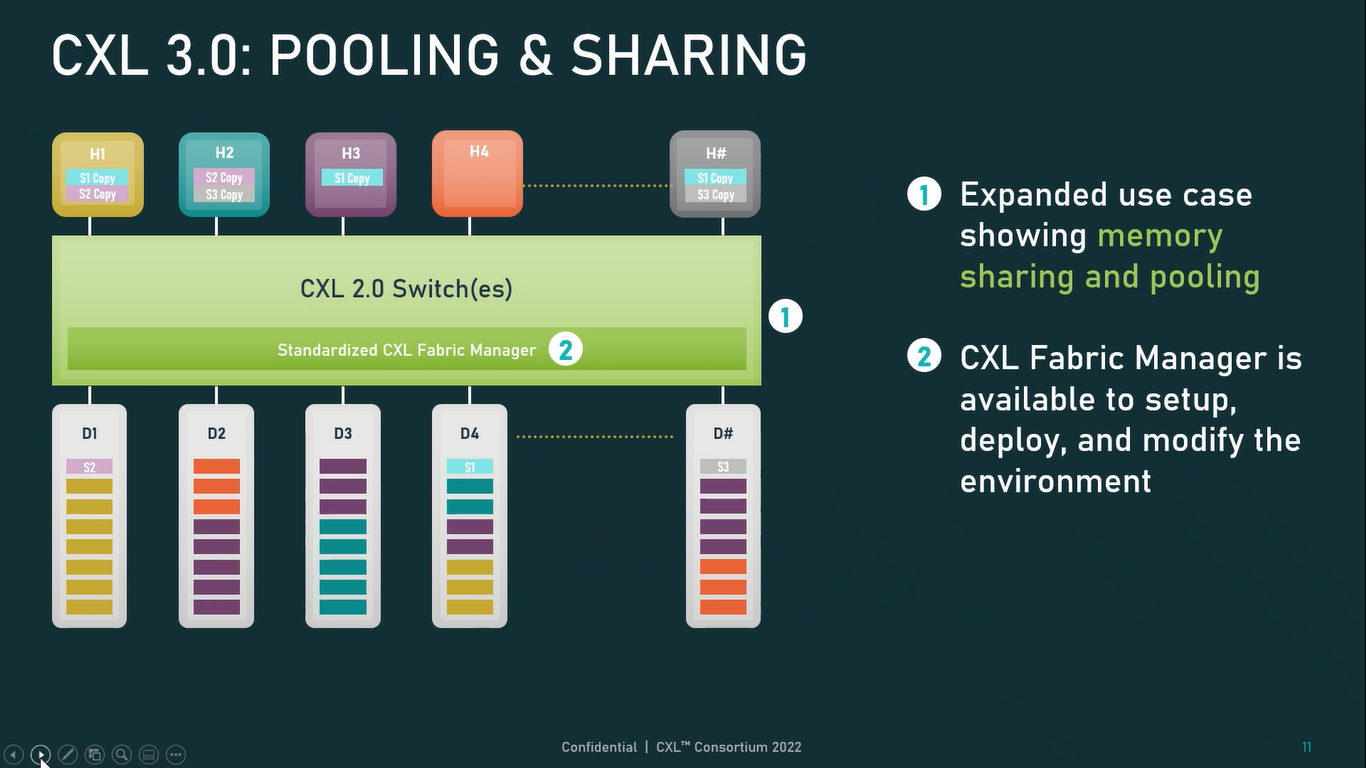 Сама фабрика CXL 3.0 теперь допускает создание и подключение «многоголовых» (multi-headed) устройств, расширены возможности по управлению фабрикой, улучшена поддержка пулов памяти, введены продвинутые режимы когерентности, а также появилась поддержка многоуровневой коммутации. При этом CXL 3.0 сохранил обратную совместимость со всеми предыдущими версиями — 2.0, 1.1 и даже 1.0. В этом случае часть имеющихся функций попросту не будет активирована. 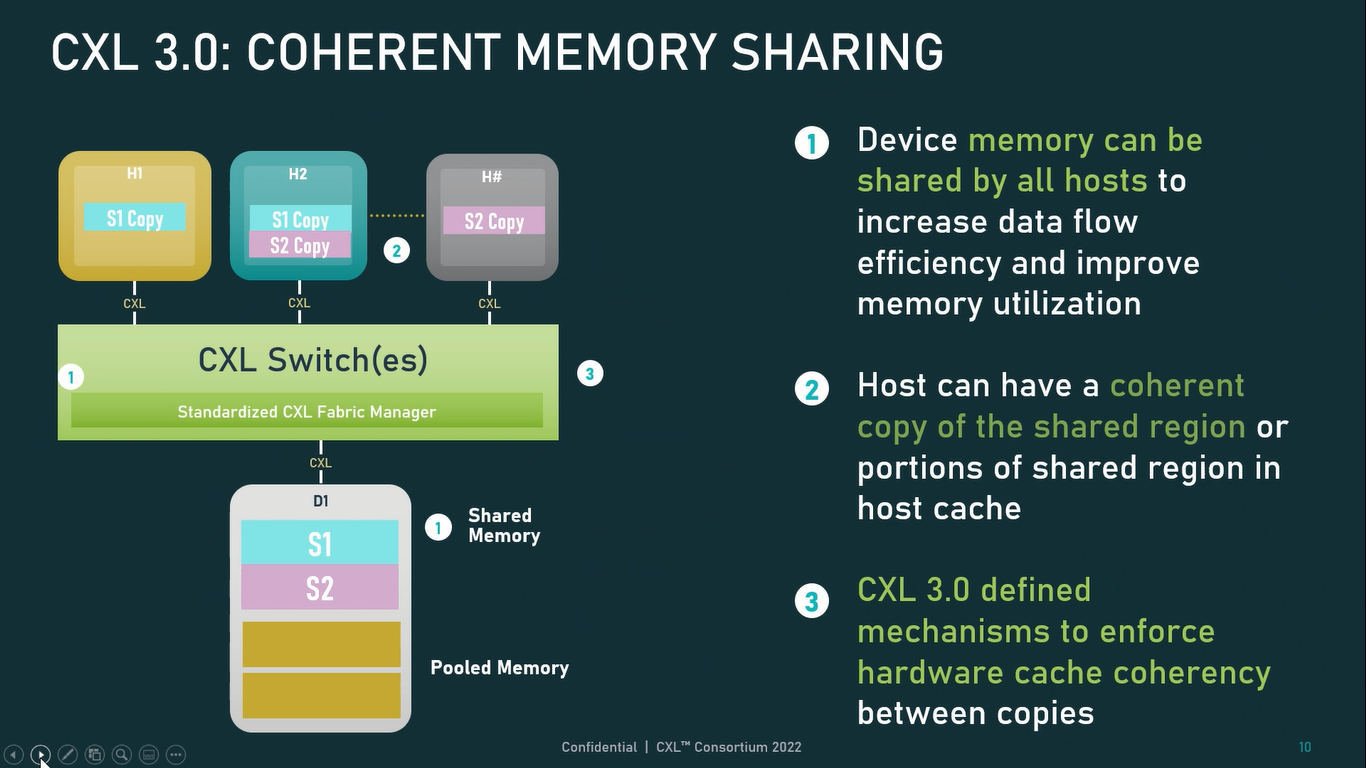 Одно из ключевых новшеств — многоуровневая коммутация. Теперь топология фабрики CXL 3.0 может быть практически любой, от линейной до каскадной с группами коммутаторов, подключенных к коммутаторам более высокого уровня. При этом каждый корневой порт процессора поддерживает одновременное подключение через коммутатор устройств различных типов в любой комбинации. 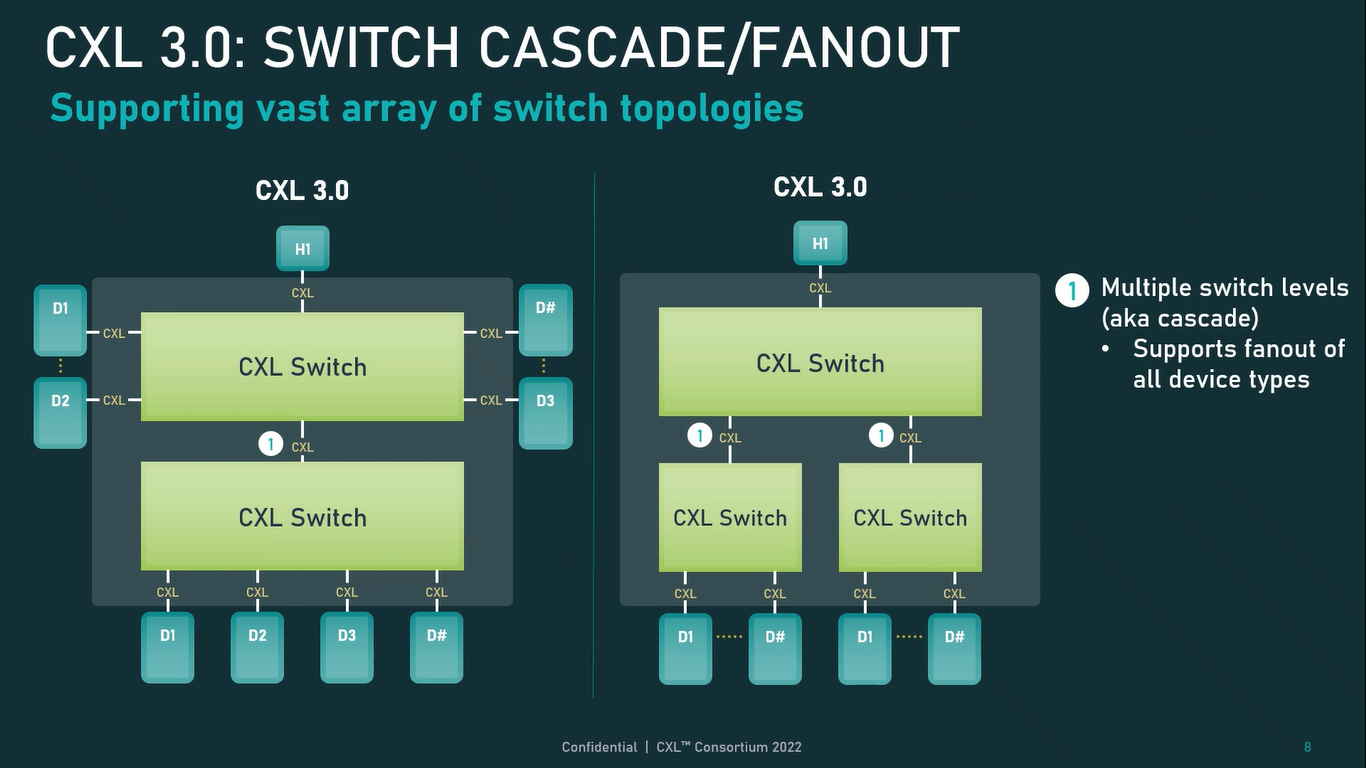 Ещё одним интересным нововведением стала поддержка прямого доступа к памяти типа peer-to-peer (P2P). Проще говоря, несколько ускорителей, расположенных, к примеру, в соседних стойках, смогут напрямую общаться друг с другом, не затрагивая хост-процессоры. Во всех случаях обеспечивается защита доступа и безопасность коммуникаций. Кроме того, есть возможность разделить память каждого устройства на 16 независимых сегментов. 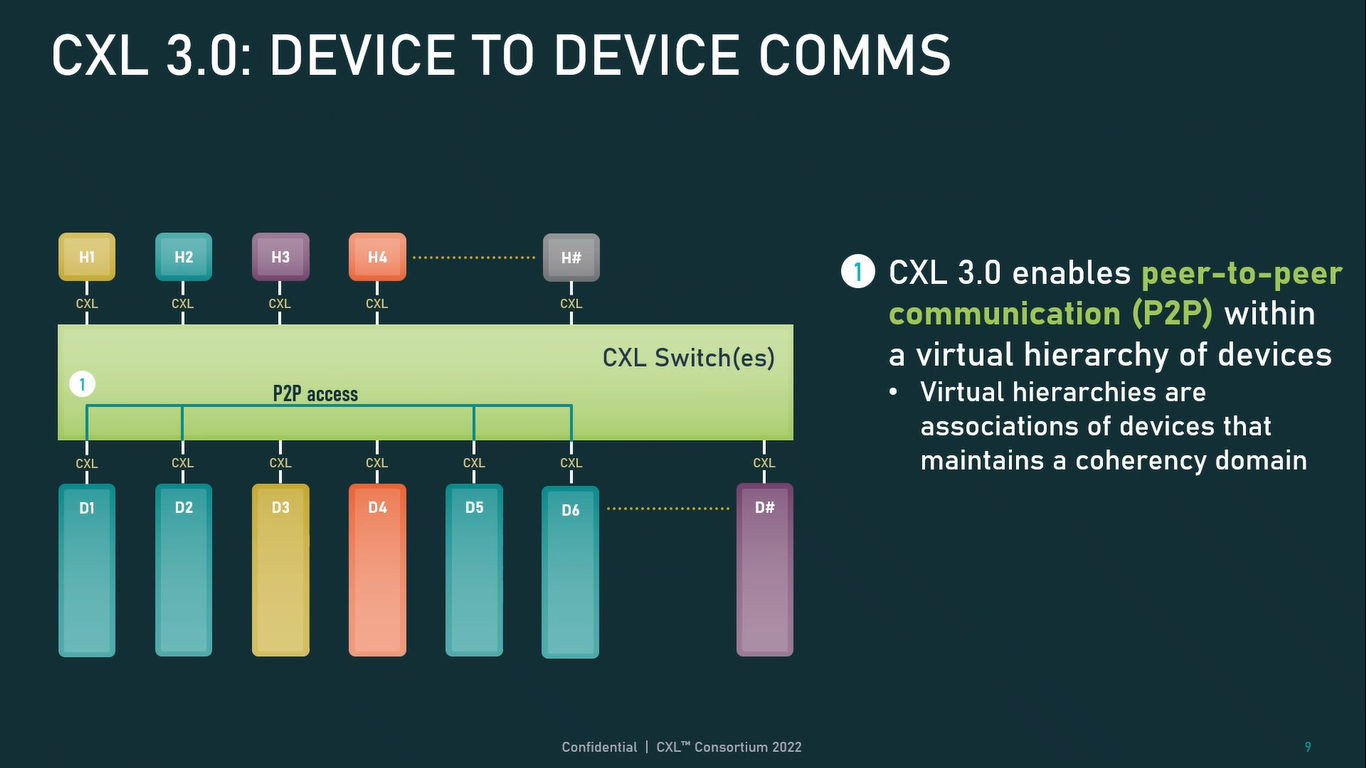 При этом поддерживается иерархическая организация групп, внутри которых обеспечивается когерентность содержимого памяти и кешей (предусмотрена инвалидация). Теперь помимо эксклюзивного доступа к памяти из пула доступен и общий доступ сразу нескольких хостов к одному блоку памяти, причём с аппаратной поддержкой когерентности. Организация пулов теперь не отдаётся на откуп стороннему ПО, а осуществляется посредством стандартизированного менеджера фабрики. 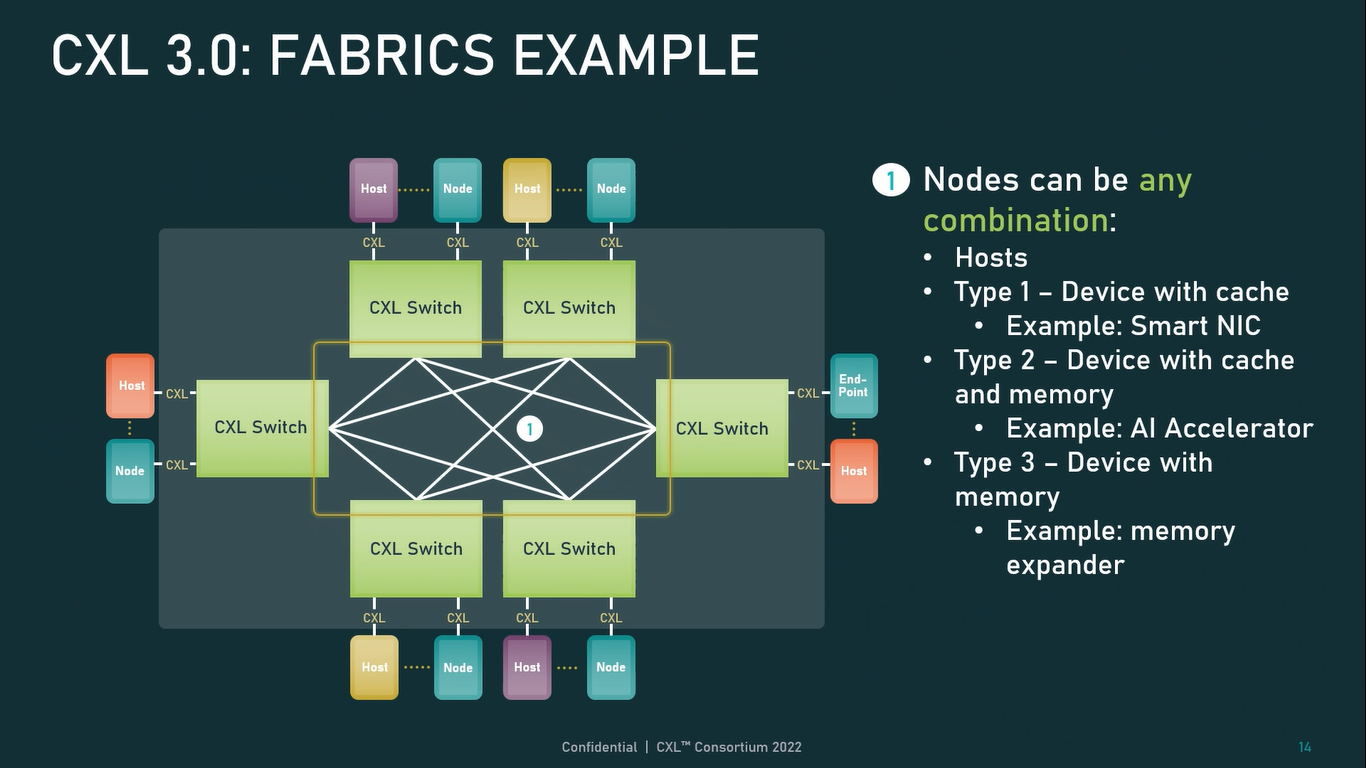 Сочетание новых возможностей выводит идею разделения памяти и вычислительных ресурсов на новый уровень: теперь возможно построение систем, где единый пул подключенной к фабрике CXL 3.0 памяти (Global Fabric Attached Memory, GFAM) действительно существует отдельно от вычислительных модулей. При этом возможность адресовать до 4096 точек подключения скорее упрётся в физические лимиты фабрики. 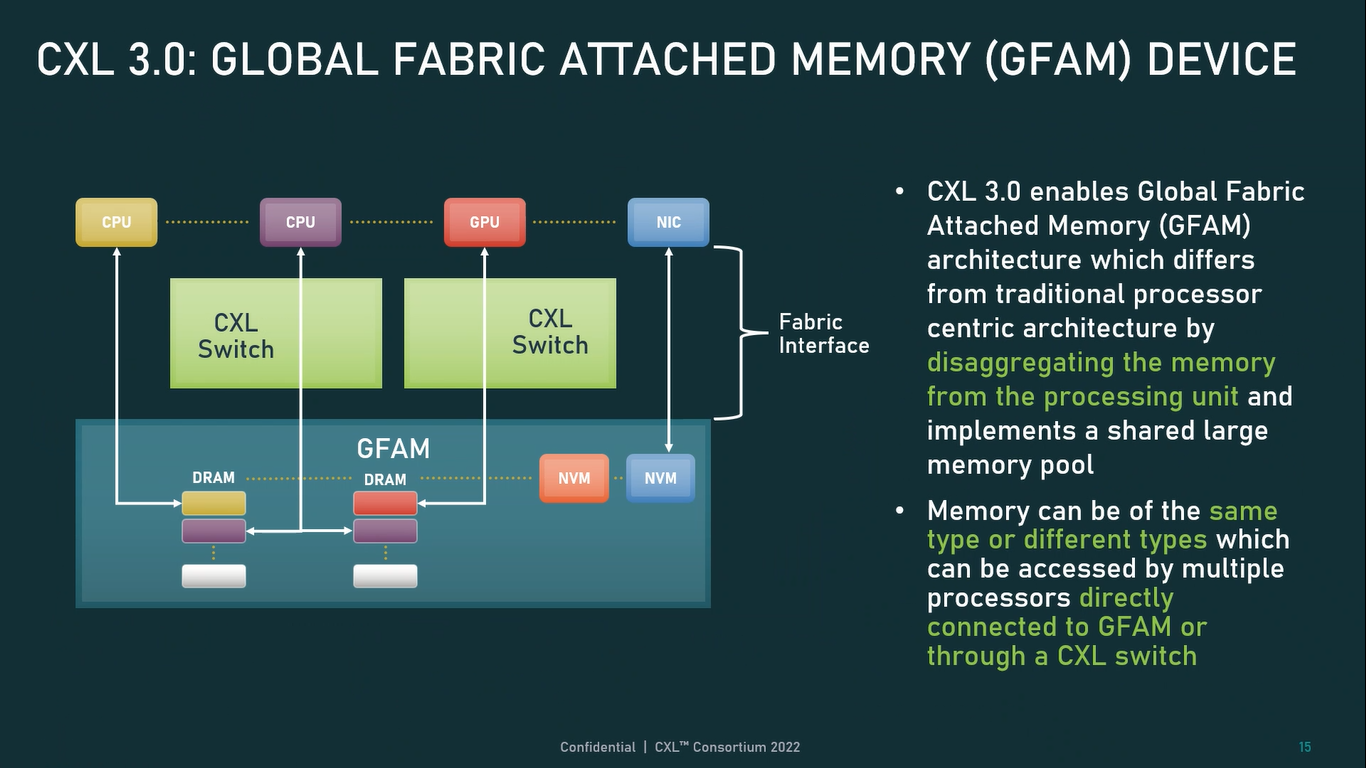 Пул может содержать разные типы памяти — DRAM, NAND, SCM — и подключаться к вычислительным мощностями как напрямую, так и через коммутаторы CXL. Предусмотрен механизм сообщения самими устройствами об их типе, возможностях и прочих характеристиках. Подобная архитектура обещает стать востребованной в мире машинного обучения, в котором наборы данных для нейросетей нового поколения достигают уже поистине гигантских размеров. 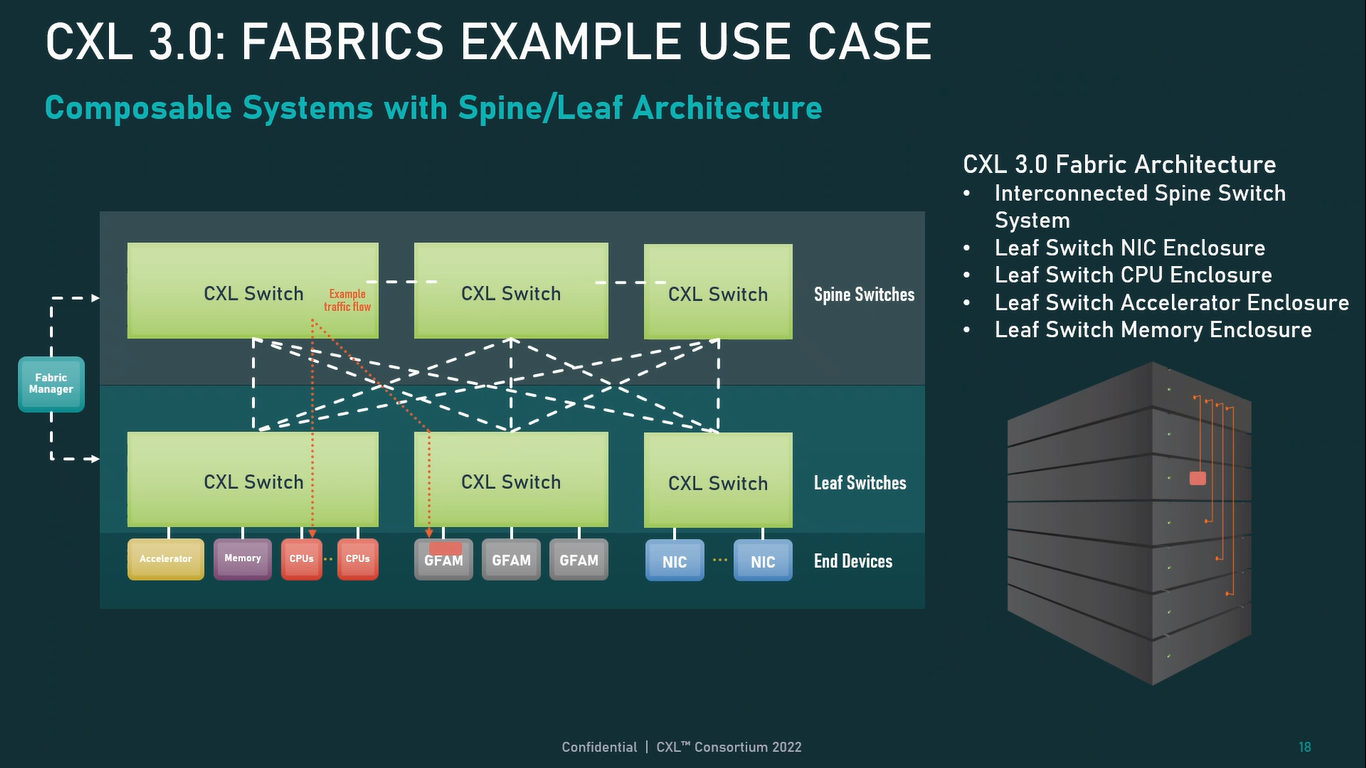 В настоящее время группа CXL уже включает 206 участников, в число которых входят компании Intel, Arm, AMD, IBM, NVIDIA, Huawei, крупные облачные провайдеры, включая Microsoft, Alibaba Group, Google и Meta✴, а также ряд крупных производителей серверного оборудования, в том числе, HPE и Dell EMC.
18.11.2021 [23:45], Алексей Степин
GigaIO FabreX с CXL позволит вынести пулы оперативной памяти за пределы серверовКомпания GigaIO, один из пионеров в области разработки современных компонуемых сред для ЦОД, кластеров и облачных систем, показала на конференции SC21 свои последние разработки и решения. Компания намерена всего через два года создать универсальную компонуемую платформу, которая позволит на лету собирать сервер любой конфигурации из удалённых SSD, GPU, DPU, FPGA и даже DRAM. 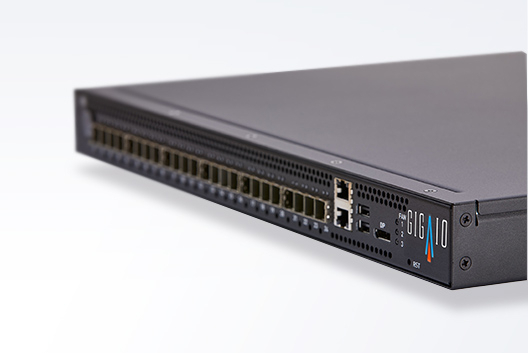
Коммутатор GigaIO FabreX Использовать в качестве основы такой платформы PCIe-фабрику — идея заманчивая, поскольку эта универсальная, стандартная и используемая сегодня в любых ИТ-системах шина обеспечивает высокую производительность при минимальном уровне задержек. У GigaIO уже есть коммутаторы FabreX с поддержкой PCIe 4.0. А CXL позволит добиться практически идеальной дезагрегации ресурсов. Отдельные стойки будут содержать различные массивы DRAM и SCM, флеш-массивы, ускорители самых разных типов и т.д. 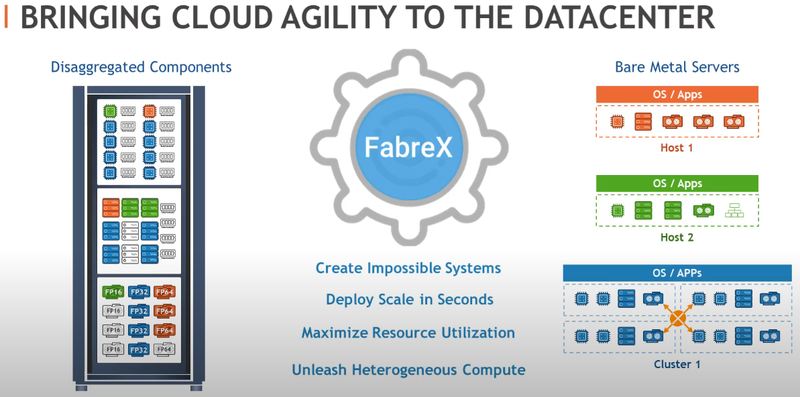 Такие стойки-массивы войдут в общую фабрику FabreX, а уже из неё нужные ресурсы смогут получать как традиционные серверы, так и целые кластеры — технологии GigaIO позволяют крайне гибко разграничивать ресурсы, черпаемые из единого пула и раздавать их разным клиентам в нужных пропорциях. Такой подход напоминает современные облачные системы, к которым может подключиться кто угодно и использовать столько ресурсов нужного типа, сколько надо для данной задачи. 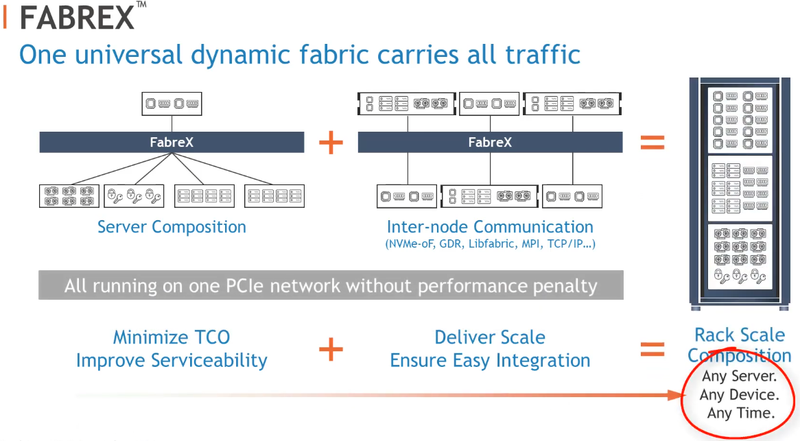 Всё управление траифком берёт на себя FabreX, а в клиентские системы остаётся только установить соответствующие HBA-адаптеры, также разработанные GigaIO. Модули Hydra, показанные компанией в конце 2020 года, обеспечивает пропускную способность до 32 Гбайт/с на слот PCIe 4.0 x16. Для кабельной инфраструктуры FabreX использует стандартные кабели с коннекторами SFF-8644 (возможны как чисто медные варианты, так и активные, с оптическими трансиверами). 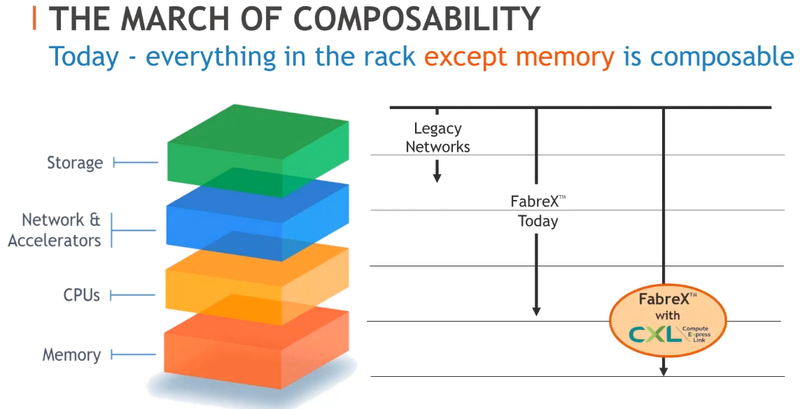 К тому же FabreX обеспечивает беспроблемную переброску практически любых протоколов и приложений между любыми узлами, включёнными в сеть — будь то TCP/IP, MPI, NVMe-oF и другие виды трафика. Последним барьером, мешающим достигнуть полной дезагрегации ресурсов GigaIO справедливо считает оперативную память, которая в большинстве систем пока ещё находится на стороне процессоров общего назначения в клиентских серверах. Но в партнёрстве с AMD компания уже работает над этой проблемой. 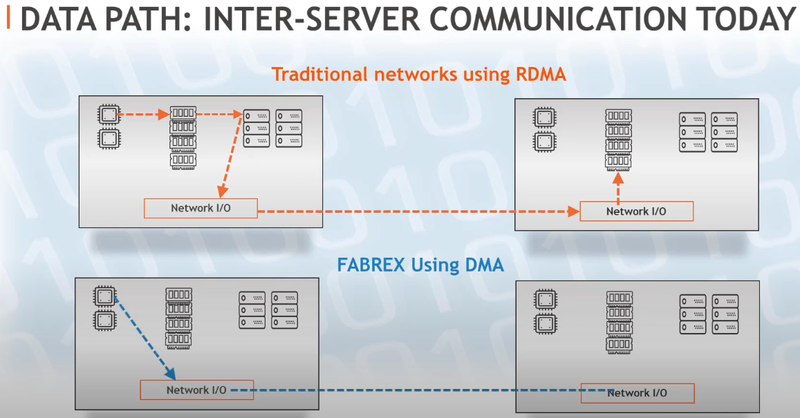 Попытки вынести оперативную память за пределы серверов снижают производительность даже при использовании RDMA. Однако последние разработки GigaIO для FabreX и интеграция в эту систему стандарта CXL должны позволить использовать истинный прямой NUMA-доступ к памяти, даже если она вынесена за пределы клиентской системы и находится в общем пуле-массиве. Последний барьер к полной дезагрезации ресурсов практически пал. 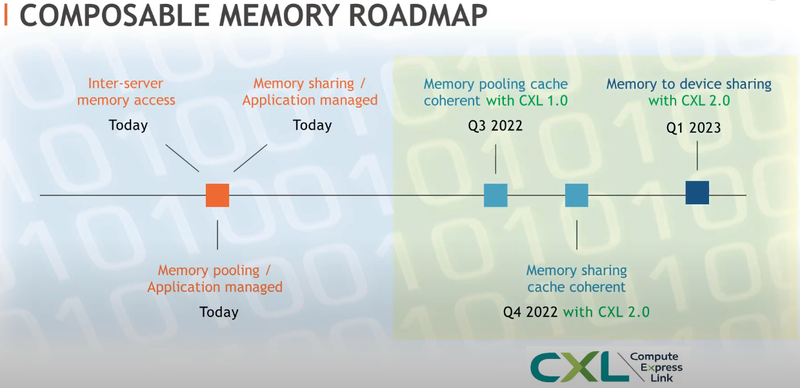 Таким образом, любой сервер в сети FabreX сможет получить полноценный доступ к любой памяти — соседнего сервера или стойки пула, с минимальным ростом латентности и максимально возможной в рамках PCIe пропускной способностью. Пулинг оперативной памяти с сохранением когерентности кешей, по словам GigaIO, будет реализован в 3 квартале следующего года на базе CXL 1.0. В четвёртом квартале должна появиться поддержка CXL 2.0 с возможностью систем делиться ресурсами памяти между собой, а в начале 2023 года компания планирует внедрить весь спектр возможностей CXL 2.0. 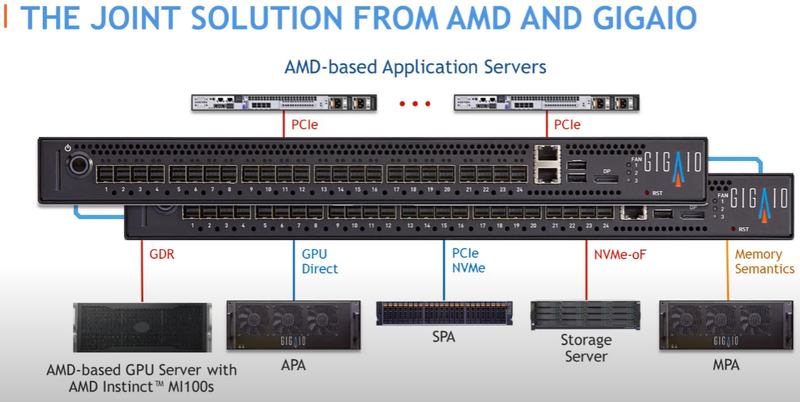 В числе преимуществ FabreX GigaIO также называет использование открытых стандартов, даже собственное ПО GigaIO будет находиться в открытом доступе. Клиенты, уже использующие FabreX, без проблем перейдут на новую версию с CXL, поскольку этот стандарт базируется на PCIe 5.0. Им не потребуется вносить изменения в уже работающие контейнеры, ВМ и прочее ПО, зато они смогут использовать все преимущества FabreX в области дезагрегации ресурсам, включая удалённые пулы DRAM. |
|

