
Материалы по тегу: gigaio
|
03.04.2026 [09:52], Сергей Карасёв
d-Matrix приобрела разработки GigaIO в области дата-центров, включая НРС-платформу SuperNODEСтартап d-Matrix, занимающийся разработкой ИИ-ускорителей и других специализированных изделий для НРС-систем, объявил о заключении соглашения по приобретению у компании GigaIO активов и разработок, связанных с дата-центрами. Стоимость сделки не раскрывается. В ассортименте d-Matrix присутствуют ускорители Corsair, базирующиеся на технологии вычислений в памяти DIMC (digital in-memory computing), а также IO-карты JetStream, предназначенные для распределения нагрузок ИИ-инференса между серверами в дата-центре. Кроме того, стартап создал стоечную систему SquadRack для пакетного инференса со сверхнизкой задержкой. В свою очередь, GigaIO предлагает так называемый суперкомпьютер в стойке SuperNODE для рабочих нагрузок генеративного ИИ и приложений НРС. Компания разработала архитектуру FabreX на базе PCI Express, которая позволяет объединять различные компоненты, включая GPU, FPGA и пулы памяти. Ещё одним продуктом GigaIO является «суперкомпьютер в чемодане» Gryf, который, как утверждается, обеспечивает ИИ-производительность класса ЦОД на периферии. 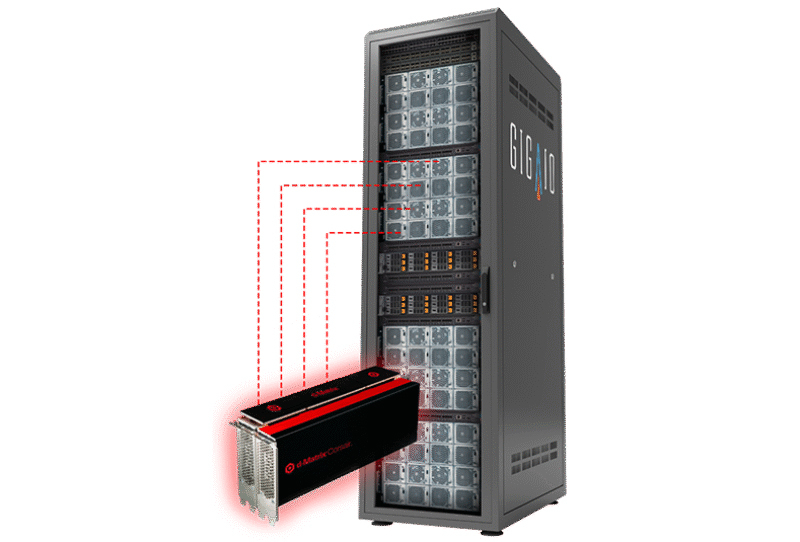
Источник изображения: GigaIO d-Matrix и GigaIO начали сотрудничество весной 2025 года. Тогда стороны объединили усилия для создания «самого масштабируемого в мире» решения для инференса. Речь идёт об интеграции ИИ-ускорителей Corsair в состав платформы SuperNODE. В рамках нового соглашения d-Matrix приобрела у GigaIO основные технологии для дата-центров, включая SuperNODE и архитектуру FabreX. По условиям сделки, в d-Matrix перейдут ведущие специалисты GigaIO по разработке стоечных систем: предполагается, что это позволит ускорить развёртывание комплексных решений для высокопроизводительного инференса в ЦОД. Вместе с тем GigaIO сосредоточится на внедрении вычислительных мощностей уровня ЦОД непосредственно на периферии. В частности, планируется дальнейшее развитие концепции Gryf. По заявления GigaIO, рынок периферийных вычислений обладает огромным потенциалом. Благодаря решениям на основе Gryf клиенты смогут обрабатывать критически важные данные ближе к их источнику без проблем с задержками. При этом монтировать Gryf можно практически в любой локации.
05.05.2025 [13:28], Сергей Карасёв
GigaIO и d-Matrix предоставят инференс-платформу для масштабных ИИ-развёртыванийКомпании GigaIO и d-Matrix объявили о стратегическом партнёрстве с целью создания «самого масштабируемого в мире» решения для инференса, ориентированного на крупные предприятия, которые разворачивают ИИ в большом масштабе. Ожидается, что новая платформа поможет устранить узкие места в плане производительности и упростить внедрение крупных ИИ-систем. В рамках сотрудничества осуществлена интеграция ИИ-ускорителей d-Matrix Corsair в состав НРС-платформы GigaIO SuperNODE. Архитектура Corsair основана на модифицированных ячейках SRAM для вычислений в памяти (DIMC), работающих на скорости около 150 Тбайт/с. По заявлениям d-Matrix, ускоритель обеспечивает непревзойдённую производительность и эффективность инференса для генеративного ИИ. Устройство выполнено в виде карты расширения с интерфейсом PCIe 5.0 х16. Быстродействие достигает 2,4 Пфлопс с (8-бит вычисления). Изделие имеет двухслотовое исполнение, а показатель TDP равен 600 Вт. В свою очередь, SuperNODE использует фирменную архитектуру FabreX на базе PCIe, которая позволяет объединять различные компоненты, включая GPU, FPGA и пулы памяти. По сравнению с обычными серверными кластерами SuperNODE обеспечивает более эффективное использование ресурсов. 
Источник изображения: d-Matrix Новая модификация SuperNODE поддерживает десятки ускорителей Corsair в одном узле. Производительность составляет до 30 тыс. токенов в секунду при времени обработки 2 мс на токен для таких моделей, как Llama3 70B. По сравнению с решениями на базе GPU обещаны трёхкратное повышение энергоэффективности и в три раза более высокое быстродействие при сопоставимой стоимости владения. «Наша система избавляет от необходимости создания сложных многоузловых конфигураций и упрощает развёртывание, позволяя предприятиям быстро адаптироваться к меняющимся рабочим нагрузкам ИИ, при этом значительно улучшая совокупную стоимость владения и операционную эффективность», — говорит Alan Benjamin (Алан Бенджамин), генеральный директор GigaIO.
28.04.2025 [14:48], Сергей Карасёв
ИИ-суперкомпьютер в чемодане — GigaIO Gryf обеспечит производительность до 30 ТфлопсКомпания GigaIO объявила о доступности системы Gryf — так называемого ИИ-суперкомпьютера в чемодане, разработанного в сотрудничестве с SourceCode. Это сравнительно компактное устройство, как утверждается, обеспечивает производительность ЦОД-класса для периферийных развёртываний. Первая информация о Gryf появилась около года назад. Устройство выполнено в корпусе с габаритами 228,6 × 355,6 × 622,3 мм, а масса составляет примерно 25 кг. Система может эксплуатироваться при температурах от +10 до +32 °C. Конструкция предусматривает использование модулей Sled четырёх типов: это вычислительный узел Compute Sled, блок ускорителя Accelerator Sled, узел хранения Storage Sled и сетевой блок Network Sled. Доступны различные конфигурации, но суммарное количество модулей Sled в составе Gryf не превышает шести. Плюс к этому в любой комплектации устанавливается модуль питания с двумя блоками мощностью 2500 Вт. Узел Compute Sled содержит процессор AMD EPYC 7003 Milan с 16, 32 или 64 ядрами, до 512 Гбайт DDR4, системный SSD формата M.2 (NVMe) вместимостью 512 Гбайт и два порта 100GbE QSFP56. Блок Storage Sled объединяет восемь накопителей NVMe SSD E1.L суммарной вместимостью до 492 Тбайт. Модуль Network Sled предоставляет два порта QSFP28 100GbE и шесть портов SFP28 25GbE. За ИИ-производительность отвечает модуль Accelerator Sled, который может нести на борту ускоритель NVIDIA L40S (48 Гбайт), H100 NVL (94 Гбайт) или H200 NVL (141 Гбайт). В максимальной конфигурации быстродействие в режиме FP64 достигает 30 Тфлопс (3,34 Пфлопс FP8), а пропускная способность памяти — 4,8 Тбайт/с. 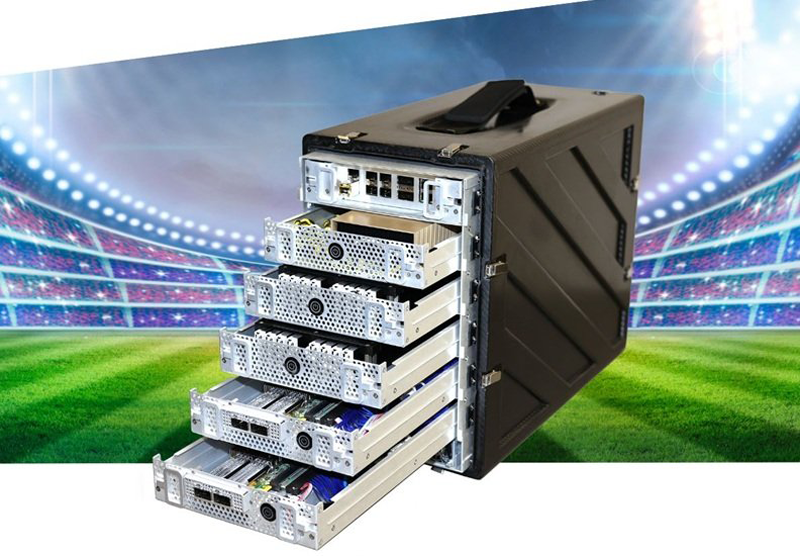
Источник изображения: GigaIO Архитектура новинки обеспечивает возможность масштабирования путём объединения в единый комплекс до пяти экземпляров Gryf: в общей сложности можно совместить до 30 модулей Sled в той или иной конфигурации. Заказы на Gryf уже поступили со стороны Министерства обороны США, американских разведывательных структур и пр.
29.03.2024 [13:39], Сергей Карасёв
GigaIO представила оптические кабели PCIe 5.0 для развёртывания масштабных ИИ-кластеровКомпания GigaIO, разрабатывающая систему распределённого интерконнекта на базе PCI Express под названием FabreX, представила первые в отрасли оптические кабели QSFP-DD с поддержкой PCIe 5.0. Отмечается, что оптические кабели обеспечивают ряд преимуществ перед традиционными медными соединениями. Это, в частности, повышенная пропускная способность. Кроме того, длина оптических линий может превышать 3 м, что является ограничением для медных кабелей. Представленные кабели используют конфигурацию PCIe 5.0 x8 с возможностью агрегации 16 линий. Благодаря этим изделиям упрощается развёртывание высокопроизводительных систем GigaIO SuperNODE, которые позволяют связать воедино до 32 ускорителей посредством упомянутой платформы FabreX. 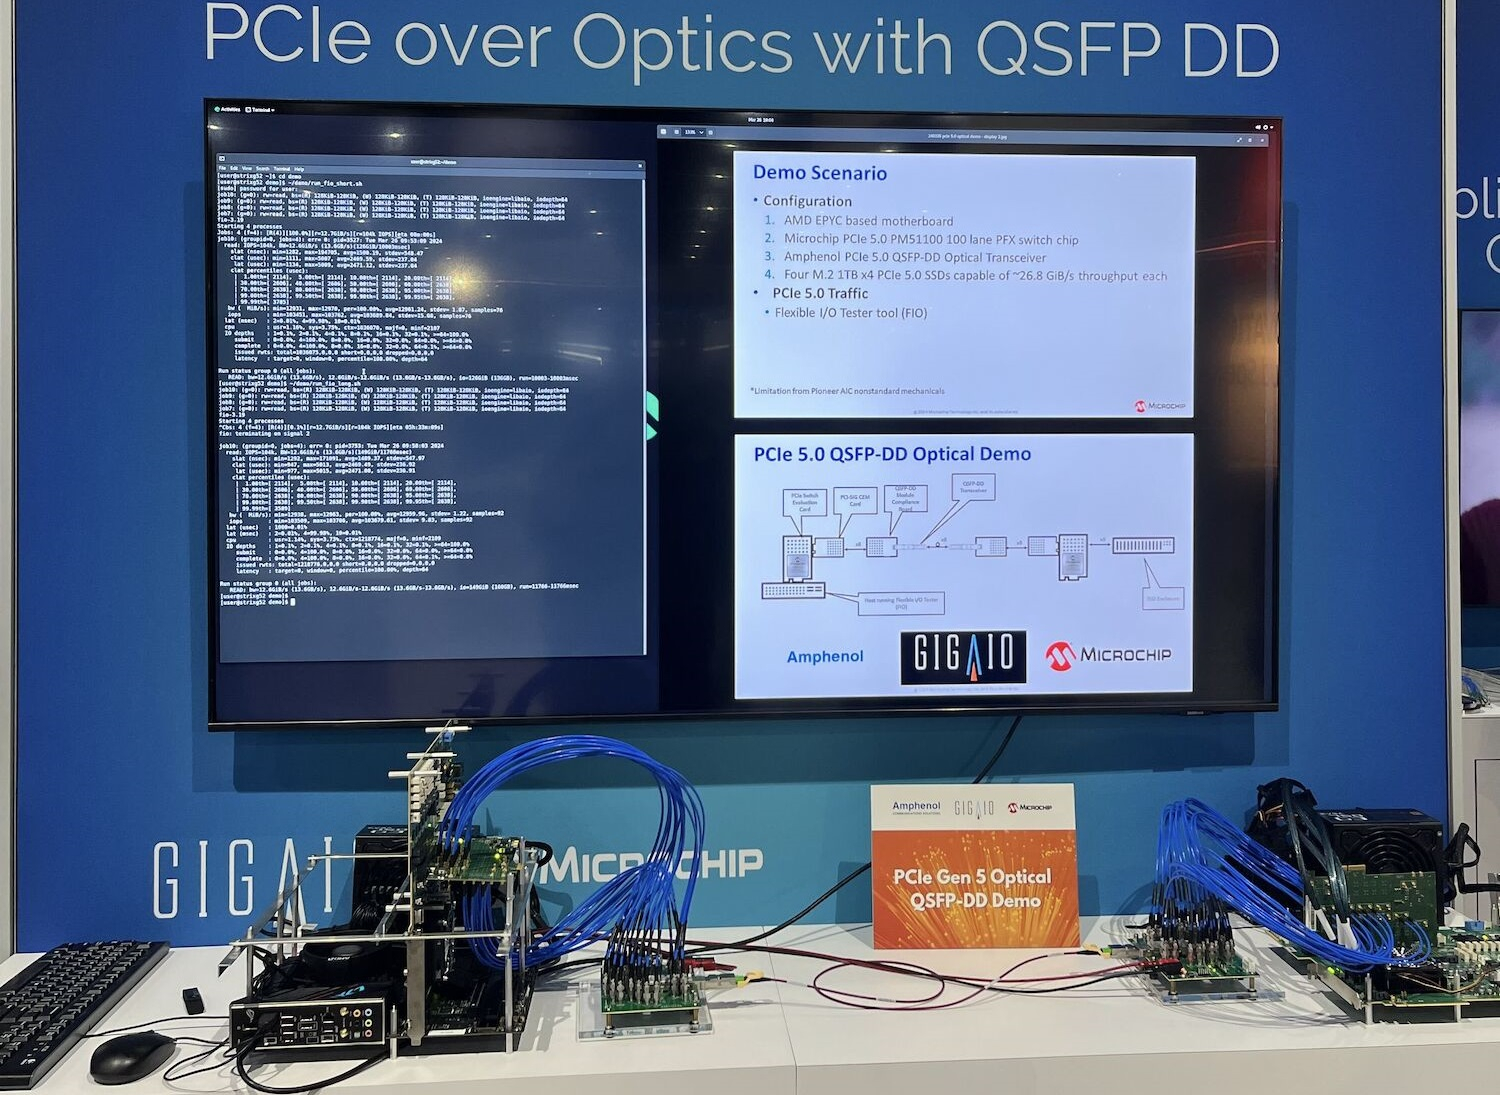
Фото: LinkedIn/GigaIO Отмечается, что оптические кабели способны обеспечить передачу данных с высокой скоростью на десятки метров. Таким образом, несколько систем SuperNODE или SuperDuperNODE могут быть объединены в единый кластер для решения наиболее ресурсоёмких задач ИИ. Медные соединения обычно ограничивают размер кластеров двумя–тремя стойками. В случае оптических кабелей предоставляется гораздо большая гибкость в плане конфигурации оборудования. В результате системы SuperNODE могут быть развёрнуты даже в тех дата-центрах, в которых существуют жёсткие ограничения по мощности и охлаждению в расчёте на стойку. Оптические кабели QSFP-DD с поддержкой PCIe 5.0 станут доступны предстоящим летом.
11.11.2023 [23:59], Алексей Степин
СуперДупер: GigaIO SuperDuperNODE позволяет объединить посредством PCIe сразу 64 ускорителяКомпания GigaIO, чьей главной разработкой является система распределённого интерконнекта на базе PCI Express под названием FabreX, поставила новый рекорд — в новой платформе разработчикам удалось удвоить количество одновременно подключаемых PCIe-устройств, увеличив его с 32 до 64. О разработках GigaIO мы рассказывали читателям неоднократно. Во многом они действительно уникальны, поскольку созданная компанией композитная инфраструктура позволяет подключать к одному или нескольким серверам существенно больше различных ускорителей, нежели это возможно в классическом варианте, но при этом сохраняет высокий уровень утилизации этих ускорителей. 
GigaIO SuperNODE. Источник изображений здесь и далее: GigaIO В начале года компания уже демонстрировала систему с 16 ускорителями NVIDIA A100, а летом GigaIO представила мини-кластер SuperNODE. В различных конфигурациях система могла содержать 32 ускорителя AMD Instinct MI210 или 24 ускорителя NVIDIA A100, дополненных СХД ёмкостью 1 Пбайт. При этом система в силу особенностей FabreX не требовала какой-либо специфической настройки перед работой. 
FabreX позволяет физически объединить все типы ресурсов на базе существующего стека технологий PCI Express На этой неделе GigaIO анонсировала новый вариант своей HPC-системы, получившей незамысловатое название SuperDuperNODE. В ней она смогла удвоить количество ускорителей с 32 до 64. Как и прежде, система предназначена, в первую очередь, для использования в сценариях генеративного ИИ, но также интересна она и с точки зрения ряда HPC-задач, в частности, вычислительной гидродинамики (CFD). Система SuperNODE смогла завершить самую сложную в мире CFD-симуляцию всего за 33 часа. В ней имитировался полёт 62-метрового авиалайнера Конкорд. Хотя протяжённость модели составляет всего 1 сек, она очень сложна, поскольку требуется обсчёт поведения 40 млрд ячеек объёмом 12,4 мм3 на протяжении 67268 временных отрезков. 29 часов у системы ушло на обсчёт полёта, и ещё 4 часа было затрачено на рендеринг 3000 4К-изображений. С учётом отличной масштабируемости при использовании SuperDuperNODE время расчёта удалось сократить практически вдвое. Как уже упоминалось, FabreX позволяет малой кровью наращивать число ускорителей и иных мощных PCIe-устройств на процессорный узел при практически идеальном масштабировании. Обновлённая платформа не подвела и в этот раз: в тесте HPL-MxP пиковый показатель утилизации составил 99,7 % от теоретического максимума, а в тестах HPL и HPCG — 95,2 % и 88 % соответственно. Компания-разработчик сообщает о том, что программное обеспечение FabreX обрело завершённый вид и без каких-либо проблем обеспечивает переключение режимов SuperNODE между Beast (система видна как один большой узел), Swarm (множество узлов для множества нагрузок) и Freestyle Mode (каждой нагрузке выделен свой узел с заданным количеством ускорителей). Начало поставок SuperDuperNODE запланировано на конец года. Партнёрами, как и в случае с SuperNODE, выступят Dell и Supermicro.
18.07.2023 [22:45], Сергей Карасёв
Суперкомпьютер в стойке: GigaIO SuperNODE позволяет объединить 32 ускорителя AMD Instinct MI210Компания GigaIO анонсировала HPC-систему SuperNODE, предназначенную для решения ресурсоёмких задач в области генеративного ИИ. SuperNODE позволяет связать воедино до 32 ускорителей посредством компонуемой платформы GigaIO FabreX. Архитектура FabreX на базе PCI Express, по словам создателей, намного лучше InfiniBand и NVIDIA NVLink по уровню задержки и позволяет объединять различные компоненты — GPU, FPGA, пулы памяти и пр. SuperNODE даёт возможность более эффективно использовать ресурсы, нежели в случае традиционного подхода с ускорителями в составе нескольких серверов. В частности для SuperNODE доступны конфигурации с 32 ускорителями AMD Instinct MI210 или 24 ускорителями NVIDIA A100 с хранилищем ёмкостью до 1 Пбайт. При этом платформа компактна, энергоэффективна (до 7 кВт) и не требует дополнительной настройки перед работой. 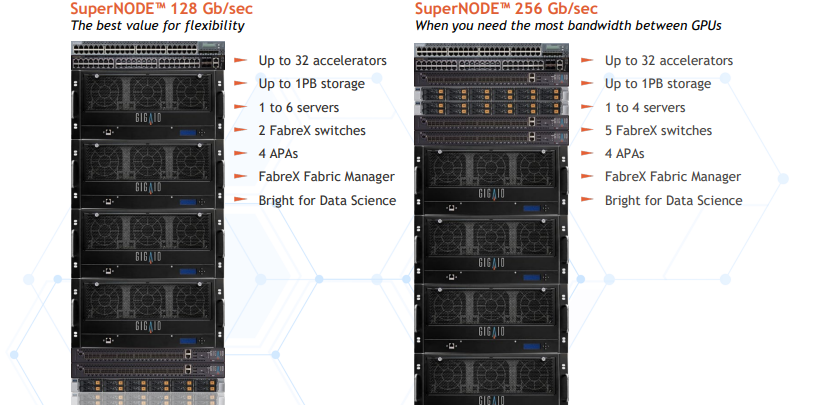
Источник изображений: GigaIO Поскольку приложения с большими языковыми моделями требуют огромных вычислительных мощностей, технологии, которые сокращают количество необходимых обменов данными между узлом и ускорителем, имеют решающее значение для обеспечения необходимой скорости выполнения операций при снижении общих затрат на формирование инфраструктуры. Что немаловажно, платформ, по словам разработчиков, демонстрирует хорошую масштабируемость производительности при увеличении числа ускорителей. 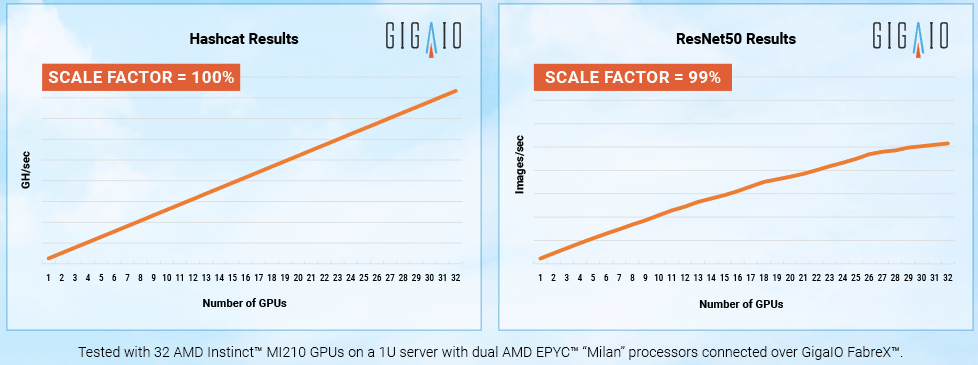 «Система SuperNODE, созданная GigaIO и работающая на ускорителях AMD Instinct, обеспечивает привлекательную совокупную стоимость владения как для традиционных рабочих нагрузок HPC, так и для задач генеративного ИИ», — сказал Эндрю Дикманн (Andrew Dieckmann), корпоративный вице-президент и генеральный менеджер по дата-центрам AMD. Стоит отметить, что у AMD нет прямого аналога NVIDIA NVLink, так что для объединение ускорителей в большие пулы с высокой скоростью подключения возможно как раз с использованием SuperNODE.
25.01.2023 [18:30], Алексей Степин
GigaIO FabreX обещает удвоить эффективность использования ресурсов ускорителей для платформ на базе Sapphire RapidsКомпания GigaIO, разработчик компонуемой платформы FabreX также поддержала выпуск новых процессоров Intel Xeon. Сертифицированная платформа GigaIO GigaPod на базе Sapphire Rapids показала возросший на 106 % уровень утилизации ускорителей в сравнении с платформой NVIDIA DGX, использующей InfiniBand. 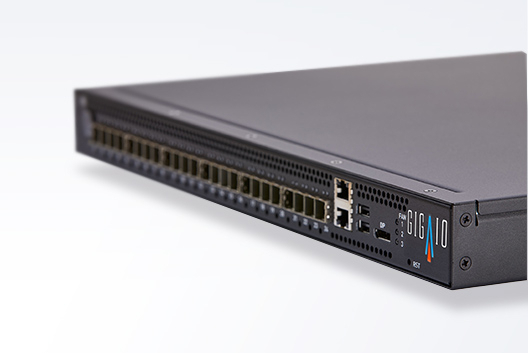
Коммутатор FabreX. Источник здесь и далее: GigaIO Конфигурация тестовой системы включала в себя сервер на базе Sapphire Rapids, к которому с помощью FarbeX были подключены 16 ускорителей NVIDIA A100. Как показало тестирование, такая конфигурация куда эффективнее использует ресурсы, нежели в случае традиционного подхода, когда ускорители «раскиданы» по нескольким серверам и коммуникация между ними осуществляется посредством высокоуровневой сети вроде InfiniBand. 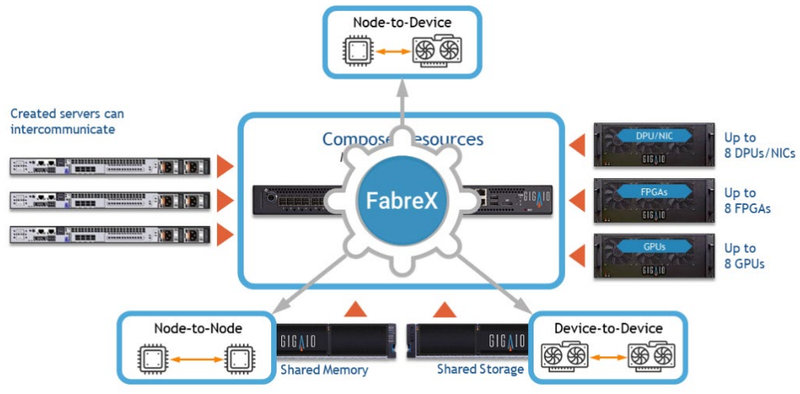
Интерконнект GigaIO FabreX универсален и поддерживает подключение любых типов устройств в рамках платформы GigaPod Глава GigaIO отметил, что в классическом варианте уровень загрузки ускорителей может опускаться до 15 %, и это при том, что стоимость мощных ускорителей иногда составляет до 80 % стоимости всей системы. Финальный выигрыш в стоимости GigaPod в версии с процессорами Sapphire Rapids может достигать 30 % в пользу решения GigaIO. Компонуемая архитектура, продвигаемая GigaIO, существенно эффективнее традиционных: в её основе лежит PCI Express, что гарантирует задержку на уровне менее 1 мкс. По этому показателю FabreX превосходит и InfiniBand, и NVIDIA NVLink. При этом полностью поддерживается DMA. 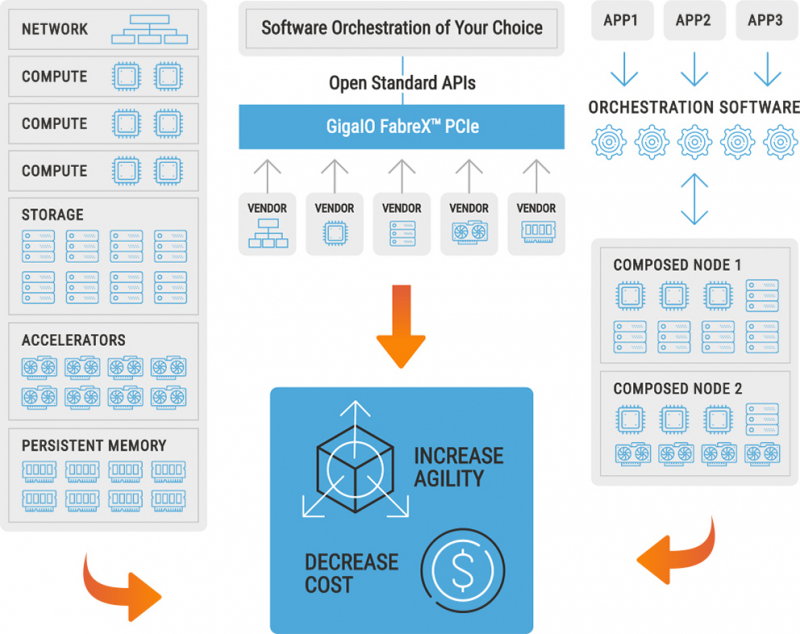
Программная архитектура FabreX Платформа FabreX универсальна, она позволяет подключать к системе практически любые компоненты, от GPU до пулов памяти и FPGA, в том числе с CXL. Ещё на SC20 компания продемонстрировала 5U-шасси, вмещающие до 10 ускорителей с интерфейсом PCIe 4.0. Архитектура GigaIO является программно-определяемой и совместима с большей частью современного ПО для управления и распределения нагрузки, в ней реализован набор открытых API Redfish.
18.11.2021 [23:45], Алексей Степин
GigaIO FabreX с CXL позволит вынести пулы оперативной памяти за пределы серверовКомпания GigaIO, один из пионеров в области разработки современных компонуемых сред для ЦОД, кластеров и облачных систем, показала на конференции SC21 свои последние разработки и решения. Компания намерена всего через два года создать универсальную компонуемую платформу, которая позволит на лету собирать сервер любой конфигурации из удалённых SSD, GPU, DPU, FPGA и даже DRAM. 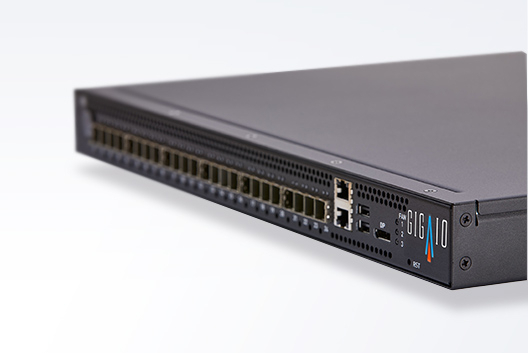
Коммутатор GigaIO FabreX Использовать в качестве основы такой платформы PCIe-фабрику — идея заманчивая, поскольку эта универсальная, стандартная и используемая сегодня в любых ИТ-системах шина обеспечивает высокую производительность при минимальном уровне задержек. У GigaIO уже есть коммутаторы FabreX с поддержкой PCIe 4.0. А CXL позволит добиться практически идеальной дезагрегации ресурсов. Отдельные стойки будут содержать различные массивы DRAM и SCM, флеш-массивы, ускорители самых разных типов и т.д. 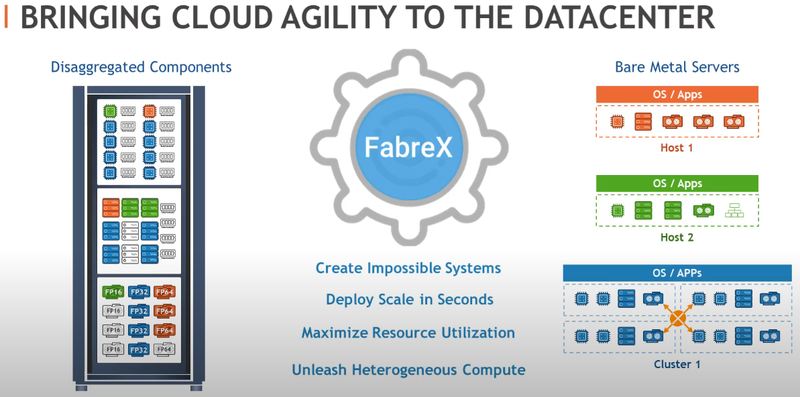 Такие стойки-массивы войдут в общую фабрику FabreX, а уже из неё нужные ресурсы смогут получать как традиционные серверы, так и целые кластеры — технологии GigaIO позволяют крайне гибко разграничивать ресурсы, черпаемые из единого пула и раздавать их разным клиентам в нужных пропорциях. Такой подход напоминает современные облачные системы, к которым может подключиться кто угодно и использовать столько ресурсов нужного типа, сколько надо для данной задачи. 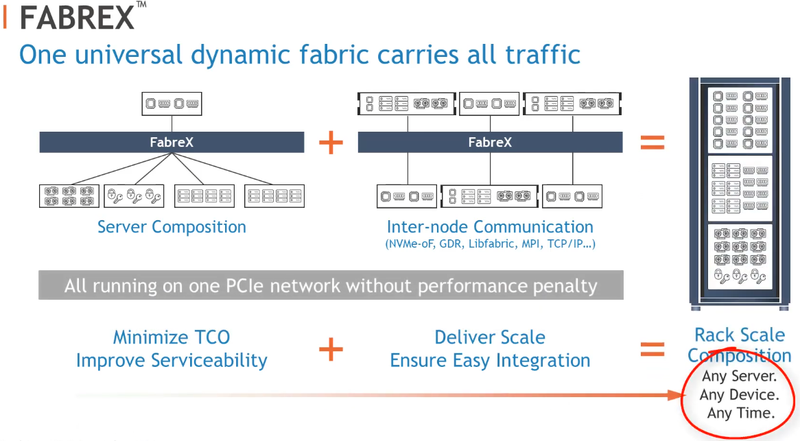 Всё управление траифком берёт на себя FabreX, а в клиентские системы остаётся только установить соответствующие HBA-адаптеры, также разработанные GigaIO. Модули Hydra, показанные компанией в конце 2020 года, обеспечивает пропускную способность до 32 Гбайт/с на слот PCIe 4.0 x16. Для кабельной инфраструктуры FabreX использует стандартные кабели с коннекторами SFF-8644 (возможны как чисто медные варианты, так и активные, с оптическими трансиверами). 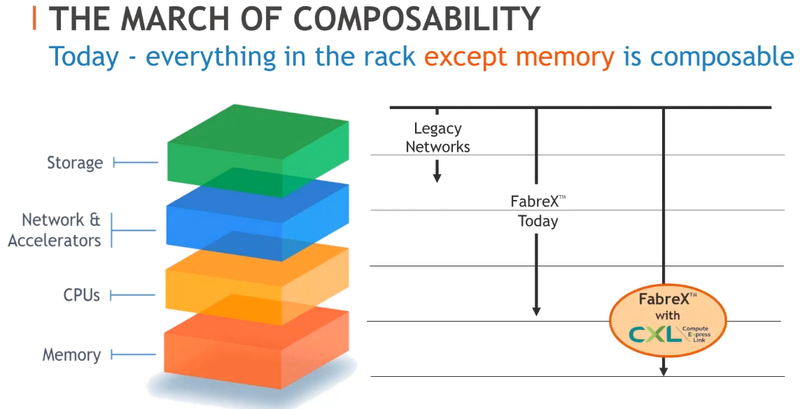 К тому же FabreX обеспечивает беспроблемную переброску практически любых протоколов и приложений между любыми узлами, включёнными в сеть — будь то TCP/IP, MPI, NVMe-oF и другие виды трафика. Последним барьером, мешающим достигнуть полной дезагрегации ресурсов GigaIO справедливо считает оперативную память, которая в большинстве систем пока ещё находится на стороне процессоров общего назначения в клиентских серверах. Но в партнёрстве с AMD компания уже работает над этой проблемой. 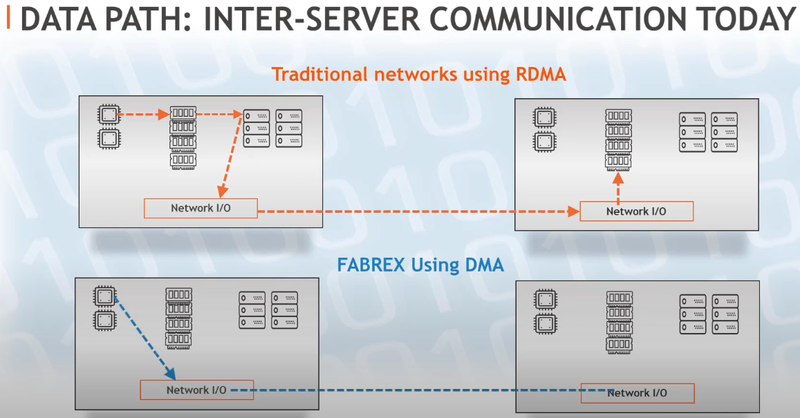 Попытки вынести оперативную память за пределы серверов снижают производительность даже при использовании RDMA. Однако последние разработки GigaIO для FabreX и интеграция в эту систему стандарта CXL должны позволить использовать истинный прямой NUMA-доступ к памяти, даже если она вынесена за пределы клиентской системы и находится в общем пуле-массиве. Последний барьер к полной дезагрезации ресурсов практически пал. 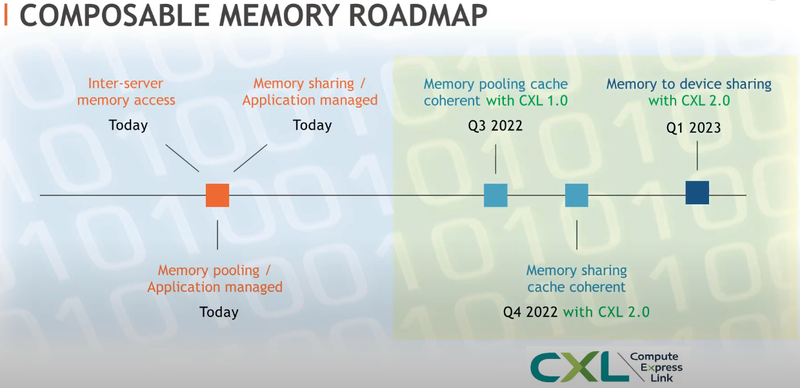 Таким образом, любой сервер в сети FabreX сможет получить полноценный доступ к любой памяти — соседнего сервера или стойки пула, с минимальным ростом латентности и максимально возможной в рамках PCIe пропускной способностью. Пулинг оперативной памяти с сохранением когерентности кешей, по словам GigaIO, будет реализован в 3 квартале следующего года на базе CXL 1.0. В четвёртом квартале должна появиться поддержка CXL 2.0 с возможностью систем делиться ресурсами памяти между собой, а в начале 2023 года компания планирует внедрить весь спектр возможностей CXL 2.0. 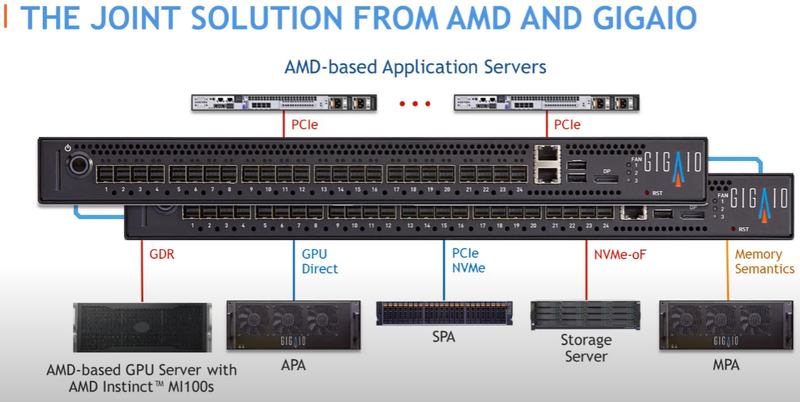 В числе преимуществ FabreX GigaIO также называет использование открытых стандартов, даже собственное ПО GigaIO будет находиться в открытом доступе. Клиенты, уже использующие FabreX, без проблем перейдут на новую версию с CXL, поскольку этот стандарт базируется на PCIe 5.0. Им не потребуется вносить изменения в уже работающие контейнеры, ВМ и прочее ПО, зато они смогут использовать все преимущества FabreX в области дезагрегации ресурсам, включая удалённые пулы DRAM. |
|

