Лента новостей
|
23.11.2023 [20:38], Сергей Карасёв
1,5 кВт на чип: ZutaCore показала высокоэффективную систему прямого жидкостного охлаждения HyperCoolКомпания ZutaCore на конференции SC23 сообщила о том, что её система прямого жидкостного охлаждения HyperCool Direct-On-Chip вошла в состав серверов Dell и Pegatron на платформе Intel Xeon Sapphire Rapids. Двухфазная система HyperCool способна эффективно отводить тепло от самых мощных серверных процессоров — с показателем TDP 1500 Вт и более. Это комплексное решение с замкнутым контуром вместо воды использует специальную диэлектрическую жидкость, благодаря чему оборудование защищено от коррозии. Платформа HyperCool обладает хорошей масштабируемостью и может быть развёрнута в новых или модернизированных дата-центрах — cтандартизированный интегрированный 6U-модуль способен отводить 100 кВт и выше. Система обеспечивает коэффициент PUE меньше 1,02. Конструкция HyperCool позволяет повторно использовать выделяемое тепло — например, для обогрева зданий. СЖО подходит для применения в ЦОД, ориентированных на решение задач ИИ и НРС. Система позволяет снизить общее энергопотребление и сократить выбросы вредных газов в атмосферу. 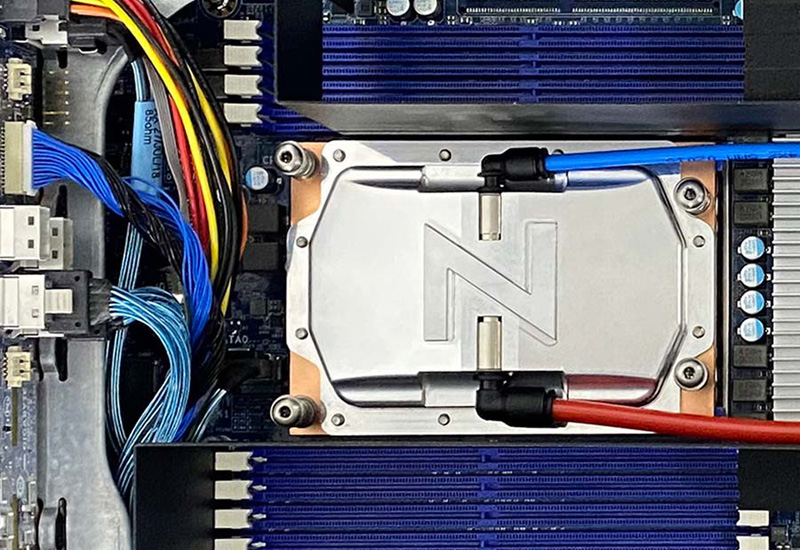
Источник изображения: ZutaCore Отмечается, что недавно технология HyperCool была сертифицирована для высокопроизводительных серверов ASUS. Кроме того, в экосистему ZutaCore входят AMD, Boston Limited, Dell, Equinix, Intel, World Wide Technologies (WWT) и другие. Утверждается, что по сравнению с традиционными системами охлаждения решение HyperCool обеспечивает сокращение совокупной стоимости владения на 50 %.
23.11.2023 [09:42], Руслан Авдеев
Broadcom закрыла сделку по покупке VMware за $69 млрдСделка по приобретению VMvare компанией Broadcom, заключённая ещё во II квартале 2022 года, наконец закрыта после длительного процесса одобрения регуляторами нескольких стран. Как сообщает ServeTheHome, эта новость вызвала смешанную реакцию у клиентов VMware с учётом того, что Broadcom обычно уделяет основное внимание крупным клиентам и повышает цены на сервисы и ПО приобретённых бизнесов. Хотя в случае с VMware покупатель обещал обойтись без этого. После одобрения сделки Китаем более не осталось препятствий для завершения поглощения, ранее также получившего «добро» от США, Великобритании, ЕС, Южной Корее и Японии. Дольше всех с одобрением сделки тянул Китай, причём случилось это после визита главы этой страны Си Цзиньпина в США. Хотя многие клиенты VMware беспокоятся о возможном росте цен, покупка всё-таки состоялась из-за того, что реальной угрозы монополии на рынке не возникнет из-за множества альтернативных решений. Ранее Broadcom пообещала ежегодно выделять $2 млрд на развитие продуктов и услуг VMware. 
Источник изображения: VMware Покупка стоимостью $69 млрд даст Broadcom дополнительную точку опоры для роста на корпоративном рынке. Компания уже широко представлена в ЦОД благодаря большому портфолио сетевых решений, RAID, PCIe и т.д. Всё это оборудование Broadcom и без того активно применяется в дата-центрах, но приобретение VMware обеспечит компании дополнительное преимущество. В будущем сделка способна обеспечить Broadcom огромную выгоду в сфере корпоративной сетевой инфраструктуры. VMware уже предлагает платформу NSX и интеграцию с другими аппаратными решениями и ПО. Broadcom получит возможность интеграции большего числа своих предложений, а также доступ к другим программным решениям VMware вроде vRealize Automation и Workspace ONE. Наконец, Broadcom будет обеспечен доступ к клиентской базе VMware. Впрочем, за последние кварталы многое изменилось. Традиционно покупка производителем аппаратного обеспечения компании разработчиков ПО ведёт к росту прибыли, как было в случае Dell и VMware. Тем не менее, вектор развития IT-рынка сместился. Последние успехи NVIDIA показали, что ИИ-решения стали более значимым фактором роста прибыли и рыночной капитализации — классическая виртуализация отошла на второй план в сравнении с разработками в сфере ИИ.
22.11.2023 [11:18], Сергей Карасёв
NVIDIA представила сетевой ускоритель SuperNIC для ИИ-нагрузокКомпания NVIDIA анонсировала аппаратное решение SuperNIC — это сетевой ускоритель нового типа, предназначенный для масштабных рабочих нагрузок ИИ в системах на базе Ethernet. Устройство обеспечивает скорость передачи данных до 400 Гбит/с с использованием RDMA (RoCE). Новинка выполнена на основе DPU BlueField-3: это часть сетевой 400G/800G-платформы Spectrum-X, которая предусматривает использование коммутаторов на базе ASIC NVIDIA Spectrum-4 (51,2 Тбит/с). Отмечается, что сообща BlueField-3 SuperNIC и Spectrum-4 составляют основу вычислительной системы, специально разработанной для ускорения ИИ-нагрузок. При этом платформа Spectrum-X обеспечивает высокую эффективность сети, превосходя по производительности традиционные среды Ethernet. По заявления NVIDIA, DPU предоставляет множество расширенных функций, таких как высокая пропускная способность, подключение с небольшой задержкой и пр. 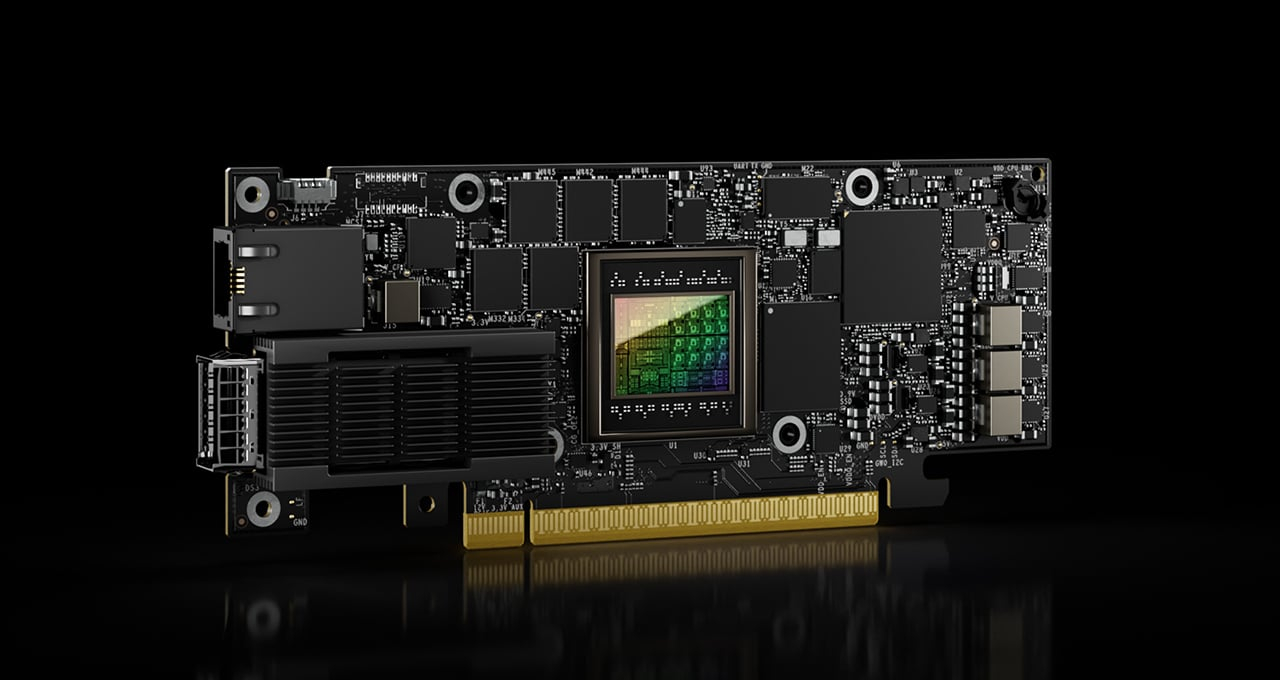
Источник изображения: NVIDIA Среди ключевых особенностей SuperNIC называются: высокоскоростное переупорядочение пакетов; расширенный контроль перегрузок с использованием данных в реальном времени и специализированных сетевых алгоритмов; возможность программирования ввода-вывода (I/O); энергоэффективный низкопрофильный дизайн; полная оптимизация для ИИ (включая вычисления, сети, хранилище, системное ПО, коммуникационные библиотеки). В одной системе могут быть задействованы до восьми SuperNIC, что позволяет добиться соотношения 1:1 с GPU. А это даёт возможность максимизировать производительность при выполнении сложных задач ИИ.
19.11.2023 [03:00], Сергей Карасёв
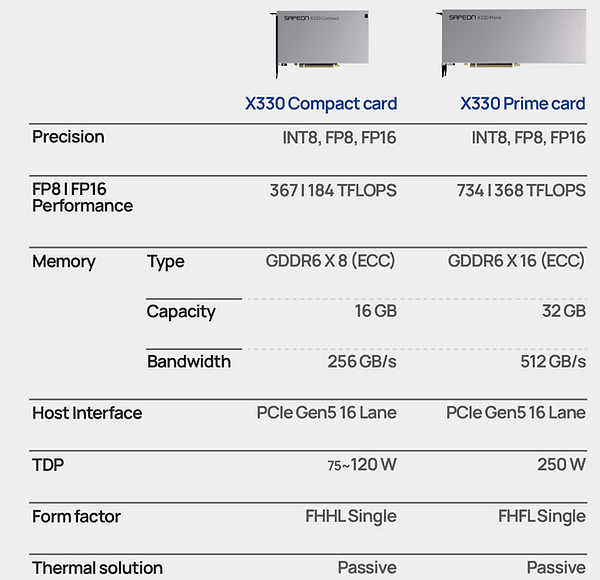
Южнокорейский стартап Sapeon представил 7-нм ИИ-чип X330ИИ-стартап Sapeon, поддерживаемый южнокорейским телекоммуникационным гигантом SK Group, анонсировал чип X330, предназначенный для инференса и обслуживания больших языковых моделей (LLM). Изделие ляжет в основу специализированных ускорителей для дата-центров. Sapeon заявляет, что новый нейропроцессор (NPU) обеспечивает примерно вдвое более высокую производительность и в 1,3 раза лучшую энергоэффективность, чем продукты конкурентов, выпущенные в этом году. По сравнению с предыдущим решением самой компании — Sapeon X220 — достигается увеличение быстродействия в четыре раза и повышение энергоэффективности в два раза. 
Изображения: Sapeon Новинка будет изготавливаться на TSMC по 7-нм технологии. Массовое производство запланировано на I полугодие 2024 года. На базе чипа будут предлагаться два ускорителя — X330 Compact Card и X330 Prime Card. Оба имеют однослотовое исполнение и оснащаются системой пассивного охлаждения. Для подключения применяется интерфейс PCIe 5.0 х16. Карты могут осуществлять вычисления INT8, FP8 и FP16. 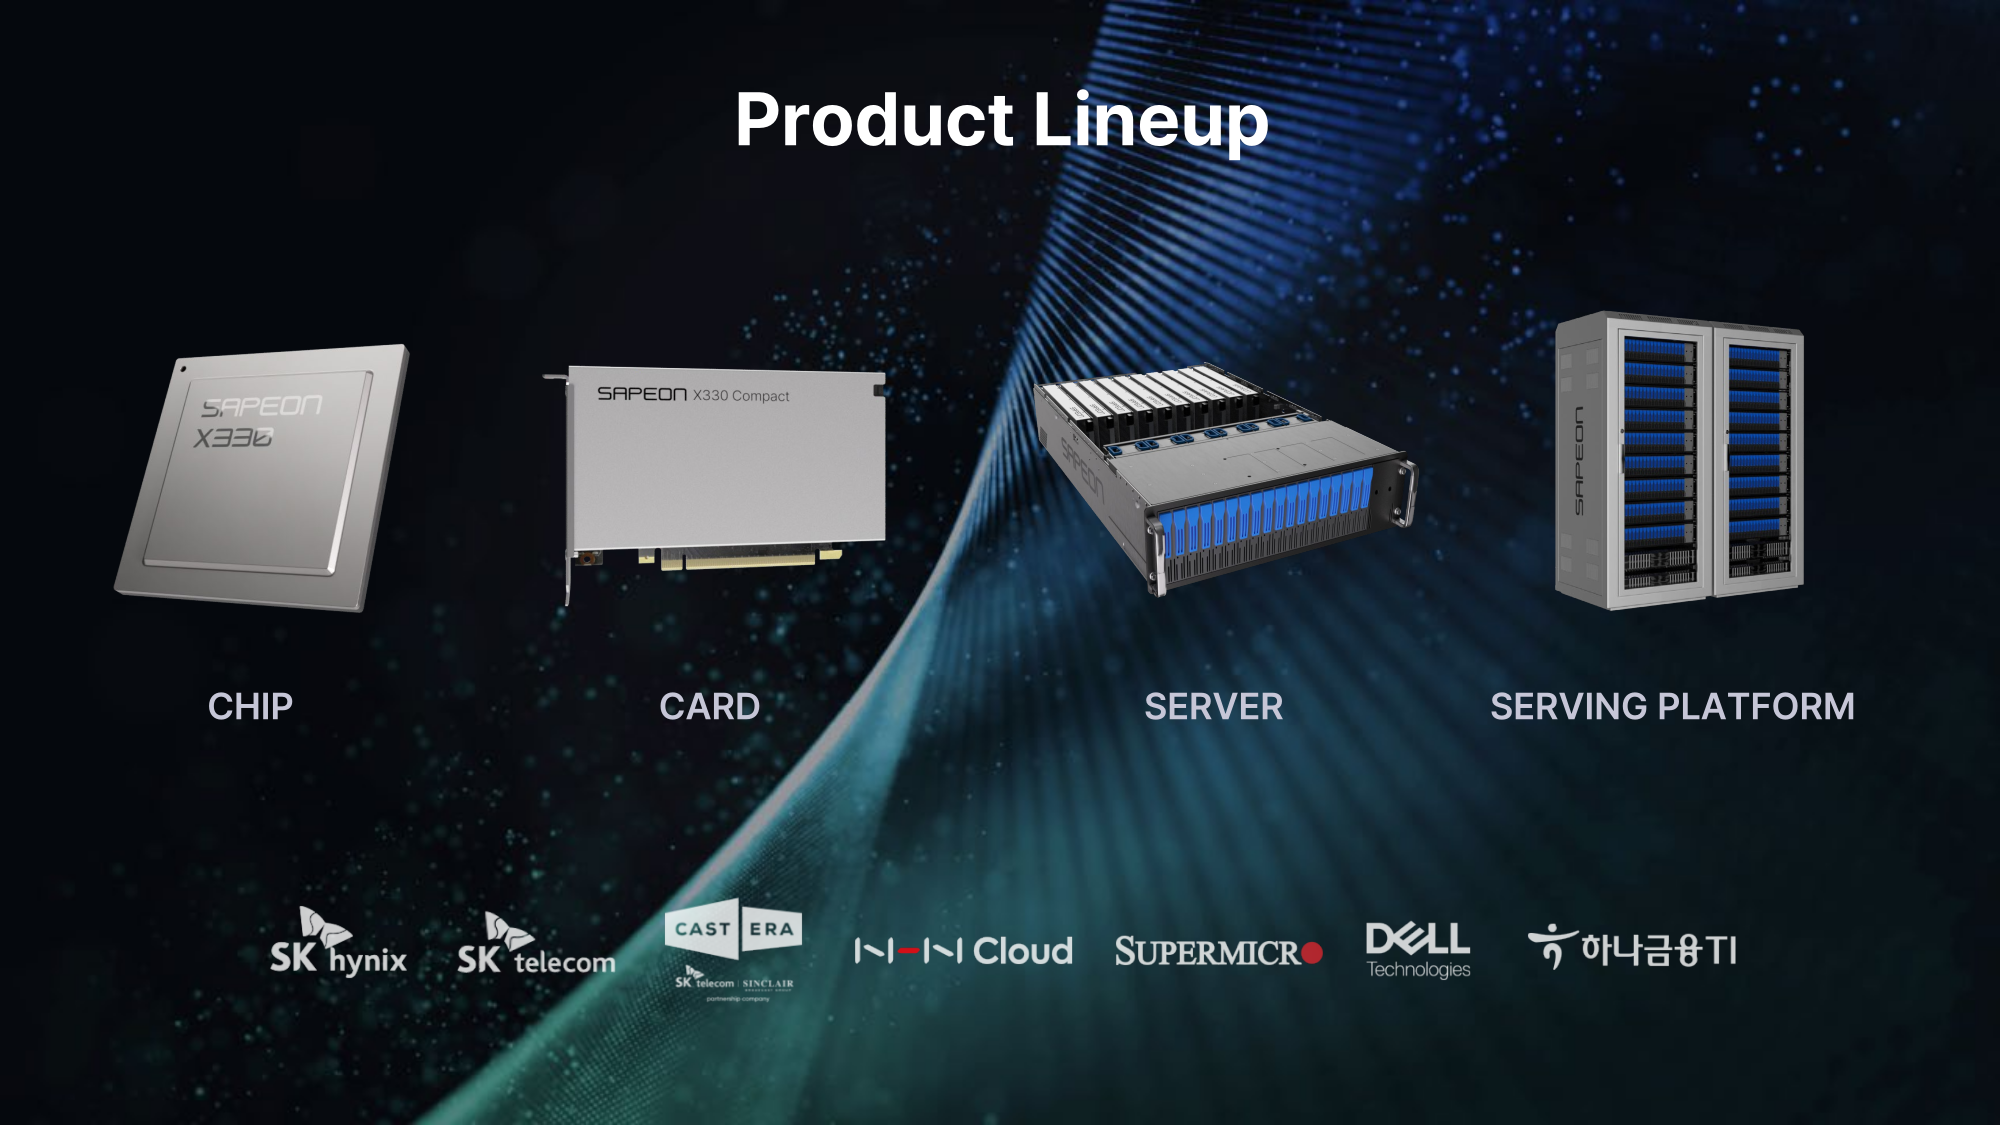 Модель X330 Compact Card уменьшенной длины несёт на борту 16 Гбайт памяти GDDR6 с пропускной способностью до 256 Гбайт/с. Заявленная производительность на операциях FP8 и FP16 достигает соответственно 367 и 184 Тфлопс. Энергопотребление варьируется в диапазоне от 75 до 120 Вт. Полноразмерная модификация X330 Prime Card получила 32 Гбайт памяти GDDR6 с пропускной способностью до 512 Гбайт/с. Заявленное быстродействие FP8 и FP16 составляет до 734 и 368 Тфлопс. Энергопотребление — 250 Вт. 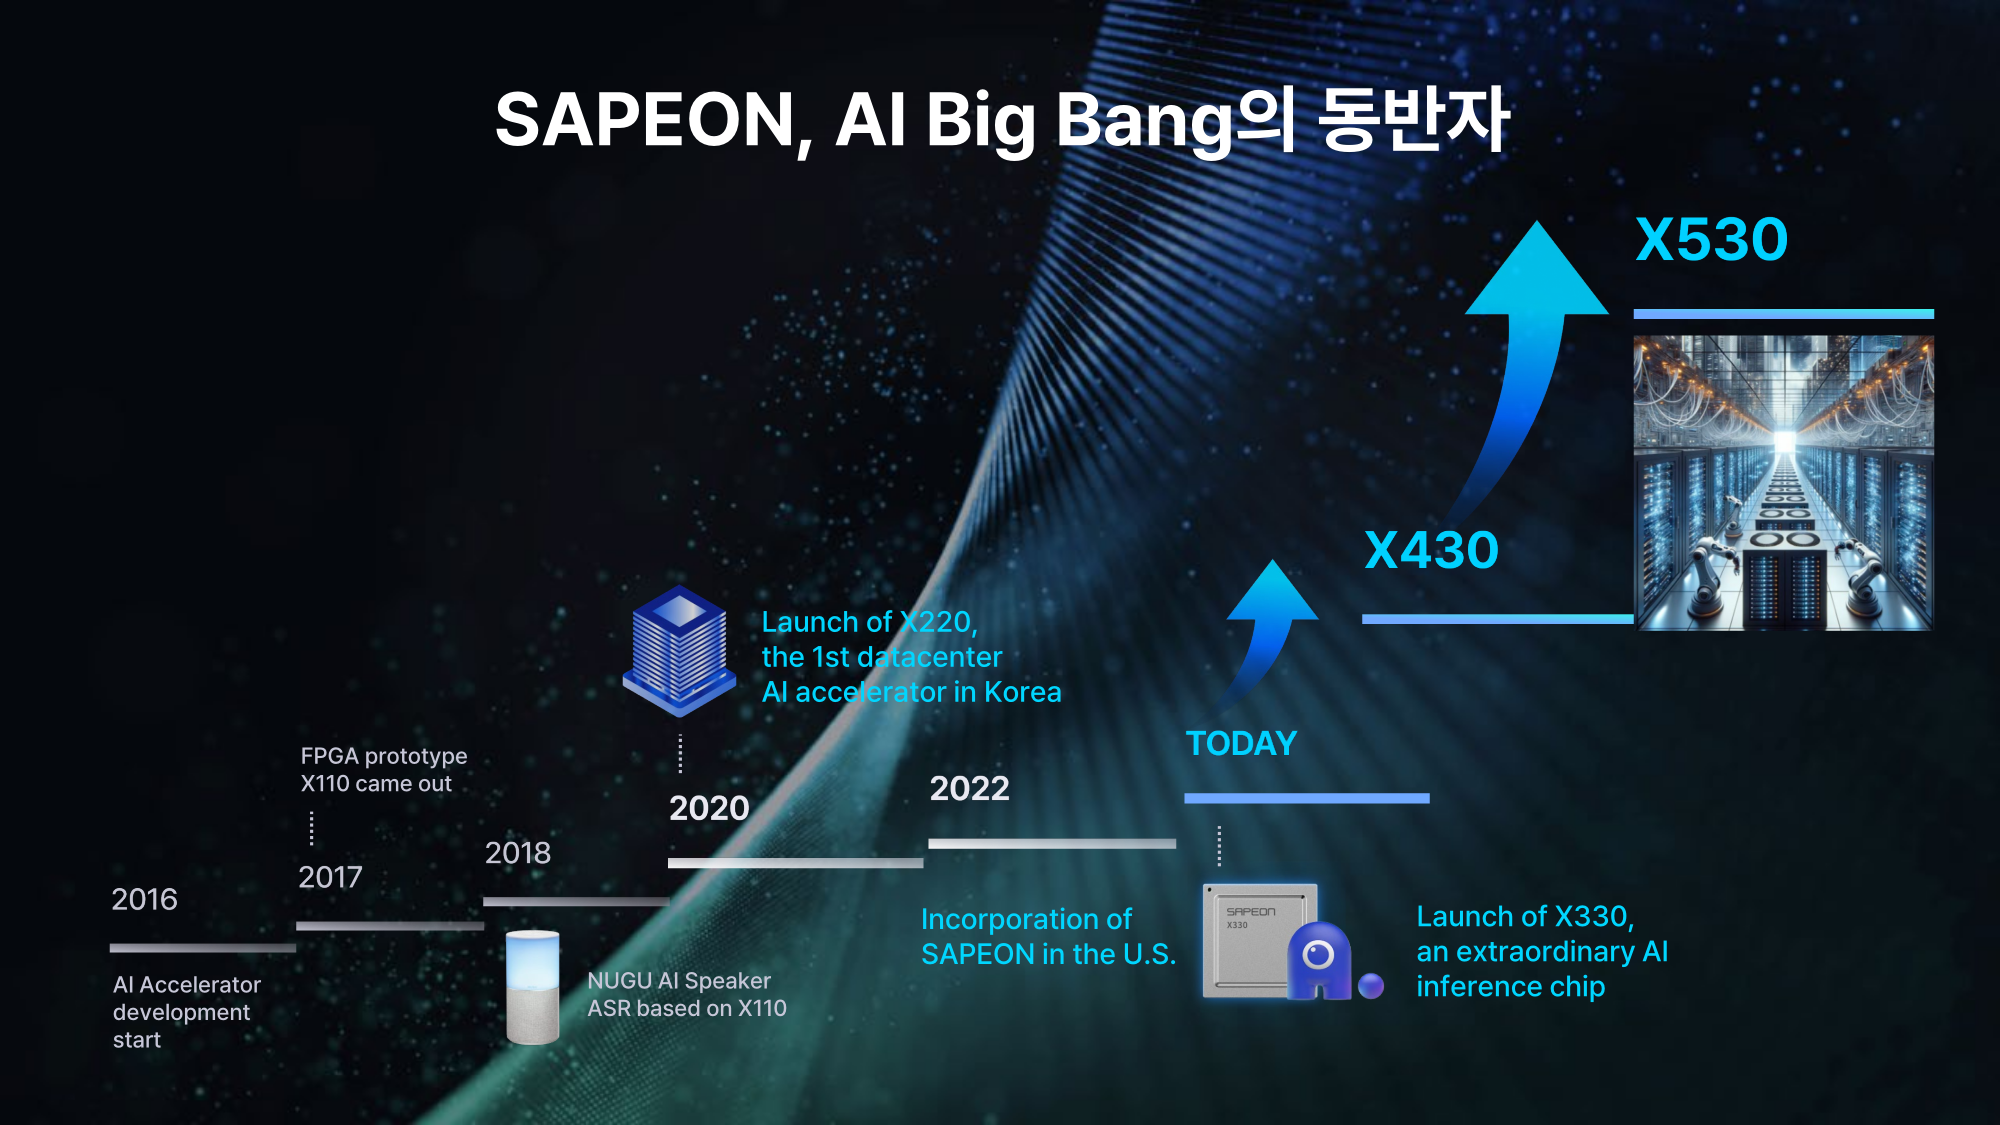 Группа SK в последнее время активно вкладывается в развитие ИИ, инвестируя напрямую или через дочерние структуры как в софт, так и в железо. С ней, в частности, связан ещё один южнокорейский разработчик ИИ-чипов Rebellions, также поддерживаемый правительством страны, которое намерено к 2030 году довести долю отечественных ИИ-чипов в местных дата-центрах до 80 %. Делается это для того, чтобы снизить зависимость от иностранных решений и избежать дефицита. Сама же Sapeon готовит ещё минимум два поколения своих чипов.
19.11.2023 [02:10], Владимир Мироненко
Fujitsu продала свой частный облачный бизнес в Германии инвестиционной компании AEQUITAFujitsu объявила о «стратегической реорганизации» бизнеса в Германии, в рамках которой она заключила сделку по продаже немецкой инвестиционной компании AEQUITA из Мюнхена своего подразделения Fujitsu Services GmbH, предоставляющего услуги частного облака и управляемых сервисов, а также услуги по обеспечению кибербезопасности клиентской базе, включающей средние и крупные предприятия частного и государственного сектора. Ожидается, что сделка будет завершена в начале 2024 года. Её условия не разглашаются. Японская компания сообщила, что «следует своей глобальной стратегии» и что новая организация под эгидой Fujitsu Group предоставит «адаптированный и оптимизированный» портфель услуг. Обновлённые предложения компании будут включать публичные облачные сервисы, портфель решений Uvance для создания устойчивого мира путём цифровых инноваций, приложения и сервисы, связанные с мейнфреймами BS2000, а также бизнес-приложения, которые помогут клиентам ориентироваться в цифровом мире и использовать его потенциал для роста. 
Источник изображения: Fujitsu AEQUITA сообщила, что в прошлом году выручка приобретённой Fujitsu Services GmbH составила около €200 млн, и что её штат насчитывает около 1200 сотрудников. Fujitsu Services GmbH предоставляет услуги с опорой на свои ЦОД во Франкфурте, Неккарзульме и Нойенштадте, которые будет использовать и AEQUITA. Во время переходного периода компании будут сотрудничать, чтобы не прерывать бизнес-процессы клиентов. Fujitsu ранее в этом году объявила о закрытии бизнеса ЦОД в США из-за отсутствия мощностей, необходимых для конкуренции на этом рынке. Также компания недавно сообщила о решении поглотить свою облачную «дочку» FJCT. Кроме того, Fujitsu полностью свернёт бизнес в России.
16.11.2023 [23:33], Руслан Авдеев
NTT и NEC научились оценивать снежный покров на дорогах по вибрации оптоволокнаЯпонский техногигант NTT разработал решение, которое, как надеются в компании, поможет компенсировать дефицит рабочих рук в стране, связанный со старением населения и скорым введением правил, запрещающим переработки. Как сообщает The Register, один из экспериментов компании предполагает использование уже действующих оптоволоконных кабелей, чтобы определить, стоит ли технике выезжать на расчистку дорог. NTT совместно с NEC разработали технологию, позволяющую применять имеющиеся подземные ВОЛС в качестве своеобразного сенсора, позволяющего регистрировать вибрации при прохождении света по оптоволокну. Подобные решения уже давно используются, например, в составе охранных систем. У самой NEC уже имеется система, оценивающая скорость проходящего мимо кабеля транспорта, а при участии NTT в городе Аомори (Aomori) удалось разработать механизм, позволяющий оценить снежный покров на дорогах. 
Источник изображения: Samuel Berner/unsplash.com На базе информации о скорости проходящего транспортного средства и анализ частот вибраций, характерных для того или иного вида поверхности проезжей части, система на базе машинного обучения определяет, сколько выпало снега, и даёт достоверные рекомендации, когда и где его следует чистить. Технология имеет большую ценность, поскольку быстро оценить дорожные условия дистанционно пока можно только днём, а дефицит кадров (особенно в сельской местности) означает, что для проверок персонала может не хватить. 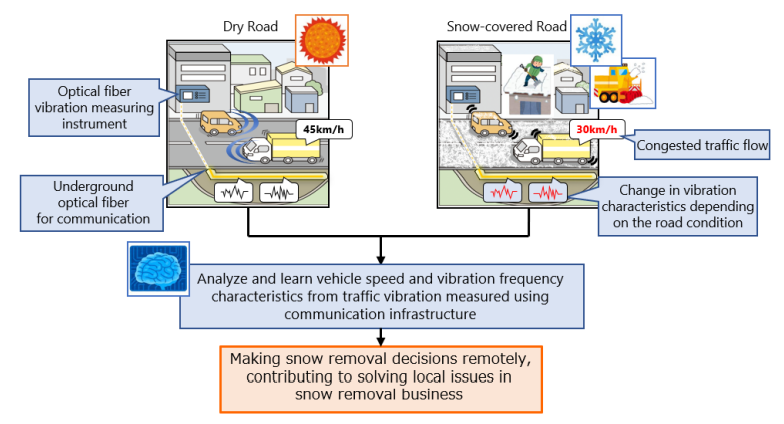
Изображение: NTT Дополнительно NTT провела на своей сети All Photonics Network эксперимент с удалённым управлением экскаватором. Для оконечного соединения оптоволокно подключается к некому беспроводному модулю, передающему данные машине и обратно. Технология позволяет передавать 4K-видео с задержкой 500 мс, которая признана допустимой для безопасной работы тяжёлой техники с участием удалённого оператора. NTT и NEC будут проводить дальнейшие эксперименты в других регионах для совершенствования технологии. Одним из дополнительных стимулов для внедрения технологии является вступление в силу в 2024 году закона, ограничивающего время ежегодных допустимых переработок для рабочих. В NTT полагают, что отсутствие необходимости в перемещении людей с площадки на площадку позволит снизить время переработок. А в конце прошлого года компания сообщила о намерении использовать в ЦОД роботов, способных в перспективе высвободить человеческие ресурсы.
16.11.2023 [02:43], Алексей Степин
Microsoft представила 128-ядерый Arm-процессор Cobalt 100 и ИИ-ускоритель Maia 100 собственной разработкиГиперскейлеры ради снижения совокупной стоимости владения (TCO) и зависимости от сторонних вендоров готовы вкладываться в разработку уникальных чипов, изначально оптимизированных под их нужды и инфраструктуру. К небольшому кругу компаний, решившихся на такой шаг, присоединилась Microsoft, анонсировавшая Arm-процессор Azure Cobalt 100 и ИИ-ускоритель Azure Maia 100. 
Изображения: Microsoft Первопроходцем в этой области стала AWS, которая разве что память своими силами не разрабатывает. У AWS уже есть три с половиной поколения Arm-процессоров Graviton и сразу два вида ИИ-ускорителей: Trainium для обучения и Inferentia2 для инференса. Крупный китайский провайдер Alibaba Cloud также разработал и внедрил Arm-процессоры Yitian и ускорители Hanguang. Что интересно, в обоих случаях процессоры оказывались во многих аспектах наиболее передовыми. Наконец, у Google есть уже пятое поколение ИИ-ускорителей TPU. 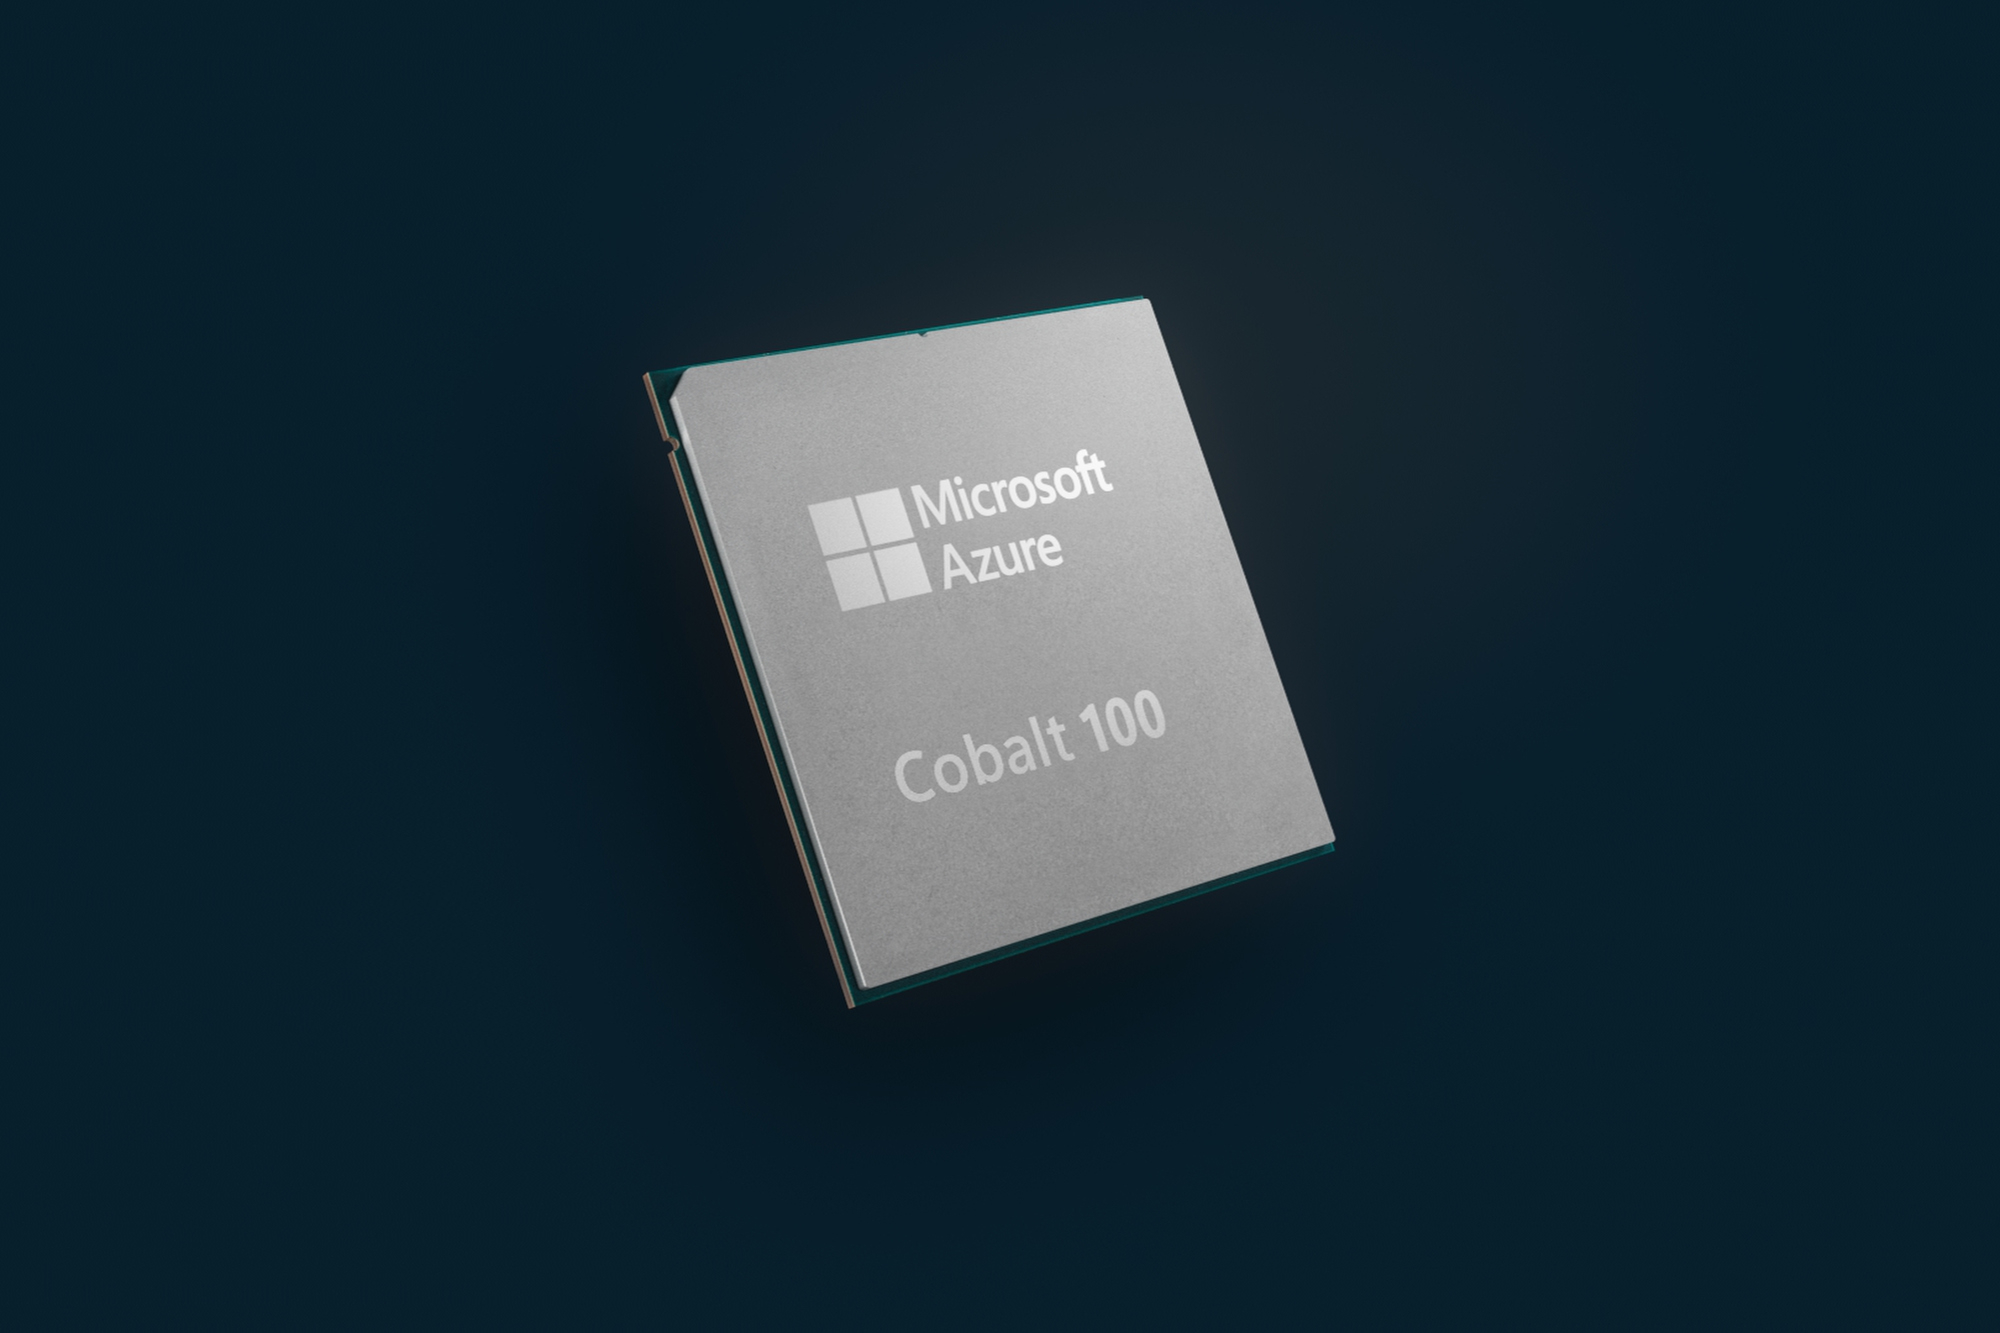 Microsoft заявила, что оба новых чипа уже производятся на мощностях TSMC с использованием «последнего техпроцесса» и займут свои места в ЦОД Microsoft в начале следующего года. Как минимум, в случае с Maia 100 речь идёт о 5-нм техпроцессе, вероятно, 4N. В настоящее время Microsoft Azure находится в начальной стадии развёртывания инфраструктуры на базе новых чипов, которая будет использоваться для Microsoft Copilot, Azure OpenAI и других сервисов. Например, Bing до сих пор во много полагается на FPGA, а вся ИИ-инфраструктура Microsoft крайне сложна. 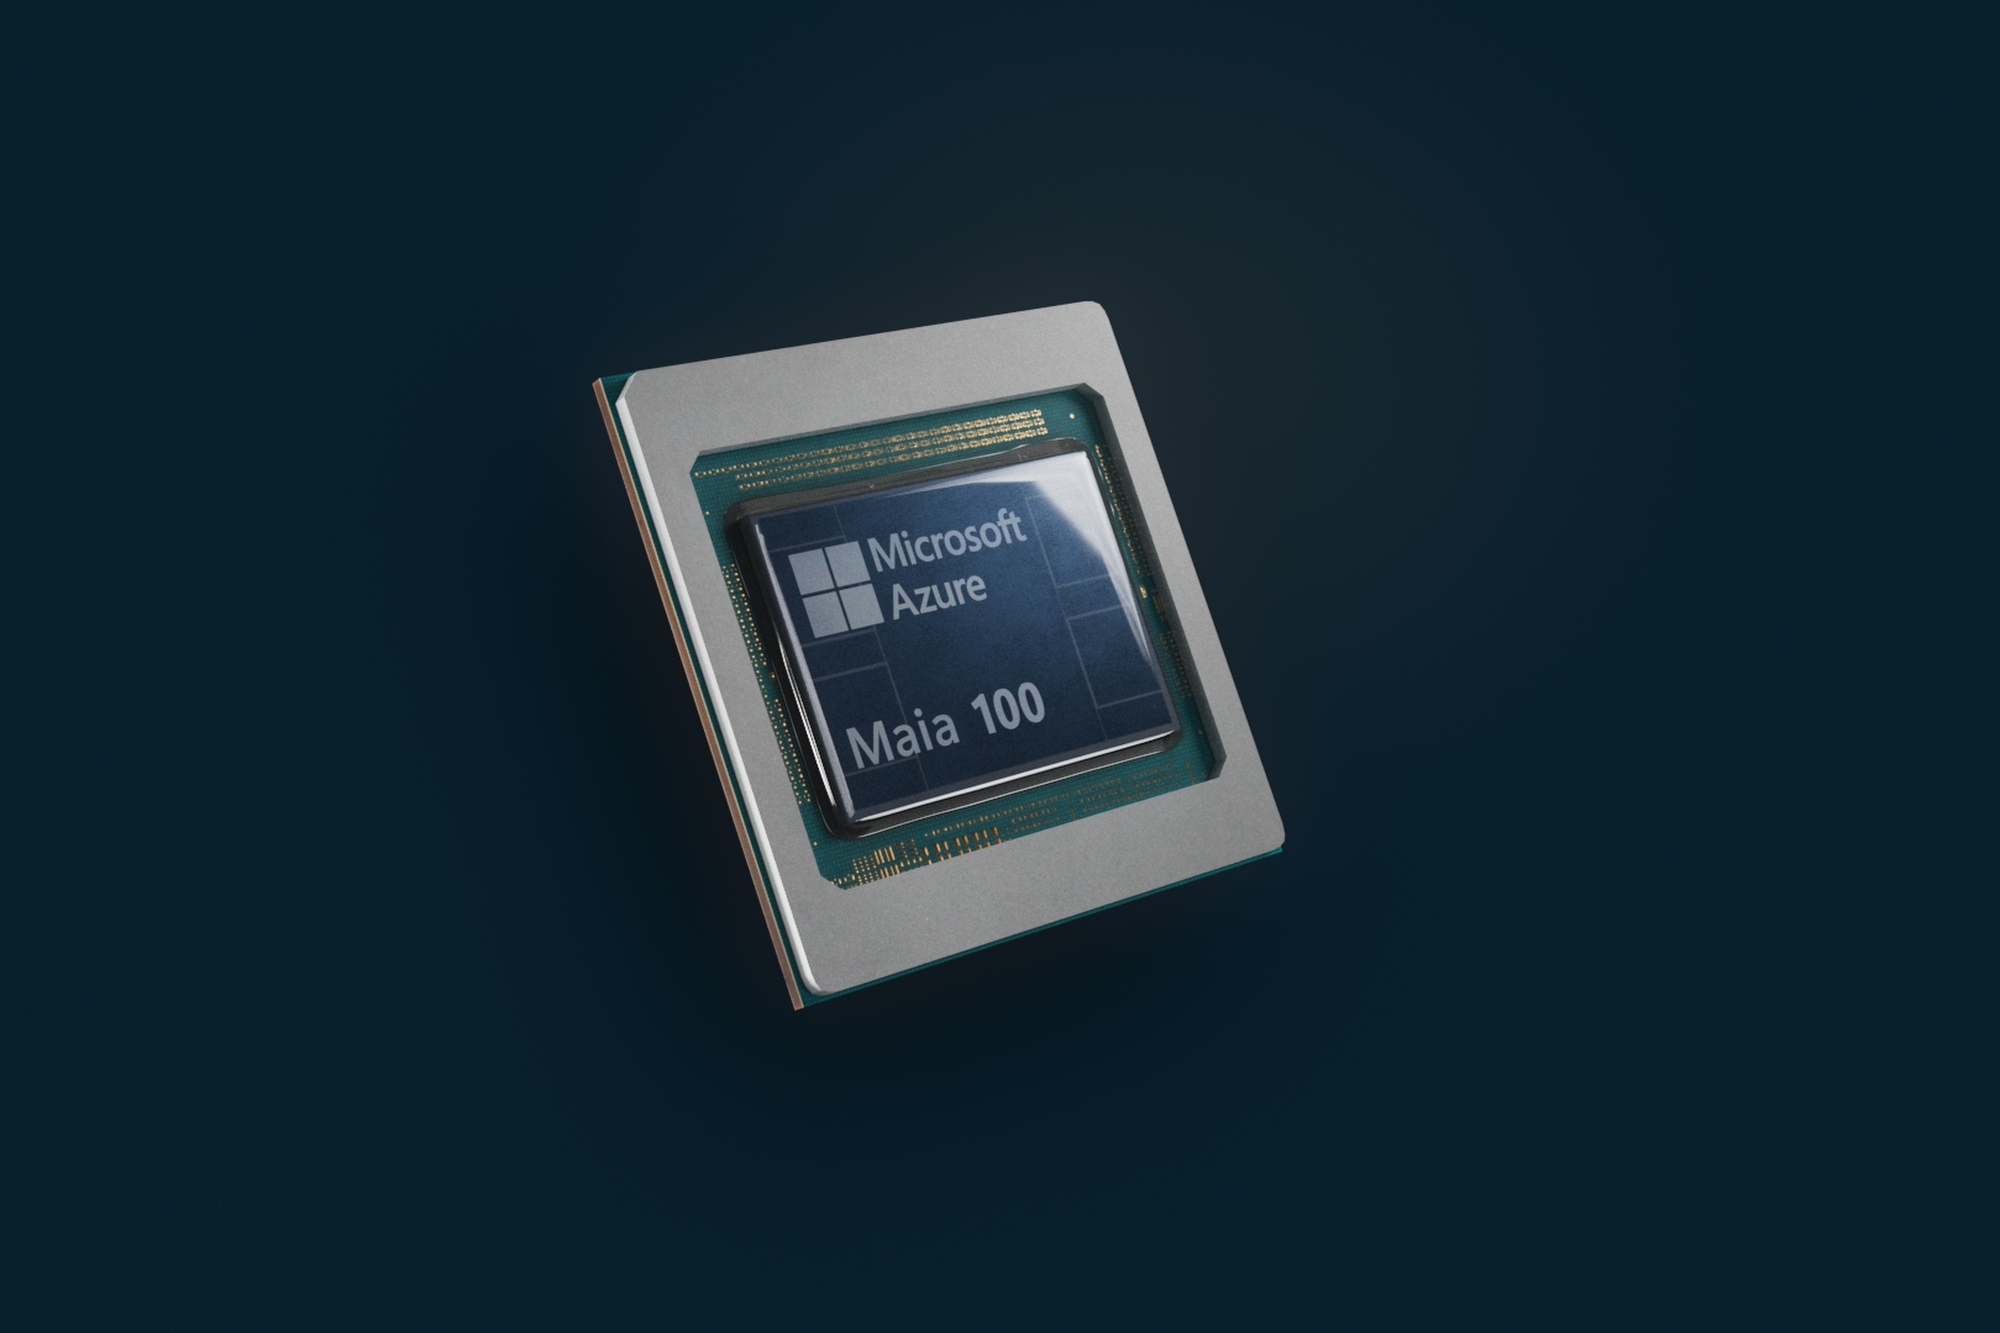 Microsoft приводит очень мало технических данных о своих новинках, но известно, что Azure Cobalt 100 имеет 128 ядер Armv9 Neoverse N2 (Perseus) и основан на платформе Arm Neoverse Compute Subsystem (CSS). По словам компании, процессоры Cobalt 100 до +40 % производительнее имеющихся в инфраструктуре Azure Arm-чипов, они используются для обеспечения работы служб Microsoft Teams и Azure SQL. Oracle, вложившаяся в своё время в Ampere Comptuing, уже перевела все свои облачные сервисы на Arm. 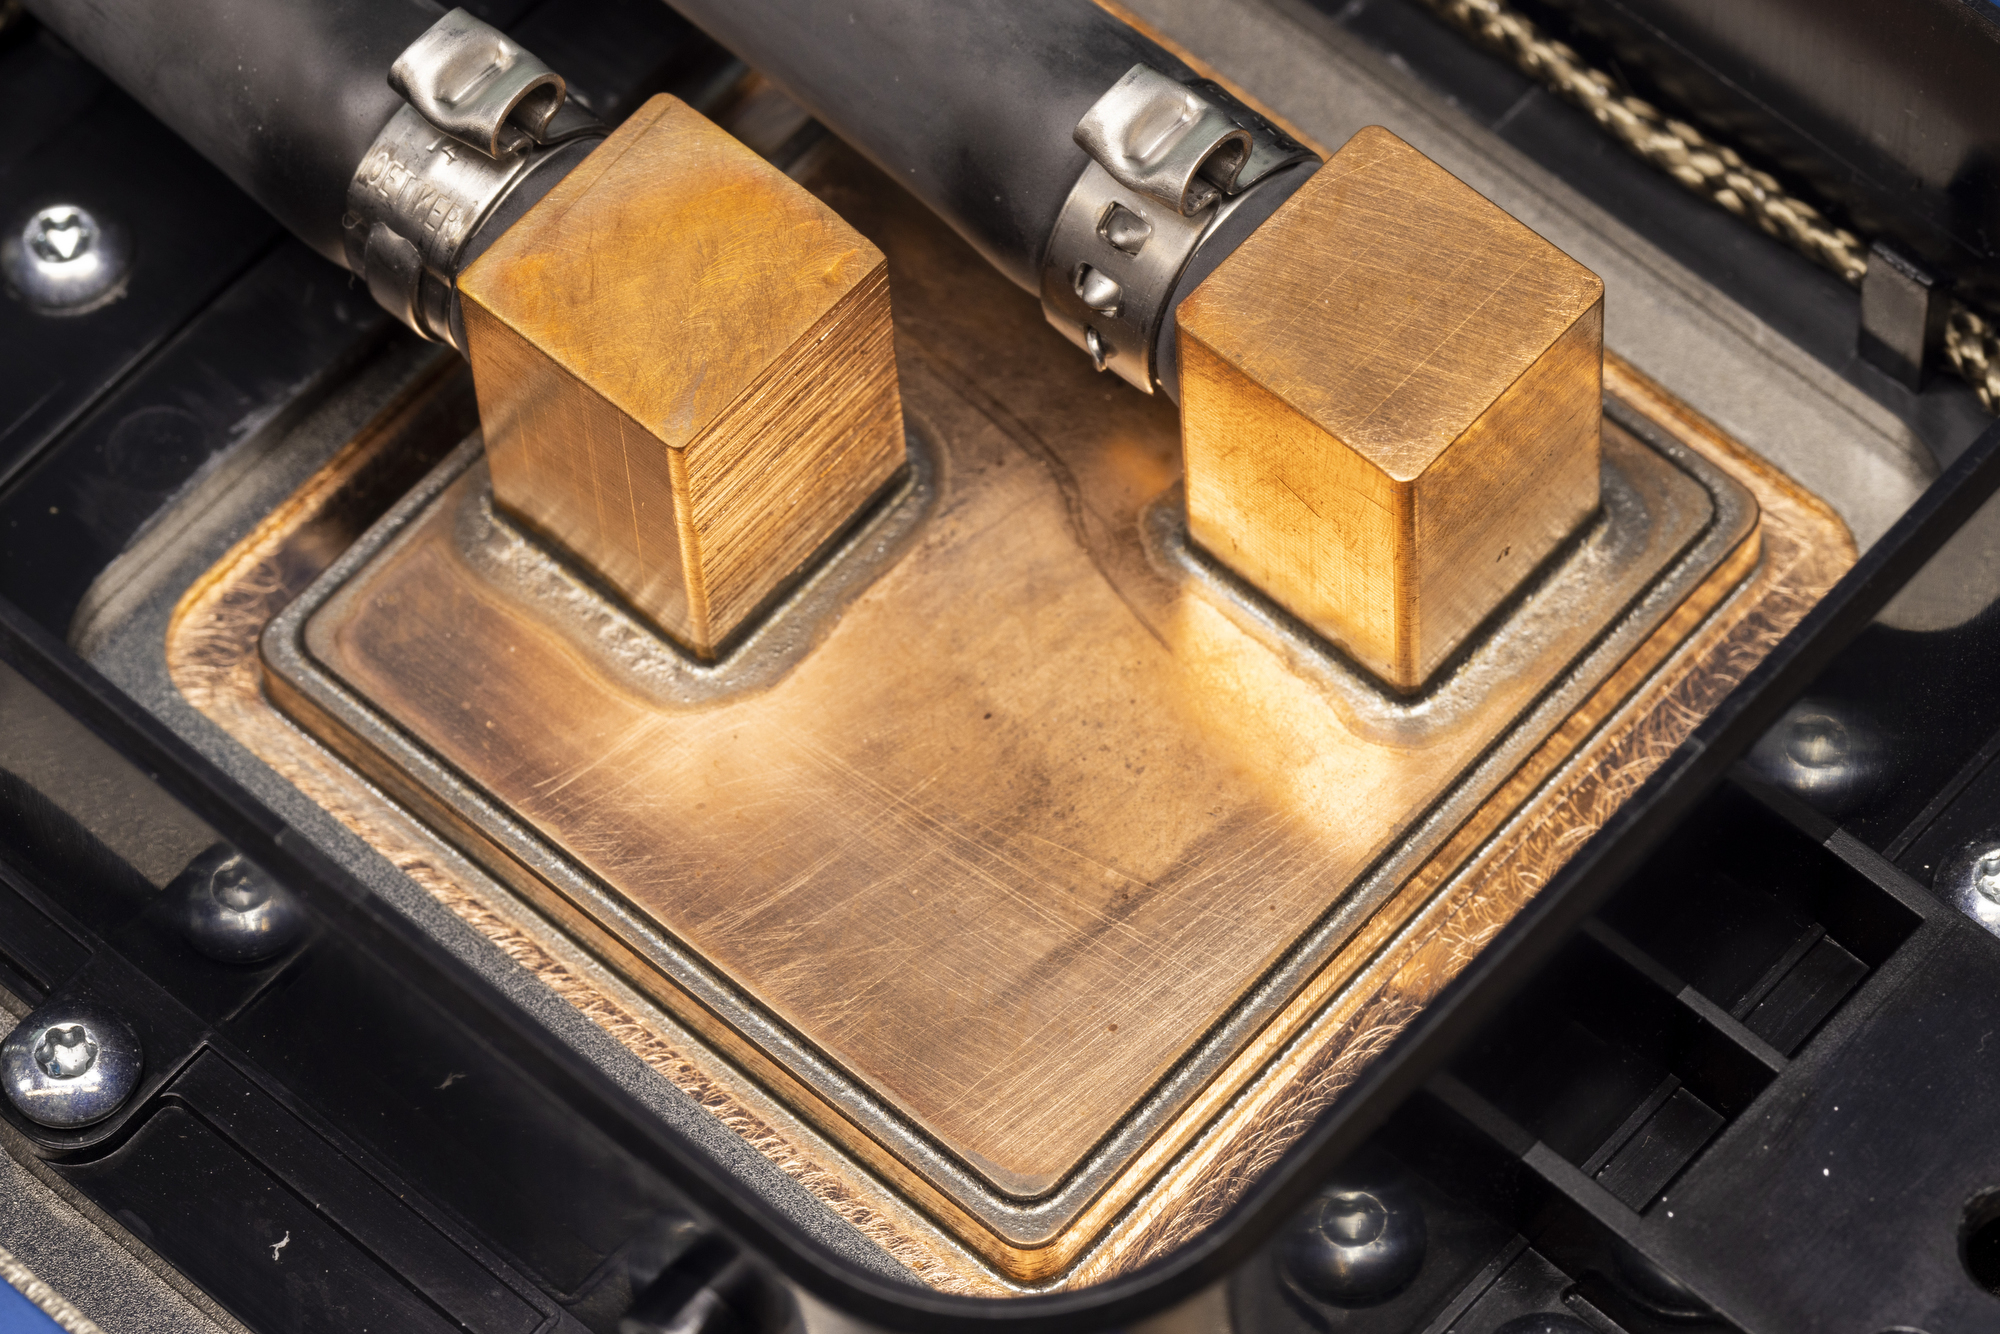 Чип Maia 100 (Athena) изначально спроектирован под задачи облачного обучения ИИ и инференса в сценариях с использованием моделей OpenAI, Bing, GitHub Copilot и ChatGPT в инфраструктуре Azure. Чип содержит 105 млрд транзисторов, что больше, нежели у NVIDIA H100 (80 млрд) и ставит Maia 100 на один уровень с Ponte Vecchio (~100 млрд). Для Maia организован кастомный интерконнект на базе Ethernet — каждый ускоритель располагает 4,8-Тбит/с каналом для связи с другими ускорителями, что должно обеспечить максимально эффективное масштабирование. 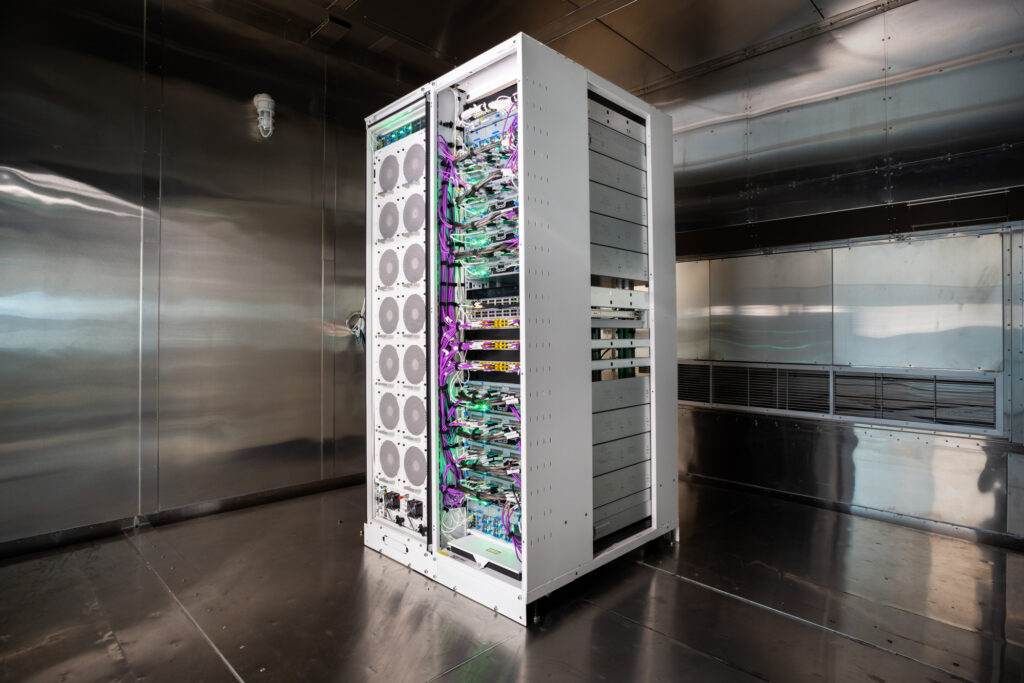 Сами Maia 100 используют СЖО с теплообменниками прямого контакта. Поскольку нынешние ЦОД Microsoft проектировались без учёта использования мощных СЖО, стойку пришлось сделать более широкой, дабы разместить рядом с сотней плат с чипами Maia 100 серверами и большой радиатор. Этот дизайн компания создавала вместе с Meta✴, которая испытывает аналогичные проблемы с текущими ЦОД. Такие стойки в настоящее время проходят термические испытания в лаборатории Microsoft в Редмонде, штат Вашингтон. 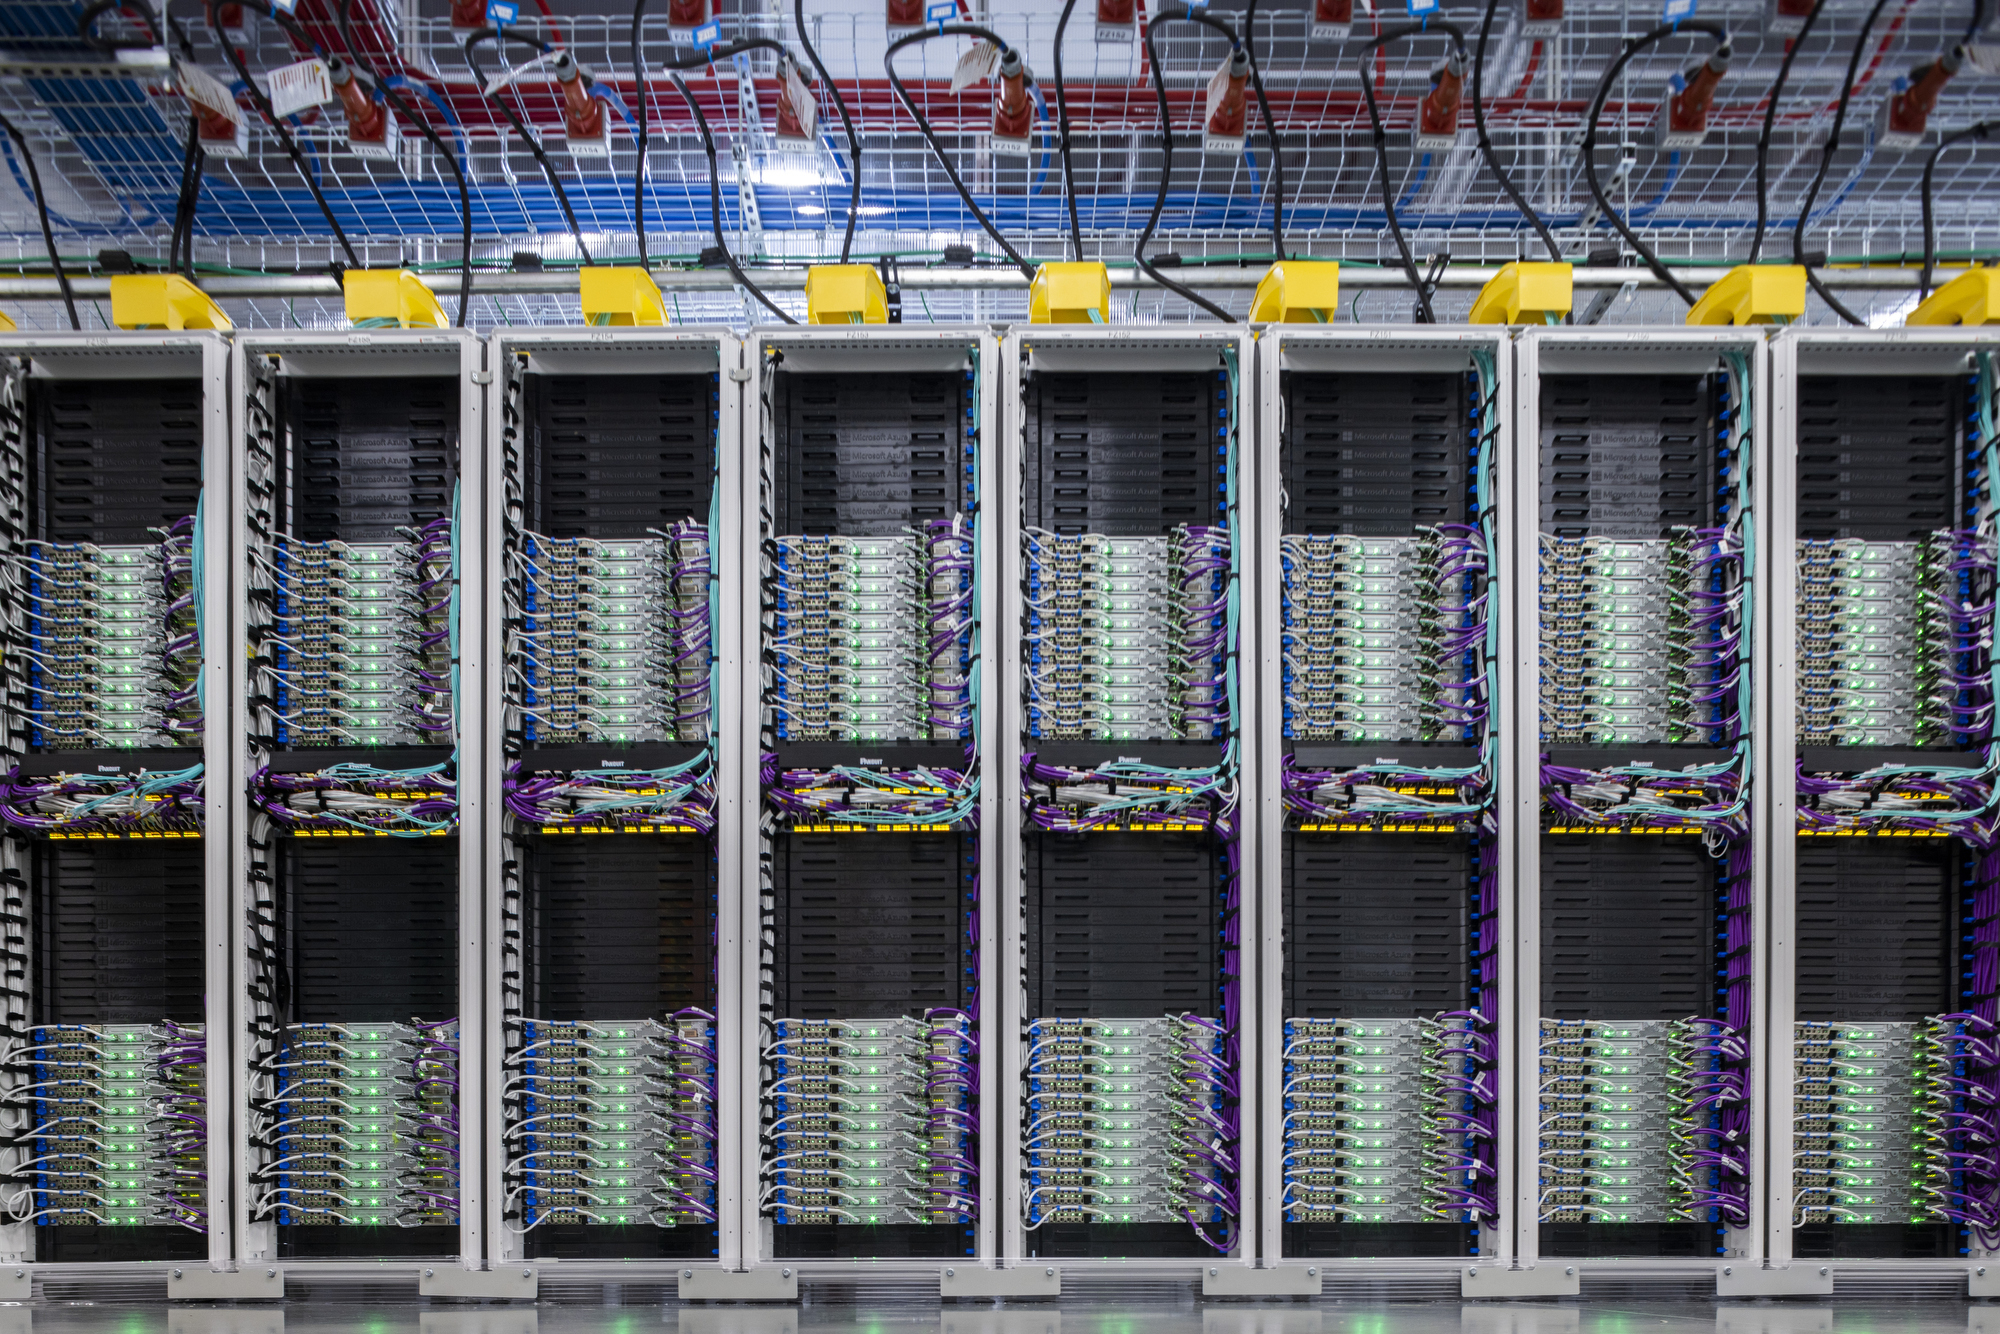 В дополнение к Cobalt и Maia анонсирована широкая доступность услуги Azure Boost на базе DPU MANA, берущего на себя управление всеми функциями виртуализации на манер AWS Nitro, хотя и не целиком — часть ядер хоста всё равно используется для обслуживания гипервизора. DPU предлагает 200GbE-подключение и доступ к удалённому хранилищу на скорости до 12,5 Гбайт/с и до 650 тыс. IOPS. 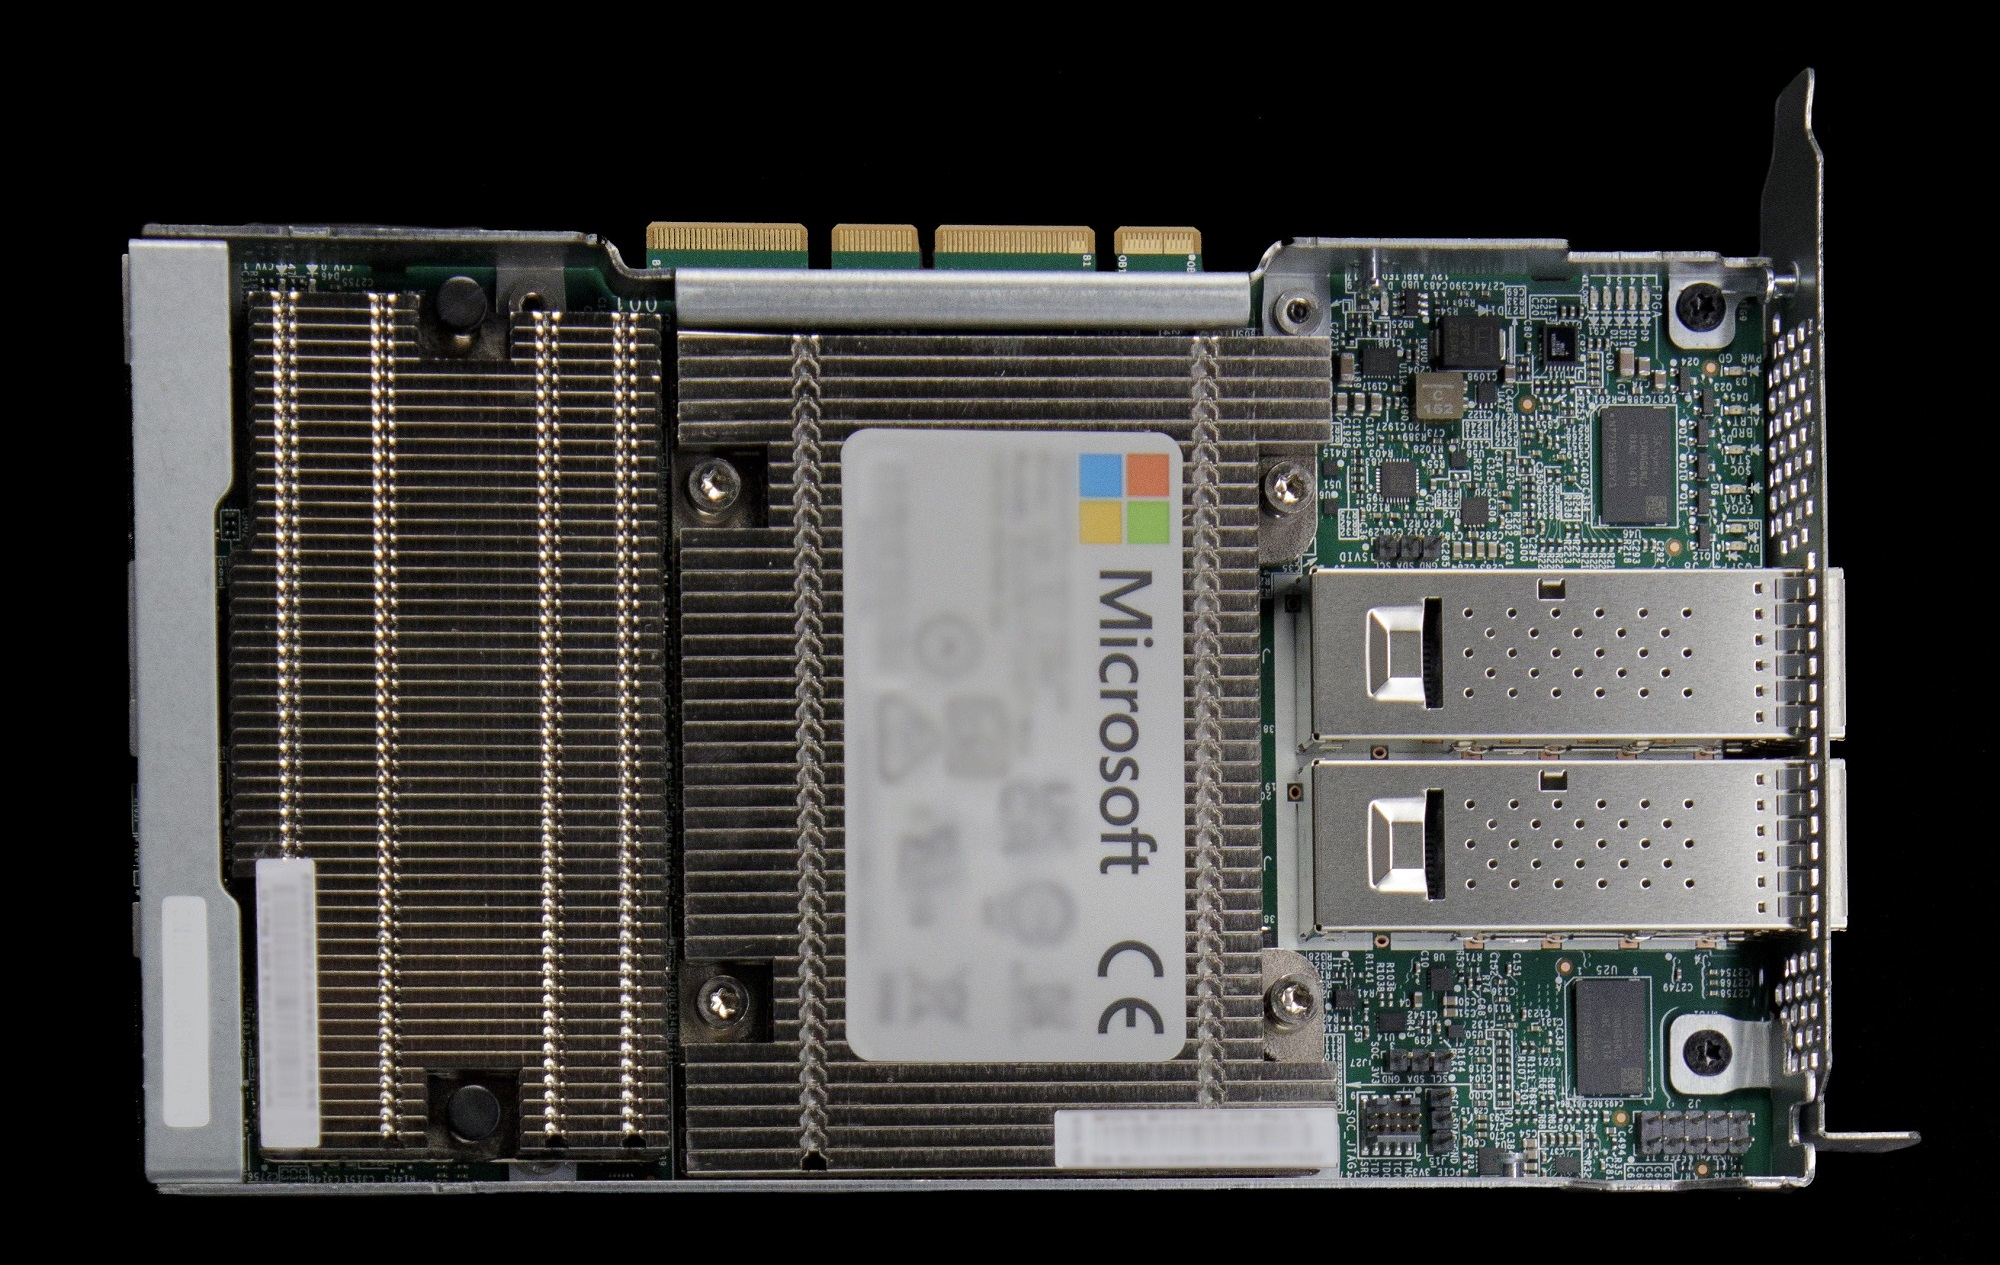 Microsoft не собирается останавливаться на достигнутом: вводя в строй инфраструктуру на базе новых чипов Cobalt и Maia первого поколения, компания уже ведёт активную разработку чипов второго поколения. Впрочем, совсем отказываться от партнёрства с другими вендорами Microsoft не намерена. Компания анонсировала первые инстансы с ускорителями AMD Instinct MI300X, а в следующем году появятся инстансы с NVIDIA H200. 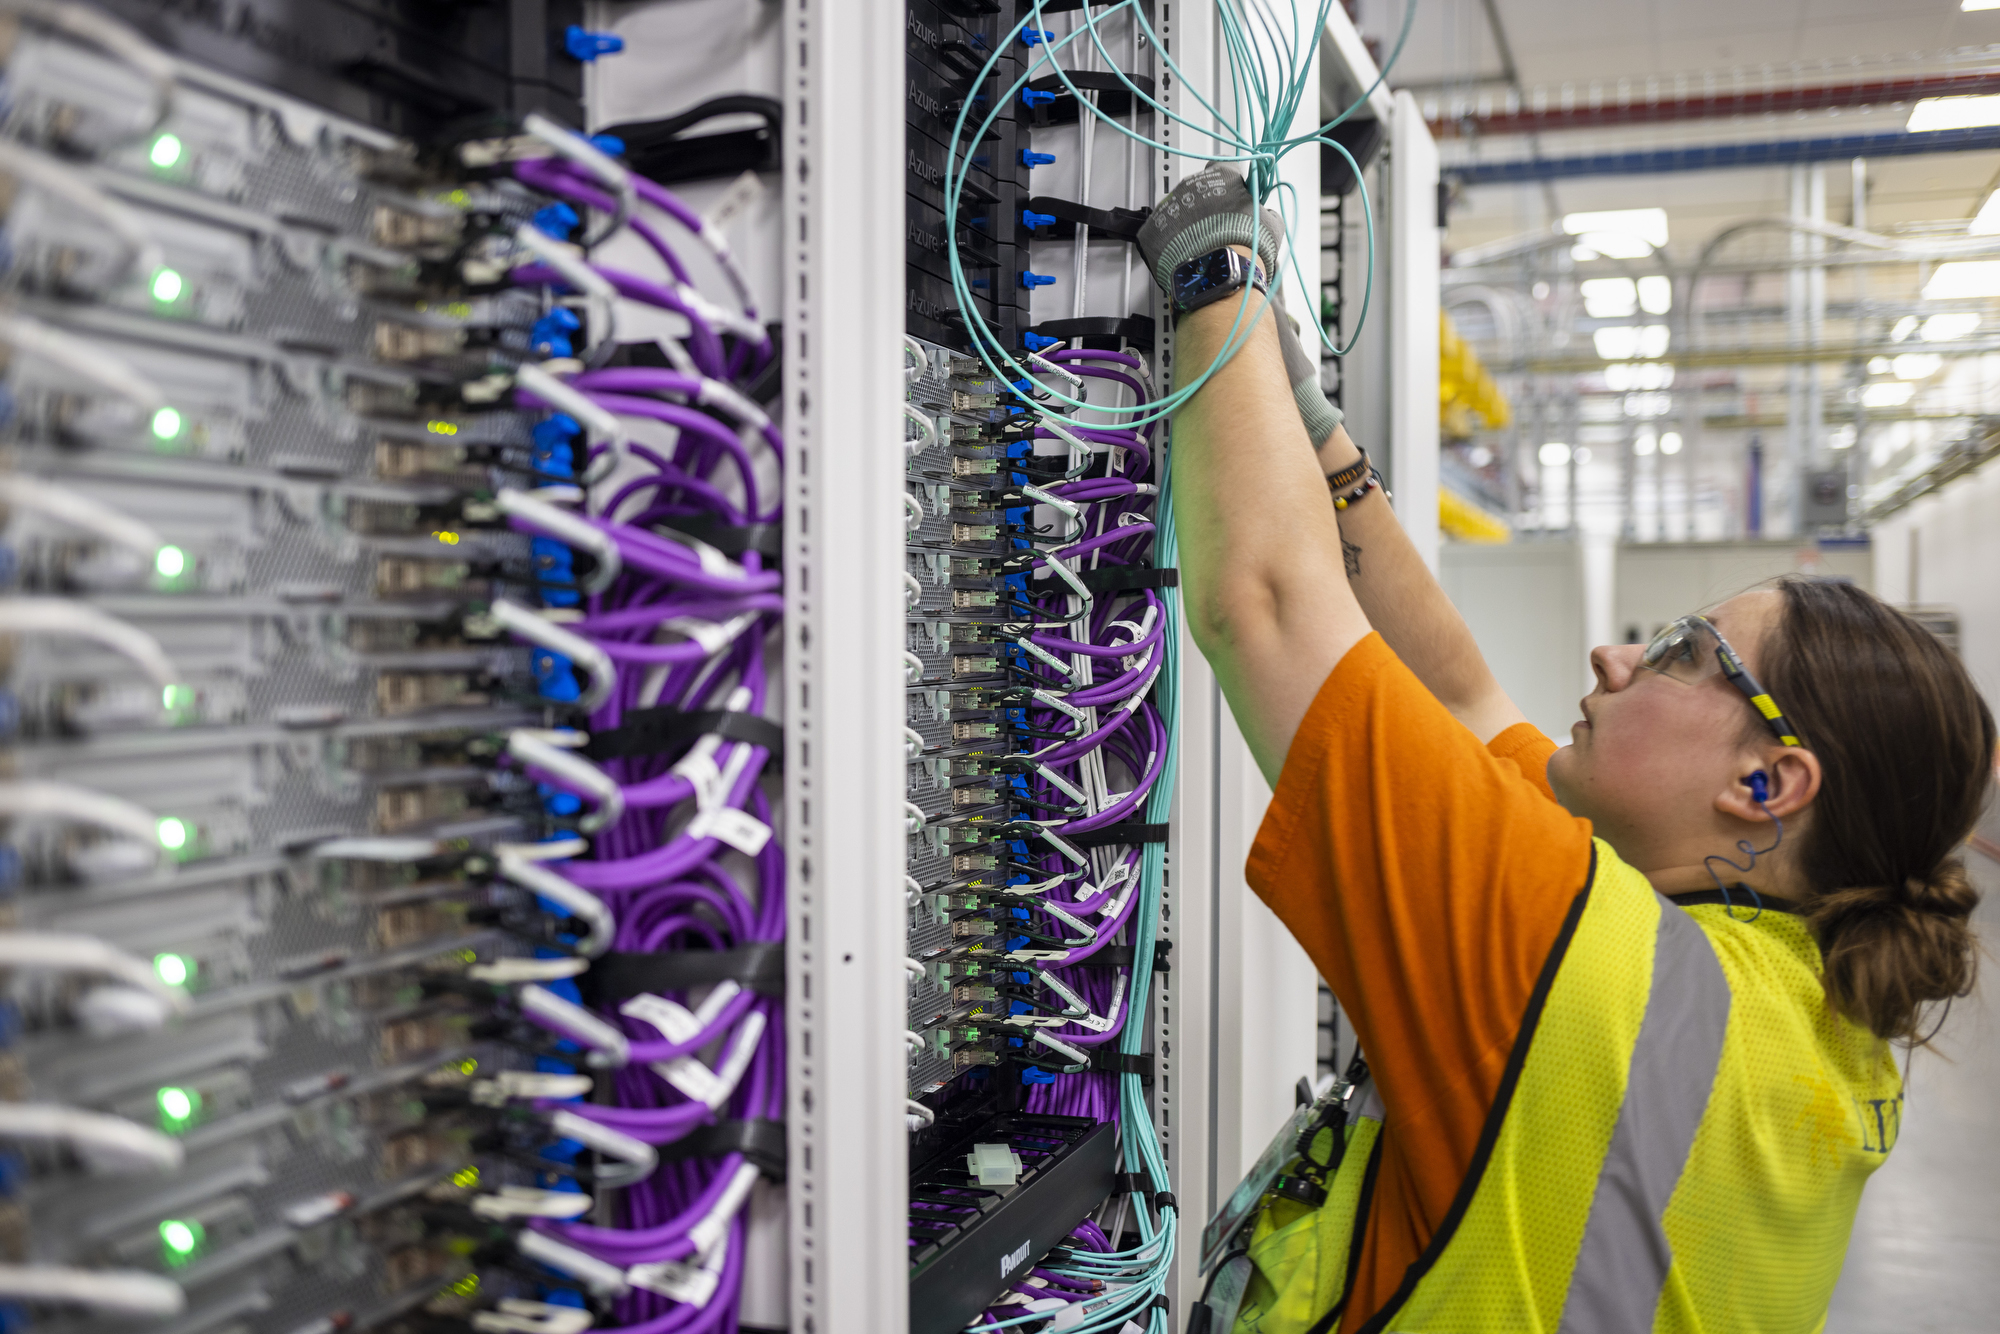
13.11.2023 [17:00], Игорь Осколков
NVIDIA анонсировала ускорители H200 и «фантастическую четвёрку» Quad GH200NVIDIA анонсировала ускорители H200 на базе всё той же архитектуры Hopper, что и их предшественники H100, представленные более полутора лет назад. Новый H200, по словам компании, первый в мире ускоритель, использующий память HBM3e. Вытеснит ли он H100 или останется промежуточным звеном эволюции решений NVIDIA, покажет время — H200 станет доступен во II квартале следующего года, но также в 2024-м должно появиться новое поколение ускорителей B100, которые будут производительнее H100 и H200. 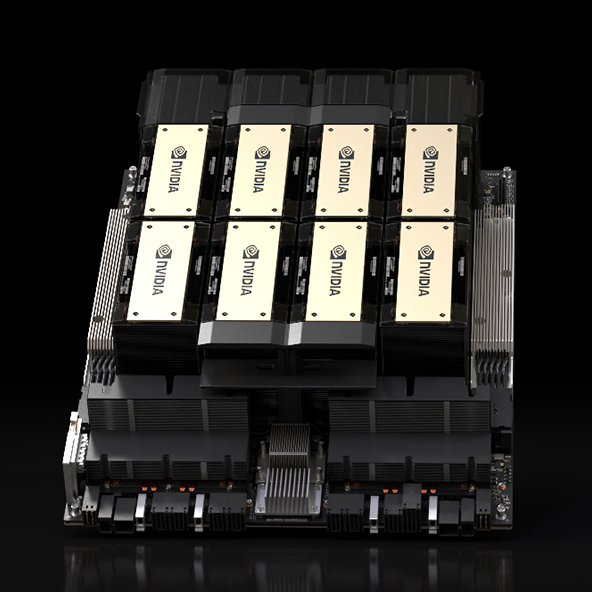
HGX H200 (Источник здесь и далее: NVIDIA) H200 получил 141 Гбайт памяти HBM3e с суммарной пропускной способностью 4,8 Тбайт/с. У H100 было 80 Гбайт HBM3, а ПСП составляла 3,35 Тбайт/с. Гибридные ускорители GH200, в состав которых входит H200, получат до 480 Гбайт LPDDR5x (512 Гбайт/с) и 144 Гбайт HBM3e (4,9 Тбайт/с). Впрочем, с GH200 есть некоторая неразбериха, поскольку в одном месте NVIDIA говорит о 141 Гбайт, а в другом — о 144 Гбайт HBM3e. Обновлённая версия GH200 станет массово доступна после выхода H200, а пока что NVIDIA будет поставлять оригинальный 96-Гбайт вариант с HBM3. Напомним, что грядущие конкурирующие AMD Instinct MI300X получат 192 Гбайт памяти HBM3 с ПСП 5,2 Тбайт/с. 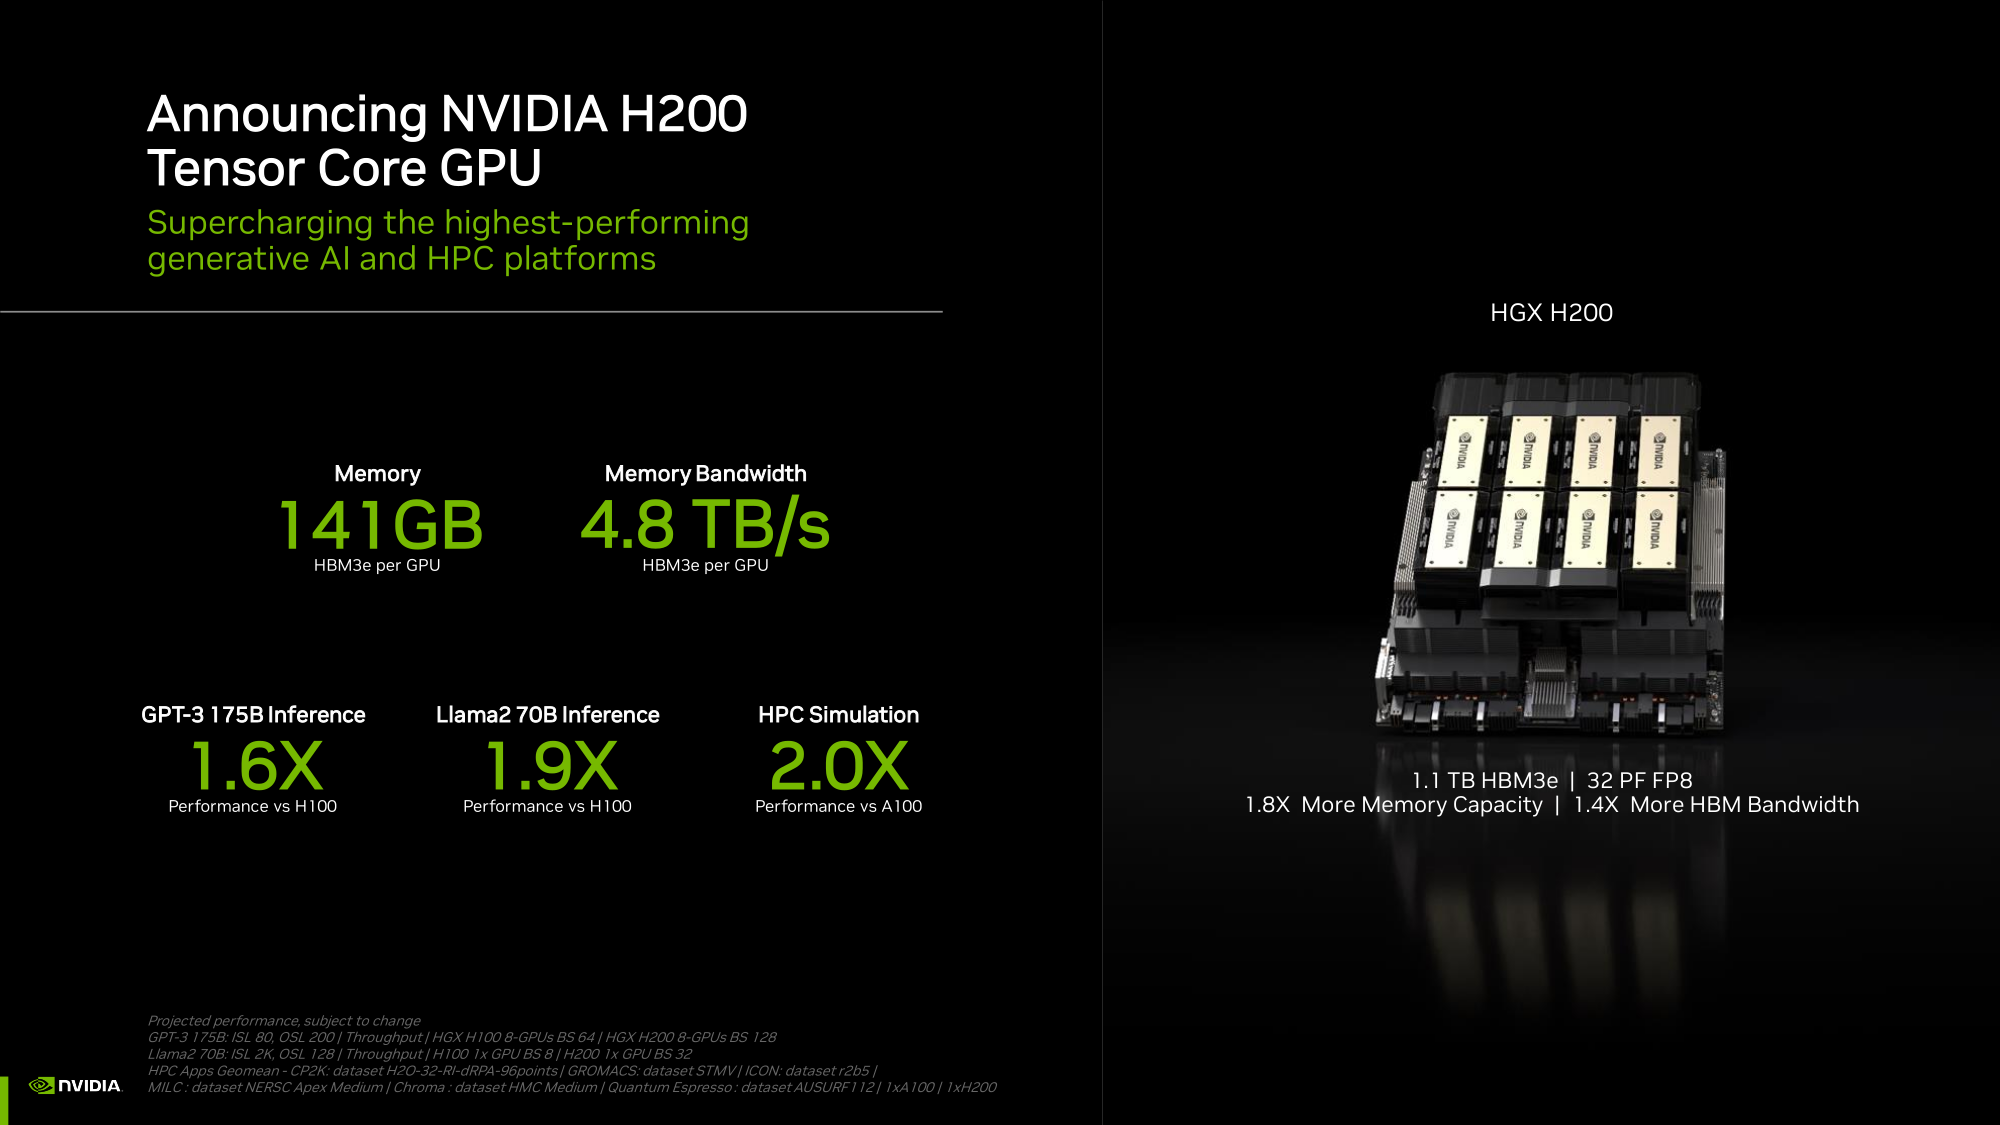 На момент написания материала NVIDIA не раскрыла полные характеристики H200, но судя по всему, вычислительная часть H200 осталась такой же или почти такой же, как у H100. NVIDIA приводит FP8-производительность HGX-платформы с восемью ускорителями (есть и вариант с четырьмя), которая составляет 32 Пфлопс. То есть на каждый H200 приходится 4 Пфлопс, ровно столько же выдавал и H100. Тем не менее, польза от более быстрой и ёмкой памяти есть — в задачах инференса можно получить прирост в 1,6–1,9 раза. 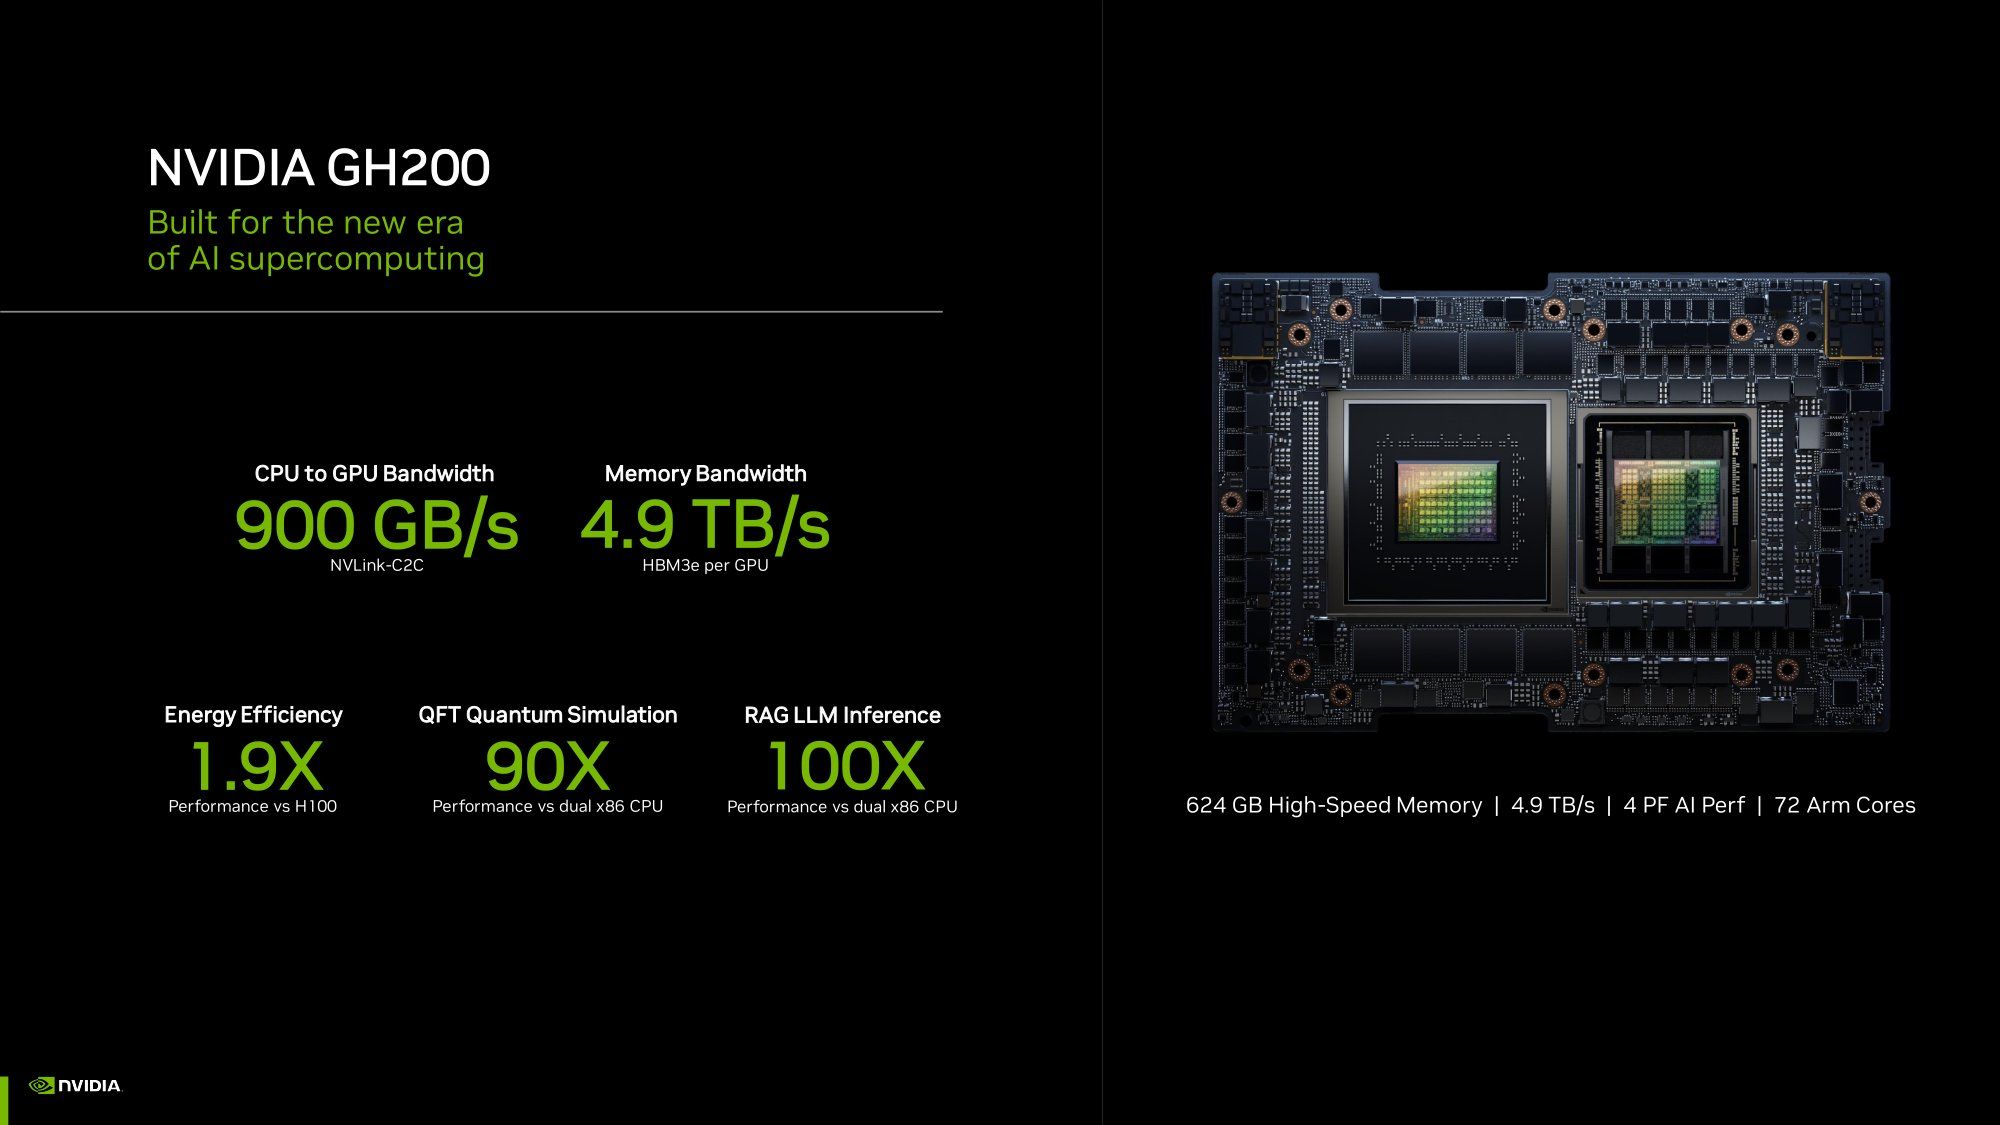 При этом платы HGX H200 полностью совместимы с уже имеющимися на рынке платформами HGX H100 как механически, так и с точки зрения питания и теплоотвода. Это позволит очень быстро обновить предложения партнёрам компании: ASRock Rack, ASUS, Dell, Eviden, GIGABYTE, HPE, Lenovo, QCT, Supermicro, Wistron и Wiwynn. H200 также станут доступны в облаках. Первыми их получат AWS, Google Cloud Platform, Oracle Cloud, CoreWeave, Lambda и Vultr. Примечательно, что в списке нет Microsoft Azure, которая, похоже, уже страдает от недостатка H100. 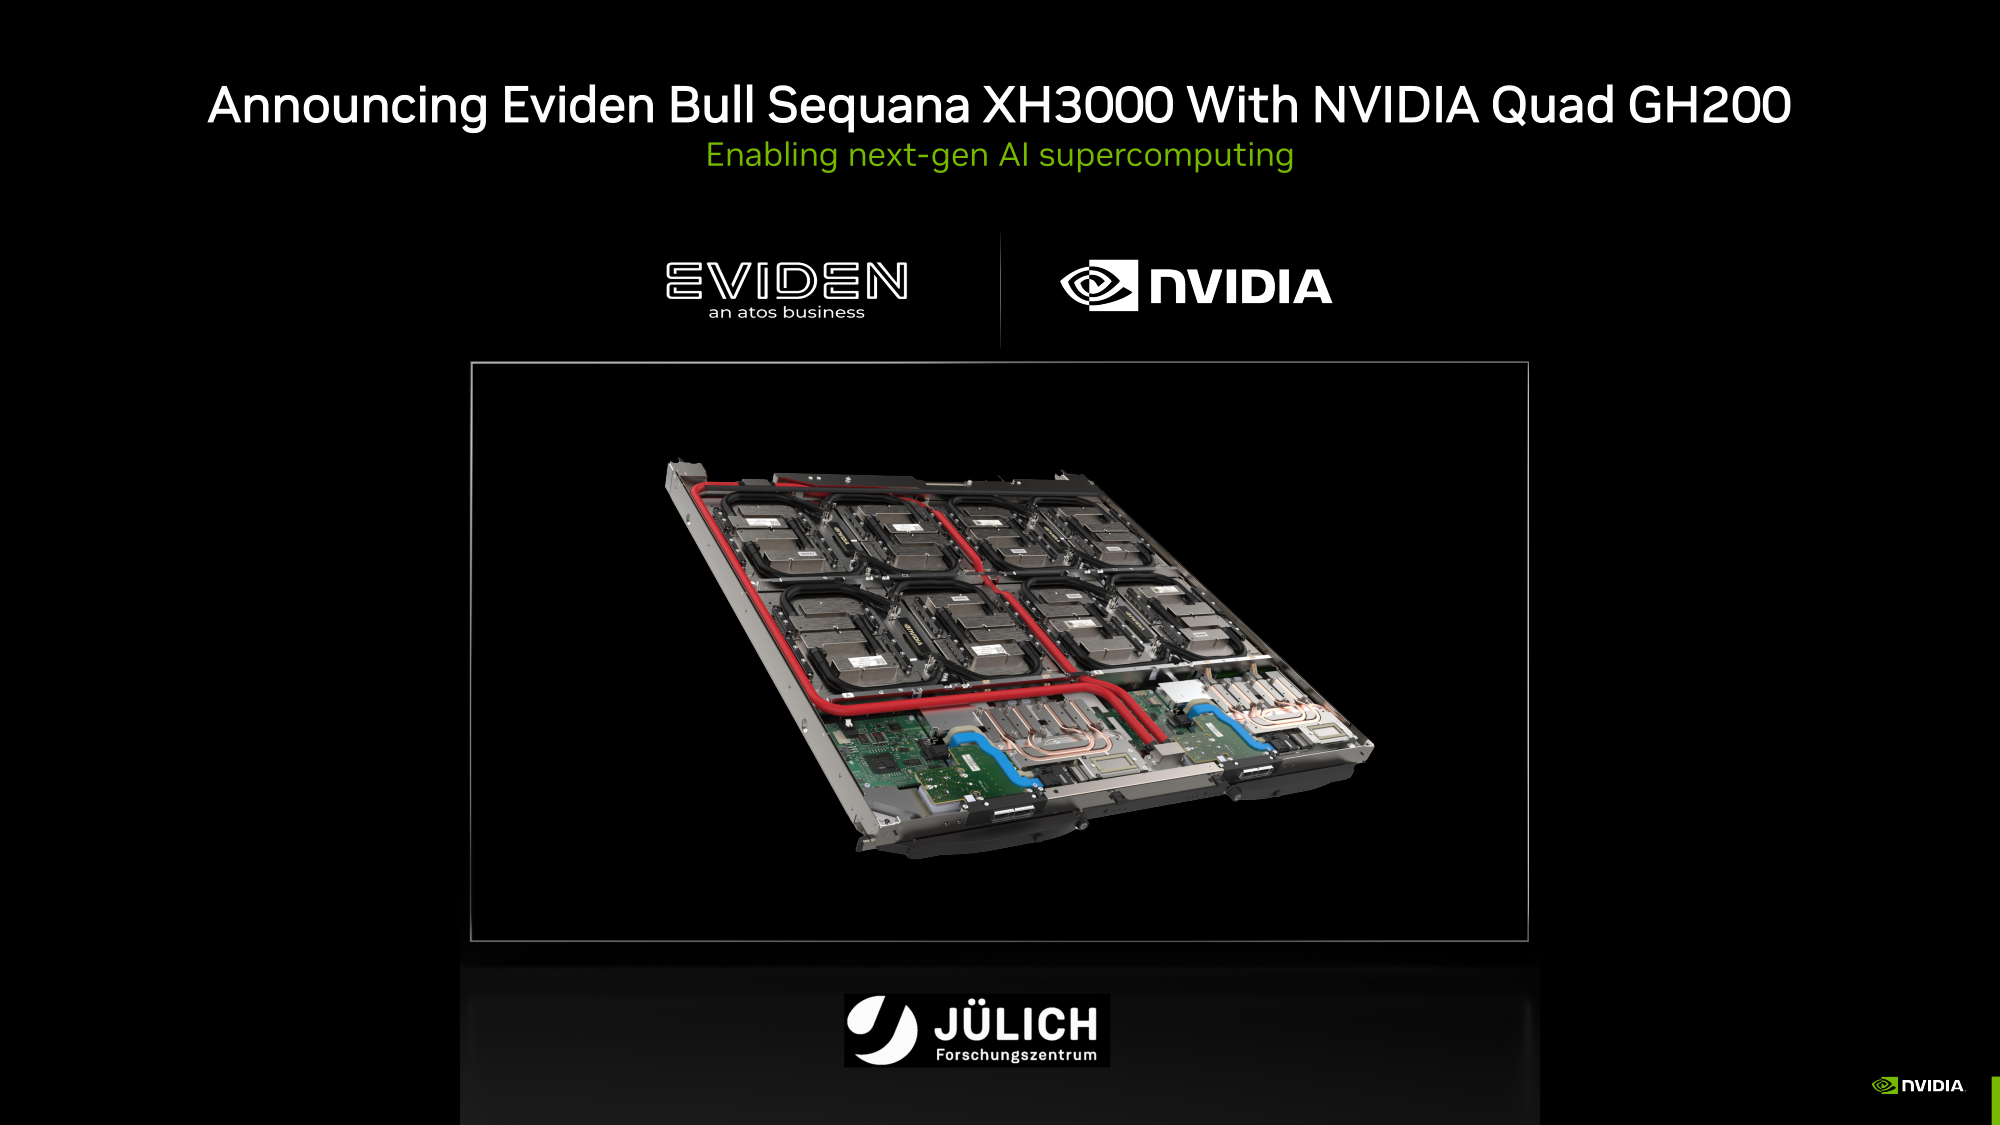 GH200 уже доступны избранным в облаках Lamba Labs и Vultr, а в начале 2024 года они появятся у CoreWeave. До конца этого года поставки серверов с GH200 начнут ASRock Rack, ASUS, GIGABYTE и Ingrasys. В скором времени эти чипы также появятся в сервисе NVIDIA Launchpad, а вот про доступность там H200 компания пока ничего не говорит. 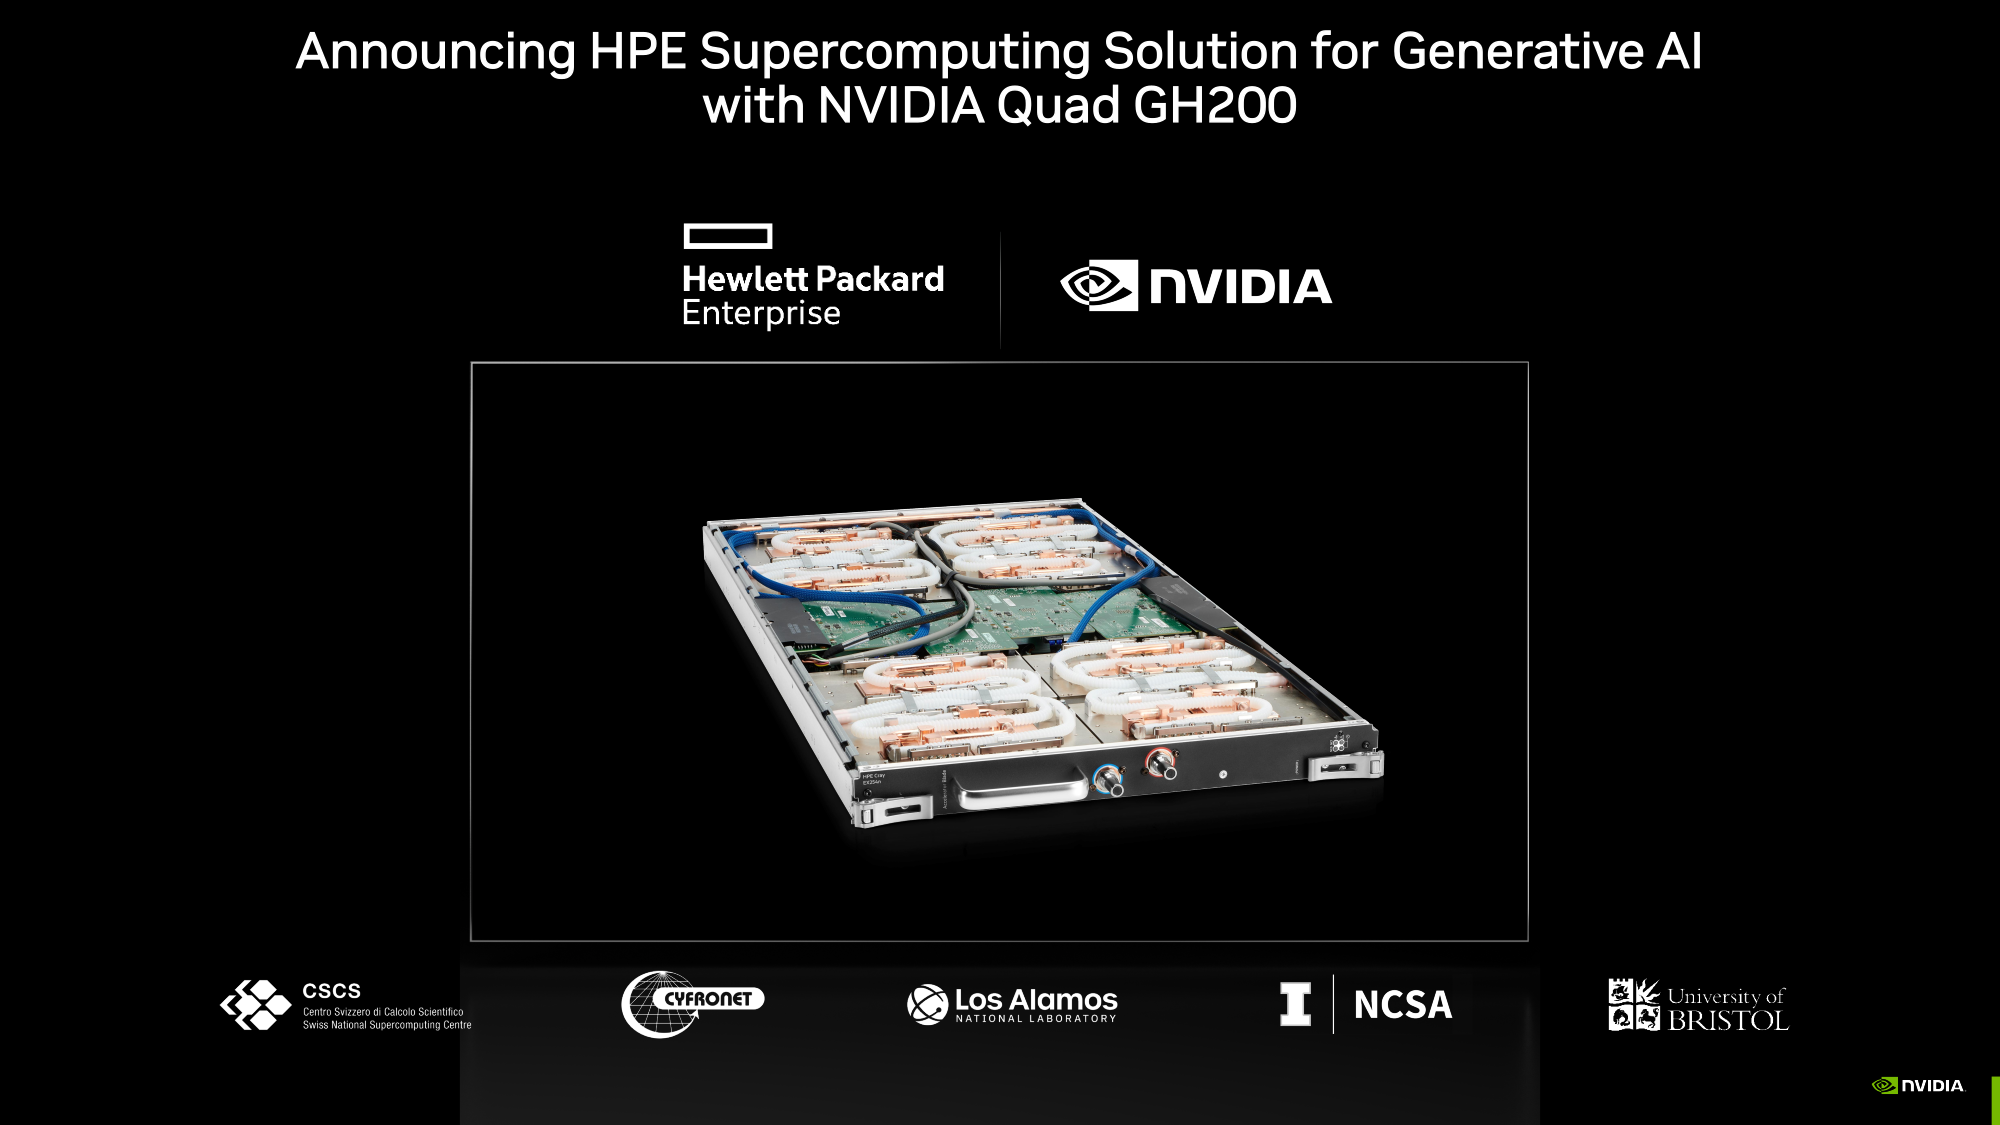 Одновременно NVIDIA представила и базовый «строительный блок» для суперкомпьютеров ближайшего будущего — плату Quad GH200 с четырьмя чипами GH200, где все ускорители связаны друг с другом посредством NVLink по схеме каждый-с-каждым. Суммарно плата несёт более 2 Тбайт памяти, 288 Arm-ядер и имеет FP8-производительность 16 Пфлопс. На базе Quad GH200 созданы узлы HPE Cray EX254n и Eviden Bull Sequana XH3000. До конца 2024 года суммарная ИИ-производительность систем с GH200, по оценкам NVIDIA, достигнет 200 Эфлопс.
09.11.2023 [16:15], Сергей Карасёв
NVIDIA готовит для Китая три новых ускорителя взамен подпавших под санкции: H20, L20 и L2Компания NVIDIA, по сообщению Reuters, планирует выпустить три новых ИИ-ускорителя, модифицированных специально для Китая с учётом дополнительных санкций со стороны США. Изделия фигурируют под обозначениями HGX H20 (SXM), L20 (PCIe) и L2 (PCIe), а их официальная презентация состоится не раньше 16 ноября. Напомним, в середине октября 2023 года США ввели новые ограничения на поставку передовых чипов NVIDIA в Китай: они затронули решения A800 и H800 — модифицированные версии A100 и H100, созданные специально для рынка КНР с учетом ранее действовавших американских ограничений. После этого NVIDIA пришлось искать новые регионы сбыта для «урезанных» ускорителей, предназначавшихся для Поднебесной. Как теперь сообщается, NVIDIA снова нашла возможность поставлять ускорители на китайский рынок, который потенциально может обеспечить значительную выручку. Решения H20, L20 и L2 не подпадают ни под одно из действующих экспортных ограничений. Обратной стороной медали является то, что производительность у них серьёзно снижена (см. характеристики в таблице выше), передаёт SemiAnalysis. 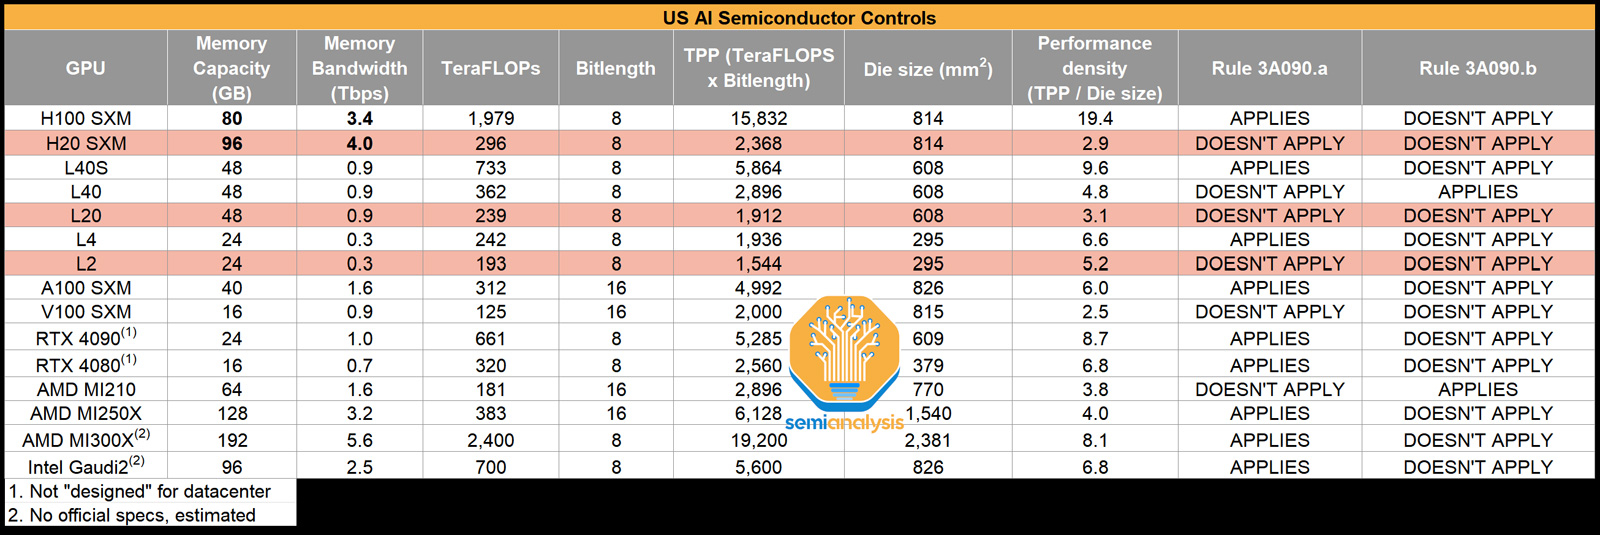
Источник: SemiAnalysis Отмечается, что у NVIDIA уже готовы образцы новых ускорителей для китайского рынка, а их массовое производство будет организовано в течение следующего месяца. Сама компания какие-либо комментарии по поводу обнародованной в интернете информации не даёт.
09.11.2023 [03:15], Алексей Степин
RISC-V с приправой: модульные 192-ядерные серверные процессоры Ventana Veyron V2 можно дополнить ускорителямиВ 2022 года компания Ventana Micro Systems анонсировала первые по-настоящему серверные RISC-V процессоры Veyron V1. Анонс чипов, обещающих потягаться на равных с лучшими x86-процессорами с архитектурой x86, прозвучал громко. Популярности, впрочем, Veyron V1 не снискал, но на днях компания анонсировала второе поколение чипов Veyron V2, более полно воплотившее в себе принципы модульного дизайна и получившее ряд усовершенствований. Как и в первом поколении, компания-разработчик продолжает придерживаться концепции «процессора-конструктора» с чиплетным дизайном. В центре 4-нм Veyron V2 по-прежнему лежит I/O-хаб на базе AMBA CHI, охватывающий контроллеры памяти и шины PCI Express, а также блоки IOMMU и AIA. К нему посредством интерфейса UCIe подключаются вычислительные чиплеты. Латентность UCIe-подключения составляет менее 7 нс. 
Источник изображений здесь и далее: Ventana Micro Systems Чиплеты эти могут быть разных видов: либо с ядрами общего назначения (по 32 ядра на чиплет), образующие собственно процессор Veyron V2, либо содержащие специфические сопроцессоры под конкретную задачу (domain-specific acceleration, DSA). Последние могуть быть представлены FPGA, ИИ-ускорителями и т.д. Более того, Ventana по желанию заказчика может оптимизировать и I/O-хаб для повышения эффективности работы ядер CPU с сопроцессорами. 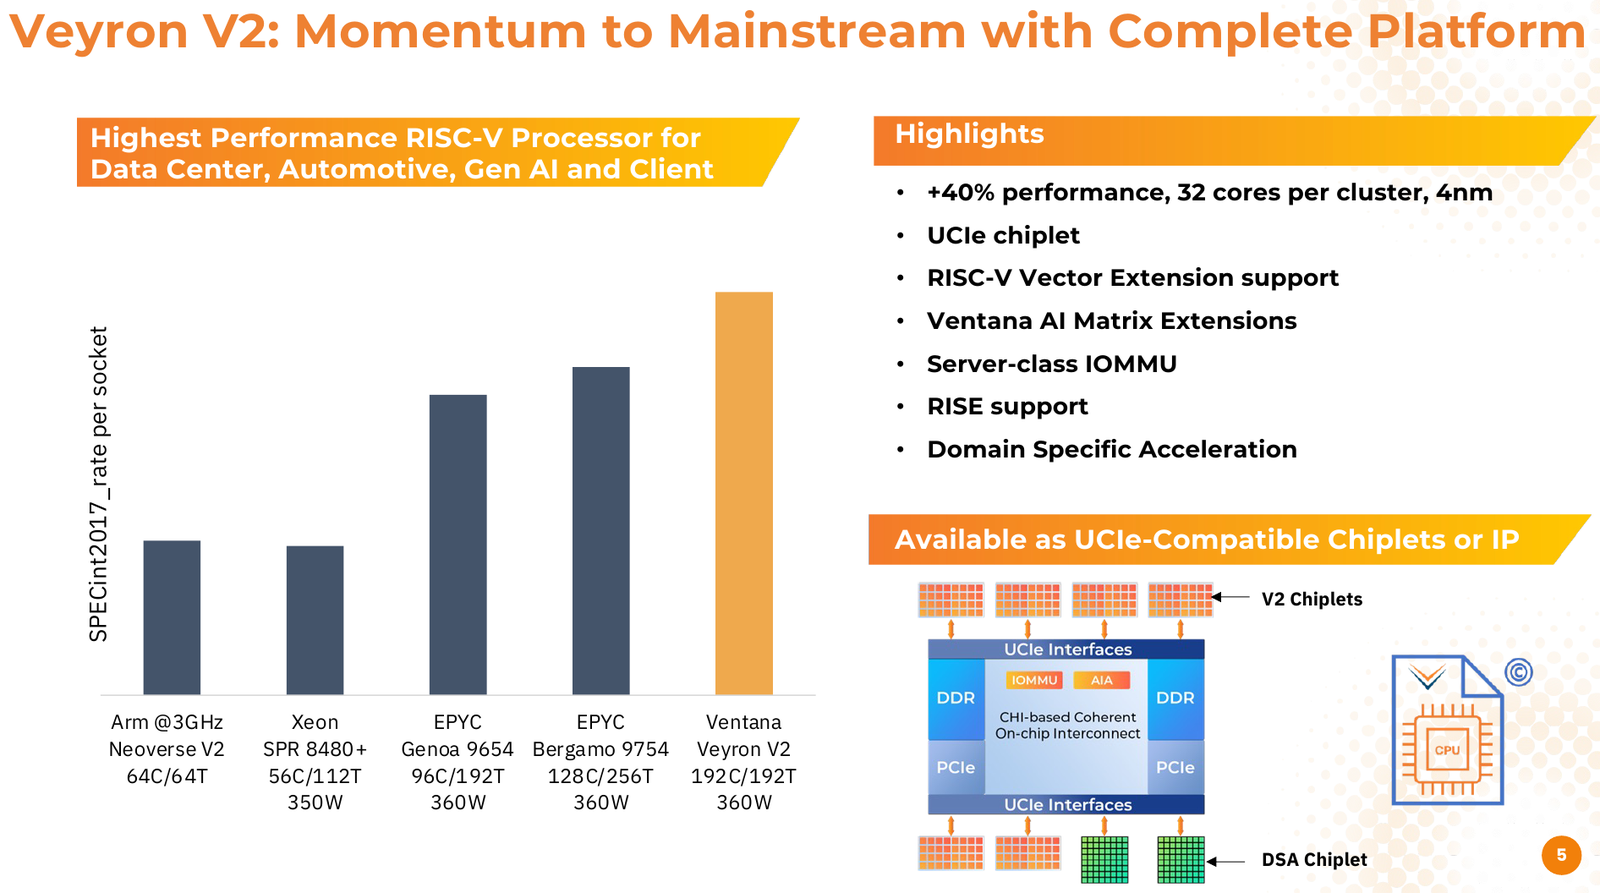 В классическом варианте Veyron V2 может иметь до шести чиплетов с RV64GC-ядрами V2, что в сумме даёт 192 ядра. Поддержка SMT отсутствует. Удельная производительность в пересчёте на ядро получается несколько ниже, чем у AMD Zen 4c, но согласно результатам тестов, предоставленных Ventana, 192-ядерный Veyron V2 заметно опережает AMD EPYC Bergamo 9754 (128C/256T) при аналогичном теплопакете в 360 Вт. 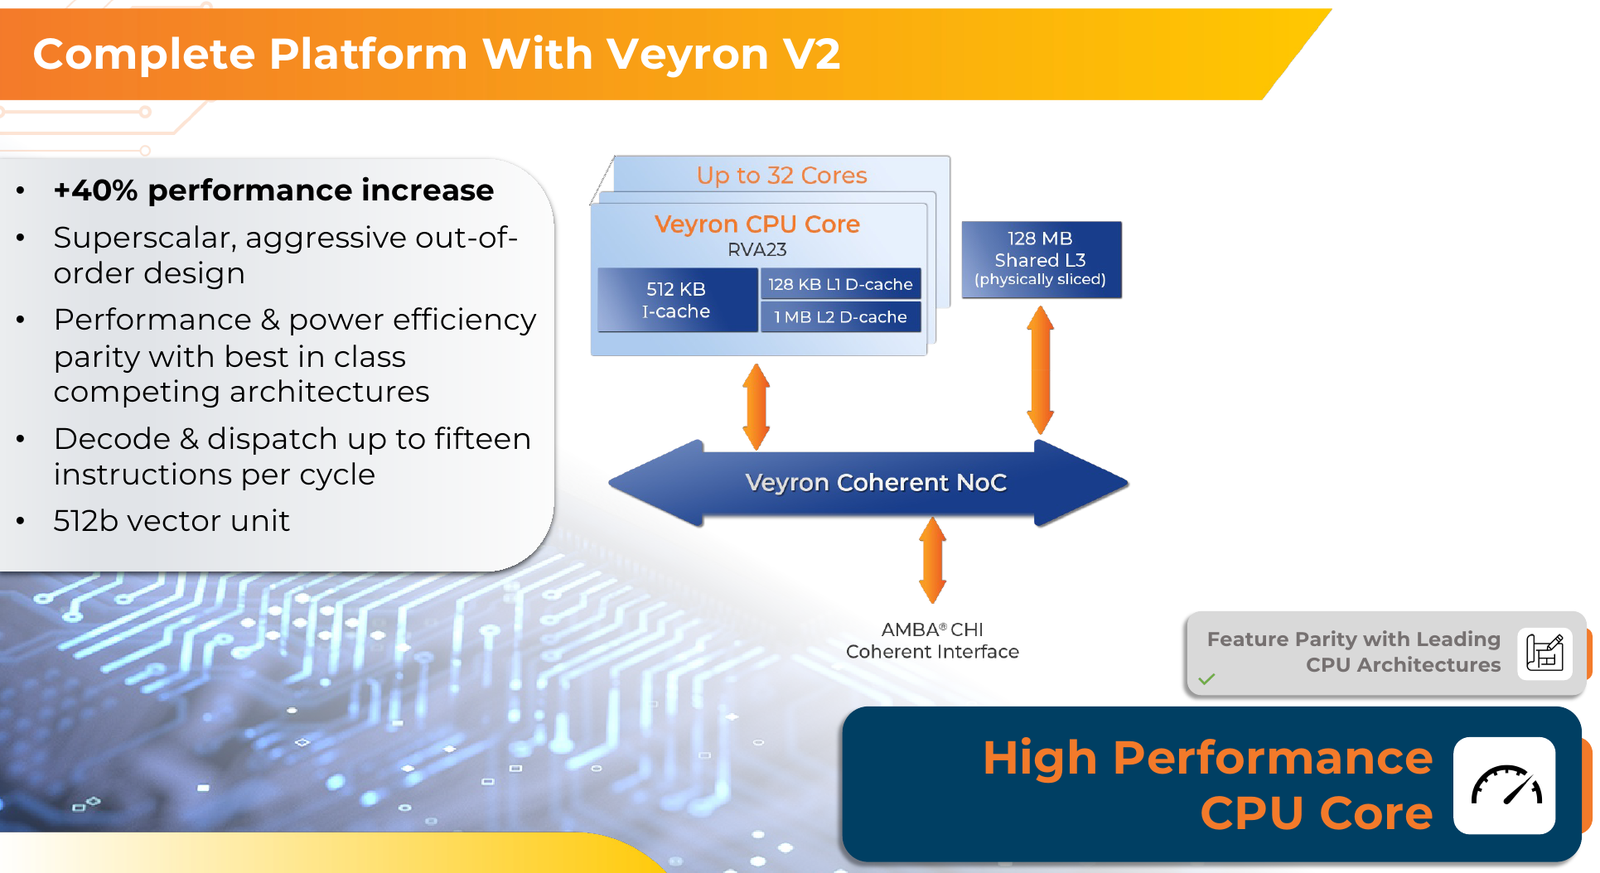 Столь неплохой результат достигнут за счёт оптимизации архитектуры Veyron: по сравнению с первым поколением говорится о 40 % прибавке производительности. Что немаловажно, во втором поколении процессоров Veyron была реализована поддержка 512-бит векторных расширений, фирменных матричных расширений, а также целого ряда других спецификаций. В целом ради совместимости разработчики предпочли остаться в рамках общего профиля RVA23. 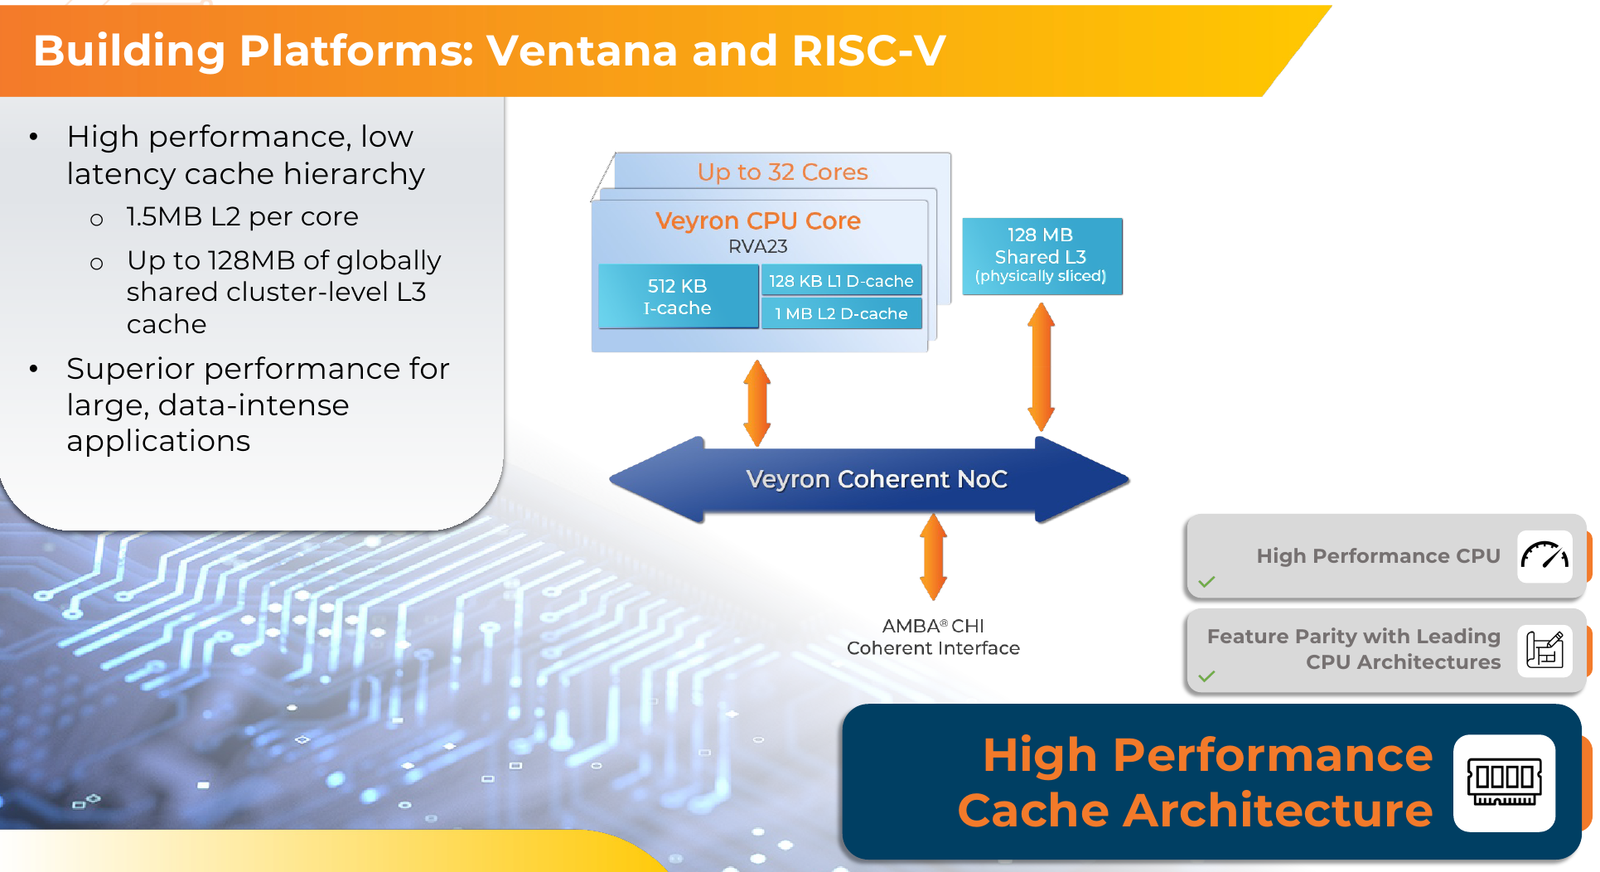 Сами ядра V2 используют суперскалярный дизайн с агрессивным внеочередным исполнением и продвинутым предсказанием ветвлений. Возможно декодирование и обработка до 15 инструкций за такт. Объём L1-кешей составляет 512 Кбайт для инструкций и 128 Кбайт для данных, дополнительно каждое ядро имеет свой кеш L2 объёмом 1 Мбайт. Общий для всего 32-ядерного чиплета L3-кеш имеет объём 128 Мбайт. Производительность внутренней когерентной шины составляет до 5 Тбайт/с. 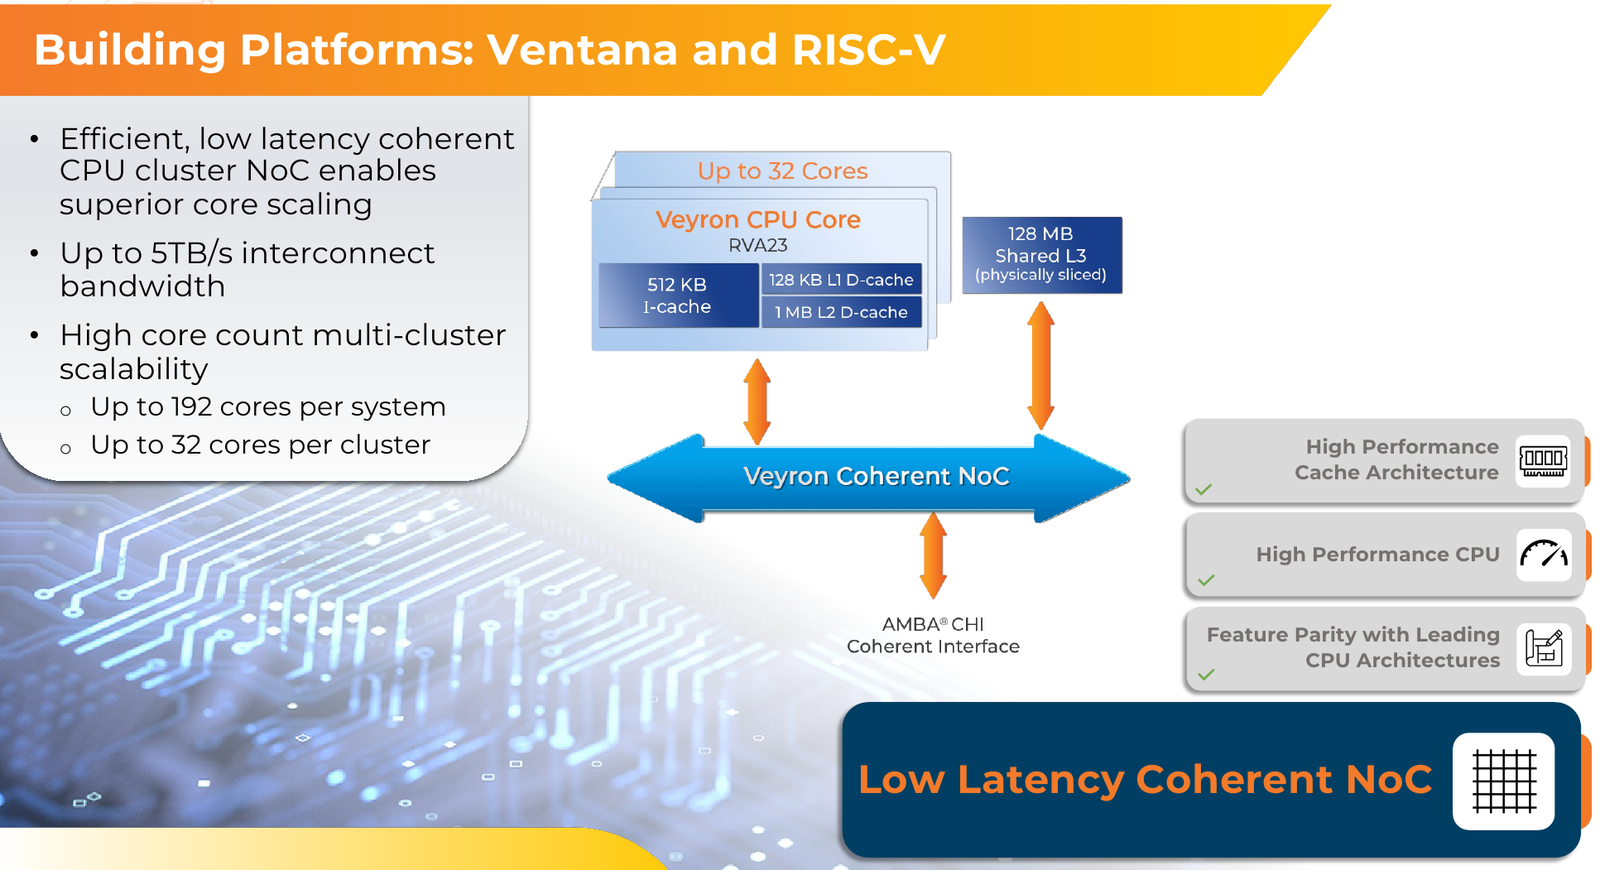 Позиционируемый в качестве решения для гиперскейлеров, крупных ЦОД и HPC, Veyron V2 имеет развитые средства предотвращения ошибок и защиты данных, от ECC-кешей и поддержки Secure Boot до аутентификации на уровне чиплета и продвинутых RAS-функций. Кроме того, реализована защита от атак по сторонним каналам. 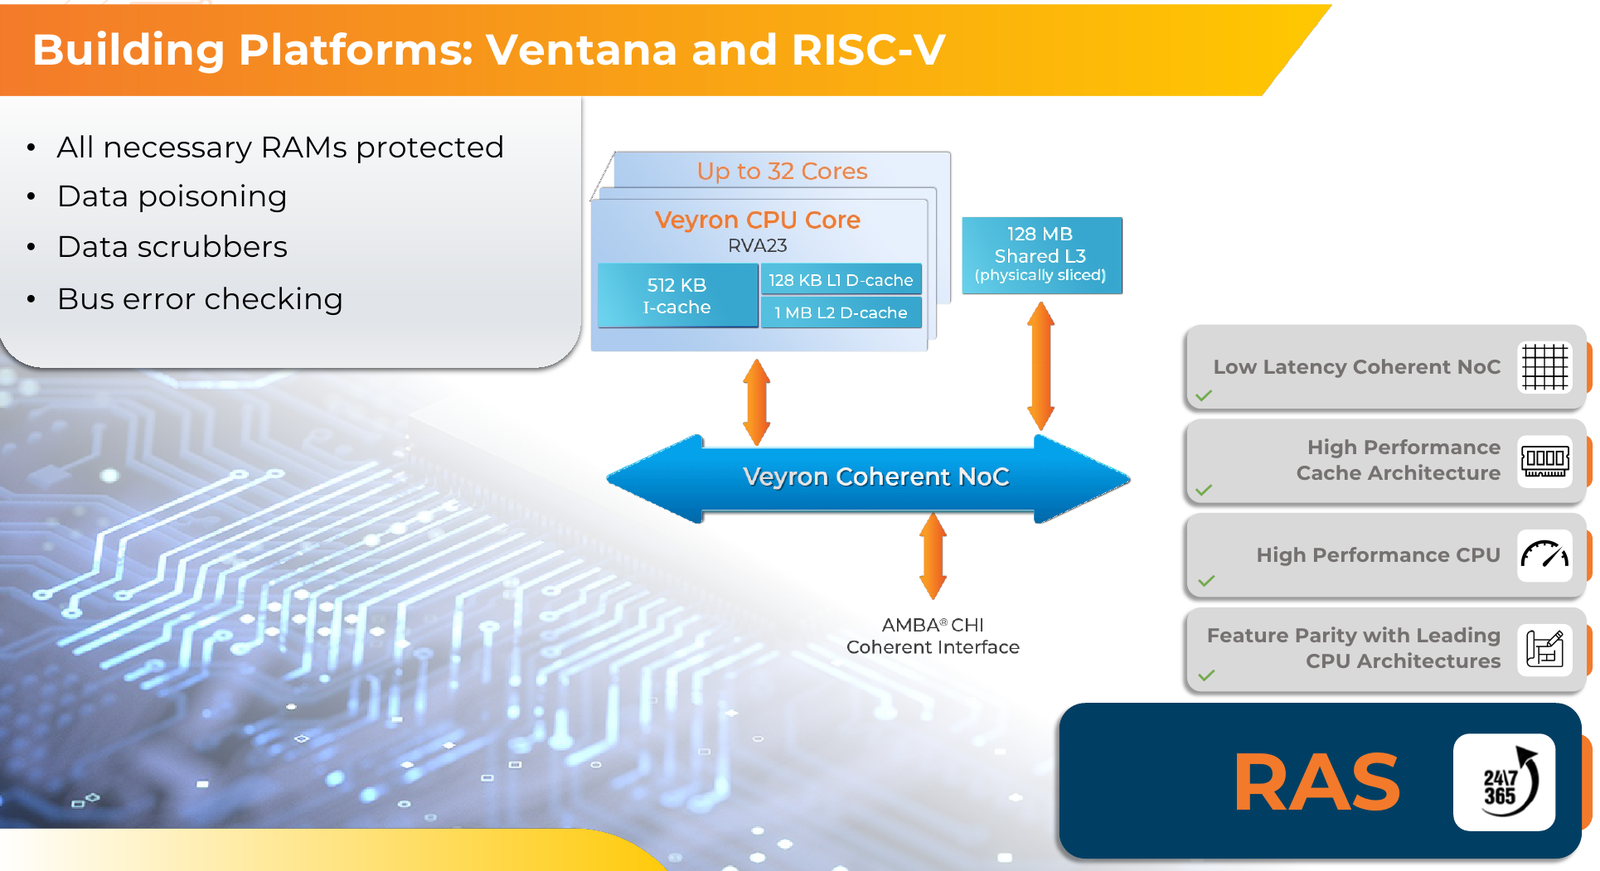 Несмотря на то, что мир RISC-V пока ещё похож на «Дикий Запад», Ventana старается опираться на развитые и популярные стандарты: в частности, это выражается в применении UCIe для подключения чиплетов, поддержку гипервизоров первого и второго типа, вложенную виртуализацию и совместимость с программной экосистемой RISC-V RISE. 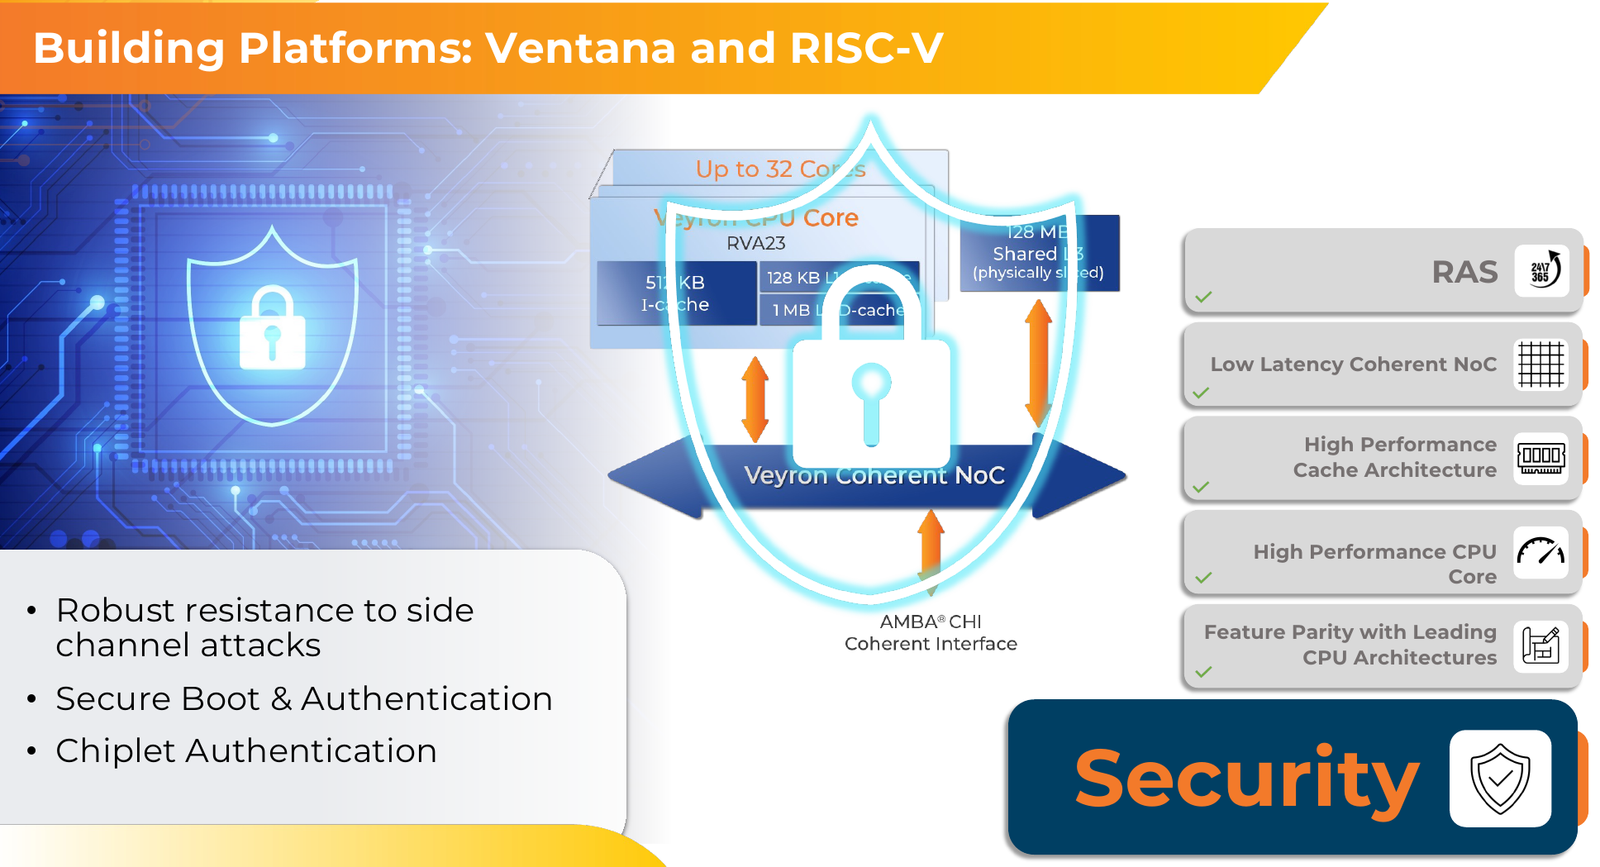 Подход Ventana позволит избежать недостатков, свойственных дискретным PCIe-ускорителям (высокая латентность, энергопотребление и стоимость) и сложным монолитным SoC (очень высокая стоимость разработки и сроки), снизить время и стоимость стоимость новых решений, а также обеспечить более низкий уровень энергопотребления. В общем, компания явно целится в гиперскейлеров. 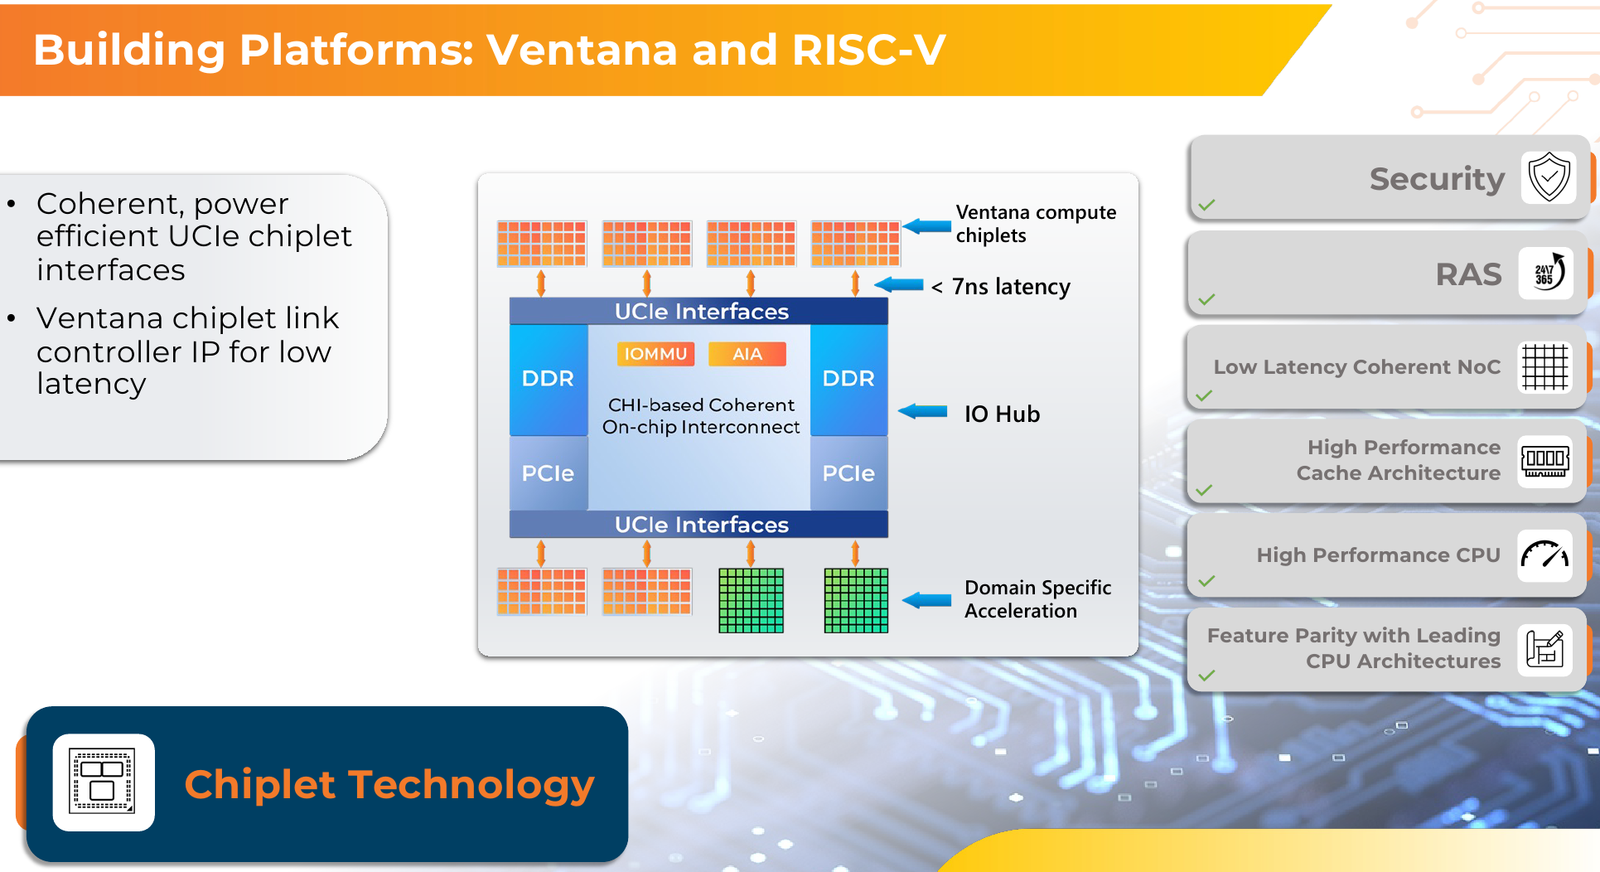 Видение сценариев применения DSA у Ventana очень широкий — от БД-ускорителей и блоков компрессии-декомпрессии данных до поддержки специфических алгоритмов в задачах аналитики и транскодеров в системах доставки контента. Также становятся ненужными дискретные DPU. Первым партнёром Ventana стала Imagination Technologies, крупный разработчик GPU. 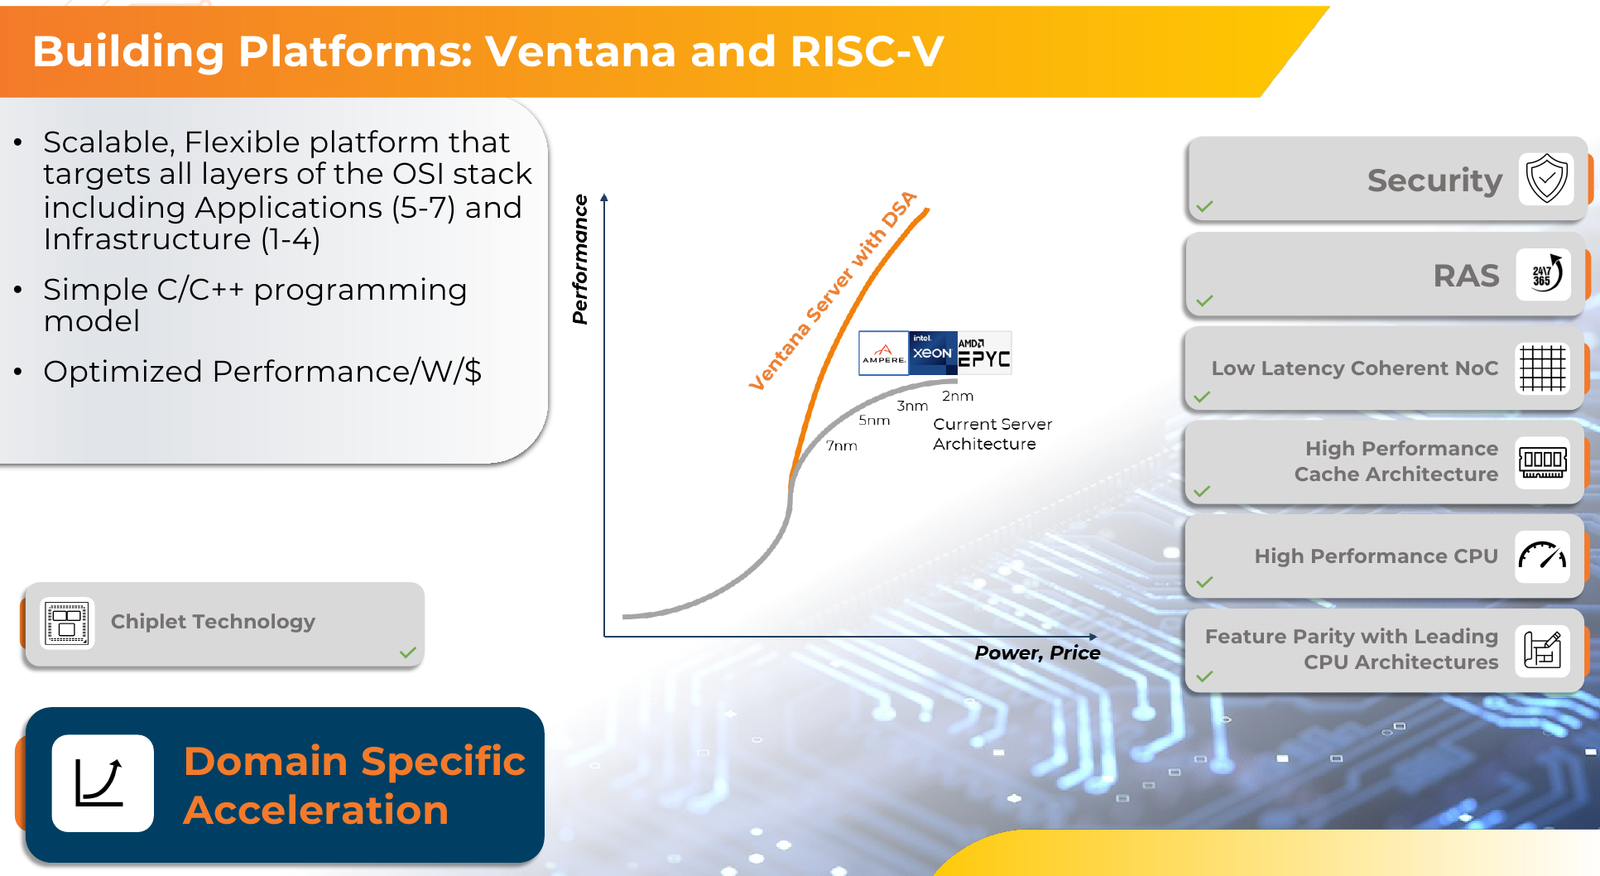 В качестве вариантов физической реализации новой платформы Ventana предлагает компактный 1U-сервер, содержащий один чип Veyron V2 со 192 ядрами, работающими на частотах до 3,6 ГГц, и 12 каналами DDR5-5600. Вероятнее всего, производителем новой платформы станет GIGABYTE. Ожидать первых поставок следует не ранее II квартала 2024 года. 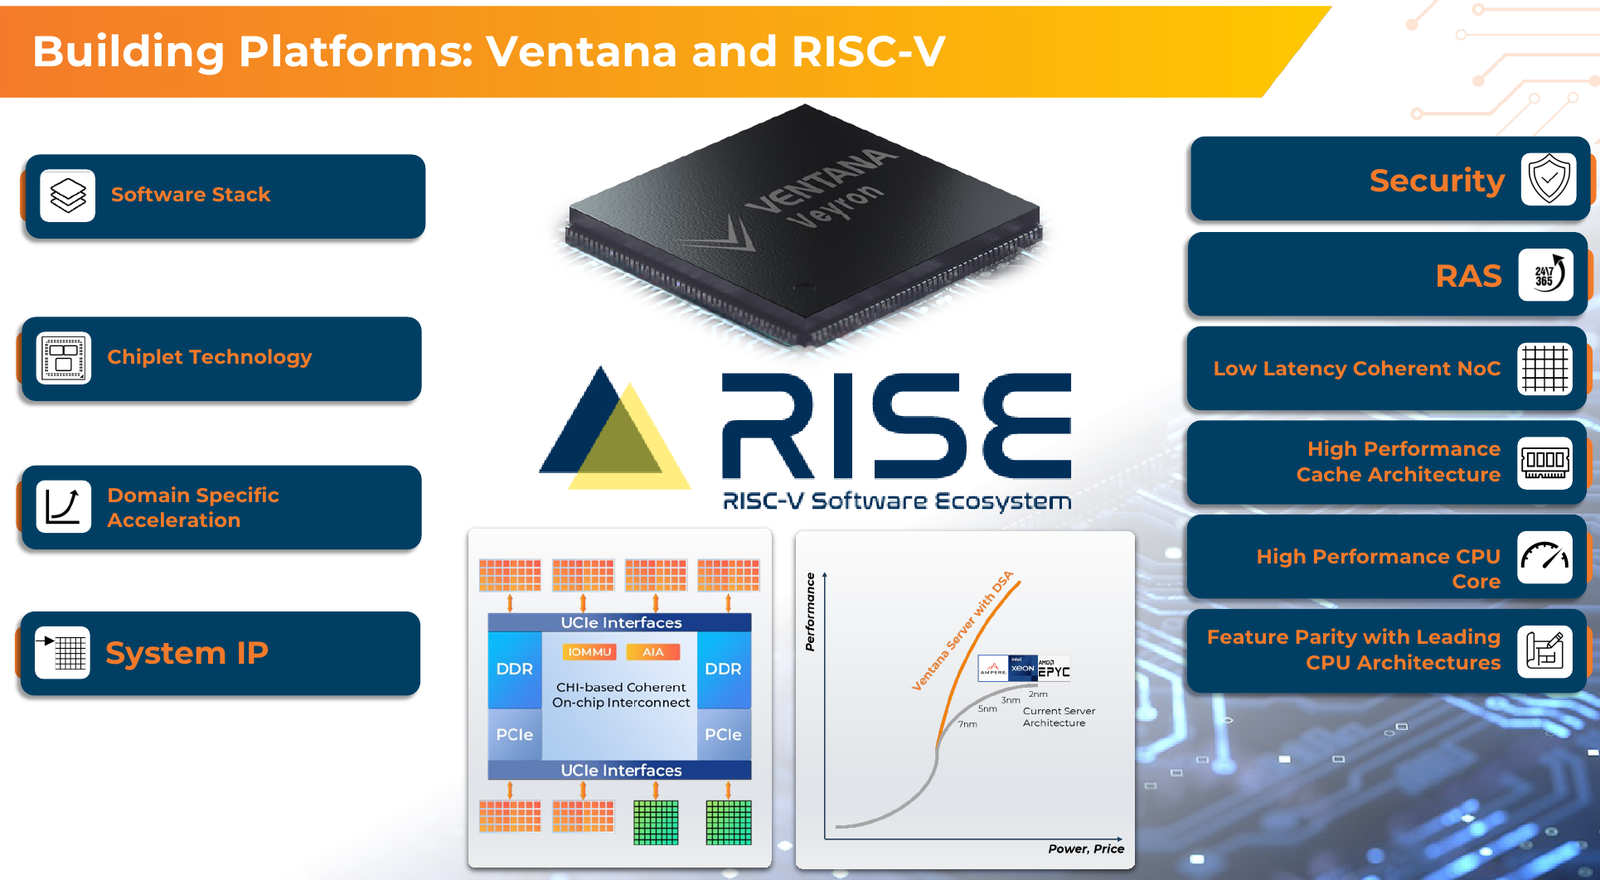 В целом, видение высокопроизводительной модульной платформы, продвигаемое Ventana, выглядит перспективно, а упор на применение DSA может выгодно отличать её большинства Arm-серверов, конкурирующих с решениями Intel/AMD лоб в лоб. Вопрос лишь в поддержке со стороны разработчиков программного обеспечения — и здесь может сыграть ставка разработчиков на максимально открытые, широкие стандарты. |
|